

AWS Graviton5搭載のEC2 R9gが一般提供開始。R8g比で最大25%の性能向上
AWSがGraviton5プロセッサを搭載したEC2 R9gとR9gdインスタンスを一般提供開始した。メモリ最適化インスタンスの新世代で、R8gと比較してコンピュート性能が最大25%向上している。
Graviton5はDDR5メモリの高速化、L3キャッシュの5倍拡大、ネットワーク帯域幅の最大2倍化など、複数のハードウェア改良を備える。データベースやインメモリキャッシュなどメモリ集約型のワークロードで効果が大きい。
この記事ではR9gの技術的な変更点、インスタンススペック、移行手順、利用可能リージョンを解説する。
Graviton5がもたらす性能向上の全容

Graviton5プロセッサはGraviton4から複数のハードウェア改良が加えられた。まずコンピュート性能がvCPUあたり最大25%向上している。これは命令処理の効率化と高クロック動作によるものだ。またAWSがこれまでに構築した中で最もエネルギー効率の高いプロセッサでもある。
このデモはGraviton4(R8g)とGraviton5(R9g)の主要スペックを比較している。特にL3キャッシュの5倍拡大とメモリ帯域の高速化がデータ処理の遅延低減に効く。
メモリとキャッシュの大幅強化
メモリはDDR5 8800 MT/sに対応した。Graviton4の5600 MT/sから大幅に高速化されており、AWSのクラウド上で利用可能な最速のメモリ帯域を実現している。これは大量のデータを扱うインメモリキャッシュ・データベースにとって応答時間の短縮に直結する。
L3キャッシュも5倍に拡大された。L3キャッシュとはCPU内部にある高速なメモリ領域で、頻繁にアクセスするデータを一時的に保持する役割を持つ。この容量が増えると、主メモリへのアクセス回数が減り、データ処理の遅延が小さくなる。データ局所性が高いワークロードほど恩恵を受けやすい。
ネットワーク帯域幅とパケット処理の改善
ネットワーク帯域幅とAmazon EBSの帯域幅は、最大サイズのインスタンスで最大2倍に向上した。48xlargeではネットワークが最大100 Gbps、EBSが最大72 Gbpsに達する。またパケット処理性能は最大3倍に改善されている。
さらにR9gとR9gdはInstance Bandwidth Configuration(IBC)に対応している。これはEBSとネットワークの帯域配分を25%単位で調整できる機能だ。データベースやキャッシュなど、帯域要件が特定方向に偏るワークロードで性能を最適化できる。例えばネットワーク処理が少なくディスクI/Oが多いワークロードでは、帯域をEBS側に寄せるといった調整が可能になる。
Nitro Isolation Engineによるセキュリティ強化

すべてのR9gとR9gdインスタンスはAWS Nitro System上で動作する。Nitro Systemは仮想化、ストレージ、ネットワークを専用ハードウェアにオフロードする仕組みだ。これにより仮想マシンのオーバーヘッドが減り、ベアメタルに近い性能と強固なセキュリティ分離を両立できる。
R9gとR9gdにはNitro Isolation Engine(NIE)が搭載されている。NIEはC9gとM9gで今年前半に導入されたコンポーネントで、仮想マシン間の分離を強制する役割を担う。仮想マシンのメモリ、CPUレジスタ状態、I/Oデバイスへのすべてのアクセスを最小限のAPIセットで仲介する。
このデモはNIEが仮想マシンとハードウェアの間に位置し、すべてのアクセスを仲介する関係を示している。分離の保証はソフトウェア的な工夫ではなく、形式的な数学証明によって裏付けられている点が特徴だ。
NIEの特徴は形式検証(formal verification)という手法を活用している点にある。これはハードウェアやソフトウェアが意図通りに動作することを数学的に証明する手法だ。特定のテストケースだけでなく、あらゆる条件下で正しく動作することを保証する。この取り組みにより、Nitroはクラウドハイパーバイザーとして初めて形式検証を受けた存在になった。
形式検証の対象範囲や前提条件などの詳細はAWSのテクニカルホワイトペーパーで公開されている。セキュリティ要件が厳しい金融系ワークロードやマルチテナント環境を扱う場合には、このホワイトペーパーを参照してリスク評価に役立てるとよい。
R9gとR9gdのインスタンススペック

R9gとR9gdはそれぞれ11サイズで提供される。最小のmediumから最大のmetal-48xlまで、幅広い要件に対応する。以下では2つの違いを中心に説明する。
このデモはR9gとR9gdの違いを整理している。NVMe SSDの有無が唯一の差で、用途に応じて選べる。
R9gのスペック
R9gはEBSストレージのみを使用する構成だ。最小のr9g.mediumは1 vCPUと8 GiBメモリ、最大のr9g.48xlargeとr9g.metal-48xlは192 vCPUと1536 GiBメモリを搭載する。ネットワーク帯域幅はmediumから2xlargeまで最大15 Gbps、8xlargeで17 Gbps、12xlargeで25 Gbps、16xlargeで34 Gbps、24xlargeで50 Gbps、48xlargeで100 Gbpsに達する。
EBS帯域幅はmediumから4xlargeまで最大12 Gbps、8xlargeで12 Gbps、12xlargeで18 Gbps、16xlargeで24 Gbps、24xlargeで36 Gbps、48xlargeで72 Gbpsとなっている。データベース用途ではEBS帯域幅が性能のボトルネックになりやすいため、サイズ選定の際はこの値にも注目したい。
R9gdのNVMeストレージ
R9gdはR9gと同じコンピュート性能とネットワーク性能を持ちながら、ローカルNVMe SSDを搭載している。mediumでは59 GB、largeで118 GB、xlargeで237 GBとサイズに応じて容量が増える。最大のr9gd.48xlargeでは3台の3800 GB NVMe SSD(合計11.4 TB)を備える。
ローカルNVMe SSDはEBSと比べてレイテンシが低く、一時的なスクラッチ領域やキャッシュ用途に向いている。オープンソースデータベース、分散リアルタイムビッグデータ分析、大規模インメモリデータベース、大容量キャッシュワークロードで効果を発揮する。
R8gからの移行と始め方

R8gで運用中のワークロードがある場合、R9gへの移行はシンプルだ。多くのアプリケーションでコード変更は不要。同等サイズのR9gインスタンスを選択すれば、そのままより高い性能を得られる。
このデモはR8gからR9gへの移行手順を4ステップで示している。インスタンスタイプを変更するだけで性能が向上するケースが多い。
対応OSとコンテナ環境
R9gはAmazon Linux 2023、Amazon Linux 2、Ubuntu 22.04以降、RHEL 8.4以降、SUSE Linux Enterprise Server 15 SP3以降、Debian 12以降など主要なLinuxディストリビューションに対応する。EC2コンソールからArmベースのAMIを選択すれば、すぐに起動できる。
コンテナワークロードではAmazon EKS、Amazon ECS、標準的なKubernetes環境で動作する。Arm64向けにビルドされたマルチアーキテクチャのコンテナイメージなら変更なしで動く。Dockerイメージをマルチアーキテクチャ対応にしておくと、x86からArmへの移行がスムーズになる。
移行を支援するツール
AWSはGravitonへの移行を支援する複数のリソースを提供している。Graviton Getting Started Guideは構築、実行、最適化の方法をまとめたガイドだ。Graviton Savings Dashboardではコスト削減効果を追跡できる。AWS TransformはJavaアプリケーションをx86からGraviton向けに変換するコード変換を自動化するツールだ。
Javaアプリケーションの場合、依存ライブラリにネイティブコードが含まれているとArm64への移行が難しいことがある。AWS Transformはこうしたコード変換を自動化して移行の手間を減らす。まず小規模なワークロードで試し、問題がないことを確認してから本番移行に進むのが現実的な進め方だ。
料金と利用可能リージョン

R9gとR9gdは米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、欧州(フランクフルト)の各リージョンで利用できる。日本国内のリージョン(アジアパシフィック東京)では現時点で提供されておらず、今後の展開が待たれる。
購入オプションはSavings Plans、On-Demand、Spot Instances、Dedicated Instances、Dedicated Hostsから選択可能だ。長期運用する場合はSavings Plans、一時的なバッチ処理やテスト用途ではSpot Instancesがコスト効率に優れる。料金の詳細はAmazon EC2の料金ページで確認できる。
インスタンスサイズや購入オプションによって価格が異なるため、ワークロードに合わせて最適な組み合わせを選ぶことが重要だ。特にR8gと比較した場合、同じサイズでも性能が向上しているため、より小さなサイズに移行してコストを削減できる可能性もある。
この記事のポイント
- AWS Graviton5搭載のEC2 R9gとR9gdが一般提供を開始した
- R8g比でコンピュート性能が最大25%向上し、エネルギー効率も改善
- DDR5 8800 MT/sメモリとL3キャッシュ5倍拡大でデータ処理が高速化
- Nitro Isolation Engineにより形式検証されたセキュリティ分離を実現
- R9gはEBSのみ、R9gdはローカルNVMe SSDを搭載した構成
- R8gからの移行はコード変更不要のケースが多く、Arm64対応イメージでそのまま動作

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WPLP Cookie Consent脆弱性を狙った攻撃からWordPressを守る3つの対策
Cookie同意プラグイン「WPLP Cookie Consent(スラッグ gdpr-cookie-consent)」のバージョン4.4.1以前には、未認証の攻撃者に任意のファイルをアップロードされる脆弱性がある。サイトを守るには、プラグインを4.4.2以上へ更新し、アップロードディレクトリ内でのPHP実行をサーバー側で拒否し、不正な管理者アカウントが作られていないか確認することが最優先だ。
なぜWPLP Cookie Consent 4.4.1が危険なのか
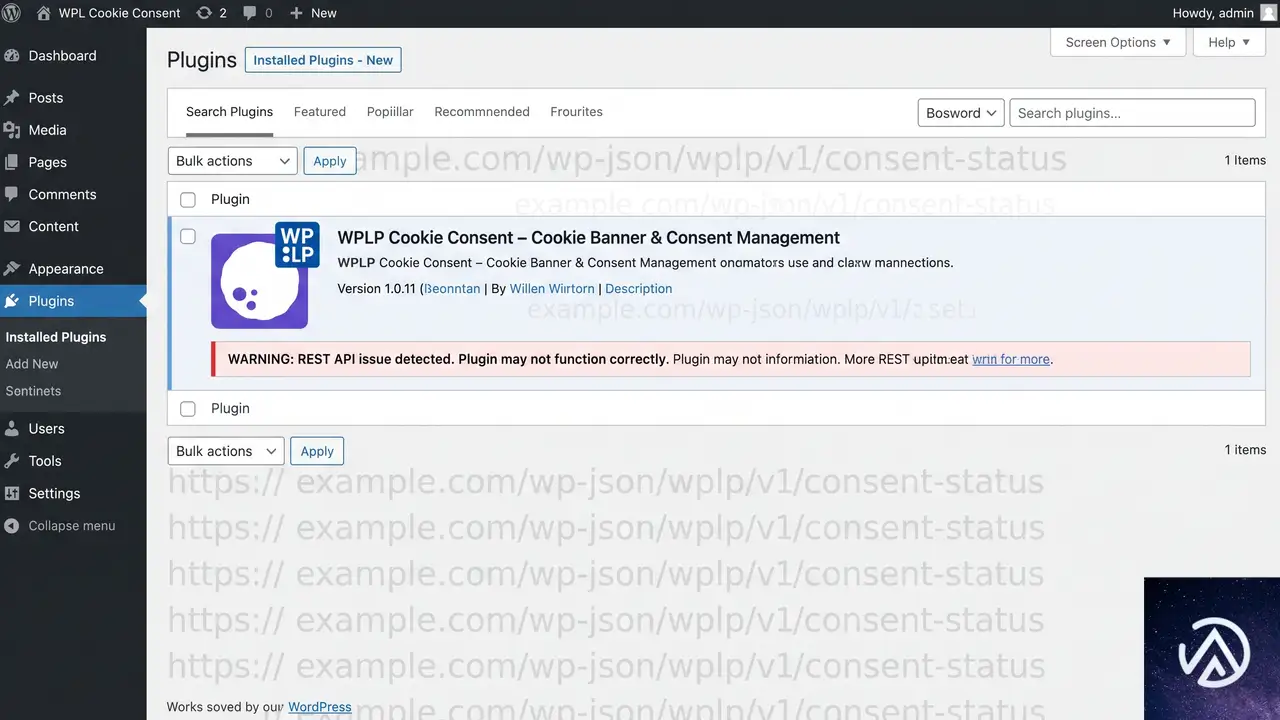
この脆弱性は、プラグインのREST APIエンドポイントに認可の不備があることから発生する。攻撃者は誰でもアクセスできる2つのエンドポイントを悪用し、WordPressのオプション設定を書き換えたうえで、任意のファイルをサーバーに保存できる。特に問題なのが、保存先が通常のアップロードフォルダ(wp-content/uploads)であり、ファイル名や拡張子の検証がまったく行われていなかった点だ。
つまり攻撃者は「画像ファイルに見せかけたPHPプログラム」をサイトに置くだけで、その後の実行に成功すれば管理者権限を奪取できる。バージョン4.4.1は攻撃が確認された時点で最新版だったため、更新を怠っていたサイトだけでなく、常に最新にしていたサイトも危険にさらされた。修正版の4.4.2が公開されてからは、この経路は塞がれているが、攻撃キャンペーンがすでに自動化されて動いている以上、更新前のサイトは今も標的になる。
攻撃の流れと侵入の仕組み

実際に確認された攻撃は、わずか20秒足らずで4段階のプロセスが自動実行される。最初にユーザー一覧を取得して管理者のユーザー名を特定し、次にプラグイン固有のオプションを毒して鍵をすり替え、最後にその鍵を使ってファイルを書き込む。下の図はその一連の流れを表している。
この攻撃チェーンのうち、最初の3段階は特定のプラグインがなければ成立しない。一方で、最後のPHP実行だけはサーバー側の設定次第でどのサイトでも防げる。ここが多層防御の要になる。
まず行う3つの緊急対応

サイトがこの脆弱性の影響を受けるかどうかに関係なく、次の3つを優先して実行する。順番はプラグインの更新、サーバー設定の確認、不正アカウントの確認が推奨される。
プラグインを4.4.2以上へ更新する
WPLP Cookie Consent(gdpr-cookie-consent)を使っている場合、まず管理画面の「プラグイン」から更新が来ていないか確認する。更新が見つからない場合は、WordPress.orgのプラグインページから最新版を手動でダウンロードし、既存のプラグインを上書きする。バージョン4.4.2では、脆弱性の原因だったアップロード用エンドポイントが削除され、残ったREST APIにもHMAC-SHA256署名によるリクエスト検証が追加されている。
更新後は、キャッシュ系プラグインを使っている場合はキャッシュを削除しておく。古いRESTエンドポイントの応答がキャッシュに残っていると、攻撃者からまだ有効に見えることがあるためだ。
アップロードディレクトリ内でのPHP実行を拒否する
今回の攻撃では、脆弱なプラグインによって「wp-content/uploads」ディレクトリにPHPファイルが書き込まれた。しかし、そのディレクトリ内でのPHP実行がサーバー側で拒否されていたため、攻撃は最終段階で失敗している。この設定は多くのレンタルサーバーで最初から有効になっているが、そうでない環境もある。
Apacheサーバーの場合、wp-content/uploads ディレクトリに以下の内容の .htaccess ファイルを置くことで、PHPファイルの実行を拒否できる。
<FilesMatch "\.(php|php5|phtml)$">
  Require all denied
</FilesMatch>
Nginxの場合は、サーバー設定で該当ディレクトリに対するPHPの処理を除外する。レンタルサーバーを利用しているなら、管理パネルに「PHP実行の無効化」や「セキュリティ設定」が用意されているか確認する。設定を変更できない場合は、サーバー会社に問い合わせて、アップロードディレクトリ内のPHP実行がブロックされているか確認するのが確実だ。
上の対比のように、ファイルが置かれても実行できなければウェブシェルとして機能しない。プラグインの更新とあわせて、このサーバー側の防御を必ず確認する。
不正な管理者アカウントを探す
今回確認されたマルウェアは、実行に成功すると管理者アカウントを自動生成する。しかも、登録日時を既存ユーザーの日時に合わせて改ざんするため、「新しく作られたユーザー」を探すだけでは見つからない。次の3つの兆候を手がかりに、phpMyAdminやWP-CLIで WordPress の wp_users テーブルを確認する。
- ユーザー名が「サイトのドメイン名+ランダム3文字」になっている
- 表示名が「Lucas Hayes」になっている
- メールアドレスのドメインが ifuqpatr.com になっている
心当たりのない管理者アカウントを見つけたら、そのユーザーを削除し、全ユーザーのパスワードをリセットする。また、登録日時が既存ユーザーと完全に一致するアカウントがないかもあわせて確認する。
侵害を検知する具体的な手順

すでに攻撃を受けた形跡がないかは、ログとファイルの両面から確認する。攻撃が失敗していても、ファイルの残骸や不審なアクセスが残っていることが多い。
サーバーのアクセスログを精査する
攻撃者は決まったエンドポイントに順番にアクセスする。アクセスログで次のパターンを検索し、該当するリクエストが記録されていないか確認する。
- GET /wp-json/wp/v2/users?per_page=100
- POST /wp-json/wplp-react-gdpr/v1/store-auth
- POST /wp-json/wplp-react-gdpr/v1/upload-logo
これらのリクエストがすべて記録されていれば、攻撃者がサイトに到達した証拠になる。アクセスログはサーバー会社の管理パネルや、レンタルサーバーのログ保存機能から取得できる。ログの保存期間が短いと痕跡が消えるため、普段から長めに保存する設定にしておくことが重要だ。
マルウェアスキャナーでファイルを検査する
サーバーに導入されているマルウェアスキャナーや、WordPress用のセキュリティプラグインを使って wp-content ディレクトリ全体をスキャンする。特に「*.jpg.php」のような二重拡張子のファイルや、最近改変されたPHPファイルが検出対象になる。
スキャナーは攻撃直後の未知のマルウェアを検出できないこともあるが、時間が経ってから見つかることも多い。複数のスキャナーを併用すると検出率が上がる。手動で確認する場合は、wp-content/uploads 以下のファイルで、画像に見せかけたPHPファイルが残っていないかを調べる。
テーマとプラグインの改ざんを確認する
攻撃者はすでに侵入に成功している場合、バックドアを別の場所に仕込んでいる可能性がある。アクティブなテーマの functions.php や、プラグインのディレクトリに不審なコードが追加されていないかを確認する。特に、難読化されたコードや、外部と通信する関数(file_get_contents、curl、eval など)が含まれている場合は注意が必要だ。
再発を防ぐための設定

今回の攻撃は特定のプラグインに依存しているが、同種の攻撃は他のプラグインでも発生する。サイト全体の防御力を上げるために、次の設定を検討する。
REST APIのユーザー一覧取得をブロックする
攻撃の第一段階では、WordPress標準のREST APIからユーザー一覧を取得して管理者のユーザー名を特定している。このエンドポイントを無効化するか、ログイン済みユーザーに限定すれば、攻撃の難易度を上げられる。
子テーマの functions.php に次のコードを追加すると、未認証のユーザー一覧取得を防げる。
add_filter( 'rest_endpoints', function( $endpoints ) {
    if ( isset( $endpoints['/wp/v2/users'] ) ) {
        unset( $endpoints['/wp/v2/users'] );
    }
    return $endpoints;
} );
このコードはユーザー一覧のエンドポイントそのものを削除するため、ログイン中でも一覧を取得できなくなる。一部のプラグインがこの機能を使っている場合は影響を確認してから適用する。
アクセスログを長期間保存する
攻撃の痕跡は時間が経つと消える。サーバーのアクセスログを最低でも数週間、可能なら数ヶ月保存しておくと、侵害の調査や再発防止に役立つ。レンタルサーバーの標準設定では数日しか保存されないこともあるため、管理パネルやサーバー会社に確認して保存期間を延ばす。
プラグインの選定と更新ポリシーを見直す
Cookie同意プラグインに限らず、インストール数が少ないプラグインでも攻撃対象になる。更新が止まっているプラグインや、あまり知られていない開発元のプラグインを使い続ける場合は、代替手段を検討する。定期的にプラグインの更新を確認し、不要なプラグインは削除する。
よくある質問
WPLP Cookie Consentを使っていないが対策は必要か
今回の脆弱性はこのプラグイン固有のものだが、アップロードディレクトリでのPHP実行を拒否する設定や、REST APIのユーザー列挙対策はどのサイトでも有効な防御策になる。プラグインの更新とサーバー設定の見直しは、サイト全体のセキュリティを底上げする。
更新したのに攻撃された兆候が残っている場合はどうすればいいか
更新してもすでに設置されたマルウェアは消えない。不正な管理者アカウントの削除、マルウェアスキャン、テーマやプラグインの改ざん確認を行い、必要ならバックアップから復元する。確実なのは、クリーンなバックアップに置き換えて、全パスワードを再発行することだ。
アップロードディレクトリのPHP実行を拒否すると何か問題はあるか
通常のWordPressサイトでは、wp-content/uploads にPHPファイルを置く運用は推奨されていない。画像や文書の配信には影響しない。一部の特殊なプラグインやテーマがこの場所にPHPを置く場合は、事前に動作確認を行う。
REST APIを完全に無効化したほうがいいのか
完全な無効化は、ブロックエディタや一部の機能が動作しなくなるため現実的ではない。ユーザー一覧だけを狙ったエンドポイントを制限するか、認証を要求する設定が現実的な落とし所になる。
この記事のポイント
- WPLP Cookie Consent 4.4.1以前には未認証でファイルをアップロードされる脆弱性がある
- まずプラグインを4.4.2以上へ更新し、古いバージョンのままにしない
- wp-content/uploads 内のPHP実行をサーバー側で拒否する
- 不正な管理者アカウントがないか wp_users を確認する
- アクセスログとマルウェアスキャナーで侵害の痕跡を調査する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

WooCommerce 11.1でREST APIとStore APIが最大42%高速化。ブロック登録スキップの仕組み
WooCommerce 11.1がブロック登録の仕組みを大きく変更する。REST APIとStore APIのリクエストが従来より13〜18ミリ秒、割合で30〜42%速くなる見込みだ。
これまでWooCommerceはほぼすべてのリクエストでブロックタイプとパターンを登録していた。画面にブロックを描画しないAPIリクエストでも同じ準備処理が走り、無駄なコストになっていた。
この記事では変更の背景と仕組み、影響を受ける開発者の条件、具体的な対応方法を解説する。11.1は正式リリース前の段階のため、エクステンションを配布している開発者は事前テストが求められる。
なぜブロック登録をスキップするのか
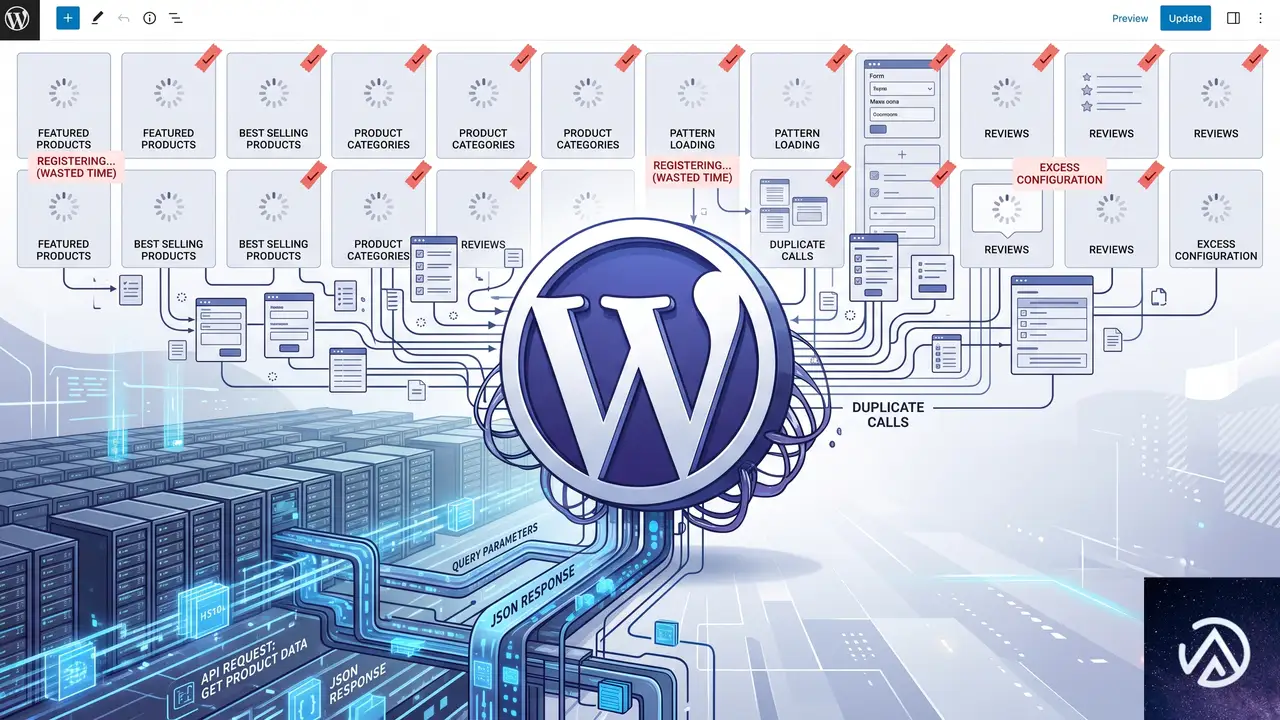
ほぼ全リクエストで発生していた無駄な処理
WooCommerceはこれまで、ブロックタイプとパターンをほぼすべてのリクエストで登録していた。商品データを返すだけのREST APIリクエストでも、カート情報を返すStore APIリクエストでも、ブロックを描画しないのに登録処理が実行されていた。
ブロック登録にはファイル読み込みやメタデータ解析が伴う。1リクエストあたりの負荷は小さくても、APIを多用する店舗やヘッドレスコマース構成では応答速度に影響する。WooCommerceチームは「リクエストはブロックを描画または編集できる場合にのみ、ブロック登録のコストを支払うべき」という方針を取った。
Beforeではすべてのリクエストがブロック登録を経由していた。Afterではブロックを描画しないAPIリクエストが登録処理を飛ばし、その分だけレスポンスが速くなる。
描画しないリクエストに課されるコスト
従来の挙動は、ブロックを編集も描画もしないリクエストまでブロックエディタの準備をさせるものだった。この無駄はアクセス数に比例して増える。とくにモバイルアプリやフロントエンドを別システムで構築し、WooCommerceをAPI経由で使う構成では影響が大きい。
今回の最適化は、APIリクエスト全体に占めるブロック登録のコストが想定以上に大きかったことを示している。13〜18ミリ秒の改善は体感的には小さいが、ピーク時に多数のリクエストを処理する店舗では合計の短縮効果が積み上がる。
11.0から11.1へ段階的に進めた変更

11.0で導入したパターンの遅延読み込み
第一段階はWooCommerce 11.0で実装された。パターンがファイルパスで登録され、エディタから要求されたときだけ内容が読み込まれるようになった。WordPressコアと同じ挙動だ。ブロックを登録するリクエストごとに5〜8ミリ秒の節約が確認されている。
11.1のBlockRegistrationContextガード
11.1では新しいBlockRegistrationContextガードが追加された。このガードがリクエストを判定し、ブロックを描画しない場面ではブロックタイプとパターンの登録をまとめてスキップする。
商品説明を守るオンデマンド登録の例外
1つだけ例外がある。商品説明やバリエーション説明にWooCommerceブロックが含まれる場合、woocommerce_short_descriptionフィルター経由で必要なときにブロックタイプが登録される。これにより商品REST API、Store API、バリエーションAJAXエンドポイント、商品のWebhookでも説明が正しく描画される。
2段階の変更により、パターン読み込みとブロック登録という2つの重い処理がAPIリクエストから外れた。完成した最適化の効果が30〜42%という数字に表れている。
対象リクエストと安全性の設計

スキップ対象と従来どおりのリクエスト
スキップされるのはブロックを描画しないリクエストのみだ。フロントエンド、管理画面、ブロックエディタ、サイトエディタのリクエストは従来どおりブロックを登録する。
見落としがあっても表示は壊れない
ガードは自身が認識したコンテキストだけをスキップする。認識できない場面では登録を継続するため、分類に漏れがあったとしても描画の後退にはつながらない。性能が少し落ちるだけで済む設計だ。
この設計は保守性の面でも合理的だ。未知のリクエストに対して安全側に倒すため、WooCommerceの内部判断が変わっても既存サイトの表示が突然崩れるリスクを抑えられる。
開発者が確認すべき影響範囲

影響を受けるエクステンションの条件
この変更はWooCommerce 11.1.0から適用される。スキップされるリクエスト中にWooCommerceブロックを描画するエクステンション、またはWooCommerceのブロックタイプ、パターン、ブロックごとのアセット登録に依存するエクステンションが影響を受ける。
スキップされた場面では、WooCommerceブロックは生のブロックマークアップか、動的出力のない静的なHTMLとして返る。テンプレートに直接ブロックを組み込んでいるエクステンションは、表示内容が変わらないか確認が必要だ。
コードで確認する方法
影響の有無はコードで確認できる。以下のコードはWooCommerce 11.1以降のスキップ対象リクエストでfalseを返す。
// WooCommerce 11.1以降、スキップされた場面では false を返す。
WP_Block_Type_Registry::get_instance()->is_registered( 'woocommerce/mini-cart' );
商品説明と自前ブロックは影響なし
商品説明とバリエーション説明はオンデマンドで処理されるため対応は不要だ。register_block_type()で自前登録しているブロックも影響を受けない。今回の変更はWooCommerce自身が行う登録だけが対象になる。
実務では「自前でブロックを登録しているか」「WooCommerceのブロック登録に依存しているか」の切り分けが重要になる。前者は今回の変更を意識する必要がなく、後者だけが対応を検討すればよい。
開発者が取るべき対応と正しいブロック作成

woocommerce_should_register_blocksフィルターで復帰
影響を受けるエクステンションは、新しいwoocommerce_should_register_blocksフィルターを使い、実際にブロックを描画するリクエストのときだけtrueを返す。
add_filter(
    'woocommerce_should_register_blocks',
    function ( $should_register ) {
        return my_context_renders_blocks() ? true : $should_register;
    }
);フィルターはプラグイン読み込み時に実行され、メインクエリが解析される前の段階で呼ばれる。そのため条件には$_SERVERや$_GETなど、この初期段階で利用できる情報だけを使うことになる。
復帰させる範囲を絞りすぎるとブロックが見つからず表示が変わることがある。逆に広げすぎると今回の性能改善が失われる。描画が実際に発生するリクエストを正確に判定する条件を書くのが開発者の作業になる。
内部クラスAbstractBlockを避ける
WooCommerceはブロックをAbstractBlockという内部クラスの上に構築しないよう推奨している。内部クラスを継承すると、WooCommerceが下すすべての登録判断、今回のスキップも含めて引き継ぐことになる。
登録の最適化が進むにつれ、内部クラスのライフサイクルは今後も変わり続ける。依存すると将来のアップデートで予期しない挙動になる可能性が高い。
標準のWordPress Block APIを使う
サポートされる方法は標準のWordPress Block APIだ。ブロックをblock.jsonに定義し、init時にregister_block_type()で登録する。カートやチェックアウトの内部ブロックには@woocommerce/extend-cart-checkout-blockテンプレートがある。
WooCommerceの公式ドキュメントにあるスキャフォールディングとサンプルストアデータ、@wordpress/create-blockも出発点として適している。標準APIに沿って作れば、今後の最適化に追随しやすい。
正式リリース前の段階で、WooCommerceはエクステンション開発者に11.1へのテストを呼びかけている。とくに商品データやカート情報をAPIで扱う拡張を配布している場合は、早めの動作確認が安全だ。
この記事のポイント
- WooCommerce 11.1はブロックを描画しないリクエストでブロック登録をスキップする
- Store APIとREST APIは13〜18ミリ秒、割合で30〜42%高速化する
- 商品説明や自前登録ブロックは影響を受けず対応不要
- 影響を受ける場合のみ woocommerce_should_register_blocks フィルターで復帰させる
- 内部クラスAbstractBlockではなく標準のWordPress Block APIでブロックを作る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Product Feed PROでブランド・変動商品・商品カテゴリが出力されない時の直し方
Product Feed PRO for WooCommerceでブランド・変動商品・Google商品カテゴリがXMLに出力されない場合、まず確認すべきはフィールドマッピングの重複定義とキャッシュの遅延だ。症状が3つ同時に出ていても原因はそれぞれ別で、マッピング設定と条件設定を正しく組み替えれば大半は解決する。
ブランドがXMLに間欠的に出力される原因
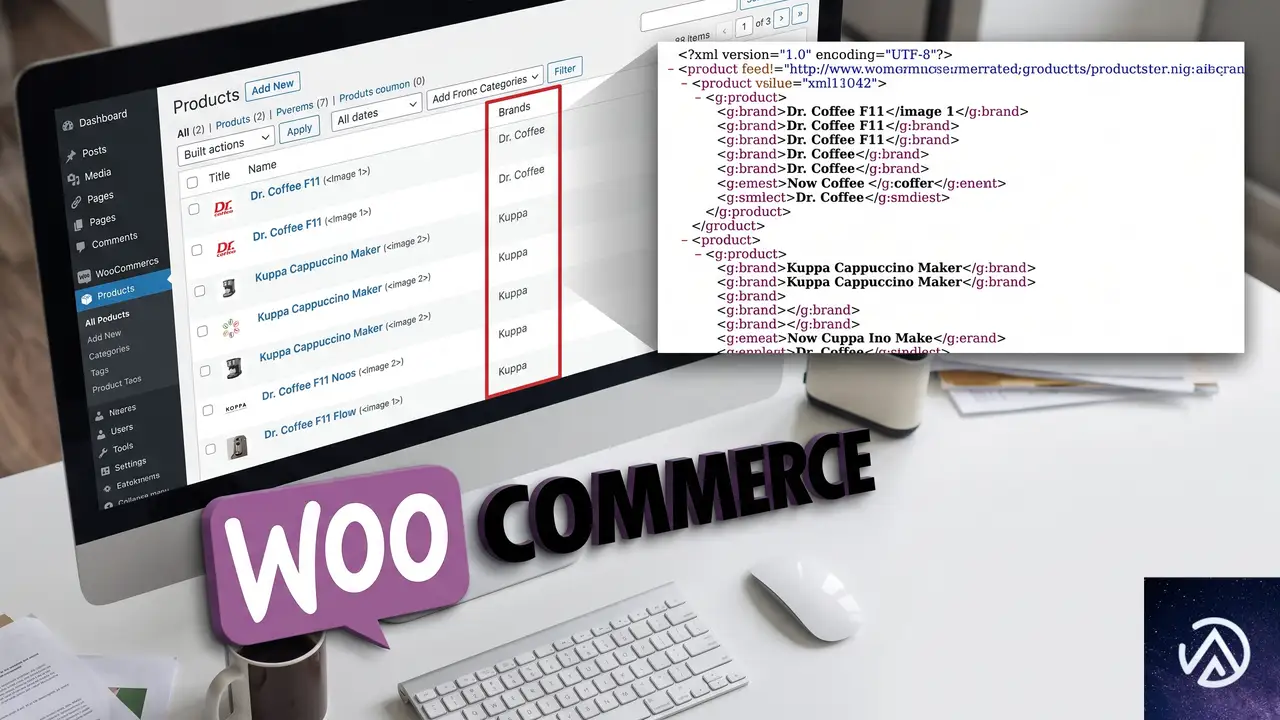
同じブランドを割り当てた商品の一部にだけ<g:brand>が出力されない場合、最も多いのが「ブランドの取得ソースが複数存在している」ケースだ。WooCommerceの商品編集画面ではブランドが正しく見えていても、フィードプラグインは別のソースを参照して空の値を受け取ることがある。
Product Feed PROにはブランドを取得するための選択肢が複数用意されている。商品ブランド(product_brand)タクソノミー、商品属性(pa_brand)、YITH Brandプラグイン用の「Brand」、WooCommerce Brandsプラグイン用の「Product brand」などが代表だ。これらが混在していると、商品Aはタクソノミーから値を取得し、商品Bは未設定の商品属性を参照して空振りする、という動きになる。
特に複数のプラグインを併用していたり、過去にブランド管理の方法を変更したサイトで起きやすい。商品一覧のCSV書き出しでブランド列を確認すると、同じブランド名でも保存されている場所が商品によって異なるのがわかる。
商品B Dr Coffee → タクソノミーに設定済み → 属性は未設定 → 出力なし
商品B Dr Coffee → タクソノミーから取得 → 出力あり
このデモは、ブランドの取得ソースを属性にしたままタクソノミーのみ設定した商品で出力が欠落する状況を示している。対処は連載の後半でまとめて説明する。
商品ごとにブランドの保存場所を確認する
WooCommerceの商品一覧からCSVを書き出し、ブランドのタクソノミー列と属性列の両方を確認する。片方だけに値が入っている商品があれば、その商品群で出力が欠落しているはずだ。同じブランド名を保ったまま、フィードが参照するソースにデータを揃える必要がある。
フィードプラグインのフィールドマッピングを再定義する
フィードのフィールドマッピング画面で、<g:brand>フィールドの「取得ソース」を確認する。プルダウンに複数のブランド候補が並んでいたら、実際に価値が入っているタクソノミー(product_brand)を選択し直し、フィードを再生成する。
変動商品がフィードから完全に欠落する原因
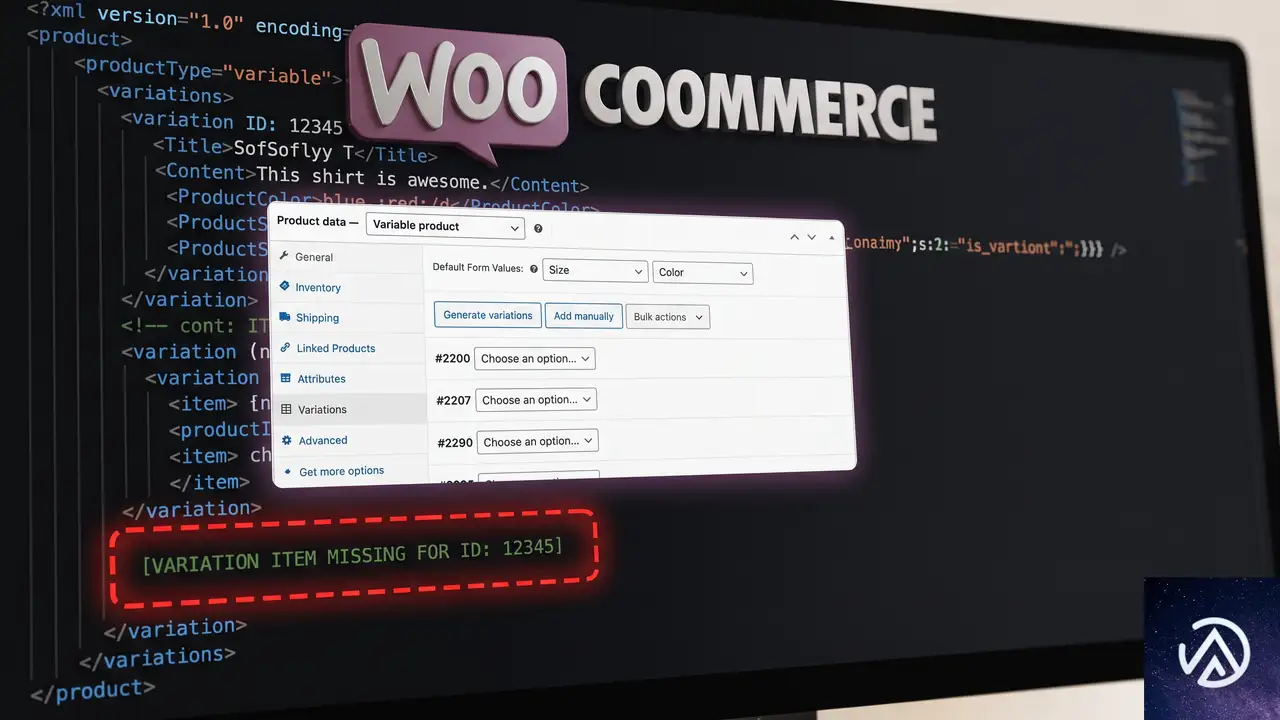
変動商品(バリエーションを持つ商品)がXMLに一切出力されない場合、最初に確認するのは「デフォルトのバリエーション」の設定だ。WooCommerceの変動商品では「デフォルトのバリエーションを選択」プルダウンが「デフォルトを選択」のままになっていると、親商品がフィードの出力対象から外れることがある。
フィードプラグインの設定で「商品のバリエーションを含める」を有効にしても、親商品のバリエーション自体が正しく構築されていないと出力はできない。各バリエーションに価格・在庫状況・画像が設定されているか、親商品がカタログに表示される設定になっているかも重要なチェックポイントだ。
プルダウン「デフォルトを選択」のまま → フィード生成スキップ
バリエーション3点も非出力
プルダウンで1件選択 → フィードに親商品とバリエーションが出力
価格と在庫のある3バリエーションも表示
このデモは、デフォルトのバリエーション未選択で変動商品が出力から漏れる典型的なパターンを表している。ほかに価格未入力や在庫切れでも同様の欠落が起こる。
バリエーションの設定を一括で点検する
変動商品の編集画面で、各バリエーションに通常価格またはセール価格が登録されているか、在庫ステータスが「在庫あり」または「予約可能」になっているかを確認する。バリエーションが「非公開」や「カタログに表示しない」になっていないかも見る。
親商品の「商品データ」メタボックスでは、プルダウンで「デフォルトのバリエーション」を必ず1つ選ぶ。この操作が済んでいない変動商品は、フィードプラグイン側の設定に関係なく出力対象外になるケースが多い。
フィード設定の「商品のバリエーションを含める」を再確認する
Product Feed PROのフィード編集画面で、変動商品に関するオプションが有効か確認する。「商品のバリエーションを含める」と「親商品も含める」の両方が目に入るが、どちらか一方だけ有効になっていると期待した出力にならない。特に親商品を表示するには、その商品自体がカタログに表示される設定である必要がある。
Google商品カテゴリが出力されない原因

Google商品カテゴリ(<g:google_product_category>)がXMLに出ない場合、原因はほぼ「カテゴリマッピングの条件不一致」か「フィールドマッピングの取得ソースにgoogle_categoryが設定されていない」のどちらかだ。カテゴリマッピング画面でWooCommerceカテゴリとGoogleカテゴリを紐づけただけでは、フィードに反映されない。
カテゴリマッピングの画面では、左側にWooCommerceの商品カテゴリ、右側にGoogleの商品カテゴリを割り当てる。この割り当てが「すべてのカテゴリ」ではなく、一部のカテゴリだけに適用される条件で作られていると、対象外のカテゴリに属する商品からはカテゴリが出力されない。
→ 他のカテゴリ(ドリップ用品など)は
<g:google_product_category>が空のまま→ すべての商品に
<g:google_product_category>が出力このデモは、カテゴリマッピングの条件漏れで一部商品のGoogleカテゴリが空になる状況を示している。カテゴリマッピング画面は商品数が多いほど設定漏れが起きやすいので、全カテゴリを対象にするのが基本だ。
フィールドマッピングでgoogle_categoryが設定されているか確認する
フィードのフィールドマッピング画面で、Google側の<g:google_product_category>フィールドに対して、取得ソースが「google_category」になっていることを確認する。このソースは、カテゴリマッピング画面で定義した対照表を参照する専用の値だ。
誤って商品カテゴリそのものを割り当てていると、Googleが求める形式(例: Home & Garden > Kitchen & Dining > Coffee Makers)ではなく、WooCommerceのカテゴリ名だけが出力される。Google Merchant Center側でエラーまたは警告になるため、ソース設定は丁寧に見直す必要がある。
カテゴリマッピングを全カテゴリに適用する
カテゴリマッピング画面で、WooCommerceの各カテゴリに対応するGoogleカテゴリをすべて埋める。カテゴリが多い場合は「未マッピングのカテゴリ」フィルタを使うと、設定漏れのカテゴリだけを洗い出せる。親カテゴリを割り当てたら、子カテゴリが自動的に引き継がれるかどうかも確認する。
3つの問題をまとめて修正する手順
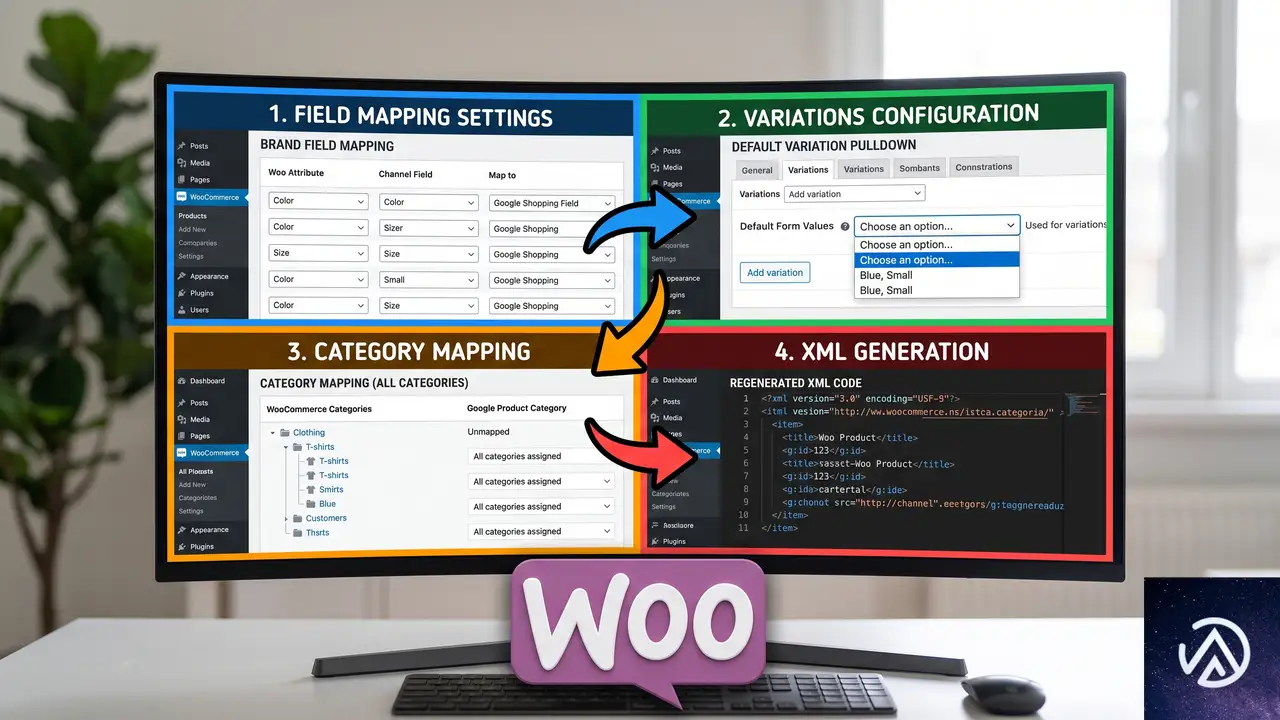
3つの問題が同時に起きている場合は、それぞれを個別に直すよりも、フィードの基本設定を順番に整える方が早い。次の手順でフィールドマッピング、変動商品設定、カテゴリマッピングを見直す。
このデモは、3つの症状をまとめて修正する際の優先順位を表している。ブランドの取得ソースを先に統一すると、変動商品とGoogleカテゴリの修正結果をXMLで正確に確認できる。
フィード再生成とキャッシュの扱い
設定を変更したあとは、フィードプラグインの「再生成」または「今すぐ更新」ボタンを実行する。WooCommerceやサーバー側のキャッシュが効いていると、更新前のXMLが表示され続けることがある。キャッシュプラグインを使っている場合は、フィードを再生成する前にキャッシュを削除すると確実だ。
生成されたXMLをブラウザで開き、<g:brand>、<g:google_product_category>、変動商品のIDやタイトルが表示されているかをCtrl+F(MacではCommand+F)で検索する。変動商品は親商品とバリエーションが別々の<item>要素として出力されるため、商品IDではなく商品名の一部で検索すると見つけやすい。
よくある質問
ブランドの出力が安定しないのはキャッシュが原因か?
キャッシュだけが原因になる場合は少ない。ブランドタクソノミーと商品属性の両方に同名のブランドが存在し、フィードのマッピングが不安定なソースを参照していることが多い。キャッシュを削除しても再発するなら、取得ソースの統一が先だ。
変動商品だけがXMLから消えるのはなぜか?
変動商品は親商品と各バリエーションが個別の商品として扱われるため、単純商品より出力条件が厳しい。デフォルトのバリエーション未選択、価格未入力、在庫切れ、または「商品のバリエーションを含める」設定のミスが典型的な原因になる。
Google商品カテゴリの出力形式が正しいか確認する方法は?
出力されたXML内の<g:google_product_category>の値を確認し、Google Merchant Centerが求める形式(不等号で区切られた英語の数字付きカテゴリパス)になっているかを見る。WooCommerceのカテゴリ名だけが入っている場合は、フィールドマッピングの取得ソースが誤っている。
設定を変えてもフィードが更新されない場合は?
フィードの再生成ボタンを押したあと、ブラウザでXMLを開いたときに古い内容が表示されることがある。キャッシュプラグインの削除、サーバー側のキャッシュ(OPcacheやVarnish)のクリア、またはクエリパラメータを付けて開く(例: feed.xml?nocache=1)と最新の出力を確認できる。
ブランドが空の商品はどうやって特定するか?
WooCommerceの商品一覧でフィルタ機能を使い、ブランドタクソノミーが空の商品を絞り込む。もし全商品にブランドが付いているのにXMLには一部しか出ていないなら、取得ソースの不一致を疑う。CSV書き出しでブランド列とブランド属性列を並べて比較すると特定しやすい。
この記事のポイント
- ブランドは取得ソースの統一が最優先
- 変動商品はデフォルトバリエーションの選択が必須
- Google商品カテゴリは全カテゴリのマッピングが必要
- 設定変更後はキャッシュを削除して再生成する
- XMLを検索して各フィールドの出力を検証する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

Googleサーチコンソールの生成AIレポートが全世界展開。見方とオプトアウトの注意点
Googleサーチコンソールの生成AIレポートが、2026年8月31日付で全世界のサイトに展開された。AI OverviewsやAI Modeなど生成AI機能での表示回数を、ページ別・国別・日付別に確認できる。
一方で、クリックデータはまだ提供されていない。表示はされても実際のサイト訪問につながったかは分からない。この記事ではレポートの見方、オプトアウト設定の仕組み、SEO担当者が取るべき対応を整理する。
生成AIレポートの全体像

2026年6月から段階的に展開が始まった生成AIレポートは、8月31日付の公式注記で全世界のサイトに行き渡った。Search Consoleにログインすると、検索レポートとDiscoverレポートのそれぞれで生成AI関連のデータを確認できる。
レポートが対象とするのは、AI Overviews、AI Mode、Discoverの生成AI機能だ。AI Overviewsは検索結果の上部に生成AIが回答の要約を表示する機能を指す。AI Modeは対話形式で検索を続けられる専用モードだ。DiscoverはGoogleアプリのフィードで、ここにも生成AIによるコンテンツ表示が含まれる。
従来の検索ではクリックが発生してサイト訪問につながっていた。生成AI検索ではサイトが回答の参照元として表示されても、ユーザーがクリックするとは限らない。この違いがレポートの重要性を高めている。
レポートで確認できる指標
レポートには生成AI機能での表示回数、つまりインプレッションが記録される。検索レポートではページ別・国別・日付別に加えて、デバイス別の内訳も確認できる。Discoverレポートでも同様に、ページ・国・日付の切り口でデータを見られる。
たとえば、自社の記事がAI Overviewsの中でどの国で多く表示されているか、日を追って伸びているかを把握できる。特定のページが頻繁に参照されているなら、その分野のコンテンツが生成AIに評価されている可能性を示す。
クリックデータは含まれない
公開時点でレポートにクリックデータは含まれていない。クリック数やクリック率は確認できず、表示が実際のサイト訪問につながったのかは分からない。この制約は、レポートの活用方法を考えるうえで大きなポイントになる。
Googleはアクセスについても、すべてのプロパティに展開が完了したわけではないとヘルプページで説明している。AIインプレッションが十分に蓄積されていないサイトでは、レポート自体が表示されない可能性がある。
オプトアウト設定の仕組み

レポートと同時に提供されているのが「Search generative AI control」というオプトアウト設定だ。Search Consoleの設定画面に配置されており、プロパティ単位で有効にできる。この設定を使うと、AI Overviews、AI Mode、Discover生成AIの3つの表示面からサイトのリンクとコンテンツを除外できる。
オプトアウトしたサイトは、これらの生成AI機能からのトラフィックとインプレッションが一切発生しなくなる。Googleは公式発表で、この設定が通常の検索ランキングのシグナルとして使われることはないと明言している。生成AI機能に表示されないことが、通常の検索順位に影響することはないという意味だ。
レポートはこの3つの表示面を対象にインプレッションを集計する。オプトアウト設定も同じ3面が対象になるため、運用の判断ではこの対応関係を理解しておきたい。
設定の効果と影響範囲
オプトアウトはプロパティ単位で適用される。つまり、サイト全体がまとめて生成AI機能から除外される形だ。ページ単位で一部だけ除外するような細かい制御は、現時点では提供されていない。
除外を有効にすると、生成AI機能からの表示は完全に止まる。生成AI経由の露出をすべて断つことになるため、ブランド認知や間接的な流入を期待している場合は慎重な判断が求められる。
AIトレーニングとは別の設定
このオプトアウトは、生成AIの学習データへの利用を制御する仕組みとは別物だ。Googleの生成AIトレーニングへの利用可否は、Google-Extendedという別の制御で管理される。Search generative AI controlを有効にしても、AIトレーニングへの利用は止まらない。
「生成AI機能への表示」と「AIの学習利用」は異なる設定で管理されている。SEO担当者は、この2つを混同せずに運用方針を決める必要がある。
ここまでの展開経緯
生成AIレポートとオプトアウト設定は、2026年6月3日にGoogleから同時に発表された。当初は英国のウェブサイト運営者の一部を対象にした限定的なテストとして始まっている。
同日、英国の競争・市場庁(Competition and Markets Authority / CMA)は行動要件を発行した。Googleに対し、サイトが通常の検索結果でペナルティを受けることなくAI検索機能からオプトアウトできるようにすることを求めた。
6月の発表と英国限定テスト
6月の時点では、レポートとオプトアウト設定は英国の選ばれたサイト運営者にのみ提供された。規制当局の要求と同時期に動き出した形だ。検索市場における競争環境を意識した展開だったといえる。
7月以降の段階的な拡大
7月になると、英国以外のアカウントでも設定が表示され始めた。その後、8月31日付の注記で全世界のサイトへの展開が完了したとされた。ただし、ヘルプページには展開が進行中であるとの記載が残っており、実際のアクセスにはタイムラグがあるようだ。
なぜ重要なのか

レポートが見えるようになると、オプトアウトを判断する前に生成AI機能での表示状況を確認できる。これまではブラックボックスだったAI検索内での露出が、数字として見えるようになる。
ただし、インプレッションの真の価値はまだ明確ではない。表示回数が多くても、クリックにつながるかどうかは別の問題だ。生成AI検索では、ユーザーが回答だけで満足してサイトを訪れないケースが増えると指摘されている。
レポートで見えるのは表示回数のみ。実際のトラフィック効果を測るにはクリックデータが必要になる。SEO担当者はこの制約を踏まえたうえでデータを読む必要がある。
SEO担当者が取るべき対応
まずはSearch Consoleでレポートの有無を確認する。すでに表示されている場合は、どのページがどの表示面でインプレッションを得ているかを把握できる。AIインプレッションが少ないサイトでは、レポート自体が表示されないこともある。
表示回数が少ない場合や、自社ブランドと合わない文脈で引用されている場合は、オプトアウトを検討する余地がある。ただし、クリックデータがないため、露出を継続した場合の潜在的な影響を過小評価しないことも重要だ。
既存の検索パフォーマンスレポートと併用し、通常検索の推移と生成AI検索の露出を比較しながら総合的に判断する。オプトアウトはプロパティ単位でしか実行できないため、サイト全体への影響を考慮する必要がある。
インプレッションデータの限界
最大の限界は、クリック数が分からない点だ。表示回数が増えても、サイトへの訪問が増えていなければビジネス上の価値は低い。生成AI回答にサイトの情報が引用されても、ユーザーがリンクを押さなければ意味がない。
加えて、引用位置や文脈も確認できない。自社サイトが回答の根拠として適切に扱われているのか、単に名前が出ているだけなのかをレポートから読み取ることはできない。インプレッションの質を評価する材料が不足しているのが現状だ。
今後の展望
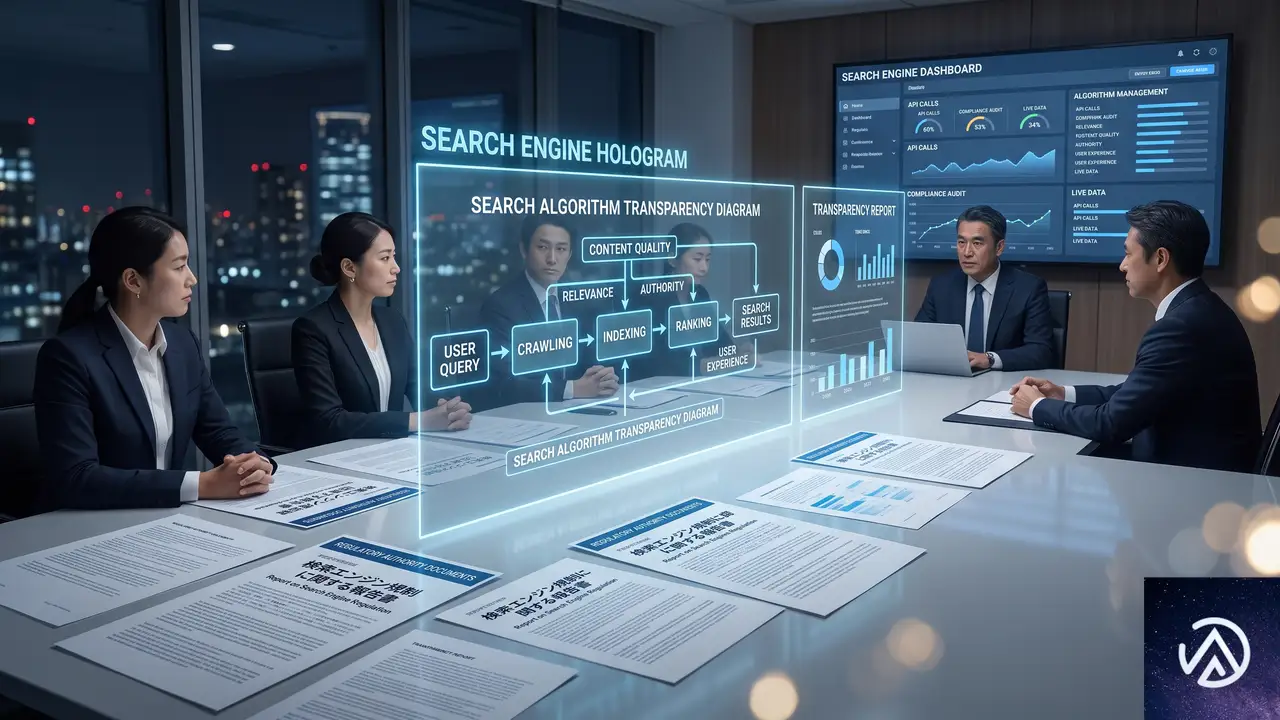
CMAは2027年3月までに、ページ単位の生成AI機能コントロールを導入するようタイムラインを設定している。現在のプロパティ単位の設定より細かい制御が求められている。
規制当局はクリックデータの提供も期待している。しかし、8月31日の更新ではクリックレポートへの言及はなかった。クリックデータが追加されれば、レポートの実用性は大きく高まる。
CMAの要求とタイムライン
ページ単位のコントロールは、サイト全体ではなく特定のページだけを生成AI機能から除外できる仕組みを指す。これが実現すれば、オプトアウトの判断がより柔軟になる。生成AI経由の露出を活かしたいページと、除外したいページを分けて運用できるようになる。
クリックデータ提供の行方
クリックデータが追加されるかは、現時点では未定だ。Googleは最初の1年間、コンプライアンス状況を6か月ごとに報告する義務を負っている。規制当局の継続的な監視が、レポートの改善を後押しする可能性は高い。
この記事のポイント
- 生成AIレポートは2026年8月31日付で全世界のサイトに展開された
- 対象はAI Overviews、AI Mode、Discover生成AIの3面で、ページ別・国別・日付別に表示回数を確認できる
- クリックデータはまだ提供されておらず、表示がトラフィックにつながるかは分からない
- オプトアウトはプロパティ単位で、検索ランキングには影響しないとGoogleが明言している
- CMAは2027年3月までにページ単位のコントロールを要求しており、今後の仕様変更に注意が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験