

OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.1.2リリース!商品ギャラリーの無限再帰とメールレビュー検証を修正
WooCommerce 11.1.2が2026年9月22日にリリースされた。商品バリエーションギャラリーで発生する無限再帰の修正と、メール経由の商品レビューにおける入力検証の強化が含まれるドットリリースだ。
今回の更新はセキュリティ更新に該当する。データベースの更新は不要で、適用のハードルは低い。ECサイト運営者は早めのアップデートを検討したい。
WooCommerce 11.1.2のリリース概要
WooCommerceのドットリリースとは、メジャーバージョンやマイナーバージョンの間に挟まれる小規模な修正更新のことだ。新機能の追加はなく、既知の不具合修正とセキュリティ強化に絞られる。
今回の11.1.2は、2026年9月22日に公開された。公式のリリースノートによると、セキュリティ更新に該当し、データベース更新は不要とされている。つまり、プラグインの更新ボタンを押すだけで適用が完了する。
修正内容は2つに絞られている。1つ目は商品バリエーションギャラリーにおける無限再帰の防止、2つ目はメールベースの商品レビューにおける検証の厳格化だ。どちらもECサイトの安定稼働に直結する内容である。
商品バリエーションギャラリーの無限再帰を修正
1つ目の修正は、テーマがテンプレートファイル内で get_available_variations 関数を呼び出した際に無限再帰が発生する問題への対処だ。GitHubのプルリクエスト番号68939で修正されている。
無限再帰とは何か
無限再帰とは、関数が終了条件なしに自分自身を呼び出し続ける状態を指す。プログラミングの世界では「スタックオーバーフロー」と呼ばれるエラーにつながる。たとえるなら、合わせ鏡の間に立ったときに像が無限に反射して見えるのに似ている。どこかで止める仕組みがなければ、コンピュータのリソースを使い果たしてしまう。
WooCommerceの商品バリエーションギャラリーでは、テーマが独自に get_available_variations を呼び出すケースが問題になった。テーマのテンプレートファイルにこの関数の呼び出しが含まれていると、内部のフックが再帰的に呼び出されてスタックが溢れ、商品ページ全体が白画面になったり応答しなくなったりする。
修正の内容と影響範囲
修正後は、テーマが get_available_variations をテンプレートファイルで呼び出しても、再帰的な呼び出しが防止される。バリエーションごとの画像ギャラリーが正常に表示され、商品ページが通常どおり動作するようになる。
影響を受けるのは、バリエーション商品を持つECサイトで、なおかつテーマがこの関数を直接呼び出している場合に限られる。標準のWooCommerceテーマや多くの人気テーマでは問題は発生しない。しかし、独自にカスタマイズしたテーマを使っている場合は注意が必要だ。
get_available_variations をテンプレート内で呼び出すと、内部フックが再帰的に実行されてスタックが溢れる。商品ページ全体が白画面になり、購入フローが停止する。上図のとおり、修正前は get_available_variations の再帰呼び出しにより商品ページ全体が停止する可能性があった。修正後はこの再帰が防止され、ギャラリーが正しく表示される。独自テーマを運用している場合は、この修正の適用前にステージング環境で動作確認することを推奨する。
メールレビューの検証を強化
2つ目の修正は、メール経由で投稿される商品レビューの入力検証を厳格化するものだ。GitHubのプルリクエスト番号68961で対応された。セキュリティ更新とされる理由はこの修正にある。
メールベースのレビュー機能とは
WooCommerceには、購入者からのレビューをメールで受け付ける仕組みがある。顧客が注文後に届くメール内のリンクからレビューを投稿できる機能だ。ECサイトにとってレビューは信頼構築の要であり、この導線はコンバージョン率にも影響する。
問題は、このメール経由の投稿経路において入力値の検証が十分でなかった点だ。悪意のある第三者が不正なデータを送信する余地があり、セキュリティリスクになり得た。今回の修正では、この検証処理が厳格化されている。
検証強化がもたらす効果
検証の厳格化により、不正な入力や改ざんされたデータがレビューとして投稿されるリスクが低減される。レビューの信頼性が保たれ、ECサイトの評判管理にも好影響を与える。
店舗運営者の目線では、この変更によってレビュー投稿のフローに大きな変化はない。顧客が正規のメールリンクからアクセスする限り、従来どおりの手順でレビューを投稿できる。内部のバリデーションが強化されただけなので、ユーザビリティへの影響はない。
上図のとおり、メール経由のレビュー投稿は4段階で処理される。今回の修正はSTEP 3の検証処理に焦点を当てており、不正なデータの流入を防ぐ役割を担う。顧客側の操作フローに変更はない。
ECサイト運営者が取るべき対応
この更新はセキュリティ更新のため、基本的には即時適用が望ましい。ただし、独自テーマやカスタムコードを使っているサイトでは、事前の動作確認を怠らないことが重要だ。
更新前の準備
更新の前に、サイト全体のバックアップを取得する。WooCommerceを運用するECサイトでは、商品データ、注文履歴、顧客情報が失われると事業に直結する。更新作業の前には必ずデータベースとファイルの両方をバックアップしておく。
また、ステージング環境が利用できるのであれば、本番環境に適用する前に更新後の動作を確認する。特にバリエーション商品を持つ場合は、商品ページでギャラリーが正しく表示されるかをチェックしたい。
更新手順の目安
WooCommerceの更新はWordPressの管理画面から行える。プラグイン一覧からWooCommerceを選択し、更新を実行するだけだ。データベース更新が不要なため、更新後のマイグレーション処理も発生しない。
更新後は、商品ページ、カート、チェックアウト、レビュー投稿の各フローが正常に動作するかを確認する。特にメールレビュー機能を有効にしている場合は、テスト用のレビューを1件投稿して検証すると安心だ。
この記事のポイント
- WooCommerce 11.1.2は2026年9月22日に公開されたセキュリティ更新で、データベース更新は不要
- 商品バリエーションギャラリーの無限再帰を修正し、独自テーマ利用時の白画面リスクを解消
- メール経由の商品レビューにおける入力検証を強化し、不正データの投稿リスクを低減
- 独自テーマやカスタムコードを運用中のサイトは、ステージング環境での事前確認を推奨
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS CloudWatch Omniが登場。AIとチームで行う新しい可観測性
AWSがCloudWatch Omniを発表した。アプリケーションとAIエージェントの両方を監視できる新しい可観測性体験で、チーム全体が同じワークスペースで調査を進められる。
OpenTelemetryベースで構築されており、既存のCloudWatchテレメトリをそのまま活用できる。AWSマネジメントコンソールへのアクセス権限がなくても、専用URLとSSOで利用可能だ。
この記事では、CloudWatch Omniの主要機能、AI調査の仕組み、セットアップ手順、既存環境との関係を解説する。運用チームが抱えるダッシュボード管理や障害調査の負担をどう軽減するかが焦点だ。
CloudWatch Omniとは何か
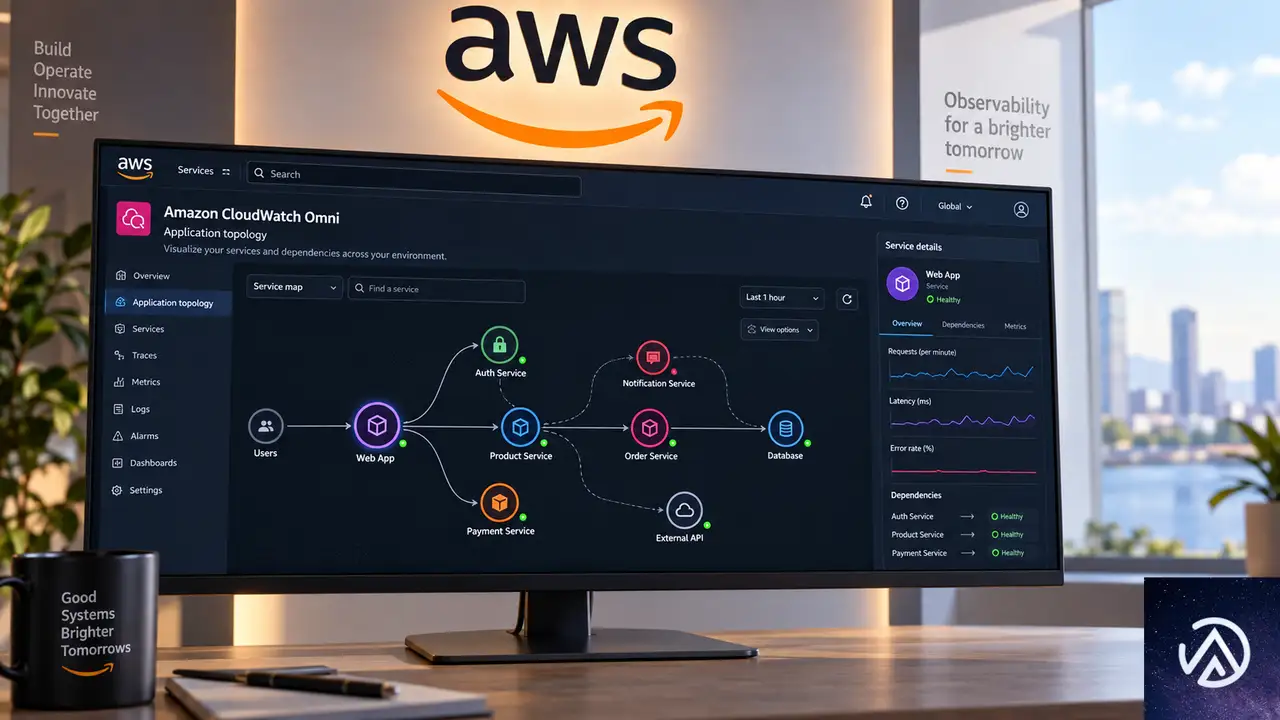
アプリケーション中心の可観測性
CloudWatch Omniは、インフラストラクチャ単位ではなく、アプリケーション単位でテレメトリを整理する。従来のモニタリングツールはサーバーやコンテナといったリソースごとに指標を表示するが、Omniはサービス同士の依存関係を自動的にマッピングし、システム全体をひとつの接続された構造として見せる。
このアプローチにより、担当者は「どのサーバーでエラーが出たか」ではなく「どのアプリケーションで問題が起きているか」を即座に把握できる。ダッシュボードを手動で更新する手間も減る。
この比較デモは、リソース中心からアプリ中心への考え方の転換を示している。Omniは自動検出とトポロジーマッピングにより、運用者が全体像を維持する負担を軽減する。
OpenTelemetryとの統合
CloudWatch OmniはOpenTelemetryを基盤としている。OpenTelemetryは、メトリクス・ログ・トレースなどのテレメトリデータを収集するためのオープン標準だ。すでにCloudWatchに送信しているテレメトリは、再設定なしでOmniに表示される。
さらに、OpenTelemetryで計装された他のワークロードも、OTLP(OpenTelemetry Protocol)エンドポイントを通じてOmniに取り込める。これにより、オンプレミス環境や別のクラウドで稼働するアプリケーションも同じワークスペースで監視できる。
チーム全体で使える共同作業の仕組み
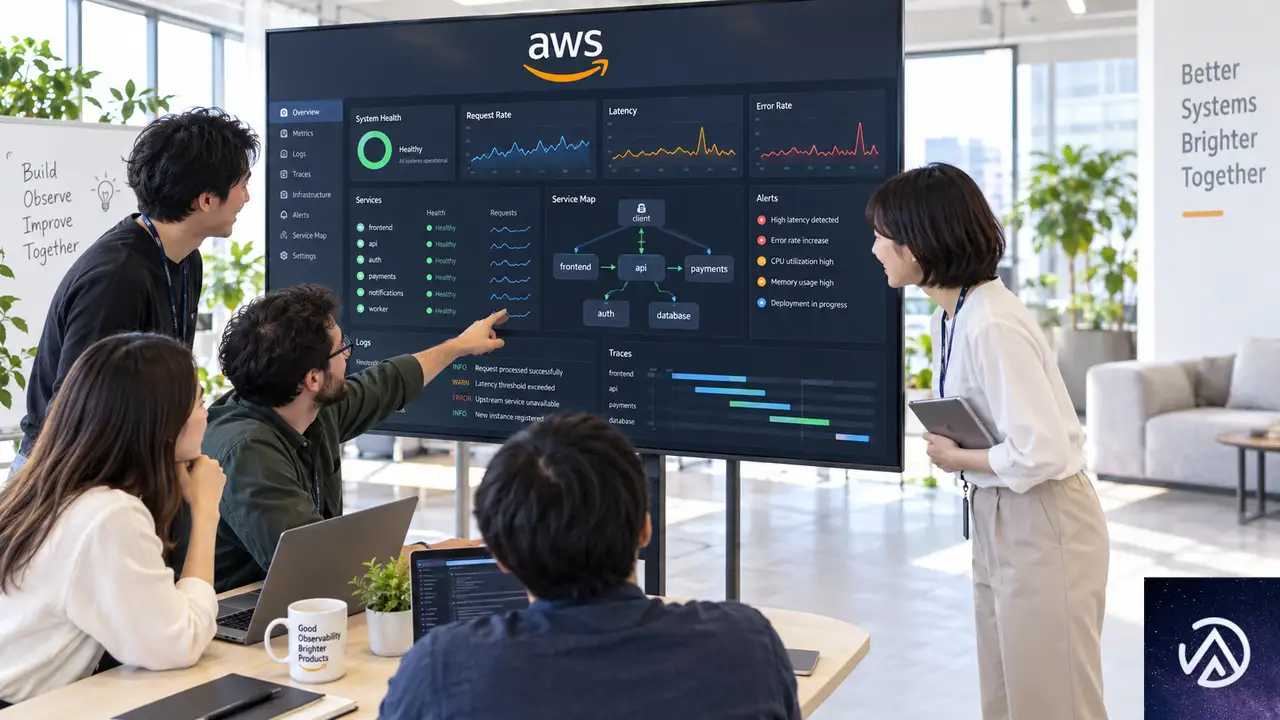
CloudWatch Omniの大きな特徴は、チーム全員が同じワークスペースを共有できる点にある。エンジニアは専用URLにアクセスし、企業のSSO(シングルサインオン)でログインする。AWSマネジメントコンソールへのアクセス権限は不要だ。
IAM Identity Centerを通じてOktaやAzure ADなどのIDプロバイダーと連携できる。SRE、開発者、データベースエンジニア、マネージャーが同じデータと調査コンテキストを共有する。
このフローは、通常のインシデント対応時にOmniがどのように進行するかを示している。チーム間の引き継ぎ時にコンテキストが失われる問題が解消される。
エスカレーション時の連携強化
障害がチームの境界を越えると、Slackのスレッドやスクリーンショットでの情報共有になりがちだ。Omniでは次の担当者が同じセッションに参加し、これまでの調査内容をそのまま引き継げる。
調査履歴は自動的に記録されるため、インシデントレポートを別途作成する必要もない。
AIが調査を支援するAmazon DevOps Agent
CloudWatch Omniには、Amazon DevOps Agentと呼ばれるAIアシスタントが組み込まれている。調査セッションの中で、シグナルの相関分析や次のアクションの提案を行う。
このエージェントは、エンジニアが見ているのと同じテレメトリデータを参照する。そのため、提案内容はアプリケーションの実際の状態に基づいたものになる。
DevOps Agentは、相関イベントの特定や依存関係グラフを通じた根本原因の追跡を支援する。調査履歴は事後レビューにも活用できる。
エージェントの役割と限界
DevOps Agentはあくまで支援ツールであり、人間の判断を代替するものではない。提案内容をそのまま鵜呑みにするのではなく、エンジニアの専門知識と組み合わせて使うことが重要だ。
また、エージェントはテレメトリデータのみに基づいており、コードのビジネスロジックや組織固有の事情までは考慮しない。この点は運用チームが補完する必要がある。
セットアップ手順
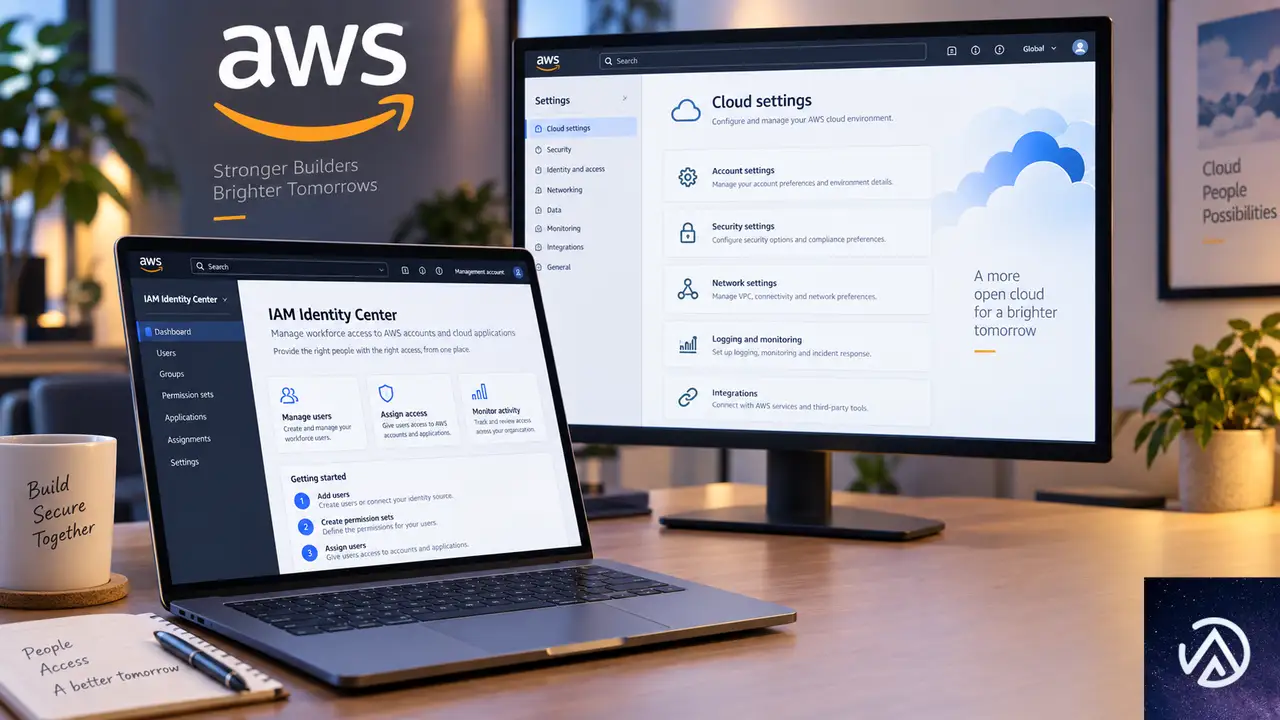
CloudWatch Omniのセットアップは数分で完了する。既存のCloudWatch環境を再設定する必要はない。
既存CloudWatchユーザーの場合
CloudWatchコンソールで「Try CloudWatch Omni」をクリックするだけで、既存のログ、メトリクス、トレース、アラームが即座に利用可能になる。ワークロードは自動的に検出され、アプリケーショントポロジーをすぐに確認できる。
組織全体への展開
管理者はドメインを設定し、IAM Identity Center経由でIDプロバイダーを接続する。その後、チームと環境ごとにSpaceを定義し、ユーザーを招待する。各Spaceは既存のCloudWatchデータを参照するため、データの移動は不要だ。
他環境のアプリケーション取り込み
オンプレミスや他クラウドで稼働するアプリケーションも、コネクターを利用してテレメトリをOmniに取り込める。取得したデータはAWSデータと同じSpaceや調査セッションに表示される。
既存のCloudWatchとの関係と料金
CloudWatch OmniはCloudWatchを置き換えるものではなく、拡張するものだ。既存のアラーム、ダッシュボード、API、コンソールのワークフローはそのまま機能する。
アクセスは専用のWebアプリケーション経由で、エンタープライズSSOに対応する。セットアップ後、DevOps AgentはすべてのOmni調査セッションでデフォルトで有効になる。
料金体系
料金の詳細はAWSの公式価格ページで確認できる。既存のCloudWatchユーザーはコンソールから直接試用できる。
導入コストの見積もりには、監視対象のワークロード数と取り込むテレメトリ量が影響する。
生成AIワークロードへの対応
CloudWatch Omniは、生成AIやエージェントワークロード向けの専用可観測性も提供する。トレース探索、評価フレームワーク、リアルタイムモニタリングが含まれる。
詳細はAWSの別記事で紹介されている。エージェント可観測性のハンズオンも参照できる。
この記事のポイント
- CloudWatch Omniはアプリケーション中心の可観測性を提供する
- OpenTelemetryベースで既存テレメトリを活用できる
- チーム全体が同じワークスペースで共同調査できる
- Amazon DevOps AgentがAI支援で根本原因特定を助ける
- セットアップは数分で完了し、既存環境への影響はない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleが商品カルーセルを欧州で削除、EC事業者の有機的流入が激減
Googleが2026年9月、欧州経済領域(EEA)で商品カルーセルの表示をほぼ全廃した。EC事業者がGoogle検索からオーガニックで顧客を獲得する主要経路が突然消えた形だ。
オランダの分析プラットフォームProductriseの計測では、EEA圏内の商品カルーセル表示回数は90〜100%減少している。英国や米国では変化がない。この変更は欧州のEC事業者だけに影響する。
デジタル市場法(DMA)への対応が理由で、Googleは29年の歴史で最大の検索品質低下と述べる。この記事では、変更の実態、EC事業者への影響、そして取るべき具体的な対策を解説する。
商品カルーセル消失の実態
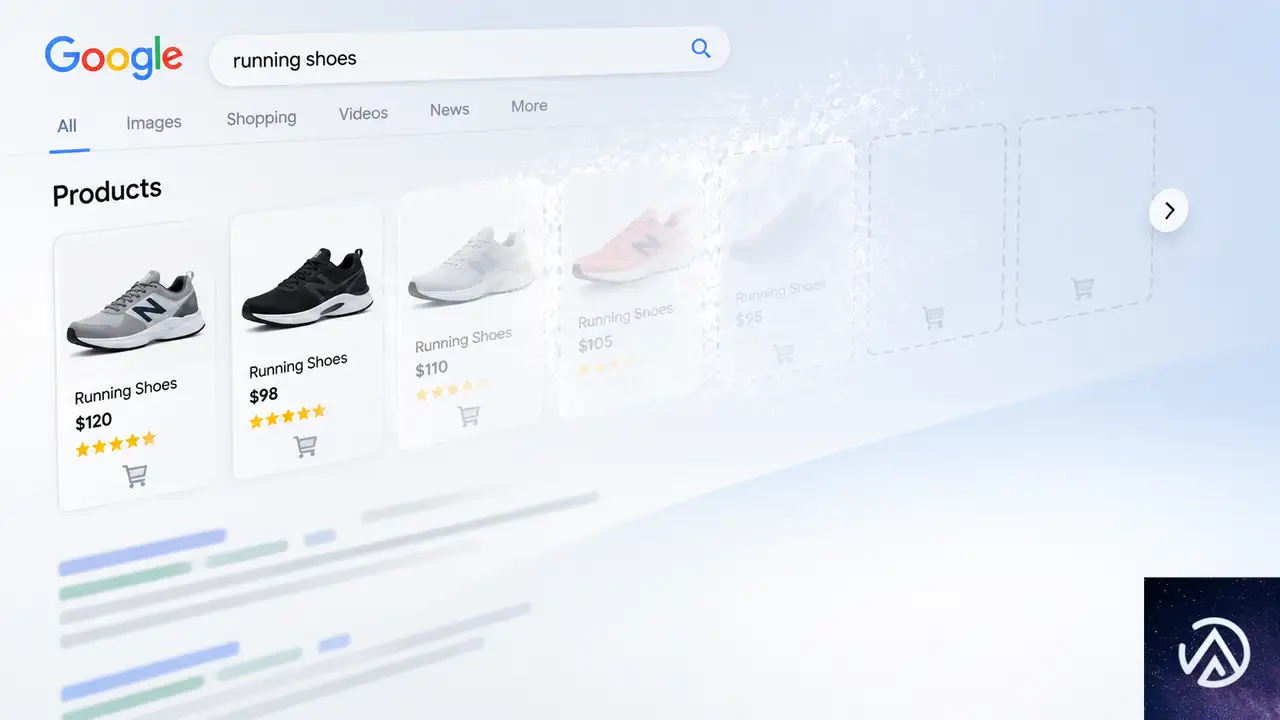
商品カルーセルとは何か
商品カルーセルとは、Google検索で商品名を入力した際に検索結果の上部に表示される横並びの商品一覧だ。商品画像、商品名、価格、ショップ名が一目で確認でき、ユーザーは検索結果から直接商品ページへ遷移できる。EC事業者にとっては、Google Merchant Centerに商品情報を登録するだけでオーガニック流入を得られる重要な表示だった。
このデモは検索結果の表示変化を示している。商品カルーセルが消え、ショップリストに置き換わった。
90〜100%という減少幅
Productriseは数千件の検索クエリを毎日追跡している。同社の計測によると、ドイツ、フランス、オランダ、ベルギー、スウェーデンの5カ国で商品カルーセルの表示回数が90〜100%減少した。Productrise創設者のHugo Huijer氏は「わずか数日で90〜100%の減少が見られる。一方、英国、米国、オーストラリアなどEEA圏外では変化がない」とEcommerce News Europeに語っている。
EEAはEU加盟27カ国にノルウェー、アイスランド、リヒテンシュタインを加えた30カ国で構成される。対象となるのはこの30カ国に限られ、日本を含むEEA圏外の検索結果では従来通り商品カルーセルが表示される。
DMA(デジタル市場法)遵守が理由
DMAの概要とGoogleの判断
DMA(Digital Markets Act / デジタル市場法)は、巨大プラットフォーム企業による市場支配を規制するEU法だ。2022年に成立し、Google、Apple、Meta、Amazon、Microsoftのような「ゲートキーパー」と指定された企業に対し、自社サービスを競合より有利に扱うことを禁じている。
Googleは、商品カルーセルがDMAの「自己優遇の禁止」条項に抵触する可能性があると判断した。商品カルーセルはGoogle Shoppingという自社サービスへの誘導を促進する機能であり、競合する価格比較サイトやアグリゲーターを不利にする。この判断に基づき、EEA圏内では商品カルーセルを削除し、代わりにショップ名とアグリゲーターのリストを表示する方式に切り替えた。
Shoppingタブの消滅
ドイツの業界プラットフォームSEO SüdwestのKristian Kunz氏によると、GoogleのタブナビゲーションからShoppingタブも削除された。「その他」メニューにも表示されず、残っているのはGoogle Shopping Ads(有料広告)のみだ。Googleは今回の変更について「29年の歴史で最大の検索品質低下」と述べている。これは同社の主張であり、DMA対応がいかに抜本的な変更であるかを示す言葉だ。
ここで重要なのは、変更の対象が「オーガニック表示」に限定されている点だ。Google Shopping Adsは有料広告であり、DMAの規制対象外としてEEA圏内でも引き続き表示される。Googleにとって広告収入は維持される構造となっている。
EC事業者への影響を読み解く
中小事業者と大手の明暗
この変更の影響は事業規模によって異なる。中小規模のEC事業者は、オーガニック検索からの商品ページへの直接流入が大幅に減る。商品カルーセルは商品名、価格、画像を直接検索結果に表示していたため、ユーザーがクリックする前に商品情報を確認し、そのまま商品ページに遷移できた。この経路が絶たれたことで、商品個別ページへの流入は激減する。
このデモは流入経路の変化を示している。直接流入から間接流入へと質が変わった。
一方、大手小売業者にはプラスに働く面もある。ブランド認知度が高い大手は、ユーザーが直接サイト名やブランド名を検索する「ブランド検索」からの流入が増える可能性がある。Hugo Huijer氏も「多くの企業が戦略の基盤としてきた機能が消えた」と指摘しつつ、この変化を「オーガニック可視性の根本的な転換」と表現している。
Google Merchant Centerの価値低下
Google Merchant Centerへの商品登録の価値も大きく下がった。従来は登録した商品情報が商品カルーセルやGoogle Shoppingタブに表示されていたが、これらのオーガニック表示が消えた今、Merchant Centerへの登録は商品広告(Google Shopping Ads)を出稿する場合を除き、オーガニック流入を生まない。Kunz氏は「SEO for productsも、少なくともGoogle Shoppingに直接関係する施策に関しては重要性が低下した」と述べている。
EEA圏内のEC事業者が取るべき対策
カテゴリーページのSEO強化が最優先
Productriseは、商品カルーセルの代替としてカテゴリーページがオーガニック検索で重要性を増すと予測している。カテゴリーページとは、「ランニングシューズ」「ワイヤレスイヤホン」のような商品群をまとめたページだ。商品個別ページではなく、カテゴリーページが検索結果の上位に表示される可能性が高まる。カテゴリーページのタイトル、メタディスクリプション、コンテンツ、内部リンクを最適化する必要がある。
WooCommerceを使っているECサイトの場合、カテゴリーページの構造は比較的最適化しやすい。WooCommerceの商品カテゴリーはアーカイブページとして自動生成されるため、カテゴリーの説明文、タイトル、メタ情報を設定するだけで基本的なSEO対策ができる。さらに商品カテゴリーごとに固有のコンテンツを追加することで、検索エンジンからの評価を高められる。例えば「ランニングシューズ 選び方」のような購買ガイド記事をカテゴリーページに組み込むと効果的だ。
ショッピング広告と価格比較サイトの活用
オーガニック表示が消えたことで、有料広告の価値が相対的に高まった。Google Shopping AdsはEEA圏内でも引き続き表示されるため、予算に余裕がある事業者はショッピング広告への投資を増やすことを検討すべきだ。広告費は増えるが、商品カルーセルが消えたことで競合の有機的な露出も減少しており、広告のクリック率や費用対効果が改善する可能性がある。
同時に、価格比較サイトやアグリゲーターへの掲載を強化することも有効だ。Googleが表示するショップリストには、価格比較サイトやアグリゲーターが並ぶ。これらのサイトに商品を掲載することで、間接的にGoogle検索からの流入を確保できる。手数料は発生するが、オーガニック流入が激減した現状では、顧客獲得コストとして捉える必要がある。
このデモはEC事業者が取るべき対策を4つのステップで示している。優先順位の高い順に並んでいる。
ブランド検索の強化と分散戦略
四つ目に、ブランド検索の強化がある。ユーザーが「ショップ名+商品名」で検索した際に、自社サイトが確実に上位表示されるようにする。Googleが商品カルーセルを削除しても、ブランド検索には影響がないためだ。ブランドの認知度を高めるためのコンテンツマーケティング、SNS活用、メールマーケティングにも投資すべきだ。特定のプラットフォームに依存しすぎない「分散戦略」が、今回のような突然の仕様変更への備えとなる。
この記事のポイント
- GoogleがEEA圏内で商品カルーセルを削除、表示回数は90〜100%減少した
- DMA(デジタル市場法)対応のためで、Shoppingタブも消滅した
- カテゴリーページのSEO強化が今後の最重要課題となる
- Google Shopping Adsと価格比較サイトへの掲載が代替流入手段として浮上する
- 中小EC事業者は直接流入の減少で打撃を受け、大手はブランド検索で恩恵を受ける可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareがrobots.txtを自動生成するBot Preference Syncの仕組みと検証
Cloudflareが2026年8月21日、サイトのrobots.txtを自動生成する新機能「Bot Preference Sync」を発表した。Search、Agent、Trainingの3つのカテゴリ設定から、Cloudflareがrobots.txtの該当部分を自動的に書き換える仕組みだ。robots.txtとエッジ強制設定の矛盾を解消すると期待される。
この機能は無料プランから利用でき、新規顧客にはデフォルトでオンになる予定だ。一方でカテゴリ単位の設定には粗さがあり、個別クローラー単位のビジネス判断を表現できないという課題もある。本記事では機能の仕組みと限界、サイト運営者が取るべき対応を検証する。
robots.txtとエッジ強制の矛盾が生んだ新機能
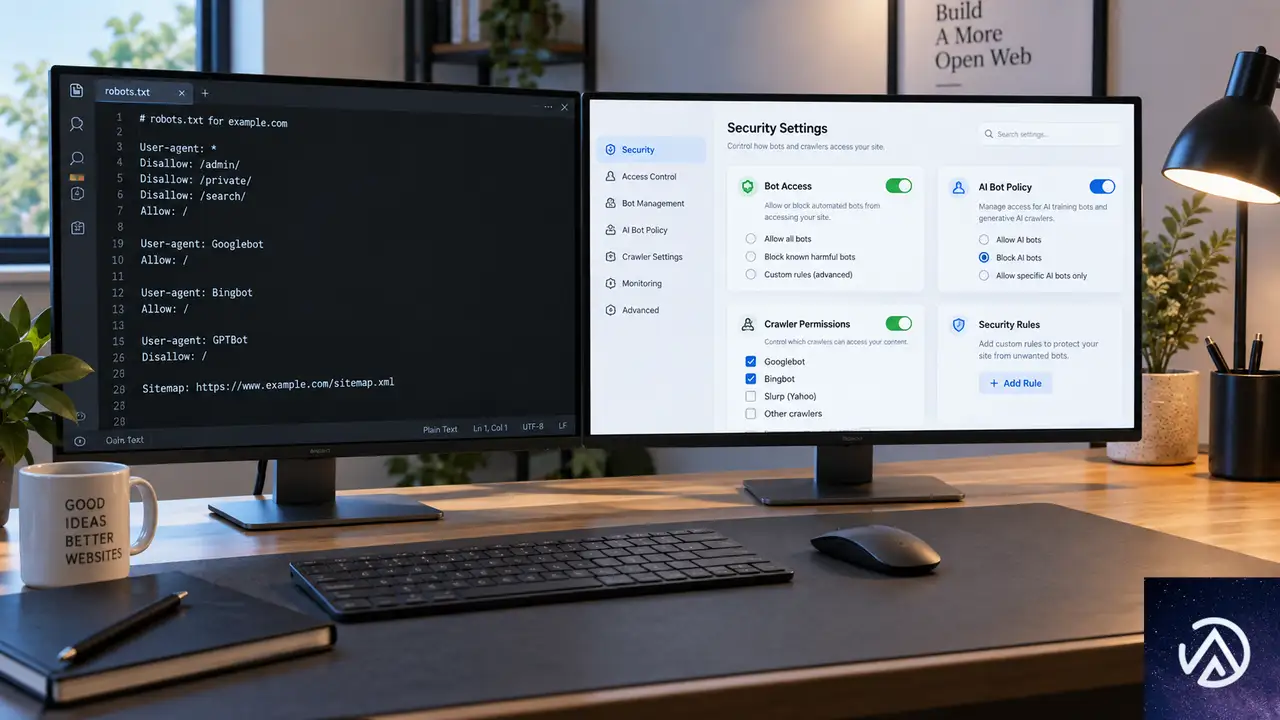
Webサイトのクローラーポリシーは2つの場所で管理される。1つはrobots.txtファイル、もう1つはWAFやCDNのエッジ側で動作するブロック設定だ。robots.txtはテキストファイルであり、クローラーへのリクエスト(お願い)を記述する。エッジ強制設定はダッシュボードで操作し、実際にHTTPリクエストを拒否する。
この2つは別々の場所で管理されるため、時間とともに矛盾が生じやすい。robots.txtは一度作成すると放置されがちで、エッジ設定は後から変更されることが多い。No Hacksの記事は、運営者自身のサイトでこの問題が発生していた例を報告している。robots.txtではBytespiderを許可する記述が数ヶ月間残っており、意図しないクローラーを歓迎する状態だったという。
CloudflareのBot Preference Syncは、この矛盾を自動的に解消する。ダッシュボードで設定したAIボットポリシーをrobots.txtに反映し、エッジ強制設定との乖離を防ぐ。Cloudflareがrobots.txtを書くという行為は、サイト運営者の代わりにポリシーを文書化することでもある。
Bot Preference Syncの仕組みと3つのカテゴリ設定
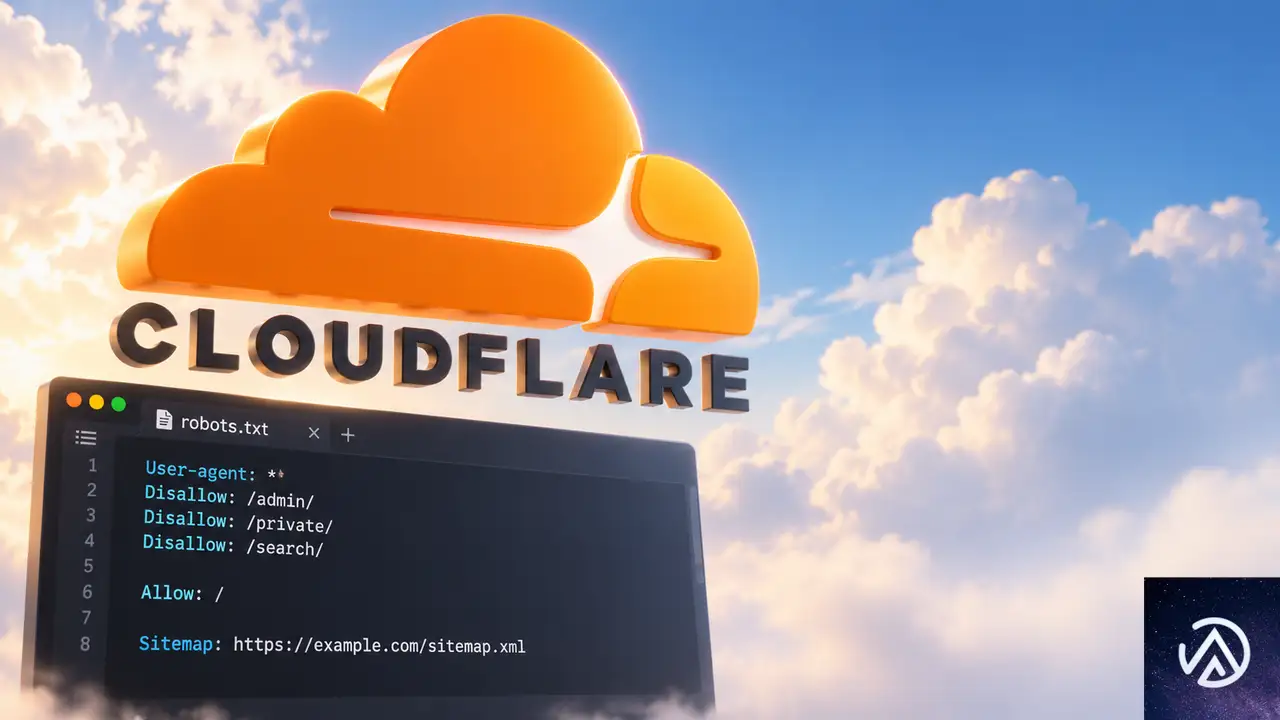
Bot Preference Syncは、セキュリティ設定の「AIボットポリシー」で設定した内容をrobots.txtに変換する。設定項目はSearch(検索)、Agent(エージェント)、Training(トレーニング)の3カテゴリだ。各カテゴリには「全ページでブロック」「広告表示ページのみブロック」「許可」の選択肢がある。
生成されたrobots.txtには、Cloudflare Bot Preference Syncの開始マーカーと終了マーカーが付与される。既存のrobots.txtコンテンツはその下に保持される。つまりCloudflareが書き込むのはマーカーの間の部分だけで、サイト運営者が手動で書いた部分は残る仕組みだ。
Bot Preference Syncは設定をrobots.txtへ反映する一連の流れを自動化する。
Cloudflareの発表によると、この機能は無料プランから利用可能で、新規顧客にはデフォルトでオンになる。ただし2026年9月13日時点では、Bot Preference Syncの公式Changelogへの記載がなく、Cloudflareのボットドキュメントにも言及がない。また一部のサイトではrobots.txtに生成ブロックがまだ現れていない。本記事は発表内容に基づく検証となる。
カテゴリ単位の設定では表現できない個別ポリシー
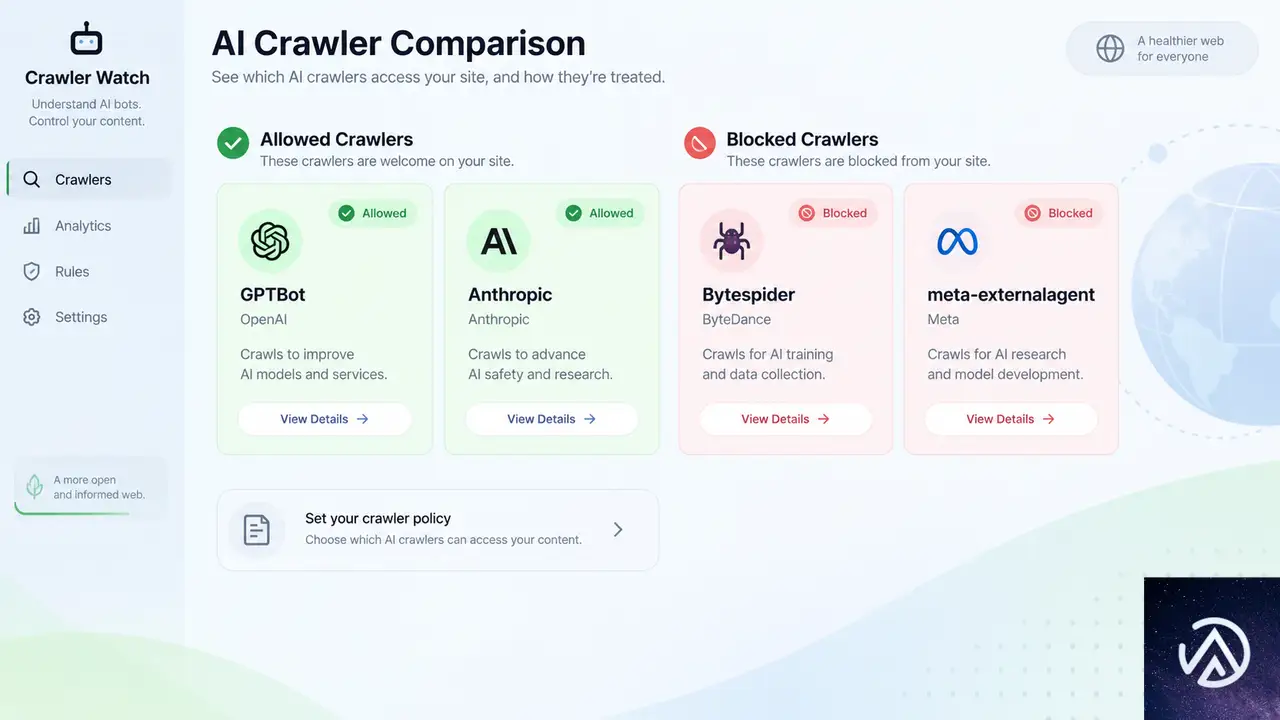
Bot Preference Syncの3カテゴリ設定は、サイト運営者のビジネス判断を必ずしも表現できない。No Hacksの記事の運営者は、OpenAIのGPTBot、Anthropicのクローラー、PerplexityBotを許可し、Bytespiderとmeta-externalagentをブロックしている。この判断は企業ごとの見返りに基づく。前者は自社ページをアシスタントの回答に表示してくれるが、後者は何も返さない、という理由だ。
このポリシーを3カテゴリ設定で表現しようとすると、矛盾が生じる。Trainingをブロックに設定すれば、許可したいGPTBotまでブロックされる。Trainingを許可に設定すれば、ブロックしたいBytespiderまで許可される。個別クローラー単位のビジネス上の決定は、カテゴリ単位の設定では表現できない。
個別クローラー単位のポリシーは3カテゴリ設定では表現できない。許可したいクローラーの扱いが、設定次第で逆転してしまう。
Cloudflareは、より細かい制御が必要な場合の対応策として、同期機能をオフにして手動でrobots.txtを管理することを挙げている。これはBot Preference Syncが万人向けではなく、カテゴリ単位の粗さを受け入れられるサイトに向けた機能だということを示している。
独自の見解として、日本のサイト運営者にもこの課題は当てはまる。コンテンツをAIトレーニングに提供する見返りを個別に評価している企業は、3カテゴリの設定では対応できない。Bot Preference Syncはあくまで「全許可」か「全拒否」に近いポリシーを持つサイト向けの省力化ツールと捉えるべきだ。
Cloudflareが公開した4つの開示条件とブロッキング
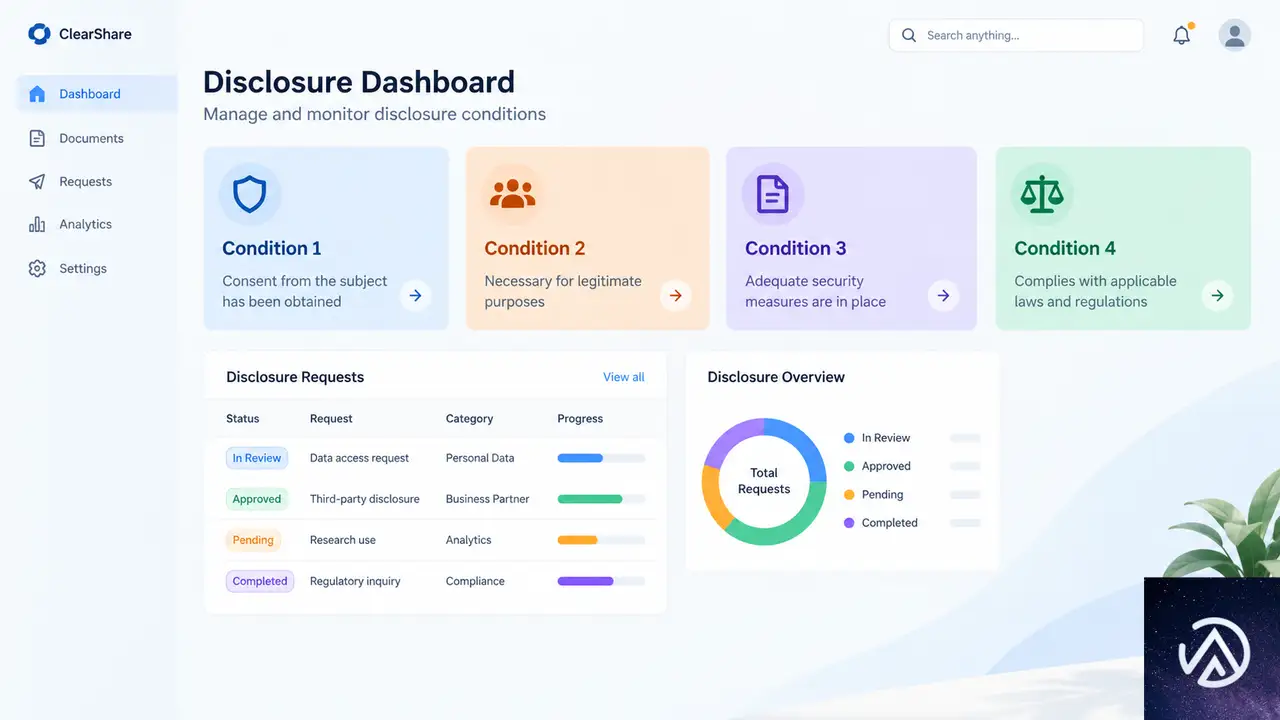
TrainingをDisallowに設定すると、robots.txtにno-training行が書き込まれる。同時に、Cloudflareが「不透明」と判断したAIクローラーがブロックされる。Cloudflareはこのブロックを回避するために、クローラーが満たすべき4つの条件を公開している。
4つの条件を満たさないクローラーは不透明とみなされ、TrainingをDisallowに設定したサイトではブロック対象となる。
条件2と条件4はGoogleを記述している。条件4についてGoogleはすでに満たしている。Googleのクローラードキュメントは、Google-ExtendedがGeminiモデルのトレーニングを制御し、検索結果への掲載やランキングシグナルには影響しないと明記している。これは条件4が求める公開声明に該当する。
一方で条件2はGoogleが答えを持っていない。条件2はAIサマリーからオプトアウトする方法を求めている。GoogleのAI機能のドキュメントによると、AI概要から除外するにはnosnippet、data-nosnippet、max-snippet、noindexのいずれかを使うことになる。しかし、これらはすべて通常の検索表示にも影響する。AI概要だけから外れて通常の検索スニペットは残す、という設定は存在しない。
Microsoftは2023年9月に条件2への回答を示している。NOARCHIVEタグを付けたコンテンツはBing Chatの回答に含まれないが、検索結果には引き続き表示される。検索インデックスから除外せず、チャットの回答からだけ除外できる仕組みだ。Cloudflareは2026年7月の記事で、BingBotとGooglebotを混合用途クローラーとしてこの条件の対象に挙げている。
CloudflareがAI企業への開示要求を明文化した点は評価できる。ただし、その条件を書いたのも執行するのもCloudflareという単一ベンダーだ。条件を読まずにダッシュボードのトグルをクリックしたサイト運営者も多い。パブリッシャーがAI企業に求めてきた説明責任は、いまやCloudflareにも向けられている。
新規顧客にデフォルト適用される意味とリスク
2026年9月15日から、Cloudflareは新規ドメインのデフォルト設定を変更する。広告を表示するページではTrainingとAgentがブロックされ、Searchは許可される。オンボーディング時に「広告付きページで収益化している」を選択すると、TrainingがDisallowに自動設定される。
これはビジネスモデルに関する質問であり、その回答がrobots.txt上のAIトレーニングに関する公開ポジションになる。広告収益に依存するサイトは、AIトレーニングを拒否する立場を自動的に表明することになる。サイト運営者がこの設定を認識していなければ、意図しないポジションが公開され続ける。
リスクが大きいのは、robots.txtを二度と開かず、自分の代わりに書かれたポジションを読まないサイトだ。Cloudflareはすでにアナリティクススクリプトを無料プランのサイトにデフォルトで書き込んでいる。同じオンデフォルトのパターンがrobots.txtにも及ぶ。サイト運営者が設定を確認しなければ、AIトレーニングに関する自社の立場を外部ベンダーに委ねることになる。
SEO担当者の観点では、このデフォルト変更を黙認してはいけない。自社サイトがAIトレーニングを拒否しているのか許可しているのかは、AI時代の検索戦略を左右する。デフォルト設定のまま放置するのではなく、自社のビジネスモデルに合わせて意図的に選択することが重要だ。
robots.txtが守れる範囲と守れない範囲
robots.txtのルールは、停止することを選ぶクローラーを停止させるだけだ。ルールを無視するクローラーには何も影響しない。No Hacksの記事は、同サイトのログで最大のAIクローラーが認証情報を探していたと報告している。非営利研究アーカイブの名前を使い、/.envやSSHキーを要求するクローラーがいたという。テキストファイルのルールはそのようなクローラーを不便にさせることすらできない。
それでもBot Preference Syncは有用だ。インターネットの誠実な側、つまりルールを守るクローラーに対しては機能する。エッジでの強制が実際の防御であり、robots.txtは意図の文書化として、後から紛争になった時に意味を持つ。リクエストが到着した瞬間の防御にはならないが、自社のポリシーを明確に残しておく価値はある。
最終的には、robots.txtとCloudflareのAIボットポリシーを突き合わせて確認する作業が欠かせない。Bot Preference Syncが自サイトに到達したら、書かれた内容を必ず確認すること。読んでいないポリシーファイルは、他人が自分の代わりに表明した立場になる。
この記事のポイント
- CloudflareのBot Preference Syncはrobots.txtとエッジ強制設定の矛盾を解消する自動化機能である
- Search、Agent、Trainingの3カテゴリ設定では個別クローラー単位のビジネス判断を表現できない
- Cloudflareは4つの開示条件を公開し、不透明なクローラーをブロック対象にした
- 新規顧客にはデフォルトでオンになり、広告収益化サイトではTrainingがブロックされる
- robots.txtは誠実なクローラーにしか効かないため、エッジ強制が依然として重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPress 7.1.1セキュリティリリース公開。11件の脆弱性修正と即時更新のすすめ
WordPress 7.1.1が2026年9月17日に公開された。セキュリティリリースと位置づけられ、11件の脆弱性修正を含む。コアのバグ修正は17件、ブロックエディタのバグ修正は19件だ。
今回のリリースはセキュリティ修正を主目的としている。すべてのサイト管理者に即時更新が推奨される。自動更新が有効なサイトでは、すでに適用が始まっている場合もある。
セキュリティリリースの最大の特徴は、放置した場合のリスクが高いことだ。XSS(クロスサイトスクリプティング)やパストラバーサルなど、攻撃者に悪用されかねない脆弱性が多数修正されている。サイトを守るには更新が最優先となる。
WordPress 7.1.1リリースの概要
WordPress 7.1.1は「ショートサイクルリリース」と呼ばれる短い間隔で提供される更新だ。メジャーリリースの7.1から間もない段階で、セキュリティと安定性の向上を目的に公開された。次のメジャーリリースは7.2で、12月を予定している。
今回の修正内容は、コア17件、ブロックエディタ19件、セキュリティ11件の合計47件にのぼる。セキュリティ修正が全体の約4分の1を占めており、いかにセキュリティ面が重視されたリリースかがわかる。
セキュリティリリースの最大の特徴は、対応の緊急性だ。通常の更新と異なり、脆弱性がすでに公開されている可能性があるため、更新を先延ばしにすると攻撃の標的になりやすい。公式発表でも「直ちに更新すること」が明記されている。
更新は管理画面から4ステップで完了する。自動更新が有効な環境では、手動操作なしで適用される。
修正されたセキュリティ脆弱性の詳細
11件のセキュリティ修正は、XSS、パストラバーサル、権限チェックの欠落、情報漏洩の4つに大別できる。それぞれ攻撃の仕組みや影響範囲が異なるため、サイト運営者は全体像を把握しておくとよい。
11件のセキュリティ修正を種類ごとに分類すると、XSS、パストラバーサル、権限チェック欠落、情報漏洩の4つに大別される。それぞれの詳細を確認していく。
XSS関連の重大修正
XSS(クロスサイトスクリプティング)とは、悪意のあるスクリプトをWebページに埋め込む攻撃手法を指す。閲覧者がそのページを開くとスクリプトが実行され、クッキーの窃取やセッションハイジャックなどの被害につながる。
今回修正された中でも特に注意が必要なのが、wpautop()関数の格納型XSSだ。コメントを処理する際に悪意のあるスクリプトが保存され、コメントが承認されると訪問者のブラウザ上で実行される可能性があった。報告者はAwesome MotiveのRafie Muhammad氏だ。
カスタムヘッダーをサポートする一部テーマでも、同様の格納型XSSが確認された。テーマの機能を利用してスクリプトが保存され、後から閲覧したユーザーに影響が及ぶ構造だった。こちらはWordPressセキュリティチームのJeremy Felt氏が報告した。
wpautop()のXSS脆弱性が修正された。コメント内に埋め込まれたスクリプトが、実行可能なコードではなく単なる文字列として扱われるようになる。
権限・アクセス制御の修正
2件目はHTML APIのset_modifiable_text()関数で見つかった。突然閉じるシーケンスを使うことで、コメントの範囲を脱出できるという問題だ。WordPressセキュリティチームのJeremy Felt氏が報告した。
3件目は、特別に細工されたURLで非アクティブなテーマを自動的にインストールし、プレビューできる問題。攻撃者が意図しないテーマを読み込ませる可能性があった。Paulos Yibelo氏とpwn.aiの報告だ。
権限チェックの欠落も深刻だ。サイト管理者がネットワーク専用プラグインをネットワーク有効化できる問題、寄稿者(Contributor)以上の権限を持つユーザーが任意の投稿を上書きできる問題、WP REST Templates Controllerでの認証済みパストラバーサルなどが修正された。
パストラバーサルとは、ファイルパスを操作して本来アクセスできないファイルやディレクトリにアクセスする攻撃を指す。WP REST Templates Controllerの脆弱性では、認証済みユーザーがサーバー上のファイルに不正アクセスできる可能性があった。Anthropicの報告によるものだ。
寄稿者(Contributor)はWordPressのユーザー役割の一つで、投稿の作成はできるが公開はできない。この役割以上のユーザーによる不正な投稿上書きや、下書き・保留中投稿のスラッグ開示なども今回修正された。
XML-RPC経由の脆弱性も見逃せない。customize_changeset投稿を公開することでedit_cssのチェックを迂回できる問題が、WordPressセキュリティチームのBen Bidner氏によって報告された。XML-RPCはWordPressの外部アプリからの操作を受け付けるAPIで、これを悪用した攻撃が可能だった。
情報漏洩を防ぐ修正
attachment_submitbox_metadata()関数にread_postチェックが欠落しており、プライベートな親投稿のタイトルが漏れる問題が修正された。HDWSecの報告によるものだ。メディアライブラリの添付ファイル表示画面で、本来なら見えないはずの親投稿タイトルが露出する可能性があった。
コメントが認証済みユーザーなら誰でも再親付けできる問題も修正された。コメントの親子関係を任意に変更できることで、スレッド構造が破壊されたり、悪意のある内容が目立つ位置に表示されたりする可能性があった。Justin Hart氏とViridis Securityの報告だ。
コアとブロックエディタのバグ修正
セキュリティ修正以外にも、コア17件とブロックエディタ19件のバグ修正が含まれる。コアの修正はTracというバグ追跡システムで管理され、ブロックエディタの修正はGitHub上のGutenbergリポジトリで進められた。
ブロックエディタの19件の修正は、GitHubのPull Request #82383にまとめられている。エディタの安定性や操作性を向上させる修正が中心で、サイト制作に携わるユーザーにとっては作業効率の改善につながる。
メンテナンスリリースの目的は、新機能の追加ではなく既存機能の安定化だ。7.1系で発生していたバグが解消され、より快適な運用が可能になる。特にブロックエディタは日々のサイト更新作業に直結するため、19件の修正は実務での効果が期待できる。
更新手順と自動更新の仕組み
WordPress 7.1.1への更新は、公式サイトからZIPファイルをダウンロードするか、管理画面の「更新」セクションから行う。管理画面では「更新」をクリックし、「今すぐ更新」をクリックするだけの簡単な操作で完了する。
自動バックグラウンド更新を有効にしているサイトでは、更新プロセスが自動的に開始される。共有サーバーやVPSなど、サーバー環境によって自動更新の動作は異なるが、手動更新でも数分以内に完了する。
更新前にバックアップを取得しておくのが望ましい。セキュリティリリースは即時適用が推奨されるが、万一のトラブルに備えて、データベースとwp-contentディレクトリのバックアップを取ってから更新するのが安全策だ。
更新前にバックアップを取り、更新後にサイト表示を確認する流れが安全だ。セキュリティリリースは緊急性が高いが、手順を守って適用する。
バックポートとサポート対象
今回のセキュリティ修正は、WordPress 4.7まで遡ってバックポートされる。バックポートとは、最新版で修正された内容を古いバージョンにも適用することで、セキュリティ対策を広範囲に届ける仕組みだ。
ただし、公式にアクティブサポートされているのは最新版のWordPressのみだ。古いバージョンを使い続けるのはセキュリティリスクが高いため、できるだけ早く最新版へ移行するのが望ましい。バックポートはあくまで移行期間の猶予として機能する。
バックポートは順次進められており、準備が整い次第リリースされる。対象バージョンを使用している場合も、最新版への更新を優先して検討するのが推奨される。古いバージョンはセキュリティ面だけでなく、機能面でも取り残されるためだ。
この記事のポイント
- WordPress 7.1.1はセキュリティリリースで、11件の脆弱性修正を含む
- 格納型XSSやパストラバーサルなど、悪用リスクの高い問題が修正された
- コア17件とブロックエディタ19件のバグ修正も含まれる
- すべてのサイト管理者に即時更新が推奨される
- バックポートは4.7まで提供されるが、最新版への移行が最優先
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleのAIコンテンツ支払い、CloudflareとMicrosoftが示す3つの設計思想
Google、Cloudflare、Microsoftの3社がAIによるコンテンツ利用への対価支払いモデルをそれぞれ試験している。支払いの発生条件、価格設定の主導権、運営者に返るレポートの中身は3社で大きく異なる。
Googleは「重要な貢献」と判定した場合のみ支払う招待制パイロットだ。Cloudflareはクロール1回ごとに課金する独自モデルを持つ。Microsoftはライセンス型マーケットプレイスを2月に発表した。
この違いが、サイト運営者がAIにコンテンツを提供する際の収益性とリスクを左右する。本記事では3モデルの設計思想とSEOへの影響を整理する。
3社のAIコンテンツ支払いモデルの全容
Google、Cloudflare、Microsoftは2026年に入り、AIがウェブサイトのコンテンツを利用する際の対価支払いモデルをそれぞれ提示した。3社のアプローチは課金の単位、価格設定の主導権、レポートの粒度で根本から異なる。
3社のモデルは支払い方式とコントロール権限のバランスで大きく異なる。
Googleは「貢献度」判定、Cloudflareは「取得単位」課金
Googleのパイロットプログラムは、Gemini、AI Overviews、AI Modeのいずれかで、サイトのコンテンツがAI生成応答に「重要な貢献をした」と判断された場合に支払いが発生する。回答生成後のリンク表示や確認だけでは条件を満たさない。Googleは6月18日の公式投稿で、AI回答の根拠となる情報を提供するウェブサイト向けの新モデルを試験する方針を示した。
一方、CloudflareのPay Per Crawlは2025年から非公開ベータとして提供されてきた。クローラーがコンテンツを正常に取得するたびに課金が発生する仕組みで、サイト運営者はクロール1回あたりの価格を設定できる。最低価格は0.001ドルだ。価格に同意したクローラーには正常応答コードでページが返る。
Microsoftはライセンス型マーケットプレイス
Microsoftは2月3日にPublisher Content Marketplaceを発表した。Copilotの回答を支えるためのプレミアムコンテンツのライセンスを提供する仕組みで、パブリッシャーは提供価値に基づいて支払いを受ける。利用条件とライセンス条件はパブリッシャーが定義し、利用ベースのレポートも提供される。Copilotが最初の需要パートナーとなり、Yahooも導入を進めている。
関連する動きとして、Ceramic.aiは自社の検索結果にサイトのコンテンツが表示された際に参加サイトへ支払うモデルを採用している。You.comは特定のプレミアムコンテンツをオンデマンドで利用した時点で支払う仕組みだ。
支払いトリガーを決めるのは誰か
各モデルは支払い発生のイベント定義が異なる。ここが運営者の収益予測を難しくする根本原因だ。Googleは「重要な貢献」という質的基準、Cloudflareは「取得成功」という機械的基準、Microsoftは「提供価値」という経済的基準を採用している。
判定者が誰かによって、収益予測の立てやすさが変わる。
Googleの「重要な貢献」はブラックボックス
Digidayの報道によれば、Googleのパイロットでは支払いがコンテンツの使用量ではなく価値に基づくとされている。Googleが自社で「意味のある貢献だったか」を判断する仕組みで、プログラムに詳しい企業幹部はDigidayの取材に対し「かなりブラックボックスだ」と述べている。Googleは判定基準を公表していない。
サイト運営者から見れば、この構造は収益の予測可能性を著しく下げる。何が支払いにつながるかの明確な基準が分からない状態で、コンテンツ戦略の投資判断を下すのは難しい。
Cloudflareは機械的なイベント、Microsoftは定義自体が不明
Pay Per Crawlのイベントは機械的だ。価格に同意したクローラーへの正常応答が課金の条件と明確に定義されている。ただしCloudflareの7月1日の投稿は、クロール回数が価値の粗い指標であると自認している。1回だけクロールされたページが何千もの回答に引用されることもあれば、何度もクロールされながら一度も使われないページもある。
Microsoftは支払い単位を公開していない。提供価値に基づくと説明するが、具体的な計算式や契約上の定義は明らかにされていない。価格設定もパブリッシャーとの共同設計の対象とされるが、誰が最終決定するかは公開情報では分からない。
サイト運営者がコントロールできる範囲
3社のモデルはサイト運営者がどのような条件を設定できるかも異なる。価格を自分で決められるのか、参加の是非だけなのか、利用条件まで定義できるのか。この差は収益性と交渉力に直結する。
Googleは参加の是非のみ、条件交渉の余地なし
Googleのパイロットは招待制だ。参加者はSearch Consoleからいつでもオプトアウトできるが、参加するかどうか以外の条件交渉の余地は公開情報から見えてこない。Digidayによれば、ある企業幹部は提示された金額が低すぎてオプトインしなかったと述べ、Googleとの交渉は継続中だという。
この点は小規模なサイト運営者ほど不利になる。招待を受けるか、提示された条件で飲むか。その二択しか選べない状況では、交渉力のある大手メディアと中小サイトの間に収益格差が生まれやすい。
Cloudflareは価格を運営者が設定、Microsoftは利用条件を定義
Pay Per Crawlでは、サイト運営者がドメインごとの価格を設定できる。パス単位で価格を変える動的プライシングにも対応し、クローラーごとに課金、許可、ブロックを選べる。Pay Per Useでは、サイト運営者はパートナーのプログラムに参加する形で、パートナーによって支払い条件が変わる。
Microsoftのマーケットプレイスは加入が任意で、パブリッシャーはコンテンツの所有権と編集の独立性を保持する。ただし、ライセンス条件と利用条件の具体的な内容は公開されていない。価格決定者も不明のままだ。
レポートで見える情報と見えない情報
収益化の判断には、どれだけの情報が返ってくるかが重要だ。3社のレポート粒度と透明性にも明確な差がある。
Googleの月次収益表示と計算式の非公開
Googleの参加者はSearch ConsoleのAI貢献パネルで月次収益額と履歴を確認できる。しかしDigidayは、支払い計算の詳細は提供されないと報じている。Googleは一部のパートナーと週次会議も行っている。パブリッシャー連合SpurのDavid Buttle氏は、第一歩として「パブリッシャーが自分のコンテンツが回答に影響したことを知る権利がある」という前例を作ることだと述べた。
月次収益という数字は見えるが、その数字がどう算出されたかは見えない。この非対称性は、運営者が支払い額の妥当性を検証できないことを意味する。
Cloudflareの残高非表示とCeramicの詳細レポート
Pay Per Crawlでは、課金イベント発生時に記録が残る。ダッシュボードにはどのクローラーがアクセスしたか、課金が何回発生したかが表示される。ただし獲得残高はダッシュボードに表示されず、Cloudflareチームへの問い合わせが必要だ。
Pay Per Useでは、Ceramicプログラムに参加するサイトが、コンテンツが表示された検索クエリ、該当ページ、スニペット、検索結果内の平均順位まで含むレポートを受け取れる。こちらの方が実務的には使える情報が多い設計だ。
Microsoftの利用ベースレポートは中身が非公開
Microsoftは「コンテンツがどのように評価され、どこでさらに価値を提供できるか」を確認できる利用ベースのレポートを約束している。ただし、レポートに含まれる具体的な項目は公開されていない。参加者がレポート内容について説明した記録も見つからない。
Googlebotへの従量課金が招くSEOリスク
CloudflareのPay Per Crawlは、ディレクトリに登録されたあらゆるクローラーに従量課金を設定できる。Googlebotも対象だ。ここにSEO上の大きな落とし穴がある。
CloudflareのBlock設定をGooglebotに適用すると、検索インデックスからの削除リスクが連鎖的に発生する。
Googleのクローラードキュメントによれば、4xxステータスコードを返すURLのコンテンツは使用されない。402 Payment Requiredも4xxに該当するため、Googlebotに課金を設定して402を返すと、時間の経過とともに検索インデックスから削除される可能性がある。
Cloudflareが9月15日に公開した新設定はこの状況を変えるものではない。Disallow AI Training設定はrobots.txtに学習拒否の意思を公開し、GoogleとAppleはこれを尊重しつつ検索クローリングは続ける。一方、BlockオプションはGooglebotを含むクローラーを完全に停止する。
つまり、Googlebotに対して「学習は拒否したいが検索クロールは許可したい」場合は、BlockではなくDisallow AI Trainingを選ぶ必要がある。Cloudflareの報告では、検索ボットをブロックしているサイトは1%未満、何らかの学習ブロックを使っているサイトは17%に上る。
また、Googleは数週間以内にGoogle-Extendedに関連するURL単位の透明性ツールを提供する予定だとCloudflareは伝えている。これはパイロットの貢献レポートとは別のものだ。
サイト運営者が今取るべき行動
3社のモデルは完成形ではなく、すべて試験段階にある。運営者が今できるのは、自社のコンテンツの性質とリスク許容度に合わせて選択肢を評価することだ。
Cloudflare設定の見直しが最優先
すでにCloudflareを利用しているサイトは、現在の設定状態を確認すべきだ。従来の設定が移行されている可能性があり、Googlebotに対して意図しないBlockがかかっていないかを確認する必要がある。学習拒否と検索継続を両立するには、Training controlをDisallow AI Trainingに設定する。Blockにしてしまうと検索クロールも停止する。
この設定の分岐は、サイト運営者にとって「収益化のチャンス」と「検索順位のリスク」を同時に含む。学習を拒否するか、検索クロールを維持するか、あるいは課金対象としてGooglebotに支払いを求めるか。それぞれの選択肢の帰結を理解した上で決める必要がある。
契約前に確認すべき情報
Googleのパイロット招待を受けた場合、オプトイン前に「重要な貢献」の定義、計算方法、Search Consoleの生成AIコントロールとの関連性についてGoogleに確認するべきだ。Microsoftのマーケットプレイスを検討する場合は、誰が価格を決定するのか、レポートに何が含まれるのかを契約前に明確にする必要がある。公開情報だけではこれらの質問に答えられない。
3社のモデルは「支払いの透明性」に対するアプローチが根本から異なる。Googleは判定をブラックボックスにすることで柔軟性を確保し、Cloudflareは機械的なイベントで透明性を確保し、Microsoftはパブリッシャーに条件定義を委ねる。いずれもまだ実験段階であり、最終的な設計が現在の形のまま展開されるとは限らない。
特に重要なのは、Cloudflareが自ら「クロール回数は価値の粗い指標」と認めた点だ。同じコンテンツでも1回のクロールで何千回も引用される場合と、何度もクロールされながら全く利用されない場合がある。この非対称性は、現在のすべての支払いモデルが「価値の正確な測定」にまだ到達していないことを示している。
サイト運営者は、今後のレポート精度の向上と透明性ツールの展開を注視しつつ、自社のコンテンツがAI応答にどう使われているかを定期的に確認する姿勢が求められる。
この記事のポイント
- Googleは招待制で「重要な貢献」と判定した場合のみ支払う。判定基準は非公開
- Cloudflareはクロール取得単位の課金とパートナー主導の利用課金の2軸で展開
- Microsoftはライセンス型で利用条件はパブリッシャーが定義するが価格決定者は不明
- Googlebotを含むクローラーにBlock設定を適用するとSEOリスクが連鎖する
- 3社とも試験段階で、価値測定の正確性が今後の焦点となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWSが低コストなEC2 T8iインスタンスを発表!T3比で最大70%の性能向上
AWSが新型の低コストバースト可能インスタンス「Amazon EC2 T8i」の一般提供を開始した。T3インスタンスの後継となるもので、価格性能比が最大30%改善している。
T8iはカスタム設計された第6世代Intel Xeon Scalable Processorを搭載し、AWSのNitro System上で動作する。既存のT3ユーザーは同じCPUクレジット方式のまま移行できる設計だ。
T8iインスタンスの位置づけ
EC2のTシリーズは「バースト可能インスタンス」と呼ばれる。平時はベースライン性能で動作し、負荷が上がった時にCPUクレジットを消費して性能を一時的に引き上げる仕組みを持っている。
この仕組みが適しているのは、普段はCPU使用率が低いが瞬間的に負荷が上がるワークロードだ。低トラフィックのWebサイト、開発・テスト環境、小規模データベース、マイクロサービス、ログインゲートウェイなどが代表例になる。
T8iはこのバーストモデルを踏襲しつつ、CPUとネットワーク性能を大幅に引き上げたモデルだ。
性能向上の内訳
価格性能比とコンピューティング性能
AWSの発表によると、T8iはT3と比較して以下の改善が実現されている。
- 価格性能比が最大30%向上
- コンピューティング性能が最大70%向上
- ネットワーク帯域が最大1.25倍
- EBS帯域が最大2.4倍
特にEBS帯域の2.4倍という数字は見逃せない。ディスクI/Oがボトルネックになりがちな小規模データベースやデータ処理ジョブでは、体感できる改善が期待できる。
CPUクレジット方式と無制限モード
T8iはT3と同じCPUクレジット方式を採用している。StandardとUnlimitedの2つのモードがあり、デフォルトはUnlimitedモードだ。Unlimitedモードではクレジット残高がゼロになっても、追加料金を支払うことでベースラインを超える性能を維持できる。
クレジットは時間の経過とともに自動で蓄積される。例えばt8i.microなら1時間に6クレジット、t8i.smallなら12クレジットが付与される仕組みだ。
インスタンスタイプとスペック
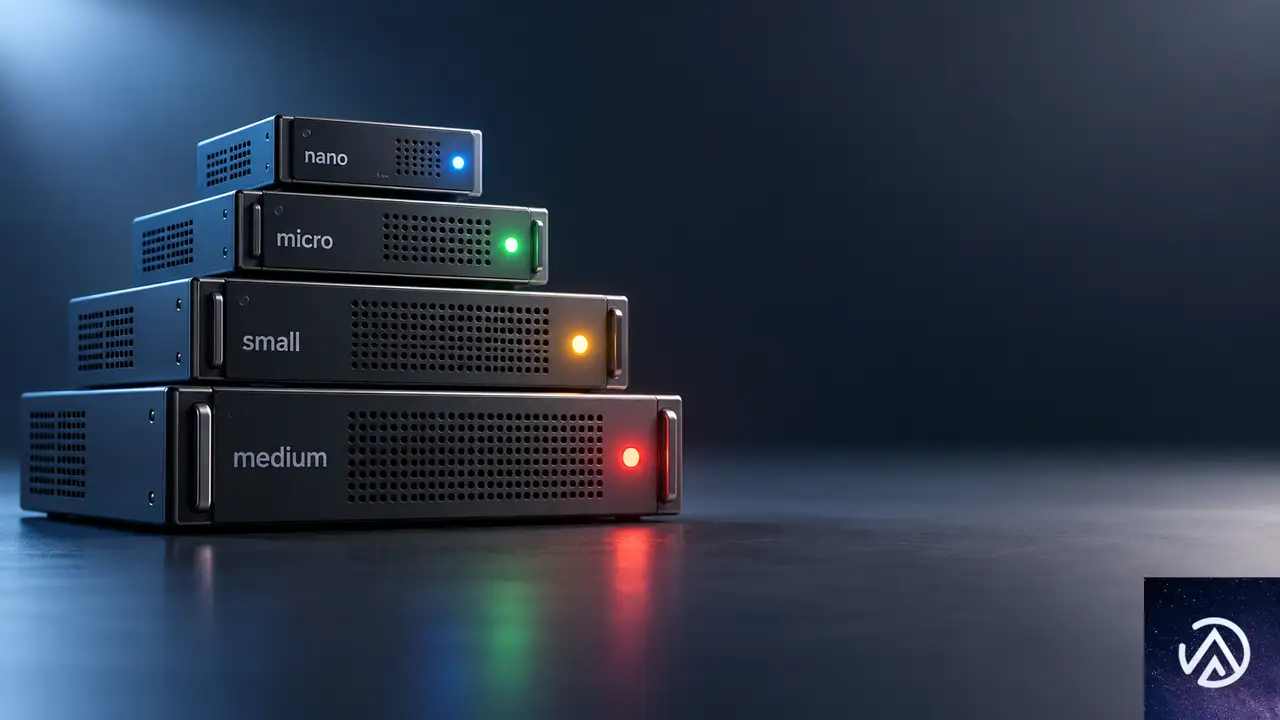
T8iは4つのサイズで提供される。すべて2 vCPUを1コアとして提供するのが特徴で、vCPUとメモリの比率が他シリーズにはない特殊な構成になっている。
- t8i.nano
- t8i.micro
- t8i.small
- t8i.medium
メモリ比率はnanoが1対0.25、microが1対0.5、smallが1対1、mediumが1対1となっている。2 vCPUでメモリ0.25GiBという構成は他のEC2インスタンスにはない特徴的なスペックだ。
利用シーンと移行方法
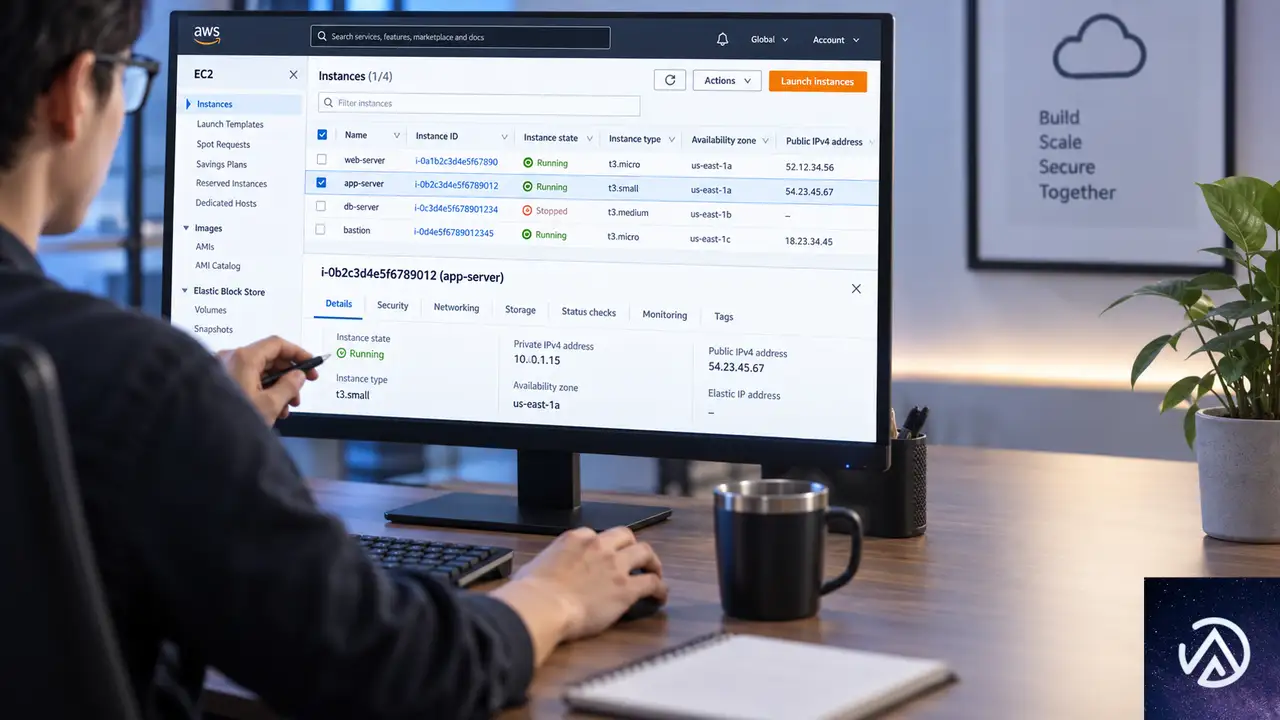
どんな場面で使うべきか
T8iは低〜中程度のCPU使用率で動くワークロードに向いている。具体的には以下のようなケースが想定されている。
- フリーミアムサービスの小規模プラン
- トレーニング・デモ環境
- ステージング・開発環境
- データ処理ジョブ
- マイクロサービスアーキテクチャの一部
- 低トラフィックのWebサイト
- ログインゲートウェイ
- バッチ処理やCI/CDパイプライン
常に高いCPU使用率が続く本番環境や、大規模なデータベースサーバーには向かない。そうした用途ではM8i Flexなど、より大きなインスタンスの選択が推奨されている。
T3からの移行手順
既存のT3ユーザーにとって移行はシンプルだ。インスタンスタイプをT3からT8iに変更するだけで、アプリケーションの設定変更やコードの書き換えは原則不要とされている。
CPUクレジット方式もT3と同じなので、運用ノウハウはそのまま活かせる。Auto ScalingやCloudWatchの設定も流用できるため、移行コストは最小限だ。
提供リージョンと利用方法
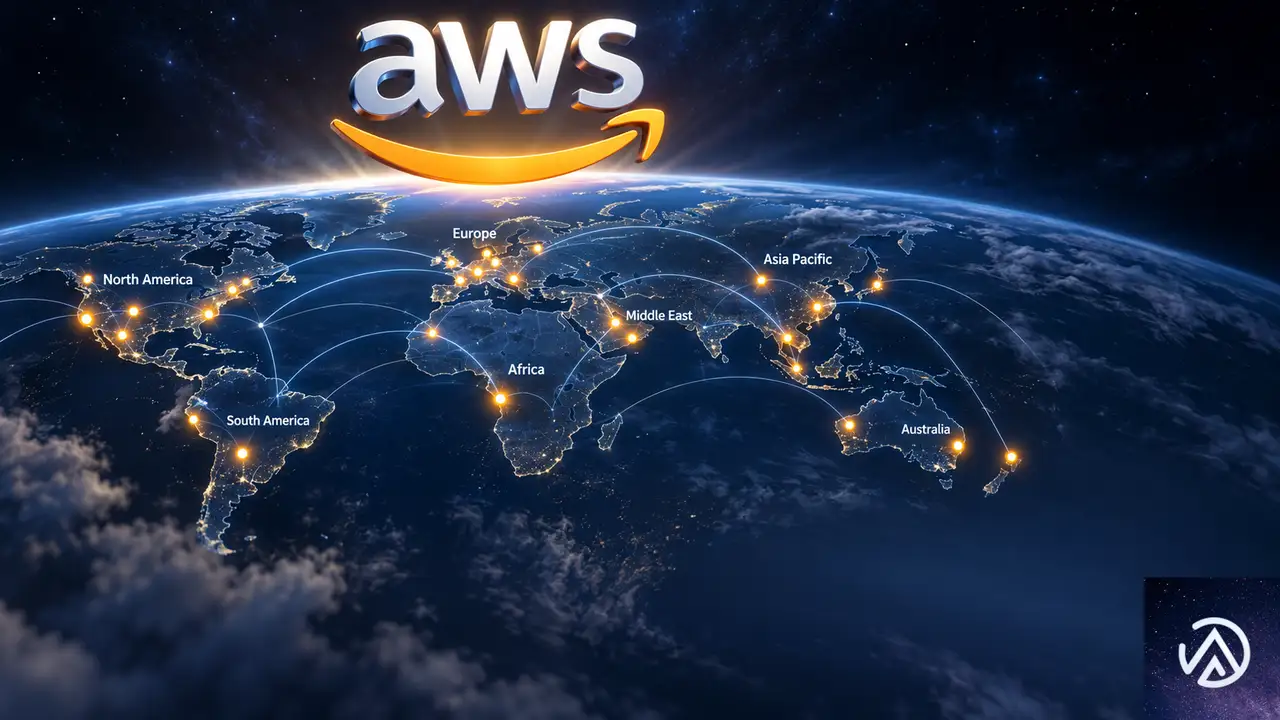
T8iは以下のAWSリージョンで利用できる。
- 米国東部(バージニア北部・オハイオ)
- 米国西部(オレゴン・北カリフォルニア)
- アジアパシフィック(ハイデラバード・マレーシア・ムンバイ・ソウル・シンガポール・シドニー・東京)
- カナダ(中部)
- ヨーロッパ(フランクフルト・アイルランド・ロンドン・パリ)
購入方法はオンデマンドとスポットインスタンスに対応している。Savings Planは近日対応予定だ。t8i.microとt8i.smallはAWS無料利用枠でも使えるため、新規ユーザーがAWSの使い方を学ぶ用途にも適している。
共有テナンシーのみ対応しており、専有テナンシーや専有ホストは利用できない点には注意が必要だ。
この記事のポイント
- T8iはT3の後継となる低コストバースト可能インスタンス
- コンピューティング性能が最大70%向上し、EBS帯域は2.4倍に
- CPUクレジット方式はT3と同じで移行が容易
- 4サイズ構成で東京リージョンでも利用可能
- 無料利用枠の対象サイズもあり、新規ユーザーの入門にも適している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
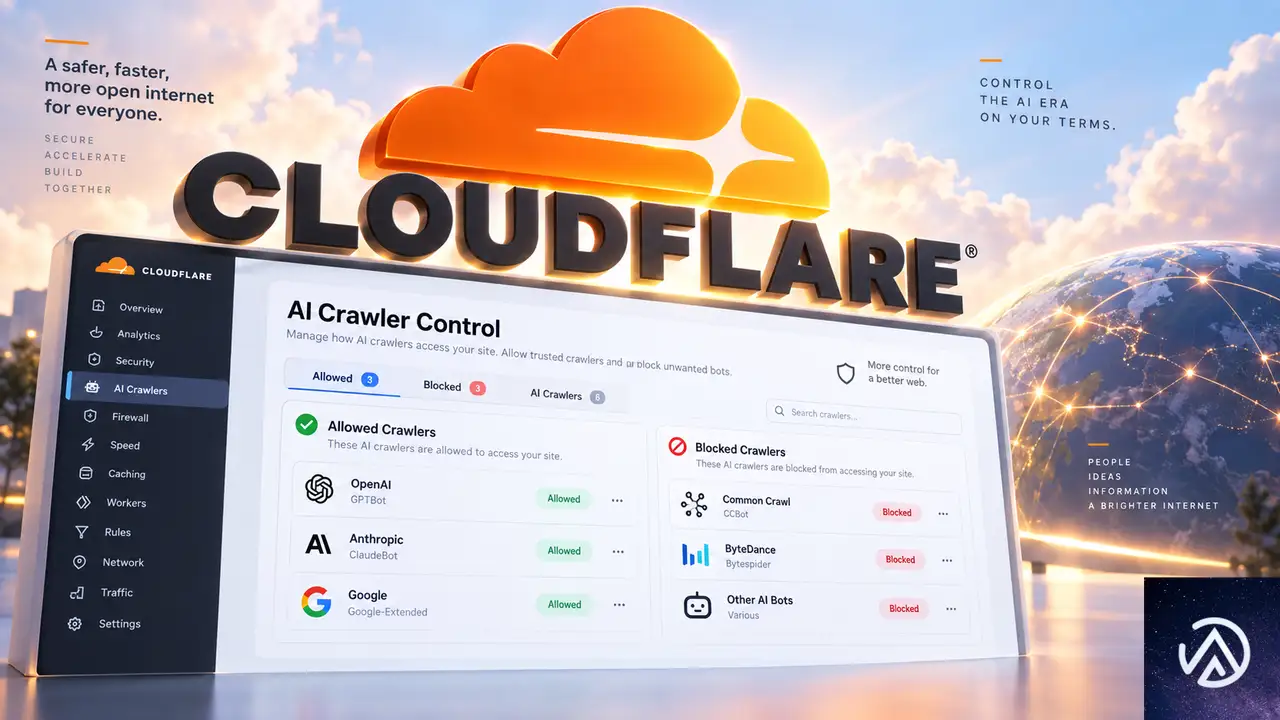
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
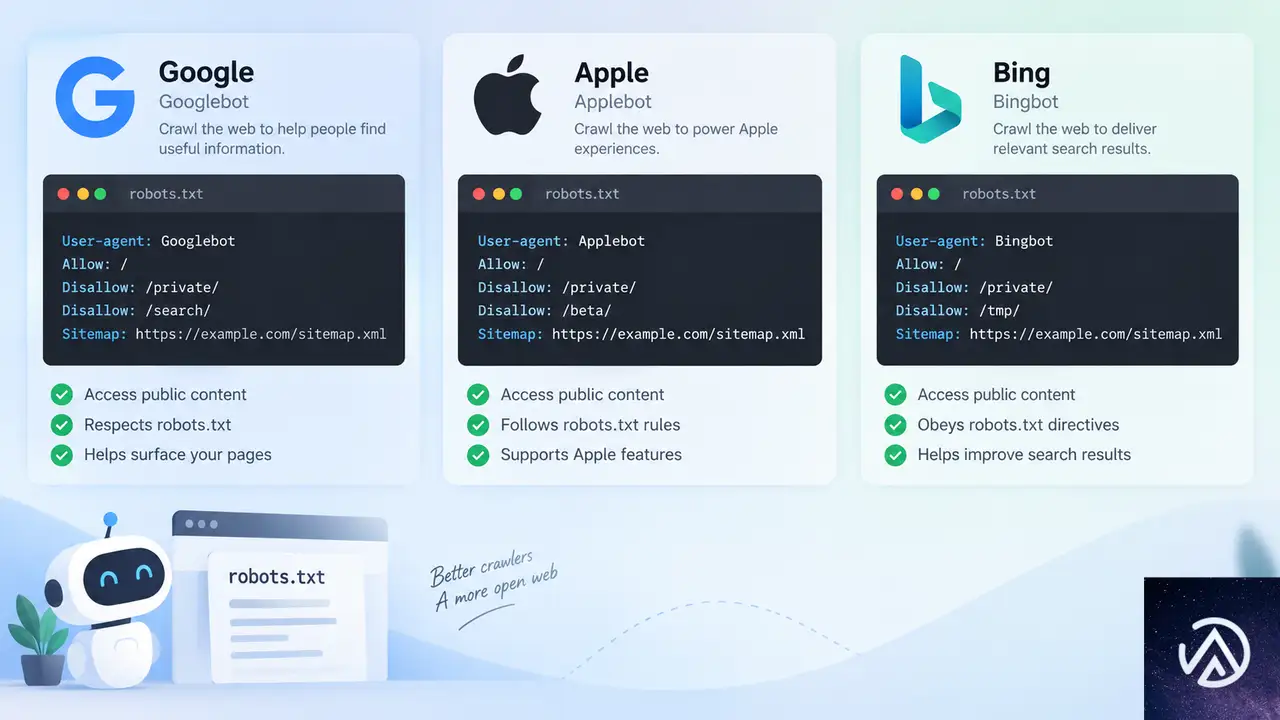
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.8 Liveシリーズ登場、音声AIエージェントの新基盤に
Google DeepMindが9月15日、Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表した。音声エージェント向けに設計された2つの新モデルで、リアルタイム推論能力が大幅に強化されている。
Gemini 3.8 Liveはスケールとコスト効率を重視したモデルだ。Gemini 3.8 Live Extended Thinkingは高複雑度タスク向けで、複数ステップの推論を会話の流れを止めずに実行できる。
開発者API、Google Workspace、Search Liveなど幅広い経路で提供が始まっている。音声で複雑なタスクを処理する新しい基盤になる。
Gemini 3.8 Liveシリーズの全体像
会話知能と自然な対話、視覚的な理解を組み合わせたモデル。スケールとコスト効率を重視しており、大量の同時接続を処理する音声エージェントに向く。
高複雑度タスク向けに設計されたモデル。複数ステップの推論と、より高い知能を備える。会話の流れを止めずに深い思考ができるのが特徴。
2つのモデルは用途が明確に分かれている。音声エージェントを大量に展開する場合は標準版、複雑な業務フローを音声で処理する場合はExtended Thinkingを選ぶ形になる。
2つのモデルの役割分担
Gemini 3.8 Liveは会話の自然さと視覚的な文脈理解を兼ね備えている。コストパフォーマンスを重視する開発者や企業に向く設計だ。
Gemini 3.8 Live Extended Thinkingは、より複雑な推論が必要な場面を想定している。話しながら考え、バックグラウンドで複数ステップのタスクを進められる点が最大の違いだ。
展開される利用経路
両モデルとも、Geminiアプリ、Google Workspace、Search Liveに順次展開される。特にWorkspaceではDocs Live、Gmail Live、Keep Liveといったアプリ内の音声機能として利用できる。
コンシューマー向けにはSearch Liveが最初の接点になる。検索中に音声で質問し、そのまま会話を続けられる体験が提供される。
ベンチマークが示す性能とコスト効率
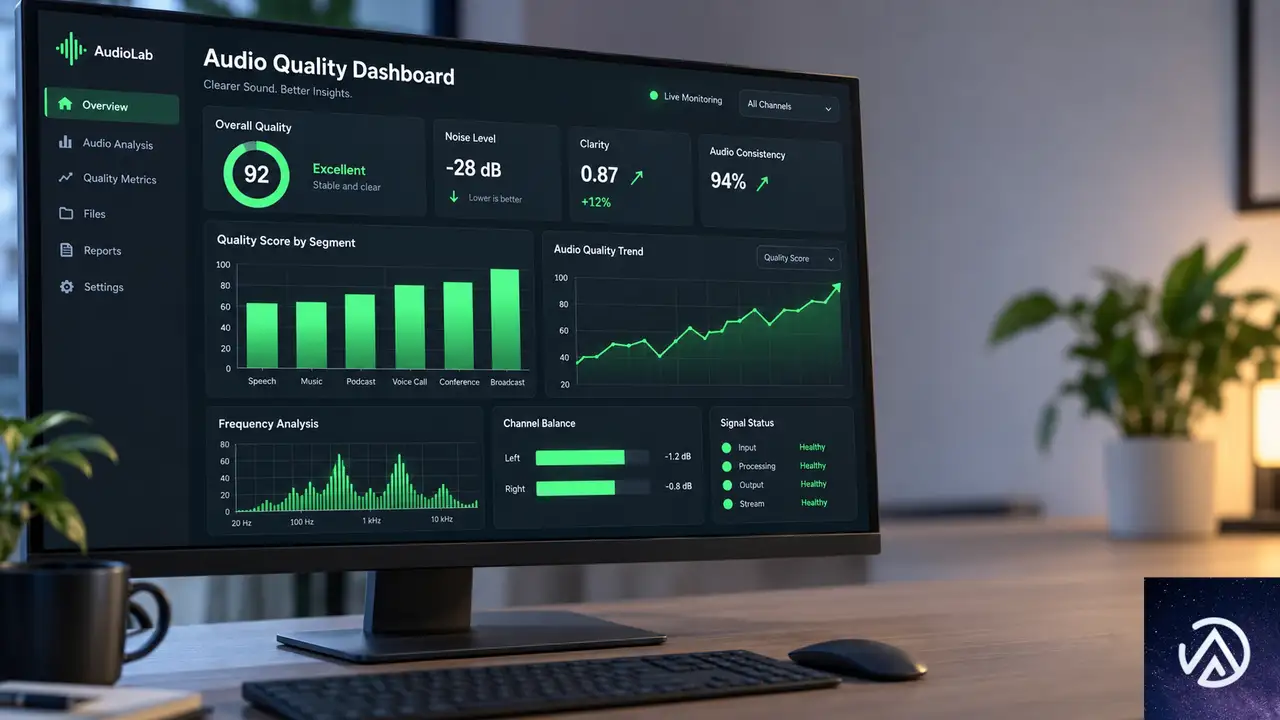
音声品質とエージェント性能の両面で、既存モデルを上回る結果が示されている。コスト面でも競争力のある価格帯を維持している点が特徴だ。
音声品質とエージェント性能
Artificial AnalysisのSpeech to Speech Quality Indexでは82.6を獲得し、総合第1位となった。音声の自然さと応答品質のバランスで他モデルを上回っている。
エージェントタスクの完了率でも強さを示している。τ-Voiceベンチマークで68.6%、Sierraのτ-Voiceバンキングベンチマークでは35.1%を記録した。音声だけで業務フローを完結させる能力が評価された形だ。
推論能力を示すBig Bench Audioでは97.7%と高いスコアを出している。音声を聞いて正しく推論する基盤能力の高さが確認できる。
コスト競争力とユーザー評価
Gemini 3.8 LiveはSpeech Agent Arenaで第2位を獲得している。ユーザーからの選好度が高いモデルでありながら、高いコスト効率を実現している点が重要だ。
ServiceNowのEVA-Benchでは、複雑なワークフローにおける正確性と会話品質のバランスでパレートフロンティアを更新した。エンタープライズ向け音声エージェントの実用性が裏付けられている。
リアルタイム推論の技術的進化
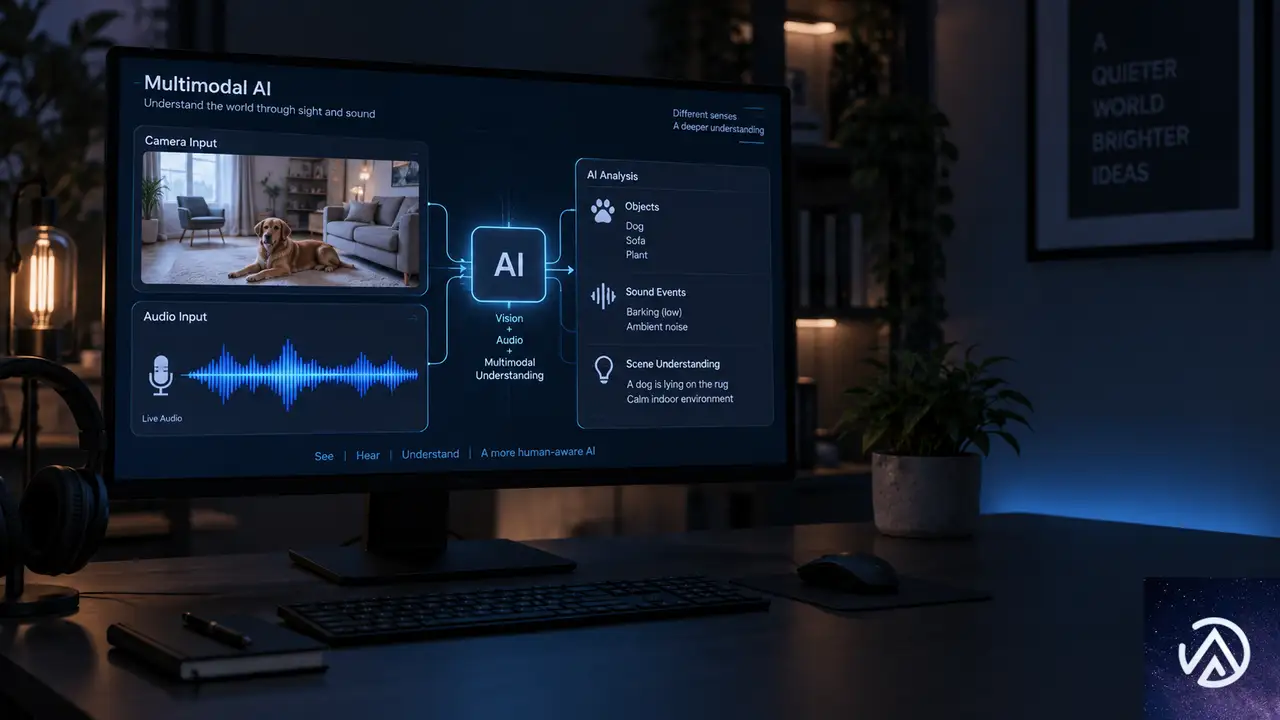
会話を止めずに裏側でタスクを進める設計が、これまでの音声AIと大きく異なる点だ。
視覚入力と言語対応
Gemini 3.8 Liveは視覚入力をほぼリアルタイムで処理する。カメラに映ったものや画面上の情報を文脈として会話に取り込めるため、状況に応じた助言が可能になった。
言語対応も強力だ。97の言語を自動的に検出し、会話の途中でもシームレスに切り替えられる。多言語環境で使う音声エージェントに適している。
公式デモでは、従業員のオンボーディングをリアルタイムで案内する様子や、チェスの盤面を見ながら対局を進める様子が紹介されている。視覚と会話の統合が実用レベルに達していることを示す例だ。
バックグラウンド実行と同時推論
ツールやAPIの実行はバックグラウンドで進められる。ユーザーの要求を受け付けたら、処理が終わるまで待たせず、会話を続けながら結果を伝える動きができる。
Extended Thinking版は「話しながら考える」能力を持つ。「確認させてください」といった短い言葉で応答しながら、裏側で複数ステップの推論を進める。進捗状況を自然な会話で伝える機能も備わっている。
公式デモでは、手書きスケッチと音声フィードバックからReactコンポーネントを生成する例や、複数ステップの予約を非同期で処理する例が公開された。音声だけで開発作業や業務処理を進められる可能性が広がっている。
開発者と企業のエコシステム
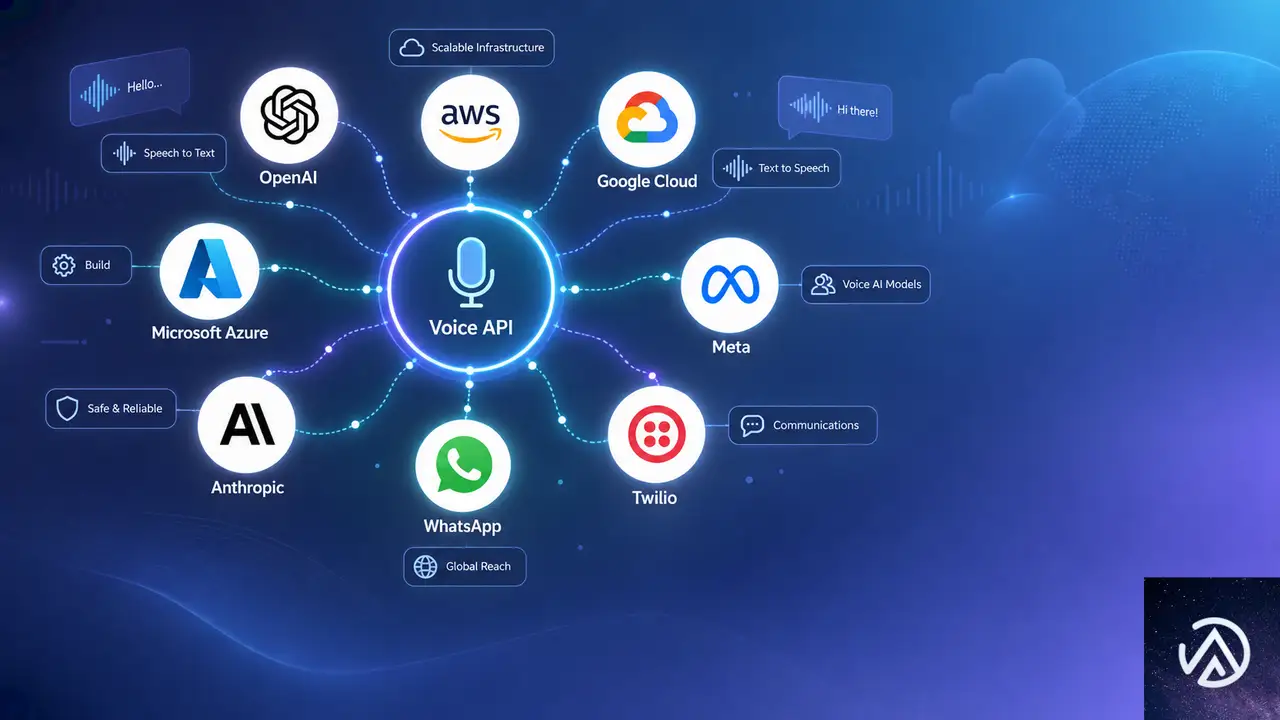
Gemini Live APIと開発者プラットフォーム
両モデルはGemini Live APIを通じて利用できる。開発者はこのAPIを使い、音声駆動のインターフェースを自社サービスに組み込める。リアルタイムのメディアストリーミング基盤はプラットフォーム側が処理してくれるため、UX設計に集中できる。
Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision AgentsなどのプラットフォームがGemini Live APIに統合済みだ。これらのツールを使えば、音声エージェントの構築からデプロイまでを短縮できる。
企業パートナーと展開スケジュール
Salesforce、Genspark、Lumerisなどの企業が3.8 Liveシリーズの導入に意欲を示している。低遅延性、会話の流暢さ、ツール呼び出し能力が評価されている。
展開スケジュールは以下の通りだ。開発者向けにはGemini APIとGoogle AI Studioで即日利用できる。企業向けにはGemini Enterpriseでプライベートプレビューが始まり、Gemini Enterprise for Customer Experienceにも順次提供される。
コンシューマー向けでは、Search Liveが最初の提供経路になる。Gemini Liveでも利用可能で、Google AI ProおよびUltraの加入者はWorkspaceのDocs、Gmail、KeepでExtended Thinking版を試せる。
透明性確保の仕組み
SynthIDによる音声ウォーターマーク
AIが生成した音声にはすべてSynthIDのウォーターマークが埋め込まれる。人間の耳には聞こえない形で音声出力に直接織り込まれており、AI生成コンテンツの検出を可能にする。誤情報の拡散防止が狙いだ。
安全性と責任あるAIへの取り組みの詳細は、モデルカードで確認できる。音声AIが社会に広がる中で、透明性の確保は実用化の前提条件になっている。
この記事のポイント
- Gemini 3.8 LiveとLive Extended Thinkingが9月15日に発表された
- 標準版はコスト効率、Extended Thinking版は複雑タスク向けと役割が分かれている
- Speech to Speech Quality Indexで82.6を獲得し総合第1位
- 97言語対応、視覚入力、バックグラウンド実行など技術面が大幅強化
- Gemini Live API経由で開発者が即日利用できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験