

Google、匿名化検索データを競合と共有へ EUのDMA決定の全容
EUの欧州委員会が2026年7月16日、Googleに対して2つの拘束力のある決定を下した。検索データを匿名化した上で競合他社と共有すること、そしてAndroidの一部機能を競合AIアシスタントに開放することだ。いずれもデジタル市場法(DMA)に基づく措置である。
この決定の影響は検索エンジンにとどまらない。AIチャットボットも対象に含まれており、検索とAIが融合しつつある現在の状況において、今後の競争環境を左右する転換点となる可能性が高い。
DMAに基づく2つの決定の全体像
今回の決定は、欧州委員会が2026年4月に公開協議を経て暫定的な見解を示していたものを最終化した形だ。2つの柱で構成されている。
- 検索データの共有義務。Googleの検索結果に関するクエリ、クリック、閲覧、ランキング位置の匿名化データを、公正かつ非差別的な条件で競合に提供すること
- AndroidのAI相互運用性の確保。競合AIアシスタントが音声起動やアプリ内操作を実行できるよう、OSレベルの機能を開放すること
違反時の罰金を伴う独占禁止法の案件とは異なり、DMAに基づく今回の措置は構造的な是正を目的とする。欧州委員会は、Googleの現在のデータ共有の取り組みは不十分だと明確に指摘している。
この図で示した通り、データ共有の枠組みが整うことで、競合検索エンジンやAIチャットボットはGoogleが長年かけて蓄積してきた規模の検索インタラクションデータを活用できるようになる。
検索データ共有の具体的な仕組みと対象範囲
共有されるデータの内容
共有対象となるのは、Google検索の無料・有料を問わずすべての検索結果から生成される匿名化データである。具体的には以下の情報が含まれる。
- 検索クエリ(ユーザーが入力した検索語句)
- メタデータ(使用言語、デバイスの種類)
- 表示されたURL一覧
- ユーザーのクリックや閲覧といったインタラクション情報
- 検索結果内での表示位置(ランキング)
一方で、Googleのランキングアルゴリズムそのものは共有対象外だ。また個人を特定できる情報(アカウント詳細、検索履歴、タイムスタンプ、極端に稀または長大なクエリ)は除外される。
利用資格と審査プロセス
このデータを利用できるのは誰でもない。欧州委員会が定めた要件を満たす必要がある。
- EU圏内で月間5万人以上のユーザーを持つこと
- 2年以上の事業運営実績があること。新規参入企業の場合は投資実績による代替審査を受けること
- セキュリティ審査と独立監査を通過すること
これらの条件をクリアした事業者のみが、Googleとライセンス契約を結びデータの提供を受けることができる。データ価格は市場レートではなくコスト回収ベースで算定される。
AIチャットボットについても、DMA上でオンライン検索エンジンと見なされるものは利用資格がある。ただしデータの用途は、自社の検索・ランキングシステムの改善に限定され、汎用AIモデルの学習やGoogleの検索結果の複製には使用できない。
AI検索時代におけるデータの重要性
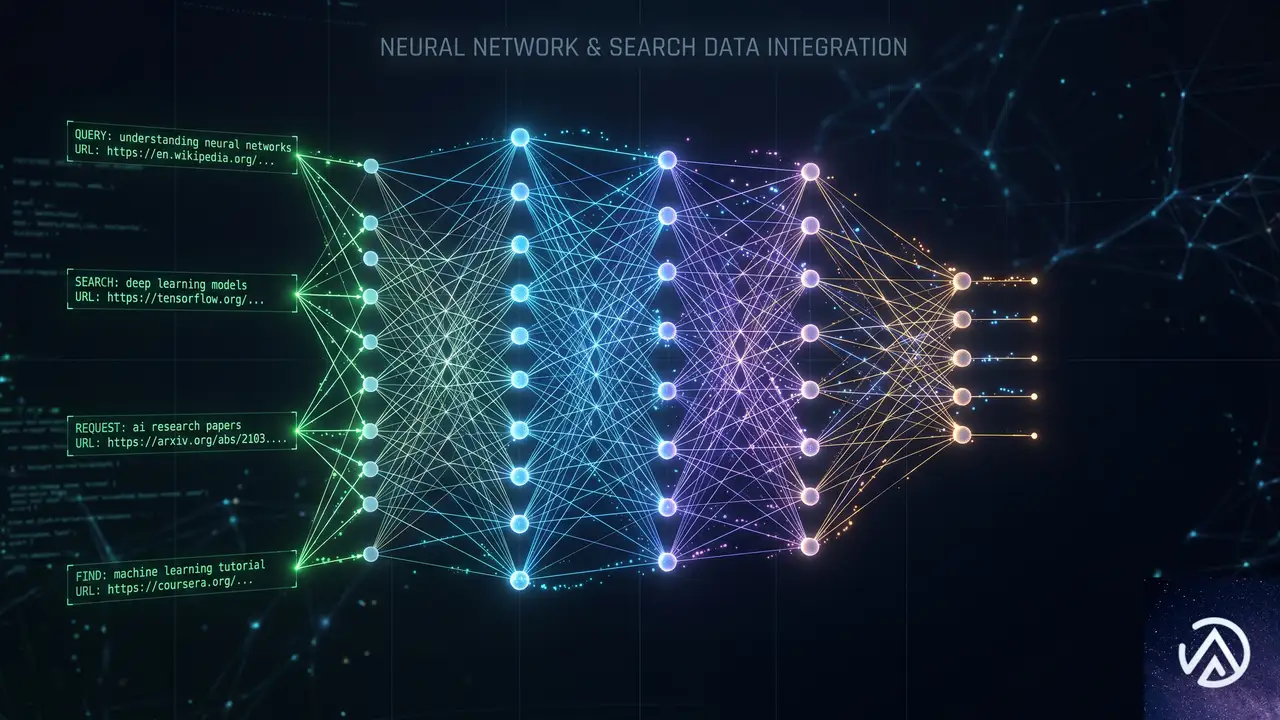
この決定が単なる検索エンジン間の競争を超えた意味を持つのは、AIチャットボットが回答を生成する仕組みと深く関わるからだ。
グラウンディングと検索データ
AIチャットボットが正確な回答を返すためには「グラウンディング(事実確認のための根拠付け)」と呼ばれるプロセスが欠かせない。最新のWebデータを参照し、回答の確からしさを検証する仕組みだ。
Googleは自社のAIに対して「FastSearch」というシステムでグラウンディングを行っている。これはGoogle自身の検索ランキング信号に依存する仕組みであり、当然ながら競合には提供されていなかった。
今回の決定で共有される匿名化データ(クエリ、クリック、閲覧、結果位置)は、競合各社が独自の情報検索・ランキングシステムを構築するための材料となる。グラウンディングもこの用途の一つとして認められている。
検索トラフィックへの影響は限定的か
短期的に見れば、Webサイト運営者が感じるトラフィックへの影響は限定的だろう。SE Rankingのデータによると、2026年1月時点で全AIプラットフォームを合わせた紹介トラフィックは、世界のインターネットトラフィック全体の約0.24%に過ぎない。
データへのアクセスが改善されれば競合エンジンやチャットボットの開発が進む可能性はあるが、それだけでユーザーの検索行動が一気に変わるわけではない。重要なのは、このデータを実際に製品開発に活かせるかどうかだ。
AndroidのAIアシスタント開放
2つ目の決定はAndroidに関するものだ。GoogleはOSレベルの機能を競合AIアシスタントに開放する義務を負う。
- ユーザーが「Hey Google」のような音声コマンドで競合アシスタントを起動できるようにすること
- 競合アシスタントがアプリ内で動作し、タクシーの予約や返信文の作成といった操作を実行できるようにすること
Google自身のGeminiアシスタントはすでにこのレベルのアクセス権を持っている。今回の決定はこの非対称性を是正するものだ。
主な機能の実装期限は次期メジャーリリースのAndroid 18、遅くとも2027年8月1日までとされている。複数のアシスタントが異なるウェイクワードで同時応答できる機能にはさらに1年の猶予が与えられ、2028年8月1日が期限となる。
Googleの反応とプライバシーをめぐる議論
Googleは両方の決定に反対の立場をとっている。Alphabetのグローバル問題担当プレジデントであるKent Walker氏は公式ブログで、「数百万人の欧州市民にとって不可欠なプライバシーとセキュリティの防御線を損なうリスクがある」と表明した。
同氏はまた、GoogleがDMAの目的に沿った解決策を繰り返し提案してきたことも強調している。検索データの共有については、適切な匿名化やユーザーの知識・同意なしに、欧州の検索データが見知らぬ企業に開示されることへの懸念を示した。
これに対し欧州委員会は、匿名化のプロセスが多層的な技術処理と契約上の保護措置で構成されており、内部および外部のプライバシー専門家の関与のもとで開発されていると説明する。Googleはデータ共有前にサイバーセキュリティやデータ保護の基準に基づいて申請者を審査できる。独立したテストで保護措置が不十分と判明した場合は、措置の見直しも可能だ。
今後の展開とスケジュール
2026年後半は、Googleがデータセットの整備と提供条件の策定に費やす期間となる。価格提案の期限は遅くとも2027年1月だ。各事業者はライセンス契約と価格合意を経て、それぞれのスケジュールでデータ提供を受けることになる。
Android側の主な変更は2027年8月1日、複数アシスタントの同時音声起動は2028年8月1日が期限だ。欧州委員会はこれらの措置を2年ごとに見直し、匿名化が不十分と判断されれば再検討を行うとしている。
この決定が実際に検索エンジンやAIチャットボットの多様化を促すかどうかは、資格審査を通過する事業者の顔ぶれと、提供されたデータをどれだけ製品開発に活かせるかにかかっている。すぐに目に見える変化はないが、中長期的には検索とAIの競争環境を変える可能性を秘めた決定と言えるだろう。
この記事のポイント
- EU欧州委員会がDMAに基づき、Googleに匿名化検索データの共有とAndroidのAIアシスタント開放を義務付ける決定を下した
- 共有対象はクエリ・クリック・閲覧・結果位置のデータで、ランキングアルゴリズム自体は対象外。AIチャットボットも利用資格あり
- Googleはプライバシーとセキュリティへの懸念を表明しているが、欧州委員会は多層的な匿名化と審査プロセスで対応
- 短期的な影響は限定的だが、中長期的には検索とAIの競争環境に変化をもたらす可能性がある

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ハッキングされたWordPressサイトの完全復旧手順と再発防止策
ハッキングされた WordPress サイトを復旧するには、マルウェアの削除だけでは不十分であり、SFTP や SSH といったホスティングレベルの認証情報をすべてローテーションし、バックドアを残さず完全に除去した上で、数週間にわたって再感染していないか監視を続ける必要がある。
WordPress がハッキングされる主な原因はどこにあるのか
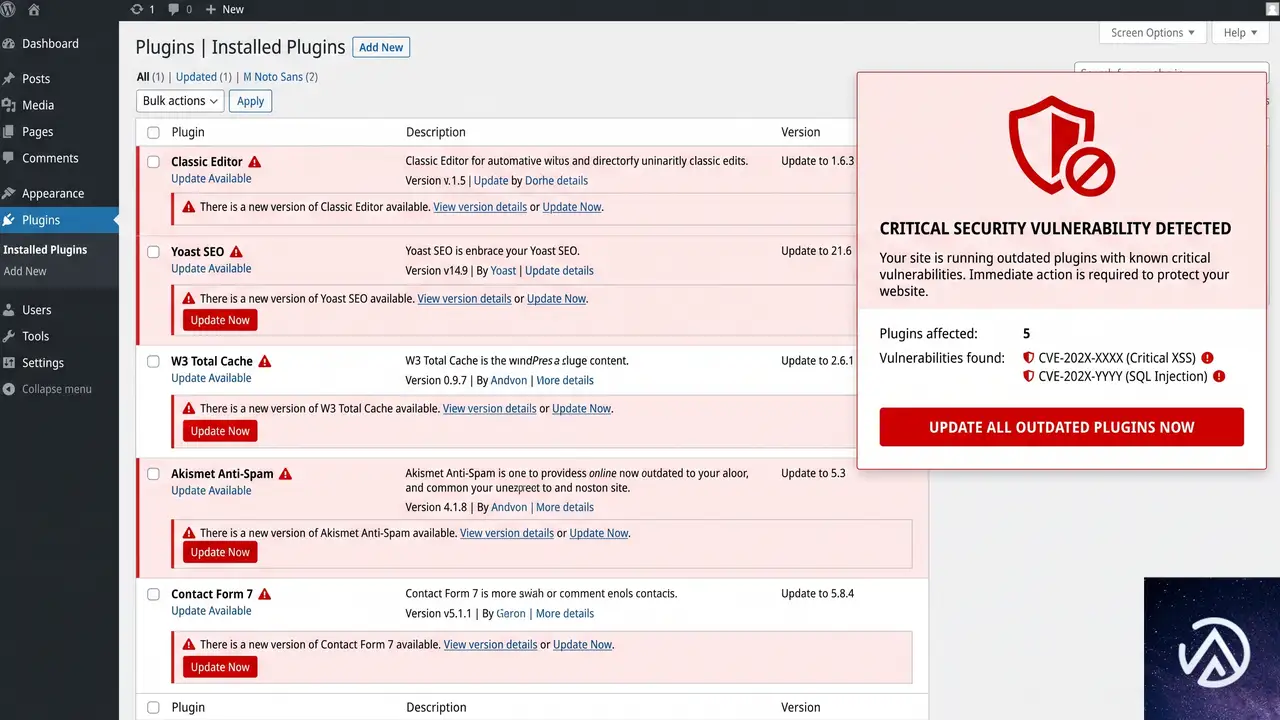
侵入経路として圧倒的に多いのが、更新されていないプラグインやテーマの脆弱性だ。Patchstack の統計では、WordPress エコシステム全体の脆弱性の約96%がプラグイン、残り4%がテーマに存在し、コア本体に起因するものはごくわずかである。脆弱性が公表され修正パッチがリリースされると、攻撃者は数時間以内にそのバージョンを標的としたスキャンを開始する。
もう一つの主な侵入口は、弱いパスワードや使い回しの認証情報、あるいはフィッシング詐欺などで盗まれたログイン情報だ。攻撃者は WordPress の管理画面だけでなく、SFTP や SSH、ホスティングコントロールパネルといった上位のアクセス権も狙う。
侵入に成功した攻撃者は、すぐに目立った改ざんを行うとは限らない。ファイルに巧妙に偽装したバックドアを仕込み、追加の管理者アカウントを作成した後、数週間から数カ月潜伏するケースが一般的だ。そのため、サイト改ざんの直前に取得したバックアップであっても、見えないバックドアがすでに仕込まれている可能性を前提に復旧作業を進めなければならない。
上図の流れが示すとおり、攻撃者はサイトに侵入したあと長期間潜伏し、ファイルやデータベースの奥深くに復旧を妨げる仕掛けを残す。
完全な掃除と再発防止のための5ステップ
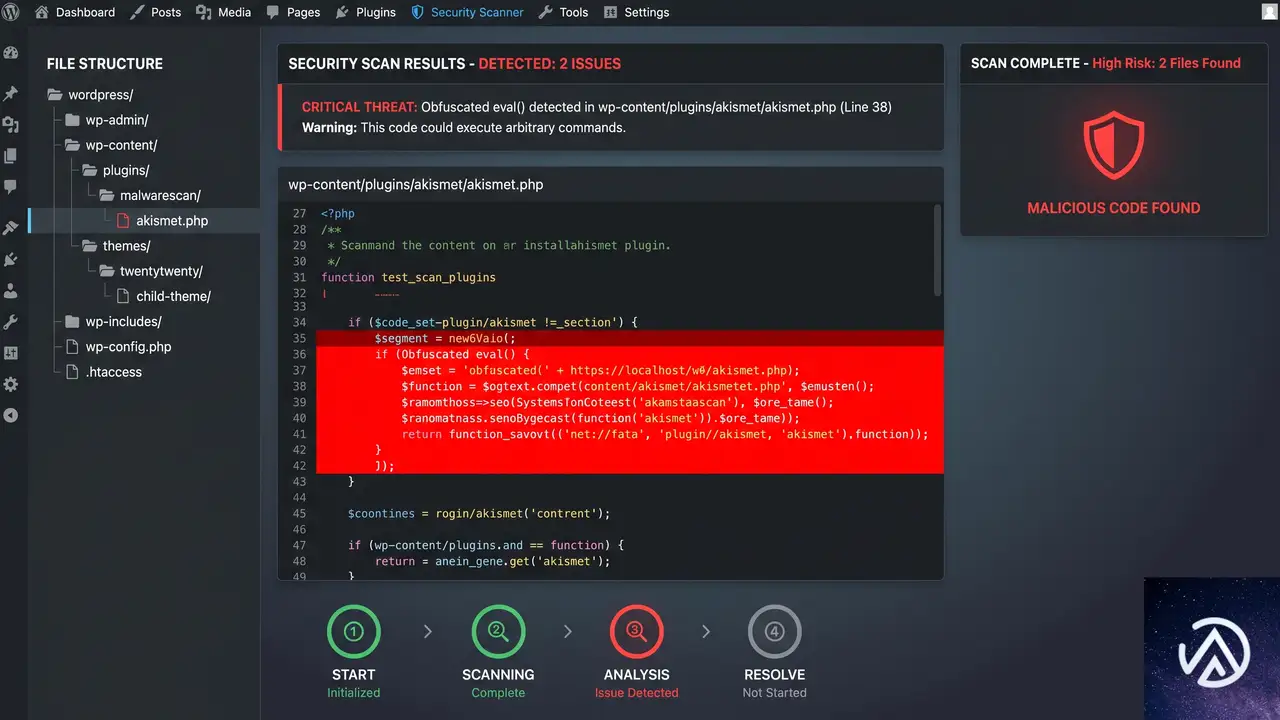
証拠を保全しログを収集する
復旧作業に着手する前に、改ざんされた状態のサイト全体(全ファイルとデータベースダンプ)のバックアップを取得し、証拠として安全な場所に保管する。ログの収集も同時に行う。利用しているサーバー会社へ、ウェブアクセスログ、SSH ログ、SFTP ログを依頼する。ログの保存期間はサーバー会社によって異なり、ウェブアクセスログは48時間程度、SFTP ログは提供されない場合もあるため、できるだけ早く依頼する必要がある。
解析ツールを使って感染範囲を特定する
取得したバックアップとログを解析する。AI を活用した解析ツールを使うと、大量のファイルからパターンを検出しやすい。もし感染前のクリーンなバックアップが存在するなら、それと比較することで未知のバックドアの発見率が大幅に上がる。スキャン範囲は wp-content ディレクトリ内だけに限定せず、ドキュメントルート全体とし、フォントファイルやキャッシュディレクトリに偽装されたシェルスクリプトも見落とさないようにする。
見つかったマルウェアと不正アカウントを削除する
検出された悪意のあるファイルは無効化ではなく削除する。単にプラグインを無効化しただけでは、該当ファイルに直接 URL でアクセスされると動作してしまう。また、管理画面のユーザー一覧に表示されない管理者アカウントや、データベースに直接埋め込まれた不正なエントリも除去する。
すべての認証情報をローテーションする
ファイルの掃除が完了しても、認証情報が漏洩したままだと再感染を繰り返す。WordPress のソルト(暗号化用の乱数文字列)とデータベースのパスワードを変更し、全ユーザーのパスワードをリセットする。さらに、SFTP のパスワード、SSH の公開鍵(身に覚えのない鍵はすべて削除)、API トークン、ホスティングのコントロールパネルのパスワードもすべて変更し、多要素認証を有効にする。作業に関わった全員が、自分のパソコンをマルウェアスキャンし、FTP クライアントにパスワードを保存する習慣をやめることも忘れてはならない。
この三層すべてで認証情報を更新しない限り、攻撃者は残った認証情報を使って何度でも侵入できる。
再感染の有無を監視し、クリーンな状態を維持する
一度の掃除で完全に除去できたと判断してはならない。掃除中に攻撃者が再侵入している可能性もあるため、作業が完了したら新しいバックアップとログを取得し、最初の解析ステップから再度実行する。このサイクルを、少なくとも二回連続で異常が検出されなくなるまで繰り返す。
本当にクリーンだと確信できるバックアップが取得できたら、それを信頼できるソース・オブ・トゥルース(基準点)として保管する。その後の定期バックアップはすべてこの基準点と比較し、差分が発生した瞬間を検知できるようにする。サイトが改ざんされる前に異常を捉えるには、復旧後も数週間は毎日バックアップとスキャンを継続し、問題がなければ監視頻度を徐々に落としていく方法が現実的だ。
アクセス権限を「必要性」で見直す
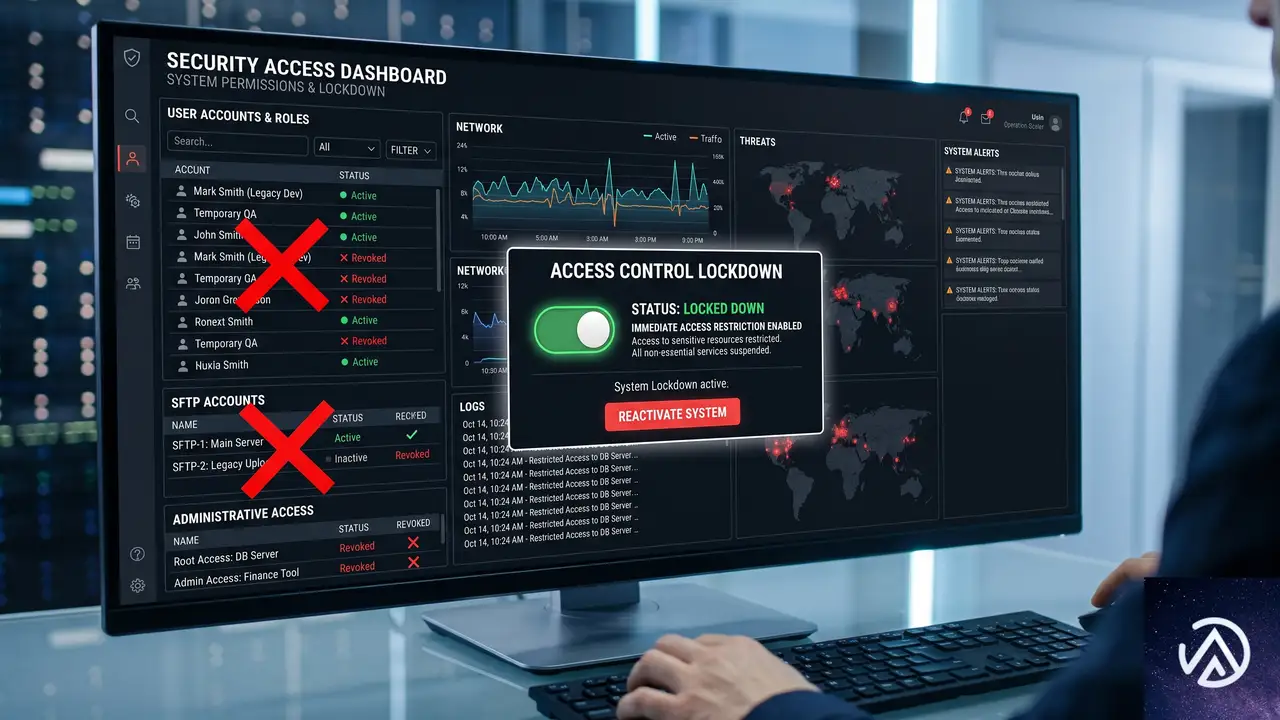
WordPress の管理者アカウント、SFTP ユーザー、SSH 鍵、ホスティングのコントロールパネルユーザーは、それぞれが攻撃者にとっての侵入口になり得る。信頼できる人物であっても、その人が使うパソコンがマルウェアに感染したり、パスワードがフィッシング詐欺で盗まれたりすれば、そのアカウントは攻撃者に利用される。
そのため、アクセス権限は「信頼」ではなく「業務上の必要性」だけを基準に付与する。サイトの編集者に管理者権限は必要ないし、たまにコンテンツを修正するだけの担当者に SFTP アカウントは不要だ。経営者であっても、サーバーの操作が業務に含まれないならば管理者アクセスを持つべきではない。権限を持つアカウントの数を最小限に減らし、それぞれの権限レベルも必要最低限に絞ることが、最も低コストで効果的な防御策となる。
上記のように、権限を必要最低限に絞り込むだけで、攻撃者が悪用できる認証情報の総数は大幅に減る。
よくある質問
バックドアはどこに隠れていることが多いのか
wp-content 内のプラグインやテーマだけではなく、ドキュメントルート直下や、画像アップロードディレクトリ、キャッシュフォルダなどに偽装されるケースが多い。フォントファイル(.woff や .ttf)に偽装した悪意ある PHP コードが埋め込まれている事例もある。スキャンは必ずサイトのルート全体を対象にする必要がある。
データベースにもバックドアは残るのか
残る。管理画面のユーザー一覧に表示されない管理者アカウントや、プラグイン一覧から隠蔽された悪意あるプラグインのエントリがデータベースに直接書き込まれていることがある。ファイルの掃除だけでなく、データベースの直接確認も必須だ。
無料のセキュリティプラグインだけで復旧できるのか
セキュリティプラグインは感染の検知や予防には有効だが、すでに深く侵入されたサイトの完全な復旧を保証するものではない。特にホスティングレベルの認証情報が漏洩している場合、プラグインのスキャンでは検出できない経路から再侵入される。認証情報のローテーションと継続的なスキャンの組み合わせが不可欠になる。
復旧後、いつまで監視を続ければよいのか
少なくとも2週間は毎日のバックアップとスキャンを継続するのが現実的な目安だ。攻撃者が盗んだ認証情報をしばらく寝かせてから使うケースもあるため、数日間問題がなかったというだけで監視をやめてはいけない。2週間以上経過し、その間の全スキャンで異常がなければ、監視頻度を週に数回へ徐々に落としてもよい。
WP CLI を使わずに復旧作業は可能か
可能だが、手作業でのファイルの確認やデータベースの直接操作が必要になるため、作業時間と見落としのリスクが増加する。WP CLI に抵抗がある場合は、信頼できるエンジニアに依頼する方が安全だ。サーバー会社によっては、マルウェアスキャンと駆除の有償サービスを提供しているところもある。
この記事のポイント
- ハッキングの侵入経路はプラグインやテーマの脆弱性、および漏洩した認証情報が大半を占める
- バックドアはファイルとデータベースの両方に潜伏し、直近のバックアップも汚染されている前提で作業する
- 復旧にはファイル削除と同時に、WordPress、ホスティング、作業端末の三層で認証情報のローテーションが必須
- アクセス権限は「信頼」ではなく「必要性」で付与し、不要なアカウントは即座に削除する
- 一度の掃除で完了とせず、数週間の継続監視と複数回のスキャンで再感染の有無を確認する

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

Cloud Runのマルチリージョン高可用性が強化、障害検知と自動復旧が数秒単位に
発表の概要

Google Cloudは2026年7月20日、Cloud Runにおけるマルチリージョン高可用性の機能強化を発表した。ミッションクリティカルなアプリケーションのダウンタイムは、企業の収益や評判に直結する問題だ。これに対処するため、Cloud Runは単一コマンドで複数リージョンに同一サービスを展開できる設計をとってきたが、今回のアップデートで障害検知と自動復旧の精度が大幅に向上している。
新たに導入された機能は「Readiness Probe」と「Service Health」の2つだ。インスタンスレベルの死活監視とリージョンレベルの健全性評価を組み合わせることで、リージョン障害が発生した際のトラフィック迂回が数秒単位で自動化される。
マルチリージョン高可用性を支える2つの新機能

Readiness Probeの役割は「個々のコンテナが外部リクエストを受け付けられる状態か」を確認することだ。この結果はCloud Runコンソールからもリージョン別に確認でき、どのリージョンでインスタンスが縮退しているかが一目で分かる。
Service Healthはこのプローブ結果をリージョン単位で集約するレイヤーにあたる。複数のヘルスチェック結果を「そのリージョンが正常に稼働しているかどうか」というひとつの評価に落とし込み、グローバルロードバランサがこの評価に基づいてルーティングを切り替える。この仕組みにより、障害発生時の手動オペレーションが原則不要になる。
パブリックとプライベートで異なる自動フェイルオーバーの経路

自動フェイルオーバーを実現するには、トラフィックが流入してくるネットワーク層によってロードバランサの種類を選択する必要がある。Cloud Runは外部向けと内部向けで最適なバランサ構成を用意している。
この構成の利点は、どちらのパターンでもロードバランサ側が自動でService Healthを参照し、異常リージョンをルーティング対象から外してくれる点にある。手動でのDNS切り替えや手作業によるトラフィック操作が不要になるため、復旧までの時間が大幅に短縮される。
設計段階で押さえるべき3つのポイント

Service Healthの活用を前提にマルチリージョン構成を設計する際、見落としやすい検討項目が3つある。いずれも高可用性に直結するため、初期段階で整理しておくことが望ましい。
単一障害点をなくすには、インフラ層だけでなくアプリケーション自体のステートレス設計が前提になる。データ層を別途冗長化し、ロードバランサの背後で自由にインスタンスを入れ替えられる状態を作っておくことが、Cloud Runのマルチリージョン構成を最大限活かす秘訣だ。
利用開始とコスト
Cloud Runのマルチリージョン高可用性に関する一連の機能は、すでに全リージョンで利用可能だ。Service Healthの機能そのものに追加料金は発生しない。Readiness Probeの実行に伴う標準的なCPU・メモリ消費のみが課金対象となる。
導入にあたっては、既存のCloud RunサービスにReadiness Probeを設定し、Service Healthを有効にしたうえで適切なロードバランサに接続するだけでよい。公式ドキュメントにチュートリアルが用意されており、少ないステップでマルチリージョン高可用性の基盤を整えられる。
この記事のポイント
- Readiness Probeがコンテナ単位の死活監視を行い、Service Healthがリージョン単位の健全性を可視化する
- Serverless NEGを通じてグローバルロードバランサに健全性が通知され、障害リージョンを数秒で自動迂回する
- パブリック向けは外部ALB、VPC内向けは内部ALBを選択すれば、どちらも自動フェイルオーバーに対応可能
- DB層を含めた全レイヤーでの冗長化と、データレプリケーションの方針決定が設計の鍵を握る
- 機能追加に伴う追加コストはなく、通常のリソース消費のみで全リージョンですぐに利用を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

grüumがShopifyとMagentoを評価しWooCommerceを選んだ理由
イギリス発のスキンケアブランド「grüum(グルーム)」は、月間8万件の注文を1人のフルタイム開発者で処理する。2023年、彼らは成長に伴い「WooCommerceでこのまま進むべきか」を再検討した。Shopify PlusとMagento(Adobe Commerce)を4か月かけて評価した結果、grüumはWooCommerceに残る決断を下した。
その背景には、複雑な商品構成を維持するための柔軟性、サブスクリプション収益に比例する手数料の回避、そして顧客データの完全な所有権があった。本記事では、月間8万件規模のEC事業者が下したプラットフォーム選定の判断基準を具体的に解説する。
grüumのビジネスモデルと商品構成の複雑さ

grüumは2016年、英国とオランダで活動する4人の同僚によって設立された。当初は男性向けスキンケアとシェービング製品を中心に約10商品でスタートしたが、現在では年齢や性別を問わず使えるスキンケア、ヘアケア、ボディケア、シェービング製品を展開する。売れ筋はシャンプーバーで、累計数百万個を販売している。
製造は英ストックポートの自社工場で一貫して行い、化粧品科学者も社内に抱える。段ボール包装の徹底、水を使わない製剤、天然成分の使用など、サステナビリティを製品開発の中心に据えている点が特徴だ。
300SKUを支える特殊なバンドル構造
grüumは約300SKUの商品を扱い、単品購入、定期購入(サブスクリプション)、そして独自の組み合わせが可能なバンドル販売を提供している。共同創業者のBethanie Sleigh氏は「私たちは製品の設定方法に多くの独自の仕組みを持っている」と語る。彼らの商品バンドルは「内容物、価格設定、在庫管理」を1つの設定単位として扱う必要がある。
具体的には、顧客は石鹸セットを購入した上で別の製品を追加したり、個別の製品を定期購入に切り替えて割引を受けたりできる。このような複雑な商品構成は、標準的なECプラットフォームの枠組みでは再現が難しい。
オープンソースであるWooCommerceは、条件付きロジックを必要とするバンドル機能があれば、拡張機能を導入するか開発者が独自に作成できる。ほとんどのEC事業者には不要な機能でも、特殊なカタログ構造を持つブランドにとっては事業形態を変えずに販売を継続できることを意味する。
Shopify Plusがgrüumのビジネスに合わなかった理由

grüumが最初に評価したShopify Plusは、ホスティングやセキュリティをプラットフォーム側で管理するSaaS型ECの代表格だ。しかし、grüumの複雑な商品構成を前にして、Shopify Plusではビジネス側をプラットフォームに合わせる必要があった。
プラットフォームに事業を合わせるのか、事業にプラットフォームを合わせるのか
共同創業者のSimon Leonard氏は「Shopify Plusに移行するなら、私たちのビジネスをプラットフォームに合わせて変えなければならなかった」と振り返る。WooCommerce Blogの記事によれば、grüumのバンドル構造(内容物、価格設定、在庫管理を1つの設定単位として扱う)はShopify Plusではネイティブにサポートされていなかった。
この制約は、EC事業者にとって重要な分岐点を浮き彫りにする。プラットフォームのデフォルト機能から外れた運用をしている場合、SaaS型では「ビジネスを変える」か「高額なカスタム開発に投資する」かの二択になりがちだ。WooCommerceはオープンソースであるため、プラットフォームを事業に合わせて拡張できる。Leonard氏は「私たちはWooCommerceを自分たちのビジネスに合わせて機能させることができる。原則を変える必要はない」と結論づけた。
サブスクリプション収益に比例する手数料の重み
grüumにとってサブスクリプション(定期購入)は重要な収益源だ。全収益の10%を占め、平均継続期間は30か月に達する。この定着率の高さゆえに、サブスクリプションのインフラコストは事業の収益性を大きく左右する。
Shopifyはサブスクリプション収益に対して売上の一定割合を手数料として課金する。Leonard氏が試算したところ、サブスクリプション経由で100万ポンド(約1.9億円)から1,000万ポンド(約19億円)の売上がある場合、年間10万ポンド(約1,900万円)規模の手数料が発生する計算になる。
一方、WooCommerce Subscriptionsは定額制の年間ライセンス料で提供される。grüumの規模では、Shopifyの従量課金モデルと比較して大幅なコスト削減につながる。これは「成長すればするほど手数料が増える」モデルと「成長しても固定費で済む」モデルの構造的な違いだ。
この料金体系の違いは、月間8万件の注文を処理するEC事業者にとって年間数百万円規模のコスト差を生む。WooCommerce Blogの記事でも、Leonard氏が「サブスクリプションで100万ポンドや1,000万ポンドの売上があると、すぐに年間10万ポンドの出費になる」と試算したことが紹介されている。
Magento(Adobe Commerce)の運用負荷とコスト構造

grüumが次に評価したMagento(現在のAdobe Commerce)は、エンタープライズ向けの高度なカスタマイズ性を持つオープンソースプラットフォームだ。Shopify Plusとは異なり、Magentoは拡張性の面ではgrüumの要件を満たす可能性があった。
専任の技術チームが不可欠な運用現実
しかし、Magentoの運用には相応の技術リソースが必要になる。サーバー管理、パフォーマンスチューニング、セキュリティパッチ適用、バージョンアップ対応などを継続的に行うには専任の技術スタッフが欠かせない。Leonard氏は「ウェブサイトを運営するために20人のチームを雇うつもりはなかった」と語っている。
grüumの開発チームはフルタイム1人とパートタイムのQAテスター1人という最小構成で運営されている。Magentoの運用に必要なリソースは、この体制では経済的に成立しなかった。拡張性の高さと引き換えに、運用負荷とインフラコストが大きく跳ね上がる点が決定的なマイナス要因となった。
これは中規模EC事業者にとって重要な示唆だ。機能の豊富さや拡張性だけでプラットフォームを選ぶと、運用フェーズで想定外のコストが発生する。自社の技術リソースと運用体制を正確に見積もった上で判断する必要がある。
この比較から見えるのは、ECプラットフォーム選定において「機能の多さ」よりも「自社の運用体制に合うか」が重要だということだ。grüumはMagentoの拡張性を評価しつつも、1人体制で回せる軽量な運用を優先した。
1人の開発者で月間8万件を処理できる運用設計

grüumのWebサイトは、フルタイム開発者1人とパートタイムのQAテスター1人で運用されている。小規模なコンテンツチームが商品登録、ページ作成、日々のコンテンツ更新を担当し、開発者の手を借りることはほとんどない。
非エンジニアが自律的に運営できるツール選定
コンテンツチームはページ作成にGutenberg(WordPressのブロックエディタ)、ナビゲーション管理にMax Mega Menu、SEO対策にYoast SEOを使用している。商品リスティング、プロモーション、季節ごとの更新はすべて開発者の介在なしで完了する。
この分業が成立するのは、WordPressエコシステムに成熟したノーコードツールが豊富に存在するからだ。grüumの開発者は、ルーチン作業ではなく顧客体験の改善や新機能の開発に集中できる。WooCommerce Blogの記事によれば、CTOの試算では「以前なら1年かかっていたタスクがWooCommerceなら1か月で完了する」という。開発速度の差はそのままコスト削減と市場投入の迅速化につながる。
決済基盤としてのWooPayments
決済についても、grüumはWooCommerceネイティブのWooPaymentsを選択した。外部の決済サービスを別途契約するのではなく、WooCommerceに統合された決済基盤を使うことで管理の一元化と手数料の最適化を図っている。プラットフォームと決済が分離していると、売上データの突合や手数料計算が複雑化するが、統合されていれば管理負荷が大幅に下がる。
この構成図からわかるように、grüumの運営は「開発者がルーチン作業から解放されている」点が最大の強みだ。コンテンツチームが自律的に動けるツールを選び、開発者は成長のための改善に専念する。この分業設計が1人体制での月間8万件処理を可能にしている。
データ所有権がもたらす事業の独立性

grüumがWooCommerceに残る決断をした理由の最後の1つが、データ所有権だ。SaaS型ECプラットフォームでは、顧客データや購買履歴はプラットフォーム側のデータベースに保存され、事業者が自由にアクセスできるとは限らない。移行時にはデータのエクスポートに制限があったり、追加費用が発生したりするケースもある。
30か月の顧客関係を自社で保有する意味
grüumのサブスクリプション顧客の平均継続期間は30か月だ。この間に蓄積された購買履歴、好み、購買パターンは、マーケティング戦略の基盤となる重要な資産である。Leonard氏はWooCommerce Blogの記事で「データは私たちのものだ。他のサブスクリプションプラットフォームとは大きく異なる。顧客をサードパーティに渡すのではなく、自分たちで管理できる」と述べている。
オープンソースのWooCommerceでは、データベースは事業者のサーバー上に存在する。仮に将来プラットフォームを移行する場合でも、データを完全な形でエクスポートできる。これはSaaS型プラットフォームにはない構造的な優位性だ。特にサブスクリプションモデルで長期的な顧客関係を構築しているEC事業者にとって、データアクセスの制限は重大な事業リスクになる。
データ所有権の問題は、短期的なコスト比較では見落とされがちだ。しかし、サブスクリプション事業のように顧客との長期関係が収益の柱となるビジネスモデルでは、データの可搬性とアクセス権が戦略的な価値を持つ。grüumの判断は、この点を明確に意識したものと言える。
この記事のポイント
- grüumは月間8万件の注文を1人の開発者で処理する中規模EC事業者であり、Shopify PlusとMagentoを評価した結果WooCommerceに残る決断を下した
- 複雑な商品バンドル(内容物、価格設定、在庫管理の一元設定)はShopify Plusではネイティブにサポートされず、ビジネス側をプラットフォームに合わせる必要があった
- サブスクリプション収益に対する従量課金(Shopify)と定額制(WooCommerce)の差は、年商1,000万ポンド規模で年間約10万ポンドのコスト差を生む
- Magentoは拡張性は高いが、運用に専任の技術チームが必要で、grüumの1人体制では経済的に成立しなかった
- オープンソースのWooCommerceはデータベースを事業者が完全に所有でき、顧客データの可搬性とアクセス権がSaaS型よりも優位
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google NotebookLMがGemini Notebookに改称、AIスクレイピング対策の緊急対応
Googleが研究支援ツールNotebookLMをGemini Notebookに改称した。実体は同じだが、このタイミングでユーザーエージェントの表記が「Google-NotebookLM」から「Google-GeminiNotebook」に変更される。旧ユーザーエージェントは2026年8月をもって廃止されるため、サイト運営者は数週間のうちにスクレイピング対策の見直しを迫られている。
今回の変更は単なる名称の刷新にとどまらず、AIによる自動コンテンツ収集と再利用のリスクを改めて浮き彫りにする。本記事では、Gemini Notebookのスクレイピング機能の実態、robots.txtを無視するユーザートリガー型フェッチャーの仕組み、そして具体的なブロック手法を簡潔にまとめる。
NotebookLMがGemini Notebookに改称、機能は変わらず
名前変更の背景と影響
2026年7月18日、Googleはユーザートリガー型フェッチャーのドキュメントを更新し、NotebookLMをGemini Notebookに置き換えた。ブランド統合の一環であり、既存のNotebookLMユーザーにとって使い勝手に違いは生じない。
しかし、サイト運営者にとって重大なのは、旧ユーザーエージェント「Google-NotebookLM」が2026年8月で無効になる点だ。ファイアウォールや.htaccessにこの文字列を直書きしている場合、猶予期間内に新しいユーザーエージェントへ切り替えなければ、ブロックが機能しなくなる。
Gemini Notebookの主な機能
Gemini Notebookは、ユーザーが提供した文書やURLを「グランドトゥルース(信頼できる基盤情報)」として扱い、AIが調査や学習を支援するマルチモーダルツールだ。YouTubeの動画や音声ファイルを取り込んで分析することも、逆にアップロードされた資料を音声ポッドキャストや動画解説に変換することもできる。
この「資料をもとに新しいコンテンツを自動生成する」という特徴が、後述するスクレイピング問題の根本にある。生成された音声や動画がオンラインで公開されれば、元の記事と直接競合する可能性があるからだ。
Gemini Notebookが引き起こすスクレイピング問題
Discover Sourcesによる自動スクレイピング
Gemini Notebookの「Discover Sources」機能は、ユーザーが設定したクエリやテーマに沿って最大10件のオンライン記事を自動で収集し、AI要約を生成する。問題は、サイト所有者の許可を一切取らずにクローリングが行われ、参照元へのリンクも一切発生しない点だ。
従来の検索エンジンであれば、クローラーが収集した情報は検索結果としてユーザーをサイトへ誘導する。しかしGemini Notebookの要約はクローズドな環境で完結し、トラフィックの恩恵は元サイトに還元されない。SEOの観点からは、コンテンツが無断で「搾取」される構造といえる。
音声・動画コンテンツの自動生成と競合
さらに、アップロードした資料からポッドキャストや動画解説を生成できる点も看過できない。仮に自社サイトの記事が材料に使われ、第三者が公開すれば、同一テーマでオリジナルと競合する二次コンテンツが無数に生まれる危険がある。
Googleのドキュメント上、これらは「ユーザー調査のための機能」と位置づけられているが、実質的には許可なきスクレイピングとリパーパス(再利用)を自動化する仕組みにほかならない。コンテンツを資産とするウェブサイト運営者にとって、対策は急務だ。
緊急対応すべきブロック手法
ユーザートリガー型フェッチャーとは
Gemini Notebookのクローラーは「ユーザートリガー型フェッチャー」に分類される。これは、ユーザーが明示的に指示(URL貼り付けやDiscover Sourcesの実行)をトリガーとして起動するため、robots.txtの指示に従わない。robots.txtはあくまで紳士協定であり、一般的なクローラーは自発的に従うが、ユーザートリガー型には適用されないのだ。
ただし、robots.txtが効かないからといって手立てがないわけではない。サーバー側でHTTPリクエストのユーザーエージェント文字列を検査し、該当するアクセスを拒否することは可能である。
.htaccessによる具体的なブロック例
多くのレンタルサーバーで使えるApache環境であれば、.htaccessに以下のルールを追記するだけでGemini Notebookのアクセスを遮断できる。
RewriteEngine On

# Gemini Notebookのユーザーエージェントをブロック
RewriteCond %{HTTP_USER_AGENT} Google-GeminiNotebook [NC]
RewriteRule ^ - [F,L]
この設定により、該当のユーザーエージェントを含むすべてのリクエストに対して「403 Forbidden」が返される。Nginxを利用している場合は、if ($http_user_agent ~* "Google-GeminiNotebook") { return 403; } のような記述で同様の制御が可能だ。
重要なのは、新旧両方のユーザーエージェントをカバーするか、あるいは直ちに新UAのみに移行することである。2026年8月以降、旧UAはGoogle側で廃止されるが、それまでにサイト側のルールを更新しておかなければ、一時的にブロックがすり抜けるリスクが生じる。
旧ユーザーエージェントの猶予期間と注意点
Googleはドキュメント内で、旧ユーザーエージェント「Google-NotebookLM」を2026年8月までサポートすると明記している。ハードコードしているサイト運営者は、この期間内に新しい文字列へ切り替える必要がある。
なお、合わせて「Project Mariner」に関する記述がドキュメントから完全に削除された。同プロジェクトは2026年5月に終了しており、混乱を避ける意味でも、ユーザーエージェント周辺の情報は最新版を参照すべきである。
この記事のポイント
- NotebookLMはGemini Notebookに改称され、ユーザーエージェントが変更された
- Discover Sources機能が許可なく記事を収集し、AI要約や音声コンテンツを生成する
- ユーザートリガー型フェッチャーはrobots.txtを無視するが、ファイアウォールや.htaccessでブロック可能
- 旧UA「Google-NotebookLM」は2026年8月に廃止、既存のルールを直ちに更新する必要がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
bot判定画面が原因でGoogleインデックスから消える?セキュリティ対策の盲点と解決策
Webサイトの安全を守るセキュリティ対策が、意図せず検索順位を急落させる原因になっているかもしれない。不審なアクセスを防ぐための「bot判定画面」が、Googleの巡回を妨げる事例が報告されている。
この問題が発生すると、検索エンジンにページが登録されなくなったり、他サイトのコピーとして処理されたりするリスクがある。サイト運営者が気づかないうちに進行する、セキュリティとSEOの衝突について詳しく解説する。
bot判定画面がGoogleインデックスからページを消し去る仕組み
サイトのセキュリティを強化すると、不正なアクセスやスパムを遮断できる。しかし、その防御壁がGoogleのクローラー(検索エンジンの巡回ロボット)まで阻んでしまうことがある。これがインデックス消失を引き起こす引き金だ。
不審なアクセスと判定されたGooglebot
クローラーとは、世界中のWebサイトを巡回して情報を集める自動プログラムのことだ。Googleが派遣するクローラーは「Googlebot(グーグルボット)」と呼ばれる。通常、このGooglebotはサイトのコンテンツを自由に読み取れる必要がある。
しかし、サイトのセキュリティフィルターがGooglebotのアクセスパターンを「不審な自動プログラム」と誤認することがある。その結果、本来のコンテンツの代わりに「私はロボットではありません」という確認を求める画面を返してしまう。この画面は一般に「インターシャルページ」や「bot判定画面」と呼ばれるものだ。
重複コンテンツとして処理されるリスク
Googlebotがサイトを巡回した際、どのページにアクセスしても同じ「bot判定画面」が返ってくると、検索エンジンは混乱する。すべてのページの中身が同一であると判断してしまうからだ。
Search Engine Journalの記事で紹介されたGoogleのJohn Mueller(ジョン・ミューラー)氏の解説によると、このような状況ではGoogleは複数のページを「重複コンテンツ」として処理する。さらに、他の多くのWebサイトでも同じセキュリティサービスのbot判定画面が使われているため、Googleはそれらをすべて同じグループとみなしてしまう。最悪の場合、他人のサイトのページが本物(正規バージョン)と判定され、自サイトのページが「コピー」として検索結果から排除される事態に陥る。
上の図が示すように、セキュリティが強すぎるあまりGooglebotを一般の不審なアクセスと区別できなくなると、検索エンジンにはエラー画面しか届かなくなる。
なぜサイト運営者はこの問題に気づきにくいのか
この問題の最も恐ろしい点は、サイトの管理者が普通に自分のサイトを閲覧しているだけでは、異常に全く気づけないことだ。問題が静かに進行し、検索順位が落ちて初めて事態を把握することになる。
一般ユーザーには正常に表示される罠
bot判定画面は、すべての訪問者に表示されるわけではない。セキュリティシステムが「怪しい」と判定したアクセスに対してのみ表示される。サイト運営者や一般的なファンがパソコンやスマートフォンからアクセスする場合、通常は信頼できるアクセスとして処理されるため、何の問題もなくサイトが表示される。
そのため、運営者が「今日もサイトはきれいに表示されている」と思っていても、Googlebotだけは裏でブロックされ、エラー画面を見せられ続けているというねじれ現象が起きる。これが発見を遅らせる最大の原因だ。
Search Consoleで異常を検知する方法
この問題を検知するには、Googleが公式に提供している無料ツール「Google Search Console(グーグルサーチコンソール)」を活用するしかない。具体的には以下のステップで確認を進める。
- 「ページ」レポートを開き、エラーの推移を確認する
- 「重複コンテンツ」や「送信されたURLが正規URLとして選択されていません」というステータスが急増していないかチェックする
- 不審なページの「URL検査」を実行する
- Googleが選択した正規URLの項目を確認し、自分のドメインとは異なる見知らぬ外部サイトのURLが登録されていないか確認する
もしURL検査の結果、Googleが選択した正規URLに他人のサイトが指定されていた場合、自サイトのbot判定画面が他サイトのそれと「同一の重複コンテンツ」とみなされた可能性が極めて高い。
セキュリティ対策とクローラー巡回の衝突
なぜこのような誤判定が起きるのだろうか。それは、Webサイトを高速化・安全化するためのインフラの仕組みに関係している。
CDNやホスティングによる自動ブロック
多くのWebサイトは、CDN(コンテンツ配信ネットワーク)やホスティングサーバーが提供するセキュリティ機能を利用している。CDNとは、世界中に配置されたサーバーを経由してサイトの表示を高速化し、同時に不正なアクセスからサイトを守る仕組みだ。
これらのセキュリティシステムは、短時間に大量のアクセスを行う接続元を自動的に検知し、アクセス制限をかける。Googlebotはサイト内の多くのページを素早く巡回するため、クローラーの活動が活発になったタイミングで、セキュリティシステムが「DDoS攻撃(サーバーに過剰な負荷をかける攻撃)」や「不正な情報引っこ抜き」と誤認してブロックを起動してしまうのだ。
「エラーコードなし」でコンテンツが空になる現象
この問題がさらに厄介なのは、サーバーが「アクセス拒否」を示すエラーコード(403 Forbiddenなど)を返さないケースがある点だ。セキュリティシステムによっては、接続自体は「200 OK(正常に通信完了)」として処理し、画面の見た目だけをbot判定画面に差し替える。
Googleのクローラーは「通信は成功した」と受け取るため、壊れたページとして処理せず、そのままbot判定画面のテキストをインデックスしてしまう。過去にも、セキュリティ設定がGooglebotのアクセスを静かに遮断し、中身が全くない状態でページが登録されるトラブルが報告されている。通信の成否だけを監視する単純なチェックツールでは、この異常を検出できない。
通信自体が「正常終了」とみなされるパターンBの場合、システム監視をすり抜けてしまうため、SEOに深刻なダメージを与えるまで放置されやすい。
検索順位を守るための具体的な解決手順
もしSearch Consoleで「重複コンテンツ」のエラーを発見したり、特定のページがインデックスから消えていることに気づいたりした場合は、迅速な対処が必要だ。
セキュリティ設定のホワイトリスト化
根本的な解決策は、導入しているセキュリティサービスやCDN、ホスティングサーバーの設定を見直すことだ。Googlebotなどの主要な検索エンジンクローラーを「ホワイトリスト」に登録し、bot判定の対象から除外する設定を行う。
多くの大手セキュリティサービス(Cloudflareなど)には、検索エンジンのクローラーを自動的に認識して通過させる機能が標準で備わっている。この機能がオフになっていないか、またはカスタムルールによって上書きされてブロックされていないかを確認する必要がある。設定が難しい場合は、セキュリティの担当者やサーバーのサポート窓口に相談することを推奨する。
修正後の再クロール申請
ブロック設定を解除した後は、Googleにサイトが修正されたことを伝える必要がある。これを放置すると、Googleが次の巡回を行うまでエラー状態が維持されてしまう。
具体的には、Search Consoleを開き、該当するエラーレポート内にある「修正を検証」ボタンをクリックする。これにより、Googleに対して優先的な再クロールをリクエストできる。また、特に検索トラフィックにとって重要なページがある場合は、「URL検査」ツールから個別に「インデックス登録をリクエスト」を送信すると、より早く検索結果に復帰させることができる。
この記事のポイント
- セキュリティ対策のbot判定画面が、Googleクローラーの巡回を遮断することがある
- Googlebotがブロックされると、サイト内の全ページが「同じエラー画面」になり重複コンテンツとみなされる
- 他サイトの同じエラー画面と同一視され、最悪の場合は他サイトのコピー扱いとしてインデックスから消える
- 一般ユーザーには正常に表示されるため気づきにくく、Search Consoleでの定期的なエラー確認が必須となる
- 解決には、CDNやサーバーのセキュリティ設定でGooglebotをホワイトリストに登録し、修正後に再クロールを申請する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google AI OverviewsにTop Stories表示、米国モバイルで本格展開
Google AI Overviewsにニュース表示機能が本格実装、Top Storiesが米国モバイルで展開開始

Googleが2026年7月中旬、検索結果のAI Overviews内にニュースとTop Storiesを表示する機能の本格展開を開始した。米国モバイルユーザー向けに完全展開されており、今後対象地域が拡大される見込みだ。
この機能は2026年5月にGoogleが発表した「AI Overviewsにおける新鮮な視点、最新情報、目立つリンク」構想の一環として導入された。発展中のトピックに関する質問に対し、タイムリーな記事をより目立つ形で表示するキャッセル形式を採用する。
Googleの広報担当者はこの展開が米国モバイル向けに完全にライブであることを確認している。AI OverviewsとAI Modeといった検索機能からサイトへのトラフィックが増加する可能性を示す重要なアップデートといえる。
AI OverviewsのTop Stories表示とは、何が変わるのか

これまでAI Overviewsは主にGoogleが収集した知識グラフや静的コンテンツから回答を生成していた。そこにニュースや最新情報のカルーセルが統合されたことで、リアルタイム性の高い情報がAI生成回答と並列で表示されるようになった。
表示の仕組み、カルーセル形式でニュースを可視化
AI Overviewsのセクション内に、水平スクロール可能なカルーセルとしてニュース記事が表示される。各項目にはニュースメディア名、見出し、アイキャッチ画像が含まれ、ユーザーは回答文に加えてリアルタイムの情報をワンタップで確認できる。
このカルーセルは「Preferred Sources」と呼ばれる、Googleが信頼性を評価したソースを優先的に表示する仕組みと連動する。ニュースメディアにとっては、検索結果ページ内での露出機会を大幅に拡大するチャンスとなる。
Preferred Sourcesの影響力がさらに拡大
Googleは2026年5月の発表時に、Preferred Sourcesをニュースカルーセルでも優先表示すると明言していた。今回の本格展開により、Googleに信頼できる情報源として認識されるメディアは、AI Overviews経由のトラフィックをより多く獲得できる環境が整った。
この仕組みは単なるアルゴリズム評価だけでなく、メディア側のE-E-A-T(経験、専門性、権威性、信頼性)をより重視する検索エコシステムへの移行を加速させる。検索結果の質を担保しつつ、タイムリーなニュースを適切に届けるための設計といえる。
AI Overviews経由のクリック、メディアへのトラフィック増加が期待される

Googleは2026年7月、AI検索機能がウェブサイトに毎週数十億回のクリックを送っていると発表した。AI OverviewsやAI Modeを含むこれらの機能は、従来の検索結果とは異なる経路でユーザーをオンラインコンテンツに誘導する役割を果たす。
AI検索とトラフィックの関係、新しい導線設計
AI Overviews内のニュースカルーセルは、従来の検索結果よりも目立つ位置に配置される。テキスト回答の直下または横に表示されるため、スクロールなしでニュース記事にアクセスできる。これは単なるクリック率向上にとどまらず、発展中のニューストピックにおける情報鮮度と発信者評価を結びつける設計だ。
AI Modeとの統合がもたらす波及効果
AI ModeはGoogleが提供するAI専用の検索モードで、会話形式の対話と情報探索を組み合わせた機能だ。Top Stories表示はAI OverviewsだけでなくAI Mode内でも有効であり、ユーザーが対話的にニュースを掘り下げる際にもメディアの記事が提示される。
これにより、キーワード検索だけに依存しない多層的な導線が形成される。ユーザーが自然言語で質問を重ねるたびに新たなニュースが表示される可能性があり、メディアにとってはAI検索最適化が新たなSEO領域として重要性を増す。
ニュースメディアのSEO戦略、AI Overviews対応が急務に

AI OverviewsにTop Storiesが統合されたことで、メディアのSEO戦略は新たな段階に入った。従来のテキスト検索向け最適化に加え、AI Overviews内で優先表示されるための対策を講じる必要性が高まっている。
Preferred Sourcesとしての評価を高める施策
Googleが示すPreferred Sourcesの評価基準は完全には公開されていないが、一般的にE-E-A-Tが重視されることは明白だ。メディアは記事の正確性、著者の専門性、サイト全体の信頼性を継続的に向上させる必要がある。
- 著者情報の充実 執筆者の経歴、専門分野、過去の実績を明確に提示する
- 事実確認のプロセス可視化 情報源の明示、訂正ポリシーの公開、編集基準の提示
- 構造化データの適切な実装 NewsArticle、Article、Authorなどのスキーマを正確にマークアップする
- サイト全体のページ速度とモバイル対応 コアウェブバイタルの基準を満たし、ユーザー体験を最適化する
AI可視性を高めるコンテンツ戦略
AI Overviewsで表示されるためには、GoogleのAIが質問の意図を理解し、回答の情報源として適切と判断するコンテンツ設計が求められる。具体的には、明確な見出し構造、簡潔な要約文、信頼性の高い統計データの提示が有効だ。
今後の展開と検索エコシステムへの影響
現時点では米国モバイルユーザー向けに限定されているが、Googleは今後デスクトップや他地域への拡大を示唆している。AI Overviewsの機能拡張は段階的に行われるため、日本のメディア関係者も早期の準備が重要だ。
Googleの継続的なAI検索改善とメディアの対応
Search Engine Landの記事によれば、GoogleはAI検索機能からオープンウェブへのクリックを改善する方針を継続している。Top Stories表示はその一環であり、検索とメディアの関係を再構築する取り組みと位置づけられる。
メディア企業はAI Overviewsでの表示を単なるトラフィック獲得手段としてだけでなく、コンテンツの質と信頼性を問われる新たな評価指標として捉えるべきだ。AI検索時代のSEOは、キーワード密度や被リンク数から、情報の正確性と権威性の証明へと重心を移している。
この記事のポイント
- Google AI OverviewsにTop Stories表示機能が米国モバイル向けに本格実装された
- ニュースカルーセルはPreferred Sourcesを優先表示し、メディアのAI可視性を高める
- AI検索機能はサイトに週数十億回のクリックを送り、新たなトラフィック導線を形成
- メディアのSEO戦略はE-E-A-T強化と構造化データ実装によるAI Overviews対応が急務
- AI Overviews展開は他地域やデスクトップにも拡大予定で、早期の対策準備が重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce Taxが配送先住所を無視する原因と修正手順
WooCommerceの自動税計算(WooCommerce Tax)が配送先住所を無視して店舗住所の税率を適用し続ける場合、設定のキャッシュか配送先住所の認識不良が原因だ。税計算の基準を再確認し、プラグインのトランジェントデータを手動で削除すれば、多くのケースで正しい税率に戻る。
配送先住所ではなく店舗住所の税率が使われる原因
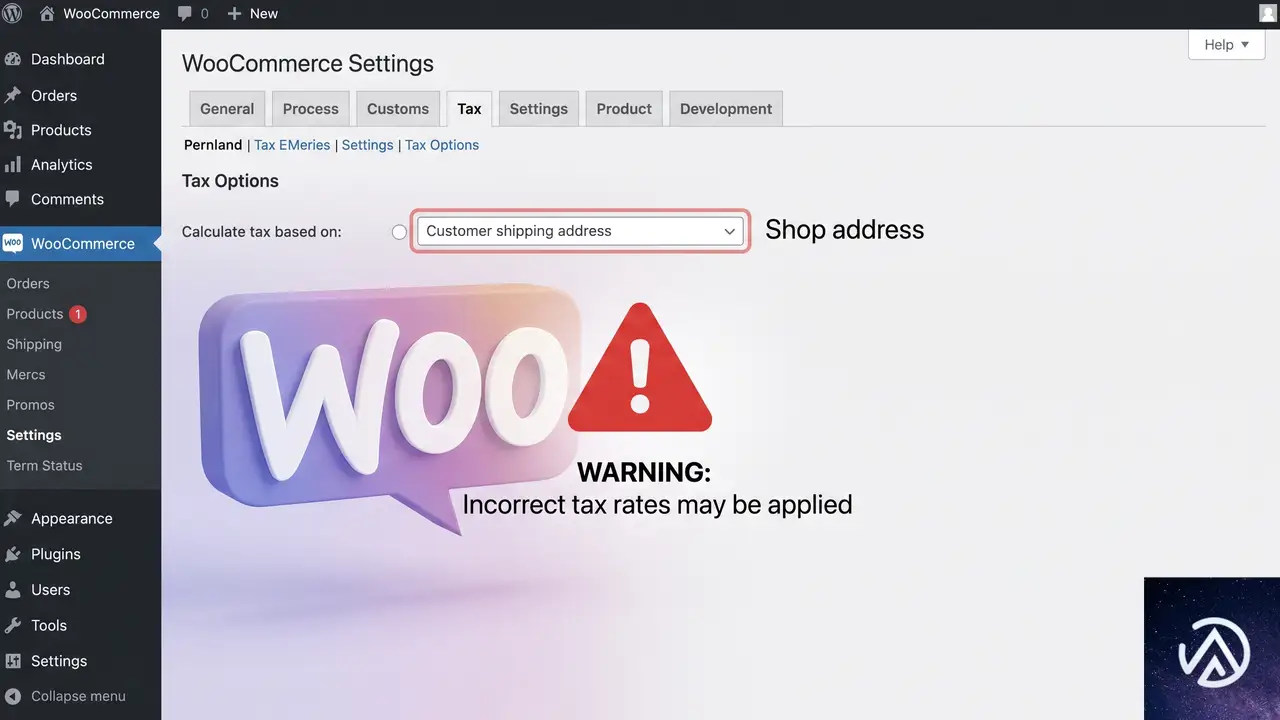
WooCommerce Tax(旧称 WooCommerce Shipping & Tax)は、有効化すると TaxJar の自動税率データベースを参照して税額を算出する。管理画面の「WooCommerce > 設定 > 税」で「顧客の配送先住所に基づいて計算する」を選択しているにもかかわらず店舗住所の税率が使われるのは、次のいずれかが起きていると考えられる。
- 税計算の基準設定が実際には店舗住所のまま保存されていない、または別のフィルターで上書きされている
- プラグインが内部に保持するトランジェントキャッシュが古い設定を返し、配送先住所を無視している
- チェックアウト時に配送先住所が正しくシステムに渡っていない(テーマや他のプラグインによる競合)
- WooCommerce Tax が店舗の税ネクサス(課税拠点)を元にした「オリジンベース課税」のルールを配送先住所より優先してしまっている
特に最後の点は、米国のように州ごとにオリジンベース/デスティネーションベースの課税方式が異なる地域で混乱しやすい。日本国内のオンラインショップでは基本的に配送先住所の税率(消費税10%または軽減税率8%)が使われるべきだが、WooCommerce Tax が海外の課税ロジックを引きずっている場合もあり、実際に「店舗住所を変えると税率が変わってしまう」といった現象が報告されている。
配送先住所「大阪市 530-0001」(税率8.25%のはず)
↓
適用される税率 → 店舗住所「東京都 100-0001」の税率10%
配送先住所「大阪市 530-0001」
↓
適用される税率 → 配送先住所の8.25%
このデモのように、配送先住所を正しく入力していても、店舗住所の税率だけが繰り返し使われるのが典型的な症状だ。
税計算の基準が本当に配送先住所になっているか再確認する
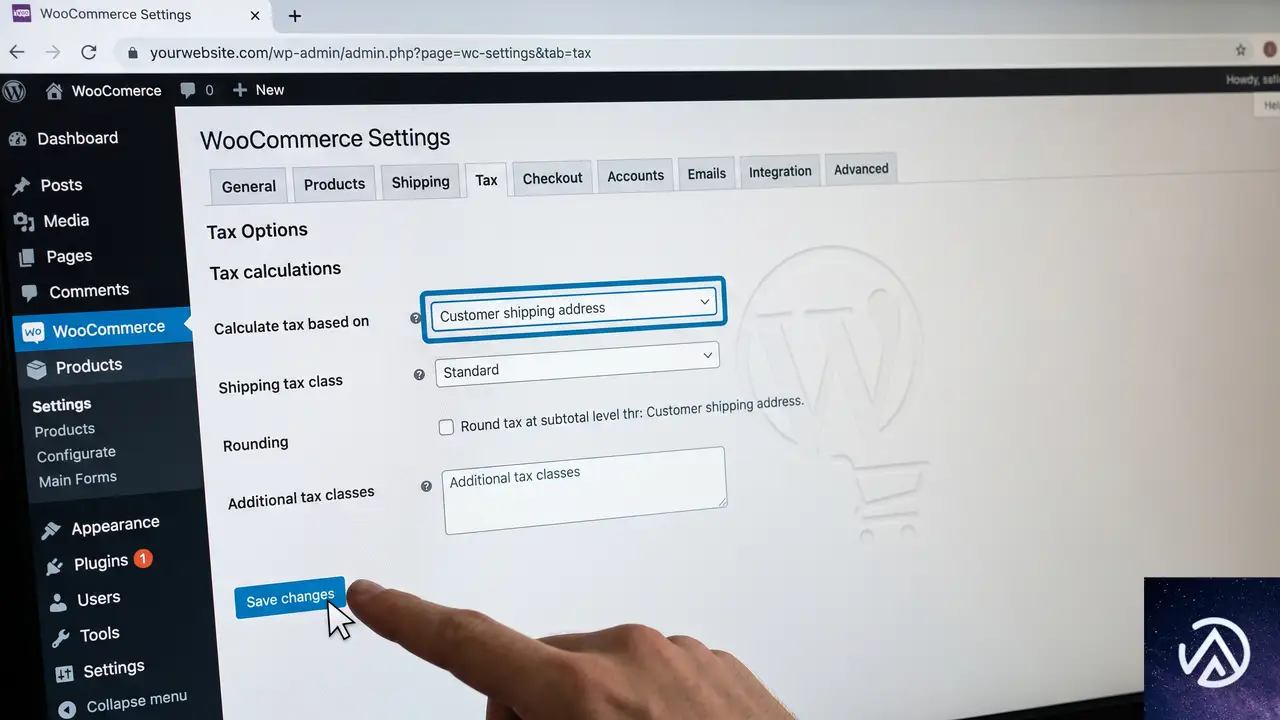
まず根本的な設定ミスがないか、管理画面をチェックする。
設定画面上は正しく見えていても、内部的に値がロックされている場合がある。STEP 3 のように一度無効化して再保存することで、WooCommerce Tax の内部キャッシュをリセットできる。
トランジェントキャッシュを手動で削除する
WooCommerce Tax は API から取得した税率データを WordPress のトランジェント(一時キャッシュ)に保存している。このキャッシュが古いままだと、配送先住所が変わっても最初に引いた店舗住所のレートを返し続けることがある。
データベースを直接操作せずにキャッシュをクリアする方法
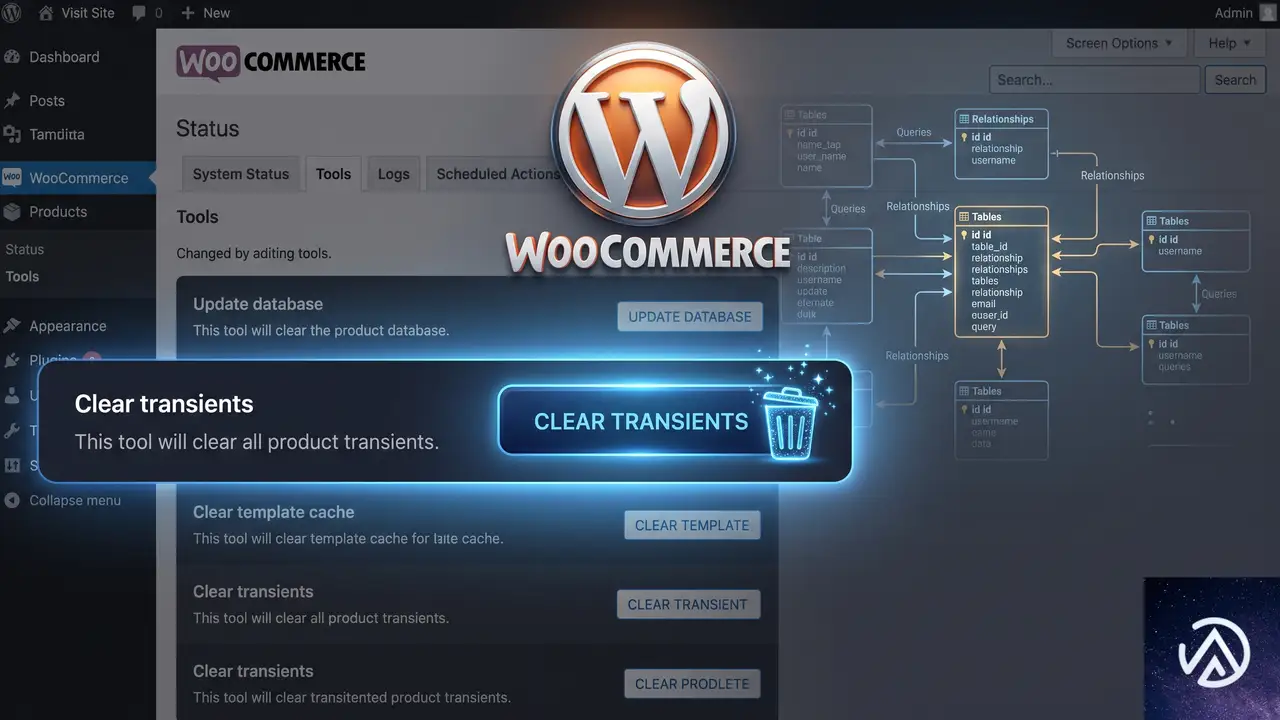
- WooCommerce > ステータス > ツール に移動する
- 「WooCommerce トランジェントをクリア」を実行する
- さらに「顧客セッションをクリア」も実施する
- 必要に応じて、WooCommerce Tax プラグインを無効化してから削除し、再度インストールして有効化する
再インストール時には、プラグインが新しい API キーを取得し、税設定が初期化される。その後、必ず「WooCommerce > 設定 > 税」で「配送先住所に基づいて計算する」を再設定する。
配送先住所の受け渡しをデバッグモードで検証する
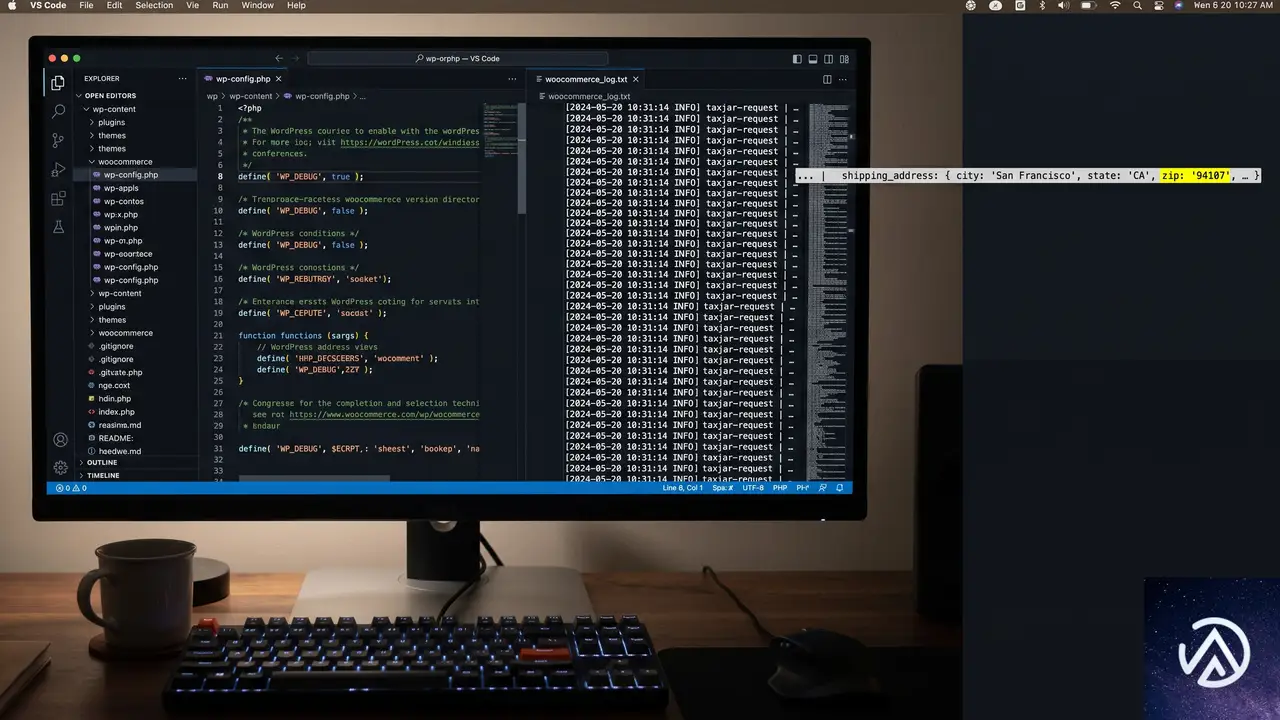
テーマや他のプラグインの影響で、チェックアウト画面から正しい配送先住所が WooCommerce Tax に渡っていない可能性もある。WooCommerce のデバッグモードを有効にして、税計算の内部ログを確認する。
define('WP_DEBUG', true); を追加WooCommerce > ステータス > ログ に、woocommerce-tax や taxjar のログファイルが生成される。配送先住所ではなく店舗住所が送信されているようであれば、テーマの functions.php やカスタムコードが住所情報を改変していないか精査する。
応急的に店舗住所を「配送先住所」と同じ扱いにするフィルター
どうしても自動税計算が配送先住所を認識せず、緊急で正しい税率を適用しなければならない場合、WordPress のフィルターフックを使って一時的に配送先住所を強制的に税計算に使わせることもできる。
add_filter( 'woocommerce_tax_based_on', function( $base ) {
    if ( is_checkout() || is_cart() ) {
        return 'shipping';
    }
    return $base;
});
このコードを子テーマの functions.php に追加すれば、カート・チェックアウト画面では常に配送先住所ベースの計算が強制される。ただし、根本原因の解決にはならないため、あくまで応急策として利用する。
よくある質問
WooCommerce Tax を再インストールしても直らないのはなぜか
再インストールだけでは、データベースに残ったトランジェントや設定値が削除されないことがある。プラグインを削除した後に「WooCommerce > ステータス > ツール」からトランジェントを完全クリアし、その上で再インストールする必要がある。
配送先住所が正しく入力されているのに税率が変わらないのはどうしてか
WooCommerce Tax は TaxJar API に配送先の ZIP コードと国・州の情報を送り、税率を取得する。このとき、ZIP コードが実在しないか API が認識できない場合、フォールバックとして店舗住所の税率を返す仕様がある。テストする住所が実在するか、郵便番号のフォーマットが正しいかを再確認する。
WooCommerce Tax を使わずに日本国内の税率を正確に計算するにはどうすればよいか
日本国内のオンラインショップで消費税のみを扱うなら、自動税率プラグインを無効化し、WooCommerce 標準の税率設定で「標準税率(10%)」と「軽減税率(8%)」を手動で登録する方が安定する。配送先住所の県や市町村による税率差分が不要なケースが大半のため、あえて自動計算を導入する必要はない。
テスト注文を何度も行っても税額が変わらない場合の最終確認事項は
テスト注文時には、必ずブラウザのシークレットウィンドウを使い、サイトのキャッシュやセッションの影響を排除する。また、カートの計算がセッション情報に依存するため、住所を変えるたびにカートを空にしてから再度商品を追加する。
特定の州や地域でオリジンベース課税のせいで税率が店舗住所になることはあるのか
米国の一部の州では、店舗所在地と配送先の両方が同じ州内にある場合、店舗所在地の税率を適用するオリジンベース課税が採用されている。しかし、WooCommerce Tax は州ごとの課税方式を自動で判別するわけではなく、設定上のトラブルでこの現象が起こることがある。日本のショップでは関係ないが、海外向けに販売する場合は注意が必要だ。
この記事のポイント
- 自動税計算が配送先住所を無視するのは、設定キャッシュか住所の受け渡し不良が主な原因
- 「WooCommerce > 設定 > 税」の計算基準を再確認し、無効化→再有効化で内部リセットを試す
- トランジェントキャッシュを手動クリアし、必要ならプラグインの再インストールを行う
- デバッグログで TaxJar API へのリクエスト内容を検証する
- 日本国内のみのショップなら自動税率をやめ、標準税率を手動設定する方が安定する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

VercelがNode.js 20を非推奨化、10月1日から新規デプロイ不可に
VercelにおけるNode.js 20非推奨の概要

Vercelは2026年10月1日をもって、ビルドおよびFunctionsにおけるNode.js 20のサポートを終了する。これは2026年4月30日にNode.js 20がEOL(End of Life / サポート終了)を迎えたことを受けた動きだ。
Node.jsの各バージョンにはライフサイクルが定められている。長期サポート(LTS)が終了すると、セキュリティパッチの提供も停止される。Vercelがプラットフォームとして非推奨とするのは、ユーザーに安全で最新の実行環境を提供し続けるための当然の判断といえる。
この変更で影響を受けるのは、Node.js 20を指定している新規デプロイメントだ。既にデプロイ済みのサーバーレス関数は、その後も問題なく動作し続ける。
上図の通り、Node.js 20を指定したプロジェクトは、10月1日を境に新規デプロイができなくなる。Node.js 22または24への移行が必須だ。
なぜNode.js 20は非推奨となるのか
Node.js 20のLTSは2026年4月30日に終了した。LTS終了後は重大な脆弱性が見つかっても公式の修正は行われない。VercelのようなPaaS(サービスとしてのプラットフォーム)がEOLバージョンをサポートし続けることは、プラットフォーム全体のセキュリティリスクを高める。
実際、Node.jsのEOL後も古いバージョンを使い続けると、依存パッケージの互換性問題やパフォーマンス低下にもつながる。Vercelのこの方針は、ユーザーに対して積極的なアップグレードを促すための健全な措置だ。
影響を受けるプロジェクトの確認方法

まず最初に、自分が管理するVercelプロジェクトのうち、どれが今回の非推奨の影響を受けるかを確認する必要がある。Vercel CLIを使えば、コマンド一発で該当プロジェクトの一覧を取得できる。
最新のVercel CLIをインストールし、以下のコマンドを実行するだけだ。
npm i -g vercel@latest
vercel project ls --update-required
このコマンドは、非推奨のNode.jsバージョンをターゲットにしているプロジェクトの一覧を表示する。出力結果にプロジェクトが表示された場合、早急な対応が必要だ。
このフローで影響範囲を可視化できる。チームで複数のプロジェクトを運用している場合、全メンバーがこの確認を共有しておくとスムーズだ。
既存のデプロイメントは安全
ここで一つ重要なポイントがある。2026年10月1日以降も、既にデプロイ済みのサーバーレス関数は影響を受けない。すでに本番環境で稼働している関数への呼び出しは、これまで通り正常に動作する。
非推奨の影響が出るのは、あくまで新しいデプロイメントを作成するときだ。既存の環境が突然停止することはないため、慌てて不完全な状態でアップグレードする必要はない。計画的に移行を進められる。
Node.jsバージョンのアップグレード手順

Node.jsのバージョンを変更する方法は大きく2つある。プロジェクト設定のGUIから変更する方法と、package.jsonのenginesフィールドで指定する方法だ。
package.jsonで指定する場合は、以下のように記述する。
{
  "engines": {
    "node": "24.x"
  }
}
この設定がデプロイ時に読み取られ、Node.js 24が使用される。プロジェクト設定の値よりもpackage.jsonの指定が優先されるため、リポジトリにこの設定を含めておけば、デプロイのたびにGUIで変更する手間が省ける。
また、Vercelの公式ブログでは、コーディングエージェントにアップグレードを依頼する際のプロンプトも紹介されている。
Upgrade this Vercel project from Node.js 20 to 24.
Set the engines field in package.json to { "node": "24.x" },
which overrides the Project Settings version on the next deployment.
Update any Node 20 pins in .nvmrc, .node-version, or CI configs.
Switch the local runtime to Node 24, reinstall dependencies,
run the build and tests, and fix any breaking changes.
After deploying, confirm the version by logging process.version.
このプロンプトをClaudeやChatGPTなどのコーディングエージェントに渡せば、Node.jsバージョンの変更に伴う一連の作業をある程度自動化できる。
上記の対比の通り、コーディングエージェントを活用すれば複数ファイルの一括更新が可能で、変更漏れのリスクを減らせる。
アップグレード時に気をつけるべき破壊的変更
Node.js 20から22、あるいは24へ移行する際、APIの破壊的変更がいくつか存在する。特に注意すべきなのは、以下の点だ。
- 廃止されたAPI(fs.rmdirのコールバック形式など)が完全に削除されている可能性
- ESM(ECMAScript Modules)の取り扱いに関するデフォルト挙動の変更
- ネイティブアドオンのABI互換性(再ビルドが必要になるケース)
- V8エンジンのバージョンアップに伴うパフォーマンス特性の変化
移行前に必ずローカル環境でNode.jsのバージョンを切り替え、依存関係を再インストールした上で、ビルドとテストを実行してほしい。CIパイプラインでNode.jsのマトリクステストを実施している場合は、テスト対象に新しいバージョンを追加しておくと安全だ。
アップグレードが間に合わない場合の緊急回避策

どうしても10月1日までにNode.jsのバージョンアップが完了できないプロジェクトが出てくるかもしれない。大規模なコードベースや、多数の依存パッケージとの互換性確認に時間がかかるケースだ。
そうした状況のために、Vercelはコンテナイメージとしてデプロイする代替手段を用意している。
プロジェクトのルートにDockerfile.vercelを作成し、Node.js 20をベースイメージとして指定するだけでよい。
FROM node:20-alpine
WORKDIR /app
COPY . .
RUN npm ci
# サーバーは $PORT をリッスンする必要がある
CMD ["node", "server.js"]
この方法を使えば、プロジェクト設定のNode.jsバージョンはコンテナに適用されない。つまり、プラットフォーム側のNode.js 20非推奨の影響を受けずにデプロイを継続できる。
コンテナデプロイはあくまで一時的な回避策だ。Node.js 20のセキュリティサポートはすでに終了している。長期的に見れば、Node.jsのバージョンアップこそが唯一の正しい解決策である。
この記事のポイント
- Vercelは2026年10月1日にNode.js 20を非推奨とする。既存デプロイメントは影響を受けない
- vercel project ls –update-required で影響を受けるプロジェクトを特定できる
- package.jsonのenginesフィールドでNode.js 22または24を指定して移行する
- コーディングエージェント用のプロンプトを使うと、複数ファイルの一括更新が効率的
- どうしても間に合わない場合はコンテナデプロイ(Dockerfile.vercel)で緊急回避が可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Stripe for WooCommerce決済不備を修正、影響バージョンと更新手順
WooCommerce公式開発ブログが7月14日、決済プラグイン「Stripe for WooCommerce」の重要な修正パッチをリリースした。一部の環境でAdaptive Pricing(適応型価格設定)が有効になっている場合、決済処理中にカートの合計金額と実際の請求額が一致しない可能性があるという決済検証の不具合が確認されたためだ。
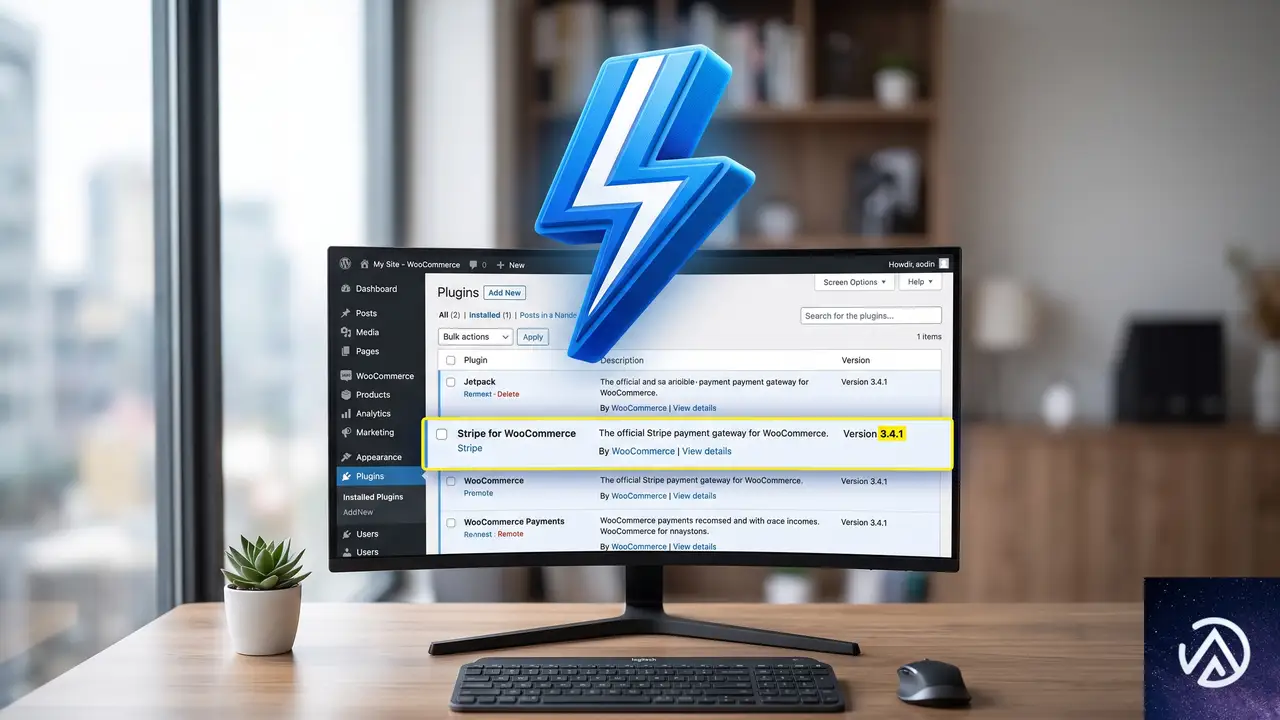
影響を受けるのはバージョン10.6.0から10.8.3。修正バージョンは10.6.2、10.7.1、10.8.4の三系統で提供されている。自動更新が可能なサイトではすでに適用が進んでいるが、手動更新が必要なケースも残っており、運営者はすぐにバージョン確認を進める必要がある。
なぜ今すぐ更新が必要なのか
今回の不具合は、ストアの売上管理や顧客との信頼に直結する重大な問題だ。Adaptive PricingはStripeが提供する機能で、海外顧客向けに現地通貨での価格表示や決済をサポートする。しかし特定条件下で、WooCommerce側で計算された注文金額と、Stripe側で実際に処理される決済金額に差が生じることが判明した。
Adaptive Pricingの簡易的な役割
Adaptive Pricingとは、簡単に言えば「海外ユーザーが自分の通貨で価格を見て、そのまま支払える仕組み」だ。例えば米ドル建ての商品を、日本の顧客が日本円換算でチェックアウトできる。通貨換算レートの自動反映や、支払い手段の最適化も行われるため、越境ECでは非常に便利な機能である。しかしこの換算処理が絡む分、プラグイン内部の金額バリデーションが正しく行われないと、過少請求や過大請求が起こり得る。
具体的に何が問題だったのか
WooCommerce開発ブログのアドバイザリーによると、バリデーションロジックの一部がAdaptive Pricingの有効時に期待どおり動作しないケースが確認された。詳細な技術情報は修正が行き渡るまでは公開されないが、「WooCommerceの注文合計とStripeの処理金額が一致しない」という症状が報告されている。Adaptive Pricingが有効なストアでは、特に10.8.x系で広範に影響が出る可能性があるため、注意が必要だ。
上図は問題の概念を示したイメージである。注文合計と実際の請求額がずれてしまうと、ストア側は過不足金の調整や顧客への説明に追われ、信頼を損ねるリスクがある。このため公式からも即時更新が強く推奨されている。
影響を受ける条件を3点でチェック
すべてのストアが影響を受けるわけではない。以下の3つの条件がすべて重なった場合にのみ、今回の不具合が発生し得る。
バージョン系統ごとの影響度の違い
10.8.x系では、Adaptive Pricingが接続先アカウントに対して幅広く有効化されていたため、最も広範囲に影響が出る。10.7.x系では新規マーチャント向けにAdaptive Pricingが有効にされており、比較的新しく設定したストアがリスクにさらされる。10.6.x系は手動でAdaptive Pricingを有効にした場合に限られる。いずれにせよ、該当するならば速やかな対応が必要だ。
修正バージョンへのアップデート手順
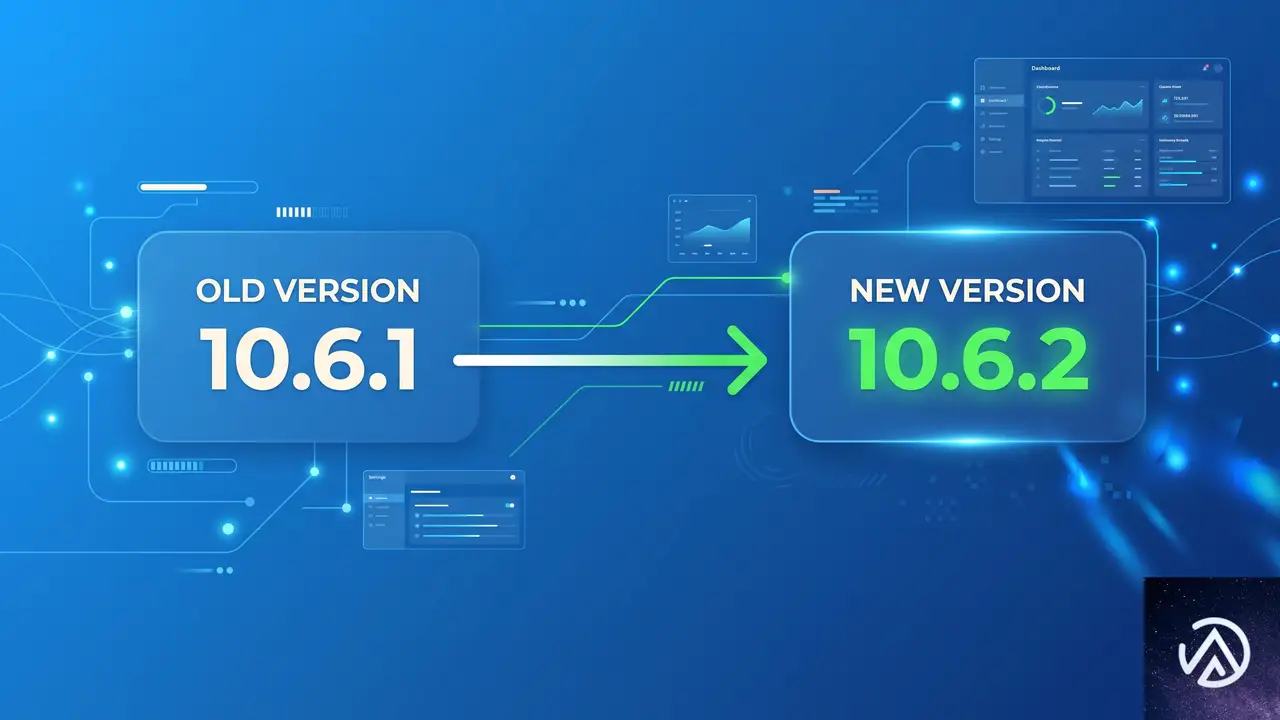
修正パッチは10.6.2、10.7.1、10.8.4として提供されている。以下の対応表に沿って、自分のストアのバージョンを確認し、該当する修正バージョンへ更新しよう。
管理画面からの手動更新方法
自動更新が走っていない、あるいは手動で確認したい場合は、以下の手順でアップデートを実施できる。
- WordPress管理画面の「ダッシュボード」→「更新」へ移動する
- 「Stripe for WooCommerce」または「WooCommerce Stripe Payment Gateway」の更新が表示されたら選択する
- 「今すぐ更新」ボタンをクリックし、完了を待つ
- プラグイン一覧でバージョンが10.6.2、10.7.1、10.8.4のいずれかであることを確認する
すぐに更新できない事情がある場合は、応急処置としてAdaptive Pricingを一時的に無効化することで、不具合の発生を回避できる。ただしこれはあくまで短期的な緩和策であり、根本対応は修正バージョンへのアップデートとなる。無効化後もできるだけ早く更新を済ませることが望ましい。
開発者・代理店・ホスティング事業者が取るべき対応
クライアントのWooCommerceサイトを管理・保守している開発者や代理店、あるいはWooCommerce向けホスティングを提供している事業者は、以下の確認を即座に実施することが推奨される。
- 管理下にある全サイトでStripe for WooCommerceのバージョンを直接確認する
- 特にAdaptive Pricingが有効なサイトを優先して修正バージョンへの更新を完了させる
- クライアントへこのアドバイザリーの内容を共有し、状況を説明する
- 更新がすぐに行えない場合は、Adaptive Pricingを一時無効化し、後日必ず更新するスケジュールを組む
- 影響を受けたストアでは、更新後に過去の注文で金額不一致がないか確認する
WooCommerce公式ブログのアドバイザリーでも強調されているが、「マーチャント向けの通知が届くのを待たずに、直接バージョンを確認する」ことが最も安全な対応だ。影響サイトの放置は、金銭的なトラブルだけでなく、顧客からのクレームや返金処理の増加につながる。特に繁忙期や越境ECを積極的に行っているストアでは、早期対応が欠かせない。
発見の経緯と今後の教訓
この問題は、HackerOneを通じてセキュリティ研究者のe0x1337氏から責任ある報告が行われたことで発覚した。WooCommerceチームは直ちに修正パッチを準備し、WordPress.orgプラグインチームと連携して自動更新の展開も進めている。
ストア運営者が学ぶべきこと
今回の事例は、決済プラグインの更新管理の重要性を改めて示している。Adaptive Pricingのような高度な機能はビジネス拡大に貢献する一方で、内部ロジックが複雑化する分、不具合が紛れ込む余地も生まれる。以下のポイントを日常的に意識することで、類似リスクを減らせる。
- WooCommerceおよび関連プラグインの自動更新を可能な限り有効にしておく
- 週次など定期的に管理画面の「更新」セクションをチェックする習慣をつける
- 決済系プラグインの変更履歴(Changelog)やセキュリティアドバイザリーをウォッチする
- テスト環境(ステージング)で決済フローを定期的に動作確認する
- 不審な金額の注文や顧客からの問い合わせがあった場合、プラグインのバージョンと設定を真っ先に疑う
WooCommerceコミュニティの迅速な対応により、今回の不具合は大事に至る前に修正パッチが提供された。しかし、プラグインを更新しなければリスクは残る。自分のストアが該当するかどうかを今一度確認し、必要なアクションを取ることが、安全なオンラインビジネスの継続につながる。
この記事のポイント
- Stripe for WooCommerce 10.6.0〜10.8.3でAdaptive Pricing有効時に決済金額不一致の不具合
- 修正バージョンは10.6.2、10.7.1、10.8.4。即時更新が強く推奨される
- 自動更新が走っていない場合は管理画面の「更新」から手動でアップデート
- 開発者や代理店はクライアントサイトのバージョン確認と優先更新が必要
- 影響を防ぐ一時策としてAdaptive Pricingの無効化も可能だが、根本解決には更新が不可欠
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験