


Nuxt 4.5リリース、Vite 8とRspack 2でビルド基盤を刷新
Nuxt 4.5の全体像とNuxt 5への布石

2026年7月18日、Vue.jsベースのフルスタックフレームワーク「Nuxt」の最新メジャーアップデート、バージョン4.5が公開された。今回のリリースは、ビルド基盤の刷新から実験的なSSRストリーミング、新たなコンポーザブルや安定したエラーコードシステムの導入に至るまで、多岐にわたる変更を含む大規模なものだ。同時に、次のメジャーバージョンであるNuxt 5に向けた内部的な準備が大きく進んだ節目でもある。
Nuxtチームの声明によれば、本リリースの大きな柱は3つある。Vite 8への移行、Rspack 2とRsbuildによるビルダーの再構築、そして実験的機能として提供されるSSRストリーミングだ。これらはいずれも開発体験と本番環境のパフォーマンスに直結するテーマであり、エンジニアにとっては見逃せないポイントが詰まっている。また、Nuxt 3系の最終ラインとなるv3.21.9も同時にリリースされ、3系ユーザーはv4への移行が推奨される状況となった。
上図のように、Nuxt 4.5は過去と未来をつなぐ架け橋の役割を担っている。3系から4系への移行は比較的スムーズだったとの声が多く、公式のアップグレードガイドも継続的にメンテナンスされている。v4.5で入った基盤変更の多くは「将来のv5への移行をできるだけ退屈にする」ための仕込みだ。チームは今後、Nuxt 5の安定化と互換性ユーティリティの作成に注力する方針を示している。
ビルド基盤の刷新 〜 Vite 8 と Rspack 2 + Rsbuild

Vite 8 への移行と開発体験の向上
Nuxt 4.5の内部では、ビルドツールがVite 8に引き上げられた。Vite 8はRolldownを採用した次世代の内部アーキテクチャを持ち、コールドスタートの高速化やHMR(Hot Module Replacement)の安定性向上が図られている。Nuxtブログの記事によれば、多くのアプリケーションにとってこのアップグレードは透過的であり、特別な設定変更なしに恩恵を受けられるという。
とはいえ、独自のViteプラグインやvite.configに手を加えているプロジェクトでは、Viteの移行ガイドを確認したほうが安全だ。エコシステム内のプラグインの中には特定のViteバージョンに依存しているものもあるため、本番環境に適用する前に互換性を検証することが推奨される。
Rspack 2 と Rsbuild ベースの新ビルダー
Rspackビルダーを利用しているプロジェクトにとっては、今回の変更はより大きな意味を持つ。Nuxt 4.5ではRust製バンドラであるRspackがバージョン2にアップデートされ、さらにそのビルダーはRsbuild(Rspackをラップする高レベルツール)を基盤とする形に再構築された。
パブリックなインターフェースは変わらず、従来通り builder:'rspack' の設定で利用できる。内部では、開発サーバーがRsbuildのミドルウェアモードで動作するようになり、webpack-dev-middlewareやwebpack-hot-middlewareが置き換えられた。また、SSR時のスコープ付きスタイルIDや厳密なESM解決のためにRspack専用のVueローダーが新たに導入されている。
この変更により、ビルド時間の短縮や開発サーバーの応答性向上が期待できる。Nuxtブログの記事では「内部的には全面的にRsbuildに移行したが、外部からはほとんど意識させない」と説明されており、アップグレード時の学習コストは低く抑えられている。
実験的SSRストリーミングで変わる初期表示速度

Nuxt 4.5で導入された実験的機能の中でも、特に注目度が高いのがSSRストリーミングだ。これは従来のサーバーサイドレンダリング(SSR)の常識を覆し、First Contentful Paint(FCP)やTime to First Byte(TTFB)を大幅に改善する可能性を秘めている。
従来のSSRとの違い
これまでのNuxtのSSRでは、サーバー側でページ全体のレンダリングが完了するまでHTMLのバッファリングを行い、完成したレスポンスを一括でクライアントに送信していた。これに対し、SSRストリーミングでは、HTMLの骨格部分(head要素、スタイル、プリロードヒント、エントリースクリプト)を直ちにフラッシュし、その後Vueがボディをレンダリングしながらストリームで送り出す仕組みになっている。
ブラウザはhead部分を受け取った時点でCSSやフォントのダウンロードを開始できるため、ユーザーは白い画面を待たされる時間が減る。特にヒーローイメージや重いスクリプトを次のページでプリロードしたいケースでは、その効果が顕著になるだろう。
クローラー対応と注意点
検索エンジンのボットに対しては、SSRストリーミングが自動的に無効化され、従来通り完全にレンダリングされたHTMLが返される。ユーザーエージェントの正規表現でカスタマイズも可能で、特定のルートだけストリーミングを無効にすることもできる。
ただし、ストリーミングを有効にする前に理解しておくべき制約が1つある。ストリーミングではHTTPステータスコードやヘッダーが最初のバイトで確定するため、レンダリング中にレスポンスを変更する処理(例えばsetup内でのsetResponseStatusやミドルウェアでのCookie書き込み)はクライアントに届かなくなる。Nuxtはリダイレクトやキャッシュルールなど、よくあるケースについては自動的にバッファリングレンダラーにフォールバックする仕組みを備えている。開発時には、ドロップされたミューテーションを警告で通知してくれるため、予期せぬ不具合に気づきやすい。
安定したエラーコードと新しいコンポーザブル

Nuxt 4.5では開発者体験を向上させる構文やユーティリティが複数追加された。その中でも、全開発者に影響がある安定したエラーコードシステムと、実務で即戦力となる新コンポーザブルについて解説する。
nostics ベースの安定エラーコード
Nuxtは今回、nosticsという仕組みを採用し、ビルド時や実行時の警告・エラーに「NUXT_E1001」のような不変のコードを付与するようになった。各コードには、なぜそれが発生したのかの説明と具体的な修正案がインラインで表示される。さらに、1行では説明しきれないエラーは専用のドキュメントページにリンクされる。
たとえば「コンポーザブルがNuxtコンテキスト外で呼ばれた」という古くからのエラーは、NUXT_E1001としてコード化され、runWithContext()の使い方まで含めた解説ページが用意された。本番ビルドでは冗長なテキストが削除され、コードだけが残るため、バンドルサイズへの影響も最小限に抑えられている。
この仕組みは、エラーの切り分けやチーム内での情報共有を格段に容易にする。Nuxtブログの記事では「この基盤の上に、さらに優れたエラーメッセージを積み重ねていく」と述べられており、今後のリリースでも拡充が続く見込みだ。
useLayout コンポーザブルと名前付きビュー
新たに追加された useLayout コンポーザブルは、現在のルートに解決されたレイアウト名をリアクティブに取得できる。これまではコンポーネント内から「このページはどのレイアウトを使っているか」をクリーンに知る手段がなく、工夫が必要だった。useLayoutは読み取り専用のcomputed refを返すため、ナビゲーションに応じて自動的に値が更新される。
さらに、名前付きビュー(Named Views)のサポートも公式に組み込まれた。親ページが複数の <NuxtPage> アウトレットをレンダリングする場合、ファイル名に 名前@ビュー名.vue の規約を使うことで、各アウトレットに対応するページコンポーネントを配置できる。これはVue Routerでは以前から可能だった機能を、Nuxtのファイルベースルーティングに統合したものだ。
useFetch / useAsyncData の enabled オプション
データフェッチの制御が柔軟になったのも地味に嬉しいポイントだ。useFetchやuseAsyncDataに enabled オプションが追加され、条件を満たすまでリクエストをブロックできるようになった。enabledがfalseの間は、初回フェッチも手動のexecute/refreshも、ウォッチャーによるトリガーもすべて抑制される。trueからfalseに変わった場合は実行中のリクエストがキャンセルされ、既存のdataは維持されるため、UIの一貫性を保ちやすい。
Nuxtブログの記事では、検索窓の入力が2文字を超えるまでAPIを叩かない、というユースケースが例示されている。依存関係の多いクエリや条件付きのデータ取得が必要な画面で、コードをシンプルに保てるだろう。
パフォーマンス改善とアップグレード時の注意点

Nuxt 4.5では、上記の主要機能に加えて、開発サーバーの起動高速化や本番ビルドのスリム化といったパフォーマンス改善も多数盛り込まれている。たとえば、NuxtがViteのファイルウォッチャーを共有する「共有ウォッチャー」モードは、メモリ使用量とファイルハンドル数を削減し、大規模プロジェクトでの起動時間を短縮する。この機能は将来のデフォルトだが、今すぐ experimental.watcher:'builder' で試すことができる。
また、プロダクションビルドでは、アイランド(Islands)を使用しない場合にアイランドレンダラーのチャンクが丸ごと省略されるなど、不要なコードの除去も進んだ。これらは設定不要で自動的に適用される。
アップグレード前に確認すべきポイント
今回のリリースはメジャーな依存関係のアップグレードを3つ含んでいるため、アップグレード時にはいくつか注意点がある。Nuxtチームが推奨するアップグレードコマンドは npx nuxt upgrade --dedupe で、ロックファイルの重複を整理しつつ、関連するunjsエコシステムのパッケージもまとめて更新できる。
- Vite 8:カスタムViteプラグインやvite.configの特殊設定がある場合、Viteの移行ガイドを事前に確認する
- Rspack 2:builder: ‘rspack’ を使用中の場合、内部がRsbuildベースに切り替わっているため、独自のRspack設定を見直す必要があるかもしれない
- unhead v3:useHeadの型が厳格化され、v2で許容されていた一部のコードが型エラーになる可能性がある。ただしランタイム動作は幅広く互換性が保たれている
これらの確認を経れば、多くのプロジェクトはスムーズに移行できるだろう。Nuxtブログの記事でも「大半のアプリでは透過的なアップグレードになる」とされており、恐れるほどの破壊的変更は限定的だ。
この記事のポイント
- Nuxt 4.5はVite 8、Rspack 2 + Rsbuildへの移行によりビルドパフォーマンスが底上げされた。v5への布石として内部基盤の刷新が進んでいる
- 実験的SSRストリーミングを有効にすると、HTMLシェルを先に送信しTTFBを改善できる。クローラーには自動で従来のSSRが提供される
- 安定エラーコードシステムにより、エラーの原因と修正法がコードベースで即座に把握可能になり、開発生産性が向上する
- useLayout、名前付きビュー、enabledオプションなど、実務ですぐ使える新構文が追加された
- アップグレード時はVite 8、Rspack 2、unhead v3の3点を中心に互換性を確認すれば、多くのプロジェクトはスムーズに移行できる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WordPress 7.0.2リリース、SQLインジェクションとRCEの深刻な脆弱性を修正
WordPress 7.0.2が2026年7月17日にリリースされた。今回のアップデートは深刻度「クリティカル」1件と「高」1件、計2件のセキュリティ脆弱性を修正する緊急リリースだ。
対象となる脆弱性は悪用されればサイトの完全掌握につながる可能性がある。WordPress.orgは影響を受ける全サイトに対し、自動更新システムを通じた強制アップデートを有効化した。手動更新も含め、即座の対応が強く推奨される。
この記事では脆弱性の詳細、影響を受けるバージョン、具体的な更新手順を整理する。サイト管理者はまず自サイトのバージョンを確認し、該当する場合は今すぐアップデートを実行してほしい。
修正された2件の脆弱性の概要

WordPress 7.0.2では、SQLインジェクションとREST API経由のリモートコード実行(RCE)という2件の深刻な問題が修正された。いずれも攻撃者にサイトの内部データへの不正アクセスや、サーバー上での任意コード実行を許す可能性がある。
SQLインジェクションの脆弱性
1件目はSQLインジェクションの脆弱性だ。SQLインジェクションとは、Webアプリケーションがデータベースに送るSQL文(問い合わせ命令)に、攻撃者が不正な文字列を紛れ込ませる攻撃手法を指す。これが成功すると、データベース内の情報を盗み見られたり、データを改ざんされたりする。
今回の脆弱性はTF1T、dtro、haongoの3名によるチーム報告で発見された。WordPressの内部処理で、特定の条件下においてSQLクエリが適切にサニタイズ(無害化)されず、攻撃者が細工した入力を通じてデータベース操作を実行できる状態になっていた。
上の図は、修正前後での入力処理の違いを示している。修正前は攻撃者の細工した文字列がそのままSQL文に渡っていたが、修正後はエスケープ処理によって危険な文字が無害化される。
REST API経由のRCE脆弱性
2件目はさらに深刻だ。REST APIのバッチルートの混乱とSQLインジェクションが組み合わさり、リモートコード実行(RCE)に至る脆弱性である。RCEとは、攻撃者が遠隔からサーバー上で任意のプログラムコードを実行できる状態を指す。サイトの完全な乗っ取りが可能になる、最悪のシナリオだ。
REST APIとは、WordPressが外部アプリケーションとのデータ送受信に使うインターフェースである。バッチルートは複数のAPIリクエストを1回でまとめて処理する仕組みで、ここにリクエスト経路の混乱(どのエンドポイントが処理すべきかの取り違え)が発生していた。
この脆弱性はAssetnote / Searchlight Cyber所属のAdam Kues氏によって報告された。REST APIのバッチ処理で生じる経路混乱を起点にSQLインジェクションを発生させ、最終的にサーバー上でのコード実行につなげる攻撃チェーンが成立していた。
この攻撃チェーンは多段階で構成される。REST APIのバッチ処理を入り口に、経路混乱→SQLインジェクション→RCEという流れでサーバーへの侵入を許していた。7.0.2では各段階の根本原因が修正されている。
影響を受けるバージョンとバックポート

WordPress 7.0.2のリリースと同時に、複数の旧バージョン向けバックポート(修正の遡及適用)も公開されている。現在運用中のサイトがどのバージョンに該当するか、以下の一覧で確認してほしい。
6.8系はREST API経由のRCE脆弱性の影響を受けない点が救いだが、SQLインジェクションのリスクは残る。6.8.6への更新は必須だ。6.9系と7.0系、および7.1ベータは両方の脆弱性の影響を受けるため、対応バージョンへの即時更新が求められる。
今すぐ実行すべきアップデート手順

WordPress 7.0.2はセキュリティリリースのため、WordPress.orgが自動更新システムを通じた強制アップデートを有効化している。自動バックグラウンド更新に対応しているサイトでは、すでに更新が始まっているはずだ。
管理画面からの手動更新
自動更新が動作していない環境や、今すぐ手動で更新したい場合は以下の手順で対応する。
上記の手順で数分以内に更新は完了する。更新後はサイトの表示や主要機能が正常に動作することを必ず確認してほしい。プラグインとの互換性問題が発生した場合は、プラグイン側のアップデート有無も合わせてチェックするとよい。
手動ダウンロードとFTP更新
何らかの理由で管理画面から更新できない場合は、WordPress.orgからZIPファイルを直接ダウンロードし、FTP/SFTPでサーバーにアップロードする方法もある。この方法はファイルの上書きミスによるサイト停止リスクを伴うため、可能な限り管理画面からの更新を推奨する。
セキュリティリリースの背景と教訓

今回の2件の脆弱性に共通するのは入力値の検証不足とAPIエンドポイントの経路管理の不備である。いずれもWebアプリケーション全般に共通する古典的な脆弱性パターンだが、WordPressほどの巨大プロジェクトでも発生しうるという事実は重い。
REST APIのセキュリティと運用上の注意
REST APIはWordPress 4.7で導入されて以来、外部サービス連携やヘッドレスCMS構成に不可欠な存在となっている。一方で、APIエンドポイントが増えるほど攻撃対象領域(アタックサーフェス)も広がる。今回のバッチルート問題は、複雑なAPI設計に潜むリスクを浮き彫りにした。
サイト管理者として取れる対策は限られているが、最低限以下の運用を徹底したい。
- WordPress本体および全プラグインを常に最新バージョンに保つ
- 使用していないREST APIエンドポイントは必要に応じて無効化する
- WAF(Webアプリケーションファイアウォール)の導入を検討する
- 定期的なセキュリティ監査とログ監視を実施する
WordPress.orgの強制自動更新は両刃の剣
今回、WordPress.orgは深刻度の高さを理由に強制自動更新を有効化した。この判断は「脆弱性が悪用される前に全サイトを保護する」という観点では合理的だが、自動更新によってサイトが意図せず停止するリスクもゼロではない。
特にカスタム開発の多いサイトや、互換性テストを経ていないプラグインを多数導入している環境では、更新後の動作確認が必須だ。自動更新はセキュリティ上の「最後の砦」として機能するが、日頃から更新適用前のテスト環境を用意しておくことが理想である。
この記事のポイント
- WordPress 7.0.2は深刻度「クリティカル」と「高」の脆弱性2件を修正する緊急セキュリティリリース
- SQLインジェクションとREST API経由のRCEが修正対象。悪用されればサイトの完全掌握が可能
- WordPress 6.8〜7.1 Beta 1が影響を受ける。各バージョン向けのバックポートが同時公開された
- WordPress.orgが強制自動更新を有効化済み。手動更新は管理画面の「更新」から即座に実行できる
- 更新前のバックアップ取得と更新後の動作確認は必須。日頃からのテスト環境整備が被害を防ぐ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Booking Calendar更新後にサイトが壊れた時の原因と直し方
Booking Calendar プラグインを 11.4.1 から 11.4.2 へ更新した直後にサイトが壊れた場合、無料版(Booking Calendar)と有料版(Booking Calendar Pro または Booking Manager)のバージョン不一致が主要因だ。手動で両方を同一の最新バージョンに揃え、かつ Pro 版のライセンスを再適用すれば復旧できる。
なぜバージョン 11.4.2 への更新でサイトが壊れたのか
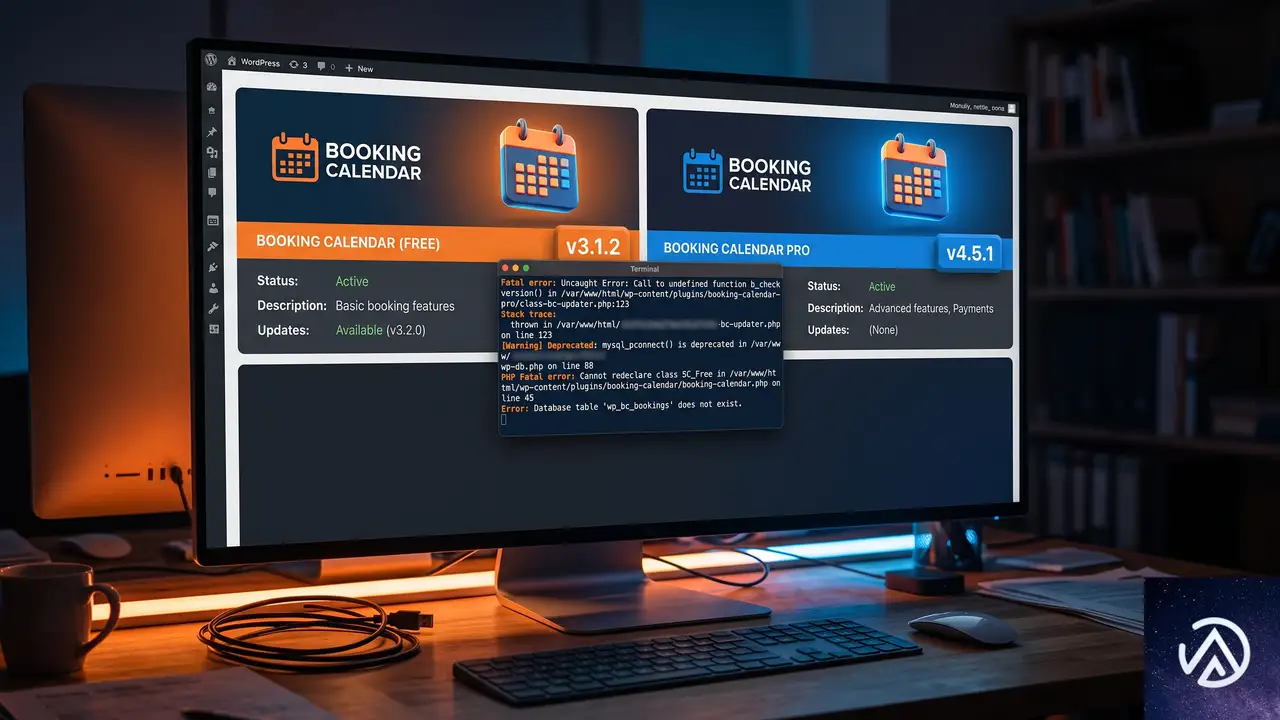
Booking Calendar は無料版(WordPress.org 配布)と、追加機能を提供する Pro 版(開発元サイトで購入)が連携して動作する設計になっている。無料版は管理画面の「プラグイン」から自動更新される一方、Pro 版は手動で更新する必要がある。両者のバージョンが食い違うと、共有する関数やデータベース構造に不整合が生じ、PHP の致命的エラーを引き起こして画面が表示されなくなる。
とくに 11.4.2 では内部 API の変更が加えられており、Pro 版が旧バージョンのまま無料版だけを更新すると競合が起きやすい。この状態で WordPress の「このサイトで重大なエラーが発生しました」というメッセージが表示されたり、管理画面にアクセスできなくなったりする。
サイトを元に戻す具体的な手順
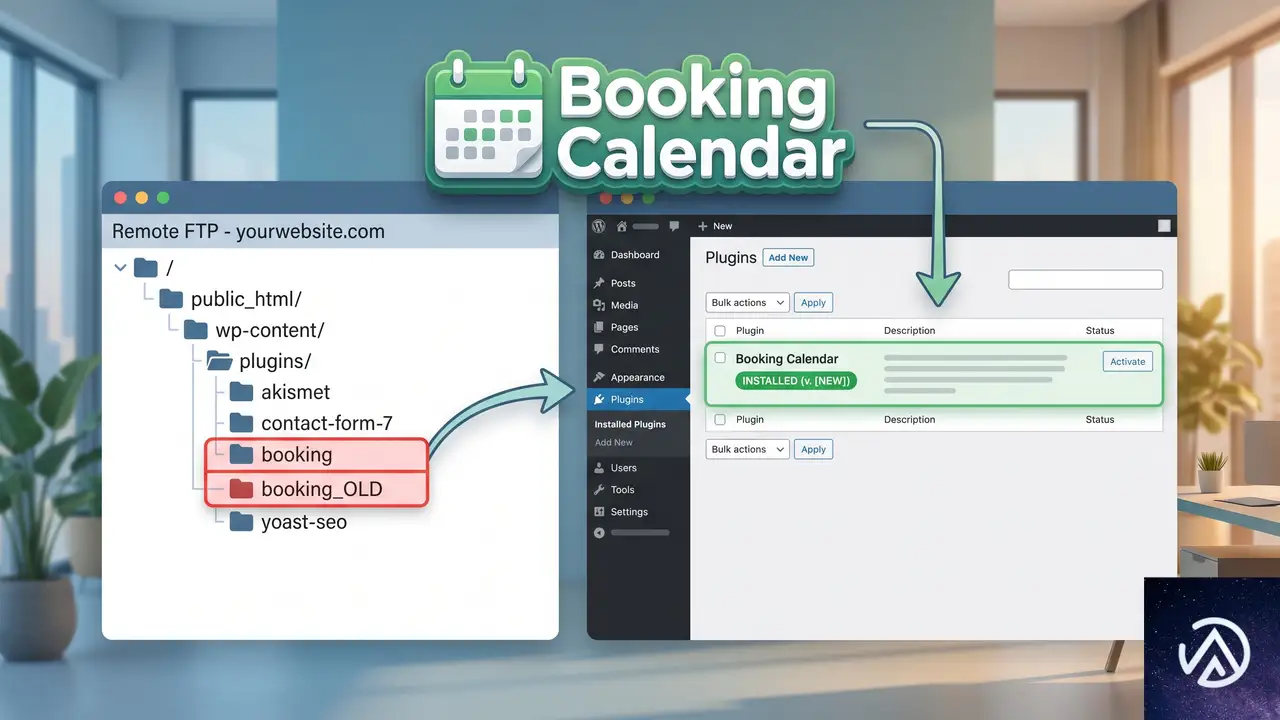
以下の手順で、無料版と Pro 版を安全に最新へ揃える。作業前に必ずサイト全体のバックアップを取得しておく。
/wp-content/plugins/ にアクセスするbooking → booking_old)プラグインフォルダを特定して無効化する
サイトが壊れて管理画面に入れない場合は、FTP(File Transfer Protocol)クライアントやレンタルサーバーのファイルマネージャを使う。/wp-content/plugins/ ディレクトリ内に、無料版(通常は booking または booking-calendar)と Pro 版(booking-calendar-pro や wpdev-booking など)のフォルダが存在する。両方をリネームすれば、WordPress はプラグインを強制的に無効化し、サイトが最低限の状態で表示されるようになる。リネーム後のフォルダ名は削除せず控えておく。
無料版を最新にして Pro 版を再適用する
管理画面にアクセスできる状態になったら、プラグイン一覧画面で一度 Booking Calendar を削除する。削除しても予約データはデータベースに保持されるため、消えることはない。その後「新規追加」から再度 Booking Calendar 11.4.2 をインストールし有効化する。
続いて開発元サイト(wpbookingcalendar.com)のアカウントページから、無料版と同一バージョン(11.4.2)に対応した Pro 版の ZIP ファイルをダウンロードする。管理画面の「プラグイン」→「新規追加」→「プラグインのアップロード」から ZIP を投入し、有効化後にライセンスキーを入力すれば復旧が完了する。Pro 版の最新ファイルが入手できない場合は、開発元のサポートへ直接更新ファイルを依頼する。
どうしても復旧できない場合の最終手段
Pro 版の最新 ZIP が手元になく、サイトのダウンタイムが許容できない状況では、無料版を旧バージョン(11.4.1)にダウングレードする選択肢もある。WordPress.org のプラグインページにある「以前のバージョン」から 11.4.1 の ZIP を入手し、FTP で手動上書きすれば以前の動作に戻せる。ただしセキュリティ修正が含まれている可能性があるため、この状態は恒久的な対策にはならず、早期に Pro 版を最新化する必要がある。
再発を防ぐための運用ルール
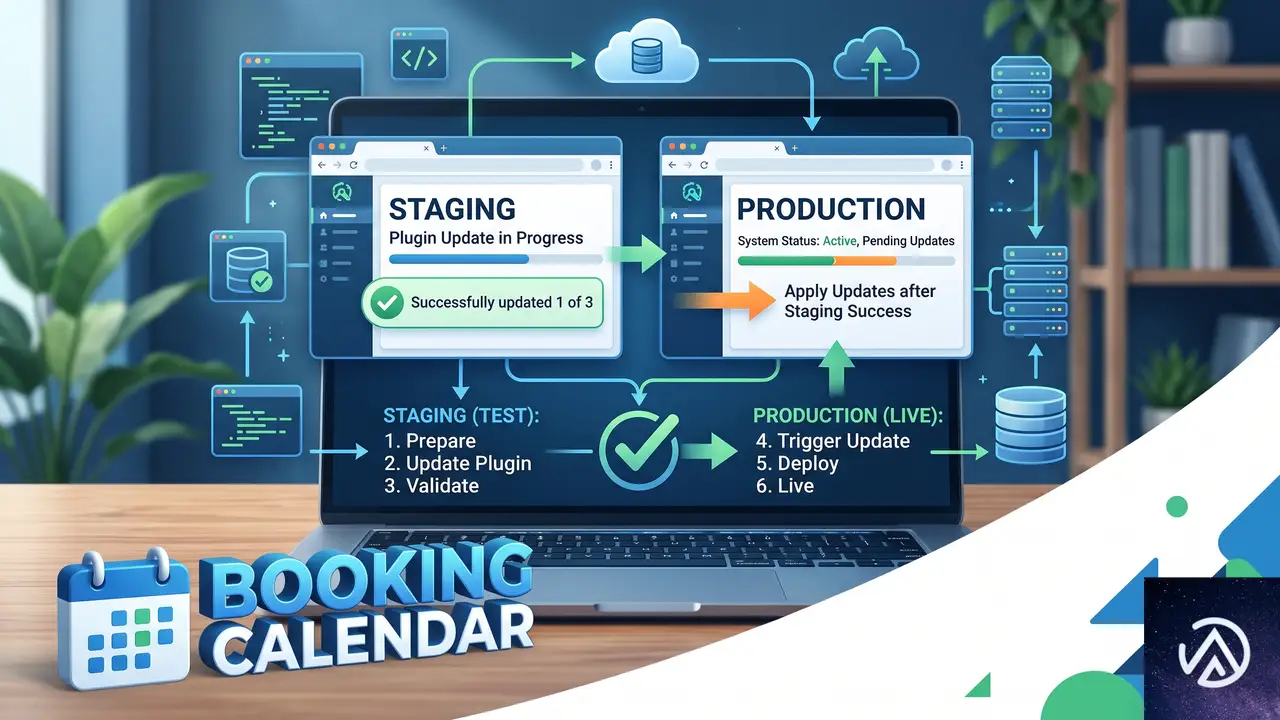
Booking Calendar のように無料版と有料版が連動するプラグインは、無料版の自動更新をオフにするか、更新前に必ず Pro 版の対応バージョンがリリースされているかを確認する習慣をつける。開発元のチェンジログやメーリングリストを購読しておくと、更新のタイミングを逃さない。
また本番環境に直接適用する前に、ステージング環境(本番と同一構成のテストサイト)で無料版と Pro 版の同時更新を試すのが最も確実な予防策になる。レンタルサーバーのステージング機能を使うか、WP Staging のようなプラグインで簡易的なテスト環境を用意できる。
よくある質問
Pro 版の最新ファイルがアカウントページに見当たらない場合はどうすればよいか
開発元の公式サイトにある問い合わせフォームまたはサポートチケットから、Pro 版の最新 ZIP ファイルを直接依頼する。購入時のメールアドレスやライセンスキーを記載すれば、通常は数営業日以内にダウンロードリンクが提供される。
フォルダをリネームしたがサイトがまだ壊れている
キャッシュ系プラグインや CDN(コンテンツデリバリネットワーク / 配信網)が古いエラー画面を配信し続けている可能性がある。サーバー側のキャッシュをすべてクリアし、ブラウザのシークレットモードで確認する。また wp-content/mu-plugins/ に手動で入れたファイルが競合していないかも調べる。
ライセンスキーを入力しても Pro 版の機能が有効にならない
ライセンスキーが旧バージョン向けのまま失効している可能性がある。開発元のマイページでキーを再発行するか、サポートにキーのリセットを依頼する。ドメインを変更した場合もライセンスの再割り当てが必要になる場合がある。
この記事のポイント
- Booking Calendar 11.4.1 から 11.4.2 への更新障害は無料版と Pro 版のバージョン競合が原因
- FTP で両方のプラグインフォルダをリネームし強制無効化して管理画面へ復帰
- 無料版は削除後に 11.4.2 を再インストール、Pro 版は開発元から同一バージョンを入手
- Pro 版がすぐ用意できない場合は無料版のみ旧バージョン 11.4.1 に戻す応急処置も可能
- 再発防止には無料版の自動更新を止め、Pro 版のリリース確認後に揃えて更新する

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

WordPressをサブフォルダにインストールするとREST APIが404になる原因と直し方
WordPressをサブフォルダにインストールしている環境で、REST APIのエンドポイントが404エラーを返す場合は、プラグインがサブフォルダを考慮せずにAPIのURLを生成しているバグが原因だ。該当プラグインを最新版に更新するか、パーマリンク設定のリフレッシュで解決する。
なぜサブフォルダ環境でプラグインのAPIが404になるのか

WordPressをドキュメントルート直下ではなく/blogや/siteのようなサブフォルダにインストールした場合、REST APIのベースURLはhttps://example.com/subfolder/wp-json/となる必要がある。ところが一部のプラグインは、内部でAPIのURLを組み立てる際にこのサブフォルダを考慮しておらず、https://example.com/wp-json/...のようにルート直下を指してしまう。その結果、実在しないパスへのリクエストとなり404が返る。
今回のケースでは、プラグインが独自に追加したエンドポイント/profeedwp/v1/linkedin/company-posts/smartに対して、サブフォルダを含まない不完全なURLでリクエストを発行していた。同様の問題は、テーマや他のプラグインがrest_url()関数を正しく使わずにハードコードしたパスを参照している場合にも起こる。
解決手順

まず簡単かつ即効性のある方法として、問題のプラグインを最新版へ更新する。次に、WordPressのパーマリンク設定をリセットし、REST APIのルートURLが正しく再構築されるか確認する。これで直らない場合は、手動でrest_url()が返す値を検証し、他のプラグインとの競合を調べる。
プラグインを最新版に更新する
本件ではバージョン1.6.10で修正が行われている。管理画面の「プラグイン」→「インストール済みプラグイン」から対象プラグインを確認し、更新が表示されていれば適用する。更新が出ていない場合は、一度プラグインを削除して再インストールするか、開発元の公式ページから修正版がリリースされていないか確認する。
パーマリンク設定をリセットする
プラグインの更新で直らなかった場合、パーマリンク構造の再保存でWordPress内部のルーティングをリフレッシュできる。「設定」→「パーマリンク」を開き、現在選択されている設定をそのままの状態で「変更を保存」をクリックする。これにより.htaccessの再生成と、REST APIのルート定義が再構築される。サブフォルダ環境では特に、リライトルールが正しくサブフォルダをプレフィックスとして含む必要があるため、この一手順で解決するケースが多い。
rest_url() の戻り値を検証する
根本原因がプラグイン側のURL組み立てにあるかどうかを切り分けるには、WordPressが正しいREST APIのルートURLを返しているかを確認する。テーマのfunctions.phpなどに次のようなテストコードを一時的に追加する。
add_action('wp_footer', function() {
    echo '<!-- REST URL: ' . esc_url(rest_url()) . ' -->';
});サイトのフッター部分のHTMLソースに出力されたURLがhttps://example.com/subfolder/wp-json/の形式になっていれば、WordPress本体の認識は正しい。もし/subfolderが欠落している場合は、wp-config.phpでWP_HOMEとWP_SITEURLが正しくサブフォルダを含んだ値で定義されているか確認する。
全プラグインを無効化して競合を切り分ける
それでも404が解消しない場合、別のプラグインがREST APIのルーティングに干渉している可能性がある。すべてのプラグインを一括で無効化し、問題のエンドポイントにアクセスして200番台のレスポンスが返るかテストする。正常動作が確認できたら、プラグインを1つずつ有効化して原因のプラグインを特定する。キャッシュ系プラグインやセキュリティプラグインは、REST APIへのリクエストをブロックしたり、URLを書き換えたりする設定項目を持つことがあるため、該当するプラグインの設定もあわせて確認する。
よくある質問
サブフォルダにインストールする際にwp-config.phpで注意すべき点は?
WP_HOMEとWP_SITEURLの定数をhttps://example.com/subfolderのようにサブフォルダを含めて明示的に定義しておくと、サイトURLの誤認識を防げる。wp-config.phpに記述しなければならないわけではないが、マルチサーバー構成やリバースプロキシの背後で運用する場合は特に有効だ。
REST APIの404エラーはどのようにデバッグすればいいか?
ブラウザのデベロッパーツールのネットワークタブで、実際に送信されたリクエストURLを確認する。サブフォルダが欠落したURLでリクエストが発生している場合は、呼び出し元のJavaScriptファイルやPHPコードでURLの組み立て方をチェックする。rest_url()を使わずにハードコードされたパスが原因であることが多い。
プラグインを更新しても問題が再発する場合は?
修正パッチが適用されたバージョンでも、キャッシュの残存やデータベースに保存された古い設定値が原因で再発することがある。プラグインを完全に削除したあと、wp_optionsテーブルに残っている該当プラグインのオプションを手動で削除し、最新版を再インストールすると改善する場合がある。
サブフォルダ環境でなくてもAPIが404になる原因は?
パーマリンク設定が「基本」になっているとREST APIが動作しない。また、セキュリティプラグインが/wp-json/へのアクセスを制限しているケースもある。.htaccessのリライトルールが破損している場合も404になるため、パーマリンク設定の再保存でリフレッシュするのが初手として有効だ。
この記事のポイント
- サブフォルダ環境でプラグインのAPIが404になるのは、URLにサブフォルダが含まれない不完全なパスが原因
- 問題のプラグインを最新版に更新し、パーマリンク設定を再保存するのが解決の基本手順
- rest_url() の戻り値とwp-config.phpの設定を確認し、WordPress本体のURL認識が正しいか検証する
- 全プラグインの無効化で競合を切り分け、キャッシュやセキュリティ系プラグインの干渉を疑う
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
.ALドメインのDNSSEC障害、CloudflareがEDE 33で透明性を向上
2026年7月3日、アルバニアの国別コードトップレベルドメイン「.AL」でDNSSECの鍵ロールオーバーに失敗する障害が発生した。この影響で、.ALドメインを使用する政府機関や銀行、メディアサイトが一時的にアクセス不能となった。
Cloudflareが運用するパブリックDNSリゾルバ「1.1.1.1」は、この障害に対してネガティブトラストアンカー(NTA)を適用して暫定対応を実施。同時に、新しい拡張DNSエラー(EDE)コード「EDE 33」を初めて導入し、NTAが適用されていることをクライアントに明示した。
この記事では、.AL障害の経緯と、DNS運用におけるNTAの透明性を高めるEDE 33の技術的意義を解説する。TLDレベルのDNSSEC障害がもたらす影響と、再発防止に向けた課題を考察する。
.ALドメインで何が起きたのか
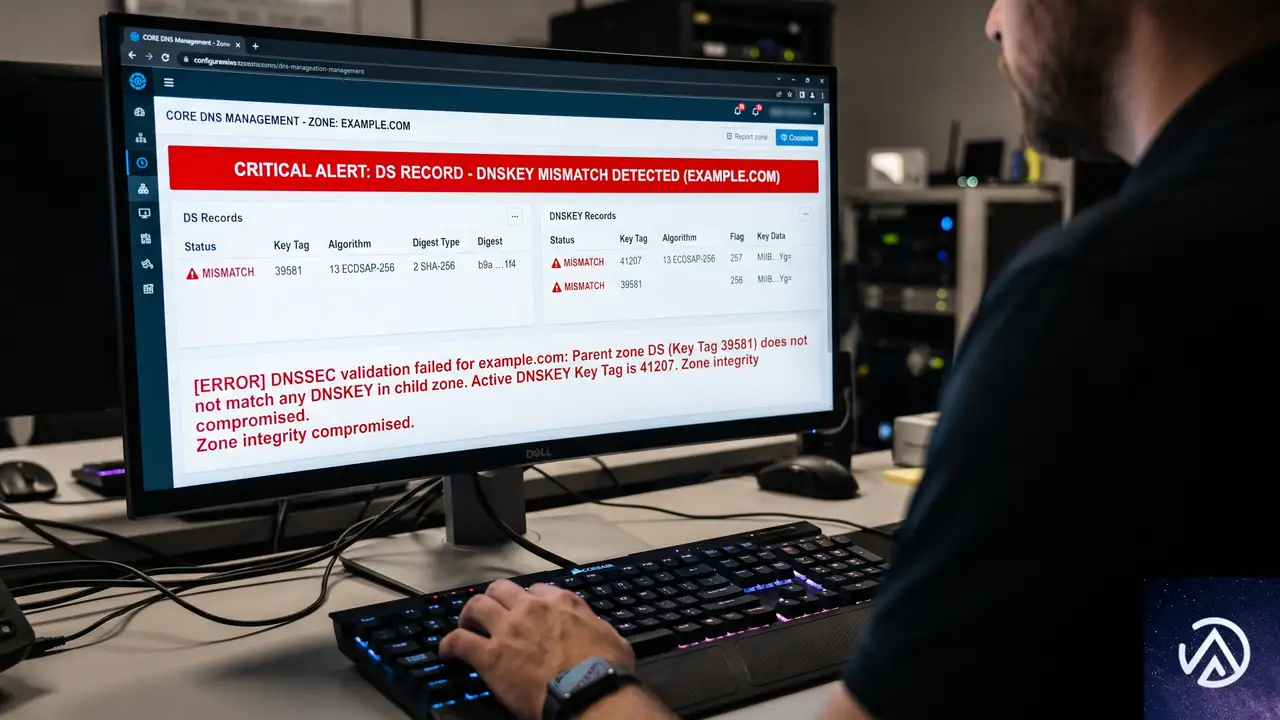
2026年7月3日14時15分(UTC)ごろ、アルバニアの通信規制当局AKEPが.AL TLDのDNSSEC鍵を更新しようとした際に設定ミスが発生した。新しいDNSKEYを公開したが、ルートゾーンに登録されていたDSレコードは古い鍵のままであり、DNSSECの信頼チェーンが切断された。
その結果、1.1.1.1を含む世界中の検証対応DNSリゾルバは、.ALドメインのDNS応答を検証エラー(SERVFAIL)として拒否するようになった。障害発生から約3時間後の17時15分、Cloudflareは1.1.1.1に.AL向けのNTAを適用し、検証を一時的にバイパスして名前解決を回復させた。
AKEPはその後、新しいDNSKEYも削除してしまい、ゾーンからDNSKEYが存在しない状態に陥った。最終的に19時15分ごろ、ルートゾーンからDSレコードが削除され、.AL全体がDNSSEC未署名の状態で名前解決が再開された。記事公開現在も、.ALは未署名のままである。
.DEに続くTLD障害の連鎖
この障害は、わずか2ヶ月前にドイツの.DE TLDで発生した同様のDNSSEC障害を想起させる。.DEの事例でも、1.1.1.1はNTAを適用して暫定対処を行い、事業者の対応を待つ形となった。
TLDレベルのDNSSEC障害は頻発するものではないが、一度発生すると配下の全ドメインに影響が波及する。.ALはCloudflare RadarのTLDランキングで191位に位置し、アルバニアの政府サービスや金融機関、報道機関などが集まる重要なドメイン空間だ。
この比較からわかるように、DNSSECの信頼チェーンはルートゾーンのDSレコードとTLDゾーンのDNSKEYが一致して初めて成立する。ロールオーバーの手順を誤ると、連鎖的に全下位ドメインの検証が失敗する仕組みだ。
NTA適用の判断基準
CloudflareはNTAを適用する前に、AKEPへの直接連絡とDNS-OARC Mattermostへの投稿を通じてコミュニティに注意喚起を行った。しかし、AKEPの連絡先アドレス自体が.ALドメインだったため、障害発生中は連絡が取れないという悪循環に陥った。
NTAの適用は、DNSSEC検証を停止するという強い措置だ。Cloudflareの著者によれば、.DEの事例と同様に「障害が公共に確認されており、すべての検証リゾルバに等しく影響する」という点を重視して判断したという。検証を停止しても名前解決を維持する方を優先した格好だ。
NTAの抱える透明性の課題
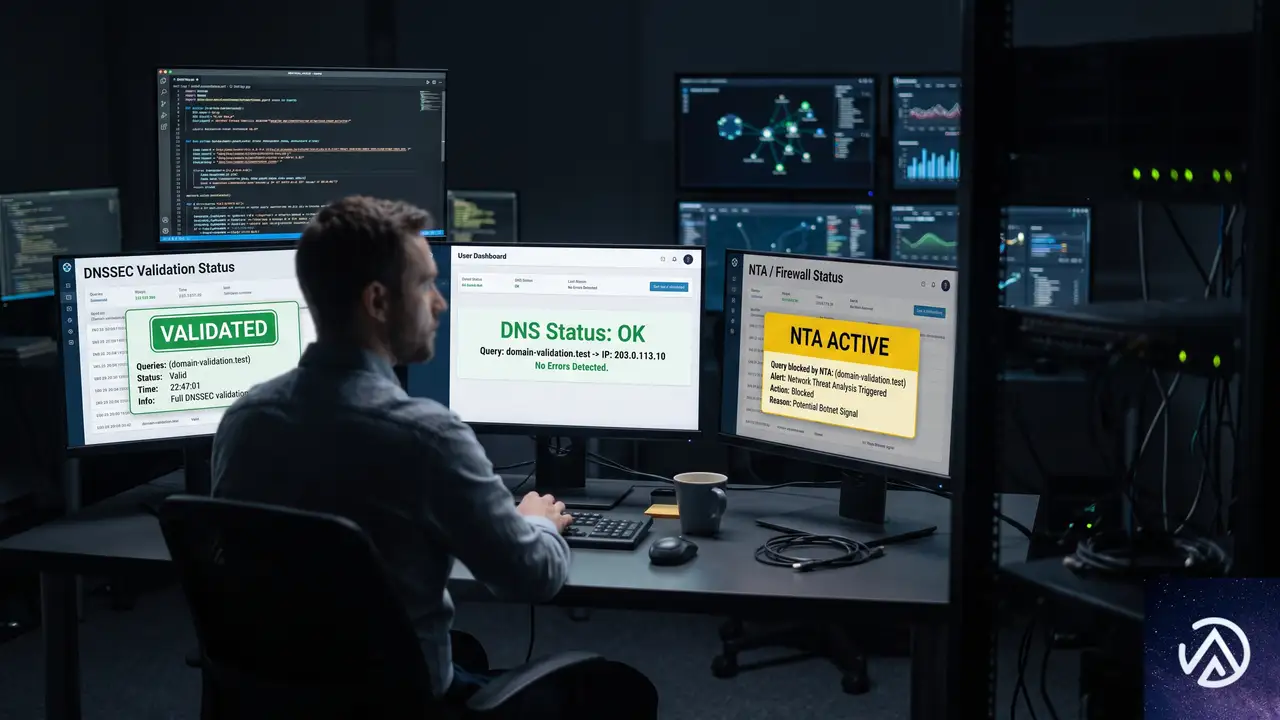
NTAはDNSSECの緊急回避手段として有効だが、一つ大きな欠点がある。それは、クライアント側からNTAの適用を検知できないことだ。NTA配下で返されたDNS応答は、通常の検証済み応答と見分けがつかない。
RFC 7646でもこの問題は認識されており、NTAの適用状況を運用者が公開することが推奨されている。Cloudflareは.DEや.ALの際にステータスページで情報を公開したが、それでも利用者が自発的に確認しなければ気づけない。監視ツールやアプリケーションがDNS応答だけで状況を把握する手段がなかった。
ANSWER: google.al → 142.251.142.196
EDE: 9 (DNSKEY Missing)
EDE: 33 (Negative Trust Anchor)
ANSWER: google.al → 142.251.142.196
● EDE 9で根本的なDNSSECエラーも同時に通知
この「見えないNTA」は、なりすましDNS応答と正当な応答を区別するDNSSECの根幹を揺るがす。NTAが適用されている間、利用者は保護されていない状態で通信していることになるが、それを知る術がなかったのだ。
EDE 33がもたらす透明性
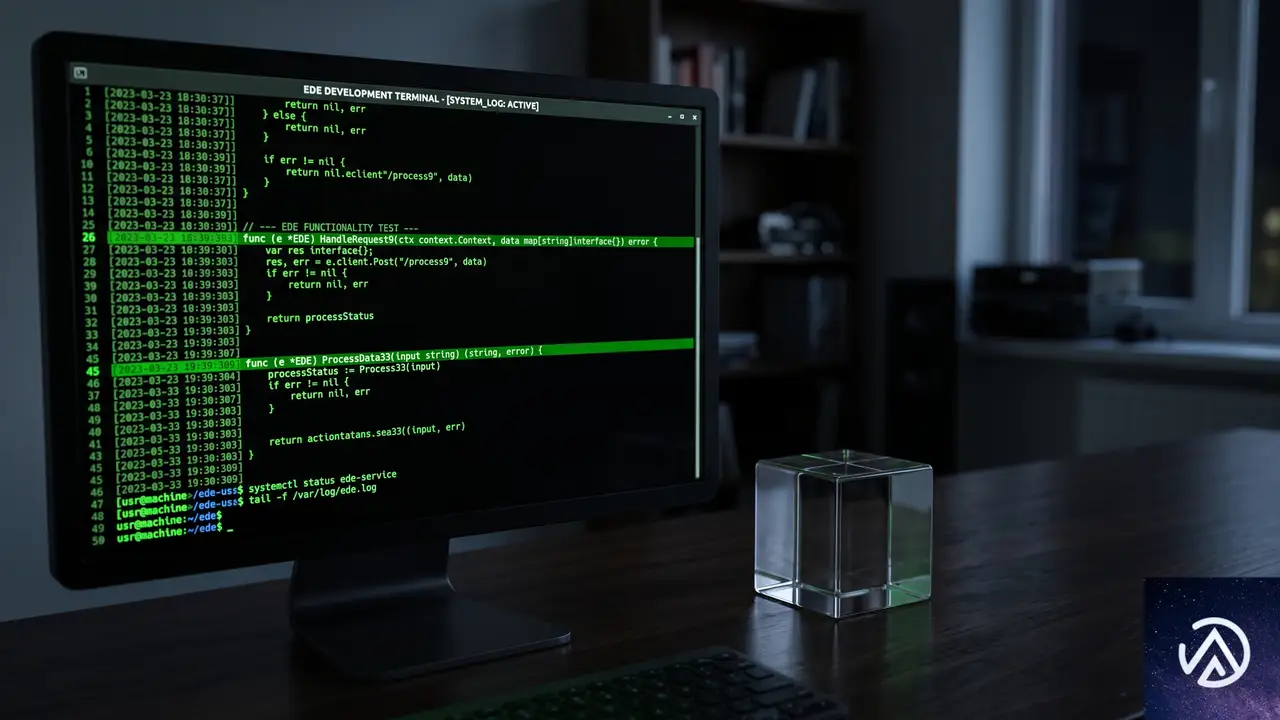
拡張DNSエラー(EDE)コードはRFC 8914で定義されており、DNSリゾルバがエラー時だけでなく成功応答にも追加のコンテキスト情報を付加できる仕組みだ。Quad9のBabak Farrokhi氏が提案し、Cloudflareも共同執筆者として参加したインターネットドラフトで、NTAの適用を示す新しいEDEコード「EDE 33」が定義された。
1.1.1.1は.AL障害において、このEDE 33を初めて実運用に投入した。NTAが適用されている間、.ALドメインへのすべてのDNSクエリに対して、EDE 33が付加された応答が返されている。これにより、クライアントや監視ツールはDNS応答だけで「この応答はDNSSEC未検証である」と判断できるようになった。
EDE 33の実装と応答例
以下は、1.1.1.1にgoogle.alの名前解決を問い合わせた際の応答だ。ステータスはNOERRORで正しい回答が返されているが、2つのEDEコードが付加されている。
$ kdig @1.1.1.1 google.al
;; ->>HEADER<<- opcode: QUERY; status: NOERROR; id: 32848
;; Flags: qr rd ra; QUERY: 1; ANSWER: 1; AUTHORITY: 0; ADDITIONAL: 1

;; EDNS PSEUDOSECTION:
;; Version: 0; flags: ; UDP size: 1232 B; ext-rcode: NOERROR
;; EDE: 9 (DNSKEY Missing): 'no SEP matching the DS found for al.'
;; EDE: 33 (Negative Trust Anchor): 'a Negative Trust Anchor has been applied for this query (see RFC 7646)'

;; ANSWER SECTION:
google.al.              300    IN    A    142.251.142.196
EDE 9(DNSKEY Missing)は、DNSSECの信頼チェーンが切断された根本原因を示している。EDE 33(Negative Trust Anchor)は、1.1.1.1がNTAを適用して応答を返したことを示す。この2つの情報が揃うことで、運用者は「本来は検証エラーになる状況だが、NTAによって暫定的に解決された」という全体像を把握できる。
このフローは、1.1.1.1内部でNTAがどのように処理されるかを示している。EDE 33は、NTAが有効な間、DNSSECを使っていないドメインへのクエリにも付加される。NTAはゾーン全体に適用されるため、透明性もゾーン全体に対して一律に提供される設計だ。
.DE障害で生じた問題も解決
.DE障害の際、1.1.1.1はDNSSECの根本エラーではなく「EDE 22(No Reachable Authority)」を誤って返していた。これは、NTA配下で権威サーバーに到達できない場合に発生するエラーであり、真の原因を隠蔽してしまう問題があった。
.AL障害ではこの点が改善され、EDE 9(DNSKEY Missing)が正しく返されている。EDE 33と組み合わせることで、「なぜ検証に失敗したのか」と「なぜ応答が返されたのか」の両方をクライアントが把握できるようになった。
今後の標準化と運用への影響
EDE 33はIANA(Internet Assigned Numbers Authority)によって正式に割り当てられており、Knot DNSプロジェクトのkdigツールはすでにEDE 33を名前で認識するようになっている。また、Unbound向けのプルリクエストもレビュー段階にある。他のDNSリゾルバ実装も追随することが期待される。
このインターネットドラフトはIETFのDNSOPワーキンググループに提出済みで、2026年7月18日から24日にウィーンで開催されるIETF会合で議論される予定だ。標準化が進めば、EDE 33はすべての主要DNSリゾルバで実装される可能性が高い。
国内DNS運用者への示唆
国内のISPや企業が運用するDNSリゾルバでも、DNSSEC検証を有効にしているケースが増えている。.ALのようなTLDレベルの障害は稀だが、.JPや他のccTLDで発生しないとは限らない。EDE 33に対応したリゾルバ実装を採用することで、障害時の透明性を確保できる。
また、NTAの運用には慎重さが求められる。Cloudflareは.DEと.ALの両方で、コミュニティへの通知後にNTAを適用し、問題解決後に速やかに解除している。このバランス感覚は、他のDNS運用者にとっても参考になる対応だ。
残された課題
記事公開現在、.ALはDNSSEC未署名のままだ。DSレコードがルートゾーンに再登録されない限り、.AL配下のすべてのドメインはDNSSECの保護を受けられない。AKEPがいつ復旧作業を完了させるかは不透明である。
より根本的な問題として、TLD事業者のDNSSEC運用スキル不足が浮き彫りになった。鍵ロールオーバーは手順を誤ると広範囲に影響を及ぼす重要なオペレーションだ。ICANNやレジストリコミュニティによるガイドラインの整備や訓練の機会提供が求められる。
この記事のポイント
- .AL TLDのDNSSEC鍵ロールオーバー失敗により、2026年7月3日に全.ALドメインが一時的に解決不能となった
- Cloudflareの1.1.1.1はNTAを適用して暫定対処を行い、同時に新しいEDEコード「EDE 33」を初めて実運用に投入した
- EDE 33はNTAの適用をDNS応答内で明示し、従来の「見えないNTA」問題を解決する
- .DEに続くTLDレベルのDNSSEC障害は、TLD事業者の運用スキル向上とNTAの標準化の必要性を浮き彫りにした
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

83%の組織がエージェントAI対応にインフラ刷新が必要と回答、Google Cloud調査
Google Cloudが2026年7月に公開した「State of AI Infrastructure」レポートによると、実に83%の組織が「本番レベルのエージェントAIを支えるにはインフラの刷新が不可欠だ」と回答した。この数字はもはや一部の先進企業だけの課題ではなく、業種を問わず広がる構造的な問題を浮き彫りにしている。
本記事では、Google Cloud Blogの調査概要をもとに、エージェントAIが既存のクラウド基盤に与える負荷と、企業が次に打つべきインフラ戦略を解説する。推論コストの急増やエージェントの統制不能、データの断片化、エネルギー制約といったテーマを具体的なデータとともに取り上げる。
推論コストの急増と流動的コンピューティング

推論税の正体
エージェントAIは1回の指示で数百の後続アクションを連鎖的に引き起こす。チャット型AIのように単発で完結する処理とは根本的に負荷の性質が異なる。Google Cloud BlogのDrew Bradstock氏によれば、この連続推論ループがレガシーアーキテクチャに加わる経済的負担を「推論税」と呼んでいる。
調査では62%のリーダーが「データエグレス料金やストレージ肥大化、アイドル状態の専用ハードウェアによって深刻な推論税が発生している」と回答した。81%は運用の複雑さをAIスケーリングの隠れたコストとして挙げている。
上図が示すのは、エージェントAIの負荷特性と基盤の適合性がコストを左右する構図だ。ストレージ肥大化を放置すれば推論税は雪だるま式に膨らみ、競争力を大きく損なう。
TPU 8tとTPU 8iが示す選択肢
規模の大きいトレーニングにはTPU 8t、低レイテンシ推論にはTPU 8iといった具合に、用途に合わせた計算リソースを動的に組み合わせる発想が鍵になる。Google Cloud Blogの記事では、重いトレーニング、リアルタイム推論、オーケストレーションの3層に分けた「流動的コンピュート」が提案されている。
- 大規模学習向け:TPU 8t(第8世代)は第7世代比で約3倍の性能と最大2倍の電力効率を達成。超大規模モデルの学習時間を大幅に短縮する
- 低レイテンシ推論向け:TPU 8iはオンチップメモリを最大化し、リアルタイム応答が求められるエージェントの思考と反応を高速化する
- 制御プレーン向け:ArmベースのGoogle Axion CPUが強化学習シミュレーションやエージェントのオーケストレーションをコスト効率よく実行する
こうした選択肢を使い分けることで、ピーク負荷時だけ専用チップを割り当て、普段は汎用プロセッサに戻すといった柔軟なリソース管理が可能になる。
急拡大するエージェントの統制

エージェントスプロールの現実
エージェントはメールの読み取りからデータベース照会、業務ワークフロー実行まで自律的に動く。組織内で数十、数百のエージェントが稼働し始めると、個別管理が極めて難しくなる。これを業界では「エージェントスプロール(agent sprawl)」と呼び始めており、調査でも79%のリーダーがセキュリティ・ガバナンス・MLOpsを推論スケーリングの最大の課題に挙げている。
上図のように、統制プレーンを導入することで、これまで管理者が人力で追いかけていた権限設定や操作ログが集約され、監査や緊急停止も一元的に実施できる。調査では78%の組織が生成AIソリューションをメインのクラウドパートナーから直接調達しており、この集中傾向は2025年から30ポイント上昇している。
Agent Gatewayが担う役割
Google Cloud Blogで紹介されているAgent Gatewayは、企業向けに設計されたエージェント統制のハブだ。エージェント同士のデータ共有を可視化し、読み取りと書き込みのスコープを細かく設定できる。重要なアクションの前には人間の承認を挟むヒューマンインザループ機能も提供する。
- 全エージェントの認証を統一し、分散ツールをつなぎ合わせる必要がない
- データ共有のログと監査証跡を完全に管理できる
- エージェント単独では実行できない重要操作に対して、人による承認フローを組み込める
スケールする自律エージェント群を安全に運用するうえで、こうした統制基盤はもはやオプションではなく必須のレイヤーになりつつある。
データ基盤の統一

自律型エージェントは推論のたびに組織全体へ重いクエリを発行する。Drew Bradstock氏の指摘では、データがサイロ化して断片化していると「エージェントは事実上、目隠しをされたまま飛んでいる」状態になるという。このため、断片化したデータを単一の文脈で扱える統合データ層の整備が急務とされている。
統合データ層が整うと、エージェントはデータの置き場所を意識せずに検索・推論できる。非構造化データを自動的に構造化するSmart Storageと、マルチクラウド環境を横断するCross-Cloud Lakehouseが、この層を現実のものにしている。
ハイブリッドマルチクラウドとデジタル主権

パブリッククラウドかオンプレミスかという二者択一はすでに終わっている。調査では52%の組織がハイブリッドマルチクラウド構成を採用していた。これは単なるコスト分散ではなく、デジタル主権とデータの重力が強い推進力になっているからだ。
- データ所在地規制への対応:調査参加者の48%が厳格なデータレジデンシー管理を優先事項に挙げている。各国の法改正に即応できる柔軟な配置が求められる
- 完全隔離環境の需要:Google Distributed Cloudのようにパブリッククラウド技術をオフラインで利用できるサービスが、政府機関や金融機関を中心に拡大している
- データ重力の現実:巨大なデータセットは動かすより「その場で処理する」方が現実的で、エッジやオンプレとの組み合わせが不可欠になる
つまり、単一のクラウドに依存する時代は終わり、データの物理的な位置と主権に合わせてAIを走らせる場所を選べるアーキテクチャが標準になりつつある。
エッジでのAI実行が必然になる理由

調査結果の中で特に目を引くのが、90%の組織が「エッジへのAI配置が重要」と回答し、72%は「極めて重要」または「非常に重要」と位置づけた点だ。エージェントAIのリアルタイム性を追求するほど、集中型クラウドだけでは限界が露呈する。
エッジに推論機能を分散させると、クラウド往復のレイテンシが不要になるだけでなく、通信断でも業務が停止しない耐障害性と、トークンあたりの変動費削減を同時に実現できる。製造現場や病院、小売店舗など「止まらない自律処理」が求められる現場にとって、これが決定的な価値になる。
エネルギー壁を突破する設計

91%のリーダーがハードウェア選定時に消費電力を考慮し、61%はそれを「主要または極めて重要な要素」と位置づけている。かつて年次報告書のサステナビリティ指標でしかなかった電力消費が、今ではデータセンターの立地や事業継続そのものを左右する制約に変わっている。
- 電力網の逼迫:一部地域では追加電力の調達が不可能で、新規の計算インフラをプロビジョニングできない
- 規制圧力の強化:ドイツでは新設データセンターにPUE 1.2以下が義務化。アイルランドは大規模データセンターに100%のオンサイト発電能力を要求
- TCOへの影響:高消費電力のハードウェアは冷却設備やラック設計の大規模投資を強いり、総保有コストを押し上げる
Google Cloud Blogによれば、ワットあたりの性能向上が「戦略的資産」として位置づけられている。TPU 8tは第7世代比で最大2倍の電力効率を達成しており、規制基準を満たしながら高性能を維持する設計思想がエネルギー壁を突破するカギだとされている。
まとめ
本レポートの核心は「エージェントAI時代のインフラは、計算・セキュリティ・データ・エッジ・電力のすべてを統合的に設計しなければならない」という一点に集約される。AI Hypercomputerのような各レイヤーを共同設計するアーキテクチャが、高コストで機能不全に陥る従来モデルからの脱却策として注目されている。
物理世界とデジタルを結ぶフィジカルAIの波も現実化しつつあり、ロボットのトレーニングにデジタルツインを使う取り組みがGoogle Cloud上で始まっている。インフラ戦略を抜本的に見直すタイミングが、いま訪れていると言える。
この記事のポイント
- 83%の組織がエージェントAI本番運用にインフラ刷新が必要と回答
- 62%が推論税、81%が運用の複雑さをスケーリングの隠れコストと認識
- 79%がセキュリティ・ガバナンス・MLOpsを最大の課題に挙げている
- 90%がエッジAIを重要視し、72%は「極めて重要」と回答
- 91%がハードウェア選定で消費電力を考慮し、ワットあたり性能が新たな指標に
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WP-CLIとREST APIとAbilities API、WordPressインターフェースの選び方
3つのインターフェースの全体像
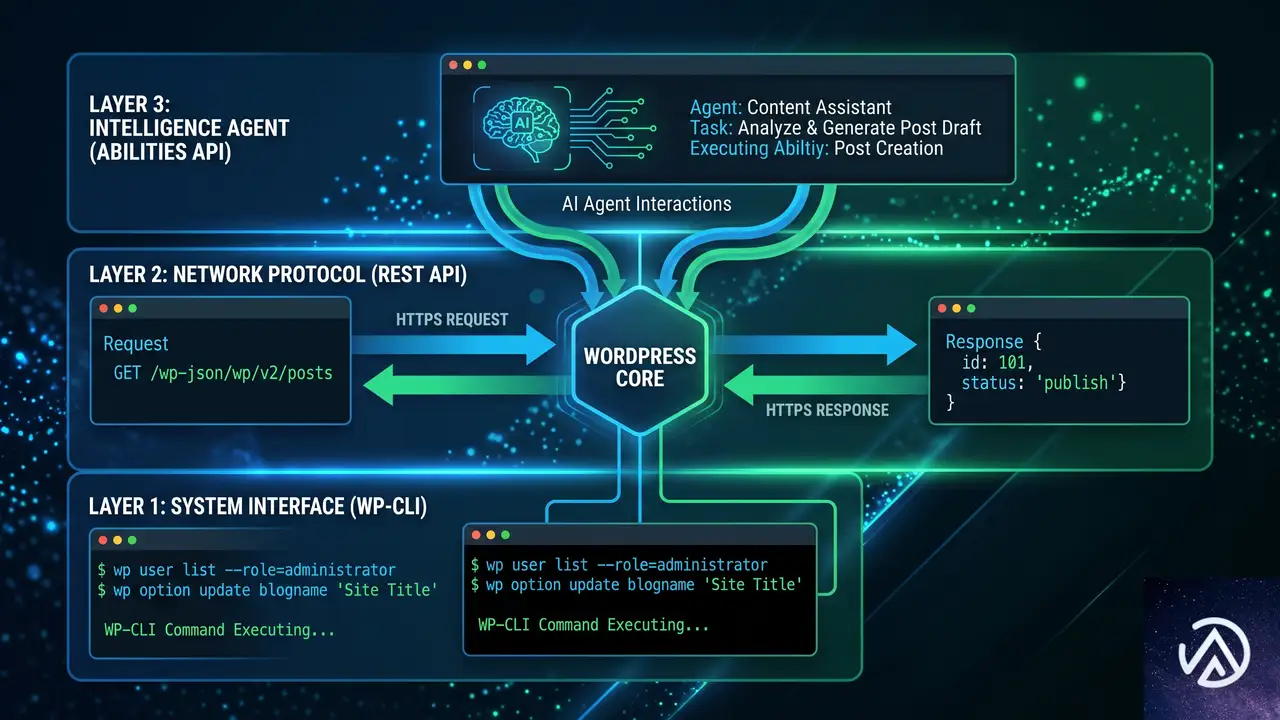
WordPressには外部からデータをやり取りするための主要なインターフェースが3つ存在する。WP-CLI、REST API、Abilities APIだ。それぞれが異なる距離感でWordPressと向き合い、異なる呼び出し元に対応する。これらを競合関係と捉えるのは誤りで、実際には階層構造をなしている。
WP-CLIはサーバー上で動作し、REST APIはHTTPを介して通信する。そしてAbilities APIは、そのさらに上位に位置し、AIエージェントが何をすべきかを判断する層になる。どのレイヤーがどこに位置するのかを理解すれば、タスクに応じた最適な選択はおのずと見えてくる。
- WP-CLI:サーバー上で直接PHPを実行(またはSSH経由)。一括操作、移行、デプロイ、メンテナンス向き
- REST API:wp-jsonへのHTTPリクエスト。ブラウザ、モバイルアプリ、外部サービスからコンテンツの読み書きに使用
- Abilities API:RESTとMCPで公開される名前付きPHPケイパビリティ。AIエージェントが安全に操作を行えるように設計
3つのインターフェースは、下位ほど呼び出し元がサイトに近く、信頼度も高い。上位になるほど、呼び出し元は自律的で遠隔地に位置する。この構造を理解すれば、「どれを使うべきか」の判断はシンプルになる。
WP-CLI:サーバー上のコマンドライン
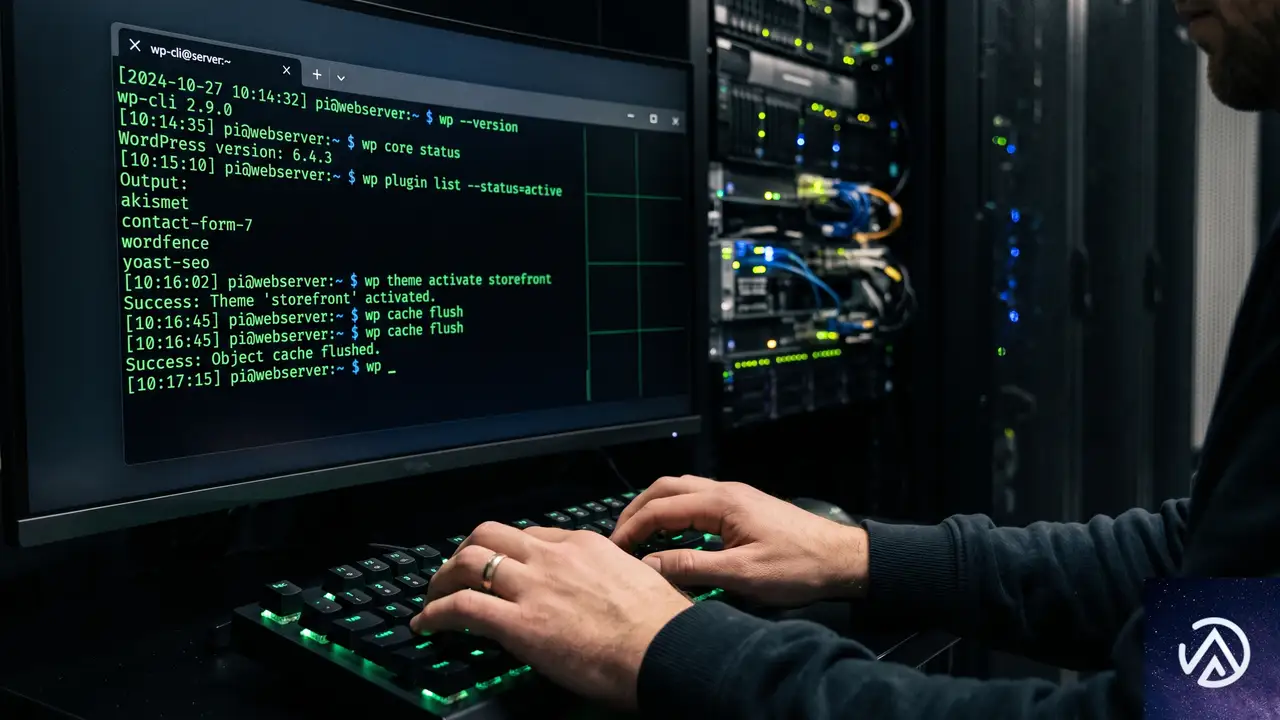
WP-CLIはWordPressのインストール環境に対して直接PHPを実行する。コマンド例としては wp post create、wp plugin update、wp search-replace、wp db export などがある。実行にはサーバーへのシェルアクセス(SSH)が前提だが、その分HTTPの往復も認証トークンの管理も不要になる。
WP-CLIが最も威力を発揮するのは、サイトを完全に制御できる状況だ。1000件の投稿を移行する、データベース全体でドメインを置換する、定期メンテナンスをスクリプト化する、あるいはデプロイの自動化など、スピードが求められる一括操作では他の追随を許さない。
WP-CLIはシェルアクセスが前提のため、ブラウザやモバイルアプリ、外部サービスがサイトと通信する手段にはなりえない。しかし開発者がサイト全体を制御できる状況では、WP-CLIは圧倒的な速度と柔軟性を提供する。ターミナルからすべてを操作するワークフローが浸透している開発現場も多く、管理画面(wp-admin)をほとんど開かない運用も可能だ。
REST API:HTTP越しのWordPress
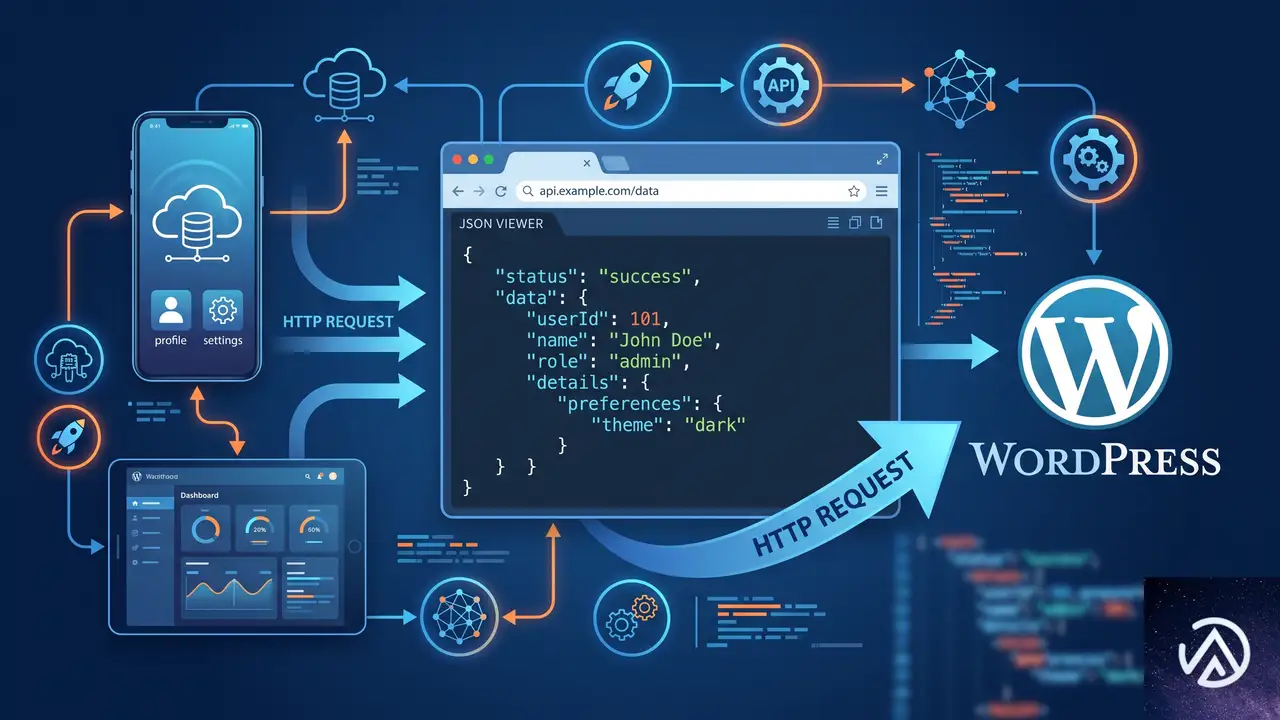
REST APIはWordPressサイトを、あらゆるHTTPクライアントが読み書きできる状態に変換する。エンドポイントは /wp-json/wp/v2/ 配下に存在し、認証にはアプリケーションパスワード、Cookieとnonce、あるいはOAuthを用いる。ブラウザ、モバイルアプリ、外部サービスがインターネット越しにコンテンツを取得・更新できるようになる。
ヘッドレスCMS構成のWordPressは、このREST APIを基盤に動作する。AstroやNext.jsで構築したフロントエンドがREST経由でコンテンツを取得し、モバイルアプリが投稿を行い、サードパーティ連携がデータを同期する。呼び出し元がサーバー外にいる場合、REST APIがほぼ唯一の通信経路となる。
投稿、ユーザー、タクソノミー、設定といった「リソース」
「誰が何をしたいのか」という意図や操作の文脈
REST APIには重要な限界がある。公開するのは「データの構造」であり、「そのデータで何をしたいのか」という操作の意図までは記述しない。どのエンドポイントが存在し、どうリクエストを組み立てるべきかは、呼び出し元が自ら理解する必要がある。人間の開発者であれば問題ないが、AIエージェントにとっては推論すべき情報が多すぎるという課題が残る。
Abilities API:AIエージェントのためのケイパビリティ層
Abilities APIはWordPress 6.9でコアに導入された最新のインターフェースだ(それ以前のバージョン向けにはプラグインも提供されている)。REST APIが残した「AIエージェントが何を許可されているのかをどう知るか」という課題を解決するために設計された。
Abilities APIでは、生のリソースを公開する代わりに、プラグインやテーマが「名前付きケイパビリティ(能力)」を登録する。各アビリティは、一意のID、人間が読めるラベル、説明文、入力・出力のスキーマ、権限チェックのコールバック、そして実行コールバックを備えた独立した操作単位となる。
add_action( 'wp_abilities_api_init', function () {
    wp_register_ability( 'my-plugin/publish-draft', [
        'label'             => '下書きを公開',
        'description'       => 'IDを指定して既存の下書き投稿を公開する',
        'category'          => 'my-plugin',
        'input_schema'      => [ /* 期待する入力のJSON Schema */ ],
        'output_schema'     => [ /* 結果のJSON Schema */ ],
        'permission_callback' => 'my_plugin_can_publish',
        'execute_callback'  => 'my_plugin_publish_draft',
        'meta'              => [ 'show_in_rest' => true ],
    ] );
} );meta.show_in_rest をtrueに設定すると、そのアビリティは wp-json/wp-abilities/v1/abilities で公開され、クライアントが検出できるようになる。JavaScript側では @wordpress/abilities パッケージを介して利用する。
Abilities APIの最大の価値は、エージェントが安全に行動するために必要な「契約」を提供することだ。操作の定義、必要な入力形式、実行許可の条件が明示されるため、AIエージェントがサイトを壊すリスクを最小限に抑えられる。複数のエージェントが共通の語彙で協調動作するマルチエージェント構成でも、Abilities APIが基盤になりつつある。
3つのインターフェースの積み重なり方
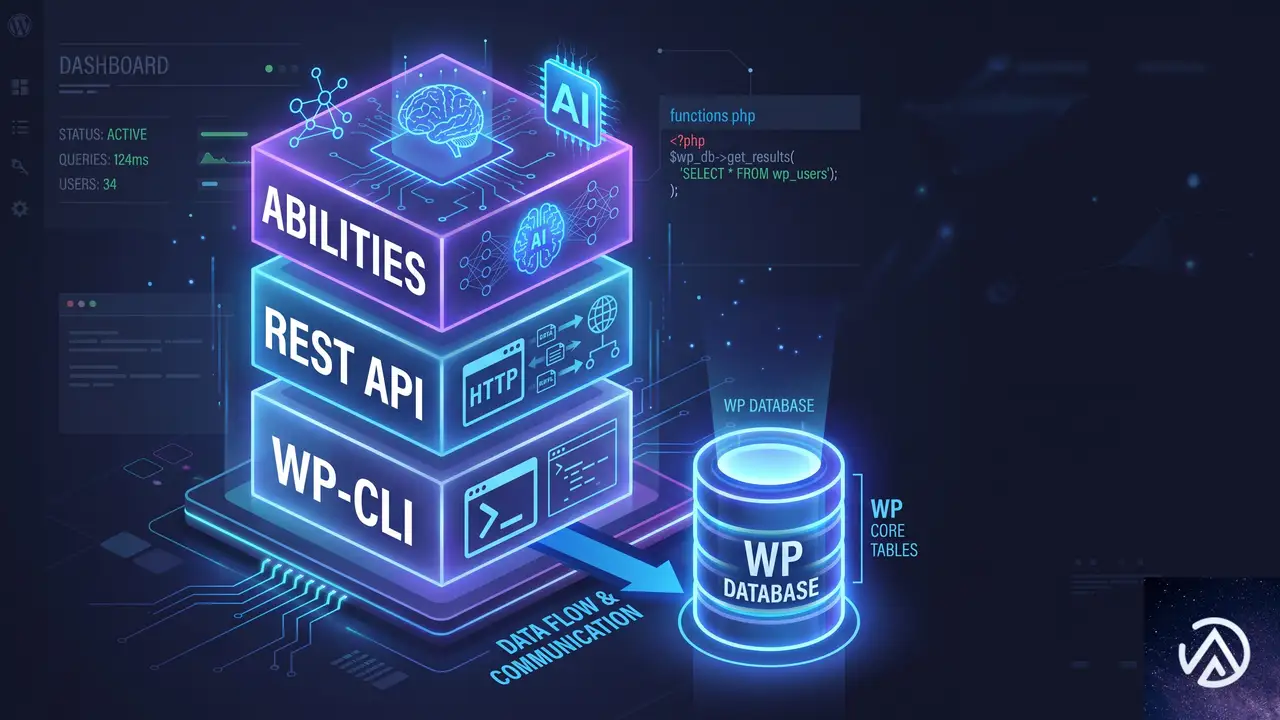
3つのインターフェースは互いに積み重なる関係にある。Abilities APIは多くの場合REST APIの上に構築され、REST APIはWP-CLIが直接駆動するPHPの上で動作する。すべての基盤にあるのは、同じWordPressコア、同じデータベース、同じ関数群だ。
したがって問うべきは「どれが最善か」ではない。「呼び出し元がサイトからどれだけ離れているか」「操作の意図をどこまで明示する必要があるか」という視点で選択することが本質になる。呼び出し元が近く信頼できるほど下位層を、自律的で遠隔にあるほど上位層を使う。
上位層になるほど「記述性」と「安全性」が重視され、下位層ほど「速度」と「直接制御」に優れる。これらは設計上、相補的な関係にあり、実際のプロジェクトではすべてを併用するのが理想的な構成だ。
各インターフェースの使い分け方
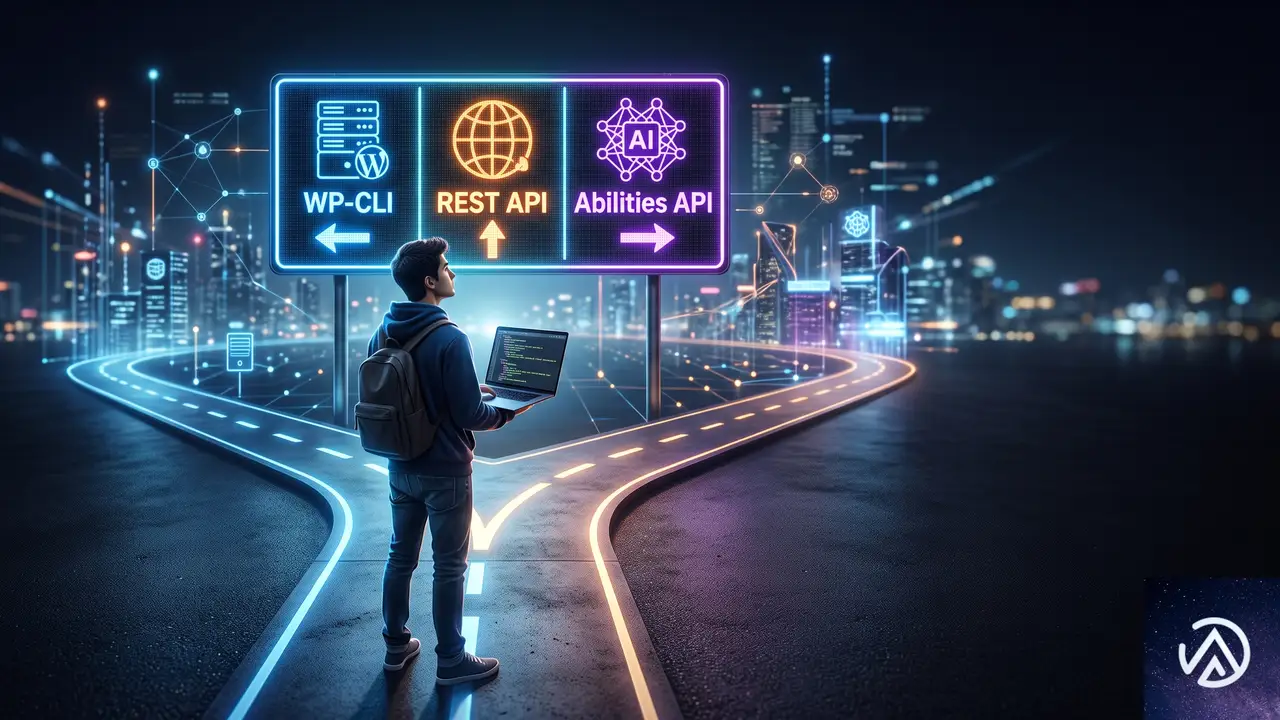
日常的なタスクにおける選択指針を整理する。
- 自分が制御するサイトに対して、一括かつ高速に操作したい → WP-CLI。移行、デプロイ、定期ジョブ、データベース操作が該当する
- ブラウザ、アプリ、外部サービスがコンテンツを読み書きする必要がある → REST API。ヘッドレスフロントエンド、モバイルアプリ、外部連携が該当する
- AIエージェントにサイトを壊さず操作させたい → Abilities API。許可したい操作をスキーマと権限付きで登録し、エージェントに発見させる
実際のプロジェクトでは、この3つを排他的に使うことはまれだ。むしろそれぞれの得意領域を活かして組み合わせるのが、効率的なWordPress運用の鍵になる。
3つを組み合わせた実践的な構成
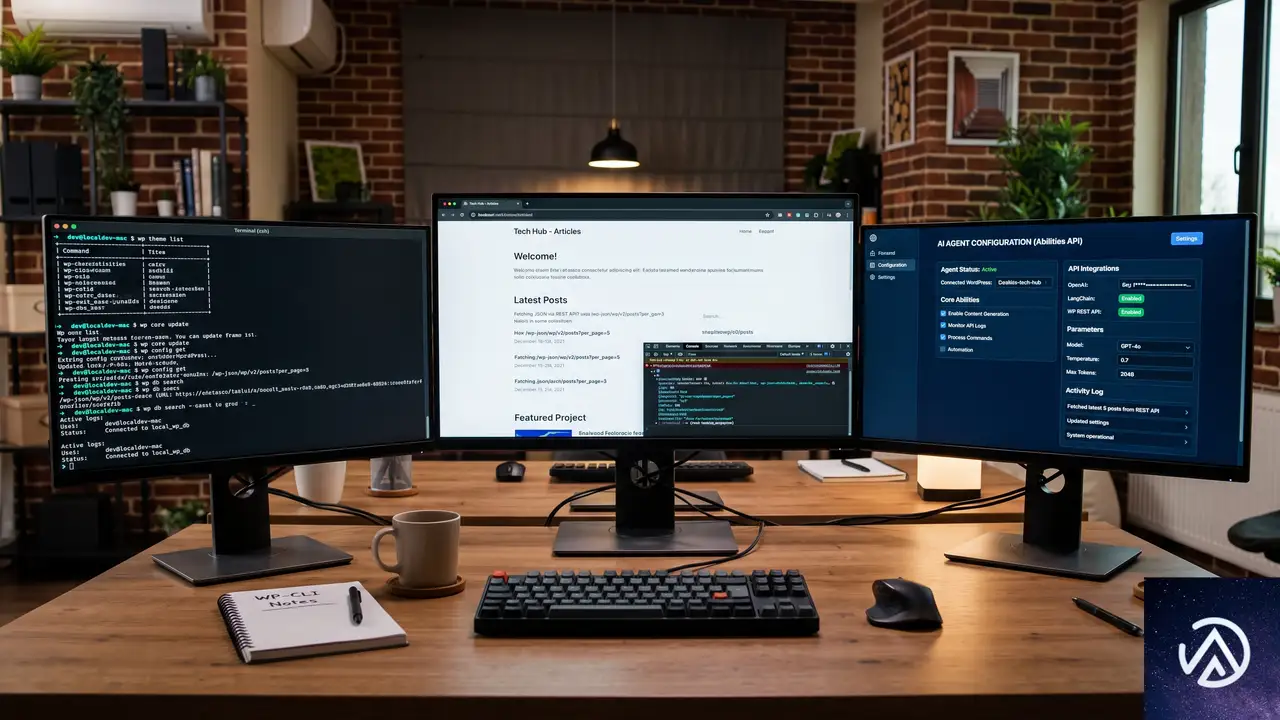
WP Mayorの記事では、実際に3つのインターフェースを併用している構成例が紹介されている。まず、公開運用と日常的な運用作業はSSH経由のWP-CLIで実行される。新規投稿、メディアのインポート、プラグイン更新、キャッシュクリアといった操作をターミナルから完結させ、管理画面(wp-admin)をほとんど開かない運用が行われている。
フロントエンドはヘッドレス構成で、REST API越しにコンテンツを取得する。Astroで構築されたサイトが wp-json 経由でWordPressからデータを取得し、高速な静的ページとして配信する。訪問者はWordPressテーマに触れることなく、WordPressはバックエンドのエンジンとして機能し、REST APIがそのパイプ役を担う。
エージェント向けの機能はAbilities APIを通じて提供される。AIエージェントに限定的なタスクを任せたい場合、関連プラグインがその操作をアビリティとして登録する。権限チェックとスキーマを伴うため、シェルアクセスを丸ごと渡したり、大量の生エンドポイントをエージェントに解析させたりする必要がなくなる。
WP-CLIは速度と一括処理能力で、REST APIは外部連携の柔軟性で、Abilities APIはAIエージェントの安全性で優位性を持つ。1つのインターフェースに別の役割を強制しようとするところから問題は始まる。3つのレイヤーを適材適所で使い分けることが、WordPress自動化の効率を最大化する道筋だ。
この記事のポイント
- WP-CLI、REST API、Abilities APIは競合ではなく、呼び出し元の距離に応じた階層構造をなす
- WP-CLIはサーバー上の直接操作に最適で、一括処理と速度が求められる場面で選ぶ
- REST APIはHTTP越しのデータ読み書きを担い、ヘッドレス構成やモバイルアプリ連携の基盤となる
- Abilities APIはAIエージェントに操作の安全な契約を提供し、マルチエージェント構成でも威力を発揮する
- 実際のプロジェクトでは3つを組み合わせ、各レイヤーの得意領域を活かすのが理想的な運用だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Gravity Forms PDFで合計金額が倍になる原因と修正方法
Gravity Forms で作成したフォームから PDF を出力するプラグイン「PDF Invoices for Gravity Forms」を使っていて、テンプレート内で get_total() メソッドを複数回呼び出すと合計金額が呼び出し回数に応じて倍々に膨らんでしまう現象は、静的変数 self::$total が各呼び出しのたびに加算され続ける設計になっているのが原因だ。直すにはヘルパークラスを子テーマから拡張し、get_total() の内部で毎回リセットして再計算させる変更を加える。
合計金額が倍になる現象はどのようなときに起こるのか
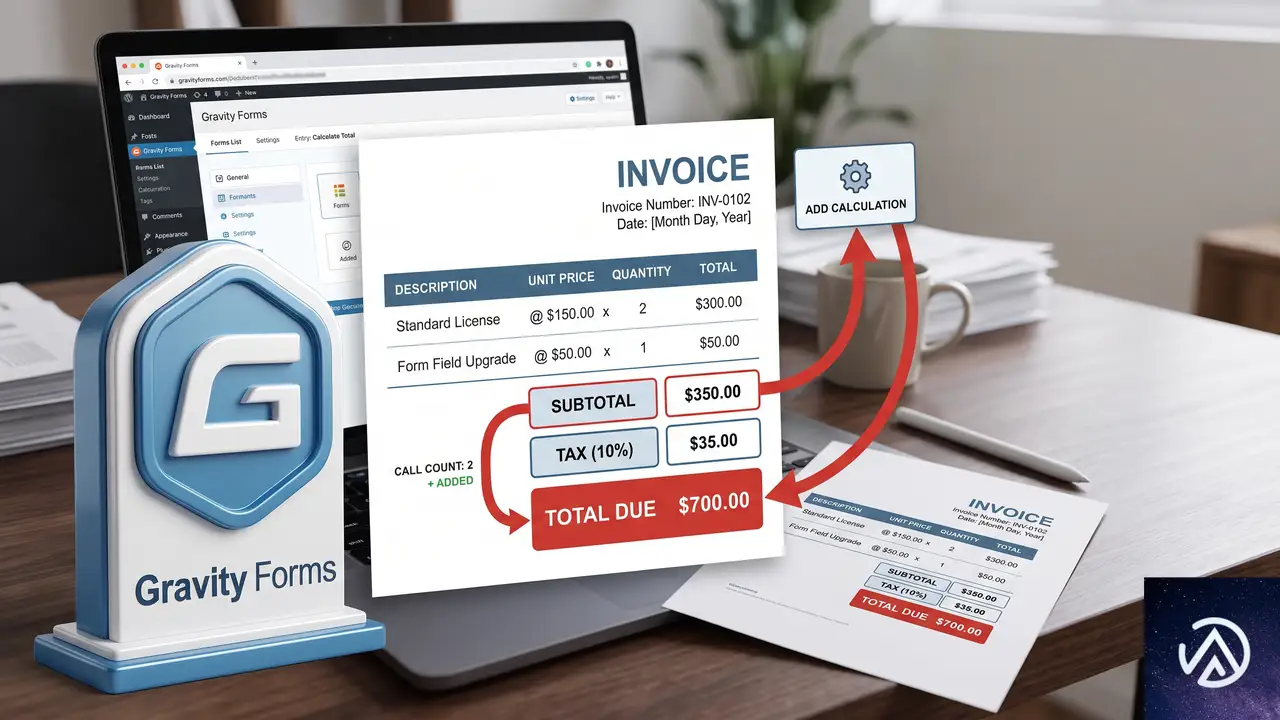
たとえば請求書のテンプレートに「小計」と「総合計」を別々の位置に表示したい場合、PDF_Invoices_For_GravityForms_Helpers::get_total() を2回呼ぶことになる。ところがイベント参加登録や商品注文フォームなどで実際にこの処理を通すと、2回目の呼び出し時には1回目に加算された値にさらに同じ計算が上乗せされ、本来 10,000 円のところが 20,000 円になるといった不具合が起きる。
なぜ get_total() を複数回呼ぶと値が積み上がるのか

問題の根本は class-pcafe-gfpi-helpers.php ファイル内の get_total() メソッドにある。このメソッドは静的変数 self::$total を使い、内部で次のように加算している。
public static function get_total(){
    self::$total += self::get_subtotal();
    self::$total += self::$shipping;
    return self::$total;
}
静的変数はリクエストの間ずっと値を保持するため、同じ処理中に get_total() が呼ばれるたびに前回の合計に小計と送料が足されていく。2回呼べば「小計 + 送料」が2倍になり、3回なら3倍になる。通常、こうした合計取得メソッドは毎回ゼロから計算し直すべきであり、内部で継ぎ足す構造は意図したものでない可能性が高い。
変数 self::$total が 10,500 を保持したまま
2回目呼び出し: 変数をリセット後 再計算 → total=10,500
上の図のように、2回目で合計が倍になる。特に「小計」「消費税」「総合計」など複数の金額を PDF テンプレートに配置する場合にこの問題が顕在化しやすい。
get_total() 修正の基本的な考え方

プラグイン本体のファイルを直接編集してしまうと、アップデートのたびに修正が上書きされて消える。そのため子テーマの functions.php を使い、プラグインのヘルパークラスを拡張した独自クラスを用意する方法をとる。拡張クラスでは get_total() メソッドをオーバーライドし、計算前に self::$total を強制的に 0 にリセットしてから小計と送料を加算する。
子テーマでヘルパークラスを拡張して修正する手順

独自ヘルパークラスを作成する
まず子テーマの functions.php に、プラグインのヘルパークラスを継承したクラスを定義する。子テーマがない場合は、Code Snippets プラグインを使うか、wp-content/themes/(現在のテーマ)/functions.php に追記する形でもよい。コードは以下のようになる。
class Custom_GFPI_Helpers extends PDF_Invoices_For_GravityForms_Helpers {

    public static function get_total() {
        self::$total = 0; // 計算前に必ずリセットする
        self::$total += self::get_subtotal();
        self::$total += self::$shipping;
        return self::$total;
    }
}
テンプレート内でカスタムクラスを呼び出す
拡張クラスを作っただけでは既存のテンプレートには反映されない。PDF テンプレート内で PDF_Invoices_For_GravityForms_Helpers::get_total() を呼んでいる箇所を、先ほど定義した Custom_GFPI_Helpers::get_total() に置き換える。
テンプレートファイルは多くの場合 wp-content/uploads/pdf-invoices-for-gravity-forms/templates/ 以下にカスタムテンプレートとして配置されている。該当の .php ファイルを開き、以下のように書き換える。
<?php
// 修正前
// echo PDF_Invoices_For_GravityForms_Helpers::get_total();

// 修正後
echo Custom_GFPI_Helpers::get_total();
?>
これでテンプレート内のどの場所から呼び出しても、毎回リセット後に計算が走るため合計が積み上がることはなくなる。
変更後にキャッシュと動作を確認する
変更を加えたあとは、必ず PDF を生成し直して合計金額が正しいか確認する。Gravity Forms のエントリーから「PDFを表示」ボタンで実際の請求書を開き、同じ合計が要求された位置すべてに正しく表示されているかをチェックする。サイトでキャッシュプラグインを使っている場合は、キャッシュを全削除してから確認すると確実だ。
よくある質問
プラグイン本体のファイルを直接修正してもよいか
推奨しない。プラグインがアップデートされるたびに修正が上書きされ、その都度同じ変更を加えなければならなくなる。子テーマや Code Snippets を使う方法なら、アップデートに影響されず継続的に動作する。
他の金額表示(税額や値引き額)も倍増している場合の対処は
同じヘルパークラス内で定義されている get_tax() や get_discount() にも同様の静的変数の加算構造がある可能性が高い。それらのメソッドも同じ要領でカスタムクラス内にオーバーライドし、内部で該当の静的変数をリセットする処理を加えるとよい。
子テーマを使っていない場合でも対応できるか
子テーマがない場合は Code Snippets プラグインが便利だ。スニペットとしてクラス定義を追加すれば、テーマに依存せず同じ修正を適用できる。テンプレートの書き換えは手動で行う必要があるが、クラスの読み込み自体はスニペット経由で問題なく動作する。
修正後に PDF が真っ白になる場合の確認点は
クラス名やメソッド名のスペルミス、オートローダーがカスタムクラスを見つけられていないケースが考えられる。まず PHP のエラーログを確認し、クラスが見つからないという趣旨の致命的エラーが出ていないか調べる。出ている場合はクラス定義の記述ミスか、定義のタイミングが早すぎる可能性があるため、init フックなどで定義を遅らせると改善することがある。
この記事のポイント
get_total()の多重呼び出しで合計が倍増するのは、静的変数self::$totalが加算され続ける設計のため- プラグイン本体を直接修正せず、子テーマの functions.php でカスタムクラスを定義する
- カスタムクラス内で
get_total()をオーバーライドし、計算前にself::$total = 0;でリセットする - PDF テンプレート側の呼び出しをカスタムクラスに差し替え、キャッシュ削除後に動作確認する
- 同様の構造を持つ
get_tax()やget_discount()も併せて修正を検討する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
GA4にAI Assistantチャネル追加、ChatGPT流入を可視化
Google Analytics 4(GA4)に2026年5月、生成AIプラットフォームからの流入を可視化する「AI Assistant」チャネルが追加された。ECサイト運営者にとって、ChatGPTやClaudeが商品情報を紹介した結果のトラフィックを正確に把握できる初めての標準機能だ。
この記事ではAI Assistantチャネルの基本的な仕組みと、ECサイトでの具体的な活用法を解説する。設定不要でデータが自動収集される一方、AI Overviewsは含まれないといった注意点もあるため、正しい読み方を押さえておく必要がある。
WooCommerceサイトを運営する中小企業の担当者や、ECのアクセス解析を担当するWeb担にとって、これまで「参照元不明」だったAI経由の流入を可視化できる意味は大きい。
AI Assistantチャネルとは何か
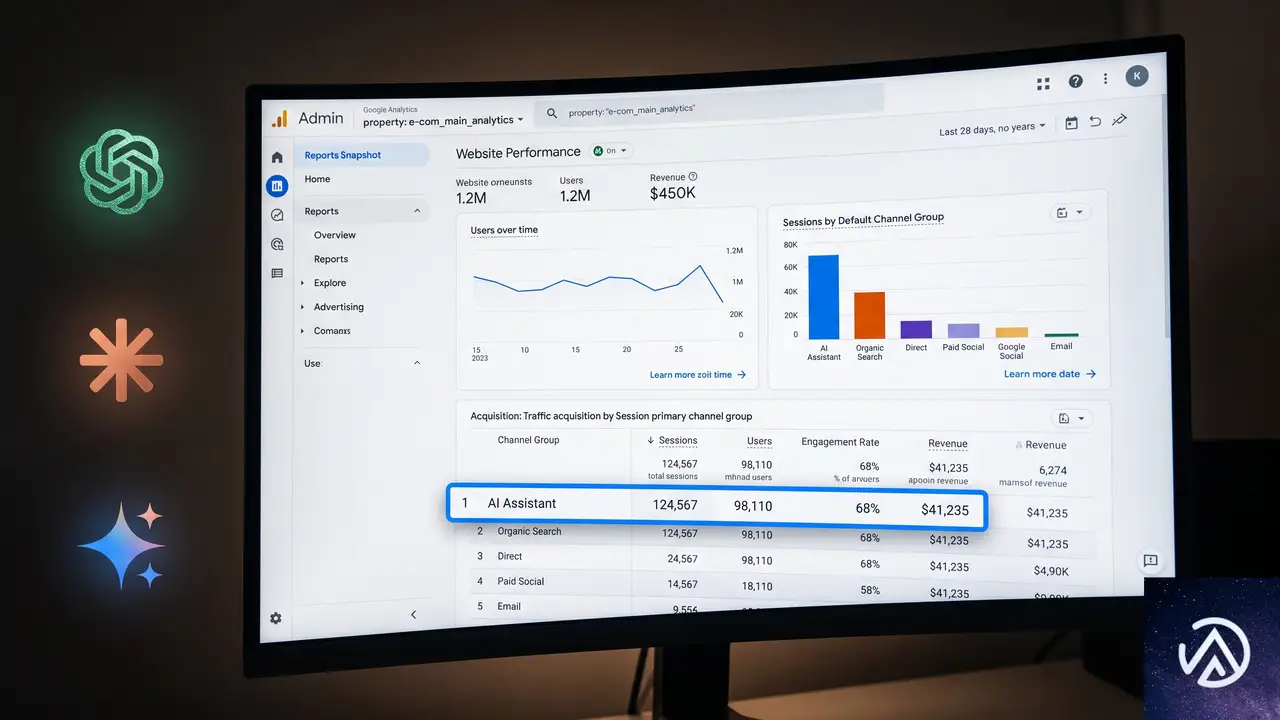
AI Assistantチャネルは、GA4のデフォルトチャネルグループに追加された新しい分類項目だ。ChatGPTやGemini、Claudeといった主要な生成AIプラットフォームからのトラフィックを自動的に判別し、ひとつのチャネルとして集計する。
計測対象となるプラットフォーム
Googleの公式ヘルプドキュメントによると、AI Assistantチャネルに含まれるのは「ChatGPT、Gemini、Claudeといったチャットボット」からのトラフィックだ。具体的な全リストは公開されていないが、主要な生成AIサービスはおおむねカバーされていると見てよい。
ここで重要な注意点がある。Google検索のAI Overviews(旧SGE)やAI Modeは、このチャネルには含まれない。これらは引き続き「Organic Search(オーガニック検索)」チャネルとして報告される。同じAI由来の流入でも、検索エンジン経由かチャットボット経由かで扱いが異なるわけだ。
ECサイトにとっての意味
ECサイト運営者にとって、AIチャットボット経由の流入は従来のSEOとは異なる文脈で発生する。たとえば「予算3万円で買えるおすすめのワイヤレスイヤホン」といった自然言語の質問に対し、ChatGPTが具体的な製品名とURLを提示するケースだ。この流入経路を正確に把握できれば、AIに自社商品がどのような文脈で言及されているかを分析できる。
AIトラフィックの確認手順
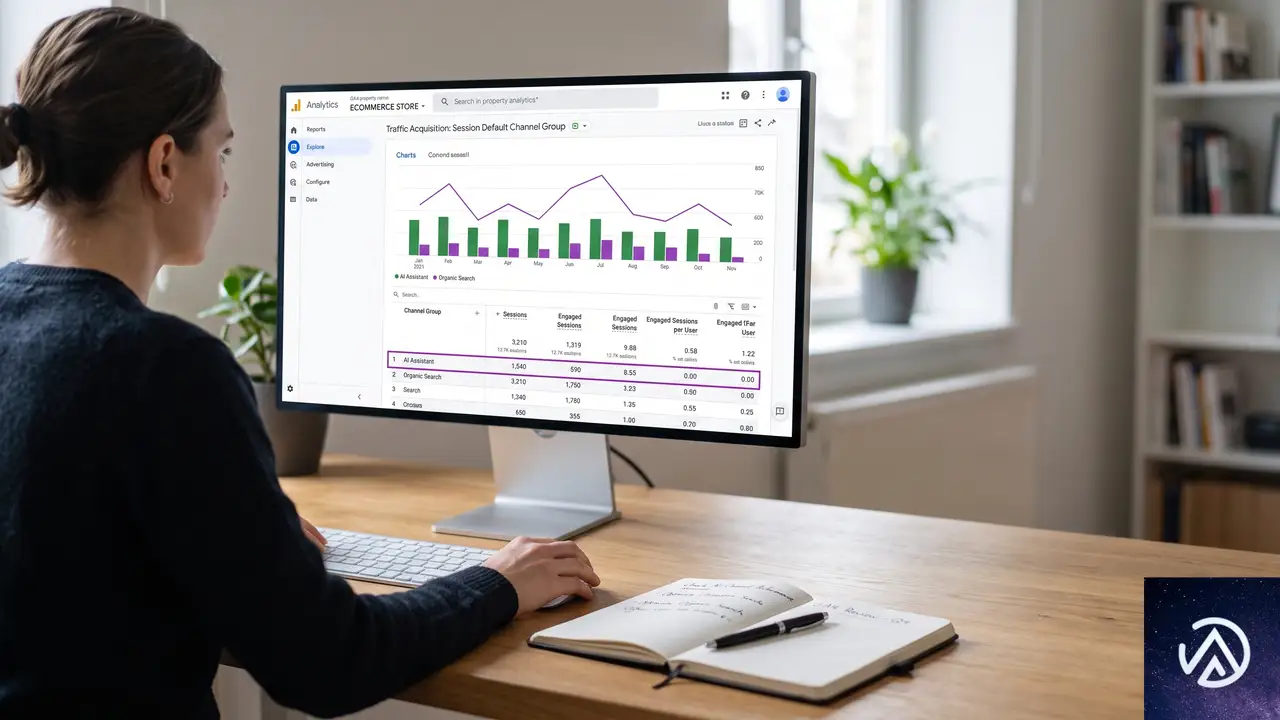
GA4でAI Assistantチャネルのデータを見るための手順を解説する。初期設定は不要で、GA4が自動的に分類を開始しているため、すぐに確認できる。WooCommerceサイトでGA4を導入済みであれば、追加のコード実装も必要ない。
トラフィック全体像の把握
まずはECサイト全体で、AI経由の流入がどの程度あるのかを確認する。GA4管理画面で「レポート」→「集客」→「トラフィック獲得」の順に開き、「セッションのデフォルトチャネルグループ」ディメンションを選択する。ここで「AI Assistant」という行が表示されていれば、すでにAI経由のトラフィックが発生している。
表示される指標はエンゲージメント率、セッションあたりのイベント数、平均セッション時間などだ。これらの数字をOrganic Searchチャネルと比較することで、AI経由ユーザーの行動特性が見えてくる。
ランディングページの特定
AIがどの商品ページを参照しているのかを特定するには、「レポート」→「エンゲージメント」→「ページとスクリーン」を開く。画面上部の「フィルタを追加」から、以下の条件で絞り込む。
- ディメンション:セッションのデフォルトチャネルグループ
- マッチタイプ:完全一致
- 値:AI Assistant
このフィルタを適用すると、AIプラットフォームからのクリックが多いページが上位に表示される。WooCommerceの商品ページやカテゴリページのうち、どのURLがAIに評価されているかを把握できるはずだ。
AIトラフィックと他チャネルの比較
同じ「ページとスクリーン」レポートで「比較を追加」ボタンを使うと、AI経由とオーガニック検索経由のトラフィックを横並びで比較できる。Practical Ecommerceの記事著者Carlo Daniele氏の検証によれば、オーガニック検索で上位のページとAI Assistant経由で上位のページは重複しなかったという。
これはEC担当者にとって示唆が大きい。Google検索で上位表示されている商品と、AIがユーザーに推薦する商品が異なる可能性があるためだ。AI経由の流入を伸ばすには、従来のSEO対策とは別のアプローチが必要になるかもしれない。
正規表現を使った詳細なソース分析
AI Assistantチャネルは便利だが、どのAIプラットフォームからの流入なのかまでは分解できない。ChatGPT経由なのかClaude経由なのかを個別に知りたい場合は、正規表現(regex)を使ったフィルタリングが有効だ。
設定手順
「レポート」→「集客」→「トラフィック獲得」で、グラフ上部の「フィルタを追加」をクリックする。ディメンションに「セッションの参照元/メディア」、マッチタイプに「matches regex」を選択し、以下の正規表現を値欄に貼り付ける。
.*chatgpt.com.*|.*perplexity.*|.*edgepilot.*|.*copilot.microsoft.com.*|.*openai.com.*|.*gemini.google.com.*|.*claude.ai.*|.*grok.x.ai.*このフィルタを適用すると、AIプラットフォームごとのセッション数やエンゲージメント指標を一覧できる。ただしPractical Ecommerceの記事でも指摘されているように、AI Assistantチャネルとの間にわずかなデータの不一致が生じる場合がある。これは「Organic」や「(not set)」と分類される一部のAIトラフィックが正規表現では拾えていないためだ。
WooCommerceサイトでの活用ポイント
正規表現フィルタを使えば、たとえば「ChatGPT経由では商品Aへの流入が多いが、Claude経由では商品Bが多い」といったプラットフォーム別の傾向を把握できる。AIによって得意とする商品カテゴリや、参照する情報ソースが異なる可能性があるためだ。
このデータをもとに、特定のAIプラットフォームで自社商品が言及されやすいコンテンツを強化するといった戦略が考えられる。Semrushなどの外部ツールで、どのようなプロンプトがAIの引用を生んでいるのかを調査するのも有効だ。
EC担当者が今すぐやるべき3つのアクション
AI Assistantチャネルの登場を受けて、ECサイトのアクセス解析にすぐに組み込むべき施策を整理する。いずれも追加コストなしで今すぐ始められるものばかりだ。
特にアクション2は重要だ。AIは商品スペックや口コミ、価格情報を総合的に評価して回答を生成する。商品ページの情報が不十分だとAIに引用されにくくなるため、商品説明の充実や構造化データの実装はAI時代のECに不可欠な施策といえる。
AIトラフィックとECの未来
GA4のAI Assistantチャネルは、ECにとって「AI経由の流入」という新たな指標を提供し始めた。現時点ではまだAIトラフィックの絶対量は小さいかもしれないが、ChatGPTやClaudeがデフォルトでWeb検索を行うようになり、AIを経由した商品発見は確実に増えていく。
AI OverviewsがOrganic Searchに含まれるという設計からもわかるように、GoogleはAIを「検索の拡張」と位置づけている。EC担当者はSEOとAI最適化を別物ではなく、同じ「検索体験」の両輪として捉えるべきフェーズに入ったといえる。
WooCommerceサイトであれば、GA4の標準機能だけでAIトラフィックの可視化は十分に可能だ。まずはデータを取得し、AIが自社商品をどう評価しているのかを把握することから始めてほしい。
この記事のポイント
- GA4に2026年5月追加のAI Assistantチャネルで、ChatGPTやClaudeなど生成AIからの流入が自動分類される
- AI OverviewsやAI Modeは含まれず、これらはOrganic Searchとして報告される点に注意が必要
- ページとスクリーンレポートでAI経由ランディングページを特定し、商品情報の最適化に活かせる
- 正規表現フィルタでAIプラットフォーム別の傾向を把握し、より細かな流入分析が可能
- AIトラフィックはSEOと地続きの指標であり、商品ページの情報充実がAIからの引用を増やす鍵になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WooCommerceで北アイルランド向けVAT税率だけ20%に設定する方法
{ “title”: “WooCommerceで北アイルランド向けVAT税率だけ20%に設定する方法”, “meta_description”: “WooCommerceで英国は税率0%、北アイルランドだけ税率20%に設定するには、国「UK」と州コード「Northern Ireland」を組み合わせる。設定手順とテスト方法まで解説。”, “tags”: [“WooCommerce”, “税率設定”, “VAT”, “北アイルランド”, “EC運営”, “Brexit”], “slug”: “woocommerce-northern-ireland-tax-rate”, “image_prompt”: “WooCommerceのロゴ(紫の丸みを帯びたマーク)を3Dで目立つように大きく配置する。上部には、ダークなEU地図の上に北アイルランドだけがハイライトされ、20%のプレートが浮かぶリアルな構図。下部には英国本土と北アイルランドが色分けされたVAT設定画面のUIを配置。構図は上下分割スタイルとし、主要な視覚要素を画面の上部と下部に配置して、その間を自然で大気感のあるトランジションでつなぐ。画面を横切る水平の帯やストライプは描かない。画像の右下の領域には文字・ロゴ・重要な被写体を置かず、背景や余白にする。アスペクト比16:9。UI画面・ダッシュボード・コードエディタ・管理画面が写る場合、その中の文字はすべて英語にする。ノートPCやモニターが写る場合は極細ベゼルの現代的なデザインにする。カレンダー・画面・書類・タイムラインに年号の数字を表示しない。”, “featured_text”: “北アイルランドだけ\n税率20%にしたい?” }
WooCommerceで英国本土と北アイルランドに異なるVAT税率を設定するには、税率設定画面で国として「United Kingdom (UK)」を選び、州コードに「Northern Ireland」を指定して、英国全体の税率と北アイルランドのみの税率をそれぞれ登録する。
WooCommerceの税率設定で英国と北アイルランドを区別できない原因

WooCommerceは国単位で税率をマッチさせるが、標準状態では英国全体が「GB」という国コードでまとめられている。そのため、英国本土向けの税率と北アイルランド向けの税率を単一の国設定で区別できないように見える。しかし実際には、州コード(State Code)を使って地域を細分化できる仕組みが備わっている。英国本土と北アイルランドはVAT制度上、EUと英国内で異なる扱いを受けるため、州レベルでの切り分けが不可欠だ。
WooCommerceで英国本土と北アイルランドの税率を別々に設定する手順

WooCommerceの管理画面から、税率の新規追加・編集を行う。まずは英国全体に対する税率0%を設定し、その後に北アイルランドだけを対象とした税率20%を追加する。この順序で設定する必要は必ずしもないが、後のテストが楽になる。
このデモは英国全体(州コードなし)と北アイルランド(州コードあり)の2つの税率エントリを示している。実際の設定画面でも同じ構造で登録する。
英国全体の税率0%を設定する

WooCommerceの管理メニューから「WooCommerce」→「設定」→「税率」タブを開く。「税率を追加」ボタンを押し、以下のように入力する。
- 国コード: ドロップダウンから「United Kingdom (UK)」を選ぶ
- 州コード: 何も入力せず空欄のままにする
- 税率: 0%(英国本土向けVATは0%のため)
- 税率名: 例「UK VAT 0%」など分かりやすい名前
- 税率の優先度: 0(デフォルトで問題ない)
「変更を保存」をクリックする。これで英国本土向けの注文には0%が適用される。
北アイルランド向けの税率20%を設定する
同じ税率一覧画面で再び「税率を追加」を押す。今度は州コードを指定して北アイルランドだけに20%が適用されるエントリを作る。
- 国コード: 「United Kingdom (UK)」を選ぶ
- 州コード: ドロップダウンまたは手入力で「Northern Ireland」を指定する。入力欄に文字を打つと候補が表示される
- 税率: 20%(標準VAT)
- 税率名: 例「Northern Ireland VAT 20%」
- 税率の優先度: 0
「変更を保存」をクリックする。WooCommerceは注文時に配送先住所の国と州を照合し、より具体的な州コード指定のある税率エントリを優先して適用する。これで北アイルランド宛ての注文には20%が、それ以外の英国本土宛てには0%が自動で適用される。
設定後は必ずテスト購入で税率を確認する
本番運用する前に、かならずテストモードまたはステージング環境で実際の購入フローを試してほしい。配送先住所を英国本土(例: London)と北アイルランド(例: Belfast)の2パターンで入力し、カートやチェックアウト画面に表示される税額が想定どおりになっているか確認する。
もし北アイルランド住所でも税率が0%のままだった場合は、税率エントリの州コードが正しく「Northern Ireland」になっているか、また住所欄に入力した州名が税率設定のものと一致しているかをチェックする。WooCommerceは住所の州名と税率テーブルの州コードを厳密に突き合わせるため、スペルミスや表記ゆれがあるとマッチしない。
よくある質問
英国全体の税率エントリと北アイルランドの税率エントリの優先度は同じでよいのか
問題ない。どちらも優先度が同じ場合、WooCommerceはより具体的な条件を持つエントリ(州コード指定あり)を自動的に優先する。本土用(州指定なし)より北アイルランド用(州指定あり)のほうが具体的なため、優先度の値にかかわらず正しく適用される。
州コードに「Northern Ireland」が表示されない場合はどうするか
WooCommerceの州コードリストはデフォルトで主要な州を含んでいるが、何らかの理由で表示されない場合は手入力も可能だ。入力欄に直接「Northern Ireland」とタイプして保存すれば機能する。もしどうしてもリストに出ないなら、WooCommerceの一般設定で販売地域を「すべての国に出荷する」などに一時変更してから再確認する。
欧州連合(EU)のVAT設定と衝突しないか
WooCommerceの税率設定は国単位・州単位で独立しているため、EU加盟国向けの税率エントリとは別に管理できる。英国(GB)向けのエントリは、EUの税率設定テーブルとは独立して動作するので衝突しない。ただしEU全域向けの税率設定をまとめて有効にしている場合は、英国向けエントリが優先されるよう、税率の優先度や対象地域を整理しておくと安心だ。
北アイルランド宛ての配送時にだけ異なる税率を表示したいが可能か
可能だ。本記事で解説した州コード指定の方法を使えば、北アイルランド向けの注文だけ異なる税率(例: 20%)を表示し、英国本土向けには別の税率(例: 0%)を表示できる。条件は住所の州名が税率エントリの州コードと一致することだけだ。
WooCommerce以外のプラグインでもこの方法は使えるか
この解説はWooCommerceの税率設定機能を前提としている。ECプラグインによっては州コードを使った税率の細分化に対応していない場合もあるため、利用しているプラグインのドキュメントを確認する必要がある。WooCommerceを推奨する趣旨ではないが、同様の要件を満たすには国と州を組み合わせた柔軟な税率設定ができるプラグインを選ぶことがポイントになる。
この記事のポイント
- WooCommerceでは国コード「GB」と州コード「Northern Ireland」で税率を分けられる
- 州コード指定のある税率エントリは、指定のないエントリより優先される
- 英国全体に税率0%、北アイルランドに税率20%をそれぞれ追加する
- 設定後はテスト購入で英国本土と北アイルランド両方の税額を確認する
- 州コードは手入力でも有効、表示されない場合は直接タイプする
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている