

Cloudflare Workers Cache登場、Worker専用キャッシュでコスト削減
Workers Cache の登場でCloudflare Workersが「オリジン」から「静的配信」へ進化
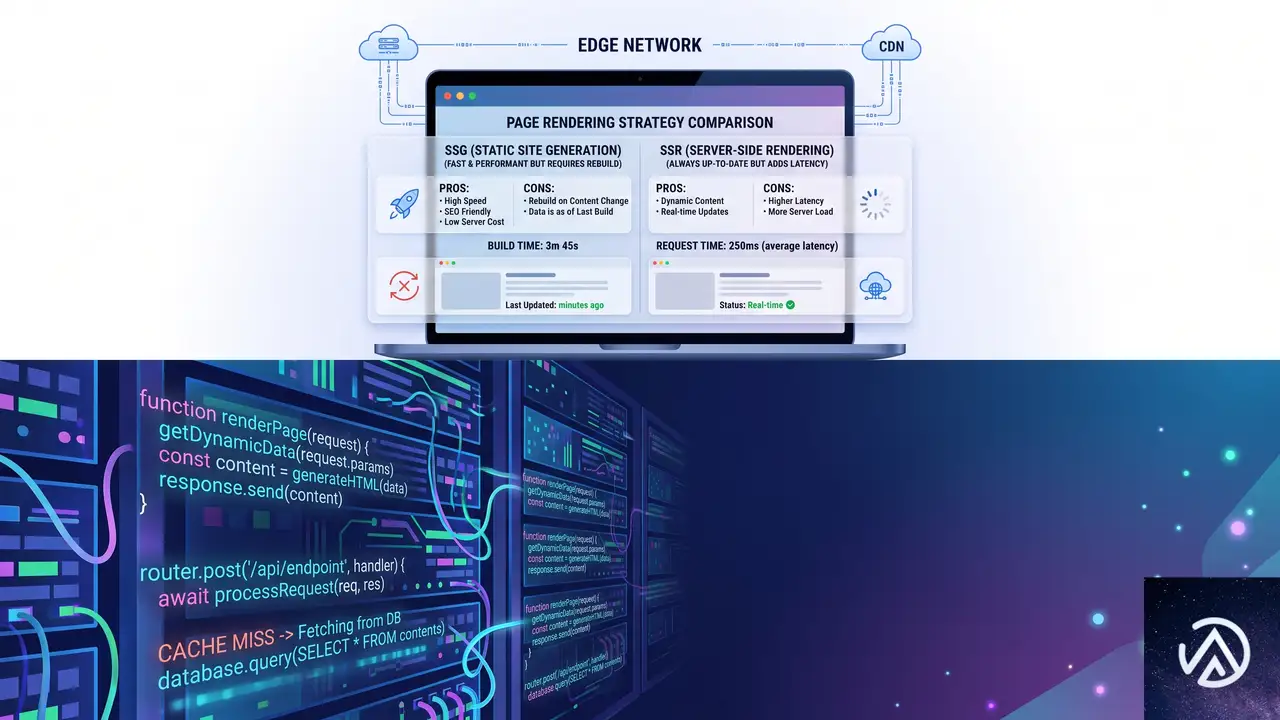
CloudflareがWorkers Cacheを正式にリリースした。これは単なるキャッシュ機能の追加ではない。Workersのアーキテクチャを根本から覆し、コストとパフォーマンスのトレードオフを解消する大きな転換点だ。一言で表せば「あなたのWorkerの前に、そのWorker専用のキャッシュを置ける機能」である。
1行の設定を追加するだけで、Workerが生成したレスポンスはCloudflareのエッジネットワークにキャッシュされる。キャッシュが有効な間はWorkerそのものが実行されず、CPU時間の課金もゼロになる。これは特に、サーバーサイドレンダリング(SSR)を行うアプリケーションにとって、待望のソリューションだ。
本記事では、なぜこの機能が必要とされていたのか、具体的に何が変わるのか、そして開発者がどのように活用できるのかを詳しく解説する。
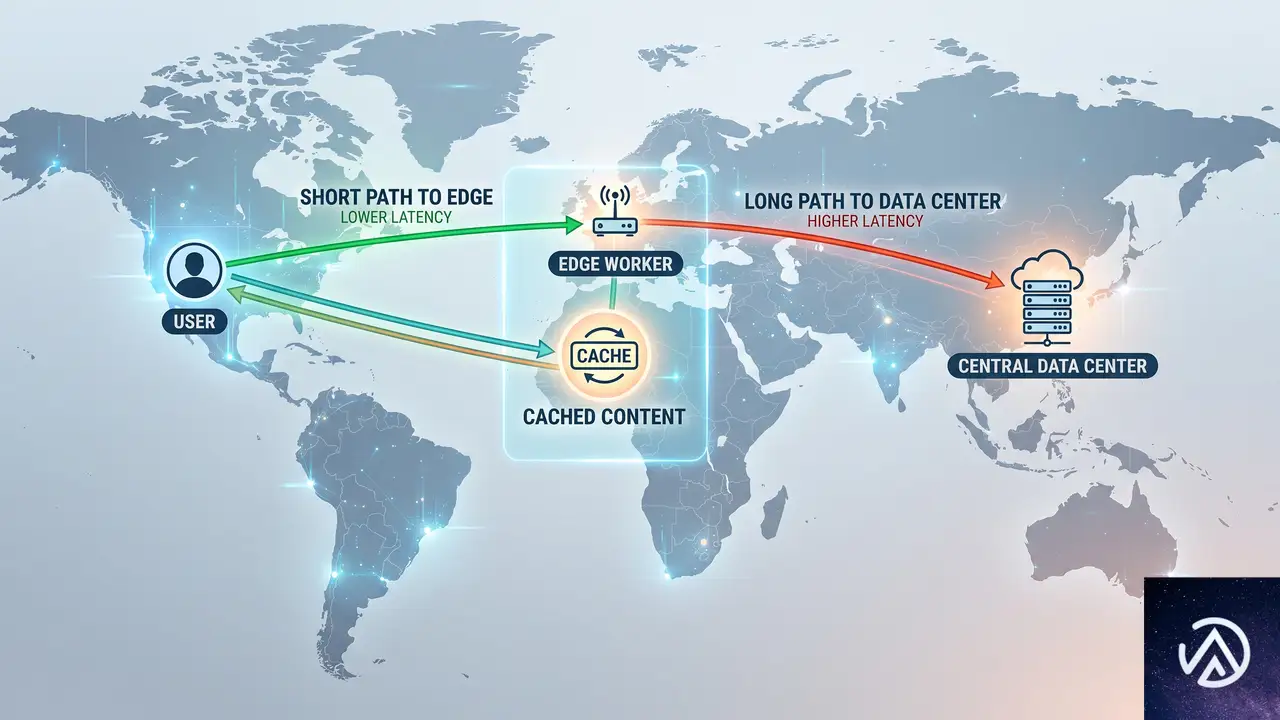
問題: Workerがオリジンの場合、処理のたびにコードが実行され、キャッシュの恩恵を受けにくい。
効果: レスポンスが高速化し、WorkerのCPU実行コストが削減される。
この図が示すように、Workers Cacheはリクエストの最前線に立つ。これにより、Workerが事実上のオリジンサーバーとして振る舞う現代的なアプリケーションのパフォーマンスとコスト構造が劇的に改善される。
なぜサーバーサイドアプリに「Workerの前のキャッシュ」が必要だったのか
Workerが「経由点」から「オリジン」へ変わった世界
2017年のリリース当初、Cloudflare Workersはオリジンサーバーの手前でリクエストを書き換える「中間処理層」として設計された。A/Bテストの振り分けやヘッダーの追加といった、軽量な処理をエッジで実行するユースケースが中心だったのだ。当時、Workerはキャッシュよりもさらにオリジンに近い位置にあった。
しかし状況は一変した。AstroやNext.js、SvelteKitといった主要フレームワークが、ビルド成果物をCloudflare Workersで直接動かすアダプターを提供し始めたのである。これにより、Workerはもはや単なる中継点ではない。アプリケーションそのものがWorker上で動作する「サーバー」になった。裏側に別のオリジンサーバーは存在しなくなり、Worker自体がリクエストを処理するようになったのだ。
この変化は大きな問題を生んだ。従来のアーキテクチャでは、Workerがオリジンになると、すべてのリクエストがコードの実行を必要とするようになる。たとえ1秒前と全く同じHTMLを返す場合でも、だ。これはパフォーマンス上のレイテンシと、無視できないCPU実行コストを常に発生させることを意味していた。
静的生成と動的レンダリングのジレンマを解決する第三の道
この問題に対し、開発者はこれまで2つの選択肢から選ぶしかなかった。
- 静的サイト生成(SSG):すべてのページをビルド時に事前生成する。表示は高速だが、コンテンツを更新するたびに全ページを再ビルドする必要がある。数千ページのサイトでは、このビルド時間が大きなボトルネックになる。
- サーバーサイドレンダリング(SSR):リクエストのたびにページを動的に生成する。コンテンツは常に最新だが、全てのアクセスでレンダリングコストとレイテンシが発生する。
Workers Cacheはここに第三の選択肢、つまり「オンデマンドでサーバーレンダリングし、結果をキャッシュし、指定したTTL(生存期間)で更新する」という新しい手法を提供する。最初のリクエストだけがレンダリングコストを支払い、後続のリクエストはキャッシュから静的ファイルのように配信されるのだ。これはフレームワーク独自の複雑な仕組み(ISRなど)に依存しない、HTTP標準に則った解決策である。
パフォーマンスを極める主要機能「SWR」と「Vary」の内部動作
stale-while-revalidate が「待ち時間ゼロ」を実現する仕組み
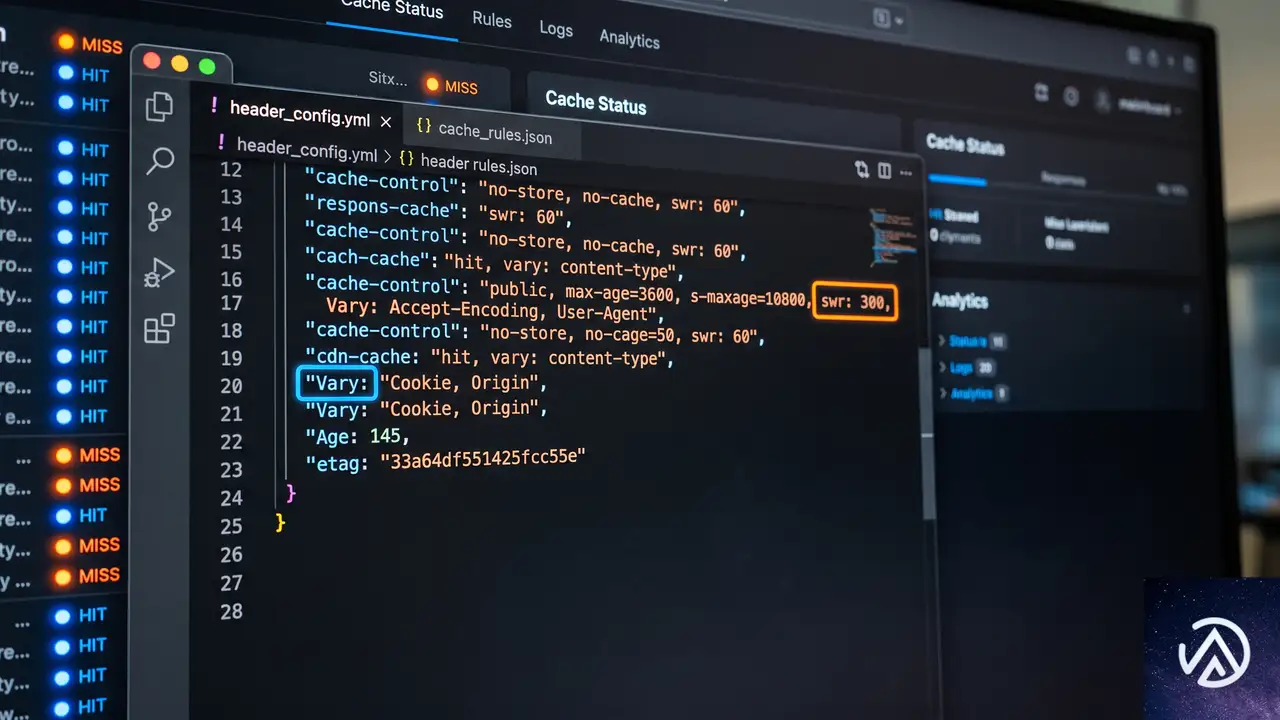
Workers Cacheの真価を引き出すのが、stale-while-revalidate(SWR)ディレクティブだ。これはキャッシュされたレスポンスがTTLを超過した「古い(Stale)」状態でも、とりあえずその古いデータをユーザーに返しつつ、バックグラウンドで最新のデータを取得し直すHTTPの仕組みである。
SWRがない場合、キャッシュの有効期限が切れた後の最初のリクエストは、必ずWorkerが一からページをレンダリングするまで待たされる。しかしSWRがあれば、この最初のリクエストに対しても古いキャッシュが即座に返され、ユーザーは待ち時間を感じない。Workers CacheはこのSWRを完全にサポートしており、これによって「動的なサイトなのに、まるで静的サイトのように感じる」という体験を実現している。
この図の通り、SWRはTTLが切れた後の「最初の一人」が被る待ち時間を帳消しにする。Cloudflare Blogの記事によれば、Cloudflareは今年の早期にこのSWR機能をフルサポートしており、Workers Cacheはその上に構築されていることがわかる。
Vary ヘッダーが複数の表現をキャッシュする
現実のアプリケーションは、同じURLでもクライアントに応じて異なるレスポンスを返す必要がある。例えばブラウザにはHTMLを、APIクライアントにはJSONを返す場合や、対応状況に応じてWebPとJPEGを出し分ける場合だ。Workers Cacheは、このコンテンツネゴシエーションをHTTP標準のVaryヘッダーで解決する。
WorkerがVary: Acceptというヘッダーを付けてレスポンスを返すと、Cloudflareは「Acceptリクエストヘッダーの値」ごとに別々のキャッシュエントリを自動で作成・管理する。これにより、WebPに対応したブラウザにはWebP画像のキャッシュが、そうでない環境にはJPEG画像のキャッシュが返るようになる。開発者は複雑なキャッシュキーの設定を意識する必要はなく、標準的なHTTPのルールに従うだけで、安全かつ効率的に複数表現をキャッシュできるのだ。
開発者が知っておくべき設計思想「ゾーンではなくWorkerのキャッシュ」
エントリーポイント単位の柔軟なキャッシュ制御
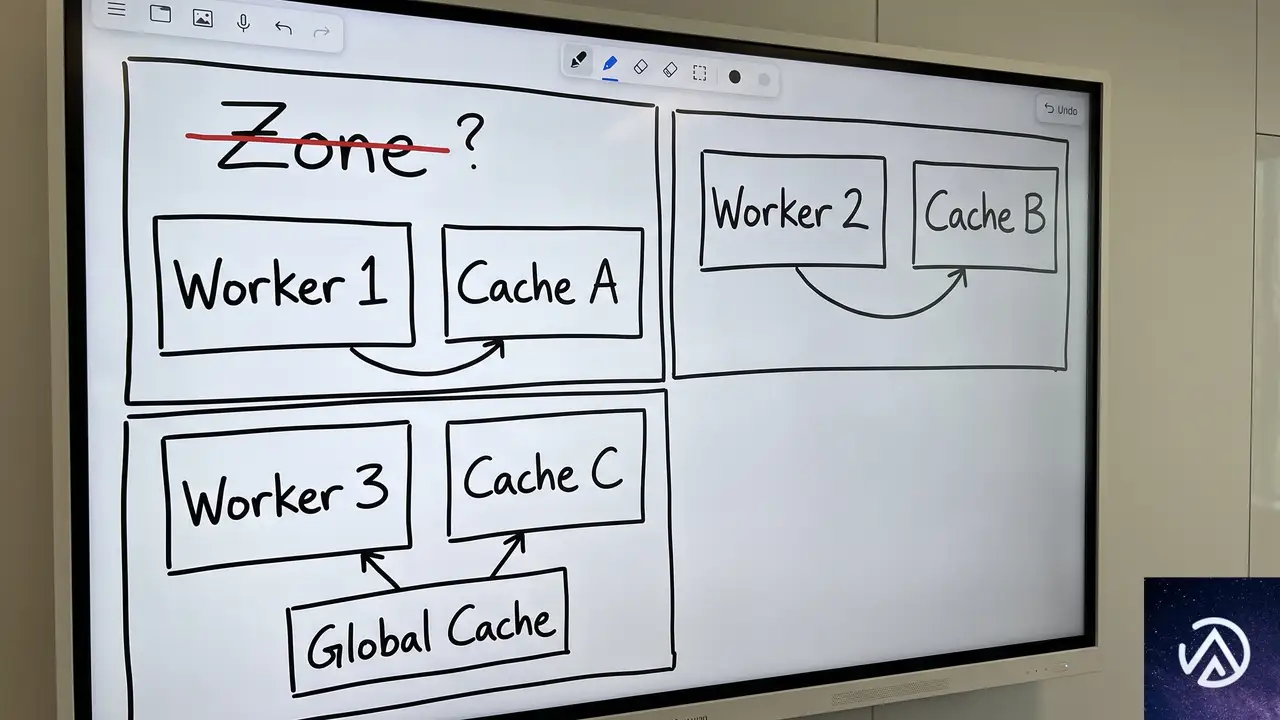
Workers Cacheの最も革新的な部分は、それが「ゾーン(ドメイン)」ではなく「Worker」に紐づくという設計思想にある。この思想が、従来のCDNでは実現できなかったいくつもの高度なユースケースを可能にしている。
特に重要なのが、Workerのエントリーポイントごとにキャッシュの有効・無効を設定できる点だ。設定ファイルでエクスポート名("default"や"CachedBackend")を指定するだけで、認証処理を行うゲートウェイWorkerはキャッシュを無効化し(常にコードを実行するため)、その背後で重い処理を行うバックエンドWorkerだけにキャッシュを有効化する、といった構成が可能になる。
このエントリーポイント単位の制御により、キャッシュはアプリケーションアーキテクチャの一部として自然に組み込めるようになる。単一のWorkerの中に、キャッシュするレイヤーとしないレイヤーを共存させ、それらをコードで自在に結合できるのだ。これは、CDNキャッシュを単一のオリジンの前に置くという従来の考え方とは一線を画す。
マルチテナントを安全にする ctx.props の仕組み
ユーザーごとに異なる情報を返すAPIのキャッシュは、セキュリティ上の大きな課題を伴う。ユーザーAのキャッシュがユーザーBに見えてしまうような事故は、絶対に避けなければならない。Workers Cacheはこの問題を、ctx.propsの一部を自動的にキャッシュキーに含めることで根本的に解決している。
例えば、ゲートウェイWorkerで認証したユーザーIDをctx.propsにセットし、キャッシュが有効なバックエンドWorkerを呼び出すとする。Workers Cacheはこの「ユーザーID」の違いを認識し、ユーザーごとに完全に独立したキャッシュ空間を作り出す。これにより、「認証済みAPIはキャッシュできない」という固定観念を覆し、ユーザー単位で安全にレスポンスをキャッシュできるようになる。Cloudflare Blogによれば、これは他の主要CDNでは提供されていない、Workers Cache独自の強力な利点だという。
Workers Cacheがもたらすプラットフォームとしての進化
パフォーマンスとデータの近接性を両立するアーキテクチャ
Webパフォーマンスにおいては、コードを「ユーザーの近く」で実行するのと「データの近く」で実行するのは、しばしばトレードオフの関係になる。Workers Cacheはこのジレンマに対して、キャッシュを「糊(にかわ)」として利用する解決策を提示する。
具体的には、次のような構成が現実的になる。ユーザーの近くで動き、認証やルーティングといった軽量な処理を担当するWorker Aを配置する。一方、データベースへの重いクエリやレンダリングを実行するWorker Bを、Smart Placement機能でデータの近くに配置する。Workers Cacheは、このWorker Bの手前にのみ配置する。
リクエストが来ると、Worker Aが処理した後、サービスバインディングを通じてWorker Bを呼び出す。この時、Worker Bのキャッシュがヒットすれば、データの近くにあるWorker Bは実行されることなく、ユーザーの近くにあるキャッシュからレスポンスが返る。キャッシュミス時のみ、実際のデータへのアクセスが発生する。これにより、「ユーザー近接性」と「データ近接性」の良いとこ取りが可能になるのだ。
フレームワークとの統合とコストの透明性
Workers CacheはすでにAstroフレームワークのアダプターでネイティブサポートされている。設定ファイルに数行追加するだけで、ページ単位のTTLやタグベースのキャッシュパージが利用できる。TanStack StartやNext.js(Vinext経由)など他のフレームワークへの統合も現在進行中だ。
コスト面も明快だ。Workers Cacheのキャッシュヒット時は、通常のリクエスト課金は発生するが、WorkerのCPU実行時間に対する課金はゼロになる。キャッシュストレージに対する追加のGB単位の課金もないため、コスト削減効果を予測しやすい。ダッシュボードでは、キャッシュヒット率やヒット/ミス/バイパスの内訳が確認でき、パフォーマンスチューニングに必要なデータが一元管理されている。
この記事のポイント
- Workers Cacheは、Workerの手前に専用の階層型キャッシュを配置する新機能である。
- これにより、サーバーサイドアプリが静的サイトのような速度を実現しつつ、CPU実行コストを削減できる。
stale-while-revalidateの完全サポートにより、キャッシュ更新中もユーザーを待たせない。- ゾーンではなくWorkerに紐づく設計により、エントリーポイント単位で柔軟なキャッシュ戦略をコードで記述できる。
ctx.propsをキャッシュキーに含めることで、マルチテナント環境でも安全なキャッシュが実現する。

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubが依存関係のライセンス遵守を自動化する新機能を発表
GitHubは2026年6月30日、オープンソースの依存関係におけるライセンス遵守を自動化する「License Compliance」機能を公開プレビューとして発表した。GitHub Advanced Security(GHAS)のCode Securityライセンスを持つEnterprise Cloudユーザーが対象だ。
この機能はPull Request上で新たに追加される依存関係のライセンスを自動スキャンし、組織のポリシーに反するものがあればアラートを出す。GitHub自身のOpen Source Program Office(OSPO)も数カ月前からこの機能に移行し、社内ツールを置き換えた実績がある。
ソフトウェア開発において依存関係のライセンス管理は、後回しにされがちな領域だ。しかし、ライセンス違反は訴訟リスクやコードの公開義務といった深刻な結果を招く。この記事では、GitHubの新機能の仕組みと、実際に運用する組織がどのようにポリシーを設計すべきかを解説する。
オープンソースライセンスの遵守が企業にとって重大な理由

ほぼすべてのソフトウェアには何らかのライセンスが付与されている。ライセンスはそのプロジェクトを利用する許可を与えるが、同時に遵守すべき義務も課す。義務の内容は、ドキュメントに原著作者のクレジットを記載するだけの緩やかなものから、プログラムを配布する際に自社の全ソースコードを公開しなければならない強力なものまで幅広い。
商用ソフトウェアにおけるリスク
商用のクローズドソース製品を販売する組織であれば、GPL系のライセンスを持つ依存関係をうっかり混入させると、自社のプロプライエタリなコード全体をオープンソース化せざるを得なくなる可能性がある。これはビジネスモデルを根底から覆す致命的な事態だ。
逆に、自社プロジェクトをオープンソースとして公開する予定があるなら、商用ライセンスや互換性のないオープンソースライセンスの依存関係を避ける必要がある。いずれにせよ、ライセンス義務を満たせない依存関係は排除しなければならない。後から該当ライセンスのコードを除去するには大きな工学的コストがかかるし、企業ソフトウェアにとって違反のビジネスリスクは甚大だ。高額な訴訟やレピュテーションの損傷に直結する。
従来のレビュー手法とその限界
これまでライセンスレビューは手作業か、サードパーティ製ツールで行われてきた。しかし、依存関係が増えるたびに人手でライセンスを確認するのは現実的ではない。ツールを使うにしても、開発フローとは別の場所でチェックが走るため、問題が見つかった時点では既にコードがマージされた後、というケースも少なくなかった。
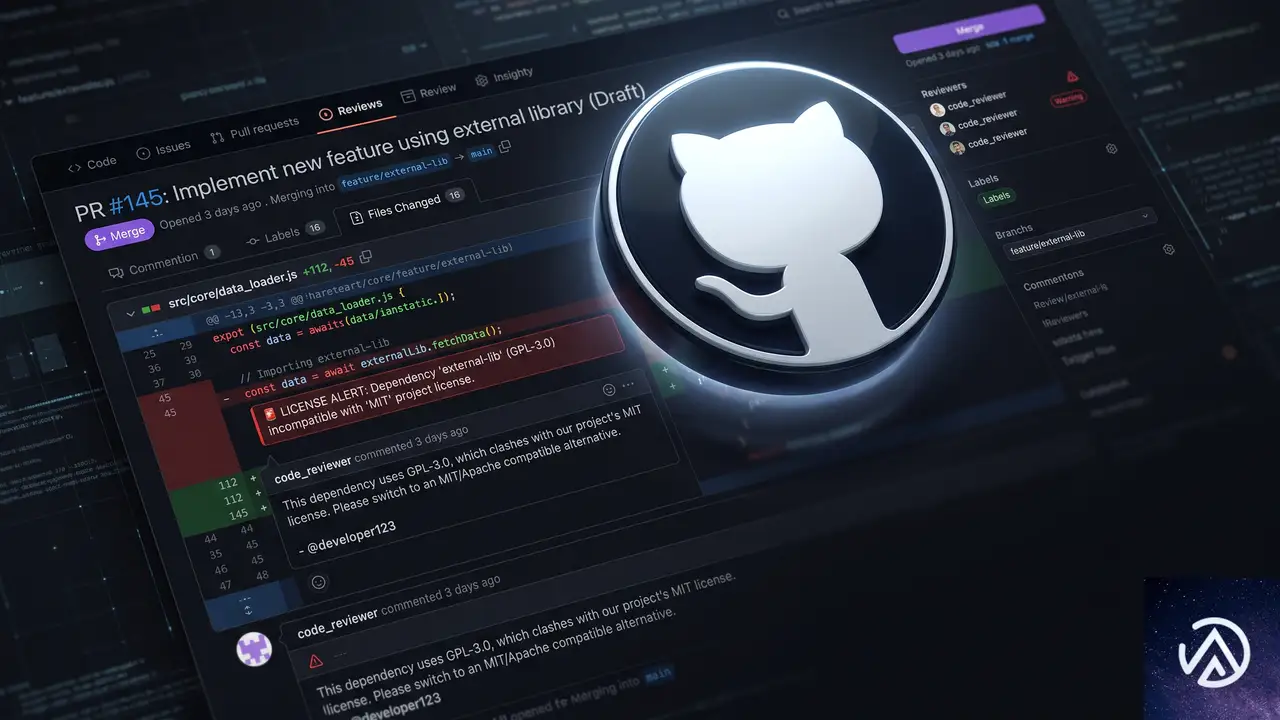
GitHubのLicense Compliance機能はこの課題に直接アプローチする。Pull Requestの段階で新しい依存関係をスキャンし、ポリシーに合致しないライセンスがあれば、マージ前に開発者へフィードバックを返す。開発フローに組み込まれた「シフトレフト」なアプローチだ。
GitHubのLicense Compliance機能の仕組み
この機能は、リポジトリに適用するルールセット(ruleset)を通じて有効化される。カスタムプロパティを使って対象リポジトリを指定し、「Active」モードか「Evaluate」モードかを選択する仕組みだ。
ルールセットの対象となったリポジトリでは、依存関係を変更するPull Requestが作成されると自動スキャンが走る。新しい依存関係それぞれのライセンスを照会し、既に許可済みのライセンスやパッケージ固有の例外に該当すればチェックをパスする。問題がある場合は、直接の依存関係だけでなく推移的依存関係(依存関係がさらに依存しているパッケージ)についても、Pull Requestのコメントとしてアラートが投稿される。
開発者から見たフロー
開発者はアラートを受け取ったら、その依存関係が受け入れ可能かどうかを判断する。受け入れられないと判断すれば、コードを修正するかPull Requestをクローズして依存関係を除去する。一方、そのライセンスやパッケージを許可すべきだと考えた場合は、例外申請を上げることができる。申請は組織内のポリシーチームに通知され、ポリシーを修正するかどうかが判断される。
GitHub OSPOの運用実績
GitHub自身のOSPOは、この機能が社内公開される前からアーリーアダプターとして利用してきた。当初は組織全体のルールセットに「Evaluate」モードを適用し、Pull Requestにアノテーションを表示するだけでマージはブロックしない設定でスタートした。これにより、開発者が新しいワークフローに慣れる時間を確保しつつ、旧来の社内ツールと並行稼働させて挙動の差異を検証したという。
約1カ月の並行稼働を経て、アラートの大半が「通常とは異なるライセンス」「ライセンス情報の欠落」「明示的に禁止されたライセンス」に絞り込まれた段階で、Activeモードへ移行した。大規模で動きの速い企業でも、段階的なロールアウトによって摩擦を最小化できる好例といえる。
ポリシー設計の実践アプローチ

効果的なライセンスコンプライアンスを実現するには、適切なポリシー設計が不可欠だ。GitHub OSPOの経験から、以下の3段階で考えると整理しやすい。
重要なのは、ポリシーを「作って終わり」にしないことだ。新しいライセンスやパッケージ固有の例外は、ポリシーチームが継続的に審査し、必要に応じて追加していく。この運用プロセスが整っていないと、開発者は Pull Request がブロックされたまま放置される「ポリシー渋滞」に巻き込まれる。
ライセンス許可とパッケージ例外の使い分け
ポリシー修正には大きく2つの判断軸がある。「ライセンスそのものを許可する」か「特定のパッケージだけを例外として許可する」かだ。さらに、その許可を「Enterprise全体(組織全体)」に適用するか「特定のリポジトリのみ」に限定するかも決定する。
安全なライセンスで単に初出だっただけなら、Enterpriseレベルでライセンスを追加すれば済む。一方、商用ライセンスのパッケージで、特定のチームだけが購入済みのソフトウェアなら、そのリポジトリだけに例外を設定する。パッケージ例外にはワイルドカードマッチが使えるため、例えば @github-ui/* のような形で名前空間単位の許可も可能だ。
緊急時のオーバーライドと開発者教育

ライセンスポリシーによってPull Requestがブロックされる仕組みは強力だが、クリティカルな修正を緊急でマージしなければならない場面も想定しておく必要がある。GitHub OSPOは「ブレークグラス(緊急時オーバーライド)」の手順を整備している。
仕組みはシンプルだ。ルールセットの条件はカスタムプロパティの値を参照しているため、そのプロパティ値を切り替えるだけで一時的にポリシー適用を無効化できる。GitHub OSPOのこれまでの運用では、このオーバーライドを使ったのは1度だけだったという。頻繁に使うものではないが、いざという時に選択肢があることが重要だ。
開発者へのトレーニングとドキュメント
ツールを導入するだけでは不十分だ。開発者が「なぜライセンス遵守が自分ごとなのか」を理解していなければ、例外申請のプロセスは形骸化する。GitHub OSPOは社内向けのドキュメントとトレーニングを提供し、ライセンスコンプライアンスが全員の責務であるという認識を浸透させている。
開発者が情報に基づいた依存関係の選択をできるようになれば、後からの修正作業や法的トラブルを未然に防げる。ライセンス遵守は「コンプライアンス部門だけの仕事」ではなく、サプライチェーン全体で取り組むべき課題だ。
依存関係管理のこれから
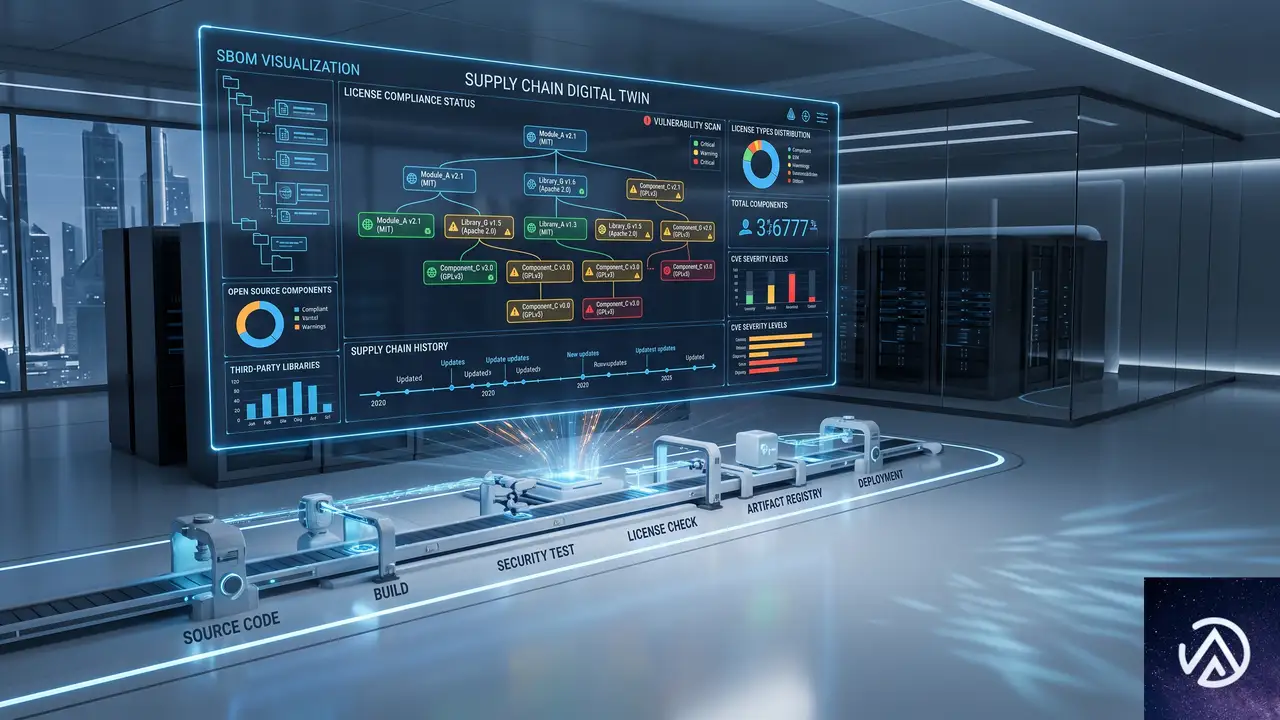
ソフトウェアサプライチェーンのセキュリティとコンプライアンスは、近年急速に注目を集めている領域だ。SBOM(Software Bill of Materials)の普及や、米国大統領令によるソフトウェアサプライチェーンセキュリティの強化など、規制面からの要請も強まっている。
GitHubのLicense Compliance機能は、こうした流れの中で「Pull Request時点でライセンスをチェックする」というプラクティスを標準化しようとする試みだ。開発フローに自然に溶け込む形で提供されるため、導入障壁は従来のサードパーティツールよりも低い。
現時点ではパブリックプレビューであり、対象はGitHub Enterprise CloudでGHAS Code Securityライセンスを保有するユーザーに限られる。しかし、GitHub自身が大規模な組織で実績を積んでいる点は、導入を検討する企業にとって心強い材料だろう。
この記事のポイント
- GitHubが依存関係のライセンス遵守をPull Request上で自動チェックする新機能を公開プレビューとして発表した
- ルールセットを通じてリポジトリ単位で適用し、Evaluateモードから段階的に導入できる
- GitHub自身のOSPOがアーリーアダプターとして社内で運用実績を積んでいる
- ライセンス違反は訴訟リスクやソースコード公開義務といった深刻な結果を招くため、開発フローへの組み込みが重要
- ポリシー設計は「基本ライセンスの登録 → Evaluateモード → Activeモード」の3段階で進めるのが現実的
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Nano Banana 2 LiteとGemini Omni Flash登場、高速画像生成と動画編集がAPIで利用可能に
Google DeepMindは2026年6月30日、高速画像生成モデル「Nano Banana 2 Lite」と、動画生成・編集モデル「Gemini Omni Flash」を開発者向けに公開した。どちらもGoogle AI StudioとGemini APIから即日利用できる。
Nano Banana 2 Liteはテキストから画像をわずか4秒で生成し、1,000枚あたり0.034ドルという低コストが売りだ。Gemini Omni Flashは自然言語による動画編集と高品質な動画生成を両立し、1秒あたり0.10ドルで提供される。
この2つのモデルを組み合わせることで、画像を生成して即座に動画化するといったマルチメディア制作のワークフローが一気に加速する。本記事では各モデルの性能、活用シナリオ、連携方法を詳しく見ていく。
Nano Banana 2 Liteの概要と位置づけ

Nano Banana 2 Lite(モデル名 gemini-3.1-flash-lite-image)は、Nano Bananaファミリーの中で最も高速かつ低コストな画像生成モデルだ。主に短時間でのプロトタイピングや大量の画像生成が必要な開発パイプラインを想定している。
旧モデルであるNano Banana(gemini-2.5-flash-image)からの置き換えが推奨されており、差し替えるだけで速度・品質・コストのすべてで改善が見込める。
速度とコストの具体的な数値
- レイテンシ(処理時間) テキストから画像を出力するまでの時間は約4秒。対話的なプロトタイピングや下書き用途に向く。
- 料金 1,000枚あたり0.034ドル。大量生成や予算管理が求められるプロジェクトでコストを抑えやすい。
- 品質のバランス 速度優先ながら、プロンプトへの忠実度・キャラクターの一貫性・画像内テキストの可読性は確保されている。
Nano Bananaファミリー全体の比較
Nano Bananaシリーズには4つのモデルが存在し、用途に応じて使い分ける設計だ。以下が各モデルの位置づけである。
開発者は自分たちのプロジェクトが「速度」を求めるのか「品質」を求めるのかによって、Lite・標準・Proを切り替えられる。たとえば広告バナーの大量生成ならNano Banana 2 Lite、製品写真の精密な加工ならNano Banana Proといった使い分けが現実的だ。
Gemini Omni Flashがもたらす動画編集の変化
Gemini Omni Flash(gemini-omni-flash-preview)は、テキスト・画像・動画を組み合わせたマルチモーダル入力をネイティブに扱い、高品質な動画生成と会話型編集を実現するモデルだ。2026年5月のGoogle I/Oで発表され、今回初めてGemini APIとGoogle AI Studioに公開された。
料金は出力動画1秒あたり0.10ドル。Veo 3.1 Fastと同水準であり、動画生成AIとしては競争力のある価格設定だ。
4つの得意領域
従来の動画生成AIでは「1回のプロンプトで動画を出力して終わり」という単発的な使い方が多かった。Omni Flashは会話を重ねながら微調整できる点が大きく異なる。動画の一部だけを修正したり、複数回の編集を積み重ねたりするワークフローが自然に回せるようになる。
現在の制限事項
- 生成できる動画の長さは現時点で10秒まで。長時間の動画生成は今後対応予定。
- 音声参照のアップロードとシーン延長機能は、今回のAPIでは未サポート。
- APIの仕様上は3秒までの動画参照を受け付けるが、現時点では正しく処理されない。
- シーン切り替えやパン(カメラの横移動)時のキャラクター一貫性に制限あり。改善中。
「10秒制限」は短く感じるかもしれないが、SNS向けショート動画やeコマースの商品紹介動画であれば十分な長さだ。3秒の動画参照制限についても、短いクリップを下敷きにした編集という使い方であれば実用範囲内といえる。
2つのモデルを連携させた実践ワークフロー

Nano Banana 2 LiteとGemini Omni Flashの真価は、両者を組み合わせることで発揮される。具体的には次のような流れだ。
Interactions APIを使うことでセッション履歴とコンテキストが保持されるため、ユーザーは最大3回まで連続した編集を積み重ねられる。1回の生成で終わらない、試行錯誤を前提としたクリエイティブ制作に適した設計だ。
公式デモアプリに見る実用例
Google DeepMindは両モデルを組み合わせた3つのデモアプリを公開している。いずれもGoogle AI Studio上で動作し、ソースコードをリミックスして自社サービスに組み込める。
これらのデモは、画像生成と動画編集を別々のAIに任せるのではなく、一つのワークフローとして統合することで生まれる価値を示している。eコマース事業者であれば、商品写真のバリエーションを大量生成し、その中から選んだ数枚だけを動画化するといった効率的な運用が可能になる。
開発者が知っておくべき安全性とモデル情報
両モデルともGoogleのセキュアなインフラ上で動作し、SynthIDによる電子透かし(ウォーターマーク)が埋め込まれる。SynthIDはAI生成コンテンツであることを検証可能にする技術で、GeminiアプリやChrome、Google検索を通じてコンテンツの来歴を確認できる。
すでにNano Banana 2 Liteは検索のAI Mode、Geminiアプリ、NotebookLM、Google Photos、Stitch、Google Flow、Google Adsなど、Googleの一般向けサービスにも順次展開されている。
API経由での利用にあたっては、各モデルの詳細な機能やリージョン別の制限が公式ドキュメントにまとめられている。開発を始める前に、Google AI Studioのプレイグラウンドで実際の挙動を試すのが確実だ。
この記事のポイント
- Nano Banana 2 Liteは4秒で画像を生成し、1,000枚あたり0.034ドルの低コストで利用できる
- Gemini Omni Flashは自然言語による動画編集と高品質な動画生成を両立し、1秒あたり0.10ドルで提供される
- 両モデルを連携させると、画像生成から動画化・編集までを一貫したワークフローで回せる
- Google AI StudioとGemini APIから即日利用可能で、具体的なデモアプリも公開済み
- SynthIDによるAI生成コンテンツの検証機能が組み込まれており、商用利用にも配慮されている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
VS Code 1.127リリース、エージェントブラウザツールがGAに
VS Code 1.127が2026年7月1日に公開された。今回のアップデートの焦点は、エージェント機能向けの統合ブラウザツールがプレビューを経て一般提供(GA)になった点と、エージェントウィンドウのセッション管理が大幅に強化された点にある。
ブラウザツールによって、AIエージェントはVS Code内のブラウザでページを開き、スクリーンショットを取得し、クリック操作まで行えるようになる。セッション管理ではグループ化やドラッグ&ドロップ、チャット入力バナーによるCI/CD統合、マルチチャットの改善が含まれ、開発者の生産性を高める機能が多数追加された。
エージェント向けブラウザツールが一般提供に、サイトごとの権限制御も実装

「ブラウザツール」の概要とGA化の意義
エージェント向けブラウザツールは、VS Codeの統合ブラウザ上でAIエージェントがWebアプリを開き、コンテンツの読み取り、コンソールエラーの取得、スクリーンショット撮影、さらにはクリックや入力といった操作を自律的に行えるようにする機能だ。これまでプレビューとして提供されていたが、1.127で一般提供へ移行し、デフォルトで有効化された。
このツールにより、エージェントは「Webアプリを構築して」という指示に対し、コード生成だけでなく実際のブラウザ上での表示確認やエラー検出、修正までをひとつのループで完結させられる。従来は開発者が逐一ブラウザで確認し、エージェントに修正を依頼する手間があったが、そのサイクルが自動化される。外部のMCPサーバーを用意する必要もない。
管理者はエンタープライズポリシーでブラウザツールの利用を制御できる。BrowserChatToolsポリシーで機能自体を無効化したり、エージェントネットワークフィルタリングによってアクセス可能なドメインを制限したりすることが可能だ。
ブラウザツールを活用すると、エージェントが独力でビルドからテスト、修正までのサイクルを回せる。開発者が手動で行っていた確認作業の大部分が自動化され、より高次の設計やレビューに集中できるようになる。
カメラや位置情報などサイト単位の権限制御
統合ブラウザにサイト単位の権限設定が追加された。ページがカメラ、マイク、位置情報、加速度センサー、Bluetooth、USBなどのWeb APIを要求した際、通常のブラウザと同様に許可・拒否のプロンプトが表示される。許可した内容は「サイト権限」メニューから一括管理できる。
これにより、ビデオ会議やフィットネス系Webアプリのテストなど、従来は統合ブラウザでは動作が制限されていたシナリオでもエージェント検証が可能になる。エージェントがカメラ映像を解析する必要があるテストも、この権限制御のもとで安全に実施できる。
エージェントセッション管理が大幅強化、グループ化やマルチチャットで並行作業を効率化

セッションをグループで整理し、ドラッグ&ドロップで並べ替え
エージェントウィンドウのセッションリストにグループ機能が追加された。複数のセッションを任意のグループにまとめられ、グループヘッダーを折りたたむことでリストを整理できる。各グループには「新しいセッションを開始」「グループ内の全セッションを完了としてマーク」といったクイックアクションも用意されている。
ドラッグ&ドロップにも新たに対応し、セッションの並べ替えやグループ間の移動、ピン留めが直感的に行える。複数セッションを選択してまとめて移動することも可能だ。
チャット入力バナーでプルリクエストのCI失敗やレビューコメントに即対応
エージェントがプルリクエストを作成しているセッションでは、チャット入力欄の真上にバナーが表示される。CIチェックが失敗した場合は「2 of 5 checks failed」といった件数とともに「チェックを修正」「詳細を表示」のアクションボタンが現れ、新たなレビューコメントが届いた際も同様に「コメントに対処」「コメントを表示」がワンクリックで実行できる。
従来はGitHubの画面を開いて状況を確認し、別途エージェントに指示を出す必要があった。このバナーにより、会話の流れを中断せずにエージェントへ修正を委ねられる。
チャット入力バナーにより、プルリクエストのCI失敗やレビューコメントが即座に可視化され、対応のリードタイムが短縮される。開発者がコンテキストを切り替える頻度も減るため、集中力を保ちやすい。
マルチチャットセッションの改善とエディタガターからのフィードバック
ひとつのエージェントホストセッション内で複数のチャットを走らせるマルチチャット機能にも改良が加わった。タブでチャットを切り替えられ、不要なチャットは閉じて非表示にし、後から「会話」ドロップダウンで再表示できる。完全に削除したい場合はタブのコンテキストメニューから「チャットを削除」を選択する。
進捗状況とファイル変更は全チャットで集約されるようになった。ひとつのチャットが作業中であればセッション全体が進行中と表示され、各タブにも個別の進捗が示される。セッションヘッダーの「Changes」ピルには、すべてのピアチャットの編集内容が合算されるため、並行して行われている変更の全容を把握しやすくなった。
会話のフォークも改善され、マルチチャットセッション内ではフォークが新たなピアチャットとして作成される。フォークしたチャットは分岐点までの会話を引き継ぎ、兄弟チャットとは独立して動作する。エディタのガターからは直接フィードバックを追加できるようになり、エージェントに修正してほしい行をホバー操作で即座に指摘できる。
チャットとターミナルの新機能、コスト管理の透明化

/troubleshootコマンドでエージェントの動作を診断
エージェントの動作に問題がある場合に利用できる/troubleshootコマンドが拡張され、エージェントホストセッションも診断対象になった。チャット入力欄で/troubleshootを入力し、続けて#sessionで特定のセッションを選択し、質問や問題の説明を追加すると、チャットログを解析してエージェントの振る舞いに関するインサイトを提示する。カスタム指示が無視される理由や応答が遅い原因の調査に役立つ。
ターミナルコマンドのサンドボックス化(macOSとLinux)
エージェントが実行するターミナルコマンドを、ネットワークアクセスを遮断しファイルシステムへのアクセスを制限したサンドボックス内で動作させる機能がmacOSとLinux向けに展開された。コマンドをサンドボックス外で実行する必要がある場合にのみエージェントが承認を求める仕組みで、毎回のプロンプト表示頻度が大幅に減る。
この機能はデフォルトで有効だが、権限設定のドロップダウンからオフにすることも可能だ。サンドボックス化によってエージェントの自律性が高まり、定型作業中の中断が少なくなる。開発者の心理的負荷も軽減されるだろう。
ターミナルコマンドのサンドボックス化は、エージェントの自律性を大きく引き上げる。毎回の承認待ちがなくなることで、ビルドからテストまでのパイプラインをエージェントがほぼ自動で進められるようになり、開発者の介入は「昇格が必要な重大操作」に絞られる。
サブエージェントの消費クレジットをホバー表示
エージェントがサブエージェントに作業を委譲した際、どの程度のAIクレジットが消費されたかが分かりにくいという課題があった。今回のアップデートで、チャット応答内のサブエージェントセクションにマウスカーソルを合わせると、そのサブエージェントが使用したクレジット数が表示されるようになった。コストの透明性が向上し、エージェントの利用計画を立てやすくなる。
Ollama内蔵プロバイダーが非推奨に、公式拡張への移行を推奨
公式Ollama拡張の提供開始と内蔵プロバイダーの非推奨化
モデルプロバイダーを拡張機能として提供する方針が明確化され、Ollamaの公式VS Code拡張がマーケットプレイスで公開された。これに伴い、これまで内蔵されていたOllamaプロバイダーは非推奨となった。ローカルのOllamaモデルをチャットで利用するには、公式拡張をインストールする方法が推奨される。
Bring Your Own Key(BYOK)で内蔵プロバイダーを使っていたユーザーは、公式拡張をインストールした後に内蔵プロバイダーを削除することで、継続してモデルを利用できる。非推奨プロバイダーの削除手順は、VS Code Blogのリリースノート内の動画で確認できる。
公式拡張への移行は、今後のOllamaモデルへの迅速な対応やセキュリティ更新を受け取るためにも重要だ。非推奨プロバイダーは近い将来削除されるため、早めの切り替えが望ましい。
エンタープライズ向け設定をファイル配信可能に、デバイス管理外でも適用
managed-settings.jsonによるCopilot設定の配信
管理者がGitHub Copilotのポリシーを適用する手段として、JSONファイルをOS固有のパスに配置する方式が追加された。MDM(モバイルデバイス管理)に登録されていないマシンや、構成管理システムでファイルを配信する方が簡便な環境で役立つ。macOSでは/Library/Application Support/GitHubCopilot/managed-settings.json、Linuxでは/etc/github-copilot/managed-settings.json、Windowsでは%ProgramFiles%\GitHubCopilot\managed-settings.jsonにファイルを置く。
ファイルのスキーマはGitHub.com上で管理者が設定する場合と同一で、アクセス許可やプラグインの有効・無効を制御できる。このファイルは、MDMやアカウントベースのエンタープライズ設定が存在しない場合にのみ適用されるため、既存の管理手法と競合しない。
この記事のポイント
- エージェント向けブラウザツールが一般提供開始、外部MCPサーバー不要でテスト自動化が可能に
- セッション管理がグループ化・ドラッグ&ドロップ・マルチチャット強化で並行作業の効率が向上
- チャット入力バナーでCI/CDフィードバックをその場で処理、ワークフローが途切れない
- ターミナルコマンドのサンドボックス化でエージェントの自律性が高まり、承認回数が減少
- Ollamaは公式拡張に移行し、内蔵プロバイダーは非推奨へ
- エンタープライズ向けに設定ファイル配信が可能になり、管理対象外端末にもポリシーを適用
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
XMLサイトマップで「XML 宣言はドキュメントの先頭でのみ許可されています」エラーの直し方
XMLサイトマップのURLを開いたときに「XML 宣言はドキュメントの先頭でのみ許可されています」というエラーが表示された場合、原因はほぼ確実に出力の先頭に空行や余計な改行が混入していることにある。この症状は、PHPファイルの末尾の閉じタグ ?> のあとの空白や、プラグイン・テーマが意図せず出力した文字がXML宣言より前に現れることで発生する。解決には、サイトのキャッシュを完全にクリアしたうえで、すべてのプラグインを停止し標準テーマに切り替えて原因を切り分け、問題のファイルから不要な空白を取り除く手順を踏む。
なぜXMLサイトマップに「XML 宣言は先頭でのみ許可」エラーが出るのか
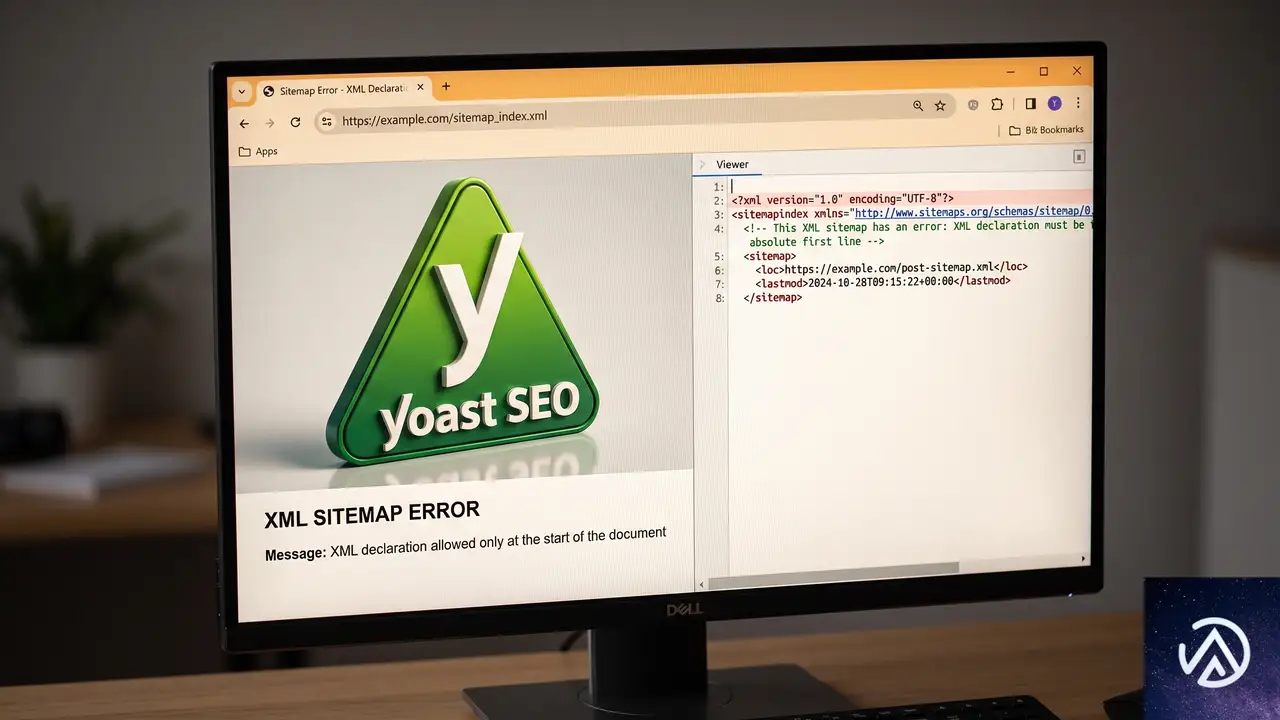
XMLサイトマップはブラウザや検索エンジンが読み取る形式で、文書の最初に <?xml version="1.0" encoding="UTF-8"?> という宣言がなければならない。ところが、この宣言よりも前に空白や改行が1文字でも出力されると、パーサーが「XML宣言はドキュメントの先頭でのみ許可されています」という旨のエラーを返す。
WordPress環境では、PHPスクリプトが実行されて最終的なXMLを生成するが、意図しない場所で echo や ?php 外の空白が出力されると、それが先頭に紛れ込む。代表的なのは、テーマの functions.php やプラグインファイルの末尾に閉じタグ ?> を書いたうえでその後に改行が入っているパターンだ。PHPファイルでは閉じタグを省略することが推奨されており、記述すると余計な空白が出力されるリスクが常につきまとう。
← ここに空白行が存在する
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
<url><loc>https...</loc></url>
</urlset><?xml version="1.0" encoding="UTF-8"?> <urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9"> <url><loc>https...</loc></url> </urlset>
この図のように、たった1行の空行がXML宣言の前に置かれるだけでサイトマップ全体がエラーになる。実際に自分のサイトのサイトマップURLを開き、ページのソースを表示(ブラウザの「ページのソースを表示」機能)すると、1行目に空行が入っていないか容易に確認できる。
空白行の混入源を特定する手順
STEP 1 キャッシュを完全にクリアする
まず、キャッシュ系プラグイン(WP Super CacheやW3 Total Cacheなど)のキャッシュをすべて削除する。サーバー側のキャッシュが有効な場合、そちらも管理パネルからクリアする。さらにブラウザのキャッシュも念のため削除しておくと、変更がすぐに反映される。
STEP 2 全プラグインを無効化し標準テーマに切り替える
プラグイン画面からすべてのプラグインを一括で無効化する。その際、SEOプラグイン(Yoast SEOなど)も例外なく停止する。その後、外観→テーマで「Twenty Twenty-Five」など公式の標準テーマを有効化する。この状態がいわゆる「切り分けの初期状態」になる。
もし管理画面にすら入れない障害がある場合は、FTPソフトやレンタルサーバーのファイルマネージャーで /wp-content/plugins/ ディレクトリごとリネームする方法でも一括無効化できる。
STEP 3 サイトマップを開きエラーが消えたか確認する
プラグインを無効にして標準テーマの状態で、Yoast SEOのサイトマップURL(通常 /sitemap_index.xml)にアクセスする。この時点でエラーが消え、正常なXMLが表示されれば、テーマやプラグインのいずれかが原因だと確定できる。
STEP 4 原因のプラグインかテーマを特定する
1つずつプラグインを有効化しながらサイトマップを確認し、エラーが再発するタイミングを探る。エラーが出た時点で最後に有効化したプラグインが原因だ。テーマの場合は、標準テーマで問題が消えた段階で疑いが濃くなる。自作ブロックテーマやカスタムブロックを使っているなら、そのテーマの functions.php に余計な空白がないかも確認しよう。
空白を出力しているファイルを修正する具体的方法
原因が特定できたら、実際のPHPファイルを編集して不要な空白を取り除く。典型的な作業は次のとおりだ。
閉じタグ ?> を削除する PHPファイルの末尾に ?> が記述されていると、その後の改行が出力の先頭に混入する。ファイルの最終行が ?> で終わっている場合は、この閉じタグをまるごと削除する。PHPではファイル末尾の閉じタグが省略可能で、むしろ推奨されていない。削除後に空行が残っていればそれも取り除く。
ファイルの先頭と末尾の空白を確認する <?php の前や、ファイルの最終行より後ろに空白がないかエディタで確認する。改行やスペースが残っている場合はそれらを削除する。複数の開発者が触るテーマでは、意図せず混入していることが多い。
プラグインやテーマのファイルを直接編集する FTPクライアントやレンタルサーバーのファイルマネージャー、あるいはWordPress管理画面の「プラグインファイルエディター」「テーマファイルエディター」を使って該当ファイルを開き修正する。編集後は必ず再度キャッシュをクリアしてからサイトマップを確認する。
キャッシュとPHP設定が影響するケース
空白行が混入していなくても、キャッシュが原因でエラーが表示され続けることがある。ページキャッシュがXML出力の古い状態を保持していると、修正後もエラーが消えないように見える。以下の点を必ず実施しよう。
WP Super Cacheなどキャッシュプラグインのキャッシュを完全に削除する
キャッシュプラグインの設定画面にある「キャッシュを削除」「全キャッシュを削除」といったボタンで全データをクリアする。さらに、サイトマップURLにクエリパラメータ(例 ?nocache=1)を付けてアクセスすることでキャッシュを通さずに表示し、エラーの有無を確認できる。
PHPのメモリ制限は256MBあれば十分だが512MBにしても直らない
メモリ不足が原因で似たエラーが出ることはあるが、今回の「XML宣言は先頭のみ」というエラーはメモリとは無関係であることがほとんどだ。実際に256Mから512Mに増やしても改善しなかったという報告も多い。メモリ増加で解決しなかった場合は迷わず空白行の調査に戻る。
よくある質問
サイトマップのエラーが特定の投稿タイプ(例 商品)でのみ発生するのはなぜか
WooCommerceの商品サイトマップなど、特定の投稿タイプだけ別のファイルで生成される場合、その処理を行うプラグインやテーマの該当部分に空白が混入している可能性が高い。原因箇所を特定するには、SEOプラグインが生成する個別のサイトマップURL(product-sitemap.xmlなど)に直接アクセスし、同じ手順で切り分けを行う。
空白行を削除してもエラーが直らない場合に次に試すことは
キャッシュの削除漏れや、サーバー側のVarnishやCDNがXMLをキャッシュしている可能性を疑う。また、wp-config.php ファイルの先頭や末尾に空白が入っているケースも、サイト全体の出力に影響を及ぼすため確認する。さらに、PHPの出力バッファリングが影響している場合もあるが、まずは wp-config.php まで含めた全ファイルの空白確認を徹底する。
Health Checkトラブルシューティングプラグインは役に立つのか
Health Check & Troubleshootingプラグインは、管理画面からセッションベースでプラグインの停止やテーマの切り替えを安全に行えるため、切り分け作業を効率化できる。有効化して「トラブルシューティングモード」に入れば、他の訪問者には影響を与えずにテストできる。ただし、空白行の直接の修正までは行わないため、あくまで原因特定の補助ツールとして使う。
Yoast SEOのXMLサイトマップキャッシュを個別にクリアする方法は
Yoast SEOはサイトマップの生成結果をキャッシュしないが、外部のキャッシュプラグインと競合することがある。Yoast SEO側で直接キャッシュをクリアする機能はないため、前述のようにサイト全体のキャッシュを削除し、可能ならSEOプラグインを一度無効化してから再度有効化すると、内部のトランジェントが更新されて問題が解消されることもある。
オリジナルブロックテーマを使っているが、どこに注意すればよいか
ブロックテーマでは functions.php の末尾に空白が入っていないか、そしてカスタムブロックのプラグインとしてのPHPファイル(ブロックの動的レンダリング部分)に閉じタグ ?> と空白が残っていないかを必ずチェックする。自作ブロックは開発時にテストを繰り返すため、ファイル末尾の処理が甘くなりがちで、意外な場所から空白が出力されることがある。
この記事のポイント
- エラーの直接原因はXML宣言より前に出力された空白行か改行である
- キャッシュを完全にクリアし、全プラグイン無効化と標準テーマ切り替えで切り分ける
- PHPファイル末尾の閉じタグ
?>とその後ろの空白を削除する wp-config.phpの先頭・末尾や自作テーマのファイルも忘れずに確認する- メモリ増加ではこのエラーはまず直らないため空白行調査に集中する

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
Safari MCP ServerでAIデバッグ、SEOとCWV改善の新時代
Safari MCP Serverとは何か、その本質
WebKitチームが2026年7月、Safariブラウザ向けのMCPサーバーを発表した。これはAIエージェントがSafariブラウザの内部データに直接アクセスし、デバッグやパフォーマンス分析を自律的に行うための仕組みである。開発者やSEO担当者が手作業で行っていたSafari固有の問題検出が、AIとの対話によって自動化される可能性を示している。
Safariは世界で2番目に利用者の多いブラウザであり、特に米国市場では25%から30%超のシェアを維持する。日本国内でもiPhoneユーザーを中心に無視できない存在だ。つまり、Safariでサイトが正常に動作しないことは、ビジネス機会の直接的な損失を意味する。今回のMCP対応は、この課題を根底から変える契機となる。
デモが示すように、手動で行っていた一連の作業をAIが肩代わりする。この変化は単なる効率化ではなく、Safari対応の質そのものを底上げする力を持つ。
発表の背景とSafariの市場地位
Statcounterの2026年データによれば、Safariの米国市場シェアは四半期によって25%から33%の間で推移している。モバイルに限定すればさらに高く、iOSデバイスが支配的な日本市場でも同様の傾向だ。Web制作者にとってSafari対応は「できれば対応したい」ではなく「対応しなければ事業機会を逃す」段階に入っている。
しかしSafariは、Chromium系ブラウザとは異なるレンダリングエンジン(WebKit)を採用しており、CSSの解釈やJavaScriptの挙動に差異が生じる。これまではMac実機やSafariの開発者ツールを使い、人間が一つひとつ問題を探る必要があった。この非効率をAIで解決するのが、今回のMCPサーバー投入の狙いだ。
MCPが変えるブラウザとAIの関係
MCP(Model Context Protocol)は、AIモデルが外部のツールやデータソースと安全に通信するためのオープンプロトコルである。Anthropicが2024年に提唱し、いまではWordPressやShopify、Google Search Console、Screaming Frogなど主要なCMSやSEOツールが対応している。ブラウザがMCPに対応するのは自然な流れであり、Safariはその先陣を切った形だ。
従来、AIにデバッグを依頼する際は、開発者が問題状況を文章で詳細に説明する必要があった。状況説明が曖昧だとAIの回答精度も落ちる。Safari MCPサーバーはこの壁を取り払う。AIエージェントが自らブラウザのDOM構造やネットワークリクエストを取得し、問題を直接把握できるようになるからだ。
なぜ今Safariのデバッグが重要なのか

Webサイトの表示崩れや機能不全は、直帰率の上昇とコンバージョン率の低下に直結する。とくにSafariはiOSユーザーという購買意欲の高い層を抱えており、ここでの不具合はECサイトや予約サイトにとって致命的だ。にもかかわらず、Safari固有のバグ検出にはこれまで大きな労力がかかっていた。
さらに、Core Web Vitals(CWV)の評価は検索順位にも影響を与える。Googleのランキングシグナルとして機能するCWVにおいて、Safari上での読み込み遅延やレイアウトシフトが起きていれば、それは検索パフォーマンス全体を引き下げる要因になる。AIデバッグによってこの問題を素早く特定し修正できる意義は大きい。
Safari固有の問題がSEOに与える損害
Safariでは、特定のCSSプロパティ(例えばbackdrop-filterの挙動やscroll-behaviorの解釈)が他ブラウザと異なる。JavaScriptにおいてもResizeObserverのループ制限やIntersection Observerのしきい値処理に差異が見られる。これらの不一致がCWVのスコア悪化を引き起こし、結果として検索順位の低下を招く。
従来は、Mac環境がないチームはSafari検証を後回しにする傾向があった。しかしAIが代わりに検証してくれるなら、開発プロセスの初期段階からSafari互換性を組み込める。SEOの観点では、これはリリース後の急な順位下落リスクを減らす直接的な効果を持つ。
デバッグの民主化がもたらす競争環境の変化
AIエージェントによる自動デバッグは、個人事業主や小規模チームにこそ恩恵が大きい。専任のSafari検証担当者を置けない組織でも、AIがその役割を果たすからだ。大企業と中小企業のあいだにあった「ブラウザ互換性の検証格差」が縮まり、Safari上でのユーザー体験を基準にした真の実力勝負に近づく。
これはSEOの世界においても、小手先のテクニックよりも基本品質がモノを言う時代の到来を意味する。Safari MCPサーバーはその流れを加速させるツールであり、いち早く導入したサイト運営者が優位に立つ構図が予想される。
上記のリストは、Safari MCPサーバーがSEO施策に与えるインパクトを整理したものだ。これらの効果はすべて、従来の手動デバッグでは「時間がかかりすぎるから後回し」とされてきた領域である。AIがこの障壁を取り除く。
MCP(Model Context Protocol)の基礎知識

MCPはAIモデルが外部リソースと対話するための標準プロトコルだ。簡単に言えば「AIのためのUSB規格」のような存在である。USBがあらゆる周辺機器を共通の接続方式で扱えるように、MCPはあらゆるデータソースやツールをAIが共通の手順で扱えるようにする。
従来、AIに特定のタスクを実行させるには、そのツール専用のAPI連携を個別に開発する必要があった。MCPはこの非効率を解消する。SafariがMCPサーバーを提供することで、あらゆるMCP対応AIクライアントがSafariのブラウザ情報にアクセスできるようになった。
MCPのエコシステムと業界全体の動き
MCPはAstroやWordPress、WooCommerce、Shopifyといった主要CMSがすでにサポートを表明している。SEOツールのScreaming FrogもMCPを採用し、Google Search Consoleも対応を進めている。Safariの参入は、このプロトコルがブラウザというWeb技術の最前線にまで到達したことを示すマイルストーンだ。
Search Engine Journalの記事では、この流れを「ブラウザとAIの統合が新たな段階に入った」と評している。AIが単にコードを提案するだけの存在から、実行環境の状態をリアルタイムで把握しながら問題解決する存在へと進化しているのだ。
MCP対応の広がりは、AIエージェントが一つのプロトコルで多様なツールを横断的に操作できる未来を示している。SEO担当者はScreaming FrogとSafariとGoogle Search Consoleのデータを、一つのAI対話の中で統合的に扱えるようになるだろう。
Safari MCP Serverが切り拓くAIデバッグの実態

WebKitの公式発表によれば、Safari MCPサーバーは以下の5つの主要ユースケースを想定している。(1)アクセシビリティテスト、(2)Safari互換性テスト、(3)任意のユーザー状態の検証、(4)Safari上でのWeb開発、(5)Webパフォーマンス分析、である。これらはいずれもSEOに密接に関係する領域だ。
特筆すべきは、AIエージェントが「ブラウザの中で何が起きているかを自分で調べる」能力を得た点だ。公式アナウンスにある「完璧なプロンプトを書く必要がなくなる」という言葉が、この変化の本質を突いている。開発者はAIに「このページのCWVを改善して」と大まかに指示するだけで、AIが必要なデータを収集し分析し提案まで行う。
アクセシビリティとSEOの融合
アクセシビリティテストの自動化は、SEOの観点からも見逃せない。画像のalt属性不足やセマンティックHTMLの欠如は、スクリーンリーダー利用者の体験を損なうだけでなく、検索エンジンのコンテンツ理解も阻害する。AIがSafari上でこれらの問題を自動検出することで、SEOとアクセシビリティの両面改善が同時に進む。
Webパフォーマンス分析の深化
Webパフォーマンス分析では、ネットワークリクエストのタイムラインやDOMの構築過程をAIが精査する。従来のLighthouse監査では検出できなかったSafari固有のボトルネック、例えば特定のフォント読み込みがWebKitでだけ遅延する問題なども、AIが実ブラウザ上で直接観測できる。
この「実機ブラウザベースのパフォーマンス分析」は、合成監視では得られないリアルなデータをもたらす。CWVのフィールドデータとラボデータの乖離に悩まされてきたSEO担当者にとって、Safari MCPサーバーは問題の根本原因を特定する強力な武器になる。
5つのユースケースはそれぞれ独立しているが、実際の開発フローではこれらが複合的に作用する。たとえばアクセシビリティの問題を修正した結果、DOM構造が変わりCWVにも影響が出る、といった連鎖的な改善をAIが一括管理できる点が新しい。
SEOとCore Web Vitalsへの実戦的インパクト

Safari MCPサーバーがSEOにもたらす最大の恩恵は、CWV(Core Web Vitals)のスコア改善スピードが飛躍的に上がることだ。これまでLCP(Largest Contentful Paint)の改善には、どのリソースがクリティカルレンダリングパスを塞いでいるかを人間が特定する必要があった。AIがSafariのネットワークタイムラインを直接解析すれば、この作業は数秒で完了する。
CLS(Cumulative Layout Shift)についても同様だ。Safariはフォントのレンダリング方式や画像の遅延読み込みの挙動がChromium系と微妙に異なり、意図しないレイアウトシフトが発生することがある。AIが実際のSafariブラウザ上で測定することで、ラボツールでは再現できない問題まで捕捉できる。
フィールドデータとラボデータの統合分析
Google Search ConsoleのCWVレポートはフィールドデータに基づくが、問題の原因特定にはラボデータが必要になる。Safari MCPサーバーは、実ブラウザのラボデータをAIが直接取得するため、この二つのデータの橋渡し役を担う。フィールドデータでCWV低下を検知したら、すぐにSafari上でAIデバッグを実行し、具体的な修正案を得られる流れが現実的になる。
AI時代のSEOワークフロー
従来のSEOワークフローは「監視→検出→人間が仮説立案→人間が検証→修正→再測定」というサイクルだった。Safari MCPサーバーの登場により、「監視→AIが検出→AIが原因特定→AIが修正案提示→人間が承認→修正→AIが再検証」という形に変わる。人間の役割は「仮説立案」から「AI提案の判断と承認」へとシフトする。
この変化は、SEO担当者のスキルセットにも影響を与えるだろう。Safari DevToolsを細かく操作する技術よりも、AIに適切な指示を出し、出力結果の品質を見極める能力が重視されるようになる。Search Engine Journalの記事が伝える内容からも、このパラダイムシフトは2026年後半から本格化すると見られる。
このワークフロー比較が示すように、Safari MCPサーバーはSEOオペレーションの速度と精度を根本から変える。人間は戦略判断に集中し、反復的な検証作業はAIに任せるという分業が可能になる。
導入から活用までの具体的ステップ

Safari MCPサーバーは発表されたばかりであり、本格的な実装と提供方法についてはAppleからの続報が待たれる段階だ。しかし、すでにMCPを導入している他ツールの事例から、準備すべき環境と心構えは明確になっている。以下に、現時点で想定される導入ステップを示す。
環境準備とAIクライアントの選定
まず必要なのはMac環境と、MCP対応のAIクライアントだ。Claude Desktopや、Cursor、WindsurfなどMCPをサポートするエディタが候補になる。Safari Technology Previewの最新版にMCPサーバー機能が組み込まれる可能性が高く、WebKit公式ブログのアップデートを追うことが最初の一歩になる。
既存のデバッグフローへの組み込み方
AIデバッグは強力だが、いきなり全工程を任せるのではなく、まずは既存のCWV監視フローの補助として導入するのが現実的だ。たとえば、Search ConsoleでCLS悪化を検知したら、AIにSafari上でのCLS発生箇所の特定を依頼する。AIの提案を人間が評価し、問題なければ本番環境に適用するという段階的なアプローチが失敗を防ぐ。
また、AIの出力にはハルシネーション(もっともらしい誤情報)が含まれる可能性がある。特にCSSの修正提案は、Safariで意図通りに動作するかを必ず実機で確認するプロセスを残すべきだ。AIは検出と提案を高速化するが、最終的な品質保証は人間の役割である。
上記の3ステップは、あくまで現時点での想定に基づく。Safari MCPサーバーの正式リリース時に詳細なドキュメントが公開されるはずだ。WebKit公式ブログやApple Developerサイトの情報を定期的に確認し、最新の導入手順に従うことを推奨する。
この記事のポイント
- Safari MCPサーバーはAIエージェントがブラウザ内部データに直接アクセスしデバッグを自動化する仕組みである
- 米国で25%超のシェアを持つSafariの互換性問題をAIが解決することでSEOとCWVが大幅に改善する
- MCPは業界標準プロトコルとしてWordPressやGoogle Search Consoleも対応しておりエコシステムが拡大している
- 導入はMac環境とMCP対応AIクライアントから始め段階的に既存フローへ組み込むのが現実的な戦略だ
- AIの提案を鵜呑みにせず最終的な品質確認は人間が行うプロセスを維持することが失敗を防ぐ鍵になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CSS疑似クラスでJavaScript代用、状態監視の全貌とevent-triggerの将来像
CSSは状態を追跡するための仕組みを着実に増やしている。かつてはJavaScriptでしか扱えなかったUIの変化を、疑似クラスだけで表現できる場面が広がっているのだ。
:hoverや:focusといった基本的なものから、:autofillや:volume-lockedのような新しい疑似クラスまで、その数は増え続けている。これらをJavaScriptイベントリスナーと比較しながら整理すると、CSSの設計思想がより明確に見えてくる。
ポインター系疑似クラス、UI反応の基本
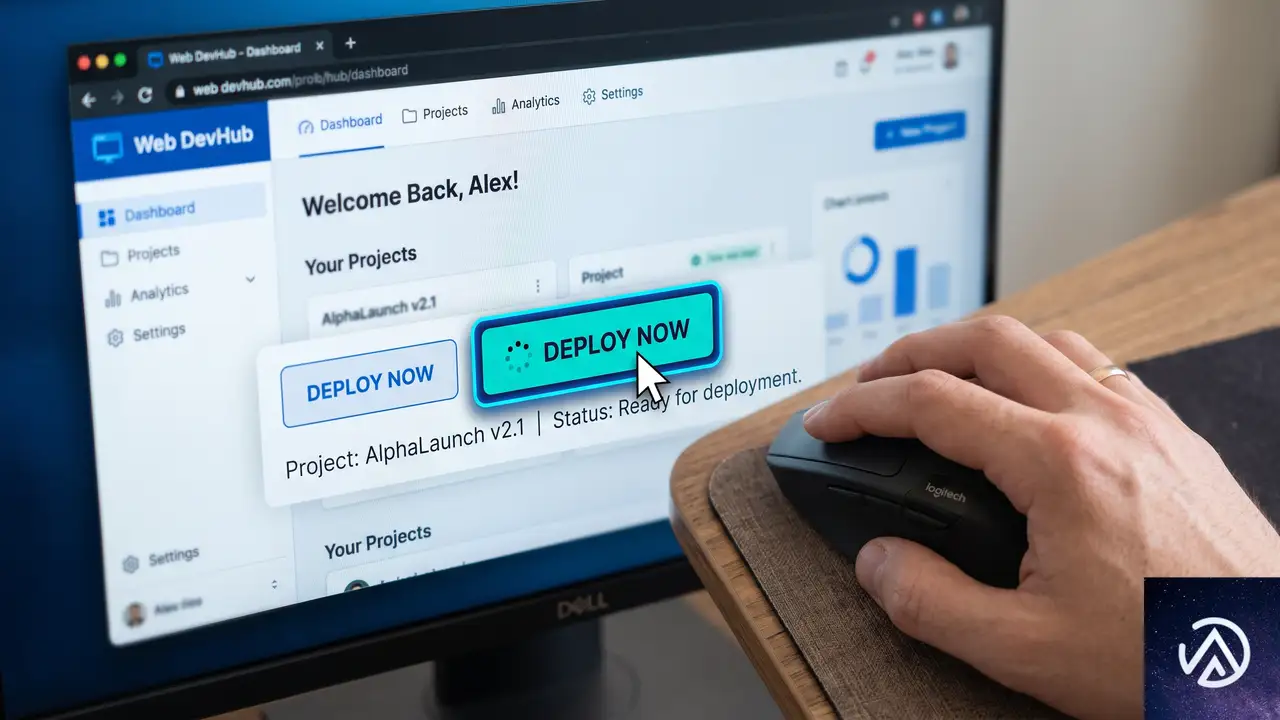
マウスやタッチ操作に反応する疑似クラスは、ウェブデザインの基本だ。:hoverはpointerenterからpointerleaveまでの継続的な状態を表し、:activeは押下中の瞬間を捉える。これらは単なる一時的な出来事ではなく、ブラウザが認識する「状態」として設計されている。
:hoverと:activeの本質
CSS-Tricksの著者Carlo Daniele氏は、疑似クラスが「イベントではなく状態を追跡する」点を強調している。:hoverはpointerenterとpointerleaveという2つのJavaScriptイベントの間を継続的に監視する状態であり、:activeはpointerdownとpointerupの間の押下状態だ。この違いを理解すると、CSSとJavaScriptの適切な役割分担が明確になる。
上記のデモは静的な比較だが、実際の:hoverはカーソルが要素に乗っている間だけ継続する。JavaScriptではpointerenterとpointerleaveを個別に監視する必要があるが、CSSなら1行のセレクタで完結する。この簡潔さがCSSの強みだ。
pointer-eventsプロパティで反応を制御する
pointer-events: noneを指定すると、その要素はポインター関連のイベントを一切発火しなくなる。CSSで直接イベントの発生を抑制できる点は、JavaScriptでpreventDefaultを行うのとは異なる設計思想だ。装飾的なオーバーレイや無効化されたボタンなど、視覚的に存在するが操作対象ではない要素に有効な手法である。
フォーカス系疑似クラス、アクセシビリティの根幹
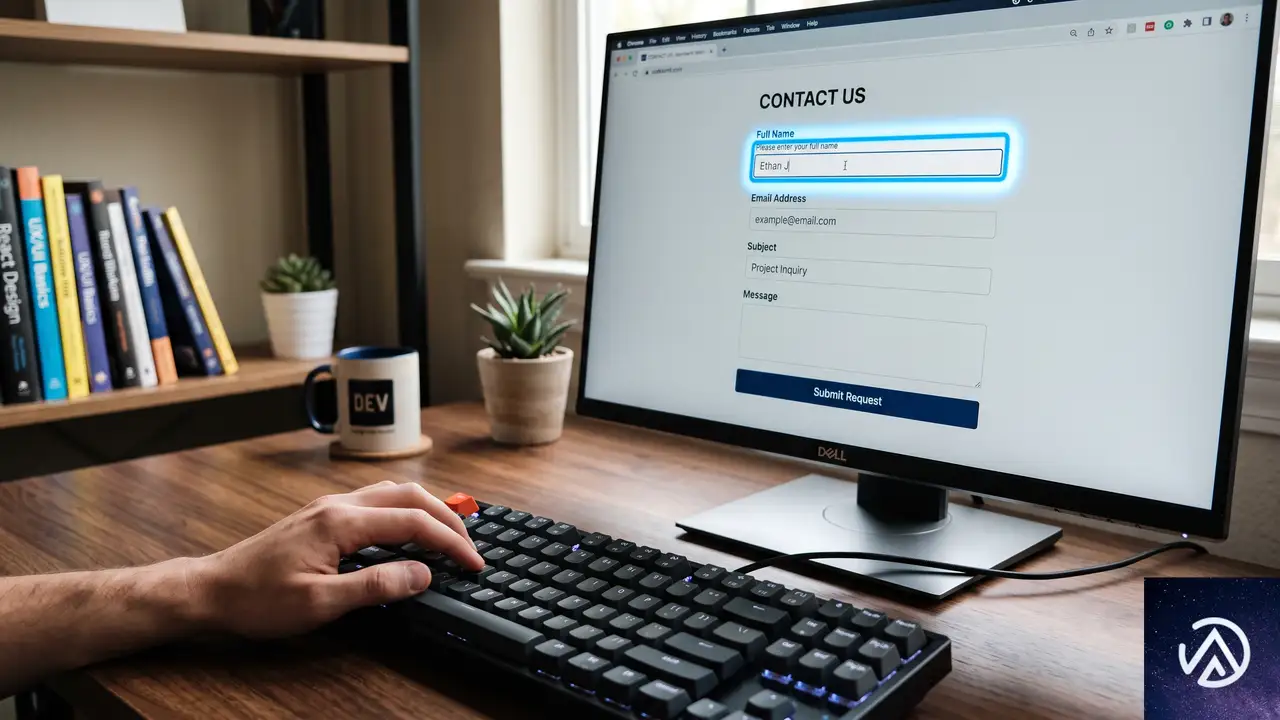
フォーカス管理はユーザビリティとアクセシビリティの両面で重要だ。CSSの疑似クラスは、JavaScriptのfocus/blurイベントよりも直感的にフォーカス状態をスタイリングできる。
:focusと:focus-visibleの使い分け
:focusは要素がフォーカスを受け取った瞬間に発動するが、マウス操作でもキーボード操作でも一律に適用される。一方、:focus-visibleはブラウザのヒューリスティック(経験則)に基づき、フォーカスインジケーターを表示すべきかどうかを判断する。キーボード操作時にはアウトラインを表示し、マウスクリック時には非表示にする、といった制御がCSSだけで可能だ。
JavaScriptで同等の処理を書く場合、:focus-visible疑似クラスをmatchMediaで問い合わせる必要があるが、CSSならセレクタに:focus-visibleを追加するだけで済む。コード量の差は一目瞭然である。
:focus-withinと:has()の比較
:focus-withinは子孫要素がフォーカスを持っている場合に、親要素をスタイリングできる。フォーム全体をハイライトしたいときに便利だ。:has(:focus)も機能的には同等だが、:has()はより汎用的な「条件付き親セレクタ」として設計されており、フォーカス以外の条件にも対応できる。どちらを使うかは文脈次第だが、フォーカス特化の:focus-withinのほうが意図は明確になる。
このように、子要素のフォーカス状態を親要素のスタイルに反映させる仕組みは、JavaScriptでDOMトラバーサルを書くよりも圧倒的にシンプルだ。
フォーム系疑似クラス、バリデーションをCSSで扱う
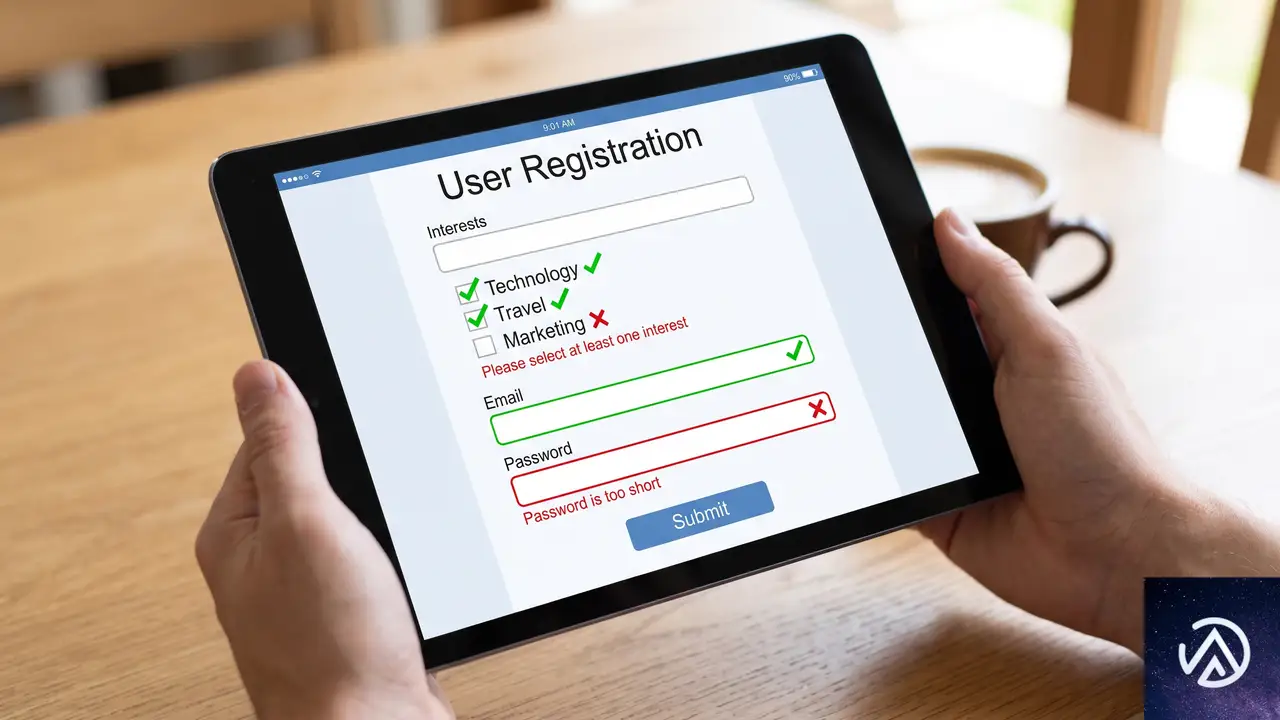
フォームの入力チェックはウェブ開発の定番だが、CSSの疑似クラスを使えば、視覚的なフィードバックの大部分をJavaScriptなしで実装できる。:validや:invalidはもちろん、:user-validや:autofillといった新しい疑似クラスも登場している。
:checkedで切り替えUIを実装する
:checkedはチェックボックスやラジオボタンの選択状態を追跡する。JavaScriptのchangeイベントと異なり、CSSセレクタとしてスタイルに直接結びつく。CSS-Tricksの著者Carlo Daniele氏も指摘しているように、CSS疑似クラスは多くの場合、2つのJavaScriptイベントの間の状態を表現するが、時には条件分岐ロジックそのものを代替する。
この切り替えはJavaScriptのchangeイベントでcheckedプロパティを判定するのと同等だが、CSSではスタイルシート内のセレクタで完結する。コードの見通しが良くなる点が大きな利点だ。
:user-validと:autofill、ユーザー体験を高める新しい疑似クラス
:validや:invalidはページ読み込み直後から評価されるため、未入力の必須フィールドが即座に赤く表示される問題があった。:user-validと:user-invalidは、ユーザーが実際に値を入力しフォーカスを外すまで評価を遅延させる。JavaScriptのchangeイベントに近い挙動だ。
:autofillはブラウザの自動入力機能を検出するJavaScriptイベントが存在しない中で、CSSだけで自動入力されたフィールドをスタイリングできる貴重な手段である。パスワードマネージャーによる自動入力を視覚的に識別したい場合に実用的だ。
JavaScriptで同等の処理を実装する場合、checkValidity()メソッドやValidityStateオブジェクトを使うことになる。フォーム送信時に全体を検証するケースではJavaScriptが適しているが、入力中のリアルタイムフィードバックはCSSの疑似クラスに任せるほうが合理的だ。
メディア要素疑似クラス、動画と音声の状態をスタイリングする
HTML5の<audio>要素や<video>要素は、これまでJavaScriptで状態を監視しなければカスタムコントロールを作成できなかった。しかし、CSSのメディア要素疑似クラスが整備されつつあり、状況は変わりつつある。これらの疑似クラスはInterop 2026の対象にもなっており、ブラウザ間の相互運用性の向上が期待されている。
:volume-lockedは特に興味深い。JavaScriptで音量ロックを検出するには、ダミーのvideo要素を生成してvolumeを設定し、その値が反映されたかどうかを確認するという回りくどい方法が必要になる。CSSなら:volume-locked疑似クラスひとつで完結する。ブラウザ側の制約をCSSが抽象化してくれる好例だ。
インタラクティブ要素疑似クラス、ポップオーバーとダイアログの制御
近年HTMLに追加された<dialog>要素やポップオーバー機能は、CSSの疑似クラスと組み合わせることで真価を発揮する。:popover-open、:open、:modal、:fullscreenといった疑似クラスは、JavaScriptのtoggleイベントに頼らずにUIの状態をスタイリングできる。
JavaScriptで同様の処理を書く場合、toggleイベントを監視してから要素のopenプロパティをチェックする2段階の処理が必要になる。CSSの疑似クラスなら、スタイルシート内で直感的に記述できる。モーダルダイアログが開いているときに背景を暗くする処理も、:modal疑似クラスと::backdrop疑似要素の組み合わせで表現可能だ。
event-trigger、CSSに真のイベントリスナーが到来する未来
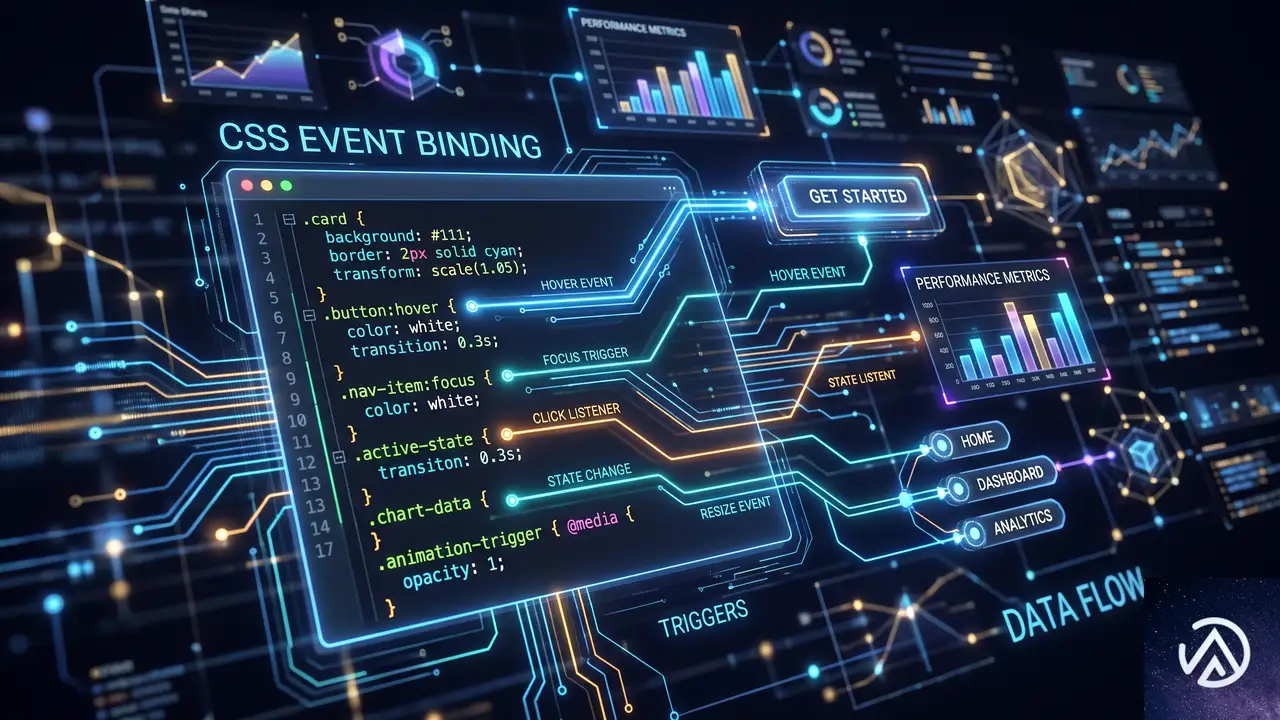
CSS-Tricksの著者Carlo Daniele氏が紹介しているAnimation Triggers仕様のevent-triggerは、現時点ではどのブラウザも未実装だが、CSSの状態監視を次の段階に引き上げる提案だ。これは従来の疑似クラスとは異なり、JavaScriptのイベントリスナーに近い働きをする。
event-triggerの基本構文
event-triggerは、CSSアニメーションを特定のイベントに結びつける仕組みである。event-trigger-nameでアニメーションの識別子を定義し、event-trigger-sourceで発火条件となるイベント(click、touch、dblclick、keypressなど)を指定する。アニメーションは通常その場で再生されるのではなく、イベントが発生するまで待機する。
@keyframes fade-in {
  from { opacity: 0; }
  to { opacity: 1; }
}

button {
  /* クリック時に --event アニメーションを発火 */
  event-trigger: --event click;
}

div {
  /* --event が発火したらアニメーションを前方再生 */
  animation-trigger: --event play-forwards;
  animation: fade-in 300ms both;
}この流れは、従来のCSS疑似クラスが「状態」を追跡していたのに対し、明らかに「イベント」の発生をトリガーとしている点が新しい。clickイベントは元に戻せない不可逆的な出来事だが、interestイベントのように出入りがあるイベントの場合は、ステートフルな双方向トリガーも定義できる。
ステートレスとステートフルの2種類のトリガー
event-triggerには2つのモードが想定されている。ステートレストリガーはclickのような一度きりのイベント向けで、アニメーションは一方向にのみ再生される。ステートフルトリガーはinterestのような持続的な関心を表すイベント向けで、イベントの開始と終了に応じてアニメーションを前後に再生できる。
/* ステートフルトリガーの例 */
button {
  event-trigger: --event interest / interest;
}

div {
  animation-trigger: --event play-forwards play-backwards;
  animation: fade-in 300ms both;
}
この構文では、interestの開始時にアニメーションを前方再生し、interestの終了時に逆再生する。ホバーでメニューがスライドインし、カーソルが離れるとスライドアウトするようなUIを、JavaScriptのイベントリスナーなしで実装できる可能性がある。
この仕様が実用化されれば、CSSのみで完結するUIコンポーネントの幅は大幅に広がるだろう。ただし、Carlo Daniele氏自身も記事内で触れているように、仕様は現在編集中であり、今後のドラフトで構成が大きく変わる可能性がある。現時点では構想段階の提案として捉えておくのが適切だ。
この記事のポイント
- CSS疑似クラスはJavaScriptイベントの代替ではなく、状態を監視する独自のレイヤーとして進化している
- :hoverや:focusのような基本疑似クラスから、:autofillや:volume-lockedのような新しい疑似クラスまで、対応範囲は拡大中
- メディア要素疑似クラスはInterop 2026の対象であり、ブラウザ間の相互運用性が今後向上する
- event-trigger仕様はCSSに真のイベントリスナーをもたらす提案だが、現時点では未実装であり将来の動向に注目すべき
- CSSとJavaScriptは競合するものではなく、適材適所で組み合わせることで効率的なUI開発が可能になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Certificate ManagerがACME対応、TLS証明書の自動更新を実現
AWS Certificate Manager が ACME プロトコルに対応
2026年6月30日、AWS Certificate Manager(ACM)が ACME(Automatic Certificate Management Environment)プロトコルに対応した。この機能追加により、AWS 上で稼働するアプリケーションの公開 TLS 証明書の取得・更新を、Certbot や cert-manager といった既存の ACME クライアントから自動化できるようになる。
証明書の有効期限は短縮の一途をたどっている。CA/Browser Forum の規定により、公開 TLS 証明書の最大有効期間は 2027 年 3 月に 100 日へ、さらに 2029 年までに 47 日へと段階的に引き下げられる見通しだ。手動での更新運用はもはや現実的ではなく、自動化が不可避の状況にある。
ACM の ACME 対応は、単なる証明書自動化の一手を超えて、組織全体の証明書ガバナンスを一元化する大きな転換点となる。PKI 管理者は DNS 管理権限をエンドポイントに集約しつつ、アプリケーション担当者には EAB(External Account Binding)認証情報だけを配布すればよく、DNS キーを組織内にばらまくリスクを排除できる。
短命化する証明書と自動化の必然性
従来の TLS 証明書は最大 1 年を超える有効期間が一般的だった。しかし、CA/Browser Forum は証明書のライフサイクル短縮を段階的に進めており、2027 年 3 月には最大 100 日、2029 年までには 47 日への短縮が義務付けられる。これは証明書の更新頻度が年 1 回から年 3〜4 回、最終的には年 7〜8 回に跳ね上がることを意味する。
手動による更新フローでは、この頻度に耐えられない。更新漏れによる証明書切れは顧客にエラー画面を表示させ、サービス自体の停止を招く。ACME プロトコルはこうした課題に対処するために策定されたオープン標準であり、Let’s Encrypt をはじめとする多数の認証局が採用している。
このデモで示すように、ACME プロトコルを利用すると証明書ライフサイクルから人手を排除できる。AWS が ACME エンドポイントをマネージドサービスとして提供することで、利用者は証明書発行インフラの運用負荷からも解放される。
Amazon Trust Services による証明書発行
ACM が ACME 経由で発行するのは、Amazon Trust Services(ATS)を認証局とする公開証明書だ。ATS のルート証明書は主要なブラウザおよび OS にデフォルトで信頼されているため、発行された証明書は即座に本番環境で利用できる。
証明書の鍵タイプは ECDSA P-256 がデフォルトだが、RSA 2048 や ECDSA P-384 も選択可能だ。クライアント側の要件に合わせて設定できる柔軟性を持ちつつ、デフォルトではより高速でセキュアな ECDSA が推奨されている。
ACME エンドポイントの設定とドメイン検証の仕組み
ACM の ACME 対応で最も特徴的なのは、ドメイン検証を PKI 管理者がエンドポイントレベルで一括実施する点だ。一般的な ACME 環境では、証明書を必要とするクライアントごとに DNS レコードの設定権限が必要になる。これに対して ACM の方式では、管理者がエンドポイント作成時にドメインを検証し、以後の証明書リクエストはそのエンドポイントが管理する。
エンドポイントの作成手順
ACM コンソールの「ACME 証明書」ページからエンドポイントを作成する。設定項目は以下の通りだ。
- エンドポイント名(任意の識別名)
- エンドポイントタイプ(Public を選択)
- 証明書タイプ(Public を選択)
- 鍵タイプ(ECDSA P-256 がデフォルト)
- ドメイン名(証明書を発行する対象ドメイン)
- ドメインスコープ(厳密なドメイン、サブドメイン、ワイルドカードの許可設定)
ドメインスコープの設定はガバナンス上とくに重要だ。Exact domain(完全一致ドメイン)だけを許可すれば、サブドメインやワイルドカード証明書の発行を防げる。たとえば本番系のエンドポイントでは Exact domain と Subdomains のみを有効化し、Wildcards は無効にすることで、証明書の発行範囲を厳格に制限できる。
エンドポイント作成後、DNS 検証が実行される。Route 53 を利用していれば CNAME レコードが自動で作成されるため、手動での DNS 設定は不要だ。外部の DNS プロバイダーを使っている場合は、表示される CNAME レコードを手動で登録する必要がある。
EAB 認証情報によるクライアント登録
エンドポイントの準備が整ったら、EAB(External Account Binding)認証情報を発行する。EAB は Key ID と HMAC Key のペアで構成され、ACME クライアントがエンドポイントにアカウントを登録する際の初回認証に使われる。
一度クライアントが登録されれば、以降の証明書リクエストはクライアント自身が生成した非対称鍵ペアで認証される。EAB 認証情報はあくまで登録時のみの使い切りであり、有効期限を設定して不要な長期保管を防ぐのが望ましい。
この仕組みにより、PKI 管理者はドメイン検証という強力な権限をエンドポイントに閉じ込めつつ、アプリケーション担当者には EAB 認証情報だけを安全に配布できる。DNS キーを組織全体に配る必要がなくなる点が、従来の ACME 運用と決定的に異なる。
Certbot を使った証明書リクエストの実例
ACM コンソールには、Certbot と acme.sh 向けの CLI リファレンスが用意されている。以下は AWS News Blog の記事で紹介されている Certbot のコマンド例を再構成したものだ。
certbot certonly --standalone --non-interactive --agree-tos \
    --email <EMAIL> \
    --server https://acm-acme-enroll.us-east-1.api.aws/<ENDPOINT_ID>/directory \
    --eab-kid <EAB_KID> \
    --eab-hmac-key <EAB_HMAC_KEY> \
    --issuance-timeout <ISSUANCE_TIMEOUT> \
    -d <DOMAIN>
--eab-kid と --eab-hmac-key に、先ほど発行した EAB 認証情報を指定する。各 ACME クライアントで引数名や設定ファイルの記法は異なるため、利用するクライアントのドキュメントを参照する必要がある。
コマンドが成功すると、Amazon Trust Services によって署名された有効な証明書が発行される。openssl コマンドで証明書の内容を確認したうえで、アプリケーションにインストールすればよい。発行された証明書は ACM コンソールの「ACME 証明書」タブにも表示され、コンソールや API 経由で発行した証明書と統合管理される。
一元管理がもたらす運用面の利点
ACM による ACME 対応は、単に証明書の自動発行を可能にするだけではない。最大の価値は、組織全体の証明書ライフサイクルを可視化し、ガバナンスを一元化できる点にある。
IAM ロールによるきめ細かなアクセス制御
ACM の ACME エンドポイントは IAM ロールと統合されている。ACME アカウントに対して IAM ロールをバインドすることで、どのクライアントがどのドメインの証明書をリクエストできるかを細かく制御できる。これにより、開発チームごとに発行可能なドメイン範囲を限定するといった運用が実現する。
監査ログとメトリクスの統合
すべての証明書リクエストは AWS CloudTrail に記録される。誰がいつどのドメインの証明書を要求したかを完全に追跡できるため、監査要件を満たすうえで強力な武器となる。また Amazon CloudWatch と連携することで、証明書の発行数やエラー率といった運用メトリクスもリアルタイムに把握できる。
ACM が標準で備える有効期限通知機能も ACME 経由で発行された証明書に適用される。更新が迫った証明書のアラートを一元管理でき、従来のように証明書管理ダッシュボードと ACME クライアントの管理画面を行き来する必要はなくなる。
上記のスタックは、ACM 単体で証明書管理から監査、予防までをカバーできることを示している。従来は外部の認証局と ACM の間で証明書管理が分断されていたが、ACME 対応によってこの断絶が解消された。
利用可能リージョンと料金体系
ACM の ACME 対応は、発表時点で全商用 AWS リージョンで利用可能だ。AWS GovCloud(US)および中国リージョン、AWS European Sovereign Cloud パーティションについては、後日の対応が予定されている。
料金は証明書発行時に含まれるドメインごとに課金される方式で、完全修飾ドメイン名(FQDN)とワイルドカードで単価が異なる。ボリュームティアは AWS アカウント単位で月間の全証明書における総ドメイン出現数に基づいて計算される。具体的な価格は ACM の公式料金ページで確認できる。
この課金体系は、ACME 経由で発行される証明書も従来の ACM 証明書と同じ仕組みでカウントされるため、新たなコスト管理の複雑さは生じない。
この記事のポイント
- ACM が ACME プロトコルに対応し、Certbot や cert-manager など既存クライアントからの証明書自動発行が可能になった
- PKI 管理者はエンドポイントレベルでドメイン検証とスコープ制御を一括管理でき、DNS キーを組織内に配布する必要がなくなる
- CloudTrail・CloudWatch・有効期限通知により、証明書ライフサイクル全体を単一ダッシュボードで可視化・監査できる
- 証明書の有効期間短縮が進む中、手動運用からの脱却と自動化基盤の構築が急務となっている
- 全商用リージョンで即日利用可能。費用はドメイン数ベースで、従来の ACM 料金体系に準じる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AutoptimizeのJavaScript最適化でドロップダウンメニューが動かない時の除外設定
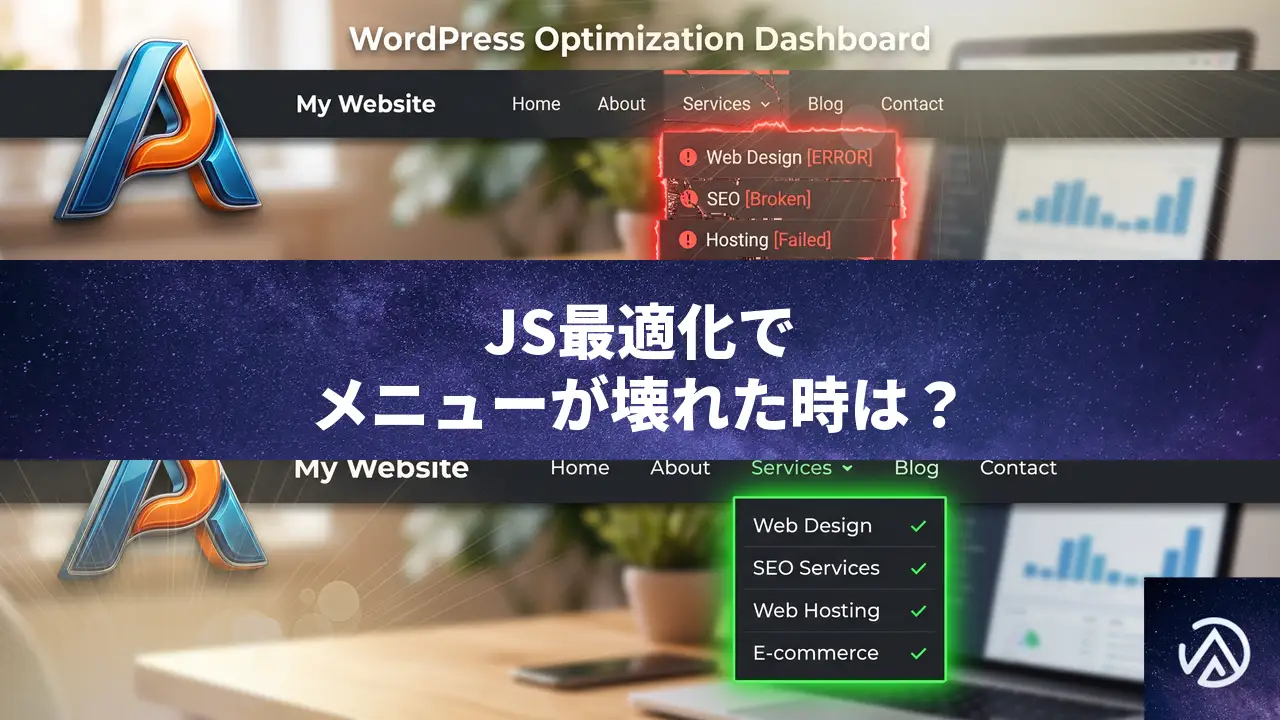
Autoptimize の「JavaScript コードを最適化」を有効にすると、ヘッダーのドロップダウンメニューが開かなくなる問題は、最適化処理がメニューを動かす JavaScript と競合するために起こる。ブラウザの開発者ツールで原因となるスクリプトを特定し、Autoptimize の「除外するスクリプト」欄にファイル名を追加すれば、最適化を維持したままメニューを正常に動作させられる。
なぜ JavaScript 最適化でメニューが動かなくなるのか
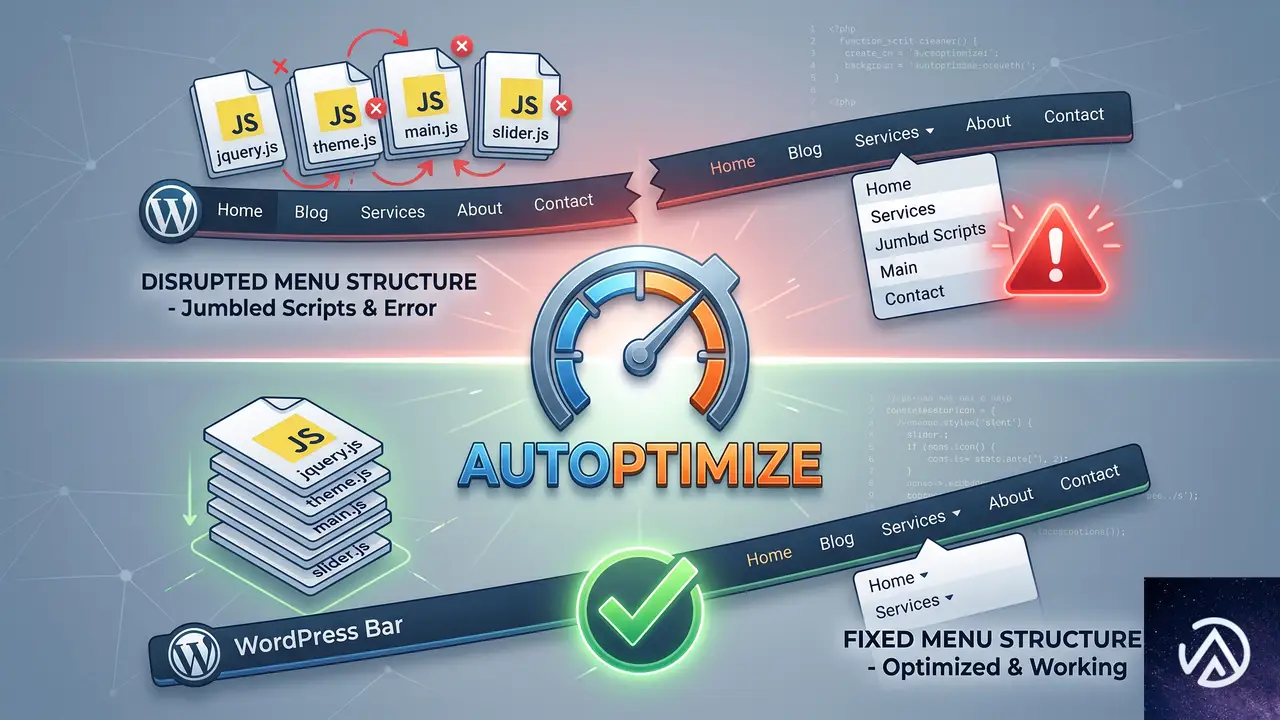
Autoptimize の「JavaScript コードを最適化」は、複数の JavaScript ファイルを1つに集約し、不要な空白やコメントを削除する「縮小(ミニファイ)」を施す機能だ。加えて、読み込みタイミングをずらす「遅延読み込み」や「非同期読み込み」も合わせて適用される。
ドロップダウンメニューは、マウスのホバーやクリックを検知してサブメニューを表示する仕組みで、内部では jQuery やテーマ独自の JavaScript が複数連携して動作する。最適化によってこれらのスクリプトの実行順序が入れ替わったり、縮小処理中に特定の構文が破損したりすると、メニューを開くイベントが発火しなくなる。
特定のページだけで発生する仕組み
トップページや一部の内部ページでは正常に動き、キャリアページや特定の投稿ページだけでメニューが壊れる場合、落ちているのは集約後の順序問題であることが多い。ページごとに読み込まれるスクリプトの組み合わせが微妙に異なるため、特定の構成でのみ実行順序の破綻が表面化する。
jQuery 依存のメニューは特に影響を受けやすい
多くの WordPress テーマはメニューの開閉に jQuery を使う。Autoptimize の標準設定では jQuery も他のスクリプトと一緒に集約されるが、jQuery は他のスクリプトより先に読み込まれなければならない。集約順序が変わって jQuery が後回しになると、$ is not defined や jQuery is not defined といったエラーが発生し、メニュー全体が沈黙する。
原因となる JavaScript ファイルを特定する手順
闇雲に除外設定を増やすのは避けたい。まずはブラウザの開発者ツールでエラーの出どころを確認し、ピンポイントで除外するファイルを決める。
autoptimize_xxxxx.js やテーマの navigation.js)を記録するwp-content/themes/テーマ名/js/... 等)を特定するエラーメッセージが「jQuery is not defined」であれば、jQuery の読み込み順がずれている。テーマ名や「navigation」「menu」を含むファイル名が表示されたら、そのファイルが縮小によって破損している可能性が高い。
エラーが出ない場合の切り分け方
コンソールにエラーが出ていないのにメニューが動かないケースもある。この場合は「Network」タブで autoptimize_xxxxx.js のレスポンスを確認し、途中で切れていないか、スクリプトの末尾が正常かを調べる。また、Autoptimize の設定で「JavaScript コードを最適化」だけをオンにし、「JavaScript を集約する」をオフにして症状が変わるかも試すと、問題の絞り込みが進む。
Autoptimize の除外設定でメニューを修復する
原因ファイルが特定できたら、Autoptimize の設定画面で除外リストに追加する。除外されたファイルは最適化の対象外となり、元の順序で単独で読み込まれるため、競合が解消する。
navigation.js と jquery.js を追加除外設定の具体的な入力方法
WordPress 管理画面の「設定」→「Autoptimize」→「JavaScript オプション」を開く。「JavaScript コードを最適化」が有効になっている状態で、その直下にある「除外するスクリプト」欄に、カンマ区切りでファイル名を入力する。
入力例を以下に示す。実際のファイル名は、サイトのテーマやプラグイン構成によって異なる。
jquery.js、 jQuery 本体jquery.min.js、 縮小版の jQuerynavigation.js、 テーマのメニュー制御スクリプトtheme-menu.min.js、 テーマが提供する縮小済みメニュー制御js_composer_front、 WPBakery 等のビルダーが出力するスクリプト
部分一致で指定できるため、jquery とだけ書けば、ファイル名に「jquery」を含むすべてのスクリプトが除外される。同様に navigation や menu といったキーワードでもよい。
「jQuery を集約しない」オプションの活用
Autoptimize の「JavaScript オプション」内には「jQuery を集約しない」というチェックボックスも用意されている。jQuery 依存のエラーが出ている場合は、個別のファイル名を書く前にまずこのチェックを入れてみると、まとめて解決することが多い。
どうしても直らない時の応用設定
除外設定を丁寧に行ってもメニューが復活しない場合、最適化モードそのものを調整する手がある。「JavaScript コードを最適化」の中には「縮小のみ(集約しない)」といった選択肢もあり、集約をやめて縮小だけに留めれば、多くの競合が回避される。
スクリプトの読み込み位置を変える
「JavaScript をフッターに移動する」や「Async(非同期)にする」といった項目も、メニューの動作に影響を与えうる。メニューはページの初期表示時に即座に動作する必要があるため、非同期読み込みにしてしまうと DOM 構築が完了する前にメニューのイベント登録が走ってしまい、動作しなくなる。まずはこれらのチェックを外して試す。
プラグイン単位での競合を疑う
まれに、Autoptimize と特定のキャッシュ系プラグインやテーマ付属の最適化機能が二重に働いて競合することがある。W3 Total Cache や WP Rocket に組み込まれた最適化と同時に使わず、いずれか一方に統一する。また、テーマの「パフォーマンス」設定内に JavaScript の最適化機能がある場合は、そちらを無効にして Autoptimize に一本化する。
よくある質問
除外設定を追加したのにメニューが直らない
Autoptimize のキャッシュが残っていると、除外設定が反映されずに古い最適化済みスクリプトが使われ続ける。管理画面の Autoptimize 設定画面で「キャッシュをクリア」ボタンを押し、さらにブラウザのキャッシュもスーパーリロード(Ctrl+F5)で破棄する。サーバーによっては CDN やサーバー側キャッシュもクリアする必要がある。
ファイル名がわからない時はどうするのか
ブラウザの開発者ツール「Network」タブで、JS ファイルの一覧を名前順に並べ、「theme」「menu」「nav」「dropdown」を含むファイルを探す。該当ファイルが見つからない場合は、テーマの開発者に「メニュー制御に使っている JavaScript ファイル名」を問い合わせるか、Autoptimize の「縮小のみ(集約しない)」モードで一旦回避する。
一部のページだけメニューが壊れるのはなぜか
ページによって読み込まれるプラグインやウィジェットのスクリプトが異なるため、集約後のファイルの構成が変わる。特定のページにだけ表示される「お問い合わせフォーム」や「求人一覧」のスクリプトが混ざると、集約後の全体の実行順序が崩れて、たまたまメニュー制御に影響が出ることがある。
Autoptimize を無効にするとサイトが遅くなるのが心配だ
JavaScript 最適化を完全に切る必要はない。問題のスクリプトだけをピンポイントで除外すれば、大部分のスクリプトは最適化されたまま配信される。PageSpeed Insights 等でスコアを確認しながら除外範囲を最小限に絞れば、速度と機能の両立は十分に可能だ。
この記事のポイント
- JavaScript 最適化によるドロップダウンメニュー不具合は、スクリプトの順序破綻や縮小破損が原因
- 開発者ツールの「Console」でエラーを特定し、原因ファイルを Autoptimize の除外リストに追加する
- 「jQuery を集約しない」オプションが有効なケースも多い
- 除外設定後は必ず Autoptimize キャッシュとブラウザキャッシュをクリアする
- 「縮小のみ」「非同期読み込みオフ」など、最適化の段階を調整することでも解決できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare Monetization Gateway発表、x402でAIエージェントに従量課金
広告型モデルの限界とAIエージェント向け従量課金

2026年7月1日、CloudflareはMonetization Gatewayを発表した。HTTPの402ステータスコードを拡張したオープンプロトコル「x402」を基盤に、ウェブ上のあらゆるリソースに対して従量課金を適用できる仕組みである。保護対象はウェブページ、データセット、API、MCPツールにおよび、代理店や大規模言語モデルが自律的に支払う時代を見据えている。
背景にはウェブビジネスモデルの構造変化がある。30年にわたり、コンテンツは広告や月額課金で収益化されてきた。しかしAIエージェントが人間に代わって情報を消費するようになると、バナー広告をクリックすることも、毎月のサブスクリプションを維持することもない。エージェントは必要なデータを一度取得すれば、数十回、数千回と繰り返しアクセスし始める。Cloudflareの発表資料によると、AIクローラーのリクエスト数は、そこからサイトへ誘導される訪問者1人あたり数百~数万回に達しているという。
従来のAPI従量課金は既存ユーザー向けに限定され、サブセント単位の少額決済には向かなかった。クレジットカードの手数料が取引額を上回るためだ。ここでCloudflareが着目したのが、ステーブルコインによる一瞬の決済である。Monetization Gatewayは、支払い検証と流量制御をエッジで完結させ、オリジンサーバーに過剰な負荷をかけずに課金を実現する。
CloudflareはすでにContent Independence DayでAIクローラーの制御機能を提供し、Pay Per Crawlでクローラーに課金する仕組みを導入していた。Monetization Gatewayはその延長線上にあり、クローラー以外の任意の呼び出し元に対して課金できる点が新しい。
エージェントが変える支払いの単位
AIエージェントが自律的に行動するようになれば、サービスの課金単位も座席数や月額から「リクエスト数」「トークン数」「成果物」へと移行する。Cloudflareが例示したのは、1回のウェブ検索あたり数セント、アップロードエンドポイントで0.001ドルの基本料金+1MBあたり0.01ドル、サポートエスカレーション解決時に0.99ドルといった単位である。
これまで実現が難しかったサブセントの決済を、x402プロトコルとステーブルコインが可能にする。ステーブルコイン(Open USDやUSDC)は1秒未満で決済が完了し、手数料が無視できるほど小さい。従来の決済手段では、手数料が支払い額を上回る逆転現象が起きていたが、それが解消される。
Cloudflareが提供する課金インフラ
Cloudflareの強みは、すでに自社の課金システムや顧客向けアナリティクスで従量課金の会計基盤を構築してきたことにある。Monetization Gatewayでは、売り手と買い手の間に入り、支払い証跡をHTTPリクエストに埋め込む形で検証パスを統合する。メータリング、支払い交換、決済はすべてオリジンサーバーの外で完結し、サイト運営者は課金ルールと価格だけを定義すればよい。買い手のオンボーディングや請求システムの構築は不要だ。
x402プロトコルとは
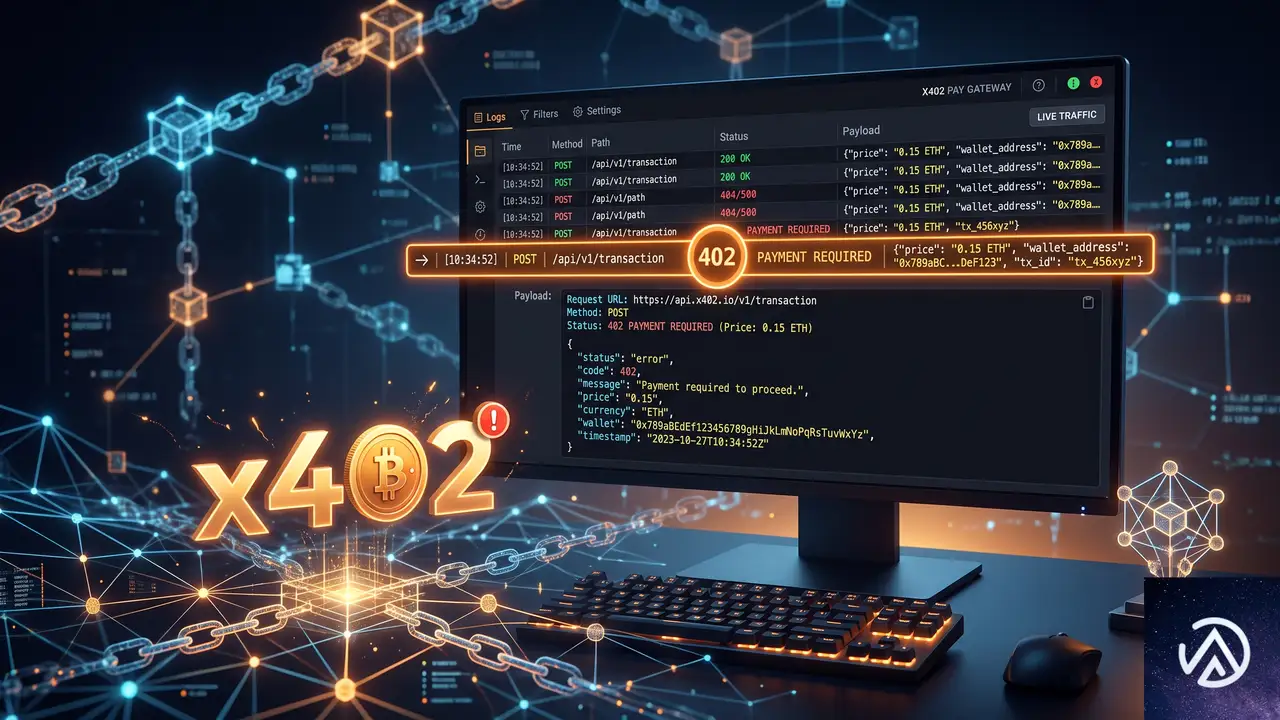
x402はHTTPのステータスコード「402 Payment Required」を実際に活用するオープンプロトコルである。この規格はCloudflareがx402 Foundationのもとで25以上の業界リーダーと共同開発を進めている。従来の402は予約状態にあり、実際の決済フローには使われていなかった。
x402のやりとりは単純だ。クライアントが支払い必須のリソースをリクエストすると、サーバーは402 Payment Requiredとともに価格、受け入れ可能な通貨、支払い先を含む小さなペイロードを返す。クライアントは支払いを実行し、支払い証明を添えてリクエストを再送する。ファシリテーター(検証者)が証明を確認し、オリジンサーバーが最終的にリソースを返す。すべてが通常のHTTPリクエスト/レスポンスの中で完了し、決済ページへのリダイレクトも個別の決済API呼び出しも発生しない。
x402の利点は2つある。1つは最小単位がセント未満まで刻めること。プロトコルのオーバーヘッドが極めて低く、取引額が支払いコストを下回る逆転を防げる。もう1つは、買い手が売り手のアカウントを事前に取得する必要がないことだ。支払い自体が資格情報として機能するため、サインアップやAPIキー発行なしに取引が成立する。
サブセント決済と一瞬の決済
ステーブルコインを使う決済は、現在の主要な決済レールでは実現できなかったスピードと低コストを両立する。Cloudflareはサブセカンド(1秒未満)の決済を目標に掲げている。エージェントが数セントのデータを購入するために数ドルの手数料と数日の決済期間を待つ必要はなくなる。この速度と低コストが、AI時代の大量のマイクロペイメントを支える。
Monetization Gatewayの機能

Monetization GatewayはCloudflareのエッジネットワーク上で動作し、330以上の都市でリクエストを処理する。x402ハンドシェイクが買い手の近くで実行されるため、レイテンシが小さくなり、オリジンサーバーへの負荷も軽減される。
具体的な課金ルールの適用方法として、以下のような機能が計画されている。
- 特定のRESTメソッドへの課金。/api/premium/* へのGETやPOSTに0.01ドルを設定できる
- タスクの複雑さに応じた変動価格。画像生成などの処理負荷に応じて最大2ドルまでの課金が可能
- 認証されていない発信者への402 Payment Requiredの返却。オリジンが401を返した際に、自動で402と価格情報に置き換える
ルールはCloudflareのダッシュボードから設定するほか、Cloudflare APIやTerraformを通じてコードとして管理できる。課金エンドポイントの追加が、単なる別のインフラ設定として扱えるようになる設計だ。
Cloudflareはまた、Web Bot Authとの連携も予定している。エージェントに認証を求め、既存のアカウントに対して従量課金を適用する柔軟性を提供する方針だ。これにより、完全な匿名取引だけでなく、信頼関係に基づく課金も選択できるようになる。
売り手にとっての変化
Monetization Gatewayを利用する売り手は、蓄積したステーブルコインをそのまま別の取引に使うことも、銀行口座で法定通貨に換金することもできる。Cloudflareが発表した構想では、支払い検証はすべてエッジで完結し、オリジンには課金ルールと実際の収益だけが残る。
これはAPIプロバイダーにとって、販売可能市場を拡大する直接的な手段になる。AIエージェントはリソースを要求し、価格を提示され、支払い、結果を得る。サインアップもAPIキーも事前の関係も必要ない。Cloudflareは、いつでも買い手の認証や既存アカウントとの紐付けを追加できる柔軟性を残している。
この記事のポイント
- CloudflareがHTTP 402を利用した従量課金プロトコルx402を実用化。Monetization Gatewayによりあらゆるウェブリソースへの課金が可能に
- AIエージェントが大量にコンテンツを消費する時代、広告に依存しない収益モデルとしてマイクロペイメントが鍵を握る
- ステーブルコインによるサブセカンド決済で、サブセント単位の取引でも手数料が収益を上回らない
- 課金ルールはコードで管理でき、売り手は買い手のオンボーディングや請求システムを構築する必要がない
- Web Bot Authとの連携や変動価格設定など、エージェント経済向けの拡張機能が計画されている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験