


Elementorエディターが重い原因と4,400個のコンテナを減らす方法
Elementor エディターが極端に重くなる最大の要因は、ページあたりのコンテナ数が過剰に積み上がっていることだ。4,400 個という数字は Elementor の実用的な上限を大きく超えており、まずはコンテナ構造の見直しと不要なネストの解除から手を付ける。
Elementor エディターが極端に重くなる根本原因は何か

Elementor のエディターは、ページを開くたびに全ウィジェットとコンテナのデータを JSON 形式で読み込み、DOM ツリーをブラウザ上に再構築する仕組みになっている。この処理は要素数に対して指数的に負荷が増えるため、数千単位のコンテナが存在するとエディターの起動そのものが数分単位で遅延する。
とくに深刻なのが、コンテナの深いネスト(入れ子)だ。親コンテナの中に子コンテナ、さらに孫コンテナと階層が深くなるほど、エディター側でのレンダリング計算量が跳ね上がる。4,400 個のコンテナのうち、3 階層以上ネストされたものが多い場合は、構造の平坦化だけでエディターの応答速度が大きく変わる。
もうひとつ見落としがちなのが、ACF(Advanced Custom Fields)の動的データ呼び出しだ。ACF フィールドを Elementor の動的タグで大量に埋め込んでいる場合、エディター読み込み時にすべてのフィールド値がデータベースから取得される。フィールド数が多いほど、このクエリ負荷がエディターの起動時間を押し上げる。
フロントエンドが高速なのは、Elementor が静的 CSS とキャッシュを生成しているからだ。エディター側はその生成前の「生の状態」を扱うため、まったく別のパフォーマンス特性になる。
4,400 個のコンテナは異常な数値なのか

はっきり言えば、異常に多い。Elementor の公式ドキュメントに明示的な上限はないが、実務上の目安として 1 ページあたりのコンテナ数は 200〜500 個に抑えるのが望ましい。4,400 個はその 10 倍近く、エディターがまともに動かなくなるのも当然の数字だ。
100 ページあるサイトで合計 4,400 コンテナであれば 1 ページ平均 44 個だが、質問者のケースでは特定の巨大ページにコンテナが集中している可能性が高い。エディターの遅さは「サイト全体のコンテナ総数」ではなく「開こうとしているページのコンテナ数」に依存する点を押さえておく。
エディター速度を改善する具体的な手順

まずは Elementor の「実験」機能とパフォーマンス設定を最適化する
Elementor の管理画面「Elementor → 設定 → 実験」には、エディターのパフォーマンスに直結する項目がいくつかある。「インライン Font Awesome アイコン」を無効化し、「DOM の出力を最適化」を有効にする。さらに「設定 → 詳細設定」で「エディターローダーの改善」を有効化すると、エディターの初期読み込みが軽くなる。
ページのコンテナ構造を平坦化する
もっとも効果が大きいのがこれだ。深くネストされたコンテナを 1〜2 階層に減らすだけで、エディターの DOM 構築コストが劇的に下がる。以下の手順で進める。
たとえば「セクション > カラム > カラム > テキスト」という 4 階層のネストは、CSS グリッドを使えば「セクション > テキスト」の 2 階層にまとめられる。この平坦化だけでコンテナ数を 30〜50% 削減できるケースが多い。
ACF 動的タグの使用を見直す
ACF の動的タグは便利だが、1 ページに数十個も埋め込むとエディター読み込み時のデータベースクエリが無視できなくなる。とくにリピーターフィールドやフレキシブルコンテンツを多用している場合は要注意だ。可能であれば、動的タグの代わりにショートコードで一括取得する方式に切り替えるか、ACF の `get_field()` をテーマ側で処理してから Elementor に渡す設計を検討する。
サーバー側のチューニングを確認する
WP Engine のようなマネージドホストであっても、PHP のメモリ制限や実行時間の設定は確認しておく。`wp-config.php` に以下の定数を追加または修正する。
define( 'WP_MEMORY_LIMIT', '512M' );
define( 'WP_MAX_MEMORY_LIMIT', '512M' );
set_time_limit( 300 );
WP Engine の場合はユーザーポータルから PHP の `max_execution_time` と `memory_limit` を確認できる。数値が十分でも、サーバー側のオブジェクトキャッシュ(Redis)が正しく動作しているかも合わせて確認する。
不要なプラグインのスクリプトをエディター画面から除外する
一部のプラグインは、エディター画面であっても独自の CSS や JavaScript を読み込む。16 個のプラグインがアクティブな状態なら、そのうち 2〜3 個がエディターの応答を悪化させている可能性がある。プラグイン「Query Monitor」を一時的に有効化し、エディター画面でどのスクリプトが重いかをプロファイリングする。
問題のスクリプトを特定したら、`functions.php` に以下のようなコードを追加してエディター画面でのみ読み込みを停止する。
add_action( 'admin_enqueue_scripts', function( $hook ) {
    if ( 'post.php' !== $hook && 'post-new.php' !== $hook ) {
        return;
    }
    wp_dequeue_style( 'problem-plugin-style' );
    wp_dequeue_script( 'problem-plugin-script' );
}, 100 );
再構築せずに長期的な安定性を確保する設計の考え方

根本的には、Elementor は「ビジュアルビルダー」であり、数千単位の要素をリアルタイムで操作するようには設計されていない。この規模のサイトでは、ページを「Elementor で編集する領域」と「テーマやプラグインで自動生成する領域」に明確に分ける設計が有効だ。
ニュース記事や個別投稿の一覧表示、ACF の繰り返しフィールドによるコンテンツ部分は、Elementor の「ループグリッド」ウィジェットやテーマテンプレートで処理し、編集者が直接触るコンテナ数を最小限に抑える。この切り分けができれば、エディターの負荷は大幅に下がり、コンテンツ更新の速度も実用的な水準に戻る。
よくある質問
コンテナ数を減らすとデザインが崩れるのでは?
CSS グリッドやフレックスボックスを適切に使えば、ネストを減らしても見た目は維持できる。むしろ不要なラッパーを外すことで CSS の特異性が下がり、スタイルの管理がしやすくなる利点もある。作業前に必ずページを複製し、ステージング環境で検証してから本番に適用する。
ACF の動的タグをやめると運用が面倒にならないか?
ショートコード化やテーマ側での処理に切り替えると、たしかにエディター上のビジュアルプレビューは失われる。しかし、エディターが実用的な速度で動くことと引き換えにすれば、運用全体のストレスは大幅に減る。プレビューはフロントエンドで確認する運用に切り替えればよい。
Elementor 以外のビルダーに移行すべきか?
即座の移行は現実的ではないが、長期的には検討に値する。ネイティブのブロックエディター(Gutenberg)は DOM 構造が比較的平坦で、同規模のサイトでもエディターの動作は軽快だ。まずは新規ページからブロックエディターを試し、既存ページは優先度の高いものから徐々に移行する段階的アプローチが安全だ。
PHP 8.4 との相性問題はあるか?
PHP 8.4 は比較的新しく、一部のプラグインで非推奨警告や互換性の問題が出ることがある。Elementor 本体は 8.4 に対応しているが、ACF や他のプラグインが完全対応していない可能性もある。PHP のエラーログを確認し、Deprecated や Warning が頻出しているようなら PHP 8.2 や 8.3 へのバージョンダウンも一時的な回避策となる。
キャッシュ系プラグインはエディター速度に影響するか?
ページキャッシュや CSS 最適化系のプラグインはフロントエンドには有効だが、エディター画面の速度にはほぼ影響しない。むしろ CSS の最適化処理がエディター保存時に走る設定になっていると、保存がさらに遅くなる場合がある。エディター編集中は CSS 最適化をオフにできるプラグインを選ぶか、保存時のフックを一時的に無効化する。
この記事のポイント
- エディターの遅延はコンテナ数とネストの深さが最大の要因
- 4,400 個のコンテナは実用上限を大幅に超過しており、平坦化で 30〜50% 削減を目指す
- ACF 動的タグの大量使用はエディター起動時の DB 負荷を高める
- プラグイン「Query Monitor」でエディター画面のボトルネックを特定できる
- 長期的には、動的コンテンツをテーマ側に寄せて Elementor の編集負荷を下げる設計が有効

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

大文字見出しがコンバージョンを下げる、CROプロが警告
ランディングページの見出しをすべて大文字にすることは、視覚的なインパクトを与える常套手段と思われている。しかし、CRO(コンバージョン率最適化)の専門家Nate Lagos氏は、それが逆効果になる可能性を指摘する。実際のA/Bテストでは、大文字をやめて各単語の先頭だけ大文字にしたところ、コンバージョン率が25%も向上した事例が報告されている。
これは、多くのECサイト担当者が見過ごしがちな落とし穴だ。本記事では、Practical EcommerceのポッドキャストでLagos氏が語ったテスト結果と、ボトムズアップアプローチに基づくCRO戦略の核心を解説する。
大文字見出しがコンバージョンを下げる意外な事実

Lagos氏が実践するCROは「ボトムズアップテスト」と呼ばれる。購入ボタンや商品説明文といった、コンバージョンに直結する部分からコピーを検証していく手法だ。トップページや認知向けの広告文よりも、まず「買うか離脱するか」の瀬戸際にある箇所を最適化する。
このアプローチの過程で浮かび上がったのが、大文字見出しの問題だ。Lagos氏はX(旧Twitter)で読んだアイデアをきっかけに、あるクライアントのランディングページでテストを実施した。それまですべて大文字だった見出しを、各単語の先頭だけ大文字にするパターンに変更したところ、驚くべき結果が出た。
25%のコンバージョン向上を実現したA/Bテスト
テスト結果は明確だった。大文字をやめたランディングページでは、コンバージョン率が25%向上した。しかも、CPA(顧客獲得単価)も低下した。トラフィックの多いページだったため、この変化はビジネスにとって大きなインパクトをもたらした。
Lagos氏によれば、これは「可読性」の問題だ。大文字だけのテキストは、単語の形状が均一になり、脳が素早く認識しにくくなる。結果として、ユーザーは読む前に離脱してしまう。見出しのフォントサイズを小さくした場合にも同様の傾向が見られ、読みやすさが購買行動に直結することが浮き彫りになった。
ボタンテキストへの応用は未検証
ただし、Lagos氏はボタンに大文字を使うことの影響まではテストしていない。CTAボタンでは大文字が効果的なケースもあるかもしれない。今回の発見は、あくまで見出しや本文レベルのテキストブロックに限定したものだ。サイトのコピーを最適化する際は、見出しから着手するのが良いだろう。
ボトムズアップアプローチの実践

Lagos氏が提唱するボトムズアップテストは、従来の広告戦略の考え方をひっくり返す。多くのマーケターは、まず認知獲得のためのトップファネルから手を付ける。しかし、購入から遠い場所にあるメッセージは、実際の購買動機とは無関係なケースが多い。だからこそ、まずは購入ボタンの近くから最適化するのだ。
購入ボタン直近のコピーを最適化する
具体的には、商品詳細ページの見出し、説明文、価格表示、そしてCTAボタンの周辺テキストをテストする。Lagos氏はOriginal Grain在籍時代、この手法で5年間にわたり収益をほぼ5倍に伸ばした実績を持つ。腕時計という「実用性が低い」商材でこれだけの成果を出せたのは、買い手の感情に響くコピーを突き詰めたからだ。
このプロセスを経ることで、「顧客が本当に求めているもの」が明確になる。腕時計の例では、時刻を知るためではなく「地位や達成感の象徴」としての価値が見えてきた。こうした深層心理を突いたコピーが、結果的にコンバージョン率や平均注文単価を押し上げた。
市場飽和を打破するターゲット拡大戦略

コアオーディエンスへのリーチが頭打ちになったブランドが次に取るべき打ち手は、商品を軸にしたターゲットの拡大だ。Lagos氏は「常に『他に誰に売れるか』を問い続けろ」と語る。
男性向け商品を女性に売る方法
Original Grainでの実例が示唆に富む。当初、同ブランドは男性向けにメッセージを打っていた。しかし、顧客データを分析したところ、実は約半数の購入者が女性だった。そこでLagos氏は女性向けのコピーライティングに注力し、最終的に顧客の80%を女性が占めるまでに至った。
成功の鍵は「ギフト需要」の掘り起こしだった。Practical EcommerceのインタビューでLagos氏が明かしたところによると、女性顧客は「夫やボーイフレンドへの感謝を示したい」という動機で腕時計を購入していた。特に父の日やクリスマス前の30〜45日間は、ギフト向けのメッセージに全面切り替え、年間を通じてはメインサイトを男性向けに戻すという柔軟な運用を行った。
女性向けマーケティングを成功させる鉄則
Lagos氏が強調するのは「女性の顧客を理解するには女性を雇え」というシンプルな原則だ。彼自身、コピーライターのSarah Levinger氏を迎え入れ、女性視点のメッセージ構築を一から学んだ。自社にない視点を取り入れることは、新しい市場を開拓するための最短ルートになり得る。
この事例は、商品そのものを変えずに、メッセージの受け手を変えるだけで大きな成長が可能なことを示している。自社のデータを見直し、思いがけない顧客層がいないかを探る価値は大きい。
CROテストを成功に導くツールと手法

Lagos氏がA/Bテストの実施に用いているのは、Intelligemsというツールだ。テストの信頼性を担保するため、統計的有意性は「対照群に勝つ確率が80%以上」を基準にしている。サイト訪問者数が数万から数十万、注文数が数千件に達するボリュームでなければ、意味のある結果は得られない。
ヒートマップで読者の行動を可視化
テストすべき箇所を特定するには、ヒートマップツールが有効だ。ユーザーが実際にどこを読んでいるのか、どこで離脱しているのかを可視化することで、コピー改善のインパクトが大きいエリアを見極められる。Lagos氏の経験では、ランディングページや商品ページの冒頭ブロックが最もレバレッジの効く領域だという。
A/Bテストは一度きりではなく、継続的な反復が前提となる。小さな改善を積み重ねることで、CVRやAOV(平均注文単価)、RPV(訪問単価)といった重要指標を持続的に押し上げていく。大文字見出しの回避は、その第一歩として取り組みやすい改善策と言えるだろう。
この記事のポイント
- ランディングページの大文字見出しをやめ、各単語の先頭だけ大文字にすることでCVRが25%向上した事例がある
- ボトムズアップテストでは、購入ボタン近くのコピーから最適化し、購買動機を明確にする
- A/BテストはIntelligems等のツールを用い、統計的有意性を確保できる十分なボリュームで実施する
- ターゲット拡大では、女性へのギフト訴求が男性向けブランドの顧客基盤を劇的に変える可能性がある
- 改善は継続的な反復が鍵。大文字見出しの見直しは、今日から始められる施策の一つだ

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

OptinMonsterやTrustPulseが原因でWordPressが乗っ取られた時の対処
特定のプラグインをインストールしていた WordPress サイトで、管理者アカウントが勝手に作られたり、マルウェアを仕込まれる被害が広がっている。無効化した状態でも影響を受けるため、すぐにユーザー一覧とプラグインフォルダを確認しなければならない。
なぜ無効化したプラグインで侵入されたのか
被害報告が相次いでいるのは、OptinMonster、TrustPulse、PushEngage という 3 つのプラグインだ。いずれも単体で配布されているほか、MonsterInsights Pro にバンドル(同梱)されて提供されている。注目すべきは、有効化していなくてもプラグインとして存在するだけで攻撃対象になった点だ。WordPress はプラグインを無効化しても、ファイル自体はサーバー上に残る。攻撃者はそのファイルに含まれる脆弱性を利用して外部からコードを実行し、管理者アカウントの新規作成や Cloudflare/ClearFake マルウェアの設置を行った。
無料版の Wordfence では検知できなかったケースが確認されている。シグネチャ(攻撃パターン)が更新されるまでの時間差や、攻撃手法が亜種に変化していたことが原因とみられる。そのため、目視での確認が不可欠だ。
このデモは、プラグインファイルが放置された状態から攻撃者が侵入し、追加の不正な要素を仕込む流れを示している。
自分のサイトが影響を受けているか確認する手順

管理者アカウントの一覧を調べる
WordPress 管理画面の「ユーザー」→「すべてのユーザー」を開き、覚えのない管理者権限のアカウントが追加されていないかを確認する。アカウント名やメールアドレスに覚えがないもの、登録日時が直近のものがあれば要注意だ。
プラグインフォルダに不審な PHP ファイルがないか調べる
FTP ソフトやレンタルサーバーのファイルマネージャーで /wp-content/plugins/ 以下を開く。特に OptinMonster、TrustPulse、PushEngage のフォルダ内に、本来あるはずのない名前の PHP ファイルや、暗号化されたような文字列が書かれたファイルがないかを確認する。
プラグインをすでに削除してしまった場合でも、/wp-content/ 直下や /wp-includes/、テーマフォルダ内に不審な PHP ファイルが残っていないか、更新日時が最近のものに心当たりがないかを見ておくとよい。
管理者アカウントとファイルの両面から、侵入の痕跡を短時間で洗い出す手順を示している。
不正アクセスが発覚した場合の緊急対応

不正な管理者アカウントを即座に削除する
覚えのない管理者アカウントを見つけたら、すぐにそのユーザーを削除する。削除時に「すべての投稿を帰属させる」選択肢が出るが、攻撃者が作成した投稿や固定ページがなければそのまま削除してよい。念のため、削除前にゴミ箱や下書きに不審なコンテンツがないかも確認しておく。
不正ファイルを削除し、該当プラグインを完全に除去する
不審な PHP ファイルは必ずバックアップを取った上で削除する。OptinMonster、TrustPulse、PushEngage のいずれかがインストールされているなら、今後も脆弱性が残る可能性を考え、プラグイン自体を完全に削除するのが安全だ。同梱元の MonsterInsights Pro を利用している場合も、これらのアドオンが自動でインストールされていないか確認する。
サイト全体のマルウェアスキャンを実施する
Wordfence や Sucuri などのセキュリティプラグインで手動の詳細スキャンを実行する。無料版の自動スキャンだけでは検知漏れが起こる可能性があるため、手動でフルスキャンをかける。Sucuri のサイトチェック(外部スキャナ)を併用すると、サーバー内部からは見えにくい改ざんも検出しやすくなる。
再発防止と今後のセキュリティ対策

使用していないプラグインやテーマは「無効化」ではなく「削除」する
WordPress では、プラグインを無効化してもファイルはサーバー上に残り続ける。今回の事例が示すように、無効状態でもファイルが存在するだけで攻撃の足場になる。今後は使わないと判断したプラグインやテーマは、面倒でも完全に削除する習慣をつけるのが鉄則だ。
プラグインの更新を常に最新に保ち、導入元を精査する
公式リポジトリ外のプラグインや、長期間更新が止まっているものはリスクが高い。どうしても必要な場合を除き、信頼できる提供元のものだけを使う。自動更新を有効にしておくと、脆弱性が公表された直後の修正パッチを適用しやすくなる。
定期的な管理者アカウントとファイルの監査を組み込む
月に一度は「ユーザー一覧」を開き、見慣れないアカウントがないかを目視点検する。あわせて、サーバーのファイル更新日時を確認し、心当たりのないタイミングで変更されたファイルがないかをチェックする。人が目で見る作業は、自動ツールの検知漏れを補う最後の砦になる。
よくある質問
無効化していてもなぜハッキングされたのか
無効化はあくまでプラグインの動作を止めるだけで、ファイルはそのままサーバーに残る。今回の攻撃はファイルの存在を前提に外部から直接コードを実行する手法だったため、有効か無効かは関係なく被害が発生した。
Wordfence が入っていれば安心なのか
今回の事案では、無料版 Wordfence で検知できなかった例がある。セキュリティプラグインに過度な期待をせず、定期的な手動確認と不要なファイルの削除を組み合わせることが欠かせない。
MonsterInsights を使っているが該当プラグインは入れていない
MonsterInsights Pro の一部バージョンでは、これらのプラグインが同梱されて自動インストールされる場合がある。プラグイン一覧を開き、OptinMonster、TrustPulse、PushEngage が存在しないか今一度確認してほしい。
すでに削除したが、まだ不安が残る場合の最終確認方法は
レンタルサーバーの管理画面で最近のアクセスログを確認し、不審な IP アドレスや POST リクエストがないかを調べる。データベースの wp_users テーブルと wp_usermeta テーブルを直接 SQL で確認し、管理者権限(wp_capabilities に administrator を含む)のユーザーに不明なものがないかを調べる方法も有効だ。
この記事のポイント
- OptinMonster、TrustPulse、PushEngage は無効化でも攻撃対象になる
- 管理者一覧とプラグインフォルダをすぐに目視確認する
- 不正アカウントと不審ファイルは即座に削除する
- 今後は使わないプラグインを無効化で放置せず完全削除する
- セキュリティプラグインだけに頼らず定期手動監査を組み込む
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

Google、悪質な住宅用プロキシネットワークNetNutを継続的に破壊
NetNutとは何か、住宅用プロキシの仕組み

今回Googleが措置を取ったNetNut(別名Popa)は、世界最大級の住宅用プロキシネットワークだ。住宅用プロキシとは、一般家庭が契約するISP(インターネットサービスプロバイダ)のIPアドレスを経由してトラフィックを中継する仕組みである。大規模なボットネットによって実現され、NetNutは少なくとも200万台のデバイスを出口ノードとして抱えていたと見られている。
住宅用プロキシの大きな特徴は、一見すると正当な住宅回線からの通信に見える点だ。攻撃者はこの特性を悪用し、実際の位置や身元を隠蔽する。データセンター経由のプロキシとは異なり、ブラックリストに載りにくいため、アカウント不正アクセスやパスワードスプレー攻撃などに利用される。
■ 家庭のデバイスが踏み台にされる
Google Threat Intelligence Group(GTIG)の推計によると、NetNutには世界で200万台以上のデバイスが接続されていた。このボットネットは主にスマートテレビやストリーミングボックスなど、家庭に常時設置されるデバイスに潜むSDKを通じて構築される。KrebsOnSecurityの報道やGoogle自身の調査により、NetNutがこうしたデバイスを悪用してプロキシネットワークを肥大化させていた実態が明らかになっている。
Googleが取った具体的な対策とその効果

Googleは2026年7月2日、FBIやLumenなどのパートナーと連携し、NetNutの運営基盤に対して以下の施策を実施した。
Googleアカウントとサービスの無効化
NetNutがマルウェアのC2(コマンド&コントロール)に使用していたGoogleアカウントと関連サービスを、利用規約違反として無効化した。これにより、攻撃者がボットネットを制御する主要な通信路が遮断された。
技術情報の共有とエコシステム全体への働きかけ
NetNutが利用していたSDKやバックエンドのC2インフラに関する技術情報を、プラットフォーム事業者や法執行機関、研究機関と共有した。この情報に基づき、各組織が同様のネットワークを監視・遮断できるようになり、より広範な防御が可能になった。
Google Play Protectによる自動防御
Androidの組み込みセキュリティ機能であるGoogle Play Protectが、NetNutのSDKを組み込んだアプリを検出し、ユーザーに警告を発するとともに自動で無効化する措置を取った。今後も新たなインストール試行に対して保護を継続する。これによって、一般ユーザーが意図せずボットネットの一部になるリスクが大幅に低減された。
これらの連携措置により、NetNutのプロキシネットワークから数百万台のデバイスが切り離され、可用性が著しく低下した。NetNutにはホワイトラベル(再販)プログラムも存在し、多くの有名住宅用プロキシブランドが実態としてNetNutのボットネットを利用していたことが分かっている。そのため、今回の措置はプロキシ業界全体に波及効果をもたらすと見られている。
ただしGTIGは、過去のIPIDEAネットワークの事例から、個別のネットワークが一見復元力を持つように見えることもあると指摘している。プロキシ事業者は自前のボットネットが弱体化すると競合からキャパシティを購入し、事実上の再販業者に転じる傾向がある。持続的な抑止には、複数の相互接続されたネットワークを同時に標的とするスケールした取り組みが不可欠だ。
なぜ住宅用プロキシがここまで危険なのか

NetNutのような住宅用プロキシは、攻撃者にとって理想的な隠れ蓑になる。2026年6月の1週間だけでも、GTIGはNetNutの出口ノードを疑われるIPから316もの異なる脅威クラスタを観測した。これにはサイバー犯罪グループだけでなく、国家支援が疑われるスパイ活動グループも含まれていた。
デバイス所有者への直接的な被害
感染したデバイスが出口ノードになると、その家庭のIPアドレスから不正な通信が行われる。最悪の場合、同じホームネットワーク内の他のプライベートデバイスにもアクセスされ、外部の脅威に晒される。ユーザーが気付かないうちに自宅の回線が犯罪に利用され、プロバイダからフラグを立てられ通信を制限されるなどの二次被害も発生する。
大規模DDoS攻撃の踏み台としての利用
SynthientやSpur、Nokia Deepfieldなどの公開レポートによれば、NetNutのインフラはMirai亜種などのDDoSボットネットにデバイスを感染させる経路としても使われていた。住宅用プロキシは単なる匿名化ツールにとどまらず、より破壊的なサイバー攻撃の温床になっている。
正規の住宅IPに見えるため、ログイン試行のブロックを回避
出口ノード化したデバイス経由で同一LAN内の機器にアクセス
多数の住宅デバイスから一斉にトラフィックを送り標的を圧迫
ISPに不正通信として検知され、正規の通信がブロックされる可能性
こうしたリスクは、一般消費者のデバイスが知らぬ間に犯罪インフラの一部と化す構造的な問題だ。「無料VPN」や「帯域を共有するだけで報酬」といった甘い言葉でインストールを促すアプリが、実は住宅用プロキシのSDKを仕込んでいるケースが後を絶たない。
一般消費者が今すぐ取るべき3つの対策

NetNutのような脅威から自分や家族のデバイスを守るために、以下の点に注意したい。
「未使用の帯域を共有する」アプリを警戒する
「帯域を貸すだけで収入が得られる」とうたうアプリは、悪質なプロキシネットワークへの参加を促す典型的な手口だ。こうしたソフトウェアは、意図せず自宅のIPを犯罪者に貸し出す結果になる。Googleは公式アプリストアの利用と、サードパーティVPNやプロキシの権限を厳格に確認するよう呼びかけている。
Google Play Protectを有効に保つ
Androidスマートフォンやテレビデバイスでは、Play Protectが自動的にNetNut関連の不正アプリを検出・無効化する。設定から保護機能が有効になっているか確認することが第一歩だ。Play Protect認証を受けていないデバイスは、セットトップボックスなどでも注意が必要だ。
信頼できるメーカーのデバイスを選ぶ
特にスマートテレビやストリーミング端末を購入する際は、公式のAndroid TV OSを搭載し、Play Protect認証を受けているかどうかを確認すべきだ。Android TVの公式サイトではパートナーメーカーの最新リストが公開されており、購入前のチェックに役立つ。
今後の展望と持続的な対策の必要性

今回のNetNut無効化は、2026年1月のIPIDEAネットワーク対策に続くGoogleの断固たる意思表示だ。しかし住宅用プロキシ業界は急速に拡大しており、単発の措置だけでは長期的な解決にならない。事業者同士がボットネットを再販し合う流動的なエコシステムでは、1つのネットワークを潰しても別のネットワークがカバーする。
GTIGも認めるように、持続的な抑止には複数の主要プロバイダのインフラを同時に標的とし、モバイルプラットフォーム、ISP、テクノロジー企業が継続的に情報を共有し、悪意あるC2サーバーをブロックする取り組みが必要だ。Googleは「業界全体の協調努力なくして根本的な解決は難しい」との立場を明確にしている。
我々一般消費者も、知らぬ間にサイバー攻撃の一端を担わされないよう、デバイスの購入元とアプリの権限に対して常に敏感でありたい。技術的な防御だけでなく、ユーザーリテラシーの向上が、悪質な住宅用プロキシの成長を鈍化させる最後の砦になる。
■ 技術的対策の要(プラットフォーム)
■ 法執行・インフラレベルでの遮断
Googleはこの発表の中で、同様の取り組みを加速させる意向を示しており、今後の脅威インテリジェンス共有の枠組みがさらに重要になるだろう。
この記事のポイント
- GoogleがNetNut(Popa)と呼ばれる世界最大級の住宅用プロキシネットワークをFBIなどと協力して無効化
- アカウント無効、SDK情報共有、Play Protectによる自動防御で数百万台のデバイスをネットワークから切り離し
- 住宅用プロキシは一般家庭のデバイスを踏み台にし、アカウント乗っ取りやDDoS攻撃の温床に
- 消費者は「未使用帯域の共有」アプリを避け、Play Protectの有効化や信頼できるデバイス選びが重要
- 業界全体での継続的な情報共有と協調した遮断が、長期的な対策には不可欠
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon EKSにKubernetesロールバック機能、アップグレードの不安を解消
Amazon EKSにKubernetesバージョンロールバック機能が導入された。クラスタのバージョンアップグレードはこれまで戻り道のない一方通行だったが、今回の機能により最大7日間であれば以前のバージョンに巻き戻せる。AWSのDonnie Prakoso氏とChanny Yun氏が2026年7月1日付のAWS News Blogで発表した内容だ。
KubernetesコミュニティではKEP-4330に基づくエミュレートバージョンでロールバックを緩和する動きが進んでいる。しかしEKSのロールバックはエミュレーションではなく、本番環境で事前に検証済みの状態へ完全に戻る点が異なる。クラスタ管理者にとってはアップグレード作業の心理的ハードルを大幅に下げる機能だ。
本記事では、この新機能の仕組みや利用手順、EKS Auto Modeでの挙動の違いを中心に、運用現場へのインパクトを具体的に整理する。
Kubernetesバージョンロールバックの概要
この図はアップグレード失敗時の対応の違いを示している。従来はクラスタ再構築が必要だったが、新機能では「元に戻す」操作が可能になった。
ロールバックが求められてきた背景
Kubernetesは年に3回のマイナーバージョンアップがリリースされる。多数のクラスタを抱える組織、とりわけ金融や医療など規制の厳しい業界では、アップグレードに数か月単位の準備期間を設ける例も珍しくない。問題発生時に復旧できる確証がなければ、アップグレードそのものを先送りする判断になりやすい。
この結果、クラスタは古いバージョンに留まり、セキュリティパッチが未適用のまま延長サポート期間に突入するケースが増えていた。ロールバック機能はこうした「アップグレード恐怖症」を解消する安全装置として位置づけられる。
エミュレートバージョンとの違い
KEP-4330で提案されているエミュレートバージョンは、クラスタを移行用の中間状態に置くアプローチだ。対してEKSのロールバックは、実際に本番で稼働していた検証済みの状態へ戻る。エミュレーションではないため、ロールバック後の動作は以前のバージョンそのものになる。運用チームにとっては「テスト環境で確認済みの状態」に復帰できる点が安心材料だ。
基本的な制約と料金
ロールバック可能な期間はアップグレード後7日間である。バージョンは1つ前のマイナーバージョンのみ戻せる。たとえば1.34から1.35にアップグレードした場合、戻り先は1.34だ。1.33へ一気に下げることはできない。
料金はロールバック機能そのものに追加コストは発生しない。標準のEKS料金とコンピューティングコストのみで利用できる。全商用AWSリージョンで本日から提供開始されている。
ロールバックの実践的な利用手順
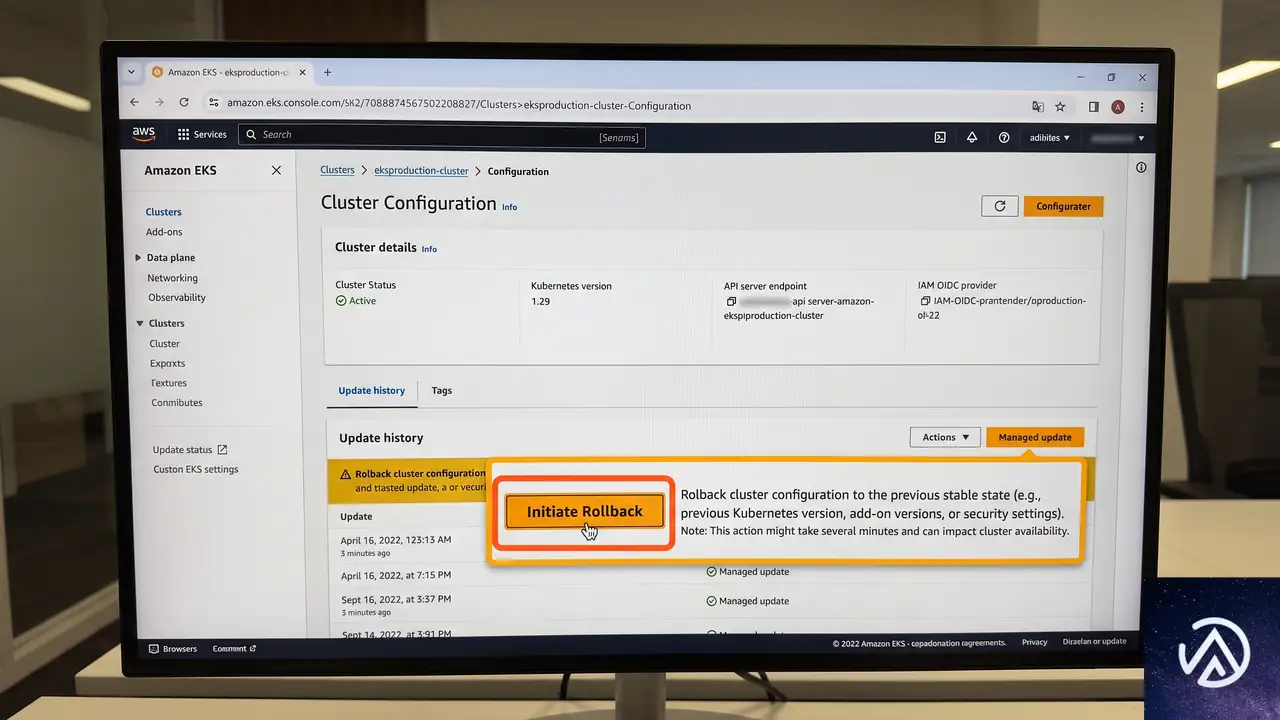
AWSのブログでは、Donnie Prakoso氏が実際にEKSコンソールからロールバックを試した手順が紹介されている。ここではその流れを整理しつつ、運用現場で意識すべきポイントを補足する。
この手順は標準的なアップグレード操作と大きく変わらない。所要時間は制御プレーンのロールバックが約20分で、通常のアップグレードと同程度だ。
ロールバックインサイトによる事前評価
EKSはロールバック実行前に、クラスタインサイト機能を使ってロールバックの準備状況を自動評価する。ノードのバージョン互換性やアドオン依存関係に問題があれば事前にフラグが立つ仕組みだ。事前評価をスキップして強制的にロールバックを進めたい場合は、--forceフラグが用意されている。
トラブルシューティング中の緊急時にはこの強制実行が有効だが、通常はインサイトの結果を確認してから進めるのが安全だ。互換性の警告を見落とすと、ロールバック後に別の問題が顕在化するリスクがある。
制御プレーンとノードのロールバック
制御プレーンのロールバックはすべてのEKSクラスタで利用できる。一方、ノードのロールバックはEKS Auto Modeを利用しているクラスタが対象となる。自分でノードを管理している構成では、制御プレーンだけがロールバックされ、ノード側は別途対応が必要になる点に注意したい。
EKS Auto ModeでのロールバックとキャンセルAPI
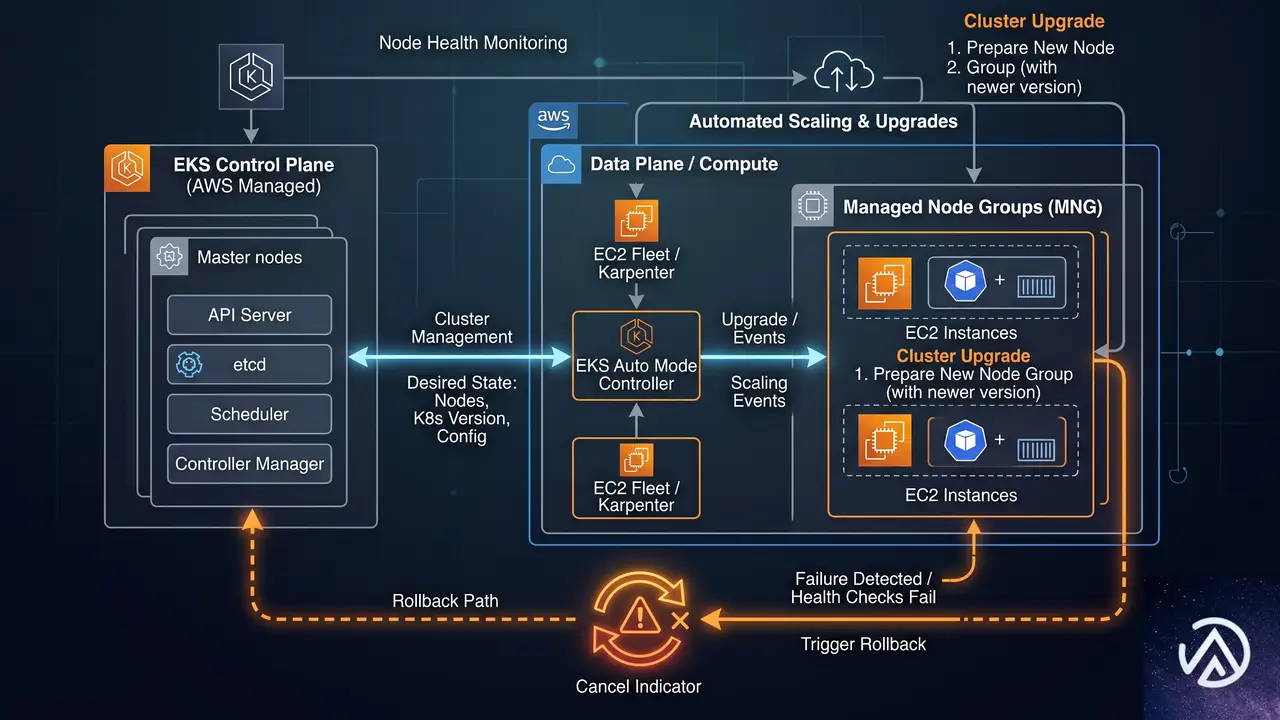
EKS Auto Modeはコンピューティング、ネットワーク、ストレージ管理を自動化するフルマネージドオプションだ。このモードでは制御プレーンと管理ノードの両方をロールバックする必要があり、ノードのロールバックはPod Disruption Budget(PDB)を尊重しながら進むため、設定によっては時間がかかる。
Auto Modeでは制御プレーンとノードが連動してロールバックされる。キャンセルAPIを使えば、所要時間が長すぎる場合に中断して戦略を練り直せる。
PDBを尊重する設計の意図
EKSはロールバック中にデフォルトでPDBをバイパスしない。ワークロードの安定性を最優先する設計思想だ。ノードの切り戻し中にPodが過剰に停止すると、アプリケーションの可用性が損なわれるからである。
ロールバックを急ぎたい場合は、運用者が自らPDBを修正または削除することで高速化できる。システムが一方的にPDBを無視しないため、安全性とスピードのバランスを利用者側でコントロールできる仕組みになっている。
キャンセルAPIの実用シナリオ
キャンセルAPIはノードロールバックの進行中に中断を指示できる機能だ。次のような状況で役立つ。ロールバックにかかる時間が想定以上に長く、ビジネスへの影響が懸念される場合。あるいはロールバック以外の代替手段(特定ノードだけの切り戻しなど)の方が適切と判断した場合だ。
中断後はPDBの調整やロールバック戦略の見直しを行い、再度実行するか別の手段を選ぶかを決められる。この柔軟性は、大規模クラスタを運用するチームにとって重要なセーフティネットになる。
運用現場へのインパクトと今後の展望
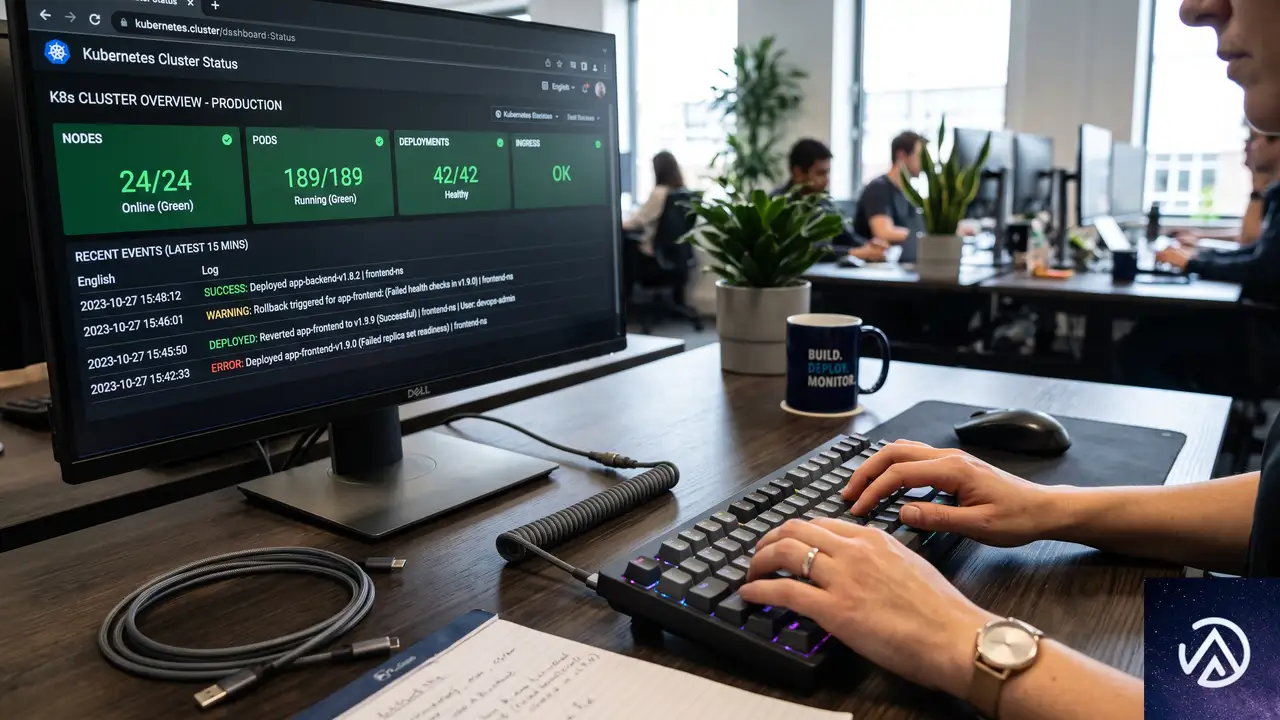
ロールバック機能の登場は、Kubernetes運用の前提を変える可能性がある。これまでは「アップグレードの前に数週間の検証期間を設けるのが常識」だったが、ロールバックが可能になったことで「まず上げてみて、問題があれば戻す」というアプローチが現実的になる。
アップグレードサイクルの短縮
Kubernetesのマイナーバージョンアップは年3回のペースで進む。これに追従するには、アップグレードサイクルを四半期以内に収める必要がある。ロールバック機能によって心理的ハードルが下がれば、検証期間を短縮しつつ最新バージョンへの追随速度を上げられる。
規制業界でも「7日間の戻し窓口がある」という事実が監査対応やリスク評価でプラスに働く可能性がある。セキュリティパッチの適用遅延リスクを低減する効果も見込めるだろう。
注意すべき制約
ロールバックは万能ではない。7日間の期間制限を過ぎると元に戻せないため、アップグレード後の監視と問題検知の仕組みは引き続き重要だ。またノードを自前管理している構成ではノードロールバックが自動化されないため、制御プレーンのみの切り戻しでは不十分なケースも想定される。
ロールバックインサイトが示す警告を無視して強制実行した場合、アドオンの互換性問題などが残る可能性もある。事前チェックを飛ばすのはあくまで緊急時の手段と心得たい。
この記事のポイント
- EKSの新機能「バージョンロールバック」はアップグレード後7日間、1つ前のマイナーバージョンに戻せる
- 制御プレーンのロールバックは全EKSクラスタ、ノードロールバックはAuto Modeクラスタが対象
- ロールバックインサイトで互換性リスクを事前評価し、
--forceでスキップも可能 - PDBを尊重する設計でワークロードの安定性を維持しつつ、キャンセルAPIで中断も選べる
- 追加料金は不要で全商用リージョンで提供開始。アップグレードサイクル短縮の追い風になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

プラグイン更新後に管理画面が真っ白になった時の原因と直し方
プラグイン更新直後に管理画面が真っ白になりエラー表示された場合、FTP で該当プラグインフォルダをリネームして無効化すればすぐに復旧する。特に Groovy Menu 無料版 1.4.7 で発生する `Call to undefined method GroovyMenuSettings::dashboard()` エラーでは、PHP の未定義メソッドが呼ばれているため管理画面が表示できなくなる。
なぜプラグイン更新で管理画面がクラッシュするのか

原因はプラグイン更新後のコードに含まれる不具合だ。今回のケースでは GroovyMenuSettings クラスに `dashboard()` メソッドが存在しないのに `render()` から呼び出そうとしたため、PHP の致命的なエラーが発生した。これにより WordPress のフック処理が中断され、管理画面が表示されない「重大なエラー」画面に切り替わる。
この種のエラーは特定のプラグインに限らず、バージョンアップ時の関数名の誤りや非互換の変更が原因でよく起こる。Query Monitor などのデバッグプラグインを入れていると、エラーメッセージとコールスタックが確認できる。
管理画面を復旧させる具体的な手順

最も確実な方法は、FTP クライアントまたはサーバーのファイルマネージャーを使って問題のプラグインフォルダ名を変更し、WordPress にそのプラグインを無効化させることだ。以下の手順で行う。
/wp-content/plugins/ ディレクトリに移動するgroovy-menu-free)を右クリック →「名前の変更」-disabled など任意の文字列を付けてリネームする上のデモは Groovy Menu 無料版の例だ。フォルダ名変更によって WordPress が「プラグインが見つからない」と解釈し、自動的に無効化してエラーループから抜け出せる。
FTP が使えない場合の代替方法
- レンタルサーバーの管理パネル(コントロールパネル)にログインする
- 「ファイルマネージャー」機能を開き、上記と同じ操作でフォルダ名を変更する
- フォルダ名を変えたら管理画面にアクセスし、復旧を確認する
FTP もファイルマネージャーも使えない時のデータベース無効化

サーバーの制限で上記の操作ができない場合、WordPress のデータベースに直接アクセスしてプラグインを無効化する手段がある。
wp_options テーブルを選択し、option_name が active_plugins の行を探すoption_value カラムの編集画面を開き、一時的に値を空文字列 "" に変更して保存するデータベースを直接操作するとリスクが伴うため、作業前に必ずバックアップを取得しておく。正常に管理画面へ入れるようになったら、すぐに問題のプラグインを削除するか、安定版がリリースされるまで更新を控える判断が必要になる。
同じトラブルを防ぐための再発防止策

ステージング環境で事前検証する
プラグイン更新を本番サイトに適用する前に、ステージング環境(本番と同じ構成のテストサイト)で動作確認を行うとトラブルを未然に防げる。多くの国内レンタルサーバーではワンクリックでステージングを作成できる機能が提供されている。
自動更新を制御する
WordPress の管理画面ではプラグインごとに自動更新のオン/オフを設定できる。信頼性の高いプラグインだけ自動更新を許可し、不安定なアップデートが多いものは手動更新に切り替えておくと安全だ。
定期バックアップとデバッグモードの活用
更新前にプラグイン一覧とデータベースをバックアップしておけば、万一の問題発生時にも迅速にロールバックできる。また、`wp-config.php` で `WP_DEBUG` を `true` に設定すると詳細なエラー内容が表示され、原因特定が容易になる。ただし本番公開サイトでは普段は `false` に戻しておく。
よくある質問
プラグインを無効化したらサイトの表示が崩れたがどうすればいい?
無効化によってメニューやレイアウトが一時的に変わることはあるが、管理画面が復旧した時点で別のバージョンのプラグインを再インストールすれば元に戻せる。必ず復旧後に適切なバージョンを入れ直すことが前提だ。
エラーログの確認方法は?
FTP で `wp-content/debug.log` が生成されていればダウンロードして確認できる。なければ `wp-config.php` に `define(‘WP_DEBUG_LOG’, true);` を追加してエラーを記録すると、後から詳しい原因を読み取れる。
フォルダ名を変更しても直らない時は?
キャッシュ系プラグインやサーバー側のキャッシュが残っている可能性がある。ブラウザキャッシュのクリア、CDN のキャッシュ削除、サーバーキャッシュのクリア(管理パネルに機能があれば)を順に試すと改善しやすい。
プラグイン開発者が修正版を出すまで待つしかないのか?
問題のバージョンを避けて1つ前の安定版を手動で上書きアップロードすれば一時的に復旧できる。公式リポジトリの「以前のバージョン」から ZIP ファイルを入手し、FTP で上書きすると過去の状態に戻せる。
この記事のポイント
- プラグイン更新後の管理画面クラッシュは、該当フォルダのリネームで直ちに復旧できる
- FTP が使えなくてもファイルマネージャーやデータベース操作で対処可能
- 原因は未定義メソッドの呼び出しで、デバッグログで特定できる
- ステージング環境での事前テストと定期バックアップが最も有効な予防策
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

CloudflareのAIクローラールールがGooglebotをブロックする危険性
CloudflareがAIクローラー対策の仕組みを抜本的に見直し、2026年9月15日から新たなデフォルト設定を適用する。この変更は単なるAIボット対策の強化にとどまらず、Googlebotのような検索クローラーまで巻き込む可能性がある。AIにコンテンツを学習されたくないという意図で設定したブロックが、結果的に検索エンジンからの流入を断つリスクをはらんでいるのだ。
特に影響が大きいのは、Cloudflareの無料プランを利用するWordPressサイトや中小企業のオウンドメディアだ。AI学習ブロックの意図がなくても、9月15日以降にデフォルト設定が自動適用され、知らぬ間にGooglebotのクロールが制限される可能性がある。本記事では3つの振る舞い分類、デフォルト変更の詳細、そして今すぐ取るべき対応策を解説する。
CloudflareがAIクローラー対策の方針を転換した背景
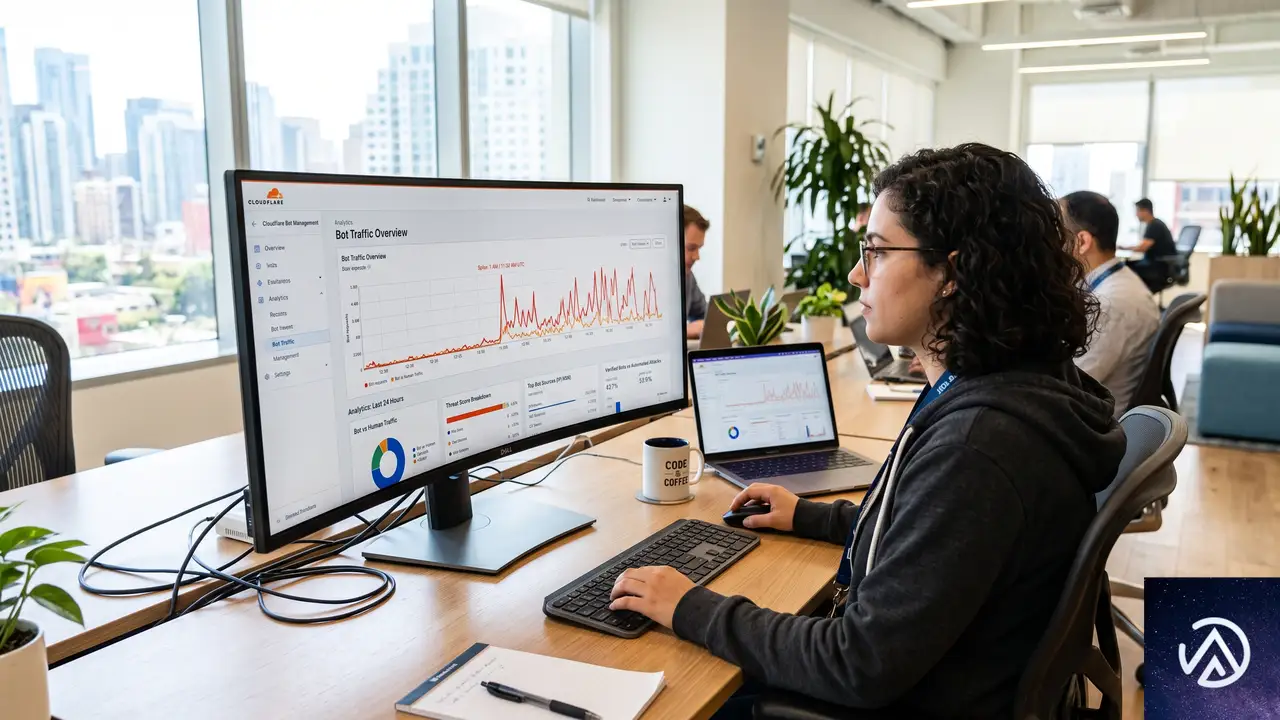
Cloudflareは2026年7月2日、第2回「Content Independence Day」の一環として、AIクローラー管理の新方式を発表した。従来の単一の「AIボットをブロック」スイッチを廃止し、クローラーの振る舞いに基づいた3つのカテゴリで制御する仕組みへ移行する。この変更は全顧客(無料プランを含む)に即時適用され、9月15日にはデフォルト設定も自動変更される。
背景にあるのは、AIクローラーによるコンテンツ収集の爆発的な増加だ。Cloudflareのネットワーク上では、AI訓練目的のクローラーリクエストが全体の過半数を占めるまでに成長した。2025年春時点では約20%だったが、1年で状況は一変した。AIエージェントのリクエスト数も前年比1700%増と、指数関数的な伸びを示している。
この急増に対し、多くのパブリッシャーやサイト運営者はAIクローラーを一律ブロックする方向に動いてきた。しかし、その「一律ブロック」が検索クローラーまで巻き込む副作用を生みつつあった。Cloudflareの今回の方針転換は、この問題に正面から取り組むものだが、同時に新たなリスクも生じさせている。
3つの振る舞い分類がクローラー制御を変える

Cloudflareの新方式は、クローラーを「AIかどうか」ではなく「サイト上で何をするか」で分類する。この考え方は、サイト運営者にとってクローラー制御の解像度を格段に上げるものだ。3つのカテゴリは以下のとおり。
Cloudflareは、ボット運営者に対して「振る舞いごとに別々のクローラーを用意すべき」と要求している。サイト側が「なぜそのボットが来ているのか」を判断し、許可・ブロックを適切に選択できるようにするためだ。この考え方自体は合理的だが、現実にはGooglebotのように検索とAI訓練の両方を行う「マルチパーパスクローラー」が存在する。この点が後述する問題の核心となる。
検索クロールとAI訓練クロールの同居がリスクを生む
Googlebot、Applebot、Bingbotは、いずれも検索インデックス作成とAIモデル訓練の両方に使用される。Cloudflareの新ルールでは、こうした「混合用途のクローラー」に対して最も厳しい制限が適用される。つまり、AI訓練目的のクロールをブロックしているサイトでは、同じクローラーによる検索目的のアクセスも自動的にブロックされるのだ。
これはrobots.txtとは根本的に異なる。robots.txtはクローラーへの「お願い」に過ぎず、無視されることもある。しかしCloudflareのブロックはネットワークレベルで動作するため、robots.txtよりはるかに強力だ。グーグルでさえバイパスできない。AI訓練を止めたい一心で設定したブロックが、検索流入というサイトの生命線を断ち切ってしまう皮肉な構造が生まれている。
9月15日のデフォルト変更が生む3つのリスク
2026年9月15日に自動適用されるデフォルト設定の変更は、Cloudflareを利用するあらゆるサイトに影響を及ぼす。特に注意すべきは以下の3点だ。
とりわけ危険なのはリスク3だ。従来の「AIボットをブロック」設定を有効にしたまま放置しているサイトは、9月15日以降にGooglebotのアクセスがネットワークレベルで遮断される可能性がある。検索クロールが停止すれば、新規コンテンツのインデックス登録が滞り、既存ページの再クロール頻度も低下する。検索順位への影響は数週間から数カ月かけて徐々に表面化するため、原因特定が遅れやすい。
robots.txtとの違いを理解しておくべき理由
多くのサイト運営者は「robots.txtでブロックしているから大丈夫」と考えがちだ。しかし、robots.txtはクローラーに対する紳士協定に過ぎず、グーグルも状況によって無視することがある。一方、Cloudflareのブロックはリクエストがオリジンサーバーに到達する前にネットワークエッジで遮断する。この違いは決定的だ。
robots.txtでのブロックは「できれば来ないでほしい」というお願いであり、Cloudflareのネットワークブロックは物理的な門番が門を閉ざすようなものだ。後者のほうが確実だが、その分だけ設定ミスの代償も大きい。AI訓練ブロックのつもりが検索クローラーまで締め出してしまうと、サイトの検索パフォーマンスは確実に悪化する。
実務者が今すぐ取るべき対応チェックリスト

9月15日までに対応を完了する必要がある。以下に具体的なアクションを時系列で整理した。
STEP 5のクロール統計監視は特に重要だ。9月15日以降にGooglebotのクロール頻度が急落した場合、Cloudflare設定に原因がある可能性が高い。Search Consoleの「クロール統計レポート」で1日あたりのクロールリクエスト数を確認し、急激な減少があれば即座にCloudflareダッシュボードを再確認する習慣をつけておきたい。
無料プランユーザーが特に注意すべきポイント
Cloudflareの無料プランを利用しているサイトは、9月15日までに一度もAIクローラー設定を変更していない場合、自動的に新デフォルトへ移行される。つまり「設定を触っていないから大丈夫」という認識が最も危険だ。何もしないことが、意図せずGooglebotブロックを招く可能性がある。
無料プランであっても、ダッシュボードから3カテゴリの設定を手動で確認・変更することは可能だ。Searchカテゴリだけは明示的に「許可」に設定し、TrainingやAgentはサイトのポリシーに応じて判断する。この一手間をかけるかどうかで、9月15日以降の検索パフォーマンスが大きく変わる。
今後の展望とサイト運営者が持つべき視点

Cloudflareは、マルチパーパスクローラーの運営者に対して「振る舞いごとにクローラーを分離する」ことを求めている。グーグルやアップル、マイクロソフトがこの要求に応じてGooglebotを用途別に分割するかどうかが、今後の分岐点となる。仮に分割が実現すれば、サイト運営者はAI訓練だけをブロックし、検索インデックスは許可するという選択が可能になる。
しかし、現時点ではその保証はない。9月15日以降もGooglebotは単一のクローラーとして動作し続ける可能性が高い。つまり、AI訓練をブロックするという選択は、当面の間「検索流入とのトレードオフ」であり続ける。この現実を直視した上で、サイト運営者は自社のコンテンツ戦略とAIポリシーを再定義する必要がある。
Cloudflareは新しいコンテンツ利用シグナルもテスト中だ。robots.txtに記述するContent Signalsの拡張で、immediate(保存しない)、reference(インデックスしてリンクバック、新デフォルト)、full(要約・複製を許可)の3段階を指定できるようにする。ただしこれは設定上の「希望表明」であり、単体ではブロック機能を持たない点に注意が必要だ。
サイト運営者が今から準備すべき3つのこと
AIにコンテンツを学習されることを完全に拒否するのか、それとも検索流入を優先するのか。この問いに明確な答えを持たないまま9月15日を迎えると、Cloudflareの新デフォルトによって想定外のブロックが発生し、検索パフォーマンスが毀損するリスクがある。サイトの規模や収益構造に応じて、今のうちに方針を固めておくことが重要だ。
この記事のポイント
- CloudflareのAIクローラー管理が3つの振る舞い分類(Search、Agent、Training)に再編された
- 9月15日から広告表示ページでTrainingとAgentがデフォルトブロックされ、無料プランユーザーも自動移行の対象
- Googlebotのような混合用途クローラーは、AI訓練をブロックすると検索クロールも停止する
- robots.txtと異なり、Cloudflareのブロックはネットワークレベルで動作しバイパスが困難
- Searchカテゴリの許可確認とSearch Consoleでのクロール統計監視が当面の最優先対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubがシークレットスキャニングで受信箱ゼロを達成した方法
20,000件のアラートと向き合う、実践の全容
GitHubが社内の15,000以上のリポジトリを対象にシークレットスキャニングを実施したところ、20,000件を超える認証情報の露出を検出した。数字だけ見ると途方もないが、9カ月後には未対応のアラートをゼロに持ち込んでいる。セキュリティ運用の現場で「受信箱ゼロ(inbox zero)」を達成した事例として注目すべきプロジェクトだ。
GitHub Blogの記事によれば、同社はシークレット管理の取り組みを数年前から開始し、自社開発中のシークレットスキャニング機能をパイロット適用したところ、想定を大きく上回る数のシークレットが浮上したという。単に検出するだけでなく、どれが本物のリスクで、誰が対応すべきかを見極め、安全に修正するフェーズへと進めた点が鍵を握る。
本記事ではGitHubの内部事例をもとに、シークレット管理の現実的な進め方をひもとく。新規にシークレットスキャニングを導入した組織が直面する「どうやって既存のシークレットを片付ければいいのか」という問いに対する、具体的な戦略と教訓をまとめた。
ノイズの切り分け、18,000件が一瞬で消えた理由
20,000件を超えるアラートが出たからといって、同じ数の重大なインシデントが存在するわけではない。GitHubが最初に取り組んだのは、本当に対処すべきアラートとノイズの仕分けだった。
わずか5リポジトリで9割を占めたテスト用シークレット
データを掘り下げると、アラート全体の約18,000件がたった5つのリポジトリに集中していた。しかも、そのすべてがテスト用のフィクスチャや無効化済みの認証情報、実在しないが有効に見えるダミーシークレットだった。シークレットスキャニングを自社開発するGitHubにとって、テスト用の本物らしいシークレットが大量に必要なのは自然なことだ。
ここで同社が取った判断は明確だ。専用テストリポジトリに含まれ、一度も実運用で使われた形跡がなく、既知のテストパターンに一致するシークレットは、まとめて「解決済み」として一括クローズした。わずか数日で約18,000件のノイズが消え、残ったのは2,000件あまりの本物のアラートだけになった。
テスト用シークレットと本物のクレデンシャルを区別する基準を事前に定めておけば、大規模な一括処理が可能になる。数字の見た目に惑わされず、まずは分類から始めるのが現実的な最初の一手だ。
コードだけではない、シークレットの潜む場所
シークレットはソースコードにだけ存在すると思いがちだが、GitHubの経験はそれを覆した。サポートチケット、バグ報奨金レポート、インシデント対応のメモ、wikiページにもシークレットは散らばっていた。
サポートチケットには顧客がうっかりトークンを含めてしまうケースがあり、バグ報奨金の報告には研究者が完全な再現手順の一環としてAPIリクエストごとトークンを提出する。インシデントの調査記録にも、緊急時にコピーされた認証情報が残ることがある。いずれもコードリポジトリの外にあるため、従来のスキャン対象から漏れやすい領域だ。
GitHubはカスタマーサポート、セキュリティインシデント対応チーム、バグ報奨金プログラムと連携し、それぞれのワークフローに共通のプレイブックを整備した。修正作業の過程で新規の課題やコミットにシークレットを載せてしまう二次被害を防ぐ工夫も、あわせて徹底されている。
スキャン対象をコードリポジトリだけに絞っていると、これら周辺領域のシークレットはいつまでも検出されない。組織全体のワークフローを見直し、サポートやバグ報奨金の運用にもシークレット対策を組み込む必要がある。
段階的な取り組みで9カ月後にゼロへ
GitHubは2万件超のアラートを少数のセキュリティエンジニアだけで片付けようとはしなかった。新規の負債を止めたうえで、既存の負債を反復可能かつ計測可能なワークフローで減らしていく、運用バックログの処理と変わらないアプローチを取っている。主なフェーズは次の6段階だ。
フェーズ1、全社への有効化と強制で新規流入を遮断
既存のシークレットを片付ける前に、新たなシークレットの蓄積を止める必要がある。GitHubは全エンタープライズと組織に対してシークレットスキャニングとプッシュプロテクションを一括で有効化した。GitHub Advanced Securityの組織レベル設定があったため、15,000以上のリポジトリを一つひとつ手動で設定する必要はなかったという。
設定は強制適用され、個々のリポジトリやチームがこっそりオプトアウトすることは許されていない。プッシュプロテクションによって新規シークレットがソース上に流入するのを根本でブロックし、バックログが増え続ける状況を断ち切った。
フェーズ2、分類とトリアージで取捨選択
2万件超のアラートをリポジトリ別、シークレットタイプ別、経過期間別に分解し、前述のとおり約18,000件を一括クローズした。残った2,000件あまりについて、GitHubは難しい判断に直面する。
課題の中にシークレットが含まれている場合、本文を編集してリビジョン履歴を消すべきか、それとも監査証跡を残すべきか。リポジトリにコミットされたシークレットは、git履歴を書き換えるべきかどうか。大規模な履歴書き換えは強制プッシュによってプルリクエストを破壊し、コミットのSHAを無効化し、開発者の作業を中断させる副作用がある。
「もう使っていないリポジトリなら削除してしまえばいいのでは」という声も出たが、GitHubの回答は原則としてノーだった。削除されたリポジトリは監査証跡もろとも消える。もしそのリポジトリのシークレットが過去に漏洩していた場合、インシデント対応に必要な証拠を失ってしまう。シークレットをローテーションしたうえで、必要に応じてアーカイブし、履歴は残すという方針を取った。
可能なかぎり露出したシークレットを先にローテーションまたは無効化し、そのうえで履歴書き換えの要否を判断する。無効化済みのシークレットが履歴に残っていても安全かどうかはケースバイケースだ。この種の判断が、プロダクトセキュリティチームが日々直面する難題の一つであると記事は述べている。
フェーズ3、実効性の検証で本物を見極める
リポジトリに置かれた認証情報は、何年も前にローテーション済みかもしれないし、いまも本番システムにアクセスできるかもしれない。違いがわからなければ優先順位はつけられない。
当時のシークレットスキャニングにはネイティブの有効性チェック機能がなかったため、GitHubは独自の検証アプローチを構築した。目的は絞り込まれている。クレデンシャルがまだ機能するかどうかを確認し、適切な場合はアラートの転送先や通知すべき所有者を特定するための最小限のメタデータを収集するにとどめた。
たとえばGitHubトークンなら、GET /userのような影響の小さいエンドポイントに1回だけ認証リクエストを送る。不明瞭なレスポンスは結論不能と扱い、リポジトリや組織などのプライバシーに関わるリソースへの追加リクエストは避けた。この検証作業はプライバシーおよび法務チームとの密接な連携のもとで進められた。
手動での検証を進める一方、プロダクトチームが有効性チェックをシークレットスキャニングにネイティブ実装し、以降の作業は大幅に加速した。現在では有効性チェックがGitHubシークレットスキャニングの標準機能として組み込まれている。
フェーズ4、所有者の特定と責任体制の確立
認証情報が生きているとわかっても、誰がそれをローテーションできるのかを特定できなければ意味がない。GitHubが発行するパーソナルアクセストークンについては、プロダクトチームと協力してトークンの作成者や作成日時、スコープといったメタデータをアラート上に直接表示できるようにした。トークンそのものを使わずに所有者を割り出せる仕組みだ。
問題はそれ以外のシークレットと、明確な所有者が存在しないリポジトリだった。GitHubにはEngineering Fundamentalsという社内のエンジニアリング基準プログラムがあり、サービスに対して永続的な所有権を義務づけている。しかし、すべてのリポジトリがサービスときれいに紐づくわけではない。この課題は、GitHub Custom Propertiesを使ったリポジトリ所有権の明確化と、認証情報管理ツール上の全シークレットに永続的な所有者を割り当てる取り組みへと発展した。所有者を特定できなければシークレットのローテーションは不可能だからだ。
フェーズ5、ロングテールへの手動トリアージ
検証とメタデータの充実を経ても、最終的には人間の判断を要するアラートが残る。それぞれについて、この認証情報が何へのアクセスを許可するのか、すでにローテーション済みか、接続先システムの所有者は誰か、修正パスは何か、という問いを一つずつ解いていく作業だ。
GitHubはクローズするアラートすべてに対し、正確な処分結果(無効化済み、テスト用、誤検知など)を記録し、修正課題へのリンクや承認されたセキュリティ例外の情報といった関連コンテキストをコメントとして残した。このフェーズは、自動化されたシグナルだけでは不十分な領域を埋めるために、複数チームの密接な連携を必要とした。
フェーズ6、仕組み化と説明責任で持続可能に
パターンが見えてきた段階で、GitHubは作業をスケーラブルな体制へと昇華させた。
- アラートを社内の脆弱性管理プラットフォームに集約し、一元的な追跡とレポートを実現
- シークレットタイプ別に修正プレイブックを文書化し、各チームが自律的に対応できるように整備
- リポジトリ所有権に基づいてアラートを適切なチームへ自動通知する仕組みを構築
最後の締めくくりは説明責任の確立だ。GitHubはシークレット修正をEngineering Fundamentalsプログラムに組み込み、セキュリティに関する基本要件として全チームを評価対象にした。明確な期待値を設定し、各チームが自分たちの状況を可視化できるダッシュボードを用意したことで、シークレット衛生は組織全体の共有責任へと変わった。着手から9カ月後、未対応アラートはゼロになった。
6つのフェーズは独立しているわけではなく、相互に補完し合う。フェーズ1で新規流入を止めなければバックログは減らず、フェーズ4の所有者特定ができなければフェーズ5の手動トリアージは停滞する。全体を一連のパイプラインとして設計した点が、9カ月での完遂を支えた。
GitHubが得た8つの教訓
今回のプロジェクトを通じてGitHubが得た教訓は、同様の課題に直面する組織にとって実践的な指針となる。以下に8つを整理した。
数字に怯えない
初期のアラート件数は2万件を超えていたが、実に9割は実害のないノイズだった。生の数字がそのまま実際の作業規模を表すことはほとんどない。まずは分類から始めるべきだ。
例外なく全社に強制適用する
部分的な展開は死角を生む。GitHubはエンタープライズレベルでシークレットスキャニングとプッシュプロテクションを有効化し、誰にもオプトアウトを許さなかった。
エスカレーションの前に検証する
検出されたシークレットのすべてが生きているわけではない。有効性チェックによって優先順位をつけ、本当に危険なものから手を付けるのが鉄則だ。
メタデータが作業時間を大幅に削減する
GitHub発行の認証情報については、トークンの作成者やスコープといったメタデータが調査時間を劇的に短縮した。サードパーティプロバイダにも同様のメタデータ提供を求め、自前で補完する層を用意するのが望ましい。
所有者不在のシークレットは修正できない
永続的な所有権の基盤に早期に投資すること。リポジトリにもクレデンシャルにも、必ず責任者を紐づける仕組みが必要だ。
検出後のワークフローを自動化する
検出はスタート地点にすぎない。本当の運用課題は、アラートの転送、所有者の追跡、そしてクローズまでのループを回し切ることにある。ワークフロー層への投資が成否を分ける。
セキュリティチームだけの課題にしない
数千件のアラートをセキュリティチームだけで修正するのは不可能だ。GitHubはシークレット衛生をエンジニアリングの基本要件に組み込み、全チームの評価指標に据えた。リーダー層がダッシュボードを注視する状況になれば、各チームは自然と修正の時間を確保する。
判断基準を文書化する
すべてのシークレットにきれいな修正パスがあるわけではない。ローテーションで十分なケース、履歴の書き換えが必要なケース、残余リスクを受け入れるケースを、どう判断するかをあらかじめ文書化しておくことが重要だ。
多くの手作業は製品機能に置き換わった
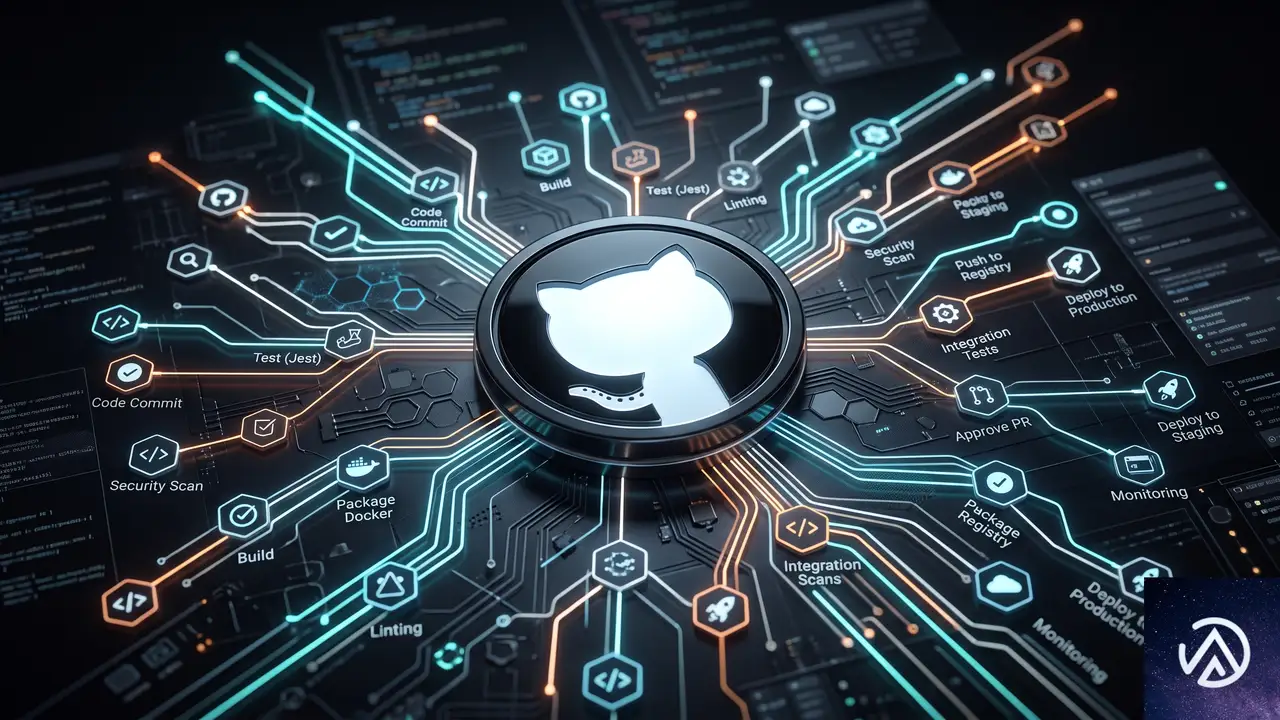
今回のプロジェクトでGitHubが手動で実施していた有効性チェックや所有者特定、一括トリアージの多くは、現在シークレットスキャニングのネイティブ機能として利用できる。同社の記事は、読者に対して「私たちが構築したものの大半を再発明する必要はない」と明言している。
新規にシークレットスキャニングを導入するなら、まず全社への有効化とプッシュプロテクションの強制適用から始め、バックログをリポジトリとシークレットタイプでトリアージし、ノイズと判断できるものは迷わず一括クローズする。その後、有効なシークレットを検証し、所有者にアラートをルーティングし、他のエンジニアリング作業と同様に修正状況を追跡する。この流れは、組織の規模を問わず適用できる現実的なアプローチだ。
この記事のポイント
- アラート件数に惑わされず、まずはテスト用や無効化済みのノイズを分類して一括除去する
- シークレットはコード以外にも存在する。サポートチケットやバグ報奨金レポートも対象に含める
- 新規流入を止める強制適用と、既存バックログの段階的処理を並行して進める
- 有効性検証とメタデータ活用で、本当に対処すべきアラートに集中する
- シークレット衛生を組織全体の評価指標に組み込み、セキュリティチームだけの負荷にしない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Events Manager更新後に公開イベントが下書きに戻る原因と修正
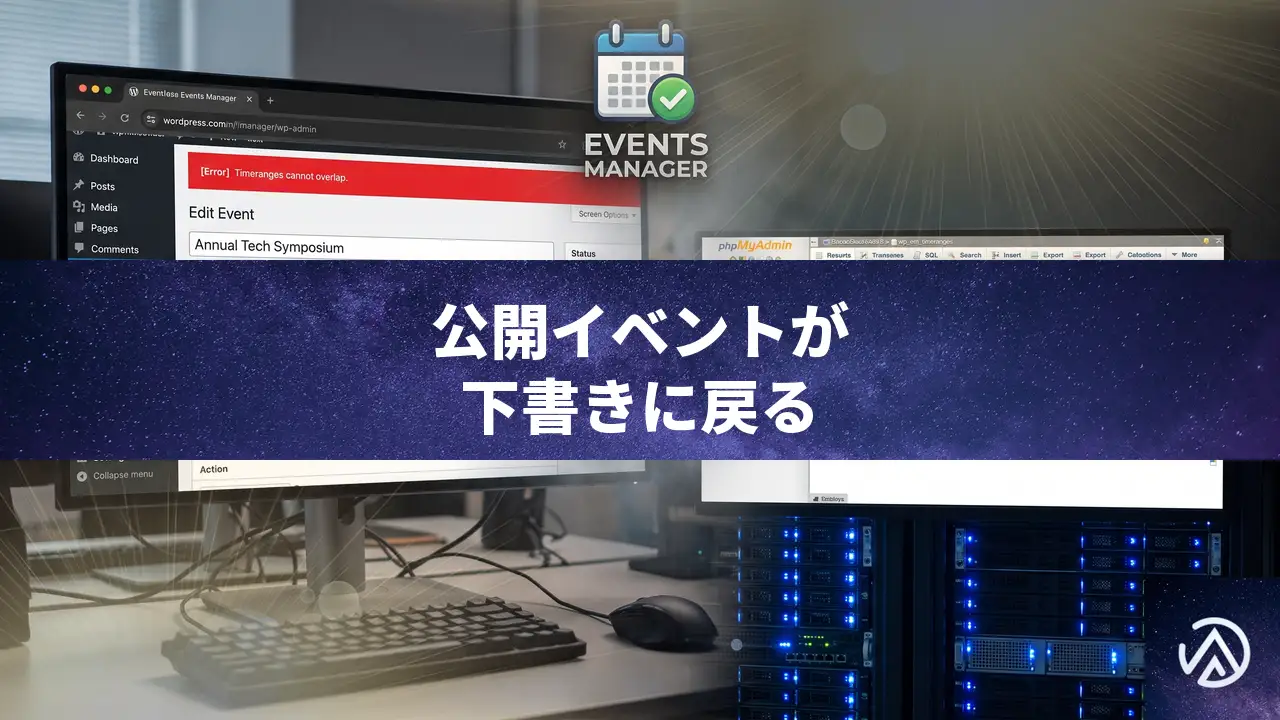
Events Manager 7.3.7.4 にアップデート後、公開済みイベントの編集画面で「更新」をクリックすると、ステータスが「下書き」に戻ってしまう現象が報告されている。原因は、終日設定のイベントに対してタイムレンジ(時間範囲)が重複してデータベースに登録されてしまうことだ。このバグにより、プラグイン内部のバリデーションが失敗し、自動的に下書きへと巻き戻される。データベースの重複を削除し、プラグインファイルに一時的なパッチをあてることで解決する。
なぜ公開済みイベントが更新時に下書きに戻ってしまうのか

Events Manager はイベントを表す EM_Event クラスが、記事が保存される前に validate_meta() メソッドで内部データの整合性をチェックしている。このチェックに引っかかると wp_insert_post_data フックが介入し、投稿ステータスを強制的に「下書き」に変更する仕様だ。
今回の問題では、「Timeranges cannot overlap with each other.(タイムレンジが重複しています)」というエラーが発生している。しかし、エディタ上では終日(All Day)設定の単一の時間範囲しか表示されていない。実際にデバッグ出力を取得すると、同一イベントに属する同一の終日タイムレンジ(開始 00:00:00、終了 23:59:59)が2件存在しており、これが重複エラーの直接的な原因だ。
データベースで重複したタイムレンジを削除する手順

STEP 1:必ずデータベースをバックアップする
今回の作業ではデータを直接操作するため、必ず事前にデータベース全体のエクスポートを取得する。何か問題が起きても元に戻せるようにしておこう。
STEP 2:重複タイムレンジを検出する
テーブル名はプラグインの設定により異なるが、多くは wp_em_timeranges となる。phpMyAdmin のSQLタブで次のクエリを実行し、同一 event_id・同一 timerange_start・timerange_end の組み合わせが複数存在しないか確認する。
SELECT event_id, timerange_start, timerange_end, COUNT(*)
FROM wp_em_timeranges
GROUP BY event_id, timerange_start, timerange_end
HAVING COUNT(*) > 1;
結果が返ってきたら、該当の event_id をメモしておく。
STEP 3:重複行のうち一方を削除する
重複している行のうち、より古いIDの行を削除する。以下のクエリは最も小さい ID 以外を削除する例だ。必ず削除対象を SELECT で事前確認してから実行する。
DELETE t1 FROM wp_em_timeranges t1
INNER JOIN wp_em_timeranges t2
WHERE t1.timerange_start = t2.timerange_start
AND t1.timerange_end = t2.timerange_end
AND t1.event_id = t2.event_id
AND t1.ID > t2.ID;
STEP 4:イベントを再編集して正常に保存されるか確認する
データベースの重複を除いたら、WordPress管理画面に戻り、該当のイベント編集画面を開く。内容を微修正して「更新」をクリックし、再び「下書き」に戻らず公開状態が維持されることを確かめる。
プラグインファイルの一時修正で重複登録を防ぐ

根本的な原因は、何らかのトリガーでタイムレンジオブジェクトが二重に追加されてしまうことだ。以下は EM_Event::validate_meta() の中で重複を除去する応急処置のコード例だ。必ずファイルのバックアップを取ったうえで追記する。
// events-manager/classes/em-event.php の validate_meta メソッド内
public function validate_meta( $data, $postarr ) {
    // タイムレンジを取得して重複を排除する
    $timeranges = $this->get_timeranges();
    $unique_timeranges = [];
    foreach ( $timeranges as $timerange ) {
        // timerange_group_id などのキーで一意にする
        $key = $timerange->timerange_group_id . '_' . $timerange->timerange_start . '_' . $timerange->timerange_end;
        if ( ! isset( $unique_timeranges[ $key ] ) ) {
            $unique_timeranges[ $key ] = $timerange;
        }
    }
    // 重複排除済みのコレクションでバリデーション
    if ( ! $unique_timeranges || ! $this->validate_timeranges_collection( $unique_timeranges ) ) {
        // エラー処理...
    }
    // 以下略
}
ただし、このパッチはあくまで暫定的なものだ。プラグインが公式に修正をリリースするまでは、更新のたびに再適用が必要になる。公式サポートフォーラムを定期的に確認し、バグ修正版がリリースされたら速やかにアップデートしよう。
よくある質問
この問題はイベントマネージャーのどのバージョンから発生したのか
少なくとも 7.3.7.4 で報告されている。それ以前のバージョンでは発生していなかった可能性が高いが、同様の重複が偶発的に起きているケースもある。
クラシックエディターを使えば回避できるか
根本原因はデータ保存時のバリデーションにあるため、グーテンベルクエディターかクラシックエディターかは関係ない。ただし、編集画面のUIの違いでトリガーが変わる可能性は否定できない。試す価値はある。
終日イベント以外でも起こるのか
現在報告されているのは終日設定時のケースだ。しかし、時間指定のあるイベントでも重複が起きれば同じエラーで下書きに戻る。該当イベントの編集時は要注意だ。
データベースを直接触らずに直す方法はあるか
現時点では、管理画面から重複を操作できる機能はない。比較的安全な方法としては、一度イベントを複製→元のイベントを削除→複製イベントを公開する、という手順でタイムレンジが正常な状態になることがある。
公式の修正はいつリリースされるのか
これはバグトラッカーや公式フォーラムを見守るしかない。開発チームが認識している問題であれば、次のパッチに含まれる可能性がある。
この記事のポイント
- Events Manager 7.3.7.4 で発生する既知のバグで、バリデーションエラーによってステータスが下書きに変更される
- 原因は終日イベントのタイムレンジがデータベース上で重複していること
- phpMyAdmin から重複行を削除することで一時的に解決する
- プラグインファイルの修正パッチで再発を防げるが、公式アップデートまでは注意が必要
- データベース操作前には必ずバックアップを取得する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

NeonがLakebase Searchを一般提供開始、Postgres拡張でベクトルとキーワードのハイブリッド検索を実現
Neonは2026年7月2日、Postgres向けのハイブリッド検索機能「Lakebase Search」を一般提供開始した。ベクトル検索用のlakebase_vectorと全文検索用のlakebase_textという2つの拡張機能で構成され、単一のデータベース上でセマンティック検索とキーワード検索の両方を大規模に処理できる。
従来のPostgres標準検索では、数百万ベクトル規模でメモリ不足やレイテンシ悪化が発生していた。Lakebase SearchはNeonのコンピュート・ストレージ分離アーキテクチャに最適化されており、10億ベクトル超のインデックスを単一で扱える点が最大の特徴だ。
開発中のアプリケーションに検索機能を組み込むエンジニアや、スケーラビリティの壁に直面しているチームにとって、検討すべき選択肢となる。本記事では仕組みと導入のポイントを解説する。
Postgres標準検索にあった3つの限界

検索機能をPostgres単体で完結させるのは、開発初期には手軽で合理的な選択だ。pgvectorのHNSWインデックスでベクトル検索を、tsvectorカラムとGINインデックスでキーワード検索を実装するパターンは広く使われている。
しかしデータ量が増えるにつれ、以下の3つの問題が顕在化する。
HNSWがRAMを圧迫する
HNSW(Hierarchical Navigable Small World)はグラフベースの近似最近傍探索アルゴリズムで、高速な検索を実現する。だがインデックス全体をメモリ上に保持する必要があるため、500万〜1000万ベクトルを超えるとPostgresインスタンスのサイジングがベクトルインデックスに引きずられる。
1億ベクトルを超えるとワーキングセットがRAMに収まらなくなり、クエリレイテンシが急上昇する。インデックス構築にも数時間を要する。さらにpgvectorのvector型はHNSWの次元数上限が2000で、text-embedding-3-large(3072次元)のような最新の埋め込みモデルを使う場合、halfvecへのキャストや次元削減といった回避策が必要だった。
GINは本来のBM25ではない
PostgreSQLの全文検索で使われるts_rankは、コーパス全体の文書頻度(IDF)を考慮しない。テーブルが大きくなるほど関連性スコアが徐々にずれていく。またGINインデックスにはTop-Kプッシュダウン機能がないため、LIMIT句が適用される前に全一致文書をスコアリングしてしまう。コーパスが大きいほどクエリは遅くなり、ランキング精度も落ちる。
ハイブリッド検索の実装は自己責任
ベクトル検索と全文検索を組み合わせる場合、スコア正規化やタイブレーク、テナント単位のフィルタリングといった処理はすべて自前のSQLで実装・保守する必要がある。データ規模が拡大するほど、この手間は無視できなくなる。
従来構成ではベクトル検索・全文検索・ハイブリッド化のすべてに構造的な課題があった。Lakebase SearchはこれらをPostgres拡張の形で解決する。
Lakebase Searchの仕組み
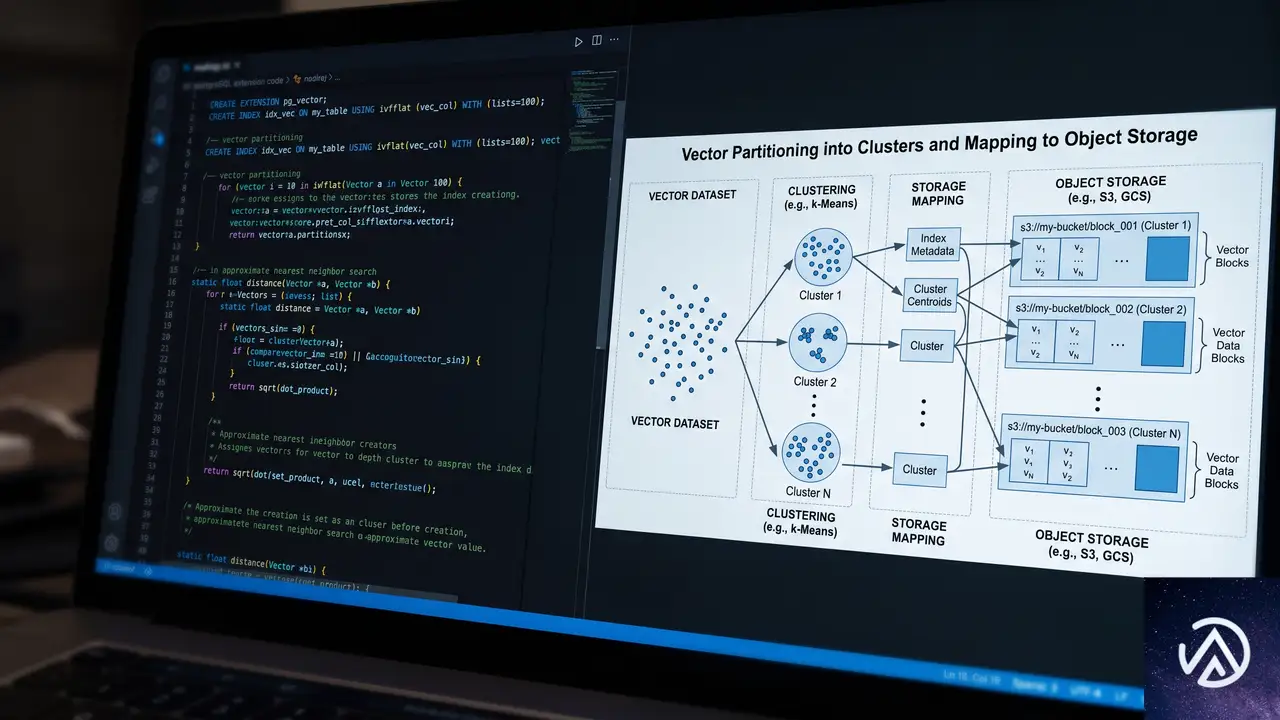
Lakebase Searchはlakebase_vectorとlakebase_textの2つのPostgres拡張機能で構成される。Lakebase(レイクベース)という名称は、Neonのコンピュートとストレージを分離したアーキテクチャに由来する。インデックスがオブジェクトストレージ上に永続化され、必要に応じてコンピュートがアタッチする仕組みだ。
lakebase_vectorの内部設計
lakebase_vectorはIVF(Inverted File)パーティショニングとRaBitQ量子化を組み合わせたlakebase_annインデックス型を提供する。RaBitQはベクトルを約32倍に圧縮する手法で、従来のHNSWでは約300GBのRAMを必要とした1億ベクトルのインデックスが10GB未満に収まる。
仕組みはこうだ。ベクトル空間を事前にクラスタ分割し、各クラスタをオブジェクトストレージ上の連続ブロックにマッピングする。クエリ時は重心との比較で関連クラスタを少数特定し、それらを並列でフェッチする。RaBitQで圧縮されたベクトルはスキャンコストが低く、クエリは少数の大きな独立リードになる。
pgvectorのベクトル型や距離演算子(<->、<#>、<=>)はそのまま使える。既存のクエリを変更する必要はなく、インデックス型だけを差し替えればよい。インデックス構築速度は同じデータのHNSW比で50〜100倍高速だ。
lakebase_textのBM25実装
lakebase_textはGINインデックスを使う従来の全文検索を、本格的なBM25(Best Matching 25)インデックスで置き換える。BM25は文書内の単語出現頻度とコーパス全体での希少性を組み合わせたランキング関数で、情報検索の分野で広く使われている。
このインデックスは構築時に文書頻度や平均文書長といったコーパス全体の統計情報を保存する。<@>演算子が本物のBM25スコアを返し、Block-Max WANDアルゴリズムによるTop-Kプッシュダウンで、全一致文書をスコアリングせずに上位K件だけを取得できる。GINにはできない動作だ。
標準のtsvector型とtsquery演算子はそのまま動作し、追加要素は<@>演算子とto_bm25query()ヘルパーのみ。既存の全文検索クエリを大きく書き換える必要はない。
アプリケーションから見ると、単一のPostgresインスタンスに対して通常のSQLを発行するだけで、内部で2つの拡張機能がオブジェクトストレージ上のインデックスを並列に検索する。
Neonアーキテクチャとの統合がもたらす利点
Neonはコンピュートとストレージを分離したサーバーレスPostgresだ。ストレージはRAM、ローカルNVMe、Pageserver、オブジェクトストレージの4階層で構成される。ホットなページはローカルディスク並のレイテンシで返り、全階層でミスした場合のみオブジェクトストレージにアクセスする。
Lakebase Searchの両インデックスはこの階層構造に合わせて設計されている。フットプリントが小さいため上位階層に収まりやすく、深い階層へのアクセスが必要な場合も連続ブロックの大きなリードになるようレイアウトされている。
スケールトゥゼロとブランチング
Lakebase Searchのインデックスはオブジェクトストレージ上に永続化される。Neonの特徴であるスケールトゥゼロ(アイドル時にコンピュートを停止する機能)と組み合わせても、インデックスはそのまま維持される。コンピュートの再起動後、インデックスは再構築不要で即座にアタッチ可能だ。
コールドスタート直後はキャッシュが空のため、最初の数クエリはオブジェクトストレージのレイテンシを支払う。レイテンシ重視のワークロード向けには、lakebase_ann_prewarm()関数で初回クエリ前にインデックスをメモリにロードできる。
Neonのブランチ機能も検索チューニングに活用できる。本番データベースを数秒でブランチし、同じlakebase_annおよびlakebase_bm25インデックスを引き継いだ状態で、異なるフュージョン戦略(RRFのk値調整やベクトル・BM25スコアの重み付け変更)を試せる。
評価スイートを本番データで実行し、再現率とレイテンシを比較した上で、良ければ本番に適用、悪ければブランチを削除すればよい。本番環境はその間も通常通り稼働し続ける。
ブランチ機能により、本番データを使った検索チューニングの実験が安全に行える。インデックスを再構築する必要がないため、評価サイクルが短縮される。
HNSWからの脱却が実現した理由

Neonは2023年にpg_embeddingというHNSWベースのベクトル検索拡張をリリースした経緯がある。しかしHNSWは従来型サーバー向けに設計されたグラフインデックスであり、Neonのアーキテクチャとは根本的に相性が悪かった。
HNSWの検索はグラフのノードをたどりながら小さなランダムリードを繰り返す。メモリ上やローカルNVMeならマイクロ秒単位で処理できるが、オブジェクトストレージでは各ホップが依存関係のあるリモートリードになり、クエリ全体が数十ミリ秒単位のラウンドトリップの連鎖にシリアライズされてしまう。
Neonにとって「ディスク」はオブジェクトストレージであり、コンピュートはゼロにスケールする。S3へのランダムリードは数十ミリ秒かかり、コールドスタートではクエリ実行前にグラフ全体の再水和が必要になる。HNSWベースの拡張を差し替えるだけでは解決できない構造的な問題だった。
Lakebase Searchはこの問題に対して、インデックスの物理設計をオブジェクトストレージに適した形に根本から再設計した。HNSWのようなランダムアクセス前提のグラフ探索ではなく、事前分割と連続ブロックリードを前提とするIVFベースの設計に切り替えたことで、Neonのアーキテクチャ上で大規模検索が実用的になった。
導入時のポイントと今後の展望

Lakebase Searchの導入はNeonプロジェクト上で拡張機能を有効化するだけだ。クイックスタートガイドが公開されており、最初のハイブリッドクエリを試すまでの手順がまとめられている。インデックスパラメータやチューニングの詳細は公式ドキュメントを参照する。
既存のpgvectorやPostgreSQL全文検索からの移行はスムーズに設計されている。pgvectorのクエリ構文はそのまま動作し、tsvector型も変更不要だ。インデックス型を差し替え、<@>演算子とto_bm25query()を追加するだけでBM25検索に移行できる。
Neonチームは今後、lakebase_vectorとpgvectorの詳細なベンチマーク比較を公開予定としている。すでにDatabricksのアナウンスではLakebaseアーキテクチャ全体のベンチマークが示されており、今回の一般提供によりNeon上での実測値が明らかになる見込みだ。
この記事のポイント
- Lakebase Searchは
lakebase_vectorとlakebase_textの2拡張で提供される - 従来のpgvector HNSWが抱えていたメモリ消費・次元数制限・構築速度の問題をIVF + RaBitQで解決
- 全文検索はGINの疑似BM25から本格的なBM25 + Top-Kプッシュダウンに刷新
- Neonのスケールトゥゼロおよびブランチ機能と統合され、インデックス再構築不要で実験可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験