

NextGEN GalleryでTrying to access array offset on null警告の原因と直し方
NextGEN Gallery(管理画面では「NextGEN Gallery」と表示)で「Trying to access array offset on null」というPHP警告が繰り返し出力される場合、原因はテンプレートファイル内で $thumb_size 変数がnullのまま配列としてアクセスされていることにある。テーマのfunctions.phpに一時的なnullチェックを追加するか、プラグインの該当テンプレートを直接修正することで警告を止められる。
なぜ「Trying to access array offset on null」が発生するのか
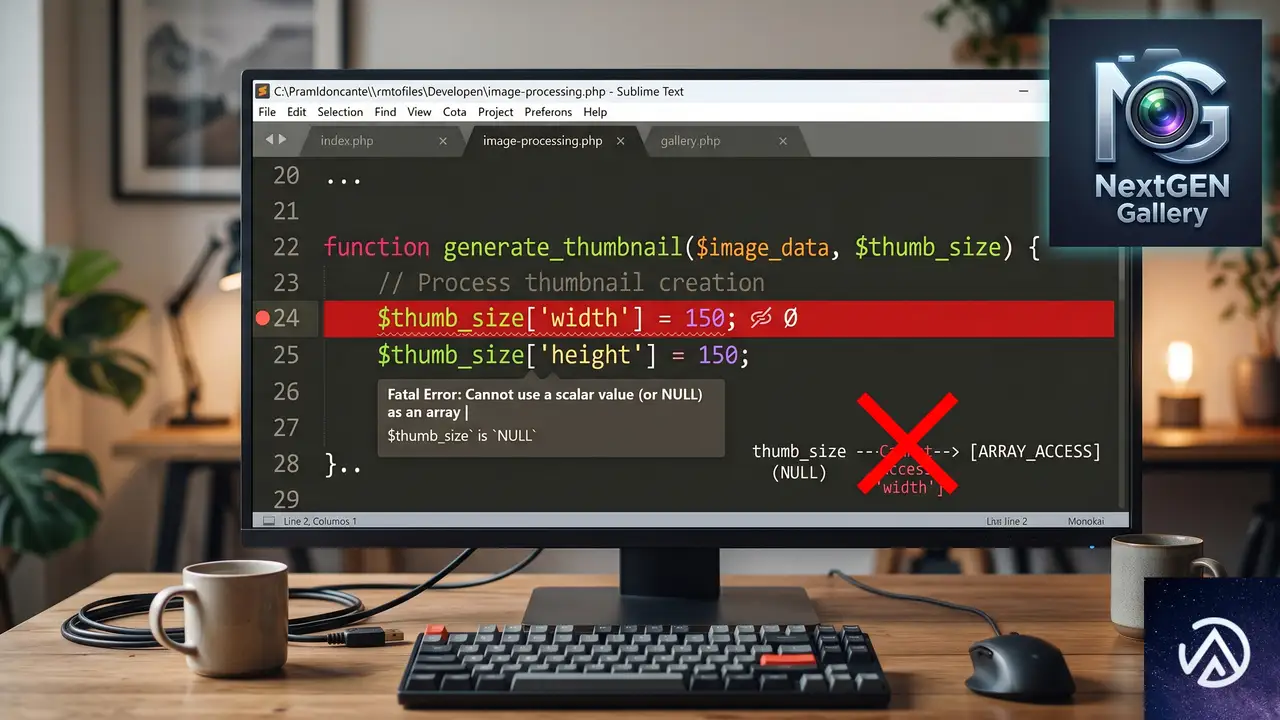
この警告はPHP 7.4以降で追加された「配列オフセットへのnullアクセス」に関するエラーレベル通知だ。NextGEN Galleryの /templates/Thumbnails/index.php 110行目周辺では、サムネイル画像の幅と高さを次のように取得しようとしている。
$thumb_size['width']
$thumb_size['height']
通常 $thumb_size にはサムネイルサイズの設定が格納された配列が入るが、特定の条件下(ギャラリー設定の不整合、画像メタデータの欠落、プラグイン内部の処理順序による変数未代入)でnullになる。nullの変数に対して配列のキーでアクセスしようとすると、PHPは警告を発行する仕組みだ。
エラーの発生箇所を特定する手順
警告メッセージにファイルパスと行番号が含まれているため、どこで問題が起きているかは一目瞭然に思える。しかし実際には以下の点を確認しておくと、修正後の再発防止に役立つ。
上図のように、変数が配列であることを確認する is_array() チェックを入れるだけで警告は出なくなる。以下に具体的な修正方法を3つのレベルで示す。
デバッグモードで警告を可視化する
本番サイトでは警告が非表示設定になっていることも多い。問題を見逃さないために、一時的に wp-config.php を編集してデバッグモードを有効にする。
define('WP_DEBUG', true);
define('WP_DEBUG_LOG', true);
define('WP_DEBUG_DISPLAY', false);
WP_DEBUG_DISPLAY をfalseにすれば画面には警告が出ず、/wp-content/debug.log に記録される。警告の再現性を確認したら、必ず WP_DEBUG をfalseに戻すことを忘れないようにしよう。
管理画面からプラグインのバージョンを確認する
「プラグイン」画面でNextGEN Galleryのバージョンが最新かどうかを確認する。2026年6月現在、NextGEN Galleryはバージョン3系が主流で、多くのnull関連の警告はバージョンアップで修正されている。更新が可能であれば、まずプラグインの更新を実行するのが最も安全な対処法だ。
エラーログで発生頻度とパターンを見極める
警告が散発的なのか、特定のページ表示時のみなのかによって対応の緊急度が変わる。デバッグログを確認し、同じ警告が何度も出ているなら恒久的な修正が必要だ。特定のギャラリーページだけなら、そのギャラリーの設定に問題がある可能性が高い。
警告を止める3つの修正アプローチ
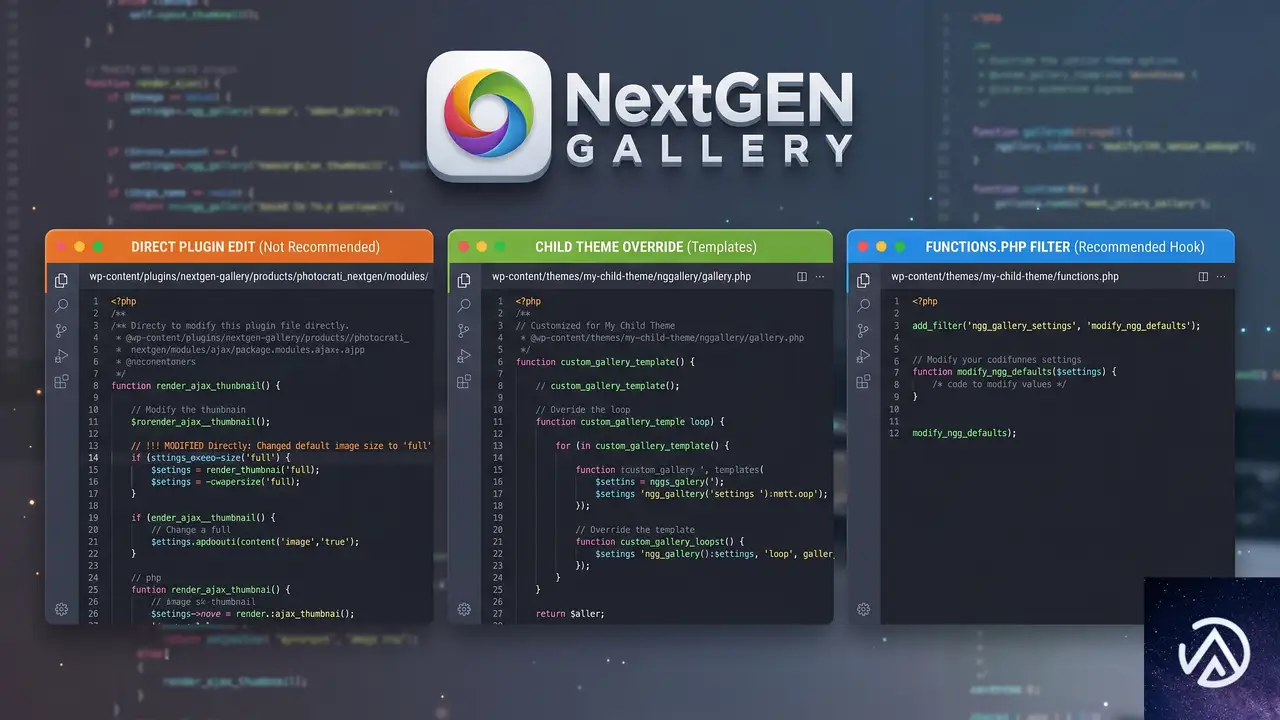
NextGEN Galleryのコアファイルを直接編集する方法、子テーマから上書きする方法、functions.phpでフィルターフックを使う方法の3つがある。サイトの運用方針に合わせて選んでほしい。
index.php にnullチェックを追加アプローチ1 プラグインのコアファイルを直接修正する
最も短期的で簡単な方法だ。ただしNextGEN Galleryが更新されると修正が上書きされるため、恒久的な対応にはならない。該当ファイルは以下にある。
wp-content/plugins/nextgen-gallery/templates/Thumbnails/index.php110行目と111行目付近の $thumb_size['width'] と $thumb_size['height'] を、以下のように is_array() で囲む。
if (is_array($thumb_size)) {
    $width  = $thumb_size['width'];
    $height = $thumb_size['height'];
} else {
    $width  = 240; // デフォルトの幅
    $height = 160; // デフォルトの高さ
}
デフォルト値には、NextGEN Galleryの「ギャラリー設定 → サムネイル設定」で指定されているサイズを入れておくと、画像が崩れずに表示される。
アプローチ2 子テーマでテンプレートを上書きする
NextGEN Galleryはテーマによるテンプレート上書きをサポートしている。修正した index.php を以下のパスに配置すれば、プラグイン更新後も修正が維持される。
wp-content/themes/your-child-theme/nggallery/thumbnails/index.php元の /templates/Thumbnails/index.php をコピーし、該当行にnullチェックを追加して保存するだけだ。子テーマを使っていない場合は、この機会に作成しておくと今後のカスタマイズにも役立つ。
アプローチ3 functions.phpで警告を抑制する(非推奨)
どうしてもテンプレートを修正できない事情がある場合は、警告そのものを表示させない方法もある。ただし根本解決ではないため、最終手段として理解しておくといい。
add_action('init', function() {
    if (defined('WP_DEBUG') && WP_DEBUG) {
        error_reporting(E_ALL & ~E_WARNING);
    }
});
このコードはWordPressのデバッグモードが有効な場合のみ警告レベルを下げる。しかし他の重要な警告も見逃すリスクがあるため、あくまで一時的な回避策として考えてほしい。
修正後も警告が消えない場合の追加チェック
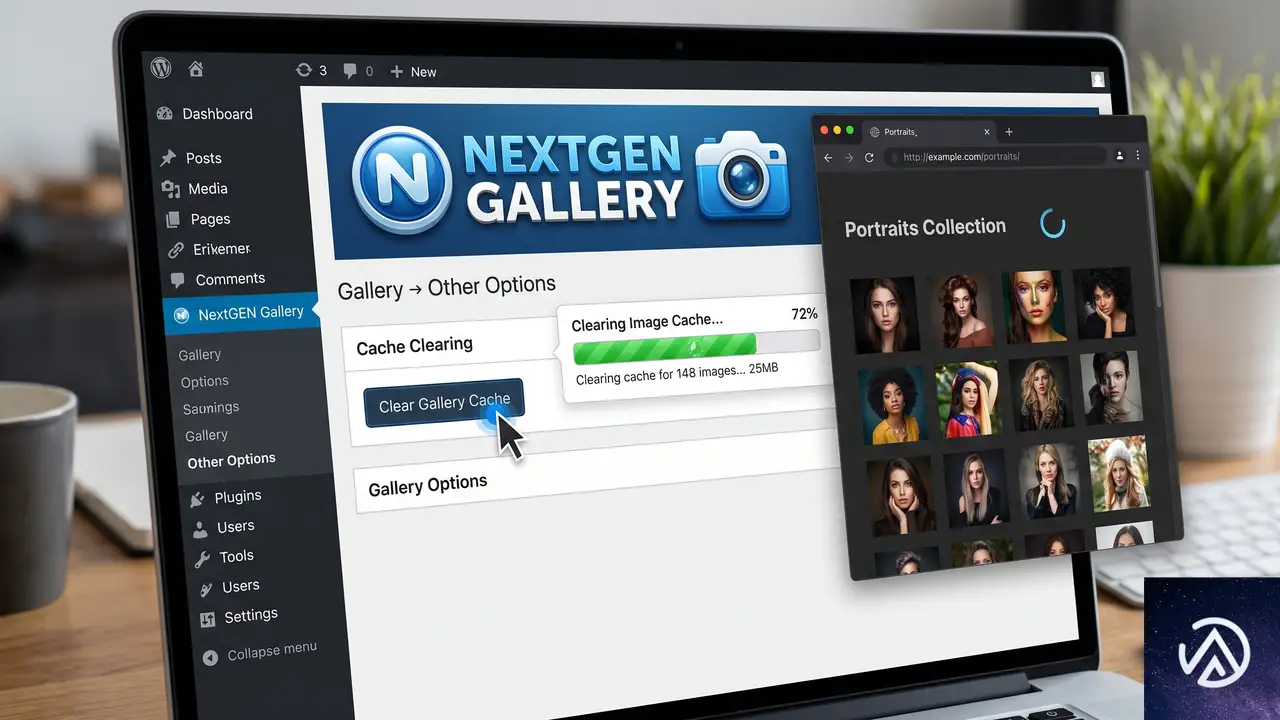
上記の修正を適用してもまだ警告が出るなら、キャッシュのクリアを試す。NextGEN Galleryは独自の画像キャッシュを持っており、テンプレートの変更がすぐに反映されないことがある。
NextGEN Galleryのキャッシュをクリアする
管理画面の「ギャラリー → その他のオプション → 画像オプション」にある「キャッシュをクリア」ボタンを実行する。さらにWordPress全体のキャッシュ(プラグインやCDNを使用している場合はそれらも含めて)をクリアすると、テンプレートの変更が確実に反映される。
nullが発生する根本原因を探る
$thumb_size がnullになるのは、ギャラリー設定や画像のアップロード時にメタデータが正しく生成されなかった場合に多い。管理画面から該当ギャラリーを開き、各画像の「メタデータを更新」を実行する。また、ギャラリー設定で「サムネイルサイズ」が未設定になっていないかも確認してほしい。
よくある質問
この警告を放置してもサイトは壊れないか
警告(Warning)はエラー(Fatal Error)と異なり、スクリプトの実行は継続される。サムネイル画像が一部表示されない可能性はあるが、サイト全体が停止することはない。ただし警告が大量に出力されるとデバッグログが肥大化し、サーバーのディスク容量を圧迫する原因になる。
NextGEN Gallery以外のプラグインでも同様の警告は出るのか
PHP 7.4以降では配列アクセスの扱いが厳格化されたため、古いプラグインやテーマで同様の警告が発生することがある。対象プラグインが更新されていない場合は、今回紹介したnullチェックの手法を応用して修正可能だ。
警告が debug.log に出続けて容量がいっぱいになりそうだ
WP_DEBUG_LOG をtrueにしたまま長期間放置すると、ログファイルが数GBに膨れ上がることがある。問題を特定したら速やかに WP_DEBUG をfalseに戻す。どうしてもデバッグを続ける必要があるなら、定期的にログローテーションを行うか、WP_DEBUG_LOG を '/path/to/custom-debug.log' のように指定して管理しやすくするといい。
プラグインを更新したくない(カスタマイズが消えるのが怖い)
NextGEN Galleryのテンプレートを直接編集している場合、プラグイン更新で修正が上書きされる不安は理解できる。今回紹介した子テーマによるテンプレート上書きを使えば、プラグイン本体には手を加えずに済む。カスタマイズを維持したまま、コアのバグ修正やセキュリティアップデートだけを取り込める。
NextGEN Galleryの代わりになるプラグインはあるか
標準の「メディアとカテゴリー」を使ったギャラリー機能でも十分な場合や、Envira GalleryやFooGalleryといった代替プラグインも選択肢になる。ただしNextGEN Galleryは長年の実績があり、ギャラリー数が多いサイトでは移行コストを考慮する必要がある。
この記事のポイント
- 「Trying to access array offset on null」はPHP 7.4以降の厳格化による警告
- NextGEN Galleryの
/templates/Thumbnails/index.phpで$thumb_sizeがnullになるのが原因 is_array()によるnullチェックで警告を止められる- 子テーマでテンプレートを上書きすればプラグイン更新後も修正が維持される
- 修正後はNextGEN GalleryのキャッシュとWordPress全体のキャッシュをクリアする

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
ドイツ裁判所、GoogleのAI回答に責任認定。SEO業界に衝撃
ドイツのミュンヘン地方裁判所が2026年5月28日、GoogleのAI Overviewが生成した虚偽の内容についてGoogle自身に責任があるとの仮処分を下した。AIが生成した回答は「プラットフォーム自身の発言」であり、単なる検索結果の羅列ではないという判断だ。この判決はSEOの前提を変える可能性を秘めている。
問題の核心は「AIがビジネスについて語るとき、誰が責任を負うのか」という問いだ。今回の判断は、AI回答が単なる情報の仲介ではなく「独自の編集行為」であると認定した点で画期的だ。つまり検索エンジンは自らが生成した文章に対して法的責任を問われうる時代に入った。この変化は企業のAI対策に根本的な再考を迫る。
裁判所がAI回答を「独自の編集物」と認定した意味
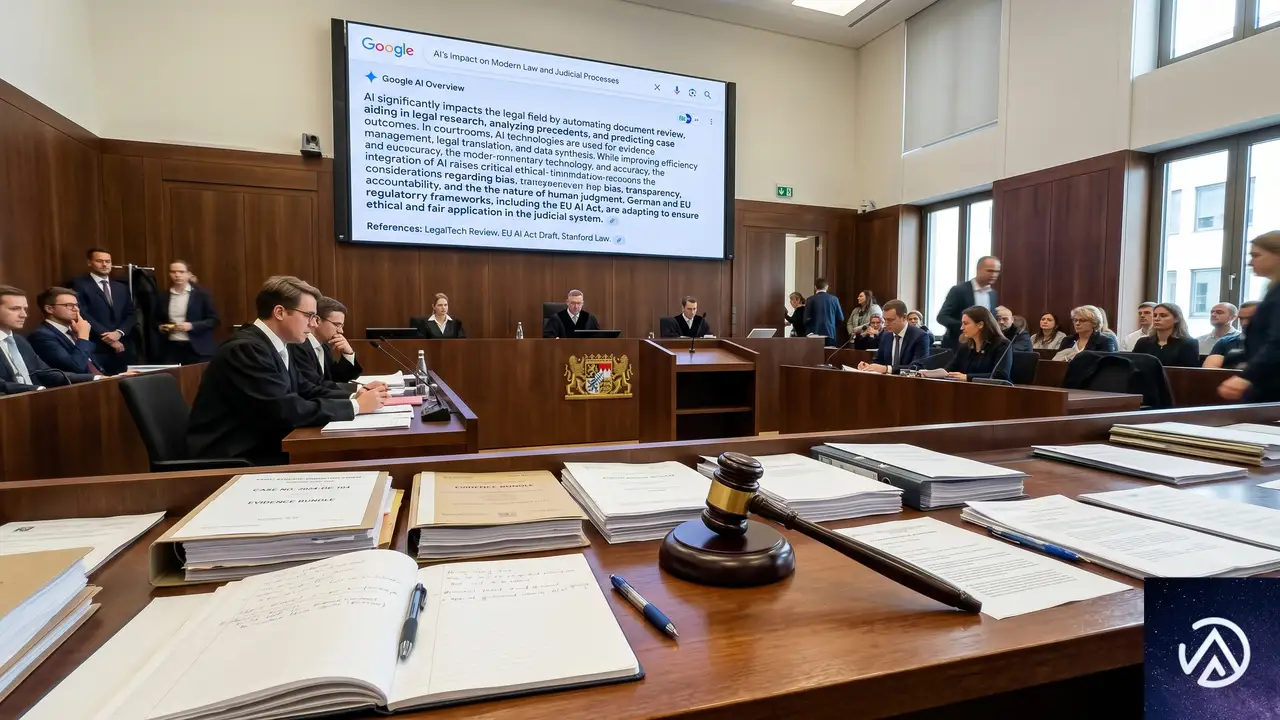
ミュンヘン地方裁判所が下した仮処分(事件番号26 O 869/26)は、GoogleのAI Overviewが2つの地域出版社について虚偽の説明を生成したことを問題視した。AI Overviewはこれらの出版社を詐欺やサブスクリプション詐欺と結びつける文章を生成していたが、引用元として示された情報源のどこにもそのような記述は存在しなかった。
AI Overview(AIによる検索結果の概要表示)とは、検索クエリに対してGoogleが従来のリンク一覧ではなく、AIが生成した要約文を画面上部に表示する機能だ。複数の情報源を読み込んで独自の文章を合成する仕組みで、2024年から本格展開が始まっている。
裁判所はこのAI Overviewについて「独立した新規の実質的な主張を生成している」と評価し、通常の検索結果一覧に適用される免責保護の対象外だと判断した。Google側は「ユーザー自身が回答の正確性を確認すべき」と主張したが、裁判所はこれを退けた。機械が文章を書くなら、その機械の所有者が責任を負うという理屈だ。
このデモが示すように、AI Overviewは従来の検索結果一覧とは法的な位置づけが根本的に異なる。裁判所は情報を「編集し合成する行為」を著作行為とみなし、そこに責任を紐づけたのだ。
この判決が持つ射程の広さ
今回の判断はあくまでドイツの一地裁による仮処分であり、EUの法的枠組みの中で下されたものだ。米国の裁判所が同じ事案を扱えば、プラットフォームを免責された仲介者とみなす従来の考え方から異なる結論に至る可能性は十分にある。ただ方向性は明確だ。AIが自律的に文章を生成する時代において、単なる「情報の受け渡し役」という位置づけは成立しなくなりつつある。
Search Engine Journalの記事では、この判決を1週間前に発表された別の調査結果と並べて論じている。その調査とは「AIに名前を挙げられることと、AIに信頼されることは別である」という分析だ。AI回答におけるビジネスの表現は、信頼の問題であると同時に説明責任の問題でもある。両方の視点が重なったとき、企業に求められる対応の輪郭が浮かび上がる。
責任を負うAIは「慎重になる」という構造的変化
法的責任を問われる可能性があるAIは、リスクを避けるために振る舞いを変える。これが今回の判決がもたらす最大の二次的影響だ。
AI回答が自社の発言として扱われるなら、プラットフォームが取る合理的な行動は「突然正確になること」ではない。「慎重になること」だ。確実に裏付けが取れるビジネスだけを安全圏として提示し、曖昧な存在は言及そのものを避けるようになる。この変化はすでに兆候を見せている。小規模な企業や評価が分かれる事業についてAIに質問すると、回答が急に歯切れが悪くなり、公式情報源に委ねたり、企業の特徴づけを完全に回避したりするケースが増えている。
AI回答「複数の情報源がありますが、公式な確認が取れません。ご自身での確認をお勧めします」
AI回答「△△社は〇〇を提供しています。公式サイトではXXと記載されています」
この変化は「どうやってAIに正しく自社を引用させるか」という問いを「AIが自信を持って名前を出せるビジネスかどうか」という一段上の問いに引き上げる。機械可読なアイデンティティの整備は、もはやSEOの一手ではなく参加資格そのものに近づく。
AIがビジネスを「疑う」4つの原因
Search Engine Journalの記事でCarlo Daniele氏が指摘するように、大半のビジネスはAIに疑念を抱かせる材料を少なくとも一つは抱えている。具体的には以下の4パターンだ。
- 法的実体の不一致:自社サイト、SNSプロフィール、過去のプレス記事で会社名や事業者名が微妙に異なる。AIはどれが正規情報か判断できない
- 役職表記のズレ:会社概要ページと過去のインタビュー記事で創業者の役職表記が食い違っている
- テキスト化されていない重要情報:製品の具体的な機能説明が画像やPDFの中にしか存在せず、AIのパーサーが読み取れない
- カテゴリの曖昧さ:人間が読めば事業内容が明確でも、マークアップ上でカテゴリが明示されておらず機械が判断できない
これらはいずれも従来のコンテンツSEOの発想では見過ごされてきた問題だ。記事が指摘するように、これはコンテンツの問題ではなくアイデンティティの問題である。1万語のコンテンツがあっても自己矛盾した情報を発信していればAIはそのビジネスを「検証困難」と判定する。一方で簡潔でもあらゆる読み取り経路で同一の事実を返すビジネスはAIにとって「引用可能」と判断される。
AIに「確信されるビジネス」になるための実践手順
この変化に対応するために法律家は必要ない。必要なのはAIに「このビジネスは確かだ」と判断させるための基盤整備だ。Search Engine Journalの記事で提示された3ステップを具体的に見ていく。
ステップ1 AIが自社をどう語っているか監査する
まずは自社ブランド名、製品名、事業カテゴリを実際に顧客が使うAI検索エンジンに投入し、生成される回答を第三者の目で読む。AI OverviewだけでなくChatGPTやClaudeなど複数のエンジンで確認することが重要だ。エンジンごとに回答は異なり、そのズレの大きさこそが自社のアイデンティティ監査の出発点になる。
チェックすべき項目は以下の4つだ。AIが自社のカテゴリを正しく述べているか、正しい製品を帰属させているか、正しい人物名を挙げているか、そして実際には無関係なネガティブ情報と結びつけていないか。Search Engine Journalの記事によれば、大半の企業はこのような監査を一度も実施したことがないという。
この監査は企業のAI上の立ち位置を可視化する最初の一歩だ。自社がどのように語られているかを把握せずに対策を立てることはできない。
ステップ2 AIが判断の根拠にする事実情報を整備する
監査で発見されたズレを修正するには、AIが参照する基盤情報の整備が不可欠だ。Search Engine Journalの記事で提唱されているMachine-First Architecture(機械優先アーキテクチャ)の考え方では、以下の3つが中核となる。
第一に、Organization構造化データの実装だ。自社が誰で、何をしており、どこで確認できるかを機械可読な形式で明示する。構造化データ(Schema.orgに準拠したマークアップ)とは、HTMLに埋め込む形で検索エンジンに情報の意味を伝える仕組みであり、AIが情報を正確に抽出するための土台となる。
第二に、全情報発信チャネルでの表記統一だ。自社サイト、Googleビジネスプロフィール、主要SNS、業界ディレクトリで社名・住所・事業内容の表記を完全に一致させる。バリエーションがあるたびにAIは「どれが正しいか」の判断を強いられ、リスク回避のために言及を控える方向に傾く。
第三に、テキスト化の徹底だ。画像やPDFに埋め込まれた重要情報をHTMLテキストとしても提供し、AIのパーサーが確実に読み取れる形にする。特に事業内容の明示的な説明は、人間向けのデザイン性よりも機械向けの明快さを優先すべき局面に入っている。
ステップ3 監査を習慣化する
企業情報は時間とともに変化し、周囲のウェブ環境も変わり、AIモデルも再学習を繰り返す。一度整備して終わりではなく、定期的にAIが自社をどう語っているかを確認する習慣が必要だ。Search Engine Journalの記事はこれを「自社のアナリティクスを確認するのと同じ感覚で」行うべきだと提案している。
訴訟そのものは稀であり管轄も限られる。しかし構造的な影響はゆっくりと確実に広がる。AI回答にリスクが伴うとき、エンジンは慎重になり、慎重なエンジンは裏付けの取れるビジネスだけを積極的に提示する。企業に求められるのは「機械に確信される存在」になるための継続的な努力だ。
この記事のポイント
- ミュンヘン地方裁判所がAI OverviewをGoogle自身のコンテンツと認定し免責を否定した
- AI回答に法的責任が生じるとプラットフォームは「慎重になり言及を避ける」方向に動く
- 企業名・役職・事業内容の表記不一致がAIの信頼を損ねる主要因である
- 構造化データの実装と全チャネルでの情報統一がAI時代の基盤対策となる
- AIによる自社の語られ方を定期的に監査する習慣が不可欠だ

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerceアナリティクスでOops something went wrongエラーが出た時の直し方
WooCommerce を 10.6.1 にアップデートした直後、アナリティクス概要に「Oops something went wrong」と表示され、ブラウザコンソールに TypeError: t(…)(…).tz is not a function というエラーが記録される場合、JavaScript のタイムゾーンライブラリを巡るプラグイン競合か、キャッシュの不整合が原因だ。まず全プラグインの無効化と標準テーマへの一時的な切り替えで原因を特定し、競合するプラグインを見つけ出すことから始める。
なぜ WooCommerce アナリティクスで tz is not a function エラーが起きるのか
WooCommerce の管理画面アナリティクスは、内部的に Moment.js とそのタイムゾーン拡張を使い、日付や時間の演算をおこなっている。10.6.1 では JavaScript アセットの読み込み順や依存関係に変更が入ったため、別のプラグインやテーマが同じ Moment.js タイムゾーンライブラリを異なるバージョンで読み込んでいる場合に .tz メソッドが上書きされるか、存在しない状態になり、今回の TypeError が発生する。
また、ブラウザやサーバー側のキャッシュに古いスクリプトが残っていると、管理画面で本来動くはずの新しいコードと混ざり、同様のエラーが出ることもある。まずは「どの拡張機能やテーマが影響しているか」を切り分けるのが近道だ。
エラーの原因を特定する手順
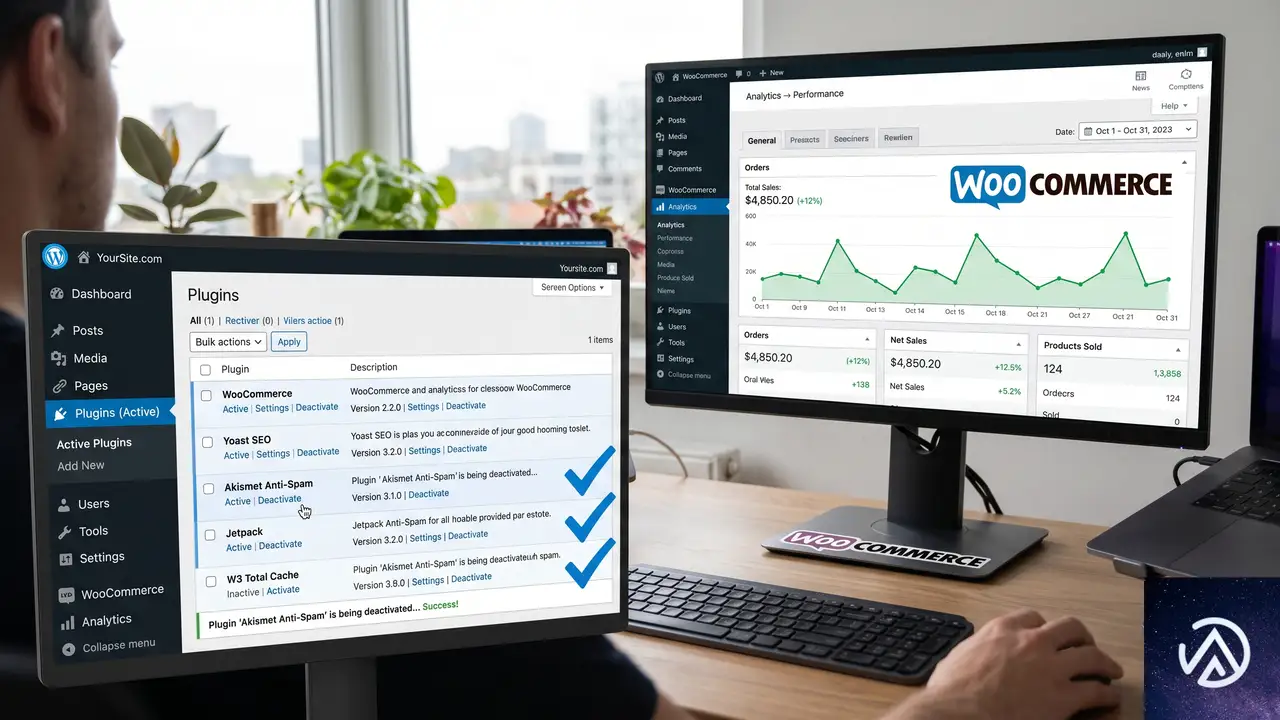
上図の手順で、問題の切り分けができる。WooCommerce 本体だけを有効にした状態でアナリティクスが正常に動けば、あとは再有効化の過程でエラーを再現させるプラグインを見つければよい。
全プラグインを無効化して競合を確認する
「プラグイン」→「インストール済みプラグイン」画面で、全てのプラグインにチェックを入れ、「一括操作」から「停止」を実行する。WooCommerce だけは残すか、最初はすべて停止し、その後 WooCommerce だけ有効化し直す。この状態で管理画面の「WooCommerce」→「アナリティクス」を開き、エラーが出ないか確認する。
テーマを Storefront など標準テーマに切り替える
有効化しているテーマの functions.php やフックが、管理画面の JavaScript 読み込みに干渉しているケースは意外に多い。「外観」→「テーマ」で Storefront や Twenty Twenty-Five など公式の軽量テーマに一時的に切り替え、同じくアナリティクス画面を確認する。
ブラウザキャッシュとサーバーキャッシュをすべて削除する
キャッシュ系プラグイン(W3 Total Cache、WP Rocket など)を使っている場合は管理画面からキャッシュを全削除する。さらにブラウザでシークレットウィンドウ(プライベートブラウジング)を開き、そちらで管理画面にログインしてテストすると、ローカルキャッシュの影響を排除できる。サーバー側で OPcache や Redis オブジェクトキャッシュを導入している場合は、それらのクリアもおこなう。
プラグインを1つずつ再有効化して原因を突き止める
無効化状態でエラーが消えたら、プラグインを1つ有効化するごとにアナリティクス画面を再読み込みし、エラーの再発をチェックする。再現したプラグインが競合元だ。よくあるのは、カスタムレポート系、日付や予約管理、多言語対応(WPML や Polylang)、ページビルダーの管理画面用スクリプトを追加するタイプのプラグインだ。
競合するプラグインを特定したあとの恒久対策
原因のプラグインが判明しても、サイト運営上どうしても外せない場合がある。そのときは、問題のスクリプトだけを管理画面のアナリティクスページでのみ読み込まないようにする手がある。
以下のコードを子テーマの functions.php に追加すると、特定のスクリプトをアナリティクス画面で解除できる。ここでは例として「moment-timezone」ハンドルを一旦解除し、WooCommerce が想定する正しいバージョンを再登録する方法を示す(実際のハンドル名は競合元により異なるため、ブラウザのデベロッパーツールで確認する)。
add_action( 'admin_enqueue_scripts', function( $hook ) {
    if ( false === strpos( $hook, 'woocommerce_page_wc-analytics' ) ) {
        return;
    }
    wp_dequeue_script( 'moment-timezone' );
    wp_deregister_script( 'moment-timezone' );
    wp_enqueue_script( 'moment-timezone', includes_url( 'js/moment-timezone.min.js' ), array( 'moment' ), null, true );
}, 100 );
この例では WordPress 本体バンドルの moment-timezone を読み直しているが、WooCommerce が読み込むパスとは異なる場合がある。より安全なのは、競合プラグイン側の更新を待つか、Asset CleanUp 系のプラグインで該当スクリプトを該当ページでのみブロックする方法だ。
それでも直らない場合の応急処置としての WooCommerce のロールバック
どうしてもすぐにエラーを止めたいときは、WooCommerce を問題のなかったバージョン(例:10.5.2)に戻す方法がある。無料プラグイン「WP Rollback」を使えば、管理画面からワンクリックで以前のバージョンにダウングレードできる。
「プラグイン」→「新規追加」で WP Rollback をインストールし有効化すると、プラグイン一覧の WooCommerce に「ロールバック」リンクが現れる。そこから 10.5.2 を選択し、ロールバックを実行する。ただし、これは一時しのぎであり、セキュリティ修正などが含まれている場合はリスクがあるため、問題の根本解決を優先する。
よくある質問
プラグインをすべて無効化してもエラーが消えないのはなぜか
テーマの functions.php や子テーマに管理画面用のスクリプトを追加している可能性が高い。必ず標準テーマ(Storefront や Twenty Twenty-Five)に切り替えて確認する。また、ブラウザ拡張機能やサーバー側のキャッシュが残っている場合もエラーが継続する。
キャッシュを削除しても改善しない場合はどうするか
ブラウザのシークレットウィンドウを使うか、別のブラウザでテストする。サーバー側で OPcache や Varnish、CDN のキャッシュが効いている場合は、そちらも合わせてクリアする。WP CLI が使えるなら wp cache flush も試す。
特定のプラグインが原因とわかったが、そのまま使い続けたい
プラグイン開発元に WooCommerce 10.6.1 への対応状況を問い合わせ、アップデートを待つのが最も確実だ。緊急時は、前述のコード例や Asset CleanUp で競合を回避する方法があるが、サイト全体の動作確認を十分におこなったうえで適用する。
WooCommerce をダウングレードしても問題ないか
ダウングレードすると、10.6.1 で修正されたセキュリティ上の問題や不具合が再発する可能性がある。あくまで原因究明と修正が終わるまでの一時的な措置と考え、早急に恒久対策を講じる。
同じエラーがフロントエンドのカートやチェックアウトでも出る
管理画面だけでなくフロントエンドでも同様の TypeError が発生する場合、テーマかキャッシュプラグインの JavaScript 最適化機能(結合・圧縮)が原因になっていることが多い。キャッシュプラグインの設定で JavaScript の結合を一時的に無効にし、テーマを標準テーマに切り替えて症状が消えるか確認する。
この記事のポイント
- WooCommerce 10.6.1 でアナリティクスに tz is not a function エラーが出るのは JavaScript のタイムゾーンライブラリ競合かキャッシュ不整合
- プラグイン全無効化+標準テーマへの切り替えで原因を特定し、1つずつ再有効化して競合プラグインを特定する
- 競合プラグインが見つかったら、更新を待つか functions.php でスクリプトを制御する
- 緊急時は WP Rollback で WooCommerce を一時的にダウングレードできるが、恒久対策が優先
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
Astro 7.0リリース、Rustコンパイラでビルド時間を最大61%短縮
Astro 7.0が6月22日に正式リリースされた。今回のメジャーアップデートは「速度」にフォーカスしており、.astroファイルのコンパイラをRustで書き直した点が最大の変更点だ。
ベンチマークによると、ビルド時間は前バージョンと比較して15〜61%短縮される。Astro公式ブログが公開したテスト結果では、13,275ページを持つaspire.devのビルドが半分以下になった事例も報告されている。Rust化された基盤、Vite 8との統合、新しいアドバンストルーティング機能が主要な柱だ。
本記事ではAstro 7.0の全変更点を、実務者の視点から詳しく解説する。
Vite 8によるバンドル基盤の刷新
Astro 7.0のビルド高速化を支える土台が、Vite 8へのアップグレードだ。Vite 8は、JavaScriptツールチェインの世界で最も注目されているリリースのひとつである。最大の変更点は、Rustベースのバンドラ「Rolldown」が標準搭載されたことだ。
Rolldownとは何か
Rolldownは、従来のesbuildとRollupを単一のバンドラで置き換えるツールである。バンドラとは、複数のJavaScriptファイルやコンポーネントを本番用の少数のファイルにまとめる役割を持つ。Rolldownのベンチマークでは、Rollupと比較して10〜30倍高速という結果が出ている。速度だけでなく、既存のRollupプラグインAPIとの互換性も維持している点が実務上の大きな利点だ。
Astroユーザーにとって重要なのは、ほとんどのプロジェクトで設定変更が不要なことだ。Vite 8には既存のesbuild設定やrollupOptions設定を自動的にRolldown用に変換する互換レイヤーが組み込まれている。カスタムViteプラグインを使っている場合も、RolldownがRollupと同じプラグインAPIをサポートするため、そのまま動作する可能性が高い。
Rust化がもたらすビルド性能の飛躍的向上
Astroのビルドプロセスは、大きく2つの段階に分かれる。1つ目はサイトのページやコンテンツ、クライアントコンポーネントをJavaScriptにバンドルする段階。2つ目は、バンドルされたコードを「小さなサーバー」として実行し、プリレンダリング対象の全ページにリクエストを送ってHTMLを生成する段階だ。
Astro 7.0は両方の段階を改善しているが、とくに1つ目のバンドル段階に注力している。ビルド時間のボトルネックになりやすい処理をRustで書かれたネイティブコードに移行することで、大幅な高速化を実現した。
上図の通り、ビルドフローの主要な構成要素がRustベースに置き換えられている。.astroファイルのコンパイル、Markdown/MDXの処理、レンダリングエンジンのすべてが刷新された。以下では各要素を詳しく見ていく。
.astroコンパイラのRust化
Astro 7.0では、.astroコンポーネント形式の新しいコンパイラがRustで構築された。このコンパイラは、以前のGoベースのコンパイラをフルリライトしたものだ。内部的には、oxc(高速なJavaScript/TypeScriptパーサ)を解析に、Lightning CSSをCSSスコープ処理に使っている。
単体ではビルド時間の約6%改善にとどまるが、数千ページ規模の大規模サイトでは、他の改善と相乗効果を発揮する。以下の3点は後方互換性に関わる変更として注意が必要だ。
- HTML自動修正の廃止。旧コンパイラは「正しいHTML」にしようと要素の並べ替えやタグの自動クローズを行っていたが、新コンパイラではマークアップをそのまま扱う。予期せぬ挙動の原因だった自動修正がなくなり、意図した通りに出力されるようになった。
- JSX形式の厳格化。
<div>Helloのような閉じタグ欠落や、<div class="Hello >のような属性の未終端は、自動修正されずエラーになる。旧コンパイラがブラウザの挙動を真似て黙って修正していた部分だ。 - JSXホワイトスペース処理。インライン要素間の改行が可視スペースを生成しなくなる。たとえば、
<span>Hello</span><span>World</span>は「HelloWorld」と表示される。スペースが必要な場合は{' '}を明示的に挿入する。
Markdown/MDX処理のSätteri移行
Astro 7.0では、デフォルトのMarkdownとMDXの処理パイプラインが、Rust製プロセッサ「Sätteri」に置き換えられた。SätteriはAstroコアチームメンバーが開発したツールで、内部的にはpulldown-cmark(CommonMark解析)とoxc(MDX式解析)を使用している。
従来のAstroは、JavaScriptベースのunified(remark/rehypeとそのプラグイン群)でMarkdownを処理していた。数千ページのサイトでは、このパイプラインがビルドの最も遅い段階になることが多かった。Astro公式ブログによれば、AstroドキュメントサイトとCloudflareドキュメントサイトでSätteriに切り替えたところ、ビルド時間が1分以上短縮されたという。
Sätteriには、これまで別途プラグインが必要だったMarkdown機能の多くがビルトインで含まれている。GFM(テーブル、脚注、取り消し線、タスクリスト)、スマートパンクチュエーション(カーリークォート)、見出しID、コンテナディレクティブ、数式、フロントマター(YAML/TOML)、上付き・下付き文字、Wikilinksなどだ。これらはfeaturesオプションで有効化できる。
既存のremark/rehypeプラグインに依存しているプロジェクトは、@astrojs/markdown-remarkを使って従来のunifiedベースのパイプラインを引き続き利用できる。
キュー型レンダリングの安定化
Astro 6.0で実験的機能として導入されたキュー型レンダリングが、Astro 7.0で安定版となりデフォルトのレンダリングエンジンになった。これは、式が密集したページで約2.4倍高速という結果が出ている。
従来のレンダリングは再帰的アプローチを取っていた。親コンポーネントが子コンポーネントを呼び出し、さらにその子が孫を呼び出すという入れ子構造でレンダリングが進む。これに対し、新しいエンジンはキュー(またはスタック)と単一のループを使う。キューに子ノードを正しい順序で追加し、キューが空になるまでループでレンダリングを続ける仕組みだ。
初回の実装では「全コンポーネントの順序付きリストを作成→リストをループしてレンダリング」という2パス方式だったが、最終版ではリスト作成とレンダリングを同時に行う方式に改善された。この方式は再帰的アプローチと比較してメモリ使用量も少ない。
アドバンストルーティングでリクエストパイプラインを完全制御
Astroは静的サイトジェネレーターとしてスタートし、ファイルベースのルーティングを基本としてきた。しかし、ミドルウェア、リダイレクト、リライト、Actions、セッション、i18nといった機能が追加されるにつれ、リクエストのライフサイクル制御が複雑化していた。
認証をActionsより先に実行したい、ログ出力をページレンダリングだけに限定したい、APIリクエストをAstroの外で先に処理したい、といったニーズに応えるため、Astro 7.0ではsrc/fetch.tsファイルを追加することでリクエストパイプラインを完全制御できるようになった。
このパターンは、Cloudflare WorkersやDeno、Bunが採用している標準的なfetchハンドラ形式に準拠している。
import { astro, FetchState } from 'astro/fetch';

export default {
  fetch(request: Request) {
    const state = new FetchState(request);

    // APIリクエストをバックエンドサービスに転送
    if (state.url.pathname.startsWith('/api')) {
      const url = new URL(
        state.url.pathname + state.url.search,
        'https://backend-api.example.com'
      );
      return fetch(new Request(url, request));
    }

    // それ以外はAstroのページやエンドポイントにフォールバック
    return astro(state);
  }
}
Honoとの統合
アドバンストルーティングAPIはHonoとも互換性がある。Honoは軽量なWebフレームワークで、豊富なミドルウェアエコシステムを持つ。以下のようにBasic認証をAstroアプリケーションに組み込める。
import { astro } from 'astro/hono';
import { Hono } from 'hono';
import { basicAuth } from 'hono/basic-auth';

const app = new Hono();
app.use(basicAuth({ username: 'admin', password: 'secret' }));
app.use(astro());

export default app;より高度な使い方として、個別のAstro機能を別々のミドルウェアとして構成できる。認証、Actions、ミドルウェア、i18n、ページの各レイヤーを任意の順序で積み重ねられるため、認証チェックをActionsより手前に置くといった制御がシンプルに実現できる。このsrc/fetch.tsファイルを追加しなければ、Astroの動作は従来通りだ。
ルートキャッシングとCDNプロバイダ連携
オンデマンドレンダリング応答のキャッシュ制御は、ホスティングサービスごとに異なる仕組みで実装されてきた。Astro 7.0で安定版となったルートキャッシングは、デプロイ先を問わない単一のキャッシングAPIを提供する。
設定の流れはシンプルだ。まずキャッシュプロバイダを一度設定し、あとはページ内でAstro.cache(APIルートではcontext.cache)を使ってレスポンスごとにキャッシュ制御を記述する。標準的なHTTPキャッシングセマンティクスに従うため、特別な知識は不要だ。
import { defineConfig, memoryCache } from 'astro/config';

export default defineConfig({
  cache: {
    provider: memoryCache(),
  },
});
---
Astro.cache.set({
maxAge: 120, // 2分間キャッシュ
swr: 60, // 再検証中は1分間 stale を返す
tags: ['products'], // タグベースの無効化用
});
---routeRulesを使えば、ルートグループ単位で宣言的にキャッシュルールを設定できる。
export default defineConfig({
  cache: { provider: memoryCache() },
  routeRules: {
    '/blog/[...path]': { maxAge: 300, swr: 60 },
  },
});キャッシュの無効化はcache.invalidate()でタグ単位またはパス単位で行える。CMSのwebhookエンドポイントをAstroで実装し、コンテンツ更新時に該当キャッシュを破棄するといった使い方が可能だ。
CDNキャッシュプロバイダ
Astro 7.0では、Netlify、Vercel、Cloudflare向けのCDNキャッシュプロバイダが実験的機能として追加された(Cloudflareはプライベートベータ)。これらはレスポンスをメモリではなく、各プラットフォームのエッジネットワークにキャッシュする。キャッシュヒット時はサーバー関数を呼び出さず、CDNから直接応答が返るため、さらに高速なレスポンスを実現できる。
アダプタごとに/cacheエントリポイントからプロバイダをインポートする。
import { defineConfig } from 'astro/config';
import netlify from '@astrojs/netlify';
import { cacheNetlify } from '@astrojs/netlify/cache';

export default defineConfig({
  adapter: netlify(),
  cache: {
    provider: cacheNetlify(),
  },
});Astro.cache、routeRules、cache.invalidate()のAPIは、どのプロバイダでも同じように動作する。各プロバイダが、Astroのキャッシュディレクティブを各プラットフォームのネイティブなキャッシュ制御ヘッダと無効化APIに変換する仕組みだ。
AIエージェント向け開発サーバー機能
AIコーディングエージェントの普及に伴い、Astro 7.0はエージェント駆動開発を支援する機能を導入した。AIエージェントは、終了しない長時間実行プロセス(開発サーバー)の扱いが苦手だ。シェルコマンドを実行し、終了を待って出力を読むワークフローに、開発サーバーは適合しない。
バックグラウンド開発サーバー
astro dev --backgroundコマンドを使うと、開発サーバーを管理されたバックグラウンドプロセスとして起動できる。コマンドはサーバーがリクエストを受け付け可能になるまでブロックし、URLとプロセスIDを出力してからデタッチする。ポーリングやスリープ、端末出力の解析は一切不要だ。
AstroはAIエージェント内で実行されていることを自動検出し、バックグラウンドモードを自動的に有効にする。エージェントワークフローでは--backgroundフラグの指定すら不要だ。
ロックファイルによって重複インスタンスが防止される。エージェントが誤って2つ目のサーバーを起動しようとすると、既存インスタンスの詳細が返される。astro dev statusで状態確認、astro dev stopで停止、astro dev logsでバックグラウンドサーバーのログを確認できる。また、全実行中の開発サーバーは/_astro/statusヘルスエンドポイントを公開し、エージェントがサーバーの生存を確認できる。
JSONログ出力
Astroのロガーが完全に設定可能になった。AIエージェント向けには、バックグラウンドモードの自動検出時にJSONログが自動的に有効化される。それ以外の用途でも、CLIまたは設定ファイルで有効化できる。
astro dev --jsonimport { defineConfig, logHandlers } from "astro/config";
export default defineConfig({
logger: logHandlers.json()
})構造化ログが必要なユースケースはAIだけではない。SSRで本番運用しているチームは、Kibana、CloudWatch、Grafana/Lokiといったログ集約サービスと統合するために構造化ログを必要としている。従来のAstroのログ出力は、色付き表示や罫線文字、複数行エラーフォーマットなど、人間の可読性に特化しており、機械による解析が困難だった。
compose() APIを使えば、人間向けのコンソール出力と機械向けのJSONログを同時に出力できる。
import { defineConfig, logHandlers } from "astro/config";

export default defineConfig({
  logger: logHandlers.compose(
    logHandlers.console(),
    logHandlers.json()
  )
})
この記事のポイント
- Astro 7.0は.astroコンパイラとMarkdown/MDX処理をRust化し、ビルド時間を15〜61%短縮した
- Vite 8のRust製バンドラRolldownが標準搭載され、既存の設定をほぼそのまま使える
- アドバンストルーティングでリクエストパイプラインを完全制御でき、Honoとの統合も可能
- ルートキャッシングが安定版となり、Netlify/Vercel/CloudflareのCDNキャッシュプロバイダも追加された
- AIエージェント向けにバックグラウンド開発サーバーとJSONログ出力が自動有効化される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Diviビルダーでカスタムパーマリンクのページが404になる原因と直し方
Diviビルダーでカスタムパーマリンクを設定した固定ページを編集しようとしたとき、編集画面が404エラーになる現象は、パーマリンク管理プラグインがビルダー専用のクエリパラメータを不正に処理しているために起こる。多くの場合、プラグインの詳細設定で特定のクエリ文字列を除外するだけで解決する。
なぜDiviビルダーがカスタムパーマリンクのページで404エラーを起こすのか
Diviのビジュアルビルダー(フロントエンド編集)は、管理画面から対象ページのURLに「?et_fb=1」といったクエリパラメータを付与し、そのページをiframe内で読み込んで動作する。このとき、パーマリンク管理プラグイン(Permalink Manager Lite など)が設定したカスタムパーマリンクのリダイレクトルールが厳しすぎると、「?et_fb」がついたURLを本来とは別の場所に転送したり、存在しないページとみなして404ステータスを返してしまう。ページ自体は正常に表示されていても、ビルダーという編集専用のアクセスだけがブロックされるかたちになる。
具体的には、パーマリンク管理プラグインの「リダイレクト設定」や「正規化」機能が、付加されたクエリ文字列を除去してしまったり、ビルダー用のパラメータを含むURLをリダイレクト対象から外す設定になっていないことが原因だ。また、一部のキャッシュ設定が影響して、ビルダーがキャッシュ済みの不完全なページを読み込んで404を返すケースもある。
Permalink Manager Lite の設定を調整して404を解消する
カスタムパーマリンクで運用している環境でDiviビルダーが使えなくなったら、まずパーマリンク管理プラグインの詳細設定を見直す。ここでは日本語環境でも多く使われている「Permalink Manager Lite」を例に手順を示すが、他のパーマリンク系プラグインでも同様の考え方で対処できる。
上記の「除外するクエリパラメータ」には「et_fb」とだけ入力すればよい。クエリキー名のみをカンマ区切りで列挙する仕様のため、値や「?」を含める必要はない。保存後にDiviビルダーでカスタムパーマリンクのページを開き直し、編集画面が正しく表示されるか確認する。
リダイレクト無効化で管理者の編集を保護する
もう一つの有効な方法は、特定のユーザーに対してリダイレクト機能を一時的に無効化する設定だ。「詳細設定」画面の「リダイレクトを無効化するユーザー」で「管理者」にチェックを入れて保存する。こうすると管理画面からビルダーを開く管理者のリクエストにはリダイレクトルールが適用されず、クエリパラメータがそのまま残るため404が発生しなくなる。ただし、この設定は公開側のパーマリンク動作には影響しない。
デバッグモードで原因を可視化する
設定を変更しても改善しない場合は、「ツール」→「Permalink Manager」→「設定」→「詳細設定」にある「デバッグモード」を有効にしてみる。デバッグモードをオンにすると、ビルダーで404になった際にプラグインがどのURLを解決しようとして失敗したか、詳細なログが記録される。これを見ることで「et_fb」以外に必要な除外パラメータが見つかったり、リダイレクトルールの競合を特定できる。
キャッシュプラグインの影響を切り分ける
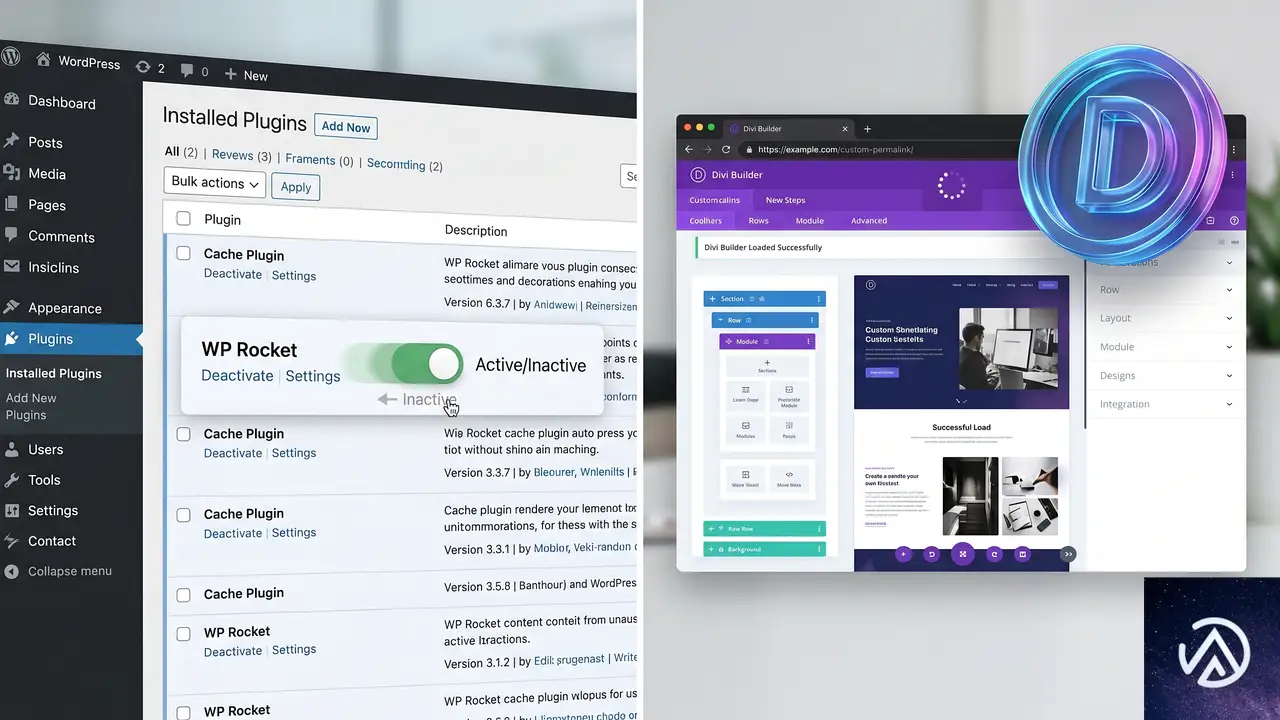
パーマリンク管理プラグインの設定を見直しても直らないときは、サーバーキャッシュやWordPressのキャッシュプラグインの影響を疑う。ビルダー読み込み時の動的URLがキャッシュから誤ったレスポンスを返す場合があるため、以下の手順で一時的にキャッシュを無効化し、症状が消えるか確認する。
- 使用しているキャッシュプラグイン(WP Super CacheやW3 Total Cacheなど)を一時停止する
- サーバー側でNginxのfastcgi_cacheやApacheのmod_cacheを使っているなら、管理画面経由でキャッシュをクリアするか、一時的に無効にする
- ブラウザのキャッシュもクリアしてからビルダーを再読込する
キャッシュを切った状態で編集が成功したなら、キャッシュプラグインの「除外するURLパターン」に「?et_fb」を含む設定を追加する。たとえば、et_fb というクエリ文字列がついたリクエストはキャッシュしないように設定すれば、運用を続けながら編集機能を維持できる。
どうしても直らないときの代替手段
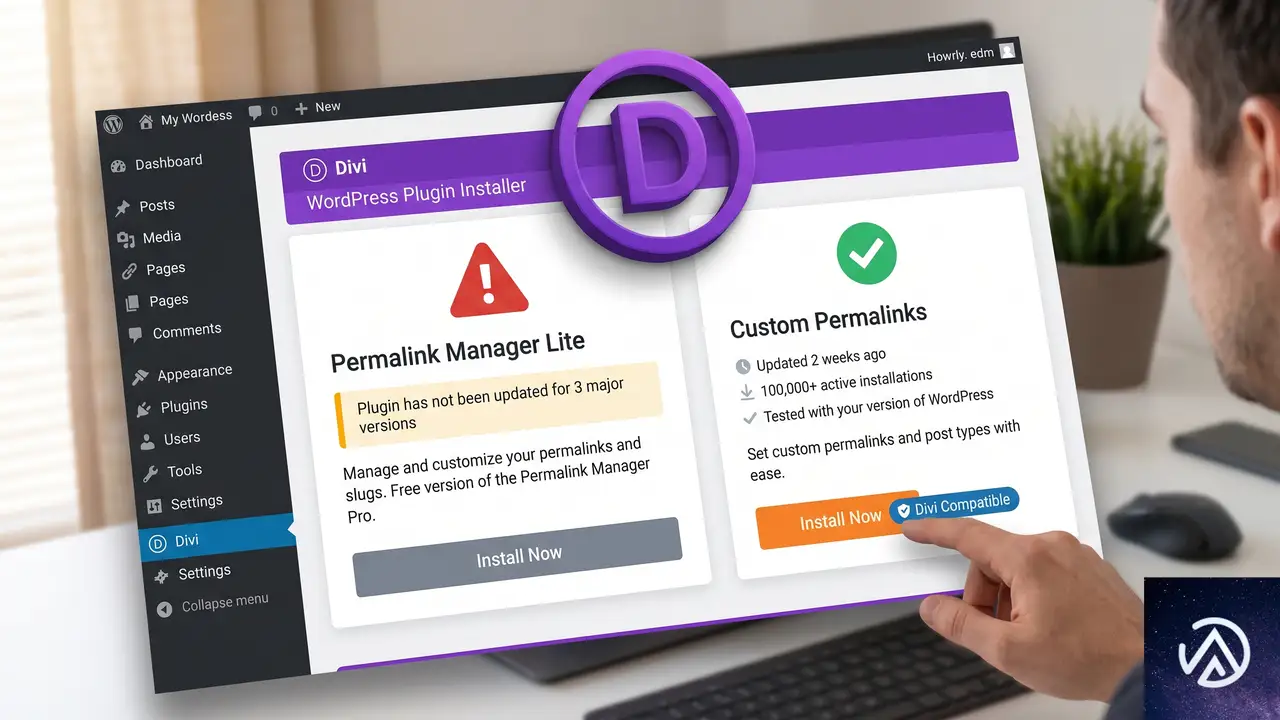
上記すべてを試してもビルダーが404を返す場合、根本的にプラグインの仕組みがDiviビルダーと相性が悪い可能性がある。以下の対策を順に検討する。
パーマリンクプラグインを別のものに切り替える
カスタムパーマリンク機能自体は別のプラグインでも実現できる。「Custom Permalinks」や「WP Permalink」など、Diviとの競合報告が少ないプラグインを試すことで、リダイレクトの挙動を根本から変えられる。ただし、移行時には既存のURL構造を維持できるか事前にテスト環境で確認する必要がある。
ページ編集時だけパーマリンクを一時的にデフォルトに戻す
最終手段として、編集したい固定ページのパーマリンク設定を一時的に「デフォルト(?p=123)」に変更してビルダーで作業し、公開直前にカスタムパーマリンクに戻す方法もある。ただし、編集のたびに手作業が発生するため、恒常的な運用には向かない。
よくある質問
エラーは「このサイトで重大なエラーが発生しました」ではなく「404 Not Found」と表示されるのはなぜか
Diviビルダーはページをiframeで読み込む際に、サーバーに実際のHTTPリクエストを送る。カスタムパーマリンクのルールがリクエストを処理できないと、WordPressのルーティングが失敗し「ページが見つかりません」という404ステータスが返る。これはPHPの致命的エラーではなく、あくまでもURL解決の失敗が原因だ。
特定の固定ページだけ編集できず、他のカスタムパーマリンクページは問題ないのはなぜか
スラッグの重複やリダイレクトルールの複雑さによって、一部のURLだけ誤って別のルールにマッチしてしまうことがある。全ページに同じカスタム構造を割り当てていても、個別に手動で追加したリダイレクト設定が干渉している場合もあるため、プラグインの「重複チェック」や「リダイレクトリスト」を確認する必要がある。
除外するクエリパラメータに「et_fb」を追加しても直らない場合はどうすればよいか
その場合は、ビルダーが使用する可能性のあるすべてのクエリパラメータを確認する。たとえば「et_fb」「et_pb_preview」「et_fb_iframe」「preview」「preview_id」などが考えられる。開発者ツールのネットワークタブでビルダー起動時に送信されるリクエストを調べ、404になっているURLに含まれるパラメータをすべて除外リストに追加する。
キャッシュプラグインを停止しても404が消えない
サーバーレベルのキャッシュ(VarnishやNginx FastCGI)が影響している可能性がある。レンタルサーバーの管理パネルからキャッシュを手動でクリアするか、サーバー会社のサポートに一時的なキャッシュ停止を依頼して切り分ける。WordPressのキャッシュプラグインだけでは制御できない層があるためだ。
この記事のポイント
- パーマリンク管理プラグインの除外設定に「et_fb」を追加すれば大半のケースで解決する
- 管理者向けのリダイレクト無効化も有効な回避策になる
- キャッシュプラグインやサーバーキャッシュが404を悪化させることがあるため、一時停止して切り分ける
- デバッグモードで詳細なログを確認すれば、除外すべき追加パラメータを特定できる
- 根本的に相性が悪い場合は、パーマリンクプラグインの変更も選択肢に入る
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
CSSスクロール駆動アニメーションで逆方向スクロールを実現
スクロールに応じてアイテムが上下逆方向に動くレイアウトを実現する手法がある。CSS-Tricksの著者が紹介したこのテクニックは、CSSの「スクロール駆動アニメーション」と疑似要素によるマスク効果を組み合わせたものだ。通常のアニメーションと異なり、ユーザーがスクロールした量だけアニメーションが進行するため、インタラクティブな表現が可能になる。本記事ではその仕組みと実装手順を詳しく解説する。
具体的なコードを見ていこう。元記事では3つのカラムがあり、左右のカラムはスクロールに応じて上方向へ、中央のカラムは下方向へ移動する。コンテナの上下端ではアイテムがふわりと消えるフェード効果がかかる。この動きはCSSの animation-timeline プロパティと view() 関数で制御される。
スクロール駆動アニメーションの基本概念
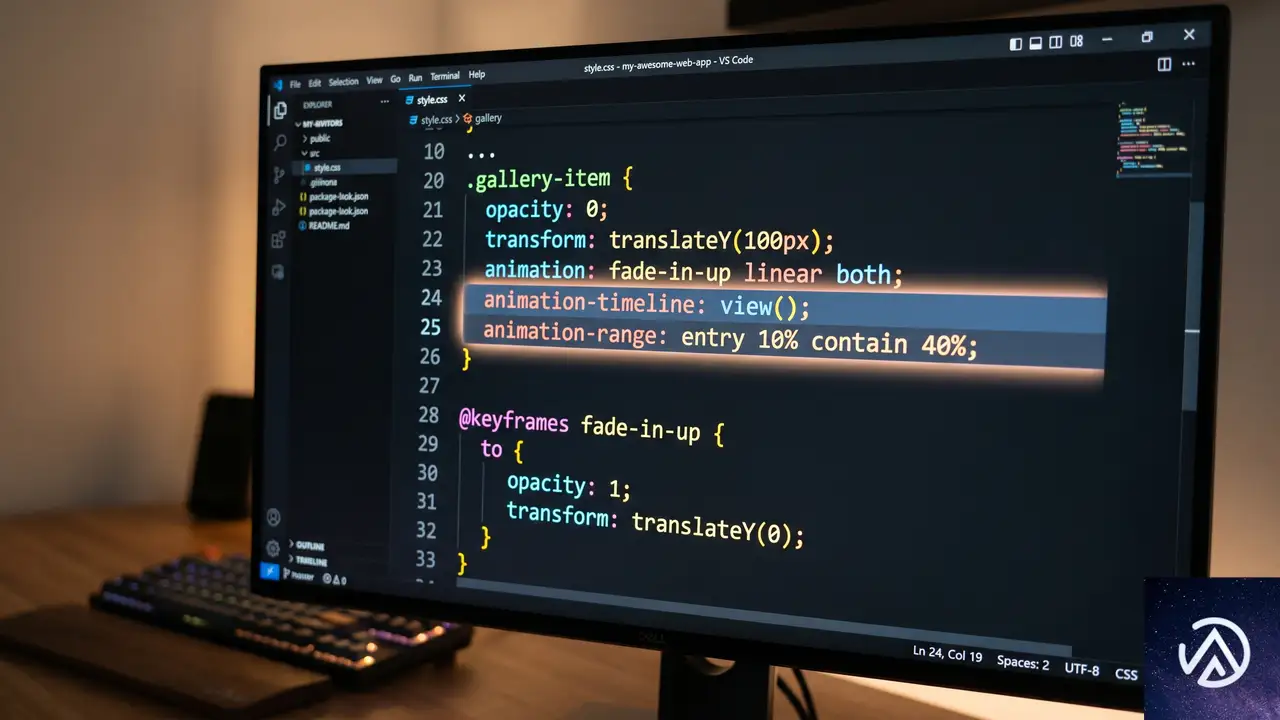
スクロール駆動アニメーション(Scroll-Driven Animations)とは、アニメーションの進行をスクロール位置に連動させるCSSの新機能である。従来のCSSアニメーションは時間ベースで動いていたが、この機能を使えば「要素が画面のどこにあるか」や「スクロール量がどれだけ進んだか」を基準にアニメーションを再生できる。
これを実現するのが animation-timeline プロパティだ。ここには scroll() 関数または view() 関数を指定する。scroll() は親要素やルートのスクロール位置を追跡し、view() は要素自身がスクロールポート(スクロール可能な表示領域)に出入りする過程を追跡する。今回の逆方向スクロールでは、各カラム内のアイテムがコンテナ領域に入ったり出たりする動きが肝になるため、view() が採用された。
view() 関数の仕組み
view() 関数は、アニメーション対象の要素がスクロールポートのどの範囲にあるかを0%から100%の進捗で返す。例えば、要素がスクロールポートの下端にさしかかった瞬間が0%、完全に反対側へ出切った瞬間が100%だ。この進捗をアニメーションのタイムラインにマッピングすることで、スクロールに同期した動きを作れる。
CSS-Tricksの著者は、この関数に「entry 0% cover 100%」というインセットを設定している。これは、要素がスクロールポートに入り始めた瞬間(entry)の0%から、完全に通り抜けて隠れきった瞬間(cover)の100%までをアニメーションの範囲とする指定だ。この設定により、各カラムのアイテムが表示領域に姿を現し、消えるまでの全行程をアニメーションでカバーできる。
このデモは、要素がスクロールポートに出入りする際のマスク効果を静的に表現している。実際のブラウザでは、スクロール量に応じて要素の位置が連続的に変化し、上下のグラデーション部分に重なると自然に溶け込むように見える。
animation-range による範囲の精密制御
animation-range プロパティは、タイムラインのどの区間を使ってアニメーションを再生するかを決める。デフォルトでは「entry 0% exit 100%」だが、CSS-Tricksの例では「entry 0% cover 100%」としている。これは entry が「要素がスクロールポートに入り始める瞬間」、cover が「要素がポートを完全に覆い隠した瞬間(つまり反対側へ出切った瞬間)」の2点を基準にする記法だ。
この指定により、アイテムが画面に現れた瞬間から消える最後までアニメーションが継続する。逆に言えば、画面外に完全に隠れている間はアニメーションが停止しているのと同じ状態になる。結果として、ユーザーがスクロールしている間だけアイテムがスムーズに動き続けるインタラクションが実現する。
HTMLのシンプルな構造
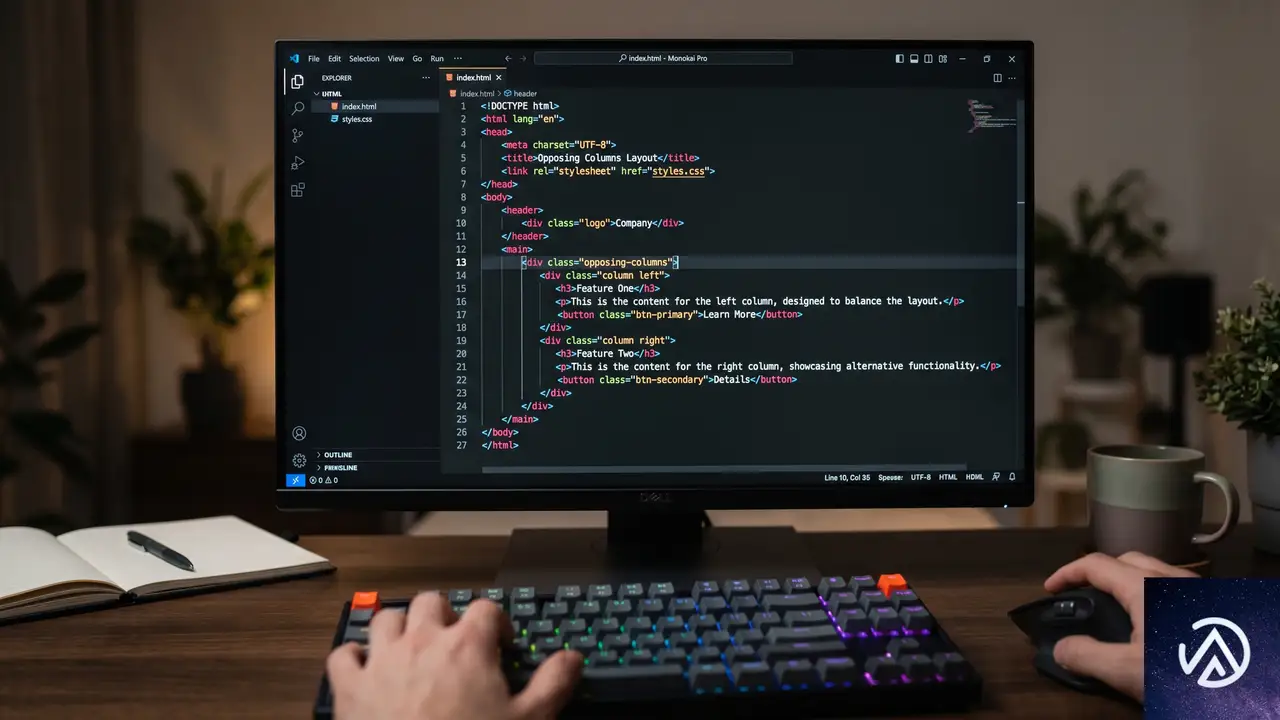
CSS-Tricksの記事で示されているHTMLは非常に簡素だ。複雑なJavaScriptや追加のラッパーは不要で、大きく分けて3階層の要素があればよい。
<div class="opposing-columns">
  <div class="opposing-column">
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
  </div>
  <div class="opposing-column">
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
  </div>
  <div class="opposing-column">
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
  </div>
</div>このシンプルな構造がポイントだ。CSS側でスクロール駆動アニメーションを定義する際、各カラム(.opposing-column)ごとに異なるアニメーションを適用し、その中に含まれるアイテムが一括して動く仕組みになっている。
CSSによるマスク効果の実装
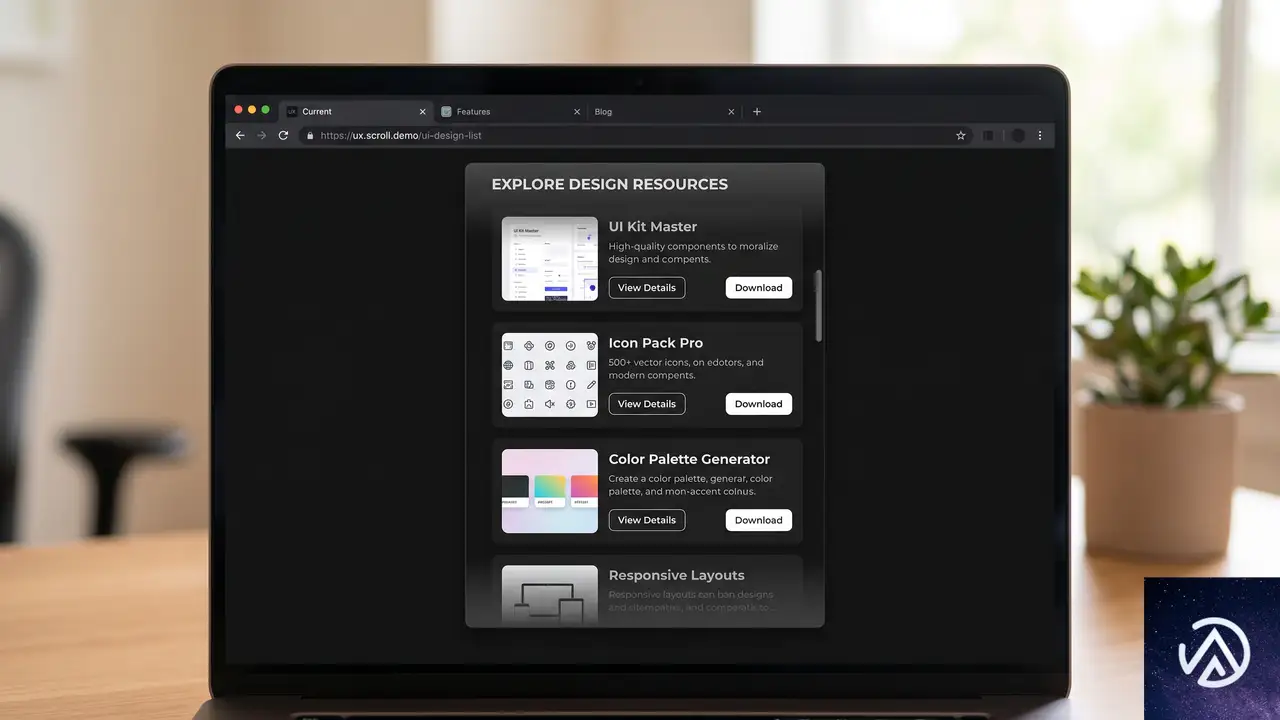
アイテムがコンテナの上下端でふわっと消える演出は、疑似要素とグラデーションによるマスクで作られている。透明度や opacity を直接操作するのではなく、背景色と同じ色のグラデーションを重ねることで、コンテンツが自然に隠れるように見せているのだ。
疑似要素でマスクを生成する
親コンテナ .opposing-columns に position: relative を設定したうえで、::before と ::after 疑似要素を絶対配置している。これらの疑似要素はコンテナの上下にそれぞれ配置され、幅はコンテナ全体、高さはCSS変数 --opposing-mask の3倍に設定されている。
@media screen and (width >= 50rem) {
  .opposing-columns {
    position: relative;
    margin-block: var(--opposing-mask, 3rem);
  }

  .opposing-columns::before,
  .opposing-columns::after {
    content: "";
    position: absolute;
    inset-inline: 0;
    block-size: calc(var(--opposing-mask) * 3);
    pointer-events: none;
    z-index: 1;
  }
}疑似要素には pointer-events: none が指定されており、クリックやホバーの邪魔をしない。これはユーザビリティを損なわないための重要な配慮だ。
グラデーションで自然なフェードを生み出す
次に、これらの疑似要素に線形グラデーションを適用する。上側の ::before には to bottom(上から下)方向のグラデーションを設定し、始点をドキュメントの背景色 --opposing-bg、終点を透明にする。下側の ::after はこれを逆にして、to top(下から上)方向のグラデーションを設定する。
.opposing-columns::before {
  background-image: linear-gradient(
    to bottom,
    var(--opposing-bg) var(--opposing-mask),
    transparent
  );
  inset-block-start: calc(var(--opposing-mask) * -1);
}

.opposing-columns::after {
  background-image: linear-gradient(
    to top,
    var(--opposing-bg) var(--opposing-mask),
    transparent
  );
  inset-block-end: calc(var(--opposing-mask) * -1);
}これにより、カラム内のアイテムがコンテナの上下端に近づくと、グラデーション部分に重なって自然に消えていくように見える。背景色とマスクの色が同一であるため、アイテムが溶け込むようなスムーズなフェードが実現する。
キーフレームアニメーションの設計
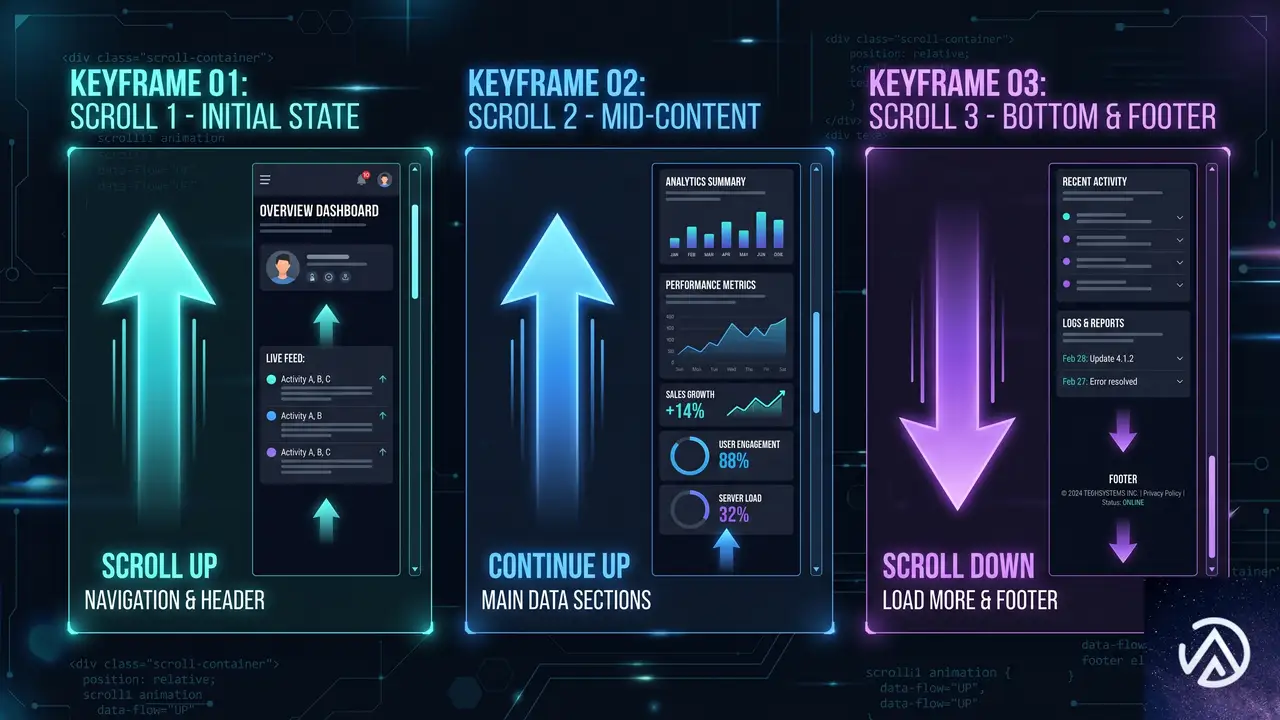
マスクの準備が整ったら、実際にアイテムを上下に動かすアニメーションを定義する。CSS-Tricksの著者は3つの異なるキーフレームを用意し、各カラムに割り当てている。
3種類の動きをキーフレームで定義
アニメーションは transform: translateY() による垂直移動で構成される。1つ目の scroll1 はアイテムを上方向に移動させ、2つ目の scroll2 はその逆方向(下方向)に動かす。3つ目の scroll3 はややオフセットを持たせた上方向の動きで、カラム間のタイミングにわずかなズレを生み出している。
@keyframes scroll1 {
  from { transform: translateY(var(--opposing-mask)); }
  to   { transform: translateY(calc(var(--opposing-mask) * -1)); }
}

@keyframes scroll2 {
  from { transform: translateY(calc(var(--opposing-mask) * -1)); }
  to   { transform: translateY(var(--opposing-mask)); }
}

@keyframes scroll3 {
  from { transform: translateY(calc(var(--opposing-mask) * .66)); }
  to   { transform: translateY(calc(var(--opposing-mask) * -.33)); }
}このオフセットの考え方は応用が利く。例えば同じ方向に動く2つのカラムでも、開始位置を微妙にずらすだけで視覚的なリズムが生まれ、単調さを回避できる。
カラムごとに異なるアニメーションをバインド
キーフレームを定義したら、各カラムにアニメーション名を割り当てる。nth-of-type 疑似クラスを使い、1番目のカラムには scroll1、2番目には scroll2、3番目には scroll3 を適用する。これにより、カラムの位置に応じて移動方向が自動的に決まる。
.opposing-column:nth-of-type(1) { animation-name: var(--animation-1); }
.opposing-column:nth-of-type(2) { animation-name: var(--animation-2); }
.opposing-column:nth-of-type(3) { animation-name: var(--animation-3); }
さらに、これらのアニメーションは animation-timeline: view() と animation-range: entry 0% cover 100%、そして animation-timing-function: linear がセットで指定される。線形のタイミング関数を選ぶことで、スクロール速度に応じてアイテムが等速で動き、自然な同期感が得られる。
アクセシビリティとブラウザ対応
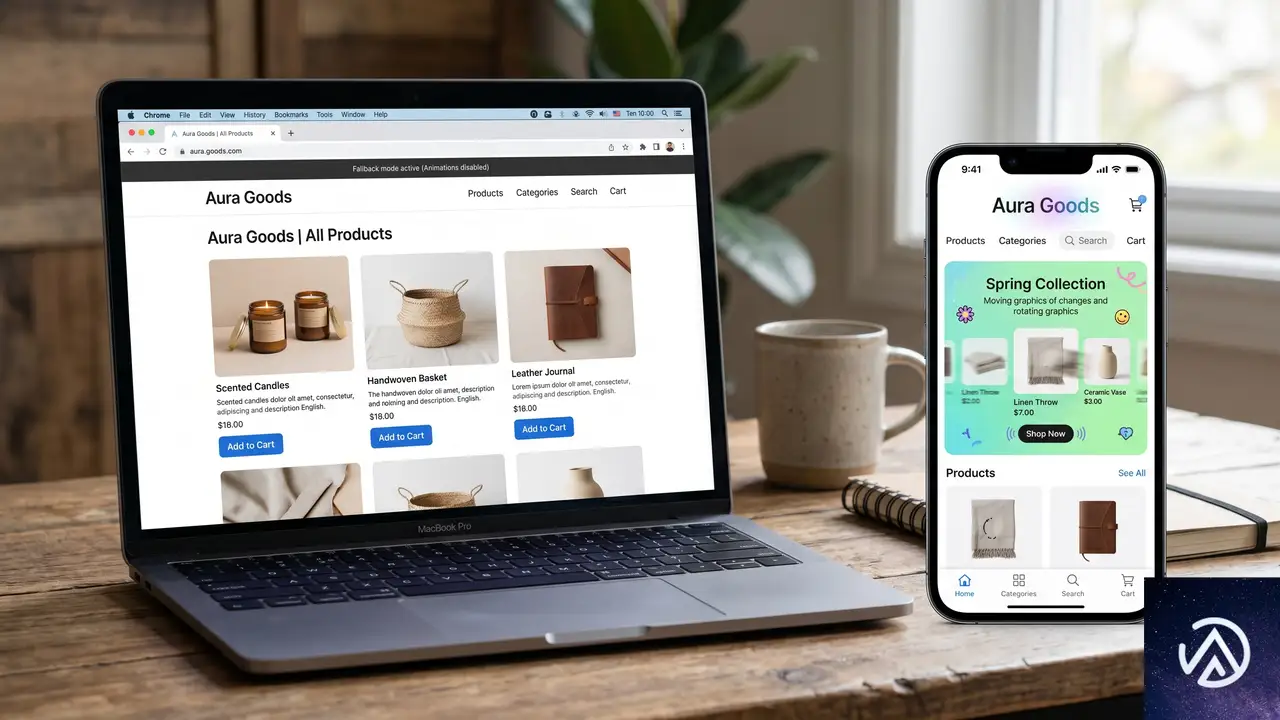
実装にあたっては、モーションに敏感なユーザーへの配慮と、ブラウザ間の互換性を考慮する必要がある。CSS-Tricksの元記事でもこの点に言及しており、適切なフォールバックを組み込んでいる。
prefers-reduced-motion への対応
OSやブラウザの設定で「視差効果を減らす」を有効にしているユーザー向けに、メディアクエリ prefers-reduced-motion: reduce を用いてアニメーションを無効化する。このクエリが一致した場合、アニメーションを unset で打ち消し、さらに疑似要素のマスクも削除する。マスクだけが残ると、動かないアイテムが不自然に隠れてしまうからだ。
@media (prefers-reduced-motion: reduce) {
  .opposing-column {
    animation: unset;
  }
  .opposing-column::before,
  .opposing-column::after {
    content: unset;
  }
}
これにより、動きを減らしたいユーザーには静的なレイアウトが提供され、意図しないストレスを回避できる。
@supports を使った段階的な実装
スクロール駆動アニメーションは、2026年6月時点でChromeとSafariがサポートしているが、Firefoxは未対応だ。そのため、@supports (animation-timeline: view()) を用いて、機能が使えるブラウザでのみアニメーションを有効化するのが安全だ。サポートされない環境では、通常のスクロールと同様の静的な表示になるよう設計しておけば、すべてのユーザーに破綻のない体験を届けられる。
@supports (animation-timeline: view()) {
  /* スクロール駆動アニメーションのスタイル */
}この手法はプログレッシブエンハンスメントの好例で、新しいCSS機能を安全に導入したい現場でも参考になるだろう。
独自の視点:逆方向スクロールの応用可能性
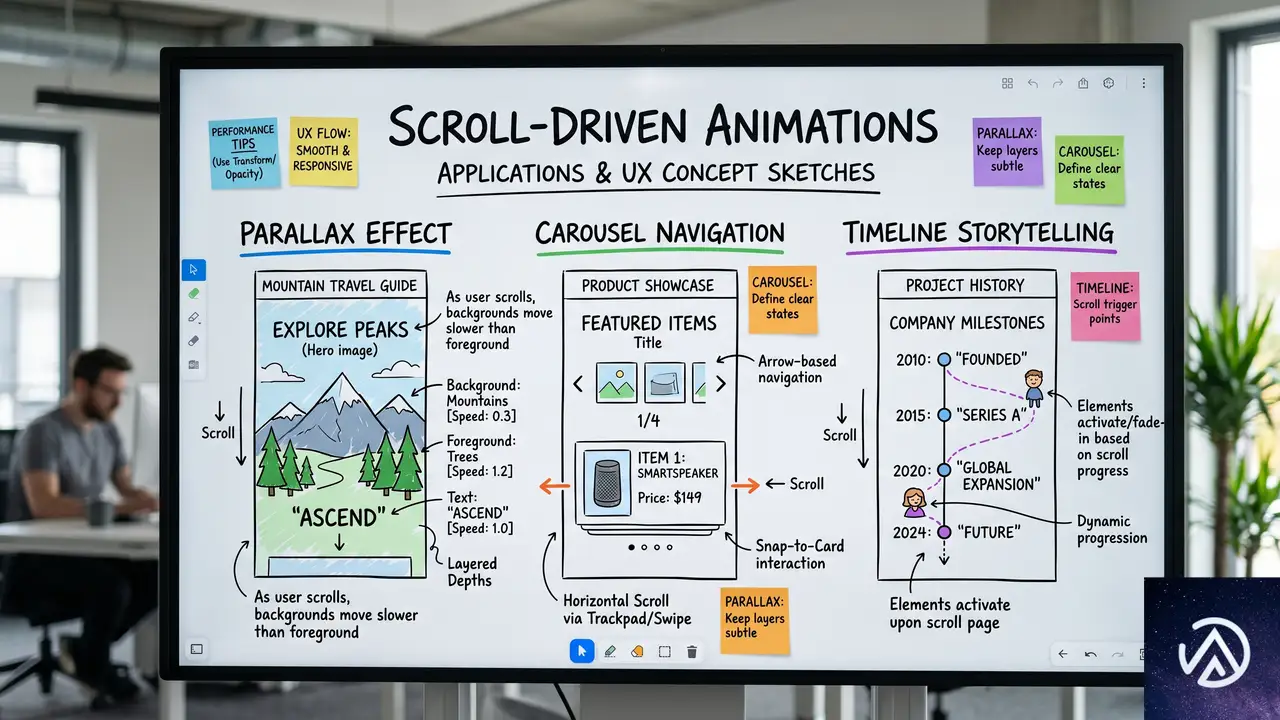
ここまで見てきたテクニックは、単なる逆方向スクロールの演出にとどまらない。CSSのスクロール駆動アニメーションは、タイムラインを自在に操作できるため、さまざまなインタラクティブ表現の土台となる。
タイミングのオフセットを使ったリズム演出
元記事の scroll3 のように、開始位置や終了位置をパーセンテージでずらすことで、カラム間の動きにリズムを生み出せる。たとえば、5カラムのレイアウトでそれぞれの移動量を微調整すれば、波のようなうねりを表現することも可能だ。マスクの高さやアニメーションのインセットをCSS変数で管理しておけば、デザインの微調整も容易になる。
このようなオフセット設計は、プロモーションサイトやポートフォリオのビジュアルリッチなセクションで特に効果を発揮するだろう。
パララックス効果との自然な組み合わせ
従来のパララックス(視差効果)はJavaScriptで実装されることが多かったが、スクロール駆動アニメーションを使えば、CSSだけで多層的な視差を表現できる。背景画像や装飾要素に別の animation-timeline を割り当て、移動速度を変えれば、奥行きのあるスクロール体験をJavaScriptに頼らずに構築できる。
例えば、背景の大きな画像にはゆっくりした上方向のアニメーションを、前景のテキストにはやや速い動きを設定するといった組み合わせだ。マスク効果を応用すれば、画面外への自然な消え方も統一感を持って演出できる。
カルーセルやタイムライン表現への展開
逆方向スクロールの考え方は、横方向のカルーセルやタイムライン表示にも転用できる。view() 関数の軸指定(block や inline)を切り替えれば、水平スクロールにも対応可能だ。また、scroll() 関数と組み合わせれば、ページ全体のスクロール量に応じてインジケーターを進める、といった使い方もできる。
CSS-Tricksの元記事は比較的シンプルな例だが、この基盤さえ理解すれば、より複雑なレイアウトやストーリーテリング演出にも発展させられる。
この記事のポイント
- スクロール駆動アニメーションは
animation-timeline: view()で実装し、スクロールに同期した動きを簡単に作れる - 疑似要素と背景色ベースのグラデーションを組み合わせると、自然なフェード効果を実現できる
- 動きのオフセットや逆方向設定によって、単調でないリズミカルな演出が可能になる
@supportsとprefers-reduced-motionで、アクセシビリティとブラウザ互換性を両立させる- 今回のテクニックはパララックス、水平カルーセル、タイムラインなど多彩な表現に展開できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
プラグイン更新後にログイン不可「ユーザー名またはパスワードが間違っています」と表示される原因と直し方
プラグインの更新後、正しいユーザー名とパスワードを入力しているにもかかわらずログインできず「ユーザー名またはパスワードが間違っています」というエラーが表示されるなら、その原因は特定のプラグインが認証フローに干渉したことによる競合だ。特にログインフォームをカスタマイズするプラグインと、追加のセキュリティ認証(Cloudflare Turnstileなど)を組み合わせている場合に発生しやすい。
なぜ正しいパスワードなのに「間違っています」と表示されるのか
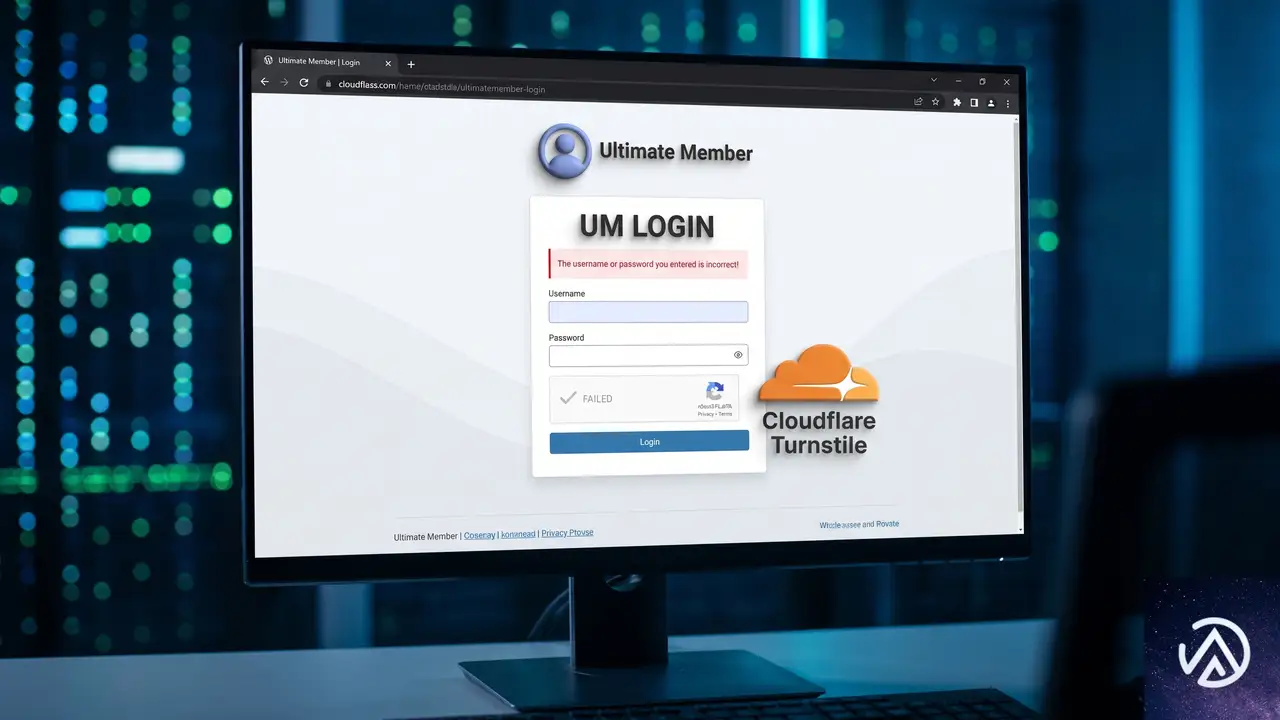
WordPressは通常、ログイン認証を「wp-login.php」を通じて処理している。ここにプラグインが独自のログインフォームを追加したり、認証前にCAPTCHAや追加認証を挟むと、データの送信順序や検証の流れが変わる。プラグインのバージョンアップでこの処理順序が微妙に変わった結果、正しい認証情報がバックエンドの判定に渡る前に「誤り」と判定されるケースが起きる。
典型的なパターンとして、会員制サイト用のプラグイン(Ultimate Memberなど)が生成する独自ログインページと、追加のボット対策機能(Cloudflare TurnstileやreCAPTCHA)が衝突する問題が挙げられる。どちらか一方が先にフォームの値を検証し、もう一方に正しい情報を渡せなくなることが原因だ。
まず試す緊急回避策 管理画面に入れない場合の対処
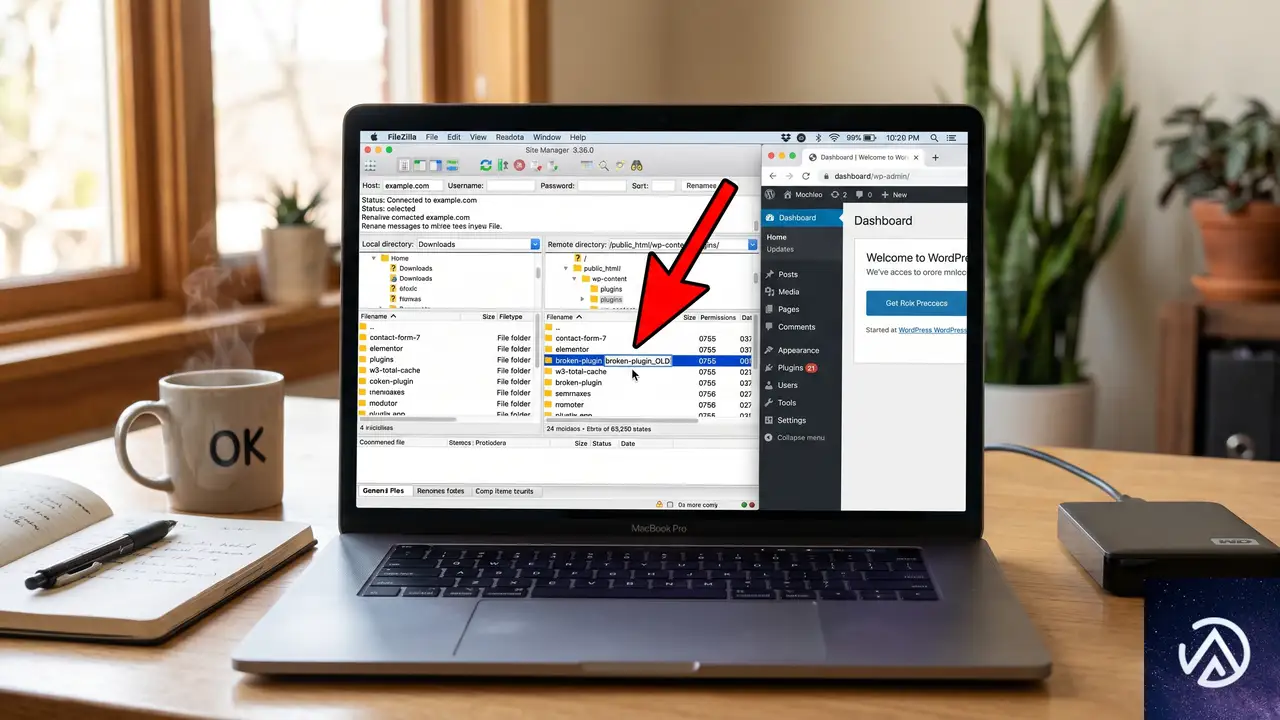
ログインできない状態では管理画面からプラグインを停止できない。次のいずれかの方法でプラグインを一時的に無効化し、管理画面に再アクセスできるようにする。
FTPやファイルマネージャーでプラグインフォルダの名前を変更する
レンタルサーバーのファイルマネージャーやFTPソフトでサイトのファイルにアクセスし、「/wp-content/plugins/」ディレクトリを開く。問題を起こしているプラグインのフォルダ名を一時的に「_(アンダースコア)」を付けるなどして変更する。WordPressは存在しないプラグインディレクトリを無効化するため、余分な認証処理が外れて本来のログインフローが復活する。
具体的な対象は、直近で更新したプラグインか、ログインフォームをカスタマイズしているプラグインだ。Ultimate Memberのような会員制プラグインや、Cloudflare Turnstileを追加しているプラグインが該当する。
wp-config.phpでプラグインを一括無効化する
FTPでWordPressのルートディレクトリにある「wp-config.php」をダウンロードし、次の一行を「/* 編集が必要なのはここまでです ! */」の直前に追加する。
define('DISABLE_PLUGINS', true);この状態でファイルを上書きアップロードすると、すべてのプラグインが一時的に無効化される。管理画面にログインできたらこの行を削除し、原因のプラグインだけを停止してから他のプラグインを再有効化する。ただし、この定数は非公式の回避策で、すべての環境で動作するとは限らない点に注意する。
原因となったプラグインの特定と恒久対応
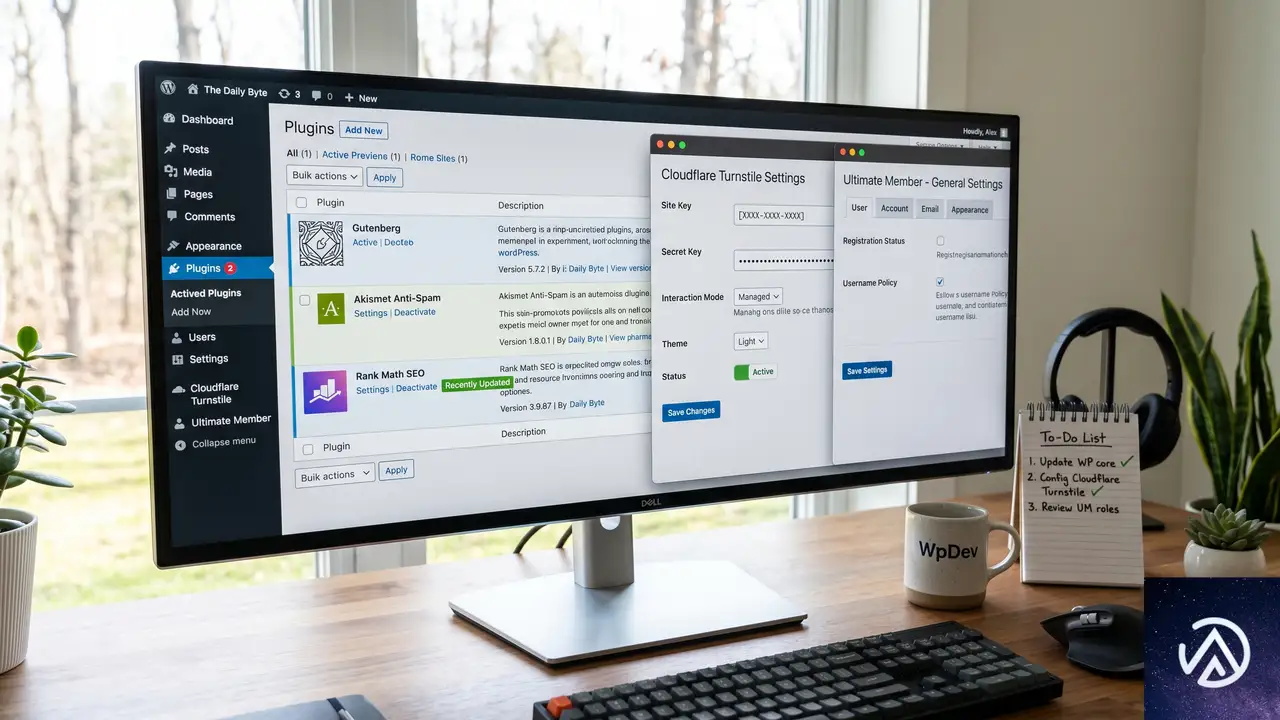
管理画面にログインできたら、プラグイン一覧画面で「直近更新されたプラグイン」を順に停止し、問題が再現するか確認する。特に次の組み合わせに心当たりがあれば、真っ先に疑うべきだ。
- 独自のログインフォームを提供するプラグイン(Ultimate Memberなど)
- Cloudflare TurnstileやreCAPTCHAなどの認証機能をログイン画面に追加するプラグイン
旧バージョンに戻す方法
プラグインの以前のバージョンは、WordPress公式プラグインディレクトリの「以前のバージョン」セクションからダウンロードできる。プラグインページの下部にある「詳細を見る」→「開発」→「以前のバージョン」の順に進むと、過去のすべての安定版がzipで入手可能だ。管理画面のプラグイン新規追加から手動でアップロードし直すか、FTPで「/wp-content/plugins/」に解凍して上書きすれば戻せる。
Cloudflare Turnstileをそのまま使いたい場合の設定見直し
TurnstileのWidget Modeを「Managed」から「Non-interactive」に変更するか、ログインページだけ設定を除外する方法を試すと競合が緩和されることがある。Cloudflareのダッシュボード側で該当サイトの「Security → Bots → Turnstile」から、Fail-open動作(認証失敗時にアクセスを通す)を有効にするのも有効な回避策だ。
根本原因を理解して今後の更新に備える
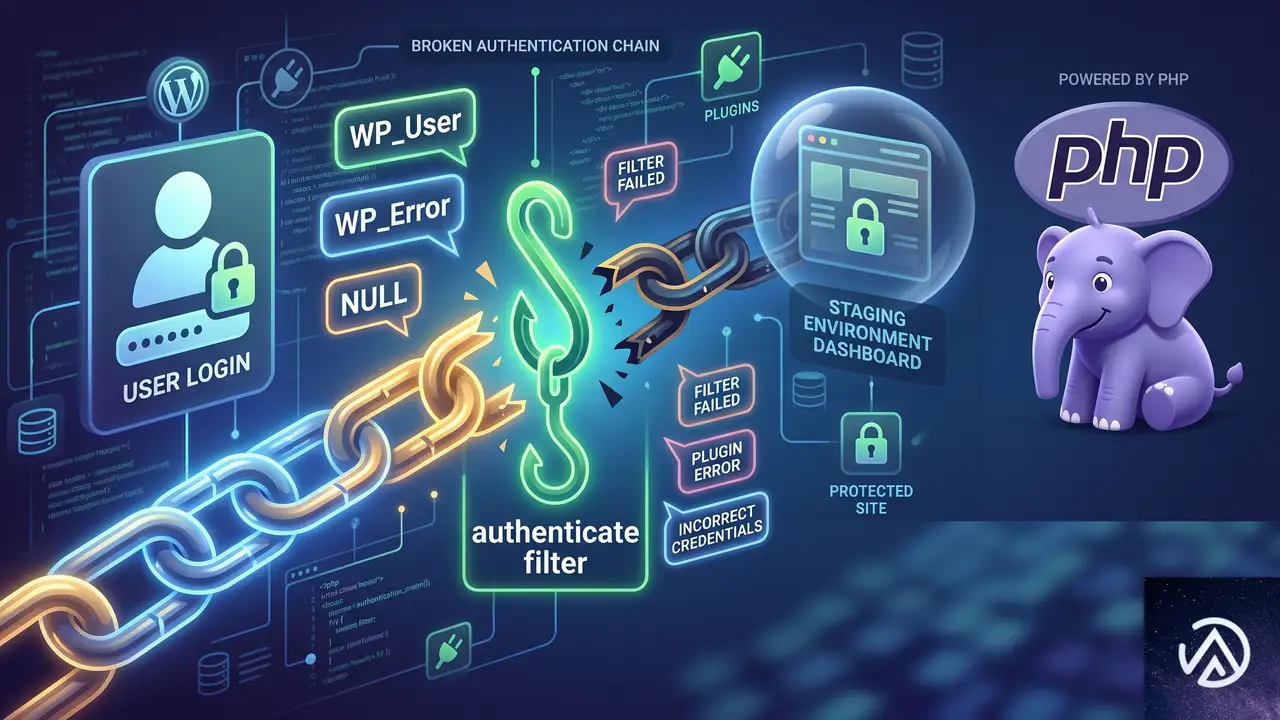
この問題の本質は、WordPressの認証フック(authenticateフィルター)に対して複数のプラグインが非標準的な順序で割り込んだことにある。WordPressのコア認証は、ユーザー名とパスワードが一致したらWP_Userオブジェクトを返す。しかし追加認証を挟むプラグインは、認証が成功しても「null」を返したり、エラーオブジェクト(WP_Error)に差し替えたりする。バージョンアップでこのフィルターの優先度(priority)が変わると、突然認証が通らなくなるというわけだ。
将来的に同様のトラブルを避けるには、本番環境の更新前にステージング環境で動作確認することが最も確実な対策になる。また、会員制プラグインとセキュリティ認証プラグインの両方を使用している場合は、片方のログイン機能をオフにしてWordPress標準のログインページに一本化するのも安定性を高める選択肢だ。
よくある質問
Ultimate Memberのログインフォームだけエラーになるのはなぜか
Ultimate MemberはWordPress標準の認証処理を大きくカスタマイズし、独自の認証フックを追加している。ここにCloudflare Turnstileのような外部検証が割り込むと、UM側で生成したnonce(ワンタイムトークン)やセッション情報が検証前に消費されたり、書き換えられてしまう。UMはバリデーションが1つでも失敗すると「認証情報が間違っている」と一般化して表示する設計のため、実際のパスワードは合っていてもエラーになる。
プラグインを旧バージョンに戻したがサイトが脆弱にならないか
旧バージョンに戻すことは一時的な対処であり、修正が適用された最新版に更新できるまでの猶予と考えるべきだ。緊急回避の間は、WAF(Webアプリケーションファイアウォール)のルールを厳しくする、ログイン試行回数の制限をかける、IP制限を追加するなど、他の手段で防御を補強しておく。該当プラグインのサポートフォーラムで同様の報告がないか確認し、解決パッチを待つか、開発元に直接報告するのが安全な進め方だ。
Cloudflare Turnstileを完全に外す以外の選択肢はあるか
Cloudflare側の設定で「アクション」を「管理モード」から「監視モード」に変更し、認証を可視化せず裏側でリスク評価だけさせる手がある。また、一部のプラグインでは特定のページ(wp-login.phpなど)だけ検証をスキップするフックが用意されている場合がある。プラグインのドキュメントやフックリファレンスに「bypass turnstile on specific page」の情報がないか探してみるとよい。
管理画面にすら入れない場合、データベースから直接プラグインを無効化できるか
可能だ。phpMyAdminなどでWordPressのデータベースにアクセスし、「wp_options」テーブルの「active_plugins」レコードを編集する。このレコードには有効化されているプラグインの一覧がシリアライズされた配列で保存されている。該当プラグインのパスを削除して保存すれば、そのプラグインだけが無効化される。ただしシリアライズされたデータの文字数カウントを修正する必要があるため、FTPでのフォルダ名変更のほうが手軽で安全だ。
この記事のポイント
- 正しいパスワードでログインエラーになるのは、認証フックに割り込むプラグインの競合が原因
- FTPで問題のプラグインフォルダをリネームするか、wp-config.phpで全プラグインを一時停止して管理画面に入る
- Cloudflare TurnstileやreCAPTCHAの設定をオフにするか、旧バージョンへのダウングレードで即座に解決する
- 恒久対応は、開発元への不具合報告と、ステージング環境での更新前検証の徹底
- 同種のプラグインを併用する場合は、WordPress標準ログインページへの統一も検討する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
EC向けAIフライホイール構築、4つの価値レバーと実践法
EC事業におけるAI活用は、単純なタスクの自動化から、複数の施策が連鎖的に成果を生み出す仕組み作りへと移行しつつある。マッキンゼー・アンド・カンパニーが2026年6月に公開したレポート「Europe’s new ecommerce agenda How AI is resetting growth and competition」では、AIがもたらす価値は断片的な実験ではなく統合にあると指摘されている。
成功するEC事業者は、商品のパーソナライズ、需要予測、在庫管理、価格設定といった複数の意思決定をAIでつなぎ合わせ、全体として加速度的に回転する「フライホイール」を構築している。このフライホイールは、各施策が互いに強化し合い、一度回り始めると追加のリソースを大きく投じなくても成果が積み上がっていく。
この記事では、マッキンゼーが示した「4つの価値レバー」を軸に、大企業だけでなくデータや人的リソースが限られる中小規模EC事業者でも実践できる小さなAIフライホイールの始め方を、具体例とともに解説する。
AIフライホイールの基本概念
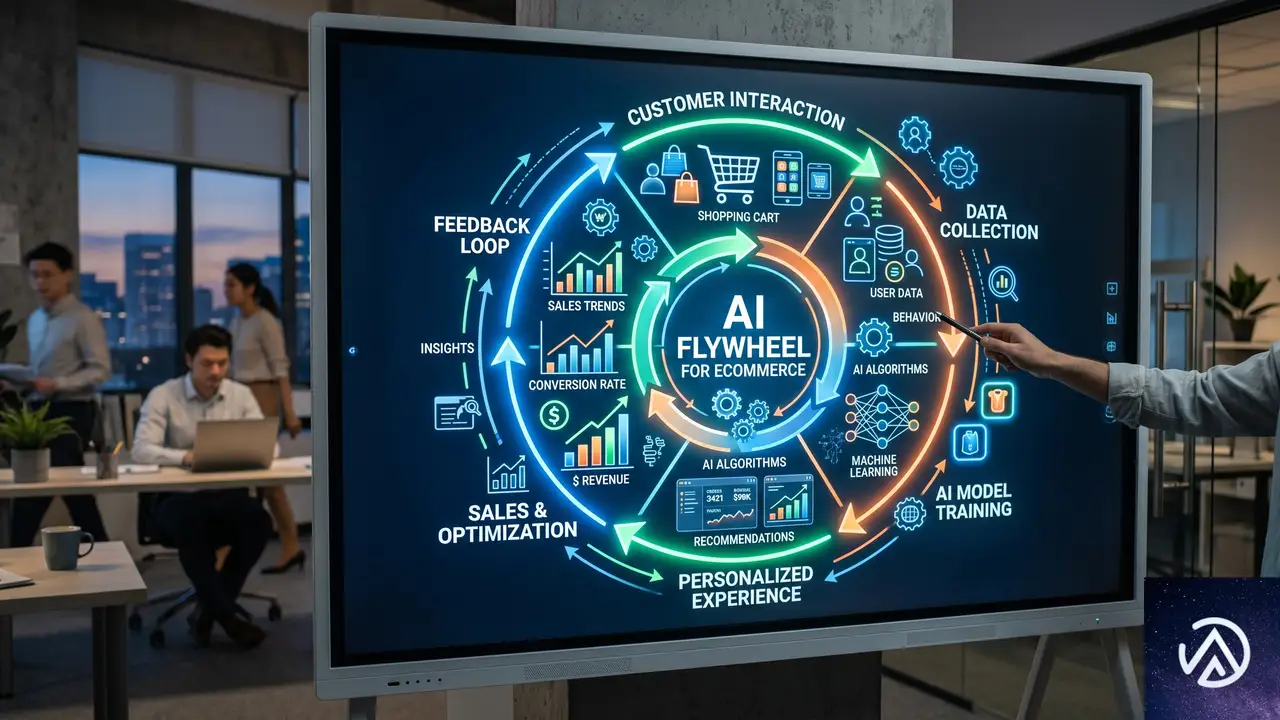
フライホイールが回る仕組み
AIフライホイールとは、あるプロセスが次のプロセスを改善し、その改善が再び最初のプロセスを後押しする、自己強化型の循環システムのことだ。たとえば、AIによるパーソナライズで顧客エンゲージメントが高まると、より正確な需要シグナルが得られる。そのシグナルを使って価格や在庫の判断を最適化すれば、再びエンゲージメントが向上し、さらに多くのデータが蓄積される。
このループを1回転させるごとに、データの質と意思決定の精度が上がり、フライホイールはより少ないエネルギーで回り続ける。一度きりのプロジェクトではなく、持続的な成長エンジンとして機能する点が最大の特徴だ。
単体タスクの自動化との違い
AIフライホイールは、単一の作業をAIに任せる「自動化」とは根本的に異なる。商品説明文をAIで生成すれば時間は短縮できるが、それだけではビジネス全体の流れは変わらない。一方、フライホイール思考では、顧客からの問い合わせ内容をAIで分析し、商品ページの改善に活かし、コンバージョン率の変化を追跡し、その結果を次の仕入れや価格戦略に反映させる。こうした相互連鎖によって、初めて収益構造が強化される。
この概念図では、断片化されたAI活用と、連鎖的に回るフライホイールの違いを視覚化している。単体の導入では部分最適にとどまるが、相互に強化し合うループを作ることで、事業全体の底上げが可能になる。
成長を加速する4つの価値レバー

相互に強化し合う4つの要素
マッキンゼーのレポートでは、ECにおけるAIフライホイールを構成する4つの「価値レバー」として、成長、生産性、バリューチェーン効率、収益性が挙げられている。いずれも独立した施策ではなく、意図的につなぎ合わせることでレバレッジが効く。
成長は、商品発見の最適化やレコメンデーション、メールセグメンテーション、広告クリエイティブの自動生成などを通じて、適切な購入者に適切な商品を届ける活動を指す。AIが顧客行動を深く理解し、一人ひとりに合った購買体験を提供することで、売上の上昇に直結する。
生産性は、カスタマーサポートやコンテンツ制作、販売管理、レポート作成といった反復作業をAIで削減する領域だ。定型業務から人手を解放し、戦略的な思考が求められる高付加価値業務に人材を集中させられる。
バリューチェーン効率は、需要予測と在庫管理、フルフィルメント、返品処理をAIで連携させるものだ。何が売れるか、どこに在庫があるか、いつ届くかをリアルタイムに把握し、コストと在庫リスクを最小化する。
収益性は、価格設定やプロモーション、バンドル販売、値下げ判断をデータ駆動で行う領域である。AIは利益率を損なう過度な値引きや無駄なキャンペーンを可視化し、マージンを最大化する行動を提案する。
商品発見、レコメンド、広告クリエイティブの最適化で適切な顧客にリーチ
反復作業の削減と人員の高付加価値業務へのシフト
需要・在庫・配送・返品を統合しコストを最小化
価格・プロモーション・値下げ判断のデータ駆動化で利益率を向上
これら4つのレバーは、相互にデータを供給し合うことで単体の数倍の効果を発揮する。たとえば、成長施策で得たエンゲージメントデータが在庫効率を改善し、その結果生まれた余剰在庫をデータに基づく値下げ判断で処理しながら収益性を守る、といった連携が可能だ。
中小規模ECが実践できる小さなフライホイール

顧客フィードバック分析から商品ページ改善へ
大企業のように整備されたデータ基盤や高度なシステムがなくても、AIフライホイールは始められる。中小規模EC事業者であっても、問い合わせメールやチャット履歴、レビュー、返品理由といった顧客の声は確実に存在している。これらをAIで分析し、たとえば「サイズ感が合わない」「同梱物がわかりにくい」「配送目安が不明瞭」といった共通の課題を抽出することが、最初の一手になる。
次に、得られたインサイトを商品ページの改善に反映する。サイズガイドの追加や比較表の設置、よくある質問の充実、利用シーンを想起させる商品写真の差し替えなど、具体的な対応を取るのが有効だ。これらの変更は、無料または低コストのAIツールで十分に実施できる。
改善が次のサイクルを生む
商品ページの改修後は、コンバージョン率や返品率、サポートへの問い合わせ件数といった指標を追跡する。ここでもAIを活用すれば、変更の効果を自動で検知し、仮説の精度を高めていくことが可能だ。たとえば「返品理由の上位にあったサイズ感の問題が解消され、返品率が15パーセント低下した」といった成果が得られれば、次の購買データもクリーンになる。
こうした小さなサイクルを繰り返すことで、顧客の声が商品体験を改善し、改善がより良いデータを生み、そのデータがさらに精度の高い意思決定を支えるループが出来上がる。規模は小さくとも、自己強化のメカニズムは大企業のそれと同じだ。
この小さなフライホイールは、初期投資を抑えながら着実に成果を出せる。顧客フィードバックはすでに手元にある資産であり、AIを分析エンジンとして活用するだけで、商品改善と売上向上のエンジンが動き始める。
意思決定の連鎖がもたらすもの

部門を横断したAI活用
AIフライホイールの本質は、カスタマーサービスと商品コンテンツ、サイト内検索とマーチャンダイジング、在庫管理とプロモーションといった、これまで別々に行われてきた意思決定を一本の線でつなぐことにある。AIが仲介役となり、各部門から得られるデータを相互に変換しながら、最適なアクションを導き出す。
たとえば、顧客からの問い合わせに使われる自然言語の傾向をAIが学習すれば、それはサイト内検索のレコメンド精度向上にも活かせる。また、返品理由の分析結果をプロモーション担当に共有すれば、値引きすべき商品や強化すべき訴求ポイントが明確になる。AIがデータの共通言語となることで、組織全体の意思決定が同期し始める。
マネジメント視点の重要性
中小EC事業者が真にAIで競争優位を築けるかどうかは、最新モデルへのアクセスよりも、経営的な視点の差で決まる。AIを単なるツールとして導入するのではなく、業務プロセス全体を俯瞰し、データが流れる経路を設計し、測定と改善を繰り返す管理のしくみを構築することが求められる。
これは技術の話ではなく、経営戦略の話だ。顧客の声を商品に反映し、その成果を在庫や価格に転嫁し、得られた利益を再び顧客体験に投資する。この連鎖を回す主体は、AIではなく事業者自身である。AIはその回転を支えるエンジンに過ぎない。
この記事のポイント
- AIフライホイールは、部分的な自動化ではなく、複数の施策が連鎖して加速する自己強化型のシステムである
- マッキンゼーが示す成長、生産性、バリューチェーン効率、収益性の4つのレバーを組み合わせることで、レバレッジが最大化される
- 中小EC事業者は、すでに保有する顧客フィードバックをAIで分析し、商品ページ改善につなげる小さなサイクルから始められる
- AIの真価は、部門を横断した意思決定の同期と、経営全体をデータ駆動で回すマネジメントの仕組みにある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PHP Parse Error unexpected クエスチョンでWordPressが真っ白になる原因と直し方
「PHP Parse error: syntax error, unexpected ‘?’」が error_log に記録され、WordPress の管理画面を含むサイト全体が真っ白になる症状は、実行環境の PHP バージョンが古すぎて、WordPress コアファイルが記述する構文を解釈できないことが原因だ。とくに wp-includes/compat-utf8.php の 47 行目でエラーになるケースでは、PHP 5.x 系で動作している可能性が高い。サーバーの PHP を 7.4 以上(WordPress 7.0 の動作要件には 8.0 以上が推奨)に切り替えれば、このエラーは即座に解消する。
なぜ compat-utf8.php で unexpected ‘?’ が発生するのか
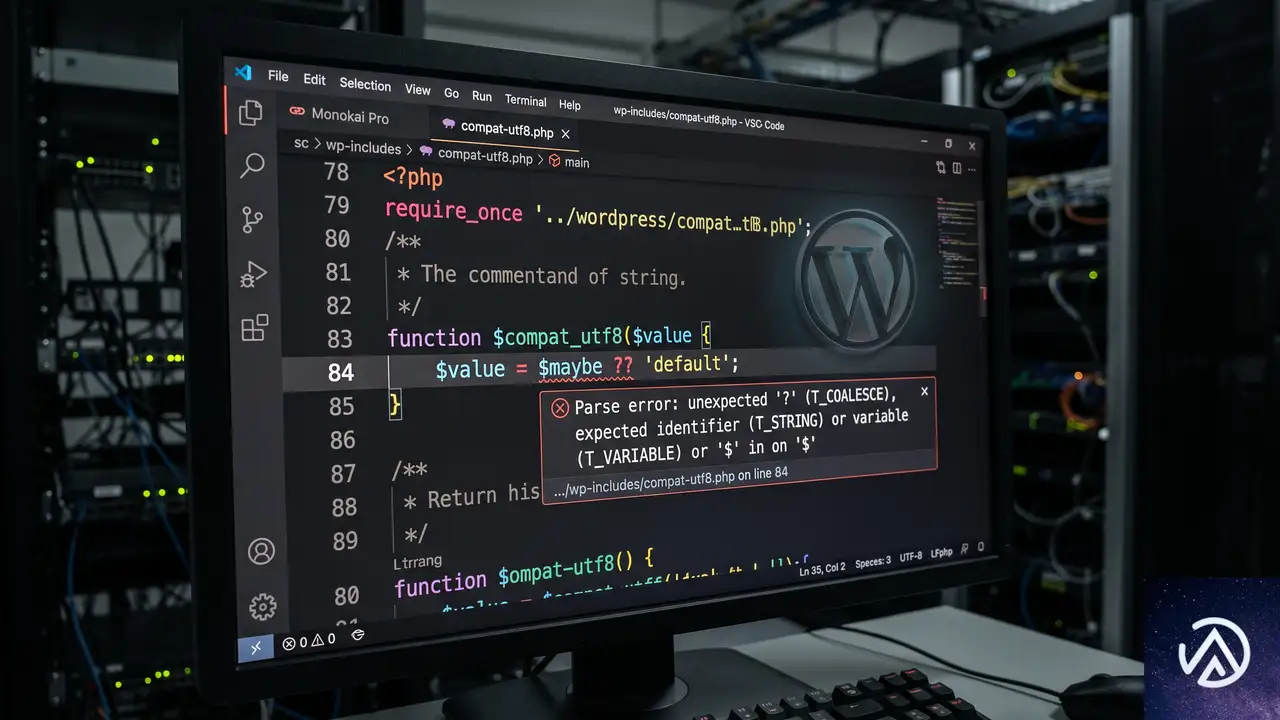
WordPress のコアファイル compat-utf8.php は、マルチバイト文字列を安全に扱うための互換関数群を収めている。中では null 合体演算子(??)やシンプルな三項演算子が使われる場面があり、これらは PHP 7.0 以降で導入された構文だ。もしサーバーが PHP 5.6 以前のバージョンで動作していると、「?’」の部分で構文エラーが発生し「unexpected ‘?’」というメッセージを吐く。つまり PHP バージョン不足が根本原因になる。
エラーの「expecting variable (T_VARIABLE)」は、処理系が疑問符を見て、本来そこに変数が来るはずの三項演算子の前半部分と誤解したことを示す。古い PHP は「??」を認識できずに文法的に未知のトークンとしてパースエラーを起こす。WordPress 7.0 が標準で要求する PHP バージョンはさらに高く、8.0 以降を推奨するケースも多い。
サイト全体が真っ白
上図のように PHP バージョンが低いとコアファイルの構文エラーで画面が真っ白になり、適切なバージョンにすると何も修正しなくてもその場で直る。
PHP バージョンを確認してサーバーで変更する手順
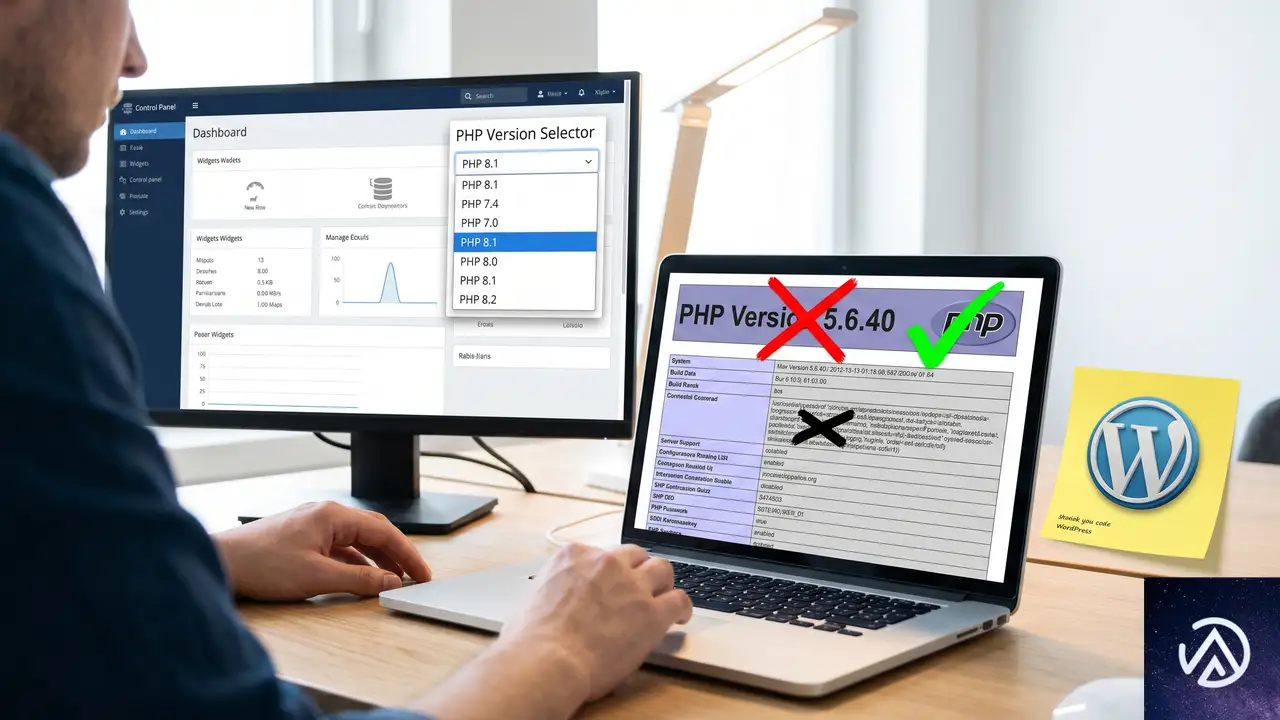
最初にサーバーが現在どの PHP バージョンで動いているかを調べ、続いて管理画面からバージョンを切り替える。操作性はレンタルサーバーによって異なるが、多くの場合 cPanel か独自コントロールパネルに PHP セレクターが用意されている。
phpinfo() で現在の PHP バージョンを調べる
サーバーの公開ディレクトリに info.php などのファイルを作り、内容を <?php phpinfo(); ?> にしてブラウザで開く。表示されるページの最上部に「PHP Version」として現在のマイナーバージョンまで確認できる。この値が 5.6 や 7.0 であれば、まさにこの構文エラーを引き起こす原因になっている。
コントロールパネルで PHP バージョンを変更する
cPanel の場合は「Select PHP Version」または「マルチPHP マネージャー」といった項目からドロップダウンで選択し、その場で切り替えが可能だ。PHP 7.4 や 8.0 が用意されていないときは、ホスティング会社のサポートに「PHP のバージョンアップグレードをお願いします」と連絡して対応を依頼する。
WordPress が推奨する動作環境は年々上がっている。WordPress 7.0 であれば PHP 8.0 以降を選択するほうが安全で、プラグインの互換性も考慮してなるべく新しい安定バージョン(8.1 や 8.2)を選ぶとよい。
変更後にサイトが復旧したかどうか確認する
PHP バージョンを切り替えたら、キャッシュが残らないようシークレットウィンドウで管理画面とトップページを開く。真っ白だった画面が正常に表示されれば解決だ。もし引き続きエラーが出る場合は、次節のチェックポイントを試す。
PHP をアップグレードしても直らないときの確認ポイント
PHP バージョンが適切でも compat-utf8.php で同じエラーが出るなら、コアファイルの破損や、別の場所から読み込まれた古い互換コードが原因の可能性が残る。
コアファイルを再アップロードして整合性を確かめる
wp-admin と wp-includes ディレクトリ、およびルートのファイルを公式アーカイブからダウンロードし、FTP で上書きする。このとき wp-content は触らない。アップロード後もエラーが出るなら、WP-CLI が使える環境では「wp core verify-checksums」コマンドでファイルの改ざんや破損を検出できる。
wp-content 内のカスタムコードを調査する
まれに mu-plugins(Must Use プラグイン)やテーマの functions.php に記述された互換用のオーバーライドが、古い PHP 構文を含んでいるケースがある。wp-content/mu-plugins を一時的に空にし、子テーマを標準テーマに切り替えてアクセスしてみる。これでエラーが消えたら、該当ファイル内の記述を新しい書き方に書き換える必要がある。
サーバーの .htaccess や php.ini を確認する
特定のディレクトリだけ古い PHP ハンドラが割り当てられている場合、.htaccess に AddHandler や SetHandler で別バージョンが指定されていることがある。推測されるハンドラ名があればコメントアウトして様子を見る。また、php.ini に意図しない設定でバージョン互換モードが指定されていないかも確認する。
よくある質問
エラーメッセージの unexpected ‘?’ と expecting variable は何を意味しているのか
PHP がソースコードを解析する際に、予期しない「?」を見つけて構文エラーを起こしたという意味だ。古い PHP では null 合体演算子(??)が文法として認識されず、単独の疑問符として解釈され「ここには変数が来るべきだ」と報告される。PHP 5.6 以下でしか発生しない典型的なエラーパターンである。
WordPress 7.0 にアップグレードしたらこのエラーが出るのはなぜか
WordPress 7.0 のコアが新たに PHP 7.4 や 8.0 の構文を使い始めたためだ。以前のバージョンでは問題なく動いていても、最新のコアに置き換えた途端に PHP のバージョン要件が上がり、サーバー側が追いついていないと構文エラーが発生する。
レンタルサーバーで PHP バージョンが変更できない場合の対処法は
低スペックの格安プランや古い共用サーバーでは PHP セレクターが提供されていないこともある。その場合はホスティング会社のサポートへ「PHP のバージョンを 7.4 以上に変更してほしい」と申請する。対応してもらえなければ、別のサーバーへの移転も検討する必要がある。
compat-utf8.php 以外のファイルで同じ構文エラーが出た場合も同じ対処でいいのか
はい。ファイル名が異なっていても、unexpected ‘?’ という構文エラーは PHP バージョン不足が原因である可能性が極めて高い。ただ、プラグインやテーマが原因の場合もあるため、エラーが wp-content 配下のファイルで出るならそのプラグインを無効化するか、開発元に PHP バージョン要件を問い合わせるのが早い。
この記事のポイント
- 画面真っ白と unexpected ‘?’ 構文エラーは PHP 5.x 系で発生しやすい
- まず phpinfo() で現在の PHP バージョンを調べ、7.4 以上に切り替える
- サーバー管理画面の PHP セレクターかサポート依頼でバージョンを上げる
- 切り替え後も直らなければコアファイルの再アップロードと mu-plugins の調査を
- WordPress 7.0 なら PHP 8.0 以降の利用が推奨される
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
GoogleとMicrosoftがAIエージェント共通仕様ARDを公開、11社が賛同
GoogleとMicrosoftを含む11社が、AIエージェントがウェブ上のツールやスキルを自動検出するための共通仕様「ARD(Agentic Resource Discovery)」を2026年6月17日に公開した。
GitHubやHugging Face、NVIDIA、Salesforceも名を連ねるこの仕様は、各社が公開するAIエージェント向け機能を、事前の手動接続なしに実行時に見つけ出せる仕組みだ。Apache 2.0ライセンスで公開され、同日に複数の参照実装もリリースされた。
この仕様が実用化されれば、AIエージェントは必要なツールを自ら探し出して接続できるようになる。開発者やサービス提供者にとっては、自社のAPIやエージェント機能をAIシステムに自動的に見つけてもらうための新たな方法が生まれることになる。
ARDとは何か
ARD(Agentic Resource Discovery)は、AIエージェントがウェブ上で「使えるツールや機能」を自動的に見つけ出すための共通ルールを定めた仕様だ。Linux Foundationのワーキンググループが管理するAI Catalogデータモデルを基盤に構築されている。
現在のAIエージェントは、あらかじめ各ツールやMCPサーバー、APIとの接続を手動で設定する必要がある。企業が公開する機能が増え続けるなか、この「事前配線」方式では拡張性に限界があった。ARDはこの問題に対処するために設計されている。
ARDの仕組みは、企業が自社ドメインに公開するカタログと、それを収集してインデックス化するレジストリの2層構造で成り立っている。人手による接続設定を実行時の検索に置き換えることで、AIエージェントが自律的に機能を発見できる世界を目指している。
ARDの技術的な仕組み
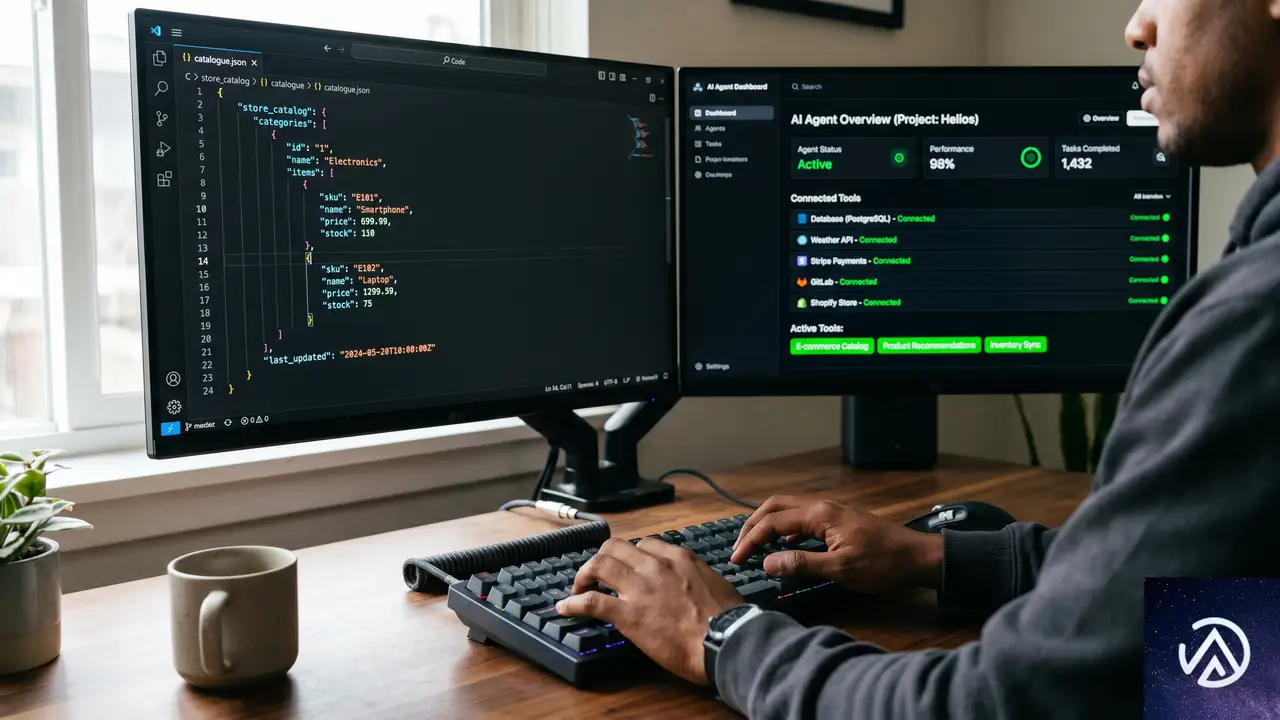
カタログとレジストリの2層構造
ARDの中核は「カタログ」と「レジストリ」という2つの要素だ。まず、ツールやエージェントを提供する企業は、自社ドメインの定められたパスにai-catalog.jsonというファイルを設置する。このファイルには、公開するツール、MCPサーバー、エージェント、APIの一覧が記述される。
次に「レジストリ」がこれらのカタログを巡回(クロール)してインデックス化する。AIエージェントが「この処理に使えるツールはないか」と自然言語で問い合わせると、レジストリが該当するカタログ情報を返す仕組みだ。
ai-catalog.json を設置カタログが公開者の自社ドメインに置かれることで、ドメイン所有権が公開者の検証手段として機能する。本番運用では、暗号化された信頼メタデータを付与し、接続前に公開者の身元を確認することも可能だ。ツールが選定された後は、ARDの役割は終了し、実際の接続は各ツール固有のプロトコルで直接行われる。
誰に向けた仕様なのか
ARDが主に対象とするのは、APIやMCPサーバー、エージェントといった「呼び出し可能な機能」を提供する企業だ。ツールを公開する企業には、AIエージェントに見つけてもらい、信頼してもらうための明確な方法が提供される。
一方、一般的なコンテンツサイトにとっては、現時点で直接的な活用方法は示されていない。Search Engine Journalの記事でも「典型的なコンテンツサイトに今日すぐ取るべきアクションはない」と指摘されている。
公開当日に登場した参照実装
ARDの草案公開と同日に、複数の参加企業が実際に動作するツールをリリースした。
- GitHub Copilot向けに「Agent Finder」を導入。選択したレジストリからMCPサーバー、スキル、ツール、エージェントを検出し、ユーザーが接続対象を制御できる仕組みだ。
- Hugging Face ARDサービス全体からスキルやMCPサーバーを検索する「Discover Tool」を公開した。
- Cisco Linux Foundation傘下のオープンソースプロジェクト「AGNTCY Agent Directory」にARDを統合した。
GitHubのAgent Finderは特に関心を集めている。Copilotのユーザーがレジストリから必要な機能を見つけ出し、自分の判断で接続を許可できる設計は、エージェントの自律性とユーザー制御のバランスを取る試みといえる。
この流れは、ウェブの「機械可読層」を整備する一連のオープン仕様の延長線上にある。GoogleはARD公開の2日前にも、AIシステム間で組織知識を共有するための「Open Knowledge Format」仕様を発表している。いずれも自社ドメインに構造化ファイルを設置するだけで、AIシステムが人手の配線なしに情報を利用できるようにする考え方だ。
Googleの立ち位置と今後の展開
GoogleはARDにおいて、Gemini Enterprise Agent Platformの一部である「Agent Registry」を中心的な役割として位置づけている。これはエージェント向けリソースのホスティングと検索、企業向けのガバナンス管理を担う基盤だ。
Search Engine Journalの記事によれば、Agent RegistryへのネイティブARD対応は数カ月以内に予定されている。これが実現すれば、組織は内部レジストリを広域ネットワークに接続できるようになる。
ただし現時点でこの対応は稼働しておらず、ARDはあくまで「仕様」であってGoogle検索の機能ではない。検索エンジンとしてのGoogleがARDカタログを直接検索結果に反映するわけではない点は、区別して理解しておく必要がある。
コンテンツ制作者が今考えるべきこと
ARDがもたらす影響は、ビジネスの性質によって大きく異なる。ツールやAPIを提供する企業には、AIエージェントに発見されるための具体的な手段が用意された。一方で、一般的なコンテンツサイト運営者にとっての即効性は限定的だ。
この仕様の価値については業界内でも議論がある。GoogleのJohn Mueller氏は、LLMシステムがllms.txtのようなファイルでサイトを区別することはできないと指摘し、将来のエージェント向け戦略よりも現在のニーズに注力するよう助言している。ARDが対象とするのはツールやエージェントであり、コンテンツではないという点は、こうした議論の背景として押さえておきたい。
仕様はまだv0.9草案であり、GitHubリポジトリで変更提案を受け付けている段階だ。実用性を左右するのは、カタログを大規模にクロールしてインデックス化できるレジストリのエコシステムだが、それもまだ初期段階にある。
エコシステムが成熟した場合に最も恩恵を受けるのは、他者が必要とするツールやエージェントを提供する企業だ。GoogleがUlrtaユーザー向けに展開し始めたエージェント主導の検索機能も、この方向性を示唆している。今すぐ取るべき現実的なアクションは、自社が使っているプラットフォームやツールがARDに対応するかどうか、そして対応時にどのような公開情報が求められるかを注視することだ。
この記事のポイント
- ARDはAIエージェントがツールやAPIを実行時に自動発見するためのオープン仕様である
- カタログ(ai-catalog.json)とレジストリの2層構造で、ドメイン所有権が信頼の基盤となる
- GitHubやHugging Faceが公開初日から参照実装を提供しており、実用化に向けた動きは速い
- 一般的なコンテンツサイトよりも、ツールやAPIを公開する企業に直接的な恩恵がある
- v0.9草案段階であり、レジストリのエコシステム構築が今後の鍵を握る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験