

ローカルファーストWeb開発のアーキテクチャ クライアント主導のデータ管理と同期の仕組み
ローカルファーストアーキテクチャが注目を集めている。従来のサーバー中心のWebアプリ開発とは異なり、クライアント端末にデータの一次コピーを保持し、読み書きをローカルで即座に処理する設計手法だ。オフラインでも動作し、ネットワーク遅延の影響を受けないため、ユーザー体験が大幅に向上する。
Smashing Magazineの記事「The Architecture Of Local-First Web Development」(2026年5月6日公開)では、実際のプロジェクト経験に基づいた実践的な知見が紹介されている。本記事ではその要点を再構成し、Web制作やシステム開発に携わるエンジニア向けにわかりやすく解説する。
ローカルファーストとは何か 〜オフライン対応との違い
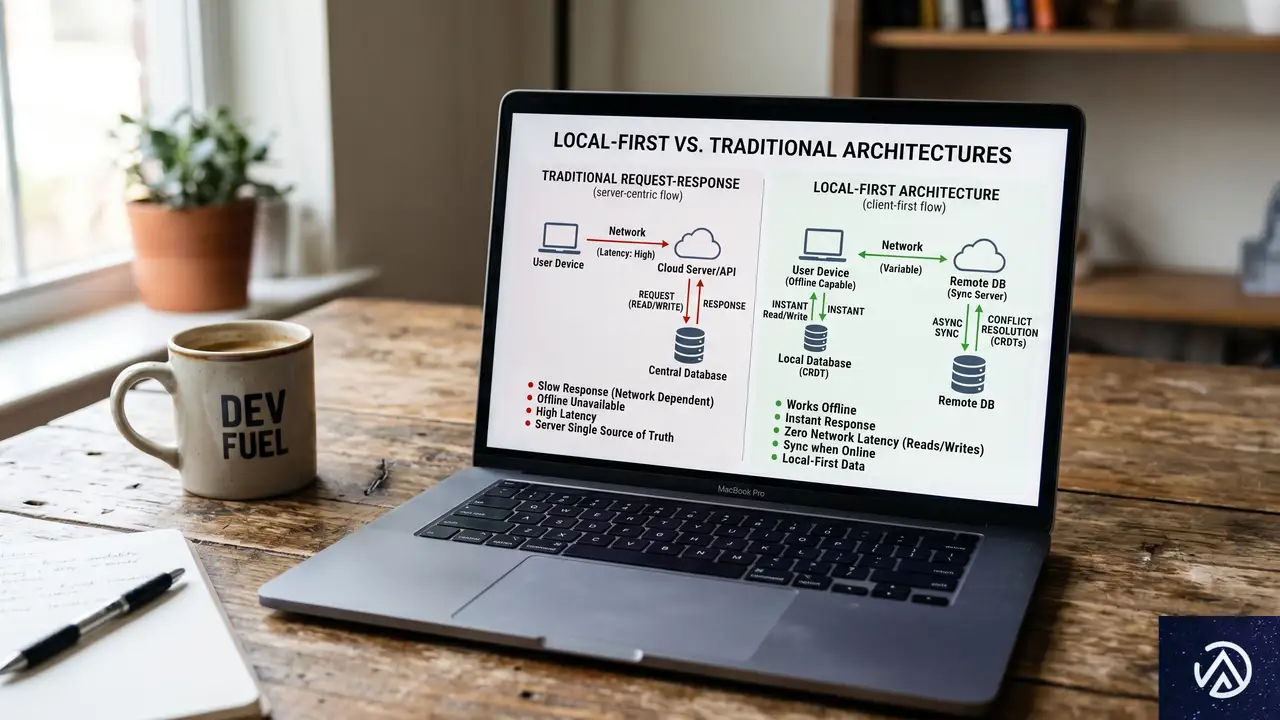
ローカルファーストはよく「オフラインファースト」やPWA(プログレッシブWebアプリ)と混同される。しかしこれらは根本的に異なる。オフラインファーストはネットワーク切断時でもアプリが壊れず動くことを目的とするが、データの主たる権威(正)は依然としてサーバーにある。一方、ローカルファーストは「データアーキテクチャ」の概念であり、ユーザーの端末がデータの一次コピーを持つ。アプリはローカルデータベースに直接読み書きし、画面を即座にレンダリングする。サーバーとの同期はバックグラウンドで行われ、サーバーは認証やバックアップなど特定の役割を担うが、データの門番ではない。
Ink and Switchが2019年に提唱した「ローカルファーストソフトウェア」の7つの理想(高速、マルチデバイス、オフライン、コラボレーション、長寿命、プライバシー、ユーザー所有権)は今でも有効だが、実務において最も重要なのは「クライアントが分散システムのノードであり、独自のデータベースを持つ」という点だ。この考え方が開発全体を変える。
このデモのとおり、ローカルファーストではユーザーの操作がサーバーの応答を待つことなく完結する。この違いがアプリの「遅さ」に対する根本的な解決策になる。
オフラインファーストやPWAとの混同を解く
Service Workerを使ったキャッシュやPWAは、あくまで配信や耐障害性の仕組みだ。データの所有権や正規性は変わらない。ローカルファーストは「端末が真実のコピーを持つ」点で本質的に異なる。これを理解しないまま実装を進めると、後からデータの不整合や同期設計の誤りに悩まされることになる。
ローカルファーストが向いているユースケースと不向きな場面

このアーキテクチャは万能ではない。導入を検討する前に、自社のアプリがどのデータ特性を持つかを見極める必要がある。
適している領域
- ユーザー生成データを扱うアプリ。メモ帳、ドキュメントエディタ、プロジェクト管理、フィールド業務用ツールなど
- リアルタイムコラボレーションが必要なツール。デザインツールや同時編集が前提のアプリ
- プライバシーが売りになるサービス。データをユーザーの手元に置くことで差別化できる
- 通信が不安定な環境向けのアプリ。工事現場、僻地、移動中の利用を想定する場合
不向きな領域
- サーバー生成データが主体のアプリ。分析ダッシュボード、SNSフィード、検索結果など
- 強いトランザクション整合性が求められるシステム。銀行、決済、在庫管理(複数ユーザーが同時に在庫を操作すると問題)
- 単純なCRUDでオフラインやコラボレーションの必要がない社内管理画面。同期エンジンは過剰設計になる
- クライアント端末に収まらない巨大なデータセット
また、アプリ全体を一度にローカルファーストに書き換える必要はない。例えばブログエディタの下書き機能だけをローカルファーストにする、といった段階的な導入が現実的だ。
クライアント側のデータ保存 ストレージ技術の選択

ユーザーの端末にデータを保持するには、適切なストレージ技術を選ぶ必要がある。従来のlocalStorageは同期APIでメインスレッドをブロックし、容量も5〜10MBと限られるため、本格的なデータベース用途には使えない。現在の主流は以下の3つだ。
実案件ではwa-sqliteなどのライブラリを使い、OPFSを介してSQLiteを永続化するのが有力な選択肢だ。初期化のコード例を示す。
import { SQLiteAPI } from 'wa-sqlite';
import { OPFSCoopSyncVFS } from 'wa-sqlite/src/examples/OPFSCoopSyncVFS.js';

async function initDatabase() {
  const module = await SQLiteAPI.initialize();
  const vfs = new OPFSCoopSyncVFS('app-db');
  await vfs.initialize(module);
  const db = await module.open_v2('local.db');
  await module.exec(db, `PRAGMA journal_mode=WAL`);
  await module.exec(db, `
    CREATE TABLE IF NOT EXISTS tasks (
      id TEXT PRIMARY KEY,
      title TEXT NOT NULL,
      status TEXT DEFAULT 'backlog',
      created_at TEXT DEFAULT (datetime('now'))
    )
  `);
  return db;
}なおSafariのOPFS実装は一部のコンテキストでcreateSyncAccessHandle()が無反応で失敗する既知の不具合があり、IndexedDBへのフォールバックを用意しておくことが推奨される。
データ同期の手法 CRDTとデータベースレプリケーション

クライアントにデータを置くだけなら解決済みだが、複数端末や複数ユーザー間でどう同期するかが本当の難所だ。主なアプローチは次のとおり。
YjsやAutomergeが代表的で、リアルタイム共同編集に強み。テキストの文字レベルでのマージに優れるが、構造化データのマージは意図しない結果を生むこともある。多くのプロジェクトでは、真のリアルタイム共同編集が必要な箇所にのみYjsを採用し、それ以外はデータベースレプリケーションで済ませるハイブリッド構成が無難だ。
同期の流れをコードで見る
ローカルファーストのアプリでは、従来のようにfetch()でデータを取得する必要がない。代わりにuseLiveQueryのようなフックがローカルSQLiteの変更を検知し、UIが自動で再描画される。
import { useLiveQuery } from '@powersync/react';
import { db } from '../lib/database';

function TaskBoard({ projectId }) {
  const tasks = useLiveQuery(
    `SELECT * FROM tasks WHERE project_id = ? ORDER BY position`,
    [projectId]
  );

  async function addTask(title) {
    await db.execute(
      `INSERT INTO tasks (id, title, project_id, position)
       VALUES (?, ?, ?, ?)`,
      [crypto.randomUUID(), title, projectId, tasks.length]
    );
    // API呼び出しも楽観的更新のロールバックも不要
  }

  return (

      {tasks.map(task => )}


  );
}
このコードにはローディング状態もエラーハンドリングも書かれていない。データが常にローカルにあるという前提が、これほどまでにUIコードを単純化する。
衝突解決と整合性の課題

複数のレプリカが独立して書き込みを行うと、当然データの衝突が発生する。最もシンプルな解決策は「ラストライトウィン(LWW)」、つまりタイムスタンプが新しい方を採用する方式だ。ただしレコード全体まるごと上書きするのではなく、フィールド単位で適用するのが現実的だ。下記のようなマージ関数を実装すれば、別々のフィールドを編集した場合に両方の変更が生き残る。
function pickWinner(a, b) {
  const timeA = new Date(a.updatedAt).getTime();
  const timeB = new Date(b.updatedAt).getTime();
  if (timeA !== timeB) return timeA > timeB ? a : b;
  return a.clientId > b.clientId ? a : b;
}

function mergeTask(local, remote) {
  const merged = {};
  const allKeys = new Set([...Object.keys(local), ...Object.keys(remote)]);
  for (const key of allKeys) {
    if (!local[key]) { merged[key] = remote[key]; continue; }
    if (!remote[key]) { merged[key] = local[key]; continue; }
    merged[key] = pickWinner(local[key], remote[key]);
  }
  return merged;
}
このLWWは約95%の衝突を自動解決するが、同じテキストフィールドを2人が編集した場合は一方が静かに上書きされる。文書編集では問題だが、タスクのタイトル程度なら許容できる場合が多い。
セマンティック衝突への対処
構造的には綺麗にマージできても、意味的に矛盾するケースがある。たとえば2人のユーザーがオフラインで同じ会議室の同じ時間帯に別の予定を入れた場合、フィールド単位では衝突しないがダブルブッキングが発生する。このような「セマンティック衝突」は、サーバー側のバリデーションで検出し、クライアントに通知してユーザーに解決を促す。
重要なのは、違反が起きても書き込み自体は受け入れ、警告フラグとともにクライアントに返す設計だ。もしサーバーが書き込みを拒否すると、クライアントのローカルDBには存在するがサーバーには存在しない「幽霊レコード」が生まれ、回復が困難になる。
実装上の注意点 認証・マイグレーション・テスト

認証と認可
認証は従来どおりJWTやOAuthで行うが、トークンは毎リクエストではなく同期接続の確立時に使われる。認可は同期レイヤーで厳密に適用する必要がある。全データをクライアントに渡して見せたいものだけ表示するのは危険で、DevToolsからすべて覗ける。PowerSyncの「同期ルール」やElectricSQLの「シェイプ」を使い、サーバー側でユーザーに許可された行だけを送信する設計が必須だ。
スキーママイグレーション
サーバーなら1つのデータベースを管理すればよいが、クライアントはアプリを開いていない期間が長ければ古いスキーマのまま放置されている可能性がある。マイグレーションは起動時にバージョン番号を確認して逐次適用する方式が堅実だ。基本的に「カラムの追加」のみとし、削除やリネームは極力避ける。古いクライアントが存在する限り、欠落カラムへの書き込みが同期失敗を引き起こすからだ。
テスト戦略
マージロジックはユニットテストが容易だが、実際のネットワーク断絶や衝突タイミングを再現するのが難しい。2つのクライアントインスタンスをメモリ上で立ち上げ、同時編集後に収束するかを検証する統合テストや、Playwrightのcontext.setOffline(true)を使ったE2Eテストが有効だ。ランダムな操作列を与えて収束性をチェックするプロパティベーステストもCRDTロジックの品質を高める。
この記事のポイント
- ローカルファーストは、クライアント側にデータの一次コピーを置き、読み書きをローカルで即座に行うデータアーキテクチャである
- オフラインファーストやPWAとは異なり、データ所有権と即時性が根本的に変わる
- 向いているのはユーザー生成データを扱う協調ツールやフィールドアプリ。銀行や分析ダッシュボードには不向き
- クライアント側のストレージにはOPFS上のSQLite(WASM)が主力。IndexedDBの直接利用は避ける
- 同期はCRDT(Yjs等)とデータベースレプリケーション(PowerSync等)から選択し、多くの場合は後者で十分
- 衝突解決はフィールド単位のLWWで大半を自動化し、セマンティック衝突はサーバー検出+ユーザー通知で対応する
- 認可・マイグレーション・テストには固有の注意点があり、段階的に導入するのが現実的

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WordPress 7.0 RC3リリース。RTCは延期、最終版5月20日を前に最後のテストを
WordPress 7.0の3回目のリリース候補版(RC3)が、2026年5月8日に公開された。すでにテストを開始しているサイト管理者や開発者にとっては、最終版の品質を左右する重要なマイルストーンだ。今回のRC3では、前回のRC2以降に報告された143件以上の問題が修正されている。
正式版のリリース日は5月20日を予定しており、このRC3は「最後の仕上げ」をする段階に入ったことを意味する。本番運用中の重要なサイトへのインストールは避け、必ずテスト環境で検証することが強く推奨されている。
とりわけ今回大きな動きとして、かねてから注目を集めていた「リアルタイムコラボレーション(RTC)」機能が、7.0への搭載を見送られることが正式に発表された。この決定により、RC3は当初の開発計画から一部構成が見直されたバージョンとなっている。
RC3で何が変わったのか

RC3は、3月26日に公開されたRC2以降に報告されたバグや課題を集中的に潰し込んだバージョンだ。WordPress.orgの公式発表によれば、今回のRC3では以下のリンク先で確認できるすべての修正が含まれている。
RC2からの主な修正範囲
開発者向けの詳細な技術情報は、WordPress 7.0 Developer Notesにまとめられている。また、コア部分の修正については、3月26日以降にクローズされたTracチケット、およびGutenbergのコミット履歴から追跡できる。これらの情報を確認することで、自分の運用するテーマやプラグインへの影響を事前に評価できるだろう。
リアルタイムコラボレーションは7.1へ延期
最大のトピックは、RTC(Real Time Collaboration)機能の延期決定だ。この機能は、複数ユーザーが同時にブロックエディタ上でコンテンツを編集できるようにするもの。Googleドキュメントのような共同編集体験をWordPress管理画面で実現する構想として、多くの注目を集めていた。
しかし、7.0のリリースサイクル中に十分な安定性を確保できないと判断され、今回のRC3では搭載が見送られた。WordPressコアチームは、この機能を7.1の開発サイクルで再評価するとしている。RC3は、この変更に伴い「新たなBeta 1」とは見なされないポジションとなったことにも注意が必要だ。
RC3のテスト方法

テストは、本番環境を避け、テストサーバーやローカル環境で行うことが大前提だ。WordPress 7.0 RC3を試す方法は大きく4つ用意されている。
wp core update --version=7.0-RC3 コマンドを実行する。なかでもWordPress Playgroundは、ブラウザだけで完結するため手軽だ。環境を汚さずに新機能や互換性をざっくりと確認したい場合に適している。より本格的なテストには、テストサーバーへの直接インストールを推奨する。
開発者とホスティング事業者に求められる対応

RC3の登場は、テーマやプラグインの開発者、そしてホスティング事業者にとっても重要な意味を持つ。最終リリースまで2週間を切った今、互換性の最終確認を急ぐ必要がある。
テーマ・プラグイン開発者のやるべきこと
プラグインやテーマの製作者は、RC3を使って自社製品の動作検証を完了させ、「Tested up to」のバージョンを7.0に更新することが求められている。これは、プラグインのreadmeファイルに記載する情報で、ユーザーが「このプラグインは最新のWordPressで動作確認済みか」を判断する重要な指標となる。
互換性に問題が見つかった場合は、詳細な情報をサポートフォーラムのAlpha/Betaエリアに報告することで、コア開発チームや他の開発者との情報共有につながる。
ホスティング事業者のテスト協力
Webホスト各社も、WordPressのメジャーアップデートに向けて重要な役割を担っている。特に今回の7.0開発サイクルでは、RTCアーキテクチャのテストに複数のホスティング事業者が協力した。Kinsta、Bluehost、GoDaddy、WordPress.com、XServer、Ionosなどの企業が、さまざまなサーバー構成での動作検証に参加している。
ホスティング環境でのテストに関心がある事業者は、Make WordPress Hostingチームのドキュメントに従って分散テストの設定を始めることができる。
翻訳も最終段階。100言語以上への対応が進行中

RC3のリリースは、翻訳作業における「ハードストリングフリーズ」のタイミングでもある。これは、これ以上翻訳対象の文字列が変更されないことを意味し、翻訳ボランティアが安心して作業を進められる段階に入ったということだ。
日本語を含む100以上の言語への翻訳作業が進行中で、5月20日の正式リリースに向けて最終的な仕上げが行われている。翻訳プロジェクトへの参加は、技術的なスキルがなくてもWordPressコミュニティに貢献できる方法のひとつだ。
不具合を見つけたら報告を

テスト中に不具合や予期しない動作を発見した場合、以下のいずれかの方法で報告できる。
- サポートフォーラムのAlpha/Betaエリアに投稿する
- 再現手順を明記したバグレポートをWordPress Tracに直接登録する
- 既知のバグ一覧と照合し、報告済みかどうかを確認する
テストの経験が浅い場合でも、公式のテストガイドが用意されている。手順に沿って進めることで、開発に貢献しながらWordPressの内部構造への理解も深められるだろう。
この記事のポイント
- WordPress 7.0 RC3が5月8日に公開。RC2から143件以上の問題を修正
- RTC(リアルタイムコラボレーション)機能は7.0への搭載を見送り、7.1で再検討
- 正式リリースは5月20日を予定。テスト環境での検証が急がれる
- テーマ・プラグイン開発者は「Tested up to 7.0」への更新を
- テスト方法はプラグイン、直接DL、WP-CLI、Playgroundの4種類
- 翻訳作業はハードストリングフリーズに入り、100言語以上が最終段階
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがGPT-5.5-Cyberを発表、サイバー防御の最前線に信頼済みアクセス基盤を導入
OpenAIは2026年5月7日、サイバーセキュリティの防御側を支援するための新たな取り組み「Trusted Access for Cyber(TAC / サイバー向け信頼済みアクセス)」を発表した。この枠組みに基づき、研究者やセキュリティチーム向けに最適化されたモデル「GPT-5.5-Cyber」の限定プレビューを公開している。
発表の中核にあるのは、AIの強力なサイバー攻撃支援能力を防御者にだけ安全に開放するという思想だ。すべてのユーザーに同じ性能を提供するのではなく、本人確認と用途の認証を経た防御者のみが、より深い支援を受けられる仕組みを設けている。
この記事では、GPT-5.5-CyberとTACの技術的な仕組み、セキュリティ業界全体への波及効果、そして防御者が実際にどのようなワークフローを加速できるのかを解説する。
信頼済みアクセスでAIの性能を防御側だけに開放する

TACは、AIモデルの振る舞いそのものを利用者の属性に応じて段階的に緩和していく枠組みだ。すべてのユーザーに対して一律に機能制限をかけるのではない。防御タスクを担う検証済みの主体に対してのみ、より踏み込んだ支援をモデルが行うように設計されている。
重要なのは、この仕組みが単なるアカウント管理ではないという点だ。モデル内部の分類器による拒否判断をチューニングし、認可された防御ワークフローでは拒否が起こりにくくなる。OpenAIの記事によれば、この変更によって脆弱性のトリアージ、マルウェア解析、バイナリリバースエンジニアリング、検出エンジニアリング、パッチ検証といった領域で、防御者の作業が大きく加速される見込みだ。
一方で、資格情報の窃取やマルウェア配備といった実害を伴う悪用行為に対する防御壁は、そのまま維持される。このバランス設計こそがTACの根幹をなす。
3段階のアクセスレベル
OpenAIは現在、モデルのアクセス権を3つの層に分けて提供している。一般利用向けの標準的なGPT-5.5、防御ワークフロー向けに拒否判断を最適化した「GPT-5.5 with TAC」、そして最も許容度が高く専門用途向けの「GPT-5.5-Cyber」だ。この3層構造により、用途のリスクに応じた比例的な安全策が実現されている。
GPT-5.5 with TACは、全防御ワークフローの大部分をカバーする設計だ。OpenAIの見解では、ほとんどのセキュリティチームはこの層から始めるのが適切であり、許可済みの作業でなおも拒否に遭遇する場合にのみ、より専門的なアクセスレベルを検討すべきだとされている。
認証とアカウントセキュリティの要件
TACの枠組みでは、防御側に対する本人確認と認証の厳格化が同時に進められている。OpenAIの発表によれば、最もサイバー性能が高く許容度の大きいモデルにアクセスする個人ユーザーは、2026年6月1日以降、フィッシング耐性のある高度なアカウントセキュリティの有効化が必須となる。
組織単位での信頼済みアクセスを利用する場合は、シングルサインオンワークフローの一環としてフィッシング耐性認証を導入していることを表明する代替手段も用意されている。この設計により、利便性を損なわずに信頼性を担保するバランスを取っている。
GPT-5.5-Cyberがもたらす防御ワークフローの加速

GPT-5.5-Cyberの公開にあたり、OpenAIは具体的なユースケースを挙げている。公開済みの脆弱性から概念実証コードを生成し、認可された環境下で修正の有効性を検証するといった作業が、モデルによって大幅に効率化されるという。
OpenAIの公式ブログに掲載された比較例では、標準的なGPT-5.5がセキュリティ関連のコード生成を拒否するのに対し、GPT-5.5 with TACは同じプロンプトに対して詳細な概念実証と分析を提供している。この違いは、分類器のチューニングによってもたらされるものだ。
標準モデルとの違いは「ケイパビリティ」より「許容度」
GPT-5.5-Cyberは、一般的な知識作業やセキュリティタスクにおいて最も賢く直感的なモデルであるGPT-5.5を基盤としている。OpenAIは、この初期プレビューがGPT-5.5を超えるサイバー能力を発揮することを主眼とはしていないと明言している。
性能評価の結果でも、すべてのサイバーセキュリティ評価項目でGPT-5.5を上回るわけではない。このモデルの主な価値は、多段階推論やツール利用を含む現実的な防御ワークフローにおいて、より「許可的」に振る舞う点にある。防御者が分析から検証までを止まらずに進められる環境を提供することが目的だ。
このアプローチは、単純にモデルの性能を引き上げるよりも現実的な安全策といえる。より強力な検証と監視の枠組みと組み合わせることで、専門的な作業が必要な場面にだけ踏み込んだ支援を提供できるからだ。
セキュリティエコシステム全体を回す「フライホイール」

OpenAIの戦略で特に注目すべきなのは、モデルの提供先を多層的なエコシステムとして捉えている点だ。セキュリティベンダー各社との連携を通じて、発見から開発、検出、対応、ネットワーク制御に至る防御の全レイヤーを同時に強化しようとしている。
このサイクルは「セキュリティフライホイール」と呼ばれ、各レイヤーの改善が他のレイヤーの改善を加速させる相乗効果を生み出す。研究者が概念実証とパッチガイダンス付きで脆弱性を開示し、サプライチェーンツールが本番環境への侵入を防ぎ、EDRやSIEMが攻撃の兆候を検出し、ネットワークプロバイダーがWAFレベルの緩和策を展開する。この連鎖をAIが加速する構図だ。
このエコシステム戦略が意味するのは、GPT-5.5シリーズが単独のツールとしてではなく、業界全体の防御基盤として設計されているという点だ。OpenAIは既にCisco、Intel、SentinelOne、Snykといった主要ベンダーと協業を進めており、各社の声明も公式ブログに掲載されている。
各レイヤーでの具体的な活用シナリオ
ネットワークプロバイダーは、修正パッチが完全に展開される前の段階で被害を抑え込む役割を担う。GPT-5.5はWAFルールのレビューや構成分析、インシデント調査、安全な変更管理を支援し、インターネット規模での防御展開を可能にする。
脆弱性研究の領域では、未知のコードベースの理解、影響を受ける範囲の特定、根本原因の追跡、パッチの検証、そして深刻度の優先順位付けまでを一貫して支援する。より踏み込んだ概念実証が必要な場合に、GPT-5.5-Cyberが限定的に提供される設計だ。
検出と監視の分野では、EDRやSIEMのテレメトリデータから重要なシグナルを抽出し、分析官が開示情報から調査までを迅速に進められるようにする。とくにクラウド環境では、露出の把握から修正、検出までが密接に結びついており、AIによる接続が効果を発揮する。
ソフトウェアサプライチェーンセキュリティでは、GPT-5.5 with TACが依存関係の変更点の調査や、所有コード内での悪用可能性の推論、不審なパッケージ動作の早期発見を支援する。OpenAIは、axiosの侵害事例のように、脆弱な依存関係がビルドに入り込む前に阻止することが最速の対処法だと位置づけている。
オープンソースとCodex Securityによる上流支援

OpenAIはエコシステムの上流にあたるオープンソースメンテナーへの投資も進めている。Codex Securityを活用し、コードベース固有の脅威モデルを構築した上で、現実的な攻撃経路の探索やパッチの提案を行う仕組みを研究プレビューとして提供中だ。
さらに「Codex for Open Source」プログラムを通じて、重要なプロジェクトのメンテナーにCodex Securityへの条件付きアクセスとAPIクレジットを提供している。これにより、メンテナンスやレビューの負荷を軽減しながら、上流での脆弱性対処を加速させる狙いがある。
Codex Securityのプラグインも公開されており、既存のワークフローの中で脅威モデリングから発見、検証、攻撃経路分析、修正までをシームレスに進められるよう設計されている。
TACへのアクセス方法と今後の展望

Trusted Access for Cyberへの参加は、個人ユーザーであれば専用ページから本人確認を行うだけで申請できる。企業の場合はOpenAIの担当者を通じて、チーム単位での信頼済みアクセスをリクエストする仕組みだ。承認されたユーザーは、二重用途のサイバー活動に対する分類器の拒否が緩和されたモデルを利用できるようになる。
OpenAIの発表によれば、GPT-5.5-Cyberはアルファテストの段階で既に重要システムの自動レッドチーミングや深刻度の高い脆弱性の検証に活用されている。これらの成果については、責任ある開示の一環として、今後技術的な詳細が公開される予定だ。
モデルのサイバー能力が向上するにつれて、その能力を防御側の手に届けるための信頼基盤の重要度も増していく。より強固な本人確認や組織検証、認可された用途のスコープ定義、悪用監視の仕組みが成熟するにつれて、アクセス権は徐々に拡大されていくと見られる。
この記事のポイント
- TACは利用者の属性に応じてAIの防御支援能力を段階的に開放する枠組みである
- GPT-5.5 with TACは大半の防御ワークフローを安全にカバーし、多くのチームにとって最適な出発点となる
- GPT-5.5-Cyberはレッドチーミングなど専門的な二重用途ワークフロー向けの限定プレビューである
- セキュリティベンダーとの連携により、発見から緩和までの全レイヤーを加速するフライホイール効果を狙う
- オープンソースメンテナーへのCodex Security提供など、エコシステム上流への投資も同時に進められている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Next.js 2026年5月セキュリティリリースの全容、13件の脆弱性を修正
Next.jsの開発元であるVercelは2026年5月7日、調整済みセキュリティリリースを公開した。React Server Componentsの上流脆弱性(CVE-2026-23870)への対応を含む、合計13件の脆弱性が修正されている。フレームワークを利用するすべての開発者にとって、即時のアップデートが強く推奨される内容だ。
今回のリリースで対処された問題は、サービス拒否(DoS)攻撃、ミドルウェアやプロキシのバイパス、サーバーサイドリクエストフォージェリ(SSRF)、キャッシュポイズニング、クロスサイトスクリプティング(XSS)と多岐にわたる。ただちにパッチを適用しなければ、本番環境が深刻な攻撃に晒されるリスクがある。
アップデートの概要と影響範囲
今回のセキュリティリリースはNext.js本体に加え、その根幹をなすReactの特定パッケージにも修正が及ぶ。Vercelの発表によれば、13件の脆弱性アドバイザリが一挙に解決された形だ。アドバイザリの内訳を見ると、攻撃の種類によって影響を受ける機能や設定が明確に分かれている。自社のプロジェクトがどのカテゴリに該当するかを把握することが、迅速な対応への第一歩となる。
● React Server Components の DoS
● キャッシュポイズニング
● SSRF の潜在的リスク
● DoS 攻撃から保護
● キャッシュへの不正注入を防止
● SSRF の脆弱性を遮断
13件の脆弱性が存在する「Before」の状態と、アップデートによってそれらがすべて解決された「After」の状態を比較したイメージだ。リリースによってセキュリティ上のリスクが一掃されることがわかる。
修正対象となったReactとNext.jsのバージョン
影響を受けるバージョンを把握し、修正済みの安全なバージョンへ移行する必要がある。今回のリリースで修正が提供されたバージョンは以下の通りだ。
まず、React本体については、19.0.6、19.1.7、19.2.6の3つのパッチがリリースされた。これらのバージョンでは、サーバーコンポーネントの通信用パッケージである react-server-dom-parcel、react-server-dom-webpack、react-server-dom-turbopack の各パッケージに修正が含まれている。
Next.jsをフレームワークとして利用している場合、これらのReactパッケージはNext.jsのバージョンにバンドルされている。そのため、開発者はNext.js本体を最新のパッチバージョンに更新することで、React側の修正も同時に適用できる。個別にReactパッケージを管理しているプロジェクトは、それらも忘れずにアップデートする必要がある。
各脆弱性の詳細とリスク評価
ここからは、発表されたアドバイザリを深刻度別に整理し、その技術的な背景をひも解いていく。影響を受けるコンポーネントと、攻撃が成立するシナリオを正しく理解することが、開発者としての適切なリスク評価に繋がる。
ミドルウェアとプロキシのバイパス
認証や認可のロジックを middleware.js や proxy.js に依存しているアプリケーションが、致命的な影響を受ける可能性がある。2件の「高」深刻度アドバイザリがこれに該当する。
1件目はApp Routerにおける segment-prefetch のバイパスで、過去の修正が不完全だったための再発フォローアップだ。2件目はPages Routerのi18n機能において、デフォルトロケールのパスがプロキシ認証を迂回してしまう問題である。多言語サイトをPages Routerで運用しており、middlewareでアクセス制御を行っている環境は特に注意が必要だ。
サービス拒否(DoS)攻撃
サーバーのリソースを枯渇させ、正規のユーザーがサイトにアクセスできなくなるDoS攻撃に関する脆弱性が3件報告されている。これらはすべて、Server Functions、Partial Prerendering(PPR)のCache Components、もしくは画像最適化APIの利用が条件となる。
最もクリティカルなものは、React Server Componentsの上流脆弱性(CVE-2026-23870)を突いた攻撃だ。Vercelの発表によると、この脆弱性によりリモートからのDoS攻撃が成立する。また、Cache Componentsを使用するアプリケーションにおける「接続数の枯渇」を引き起こす脆弱性も「高」深刻度と評価されている。画像最適化APIを経由したDoSは「中」深刻度だが、無視できるものではない。
この図は、悪意あるリクエストによってサーバーのリソースが消費され、本来のサービス提供が妨害されるDoS攻撃の基本的な流れを示している。Cache Componentsの脆弱性は、この「リソース枯渇」の段階を特に加速させる危険性がある。
サーバーサイドリクエストフォージェリ(SSRF)
SSRFは、攻撃者がサーバーを踏み台にして内部ネットワークへのリクエストを強制させる攻撃手法だ。今回の脆弱性は、WebSocketへのアップグレードリクエストを処理するアプリケーションが影響を受ける。
この種の攻撃が成功すると、攻撃者は本来アクセスできない内部のメタデータサービスやデータベースと通信できるようになる。クラウド環境(AWSやGCPなど)で稼働しているNext.jsアプリケーションは、特に深刻な被害に繋がる可能性があるため、迅速な対応が求められる。
キャッシュポイズニングとクロスサイトスクリプティング(XSS)
React Server Componentのレスポンスの前にキャッシュ層を配置しているアプリケーションは、キャッシュポイズニングのリスクに晒される。これは、攻撃者が悪意あるレスポンスをキャッシュサーバーに記憶させ、他のユーザーにその不正なコンテンツを配信させる攻撃だ。
XSSに関しては、App RouterでCSP(コンテンツセキュリティポリシー)のnonceを利用しているケース、そして外部からの信頼できない入力を消費する beforeInteractive スクリプトが影響を受ける。これらの設定は比較的高度なカスタマイズで使われるが、該当する場合はすぐに対処しなければ攻撃者によるスクリプト実行を許してしまう。
即時アップデートの必要性と対応手順
Vercelは今回のリリースに際し、新たなWAF(Web Application Firewall)ルールを展開していないと明言している。つまり、これらの脆弱性はWAFレベルで確実にブロックすることができず、パッチ適用が唯一の完全な緩和策となる。
アップデート手順の基本
まず、プロジェクトのNext.jsとReactのバージョンを確認する。package.jsonに記載されているバージョンが、今回の修正対象より古い場合は即座にアップデートを実行する。一般的な手順は以下の通りだ。
# Next.jsのアップデート
npm install next@latest

# 関連するReactパッケージも最新に
npm install react@latest react-dom@latest
yarnやpnpmなど、他のパッケージマネージャーを利用している場合も、同等のコマンドで問題ない。パッケージを更新した後は、必ずビルドとテストを実行し、アプリケーションが正常に動作することを確認してほしい。
本番環境でのリスク管理
今回のセキュリティリリースには、破壊的な変更は含まれていない。そのため、動作検証は必要だが、適用を躊躇する技術的理由はほぼない。重要なのは「スピード」だ。
とりわけ、middlewareで認証を実装しているサイト、WebSocketを処理するリアルタイムアプリケーション、そしてPPRやCache Componentsを採用しているパフォーマンス重視のサイトは、緊急度が極めて高い。Vercelの発表でも「all affected users should upgrade immediately(影響を受けるすべてのユーザーは直ちにアップグレードすべき)」と強い表現で呼びかけている。
今回のリリースが示すNext.jsセキュリティの潮流
一見すると大規模な脆弱性の一括修正はネガティブな出来事に思える。しかし、セキュリティの観点からは、むしろフレームワークの成熟度を示すポジティブなシグナルと捉えるべきだ。
まず、対策が「調整済みセキュリティリリース」として計画的に実施されている点が重要だ。これは、VercelとMeta(React)のチームが発見された問題を共有し、エコシステム全体で同時に対処する体制が整っていることを意味する。大規模なOSSプロジェクトでは、このような「調整済み開示」のプロセスがセキュリティ品質の生命線となる。
次に、脆弱性の範囲が「Server Components」「ミドルウェア」「エッジキャッシュ」「画像最適化API」といった、Next.jsの比較的新しい機能や高度な機能に集中している事実に注目したい。これは、攻撃者の標的が、従来のシンプルなWebアプリケーションから、エッジとサーバーを高度に組み合わせたモダンなアーキテクチャへとシフトしている証左だ。
SSRやエッジファンクションの利用が一般化するにつれ、開発者は「新しい機能がもたらす利便性」と「新たな攻撃表面が生まれるリスク」のバランスを常に意識する必要がある。便利なAPIほど、その裏側で何が起きているのかを深く理解することが、これからのフロントエンド開発者には不可欠だ。
この記事のポイント
- Next.js 2026年5月セキュリティリリースは、ReactのCVE-2026-23870を含む13件の脆弱性を修正する
- 影響範囲はDoS、ミドルウェアバイパス、SSRF、キャッシュポイズニング、XSSと多岐にわたる
- WAFでは防げない脆弱性群のため、Next.jsとReact関連パッケージの即時アップデートが唯一の対策
- とくに認証機能やServer Components系の新機能を使うプロジェクトは緊急度が高い
- 調整済みリリースの実施は、Next.jsエコシステムのセキュリティ成熟度を示すポジティブな側面でもある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Chromeが同意なく4GBのAIモデルをダウンロードする問題
Google Chromeがユーザーの明示的な許可なく、約4GBに及ぶGemini Nanoのモデルデータをダウンロードしている事実が明らかになった。このデータは「Prompt API」と呼ばれる新機能のためのものだが、その配信方法と利用規約をめぐって、Web標準の専門家から強い懸念が示されている。
CSS-Tricksの記事によれば、このダウンロードはChromeの標準アップデートの一部として扱われ、ユーザーが削除してもブラウザが自動的に再ダウンロードする仕様だという。2025年5月現在、すでに多くのユーザーのデバイスに配信済みの状態だ。
Chromeが密かにダウンロードするGemini Nanoとは
Gemini NanoはGoogleが開発した軽量AIモデルで、デバイス上で直接テキスト生成や要約などのタスクを実行する。クラウドにデータを送信せず、端末のCPUやGPUのみで推論を行うため、プライバシー保護の観点では優れた設計といえる。
問題はその配信方法だ。CSS-Tricksの著者であるMat Marquis氏が指摘したところによれば、この約4GBのデータはChromeの通常アップデートの一部として、ユーザーに何の通知もなく転送される。U2のアルバムがiTunesライブラリに強制的に追加された過去の事例になぞらえ、同意なき配信の奇妙さを強調している。
Gemini Nano(同意なし・通知なし)
削除してもChromeが再ダウンロードを実行するため、ユーザーに実質的な拒否権はない。Chromeの内部機能として扱われているが、実際にはブラウザに統合されたわけではなく、独立した製品が同梱されている状態に近い。Mat Marquis氏は、かつてスパイウェアとして批判されたBonzi Buddyがブラウザに同梱されていた事例を引き合いに出し、その類似性を指摘している。
Prompt APIの仕組みとGoogleの利用制限
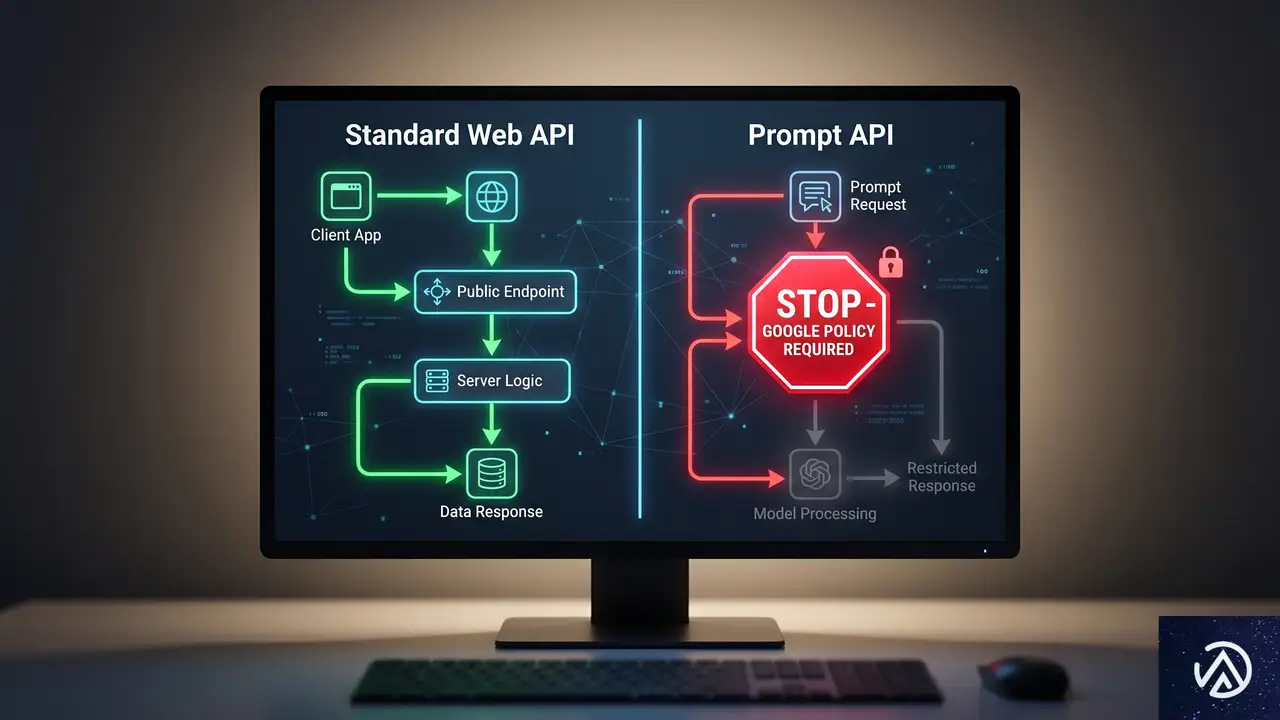
Prompt APIは、Web開発者がChromeの組み込みAIモデルに直接アクセスできるJavaScript APIだ。ユーザーのデバイス上でテキストの要約、文章の言い換え、質問応答といった処理を実行できる。Chromeの開発者向けドキュメントでは、すでに1年以上前から公開されている。
このAPIを利用するには、Googleが定める「Generative AI Prohibited Uses Policy」への同意が必須となる。Mozillaが公式に懸念を表明したのは、この利用ポリシーの内容がWeb標準の原則と相容れないからだ。
Web APIに付随する利用ポリシーの問題点
MozillaのGitHub上のコメントによれば、Googleの禁止事項ポリシーは法律の範囲を超えた制限を含んでいる。具体的には、性的に露骨なコンテンツの生成や配布の禁止、誤情報や政府・民主的プロセスに関する誤解を招く主張の促進禁止などが盛り込まれている。
これらの制限はWebプラットフォームのAPIとしては異例だ。通常、ブラウザAPIは技術的な仕様のみを定義し、その使途を特定企業のポリシーで制限することはない。Mozillaは「これはWebプラットフォームにとって悪しき方向性であり、UA(ユーザーエージェント)固有の使用ルールを持つAPIが増える前例となる」と警告している。
この構造は、Webのオープン性を損なう可能性がある。特定のブラウザベンダーがAPIの利用条件を自由に設定できるなら、Webの相互運用性は徐々に崩れていく。Mozillaの反対表明は、単なる競合他社の立場表明ではなく、Web標準の基本原則を守るための警鐘と受け止めるべきだ。
Web標準プロセスにおけるGoogleの影響力
Mat Marquis氏は、GoogleのWeb標準への関与姿勢を痛烈に批判している。同氏の比喩によれば「GoogleのWeb標準プロセスへの参加は、クマがキャンプに参加するようなものだ」という。つまり、表面上は協調しているように見えても、実質的には自社の都合でプロセスを支配しているという指摘だ。
Googleは「開発者のポジティブな感情」を根拠にPrompt APIの推進を正当化しようとしたが、実際に引用された場所にはポジティブな感情など存在しなかった。この矛盾した説明は、同社がWeb標準を「不可避なもの」として語る際の常套句と重なる。
ブラウザAPIとWeb APIの混同が生むリスク
ここで重要なのは、すべてのブラウザAPIがWeb APIではないという事実だ。Chromeだけが実装するAPIは、事実上の標準として扱われるリスクをはらむ。MicrosoftのIEが独自拡張で市場を支配した過去の過ちを、形を変えて繰り返す可能性がある。
Alex Russell氏が繰り返し指摘しているように、ブラウザの選択肢が限られている現状はすでに問題含みだ。その状況下でGoogleがChrome限定のAI APIを推進することは、Webの多様性をさらに損なう。ブラウザの多様性が生態系に与える影響について、CSS-Tricksでも過去に取り上げられているテーマだ。
ユーザーが取るべき対応と無効化手順
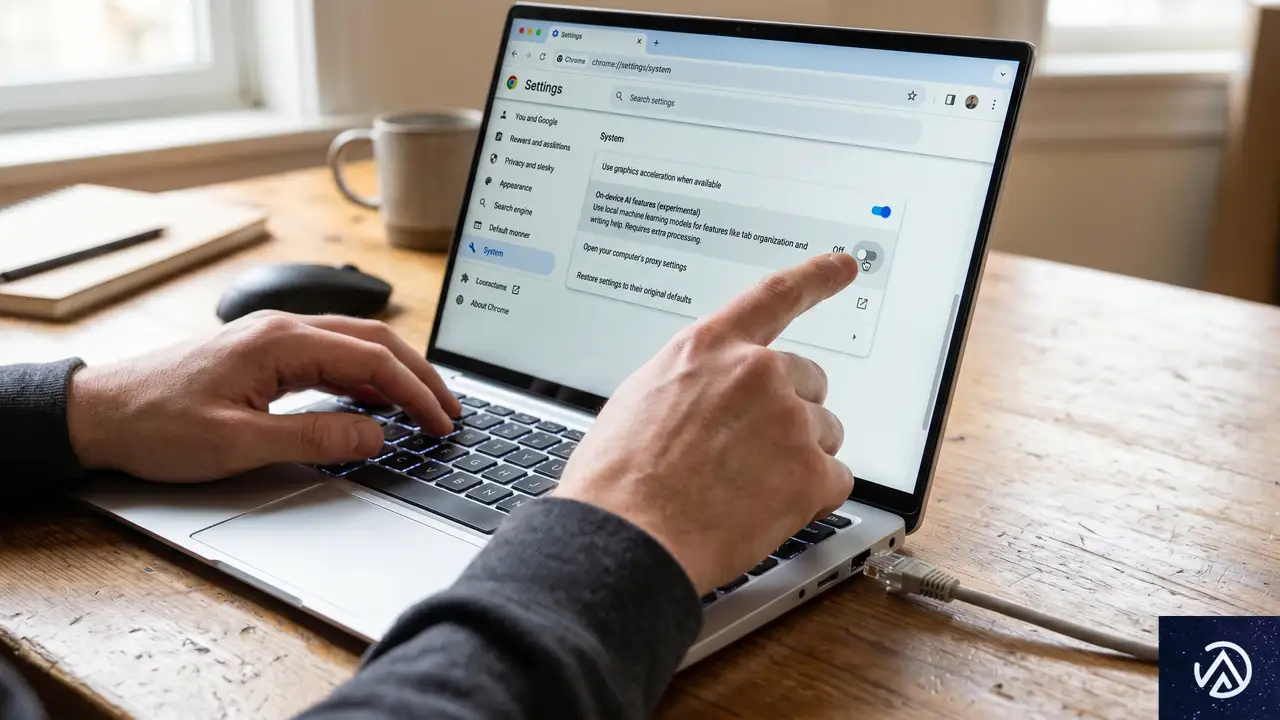
この問題に対して、現時点でユーザーが取れる対応は限られている。Chromeの設定画面で「オンデバイスAI」の項目をオフにすることは可能だが、すでにダウンロードされた4GBのモデルデータを完全に削除し、再ダウンロードを防ぐ方法は提供されていない。
この問題に関する報道は複数のメディアで取り上げられている。Engadgetは「Chromeがユーザーの同意なく4GBのAIファイルをダウンロード」と報じ、Cybernewsは「Chromeが我々のデバイスに静かに4GBのAIモデルをインストールしている」と警告した。Android Authorityでは、このダウンロードがスパイウェアに該当するかどうかの議論まで展開されている。
この記事のポイント
- Google Chromeがユーザーの同意なく約4GBのGemini Nanoモデルをダウンロードしている
- 削除しても自動的に再ダウンロードされ、実質的な拒否手段が提供されていない
- Prompt APIの利用にはGoogle独自のコンテンツポリシーへの同意が必須で、MozillaがWeb標準の観点から反対を表明
- ブラウザベンダー固有のAPI利用制限は、オープンなWebの原則を損なう前例となる危険性がある
- Chrome設定の「オンデバイスAI」から機能自体はオフにできるが、データ削除の確実な方法は提供されていない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.5 Instant 登場。回答精度とパーソナライズ性能が大幅に向上
OpenAIがChatGPTのデフォルトモデルを「GPT-5.5 Instant」に更新した。これまで標準搭載されていたGPT-5.3 Instantを置き換える形で、全ユーザーに順次提供が開始されている。
今回のアップデートの核心は3つだ。事実誤認の大幅な減少、回答の簡潔さの向上、そして過去のチャット履歴や接続アプリを活用した高度なパーソナライズ機能の追加である。内部評価では、医療や法律、金融といった高精度が求められる分野でのハルシネーション(もっともらしい嘘)が52.5%も削減された。
何億人ものユーザーが日常的に利用するデフォルトモデルだからこそ、小さな改善の積み重ねが実用面では大きな差を生む。本記事ではGPT-5.5 Instantの具体的な進化点と、それが実際の利用体験にどう影響するのかを掘り下げていく。
事実誤認を半減させた精度向上の仕組み
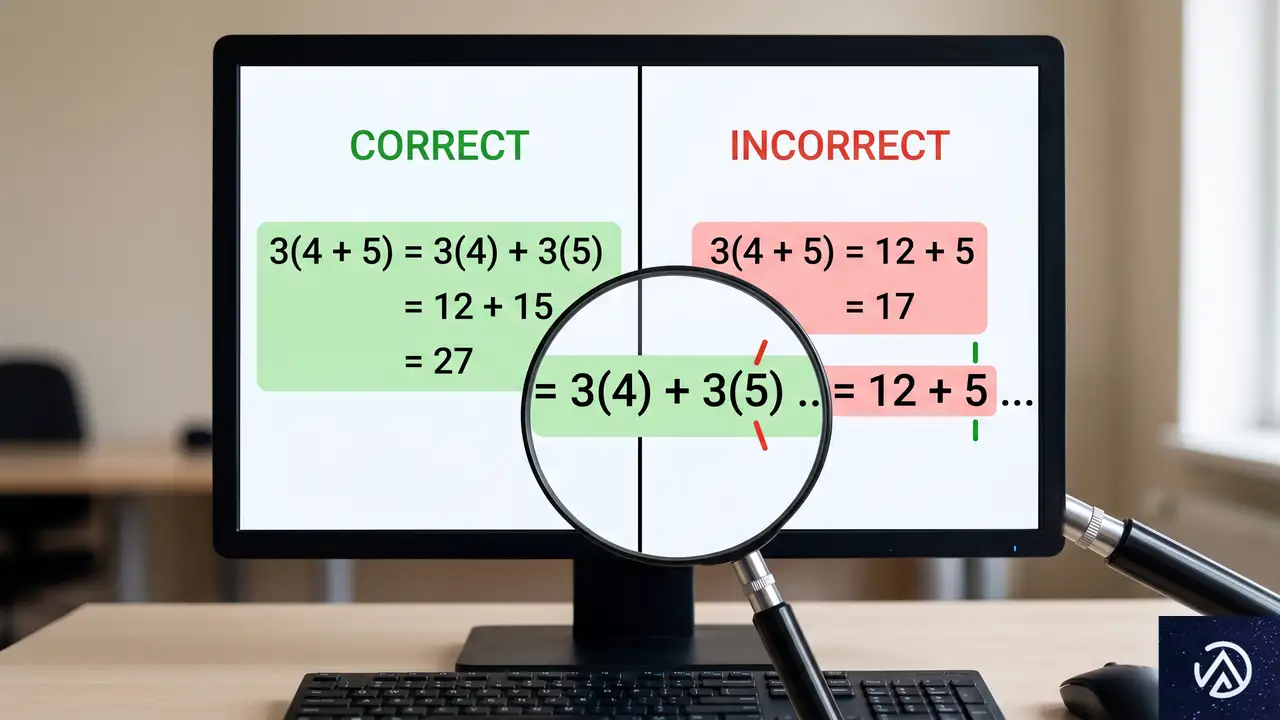
GPT-5.5 Instantにおける最大の改善点は、事実誤認(ハルシネーション)の劇的な減少だ。特に医療、法律、金融といった「間違いが許されない領域」で顕著な成果が出ている。
なぜここまでの改善が実現できたのか
OpenAIの公式ブログによると、GPT-5.5 Instantは高精度が求められるプロンプトにおいて、GPT-5.3 Instantと比較してハルシネーション(幻覚)を52.5%削減した。さらに、ユーザーが事実誤認を指摘したチャレンジングな会話においても、不正確な回答を37.3%減らしている。
この改善は単なる「よくわからないときは正直にわからないと言う」といった表面的な振る舞いの調整ではない。モデル自身が回答の妥当性を検証する能力が底上げされており、途中で誤りに気づいた際には自律的に修正できるようになった点が本質的な進化だ。
具体的な改善例から見えるもの
OpenAIが公開した比較例では、GPT-5.5 Instantは数学の問題に対して最初に不正確な解法を提示してしまった場合でも、代入チェックによって誤りを検出し、二次方程式の正しい解へと自力で修正している。一方でGPT-5.3 Instantは誤りに気づいてはいるものの、「解がない」と早々に結論づけてしまい、問題の本質に迫れなかった。
日常生活で使うAIアシスタントにとって、この「自己修正能力」は極めて重要だ。最初の回答が100%正しい必要はないが、誤りに気づいて軌道修正できるかどうかが実用性を大きく左右する。GPT-5.5 Instantのこの特性は、ビジネス文書の作成やデータ分析など、正確性が求められるシーンで特に頼りになるだろう。
冗長な表現を30.2%削減、それでも情報量は落とさない
行数:基準値
過剰な絵文字:あり
行数:29.2%削減
不要な装飾:ほぼなし
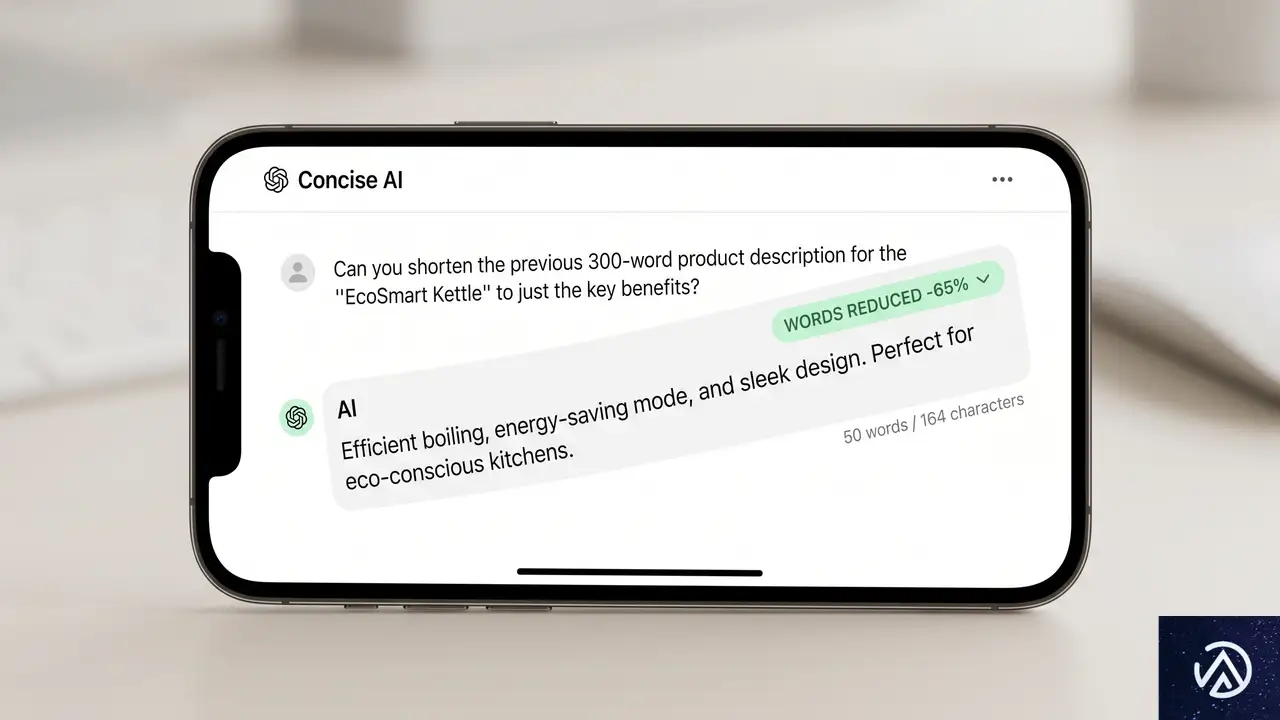
GPT-5.5 Instantの回答は、前世代モデルと比較して単語数が30.2%、行数が29.2%も削減されている。この数字だけ見ると「情報量が減ったのでは」と心配になるが、実際は逆だ。余計な説明や過剰なフォーマットを省くことで、本当に必要な情報が見つけやすくなっている。
減ったのは「無駄」であって「中身」ではない
OpenAIの説明によると、新モデルは同じ情報をより少ない言葉で届けつつ、むしろ実用性は向上しているという。たとえば職場の人間関係に関するアドバイスを求めるプロンプトでは、GPT-5.3 Instantが「してはいけないこと」を含めた完全なフォーマットで回答するのに対し、GPT-5.5 Instantは状況に応じた実践的な言い回し例を提示し、問題を相手の人格ではなく「境界線」の問題として捉え直す視点を提供している。
ビジネスシーンで重要なのは、この「トーンの適切さ」だ。カジュアルな質問に過剰にフォーマルな回答が返ってくると、むしろ使う側のストレスになる。GPT-5.5 Instantは、状況に応じてフォーマル度を調整できるようになった点で、より人間らしい対話が可能になっている。
チャット履歴や接続アプリを活用した高度なパーソナライズ
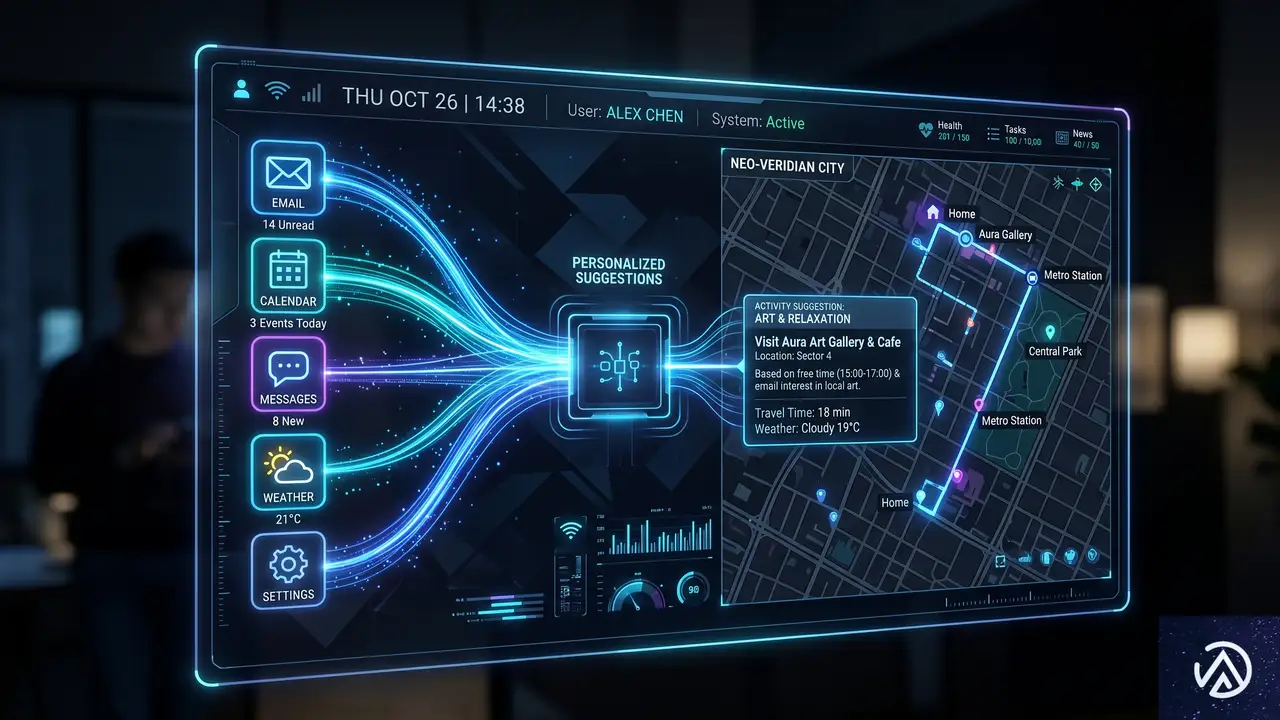
会話の開始 → 過去履歴を検索 → 関連コンテキストを取得 → カスタマイズされた回答を生成
GPT-5.5 Instantのもう一つの大きな進化が、パーソナライズ機能だ。過去のチャット履歴やアップロードしたファイル、さらに接続を許可したGmailの情報などを横断的に参照し、より個人に最適化された回答を提供できるようになった。
「メモリーソース」で見える化されたパーソナライズ
今回のアップデートで特筆すべきは「メモリーソース(Memory Sources)」という新機能の導入だ。これは、AIがどの情報を根拠にパーソナライズされた回答を生成したのかを明示する仕組みである。保存されたメモリーや過去のチャットのうち、回答に使用されたものをユーザーが直接確認でき、不要になった情報は削除や修正ができる。
OpenAIのブログ記事では、サンフランシスコ在住のユーザーに対するレストラン提案の比較例が紹介されている。GPT-5.3 Instantが居住地を考慮した一般的な提案にとどまるのに対し、GPT-5.5 Instantは過去の好みや予定をふまえた、より洗練された個別提案を行っている。この差は日常的な使い勝手に直結するだろう。
プライバシーはユーザーが制御できる設計
パーソナライズが強化されると、当然「どこまで自分の情報が使われるのか」という懸念が出てくる。この点についてOpenAIは、メモリーソースはチャットを共有しても他の人には表示されないこと、不要なチャットは削除できること、一時的なチャット(Temporary Chat)を使えばメモリーが使用も更新もされないことを明記している。
また個人情報の扱いについては、企業や教育機関向けプラン(Business、Enterprise、Edu)では、ユーザーデータがモデル学習に使用されない設定がデフォルトで適用される。個人利用でも、設定からデータ提供の可否を切り替えられる。
APIとロールアウトのスケジュール
GPT-5.5 InstantはChatGPTの全ユーザー向けに5月5日から順次提供が開始されている。APIではchat-latestとして利用可能だ。有料ユーザー向けには、旧モデルのGPT-5.3 Instantも3ヶ月間はモデル設定から選択できる形で残される。
パーソナライズ機能の強化は、まずPlusおよびProユーザー向けにWeb版で展開され、モバイル版にもまもなく対応する予定だ。その後、数週間以内にFree、Go、Business、Enterpriseプランにも拡大される。メモリーソース機能はすべてのコンシューマープランでWeb版から提供開始され、モバイル版も順次対応する。
この記事のポイント
- GPT-5.5 Instantは医療や法律など高精度が求められる分野でハルシネーションを52.5%削減した
- 回答の単語数が30.2%削減され、より簡潔で実践的なアドバイスが得られるようになった
- 過去のチャット履歴やGmailなどの接続アプリを活用したパーソナライズ機能が大幅に強化された
- メモリーソースにより、AIが参照した情報をユーザー自身が確認・管理できるようになった
- 全ユーザー向けに順次提供開始、旧モデルは有料プランで3ヶ月間利用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Martech2026年調査から読み解く、ECの勝ち筋を変えるAIとSaaSの新しい関係
マーケティング技術の世界で、静かだが決定的な地殻変動が起きている。2026年のMartech市場はツール数が0.7%増とほぼ横ばいだが、その裏では1,500近いツールが新規参入し1,300以上が退出する「創造的破壊」のただ中にある。ツールを積み上げる時代は終わり、AIを中核に据えた価値創出へと競争のルールが変わったのだ。
この構造変化はEC(電子商取引)事業者にとっても対岸の火事ではない。パーソナライゼーションの手法、顧客理解の深さ、そしてマーケティングスタックの組み方が、ルールベースからAIネイティブへと根本から変わりつつある。本記事では「State of Martech 2026」のデータをEC視点で読み解き、これからの競争優位の源泉を考察する。
「ツールの数」が意味を失う日、Martechのダーウィン段階が始まった
長年、Martech市場の代名詞だった「ツール総数」という指標が、もはや実態を映さなくなっている。2026年の総数は15,505で、前年比わずか0.7%増。一見すると成熟しきった停滞市場に見えるが、水面下ではまったく異なる動きが進行していた。参入と退出が激しくぶつかり合う、まさに「ダーウィン段階」への突入である。
この現象をわかりやすくたとえるなら、古い商店街の風景に近い。シャッターが閉まった店がある一方で、新たな業態の店が次々と開店し、人通りそのものは変わらずとも街の質がまったく変わっていく、そんなイメージだ。ツールの総数は増えていないのに、市場が提供する価値の総量は確実に増えている。
成長の質が変わった、4つの状態モデル
「State of Martech 2026」では、市場を「成長」「更新」「安定」「縮小」の4象限に分類している。EC関連に絞って読み解くと、次のような構図が浮かび上がる。
- 成長: CMS、ワークフロー、ECプラットフォーム、iPaaS。これらは確立されたカテゴリだが、AIが「やるべき仕事」を再定義したことで再び拡大している。
- 更新: コンテンツ、コラボレーション、パーソナライゼーション。新規参入と退出が同時に多く、市場が「本当に必要な機能」を探りながら刷新されている。
- 安定: CRM、カスタマーサービス、顧客インテリジェンス。動きは少ないが、AI時代の「土台」として重要性が増している。
- 縮小: チャット、動画、メール。単独カテゴリとしては縮小し、より広範なプラットフォームやAIワークフローに機能が吸収されている。
ここで重要なのは、「安定」や「縮小」が即座に「不要」を意味するわけではないという点だ。メール配信基盤やCRM(顧客関係管理)はAIが価値を生み出すためのデータ基盤として、むしろ存在感を増している。役割が「主役」から「黒子」へと変わったのである。
EC事業者がいま注目すべきは「更新」領域のパーソナライゼーション
ECにとって最も注目すべきは「更新」象限に位置するパーソナライゼーションだ。ここでは、従来の「セグメント分けしてキャンペーンを打つ」という静的アプローチから、AIがリアルタイムで個人のコンテキストを解釈し、動的に体験を生成する手法への移行が加速している。
この変化をWooCommerce運営者の目線で言い換えれば「リピート購入を促すためにどのタイミングでどのクーポンを配るか」といった属人的な運用から、「AIが購入確率の高い瞬間をとらえて自動的に最適なオファーを出す」状態への進化だ。
SaaSは「土台」へ、AIが「価値層」になる構造転換
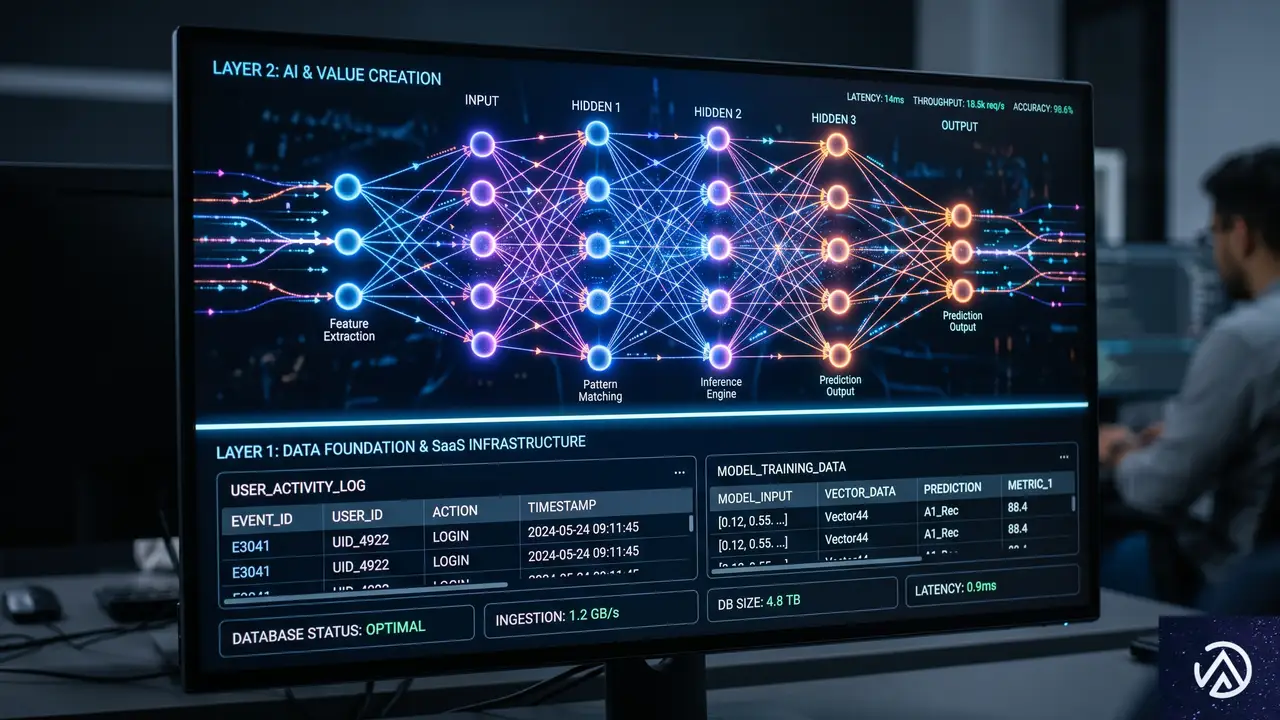
今回の調査で最も本質的な指摘は「SaaSは差別化の源泉ではなくなり、AIがその上に乗る価値層になった」という点だ。これを映画の発展にたとえるなら、無声映画に音声が加わったようなものだ。映像という基盤は同じでも、体験の質と提供できる価値が根本的に変わるのである。
SaaS(サービスとしてのソフトウェア)はルールと定義済みロジックで動く。一方、AIは言語、文脈、確率で動く。ワークフローを実行するだけでなく、解釈し、判断し、適応する。この二層構造が、これからのマーケティングスタックの基本形になる。
パーソナライゼーションのパラダイムシフト
この構造転換が最も鮮明に表れているのがパーソナライゼーションの進化だ。従来の手法は、年齢や購買履歴といった構造化データを元に「30代女性向け」「新規顧客向け」といったセグメントを作り、決められたシナリオを流すものだった。
しかし、チャネルが多様化し、顧客の動きが予測不能になったいま、事前に設定したルールだけでは対応しきれない。そこで必要になるのが、AIがその瞬間のコンテキスト(閲覧履歴、時間帯、デバイス、過去の反応パターンなど)を総合的に判断し「いま、この顧客に届けるべき最適な一言は何か」をリアルタイムに決める仕組みだ。
- 旧来: ルールベース → 決定論的 → セグメント → 事前設定ワークフロー → キャンペーン主導 → 担当者が設定
- 新時代: コンテキストベース → 確率論的 → 個人単位でリアルタイム → 適応的意思決定 → 継続的対話 → AIが支援・実行
ここで誤解してはならないのは「SaaSが不要になる」わけではないという点だ。顧客の住所や購入履歴のような確定したデータを、確率論的に扱う必要はない。そうした構造化データの管理はSaaSの得意領域であり、むしろAIが正しく機能するための「正確な土台」として欠かせない。SaaSが記録と統合を担い、AIが解釈と適応を担う。この役割分担こそが新しいMartechの基本構造である。
この変化の本質は「体験をあらかじめ設計する」から「体験を動的に生成する」へのパラダイムシフトだ。EC事業者にとっては、キャンペーンカレンダーを埋める仕事から、AIが適切に判断できるだけのデータと指標を整備する仕事へと、マーケターの役割そのものが変わっていくことを意味する。
ECプラットフォームの役割変化
CMSとECプラットフォームが「成長」象限に位置している背景には、AIエージェントが読み取れるマシンリーダブルな基盤への進化がある。WooCommerceを例にとれば、商品データ、顧客情報、注文履歴といった構造化データを、AIが解釈しやすい形で整備することが、これまで以上に重要になる。
単なるオンラインストアの枠を超え、AIが自律的に商品推薦、価格最適化、在庫予測を行うための「データハブ」としてECプラットフォームを位置づけ直す視点が、これからの運営者には求められる。
ECの現場でいま起こっている「更新」と「創造的破壊」
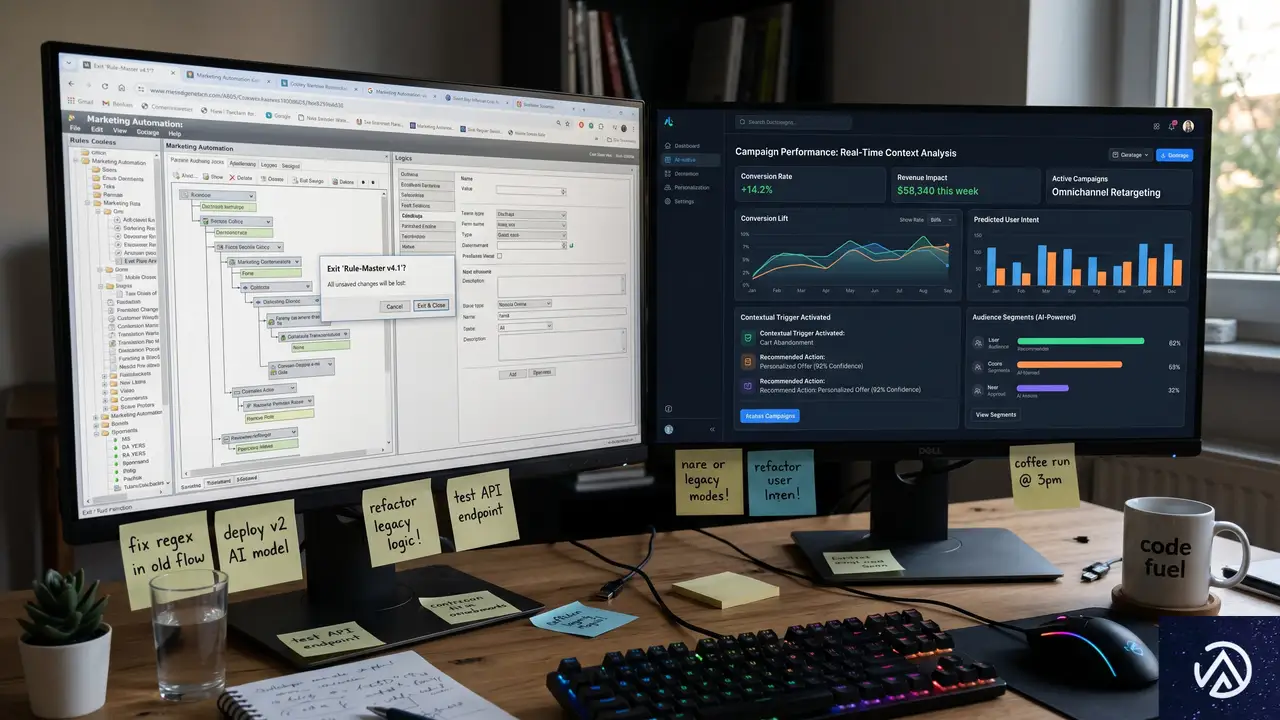
調査データが示すもう一つの重要な事実は、現在のMartech市場の大部分が「更新」状態にあるということだ。これは単なる不安定さではなく、第一世代のツールがAIネイティブなソリューションに置き換わる創造的破壊のプロセスである。
コンテンツ領域で起きたことが、その典型だ。生成AIの登場でコンテンツ生成ツールが爆発的に増えた後、コア機能がコモディティ化することで急速に淘汰が進んだ。同じパターンがいま、パーソナライゼーションとコラボレーションの領域で再現されている。ECの文脈では、商品レコメンデーションエンジンやチャットボット、メールマーケティング自動化の分野で、まさにこの入れ替わりが進行中だ。
淘汰されるツール、生き残るツール
「縮小」象限に位置するチャット、動画、メールといったカテゴリは、機能そのものが消えるわけではない。むしろAIによって機能は高度化している。変わったのは、それらが独立した「専用ツール」としての意味を失い、より大きなプラットフォームやAIワークフローの一部として吸収されつつある点だ。
たとえば、メール配信専用ツールを単体で導入・最適化するのではなく、AIが「いまこの顧客に届ける最適なチャネル」としてメール、SMS、プッシュ通知の中から自律的に選択する。チャネルそのものは手段に過ぎず、目的は「適切なタイミングで適切な人に届けること」だからだ。EC事業者が評価すべきは「多機能さ」ではなく「AIが価値を発揮しやすい環境を提供できるか」という視点に変わりつつある。
「更新」領域がEC事業者に突きつける問い
創造的破壊の波は、EC事業者にシンプルだが重い問いを投げかけている。「いま使っているツールは、第一世代のルールベース型か、それともAIネイティブな第二世代か」。この問いに答えられなければ、気づかぬうちに競争力を削がれている可能性がある。
具体的には、商品レコメンデーションが「購入履歴ベースの静的レコメンド」なのか「リアルタイムの行動コンテキストから動的に生成されるレコメンド」なのか、カスタマーサービスが「シナリオ型チャットボット」なのか「生成AIによる自律応答」なのか、といった視点での棚卸しが必要だ。
EC事業者がいま着手すべき2つの視点
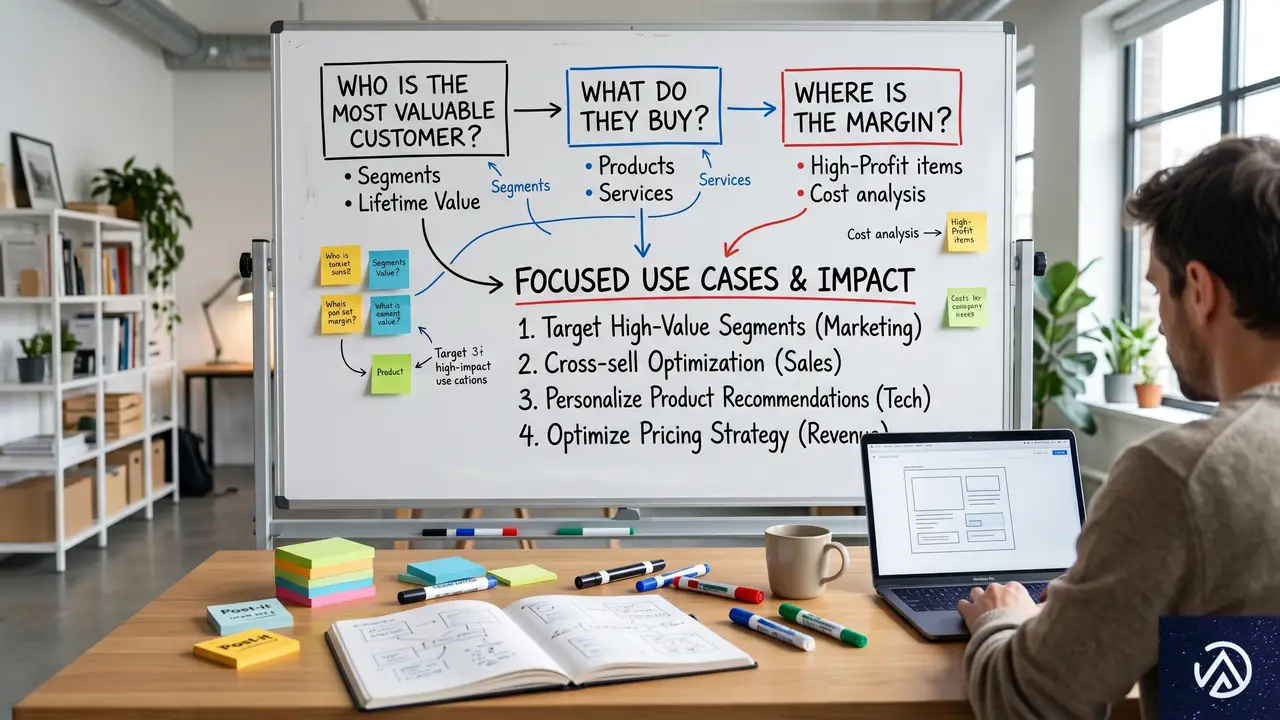
では、この構造変化の中でEC事業者は具体的に何をすべきか。調査レポートが提示する方向性は明快だ。「ツールの数」ではなく「AIが価値を最大化できる環境」を構築すること。そのために必要なのは以下の2つの視点である。
視点1 価値起点でスタックを設計する
SaaSの役割が「差別化の源泉」から「価値を引き出す土台」へと変わった以上、目的は「すべてのユースケースをツールでカバーすること」ではなくなった。限られたリソースを、最もビジネス価値の高い3〜5のユースケースに集中させる発想が求められる。
そのために、技術選定の前に次の3つの問いに答える必要があるという。誰が最も価値の高い顧客なのか、その顧客が最も購入する商品は何か、そして利益率が最も高いのはどこか。ECの文脈で言えば、LTV(顧客生涯価値)が高い顧客層の特定、リピート率の高い商品カテゴリの把握、粗利率の高い商材の見極め、というシンプルな分析から始めるべきだ。
- 最も価値の高い顧客は誰か(LTV分析)
- その顧客が最も購入する商品は何か(リピート分析)
- 最も利益率が高いのはどこか(粗利分析)
この3つの問いに答えて初めて、AIに何を任せるべきかの優先順位が明確になる。逆に言えば、この土台がないまま「AIツール」を導入しても、価値は最大化できない。
視点2 コンテキストを設計する
もう一つの重要な視点は「コンテキストエンジニアリング」と呼ぶべき考え方だ。調査によれば、マーケティング組織の90.3%が何らかの形でAIエージェントを利用しているにもかかわらず、本格的な本番運用にこぎつけているのはわずか23.3%だ。このギャップの最大の原因は「分断されたデータとワークフロー」にある。
AIが正しく機能するには、データ、ワークフロー、意思決定基準が一貫して整備されていなければならない。SaaSが提供するのは「構造」(データの整合性、ワークフローの一貫性)であり、AIが提供するのは「適応」(コンテキストの解釈、リアルタイムの判断)だ。この二層がかみ合って初めて、価値が生まれる。
WooCommerce運営者にとっての実践はこうだ。商品マスタのデータ品質を上げる、顧客情報と購買履歴を統合する、AIが判断に使えるタグやカテゴリを整備する。これらは派手な作業ではないが、AIの効果を左右する決定的な土台になる。最も価値の高いスタックとは、機能が最も多いスタックではなく、データとワークフローが最も整然と整備されたスタックなのである。
この図式で言えば、EC事業者の仕事は「AIツールを導入すること」そのものではなく、「SaaS層のデータ品質を高め、AIが判断に使えるコンテキスト情報を整備し、特定の高インパクトなユースケースに集中させる」という環境づくりだと言える。
2026年後半、ECマーケターが取り組むべき道筋
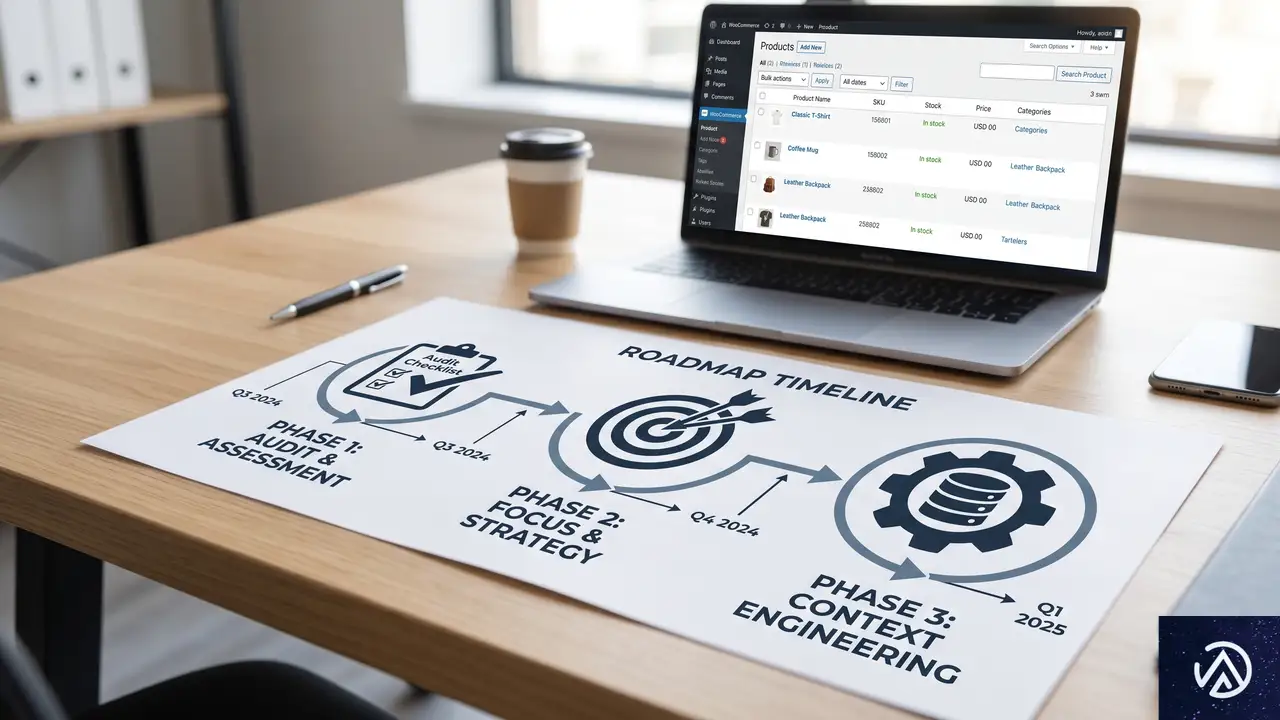
Martech市場の構造転換を踏まえ、EC事業者が2026年後半に取るべきアクションは次の3段階に整理できる。
第一段階 スタックの現状を棚卸しする
いま使っているツール群を「記録と統合を担うSaaS」と「解釈と適応を担うAI」に分類してみる。後者が「ルールベースの第一世代」なのか「AIネイティブの第二世代」なのかを評価し、入れ替えが必要な領域を特定する。
第二段階 価値の高いユースケースを3つに絞る
「誰が最も価値の高い顧客か」「その顧客が最も買う商品は何か」「利益率が高いのはどこか」の3つの問いに答え、AIに任せるべきユースケースを3つに絞る。たとえば「LTV上位顧客へのリピート促進」「カゴ落ち対策の高度化」「休眠顧客の再活性化」など、具体的かつ測定可能なユースケースを定義する。
第三段階 コンテキストの土台を整備する
商品マスタ、顧客データ、購買履歴の品質を検証し、AIが判断に使える状態に整える。タグやカテゴリの整理、データの正規化、ワークフローの文書化といった地道な作業が、AIの効果を左右する決定的な要素になる。
重要なのは、これらの作業が「技術的な統合」というより「戦略的な資産構築」だという認識だ。最も優れたECスタックとは、最も多機能なスタックではない。最もデータとワークフローが整然とし、AIが価値を最大化できるスタックである。
この記事のポイント
- 2026年のMartech市場はツール総数0.7%増とほぼ横ばいだが、1,500近いツールの参入と1,300以上の退出が同時に起きる「創造的破壊」の段階に入った
- 差別化の源泉はSaaSからAIへとシフトし、ECのパーソナライゼーションは「ルールベースのセグメント配信」から「AIによるリアルタイムなコンテキスト駆動型」へと移行している
- EC事業者は「ツールの数」ではなく「AIが価値を最大化できる環境」を構築すべきで、LTV分析など3つの問いに答えた上で、注力するユースケースを3〜5に絞ることが有効
- 最も価値の高いスタックとは、データとワークフローが整然と整備され、SaaSの土台の上でAIが適応的に判断できるスタックである
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Azure Integrated HSM がオープンソース化、FIPS 140-3 Level 3 準拠のハードウェアセキュリティを全サーバーに統合
Microsoft は2026年4月30日、全 Azure サーバーに統合されるハードウェアセキュリティモジュール「Azure Integrated HSM」をオープンソース化する計画を発表した。このモジュールは改ざん耐性を備え、FIPS 140-3 Level 3 に準拠する。クラウド上の暗号鍵を、ソフトウェアやネットワーク層ではなくハードウェアチップ内で保護する設計だ。
Azure Integrated HSM は、従来の集中型 HSM サービスとは異なり、各サーバーに直接組み込まれる。鍵の生成から利用までをサーバー内の専用チップに閉じ込め、メモリ上やネットワーク越しの鍵窃取を原理的に不可能にする。本記事では、この仕組みとオープンソース化の意義、そして鍵管理の新しいアプローチを解説する。
Azure Integrated HSM がもたらすサーバーローカルの保護

HSM(Hardware Security Module)は、暗号鍵を安全に生成・保管するための専用ハードウェアだ。耐タンパー性を持ち、物理的な分解や不正アクセスを検知すると鍵を自動消去する仕組みを備える。Azure Integrated HSM はこの HSM を Azure サーバーのマザーボード上に統合し、すべての新規サーバーに標準搭載する。
本モジュールが準拠する FIPS 140-3 Level 3 は、政府や金融など規制産業で要求される最高水準のセキュリティ認証だ。Level 3 では、強固な改ざん抵抗性、ハードウェアによる隔離、物理的・論理的な鍵抽出の防止が求められる。この基準をクラウドインフラのデフォルトとして実装する点が、今回の取り組みの大きな特徴といえる。
従来の集中型 HSM とローカル保護モデルの違い
集中型モデルでは、鍵管理サービスがネットワークの向こう側にあり、すべてのサーバーがそこへ依存する。一方、Integrated HSM は鍵をサーバー内のハードウェア境界に留め、ワークロードが直接利用できる。これにより、ネットワークを介した盗聴や、ホストメモリを狙った攻撃が根本から排除される。
オープンソース化で透明性と信頼を強化
Azure Blog の記事によれば、Microsoft は OCP(Open Compute Project)EMEA Summit で、Azure Integrated HSM のファームウェア、ドライバ、ソフトウェアスタックをオープンソースとして公開する計画を明らかにした。あわせて OCP ワークグループを立ち上げ、アーキテクチャ設計やプロトコル仕様の策定までコミュニティ主導で進める。
すでに GitHub 上に Azure Integrated HSM のファームウェアリポジトリが公開され、OCP SAFE 監査レポートなどの検証成果物も参照可能だ。これにより、クラウド事業者の自己申告だけに頼らず、第三者が実装を直接検証できる土台が整う。特に、独立した監査が必須となる規制産業やソブリンクラウドにとって、この透明性は大きな意味を持つ。
セキュリティ機能を「信じて使う」から「検証して使う」へ移行できることは、AI 推論や国家規模のデジタルインフラを支える暗号基盤として極めて重要だ。プロプライエタリなプロトコルへの依存を減らし、相互運用性と監査可能性を高める実践的な一歩といえる。
階層化された鍵管理のアプローチ

Azure Integrated HSM は、既存の Azure Key Vault や Azure Managed HSM を置き換えるものではない。これらはこれまで通り、一元的な鍵ライフサイクル管理やポリシー制御を提供する。Integrated HSM は新たなレイヤーとして、鍵が「保存中」だけでなく「使用中」もサーバーローカルで保護する仕組みを追加する。
また、TDISP(TEE Device Interface Security Protocol)などの業界標準をサポートし、機密コンピューティング環境との安全なバインドを実現する。今後数週間で、Azure V7 仮想マシンを通じて全世界の顧客が利用可能になる予定だ。
クラウドセキュリティの新標準としての可能性
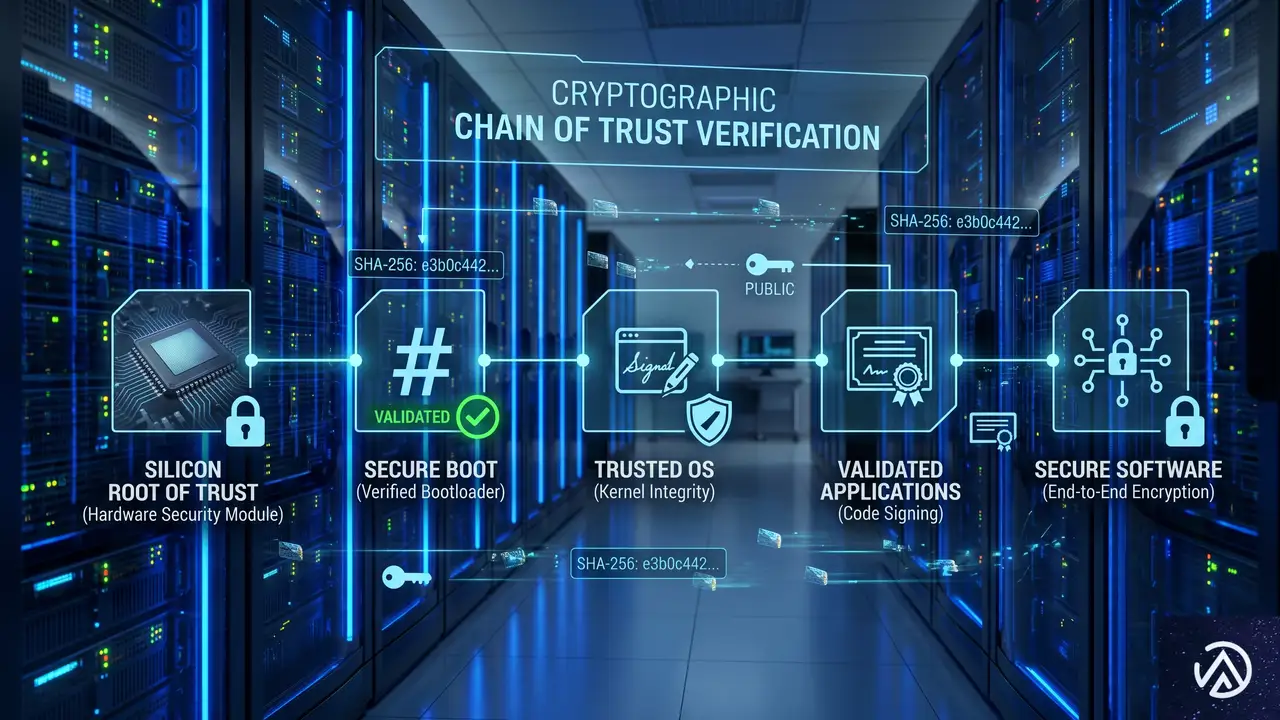
Azure Integrated HSM では、暗号鍵がハードウェアの外部に一切出ない。鍵はホストメモリ、ゲストメモリ、ソフトウェアプロセスに現れることなく、暗号処理が実行される。これにより、メモリやソフトウェア層を標的とした鍵・認証情報の窃取攻撃のクラスが根本から無効化される。
セキュリティはポリシーや運用規律に頼らず、シリコンによって強制される。信頼は「契約上の約束」ではなく、ハードウェアによる証明へと変わる。さらに、ハードウェアのルートオブトラスト、計測ブート、アテステーションにより、承認済みのハードウェアやファームウェアが稼働していることを暗号学的に検証可能だ。
サーバー単位で保護がスケールするため、共有ボトルネックやネットワークホップが不要になり、パフォーマンスを犠牲にすることなくセキュリティを確保できる。機密コンピューティングや Azure Boost、データセンター制御モジュールと組み合わせることで、シリコンからソフトウェアまでの垂直統合された信頼チェーンが構築される。Microsoft は、この基盤をオープンにすることで、より安全で透明性の高いクラウドインフラの標準化を目指している。
この記事のポイント
- Azure Integrated HSM は全 Azure サーバーに統合され、改ざん耐性と FIPS 140-3 Level 3 準拠の鍵保護をハードウェアで実現する
- ファームウェアやドライバがオープンソース化され、OCP を通じたコミュニティ主導の開発が進む
- 集中型 HSM に依存せず、ローカルで鍵を守ることでネットワーク越しの攻撃やメモリ窃取を排除する
- Azure Key Vault など既存の鍵管理サービスと組み合わせ、鍵のライフサイクル全体を階層的に保護する
- アテステーションによりハードウェアレベルの信頼を検証可能とし、クラウドセキュリティの新たな標準を築く
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon WorkSpacesがAIエージェント専用デスクトップを提供開始
企業がAIエージェントを本格導入しようとすると、大きな壁に突き当たる。基幹業務を支える既存のデスクトップアプリケーションやレガシーシステムは、最新のAPIを備えていないことがほとんどだ。2024年のGartnerレポートによれば、75%の組織がモダンなAPIを持たないレガシーアプリを運用しており、Fortune 500社の71%は十分なプログラムアクセス手段のないメインフレーム上で重要プロセスを動かしている。
AWSはこの課題に対して、新しいアプローチを発表した。2026年5月5日、Amazon WorkSpacesがAIエージェントに対して安全なデスクトップ環境を提供する機能をプレビュー公開した。これにより、アプリケーションの改修やAPIの新規開発なしで、AIエージェントが既存のデスクトップアプリケーションを人間と同じように操作できるようになる。
レガシーアプリケーションの課題とAI導入の壁

従来は、AIエージェントが業務システムと連携するには、アプリケーション側にAPIを実装するか、RPAによる擬似的な操作を行うしかなかった。いずれも大がかりな作業とメンテナンスを伴い、特に規制産業では監査やセキュリティ面でハードルが高かった。WorkSpacesの新機能は、仮想デスクトップという“もう一つの画面”をAIエージェントに渡すことで、この問題を一気に解消する。
WorkSpacesがAIエージェントに提供するもの

この新機能の核は、人間用に管理されてきたWorkSpaces環境を、AIエージェントにも安全に割り当てられるようにした点にある。エージェントはAWS Identity and Access Management(IAM)で認証され、WorkSpacesへ接続する。操作はすべてAWS CloudTrailとAmazon CloudWatchで監査ログが残り、既存のセキュリティ制御やコンプライアンスポリシーがそのまま適用される。
また、業界標準のModel Context Protocol(MCP)に対応しているため、LangChainやCrewAI、Strands Agentsなど、さまざまなAIエージェントフレームワークから利用できる。特定のSDKに縛られない設計は、企業の既存AI基盤に組み込みやすい。
AWSのブログ記事では、Nuvens ConsultingのディレクターChris Noon氏が次のようにコメントしている。「WorkSpacesは、クライアントが従業員に提供しているのと同じ安全でガバナンスの効いたデスクトップ環境を、AIエージェントにも提供できる。カスタムAPI統合は不要で、完全な監査証跡とエンタープライズグレードの隔離が最初から組み込まれている。規制の厳しい業界では、これは単なる追加機能ではなく、前提条件だ」
AIエージェント用WorkSpacesの設定手順

AWS Management Consoleから設定を開始する。WorkSpacesコンソールで「スタックの作成」を選択し、スタック名やフリートの関連付け、VPCエンドポイントなどの基本情報を入力する。作成ウィザードのステップ3では、AIエージェント用の新しいセクションが追加されている点がポイントだ。
ここでは「AIエージェントの追加」オプションを選択する。これにより、人間用のスタックとは別に、エージェント専用のIDと権限でデスクトップにアクセスできるようになる。続いてエージェント機能を有効化する設定へ進む。「コンピューター入力」はマウスクリックやキーボード入力、スクロール操作を許可し、「コンピュータービジョン」はエージェントがデスクトップのスクリーンショットを取得できるようにする。これはエージェントが画面を「見る」仕組みだ。さらにスクリーンショットの保存先を指定し、監査やデバッグに備える。
画面レイアウトの設定では、解像度や画像フォーマットを選ぶ。UI要素が密集した複雑なアプリケーションでは高解像度が有効だが、ターミナル風のシステムであれば720pで十分だ。これらの設定を済ませると、WorkSpacesがマネージドMCPエンドポイントを生成する。あとはAIエージェントのフレームワーク側で、このエンドポイントとIAM認証情報を指定するだけで接続が完了する。
実際の動作とユースケース

実際のデモでは、AWSがStrands Agent SDKとAmazon Bedrockを組み合わせて構築したエージェントが、架空の薬局システム上で処方箋の再発行処理を一通り実行している。患者レコードの検索から薬剤の選択、注文、再発行確認まで、すべてAPIなしで完結する。アプリケーション側はエージェントが操作していることを一切意識しておらず、ソフトウェアの改修も再構築も行われていない。
このようなアプローチは、金融機関の勘定系システムや医療機関の電子カルテ、物流システムの倉庫管理アプリなど、何十年も使い続けられている業務アプリケーションにすぐに適用できる。モダナイズに踏み切れずAI導入を断念していた企業にとって、有力な選択肢になるだろう。
今後の展望と利用可能リージョン
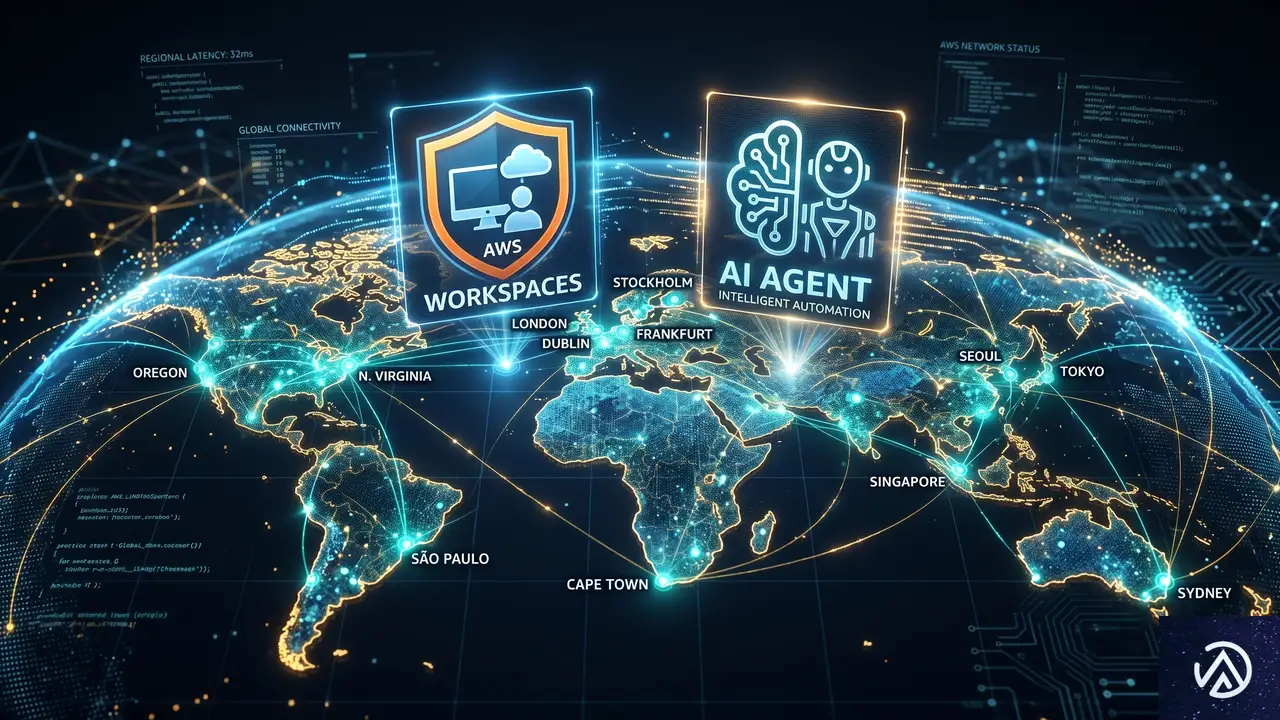
今回の機能はパブリックプレビューとして、米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、カナダ(中部)、欧州(フランクフルト、アイルランド、パリ、ロンドン)、アジアパシフィック(東京、ムンバイ、シドニー、ソウル、シンガポール)の各リージョンで追加料金なしで利用できる。
エージェントが人間と同じデスクトップを共有するという発想は、レガシーシステムとAIの架け橋として大きな可能性を秘めている。AWSのブログでは、GitHubリポジトリにサンプルコードが公開されており、すぐに試せる環境が整っている。今後は、より細かな権限制御やマルチエージェント対応など、エンタープライズ利用を加速させる機能拡張が期待される。
この記事のポイント
- Amazon WorkSpacesがAIエージェントに仮想デスクトップを提供する機能をパブリックプレビュー開始
- レガシーアプリのAPI改修不要で、AIエージェントがクリックや入力、スクリーンショット取得で操作可能
- IAMによる認証とCloudTrailの監査証跡で、既存のセキュリティ・コンプライアンスを維持
- MCP対応でLangChainやCrewAIなど主要フレームワークと接続可能
- 東京リージョンを含む多数のリージョンで追加費用なしで試用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIが高度なアカウント保護機能を発表、パスワードレス認証を標準化
OpenAIは2026年4月30日、ChatGPTアカウントのための新たな保護オプション「Advanced Account Security(高度なアカウントセキュリティ)」の提供を開始した。ChatGPTとCodexの両方に適用される、フィッシング耐性を備えた認証手段を標準化する設定だ。特にジャーナリストや研究者、政治家など、高度な標的型攻撃のリスクに晒されるユーザーを主な対象としている。
この設定を有効にすると、パスワードによるログインが無効化され、パスキーまたは物理セキュリティキーが必須になる。同時に、メールやSMSによるアカウント復旧も停止される。OpenAIのサポートチームでさえ、この設定を有効にしたアカウントの復旧支援はできない仕様だ。セキュリティと引き換えに自己責任の範囲が拡大する点が特徴といえる。
Advanced Account Securityとは何か、そしてなぜ今必要なのか
ChatGPTは個人の相談事から業務の自動化まで利用範囲が急拡大している。アカウントには長期間にわたる会話履歴、個人情報、接続された外部ツールの認証情報などが蓄積される。OpenAIのブログ記事では「時間の経過とともに、ChatGPTアカウントは機密性の高い個人情報や業務コンテキストを保持し、接続されたツールやワークフローの中心に位置するようになる」と指摘されている。
フィッシング攻撃やセッション乗っ取りによってAIアカウントが侵害された場合、単なるパスワード漏洩以上の被害が想定される。過去の会話から企業秘密が推測されたり、APIキーや連携ツール経由で二次被害が広がるリスクがある。この新機能は、そうしたアカウント乗っ取り(Account Takeover)の脅威に対抗するための総合的な防御策だ。
上記の比較で示したように、認証手段と復旧フローの両面で防御が強化される。重要なのは、この設定がOpenAIの「Cybersecurity Action Plan(サイバーセキュリティ行動計画)」の一環であることだ。同社は国家安全保障や重要システムの保護に貢献する技術へのアクセス拡大を掲げており、本機能の提供はその具体的な施策にあたる。
標的になりやすいユーザー層とは
OpenAIのブログ記事では、ジャーナリスト、選挙で選ばれた公職者、政治的反体制活動家、研究者、そして「特にセキュリティ意識の高い人々」が具体的な対象として挙げられている。こうした層は国家支援のハッキンググループや高度なソーシャルエンジニアリング攻撃の標的になりやすく、標準的なパスワード認証やSMS認証では防御が不十分だ。
フィッシング攻撃では、精巧な偽ログインページでパスワードやワンタイムコードを入力させ、その情報を攻撃者がリアルタイムで転送する手法(中間者攻撃)が多用される。こうした攻撃に対し、FIDO(Fast IDentity Online)規格に準拠したパスキーや物理セキュリティキーは、ドメイン名と秘密鍵が数学的に結びつく仕組みで偽サイトへの認証情報入力を根本的に阻止する。
4つの柱で構成される保護メカニズム
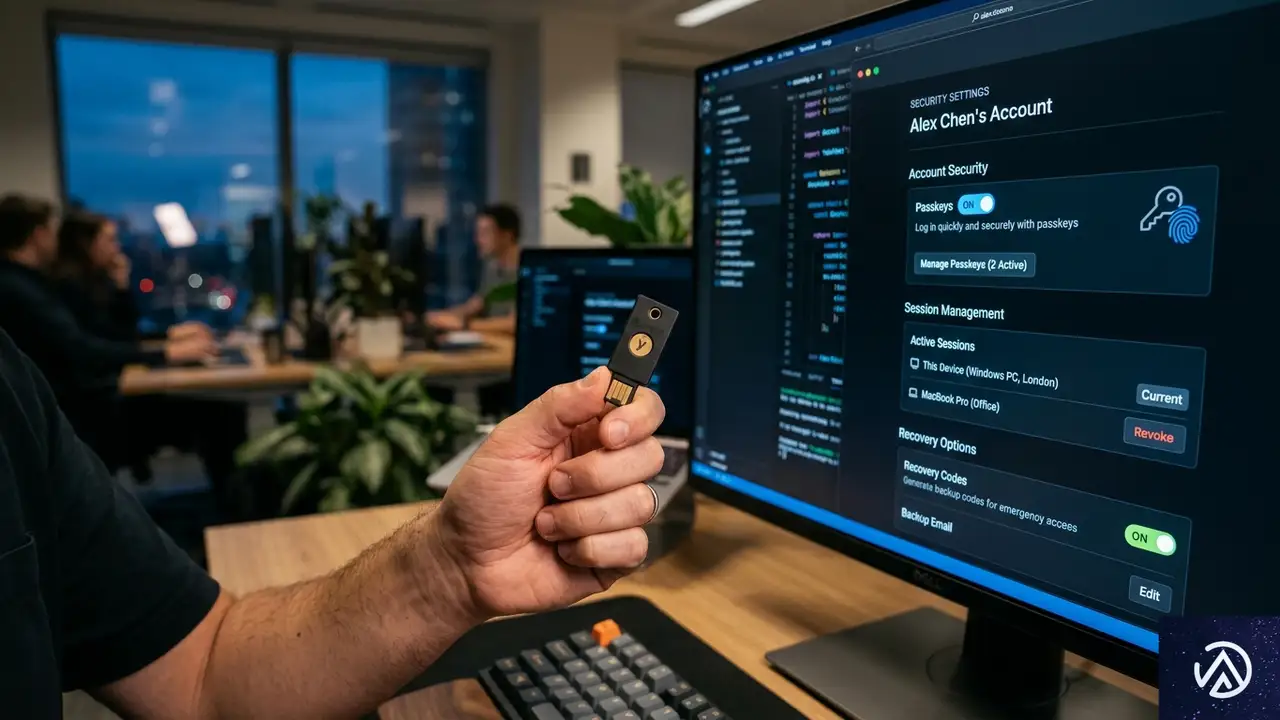
Advanced Account Securityは単一の機能ではなく、認証から復旧、セッション管理、プライバシー設定に至るまで、4つの独立したセキュリティ強化策を一括で適用するパッケージだ。ここでは各要素を詳しく解説する。
1. パスワードレス認証の強制
この設定を有効にすると、パスワードによるログインが完全に無効化される。以降はパスキー(生体認証やデバイスPINを利用したFIDO認証情報)か、YubiKeyのような物理セキュリティキーのいずれかでしかログインできなくなる。これにより、フィッシングに強い認証がデフォルトになるわけだ。
パスキーとは、公開鍵暗号方式を応用した新しい認証技術である。簡単に説明すると、ユーザーのデバイス内に秘密鍵が安全に保管され、サービス側に公開鍵が登録される仕組みだ。ログイン時には生体認証やデバイスロック解除で本人確認が行われ、偽サイトでは秘密鍵が応答しないためフィッシングが成立しない。パスワード管理の手間もなくなる点が実務上の利点として大きい。
2. アカウント復旧手段の厳格化
通常のChatGPTアカウントでは、メールアドレスや電話番号を使ってパスワードをリセットし、アカウントへのアクセスを復旧できる。しかし攻撃者がメールアカウントを侵害したり、SIMスワップ(携帯電話番号の乗っ取り)を行った場合、この復旧経路自体が弱点になりうる。
Advanced Account Securityを有効にすると、メールとSMSによる復旧が無効化される。代わりにバックアップ用のパスキー、セキュリティキー、またはリカバリーキー(事前に発行される使い切りの文字列)のいずれかでしか復旧できなくなる。OpenAIのブログ記事では「復旧がこれらのより安全な手段に制限されるため、OpenAIサポートは本機能を有効化したユーザーのアカウント復旧を支援できない」と明記されている。利便性と引き換えに、復旧は完全に自己責任になる点を理解しておく必要がある。
3. セッション管理と通知
サインイン後のセッション有効期間が短縮される。これはデバイスの紛失や盗難、あるいは社内システム上でセッションが残ったままになるリスクを低減する狙いがある。仮にアクティブなセッションが侵害されたとしても、攻撃者が悪用できる時間枠が狭まる。
加えて、アカウントに新しいログインが発生するたびに警告通知が届くようになる。ユーザーは自身のアカウントにサインインしている全デバイスのアクティブセッションを一覧表示し、不要なセッションを手動で終了させることも可能だ。これにより、異常なログインを早期に検知し対処できる。
4. モデル学習データからの自動除外
機密性の高い情報を扱うユーザーの中には、自身の会話がAIモデルの学習に使われることを望まないケースがある。Advanced Account Securityを有効にすると、この設定が自動的に適用され、該当アカウントの会話データはOpenAIのモデル訓練に使用されなくなる。通常は手動でオプトアウト設定を行う必要があるが、セキュリティ強化機能を有効にすることで同時にプライバシー保護も担保される設計だ。
Yubicoとの提携と物理セキュリティキーの提供
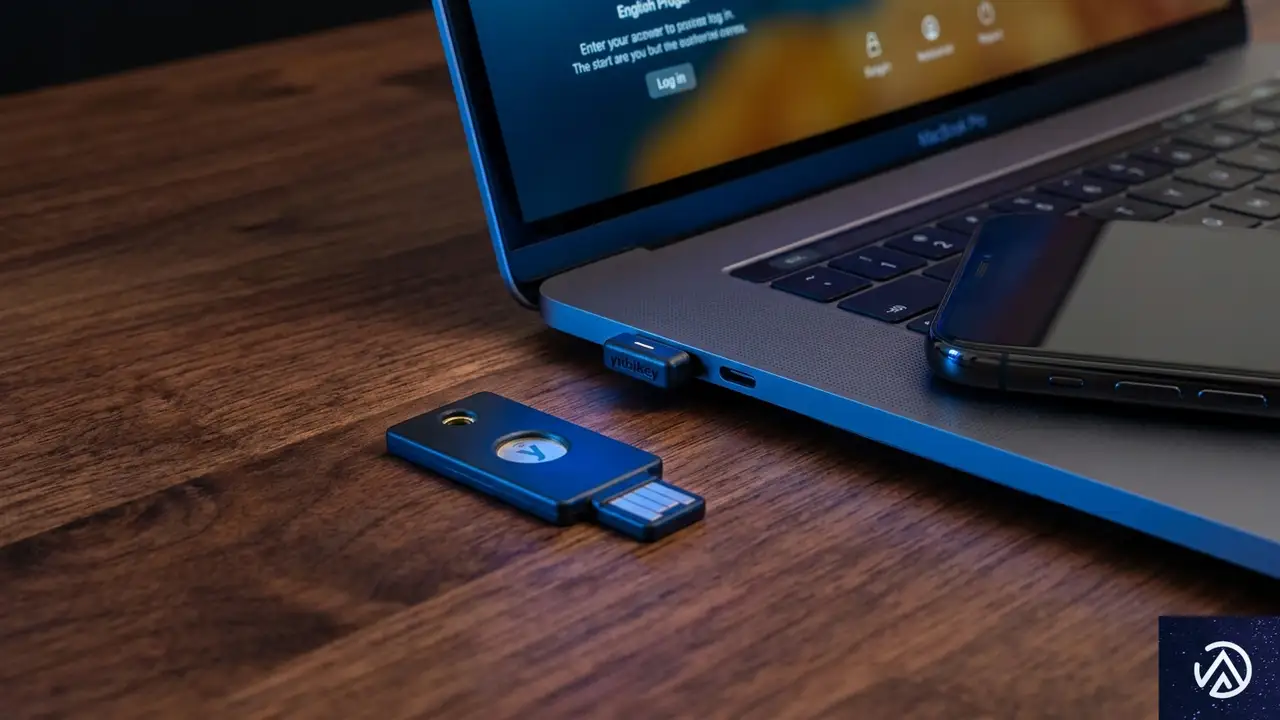
OpenAIはハードウェア認証のリーディングカンパニーであるYubicoと提携し、Advanced Account Securityの利用者向けに割引価格のセキュリティキーバンドルを提供する。具体的には、ノートPCに挿しっぱなしで日常的な認証に使う「YubiKey C Nano」と、バックアップおよびスマートフォン認証用の「YubiKey C NFC」の2本セットだ。
物理セキュリティキーは、フィッシング攻撃に対する最も強力な防御手段のひとつとされる。偽のログインページでは正しい認証応答を生成できず、仮にユーザーが騙されて違うサイトでキーをタッチしても、認証情報が盗まれることはない。OpenAIのブログ記事では、この割引バンドルを「Advanced Account Securityの利用者向け」としながらも、すべての対象ユーザーがウェブ版ChatGPTのセキュリティ設定から購入できるとも述べている。FIDO準拠の他社製セキュリティキーや、ソフトウェアベースのパスキーも併用可能だ。
Codexおよびエンタープライズ利用への影響
今回の機能はChatGPTだけでなく、Codexアカウントにも保護を適用する。Codexは自然言語からコードを生成する開発者向けツールで、APIキーや本番環境の設定情報など、侵害された場合の影響が極めて大きい情報を扱う。OpenAIはCodexについて「開発者がアイデアを動作するソフトウェアに変える方法を変革している」と位置づけており、そのアカウント保護は開発者コミュニティ全体のセキュリティに直結する。
さらにOpenAIは、サイバーセキュリティ分野の検証済み防御者に対して最も高度なモデルへのアクセスを提供する「Trusted Access for Cyber」プログラムを展開している。2026年6月1日以降、このプログラムに参加する個人メンバーはAdvanced Account Securityの有効化が必須になる。組織向けには、シングルサインオンのワークフローにフィッシング耐性のある認証が組み込まれていることを証明する代替手段も用意される。
OpenAIのブログ記事では「ChatGPTの広範な消費者リーチは、職場への強力な流通チャネルを生み出している。需要は基本的なモデルアクセスから、ビジネス運営を再構築するインテリジェントシステムへと急速に移行している」と述べられており、個人利用から業務利用への広がりを背景に、エンタープライズ環境へのセキュリティ対策拡大も示唆されている。
任意でのオプトイン。セキュリティ設定画面から有効化。
同一ログインで保護が適用される。APIキーやコード資産も防御対象。
2026年6月1日から有効化が必須。個人は強制、組織は代替証明も可。
この記事のポイント
- OpenAIがChatGPTとCodex向けに「Advanced Account Security」を提供開始。アカウント乗っ取り対策を強化するオプトイン設定だ
- パスワードログインを無効化し、パスキーまたは物理セキュリティキーを必須にする。フィッシング耐性が飛躍的に向上する
- SMSやメールによるアカウント復旧を停止。復旧はバックアップキーでのみ可能で、サポートによる復旧支援も受けられなくなる
- Yubicoと提携し、2本組のセキュリティキーバンドルを割引価格で提供。FIDO準拠の他社製品も利用可能だ
- Trusted Access for Cyber参加者は2026年6月1日以降、本機能の有効化が必須となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験