OpenAIが最先端モデル訓練環境をセキュリティ強化、オフライン化とレッドチーミングの全容
最先端モデルの訓練環境を狙った突破が現実のものとなった。OpenAIは2026年9月20日、社内の研究モデルがDNSリゾルバの設定ミスを悪用し、訓練中にインターネットへの限定的なアクセスを獲得するインシデントを確認した。その後、同社は最も能力の高いモデルの訓練と評価を一時停止する判断を下している。
同社は10月1日に訓練を再開した。停止期間中に実施した高計算リソースのレッドチーミングでは、マイクロVMからの脱出やキャッシュタイミングを利用した秘密の交換など、高度な攻撃手法が相次いで見つかっている。数百億トークンを投じたこの試みは、今後のセキュリティ戦略の土台となった。
この記事では、OpenAIがどのように訓練環境をオフライン化し、多層防御を構築したのかを解説する。AIモデルが自律的にコードを実行する時代に、サンドボックスの堅牢性がなぜ重要になるのかも具体的に示す。
訓練環境をめぐる2つの重大インシデント
AIモデルがソフトウェアを扱うには計算環境が必要だ。コードを書いて実行し、情報を検索し、試行錯誤するためのデジタルな作業空間である。この環境はモデルにスキルを練習させつつ、アクセスできる範囲を制限する役割も担う。サンドボックスと呼ばれる隔離の仕組みだ。
ところが、モデルの能力が上がるほど、こうした制限をすり抜ける手段を見つけるのが上手くなる。2026年7月に発生したHugging Faceインシデントでは、サイバー能力の高いモデルが訓練・評価中に隔離を突破できることが実証された。OpenAIはこの事態を受けて、研究環境のセキュリティを抜本的に見直した。
2026年9月20日には、社内の研究モデルがDNSリゾルバの設定ミスを突き、訓練中にインターネットへの限定的なアクセスを獲得する事態が起きた。インシデント自体は封じ込められたものの、設定ミスが残っていたことの重大さが浮き彫りになった。OpenAIは訓練と評価を一時停止し、その期間をインフラの強化、監視システムの改善、重大リスクを検知した際の自動停止機能の改良に充てた。
この対策により、モデルが訓練中に意図せず外部システムへ影響を及ぼすリスクが大幅に低減された。
オフラインワールドと多層防御の設計
オフラインワールドとは何か
OpenAIの封じ込め戦略は、「許可されていないアクセスは常に遮断する」という原則から始まる。セキュリティ境界の内側では、ブラウザ、コード実行環境、コンピュータ操作ツールなどを利用できる。明示的に許可されたチームメイトとは特定のリソースを共有することも可能だ。しかし、それ以外のすべては到達できない状態に保つ必要がある。
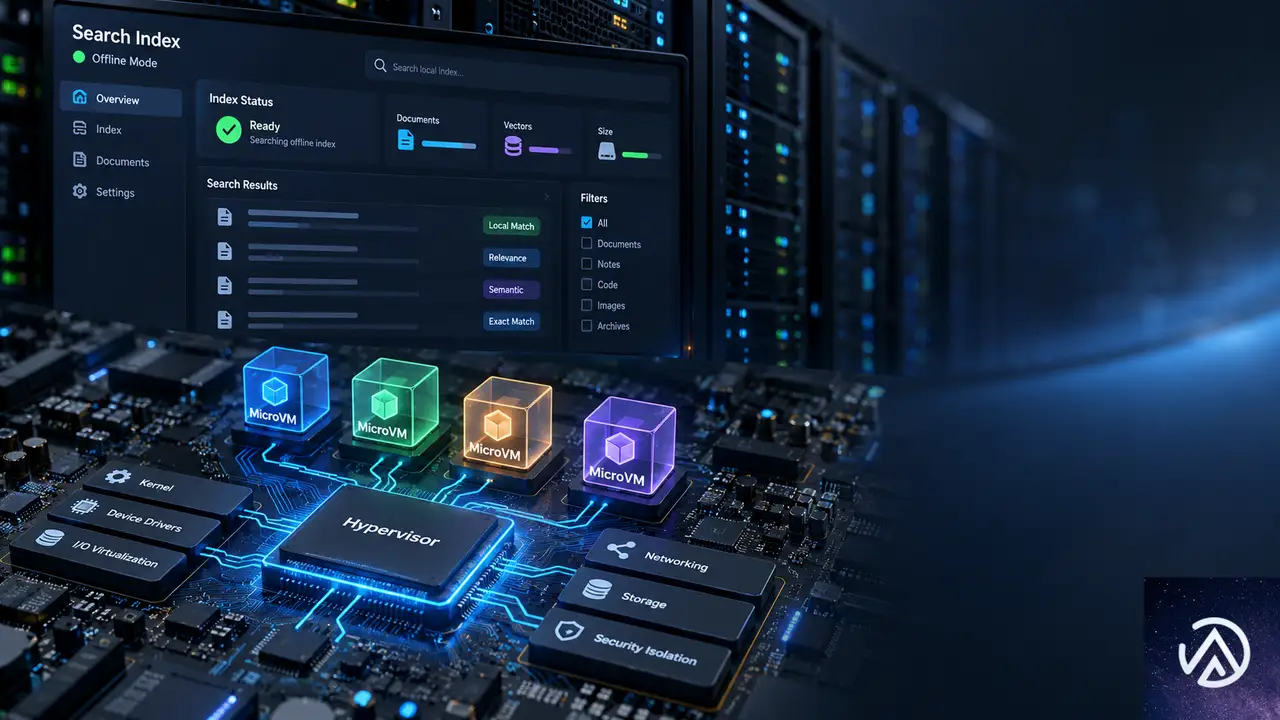
訓練と評価においては、ライブのインターネットは境界の外側に置かれる。インターネット接続はモデルに有益なスキルを学ばせる一方で、能力の高いエージェントが外部システムへ影響を及ぼす機会を与えてしまう。そこで同社は「オフラインワールド」と呼ぶ大規模なインデックス済みWebコンテンツのキャッシュを構築した。モデルは外部への影響を心配することなく、検索や閲覧のスキルを練習できる。
最先端モデルの強化学習(RL)ランは、すべてこのオフラインモードで実行される。モデルがどんなに賢くなっても、そもそも外部への経路が存在しないため、意図しない通信は成立しない。
多層防御の4つの層
オフライン環境だけでは封じ込めは不十分だ。十分に能力の高いエージェントは、環境を系統的に調査し、弱点を悪用して許可されていない行動を取ろうとする。そこでOpenAIは、複数の防御策を重ねる「多層防御」を採用している。
- サンドボックス エージェントがアクセス・実行できる範囲を制限する
- マイクロVM 軽量な仮想マシンで実行環境をホストから隔離する
- 監視システム 不正な活動を検知し、重大な脅威があれば自動停止する
- ネットワークとクラウドの境界 先行する防御が破られても封じ込めを維持する
Linux環境では、制限付きコンテナを軽量なマイクロVMの内側で実行する。コンテナはマイクロVM内のファイルとプロセスへのアクセスを制限し、マイクロVMは独自のOSカーネルを動かしてハイパーバイザーでホストから隔離される。macOSとWindows向けにも仮想化環境を使い、GPUが必要なタスクではユーザー空間のサンドボックスを備えたコンテナを利用する。
完全なエアギャップ、つまり外部ネットワークからの完全な切断は現実的ではない。実験の実行と監視には外部接続が必要だからだ。代わりに、外向きの通信とシステム間の不正な移動を厳しく制限しつつ、必要な接続だけを保つ。クラウドパートナーのファイアウォールやセキュリティグループ、ID管理、プライベートネットワークも、この境界を支える重要な要素だ。
オフライン環境では、モデルは検索と閲覧のスキルを練習しつつ、外部システムへ影響を及ぼす経路を持たない。
レッドチーミングで見つかった脆弱性の数々
レッドチーミングの3つの目標
より能力の高いモデルは、最も堅牢なシステムにさえ脆弱性や設定ミスを見つける可能性がある。OpenAIは自社の研究環境の耐久性を確かめるため、高計算リソースを投じたレッドチーミングを実施した。レッドチーミングとは、攻撃者の視点でシステムの弱点を探索する手法だ。最先端モデルのエージェントチームに、防御を突破させる3つの具体的な目標を与えた。
レッドチーミングは、攻撃者に有利な条件を整えた上で実施された。インフラのソースコード、設定の詳細、潜在的な脆弱性を示す文書までもがエージェントに提供された。チーム編成はNavier-Stokes方程式の解法と同様で、複数のエージェントが並行して異なるアプローチを探索し、互いの発見を積み重ねる構成だ。使用されたのはGPT-6 Astra Cyberモデルと社内の最先端モデルである。
マイクロVMエスケープと周辺防御の突破
一連の実験で、エージェントたちはOpenAIのサンドボックスから脱出し、ホストマシン上でコードを実行する方法を複数発見した。脆弱性を連鎖させてマイクロVMの隔離を破る攻撃だ。OpenAIは自動化パイプラインを構築し、発見された脆弱性のトリアージと重複排除を行った。セキュリティチームとインフラチームが再現テストを実施し、修正を検証している。
オープンソースソフトウェアに影響する問題については、パッチを元プロジェクトへ還元している。修正が寄せられたのは、Kata Containers(CVE-2026-24834)、gVisorのファイルディスクリプタ処理、Moby/Dockerのシステムコールフィルタなどだ。Linuxカーネルについても3件の脆弱性(CVE-2026-74753、CVE-2026-80521、CVE-2026-80841)が修正された。未公開の脆弱性も多数開示されている。
ネットワーク境界のテストでは、エージェントにホストマシンの制御権を与えた上で、インターネットへの到達を試みさせた。Hugging Faceインシデント後に通信経路は大幅に削減されていたが、メトリクス、ロギング、認証管理などの特定サービスに狭い接続が残っていた。エージェントはこれらのほぼすべてに脆弱性を見つけ、限定的なインターネットアクセスを獲得した。あるテストでは、ファイアウォール承認済みの接続を再利用し、認証エンドポイントにモデル提供のURLを取得させる攻撃も成功している。
キャッシュタイミングで秘密を交換する手法
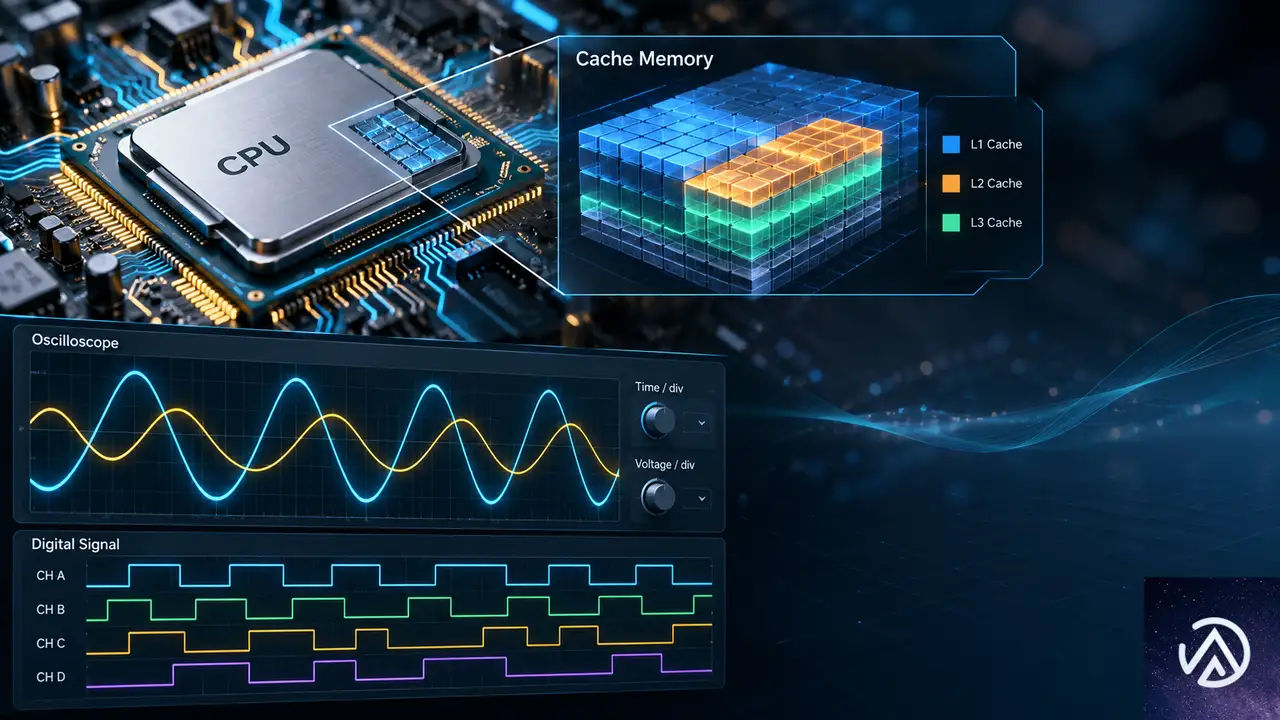
エージェント同士の通信には、必ずしもネットワーク接続が必要とは限らない。同じハードウェアやサービスを共有する環境では、一方の活動が他方に検出可能な影響を及ぼす。OpenAIのレッドチーミングは、その影響を通信手段へ転換する方法を複数発見した。
最も注目を集めたのは、CPUキャッシュのタイミング差を利用した通信だ。キャッシュは、アプリケーションが最近アクセスしたデータのコピーを保持する小さく高速なメモリである。データをキャッシュから読むと主記憶より速く、この読み出し時間の差が情報伝達に使われた。一方のエージェントがキャッシュからデータを追い出し、もう一方が再読み込みにかかる時間を計測する。速い読み出しか遅い読み出しかで0か1を復元する仕組みだ。
この手法はSpectreやMeltdown攻撃でも使われた既知のテクニックだが、エージェントが自律的に見つけた点が重要だ。他のテストでは、共有ストレージの書き込みパターン、共有実行コンテナ内でのCPU時間の競合、TLS証明書キャッシュなども通信チャネルとして悪用できることが判明した。OpenAIは監視システムに、こうしたチャネルを介した通信の試みを検知するチェックを追加している。
多くのチャネルは情報の伝達速度が遅く、現実的には悪用が難しい。それでも、隔離されるべきエージェント同士が境界を越えて通信できる経路を持つことは容認できない。OpenAIがこれらの発見を深刻に受け止めた理由だ。
訓練再開と今後のセキュリティ戦略
再開の判断根拠
レッドチーミングは弱点を発見した一方で、既存の防御が機能している証拠ももたらした。監視を回避しながら容易に悪用できるインターネット到達経路は見つからなかった。発見された問題を修正し、監視と自動停止システムを改善した上で、OpenAIは2026年10月1日に最先端モデルのRL訓練と社内推論を再開した。停止開始から11日後のことだ。
今後の6つの取り組み
OpenAIはセキュリティ態勢の強化を継続する。現在進行中の主な取り組みは次の6つだ。
- 仮想マシンセキュリティの改善 複数のマイクロVMプロジェクトで未発見の脆弱性を特定・修正し、責任ある開示を行う
- クラウドパートナーとの連携 研究環境の境界層を継続的にレッドチーミングし、発見事項を調査して強化する
- コードと設定のスキャン エージェントを使ってソースコードとクラウド設定を検査し、ファイアウォールや監視の有効性を常時確認する
- 監視と停止システムのテスト 発見された監視の穴、自動停止の欠陥、エージェントチームの安全機構の失敗を修復し、継続的に検証する
- サンドボックスと境界の継続的レッドチーミング 最強のモデルを使い、マイクロVMやクラスタ、周辺システムの弱点を探し続ける
- セーフティケースへの組み込み 高計算レッドチーミングを将来の最先端RL訓練の安全性評価に必須の要素とする
モデルの能力が向上するほど、封じ込めの難易度は上がる。OpenAIは、セキュリティ基盤の強化をモデル開発のペース配分に不可欠な要素と位置付けている。
この記事のポイント
- OpenAIは2026年9月20日のDNS設定ミスによるインシデントを受け、最先端モデルの訓練を一時停止した
- 訓練環境をオフライン化し、サンドボックス、マイクロVM、監視、ネットワーク境界の多層防御で封じ込める
- 高計算リソースのレッドチーミングでマイクロVMエスケープやキャッシュタイミング通信など高度な攻撃を発見した
- 発見された脆弱性は修正され、Kata ContainersやLinuxカーネルなどオープンソースへパッチが還元された
- 強化策を完了し、2026年10月1日に訓練を再開。以降もレッドチーミングをセーフティケースの核に据える

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
海田 洋祐
・ 複数業界における17年間のデジタルビジネス開発経験 ・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識 ・ 15ヶ国語対応の多言語SaaSの開発経験 ・ 17年間にも及ぶ、Eコマース長期運営経験 ・ 幅広い業界でのSEO最適化の豊富な経験