

B2BKingのMCP連携でWooCommerce B2BストアをAIが設定。仕組みと接続手順
WooCommerce向けB2B・卸売販売プラグインのB2BKingが、MCP連携機能を実装した。AIアシスタントが自然言語の指示だけで、ストア設定の読み取りから変更までを実行できる。従来は数時間かかっていた設定作業が、数分で完了する可能性がある。
対応するのはClaude、Codex(OpenAIのコーディングエージェント)、Cursor、VS Codeなど、MCP(Model Context Protocol)をサポートするすべてのAIツールだ。コードを書く必要も、設定画面を1つずつ巡回する必要もない。
B2BKingのMCP連携とは何か
B2BKingはWooCommerce向けのB2B・卸売販売プラグインだ。約7年の開発実績を持ち、累計1万5,000以上のWooCommerceストアで稼働している。このB2BKingが、WordPressの標準API群を通じてAIアシスタントから直接設定を変更できる仕組みを実装した。
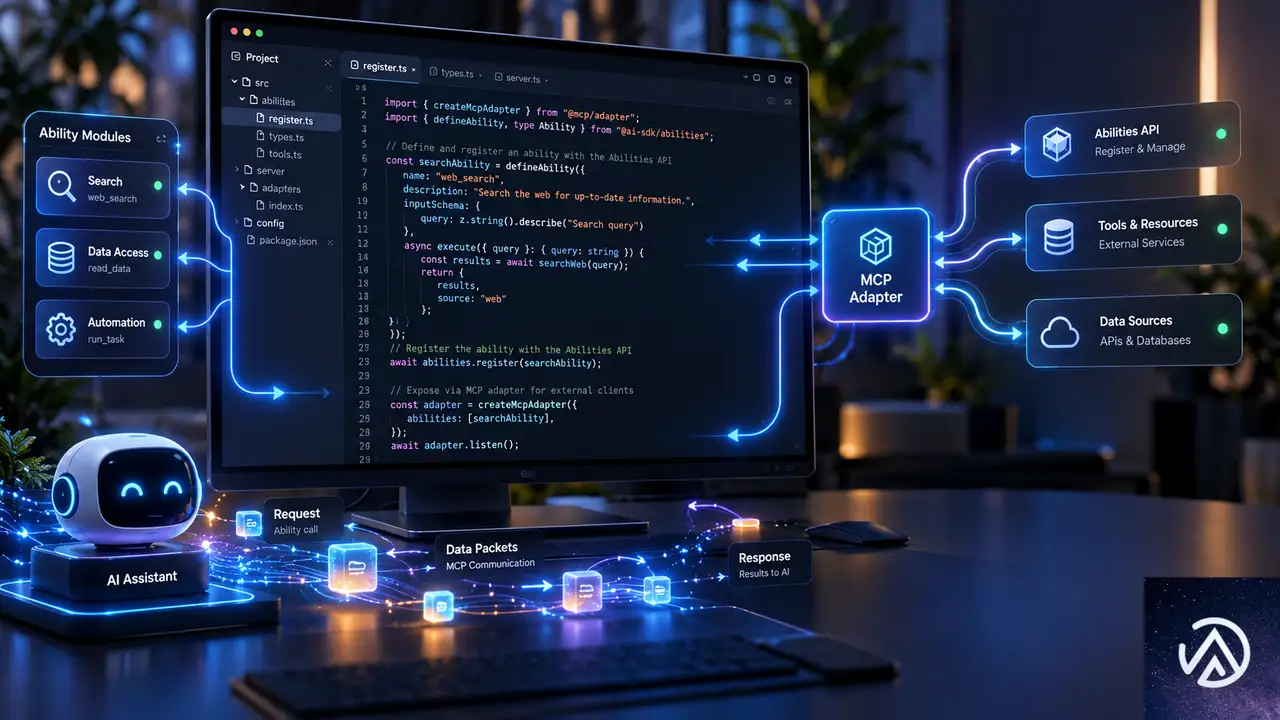
具体的には、B2BKingがWordPress Abilities APIに主要なストア設定を「能力」として登録する。その能力を公式のWordPress MCP AdapterがMCP経由で外部に公開し、MCPをサポートするAIアシスタントが利用できるようになる。特定のAI製品向けの独自コネクタを作るのではなく、オープンな標準の上に構築されている点が特徴だ。
一度接続すると、英語で普通の文章を入力するだけでストア設定を操作できる。B2B限定ストアとハイブリッドB2B/B2Cの切り替え、ゲストの閲覧制御、顧客グループの作成、卸売価格や最低注文金額の設定、顧客のグループ割り当てなどが対象となる。
指示はAIアシスタントからMCP Adapterへ送られ、B2BKingが登録した能力を通じてWooCommerceに反映される。すべて標準化されたプロトコル上で動作するため、特定のAI製品に依存しない。
AIが設定できる5つの領域
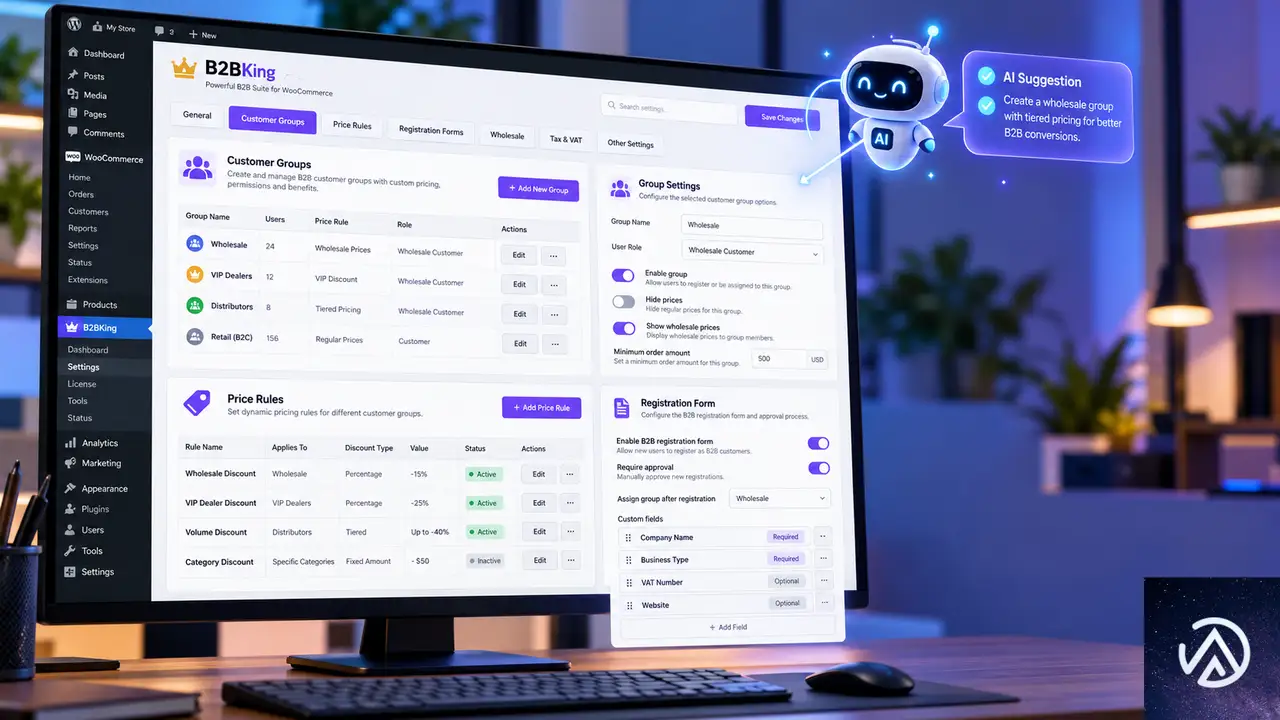
現時点でAIが操作できる範囲は、B2Bストアの構築に必要な主要な決定事項をカバーしている。大きく5つの領域に分類できる。
ストア全体の設定と登録機能
1つ目はストア構成だ。AIがB2BKingの設定全体を読み取り、B2B限定モードとハイブリッドB2B/B2Cモードを切り替えられる。ゲストが見る内容も制御でき、価格の非表示、ショップ全体の非表示、ログイン限定ストア、価格の代わりに見積依頼を表示する設定などに対応する。
2つ目は登録と機能の制御だ。B2B登録フォームの有効化、ロールのドロップダウン表示、アカウント承認フローをオン・オフできる。見積依頼、会話機能、オファー、購入リスト、一括注文フォーム、会社サブアカウントなどの機能も同様に操作できる。
顧客グループと価格ルールの操作
3つ目は顧客グループの管理だ。既存のグループを一覧表示するだけでなく、リセラーやディストリビューターなどの新しいグループを作成できる。グループには与信枠を設定することも可能だ。
4つ目は価格ルールだ。パーセント割引、固定金額割引、固定価格、送料無料、最低注文金額などのルールを、全B2B顧客または特定のグループに対して設定できる。適用範囲もカタログ全体、単一商品、カテゴリ単位で指定できる。
5つ目は顧客の個別管理だ。特定の顧客のB2Bステータス、所属グループ、承認状態を確認し、B2Bグループへの移動やB2Cへの戻しを実行できる。グループを作成した後のルール適用や顧客の移動も、同じ会話の中で続けて指示できる。
手動で設定画面を巡回する作業が、AIアシスタントへの1つの指示文で置き換わる。所要時間は数時間から数分へ短縮される。
WordPress Abilities APIとMCPの技術的仕組み
Abilities APIの役割
WordPress Abilities APIはWordPress 6.9からコアに導入された標準機能だ。プラグインが「自分に何ができるか」をAIに宣言するための共通の方法を提供する。各能力(アビリティ)には、説明文、期待する入力データのスキーマ、権限チェックの3つが含まれる。
これによりAIは、ある操作が何をするのかを事前に理解できる。さらに、ログイン中のユーザーがその操作を実行できるかどうかも、何かが起こる前に検証される。B2BKingは主要なストア設定をこのAbilities APIに登録している。
MCP Adapterの役割
MCP(Model Context Protocol)は、AIアシスタントが外部ツールと会話するためのオープンプロトコルだ。Claude、Codex、Cursor、VS Codeが同じB2BKingの設定を操作できるのは、このMCPが共通の通信基盤になっているからだ。
公式のWordPress MCP Adapterは、Abilities APIに登録された能力をMCP経由で外部に公開する橋渡し役を担う。ライブサイトとローカル開発環境の両方で動作し、WordPressのAIエコシステム全体が成熟するほどB2BKingも自動的に恩恵を受ける構造だ。
注目すべきは、この設計が特定のAI製品へのロックインを避けている点だ。独自のコネクタを開発するのではなく、オープンな標準に乗っているため、MCPをサポートする新しいAIツールが登場すれば、追加の開発なしで利用可能になる。
AIによるストア設定の安全性
AIがストア設定を変更できると聞くと、多くのストア運営者は「制御を失うのでは」と不安に感じる。B2BKingはこの懸念に対して、複数の安全機構を実装している。
実行前のチェック機構
第1に、すべての能力が実行前に接続ユーザーのWordPress権限(ケイパビリティ)をチェックする。権限のないユーザーが接続しても、変更操作は実行できない。
第2に、入力値の検証が行われる。存在しないグループやカテゴリを指定したルール、100%を超える割引率などをAIが指示しても、検証によって拒否される。B2BKingが各ステップを実行時に確認する仕組みだ。
第3に、各能力は読み取り専用か変更を伴うものかがラベル付けされている。AIクライアントは変更実行前にユーザーへ確認を求める設定にできる。第4に、ライセンスキーはAIアシスタントに渡らない設計になっている。
4つの安全機構により、AIがストア設定を誤って変更するリスクを抑えている。特にライセンスキーがAIに渡らない設計は、セキュリティ面で重要なポイントだ。
開発者向けフィルター
開発者向けには2つのフィルターが用意されている。b2bking_mcp_enabledでMCP連携を完全に無効化できる。またb2bking_mcp_write_enabledで読み取り専用に制限することも可能だ。本番ストアでは読み取り専用にしておき、ステージング環境でのみ書き込みを許可するといった運用が現実的だろう。
ClaudeやCodexとB2BKingの接続手順
MCPをサポートするAIアシスタントならどれでも動作するが、ClaudeとCodexが最も始めやすい。接続設定自体もAIに任せられるためだ。コードを書く必要はない。AIはB2BKingに組み込まれた能力を通じてのみ動作する。
AIに接続設定を任せる方法
最も簡単な方法は、ClaudeやCodexに「公式WordPress MCP Adapterを使用してMCP経由でストアに接続したい」と伝えることだ。AIが必要なインストールと設定を判断して進めてくれる。
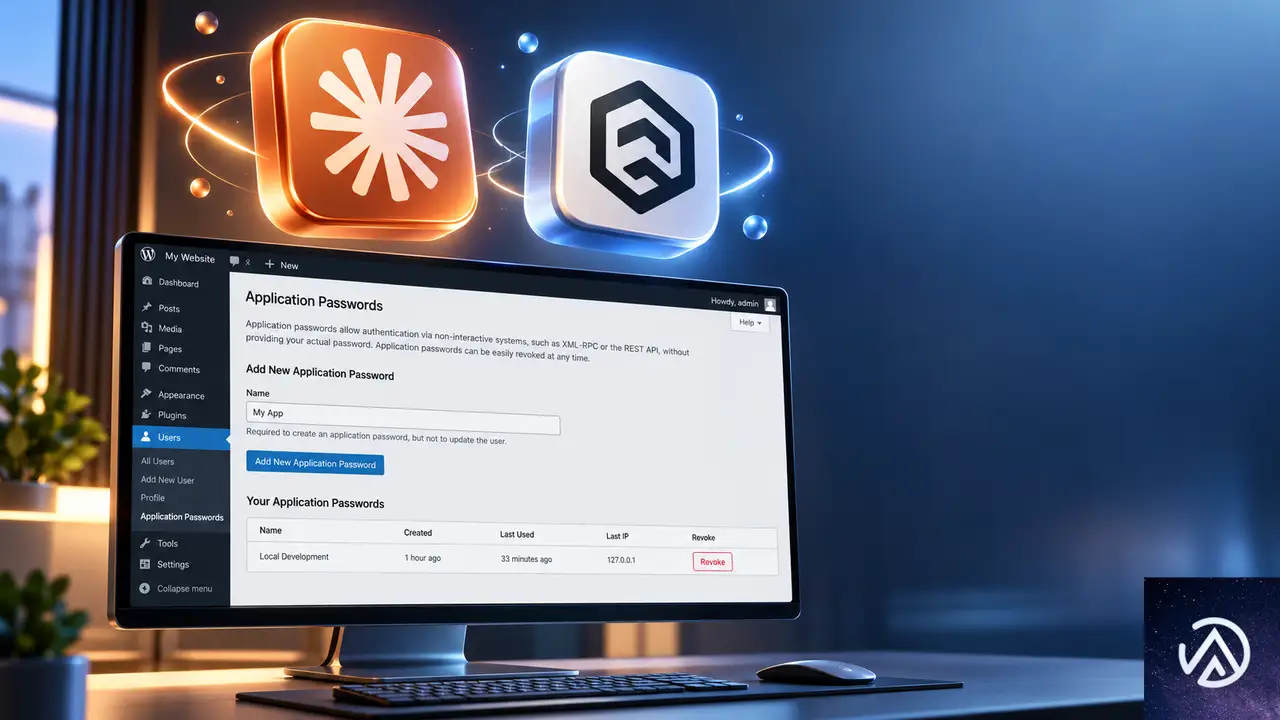
通常、AIが求めるのはアプリケーションパスワードのみだ。WordPress管理画面の「ユーザー」→「プロフィール」→「アプリケーションパスワード」から作成できる。これだけで接続は完了する。
手動で接続する手順
自分で設定する場合は、以下の手順を踏む。まずWordPress 6.9以降と最新版のB2BKingが必要だ。次にMCP Adapterプラグインをインストールし、アプリケーションパスワードを作成する。最後にAIクライアントのMCP設定に短い設定項目を追加する。
B2BKing側で何かを有効化する必要はない。能力は自動的に登録されるためだ。設定スニペットの全文はB2BKing公式サイトの「AIによるWooCommerce B2Bストア構築ガイド」に掲載されている。
接続後は、以下のような指示文を送るだけで設定作業が始まる。
ストアをハイブリッドB2B/B2Cモードに設定して。ゲストには価格の代わりに見積依頼を表示。Wholesaleグループを与信枠5,000ドルで作成し、全体に15%割引と最低注文300ドルを適用。AIはまず現在のB2BKing設定を読み取り、状況を把握する。その後、ハイブリッドモードへの切り替え、ゲスト見積依頼の設定、Wholesaleグループの作成、15%割引ルールと300ドル最低注文ルールの追加を順番に実行する。各ステップでB2BKingが検証を行い、すべて完了するとAIが変更内容を報告する。
この記事のポイント
- B2BKingがMCP連携に対応し、ClaudeやCodexから自然言語で操作できる
- Abilities APIとMCP AdapterというWordPress標準の仕組みで構築されている
- ストア構成、登録機能、顧客グループ、価格ルール、顧客管理の5領域を設定できる
- 権限チェック、入力検証、読み取り/書き込み区別、ライセンスキー遮断の4重の安全機構を備える
- 7年の実績と1万5,000以上のストアで使われてきた信頼性の上にAI連携が乗っている

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubがGit基盤を刷新、エージェント開発時代の書き込み性能を35倍に
GitHubが稼働を止めずにGit基盤を再構築している。AIエージェントがコードを書き、コミットし、レビューするエージェント開発が、次のアーキテクチャシフトを引き起こしているからだ。
2026年9月だけで、GitHub上で作られたコミットは73.8億回に達した。前年同期と比べると5倍超だ。月間のGitイベント総数も4733億件まで増えている。
現行のアーキテクチャでは、読み取りの拡張と書き込みの耐久性が同じディスクコピーに依存している。GitHubはこの2つを分離する新アーキテクチャを構築し、内部ベンチマークで書き込みスループットを最大35倍まで高めた。本記事では、その設計原則と移行方針を解説する。
エージェント開発が生む爆発的な負荷
日常的なリポジトリと最も負荷の高いリポジトリの差は、想像以上に大きい。GitHub Blogの記事によれば、2026年8月時点で最も忙しいリポジトリは、1か月で約10億回のリクエストを受けていた。
月間4733億イベントという規模
リポジトリのアクティビティ分布を見ると、高い負荷が一握りのリポジトリに集中している。GitHub全体のGitアクティビティは2025年9月から2026年8月にかけて、月間2182億イベントから4733億イベントへと2倍以上に増加した。
Gitアクティビティが1年で2倍超に増えた推移を示している。
2026年9月のコミット数73.8億回というのは、従来の人間中心の開発ペースでは説明できない成長速度だ。リポジトリ内でエージェントと開発者が同時並行で作業する時代に入ったことを示している。
書き込みが読み取りより難しい理由
読み取りの拡張は比較的容易だ。キャッシュやレプリカを追加し、同じデータをより多くのクライアントに配ればよい。一方で書き込みは桁違いに難しい。GitHubのプリンシパルソフトウェアエンジニアであるBrian Celenza氏は、すべてのプッシュを永続的に保存し、次のエージェントやCIジョブが積み上げられる前に一貫性を保って可視化する必要があると指摘する。
書き込みは単なる負荷の問題ではなく、正しさの問題を含む。エージェントが並行して作業するリポジトリでは、この両立こそが核心になる。
現行アーキテクチャの仕組みと限界
Spokesと5台のファイルサーバー
現在のGitHubは、Spokesという保存システムですべてのリポジトリを管理している。Spokesとは、リポジトリの完全コピーを複数のファイルサーバーのローカルディスクに保持する仕組みで、デフォルトでは5台に保存する。高速なローカルディスクによりGit操作は低レイテンシーでデータを読み取れる。
複数のコピーは冗長性を担保しながら、読み取りを複数のファイルサーバーに分散させている。プッシュによって参照が更新されると、3相コミットプロトコルが動作する。これは複数サーバー間でデータの一貫性を保つ合意形成の手順で、過半数の合意(クォーラム)を取ってから反映する仕組みだ。CIやWeb UI、APIクライアントから見て、常に一貫したリポジトリ状態が見える。この組み合わせで、現時点で10億のリポジトリを支えている。
レプリカ追加が書き込みを遅くする構造
ここに構造的な課題がある。耐久性の仕組みとスケールの仕組みが同じディスクコピーに依存していることだ。ディスク上のコピーが真実の源なので、読み取り容量を増やすには耐久レプリカを追加するしかない。
ところが、すべてのレプリカはすべての書き込みに参加する。プッシュはレプリカセットの中で最も遅いものに合わせて完了する。つまり、読み取り負荷を吸収するためにレプリカを追加すると、書き込みが遅くなるのだ。
耐久性と読み取りの分離が書き込み性能に直結することを示している。
大多数のリポジトリではこのトレードオフは問題にならない。しかし、最も活発なリポジトリでは天井になる。レプリカを追加すれば書き込みのオーバーヘッドが増え、レプリカを失えば読み取り容量が減り、クォーラムを失えば書き込みが完全に止まる。この状況はエージェント時代の負荷には耐えられない。
新アーキテクチャの設計原則
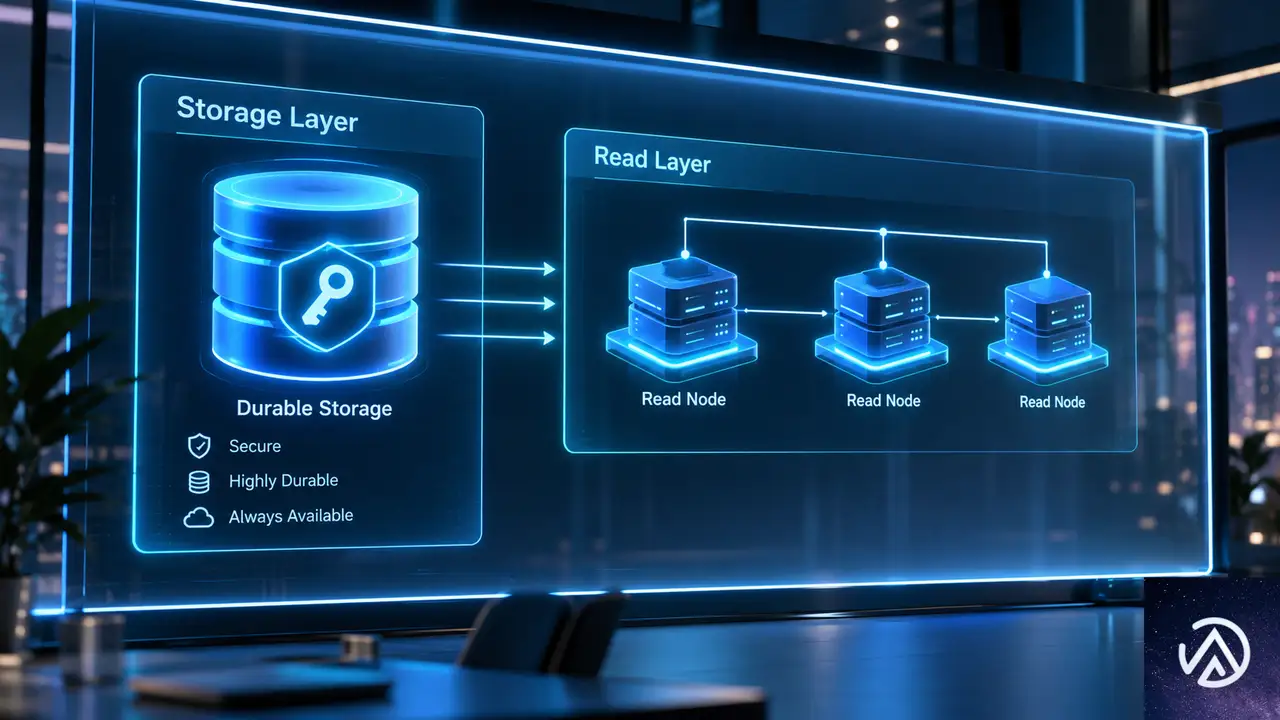
GitHubは世界のコードが止まるメンテナンスウィンドウなしに、再構築を進めている。新アーキテクチャは2つの原則を中心に据えている。
耐久性とスケールの分離
第1の原則は、耐久ストレージと読み取り層の分離だ。従来は完全コピーが両方を兼ねていた。分離すれば、書き込みを確実に保存する層と、Gitリクエストに応答する層をそれぞれ独立に拡張できる。
これは、読み取り容量を増やすたびに書き込みが遅くなるという現行のトレードオフを断ち切る設計変更である。読み取りは需要に応じて横に広げ、書き込みは耐久性を保ったまま高速化できる。
必要な協調だけを残す
第2の原則は、Gitの意味論が要求する協調だけを残し、それ以外を独立して動作させることだ。多くのプッシュを受け取るリポジトリは、更新を素早く受け付けて公開しなければならない。協調は正しさを守る上で価値があるが、多すぎると書き込みスループットを制限し、忙しいリポジトリをボトルネックに変える。
協調を最小限に絞る2つの原則を整理したものだ。
現行アーキテクチャは、結合する必要のない場所まで密結合している。新設計では、Gitの意味論に必要な合意形成だけを残し、読み書きの経路を分離してスループットを引き上げる。
ベンチマーク結果と今後の展望
書き込みスループット35倍の意味
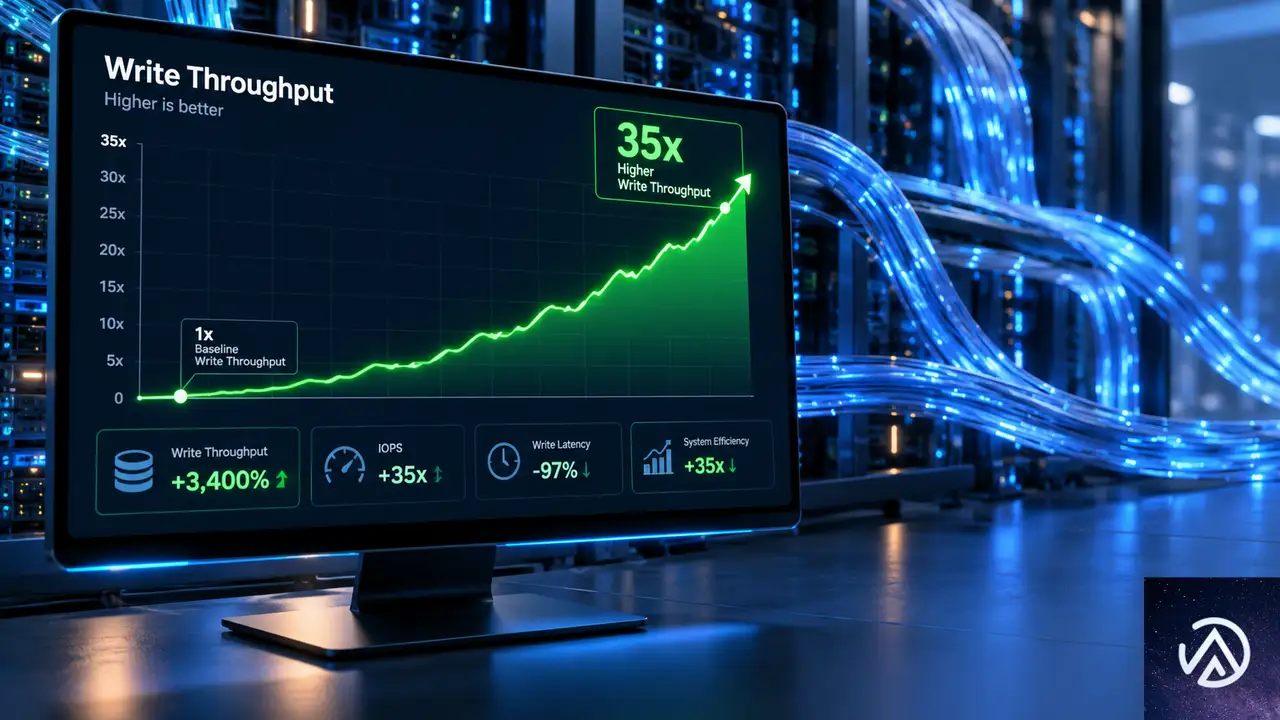
新アーキテクチャは、最高のスループットと信頼性を提供するよう設計されている。読み取りと書き込みは独立に拡張でき、障害からは優雅に回復する。内部ベンチマークでは、書き込みスループットが最大35倍まで向上した。読み取り容量も需要に応じて単独で拡張できる。
35倍という数字は、現行のレプリカモデルでは到達できない領域だ。エージェントが並行して作業するリポジトリでは、書き込みの頻度と同時実行性が飛躍的に高まる。GitHubはこの基盤を、オープンソースコミュニティとエンタープライズの双方に提供するとしている。
既存のコントロールをどう残すか
アーキテクチャを変えても、既存の管理機能は維持される。メンテナはブランチ保護と必須レビューを使い、未レビューの変更がデフォルトブランチに入らないようにできる。セキュリティチームは監査ログとリポジトリの可視性を使って、不審なアクセスを調査できる。オンコール担当者は、デプロイ失敗の原因を追える自動化と可観測性に頼れる。
この点は重要だ。スケールを優先してガバナンスを失えば、信頼は崩れる。GitHubはエージェント時代の負荷に対応しつつ、これまでチームが運用してきた制御を維持すると明言している。次回のシリーズ記事では、将来アーキテクチャとそこに至る過程をより深く掘り下げるとしている。
この記事のポイント
- GitHubは稼働を止めずにGit基盤を再構築している
- 2026年9月のコミット数は73.8億回で、前年同期比5倍超
- 現行のSpokesは耐久性と読み取りの両方を同じディスクコピーが担うため、レプリカ追加が書き込みを遅くする
- 新アーキテクチャは耐久ストレージと読み取り層を分離し、書き込みスループットを最大35倍に高めた
- ブランチ保護や監査ログなど既存のコントロールは維持される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Discoverが大規模刷新へ。AI搭載のコンシェルジュ体験に進化するのか
Google Discoverが大規模な転換期を迎える可能性が出てきた。Googleの採用情報から、Discoverが「レコメンドエンジン」から「AI搭載のコンシェルジュ体験」へ再定義されようとしていることが明らかになった。
2026年10月に公開されたPrincipal UX Leadの求人では「Discoverをプロアクティブでハイパーパーソナライズされたコンシェルジュ体験に変革する」という文言が明記されている。これは単なるアップデートではなく、サービスの根本的な方向転換を示唆するものだ。
パブリッシャーやクリエイターにとっては、Discoverからの流入の質と量が変わる可能性がある。この記事では求人情報から読み取れる5つの変更点を整理し、コンテンツ戦略への影響を考察する。
Google Discoverがコンシェルジュ型へ再定義する
求人情報の中で特に目を引くのは、Discoverの役割が「レコメンドエンジン」から「コンシェルジュ」へ再定義されている点だ。コンシェルジュとはホテルなどで宿泊客の要望を先回りして手配する人のこと。Googleはこの概念をDiscoverに適用しようとしている。
このデモで示したように、Discoverは「記事を届ける仕組み」から「ユーザーの目標達成を支援する仕組み」へ変わろうとしている。求人には「ユーザーが自分のゴールに向かって進歩できるよう支援する」という文言がある。
レコメンドエンジンから「目標達成支援ツール」への転換
従来のDiscoverは、ユーザーの検索履歴や閲覧パターンから興味・関心を推定し、関連する記事を表示する仕組みだった。新しいDiscoverは、単に記事を推薦するだけでなく、ユーザーが抱える継続的な関心や目標を認識し、その達成に必要な情報・商品・サービス・次のステップまで提案する。
たとえば「ランニングを始めたい」という関心を持つユーザーに対して、従来はランニングに関する記事を表示するだけだった。新しいコンシェルジュ型では、ランニングシューズの比較記事、近所のランニングコース、初心者向けトレーニングプラン、シューズの購入リンクまで一貫して提案することが想定される。
ピチャイCEOが語るエージェンティック検索との接続
この方向性は、Googleのスンダー・ピチャイCEOが提唱する「エージェンティック検索」の考え方と一致する。ピチャイ氏は検索の未来について「情報を探すだけのクエリの多くは、タスクを完了するエージェンティック検索に置き換わる」と述べている。
エージェンティック検索とは、ユーザーが情報を探すだけでなく、検索を通じて実際のタスクを完了できるようにする仕組みだ。Discoverのコンシェルジュ型への転換は、このビジョンをフィード体験に適用したものと位置づけられる。
フィードの仕組みが変わる。AI駆動の新フォーマット
求人情報にはフィードのインタラクション、コンテンツフォーマット、AI駆動の探索体験を再定義する責任が明記されている。具体的には、AI対応フォーマットの拡充、新しいエンゲージメントメカニズムの設計、フィード内での人間の声や視点の向上が挙げられている。
上記のステップ図は、新しいDiscoverのフィード生成フローを概念化したものだ。AIによるパーソナライズと人間のクリエイターのコンテンツを組み合わせる点が特徴になる。
AI対応フォーマットと人間の声の両立
求人情報には「AI対応フォーマットをスケールさせ、フィード内で人間の声と視点を高める」という記述がある。AIによる効率的なコンテンツ生成と、人間クリエイターの独自性を両立させる設計方針が示されている。
この点はパブリッシャーにとって重要だ。AIが生成した要約や情報だけが表示されるのではなく、人間によるオリジナルな視点や体験がフィード内で明確に評価される可能性がある。
セマンティックインテントの理解
Googleの2026年の研究論文では、ユーザーのセマンティックインテント(意味的な意図)を検出するレコメンダーシステムが解説されている。この仕組みは、主観的でパーソナライズされた「ソフト属性」の理解に重点を置く。
ソフト属性とは「心地よい」「刺激的」「上質な」といった、人によって解釈が異なる主観的な特徴のこと。従来のレコメンドはクリックや滞在時間などの行動データに依存していたが、新しい仕組みはコンテンツの持つ曖昧で主観的な特性まで理解しようとする。
検索を超えたGoogleサービスとの統合
Discoverは現在、Google Search Console上で検索の一部として扱われている。しかし求人情報では、YouTube、Shopping、Chrome、Androidなどの他プロダクトとの緊密な連携が求められている。
この統合図は、Discoverが単独のフィードではなく、Googleエコシステム全体をつなぐハブとして機能する可能性を示している。ユーザーはDiscoverでコンテンツを発見し、そのままYouTubeの動画を視聴したり、Shoppingで商品を購入したりできるようになる。
YouTubeやShoppingとの連携強化
求人情報では「Product Management、Engineering、Data Science、UX Research、そして組織横断的なパートナー(YouTube、Shopping、Chrome、Android)と緊密に連携し、統一された体験を提供する」と明記されている。
これは単なるリンクの追加ではない。ユーザーがDiscoverで見つけた情報から、YouTubeの動画視聴、Google Shoppingでの商品購入、Chromeでの閲覧、Androidでの通知まで、一貫した体験を提供する構想が見える。
若年層を狙う戦略
求人情報には「若年層向けの製品戦略を定義し、競争の激しいコンテンツエコシステムで製品市場適合性を推進した実績」が求められている。GoogleはDiscoverを若年層にとってより魅力的なサービスにしたい考えだ。
製品市場適合性とは、製品がターゲットとする層の期待にどれだけ応えているかを示す指標。Googleがこれを明示した背景には、TikTokやInstagramなどのソーシャルメディアに若年層の時間を奪われている危機感がある。
パブリッシャーとクリエイターへの影響
Discoverのコンシェルジュ型への転換は、パブリッシャーやクリエイターがDiscoverから読者を獲得する方法を変える可能性がある。従来の「記事を推薦する」仕組みから「目標達成を支援する」仕組みへの変化は、コンテンツが評価される基準自体の変化を意味する。
Search Engine Journalの記事によれば、同記事の著者は最近DiscoverでMeta Threadsの提案を経験したと報告している。これは一部の変更がすでにテスト段階にある可能性を示唆する。
Discover流入の質が変わる可能性
従来のDiscover流入は「偶然の閲覧」に近い性質が強かった。ユーザーが興味を持ちそうな記事が表示され、クリックして訪問するという流れだ。コンシェルジュ型では、ユーザーが特定の目標に向かって行動している文脈でコンテンツが表示されるため、流入の意図がより明確になる。
たとえば「筋トレを始めたい」という目標を持つユーザーに対して、トレーニング記事、ジムの比較、プロテインの購入情報などが一連の流れとして表示される。パブリッシャーは単発の記事ではなく、ユーザーの目標達成プロセス全体を見据えたコンテンツ設計が求められる。
コンテンツ戦略の再考
Discoverの新しい方向性は、コンテンツの文脈がより重要になることを示している。孤立した記事よりも、ユーザーのゴール達成に役立つ一連のコンテンツや、次のアクションにつながる情報が評価される可能性が高い。
また、求人情報に「人間の声と視点を高める」とあるように、AIが生成した画一的なコンテンツよりも、実際の体験に基づく独自の視点が重視される方向性が見える。パブリッシャーは量より質、そして独自性に投資する必要がありそうだ。
特に重要なのは、Discoverが検索よりもソーシャルメディアのフィードに近い性質を持つようになる点だ。ユーザーは受動的にコンテンツを消費し、その中から興味を持つものを選ぶ。パブリッシャーは「検索で見つけてもらう」発想から「フィードで選ばれる」発想への転換を迫られるだろう。
この記事のポイント
- Google DiscoverはレコメンドエンジンからAI搭載のコンシェルジュ体験へ再定義される可能性がある
- 求人情報から「目標達成支援」「AI対応フォーマット」「人間の声の重視」という3つの方向性が見える
- YouTube、Shopping、Chrome、Androidとの統合が進み、エコシステム全体をつなぐハブになる構想だ
- 若年層の取り込みを狙い、ソーシャルメディアに対抗するエンゲージメント戦略が示されている
- パブリッシャーは単発記事ではなく、ユーザーの目標達成プロセスを見据えたコンテンツ設計が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPressのMCP接続、3つの選択肢を比較。Elementorユーザーが最初に試すべき方法
WordPressにMCP(Model Context Protocol)でAIエージェントを接続する方法が、2026年10月に入って大きく変わった。WordPressプロジェクトが公式のMCPアダプターをリリースし、一方でElementorはバージョン4.3.0からMCP機能を標準搭載した。
現在、WordPress向けMCP接続には3つの選択肢がある。公式のWordPress MCP Adapter、非公式のMCPサーバー、そしてElementor内蔵のMCPだ。それぞれ設定の手間やメンテナンス負担が異なる。
この記事では3つの選択肢の違いを整理し、どのようなサイト運営者がどれを選ぶべきかを解説する。特にElementorを使っているなら、追加インストール不要の内蔵MCPが最短ルートになる。
WordPressのMCP接続とは何か

MCP(Model Context Protocol)は、AIエージェントが外部のサイトやツールに接続するための共通規格だ。ClaudeやCodexなどのAIクライアントが、WordPressサイトの機能を呼び出すための橋渡し役を果たす。この仕組みを使うと、AIエージェントはサイト上の操作を自動化できるようになる。
MCPが登場する前は、AIエージェントをWordPressに接続する手段が統一されていなかった。サービスごとに独自のAPIを用意する必要があり、開発者にとっては接続のたびに学習コストがかかっていた。MCPはこの接続方法を標準化し、1つの仕組みでさまざまなAIクライアントと連携できる道を開いた。
MCPが解決する接続の課題
従来の接続方式では、サイト側とAIクライアント側の両方に個別の設定が必要だった。MCPはこの複雑さを抽象化し、AIエージェントが「ツール」「リソース」「プロンプト」という3つの単位でサイトの機能を扱えるようにする。たとえば「商品を更新する」「スタイルを変更する」といった操作が、AIエージェントから呼び出せる単位になる。
WordPressのAbilities APIとは
WordPressにはAbilities APIという標準がある。これは、WordPress本体や各プラグインが持つ機能をAIエージェントに公開するための仕組みだ。Abilities APIに登録された機能は、MCP接続を通じてAIエージェントが発見し、呼び出せるようになる。
重要なのは、Abilities APIはどのMCP接続方式でも利用できる点だ。WordPress MCP Adapterでも、Elementor内蔵MCPでも、同じ標準に基づいて機能が公開される。つまり、MCP接続の選択肢が増えても、プラグイン側が対応すべき仕組みは共通である。
3つの方法はそれぞれ性質が異なる。次のセクションから順番に見ていく。
WordPress MCP Adapterの仕組み
2026年10月2日、WordPress MCP Adapterのバージョン0.7.0がWordPress.orgのプラグインディレクトリに公開された。これまでGitHub上でのみ入手可能だったが、公式ディレクトリに登場したことで、一般のサイト運営者にとって入手のハードルが大きく下がった。
このプラグインの役割は、Abilities APIに登録された機能をMCPの「ツール」「リソース」「プロンプト」に変換することだ。AIエージェントはこの変換を通じて、WordPressサイトの機能を発見し、呼び出せるようになる。注意すべきなのは、このプラグイン自体はAI機能を追加しないという点だ。
WordPress MCP Adapterは「橋」にすぎない。実際にAIエージェントが実行できる操作は、サイトに導入済みのプラグインがAbilities APIに登録した内容に依存する。つまり、Adapterを導入しただけでは何も起きず、Abilitiesを提供するプラグインが揃って初めて機能する。
手動設定の具体的な手順
WordPress MCP Adapterには、現時点で設定画面や製品内の案内が用意されていない。接続するには、まずWordPressでアプリケーションパスワードを生成し、次にAIクライアントの設定ファイルを編集してサーバーエンドポイントを指定する必要がある。設定ファイルの編集に慣れている開発者向きの手順だ。
Adapterが持つ制約
WordPress MCP Adapterはバージョン0.7.0という早期段階にある。動作にはWordPress 6.9以降が必要で、まだ正式リリースには至っていない。今後のバージョンアップで設定画面が追加される可能性はあるが、現時点では技術的な知識なしに接続するのは難しい。
非公式MCPサーバーの注意点

WordPress向けの非公式MCPサーバーは、個人開発者やサードパーティが公開しているプラグインやリポジトリとして存在する。これらは公式のWordPress MCP Adapterが登場する前から利用されてきた経緯がある。
メンテナンスと権限のリスク
非公式MCPサーバーを使う際の最大の懸念は、品質のばらつきだ。メンテナンスが継続的に行われているか、どの権限を要求するか、サイトや利用者に関するどのようなデータを保存するか、AIエージェントにどこまで操作を許可するか。これらがサーバーごとに異なる。
また、非公式MCPサーバーの多くは手動設定が必要だ。WordPress MCP Adapterと同様に、アプリケーションパスワードを生成してAIクライアント側に設定する作業が発生する。さらに、更新の有無を自分で確認し続ける必要がある。
セキュリティの観点では、信頼できる開発者による実績のあるサーバー以外は避けるのが無難だ。特にクライアントの本番サイトでは、権限が過剰なものやデータの取り扱いが不透明なものは導入すべきではない。
Elementor内蔵MCPの違い
公式のElementor MCPは、Elementor 4.3.0以降に標準搭載されている。追加でダウンロードするプラグインは不要だ。Elementorがインストールされて有効化されていれば、そのままMCP接続を開始できる。
この「追加インストール不要」という点は、サイト運営者にとって実務上の大きな利点になる。プラグインを増やせば増やすほど、更新の手間や互換性リスクが積み上がる。内蔵機能としてMCPが使えるなら、その負担を増やさずに済む。
UIで完結する設定フロー
Elementor MCPの設定は、WordPressダッシュボード内の専用UIで完結する。「Elementor」メニューから「Elementor MCP」を開き、利用するAIツールを選択して、画面に表示される手順に従うだけだ。設定ファイルを直接編集する必要はない。
アプリケーションパスワードはElementorがバックグラウンドで自動生成する。利用者がパスワードを手動で生成したり、AIクライアントに設定を書き込んだりする作業は不要だ。この手順の簡潔さは、技術的な知識がないサイト運営者にとって大きな意味を持つ。
直接接続がもたらす安全性
Elementor MCPの接続では、アプリケーションパスワードはサイトとAIツールの間だけで保持される。Elementorがパスワードを閲覧することはなく、AIツールはサイトに直接接続する。中間に何かを介在させない設計になっている。
設定の手間を比較すると、Elementor内蔵MCPは技術的な知識がなくても接続できる。対してWordPress MCP Adapterと非公式サーバーは、設定ファイルの編集という作業が発生する。この差は実務上の導入障壁に直結する。
ProとAngieで広がる機能
Elementor単体でもMCP接続は可能だが、Elementor ProとAngieを追加すると、AIエージェントが扱えるAbilitiesの範囲が広がる。どちらを選ぶにせよ、MCP接続の方式とは独立した追加機能として考えるのがよい。
Elementor Proが追加するAbilities
Elementor Proは、Theme Builder、Loops、Forms、動的コンテンツ、表示条件などのツールを追加する。これらの機能がAbilitiesとして登録されることで、AIエージェントはより高度なサイト構築・編集作業を実行できるようになる。
Angieが開くプラグイン連携の幅
AngieはElementor公式のAIプラグインだ。カスタムウィジェットやアプリの生成、WordPress管理画面のカスタマイズ、サイト全体にわたる一括操作などをAIエージェントに提供する。Angie自身が独自のAbilitiesを持つことに加えて、他のプラグインがAbilities APIに登録した機能にも到達できるようになる。
具体的には、WooCommerce、Yoast、WPForms、Jetpack、ACFなどがAbilities APIに登録した機能を、Elementor MCPの接続を通じてAIエージェントが利用できる。1つの接続でサイト全体のスタックにアクセスできる点がAngie導入の強みだ。
Angieを導入すると、Elementorの機能に限定されないサイト全体の自動化が視野に入る。ECサイトの商品更新、SEO設定の調整、フォームデータの処理など、プラグインごとの機能をAIエージェントが横断的に扱えるようになる。
どの選択肢を選ぶべきか
3つの選択肢を比較したうえで、実際にどれを導入するかはサイトの状況によって異なる。ここではサイト運営のタイプ別に推奨を整理する。
サイト運営タイプ別の推奨
- Elementorを使っている場合 → 追加インストール不要の内蔵MCPから始めるのが最短。Elementor 4.3.0以降にアップデートして、ダッシュボードの「Elementor」→「Elementor MCP」から設定する。
- Elementorを使っていない場合 → WordPress MCP Adapterが公式の選択肢になる。ただし手動設定が必要なため、設定ファイルの編集に慣れていることが前提になる。
- 全プラグインのAbilitiesを横断的に使いたい場合 → ElementorユーザーならAngieを追加する。Elementorユーザーでなければ、Abilities API対応プラグインを個別に導入してWordPress MCP Adapterで接続する。
- セキュリティを最優先する場合 → 実績のある公式の選択肢(WordPress MCP AdapterまたはElementor MCP)を選ぶ。非公式サーバーは権限やデータ取り扱いを個別に精査してから判断する。
1つ留意すべき点がある。この比較はElementor公式ブログの記事に基づいており、自社製品に有利な視点が含まれる可能性は否定できない。特に「設定の簡潔さ」や「直接接続の安全性」といった評価は、Elementor側の主張として受け止めるのが妥当だ。
とはいえ、MCPの標準化そのものはプラグインやベンダーに依存しない動きであり、WordPress全体のエコシステムにとって前進である。WordPress MCP Adapterが公式ディレクトリに登場したことと、Elementorが内蔵MCPを提供したことは、どちらも「AIエージェントがWordPressに接続する」という流れを加速させる。
今後、WordPress MCP Adapterのバージョンが進み、設定画面が追加されれば、技術的な知識がない運営者でも公式アダプターを使いやすくなる可能性がある。Abilities APIに対応するプラグインが増えれば、MCP接続の価値はさらに高まる。選択肢の優劣は、時間とともに変わることを見越しておくのがよい。
この記事のポイント
- WordPress向けMCP接続には「WordPress MCP Adapter」「非公式MCPサーバー」「Elementor内蔵MCP」の3つの選択肢がある。
- WordPress MCP Adapterは2026年10月2日にWordPress.orgへ登場。バージョン0.7.0で、WordPress 6.9以降が必要。設定は手動。
- 非公式MCPサーバーはメンテナンスや権限のばらつきが大きく、本番サイトでは慎重な選定が必要。
- Elementor MCPは4.3.0以降に内蔵され、追加インストール不要。UIで数ステップの設定で完了する。
- Angieを導入すると、WooCommerceやYoastなど他プラグインのAbilitiesにも1つのMCP接続で到達できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleがインデックス不要のランキングを理論実証。検索結果ページは見えなくなる
Googleの研究チームが、インデックスなしで文書をランキングできる計算手法を理論的に証明した。検索結果ページは「見るもの」から「モデルが内部で処理するステップ」に変わる可能性がある。
この研究は2026年1月に発表されたAutoRegressive Ranking(ARR、自己回帰ランキング)という手法に関する論文が基盤になる。Googleは2021年から同じ方向の研究を積み重ねてきた。
実務者にとって重要なのは、ビームサーチと呼ばれる生成プロセスが可視性の境界線になることだ。ランキング上位の限られた件数に入れない限り、そもそも生成されないため「圏外」と「生成されず」の区別すらできなくなる。
Googleが2021年から進めてきた研究の集大成
この論文は突然出てきたものではない。2021年にGoogleの研究者4人が発表した「Rethinking Search(検索の再考)」では、検索システムは参照リストを提示するのではなく、引用可能なコーパスから直接回答すべきだと主張していた。これは研究提案であり製品ロードマップではないとの但し書きが付いていた。
2022年にはほぼ同じ研究グループがDifferentiable Search Index(微分可能検索インデックス、DSI)を発表した。1つのTransformerモデルがクエリを文書識別子に直接マッピングできることを示した。コーパス全体がモデルのパラメータにエンコードされる。これが新しいランキング手法の原型だ。
2026年1月の論文はその理論を埋める。デュアルエンコーダの埋め込み次元は文書数に比例して拡大する必要があるのに対し、固定の隠れ次元を持つ自己回帰モデルは任意の数をランキングできることを証明した。さらにSToICaLという学習ロスを導入し、モデルが上位1件だけでなくリスト全体を意識して学習するようにした。提案、プロトタイプ、証明という流れで、5年間の研究が1つの方向に収束している。
従来の検索は「検索してから並べ替える」2段階だったが、新しい手法では1つのモデルが文書識別子を生成しながらランキングまで完了する。この違いはアーキテクチャの変更ではなく、検索という概念の再定義に近い。
文書はコードになり、コードがランクされる
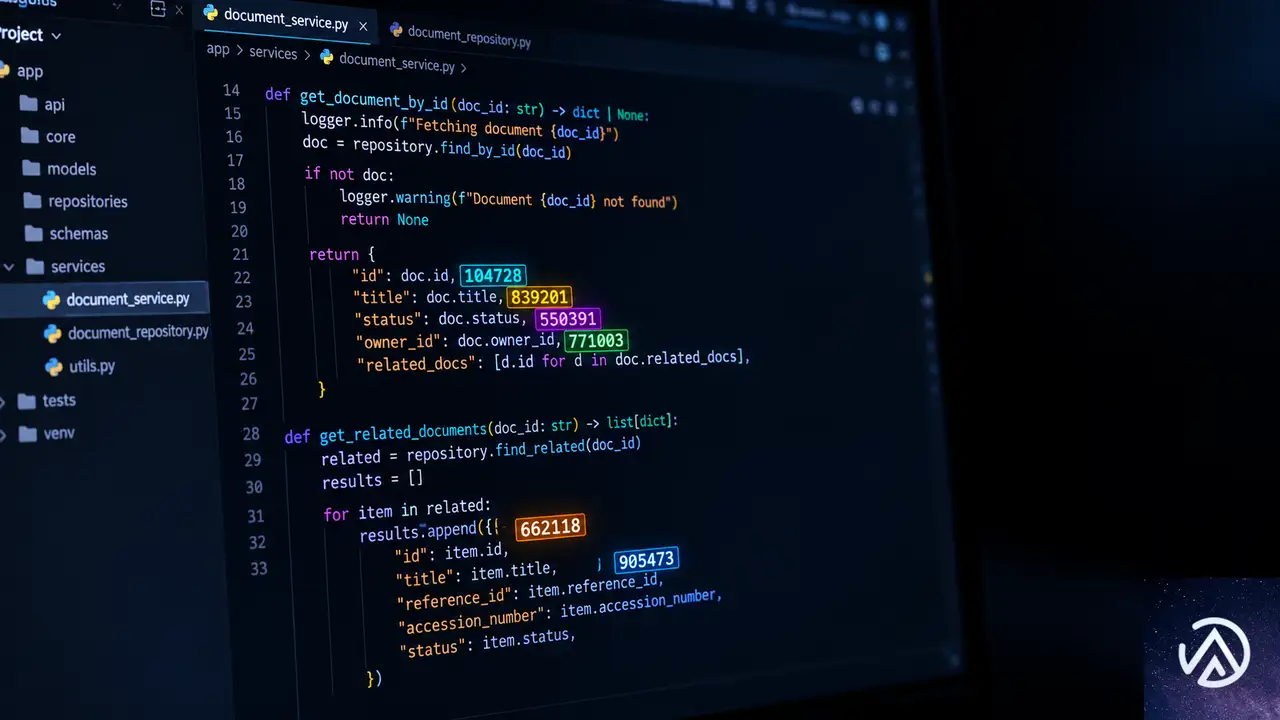
このアーキテクチャでは文書はURLではない。docID(文書識別子)という短いトークン列として扱われる。モデルは単語を生成するのと同じ仕組みで、文書識別子を1つずつ生成していく。
ショッピング実験では、各商品の識別子を商品タイトルの埋め込みベクトルから3つの数字に圧縮して作った。識別子自体が意味を持ち、似た商品は似た数字の並びを共有する。モデルは最も確からしい識別子から順にビームサーチで生成していく。調べるのではなく、アドレスを生成する。検索ルックアップが存在しない点が本質的な違いだ。
ショッピング実験では、商品タイトルの埋め込みベクトルを3つの数字に圧縮して識別子を作った。似た商品は似た識別子を持つため、ランキングが意味を持つ。
識別性が最適化目標になる
ページが埋め込み空間で隣接するページと区別できない場合、安定した識別子を持てない。2つの重複に近い商品ページは隣接する順位を争うのではなく、同じアドレスを争うことになる。そして片方は完全に負ける。
ランキング関数はトレーニングセットそのものになる。SToICaLはクエリ、文書識別子、真のランクの3つ組で学習する。クリックログ、評価者の判断、エンゲージメント信号など、グレード付きリストを生成したものがアルゴリズムになる。リバースエンジニアリングすべきランキング要素の層は存在しなくなる。
鮮度がトレーニング問題に変わる
従来のインデックスでは新しいページはクロールして挿入するだけでよかった。パラメトリック生成インデックスでは学習する必要がある。Googleの後続研究DSI++では、新しい文書を継続的にインデックスすると既存文書の記憶が大幅に失われることが分かっている。
ニュースパブリッシャーにとって「インデックスされた」と「ランカーに認識された」は別のイベントになる。ARR実験では候補をプロンプト内に置くことで回避している。実際の展開も古典的検索が生成ランカーに候補を供給するハイブリッドから始まる可能性が高い。純粋な生成インデックスは長期的な方向性だ。
ビームサーチが可視性の境界線になる
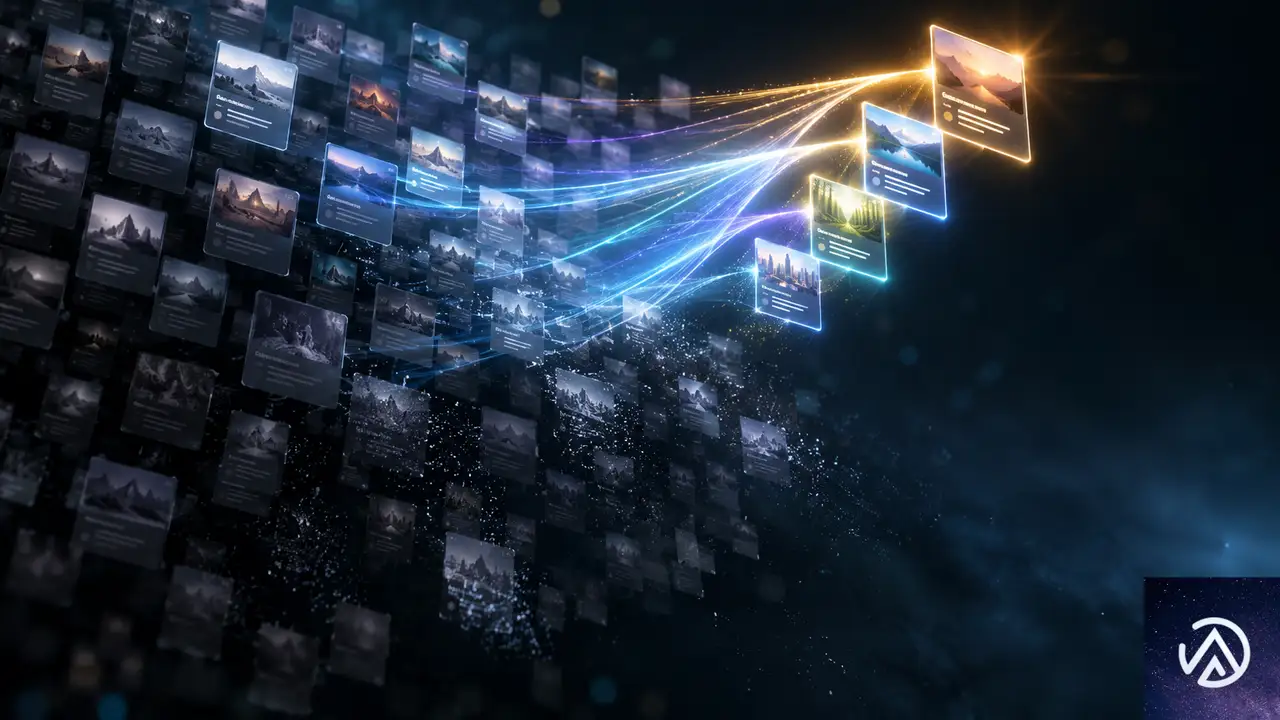
ビームサーチは生成モデルが1つの答えではなく短いリストを生成する仕組みだ。各生成ステップで確率の高い部分列を一定数(ビーム幅)だけ保持し、他は捨てる。ビーム幅が10なら最終リストは10件を超えない。
ポイントは11位が「悪い結果」ではなく「存在しない」ことだ。従来のデュアルエンコーダなら最近傍インデックスで上位1000件をほぼ無料で取得できた。スコアリングが安価だからリストは副産物だった。しかしビーム幅10の生成モデルでは11位はそもそも生成されない。
ビームサーチでは各ステップで一定数(ビーム幅)の候補だけが生き残る。ビーム幅が10なら結果は10件止まりで、11位は計算すらされない。
ランクトラッキングの意味が消える
ページ2は設計上の決定ではなく、存在しないものになる。ビーム幅以下のランクトラッキングは何も測定しない。可視性は2値化する。「生成されたセットに入っているか、入っていないか」だ。
外部からは「ランキングが悪い」と「生成されなかった」を区別できない。どちらも見た目は同じだからだ。実務者の問いは「何位か」から「生成セットに入っているか、どのクエリ形状で、どれだけ一貫して」に変わる。これが可視性計測プラットフォームが答えるべき問いになる。
論文には皮肉な点がある。実際の貢献は1位以下の改善だ。WordNetでの実験では、ランク認識型トレーニングが2位から5位の再現率を50%台から90%台半ばまで押し上げた。2位から5位の並び順が改善される瞬間に、検索結果画面には表示されない領域が広がっていく。
広告と収益モデルへの影響
Alphabetの2026年第2四半期のGoogle検索およびその他収益は632億7000万ドル、前年比17%増だった。広告オークションは別システムであり、この論文は直接触れない。収益に関係するのはコスト面だ。
2段階パイプラインが存在するのは、クロスエンコーダをコーパス全体に実行するのが高すぎるからだ。自己回帰ランキングは最近傍インデックスを不要にし、全文書を個別にスコアリングしない。生成結果の構造的なコスト削減になる。
コストはGoogleがAI回答をデフォルト体験としてどこまで押し広げるかの静かな制約だった。十分なコスト削減が実現すれば、広告在庫が存在する10個の青いリンクを維持する構造的な理由が弱くなる。広告が消えるのではなく、広告を載せる面が変わる。広告も一緒に移動するのだ。
広告システムの変容は始まっている
Search Engine Journalの著者Duane Forrester氏は2025年8月に「Cohorts, Clusters, and the Coming AI Ad System(コホート、クラスタ、到来するAI広告システム)」という記事を公開し、Intent Vector Bidding(意図ベクトル入札)という概念を提唱した。広告主のコンテンツがユーザープロンプトの意味とどれだけ近いかで掲載が決まり、広告自体もクエリ時に広告主の資産から組み立てられるという仕組みだ。
9か月後のGoogle Marketing Liveで、GoogleはAI検索向けの広告フォーマットを発表した。ユーザー固有のクエリに即座に合わせ、質問の具体的な言い回しからクリエイティブを生成する。キャンペーンを実行し資産を供給する点は従来通りだが、クリエイティブの半分は実現した。
ARR論文はそのメカニズムを完成させる。Google Researchのトークンオークション論文は、広告主がトークンごとに生成される広告テキストに影響を与えるために入札するオークションを設計した。自己回帰ランキングは有機的な文書識別子をトークンごとに生成する。同じ生成プロセスが答え、有機ソース、スポンサード掲載を同時に生成できる可能性がある。
実務者が今着手すべき3つの対策
研究論文を基盤にプログラム全体を再構築する必要はない。この段階では3つの小さな動きが釣り合いの取れた対応になる。
この3つの対策は即座に実行可能で、研究の進展を待たずとも価値がある。識別性の監査と可視性測定の移行は、現在の検索環境でも有効な施策だ。
この記事のポイント
- Googleがインデックスなしで文書をランキングできる計算手法を理論的に証明した
- 文書はdocIDというコードになり、モデルが生成するアドレスに変わる
- ビームサーチが可視性の境界線になり、上位10件以外は存在しない扱いになる
- ランクトラッキングより生成セットへの含有率測定が重要になる
- 広告システムはトークン単位の入札と生成型クリエイティブへ進化する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.2.1リリース。住所フィールドと郵便番号の不具合を修正
WooCommerce 11.2.1が2026年10月9日にリリースされた。今回のドットリリースは、11.2.0で発生した2件のチェックアウト関連バグを修正する内容だ。
住所フィールドを削除したストアで発生するエラーと、アルゼンチンなど特定の国で郵便番号が拒否される問題が対象になる。セキュリティ更新とデータベース更新は含まれない。
記事を読めば、修正された2つのバグの内容と、アップデート前に確認すべきポイントがわかる。
WooCommerce 11.2.1の概要
WooCommerceはWordPressでECサイトを構築する無料プラグインだ。今回の11.2.1は「ドットリリース」と呼ばれる、バグ修正に限定された小規模な更新になる。新機能の追加はなく、11.2.0で見つかった不具合を修正するためにリリースされた。
修正対象は2件ある。1件目はクラシックチェックアウトで住所フィールドを削除したストアに発生するブロックエラーで、2件目はチェックアウトブロックでアルゼンチンなどの郵便番号が拒否される問題だ。
WooCommerceのチェックアウトには大きく分けて2つの方式がある。1つはショートコードで表示する「クラシックチェックアウト」、もう1つはGutenbergブロックエディタで構築された「チェックアウトブロック」だ。今回の修正は両方を1つずつカバーしている。
このデモは、11.2.1で修正された2つの不具合と、セキュリティ更新やデータベース更新が含まれないことを示している。
クラシックチェックアウトの住所フィールド修正
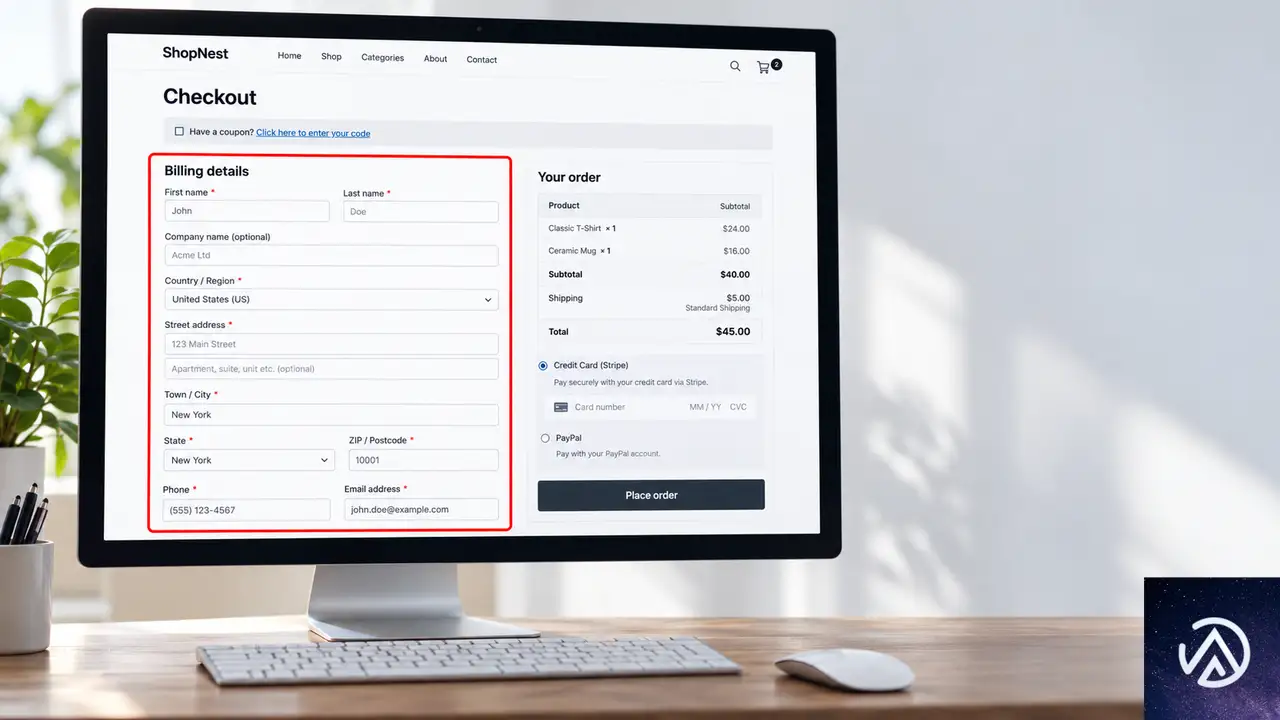
クラシックチェックアウトは、ショートコード [woocommerce_checkout] で表示される従来型のチェックアウト画面だ。WooCommerceの初期から提供されている方式で、現在も多くのストアで使われている。
住所フィールドとは、請求先住所や配送先住所の入力欄のことだ。多くのストアでは必須項目だが、デジタル商品のみを販売するストアなどでは不要な場合がある。そうしたストアは、woocommerce_billing_fields または woocommerce_default_address_fields というフィルターを使って住所フィールドを削除するカスタマイズを行う。
フィルターとは、WordPressやWooCommerceの動作をサイト独自に変更するための仕組みだ。テーマのfunctions.phpやカスタムプラグインにコードを追加して使う。住所フィールドを削除するカスタマイズは、決して珍しいものではない。
11.2.0では、注文サマリーが更新される際の住所データ送信に問題があった。住所フィールドを削除したストアで、以下のような不具合が発生する可能性があった。
- 「続行するには住所を入力してください」というエラーでチェックアウトがブロックされる
- 税金が正しく計算されない
- 配送方法の選択肢が表示されなくなる
11.2.1では、11.1の動作に戻す修正が入った。注文サマリーのリフレッシュ時に、住所データが正しく送信されるようになる。住所フィールドを削除するカスタマイズを利用しているストアは、このバージョンで問題が解消される。
住所フィールドを削除したストアでは、11.2.0のエラーが11.2.1で解消される。
チェックアウトブロックの郵便番号バリデーション修正
チェックアウトブロックは、ブロックエディタで構築された新しいチェックアウトフローだ。カートブロックやチェックアウトブロックなど、複数のブロックを組み合わせて柔軟にレイアウトを変更できる。
バリデーションとは、入力された値が正しい形式かどうかを検証する仕組みだ。たとえば郵便番号の入力欄に「123」など桁数の少ない値を入力するとエラーになるのは、バリデーションが働いているからだ。今回の問題は、この検証が厳しくなりすぎたことによって発生した。
11.2.0では、アルゼンチンの郵便番号で州文字なしの形式(例 1213)が拒否されるようになった。さらに、エルサルバドル、セントビンセントおよびグレナディーン諸島、イギリス領ヴァージン諸島の郵便番号フォーマットも拒否されていた。
11.2.1では、アルゼンチンの州文字なし郵便番号を再び受け入れ、上記3カ国のフォーマットにも対応する。該当する国への配送を行っているストアは、チェックアウトブロックでエラーが解消される。
11.2.1では、アルゼンチンの州文字なし郵便番号が再び有効になる。
アップデート前の確認ポイント
今回の修正はバグ修正に限定されているため、更新によるリスクは比較的低い。ただし、チェックアウトは売上に直結する機能だ。更新前には以下のポイントを確認しておきたい。
- 住所フィールドを削除するカスタマイズを使っているか
- チェックアウトブロックを利用しており、対象国に配送しているか
- ステージング環境で実際のチェックアウトフローをテストしたか
- 更新前にバックアップを取得しているか
特に住所フィールドを削除するカスタマイズを使っているストアは、11.2.0をスキップして11.2.1に直接更新することをおすすめする。11.2.0に更新してしまった場合は、できるだけ早く11.2.1への更新が望ましい。
この記事のポイント
- WooCommerce 11.2.1は2026年10月9日にリリースされたドットリリース
- クラシックチェックアウトで住所フィールドを削除したストアのエラーを修正
- チェックアウトブロックでアルゼンチンなどの郵便番号バリデーションを修正
- セキュリティ更新とデータベース更新は含まれない
- 住所フィールド削除カスタマイズ利用中のストアは更新推奨
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがAI偽装フロント作戦2件を遮断。ロシア発は過去最大級カテゴリ5
OpenAIは2026年10月8日、ロシア発とイラン発のAIを利用した偽装フロント作戦2件を遮断したと発表した。ロシア発の作戦は影響工作の評価尺度でカテゴリ5と判定され、これはOpenAIが報告を開始して以来初の事例となる。
偽装フロントとは、実在しない組織や人物を装って情報を流す手口だ。ロシア発の作戦はラテンアメリカで偽のシンクタンクを運営し、イラン発の作戦は7人の偽ジャーナリスト人格を使って記事を各国メディアに売り込んだ。いずれもAIが作業の効率化に使われていた。
この記事では、2件の作戦の具体的な手口と影響力評価、AIが偽装フロントに与える利点、そしてメディアや企業が取るべき対策を解説する。
摘発の概要と偽装フロントの仕組み
OpenAIは2025年初頭から、AIモデルを使ったサイバー攻撃や隠密影響工作、詐欺などの悪用事例を継続的に報告してきた。今回の発表はその一環で、ロシア発とイラン発の組織的な作戦2件を特定し、関連するChatGPTアカウント群を停止した。
偽装フロントとは、実在する組織や人物を装って活動の正体を隠す手法だ。今回摘発された2件はいずれも、AIと従来型の技術を組み合わせて偽装組織を運営していた。目的は、地政学的な対立や紛争に関するメッセージを対象者に届けることにある。
AIが加わった偽装フロントの特徴
OpenAIの報告によると、今回の2件はAI以前の影響工作に似ている一方で、AIによって作業の一部が効率化されていた。イラン発の作戦では長文記事の推敲や編集者への売り込みメール作成に、ロシア発の作戦では内部報告書の草案作成にChatGPTが使われた。
OpenAIが2024年初頭以降に摘発した30件の隠密影響工作を分析すると、メディア掲載に成功した作戦ほど影響力が高くなる傾向がある。ソーシャルメディアだけで拡散させる作戦はカテゴリ1から3にとどまり、実在のメディアに記事を掲載させた作戦はカテゴリ4から5に達していた。
影響工作の評価尺度 Breakout Scale
OpenAIは影響工作の影響力を、米ブルッキングス研究所のBreakout Scale(ブレイクアウトスケール)で評価している。カテゴリ1から6までの6段階で、数字が大きいほど影響力が高い。カテゴリ5は政治家の公的コメントを引き出した水準だ。
Breakout Scaleは米ブルッキングス研究所が提唱した影響工作の評価尺度だ。
ロシア発の作戦 ダーククラーク
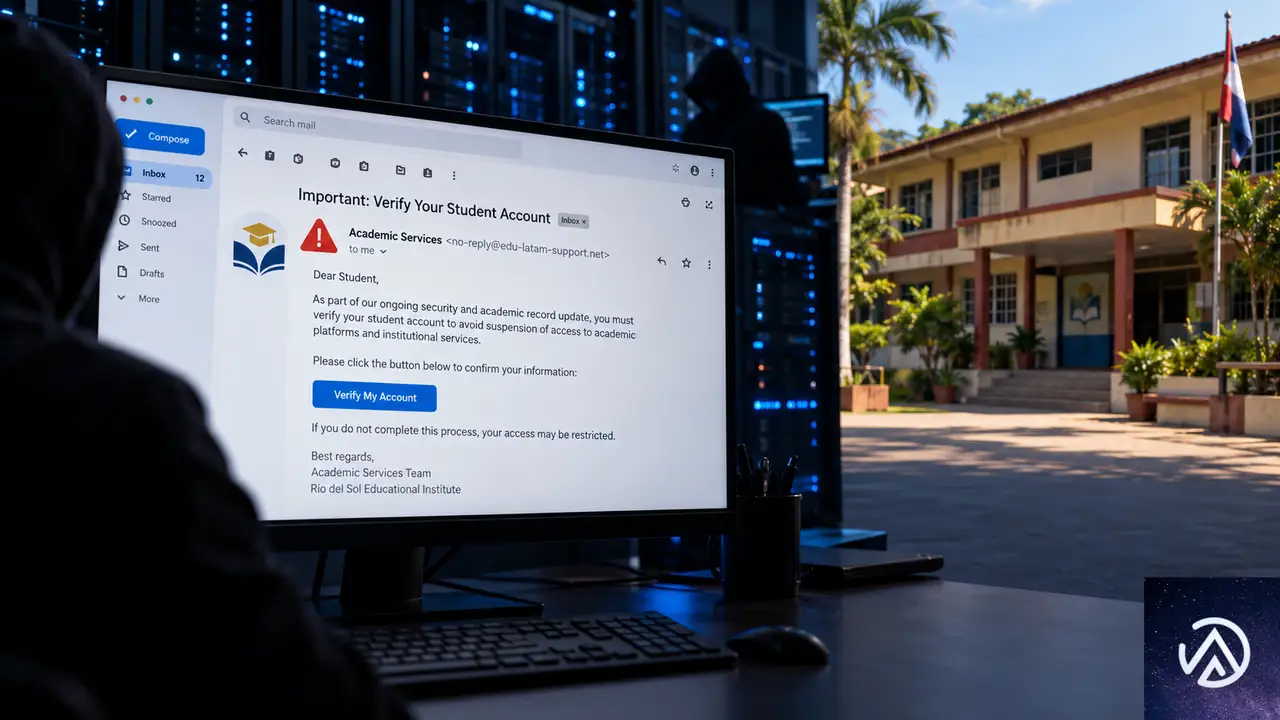
OpenAIはロシアを発信元とするChatGPTアカウント群を停止した。この作戦はラテンアメリカ各国を標的にした隠密影響工作で、ウクライナの評判を落とすことと、アルゼンチンやボリビアなどの国内政治に介入することが主な目的だった。
作戦の運営者はChatGPTを主に3つの作業に使っていた。1つ目は内部報告書の作成、2つ目は作戦用コンテンツの生成、3つ目は偽のシンクタンクの業績報告書の草案作成だ。OpenAIはロシアからのモデルアクセスを許可していないため、運営者はVPNを使って接続していた。
偽シンクタンクSRCの運営実態
この作戦の中心にあったのが、社会調査センター(Social Research Center / SRC)という自称のリサーチプラットフォームだ。表向きはインド系移民とラテンアメリカの関係を研究する組織だったが、実際にはロシアのオペレーターが偽人格のミア・クラーク(Mia Clark)を使って制御していた。
内部報告書には、給与体系や雇用、解雇などの人事決定が記録されており、運営者が単なる協力者ではなく組織を支配していたことを示している。ただし、現地スタッフは自分たちがロシアの作戦のために働いているとは知らなかった。OpenAIの見解では、知らずに利用されたスタッフが誠実に調査業務を行っていた。
SRCのウェブサイトには60本以上の記事が掲載されており、その大半は現地スタッフによる独自の内容だった。これは、過去に摘発された別のロシア系偽シンクタンクが記事の多くを盗用していたのとは対照的だ。OpenAIは、この作戦がより長期的に存続可能な偽装組織を構築しようとしていたと分析している。
学校や地域社会を巻き込んだ偽情報
ロシア発の作戦で特徴的だったのは、現地の学校や公的機関を意図せず偽情報の拡散に巻き込んだ点だ。
2026年5月、運営者はペルーのリマ教育地方局を装った偽のメールアドレスを作成し、文化・言語多様性の日にウクライナにちなんだ行事を開催するよう学区の学校に指示した。メールには、物議を醸す20世紀のウクライナ民族主義者ステパン・バンデラへの言及を求める指示が含まれていた。一部の学校は偽メールに返信し、行事を実施したと報告して写真まで提供していた。
その後、運営者はペルーとポーランドのメディアにこの出来事の記事を掲載させることに成功した。ウクライナが超国家主義的な思想を輸出しているという主張が広がり、ポーランドの欧州議会議員が反応する事態に発展した。ロシアの偽情報は、ウクライナ人とポーランド人の間の歴史的な緊張を刺激する形で設計されていた。
2026年6月には、別の偽メールアドレスを使ってエクアドルの学校を騙し、ダニエル・ノボア大統領と民間軍事会社ブラックウォーターの元トップ、エリック・プリンスへの忠誠宣誓式を開催させようとした。この出来事はエクアドル国内で大きな反響を呼び、政府が偽情報を否定する声明を出すまでに至った。
ロシア発の作戦は、現地の教育機関やメディアを意図せず巻き込むことで信頼性を高めていた。
ボリビアでは2026年5月下旬、反政府デモが激化する中で、国営水道会社EPSASの職員を装った偽の音声を拡散した。政府が行政首都ラパスへの給水を停止し、非常事態を宣言するという内容だった。この偽情報は公式の否定とファクトチェックを引き起こすほど拡散した。
アルゼンチンでは2024年、ハビエル・ミレイ大統領に関する2つの偽情報キャンペーンを実施したと報告している。1つはミレイ氏が愛犬のためにカルティエの宝石付き首輪を購入したという偽の報道、もう1つはブエノスアイレスで反ミレイの落書きを地元の人物に依頼したというものだ。これらの主張は、公開された内部文書に基づいてポリトロジーやラ・コンパニアと呼ばれるロシアの組織に帰属されている。
カテゴリ5という過去最大級の評価
OpenAIはこの作戦をBreakout Scaleのカテゴリ5と評価した。複数の国の政治家から公的なコメントを引き出したことが決め手となった。これはOpenAIが報告を始めて以来、初めてカテゴリ5を付けた事例だ。
ただし、運営者の自己申告には誇張が含まれている可能性がある。OpenAIの調査では、運営者が自分たちの作戦とは無関係の出来事を成果として報告する傾向があった。例えば、ブラジル人兵士の捕虜に関する報道を自らの成果と主張したが、実際にはその報道は作戦とは無関係だった。運営者が自分の雇用主に対しても影響工作を行っていた可能性が指摘されている。
イラン発の作戦 ボガス・バインラインズ
OpenAIはイランを発信元とするChatGPTアカウント群も停止した。この作戦はペルシャ語でプロンプトを入力し、ペルシャ語と英語でコンテンツを生成していた。運営者はVPNを使ってアクセス元を偽装していた。
作戦の主な活動は、米国とイランの紛争に関する長文記事の推敲と、編集者への売り込みメールの生成だった。加えて、ソーシャルメディアのコメントを大量に生成し、内部報告書の作成にもAIを使っていた。OpenAIはこの作戦にボガス・バインラインズ(Bogus Bylines、偽の署名)という名前を付けた。
7つの偽ジャーナリスト人格
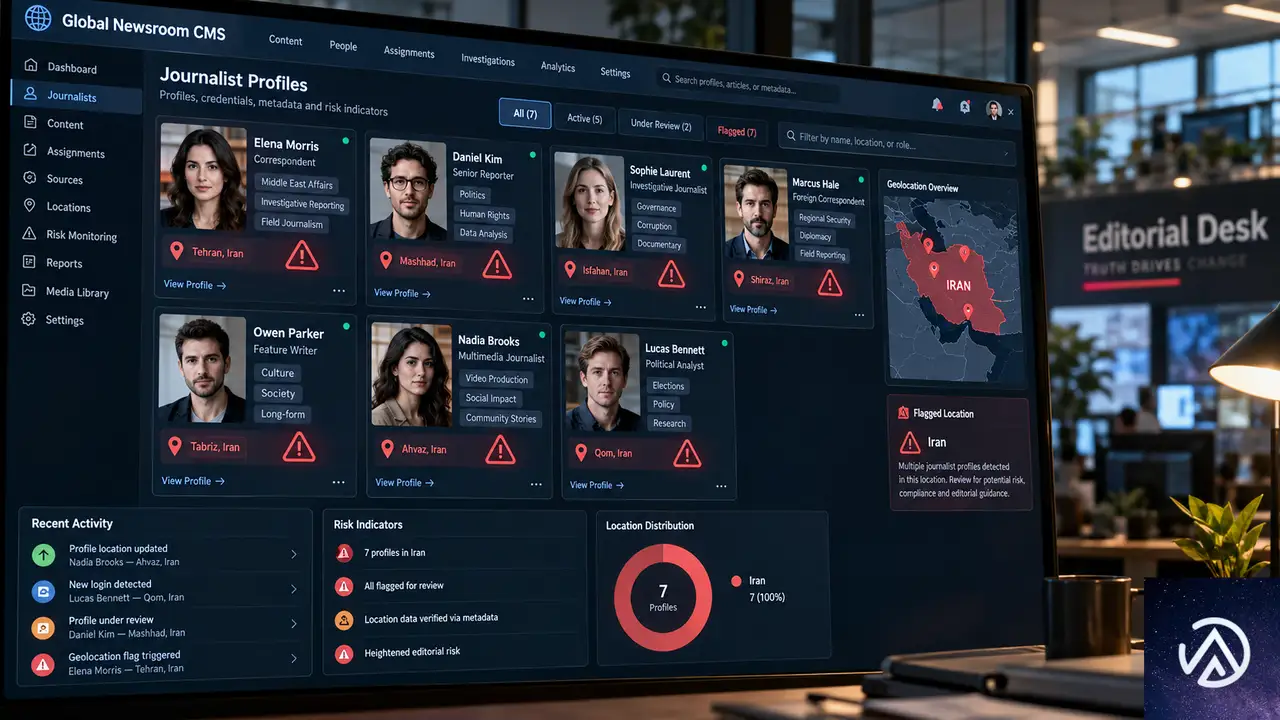
記事の売り込みには7つの偽の署名が使われた。アービン・B・ホスキンズ、ノア・ラミントン、ソフィア・ゴンザレス、マイケル・ハリソン、エリカ・フューザー、ジェニー・ウィリアムズ、アリス・ジョンソンだ。
記事と一緒に公開されたプロフィールでは、それぞれが西洋のジャーナリストを装っていた。多くは米国人ジャーナリストで、国際政治や中東、人権、紛争を専門としていた。ノア・ラミントンはニュージーランド在住と主張していた。マイケル・ハリソンの経歴は、ChatGPTに生成させたものだった。
一部の偽人格は、複数のソーシャルメディアに裏付けアカウントを持っていた。アービン・B・ホスキンズはX、Facebook、Instagram、Threadsにアカウントを持ち、米国人フリーランスライターと自称していたが、アカウントの透明性情報では所在地がイランと表示されていた。
一部の偽人格はSNSアカウントで裏付けされ、信頼性を高めていた。
OpenAIはオープンソース調査により、これらの偽署名で公開された記事を約100本、10数媒体で確認した。対象は主に国際情勢や中東問題を扱う中小規模のオンラインメディアで、米国とイランの紛争が激化した2026年3月以降に記事数が急増していた。
記事掲載とコメント生成の影響力の差
記事掲載とコメント生成という2つの活動の影響力は、大きく異なっていた。
記事掲載は高い成果を上げた。記事を掲載したメディアの中には、Facebookで約200万、Xで約35万5000、Instagramで約54万4000のフォロワーを持つものもあった。メディアが記事をSNSで宣伝することで、運営者は自分たちだけでは届かなかった読者にアクセスできた。OpenAIは記事掲載部分をカテゴリ4と評価している。
一方、コメント生成はほとんど影響力を生まなかった。生成されたコメントは「いいね」や返信が1桁から2桁程度にとどまり、投稿に対する全コメントの中でも少数派だった。コメント部分はカテゴリ2と評価されている。
さらに、運営者はコメントの影響力を水増しする計算方法を使っていた。返信先の投稿の閲覧数をコメント投稿前後で比較し、その差をすべて自らの成果として計上していた。投稿の人気や他のコメントによる閲覧増加を考慮しておらず、実際の影響力を大幅に誇張していたことになる。
AI偽装フロントがもたらすリスクと対策
AIが偽装フロントに与える4つの利点
OpenAIの分析では、AIは偽装フロント作戦に規模、効率、言語能力、編集能力の4つの利点をもたらす。運営者はこれらの利点を悪用して、従業員や編集者などの無自覚な被害者を利用し、背後に誰がいるのかを知らない読者の前にコンテンツを置くことができる。
特に言語能力の向上は大きい。イラン発の作戦ではペルシャ語話者が英語の長文記事を推敲するためにChatGPTを使い、ロシア発の作戦ではスペイン語の文章を現地の文体に合わせて調整するために使っていた。AIがなければ、外国語のネイティブレベルの文章を作るのは難しかったはずだ。
編集能力も重要だ。記事を各メディアの投稿基準に合わせて調整し、編集者への売り込みメールを個別に作成する作業は、AIによって自動化されていた。これにより、少人数のオペレーターでも多数の媒体に同時に売り込みをかけられた。
組織とメディアのチェックポイント
こうした偽装フロント作戦への対策として、メディア編集部と企業広報部門が確認すべきポイントを整理する。
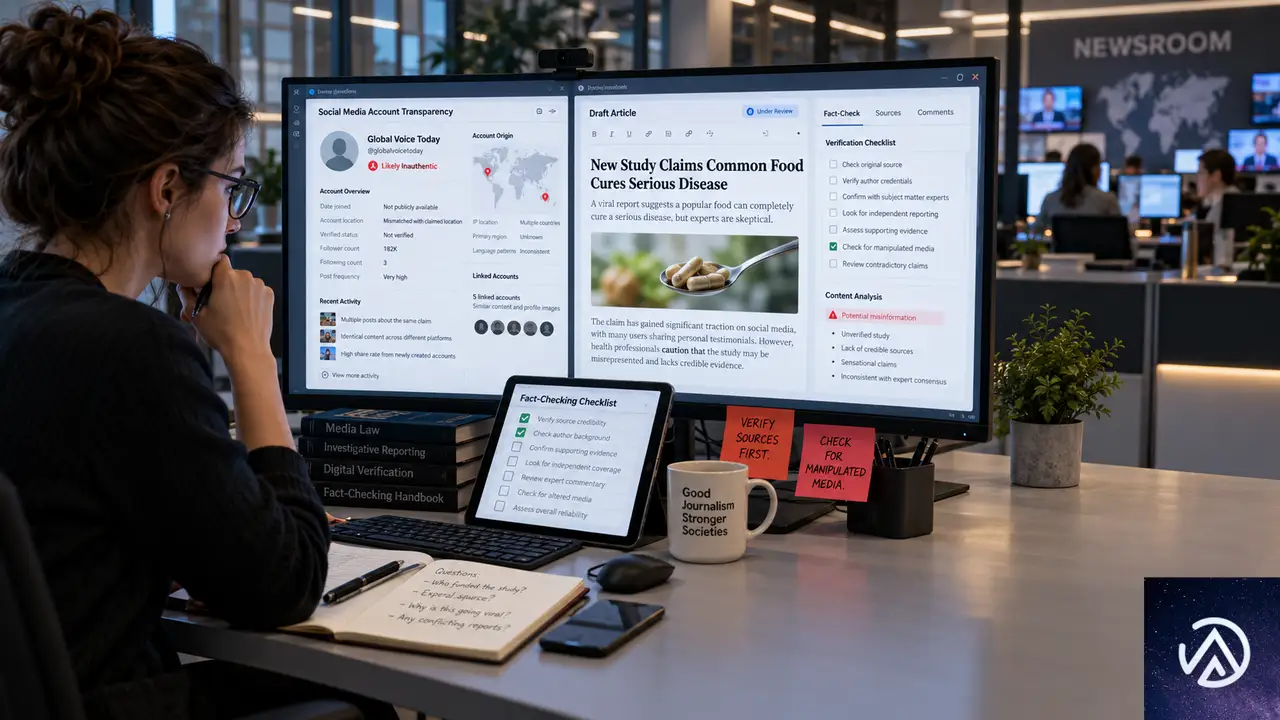
- 寄稿者の実在性確認。SNSのアカウント透明性情報で実際の所在地を確認する。今回の偽ジャーナリストは、プロフィールでは米国人と自称しながら透明性情報ではイランと表示されていた
- 同一人物から複数媒体への同時売り込みを警戒する。短い期間に複数の偽名で似た記事が届く場合は注意が必要だ
- 公的機関を装うメールは必ず公式ルートで確認する。学校や水道会社などの信頼を利用する手口が増えている
- コメント欄の不自然な投稿パターンを監視する。短時間に大量の賛同コメントが付く場合は、運営による自作自演の可能性がある
- 情報の出所が確認できない記事の掲載を避ける。特に地政学的な紛争に関する寄稿は、著者の経歴だけでなく過去の執筆実績まで確認する
OpenAIが指摘するように、偽装フロント作戦は暴露されると活動を停止する傾向がある。2016年から2017年にかけて活動した偽ジャーナリストのアリス・ドノバンも、2020年にMetaが摘発したピースデータも、露出後に活動をやめた。責任ある情報開示が抑止力になる点は、AI時代でも変わらない。
この記事のポイント
- OpenAIはロシア発とイラン発のAI偽装フロント作戦2件を遮断した
- ロシア発のダーククラークは偽シンクタンクを運営し、過去最大級のカテゴリ5と評価された
- イラン発のボガス・バインラインズは7つの偽ジャーナリスト人格で記事を約100本掲載させた
- AIは偽装フロントに規模、効率、言語能力、編集能力を与え、影響工作の質を高める
- メディアと企業は寄稿者確認やコメント監視など、基本的な対策の徹底が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-6がChatGPTに搭載、対話で動くUIを自動生成するIntelligent UIを解説
OpenAIは2026年10月7日、ChatGPT向けにGPT-6を正式展開した。最大の変更点はIntelligent UIと呼ばれる新機能で、質問ごとにボタンやグラフなどの操作画面を対話の中で動的に生成する。これにより回答が単なるテキストではなく、実際に触れて操作できる体験に変わる。
対象は当初Plus、Pro、Business、Enterpriseの各プランで、翌10月8日からFreeとGoにも展開される。ChatGPTの週間利用者数は12億人を超えており、この規模に次世代の対話型UIが一気に広がる。
さらにGPT-6は回答を書き始める速度も大幅に改善した。従来の推論モデルは思考が完了してから回答を開始していたが、GPT-6は考えながら回答を進める。これはAIとのやり取りの体感時間を変える変更だ。
Intelligent UIの正体、質問ごとに操作画面を組み立てる
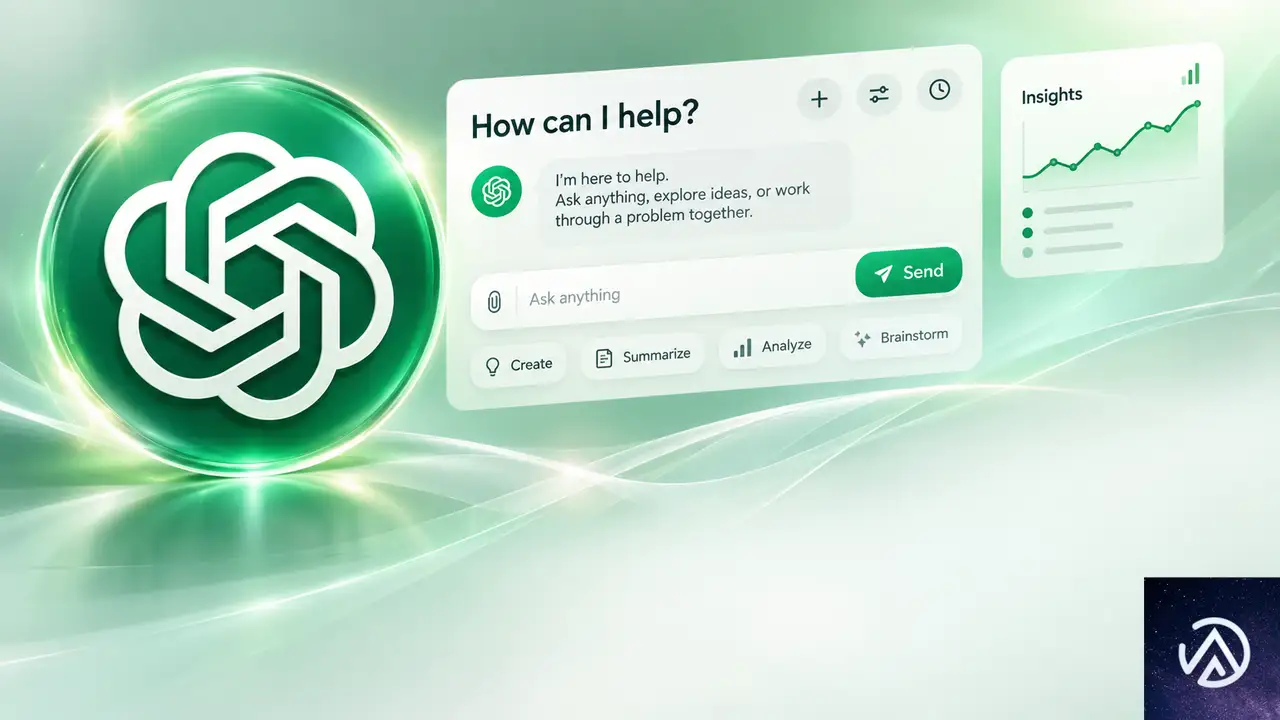
Intelligent UIは、ChatGPTが回答をテキストだけでなく、図表、タップ可能なボタン、フォーム、グラフ、そして対話内で直接使えるインタラクティブな体験として構成する機能だ。OpenAIはGPT-6にこうした要素を使い分ける訓練を施したとしている。
回答のフォーマットは質問内容に応じて変わる。商品の比較なら並べて見られるレイアウト、仕組みの説明なら操作できる図、単純な答えで足りる問いにはテキストだけを返す。GPT-6自身がその都度、最も有用な形を選ぶ。
従来のテキスト回答との違い
従来のChatGPTは、ほぼすべての質問を同じ会話フォーマットに当てはめていた。Intelligent UIが加わったことで、1つの質問に対してUI、データ、操作を組み合わせた回答が可能になった。ChatGPTがソフトウェアの固定画面ではなく、その場で作った専用画面を提供する方向への第一歩だ。
上記はコンセプトを示した例だ。従来は文章で説明されていた内容が、ボタンや数値カードを備えた操作画面に置き換わる。ユーザーは表示された値を動かして、自分の条件に合う結果をその場で確かめられる。
フォーマットは質問内容が決める
すべての質問にUIが付くわけではない。比較は左右に並べる、説明は操作できる図にする、簡単な質問にはテキストのみを返す。GPT-6が内容に応じてフォーマットを決めることで、必要以上に凝った画面を表示して速度を落とす事態を避けている。
生成されるUIの具体例、旅程から計算ツールまで
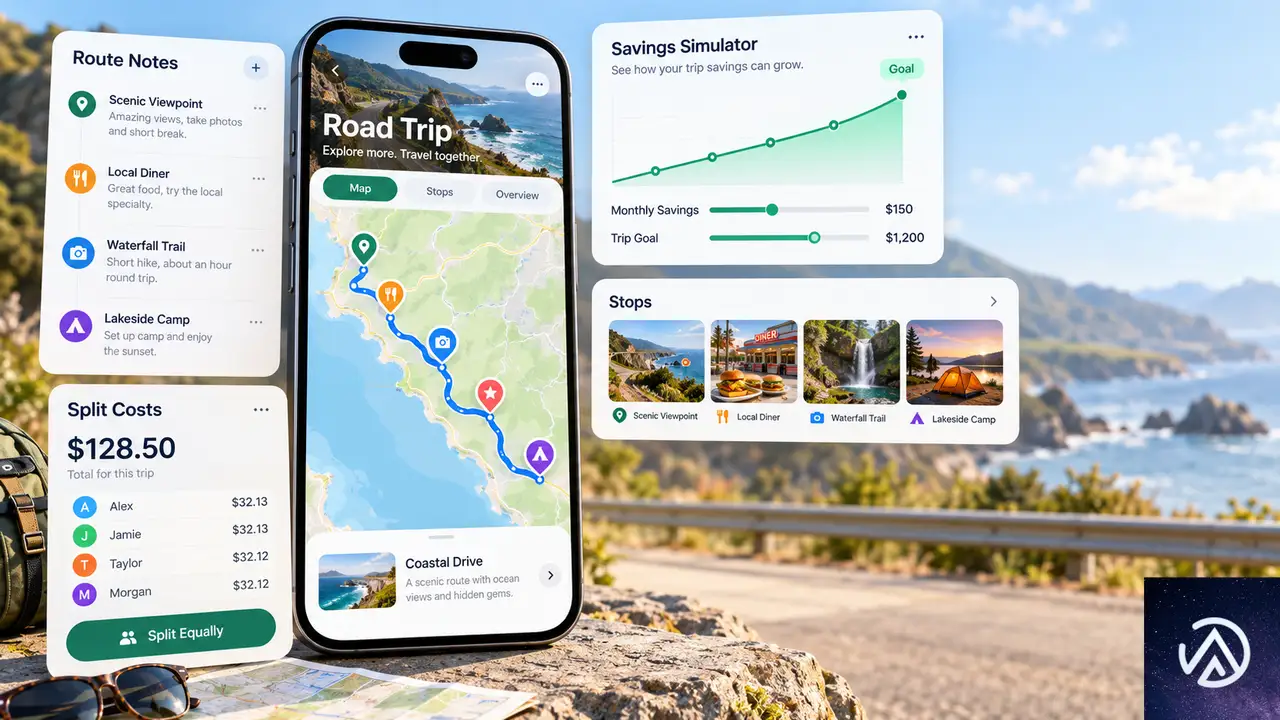
Intelligent UIが作る画面は、日常のあらゆる問いに対応する。例えばサンデーローストの献立を尋ねた場合、レシピの横に調理タイミングを並べて表示する。ロードトリップの相談では、地図上に立ち寄り先をマークし、立ち寄る価値のある場所のメモを添える。単に文章を読むより、予定や段取りが把握しやすい。
視覚的で操作可能な説明も特徴だ。仕組みを理解するために図を動かして入力値を変えたり、問題を順番に解いたりできる。従来なら数回に分けて質問していた内容が、1つの回答画面の中で完結する。
その場でツールを作れる
ChatGPTに対話の中でツールの作成を頼むこともできる。貯金の増え方を試算する電卓、友人との食事代を割り勘するスプリッター、会話の中で遊べるゲームなどだ。OpenAIは「目の前のタスクを解決するツールをその場で作れる」と説明している。
比較・説明・テキストの使い分け
Intelligent UIの出力形式は固定されていない。比較は並べて見せる、説明は操作できる図にする、テキストだけで十分な場面では余計なUIを出さない。GPT-6は質問の意図を読み取り、その答えを最も理解しやすい形に整える。
技術的な仕組み、部品ライブラリとコンパイラが支える
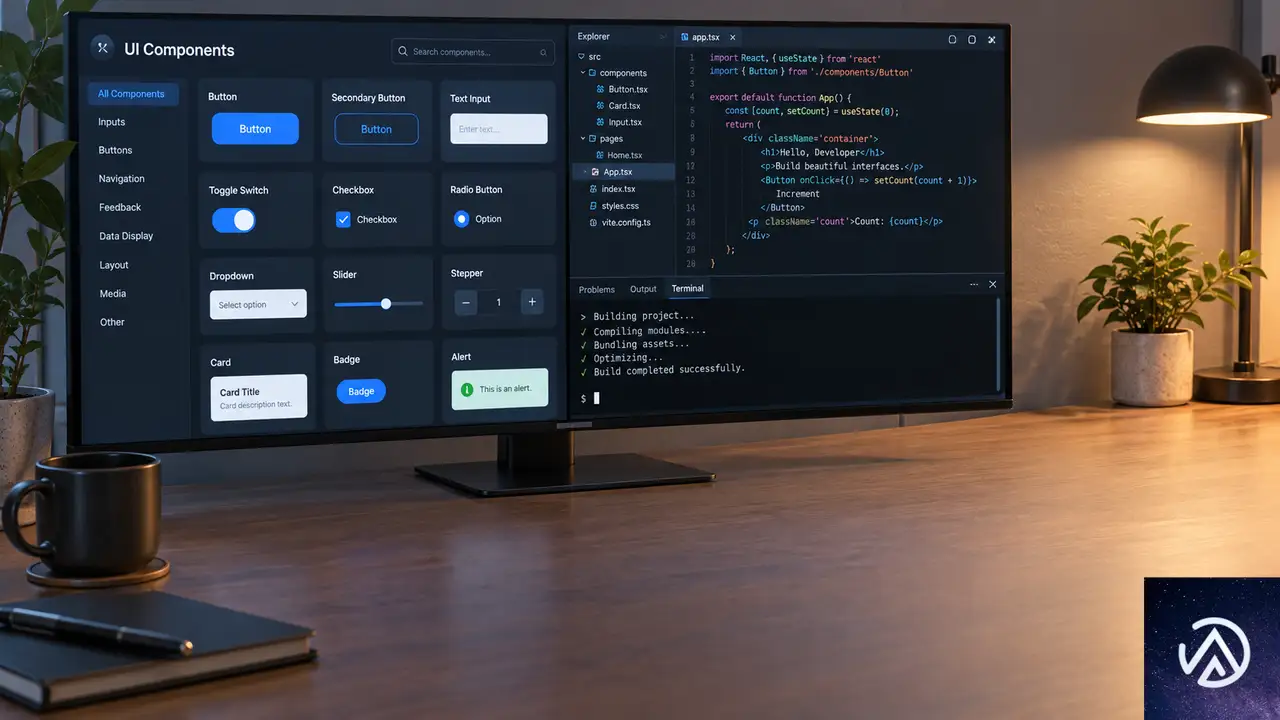
Intelligent UIの土台には、ネイティブでストリーミング可能な部品ライブラリと、モデルが生成するインターフェースを処理するコンパイラがある。部品ライブラリは回答に共通のデザイン基盤を与えつつ、モデルが部品の組み合わせ方を柔軟に選べる余地を残す。
コンパイラは、モデルが回答を生成している途中でインターフェースを段階的に表示する。回答全体の完成を待たずに、画面が少しずつ組み上がっていく。これにより体感速度が維持される。
ストリーミング表示を支える2つの要素
このデモは、モデルが部品を選び、コンパイラがそれを画面へ段階的に反映する流れを示している。ユーザーから見ると、回答が完成する前からUIが少しずつ現れてくる。
訓練で設計判断を学習
訓練手法も拡張された。インターフェースの明瞭さ、有用性、完成度を評価する仕組みを追加し、GPT-6は情報を整理して見せる方法、操作を付け足すタイミング、テキストだけで済ませる場面を学習した。OpenAIは設計判断の改善と作れるものの拡張は今後の課題だとしつつ、人々がChatGPTとやり取りする方法の大きな転換だと位置づけている。
待たずに答え始める、推論と回答を同時に進める改善
推論モデルが登場してより難しい問題に対応できるようになった一方、回答開始までにモデルが思考を終えるのを待つ必要があった。今回のGPT-6は、思考と回答を交互に進めるよう訓練されている。ユーザーの待ち時間を考慮し、その時点までの知識と発見を使って少しずつ回答を組み立てる。複数の部分回答を積み上げても、まとまりと正確さは一気に書いた回答と同等になるよう設計されている。
OpenAIの社内評価によると、日常的なエージェントタスクでGPT-6 Extra HighはGPT-5.6 Mediumと同じ時間で回答を開始しつつ、スコアはGPT-5.6 Extra Highを上回った。Web検索を必要とする質問では、GPT-6 InstantがGPT-5.6 Instantより平均44%早く回答を始める。
質問に応じた速度改善の実測値
この比較は、Web検索を伴う質問で回答開始までの時間が短縮された様子を表している。44%という数字はOpenAIの社内評価によるものだ。
Web検索の質も向上
Web検索を使う回答の質も改善されている。調べるべきタイミングをより正しく判断し、回答の裏付けとなる情報をより確実に探し出す。難しい問題を対象にした社内評価では、ユーザーの質問の核心に正しく対処する割合がGPT-5.6より高まったとしている。
安全性の改善と展開対象プラン
安全性と整合性の評価
GPT-6はAstraの安全面の進歩を土台に、安全訓練をすり抜けようとする試みへの耐性を高めた。実利用からの教訓を訓練に反映し、サイバー攻撃、生物学的脅威、暴力に関わる悪用への保護を強化している。複数ターンにまたがる攻撃など、単一のプロンプトからは見えにくいリスクも文脈や会話履歴から認識する。
無害な依頼に対する不要な拒否は避けつつ、高リスクな場面では安全に応答する。自身の能力の限界を認識して伝える点でも改善が見られ、評価結果の詳細はシステムカードにまとめられている。
展開スケジュールと利用モデル
Intelligent UIを備えたGPT-6は、発表日時点でPlus、Pro、Business、EnterpriseのChatタブに順次展開された。翌日にはFreeとGoにも展開が広がる。Enterpriseでの利用可否は企業の管理者設定に依存する。
有料プランはGPT-6 Sol、無料およびGoはGPT-6 Lunaが会話向けに調整されたモデルとして動作する。今回の変更はChat体験のみが対象で、WorkとCodexを支えるモデルは変わらない。
この記事のポイント
- OpenAIがGPT-6とIntelligent UIをChatGPTに展開した
- 質問ごとにボタンやグラフなどの操作画面を動的に生成する
- 推論と回答を並行して進め、待ち時間を短縮した
- 部品ライブラリとコンパイラで高速にUIを表示する
- 安全性と整合性の評価も強化された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.2が登場、商品CSVのUPC照合と決済日付入力を追加
WooCommerce 11.2が2026年10月8日にリリースされた。今回のアップデートでは商品CSVインポートの照合方法が拡張され、サプライヤーから届いたUPCだけの価格表をそのまま取り込めるようになった。ほかにもチェックアウトでの日付入力、注文撤回メールの設定、カタログ画面のパフォーマンス改善が含まれる。
ECサイトを運営する担当者にとって、日々の商品管理と受注業務に直結する変更が中心だ。特に商品コードを使った一括更新は、数千点規模の在庫を扱う店舗で作業時間を大きく短縮できる。本記事ではWooCommerce 11.2の主要な変更点と、アップデート前に確認しておきたい注意事項をまとめる。
WooCommerce 11.2の主な変更点
WooCommerce 11.2はWordPressのECプラグインとして広く利用されているWooCommerceのマイナーアップデートだ。公式ブログでは変更点を6つの項目に分けて紹介している。いずれも店舗運営の効率化に寄与する内容で、商品管理から顧客体験の改善まで幅広い。
上記のほか、セキュリティ改善とデータベース更新も含まれる。更新前にバックアップを取得しておくことが推奨される。
商品CSVインポートがUPC・GTINなどのコードに対応
商品コードとは
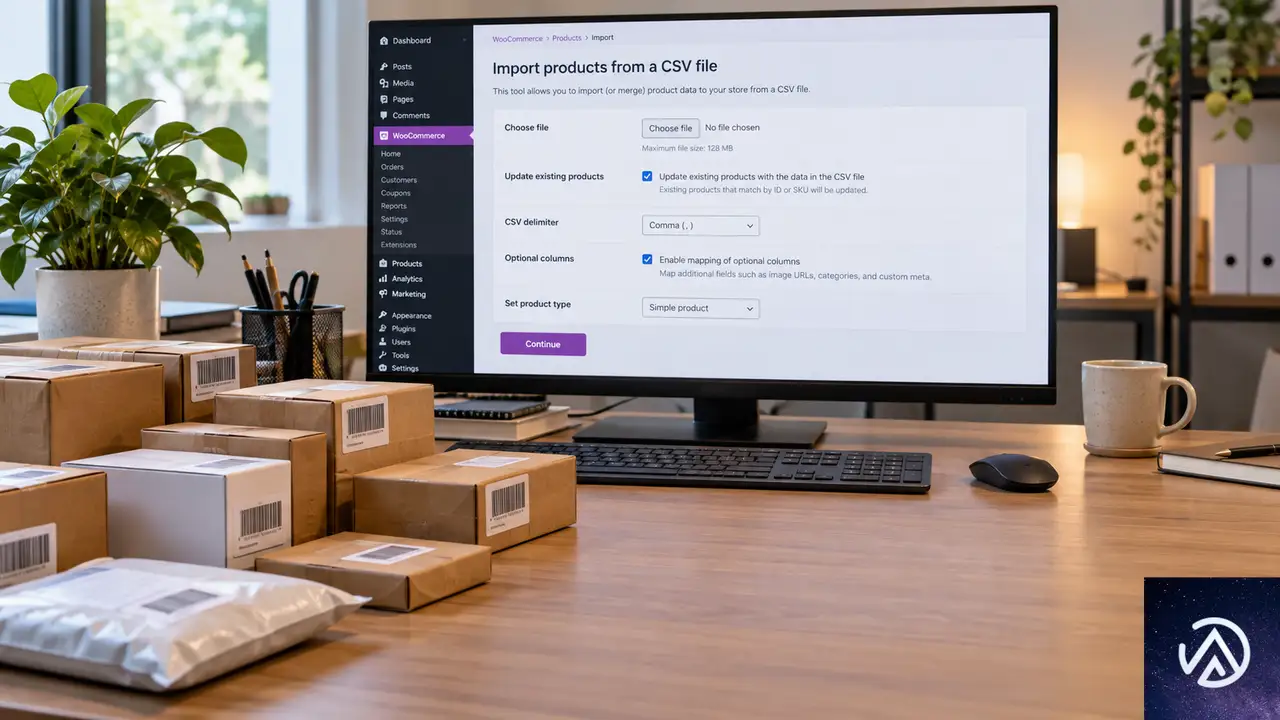
UPC(Universal Product Code)は主に米国で使われるバーコード規格で、商品パッケージに印刷された12桁の数字を指す。GTIN(Global Trade Item Number)は国際標準の商品識別コード、EAN(European Article Number)は欧州で広く使われるバーコード、ISBNは書籍の識別コードだ。いずれも商品を一意に特定するための番号で、サプライヤーから届く価格表にはこれらのコードだけが記載されていることが多い。
インポート時の照合の流れ
WooCommerceの商品CSVインポート機能では、これまで各行を商品IDまたはSKUで照合して既存商品を更新していた。11.2では照合の優先順位が拡張され、ID、SKU、GTIN、UPC、EAN、ISBNの順に一致する商品を探す。サプライヤーからUPCだけの価格表を受け取った場合でも、そのままCSVファイルとしてアップロードできるようになった。
利用するにはインポート画面で「既存の商品を更新」を有効にする必要がある。同一商品にSKUとUPCの両方が登録されている場合はSKUが優先される仕組みだ。
チェックアウトで日付入力を追加できる
日付フィールドの用途
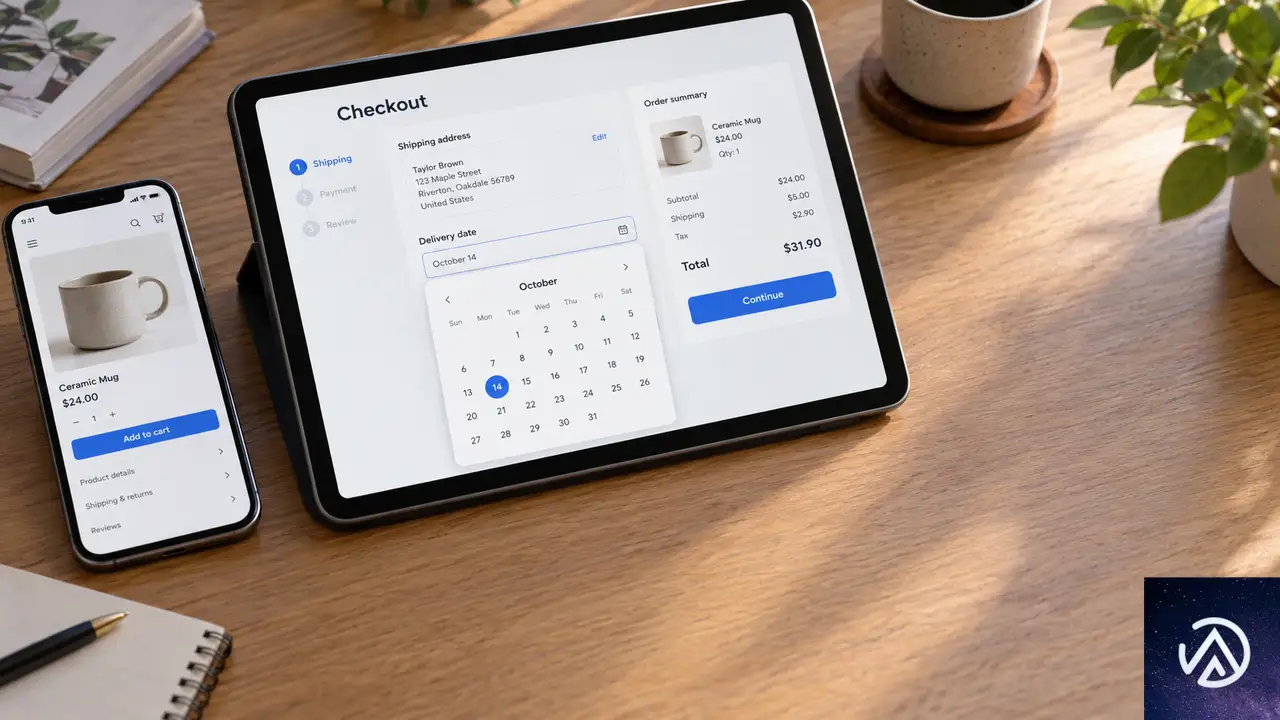
チェックアウトブロックを使用している店舗では、注文手続き中に顧客へ日付を尋ねられるようになった。配達希望日や誕生日など、商品の性質に合わせて自由に用途を決められる。顧客はスマートフォンやブラウザ標準の日付ピッカーを使って日付を選択する。店舗側は選択できる日付の範囲も制限できる。
設定方法
この日付フィールドを追加するには、チェックアウトブロックの設定にショートコードスニペットを追加する。テーマのfunctions.phpやコード管理プラグインに数行のコードを貼り付けるだけで有効化できる。コードの詳細は公式のリリースノートに記載されている。
この例では配達希望日を追加しているが、誕生日や引き取り希望日など、店舗の運用に合わせて自由にラベルを変更できる。
注文撤回メールを管理可能に
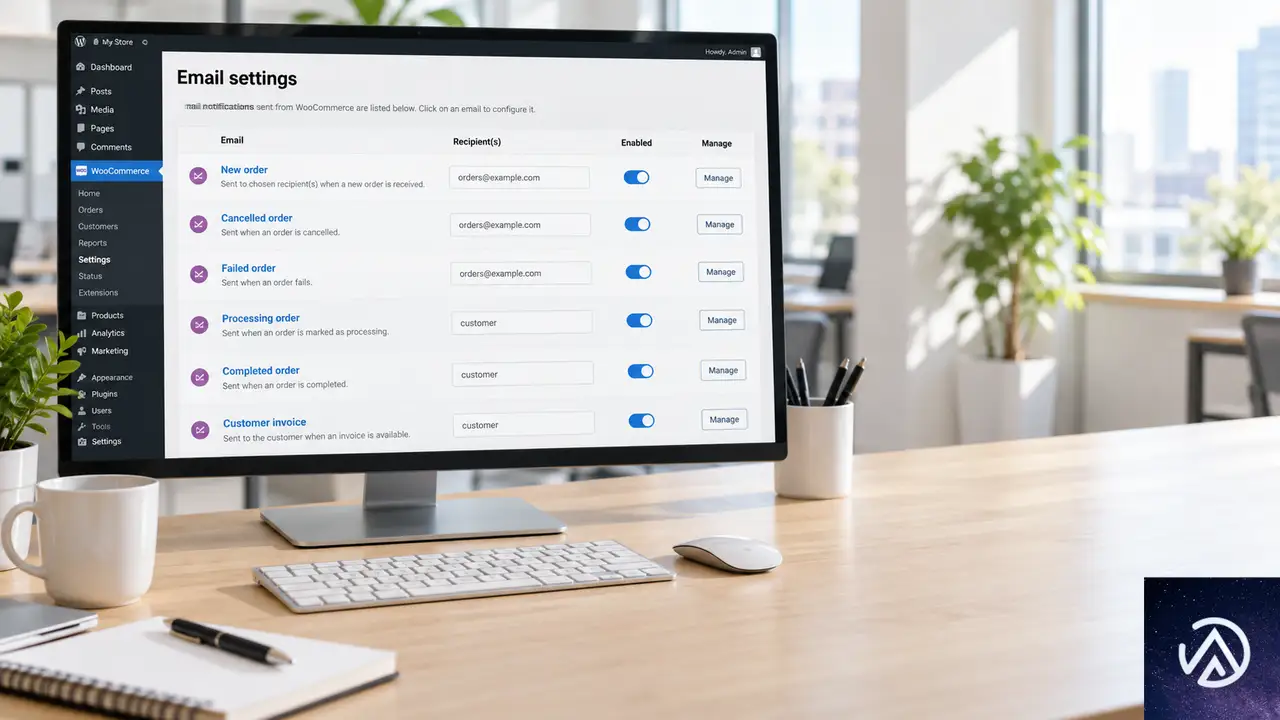
EU圏の顧客に販売している店舗向けの変更も入った。注文撤回(キャンセル要求)が発生したときに送信される2種類のメールを、管理画面から設定できるようになった。1つは顧客が受け取る確認メール、もう1つは店舗側に届く通知メールだ。
WooCommerceの設定画面にある「メール」セクションで、それぞれのメールに独自のメッセージを追加できる。プレビューで内容を確認し、通知を受け取る担当者を選び、必要なければメール自体を無効化することも可能だ。これまではコードでしか変更できなかった設定が、管理画面だけで完結するようになった。
パフォーマンス改善とブロックの新スタイル
カタログと管理画面の高速化
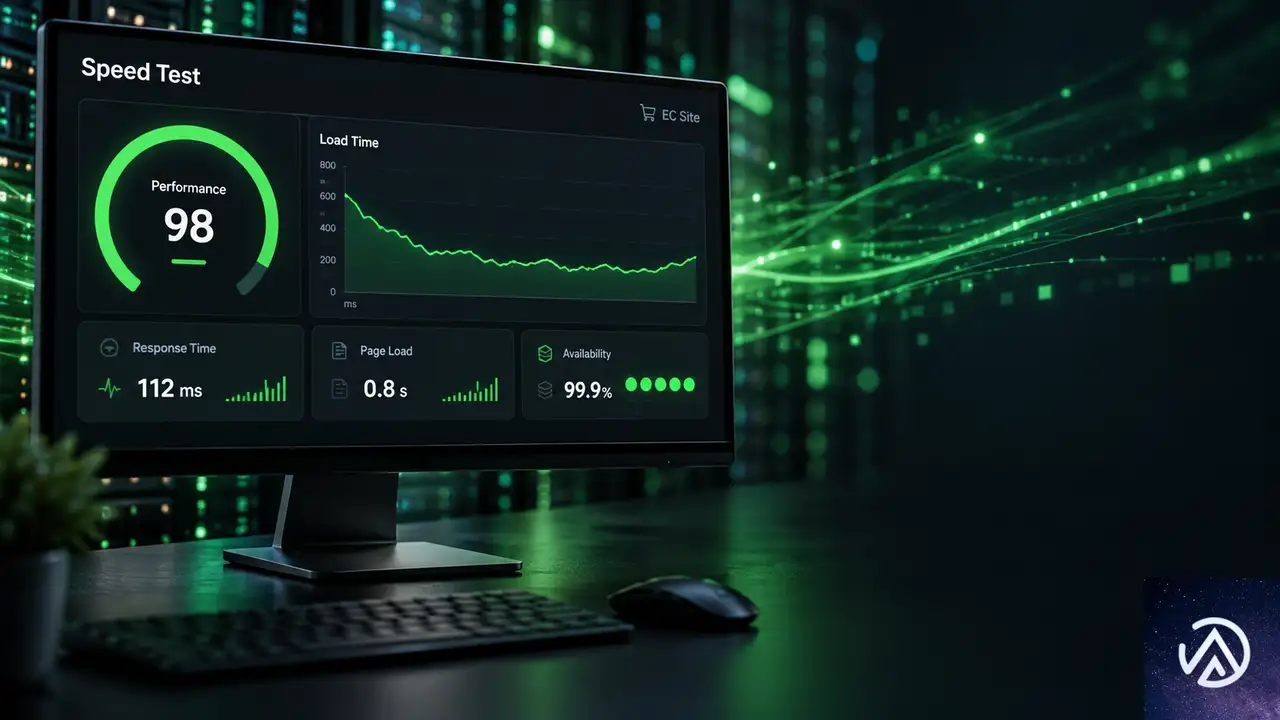
商品数が5点でも5万点でも、カタログ画面で商品を自由に並べ替えられるようになった。可変商品(サイズや色などのバリエーションを持つ商品)を含む店舗では、商品ページの読み込みとチェックアウト処理が高速化している。レポート集計ではデータベースへのクエリ数が減り、顧客数が増えてもメモリ使用量が増加しにくくなった。
大量の顧客データを持つ店舗ほど、この改善による管理画面の体感速度は大きく変わる。レポート表示が遅くて開くのを待っていた店舗は、更新後に改善を実感しやすい。
商品フィルターブロックのスティッキー表示
商品フィルターブロックにスティッキー(追従)表示のオプションが追加された。長いカテゴリーページを顧客が下へスクロールしても、フィルター条件が画面上部に表示され続ける。絞り込みのたびにページ先頭まで戻る手間がなくなる。
ほかにも数量セレクター(カート内のものを含む)は枠線、影、色、角丸を設定できる。商品画像には枠線、フィルターチップにはフォントと余白のコントロールと角丸が追加された。これらのスタイルは外観 > エディター > スタイル > ブロックの画面で店舗全体に一括設定するか、ブロック単位で個別に調整する。
アップデート前に知っておくべき注意点
既存メール設定への影響
パスワードリセット、新規アカウント作成、メール確認の各メールについて、自分自身をCCまたはBCCでコピー受信していた場合、その配信が停止される。これらのメールにはログインリンクが含まれるため、本人以外には送られないようにするセキュリティ上の変更だ。
ダウンロードリンクと権限の変更
標準のダウンロードリンクは従来どおり動作する。ただし、まれにカスタム登録やインポートで不正なデータを持つリンクは動作しなくなる可能性がある。顧客から報告があれば、注文画面からリンクを再発行すればよい。
ショップマネージャー(店舗運営者)が、フォーラム権限や会員権限など特定の追加権限を持つユーザーを編集できなくなる。そのようなユーザーの編集はWordPress管理者が行うことになる。
アップデート手順の注意
WooCommerce 11.2にはセキュリティ改善とデータベース更新が含まれるため、運営中のすべての店舗でアップデートを適用することが推奨される。データベース更新が走るので、事前のバックアップが必須だ。
この記事のポイント
- WooCommerce 11.2は2026年10月8日にリリースされた
- 商品CSVインポートがUPC・GTIN・EAN・ISBNでの照合に対応した
- チェックアウトブロックに日付入力欄を追加できる
- 注文撤回メールの管理画面設定が可能になった
- パフォーマンス改善とセキュリティ更新を含むためバックアップしてアップデートを
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Nuxt 4.6リリース、Server API刷新と高速化した型推論の全容
Nuxt 4.6が2026年10月5日にリリースされた。Nuxt CLI v4が同梱され、開発サーバーの起動と再起動が大幅に速くなっている。今回の目玉はサーバーコードを移行しやすくする新しいimportソースだ。
サーバー非依存化への大きな一歩となる。型付き$fetchも再構築され、大規模プロジェクトで問題になっていた型推論の遅さが解消された。Nuxt 3は2026年7月末にEOLを迎えており、移行を考える契機になる。
Nuxt CLI v4の変更点
Nuxt 4.6にはメジャーアップデート版のNuxt CLI v4が含まれる。依存関係として自動的に導入されるため、Nuxt 4.6に更新すれば新しいCLIが使える。変更の中心は開発サーバーだ。
インタラクティブパネルと新コマンド
端末の下部に専用パネルが固定表示される。URL、起動の進行状況、ショートカットキーが並ぶ。キー1つで再起動、ページを開く、ログ確認、リクエスト確認、ページとサーバールートの一覧表示が可能だ。
各リクエストにはIDが付与され、ログとエラーがどのリクエストから発生したか追跡できる。クラシックな出力に戻したい場合は--no-tuiを渡せばよい。
開発サーバーは再読み込みと再起動の理由も教えてくれる。どのnuxt.configキーが変わったのか、起動が遅い場合に時間がどこにかかったのか、各モジュールのセットアップ時間も個別に表示される。内容が変わらない保存では再起動が起きない。
数値で見る高速化
初回表示は6.6倍速くなり、メモリ使用量も30%減った。ロックファイルによって複数の開発サーバー起動が衝突せず、新しいnuxt curlやnuxt taskコマンドも動作する。
Server API nuxt/serverの導入
今回のリリースで最も重要な変更がサーバーコードの抽象化だ。新しいimportソースであるnuxt/serverが追加された。ハンドラー、ミドルウェア、ユーティリティをここから読み込む。ブラウザでも動くnuxt/appのサーバー版にあたる。
サーバー非依存化の目的
これまでサーバーコードはh3とNitroに密結合していた。h3やNitroのメジャーバージョンが上がると、エコシステム全体に影響が波及する構造だった。Nuxt 5でNitro v3とh3 v2へ移行するにあたり、この結合を解消する必要があった。
nuxt/serverは自前の型を定義し、外部パッケージを参照しない。同じハンドラーがNitro v2、Nitro v3、実験的なViteサーバーのどこでも動く。モジュール作者はh3やnitropackへのピア依存を気にせずに済む。
サーバーコードをnuxt/serverで書いておけば、Nuxt 5に更新しても同じファイルがそのまま動く。モジュールも1つのファイルで両バージョンをサポートできる。
コード例とAPIサーフェス
import { defineEventHandler, getQuery } from 'nuxt/server'

export default defineEventHandler((event) => {
  const { name } = getQuery<{ name?: string }>(event)
  return { message: `Hello, ${name ?? 'world'}!` }
})
イベントオブジェクトはWeb標準に基づく。リクエストURL、レスポンスヘッダー、クッキー、リダイレクト、セッションなどが扱える。必要ならZodなどのバリデーションライブラリと組み合わせて、リクエスト本文を検証してから処理を進められる。
従来のh3やnitropackから読み込む方法も削除されていない。特定のハンドラーで低レベルな機能が必要な場合は、これまで通りdefineEventHandlerをh3から読み込めば動く。
Typed $fetchの再構築
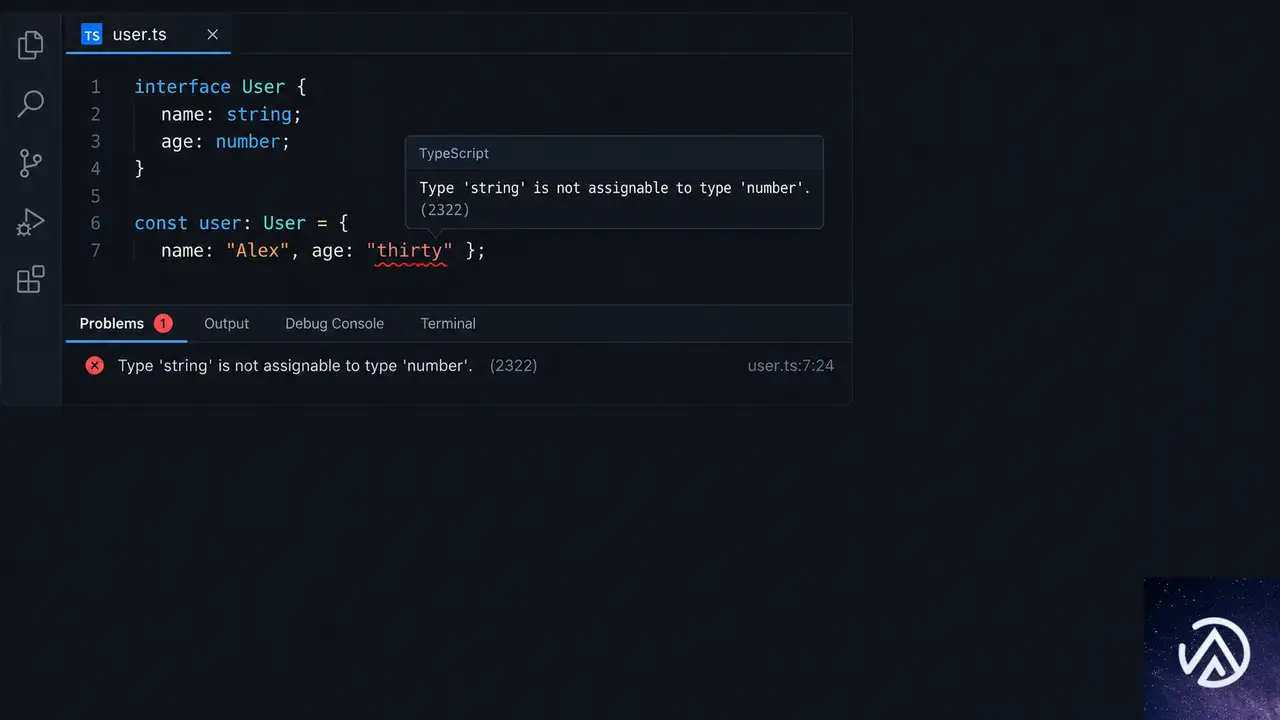
$fetchとuseFetchはサーバールートから型を推論できた。しかし数百ルートを超えるとTypeScriptのインスタンス化上限に達し、コンパイルが止まることがあった。
型推論の高速化
型システムをfetchdtsベースで再実装した。静的なパスは完全一致テーブルとしてコンパイルされ、ルート数ではなく参照箇所の数で処理コストが決まる。
3000ルートの処理が53.63秒から0.62秒に短縮された。ピークメモリも946 MBから140 MBへ大幅に減っている。大規模プロジェクトほど効果を実感できる。
新しい型チェック機能
ルートごとに検証済みのbody、query、headersが型情報に含まれる。間違った形のリクエストを送ると、呼び出し側でエラーが出るようになった。存在しないパスへの$fetchを拒否するexperimental.strictRouteTypesも追加されている。
Nuxt 4ではオプトイン機能だ。Dateの戻り値が呼び出し側ではstringになるなどの小さな推論の違いがあるため、デフォルトにはしていない。Nuxt 5では標準で有効になる。
開発体験の改善
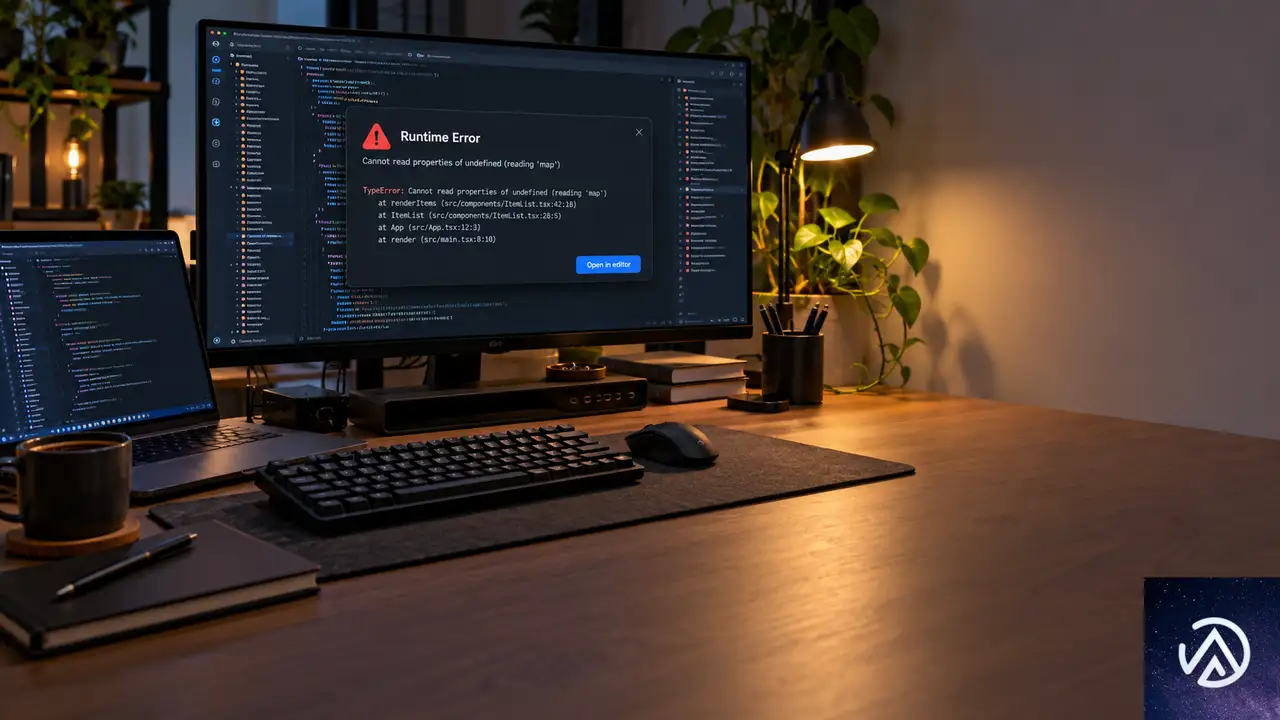
開発時のエラー表示と起動画面が刷新された。開発者にとって地味に見える変更だが、原因特定までの時間を短縮する効果は大きい。
my-badによる新しいエラー表示
サーバーサイドエラーのスタックトレースにソース位置とコードフレームが表示されるようになった。Youchの埋め込みiframeは廃止され、my-badという新しいオーバーレイに置き換えられた。
エラーレポートにはコピーボタンがある。Markdown形式、エージェントに手渡せるプロンプト形式、JSON形式を選べる。AIコーディングエージェントが普及した今、エラー情報をそのまま渡せる設計は実務的だ。
致命的な起動エラーもページとして表示される。nuxt.config.tsに構文エラーがあっても専用ページが表示され、修正後に自動で再読み込みされる。ワーカー再起動をまたいでエラー情報が保持される仕組みだ。
Vue Vapor対応とローディング画面
Vue 3.6のVapor Modeに相互運用モードで対応した。アプリ本体は仮想DOMのまま、コンポーネント単位でVaporを選択できる。<script setup vapor>と書くだけだ。ルーティングやuseAsyncData、レイアウトは変更なしで動く。
開発サーバー起動中のローディング画面も新しくなった。WebGL2のパーティクルフィールドが山脈を描く。WebGL2非対応環境では静止画にフォールバックし、prefers-reduced-motion設定時はアニメーションを止める。モーションに配慮した実装になっている。
パフォーマンスと移行
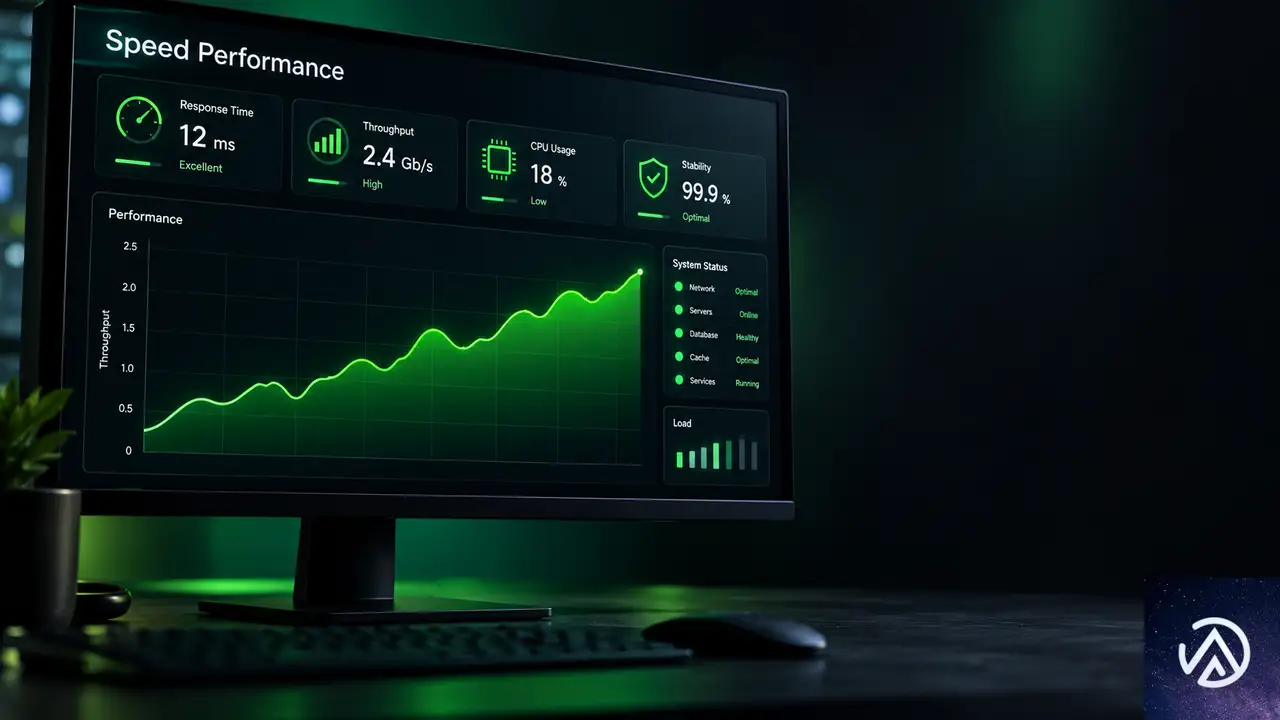
実測値と改善ポイント
ベンチマークではNuxt 4.5.2と比較して、スタータープロジェクトのビルドが4.4秒から3.6秒に短縮された。200ページ・200コンポーネント・50ルートのビルドも11.6秒から10.3秒に改善している。
SSRスループットは300個の<NuxtLink>を含むページで1秒あたり110リクエストから140リクエストに向上した。内部リンクがサーバー上でプレーンな<a>タグとしてレンダリングされるようになり、リアクティブ状態を持たなくなった効果だ。
experimental.early404を有効にすると、ルートに一致しないリクエストがVueアプリの生成をスキップする。30ページでブート処理が約23 msのアプリでは、JSON 404応答が37.1 msから0.3 msに短縮される。
Nuxt 5への準備
Nuxt 5のデフォルト機能の多くがすでに4.6に入っている。future.compatibilityVersion: 5を設定すれば、一括で有効にできる。個別にトグルすることも可能だ。
- 型付きページ(
experimental.typedPages) - 型付き
$fetch(experimental.routeTypedFetch) - 大文字小文字を区別するルーティング
- ビルド時のページメタデータ抽出
- インラインエラーレンダリング
サーバーコードをnuxt/serverで書いておけば、Nuxt 5移行時に書き換えが不要になる。今のうちに移行しておくのが安全だ。
アップグレードはnpx nuxt upgrade --dedupeを実行する。ロックファイルを更新し、Nuxt CLI v4を含む最新の依存関係が導入される。Node.jsは22.22.3以上、24.15.0以上、または26.0.0以上が必要だ。
この記事のポイント
- Nuxt 4.6はサーバー非依存化への大きな一歩。新しいimportソース
nuxt/serverが追加された - Nuxt CLI v4が同梱され、開発サーバーの初回表示が330 msから50 msへ高速化
- 型付き$fetchが再構築され、3000ルートの型推論が53.63秒から0.62秒に短縮
- Nuxt 3は2026年7月末にEOL。移行を進めるなら
future.compatibilityVersion: 5で事前テストが可能 - アップグレードは
npx nuxt upgrade --dedupeで実行できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験