

WordPress 7.1の管理画面テーブル変更、一部プラグインに影響の可能性
WordPress 7.1が2026年8月19日にリリース予定だ。このバージョンでは管理画面のアクセシビリティを大幅に改善する変更が含まれる。具体的には、投稿一覧などの管理用テーブルでHTMLのセマンティクスが修正される。この修正自体は好ましい進化だが、一部のプラグインやテーマで管理画面の動作に影響が出る可能性がある。特に、管理用のテーブル構造を前提にCSSやJavaScriptでカスタマイズしている場合は注意が必要だ。
変更の規模はそれほど大きくないが、プラグイン開発者だけでなく、サイト運営者も事前に互換性を確認しておくことで、アップデート後のトラブルを回避できる。この記事では、変更の具体的な内容と、利用者・開発者それぞれが取るべき対策を簡潔にまとめる。
管理画面テーブルのHTML構造が変わる
WordPress 7.1では、投稿・固定ページ・カスタム投稿タイプなどを一覧表示する管理画面のテーブル(リストテーブル)のHTMLマークアップが一部変更される。修正の対象は、主に各行の左端にあるチェックボックス列と、投稿タイトル列だ。変更点を整理すると以下のようになる。
- チェックボックス列が
<th>(行ヘッダー)から<td>(通常のセル)に変更される - 投稿タイトル列が
<td>から<th scope="row">(行ヘッダー)に変更される - 投稿タイトルの行ヘッダーには、投稿名を含む
aria-label属性が追加される - レスポンシブ表示時の折りたたみセルがFlexboxレイアウトに更新される
この変更によって、スクリーンリーダーを利用するユーザーは、各行で「どの投稿を操作しているのか」を正確に認識できるようになる。従来は、チェックボックス列が行ヘッダーだったために「すべて選択」といった無意味なラベルが読み上げられることが多く、特に投稿がロックされている場合などは混乱の原因になっていた。
変更前と変更後のコード比較
具体的にHTMLがどのように変更されるのか、簡単な例を示す。まずは現行バージョンの構造だ。
<tr>
<th scope="row" class="check-column">
<input type="checkbox" name="post[]" value="123">
</th>
<td class="title column-title column-primary page-title">
<a class="row-title" href="...">Hello world!</a>
</td>
<td class="author column-author">admin</td>
</tr>
これがWordPress 7.1では以下のように変わる。
<tr>
<td class="check-column">
<input type="checkbox" name="post[]" value="123">
</td>
<th scope="row" class="title column-title column-primary page-title" aria-label="Hello world!">
<a class="row-title" href="...">Hello world!</a>
</th>
<td class="author column-author">admin</td>
</tr>
チェックボックスのセルが <th> から <td> になり、代わりにタイトル列が <th scope="row"> として行の見出しの役割を担う。これにより、支援技術は「Hello world!」という投稿タイトルを行の識別子として扱えるようになる。
この変更は、サイトのフロントエンド(公開側)には一切影響しない。問題が発生するのはあくまで管理画面の投稿一覧テーブルをカスタマイズしている場合に限られる。
11年越しのバグ修正がもたらすアクセシビリティ向上
WordPressのコア開発チケット「#32892」は、この問題を報告してから実に11年が経過していた。修正が長期化した背景には、管理画面のテーブルマークアップが広範囲に影響するため、影響範囲の調査とテストに時間を要したことがある。
従来の構造では、スクリーンリーダーが各行を読み上げる際に、チェックボックスに関連付けられたラベル(多くの場合「すべて選択」)を読み上げてしまい、ユーザーはどの投稿の行にいるのか理解しづらかった。特に投稿が他ユーザーによってロックされている時に表示される鍵アイコンには、読み上げ用のラベルがなく、スクリーンリーダーは「すべて選択」と繰り返すだけだった。今回の変更により、行の主たる識別子である投稿タイトルが適切に読み上げられるようになり、管理画面の操作性が大きく改善される。
サイト運営者が今すぐすべきこと
影響を受けるのは、管理画面の投稿一覧に対して何らかの情報や操作を追加しているプラグインのみだ。具体的には、CSSやJavaScriptで特定の <th> や <td> をターゲットにしてカスタマイズしているプラグインが対象となる。多くのサイトでは問題は起きないが、念のため以下の手順で確認することをおすすめする。
プラグインの互換性情報を確認
WordPress 7.1の公開後、利用中のプラグインが互換性テストをパスしているかどうかをまずチェックしよう。方法は簡単で、「プラグイン名 changelog」や「プラグイン名 WordPress 7.1」で検索すれば、開発元の公式ブログやチェンジログが見つかる。プラグインが「7.1対応済み」と明記されていれば、先にプラグインを最新版に更新してからWordPress本体のアップデートを行うと安全だ。
互換性が未確認の場合は、本番環境に直接アップデートを適用せず、ステージングサイト(テスト環境)で事前に動作確認を行うことが望ましい。特に管理画面に大きく依存したワークフローを構築しているサイトでは、ステージングでのテストは必須に近いと考えていい。
主要SEOプラグインへの影響はほぼなし
多くのサイトで利用されているYoast SEO、Rank Math、All in One SEO(AIO SEO)の3つのSEOプラグインには、管理画面の投稿一覧に独自のカラムを追加する機能が含まれている。こうしたプラグインこそ影響を受けやすいように見えるが、Search Engine Journalの記事によると、公開されているコードを確認した限りでは、今回変更される <th> と <td> の構造に依存したセレクタは見つからなかったという。したがって、これらのプラグインがWordPress 7.1で即座に動作しなくなる可能性は極めて低い。
ただし、これは公式の保証ではない。各プラグインの公式ブログやチェンジログで、7.1対応についてアナウンスがないか確認しておくに越したことはない。
万が一問題が出た場合の対処
仮にプラグインが管理画面の投稿一覧で表示崩れや機能停止を起こしたとしても、フロントエンドの表示やSEO評価に直接影響が出ることはまずない。管理画面の一部の機能が不安定になる程度と考えてよい。その場合は、問題のプラグインを一時的に無効化するか、開発元の対応を待つことになる。落ち着いてステージング環境で原因を特定し、本番への影響を最小限に抑える対応を取ろう。
プラグイン開発者とカスタム実装者に向けて
WordPress向けのプラグインや管理画面のカスタマイズを行っている開発者は、今回の変更を事前に把握し、影響を受けるセレクタを修正する必要がある。特にノーコードツールやAIによるコーディング(いわゆるVibe Coding)で生成されたコードをそのまま利用している場合、セレクタの記述が <th> や <td> に依存している可能性が高いため、注意が必要だ。
修正すべきセレクタの典型例
問題となるのは、以下のようなCSSやJavaScriptのセレクタだ。
#the-list tr th.check-columnのような、チェックボックスの<th>を前提としたCSSルールdocument.querySelectorAll('tbody td.title')のように、タイトル列を<td>として取得するJavaScript- カスタムカラムを追加する際に、
<td>の直後に<td>を挿入するロジック
開発者は、セレクタをタグ名ではなくクラス名(.check-column や .title)に基づいたものに書き換えることで、新旧両方のマークアップに対応できる。WordPress 7.1への移行期間中は、<th> と <td> の両方にマッチするようなセレクタを用意するか、バージョン分岐処理を入れるのが安全だ。変更自体は単純なため、対応に膨大な工数がかかることはないだろう。
tr th.check-column で背景色を変更<td> になるためスタイルが当たらなくなるtr .check-column で背景色を変更なお、公式の発表では、テーマのフロントエンド側マークアップには一切手が加えられていないことが明言されている。管理画面のカスタマイズだけをメンテナンスすればよく、影響範囲は極めて限定的だ。
この記事のポイント
- WordPress 7.1ではアクセシビリティ向上のため、管理画面の投稿一覧テーブルのHTML構造が変更される
- チェックボックス列が
<th>から<td>に、タイトル列が<td>から<th scope="row">に変わる - フロントエンドへの影響はなく、管理画面のカスタマイズに依存する一部プラグインのみ注意が必要
- 主要SEOプラグイン(Yoast、Rank Math、AIO SEO)は現時点で影響が確認されておらず、互換性情報の確認を推奨
- 開発者はタグ名ではなくクラス名ベースのセレクタに修正することで新旧両対応が可能

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.0が公開、ゲスト注文の連携と大規模ストア向けパフォーマンス改善
WooCommerce 11.0が2026年8月4日にリリースされた。このバージョンは551件のプルリクエストを含む、近年最大規模のアップデートのひとつだ。バックログの整理とコアの基盤強化に重点が置かれ、ゲスト購入者が過去の注文を自分のアカウントに紐づけられる機能や、アナリティクスの信頼性向上、大規模ストア向けのパフォーマンスチューニングが行われている。
本記事では、運用者と開発者の両方にとって重要な変更点を中心に、WooCommerce 11.0の中身を解説する。カタログが数千点を超える店舗でも体感できる速度改善や、新しいゲスト注文管理の仕組みを詳しく見ていこう。
大規模ストアで効くパフォーマンス最適化
WooCommerce 11.0のパフォーマンス改善は、商品点数が多く、過去の注文データが膨大な店舗ほど効果を発揮する。内部クエリの最適化を中心に、Store APIの改良や注文処理中の在庫ステータス管理がより軽量になった。
内部クエリの見直しとStore APIの改善
大規模ストアでは、商品一覧や注文履歴を表示するたびにデータベースへ重いクエリが走り、管理画面やフロントエンドのレスポンスが悪化しがちだ。今回のアップデートでは、こうしたクエリに不要なJOINやサブクエリが含まれていないかを洗い出し、インデックスを活用したシンプルな構造に書き換える修正が多数含まれている。
Store APIも改良された。Headless構成やカスタムストアフロントでWooCommerceを利用している場合、商品データの取得やカート操作がより高速になる。具体的には、APIの内部で使用するキャッシュ戦略とデータ構造が見直され、同じデータを重複して取得する無駄が省かれた。
在庫管理まわりの処理が軽量化
注文が入るたびに在庫数を更新し、ステータスを変更するフローもチューニングされている。特に、バックエンドで複雑な在庫チェックを繰り返していた処理が一本化され、注文から在庫確保までの一連の流れがスリムになった。商品バリエーションが多い店舗では、これによる管理画面の操作感向上が期待できる。
上記のように、規模が大きくなるほど効果が明確になる。クエリ最適化は累積的なため、今後のWooCommerceバージョンでも継続して改善が加えられる見込みだ。
ゲスト購入とアカウントの連携がスムーズに
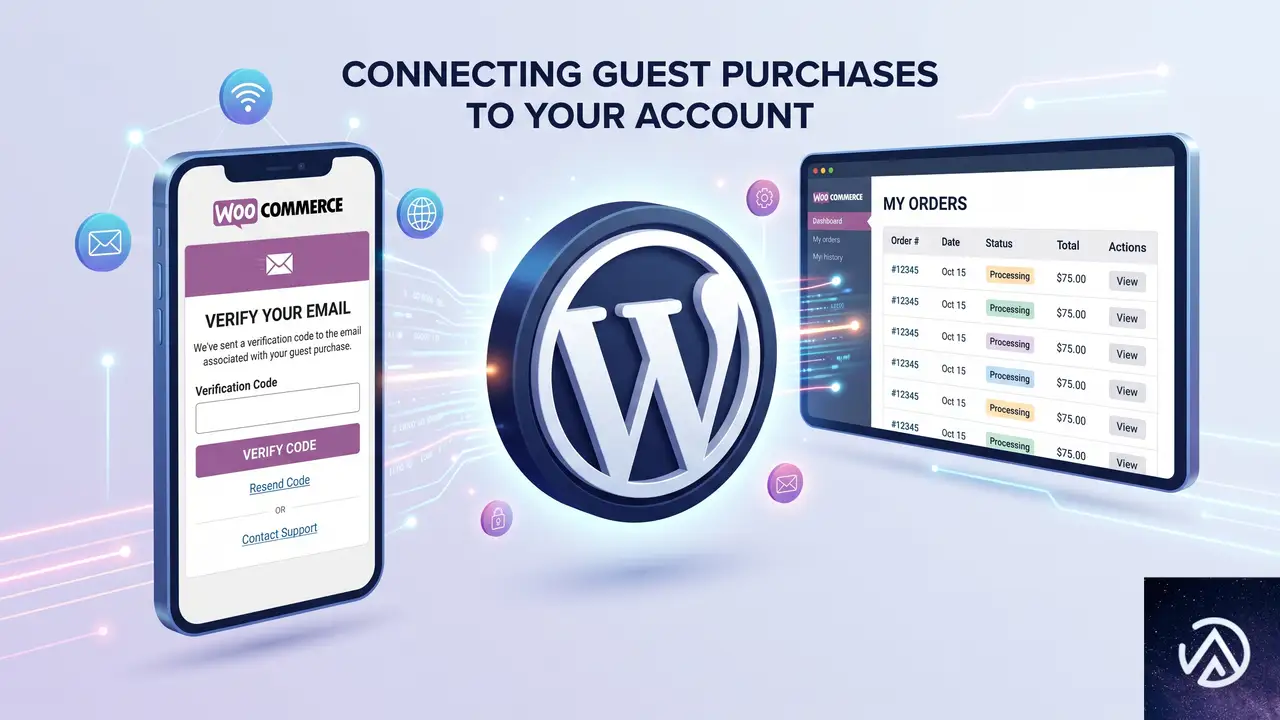
WooCommerce 11.0では、購入後のアカウント作成フローがさらに強化された。これまではゲストとして注文した後にアカウントを作っても、過去の注文は引き継がれなかった。今回のアップデートで、ゲスト購入者が自分の過去注文を見つけ、メール認証を通じてアカウントに紐づけられるようになっている。
メール認証による過去注文の引き継ぎ
具体的な流れはこうだ。ゲスト購入者が新たにアカウントを作成すると、WooCommerceはそのメールアドレスに関連する過去のゲスト注文を検索し、一覧を提示する。ユーザーは「自分の注文」として承認するかどうかを選択でき、承認されるとアカウントの注文履歴に統合される。この仕組みにより、リピート購入への心理的なハードルが下がり、顧客ロイヤルティの向上にもつながる。
この機能は、WooCommerce 9.5で導入された購入後アカウント作成の自然な拡張だ。単に「購入後にアカウントを作れる」だけでなく、「過去の購入履歴もまとめて管理できる」ようになる点が、顧客体験として大きな進化といえる。
アナリティクス報告の信頼性が向上
WooCommerce 11.0では、売上分析や注文レポートの精度が高められた。イベントトラッキングの確実性が増し、返金データが売上APIの数値に正しく反映されるようになった。また、過去データのインポートに失敗した場合、再試行できる機能が追加され、管理画面からエラー状況を確認しやすくなっている。
返金が売上レポートに正しく反映
これまでのアナリティクスでは、返金処理が行われても売上APIの数値が更新されないケースがあった。11.0では、返金も含めた正味売上が計算されるため、ダッシュボードの数字と実際の会計がずれる問題が解消される。
失敗時のリトライ機能でデータ欠損を防止
大量の履歴データを一括でインポートする際、サーバーの制限などで処理が途切れることがある。今回のアップデートで、インポートに失敗したジョブの一覧が表示され、管理者が手動でリトライできるようになった。大規模なデータ移行やバックアップからの復元作業が、より安全で扱いやすくなっている。
開発者向けアップデートと基盤整理
WooCommerce 11.0には、開発者向けの変更も数多く含まれている。Abandoned Cartメールやブロックベースのメール編集、新しい設定UIといった試験的機能が追加されたほか、Product Editor Betaの完全廃止、内部依存ライブラリであるAction Schedulerが4.0.0へ更新されている。
Action Scheduler 4.0.0への移行
Action Schedulerとは、WordPressのWP-Cronに代わる形で定期的なジョブや遅延タスクを実行するライブラリで、WooCommerceの購読や自動メールなど多くの機能を支えている。今回、依存バージョンが4.0.0に引き上げられ、ジョブの登録と実行の仕組みが改善された。具体的には、処理の重複防止やエラーハンドリングが強化され、長期間のタスクでも安定して動くようになっている。
試験的機能と廃止スケジュール
Abandoned Cartメールは、カゴ落ちしたユーザーに自動でリマインダーを送る機能だが、これまではサードパーティのプラグインに頼る必要があった。今回、コアに試験的実装が加わり、将来的な標準機能化への布石となっている。ブロックベースのメール編集や新しい設定UIも、まだ試験的ではあるが、より直感的な管理画面を目指す方向性を示している。
一方、Product Editor Betaは今回のバージョンで完全に廃止された。すでに新しい商品編集エディタが安定版へ移行しており、以前のベータ版に依存していたカスタムコードがある場合は、早めの移行が推奨される。
この記事のポイント
- WooCommerce 11.0は551件のPRを含む大規模アップデートで、基盤整理とパフォーマンス改善が中心
- ゲスト購入者が過去の注文をメール認証でアカウントに紐づけられるようになり、リピート率向上に寄与
- 大規模ストア向けにクエリ最適化とStore API改良が行われ、管理画面とフロントエンドのレスポンスが向上
- 返金データが売上APIに正しく反映され、アナリティクスの信頼性が高まった
- 開発者向けにはAction Scheduler 4.0.0への移行や試験的機能の追加、Product Editor Betaの廃止が行われた
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WeatherNext AIがサイクロン予測で1日分の警報リードタイムを実現、オープンソース化へ
Google DeepMindは2026年8月6日、AI気象予測モデル「WeatherNext」がサイクロン(ハリケーン・台風)予測において、警報のリードタイムを1日延長する画期的な精度を達成したと発表した。同モデルはすでに2025年のハリケーンシーズンで実運用され、上陸地点と急速発達の予測に貢献している。さらにコードとモデル加重がオープンソース化され、研究コミュニティ全体での活用が可能になった。
この成果は、過去50年間で70万人以上の死者と1.4兆ドルの経済損失をもたらしてきた熱帯低気圧への対策に、AIが本格的に実用化される転換点となる。本記事ではWeatherNextの技術的ブレークスルーと、それが実際の防災現場にもたらすインパクトを掘り下げる。
サイクロン予測で警報リードタイムを1日延長
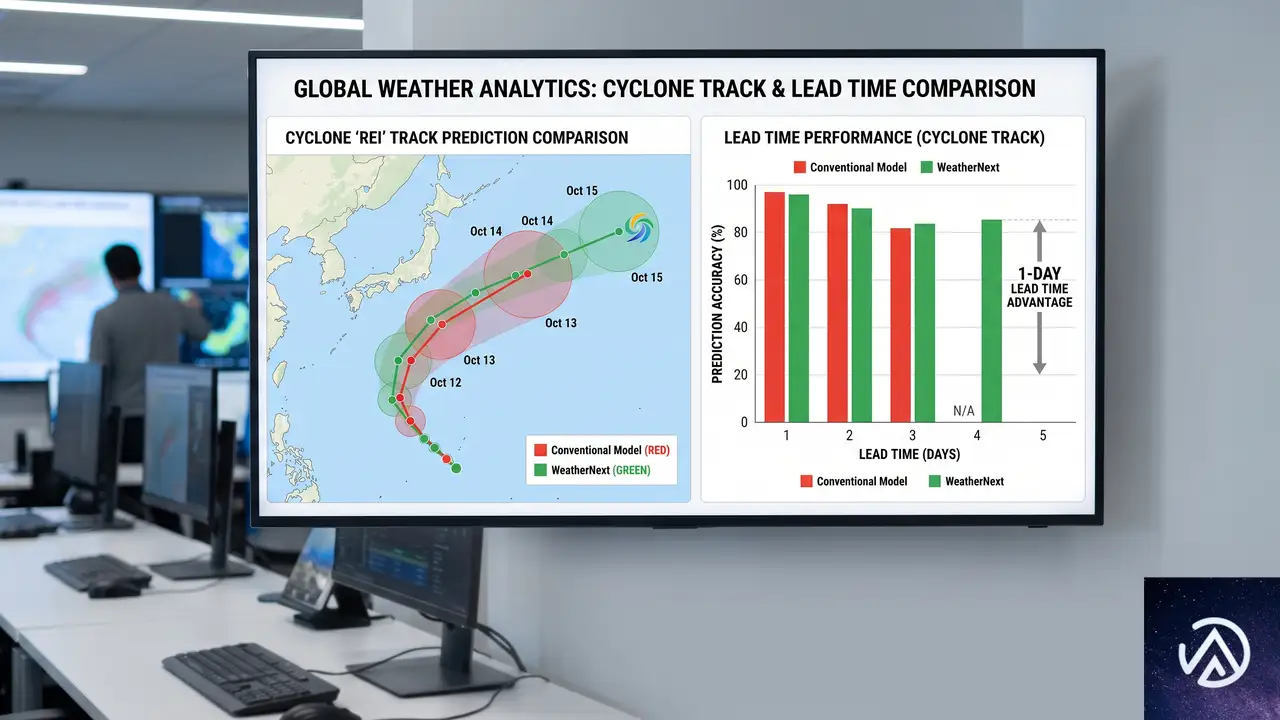
WeatherNextは、サイクロンの進路(どこに行くか)・強度(どれだけ強くなるか)・風構造の3要素すべてで最先端の予測精度を達成した。平均すると、3日先の予測が従来の最優秀モデルの2日先予測と同等の正確さを示し、1日分のリードタイム短縮に相当する。気象学分野では、このレベルの改善は約10年分の技術進歩に匹敵するという。
この大幅な改善は、3日後の進路・強度・風構造すべてにわたる。気象庁や米国国立ハリケーンセンター(NHC)のような機関が早期警報を出せる余地が格段に広がることを意味する。
WeatherNextが予測精度を高める仕組み

従来のサイクロン予測には、大きなジレンマがあった。進路は地球規模の大気の流れが支配するため、広域を粗い解像度でモデル化する全球モデルが必要だった。一方、強度や風構造は台風の目の周辺数十キロメートルの局所的な対流活動が決め手となるため、高解像度の局地モデルが不可欠とされてきた。この二つの異なるモデルを併用するアプローチが限界を生んでいた。
WeatherNextは単一のAIモデルでこのギャップを埋める。全球の気象力学と、専門家が蓄積してきた過去約5,000個のサイクロン観測データ(IBTrACS)を同時に学習することで、広域のパターンも局所的な暴風構造も一貫して予測できるようになった。学習に使った大気データは約20テラバイトに及ぶ。
もう一つの鍵は、機能的生成ネットワーク(FGNs)を用いたアンサンブル予測だ。気象には本質的に不確実性が伴うため、1つの予測ではなく多数のシナリオを生成し、その確率分布からリスクを評価する。WeatherNextはTPU上で1度の15日予測を1分未満で実行でき、当初50メンバーだったアンサンブルを現在は1,000メンバーに拡大。ハリケーン・メリッサ(2025年)のような急速発達イベントも、低確率ながら重大なテールリスクとして捉えられるようになった。
驚くべきことに、WeatherNextは従来の局地モデルより100倍粗い28km四方の解像度データだけで高精度な強度予測を実現している。さらに111km四方の解像度で動作する軽量版「WeatherNext 2-mini」でも高い性能を示しており、なぜこれほど粗いデータで正確な予測ができるのかは、まだ科学的に完全には解明されておらず、研究コミュニティとともに探求するテーマだ。
2025年ハリケーンシーズンでの実績とオープンソース化

WeatherNextはすでに実際の防災判断に貢献している。2025年のハリケーンシーズン、NHCはWeatherNextの予測をもとにハリケーン・メリッサの急速発達とジャマイカ上陸を早期に警告した。これにより現地の準備期間が確保され、人命とインフラを守る重要な一手になったと報告されている。
2026年8月のNature掲載論文と並行して、Google DeepMindはWeatherNext 2およびWeatherNext Cyclonesモデルのコードと重みをGitHubで公開した。商用利用を含め自由に利用でき、学術研究から各国の気象機関による現業予報、さらに地域特化のカスタムモデル開発まで幅広く活用できる。また、無料のColabノートブックで動作する軽量版も提供され、個人や小規模組織でも気象AIのプロトタイプを試せる環境が整った。
気象予測の民主化として、このオープンソース化は大きな意味を持つ。途上国や島嶼国の気象機関にとって、高価なスーパーコンピュータがなくてもTPU相当のクラウドリソースがあれば、世界最高水準のサイクロン予測を運用できる可能性が開けたからだ。
今後の展望とコミュニティへの期待
Google DeepMindは、研究者や気象機関に対し、WeatherNextをベースにした共同開発や改良を呼びかけている。最終的な警報や避難指示は各国の気象当局が発出するものであり、AIはあくまでその判断を支えるツールだが、予測精度の向上が地域コミュニティのレジリエンスを高めることは明らかだ。
粗解像度で高精度を達成した理由の解明や、より長期の予測への応用など、学術的にも興味深い課題が残されている。WeatherNextのオープンソース公開により、世界中の研究者がこれらの謎に取り組み、気象学とAIの融合をさらに加速させることが期待される。
この記事のポイント
- WeatherNextはサイクロンの進路・強度・風構造を3日前の時点で高い精度で予測し、警報リードタイムを1日延長
- 単一AIモデルで広域と局所の両方をカバー。28km解像度の粗いデータでも高性能
- 2025年ハリケーンシーズンで実際にNHCの早期警報を支援し、オープンソース化で全世界に利用拡大
- 機能的生成ネットワークにより1,000メンバーのアンサンブル予測を1分未満で実行し、レアシナリオを捕捉
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WooCommerce Stripeに緊急セキュリティアップデート。バージョン10.8.5へ即時更新を
WooCommerceは2026年8月6日、公式決済プラグイン「Stripe for WooCommerce」のセキュリティアップデートをリリースした。影響を受けるのはバージョン9.7.0から10.8.4まで。すべてのストア管理者は直ちにバージョン10.8.5または各リリースラインのパッチ版へ更新する必要がある。
今回の問題はAutomattic社内のプロアクティブなセキュリティテストで発見された。現時点で悪用された証拠はなく、顧客情報や決済データへの不正アクセスも確認されていない。しかし、特定の条件下でストアが利用不能になる可能性があるため、迅速な対応が求められる。
影響範囲とパッチバージョン
今回の脆弱性はStripe for WooCommerceプラグインのバージョン9.7.0から10.8.4に存在する。9.7.0より前のバージョンは影響を受けないが、それらは古いリリースのため、最新のサポート対象バージョンへの移行が推奨される。
WooCommerceチームは、影響を受けるすべてのリリースラインに対してパッチを用意した。理想は最新の10.8.5に更新することだが、何らかの事情ですぐにメジャーバージョンを上げられない場合は、以下のパッチ版を適用すればよい。
更新手順と確認ポイント

管理画面からの手動更新
自動更新を設定しているストアでも、念のためバージョンを直接確認することが重要だ。管理画面の「プラグイン」→「インストール済みプラグイン」から「WooCommerce Stripe Payment Gateway」または「Stripe for WooCommerce」を探し、更新が利用可能な場合は「今すぐ更新」をクリックする。更新後は必ず決済テストを実施し、Stripe決済手段が正常に表示されることを確認しておきたい。
自動更新とインフラストラクチャ対応
WordPress.orgプラグインチームと連携した自動更新の配信も進められている。Automatticの管理下にあるストアや、プラグインの自動更新を有効にしている環境では、すでにパッチが適用されている可能性がある。しかし、複数ストアを管理する開発者や代理店、ホスティング事業者は、実際のバージョンを直接確認することを怠ってはならない。
今回の脆弱性の内容と影響

最も深刻な問題は、特定の条件下でストア自体が利用不能になるというものだ。顧客のクレジットカード情報や購入履歴といった機密データにアクセスされる性質のものではないが、サイトが停止すれば売上機会の損失に直結する。WooCommerceは今回の脆弱性を悪用した実例は確認されていないとしている。
このアップデートでは、利用不能を引き起こす可能性のある問題に加えて、関連するセキュリティ上の問題点も修正されている。具体的な脆弱性の手順は、多くのストアが更新を完了するまでは公開されない方針だ。未パッチのサイトを狙った攻撃を防ぐためであり、詳細な技術情報は安全が確認され次第、アドバイザリに追記される予定である。
7月14日のアップデートとの違いに注意

今回のリリースは、2026年7月14日に公開されたStripe for WooCommerceの決済検証パッチとは別のアップデートである。7月のアドバイザリ対応でバージョン10.6.2、10.7.1、10.8.4に更新したストアも、重ねて今回のパッチを適用しなければならない。両方の修正を含んだ最新版は10.8.5だ。
困ったときのサポート窓口

更新作業に手詰まりを感じたら、WooCommerceの公式サポートに問い合わせるのが確実だ。ストア管理者はWooCommerceサポートページからチケットを発行できる。プラグイン開発者やホスティング事業者など、技術的な質問がある場合は、WooCommerce Community Slackの利用が案内されている。
この記事のポイント
- Stripe for WooCommerce 9.7.0〜10.8.4にセキュリティ脆弱性。全ストアで即時更新が必要
- 推奨更新先は10.8.5。各リリースラインにパッチ版あり
- ストアが利用不能になる可能性があるが、決済データ等へのアクセスはない
- 7月のパッチとは別のアップデート。両方の修正を含む最新版への移行が必須
- 自動更新環境でも必ず手動でバージョンを確認し、テスト購入を行う
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAI、GPT-5.6 SolとLunaをChatGPTに展開。無料ユーザーに無制限チャット、事実誤認を最大68%削減
OpenAIは2026年8月6日、ChatGPTの大幅なモデルアップデートを発表した。有料ユーザー向けにGPT-5.6 Solの回答品質を刷新し、無料ユーザー向けにはGPT-5.6 Lunaのデフォルト化と無制限テキストチャットを実現する。内部評価では事実誤認が最大68%削減されており、実務利用に直結する進化といえる。
週に10億人が利用するChatGPTにとって、この変更は情報検索や企画立案、専門的な意思決定の質を大きく左右する。有料ユーザーには思考深度を調整できる新しいスライダーが提供され、無料ユーザーは難しい質問に対して深い推論を呼び出す「Think」ボタンを利用できるようになる。
GPT-5.6 Solが実現する3つの改善点
事実誤認が最大68%減少
今回のGPT-5.6 Solでは、金融・医療・法律といった専門領域で事実誤認を大幅に減らすことに注力した。OpenAIの内部評価によると、GPT-5.5 Instantと比較してGPT-5.6 Lunaでは約62%、GPT-5.6 Solでは約68%も事実誤認を含む回答が減少している。日付や数字、出典や前提条件に依存する問いに対して、より正確に情報を引き出せるようになった。
回答の簡潔さと一貫性の向上
GPT-5.6 Solは質問の粒度に応じて回答の詳細度を自動調整する。たとえば「明日の午前中に自転車で移動するが、天気は問題ないか」という問いに対して、従来モデルが降水確率や風速を列挙するだけであったのに対し、新モデルは「風が強いため注意が必要」という核心を先に伝え、必要な詳細だけを整理して返す。
また、同じモデルで即時応答(Instant)と深い思考(Thinking)の両方をカバーするため、思考深度を切り替えても回答のトーンやスタイルが一貫している。「別のAIに切り替わった」ような違和感はなく、単に「より時間をかけて包括的に答えてくれる」という自然な体験になる。
この例のように、GPT-5.6 Solは本当に知りたいことを捉え、余計なフォーマットや関係の薄い詳細を省く。技術的な質問や多段階の計画立案でも、中心的な推奨事項が明確に示される。
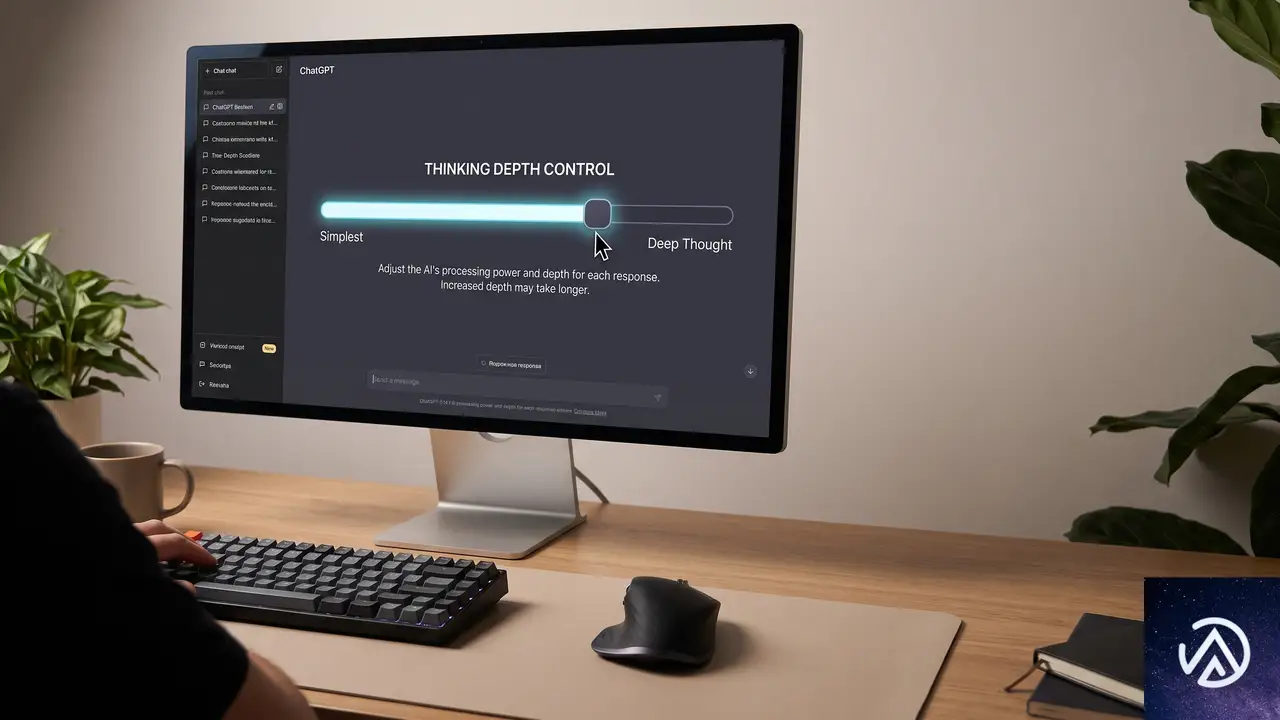
思考深度を調整するスライダー(Plus・Pro向け)
ChatGPTのウェブ版・モバイル版・デスクトップ版に新しく搭載されたスライダーを使うと、日常的な質問では素早く回答を得て、企画・調査・コーディング・意思決定のような深い思考が必要な場面ではスライダーを上げるだけでモデルがより多くの計算リソースを割くようになる。同じGPT-5.6 Solモデルの中で推論量を変えるため、品質と一貫性が保たれる。
無料ユーザー向けの大幅な機能拡張

デフォルトモデルがGPT-5.6 Lunaに
これまで無料ユーザーが利用できたGPT-5.5 Instantに代わり、GPT-5.6 Lunaが標準モデルとして展開される。GPT-5.6 Lunaは事実誤認の削減や回答の一貫性でGPT-5.5 Instantを上回り、日常的なチャットの質を底上げする。
テキストチャットが無制限に
無料ユーザーはテキストチャットの回数制限がなくなり、連続して質問を続けたり、アイデアを深掘りしたりできるようになる。ファイルアップロードや画像生成などの他のツールには引き続き制限がかかるが、言語でのやり取りが事実上無制限になることで、学習や日常業務でのハードルが大きく下がる。
難しい質問に使える「Think」ボタン
無料ユーザー向けのインターフェースには新たに「Think」ボタンが追加される。より深い推論が必要な質問に対して、このボタンをタップするとGPT-5.6 Lunaが追加の計算時間をかけて回答を導き出す。複雑な比較検討や論理的な分析が必要な場面で、有料プランに近い推論品質の恩恵を得られる。
「2つの事業計画のリスクとリターンを比較し、最適な選択肢はどれか」
なお、悪用防止のためのガードレールが設けられており、過度な連続利用には制限がかかる。しかし、重要な場面で深い回答が得られる点は無料ユーザーにとって大きな価値となる。
スライダーで思考量を自在にコントロール
操作の仕組みと実務での活用
スライダーは左から右に動かすほど、GPT-5.6 Solが回答の生成に費やす推論時間が増加する。左端ではシンプルな事実確認や挨拶のような即答に適し、右端では複数ステップの計画立案、技術的なトラブルシューティング、長文の分析レポート作成に適した深い回答が得られる。
たとえば「自社サイトのSEO状況を改善したい」という場合、スライダーを低く設定すれば基本的なチェックリストを得られる。高く設定すると、具体的なデータ分析の手順やツールの選定、優先順位付けまで含めた戦略的なアドバイスを引き出せる。
未成年ユーザー保護への取り組み

18歳未満を対象にした安全訓練とシステム保護
OpenAIは今回のアップデートに伴い、18歳未満と推定されるユーザー向けの安全性対策を強化した。モデルは恋愛ロールプレイや年齢制限のあるチャレンジ、現実の人間関係の代替として振る舞うことを避けるよう訓練されている。さらに、性的コンテンツや摂食障害、危険行為、過激な暴力表現に対する年齢相応の境界も設定された。
システムレベルでの保護も重ねられ、10代のユーザーがサポートを必要としていると判断した場合には、信頼できる大人とのつながりを促すように設計されている。これらの対策の詳細は公開されたシステムカードに記載されており、未成年ユーザーに対するモデルの振る舞いを継続的に改善する姿勢が示された。
このアップデートがもたらすAI活用の展望
無料ユーザーへの高機能提供が意味すること
無制限テキストチャットとThinkボタンの提供は、「高度なAI機能は有料」という従来の常識を覆す。個人事業主や学習者にとっては、リサーチやアイデア出しの頻度を気にせずAIを活用できる環境が整った。アクセスの拡大は学習機会やビジネスチャンスの格差を縮める一歩といえる。
ビジネスユーザーにとっての実用性向上
事実誤認の大幅な減少と回答の簡潔化は、レポート作成や顧客対応の下調べ、契約書のレビューといった業務でミスを減らす直接的な効果をもたらす。スライダーによって手軽に深い分析と迅速な回答を使い分けられるため、AIを実務のパートナーとして日常的に組み込む企業が増える可能性がある。
この記事のポイント
- GPT-5.6 Solは事実誤認を最大68%削減し、回答の的確さと一貫性が向上した
- Plus・Proユーザー向けのスライダーで、同じモデル内で思考深度を自由に調整できる
- 無料ユーザーはGPT-5.6 Lunaがデフォルトモデルとなり、テキストチャットが無制限に
- 無料ユーザーも「Think」ボタンで深い推論が必要な質問に対応可能になった
- 未成年保護の安全対策が強化され、18歳未満向けのモデル訓練とシステム保護が導入された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPress 7.0.3が緊急リリース。深刻なXSS脆弱性など12件を修正、早急な更新を
WordPressのセキュリティアップデート「7.0.3」が2026年8月6日に公開された。このリリースでは12件の脆弱性が修正され、特に認証前の反射型クロスサイトスクリプティング(XSS)が深刻度8.9と評価されている。
当該のXSS脆弱性は、攻撃者が細工したサイトを経由してログイン画面にアクセスさせることで、リモートコード実行(RCE)に発展する可能性がある。全バージョンのWordPressに影響し、過去のブランチにまでパッチがバックポートされた点からも、緊急性の高さが伺える。
本記事では、修正された脆弱性の詳細と、ユーザーがすぐに実践できる対策をまとめた。
今回修正された12件の脆弱性の概要

WordPress 7.0.3では、以下の12件の脆弱性が修正された。公式発表では深刻度などの情報が最小限に留められているが、いずれも実運用に影響を与え得るものだ。
- 投稿日付ブロックでのContributor+保存型XSS
- 投稿コンテンツブロックでのContributor+保存型XSS
- 最新コメントブロックにおける情報開示(パスワード保護された投稿のコメントが露出)
- メールアドレス確認フローのバイパス
- Author+による安全なCSS属性フィルターのバイパスを介したCSSインジェクション
- 絵文字設定要素を介したContributor+保存型XSS
- マルチサイトネットワークでの権限昇格(ユーザー登録が有効な場合、新規サイト作成が可能)
- URL検証におけるSSRF(サーバーサイドリクエストフォージェリ)により、リンクローカル範囲へのリクエストが可能
- ログイン画面における認証前の反射型XSS(PHPコード実行の可能性あり)
- コメントフィードでのノート開示
- 投稿スラッグの列挙
- 多数のユーザーが存在するサイトでのクイック編集におけるContributor+保存型XSS
特に注意が必要な3つの深刻な脆弱性

修正された12件のうち、以下の3つは危険度が突出して高い。中でもログイン画面のXSSは、リモートコード実行に繋がる恐れがあり、深刻度は10点満点中8.9と評価された。
パスワード: ********
パスワード: ********
上のデモは、ログインエラーメッセージにスクリプトが紛れ込むケースを簡略化したものだ。修正前は悪意のあるコードがそのまま実行されてしまうが、修正後は出力が適切にエスケープされ、安全なテキストとして表示される。
ログイン画面の反射型XSS(深刻度8.9)
この脆弱性は、認証前(Pre-auth)の反射型XSSに分類される。攻撃者は特別に細工した悪意のあるWebサイトを用意し、標的ユーザーをそこへ誘導する。ユーザーがそのサイトを経由してWordPressのログイン画面にアクセスすると、不正なスクリプトが実行される可能性がある。
公式のGitHubセキュリティリポジトリによると、この脆弱性を悪用するとリモートコード実行(RCE)にまで発展する恐れがあるという。ただし、攻撃を成立させるにはソーシャルエンジニアリングが必須であり、標的ユーザーが意図的にアクションを起こす必要がある点が緩和要因となっている。
セキュリティ企業Patchstackのオリバー・シルド氏はSearch Engine Journalの取材に対し、「ソーシャルエンジニアリングが必要なため、ハッカーがこのXSSを積極的に悪用する可能性は低いと考えている」とコメントしている。同社では開示時点で緩和ルールを顧客に提供済みだ。
SSRF(サーバーサイドリクエストフォージェリ)による内部情報露出
SSRFとは、サーバーが内部ネットワークに対して不正なリクエストを送信させられる脆弱性だ。今回の事例では、リンクローカルIP範囲(サーバー内のプライベート通信で使われるアドレス)へのリクエストが可能になる。
これにより、本来外部からアクセスできない内部の機密情報が漏洩するリスクがある。公式発表では詳細が明かされていないが、仮想ホスト環境やクラウドインスタンスのメタデータサービスなどが標的になる可能性がある。
マルチサイト環境での権限昇格(新規サイト作成)
ユーザー登録が有効なマルチサイトネットワークにおいて、権限を持たないユーザーが新たなサイトを作成できる脆弱性だ。大学や企業のポータルサイトのような大規模マルチサイト環境では、悪意のあるサイト作成によってブランド毀損やフィッシングサイトの設置などに悪用される恐れがある。
単一サイトの運営者には影響しないが、WPMU(WordPress Multisite)を利用している管理者は直ちにアップデートを適用する必要がある。
XSSの危険性を正しく理解する
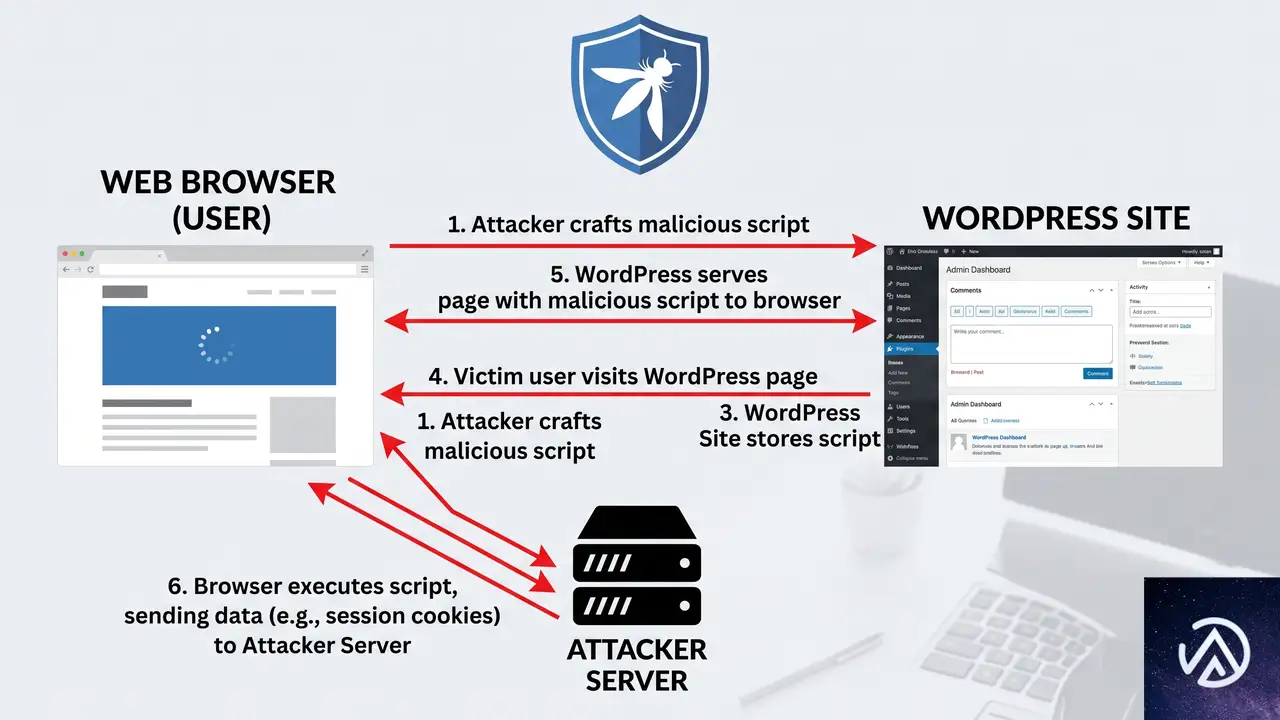
今回のリリースで最も注意を集めている脆弱性が反射型XSSだ。クロスサイトスクリプティングは、古くから存在する攻撃手法でありながら、依然として多くのWebアプリケーションで発見される。
OWASP(Open Worldwide Application Security Project)は、XSSを「悪意のあるスクリプトが、信頼された正規のWebサイトに注入される攻撃」と定義する。攻撃者は、ユーザーの入力を適切に検証・エンコードせずに出力することで、任意のスクリプトを実行させる。
実行されたスクリプトは、Cookieやセッショントークンといった機密情報にアクセスできるため、アカウントの乗っ取りや個人情報の窃取に直結する。WordPressのログイン画面でこの攻撃が成立すれば、サイト全体の管理者権限を奪取されるリスクもゼロではない。
WordPressユーザーが取るべき具体的な対策
自動更新が有効か確認する
WordPress 7.0.3はセキュリティリリースのため、自動更新がデフォルトで有効になっている環境では速やかに適用される。管理画面の「ダッシュボード」→「更新」から、現在のバージョンを確認しておこう。
手動更新が必要な場合の手順
何らかの理由で自動更新が失敗した場合は、手動での更新を推奨する。FTP/SFTPでWordPressファイルを上書きする方法が一般的だが、事前にデータベースとファイルの完全バックアップを取得しておくことが鉄則だ。
マルチサイト運営者は特に注意を
ユーザー登録を許可しているマルチサイトネットワークでは、権限昇格の脆弱性が悪用される前に即座に更新する必要がある。また、新規サイト作成の監査ログを確認し、不審なサイトが作成されていないかも点検すべきだ。
この記事のポイント
- WordPress 7.0.3では12件の脆弱性が修正され、ログイン画面の反射型XSSは深刻度8.9
- SSRFやマルチサイト権限昇格も深刻で、特にマルチサイト運営者は早急な対応が必要
- 攻撃にはソーシャルエンジニアリングが必要だが、RCEに繋がる可能性があるため軽視できない
- 自動更新の確認と、全バージョンへのパッチ適用を今すぐ実施すべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare AI Searchがエージェント検索を簡素化、公開エンドポイントと価格プレビュー発表
Cloudflareは2026年8月6日、AI Searchに大規模な機能拡張を発表した。従来はWorkers AIやVectorize、R2、Browser Runといった複数のプリミティブを組み合わせて独自の検索パイプラインを構築する必要があった。今回のアップデートによりAI Searchがこれらの処理を自動化し、開発者やエージェントが、まるで自前の検索エンジンを持っているかのような感覚で扱えるようになった。
新機能として、複数のWebサイトやファイルを横断して検索できる公開エンドポイントの提供、サイトマップ不要のクロール機能、カスタムドメインによるブランディング、EmDash CMS向けの検索プラグインなどが追加された。さらにプレビュー価格モデルも発表され、デフォルトの埋め込み・リランキングモデルを利用すれば、これらの処理が無料になる予測可能な料金体系が示されている。エージェントが信頼できる情報源から回答を引き出せるインフラが、これまでより格段に手軽になった。
AI Searchの主な機能強化点

AI Searchを導入する前は、ベクトル化したデータの格納先やクローリングの仕組み、リランキングのパイプラインなどを開発者が自前で組み上げる必要があった。しかし今回の強化により、それらの低レベルなサービスを意識せずに済む。結果としてエージェントが信頼できる最新情報を引き出せるインフラが、数分で立ち上がるようになった。
インデックス作成の簡素化
これまでAI SearchでWebサイトをインデックスに追加する際は、サイトマップが必須だった。しかし新たに追加された「Discover」パースオプションを使えば、サイトマップがなくてもページ内のリンクを辿って自動的にコンテンツを収集できる。Cloudflareアカウントに登録されたゾーンであれば、特定のページから始まる全サイトデータを取り込めるようになった。
さらに、HTMLやPDFなどの非構造化データから構造化データまで、幅広いファイル形式に対応した取り込みが可能になった。これにより社内Wikiや製品マニュアルといった多様なデータソースをエージェントの検索対象に加えやすくなっている。
公開検索/MCPエンドポイント
ネームスペースに対して公開URLを有効化すると、/search と /mcp のエンドポイントが即座に利用できるようになる。/search は通常のREST APIとして、/mcp はモデルコンテキストプロトコル(MCP)に対応した形で提供される。どちらも認証不要で、複数のインスタンスにまたがる横断検索を1つのリクエストで実行できる。
外部のエージェントやアプリケーションに検索機能を提供したい場合、このエンドポイントをそのまま公開するだけで済む。Cloudflare以外の顧客に自社データへアクセスしてもらうシナリオでも、認証が不要で、URLを渡すだけのシンプルな共有が可能になっている。
EmDashとの統合とbotポリシー
Cloudflareが公開しているOSSのCMS「EmDash」向けに、AI Searchプラグインが提供された。これを導入すると、EmDashで構築したサイト内にセマンティック検索を組み込める。実際にCloudflare BlogやDeveloper Docsもこの仕組みで動いている。
また、AI Searchのクローラは独自のユーザーエージェント「Cloudflare-AI-Search」を使い、各サイトのrobots.txtに従う。ブラウザベースのクローリング機能を使う場合でも、このポリシーは変わらない。サイト運営者がクロールを拒否すれば収集が停止されるため、著作権や利用規約上の配慮が十分になされている。
Cloudflare Dev Stack MCPの実装事例
Cloudflare自身がAI Searchをどう活用しているかを示す好例が、新しく公開された「Cloudflare Dev Stack MCP」だ。これはCloudflareのエコシステム全体(ドキュメント、ブログ、APIリファレンス、コミュニティなど)を横断検索し、コーディングエージェントへ最新の引用付き回答を返す仕組みである。古いトレーニングデータではなく、常にフレッシュな情報を基にコードを生成できる。
インスタンス作成とクロール
CloudflareはDocs、Blog、API Docs、コミュニティ、Astro、Viteなど計10以上のサイトに対して、それぞれ個別のAI Searchインスタンスを作成した。各インスタンスはドメインが異なるが、Cloudflareが所有するサイトデータであるため、統一的な方法でクロールできる。
npx wrangler ai-search instance create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
--parse-type discover上記のコマンドでは、--parse-type discover を指定することでサイトマップなしにページを発見するクロールを実行している。この内部ではBrowser Runの/crawl機能が使用され、リンクを辿って再帰的にページを見つけ出す。
Workerを使ったマルチインスタンス統合
10個のインスタンスにまたがる横断検索を実現するため、CloudflareはWorkerを用いたMCPサーバを構築した。wrangler.jsonにAI Searchネームスペースのバインディングを追加し、1つのツール呼び出しで全インスタンスを同時に検索する。
{
  "ai_search_namespaces": [
    { "binding": "AI_SEARCH", "namespace": "cloudflare-stack" }
  ]
}
context.registerTool(
'search_dev_stack',
{
description: 'Search current docs across the Cloudflare stack.',
inputSchema: z.object({ query: z.string() }),
},
async ({ query }) => {
const res = await context.env.AI_SEARCH.search({
query,
ai_search_options: {
instance_ids: ['developers-cloudflare-com', 'astro', /* ... */],
retrieval: { max_num_results: 10 },
reranking: { enabled: true },
},
})
return { content: [{ type: 'text', text: format(res.chunks) }] }
}
)この方式により、エージェントが単一のツール呼び出しで全ドキュメントを検索でき、結果にはどのインスタンスから取得されたかのメタデータが付与される。複数の検索先を順に叩く必要がなく、応答速度も一括で処理される。
コード不要の公開エンドポイントも選択可能
Workerを書かずに済ませたい場合、ネームスペースの公開URLを有効化するだけで、すべてのインスタンスにクエリを投げる/searchおよび/mcpエンドポイントが得られる。設定画面からワンクリックで有効化でき、即座に利用を開始できる。Cloudflare自身のMCPサーバもこの公開エンドポイントを活用している。
コードを書く場合は細かいチューニングやMCPツールとしての統合が可能で、コードを書かない場合は設定画面上の操作だけで外部共有が完了する。どちらの選択肢も提供されている点が、利用者のスキルや要件に応じた柔軟な導入を後押しする。
公開エンドポイントとカスタムドメインで検索を共有
AI Searchでは、公開エンドポイントに独自のカスタムドメインを割り当てられる。デフォルトのCloudflare管理URLではなく、search.example.com/mcpといったブランド化されたエンドポイントを用意できるため、サービス提供時の信頼感が高まる。
さらに、検索を限定公開したいケースではCloudflare Accessを介した認証ゲートを追加できる。これによりエンドポイントへのアクセスを許可された人物やエージェントだけに制限し、認証情報を持たない第三者からの不正なクエリを防げる。社内データや顧客限定の検索サービスを安全に運用できる設計になっている。
このカスタムドメイン機能は、SaaSプロダクトやエージェントサービスを展開する事業者にとってとくに有用だ。自社ブランドのURLで検索APIを提供することで、サービス全体の統一感が生まれ、導入先からの信頼獲得につながる。
プレビュー価格モデルでコストを予測可能に
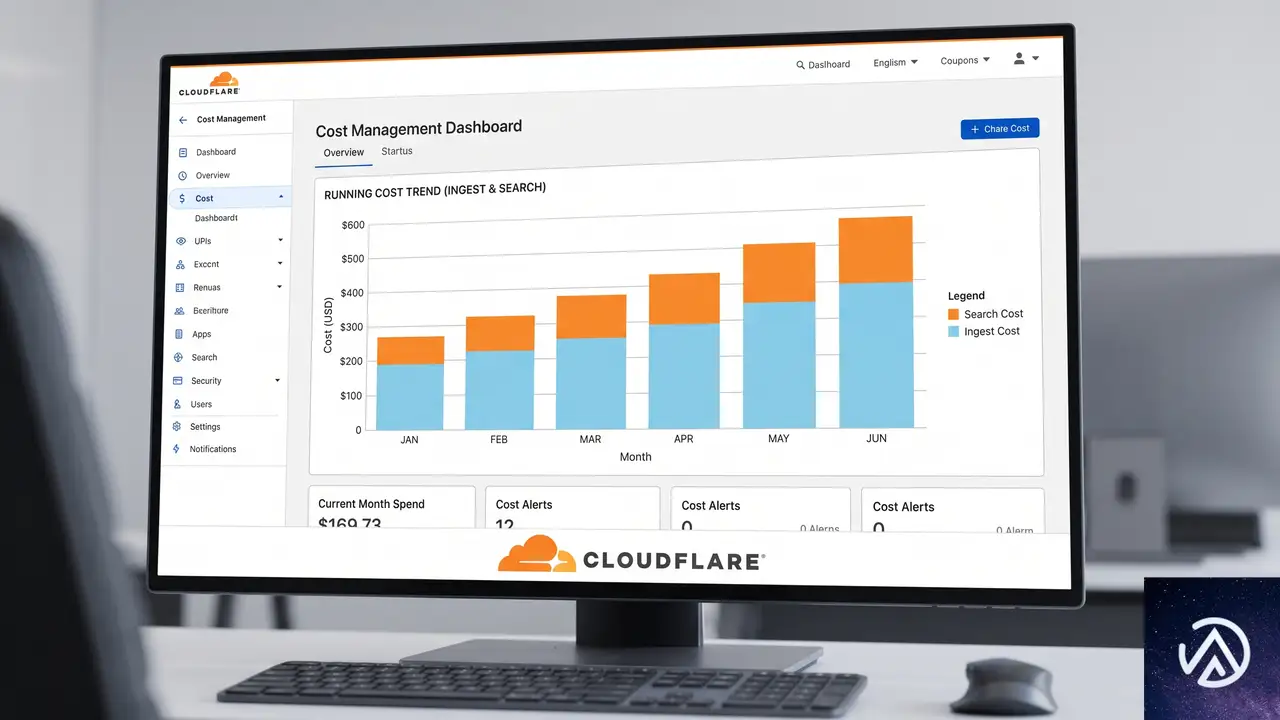
AI Searchは現在ベータ版として無料提供されているが、正式版に向けたプレビュー価格が公開された。課金開始前には十分な通知が行われる予定だ。料金設計の中心にある考え方は「予測可能でスケーラブル」であり、埋め込みとリランキングをデフォルトモデル利用時に無料化することで、トークン数の見積もりに頭を悩ませる必要をなくしている。
料金の主な内訳
- インジェスト(テキスト): $0.75 / 1Mトークン。月間無料枠5Mトークン。
- 画像処理アドオン: +$0.50 / 1Mトークン。画像の埋め込みに使用される。
- ストレージ: $2.00 / GB・月。月間無料枠10GB。
- セマンティック検索(ハイブリッド+ベクトル): $0.75 / 1,000クエリ。無料枠2,000クエリ。
- 全文検索: $0.10 / 1,000クエリ。同上の無料枠と共有。
- 埋め込みとリランキング: 指定モデル利用時は無料。それ以外はWorkers AIの従量課金。
無料枠はインジェスト5Mトークンと検索2,000クエリがそれぞれ一つのプールとしてまとめられており、用途を気にせず使い切れる。埋め込みやリランキングのコストが気にならないため、データ更新や再インデックスの頻度を高めやすい。これは頻繁に情報が変わるナレッジベースをエージェントに与えたい開発者にとって大きなメリットだ。
2万ドキュメント規模の試算例
以下は、2万件の文書(約2,000万トークン)と1,000枚の画像をインジェストし、月間3万回のセマンティッククエリを実行した場合の想定コストである。ワーカーズ有料プランが前提で、埋め込みとリランキングにはデフォルトモデルを使用する。
- インジェスト(テキスト): 18.1Mトークン × $0.75/1M = $13.58
- 画像アドオン: 1.1Mトークン × $0.50/1M = $0.55
- ストレージ: 約1.2GB → 無料枠内で$0
- 検索: 28,000クエリ × $0.75/1k = $21.00
- 埋め込み・リランキング: $0
- 合計: 約$35.13
初月にインジェスト費用がかかるが、2か月目以降は主に検索クエリ分だけ(この例では約$21)で運用できる。ドキュメントの大幅な増加がなければ、ランニングコストを低く抑えられる構造だ。
このように、AI Searchのコストは初回のデータ登録が大部分を占め、その後は利用量に比例した検索料金のみになる。大規模なデータベースを抱える場合でも、固定費ではなく使った分だけ支払うモデルのため、予算計画が立てやすい。
AI Searchの導入方法
AI SearchはCloudflareダッシュボードから有効化し、すぐに使い始められる。もっとも簡単な導入は、次のwranglerコマンドでインスタンスを作成する方法だ。
npx wrangler ai-search create my-search \
  --namespace my-namespace \
  --source https://my-website.com \
  --type web-crawler \
--hybrid-searchこの1行でWebクローラー型のインスタンスが立ち上がり、ハイブリッド検索(セマンティック+キーワード)が有効になる。クロールが完了すれば、/searchエンドポイントで検索APIとして利用できる。さらに/mcpエンドポイントを使えば、ChatGPTやClaudeなどのモデルが直接ツールとして呼び出せる。
既存のアプリに組み込む場合はWorker経由でバインドし、エージェントと連携させればよい。カスタムドメインやCloudflare Accessを設定すれば、プライベートな検索サービスとしても公開できる。詳しい手順は公式ドキュメントを参照してほしい。
この記事のポイント
- Cloudflare AI Searchは、複数サービスの組み合わせを自動化し、データ検索基盤をワンストップで提供する。
- 公開/MCPエンドポイントやカスタムドメインにより、エージェントへの組み込みや外部共有が容易になった。
- サイトマップ不要のクロールやEmDash CMSとの統合で、あらゆるデータソースを取り込める。
- プレビュー価格ではデフォルトモデルの埋め込み・リランキングが無料で、予測しやすいコスト構造が示された。
- wranglerコマンド1行でセットアップが完了し、すぐにエージェント向け検索エンジンとして利用開始できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIが解説、GPT-Liveのリアルタイム音声AI基盤 6か月で会話応答を実現へ
OpenAIが2026年8月、新たな音声AIシステム「GPT‑Live」の設計を解説するブログ記事を公開した。同社の音声AIは、従来のターンベースからフルデュプレックスへと進化し、人が会話で無意識に行う「間」の制御を大幅に改善したという。わずか6か月で実用化にこぎつけたその裏側には、ストリーミング推論、状態管理、プロトコル最適化といった多層的な技術的挑戦があった。
本記事では、このブログで語られたGPT‑Liveのシステム設計に焦点を当てる。なぜ従来の音声応答では違和感が残ったのか、そしてどのようにして「息の合った」会話をスケールさせたのかを、具体的な設計上の工夫とともに紹介する。
ターンベースの限界、なぜ音声AIは「間」に弱いのか

人間同士の会話では、わずか0.5秒以下の間で話者交替が行われる。しかし従来の音声AIはテキスト向けLLMの流れを引き継ぎ、音声をテキストに変換し、推論してから音声を合成するという逐次処理が基本だった。スピーチトゥスピーチモデルの登場で音声を直接扱えるようになったが、依然として「発話が終わったか」を判断する小さなターン検出器に依存していた。
この検出器はジレンマを抱える。早すぎる判断はユーザの言葉を遮り、遅すぎる判断は応答の間延びを生む。しかも検出器の判断後に大規模なLLMが起動するため、応答までの遅延は避けられなかった。
OpenAIのブログ記事では、この課題を「誰がいつ話すかを決める小さなモデルに会話のリズムを委ねることは非効率だった」と指摘している。
上の図のように、GPT‑Liveはターン検出器を音声パスから完全に排除した。音声の送受信を同時に行うフルデュプレックス方式により、会話の流れが途切れず、より自然なやり取りを実現している。
GPT‑Liveの中核、フルデュプレックスと非同期委任の仕組み
GPT‑Liveでは、音声そのものを処理する経路と、より深い思考やツール実行を担う経路を意図的に分離している。会話のリアルタイム性を支える「メディア高速パス」と、大規模なフロンティアモデルGPT‑5.5を呼び出す「アプリケーション低速パス」だ。音声モデルは常に会話を続けながら、必要に応じて非同期RPCでGPT‑5.5に委任する。これにより、たとえ委任先の応答に時間がかかっても、音声の流れが止まることはない。
この分離設計は、機能拡張の面でも恩恵が大きい。アプリケーション側のツールやポリシーを変更しても、音声応答の核となるメディアパスに影響を与えずに済む。今後、ChatGPTのデスクトップアプリでコンピュータ操作やエージェント連携といった新機能を追加する際も、音声体験の即時性を犠牲にしない基盤がすでに整っている。
途切れない音声を保つ、推論基盤の最適化

フルデュプレックスの会話をスケールさせるには、ステートフルな推論と動的なコンテクスト管理が欠かせない。音声セッションは長時間に及び、その間コンテクストが増え続ける。モデルインスタンスも需要に応じて増減するため、途切れのない体験を維持するには高度なハンドオフ機構が必要になる。
GPT‑Liveは、モデルインスタンス間のシームレスな切り替えを導入した。切り替えが必要な場合、既存のインスタンスと並行して新しいインスタンスを立ち上げ、現在のセッションコンテクストを事前に読み込ませる。両方のインスタンスで推論を並行して行い、新しいインスタンスの準備が整った時点で切り替える。この一連の処理はメディアパスの外側で実行されるため、会話が中断される心配はない。
同様に、コンテクストがモデルの上限を超えた場合も、同じ並行ハンドオフの考え方で対応する。従来は推論を止めてコンテクストを圧縮し、KVキャッシュを再構築する必要があったが、GPT‑Liveでは圧縮作業と新インスタンスの準備をバックグラウンドで行う。元のインスタンスが会話を続けている間に、圧縮済みコンテクストを持った代替インスタンスが準備され、問題なく切り替えられる。この仕組みにより、長時間の通話でも音声が途切れず、ユーザはコンテクストの上限を意識することがない。
起動遅延を1回のUDPパケットに、プロトコル改善の舞台裏
音声AIの応答速度は、会話の開始ボタンを押した瞬間から問われる。GPT‑Liveでは、WebRTCをベースにメディアパスを確立し、モデルへの音声入力を開始するまでの時間を極限まで削り取った。そのために生み出されたのが、WARP(WebRTC Abridged Roundtrip Protocol)とInstant Connectという2つの新技術だ。
標準的なWebRTCでは、メディアとデータの開始までにICE、DTLS、SCTP、データチャネルの確立と、最大6回のネットワーク往復が必要だった。OpenAIのエンジニアは、DTLSハンドシェイクをICEに便乗させるSPEDや、SCTPのネゴシエーションを事前共有するSNAPなどを考案し、これらの手順を1往復に圧縮した。さらにInstant Connectにより、SDPパラメータの事前共有を実現。ユーザがボタンを押した瞬間、最初のUDPパケットでセッションが成立し、即座に音声ストリームが流れ始める。
これらのプロトコル改良は、OpenAIだけでなくWebRTCコミュニティにも公開されており、すでにlibwebrtcやPionに実装が進んでいる。IETFのTSVWGワーキンググループを通じて標準化も目指されているという。
本番さながらのテストが教えた教訓

理論上の性能がいくら優れていても、実際の音声トラフィックの前では想定外のボトルネックが顔を出す。OpenAIはGPT‑Liveの本格提供前に、サイレントシャドーテストと呼ばれる手法を採用した。ChatGPT Voiceの実際のユーザセッションの一部を、既存のAdvanced Voice Modeと並行して、新しいシステムに読み取り専用で流し込むのだ。
このテストで最初に判明したのは、GPUの処理能力だけを見ていては不十分だという事実だった。音声セッションは継続的にフレームを送り続けるため、CPU側のストリームハンドラやキュー、ネットワーク経路もGPUと同等にスケールしなければならない。サイレントテストにより、負荷試験では見落とされがちなCPU飽和が検出され、レイテンシの蓄積を防ぐ対策が取られた。
- GPUあたりのリクエスト数だけを見る
- 長時間接続や再接続のパターンを検証できない
- 地理的な遅延差が考慮されない
- 実際のユーザーの音声セッションを読み取り専用で流す
- CPU側のストリーム処理やネットワーク経路も含めて検証
- 地域別の遅延や長時間の状態圧縮の挙動を観測
また地理的な要素も無視できない教訓をもたらした。ユーザに近い場所に推論リソースを配置しなければ、起動時やストリーミング中の遅延が増加する。OpenAIは地域別の容量とトラフィック誘導を定常的に検証し、エンドツーエンドの応答性を部品ごとに可視化する監視体制を整えた。さらに、メトリクスの粒度を上げ、ダッシュボードが不健全なエンジンを埋もれさせないように改善。段階的なロールアウトやパスの隔離など、本番品質を支える運用技術も同時に鍛え上げられた。
この記事のポイント
- GPT‑Liveはターン検出器を排除したフルデュプレックス方式で、発話中の同時送受信を実現
- 音声モデルとフロンティアモデルを非同期に分離し、深い思考を会話の遅延なく組み込む設計
- ステートフル推論と動的コンパクションにより、長時間の会話でも途切れない音声を維持
- WebRTCのハンドシェイクを1往復に圧縮するWARPやInstant Connectで、起動遅延を極限まで低減
- 本番トラフィックを使ったサイレントテストで、実際の運用に耐えるシステムへと練り上げた
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AppleがOpenAIを提訴、訴訟内容に事実誤認か? メールが示す真実
2026年8月3日、OpenAIが公式ブログでAppleの訴訟内容に反論する記事を公開した。Appleが起こした訴訟には事実誤認が含まれており、OpenAIはメールやiMessageのやり取りを公開して真相を明らかにしている。
この訴訟は、元Apple社員がOpenAIへ転職した際の機密情報持ち出し疑惑に端を発する。しかしOpenAI側は、Apple側の情報管理の不備や誤解によるものであると主張。一方的な提訴に疑問を投げかけている。
Appleの提訴と事実のギャップ
Appleは2026年7月末、OpenAIと元自社社員3名を相手取り訴訟を起こした。主な主張は、元従業員が退職時に機密情報を持ち出し、OpenAIの製品開発に流用したというものだ。訴状では、OpenAIに対して仮差止命令(Preliminary Injunction)も求めている。
しかしOpenAIのブログ記事によれば、これらの主張の多くは事実と異なる。同社は自社の法務責任者(General Counsel)であるChe Chang氏とAppleの外部弁護士、社内法務チーム間のメールのやり取りを全文公開し、Appleの説明が実際の経緯を隠蔽していると批判した。
- 2026年2月にOpenAIへ連絡したが返答なし
- OpenAIの法務責任者と協議を行った
- 元従業員が退職後に機密情報にアクセスした
- 外部弁護士が中国人姓を混同し、誤った人物にメール送信。OpenAIが指摘するまで気づかず。
- 協議は行われておらず、後にAppleも認める
- Apple社員が元同僚に業務上の問い合わせをしていた(残留アクセスの問題)
このように、Appleが公式の法的手続きで述べた内容と、公開された文書が示す事実には大きな隔たりがある。特にコミュニケーションの行き違いは、大企業間の訴訟プロセスとして異例の稚拙さと言える。
訴訟の背景
問題となっているのは、Appleの元社員であるChang Liu氏、Tang Tan氏らがOpenAIに転職したことだ。Appleは彼らが自社の設計や製造プロセスに関する極秘情報を不正に保持し、OpenAIのAIハードウェア開発に利用したと主張している。Tang Tan氏はAppleに24年以上在籍し、最も革新的なリーダーの一人として知られていた人物だ。
OpenAIによる反論のポイント
OpenAIの反論は主に3つに集約される。
- AppleがOpenAIに連絡しなかったとされる点について、実際にはAppleの外部弁護士がChe Chang氏(姓が異なる別人)に誤ってメールを送っていた。OpenAIから指摘を受けて初めて謝罪した。
- 「法務責任者と協議した」という主張は虚偽であり、後に取り下げた。
- Chang Liu氏が退職後にAppleの機密情報にアクセスしたという疑惑は、むしろApple社員が業務上の問い合わせを元同僚に行っていた事実を示すiMessageの記録で反証される。
残留アクセス問題が浮き彫りにした情報管理の甘さ

訴訟でAppleが「Chang Liu氏が退職後に機密情報へ不正アクセスした」と主張する一方、OpenAIはその主張を覆すiMessageのスクリーンショットを公開した。それによると、Appleの社員が退職直後のChang Liu氏に連絡を取り、ファイルの所在確認や作業の補助を依頼していたのだ。
Chang Liu氏とApple社員のiMessage
公開されたメッセージでは、2026年1月22日が最終出社日だったChang Liu氏に対し、元同僚が「この文書はどこにあるか」「以前のプロジェクトの資料を探してほしい」といった内容を送っている。つまり、Apple内部で情報の引継ぎが不十分だったために、退職者に頼らざるを得なかった状況が浮かび上がる。
「残留アクセス」の実態
OpenAIはこの点を「残留アクセス(residual access)」という言葉で説明する。これは退職後も社内システムやファイルへのアクセス権が適切に削除されていない状態を指す。Appleの情報管理プロセスに問題があるからこそ、退職者が意図せず情報を見られてしまう状況が生まれているとOpenAIは指摘する。この指摘は、AI業界に限らず多くの企業にとって、退職者のアクセス権管理という普遍的な課題を投げかけるものだ。
誤送信メールが示すコミュニケーションの混乱
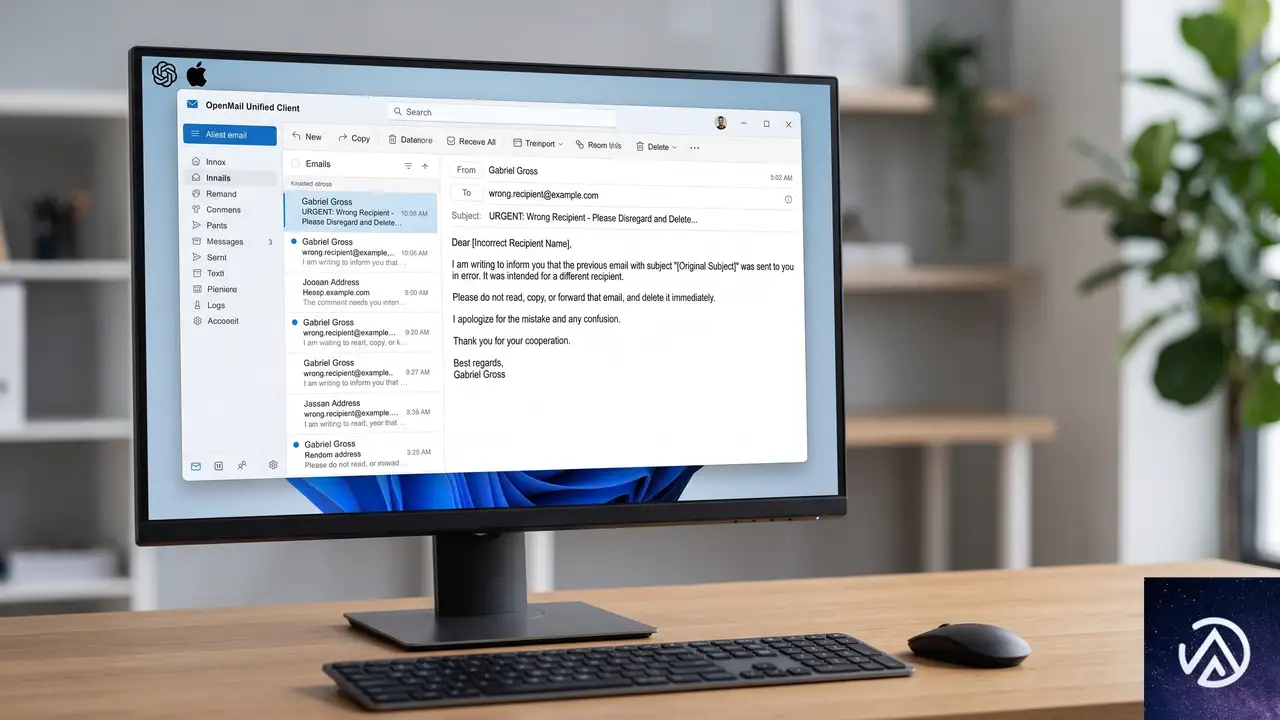
訴訟の根幹にある「AppleはOpenAIに連絡したが無視された」という主張も、電子メールの証拠によって崩れている。OpenAIが全文公開したメールのやり取りは、Appleの外部弁護士事務所Weil Gotshalのパートナー弁護士Gabriel Gross氏と、OpenAIのChe Chang氏、Apple社内法務チームの間で交わされたものだ。
弁護士のメール誤送信と虚偽報告
2026年2月23日、Gross氏はChe Chang氏宛てにAppleを代理する内容のメールを送信した。しかしこのメールは本来、同じく元Apple社員の「Wang」氏に送る予定だったものだ。Chinese surname(中国系の姓)の混同により誤って別人物に届いた。
さらにGross氏は、同日にChang氏と電話で話したと記したが、Chang氏はそれを否定し「私は彼を知らないし話していない。虚偽だ」とApple社内法務にメールで抗議した。翌24日、Gross氏は誤りを認め謝罪。「Wang氏と話した後に返信しようとして誤ってあなたとのメールチェーンに返信してしまった」と説明した。
問題解決の意思と5か月の沈黙
この一連の混乱のなかで、Gross氏は「問題を解決する(resolving any issues)」と述べており、Apple側に訴訟の具体的な主張を事前に伝えることはなかった。その後、5か月もの間何の連絡もないまま、突然訴訟が提起された。OpenAIは「提訴前にこうした問題を提起してくれれば喜んで協力したのに」とコメントしている。
OpenAIの姿勢と今後の展望
OpenAIは今回の訴訟について、「Appleの仮差止命令の申し立ては虚偽の情報に基づいており、まったく不要なものだ」と断じている。同社はAppleの機密情報を望んでおらず、保有もしていないと断言する。
また、将来的にAppleと協調して問題解決にあたる用意があることを示しつつも、訴訟の場で事実を歪曲する行為には強く反発している。AI業界全体としては、優秀な人材の移動に伴う知的財産の取扱いに関するルール整備が急務であるとの見方も出ている。
この記事のポイント
- AppleがOpenAIを提訴した内容には、事実誤認が複数含まれているとOpenAIが反論した
- メールの誤送信や虚偽の申し立てなど、コミュニケーションの混乱が訴訟の背景にある
- 退職者の残留アクセス問題は、Apple自身の情報管理の甘さに起因する可能性が高い
- OpenAIは機密情報の利用を否定し、建設的な対話を求めている
- AI業界では人材流動性が高まるなか、知的財産管理の再考が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GoogleサーチコンソールにAI検索レポート登場。見るべきポイントと活用術
Google は 2026 年 6 月 3 日、Search Console に生成 AI 専用のパフォーマンスレポートを追加した。AI Overviews(AI 概要)や AI Mode(AI モード)といった検索体験の一部として、自社サイトの URL がどの程度表示されたかを切り分けて確認できるようになっている。
これまで「AI 検索に自社のコンテンツが出ているのかどうか」は、通常の検索パフォーマンスの数字に埋もれてわからなかった。今回の分離によって、どのページが生成 AI の回答元として使われているのかを確認できるようになったが、あくまで「表示回数」ベースのデータであり、クリックや引用のされ方までは把握できない点に注意が必要だ。
この記事では、新レポートで何が読み取れるのか、従来の検索表示回数とどう違うのか、そして実際にサイト改善に役立てるための診断フローを解説する。
AI検索レポート、ついに独立

生成AI専用レポートの概要
この新しい Search レポートは、AI Overviews と AI Mode からの表示回数のみを集計する。Discover 向けの生成 AI 機能は別レポートとして提供されている。また、Labs の実験的機能は対象外だ。
レポートでは、URL 単位、国別、デバイス別、日付別に表示回数をセグメントできる。ただし現時点では、以下の指標は含まれていない。
- 検索クエリ
- クリック、クリック率(CTR)
- 平均掲載順位
- 引用の位置(回答内でリンクがどの順序で表示されたか)
- 回答の基となった文章の特定
- コンバージョンや収益データ
Google は「今後、追加指標の要望をサイト運営者とともに検討する」と述べており、機能拡張の可能性はある。また、AI Overviews や AI Mode にコンテンツを含めるかどうかを制御する新しい設定も Search Console でテスト中だ。デフォルトは「含める」で、オプトアウトすると従来の検索結果には影響なく、生成 AI の回答からも自社コンテンツが除外される。
まずは「どの部分が使われているか」を把握するために
現時点のレポートが答えられるのは「サイトのどのページが生成 AI の表示に使われているのか、どのくらいの頻度か」という問いだ。それ以上の詳細は得られないが、この可視化だけでもこれまでにない手がかりになる。
AI表示回数は従来の表示回数とは異なる

表示回数の数え方の基本
Google の定義では、AI 表示回数とは「生成 AI の機能内でユーザーにリンクが表示された回数」を指す。集計方法はレベルによって異なり、グラフのプロパティ全体では、1 つの回答内に同じサイトの異なる URL が複数出ても 1 回とカウントされることがある。一方、ページテーブルでは各 URL が個別に 1 回ずつ計上されるケースもある。
つまり、ページレベルの表示回数を足し上げた合計が、必ずしもプロパティ合計と一致しない。これは集計単位の違いによるもので、数値に矛盾があるわけではない。
従来の検索との違いと混同禁止
従来の検索結果での表示回数は、検索結果リスト内の 1 つの掲載としてユーザーが認識しやすい。一方、AI Overviews や AI Mode の表示は、合成された回答文の一部として現れる。リンクが目立つ場合もあれば、折りたたまれた引用リストの中に埋もれている場合、フォローアップの質問の後に出現する場合もある。
また、AI Overviews ではリンクがスクロールされるか展開されるまで表示回数としてカウントされない。AI Mode ではフォローアップの質問が新しいクエリとして扱われ、後続の回答で表示されたリンクが追加の表示回数を生む。
これらの違いから、生成 AI の表示回数と通常の検索表示回数を合算して「総検索可視性」のように扱うのは全くの誤りだ。CTR のブレンド計算も同様に意味をなさない。レポート画面で数字が並んでいても、それらは性質の異なる指標であることを肝に銘じたい。
このレポートで診断できること

このレポートの真価は、表示回数の総数ではなく、どのページが生成 AI 検索で使われているかを通常の検索パフォーマンスと比較できる点にある。
これは概念図だが、レポートの表示回数を通常の Search Console の検索パフォーマンスと並べて分類すると、上記の4パターンに整理できる。それぞれ次のような特徴がある。
高オーガニック表示・低AI表示のページ
通常検索ではよく見られていても、生成 AI の回答にはあまり使われないページだ。必ずしも問題とは限らない。クエリ自体が AI 応答を引き起こさないケースもある。しかし、次のような点を確認すると原因が見えてくる。
- 具体的な質問に直接答えているか
- 見出し構造が整理されているか
- 重要な情報がテキストとして HTML 上に露出しているか(タブや画像、JavaScript に隠れていないか)
- AI 応答が発生しやすいクエリにマッチする内容か
通常のランキングで上位に上がる能力があっても、合成に使えるクリーンな回答を提供できなければ、AI 表示にはつながりにくい。
低オーガニック表示・高AI表示のページ
こちらの方が注目に値する。通常の検索では目立たずとも、生成 AI で高い頻度で表示されるページがある。定義や統計、比較、説明が明快なコンテンツがこれにあたる。
こうしたページを分析すると、以下の共通点が見えてくることが多い。
- セクションの冒頭付近で直接的な回答を提示している
- 見出しの階層が明確で情報が取り出しやすい
- 独自の調査や一次情報を含んでいる
- 有益な表やリストがある
- トピックの範囲が絞られており、曖昧な表現が少ない
1 つの成功パターンを見つけたからといって、それを再生産すればうまくいくとは限らないが、サイト内で「Google が使いやすい」と判定している構造や表現のヒントになる。
ページ改修の効果を追う
コンテンツを大幅に修正した後に、AI 表示回数がどう変化するかをウォッチするのにも有用だ。たとえば以下のような改修が効果を持つ可能性がある。
- 明確な要約や定義を冒頭に追加
- 古い情報を更新し、鮮度を高める
- 重複したページを統合
- 見出しを書き直して情報の抽出を助ける
- 画像や動画に頼っていた重要情報を HTML テキストに移す
- 独自の証拠や専門家のコメントを加える
ただし、1 つの見出しを変えた翌週に数字が上がったからといって「AI 検索のアルゴリズムを解明した」と騒ぐのは禁物だ。需要や競合、AI 機能の出現頻度そのものが変動する。持続的な増加が確認できて初めて意味のあるシグナルとなる。
データを分析する実践ワークフロー

エクスポートと分類、従来データとの比較
分析は次の 6 ステップを踏むと整理しやすい。
- AI 表示回数の上位ページをエクスポート
意味のある期間を選ぶ。リリース直後の数日で判断しない。 - 同じ URL・期間で通常の検索パフォーマンスをエクスポート
通常の検索表示回数、クリック、CTR、平均順位、可能なら上位クエリを加える。比較することで、AI と通常検索で差があるページを特定できる。 - ページを属性で分類
ページタイプ、トピック、検索意図、テンプレート、著者、公開日、最終改訂日、ファネルステージなどを付与。URL と表示回数を並べただけでは分析にならない。 - 外れ値を調査
AI 表示回数が極端に高いページや低いページを探す。テンプレートやトピック、著者によってなぜ差が生まれるのかを実際に HTML 構造や本文を見て確認する。この段階で初めて手を動かす必要がある。 - アナリティクスのデータを別に確認
AI 経由のトラフィックやコンバージョンが特定できれば、表示回数がどの程度実際の訪問につながっているかを評価する。ただし Search Console と Analytics では計測方法が異なるため、数字のズレに一喜一憂しない。 - 日次の変動ではなくトレンドを追う
新しいデータは暫定的な数値の可能性もある。週次や月次で傾向を見るほうが建設的だ。1 日で上がった下がったに右往左往しない。
経営ダッシュボードに載せるべきではない指標

「AI」とラベルされた大きな数字が現れると、ダッシュボードの一番上に大きく表示したくなるものだ。しかし、生成 AI の表示回数はあくまで特定の状況でのリンク出現を示しており、ビジネス成果に直結するとは限らない。
以下のような報告は避けるべきだ。
- 生成 AI 表示回数と通常検索表示回数を合算した「総視認性」
- 両者をブレンドしたクリック率
- 自社の AI 表示回数だけを元にした「AI シェア」
- 表示回数に紐づけたコンバージョンの推測
- 1 つの最適化施策が効いたかのように見せるための表示回数の増加報告
- ページレベルの合計をプロパティ全体の露出と誤認させる表示
代わりに、ダッシュボードに盛り込むべきは「生成 AI 表示回数の推移」「表示回数がついたページ数」「表示されているトピック・ページタイプ」「AI 可視ページと通常検索パフォーマンスとの関係」「期間中に実施した改修」「AI 経由の識別可能なトラフィックやコンバージョン(分けて報告)」「追加調査が必要な仮説」といった項目だ。
この記事のポイント
- Search Console の新レポートで、AI Overviews と AI Mode の表示回数が通常検索と分離された
- 表示回数はクリックや引用位置の情報を含まず、あくまで「リンクが表示された」という指標である
- 従来の検索表示回数とは性質が異なり、合算やブレンド分析は誤解を招くため厳禁
- 通常検索との比較で、コンテンツの抽出しやすさや構造の課題を発見できる
- 分析の際は長期的なトレンドとページ属性の分類が不可欠で、数字の上下だけで施策の成否を判断しない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験