


Supabase Evals公開、AIエージェントのコード品質を自動評価する基盤
Supabaseが2026年7月31日、AIコーディングエージェント向けの評価フレームワーク「Supabase Evals」をオープンソースで公開した。Claude CodeやCodex、OpenCodeといった主要エージェントを使い、実際のSupabaseプロジェクト開発を自動で試行し、その成否を定量的に測る仕組みだ。
このフレームワークは、エージェントがデータベーススキーマの構築やEdge Functionsのデバッグ、RLSポリシーの修正といったタスクをどれだけ正確にこなせるかを評価する。公開されたベンチマーク結果は誰でも閲覧でき、エージェントの得意分野や弱点が数値で把握できる。
なぜSupabaseがこの基盤を作ったのか。AIを使ってSupabase上にアプリを構築する開発者が急増する中、エージェントの「実力」を正確に把握し、改善につなげる必要があった。本記事ではその仕組みと、初期の評価で明らかになったエージェントの弱点、そして今後の展望を解説する。
Supabase Evalsが目指すもの
Supabase Evalsは、AIコーディングエージェントがSupabaseを使った開発タスクを実行する際のパフォーマンスを評価するためのフレームワークだ。ベンチマークテストとリグレッション(回帰)テストの2つのスイートを持ち、エージェントの実力を多角的に測る。
具体的には、エージェントがCLIやMCPサーバー、各種ドキュメントを活用しながらスキーマ設計やEdge Functionsの作成、RLSポリシーの修正などを行う。その結果を「ユーザーが特定のデータにアクセスできるか」「Edge Functionが期待通りのレスポンスを返すか」といった決定論的なチェックと、LLMによる判定(LLM-as-a-judge)でスコア化する。
この基盤は、Supabaseが公開する公式ベンチマークのほか、日次で動作する内部のリグレッションスイートにも利用されている。これにより、新しい機能がエージェントの動作を悪化させていないかを継続的に監視できる。
なぜ今、AIエージェント評価基盤が必要なのか

AIコーディングエージェントを使った開発は日常化しつつある。SupabaseのCLIやMCPサーバー、エージェントスキル、ドキュメントを介してエージェントがプロジェクトを構築するケースが増えてきた。しかし、各エージェントがどこでつまずき、どの機能がうまく使えていないのかを体系的に把握する手段が不足していた。
Supabaseの公式ブログ記事によれば、エージェントが苦手とするパターンを特定し、それを修正した上で再発防止(リグレッション)を確認するサイクルを回すことが目的だ。単一のツールだけではなく、Supabaseが提供するすべてのインターフェースを横断的に評価できる点が特徴である。
従来は開発者自身が手動でコードを書く前提だったため、エージェントに特化したテスト基盤は存在しなかった。Evalsの登場により、AI時代の開発者体験を数値で議論できる土台が整ったと言える。
評価の仕組みとベンチマーク/リグレッションの二層構造

このフレームワークでは、エージェントが実際のSupabase環境で作業するため、机上の空論ではない実用的な評価が可能だ。テスト結果はWebアプリで可視化され、誰でも確認できる。
初期ベンチマークが明らかにしたAIエージェントの弱点

スキル読み込みの効果は想定以上に限定的、ただしドキュメント参照は改善
Supabase Evalsのベンチマーク結果では、エージェントがスキル(エージェント向けの最適化ガイド)を読み込んでいない状態でも、多くのシナリオをクリアできることがわかった。ビルド段階では、Opus 5とKimi K3がスキルなしで100%のスコアを達成している。
スキル読み込みの効果は限定的だが、Sonnet 5は78%から100%へ、GPT-5.6 Solは89%から100%へ、GPT-5.4 miniは78%から89%へと改善した。特に、スキルを有効にするとSupabaseドキュメントの参照頻度が一貫して増え、古い事前学習知識を上書きする必要があるエッジケースで差がついた形だ。
宣言的スキーマを使わず、マイグレーションを手書きする傾向
Supabaseには宣言的スキーマという、データベースの構造を一つのファイルで管理できる仕組みがある。本来は複数のマイグレーションファイルをつなぎ合わせるより効率的だが、エージェントは既に宣言的スキーマが使われているプロジェクトでも、手書きのマイグレーションを作成しようとする傾向があった。
この問題を受け、Supabaseはエージェントスキルの中で「どのワークフローを選ぶべきか」の指針を明確に改訂し、Evalsを使って修正が正しく反映されたことを確認した。
新しいライブラリ「@supabase/server」の発見率が低い
Supabaseは最近、Edge Functionsを安全に書くためのボイラープレートを簡略化する@supabase/serverパッケージをリリースした。しかし、エージェントは依然としてsupabase-jsを使い、手動で認証を検証する方法を選んでしまう。
このためSupabaseは「どのパッケージを選ぶべきか」を解説する専用ガイドを公開し、エージェントの判断材料として提供している。
Postgresベストプラクティススキルの有効化が不安定
Evalsは、エージェントがセッション中にどのスキルを読み込んだかを追跡している。主要な「supabase」スキルはほぼ常に読み込まれるのに対し、Postgresのベストプラクティスを教えるスキルは当初、約1割のシナリオでしか有効化されなかった。
スキルの説明文を具体的なトリガーで書き直した結果、有効化率は60%まで向上したが、それでもOpenAIモデルの方がより安定してスキルを活用する傾向が見られる。
ドキュメント参照の頻度に大きなばらつき
Evalsの実行中、エージェントがSupabaseドキュメントを読む頻度も測定している。CodexベースのエージェントはClaude Codeよりもドキュメントをチェックする傾向があり、最も高性能なOpenAIモデルは毎シナリオ約8ページを読むのに対し、Claude Codeは約2ページにとどまる。
しかもClaude Codeはスキルを読み込んでいても、40%未満のシナリオでしかドキュメントを確認しない。Supabaseはエージェントが必要な情報を確実に見つけられるよう、改善を進めている。
AIエージェント時代のSupabase開発体験を支える展望
Supabase Evalsはまだ出発点に過ぎない。今後はエッジケースのカバレッジを広げ、エージェントやプロダクトの進化に合わせて新しいシナリオを追加していく計画だ。スコアリングの精度と安定性も引き続き強化される。
また、内部のリグレッションシナリオのなかで信頼性が確認されたものは、順次公開ベンチマークへと格上げされる方針である。さらに、エージェントがタスクに失敗した際にフィードバックを提出できるCLIコマンドやMCPツールも開発中で、これにより次の改善優先度をデータドリブンに決定できるようになる見込みだ。
AIコーディングエージェントを本格的にプロダクト開発に組み込むチームにとって、Supabase Evalsは「エージェントが何を得意とし、どこでつまずくのか」を数値で判断する貴重な羅針盤になる。公開されたベンチマークはsupabase.com/evalsで誰でも確認できる。
この記事のポイント
- SupabaseがAIコーディングエージェント向け評価フレームワーク「Supabase Evals」をOSS公開
- 実際のSupabase環境でエージェントを動作させ、ベンチマークとリグレッションの2層でスコア化
- 初期のベンチマークでは、スキル無しでも高スコアの一方、宣言的スキーマの無視や新ライブラリの未発見など弱点が判明
- ドキュメント参照頻度のばらつきやスキル活性化の不安定さも浮き彫りに
- 今後はエッジケースの拡充やエージェントからのフィードバック収集機能の追加を予定

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
エージェント開発ライフサイクル(ADLC)がCloudflareで始動。SDLCを超える新たな枠組み
ソフトウェア開発のライフサイクル(SDLC)が、AIエージェントの登場によって根本から再定義されようとしている。Cloudflareは2026年8月4日、エージェント中心の新たな開発モデル「Agent Development Lifecycle(ADLC)」の構想と、それを支える具体的なツールセットを発表した。
従来のSDLCは「計画→設計→実装→テスト→デプロイ→保守」という人間中心の工程だった。しかしAIエージェントがコード生成の速度を劇的に高めた結果、周辺の工程がボトルネック化している。ADLCはこの課題を解決し、エージェントがライフサイクル全体を自律的に管理できる環境を提供する。
ADLC(エージェント開発ライフサイクル)とは何か
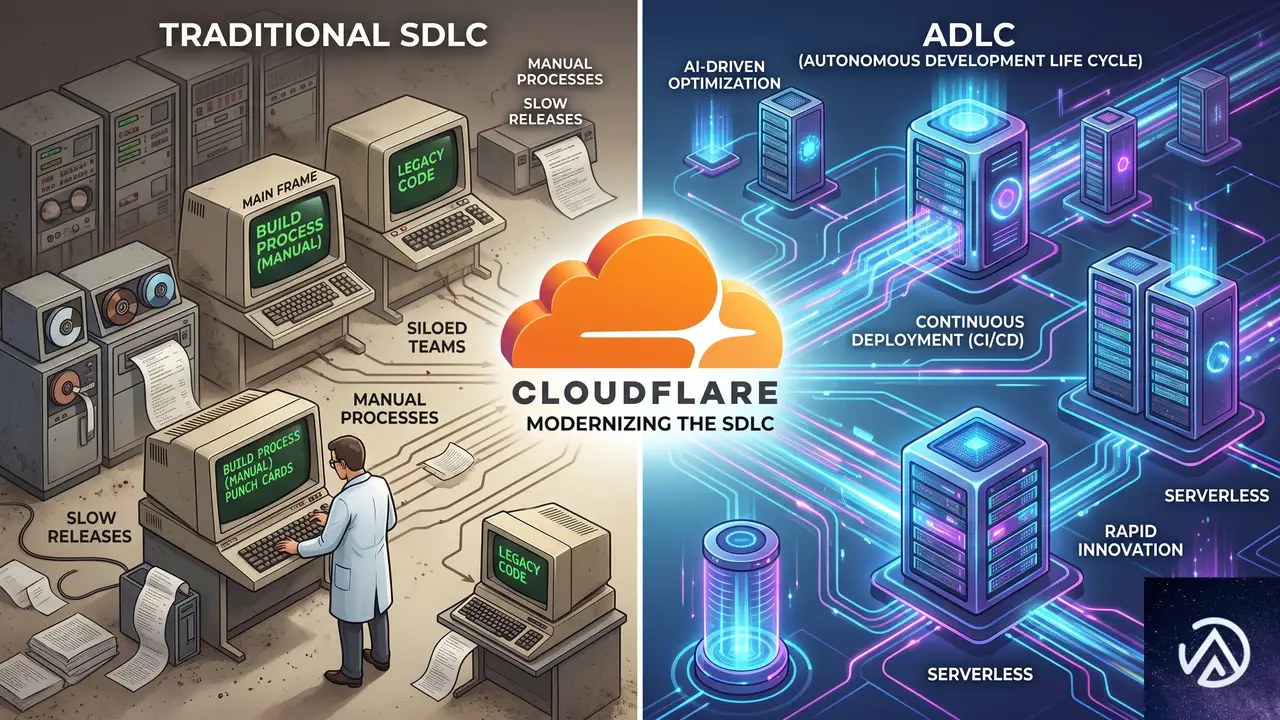
ADLCは、従来のSDLC(Software Development Lifecycle)をエージェント時代に合わせて再設計した概念だ。SDLCは1975年にランド研究所が提唱した「Systems Development Lifecycle」を起源とし、長年にわたりソフトウェア開発プロセスの標準だった。しかし、AIエージェントがコードを実装する速度は人間の比ではなく、テストやレビュー、デプロイといった他の工程が追いつかなくなっている。
Cloudflare Blogの著者Carlo Daniele氏によると、AIによって「実装」が最速かつ最安になった一方で、他の工程に携わる人々が膨大なプルリクエストやイシューに圧倒されるという逆説的な状況が生まれている。オープンソースメンテナの疲弊や本番環境の不安定化は、まさにこの非対称性の表れだ。
ADLCは、エージェントが実装だけでなく、テスト・デプロイ・監視・改善までを一貫して担うことを前提とする。そのために必要な要件は、プログラムによる操作が可能(Programmatic)、水平スケーラブル、再現可能、リアルタイムのプッシュ型イベント対応、アトミックな変更管理、適切な権限制御、そして自己改善能力の7つに整理されている。
ADLCへの移行は、単にエージェントにタスクを委譲するだけでは実現しない。Cloudflareが提唱する7要件は、いずれも人間向けに設計された既存の開発基盤では満たせないものだ。次のセクションでは、なぜこのタイミングでパラダイムシフトが必要なのかを掘り下げる。
SDLCからADLCへ なぜ今パラダイムシフトが必要なのか
エージェント時代の「人間ボトルネック」
ChatGPTやClaude、GitHub CopilotといったAIツールの普及により、コード生成のスピードは飛躍的に向上した。ところが開発現場の実態を見ると、生成されたコードのレビューやテスト、本番デプロイは依然として人間が担っている。結果として、プルリクエストの滞留が慢性化し、オープンソースプロジェクトではメンテナが数千件のイシューに対処しきれずに疲弊する事例が相次いでいる。
Cloudflareの見解では、これは「エージェントを部分的にしか使えていない」ことに起因する。実装だけをエージェントに任せ、他の工程を人間が管理するという中途半端な状態が、かえって現場の負荷を増大させているのだ。
自律走行車に学ぶ「全体最適」の視点
Cloudflare Blogの記事では、ADLCの必要性を自律走行車に例えて説明している。人間向けの車にAIを載せただけでは、80%の性能は出せても、残りの20%が致命的な事故を引き起こす。安全に走行するには、LiDARや高性能コンピュータ、遠隔制御システムといった専用設計の技術が必要だ。
ソフトウェア開発でも同じで、エージェントが安全にコードをマージし、本番にデプロイするには、人間向けのCI/CDパイプラインでは不十分だ。エージェント専用のインフラ、トレーシング、権限管理、自己修復の仕組みが求められる。
ここで鍵となるのが、Cloudflare Workflowsとエージェントの組み合わせだ。従来のGitHub Actionsのような線形のパイプラインではなく、動的に分岐し、コンテナやブラウザを立ち上げ、ログを解析しながら自律的にソフトウェアを出荷する「ワークフロー」がADLCの中核を担う。
Cloudflareが提供するADLC基盤の全容

Workflowsが実現する動的なCI/CD
Cloudflare Workflowsは、複数のステップをチェーンし、失敗したタスクを自動リトライし、数時間から数週間にわたって状態を保持できるサービスだ。従来のCI/CDパイプラインが静的なYAML定義だったのに対し、WorkflowsはTypeScriptで動的にワークフローを定義できる。
さらにWorkflowsは、エージェントや別のWorkflowを子プロセスとして起動できる。たとえば、毎晩収集したデータをエージェントにレビューさせ、その結果を元に次のステップを動的に決定する、といった高度なオーケストレーションが可能だ。
import { CIWorkflow } from '@cloudflare/ci'

// CIパイプラインの例: 依存関係インストール後、lint/test/typecheck/buildを並列実行
const deps = await ci.runner({
  name: 'install',
  command: 'bun install --frozen-lockfile',
  cache: { inputs: ['package.json', 'bun.lock'] },
});
await Promise.all([
  deps.runner({ name: 'lint', command: 'bun run lint' }),
  deps.runner({ name: 'test', command: 'bun run test' }),
  deps.runner({ name: 'typecheck', command: 'bun run typecheck' }),
  deps.runner({ name: 'build', command: 'bun run build' }),
]);
await deps.runner({
  name: 'deploy',
  command: 'bun wrangler deploy',
  cloudflareCredentials: { accountId: this.env.CLOUDFLARE_DEPLOY_ACCOUNT_ID },
});
このコードは、依存関係のインストールをキャッシュしつつ、後続のlintやテスト、ビルドを並列で実行するパイプラインを簡潔に表現している。Workflowsによって、エージェントが生成したコードを安全に検証し、本番へデプロイするまでの一連の流れを自動化できる。
エージェントの可観測性と自己改善
ADLCにおいて、エージェントの動作を監視し、改善につなげる仕組みは欠かせない。Cloudflareは、OpenTelemetryベースのトレーシングをローカル開発環境(WranglerやViteプラグイン)に組み込み、本番環境と同等の可観測性を提供する。また、Agent Tracesによってエージェントのセッション全体をキャプチャし、パフォーマンス向上に活用できる。
さらに、Feature Flag管理のFlagshipや、段階的デプロイメント(Gradual Deployments)、Browser Runによるヘッドレスブラウザのプログラム操作など、エージェントが自律的にソフトウェアをテストし、リリースするためのプリミティブが一通り揃っている。
エージェントが主導するソフトウェアファクトリーの実践例
Cloudflare自身のエンジニアリング標準化
Cloudflareは自社の全プロダクトとシステムリポジトリにわたり、AIを用いてエンジニアリング標準の遵守を強制している。具体的には、コードレビューや仕様チェックをエージェントが補助し、人間のレビュアーの負荷を軽減する仕組みだ。
これにより、コーディング規約の違反やセキュリティパターンの逸脱を自動検出し、修正案まで提示できる。人間はより創造的な設計判断や顧客との対話に時間を割けるようになったという。
Astroプロジェクトにおけるイシューゼロへの挑戦
また、CloudflareはAstroというオープンソースプロジェクトにおいて、イシューの自動トリアージ、再現、修正を行うシステムを構築した。この「ソフトウェアファクトリー」により、GitHub上のイシュー件数をゼロに近づける試みが行われている。
エージェントがバグレポートを受け取り、自動で再現環境をセットアップし、修正PRを作成する。Workflowsがこれらのステップをオーケストレーションし、テストと検証を経てマージする流れだ。この事例は、ADLCが現実のプロジェクトで有効に機能することを示している。
ADLCがもたらす開発現場の未来と課題
ソフトウェアファクトリーの民主化
現在、最先端の企業だけがソフトウェアファクトリーを構築できているのが実情だ。Cloudflareは、WorkflowsやAgent Traces、Browser Runといったプリミティブを誰でも使える形で提供することで、この格差を埋めようとしている。小規模なスタートアップでも、ADLCの恩恵を受けられるようにする狙いだ。
具体的には、@cloudflare/ciパッケージによるCI/CDの簡素化や、Flueエージェントフレームワークとの統合によって、複雑なオーケストレーションを少ないコードで実装できるようになっている。
残る課題と人間の役割
ただし、ADLCへの移行には越えるべきハードルもある。エージェントが本番環境に直接変更を加えることへの心理的な抵抗感は依然として強い。Cloudflare自身も、権限の段階的な委譲(エスカレーション)の仕組みや、監査証跡の確保が不可欠だと認識している。
また、エージェントが生成するコードの品質をどう担保するか、未知のエッジケースにどう対応するかは、自律走行車と同じく「99%の壁」をどう突破するかの問題だ。CloudflareはAgent Tracesを通じてエージェントの経験値を蓄積し、時間とともにパフォーマンスが向上する仕組みを描いているが、実運用でのデータ蓄積がこれから本格化する。
それでも、コードを書くだけのエージェントから、ソフトウェアのライフサイクル全体を駆動するエージェントへの進化は、もはや避けられない流れだろう。ADLCは、そのための地図と道路を提供するものだ。
この記事のポイント
- ADLC(Agent Development Lifecycle)は、従来のSDLCをエージェント中心に再設計した新しい開発モデルである。
- AIエージェントの実装速度に他の工程が追いつかない「人間ボトルネック」の解決を目指す。
- Cloudflare Workflowsを中核に、動的でスケーラブルなCI/CDとエージェントオーケストレーションを実現する。
- Agent TracesやBrowser Runなどのプリミティブが、エージェントの自己改善と安全な本番運用を支える。
- ソフトウェアファクトリーの民主化により、スタートアップから大企業までADLCの恩恵を受けられる時代が近づいている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini Robotics ER 2 が登場、動画理解とタスク自動化でロボット知能が進化
Google DeepMindは2026年7月30日、ロボット向けの大規模モデル「Gemini Robotics ER 2」を発表した。このモデルは、連続した動画フィードを理解してタスクの進捗を自律的に判断し、複数のロボットを協調させる能力を持つ。
従来のモデルに比べてツール制御や安全性の面で大幅な性能向上が確認されており、GitHub上でサンプルコードも公開された。ロボットが実世界で人間を支援するための基盤技術として注目される。
Gemini Robotics ER 2 の概要と開発者向け提供
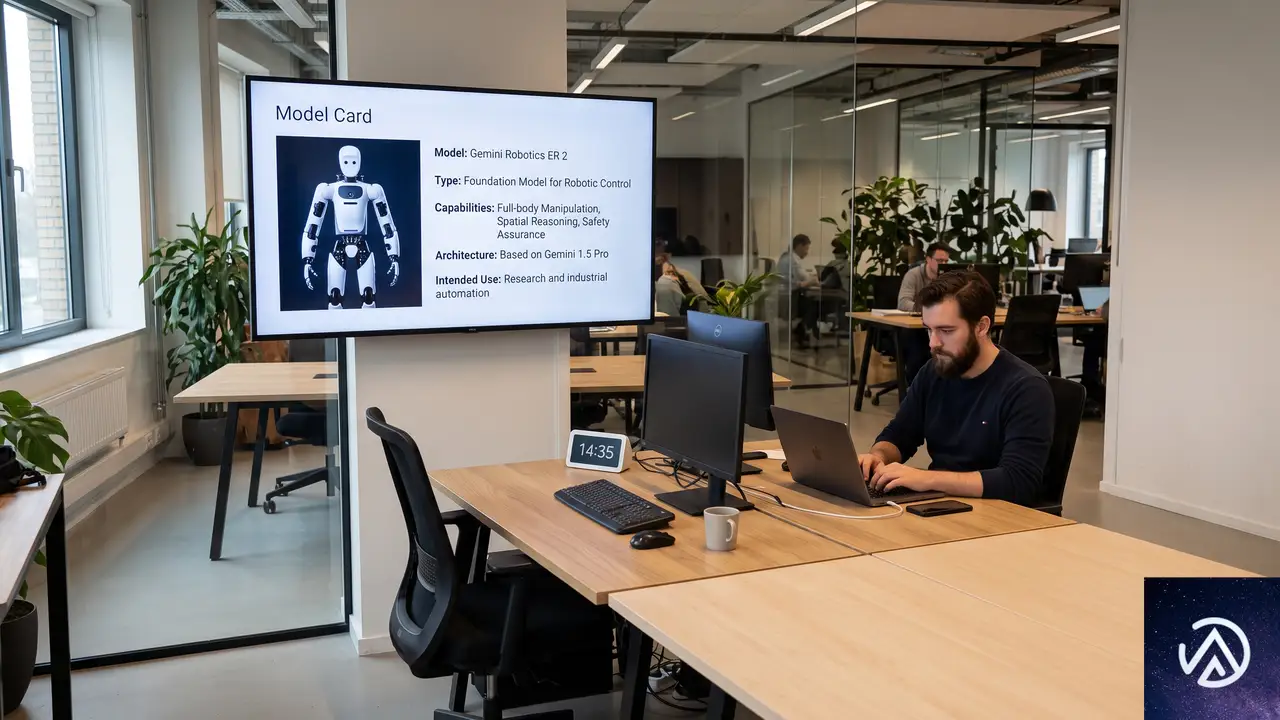
Gemini Robotics ER 2 は、ロボットの「高次脳」として設計されたモデルだ。人間との自然な対話や空間把握、複数ステップのタスク計画を担い、実際の動作は下位の視覚言語行動(VLA)モデルやAPIに委ねる。この階層的な設計により、思考と実行を並列で進めることが可能になる。
開発者は Gemini API、Google AI Studio、Gemini Enterprise Agent Platform(プライベートプレビュー)を通じてモデルを利用できる。スターター用のノートブックが GitHub で公開されており、物理AIタスクへの組み込みがすぐに試せる。
物理的なエージェント能力の進化

多くの実作業は複数ステップを必要とする。Gemini Robotics ER 2 は、VLAモデルやナビゲーションAPIなどをツールとして宣言するだけで、動画や音声、テキストのマルチモーダル入力をストリーミング処理し、ロボットの動作を自動的にオーケストレーションする。途中で失敗しても自己修正が可能だ。
ツールオーケストレーションの仕組み
従来のロボット制御では、各動作を人間が順序立ててプログラムする必要があった。Gemini Robotics ER 2 はこれを自動化し、低遅延の双方向ストリーミングを活かして「停止して考える」ような間断のない滑らかな指令を実現する。評価では、実VLA・シミュレーションVLA・遠隔操作の3つの制御モードすべてで前世代のER 1.6を上回る性能を示した。
実機デモと開発リソース
このオーケストレーション能力を示すため、Boston Dynamics の四足歩行ロボット「Spot」を用いたデモが公開された。Gemini Robotics ER 2 が Spot のナビゲーションAPIやマニピュレーターを制御し、自然言語の指示でポップコーンを取りに行く様子が確認できる。対応コードは GitHub の robotics-samples リポジトリから入手可能だ。
タスク進捗把握のための時間的知能
ロボット工学の大きな課題は「タスクがいつ完了したか」を正確に判断することだ。Gemini Robotics ER 2 は連続動画フィードから進捗を追跡し、電球の締め付けやゴミ袋の結束といった作業が正しく終わったことを検証してから次のステップに移行できる。
連続的な進捗分類
このモデルは動画の各フレームを 0〜20%、20〜40% といった 5 段階の進捗レベルに分類する。その精度は 57.4% に達し、前世代モデルや他の最先端モデルを上回った。これによりロボットはリアルタイムで状況を把握し、途中で動作を調整したり、失敗したステップだけを再実行したりできる。
精密なモーメント検出
「コーヒーを注ぐのを止める瞬間」のような重要なタイミングを特定するモーメント検出では、91.3% の精度と平均絶対誤差 0.96 秒を達成した。大規模モデルと同等の性能を、より少ない計算量と約 4 倍の実行速度で実現している。物理世界で安全に動くために必要なサブ秒レイテンシを満たす点が重要だ。
マルチロボット連携
車輪型ローバーは屋内走行が得意だが、人型ロボットは不整地に強い。Gemini Robotics ER 2 は異なるロボット間で意味的な理解を共有し、タスクの引き継ぎを可能にする。Apptronik の Apollo 2 と Franka F3 Duo が協調して作業を行うデモも公開されている。
空間知能と安全性の向上

コアな空間推論能力も底上げされた。成功・失敗の検出は静止画ではなく生の動画を扱い、こぼれや滑りといった実行中のミスを捉える。一般計器の読み取りは円形ダイヤルだけでなく、デジタルディスプレイ、リニアスケール、温度計など 10 種類に対応した。空間VQAでもマルチモーダル理解の進歩が活きている。
安全性の面では、安全指示の遵守と人間の近接検知の両ベンチマークでER 1.6や他の競合モデルを上回った。Gemini Robotics ER 2 は近くに人がいることを感知すると人型ロボットを停止させ、エリアが安全になったら自律的に作業を再開する。さらに、安全なVLAオーケストレーターとしての能力を評価する新しいベンチマークも導入された。詳細は安全技術レポートを参照できる。
この記事のポイント
- Gemini Robotics ER 2 は高次脳としてタスク計画とツール制御を担い、低次動作モデルと組み合わせて使う
- 連続動画フィードから進捗を5段階で分類し、最適なタイミングで次のステップへ移行できる
- 複数ロボットの協調が可能になり、台車型と人型が役割分担する実証も進んでいる
- 安全性ベンチマークで前世代を大幅に上回り、人検知や自己停止が自動で行える
- Gemini APIやGitHub経由ですぐに試せる開発環境が整っている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce Social Loginに深刻度9.8の脆弱性。管理者アカウント乗っ取りの危険
WooCommerce Social Loginプラグインに、未認証の攻撃者が任意のユーザーアカウントにログインできる重大な脆弱性が報告された。CVSSスコアは9.8と最高クラスの深刻度であり、管理者権限の奪取も可能になる。バージョン2.8.7以下を利用しているすべてのサイトが対象だ。
この脆弱性はAppleログイン処理に存在し、攻撃者は特別な権限を必要としない。正規のユーザーのメールアドレスさえ知っていれば、管理者を含む任意のアカウントに不正ログインできる。2026年8月1日に公開されたCVE-2026-8457として識別されており、即時対応が求められる。
深刻度9.8の認証バイパス脆弱性と影響範囲
Wordfenceのセキュリティ研究者によって発見されたこの脆弱性は、WooCommerce Social LoginのAppleサインイン機能に潜んでいた。ユーザーがAppleアカウントでログインする際、プラグインはAppleから返されるIDトークンの正当性を検証していなかった。このため攻撃者は、なりすましたいユーザーのメールアドレスを含む偽のトークンを作成し、認証をすり抜けられる。
被害を受けるのはWooCommerce Social Loginのバージョン2.8.7以下の全インストールだ。プラグインを有効化しているサイトであれば、特別な設定ミスがなくても攻撃が成立する。攻撃者はユーザー名やパスワードを一切知る必要がなく、標的のメールアドレスさえ分かれば管理者権限でログイン可能になる。
一般的なWordPressの脆弱性では、攻撃者が何らかの権限をあらかじめ持っていたり、管理者がリンクをクリックするなどの操作が必要になることが多い。しかし今回は、攻撃者が標的サイトにリクエストを送るだけで管理者アカウントにログインできてしまう。いわゆる「認証なしの管理者乗っ取り」に分類され、CVSS 9.8という評価はその直接的な危険性を反映している。
なぜこれほど危険なのか
認証バイパスにより管理者権限を取得した攻撃者は、WooCommerceサイトの全データを自由に操作できる。具体的には、顧客情報や注文データの窃取、不正な管理者アカウントの追加、プラグインやテーマの改ざんによるマルウェア注入、支払い情報への介入などが考えられる。さらに、サイトのSEO評価を意図的に下げるスパムリンクの埋め込みや、Googleからのインデックス削除といった攻撃も容易に行われてしまう。
WooCommerceを利用するECサイトでは、顧客の個人情報や購入履歴が保存されている。こうしたデータが流出した場合、個人情報保護法やGDPRなどの規制違反に発展する可能性もある。サイトの信用失墜だけでなく、法的なリスクや多額の損害賠償にまでつながりかねない。
WooCommerceのコア機能や他の決済プラグインでは、こうした認証処理に対する検証が厳格に行われている。しかし、Social LoginプラグインのAppleログイン部分だけが例外的に署名検証を欠いていた。そのため、攻撃の標的として非常に狙われやすい。
Appleログイン処理の具体的な問題点
Appleサインインでは、ユーザーが認証を完了すると、AppleのサーバーからIDトークンと呼ばれるデータがサイト側に送られる。このトークンにはユーザーのメールアドレスなどの情報が含まれ、改ざんを防ぐためにAppleの秘密鍵で電子署名が付与されている。プラグインは本来、Appleが公開している鍵を使ってこの署名を検証し、トークンが本物であることを確認しなければならない。
ところが、WooCommerce Social Loginはこの署名検証のステップを実装しておらず、受け取ったメールアドレスをそのまま信頼してログイン処理に使っていた。結果として、攻撃者が偽のIDトークンを作り、その中に標的ユーザーのメールアドレスを入れて送信するだけで、そのユーザーとして認証が通ってしまう状態になっていた。
Wordfenceの調査によると、管理者ロールかどうかのチェックも行われていなかった。攻撃者が管理者のメールアドレスを指定すれば、管理画面へのフルアクセスが即座に与えられる。これはIDトークンに含まれる「email」フィールドを、ログインにそのまま使う実装ミスに起因している。
つまり、IDトークンの署名確認という重要な防御ラインがまるごと欠落していたわけだ。この種の不備は、OpenID ConnectやOAuth 2.0を利用するソーシャルログイン実装では絶対にあってはならないものであり、Wordfenceの報告では「未認証の攻撃者が、偽造したid_tokenのペイロードに対象ユーザーの電子メールアドレスを含めて送信するだけで、管理者を含む任意のアカウントでログインできる」と指摘されている。
影響を受けるバージョンと今すぐ取るべき対策
この脆弱性の影響を受けるのは、WooCommerce Social Loginバージョン2.8.7以下のすべてのリリースだ。8月1日の公開後、プラグイン開発元はすぐに修正版2.8.8をリリースしている。Wordfenceは、該当バージョンを使用しているユーザーに対して、2.8.8またはそれ以降のバージョンへの即時アップデートを強く推奨している。
アップデートを適用しないまま放置すると、攻撃者に管理者権限を奪取された後に、バックドアを仕込まれたり、サイトの完全な乗っ取りが発生する可能性が高い。特にWooCommerceサイトでは決済情報や顧客データが絡むため、被害が拡大する前に一刻も早く更新を済ませてほしい。
- WordPress管理画面から「プラグイン」→「インストール済みプラグイン」を開く
- 「WooCommerce Social Login」を探し、利用可能なアップデートがあれば「今すぐ更新」をクリック
- バージョンが2.8.8以上になっていることを確認する
- 万が一、プラグインをすぐに更新できない事情がある場合は、一時的にプラグインを無効化する
また、サイトの管理者アカウントに不正なログインがなかったかどうか、アクセスログやユーザー一覧を至急確認してほしい。身に覚えのない管理者アカウントが追加されている場合は、すでに攻撃を受けている可能性がある。その場合は、プラグインの更新だけでなく、全ユーザーのパスワードリセットや、サイト全体のマルウェアスキャンも併せて実施する必要がある。
この記事のポイント
- WooCommerce Social Login 2.8.7以下にCVSS 9.8の認証バイパス脆弱性が存在する
- AppleログインのIDトークン署名検証が行われておらず、攻撃者が任意のユーザーになりすませる
- 管理者アカウントも標的になるため、ECサイトの全データが危険にさらされる
- 修正版2.8.8への即時アップデートが必須
- すでに攻撃を受けた可能性がある場合は、ユーザー一覧の確認とサイト全体のセキュリティチェックを推奨
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
大量メール配信の落とし穴、800,000通で自社サイトがダウンした理由
2026年、WooCommerce.comが約80万の購読者に向けてニュースレターを一斉配信したところ、わずか数分でサイトがダウンするという思わぬトラブルが発生した。原因は攻撃でもリリースミスでもなく、メール配信そのものだった。配信先に企業向けメールシステムが多く含まれていたため、メールセキュリティスキャナーが一斉にリンク先を自動クロールし、膨大なトラフィックを引き起こしたのである。
この出来事は、当該チームに「大量メール配信はインフラの負荷テストと同義である」という教訓を残した。本記事では、この障害の経緯と原因、そして再発防止策を紹介する。メールマーケティング施策を運営するすべての企業にとって、無視できない警鐘だ。
800,000通のメールで自社サイトがダウン、その経緯
ある日の午前9時15分(UTC)、WooCommerceのチームは約80万人に向けたニュースレター配信を実行した。配信開始からわずか3分後の9時18分、同僚からの「サイトが落ちている」という一報が届く。監視アラートが作動したのはその4分後(9時22分)であり、人が気づく方が先だった。
状況をさらに混乱させたのは、その朝には一切のデプロイがなく、攻撃の痕跡も皆無だった点だ。にもかかわらず、エッジレベルでのリクエスト総数は平時の約25万から急増し、ピーク時には約53万を記録した。実際のダウンタイムは3〜4分程度にとどまった。この短い間に、一部のユーザーには「429 Too Many Requests」が返され、ごく一部で5xx系エラーも発生したが、大多数のリクエストは正常な200応答を返し続けている。つまり「短時間の部分的な停止」であり、それでも立派なインシデントだった。
補足すると、当初のトラフィックグラフでは合計リクエスト数が実際の2倍に表示されるというダッシュボードの不具合が見つかった。後に修正されたが、正しい数字はステータス別の線であり、ピークは約53万、平常時が約25万。いつも通りの約2倍のトラフィックが数分間だけ発生したことに変わりはない。
原因はメールセキュリティスキャナーだった
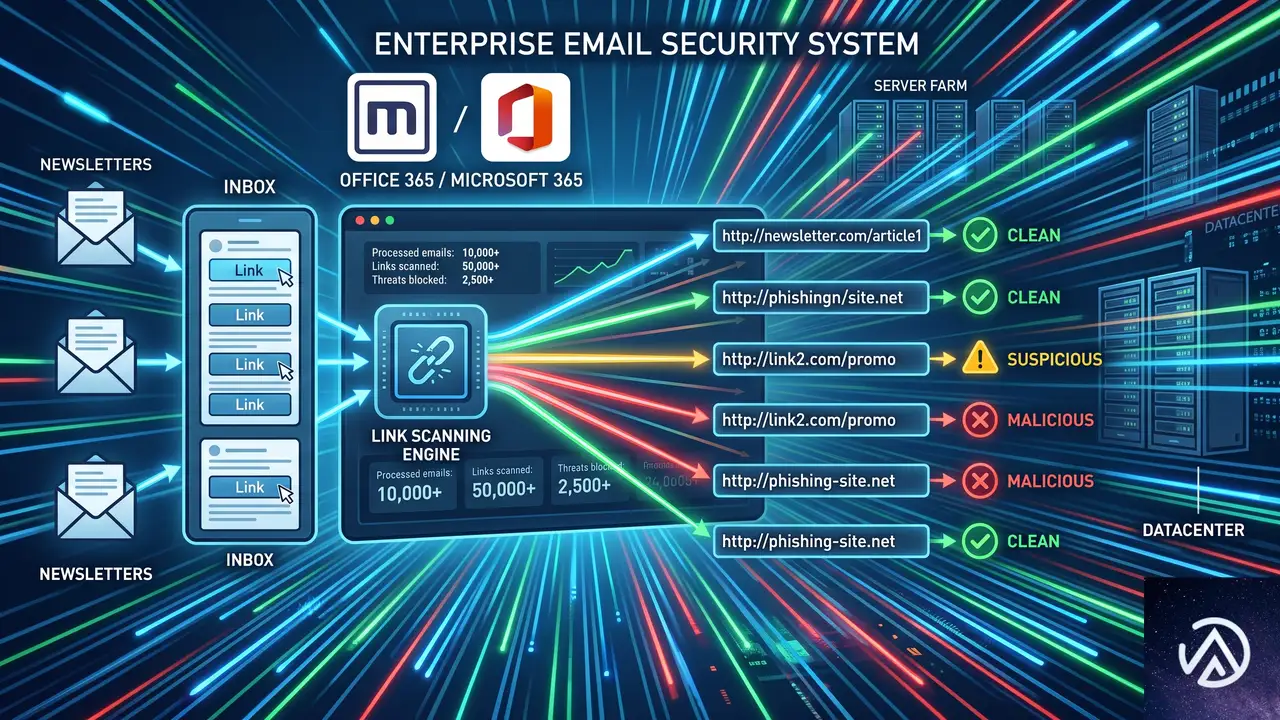
まず疑ったのは当日のリリースや攻撃の兆候だが、どれも該当しなかった。しかしアクセスログには二つの異様な痕跡が残されていた。
一つは、トラフィック元の大半がデータセンターやVPNのIPアドレスで、実際のショッピング利用者が使うような一般ISPからではなかった点だ。もう一つは「JavaScript ChunkLoadError」の大量発生である。ChunkLoadErrorとは、HTMLだけを取得し、ページのJavaScript(JS)をダウンロードする前に接続が切断された場合に起こるエラーだ。数千回のこのエラーが数秒のうちに集中した。
この断片的な情報をつなぎ合わせると、犯人像が見えてくる。企業向けメールシステム(Office 365やMimecastなど)は、メールが受信トレイに届いた瞬間に、本文中のすべてのリンクを自動的にたどり、マルウェアチェックを行う。受信者がメールを開封する以前に、セキュリティスキャナーがリンク先を叩くのだ。
WooCommerceのニュースレターはストアオーナー向けだったため、送信先には企業ドメインが非常に多かった。80万通を一斉に配信すると、それら企業メールシステムのスキャナー群もほぼ同時に作動し、一瞬のうちに大量のリクエストが殺到した。これがスパイクの正体である。もし同じ配信をGmailが中心の一般消費者向けに行っていれば、このような急増は起きなかっただろう。
なぜ同じ規模の前回は耐えられたのか
実はその1週間前にも、さらに大規模な配信を実施していた。その際にも今回とほぼ同じボットトラフィックのスパイクが発生していたが、誰も気づかないままインフラは何事もなく耐え抜いた。だから今回も「配信量が特に多すぎた」わけではない。
問題は配信のサイズではなく、タイミングだった。前回の配信では偶発的に、ボットの同時接続数がわずかに抑えられたり、キャッシュの状態が良好だったりした可能性がある。今回はほんのわずかな違いが、耐えられる負荷と許容限界との差になった。正確な理由を断定するのは難しいが、一瞬の集中がすべてを変えたことは確かだ。
オートスケーリングが追いつかなかった瞬間
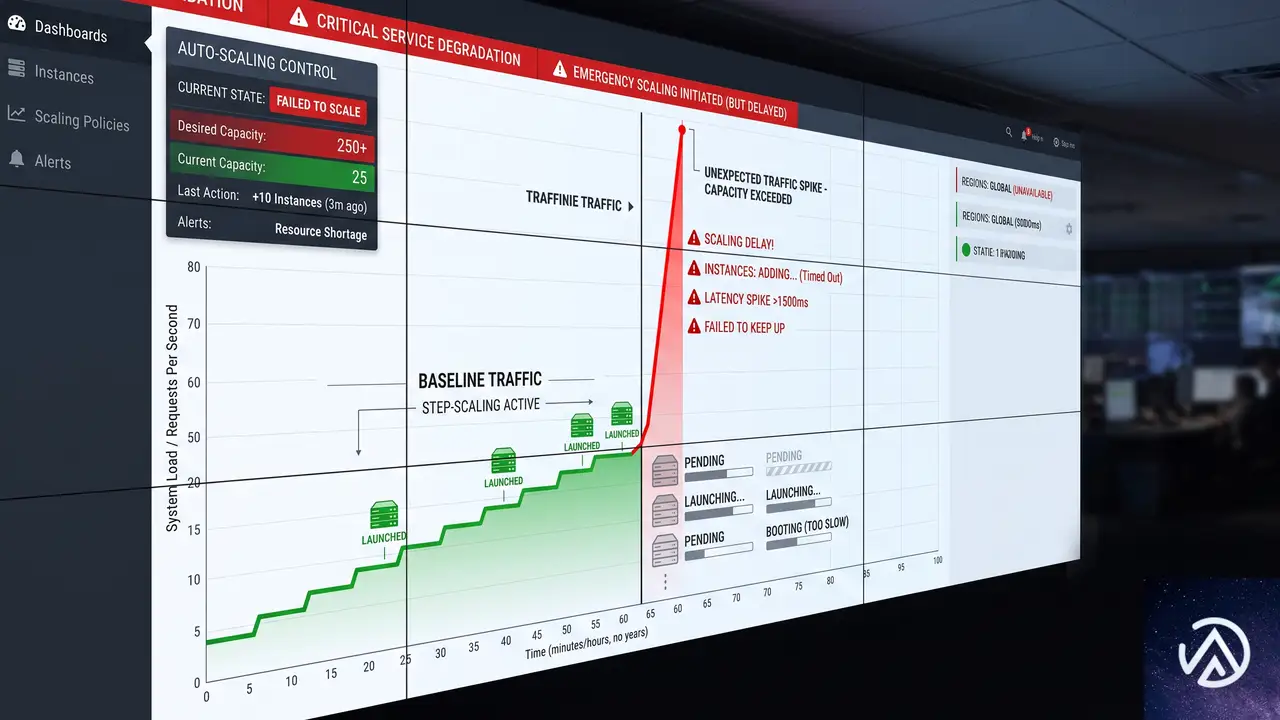
WooCommerce.comはWordPress VIPのホスティング上で稼働しており、オートスケーリングは正常に動作していた。もしトラフィックが徐々に増加するパターンであれば、新しいリソースが立ち上がるまでの数分間で対応できたはずである。実際に追加されたキャパシティが整った頃には、スパイクはすでに通過し、被害も収束していた。
しかし今回の攻撃(自爆攻撃とも言える)は、段階的な増加ではなく「ステップ関数」のような瞬間的な跳ね上がりだった。スケーリングが反応するための傾斜が存在しないため、自動化の仕組みは事実上役に立たなかった。問題はサーバーに到達する前、配信の仕組みそのものにあったのだ。
トラフィックが瞬間的に跳ね上がる一斉配信と、分散されて緩やかな山になるバッチ配信の比較を示した。今回の対策では、後者の方式を採用することでスパイクを回避した。
対策〜バッチ配信でスパイクを防ぐ
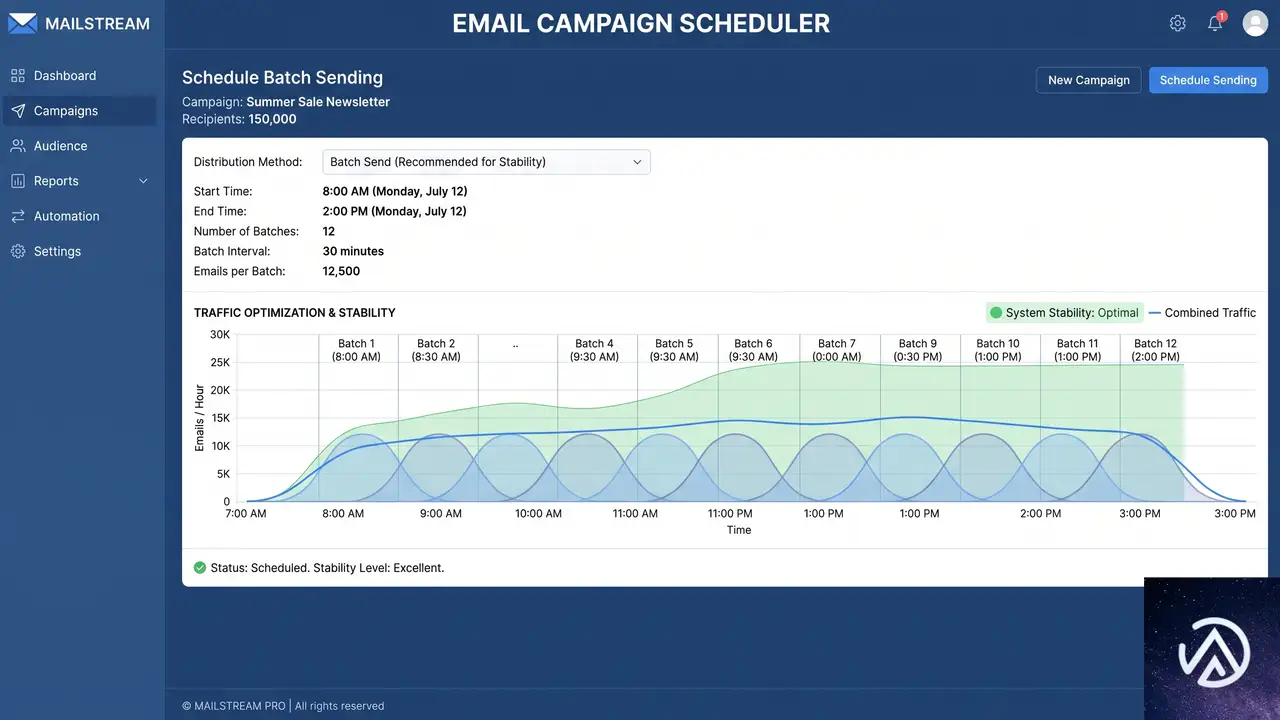
次のキャンペーンは、たまたま1週間後のブラックフライデーに予定されていた。チームは全リストを一気に送信するのではなく、数時間かけて小分けにバッチ配信する方式に変更した。利用しているメール配信プラットフォームがこの機能をサポートしているかを事前に確認した上での判断である。
結果は明確だった。バッチ配信へ切り替えた後は、あのスパイクは一切発生しなくなった。追加のサーバーキャパシティは投入しておらず、今後も増強予定はない。オートスケーリングは自然な成長や季節変動を十分に吸収できるが、自ら招く瞬間的な高負荷には対応しきれないからだ。
大規模なマーケティングメールの配信は「インフラに関わるイベント」として認識し、特に最大規模の配信の前にはサーバー運用チームと連携することが推奨される。
大量メール配信は負荷テストである、という教訓
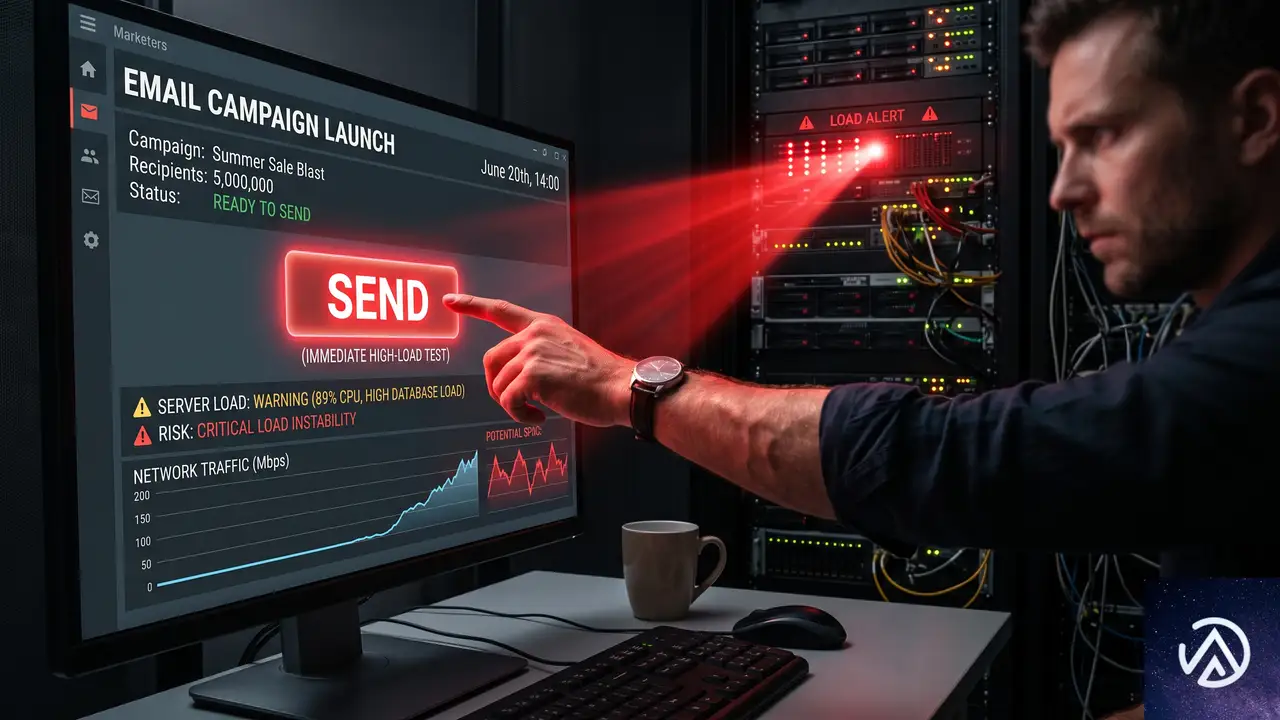
企業向けのメールアドレスを含む大規模リストに一斉配信を行うと、受信者が何もしなくても、配信開始と同時にメールセキュリティスキャナーがすべてのリンクを叩く。これは結果として、自社サイトに対して意図しない大規模な負荷テストを実施しているのと同じだ。
重要なのは、配信停止やメールマーケティングの否定ではない。適切に管理すればニュースレターは強力なチャネルである。ただし、送信ボタンを押す前に「ボットによる一斉アクセスが起こりうる」と想定しておくことが不可欠だ。配信のタイミングを分散するだけでも、今回のような障害は回避できる。
この記事のポイント
- 80万通のメール一斉配信で自社サイトが3〜4分ダウンした
- 原因は企業向けメールセキュリティスキャナーの一斉リンクチェックだった
- 同じ規模の前回は偶然耐えられたが、タイミング次第で失敗しうる
- オートスケーリングは段階的な増加には強いが、瞬間的なスパイクには無力
- 対策として配信を時間差バッチに変更し、再発を防止した
- 大量メール配信は意図しない負荷テストとなりうる、分散配信が鍵
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GKE Agent Sandboxがエージェント1台あたりのコストを75%削減する仕組み
AIエージェントを本番環境でスケールさせようとすると、すぐにコストとリソースの壁にぶつかる。Google Cloudが2026年7月30日に公開したブログ記事では、Google Kubernetes Engine(GKE)の新機能「GKE Agent Sandbox」とオーケストレーションを組み合わせることで、同一の仮想マシン上で動かせるエージェント数を最大3.5倍に増やし、エージェント1台あたりのコストを最大75%削減できるという検証結果が示された。
エージェントは要求に応じて動作するバースト型のワークロードであり、何もしない待機時間が長い。従来のように固定的なコンピュートリソースを割り当てる方法では、遊休状態のエージェントが貴重なCPUやメモリを消費し続けてしまう。この問題に対するGKEのアプローチを詳しく見ていく。
マイクロVM方式の限界とGKE Agent Sandboxの登場
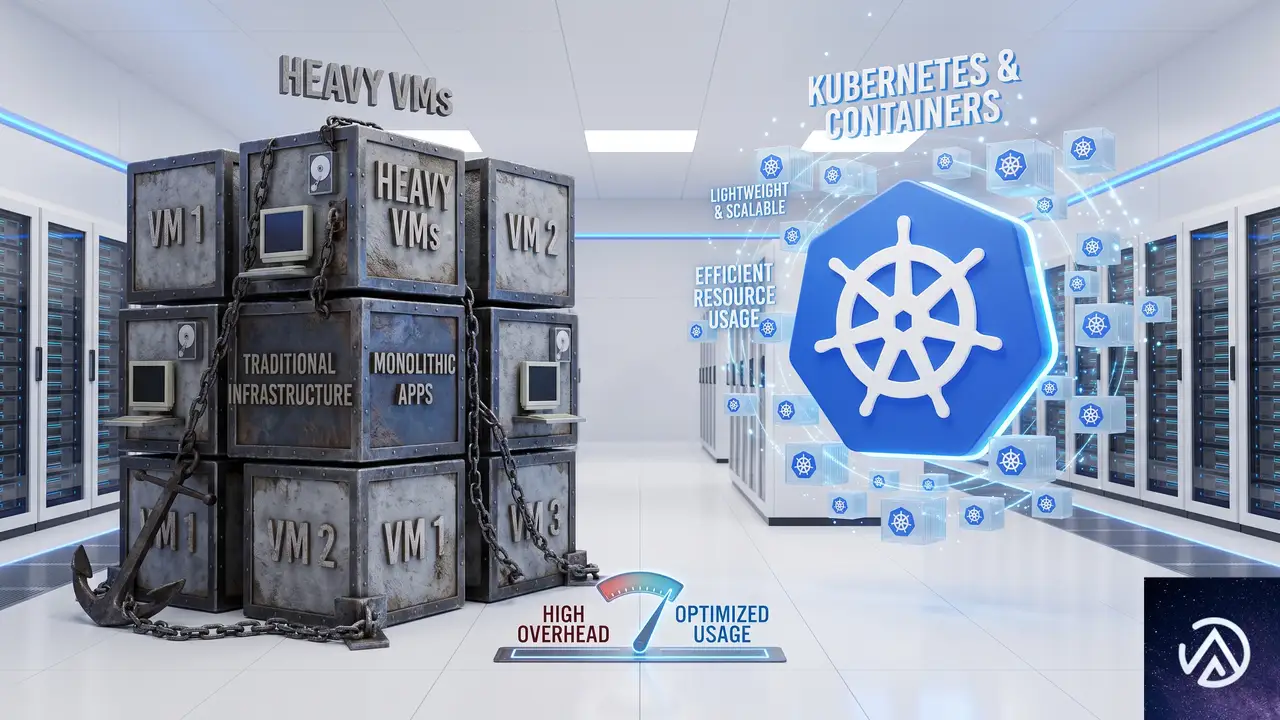
マルチエージェントを安全に動かすための一般的な方法として、各エージェントを専用のマイクロVM(Kata Containersなど)で隔離するやり方がある。ハードウェアレベルの隔離によってセキュリティを確保する狙いだ。しかしこの方式には大きな落とし穴がある。
マイクロVMはエージェントごとにゲストOSを起動するため、メモリとCPUに無視できないオーバーヘッドが生じる。実際にGoogle CloudのチームがOpenClawプロファイルを使い、48vCPUの標準VMインスタンス(n2-standard-48)上でテストしたところ、61個のエージェントを起動した時点で信頼性が低下し、ヘルスチェックの失敗が頻発し始めたという。
これに対してGKE Agent Sandboxは、gVisorというオープンソースのセキュアコンテナサンドボックスを土台にしている。gVisorはユーザー空間カーネル(Sentry)でシステムコールを捕捉・フィルタリングし、ハードウェア隔離に近いセキュリティを実現しつつ、ゲストOSを丸ごと動かす必要をなくした。
結果として、同一VM上で動作可能なエージェント数は88個まで増加。これはベースライン比で44%の密度向上であり、エージェント1台あたりのコストは30%以上削減された計算になる。しかも性能プロファイルはほぼ維持できると報告されている。
この方式が評価を得たのは早く、2026年5月の一般提供開始から4週間足らずで利用量が7倍以上に急増した事実が、その実用性を裏付けている。
遊休エージェントを「凍結」するオーケストレーションの威力
GKE Agent Sandboxは稼働中のワークロードを効率化するが、遊休状態のエージェントがリソースを占有し続ける問題は残る。そこでカギを握るのが、Kubernetes本来のオーケストレーション機能とGKE Podスナップショットを組み合わせた「凍結・再開」パターンだ。
具体的には、エージェントが待機状態に入ったタイミングでPodスナップショットを作成し、永続ストレージにチェックポイント(凍結)として保存する。これにより物理的なCPUとメモリが解放され、クラスタに返却される。新しいトリガーが届くと、軽量なコントローラやイベントゲートウェイがリクエストを捕捉し、ミリ秒単位でスナップショットからエージェントを再開する。
この仕組みによって、物理リソースをワークロードの実態に基づいて「オーバーサブスクライブ(超過割り当て)」できるようになる。つまり、実際の瞬間的な需要以上のエージェントを同じノードに詰め込めるわけだ。その結果、間欠的にしか動かないエージェントであれば、ベースラインの3.5倍にあたる274個のエージェントを単一ノードで動作させることが可能になった。
ただし、やみくもに詰め込めばよいわけではない。エージェントの種類によって求められる起動時間やレイテンシは大きく異なるからだ。
エージェントの特性に合わせた3つのデプロイ戦略
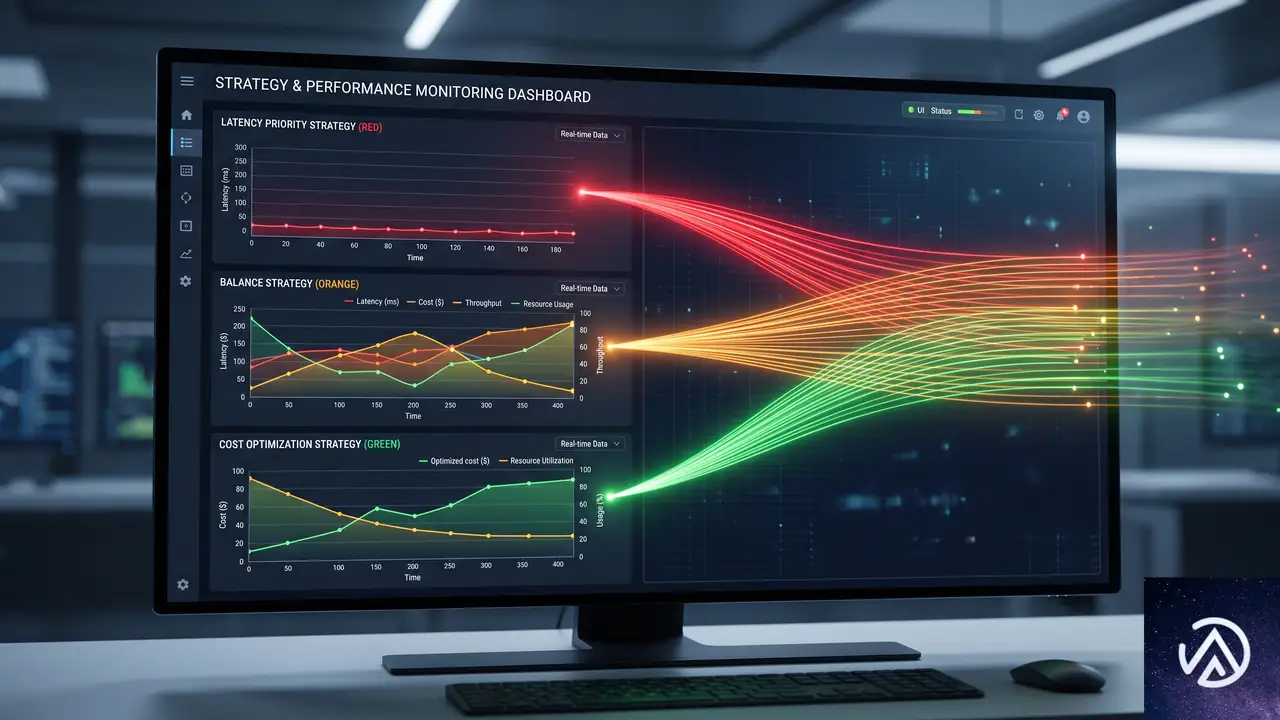
GKEでは、すべてのエージェントに一律の戦略を強制するのではなく、ノードプールやワークロード設定ごとに異なる挙動を共存させられる。Google Cloudのブログでは、レイテンシ要件に応じた3つの典型例が紹介されている。
リアルタイムコーディングアシスタント(レイテンシ重視)
開発者向けの対話型エージェントでは、起動時間が1秒未満であることと、待ち行列が一切発生しないことが絶対条件だ。このケースでは、GKE Podスナップショットと「Agent Sandboxウォームプール」を組み合わせる。事前にウォームアップされた隔離サンドボックスを常時待機させておくことで、ほぼ瞬時に実行を開始できる。この構成で同一ノード上に133個のエージェントを収容できたと報告されている。
自律的なチームメイト型エージェント(バランス型)
バックグラウンドで対話的に動くエージェントは、平均的な起動時間(数秒)を許容できる。サスペンド&レジューム機能を利用し、遊休時にはリソースを解放、必要時にオンデマンドで復元する。待機中のコンピュートコストを支払う必要はない。
ヘッドレスなバックグラウンドエージェント(レイテンシ許容型)
日次レポートの生成や調査タスクのような定期ジョブは、多少の待ち時間があってもビジネス成果に支障をきたさない。こうしたエージェントには最大限のリソース超過割り当てを適用し、クラスタに空きが出るまで1時間ほど待つ戦略も有効だ。
このように、ワークロードの性質に合わせて「パフォーマンス最適化」と「コスト最適化」のバランスをチューニングできるのがGKEの強みだ。サンダリングハード(多数のエージェントが一斉に起動してコンピュートを要求する問題)に対しても、ウォームプールやサスペンド&レジュームの設定で自由度の高い制御が可能になる。
コスト削減を実現するための実践的なアプローチ
GKE Agent Sandboxとオーケストレーションの組み合わせによって、エージェントの台数に比例してインフラ予算が増えていく構図を抜本的に変えられる。Google Cloudの検証では、パフォーマンスを重視する構成でも133個のエージェント(ベースライン比約2.2倍)、コスト最適化を突き詰めた構成では274個(同3.5倍)のエージェントを同一ノードで動作させることに成功した。
実務に落とし込む際のポイントは3つある。第一に、セキュリティを保ったままオーバーヘッドを削減するGKE Agent Sandboxへの移行を検討すること。第二に、Podスナップショットによる「凍結・再開」をアーキテクチャに組み込み、遊休リソースを徹底的に活用すること。第三に、すべてのエージェントを同じ扱いにせず、レイテンシ要件に応じてデプロイ設定を変えることだ。
なお、GKE Agent Sandboxの詳細な設定やウォームプール、サスペンド&レジュームの具体的な手順は、Google Cloudの公式ドキュメントで公開されている。まずは既存のエージェントワークロードを対象に、小規模なPoCから始めてみるとよいだろう。
この記事のポイント
- GKE Agent SandboxはgVisorベースの軽量サンドボックスで、マイクロVMに比べてエージェント密度を44%向上させ、1台あたりのコストを30%以上削減する
- Podスナップショットとサスペンド&レジュームの組み合わせにより、遊休エージェントを凍結して物理リソースを解放し、理論上3.5倍の密度(最大75%のコスト削減)を達成可能
- ワークロードのレイテンシ要件に応じて「リアルタイム型」「バランス型」「コスト最適化型」の3戦略を使い分けることで、無理なくスケールできる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareがオリジン接続でポスト量子認証をサポート開始
Cloudflareがオリジンサーバーとの接続に対するポスト量子(PQ)認証のサポートを開始した。Authenticated Origin Pulls(AOP)とCustom Origin Trust Store(COTS)の2製品で、格子ベースのデジタル署名アルゴリズムML-DSAを導入する。これにより、Cloudflareと顧客オリジン間の相互TLS接続を完全に量子耐性化できるようになった。
今回の対応は、Cloudflareが掲げる2029年の完全ポスト量子セキュリティ達成に向けたマイルストーンの第一歩だ。量子コンピュータによるなりすまし攻撃の脅威が現実味を増すなか、暗号化だけでなく認証のレベルでも対策を打てる段階に入ったことを意味する。
量子コンピュータに備える認証のアップグレード
Harvest-Now/Decrypt-Laterだけでは足りない
これまで量子耐性の議論は「Harvest-Now/Decrypt-Later」と呼ばれる攻撃への対策が中心だった。攻撃者が現在の暗号化通信を蓄積しておき、将来の量子コンピュータで解読するというシナリオだ。Cloudflareも2022年から来訪者との接続、2023年からはオリジン接続でポスト量子暗号化をサポートし、広く使われてきた。
しかし、近年の量子コンピュータと暗号解読のブレークスルーにより、スケジュールが前倒しされている。問題は暗号化にとどまらない。量子コンピュータは古典的な認証情報も破ることができるため、攻撃者が正規のサーバーになりすます「なりすまし攻撃」の脅威が高まっている。そこで認証にもポスト量子の仕組みを導入する必要が出てきた。
オリジン接続だからこそ先行できる理由
訪れるユーザーとCloudflareの間の接続(コネクション1)では、Web PKIの制約があり、ポスト量子証明書の普及には時間がかかる。一方、Cloudflareと顧客オリジンサーバー間の接続(コネクション2)は、あらかじめ信頼関係が確立された閉じた環境だ。このため、公開インターネット向けの証明書基盤を待たずに、独自のPKIでML-DSA署名を導入できる。
また、Cloudflareがクライアント側になるため、接続プーリングによって多数のリクエストを少数の接続に集約できる。これにより、ポスト量子署名の処理負荷をならすことが可能だ。クラウドサービスならではの制御性を活かし、Web PKIが同様の対応をするよりも早く、実際に運用できる段階までこぎつけた。
この接続構成では、Cloudflareがクライアント証明書を提示し、オリジン側でそれを検証することで、なりすましを阻止する。両者とも量子耐性のある署名アルゴリズムだけを信頼するよう設定すれば、ダウングレード攻撃も防げる。
AOPとCOTSの設定手順
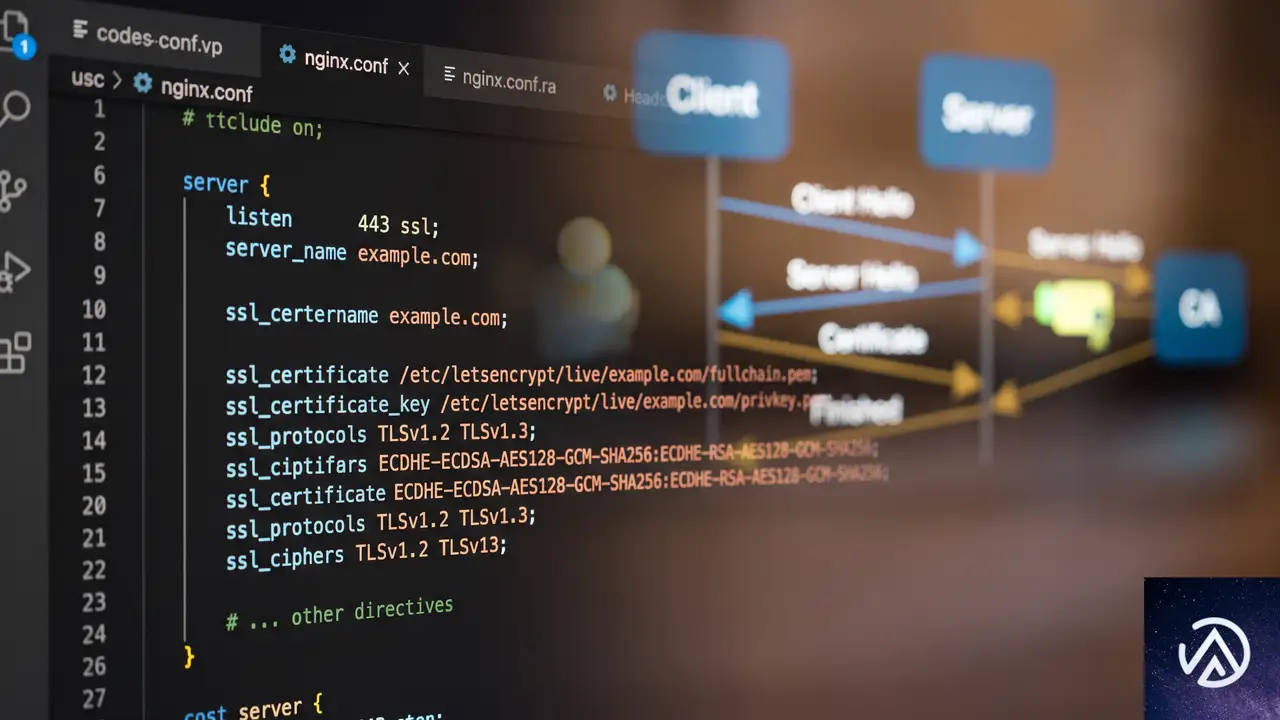
ポスト量子認証を有効にするには、Custom Origin Trust Store(COTS)にML-DSAのCA証明書をアップロードし、Authenticated Origin Pulls(AOP)にはクライアント証明書と秘密鍵を登録する。以下にCloudflare APIを使った手順を示す。すべての鍵生成にはOpenSSL 3.5.0以降が必要で、秘密鍵はFIPS 204 seed-only形式を利用する。
COTS:オリジン証明書チェーンのML-DSA化
COTSは、デフォルトの公開CAに代えて顧客が指定したCAだけを信頼する仕組みだ。ML-DSA対応により、オリジンに接続する際のサーバー証明書をポスト量子化できる。まず、ML-DSA-44のプライベートCAを作成し、そのCAでオリジンサーバー証明書に署名する。
# プライベートML-DSA-44 CAの作成
openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out origin-ca.key

openssl req -new -x509 -key origin-ca.key \
  -out origin-ca.crt -days 10950 \
  -subj "/CN=Origin Server CA"

# オリジンサーバー証明書の生成
openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out origin-server.key

openssl req -new -key origin-server.key \
  -out origin-server.csr \
  -subj "/CN=origin.example.com"

openssl x509 -req -in origin-server.csr \
  -CA origin-ca.crt -CAkey origin-ca.key -CAcreateserial \
  -out origin-server.crt -days 5475 \
  -extfile <(printf "basicConstraints=CA:FALSE\nkeyUsage=digitalSignature\nsubjectAltName=DNS:origin.example.com\n")
生成したCA証明書をCOTSにアップロードし、SSL/TLSモードをFull(strict)に設定する。これでCloudflareは、アップロードされたCAからチェーンする証明書を持つオリジンとのみ接続するようになる。
AOP:Cloudflare側のクライアント証明書
オリジンサーバーがCloudflareからの接続だけを受け付けるようにするには、AOPでクライアント証明書を設定する。ML-DSA証明書とseed形式の秘密鍵をAPI経由で登録すれば、Cloudflareがオリジンに対して自らの身元を証明するようになる。
# AOP用CAとクライアント証明書の作成
openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out aop-ca.key

openssl req -new -x509 -key aop-ca.key \
  -out aop-ca.crt -days 10950 \
  -subj "/CN=Authenticated Origin Pull CA"

openssl genpkey -algorithm mldsa44 \
  -provparam ml-dsa.output_formats=seed-only \
  -out aop-client.key

openssl req -new -key aop-client.key \
  -out aop-client.csr \
  -subj "/CN=cloudflare-aop-client"

openssl x509 -req -in aop-client.csr \
  -CA aop-ca.crt -CAkey aop-ca.key -CAcreateserial \
  -out aop-client.crt -days 5475 \
  -extfile <(printf "basicConstraints=CA:FALSE\nkeyUsage=digitalSignature\n")
AOPはゾーン単位またはホスト名単位で有効化できる。グローバル設定のML-DSA対応は、より大規模な変更が必要なため後日対応予定だ。
ダウングレード対策と接続確認
ポスト量子署名を導入しても、検証側が従来のRSAやECDSAを引き続き信頼していれば、経路上の攻撃者によるダウングレード攻撃を受ける可能性が残る。完全な量子耐性を確保するには、オリジン側で量子脆弱な認証方式を無効化し、ML-DSAのみを信頼する設定にしなければならない。
設定後は、openssl s_clientで署名タイプを確認したり、nginxのログにクライアント証明書のシリアル番号を出力させたりして、CloudflareがML-DSA証明書を提示していることを検証する。鍵合意でもX25519MLKEM768がネゴシエートされていることをあわせて確認したい。
これらの手順を踏むことで、Cloudflareとオリジン間の通信が暗号化と認証の両面でポスト量子化される。
実装の舞台裏と教訓

制御プレーンはGoの壁をCIRCLで突破
CloudflareのSSL/TLS設定を管理するサービスはGoで書かれている。ML-DSA対応にあたり、Goの標準ライブラリがまだ同アルゴリズムをサポートしていないという課題があった。そこでCloudflareは自社の暗号ライブラリCIRCLに必要な機能を実装し、標準ライブラリの不足を補った。
ただし、このアドホックな対応は一時的なもので、2026年8月にリリース予定のGo 1.27ではML-DSAがネイティブサポートされる。バージョンアップのみで多くのサービスがポスト量子認証に対応できるようになるため、エコシステム全体にとっての追い風となる見込みだ。
BoringSSL更新の遅れとインシデント
データプレーン側では、プロキシフレームワークPingoraのオリジン接続サービスがBoringSSLに依存している。同ライブラリには4年間ものアップデートが行われておらず、Cloudflareは内部フォークをメンテナンスして機能を追加していた。ML-DSAサポートがBoringSSL本体に取り込まれたことを機に、ついにアップデートを決断した。
しかし、4年分の変更にはKeyUsageルールの厳格化が含まれており、一部の顧客証明書がRFC準拠でないと判定されてしまった。慎重にテストを重ねたにもかかわらず、2026年6月10日に小規模な接続障害が発生し、ロールバックを余儀なくされた。その後、RSA証明書向けの緩和パッチを当てて再開し、現在は安定稼働している。長期間アップデートを控えることのリスクを改めて浮き彫りにした出来事だったといえる。
完全ポスト量子化へのロードマップ
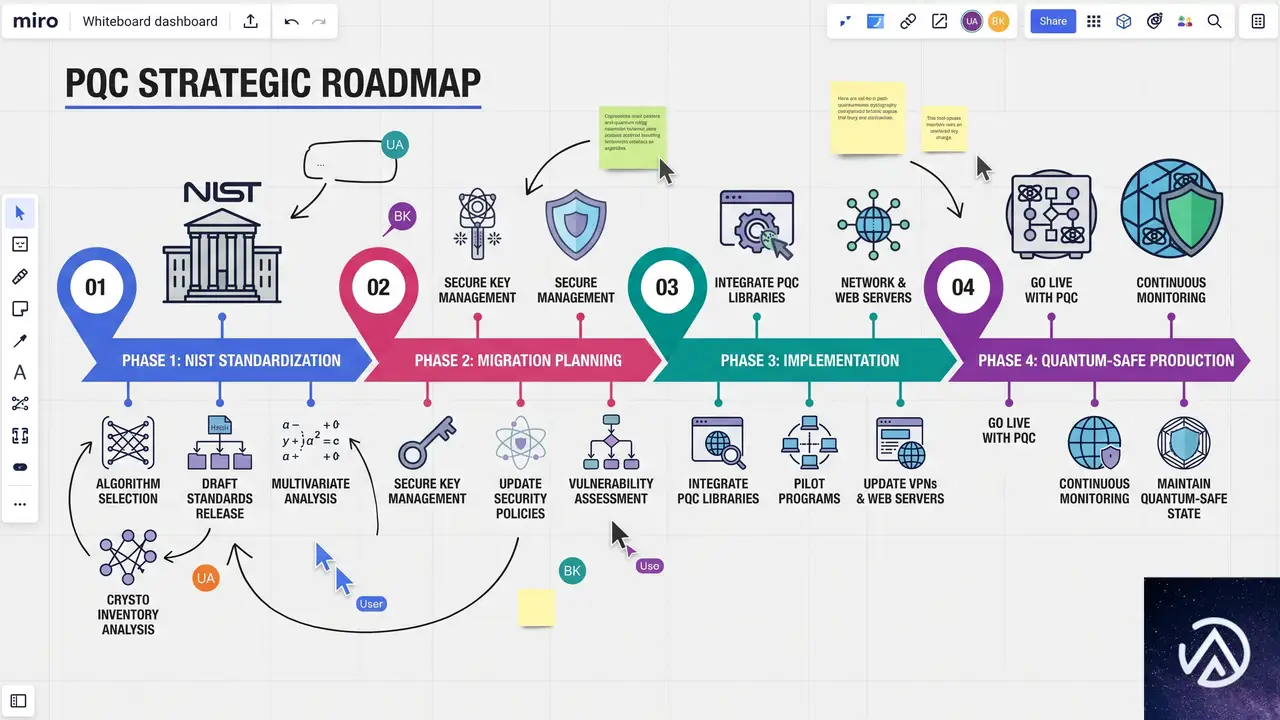
Cloudflareは2029年の完全ポスト量子セキュリティ達成を目標に掲げている。今回のAOP/COTS対応は最初のマイルストーンに過ぎない。ユーザーとCloudflare間の認証については、IETFで策定が進むMerkle Tree Certificates(MTC)による高速なポスト量子証明書の実験を経て、2027年をめどに初期展開を予定している。
Go 1.27の登場やブラウザベンダーの取り組みが進むにつれ、ポスト量子認証は急速に普及すると予想される。ひとまず、オリジンとの相互接続でML-DSAによる完全な量子耐性を確保できるようになったことは、インフラを預かる技術者にとって心強い前進だ。Cloudflareの製品別ポスト量子対応状況は、公式ドキュメントで継続的に更新されているため、導入の際は参照してほしい。
この記事のポイント
- CloudflareがAOPとCOTSでML-DSA署名をサポートし、オリジン接続の相互TLSをポスト量子化
- 量子コンピュータによるなりすまし攻撃に備え、暗号化だけでなく認証の強化が急務に
- OpenSSL 3.5.0+で鍵生成し、API経由で証明書をアップロード。ダウングレード防止には従来署名の信頼解除が必須
- Go 1.27のネイティブML-DSAサポートなど、エコシステム整備が加速中
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPTでSupabaseにログイン可能に。ベータ提供が開始
Supabaseは2026年7月29日、ChatGPTアカウントを使ったサインイン機能のベータ提供を開始した。supabase.comのログインページと、デスクトップ、Web、モバイル版のChatGPTプラグインの両方で利用できる。
ChatGPT WorkやCodexで開発プロジェクトを始める場面では、プロンプトとバックエンドの間のアカウント管理がシームレスになる。既存のChatGPTアカウントをそのまま使ってSupabaseアカウントを作成または連携でき、少ない手順でデータベースの準備に移れるようになった。
ChatGPTアカウントでSupabaseにログインする仕組み
GitHubアカウントでログインするのと同じ感覚で、ChatGPTアカウントを認証プロバイダーとして使えるようになる。Supabaseのログインページで「ChatGPT」を選択すると、ChatGPT側の承認画面が表示され、数クリックでダッシュボードにアクセスできる。
このサインインフローにより、初回のアカウント登録からプロジェクト作成までのハードルが大きく下がる。メールの確認リンクを待つステップがなくなり、思考の流れを止めずにバックエンドの準備に入れる。
新規アカウント作成と既存アカウントの自動連携
ChatGPTサインインは、Supabaseをまだ使ったことがない人にも、既にアカウントを持っている人にも対応する設計だ。
- 新規ユーザーの場合、ChatGPTでサインインすると自動的にSupabaseアカウントが作成される。以降はそのChatGPTアカウントのみで管理できる。
- 既存ユーザーの場合、ChatGPTアカウントに登録されているメールアドレスがSupabaseのものと一致していれば、自動的に連携が行われる。新しいアカウントは作られず、既存のSupabaseアカウントにChatGPTがもうひとつのログイン手段として追加されるだけだ。ただし、SSO(シングルサインオン)アカウントはこの自動連携の対象外となり、別管理になる。
ChatGPTがプロジェクトの出発点なら、バックエンドのアカウントも同じ場所から始められる。管理するパスワードがひとつ減り、アカウント管理の手間も軽減される。
ChatGPTやCodexからSupabaseを直接接続する手順
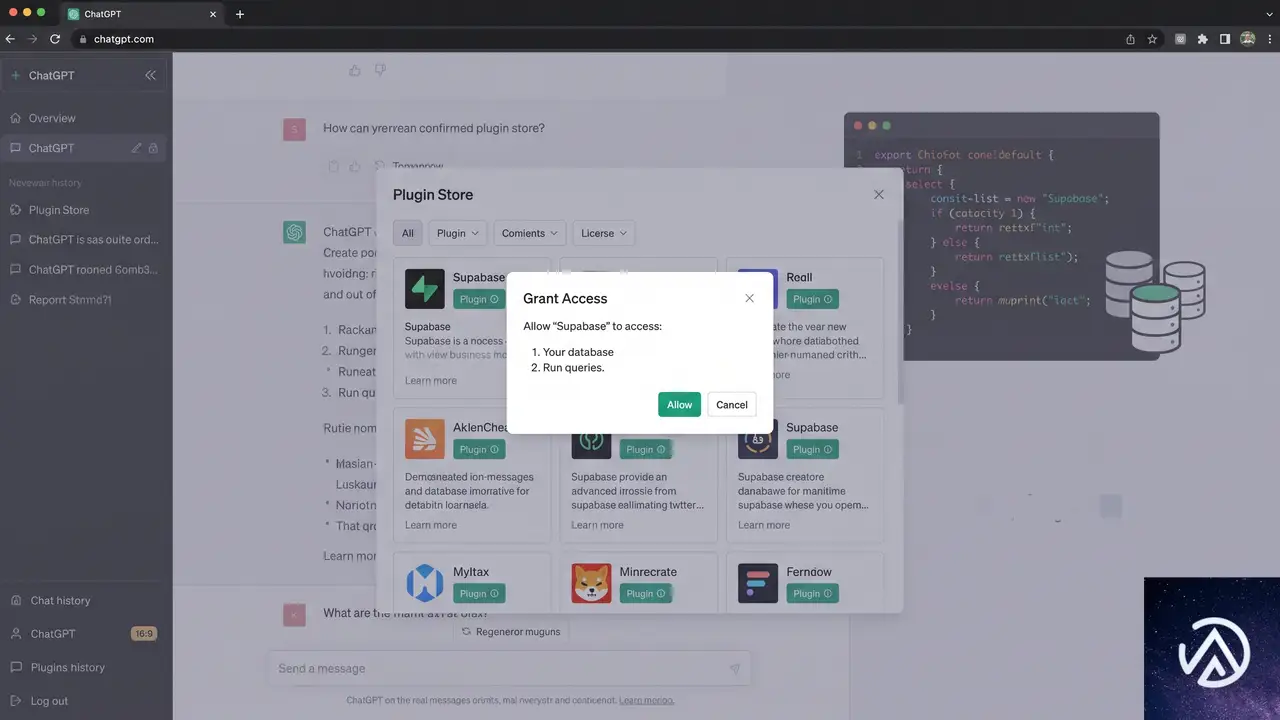
SupabaseをChatGPTに接続する操作は、クリックと承認だけで完了する。認証済みのアカウントを使い、プラグインの追加から接続までが短いステップでまとまっている。
この接続フローは認証と権限付与を明確に分離している。サインインしたあと、改めてプラグインがアクセスできる範囲が表示され、利用者がそれを確認・承認する。承認後に初めてSupabaseがChatGPTの会話に連携される仕組みだ。
許可の管理と取り消し
接続の許可はいつでもSupabaseダッシュボードから取り消せる。プロジェクトの途中で方針が変わっても、ワンクリックでChatGPTからのアクセスを遮断できるため、セキュリティ面でも柔軟に対応できる。
初めてSupabaseを使う場合、ダッシュボードで組織を作成しておく必要がある。組織がひとつでもあれば、その後はChatGPT側からプロジェクトを作成・操作できるようになる。
OpenAIとのパートナーシップで実現
この機能は、Supabaseが「Sign in with ChatGPT」のローンチパートナーに選ばれたことで実現した。OpenAIはサードパーティサービスがChatGPTアカウントを認証に使える仕組みをベータ提供しており、Supabaseはその初期導入企業のひとつにあたる。
日常的にChatGPTやCodexからSupabaseのデータベース構築や認証周りを操作している開発者は多い。今回の統合は、その導線をさらに短くする一手であり、プロンプトから本番稼働までの時間を縮める流れを加速させるものと考えられる。
この記事のポイント
- SupabaseのログインページとChatGPTプラグインで「Sign in with ChatGPT」ベータが利用可能になった
- GitHubログインと同様の操作感で、既存のChatGPTアカウントを使ったワンクリック認証ができる
- ChatGPT側からSupabaseを接続する手順は4ステップ。認証と権限付与が分離され、いつでも取り消し可能
- SupabaseはOpenAIのローンチパートナーとして、この認証機能をいち早く導入した
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Search Consoleの生成AI検索除外設定 仕組みと判断すべきポイント
Google Search Consoleに、AI OverviewsやAI Modeなど生成AIによる検索機能からサイトを除外できる新設定が追加された。Search Consoleの設定項目に新設されたこのコントロールは、サイト単位でAI検索体験への表示をオフにする一方で、通常の検索結果への影響はないとされる。しかし、実際に使うかどうかの判断は一筋縄ではいかない。Top StoriesがAI Overview内に表示されるケースが増えており、除外設定によって思いがけず貴重な掲載機会を失う可能性が指摘されているからだ。
この記事では、新設定の仕組みと背景、そしてオプトアウトを検討する前に把握しておくべき3つの要素を、データと規制動向を交えて整理する。
生成AI検索除外設定の概要
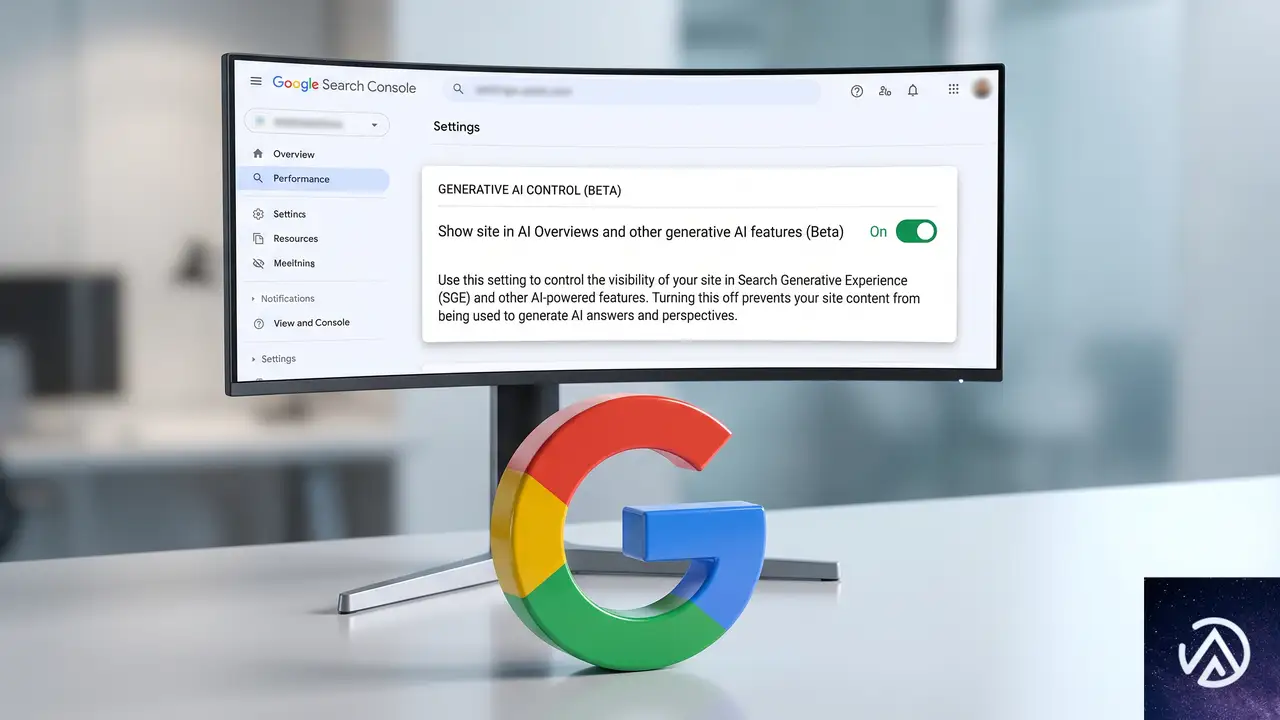
Search Consoleの「設定」内に追加されたこのコントロールは、サイトのコンテンツをAI Overviews、AI Mode、Discoverの生成AI機能に表示するかどうかを決定する。デフォルトは「サイトを含める」で、AI機能内でリンクとして表示され、AIの回答を裏付ける情報源として使われる。除外を選択すると、リンクや文章を問わず、それらの生成AI領域からサイトのコンテンツが一切表示されなくなる。
設定変更が有効になるまでには通常数日かかり、さらにキャッシュの影響で反映に1〜2日を要することもある。ただし、この設定は通常のウェブ検索結果やランキングシグナルにはまったく影響しないと公式ヘルプページで明言されている。また、Merchant CenterやGoogle Adsの参加設定を上書きするものではなく、ショッピング関連の表示とは独立した判断になる。さらに、AIの学習データとしての利用を制御する仕組みとは別物であり、そちらは別のオプトアウト(Google-Extended)を経由する。
CMAの関与と設定誕生の経緯
この除外設定が実装された背景には、英国の競争市場庁(CMA)による規制がある。今年に入るまで、AI検索機能だけを対象にサイトを除外する手段は存在しなかった。従来使えたnosnippetはスニペットを非表示にするが、同時にAI Overviewsの表示も奪うオールオアナッシングだったし、Robots.txtはクロール制御に過ぎず、インデックス済みコンテンツの表示可否は決められない。Google-ExtendedはGeminiモデルの学習や一部のグラウンディングを制御するが、AI Overviewsへの表示には関与しなかった。
状況が動いたのは今年1月だ。GoogleがAI検索機能のオプトアウト手法を検討中と発表したのと同日に、CMAが事業者へのAIオプトアウトを義務付ける協議を開始した。そして6月、CMAは生成AIをめぐるコンテンツ使用に関する「行為要件」を課し、Googleは同一週に英国のプロパティで設定のテストを開始した。現在、この要件は英国でのみ法的拘束力を持ち、より詳細な制御の導入期限は来年まで延びている。
Top StoriesとAI Overviewの融合がもたらすジレンマ
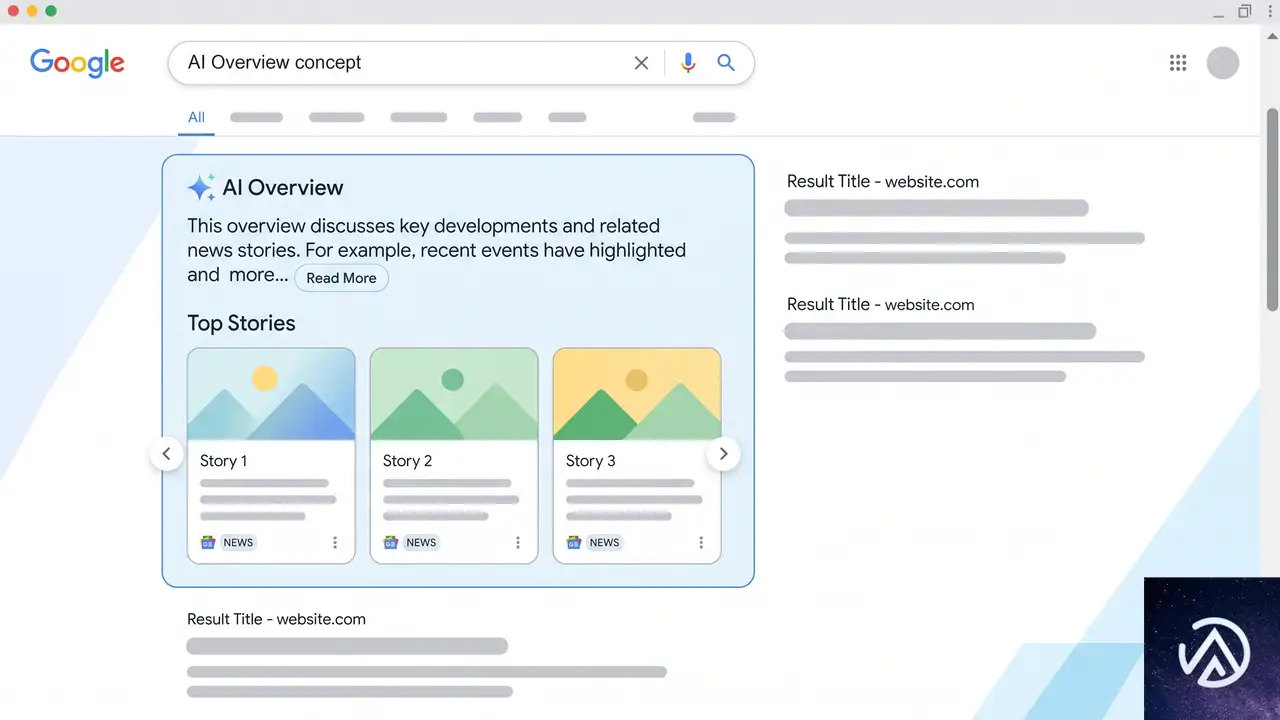
Googleの説明では、この設定はAI機能と通常の検索結果を別物として扱う。しかし実際の検索画面では、その境界が曖昧になりつつある。トレンドのニュース検索で、従来は独立して表示されていたTop Storiesのカルーセルが、AI Overviewの枠内に埋め込まれるケースが増加しているのだ。
SEO分析ツールを提供するNewzDashの調査によると、米国でトレンドニュースクエリを追跡した結果のうち15.5%、英国では17.46%で、Top StoriesがAI Overview内に表示されていたという。NewzDashのCEOであるJohn Shehata氏は、この現象について「新しいSearch Consoleの生成AI除外設定を使うと、AI Overview内のTop Storiesからもパブリッシャーが除外される可能性が高い」とLinkedIn上で指摘している。ワシントンポストのSEO責任者Kyle Sutton氏も、自身の観測として同様の傾向を確認しているとコメントしている。
ただし、この解釈はあくまでShehata氏の見解であり、Googleが公式に認めたものではない。公式ヘルプページには「除外されたサイトはAI機能に表示されなくなる」とあるが、AI機能の内部に組み込まれた伝統的な機能についての挙動は明記されていない。つまり、除外設定をオンにすると、AI Overviewsの魅力を削ぐだけでなく、これまでAI機能とは別に獲得していたTop Storiesの露出まで手放すリスクがある。軽々に設定を切り替えられない理由はここにある。
オプトアウト判断前に確認すべき3つの要素
1. AI機能での現在の表示状況を把握する
まず自社サイトがAI機能でどれだけのインプレッションを得ているかを確認する。Search Consoleには「生成AIパフォーマンスレポート」が順次ロールアウトされており、ページ別、国別、デバイス別のインプレッション数が確認できる。ただし、このレポートにはクリック数や検索クエリのデータは含まれていない。Googleアナリティクスなどの一般的な分析ツールでも、流入をAI Overviewsと通常の検索に切り分けることはできない。現状では、AI機能経由のトラフィックを正確に把握できない点を認識しておく必要がある。
2. 各制御ツールの役割を整理する
除外に関する判断を混乱させるのが、類似した複数のコントロールが存在していることだ。どのツールが何を制御するのか、違いを正しく理解しておきたい。
ポイントは、このSearch Consoleの設定がAI機能の表示だけを扱う点だ。これに対して、Google-Extendedはモデルの学習やグラウンディングに特化しており、検索結果の表示可否には関与しない。複数のレバーがあるからこそ、意図しない情報コントロールを避けるためには、それぞれの適用範囲を正確に把握しておく必要がある。
3. ビジネスへの影響を慎重に評価する
除外がもたらす影響は業態によって異なる。ニュースメディアにとっては、AI Overview内のTop Stories露出が収益源のひとつになり得る。ECサイトであれば、サイトコンテンツの表示とショッピング枠への参加は独立した意思決定であるため、除外設定が直接的に商品表示を消すわけではない。ただ、いずれの事業者にとっても共通するのは、AI機能での表示が代替しているトラフィックの規模を正確に評価する手段が今のところ存在しないという事実だ。
CMAの要件では、クリックデータやクリック率といった指標が提供される予定で、その多くは今年12月から順次展開される見通しである。だが現時点では、AI機能へのオプトアウトがもたらす具体的なコストを数字で判断できない。データがない段階での切り替えは、将来の規制対応を先取りする戦略的判断か、あるいは様子見のリスク回避か、経営方針と照らし合わせながら決めるしかない。
今後の展開と欠けているピース
CMAのスケジュールでは、より詳細なページ単位の除外設定が2027年3月までに導入されることになっている。また、Googleは検索コンソールを通じてクリックデータやクリック率を共有し、パブリッシャーがその数字を評価できるツールを提供する必要がある。さらに、初年度は半年ごとに、その後は状況が落ち着けば年次で、コンプライアンス状況の報告が求められる。
一方で、このような規制によって本当にパブリッシャーの利益が守られるのか疑問視する声もある。オックスフォード大学の研究者Spencer Cohen氏とUCLのTodd Davies氏は、学術誌に寄稿した論文の中で「オプトアウトの救済策では不十分」との見解を示している。Davies氏は過去にGoogleでソフトウェアエンジニアとして勤務した経歴を持ち、LinkedIn上でも「オプトアウトはAI Overviewsが引き起こす問題を解決せず、パブリッシャーのビジネスモデルを保護する効果は限定的だ」と述べている。
結局のところ、今はコントロールが与えられたが、その操作に必要なデータはまだ揃っていない。NewzDashは近日中に除外効果の直接テストを実施すると予告しており、近いうちに実際の影響を測る材料が増える可能性はある。当面は、設定の存在を認識しつつ、運用判断はクリックデータの提供開始後まで保留する、あるいは試験的に一部のプロパティで効果を観察するといった現実的なアプローチが求められるだろう。
この記事のポイント
- Search ConsoleにAI Overviews等の生成AI検索機能からサイトを除外する新設定が追加された。通常の検索結果には影響しない
- 英競争市場庁(CMA)の要請により導入され、現在はサイト単位でのみ制御可能。ページ単位のコントロールは2027年3月までに実装予定
- Top StoriesがAI Overview内に表示されるケースが15〜17%存在し、除外によってそれらの露出も失うリスクがある
- 現状ではAI経由のトラフィックやコンバージョンを切り分けるデータがなく、オプトアウトの損得を数値で評価することはできない
- Google-ExtendedやRobots.txtなど類似の制御ツールとの違いを理解し、本来の意図に合った設定を行う必要がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.6 API料金改定、Lunaは80%値下げでTerraも20%減。Fastモード登場
OpenAIは2026年7月30日、大規模言語モデル「GPT-5.6」シリーズのAPI料金を大幅に引き下げた。最速かつ最安価なモデル「Luna」は80%値下げされ、バランス型の「Terra」も20%安くなる。あわせて最上位「Sol」向けにFastモードも導入され、標準処理の最大2.5倍の速度を提供する。
これらの改定は、OpenAIが掲げる「高度な知能をより豊富で手頃なものにする」という目標の実践だ。企業はコストと処理速度をワークフローごとに最適化できるため、AI利用の幅が大きく広がる。
GPT-5.6 LunaとTerraの大幅値下げ

今回の値下げの中心は、高速処理向けのLunaだ。LunaはAPI料金が80%引き下げられ、100万入力トークンあたり0.20ドル、同出力トークンあたり1.20ドルという破格の水準になった。一方、日常的な業務全般に使えるTerraは20%値下げされ、入力トークン100万あたり2ドル、出力は12ドルとなっている。
この値下げによって、Lunaは1タスクあたりのコストが非常に低くなり、大量処理に適したモデルへと進化した。OpenAIのブログによれば、専門的な作業指標で測った場合、同社の旧モデルFable 5と比べてLunaの推定タスク単価は99%近く低いという。小規模事業者が高度なAIを日常的に使うハードルが格段に下がったと言える。
FastモードでSolが最大2.5倍高速化
最上位モデルのGPT-5.6 Solには、新たにFastモードが追加された。これは従来の優先処理(Priority Processing)を置き換えるもので、APIでFastモードを有効にすると、標準処理の最大2.5倍の速度で応答が得られる。価格は標準の2倍だが、知能の質はまったく変わらない。既存の優先処理指定リクエストは自動的にFastモードに移行するため、コードの修正は不要だ。
応答速度が重要な場面、たとえばユーザー向けのリアルタイムチャットボットや緊急度の高い意思決定支援などで効果を発揮する。一方で、コストが2倍になるため、処理の内容に応じて標準モードとの使い分けが鍵になる。OpenAIはこの仕組みによって、企業が「結果に対して適正な価格を払う」バランスを取りやすくしたとしている。
効率化を支えるモデル自身の最適化ループ

今回の値下げを支えているのは、GPT-5.6シリーズの稼働効率の劇的な向上だ。OpenAIはモデルそのもの、推論システム、そしてツールやコンテキストを扱うエージェント機構のあらゆる層で改良を重ねた。より直接的な処理経路の選択、ハードウェア生産性を維持するルーティング、トークン生成の最適化、重複作業を避ける賢いコンテキスト管理などが組み合わさり、同じ計算資源でより多くの有用な成果を出せるようになっている。
とりわけ注目されるのが、Sol自身が効率改善のプロセスに貢献した点だ。人間の管理のもと、Solは本番カーネルを自律的に書き換えて最適化し、トークン生成効率を高める数百の実験を設計・実行した。この取り組みによって、モデル提供にかかるエンドツーエンドのコストが20%削減され、トークン生成効率は15%以上向上した。AIがAIの運用コストを下げるフィードバックループが動き始めている。
こうした自己最適化のループは、OpenAIが目指す「インテリジェンスの価格性能比を継続的に向上させる」戦略の中核をなす。モデルが賢くなるほど、次の効率化のサイクルが加速するというわけだ。
企業がAI活用を進める際の新たな選択肢
LunaとTerraの値下げ、そしてSolのFastモードの登場によって、企業がワークフローごとに最適なモデルを選べる幅が大きく広がった。コストと速度、知能のバランスをタスク単位で調整できるようになったことで、AIの適用範囲を無理なく拡大できる。
たとえば、コード生成のワークフローを考えてみる。要件が曖昧で高度な判断が必要な設計段階ではSolを使い、確定した仕様に沿ったコード実装やテストの実行は低コストのLunaに任せる、といった割り振りが現実的になる。ドキュメントの大量分析や顧客対応の振り分けといった高頻度の業務も、Lunaを活用すれば予算内に収めやすい。
このように、単一のモデルですべてをこなすのではなく、処理の性質と求める品質に応じて使い分ける設計が、これからのAI戦略の基本になるだろう。SolのFastモードは、応答速度が収益に直結する顧客向けサービスなどで即効性が期待できる。
OpenAIのブログによれば、今回の改定によって、1年前に最先端とされたモデル並みのパフォーマンスをLunaで1タスク約6%のコストで実現できるという。AI活用が一部の専門領域から、あらゆる業務の日常ツールへと移行する大きな一歩だ。
この記事のポイント
- GPT-5.6 LunaのAPI料金が80%値下げされ、100万入力トークンあたり0.20ドルに。Terraも20%引き
- Sol向けFastモードが追加され、標準の最大2.5倍の速度を2倍の価格で提供
- 値下げの背景には、Sol自身がカーネル最適化などで推論コストを20%削減した成果がある
- 企業はタスクの難易度や処理量に応じてLuna、Terra、Solを柔軟に組み合わせ、コストと品質を両立できる
- ChatGPT WorkやCodexのサブスクリプション価格は据え置きのまま、LunaとTerraの消費クレジットが減少
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験