

Google LSAがGoogle広告に統合、2026年8月から段階移行へ
GoogleがLSA(Local Services Ads / ローカルサービス広告)の管理画面をGoogle広告に統合する。2026年8月から一部の米国広告主を対象に移行が始まり、2027年にかけて段階的に拡大される予定だ。
移行後はGoogle広告内でキャンペーン管理やリード対応が完結する。ただし入札方式やレポートの扱いが変わるため、事前の準備が欠かせない。本記事では移行のスケジュールや変更点、広告主が取るべき対応を3つのポイントに絞って解説する。
LSAのGoogle広告統合で何が変わるのか
LSA(ローカルサービス広告)は、もともとGoogle検索やマップの上部に表示される問い合わせ獲得型の広告だ。ユーザーが「近くの電気工事業者」などと検索すると、電話やメッセージでのリード獲得を主目的とした事業者一覧が表示される仕組みである。
今回の統合により、LSAはGoogle広告の管理画面から操作する形へと一本化される。従来のLSA専用ダッシュボードは廃止され、キャンペーンの作成からリード対応までをGoogle広告内で処理できるようになる。
移行スケジュールは2026年8月から段階的に
Googleが公開したスケジュールによると、最初の移行対象は米国の一部広告主であり、ペットケアやホームサービス、ウェルネス、教育関連の業種が含まれる。2026年8月にこの第1陣の移行が始まり、同年後半に米国内の対象が拡大される見込みだ。
米国以外のアカウントや残りの業種については2027年に対応が進む。アカウント管理者には移行の14日前と7日前に通知が届き、移行完了時にも確認の連絡があるため、突然ダッシュボードが使えなくなる事態は避けられる。
管理フローの一元化によって作業負荷は減る一方で、従来のLSA専用画面に慣れた事業者や代理店には操作変更への対応が求められる。
新しいLSAキャンペーンの仕組み
統合後のLSAは、Google広告のP-MAX(Performance Max)キャンペーンとして配信される。ただし名称こそP-MAXだが、配信面や課金方式は従来のLSAと変わらない点に注意が必要だ。
配信面と課金方式は変更なし
LSAは今後もキーワードの入札なしで、Google検索とマップにのみ表示される。クリック課金ではなく、電話、メッセージ、予約といった有効リードに対して料金が発生する仕組みも維持される。P-MAXと聞くとディスプレイ広告や動画広告まで配信対象が広がるイメージがあるが、LSAの場合はあくまで検索とマップに限定される形だ。
Google広告内で完結するキャンペーン管理
広告主はGoogle広告の管理画面でLSAキャンペーンの設定、リードの確認、返信をすべて行えるようになる。従来のLSA専用ダッシュボードは移行後に利用できなくなるため、操作に不慣れな場合は早めにGoogle広告の画面構成を確認しておくとスムーズだ。
キャンペーン管理で変わる5つのポイント
統合に伴い、予算の考え方や入札、レポートの扱いが一部変更される。Search Engine Journalの記事で挙げられた主な変更点を整理する。
予算は週単位から日単位へ
従来のLSAは週平均の予算で運用されていたが、移行後はGoogle広告の他のキャンペーンと同様に日額予算での管理に変わる。1日あたりの支出上限が設定されるため、週単位のざっくりした予算配分からより細かい調整が必要になる。
手動入札が廃止され目標CPAがキャンペーン単位に
これまで一部の広告主は「リード1件あたりの上限単価」を手動で設定できたが、この機能は使えなくなる。代わりに、Googleが算出するキャンペーン単位の目標CPA(リード獲得単価の目標値)が適用される。
サービスカテゴリごとに異なる目標CPAを設定することもできなくなる。たとえば配管工事と空調工事の両方を1つのキャンペーンで広告している事業者の場合、双方のリードコスト差にかかわらず1つの目標CPAに統一される。この点は業種によって影響が大きいため、キャンペーン分割の要否を検討する必要がある。
ビジネス情報はGBPと自動同期
事業者名や住所、営業時間といった基本情報はGBP(Google Business Profile / グーグルビジネスプロフィール)から自動で同期される。これまではLSAとGBPで別々に情報を更新する手間があったが、統合により片方だけ変更するリスクは減る。ただし、大幅な名前や住所の変更を行うと24〜48時間の確認プロセスが入り、キャンペーンが一時停止する可能性がある。
レポートとリード管理の拠点が切り替わる
過去のパフォーマンスレポートはGoogle広告に引き継がれない。リードの履歴は移行されるものの、レポートデータへのアクセスは移行完了と同時に失われる。年度比較や顧客報告に必要なデータは事前にダウンロードしておくことが必須だ。リード対応についても、Google広告内のLead Manager(リード管理画面)に切り替わる。
広告主が移行前後に取るべき対策
移行をスムーズに進めるために、広告主や代理店が今から着手できる準備を整理する。移行の通知を受け取ってから慌てないよう、以下の2点を押さえておきたい。
履歴レポートのダウンロードを最優先に
最も重要なのは、LSAダッシュボードに保存されている過去のパフォーマンスデータをエクスポートすることだ。移行後はレポート画面自体がなくなるため、後から取り出すことはできない。
複数アカウントを管理する代理店は、通知を受け取る前にバックアップ作業を始めておくと安全だ。前年比較レポートを作る予定のある事業者も、今のうちに必要な期間のデータを保存しておくことを推奨する。
移行後の設定を丁寧に確認する
Googleがキャンペーン設定を自動で移行するが、広告主自身で以下の項目を再確認すべきである。
- 日額予算が事業計画と合っているか
- キャンペーン単位の目標CPAが過去のリード単価と大きく乖離していないか
- サービスカテゴリや配信地域が正しく設定されているか
- 広告スケジュールが想定通りか
- リード転送先の電話番号や写真、訴求文に誤りがないか
事業者名や住所に大きな変更があると、前述の通り審査が入りキャンペーンが止まる可能性がある。配信再開までに数日かかるケースもあるため、移行直後の大口変更は避けたほうが無難だ。
Googleは移行後すぐに広告が表示される場合もあるとしているが、パフォーマンスが安定するまで最大2週間をみておく必要がある。
統合がもたらす影響と今後の見通し
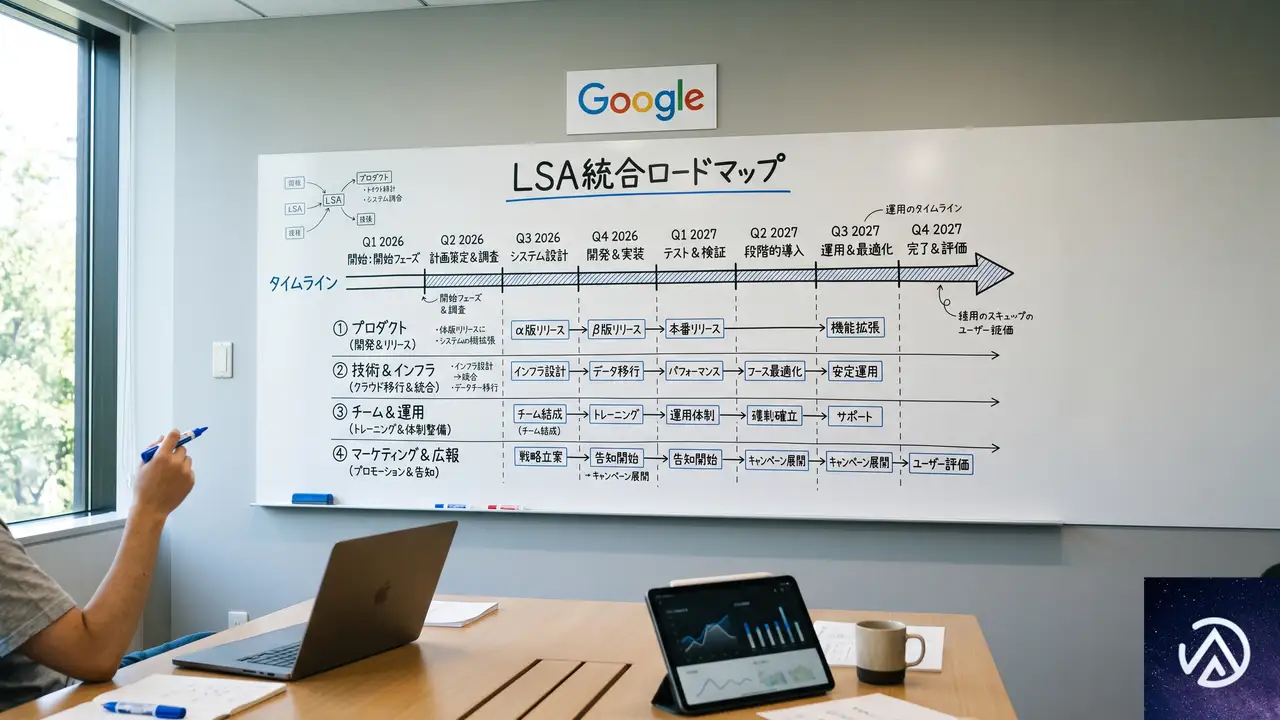
今回の統合の最大の焦点は、カテゴリ別の目標CPAが廃止される点にある。リード単価の大きく異なる複数サービスを1つのキャンペーンで運用してきた事業者は、キャンペーンを分割するか、まとめたまま自動入札に任せるかの判断を迫られる。
分割すれば入札のコントロールは細かくなるが、各キャンペーンのコンバージョンデータが少なくなり、Googleの自動最適化が働きにくくなる面もある。リード数の多い事業者は分割、まだボリュームの少ない事業者は統合したまま様子を見るという選択肢が現実的だ。
初期移行グループの状況を見ながら、Googleは追加のガイダンスを出すとみられる。とくに日本国内の広告主が対象となるのは2027年以降と見込まれるため、まずは米国の事例を参考にしつつ、自社のLSAデータを整理しておくのが賢明だろう。
この記事のポイント
- LSAの管理画面が2026年8月からGoogle広告に統合される
- 配信面とリード課金の仕組みは変わらないが、予算管理や入札方式が変更される
- カテゴリ別目標CPAの廃止が事業者に与える影響は大きく、キャンペーン分割の要否を検討する必要がある
- 過去レポートは移行前に必ずダウンロードしておくこと
- 日本国内の移行は2027年以降の見込みだが、今からデータ整理を始めておくとよい

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce.comがプラグイン読み込みを最適化、応答時間を最大400ms短縮
WooCommerce.comが大規模WordPressサイトのパフォーマンスを大幅に改善した手法が公開された。特定のリクエストで不要なプラグインを読み込まない「選択的プラグイン読み込み」である。この手法により、WooCommerce.comの内部APIエンドポイントではメモリ使用量が50%以上削減され、主要エンドポイントの応答時間が最大400ミリ秒以上短縮されたという。
WordPressはリクエストのたびにすべての有効化プラグインを読み込む仕組みだ。大多数のサイトでは問題にならないが、WooCommerce.comのように100を超えるプラグインが稼働する大規模サイトでは無視できないオーバーヘッドになる。今回の事例は、大規模WordPressサイトのパフォーマンスチューニングに新たな選択肢を示すものだ。
プラグインの一括読み込みは大規模サイトの足かせになる
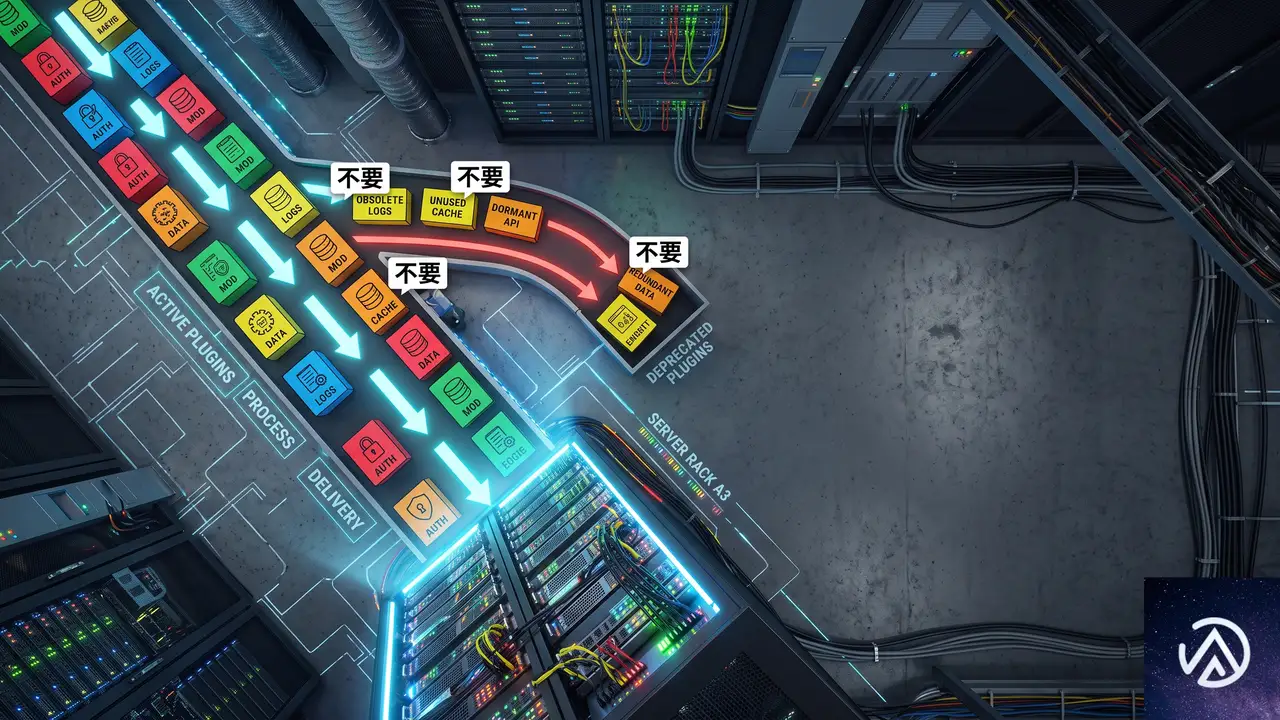
WordPressのプラグインモデルはシンプルだ。有効化されているプラグインは、フロントエンドの表示でも管理画面の操作でも、REST APIの呼び出しでも、すべてのリクエストで例外なく読み込まれる。ほとんどのサイトにとってこれは合理的な設計である。挙動が予測しやすく、プラグイン同士の依存関係を意識せずに組み合わせられる。
しかしWooCommerce.comのように、マーケットプレイス、決済、アカウント管理、API、チェックアウト、パートナー向けワークフロー、検索連携、トラッキング、そして運用コードが複雑に絡み合う大規模アプリケーションでは、事情が異なる。100個以上のプラグインのうち、特定のリクエストで実際に必要なのはごく一部であることが多いのだ。
WooCommerce.comの開発者ブログで紹介された実例を見てみよう。商品の検索・表示ページは、マーケットプレイスへの出品ツールを必要としない。キャッシュされた内部APIは、チェックアウト処理と同じプラグイン群を必要としない。公開ドキュメントの表示に注文番号の採番ロジックは不要だ。にもかかわらず、これらすべてのリクエストが同じプラグインセットを読み込んでいる。
各プラグインは読み込み時にフックの登録、サービスの初期化、オプションの読み出し、翻訳ファイルのロード、カスタム投稿タイプの定義、RESTルートの追加、アセットのキューイング、互換性コードの実行などを行う。1つひとつは小さなコストでも、成熟したWooCommerceアプリケーションで積み重なると無視できない負荷になる。
ページキャッシュやエッジキャッシュはこの問題をある程度隠すが、根本的な解決にはならない。キャッシュミスは依然として発生する。APIリクエストは動的なものが多い。ログイン状態のリクエストはキャッシュをバイパスする。トラフィックが急増するタイミングで、運用系のエンドポイントが高いレイテンシに悩まされることもある。大規模WordPressサイトにとって、ブートストラップ処理の削減は確かなパフォーマンス向上手段だ。
選択的プラグイン読み込みの基本的な仕組み
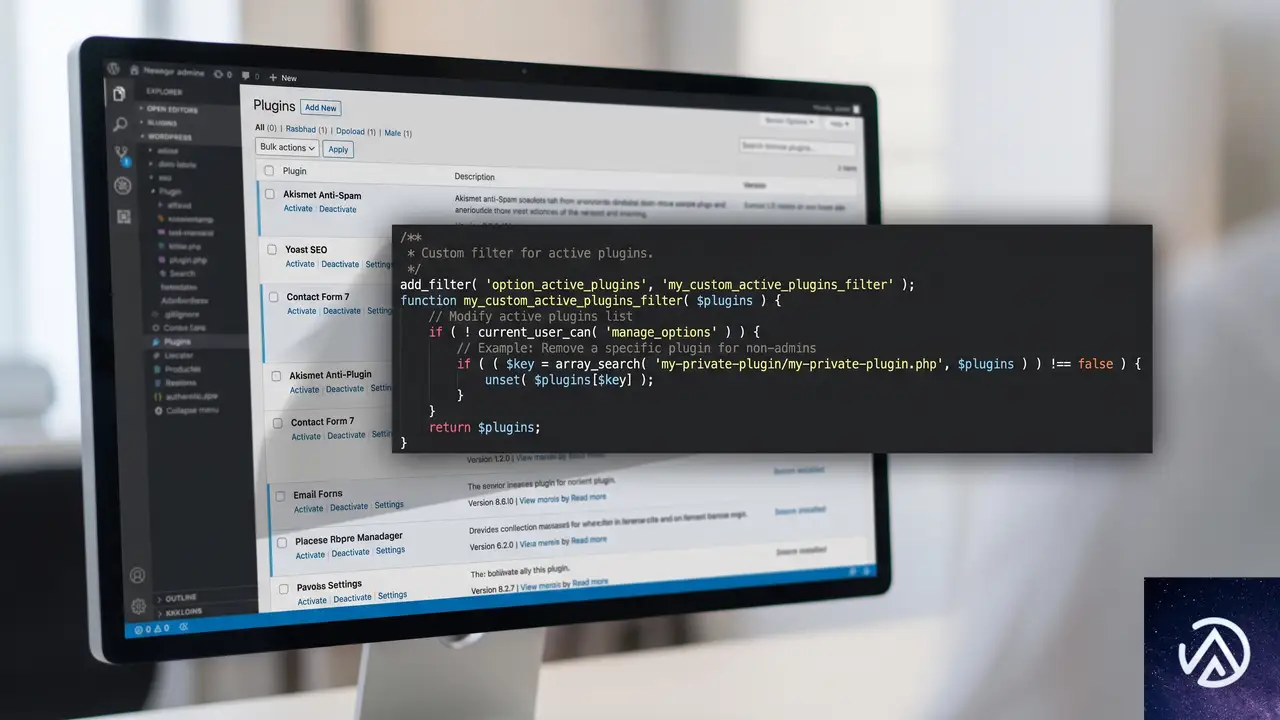
WordPressは有効化プラグインの一覧を active_plugins オプションに保持している。ブートストラップ時にこのオプションを読み取り、リストにある各プラグインのメインファイルを順に読み込んでいく。
ここに介入する仕組みがオプションフィルターだ。pre_option_active_plugins または option_active_plugins フィルターを使えば、WordPressが実際にプラグインを読み込む前にリストを書き換えられる。重要なのは、このフィルターを通常のプラグインより先に実行される mu-plugin(Must-Use Plugin)に配置することだ。
add_filter(
    'option_active_plugins',
    function ( array $plugins ): array {
        if ( ! should_limit_plugins_for_this_request() ) {
            return $plugins;
        }
        return array_values(
            array_diff(
                $plugins,
                plugins_to_skip_for_this_request()
            )
        );
    }
);
このコードの要点は3つある。どのリクエストでフィルターを適用するか、そのリクエストにとって安全に除外できるプラグインはどれか、そしてプラグインの一部を読み込まなかったことでサイト全体の状態が破損しないか、という点だ。
WooCommerce.comでは、mu-pluginでルートルールを早期に登録し、リクエストURIを完全一致、前方一致、または正規表現で照合する。ルールがマッチすると、あらかじめ定義されたプラグインを読み込み対象から外す仕組みだ。
この仕組みは、APIエンドポイントやブログ記事の表示など「ほとんどのプラグインが不要なリクエスト」で高い効果を発揮する。
ルール設計と安全性のトレードオフ
許可リストと除外リスト
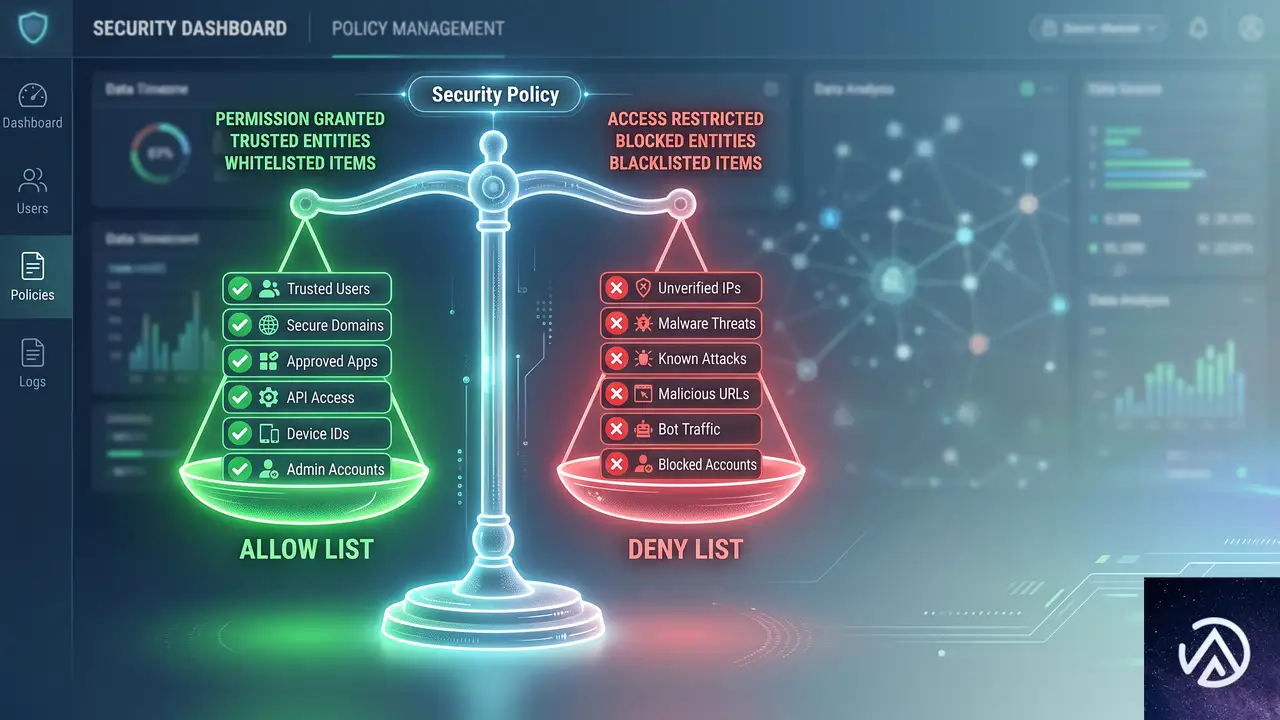
選択的プラグイン読み込みの設計で最初に直面するのが、読み込むプラグインを決める方式だ。大きく分けて許可リスト方式と除外リスト方式がある。
許可リスト方式は、そのルートに絶対必要なプラグインだけをゼロからリストアップする。理論上は最も効果が高いが、大規模サイトでは脆さが問題になる。テーマ関数が別プラグインのクラスに依存しているケース、RESTハンドラが間接的に他のプラグインのヘルパー関数を呼んでいるケース、キャッシュミス時にのみ実行されるコードパスなど、暗黙の依存関係を見落とすとルートが壊れる。見落としはテストをすり抜けやすい。
除外リスト方式は、通常のアクティブプラグインリストから「このルートでは確実に不要」とわかっているものだけを取り除く。理想的な最小化にはならないが、安全性が段違いに高い。管理画面専用ツール、決済ゲートウェイ、メール配信処理など、明らかに関係ないグループをまとめて外すので、予期せぬ依存による障害が起こりにくい。
WooCommerce.comのチームは後者を主軸に採用している。開発者ブログの言葉を借りれば「各ルールをコードレビューの差分として確認でき、どのプラグインを残したか、なぜ外したかをコメントで説明できる」状態が、運用上の安心感をもたらすという。
除外が危険なリクエスト
すべてのリクエストが選択的読み込みの対象になるわけではない。WooCommerce.comでは以下のリクエストタイプを一律で除外対象から外している。
- wc-ajax
- wc-api
- rest_route(広範なクエリ文字列エントリポイント)
- クエリパラメータを含むダウンロードリクエスト
これらは動的に多様なコードパスに分岐する可能性があり、副作用の範囲を予測しにくいためだ。チェックアウト、カート、アカウント、管理画面、cron、Webhook、決済コールバック、ダウンロードといった「金銭・顧客データ・認証・権利確認・メール送信・サードパーティ連携」に触れるリクエストには、特に慎重な扱いが求められる。
依存関係の発見が最大の難所
動的なWordPressアプリケーションでは、あるルートが実際にどのプラグインに依存しているかを静的に解析する方法は存在しない。WooCommerce.comのチームは、ルートのコードを読み込み、明白な依存関係を追跡し、手動でリクエストフローを検証し、URLマッチングとエンドポイント動作のテストを書き、段階的にロールアウトしてエラーログとパフォーマンスデータを監視する、という実践的なアプローチを取っている。
注意すべきは、問題が特定の条件下でのみ表面化することだ。特定の商品ページ、特定のロケール、特定のリクエストパラメータ、キャッシュミス時、ログイン状態など、組み合わせは膨大になる。プラグインの読み込み不足によるエラーは再現条件が狭く、発見が遅れやすい。
WooCommerce.comで得られた具体的な効果
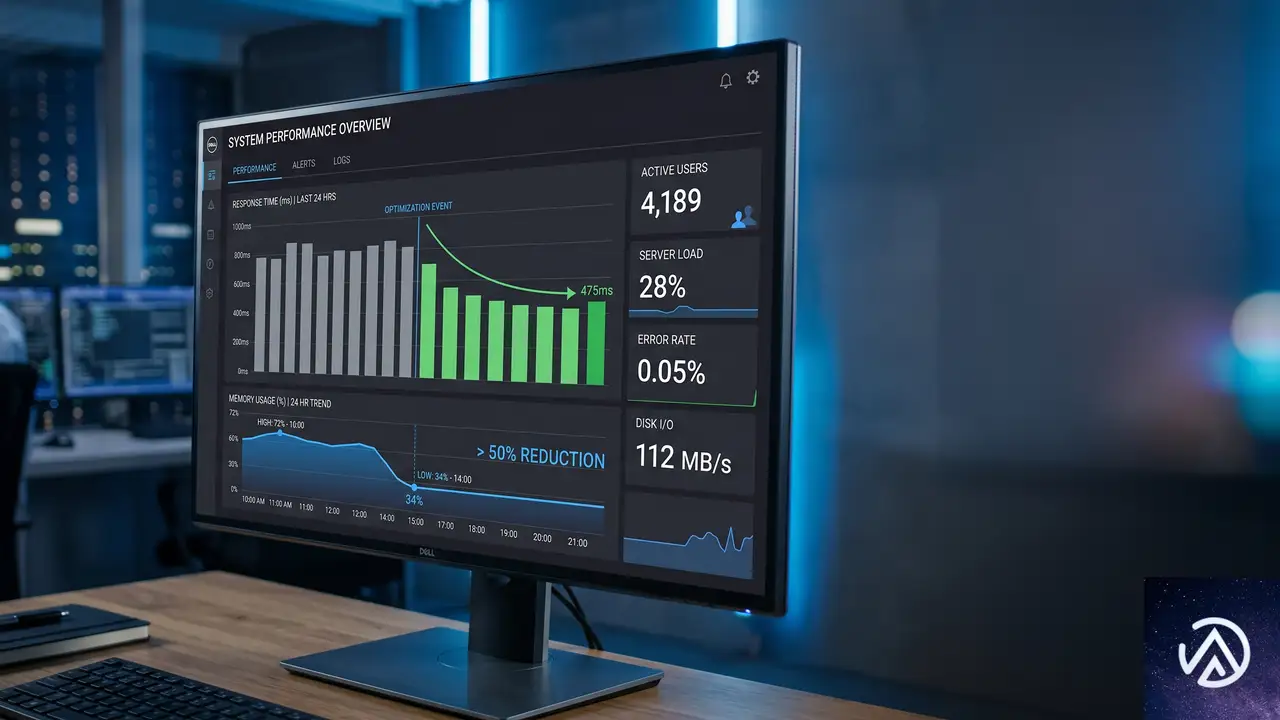
WooCommerce.comの開発者ブログでは、いくつかのエンドポイントで測定された具体的な数値が公開されている。
- 必要なプラグインのみを読み込んだリクエストでは、メモリ使用量が50%以上削減された
- 接続ストアが所有する有料サブスクリプション情報を返すエンドポイントは、約800msから約475msに短縮
- ストアにインストールされたプラグインの利用可能アップデートを通知するエンドポイントは、約880msから約550msに短縮
- WooCommerceオンボーディングフローで毎回呼ばれるエンドポイントも、同様の大幅改善
- 商品ページに対して決済ゲートウェイと無関係な拡張機能を除外した初期テストでは、ページ生成時間が約10%改善
これらの改善は、高トラフィックで責務が限定されたエンドポイントや、大規模なプラグイン構成を持つ匿名ユーザー向けページで特に顕著だった。逆に、ほぼすべてのプラグインが関与しうる動的なステートフルフローでは、相対的な効果は小さくなる。
監視すべき指標は、レスポンスタイム、PHPメモリ使用量、データベースクエリ数、高コストなプラグインのブートストラップ処理、デプロイ後のエラー率、予期しないリライトルールの変更、キャッシュミス時のルート固有の致命的エラーなど、多岐にわたる。
この手法が適するサイトと適さないサイト
この手法が効果を発揮するのは、以下の条件が揃っているサイトだ。
繰り返しになるが、これは最初に手をつけるべき最適化ではない。キャッシュ戦略の見直し、クエリパフォーマンスの改善、アセット読み込みの最適化、オブジェクトキャッシュの導入、明らかに不要なプラグインの整理といった基本的な施策を先に済ませてから検討するのが現実的な順序だ。
この記事のポイント
- 特定のリクエストで不要なプラグインを読み飛ばす「選択的プラグイン読み込み」により、WooCommerce.comの大規模サイトでメモリ使用量50%以上の削減と大幅な応答時間短縮が達成された
- 仕組みは
option_active_pluginsフィルターとmu-pluginの組み合わせで実装でき、技術的なハードル自体は高くない - 安全性を確保するには「許可リスト」より「除外リスト」方式が現実的であり、ルールをコードとして管理しテストと監視を徹底することが不可欠
- この手法は大規模サイト向けの「最後の一手」であり、キャッシュやクエリ最適化といった基本的な施策を先に実施すべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIで返金証拠の偽造が容易に、EC事業者に迫る新たな脅威
オンラインストアにおける返金申請に、生成AIで偽造された証拠写真や配送記録を使う手口が急増している。実店舗を持たずに商品を販売するEC事業者にとって、返品プロセスのデジタル化はコスト削減に直結するが、その裏で「証拠の信頼性」という前提が根底から揺らぎ始めたのだ。特に自動審査システムを導入する事業者ほど、巧妙化するAI画像に脆弱になりやすい。
米国では2025年の返品総額が約8,499億ドルに達し、そのうち約9%が不正申告と推計されている。ECの返品率は実店舗の2倍以上に上る。実務に詳しい業界関係者の間では、これまで人の手で検知できていた偽装が、AIによって誰でも量産できる段階へ移行したとの危機感が強い。この記事では、AI返金詐欺の実態と、事業者が現実的に取りうる対策、そしてその経済的なジレンマまでを整理する。
EC返金の仕組みと「証拠写真」の脆さ
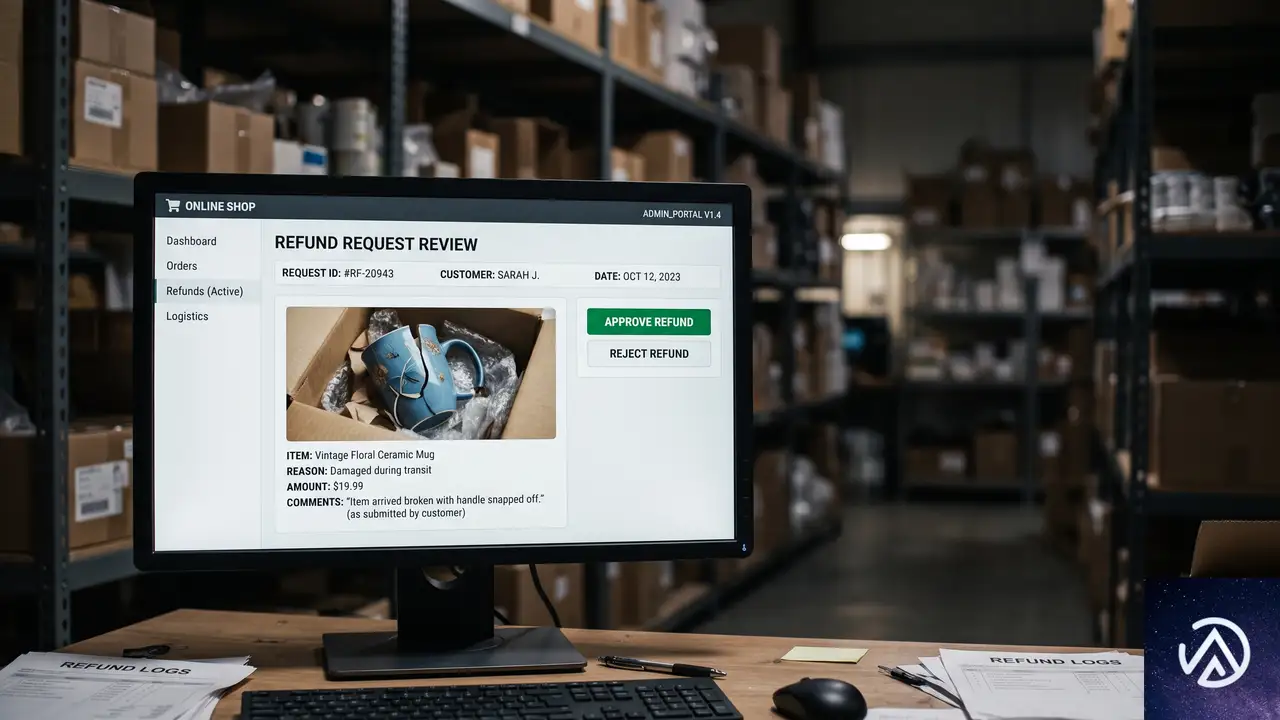
写真1枚で成立していた返金審査
一般的なECサイトでは、返品返金の審査を写真と購入者の申告文のみで完了させるケースが多い。商品の破損やパッケージの潰れを写した画像を確認し、配送記録と照合して問題がないと判断すれば、そのまま返金が実行される。
この流れを支える前提は「購入者が提出する写真は、実際の商品を写したものだ」という一点に尽きる。生成AIはこの前提そのものを無力化してしまう。実在しない破損をあたかも本物のように描写できるため、写真1枚の信頼性では太刀打ちできなくなるからだ。
特に低額商品や食品など、返送コストが商品価格を上回るケースでは、商品の返却を求めずに返金に応じる「返品不要返金」が多用される。詐欺師がこの仕組みを悪用するのは以前からだが、AI画像の登場でそのハードルは大幅に下がった。
返品不要返金が狙われる理由
送料と検品コストを考慮し、商品を送り返させずに返金する方式は、カスタマーサポートの効率化に寄与する。しかし同時に、詐欺師にとっては「商品を手元に残したまま返金だけを受け取れる」絶好の抜け穴になる。生成AIによる偽造証拠は、この穴をさらに拡大する存在だ。
Practical Ecommerceの記事は、米国の小売企業Bogg BagとBoll & Branchが、実際にAIで改ざんされた返品証拠に遭遇したと報じている。こうした事例は大企業に限らず、中規模以下のネットショップにも波及しつつある。
生成AIが作る偽造証拠の手口
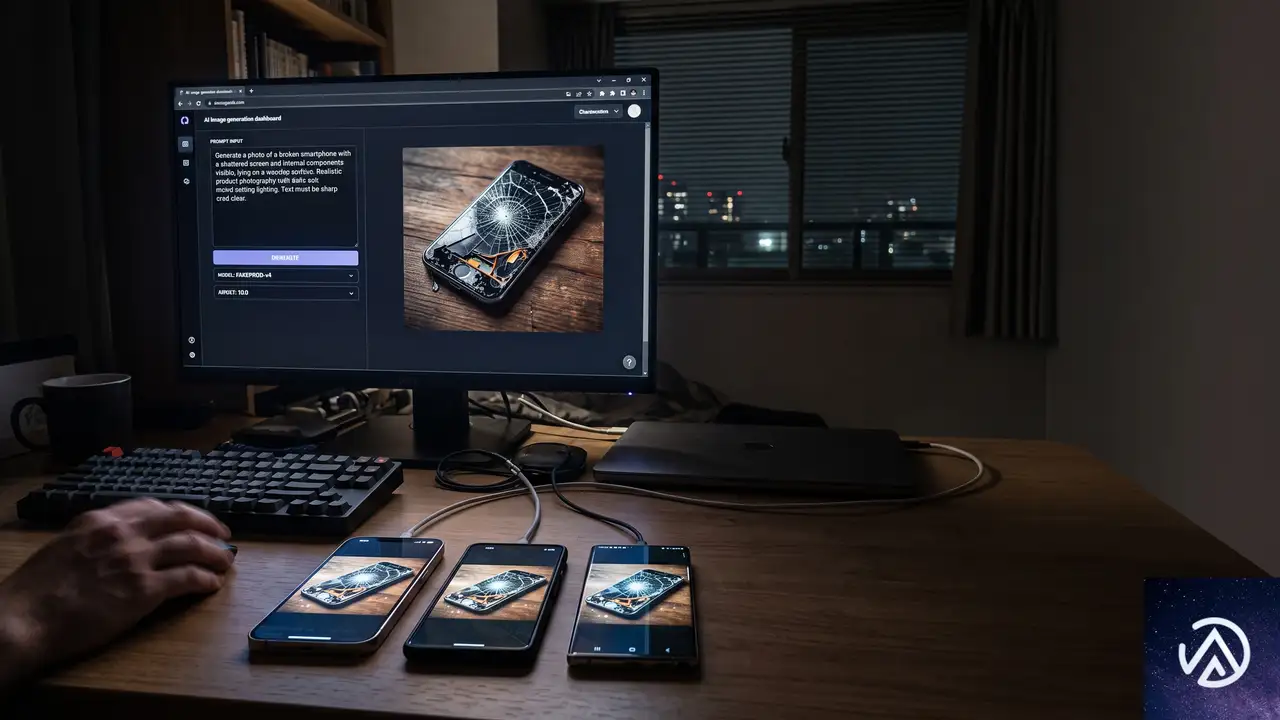
AIによる返金詐欺は、単に商品画像を改変するだけにとどまらない。返品プロセス全体のストーリーを捏造できる点が、これまでの手口と一線を画す。
偽造できる証拠の範囲
詐欺師が短時間で生成できる偽造証拠の範囲は広い。以下に主な種類を整理する。
- 商品のひび割れ、汚れ、カビ、破れ、漏れ、へこみ、部品欠落
- 損傷したパッケージや潰れた配送箱の写真
- 掲載写真と色・機能が異なると見せかける加工
- 「返金を承諾した」とする架空のカスタマーサポートチャット
- 配送記録、運送会社の書類、配達完了画面の偽スクリーンショット
- 各ストアの返品ポリシーに合わせた苦情文の自動生成
- 複数店舗で使い回すためのバリエーション作成
いずれの偽造も、数回のプロンプト入力で完成させられる。写真編集ソフトの知識や文書の改ざんスキルはもはや不要だ。これが「誰でも詐欺師になれる」と言われるゆえんである。
AI画像のリアリティと簡単さ
Practical Ecommerceの記事では、わずか10単語のプロンプトから、ガラス花瓶が粉々に割れた説得力のある画像が生成された例が紹介されている。照明の反射や影の付き方まで自然で、一見しただけでは実写と区別がつかない。
詐欺の実行に必要なコストも時間も極小化され、同時に複数アカウントや複数店舗を横断して悪用できる。従来のように一人の詐欺師が手作業で細工する手法とは、規模感がまったく異なる。AI返金詐欺は、取引・紛争・物流・カスタマーサポートの各段階にまたがる「拡張可能な欺瞞」と呼べるレベルに達している。
この比較で示すように、詐欺の効率性と拡張性が段違いに向上した。事業者は、こうした「量産型の偽装」への耐性を今から備えなければならない。
AI詐欺に立ち向かうための対策とコスト
検知技術と審査プロセスの強化
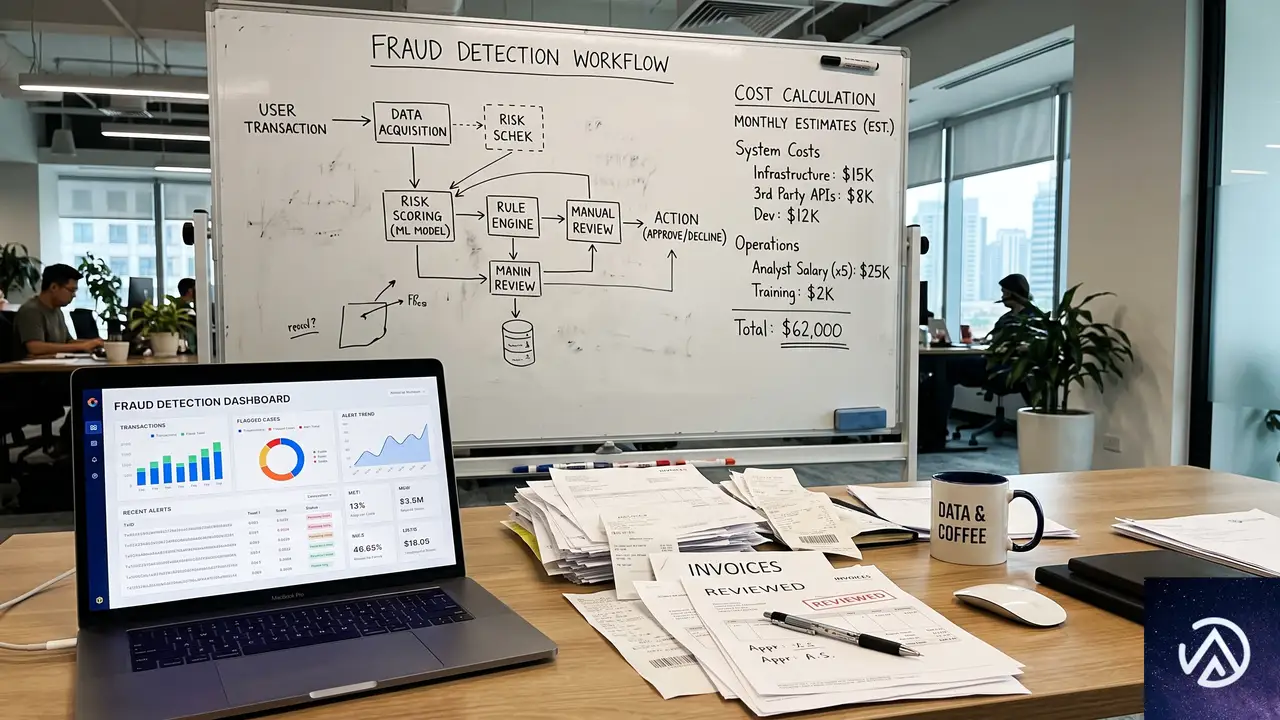
EC事業者が取れる防御策はいくつか存在する。画像のメタデータ分析や圧縮パターンの精査、逆画像検索による使い回し画像の発見、アカウントの返品履歴や行動ログのスコアリングなどは、従来からある不正検知の延長線上にある手法だ。
さらに実効性が高いとされるのは、次のような対策である。
- 商品写真を1枚だけでなく、別アングルや短い動画の提出を必須にする
- 高額商品や返品履歴に不審な動きがあるアカウントは、人手による詳細審査に切り替える
- 特定の商品カテゴリや顧客セグメントに対して、返品時に現物の返送を義務付ける
- 提出された画像をAIでスキャンし、合成や改変の痕跡を自動判定する
ただし、これらの対策にも限界はある。AIによる画像生成技術は日進月歩で進化しており、検知ツールが誤って正当な申告を不正とみなす「偽陽性」も無視できない。偽陽性が増えれば、誠実な顧客に無用な負担を強いることになり、サポートコストやブランドイメージへの悪影響につながる。
対策コストが上回るジレンマ
より深刻なのは、不正防止にかけるコストが、防げる被害額を上回ってしまうケースだ。Practical Ecommerceの記事は「3万ドルの不正を防ぐために10万ドルのコストをかけるのは無意味だ」という端的な指摘を紹介している。
厳格な返品ポリシーを設ければ、返送送料や検品費用、カスタマーサポートの問い合わせ対応が増大する。顧客満足度の低下がリピート率やLTV(顧客生涯価値)に及ぼす影響を加味すれば、単純に「不正をゼロにする」施策は経済合理性を欠くのだ。
このジレンマは、AI詐欺のコストがあまりに低いことに起因する。詐欺師側は数分で偽造証拠を作れる一方、事業者側はそれを証明するためにサポートスタッフの確認作業、倉庫記録の照合、運送会社との連携、場合によっては正式な異議申し立て手続きまでが必要になる。攻撃と防御の非対称性が、年々拡大しているのが現状だ。
攻撃側と防御側の非対称性を視覚化すると、その差は歴然としている。AIがもたらすインパクトは、単に詐欺が増えたという量的な問題にとどまらず、防御の経済性そのものを破綻させかねない質的な変化だ。
実務に落とし込む現実的なアプローチ
全件精査ではなく「優先度ベースの審査」へ
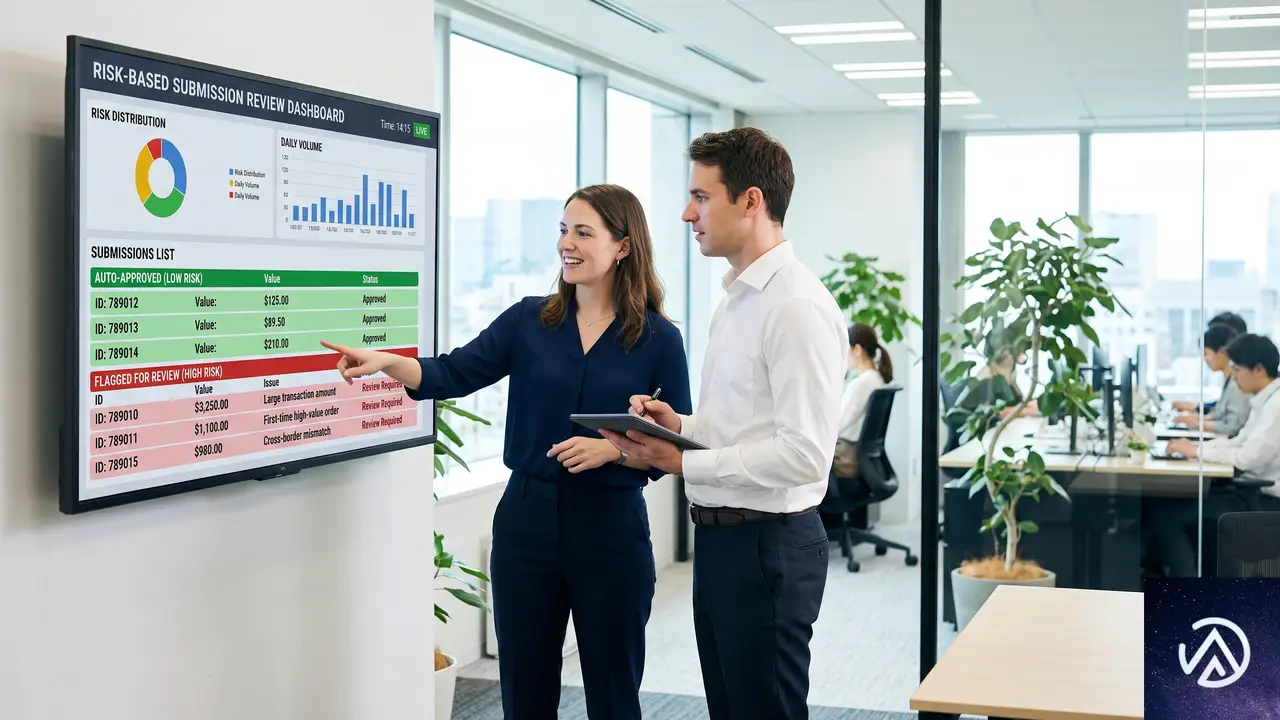
限られたリソースの中でAI詐欺に対抗するには、「全件を完璧に防ぐ」発想を手放すことが出発点になる。代わりに、不正のリスクが高い申告を優先的に精査し、それ以外はある程度の漏れを許容する設計が現実的だ。
具体的には、商品単価の高い申告、返品頻度が異常に高い顧客、新規アカウントからの高額返金申請、画像のメタデータに不自然な欠落があるケースなどをスコアリングし、閾値を超えたものだけを手動で再確認する仕組みが考えられる。これらのルールベースのフィルタは、AI検知ツールと組み合わせることで精度を上げられる。
不正対策とCXのバランス設計
返品ポリシーを厳格化するほど、一般的な顧客の購入障壁は上がる。「返品時に動画を必須とする」「返送を全商品に義務付ける」といった一律のルール変更は、CX(顧客体験)を大きく毀損し、売上全体に悪影響を及ぼす可能性が高い。
むしろ有効なのは、優良顧客と疑わしい顧客をセグメントし、前者にはこれまで通りのスムーズな返金体験を維持しつつ、後者にのみ追加の証拠提出を求める段階的なアプローチだ。購買履歴や会員登録からの経過期間、過去の返品率などは、セグメントの判断材料として実装しやすい。
また、AIによる画像スクリーニングを導入する場合も、完全自動化ではなく「疑わしい画像を人間の担当者に提示する」補助ツールとして位置づけることで、偽陽性による誤った拒否を減らせる。
この段階的なアプローチなら、防御コストを抑えつつ、AIが生成した偽装画像の多くを発見できる可能性が高まる。最初から完璧を目指さず、リスクベースでリソースを集中させる考え方こそ、AI時代の返金審査に求められる現実解である。
今後広がるAI詐欺とEC事業者の備え
画像生成AIの進化はさらに加速する
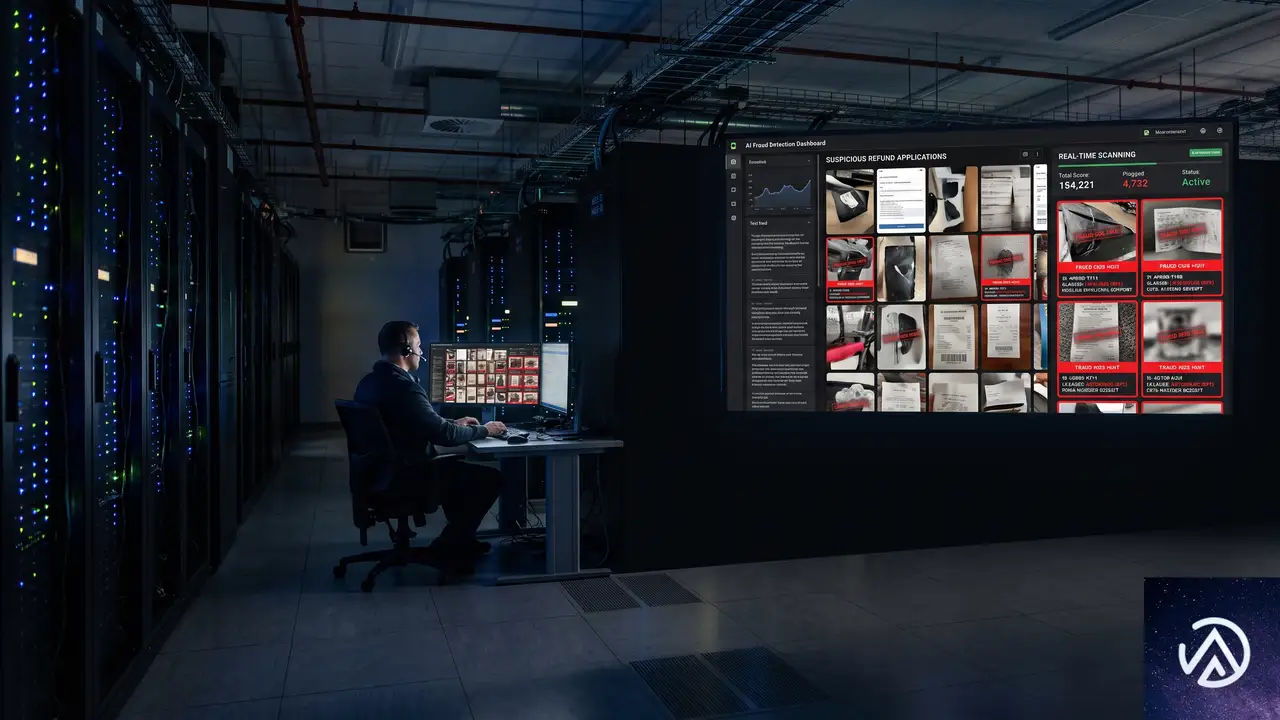
画像生成AIの品質は、ここ1〜2年だけでも目覚ましく向上してきた。指の本数に違和感が残っていた初期段階はすでに過去のものとなり、テクスチャの再現性や光の反射、被写界深度の自然さは、人間の目では実写と区別できない水準に近づいている。
音声や動画の生成技術も同時に進化しており、将来的には「壊れた商品を手にした購入者が不満を訴える短い動画」すら数クリックで捏造される可能性がある。そうなれば、動画による証拠提出ですら防御策としての有効性を失いかねない。
まずは直近の返金履歴を監査する
Practical Ecommerceの記事は「問題を認識することが戦いの半分だ」と述べ、近い時期の返金記録を精査し、AIによる偽装がすでに紛れ込んでいないか確認することを推奨している。
具体的には、過去3〜6ヶ月の返金申請から、同じような構図・影の付き方・背景の写真が複数アカウントで使われていないか、メタデータに不自然な欠落や一貫性のなさがないか、という観点でのチェックが有効だ。AI画像生成ツールは撮影機器情報やGPSタグを埋め込まないため、Exifデータの不在そのものが一つのシグナルになりうる。
AI返金詐欺はまだ黎明期にある。にもかかわらず、手口の洗練と低コスト化は予想以上の速度で進んでいる。EC事業者にとっての最善手は、抜本的な対策を急ぎつつ、経済的なバランスを冷静に見極めることだ。
この記事のポイント
- 生成AIにより、返金詐欺の証拠写真や文書が誰でも短時間で偽造できるようになった
- 「返品不要返金」のような効率重視のプロセスが、AI詐欺に悪用されやすい構造になっている
- 防御策には画像解析や動画提出の義務化があるが、偽陽性やコスト増という副作用を伴う
- 不正額を上回る防御コストをかけることは経済的に無意味であり、リスクベースの優先審査が現実解
- まずは直近の返金履歴を監査し、AIによる偽装の混入有無を確認することから始めるべきである
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google、匿名化検索データを競合と共有へ EUのDMA決定の全容
EUの欧州委員会が2026年7月16日、Googleに対して2つの拘束力のある決定を下した。検索データを匿名化した上で競合他社と共有すること、そしてAndroidの一部機能を競合AIアシスタントに開放することだ。いずれもデジタル市場法(DMA)に基づく措置である。
この決定の影響は検索エンジンにとどまらない。AIチャットボットも対象に含まれており、検索とAIが融合しつつある現在の状況において、今後の競争環境を左右する転換点となる可能性が高い。
DMAに基づく2つの決定の全体像
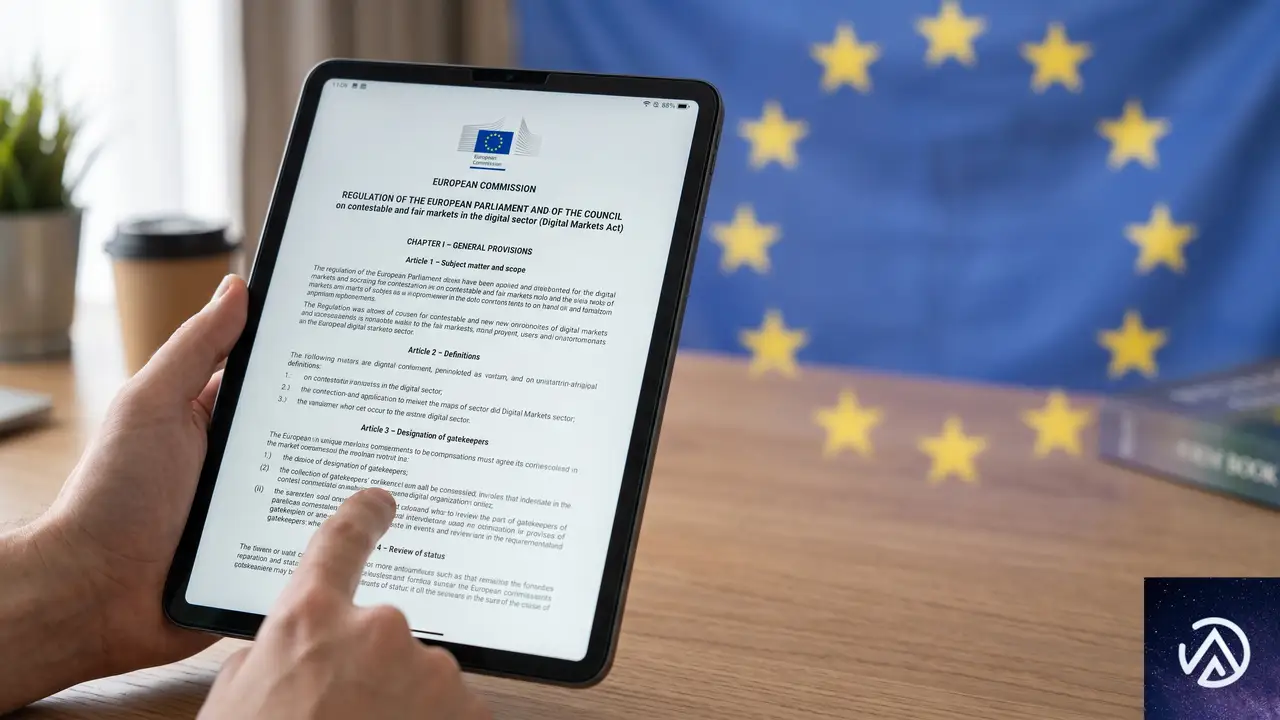
今回の決定は、欧州委員会が2026年4月に公開協議を経て暫定的な見解を示していたものを最終化した形だ。2つの柱で構成されている。
- 検索データの共有義務。Googleの検索結果に関するクエリ、クリック、閲覧、ランキング位置の匿名化データを、公正かつ非差別的な条件で競合に提供すること
- AndroidのAI相互運用性の確保。競合AIアシスタントが音声起動やアプリ内操作を実行できるよう、OSレベルの機能を開放すること
違反時の罰金を伴う独占禁止法の案件とは異なり、DMAに基づく今回の措置は構造的な是正を目的とする。欧州委員会は、Googleの現在のデータ共有の取り組みは不十分だと明確に指摘している。
この図で示した通り、データ共有の枠組みが整うことで、競合検索エンジンやAIチャットボットはGoogleが長年かけて蓄積してきた規模の検索インタラクションデータを活用できるようになる。
検索データ共有の具体的な仕組みと対象範囲
共有されるデータの内容
共有対象となるのは、Google検索の無料・有料を問わずすべての検索結果から生成される匿名化データである。具体的には以下の情報が含まれる。
- 検索クエリ(ユーザーが入力した検索語句)
- メタデータ(使用言語、デバイスの種類)
- 表示されたURL一覧
- ユーザーのクリックや閲覧といったインタラクション情報
- 検索結果内での表示位置(ランキング)
一方で、Googleのランキングアルゴリズムそのものは共有対象外だ。また個人を特定できる情報(アカウント詳細、検索履歴、タイムスタンプ、極端に稀または長大なクエリ)は除外される。
利用資格と審査プロセス
このデータを利用できるのは誰でもない。欧州委員会が定めた要件を満たす必要がある。
- EU圏内で月間5万人以上のユーザーを持つこと
- 2年以上の事業運営実績があること。新規参入企業の場合は投資実績による代替審査を受けること
- セキュリティ審査と独立監査を通過すること
これらの条件をクリアした事業者のみが、Googleとライセンス契約を結びデータの提供を受けることができる。データ価格は市場レートではなくコスト回収ベースで算定される。
AIチャットボットについても、DMA上でオンライン検索エンジンと見なされるものは利用資格がある。ただしデータの用途は、自社の検索・ランキングシステムの改善に限定され、汎用AIモデルの学習やGoogleの検索結果の複製には使用できない。
AI検索時代におけるデータの重要性
この決定が単なる検索エンジン間の競争を超えた意味を持つのは、AIチャットボットが回答を生成する仕組みと深く関わるからだ。
グラウンディングと検索データ
AIチャットボットが正確な回答を返すためには「グラウンディング(事実確認のための根拠付け)」と呼ばれるプロセスが欠かせない。最新のWebデータを参照し、回答の確からしさを検証する仕組みだ。
Googleは自社のAIに対して「FastSearch」というシステムでグラウンディングを行っている。これはGoogle自身の検索ランキング信号に依存する仕組みであり、当然ながら競合には提供されていなかった。
今回の決定で共有される匿名化データ(クエリ、クリック、閲覧、結果位置)は、競合各社が独自の情報検索・ランキングシステムを構築するための材料となる。グラウンディングもこの用途の一つとして認められている。
検索トラフィックへの影響は限定的か
短期的に見れば、Webサイト運営者が感じるトラフィックへの影響は限定的だろう。SE Rankingのデータによると、2026年1月時点で全AIプラットフォームを合わせた紹介トラフィックは、世界のインターネットトラフィック全体の約0.24%に過ぎない。
データへのアクセスが改善されれば競合エンジンやチャットボットの開発が進む可能性はあるが、それだけでユーザーの検索行動が一気に変わるわけではない。重要なのは、このデータを実際に製品開発に活かせるかどうかだ。
AndroidのAIアシスタント開放
2つ目の決定はAndroidに関するものだ。GoogleはOSレベルの機能を競合AIアシスタントに開放する義務を負う。
- ユーザーが「Hey Google」のような音声コマンドで競合アシスタントを起動できるようにすること
- 競合アシスタントがアプリ内で動作し、タクシーの予約や返信文の作成といった操作を実行できるようにすること
Google自身のGeminiアシスタントはすでにこのレベルのアクセス権を持っている。今回の決定はこの非対称性を是正するものだ。
主な機能の実装期限は次期メジャーリリースのAndroid 18、遅くとも2027年8月1日までとされている。複数のアシスタントが異なるウェイクワードで同時応答できる機能にはさらに1年の猶予が与えられ、2028年8月1日が期限となる。
Googleの反応とプライバシーをめぐる議論
Googleは両方の決定に反対の立場をとっている。Alphabetのグローバル問題担当プレジデントであるKent Walker氏は公式ブログで、「数百万人の欧州市民にとって不可欠なプライバシーとセキュリティの防御線を損なうリスクがある」と表明した。
同氏はまた、GoogleがDMAの目的に沿った解決策を繰り返し提案してきたことも強調している。検索データの共有については、適切な匿名化やユーザーの知識・同意なしに、欧州の検索データが見知らぬ企業に開示されることへの懸念を示した。
これに対し欧州委員会は、匿名化のプロセスが多層的な技術処理と契約上の保護措置で構成されており、内部および外部のプライバシー専門家の関与のもとで開発されていると説明する。Googleはデータ共有前にサイバーセキュリティやデータ保護の基準に基づいて申請者を審査できる。独立したテストで保護措置が不十分と判明した場合は、措置の見直しも可能だ。
今後の展開とスケジュール
2026年後半は、Googleがデータセットの整備と提供条件の策定に費やす期間となる。価格提案の期限は遅くとも2027年1月だ。各事業者はライセンス契約と価格合意を経て、それぞれのスケジュールでデータ提供を受けることになる。
Android側の主な変更は2027年8月1日、複数アシスタントの同時音声起動は2028年8月1日が期限だ。欧州委員会はこれらの措置を2年ごとに見直し、匿名化が不十分と判断されれば再検討を行うとしている。
この決定が実際に検索エンジンやAIチャットボットの多様化を促すかどうかは、資格審査を通過する事業者の顔ぶれと、提供されたデータをどれだけ製品開発に活かせるかにかかっている。すぐに目に見える変化はないが、中長期的には検索とAIの競争環境を変える可能性を秘めた決定と言えるだろう。
この記事のポイント
- EU欧州委員会がDMAに基づき、Googleに匿名化検索データの共有とAndroidのAIアシスタント開放を義務付ける決定を下した
- 共有対象はクエリ・クリック・閲覧・結果位置のデータで、ランキングアルゴリズム自体は対象外。AIチャットボットも利用資格あり
- Googleはプライバシーとセキュリティへの懸念を表明しているが、欧州委員会は多層的な匿名化と審査プロセスで対応
- 短期的な影響は限定的だが、中長期的には検索とAIの競争環境に変化をもたらす可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Runのマルチリージョン高可用性が強化、障害検知と自動復旧が数秒単位に
発表の概要

Google Cloudは2026年7月20日、Cloud Runにおけるマルチリージョン高可用性の機能強化を発表した。ミッションクリティカルなアプリケーションのダウンタイムは、企業の収益や評判に直結する問題だ。これに対処するため、Cloud Runは単一コマンドで複数リージョンに同一サービスを展開できる設計をとってきたが、今回のアップデートで障害検知と自動復旧の精度が大幅に向上している。
新たに導入された機能は「Readiness Probe」と「Service Health」の2つだ。インスタンスレベルの死活監視とリージョンレベルの健全性評価を組み合わせることで、リージョン障害が発生した際のトラフィック迂回が数秒単位で自動化される。
マルチリージョン高可用性を支える2つの新機能

Readiness Probeの役割は「個々のコンテナが外部リクエストを受け付けられる状態か」を確認することだ。この結果はCloud Runコンソールからもリージョン別に確認でき、どのリージョンでインスタンスが縮退しているかが一目で分かる。
Service Healthはこのプローブ結果をリージョン単位で集約するレイヤーにあたる。複数のヘルスチェック結果を「そのリージョンが正常に稼働しているかどうか」というひとつの評価に落とし込み、グローバルロードバランサがこの評価に基づいてルーティングを切り替える。この仕組みにより、障害発生時の手動オペレーションが原則不要になる。
パブリックとプライベートで異なる自動フェイルオーバーの経路

自動フェイルオーバーを実現するには、トラフィックが流入してくるネットワーク層によってロードバランサの種類を選択する必要がある。Cloud Runは外部向けと内部向けで最適なバランサ構成を用意している。
この構成の利点は、どちらのパターンでもロードバランサ側が自動でService Healthを参照し、異常リージョンをルーティング対象から外してくれる点にある。手動でのDNS切り替えや手作業によるトラフィック操作が不要になるため、復旧までの時間が大幅に短縮される。
設計段階で押さえるべき3つのポイント

Service Healthの活用を前提にマルチリージョン構成を設計する際、見落としやすい検討項目が3つある。いずれも高可用性に直結するため、初期段階で整理しておくことが望ましい。
単一障害点をなくすには、インフラ層だけでなくアプリケーション自体のステートレス設計が前提になる。データ層を別途冗長化し、ロードバランサの背後で自由にインスタンスを入れ替えられる状態を作っておくことが、Cloud Runのマルチリージョン構成を最大限活かす秘訣だ。
利用開始とコスト
Cloud Runのマルチリージョン高可用性に関する一連の機能は、すでに全リージョンで利用可能だ。Service Healthの機能そのものに追加料金は発生しない。Readiness Probeの実行に伴う標準的なCPU・メモリ消費のみが課金対象となる。
導入にあたっては、既存のCloud RunサービスにReadiness Probeを設定し、Service Healthを有効にしたうえで適切なロードバランサに接続するだけでよい。公式ドキュメントにチュートリアルが用意されており、少ないステップでマルチリージョン高可用性の基盤を整えられる。
この記事のポイント
- Readiness Probeがコンテナ単位の死活監視を行い、Service Healthがリージョン単位の健全性を可視化する
- Serverless NEGを通じてグローバルロードバランサに健全性が通知され、障害リージョンを数秒で自動迂回する
- パブリック向けは外部ALB、VPC内向けは内部ALBを選択すれば、どちらも自動フェイルオーバーに対応可能
- DB層を含めた全レイヤーでの冗長化と、データレプリケーションの方針決定が設計の鍵を握る
- 機能追加に伴う追加コストはなく、通常のリソース消費のみで全リージョンですぐに利用を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

grüumがShopifyとMagentoを評価しWooCommerceを選んだ理由
イギリス発のスキンケアブランド「grüum(グルーム)」は、月間8万件の注文を1人のフルタイム開発者で処理する。2023年、彼らは成長に伴い「WooCommerceでこのまま進むべきか」を再検討した。Shopify PlusとMagento(Adobe Commerce)を4か月かけて評価した結果、grüumはWooCommerceに残る決断を下した。
その背景には、複雑な商品構成を維持するための柔軟性、サブスクリプション収益に比例する手数料の回避、そして顧客データの完全な所有権があった。本記事では、月間8万件規模のEC事業者が下したプラットフォーム選定の判断基準を具体的に解説する。
grüumのビジネスモデルと商品構成の複雑さ

grüumは2016年、英国とオランダで活動する4人の同僚によって設立された。当初は男性向けスキンケアとシェービング製品を中心に約10商品でスタートしたが、現在では年齢や性別を問わず使えるスキンケア、ヘアケア、ボディケア、シェービング製品を展開する。売れ筋はシャンプーバーで、累計数百万個を販売している。
製造は英ストックポートの自社工場で一貫して行い、化粧品科学者も社内に抱える。段ボール包装の徹底、水を使わない製剤、天然成分の使用など、サステナビリティを製品開発の中心に据えている点が特徴だ。
300SKUを支える特殊なバンドル構造
grüumは約300SKUの商品を扱い、単品購入、定期購入(サブスクリプション)、そして独自の組み合わせが可能なバンドル販売を提供している。共同創業者のBethanie Sleigh氏は「私たちは製品の設定方法に多くの独自の仕組みを持っている」と語る。彼らの商品バンドルは「内容物、価格設定、在庫管理」を1つの設定単位として扱う必要がある。
具体的には、顧客は石鹸セットを購入した上で別の製品を追加したり、個別の製品を定期購入に切り替えて割引を受けたりできる。このような複雑な商品構成は、標準的なECプラットフォームの枠組みでは再現が難しい。
オープンソースであるWooCommerceは、条件付きロジックを必要とするバンドル機能があれば、拡張機能を導入するか開発者が独自に作成できる。ほとんどのEC事業者には不要な機能でも、特殊なカタログ構造を持つブランドにとっては事業形態を変えずに販売を継続できることを意味する。
Shopify Plusがgrüumのビジネスに合わなかった理由

grüumが最初に評価したShopify Plusは、ホスティングやセキュリティをプラットフォーム側で管理するSaaS型ECの代表格だ。しかし、grüumの複雑な商品構成を前にして、Shopify Plusではビジネス側をプラットフォームに合わせる必要があった。
プラットフォームに事業を合わせるのか、事業にプラットフォームを合わせるのか
共同創業者のSimon Leonard氏は「Shopify Plusに移行するなら、私たちのビジネスをプラットフォームに合わせて変えなければならなかった」と振り返る。WooCommerce Blogの記事によれば、grüumのバンドル構造(内容物、価格設定、在庫管理を1つの設定単位として扱う)はShopify Plusではネイティブにサポートされていなかった。
この制約は、EC事業者にとって重要な分岐点を浮き彫りにする。プラットフォームのデフォルト機能から外れた運用をしている場合、SaaS型では「ビジネスを変える」か「高額なカスタム開発に投資する」かの二択になりがちだ。WooCommerceはオープンソースであるため、プラットフォームを事業に合わせて拡張できる。Leonard氏は「私たちはWooCommerceを自分たちのビジネスに合わせて機能させることができる。原則を変える必要はない」と結論づけた。
サブスクリプション収益に比例する手数料の重み
grüumにとってサブスクリプション(定期購入)は重要な収益源だ。全収益の10%を占め、平均継続期間は30か月に達する。この定着率の高さゆえに、サブスクリプションのインフラコストは事業の収益性を大きく左右する。
Shopifyはサブスクリプション収益に対して売上の一定割合を手数料として課金する。Leonard氏が試算したところ、サブスクリプション経由で100万ポンド(約1.9億円)から1,000万ポンド(約19億円)の売上がある場合、年間10万ポンド(約1,900万円)規模の手数料が発生する計算になる。
一方、WooCommerce Subscriptionsは定額制の年間ライセンス料で提供される。grüumの規模では、Shopifyの従量課金モデルと比較して大幅なコスト削減につながる。これは「成長すればするほど手数料が増える」モデルと「成長しても固定費で済む」モデルの構造的な違いだ。
この料金体系の違いは、月間8万件の注文を処理するEC事業者にとって年間数百万円規模のコスト差を生む。WooCommerce Blogの記事でも、Leonard氏が「サブスクリプションで100万ポンドや1,000万ポンドの売上があると、すぐに年間10万ポンドの出費になる」と試算したことが紹介されている。
Magento(Adobe Commerce)の運用負荷とコスト構造

grüumが次に評価したMagento(現在のAdobe Commerce)は、エンタープライズ向けの高度なカスタマイズ性を持つオープンソースプラットフォームだ。Shopify Plusとは異なり、Magentoは拡張性の面ではgrüumの要件を満たす可能性があった。
専任の技術チームが不可欠な運用現実
しかし、Magentoの運用には相応の技術リソースが必要になる。サーバー管理、パフォーマンスチューニング、セキュリティパッチ適用、バージョンアップ対応などを継続的に行うには専任の技術スタッフが欠かせない。Leonard氏は「ウェブサイトを運営するために20人のチームを雇うつもりはなかった」と語っている。
grüumの開発チームはフルタイム1人とパートタイムのQAテスター1人という最小構成で運営されている。Magentoの運用に必要なリソースは、この体制では経済的に成立しなかった。拡張性の高さと引き換えに、運用負荷とインフラコストが大きく跳ね上がる点が決定的なマイナス要因となった。
これは中規模EC事業者にとって重要な示唆だ。機能の豊富さや拡張性だけでプラットフォームを選ぶと、運用フェーズで想定外のコストが発生する。自社の技術リソースと運用体制を正確に見積もった上で判断する必要がある。
この比較から見えるのは、ECプラットフォーム選定において「機能の多さ」よりも「自社の運用体制に合うか」が重要だということだ。grüumはMagentoの拡張性を評価しつつも、1人体制で回せる軽量な運用を優先した。
1人の開発者で月間8万件を処理できる運用設計

grüumのWebサイトは、フルタイム開発者1人とパートタイムのQAテスター1人で運用されている。小規模なコンテンツチームが商品登録、ページ作成、日々のコンテンツ更新を担当し、開発者の手を借りることはほとんどない。
非エンジニアが自律的に運営できるツール選定
コンテンツチームはページ作成にGutenberg(WordPressのブロックエディタ)、ナビゲーション管理にMax Mega Menu、SEO対策にYoast SEOを使用している。商品リスティング、プロモーション、季節ごとの更新はすべて開発者の介在なしで完了する。
この分業が成立するのは、WordPressエコシステムに成熟したノーコードツールが豊富に存在するからだ。grüumの開発者は、ルーチン作業ではなく顧客体験の改善や新機能の開発に集中できる。WooCommerce Blogの記事によれば、CTOの試算では「以前なら1年かかっていたタスクがWooCommerceなら1か月で完了する」という。開発速度の差はそのままコスト削減と市場投入の迅速化につながる。
決済基盤としてのWooPayments
決済についても、grüumはWooCommerceネイティブのWooPaymentsを選択した。外部の決済サービスを別途契約するのではなく、WooCommerceに統合された決済基盤を使うことで管理の一元化と手数料の最適化を図っている。プラットフォームと決済が分離していると、売上データの突合や手数料計算が複雑化するが、統合されていれば管理負荷が大幅に下がる。
この構成図からわかるように、grüumの運営は「開発者がルーチン作業から解放されている」点が最大の強みだ。コンテンツチームが自律的に動けるツールを選び、開発者は成長のための改善に専念する。この分業設計が1人体制での月間8万件処理を可能にしている。
データ所有権がもたらす事業の独立性

grüumがWooCommerceに残る決断をした理由の最後の1つが、データ所有権だ。SaaS型ECプラットフォームでは、顧客データや購買履歴はプラットフォーム側のデータベースに保存され、事業者が自由にアクセスできるとは限らない。移行時にはデータのエクスポートに制限があったり、追加費用が発生したりするケースもある。
30か月の顧客関係を自社で保有する意味
grüumのサブスクリプション顧客の平均継続期間は30か月だ。この間に蓄積された購買履歴、好み、購買パターンは、マーケティング戦略の基盤となる重要な資産である。Leonard氏はWooCommerce Blogの記事で「データは私たちのものだ。他のサブスクリプションプラットフォームとは大きく異なる。顧客をサードパーティに渡すのではなく、自分たちで管理できる」と述べている。
オープンソースのWooCommerceでは、データベースは事業者のサーバー上に存在する。仮に将来プラットフォームを移行する場合でも、データを完全な形でエクスポートできる。これはSaaS型プラットフォームにはない構造的な優位性だ。特にサブスクリプションモデルで長期的な顧客関係を構築しているEC事業者にとって、データアクセスの制限は重大な事業リスクになる。
データ所有権の問題は、短期的なコスト比較では見落とされがちだ。しかし、サブスクリプション事業のように顧客との長期関係が収益の柱となるビジネスモデルでは、データの可搬性とアクセス権が戦略的な価値を持つ。grüumの判断は、この点を明確に意識したものと言える。
この記事のポイント
- grüumは月間8万件の注文を1人の開発者で処理する中規模EC事業者であり、Shopify PlusとMagentoを評価した結果WooCommerceに残る決断を下した
- 複雑な商品バンドル(内容物、価格設定、在庫管理の一元設定)はShopify Plusではネイティブにサポートされず、ビジネス側をプラットフォームに合わせる必要があった
- サブスクリプション収益に対する従量課金(Shopify)と定額制(WooCommerce)の差は、年商1,000万ポンド規模で年間約10万ポンドのコスト差を生む
- Magentoは拡張性は高いが、運用に専任の技術チームが必要で、grüumの1人体制では経済的に成立しなかった
- オープンソースのWooCommerceはデータベースを事業者が完全に所有でき、顧客データの可搬性とアクセス権がSaaS型よりも優位
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google NotebookLMがGemini Notebookに改称、AIスクレイピング対策の緊急対応
Googleが研究支援ツールNotebookLMをGemini Notebookに改称した。実体は同じだが、このタイミングでユーザーエージェントの表記が「Google-NotebookLM」から「Google-GeminiNotebook」に変更される。旧ユーザーエージェントは2026年8月をもって廃止されるため、サイト運営者は数週間のうちにスクレイピング対策の見直しを迫られている。
今回の変更は単なる名称の刷新にとどまらず、AIによる自動コンテンツ収集と再利用のリスクを改めて浮き彫りにする。本記事では、Gemini Notebookのスクレイピング機能の実態、robots.txtを無視するユーザートリガー型フェッチャーの仕組み、そして具体的なブロック手法を簡潔にまとめる。
NotebookLMがGemini Notebookに改称、機能は変わらず
名前変更の背景と影響
2026年7月18日、Googleはユーザートリガー型フェッチャーのドキュメントを更新し、NotebookLMをGemini Notebookに置き換えた。ブランド統合の一環であり、既存のNotebookLMユーザーにとって使い勝手に違いは生じない。
しかし、サイト運営者にとって重大なのは、旧ユーザーエージェント「Google-NotebookLM」が2026年8月で無効になる点だ。ファイアウォールや.htaccessにこの文字列を直書きしている場合、猶予期間内に新しいユーザーエージェントへ切り替えなければ、ブロックが機能しなくなる。
Gemini Notebookの主な機能
Gemini Notebookは、ユーザーが提供した文書やURLを「グランドトゥルース(信頼できる基盤情報)」として扱い、AIが調査や学習を支援するマルチモーダルツールだ。YouTubeの動画や音声ファイルを取り込んで分析することも、逆にアップロードされた資料を音声ポッドキャストや動画解説に変換することもできる。
この「資料をもとに新しいコンテンツを自動生成する」という特徴が、後述するスクレイピング問題の根本にある。生成された音声や動画がオンラインで公開されれば、元の記事と直接競合する可能性があるからだ。
Gemini Notebookが引き起こすスクレイピング問題
Discover Sourcesによる自動スクレイピング
Gemini Notebookの「Discover Sources」機能は、ユーザーが設定したクエリやテーマに沿って最大10件のオンライン記事を自動で収集し、AI要約を生成する。問題は、サイト所有者の許可を一切取らずにクローリングが行われ、参照元へのリンクも一切発生しない点だ。
従来の検索エンジンであれば、クローラーが収集した情報は検索結果としてユーザーをサイトへ誘導する。しかしGemini Notebookの要約はクローズドな環境で完結し、トラフィックの恩恵は元サイトに還元されない。SEOの観点からは、コンテンツが無断で「搾取」される構造といえる。
音声・動画コンテンツの自動生成と競合
さらに、アップロードした資料からポッドキャストや動画解説を生成できる点も看過できない。仮に自社サイトの記事が材料に使われ、第三者が公開すれば、同一テーマでオリジナルと競合する二次コンテンツが無数に生まれる危険がある。
Googleのドキュメント上、これらは「ユーザー調査のための機能」と位置づけられているが、実質的には許可なきスクレイピングとリパーパス(再利用)を自動化する仕組みにほかならない。コンテンツを資産とするウェブサイト運営者にとって、対策は急務だ。
緊急対応すべきブロック手法
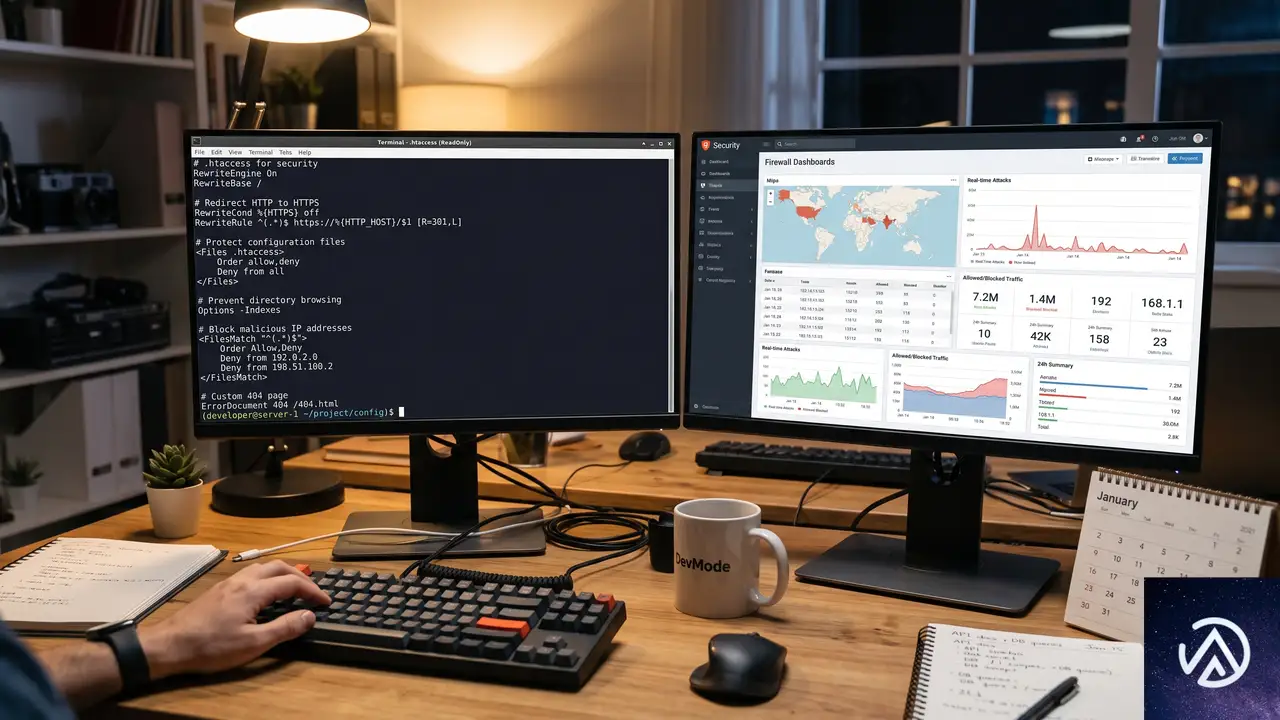
ユーザートリガー型フェッチャーとは
Gemini Notebookのクローラーは「ユーザートリガー型フェッチャー」に分類される。これは、ユーザーが明示的に指示(URL貼り付けやDiscover Sourcesの実行)をトリガーとして起動するため、robots.txtの指示に従わない。robots.txtはあくまで紳士協定であり、一般的なクローラーは自発的に従うが、ユーザートリガー型には適用されないのだ。
ただし、robots.txtが効かないからといって手立てがないわけではない。サーバー側でHTTPリクエストのユーザーエージェント文字列を検査し、該当するアクセスを拒否することは可能である。
.htaccessによる具体的なブロック例
多くのレンタルサーバーで使えるApache環境であれば、.htaccessに以下のルールを追記するだけでGemini Notebookのアクセスを遮断できる。
RewriteEngine On

# Gemini Notebookのユーザーエージェントをブロック
RewriteCond %{HTTP_USER_AGENT} Google-GeminiNotebook [NC]
RewriteRule ^ - [F,L]
この設定により、該当のユーザーエージェントを含むすべてのリクエストに対して「403 Forbidden」が返される。Nginxを利用している場合は、if ($http_user_agent ~* "Google-GeminiNotebook") { return 403; } のような記述で同様の制御が可能だ。
重要なのは、新旧両方のユーザーエージェントをカバーするか、あるいは直ちに新UAのみに移行することである。2026年8月以降、旧UAはGoogle側で廃止されるが、それまでにサイト側のルールを更新しておかなければ、一時的にブロックがすり抜けるリスクが生じる。
旧ユーザーエージェントの猶予期間と注意点
Googleはドキュメント内で、旧ユーザーエージェント「Google-NotebookLM」を2026年8月までサポートすると明記している。ハードコードしているサイト運営者は、この期間内に新しい文字列へ切り替える必要がある。
なお、合わせて「Project Mariner」に関する記述がドキュメントから完全に削除された。同プロジェクトは2026年5月に終了しており、混乱を避ける意味でも、ユーザーエージェント周辺の情報は最新版を参照すべきである。
この記事のポイント
- NotebookLMはGemini Notebookに改称され、ユーザーエージェントが変更された
- Discover Sources機能が許可なく記事を収集し、AI要約や音声コンテンツを生成する
- ユーザートリガー型フェッチャーはrobots.txtを無視するが、ファイアウォールや.htaccessでブロック可能
- 旧UA「Google-NotebookLM」は2026年8月に廃止、既存のルールを直ちに更新する必要がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
bot判定画面が原因でGoogleインデックスから消える?セキュリティ対策の盲点と解決策
Webサイトの安全を守るセキュリティ対策が、意図せず検索順位を急落させる原因になっているかもしれない。不審なアクセスを防ぐための「bot判定画面」が、Googleの巡回を妨げる事例が報告されている。
この問題が発生すると、検索エンジンにページが登録されなくなったり、他サイトのコピーとして処理されたりするリスクがある。サイト運営者が気づかないうちに進行する、セキュリティとSEOの衝突について詳しく解説する。
bot判定画面がGoogleインデックスからページを消し去る仕組み
サイトのセキュリティを強化すると、不正なアクセスやスパムを遮断できる。しかし、その防御壁がGoogleのクローラー(検索エンジンの巡回ロボット)まで阻んでしまうことがある。これがインデックス消失を引き起こす引き金だ。
不審なアクセスと判定されたGooglebot
クローラーとは、世界中のWebサイトを巡回して情報を集める自動プログラムのことだ。Googleが派遣するクローラーは「Googlebot(グーグルボット)」と呼ばれる。通常、このGooglebotはサイトのコンテンツを自由に読み取れる必要がある。
しかし、サイトのセキュリティフィルターがGooglebotのアクセスパターンを「不審な自動プログラム」と誤認することがある。その結果、本来のコンテンツの代わりに「私はロボットではありません」という確認を求める画面を返してしまう。この画面は一般に「インターシャルページ」や「bot判定画面」と呼ばれるものだ。
重複コンテンツとして処理されるリスク
Googlebotがサイトを巡回した際、どのページにアクセスしても同じ「bot判定画面」が返ってくると、検索エンジンは混乱する。すべてのページの中身が同一であると判断してしまうからだ。
Search Engine Journalの記事で紹介されたGoogleのJohn Mueller(ジョン・ミューラー)氏の解説によると、このような状況ではGoogleは複数のページを「重複コンテンツ」として処理する。さらに、他の多くのWebサイトでも同じセキュリティサービスのbot判定画面が使われているため、Googleはそれらをすべて同じグループとみなしてしまう。最悪の場合、他人のサイトのページが本物(正規バージョン)と判定され、自サイトのページが「コピー」として検索結果から排除される事態に陥る。
上の図が示すように、セキュリティが強すぎるあまりGooglebotを一般の不審なアクセスと区別できなくなると、検索エンジンにはエラー画面しか届かなくなる。
なぜサイト運営者はこの問題に気づきにくいのか
この問題の最も恐ろしい点は、サイトの管理者が普通に自分のサイトを閲覧しているだけでは、異常に全く気づけないことだ。問題が静かに進行し、検索順位が落ちて初めて事態を把握することになる。
一般ユーザーには正常に表示される罠
bot判定画面は、すべての訪問者に表示されるわけではない。セキュリティシステムが「怪しい」と判定したアクセスに対してのみ表示される。サイト運営者や一般的なファンがパソコンやスマートフォンからアクセスする場合、通常は信頼できるアクセスとして処理されるため、何の問題もなくサイトが表示される。
そのため、運営者が「今日もサイトはきれいに表示されている」と思っていても、Googlebotだけは裏でブロックされ、エラー画面を見せられ続けているというねじれ現象が起きる。これが発見を遅らせる最大の原因だ。
Search Consoleで異常を検知する方法
この問題を検知するには、Googleが公式に提供している無料ツール「Google Search Console(グーグルサーチコンソール)」を活用するしかない。具体的には以下のステップで確認を進める。
- 「ページ」レポートを開き、エラーの推移を確認する
- 「重複コンテンツ」や「送信されたURLが正規URLとして選択されていません」というステータスが急増していないかチェックする
- 不審なページの「URL検査」を実行する
- Googleが選択した正規URLの項目を確認し、自分のドメインとは異なる見知らぬ外部サイトのURLが登録されていないか確認する
もしURL検査の結果、Googleが選択した正規URLに他人のサイトが指定されていた場合、自サイトのbot判定画面が他サイトのそれと「同一の重複コンテンツ」とみなされた可能性が極めて高い。
セキュリティ対策とクローラー巡回の衝突
なぜこのような誤判定が起きるのだろうか。それは、Webサイトを高速化・安全化するためのインフラの仕組みに関係している。
CDNやホスティングによる自動ブロック
多くのWebサイトは、CDN(コンテンツ配信ネットワーク)やホスティングサーバーが提供するセキュリティ機能を利用している。CDNとは、世界中に配置されたサーバーを経由してサイトの表示を高速化し、同時に不正なアクセスからサイトを守る仕組みだ。
これらのセキュリティシステムは、短時間に大量のアクセスを行う接続元を自動的に検知し、アクセス制限をかける。Googlebotはサイト内の多くのページを素早く巡回するため、クローラーの活動が活発になったタイミングで、セキュリティシステムが「DDoS攻撃(サーバーに過剰な負荷をかける攻撃)」や「不正な情報引っこ抜き」と誤認してブロックを起動してしまうのだ。
「エラーコードなし」でコンテンツが空になる現象
この問題がさらに厄介なのは、サーバーが「アクセス拒否」を示すエラーコード(403 Forbiddenなど)を返さないケースがある点だ。セキュリティシステムによっては、接続自体は「200 OK(正常に通信完了)」として処理し、画面の見た目だけをbot判定画面に差し替える。
Googleのクローラーは「通信は成功した」と受け取るため、壊れたページとして処理せず、そのままbot判定画面のテキストをインデックスしてしまう。過去にも、セキュリティ設定がGooglebotのアクセスを静かに遮断し、中身が全くない状態でページが登録されるトラブルが報告されている。通信の成否だけを監視する単純なチェックツールでは、この異常を検出できない。
通信自体が「正常終了」とみなされるパターンBの場合、システム監視をすり抜けてしまうため、SEOに深刻なダメージを与えるまで放置されやすい。
検索順位を守るための具体的な解決手順
もしSearch Consoleで「重複コンテンツ」のエラーを発見したり、特定のページがインデックスから消えていることに気づいたりした場合は、迅速な対処が必要だ。
セキュリティ設定のホワイトリスト化
根本的な解決策は、導入しているセキュリティサービスやCDN、ホスティングサーバーの設定を見直すことだ。Googlebotなどの主要な検索エンジンクローラーを「ホワイトリスト」に登録し、bot判定の対象から除外する設定を行う。
多くの大手セキュリティサービス(Cloudflareなど)には、検索エンジンのクローラーを自動的に認識して通過させる機能が標準で備わっている。この機能がオフになっていないか、またはカスタムルールによって上書きされてブロックされていないかを確認する必要がある。設定が難しい場合は、セキュリティの担当者やサーバーのサポート窓口に相談することを推奨する。
修正後の再クロール申請
ブロック設定を解除した後は、Googleにサイトが修正されたことを伝える必要がある。これを放置すると、Googleが次の巡回を行うまでエラー状態が維持されてしまう。
具体的には、Search Consoleを開き、該当するエラーレポート内にある「修正を検証」ボタンをクリックする。これにより、Googleに対して優先的な再クロールをリクエストできる。また、特に検索トラフィックにとって重要なページがある場合は、「URL検査」ツールから個別に「インデックス登録をリクエスト」を送信すると、より早く検索結果に復帰させることができる。
この記事のポイント
- セキュリティ対策のbot判定画面が、Googleクローラーの巡回を遮断することがある
- Googlebotがブロックされると、サイト内の全ページが「同じエラー画面」になり重複コンテンツとみなされる
- 他サイトの同じエラー画面と同一視され、最悪の場合は他サイトのコピー扱いとしてインデックスから消える
- 一般ユーザーには正常に表示されるため気づきにくく、Search Consoleでの定期的なエラー確認が必須となる
- 解決には、CDNやサーバーのセキュリティ設定でGooglebotをホワイトリストに登録し、修正後に再クロールを申請する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google AI OverviewsにTop Stories表示、米国モバイルで本格展開
Google AI Overviewsにニュース表示機能が本格実装、Top Storiesが米国モバイルで展開開始
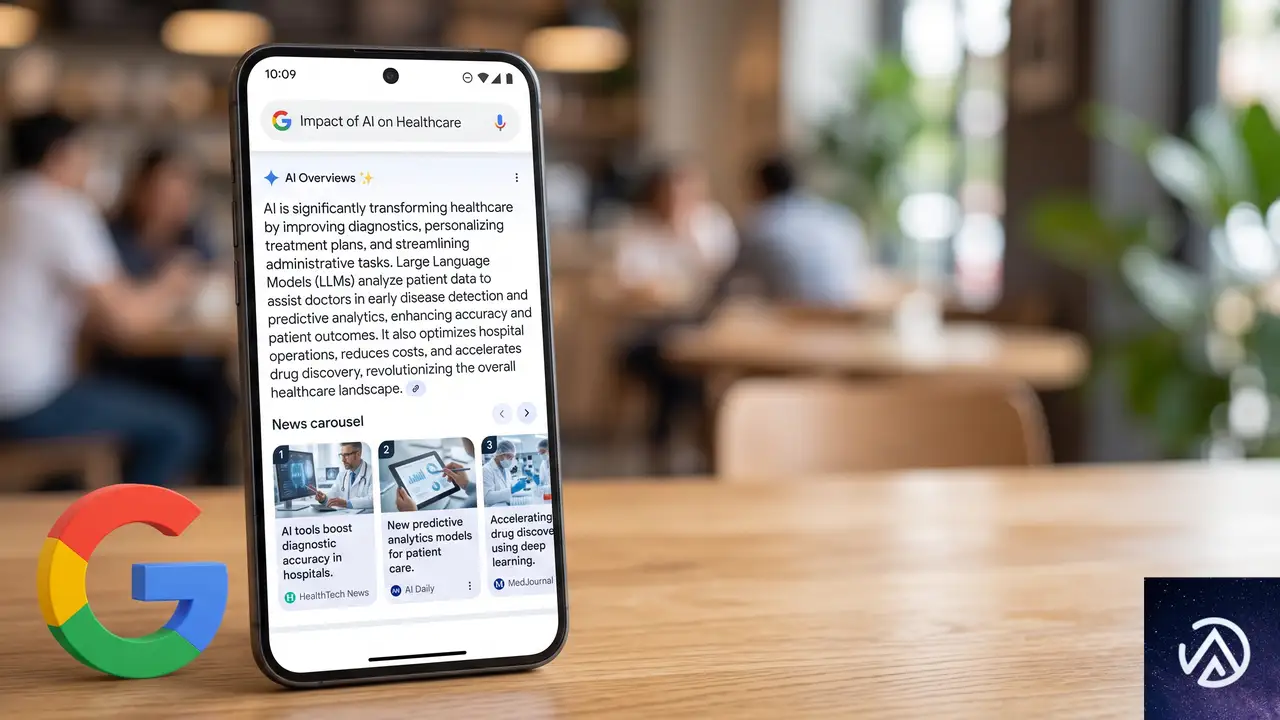
Googleが2026年7月中旬、検索結果のAI Overviews内にニュースとTop Storiesを表示する機能の本格展開を開始した。米国モバイルユーザー向けに完全展開されており、今後対象地域が拡大される見込みだ。
この機能は2026年5月にGoogleが発表した「AI Overviewsにおける新鮮な視点、最新情報、目立つリンク」構想の一環として導入された。発展中のトピックに関する質問に対し、タイムリーな記事をより目立つ形で表示するキャッセル形式を採用する。
Googleの広報担当者はこの展開が米国モバイル向けに完全にライブであることを確認している。AI OverviewsとAI Modeといった検索機能からサイトへのトラフィックが増加する可能性を示す重要なアップデートといえる。
AI OverviewsのTop Stories表示とは、何が変わるのか
これまでAI Overviewsは主にGoogleが収集した知識グラフや静的コンテンツから回答を生成していた。そこにニュースや最新情報のカルーセルが統合されたことで、リアルタイム性の高い情報がAI生成回答と並列で表示されるようになった。
表示の仕組み、カルーセル形式でニュースを可視化
AI Overviewsのセクション内に、水平スクロール可能なカルーセルとしてニュース記事が表示される。各項目にはニュースメディア名、見出し、アイキャッチ画像が含まれ、ユーザーは回答文に加えてリアルタイムの情報をワンタップで確認できる。
このカルーセルは「Preferred Sources」と呼ばれる、Googleが信頼性を評価したソースを優先的に表示する仕組みと連動する。ニュースメディアにとっては、検索結果ページ内での露出機会を大幅に拡大するチャンスとなる。
Preferred Sourcesの影響力がさらに拡大
Googleは2026年5月の発表時に、Preferred Sourcesをニュースカルーセルでも優先表示すると明言していた。今回の本格展開により、Googleに信頼できる情報源として認識されるメディアは、AI Overviews経由のトラフィックをより多く獲得できる環境が整った。
この仕組みは単なるアルゴリズム評価だけでなく、メディア側のE-E-A-T(経験、専門性、権威性、信頼性)をより重視する検索エコシステムへの移行を加速させる。検索結果の質を担保しつつ、タイムリーなニュースを適切に届けるための設計といえる。
AI Overviews経由のクリック、メディアへのトラフィック増加が期待される
Googleは2026年7月、AI検索機能がウェブサイトに毎週数十億回のクリックを送っていると発表した。AI OverviewsやAI Modeを含むこれらの機能は、従来の検索結果とは異なる経路でユーザーをオンラインコンテンツに誘導する役割を果たす。
AI検索とトラフィックの関係、新しい導線設計
AI Overviews内のニュースカルーセルは、従来の検索結果よりも目立つ位置に配置される。テキスト回答の直下または横に表示されるため、スクロールなしでニュース記事にアクセスできる。これは単なるクリック率向上にとどまらず、発展中のニューストピックにおける情報鮮度と発信者評価を結びつける設計だ。
AI Modeとの統合がもたらす波及効果
AI ModeはGoogleが提供するAI専用の検索モードで、会話形式の対話と情報探索を組み合わせた機能だ。Top Stories表示はAI OverviewsだけでなくAI Mode内でも有効であり、ユーザーが対話的にニュースを掘り下げる際にもメディアの記事が提示される。
これにより、キーワード検索だけに依存しない多層的な導線が形成される。ユーザーが自然言語で質問を重ねるたびに新たなニュースが表示される可能性があり、メディアにとってはAI検索最適化が新たなSEO領域として重要性を増す。
ニュースメディアのSEO戦略、AI Overviews対応が急務に
AI OverviewsにTop Storiesが統合されたことで、メディアのSEO戦略は新たな段階に入った。従来のテキスト検索向け最適化に加え、AI Overviews内で優先表示されるための対策を講じる必要性が高まっている。
Preferred Sourcesとしての評価を高める施策
Googleが示すPreferred Sourcesの評価基準は完全には公開されていないが、一般的にE-E-A-Tが重視されることは明白だ。メディアは記事の正確性、著者の専門性、サイト全体の信頼性を継続的に向上させる必要がある。
- 著者情報の充実 執筆者の経歴、専門分野、過去の実績を明確に提示する
- 事実確認のプロセス可視化 情報源の明示、訂正ポリシーの公開、編集基準の提示
- 構造化データの適切な実装 NewsArticle、Article、Authorなどのスキーマを正確にマークアップする
- サイト全体のページ速度とモバイル対応 コアウェブバイタルの基準を満たし、ユーザー体験を最適化する
AI可視性を高めるコンテンツ戦略
AI Overviewsで表示されるためには、GoogleのAIが質問の意図を理解し、回答の情報源として適切と判断するコンテンツ設計が求められる。具体的には、明確な見出し構造、簡潔な要約文、信頼性の高い統計データの提示が有効だ。
今後の展開と検索エコシステムへの影響
現時点では米国モバイルユーザー向けに限定されているが、Googleは今後デスクトップや他地域への拡大を示唆している。AI Overviewsの機能拡張は段階的に行われるため、日本のメディア関係者も早期の準備が重要だ。
Googleの継続的なAI検索改善とメディアの対応
Search Engine Landの記事によれば、GoogleはAI検索機能からオープンウェブへのクリックを改善する方針を継続している。Top Stories表示はその一環であり、検索とメディアの関係を再構築する取り組みと位置づけられる。
メディア企業はAI Overviewsでの表示を単なるトラフィック獲得手段としてだけでなく、コンテンツの質と信頼性を問われる新たな評価指標として捉えるべきだ。AI検索時代のSEOは、キーワード密度や被リンク数から、情報の正確性と権威性の証明へと重心を移している。
この記事のポイント
- Google AI OverviewsにTop Stories表示機能が米国モバイル向けに本格実装された
- ニュースカルーセルはPreferred Sourcesを優先表示し、メディアのAI可視性を高める
- AI検索機能はサイトに週数十億回のクリックを送り、新たなトラフィック導線を形成
- メディアのSEO戦略はE-E-A-T強化と構造化データ実装によるAI Overviews対応が急務
- AI Overviews展開は他地域やデスクトップにも拡大予定で、早期の対策準備が重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
VercelがNode.js 20を非推奨化、10月1日から新規デプロイ不可に
VercelにおけるNode.js 20非推奨の概要

Vercelは2026年10月1日をもって、ビルドおよびFunctionsにおけるNode.js 20のサポートを終了する。これは2026年4月30日にNode.js 20がEOL(End of Life / サポート終了)を迎えたことを受けた動きだ。
Node.jsの各バージョンにはライフサイクルが定められている。長期サポート(LTS)が終了すると、セキュリティパッチの提供も停止される。Vercelがプラットフォームとして非推奨とするのは、ユーザーに安全で最新の実行環境を提供し続けるための当然の判断といえる。
この変更で影響を受けるのは、Node.js 20を指定している新規デプロイメントだ。既にデプロイ済みのサーバーレス関数は、その後も問題なく動作し続ける。
上図の通り、Node.js 20を指定したプロジェクトは、10月1日を境に新規デプロイができなくなる。Node.js 22または24への移行が必須だ。
なぜNode.js 20は非推奨となるのか
Node.js 20のLTSは2026年4月30日に終了した。LTS終了後は重大な脆弱性が見つかっても公式の修正は行われない。VercelのようなPaaS(サービスとしてのプラットフォーム)がEOLバージョンをサポートし続けることは、プラットフォーム全体のセキュリティリスクを高める。
実際、Node.jsのEOL後も古いバージョンを使い続けると、依存パッケージの互換性問題やパフォーマンス低下にもつながる。Vercelのこの方針は、ユーザーに対して積極的なアップグレードを促すための健全な措置だ。
影響を受けるプロジェクトの確認方法
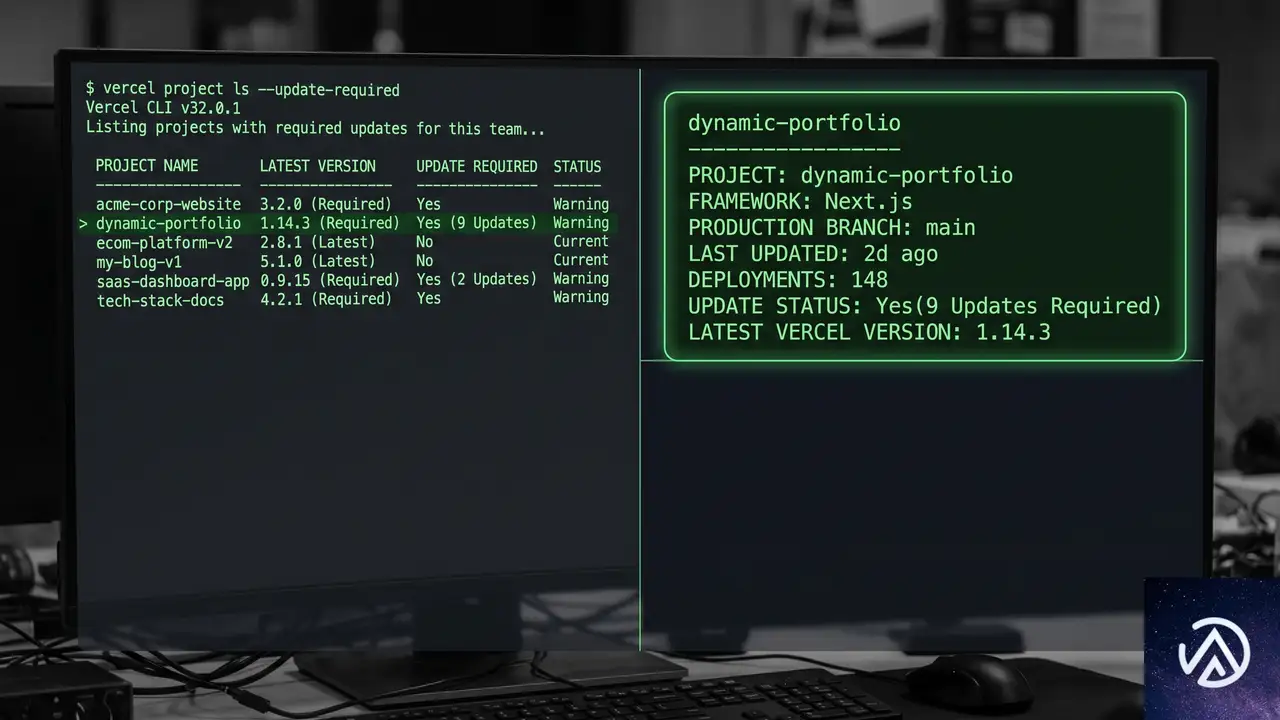
まず最初に、自分が管理するVercelプロジェクトのうち、どれが今回の非推奨の影響を受けるかを確認する必要がある。Vercel CLIを使えば、コマンド一発で該当プロジェクトの一覧を取得できる。
最新のVercel CLIをインストールし、以下のコマンドを実行するだけだ。
npm i -g vercel@latest
vercel project ls --update-required
このコマンドは、非推奨のNode.jsバージョンをターゲットにしているプロジェクトの一覧を表示する。出力結果にプロジェクトが表示された場合、早急な対応が必要だ。
このフローで影響範囲を可視化できる。チームで複数のプロジェクトを運用している場合、全メンバーがこの確認を共有しておくとスムーズだ。
既存のデプロイメントは安全
ここで一つ重要なポイントがある。2026年10月1日以降も、既にデプロイ済みのサーバーレス関数は影響を受けない。すでに本番環境で稼働している関数への呼び出しは、これまで通り正常に動作する。
非推奨の影響が出るのは、あくまで新しいデプロイメントを作成するときだ。既存の環境が突然停止することはないため、慌てて不完全な状態でアップグレードする必要はない。計画的に移行を進められる。
Node.jsバージョンのアップグレード手順

Node.jsのバージョンを変更する方法は大きく2つある。プロジェクト設定のGUIから変更する方法と、package.jsonのenginesフィールドで指定する方法だ。
package.jsonで指定する場合は、以下のように記述する。
{
  "engines": {
    "node": "24.x"
  }
}
この設定がデプロイ時に読み取られ、Node.js 24が使用される。プロジェクト設定の値よりもpackage.jsonの指定が優先されるため、リポジトリにこの設定を含めておけば、デプロイのたびにGUIで変更する手間が省ける。
また、Vercelの公式ブログでは、コーディングエージェントにアップグレードを依頼する際のプロンプトも紹介されている。
Upgrade this Vercel project from Node.js 20 to 24.
Set the engines field in package.json to { "node": "24.x" },
which overrides the Project Settings version on the next deployment.
Update any Node 20 pins in .nvmrc, .node-version, or CI configs.
Switch the local runtime to Node 24, reinstall dependencies,
run the build and tests, and fix any breaking changes.
After deploying, confirm the version by logging process.version.
このプロンプトをClaudeやChatGPTなどのコーディングエージェントに渡せば、Node.jsバージョンの変更に伴う一連の作業をある程度自動化できる。
上記の対比の通り、コーディングエージェントを活用すれば複数ファイルの一括更新が可能で、変更漏れのリスクを減らせる。
アップグレード時に気をつけるべき破壊的変更
Node.js 20から22、あるいは24へ移行する際、APIの破壊的変更がいくつか存在する。特に注意すべきなのは、以下の点だ。
- 廃止されたAPI(fs.rmdirのコールバック形式など)が完全に削除されている可能性
- ESM(ECMAScript Modules)の取り扱いに関するデフォルト挙動の変更
- ネイティブアドオンのABI互換性(再ビルドが必要になるケース)
- V8エンジンのバージョンアップに伴うパフォーマンス特性の変化
移行前に必ずローカル環境でNode.jsのバージョンを切り替え、依存関係を再インストールした上で、ビルドとテストを実行してほしい。CIパイプラインでNode.jsのマトリクステストを実施している場合は、テスト対象に新しいバージョンを追加しておくと安全だ。
アップグレードが間に合わない場合の緊急回避策

どうしても10月1日までにNode.jsのバージョンアップが完了できないプロジェクトが出てくるかもしれない。大規模なコードベースや、多数の依存パッケージとの互換性確認に時間がかかるケースだ。
そうした状況のために、Vercelはコンテナイメージとしてデプロイする代替手段を用意している。
プロジェクトのルートにDockerfile.vercelを作成し、Node.js 20をベースイメージとして指定するだけでよい。
FROM node:20-alpine
WORKDIR /app
COPY . .
RUN npm ci
# サーバーは $PORT をリッスンする必要がある
CMD ["node", "server.js"]
この方法を使えば、プロジェクト設定のNode.jsバージョンはコンテナに適用されない。つまり、プラットフォーム側のNode.js 20非推奨の影響を受けずにデプロイを継続できる。
コンテナデプロイはあくまで一時的な回避策だ。Node.js 20のセキュリティサポートはすでに終了している。長期的に見れば、Node.jsのバージョンアップこそが唯一の正しい解決策である。
この記事のポイント
- Vercelは2026年10月1日にNode.js 20を非推奨とする。既存デプロイメントは影響を受けない
- vercel project ls –update-required で影響を受けるプロジェクトを特定できる
- package.jsonのenginesフィールドでNode.js 22または24を指定して移行する
- コーディングエージェント用のプロンプトを使うと、複数ファイルの一括更新が効率的
- どうしても間に合わない場合はコンテナデプロイ(Dockerfile.vercel)で緊急回避が可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験