

Stripe for WooCommerce決済不備を修正、影響バージョンと更新手順
WooCommerce公式開発ブログが7月14日、決済プラグイン「Stripe for WooCommerce」の重要な修正パッチをリリースした。一部の環境でAdaptive Pricing(適応型価格設定)が有効になっている場合、決済処理中にカートの合計金額と実際の請求額が一致しない可能性があるという決済検証の不具合が確認されたためだ。
影響を受けるのはバージョン10.6.0から10.8.3。修正バージョンは10.6.2、10.7.1、10.8.4の三系統で提供されている。自動更新が可能なサイトではすでに適用が進んでいるが、手動更新が必要なケースも残っており、運営者はすぐにバージョン確認を進める必要がある。
なぜ今すぐ更新が必要なのか
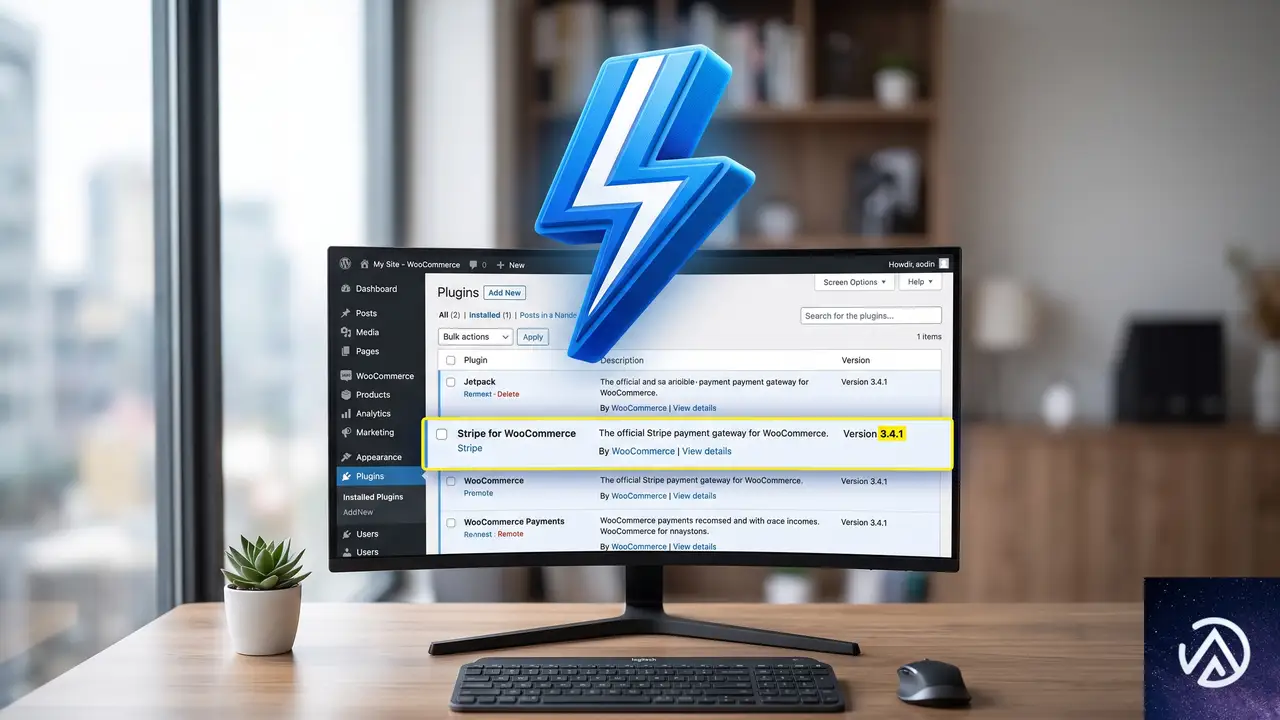
今回の不具合は、ストアの売上管理や顧客との信頼に直結する重大な問題だ。Adaptive PricingはStripeが提供する機能で、海外顧客向けに現地通貨での価格表示や決済をサポートする。しかし特定条件下で、WooCommerce側で計算された注文金額と、Stripe側で実際に処理される決済金額に差が生じることが判明した。
Adaptive Pricingの簡易的な役割
Adaptive Pricingとは、簡単に言えば「海外ユーザーが自分の通貨で価格を見て、そのまま支払える仕組み」だ。例えば米ドル建ての商品を、日本の顧客が日本円換算でチェックアウトできる。通貨換算レートの自動反映や、支払い手段の最適化も行われるため、越境ECでは非常に便利な機能である。しかしこの換算処理が絡む分、プラグイン内部の金額バリデーションが正しく行われないと、過少請求や過大請求が起こり得る。
具体的に何が問題だったのか
WooCommerce開発ブログのアドバイザリーによると、バリデーションロジックの一部がAdaptive Pricingの有効時に期待どおり動作しないケースが確認された。詳細な技術情報は修正が行き渡るまでは公開されないが、「WooCommerceの注文合計とStripeの処理金額が一致しない」という症状が報告されている。Adaptive Pricingが有効なストアでは、特に10.8.x系で広範に影響が出る可能性があるため、注意が必要だ。
上図は問題の概念を示したイメージである。注文合計と実際の請求額がずれてしまうと、ストア側は過不足金の調整や顧客への説明に追われ、信頼を損ねるリスクがある。このため公式からも即時更新が強く推奨されている。
影響を受ける条件を3点でチェック
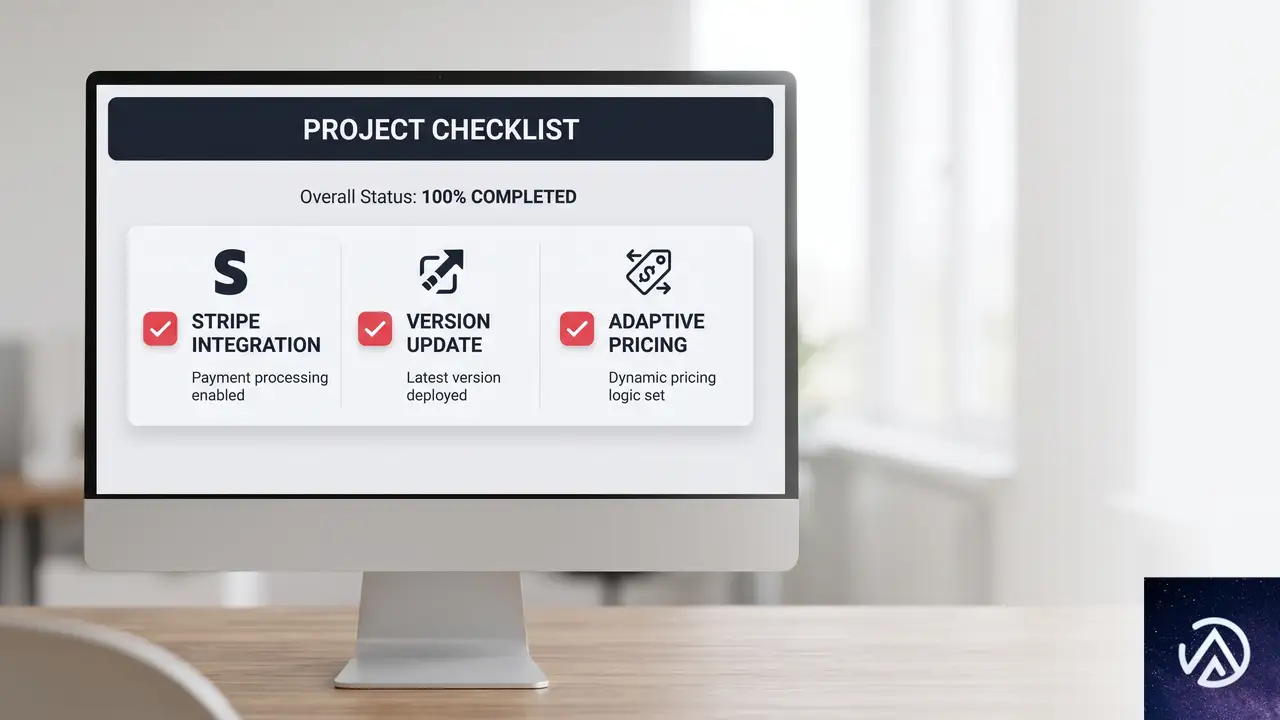
すべてのストアが影響を受けるわけではない。以下の3つの条件がすべて重なった場合にのみ、今回の不具合が発生し得る。
バージョン系統ごとの影響度の違い
10.8.x系では、Adaptive Pricingが接続先アカウントに対して幅広く有効化されていたため、最も広範囲に影響が出る。10.7.x系では新規マーチャント向けにAdaptive Pricingが有効にされており、比較的新しく設定したストアがリスクにさらされる。10.6.x系は手動でAdaptive Pricingを有効にした場合に限られる。いずれにせよ、該当するならば速やかな対応が必要だ。
修正バージョンへのアップデート手順
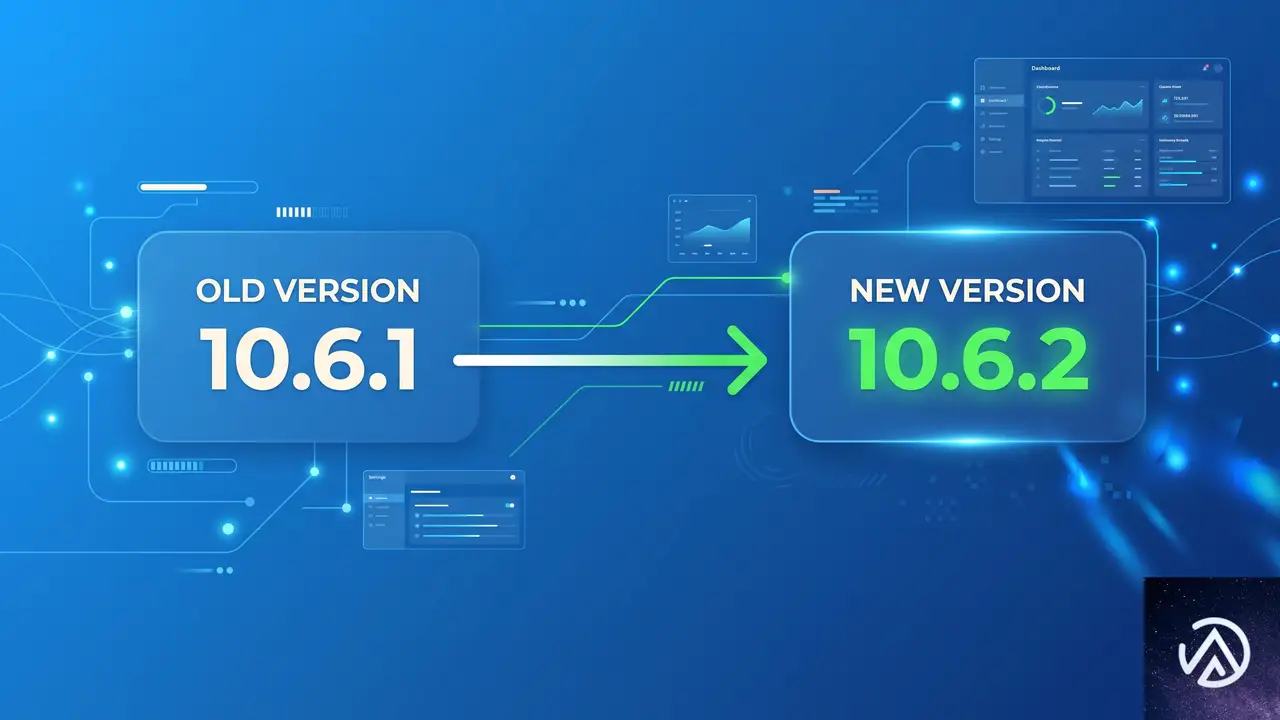
修正パッチは10.6.2、10.7.1、10.8.4として提供されている。以下の対応表に沿って、自分のストアのバージョンを確認し、該当する修正バージョンへ更新しよう。
管理画面からの手動更新方法
自動更新が走っていない、あるいは手動で確認したい場合は、以下の手順でアップデートを実施できる。
- WordPress管理画面の「ダッシュボード」→「更新」へ移動する
- 「Stripe for WooCommerce」または「WooCommerce Stripe Payment Gateway」の更新が表示されたら選択する
- 「今すぐ更新」ボタンをクリックし、完了を待つ
- プラグイン一覧でバージョンが10.6.2、10.7.1、10.8.4のいずれかであることを確認する
すぐに更新できない事情がある場合は、応急処置としてAdaptive Pricingを一時的に無効化することで、不具合の発生を回避できる。ただしこれはあくまで短期的な緩和策であり、根本対応は修正バージョンへのアップデートとなる。無効化後もできるだけ早く更新を済ませることが望ましい。
開発者・代理店・ホスティング事業者が取るべき対応
クライアントのWooCommerceサイトを管理・保守している開発者や代理店、あるいはWooCommerce向けホスティングを提供している事業者は、以下の確認を即座に実施することが推奨される。
- 管理下にある全サイトでStripe for WooCommerceのバージョンを直接確認する
- 特にAdaptive Pricingが有効なサイトを優先して修正バージョンへの更新を完了させる
- クライアントへこのアドバイザリーの内容を共有し、状況を説明する
- 更新がすぐに行えない場合は、Adaptive Pricingを一時無効化し、後日必ず更新するスケジュールを組む
- 影響を受けたストアでは、更新後に過去の注文で金額不一致がないか確認する
WooCommerce公式ブログのアドバイザリーでも強調されているが、「マーチャント向けの通知が届くのを待たずに、直接バージョンを確認する」ことが最も安全な対応だ。影響サイトの放置は、金銭的なトラブルだけでなく、顧客からのクレームや返金処理の増加につながる。特に繁忙期や越境ECを積極的に行っているストアでは、早期対応が欠かせない。
発見の経緯と今後の教訓
この問題は、HackerOneを通じてセキュリティ研究者のe0x1337氏から責任ある報告が行われたことで発覚した。WooCommerceチームは直ちに修正パッチを準備し、WordPress.orgプラグインチームと連携して自動更新の展開も進めている。
ストア運営者が学ぶべきこと
今回の事例は、決済プラグインの更新管理の重要性を改めて示している。Adaptive Pricingのような高度な機能はビジネス拡大に貢献する一方で、内部ロジックが複雑化する分、不具合が紛れ込む余地も生まれる。以下のポイントを日常的に意識することで、類似リスクを減らせる。
- WooCommerceおよび関連プラグインの自動更新を可能な限り有効にしておく
- 週次など定期的に管理画面の「更新」セクションをチェックする習慣をつける
- 決済系プラグインの変更履歴(Changelog)やセキュリティアドバイザリーをウォッチする
- テスト環境(ステージング)で決済フローを定期的に動作確認する
- 不審な金額の注文や顧客からの問い合わせがあった場合、プラグインのバージョンと設定を真っ先に疑う
WooCommerceコミュニティの迅速な対応により、今回の不具合は大事に至る前に修正パッチが提供された。しかし、プラグインを更新しなければリスクは残る。自分のストアが該当するかどうかを今一度確認し、必要なアクションを取ることが、安全なオンラインビジネスの継続につながる。
この記事のポイント
- Stripe for WooCommerce 10.6.0〜10.8.3でAdaptive Pricing有効時に決済金額不一致の不具合
- 修正バージョンは10.6.2、10.7.1、10.8.4。即時更新が強く推奨される
- 自動更新が走っていない場合は管理画面の「更新」から手動でアップデート
- 開発者や代理店はクライアントサイトのバージョン確認と優先更新が必要
- 影響を防ぐ一時策としてAdaptive Pricingの無効化も可能だが、根本解決には更新が不可欠

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Nuxt 4.5リリース、Vite 8とRspack 2でビルド基盤を刷新
Nuxt 4.5の全体像とNuxt 5への布石
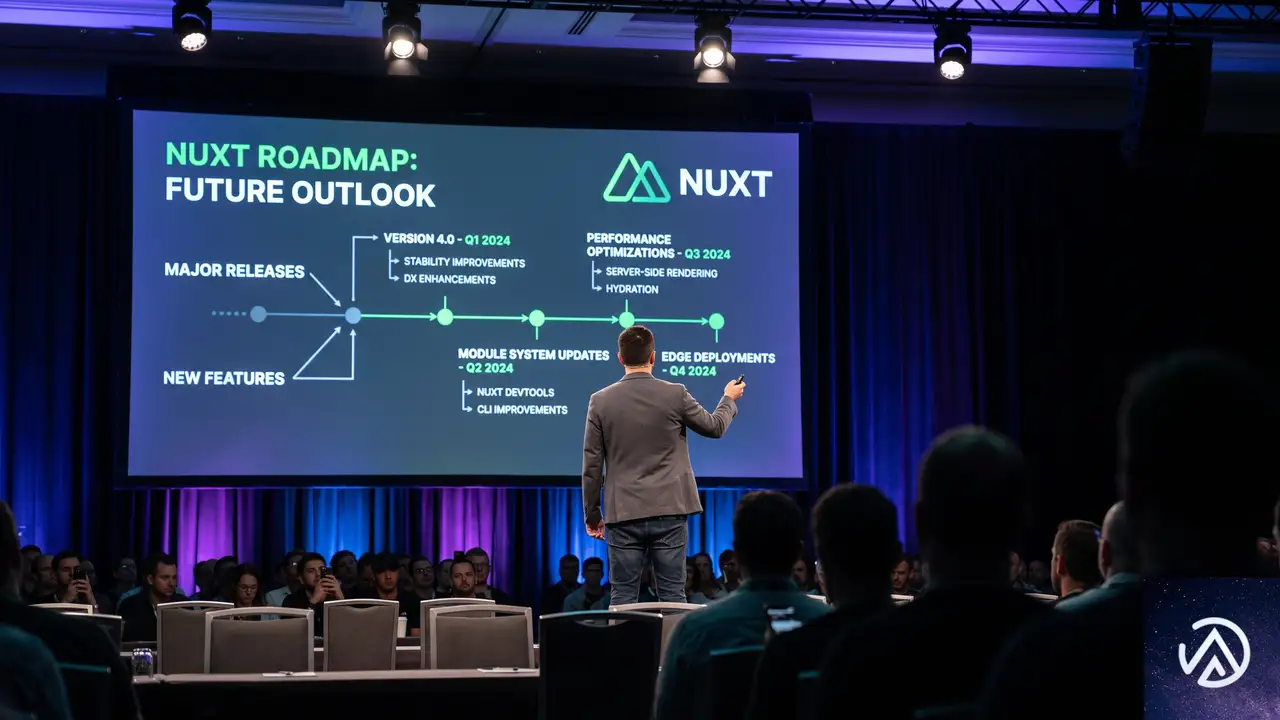
2026年7月18日、Vue.jsベースのフルスタックフレームワーク「Nuxt」の最新メジャーアップデート、バージョン4.5が公開された。今回のリリースは、ビルド基盤の刷新から実験的なSSRストリーミング、新たなコンポーザブルや安定したエラーコードシステムの導入に至るまで、多岐にわたる変更を含む大規模なものだ。同時に、次のメジャーバージョンであるNuxt 5に向けた内部的な準備が大きく進んだ節目でもある。
Nuxtチームの声明によれば、本リリースの大きな柱は3つある。Vite 8への移行、Rspack 2とRsbuildによるビルダーの再構築、そして実験的機能として提供されるSSRストリーミングだ。これらはいずれも開発体験と本番環境のパフォーマンスに直結するテーマであり、エンジニアにとっては見逃せないポイントが詰まっている。また、Nuxt 3系の最終ラインとなるv3.21.9も同時にリリースされ、3系ユーザーはv4への移行が推奨される状況となった。
上図のように、Nuxt 4.5は過去と未来をつなぐ架け橋の役割を担っている。3系から4系への移行は比較的スムーズだったとの声が多く、公式のアップグレードガイドも継続的にメンテナンスされている。v4.5で入った基盤変更の多くは「将来のv5への移行をできるだけ退屈にする」ための仕込みだ。チームは今後、Nuxt 5の安定化と互換性ユーティリティの作成に注力する方針を示している。
ビルド基盤の刷新 〜 Vite 8 と Rspack 2 + Rsbuild
Vite 8 への移行と開発体験の向上
Nuxt 4.5の内部では、ビルドツールがVite 8に引き上げられた。Vite 8はRolldownを採用した次世代の内部アーキテクチャを持ち、コールドスタートの高速化やHMR(Hot Module Replacement)の安定性向上が図られている。Nuxtブログの記事によれば、多くのアプリケーションにとってこのアップグレードは透過的であり、特別な設定変更なしに恩恵を受けられるという。
とはいえ、独自のViteプラグインやvite.configに手を加えているプロジェクトでは、Viteの移行ガイドを確認したほうが安全だ。エコシステム内のプラグインの中には特定のViteバージョンに依存しているものもあるため、本番環境に適用する前に互換性を検証することが推奨される。
Rspack 2 と Rsbuild ベースの新ビルダー
Rspackビルダーを利用しているプロジェクトにとっては、今回の変更はより大きな意味を持つ。Nuxt 4.5ではRust製バンドラであるRspackがバージョン2にアップデートされ、さらにそのビルダーはRsbuild(Rspackをラップする高レベルツール)を基盤とする形に再構築された。
パブリックなインターフェースは変わらず、従来通り builder:'rspack' の設定で利用できる。内部では、開発サーバーがRsbuildのミドルウェアモードで動作するようになり、webpack-dev-middlewareやwebpack-hot-middlewareが置き換えられた。また、SSR時のスコープ付きスタイルIDや厳密なESM解決のためにRspack専用のVueローダーが新たに導入されている。
この変更により、ビルド時間の短縮や開発サーバーの応答性向上が期待できる。Nuxtブログの記事では「内部的には全面的にRsbuildに移行したが、外部からはほとんど意識させない」と説明されており、アップグレード時の学習コストは低く抑えられている。
実験的SSRストリーミングで変わる初期表示速度
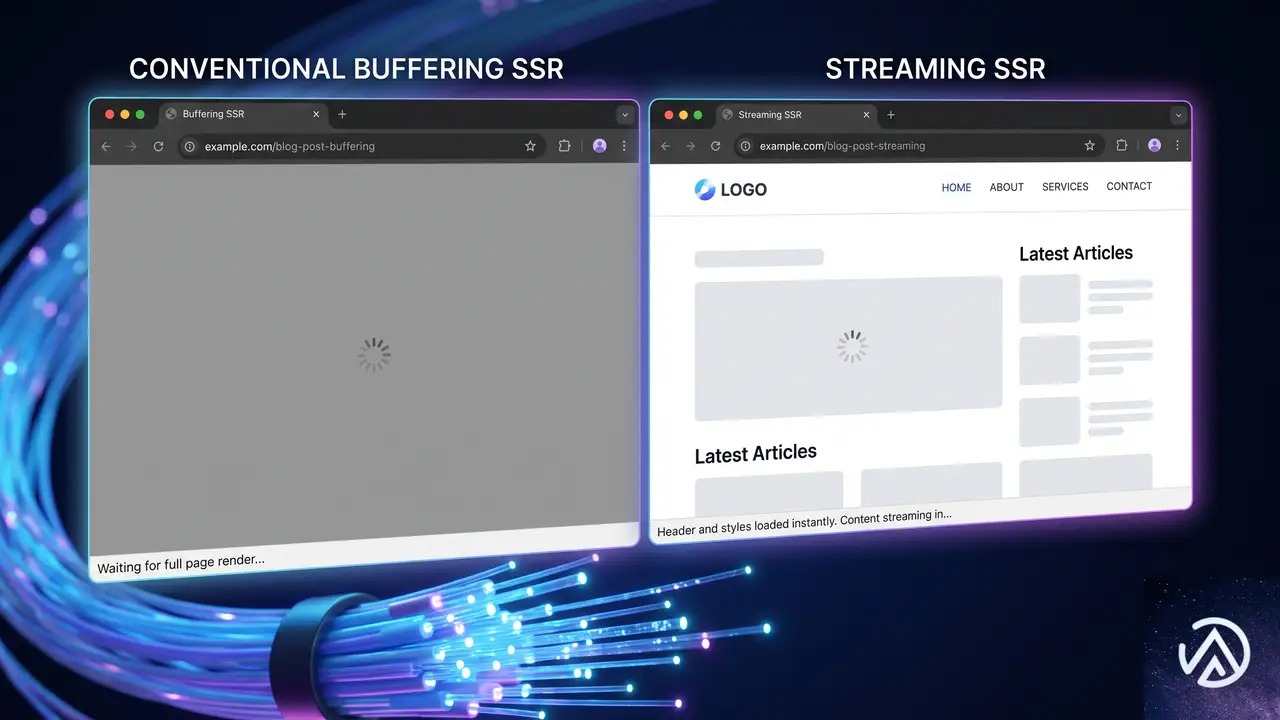
Nuxt 4.5で導入された実験的機能の中でも、特に注目度が高いのがSSRストリーミングだ。これは従来のサーバーサイドレンダリング(SSR)の常識を覆し、First Contentful Paint(FCP)やTime to First Byte(TTFB)を大幅に改善する可能性を秘めている。
従来のSSRとの違い
これまでのNuxtのSSRでは、サーバー側でページ全体のレンダリングが完了するまでHTMLのバッファリングを行い、完成したレスポンスを一括でクライアントに送信していた。これに対し、SSRストリーミングでは、HTMLの骨格部分(head要素、スタイル、プリロードヒント、エントリースクリプト)を直ちにフラッシュし、その後Vueがボディをレンダリングしながらストリームで送り出す仕組みになっている。
ブラウザはhead部分を受け取った時点でCSSやフォントのダウンロードを開始できるため、ユーザーは白い画面を待たされる時間が減る。特にヒーローイメージや重いスクリプトを次のページでプリロードしたいケースでは、その効果が顕著になるだろう。
クローラー対応と注意点
検索エンジンのボットに対しては、SSRストリーミングが自動的に無効化され、従来通り完全にレンダリングされたHTMLが返される。ユーザーエージェントの正規表現でカスタマイズも可能で、特定のルートだけストリーミングを無効にすることもできる。
ただし、ストリーミングを有効にする前に理解しておくべき制約が1つある。ストリーミングではHTTPステータスコードやヘッダーが最初のバイトで確定するため、レンダリング中にレスポンスを変更する処理(例えばsetup内でのsetResponseStatusやミドルウェアでのCookie書き込み)はクライアントに届かなくなる。Nuxtはリダイレクトやキャッシュルールなど、よくあるケースについては自動的にバッファリングレンダラーにフォールバックする仕組みを備えている。開発時には、ドロップされたミューテーションを警告で通知してくれるため、予期せぬ不具合に気づきやすい。
安定したエラーコードと新しいコンポーザブル
Nuxt 4.5では開発者体験を向上させる構文やユーティリティが複数追加された。その中でも、全開発者に影響がある安定したエラーコードシステムと、実務で即戦力となる新コンポーザブルについて解説する。
nostics ベースの安定エラーコード
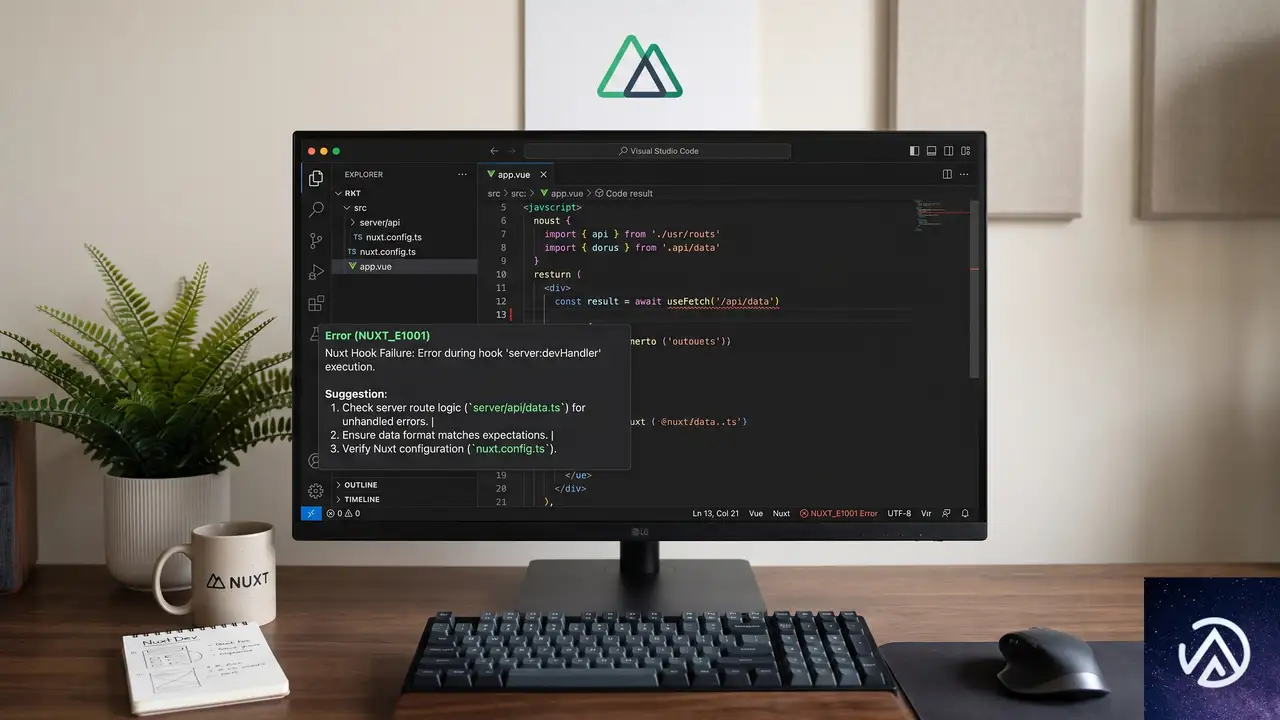
Nuxtは今回、nosticsという仕組みを採用し、ビルド時や実行時の警告・エラーに「NUXT_E1001」のような不変のコードを付与するようになった。各コードには、なぜそれが発生したのかの説明と具体的な修正案がインラインで表示される。さらに、1行では説明しきれないエラーは専用のドキュメントページにリンクされる。
たとえば「コンポーザブルがNuxtコンテキスト外で呼ばれた」という古くからのエラーは、NUXT_E1001としてコード化され、runWithContext()の使い方まで含めた解説ページが用意された。本番ビルドでは冗長なテキストが削除され、コードだけが残るため、バンドルサイズへの影響も最小限に抑えられている。
この仕組みは、エラーの切り分けやチーム内での情報共有を格段に容易にする。Nuxtブログの記事では「この基盤の上に、さらに優れたエラーメッセージを積み重ねていく」と述べられており、今後のリリースでも拡充が続く見込みだ。
useLayout コンポーザブルと名前付きビュー
新たに追加された useLayout コンポーザブルは、現在のルートに解決されたレイアウト名をリアクティブに取得できる。これまではコンポーネント内から「このページはどのレイアウトを使っているか」をクリーンに知る手段がなく、工夫が必要だった。useLayoutは読み取り専用のcomputed refを返すため、ナビゲーションに応じて自動的に値が更新される。
さらに、名前付きビュー(Named Views)のサポートも公式に組み込まれた。親ページが複数の <NuxtPage> アウトレットをレンダリングする場合、ファイル名に 名前@ビュー名.vue の規約を使うことで、各アウトレットに対応するページコンポーネントを配置できる。これはVue Routerでは以前から可能だった機能を、Nuxtのファイルベースルーティングに統合したものだ。
useFetch / useAsyncData の enabled オプション
データフェッチの制御が柔軟になったのも地味に嬉しいポイントだ。useFetchやuseAsyncDataに enabled オプションが追加され、条件を満たすまでリクエストをブロックできるようになった。enabledがfalseの間は、初回フェッチも手動のexecute/refreshも、ウォッチャーによるトリガーもすべて抑制される。trueからfalseに変わった場合は実行中のリクエストがキャンセルされ、既存のdataは維持されるため、UIの一貫性を保ちやすい。
Nuxtブログの記事では、検索窓の入力が2文字を超えるまでAPIを叩かない、というユースケースが例示されている。依存関係の多いクエリや条件付きのデータ取得が必要な画面で、コードをシンプルに保てるだろう。
パフォーマンス改善とアップグレード時の注意点
Nuxt 4.5では、上記の主要機能に加えて、開発サーバーの起動高速化や本番ビルドのスリム化といったパフォーマンス改善も多数盛り込まれている。たとえば、NuxtがViteのファイルウォッチャーを共有する「共有ウォッチャー」モードは、メモリ使用量とファイルハンドル数を削減し、大規模プロジェクトでの起動時間を短縮する。この機能は将来のデフォルトだが、今すぐ experimental.watcher:'builder' で試すことができる。
また、プロダクションビルドでは、アイランド(Islands)を使用しない場合にアイランドレンダラーのチャンクが丸ごと省略されるなど、不要なコードの除去も進んだ。これらは設定不要で自動的に適用される。
アップグレード前に確認すべきポイント
今回のリリースはメジャーな依存関係のアップグレードを3つ含んでいるため、アップグレード時にはいくつか注意点がある。Nuxtチームが推奨するアップグレードコマンドは npx nuxt upgrade --dedupe で、ロックファイルの重複を整理しつつ、関連するunjsエコシステムのパッケージもまとめて更新できる。
- Vite 8:カスタムViteプラグインやvite.configの特殊設定がある場合、Viteの移行ガイドを事前に確認する
- Rspack 2:builder: ‘rspack’ を使用中の場合、内部がRsbuildベースに切り替わっているため、独自のRspack設定を見直す必要があるかもしれない
- unhead v3:useHeadの型が厳格化され、v2で許容されていた一部のコードが型エラーになる可能性がある。ただしランタイム動作は幅広く互換性が保たれている
これらの確認を経れば、多くのプロジェクトはスムーズに移行できるだろう。Nuxtブログの記事でも「大半のアプリでは透過的なアップグレードになる」とされており、恐れるほどの破壊的変更は限定的だ。
この記事のポイント
- Nuxt 4.5はVite 8、Rspack 2 + Rsbuildへの移行によりビルドパフォーマンスが底上げされた。v5への布石として内部基盤の刷新が進んでいる
- 実験的SSRストリーミングを有効にすると、HTMLシェルを先に送信しTTFBを改善できる。クローラーには自動で従来のSSRが提供される
- 安定エラーコードシステムにより、エラーの原因と修正法がコードベースで即座に把握可能になり、開発生産性が向上する
- useLayout、名前付きビュー、enabledオプションなど、実務ですぐ使える新構文が追加された
- アップグレード時はVite 8、Rspack 2、unhead v3の3点を中心に互換性を確認すれば、多くのプロジェクトはスムーズに移行できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPress 7.0.2リリース、SQLインジェクションとRCEの深刻な脆弱性を修正
WordPress 7.0.2が2026年7月17日にリリースされた。今回のアップデートは深刻度「クリティカル」1件と「高」1件、計2件のセキュリティ脆弱性を修正する緊急リリースだ。
対象となる脆弱性は悪用されればサイトの完全掌握につながる可能性がある。WordPress.orgは影響を受ける全サイトに対し、自動更新システムを通じた強制アップデートを有効化した。手動更新も含め、即座の対応が強く推奨される。
この記事では脆弱性の詳細、影響を受けるバージョン、具体的な更新手順を整理する。サイト管理者はまず自サイトのバージョンを確認し、該当する場合は今すぐアップデートを実行してほしい。
修正された2件の脆弱性の概要
WordPress 7.0.2では、SQLインジェクションとREST API経由のリモートコード実行(RCE)という2件の深刻な問題が修正された。いずれも攻撃者にサイトの内部データへの不正アクセスや、サーバー上での任意コード実行を許す可能性がある。
SQLインジェクションの脆弱性
1件目はSQLインジェクションの脆弱性だ。SQLインジェクションとは、Webアプリケーションがデータベースに送るSQL文(問い合わせ命令)に、攻撃者が不正な文字列を紛れ込ませる攻撃手法を指す。これが成功すると、データベース内の情報を盗み見られたり、データを改ざんされたりする。
今回の脆弱性はTF1T、dtro、haongoの3名によるチーム報告で発見された。WordPressの内部処理で、特定の条件下においてSQLクエリが適切にサニタイズ(無害化)されず、攻撃者が細工した入力を通じてデータベース操作を実行できる状態になっていた。
上の図は、修正前後での入力処理の違いを示している。修正前は攻撃者の細工した文字列がそのままSQL文に渡っていたが、修正後はエスケープ処理によって危険な文字が無害化される。
REST API経由のRCE脆弱性
2件目はさらに深刻だ。REST APIのバッチルートの混乱とSQLインジェクションが組み合わさり、リモートコード実行(RCE)に至る脆弱性である。RCEとは、攻撃者が遠隔からサーバー上で任意のプログラムコードを実行できる状態を指す。サイトの完全な乗っ取りが可能になる、最悪のシナリオだ。
REST APIとは、WordPressが外部アプリケーションとのデータ送受信に使うインターフェースである。バッチルートは複数のAPIリクエストを1回でまとめて処理する仕組みで、ここにリクエスト経路の混乱(どのエンドポイントが処理すべきかの取り違え)が発生していた。
この脆弱性はAssetnote / Searchlight Cyber所属のAdam Kues氏によって報告された。REST APIのバッチ処理で生じる経路混乱を起点にSQLインジェクションを発生させ、最終的にサーバー上でのコード実行につなげる攻撃チェーンが成立していた。
この攻撃チェーンは多段階で構成される。REST APIのバッチ処理を入り口に、経路混乱→SQLインジェクション→RCEという流れでサーバーへの侵入を許していた。7.0.2では各段階の根本原因が修正されている。
影響を受けるバージョンとバックポート
WordPress 7.0.2のリリースと同時に、複数の旧バージョン向けバックポート(修正の遡及適用)も公開されている。現在運用中のサイトがどのバージョンに該当するか、以下の一覧で確認してほしい。
6.8系はREST API経由のRCE脆弱性の影響を受けない点が救いだが、SQLインジェクションのリスクは残る。6.8.6への更新は必須だ。6.9系と7.0系、および7.1ベータは両方の脆弱性の影響を受けるため、対応バージョンへの即時更新が求められる。
今すぐ実行すべきアップデート手順
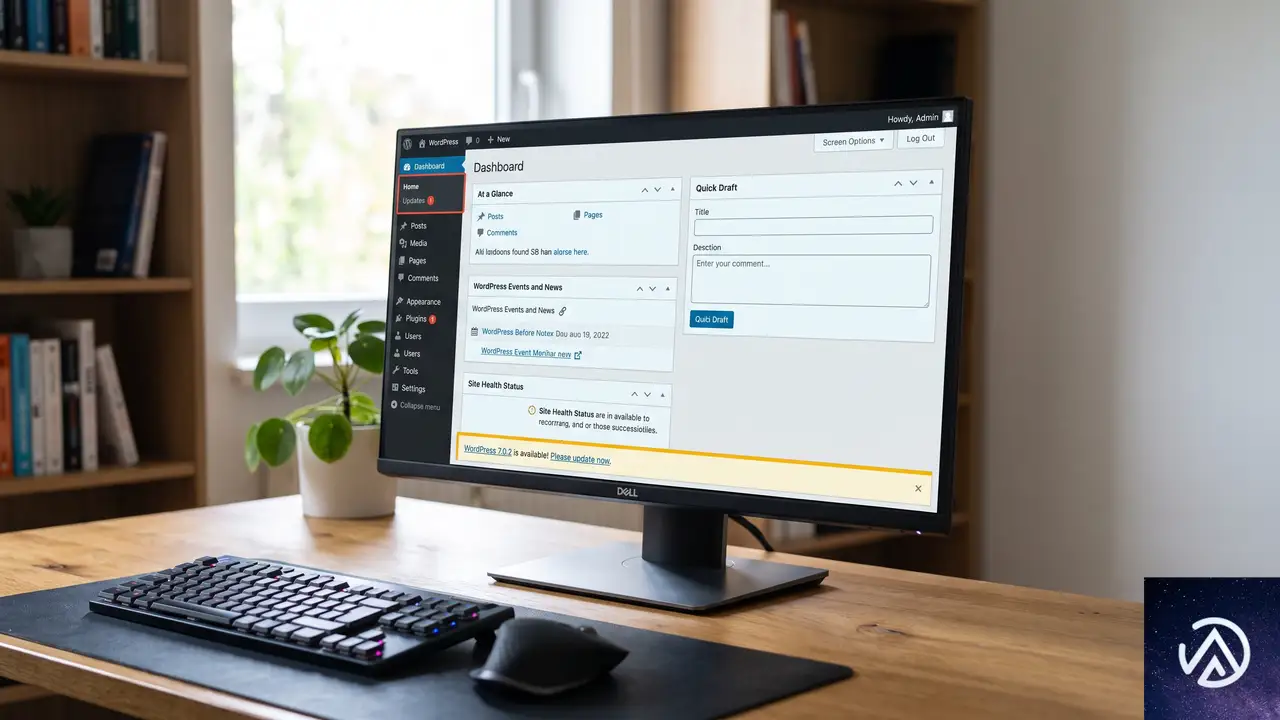
WordPress 7.0.2はセキュリティリリースのため、WordPress.orgが自動更新システムを通じた強制アップデートを有効化している。自動バックグラウンド更新に対応しているサイトでは、すでに更新が始まっているはずだ。
管理画面からの手動更新
自動更新が動作していない環境や、今すぐ手動で更新したい場合は以下の手順で対応する。
上記の手順で数分以内に更新は完了する。更新後はサイトの表示や主要機能が正常に動作することを必ず確認してほしい。プラグインとの互換性問題が発生した場合は、プラグイン側のアップデート有無も合わせてチェックするとよい。
手動ダウンロードとFTP更新
何らかの理由で管理画面から更新できない場合は、WordPress.orgからZIPファイルを直接ダウンロードし、FTP/SFTPでサーバーにアップロードする方法もある。この方法はファイルの上書きミスによるサイト停止リスクを伴うため、可能な限り管理画面からの更新を推奨する。
セキュリティリリースの背景と教訓
今回の2件の脆弱性に共通するのは入力値の検証不足とAPIエンドポイントの経路管理の不備である。いずれもWebアプリケーション全般に共通する古典的な脆弱性パターンだが、WordPressほどの巨大プロジェクトでも発生しうるという事実は重い。
REST APIのセキュリティと運用上の注意
REST APIはWordPress 4.7で導入されて以来、外部サービス連携やヘッドレスCMS構成に不可欠な存在となっている。一方で、APIエンドポイントが増えるほど攻撃対象領域(アタックサーフェス)も広がる。今回のバッチルート問題は、複雑なAPI設計に潜むリスクを浮き彫りにした。
サイト管理者として取れる対策は限られているが、最低限以下の運用を徹底したい。
- WordPress本体および全プラグインを常に最新バージョンに保つ
- 使用していないREST APIエンドポイントは必要に応じて無効化する
- WAF(Webアプリケーションファイアウォール)の導入を検討する
- 定期的なセキュリティ監査とログ監視を実施する
WordPress.orgの強制自動更新は両刃の剣
今回、WordPress.orgは深刻度の高さを理由に強制自動更新を有効化した。この判断は「脆弱性が悪用される前に全サイトを保護する」という観点では合理的だが、自動更新によってサイトが意図せず停止するリスクもゼロではない。
特にカスタム開発の多いサイトや、互換性テストを経ていないプラグインを多数導入している環境では、更新後の動作確認が必須だ。自動更新はセキュリティ上の「最後の砦」として機能するが、日頃から更新適用前のテスト環境を用意しておくことが理想である。
この記事のポイント
- WordPress 7.0.2は深刻度「クリティカル」と「高」の脆弱性2件を修正する緊急セキュリティリリース
- SQLインジェクションとREST API経由のRCEが修正対象。悪用されればサイトの完全掌握が可能
- WordPress 6.8〜7.1 Beta 1が影響を受ける。各バージョン向けのバックポートが同時公開された
- WordPress.orgが強制自動更新を有効化済み。手動更新は管理画面の「更新」から即座に実行できる
- 更新前のバックアップ取得と更新後の動作確認は必須。日頃からのテスト環境整備が被害を防ぐ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
.ALドメインのDNSSEC障害、CloudflareがEDE 33で透明性を向上
2026年7月3日、アルバニアの国別コードトップレベルドメイン「.AL」でDNSSECの鍵ロールオーバーに失敗する障害が発生した。この影響で、.ALドメインを使用する政府機関や銀行、メディアサイトが一時的にアクセス不能となった。
Cloudflareが運用するパブリックDNSリゾルバ「1.1.1.1」は、この障害に対してネガティブトラストアンカー(NTA)を適用して暫定対応を実施。同時に、新しい拡張DNSエラー(EDE)コード「EDE 33」を初めて導入し、NTAが適用されていることをクライアントに明示した。
この記事では、.AL障害の経緯と、DNS運用におけるNTAの透明性を高めるEDE 33の技術的意義を解説する。TLDレベルのDNSSEC障害がもたらす影響と、再発防止に向けた課題を考察する。
.ALドメインで何が起きたのか
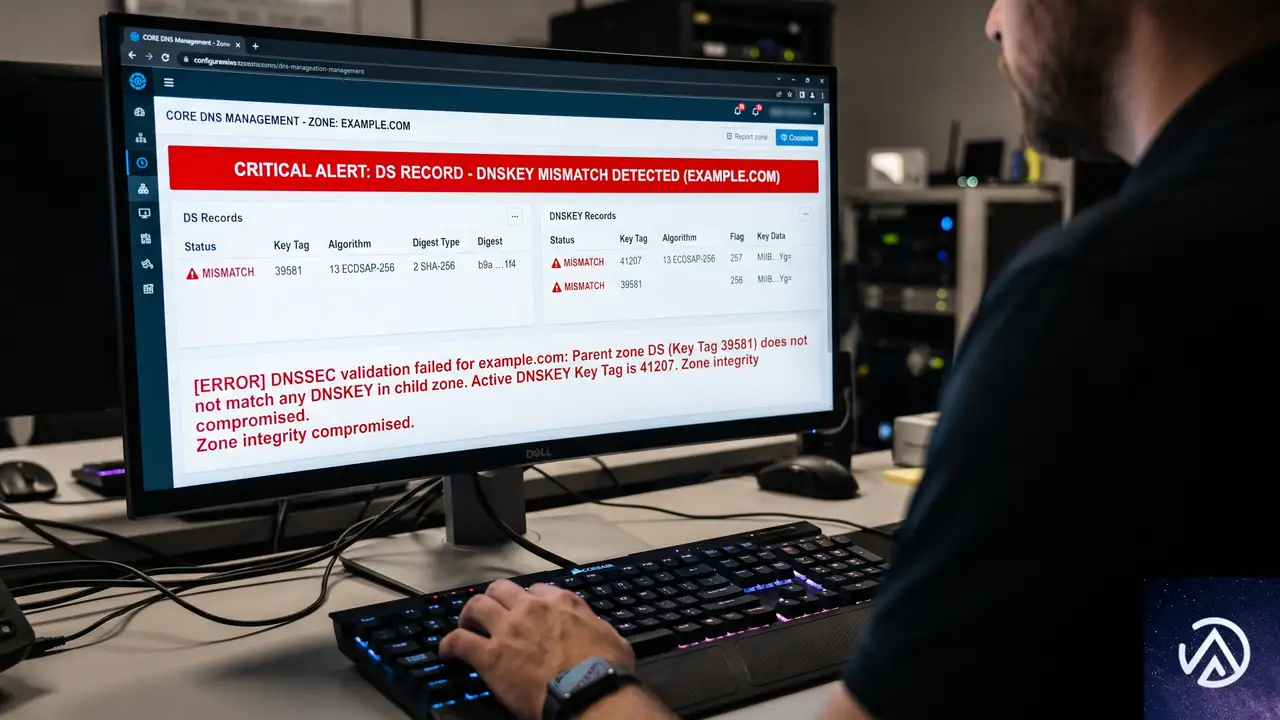
2026年7月3日14時15分(UTC)ごろ、アルバニアの通信規制当局AKEPが.AL TLDのDNSSEC鍵を更新しようとした際に設定ミスが発生した。新しいDNSKEYを公開したが、ルートゾーンに登録されていたDSレコードは古い鍵のままであり、DNSSECの信頼チェーンが切断された。
その結果、1.1.1.1を含む世界中の検証対応DNSリゾルバは、.ALドメインのDNS応答を検証エラー(SERVFAIL)として拒否するようになった。障害発生から約3時間後の17時15分、Cloudflareは1.1.1.1に.AL向けのNTAを適用し、検証を一時的にバイパスして名前解決を回復させた。
AKEPはその後、新しいDNSKEYも削除してしまい、ゾーンからDNSKEYが存在しない状態に陥った。最終的に19時15分ごろ、ルートゾーンからDSレコードが削除され、.AL全体がDNSSEC未署名の状態で名前解決が再開された。記事公開現在も、.ALは未署名のままである。
.DEに続くTLD障害の連鎖
この障害は、わずか2ヶ月前にドイツの.DE TLDで発生した同様のDNSSEC障害を想起させる。.DEの事例でも、1.1.1.1はNTAを適用して暫定対処を行い、事業者の対応を待つ形となった。
TLDレベルのDNSSEC障害は頻発するものではないが、一度発生すると配下の全ドメインに影響が波及する。.ALはCloudflare RadarのTLDランキングで191位に位置し、アルバニアの政府サービスや金融機関、報道機関などが集まる重要なドメイン空間だ。
この比較からわかるように、DNSSECの信頼チェーンはルートゾーンのDSレコードとTLDゾーンのDNSKEYが一致して初めて成立する。ロールオーバーの手順を誤ると、連鎖的に全下位ドメインの検証が失敗する仕組みだ。
NTA適用の判断基準
CloudflareはNTAを適用する前に、AKEPへの直接連絡とDNS-OARC Mattermostへの投稿を通じてコミュニティに注意喚起を行った。しかし、AKEPの連絡先アドレス自体が.ALドメインだったため、障害発生中は連絡が取れないという悪循環に陥った。
NTAの適用は、DNSSEC検証を停止するという強い措置だ。Cloudflareの著者によれば、.DEの事例と同様に「障害が公共に確認されており、すべての検証リゾルバに等しく影響する」という点を重視して判断したという。検証を停止しても名前解決を維持する方を優先した格好だ。
NTAの抱える透明性の課題
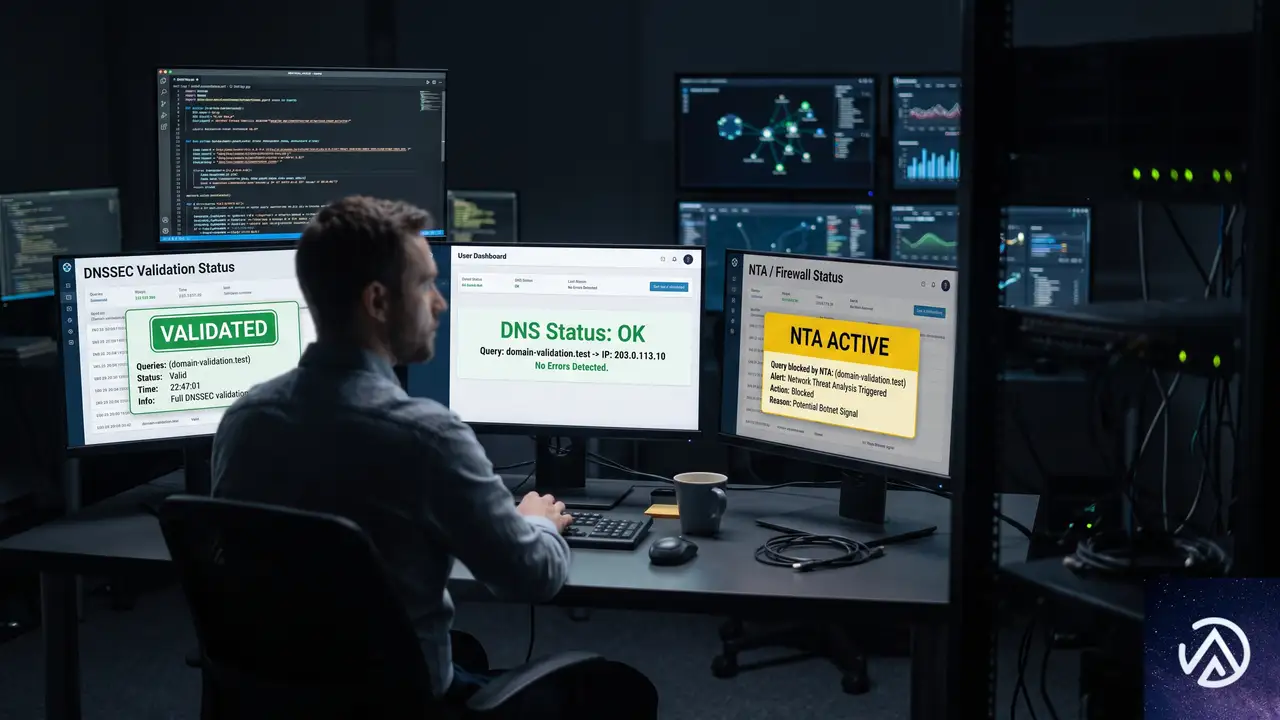
NTAはDNSSECの緊急回避手段として有効だが、一つ大きな欠点がある。それは、クライアント側からNTAの適用を検知できないことだ。NTA配下で返されたDNS応答は、通常の検証済み応答と見分けがつかない。
RFC 7646でもこの問題は認識されており、NTAの適用状況を運用者が公開することが推奨されている。Cloudflareは.DEや.ALの際にステータスページで情報を公開したが、それでも利用者が自発的に確認しなければ気づけない。監視ツールやアプリケーションがDNS応答だけで状況を把握する手段がなかった。
ANSWER: google.al → 142.251.142.196
EDE: 9 (DNSKEY Missing)
EDE: 33 (Negative Trust Anchor)
ANSWER: google.al → 142.251.142.196
● EDE 9で根本的なDNSSECエラーも同時に通知
この「見えないNTA」は、なりすましDNS応答と正当な応答を区別するDNSSECの根幹を揺るがす。NTAが適用されている間、利用者は保護されていない状態で通信していることになるが、それを知る術がなかったのだ。
EDE 33がもたらす透明性
拡張DNSエラー(EDE)コードはRFC 8914で定義されており、DNSリゾルバがエラー時だけでなく成功応答にも追加のコンテキスト情報を付加できる仕組みだ。Quad9のBabak Farrokhi氏が提案し、Cloudflareも共同執筆者として参加したインターネットドラフトで、NTAの適用を示す新しいEDEコード「EDE 33」が定義された。
1.1.1.1は.AL障害において、このEDE 33を初めて実運用に投入した。NTAが適用されている間、.ALドメインへのすべてのDNSクエリに対して、EDE 33が付加された応答が返されている。これにより、クライアントや監視ツールはDNS応答だけで「この応答はDNSSEC未検証である」と判断できるようになった。
EDE 33の実装と応答例
以下は、1.1.1.1にgoogle.alの名前解決を問い合わせた際の応答だ。ステータスはNOERRORで正しい回答が返されているが、2つのEDEコードが付加されている。
$ kdig @1.1.1.1 google.al
;; ->>HEADER<<- opcode: QUERY; status: NOERROR; id: 32848
;; Flags: qr rd ra; QUERY: 1; ANSWER: 1; AUTHORITY: 0; ADDITIONAL: 1

;; EDNS PSEUDOSECTION:
;; Version: 0; flags: ; UDP size: 1232 B; ext-rcode: NOERROR
;; EDE: 9 (DNSKEY Missing): 'no SEP matching the DS found for al.'
;; EDE: 33 (Negative Trust Anchor): 'a Negative Trust Anchor has been applied for this query (see RFC 7646)'

;; ANSWER SECTION:
google.al.              300    IN    A    142.251.142.196
EDE 9(DNSKEY Missing)は、DNSSECの信頼チェーンが切断された根本原因を示している。EDE 33(Negative Trust Anchor)は、1.1.1.1がNTAを適用して応答を返したことを示す。この2つの情報が揃うことで、運用者は「本来は検証エラーになる状況だが、NTAによって暫定的に解決された」という全体像を把握できる。
このフローは、1.1.1.1内部でNTAがどのように処理されるかを示している。EDE 33は、NTAが有効な間、DNSSECを使っていないドメインへのクエリにも付加される。NTAはゾーン全体に適用されるため、透明性もゾーン全体に対して一律に提供される設計だ。
.DE障害で生じた問題も解決
.DE障害の際、1.1.1.1はDNSSECの根本エラーではなく「EDE 22(No Reachable Authority)」を誤って返していた。これは、NTA配下で権威サーバーに到達できない場合に発生するエラーであり、真の原因を隠蔽してしまう問題があった。
.AL障害ではこの点が改善され、EDE 9(DNSKEY Missing)が正しく返されている。EDE 33と組み合わせることで、「なぜ検証に失敗したのか」と「なぜ応答が返されたのか」の両方をクライアントが把握できるようになった。
今後の標準化と運用への影響
EDE 33はIANA(Internet Assigned Numbers Authority)によって正式に割り当てられており、Knot DNSプロジェクトのkdigツールはすでにEDE 33を名前で認識するようになっている。また、Unbound向けのプルリクエストもレビュー段階にある。他のDNSリゾルバ実装も追随することが期待される。
このインターネットドラフトはIETFのDNSOPワーキンググループに提出済みで、2026年7月18日から24日にウィーンで開催されるIETF会合で議論される予定だ。標準化が進めば、EDE 33はすべての主要DNSリゾルバで実装される可能性が高い。
国内DNS運用者への示唆
国内のISPや企業が運用するDNSリゾルバでも、DNSSEC検証を有効にしているケースが増えている。.ALのようなTLDレベルの障害は稀だが、.JPや他のccTLDで発生しないとは限らない。EDE 33に対応したリゾルバ実装を採用することで、障害時の透明性を確保できる。
また、NTAの運用には慎重さが求められる。Cloudflareは.DEと.ALの両方で、コミュニティへの通知後にNTAを適用し、問題解決後に速やかに解除している。このバランス感覚は、他のDNS運用者にとっても参考になる対応だ。
残された課題
記事公開現在、.ALはDNSSEC未署名のままだ。DSレコードがルートゾーンに再登録されない限り、.AL配下のすべてのドメインはDNSSECの保護を受けられない。AKEPがいつ復旧作業を完了させるかは不透明である。
より根本的な問題として、TLD事業者のDNSSEC運用スキル不足が浮き彫りになった。鍵ロールオーバーは手順を誤ると広範囲に影響を及ぼす重要なオペレーションだ。ICANNやレジストリコミュニティによるガイドラインの整備や訓練の機会提供が求められる。
この記事のポイント
- .AL TLDのDNSSEC鍵ロールオーバー失敗により、2026年7月3日に全.ALドメインが一時的に解決不能となった
- Cloudflareの1.1.1.1はNTAを適用して暫定対処を行い、同時に新しいEDEコード「EDE 33」を初めて実運用に投入した
- EDE 33はNTAの適用をDNS応答内で明示し、従来の「見えないNTA」問題を解決する
- .DEに続くTLDレベルのDNSSEC障害は、TLD事業者の運用スキル向上とNTAの標準化の必要性を浮き彫りにした
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

83%の組織がエージェントAI対応にインフラ刷新が必要と回答、Google Cloud調査
Google Cloudが2026年7月に公開した「State of AI Infrastructure」レポートによると、実に83%の組織が「本番レベルのエージェントAIを支えるにはインフラの刷新が不可欠だ」と回答した。この数字はもはや一部の先進企業だけの課題ではなく、業種を問わず広がる構造的な問題を浮き彫りにしている。
本記事では、Google Cloud Blogの調査概要をもとに、エージェントAIが既存のクラウド基盤に与える負荷と、企業が次に打つべきインフラ戦略を解説する。推論コストの急増やエージェントの統制不能、データの断片化、エネルギー制約といったテーマを具体的なデータとともに取り上げる。
推論コストの急増と流動的コンピューティング

推論税の正体
エージェントAIは1回の指示で数百の後続アクションを連鎖的に引き起こす。チャット型AIのように単発で完結する処理とは根本的に負荷の性質が異なる。Google Cloud BlogのDrew Bradstock氏によれば、この連続推論ループがレガシーアーキテクチャに加わる経済的負担を「推論税」と呼んでいる。
調査では62%のリーダーが「データエグレス料金やストレージ肥大化、アイドル状態の専用ハードウェアによって深刻な推論税が発生している」と回答した。81%は運用の複雑さをAIスケーリングの隠れたコストとして挙げている。
上図が示すのは、エージェントAIの負荷特性と基盤の適合性がコストを左右する構図だ。ストレージ肥大化を放置すれば推論税は雪だるま式に膨らみ、競争力を大きく損なう。
TPU 8tとTPU 8iが示す選択肢
規模の大きいトレーニングにはTPU 8t、低レイテンシ推論にはTPU 8iといった具合に、用途に合わせた計算リソースを動的に組み合わせる発想が鍵になる。Google Cloud Blogの記事では、重いトレーニング、リアルタイム推論、オーケストレーションの3層に分けた「流動的コンピュート」が提案されている。
- 大規模学習向け:TPU 8t(第8世代)は第7世代比で約3倍の性能と最大2倍の電力効率を達成。超大規模モデルの学習時間を大幅に短縮する
- 低レイテンシ推論向け:TPU 8iはオンチップメモリを最大化し、リアルタイム応答が求められるエージェントの思考と反応を高速化する
- 制御プレーン向け:ArmベースのGoogle Axion CPUが強化学習シミュレーションやエージェントのオーケストレーションをコスト効率よく実行する
こうした選択肢を使い分けることで、ピーク負荷時だけ専用チップを割り当て、普段は汎用プロセッサに戻すといった柔軟なリソース管理が可能になる。
急拡大するエージェントの統制

エージェントスプロールの現実
エージェントはメールの読み取りからデータベース照会、業務ワークフロー実行まで自律的に動く。組織内で数十、数百のエージェントが稼働し始めると、個別管理が極めて難しくなる。これを業界では「エージェントスプロール(agent sprawl)」と呼び始めており、調査でも79%のリーダーがセキュリティ・ガバナンス・MLOpsを推論スケーリングの最大の課題に挙げている。
上図のように、統制プレーンを導入することで、これまで管理者が人力で追いかけていた権限設定や操作ログが集約され、監査や緊急停止も一元的に実施できる。調査では78%の組織が生成AIソリューションをメインのクラウドパートナーから直接調達しており、この集中傾向は2025年から30ポイント上昇している。
Agent Gatewayが担う役割
Google Cloud Blogで紹介されているAgent Gatewayは、企業向けに設計されたエージェント統制のハブだ。エージェント同士のデータ共有を可視化し、読み取りと書き込みのスコープを細かく設定できる。重要なアクションの前には人間の承認を挟むヒューマンインザループ機能も提供する。
- 全エージェントの認証を統一し、分散ツールをつなぎ合わせる必要がない
- データ共有のログと監査証跡を完全に管理できる
- エージェント単独では実行できない重要操作に対して、人による承認フローを組み込める
スケールする自律エージェント群を安全に運用するうえで、こうした統制基盤はもはやオプションではなく必須のレイヤーになりつつある。
データ基盤の統一

自律型エージェントは推論のたびに組織全体へ重いクエリを発行する。Drew Bradstock氏の指摘では、データがサイロ化して断片化していると「エージェントは事実上、目隠しをされたまま飛んでいる」状態になるという。このため、断片化したデータを単一の文脈で扱える統合データ層の整備が急務とされている。
統合データ層が整うと、エージェントはデータの置き場所を意識せずに検索・推論できる。非構造化データを自動的に構造化するSmart Storageと、マルチクラウド環境を横断するCross-Cloud Lakehouseが、この層を現実のものにしている。
ハイブリッドマルチクラウドとデジタル主権

パブリッククラウドかオンプレミスかという二者択一はすでに終わっている。調査では52%の組織がハイブリッドマルチクラウド構成を採用していた。これは単なるコスト分散ではなく、デジタル主権とデータの重力が強い推進力になっているからだ。
- データ所在地規制への対応:調査参加者の48%が厳格なデータレジデンシー管理を優先事項に挙げている。各国の法改正に即応できる柔軟な配置が求められる
- 完全隔離環境の需要:Google Distributed Cloudのようにパブリッククラウド技術をオフラインで利用できるサービスが、政府機関や金融機関を中心に拡大している
- データ重力の現実:巨大なデータセットは動かすより「その場で処理する」方が現実的で、エッジやオンプレとの組み合わせが不可欠になる
つまり、単一のクラウドに依存する時代は終わり、データの物理的な位置と主権に合わせてAIを走らせる場所を選べるアーキテクチャが標準になりつつある。
エッジでのAI実行が必然になる理由

調査結果の中で特に目を引くのが、90%の組織が「エッジへのAI配置が重要」と回答し、72%は「極めて重要」または「非常に重要」と位置づけた点だ。エージェントAIのリアルタイム性を追求するほど、集中型クラウドだけでは限界が露呈する。
エッジに推論機能を分散させると、クラウド往復のレイテンシが不要になるだけでなく、通信断でも業務が停止しない耐障害性と、トークンあたりの変動費削減を同時に実現できる。製造現場や病院、小売店舗など「止まらない自律処理」が求められる現場にとって、これが決定的な価値になる。
エネルギー壁を突破する設計

91%のリーダーがハードウェア選定時に消費電力を考慮し、61%はそれを「主要または極めて重要な要素」と位置づけている。かつて年次報告書のサステナビリティ指標でしかなかった電力消費が、今ではデータセンターの立地や事業継続そのものを左右する制約に変わっている。
- 電力網の逼迫:一部地域では追加電力の調達が不可能で、新規の計算インフラをプロビジョニングできない
- 規制圧力の強化:ドイツでは新設データセンターにPUE 1.2以下が義務化。アイルランドは大規模データセンターに100%のオンサイト発電能力を要求
- TCOへの影響:高消費電力のハードウェアは冷却設備やラック設計の大規模投資を強いり、総保有コストを押し上げる
Google Cloud Blogによれば、ワットあたりの性能向上が「戦略的資産」として位置づけられている。TPU 8tは第7世代比で最大2倍の電力効率を達成しており、規制基準を満たしながら高性能を維持する設計思想がエネルギー壁を突破するカギだとされている。
まとめ
本レポートの核心は「エージェントAI時代のインフラは、計算・セキュリティ・データ・エッジ・電力のすべてを統合的に設計しなければならない」という一点に集約される。AI Hypercomputerのような各レイヤーを共同設計するアーキテクチャが、高コストで機能不全に陥る従来モデルからの脱却策として注目されている。
物理世界とデジタルを結ぶフィジカルAIの波も現実化しつつあり、ロボットのトレーニングにデジタルツインを使う取り組みがGoogle Cloud上で始まっている。インフラ戦略を抜本的に見直すタイミングが、いま訪れていると言える。
この記事のポイント
- 83%の組織がエージェントAI本番運用にインフラ刷新が必要と回答
- 62%が推論税、81%が運用の複雑さをスケーリングの隠れコストと認識
- 79%がセキュリティ・ガバナンス・MLOpsを最大の課題に挙げている
- 90%がエッジAIを重要視し、72%は「極めて重要」と回答
- 91%がハードウェア選定で消費電力を考慮し、ワットあたり性能が新たな指標に
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WP-CLIとREST APIとAbilities API、WordPressインターフェースの選び方
3つのインターフェースの全体像
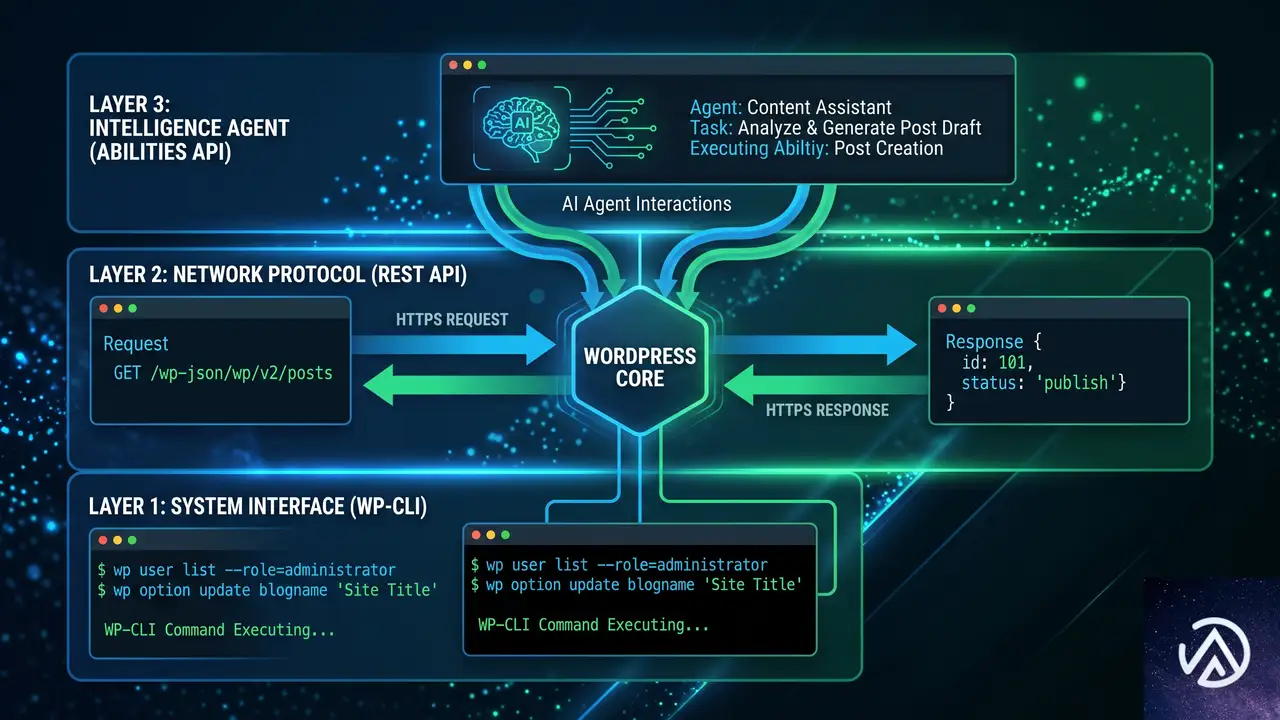
WordPressには外部からデータをやり取りするための主要なインターフェースが3つ存在する。WP-CLI、REST API、Abilities APIだ。それぞれが異なる距離感でWordPressと向き合い、異なる呼び出し元に対応する。これらを競合関係と捉えるのは誤りで、実際には階層構造をなしている。
WP-CLIはサーバー上で動作し、REST APIはHTTPを介して通信する。そしてAbilities APIは、そのさらに上位に位置し、AIエージェントが何をすべきかを判断する層になる。どのレイヤーがどこに位置するのかを理解すれば、タスクに応じた最適な選択はおのずと見えてくる。
- WP-CLI:サーバー上で直接PHPを実行(またはSSH経由)。一括操作、移行、デプロイ、メンテナンス向き
- REST API:wp-jsonへのHTTPリクエスト。ブラウザ、モバイルアプリ、外部サービスからコンテンツの読み書きに使用
- Abilities API:RESTとMCPで公開される名前付きPHPケイパビリティ。AIエージェントが安全に操作を行えるように設計
3つのインターフェースは、下位ほど呼び出し元がサイトに近く、信頼度も高い。上位になるほど、呼び出し元は自律的で遠隔地に位置する。この構造を理解すれば、「どれを使うべきか」の判断はシンプルになる。
WP-CLI:サーバー上のコマンドライン
WP-CLIはWordPressのインストール環境に対して直接PHPを実行する。コマンド例としては wp post create、wp plugin update、wp search-replace、wp db export などがある。実行にはサーバーへのシェルアクセス(SSH)が前提だが、その分HTTPの往復も認証トークンの管理も不要になる。
WP-CLIが最も威力を発揮するのは、サイトを完全に制御できる状況だ。1000件の投稿を移行する、データベース全体でドメインを置換する、定期メンテナンスをスクリプト化する、あるいはデプロイの自動化など、スピードが求められる一括操作では他の追随を許さない。
WP-CLIはシェルアクセスが前提のため、ブラウザやモバイルアプリ、外部サービスがサイトと通信する手段にはなりえない。しかし開発者がサイト全体を制御できる状況では、WP-CLIは圧倒的な速度と柔軟性を提供する。ターミナルからすべてを操作するワークフローが浸透している開発現場も多く、管理画面(wp-admin)をほとんど開かない運用も可能だ。
REST API:HTTP越しのWordPress
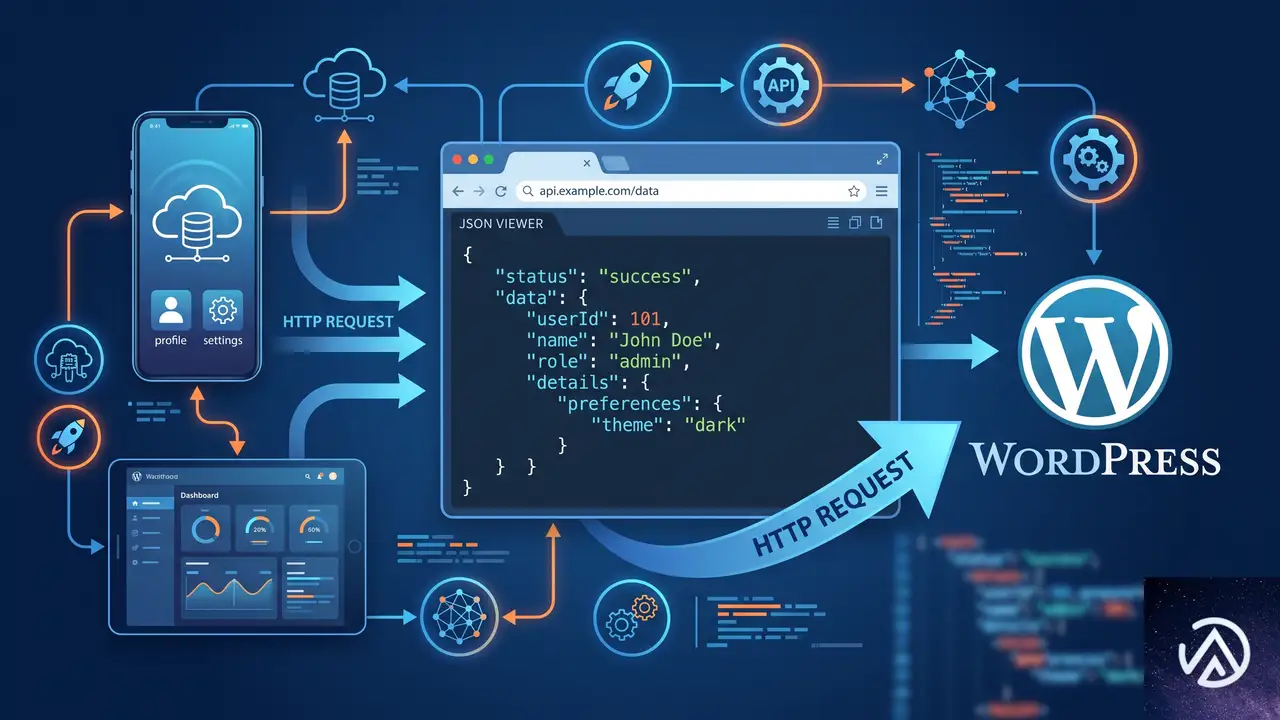
REST APIはWordPressサイトを、あらゆるHTTPクライアントが読み書きできる状態に変換する。エンドポイントは /wp-json/wp/v2/ 配下に存在し、認証にはアプリケーションパスワード、Cookieとnonce、あるいはOAuthを用いる。ブラウザ、モバイルアプリ、外部サービスがインターネット越しにコンテンツを取得・更新できるようになる。
ヘッドレスCMS構成のWordPressは、このREST APIを基盤に動作する。AstroやNext.jsで構築したフロントエンドがREST経由でコンテンツを取得し、モバイルアプリが投稿を行い、サードパーティ連携がデータを同期する。呼び出し元がサーバー外にいる場合、REST APIがほぼ唯一の通信経路となる。
投稿、ユーザー、タクソノミー、設定といった「リソース」
「誰が何をしたいのか」という意図や操作の文脈
REST APIには重要な限界がある。公開するのは「データの構造」であり、「そのデータで何をしたいのか」という操作の意図までは記述しない。どのエンドポイントが存在し、どうリクエストを組み立てるべきかは、呼び出し元が自ら理解する必要がある。人間の開発者であれば問題ないが、AIエージェントにとっては推論すべき情報が多すぎるという課題が残る。
Abilities API:AIエージェントのためのケイパビリティ層
Abilities APIはWordPress 6.9でコアに導入された最新のインターフェースだ(それ以前のバージョン向けにはプラグインも提供されている)。REST APIが残した「AIエージェントが何を許可されているのかをどう知るか」という課題を解決するために設計された。
Abilities APIでは、生のリソースを公開する代わりに、プラグインやテーマが「名前付きケイパビリティ(能力)」を登録する。各アビリティは、一意のID、人間が読めるラベル、説明文、入力・出力のスキーマ、権限チェックのコールバック、そして実行コールバックを備えた独立した操作単位となる。
add_action( 'wp_abilities_api_init', function () {
    wp_register_ability( 'my-plugin/publish-draft', [
        'label'             => '下書きを公開',
        'description'       => 'IDを指定して既存の下書き投稿を公開する',
        'category'          => 'my-plugin',
        'input_schema'      => [ /* 期待する入力のJSON Schema */ ],
        'output_schema'     => [ /* 結果のJSON Schema */ ],
        'permission_callback' => 'my_plugin_can_publish',
        'execute_callback'  => 'my_plugin_publish_draft',
        'meta'              => [ 'show_in_rest' => true ],
    ] );
} );meta.show_in_rest をtrueに設定すると、そのアビリティは wp-json/wp-abilities/v1/abilities で公開され、クライアントが検出できるようになる。JavaScript側では @wordpress/abilities パッケージを介して利用する。
Abilities APIの最大の価値は、エージェントが安全に行動するために必要な「契約」を提供することだ。操作の定義、必要な入力形式、実行許可の条件が明示されるため、AIエージェントがサイトを壊すリスクを最小限に抑えられる。複数のエージェントが共通の語彙で協調動作するマルチエージェント構成でも、Abilities APIが基盤になりつつある。
3つのインターフェースの積み重なり方
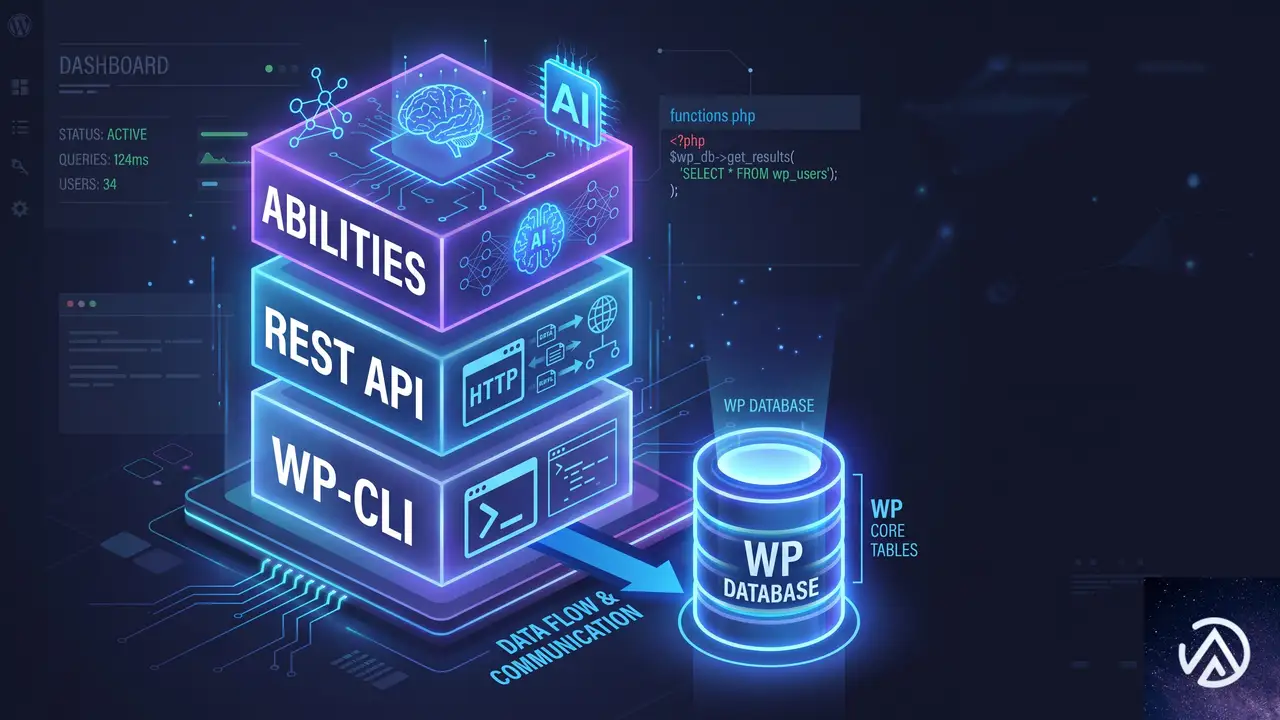
3つのインターフェースは互いに積み重なる関係にある。Abilities APIは多くの場合REST APIの上に構築され、REST APIはWP-CLIが直接駆動するPHPの上で動作する。すべての基盤にあるのは、同じWordPressコア、同じデータベース、同じ関数群だ。
したがって問うべきは「どれが最善か」ではない。「呼び出し元がサイトからどれだけ離れているか」「操作の意図をどこまで明示する必要があるか」という視点で選択することが本質になる。呼び出し元が近く信頼できるほど下位層を、自律的で遠隔にあるほど上位層を使う。
上位層になるほど「記述性」と「安全性」が重視され、下位層ほど「速度」と「直接制御」に優れる。これらは設計上、相補的な関係にあり、実際のプロジェクトではすべてを併用するのが理想的な構成だ。
各インターフェースの使い分け方
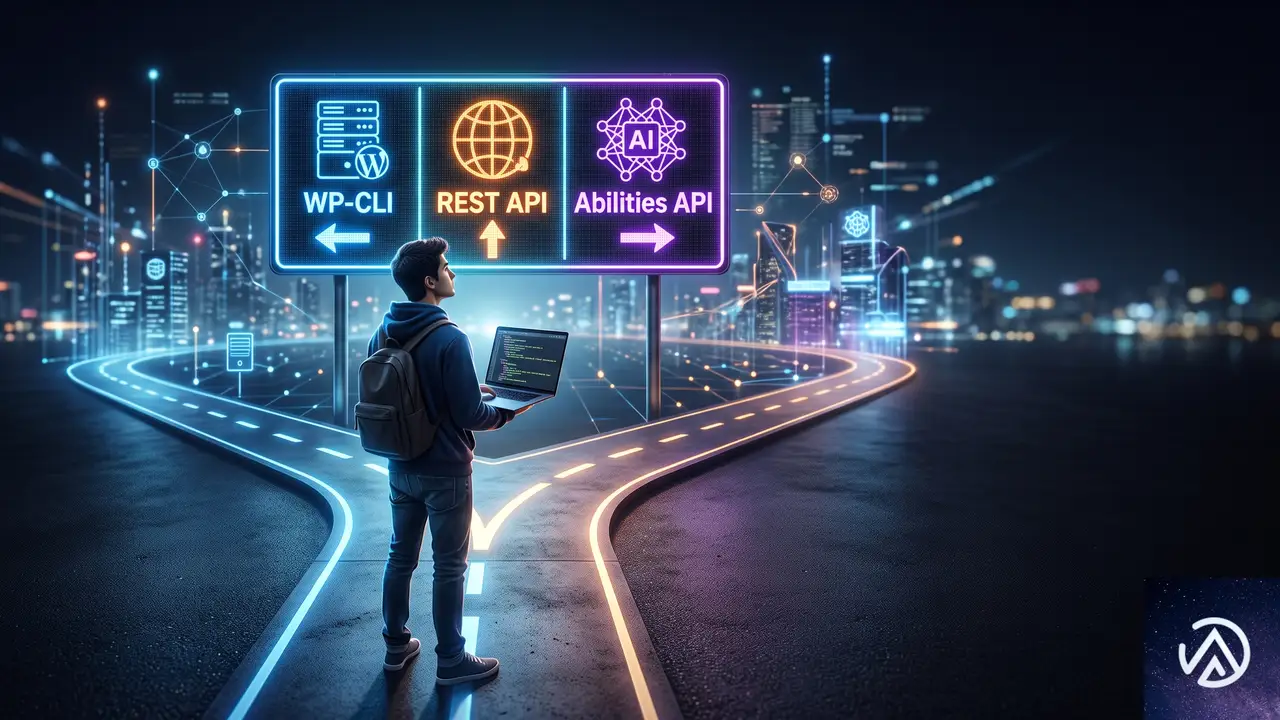
日常的なタスクにおける選択指針を整理する。
- 自分が制御するサイトに対して、一括かつ高速に操作したい → WP-CLI。移行、デプロイ、定期ジョブ、データベース操作が該当する
- ブラウザ、アプリ、外部サービスがコンテンツを読み書きする必要がある → REST API。ヘッドレスフロントエンド、モバイルアプリ、外部連携が該当する
- AIエージェントにサイトを壊さず操作させたい → Abilities API。許可したい操作をスキーマと権限付きで登録し、エージェントに発見させる
実際のプロジェクトでは、この3つを排他的に使うことはまれだ。むしろそれぞれの得意領域を活かして組み合わせるのが、効率的なWordPress運用の鍵になる。
3つを組み合わせた実践的な構成
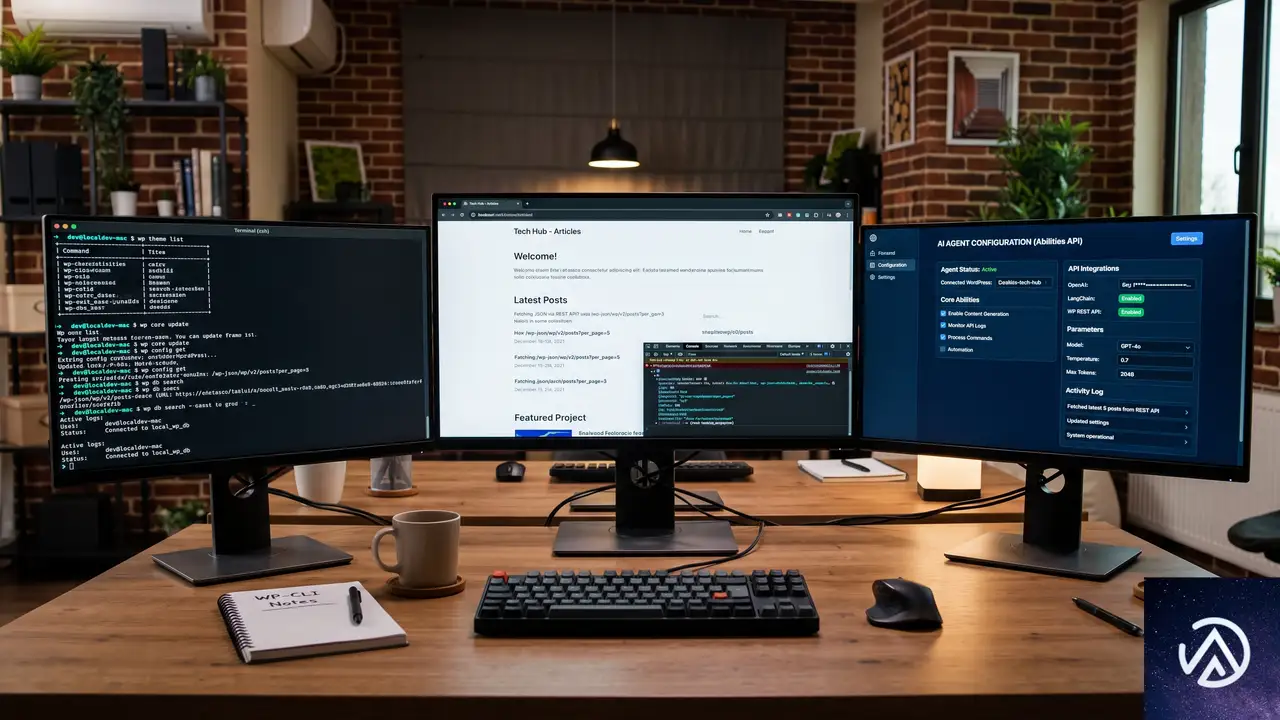
WP Mayorの記事では、実際に3つのインターフェースを併用している構成例が紹介されている。まず、公開運用と日常的な運用作業はSSH経由のWP-CLIで実行される。新規投稿、メディアのインポート、プラグイン更新、キャッシュクリアといった操作をターミナルから完結させ、管理画面(wp-admin)をほとんど開かない運用が行われている。
フロントエンドはヘッドレス構成で、REST API越しにコンテンツを取得する。Astroで構築されたサイトが wp-json 経由でWordPressからデータを取得し、高速な静的ページとして配信する。訪問者はWordPressテーマに触れることなく、WordPressはバックエンドのエンジンとして機能し、REST APIがそのパイプ役を担う。
エージェント向けの機能はAbilities APIを通じて提供される。AIエージェントに限定的なタスクを任せたい場合、関連プラグインがその操作をアビリティとして登録する。権限チェックとスキーマを伴うため、シェルアクセスを丸ごと渡したり、大量の生エンドポイントをエージェントに解析させたりする必要がなくなる。
WP-CLIは速度と一括処理能力で、REST APIは外部連携の柔軟性で、Abilities APIはAIエージェントの安全性で優位性を持つ。1つのインターフェースに別の役割を強制しようとするところから問題は始まる。3つのレイヤーを適材適所で使い分けることが、WordPress自動化の効率を最大化する道筋だ。
この記事のポイント
- WP-CLI、REST API、Abilities APIは競合ではなく、呼び出し元の距離に応じた階層構造をなす
- WP-CLIはサーバー上の直接操作に最適で、一括処理と速度が求められる場面で選ぶ
- REST APIはHTTP越しのデータ読み書きを担い、ヘッドレス構成やモバイルアプリ連携の基盤となる
- Abilities APIはAIエージェントに操作の安全な契約を提供し、マルチエージェント構成でも威力を発揮する
- 実際のプロジェクトでは3つを組み合わせ、各レイヤーの得意領域を活かすのが理想的な運用だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GA4にAI Assistantチャネル追加、ChatGPT流入を可視化
Google Analytics 4(GA4)に2026年5月、生成AIプラットフォームからの流入を可視化する「AI Assistant」チャネルが追加された。ECサイト運営者にとって、ChatGPTやClaudeが商品情報を紹介した結果のトラフィックを正確に把握できる初めての標準機能だ。
この記事ではAI Assistantチャネルの基本的な仕組みと、ECサイトでの具体的な活用法を解説する。設定不要でデータが自動収集される一方、AI Overviewsは含まれないといった注意点もあるため、正しい読み方を押さえておく必要がある。
WooCommerceサイトを運営する中小企業の担当者や、ECのアクセス解析を担当するWeb担にとって、これまで「参照元不明」だったAI経由の流入を可視化できる意味は大きい。
AI Assistantチャネルとは何か
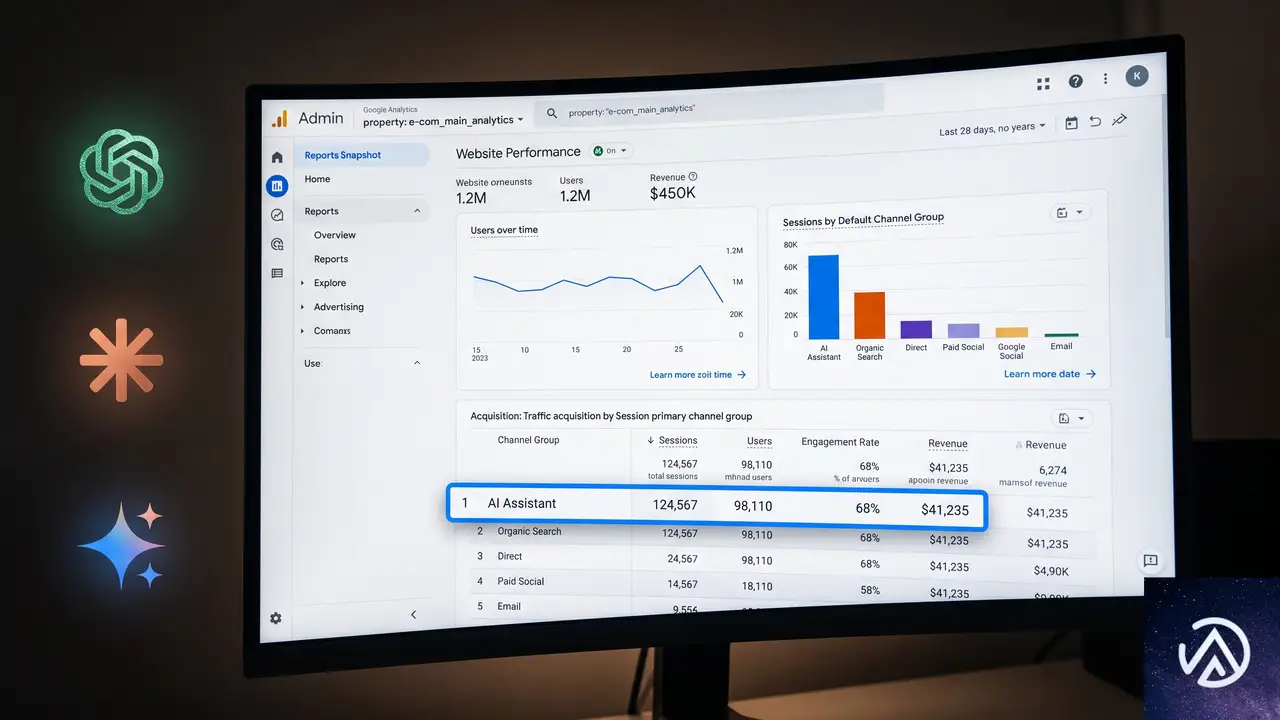
AI Assistantチャネルは、GA4のデフォルトチャネルグループに追加された新しい分類項目だ。ChatGPTやGemini、Claudeといった主要な生成AIプラットフォームからのトラフィックを自動的に判別し、ひとつのチャネルとして集計する。
計測対象となるプラットフォーム
Googleの公式ヘルプドキュメントによると、AI Assistantチャネルに含まれるのは「ChatGPT、Gemini、Claudeといったチャットボット」からのトラフィックだ。具体的な全リストは公開されていないが、主要な生成AIサービスはおおむねカバーされていると見てよい。
ここで重要な注意点がある。Google検索のAI Overviews(旧SGE)やAI Modeは、このチャネルには含まれない。これらは引き続き「Organic Search(オーガニック検索)」チャネルとして報告される。同じAI由来の流入でも、検索エンジン経由かチャットボット経由かで扱いが異なるわけだ。
ECサイトにとっての意味
ECサイト運営者にとって、AIチャットボット経由の流入は従来のSEOとは異なる文脈で発生する。たとえば「予算3万円で買えるおすすめのワイヤレスイヤホン」といった自然言語の質問に対し、ChatGPTが具体的な製品名とURLを提示するケースだ。この流入経路を正確に把握できれば、AIに自社商品がどのような文脈で言及されているかを分析できる。
AIトラフィックの確認手順
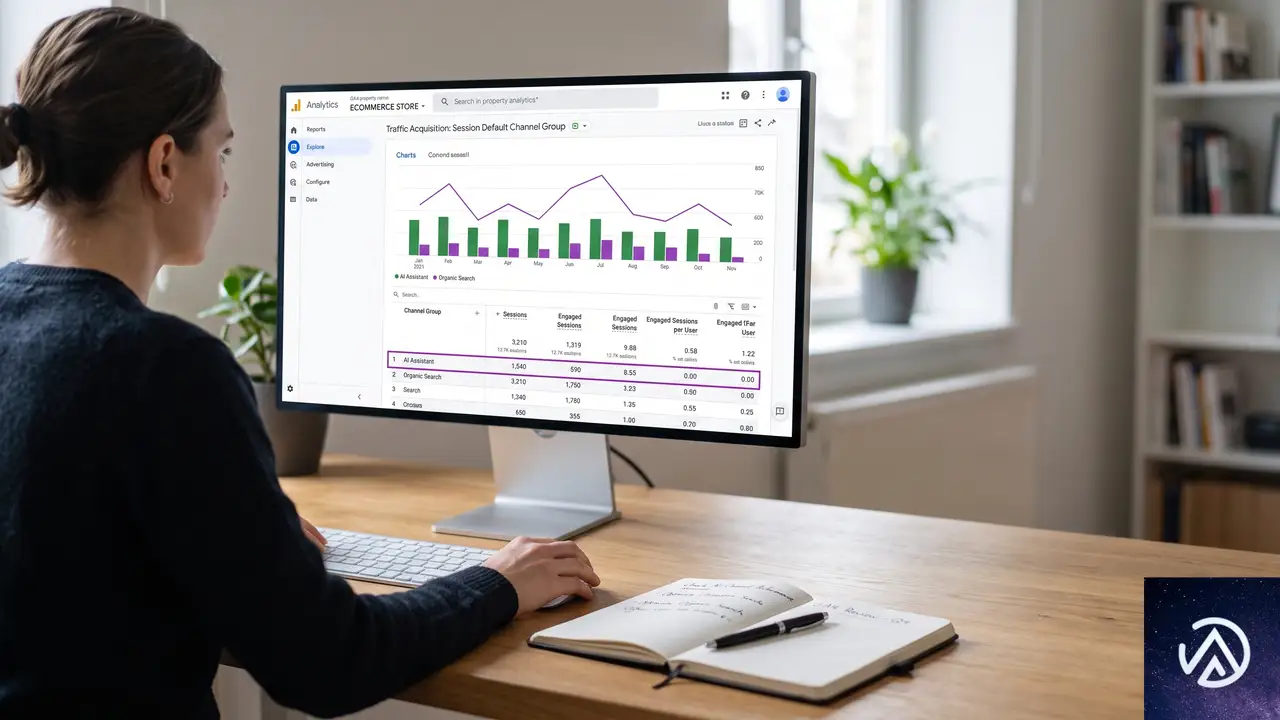
GA4でAI Assistantチャネルのデータを見るための手順を解説する。初期設定は不要で、GA4が自動的に分類を開始しているため、すぐに確認できる。WooCommerceサイトでGA4を導入済みであれば、追加のコード実装も必要ない。
トラフィック全体像の把握
まずはECサイト全体で、AI経由の流入がどの程度あるのかを確認する。GA4管理画面で「レポート」→「集客」→「トラフィック獲得」の順に開き、「セッションのデフォルトチャネルグループ」ディメンションを選択する。ここで「AI Assistant」という行が表示されていれば、すでにAI経由のトラフィックが発生している。
表示される指標はエンゲージメント率、セッションあたりのイベント数、平均セッション時間などだ。これらの数字をOrganic Searchチャネルと比較することで、AI経由ユーザーの行動特性が見えてくる。
ランディングページの特定
AIがどの商品ページを参照しているのかを特定するには、「レポート」→「エンゲージメント」→「ページとスクリーン」を開く。画面上部の「フィルタを追加」から、以下の条件で絞り込む。
- ディメンション:セッションのデフォルトチャネルグループ
- マッチタイプ:完全一致
- 値:AI Assistant
このフィルタを適用すると、AIプラットフォームからのクリックが多いページが上位に表示される。WooCommerceの商品ページやカテゴリページのうち、どのURLがAIに評価されているかを把握できるはずだ。
AIトラフィックと他チャネルの比較
同じ「ページとスクリーン」レポートで「比較を追加」ボタンを使うと、AI経由とオーガニック検索経由のトラフィックを横並びで比較できる。Practical Ecommerceの記事著者Carlo Daniele氏の検証によれば、オーガニック検索で上位のページとAI Assistant経由で上位のページは重複しなかったという。
これはEC担当者にとって示唆が大きい。Google検索で上位表示されている商品と、AIがユーザーに推薦する商品が異なる可能性があるためだ。AI経由の流入を伸ばすには、従来のSEO対策とは別のアプローチが必要になるかもしれない。
正規表現を使った詳細なソース分析
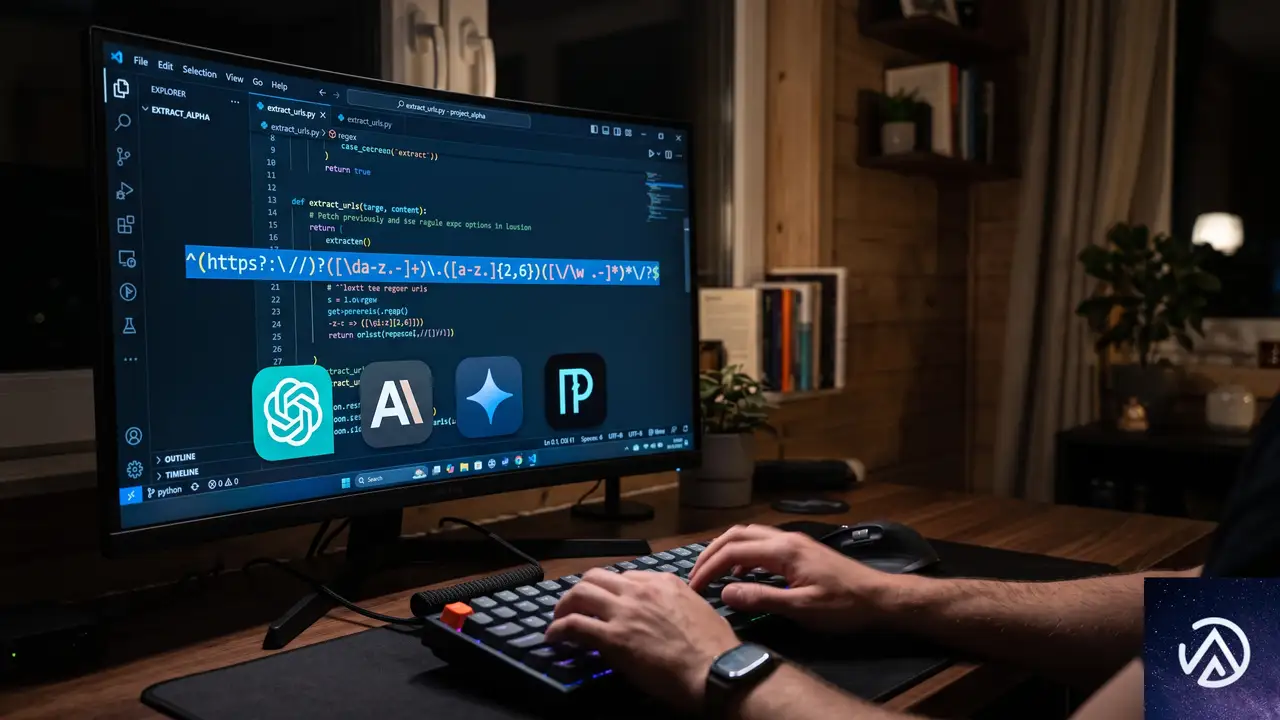
AI Assistantチャネルは便利だが、どのAIプラットフォームからの流入なのかまでは分解できない。ChatGPT経由なのかClaude経由なのかを個別に知りたい場合は、正規表現(regex)を使ったフィルタリングが有効だ。
設定手順
「レポート」→「集客」→「トラフィック獲得」で、グラフ上部の「フィルタを追加」をクリックする。ディメンションに「セッションの参照元/メディア」、マッチタイプに「matches regex」を選択し、以下の正規表現を値欄に貼り付ける。
.*chatgpt.com.*|.*perplexity.*|.*edgepilot.*|.*copilot.microsoft.com.*|.*openai.com.*|.*gemini.google.com.*|.*claude.ai.*|.*grok.x.ai.*このフィルタを適用すると、AIプラットフォームごとのセッション数やエンゲージメント指標を一覧できる。ただしPractical Ecommerceの記事でも指摘されているように、AI Assistantチャネルとの間にわずかなデータの不一致が生じる場合がある。これは「Organic」や「(not set)」と分類される一部のAIトラフィックが正規表現では拾えていないためだ。
WooCommerceサイトでの活用ポイント
正規表現フィルタを使えば、たとえば「ChatGPT経由では商品Aへの流入が多いが、Claude経由では商品Bが多い」といったプラットフォーム別の傾向を把握できる。AIによって得意とする商品カテゴリや、参照する情報ソースが異なる可能性があるためだ。
このデータをもとに、特定のAIプラットフォームで自社商品が言及されやすいコンテンツを強化するといった戦略が考えられる。Semrushなどの外部ツールで、どのようなプロンプトがAIの引用を生んでいるのかを調査するのも有効だ。
EC担当者が今すぐやるべき3つのアクション
AI Assistantチャネルの登場を受けて、ECサイトのアクセス解析にすぐに組み込むべき施策を整理する。いずれも追加コストなしで今すぐ始められるものばかりだ。
特にアクション2は重要だ。AIは商品スペックや口コミ、価格情報を総合的に評価して回答を生成する。商品ページの情報が不十分だとAIに引用されにくくなるため、商品説明の充実や構造化データの実装はAI時代のECに不可欠な施策といえる。
AIトラフィックとECの未来
GA4のAI Assistantチャネルは、ECにとって「AI経由の流入」という新たな指標を提供し始めた。現時点ではまだAIトラフィックの絶対量は小さいかもしれないが、ChatGPTやClaudeがデフォルトでWeb検索を行うようになり、AIを経由した商品発見は確実に増えていく。
AI OverviewsがOrganic Searchに含まれるという設計からもわかるように、GoogleはAIを「検索の拡張」と位置づけている。EC担当者はSEOとAI最適化を別物ではなく、同じ「検索体験」の両輪として捉えるべきフェーズに入ったといえる。
WooCommerceサイトであれば、GA4の標準機能だけでAIトラフィックの可視化は十分に可能だ。まずはデータを取得し、AIが自社商品をどう評価しているのかを把握することから始めてほしい。
この記事のポイント
- GA4に2026年5月追加のAI Assistantチャネルで、ChatGPTやClaudeなど生成AIからの流入が自動分類される
- AI OverviewsやAI Modeは含まれず、これらはOrganic Searchとして報告される点に注意が必要
- ページとスクリーンレポートでAI経由ランディングページを特定し、商品情報の最適化に活かせる
- 正規表現フィルタでAIプラットフォーム別の傾向を把握し、より細かな流入分析が可能
- AIトラフィックはSEOと地続きの指標であり、商品ページの情報充実がAIからの引用を増やす鍵になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAI、フルデュプレックス音声モデルGPT‑Liveを発表、会話の自然さを大幅向上
OpenAIは2026年7月8日、新しい音声対話モデル「GPT‑Live」を発表した。人が話しかけるのと同時に聞き取り、相槌を打ったり沈黙を尊重したりできるフルデュプレックスアーキテクチャが最大の特徴だ。
モデル自体は単体の音声モデルでありながら、高度な質問に対してはバックエンドのGPT‑5.5に自動で推論を委譲する。これにより、速さと知性を両立させた自然な会話体験を実現している。
フルデュプレックスアーキテクチャが会話の自然さを変える

従来の音声AIが抱えていた限界
これまでのChatGPT音声機能は、大きく分けて2つの方式を経て進化してきた。最初のカスケード型は、音声認識→テキスト生成→音声合成という3つのモデルを直列に繋いでいた。各段階で情報が欠落し、応答までに長い沈黙が生まれる欠点があった。
次世代のターンベース型(Advanced Voice Mode)は単一モデルで音声を処理し、レイテンシを削減した。しかし「ユーザーが話し終えるまで待つ」というターン制のため、割り込みや考え込む間といった自然なやり取りができず、わずかな無音で誤って応答を開始する問題も残っていた。
このデモはGPT‑Liveがもつ同時双方向処理の概念を簡略化したものだ。実際の会話では秒単位で割り込みやツール呼び出しの判断が行われている。
連続的な相互作用が生むリアルタイム性
GPT‑Liveのフルデュプレックス構造では、入力と出力が同時に連続的に処理される。モデルは1秒間に何度も発話や傾聴、一時停止、割り込み、ツール起動といった行動を判断できる。この仕組みが、相槌や「ええ」といった自然なフィードバック、沈黙の尊重、さらには会話中のリアルタイム翻訳まで可能にしている。
バックエンド委譲で高度な推論をリアルタイム対話に統合

対話と思考の分離がもたらすメリット
GPT‑Liveはフロントエンドの自然な対話と、バックエンドの深い処理を分離した。Web検索や複雑な推論が必要な質問が来ると、自身は会話を続けながらGPT‑5.5にタスクを委譲する。回答が用意でき次第、会話に自然に織り込まれる。
この分離により、常に最新のフロンティアモデルが活用され、モデル更新のたびにGPT‑Liveの知性も自動的に向上する。発表時点ではGPT‑5.5がバックエンドとして使われる。
この委譲の仕組みにより、GPT‑Liveは会話のテンポを保ちつつ、最新のフロンティアモデルの知性を引き出せる。
評価指標が示す会話品質の飛躍的向上
人間による比較評価でAdvanced Voice Modeを圧倒
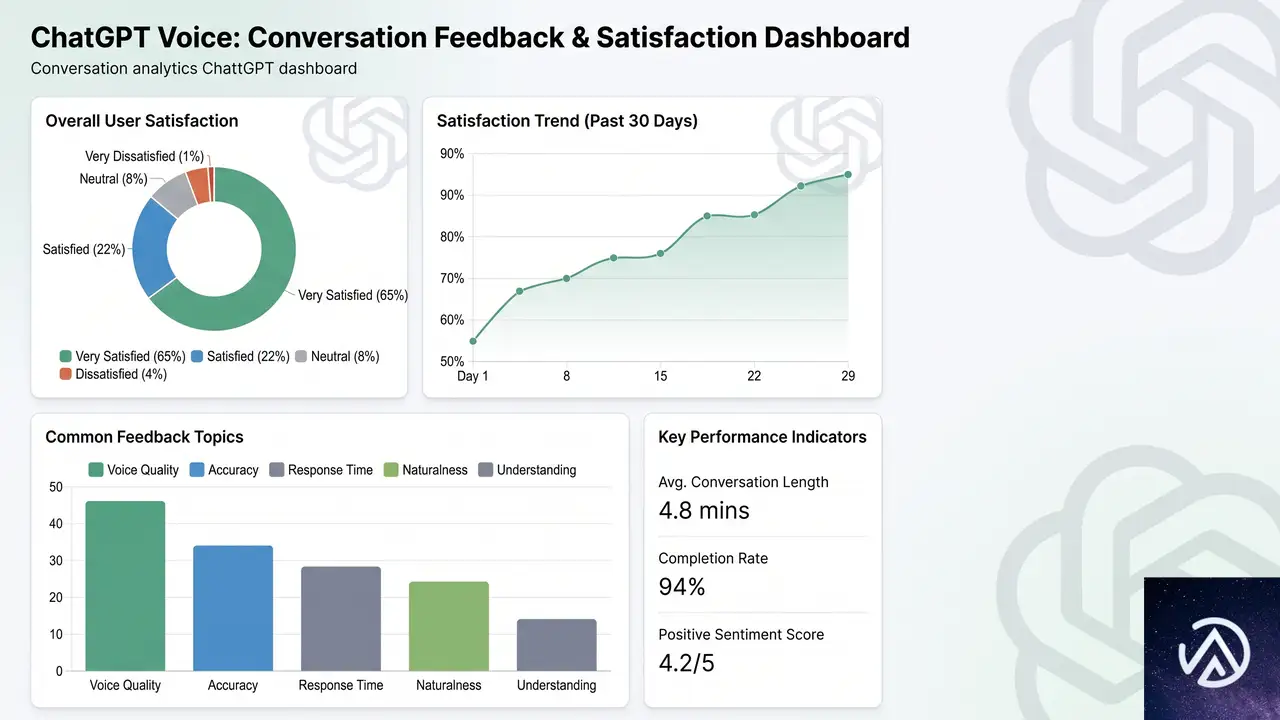
OpenAIの発表によれば、5〜10分の会話を対象にした人間評価では、GPT‑Live‑1とGPT‑Live‑1 miniの両方がAdvanced Voice Modeより強く選好された。話者交替のスムーズさ、割り込みの自然さ、会話全体の心地よさで高い評価を得ている。
専門的な推論力を測るGPQA(物理学・化学・生物学の高度な質問)ではGPT‑Live‑1が大幅に上回り、Web検索能力を問うBrowseCompでも強い改善を見せた。音声エージェントとしての電話サポートタスクでも、内部指標でAdvanced Voice Modeを凌駕した。
ChatGPT Voiceに搭載される新機能と使い勝手

相槌や割り込み、視覚的応答の追加
GPT‑Liveの導入により、ChatGPTの音声ボタンを押すとすぐに自然な会話が始まる。ユーザーは質問を遮ったり、考え込む間を作ったり、「ゆっくり話して」と頼んだりできる。モデルは「うん」「なるほど」といった相槌で話を聞いていることを伝え、背景ノイズがあっても話者の声に集中する。
さらに、天気や株価、スポーツの試合予定などの情報は、音声会話中にビジュアルカードとして画面に表示される。従来通り画像やファイルのアップロードにも対応し、Web検索やメモリー機能とも連携する。
回答の思考深度も選択可能で、「Instant」なら即答、「Medium」や「High」にするとモデルが時間をかけて深く推論する。全9種類の声もGPT‑Live向けにリマスターされた。
音声特化の安全性設計と継続的な監視

リアルタイムの有害出力検出と介入
GPT‑Liveは音声会話の即時性に対応するため、発話中でも安全性チェックが動作する。不適切な内容が検出されると、より安全な応答へ誘導したり、追加の安全メッセージを表示したり、深刻なケースでは会話を終了させたりする。
自傷行為に関する会話では、専門家が確認したクライシスヘルプライン情報を音声で案内する仕組みも組み込まれた。10代のユーザー向けには年齢に適した振る舞いを直接モデルに学習させ、保護者がChatGPT Voiceの利用を制限できる機能も用意されている。
実利用データに基づく安全対策の進化
OpenAIは感情的な依存に関する長期モニタリングを展開し、実際の利用パターンから新たなリスクを特定して対策を強化する方針だ。音声のなりすましを防ぐため、GPT‑LiveはChatGPTに用意された定義済みの声のみを使用し、実在の人物の声を模倣しないように設計されている。
この記事のポイント
- GPT‑Liveはフルデュプレックス構造で同時に聞きながら話し、相槌や沈黙を自然に扱える音声モデル
- 高度な質問はバックエンドのGPT‑5.5に自動委譲し、会話のテンポを保ったまま深い推論結果を返す
- 人間評価やGPQAなどのベンチマークでAdvanced Voice Modeを大きく上回る会話品質と知性を達成
- ChatGPT Voiceに即日導入され、ビジュアル応答や思考深度の選択が可能に
- リアルタイムの安全性介入や利用後監視により、音声ならではのリスクに対処している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.6ファミリー登場、Sol・Terra・Lunaの全容と実務メリット
OpenAIは2026年7月9日、次世代フラッグシップモデル「GPT-5.6」ファミリーを一般提供開始した。プレビュー期間を経て投入された本リリースには、フラッグシップのSol、バランスモデルのTerra、コスト効率重視のLunaの3モデルが揃う。
GPT-5.6 Solはコーディング、知識労働、サイバーセキュリティ、科学研究の各領域で従来のフロンティアモデルを上回る性能を達成しつつ、消費トークン数と推定コストの大幅削減を両立した。これにより同一予算でもより多くの成果を出せる、いわば「コストパフォーマンスの再定義」を実現している。
この記事では、GPT-5.6の各モデルの特徴と性能、実務者にとってのメリット、そしてOpenAIが打ち出した新たな安全性対策を掘り下げる。
GPT-5.6ファミリーの全体像~3モデルの違いと狙い

GPT-5.6ファミリーは3つのモデルで構成される。Sol・Terra・Lunaはいずれも第5.6世代の基盤技術を共有するが、ターゲットとする用途とコスト構造が異なる。OpenAIによれば、これらのモデル名(Sol・Terra・Luna)は永続的な能力階層を示しており、今後それぞれのペースでアップデートが進む見込みだ。
Solが実現する「1トークンあたりの仕事量」の進化
Solの最大の特徴は、消費トークンあたりの実用成果の高さにある。Agents’ Last Exam(55分野の長時間ワークフロー評価)ではスコア53.6を記録し、競合のClaude Fable 5を13.1ポイント上回った。中程度の推論設定でも、Fable 5に対して11.4ポイント優位に立ちつつ、推定コストは約4分の1に抑えている。
この効率性は下位モデルにも波及している。GPT-5.6 TerraとLunaは、Fable 5の性能を上回りながら推定コストは約16分の1だ。単に「強いAI」を作るだけでなく、同じ予算でより多くの知的作業をこなせる点が、今回のリリースの中核的価値といえる。
ultra設定がもたらす並列エージェント駆動
GPT-5.6 Solには「ultra」と呼ばれる最高能力設定が搭載された。ultraはデフォルトで4つのエージェントを並列動作させ、複雑なタスクを複数のワークストリームに分割して処理する。これにより単一エージェント構成と比べて、スコアとレイテンシの両方で改善が確認されている。
BrowseComp、SEC-Bench Pro、Terminal-Bench 2.1の3評価すべてで、並列エージェントの追加により「より高スコアをより短時間で」達成する結果が得られた。開発者はAPIのマルチエージェントベータ機能を通じて、同様の並列処理を独自に構築することも可能だ。
実務者にとってのGPT-5.6~コストと速度の再定義

GPT-5.6の真価はベンチマークスコアだけではない。実務者が日々使うツールやワークフローの中で、どれだけ「手戻り」を減らし「完成度」を高められるかが鍵だ。
Programmatic Tool Callingでツール連携が変わる
GPT-5.6に導入された Programmatic Tool Calling(プログラマティックツール呼び出し)は、モデル自身が軽量なプログラムをメモリ内で作成・実行し、ツール連携や中間結果の処理を自律的に進める仕組みだ。開発者が全ステップをスクリプト化する必要はなく、大量の中間データから必要な情報だけを抽出して次のアクションを判断する。
この仕組みにより、ツールを多用するワークフローでのトークン消費と往復回数が大幅に削減される。Responses APIで利用可能で、Zero Data Retention(ZDR)にも対応している。
max・ultra設定で複雑タスクを加速
GPT-5.6は効率重視のデフォルト動作に加えて、難易度の高いタスクに対して計算リソースを集中的に投下する設定を備える。max設定はxhighより長時間の推論と検証を許容し、ultraは並列エージェントで処理を高速化する。APIの価格帯は Sol が入力100万トークンあたり5ドル、出力同30ドルと公表されている。
コーディング性能の飛躍~開発者にとってのGPT-5.6

GPT-5.6 Solは現時点で最強のコーディングモデルと位置づけられている。Artificial Analysis Coding Agent Indexでは、max推論設定でスコア80を達成し、Claude Fable 5を2.8ポイント上回った。出力トークン数は半分未満、所要時間も半分以下、推定コストは約3分の1減という結果だ。
実コードベースでの強さ~DeepSWEとTerminal-Bench
GPT-5.6の優位性は、実コードベースでの長期エンジニアリングタスクを評価するDeepSWE v1.1やTerminal-Bench 2.1でも確認されている。Terminal-Bench 2.1ではSolが88.8%、ultra設定では91.9%に達し、GPT-5.5(85.6%)やClaude Fable 5(83.1%)を明確に引き離した。
複雑なコマンドラインワークフローを自律的に処理できるようになったことで、開発者がスクリプトの細部を逐一指示する必要は減り、「何を実現したいか」の指示だけで作業が進む体験に近づいている。
知識労働とデザイン判断力の進化

GPT-5.6は知識労働の質でも段違いの進化を見せる。Slack、Notion、Microsoft 365、Google Driveといった日常ツールから雑多な文脈を取り込み、専門家レベルの成果物に変換する能力が強化された。
プレゼンテーション・文書作成の実力
特に顕著なのがプレゼンテーション作成能力だ。GPT-5.6はプロンプトとソース資料から完全に編集可能なスライドを一から生成できる。レイアウト、階層構造、デザインの一貫性を備えた視覚的ナラティブを構築し、テンプレートやリファレンスデッキがある場合は、スライドマスターに埋め込まれたデザインルールさえ推論して適用する。
OpenAIの比較事例では、GPT-5.5が参照ファイルのマスタースライドコンポーネントを欠落させたのに対し、GPT-5.6はレイアウト・タイポグラフィ・配色・コンテンツパターンを忠実に再現した。文書やスプレッドシートでも、複雑な参照フォーマットの遵守、数式や財務モデルの精度、ページレイアウトの洗練度が向上している。
コンピュータ操作とUIデザインの判断力
GPT-5.6のコンピュータ操作能力は、コード生成にとどまらず、レンダリング結果の視覚的検証と改善までカバーする。高水準の指示だけで機能的かつ洗練されたUIを作成し、仕上がりを目視確認してから納品するフローが可能になった。BrowseCompではスコア92.2%と競合を上回り、OSWorld 2.0では62.6%を達成しながら出力トークン数を85%削減している。
セキュリティと安全性~進化した防護策

GPT-5.6はサイバーセキュリティ領域で飛躍的な性能向上を示した。ExploitBenchではGPT-5.5の47.9%から73.5%へ、ExploitGymでは15.1%から24.9%(2時間制限、6時間では33.7%)へと大幅に改善している。
デュアルユースを前提とした安全性設計
サイバーセキュリティは本質的にデュアルユース(両義的利用)の領域だ。脆弱性をつく能力が高まれば、同時にそれを見つけて修正する防御能力も高まる。OpenAIは「過剰なブロックは防御側の活動を阻害し、攻撃者は他のモデルやオープンソースツールを使い続ける」との立場をとっている。
そのためGPT-5.6の安全策は、一律ブロックではなく、リクエストの文脈と想定される結果を評価する多層構造を採用した。モデル内部に訓練された保護機能に加え、リアルタイムチェック、継続的モニタリング、アカウントレベルの制御が重層的に機能する。最も機微な能力はOpenAI DaybreakのTrusted Access for Cyberプログラムを通じて、認証済みの利用者のみに提供される。
約70万GPU時間のレッドチーミング
一般提供に先立ち、OpenAIは過去最大規模の安全性評価を実施した。外部専門家によるレッドチーミングに加え、約70万A100e GPU時間を投じたブラックボックス型の自動レッドチーミングで弱点を体系的に探索した。GPT-5.6 Solのサイバーセーフガードは、GPT-5.5比で約10倍の有害活動をブロックしている。
提供形態と価格~ChatGPT・Codex・APIのロールアウト

GPT-5.6は7月9日から全世界で段階的に提供が開始され、24時間以内に全ユーザーへの展開が完了する予定だ。
Free/Go Terraを利用可能
Terra $2.50 input / $15 output
Luna $1 input / $6 output
ChatGPTでは、Plus・Pro・Business・EnterpriseユーザーがGPT-5.6 Solに中〜高エフォート設定でアクセスできる。ProとEnterpriseは最高品質のSol Proも選択可能だ。Codexでは、Plus以上でSol・Terra・Lunaを選択でき、ultraはProとEnterpriseが利用できる。
APIの価格体系は前世代と比べて明確な選択肢を提供する。TerraとLunaの登場により、予算やタスクの重要度に応じて同じGPT-5.6アーキテクチャの恩恵を受けながら、コストを最適化できるようになった。
AI研究の自己加速~内部導入で見えた効果
OpenAIの社内では、GPT-5.6のテスト期間中に研究者1人あたりの1日平均出力トークン数がGPT-5.5のピーク時の2倍以上に達した。過去6カ月間で社内の研究向けコーディング推論の計算リソース消費は100倍に、エージェント型トークン利用は約22倍に増加している。
OpenAIはこの再帰的自己改善能力を「RSI Index」という内部評価指標でスコア化しており、GPT-5.6 SolはGPT-5.5から16.2ポイントの改善を示した。研究デバッグ、カーネル最適化、機械学習実験の自動化など、AIがAIの開発を加速する好循環が始まっている。
この記事のポイント
- GPT-5.6はSol・Terra・Lunaの3モデル構成で、フラッグシップから低コストまで用途に応じた選択が可能
- コーディング・知識労働・サイバーセキュリティ・科学研究の全領域でGPT-5.5を大幅に上回る性能を達成
- 消費トークン数とコストの大幅削減により、同一予算での成果最大化を実現
- 並列エージェントのultra設定やProgrammatic Tool Callingで複雑タスクの自律処理が加速
- 約70万GPU時間のレッドチーミングを含む多層的安全策で、防御的利用を阻害せずに悪用を抑制
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.0でget_queried_object()がショップページでもWP_Postを返す改善
WooCommerce 11.0より、ショップページで get_queried_object() を呼び出した際の戻り値の型が WP_Post_Type から WP_Post に統一される。これまでショップページだけが例外的に商品の投稿タイプオブジェクトを返していたが、今回の変更でWordPress標準の挙動と一貫性が保たれることになる。
この修正は、WooCommerceが内部的に管理するクエリの取り扱いをWordPressコアに合わせるもので、テーマやプラグインの開発者が「ショップページかどうか」を意識せずに get_queried_object() を扱えるようにする狙いがある。フロントページにショップページを設定している場合も同様の挙動となる。
WooCommerce 11.0のショップページ改善
get_queried_object() は現在のWordPressクエリに対応するオブジェクトを取得する標準関数だ。通常の固定ページや投稿ページでは WP_Post オブジェクトを返すが、これまでのWooCommerceではショップページに限り WP_Post_Type オブジェクト、つまり商品(product)の投稿タイプ情報を返していた。この不一致が開発者にとって混乱の元となっていた。
WooCommerce Developer Blogの説明によれば、ショップページで get_queried_object() を呼び出して「商品アーカイブであること」を判定するコードを書いていた場合、この変更の影響を受ける可能性がある。逆に言えば、今回の修正で is_shop() のような条件分岐タグと get_queried_object() の戻り値の関係が整理され、より直感的なコードが書けるようになる。
この変更の背景には、WordPressの「投稿ページ」設定と同様にショップページでも WP_Post を返すべき、という設計上の判断がある。WooCommerce 11.0ではこの長年の不一致が解消され、より予測しやすいAPIへと改善された。
影響を受けるコードの判断方法
自作のテーマやプラグインでショップページのクエリオブジェクトを参照している場合、以下のいずれかの関数やプロパティを使用していないか確認する必要がある。
get_queried_object()を呼び出しているget_queried_object_id()を呼び出している$query->queried_objectに直接アクセスしている$query->queried_object_idに直接アクセスしている
これらのコードがショップページ上で実行され、戻り値として WP_Post_Type オブジェクトを期待しているなら、WooCommerce 11.0へのアップデート後に動作が変わる可能性が高い。とくに、queried_object->labels->name などのプロパティに依存している場合は要注意だ。
Before / After コードの比較
具体的なコードの違いを見てみよう。以下はショップページでの get_queried_object() の戻り値の変化を示している。
// WooCommerce 10.x まで Shopページのみ例外
get_queried_object();          // → WP_Post_Type
get_post_type_object( 'product' ); // → WP_Post_Type

// その他の固定ページ
get_queried_object();          // → WP_Post
get_post_type_object( 'product' ); // → WP_Post_Type
// WooCommerce 11.0 以降 Shopページも含めて統一
get_queried_object(); // → WP_Post
get_post_type_object( 'product' ); // → WP_Post_Typeこの変更の影響を受けないケース
次のような状況では、WooCommerce 11.0の変更による影響はなく、既存のコードはそのまま動作する。
- 単一の商品ページ(
single-product)では引き続き商品のWP_Postオブジェクトが返る - 商品カテゴリやタグ、ブランド、属性などのタクソノミーページでは
WP_Termオブジェクトが返る - その他の投稿タイプアーカイブや個別ページはもともと変更の対象外
is_shop()やis_archive()、is_post_type_archive( 'product' )といった条件分岐関数の挙動は従来どおり変わらない
開発者が取るべき具体的な対応
もし既存のコードがショップページで get_queried_object() の戻り値を WP_Post_Type として扱っている場合、WooCommerce 11.0へのアップデートに備えて改修が必要だ。修正の基本方針は「オブジェクトの型をチェックしてからプロパティにアクセスする」ことにある。
商品の投稿タイプ情報を取得する推奨方法
商品の WP_Post_Type オブジェクトが必要な場合は、get_post_type_object() を使うのが安全で推奨される方法だ。この関数はWooCommerceのバージョンに関係なく常に正しいオブジェクトを返す。
$product_post_type = get_post_type_object( 'product' );

if ( $product_post_type instanceof WP_Post_Type ) {
    // 商品のWP_Post_Typeオブジェクトは
    // get_post_type_object() から引き続き取得できる
    $singular_name = $product_post_type->labels->singular_name;
}
ショップページのWP_Post情報を扱うコード例
ショップページ自体の情報(ページタイトルやスラッグなど)を取得したい場合は、WooCommerce 11.0以降は get_queried_object() から直接 WP_Post としてアクセスできるようになる。以下はその典型的な使用例だ。
$shop_page = get_queried_object();

if ( $shop_page instanceof WP_Post ) {
    // WooCommerce 11.0以降、ショップページでも
    // WP_Postとして扱える
    $shop_title = $shop_page->post_title;
    $shop_slug  = $shop_page->post_name;
}get_queried_object() / $query->queried_object を使っている箇所を特定するWP_Post_Type として使っているか確認する( instanceof や型チェックをしていない場合)get_post_type_object( 'product' ) で商品の投稿タイプ情報を個別に取得し、既存コードを書き換える重要なのは、get_queried_object() の戻り値に依存した条件分岐を書く前に、必ず instanceof でオブジェクトの型をチェックする習慣をつけることだ。これにより、WooCommerceの将来のアップデートや他のプラグインとの競合にも強いコードになる。
この記事のポイント
- WooCommerce 11.0ではショップページの
get_queried_object()がWP_Postを返すように統一される - 商品の投稿タイプ情報が欲しい場合は
get_post_type_object( 'product' )を使用する is_shop()などの条件分岐関数の挙動は変わらないため、ページ判定ロジックの修正は不要- 影響を受けるコードは、おもにショップページでクエリオブジェクトのプロパティに直接アクセスしている箇所
- アップデート前に
instanceofによる型チェックを追加し、テスト環境で検証するのが安全な移行手順
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験