


OpenAIがコード評価ベンチマークの30%に欠陥を発見、SWE-Bench Pro監査結果
コード生成AIの能力を測るベンチマークは、モデルの安全性と展開判断の重要な根拠となる。そのベンチマーク自体に欠陥があれば、過大評価や過小評価を招き、誤った研究優先順位や安全性の見落としにつながる。
OpenAIが2026年7月、広く使われているコード評価ベンチマーク「SWE-Bench Pro」の大規模な監査結果を公開した。タスク全体の約30%に「破損(broken)」と呼ぶべき根本的な問題があり、評価指標としての信頼性が揺らいでいるという。
SWE-Bench Proとは何か

SWE-Bench Proは、AIモデルのソフトウェア開発能力をより現実的なタスクで測るために作られたベンチマークだ。前身のSWE-bench Verifiedが抱えていた設計上の問題やデータ汚染(contamination)を受け、より長期のタスクと実践的なコーディング能力を評価できるように設計されている。
具体的には、GitHub上の公開・非公開リポジトリから実際の機能変更履歴をもとにタスクを抽出する。モデルは既存の機能を壊さずに新機能を実装し、追加されたテストケースをすべて通過するコードを書く必要がある。公開されている731のタスクに対し、わずか8カ月で最先端モデルの合格率は23.3%から80.3%に急上昇した。
上の図は、SWE-Bench Proで見つかった「過度に厳格なテスト」と呼ばれる破損パターンを簡略化したものだ。プロンプトでは「ログイン機能」とだけ指示されているのに、裏側のテストでは特定のライブラリ使用を強制している。こうしたタスクでは、機能的に正しいコードが機械的に不合格になる。
監査で明らかになった破損タスクの実態

データの3割が信頼できない
OpenAIの監査パイプラインは、731件の公開タスクのうち200件(27.4%)を破損としてフラグした。さらに経験豊富なソフトウェアエンジニア5名による独立した人間レビューでは、249件(34.1%)が破損と判定されている。単純計算で、評価データの約3割がモデルの真の実力を反映していないことになる。
この数字の意味は重い。8カ月で合格率が約3.4倍に向上したという華々しい進歩の裏で、点数を押し上げた要因の一部が「タスク側の欠陥をうまくすり抜ける能力」だった可能性を否定できないからだ。
4つの主要な破損カテゴリ
監査で特定された問題は、大きく4つのタイプに分類される。いずれも「モデルが正しくコーディングできたか」ではなく「テストの書き方やプロンプトの不完全さ」が合否を決めてしまうパターンだ。
- 過度に厳格なテスト(Overly strict tests): プロンプトには書かれていない特定の実装詳細(使用するライブラリ、関数名、データ構造など)をテストが要求する。機能としては正しいコードが不合格になる。
- 要件不足のプロンプト(Underspecified prompts): プロンプトに記載されていない要件が隠しテストで課せられている。しかも、周辺コードやリポジトリの慣習からも合理的に推測できない内容だ。
- 低カバレッジのテスト(Low-coverage tests): テストが機能のごく一部しか検証しておらず、不完全な実装でも合格してしまう。
- ミスリーディングなプロンプト(Misleading prompt): プロンプトの指示がテストの要件と矛盾している。モデルが指示通りに実装すると不合格になるという、本末転倒な状態。
特に注目すべきは、人間レビューとエージェントによる自動分析で頻度の評価が異なった点だ。最も顕著な差が出たのが「低カバレッジのテスト」で、エージェントが4.1%と評価したのに対し、人間レビューでは9.4%がこれを主な問題として指摘した。人間の方が複数の破損パターンの重なりを認識しやすいことが一因とみられる。
品質監査パイプラインの仕組み

3段階のフィルタリング
OpenAIが構築した監査プロセスは、大きく3つの段階で構成されている。
第1段階は自動フィルタリングだ。プロンプトの指示内容、モデルの解答試行、採点用テストの3つを照合し、矛盾や問題のありそうなタスクを機械的に抽出する。この段階で286件がフラグされた。
第2段階はエージェント支援の詳細監査。Codexベースの調査エージェントがリポジトリ環境にアクセスし、テストの実行、ファイルの精査、モデルの解答パターンと失敗モードの分析を繰り返す。周辺コードやリポジトリの慣習を理解した上で「単なる曖昧さ」と「真の要件不足」を区別する点がポイントだ。
第3段階は経験豊富なソフトウェアエンジニア5名による独立レビュー。各タスクについて、問題文、テストケース、正解パッチを検討した後に、エージェントの分析結果を補足情報として参照する。意見が分かれたり確信度の低いケースは追加レビューに回された。
この3段階構成で特筆すべきは、AIエージェントと人間のダブルチェック体制だ。AIだけでは保守的になりがちな判定を、複数人の専門家が補完する。OpenAI Blogの記事によれば、エージェントが「破損でない」と判断したタスクで、人間レビューで最も多いラベルが「破損」だったケースはゼロだったという。74%のケースで両者の判断は重なっていた。
なぜ破損タスクが生まれるのか
根本的な原因は、SWE-Benchシリーズのタスク抽出方法にある。GitHub上の実際のIssueやプルリクエストは、元々人間同士の協業のために書かれたものだ。メンテナーとコントリビューターの間で長いやり取りを経て仕様が固まり、コードがマージされる。
このプロセスでは、問題文とマージされたコード、添付されたユニットテストがきれいに一対一対応するとは限らない。テストは「その変更が正しいか」を検証するために書かれており、「同じ機能を実現する他の方法」を許容するようには設計されていないケースが多い。つまり、人間用の協業ツールをそのままAI評価用に流用したことに、そもそも無理があったというのが実態だ。
ベンチマーク設計の難しさと今後の展望

「難しくて公平」なベンチマークのジレンマ
評価の難易度と公平性はトレードオフの関係にある。難しくしようとすればタスクは複雑になり、意図せず特定の実装方法に依存したテストが紛れ込む。公平にしようとすればタスクは抽象的になり、現実のソフトウェア開発から乖離する。
SWE-Bench Proのケースは、このジレンマに真っ向から直面した好例だ。最先端モデルの合格率が80%を超えた段階で「さらに難しい評価が必要」という圧力がかかる一方、タスクの質を担保する仕組みが追いついていなかった。
AIエージェントによる品質チェックの可能性
今回の監査自体が、AIエージェントの新しい活用方向を示している。Codexベースの調査エージェントは、大量のタスクに対してテスト実行やリポジトリ精査を高速に繰り返し、人間だけではスケールしない品質チェックを実現した。
従来、ベンチマークの品質管理は人手に頼る部分が大きく、大規模なデータセットでは現実的ではなかった。OpenAIの事例は「AIがAIの評価基準をチェックする」というメタ評価の時代の到来を感じさせる。
これからのベンチマーク開発に求められるもの
OpenAIは今回の監査結果を受け、SWE-Bench Proを推奨するという以前の見解を撤回した。同時に、評価コミュニティ全体に向けて、経験豊富なソフトウェア開発者がAI評価専用にベンチマークを設計するアプローチを提唱している。
重要なのは「ゲーム化されにくく」「信頼でき」「本当のモデル能力を反映する」評価基盤だ。それが安全性判断や展開戦略の土台になるからだ。SWE-Bench Proの教訓は、どんなに広く使われているベンチマークでも、定期的な品質監査が欠かせないというシンプルな事実に尽きる。
この記事のポイント
- SWE-Bench Proの公開タスク731件のうち、約30%が破損していると判明した
- 問題は「過度に厳格なテスト」「要件不足のプロンプト」「低カバレッジテスト」「ミスリーディングなプロンプト」の4カテゴリに分類される
- OpenAIは3段階の品質監査パイプライン(自動抽出 → AIエージェント調査 → 人間レビュー)で問題を特定した
- ベンチマークの定期監査と、AI評価専用に設計されたデータセットの必要性が改めて浮き彫りになった

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.6がMicrosoft 365 Copilotの優先モデルに。WordやExcelでのAI活用が大きく変わる
OpenAIは2026年7月9日、最新のフラッグシップモデル「GPT-5.6」を発表した。このモデルはMicrosoft 365 Copilotの新しい優先モデルとして、Word、Excel、PowerPoint、Copilot Chat、そして新コラボレーションツールのCoworkに導入される。
GPT-5.6の最大の特徴は、トークンあたりの有用な作業量を大幅に向上させたことだ。複雑なタスクをオンデマンドで処理する能力を持ちながら、コストパフォーマンスにも優れている。日常的に使うオフィスツールで、より高度なAI支援が受けられるようになる。
このアップデートは、すでにMicrosoft 365を契約しているユーザーにとっては追加費用なしで利用できる見込みだ。AIアシスタントがビジネス文書の作成からデータ分析まで、より深く関与する時代が本格的に到来する。
GPT-5.6の位置づけと技術的特徴

GPT-5.6はOpenAIの最新フラッグシップシリーズに位置する。従来のGPT-5シリーズと比較して、モデルアーキテクチャと学習手法の両面で改良が加えられている。特に「トークンあたりの有用な作業量」という指標が大幅に改善された点が重要だ。
トークン効率の改善がもたらすもの
GPT-5.6は、同じプロンプトに対してより少ないトークン数で高品質な結果を返す。これはAPIの利用料金削減に直結するだけでなく、長文のドキュメント作成や大規模なデータ分析において、途中で文脈が途切れるリスクを低減する。
具体的には、GPT-5.5と比較してPDFなどの複雑なドキュメントの読込精度が約20パーセント向上し、プログラミングにおいては20パーセント多くのコード変更を正確に提案できるようになった。日常的なオフィスワークの場面では、素早く意図を理解し、より少ない修正で作業を完了できることを意味する。
オンデマンドの複雑タスク処理能力
GPT-5.6は、単純な質問応答から高度な分析まで、タスクの複雑さに応じて処理能力を段階的に引き上げる設計がなされている。軽いタスクではトークンを節約しつつ、必要なときだけ深い推論を実行する仕組みだ。
このオンデマンド機能は、Microsoft 365 Copilotの利用体験を大きく変える。Wordで文章の校正を依頼するような日常的な操作では軽快に動作し、Excelで売上データの多変量解析を依頼するような複雑なタスクでは、モデルが自律的に深い思考を展開する。
OpenAIのAPIプロダクト責任者であるNikunj Handa氏は、ブログ記事の中で「GPT-5.6をOpenAI API経由でMicrosoft 365 Copilotに提供することで、組織がすべてのトークンからより有用な作業を得られるように支援する」と述べている。
各アプリケーションでの具体的な変化

GPT-5.6の導入により、Microsoft 365の各アプリケーションでどのような改善が期待できるのか。公式発表の内容を基に整理する。
Wordでの文書作成と編集
Wordでは、ドキュメントの下書き作成、編集、推敲にかかるプロンプト操作の往復回数が減る。GPT-5.6が文脈をより深く理解し、ユーザーが求める文体や構成に近い結果を初回から提示できるためだ。
従来のAI支援では「もう少しフォーマルに」「3段落目をもう少し詳しく」といった追加指示が頻繁に必要だった。GPT-5.6では、最初の指示だけで目的に合った文書の完成度が大幅に高まる。ビジネス提案書や報告書の作成時間が短縮されることは間違いない。
Excelでのデータ分析
Excelでは、より深いデータ分析をより効率的なトークン使用量で実行できるようになる。GPT-5.6はスプレッドシートの構造を正確に把握し、複数のシートにまたがる複雑な関係性も理解する。
ユーザーは「売上データから地域別のトレンドを抽出してグラフ化して」といった自然言語での指示から、数クリックでインサイトを得られるようになる。トークン効率が向上したことで、大規模なデータセットを扱う場合でもレスポンスが速く、分析の途中で途切れることが少なくなる。
PowerPointでのプレゼンテーション作成
PowerPointでは、初期アイデアをより洗練されたプレゼンテーションに仕上げるプロセスが加速する。GPT-5.6はスライド構成の提案からビジュアルデザインの方向性まで、従来よりも少ない手動調整で高い完成度を実現する。
特に複数人でのレビューを経る企業プレゼンの作成では、初稿のクオリティが上がることでレビューサイクルが短縮される効果が期待できる。MicrosoftのCopilot & Agents Core担当プレジデントであるNitin Agrawal氏も「より洗練されたアウトプットを生み出せる」と強調している。
Coworkでのチームコラボレーション
CoworkはMicrosoft 365に新たに追加されたコラボレーションツールで、GPT-5.6の優先モデル化対象に含まれている。チーム間の複雑で機能横断的な作業をAIが支援し、手動での調整作業を減らして高品質な成果物を生み出せるようになる。
プロジェクト管理やタスクの割り振り、進捗の可視化といった領域でAIが積極的に関与することで、チーム全体の生産性向上が見込まれる。複数部署が関わる大規模プロジェクトほど、その恩恵は大きいだろう。
実務へのインパクトと今後の展望

GPT-5.6を搭載したMicrosoft 365 Copilotは、単なる文章作成支援ツールの枠を超えつつある。ビジネスの現場でAIが担う役割は、補助から中核へと移行していく転換点にあると言える。
特に重要なのは、Microsoftがモデルをネイティブ提供するだけでなく、OpenAI APIを直接経由してGPT-5.6にアクセスする方式も併用している点だ。これにより、モデルのアップデートサイクルがより柔軟になり、最新のAI機能がより早くユーザーに届くようになる。
従来のCopilotでは、最初の回答に対して追加の指示を出して修正する場面が多かった。GPT-5.6では、最初のプロンプトだけで高品質な結果が得られる可能性が大幅に高まっている。日常的なAI利用の心理的ハードルが下がることを意味する。
中小企業や個人事業主にとっての意味
大企業向けの話に聞こえるかもしれないが、このアップデートは中小企業や個人事業主にとっても大きな意味を持つ。Microsoft 365の契約があれば追加費用なしで利用できるため、高度なAI支援を手軽に業務に取り入れられる。
特に、一人で複数の役割をこなす必要がある個人事業主にとって、文書作成、データ分析、プレゼン資料作成のすべてをAIが支援してくれるのは強力だ。GPT-5.6によるトークン効率の向上は、限られた時間でより多くの成果を出すことにつながる。
今後のAIアシスタントの方向性
GPT-5.6のMicrosoft 365 Copilotへの統合は、AIアシスタントが「質問に答えるツール」から「自律的に作業を進めるパートナー」へと進化する道筋を示している。トークン効率とオンデマンド推論の組み合わせは、今後のAIモデル開発における標準的なアプローチになるだろう。
OpenAIとMicrosoftのパートナーシップは、AIの恩恵をより多くの個人や組織に届けるという共通の目標に基づいている。両社はこの協力関係をさらに深めていく意向を表明しており、今後のアップデートにも注目が集まる。
この記事のポイント
- GPT-5.6はトークン効率を大幅に改善し、Word、Excel、PowerPoint、CoworkでのAI支援がより高精度になった
- 複雑なタスクではオンデマンドで深い推論を実行し、軽いタスクでは素早く応答する設計
- Microsoft 365ユーザーは追加費用なしで最新のAI機能を利用できる見込み
- 中小企業や個人事業主も、日常業務の効率化にこのアップデートを活用できる
- OpenAIとMicrosoftの協力関係は継続し、今後もAIアシスタントの進化が期待される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Hostingerが写真から即決済リンクを生成するAIツール発表、EC販売チャネルの分散化が加速
リトアニア発のホスティング企業Hostingerが、商品写真をアップロードするだけで決済リンクを生成するEC向けAIツール「Quick Links」を発表した。従来のECの常識を覆し、自社サイトを持たない販売手法を一段と推し進めるものだ。
この機能により、販売者はSNS投稿やメッセージ、メールで直接決済リンクを共有できる。見逃せないのは、単なるチェックアウト機能の追加ではなく、ECプラットフォームが「ストアの先」へと進出する方向性を明確に打ち出した点にある。
ここではQuick Linksの仕組みにとどまらず、ウェブサイトを介さないEC販売の潮流、Shopifyなど他のプラットフォームの動き、そして小規模事業者がこれから取るべき販売チャネル戦略について分析していく。
HostingerのQuick Links機能の詳細
AIが商品写真から販売ページを自動生成
Quick Linksの使い方は極めてシンプルだ。販売者が商品の写真を1枚アップロードすると、HostingerのAIが商品説明、詳細スペック、推奨価格を含む商品ページを自動で作成する。そのページには決済機能が組み込まれており、生成されたリンクをSNSやチャットで共有すれば、購入者がそのまま支払いを完了できる。
従来のECでは、まずプラットフォームを選び、ストアを構築し、商品を登録し、決済手段を設定し、集客するという手順が必要だった。Quick Linksは、この流れを「写真1枚で販売開始」まで圧縮する。ECの専門知識がない個人や小規模事業者にとって、参入障壁が極めて低くなる仕組みだ。
ウェブサイト不要のEC販売は目新しいか
しかし、この「サイト不要」というコンセプト自体は完全な新機軸ではない。決済リンク(Payment Links)やリンクインバイオツール、ダイレクトメッセージを使った販売は以前から存在している。StripeやSquare、PayPal、Shopify Starter、TikTok Shop、Instagram、Facebook Marketplace、WhatsAppなど、すでに多くの企業が従来型ストアの外側で取引を完結させる手段を提供してきた。
決定的な違いは、AIによる「写真から商品ページを自動生成する」工程が加わったことだ。これにより、販売者は商品情報を手入力する手間さえも省ける。Hostingerは単なる決済手段の提供ではなく、「AIが販売を組み立てる」という次元へ踏み込んだ。
社会的文脈とHostingerのポジショニング
HostingerのウェブサイトビルダーおよびEC責任者であるAuksė Žirgulė氏は、次のように述べている。「コマースは単純なストアからエコシステムへと移行している。人々は多様なチャネルで商品を発見し、AIエージェントが選択や比較、購入を支援することが増えている。小規模販売者にとって、この変化は大きな機会だが、顧客と同じスピードで事業を動かせる場合に限られる」
この発言の核心は「次にどのチャネルが重要になるかを予測しなくてよい」というホスティング事業者の新たな役割提示にある。販売者はチャネル開拓に頭を悩ませる必要はなく、まず商品を素早く世に出すことが優先される。チャネル戦略の複雑さをプラットフォーム側が吸収する、という宣言ともとれる。
ECプラットフォームが直面する販売チャネルの分散化
上図のように、従来はストア構築から集客、決済まで一気通貫で自前管理するのが常識だった。Quick Linksはこの流れを「商品情報をAIが生成して即座に販売リンク化」するモデルへと変える。販売者は来店を待つ必要がなく、自ら顧客のいる場所へリンクを届けにいける。
ECソフトウェアの従来モデルが揺らぐ理由
ECソフトウェアは長年、「ストアを作り、商品を並べ、トラフィックを集め、訪問者を購入に転換する」という単純明快なモデルに依存してきた。このモデルは今でも通用するが、その確実性は低下している。
- 検索エンジンは質問に直接回答するようになり、ユーザーが商品ページに到達するまでにAIが情報を要約してしまう。
- SNSプラットフォームはユーザーをフィードやアプリ内に留め、外部リンクへの遷移を抑制する傾向を強めている。
- マーケットプレイスは需要を一手に集め、販売ルールをコントロールする。
- 生成AIが商品の比較や選定を、販売者のサイトを訪れる前に行う可能性が高まっている。
Googleが構想する「ユニバーサルカート」は、検索結果やYouTube、Gmail、AI体験上でカートを形成し、販売者のサイト外で購入が完結する世界を示唆している。販売者は在庫やフルフィルメント、カスタマーサービスを引き続き担うが、購買ジャーニーの起点やカートの支配権は手放すことになるかもしれない。
Hostingerの方向性が示すプラットフォーム間競争
この不確実性の高まりこそ、Hostingerのポジショニングの背景だ。同社は単にもっと速く決済リンクを作る機能を提供しているのではない。ECプラットフォームは販売者に対して「今日はSNS投稿で、明日はマーケットプレイスで、来月はAIエージェント経由で」販売できるように支援しなければならない、というメッセージを発している。
Shopifyも同様の方向にかじを切っている。ソーシャルコマース向けツールやPOS(販売時点情報管理)の強化、Shop Payの拡張、マーケットプレイス統合、AIによる商品発見支援などを通じて、販売者がより多くの販売機会を掴めるようにしている。Hostingerの発表は、その小規模販売者版だ。ECプラットフォームの役割が「ストアのホスティング」から「販売成功のための機会創出」へと変わりつつある。
販売者にとっての実務的な意味
「最初の販売」はサイト外で起こる
オンライン販売者にとって、HostingerのQuick Linksが投げかける最大の含意はこれだ。「最初の販売は、自社サイトの外で起こる時代になった」のである。潜在顧客が最初に商品を目にする場所は、SNSのタイムラインかもしれないし、友人のメッセージかもしれないし、AIアシスタントのレコメンドかもしれない。
しかし、だからといって自社サイトの重要性が消えるわけではない。信頼構築、検索プレゼンスの維持、コンテンツマーケティング、利用規約の提示、メールアドレス収集、カスタマーサービス、リピート購入促進といった要素は、依然として自社サイトが最も適した場所だ。ブランドや商品を丁寧に説明し、顧客との長期的な関係を築く場としての役割は揺るがない。
小規模事業者がまず着手すべきこと
小規模事業者がQuick Linksのようなツールを活用する際、最初に取り組むべきは「販売チャネルの即時展開」だ。商品写真さえあれば、今日からSNS上で直接販売を始められる。特設ページのデザインや決済設定に数日を費やす必要はない。
そのうえで、徐々に自社ECサイトを構築し、ブランド体験の深化やリピーター獲得の仕組みを整えていくという二段構えの戦略が現実的になる。これまでは「まずストアを作り、その後で集客」という順序だったが、これからは「まず販売を始め、その後でストアを育てる」という順序も合理的な選択肢になる。
ECの未来像:ストアとトランザクションの分離
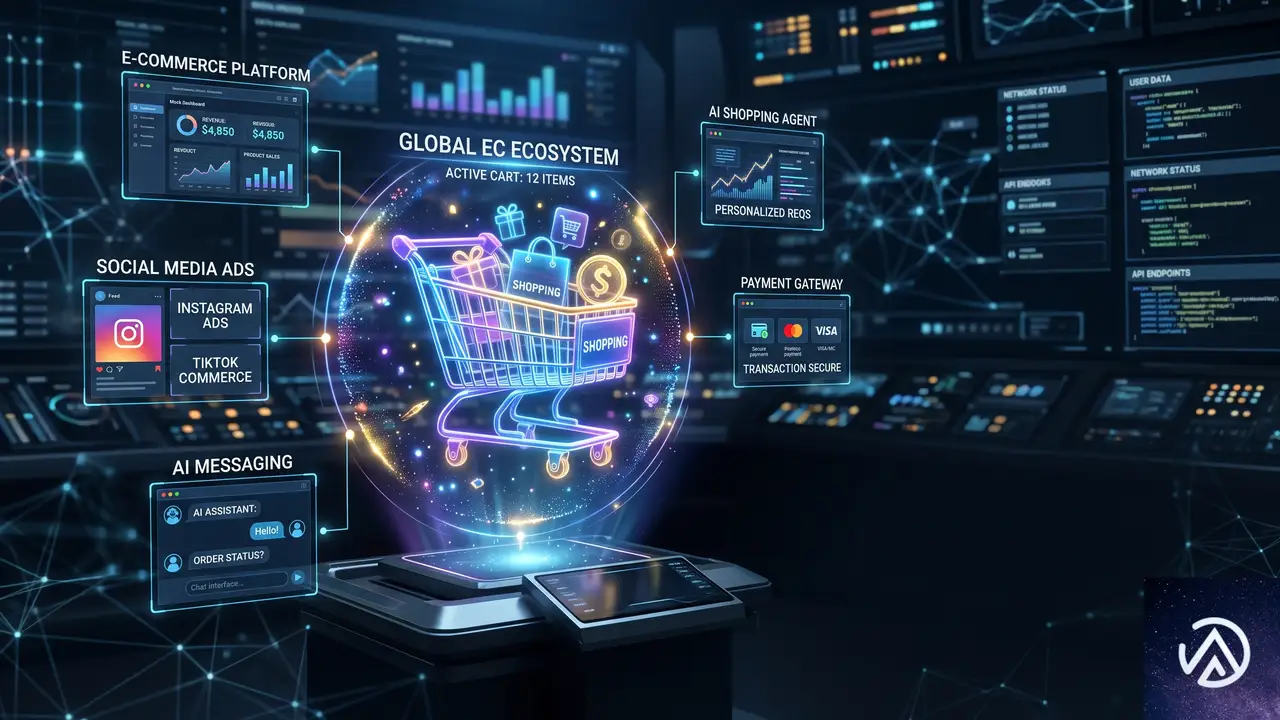
これまでのECは、ストアとトランザクション(取引)が一体化していることが前提だった。商品を買うには、販売者のストアにアクセスし、そのストアのカートを使い、そのストアの決済フローを経由する。この一体型モデルが、技術の進化とともに解体されつつある。
決済リンク、SNSショップ、マーケットプレイス、AIエージェントは、いずれも「販売者のサイトを経由しないトランザクション」を可能にする。ストアはブランドの本拠地として残り続けるが、販売そのものは多様な「セリングサーフェス(販売面)」に分散していく。
このトレンドは国内のEC事業者にも無関係ではない。BASEやSTORESのような国内プラットフォームも、SNS連携やリンク販売機能を強化している。WooCommerceで構築されたECサイトであっても、決済リンクを積極的に外部チャネルで活用する発想が求められるようになるだろう。
プラットフォーム選定の新しい基準
販売者やWeb制作者がECプラットフォームを選ぶ際、これまでは「ストア構築のしやすさ」「デザインの自由度」「決済手段の豊富さ」が主な評価ポイントだった。しかし今後は、「外部チャネルとの連携性」や「AIによる販売支援機能」が選定基準の上位に食い込んでくる可能性が高い。
特にWooCommerceユーザーは、WordPress上でのコンテンツマーケティングとの親和性を強みとしつつも、SNSやメッセージアプリでのダイレクト販売をどう取り込むかが課題になる。プラグインや拡張機能で決済リンクを発行し、AIによる商品情報の自動最適化を組み合わせるといった対策が現実的だ。
この記事のポイント
- HostingerのQuick Linksは、商品写真1枚からAIが商品ページと決済リンクを自動生成する。ストア構築の手間を完全に省くアプローチだ。
- ウェブサイト不要のEC販売自体は新しい概念ではないが、AIによる自動生成が加わったことで、販売開始のスピードが飛躍的に向上する。
- ECプラットフォームは、販売者のストア外での販売を支援する方向へシフトしている。Shopifyも同様の多チャネル戦略を推進中だ。
- 小規模事業者は「最初の販売をサイト外で行い、その後で自社サイトを育てる」という二段構えの戦略を検討する価値がある。
- WooCommerceなど既存のEC環境でも、決済リンクやAIによる販売支援を積極的に取り入れることが、今後の競争力を左右する。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
VercelがBetter Authを買収、TypeScript認証ライブラリとエージェントIDの未来
VercelがBetter Authを買収。TypeScript認証ライブラリとエージェントアイデンティティの取り込み

2026年7月7日、VercelはオープンソースのTypeScript認証ライブラリ「Better Auth」を買収したと発表した。ライブラリの週間npmダウンロード数は470万を超え、すでに850人以上のコントリビューターが開発に参加している。創設者のBereket Engida氏とコアチームはVercelに加わり、Better Authそのものと、関連プロジェクトであるエージェント認証プロトコル「Agent Auth」の開発を続ける。
今回の買収は、認証の仕組みをフレームワークやプラットフォームに依存しない形で提供する動きであり、なかでも「エージェントに独自のアイデンティティを与える」という構想が注目を集めている。背景と具体的な影響を順に整理していく。
Better Authとは何か。週間470万DLの認証ライブラリ

Better Authは、TypeScriptで書かれたオープンソースの認証ライブラリだ。従来の認証ライブラリに比べて設定がシンプルで、Next.jsやNuxtなど特定のフレームワークに依存しない。データベースやセッション管理の選択肢も広く、開発者が自前で認証周りをコントロールできる点が特徴である。
フレームワーク非依存の設計思想
多くの認証ライブラリは特定のフレームワークと密結合だったり、プラットフォームの管理画面を通さなければ設定が完了しなかったりする。Better Authは「どこでも動き、開発者が認証を所有する」という原則で作られている。これにより、プロジェクトの要件が変わっても認証部分の移行が容易になる。
コミュニティ主導の成長
470万ダウンロードと850人以上のコントリビューターという数字は、単なるGitHubスターの数ではない。実際に本番環境で使われ、機能追加やバグ修正が活発に行われている証拠である。Vercelは買収後もMITライセンスを維持し、コミュニティガバナンスを継続すると明言している。
買収の背景。Vercelが描く「オープンウェブ」と認証の位置づけ

Vercelは2025年に公開した「オープンSDK戦略」のなかで、ソフトウェアはデフォルトでオープンであり、疎結合で、どのプラットフォームにも移植可能であるべきだと述べている。Next.jsやAI SDK、Nuxtにもこの方針が適用されており、今回のBetter Auth買収もその延長線上にある。
認証を「所有する」という考え方
クラウドサービスが認証を代行する形は便利だが、ロックインのリスクがある。Better Authのようにライブラリ単位で認証を導入できれば、インフラを移行しても同じ仕組みを使い続けられる。Vercelはこの「所有可能な認証」をエコシステムに取り込むことで、開発者にとっての自由度を高めようとしている。
エージェントアイデンティティが切り開く、新しい認証の形

買収発表のなかで特に強調されたのが、エージェント(自律的に動作するソフトウェア)に「自分自身のID」を持たせるという構想だ。Better Authチームが開発している「Agent Auth」プロトコルは、まさにこれを実現するためのものである。
この概念図で示すように、Agent AuthではエージェントごとにIDを発行し、スコープを絞った権限と失効可能な認証情報を持たせることができる。ユーザーが単一のコントロールポイントから、個々のエージェントの権限を管理できる点が革新的だ。
なぜエージェントに独自IDが必要なのか
現在、AIエージェントがユーザーに代わって予約や購入を行う場合、エージェントはユーザー自身の認証情報を使ってサービスにアクセスする。この方式では、エージェントに渡す権限を細かく制御できない。また、不正が疑われた場合に特定のエージェントだけを停止することが難しく、結局すべての連携を遮断する必要があった。
Agent Authは、エージェントひとつひとつに「ペルソナ」のようなIDを割り当てる。たとえば「カレンダー参照専用エージェント」「メール送信専用エージェント」といった具合に役割を分け、不要になればそのIDだけを無効化できる。これはエージェントが当然のように動く世界において、セキュリティと管理性を両立する基盤技術といえる。
Vercel Connect と eve への統合
Better AuthチームはVercelに加わり、このエージェントアイデンティティをVercel Connectとeveに組み込むと発表されている。Vercel Connectは開発者がさまざまなサービスやAPIを安全に連携させるための仕組みであり、eveはVercelが提供するAIエージェントプラットフォームである。認証レイヤーが標準装備されることで、エージェントを使った機能をより安全かつ手軽に実装できるようになるだろう。
開発者コミュニティとライブラリの今後
買収によってBetter Authのライセンスや開発体制が変わるのではないかと懸念する声もある。しかしVercelは、ライブラリはMITライセンスのまま無料で提供され、名称も変更されず、同じコミュニティガバナンスモデルで開発が続くと明確に述べている。
オープンソースとしての継続
Better AuthのGitHubリポジトリは引き続き公開され、プルリクエストやIssueを通じたコミュニティ参加も歓迎される。Vercelのリソースが投入されることで、ロードマップの進行速度が上がったり、ドキュメントの整備が進んだりするメリットが期待できる。
フレームワークサポートの拡大
Better AuthはすでにNext.js以外にもNuxt、SvelteKit、Remixなど多様なフレームワークで利用できる。Vercelは特定のフレームワークに偏らないサポートを続ける方針を示しており、エコシステム全体への貢献が加速する可能性がある。
Vercelの戦略から見る、認証とエージェントの未来

今回の買収は、単に認証ライブラリを手に入れる以上の意味を持つ。Vercelはすでにホスティング、サーバーレス関数、エッジネットワーク、AI SDKと積み上げてきた。そこに「認証」と「エージェントアイデンティティ」というピースが加わることで、開発者がアプリケーションを作り、デプロイし、AIエージェントを安全に動かすための一気通貫のプラットフォームが姿を現しつつある。
「エージェントインフラ」の基盤として
Vercelは以前から「エージェントインフラストラクチャ(agentic infrastructure)」という概念を掲げている。これは、AIエージェントが動くための実行環境だけでなく、ストレージ、キュー、認証といったバックエンドの一式を提供する考え方だ。Better Authの買収によって、その認証レイヤーが大きく強化されることになる。
競合との差別化要因
他社のクラウドプラットフォームも認証機能を提供しているが、多くはプロプライエタリなサービスである。Better AuthのようにオープンソースでMITライセンスの認証ライブラリを中核に据えるアプローチは、ベンダーロックインを嫌う開発者層に強く支持されるだろう。とくにエージェントの台頭により認証の複雑さが増すなかで、「所有できる認証」の価値はますます高まっていく。
この記事のポイント
- VercelがオープンソースのTypeScript認証ライブラリ「Better Auth」を買収。創設者とコアチームがVercelに参加する。
- Better Authは週間470万ダウンロード、850人以上のコントリビューターを持つ。MITライセンスとコミュニティガバナンスは維持される。
- エージェントに独自のIDと制限付き権限を与える「Agent Auth」プロトコルの開発が加速し、Vercel Connectやeveに統合される予定。
- 従来のエージェント実行における権限制御の課題を解決し、エージェントごとの失効やスコープ管理が可能になる。
- Vercelは「オープンSDK戦略」に沿って認証レイヤーを強化し、エージェントインフラの基盤を固める動きを加速させている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.0で配送クラスが非公開タクソノミーに変更
WooCommerce 11.0が2026年7月28日にリリースされる。このアップデートでは、商品の送料計算に使われる「product_shipping_class」タクソノミーが非公開に変更される。これまで明示的に設定されていなかった公開フラグが、WordPress のデフォルトで true 扱いとなっていた状態が解消され、内部データとしての扱いが明確になる。
多くの店舗や拡張機能では特別な対応は不要だが、配送クラスを公開タクソノミーとして利用していたコードは見直しが必要だ。この変更の背景と、開発者が確認すべきポイントを整理する。
WooCommerce 11.0で配送クラスのタクソノミーが非公開になる
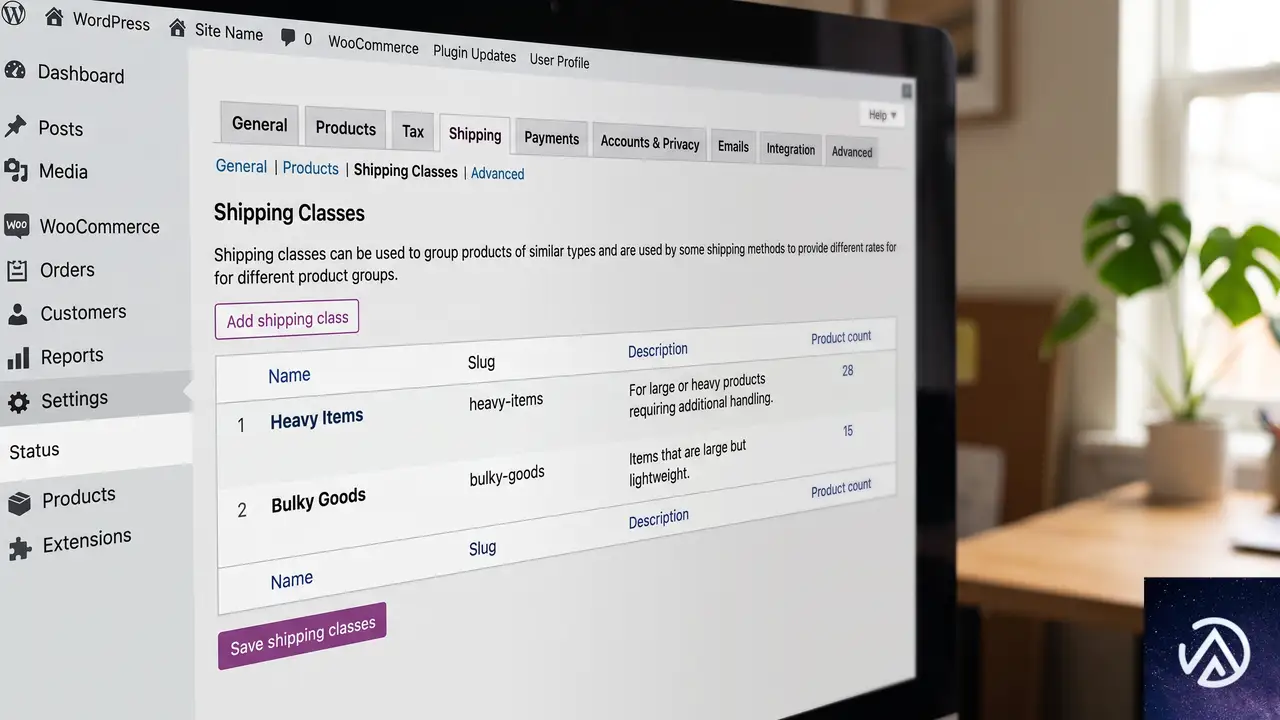
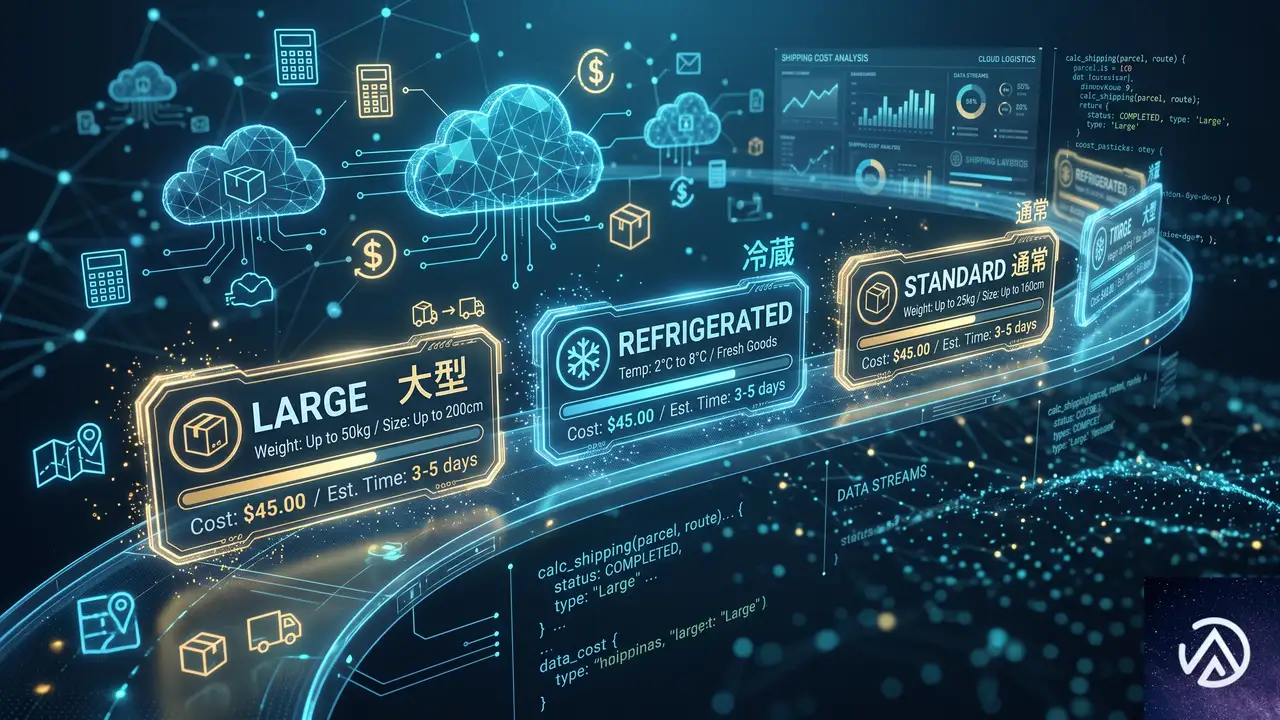
配送クラス(product_shipping_class)は、商品を送料計算のグループに割り当てるための仕組みだ。たとえば「大型商品」「冷蔵商品」といったクラスを作り、各商品に紐づけることで、配送方法ごとに異なる送料を設定できる。
これまでの動き(Before)
WooCommerce 11.0 より前のバージョンでは、配送クラスをタクソノミーとして登録する際に public 引数が指定されていなかった。WordPress のタクソノミー登録関数は public が省略されるとデフォルトで true を適用する。そのため、配送クラスは「公開タクソノミー」として扱われ、is_taxonomy_viewable() が true を返していた。
この状態では、サイトマップ生成、タクソノミーアーカイブの処理、パブリックタクソノミーを列挙するクエリなどに配送クラスが意図せず含まれることがあった。
変更後の動作(After)
WooCommerce 11.0 からは、タクソノミー登録時に 'public' => false が明示的に設定される。これにより is_taxonomy_viewable( 'product_shipping_class' ) は false を返すようになり、WordPress の各種 API で配送クラスが非公開タクソノミーとして扱われる。
この変更はデータそのものを削除するものではない。すでに登録された配送クラスのタームや商品との紐づけ、送料ルールはそのまま維持される。
なぜこの変更が必要だったのか
配送クラスは本来、商品カテゴリーやタグのように顧客に見せるためのカタログ用タクソノミーではない。あくまでも送料計算のための内部データである。ところが公開タクソノミーとして振る舞うことで、サイトマップに配送クラスのアーカイブ URL が含まれたり、SEO ツールが意図しないページを認識したりといった副作用が生じていた。
一部のストアでは、この挙動を避けるために手動で除外設定を行なっていた。WooCommerce コアの修正により、根本的な原因を取り除き、特に設定をしなくても配送クラスが公開面に漏れ出さないようになる。
また、WordPress の public フラグが false になると、publicly_queryable も自動的に false を継承する。つまり、URL で配送クラスの一覧ページに直接アクセスすることもできなくなる。こうした一貫した内部データとしての扱いが、開発者にとっても予測しやすい動作につながる。
影響を受けるコードのチェックポイント
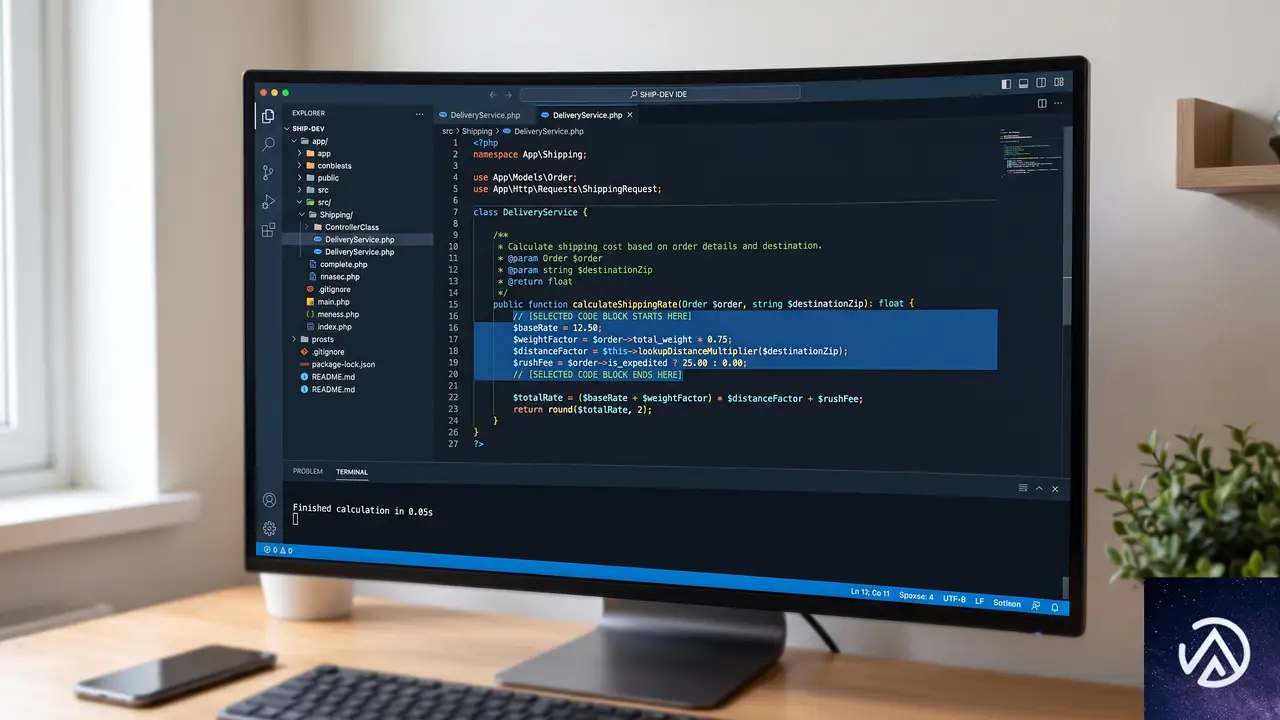
WooCommerce Developer Blog の案内に沿って、以下のようなコードを含むテーマやプラグインは変更後の動作を確認する必要がある。
is_taxonomy_viewable( 'product_shipping_class' )が true を返すことを前提にしている- 配送クラスのアーカイブページへのリンクをフロントエンドに生成している
- サイトマップや SEO、ナビゲーションの生成時に
product_shipping_classを public タクソノミーとして含めている get_taxonomies()などで公開タクソノミー一覧を取得し、その中に配送クラスが含まれることを期待している- タクソノミーの公開ステータスをもとに REST API や GraphQL のスキーマ、検索、フィルタリングをカスタマイズしている
- 送料計算以外の汎用的な商品グルーピングに配送クラスを流用している
ごく単純に、配送クラスを送料計算だけに使っている場合は影響を受けない。商品編集画面で配送クラスを設定したり、フックで送料を分岐させたりするコードはそのまま動作する。
開発者が取るべき具体的な対応
基本は何もしなくてよい
配送クラスを送料計算のみに使っているのであれば、コードの修正は不要だ。WooCommerce のコア変更がそのまま適用され、配送クラスは内部タクソノミーとして適切に管理される。
どうしても公開が必要な場合のフィルターフック
特定のサイトや拡張機能で、あえて配送クラスを公開タクソノミーとして扱い続けたいケースもあるだろう。たとえば、配送クラスのアーカイブページをカスタムデザインで用意している場合などだ。
そのような場合は、WooCommerce が用意している register_product_shipping_class_taxonomy_args フィルターを使って、登録時の引数を上書きできる。
add_filter(
    'register_product_shipping_class_taxonomy_args',
    function ( $args ) {
        $args['public']             = true;
        $args['publicly_queryable'] = true;
        return $args;
    }
);
ただし、この方法はあくまで例外的な対応である。WooCommerce Developer Blog も述べているように、公開タクソノミーとして再利用するのではなく、本来の目的に合ったカスタムタクソノミーを新たに用意するほうが長期的に健全だ。
長期的にはカスタムタクソノミーへの移行を
商品を顧客向けにグルーピングしたい場合は、商品カテゴリー、商品タグ、商品属性、あるいは専用のカスタムタクソノミーを利用すべきだ。配送クラスはあくまで内部の送料計算用と割り切り、公開用の分類とは役割を分けることで、サイト構造が整理され、SEO の観点からも無駄なアーカイブページが生まれなくなる。
この変更はデータ移行を伴わない「公開状態の切り替え」であり、既存の設定には一切手が加えられない。しかし、今回のバージョンアップをきっかけに、配送クラスを公開タクソノミーとして使っていたコードがあれば、設計を見直す良い機会になるだろう。
この記事のポイント
- WooCommerce 11.0 で配送クラスのタクソノミーが非公開になり、サイトマップやアーカイブに現れなくなる
- 送料計算だけに使っているストアや拡張機能は特別な対応不要
is_taxonomy_viewable()や公開タクソノミーの一覧に依存しているコードは見直しが必要- どうしても公開が必要な場合はフィルターフックで復活できるが、長期的にはカスタムタクソノミーの利用を推奨
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CSS border-shapeプロパティの全容、装飾が形状に追従する新機能
shape() と corner-shape の復習

border-shape を理解するには、まず土台となる shape() 関数と corner-shape プロパティを押さえておくとスムーズだ。いずれも CSS で形状を扱うための新しい道具であり、特に shape() は 2026 年に Baseline(主要ブラウザで広く使える状態)に到達したばかりである。
shape() 関数の基本
shape() は SVG のパス構文を CSS に取り込む関数だ。clip-path や offset-path の値として使う。従来の path() に比べて CSS ネイティブな記述ができ、直感的に複雑な図形を定義できる。たとえばハート形、星形、波線など、従来は polygon() などで苦労していた形状も、少ないコードで表現可能になった。
CSS-Tricks の記事では、shape() に関する全4回のシリーズ解説と、SVG パスを shape() に変換するオンラインコンバーターも公開されている。これにより、既存の SVG 図形を CSS 形状として手軽に流用できるようになった。
corner-shape プロパティの概要
corner-shape は要素の角の形状を変えるプロパティだ。border-radius と組み合わせて使う。値には round(丸)、scoop(えぐり)、bevel(面取り)、notch(切り欠き)、squircle(超楕円)といったキーワードを指定する。squircle は iOS のアイコンなどで見られる、丸みを帯びつつ四角さも残した独特の曲線だ。
corner-shape は単なる角の整形にとどまらず、三角形や菱形、六角形といった CSS のみの図形作成にも使える。何より重要なのは、角を変形させても border や box-shadow がその形状に追従することだ。これこそが border-shape の布石となる考え方である。
border-shape の基礎:clip-path との違い

border-shape の構文と基本動作
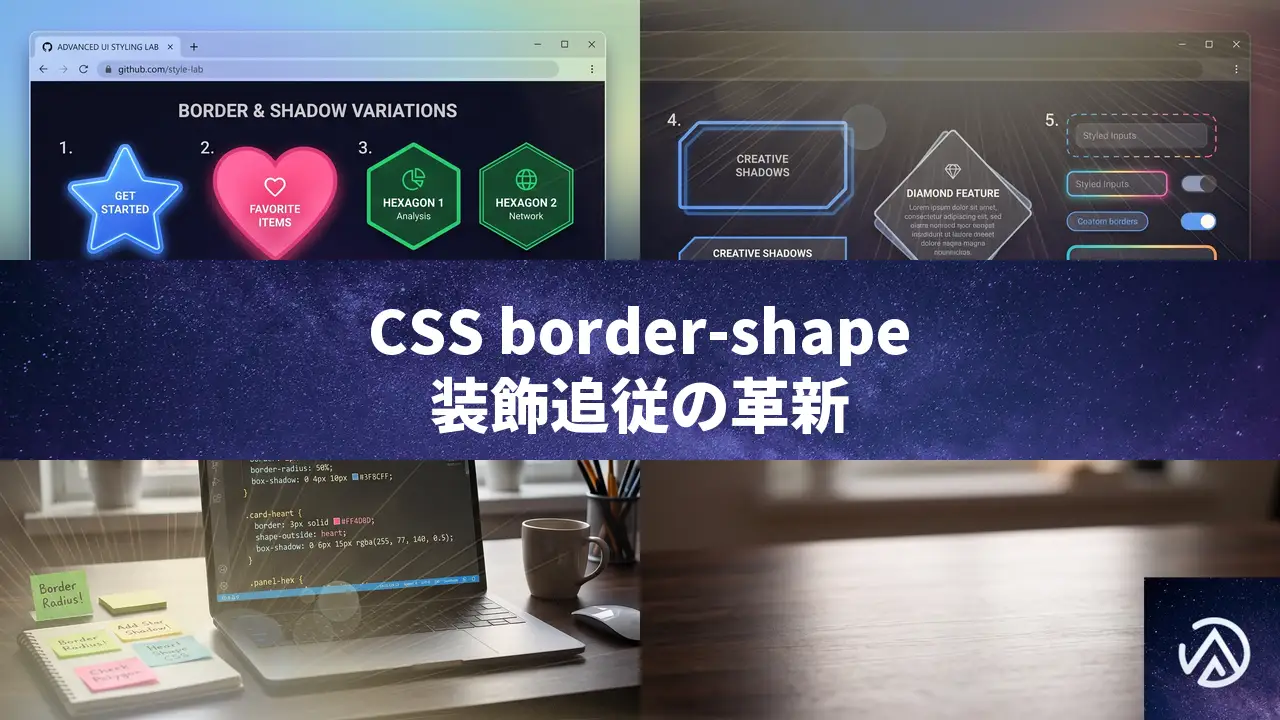
border-shape は要素の形状を定義するが、clip-path とは根本的な動作が異なる。clip-path は要素を「切り抜く」(クリッピング)。その結果、border や box-shadow などの装飾も一緒に切り取られ、形状に沿わない。一方、border-shape は要素を「変形させる」(シェイピング)。装飾は新しい形状に沿って描画される。
構文は clip-path とほぼ同じで、shape()、polygon()、circle()、inset() などを受け取る。さらに、2つの値を指定する「フィルモード」も用意されている。最初の値が外側の境界、2番目の値が内側の境界となり、その間を border で塗りつぶす動きだ。
/* 1 値のストロークモード:border が形状をなぞる */
.shape {
  border: 8px solid #1976d2;
  border-shape: shape("M ...");
}

/* 2 値のフィルモード:境界の間を border で塗る */
.cutout {
  border: 12px solid #e74c3c;
  border-shape: inset(0) shape("M ...");
}
装飾が追従する仕組みを図で見る
このデモは概念を視覚化したイメージだ。実際の border-shape は Chrome で確認できる。clip-path と異なり、星形の頂点やくぼみにぴったり沿った border が手軽に得られる。
border-shape のもう一つの利点は、border-radius を考慮する必要がない点だ。要素が丸められた矩形でなくなれば、角丸の概念自体が不要になる。代わりに形状そのもので角の挙動を制御できる。
ボーダーだけの形状を作る(Border-Only Shapes)

border-shape のわかりやすいユースケースが「輪郭だけの形状」だ。要素の背景を透明にし、border だけを設定するだけで、ハートや星、花、波線といったアウトライン図形を CSS のみで描ける。
.border-only {
  background: transparent;
  border: 8px solid #e74c3c;
  border-shape: shape("..."); /* ハート形などのパス */
}この例も概念のイメージである。実際の border-shape なら、頂点や曲線がより精密に再現される。従来は複数の疑似要素や複雑な box-shadow の重ね合わせが必要だった表現を、数行の CSS で実現できるのが大きな魅力だ。
切り抜き形状とレイアウトの応用

2つの形状値で作る切り抜き
border-shape に inset(0) と任意の形状を組み合わせると、矩形の内側に図形の穴が開いたような「切り抜き」デザインが作れる。これはフィルモードと呼ばれ、外側形状と内側形状の差分を border の領域として塗りつぶす。
.cutout {
  border: 12px solid #1976d2;
  border-shape: inset(0) circle();
}上図は border-shape のフィルモードを静的に再現したものだ。実際には、border-color や border-width を変えるだけで、動的に切り抜き形状の装飾を調整できる。
ハートや星を使った複合形状
円だけでなく、shape() で定義したハートや星形を内側形状に指定すれば、さらに凝ったデザインが可能だ。たとえば、矩形のカードの中にハート形の窓が空いたような装飾、ポリゴン型のフレームに星形が浮かぶ背景など、CSS だけで容易に作れるようになる。
はみ出し装飾と部分装飾

border-shape は要素の境界を超えて装飾を拡張することもできる。形状を要素の外側に大きく取れば、背景が画面幅いっぱいに広がるブレイクアウト効果を border の太さだけで演出できるのだ。
.breakout {
  border: 40px solid #ff9800;
  border-shape: inset(0 -100vw) circle(0);
}border-shape では border を画面外まで伸ばせるため、従来の CSS グリッドの「ブレイクアウト」テクニックよりはるかに直感的に、セクションの背景を拡張できる。
テキストに寄り添う部分装飾
shape() 関数の緻密なパス指定と組み合わせれば、テキストの特定の単語にだけ下線を引く、見出しの左端にのみ斜めの背景を付ける、といった部分装飾も可能になる。border-shape は要素全体を変形しつつ、装飾の範囲を自由にコントロールできるため、デザインの表現力が格段に向上する。
アニメーションと次の一手

border-shape はアニメーションもサポートしている。形状を動的に変えたり、border-width を操作したりすることで、多彩なインタラクションを追加できる。
3コマで見る形状アニメーション
以下のデモは、ホバーで円が星形に変化するアニメーションを静的に示したものだ。実際には約 0.5 〜 1.5 秒かけて連続的に変化する。
この変化を border-shape 上で行えば、border や影も一緒に変形するため、よりリッチなエフェクトが可能になる。他にも、border-width を 0 から太くすることで、ホバー時に形状が浮かび上がるリビール効果も実装できる。
実践的なテクニック集
CSS-Tricks の記事では、以下のような応用例も紹介されていた。
- ナビゲーションメニューで、手描き風の下線がホバーアイテムにスライドする
- コンテンツボックスの周囲を電気が走るようなフレームで囲む(タッチデバイスでも安全)
- border のみで構成されたローディングスピナー
- ドラッグ可能な円をつなぐ曲線が、距離に応じて伸び縮みする
いずれもこれまでは JavaScript や SVG を駆使しなければ実現が難しかった表現だ。border-shape と shape() を習得すれば、CSS だけで多くの装飾を完結できるようになる。
この記事のポイント
- border-shape は要素の形状を変えつつ、border や box-shadow を形状に追従させるプロパティ
- clip-path と違い、装飾が失われず、輪郭だけの形状や複雑なフレームが容易に作れる
- 2値指定のフィルモードで切り抜き効果、形状を広げてブレイクアウト背景も実現可能
- アニメーションや部分装飾にも対応し、CSS 表現の幅を大きく広げる
- 2026年7月現在 Chrome のみの先行実装だが、今後の標準化と普及に注目
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Run Sandboxesがパブリックプレビュー、AI生成コードを安全に隔離実行
Cloud Run Sandboxesがパブリックプレビューに。AI生成コードを隔離実行

Google Cloudは2026年7月9日、Cloud Run上で信頼できないコードを安全に実行するサンドボックス機能をパブリックプレビューとして公開した。AIが生成したプログラムや、エンドユーザーがアップロードしたスクリプトを、ホスト環境やクラウドの認証情報から完全に分離した状態で動かせる。
起動はミリ秒単位で、既存のCloud RunインスタンスのCPUやメモリを共有する。追加のVMや専用のサンドボックスホスティングプラットフォームを使う必要はなく、追加料金も発生しない。この発表はベルリンで開催中のWeAreDevelopers World Congressで行われた。
これまで開発者は、AIが動的に生成したコードを安全に実行するために、コンテナクラスタを組んだり、サードパーティのmicroVMランタイムを契約したりする必要があった。Cloud Run Sandboxesは、その複雑さを取り除くサーバーレスネイティブの仕組みだ。
サンドボックスとは何か、なぜ必要なのか
サンドボックスとは、プログラムを隔離された領域で実行する仕組みのことだ。子供が砂場(サンドボックス)の中で自由に遊んでも、砂が外に散らばらないのと同じで、中で何が起きても外側のシステムには影響を与えない。
AIエージェントやLLM(大規模言語モデル)がコードを生成する時代では、この隔離が極めて重要になる。モデルが書いたPythonスクリプトに意図しないファイル削除やネットワーク経由のデータ流出が含まれていたとしても、サンドボックス内で止められるからだ。
Cloud Run Sandboxesは、既存のCloud Runサービスインスタンス内でほぼ瞬時に生成できる軽量な隔離実行境界だ。専用のVMを立ち上げる必要がなく、サーバーレス環境を離れずにすべてが完結する。
サンドボックスの仕組みとセキュリティ設計

シンプルな有効化とネイティブな呼び出し
利用開始は驚くほど簡単だ。Cloud Runサービスをデプロイする際に、gcloudコマンドまたはYAML設定でサンドボックスランチャーを有効にするフラグを1つ追加するだけでよい。有効化すると、軽量なサンドボックスCLIバイナリが実行環境に自動でマウントされ、標準的なサブプロセス呼び出しでプログラムからサンドボックスを生成できる。
実際の動作例として、LLMが動的に生成したPythonコードを安全に実行するデモが公開されている。1000個のサンドボックスを起動し、それぞれの処理を実行して停止するまでの平均レイテンシは500ミリ秒だ。
ゼロトラストを前提とした3層のセキュリティ境界
Cloud Run Sandboxesは、悪意あるコードや誤ったコードからホストアプリケーションとクラウドリソースを守るために、3つの重要なセキュリティ境界を強制する。
この3層構造によって、AIが生成したコードがどれほど予測不能な動作をしても、ホスト側への影響は生じない。セキュリティを理由にAIコード実行を諦めていた開発者にとって、大きな転換点になる。
3つの主要ユースケース
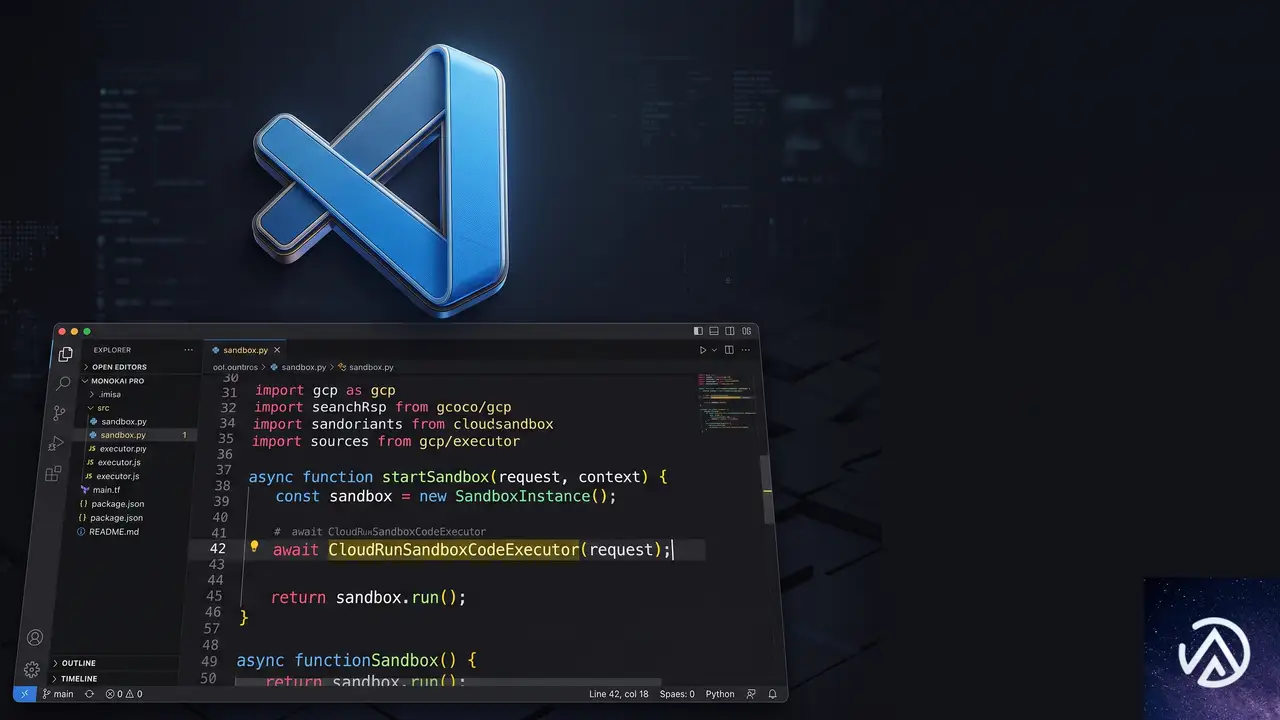
Cloud Run Sandboxesは特に以下の3つの用途で力を発揮する。いずれも「信頼できないコードを隔離実行する」という共通の要件を持つシナリオだ。
ADKとComputeSDKとの統合
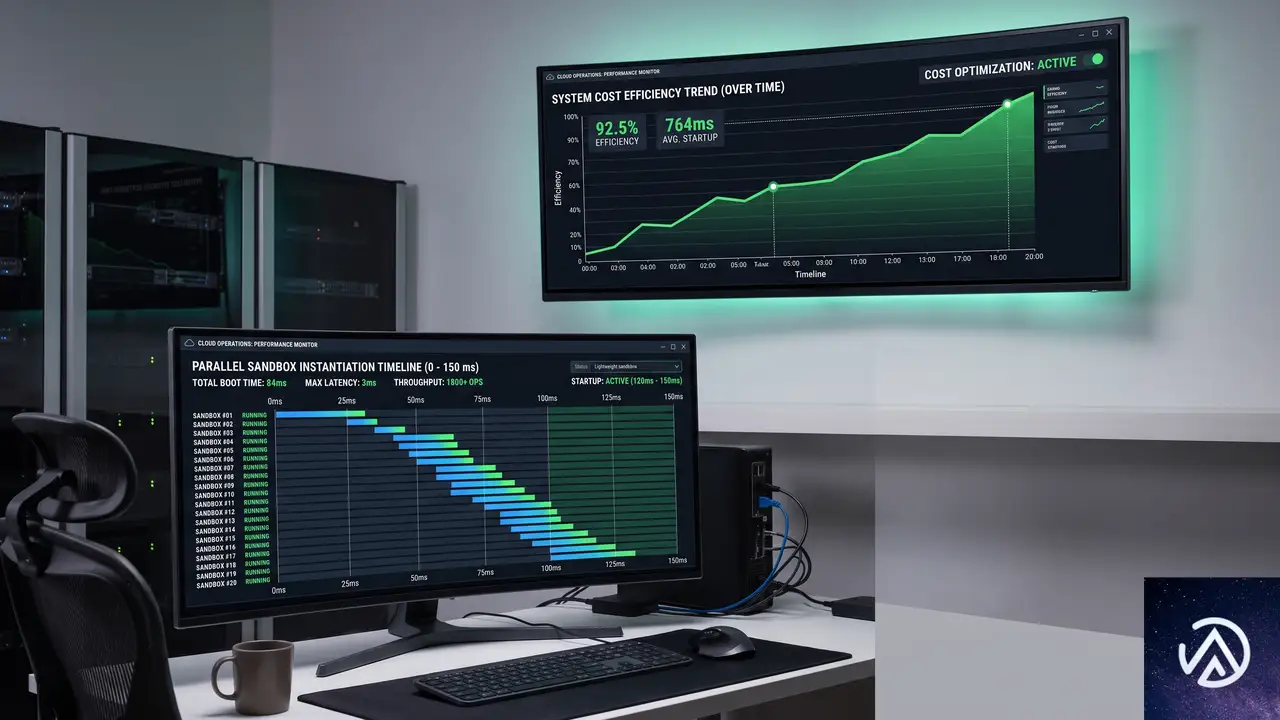
Cloud Run Sandboxesは、Googleのエージェント開発キットであるADK(Agent Development Kit)の次期バージョンでネイティブサポートされる。新しいCloudRunSandboxCodeExecutorを使うと、ADKエージェントがわずか1行のコードでサンドボックス内のコード実行を指示できる。
また、ベンダーに依存しないサンドボックス実行用SDKであるComputeSDKにも対応が追加された。このSDKを使えば、Cloud Runサービスの外部からリモートでサンドボックスを呼び出すことも、サービス上のローカルツールとして直接使うこともできる。既存のツールチェーンにスムーズに組み込める設計だ。
コスト面の利点と実運用への影響
Cloud Run Sandboxesの大きな特長は、追加コストが一切かからないことだ。オンデマンドのVMに対して高いプレミアムを課金する専用サンドボックスホスティングプラットフォームとは異なり、既存のCloud Runインスタンスに割り当てられたCPUとメモリを直接共有する。
起動時間がミリ秒単位であることも実運用上の利点だ。従来のVMベースの隔離環境では、新しいVMを立ち上げるたびに数秒から数十秒の待ち時間が発生していた。Cloud Run Sandboxesなら、ユーザーからのリクエストに対してほぼ待ち時間なく応答できる。
Google Cloud Blogの記事で紹介されたデモでは、1000個のサンドボックスを起動してコードを実行し、終了するまでの平均レイテンシが500ミリ秒だった。これは「AIが生成したコードをリアルタイムで安全に実行する」という要件に対して十分実用的な数値だ。
この記事のポイント
- Cloud Run SandboxesはAI生成コードや信頼できないバイナリを安全に実行する隔離環境で、パブリックプレビューとして公開された
- 起動はミリ秒単位で、既存のCloud Runインスタンスのリソースを共有するため追加コストは発生しない
- 環境変数の隔離、ネットワーク通信のデフォルト遮断、安全なファイルシステムオーバーレイの3層でセキュリティを確保
- LLMコードインタプリタ、ヘッドレスブラウザ、ユーザー提出コードの実行が主要ユースケース
- ADKとComputeSDKに組み込み対応し、開発者は1行のコードでサンドボックス実行を指示できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT 5.6 Sol、Terra、LunaがAI Gatewayで利用可能に
GPT 5.6の3モデルがAI Gatewayで利用可能に
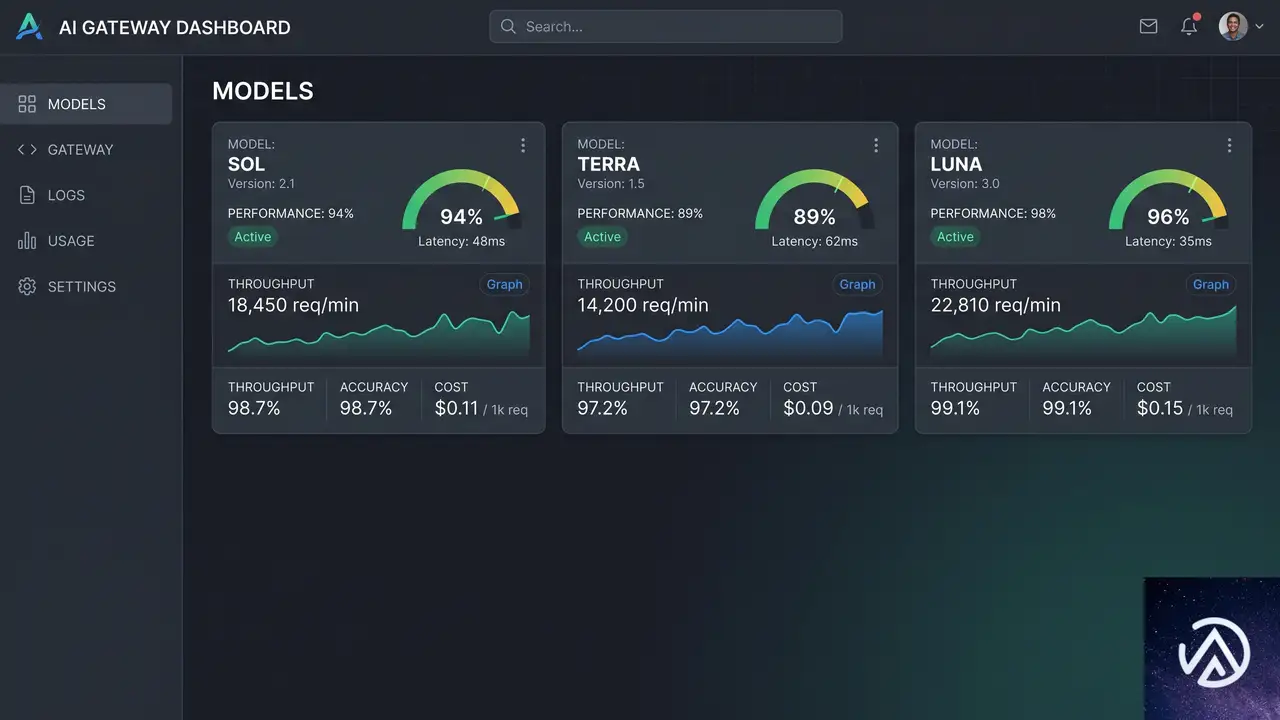
OpenAIの最新モデルシリーズ「GPT 5.6」が、VercelのAI Gatewayで限定的なプレビュー提供を開始した。Sol・Terra・Lunaの3モデルが揃い、いずれもコーディングや生物学、サイバーセキュリティといったエージェント的なタスクで従来世代より強化されている。トークン効率も向上しており、同等の処理をより少ないコストで実行できるのが特徴だ。
AI Gatewayは複数のAIプロバイダに統一APIでアクセスできるサービスで、利用状況の追跡やコスト管理、リトライやフェイルオーバー、パフォーマンス最適化を一手に引き受ける。今回の追加により、開発者はコードを変更せずに最新のGPTモデルへ移行できるルーティング機能も利用可能になった。
GPT 5.6 Sol・Terra・Lunaの違い
モデル指定はAI SDKでopenai/gpt-5.6-solのようにスラッグを渡すだけだ。用途や予算に応じて切り替えやすい設計になっている。
コードを触らずにモデルを切り替えるルーティングルール
AI Gatewayのルーティングルール機能を使うと、既存のコードを一切変更せずにモデルを差し替えられる。たとえばopenai/gpt-5.5で動いているアプリケーションを、コマンド1行でopenai/gpt-5.6-solへ振り向けることが可能だ。
rewriteルールを設定するだけで、アプリコードに手を入れず最新モデルへ移行できる。ルーティングルールはモデルのA/Bテストや段階的なロールアウトにも活用できる。本番環境でいきなり全トラフィックを新モデルに向けるのではなく、一部だけ振り分けて様子を見る運用も現実的だ。
AI Gatewayの料金体系とその他の機能
AI Gatewayはプロバイダの利用料金に上乗せせず、推論に対するプラットフォーム手数料も請求しない。BYOK(Bring Your Own Key)で自身のAPIキーを持ち込んだ場合でも同様に手数料は発生しないため、コストを厳密に管理したいチームにとっては安心できる設計だ。
利用状況の可視化と制御に役立つ機能も充実している。主なものは以下のとおりだ。
- カスタムレポートでチームやプロジェクト単位の利用状況を把握できる
- ゼロデータ保持(ZDR)に対応し、機密性の高いプロンプトの取り扱いも安心
- APIキー単位で予算上限を設定し、予期せぬコスト超過を防ぐ
- ルーティングルールでモデル切り替えやフェイルオーバーを自動化する
実際の開発フローに組み込む際の注意点
GPT 5.6シリーズは限定的なプレビュー提供の段階にある。本番環境で全面的に切り替える前に、モデルプレイグラウンドで動作を検証し、期待する出力品質やレイテンシが得られるか確認することを推奨する。特にエージェント的な使い方をする場合、従来モデルとはプロンプトの最適な書き方が変わる可能性もある。
また、Terraは「前世代と同等性能・半額」というコストメリットが明確だが、SolとLunaはユースケースによって費用対効果が大きく変わる。まずは低コストのLunaでプロトタイプを作り、本格的なタスクではSolに切り替えるといった段階的な活用が現実的な戦略になるだろう。
この記事のポイント
- GPT 5.6のSol・Terra・LunaがAI Gatewayで限定プレビュー提供を開始
- Terraは前世代と同等の性能を半額で提供するコストパフォーマンスが最大の魅力
- ルーティングルールによりコード変更なしでモデルを切り替え可能
- AI Gatewayはプロバイダ料金に上乗せせず、BYOKでも手数料なし
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.5の応答を改善、VS Codeのプロンプトチューニング手法
GPT-5.5の応答が改善された技術的背景
VS Codeが提供するAIエージェント機能は、コード生成の裏側で「コーディングハーネス」と呼ばれる仕組みが動いている。これはモデルとツール、コンテキスト、指示、エージェントのループを繋ぐ層だ。モデルがコードを書くための土台となる部分といえる。
2026年7月、VS CodeチームはOpenAIと協力し、GPT-5.5向けのシステムプロンプトを改善する実験を実施した。焦点は「エージェントの探索を減らし、検証を早める」ことにある。この変更で応答速度とコストの両方を改善できるかどうかが検証された。
プロンプトチューニングの目的と仮説
GPT-5.5のリリース後、VS Codeチームはエージェントがトークンをどのように消費しているかを分析した。分析の結果、モデルが実際の編集に入る前に過剰な探索を行っているパターンが浮かび上がった。具体的には、ファイルの再読込や周辺コードの比較に多くのトークンが費やされていた。
この観察から1つの仮説が導かれた。それは「エージェントはさまよう努力を減らし、証拠、行動、検証という意図的なループに注力すべきである」というものだ。この仮説を検証するため、2種類のプロンプトが用意された。
エージェントが編集前に「考えすぎる」状態を減らし、必要最小限の探索で行動に移すよう誘導する。この考え方は、トークン消費と応答時間の両方に直接影響を与える。
実験の中身と2つのアプローチ
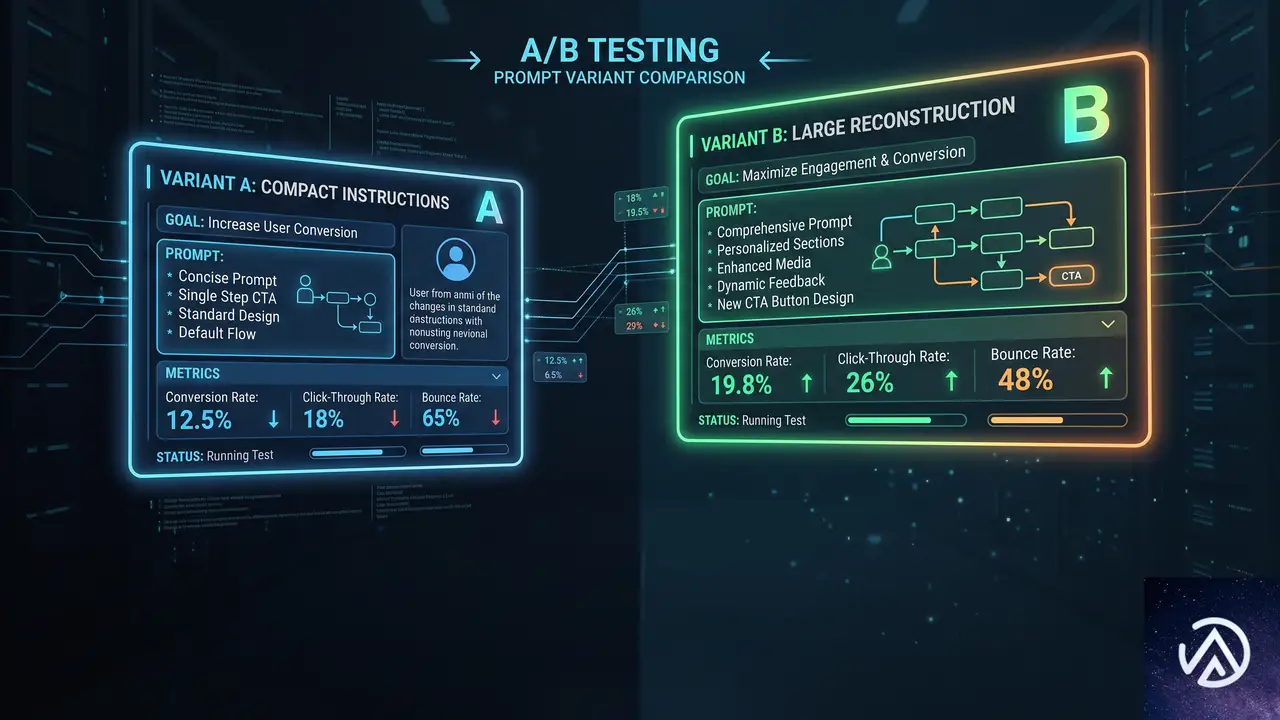
実験は2週間にわたって実施された。GPT-5.5のエージェントトラフィックを、対照群と2つの処置群に25%ずつ分割し、残りの25%はスコアカード外でデフォルトプロンプトが使用された。この設計により、同じ種類のユーザートラフィックで公平な比較が可能になる。
処置A「PRPT_SRCH」簡潔な探索と編集
処置Aは小規模で焦点を絞った変更だ。プロンプトに1つのコンパクトな指示を追加し、不必要な探索を減らすようモデルに促す。この指示は「economical_search_and_edit」セクションと呼ばれる。
具体的には、次の5つの行動指針が与えられた。最も具体的なアンカー(ファイル、シンボル、失敗している動作など)から開始すること。1つの仮説とそれを否定できる安価なチェックを選ぶために十分な周辺コンテキストだけを集めること。広範なリポジトリ探索より1回の対象検索を優先すること。最も安価な判別チェックがわかったら即座に行動すること。そして、新しい結果が関連性を示さない限り、変更されていないコンテキストを再読しないことだ。
economical_search_and_edit:
    - 最も具体的なアンカーから開始する
    - 1つの仮説とその反証チェックに十分なコンテキストだけを集める
    - 広範な探索より1回の対象検索を優先する
    - 最も安価な判別チェックがわかったら即行動する
    - 変更されていないコンテキストは再読しない
処置B「PRPT_LRG」大規模プロンプト再構成
処置Bは同じ仮説をより広範に展開したものだ。エージェントのワークフローを「Before_the_first_edit(最初の編集前)」と「After_the_first_edit(最初の編集後)」の2つの明示的なセクションに再編成する。
このアプローチの狙いは、検索ステップだけでなくループ全体を解決することにある。最初の編集前に局所的な仮説を形成し、広範な探索を避け、根拠のある最初の編集を行い、最初の実質的な編集後に即座に検証する。処置Aと異なり、プロンプト自体のサイズは大きくなるため、構造の追加が効率を改善できるかどうかが重要な論点だった。
両処置の設計思想の違いは明確だ。処置Aは最小限の介入で探索を抑えるのに対し、処置Bはエージェントの行動全体を構造化して制御しようとする。この差が実際のパフォーマンスにどう現れるかが実験の焦点になった。
2週間のスコアカードが示した結果
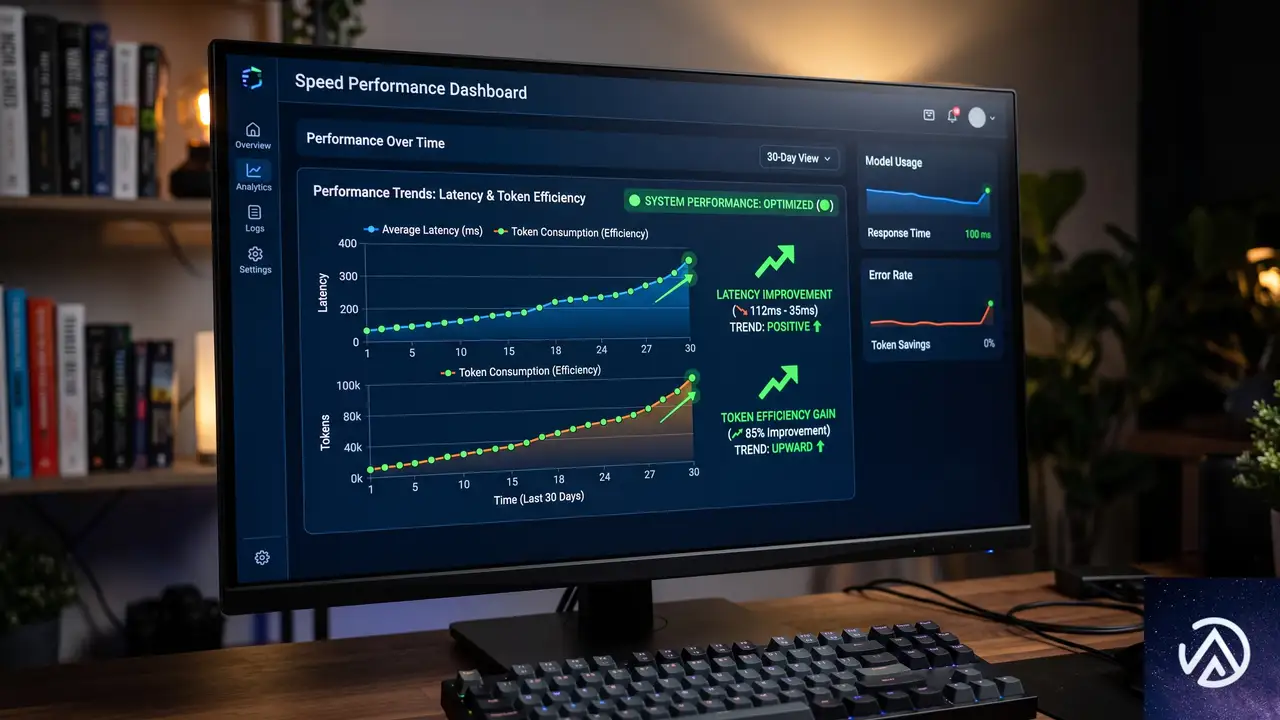
実験では品質、レイテンシ、効率の3つの次元で評価が行われた。品質は「コードが定着するか」、レイテンシは「最初の編集がどれだけ早く行われるか」、効率は「トークンとツール呼び出しの数」で測定される。
品質指標 10分生存率とコミット生存率
10分生存率は、AIが書いたコードのうち10分後もファイルに残っている割合を示す。コミット生存率は、さらに厳格にgitコミットまで生き残ったコードの割合だ。この2つが品質のガードレール指標となる。
結果として、コミット生存率は処置Bで+0.68%とわずかに上昇し、処置Aでは-0.48%とわずかに低下したが、いずれも統計的に有意ではなかった。10分生存率は両処置ともわずかに低下し、処置Bの-0.44%だけが統計的有意の閾値をわずかに超えた(p=0.0493)。VS Codeチームはこれを「実際のトレードオフとして考慮すべきだが、動きは小さく、他の品質ガードレールは後退しなかった」と評価している。
レイテンシ指標 初回編集までの時間
編集レイテンシでは処置Bが最も強い改善を示した。p50(中央値)の初回編集時間は-5.68%(3.9秒高速化、p=2e-5)、p95(下位5%の遅いケース)では-9.30%(38.8秒高速化、p=1e-10)といずれも高い統計的有意性を示した。
処置Aもp50で-2.88%(2.0秒高速化、p=0.0271)と改善したが、p95の改善は統計的に有意ではなかった。遅いケースでの差が特に顕著で、「なぜこれが遅いのか」というストレスを感じる場面での改善が大きかったことになる。
トークン効率とツール呼び出し回数
1ユーザーあたりの日次トークン消費量(p50)は両処置とも減少したが、統計的有意ではなかった。しかし、トークン消費の裾野(p95、特に重いリクエスト)では、処置Bが-7.64%(p=0.0003)、処置Aが-5.19%(p=0.0157)と明確な改善を示した。
平均ツール呼び出し回数も両処置で減少した。処置Bは-8.54%(1ターンあたり2.04回の呼び出し削減、p=1e-12)、処置Aは-3.19%(0.77回削減、p=0.0091)だ。処置Bの優位性は極めて高い統計的有意性で裏付けられた。
処置Bは総合的に最も強いプロファイルを示した。レイテンシの明確な勝利、裾野トークンの有意な削減、ツール呼び出しの減少、そして品質ガードレールのほぼ安定。10分生存率のわずかな低下は軽微な有意性(p=0.0493)にとどまり、レイテンシやトークン、ツール呼び出しの改善ははるかに大きく堅牢だった。
プロンプトチューニングが示す開発体験の進化
この実験の成果は数字の変化だけではない。重要なのは、プロバイダからのフィードバックに基づく検証可能な仮説を、オフライン評価で事前検証し、2週間の本番環境で確認するという一連のループが機能したことだ。
モデルのリリースはチューニングループの終点ではない。VS Code上の実際の動作を観察し、焦点を絞った改善をテストし、より速く、信頼性が高く、効率的な体験を実現する新たな方法を見つける機会となる。このプロンプトチューニングは、その1つの具体的な実例だ。
使用量ベース課金におけるトークン効率の重要性
この改善が特に重要なのは、使用量ベースの課金モデルが前提にあるからだ。トークン効率は単なるインフラ指標ではない。エージェントが探索に費やすすべてのトークンは、ユーザーが支払い、待たされる対象だ。根拠のある編集に早く到達するエージェントは、より良い体験とより小さい請求額の両方をもたらす。
VS Codeチームはこの取り組みを継続する方針を示している。モデル、プロンプト、ツール、コーディングハーネス全体にわたって改善点を探し続け、エージェントの予算が必要な作業に集中できるよう最適化していくという。
このループが示すのは、AI開発支援ツールの進化がモデルの性能向上だけに依存する段階から、プロンプト設計やツール連携の最適化を含む総合的な取り組みへと移行していることだ。モデルが高性能でも、使い方が適切でなければ本来の力を発揮できない。その橋渡しをするのがプロンプトチューニングの役割といえる。
この記事のポイント
- GPT-5.5向けのプロンプトチューニングで、エージェントの探索を抑制し検証を早める改善が実施された
- 処置B(大規模プロンプト再構成)が最も優れた結果を示し、p95の初回編集時間を9.30%短縮した
- ツール呼び出し回数は8.54%削減され、トークン消費の裾野(重いリクエスト)でも7.64%の改善が確認された
- 品質指標(コード定着率)はほぼ維持され、速度と効率の改善が品質を犠牲にしないことが実証された
- 使用量ベース課金の文脈では、トークン効率の改善がユーザーのコスト削減に直結する重要性を持つ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Vercel Agentが本番環境に進出、プラン即許可で安全なAI運用を実現
Vercelが2026年7月8日、自社のAIエージェント「Vercel Agent」の大幅な機能拡張を発表した。従来はアラートのトリアージやプルリクエストのレビューが中心だったが、今回のアップデートでダッシュボード上に常設され、本番環境の調査やプロジェクトへの質問応答、承認後のアクション実行まで可能になった。
Vercel Agentの最大の特徴は「プラン即許可(Plan-to-Permission)」という新しい権限モデルだ。デフォルトで読み取り専用として動作し、デプロイのロールバックや設定変更といった操作は、具体的な作業計画を提案して承認を得たうえで、そのタスクに限定された一時的な権限のみを使って実行する。
本番稼働中のアプリケーションにAIを介入させるには、安全性の担保が不可欠である。Vercel Agentは独立したIDで動作し、生成したコードは隔離されたサンドボックスで検証する。この設計により「自律的でありながら制御された状態」を実現しており、AIエージェントの運用にまつわる信頼の課題に対して、具体的な解決策を示した製品といえる。
Vercel Agentの全体像と導入背景
Vercel Agentは、Vercelプラットフォーム上で動作するAIエージェントだ。アプリケーションのデプロイと実行を支えるインフラに組み込まれているため、本番環境で問題が発生した際に、最初に対応を開始できるポジションにある。アラートを受けてから自律的にログやメトリクス、デプロイ履歴を調査し、根本原因を特定して修正案を提示する。
Vercel社内では数ヶ月前から本番運用に組み込まれており、すでに具体的な成果が出ている。典型的な事例として、深夜23時に不良デプロイが行われ、チェックアウト用のエンドポイントが500エラーを返し始めたケースでは、オンコールエンジニアがログインする前にAgentがエラーを4分前のデプロイまでトレースし、即時ロールバックを推奨した。エンジニアが計画を承認すると、Agentが前の正常なビルドにロールバックし、エンドポイント修正用のプルリクエスト作成まで自動で進めた。アラート発生から問題緩和までの時間は3分未満だったという。
このデモは、同じインシデントに対する従来の対応とVercel Agent導入後の対応を比較した概念図である。Agentが自律的に調査と提案を行い、人間は最終判断に集中できる点が最大の違いだ。
本番環境にAIを近づけるための新セキュリティモデル
アプリケーションの修正や設定変更が可能なAIエージェントを本番環境に導入する場合、最も重要な問いは「どう安全にデプロイや設定変更を任せられるか」である。多くのAIエージェントはユーザーの全権限を引き継いで動作するため、誤った指示や混乱したサブエージェントの被害がそのまま本番に及ぶという構造的な課題を抱えている。
Vercel Agentはこの問題に対して、3つの要素からなる新しい権限モデルを実装した。エージェント自身の固有ID(Principal)、タスクごとの一時的な権限付与(Plan-to-Permission)、そして生成コードの隔離実行環境(Sandbox)である。これらはプラットフォームレベルで強制されるため、AIモデルの挙動にかかわらず安全策が機能する。
エージェント固有のIDによる帰属と権限の分離
一般的なAIエージェントは、操作する人間のIDと権限をそのまま使って動作する。その場合、エージェントが行った操作と人間が行った操作を区別できず、誰が何を指示し実行したのか追跡不可能になる。
Vercel Agentは「vercel-agent」という固有のプリンシパル(主体)として動作する。すべての変更操作には「誰が依頼したか」「誰が承認したか」「Vercel Agentが実行した」という記録が必ず残る。さらに、Agentに付与される権限は、操作を指示した人間がもつ権限の範囲を超えることはない。この設計により、説明責任(アトリビューション)と権限の透明性を両立している。
⚠️ 誤指示や誤動作の影響範囲がユーザーと同等
✅ 付与される権限は承認された計画の範囲に限定
この図は、従来型エージェントとVercel Agentの権限構造の違いを表している。Vercel Agentでは、常に「依頼者」「承認者」「実行者」の3者が記録され、権限も計画単位で一時的に付与されるため、誤動作の被害範囲が極めて狭い。
プラン即許可(Plan-to-Permission)の仕組み
多くの組織がAIエージェントを開発フローに統合する際、最初に直面するのが「事前に広範な権限を付与してしまう」という課題だ。これはエージェントに必要以上の権限を、必要以上の期間与えることになる。そのエージェントにプロンプトを送れる人なら誰でも、付与された権限の範囲にアクセスできてしまうため、権限の広さがそのままセキュリティリスクの大きさに直結する。
Vercel Agentはデフォルトで読み取り専用である。デプロイのロールバック、設定変更、キャッシュのクリアといった操作が必要な場合、Agentはまず実行計画を提案し、その計画に限定されたアクセス権限を要求する。ユーザーが計画を承認すると、Agentはそのタスクに必要な能力を一時的に取得し、作業完了後は自動的に読み取り専用状態に戻る。
Agentが行うすべてのAPI呼び出しは、3つのチェックを通過する必要がある。承認された計画で付与された能力(Capability)、トークンのスコープ、そしてチームの既存権限だ。これら3つすべてが許可する場合にのみ操作が実行され、このチェックはプラットフォーム側で強制されるため、AIモデルがどのような挙動をとっても安全策が破られることはない。Vercelはこの仕組みを「プラン即許可(Plan-to-Permission)」モデルと呼び、最小権限の原則を設計レベルで組み込んでいる。
この一連の流れでは、Agentが自律的に調査と提案を行う一方で、実際の操作権限は人間の承認を経て初めて発行される。人間の判断を挟むことで安全性を確保しつつ、Agentの自律性を最大限に活かせる設計だ。
サンドボックスによる生成コードの安全な検証
コードを生成するAIエージェントにはもうひとつ重大な課題がある。それは「生成されたコードが実際に動くかどうかは、実行してみるまでわからない」という点だ。動作確認されていない修正を本番環境に適用することは、さらなる障害を引き起こすリスクを伴う。
Vercel Agentが生成したコードは、Vercel Sandbox(FirecrackerマイクロVMによる短寿命の隔離環境)内で実行される。このサンドボックスは実際のプロジェクトのコピーを持っており、Agentは生成したコードを本物のビルドプロセス、テスト、リンターに対して実行し、問題なくパスしたものだけをPRとして提示する。たとえば壊れた設定ファイルを修正する場合、Agentが変更を加えてサンドボックス内でビルドテストを通過させ、その結果をPRにまとめるという流れになる。
この仕組みにより、Agentは自由にコードを生成して実行できるが、検証に失敗したコードや壊れた修正が人間の前に提示されたり、本番環境に直接届いたりすることはない。コードレベルの安全性をインフラ側で担保している点が重要だ。
現場の開発フローがどう変わるか
Vercel Agentはインシデント対応だけでなく、開発者が日常的に直面するさまざまなタスクを支援する。具体的なユースケースを4つ紹介する。
プルリクエストのレビュー
AgentにPRの確認を依頼すると、CIがパスしているだけでは検出できないパフォーマンスの低下やリスクの高い変更を指摘する。たとえば、ある変更によってページが毎回サーバーサイドレンダリングされるようになり、キャッシュが効かなくなっていないかといった観点までチェックできる。
コスト増加の原因追及
「なぜ今月の請求額が跳ね上がったのか」という問いに対して、Agentはコード変更履歴を調査し、コスト急増の原因となった特定のコミットを特定する。たとえば、あるページがキャッシュされずに毎回サーバーサイドレンダリングされるようになったコード変更を検出し、承認を得たうえで修正PRを作成する。
ビルド失敗の修正
失敗したデプロイをAgentに調査させると、ログを読み取り、問題のある設定ファイルを特定し、修正の許可を求めてくる。ユーザーが承認すれば、Agentが設定を修正し、サンドボックス内でビルドをテストしてからPRとして提出する。
本番リリースの安全性確認
フィーチャーフラグに関する質問に対して、Agentはコードと本番のライブメトリクスの両方を分析し、その機能をロールアウトしても安全かどうかを判断する。データに基づいた客観的な判断が得られるため、リリース判断の品質が向上する。
この比較図は、日常的な開発タスクにおける負荷の変化を表している。Agentが調査と提案を担うことで、開発者はコードの質やビジネス判断といったより本質的な業務に集中できる。
反脆弱性インフラがもたらす意味
Vercel Agentの発表で最も重要なポイントは、単にAIエージェントの機能が追加されたという話ではない。AIエージェントを「本番環境に近づけても安全に運用できる」という状態を、プラットフォームの設計で実現したことだ。
AIエージェントの時代において、真の限界は2つの天井で決まる。ひとつはモデルが「何をできるか」、もうひとつはユーザーが「何を許可するか」だ。モデル性能が向上し続けるなかで、実際の運用において重要になるのは後者、すなわち信頼の設計である。どれほど高性能なモデルでも非決定論的であり、非決定論的なシステムは非決定論的に失敗する。安全性は「エージェントが毎回正しい判断をすること」に依存してはならず、システムそのものに組み込まれていなければならない。
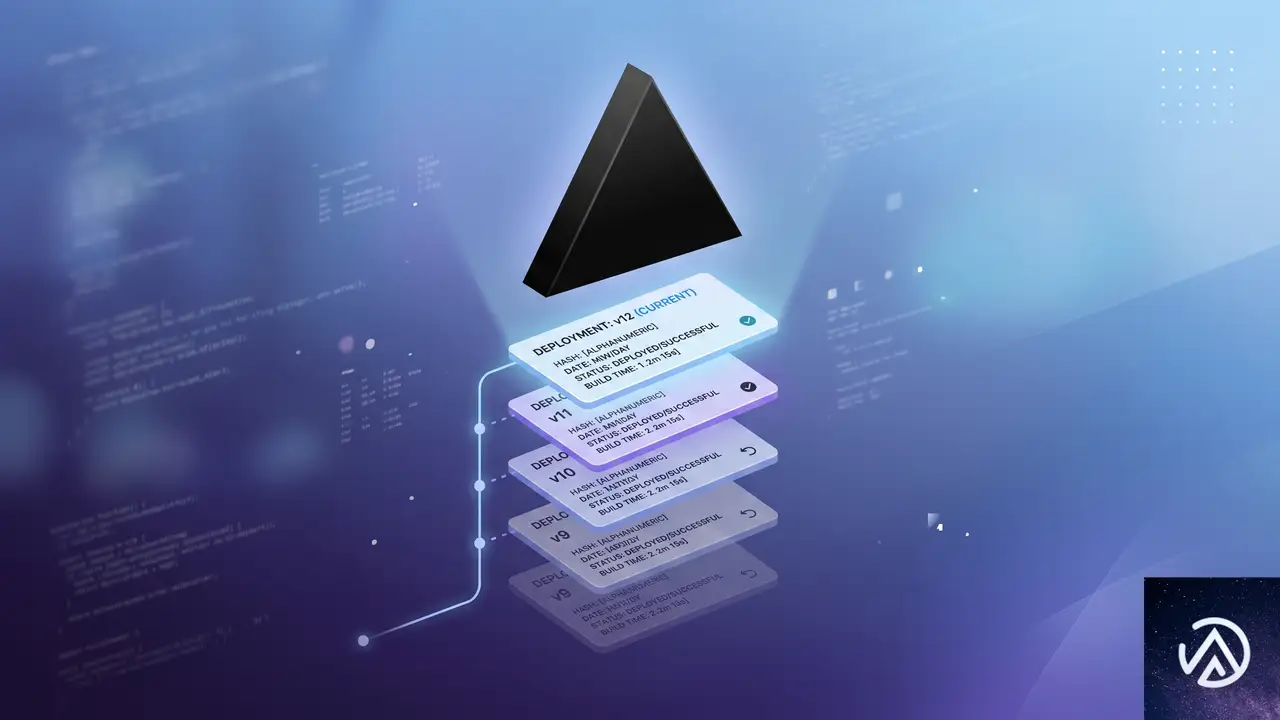
Vercelは長年にわたり、イミュータブルデプロイメント(デプロイが書き換え不可で、不良デプロイは1回のロールバックで元に戻せる仕組み)をはじめとする安全策を積み上げてきた。これらはもともとAIエージェントのために設計されたものではないが、自律システムが必要とするガードレールそのものとして機能する。Vercelはこの考え方を「反脆弱性インフラ(Anti-fragile Infrastructure)」と呼んでいる。
反脆弱性インフラの本質は、エージェントに誤りがあっても被害を局所化でき、人間のミスさえもコストを抑えられる点にある。安全性がインフラ層に組み込まれているため、エージェントが正しいことを前提にせずとも、実用的な権限を委譲できる。Vercel Agentのケースでは、自律的に調査と提案を行い、人間が承認した範囲内でのみ操作を実行し、何か問題があれば即座にロールバックできる。
このモデルは、AIエージェントの実運用における「自律性 vs 安全性」というトレードオフに対して、明快な解を示している。エージェントが仕事をし、人間が最終判断を保持し、インフラがフェイルセーフとして機能する。この3層構造が揃って初めて、本番環境にAIを近づける信頼の土台が成立する。
Vercel Agentの将来展望と利用開始方法
現時点でのVercel Agentは、異常の調査、プルリクエストの作成、プロジェクトや本番アプリに関する質問への回答が可能だ。今後のロードマップとして、特定分野の専門家エージェントへの委任機能が予定されている。たとえば、コードベース全体に対する詳細なセキュリティレビューや、フロントエンドのデザイン・UXレビューを、オンデマンドで専門家AIに依頼できるようになる見込みだ。
Vercel Agentは、ProプランおよびEnterpriseプランのチームに対して段階的にロールアウトされている。利用を希望する場合は、Vercelのアーリーアクセスページから申請するか、ダッシュボードのサイドバーにある「Agent」セクションから有効化できる。
この記事のポイント
- Vercel Agentは本番環境の異常を自律的に調査し、人間の承認を得て修正を実行するAIエージェントである
- 「プラン即許可」モデルにより、Agentの権限はタスク単位で一時的に付与され、完了後は読み取り専用に戻る
- 生成されたコードは隔離されたサンドボックスで検証され、本番環境に直接影響を与えない設計になっている
- イミュータブルデプロイメントなどのインフラ安全策と組み合わせることで、エージェントの誤動作コストを最小化する
- AIエージェントの実運用における信頼の課題に対して、プラットフォーム設計で安全性を担保するアプローチを具体化した製品といえる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験