

OpenAI GPT-Live登場、ChatGPT Voiceに検索機能を統合
OpenAIが音声会話と検索を融合させた新モデル「GPT-Live」の展開を開始した。2026年7月8日に発表されたこのアップデートにより、ChatGPT Voiceは会話の途中で最新の推論モデルやウェブ検索に質問を引き継げるようになる。
有料ユーザー(Go・Plus・Pro)には「GPT-Live-1」、無料ユーザーには「GPT-Live-1 mini」がデフォルトで提供される。Search Engine JournalのMatt G. Southern氏が報じたところによれば、週に1億5千万人以上がChatGPTと音声や音声入力で会話しており、今回の変更はその巨大なユーザー基盤に直接影響を及ぼす。
SEOの観点から特に注目すべきは、音声経由の検索結果が「どのように引用元を扱うか」の詳細がまだ明らかにされていない点だ。テキストベースのChatGPTでは回答の横にソースリンクが表示されるが、音声会話の中でどの程度サイトへの導線が確保されるかは、今後のトラフィック戦略を左右する。
GPT-Liveの仕組みと変更点
GPT-Liveの最大の特徴は、会話の自然さを追求した「全二重(Full-Duplex)」通信への移行だ。これは音声入力と応答生成を同時に行う技術で、ユーザーが話し終える前に割り込まれにくくなり、より人間らしい対話のテンポが実現される。
具体的に以下の要素で構成されている。
- 音声入力の処理と応答の生成を同時に実行し、待ち時間を短縮
- ユーザーが発話をためらった際に適切な間を取り、自然なターンテイキングを実現
- 有料ユーザー向けのGPT-Live-1と、無料ユーザー向けのGPT-Live-1 miniの2種類を用意
- 深い推論が必要な質問は自動的に最先端モデル(現在はGPT-5.5)に引き継ぐ
OpenAIの社内評価では、5分から10分の会話においてGPT-Live-1とGPT-Live-1 miniは従来のAdvanced Voice Modeよりも高く評価された。評価基準は全体的な好ましさ、ターンテイキング、割り込みの少なさ、会話の流れ、自然さだ。
音声検索の裏で動く推論と視覚カード
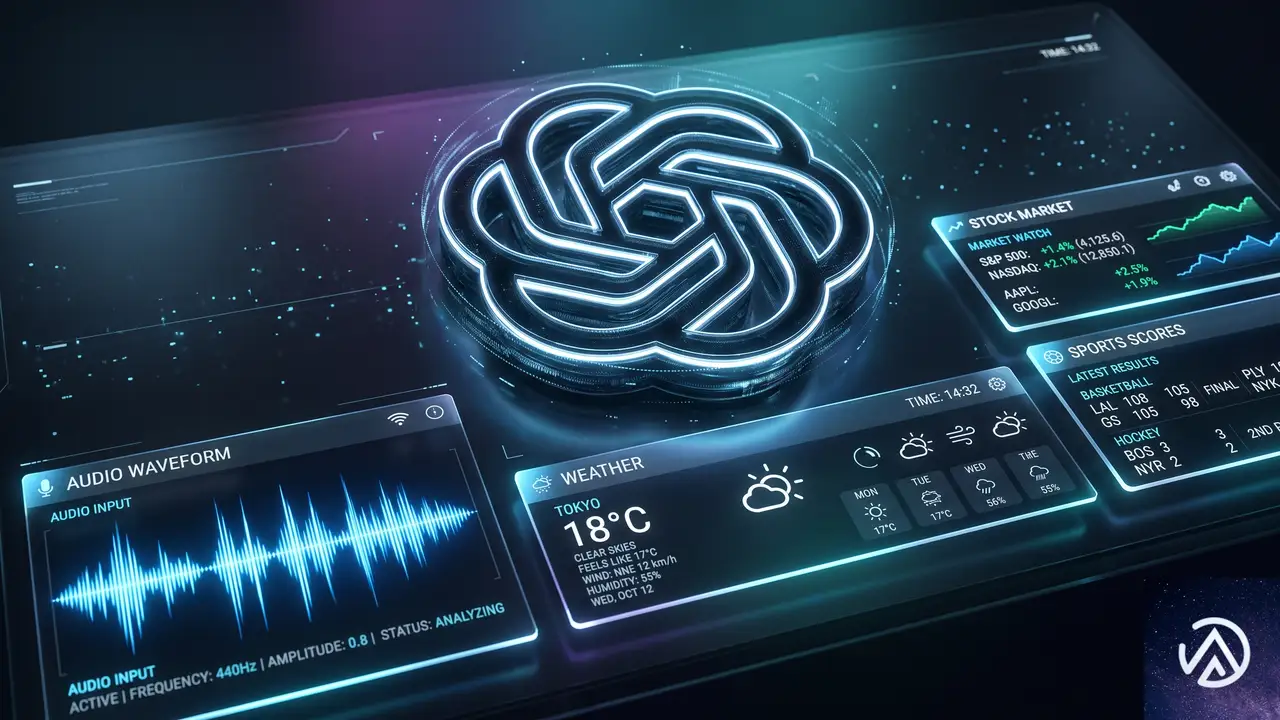
GPT-Liveの登場により、ChatGPT Voiceは単なる音声応答の枠を超え、天気や株価、スポーツといったトピックに対して視覚的なカードを画面に表示するようになった。これにより、ユーザーは音声で答えを聞きながら同時に画面で詳細を確認できる。
ユーザーは推論レベルを3段階から選択できる仕組みだ。即時応答を求める「Instant」モードはGPT-5.5 Instantで動作し、より深い回答が必要な「Medium」や「High」モードはGPT-5.5 Thinkingを使用する。音声会話の自然さを保ちながら、必要に応じて高度な推論エンジンに処理を委ねる設計になっている。
この仕組みは、音声経由の検索体験を大きく変える可能性がある。画面に情報カードが表示されることで、ユーザーは検索結果ページを経由せずに目的の情報を得られるからだ。
この変化はSEO担当者にとって無視できないシグナルだ。音声検索の結果が可視化されない形で提供されることで、従来の検索エンジン経由のトラフィックが一部置き換わる可能性がある。
GPT-Liveがまだ実装していない機能
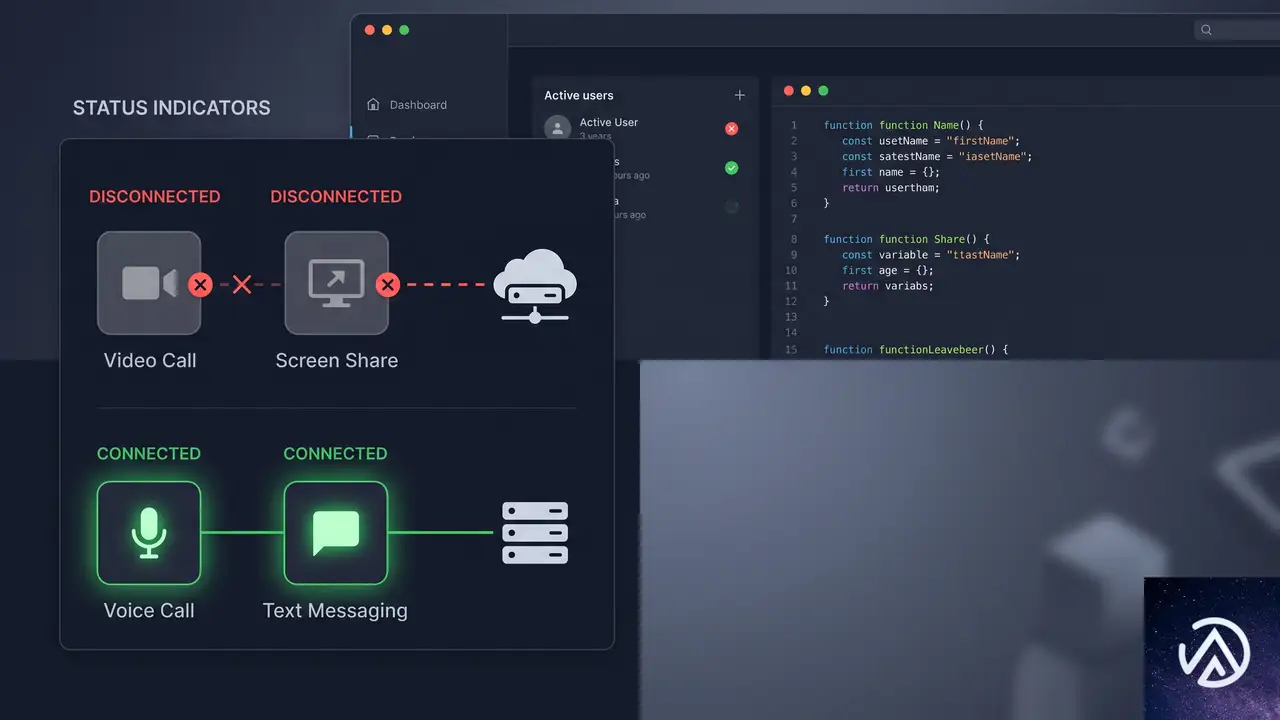
GPT-Liveは現時点で、ChatGPTにおけるビデオや画面共有を伴う音声には対応していない。OpenAIはこれらの機能の追加に取り組んでいることを明言しており、ビデオや画面共有が必要な場面では従来のStandard Voice ModeおよびAdvanced Voice Modeが引き続き利用できる。
実務的に重要なのは、この制約が一時的なものである可能性が高いという点だ。ビデオ・画面共有対応が追加されれば、ユーザーは画面を見せながら質問し、GPT-5.5の推論と検索を組み合わせた回答をその場で得られるようになる。視覚的な情報提供の幅がさらに広がることで、従来型の検索エンジンへの依存はより一層低くなるだろう。
引用とソース表示の不透明さがもたらすSEOリスク
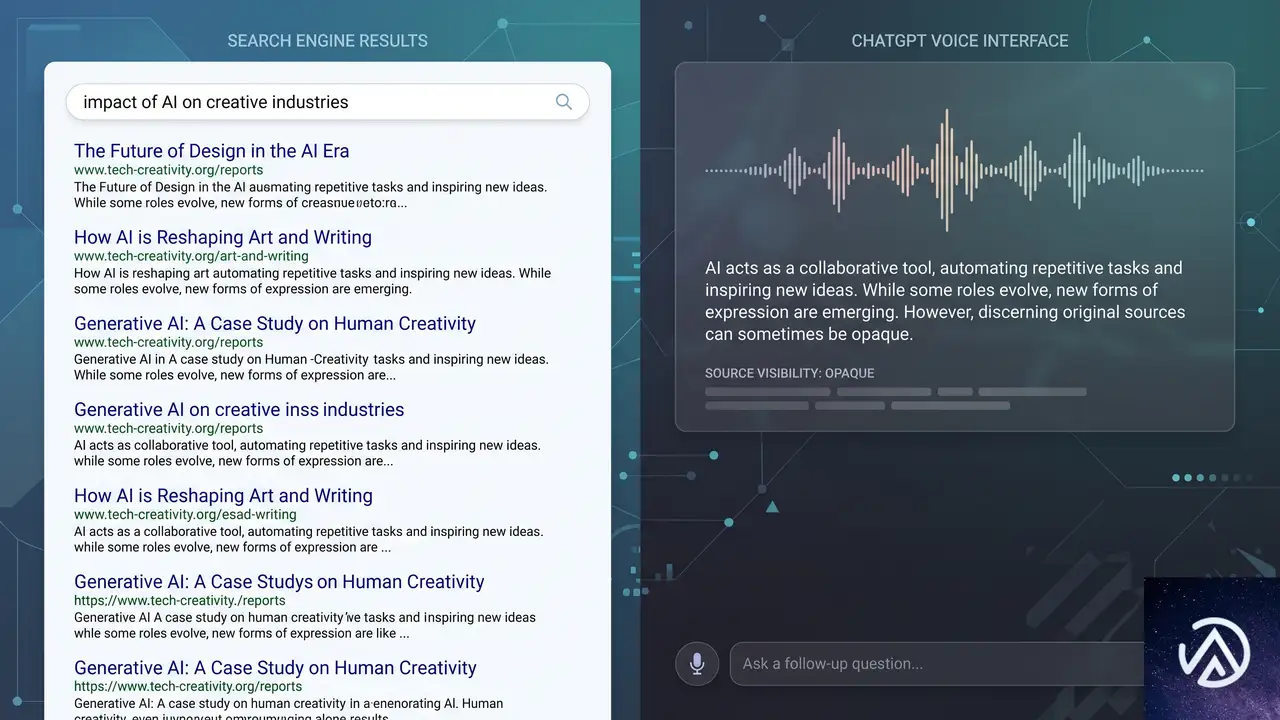
OpenAIの発表で最も詳細が不足しているのが、音声検索結果の引用(Citation)の扱いだ。テキスト版のChatGPTでは、回答の横にソースリンクが明示される。しかしGPT-LiveがGPT-5.5のウェブ検索を通じて得た情報を音声で回答する際、どのように引用元を示すのかはまだ明らかにされていない。
可能性としては以下の3つのシナリオが考えられる。
- 音声でソース名を読み上げて紹介する
- 画面上にテキストと同様のソースリンクを表示する
- ソースを一切提示せずに回答のみを提供する
3番目のシナリオが現実になれば、情報を提供しているウェブサイトにとっては深刻な問題となる。ユーザーが音声で質問し、画面を見ずに回答だけを得て終了すれば、検索トラフィックは完全に消失するからだ。
Search Engine JournalのMatt G. Southern氏は、音声検索結果がソースを「口頭で読み上げるのか、画面に表示するのか、あるいは完全に省略するのか」が、検索からサイトへの送客が維持されるかどうかを決める鍵だと指摘している。ChatGPTの音声会話がウェブサイトのトラフィックに与える影響を測る上で、最も注視すべきポイントだ。
音声検索時代に備えるための実務アプローチ
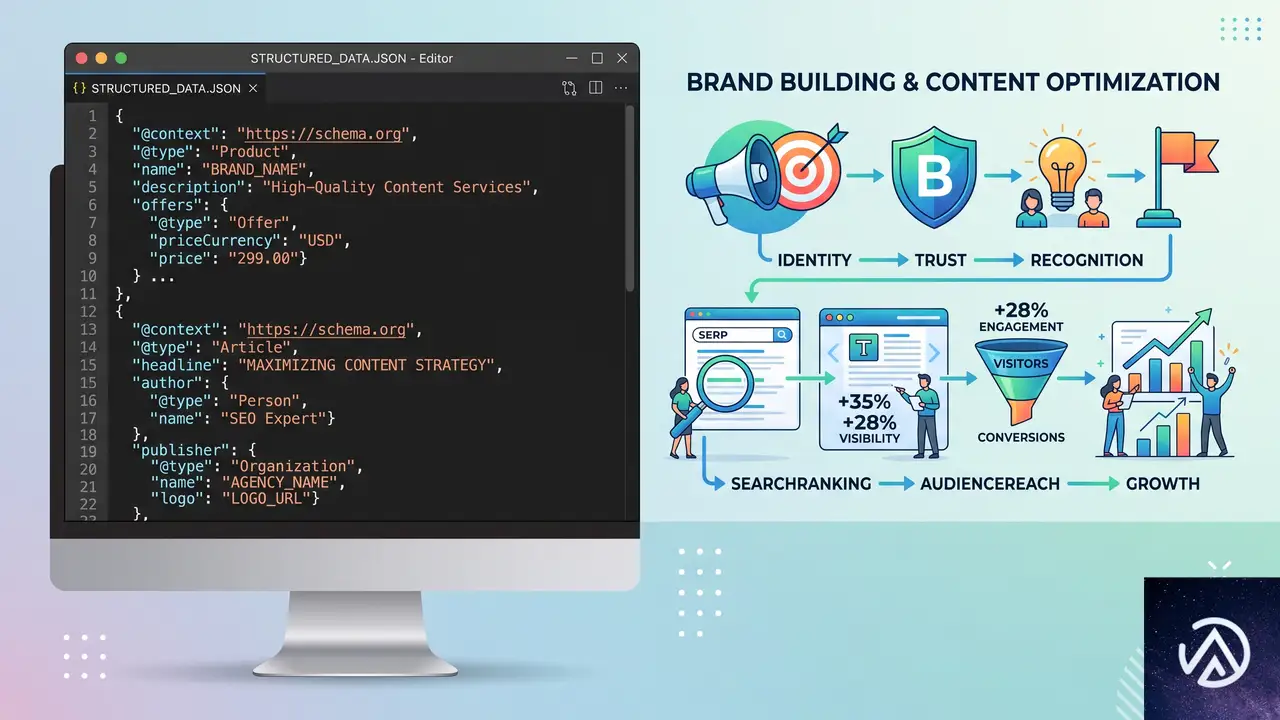
GPT-Liveのような音声と検索の融合が進む中で、SEO対策は従来のランキング上位表示だけでなく、「AIに情報源として選ばれること」を視野に入れる必要がある。以下の3つの観点が重要になる。
構造化データの強化と情報の整理
AIモデルがウェブ上の情報を正確に取得し、適切に引用するためには、ページの情報構造を機械が読み取りやすい形で提供することが欠かせない。Schema.orgに準拠した構造化データのマークアップは、検索エンジンだけでなくAIによる情報抽出の精度にも影響する。
特にFAQページやHowToコンテンツは、音声での質問応答に直接活用される可能性が高い。質問と回答のペアを明確にマークアップし、簡潔で正確な情報を提供することが有効だ。
ブランド認知と信頼性の蓄積
音声検索の結果としてソースが表示される場合、ユーザーがクリックするのは「知っている名前」や「信頼できると感じるサイト」である可能性が高い。AI時代のSEOでは、単なる検索順位だけでなく、ブランドとしての認知度や専門性の確立がクリック率に直結する。
具体的には、業界内での継続的な情報発信、オリジナルデータや独自調査の公開、著名なメディアからの被リンク獲得など、E-E-A-T(経験・専門性・権威性・信頼性)を高める施策がこれまで以上に重要になる。
音声向けコンテンツの設計
音声で読み上げられることを想定したコンテンツ設計も視野に入れるべき段階に入った。長文の説明よりも、要点を簡潔にまとめた「音声向けサマリー」をページの冒頭に配置することで、AIが情報を抽出しやすくなる。
また、天気や株価、スポーツのスコアといったリアルタイム性の高い情報は、構造化データと組み合わせることでAIに直接取得されやすい。これらの情報を提供しているサイトは、API連携やデータフィードの整備を通じて、機械可読な形式での情報提供を強化することが望ましい。
この記事のポイント
- GPT-Liveは音声会話中にGPT-5.5への推論依頼とウェブ検索を自動的に組み合わせる
- 天気・株価・スポーツなどの視覚カードにより、検索結果ページを経由しない情報取得が拡大
- 音声検索結果の引用表示方法が未公表であり、サイトへのトラフィック維持に直結する課題
- 構造化データの強化とブランド認知の蓄積が、AI時代のSEOにおける重要な差別化要素になる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHub CopilotでDNS設定ゼロ、Pagesカスタムドメインを14分で公開
GitHub Copilot CLIでDNS設定ゼロ。GitHub Pagesカスタムドメインを14分で公開
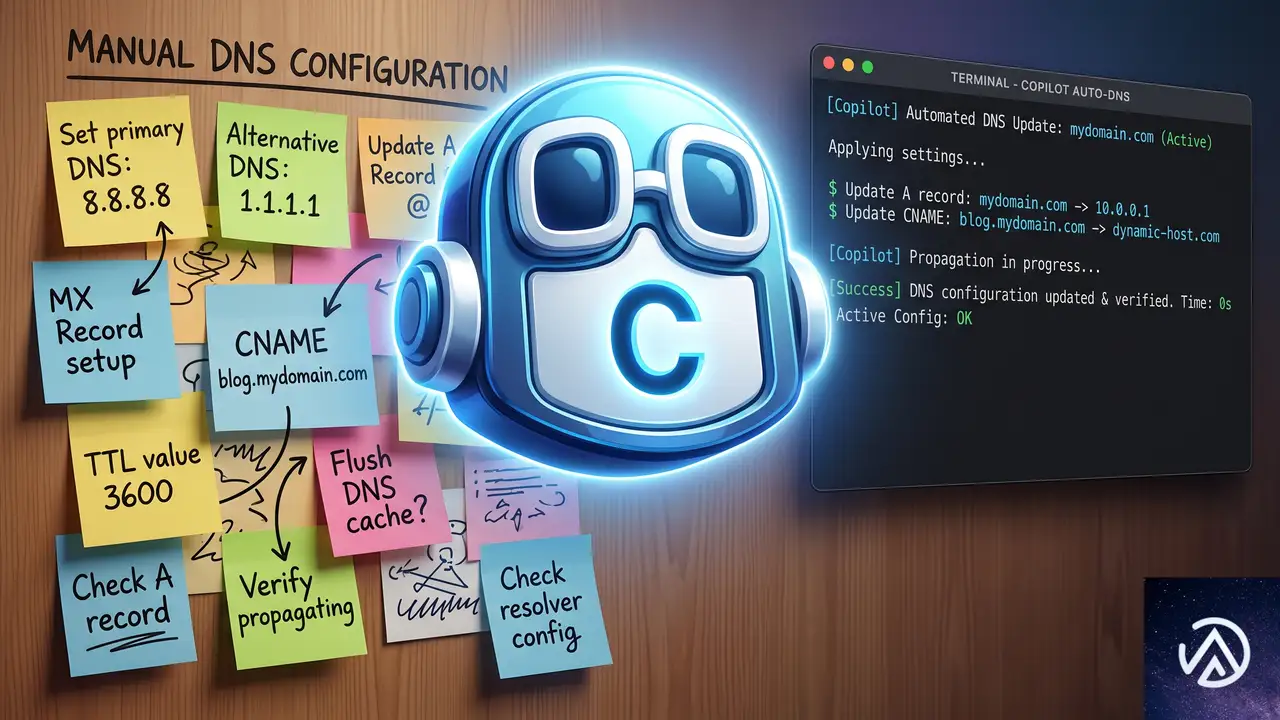
カスタムドメインの取得とDNS設定は、多くの開発者にとって「最後の関門」だ。Aレコード、CNAMEエントリ、TTL(Time To Live / DNSキャッシュの有効期間)、そして「設定が反映されたのかどうかもわからない」という長い待ち時間。これらの煩わしさが、せっかくのプロジェクト公開を先延ばしにする原因になっている。
GitHub Blogで2026年7月8日に公開された記事によれば、GitHub Copilot CLIとコミュニティ製のNamecheapスキルを組み合わせることで、DNSレコードを手動で1行も編集せずに、約14分でカスタムドメインの設定からHTTPS化されたサイト公開までを完了できることが実証された。空のリポジトリから公開まで、わずか14分だ。
本記事では、このワークフローをステップごとに分解し、技術的な仕組みと実務への応用方法を解説する。DNSの知識がなくても理解できるよう、専門用語には都度説明を加えながら進める。
Copilot CLIがDNSの常識を変える、手動設定から自動化への転換
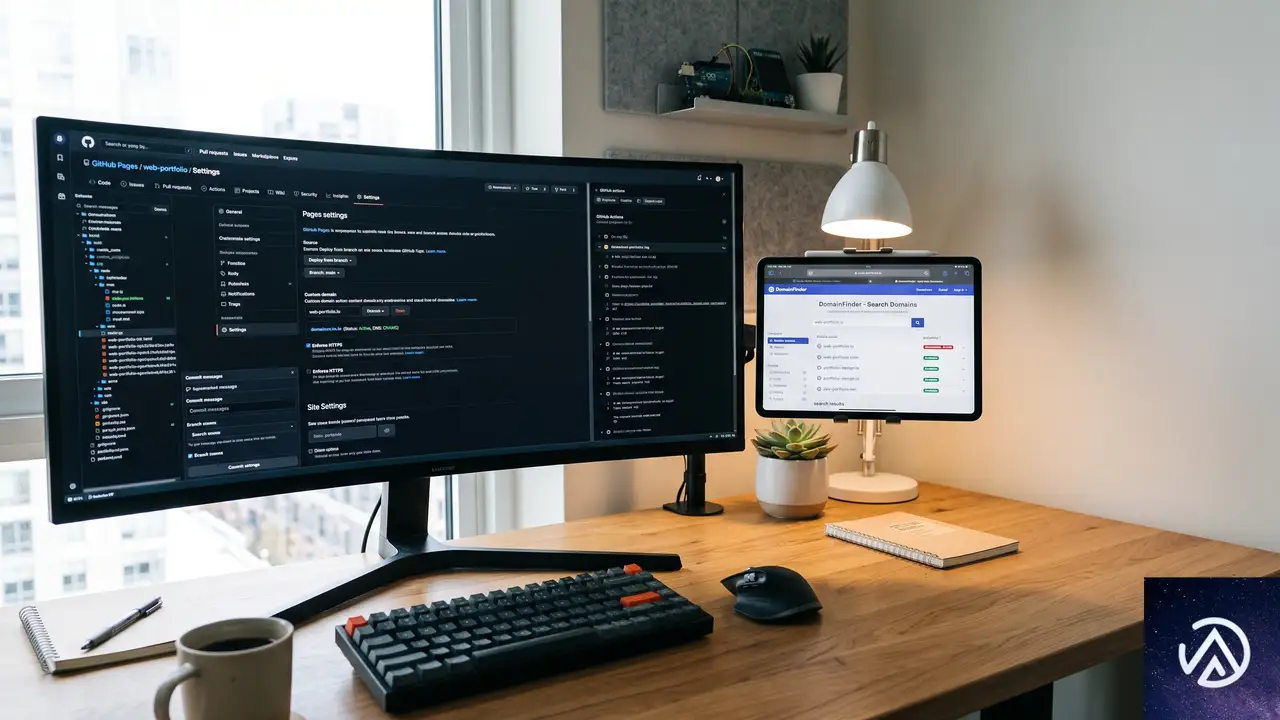
従来のDNS設定が抱える3つの課題
カスタムドメインをGitHub Pagesに紐付けるには、従来以下の作業が必要だった。ドメインを購入し、レジストラ(ドメイン管理会社)の管理画面でAレコードとCNAMEレコードを手動で追加し、GitHubリポジトリ側にもCNAMEファイルをコミットする。さらにDNSの伝播(設定がインターネット全体に行き渡るプロセス)を待ち、最大で48時間かかることもある。
この一連の作業には大きく3つの課題がある。第一に手順の複雑さだ。AレコードやCNAMEといったDNSレコードの種類を理解し、正しい値を入力する必要がある。第二にフィードバックの遅さ。設定が正しいかどうかの確認に長時間を要する。第三にミスのリスク。1文字でも間違えるとサイトが表示されず、原因特定にも手間取る。
Copilot CLIが解決するDNS設定の自動化
GitHub Copilot CLIは、自然言語での指示をシェルコマンドやAPI操作に変換するAIアシスタントだ。これにレジストラのAPIと連携するスキルを組み合わせることで、DNSレコードの読み取り・設定・検証までを自動化できる。
今回のワークフローでは、Namecheap(ドメインレジストラ)のAPIを操作するコミュニティ製スキル「namecheap-skill」を使用する。Copilot CLIに対して「このドメインをGitHub Pagesに向けて」と指示するだけで、スキルが必要なAレコードとCNAMEレコードを自動生成し、レジストラのAPI経由で設定する。さらにGitHubリポジトリ側のCNAMEファイルも自動でコミットする。
手動で6ステップかかっていたDNS設定が、自然言語の指示1行で完結する。ミスのリスクが排除され、待ち時間も大幅に短縮される点が最大の利点だ。
準備編、GitHub Pagesへの公開と格安ドメインの取得
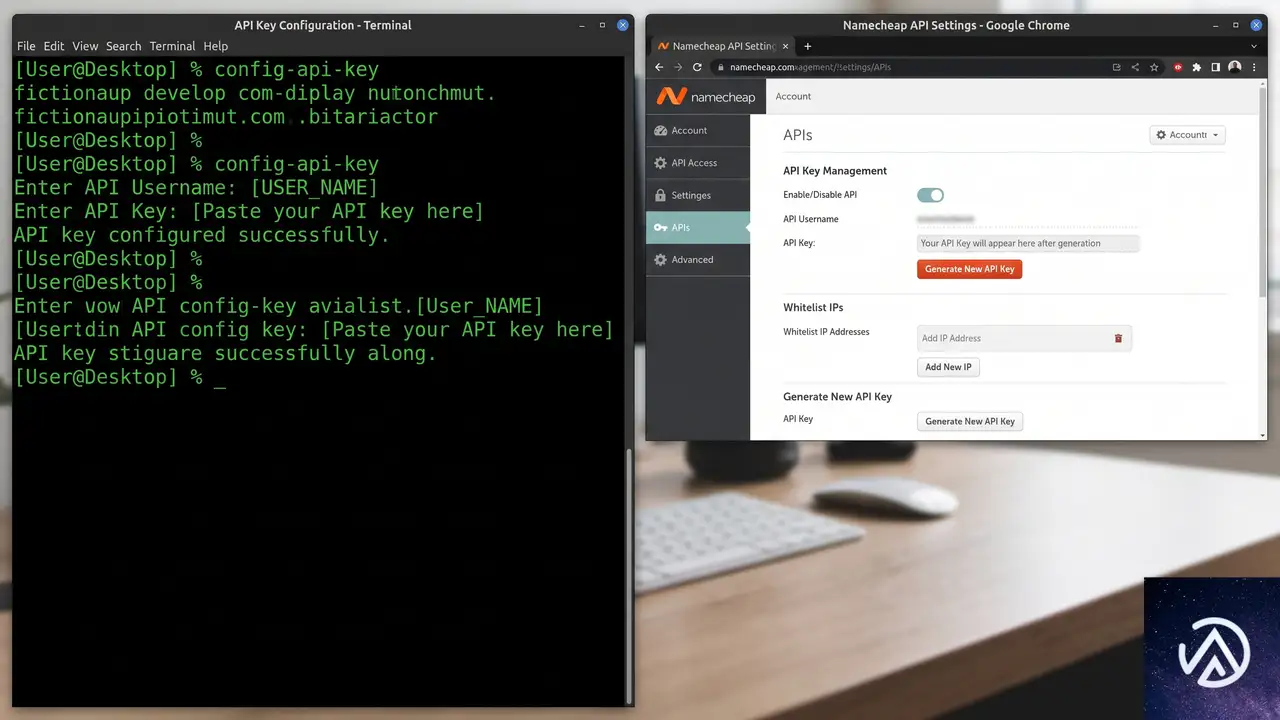
ステップ1、GitHub Pagesでランディングページを公開する
まずは公開用のリポジトリを作成する。空のパブリックリポジトリを用意したら、index.htmlを手書きする必要はない。Copilot CLIに「このリポジトリでGitHub Pagesを有効にして、カスタムドメインに関するランディングページを作成して」と指示するだけで、HTMLの生成からPagesの有効化までを自動実行してくれる。
この時点でサイトは ユーザー名.github.io というURLで公開される。まずはデフォルトドメインでサイトが表示されることを確認し、次に独自ドメインの設定に進む。
ステップ2、低コストでドメインを取得する
サイドプロジェクトにプレミアムな .com ドメインは必須ではない。今回の検証では、最も安価なTLD(トップレベルドメイン / .comや.orgなどのドメイン末尾部分)のひとつである .click が選択された。購入費用はわずか2米ドル(約300円)だ。サイドプロジェクトでカスタムドメインを試すにはリスクの低い金額といえる。
Namecheapでドメインを検索し、利用可能な名前を選んで購入する。決済が完了すれば、次のステップでAPI経由のDNS設定に進む準備が整う。
Namecheap APIとCopilot CLIの連携でDNSレコードを自動設定
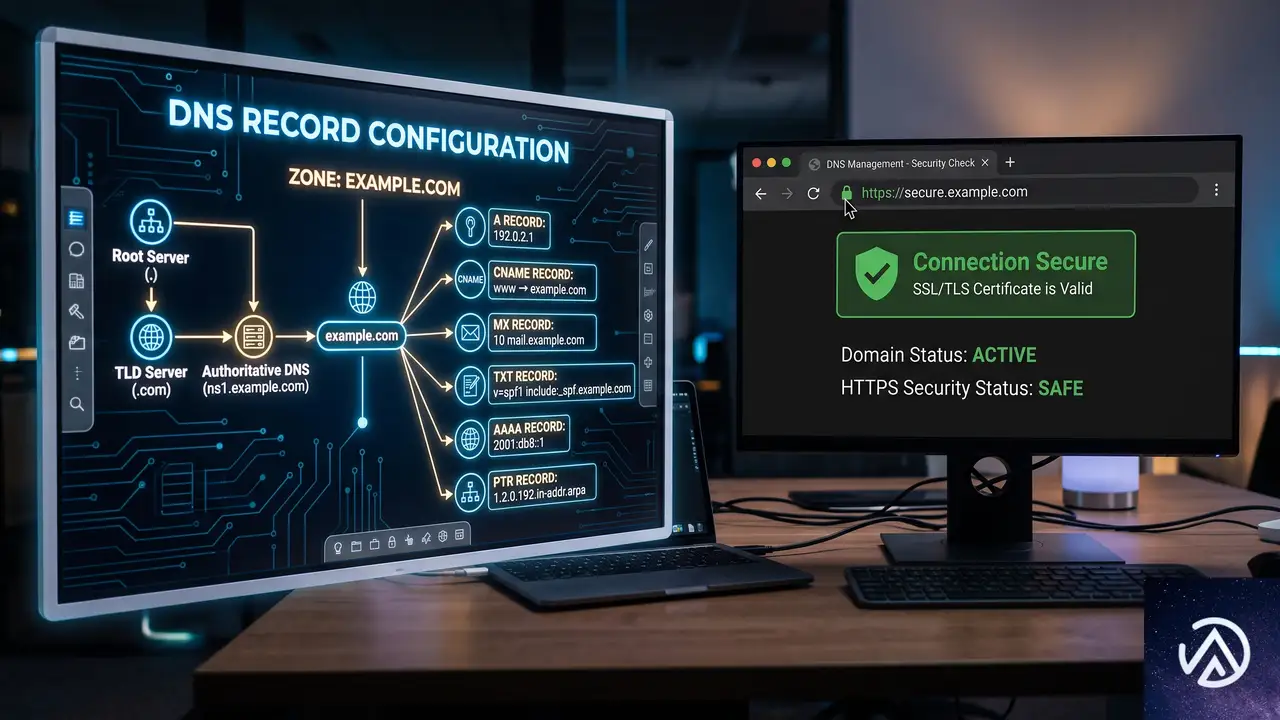
Namecheap APIアクセスを有効化する
Copilot CLIがDNSを操作するには、事前にNamecheapのAPIを有効化する必要がある。Namecheapの管理画面で「Profile → Tools → Business & Dev Tools」と進み、Namecheap API Accessの管理画面を開く。ここで3つの設定を行う。
- APIをONに切り替える
- APIを呼び出すマシンのパブリックIPを許可リスト(ホワイトリスト)に追加する
- APIキーをコピーして安全な場所に保管する
APIキーは後続のステップでCopilot CLIに入力するため、手元に控えておく必要がある。NamecheapのAPIを使うと、ドメイン一覧の取得やDNSレコードの読み書きをプログラムから実行できるようになる。
Namecheapスキルをインストールする
続いて、Copilot CLIにNamecheapと通信する能力を与えるスキルをインストールする。以下の1コマンドで完了する。
gh skill install github/awesome-copilot namecheap --scope userスキルのインストール後、Copilot CLIに対して「自分のNamecheapドメインを一覧表示して」と指示すると、初回実行時にAPIキーの入力を求められる。先ほど控えたキーを入力すれば、アカウント内のドメイン一覧が表示され、連携が正常に機能していることを確認できる。
この4ステップで、Copilot CLIがドメインレジストラのAPIを直接操作できる状態になる。従来のように管理画面を手動で操作する必要はない。
ドメインの紐付けと自動検証、すべてが14分で完了
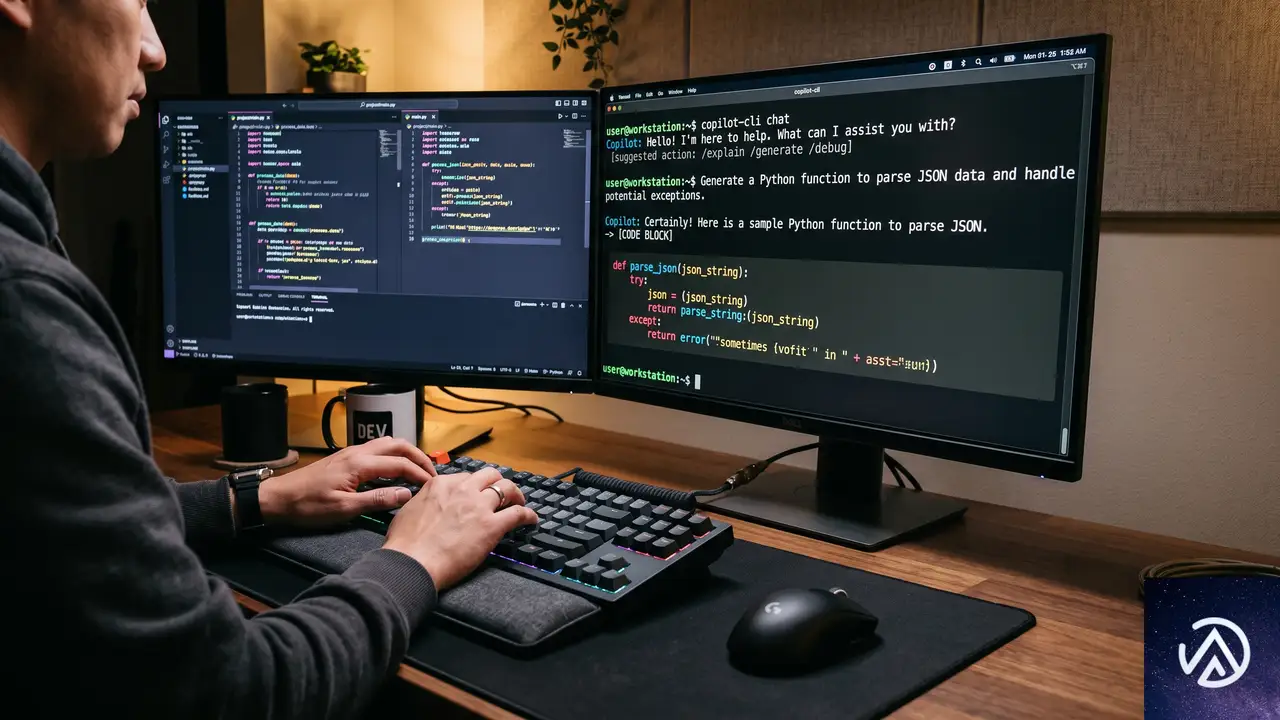
Copilot CLIにドメイン接続を指示する
準備が整ったら、Copilot CLIに対して「このGitHub Pagesサイトでカスタムドメインを有効にして」と指示する。スキルは現在のDNSレコードを確認し、変更を適用する前に確認を求めてくる。これは重要な安全設計だ。誤ったDNS変更がサイトの表示停止につながるリスクを、人間の承認によって防いでいる。
承認後、スキルは以下の作業を自動実行する。
- Namecheapのパーキングレコード(未使用ドメインの仮レコード)を削除
- GitHub PagesのAレコード(IPアドレス指定)を登録
- WWWサブドメイン用のCNAMEレコードを追加
- リポジトリにCNAMEファイルを自動コミット
これらの手順はGitHubが公式に定めるカスタムドメイン設定手順に完全に準拠している。手動で行う場合とまったく同じ結果が、人的ミスのリスクなく得られる。
自動検証でDNS設定の完了を確認する
設定が完了したら、Copilot CLIは自らの作業を検証する。まずドメインが正しく解決されるか(DNSルックアップ)を確認し、次にサイトがHTTP 200(正常応答)を返すかをチェックする。手動での動作確認すら自動化されているのだ。
実際のタイムラインを見てみよう。ドメイン購入は東部時間の午前11時21分27秒に行われた。約14分後の午前11時35分には、カスタムドメインでHTTPS化されたサイトが公開されていた。この14分にはAPIセットアップ、スキルインストール、DNS設定、伝播、検証のすべてが含まれている。
Copilot CLIがDNSルックアップとHTTPステータス確認を自動実行し、人間が待機する必要はない。設定ミスがあればすぐに検出され、修正も対話的に行える。
DNS自動化が変える開発体験、Namecheap以外でも使える汎用ワークフロー
このワークフローの本質は、Namecheapに限ったものではない。APIを提供しているレジストラであれば、同じアプローチが適用できる。専用のスキルがなくても、Copilot CLIにレジストラのAPIドキュメントを読み込ませ、「このAPIを使ってGitHub PagesのDNSレコードを設定して」と指示すればよい。レジストラが変わってもワークフローは変わらない。
DNS設定は「難しくはないが、面倒で失敗しやすく、フィードバックが遅い」という特性を持つ作業だった。Copilot CLIはこの3つの課題を同時に解決する。面倒な手順は自動化され、失敗のリスクは承認プロセスで抑制され、フィードバックは自動検証で即時に得られる。
カスタムドメインの設定を「面倒だから」と後回しにしてきた開発者にとって、このワークフローは心理的な障壁を取り除く。14分という時間は、コーヒーを淹れるのと変わらない。DNS設定がコマンド1行で済む時代が、すでに来ている。
この記事のポイント
- GitHub Copilot CLIとNamecheapスキルでDNSレコードの手動編集が不要になる
- 空のリポジトリからHTTPS化されたカスタムドメインサイトまで約14分で完了
- API経由の自動設定によりAレコードやCNAMEの入力ミスがゼロになる
- 設定後はCopilot CLIがDNS解決とHTTPステータスを自動検証する
- Namecheap以外のレジストラでも、APIがあれば同じワークフローが適用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI可視性スコアは無意味、EC事業者が取るべき代替指標と施策
AI検索の可視性スコアは、特定のプロンプトと計測条件に強く依存する。実務的な指標として機能しないケースが多く、一部の代理店ではスコアの水増しまで行われているのが現状だ。
Practical Ecommerceに掲載された論考は、この問題を「AI Visibility Scores Are Useless(AI可視性スコアは役に立たない)」と断じている。本記事では、EC事業者がすぐに着手できる代替指標と、AI検索で自社のプレゼンスを高めるための具体的な施策を解説する。
AI可視性スコアが当てにならない3つの理由
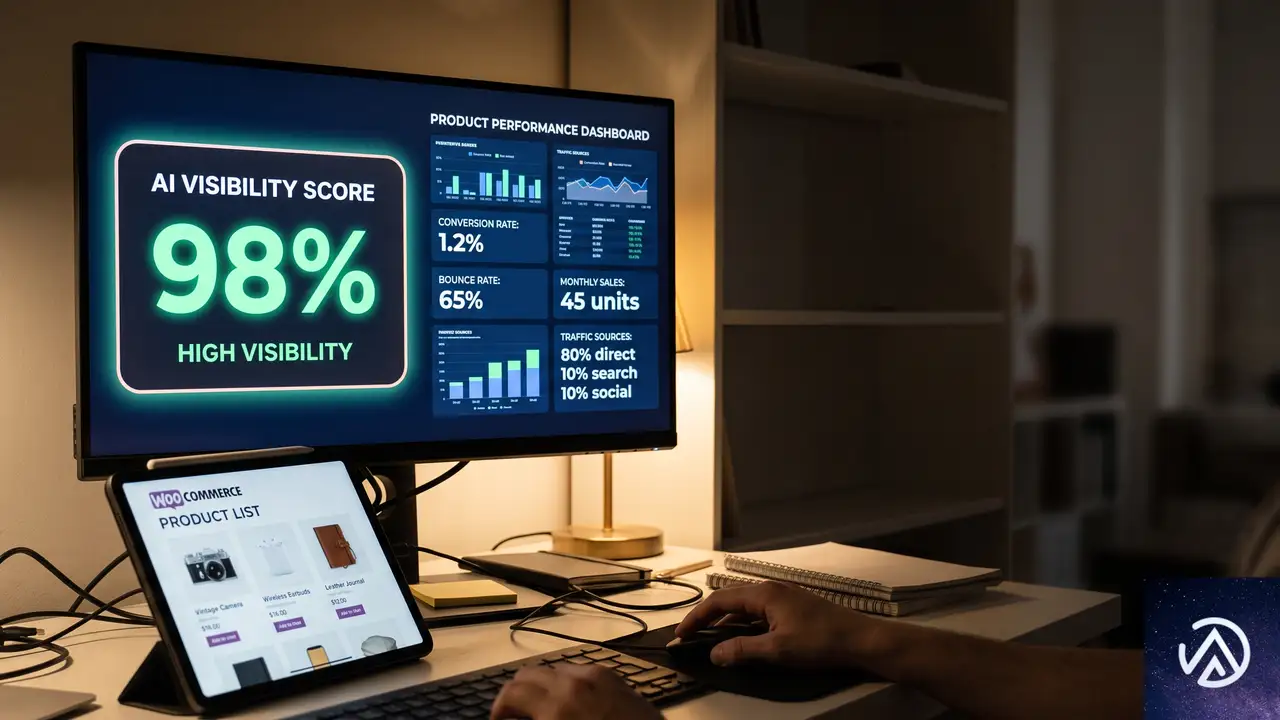
AI可視性スコアとは、ChatGPTやPerplexityといった生成AIの回答に、自社のブランドや商品がどれだけ登場するかを数値化した指標を指す。直感的には便利に思えるが、現場で使うには欠陥が多い。
プロンプトに結果が左右される脆弱さ
AIの回答は、与えられたプロンプト(質問文)によって内容が大きく変わる。たとえば「東京 おすすめ ランニングシューズ」と「[自社ブランド名] ランニングシューズ 評判」では、同じAIでも表示される情報がまったく異なるのだ。
可視性ツールの多くは、事前に用意された少数のプロンプトでスコアを算出する。そのプロンプトに自社名が含まれていればスコアは跳ね上がり、含まれていなければゼロになる。実務を反映しない、操作しやすい設計といえる。
プロンプトに自社名が入った「仕込み」の質問でスコアを稼ぐ行為は、実務的な意味を持たない。実際の消費者は、もっと漠然とした言葉で商品を探しているからだ。
スコアを水増しする手法が横行している
業界の一部では、プロンプトを加工してわざと自社が上位表示されるように誘導する操作が行われている。Practical Ecommerceの記事もこの点を指摘しており、自社名を盛り込んだプロンプトを大量に使えば、全体の平均スコアを簡単に引き上げられてしまう。
外部のコンサルタントや代理店から「AI可視性スコアが○%向上しました」といった報告を受けても、その数字がどんなプロンプトに基づくのかを確かめなければ、まったく意味が変わってくる。
引用されても購買につながらないケース
生成AIの回答には、ブランド名が明示される「見える引用」と、リンクだけが貼られてブランド名が出ない「見えない引用」の2種類がある。後者はクリックされる確率が極めて低く、トラフィックにほとんど寄与しない。
Redditの報告によれば、ChatGPT経由のトラフィックはGoogle検索と比べて極端に少ない。引用数だけをKPIにすると、実態とかけ離れた数値を追いかけることになる。
EC事業者が追うべき実践的なAI指標
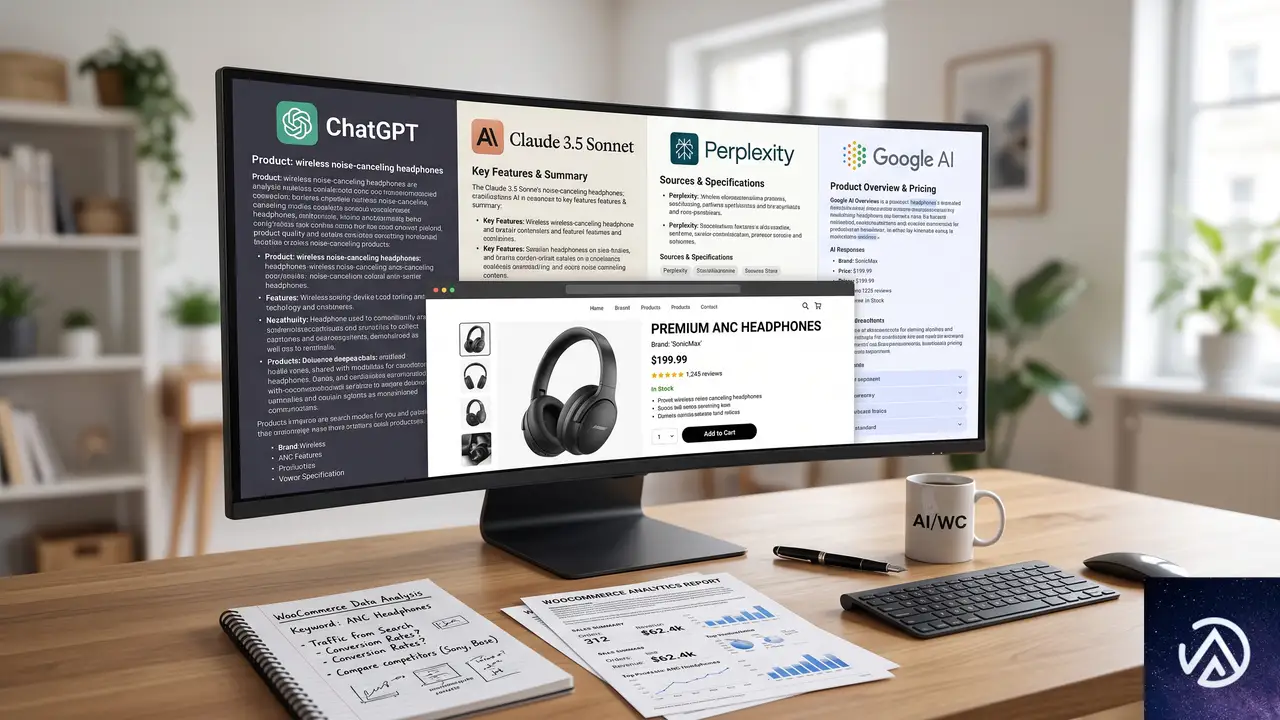
AI可視性スコアに代わる指標として、Practical Ecommerceの著者は大きく4つのポイントを挙げている。いずれも特定のツールに依存せず、自社のコンテンツ戦略に直結する項目だ。
複数AIで引用されるドメインを分析する
単一のAIモデルでの引用率ではなく、ChatGPT、Claude、Perplexity、Google AI Overviewsなど、複数の生成AIプラットフォームにまたがって引用されているドメインを追う方が有益だ。このアプローチにより、次の3つを把握できる。
- AIが回答の根拠として信頼するメディアやパブリッシャー
- AIに影響力を持つUGC(ユーザー生成コンテンツ)やSNSプラットフォーム
- 高頻度で引用されている競合サイト
複数プラットフォームで共通して引用されるドメインは、AIが「信頼できる情報源」と評価している証拠だ。ECサイトであれば、商品説明の充実度や口コミの多さ、専門メディアでの露出が共通項になりやすい。
競合の引用状況からコンテンツの穴を探す
従来のSEOではキーワードギャップ分析が行われてきたが、AI検索の文脈では「引用ギャップ」とも呼べる視点が重要になる。特定の質問に対して競合が引用されているのに自社が引用されていない場合、サイト上の情報に不足があると考えられる。
たとえば、競合ECサイトが「サイズ選びの失敗を防ぐ方法」という記事で頻繁に引用されているなら、消費者はその情報をAIに求めているとわかる。自社も同様のコンテンツを用意し、AIに拾われやすい構造で公開すれば、自然と引用対象に入りやすくなる。
見えない引用を「見える引用」に変える
AI回答にリンクは貼られているが、ブランド名やサイト名が一切表示されない状態を「見えない引用」と呼ぶ。この状態では、ユーザーがリンクをクリックする動機が弱く、トラフィック増加にはつながりにくい。
一方、ブランド名が明示される「見える引用」は、ユーザーの購買判断に直接的な影響を与える。Practical Ecommerceの著者のテストでも、見える引用が購買決定を後押しする結果が出ているという。
見えない引用を改善するには、AIが回答の要約を作る際に「ブランド名を自然に含められる」形でオンページのテキストを整備する必要がある。「当店のシューズは」ではなく「[ブランド名]のシューズは」と書くだけでも、AIの引用表記は変わりうる。
ブランドプロンプトで自社の情報鮮度を測る
AIに自社情報がどの程度正確に、どの程度詳しく伝わっているかを確かめるには、ブランド名を明示したプロンプトが有効だ。実務の文脈で使える質問例として、以下が挙げられる。
- 「[自社ブランド名]とはどんなブランドか?」
- 「[自社ブランド名]と[競合ブランド名]の違いは?」
- 「[自社ブランド名]の評判や口コミは?」
- 「[自社ブランド名]は信頼できるか?」
これらの質問に対してAIが具体的かつ最新の情報を返せるなら、オンページの情報整備とブランドシグナルが機能している証拠といえる。回答が古かったり、内容が薄い場合は、AIが参照できる情報源が不足している可能性が高い。
ECサイトが今すぐ始めるAI検索対策
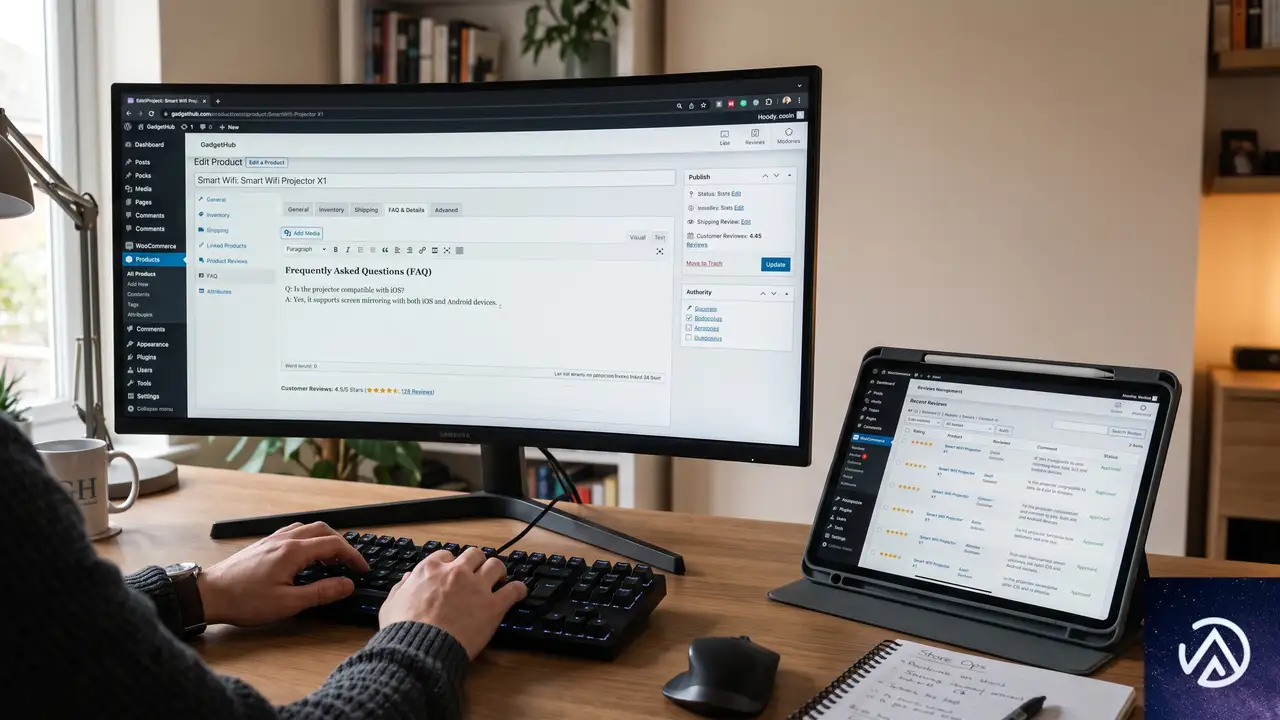
上記の指標を踏まえ、EC事業者がすぐに取り組める具体的な施策を整理する。特別なツールへの投資は不要で、サイト運営の延長線上にある作業ばかりだ。
商品ページの情報を「AIが引用しやすい形」に整える
AIは構造化された情報を好む。商品ページでは、箇条書きのスペック表、FAQ、Q&A形式の説明文などを積極的に挿入しよう。とくに、ユーザーが検索しそうな疑問文をそのまま見出しにしたFAQセクションは、AI回答の直接的な引用元になりやすい。
また、商品説明にブランド名を適度に繰り返し入れることで、「見える引用」を誘発しやすくなる。過剰なキーワード連打は避けるが、自然な文脈でブランド名を含める意識が重要だ。
UGC(口コミ・レビュー)を強化する
AIはユーザー生成コンテンツ(UGC)を重視する傾向がある。商品レビューやQ&A、SNS上の口コミなど、実際の購入者による生の声が豊富なECサイトは、AIの回答で引用される確率が上がる。
レビュー数の少ない商品については、購入後のフォローメールでレビュー依頼を自動化したり、レビュー投稿者にクーポンを提供する仕組みを導入するとよい。WooCommerceであれば、プラグインを使ってこうした導線を簡単に追加できる。
外部メディアや比較記事での露出を増やす
AIが高頻度で引用するのは、編集プロセスを経た信頼性の高いメディア記事だ。自社商品が比較記事やレビュー記事で取り上げられれば、その記事経由でAIの回答に自社ブランドが登場しやすくなる。
AI検索の時代は「自社サイトだけで完結させない」発想が求められる。第三者メディアへの露出や、インフルエンサーによる紹介記事の獲得が、間接的にAI可視性を押し上げるのだ。
この記事のポイント
- AI可視性スコアはプロンプト依存度が高く、水増し操作も容易なため実務指標として機能しない
- 複数の生成AIプラットフォームにまたがる引用ドメイン分析が、より正確な現状把握につながる
- 競合の引用状況を調べれば、自社サイトに足りないコンテンツテーマが明らかになる
- ブランド名が表示される「見える引用」を増やすために、オンページの表現とUGCの充実が有効
- 特別なツールに頼らず、商品ページのFAQ拡充やレビュー施策から着手できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索時代のSEO、5つの教訓と閉ループSEOの実践
はじめに AI検索とSEOの常識が変わった

昨年時点でAI検索経由のリードは全体の2.5%に過ぎなかった。それが2026年3月には35%まで跳ね上がっている。Search Engine JournalのウェビナーでWritesonicのCEOサマニョウ・ガーグ氏が示した数字だ。AI検索はもはや実験段階ではなく、マーケティング成果を左右する主力チャネルに成長している。
だが、この変化は単なる流入経路の増加ではない。「AI検索がSEOを殺したわけではないが、エンジニアリングの問題に変えた」とガーグ氏は指摘する。検索キーワードを詰め込む従来の対策は通用しなくなり、自社サイトの外側でいかに引用を獲得するかという設計思想の転換が求められている。
本記事では、Writesonicの調査から浮き彫りになったAI検索時代の5つの教訓を整理し、具体的なアクションに落とし込む。AI引用の96%が自社外ページから生まれている現実、引用が生き残る時間、そして「閉ループSEO」と呼ばれる継続的改善の仕組みまでを扱う。
従来のSEOは自社サイト内の最適化が中心だったが、AI検索では発想を180度転換する必要がある。
AI引用の96%は自社サイト外から発生している

Writesonicが実施した最新調査で、AI検索が引用するページの96%がサードパーティソースだった。Reddit、YouTube、フォーラム、業界メディアなどだ。数カ月前は約80%だったことから、この傾向は加速しているとみられる。
さらに、AIモデルのアップデートごとに引用先の構成比は大きく変動する。GPT 5.3からGPT 5.5への移行ではRedditとYouTubeの引用が急増し、特定ドメインに依存するリスクの高さが浮き彫りになった。
自社サイトだけに頼るリスク
ガーグ氏は「すべての卵を1つのバスケット(自社サイトや特定のサイト)に入れてはいけない」と警鐘を鳴らす。自社ドメインのページだけを最適化しても、AI検索の引用先としては取りこぼす確率が極めて高いからだ。競合がフォーラムや動画プラットフォームで引用を獲得していれば、検索のたびに自社の露出機会が失われる。
ガーグ氏はウェビナー内で、競合が引用されているのに自社が引用されていないトピックを特定し、アウトリーチ先と連絡先を自動でリスト化するエージェントのデモも披露している。
AI引用の寿命は想定よりはるかに短い

Writesonicが15万件以上の引用を分析した結果、AI検索での引用の平均寿命は多くのコンテンツ担当者が想定するより短かった。モデルは確率的に動作するため、新鮮なソースに入れ替わるたびに自社の引用枠が競合に奪われる可能性がある。
「モデルは本質的に確率的なので、非常に不安定なものだ」とガーグ氏は述べている。一度引用を獲得しても、次のモデル更新でその座を失うことは珍しくない。
引用ローテーションにどう備えるか
Writesonicのチームは引用がローテーションで外れた場合に備え、リフレッシュと多様化をセットで実行している。具体的には、引用が失効したページを即座に更新し、同時に別のプラットフォームで新たな引用候補を育成するという動き方だ。特定の1ページに依存しない体制を作ることが、AI検索での安定した可視性につながる。
1つの引用先に集中するのではなく、常に複数のエントリーポイントを育てておく発想が欠かせない。
SEOエージェントを構成する4つの層
Writesonicが構築しているSEOエージェントは「アイデンティティ」「知識」「スキル」「ツール」の4層で構成される。重要なのは、人間の専門家を置き換えるのではなく、専門家の思考パターンを再現して補佐させる設計思想だ。
ガーグ氏は「世界で最も優秀なインターンがチームに加わったようなものだ」と表現する。ポジショニングエージェントはエイプリル・ダンフォード氏のフレームワークを学習し、個別の専門家の判断ロジックを「セカンドブレイン」文書として構造化する。すべての最終判断は人間の実務者が承認する体制をとっている。
専門家ファイルの作り方
エキスパートファイルとは、特定の専門家が公開している思考フレームワークや講演内容を、AIモデルが消費しやすい構造化マークダウンに落とし込んだものだ。ガーグ氏は「1万ワードのテキストをただ並べるのではなく、モデルが新しいタスクに適用できるよう適切に構造化する必要がある」と述べている。1人の専門家から始め、成果が出てからチーム全体に広げるアプローチが推奨される。
専門家の知見を構造化してエージェントに渡せば、24時間稼働する戦略スタッフとして機能する。ただし最終判断の権限は常に人間が握っておくことが大前提だ。
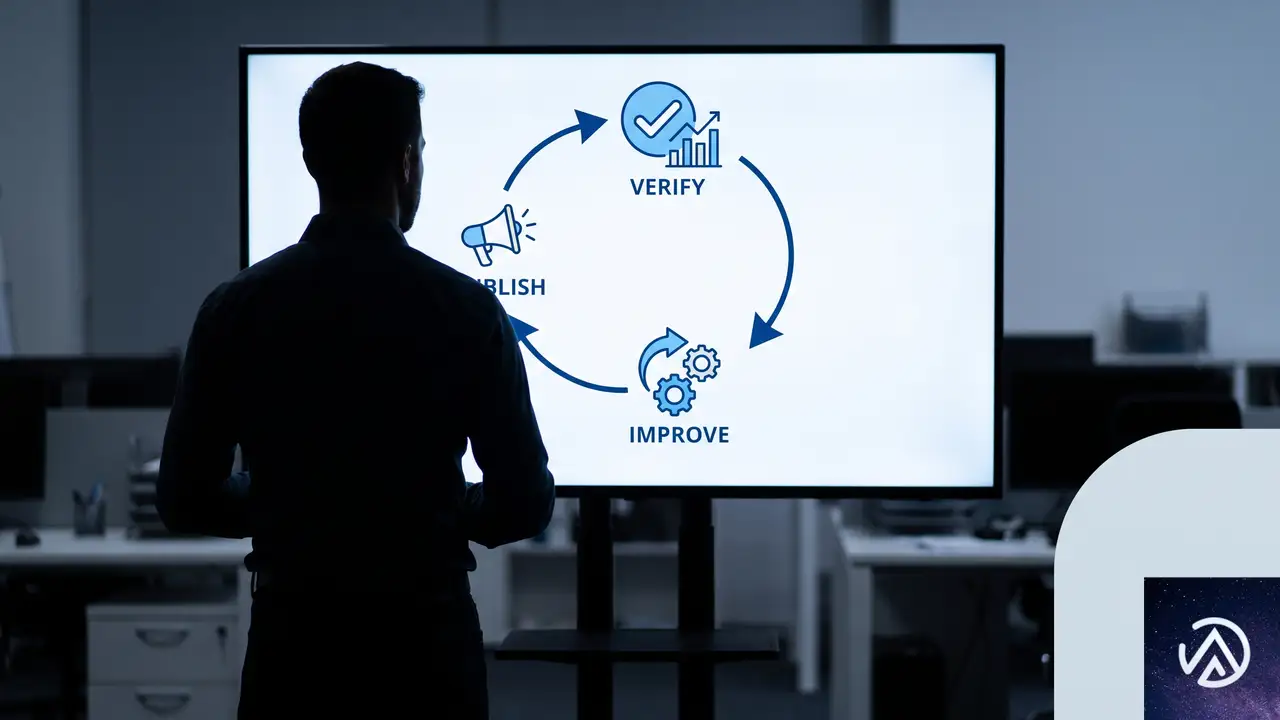
閉ループSEOの考え方 公開・検証・改善を回す
閉ループSEOとは、公開したすべてのページを実験とみなし、Googleがインデックスしたかどうか、ランキングや引用を獲得できたかどうかを検証し、その結果を次の修正にフィードバックする手法だ。ガーグ氏のチームは4つの重み付け指標で全ページをスコアリングし、100ページのバックログを優先度順の作業キューに変換している。
ウェビナーのライブ投票では、参加者の大半が「成果を測定していない」または「測定しているが行動に移していない」と回答した。ガーグ氏は「診断は今や安価になった。重要なのは実行だ」と指摘している。
自動化すべき領域と人間が握るべき領域
まず自動化すべきは、既存データソースの接続とプロアクティブな異常検知のループだ。逆に「公開ボタン」の自動化は避けるべきとガーグ氏は明確に述べている。最終送信の前に人間が検証しテストする「半自律」の状態を維持することが、AI検索対策の品質を保つ要となる。
オンページとオフページ、どちらに注力すべきか
ガーグ氏はオフページに60%、オンページに40%の比重を推奨している。ただし、自社ページが引用を獲得し始めた段階でオンページ比率を引き上げるのが現実的なバランスだ。AI検索の可視性を動かす主なドライバーがオフページ側にあるという認識は、従来のSEOとは大きく異なる点である。
従来のSEOではオンページが主戦場だったが、AI検索では外部プラットフォームでの存在感がものを言う。フォーラムへの参加や動画コンテンツの拡充といったオフページ施策が、直接的な引用獲得につながる。
AI検索経由のリードをどう計測するか
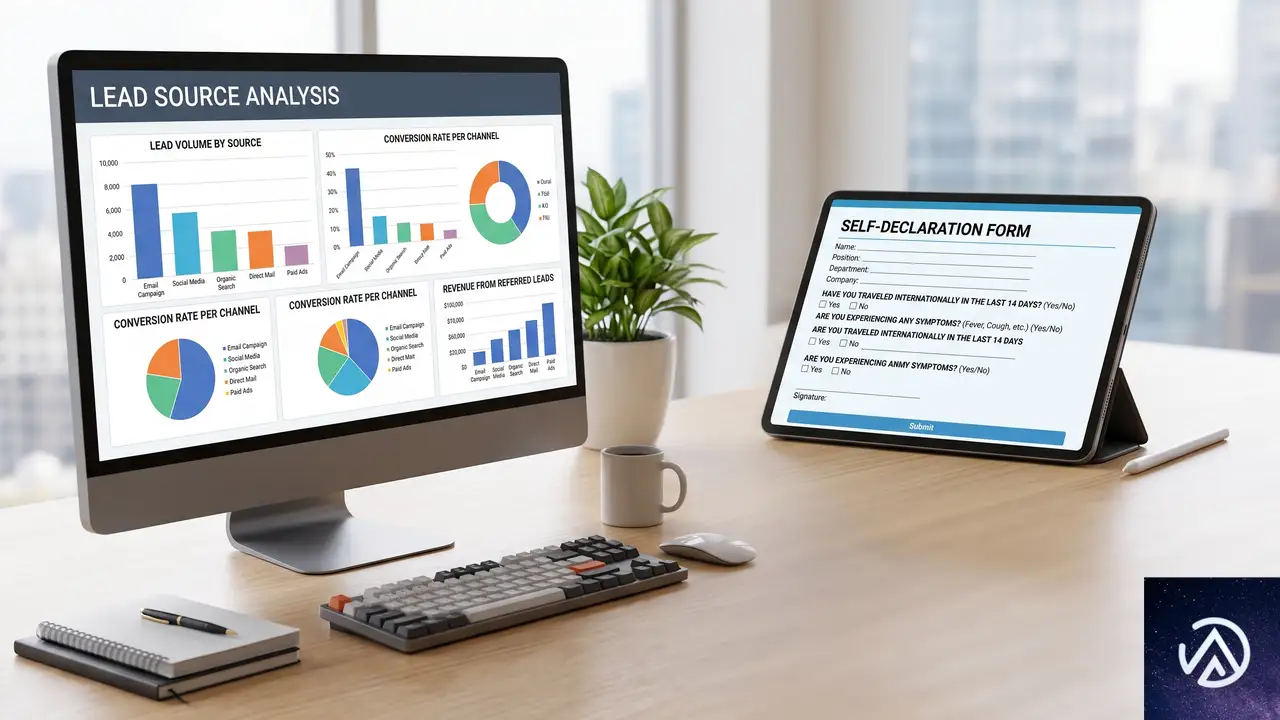
Writesonicでは「どこで当社を知ったか」を問う自己申告フォームと、セールスコールでの二重確認を組み合わせている。ガーグ氏は10〜20%程度のバイアスが入る可能性を認めつつも、「十分な指標になる」と述べている。
AI検索経由の流入を完全に追跡する技術はまだ確立されていないが、少なくとも自己申告ベースで推移をモニタリングすることは、今後の戦略立案に欠かせない。Writesonicのケースでは、この仕組みによってAI検索経由リードが2.5%から35%に伸びた事実を定量的に把握できた。
この記事のポイント
- AI検索の引用の96%は自社サイト外(Reddit、YouTube、フォーラムなど)から発生する
- AI引用の寿命は短く、モデル更新のたびにローテーションが発生するため常時監視が必要
- SEOエージェントは「専門家ファイル」で思考パターンを学習させ、人間が最終判断を下す半自律運用が効果的
- 閉ループSEOで公開→検証→改善を回し続けることが、AI検索時代の競争力を左右する
- リソース配分はオフページ60%、オンページ40%を目安に、引用獲得後にオンページ比率を引き上げる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Search Consoleにソーシャル・動画プラットフォームのプロパティが追加
Search Consoleに追加された「プラットフォームプロパティ」の概要
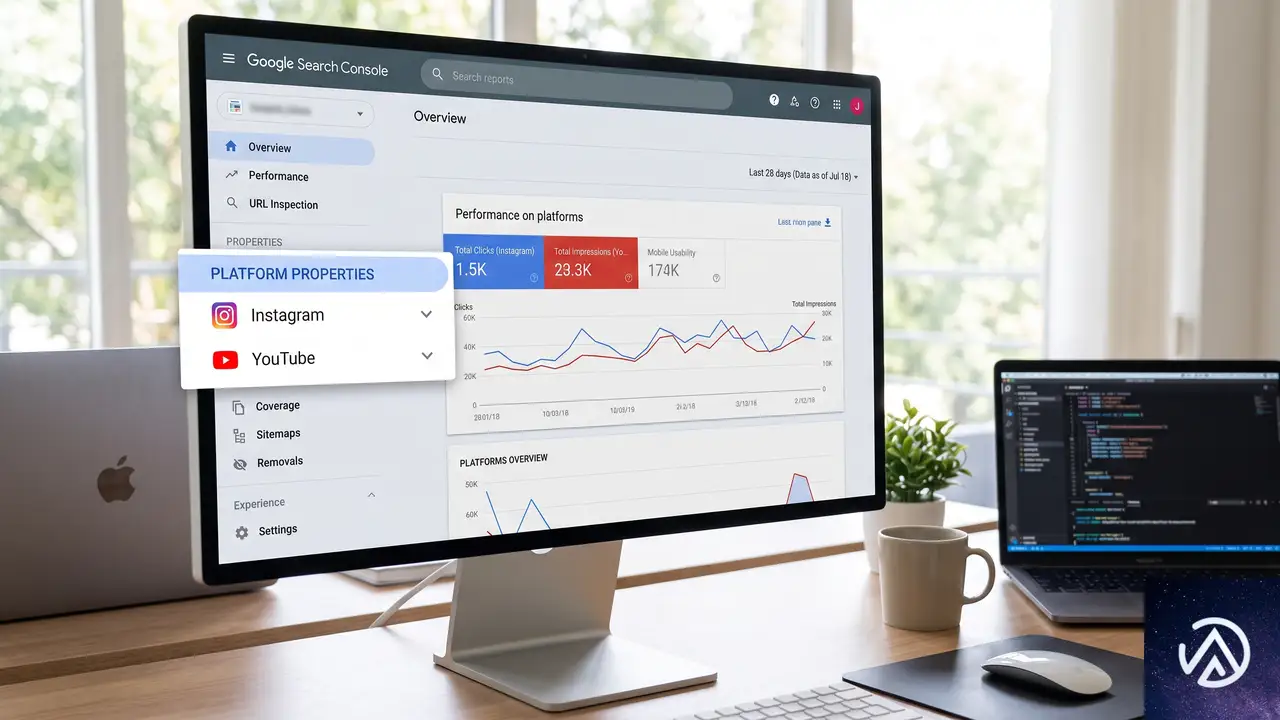
2026年7月7日、GoogleはSearch Consoleに「プラットフォームプロパティ」という新たなプロパティタイプを追加した。Instagram、TikTok、X(旧Twitter)、YouTubeといったソーシャルメディアや動画プラットフォーム上の投稿が、Google検索やDiscoverでどのように表示され、クリックされているかを分析できる仕組みだ。
これまでSearch Consoleはウェブサイトを所有する運営者向けのツールだった。今回の変更により、自社サイトを持たないクリエイターやインフルエンサーも、自身の投稿パフォーマンスをGoogleの公式データで確認できるようになる。
Search Consoleのプロダクトマネージャーを務めるMoshe Samet氏がSearch Centralブログで発表した。同氏によれば、アカウントを連携すると、どの検索キーワードから投稿にアクセスがあったか、ユーザーが投稿に対してどう行動したかを把握できるという。
上の図はSearch Consoleの管理範囲がどのように広がったかを整理したものだ。サイト単位の分析に加え、ソーシャルプラットフォーム上の個別投稿のパフォーマンスも同じダッシュボードで確認できるようになる。
利用可能な3つのレポート機能

プラットフォームプロパティでは、通常のSearch Consoleプロパティと同様のレポート構成が提供される。ただし、ソーシャルメディアや動画コンテンツに最適化された形で表示される点が特徴だ。
パフォーマンスレポート
総クリック数、表示回数(インプレッション)、平均CTR(クリック率)、平均掲載順位といった主要指標を確認できる。フィルタや並べ替え機能を使えば、どの投稿や検索クエリが最も流入に貢献しているかを特定しやすい。データはエクスポートにも対応しており、他の分析ツールでさらに深掘りすることも可能だ。
CTRとは「Click Through Rate」の略で、表示回数のうち実際にクリックされた割合を指す。たとえば100回表示されて3回クリックされればCTRは3%だ。検索結果に表示される頻度と、実際に選ばれる確率のバランスを見るための基本的な指標として使われる。
インサイトレポート
直近のトラフィック傾向や、最も成果を上げた投稿の概要、ユーザーがGoogle上でどのようにアカウントを見つけているかといった俯瞰的な情報を提供する。パフォーマンスレポートが数値ベースの詳細分析であるのに対し、インサイトレポートは「いま何が起きているか」を直感的に把握するためのダッシュボードだ。
アチーブメント
28日間の間に、検索からの総クリック数が一定のしきい値を超えるなどのマイルストーン達成を検出し、通知する仕組みだ。数値目標を持ちにくいソーシャルメディア運用において、客観的な達成基準として活用できる。
3つのレポートは独立しているのではなく、上図のように段階的に活用することで効果を発揮する。数値確認→傾向把握→成果認知→改善実行というサイクルをSearch Console内で完結できるのが強みだ。
プラットフォームプロパティの追加手順
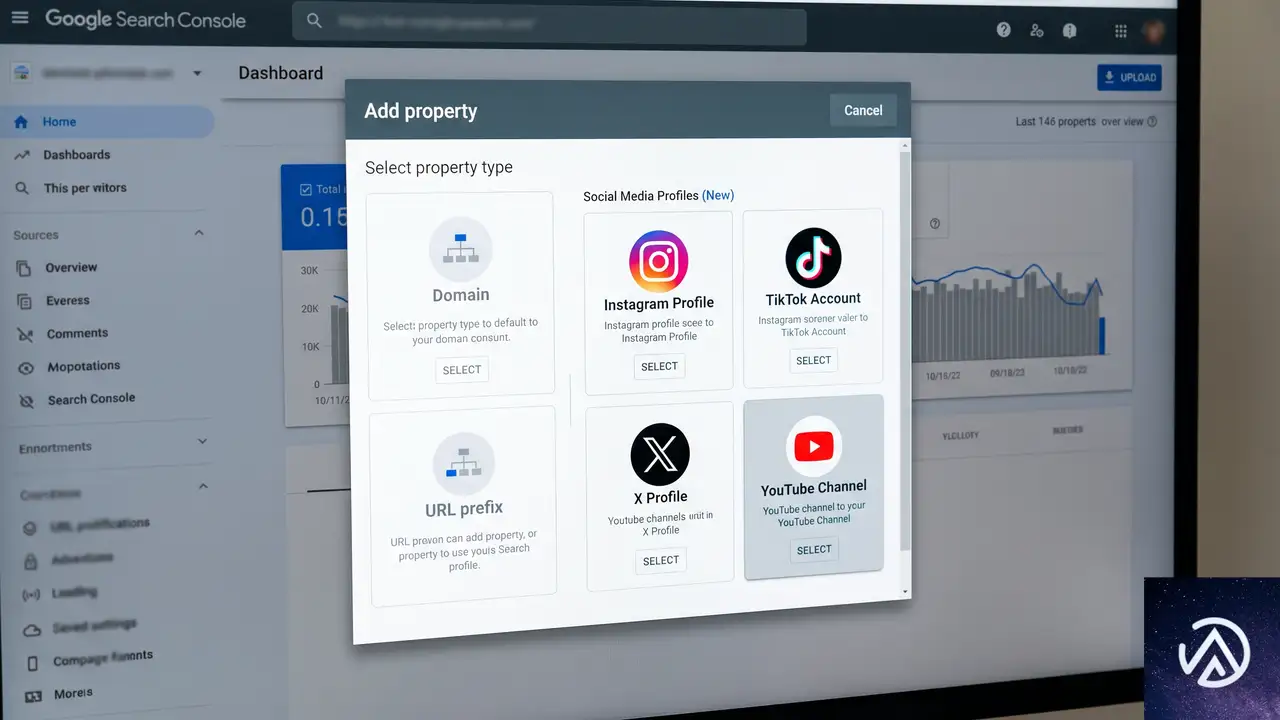
設定はSearch Consoleの所有権確認フローに沿って進める。具体的な流れは以下のとおりだ。
- Search Consoleを開き、所有権の確認ページまたはプロパティセレクタに移動する
- 「プロパティを追加」を選択する
- Instagram、TikTok、X、YouTubeのいずれかを選ぶ
- 画面の指示に従って連携を承認する
これだけで設定は完了する。従来のSearch Consoleプロパティのように、DNSへのTXTレコード追加やHTMLファイルのアップロードといった技術的な作業は不要だ。各プラットフォームのOAuth認証を使ったシンプルな連携方式が採用されている。
サーチプロファイルとの違い

2026年6月、Googleは「サーチプロファイル」という機能を公開した。フォロワー10万人以上のクリエイターやパブリッシャーを対象に、公開プロフィールページを提供する仕組みだ。プラットフォームプロパティと混同しやすいため、両者の違いを明確にしておく。
サーチプロファイルが「見せる」ための公開ページであるのに対し、プラットフォームプロパティは「測る」ための分析ツールだ。両者は補完関係にあり、検索上での存在感を高めたいクリエイターにとってはどちらも有用な機能といえる。
なお、今回のプラットフォームプロパティは、2025年12月に実施されたソーシャルチャネルデータをSearch Consoleに統合する実験を発展させたものだ。
実務への影響と活用ポイント
この機能が実務に与える影響は大きい。従来、ソーシャルメディアの投稿が検索経由でどの程度見られているかを知るには、各プラットフォームのアナリティクスに頼るしかなかった。しかし、プラットフォーム側のデータは検索エンジン経由の流入を正確に分離できないケースが多い。
Google公式のSearch Consoleでデータを取得できる意味は2つある。1つはデータの信頼性が担保されること、もう1つは検索クエリとの紐付けが可能になることだ。たとえば「おすすめ カフェ 東京」という検索キーワードでInstagramの投稿が表示され、クリックされたという因果関係を追跡できる。
ウェブサイトを持たないクリエイターへの恩恵
最大の変化は、自社サイトや個人ブログを持たないクリエイターにもSearch Consoleの門戸が開かれたことだ。これまでSearch Consoleはサイト所有者のツールであり、ドメイン認証が必須だった。今回のプラットフォームプロパティでは、ソーシャルメディアのアカウントさえあれば利用できる。
SEO担当者にとっての新たな分析軸
企業のSEO担当者にとっては、検索結果ページに表示される自社のソーシャル投稿を管理する手段が増えたことを意味する。YouTubeの動画やInstagramの投稿が検索結果に表示されるケースは増えており、それらのパフォーマンスをSearch Console上で一元管理できるメリットは無視できない。
分析ツールの断片化が解消されることは、レポート作成の手間を減らすと同時に、データの解釈を統一する効果も期待できる。これまで「Instagramのインサイトでは伸びているのに、検索からの流入が測れない」というジレンマを抱えていた運用担当者にとっては朗報だ。
今後の展開と注意点

プラットフォームプロパティは数週間かけて段階的に展開されるため、アカウントによってはまだ表示されない場合がある。Googleは初期段階として4つのプラットフォームに対応するが、今後の対応範囲拡大についても示唆している。
設定にあたっては、Googleのヘルプドキュメントが用意されているほか、Search Console内とSearch Central Communityにフィードバックリンクが設置されている。初期リリースということもあり、運用しながら改善が加えられていくフェーズと考えるのが妥当だ。
今すぐ取り組むべき3つの準備
- 利用可能になった時点で迅速に設定できるよう、Search Consoleのアカウントを最新の状態にしておく
- 現在運用中のソーシャルアカウントのうち、どのプラットフォームを優先的に連携するか社内で方針を決めておく
- 連携後にどの指標をKPI(重要業績評価指標)として追うか、事前に整理する
プラットフォームプロパティは、検索マーケティングの対象領域をウェブサイトの外側に拡張する第一歩ともいえる。検索結果が多様化する中で、テキストコンテンツだけでなく動画やソーシャル投稿も含めた総合的な検索対策が求められる時代に向けた布石だ。
この記事のポイント
- Search Consoleにプラットフォームプロパティが追加され、Instagram、TikTok、X、YouTubeの投稿パフォーマンスを分析できるようになった
- パフォーマンスレポート、インサイトレポート、アチーブメントの3種類のデータを提供する
- 自社サイトを持たないクリエイターでもSearch Consoleを利用可能になった点が最大の変化
- サーチプロファイルとは異なり、あくまで分析ツールとして機能する
- 数週間の段階的展開が予定されており、対応プラットフォームは今後拡大する可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare Workers Cache登場、Worker専用キャッシュでコスト削減
Workers Cache の登場でCloudflare Workersが「オリジン」から「静的配信」へ進化
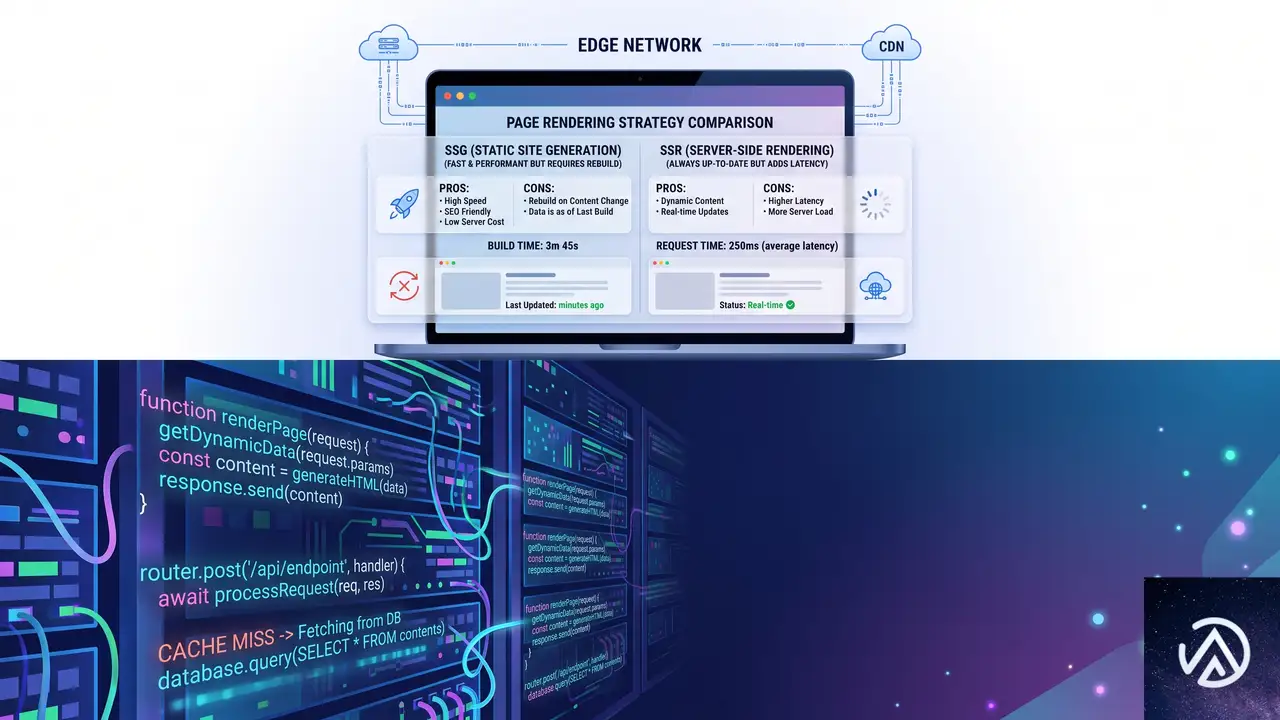
CloudflareがWorkers Cacheを正式にリリースした。これは単なるキャッシュ機能の追加ではない。Workersのアーキテクチャを根本から覆し、コストとパフォーマンスのトレードオフを解消する大きな転換点だ。一言で表せば「あなたのWorkerの前に、そのWorker専用のキャッシュを置ける機能」である。
1行の設定を追加するだけで、Workerが生成したレスポンスはCloudflareのエッジネットワークにキャッシュされる。キャッシュが有効な間はWorkerそのものが実行されず、CPU時間の課金もゼロになる。これは特に、サーバーサイドレンダリング(SSR)を行うアプリケーションにとって、待望のソリューションだ。
本記事では、なぜこの機能が必要とされていたのか、具体的に何が変わるのか、そして開発者がどのように活用できるのかを詳しく解説する。
問題: Workerがオリジンの場合、処理のたびにコードが実行され、キャッシュの恩恵を受けにくい。
効果: レスポンスが高速化し、WorkerのCPU実行コストが削減される。
この図が示すように、Workers Cacheはリクエストの最前線に立つ。これにより、Workerが事実上のオリジンサーバーとして振る舞う現代的なアプリケーションのパフォーマンスとコスト構造が劇的に改善される。
なぜサーバーサイドアプリに「Workerの前のキャッシュ」が必要だったのか
Workerが「経由点」から「オリジン」へ変わった世界
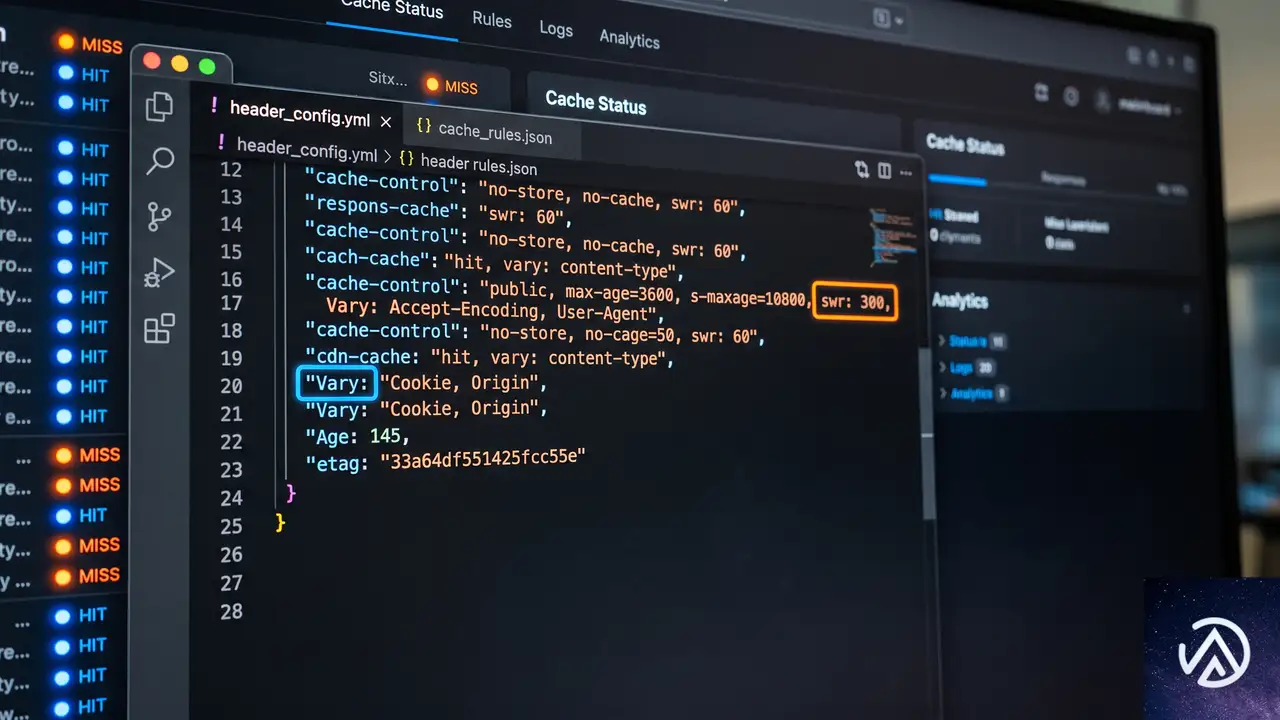
2017年のリリース当初、Cloudflare Workersはオリジンサーバーの手前でリクエストを書き換える「中間処理層」として設計された。A/Bテストの振り分けやヘッダーの追加といった、軽量な処理をエッジで実行するユースケースが中心だったのだ。当時、Workerはキャッシュよりもさらにオリジンに近い位置にあった。
しかし状況は一変した。AstroやNext.js、SvelteKitといった主要フレームワークが、ビルド成果物をCloudflare Workersで直接動かすアダプターを提供し始めたのである。これにより、Workerはもはや単なる中継点ではない。アプリケーションそのものがWorker上で動作する「サーバー」になった。裏側に別のオリジンサーバーは存在しなくなり、Worker自体がリクエストを処理するようになったのだ。
この変化は大きな問題を生んだ。従来のアーキテクチャでは、Workerがオリジンになると、すべてのリクエストがコードの実行を必要とするようになる。たとえ1秒前と全く同じHTMLを返す場合でも、だ。これはパフォーマンス上のレイテンシと、無視できないCPU実行コストを常に発生させることを意味していた。
静的生成と動的レンダリングのジレンマを解決する第三の道
この問題に対し、開発者はこれまで2つの選択肢から選ぶしかなかった。
- 静的サイト生成(SSG):すべてのページをビルド時に事前生成する。表示は高速だが、コンテンツを更新するたびに全ページを再ビルドする必要がある。数千ページのサイトでは、このビルド時間が大きなボトルネックになる。
- サーバーサイドレンダリング(SSR):リクエストのたびにページを動的に生成する。コンテンツは常に最新だが、全てのアクセスでレンダリングコストとレイテンシが発生する。
Workers Cacheはここに第三の選択肢、つまり「オンデマンドでサーバーレンダリングし、結果をキャッシュし、指定したTTL(生存期間)で更新する」という新しい手法を提供する。最初のリクエストだけがレンダリングコストを支払い、後続のリクエストはキャッシュから静的ファイルのように配信されるのだ。これはフレームワーク独自の複雑な仕組み(ISRなど)に依存しない、HTTP標準に則った解決策である。
パフォーマンスを極める主要機能「SWR」と「Vary」の内部動作
stale-while-revalidate が「待ち時間ゼロ」を実現する仕組み
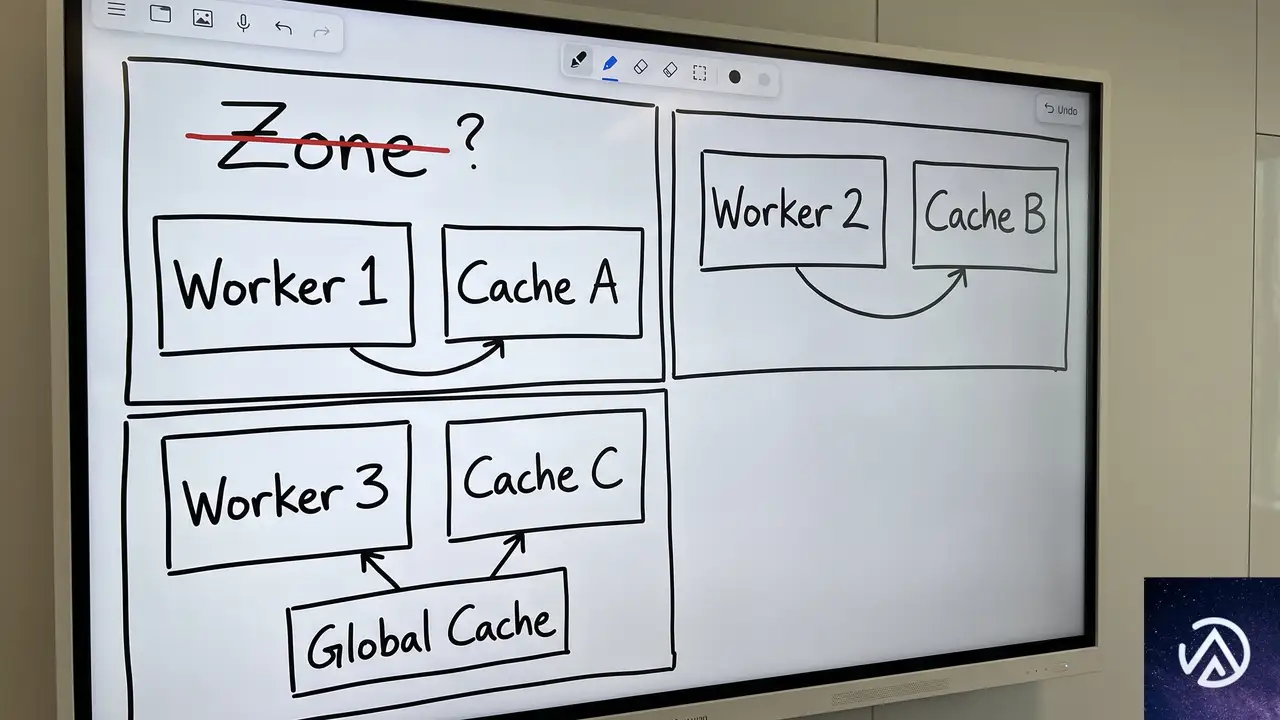
Workers Cacheの真価を引き出すのが、stale-while-revalidate(SWR)ディレクティブだ。これはキャッシュされたレスポンスがTTLを超過した「古い(Stale)」状態でも、とりあえずその古いデータをユーザーに返しつつ、バックグラウンドで最新のデータを取得し直すHTTPの仕組みである。
SWRがない場合、キャッシュの有効期限が切れた後の最初のリクエストは、必ずWorkerが一からページをレンダリングするまで待たされる。しかしSWRがあれば、この最初のリクエストに対しても古いキャッシュが即座に返され、ユーザーは待ち時間を感じない。Workers CacheはこのSWRを完全にサポートしており、これによって「動的なサイトなのに、まるで静的サイトのように感じる」という体験を実現している。
この図の通り、SWRはTTLが切れた後の「最初の一人」が被る待ち時間を帳消しにする。Cloudflare Blogの記事によれば、Cloudflareは今年の早期にこのSWR機能をフルサポートしており、Workers Cacheはその上に構築されていることがわかる。
Vary ヘッダーが複数の表現をキャッシュする
現実のアプリケーションは、同じURLでもクライアントに応じて異なるレスポンスを返す必要がある。例えばブラウザにはHTMLを、APIクライアントにはJSONを返す場合や、対応状況に応じてWebPとJPEGを出し分ける場合だ。Workers Cacheは、このコンテンツネゴシエーションをHTTP標準のVaryヘッダーで解決する。
WorkerがVary: Acceptというヘッダーを付けてレスポンスを返すと、Cloudflareは「Acceptリクエストヘッダーの値」ごとに別々のキャッシュエントリを自動で作成・管理する。これにより、WebPに対応したブラウザにはWebP画像のキャッシュが、そうでない環境にはJPEG画像のキャッシュが返るようになる。開発者は複雑なキャッシュキーの設定を意識する必要はなく、標準的なHTTPのルールに従うだけで、安全かつ効率的に複数表現をキャッシュできるのだ。
開発者が知っておくべき設計思想「ゾーンではなくWorkerのキャッシュ」
エントリーポイント単位の柔軟なキャッシュ制御
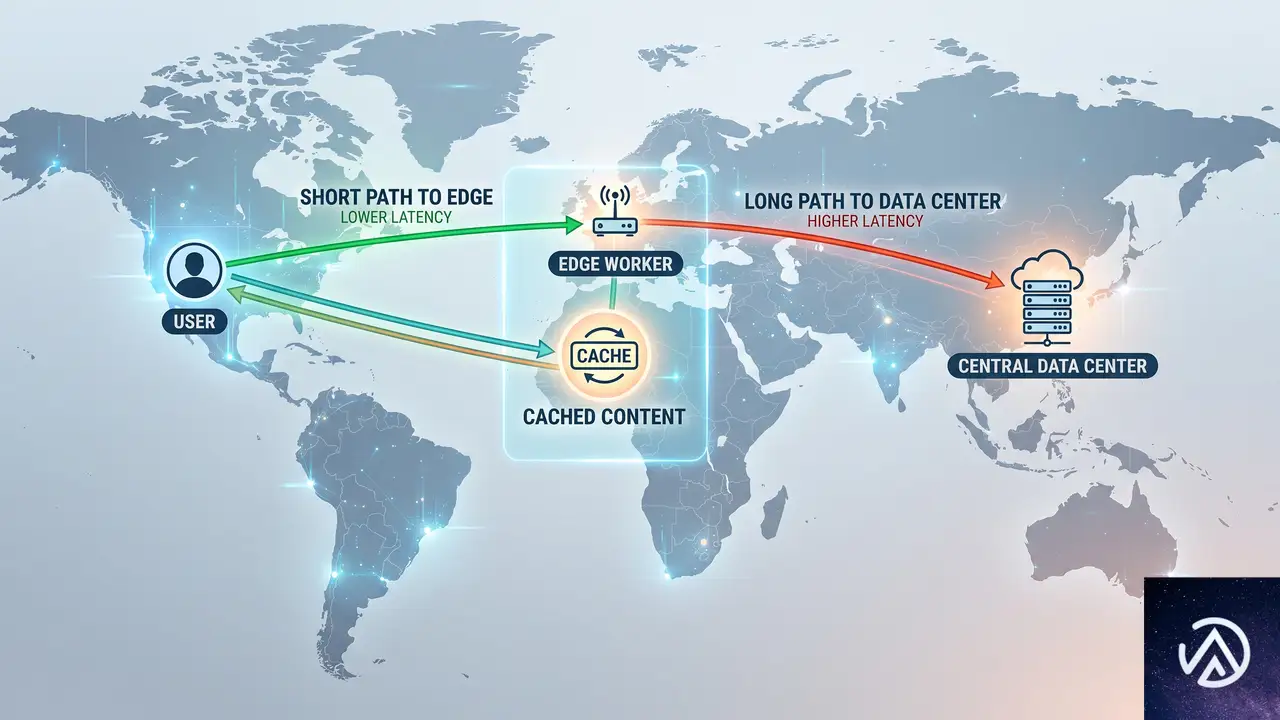
Workers Cacheの最も革新的な部分は、それが「ゾーン(ドメイン)」ではなく「Worker」に紐づくという設計思想にある。この思想が、従来のCDNでは実現できなかったいくつもの高度なユースケースを可能にしている。
特に重要なのが、Workerのエントリーポイントごとにキャッシュの有効・無効を設定できる点だ。設定ファイルでエクスポート名("default"や"CachedBackend")を指定するだけで、認証処理を行うゲートウェイWorkerはキャッシュを無効化し(常にコードを実行するため)、その背後で重い処理を行うバックエンドWorkerだけにキャッシュを有効化する、といった構成が可能になる。
このエントリーポイント単位の制御により、キャッシュはアプリケーションアーキテクチャの一部として自然に組み込めるようになる。単一のWorkerの中に、キャッシュするレイヤーとしないレイヤーを共存させ、それらをコードで自在に結合できるのだ。これは、CDNキャッシュを単一のオリジンの前に置くという従来の考え方とは一線を画す。
マルチテナントを安全にする ctx.props の仕組み
ユーザーごとに異なる情報を返すAPIのキャッシュは、セキュリティ上の大きな課題を伴う。ユーザーAのキャッシュがユーザーBに見えてしまうような事故は、絶対に避けなければならない。Workers Cacheはこの問題を、ctx.propsの一部を自動的にキャッシュキーに含めることで根本的に解決している。
例えば、ゲートウェイWorkerで認証したユーザーIDをctx.propsにセットし、キャッシュが有効なバックエンドWorkerを呼び出すとする。Workers Cacheはこの「ユーザーID」の違いを認識し、ユーザーごとに完全に独立したキャッシュ空間を作り出す。これにより、「認証済みAPIはキャッシュできない」という固定観念を覆し、ユーザー単位で安全にレスポンスをキャッシュできるようになる。Cloudflare Blogによれば、これは他の主要CDNでは提供されていない、Workers Cache独自の強力な利点だという。
Workers Cacheがもたらすプラットフォームとしての進化
パフォーマンスとデータの近接性を両立するアーキテクチャ
Webパフォーマンスにおいては、コードを「ユーザーの近く」で実行するのと「データの近く」で実行するのは、しばしばトレードオフの関係になる。Workers Cacheはこのジレンマに対して、キャッシュを「糊(にかわ)」として利用する解決策を提示する。
具体的には、次のような構成が現実的になる。ユーザーの近くで動き、認証やルーティングといった軽量な処理を担当するWorker Aを配置する。一方、データベースへの重いクエリやレンダリングを実行するWorker Bを、Smart Placement機能でデータの近くに配置する。Workers Cacheは、このWorker Bの手前にのみ配置する。
リクエストが来ると、Worker Aが処理した後、サービスバインディングを通じてWorker Bを呼び出す。この時、Worker Bのキャッシュがヒットすれば、データの近くにあるWorker Bは実行されることなく、ユーザーの近くにあるキャッシュからレスポンスが返る。キャッシュミス時のみ、実際のデータへのアクセスが発生する。これにより、「ユーザー近接性」と「データ近接性」の良いとこ取りが可能になるのだ。
フレームワークとの統合とコストの透明性
Workers CacheはすでにAstroフレームワークのアダプターでネイティブサポートされている。設定ファイルに数行追加するだけで、ページ単位のTTLやタグベースのキャッシュパージが利用できる。TanStack StartやNext.js(Vinext経由)など他のフレームワークへの統合も現在進行中だ。
コスト面も明快だ。Workers Cacheのキャッシュヒット時は、通常のリクエスト課金は発生するが、WorkerのCPU実行時間に対する課金はゼロになる。キャッシュストレージに対する追加のGB単位の課金もないため、コスト削減効果を予測しやすい。ダッシュボードでは、キャッシュヒット率やヒット/ミス/バイパスの内訳が確認でき、パフォーマンスチューニングに必要なデータが一元管理されている。
この記事のポイント
- Workers Cacheは、Workerの手前に専用の階層型キャッシュを配置する新機能である。
- これにより、サーバーサイドアプリが静的サイトのような速度を実現しつつ、CPU実行コストを削減できる。
stale-while-revalidateの完全サポートにより、キャッシュ更新中もユーザーを待たせない。- ゾーンではなくWorkerに紐づく設計により、エントリーポイント単位で柔軟なキャッシュ戦略をコードで記述できる。
ctx.propsをキャッシュキーに含めることで、マルチテナント環境でも安全なキャッシュが実現する。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubが依存関係のライセンス遵守を自動化する新機能を発表
GitHubは2026年6月30日、オープンソースの依存関係におけるライセンス遵守を自動化する「License Compliance」機能を公開プレビューとして発表した。GitHub Advanced Security(GHAS)のCode Securityライセンスを持つEnterprise Cloudユーザーが対象だ。
この機能はPull Request上で新たに追加される依存関係のライセンスを自動スキャンし、組織のポリシーに反するものがあればアラートを出す。GitHub自身のOpen Source Program Office(OSPO)も数カ月前からこの機能に移行し、社内ツールを置き換えた実績がある。
ソフトウェア開発において依存関係のライセンス管理は、後回しにされがちな領域だ。しかし、ライセンス違反は訴訟リスクやコードの公開義務といった深刻な結果を招く。この記事では、GitHubの新機能の仕組みと、実際に運用する組織がどのようにポリシーを設計すべきかを解説する。
オープンソースライセンスの遵守が企業にとって重大な理由

ほぼすべてのソフトウェアには何らかのライセンスが付与されている。ライセンスはそのプロジェクトを利用する許可を与えるが、同時に遵守すべき義務も課す。義務の内容は、ドキュメントに原著作者のクレジットを記載するだけの緩やかなものから、プログラムを配布する際に自社の全ソースコードを公開しなければならない強力なものまで幅広い。
商用ソフトウェアにおけるリスク
商用のクローズドソース製品を販売する組織であれば、GPL系のライセンスを持つ依存関係をうっかり混入させると、自社のプロプライエタリなコード全体をオープンソース化せざるを得なくなる可能性がある。これはビジネスモデルを根底から覆す致命的な事態だ。
逆に、自社プロジェクトをオープンソースとして公開する予定があるなら、商用ライセンスや互換性のないオープンソースライセンスの依存関係を避ける必要がある。いずれにせよ、ライセンス義務を満たせない依存関係は排除しなければならない。後から該当ライセンスのコードを除去するには大きな工学的コストがかかるし、企業ソフトウェアにとって違反のビジネスリスクは甚大だ。高額な訴訟やレピュテーションの損傷に直結する。
従来のレビュー手法とその限界
これまでライセンスレビューは手作業か、サードパーティ製ツールで行われてきた。しかし、依存関係が増えるたびに人手でライセンスを確認するのは現実的ではない。ツールを使うにしても、開発フローとは別の場所でチェックが走るため、問題が見つかった時点では既にコードがマージされた後、というケースも少なくなかった。
GitHubのLicense Compliance機能はこの課題に直接アプローチする。Pull Requestの段階で新しい依存関係をスキャンし、ポリシーに合致しないライセンスがあれば、マージ前に開発者へフィードバックを返す。開発フローに組み込まれた「シフトレフト」なアプローチだ。
GitHubのLicense Compliance機能の仕組み
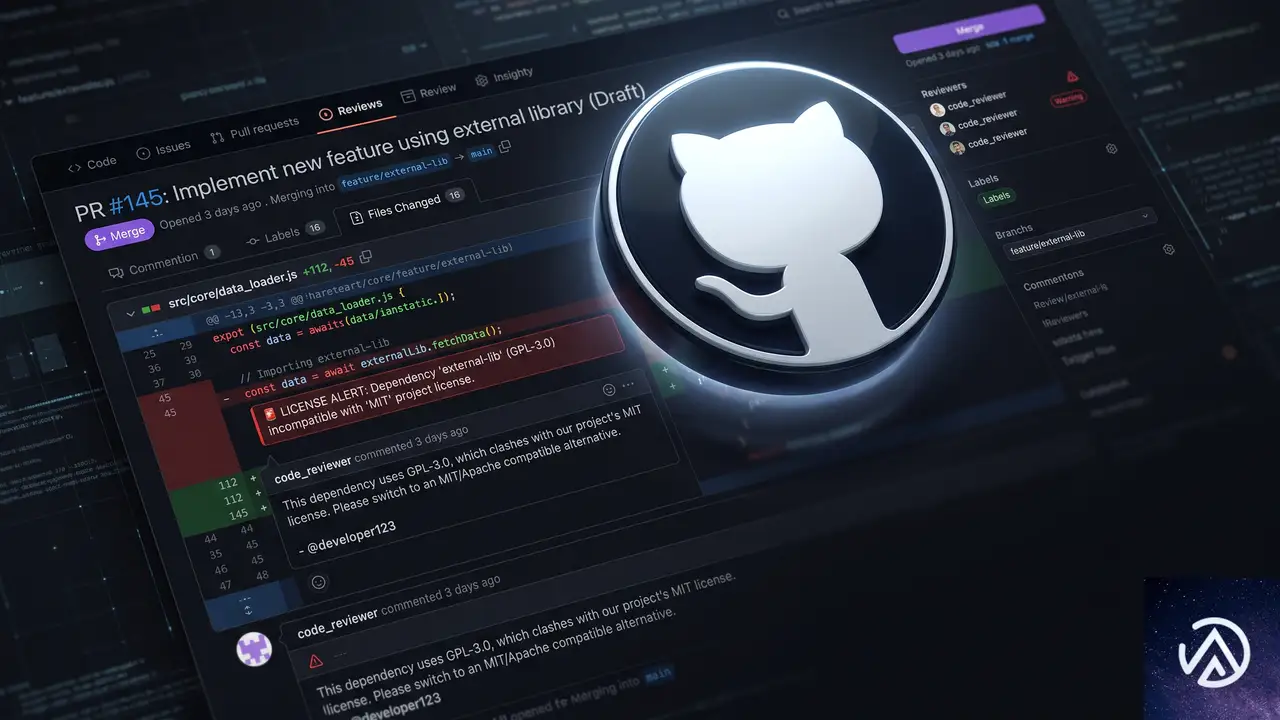
この機能は、リポジトリに適用するルールセット(ruleset)を通じて有効化される。カスタムプロパティを使って対象リポジトリを指定し、「Active」モードか「Evaluate」モードかを選択する仕組みだ。
ルールセットの対象となったリポジトリでは、依存関係を変更するPull Requestが作成されると自動スキャンが走る。新しい依存関係それぞれのライセンスを照会し、既に許可済みのライセンスやパッケージ固有の例外に該当すればチェックをパスする。問題がある場合は、直接の依存関係だけでなく推移的依存関係(依存関係がさらに依存しているパッケージ)についても、Pull Requestのコメントとしてアラートが投稿される。
開発者から見たフロー
開発者はアラートを受け取ったら、その依存関係が受け入れ可能かどうかを判断する。受け入れられないと判断すれば、コードを修正するかPull Requestをクローズして依存関係を除去する。一方、そのライセンスやパッケージを許可すべきだと考えた場合は、例外申請を上げることができる。申請は組織内のポリシーチームに通知され、ポリシーを修正するかどうかが判断される。
GitHub OSPOの運用実績
GitHub自身のOSPOは、この機能が社内公開される前からアーリーアダプターとして利用してきた。当初は組織全体のルールセットに「Evaluate」モードを適用し、Pull Requestにアノテーションを表示するだけでマージはブロックしない設定でスタートした。これにより、開発者が新しいワークフローに慣れる時間を確保しつつ、旧来の社内ツールと並行稼働させて挙動の差異を検証したという。
約1カ月の並行稼働を経て、アラートの大半が「通常とは異なるライセンス」「ライセンス情報の欠落」「明示的に禁止されたライセンス」に絞り込まれた段階で、Activeモードへ移行した。大規模で動きの速い企業でも、段階的なロールアウトによって摩擦を最小化できる好例といえる。
ポリシー設計の実践アプローチ

効果的なライセンスコンプライアンスを実現するには、適切なポリシー設計が不可欠だ。GitHub OSPOの経験から、以下の3段階で考えると整理しやすい。
重要なのは、ポリシーを「作って終わり」にしないことだ。新しいライセンスやパッケージ固有の例外は、ポリシーチームが継続的に審査し、必要に応じて追加していく。この運用プロセスが整っていないと、開発者は Pull Request がブロックされたまま放置される「ポリシー渋滞」に巻き込まれる。
ライセンス許可とパッケージ例外の使い分け
ポリシー修正には大きく2つの判断軸がある。「ライセンスそのものを許可する」か「特定のパッケージだけを例外として許可する」かだ。さらに、その許可を「Enterprise全体(組織全体)」に適用するか「特定のリポジトリのみ」に限定するかも決定する。
安全なライセンスで単に初出だっただけなら、Enterpriseレベルでライセンスを追加すれば済む。一方、商用ライセンスのパッケージで、特定のチームだけが購入済みのソフトウェアなら、そのリポジトリだけに例外を設定する。パッケージ例外にはワイルドカードマッチが使えるため、例えば @github-ui/* のような形で名前空間単位の許可も可能だ。
緊急時のオーバーライドと開発者教育

ライセンスポリシーによってPull Requestがブロックされる仕組みは強力だが、クリティカルな修正を緊急でマージしなければならない場面も想定しておく必要がある。GitHub OSPOは「ブレークグラス(緊急時オーバーライド)」の手順を整備している。
仕組みはシンプルだ。ルールセットの条件はカスタムプロパティの値を参照しているため、そのプロパティ値を切り替えるだけで一時的にポリシー適用を無効化できる。GitHub OSPOのこれまでの運用では、このオーバーライドを使ったのは1度だけだったという。頻繁に使うものではないが、いざという時に選択肢があることが重要だ。
開発者へのトレーニングとドキュメント
ツールを導入するだけでは不十分だ。開発者が「なぜライセンス遵守が自分ごとなのか」を理解していなければ、例外申請のプロセスは形骸化する。GitHub OSPOは社内向けのドキュメントとトレーニングを提供し、ライセンスコンプライアンスが全員の責務であるという認識を浸透させている。
開発者が情報に基づいた依存関係の選択をできるようになれば、後からの修正作業や法的トラブルを未然に防げる。ライセンス遵守は「コンプライアンス部門だけの仕事」ではなく、サプライチェーン全体で取り組むべき課題だ。
依存関係管理のこれから
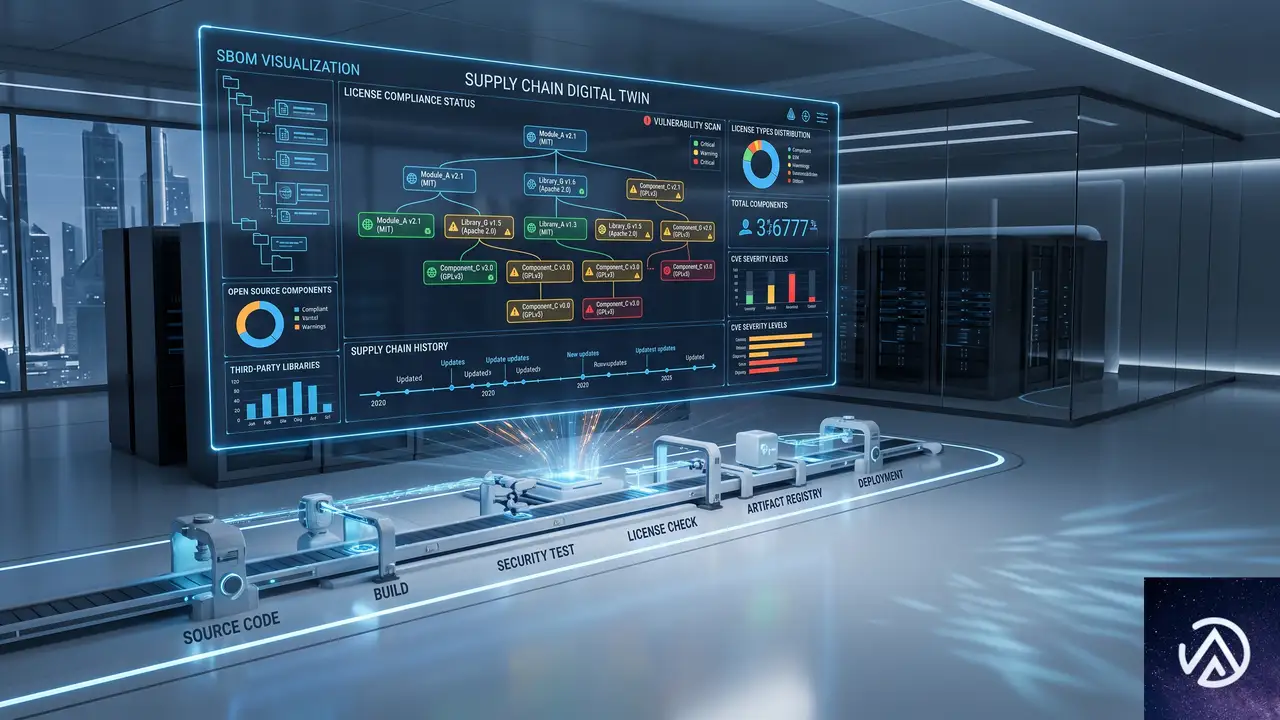
ソフトウェアサプライチェーンのセキュリティとコンプライアンスは、近年急速に注目を集めている領域だ。SBOM(Software Bill of Materials)の普及や、米国大統領令によるソフトウェアサプライチェーンセキュリティの強化など、規制面からの要請も強まっている。
GitHubのLicense Compliance機能は、こうした流れの中で「Pull Request時点でライセンスをチェックする」というプラクティスを標準化しようとする試みだ。開発フローに自然に溶け込む形で提供されるため、導入障壁は従来のサードパーティツールよりも低い。
現時点ではパブリックプレビューであり、対象はGitHub Enterprise CloudでGHAS Code Securityライセンスを保有するユーザーに限られる。しかし、GitHub自身が大規模な組織で実績を積んでいる点は、導入を検討する企業にとって心強い材料だろう。
この記事のポイント
- GitHubが依存関係のライセンス遵守をPull Request上で自動チェックする新機能を公開プレビューとして発表した
- ルールセットを通じてリポジトリ単位で適用し、Evaluateモードから段階的に導入できる
- GitHub自身のOSPOがアーリーアダプターとして社内で運用実績を積んでいる
- ライセンス違反は訴訟リスクやソースコード公開義務といった深刻な結果を招くため、開発フローへの組み込みが重要
- ポリシー設計は「基本ライセンスの登録 → Evaluateモード → Activeモード」の3段階で進めるのが現実的
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Nano Banana 2 LiteとGemini Omni Flash登場、高速画像生成と動画編集がAPIで利用可能に
Google DeepMindは2026年6月30日、高速画像生成モデル「Nano Banana 2 Lite」と、動画生成・編集モデル「Gemini Omni Flash」を開発者向けに公開した。どちらもGoogle AI StudioとGemini APIから即日利用できる。
Nano Banana 2 Liteはテキストから画像をわずか4秒で生成し、1,000枚あたり0.034ドルという低コストが売りだ。Gemini Omni Flashは自然言語による動画編集と高品質な動画生成を両立し、1秒あたり0.10ドルで提供される。
この2つのモデルを組み合わせることで、画像を生成して即座に動画化するといったマルチメディア制作のワークフローが一気に加速する。本記事では各モデルの性能、活用シナリオ、連携方法を詳しく見ていく。
Nano Banana 2 Liteの概要と位置づけ

Nano Banana 2 Lite(モデル名 gemini-3.1-flash-lite-image)は、Nano Bananaファミリーの中で最も高速かつ低コストな画像生成モデルだ。主に短時間でのプロトタイピングや大量の画像生成が必要な開発パイプラインを想定している。
旧モデルであるNano Banana(gemini-2.5-flash-image)からの置き換えが推奨されており、差し替えるだけで速度・品質・コストのすべてで改善が見込める。
速度とコストの具体的な数値
- レイテンシ(処理時間) テキストから画像を出力するまでの時間は約4秒。対話的なプロトタイピングや下書き用途に向く。
- 料金 1,000枚あたり0.034ドル。大量生成や予算管理が求められるプロジェクトでコストを抑えやすい。
- 品質のバランス 速度優先ながら、プロンプトへの忠実度・キャラクターの一貫性・画像内テキストの可読性は確保されている。
Nano Bananaファミリー全体の比較
Nano Bananaシリーズには4つのモデルが存在し、用途に応じて使い分ける設計だ。以下が各モデルの位置づけである。
開発者は自分たちのプロジェクトが「速度」を求めるのか「品質」を求めるのかによって、Lite・標準・Proを切り替えられる。たとえば広告バナーの大量生成ならNano Banana 2 Lite、製品写真の精密な加工ならNano Banana Proといった使い分けが現実的だ。
Gemini Omni Flashがもたらす動画編集の変化
Gemini Omni Flash(gemini-omni-flash-preview)は、テキスト・画像・動画を組み合わせたマルチモーダル入力をネイティブに扱い、高品質な動画生成と会話型編集を実現するモデルだ。2026年5月のGoogle I/Oで発表され、今回初めてGemini APIとGoogle AI Studioに公開された。
料金は出力動画1秒あたり0.10ドル。Veo 3.1 Fastと同水準であり、動画生成AIとしては競争力のある価格設定だ。
4つの得意領域
従来の動画生成AIでは「1回のプロンプトで動画を出力して終わり」という単発的な使い方が多かった。Omni Flashは会話を重ねながら微調整できる点が大きく異なる。動画の一部だけを修正したり、複数回の編集を積み重ねたりするワークフローが自然に回せるようになる。
現在の制限事項
- 生成できる動画の長さは現時点で10秒まで。長時間の動画生成は今後対応予定。
- 音声参照のアップロードとシーン延長機能は、今回のAPIでは未サポート。
- APIの仕様上は3秒までの動画参照を受け付けるが、現時点では正しく処理されない。
- シーン切り替えやパン(カメラの横移動)時のキャラクター一貫性に制限あり。改善中。
「10秒制限」は短く感じるかもしれないが、SNS向けショート動画やeコマースの商品紹介動画であれば十分な長さだ。3秒の動画参照制限についても、短いクリップを下敷きにした編集という使い方であれば実用範囲内といえる。
2つのモデルを連携させた実践ワークフロー

Nano Banana 2 LiteとGemini Omni Flashの真価は、両者を組み合わせることで発揮される。具体的には次のような流れだ。
Interactions APIを使うことでセッション履歴とコンテキストが保持されるため、ユーザーは最大3回まで連続した編集を積み重ねられる。1回の生成で終わらない、試行錯誤を前提としたクリエイティブ制作に適した設計だ。
公式デモアプリに見る実用例
Google DeepMindは両モデルを組み合わせた3つのデモアプリを公開している。いずれもGoogle AI Studio上で動作し、ソースコードをリミックスして自社サービスに組み込める。
これらのデモは、画像生成と動画編集を別々のAIに任せるのではなく、一つのワークフローとして統合することで生まれる価値を示している。eコマース事業者であれば、商品写真のバリエーションを大量生成し、その中から選んだ数枚だけを動画化するといった効率的な運用が可能になる。
開発者が知っておくべき安全性とモデル情報
両モデルともGoogleのセキュアなインフラ上で動作し、SynthIDによる電子透かし(ウォーターマーク)が埋め込まれる。SynthIDはAI生成コンテンツであることを検証可能にする技術で、GeminiアプリやChrome、Google検索を通じてコンテンツの来歴を確認できる。
すでにNano Banana 2 Liteは検索のAI Mode、Geminiアプリ、NotebookLM、Google Photos、Stitch、Google Flow、Google Adsなど、Googleの一般向けサービスにも順次展開されている。
API経由での利用にあたっては、各モデルの詳細な機能やリージョン別の制限が公式ドキュメントにまとめられている。開発を始める前に、Google AI Studioのプレイグラウンドで実際の挙動を試すのが確実だ。
この記事のポイント
- Nano Banana 2 Liteは4秒で画像を生成し、1,000枚あたり0.034ドルの低コストで利用できる
- Gemini Omni Flashは自然言語による動画編集と高品質な動画生成を両立し、1秒あたり0.10ドルで提供される
- 両モデルを連携させると、画像生成から動画化・編集までを一貫したワークフローで回せる
- Google AI StudioとGemini APIから即日利用可能で、具体的なデモアプリも公開済み
- SynthIDによるAI生成コンテンツの検証機能が組み込まれており、商用利用にも配慮されている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
VS Code 1.127リリース、エージェントブラウザツールがGAに
VS Code 1.127が2026年7月1日に公開された。今回のアップデートの焦点は、エージェント機能向けの統合ブラウザツールがプレビューを経て一般提供(GA)になった点と、エージェントウィンドウのセッション管理が大幅に強化された点にある。
ブラウザツールによって、AIエージェントはVS Code内のブラウザでページを開き、スクリーンショットを取得し、クリック操作まで行えるようになる。セッション管理ではグループ化やドラッグ&ドロップ、チャット入力バナーによるCI/CD統合、マルチチャットの改善が含まれ、開発者の生産性を高める機能が多数追加された。
エージェント向けブラウザツールが一般提供に、サイトごとの権限制御も実装

「ブラウザツール」の概要とGA化の意義
エージェント向けブラウザツールは、VS Codeの統合ブラウザ上でAIエージェントがWebアプリを開き、コンテンツの読み取り、コンソールエラーの取得、スクリーンショット撮影、さらにはクリックや入力といった操作を自律的に行えるようにする機能だ。これまでプレビューとして提供されていたが、1.127で一般提供へ移行し、デフォルトで有効化された。
このツールにより、エージェントは「Webアプリを構築して」という指示に対し、コード生成だけでなく実際のブラウザ上での表示確認やエラー検出、修正までをひとつのループで完結させられる。従来は開発者が逐一ブラウザで確認し、エージェントに修正を依頼する手間があったが、そのサイクルが自動化される。外部のMCPサーバーを用意する必要もない。
管理者はエンタープライズポリシーでブラウザツールの利用を制御できる。BrowserChatToolsポリシーで機能自体を無効化したり、エージェントネットワークフィルタリングによってアクセス可能なドメインを制限したりすることが可能だ。
ブラウザツールを活用すると、エージェントが独力でビルドからテスト、修正までのサイクルを回せる。開発者が手動で行っていた確認作業の大部分が自動化され、より高次の設計やレビューに集中できるようになる。
カメラや位置情報などサイト単位の権限制御
統合ブラウザにサイト単位の権限設定が追加された。ページがカメラ、マイク、位置情報、加速度センサー、Bluetooth、USBなどのWeb APIを要求した際、通常のブラウザと同様に許可・拒否のプロンプトが表示される。許可した内容は「サイト権限」メニューから一括管理できる。
これにより、ビデオ会議やフィットネス系Webアプリのテストなど、従来は統合ブラウザでは動作が制限されていたシナリオでもエージェント検証が可能になる。エージェントがカメラ映像を解析する必要があるテストも、この権限制御のもとで安全に実施できる。
エージェントセッション管理が大幅強化、グループ化やマルチチャットで並行作業を効率化

セッションをグループで整理し、ドラッグ&ドロップで並べ替え
エージェントウィンドウのセッションリストにグループ機能が追加された。複数のセッションを任意のグループにまとめられ、グループヘッダーを折りたたむことでリストを整理できる。各グループには「新しいセッションを開始」「グループ内の全セッションを完了としてマーク」といったクイックアクションも用意されている。
ドラッグ&ドロップにも新たに対応し、セッションの並べ替えやグループ間の移動、ピン留めが直感的に行える。複数セッションを選択してまとめて移動することも可能だ。
チャット入力バナーでプルリクエストのCI失敗やレビューコメントに即対応
エージェントがプルリクエストを作成しているセッションでは、チャット入力欄の真上にバナーが表示される。CIチェックが失敗した場合は「2 of 5 checks failed」といった件数とともに「チェックを修正」「詳細を表示」のアクションボタンが現れ、新たなレビューコメントが届いた際も同様に「コメントに対処」「コメントを表示」がワンクリックで実行できる。
従来はGitHubの画面を開いて状況を確認し、別途エージェントに指示を出す必要があった。このバナーにより、会話の流れを中断せずにエージェントへ修正を委ねられる。
チャット入力バナーにより、プルリクエストのCI失敗やレビューコメントが即座に可視化され、対応のリードタイムが短縮される。開発者がコンテキストを切り替える頻度も減るため、集中力を保ちやすい。
マルチチャットセッションの改善とエディタガターからのフィードバック
ひとつのエージェントホストセッション内で複数のチャットを走らせるマルチチャット機能にも改良が加わった。タブでチャットを切り替えられ、不要なチャットは閉じて非表示にし、後から「会話」ドロップダウンで再表示できる。完全に削除したい場合はタブのコンテキストメニューから「チャットを削除」を選択する。
進捗状況とファイル変更は全チャットで集約されるようになった。ひとつのチャットが作業中であればセッション全体が進行中と表示され、各タブにも個別の進捗が示される。セッションヘッダーの「Changes」ピルには、すべてのピアチャットの編集内容が合算されるため、並行して行われている変更の全容を把握しやすくなった。
会話のフォークも改善され、マルチチャットセッション内ではフォークが新たなピアチャットとして作成される。フォークしたチャットは分岐点までの会話を引き継ぎ、兄弟チャットとは独立して動作する。エディタのガターからは直接フィードバックを追加できるようになり、エージェントに修正してほしい行をホバー操作で即座に指摘できる。
チャットとターミナルの新機能、コスト管理の透明化

/troubleshootコマンドでエージェントの動作を診断
エージェントの動作に問題がある場合に利用できる/troubleshootコマンドが拡張され、エージェントホストセッションも診断対象になった。チャット入力欄で/troubleshootを入力し、続けて#sessionで特定のセッションを選択し、質問や問題の説明を追加すると、チャットログを解析してエージェントの振る舞いに関するインサイトを提示する。カスタム指示が無視される理由や応答が遅い原因の調査に役立つ。
ターミナルコマンドのサンドボックス化(macOSとLinux)
エージェントが実行するターミナルコマンドを、ネットワークアクセスを遮断しファイルシステムへのアクセスを制限したサンドボックス内で動作させる機能がmacOSとLinux向けに展開された。コマンドをサンドボックス外で実行する必要がある場合にのみエージェントが承認を求める仕組みで、毎回のプロンプト表示頻度が大幅に減る。
この機能はデフォルトで有効だが、権限設定のドロップダウンからオフにすることも可能だ。サンドボックス化によってエージェントの自律性が高まり、定型作業中の中断が少なくなる。開発者の心理的負荷も軽減されるだろう。
ターミナルコマンドのサンドボックス化は、エージェントの自律性を大きく引き上げる。毎回の承認待ちがなくなることで、ビルドからテストまでのパイプラインをエージェントがほぼ自動で進められるようになり、開発者の介入は「昇格が必要な重大操作」に絞られる。
サブエージェントの消費クレジットをホバー表示
エージェントがサブエージェントに作業を委譲した際、どの程度のAIクレジットが消費されたかが分かりにくいという課題があった。今回のアップデートで、チャット応答内のサブエージェントセクションにマウスカーソルを合わせると、そのサブエージェントが使用したクレジット数が表示されるようになった。コストの透明性が向上し、エージェントの利用計画を立てやすくなる。
Ollama内蔵プロバイダーが非推奨に、公式拡張への移行を推奨
公式Ollama拡張の提供開始と内蔵プロバイダーの非推奨化
モデルプロバイダーを拡張機能として提供する方針が明確化され、Ollamaの公式VS Code拡張がマーケットプレイスで公開された。これに伴い、これまで内蔵されていたOllamaプロバイダーは非推奨となった。ローカルのOllamaモデルをチャットで利用するには、公式拡張をインストールする方法が推奨される。
Bring Your Own Key(BYOK)で内蔵プロバイダーを使っていたユーザーは、公式拡張をインストールした後に内蔵プロバイダーを削除することで、継続してモデルを利用できる。非推奨プロバイダーの削除手順は、VS Code Blogのリリースノート内の動画で確認できる。
公式拡張への移行は、今後のOllamaモデルへの迅速な対応やセキュリティ更新を受け取るためにも重要だ。非推奨プロバイダーは近い将来削除されるため、早めの切り替えが望ましい。
エンタープライズ向け設定をファイル配信可能に、デバイス管理外でも適用
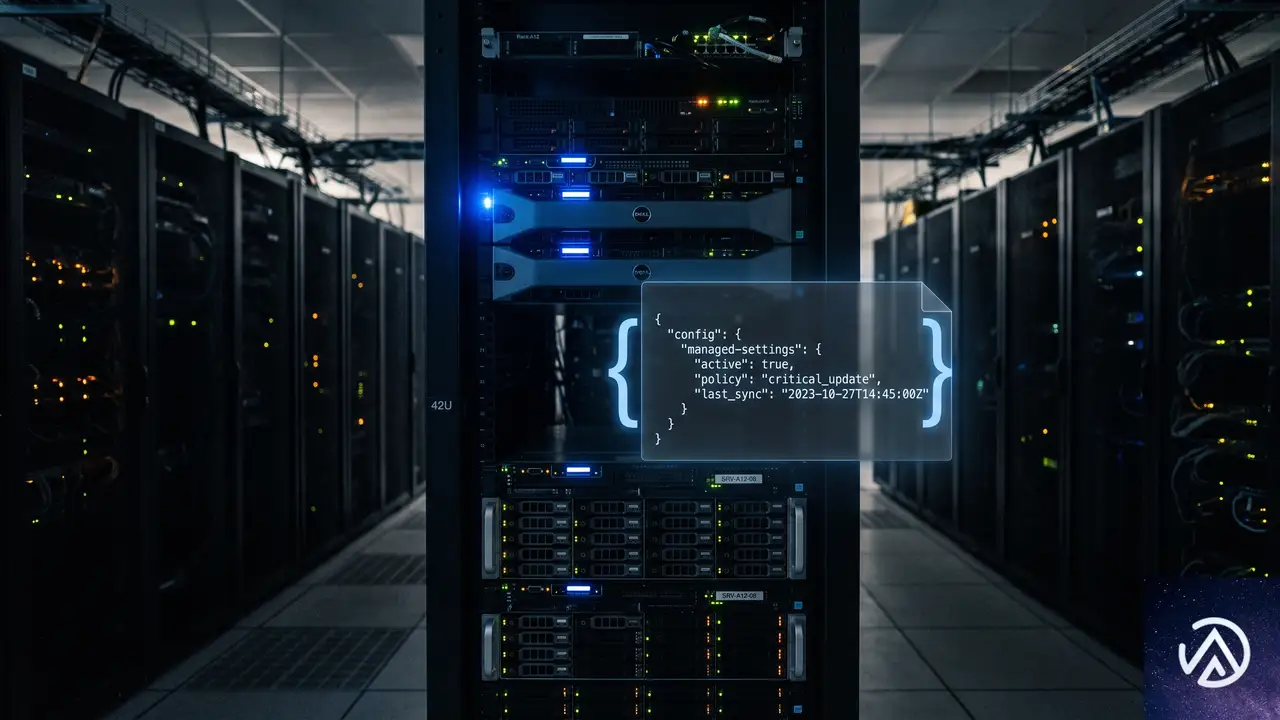
managed-settings.jsonによるCopilot設定の配信
管理者がGitHub Copilotのポリシーを適用する手段として、JSONファイルをOS固有のパスに配置する方式が追加された。MDM(モバイルデバイス管理)に登録されていないマシンや、構成管理システムでファイルを配信する方が簡便な環境で役立つ。macOSでは/Library/Application Support/GitHubCopilot/managed-settings.json、Linuxでは/etc/github-copilot/managed-settings.json、Windowsでは%ProgramFiles%\GitHubCopilot\managed-settings.jsonにファイルを置く。
ファイルのスキーマはGitHub.com上で管理者が設定する場合と同一で、アクセス許可やプラグインの有効・無効を制御できる。このファイルは、MDMやアカウントベースのエンタープライズ設定が存在しない場合にのみ適用されるため、既存の管理手法と競合しない。
この記事のポイント
- エージェント向けブラウザツールが一般提供開始、外部MCPサーバー不要でテスト自動化が可能に
- セッション管理がグループ化・ドラッグ&ドロップ・マルチチャット強化で並行作業の効率が向上
- チャット入力バナーでCI/CDフィードバックをその場で処理、ワークフローが途切れない
- ターミナルコマンドのサンドボックス化でエージェントの自律性が高まり、承認回数が減少
- Ollamaは公式拡張に移行し、内蔵プロバイダーは非推奨へ
- エンタープライズ向けに設定ファイル配信が可能になり、管理対象外端末にもポリシーを適用
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Safari MCP ServerでAIデバッグ、SEOとCWV改善の新時代
Safari MCP Serverとは何か、その本質
WebKitチームが2026年7月、Safariブラウザ向けのMCPサーバーを発表した。これはAIエージェントがSafariブラウザの内部データに直接アクセスし、デバッグやパフォーマンス分析を自律的に行うための仕組みである。開発者やSEO担当者が手作業で行っていたSafari固有の問題検出が、AIとの対話によって自動化される可能性を示している。
Safariは世界で2番目に利用者の多いブラウザであり、特に米国市場では25%から30%超のシェアを維持する。日本国内でもiPhoneユーザーを中心に無視できない存在だ。つまり、Safariでサイトが正常に動作しないことは、ビジネス機会の直接的な損失を意味する。今回のMCP対応は、この課題を根底から変える契機となる。
デモが示すように、手動で行っていた一連の作業をAIが肩代わりする。この変化は単なる効率化ではなく、Safari対応の質そのものを底上げする力を持つ。
発表の背景とSafariの市場地位
Statcounterの2026年データによれば、Safariの米国市場シェアは四半期によって25%から33%の間で推移している。モバイルに限定すればさらに高く、iOSデバイスが支配的な日本市場でも同様の傾向だ。Web制作者にとってSafari対応は「できれば対応したい」ではなく「対応しなければ事業機会を逃す」段階に入っている。
しかしSafariは、Chromium系ブラウザとは異なるレンダリングエンジン(WebKit)を採用しており、CSSの解釈やJavaScriptの挙動に差異が生じる。これまではMac実機やSafariの開発者ツールを使い、人間が一つひとつ問題を探る必要があった。この非効率をAIで解決するのが、今回のMCPサーバー投入の狙いだ。
MCPが変えるブラウザとAIの関係
MCP(Model Context Protocol)は、AIモデルが外部のツールやデータソースと安全に通信するためのオープンプロトコルである。Anthropicが2024年に提唱し、いまではWordPressやShopify、Google Search Console、Screaming Frogなど主要なCMSやSEOツールが対応している。ブラウザがMCPに対応するのは自然な流れであり、Safariはその先陣を切った形だ。
従来、AIにデバッグを依頼する際は、開発者が問題状況を文章で詳細に説明する必要があった。状況説明が曖昧だとAIの回答精度も落ちる。Safari MCPサーバーはこの壁を取り払う。AIエージェントが自らブラウザのDOM構造やネットワークリクエストを取得し、問題を直接把握できるようになるからだ。
なぜ今Safariのデバッグが重要なのか

Webサイトの表示崩れや機能不全は、直帰率の上昇とコンバージョン率の低下に直結する。とくにSafariはiOSユーザーという購買意欲の高い層を抱えており、ここでの不具合はECサイトや予約サイトにとって致命的だ。にもかかわらず、Safari固有のバグ検出にはこれまで大きな労力がかかっていた。
さらに、Core Web Vitals(CWV)の評価は検索順位にも影響を与える。Googleのランキングシグナルとして機能するCWVにおいて、Safari上での読み込み遅延やレイアウトシフトが起きていれば、それは検索パフォーマンス全体を引き下げる要因になる。AIデバッグによってこの問題を素早く特定し修正できる意義は大きい。
Safari固有の問題がSEOに与える損害
Safariでは、特定のCSSプロパティ(例えばbackdrop-filterの挙動やscroll-behaviorの解釈)が他ブラウザと異なる。JavaScriptにおいてもResizeObserverのループ制限やIntersection Observerのしきい値処理に差異が見られる。これらの不一致がCWVのスコア悪化を引き起こし、結果として検索順位の低下を招く。
従来は、Mac環境がないチームはSafari検証を後回しにする傾向があった。しかしAIが代わりに検証してくれるなら、開発プロセスの初期段階からSafari互換性を組み込める。SEOの観点では、これはリリース後の急な順位下落リスクを減らす直接的な効果を持つ。
デバッグの民主化がもたらす競争環境の変化
AIエージェントによる自動デバッグは、個人事業主や小規模チームにこそ恩恵が大きい。専任のSafari検証担当者を置けない組織でも、AIがその役割を果たすからだ。大企業と中小企業のあいだにあった「ブラウザ互換性の検証格差」が縮まり、Safari上でのユーザー体験を基準にした真の実力勝負に近づく。
これはSEOの世界においても、小手先のテクニックよりも基本品質がモノを言う時代の到来を意味する。Safari MCPサーバーはその流れを加速させるツールであり、いち早く導入したサイト運営者が優位に立つ構図が予想される。
上記のリストは、Safari MCPサーバーがSEO施策に与えるインパクトを整理したものだ。これらの効果はすべて、従来の手動デバッグでは「時間がかかりすぎるから後回し」とされてきた領域である。AIがこの障壁を取り除く。
MCP(Model Context Protocol)の基礎知識

MCPはAIモデルが外部リソースと対話するための標準プロトコルだ。簡単に言えば「AIのためのUSB規格」のような存在である。USBがあらゆる周辺機器を共通の接続方式で扱えるように、MCPはあらゆるデータソースやツールをAIが共通の手順で扱えるようにする。
従来、AIに特定のタスクを実行させるには、そのツール専用のAPI連携を個別に開発する必要があった。MCPはこの非効率を解消する。SafariがMCPサーバーを提供することで、あらゆるMCP対応AIクライアントがSafariのブラウザ情報にアクセスできるようになった。
MCPのエコシステムと業界全体の動き
MCPはAstroやWordPress、WooCommerce、Shopifyといった主要CMSがすでにサポートを表明している。SEOツールのScreaming FrogもMCPを採用し、Google Search Consoleも対応を進めている。Safariの参入は、このプロトコルがブラウザというWeb技術の最前線にまで到達したことを示すマイルストーンだ。
Search Engine Journalの記事では、この流れを「ブラウザとAIの統合が新たな段階に入った」と評している。AIが単にコードを提案するだけの存在から、実行環境の状態をリアルタイムで把握しながら問題解決する存在へと進化しているのだ。
MCP対応の広がりは、AIエージェントが一つのプロトコルで多様なツールを横断的に操作できる未来を示している。SEO担当者はScreaming FrogとSafariとGoogle Search Consoleのデータを、一つのAI対話の中で統合的に扱えるようになるだろう。
Safari MCP Serverが切り拓くAIデバッグの実態

WebKitの公式発表によれば、Safari MCPサーバーは以下の5つの主要ユースケースを想定している。(1)アクセシビリティテスト、(2)Safari互換性テスト、(3)任意のユーザー状態の検証、(4)Safari上でのWeb開発、(5)Webパフォーマンス分析、である。これらはいずれもSEOに密接に関係する領域だ。
特筆すべきは、AIエージェントが「ブラウザの中で何が起きているかを自分で調べる」能力を得た点だ。公式アナウンスにある「完璧なプロンプトを書く必要がなくなる」という言葉が、この変化の本質を突いている。開発者はAIに「このページのCWVを改善して」と大まかに指示するだけで、AIが必要なデータを収集し分析し提案まで行う。
アクセシビリティとSEOの融合
アクセシビリティテストの自動化は、SEOの観点からも見逃せない。画像のalt属性不足やセマンティックHTMLの欠如は、スクリーンリーダー利用者の体験を損なうだけでなく、検索エンジンのコンテンツ理解も阻害する。AIがSafari上でこれらの問題を自動検出することで、SEOとアクセシビリティの両面改善が同時に進む。
Webパフォーマンス分析の深化
Webパフォーマンス分析では、ネットワークリクエストのタイムラインやDOMの構築過程をAIが精査する。従来のLighthouse監査では検出できなかったSafari固有のボトルネック、例えば特定のフォント読み込みがWebKitでだけ遅延する問題なども、AIが実ブラウザ上で直接観測できる。
この「実機ブラウザベースのパフォーマンス分析」は、合成監視では得られないリアルなデータをもたらす。CWVのフィールドデータとラボデータの乖離に悩まされてきたSEO担当者にとって、Safari MCPサーバーは問題の根本原因を特定する強力な武器になる。
5つのユースケースはそれぞれ独立しているが、実際の開発フローではこれらが複合的に作用する。たとえばアクセシビリティの問題を修正した結果、DOM構造が変わりCWVにも影響が出る、といった連鎖的な改善をAIが一括管理できる点が新しい。
SEOとCore Web Vitalsへの実戦的インパクト

Safari MCPサーバーがSEOにもたらす最大の恩恵は、CWV(Core Web Vitals)のスコア改善スピードが飛躍的に上がることだ。これまでLCP(Largest Contentful Paint)の改善には、どのリソースがクリティカルレンダリングパスを塞いでいるかを人間が特定する必要があった。AIがSafariのネットワークタイムラインを直接解析すれば、この作業は数秒で完了する。
CLS(Cumulative Layout Shift)についても同様だ。Safariはフォントのレンダリング方式や画像の遅延読み込みの挙動がChromium系と微妙に異なり、意図しないレイアウトシフトが発生することがある。AIが実際のSafariブラウザ上で測定することで、ラボツールでは再現できない問題まで捕捉できる。
フィールドデータとラボデータの統合分析
Google Search ConsoleのCWVレポートはフィールドデータに基づくが、問題の原因特定にはラボデータが必要になる。Safari MCPサーバーは、実ブラウザのラボデータをAIが直接取得するため、この二つのデータの橋渡し役を担う。フィールドデータでCWV低下を検知したら、すぐにSafari上でAIデバッグを実行し、具体的な修正案を得られる流れが現実的になる。
AI時代のSEOワークフロー
従来のSEOワークフローは「監視→検出→人間が仮説立案→人間が検証→修正→再測定」というサイクルだった。Safari MCPサーバーの登場により、「監視→AIが検出→AIが原因特定→AIが修正案提示→人間が承認→修正→AIが再検証」という形に変わる。人間の役割は「仮説立案」から「AI提案の判断と承認」へとシフトする。
この変化は、SEO担当者のスキルセットにも影響を与えるだろう。Safari DevToolsを細かく操作する技術よりも、AIに適切な指示を出し、出力結果の品質を見極める能力が重視されるようになる。Search Engine Journalの記事が伝える内容からも、このパラダイムシフトは2026年後半から本格化すると見られる。
このワークフロー比較が示すように、Safari MCPサーバーはSEOオペレーションの速度と精度を根本から変える。人間は戦略判断に集中し、反復的な検証作業はAIに任せるという分業が可能になる。
導入から活用までの具体的ステップ

Safari MCPサーバーは発表されたばかりであり、本格的な実装と提供方法についてはAppleからの続報が待たれる段階だ。しかし、すでにMCPを導入している他ツールの事例から、準備すべき環境と心構えは明確になっている。以下に、現時点で想定される導入ステップを示す。
環境準備とAIクライアントの選定
まず必要なのはMac環境と、MCP対応のAIクライアントだ。Claude Desktopや、Cursor、WindsurfなどMCPをサポートするエディタが候補になる。Safari Technology Previewの最新版にMCPサーバー機能が組み込まれる可能性が高く、WebKit公式ブログのアップデートを追うことが最初の一歩になる。
既存のデバッグフローへの組み込み方
AIデバッグは強力だが、いきなり全工程を任せるのではなく、まずは既存のCWV監視フローの補助として導入するのが現実的だ。たとえば、Search ConsoleでCLS悪化を検知したら、AIにSafari上でのCLS発生箇所の特定を依頼する。AIの提案を人間が評価し、問題なければ本番環境に適用するという段階的なアプローチが失敗を防ぐ。
また、AIの出力にはハルシネーション(もっともらしい誤情報)が含まれる可能性がある。特にCSSの修正提案は、Safariで意図通りに動作するかを必ず実機で確認するプロセスを残すべきだ。AIは検出と提案を高速化するが、最終的な品質保証は人間の役割である。
上記の3ステップは、あくまで現時点での想定に基づく。Safari MCPサーバーの正式リリース時に詳細なドキュメントが公開されるはずだ。WebKit公式ブログやApple Developerサイトの情報を定期的に確認し、最新の導入手順に従うことを推奨する。
この記事のポイント
- Safari MCPサーバーはAIエージェントがブラウザ内部データに直接アクセスしデバッグを自動化する仕組みである
- 米国で25%超のシェアを持つSafariの互換性問題をAIが解決することでSEOとCWVが大幅に改善する
- MCPは業界標準プロトコルとしてWordPressやGoogle Search Consoleも対応しておりエコシステムが拡大している
- 導入はMac環境とMCP対応AIクライアントから始め段階的に既存フローへ組み込むのが現実的な戦略だ
- AIの提案を鵜呑みにせず最終的な品質確認は人間が行うプロセスを維持することが失敗を防ぐ鍵になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験