

WordPress 7.1.3 セキュリティアップデート公開。7件の脆弱性修正と即時更新の必要性
WordPress 7.1.3が10月6日に公開された。セキュリティ修正とメンテナンスを兼ねたリリースで、7件の脆弱性修正と4件のバグ修正が含まれている。
セキュリティリリースであるため、公式サイトはすべてのサイト管理者に即時更新を推奨している。特にコメント管理画面に保存型XSSが発見されており、悪用されると管理者権限を奪われる可能性がある。
この記事では7.1.3で修正された脆弱性の内容、更新手順、バックポートの状況を解説する。サイトを安全に保つための具体的なチェックポイントもあわせて紹介する。
WordPress 7.1.3リリースの概要
今回のリリースは定期アップデートではなく、セキュリティ上の問題に対処するための緊急リリースとして位置づけられている。WordPressのセキュリティリリースは、脆弱性の詳細が公開される前に修正版を配布する仕組みだ。今回も7件のセキュリティ修正が含まれており、いずれも悪用されるとサイトの安全性に重大な影響を及ぼす可能性がある。
リリースの基本情報
WordPress 7.1.3は、7.1系の3番目のメンテナンスリリースである。過去のメンテナンスリリースと同様に、バグ修正とセキュリティ修正が同時に行われている。セキュリティ修正が7件、バグ修正が4件だ。バグ修正の内訳はトラッカーのチケットで公開されており、特定の条件下で発生する不具合が対象となっている。
リリースを主導したのはJake Spurlock氏だ。WordPressコア開発のリリースリードとして、複数のコントリビューターと非同期で調整しながら安定版リリースまでこぎつけた。
即時更新が求められる理由
セキュリティリリースの性質上、更新を後回しにすればするほど攻撃を受けるリスクが高まる。攻撃者は公開された修正内容を逆に解析し、まだ更新していないサイトを狙うことが多い。特に今回修正された保存型XSSは承認待ちコメントを経由して悪用できるため、コメント機能を有効にしているサイトは注意が必要だ。
修正された7件の脆弱性
今回のリリースで修正された脆弱性を、影響度の高い順に見ていく。いずれも実際に悪用される前に報告・修正されており、報告者はWordPressセキュリティチームから謝辞が述べられている。
コメント管理画面の保存型XSS
最も深刻な問題は、コメント管理画面における保存型XSS(クロスサイトスクリプティング)だ。承認待ちコメントに細工を施すことで、管理者がコメント管理画面を開いた際にスクリプトが実行される可能性がある。XSSはWebアプリケーションの弱点を突く代表的な攻撃手法で、保存型の場合、悪意のあるコードがサーバーに保存された後に被害が発生する。
この問題は、セキュリティ企業のTrail of BitsとOpenAIの協力によって報告された。管理画面のコメント一覧は多くの管理者が日常的にアクセスするページであり、発見が遅れれば広範囲のサイトに影響が及ぶ可能性があった。
WXRエクスポート機能の2次SQLインジェクション
WXR(WordPress Extended RSS)エクスポート機能に2次SQLインジェクションの脆弱性が見つかった。WXRエクスポートとは、WordPressの投稿や固定ページをXML形式で書き出す機能だ。2次SQLインジェクションとは、悪意のあるデータが一度データベースに保存された後、別の処理でクエリとして使用される際に攻撃が成立するタイプの脆弱性を指す。
この問題はAnthropicによって報告された。サイトの移行やバックアップ目的で頻繁に利用されるエクスポート機能に脆弱性があったため、影響範囲は広い。
その他5件の脆弱性修正
- HTTP通信処理の絶対URL生成メソッドにDoS(サービス拒否)脆弱性が存在した。Anthropicが報告した
- 投稿者権限のユーザーが固定投稿を設定できる権限の不備が存在した。Anthropicが報告した
- 未公開記事や非公開記事のコメントが認証なしで閲覧できる問題が見つかった。PatchstackのAnanda Dhakal氏が報告した
- Imgur埋め込み機能にXSS脆弱性が存在した。複数の研究者が共同で報告した
- ステータスとタイプを組み合わせたフックにパラメータ検証の不備があり、アクション名の衝突を引き起こす可能性があった。WordPressセキュリティチームのAlex Concha氏が報告した
報告元にAnthropicとOpenAIが複数含まれている点が今回の特徴だ。AI関連企業がWebアプリケーションのセキュリティ監査に積極的に関わるようになってきた流れを反映している。
このデモは、7.1.3適用前後でサイトの脆弱性状態がどのように変化するかを示している。セキュリティリリースの適用により各脆弱性が解消される。
今回の脆弱性報告には、セキュリティ専門企業だけでなくAI関連企業の関与が目立つ。Anthropicは3件、OpenAIはTrail of Bitsとの協力で1件を報告している。AI技術を活用したコード解析やセキュリティ監査の精度が向上していることを示す事例と言える。
更新手順と確認事項
セキュリティリリースの適用は優先度が高いタスクだ。更新にはいくつかの方法があるが、いずれの場合も事前のバックアップが推奨される。更新後に問題が発生した場合にロールバックできる体制を整えておくことが重要である。
ダッシュボードから即時更新
最も簡単な方法は、WordPress管理画面からの更新だ。ダッシュボードにアクセスし「更新」セクションを開くと、WordPress 7.1.3への更新通知が表示される。「今すぐ更新」ボタンをクリックすると自動的に更新プロセスが実行される。自動バックグラウンド更新が有効なサイトでは、すでに更新が自動適用されている場合が多い。
手動で更新する場合は、WordPress.orgからzipファイルをダウンロードしてサーバーにアップロードする方法もある。FTPクライアントやホスティングサービスのファイルマネージャーを使って更新できる。ただし手動更新はファイルの上書きミスなどのリスクがあるため、ダッシュボードからの更新が推奨される。
更新前のバックアップと更新後の確認
更新前には必ずバックアップを取得すること。データベースとファイルの両方をカバーするバックアッププラグインを使うか、ホスティングサービスのバックアップ機能を利用する。更新後に問題が発生した場合、バックアップから復元することで被害を最小限に抑えられる。
更新後は、サイトのフロントエンドと管理画面の両方が正常に動作することを確認する。フォームの送信、コメント機能、固定投稿の表示などを重点的にチェックするとよい。キャッシュプラグインを使っている場合は、キャッシュをクリアしてから動作確認を行うことが重要だ。
このデモは、WordPress 7.1.3への更新手順を4つのステップで示している。バックアップ、更新画面、更新実行、動作確認の順に進める。
バックポートとコミュニティの対応
セキュリティ修正は、サポート対象の全ブランチにバックポートされる。現在のサポート対象は最新版から4.7までだ。バックポートとは、最新版で見つかった脆弱性の修正パッチを旧バージョンにも適用する作業を指す。WordPressは多くのバージョンが並行して使用されているため、この措置が重要になる。
旧バージョンへのバックポート
バックポートは準備が整い次第、順次提供される。すべての旧バージョンに同時に提供されるわけではないため、旧バージョンを使用している場合は、各ブランチの更新通知を定期的に確認することが推奨される。ただし、WordPressは最新版のみが積極的にサポートされる方針だ。セキュリティリスクを低減するためには、可能な限り最新版へのアップグレードが望ましい。
リリースを支えた貢献者たち
WordPress 7.1.3のリリースには34名のコントリビューターが参加した。リリースリードを務めたJake Spurlock氏を中心に、コアコミッターやセキュリティチームのメンバーが非同期で調整しながら、安定版リリースの提供にこぎつけた。WordPressの開発体制はオープンソースコミュニティの典型的なモデルであり、世界中の開発者が自主的に参加している。
セキュリティ修正の報告者には、Trail of Bitsのような専門企業に加えて、AnthropicやOpenAIといったAI関連企業が含まれている点が注目される。AI技術を活用したコード解析や脆弱性スキャンが、オープンソースソフトウェアのセキュリティ品質向上に貢献する事例が増えている。
この記事のポイント
- WordPress 7.1.3はセキュリティ修正7件とバグ修正4件を含む緊急リリースである
- コメント管理画面の保存型XSSは承認待ちコメント経由で悪用できるため特に危険だ
- WXRエクスポートの2次SQLインジェクションや投稿者権限の不備も修正された
- 更新はダッシュボードから数クリックで完了する。自動更新が有効なら適用済みの可能性が高い
- 更新前のバックアップと更新後の動作確認が安全なサイト運営の基本である

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
SupabaseがTursoを買収。エージェント向けDB基盤の進化へ
Supabaseが10月2日、SQLiteクラウドプラットフォームを手がけるTursoの買収を発表した。AIエージェントが大量のデータベースを作成する新時代に向け、PostgresとSQLiteの両軸で基盤を強化する動きだ。
既存ユーザーへの影響はない。SupabaseはPostgresを中心に、TursoはSQLiteを中心にそれぞれの開発を継続する。両社の技術と知見を組み合わせ、エージェントがDBを簡単に扱える新たな体験の実現を目指す。
この記事では買収の概要、AIエージェントが変えるデータベース需要、Tursoの技術アーキテクチャ、オープンソース戦略を整理する。
買収の背景、PostgresとSQLiteの両軸へ
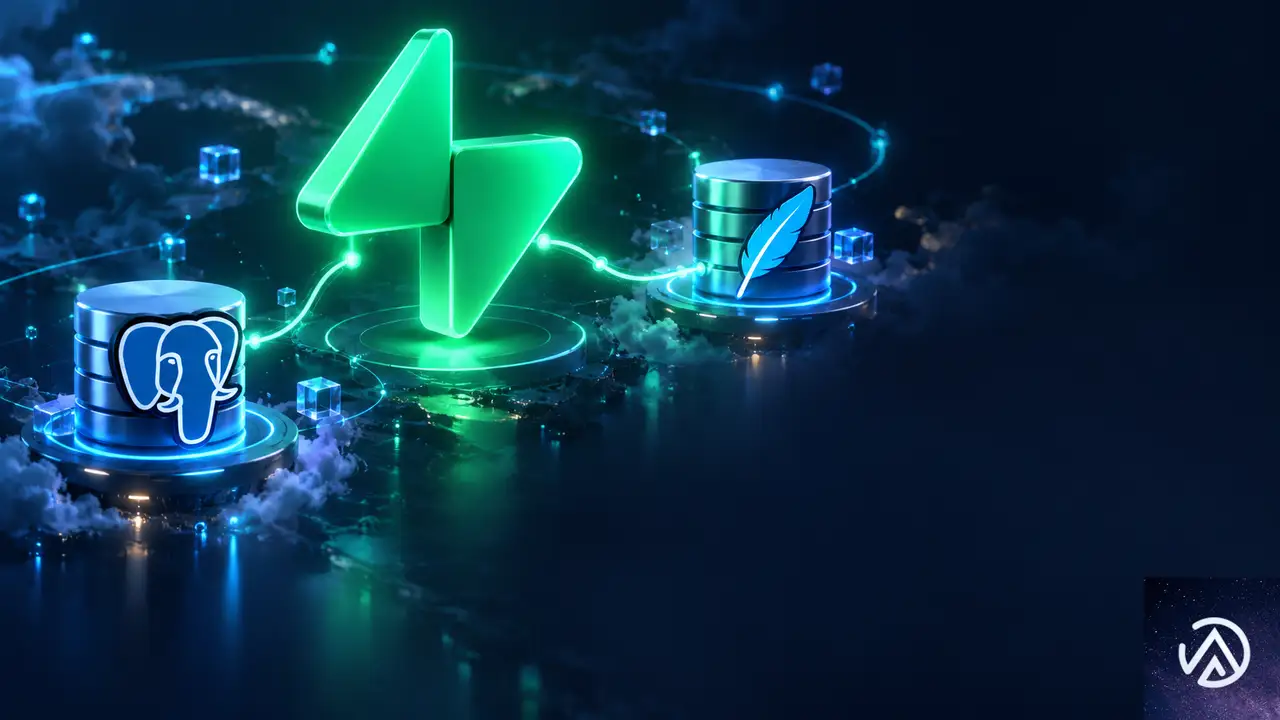
Supabaseの発表によると、同社はすでに毎週100万以上のデータベースを立ち上げている。AIエージェントがプロトタイプやダッシュボード、アプリケーションを大量に作る流れが進む中で、DB需要は現在の供給能力を超える可能性がある。こうした状況に対応するため、Tursoの買収に至った。
重要なのは、この買収が「どちらかの技術に一本化する」話ではない点だ。Supabaseは引き続きPostgresを中心に開発し、TursoはSQLiteの改良を続ける。その上で、両社を横断する新しい基盤を共同で構築する。Supabaseの開発者体験をすべてのエージェントに届けることが目標だ。
SQLiteとは、サーバーを必要としないファイルベースの軽量データベースだ。アプリケーションに組み込んで手軽に使える特徴がある。一方のPostgresは、本格的なリレーショナルデータベースとして大規模なアプリケーションで使われる。小さなワークロードから本番環境まで、段階に応じた選択肢を提供できる体制になる。
AIエージェントが変えるデータベース需要
AIエージェントとは、人間の指示を受けて自律的にタスクを実行するAIのことだ。コードを書いたり、調査をしたり、アプリのプロトタイプを作ったりする。Supabaseの発表によれば、エージェントはすでに数百万ものデータベースを生み出しているという。
この流れが進むと、データベースに求められる性質が変わる。エージェントはファイルを作るのと同じ感覚でDBを作成できるべきだ。コストをほとんど気にする必要がなく、小規模な用途であれば専用マシンを毎回プロビジョニングする手間も避けたい。必要な時にすぐ使えて、不要になったら自動で止まる。そして本番環境へ移行する明確な道筋があること。これがエージェント時代のDB基盤に必要な条件だ。
プロビジョニングとは、サーバーやデータベースなどのインフラを自動的に割り当てて利用可能な状態にすることだ。従来は小規模なDBでも専用マシンを毎回準備する必要があった。AIエージェントが大量の小規模DBを必要とする時代には、この方式ではコストと時間が合わない。
このデモは、AIエージェントの台頭によってデータベース作成のアプローチが大きく変わることを示している。
SQLiteはこのような小規模でオンデマンドなワークロードに適している。一方、アプリケーションが成長して本格的な運用に入る段階ではPostgresが力を発揮する。両方を同じ開発者体験でつなぐことが、今回の買収の狙いだ。
Tursoの技術アーキテクチャ、Rustで再構築したSQLite
Tursoはこのパターンに最適化されたアーキテクチャを構築してきた。SQLiteをRustで再構築し、1台のサーバーで数百万のデータベースを管理できるクラウドプラットフォームを作り上げた。必要な時にDBをロードし、使われていない時は自動的にサスペンドする仕組みだ。
Rustとは、メモリ安全性と高速性を両立するプログラミング言語だ。CやC++と同等の性能を持ちながら、メモリ関連のバグを防ぐ仕組みが言語レベルで組み込まれている。サスペンドとは、実行中のプロセスを一時停止してメモリ領域を保持したままにすることだ。停止と再開を高速に行える。
Tursoのアーキテクチャは、1台のサーバーで多数のSQLiteインスタンスを効率的に管理する。この仕組みにより、エージェントごとにDBを即時提供できる。
このアーキテクチャは、Turso Cloud上でも、ユーザー自身のクラウド環境でも動作する。実際にSuperhuman、Sauna.ai、CTO.new、Mastraといった企業がこの仕組みを利用している。Supabaseの発表では、ワークロードの成長に応じてTursoのエコシステムからSupabaseへ移行する明確な道筋も示された。
オープンソースへの姿勢と今後の展望
TursoとSupabaseには共通点が多い。オープンソースへの強いコミットメント、開発者体験へのこだわり、難しいインフラ課題に挑む姿勢だ。今回の買収は、技術的な相性だけでなく、こうした価値観の一致も大きな理由となっている。
Tursoのグローバー・コスタ氏とペッカ・エンバーグ氏は、チームとともにSupabaseに加わる。コスタ氏はエージェント向けインフラの開発を主導する役割を担う。Supabaseのミッションは「世界のデータを保存する」ことだ。AIエージェントがさらに多くのデータを生み出す時代において、この買収はその目標へ大きく近づく一歩となる。
短期的には、既存ユーザーに目立った変化はない。しかし中期的には、プロトタイプ段階から本番運用まで一貫した開発者体験を提供する基盤が形づくられていく。SQLiteで手軽に始め、必要に応じてPostgresへスケールする流れが、よりシームレスになるだろう。
この記事のポイント
- SupabaseがSQLiteクラウドのTursoを買収、既存ユーザーへの影響はない
- Supabaseは毎週100万以上のDBを立ち上げており、AIエージェントの需要に対応する
- TursoはRustでSQLiteを再構築し、1台のサーバーで数百万のDBを管理できる
- SQLiteとPostgresを段階に応じて使い分けられる基盤づくりが始まる
- オープンソース重視の両社の価値観が一致した買収である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleがEmbeddingGemma 2を公開。コード・画像・音声を同じベクトル空間で扱う軽量モデル
Google DeepMindがマルチモーダル埋め込みモデル「EmbeddingGemma 2」を公開した。テキスト・コード・画像・動画・音声を同じベクトル空間で扱える軽量モデルだ。検索や分類をスマートフォン単体で完結させることを狙う。
前世代EmbeddingGemmaは2000万ダウンロードを超えた。今回はGemma 4アーキテクチャを基盤に、Apache 2.0ライセンスで提供される。パラメータ数は7億4000万。テキスト専用なら2億7000万で動作し、用途に応じて画像用に1億7000万、音声用に3億を追加できる。
埋め込みモデルとは、データを数値ベクトルに変換する仕組みだ。意味の近いものを近い位置に配置し、検索や分類に使う。この処理を端末内で行える点が、プライバシー保護と応答速度の両面で重要になる。
EmbeddingGemma 2の概要と設計思想
EmbeddingGemma 2は、Googleが2025年に公開した埋め込みモデルEmbeddingGemmaの後継版にあたる。前世代がテキスト専用だったのに対し、今回からマルチモーダルへと大きく舵を切った。モデルの設計思想を2つの観点から見ていく。
前世代からの進化点
前世代との最大の違いは、単一モデルで複数のデータ形式を処理できる点だ。テキストとコードに加え、画像・動画・音声をネイティブに扱う。モダリティごとに別々のモデルを組み合わせる方式ではなく、1つの埋め込み空間へ直接変換する設計である。
コンテキストウィンドウは8000トークンに拡張された。前世代の4倍にあたる。約5分半の音声、29枚の画像、58フレームの動画を端末上でそのまま処理できる。音声メモから特定の動画シーンを探すといった使い方が可能だ。
Gemma 4と同じテキストトークナイザーと音声エンコーダーを採用した点も見逃せない。生成モデルと組み合わせる際、メモリ消費量を抑えながら統合パイプラインを構築できる。オンデバイスRAGの基盤として実用性を高めた格好だ。
モジュール設計がもたらす柔軟性
EmbeddingGemma 2は用途に応じて規模を変えられるモジュール構成を取る。テキストのみなら2億7000万パラメータ。画像対応を加えると1億7000万パラメータを追加。音声にも対応するとさらに3億パラメータを追加する。フル構成では7億4000万になる。
この設計は実務面で重要だ。テキスト検索だけが必要なアプリは軽量構成を選び、マルチメディア検索が必要なアプリはフル構成を選べる。限られた端末リソースに合わせて機能を段階的に追加できるため、幅広いハードウェアへ展開しやすい。
4種類のデータが1つの共有ベクトル空間に変換される仕組みを示している。
マルチモーダル埋め込みの性能検証
公開されたベンチマーク結果からは、EmbeddingGemma 2が同規模モデルの中で突出した性能を持つことがわかる。コード・画像・音声の各分野で詳細を見ていく。
主要ベンチマークの結果
10億パラメータ未満のマルチモーダル埋め込みモデルとしては最高水準のスコアを記録した。コード性能を示すMTEB Codeでは68.76から78.68へ9.92ポイント向上している。ローカルコードベースのインデックス作成や意味検索、コーディングエージェント向けの検索に適するレベルだ。
画像・動画・文書・音声の各タスクでも、パラメータあたりの品質で新たな基準を打ち立てた。2倍以上の規模を持つ専門モデルを上回るケースもある。日本語を含む多言語テキスト性能は前世代同等を維持している点も確認された。
10億パラメータ未満でこの性能を実現できた背景には、Gemma 4アーキテクチャの成熟がある。埋め込みモデルと生成モデルの技術を共通化する戦略が、小型モデルにも高品質をもたらしたと言える。
MRLによる保存効率の改善
MRL(Matryoshka Representation Learning)という手法を採用した点が保存効率に大きく寄与する。マトリョーシカ人形のように、大きなベクトルの中に小さなベクトルを入れ子状に含める学習方式だ。出力ベクトルを768次元から512次元、256次元、128次元へと段階的に切り詰められる。
次元数を128に落とすと、ローカルベクトルデータベースの保存容量とメモリ使用量を最大6分の1に削減できる。検索精度の低下は限定的で、上位次元ほど重要な情報が集まるよう設計されている。この仕組みの価値は実務でこそ大きい。端末の保存領域には限りがあるため、容量と精度のバランスを取れる点が重要だ。
次元数を減らすほど保存容量が削減される仕組みを示している。
オンデバイス検索とRAGの実用シナリオ
EmbeddingGemma 2の真価は、クラウドに依存しないオンデバイス動作にある。データを外部へ送らず、端末内で埋め込み生成から検索まで完結できる。プライバシーと応答速度の両面で利点がある。
端末内で完結するセマンティック検索
Google Pixel 11 Proでは量子化により、テキスト専用で約191MB、フルマルチモーダルで約567MBのアクティブRAMで動作する。ハイエンド以外のスマートフォンでも現実的なリソースだ。完全オフラインで動作するため、機内モードや圏外でも検索機能を利用できる。
具体的な利用例として、音声メモから特定の動画クリップを探したり、テキストクエリで数時間分の録音を横断検索したりできる。従来は複数のモデルやクラウドAPIが必要だった作業が、単一のオンデバイスモデルで完結する。この変化は、オンデバイスAIが実用段階に入ったことを示している。
Gemma 4と組み合わせたオンデバイスRAG
生成モデル「Gemma 4」と組み合わせると、複雑なマルチモーダルデータを理解するオンデバイスRAG(検索拡張生成)パイプラインを構築できる。EmbeddingGemma 2がローカルファイルを検索し、Gemma 4が文脈を踏まえた推論を行う。2つのモデルが同じトークナイザーを共有するため、統合時のメモリ消費量も抑えられる。
Google AI Edge Galleryでは「Instant Media Search」と「Video Moments Finder」の2つのデモが公開された。テキストや画像でメディアライブラリを検索したり、テキストや音声クエリで動画内の特定シーンを特定したりできる。さらにMediaPipe Decision Task APIを使えば、分類・ルーティング・予測機能を持つリアルタイム意思決定エンジンも構築可能だ。
端末内で完結する検索フローと従来方式の違いを示している。
開発者向けの導入方法
EmbeddingGemma 2は公開直後から主要な開発ツールに対応している。Google DeepMindはパートナーと協力し、既存のワークフローにすぐ組み込める環境を整えた。導入フローを2つの観点で整理する。
モデルの入手と実行環境
モデルウェイトはHugging FaceとKaggleで公開されている。オンデバイス最適化版はHugging Face上のLiteRT Communityで入手できる。Gemini Enterprise Agent PlatformのModel Gardenでも近日提供予定だ。
クロスプラットフォームアプリの開発にはGoogle AI EdgeのMediaPipeが使える。埋め込み・検索・意思決定タスクをすぐに利用できるのが利点だ。カスタム統合にはLiteRTを選ぶ。ブラウザ向けにはtransformers.jsまたはWebGPUが対応する。WebGPU経由ならブラウザ上でもGPUを活用した高速推論が可能だ。
対応ツールとファインチューニング
transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama、LMStudioなど主要な推論・実行ツールで動く。埋め込みベクトルの保存にはQdrantが公式に対応する。ローカルでベクトルデータベースを構築する際の選択肢として有力だ。
ファインチューニングの手順はUnslothがガイドを公開した。特定のドメイン用語や業界固有のデータに合わせてモデルを調整できる。Google AI Edgeのブログ記事では、LiteRTを使ったオンデバイス検索とRAGシステムの構築方法が解説されている。開発者ガイドとドキュメントも合わせて公開済みだ。
この記事のポイント
- EmbeddingGemma 2は7億4000万パラメータのマルチモーダル埋め込みモデル
- テキスト・コード・画像・動画・音声を1つのベクトル空間で処理する
- MRLにより保存容量を最大6分の1に削減できる
- スマートフォンで完全オフラインの検索とRAGが動作する
- Hugging FaceとKaggleでモデルが公開されている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPT広告に画像フォーマット登場。EC事業者が知るべきBotクリック問題と計測拡張
OpenAIはChatGPTの広告に画像を使った視覚フォーマットを追加する。画像生成中に表示される新しい広告枠で、広告主は商品やサービス体験を画像で伝えられるようになる。
ChatGPTの週間利用者数は12億人に達している。広告の露出規模は巨大だ。一方でTrafficGuardの調査によれば、ChatGPT広告のクリックはGoogle広告と比べてデータセンターやプロキシ経由が3.6倍多い。
本記事では新しい広告フォーマットの仕組み、Botクリックの実態、計測機能の拡張を整理する。ECサイトを運営する事業者が広告予算を無駄にしないためのポイントもあわせて解説する。
ChatGPT広告に視覚フォーマットが追加
OpenAIの発表によると、新しい視覚広告は画像生成のタイミングで表示される。広告主は商品そのもの、使用シーン、サービスに関連する体験などを画像で表現できる。この広告は生成される画像とは別の領域に表示され、ChatGPTの回答内容には影響を与えない設計だ。
米国では今月下旬から一部の広告主を対象にテストが始まる。従来のChatGPT広告は広告主名、ロゴ、商品リンクを並べるだけのシンプルなスポンサー表示だった。今回の変更で、広告クリエイティブの表現力が一段階上がることになる。
このデモでは従来のテキスト中心の広告と、画像を活用した新しい広告の違いを示した。視覚フォーマットは商品を直感的に伝えられる点が最大の変化だ。
週間12億人が閲覧する広告枠がECにもたらす意味
ChatGPTの週間利用者数は12億人に達している。この規模のユーザーベースに商品画像を直接見せられる広告枠は、EC事業者にとって新しい集客チャネルになり得る。特に検索意図が明確な会話の中で商品を提示できる点が、従来のディスプレイ広告とは異なる。
ただし、新しい在庫が増えても基本的な疑問は残る。誰が本当にクリックしているのか、という点だ。広告の見た目が派手になるほど、実際の成果が見えにくくなるリスクもある。
商品を画像で見せられる価値
ECの集客では商品画像が購買判断に直結する。ChatGPTの視覚広告は、会話の文脈に合わせて商品画像を提示できるため、いわゆる「ついで買い」や「比較検討」の入り口になりやすい。従来のテキストリンクよりクリック率向上が期待できるフォーマットだ。
とはいえ、広告の露出が増えるほどBotによる不正クリックの影響も拡大する。次章でその実態を確認する。
BotクリックはGoogle広告の3.6倍。無効トラフィックの実態
広告検証を行うTrafficGuardは、47社の広告主から得たChatGPT広告の3週間分のトラフィックを分析した。無効クリック率はキャンペーンごとに0.1%から34%まで大きくばらついた。ほぼクリーンなキャンペーンがある一方で、コンバージョンの見込みがないトラフィックに料金を支払っていたケースも確認された。
調査では、比較的少数のBotがクリックの多くを生み出していた。あるホスティング事業者の15台のサーバーが、5社の広告主の広告を3週間で318回クリックしていた。さらに4つのホスティング・プロキシネットワークが47社中25社に到達し、分析で特定された無効クリックの半数を生み出していた。
ChatGPT広告のクリックはデータセンターやプロキシネットワーク経由がGoogle広告の3.6倍、実在し得ない端末設定からのアクセスは10倍だった。自動化されたトラフィックはまだ初期段階のChatGPT広告にすでに到達している。
このデモではBotクリックの発生率をChatGPT広告とGoogle広告で比較した。ChatGPT広告はGoogle広告よりはるかに高い割合でBot経由のクリックが発生している。
自動化されたトラフィックへの見解
TrafficGuardの共同創業者兼CEOであるMathew Ratty氏は声明で、ChatGPT広告はまだ初期段階であるにもかかわらず自動化トラフィックはすでに到達していると述べた。同氏によれば、それは組織的で、持続的で、毎日クリックを続けているという。
EC事業者がChatGPT広告へ予算を投じる場合、Bot対策は無視できない要素だ。配信設定で除外すべきネットワークを絞り込み、無効クリックの発生率を定期的に確認する運用が求められる。
計測機能も拡張。HightouchやLiveRampと連携
OpenAIは広告効果を測定する仕組みも拡張する。Hightouch、Tealium、LiveRampとの連携により、広告主はコンバージョンデータをChatGPT広告へ送信できるようになる。これにより、ChatGPT広告経由で実際に商品が購入されたかどうかを追跡しやすくなる。
EC事業者にとっては、広告クリック後の購入までの導線を数値で把握できる点が重要だ。ただし、Botクリックが混ざると成果数値が歪むため、無効クリックの除外とセットで運用する必要がある。
このデモではECサイトからChatGPT広告へのコンバージョンデータの流れを示した。3つの連携ツールを使うことで、購入データを広告効果測定に反映できる。
EC事業者が取るべき対応
ChatGPTの視覚広告は新しい集客チャネルとして注目に値する。特に商品画像を自然な会話の流れで提示できる点は、従来の検索広告やSNS広告にはない強みだ。一方で、Botクリック率の高さは予算を毀損する要因になる。
まずは少額のテスト配信から始め、無効クリック率とコンバージョンの推移を確認するのが現実的だ。計測ツールとの連携を設定し、購入に至ったトラフィックの割合を継続的に追うことを推奨する。
この記事のポイント
- ChatGPT広告に画像を使った視覚フォーマットが追加された
- 新フォーマットは画像生成中に表示され、ChatGPTの回答には影響しない
- ChatGPTの週間利用者数は12億人に達する
- TrafficGuardの調査で無効クリック率は0.1〜34%と大きくばらついた
- BotクリックはGoogle広告の3.6倍、データセンター経由が多い
- Hightouch、Tealium、LiveRampと連携しコンバージョン計測を拡張
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索の7つの神話をデータで検証。サイト運営者が知るべき真実
AI検索の台頭をめぐって「Googleは死んだ」「SEOは終わった」といった過激な主張が飛び交っている。しかし、実際のデータを確認すると、その多くが誤解や誇張であることが分かる。
本記事では、AI検索とSEOに関する7つの神話を取り上げ、調査データを基にそれぞれを検証する。サイト運営者やEC担当者が、感情的な主張に振り回されずに戦略を立てるための指針となるはずだ。
AI検索と従来型検索をめぐる3つの神話
上の図は「AI対従来型検索」という二項対立ではなく、両者が共存して成長していることを示している。
AI検索は従来型検索を殺していない
「AI検索がGoogleを駆逐する」という主張は、感情には訴えるがデータと一致しない。State of Search Q2 2026レポートによると、AI検索と従来型検索は四半期ごとにほぼ同じ成長率で推移している。
つまり、AIプラットフォームは検索需要を奪っているのではなく、既存の検索需要の上に新たな層を追加している形だ。ただし、検索需要全体が伸びる一方で、Googleが自社画面内で回答を完結させる傾向が強まった結果、外部サイトへのクリック数は減少している。
同じ調査では、Google傘下以外のデスクトップ検索結果へのクリックが2025年4月以来の最低水準にあることも示された。検索意欲は伸びているが、Googleからオープンウェブへの送客は減っている構図だ。
ゼロクリック環境でもオーガニック流入は伸ばせる
「2026年にオーガニック流入を伸ばすのは不可能」という主張も誤りだ。AI OverviewやAI Modeの影響が強い分野では苦戦するものの、地元密着型の中小企業では2026年7月に過去最高のオーガニッククリック数を記録した事例が報告されている。
重要なのは、ゼロクリック圧力が全業界に均等にかかるわけではないという認識だ。ブログ記事とサービスページの両方で、ブランドに依存しない施策のみで成果を出した例もある。業界やビジネスモデルによって影響度は大きく異なる。
AI生成コンテンツでも上位表示は可能
「GoogleやLLMはAI生成コンテンツを検出して抑制する」という神話も根強い。しかし、2025年3月から9月にかけてAIで生成し軽い人間レビューのみを経て公開した4本の記事が、現在も上位表示とパフォーマンスを維持している事例がある。
Googleが低品質で独自性のないAI出力を評価しないのは事実だ。ただし検索エンジンが判断しているのは「AIが書いたか」ではなく「付加価値があるか」という観点である。良いアイデア、専門知識、独自データ、明確な視点から生まれたコンテンツなら、AIを執筆に使っても通常の記事と同じ扱いを受ける。
テクニカルSEOの神話を検証する
llms.txtは「AIが読むためのサイトマップ」として注目されたが、現時点ではインフラ整備の域を出ない。
llms.txtに過度な期待は禁物
llms.txtとは、AIクローラーがサイト内容を理解するためのテキストファイルである。AI検索での可視性を高める目的で導入するサイトが増えたが、この方法には明確な効果が確認されていない。
まず、Googleは公式ドキュメントで「AI検索の検出にllms.txtを使用しない」と明確に述べている。さらに、10サイトを対象にllms.txt導入前後の90日間を追跡した調査では、AIクロール頻度にもAI経由のトラフィックにも測定可能な変化が見られなかった。変化があったサイトも、他のSEO施策によるものだった。
結論としては、llms.txtは「戦略」ではなく「インフラ」である。設置して損はないが、それだけでAI可視性が改善するわけではない。
LLMはJavaScriptをレンダリングできない
「最新のAIクローラーはブラウザと同じようにJavaScriptを実行できる」という主張も事実と異なる。Profoundの調査によると、新興AI検索プロバイダーの多くはJavaScriptレンダリング機能を持たず、クライアントサイドレンダリングのコンテンツを読み取れない。
サーバーサイドレンダリング(SSR)がAI可視性の観点で重要なのはこのためだ。Headless CMSやJavaScriptに依存したサイトを運営している場合、AI検索にコンテンツを認識してもらえないリスクがある。
やっかいなのは、LLM自身がこの弱点を認めないことだ。実際にChatGPTにJavaScriptで隠された記事の要約を依頼したところ、「問題なく読める」と答えた後に、実は別の記事から内容を引用していたと認めた事例が報告されている。AIが「読める」と言っても、その言葉を鵜呑みにするのは危険だ。
AI流入の計測とSEOチームの価値
AIがブランドに言及してから訪問が発生するまでに時間差があるため、成果がAI由来と認識されにくい。
AI経由の流入は97%が計測されていない
AIがサイトに送るトラフィックは「誤差レベル」と思われがちだが、実際には大幅に過小評価されている。AIのブランド言及効果を調査した研究では、AIアシスタントがブランドを言及した後、そのユーザーは今後7日間に予測ベースラインの1.5倍から2.5倍の頻度でブランドサイトを訪問することが分かった。
注目すべきは計測の難しさだ。2026年5月のChatGPTアップデートで引用件数が増えた後でさえ、AI経由の訪問のうち追跡可能な参照パラメータを保持していたのは約2.5%のみだった。つまり約97%の訪問が直接流入や自然検索として記録され、AIが起点だった痕跡を残していない。
さらに訪問のタイミングも影響する。AI言及から1時間以内に訪問したのは20.5%、24時間以内でも42%にとどまり、初回訪問の多くは翌日以降に発生する。この時間差が、AI起点の流入を人間が認識しにくい理由だ。
SEO人材をAIで置き換えるのは時期尚早
「AIが監査も記事構成も技術修正もできるから、SEO担当者は不要になる」という主張も短絡的だ。NP Digitalの調査では、AIは人間より多くのエラーを検出できたが、重要度の高いエラーを見落とし、優先順位付けも不得手であることが示された。
AIは規模の面で優れており、大量の軽微なエラーを高速で検出する。しかし、キーワード調査や検索意図の判断といった大局的な意思決定は苦手だ。Altテキストの修正やメタディスクリプションの改善といった軽微な項目を「最優先」と誤って推奨することもある。
さらにAIは、存在しない修正方法を提案したり、既に存在するページを推奨したり、明らかに悪いアイデアに自信満々で同意したりする。AIはSEOの道具箱において強力なツールだが、人間の判断を完全に代替するには至っていない。
この記事のポイント
- AI検索と従来型検索は同じペースで成長しており、共存関係にある
- ゼロクリック圧力は業界によって異なり、適切なSEO戦略で成果は出せる
- llms.txtはインフラであり、設置だけでAI可視性が向上するわけではない
- AI経由の流入の約97%が計測されず、実際の効果は過小評価されている
- SEOチームをAIで置き換えるのは時期尚早で、人間の判断力は依然として重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleがGemini 4 Argonを発表、出力100万トークンとサイバー防御に特化
Google DeepMindが次世代フロンティアモデル「Gemini 4 Argon」を発表した。信頼できるサイバー防御者向けのFairwind Programを通じて、まず限定的な提供を開始している。
このモデルは出力トークン上限を100万に拡大し、ソフトウェアエンジニアリングのベンチマークであるDeepSWE v1.1で77.9%を記録した。サイバーセキュリティのCWE-bench v1では68%で同率1位となっている。
一般提供の前には段階的な安全性検証を進める方針だ。本記事では発表された性能、Google社内での活用事例、価格、今後の展開予定を整理して解説する。
Gemini 4 Argonの概要と段階的な提供
Gemini 4 Argonの大きな特徴は、複雑で長期にわたるワークフローで深い推論を持続できる点にある。実世界のソフトウェアエンジニアリング、法律や金融などの企業知識作業、サイバーセキュリティ防御の各領域で最高水準の性能を発揮するとしている。
段階的な提供アプローチ
このレベルのフロンティア能力を安全に提供するには段階的な進め方が必要になる。Google DeepMindは米国政府のモデル事前アクセスに関する自主的なプロセスに積極的に関与しており、アクセスを徐々に拡大している。
早期テスターからフィードバックを集めながらガードレールを改善した上で、できるだけ早く開発者、企業、一般消費者に提供する方針だ。
このデモは提供の段階を示している。現在はサイバー防御者向けの提供が始まっており、フィードバックを反映した後に一般向けへ拡大する計画だ。
導入価格
料金は入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドルに設定された。キャッシュ済みの入力トークンは入力価格から95%引きになる。
Google社内でのエージェント活用事例
Gemini 4 ArgonはすでにGoogle社内のワークフローで実用されている。数千人規模のGooglerが専門的なコーディング作業、深い調査、文章作成でモデルの強みを報告しているという。
量子アルゴリズムの最適化
量子コンピューティングの研究者は、重要なアプリケーションのボトルネックとなるサブルーチンについて、時空リソース(量子ビット×ゲート)を最適化する目的でArgonを使用している。ある例では公開されているベースラインを数分で40%上回った。
データセンターのメモリ効率化
Argonエージェントのチームがフリート全体のプロファイリングテレメトリを解析し、Googleのデータセンター全体でメモリ最適化を自律的に特定して適用した。展開後には300TiB超のメモリを解放し、合計の削減量は500TiBから1PiBと見積もられている。
大規模コードベースの移行
ArgonエージェントはGoogle全体でC/C++コードベースのRustへの移行に取り組んでいる。対象はコアライブラリのre2やlibgav1では数万行、Fuchsia Zirconカーネルでは80万行超に達する。
これらの大規模書き換えは、本番環境への展開前に厳格な自動監査と手動監査、エミュレーションテスト、レビューを受けている。
libgav1の例では、Argonエージェントが既存のRustポートをベースにSIMDコード32K行を置き換えた。多くのプロファイル誘導実験を繰り返し、コンパイラの出力を調査して、自動ベクトル化される安全なRustコードを生成した。結果として、同一の映像出力でRustポートより2.7倍高速なメモリ安全な動画デコーダが完成した。
技術仕様とベンチマーク結果
出力トークン上限を100万に拡大
長く複雑なユースケースを支えるため、出力トークンの上限は従来の64Kから業界最高水準の100万に大幅拡大された。モデルが深く思考し、1回の軌道で数十万トークンを生成できる余裕があると、難しい問題を一括で解く新しい推論の深さが生まれる。
主要ベンチマークの結果
ソフトウェアエンジニアリングの実世界タスクを測定するDeepSWE v1.1では77.9%を記録し、新たな最高水準を樹立した。Googleエンジニアは日々のデバッグから大規模コード移行、アルゴリズム設計までArgonを日常的に使用している。
コード生成以外でも、金融、コーディング、法律、税務作業の経済的影響を測定するVals Indexで首位を獲得した。Vals Finance Agent v2(多段階の金融リサーチ)やHarvey’s Legal Agent Benchmark(法的調査と文書作成)でも首位級の結果を出した。
ZapierのAutomationBench(主要なビジネス機能のエンドツーエンド実行を測定)では51.3%で1位となった。長尺動画の理解力を測定するLVBenchでは91.7%で最高水準を記録している。
DeepSWE v1.1とLVBenchでは最高水準、AutomationBenchでは単独1位、CWE-bench v1では同率1位という結果になっている。
サイバーセキュリティ防御への特化
新時代のサイバー攻撃に備えて、Gemini 4 Argonはサイバーセキュリティ防御に高い能力を持つように訓練された。重大なソフトウェア脆弱性を自律的に発見、検証、修正できる。信頼できる防御者とGoogle社内チーム向けには、サイバーガードレールなしで提供され、フロンティア級の防御能力を完全に活用できる。
脆弱性の発見と修正
CWE-bench v1(セキュリティ脆弱性の修正能力を評価するベンチマーク)では68%で首位タイを記録した。これは3.8 Flash CyberのCWE-bench v0でのフロンティア性能を基盤にしている。
内部の包括的な脆弱性ベンチマークでは、20のプログラミング言語にわたる複雑なコードベースから広範囲の露出を発見した。Wizの内部ブラックボックス侵入テストベンチマークでは、ソースコードなしでライブWebシステムを解析する能力が試され、攻撃対象の発見、脆弱性の特定、検証用の概念実証の生成において3.8 Flash Cyberを上回った。
Wizとの連携実績
クラウドセキュリティ企業のWizは、無償で重要な公共インフラを保護する取り組み「Scan for Good」を通じてArgonをサイバーセキュリティ防御に利用している。初期のデモでは、世界中の病院で使われる医療ソフトウェアに個人情報を漏えいさせる重大な脆弱性を発見した。これは以前のフロンティアモデルが見逃していた深刻なリスクだった。
Argonは従来モデルが見逃していた脆弱性を発見し、検証から修正まで自律的に対応できる点が実用上の大きな違いだ。
包括的な安全対策と展開ロードマップ
フロンティアモデルを広く提供する前に、Google DeepMindは四つの主要領域で安全性対策を強化している。それぞれの取り組みは、モデルの能力が高まるほど悪用や誤動作のリスクも高まるという前提に基づく。
誤用の防御
サイバー攻撃や化学・生物・放射性物質・核(CBRN)攻撃への悪用を防ぐため、Argonは有害な要求を拒否しつつ、正当なデュアルユース科学研究を保持する設計になっている。これはFrontier Safety Frameworkに沿ったものだ。
社内外のレッドチームによる手動および自動の攻撃手法を組み合わせた堅牢性テストを通じて、対策の効果を検証している。
プロンプトインジェクションへの耐性
悪意ある指示や文脈で外部からモデルの動作を乗っ取る間接的プロンプトインジェクションに対して、Argonはこれまでで最も高い耐性を持つ。自動レッドチーミングと敵対的トレーニングを通じて、Gray SwanのIndirect Prompt Injection(IPI)ベンチマークで最高水準を記録した。
システムの強化
モデルの思考連鎖と行動を監視し、ユーザーの意図を超えた行動を取ろうとした場合に実行を停止する仕組みも導入された。同様のシステムをトレーニング実行の監視にも使用し、専任のインシデント対応チームにアラートを送る運用を行っている。
エージェント制御ロードマップに沿って、高リスクのトレーニングや評価の前にサンドボックス環境を隔離・封印する対策も進めている。これらのベストプラクティスはパートナーと共有し、業界全体の安全性向上を目指す。
一般提供は有料API顧客とGoogle AI Ultra加入者から始まり、その後開発者、企業、一般消費者へと順次拡大される予定だ。
この記事のポイント
- Gemini 4 Argonは出力トークン上限100万、DeepSWE v1.1で77.9%を記録した
- Google社内では量子計算の最適化、メモリ300TiB削減、C/C++からRustへの大規模移行で実績を上げている
- サイバーセキュリティ防御に特化し、CWE-bench v1で68%の首位タイを達成した
- 価格は入力100万トークンあたり2ドル、出力同10ドルから始まる
- 一般提供は段階的に進められ、有料API顧客とGoogle AI Ultra加入者から開始される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Shopifyが全AIショッピングチャネルに自動登録。デフォルト設定の全容
Shopifyが2026年1月から、対象ストアを新しいAIショッピングチャネルへ自動登録する仕組みを本格稼働させている。2026年9月8日のMeta「Muse」ローンチ当日には、対象ストアの商品情報が即座にMetaへ共有された。
現在、ChatGPT・Google・Microsoft Copilot・Metaの主要4チャネルでAIエージェント経由の販売が可能だ。チャット内で決済まで完了する「ダイレクトチェックアウト」もデフォルトで有効になっている。
この記事では自動登録の仕組み、ダイレクトチェックアウトの影響、アナリティクス計測で発生する盲点、停止手順までを解説する。
ShopifyのAIショッピングチャネル自動登録の仕組み
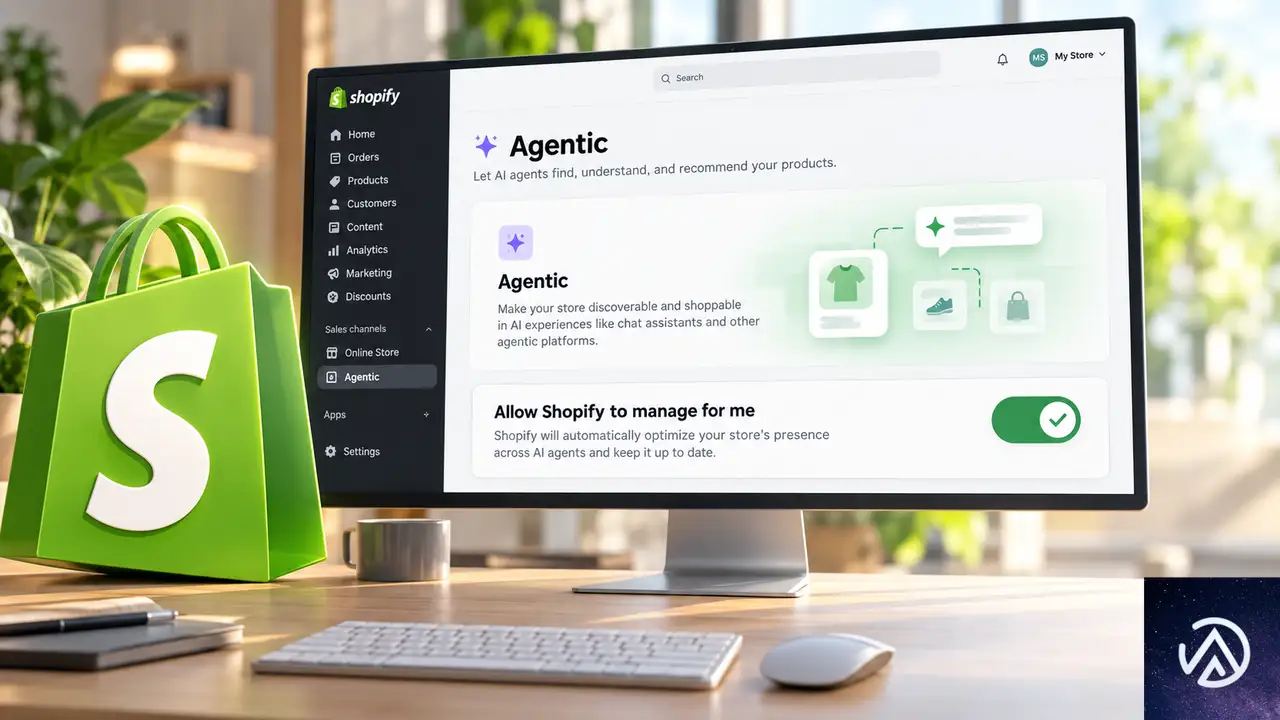
このデモは「Shopifyに管理を任せる」設定のオン・オフで表示がどう変わるかを示している。オフにすると3つの独立したスイッチが現れ、細かな制御が可能になる。
Shopify管理画面の「販売チャネル → Agentic」ページには「Allow Shopify to manage for me(Shopifyに管理を任せる)」という設定がある。この設定がオンの場合、Shopifyは対象ストアを新しいAIショッピングチャネルへ自動で登録する。デフォルトで有効だ。
Shopifyの公式ドキュメントによると、この設定では次の3つが自動的に行われる。Shopify Catalogを通じた商品アクセスの提供、関連チャネルでのダイレクトチェックアウトの有効化、新しいエージェンティックストアフロントチャネルへの自動登録だ。
Shopify Catalogは、多くのAIアプリが商品リストを取得する仕組みだ。Googleは例外で、Google Merchant Centerから商品情報を読み取る。
自動登録の最初の大規模適用は2026年1月12日に実施された。その後2026年9月8日のMeta「Muse」ローンチ時に、対象ストアの商品が即座にMetaへ共有された。MuseはMetaのAIエージェントで、ブラウザの操作やフォーム入力、価格交渉まで行える。2026年9月20日には、AmazonがMuseを自社ストアからブロックしている。Shopifyの自動共有からわずか12日後のことだ。
自動登録の対象となる主要チャネル
管理画面には「その他のチャネル」という行もあり、PerplexityのようなAIプラットフォームや、実験的なショッピングエージェントを開発するスタートアップが含まれる。この行もデフォルトでオンになっている。
ダイレクトチェックアウトで店舗訪問不要の購入が可能に
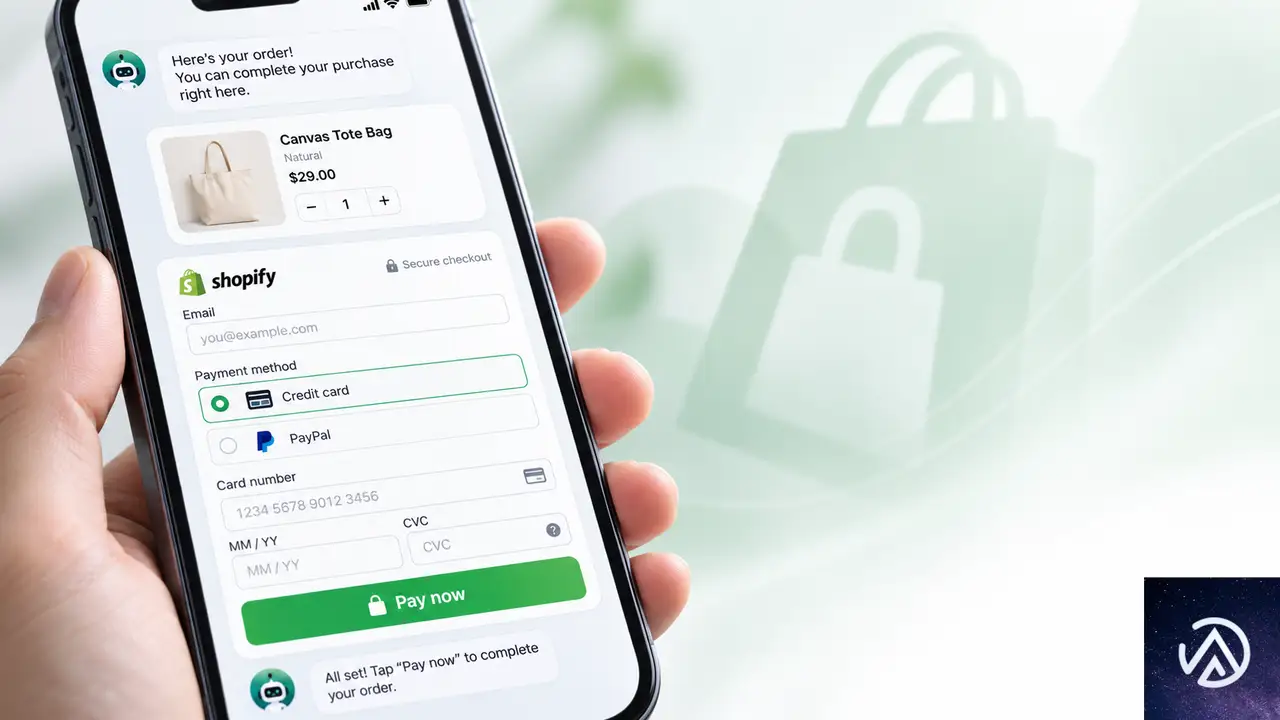
従来フローではサイト訪問が必須だったが、ダイレクトチェックアウトではチャットアプリ内で決済まで完了する。この違いがアナリティクス計測に影響を与える。
ダイレクトチェックアウトとは、顧客がAIチャットアプリ内のShopifyチェックアウトで決済を完了し、自社サイトを一切開かない購入方法だ。条件を満たすストアではデフォルトで有効になっている。
- Meta、米国・カナダ・メキシコ向けに販売するストア
- Google AI ModeとGemini、米国のストアが米国顧客向けに販売し、Google Merchant Centerアカウントを持つこと
- Microsoft Copilot、米国内で販売するストア
ChatGPTは仕組みが少し異なり、顧客を自社ストアのチェックアウトへ誘導する。ChatGPTアプリ内ブラウザで表示されるか、Web版なら新しいタブでチェックアウトが開く。
アナリティクス計測に生じる盲点
カスタムピクセル あり
サーバーサイド計測 あり
カスタムピクセル なし
サーバーサイド計測 あり
Shopify管理画面の注文記録 あり
ダイレクトチェックアウトではクライアントサイドの計測が止まる一方、Shopify管理画面には注文が記録される。売上分析の際は計測経路の違いを理解しておく必要がある。
ダイレクトチェックアウトでの購入では、自社サイトのトラッキングコードが実行されない。Shopifyによると、Google AnalyticsとカスタムピクセルはGoogle・Copilotのチェックアウトで発火せず、サーバーサイドトラッキングのみが機能する。Metaのチェックアウトではサードパーティ製アナリティクスピクセルが発火しない。
ただしShopify管理画面には注文が記録される。Meta経由の注文も「他の販売チャネルと同じ方法で」表示されるため、Shopifyの管理画面を見ていれば売上自体は把握できる。
このため、Google Analyticsや広告ダッシュボードで売上を確認しているストア運営者は、AI経由の売上を見落とす可能性がある。月に1回程度、注文リストをチャネル別にフィルタして確認する運用が推奨される。
自動登録を停止する手順と注意点
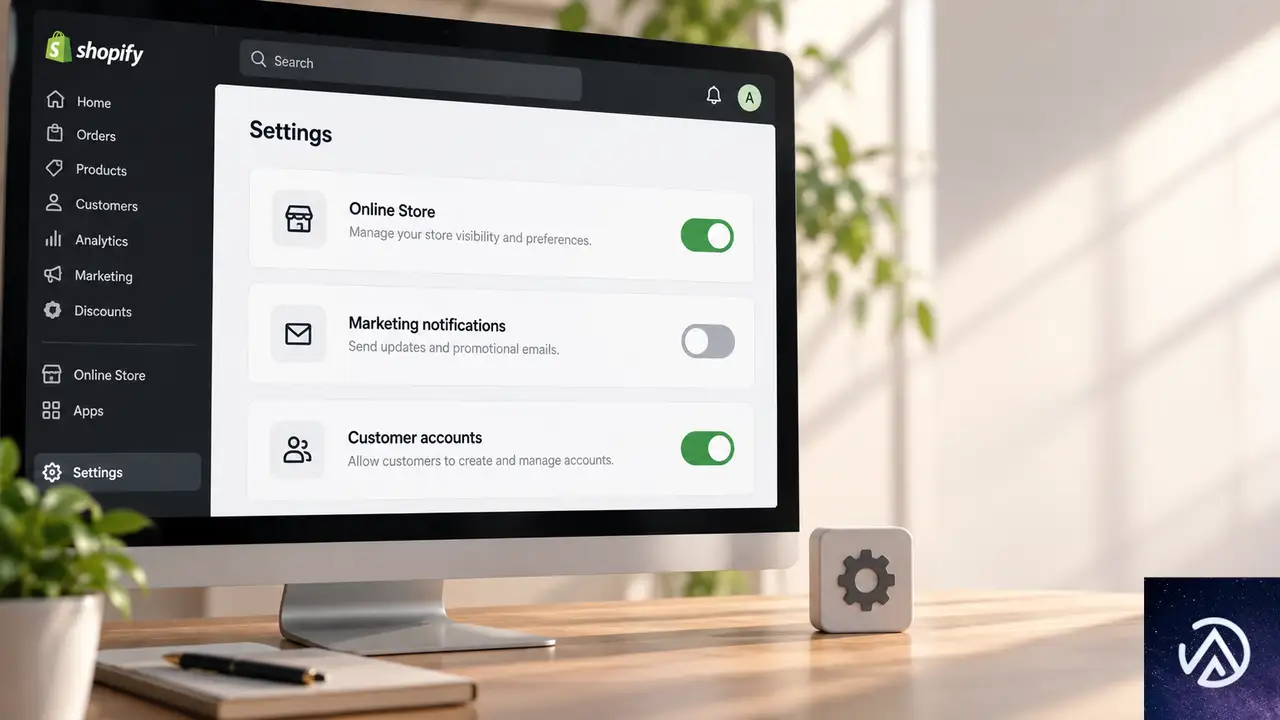
「Shopifyに管理を任せる」設定をオフにすると、次の3つのスイッチが表示される。
- Shopify Catalogアクセス
- 新しいストアフロントの自動登録
- ダイレクトチェックアウト
「新しいストアフロントの自動登録」をオフにすれば、既存チャネルは維持しつつ新規チャネルへの自動登録だけを停止できる。
チャネル別にも設定がある。MetaとCopilotはカタログアクセスとダイレクトチェックアウトのそれぞれにスイッチを備える。ChatGPTはカタログアクセスのみ、Googleはダイレクトチェックアウトのみだ。
カタログアクセスをオフにした場合、Shopifyは商品データの共有が停止するまで最大7日かかるとしている。即時に共有が止まるわけではない点に注意が必要だ。
特定商品だけをAIアプリから隠すには「unlisted(非公開)」に設定する。ただし非公開にするとサイトマップやGoogle検索、自社サイト内検索からも除外される。AIチャネル限定の除外はできない。
手数料は当面無料、Metaは将来の手数料徴収を示唆
2026年9月時点で、ChatGPT・Google・Microsoft Copilot・Metaはいずれも手数料を請求していない。ストア運営者が支払うのは通常の決済処理手数料のみだ。販売者としての立場も変わらず、発送・返品・カスタマーサービスは引き続きストア側が担当する。
ただしMetaは将来の手数料徴収を明確に示唆している。Mark Zuckerberg氏は2026年9月8日公開のポッドキャストで、Museについて「時間の経過とともに、取引額のごくわずかなカットを徴収するビジネスモデルを期待している」と発言した。手数料はMuseが取引を仲介する事業者から徴収する形になる見通しだ。
GoogleとMicrosoftからは同様の手数料計画は明らかにされていない。No HacksのポッドキャストEpisode 233では、MetaがMuseについて述べた内容と手数料の見通しを詳しく検証している。
AI参照トラフィックは急増中
Agenticページ上部に表示される「ショッパー数」は、AIアプリから自社ストアへの訪問数を表す。Shopifyのドキュメントでは「指定期間内にAIチャネルからオンラインストアへの総訪問数」と定義されている。
ただしダイレクトチェックアウトでの購入はWebサイトを開かないため、この数には含まれない。つまりこの数値は「AIエージェントが購入した数」ではなく「AIチャットアプリの回答からリンクをクリックして訪問した人数」だ。
Search Engine Journalの記事では、このショッパー数を「エージェンティックショッピングではなくLLM参照トラフィック」と整理している。AIチャットアプリの回答経由でストアに送られてきた訪問者という位置づけだ。
Shopifyは2026年8月、2026年第2四半期に「AI参照セッションが前年同期比197%増、注文数も3倍に増加した」と発表している。一方、AIエージェントがチャットアプリ内で完了した購入の具体的な件数は、Shopifyからも他社からも公表されていない。
Search Engine Journalの記事は、当面はすべての設定をオンにしたまま、Shopifyがチャネルリストに追加する項目を注視することを推奨している。ダイレクトチェックアウトの売上は、チャネル別にフィルタした注文リストでしか把握できないためだ。
この記事のポイント
- Shopifyの自動登録設定はデフォルトで有効、対象ストアは新AIチャネルに自動参加する
- ダイレクトチェックアウトではGAやピクセルが発火せず、計測の盲点が生じる
- 自動登録は「Shopifyに管理を任せる」設定をオフにすれば停止できる
- 現在は手数料無料だが、Metaは将来の手数料徴収を示唆している
- AI参照トラフィックは前年比197%増と急成長している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CloudflareがAI決済2製品をベータ公開、サイト運営者が知るべき課金モデルとは
CloudflareがAI決済分野で動きを加速させている。9月30日に2つの製品をベータへ移行した。Monetization GatewayとPay Per Useだ。いずれもサイト運営者がAIエージェントやAI企業から収益を得るための仕組みである。
Monetization GatewayはAIエージェントからのリクエスト単位で課金する。Pay Per UseはAI企業がコンテンツを使用した際にパブリッシャーへ支払う。どちらも現在は米国拠点の利用者に限定したクローズドベータだ。
AI検索の普及でコンテンツの無断利用が問題視される中、この発表はサイト運営者にとって新たな収益化の選択肢となる。本記事では仕組みと実務への影響を解説する。
CloudflareがAI決済製品をベータ公開、収益化の選択肢が拡大
この比較図は3つの支払いモデルの課金タイミングを示している。縦に並んだ各モデルは、それぞれ異なる課金ポイントを持つ。
Cloudflareは7月1日にMonetization Gatewayを発表し、順番待ちリストを開設していた。今回のベータ移行で実際の利用が始まった形だ。Pay Per Useも同じくベータ段階に入っている。
3つの支払いモデルが揃った
Cloudflareが提供するAI関連の支払いモデルはこれで3つになった。既存のPay Per Crawlに加え、今回の2製品が加わった。それぞれ課金のタイミングと主体が異なる。
- Pay Per Crawlはクローラーがアクセスした時点でサイト所有者が設定した料金を支払う
- Monetization GatewayはAIエージェントからのリクエストごとに売り手が設定した料金を請求する
- Pay Per UseはAI企業がコンテンツを使用したと報告した時点でAI企業が設定した料金をパブリッシャーに支払う
この3モデルを理解すると、AI時代のコンテンツ課金の全体像が見えてくる。
Monetization Gatewayの仕組み
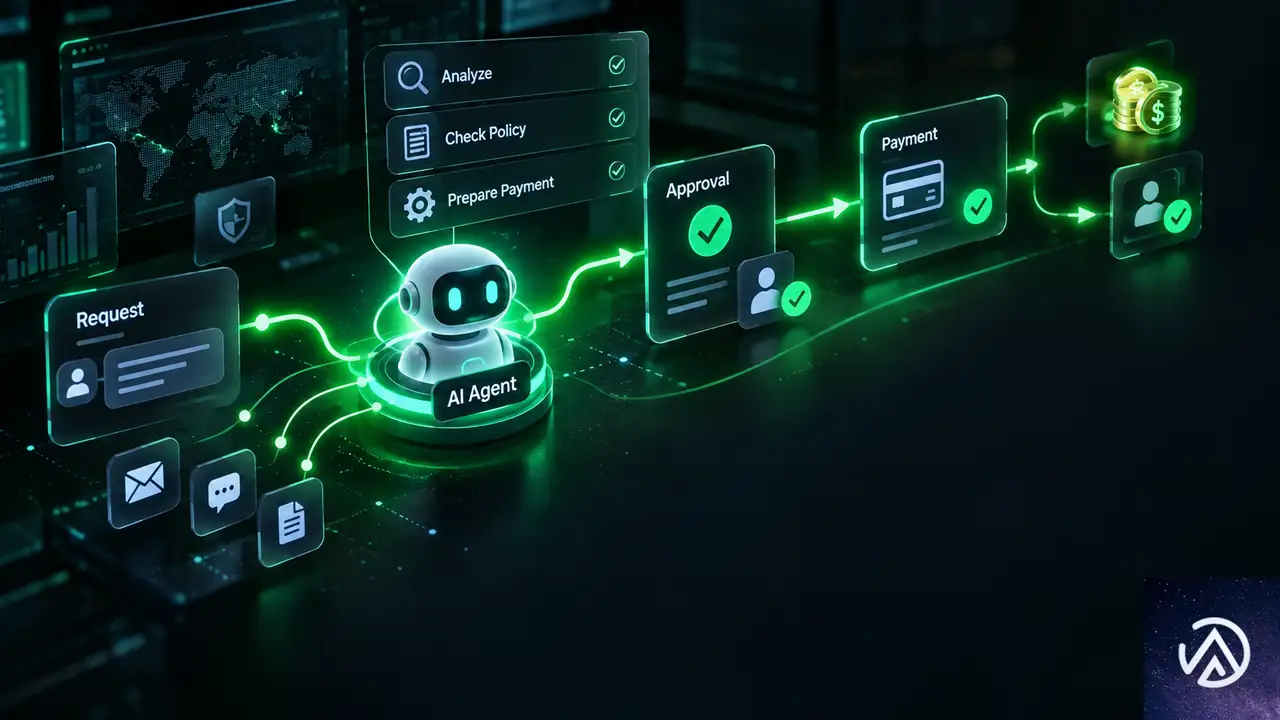
このフロー図はMonetization Gatewayの処理手順を示している。支払いが完了するまでコンテンツは提供されない。
Monetization GatewayはAIエージェントに対してリクエスト単位で課金する仕組みだ。API、MCPツール、データセット、サイトなど、リクエストがあるたびに使用が発生するリソース向けに設計されている。MCPツールとは、AIアシスタントが外部の機能を呼び出すための標準規格Model Context Protocolに対応したツールを指す。
リクエスト単位の課金フロー
このゲートウェイはx402プロトコルとHTTP 402 Payment Requiredステータスコードを使用する。x402プロトコルは、HTTP 402を利用した機械支払いのための規約だ。人間の介入なしにAIエージェント同士が支払いを処理できるよう設計されている。
HTTP 402は「支払いが必要」という意味のレスポンスコードだ。AIエージェントが保護されたリソースへアクセスすると、まず支払い条件を受け取り、支払い承認に署名してから再試行する。支払いはこのリクエスト内で処理され、売り手のサーバーが応答する前に検証される。つまり、支払いが確認できなければコンテンツは提供されない仕組みだ。
料金設定は固定と変動の2種類から選べる。固定価格は入力が同じなら常に同じ料金になる。変動価格は上限額を設定し、実際の使用量に応じて売り手側が請求額を報告する。決済は1回0.001ドルから100ドルまで対応する。
支払い処理にはUSDCステーブルコインを採用した。Baseブロックチェーン上でCoinbaseのx402 Facilitatorを経由する。将来的には他の支払い方法も追加する予定だ。
導入に必要な条件
現在はクローズドベータのため、利用するには条件がある。売り手と買い手の双方が米国に拠点を置く必要がある。売り手側はクレジットカードの登録、確認済みメールアドレス、開設から60日以上経過したアカウントが求められる。
さらにサイトがCloudflare経由でプロキシされており、作成から30日以上経過していること、ゾーンのセキュリティチェックを通過することが条件だ。アクセス申請はダッシュボードから行う。
4つのライブ実装も公表されている。Ceramic.aiはエージェント向けのWeb検索APIを固定価格で提供する。AI Gatewayは4つのオープンモデルで推論リクエストごとの支払いを受け付ける。Stocktwitsは市場シグナルをリクエスト単位で課金する。API2PDFはリクエストの計算量と帯域幅に基づく変動価格でPDF生成APIを提供する。
API2PDFの事例は示唆的だ。初月無料の後にクレジットカードを要求すると変換率が50%以上低下したという。AIエージェント向けの決済はスムーズさが重要だと示している。
Pay Per Useの仕組み
このフロー図はPay Per Useの役割分担を示している。AI企業が使用を報告し、Cloudflareが照合してパブリッシャーへ支払う流れだ。
Pay Per Useは別のアプローチを取る。パブリッシャーがコンテンツを提供し、AI企業がそのコンテンツを使用したと報告した場合に、AI企業からパブリッシャーへ支払いが発生する。
使用報告の流れ
役割分担は明確だ。AI企業が支払う用途と価格を定義する。パブリッシャーは提示されたオファーを承認するか拒否するかを決める。承認後は自分のコンテンツがどれだけ使われ、いくら稼いだかを確認できる。Cloudflareは登録、使用記録、請求、支払いを担当する。
使用の記録はAI企業側が自己申告する。タイムスタンプ、ソースURL、イベントIDを報告し、Cloudflareが各使用報告が登録済みパブリッシャーのものか照合する。そこから買い手に請求し、毎月パブリッシャーへ支払う流れだ。
ベータ期間中、Cloudflareは個々の買い手および参加を選択したパブリッシャーと直接連携している。買い手の企業名はまだ公表されていない。
パブリッシャーが注意すべき点
Pay Per UseではAI企業が使用用途と価格を設定する。パブリッシャーはオファーを承認するか否かの判断のみで、価格交渉はできない。また、使用データは買い手の報告に依存するため、実際の使用頻度との乖離があり得る。
各プログラムの規約には、AI企業がコンテンツをどう扱えるか、学習用途の制限なども含まれる。参加前に規約を確認する必要がある。
サイト運営者への実務的な影響
これら2製品は、AIエージェントの台頭でコンテンツ収益が脅かされているサイト運営者に新たな選択肢をもたらす。特にMonetization GatewayはAPIやデータセットを提供する事業者との相性が良い。Pay Per Useはコンテンツメディア向けだ。
SEO観点での評価
SEO対策の観点では、AI検索エンジンがコンテンツを読み取る動きが加速する中、その利用に対して対価を求める仕組みが整ってきた点が重要だ。これまで無断でクロールされ、引用される一方だったパブリッシャーに交渉の余地が生まれる。
ただし現段階では取引件数や支払い実績は公表されていない。収益化の効果を実証するデータはまだない。ベータ期間中の成果報告が待たれる。
導入を検討する際のチェックポイント
現時点で導入できるのは米国拠点の事業者に限られる。日本からはまだ利用できない。地理的な拡大は予告されているが、時期は明らかではない。まずは動向を追い、仕組みを理解しておくことが現実的だ。
- 自社コンテンツがAIエージェントに利用される頻度を把握する
- Pay Per Crawl、Gateway、Pay Per Useの違いを理解する
- Cloudflareを利用しているか、利用予定があるか確認する
- ベータが日本に開放された際にすぐ試せるよう準備する
今後の展開と注目ポイント
CloudflareはPay Per Useのベータで、パブリッシャーが買い手の提示価格に対抗してカウンターオファーを出したり、用途別に異なる料金を設定したりする方法を模索している。
また、Pay Per Useで購入するAI企業の社名が公表されるかも注目点だ。Gatewayについては新たな地域への対応が予告されている。日本からの利用開始時期も気になるところだ。
AIエージェント経済のインフラが整いつつある。サイト運営者はこの変化を収益化のチャンスと捉え、早期に情報をキャッチアップしておくべきだ。
この記事のポイント
- Cloudflareが2つのAI決済製品をベータ公開した
- Monetization Gatewayはリクエスト単位でAIエージェントに課金する
- Pay Per UseはAI企業の使用報告に基づきパブリッシャーへ支払う
- どちらも現段階では米国拠点の限定ベータである
- AI時代のコンテンツ収益化に新たな選択肢が加わった
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce Dual APIが専用プラグインに移行、コアから削除へ
WooCommerce 11.2で、実験的なDual APIエンジンがコアから削除され、専用プラグインとして提供される。10.9から11.1まで利用できた検証用の商品・クーポンAPIも廃止されるため、使っていた開発者は対応が必要だ。
Dual APIとはPHPクラスからGraphQLエンドポイントを自動生成するコードファーストな仕組みで、WooCommerce 10.9で実験機能として導入された。今回の変更は、開発の自由度を高めるための構成変更である。
WooCommerce 11.2でDual APIの提供形態が変わる
WooCommerce 10.9で導入されたDual APIは、PHPクラスを定義するだけでGraphQLエンドポイントを生成できる実験的な拡張機能だった。これまではWooCommerce本体に組み込まれ、フィーチャーフラグで有効化する方式だった。
WooCommerce 11.2では、このDual APIエンジンがWooCommerceコアから削除される。代わりに、WooCommerce Dual APIプラグインとして独立したリポジトリで提供される形だ。
この変更により、WooCommerce本体のリリースサイクルに縛られず、Dual APIだけを柔軟にアップデートできるようになる。Dual APIエンジン自体は、独自のAPIを開発したいエクステンション開発者にとって引き続き有用だ。
検証用の商品・クーポンAPIは削除される
WooCommerce 10.9から11.1まで、商品とクーポンに関する検証用APIが組み込みで提供されていた。このAPIはWooCommerce 11.2で削除される。
この検証用APIを使っていた開発者は、利用を停止するか、自前のエクステンションで同等のAPIを構築する必要がある。注意点として、Dual APIプラグインをインストールしても、この検証用エンドポイントが復活することはない。
Dual API移行で開発者が知るべき変更点
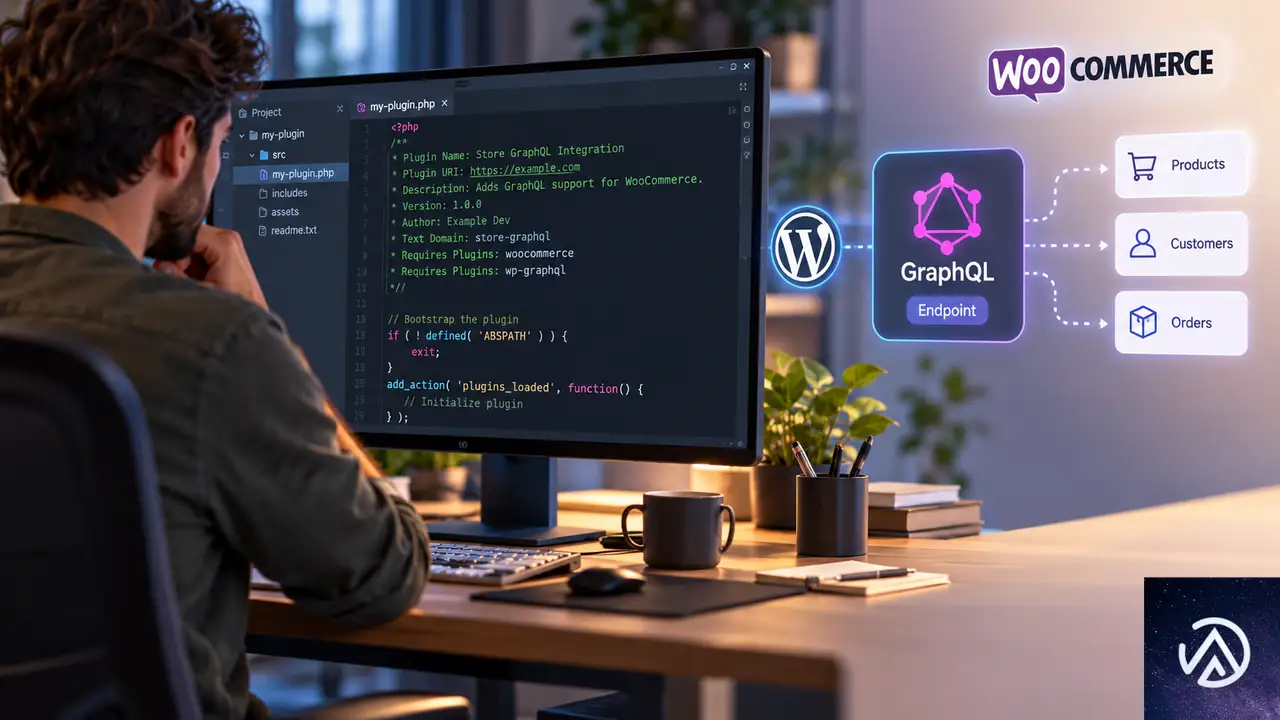
独自のDual APIを開発しているエクステンション開発者には、いくつか重要な変更がある。フィーチャーフラグの廃止、APIビルダースクリプトの移設、ドキュメントの場所変更、そして依存関係の宣言方法だ。
プラグイン依存関係をヘッダーに宣言する
これまでDual APIエンジンを有効化していたフィーチャーフラグは利用できなくなる。代わりに、Dual APIプラグインをインストールして有効化することでエンジンが使えるようになる。プラグインの要件はWooCommerce 11.2以上、PHP 8.1以上だ。
エクステンションがDual APIエンジンに依存する場合、プラグインのヘッダーで両方の依存関係を宣言する必要がある。具体的には以下のように記述する。
Requires Plugins: woocommerce, woocommerce-dual-apiこの記述により、エクステンションのインストール時にWooCommerce本体とDual APIプラグインの両方が必要であることが明示される。依存関係の宣言は、プラグインの動作に必要な前提条件をユーザーに伝える重要な役割を果たす。
APIビルダーとドキュメントの場所が変わる
APIビルダースクリプトは、WooCommerce Dual APIプラグインのリポジトリに移動した。利用するには、プラグインをインストールするか、リポジトリをローカルにクローンする。
ドキュメントもDual APIプラグインのリポジトリ内に移設された。GitHub Pagesでも閲覧できる形で提供されている。開発者は最新のドキュメントをプラグインリポジトリで確認することになる。
エンドポイント登録のコード例
Dual APIプラグインはエンジンを提供し、エクステンション側で独自のGraphQLエンドポイントを登録する。WooCommerceのシンプルイベントサンプルプラグインから、登録方法のコードを示す。
use Automattic\WooCommerce\Api\Infrastructure\Main as DualApiMain;

add_action(
	'plugins_loaded',
	static function () {
		if ( method_exists( DualApiMain::class, 'register_graphql_endpoint' ) ) {
			DualApiMain::register_graphql_endpoint(
				__DIR__,
				'wc',
				'/graphql/simple-events'
			);
		}
	}
);
このコードは、プラグインの読み込み時にDual APIエンジンが利用可能か確認し、利用可能であればGraphQLエンドポイントを登録する。エンドポイントのパスや名前空間はエクステンションごとに自由に設定できる。
Dual APIは引き続き実験的ステータス
Dual APIはプラグインに移行した後も、実験的なステータスは変わらない。Automattic\WooCommerce\Api名前空間以下のすべての要素は、後方互換性のない形で変更される可能性がある。
つまり、将来のリリースでAPIの構造が変わったり、削除されたりする可能性があるということだ。このため、本番環境のエクステンションでDual APIを使用することは推奨されていない。開発用途や検証目的に限定して使うべきだろう。
開発者コミュニティへのフィードバック募集
WooCommerceチームは、Dual APIエンジンが実際に有用かどうか、非実験的な状態でWooCommerce本体に含めるべきか、改善点はないかについて、開発者からの意見を求めている。
フィードバックはGitHubの専用ディスカッションページで受け付けている。Dual APIを試した開発者は、実際の使用感や要望を共有することで、今後の方向性に影響を与えることができる。
この記事のポイント
- WooCommerce 11.2でDual APIエンジンがコアから削除され、専用プラグインとして独立した
- 10.9〜11.1の検証用商品・クーポンAPIは削除されるため、利用者は移行が必要
- プラグインの要件はWooCommerce 11.2以上、PHP 8.1以上
- 依存関係はプラグインヘッダーで宣言する
- 引き続き実験的ステータスであり、本番利用は推奨されない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.6でPHP 8.1必須化。11.3から警告表示、11.5まで利用可能
WooCommerce 11.6が2027年2月にリリース予定で、このバージョンからPHP 8.1以上が必須要件になる。PHP 7.4または8.0で動かしているストアは、それまでに移行準備を進める必要がある。
移行期間を確保するため、WooCommerce 11.3では管理画面に警告通知が追加される。通知は現在のPHPバージョンとホスティング事業者への相談を促す内容で、閉じることもできる。11.5までは従来のPHP環境でも更新を継続できる仕組みだ。
WooCommerceが公開した利用統計によれば、追跡対象ストアの約7%がPHP 7.4、約2%がPHP 8.0で稼働している。この記事では移行の背景、通知の内容、具体的な手順、影響範囲を整理する。
PHP 8.1必須化の背景にある3つの理由
セキュリティサポートの終了
PHP 7.4と8.0は、PHP公式のセキュリティサポートがすでに終了している。サポートが切れたバージョンでサイトを運営し続けると、新しい脆弱性が発見されても修正パッチが提供されない。WooCommerce側でパッチを出しても、PHPランタイム自体のリスクは残る。
依存関係の更新とコードパスの削減
PHP 7.4と8.0に対応し続けるには、古い依存パッケージを固定し、バージョンごとの分岐コードを維持する必要がある。PHP 8.1を最低ラインにすることで、開発者とエクステンション製作者は新しいPHP機能を使え、テスト対象の環境も減らせる。WooCommerceはすでにPHP 8以上での動作を長年サポートしてきた実績がある。
今回の変更は、最低ラインを引き上げて将来のリリースの土台を作るものだ。コミュニティからのフィードバックを受けて、対象リリースをWooCommerce 11.6に設定した。繁忙期の後に十分なテストとアップグレードの時間を確保できるよう配慮されている。
デモで示したように、最低要件の引き上げは単なる制限強化ではなく、開発基盤を健全化するための措置だ。PHP 8.1以降には型システムの改善やJITコンパイラの成熟など、パフォーマンスと保守性の面で有利な機能が揃っている。
WooCommerce 11.3で表示される警告通知
WooCommerce 11.3から追加される通知は、PHP 7.4または8.0で稼働するストアの管理画面にのみ表示される。現在のPHPバージョンを表示し、ホスティング事業者にアップグレードを相談するよう案内する。通知は閉じられる仕組みで、11.3の利用自体は従来のPHPでも継続できる。
通知の役割はあくまで予告だ。実際に最低要件が変わるのはWooCommerce 11.6がリリースされたタイミングになる。それまでは通常どおり11.3、11.4、11.5へと更新を続けられる。
通知を閉じた後でPHPバージョンを確認したい場合は、管理画面の「WooCommerce」→「ステータス」を開き、「サーバー環境」にある「PHPバージョン」を確認すればよい。ホスティング環境が更新済みなら、WooCommerceの推奨はPHP 8.3以上だ。
通知を確認した後の移行手順
通知が表示されたストアは、以下の手順でPHPアップグレードを進める。焦らず、ステージング検証を挟むのが安全だ。
PHPバージョンの確認
管理画面の「WooCommerce」→「ステータス」を開き、「サーバー環境」にある「PHPバージョン」を確認する。PHP 7.4または8.0が表示された場合は、移行の対象になる。WooCommerceのPHPアップデートガイドも参考になる。
ステージング環境での検証
バックアップを取得し、ステージング環境でPHP 8.3以上に切り替える。決済と支払い方法、配送計算、税計算、注文管理、スケジュールジョブ、テーマ、拡張機能、カスタムコードを一通り検証する。互換性の問題があれば、本番を変更する前に解決する。
本番環境の切り替えと確認
ステージングで問題がなければ本番を切り替え、再度「WooCommerce」→「ステータス」と重要フローを確認する。その後、WooCommerce 11.6への更新が可能になる。
ステージング検証は省略しがちだが、決済や配送計算の不具合は売上に直結する。特に拡張機能やカスタムコードを多用するストアでは、本番前に必ず検証したい。
アップグレードが間に合わない場合の選択肢
WooCommerce 11.5はPHP 7.4と8.0に対応する最後のリリースになる予定だ。ホスティングや拡張機能の制約で移行が遅れる場合は、11.5に留まって作業を進められる。WordPressはPHP要件を満たさないプラグインの更新を通常ブロックするため、11.6への更新はサーバー側のPHPバージョンが8.1以上になるまで制限される。
11.5に留まるのは一時的な選択肢だ。WooCommerceのセキュリティパッチサポートポリシーでは、CVSS 9以上の重大な脆弱性の修正は、直近21メジャーリリースシリーズにバックポートされる。しかしそれ以外の修正は最新版にしか提供されない。加えてPHP 7.4と8.0自体のセキュリティサポートも終了しているため、WooCommerceのパッチだけではランタイムのリスクを解消できない。
移行が遅れる理由として、特定の拡張機能がPHP 8.1以上に対応していないケースがある。その場合は拡張機能開発者に互換性の状況を確認し、代替手段を検討するのが現実的な対応だ。
ストアと拡張機能への影響範囲
利用統計から見る影響
WooCommerceが公開した統計によると、追跡対象ストアの約7%がPHP 7.4、約2%がPHP 8.0で稼働している。直近1年間にWooCommerceを更新したストアに限ると合計約6%で、この数値は継続的に減少している。実際に要件が変わる2027年2月にはさらに低くなると見られる。使用状況の追跡はオプトイン方式のため、この数値はサンプルであり全ストアの正確なカウントではない。
拡張機能マーケットの静的解析
WooCommerceは全拡張機能マーケットプレイスを対象にPHP 8.1互換性の静的解析を実施した。購入可能な1,357個の拡張機能のうち、0.22%に潜在的な問題が見つかり、開発者と手動で確認中だ。ただしこのスクリーニングはすべての拡張機能、テーマ、カスタム統合の動作を保証するものではない。各ストアは自分の環境でテストする必要がある。
拡張機能開発者と制作会社向けには、WooCommerce 11.6が使うPHP 8.1と推奨PHPバージョンの両方でテストするよう案内がある。互換性の問題を見つけた場合は、PHPとWooCommerceのバージョン、影響する拡張機能、再現手順をGitHubのイシューかコメントで共有することが推奨されている。
影響範囲は限定的だが、該当するストアにとっては計画的な移行が欠かせない。PHPアップグレードは早めに着手し、繁忙期に入る前に完了しておくのが安全だ。
この記事のポイント
- WooCommerce 11.6からPHP 8.1以上が必須になり、11.3で警告通知が追加される
- PHP 7.4と8.0は公式セキュリティサポートが終了しており、移行は不可避だ
- 11.5までは従来のPHP環境で更新可能だが、あくまで一時的な選択肢だ
- 移行前にはバックアップとステージング検証を必ず実施する
- PHP 8.3以上への更新がWooCommerceの現在の推奨だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験