

Astro 7.0リリース、Rustコンパイラでビルド時間を最大61%短縮
Astro 7.0が6月22日に正式リリースされた。今回のメジャーアップデートは「速度」にフォーカスしており、.astroファイルのコンパイラをRustで書き直した点が最大の変更点だ。
ベンチマークによると、ビルド時間は前バージョンと比較して15〜61%短縮される。Astro公式ブログが公開したテスト結果では、13,275ページを持つaspire.devのビルドが半分以下になった事例も報告されている。Rust化された基盤、Vite 8との統合、新しいアドバンストルーティング機能が主要な柱だ。
本記事ではAstro 7.0の全変更点を、実務者の視点から詳しく解説する。
Vite 8によるバンドル基盤の刷新
Astro 7.0のビルド高速化を支える土台が、Vite 8へのアップグレードだ。Vite 8は、JavaScriptツールチェインの世界で最も注目されているリリースのひとつである。最大の変更点は、Rustベースのバンドラ「Rolldown」が標準搭載されたことだ。
Rolldownとは何か
Rolldownは、従来のesbuildとRollupを単一のバンドラで置き換えるツールである。バンドラとは、複数のJavaScriptファイルやコンポーネントを本番用の少数のファイルにまとめる役割を持つ。Rolldownのベンチマークでは、Rollupと比較して10〜30倍高速という結果が出ている。速度だけでなく、既存のRollupプラグインAPIとの互換性も維持している点が実務上の大きな利点だ。
Astroユーザーにとって重要なのは、ほとんどのプロジェクトで設定変更が不要なことだ。Vite 8には既存のesbuild設定やrollupOptions設定を自動的にRolldown用に変換する互換レイヤーが組み込まれている。カスタムViteプラグインを使っている場合も、RolldownがRollupと同じプラグインAPIをサポートするため、そのまま動作する可能性が高い。
Rust化がもたらすビルド性能の飛躍的向上
Astroのビルドプロセスは、大きく2つの段階に分かれる。1つ目はサイトのページやコンテンツ、クライアントコンポーネントをJavaScriptにバンドルする段階。2つ目は、バンドルされたコードを「小さなサーバー」として実行し、プリレンダリング対象の全ページにリクエストを送ってHTMLを生成する段階だ。
Astro 7.0は両方の段階を改善しているが、とくに1つ目のバンドル段階に注力している。ビルド時間のボトルネックになりやすい処理をRustで書かれたネイティブコードに移行することで、大幅な高速化を実現した。
上図の通り、ビルドフローの主要な構成要素がRustベースに置き換えられている。.astroファイルのコンパイル、Markdown/MDXの処理、レンダリングエンジンのすべてが刷新された。以下では各要素を詳しく見ていく。
.astroコンパイラのRust化
Astro 7.0では、.astroコンポーネント形式の新しいコンパイラがRustで構築された。このコンパイラは、以前のGoベースのコンパイラをフルリライトしたものだ。内部的には、oxc(高速なJavaScript/TypeScriptパーサ)を解析に、Lightning CSSをCSSスコープ処理に使っている。
単体ではビルド時間の約6%改善にとどまるが、数千ページ規模の大規模サイトでは、他の改善と相乗効果を発揮する。以下の3点は後方互換性に関わる変更として注意が必要だ。
- HTML自動修正の廃止。旧コンパイラは「正しいHTML」にしようと要素の並べ替えやタグの自動クローズを行っていたが、新コンパイラではマークアップをそのまま扱う。予期せぬ挙動の原因だった自動修正がなくなり、意図した通りに出力されるようになった。
- JSX形式の厳格化。
<div>Helloのような閉じタグ欠落や、<div class="Hello >のような属性の未終端は、自動修正されずエラーになる。旧コンパイラがブラウザの挙動を真似て黙って修正していた部分だ。 - JSXホワイトスペース処理。インライン要素間の改行が可視スペースを生成しなくなる。たとえば、
<span>Hello</span><span>World</span>は「HelloWorld」と表示される。スペースが必要な場合は{' '}を明示的に挿入する。
Markdown/MDX処理のSätteri移行
Astro 7.0では、デフォルトのMarkdownとMDXの処理パイプラインが、Rust製プロセッサ「Sätteri」に置き換えられた。SätteriはAstroコアチームメンバーが開発したツールで、内部的にはpulldown-cmark(CommonMark解析)とoxc(MDX式解析)を使用している。
従来のAstroは、JavaScriptベースのunified(remark/rehypeとそのプラグイン群)でMarkdownを処理していた。数千ページのサイトでは、このパイプラインがビルドの最も遅い段階になることが多かった。Astro公式ブログによれば、AstroドキュメントサイトとCloudflareドキュメントサイトでSätteriに切り替えたところ、ビルド時間が1分以上短縮されたという。
Sätteriには、これまで別途プラグインが必要だったMarkdown機能の多くがビルトインで含まれている。GFM(テーブル、脚注、取り消し線、タスクリスト)、スマートパンクチュエーション(カーリークォート)、見出しID、コンテナディレクティブ、数式、フロントマター(YAML/TOML)、上付き・下付き文字、Wikilinksなどだ。これらはfeaturesオプションで有効化できる。
既存のremark/rehypeプラグインに依存しているプロジェクトは、@astrojs/markdown-remarkを使って従来のunifiedベースのパイプラインを引き続き利用できる。
キュー型レンダリングの安定化
Astro 6.0で実験的機能として導入されたキュー型レンダリングが、Astro 7.0で安定版となりデフォルトのレンダリングエンジンになった。これは、式が密集したページで約2.4倍高速という結果が出ている。
従来のレンダリングは再帰的アプローチを取っていた。親コンポーネントが子コンポーネントを呼び出し、さらにその子が孫を呼び出すという入れ子構造でレンダリングが進む。これに対し、新しいエンジンはキュー(またはスタック)と単一のループを使う。キューに子ノードを正しい順序で追加し、キューが空になるまでループでレンダリングを続ける仕組みだ。
初回の実装では「全コンポーネントの順序付きリストを作成→リストをループしてレンダリング」という2パス方式だったが、最終版ではリスト作成とレンダリングを同時に行う方式に改善された。この方式は再帰的アプローチと比較してメモリ使用量も少ない。
アドバンストルーティングでリクエストパイプラインを完全制御
Astroは静的サイトジェネレーターとしてスタートし、ファイルベースのルーティングを基本としてきた。しかし、ミドルウェア、リダイレクト、リライト、Actions、セッション、i18nといった機能が追加されるにつれ、リクエストのライフサイクル制御が複雑化していた。
認証をActionsより先に実行したい、ログ出力をページレンダリングだけに限定したい、APIリクエストをAstroの外で先に処理したい、といったニーズに応えるため、Astro 7.0ではsrc/fetch.tsファイルを追加することでリクエストパイプラインを完全制御できるようになった。
このパターンは、Cloudflare WorkersやDeno、Bunが採用している標準的なfetchハンドラ形式に準拠している。
import { astro, FetchState } from 'astro/fetch';

export default {
  fetch(request: Request) {
    const state = new FetchState(request);

    // APIリクエストをバックエンドサービスに転送
    if (state.url.pathname.startsWith('/api')) {
      const url = new URL(
        state.url.pathname + state.url.search,
        'https://backend-api.example.com'
      );
      return fetch(new Request(url, request));
    }

    // それ以外はAstroのページやエンドポイントにフォールバック
    return astro(state);
  }
}
Honoとの統合
アドバンストルーティングAPIはHonoとも互換性がある。Honoは軽量なWebフレームワークで、豊富なミドルウェアエコシステムを持つ。以下のようにBasic認証をAstroアプリケーションに組み込める。
import { astro } from 'astro/hono';
import { Hono } from 'hono';
import { basicAuth } from 'hono/basic-auth';

const app = new Hono();
app.use(basicAuth({ username: 'admin', password: 'secret' }));
app.use(astro());

export default app;より高度な使い方として、個別のAstro機能を別々のミドルウェアとして構成できる。認証、Actions、ミドルウェア、i18n、ページの各レイヤーを任意の順序で積み重ねられるため、認証チェックをActionsより手前に置くといった制御がシンプルに実現できる。このsrc/fetch.tsファイルを追加しなければ、Astroの動作は従来通りだ。
ルートキャッシングとCDNプロバイダ連携
オンデマンドレンダリング応答のキャッシュ制御は、ホスティングサービスごとに異なる仕組みで実装されてきた。Astro 7.0で安定版となったルートキャッシングは、デプロイ先を問わない単一のキャッシングAPIを提供する。
設定の流れはシンプルだ。まずキャッシュプロバイダを一度設定し、あとはページ内でAstro.cache(APIルートではcontext.cache)を使ってレスポンスごとにキャッシュ制御を記述する。標準的なHTTPキャッシングセマンティクスに従うため、特別な知識は不要だ。
import { defineConfig, memoryCache } from 'astro/config';

export default defineConfig({
  cache: {
    provider: memoryCache(),
  },
});
---
Astro.cache.set({
maxAge: 120, // 2分間キャッシュ
swr: 60, // 再検証中は1分間 stale を返す
tags: ['products'], // タグベースの無効化用
});
---routeRulesを使えば、ルートグループ単位で宣言的にキャッシュルールを設定できる。
export default defineConfig({
  cache: { provider: memoryCache() },
  routeRules: {
    '/blog/[...path]': { maxAge: 300, swr: 60 },
  },
});キャッシュの無効化はcache.invalidate()でタグ単位またはパス単位で行える。CMSのwebhookエンドポイントをAstroで実装し、コンテンツ更新時に該当キャッシュを破棄するといった使い方が可能だ。
CDNキャッシュプロバイダ
Astro 7.0では、Netlify、Vercel、Cloudflare向けのCDNキャッシュプロバイダが実験的機能として追加された(Cloudflareはプライベートベータ)。これらはレスポンスをメモリではなく、各プラットフォームのエッジネットワークにキャッシュする。キャッシュヒット時はサーバー関数を呼び出さず、CDNから直接応答が返るため、さらに高速なレスポンスを実現できる。
アダプタごとに/cacheエントリポイントからプロバイダをインポートする。
import { defineConfig } from 'astro/config';
import netlify from '@astrojs/netlify';
import { cacheNetlify } from '@astrojs/netlify/cache';

export default defineConfig({
  adapter: netlify(),
  cache: {
    provider: cacheNetlify(),
  },
});Astro.cache、routeRules、cache.invalidate()のAPIは、どのプロバイダでも同じように動作する。各プロバイダが、Astroのキャッシュディレクティブを各プラットフォームのネイティブなキャッシュ制御ヘッダと無効化APIに変換する仕組みだ。
AIエージェント向け開発サーバー機能
AIコーディングエージェントの普及に伴い、Astro 7.0はエージェント駆動開発を支援する機能を導入した。AIエージェントは、終了しない長時間実行プロセス(開発サーバー)の扱いが苦手だ。シェルコマンドを実行し、終了を待って出力を読むワークフローに、開発サーバーは適合しない。
バックグラウンド開発サーバー
astro dev --backgroundコマンドを使うと、開発サーバーを管理されたバックグラウンドプロセスとして起動できる。コマンドはサーバーがリクエストを受け付け可能になるまでブロックし、URLとプロセスIDを出力してからデタッチする。ポーリングやスリープ、端末出力の解析は一切不要だ。
AstroはAIエージェント内で実行されていることを自動検出し、バックグラウンドモードを自動的に有効にする。エージェントワークフローでは--backgroundフラグの指定すら不要だ。
ロックファイルによって重複インスタンスが防止される。エージェントが誤って2つ目のサーバーを起動しようとすると、既存インスタンスの詳細が返される。astro dev statusで状態確認、astro dev stopで停止、astro dev logsでバックグラウンドサーバーのログを確認できる。また、全実行中の開発サーバーは/_astro/statusヘルスエンドポイントを公開し、エージェントがサーバーの生存を確認できる。
JSONログ出力
Astroのロガーが完全に設定可能になった。AIエージェント向けには、バックグラウンドモードの自動検出時にJSONログが自動的に有効化される。それ以外の用途でも、CLIまたは設定ファイルで有効化できる。
astro dev --jsonimport { defineConfig, logHandlers } from "astro/config";
export default defineConfig({
logger: logHandlers.json()
})構造化ログが必要なユースケースはAIだけではない。SSRで本番運用しているチームは、Kibana、CloudWatch、Grafana/Lokiといったログ集約サービスと統合するために構造化ログを必要としている。従来のAstroのログ出力は、色付き表示や罫線文字、複数行エラーフォーマットなど、人間の可読性に特化しており、機械による解析が困難だった。
compose() APIを使えば、人間向けのコンソール出力と機械向けのJSONログを同時に出力できる。
import { defineConfig, logHandlers } from "astro/config";

export default defineConfig({
  logger: logHandlers.compose(
    logHandlers.console(),
    logHandlers.json()
  )
})
この記事のポイント
- Astro 7.0は.astroコンパイラとMarkdown/MDX処理をRust化し、ビルド時間を15〜61%短縮した
- Vite 8のRust製バンドラRolldownが標準搭載され、既存の設定をほぼそのまま使える
- アドバンストルーティングでリクエストパイプラインを完全制御でき、Honoとの統合も可能
- ルートキャッシングが安定版となり、Netlify/Vercel/CloudflareのCDNキャッシュプロバイダも追加された
- AIエージェント向けにバックグラウンド開発サーバーとJSONログ出力が自動有効化される

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CSSスクロール駆動アニメーションで逆方向スクロールを実現
スクロールに応じてアイテムが上下逆方向に動くレイアウトを実現する手法がある。CSS-Tricksの著者が紹介したこのテクニックは、CSSの「スクロール駆動アニメーション」と疑似要素によるマスク効果を組み合わせたものだ。通常のアニメーションと異なり、ユーザーがスクロールした量だけアニメーションが進行するため、インタラクティブな表現が可能になる。本記事ではその仕組みと実装手順を詳しく解説する。
具体的なコードを見ていこう。元記事では3つのカラムがあり、左右のカラムはスクロールに応じて上方向へ、中央のカラムは下方向へ移動する。コンテナの上下端ではアイテムがふわりと消えるフェード効果がかかる。この動きはCSSの animation-timeline プロパティと view() 関数で制御される。
スクロール駆動アニメーションの基本概念
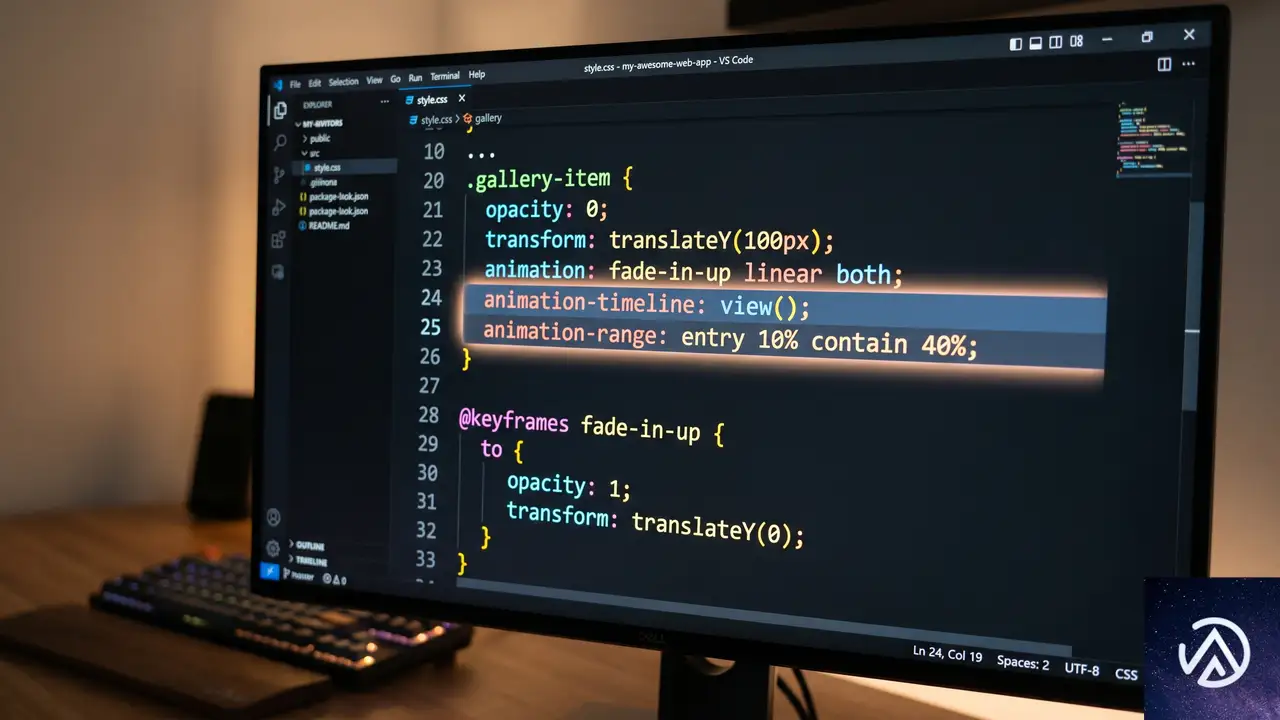
スクロール駆動アニメーション(Scroll-Driven Animations)とは、アニメーションの進行をスクロール位置に連動させるCSSの新機能である。従来のCSSアニメーションは時間ベースで動いていたが、この機能を使えば「要素が画面のどこにあるか」や「スクロール量がどれだけ進んだか」を基準にアニメーションを再生できる。
これを実現するのが animation-timeline プロパティだ。ここには scroll() 関数または view() 関数を指定する。scroll() は親要素やルートのスクロール位置を追跡し、view() は要素自身がスクロールポート(スクロール可能な表示領域)に出入りする過程を追跡する。今回の逆方向スクロールでは、各カラム内のアイテムがコンテナ領域に入ったり出たりする動きが肝になるため、view() が採用された。
view() 関数の仕組み
view() 関数は、アニメーション対象の要素がスクロールポートのどの範囲にあるかを0%から100%の進捗で返す。例えば、要素がスクロールポートの下端にさしかかった瞬間が0%、完全に反対側へ出切った瞬間が100%だ。この進捗をアニメーションのタイムラインにマッピングすることで、スクロールに同期した動きを作れる。
CSS-Tricksの著者は、この関数に「entry 0% cover 100%」というインセットを設定している。これは、要素がスクロールポートに入り始めた瞬間(entry)の0%から、完全に通り抜けて隠れきった瞬間(cover)の100%までをアニメーションの範囲とする指定だ。この設定により、各カラムのアイテムが表示領域に姿を現し、消えるまでの全行程をアニメーションでカバーできる。
このデモは、要素がスクロールポートに出入りする際のマスク効果を静的に表現している。実際のブラウザでは、スクロール量に応じて要素の位置が連続的に変化し、上下のグラデーション部分に重なると自然に溶け込むように見える。
animation-range による範囲の精密制御
animation-range プロパティは、タイムラインのどの区間を使ってアニメーションを再生するかを決める。デフォルトでは「entry 0% exit 100%」だが、CSS-Tricksの例では「entry 0% cover 100%」としている。これは entry が「要素がスクロールポートに入り始める瞬間」、cover が「要素がポートを完全に覆い隠した瞬間(つまり反対側へ出切った瞬間)」の2点を基準にする記法だ。
この指定により、アイテムが画面に現れた瞬間から消える最後までアニメーションが継続する。逆に言えば、画面外に完全に隠れている間はアニメーションが停止しているのと同じ状態になる。結果として、ユーザーがスクロールしている間だけアイテムがスムーズに動き続けるインタラクションが実現する。
HTMLのシンプルな構造
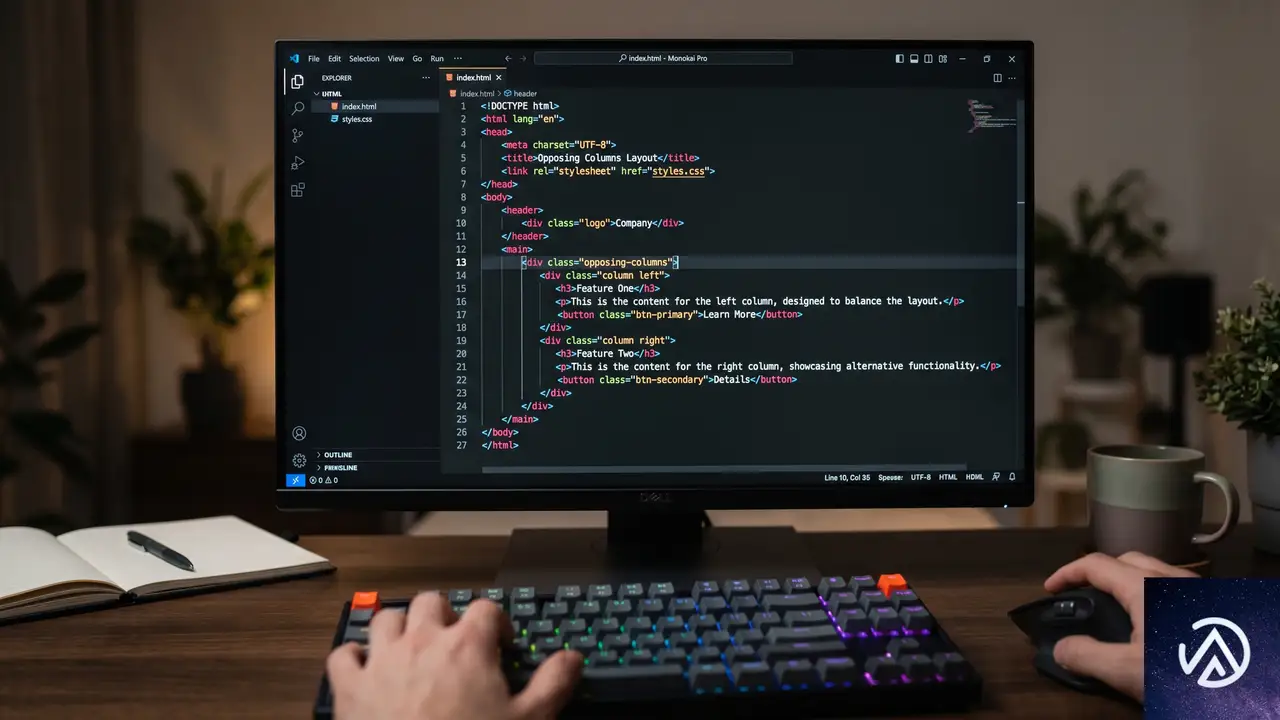
CSS-Tricksの記事で示されているHTMLは非常に簡素だ。複雑なJavaScriptや追加のラッパーは不要で、大きく分けて3階層の要素があればよい。
<div class="opposing-columns">
  <div class="opposing-column">
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
  </div>
  <div class="opposing-column">
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
  </div>
  <div class="opposing-column">
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
    <div class="opposing-item">...</div>
  </div>
</div>このシンプルな構造がポイントだ。CSS側でスクロール駆動アニメーションを定義する際、各カラム(.opposing-column)ごとに異なるアニメーションを適用し、その中に含まれるアイテムが一括して動く仕組みになっている。
CSSによるマスク効果の実装
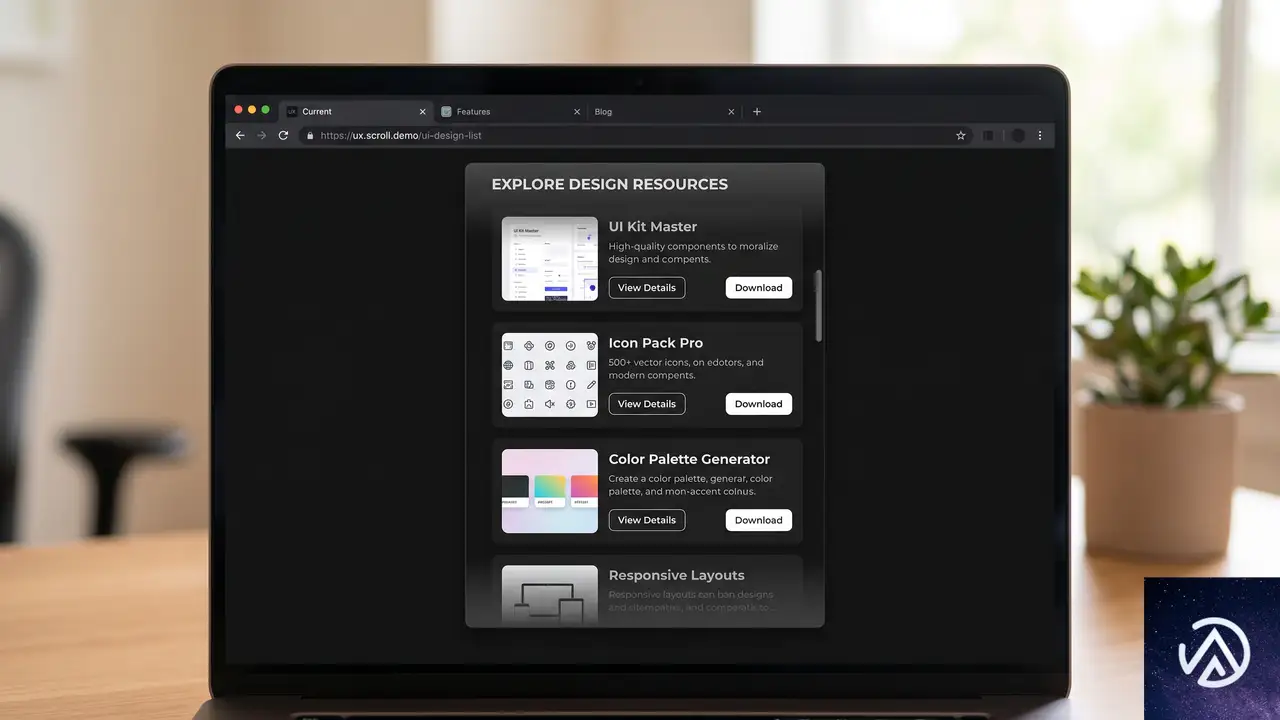
アイテムがコンテナの上下端でふわっと消える演出は、疑似要素とグラデーションによるマスクで作られている。透明度や opacity を直接操作するのではなく、背景色と同じ色のグラデーションを重ねることで、コンテンツが自然に隠れるように見せているのだ。
疑似要素でマスクを生成する
親コンテナ .opposing-columns に position: relative を設定したうえで、::before と ::after 疑似要素を絶対配置している。これらの疑似要素はコンテナの上下にそれぞれ配置され、幅はコンテナ全体、高さはCSS変数 --opposing-mask の3倍に設定されている。
@media screen and (width >= 50rem) {
  .opposing-columns {
    position: relative;
    margin-block: var(--opposing-mask, 3rem);
  }

  .opposing-columns::before,
  .opposing-columns::after {
    content: "";
    position: absolute;
    inset-inline: 0;
    block-size: calc(var(--opposing-mask) * 3);
    pointer-events: none;
    z-index: 1;
  }
}疑似要素には pointer-events: none が指定されており、クリックやホバーの邪魔をしない。これはユーザビリティを損なわないための重要な配慮だ。
グラデーションで自然なフェードを生み出す
次に、これらの疑似要素に線形グラデーションを適用する。上側の ::before には to bottom(上から下)方向のグラデーションを設定し、始点をドキュメントの背景色 --opposing-bg、終点を透明にする。下側の ::after はこれを逆にして、to top(下から上)方向のグラデーションを設定する。
.opposing-columns::before {
  background-image: linear-gradient(
    to bottom,
    var(--opposing-bg) var(--opposing-mask),
    transparent
  );
  inset-block-start: calc(var(--opposing-mask) * -1);
}

.opposing-columns::after {
  background-image: linear-gradient(
    to top,
    var(--opposing-bg) var(--opposing-mask),
    transparent
  );
  inset-block-end: calc(var(--opposing-mask) * -1);
}これにより、カラム内のアイテムがコンテナの上下端に近づくと、グラデーション部分に重なって自然に消えていくように見える。背景色とマスクの色が同一であるため、アイテムが溶け込むようなスムーズなフェードが実現する。
キーフレームアニメーションの設計
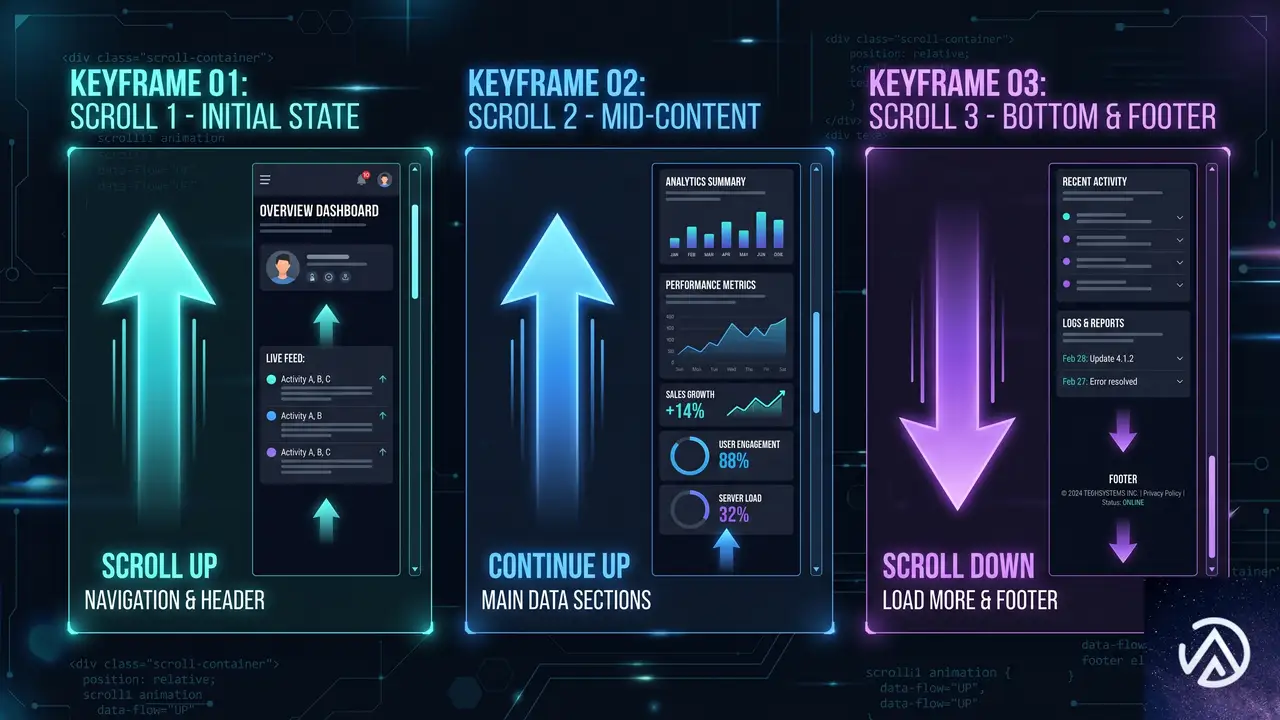
マスクの準備が整ったら、実際にアイテムを上下に動かすアニメーションを定義する。CSS-Tricksの著者は3つの異なるキーフレームを用意し、各カラムに割り当てている。
3種類の動きをキーフレームで定義
アニメーションは transform: translateY() による垂直移動で構成される。1つ目の scroll1 はアイテムを上方向に移動させ、2つ目の scroll2 はその逆方向(下方向)に動かす。3つ目の scroll3 はややオフセットを持たせた上方向の動きで、カラム間のタイミングにわずかなズレを生み出している。
@keyframes scroll1 {
  from { transform: translateY(var(--opposing-mask)); }
  to   { transform: translateY(calc(var(--opposing-mask) * -1)); }
}

@keyframes scroll2 {
  from { transform: translateY(calc(var(--opposing-mask) * -1)); }
  to   { transform: translateY(var(--opposing-mask)); }
}

@keyframes scroll3 {
  from { transform: translateY(calc(var(--opposing-mask) * .66)); }
  to   { transform: translateY(calc(var(--opposing-mask) * -.33)); }
}このオフセットの考え方は応用が利く。例えば同じ方向に動く2つのカラムでも、開始位置を微妙にずらすだけで視覚的なリズムが生まれ、単調さを回避できる。
カラムごとに異なるアニメーションをバインド
キーフレームを定義したら、各カラムにアニメーション名を割り当てる。nth-of-type 疑似クラスを使い、1番目のカラムには scroll1、2番目には scroll2、3番目には scroll3 を適用する。これにより、カラムの位置に応じて移動方向が自動的に決まる。
.opposing-column:nth-of-type(1) { animation-name: var(--animation-1); }
.opposing-column:nth-of-type(2) { animation-name: var(--animation-2); }
.opposing-column:nth-of-type(3) { animation-name: var(--animation-3); }
さらに、これらのアニメーションは animation-timeline: view() と animation-range: entry 0% cover 100%、そして animation-timing-function: linear がセットで指定される。線形のタイミング関数を選ぶことで、スクロール速度に応じてアイテムが等速で動き、自然な同期感が得られる。
アクセシビリティとブラウザ対応
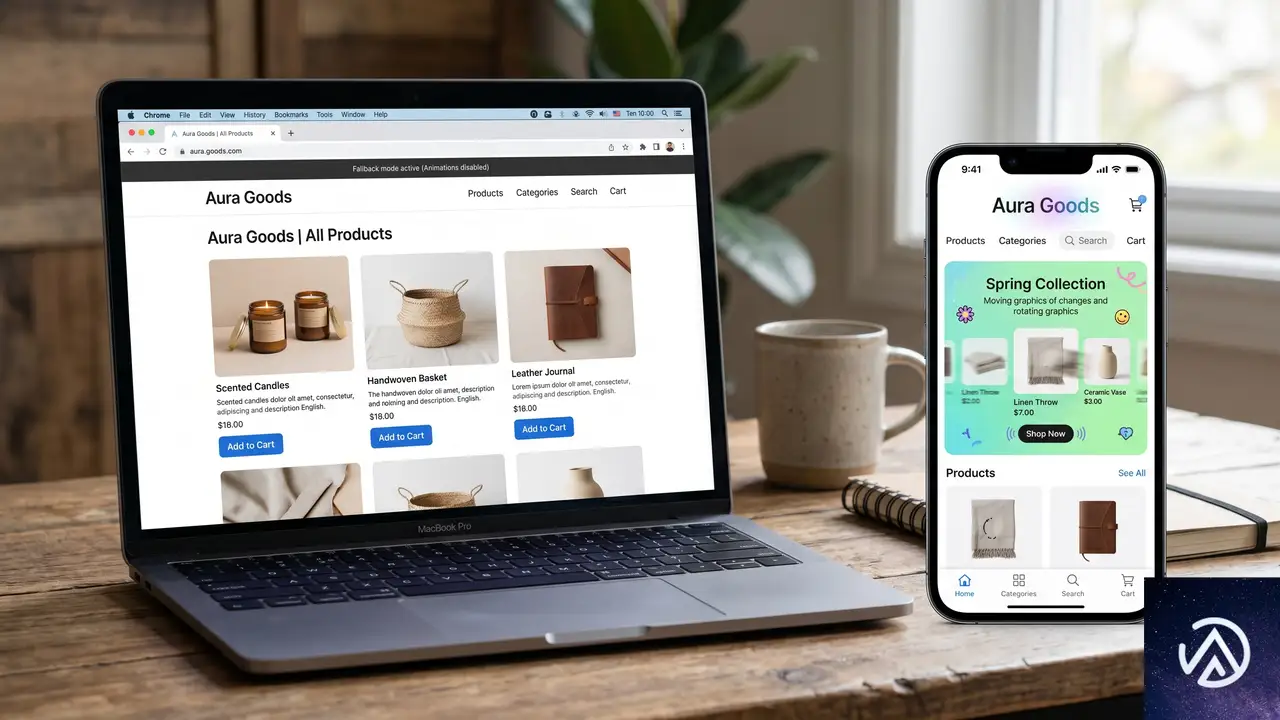
実装にあたっては、モーションに敏感なユーザーへの配慮と、ブラウザ間の互換性を考慮する必要がある。CSS-Tricksの元記事でもこの点に言及しており、適切なフォールバックを組み込んでいる。
prefers-reduced-motion への対応
OSやブラウザの設定で「視差効果を減らす」を有効にしているユーザー向けに、メディアクエリ prefers-reduced-motion: reduce を用いてアニメーションを無効化する。このクエリが一致した場合、アニメーションを unset で打ち消し、さらに疑似要素のマスクも削除する。マスクだけが残ると、動かないアイテムが不自然に隠れてしまうからだ。
@media (prefers-reduced-motion: reduce) {
  .opposing-column {
    animation: unset;
  }
  .opposing-column::before,
  .opposing-column::after {
    content: unset;
  }
}
これにより、動きを減らしたいユーザーには静的なレイアウトが提供され、意図しないストレスを回避できる。
@supports を使った段階的な実装
スクロール駆動アニメーションは、2026年6月時点でChromeとSafariがサポートしているが、Firefoxは未対応だ。そのため、@supports (animation-timeline: view()) を用いて、機能が使えるブラウザでのみアニメーションを有効化するのが安全だ。サポートされない環境では、通常のスクロールと同様の静的な表示になるよう設計しておけば、すべてのユーザーに破綻のない体験を届けられる。
@supports (animation-timeline: view()) {
  /* スクロール駆動アニメーションのスタイル */
}この手法はプログレッシブエンハンスメントの好例で、新しいCSS機能を安全に導入したい現場でも参考になるだろう。
独自の視点:逆方向スクロールの応用可能性
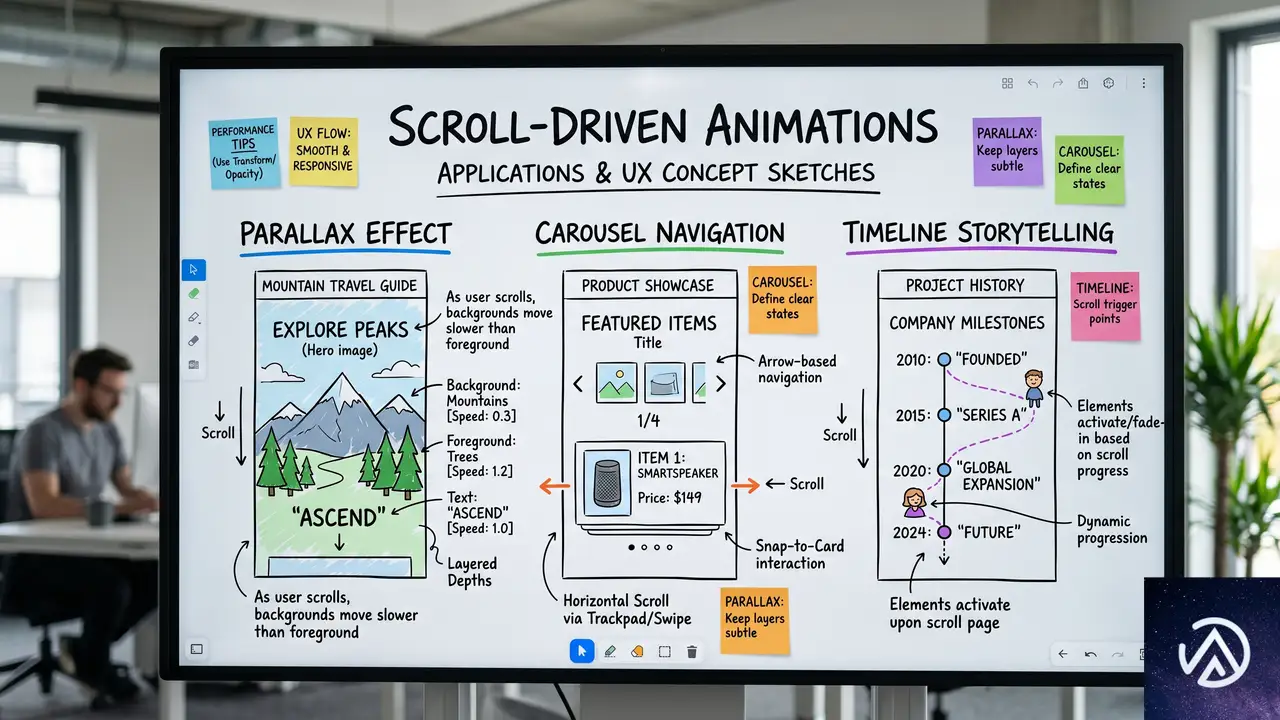
ここまで見てきたテクニックは、単なる逆方向スクロールの演出にとどまらない。CSSのスクロール駆動アニメーションは、タイムラインを自在に操作できるため、さまざまなインタラクティブ表現の土台となる。
タイミングのオフセットを使ったリズム演出
元記事の scroll3 のように、開始位置や終了位置をパーセンテージでずらすことで、カラム間の動きにリズムを生み出せる。たとえば、5カラムのレイアウトでそれぞれの移動量を微調整すれば、波のようなうねりを表現することも可能だ。マスクの高さやアニメーションのインセットをCSS変数で管理しておけば、デザインの微調整も容易になる。
このようなオフセット設計は、プロモーションサイトやポートフォリオのビジュアルリッチなセクションで特に効果を発揮するだろう。
パララックス効果との自然な組み合わせ
従来のパララックス(視差効果)はJavaScriptで実装されることが多かったが、スクロール駆動アニメーションを使えば、CSSだけで多層的な視差を表現できる。背景画像や装飾要素に別の animation-timeline を割り当て、移動速度を変えれば、奥行きのあるスクロール体験をJavaScriptに頼らずに構築できる。
例えば、背景の大きな画像にはゆっくりした上方向のアニメーションを、前景のテキストにはやや速い動きを設定するといった組み合わせだ。マスク効果を応用すれば、画面外への自然な消え方も統一感を持って演出できる。
カルーセルやタイムライン表現への展開
逆方向スクロールの考え方は、横方向のカルーセルやタイムライン表示にも転用できる。view() 関数の軸指定(block や inline)を切り替えれば、水平スクロールにも対応可能だ。また、scroll() 関数と組み合わせれば、ページ全体のスクロール量に応じてインジケーターを進める、といった使い方もできる。
CSS-Tricksの元記事は比較的シンプルな例だが、この基盤さえ理解すれば、より複雑なレイアウトやストーリーテリング演出にも発展させられる。
この記事のポイント
- スクロール駆動アニメーションは
animation-timeline: view()で実装し、スクロールに同期した動きを簡単に作れる - 疑似要素と背景色ベースのグラデーションを組み合わせると、自然なフェード効果を実現できる
- 動きのオフセットや逆方向設定によって、単調でないリズミカルな演出が可能になる
@supportsとprefers-reduced-motionで、アクセシビリティとブラウザ互換性を両立させる- 今回のテクニックはパララックス、水平カルーセル、タイムラインなど多彩な表現に展開できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
EC向けAIフライホイール構築、4つの価値レバーと実践法
EC事業におけるAI活用は、単純なタスクの自動化から、複数の施策が連鎖的に成果を生み出す仕組み作りへと移行しつつある。マッキンゼー・アンド・カンパニーが2026年6月に公開したレポート「Europe’s new ecommerce agenda How AI is resetting growth and competition」では、AIがもたらす価値は断片的な実験ではなく統合にあると指摘されている。
成功するEC事業者は、商品のパーソナライズ、需要予測、在庫管理、価格設定といった複数の意思決定をAIでつなぎ合わせ、全体として加速度的に回転する「フライホイール」を構築している。このフライホイールは、各施策が互いに強化し合い、一度回り始めると追加のリソースを大きく投じなくても成果が積み上がっていく。
この記事では、マッキンゼーが示した「4つの価値レバー」を軸に、大企業だけでなくデータや人的リソースが限られる中小規模EC事業者でも実践できる小さなAIフライホイールの始め方を、具体例とともに解説する。
AIフライホイールの基本概念
フライホイールが回る仕組み
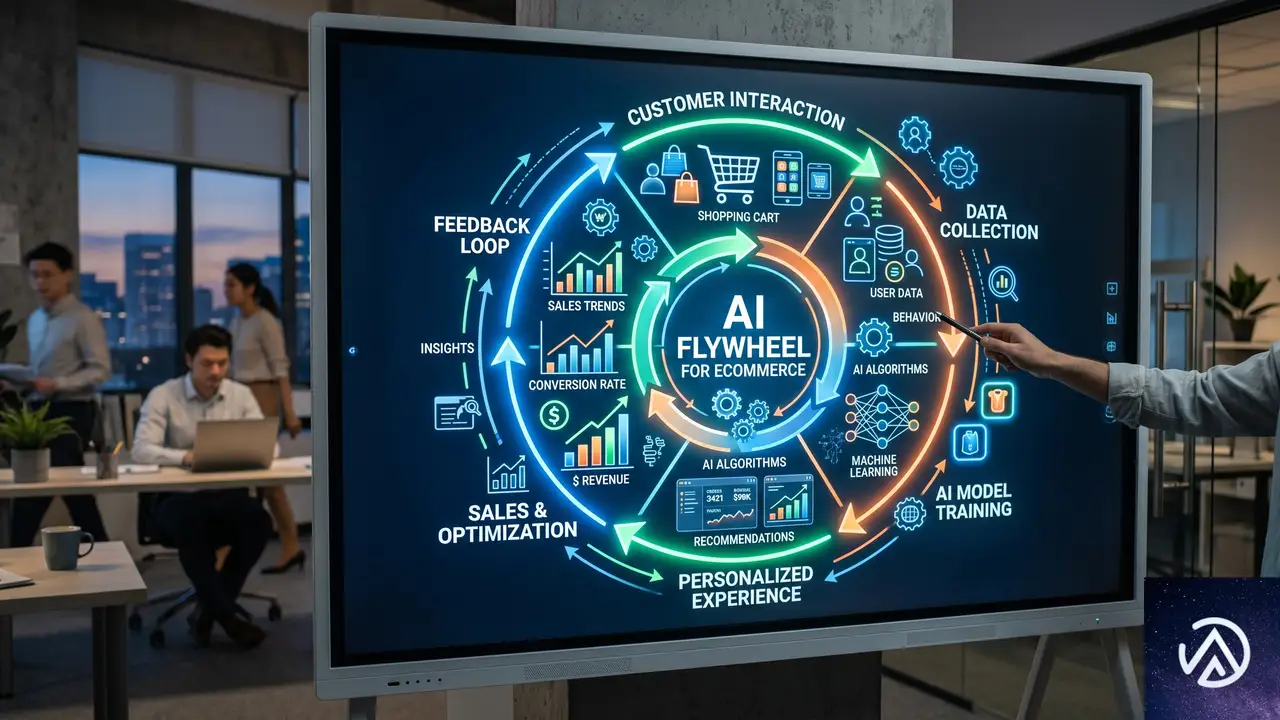
AIフライホイールとは、あるプロセスが次のプロセスを改善し、その改善が再び最初のプロセスを後押しする、自己強化型の循環システムのことだ。たとえば、AIによるパーソナライズで顧客エンゲージメントが高まると、より正確な需要シグナルが得られる。そのシグナルを使って価格や在庫の判断を最適化すれば、再びエンゲージメントが向上し、さらに多くのデータが蓄積される。
このループを1回転させるごとに、データの質と意思決定の精度が上がり、フライホイールはより少ないエネルギーで回り続ける。一度きりのプロジェクトではなく、持続的な成長エンジンとして機能する点が最大の特徴だ。
単体タスクの自動化との違い
AIフライホイールは、単一の作業をAIに任せる「自動化」とは根本的に異なる。商品説明文をAIで生成すれば時間は短縮できるが、それだけではビジネス全体の流れは変わらない。一方、フライホイール思考では、顧客からの問い合わせ内容をAIで分析し、商品ページの改善に活かし、コンバージョン率の変化を追跡し、その結果を次の仕入れや価格戦略に反映させる。こうした相互連鎖によって、初めて収益構造が強化される。
この概念図では、断片化されたAI活用と、連鎖的に回るフライホイールの違いを視覚化している。単体の導入では部分最適にとどまるが、相互に強化し合うループを作ることで、事業全体の底上げが可能になる。
成長を加速する4つの価値レバー

相互に強化し合う4つの要素
マッキンゼーのレポートでは、ECにおけるAIフライホイールを構成する4つの「価値レバー」として、成長、生産性、バリューチェーン効率、収益性が挙げられている。いずれも独立した施策ではなく、意図的につなぎ合わせることでレバレッジが効く。
成長は、商品発見の最適化やレコメンデーション、メールセグメンテーション、広告クリエイティブの自動生成などを通じて、適切な購入者に適切な商品を届ける活動を指す。AIが顧客行動を深く理解し、一人ひとりに合った購買体験を提供することで、売上の上昇に直結する。
生産性は、カスタマーサポートやコンテンツ制作、販売管理、レポート作成といった反復作業をAIで削減する領域だ。定型業務から人手を解放し、戦略的な思考が求められる高付加価値業務に人材を集中させられる。
バリューチェーン効率は、需要予測と在庫管理、フルフィルメント、返品処理をAIで連携させるものだ。何が売れるか、どこに在庫があるか、いつ届くかをリアルタイムに把握し、コストと在庫リスクを最小化する。
収益性は、価格設定やプロモーション、バンドル販売、値下げ判断をデータ駆動で行う領域である。AIは利益率を損なう過度な値引きや無駄なキャンペーンを可視化し、マージンを最大化する行動を提案する。
商品発見、レコメンド、広告クリエイティブの最適化で適切な顧客にリーチ
反復作業の削減と人員の高付加価値業務へのシフト
需要・在庫・配送・返品を統合しコストを最小化
価格・プロモーション・値下げ判断のデータ駆動化で利益率を向上
これら4つのレバーは、相互にデータを供給し合うことで単体の数倍の効果を発揮する。たとえば、成長施策で得たエンゲージメントデータが在庫効率を改善し、その結果生まれた余剰在庫をデータに基づく値下げ判断で処理しながら収益性を守る、といった連携が可能だ。
中小規模ECが実践できる小さなフライホイール

顧客フィードバック分析から商品ページ改善へ
大企業のように整備されたデータ基盤や高度なシステムがなくても、AIフライホイールは始められる。中小規模EC事業者であっても、問い合わせメールやチャット履歴、レビュー、返品理由といった顧客の声は確実に存在している。これらをAIで分析し、たとえば「サイズ感が合わない」「同梱物がわかりにくい」「配送目安が不明瞭」といった共通の課題を抽出することが、最初の一手になる。
次に、得られたインサイトを商品ページの改善に反映する。サイズガイドの追加や比較表の設置、よくある質問の充実、利用シーンを想起させる商品写真の差し替えなど、具体的な対応を取るのが有効だ。これらの変更は、無料または低コストのAIツールで十分に実施できる。
改善が次のサイクルを生む
商品ページの改修後は、コンバージョン率や返品率、サポートへの問い合わせ件数といった指標を追跡する。ここでもAIを活用すれば、変更の効果を自動で検知し、仮説の精度を高めていくことが可能だ。たとえば「返品理由の上位にあったサイズ感の問題が解消され、返品率が15パーセント低下した」といった成果が得られれば、次の購買データもクリーンになる。
こうした小さなサイクルを繰り返すことで、顧客の声が商品体験を改善し、改善がより良いデータを生み、そのデータがさらに精度の高い意思決定を支えるループが出来上がる。規模は小さくとも、自己強化のメカニズムは大企業のそれと同じだ。
この小さなフライホイールは、初期投資を抑えながら着実に成果を出せる。顧客フィードバックはすでに手元にある資産であり、AIを分析エンジンとして活用するだけで、商品改善と売上向上のエンジンが動き始める。
意思決定の連鎖がもたらすもの

部門を横断したAI活用
AIフライホイールの本質は、カスタマーサービスと商品コンテンツ、サイト内検索とマーチャンダイジング、在庫管理とプロモーションといった、これまで別々に行われてきた意思決定を一本の線でつなぐことにある。AIが仲介役となり、各部門から得られるデータを相互に変換しながら、最適なアクションを導き出す。
たとえば、顧客からの問い合わせに使われる自然言語の傾向をAIが学習すれば、それはサイト内検索のレコメンド精度向上にも活かせる。また、返品理由の分析結果をプロモーション担当に共有すれば、値引きすべき商品や強化すべき訴求ポイントが明確になる。AIがデータの共通言語となることで、組織全体の意思決定が同期し始める。
マネジメント視点の重要性
中小EC事業者が真にAIで競争優位を築けるかどうかは、最新モデルへのアクセスよりも、経営的な視点の差で決まる。AIを単なるツールとして導入するのではなく、業務プロセス全体を俯瞰し、データが流れる経路を設計し、測定と改善を繰り返す管理のしくみを構築することが求められる。
これは技術の話ではなく、経営戦略の話だ。顧客の声を商品に反映し、その成果を在庫や価格に転嫁し、得られた利益を再び顧客体験に投資する。この連鎖を回す主体は、AIではなく事業者自身である。AIはその回転を支えるエンジンに過ぎない。
この記事のポイント
- AIフライホイールは、部分的な自動化ではなく、複数の施策が連鎖して加速する自己強化型のシステムである
- マッキンゼーが示す成長、生産性、バリューチェーン効率、収益性の4つのレバーを組み合わせることで、レバレッジが最大化される
- 中小EC事業者は、すでに保有する顧客フィードバックをAIで分析し、商品ページ改善につなげる小さなサイクルから始められる
- AIの真価は、部門を横断した意思決定の同期と、経営全体をデータ駆動で回すマネジメントの仕組みにある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleとMicrosoftがAIエージェント共通仕様ARDを公開、11社が賛同
GoogleとMicrosoftを含む11社が、AIエージェントがウェブ上のツールやスキルを自動検出するための共通仕様「ARD(Agentic Resource Discovery)」を2026年6月17日に公開した。
GitHubやHugging Face、NVIDIA、Salesforceも名を連ねるこの仕様は、各社が公開するAIエージェント向け機能を、事前の手動接続なしに実行時に見つけ出せる仕組みだ。Apache 2.0ライセンスで公開され、同日に複数の参照実装もリリースされた。
この仕様が実用化されれば、AIエージェントは必要なツールを自ら探し出して接続できるようになる。開発者やサービス提供者にとっては、自社のAPIやエージェント機能をAIシステムに自動的に見つけてもらうための新たな方法が生まれることになる。
ARDとは何か
ARD(Agentic Resource Discovery)は、AIエージェントがウェブ上で「使えるツールや機能」を自動的に見つけ出すための共通ルールを定めた仕様だ。Linux Foundationのワーキンググループが管理するAI Catalogデータモデルを基盤に構築されている。
現在のAIエージェントは、あらかじめ各ツールやMCPサーバー、APIとの接続を手動で設定する必要がある。企業が公開する機能が増え続けるなか、この「事前配線」方式では拡張性に限界があった。ARDはこの問題に対処するために設計されている。
ARDの仕組みは、企業が自社ドメインに公開するカタログと、それを収集してインデックス化するレジストリの2層構造で成り立っている。人手による接続設定を実行時の検索に置き換えることで、AIエージェントが自律的に機能を発見できる世界を目指している。
ARDの技術的な仕組み
カタログとレジストリの2層構造
ARDの中核は「カタログ」と「レジストリ」という2つの要素だ。まず、ツールやエージェントを提供する企業は、自社ドメインの定められたパスにai-catalog.jsonというファイルを設置する。このファイルには、公開するツール、MCPサーバー、エージェント、APIの一覧が記述される。
次に「レジストリ」がこれらのカタログを巡回(クロール)してインデックス化する。AIエージェントが「この処理に使えるツールはないか」と自然言語で問い合わせると、レジストリが該当するカタログ情報を返す仕組みだ。
ai-catalog.json を設置カタログが公開者の自社ドメインに置かれることで、ドメイン所有権が公開者の検証手段として機能する。本番運用では、暗号化された信頼メタデータを付与し、接続前に公開者の身元を確認することも可能だ。ツールが選定された後は、ARDの役割は終了し、実際の接続は各ツール固有のプロトコルで直接行われる。
誰に向けた仕様なのか
ARDが主に対象とするのは、APIやMCPサーバー、エージェントといった「呼び出し可能な機能」を提供する企業だ。ツールを公開する企業には、AIエージェントに見つけてもらい、信頼してもらうための明確な方法が提供される。
一方、一般的なコンテンツサイトにとっては、現時点で直接的な活用方法は示されていない。Search Engine Journalの記事でも「典型的なコンテンツサイトに今日すぐ取るべきアクションはない」と指摘されている。
公開当日に登場した参照実装
ARDの草案公開と同日に、複数の参加企業が実際に動作するツールをリリースした。
- GitHub Copilot向けに「Agent Finder」を導入。選択したレジストリからMCPサーバー、スキル、ツール、エージェントを検出し、ユーザーが接続対象を制御できる仕組みだ。
- Hugging Face ARDサービス全体からスキルやMCPサーバーを検索する「Discover Tool」を公開した。
- Cisco Linux Foundation傘下のオープンソースプロジェクト「AGNTCY Agent Directory」にARDを統合した。
GitHubのAgent Finderは特に関心を集めている。Copilotのユーザーがレジストリから必要な機能を見つけ出し、自分の判断で接続を許可できる設計は、エージェントの自律性とユーザー制御のバランスを取る試みといえる。
この流れは、ウェブの「機械可読層」を整備する一連のオープン仕様の延長線上にある。GoogleはARD公開の2日前にも、AIシステム間で組織知識を共有するための「Open Knowledge Format」仕様を発表している。いずれも自社ドメインに構造化ファイルを設置するだけで、AIシステムが人手の配線なしに情報を利用できるようにする考え方だ。
Googleの立ち位置と今後の展開
GoogleはARDにおいて、Gemini Enterprise Agent Platformの一部である「Agent Registry」を中心的な役割として位置づけている。これはエージェント向けリソースのホスティングと検索、企業向けのガバナンス管理を担う基盤だ。
Search Engine Journalの記事によれば、Agent RegistryへのネイティブARD対応は数カ月以内に予定されている。これが実現すれば、組織は内部レジストリを広域ネットワークに接続できるようになる。
ただし現時点でこの対応は稼働しておらず、ARDはあくまで「仕様」であってGoogle検索の機能ではない。検索エンジンとしてのGoogleがARDカタログを直接検索結果に反映するわけではない点は、区別して理解しておく必要がある。
コンテンツ制作者が今考えるべきこと
ARDがもたらす影響は、ビジネスの性質によって大きく異なる。ツールやAPIを提供する企業には、AIエージェントに発見されるための具体的な手段が用意された。一方で、一般的なコンテンツサイト運営者にとっての即効性は限定的だ。
この仕様の価値については業界内でも議論がある。GoogleのJohn Mueller氏は、LLMシステムがllms.txtのようなファイルでサイトを区別することはできないと指摘し、将来のエージェント向け戦略よりも現在のニーズに注力するよう助言している。ARDが対象とするのはツールやエージェントであり、コンテンツではないという点は、こうした議論の背景として押さえておきたい。
仕様はまだv0.9草案であり、GitHubリポジトリで変更提案を受け付けている段階だ。実用性を左右するのは、カタログを大規模にクロールしてインデックス化できるレジストリのエコシステムだが、それもまだ初期段階にある。
エコシステムが成熟した場合に最も恩恵を受けるのは、他者が必要とするツールやエージェントを提供する企業だ。GoogleがUlrtaユーザー向けに展開し始めたエージェント主導の検索機能も、この方向性を示唆している。今すぐ取るべき現実的なアクションは、自社が使っているプラットフォームやツールがARDに対応するかどうか、そして対応時にどのような公開情報が求められるかを注視することだ。
この記事のポイント
- ARDはAIエージェントがツールやAPIを実行時に自動発見するためのオープン仕様である
- カタログ(ai-catalog.json)とレジストリの2層構造で、ドメイン所有権が信頼の基盤となる
- GitHubやHugging Faceが公開初日から参照実装を提供しており、実用化に向けた動きは速い
- 一般的なコンテンツサイトよりも、ツールやAPIを公開する企業に直接的な恩恵がある
- v0.9草案段階であり、レジストリのエコシステム構築が今後の鍵を握る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Prop For That、CSSで動的プロパティを扱う新ライブラリの全容
CSS-Tricksで紹介された「Prop For That」は、これまでのCSS設計の常識を塗り替える可能性を持つライブラリだ。ブラウザが本来CSS単体では取得できない情報、例えばマウスカーソルの座標やページのスクロール速度、現在時刻などを、あたかもネイティブのカスタムプロパティであるかのように扱えるようにする。開発者はライブラリを読み込み、対象のHTML要素に専用のデータ属性を付与するだけで、これらの動的な値を直接スタイルシートから参照できる。
CSS-Tricksの記事によれば、このライブラリの最大の魅力は、JavaScriptのロジックを意識せずに済む点にある。従来はイベントリスナーで値の変化を監視し、DOMのスタイルを逐次更新するスクリプトが必要だった。Prop For Thatを使えば、宣言的にCSSを記述する感覚のまま、高度なインタラクションを実装できる。本記事では、この新しいアプローチの仕組みや具体的な活用方法、そして現場への影響を掘り下げていく。
Prop For Thatが解決する根本的な課題
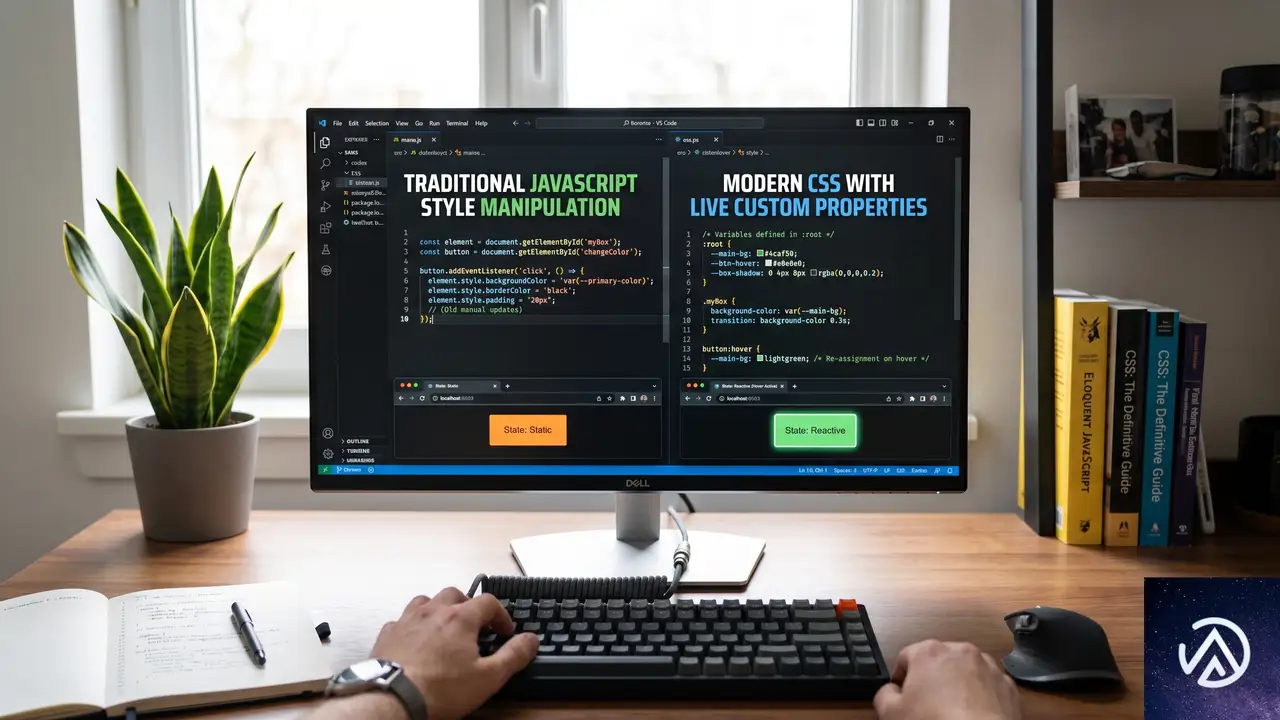
CSSは本来、ページが読み込まれた時点の静的なスタイルを定義する仕組みであり、ユーザーの操作に応じて刻一刻と変化するブラウザの内部状態を直接知覚できない。マウスポインターの位置、ページのどこまでスクロールしたか、特定のフォーム要素が今フォーカスを持っているかといった情報は、すべてJavaScriptの領分だった。この断絶が、アニメーションやインタラクションを実装する際のボトルネックになっていた。
このデモが示すように、Prop For ThatはHTMLとCSSだけの世界観を維持したまま、動的な値を扱える設計思想を持つ。これは単なるユーティリティの追加ではなく、スタイリングの責務をCSSに取り戻すパラダイムシフトだ。
主要なライブプロパティとその仕組み
ポインタートラッキングで実現する追従型インタラクション
マウスカーソルの動きをCSSだけで捉えられると、ボタンのホバーエフェクトや視差効果の表現力が格段に上がる。Prop For Thatでは、data-props-for="pointer"という属性を設定した要素に対して、--live-pointer-xと--live-pointer-yという2つのカスタムプロパティが動的に注入される。
<div class="mover" data-props-for="pointer">...</div>left: calc(var(--live-pointer-x, 0) * 1px);top: calc(var(--live-pointer-y, 0) * 1px);これらの値はリアルタイムに更新されるため、要素をposition: absoluteで配置しておけば、CSSの計算式だけで物体がカーソルを追いかける動きを表現できる。マウスの速度に応じてスタイルを変化させるなど、従来は複雑なスクリプトが必要だった演出が、数行のスタイル宣言で完結する。
スクロールベロシティと現在時刻の活用
スクロールの勢いを表すベロシティ(速度)や、刻々と変化する現在時刻も、ライブプロパティとして取得できる。これらを活用すれば、ユーザーがページを勢いよくスクロールしているときだけ特定のアニメーションを発動させたり、時刻に応じて配色を動的に切り替えるといった演出が、CSSの範囲内で実装可能になる。
/* スクロール速度に応じて要素の透明度を変化させる例 */
.scroll-aware {
  opacity: calc(var(--live-scroll-velocity, 0) * 0.01);
  transition: opacity 0.3s ease;
}CSS-Tricksの記事で特に評価されていたのは、スクロールにモメンタム(慣性)の概念を持ち込める点だ。ユーザーの操作に物理的な手応えを感じさせる、いわゆる「気持ちいいインタラクション」の実装ハードルが大きく下がる。
実装のポイントとコード例
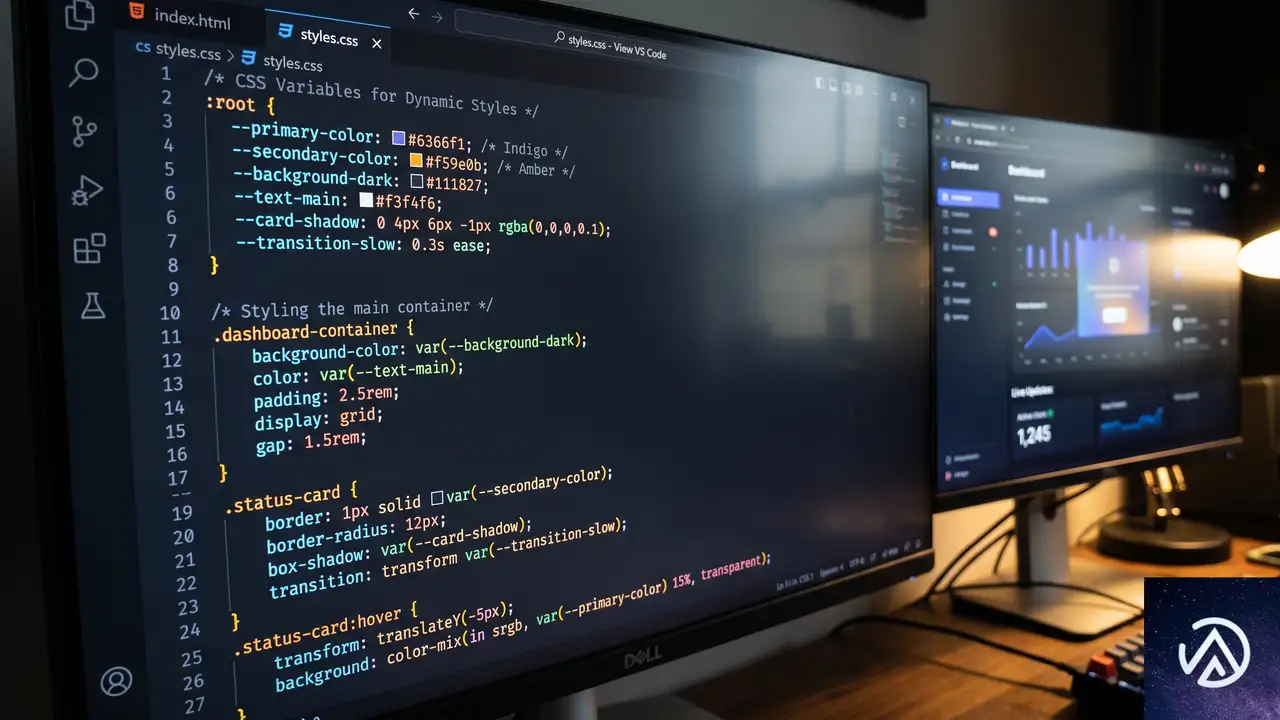
基本的なセットアップ手順
導入は極めてシンプルだ。ライブラリをプロジェクトに読み込んだあと、動的な値を取得したい要素にdata-props-for属性を追加する。あとは通常のCSSカスタムプロパティと同じ感覚で、var()関数を使って値を参照すればよい。
<!-- HTML側 -->
<div class="tracker" data-props-for="pointer">
  この要素がカーソルを追跡する
</div>

/* CSS側 */
.tracker {
  position: absolute;
  width: 60px;
  height: 60px;
  background: #3498db;
  border-radius: 50%;

  /* ライブプロパティを参照して位置を動的に計算 */
  left: calc(var(--live-pointer-x, 0) * 1px - 30px);
  top: calc(var(--live-pointer-y, 0) * 1px - 30px);

  /* スムーズな追従のためのトランジション */
  transition: left 0.1s ease-out, top 0.1s ease-out;
}このコード例では、カーソルを追いかける円形の要素を定義している。注意すべきは、var()の第2引数でフォールバック値(ここでは0)を指定している点だ。ライブラリが読み込まれる前や、何らかの理由でプロパティが未定義の場合でも、要素が想定外の位置に飛ぶのを防げる。
パフォーマンス上の配慮
ライブプロパティは高頻度で更新されるため、leftやtopのようなレイアウトを再計算させるプロパティの変更は、パフォーマンスの観点から注意が必要だ。可能であればtransformプロパティで位置を制御するほうが、ブラウザの合成処理に乗り、再描画コストを抑えられる。
/* パフォーマンスを考慮した書き方 */
.optimized-tracker {
  position: absolute;
  width: 60px;
  height: 60px;
  background: #e74c3c;
  border-radius: 50%;

  /* transformを使えばGPU合成で高速に描画される */
  transform: translate(
    calc(var(--live-pointer-x, 0) * 1px - 50%),
    calc(var(--live-pointer-y, 0) * 1px - 50%)
  );
}このtransformによる制御は、特に多数の要素を同時に動かす場合や、モバイル端末での動作を考慮する際に有効だ。CSS-Tricksの紹介するデモ群でも、このベストプラクティスが採用されている。
Web制作の現場に与える影響
JavaScriptとCSSの新たな役割分担
Prop For Thatの登場は、フロントエンド開発におけるJavaScriptとCSSの役割分担を見直す契機になる。従来は「動的なものはJavaScript、静的なものはCSS」という暗黙の線引きがあった。しかし、このライブラリが示す方向性は、表示やスタイルの変化はCSSに寄せるという考え方だ。
これは単なる書き方の変化ではない。コードの凝集度が高まり、スタイルに関するロジックがCSSファイルに集約されることで、メンテナンス性が向上する。特に、複数人で開発する大規模プロジェクトや、インタラクションの多いランディングページの制作では、このメリットが顕著に現れる。
プロトタイピングスピードの加速
CSS-Tricksの記事が高く評価していたもう一つの側面は、プロトタイピングの速さだ。アイデアを思いついてから、実際にブラウザ上で動くモックアップを作るまでの時間が大幅に短縮される。複雑なJavaScriptの設定なしに、HTMLとCSSだけでリッチなインタラクションを試せることは、クリエイティブな探求の敷居を大きく下げる。
この手軽さは、デザイナーがコーディングに踏み出すきっかけとしても機能するだろう。また、クライアントワークの現場では、「この動きを実装するのにどれだけの工数がかかるか」という見積もりの精度も変わってくる。これまでスクリプトの作成で1日かかっていた表現が、数時間のコーディングで実現できる可能性があるからだ。
この記事のポイント
- Prop For Thatは、マウス位置やスクロール速度などブラウザの動的情報をCSSカスタムプロパティとして参照できるライブラリである
- 導入はライブラリの読み込みとHTML属性の追加のみで、JavaScriptの記述を必要としない
- ポインタートラッキング、スクロールベロシティ、現在時刻など、多彩なライブプロパティが用意されている
- パフォーマンスを考慮する場合は、
leftやtopではなくtransformで位置制御するのが推奨される - JavaScriptとCSSの役割分担を見直し、スタイルの責務をCSSに集約する設計思想が背景にある
- プロトタイピングの高速化や、インタラクション実装の工数削減といった実務的なメリットが大きい
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI引用シェア率をBingが公開、llms.txtの効果に疑問符
AI検索の可視性をどう測るか、そして構造化データファイルにどこまで期待すべきか。この一週間でその答えに直結する動きが複数出てきた。
MicrosoftがAI引用のシェア率を計測する新機能を公開し、GoogleとAhrefsのデータはllms.txtの効果に冷や水を浴びせた。さらにAIエージェント向けの新仕様が2つ登場するなど、情報が一気に動いている。英国CMAによる公正ランキング命令も含め、今週のトップ4ニュースを実務視点で整理する。
BingがAI引用シェア率を公開。競合との差が初めて数値化された
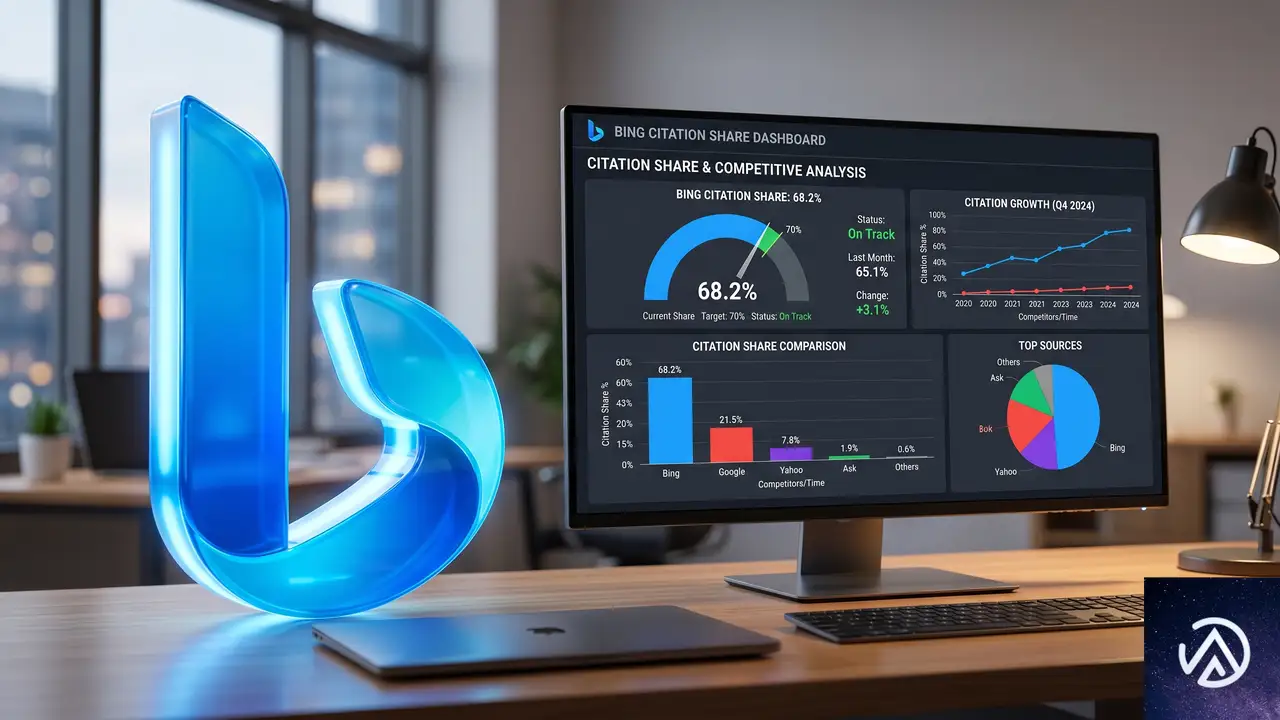
MicrosoftはBing Webmaster ToolsのAIパフォーマンスダッシュボードに、新たな4機能をプレビュー公開した。追加されたのは「Citation Share(引用シェア率)」「Intents(検索意図別グループ)」「Topics(トピック別グループ)」「Compare(期間比較)」だ。いずれも現在はプレビュー段階でグローバルに順次ロールアウトされている。
このCitation Shareによって、AI検索結果における自サイトの存在感が、競合との比較で初めて把握できるようになる。ただしこのデータはBing独自であり、CopilotやBingの回答を対象とする。Google検索側では検索コンソールにこれに相当する引用カウント機能は提供されていない。
SEO担当者の受け止めと実務への示唆
ILoveSEO.netの創業者Gianluca Fiorelli氏はLinkedInで「Bing Webmaster Toolsこそ、我々がGoogleサーチコンソールに望んでいた姿だ」と評価した。AI可視性を測る新しい物差しが登場したことは、今後の施策優先度をデータドリブンに決める上で大きい。
現時点ではBingに限られた指標だが、AI検索のトラフィックが今後さらに一般化すれば、Googleも類似の指標を導入せざるを得なくなる可能性がある。先行してBing側でのデータ取得と分析のノウハウを積んでおくことは、将来のAI検索対策で優位に立つ一手になる。
llms.txtへの期待に新データが疑問符。97%がアクセスゼロ
llms.txtは、大規模言語モデル(LLM)向けにサイト情報を構造化して提供するテキストファイルだ。AIがサイト内容を理解しやすくする目的で提唱され、導入が進んでいる。しかし今週、その効果に疑念を投げかける材料が二つ重なった。
Mueller氏は「Search Off the Record」ポッドキャストで、llms.txtが自己申告型のファイルである以上、LLMがサイトを発見したり他サイトと比較して評価したりする用途には使えないと明言した。本質的に重要なのは従来のHTMLと内部リンク構造だという立場だ。
Ahrefsのデータも同じ方向を指している。13万7000ドメインのうち、97%のllms.txtファイルには一度もボットからのアクセスがなかった。さらにアクセスが確認されたケースでも、ChatGPTやPerplexityといった引用生成ボットからのリクエストは全体の1%に過ぎない。この結果は、数ヶ月前にSE Rankingが30万ドメインを調査して導いた「llms.txtはAI引用に明確な効果を示さない」という結論とも整合する。
SEO専門家の見解と実務上の落とし所
Clio Websitesの創業者Nat Miletic氏はLinkedInで「llms.txtは公開コストが低いので置いておくのは構わない。ただしそれでAI可視性が上がるとは今は期待しないほうがいい」と総括した。コーディングエージェントや学習用クローラー向けに一部で参照されているため維持コストに見合う面はあるが、AI検索結果への表示を目的とした投資としては優先度を下げる判断が妥当だ。
AIエージェント向け新仕様が2つ登場。OKFとARDの注目点
Google Cloudは「OKF(Open Knowledge Format)」を公開した。組織内の知識(データセット、メトリクス、運用手順書など)をAIエージェントが読めるマークダウン形式でパッケージングする仕様だ。ほぼ同時期に、GoogleやMicrosoft、GitHub、Hugging Faceを含む連合が「ARD(Agentic Resource Discovery)」の草案を発表した。こちらはAIエージェントがツールやスキル、他のエージェントを発見・検証するためのプロトコルを定義する。
両仕様とも現時点で即時の対応を求めるものではない。OKFはバージョン0.1、ARDは0.9と初期段階だ。Harton Worksの創業者Martin Jeffrey氏はARDを「ページではなく機能のためのサイトマップが再来したようなものだ」と表現した。Snippet Digitalの共同創業者Suganthan Mohanadasan氏は「魔法のキノコではない。これで一夜にしてAI可視性が上がるわけではない」と期待値を引き締めている。
実務的には、どのフォーマットが実際に普及するかを見極める観察期間に入る。llms.txtの事例が示すように、仕様の存在と実際の効果は別問題だ。導入判断は普及の兆候を確認してからでも遅くない。
英国CMAがGoogleに公正ランキングを命令。事前通知義務が実務に波及
英国の競争市場庁(CMA)がGoogle検索に対し、新たなルールを設定した。オーガニック検索結果のランキングに客観的かつ非差別的な基準を使うこと、そして大規模な変更の際には事前通知を行うことを義務づける内容だ。
このルールの適用範囲は英国のオーガニック検索結果で、AI Overviewsも対象に含まれる(広告は除く)。Googleは「現行のランキングはすでに公正かつ透明だ」と反論しているが、CMAは6月初旬にもAI検索機能からのオプトアウトを認めるよう命令しており、規制圧力は強まっている。
SEO専門家の反応から読む今後の展開
Searchpediaの創業者Laura Iancu氏はLinkedInで「もうこれで『コアアップデートを突然リリースしました』なんてことはできなくなる」と単刀直入に表現した。Blue Arrayの戦略SEO責任者Chloe Smith氏は「Googleは何らかの回避策を探るだろう」と予測しつつも、事前通知と異議申し立ての枠組みができたこと自体に意味があると見ている。
現状では英国限定の措置だが、EUや他の地域にも波及する可能性は否定できない。特に、大規模アップデートの事前通知が実務化すれば、SEO施策の計画立案や緊急対応のあり方そのものが変わる。今後のGoogleの実装方法を注視する必要がある。
構造化ファイルを置くだけでは済まない。AI可視性の本質に立ち返る
今週のニュースを横断して浮かび上がるテーマは、「構造化ファイルを自ドメインに置いておけばAIに見つけてもらえる」という発想への再考だ。llms.txtはその教訓をすでに示している。ファイルを公開しても、Googleはサイト差別化に寄与しないと断言し、データは大半のファイルが読まれていない事実を突きつけた。
OKFやARDが登場したことで、構造化ファイルへの要求はこれからも繰り返されるだろう。しかし破綻しているのは「ファイルを置けば報われる」という期待のほうだ。BingのCitation Shareは、そうした取り組みが実際に引用に結びついているかを数値で示してくれる、貴重なフィードバックループになり得る。
AI検索時代の可視性は、小手先のファイル配置ではなく、コンテンツそのものの強さと、信頼される情報源としてサイト全体を設計し続ける積み重ねで決まる。今週のデータと専門家の声は、その原則を改めて強調する結果になった。
この記事のポイント
- Bing Webmaster Toolsの新機能「AI Citation Share」で、AI検索での競合とのシェア比較が初めて可能になった。Googleにはまだ同等機能はない
- llms.txtは97%がアクセスゼロ。AI検索可視性への効果はデータで否定され、自己申告ファイルの限界が明確になった
- OKFとARDという新たなAIエージェント向け仕様が登場したが、普及は未知数。llms.txtの教訓を踏まえ導入判断は慎重に行うべきだ
- 英国CMAがGoogleに対し、検索順位の公正化と大規模変更前の事前通知を義務づけた。SEO施策の計画立案に影響する可能性がある
- 結局、AI可視性の本質は構造化ファイルではなく、通常のHTMLコンテンツの品質と情報設計にある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon Bedrock AgentCoreにWeb Search機能が一般提供開始、AIエージェントの回答を最新Web情報で根拠づけ
AWSは2026年6月17日、Amazon Bedrock AgentCoreにWeb Search機能の一般提供を開始した。AIエージェントがユーザーからの質問に対し、最新のWeb情報を参照しながら根拠のある回答を提示できるようにする。トレーニングデータだけではカバーしきれない直近の出来事や新事実を、AWS環境内で安全に取得できる点が最大の特徴だ。
この機能は、Amazonが長年培ってきた検索インフラ上に構築されている。Alexa+やAmazon Quick、Kiroといった製品で実績のある基盤を活用し、WebインデックスとAmazon Knowledge Graphを組み合わせたマルチソースな根拠付けを実現する。検索クエリは外部APIプロバイダに送信されず、AWS環境内で完結するため、企業のガバナンス要件にも適合する。
本記事では、Bedrock AgentCore Web Searchの仕組み、料金体系、導入事例を詳しく解説する。
Web Search機能の概要と背景
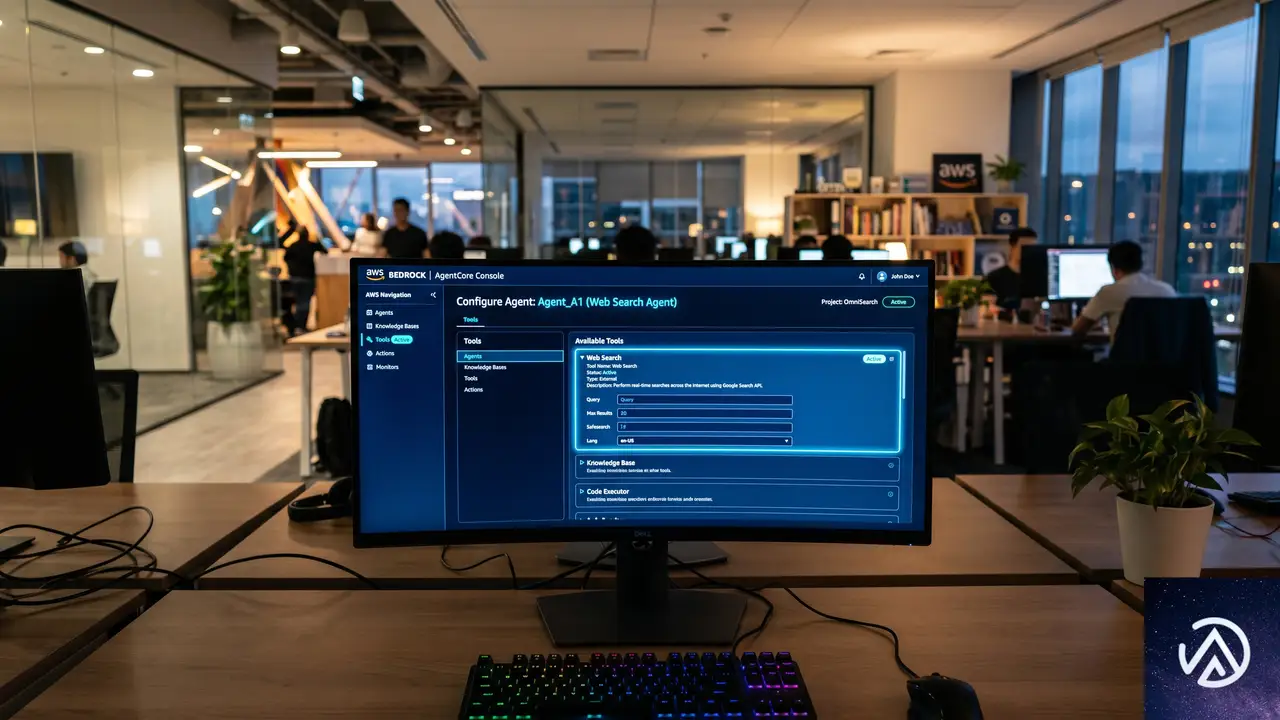
Bedrock AgentCoreの位置づけ
Amazon Bedrock AgentCoreは、AIエージェントの構築と運用を管理するフレームワークである。エージェントに必要なツールやデータソースとの接続をGatewayという仕組みで一元管理し、モデルの推論と外部機能の呼び出しを連携させる。今回発表されたWeb Searchは、AgentCore Gateway上で利用できる組み込みコネクタターゲットのひとつだ。
Web Searchが解決する課題
LLM(大規模言語モデル)は、学習時点のデータに基づいて回答を生成するため、つねに最新の情報を反映できるとは限らない。たとえば、企業の決算発表や法改正、製品アップデートなど、学習後に発生した出来事には対応できない。Web Searchを用いれば、エージェントがリアルタイムにWeb検索を実行し、得られたスニペットやURLを参照して回答を生成できる。回答には引用元が明示されるため、情報の信頼性をユーザーが確認しやすくなる。
仕組み:MCP接続とAmazon知識グラフによる根拠付け
MCP(Model Context Protocol)の役割
Web Searchは、MCP(Model Context Protocol)と呼ばれる標準プロトコルを介してAgentCore Gatewayに接続される。MCPを使うことで、エージェントは自然言語のクエリを送信し、関連性の高い検索結果(スニペット、URL、タイトル、公開日)を取得できる。GatewayがMCPターゲットとしてWeb Searchツールを仲介するため、開発者が個別に検索APIを実装する必要はない。
Amazon知識グラフとの統合
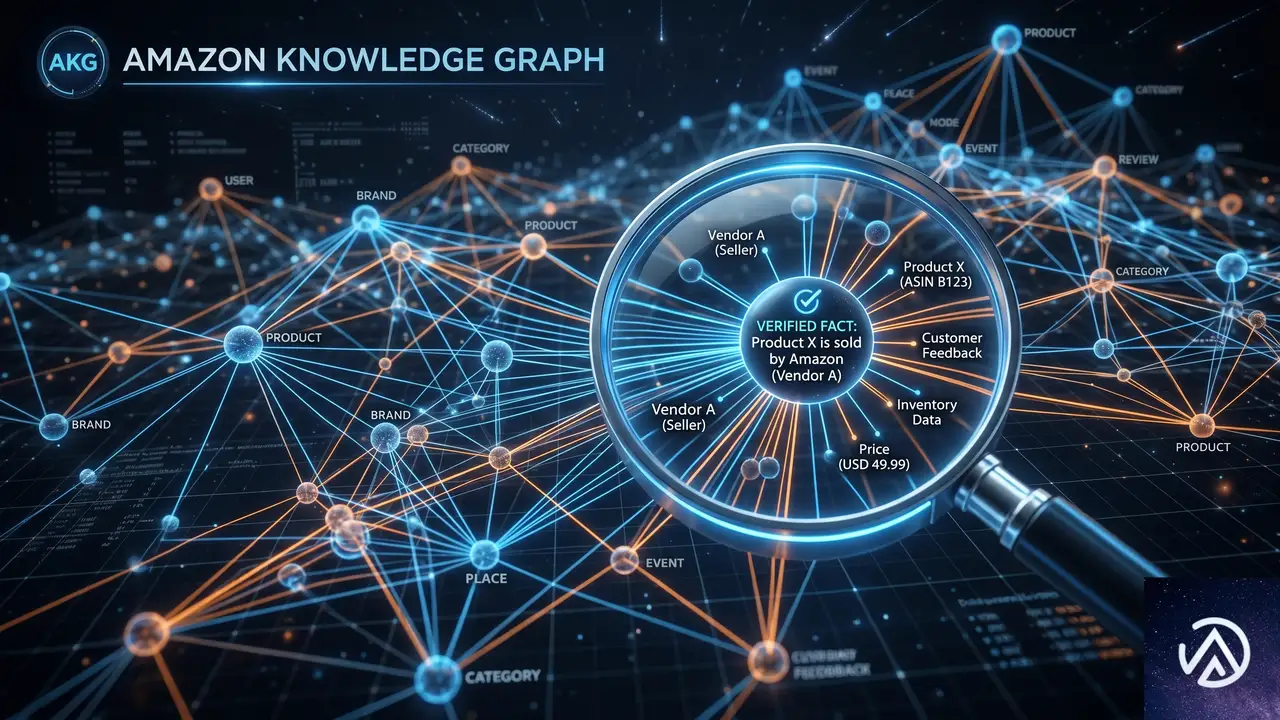
一般的なWeb検索に加え、Amazon Knowledge Graphの構造化データが検索結果に組み込まれる。これにより、単なるWebスニペットではカバーしきれない検証済みの事実情報をエージェントが参照できるようになる。AWSのブログ記事によれば、このマルチソースアプローチが従来のWeb検索だけに頼る場合と比較して、より的確な回答につながるとされている。
エージェントが回答を生成するまでの流れ
以下のデモは、ユーザーが質問してからエージェントが根拠付き回答を返すまでの一連のステップを図示したものだ。
STEP 3の段階でAmazon Knowledge Graphが活用される点が、単なるWeb検索を超えた信頼性につながる。エージェントは受け取った情報をそのまま返すのではなく、モデルが内容を推論した上で回答を構成するため、質問の文脈に合った自然な応答になる。
AWS環境内で閉じるセキュアなWeb検索の価値
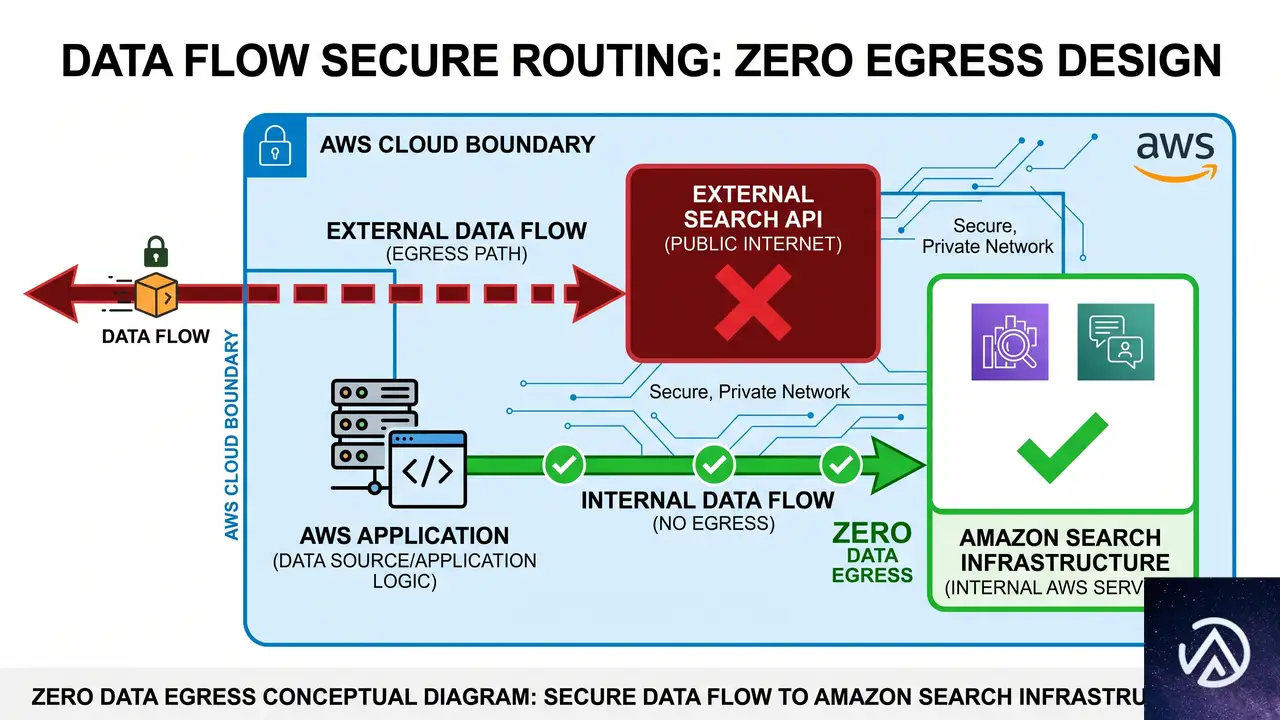
多くのAIエージェント向けWeb検索ソリューションでは、ユーザーのクエリやプロンプトが外部の検索APIプロバイダに送信される。これに対しBedrock AgentCoreのWeb Searchは、Amazon自身の検索インフラを使用するため、データがAWS環境の外に流出しない。これにより、機密性の高い業務データを扱う企業でも、ガバナンスやコンプライアンスの要件を満たしながらエージェントにWeb検索機能を組み込める。
AWSの説明によれば、この仕組みはAlexa+やKiroなどのプロダクトで培われた検索技術を基盤にしており、信頼性とスケーラビリティの両面で実績がある。ユーザーは外部の検索サービス契約やAPIキー管理を気にすることなく、AgentCoreの設定画面上でWeb Searchを有効化するだけで利用を開始できる。
料金体系と利用開始手順
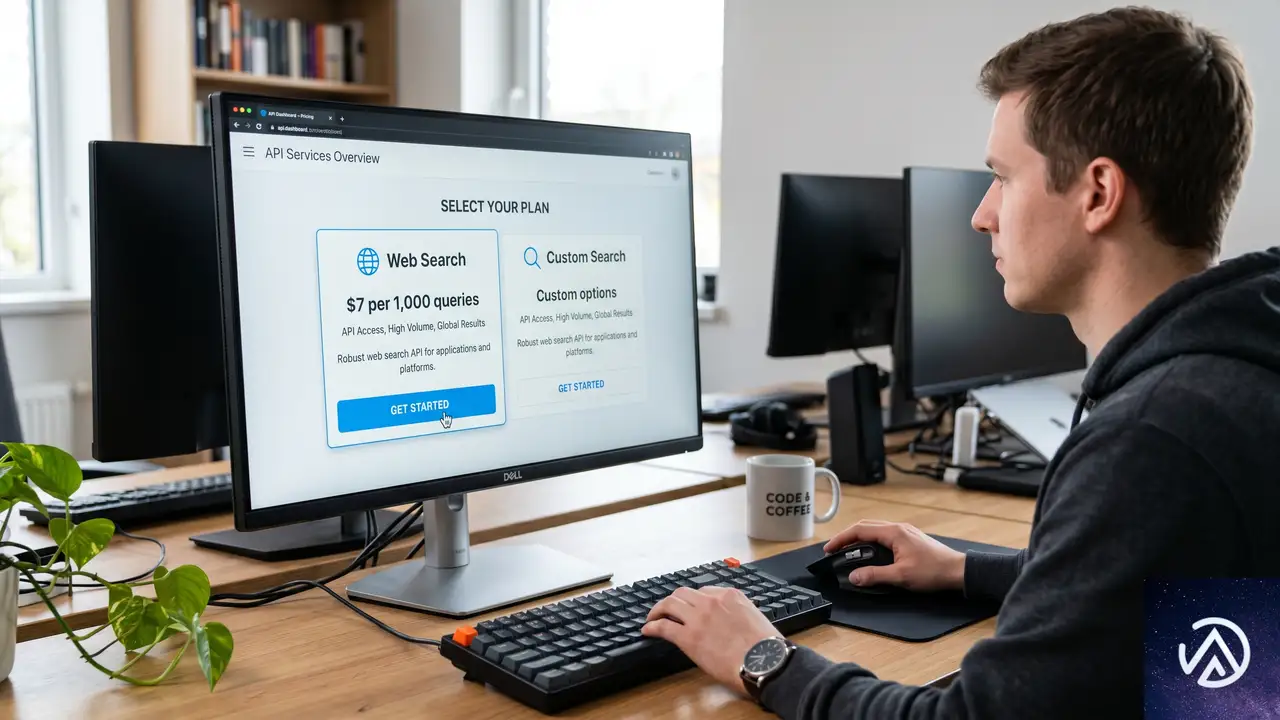
料金詳細
Web Searchの料金は従量課金制で、エージェントが実行した検索クエリの数に応じて計算される。具体的には、1,000クエリあたり7ドルである。新規のAWS顧客には最大200ドル相当の無料利用枠も提供される。利用料はすべてAWSの請求に統合されるため、別途外部サービスへの支払い管理は不要だ。
セットアップ手順
Bedrock AgentCoreコンソール(us-east-1リージョン)にアクセスし、Gatewayを作成する。ターゲットの追加時に「MCP target」プロトコルと「Connectors」タイプを選択し、プリコンフィギュアされた「Web Search tool」を指定する。Gatewayの詳細ページに遷移すると、PythonやMCP Inspectorを用いた呼び出しコードのサンプルが表示されるため、これをコピーして自環境に組み込むだけで統合が完了する。
テスト用途であれば、MCP InspectorをGatewayのリソースURLに接続し、Web Searchツールにクエリを直接入力して動作を確認できる。実運用では、エージェントのプロンプト設計にWeb検索の呼び出しトリガーを組み込み、回答生成時に適宜検索が走るように構成することになる。
企業での活用事例
Benchling:科学研究の加速
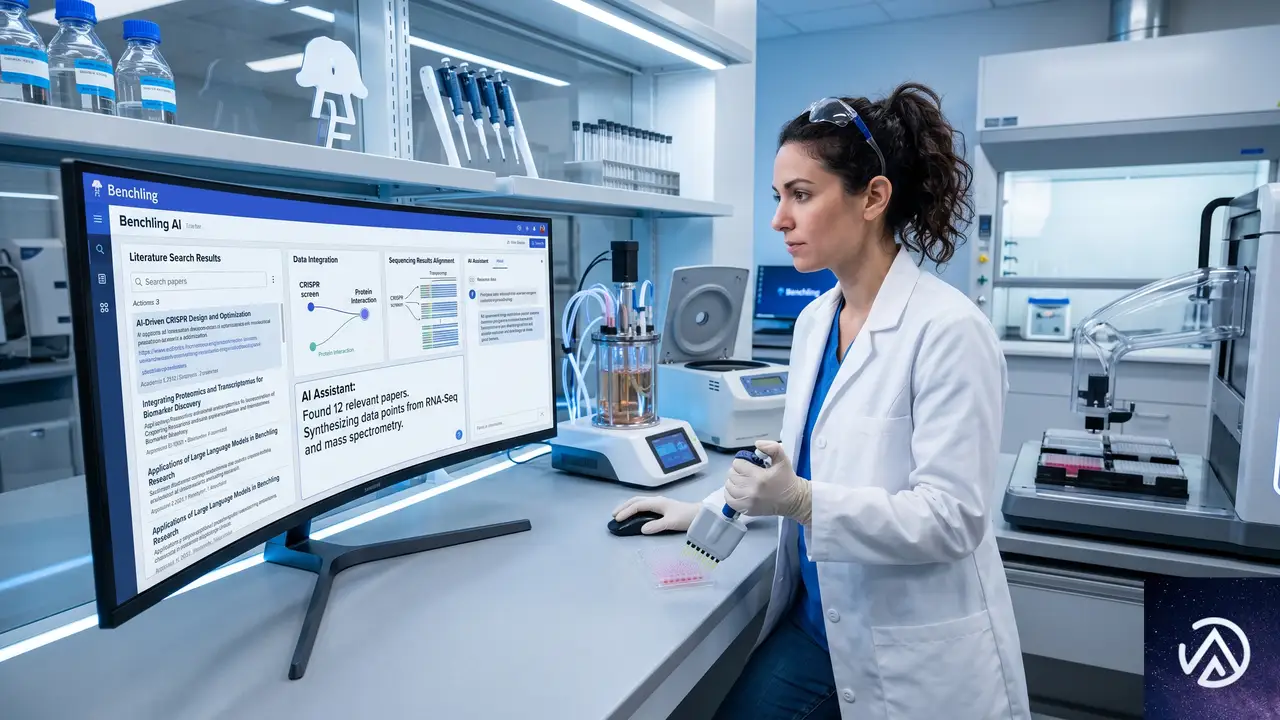
ライフサイエンス分野のR&Dプラットフォームを提供するBenchlingは、早期アクセスを通じてWeb Searchを試験導入した。同社AIエージェント責任者Nicholas Larus-Stone氏によると、科学者が研究対象について質問すると、Benchling内の組織データと公開文献の両方に基づく回答が得られるようになったという。これにより、仮説生成の質が向上し、顧客のデータ管理ポリシーにも適合する安全な環境を維持できている。
Gen Digital:オンライン評判管理の強化
消費者向けセキュリティ製品を展開するGen Digital(Nortonブランド)は、Norton RevampというサービスにWeb Searchを組み込んだ。プロフェッショナルが自身のオンライン評判を構築する際、最新のトレンドや事実に基づいたコンテンツアイデアをエージェントが提案できるようになる。同社AI・イノベーション部門シニアディレクターIskander Sanchez-Rola氏は、すべてのクエリが信頼できるAWS環境内で処理される点を高く評価しているとコメントした。
いずれの事例でも、外部サービスを利用せずにAWS内で完結するセキュリティと、Amazon独自の検索インデックスによる高精度な情報取得が決め手となっている。
この記事のポイント
- Amazon Bedrock AgentCoreでWeb Search機能が一般提供開始。MCP経由でWeb検索と知識グラフを統合し、エージェントの回答を最新情報で根拠づける
- 検索クエリはAWS環境外に出ず、Amazonの検索インフラで処理されるため、データガバナンスとコンプライアンスに対応
- 料金は1,000クエリあたり7ドルの従量課金。新規顧客向けに200ドル分の無料枠あり
- BenchlingやGen Digitalなどの企業がすでに導入し、研究支援や評判管理の精度向上に活用している
- us-east-1リージョンで利用可能。AgentCoreコンソールから数ステップで設定できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
建築許可の審査期間を半減。英国政府がGemini活用ツール、2027年全国展開
英国政府は2029年までに150万戸の新築住宅を供給する目標を掲げている。しかし自治体の計画許可部門は、大量の紙書類と行政手続きの滞留に直面しており、目標達成の大きな足かせとなっている。
この課題に対し、Google DeepMindは英国政府、Google Cloud、ならびにFacultyとの協力のもと、建築許可申請の審査にかかる時間を抜本的に短縮するAIプロトタイプの開発を進めている。目標は担当官の判断にかかる時間を半減させること。2026年6月時点で一部自治体での試験運用が始まっており、2027年には全国のすべてのカウンシルで利用可能になる見通しだ。
建築許可のボトルネックとAI活用の背景
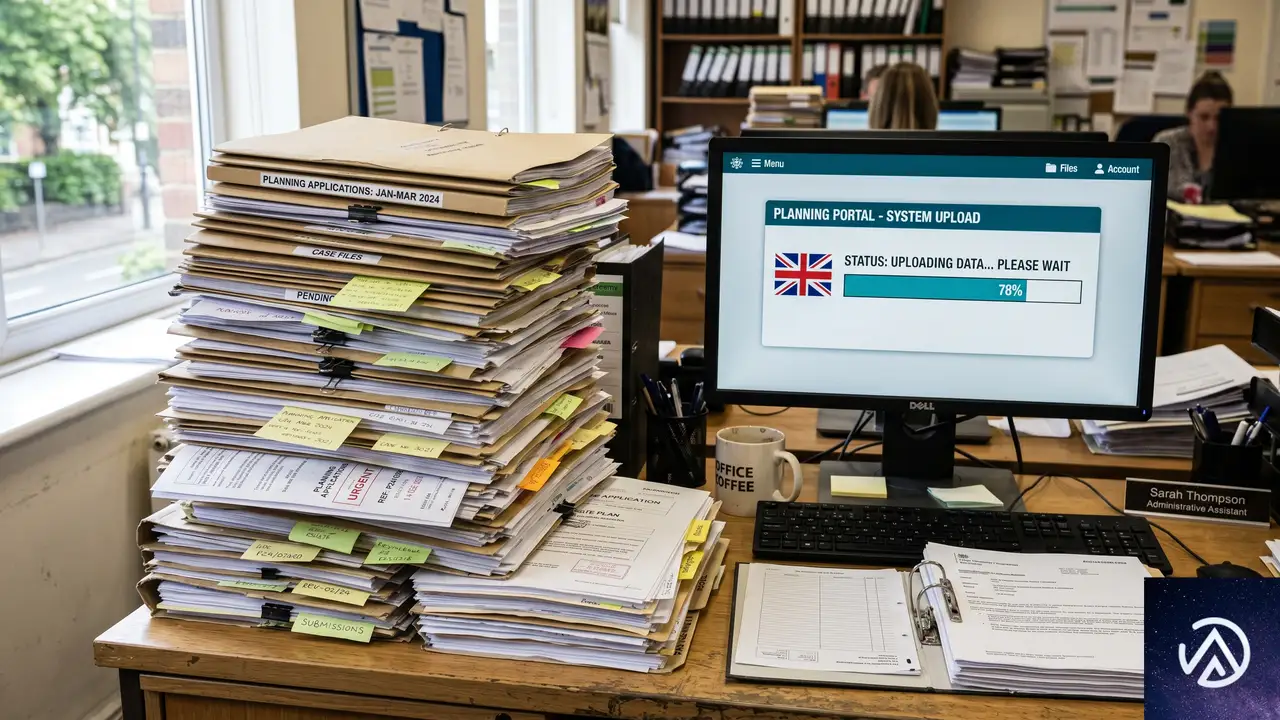
年間の計画申請のうち、住宅所有者による増築やロフト改修といった比較的単純な申請が約7割を占める。ところが担当官は一件ごとに地域の方針書、過去の許可事例、住民からの意見書など大量のPDFを手作業で照合しなければならず、この単純作業が大きなボトルネックになっている。
こうした背景から、英国政府のAIインキュベーター(i.AI)はすでにExtractというツールを開発し、旧来の文書を構造化データに変換する取り組みを進めてきた。今回のプロトタイプは、その土台の上にGeminiによる高度な解析支援を組み合わせ、審査プロセス全体を加速させる狙いがある。
AIが支援する新たな計画審査プロトタイプ
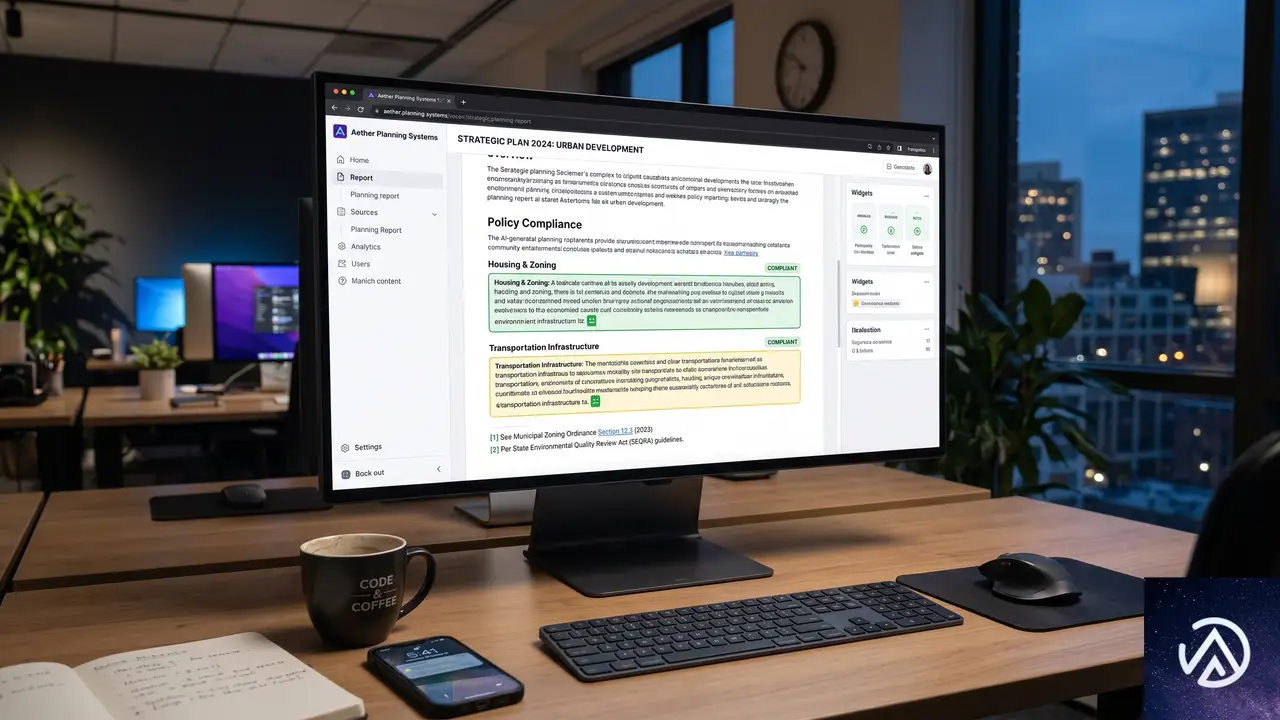
このプロトタイプは、Barnet、Camden、Dorsetの3つの自治体と共同で開発が進められている。計画担当官にとっては「熟練したアシスタント」のように機能し、データ抽出や事例分析といった重労働を肩代わりする。具体的には以下の4つの作業をAIが自動化する。
- データ統合:滞留している申請情報を前処理し、不足データの可視化やサイト主要情報の抽出を行う。担当官は1つの画面で全体を把握できる。
- 地域方針の照合:国および地域の関連方針を自動でハイライトし、事前にコンプライアンスを評価。正確な引用情報を添えて担当官に提示する。
- 住民意見の要約:個別の意見書を分析し、主要な反対意見や判例を要約する。
- 審査レポートの下書き作成:最終報告書の初稿を生成し、判断の根拠や提案する条件を整理する。
ここで重要なのは、最終的な判断を下すのは常に計画担当官であり、人間の監視が必ず残る点だ。プロトタイプは生成した文章を一歩一歩記録し、明確な思考の連鎖と監査証跡を残す設計になっている。担当官はAIが提案した内容を一行ずつレビューし、根拠を編集したうえで許可・却下を決定する。
手動では数時間かかっていた作業が、AIによる事前のデータ整理と下書き作成によって大幅に短縮される。計画担当官は単純な転記や照合から解放され、より複雑な案件や公共の利益に資する判断に集中できるようになる。
試運用で見える効果と全国展開への展望
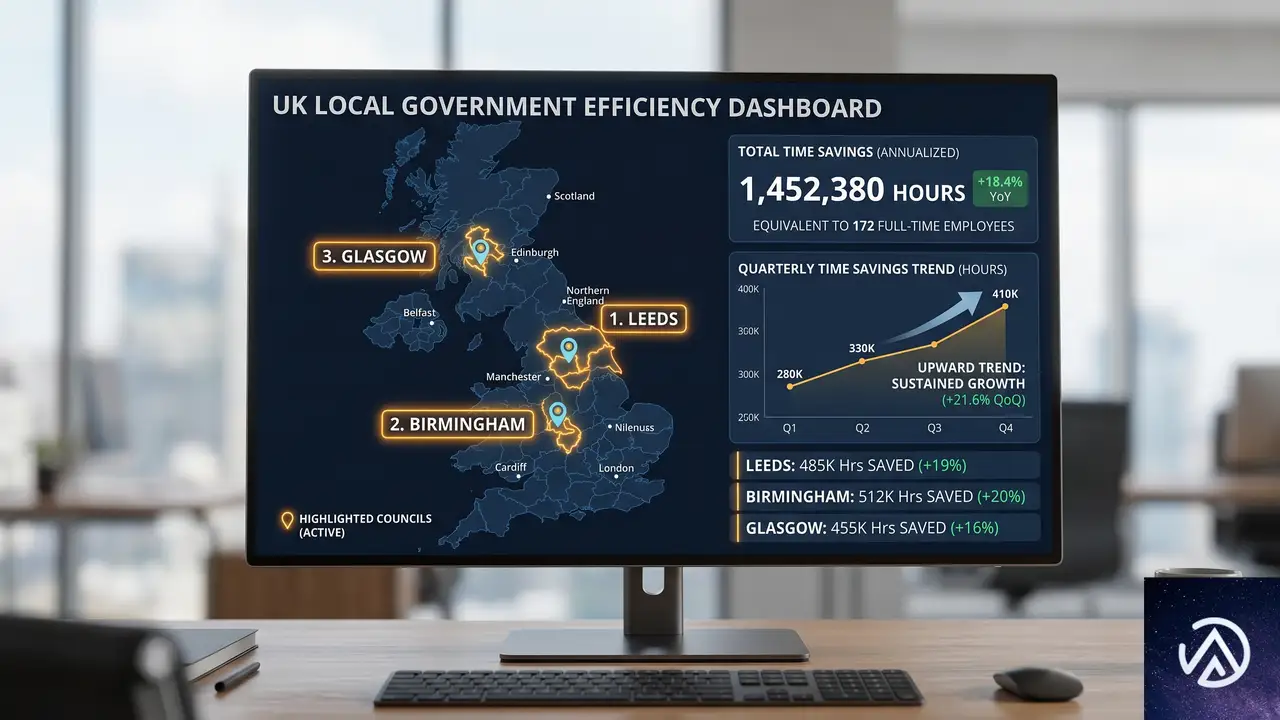
今回のプロトタイプのベースとなったExtractは、すでに20以上の自治体で試験運用され、平均的なカウンシルで年間約255時間の手動作業を削減できる実績を残している。2026年6月には全イングランドのカウンシルで利用可能となり、旧式のPDFをわずか数分で構造化データに変換できるようになった。
新しいAIツールはこのExtractの成果に加え、審査そのものの自動下書きまで踏み込んでいる。Barnet、Camden、Dorsetでの初期試験を経て、英国政府は2027年から全国すべてのカウンシルに展開する計画だ。もし全国で導入されれば、担当官の審査時間が半減し、戸建て住宅の増改築といった日常的な申請が迅速に処理されるようになる。これにより住宅供給の加速だけでなく、地域経済の活性化にもつながると期待されている。
行政におけるAI活用では、透明性と説明責任の確保が常に課題となるが、今回のプロトタイプは全ステップを記録し、人間が最終判断する設計を徹底している点が特徴だ。AIが下書きを生成し、担当官がそれを検証・修正するハイブリッド型のワークフローは、他の公共サービス分野にも応用可能なモデルケースとなるだろう。
この記事のポイント
- 英国政府とGoogle DeepMindがGeminiを活用した建築許可審査AIツールを共同開発中
- 書類統合、方針照合、意見要約、レポート下書きの4機能で担当官の負荷を大幅に軽減
- 計画担当官が最終判断を保持し、全ステップが監査証跡として記録される設計
- 試験運用を経て2027年までにイングランド全カウンシルへの提供を予定
- 単純作業の自動化により住宅供給の加速と行政リソースの最適化が期待される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
LLMjackingの実態と防御策、APIキー漏洩が招く3つのリスク
近年、AIと大規模言語モデル(LLM)は企業の業務プロセスに急速に浸透している。カスタマーサポートやデータ分析の中核にLLMが据えられ、ビジネスの依存度は日増しに高まっている。その依存を狙う新たな脅威が「LLMjacking」だ。APIキーを窃取され、LLMリソースを不正利用されるこの攻撃は、財務的損失から機密情報の流出まで、多面的な被害をもたらす。
LLMjackingは単なるリソースの不正消費ではない。カスタムモデルの悪用やデータポイズニングといった、より深刻なリスクを内包する。本記事では、LLMjackingの仕組み、具体的なリスク、攻撃経路、検知手法、防御策を解説する。
LLMjackingとは何か
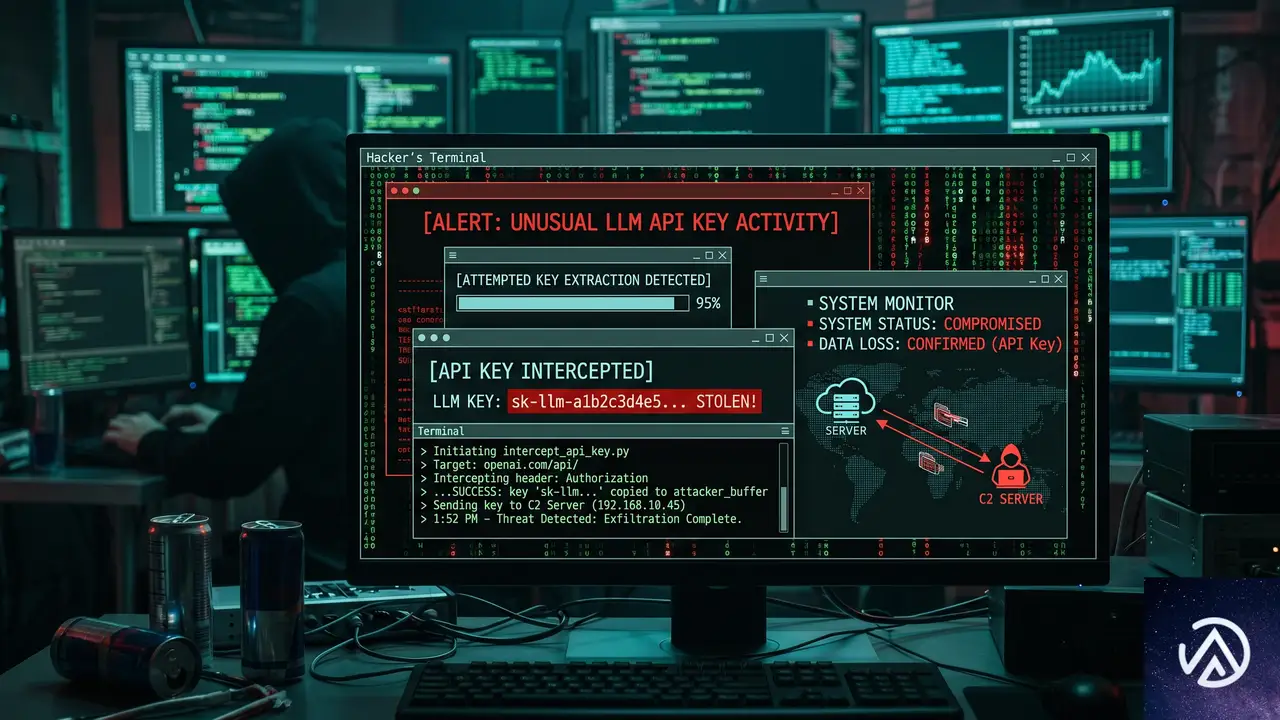
LLMjackingは、攻撃者がLLMへのアクセスを乗っ取る攻撃手法だ。広く普及した技術だが、その本質は新しいものではない。AWSやGCPのアクセスキーを狙う従来のクレデンシャル窃取と構造は同じで、標的がLLMのAPIキーに置き換わっただけである。
LLMの利用は従量課金制であることが多く、APIキーが漏洩すれば高額な請求に直結する。さらに、カスタムモデルや社内データと統合されたキーの場合、単なる計算リソースの盗用を超えて、機密情報へのアクセスが可能になる。盗まれたクラウドキーよりも、LLMの認証情報が悪用されたときの被害範囲は広がる傾向がある。
LLMがビジネスの中枢に組み込まれている現在、APIキーの漏洩はインフラ侵害以上の結果を招く。後続のセクションで具体的なリスクを整理する。
LLMjackingがもたらす3つのリスク
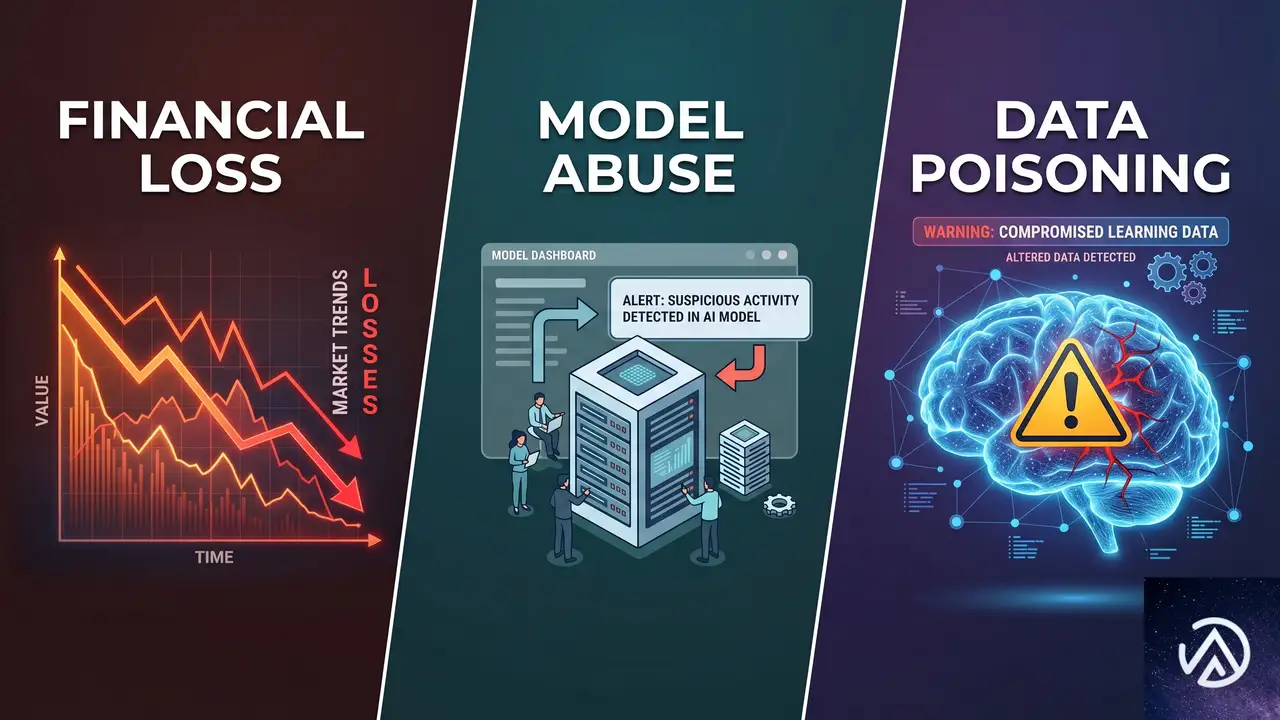
LLMjackingの被害はAPIの不正利用による請求増加にとどまらない。組織の財務、カスタムモデルの機密性、そしてモデル自体の信頼性を脅かす。以下、主要な3つのリスクを詳述する。
財務的損失
LLMのAPIは従量課金が一般的だ。攻撃者が無制限にアクセスすると、スパムメールのテンプレート生成やフィッシングサイト構築、マルウェア開発などに悪用され、短時間で高額な請求が発生する。利用上限を設定していても、LLMに依存する下流のエージェントプロセスや自動化ワークフローが巻き添えで停止し、ビジネス機会の喪失という二次的損失を生む。
カスタムモデルの悪用
多くの組織は社内文書や業務プロセスを学習させたカスタムモデルを「社内Wiki」として活用している。新入社員が業務手順を尋ねたり、特定の書類に関する質問を投げかけたりする用途だ。このモデルに攻撃者がアクセスすると、公開を想定していない組織内部の知識が流出する。攻撃者は得た情報を足がかりにネットワーク内での足場を拡大したり、ダークウェブで情報を売買したりする可能性がある。
データポイズニング
カスタムモデルが継続的に新しいデータで再学習されている環境では、訓練データや学習パイプラインへのアクセスを許すとデータ汚染のリスクが生じる。攻撃者は長期間かけてモデルに微妙なバイアスを注入し、従業員に誤解を招く応答や偏った情報を提供させることが可能だ。意思決定を徐々に歪め、誤った情報を拡散させるこの手法は検知が極めて難しい。
これらのリスクは相互に関連し、単一のインシデントから複合的な被害に発展しうる。次のセクションでは、攻撃者がどのようにAPIキーを入手するのかを説明する。
LLMjackingの攻撃経路
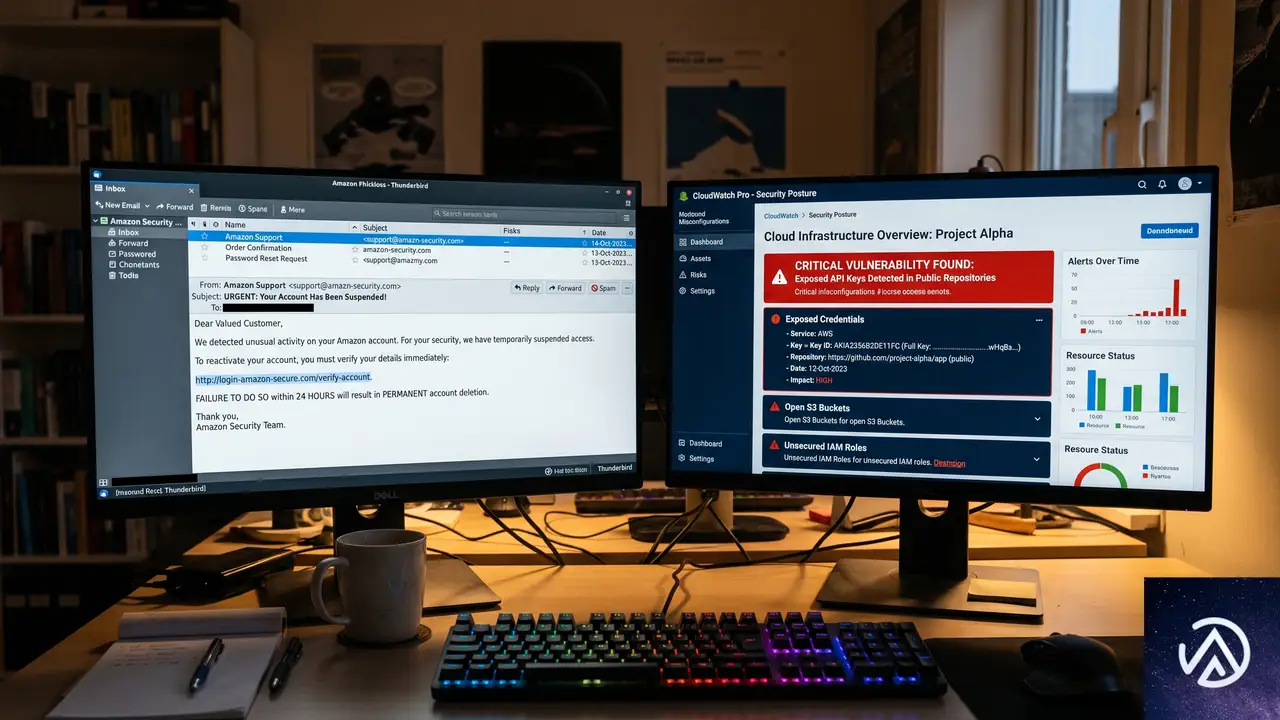
LLMjackingの攻撃ベクトルは、従来のクラウド認証情報を狙う手法と共通する部分が多い。主な経路はフィッシングと設定ミスの2つだ。
フィッシング
AI支援型の高度な攻撃が登場しても、最も古くからある「人間を騙す」手法は依然として有効だ。巧妙に作られたフィッシングページは、緊急性を装ったり、プラットフォームからの通知を偽装したりして、ユーザーに認証情報を入力させる。LLMのAPIキーも例外ではなく、従来の手口で窃取されるケースが後を絶たない。
クラウド設定やアプリケーション設定の不備
環境変数や構成ファイル、コンテナイメージ、CI/CDパイプライン、ログシステムにAPIキーが平文で保存されている事例は珍しくない。過剰な権限を持つS3バケットや公開されたKubernetesダッシュボード、適切に管理されていないGitリポジトリから、攻撃者は直接的な脆弱性を突くことなく認証情報を入手できる。
LLM統合のスピードが優先される現場では、セキュリティのベストプラクティスが後回しにされがちだ。これが認証情報の漏洩を招き、LLMへの自由なアクセスを攻撃者に与える結果となる。
どちらの経路でも、攻撃者は正規のAPIキーを手にするため、従来のファイアウォールでは検知が難しい。次のセクションで監視と検知の方法を解説する。
LLMjackingを検知する方法
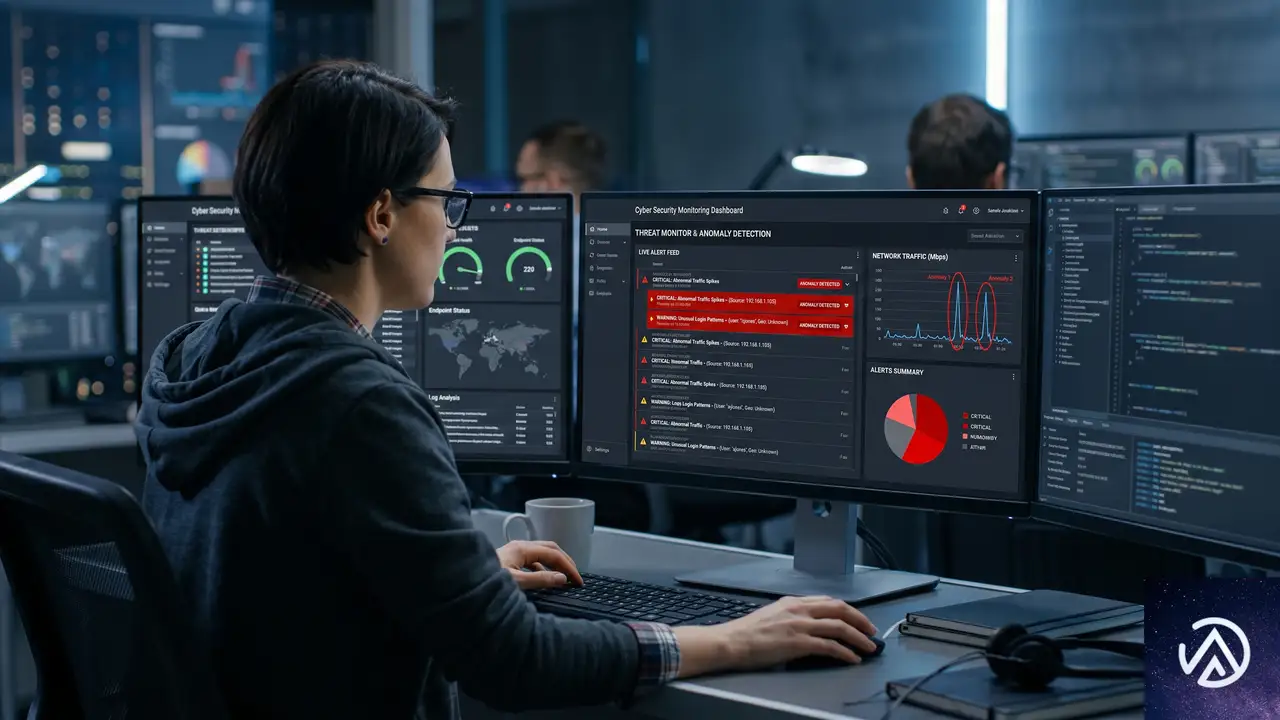
LLMjackingは単一の明らかな侵害として現れるよりも、異常な利用パターンとして表面化することが多い。検知にはベースラインの確立と継続的な監視が欠かせない。
組織のLLM利用ベースラインを確立する
異常を検知するには、まず「通常」の状態を定義する必要がある。APIリクエスト量、トークン消費量、よく使われるエンドポイントを時間帯ごとに把握し、月末のスパイクや定期的な増加パターンを基にベースラインを作成する。このベースラインと現在の利用状況を常に比較し、逸脱があれば速やかに調査することが重要だ。
請求アラートの監視
請求アラートは異常の最初の兆候であるケースが多い。攻撃者が低速度で長期間にわたりリソースを消費する「低頻度で遅い攻撃」に及んだ場合、検知は難しくなるが、大半の攻撃者はアクセスを失う前にできるだけ多くのリソースを使い切ろうとするため、請求上限アラートが作動する。アラート発生時は即座に調査し、対処を開始すべきだ。
検知体制を整えたら、次に必要なのは予防策だ。APIキーを狙う攻撃に対する実践的な防御手法を紹介する。
LLMjackingから防御するための対策
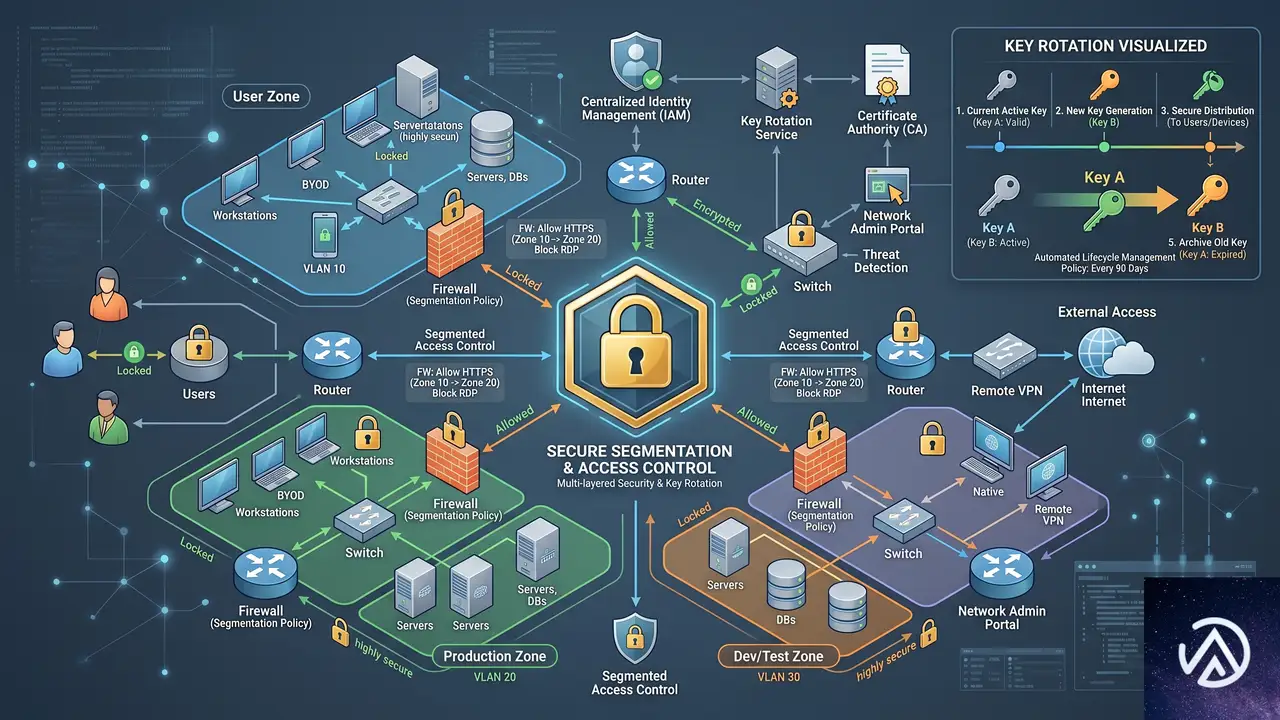
LLMjackingの防御は、結局のところ「認証情報を入手しにくくする」ことに尽きる。有効なAPIキーに依存する攻撃であるため、ファイアウォールよりも認証情報管理とアクセス制御が重要だ。
認証情報の衛生管理を徹底する
APIキーの定期的なローテーションは、漏洩した認証情報の有効期限を短縮する最も効果的な手段の一つだ。さらに、全てのワークロードに共有キーを使うのではなく、アプリケーションやサービスごとに専用のスコープを限定したキーを発行することで、異常発生時の特定と隔離が容易になる。侵害されたキーの影響範囲(ブラスト半径)も小さく抑えられる。
最小権限の原則を適用する
「念のため」と広範なアクセス権を付与する誘惑に抵抗し、人間ユーザーにも同じ原則を適用する必要がある。マーケティング部門の担当者が本番環境のプロンプトや顧客データパイプライン、法務要約モデルにアクセスできる必要はまずない。特定のワークロード、エンドポイント、モデルだけに権限を絞ることで、たとえキーが盗まれても攻撃者の可能な行動を限定できる。
基本的なセキュリティ対策を怠らない
LLMjackingは目新しい脆弱性を突く攻撃ではない。適切なシークレット管理プラットフォーム(例:HashiCorp Vault)の導入、GitHubのプッシュ保護機能の有効化、SIEMによるログの一元管理など、基本的な対策の積み重ねが防御力を高める。
- シークレット管理: Vaultなどのツールでキーの自動ローテーションを実施する。
- リポジトリ保護: GitHubのプッシュ保護が有効か確認する。万が一シークレットがコミットされたら即座にローテーションする。
- ログの一元化: SIEMソリューションで監査ログとアクセスログを集約し、ベースラインとの比較と異常検知を自動化する。
LLMjackingの本質
LLMjackingは攻撃者にとって新しい攻撃対象だが、悪用される脆弱性は新しいものではない。認証情報の窃取と悪用という構造は、クラウド時代から変わらず、サイバーセキュリティの古典的な課題に過ぎない。しかし、LLMが意思決定や業務自動化に深く組み込まれた現在、その影響度は過去のリソースハイジャックより深刻になりうる。
防御の要は、最新のセキュリティ機構ではなく、基本の徹底にある。APIキーを高価値資産として扱い、スコープを限定し、使用状況を意図的に監視すること。技術は新しくとも、攻撃者が突く弱点は既知のものであり、対応策もまた既知のものだ。
この記事のポイント
- LLMjackingはLLM APIキーを不正に利用する攻撃で、財務的損失、カスタムモデル悪用、データポイズニングの3大リスクがある。
- 攻撃経路はフィッシングや設定ミスなど、従来の認証情報窃取と共通する。
- 検知には利用ベースラインの確立と請求アラートの監視が有効。
- 防御策はAPIキーの定期ローテーション、ワークロード固有のキー発行、最小権限の徹底が中核となる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
TypeScript 7.0 RCリリース、Go実装でコンパイル速度10倍に
TypeScript 7.0 RCの概要とインストール方法
TypeScript 7.0 RCの最大の変更点は、コンパイラそのものがGo言語で再実装されたことにある。これまで約10年にわたってTypeScript自身(セルフホスト)で書かれJavaScriptにトランスパイルされてきたコードベースを、Goに移植し直した。ネイティブコードの実行速度と共有メモリによる並列処理によって、コンパイル速度はTypeScript 6.0と比較して約10倍高速化した。
パッケージのインストールは従来と変わらずnpmから行える。以下のコマンドでRelease Candidateを取得し、すぐに試せる。
npm install -D typescript@rcインストール後は npx tsc --version でバージョンを確認できる。7.0.1-rc が表示されれば準備完了だ。コマンドラインの挙動はTypeScript 6.0と変わらず、同じ型チェック結果が得られる。エディタで試すには、VS Code向けに提供されている TypeScript Native Preview 拡張機能 をインストールするとよい。この拡張機能はLanguage Server Protocol(LSP)に基づいており、Copilot CLIを含む多くのエディタで動作する。
既存のTypeScript 6.0との共存
TypeScript 7.0 RCは安定版に近いが、プログラム向けの正式なAPIは少なくとも数か月先のバージョン7.1まで提供されない。このため、TypeScriptチームは6.0と7.0を並行して使い分けられる仕組みを用意した。互換パッケージ @typescript/typescript6 を導入すると、tsc6 という別名のバイナリが利用可能になる。従来のツールチェーンは6.0に固定しつつ、開発中の7.0を試す構成が取れる。
npm install -D typescript@npm:@typescript/typescript6
npm install -D typescript-7@npm:typescript@rc
これにより tsc は7.0を指し、tsc6 は6.0を指す。typescript-eslintのようなピア依存関係を持つツールでも問題なく使い分けられる。ナイトリービルドは現在 @typescript/native-preview パッケージで提供されており、バイナリ名は tsgo となっている。安定版リリース後は typescript パッケージに統合される予定だ。
単一スレッド動作と並列化の制御
TypeScript 7.0では、解析(パース)、型チェック、出力(エミット)の各段階が並列化されている。解析と出力はファイルごとに独立して処理できるため、大規模なコードベースほど効率よくスケールする。一方、型チェックはファイル間の依存関係が複雑で、完全に独立して動かすと計算の重複やメモリ消費が増える。この課題に対処するため、7.0は 固定数の型チェッカーワーカー を立ち上げる仕組みを採用した。デフォルトのワーカー数は4で、--checkers フラグで変更できる。
CIランナーのようにCPUコア数やメモリが限られた環境では、ワーカー数を減らすことでオーバーヘッドを抑えられる。稀に、--checkers の値によって型チェック結果にわずかな順序依存の差異が出る場合がある。チーム間で同じ結果を得るには、明示的にワーカー数を固定しておくのが安全だ。
このデモで示したように、TypeScript 7.0は複数のスレッドを活用して処理を同時に進める。単一スレッドに制限したい場合は --singleThreaded フラグを指定すると、すべての処理を1スレッドで行える。デバッグやパフォーマンス比較に役立つモードだ。
プロジェクト参照ビルドの並列化
TypeScript 7.0はプロジェクト内の並列化に加え、複数のプロジェクト参照を同時にビルドできるようになった。新しい --builders フラグで、並列実行するプロジェクトビルダーの数を制御する。モノレポ構成で多数のプロジェクトを抱える開発環境では、全体のビルド時間をさらに短縮できる可能性が高い。
注意点として、--builders の数と --checkers の数は乗算で効いてくる。たとえば --builders 4 --checkers 4 と指定すると、最大で16個の型チェッカーが同時に動作し、マシンのリソースを圧迫する場合がある。CIランナーやローカル環境のコア数、メモリ容量に応じて適切なバランスを探ることが重要だ。--builders の数値を変えても型チェック結果自体は変わらないが、プロジェクト間の依存グラフがボトルネックになるため、すべてのケースでリニアに速くなるわけではない。
Goへの移植がもたらす互換性と安定性
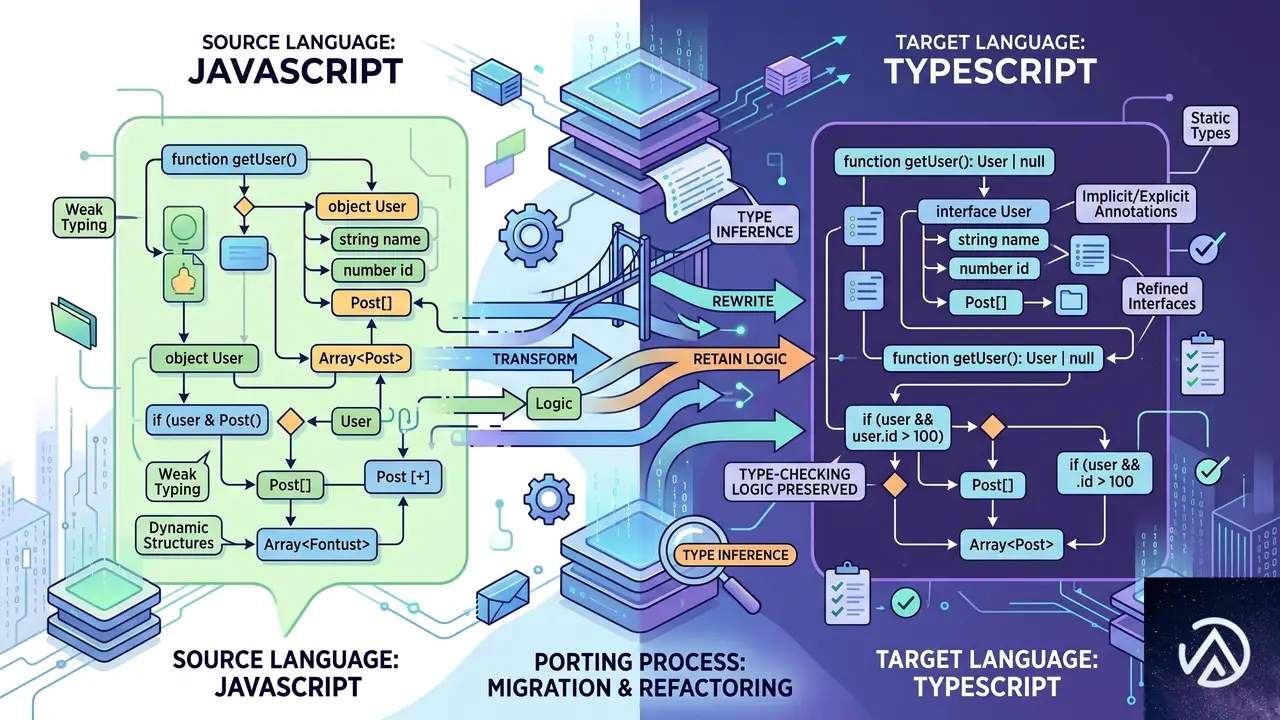
今回の移植は「スクラッチからの書き直し」ではなく、既存のTypeScript実装を忠実にGoへ移植する手法が取られた。型チェックのロジックはTypeScript 6.0と構造的に同一であり、これまで蓄積してきた膨大なテストスイートをすべてパスしている。Microsoft社内外の数百万行に及ぶコードベースで実際に使われており、高い互換性と安定性を維持している。
Bloomberg、Canva、Figma、Google、Linear、Miro、Notion、Slack、Vercelなど多くの企業がプレリリース版をテストし、ビルド時間の大幅な短縮と軽快な編集体験を報告している。TypeScriptチームはこれらのフィードバックを受け、リリース候補の品質に自信を持っている。
テンプレートリテラル型のUnicode対応改善
TypeScript 7.0では、テンプレートリテラル型におけるUnicodeコードポイントの扱いがより直感的になった。これまではJavaScriptのUTF-16インデックスに従い、サロゲートペアの分割が発生していた。たとえば "😀abc" をテンプレートリテラル型で推論すると、["\ud83d", "\ude00abc"] のように分割されることがあり、意味的に正しくない文字列リテラル型が生成される可能性があった。
7.0では for...of ループやスプレッド構文と同様に、"😀" を1つの単位として扱う。これにより、絵文字や一部の多バイト文字を含む文字列操作がより自然になり、意図しない型エラーを防げる。UTF-16コードユニット単位での操作を前提としていた型レベルユーティリティには破壊的変更となるが、ほとんどのケースで開発者の期待に沿う結果になる。
JavaScriptファイルのサポート見直し
TypeScriptはもともと、JSDocコメントや特定のコードパターンを解析することでJavaScriptファイルの型チェックをサポートしてきた。7.0ではこの動作をTypeScriptファイル(.ts)の解析ロジックとより一貫性のある形に再設計している。一部の旧来のパターンやJSDocタグの解釈が変更され、より厳密な型の扱いが求められるようになった。
たとえば、値が期待される箇所で直接型として値を使う記法は許容されず、typeof someValue と記述する必要がある。@enum タグは特別扱いされない。単独の ? を型として使うこともできず、代わりに any を使う。Closureスタイルの関数シンタックスもサポート対象外となった。詳細な変更点は公式の CHANGES.md ファイルにまとめられている。
改善されたwatchモードとエディタ体験
TypeScript 7.0の --watch モードは、ファイル監視の基盤が全面的に刷新された。新しいファイルウォッチャーは、バンドラのParcelが採用している @parcel/watcher をGoへ移植したものだ。ParcelのウォッチャーはC++で実装されており、ビルドに完全なC++ツールチェーンが必要だったが、今回の移植では最小限のアセンブリシムを併用することで、Goのみで完結する形に仕上げられた。
この移植は、C++からGoへの直接的な翻訳から始まり、最終的にはGoらしいコードへと洗練された。テストスイートも移植され、プラットフォームを問わず安定して動作する。従来のポーリングベースのファイル監視は、大規模プロジェクトで node_modules 以下のファイル変更を監視する際に計算負荷が高かったが、新しいウォッチャーはリソース消費を大幅に抑えている。TypeScriptチームは、VS Codeでの長年の使用実績を持つParcelのウォッチャーをGoでも利用可能にしたことで、エディタとCLIの両方で一貫した高速なファイル監視を実現した。
エディタでの進化とLSP対応
エディタ体験も大きく向上している。VS Code向けのTypeScript Native Preview拡張機能は、LSP(Language Server Protocol)上に構築されており、複数スレッドを活用してリクエストを並列処理する。自動インポート、ホバー情報の展開、インラインヒント、コードレンズ、ソース定義への移動、JSXのリンク編集やタグ補完など、多くの機能が追加された。ベータ版で不足していたセマンティックハイライトや「インポートの並び替え」「未使用インポートの削除」といった機能もRCで組み込まれている。
TypeScriptチームの分析によれば、言語サーバーの失敗コマンド数はTypeScript 6.0と比較して20分の1以下に削減された。GitHub上の主要なTypeScriptおよびJavaScriptコードベースを使ったファズテストを通じて、品質の高さが裏付けられている。
TypeScript 6.0からの移行で注意すべき点
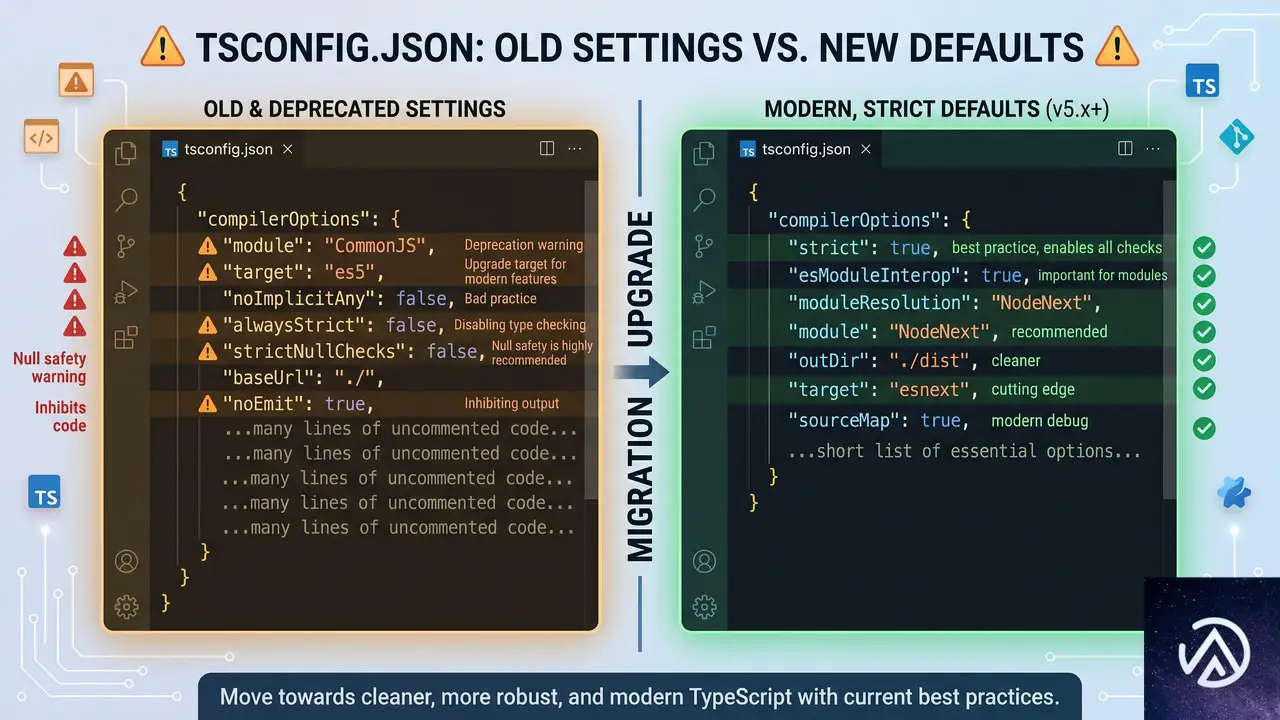
TypeScript 7.0は6.0の型チェック動作と互換性を持つが、6.0で導入された新しいデフォルトや非推奨機能はそのままハードエラーとして扱われる。6.0から7.0への移行をスムーズに進めるために、まず6.0を導入し、非推奨フラグや新しい設定にコードベースを適応させておくことが推奨されている。
以下に主なデフォルト変更点をまとめる。
- strict がデフォルトで
trueになる - module のデフォルトが
esnextになる - target が
esnext直前の安定版ECMAScriptバージョンを指す - noUncheckedSideEffectImports がデフォルトで
trueになる - libReplacement がデフォルトで
falseになる - stableTypeOrdering がデフォルトで
trueになり、無効化できない - rootDir がデフォルトで
./になり、内部のソースディレクトリを明示的に設定する必要がある - types のデフォルトが
[]になり、以前の動作に戻すには["*"]を指定する
rootDir の変更は、tsconfig.json が src のようなディレクトリの外にあるプロジェクトで影響が大きい。include で ./src を指定しつつ、compilerOptions.rootDir に ./src を追加すれば、ディレクトリ構造を維持できる。また、非推奨からハードエラーになった項目として、target: es5 や module: amd, umd, systemjs, none のサポート終了、moduleResolution: node/node10/classic の非サポート化、alwaysStrict の強制などが含まれる。詳細はTypeScript 6.0のリリースブログでも確認できる。
今後のロードマップと安定版リリース
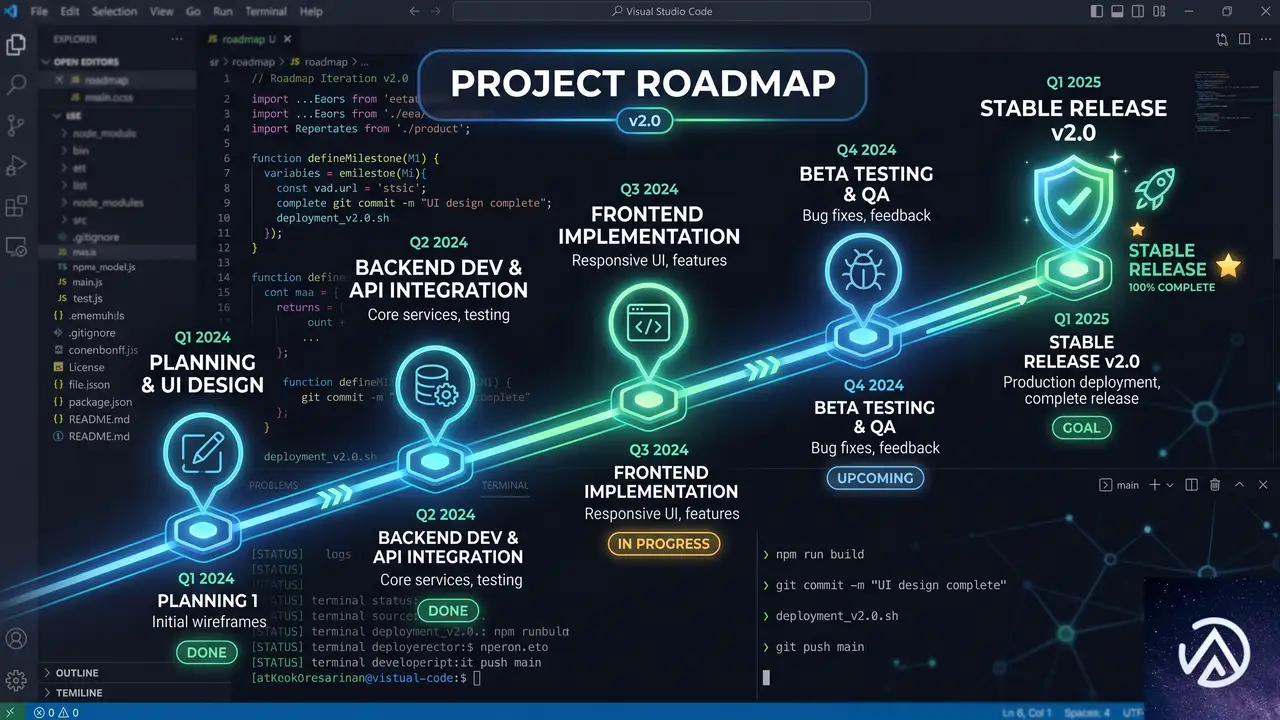
TypeScriptチームは、RCの公開から約1か月以内にTypeScript 7.0の安定版をリリースする計画を立てている。今後はリリース調整やロジスティクス、報告されたリグレッションの修正に注力し、7.1でのAPI機能の拡充にも取り組む。
実際のプロジェクトでTypeScript 7.0を試し、問題があればGitHubの microsoft/typescript-go リポジトリ でフィードバックを送ることが期待されている。TypeScriptチームは、コミュニティのテスト参加によって安定版を万全の状態で届けたいと考えている。フィードバックは、BlueskyやMastodon、Twitterでも受け付けている。
この記事のポイント
- TypeScript 7.0 RCはGo言語で再実装され、コンパイル速度が最大約10倍に向上した
- 既存のTypeScript 6.0と並行して使い分けられる共存パッケージが提供されている
- 並列化機能(–checkers、–builders)により大規模プロジェクトのビルド時間を短縮
- watchモードの刷新とエディタのLSP対応強化で、開発体験全体が高速化された
- 6.0からの移行には、非推奨機能のハードエラー化やデフォルト設定の変更に注意が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験