

ShopifyがWebMCPをチェックアウトに拡張、AIエージェントが注文確定まで対応
Shopifyが9月28日、WebMCPツールをチェックアウトに拡張した。ブラウザエージェントは購入者のタブで開いているチェックアウトを読み取り、更新し、購入者の確認を得た上で注文を確定できるようになった。
8月時点のWebMCPは商品検索とカート管理が中心だった。チェックアウトページへの誘導はできたが、注文の確定は購入者自身が行う必要があった。今回の拡張でAIエージェントが購入完了まで関与する形になる。
この記事では4つの新ツールの役割、購入者が制御を取り戻す場面、ブラウザ自動化との比較テスト結果を解説する。
WebMCPチェックアウト拡張の概要
8月の展開からの進化
WebMCPとは、ブラウザ内でAIエージェントがWebサイトの機能を利用するための仕組みだ。Shopifyは2026年8月に最初のWebMCPツールを公開した。当時は商品検索とカート管理が中心で、エージェントは購入者をチェックアウトページまで誘導するに留まっていた。
9月28日の拡張により、ブラウザエージェントはチェックアウトの状態を読み取り、配送先や支払い方法を更新し、購入者の確認を得た上で注文を確定できる。Shopifyの開発者向けチェンジログは「新しいAPIを公開するわけではなく、マーチャントの設定も不要」と説明している。
新しいツールの仕組み
新しいツールは購入者が見ているチェックアウトページと同じ状態を利用する。エージェントが裏側で別のセッションを操作するのではなく、実際に開いているチェックアウトの状態を読み書きする仕組みだ。
これにより購入者とエージェントの間で情報のずれが生じにくい。チェックアウトは各更新時に独自の検証を行い、エージェントが注文の商品を変更することはできない設計になっている。
このデモは8月時点と9月28日以降のWebMCPの機能差を示している。エージェントが「誘導役」から「取引実行役」に変わった点が今回の拡張の本質だ。
チェックアウトで利用できる4つのツール
各ツールの役割
ShopifyのチェックアウトWebMCPドキュメントによると、対象となるチェックアウトには4つのツールが登録される。
- get_checkoutはチェックアウトを読み取り、購入後は注文詳細も取得する
- update_checkoutは連絡先、配送または受け取り方法、割引コード、支払い方法、税番号などの追加項目を変更する
- complete_checkoutは注文を確定する
- navigate_to_storefrontはタブをストアに戻す
4つのツールは役割が明確に分かれている。読み取り、更新、確定、移動という一連の流れをエージェントが実行できる設計だ。
支払い方法の制限
これらのツールは新しいカード情報を受け付けない。エージェントは保存済みのShop Payカードを選択するか、ゲストチェックアウトが許可している場合はエージェントが持っているShop Pay承認を利用して支援できる。
それ以外の支払い方法は購入者がチェックアウトページで直接選択する必要がある。エージェントはあくまでもShop Payの範囲内で支払いを支援する形だ。これはエージェントがクレジットカード情報を扱うリスクを避ける設計といえる。
また、エージェントはWeb Bot Authを使用してブラウザリクエストに署名する必要がある。Web Bot AuthとはShopifyがエージェントを認識するための署名方式だ。署名がない場合、リクエストは優先度が下がったり、ボット検出システムによってブロックされたりする可能性がある。
購入者が制御を取り戻す場面
注文確定前の同意
Shopifyのドキュメントは、complete_checkoutを呼び出す前に現在の注文と合計を購入者に表示し、「注文の許可を得ること」をエージェントに指示している。
注目すべきは、Web Bot Auth署名、Shop Pay承認、準備完了ステータスはこの同意には該当しない点だ。エージェントが技術的に注文を確定できる状態であっても、人間の購入者が最終確認を行わない限り注文は実行されない。
これはAIエージェントの暴走を防ぐ安全設計として評価できる。自動化が進んでも、最終的な購入判断は人間が行うという原則を守っている。EC事業者にとっては、エージェントが勝手に注文を確定してしまうリスクを抑えられる仕組みだ。
支払いチャレンジとUI拡張
Shop Payログインや3D Secureなどの支払いチャレンジは、購入者にページ上での制御を戻す。3D Secureとはオンラインカード決済の追加認証方式で、不正利用を防ぐためにパスワードや生体認証を求める仕組みだ。
ブロッキングUI拡張機能やレビューステップも同様に、購入者が直接操作する場面となる。購入者はアプリが定義するチェックアウト拡張機能とのやり取りも管理する。エージェントがすべてを代行するのではなく、特定の場面では必ず人間が介入する仕組みになっている。
対象チェックアウトの条件と利用環境
Shop Pay必須の制限
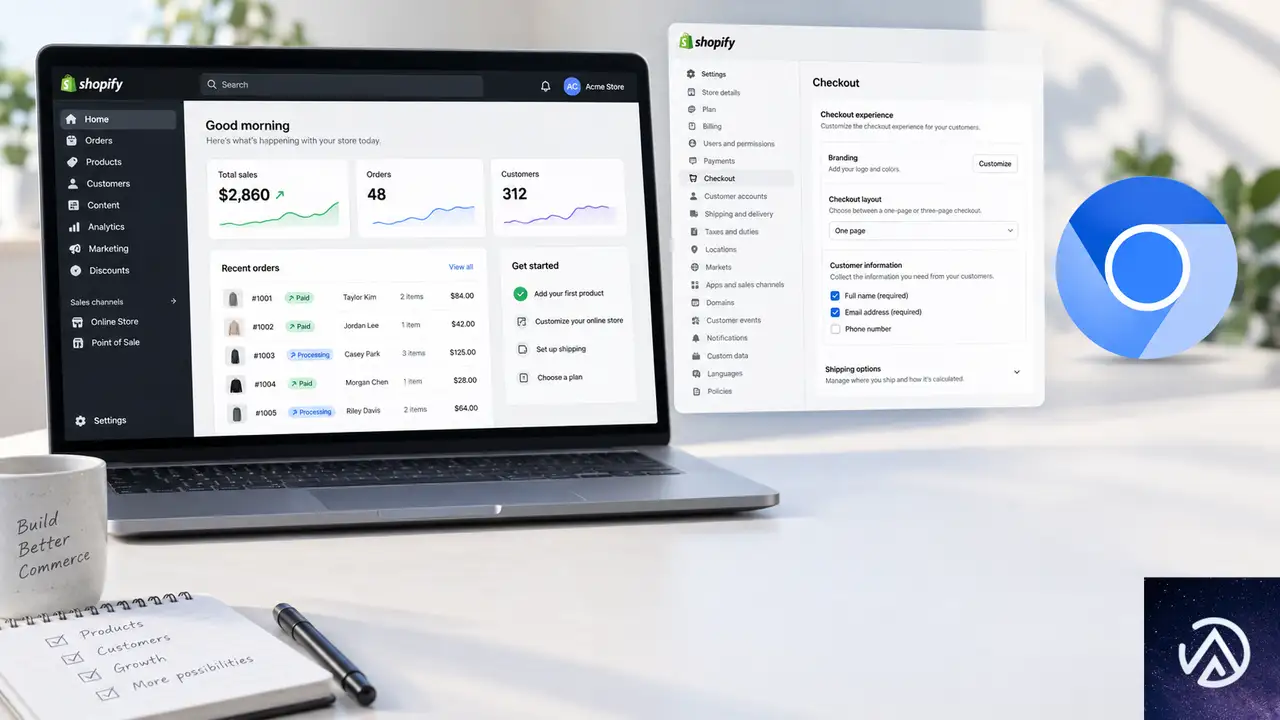
Shopifyの標準3ページチェックアウトは、購入者がShop Payでチェックアウトする場合を除き、WebMCPツールを取得しない。B2Bチェックアウト、埋め込みチェックアウト、モバイルチェックアウトSDK内のチェックアウトも対象外だ。
他のショップの商品を含むチェックアウト、ドラフト注文、注文編集、支払い回収も除外される。この制限はマーチャントにとって重要な意味を持つ。すべてのチェックアウトでAIエージェントが注文を確定できるわけではない。
現時点ではWebMCPチェックアウトの適用範囲は「Shop Payを使う標準チェックアウト」に限られる。Shop Pay以外の支払い方法を選ぶ購入者には、エージェントはチェックアウトの支援ができない。この制限がWebMCPチェックアウトの普及にどの程度影響するかは、今後の利用データを見る必要がある。
Chromiumブラウザ限定
現時点では、エージェントがWebMCPを使用できるのはChromiumベースのブラウザのみだ。ChromiumとはGoogleが開発するオープンソースのブラウザエンジンで、Google ChromeやMicrosoft Edgeが採用している。
FirefoxやSafariでは利用できない。この制限はWebMCPの普及に影響を与える可能性がある。ただしChromeとEdgeがブラウザ市場の大部分を占めていることを考えると、実用上の影響は限定的かもしれない。
Checkout WebMCPとCheckout MCPの選択
2つのルートの違い
Shopifyはチェックアウトでのエージェント向けに2つのルートを文書化している。サーバーベースのCheckout MCPと、ブラウザ内で動作するCheckout WebMCPだ。
ShopifyはサーバーベースのCheckout MCPを推奨している。この方式ではエージェントが自身のサーバーからチェックアウトセッションを管理する。Checkout WebMCPは「エージェントがすでに購入者のブラウザで動作している場合のみ」使用するよう案内している。
両方ともUniversal Commerce Protocolのチェックアウト機能に依存し、同じチェックアウトオブジェクトを使用する。Universal Commerce ProtocolとはShopifyが提唱する商取引の共通プロトコルで、異なるシステム間で取引情報をやり取りするための標準仕様だ。
Checkout WebMCPはチェックアウトページが購入者のブラウザに登録するツールを通じて動作する。一方、Checkout MCPはサーバー側でリクエストを処理する。実行場所が異なるだけで、扱うデータは同じだ。
マーチャントの立場
どちらの方法でも、Shopifyはマーチャントが記録上のマーチャントのままであると説明している。エージェントが仲介者になっても、販売者としての責任はマーチャントに残る。
これは法的・会計的な観点で重要なポイントだ。AIエージェントが注文を確定しても、取引の主体はあくまでもマーチャントである。エージェントが誤った注文を確定した場合の責任の所在も、マーチャントが負うことになる。
ブラウザ自動化との比較テスト
成功率と速度の差
Shopifyのエージェンティックコマース担当チームに所属するGil Greenberg氏は、WebMCPとブラウザ自動化を比較する社内テストの結果を公開した。ブラウザ自動化とは、エージェントがページを読み取ってクリック操作を行う方式だ。画面上の要素を視覚的に認識して操作する必要があるため、処理が遅くなりがちだ。
テストはGPT-6 Solを使って、同じプロンプトと開始条件で実施された。2つのテストショップで合計10のチェックアウトタスクを実行した結果、WebMCPは60回すべて成功した。一方、ブラウザ自動化は60回中56回の成功だった。
ページセットアップ時間を除いた1回あたりの時間は、WebMCPが10.3秒、ブラウザ自動化が27.4秒だった。WebMCPが約2.7倍高速だった計算になる。
1回あたり 10.3秒
コスト 58%削減
1回あたり 27.4秒
コスト 基準値
この比較はWebMCPの優位性を示している。成功率、速度、コストの3つの指標すべてでWebMCPが上回った。
コスト面の優位性
コスト面でもWebMCPが優位だった。OpenAIのリスト価格で比較すると、WebMCPのコストは1回あたり58%低かった。速度が速いだけでなく、API呼び出し回数やトークン消費量も抑えられるためだ。
ただし、この結果には注意点がある。テストはShopifyのテストショップと単一モデルで行われたもので、実際の注文やコンバージョン率などの実データは含まれていない。また、Greenberg氏の投稿には1行だけ60回の試行と一致しない合計値が含まれている。
とはいえ、WebMCPが「有望な方向性」を示していることは間違いない。ブラウザの画面を読み取ってクリックする方式よりも、専用のツールを介して直接操作する方式のほうが効率的であることは、このテスト結果から十分に裏付けられている。
この記事のポイント
- Shopifyが9月28日、WebMCPをチェックアウトに拡張した
- エージェントがチェックアウトの読み取り、更新、注文確定まで実行できる
- 注文確定には購入者の明示的な同意が必須
- Shop Pay必須の制限があり、対象チェックアウトは限定的
- ブラウザ自動化との比較テストで成功率100%、速度2.7倍、コスト58%削減を達成
- マーチャントが個々のツールをオフにできるかは未確認

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索時代のGEO対策、ChatGPTやPerplexityに引用されるための技術SEOとコンテンツ戦略
AI検索エンジンが情報取得の主流になりつつある。ChatGPT、Perplexity、Geminiなどの生成系エンジンは、質問に対する答えを直接生成する。従来の検索結果一覧からリンクをクリックする流れが変わり始めた。
この変化に対応するには、キーワード中心のSEOから生成エンジン最適化(GEO)への転換が必要だ。GEOとは、AIが回答を生成する際に自社コンテンツを一次情報源として引用してもらうための施策群である。従来SEOがブルーリンクのクリック獲得を目指すのに対し、GEOはAIの回答内で引用されることを目指す。
本記事ではAIクローラーへの技術対応と、AIに引用されやすいコンテンツ戦略の両面から具体的な施策を解説する。ECサイト運営者とWeb制作担当者に向けた内容だ。
GEOの基本を理解する
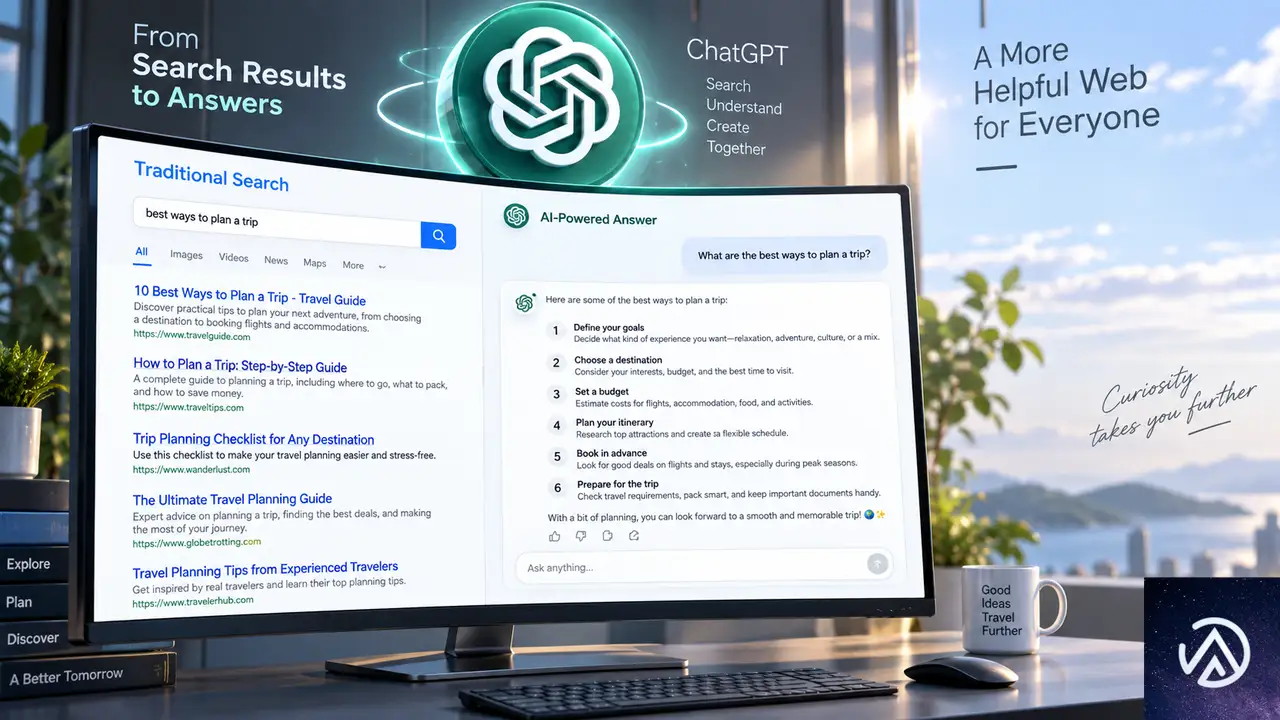
生成エンジン最適化(GEO)は、AI検索エンジンが回答を合成する際に、自社サイトのコンテンツを情報源として検出・理解・引用されることを目的とする。従来SEOが「検索結果のクリック数」を評価指標にするのに対して、GEOは「AI回答内での引用率」を重視する。
従来SEOからGEOへの考え方の転換をBeforeとAfterで対比した。
AI検索エンジンがサイトを選ぶ仕組み
AI検索エンジンは検索拡張生成(RAG)という仕組みで回答を作る。RAGとは、事前学習済みの大規模言語モデル(LLM)にリアルタイムのWeb情報を取り込ませ、最新の情報を含む回答を生成する技術だ。AIは質問を受けると、関連するWebページを取得し、その内容を引用しながら回答を合成する。
つまりAI検索で自社サイトが引用されるには、AIが「このページは信頼でき、回答に使える」と判断できる状態にしておく必要がある。そのために技術SEOとコンテンツ戦略の両面から対策を進める。
AIクローラー対応の技術SEO
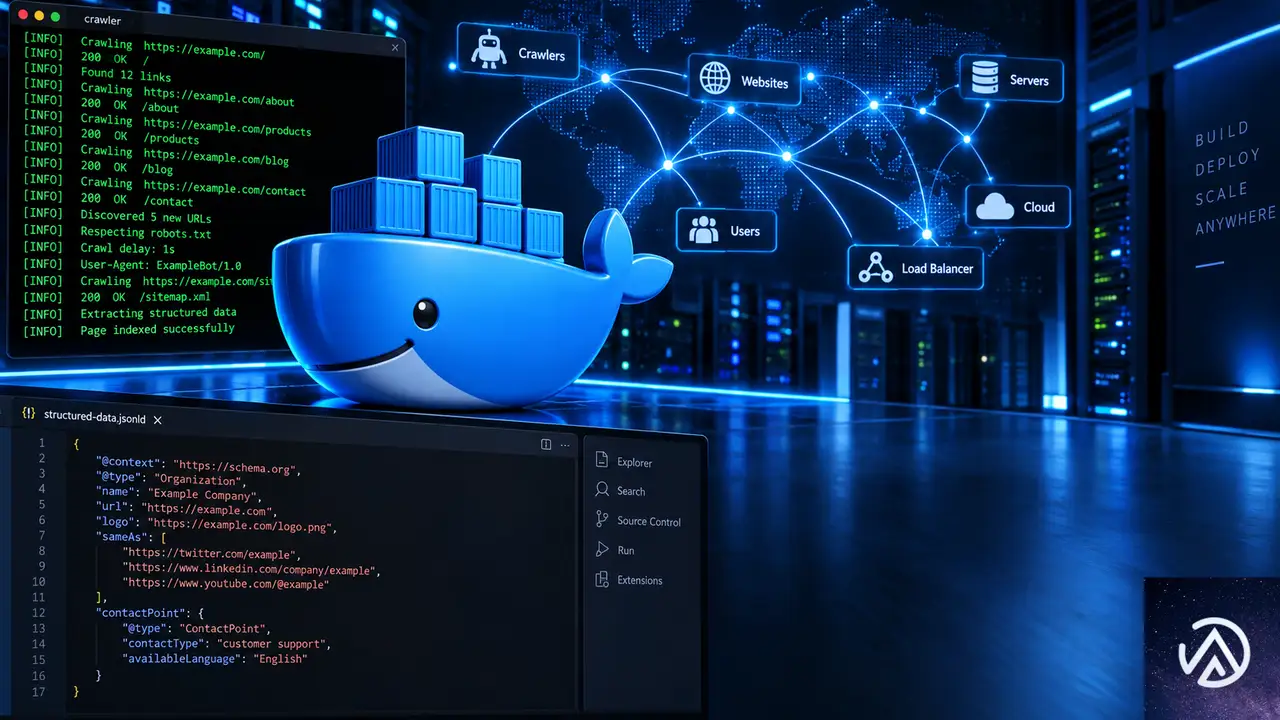
AIプラットフォームは専用のクローラーとRAGパイプラインを使ってWebコンテンツを取り込む。技術チームは、独自データを保護しながらコンテンツへのアクセスを確保する必要がある。
AI検索の裏側では、このようにクローリングから引用までの5段階の処理が走る。
robots.txtでボットを区別する
AI関連のクローラーは用途別に分かれている。学習用クローラー(GPTBotなど)とリアルタイム検索用クローラー(ChatGPT-User、PerplexityBotなど)を区別し、robots.txtで個別にアクセス制御する。学習用ボットをブロックすれば独自データを保護でき、検索用ボットを許可すればAI回答への情報提供を継続できる。
ECサイトの場合、商品の仕様データや価格情報は検索用ボットに公開しつつ、学習用ボットのアクセスを制限する運用が現実的だ。
構造化データでAIに文脈を渡す
Schema.orgの語彙を使った構造化データの実装範囲を広げることが重要だ。Organization、Product、HowTo、TechArticle、FAQPageなどのタイプを適切に付与すると、LLMのパーサーがエンティティ間の関係性を明示的に理解できるようになる。
ECサイトであれば商品ページにProductスキーマを付与し、価格、在庫状況、レビュー評価を機械可読な形式で伝える。AI検索エンジンが「この商品はいくらか」という質問に答える際、構造化データが整っているページが優先的に引用される。
RAGチャンキングを意識したHTML設計
RAGパイプラインはWebページを小さな単位(チャンク)に分割し、ベクトルデータベースに格納する。この分割処理を意識して、ページ構造を論理的なHTML階層で設計することが有効だ。<h2>や<h3>の見出しを適切に使い、各段落を独立して理解できる簡潔な長さに保つ。
見出しが明確で段落が短いと、RAGの分割処理が正確になり、回答生成時に該当箇所だけをクリーンに抽出・引用できる。長い段落に複数の話題を詰め込むと、チャンクの境界が曖昧になり引用精度が下がる。
表示速度とインデックス性の確保
AI検索エンジンはライブ検索の際、高速かつ安定したページ取得を優先する。モバイル対応を徹底し、サーバー応答時間(SRT)を短く保つことが重要だ。取得がタイムアウトすると、そのページは回答生成の候補から除外される。
SRTとはサーバーがリクエストに応答するまでの時間である。画像最適化、キャッシュ活用、CDN導入などでSRTを短縮しておくと、AIクローラーによるリアルタイム取得の成功率が上がる。
生成AIに引用されるコンテンツの作り方
AI検索エンジンはハルシネーション(誤情報生成)のリスクを減らすため、権威性の高い情報源を優先的に参照する。コンテンツ戦略は「検証可能な情報密度」を軸に再設計する必要がある。
AIが回答に使いやすいコンテンツ構成への変更点を示した。
エンティティベースの権威性構築
エンティティとは、人物、組織、商品、概念など明確に定義できる対象のことだ。自社ブランドの中核となるエンティティを中心に、関連する業界用語やトピックを密度高くまとめたトピッククラスターを作る。
具体的には、主語と述語が明確で断定を含む文章を心がける。「当社の商品Aは業界最高水準の耐久性を持つ」のような曖昧な表現ではなく、「商品Aは10万回の開閉テストに合格した」と具体的な事実を書く。このような文章はAIが抽出しやすく、引用時の信頼性も高い。
独自データとオリジナルリサーチの発信
AIモデルは集約された二次情報よりも、独自の統計、調査結果、オリジナルレポートを優先的に参照する。自社で実施したアンケート結果、商品の性能テストデータ、業界動向の独自分析などを公開することで、一次情報源としての地位を確立できる。
ECサイト運営者であれば、自社商品の比較テスト結果、顧客満足度調査、購入データから見える傾向などを記事化すると効果的だ。競合が真似できない独自データは、AI検索で安定的に引用される資産になる。
直接回答抽出フォーマットの採用
技術記事や教育コンテンツでは、ページの冒頭に要約表、箇条書きのポイント、明確な定義を配置する。検索意図の高い質問には、背景説明の前に直接回答する構成が有効だ。
たとえば「商品Aの防水性能はどの程度か」という質問を想定したページでは、冒頭に「IPX7等級で水深1メートルに30分間耐える」と明記し、その後に試験方法や比較データを展開する。この構成ならAIが回答をそのまま引用できる。
マルチモーダル検索への対応
AI検索エンジンは音声や画像を使った検索にも対応し始めている。マルチモーダル検索とは、テキスト以外の入力手段を含む検索のことだ。画像検索AIが商品を認識して回答するケースが増える。
商品画像や図表には説明的なalt属性を付与し、構造化されたキャプションを添える。画像の内容をAIが理解できるようにすることが、将来のマルチモーダル検索での可視性につながる。
AI検索を味方につける運用の転換点
従来のオーガニック検索トラフィックは、AIが直接回答を返すようになるにつれて集約化が進む可能性がある。ただし、技術インフラを最適化し、高密度な一次情報を公開し続ければ、ブランドはAI検索の裏側で推奨される情報源としての地位を維持できる。
重要なのは、目先のクリック数ではなく「AIに引用される確率」を評価指標に加えることだ。AI検索時代のブランド可視性は、回答の出典として選ばれる頻度で測られる。ECサイト運営者は、商品情報の構造化と独自データの発信を組み合わせ、この変化に対応すべきである。
SEO担当者と技術チームが協力し、クローラー管理からコンテンツフォーマットまでを一貫して整備すること。これがAI検索時代に競争優位を保つための実践的なアプローチだ。
この記事のポイント
- AI検索時代には従来のキーワード中心SEOからGEO(生成エンジン最適化)への転換が必要
- robots.txtで学習用ボットと検索用ボットを区別し、独自データを保護しつつ引用機会を確保する
- 構造化データの拡充とRAGチャンキングを意識したHTML階層設計が技術SEOの柱になる
- 独自データとオリジナルリサーチの発信がAIからの一次情報源としての地位を確立する
- 冒頭に要約と結論を置く直接回答フォーマットがAIによる引用率を高める
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Neonがリアルタイム機能を追加へ。Electricチームが語る開発の狙いと課題
NeonがバックエンドプラットフォームのGAを発表した直後、次の大きなステップとしてリアルタイム機能の追加を計画している。開発を担当するのは、2026年8月にNeonへ加わったElectricのチームだ。PostgreSQL上でのリアルタイムデータ同期に5年以上取り組んできたメンバーが中心となる。
Electric共同創業者のJames Arthur氏へのインタビューを基に、開発の狙いと技術的な課題を解説する。リアルタイム同期がなぜ本番環境で崩れやすいのか、その根本的な原因とNeonが目指す解決策が見えてくる。
Neonがリアルタイム同期をバックエンドに追加
NeonはPostgresを基盤としたサーバーレスデータベースサービスだ。2026年9月にバックエンドプラットフォーム全体のGAを発表したばかりである。このプラットフォームにリアルタイム機能が加わることで、データベースからアプリケーションへのデータ同期が自動化される。開発者はデータベースの変更を手動でポーリングする必要がなくなる。
リアルタイム同期とは、データベースに変更が発生した瞬間にアプリケーションへ反映する仕組みだ。従来のアプリケーションは一定間隔でデータベースに問い合わせて変更を取得していた。リアルタイム同期では、変更が発生した時点でクライアントへ通知される。チャットや共同編集ツールなど、即時性が求められるアプリケーションで重要になる。
このデモはポーリング方式とリアルタイム同期の違いを示している。左側ではアプリが定期的にデータベースへ問い合わせるため、変更がなくても通信が発生する。右側ではデータベースに変更が起きた時だけ通知が届く。無駄な通信がなくなり、遅延も短縮される。
開発を担当するElectricチームは、PostgreSQL上でのリアルタイムデータ同期に長年取り組んできた。Neonのブログ記事によると、James Arthur氏は大手企業への参加について「これほど強固なエンジニアリング文化を持つ環境は想像していなかった」と語っている。直属の上司がAWS Auroraを構築した人物であることにも触れ、意思決定の質の高さを実感しているという。
リアルタイム同期が本番環境で崩れる根本的な課題

リアルタイム機能には共通の弱点がある。デモでは美しく動作するが、本番環境では性能が落ちて崩れる傾向がある。James Arthur氏はこの問題を「表現力と性能の間に根本的なトレードオフがある」と表現する。
デモ環境では少量のデータと少数のクライアントで動作する。本番では大量のデータと多数のクライアントが同時に接続する。この環境で同期の正確性と速度を両立させるのは難しい。同期できる内容を増やせば表現力は上がるが、システムの性能は下がる。性能を優先すれば、同期できる内容が限られる。この二律背反が、リアルタイム同期が数十年研究されながらも主流にならない理由だ。
デモと本番の差を視覚化した。デモでは少量のデータと少数のクライアントで快適に動作する。本番では大量のデータと多数のクライアントが同時に接続し、性能が崩れる。このギャップがリアルタイム同期の導入を難しくしている。
ElectricがNeonに加わった本当の理由
Electricは同期を専門とするインフラツールとしてスタートした。しかし、ここ数年でインフラスタートアップの市場環境は大きく変わった。James Arthur氏はNeonのブログ記事で、専門的なインフラツールへの投資が減り、エージェントがより高レベルの抽象化を求めるようになったと説明する。
Electricのチームがたどり着いた結論は明確だ。同期はバックエンド・アズ・ア・サービスの機能であるべきだ。同期を中心にした製品を構築するのではなく、既存のプラットフォームを強化する方が合理的だと判断した。Neonは開発者向けに大きなリーチを持つ。Databricksは大企業向けの流通基盤と商業体制を持つ。この2つの強みを活用することで、同期技術をより早く主流にできる。
方針転換の比較を示した。Electric単独で同期ツールを販売する時代は終わり、NeonとDatabricksの流通基盤を使って同期を主流にする戦略に変わった。同期は独立した製品ではなく、バックエンドプラットフォームの一部として提供される。
Neonのバックエンド戦略とリアルタイムの位置づけ

Neonのバックエンドプラットフォームにリアルタイム機能が加わることで、Postgresを選択しない理由がなくなる。現代のアプリケーションとエージェントは、リアルタイムデータとエンドツーエンドのリアクティブ性を必要とする。CTOやテックリード、コーディングエージェントは、バックエンドを選ぶ際にリアルタイム機能の有無を確認する。
リアルタイム機能はNeonとLakebaseにネイティブに動作する。スケールトゥゼロとブランチングにも対応する予定だ。スケールトゥゼロとは、利用がない時にリソースを自動的にゼロまで縮小する仕組みだ。ブランチングはデータベースの分岐を作る機能で、開発やテストを安全に行える。これらの機能とリアルタイム同期が統合されることで、開発者は環境を意識せずにリアルタイム機能を利用できる。
リアルタイム機能がNeonに加わることで、バックエンド選定の流れが変わる。開発者は標準機能としてリアルタイム同期を利用でき、AIコーディングエージェントもNeonを推奨するようになる。これがNeonの目指す完全なバックエンドプラットフォームの姿だ。
Neonのブログ記事によると、James Arthur氏は具体的な技術仕様について「まだ詳細は言えない」としながらも、NeonとLakebaseにネイティブに動作し、スケールトゥゼロとブランチングにネイティブ対応すると明言している。正式な発表は今後行われる予定だ。早期アクセスに興味がある開発者は、NeonのDiscordコミュニティで情報を追える。
この記事のポイント
- Neonがリアルタイム同期機能をバックエンドに追加し、Electricチームが開発を担当する
- リアルタイム同期はデモでは動くが本番で崩れやすく、表現力と性能のトレードオフが根本課題
- Electricは単独の同期ツールから、NeonとDatabricksのプラットフォーム戦略に方向転換した
- リアルタイム機能はNeonとLakebaseにネイティブ対応し、スケールトゥゼロとブランチングもサポートする
- 正式な技術仕様は今後発表予定で、早期アクセスはNeonのDiscordで募集している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
カード不正利用の地域差が鮮明に。3Dセキュア義務化の効果と残る課題
カード不正利用の発生率が地域によって大きく異なる現状を、Stripeが2022年1月から2026年3月までの数十億件の取引データを分析して明らかにした。2026年第1四半期にはアジア太平洋地域が初めて欧州・中東・アフリカを下回り、3Dセキュア義務化の効果が数字で裏付けられた形だ。
一方で、中南米は依然として高水準が続く。2025年のカード不正率は欧州・中東・アフリカと比べて160%高く、アジア太平洋と比べても151%高い。国境を越えてサービスを提供する事業者にとって、地域ごとのリスク環境の違いを理解することは避けて通れない課題になっている。
この記事では、Stripeの分析結果を基に、アジア太平洋・欧州・中南米の3つの地域で何が起きているのか、どのような対策が有効なのかを、システム開発やEC運営の実務者の視点で解説する。
上の図は、2025年時点の地域別カード不正率の立ち位置を概念的に示したものだ。以降の章では、それぞれの地域で何が起きているのかを詳しく見ていく。
アジア太平洋で不正率が初めて欧州を下回った
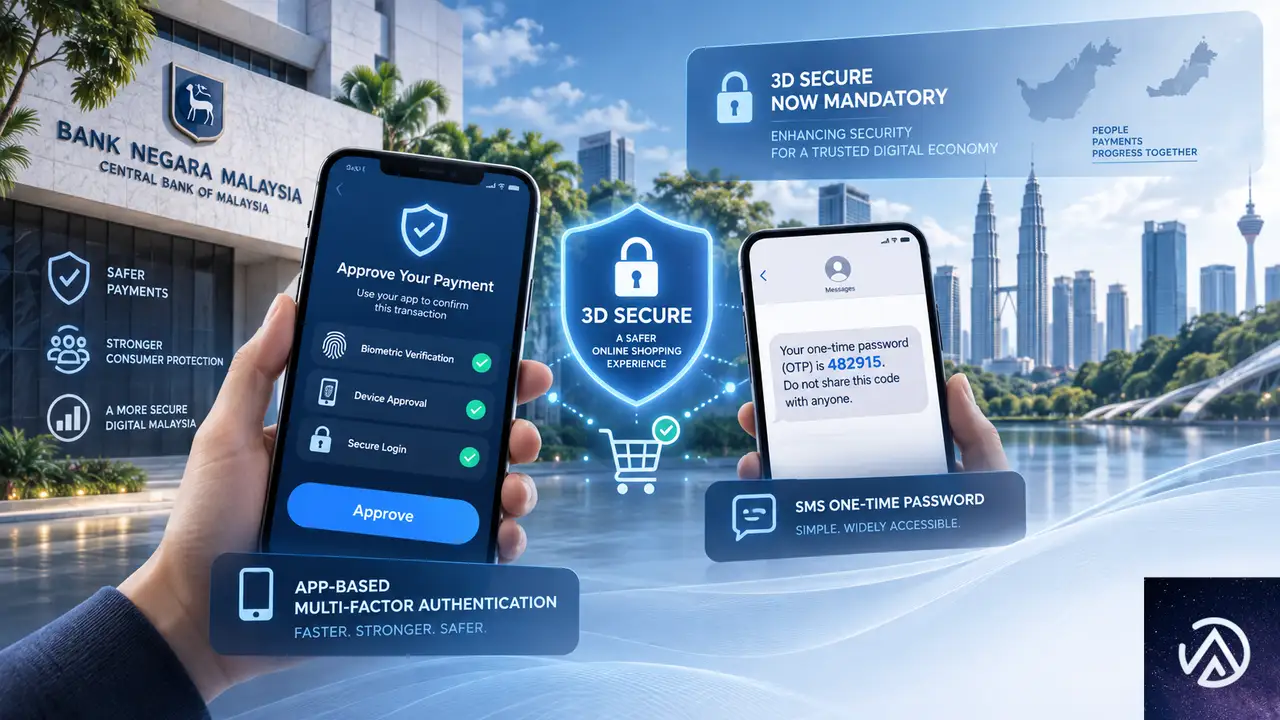
Stripeの分析によると、アジア太平洋地域の不正率は2022年から2025年にかけて最も一貫した低下傾向を示した。そして2026年第1四半期には、分析対象期間で初めて欧州・中東・アフリカ地域を下回る水準に到達している。この地域で進められてきた3Dセキュア義務化の政策効果が、データとして明確に現れた形だ。
3Dセキュアとは、オンラインカード決済時に「購入者が正当なカード所有者本人であるか」を追加認証する仕組みだ。クレジットカード番号と有効期限だけで支払えていた従来の方式に対し、ワンタイムパスワードやアプリでの承認など、もう一段階の確認を挟むことで不正利用を防ぐ。
マレーシアの3DS義務化で不正率74%減
アジア太平洋地域の中でも特に目立つのがマレーシアだ。2022年から2025年にかけて、カード不正率が74%も減少した。これはアジア太平洋地域で最大の減少幅である。
背景には、マレーシア中央銀行による比較的厳格な3Dセキュア義務化がある。金融機関には多要素認証の導入、SMSベースのワンタイムパスワードから安全なアプリベースの承認への移行、カード所有者が即座にアカウントを凍結できる機能の提供が求められている。この積み重ねにより、未認証の取引が通り抜ける余地が他市場より少なくなっている。
この改善は、単に認証を追加しただけではなく、SMSからアプリ承認へ移行した点が大きい。SMSのワンタイムパスワードはSIMスワッピングや転送攻撃の対象になりやすく、アプリベースの承認はこれを大幅に抑える。認証手段の設計が不正率に直接影響する好例だ。
日本の4月義務化も効果を確認
日本の企業も、2022年から2025年にかけて毎年不正率が低下した。この背景には2025年4月に施行された3Dセキュア義務化がある。Stripeの紛争データ分析によると、2025年の紛争率は前年同期比で30%以上低かった。
紛争率とは、カード所有者が不正な取引だと気づいて支払いに異議を申し立てる割合だ。不正利用が発生すれば紛争につながるため、紛争率は不正率と強い相関を持つ指標として使われる。日本の義務化は施行から短期間で効果を出している。
欧州は改善基調、国ごとの差が大きい
欧州全体では、カード不正率が2022年から2025年にかけて21%減少した。ただし改善ペースは国によって大きく異なる。フランスとイギリスは着実に減らしている一方で、イベリア半島は逆行して悪化している。
フランスとイギリスは着実に減少
フランスは2022年から2025年にかけて不正率が40%減少、イギリスは27%減少した。両国とも欧州の主要市場であり、決済エコシステムの成熟度が改善の原動力になっている。
ここで重要なのがSCA(Strong Customer Authentication / 強力な顧客認証)規制の存在だ。EUの決済サービス指令に基づくこの規制は、オンライン決済時に二要素認証を義務付けるものだ。イシュア(カード発行会社)に高度な不正対策インフラへの投資を促し、認証の枠組みと時間を与えてきた。
フランスには先行的な土壌もある。チップとPINによる認証をいち早く導入した国のひとつで、二要素認証が他国より何年も前から一般化していた。カード所有者が認証フローに慣れており、離脱せずに完了できる率が高いことが不正率の低下に寄与している。
イベリア半島は例外的に悪化
一方、イベリア半島(スペインとポルトガル)は、2022年から2025年にかけて不正率が毎年増加した。欧州で例外的な悪化傾向を示した地域だ。
スペインとポルトガルは、認証手段としてワンタイムパスワードを多用している。SMSベースのパスワードは生体認証やアプリ承認と比べて不正に脆弱だ。さらに、両国は金融機関を装ってSMSでカード情報を盗む「スミッシング」攻撃の標的にもなっている。認証手段の脆弱性と攻撃の集中が重なり、欧州の改善トレンドに乗れていない。
中南米は構造的要因で高止まり

中南米のカード不正率は、Stripeの分析対象地域の中で2022年1月以降一貫して最も高い。2025年時点でも、北米より65%、アジア太平洋より151%、欧州・中東・アフリカより160%高い水準だ。
一部の国では改善が見られる。エクアドル、パナマ、ブラジルでは2022年から2025年にかけて不正率が低下した。しかし地域全体では、いくつかの構造的要因が高止まりの原因になっている。
現金経済と紛争ルールの複雑さ
中南米は他地域と比べて現金ベースの経済が根強い。これはカード不正検知システムが参照できる過去データの蓄積が少ないことを意味する。機械学習による不正検知は学習データの量と質に依存するため、取引データが少ない地域では精度を上げにくい。
紛争処理の枠組みも複雑だ。この地域のカード紛争ルールはカード所有者に有利なケースが多く、異議申し立てが発生した場合の立証責任は事業者側に重くのしかかる。正当な取引であっても、事業者が証拠を提示できないとチャージバック(取引の強制取消)につながりやすい。
電子請求書の要件も国ごとに異なる
中南米の規制環境も運用負荷を高めている。多くの国で電子請求書の義務化が進んでいるが、適用範囲、フォーマット、成熟度はバラバラだ。メキシコでは、デジタルサービス提供者に対して税務当局への取引データへの恒久的なアクセス提供が義務付けられている。
メキシコのケースでは、税務当局が独自のスケジュールで事業者システムにログインし、個別の取引を検索できる。取引は1日以内に検索可能で、5年間の保存が義務付けられている。この種の要件が事業者のオペレーションを複雑にし、不正対策へのリソース配分を難しくしている。
国際展開における不正対策の実務ポイント

地域ごとに不正環境が異なる以上、単一のセキュリティポリシーを全市場に適用するのは危険だ。では、複数国でサービスを展開する事業者はどのような対応を取るべきか。データと規制の両面から、実務的なポイントを整理する。
3DS認証の最適化で不正と誤検知のバランスを取る
SCA規制の対象地域では、3Dセキュア認証の導入が不正対策の基本になる。Stripeの分析によると、SCA地域の事業者はAIによる最適化を活用することで、全取引の不正率を平均7.67%削減しつつ、コンバージョンを平均1.20%向上させられる。
ここで重要なのは、すべての取引に同じ強度の認証を求めるのではなく、リスクに応じて認証を出し分けることだ。低リスクの取引に認証を強制すると離脱につながり、高リスクの取引に認証をかけないと不正が通ってしまう。AIによるスコアリングでこのバランスを取る。
認証の出し分けは、不正率と誤検知率のトレードオフを調整する実務的な手法だ。すべてに認証をかければ不正は減るが購入完了率が下がり、認証をなければ購入はスムーズでも不正が増える。AIの精度がこのバランスの成否を左右する。
AIによる不正検知を全決済手段に拡大
カードだけでなく、銀行引き落とし、ステーブルコイン決済、デジタルウォレット、即時決済、現金バウチャーなど、決済手段は多様化している。Stripeの不正防止プロダクトは、これらすべての決済手段を保護対象に含めるよう拡大された。決済手段ごとにセキュリティの仕組みが異なるため、不正検知のレイヤーを横断的に設けることが重要だ。
企業が国際展開する際は、進出先ごとの規制要件と不正パターンを事前に把握し、認証の設定と検知ロジックを地域別にチューニングする必要がある。マレーシアや日本の3Dセキュア義務化は効果を上げており、規制が先行する地域では「義務化される前に自主的に導入する」ことで、競合より低い不正率を実現できる可能性がある。
この記事のポイント
- アジア太平洋地域のカード不正率が2026年第1四半期に初めて欧州・中東・アフリカを下回った
- マレーシアと日本の3Dセキュア義務化が不正率を大きく押し下げた
- 欧州は全体で改善基調だが、イベリア半島はSMS依存とスミッシングで逆行
- 中南米は現金経済、紛争ルール、規制の複雑さで不正率が高止まりしている
- 複数国展開ではAIによる認証の出し分けと決済手段横断の不正検知が有効
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
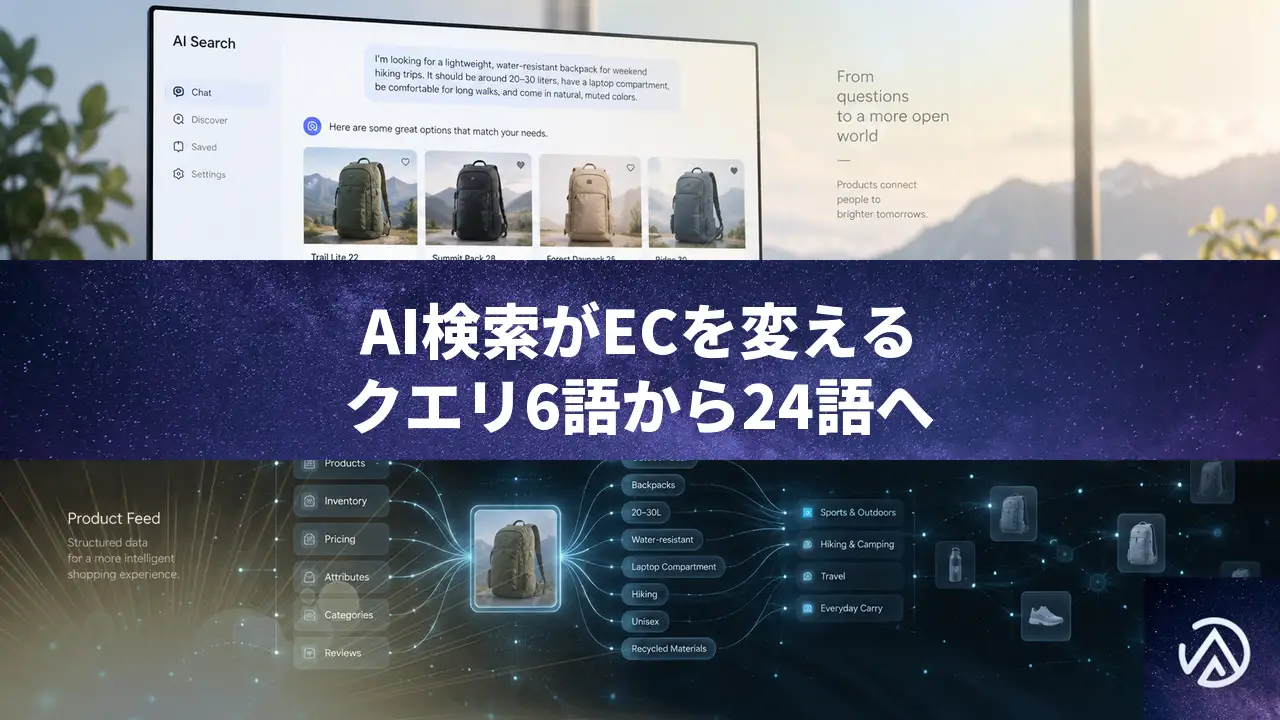
AI検索がECを変える。検索クエリは6語から24語へ拡大
AI検索エンジンの台頭により、ECサイトの商品発見の仕組みが根本から変わりはじめている。消費者は短いキーワードの組み合わせではなく、文脈や使用シーンを盛り込んだ長い自然言語で商品を探すようになった。
従来の検索エンジンでの平均クエリは約6語だった。一方、大規模言語モデル(LLM、人間のように自然な文章を理解・生成できるAIモデル)を活用したAI検索では、平均約24語にまで拡大している。この4倍の変化は、商品カタログとプロダクトページの設計思想そのものの見直しを迫るものだ。
この記事では、AI検索がECサイトに与える具体的な影響、対応策、そしてマーケティング担当者が見直すべき思考法について解説する。WooCommerceをはじめとするECプラットフォームを運営する事業者にとって、今後12ヶ月の優先課題が見えてくるはずだ。
AI検索が変える検索クエリの姿
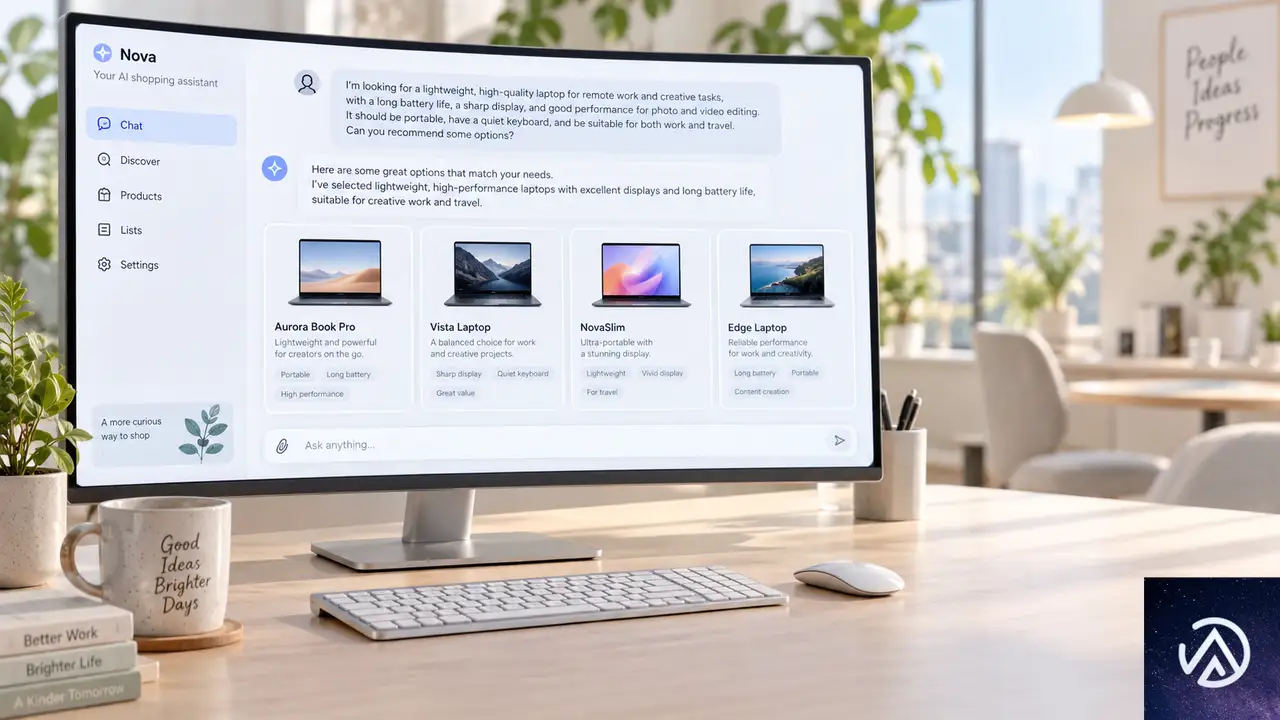
消費者が検索窓に入力する言葉が劇的に変化している。かつては「防水 ランニング シューズ 軽量」のような短いキーワードの羅列が一般的だった。いまは「雨の日でも滑りにくくて、通勤でも使える軽いランニングシューズを探しています。週末は10キロ走るのでクッション性も欲しいです」といった会話調の質問に変わっている。
6語から24語へ、検索行動の変化
MarTechのポッドキャスト「Conversations with MarTech」に出演したOpiversalのCEO、Lucas Tieleman氏は、この変化を具体的な数字で示している。従来のGoogle検索での平均クエリは約6語だった。ところがLLMを活用した検索では平均約24語に拡大している。ユーザーは検索エンジンに「単語を投げる」のではなく「相談する」姿勢に変わったのだ。
会話的クエリが商品発見に与える意味
検索クエリが会話的になるということは、商品が文脈で選ばれる時代の到来を意味する。「軽いランニングシューズ」という単語だけでは用途が見えなかった。しかし「通勤で使える」「週末に10キロ走る」といった文脈が加わることで、同じ商品が異なる理由で選ばれる可能性が生まれる。Tieleman氏は「同じ商品でも、人によって異なる意味を持ちうる」と述べている。この多義性が、これからのECサイトの設計を難しくする一方で、差別化の余地も広げている。
検索クエリが短いキーワードから会話的な長文へ変化したことを示している。ECサイト側もこの変化に対応した情報設計が必要になる。
旧来の商品カタログが抱える限界
多くのECサイトの商品ページは、青いリンクとキーワード検索の時代に作られたものだ。商品名、価格、カテゴリ、簡単な説明文という最小限の属性を並べた静的ページが中心だった。この設計は、消費者が「単語を入力して結果の一覧から選ぶ」という行動パターンを前提にしている。文脈や使用シーンを含む24語のクエリに対して、こうした静的ページは十分な回答を提供できない。
ボットトラフィックの急増が見せる新しい現実
Tieleman氏が指摘するのは、AIエージェントによるボットトラフィックの急増だ。自律型AIエージェントが実際に購入を行う段階にはまだ至っていない。しかし、ユーザーの質問に答えるためにECサイトを巡回するLLMのトラフィックは爆発的に増えている。マーケティング担当者は、インプレッション(表示回数)とセールスの関係を従来とは異なる視点で捉え直す必要がある。表示回数が増えても、それが人間の目に触れているとは限らないからだ。
文脈的な属性情報とFAQを加えることで、AIが商品を理解しやすくなることを示している。
ECサイトがAI検索に対応するための3つの施策
AI検索時代において、ECサイトが取るべき具体的な対策は3つに集約できる。構造化データの整備、動的なランディングページ生成、そしてFAQの戦略的拡充だ。どれも特別なツールなしで今日から着手できる。
構造化データと会話的属性情報の整備
商品フィードの重要性はかつてないほど高まっている。構造化データとは、商品名や価格、属性などが機械に読み取りやすい形式で整理されたデータのこと。検索エンジンとAIプラットフォームに商品の存在を知らせるためには、高度に構造化されたデータを継続的に供給する必要がある。商品名と価格だけでは不十分だ。使用シーン、解決できる課題、関連するFAQなど、会話的な属性情報を追加することで、AIが商品を文脈に応じて提案しやすくなる。
WooCommerce運営者であれば、商品データの拡張は比較的容易だ。商品説明欄を充実させるだけでなく、カスタム属性やカテゴリタクソノミーを使って使用シーンや解決課題を明示的に登録できる。属性情報は商品のタイプごとに設計し、サイト全体で一貫した命名規則を保つことが重要だ。
動的なランディングページ生成
AIがコンテンツ制作の限界費用を大幅に下げたことで、EC事業者は変動するソーシャルトレンドや自然言語のクエリに合わせてカスタムランディングページを大量に生成できるようになった。Tieleman氏は「ウェブサイトは生きた有機体である」と表現している。固定された商品ページだけでなく、検索文脈に応じたランディングページを動的に用意することが、これからのECサイトには求められる。
FAQの戦略的拡充
FAQセクションは、AI検索対策の隠れた有力手段だ。商品に関する具体的な疑問と回答を構造化して掲載することで、AIエージェントが商品のユースケースを理解しやすくなる。「このシューズは幅広の足型に対応していますか」といった具体的な質問と回答は、まさに24語クエリの世界で求められている情報だ。FAQはユーザーが実際に抱く疑問を想定して作成し、商品データの一部として機械に読み取らせる意識が重要になる。
AIエージェントが商品データを巡回し、文脈に合う商品を提案する流れを示している。各ステップで構造化データが正しく読み取れるかが成否を左右する。
エージェント型購買の現実とマーケティングの再考
Tieleman氏との対話から浮かび上がるのは、AIエージェントが本当に「購入」を行うのはまだ先だという現実だ。現在はあくまで調査・比較の段階で、ボットが商品情報を収集しているにすぎない。しかし、この段階で商品データがAIに正しく理解されているかどうかが、将来の購入決定に直結する。準備を怠れば、AI検索の世界で商品が存在しないのと同じ扱いを受けるリスクがある。
単一の正解に執着することの無意味さ
Tieleman氏は「マーケティング業界が信じている最大の嘘」として、単一の正解を探し求めることへの執着を挙げている。現実には、現代のテクノロジーを使えば複数の施策を並行して検証し、効率的に失敗しながら最適解に近づくことができる。同氏の「いまのテクノロジーを使えば、もっと効率的に間違えることができる」という指摘は、マーケティングの思考法を変える視点だ。A/Bテストを繰り返すことへの心理的障壁を下げ、失敗をデータとして蓄積する姿勢が求められる。
商品を文脈で選ばせる設計へ
「AppleはUXとデザインの重要性を示す好例だ。Amazonはそうではないことを示している」というTieleman氏の発言は、ECサイト設計の2つの方向性を端的に表している。徹底したUXで差別化するのか、価格と品揃えで勝負するのか。AI検索時代には、どちらの戦略を選ぶにせよ、商品データが文脈を伝えられるかどうかが成否を分ける。デザインの優劣ではなく、データの伝達力が新しい競争軸になるのだ。
この記事のポイント
- 検索クエリは平均6語から24語に拡大し、会話調の質問へと変化している
- 従来の静的カタログは、文脈を含む長いクエリに十分応えられない
- AIエージェントによるボットトラフィックが急増し、商品データの構造化が必須になっている
- 構造化データ、会話的属性情報、FAQの拡充がAI検索対策の3本柱となる
- 単一の正解を求める思考を捨て、複数の施策を効率的に検証する体制が有効
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.1.2リリース!商品ギャラリーの無限再帰とメールレビュー検証を修正
WooCommerce 11.1.2が2026年9月22日にリリースされた。商品バリエーションギャラリーで発生する無限再帰の修正と、メール経由の商品レビューにおける入力検証の強化が含まれるドットリリースだ。
今回の更新はセキュリティ更新に該当する。データベースの更新は不要で、適用のハードルは低い。ECサイト運営者は早めのアップデートを検討したい。
WooCommerce 11.1.2のリリース概要
WooCommerceのドットリリースとは、メジャーバージョンやマイナーバージョンの間に挟まれる小規模な修正更新のことだ。新機能の追加はなく、既知の不具合修正とセキュリティ強化に絞られる。
今回の11.1.2は、2026年9月22日に公開された。公式のリリースノートによると、セキュリティ更新に該当し、データベース更新は不要とされている。つまり、プラグインの更新ボタンを押すだけで適用が完了する。
修正内容は2つに絞られている。1つ目は商品バリエーションギャラリーにおける無限再帰の防止、2つ目はメールベースの商品レビューにおける検証の厳格化だ。どちらもECサイトの安定稼働に直結する内容である。
商品バリエーションギャラリーの無限再帰を修正
1つ目の修正は、テーマがテンプレートファイル内で get_available_variations 関数を呼び出した際に無限再帰が発生する問題への対処だ。GitHubのプルリクエスト番号68939で修正されている。
無限再帰とは何か
無限再帰とは、関数が終了条件なしに自分自身を呼び出し続ける状態を指す。プログラミングの世界では「スタックオーバーフロー」と呼ばれるエラーにつながる。たとえるなら、合わせ鏡の間に立ったときに像が無限に反射して見えるのに似ている。どこかで止める仕組みがなければ、コンピュータのリソースを使い果たしてしまう。
WooCommerceの商品バリエーションギャラリーでは、テーマが独自に get_available_variations を呼び出すケースが問題になった。テーマのテンプレートファイルにこの関数の呼び出しが含まれていると、内部のフックが再帰的に呼び出されてスタックが溢れ、商品ページ全体が白画面になったり応答しなくなったりする。
修正の内容と影響範囲
修正後は、テーマが get_available_variations をテンプレートファイルで呼び出しても、再帰的な呼び出しが防止される。バリエーションごとの画像ギャラリーが正常に表示され、商品ページが通常どおり動作するようになる。
影響を受けるのは、バリエーション商品を持つECサイトで、なおかつテーマがこの関数を直接呼び出している場合に限られる。標準のWooCommerceテーマや多くの人気テーマでは問題は発生しない。しかし、独自にカスタマイズしたテーマを使っている場合は注意が必要だ。
get_available_variations をテンプレート内で呼び出すと、内部フックが再帰的に実行されてスタックが溢れる。商品ページ全体が白画面になり、購入フローが停止する。上図のとおり、修正前は get_available_variations の再帰呼び出しにより商品ページ全体が停止する可能性があった。修正後はこの再帰が防止され、ギャラリーが正しく表示される。独自テーマを運用している場合は、この修正の適用前にステージング環境で動作確認することを推奨する。
メールレビューの検証を強化
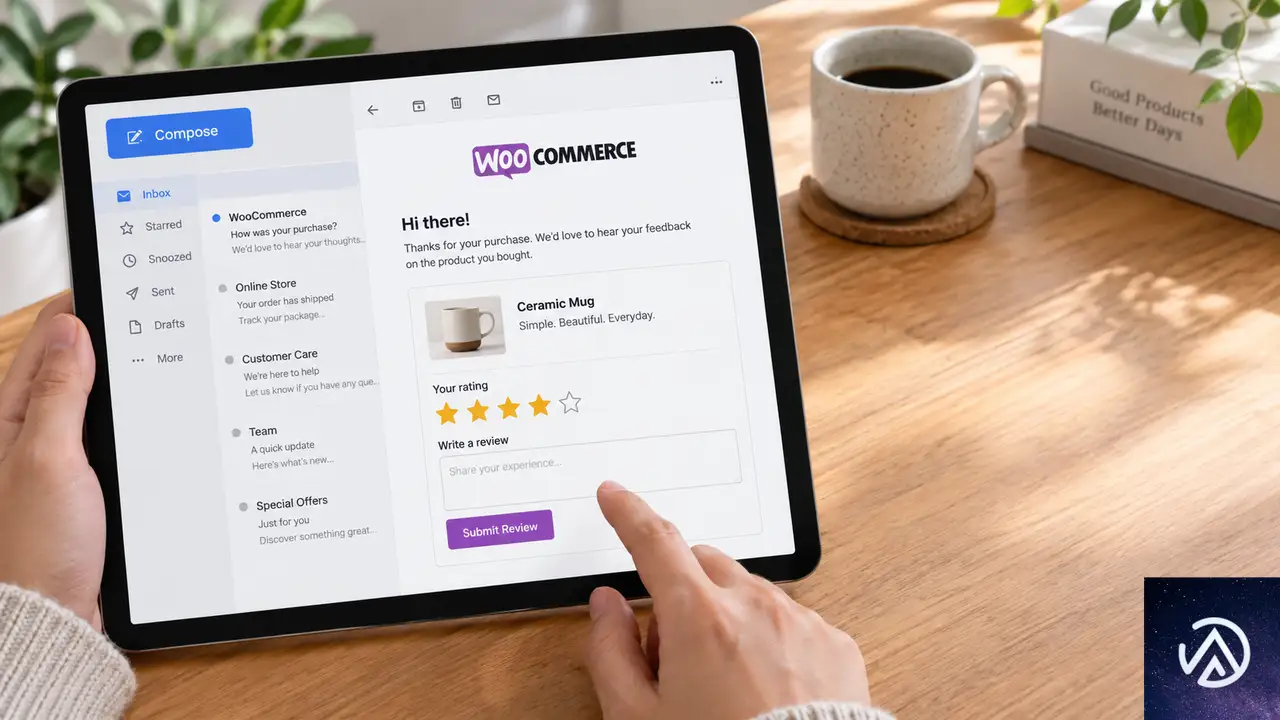
2つ目の修正は、メール経由で投稿される商品レビューの入力検証を厳格化するものだ。GitHubのプルリクエスト番号68961で対応された。セキュリティ更新とされる理由はこの修正にある。
メールベースのレビュー機能とは
WooCommerceには、購入者からのレビューをメールで受け付ける仕組みがある。顧客が注文後に届くメール内のリンクからレビューを投稿できる機能だ。ECサイトにとってレビューは信頼構築の要であり、この導線はコンバージョン率にも影響する。
問題は、このメール経由の投稿経路において入力値の検証が十分でなかった点だ。悪意のある第三者が不正なデータを送信する余地があり、セキュリティリスクになり得た。今回の修正では、この検証処理が厳格化されている。
検証強化がもたらす効果
検証の厳格化により、不正な入力や改ざんされたデータがレビューとして投稿されるリスクが低減される。レビューの信頼性が保たれ、ECサイトの評判管理にも好影響を与える。
店舗運営者の目線では、この変更によってレビュー投稿のフローに大きな変化はない。顧客が正規のメールリンクからアクセスする限り、従来どおりの手順でレビューを投稿できる。内部のバリデーションが強化されただけなので、ユーザビリティへの影響はない。
上図のとおり、メール経由のレビュー投稿は4段階で処理される。今回の修正はSTEP 3の検証処理に焦点を当てており、不正なデータの流入を防ぐ役割を担う。顧客側の操作フローに変更はない。
ECサイト運営者が取るべき対応
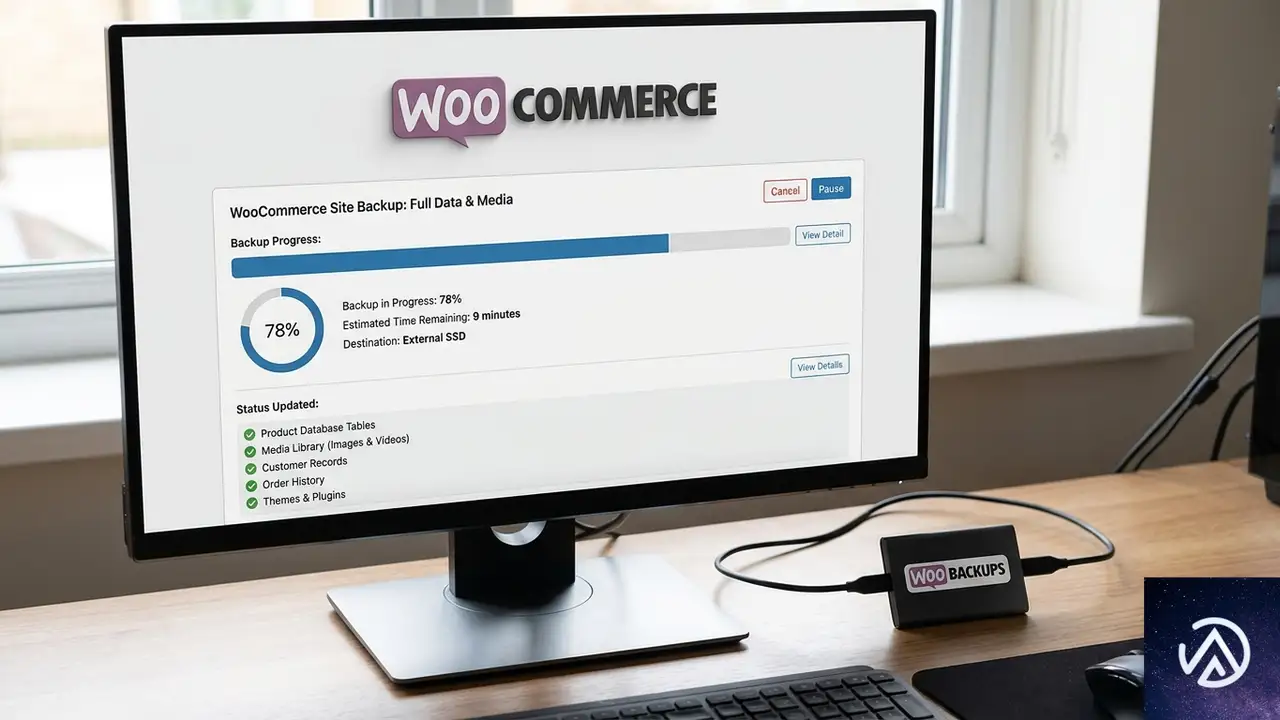
この更新はセキュリティ更新のため、基本的には即時適用が望ましい。ただし、独自テーマやカスタムコードを使っているサイトでは、事前の動作確認を怠らないことが重要だ。
更新前の準備
更新の前に、サイト全体のバックアップを取得する。WooCommerceを運用するECサイトでは、商品データ、注文履歴、顧客情報が失われると事業に直結する。更新作業の前には必ずデータベースとファイルの両方をバックアップしておく。
また、ステージング環境が利用できるのであれば、本番環境に適用する前に更新後の動作を確認する。特にバリエーション商品を持つ場合は、商品ページでギャラリーが正しく表示されるかをチェックしたい。
更新手順の目安
WooCommerceの更新はWordPressの管理画面から行える。プラグイン一覧からWooCommerceを選択し、更新を実行するだけだ。データベース更新が不要なため、更新後のマイグレーション処理も発生しない。
更新後は、商品ページ、カート、チェックアウト、レビュー投稿の各フローが正常に動作するかを確認する。特にメールレビュー機能を有効にしている場合は、テスト用のレビューを1件投稿して検証すると安心だ。
この記事のポイント
- WooCommerce 11.1.2は2026年9月22日に公開されたセキュリティ更新で、データベース更新は不要
- 商品バリエーションギャラリーの無限再帰を修正し、独自テーマ利用時の白画面リスクを解消
- メール経由の商品レビューにおける入力検証を強化し、不正データの投稿リスクを低減
- 独自テーマやカスタムコードを運用中のサイトは、ステージング環境での事前確認を推奨
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS CloudWatch Omniが登場。AIとチームで行う新しい可観測性
AWSがCloudWatch Omniを発表した。アプリケーションとAIエージェントの両方を監視できる新しい可観測性体験で、チーム全体が同じワークスペースで調査を進められる。
OpenTelemetryベースで構築されており、既存のCloudWatchテレメトリをそのまま活用できる。AWSマネジメントコンソールへのアクセス権限がなくても、専用URLとSSOで利用可能だ。
この記事では、CloudWatch Omniの主要機能、AI調査の仕組み、セットアップ手順、既存環境との関係を解説する。運用チームが抱えるダッシュボード管理や障害調査の負担をどう軽減するかが焦点だ。
CloudWatch Omniとは何か
アプリケーション中心の可観測性
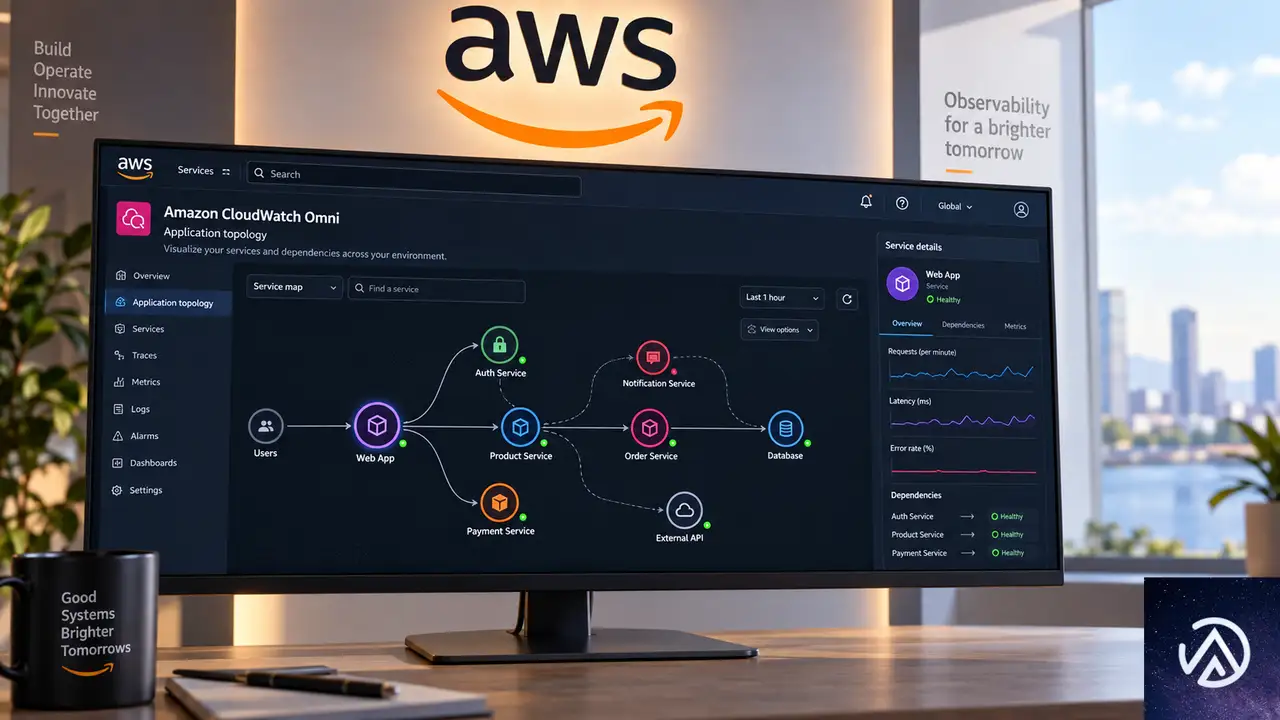
CloudWatch Omniは、インフラストラクチャ単位ではなく、アプリケーション単位でテレメトリを整理する。従来のモニタリングツールはサーバーやコンテナといったリソースごとに指標を表示するが、Omniはサービス同士の依存関係を自動的にマッピングし、システム全体をひとつの接続された構造として見せる。
このアプローチにより、担当者は「どのサーバーでエラーが出たか」ではなく「どのアプリケーションで問題が起きているか」を即座に把握できる。ダッシュボードを手動で更新する手間も減る。
この比較デモは、リソース中心からアプリ中心への考え方の転換を示している。Omniは自動検出とトポロジーマッピングにより、運用者が全体像を維持する負担を軽減する。
OpenTelemetryとの統合
CloudWatch OmniはOpenTelemetryを基盤としている。OpenTelemetryは、メトリクス・ログ・トレースなどのテレメトリデータを収集するためのオープン標準だ。すでにCloudWatchに送信しているテレメトリは、再設定なしでOmniに表示される。
さらに、OpenTelemetryで計装された他のワークロードも、OTLP(OpenTelemetry Protocol)エンドポイントを通じてOmniに取り込める。これにより、オンプレミス環境や別のクラウドで稼働するアプリケーションも同じワークスペースで監視できる。
チーム全体で使える共同作業の仕組み
CloudWatch Omniの大きな特徴は、チーム全員が同じワークスペースを共有できる点にある。エンジニアは専用URLにアクセスし、企業のSSO(シングルサインオン)でログインする。AWSマネジメントコンソールへのアクセス権限は不要だ。
IAM Identity Centerを通じてOktaやAzure ADなどのIDプロバイダーと連携できる。SRE、開発者、データベースエンジニア、マネージャーが同じデータと調査コンテキストを共有する。
このフローは、通常のインシデント対応時にOmniがどのように進行するかを示している。チーム間の引き継ぎ時にコンテキストが失われる問題が解消される。
エスカレーション時の連携強化
障害がチームの境界を越えると、Slackのスレッドやスクリーンショットでの情報共有になりがちだ。Omniでは次の担当者が同じセッションに参加し、これまでの調査内容をそのまま引き継げる。
調査履歴は自動的に記録されるため、インシデントレポートを別途作成する必要もない。
AIが調査を支援するAmazon DevOps Agent
CloudWatch Omniには、Amazon DevOps Agentと呼ばれるAIアシスタントが組み込まれている。調査セッションの中で、シグナルの相関分析や次のアクションの提案を行う。
このエージェントは、エンジニアが見ているのと同じテレメトリデータを参照する。そのため、提案内容はアプリケーションの実際の状態に基づいたものになる。
DevOps Agentは、相関イベントの特定や依存関係グラフを通じた根本原因の追跡を支援する。調査履歴は事後レビューにも活用できる。
エージェントの役割と限界
DevOps Agentはあくまで支援ツールであり、人間の判断を代替するものではない。提案内容をそのまま鵜呑みにするのではなく、エンジニアの専門知識と組み合わせて使うことが重要だ。
また、エージェントはテレメトリデータのみに基づいており、コードのビジネスロジックや組織固有の事情までは考慮しない。この点は運用チームが補完する必要がある。
セットアップ手順
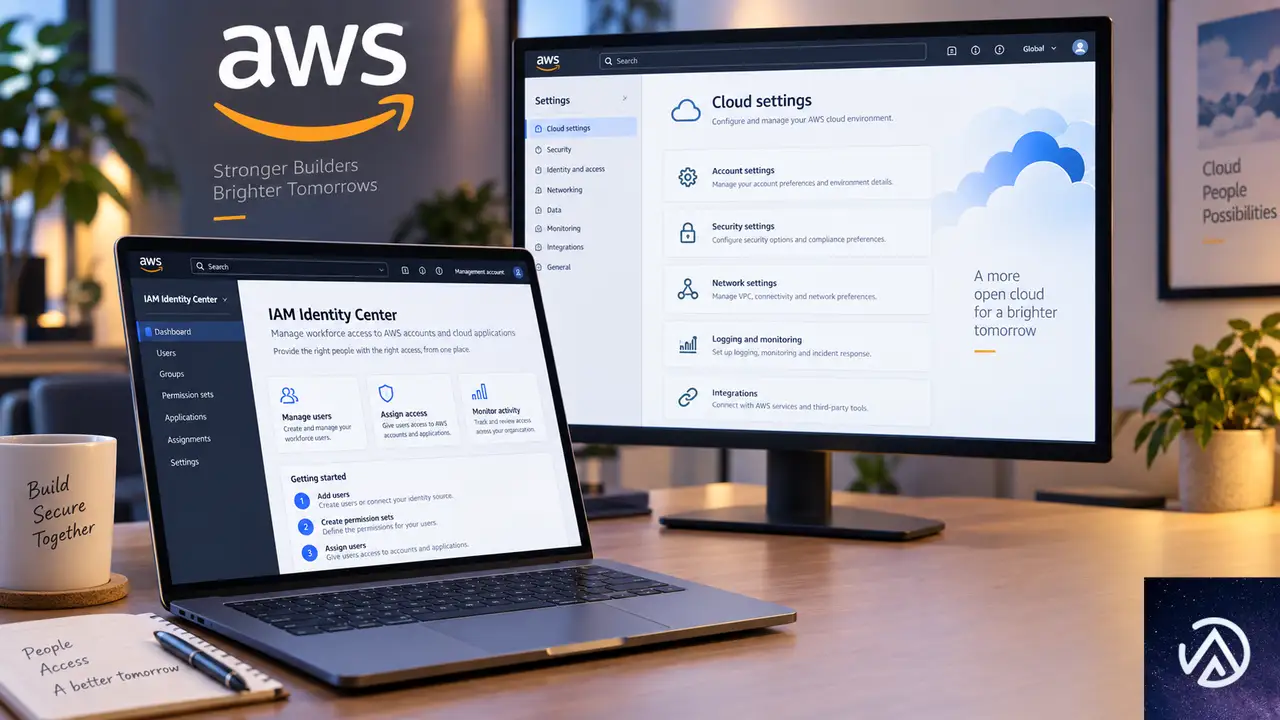
CloudWatch Omniのセットアップは数分で完了する。既存のCloudWatch環境を再設定する必要はない。
既存CloudWatchユーザーの場合
CloudWatchコンソールで「Try CloudWatch Omni」をクリックするだけで、既存のログ、メトリクス、トレース、アラームが即座に利用可能になる。ワークロードは自動的に検出され、アプリケーショントポロジーをすぐに確認できる。
組織全体への展開
管理者はドメインを設定し、IAM Identity Center経由でIDプロバイダーを接続する。その後、チームと環境ごとにSpaceを定義し、ユーザーを招待する。各Spaceは既存のCloudWatchデータを参照するため、データの移動は不要だ。
他環境のアプリケーション取り込み
オンプレミスや他クラウドで稼働するアプリケーションも、コネクターを利用してテレメトリをOmniに取り込める。取得したデータはAWSデータと同じSpaceや調査セッションに表示される。
既存のCloudWatchとの関係と料金
CloudWatch OmniはCloudWatchを置き換えるものではなく、拡張するものだ。既存のアラーム、ダッシュボード、API、コンソールのワークフローはそのまま機能する。
アクセスは専用のWebアプリケーション経由で、エンタープライズSSOに対応する。セットアップ後、DevOps AgentはすべてのOmni調査セッションでデフォルトで有効になる。
料金体系
料金の詳細はAWSの公式価格ページで確認できる。既存のCloudWatchユーザーはコンソールから直接試用できる。
導入コストの見積もりには、監視対象のワークロード数と取り込むテレメトリ量が影響する。
生成AIワークロードへの対応
CloudWatch Omniは、生成AIやエージェントワークロード向けの専用可観測性も提供する。トレース探索、評価フレームワーク、リアルタイムモニタリングが含まれる。
詳細はAWSの別記事で紹介されている。エージェント可観測性のハンズオンも参照できる。
この記事のポイント
- CloudWatch Omniはアプリケーション中心の可観測性を提供する
- OpenTelemetryベースで既存テレメトリを活用できる
- チーム全体が同じワークスペースで共同調査できる
- Amazon DevOps AgentがAI支援で根本原因特定を助ける
- セットアップは数分で完了し、既存環境への影響はない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleが商品カルーセルを欧州で削除、EC事業者の有機的流入が激減
Googleが2026年9月、欧州経済領域(EEA)で商品カルーセルの表示をほぼ全廃した。EC事業者がGoogle検索からオーガニックで顧客を獲得する主要経路が突然消えた形だ。
オランダの分析プラットフォームProductriseの計測では、EEA圏内の商品カルーセル表示回数は90〜100%減少している。英国や米国では変化がない。この変更は欧州のEC事業者だけに影響する。
デジタル市場法(DMA)への対応が理由で、Googleは29年の歴史で最大の検索品質低下と述べる。この記事では、変更の実態、EC事業者への影響、そして取るべき具体的な対策を解説する。
商品カルーセル消失の実態
商品カルーセルとは何か
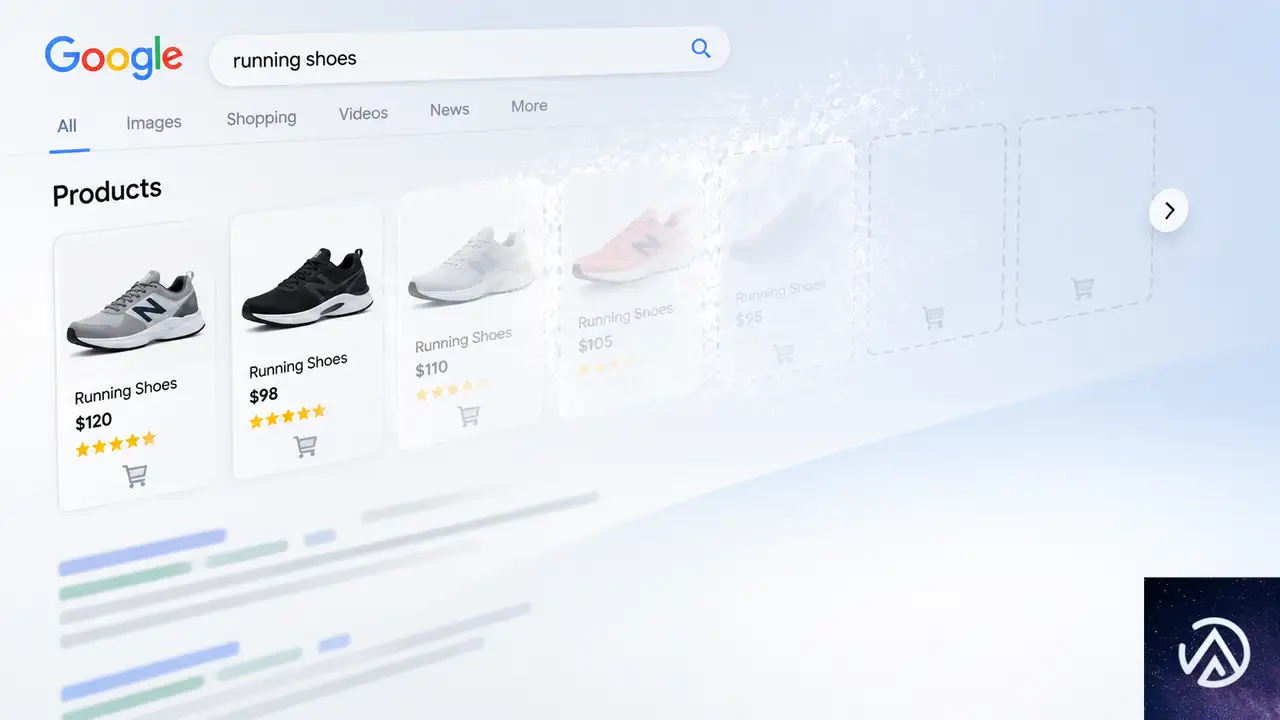
商品カルーセルとは、Google検索で商品名を入力した際に検索結果の上部に表示される横並びの商品一覧だ。商品画像、商品名、価格、ショップ名が一目で確認でき、ユーザーは検索結果から直接商品ページへ遷移できる。EC事業者にとっては、Google Merchant Centerに商品情報を登録するだけでオーガニック流入を得られる重要な表示だった。
このデモは検索結果の表示変化を示している。商品カルーセルが消え、ショップリストに置き換わった。
90〜100%という減少幅
Productriseは数千件の検索クエリを毎日追跡している。同社の計測によると、ドイツ、フランス、オランダ、ベルギー、スウェーデンの5カ国で商品カルーセルの表示回数が90〜100%減少した。Productrise創設者のHugo Huijer氏は「わずか数日で90〜100%の減少が見られる。一方、英国、米国、オーストラリアなどEEA圏外では変化がない」とEcommerce News Europeに語っている。
EEAはEU加盟27カ国にノルウェー、アイスランド、リヒテンシュタインを加えた30カ国で構成される。対象となるのはこの30カ国に限られ、日本を含むEEA圏外の検索結果では従来通り商品カルーセルが表示される。
DMA(デジタル市場法)遵守が理由
DMAの概要とGoogleの判断
DMA(Digital Markets Act / デジタル市場法)は、巨大プラットフォーム企業による市場支配を規制するEU法だ。2022年に成立し、Google、Apple、Meta、Amazon、Microsoftのような「ゲートキーパー」と指定された企業に対し、自社サービスを競合より有利に扱うことを禁じている。
Googleは、商品カルーセルがDMAの「自己優遇の禁止」条項に抵触する可能性があると判断した。商品カルーセルはGoogle Shoppingという自社サービスへの誘導を促進する機能であり、競合する価格比較サイトやアグリゲーターを不利にする。この判断に基づき、EEA圏内では商品カルーセルを削除し、代わりにショップ名とアグリゲーターのリストを表示する方式に切り替えた。
Shoppingタブの消滅
ドイツの業界プラットフォームSEO SüdwestのKristian Kunz氏によると、GoogleのタブナビゲーションからShoppingタブも削除された。「その他」メニューにも表示されず、残っているのはGoogle Shopping Ads(有料広告)のみだ。Googleは今回の変更について「29年の歴史で最大の検索品質低下」と述べている。これは同社の主張であり、DMA対応がいかに抜本的な変更であるかを示す言葉だ。
ここで重要なのは、変更の対象が「オーガニック表示」に限定されている点だ。Google Shopping Adsは有料広告であり、DMAの規制対象外としてEEA圏内でも引き続き表示される。Googleにとって広告収入は維持される構造となっている。
EC事業者への影響を読み解く
中小事業者と大手の明暗
この変更の影響は事業規模によって異なる。中小規模のEC事業者は、オーガニック検索からの商品ページへの直接流入が大幅に減る。商品カルーセルは商品名、価格、画像を直接検索結果に表示していたため、ユーザーがクリックする前に商品情報を確認し、そのまま商品ページに遷移できた。この経路が絶たれたことで、商品個別ページへの流入は激減する。
このデモは流入経路の変化を示している。直接流入から間接流入へと質が変わった。
一方、大手小売業者にはプラスに働く面もある。ブランド認知度が高い大手は、ユーザーが直接サイト名やブランド名を検索する「ブランド検索」からの流入が増える可能性がある。Hugo Huijer氏も「多くの企業が戦略の基盤としてきた機能が消えた」と指摘しつつ、この変化を「オーガニック可視性の根本的な転換」と表現している。
Google Merchant Centerの価値低下
Google Merchant Centerへの商品登録の価値も大きく下がった。従来は登録した商品情報が商品カルーセルやGoogle Shoppingタブに表示されていたが、これらのオーガニック表示が消えた今、Merchant Centerへの登録は商品広告(Google Shopping Ads)を出稿する場合を除き、オーガニック流入を生まない。Kunz氏は「SEO for productsも、少なくともGoogle Shoppingに直接関係する施策に関しては重要性が低下した」と述べている。
EEA圏内のEC事業者が取るべき対策
カテゴリーページのSEO強化が最優先
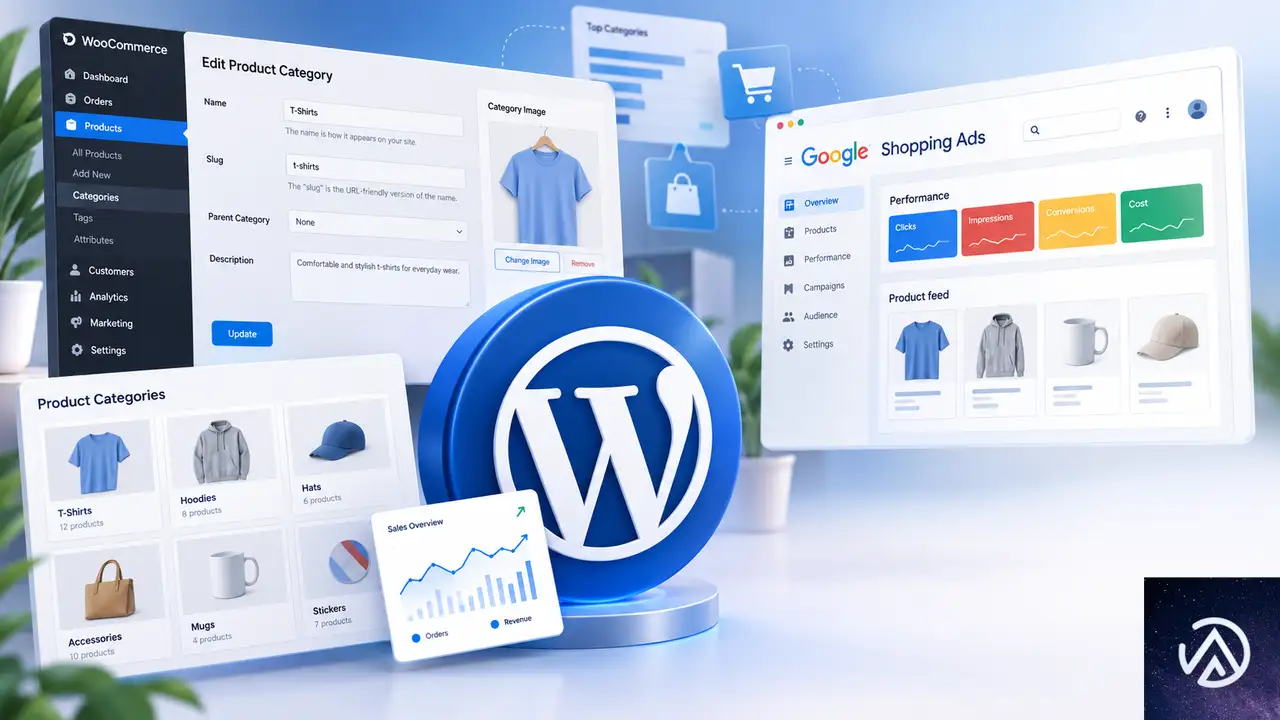
Productriseは、商品カルーセルの代替としてカテゴリーページがオーガニック検索で重要性を増すと予測している。カテゴリーページとは、「ランニングシューズ」「ワイヤレスイヤホン」のような商品群をまとめたページだ。商品個別ページではなく、カテゴリーページが検索結果の上位に表示される可能性が高まる。カテゴリーページのタイトル、メタディスクリプション、コンテンツ、内部リンクを最適化する必要がある。
WooCommerceを使っているECサイトの場合、カテゴリーページの構造は比較的最適化しやすい。WooCommerceの商品カテゴリーはアーカイブページとして自動生成されるため、カテゴリーの説明文、タイトル、メタ情報を設定するだけで基本的なSEO対策ができる。さらに商品カテゴリーごとに固有のコンテンツを追加することで、検索エンジンからの評価を高められる。例えば「ランニングシューズ 選び方」のような購買ガイド記事をカテゴリーページに組み込むと効果的だ。
ショッピング広告と価格比較サイトの活用
オーガニック表示が消えたことで、有料広告の価値が相対的に高まった。Google Shopping AdsはEEA圏内でも引き続き表示されるため、予算に余裕がある事業者はショッピング広告への投資を増やすことを検討すべきだ。広告費は増えるが、商品カルーセルが消えたことで競合の有機的な露出も減少しており、広告のクリック率や費用対効果が改善する可能性がある。
同時に、価格比較サイトやアグリゲーターへの掲載を強化することも有効だ。Googleが表示するショップリストには、価格比較サイトやアグリゲーターが並ぶ。これらのサイトに商品を掲載することで、間接的にGoogle検索からの流入を確保できる。手数料は発生するが、オーガニック流入が激減した現状では、顧客獲得コストとして捉える必要がある。
このデモはEC事業者が取るべき対策を4つのステップで示している。優先順位の高い順に並んでいる。
ブランド検索の強化と分散戦略
四つ目に、ブランド検索の強化がある。ユーザーが「ショップ名+商品名」で検索した際に、自社サイトが確実に上位表示されるようにする。Googleが商品カルーセルを削除しても、ブランド検索には影響がないためだ。ブランドの認知度を高めるためのコンテンツマーケティング、SNS活用、メールマーケティングにも投資すべきだ。特定のプラットフォームに依存しすぎない「分散戦略」が、今回のような突然の仕様変更への備えとなる。
この記事のポイント
- GoogleがEEA圏内で商品カルーセルを削除、表示回数は90〜100%減少した
- DMA(デジタル市場法)対応のためで、Shoppingタブも消滅した
- カテゴリーページのSEO強化が今後の最重要課題となる
- Google Shopping Adsと価格比較サイトへの掲載が代替流入手段として浮上する
- 中小EC事業者は直接流入の減少で打撃を受け、大手はブランド検索で恩恵を受ける可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareがrobots.txtを自動生成するBot Preference Syncの仕組みと検証
Cloudflareが2026年8月21日、サイトのrobots.txtを自動生成する新機能「Bot Preference Sync」を発表した。Search、Agent、Trainingの3つのカテゴリ設定から、Cloudflareがrobots.txtの該当部分を自動的に書き換える仕組みだ。robots.txtとエッジ強制設定の矛盾を解消すると期待される。
この機能は無料プランから利用でき、新規顧客にはデフォルトでオンになる予定だ。一方でカテゴリ単位の設定には粗さがあり、個別クローラー単位のビジネス判断を表現できないという課題もある。本記事では機能の仕組みと限界、サイト運営者が取るべき対応を検証する。
robots.txtとエッジ強制の矛盾が生んだ新機能
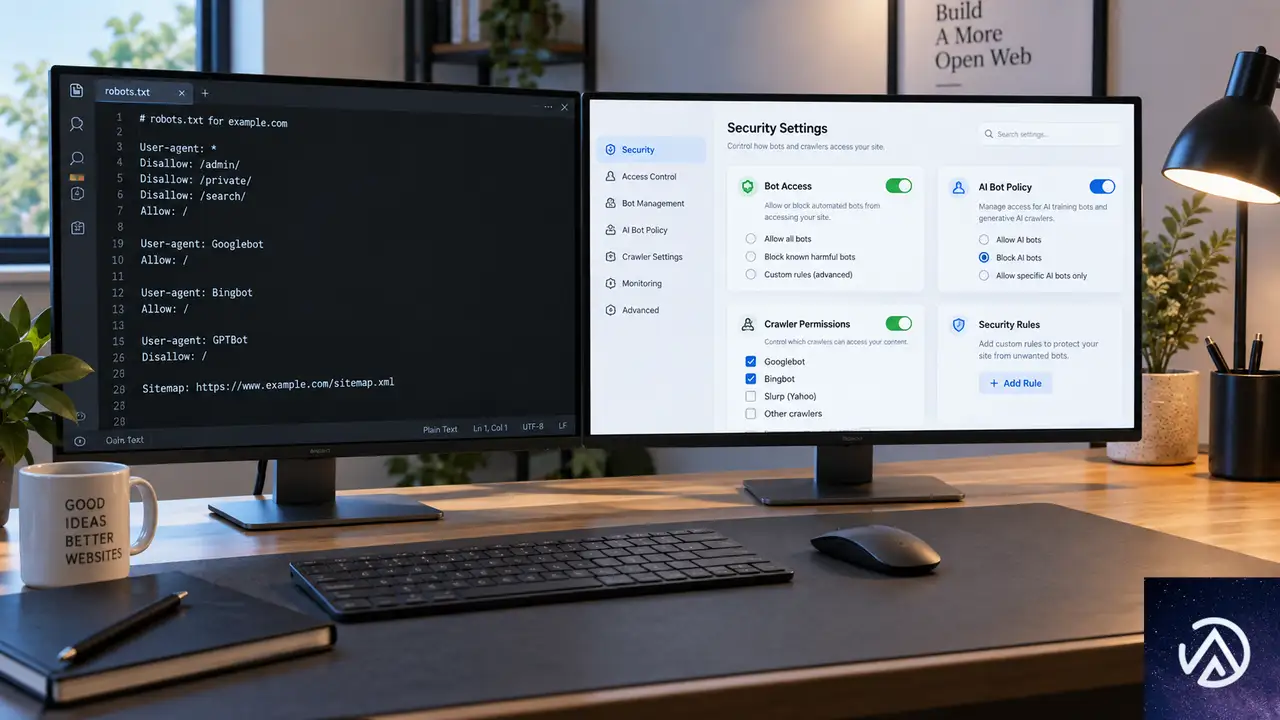
Webサイトのクローラーポリシーは2つの場所で管理される。1つはrobots.txtファイル、もう1つはWAFやCDNのエッジ側で動作するブロック設定だ。robots.txtはテキストファイルであり、クローラーへのリクエスト(お願い)を記述する。エッジ強制設定はダッシュボードで操作し、実際にHTTPリクエストを拒否する。
この2つは別々の場所で管理されるため、時間とともに矛盾が生じやすい。robots.txtは一度作成すると放置されがちで、エッジ設定は後から変更されることが多い。No Hacksの記事は、運営者自身のサイトでこの問題が発生していた例を報告している。robots.txtではBytespiderを許可する記述が数ヶ月間残っており、意図しないクローラーを歓迎する状態だったという。
CloudflareのBot Preference Syncは、この矛盾を自動的に解消する。ダッシュボードで設定したAIボットポリシーをrobots.txtに反映し、エッジ強制設定との乖離を防ぐ。Cloudflareがrobots.txtを書くという行為は、サイト運営者の代わりにポリシーを文書化することでもある。
Bot Preference Syncの仕組みと3つのカテゴリ設定
Bot Preference Syncは、セキュリティ設定の「AIボットポリシー」で設定した内容をrobots.txtに変換する。設定項目はSearch(検索)、Agent(エージェント)、Training(トレーニング)の3カテゴリだ。各カテゴリには「全ページでブロック」「広告表示ページのみブロック」「許可」の選択肢がある。
生成されたrobots.txtには、Cloudflare Bot Preference Syncの開始マーカーと終了マーカーが付与される。既存のrobots.txtコンテンツはその下に保持される。つまりCloudflareが書き込むのはマーカーの間の部分だけで、サイト運営者が手動で書いた部分は残る仕組みだ。
Bot Preference Syncは設定をrobots.txtへ反映する一連の流れを自動化する。
Cloudflareの発表によると、この機能は無料プランから利用可能で、新規顧客にはデフォルトでオンになる。ただし2026年9月13日時点では、Bot Preference Syncの公式Changelogへの記載がなく、Cloudflareのボットドキュメントにも言及がない。また一部のサイトではrobots.txtに生成ブロックがまだ現れていない。本記事は発表内容に基づく検証となる。
カテゴリ単位の設定では表現できない個別ポリシー
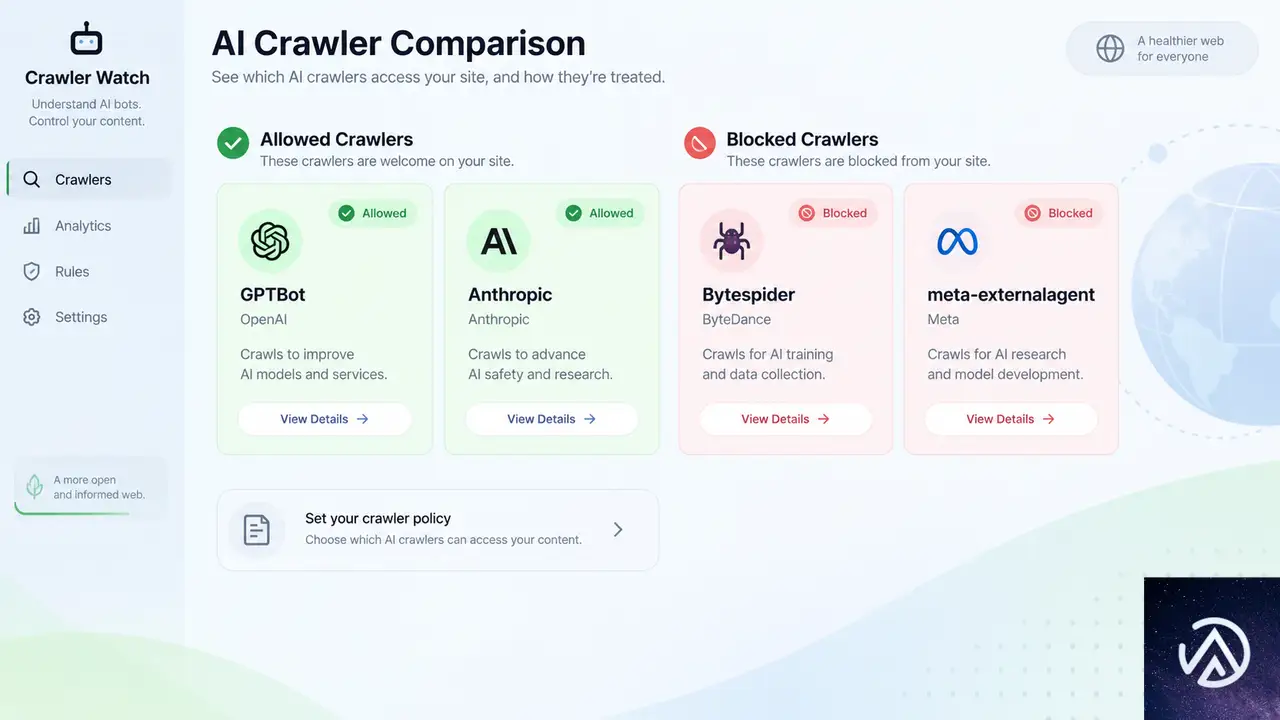
Bot Preference Syncの3カテゴリ設定は、サイト運営者のビジネス判断を必ずしも表現できない。No Hacksの記事の運営者は、OpenAIのGPTBot、Anthropicのクローラー、PerplexityBotを許可し、Bytespiderとmeta-externalagentをブロックしている。この判断は企業ごとの見返りに基づく。前者は自社ページをアシスタントの回答に表示してくれるが、後者は何も返さない、という理由だ。
このポリシーを3カテゴリ設定で表現しようとすると、矛盾が生じる。Trainingをブロックに設定すれば、許可したいGPTBotまでブロックされる。Trainingを許可に設定すれば、ブロックしたいBytespiderまで許可される。個別クローラー単位のビジネス上の決定は、カテゴリ単位の設定では表現できない。
個別クローラー単位のポリシーは3カテゴリ設定では表現できない。許可したいクローラーの扱いが、設定次第で逆転してしまう。
Cloudflareは、より細かい制御が必要な場合の対応策として、同期機能をオフにして手動でrobots.txtを管理することを挙げている。これはBot Preference Syncが万人向けではなく、カテゴリ単位の粗さを受け入れられるサイトに向けた機能だということを示している。
独自の見解として、日本のサイト運営者にもこの課題は当てはまる。コンテンツをAIトレーニングに提供する見返りを個別に評価している企業は、3カテゴリの設定では対応できない。Bot Preference Syncはあくまで「全許可」か「全拒否」に近いポリシーを持つサイト向けの省力化ツールと捉えるべきだ。
Cloudflareが公開した4つの開示条件とブロッキング
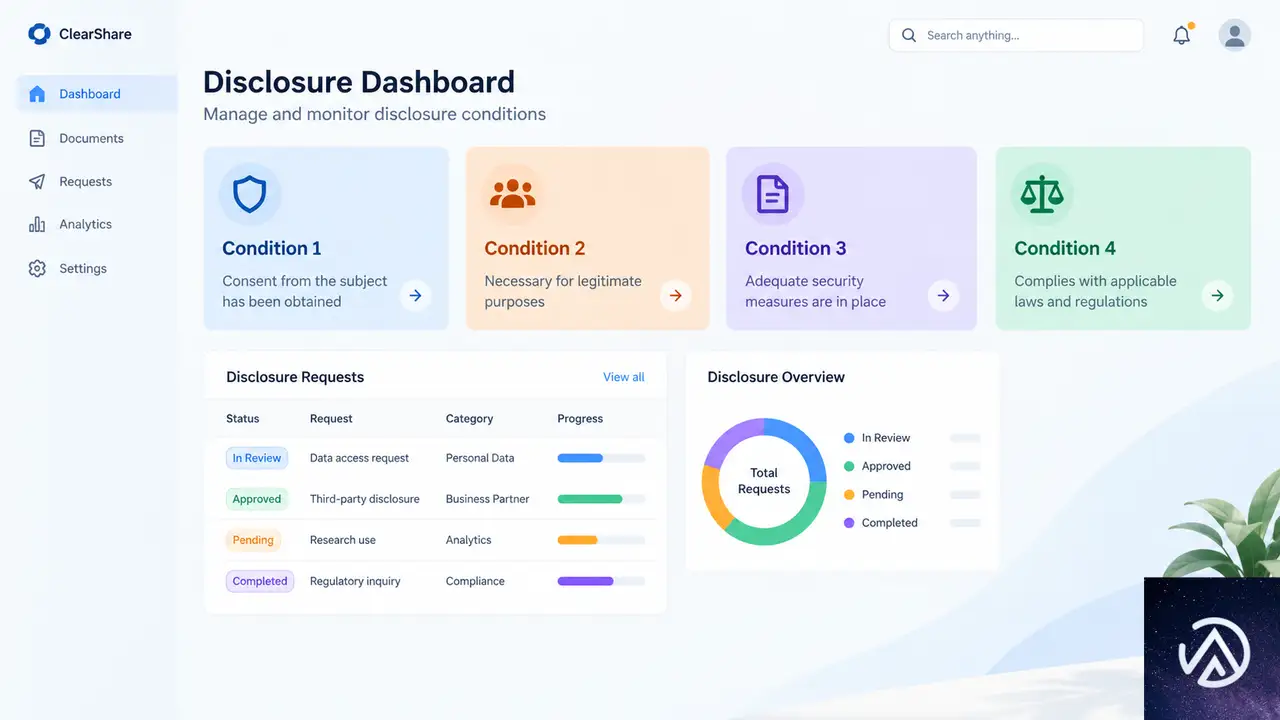
TrainingをDisallowに設定すると、robots.txtにno-training行が書き込まれる。同時に、Cloudflareが「不透明」と判断したAIクローラーがブロックされる。Cloudflareはこのブロックを回避するために、クローラーが満たすべき4つの条件を公開している。
4つの条件を満たさないクローラーは不透明とみなされ、TrainingをDisallowに設定したサイトではブロック対象となる。
条件2と条件4はGoogleを記述している。条件4についてGoogleはすでに満たしている。Googleのクローラードキュメントは、Google-ExtendedがGeminiモデルのトレーニングを制御し、検索結果への掲載やランキングシグナルには影響しないと明記している。これは条件4が求める公開声明に該当する。
一方で条件2はGoogleが答えを持っていない。条件2はAIサマリーからオプトアウトする方法を求めている。GoogleのAI機能のドキュメントによると、AI概要から除外するにはnosnippet、data-nosnippet、max-snippet、noindexのいずれかを使うことになる。しかし、これらはすべて通常の検索表示にも影響する。AI概要だけから外れて通常の検索スニペットは残す、という設定は存在しない。
Microsoftは2023年9月に条件2への回答を示している。NOARCHIVEタグを付けたコンテンツはBing Chatの回答に含まれないが、検索結果には引き続き表示される。検索インデックスから除外せず、チャットの回答からだけ除外できる仕組みだ。Cloudflareは2026年7月の記事で、BingBotとGooglebotを混合用途クローラーとしてこの条件の対象に挙げている。
CloudflareがAI企業への開示要求を明文化した点は評価できる。ただし、その条件を書いたのも執行するのもCloudflareという単一ベンダーだ。条件を読まずにダッシュボードのトグルをクリックしたサイト運営者も多い。パブリッシャーがAI企業に求めてきた説明責任は、いまやCloudflareにも向けられている。
新規顧客にデフォルト適用される意味とリスク
2026年9月15日から、Cloudflareは新規ドメインのデフォルト設定を変更する。広告を表示するページではTrainingとAgentがブロックされ、Searchは許可される。オンボーディング時に「広告付きページで収益化している」を選択すると、TrainingがDisallowに自動設定される。
これはビジネスモデルに関する質問であり、その回答がrobots.txt上のAIトレーニングに関する公開ポジションになる。広告収益に依存するサイトは、AIトレーニングを拒否する立場を自動的に表明することになる。サイト運営者がこの設定を認識していなければ、意図しないポジションが公開され続ける。
リスクが大きいのは、robots.txtを二度と開かず、自分の代わりに書かれたポジションを読まないサイトだ。Cloudflareはすでにアナリティクススクリプトを無料プランのサイトにデフォルトで書き込んでいる。同じオンデフォルトのパターンがrobots.txtにも及ぶ。サイト運営者が設定を確認しなければ、AIトレーニングに関する自社の立場を外部ベンダーに委ねることになる。
SEO担当者の観点では、このデフォルト変更を黙認してはいけない。自社サイトがAIトレーニングを拒否しているのか許可しているのかは、AI時代の検索戦略を左右する。デフォルト設定のまま放置するのではなく、自社のビジネスモデルに合わせて意図的に選択することが重要だ。
robots.txtが守れる範囲と守れない範囲
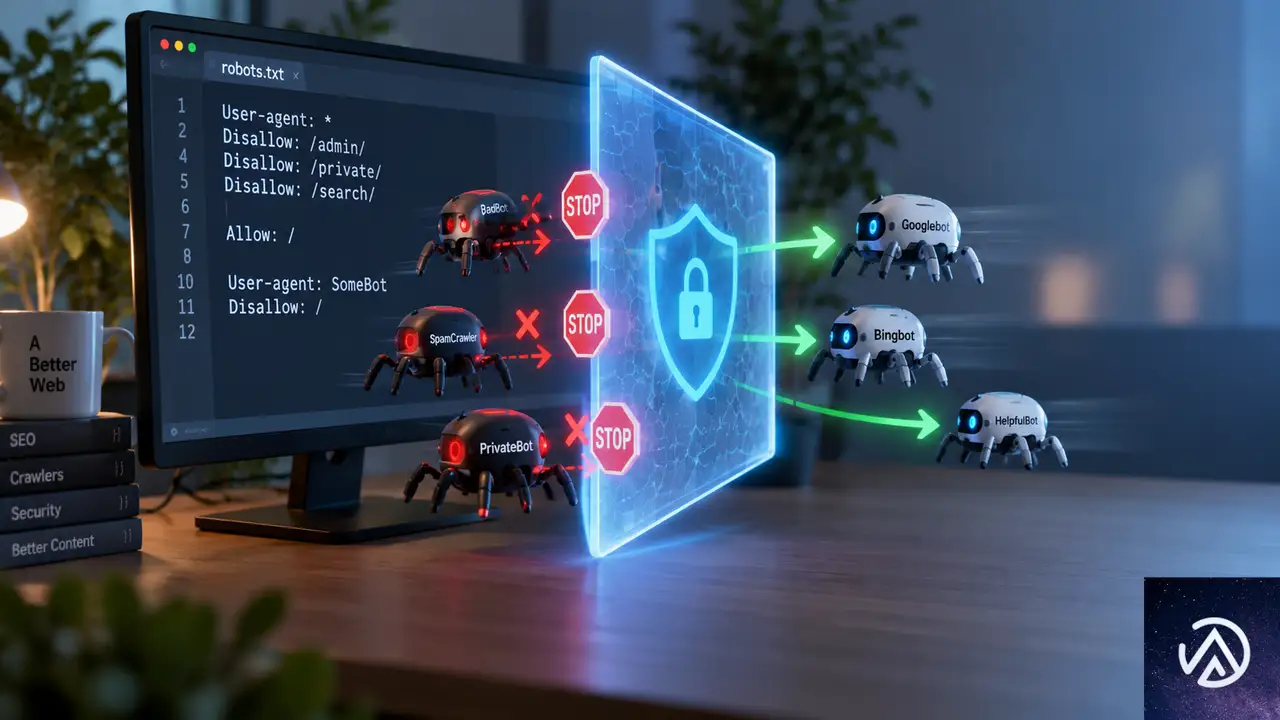
robots.txtのルールは、停止することを選ぶクローラーを停止させるだけだ。ルールを無視するクローラーには何も影響しない。No Hacksの記事は、同サイトのログで最大のAIクローラーが認証情報を探していたと報告している。非営利研究アーカイブの名前を使い、/.envやSSHキーを要求するクローラーがいたという。テキストファイルのルールはそのようなクローラーを不便にさせることすらできない。
それでもBot Preference Syncは有用だ。インターネットの誠実な側、つまりルールを守るクローラーに対しては機能する。エッジでの強制が実際の防御であり、robots.txtは意図の文書化として、後から紛争になった時に意味を持つ。リクエストが到着した瞬間の防御にはならないが、自社のポリシーを明確に残しておく価値はある。
最終的には、robots.txtとCloudflareのAIボットポリシーを突き合わせて確認する作業が欠かせない。Bot Preference Syncが自サイトに到達したら、書かれた内容を必ず確認すること。読んでいないポリシーファイルは、他人が自分の代わりに表明した立場になる。
この記事のポイント
- CloudflareのBot Preference Syncはrobots.txtとエッジ強制設定の矛盾を解消する自動化機能である
- Search、Agent、Trainingの3カテゴリ設定では個別クローラー単位のビジネス判断を表現できない
- Cloudflareは4つの開示条件を公開し、不透明なクローラーをブロック対象にした
- 新規顧客にはデフォルトでオンになり、広告収益化サイトではTrainingがブロックされる
- robots.txtは誠実なクローラーにしか効かないため、エッジ強制が依然として重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験