
Googleが2026年5月コアアップデートを配信開始、2週間で完了の見込み
Googleは2026年5月21日、5月のコアアップデートの配信を開始した。この情報はGoogle Search Status Dashboardと、Search CentralのXアカウントを通じて発表された。配信は最大2週間かけて段階的に行われ、全データセンターに反映されるまでサイトの検索順位に変動が生じる可能性がある。
2026年に入ってから、検索に関するコアアップデートは今回が2回目となる。直近では3月27日に始まったコアアップデートが4月8日に完了しており、それから約6週間という短いスパンでの実施だ。Googleは今回のアップデートについて「あらゆるタイプのサイトから、より関連性が高く満足度の高いコンテンツを検索者に提供するための定期的な更新」と説明している。
サイト運営者にとって重要なのは、コアアップデートの配信中に慌ててコンテンツを修正しないことだ。部分的な順位変動を確認しても、配信完了から最低1週間はSearch Consoleのデータを見極めるべきだ。このアップデートが何を評価し、何を重視するのか、その全体像を冷静に読み解く必要がある。
2026年5月コアアップデートの概要
5月21日に発表されたこのアップデートは、2026年における4回目のランキング変動を伴うアップデートであり、検索コアアップデートとしては3月に続く2回目の実施となる。Googleは配信開始をDashboard上で「2026年5月のコアアップデートをリリースした。配信完了までに最大2週間かかる可能性がある」と簡潔にアナウンスした。
今回のアップデートについて、Googleは個別のブログ投稿や具体的な目標を発表していない。この手法は直近の3月のコアアップデートと同様だ。3月のアップデートでは「すべてのタイプのサイトから、より関連性が高く満足度の高いコンテンツを検索者に提供するための定期的な更新」という説明が付帯された。今回も同様に、特定の業種やペナルティを目的としたアップデートではないことが推測される。
上のタイムラインを見ると、2026年に入ってからのアップデート頻度は決して低くない。特に3月から5月にかけてはコアアップデートが2回実施されており、Googleが検索品質の改善を継続的に進めていることがわかる。サイト運営者は定期的なランキング変動を前提とした運用体制を整えておく必要がある。
アップデートの位置づけ
コアアップデートとは、Googleが検索アルゴリズム全体にわたって広範な変更を加える大規模な更新のことだ。特定のスパム行為やポリシー違反を対象にするのではなく、ウェブ全体の変化に合わせてコンテンツの評価方法を調整する。これにより、従来高評価だったページが順位を下げたり、これまで目立たなかったページが浮上する可能性がある。
重要なのは、コアアップデートは「ペナルティ」ではないという点だ。特定のサイトを罰するものではなく、検索者にとってより有益な情報を届けるための調整に過ぎない。順位が下落した場合でも、それは「ルール違反」ではなく、「現時点でGoogleが評価する基準に対して相対的に適合度が下がった」ことを示すシグナルだ。
過去のアップデートとの比較
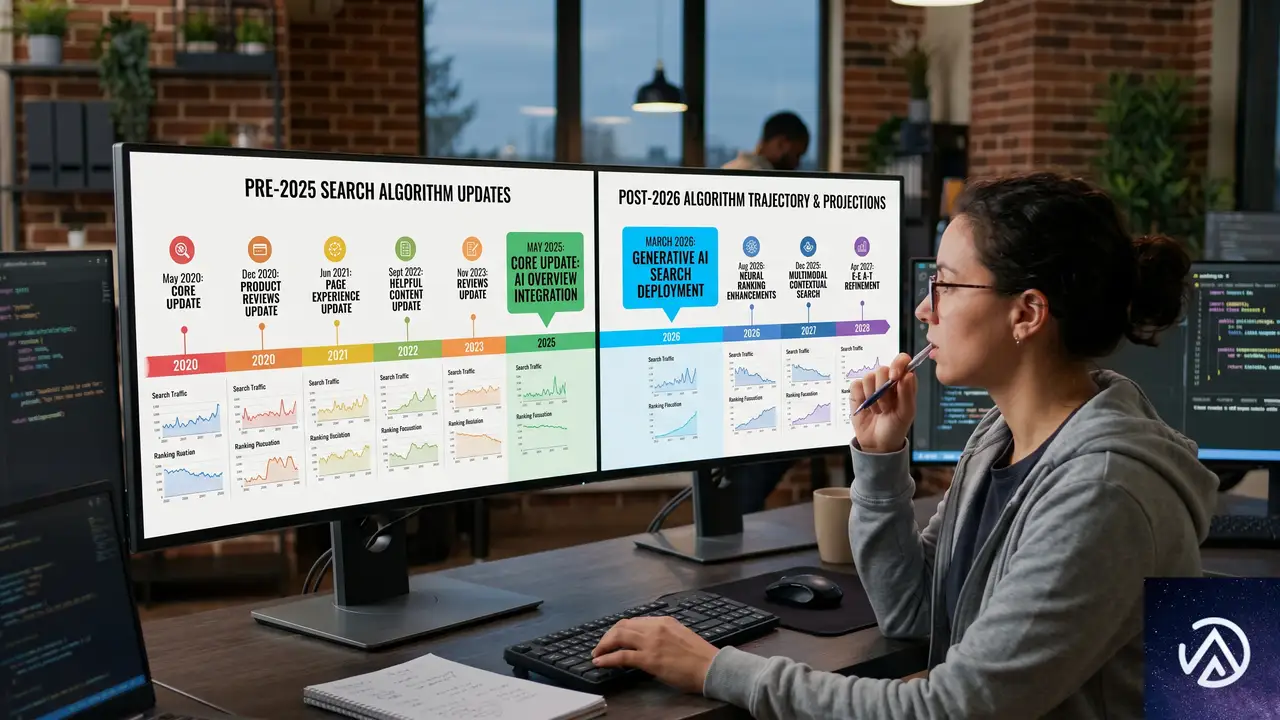
今回のアップデートを理解する上で、直近のコアアップデートの実施状況を振り返ることは有効だ。特に3月のコアアップデートとの間隔や配信期間の違いは、サイト運営者のデータ分析計画に直接影響する。
上の比較で明らかなように、コアアップデートの配信期間は12日から18日まで、回によってばらつきがある。今回の「最大2週間」という見積もりは、過去の実績から見て標準的な長さだ。3月アップデートが12日で完了したことを踏まえると、今回も同程度かやや長引く可能性がある。
アップデート間隔の短縮が示すもの
コアアップデートの実施間隔が約6週間と比較的短くなっていることは注目に値する。これはGoogleが大規模なアルゴリズム更新をより機動的に展開できるようになったことを示している。AIや機械学習によるランキングシステムの進化が、この迅速な更新サイクルを可能にしていると考えられる。
サイト運営者の視点では、この短い間隔は「次のアップデートが常に近い」状態を意味する。大幅なサイト改修を計画している場合、2ヶ月以上の長期プロジェクトよりも、改善箇所を小さく区切って順次適用していくアプローチが有効だ。コアアップデートのたびにデータを確認し、次の一手を柔軟に変えられる体制が求められる。
コアアップデート中にサイト運営者が取るべき行動
コアアップデートの配信中、多くのサイト運営者は順位変動に一喜一憂しがちだ。しかし、プロフェッショナルなSEO対応として最も重要なのは「配信中に手を加えない」ことである。Googleも公式に、コアアップデートの完了から最低1週間はSearch Consoleのデータを分析するよう推奨している。
上のフローは、Googleの公式ガイダンスに基づく基本的な対応手順だ。途中段階のデータで判断すると、まだ反映されていないデータセンターの影響で誤った分析をしてしまう可能性がある。全データセンターにアップデートが行き渡った後のデータを使うことが、正確な影響評価の前提条件となる。
順位変動への向き合い方
コアアップデートで順位が下落した場合、真っ先に疑うべきは「何か悪いことをしたか」ではなく「相対的にコンテンツの価値が再評価されたか」だ。Googleはコアアップデートの影響を受けたサイト向けに、コンテンツの品質に関する自己評価のための質問リストを公開している。このリストを活用し、客観的に自サイトのコンテンツを見直すことが有効なアプローチとなる。
一方で、順位が上昇したサイトは「たまたま今回の基準に適合した」可能性を忘れてはならない。次のアップデートで同じ評価を受ける保証はない。一時的な順位上昇に満足せず、継続的にコンテンツの品質を高める努力を続けることが、長期的なSEO成功への道筋となる。
Search Consoleデータの活用法
アップデート完了後に確認すべき主要な指標は、オーガニック検索のクリック数、表示回数、平均掲載順位、CTR(クリック率)だ。これらの指標をアップデート前の期間(5月21日以前の数週間)と比較することで、どのページが影響を受けたかを特定できる。
特に重要なのは、単純な平均順位の上下だけでなく、「検索クエリの種類」の変化にも注目することだ。上位表示されていたクエリが変わった場合、それはGoogleがそのページの関連性を異なる方向で評価し始めたことを示唆する。特定のクエリグループで順位が下落したなら、そのトピック領域のコンテンツを集中的に見直す必要がある。
メガAI検索の台頭とSEO戦略の再定義
今回のコアアップデートを、より大きな文脈で捉える必要がある。それはGoogle検索におけるAI統合の加速だ。2025年後半からAI Overviews(旧SGE)の表示頻度が段階的に拡大されており、2026年には「メガAI検索」とも呼べる新しい検索体験が本格化しつつある。
この変化が示すのは、検索結果ページに「青いリンクのリスト」以外の要素が増えている現実だ。AI Overviewsが直接回答を提示すれば、ユーザーは個別のサイトをクリックする必要がなくなる。情報提供型のコンテンツに依存していたサイトは、表示回数に対するクリック率の低下に直面する可能性がある。
AI検索時代のコンテンツ設計
メガAI検索の文脈では、単に「よく書かれた記事」であるだけでは不十分になりつつある。AIが情報を抽出し、要約し、回答として提示する前提に立つと、コンテンツは「AIに正確に読み取られる構造」を備えている必要がある。具体的には、明確な見出し階層、簡潔な定義文、信頼できる出典の明示、独自データや事例の提示といった要素が重要性を増す。
コアアップデートが「満足度の高いコンテンツ」を評価するという方向性は、このAI検索の進化と軌を一にしている。ユーザーが検索結果から直接的な価値を得られるようにするため、Googleは情報の質とアクセシビリティをこれまで以上に厳密に評価していると推測される。コンテンツ制作者は「検索エンジン向け」ではなく「検索者の疑問を解決する」という原点に立ち返りつつ、AIに適切に解析される技術的な最適化も両立させる必要がある。
2026年後半に向けたSEOの展望
5月のコアアップデートは、2026年の検索環境を占う重要なマイルストーンだ。アップデートの頻度が高まっていること、AI統合が加速していること、そしてユーザーの検索行動が変化していること。これら3つのトレンドは、SEOが単なる「順位対策」から「検索体験全体の設計」へと進化していることを示唆している。
今後注目すべきは、今回のアップデート完了後にGoogleが公開する可能性がある追加のガイダンスだ。3月のコアアップデートと同様に、今回もブログ投稿や詳細な説明がないまま配信が進行中だが、完了後に何らかの分析や推奨事項が共有される可能性がある。特に、AI Overviewsの表示基準や、コアアップデートとの関連性についての公式見解が示されれば、SEO戦略の精度を一段と高められるだろう。
サイト運営者は、目先の順位変動に振り回されることなく、コンテンツの本質的な価値向上と、変化する検索行動への適応にリソースを集中すべき段階にある。コアアップデートはその変化を映し出す鏡に過ぎない。真に重要なのは、鏡に映った自サイトの姿をどう改善するかだ。
この記事のポイント
- Googleが2026年5月21日に5月のコアアップデート配信を開始、完了まで最大2週間の見込み
- 2026年2回目のコアアップデートであり、3月のアップデートから約6週間での実施
- 配信中はコンテンツの修正を避け、完了から最低1週間はSearch Consoleデータの分析を控える
- AI検索の台頭を背景に、コンテンツ設計は「AIに正確に読み取られる構造」が重要性を増している
- 順位変動の有無に関わらず、コンテンツ品質の継続的な改善が長期的なSEO成功の鍵

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google I/O 2026 Firebase新機能、AIエージェント統合とCrashlytics Web対応発表
Google I/O 2026でFirebaseは、AIエージェント主導の開発時代に対応する多数の新機能を発表した。
Google Antigravityへのワンクリック統合、Android Studioへの標準組み込み、AI LogicのGemini 3対応、そしてWeb向けCrashlyticsの予告まで、フルスタックアプリ開発の効率を一段と高める内容だ。
これらの更新により、開発者はAIアシスタントとFirebaseバックエンドをシームレスに連携させ、より高速に本番品質のアプリを構築できるようになる。
AIエージェントと統合したフルスタック開発の加速
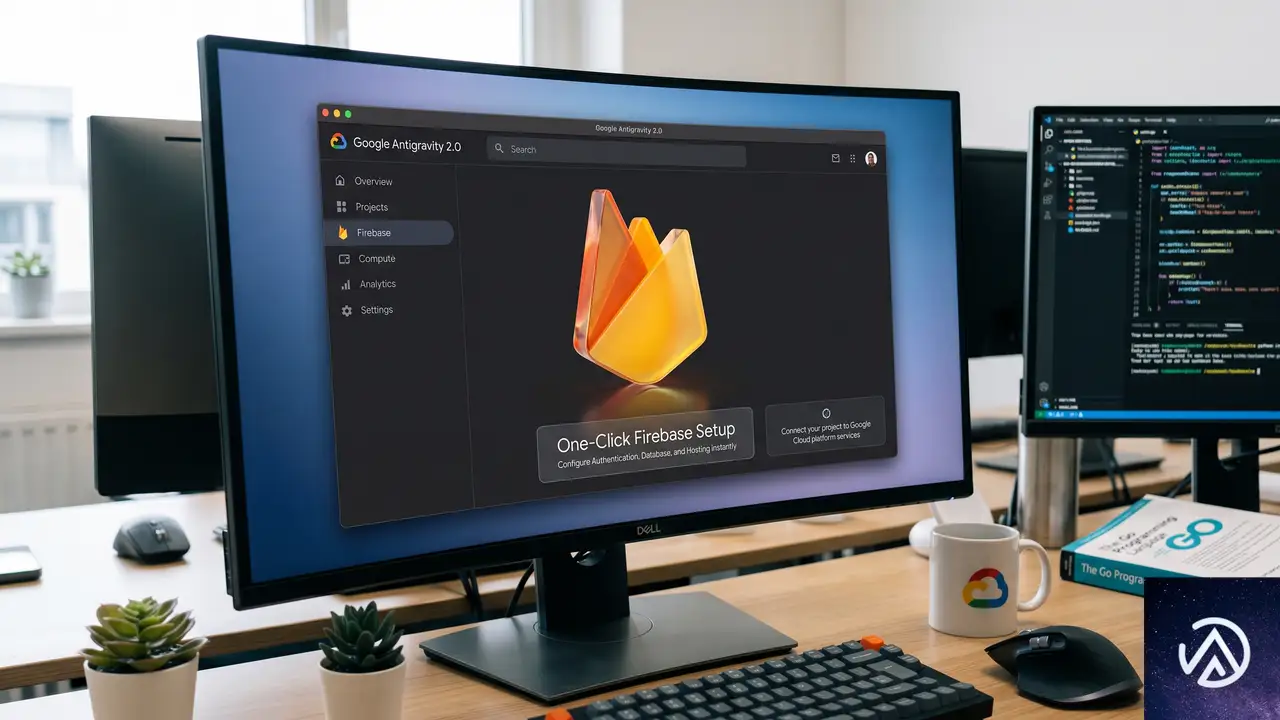
Google Antigravity 2.0とのワンクリック連携
Google Antigravity 2.0は、エージェントを中心とした開発環境を提供するデスクトップアプリだ。今回、そのオンボーディングプロセスにFirebaseをワンクリックでセットアップする機能が組み込まれた。これにより、Antigravity上でAgent SkillsとMCPサーバーを含む必要なコンポーネントが自動でインストールされ、すぐにFirebaseを利用したエージェント主導の開発を始められる。
この一連の流れにより、開発者はバックエンド設定にかかる時間を大幅に削減し、エージェントとの対話に集中できる。
Android StudioへのAgent Skills標準搭載
Android開発者にとって大きな変化は、Android StudioのエージェントモードでFirebaseのAgent Skillsがデフォルトで利用可能になった点だ。これまでは個別のセットアップが必要だったが、追加の設定なしで、エージェントがFirestoreの設定、認証コードの生成、セキュリティルールの記述まで支援してくれる。IDE内でFirebaseバックエンドを対話的に構築できるため、ドキュメントを調べる手間が省ける。
開発者の手を動かす作業が大幅に減り、アプリロジックに集中しやすくなる。
Agent Skillsがモバイル開発にも対応
これまでWeb向けに提供されていたAgent Skillsが、Android、iOS、Flutterにも拡張された。さらにCrashlyticsとRemote Configにも対応し、エージェントがクラッシュ解析や設定管理を手助けできる。例えば、IDE内で発生したクラッシュ情報をエージェントが解釈し、修正案を提示するため、ダッシュボードを切り替える必要がなくなる。
Google AI Studioの新機能、Workspace連携とデプロイ簡略化
Google AI StudioでのFirebase統合が一段と進んだ。まず、AI Studioで生成したFirebase対応アプリをワンクリックでCloud Runにデプロイできるようになり、最初の2アプリはGoogle Cloud Starter Tierにより支払い情報不要で無料公開できる。また、自然言語で「受信トレイを整理するアプリを作って」と指示するだけで、Firebase Authentication経由の「Sign in with Google」フローを通じてGmailやGoogleドキュメントといったWorkspaceデータに安全にアクセスし、自分専用の業務アプリを構築できるようになった。
さらに、マルチエージェントによる本格的な開発に進みたい場合、AI StudioからAntigravityへアプリをエクスポートできる。エクスポート時にはソースコードとAgent Skillsが自動で引き継がれ、Antigravity上で引き続き高度な調整が可能だ。
Firebase AI Logicの進化、Gemini 3対応とセキュリティ強化
Gemini 3.xモデル対応とグラウンディング強化
Firebase AI Logicは、クライアントサイドから直接Geminiモデルを呼び出すためのSDKだ。今回のアップデートでGemini 3.xシリーズに完全対応し、Google Mapsによるリアルタイムな地理情報のグラウンディング(正確な根拠をもとにした出力)でハルシネーションを抑制する。画像生成ではアスペクト比やサイズのプログラム制御が可能になり、生成に失敗した場合は「finish reasons」で原因(安全性フィルターによるブロックなど)が表示される。また、Gemini Live APIではセッション再開とコンテキスト圧縮がサポートされ、不安定なネットワークでも長時間の対話型アプリが途切れず動作する。
- モデル出力の正確性が不安定
- 画像生成に失敗しても理由が不明
- 長い会話でネットワーク切断時にリセット
- Google Maps を使ったグラウンディングでハルシネーション低減
- 画像生成失敗時に「finish reasons」で原因を表示
- セッション再開とコンテキスト圧縮で継続的対話が可能
テンプレートのみモードと認証モードでセキュリティ向上
AI機能のセキュリティも大きく強化された。新しい「テンプレートのみモード」では、クライアントが送信できるのはサーバー側に安全に保存されたプロンプトテンプレートのIDだけで、任意の指示を注入できなくなる。まもなく提供開始の「認証モード」では、有効なFirebase Authenticationトークンを伴わない限りGemini呼び出しが実行されない。さらに、Firebase App Checkにワンタイムトークンによるリプレイ攻撃保護が導入され、悪意あるAPI消費を防止する。
ハイブリッド推論のプラットフォーム拡大
ハイブリッド推論機能がiOSでも利用可能になり、Android版はGemma 4に対応した。近くChrome上でのローカルWeb推論も一般提供され、オンデバイスの軽量モデルとクラウドのGeminiを使い分けられる。これにより、プライバシーやコストを最適化しながら、ネットワーク状況に応じて常に最適な推論経路を選択できる。
エンタープライズインフラとの統合とA/B Testingの強化
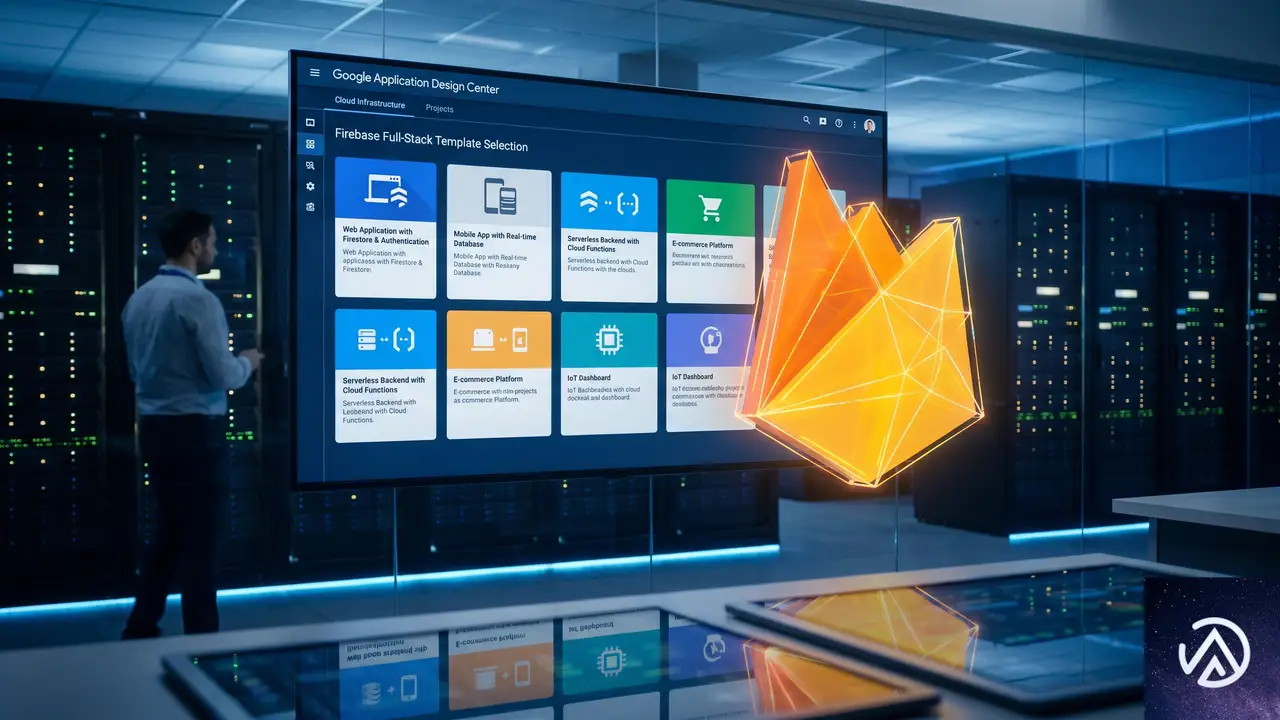
Application Design Center向けFirebaseテンプレート
Google CloudのApplication Design Center(ADC)に、Firebaseのフルスタックテンプレートが登場した。このテンプレートはFirestore(セキュリティルール付き)、Firebase Authentication、Firebase AI Logicを事前構成済みで、数クリックでプロジェクトに追加できる。ADC内で他のGoogle Cloudリソースと同じ管理モデルでFirebaseを扱えるため、大規模なクラウドインフラとモバイル・Webバックエンドを統一的に運用できる。
A/B Testingのリッチターゲティング
Firebase A/B Testingの実験作成画面が強化され、より細かいユーザーセグメントを指定できるようになった。Remote Configのリアルタイム配信と組み合わせることで、カスタムシグナルにもとづく柔軟な条件設定が可能になる。このアップデートは段階的にロールアウトされる。
Web向けCrashlyticsが登場、フロントエンドのエラー監視が可能に
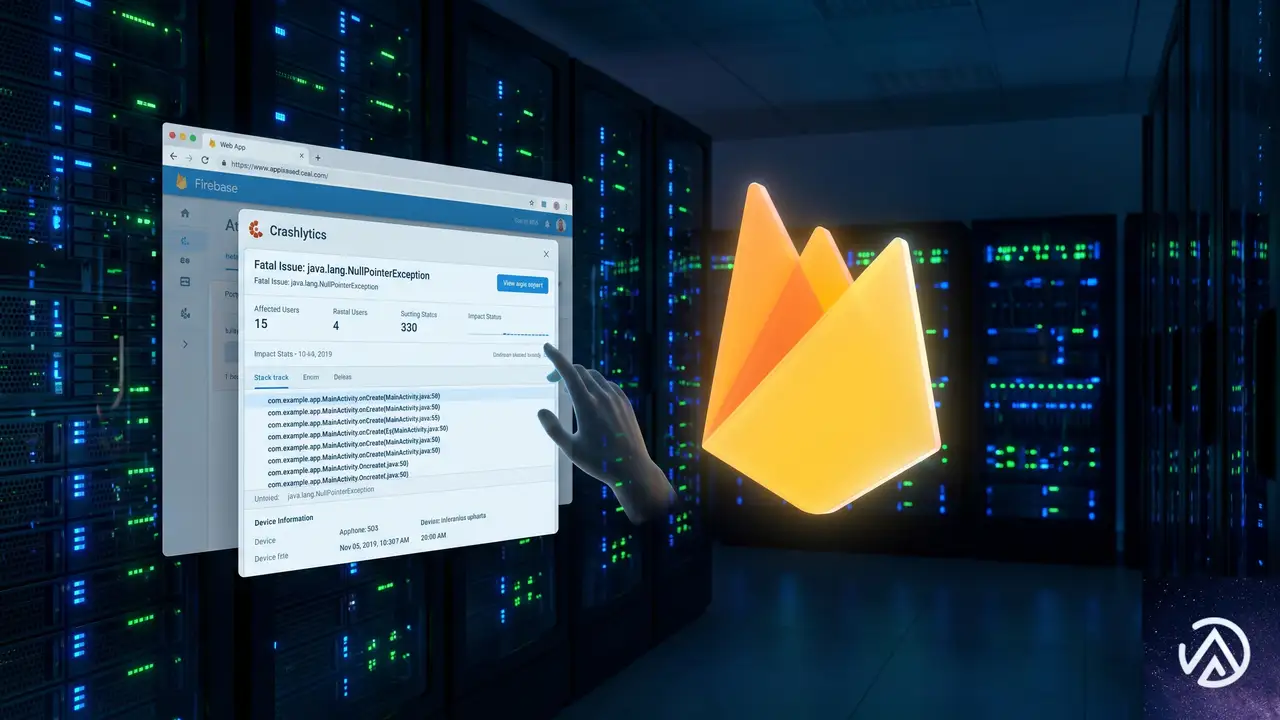
従来Crashlyticsはモバイルアプリ専用のクラッシュレポートツールだったが、Web版が間もなく提供開始される。このWebサポートはGoogle Cloud Observability Suite上に構築され、エラー情報やトレースがCloud LoggingとTraceに一括保存される。モバイルとWebの両方のデータを統合的に分析できるようになり、将来的にはクライアントからサーバーまでのエンドツーエンドデバッグが実現する。開発者はCloud Observabilityのアラート機能やカスタムダッシュボードを活用し、ユーザー体験への影響を詳細に把握できる。
Firebaseが描くエージェント時代の開発基盤
今回のアップデート群は、Firebaseが単なるモバイル向けBaaSから、AIエージェントを中心としたフルスタック開発プラットフォームへ進化していることを示している。Google AntigravityやAI Studioといったエージェント環境との統合、SQL不要の自然言語操作、そしてWebを含む包括的なオブザーバビリティにより、開発者は「何を作りたいか」に集中できるようになる。Firebaseは、エージェント主導のアプリ開発とクラウドのインフラ力を結ぶ架け橋として、今後もアップデートを続ける見込みだ。
この記事のポイント
- Google I/O 2026でFirebaseはAIエージェントとの統合を大幅に強化、Google AntigravityやAndroid Studioにワンクリックで組み込めるようになった
- Agent Skillsがモバイル(Android、iOS、Flutter)に対応し、CrashlyticsやRemote Configの設定もエージェント任せにできる
- Google AI Studioでは、Firebase Authenticationを使ったWorkspaceデータ連携が自然言語で可能になり、ワンクリックでCloud Runに無料デプロイできる
- Firebase AI LogicがGemini 3モデルに対応し、グラウンディングやハイブリッド推論で精度とコストを最適化。セキュリティ面でもテンプレート専用モードやApp Check改善が加わった
- Web向けCrashlyticsが間もなく登場し、モバイルとWebを横断したエラー監視・デバッグがGoogle Cloud Observabilityと統合される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Node.js 24.16.0 (LTS) 登場、cryptoとテストランナーが大幅進化
2026年5月21日、Node.js 24.16.0(コードネーム Krypton)が長期サポート(LTS)版としてリリースされた。
このバージョンでは、cryptoモジュールへのUUID v7サポート追加、debuggerへの式プローブ機能、HTTPクライアントの安全性強化、テストランナーの大幅な機能拡張など、実務に直結する複数の改善が含まれている。
本記事では、これらの新機能と内部改善を実装例とともに詳しく解説する。
UUID v7がNode.js標準機能に

今回のリリースで最も注目すべき追加機能のひとつが、crypto.randomUUIDv7()の実装だ。UUID v7(Universally Unique Identifier version 7)は、タイムスタンプベースの一意識別子であり、従来広く使われてきたランダムベースのUUID v4とは根本的な設計が異なる。
UUID v7とは何か
UUID v7は、RFC 9562で標準化された新しいUUIDバージョンだ。先頭48ビットにUnixタイムスタンプ(ミリ秒単位)を含み、続いてランダムビットが配置される。この構造により、生成時刻に基づいた自然なソート順が得られる。
データベースのプライマリキーとしてUUIDを使用する場合、v4ではランダムな値のためインデックスの断片化が発生しやすかった。一方、v7では時系列順に並ぶため、B-treeインデックスの効率が大幅に改善する。具体的には、書き込み性能が最大40〜60%向上したとの報告もある。
crypto.randomUUIDv7()の基本的な使い方
Node.js 24.16.0では、以下のようにシンプルに呼び出せる。
const { randomUUIDv7 } = require('node:crypto');

console.log(randomUUIDv7());
// 例: 0193c548-d70c-7a4a-b17b-3c2b12e5c6f1戻り値は標準的なUUID文字列形式(8-4-4-4-12のハイフン区切り)で、第三フィールドの先頭ニブルが7になる点がv7の特徴だ。
従来のv4に代えてv7を採用するメリットを、概念図で整理する。
上の図では、v4の全ランダム性に対して、v7が時刻情報を含む構造であることを対比している。時系列に沿ったINSERT性能が重要なシステムでは、移行を検討する価値がある。
実運用で注意すべき点
UUID v7は時刻情報を含むため、生成時刻が外部に推測される可能性がある。セキュリティ要件が厳しい環境では、この点を評価した上で採用を判断する必要がある。また、時計の巻き戻しが発生するケースでは単調増加性が保証されないため、Node.jsの実装では内部カウンターで対処している。
デバッグ体験を変えるedit-free式プローブ
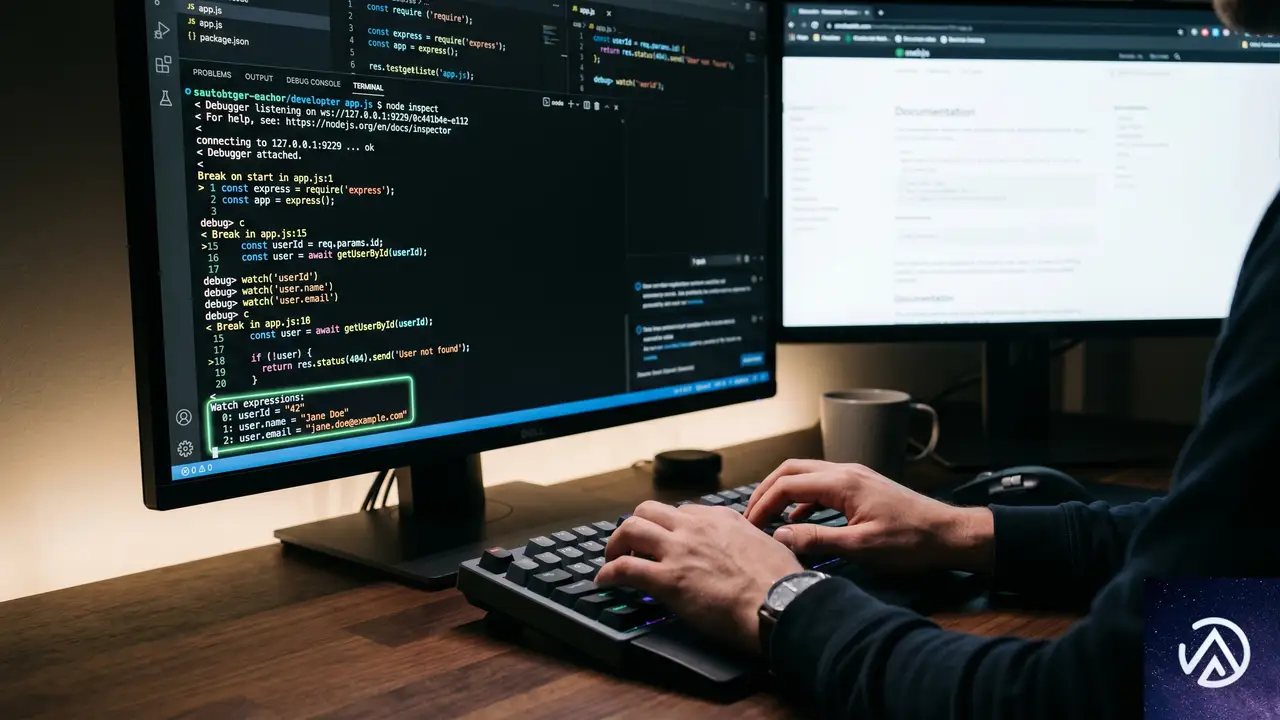
Node.js 24.16.0では、node inspectコマンドにedit-free runtime expression probesが導入された。これは、デバッグ対象のコードを一切変更することなく、実行時に任意の式を評価できる仕組みだ。
これまでのデバッグ手法との違い
従来、Node.jsアプリケーションの特定の変数の値や式の結果を確認するには、コードにconsole.log()を挿入するか、デバッガでブレークポイントを設定して手動で評価する必要があった。前者はコード改変と再起動を伴い、後者は手動操作の手間が大きい。
式プローブを使えば、稼働中のプロセスに対して外部から評価式を注入できるため、トラブルシュートのスピードが大幅に向上する。特に、再起動が難しい本番環境での障害調査で威力を発揮するだろう。
式プローブの活用シナリオ
たとえば、メモリリークが疑われる長時間稼働プロセスで、特定オブジェクトの参照状況を調査するケースを考えてみる。従来であればヒープダンプの取得と解析が必要だが、式プローブを使えばprocess.memoryUsage()や特定変数の.lengthをその場で評価できる。
この機能の追加は、貢献者のJoyee Cheung氏によるPR #62713に基づいている。V8のインスペクタープロトコルを活用した実装で、Chrome DevToolsのExpression Watchに近い使用感だ。
HTTPクライアントの安全性と利便性の向上

Node.jsのHTTPクライアント機能に、2つの重要な強化が加わった。いずれも実際のプロダクションコードの安全性と記述性に直結する改善だ。
ClientRequestのオプションマージ強化
http.ClientRequestの内部で、ユーザーが渡したオプションとデフォルト値をマージする処理が厳格化された。この変更は、プロトタイプ汚染(Prototype Pollution)攻撃のベクトルを塞ぐことを主眼としている。
プロトタイプ汚染とは、Object.prototypeや__proto__を経由してアプリケーション全体のオブジェクトの振る舞いを改変する攻撃手法だ。Node.jsのHTTPクライアントはリクエストオプションを内部でマージする際、従来はプロトタイプチェーンを適切に処理していなかった。今回のPR #63082で、マージ時にnullプロトタイプオブジェクトを使用するよう修正され、この攻撃経路が遮断された。
Node.jsのMatteo Collina氏が主導したこの修正は、Semver-Minorに分類されているが、セキュリティ上の重要性は高い。とくにユーザー入力からHTTPリクエストオプションを構築するアプリケーションでは、速やかなアップデートが推奨される。
req.signalでリクエスト中断が容易に
もう一つの改善は、http.IncomingMessageへのreq.signalプロパティの追加だ(PR #62541)。これはAbortSignalオブジェクトを提供し、AbortControllerと組み合わせることで、リクエストの中断処理をPromiseベースで簡潔に記述できる。
const controller = new AbortController();

const req = http.request(url, { signal: controller.signal });
req.end();

// 5秒後にタイムアウト
setTimeout(() => controller.abort(), 5000);

req.on('error', (err) => {
  if (err.name === 'AbortError') {
    console.log('リクエストが中断されました');
  }
});従来はreq.destroy()を手動で呼び出す必要があり、後続のエラーハンドリングも煩雑だった。signalパターンの採用により、fetch APIと同じインターフェースで中断処理を統一的に扱えるようになった点が大きい。
テストランナーが実戦的な機能を獲得

Node.jsの組み込みテストランナー(node --test)は、ここ数バージョンで急速に成熟している。24.16.0では、テスト順序のランダム化、モックタイマーのAPI整備、AbortSignal.timeoutのモックサポートという3つの重要な機能が追加された。
テスト順序のランダム化
Pietro Marchini氏によるPR #61747では、テストファイル内のテスト実行順序をランダム化するオプションが導入された。これは、テスト間の暗黙的な依存関係を炙り出すための機能だ。
node --test --test-randomize-order test/*.test.js特定の順序で実行されることを前提に書かれたテストは、ランダム化によって失敗する。これにより、グローバル状態への暗黙の依存や、テスト間のデータ共有の問題を早期に発見できる。テクニックとしては、CIパイプラインにランダム実行を常時組み込むことで、テストスイートの堅牢性を継続的に保証できる。
モックタイマーAPIの拡張
テストランナーのモックタイマー機能が、AbortSignal.timeout()にも対応した(PR #60751)。これにより、タイムアウトに依存する非同期処理のテストが、実際の時間を消費せずに実行できるようになった。
AbortSignal.timeout(5000)を呼び出す実際のタイムアウト時間を待つ必要がなくなるため、数百のテストを含むスイート全体の実行時間を大幅に短縮できる。テストの信頼性も向上し、CIでの不安定なテスト(flaky test)の削減に寄与する。
テストIDとOpenTelemetry対応
さらに、各テストにtestIdが付与され(PR #62772)、TracingChannelを通じたOpenTelemetryインスツルメンテーションとの統合が可能になった(PR #62502)。テストのトレーシング情報を本番系の監視ツールと統合することで、テスト品質の可視化と傾向分析ができるようになる。
ファイルシステムとストリームの機能強化

fsモジュールとストリームモジュールにも、実務のユースケースに即した改善が複数含まれている。
fs.stat()がAbortSignalに対応
Mert Can Altin氏によるPR #57775で、fs.stat()にsignalオプションが追加された。ネットワークファイルシステム上のファイルをstatする際に、応答が遅い場合のタイムアウト制御が可能になる。
import { stat } from 'node:fs/promises';

const ac = new AbortController();
setTimeout(() => ac.abort(), 3000);

try {
  const stats = await stat('/mnt/nfs/large-file.dat', { signal: ac.signal });
  console.log(stats.size);
} catch (err) {
  if (err.name === 'AbortError') {
    console.error('statがタイムアウトしました');
  }
}
これは、HTTPリクエストの中断パターンと同じAPI設計で、Node.js全体で一貫した中断処理のセマンティクスが浸透しつつあることを示している。
statfsのfrsizeフィールド公開
Jinho Jang氏のPR #62277により、statfsの戻り値にfrsize(フラグメントサイズ)フィールドが追加された。これはファイルシステムの最小割り当て単位を示し、ディスク使用量の正確な計算に利用できる。
import { statfs } from 'node:fs/promises';

const s = await statfs('/data');
const actualSize = Math.ceil(fileSize / s.frsize) * s.frsize;
console.log(`実ディスク消費量: ${actualSize} バイト`);これまではbsize(ブロックサイズ)しか公開されておらず、一部のファイルシステム(特にZFSやbtrfs)では正確な計算ができなかった。frsizeの追加により、クロスプラットフォームで信頼性の高いディスク容量の見積もりが可能になる。
duplexPairの破壊伝播の改善
stream.duplexPair()は、読み取り側と書き込み側が対になった2つのDuplexストリームを生成するユーティリティだ。Ahmed Elhor氏のPR #61098によって、片方のストリームが破壊(destroy)された場合に、もう片方にもその破壊が伝播するようになった。
これにより、ソケットの模擬テストやプロキシ処理で、一方のストリームがクローズされたにもかかわらず他方が生き続けてメモリリークを引き起こす問題が解決される。streamモジュールの内部的な一貫性を高める重要な修正だ。
util.styleTextの16進数カラー対応

Guilherme Araújo氏のPR #61556により、util.styleText()に16進数カラーコード(例: #ff5733)の直接指定が可能になった。ターミナル出力のスタイリングにおいて、より繊細な色表現が必要な場面で役立つ。
import { styleText } from 'node:util';

console.log(styleText('#ff5733', '注意: ディスク使用率が90%を超えています'));
console.log(styleText('#4ecdc4', '情報: バックアップが正常に完了しました'));従来はstyleText('red', ...)やstyleText('green', ...)のように、限られた色名しか使えなかった。16進数指定のサポートにより、CIログの色分けやCLIツールのブランドカラー適用など、実務での表現力が格段に向上する。
内部実装としては、ターミナルの24ビットカラー(トゥルーカラー)エスケープシーケンスを使用している。サポートしていないターミナルでは近似の8色にフォールバックされるため、互換性の問題も起きにくい。
この記事のポイント
- Node.js 24.16.0 (LTS) は、crypto.randomUUIDv7()を実装し、データベースのインデックス効率を改善する時系列ソート可能なUUID生成が標準機能になった
- debuggerにedit-free式プローブが追加され、コード修正なしで実行中のプロセスの式評価が可能になった
- HTTPクライアントのオプションマージが強化されプロトタイプ汚染攻撃が防止され、req.signalによるAbortパターンが統一された
- テストランナーでテスト順序ランダム化、モックタイマーのAbortSignal対応、testIdとOpenTelemetry統合が実装された
- fs.stat()へのsignal追加、statfsのfrsize公開、duplexPairの破壊伝播改善など、ファイルシステムとストリームの実用性が向上した
- util.styleText()で16進数カラーコードが直接指定可能になり、CLIツールの色表現力が飛躍的に向上した
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.5 Flash発表、エージェントとコード生成で最上位性能を達成
Google DeepMindが2026年5月15日、新たなAIモデル「Gemini 3.5」シリーズを発表した。その第一弾として「3.5 Flash」が即日公開され、一般ユーザーから開発者、大企業まで幅広く利用可能になった。
このモデルは「フロンティア知能と行動を融合させた」と表現されるように、高度な推論能力と実世界でのタスク実行力を両立させている。特にエージェント性能とコーディング性能で突出しており、従来の旗艦モデルと同等以上のベンチマークスコアを、4倍の出力速度で実現した。
本記事では、Gemini 3.5 Flashの具体的な性能、Antigravityプラットフォームとの連携、企業導入事例、そして個人向けエージェント「Gemini Spark」までを詳しく解説する。
Gemini 3.5 Flashの登場と基本的位置づけ

Gemini 3.5シリーズは、Google DeepMindが「より有能でインテリジェントなエージェントの構築」を目的に開発した最新モデル群だ。最初にリリースされた3.5 Flashは、高速応答に定評のあるFlashシリーズの系譜を受け継ぎつつ、旗艦モデルに匹敵する知能を獲得した点が最大の特徴となる。
フロンティア性能の定義
「フロンティア性能」とは、現在実現可能な最高水準のAI能力を指す。この領域では、モデルが単に質問に答えるだけでなく、複雑なワークフローを自律的に計画し、ツールを呼び出し、長期にわたるタスクを完遂することが求められる。
3.5 Flashはこの定義に正面から応える形で設計された。開発者が数日かけるコードベースの移行作業や、監査担当者が数週間要する文書分析を、短時間かつ低コストで遂行できるようになっている。Google DeepMindの発表によれば、コスト面でも他のフロンティアモデルの半額以下で同等以上の成果を出せるとしている。
コード性能とエージェント性能の両立
3.5 Flashの真価は、コーディング能力とエージェント能力の両面で高い成果を示したことにある。従来のモデルは、どちらか一方に特化するか、速度を犠牲にして知能を高める設計が一般的だった。しかし3.5 Flashは、このトレードオフを実用レベルで解消している。
この変化により、開発者は応答速度を気にせず複雑なタスクをAIに任せられるようになる。コードベース全体の移行や、複数エージェントを使った並列処理といった高度な活用が現実的になった。
ベンチマークスコアが示す実力

3.5 Flashの性能は、複数の厳格なベンチマークによって裏付けられている。特にエージェント性能を測る指標での躍進が顕著だ。
主要ベンチマークの結果
Google DeepMindの発表資料によると、3.5 Flashは以下のスコアを達成した。
- Terminal-Bench 2.1(コーディングとエージェントの複合テスト)で76.2%
- GDPval-AA(エージェント能力のEloレーティング)で1656 Elo
- MCP Atlas(マルチツール連携の評価)で83.6%
- CharXiv Reasoning(マルチモーダル理解)で84.2%
これらの数値は、前世代の旗艦モデル「Gemini 3.1 Pro」を上回るだけでなく、一部の指標では競合するクローズドモデルを凌駕する結果となっている。
速度と品質のトレードオフ解消
Artificial Analysisのインデックスでは、3.5 Flashは「知能と出力速度」の散布図で右上の象限に位置している。これは「高い知能を持ちながら極めて高速」であることを示す。具体的には、1秒あたりの出力トークン数が他のフロンティアモデルと比較して4倍に達する場面もある。
これにより、リアルタイム性が求められるチャットアプリや、長時間継続するエージェントタスクの両方で、安定したパフォーマンスを発揮できるようになった。
エージェントタスクの実践力

3.5 Flashの真価は、単独のモデル性能だけでなく、Googleのエージェント開発プラットフォーム「Antigravity」との組み合わせによって最大化される。
Antigravityプラットフォームとの連携
Antigravityは、複数のサブエージェントを協調させて複雑なワークフローを実行するためのハーネスだ。3.5 Flashをこの基盤に載せることで、次のようなタスクが実証されている。
- 無秩序なファイル群を動的な条件で自動リネーム・分類
- AlphaZeroの論文を解析し、6時間で完全にプレイ可能なゲームをコーディング
- レガシーコードベースをNext.jsへ変換・移行
- 都市景観の生成やブランディングコンセプトの並列作成
これらのタスクは、従来であれば熟練の開発者が数日から数週間かける規模のものだ。3.5 FlashとAntigravityの組み合わせは、単なる「便利なツール」を超えて、開発プロセスそのものを再定義する可能性を秘めている。
長期タスクの自動化事例
Google DeepMindの発表では、3.5 Flashが2つのエージェント(ビルダーとプレイヤー)を並行稼働させ、高速な自己改善ループによってゲームを開発するデモが紹介された。また、研究論文用のインタラクティブなアニメーション生成や、テキスト説明文からのインタラクティブハードウェア設計なども披露されている。
このフローは、1人の開発者が複数のAIエージェントを指揮する「AIオーケストレーション」の典型例だ。開発者は細かい実装ではなく、全体の方向性と品質判断に集中できるようになる。
企業導入の具体的事例

3.5 Flashは発表と同時に、複数の大手企業で実運用が始まっている。Google DeepMindは業界パートナーと密接に連携し、実際の業務で発生する「手間」と「複雑さ」を特定した上でモデルを最適化した。
ShopifyやSalesforceでの活用
Shopifyは、複数のサブエージェントを並列実行し、グローバル規模での加盟店の成長予測を高精度化している。長期的なデータ分析を並列化することで、従来より詳細かつ正確な予測が可能になった。
Salesforceは、自社の「Agentforce」プラットフォームに3.5 Flashを統合した。複数のサブエージェントがコンテキストを保持したまま複数ターンのツール呼び出しを実行し、複雑なエンタープライズタスクを確実に自動化する。これにより、営業担当者が手作業で行っていた見積書作成や顧客データの突合といった業務が大幅に効率化される見込みだ。
金融・会計分野での応用
Macquarie Bankは、100ページを超える複雑なドキュメントを推論し、顧客オンボーディングを高速化する試験運用を開始した。低レイテンシで関連情報を取得し、信頼性の高い推奨事項を提示できる点が評価されている。
会計ソフトウェアのXeroは、サプライヤーの特定や1099税務フォーム用の情報収集といった、数週間かかる管理業務をエージェントに委任する仕組みを構築中だ。これにより、小規模事業者が煩雑な管理タスクから解放され、本業に集中できるようになる。
Databricksは、エージェント型ワークフローを用いてリアルタイム情報の監視と大規模データセットの横断的な推論を行い、データサイエンティスト向けの問題診断と解決策の提案を自動化している。
個人向けエージェント「Gemini Spark」

3.5 Flashは企業向けだけでなく、個人ユーザーの生活にも直接的な変革をもたらす。Google I/O 2026で発表された「Gemini Spark」は、3.5 Flashを中核に据えたパーソナルAIエージェントだ。
24時間稼働のパーソナルエージェント
Gemini Sparkは、ユーザーの指示のもとで24時間365日稼働し、デジタルライフ全般を支援する。メールの整理やスケジュール調整、情報収集といった日常的なタスクを自律的に処理し、ユーザーはより創造的な作業に時間を割けるようになる。
現在は信頼できるテスター向けに展開が始まっており、米国ではGoogle AI Ultraサブスクライバー向けのベータ版が翌週に提供開始される予定だ。日本での展開時期は未発表だが、グローバル展開の一環として近い将来に利用可能になると見られている。
コーディングアシストと検索での応用
3.5 Flashのコーディング能力は、Google検索のAIモードにも統合されている。情報エージェントが24時間働き、動的な生成UIを通じてインタラクティブな解説を提供する。例えば、複雑な数理パターン「Gyroid構造」をビジュアルで示しながら説明するといった使い方が可能だ。
また、Android StudioやGoogle AI Studioを通じて、開発者が3.5 Flashを直接利用できる環境も整っている。個人開発者や中小企業の技術担当者でも、フロンティアクラスのAIを手軽にプロジェクトに組み込めるようになった。
安全性と今後の展望

高性能なエージェント型AIには、相応の安全対策が不可欠だ。Google DeepMindは、3.5シリーズの開発にあたり「Frontier Safety Framework」に準拠した厳格な安全策を施している。
Frontier Safety Framework
サイバー攻撃やCBRN(化学・生物・放射性物質・核)関連の有害コンテンツ生成を防ぐセーフガードが強化された。同時に、安全なクエリを誤って拒否する「過剰拒否」の問題も改善されている。
このバランスは、新しい安全トレーニング手法と、AIの内部推論を応答前にチェックする解釈可能性ツールの導入によって実現された。モデルが「何を考えているか」を事前に把握し、問題があれば出力前に修正する仕組みだ。
3.5 Proの予告
Google DeepMindは、より大規模な「3.5 Pro」の開発も進めている。すでに社内で使用されており、翌月には公開される見込みだ。Flashの高速性を保ちつつ、さらに高度な推論能力を求めるユースケースに対応する位置づけとなる。
3.5シリーズ全体として、Googleは「エージェントファースト」の開発プラットフォーム戦略を加速させている。AIが単なるアシスタントから、自律的に行動する「デジタルワーカー」へと進化する過渡期にあることを示す重要な発表といえる。
この記事のポイント
- Gemini 3.5 Flashはエージェント性能とコード生成でフロンティアクラスの成果を達成
- 従来の旗艦モデルと同等以上の知能を4倍の速度で提供し、実用性が大幅に向上
- Antigravityとの連携で複数エージェントの協調動作が可能になり、長期タスクの自動化が現実的に
- ShopifyやSalesforceなど大手企業での導入がすでに始まっており、金融・会計分野でも活用が進む
- 個人向けエージェントGemini Sparkや検索AIモードへの統合により、一般ユーザーの生活にも直接影響を与える
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Vibe CodingでSaaS代替は本当に得か?セキュリティや保守の隠れたコスト
Vibe Coding(AIに指示を出すだけでコードを生成する開発手法)を使えば、高額なSaaS契約を打ち切って自社ツールを構築できる。実際、AI活用で初期開発費を50%から70%削減できたスタートアップの報告もある。
だが、そのコスト削減の裏には「品質税」とも呼ばれる代償が潜んでいる。AIが生成したコードは人間が書いたコードより1.7倍多くの重大な問題を引き起こし、サンプルの45%は基本的なセキュリティ基準を満たさない。
TrustInsights.aiの共同創業者Chris Penn氏は、この差は開発の進め方に起因すると指摘する。ソフトウェア開発者であればVibe Codingをうまく使いこなせる。AIがタイピングを肩代わりするだけで、設計やアーキテクチャの重要性は変わらないからだ。本記事では、マーケターがSaaS代替を検討する際に見落としがちな4つのリスクを掘り下げる。
コスト削減の裏にある品質税の実態

Vibe Codingの最大の魅力はコスト削減だ。従来のソフトウェア開発では数千万円かかったプロジェクトが、AIを活用すれば数百万円で済むケースも出てきた。スタートアップのベンチマークでは、SaaS購入と比較して初期コストを半減以下に抑えられるというデータがある。
しかし、この数字には落とし穴がある。AIが生成したコードは「一見動くが、中身がスパゲッティ状態」になりやすい。当面のタスクを解決することを優先するため、システム全体の整合性やスケーラビリティが後回しにされるからだ。結果として、後になってから膨大な手直しコストが発生する。
Penn氏の分析では、Vibe Codingの成否は使い手のスキルに大きく依存する。ソフトウェア開発経験者であれば、AIが吐き出したコードの問題点を直感的に見抜ける。一方、プログラミング未経験のマーケターが一人でツールを構築しようとすると、表面的には動いても内部に深刻な欠陥を抱えたシステムになりがちだ。
統合の問題は設計段階で顕在化する

SaaSが持つ「当たり前」の不在
マーケターが直面する最初の壁は、他のツールとの統合だ。SaaS製品は通常、主要なマーケティングプラットフォームやCRMとのAPI連携を標準機能として提供している。しかし自社開発ツールの場合、こうした連携機能はすべて手動で実装しなければならない。
Penn氏は「マーテック担当者が新製品について最初に聞かれるのは『何と統合できますか』だ」と指摘する。統合を後付けで追加しようとすると、当初の設計と噛み合わず、場当たり的な修正の繰り返しになる。これは建築で言えば、基礎が固まった後に増築を繰り返すようなものだ。
重要なのは、Vibe Codingで代替する際に「そのツールが何とどう連携していたか」を完全に把握することだ。単に機能を再現するだけでは不十分で、既存のマーテックスタック全体との接続性を設計図に最初から組み込む必要がある。
セキュリティと信頼性は無料で付いてこない

AIが学習した「安全でないコード」の遺産
AIが生成するコードのセキュリティ品質は、現時点では深刻な懸念材料だ。大規模言語モデルは公開リポジトリのコードで訓練されており、その中には古いライブラリや脆弱性を含むサンプルが多数含まれている。AIは「動くこと」を優先する傾向があり、安全な実装は二の次になりがちだ。
調査では、AIが生成したコードサンプルの45%が基本的なセキュリティチェックに不合格だった。マーテック環境では顧客データや決済情報を扱うケースも多く、わずかな脆弱性が情報漏洩やコンプライアンス違反に直結する。
技術的負債の蓄積とシステムの脆弱化
もう一つの問題は長期的な信頼性だ。AIが生成したコードは短期的なタスク解決に特化するため、時間とともに技術的負債が雪だるま式に増える。小さな変更が無関係な機能を壊すようになり、メンテナンスコストが指数関数的に上昇する。
この現象は「コードの賞味期限」とも呼ばれる。3ヶ月前には完璧に動いていたツールが、APIの更新や依存ライブラリの変更で突然動作しなくなる。SaaSであればベンダーが責任を持って対応するが、自社開発の場合はすべて自分たちで調査して修正しなければならない。
マーケティング担当者は「コードを書けること」と「ソフトウェアを運用できること」が全く別のスキルセットであることを認識すべきだ。Vibe Codingで開発の敷居は下がったが、運用の敷居は下がっていない。
保守はあなたの仕事になる

SaaS解約が意味する「所有権の移転」
Vibe CodingでSaaSを代替する最大の見落としは「所有権」の概念だ。SaaSの月額料金には、ソフトウェアの更新、セキュリティパッチ、APIの互換性維持、サーバー監視といった運用コストがすべて含まれている。自社開発に切り替えるということは、これらの責任をすべて引き受けることを意味する。
Penn氏の分析によれば、多くのチームがこの切り替えコストを過小評価している。ツールが今日動いていても、数ヶ月後には動作しなくなる可能性がある。依存する外部APIが変更され、コードの修正が必要になる。フレームワークの脆弱性が発表され、緊急パッチの適用を迫られる。これらすべてに時間と専門知識が必要だ。
「ソフトウェアプロジェクトマネージャー」への変容
Penn氏は「Vibe Codingによって、誰もがソフトウェアプロジェクトマネージャーになった」と表現する。マーケターはもはや単なるツールの利用者ではなく、開発プロジェクトの責任者として振る舞わなければならない。
これは単なる技術的な変化ではなく、マインドセットの転換だ。要件定義、優先順位付け、品質管理、リリース判断といった、これまでSaaSベンダーが担っていた意思決定を自社で行う必要がある。そのためのスキルとリソースが社内にない場合、コスト削減効果はすぐに逆転する。
すべてのツールを代替すべきではない

代替候補となる低リスクツールの条件
Vibe CodingによるSaaS代替は、すべてのケースに適しているわけではない。適性を見極める基準として、以下の3つの観点が有効だ。単純な社内ユーティリティや、既存SaaSのごく一部の機能しか使っていないツールは、代替の候補になりやすい。
- リスクレベルが低い(顧客データや決済情報を扱わない)
- 機能セットが限定的で、複雑な統合を必要としない
- 利用頻度が低く、多少のダウンタイムが許容される
例えば、社内用のレポート自動生成ツールや、定型的なデータ変換スクリプトなどは、Vibe Codingで効率的に構築できる。これらのツールは仮に失敗してもビジネスへの影響が限定的で、学習コストとして許容できる範囲だ。
絶対に避けるべき高リスク領域
一方で、以下の領域はVibe Codingによる代替に適さない。決済処理、個人情報管理、コンプライアンス関連のシステムは、エラーが直接的な金銭的損失や法的制裁につながる。
CRMのような基幹システムも注意が必要だ。チームが拡大するにつれて、統制や権限管理の必要性が高まる。エンタープライズ向けSaaSが標準で備えるガバナンス機能を、AIにゼロから実装させるのは現実的ではない。
判断の分かれ目は「そのシステムが停止したときのビジネスインパクト」だ。軽微な業務効率の低下で済むのか、それとも売上に直接響くのか。後者であれば、SaaSを維持する方が結果的に安上がりになる。
コントロールと責任のトレードオフ

Vibe Codingがもたらす本質的な変化は、ベンダーロックインからの解放と引き換えに、運用責任を自社に取り込むことだ。柔軟性とコスト削減というメリットは、リスクと保守負担というデメリットと表裏一体である。
Penn氏の「誰もがソフトウェアプロジェクトマネージャーになった」という言葉は、この現実を端的に表している。マーケターは利用者の視点を捨て、オーナーとしての視点を持つ必要がある。設計、品質管理、セキュリティ監査、継続的なメンテナンス。これらはかつてSaaSベンダーが吸収していたコストだ。
結局のところ、Vibe Codingは魔法の杖ではない。AIはコードを書く速度を飛躍的に上げるが、「何を作るべきか」「どのように運用するか」「リスクにどう備えるか」という本質的な問いに答えるのは依然として人間の役割だ。この現実を直視せずにコスト削減だけを追いかけると、初期の節約額をはるかに上回る代償を後払いすることになる。
この記事のポイント
- AIコード生成で初期開発費を50〜70%削減できるが、品質税として1.7倍の重大バグと45%のセキュリティ未達が発生する
- 統合設計を最初から組み込まないと、後付けで破綻する。SaaS代替時は接続性の完全な再現が必須
- 保守とセキュリティ対応はすべて自社責任に移行し、長期的な運用コストが初期削減額を上回る可能性がある
- 低リスクの社内ツールは代替候補だが、決済や顧客データを扱うシステムはVibe Codingに適さない
- Vibe Codingは開発速度を上げるが、プロジェクト管理やリスク判断は依然として人間の専門知識に依存する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
クロスドキュメントビュー遷移の三大落とし穴と回避策
クロスドキュメントビュー遷移(Cross-Document View Transitions)は、MPA(マルチページアプリケーション)でありながらSPAのようなスムーズなページ遷移アニメーションを実現するブラウザAPIだ。ReactやAstroといったフレームワークは不要で、HTMLページ間のリンク遷移にブラウザが自動的にアニメーションを付与する。
しかし、この機能の導入にはいくつかの厄介な落とし穴が潜んでいる。CSS-Tricksの記事によれば、著者は実装に丸一日を費やし、何も動作しない状態からデバッグを繰り返したという。ネット上には古い情報や誤解を招くチュートリアルが溢れており、仕様自体も短期間で変更されている。
本記事では、実際の開発現場で遭遇する3つの主要な問題(非推奨metaタグ、4秒タイムアウト、画像の歪み)とその解決策を解説する。加えて、遷移ライフサイクルを制御する2つのイベントについても触れる。
非推奨となったmetaタグの罠
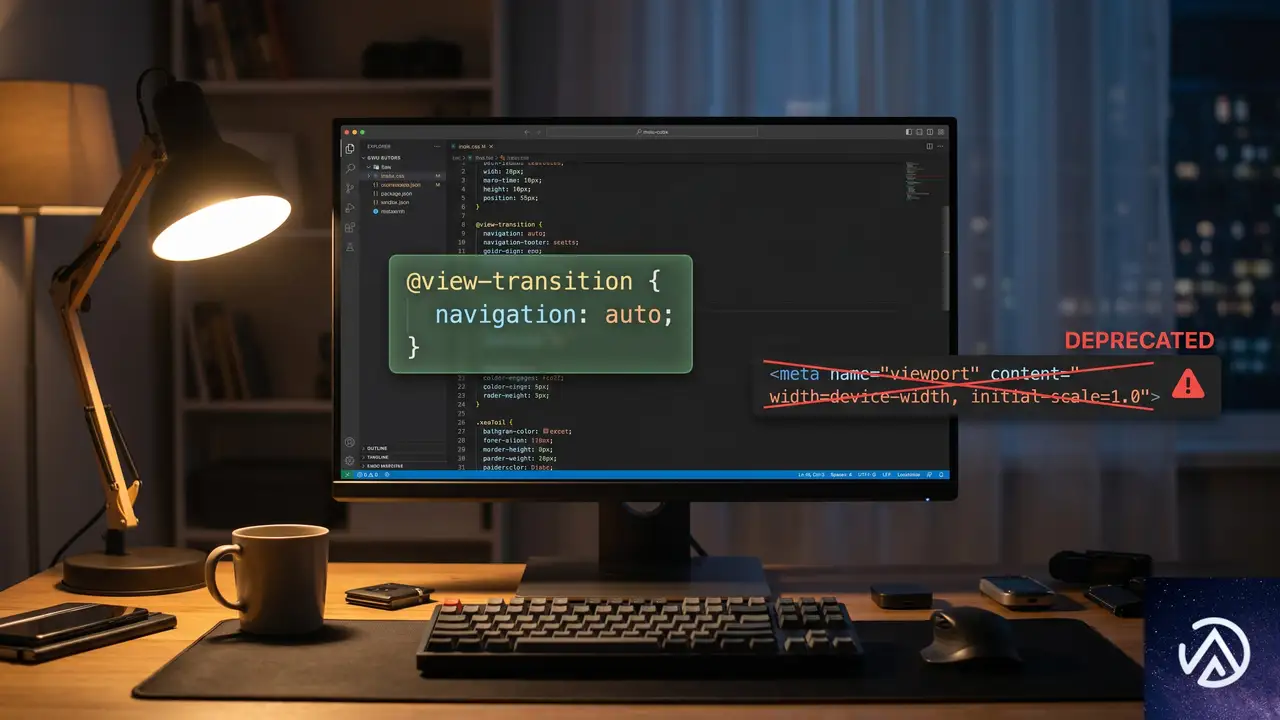
多くの開発者が最初にハマるのが、古いチュートリアルに記載された<meta>タグによるオプトイン方式だ。この方式は既に非推奨であり、現在のブラウザでは完全に無視される。
この比較が示すように、現在の正しい実装方法はCSSの@規則を使用することだ。Chrome 111でmetaタグが導入された後、Chrome 126前後でCSSベースの方式に置き換えられた。非推奨の警告はDevToolsに表示されず、古いコードは静かに動作しなくなる。
なぜCSS方式に移行したのか
metaタグ方式の最大の欠点は、ページ全体でオンかオフかの二択しかできなかったことだ。CSS方式ではメディアクエリや@supportsと組み合わせて、条件付きのオプトインが可能になる。
@media (prefers-reduced-motion: no-preference) {
  @view-transition {
    navigation: auto;
  }
}

@media (min-width: 768px) {
  @view-transition {
    navigation: auto;
  }
}
このアプローチにより、アニメーションに敏感なユーザーへの配慮や、モバイルデバイスでのパフォーマンス最適化が容易になった。CSSにオプトインが統合されたことで、既存のスタイル管理フローと一貫性を持って扱える点も大きい。
両方のページでオプトインが必須
もう一つの重要なポイントは、遷移を機能させるには遷移元と遷移先の両方のページで@view-transitionが宣言されている必要があることだ。片方だけでは何も起きない。これは意図的な設計で、404ページやログインリダイレクトなど遷移をスキップしたいページを柔軟に制御できる。
なお、navigation: autoはユーザーがリンクをクリックするかブラウザの戻るボタンを押した場合のみ発動する。window.location.hrefによるプログラム的な遷移や、クロスオリジンのリンク、POSTリクエストでは動作しない。この保守的な設計は、決済処理などの重要な操作に意図しないアニメーションが混入するのを防ぐためだ。
4秒タイムアウトが遷移を静かに殺す
ビュー遷移の実装で最もデバッグが難しい問題が、ハードコードされた4秒のタイムアウトだ。新しいページが4秒以内にレンダリング可能な状態に達しないと、遷移アニメーションは何の通知もなくキャンセルされ、通常のページ読み込みのように切り替わる。
この問題が厄介なのは、ローカル開発環境ではまず発生しないことだ。devサーバーは80msで応答するため遷移は完璧に動作するが、本番環境でサーバーレス関数のコールドスタートやCDNキャッシュミスが発生すると、最初のクリックで遷移が無効化される。
pagerevealイベントでタイムアウトを捕捉する
タイムアウトの発生を検知するには、pagerevealイベントとviewTransition.finishedプロミスを使用する。以下のコードをページに組み込めば、遷移が失敗した際にコンソールで確認できる。
window.addEventListener("pagereveal", (event) => {
  if (!event.viewTransition) {
    console.log("ビュー遷移なし");
    return;
  }
  event.viewTransition.finished
    .then(() => console.log("遷移完了 ✅"))
    .catch((err) => {
      console.error("遷移中断", err.name, err.message);
    });
});このリスナーを早期にセットアップしておけば、本番環境でのデバッグが格段に容易になる。pageswapイベントでも同様に遷移元ページ側でタイムアウトを捕捉可能だ。
実用的な対策
タイムアウト対策の基本はページの読み込み速度改善だが、より実践的なアプローチとしてrel="expect"属性の活用がある。
<link rel="expect" href="#hero" blocking="render">これはブラウザに「#hero要素がDOMに存在するまでページをレンダリング可能と見なさない」と指示するものだ。一見するとパフォーマンスを悪化させるように思えるが、ビュー遷移においては重要なコンテンツが揃ってからスナップショットを取得するため、中途半端な状態での遷移を防げる。
タイムアウトのクロックはナビゲーション開始時からカウントされるため、サーバー応答時間(TTFB)も含まれる点に注意が必要だ。サーバーが2秒かけて応答し、さらに2.5秒かけてレンダリングする場合、個別には遅く感じなくても合計で4.5秒となりタイムアウトに引っかかる。
画像が歪む根本原因と解決策
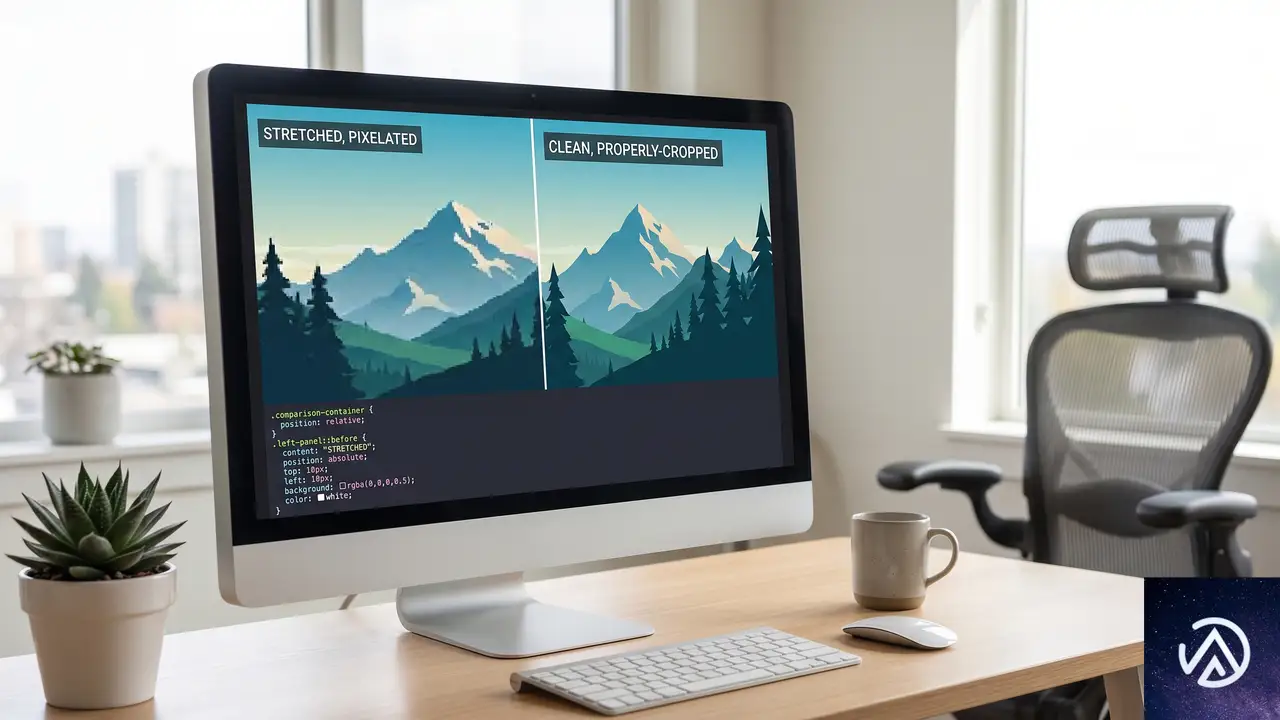
ビュー遷移の実装で視覚的に最も目立つ問題が、アスペクト比の異なる画像間の遷移で発生する歪みだ。サムネイルからヒーロー画像への遷移で、画像が引き伸ばされて見苦しくなる現象は多くの開発者が経験する。
CSS-Tricksの著者は、この問題の原因を特定するのにかなりの時間を費やしたという。根本的な原因は、ブラウザが遷移中に<img>要素そのものをアニメーションさせるのではなく、古い状態と新しい状態のスクリーンショット(ビットマップ)を取得し、それらを変形させることにある。
上記の図が示すように、解決策は疑似要素::view-transition-oldと::view-transition-newに対してobject-fit: coverを適用することだ。これにより、スナップショット画像がアスペクト比を維持したまま切り抜かれるようになる。
疑似要素ツリーの構造を理解する
ビュー遷移が発生すると、ブラウザは内部的に次のような疑似要素ツリーを生成する。
::view-transition
└── ::view-transition-group(hero-img)
    ├── ::view-transition-old(hero-img)
└── ::view-transition-new(hero-img)::view-transition-groupが古い寸法から新しい寸法へアニメーションするコンテナとして機能し、その中のoldとnewが実際のスナップショットを保持する。デフォルトではこれらの疑似要素にobject-fit: fillが適用されており、これが歪みの原因となる。
アスペクト比が大きく異なるケースでは、object-positionで切り抜き位置を調整することも有効だ。
::view-transition-old(hero-img) {
  object-fit: cover;
  object-position: center center;
}
::view-transition-new(hero-img) {
  object-fit: cover;
  object-position: center top;
}このコードでは、新しいヒーロー画像の上部を優先的に表示しつつ、遷移中の歪みを防ぐことができる。CSS-Tricksの著者も指摘するように、object-fit: coverはほぼ全ての画像遷移で必要になる設定であり、デフォルトがfillであることは実用上の大きな障壁となっている。
pageswapとpagerevealによるライフサイクル制御
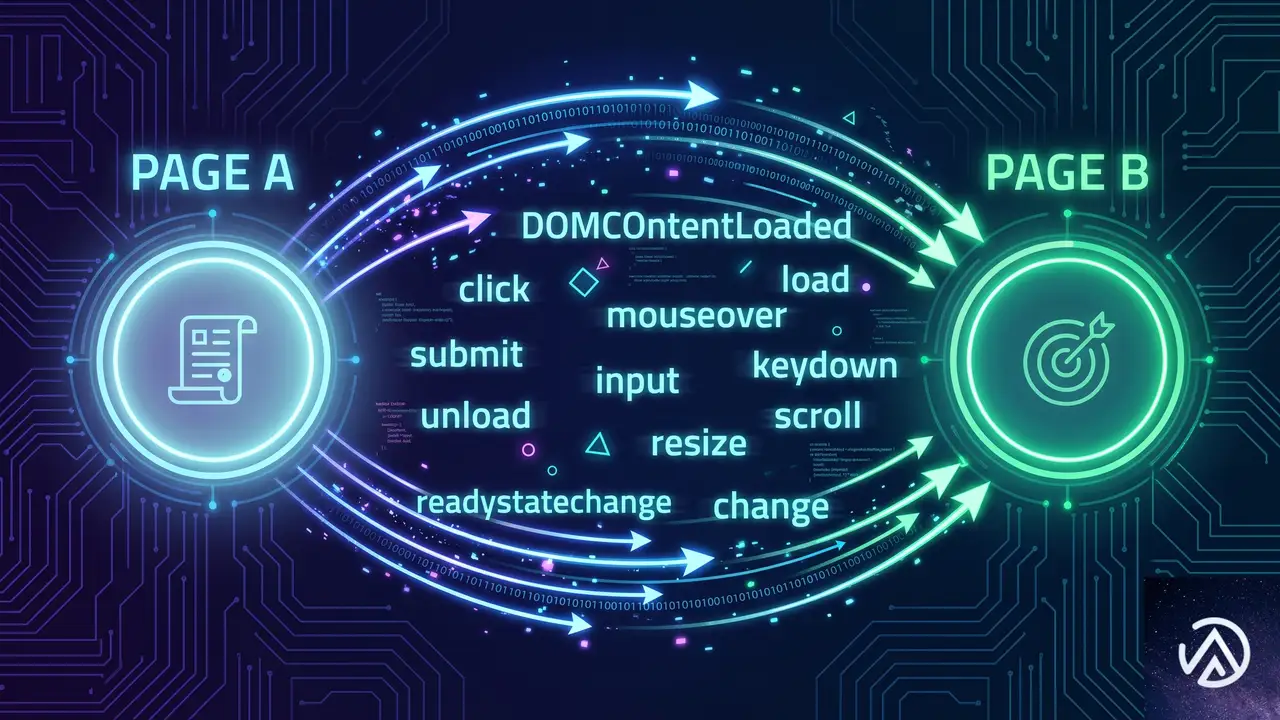
クロスドキュメントビュー遷移では、遷移元と遷移先のページがJavaScriptで直接通信できないという制約がある。この問題を解決するのがpageswapとpagerevealの2つのイベントだ。
このイベントペアにより、開発者は遷移の両端で状態を制御できる。pageswapは遷移元ページがスナップショットされる直前に発火し、event.activation.entry.urlでユーザーがどこへ向かっているかを知ることができる。
イベントハンドラの実装パターン
これらのイベントを使用する際の重要なポイントは、必ずevent.viewTransitionの存在確認を行うことだ。pagerevealはビュー遷移がない場合も含め、全てのナビゲーションで発火する。
window.addEventListener("pagereveal", (event) => {
  if (!event.viewTransition) return;

  event.viewTransition.finished.then(() => {
    // 遷移完了後のクリーンアップ
  }).catch((err) => {
    // タイムアウト等のエラー処理
  });
});CSS-Tricksの記事では、商品一覧ページから商品詳細ページへの遷移において、pageswapでクリックされた商品カードだけにview-transition-nameを動的に付与するパターンが紹介されている。この動的な名前付けは、数十から数百の要素があるページでのスケーラビリティ問題を解決する重要な手法だ。
この記事のポイント
- metaタグ方式は非推奨。CSSの
@view-transition { navigation: auto; }を使用する - 4秒のタイムアウトはTTFBを含む総時間で判定され、
pagerevealイベントで捕捉可能 - 画像歪みは疑似要素
::view-transition-old/newへのobject-fit: cover適用で解決 pageswapとpagerevealの2つのイベントが遷移全体のライフサイクルを制御する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini Omni登場、マルチモーダル動画生成の新時代
Google DeepMindは2026年5月17日、新たなマルチモーダル生成AIモデル「Gemini Omni」を発表した。テキスト、画像、音声、動画といったあらゆる形式の入力を組み合わせ、高品質な動画を生成・編集できる点が最大の特徴だ。
ファーストモデルとなる「Gemini Omni Flash」は、発表と同時にGeminiアプリ、Google Flow、YouTube Shortsで提供が開始された。自然言語による会話形式での動画編集や、現実世界の物理法則を反映したリアルな映像生成が可能になっている。
この記事では、Gemini Omniが従来の動画生成AIと何が異なるのか、具体的な機能とその仕組み、そしてコンテンツ制作の現場にもたらす変化について解説する。
上の概念図にあるように、Gemini Omniの最大の進化はインプットの柔軟性にある。テキストプロンプトだけでなく、画像や音声、既存の動画そのものを「参照素材」として組み合わせ、そこからまったく新しい映像を生み出せるのだ。DeepMindの記事によれば、将来的には画像や音声の出力にも対応する予定だという。
自然言語で動画を編集する新体験
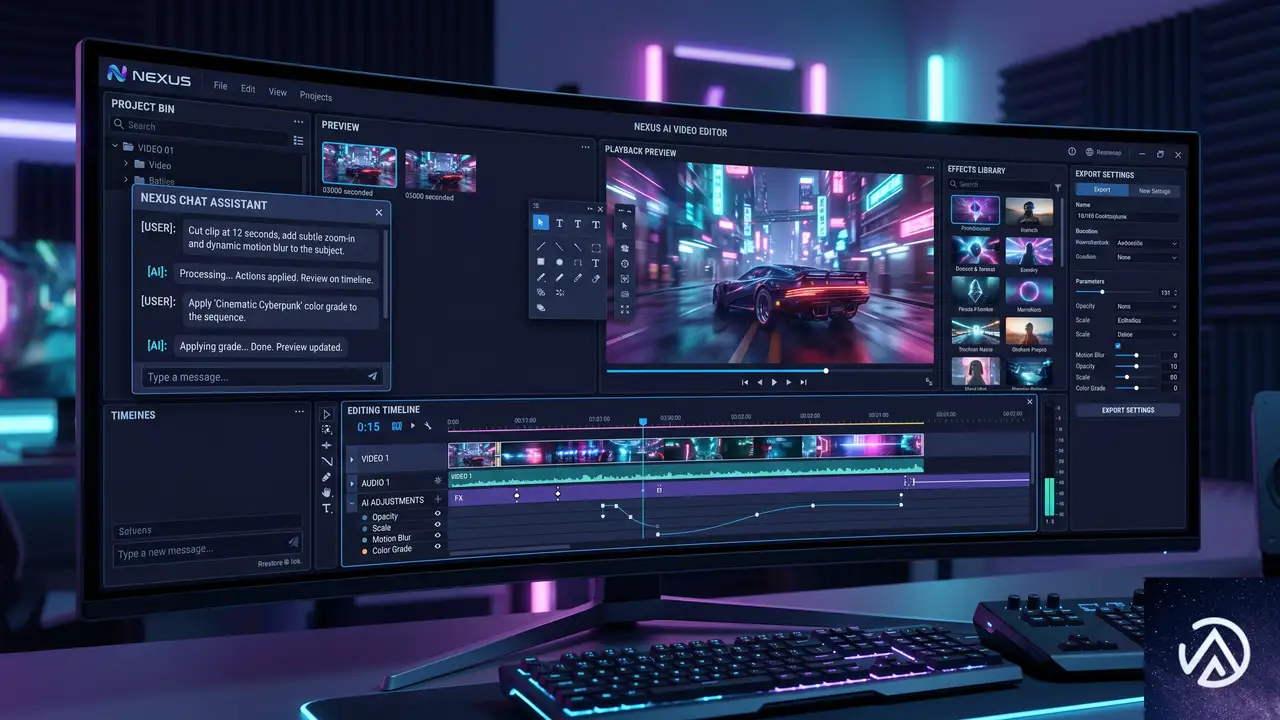
Gemini Omniが提供する最も画期的な機能のひとつが、会話形式による動画編集だ。従来の動画編集は、タイムライン上でクリップを切り貼りし、エフェクトを重ねる作業の連続だった。Omniでは、編集内容を自然言語で指示するだけで、AIが映像を理解して変更を加える。
DeepMindの発表によれば、Omniは過去の指示内容を記憶し、編集のたびに映像全体の一貫性を維持する。登場人物の見た目や物理法則、シーンの流れが破綻しない。これは単なる「映像の切り貼り」ではなく、AIが映像の文脈を理解しているからこそ実現するものだ。
映像の一部を変更、または一変させる「トランスフォーム」
Omniは、映像内の特定のオブジェクトだけを変更する、あるいはシーン全体をガラリと変えることができる。DeepMindのデモでは、「彫刻をバブル材質に変える」というプロンプトで、彫刻だけが泡状に変化する映像が紹介されている。
この機能は、例えば商品紹介動画の背景だけを差し替えたい、プロモーション映像の季節感を変更したいといった実務ニーズに直結する。撮影済みの映像を素材として、新たなクリエイティブの出発点にできるのだ。
アクションを再構築し、予想外の映像を生成
撮影済みの動画に対して「このシーンで起こっていることを変えてほしい」と指示するだけで、Omniは映像内のアクションそのものを再構築する。新しいキャラクターの追加も、光が音楽に同期して灯るような複雑な演出も可能だ。
発表資料には「手が鏡に触れた瞬間、鏡が美しい液体のように波打つ」というプロンプト例が掲載されている。こうした物理法則に基づく映像表現は、従来の動画生成AIでは難しかった領域だ。
複数ターンにわたる動画の洗練
Omniの編集は、1回の指示で終わらない。環境の変更、アングルの切り替え、スタイルの変更、特定のディテール調整といった指示を段階的に重ねることで、映像を徐々に洗練させていける。DeepMindは「バイオリニストの演奏動画」を例に、環境変更→バイオリンを透明化→肩越しのアングル変更という一連の編集を示している。
この「対話的な編集の積み重ね」は、ディレクターが編集者に指示を出す感覚に近い。クリエイティブの方向性を言葉で伝え、結果を見ながら微調整するワークフローが、AIによって実現しつつある。
世界知識が映像にリアルな文脈を与える
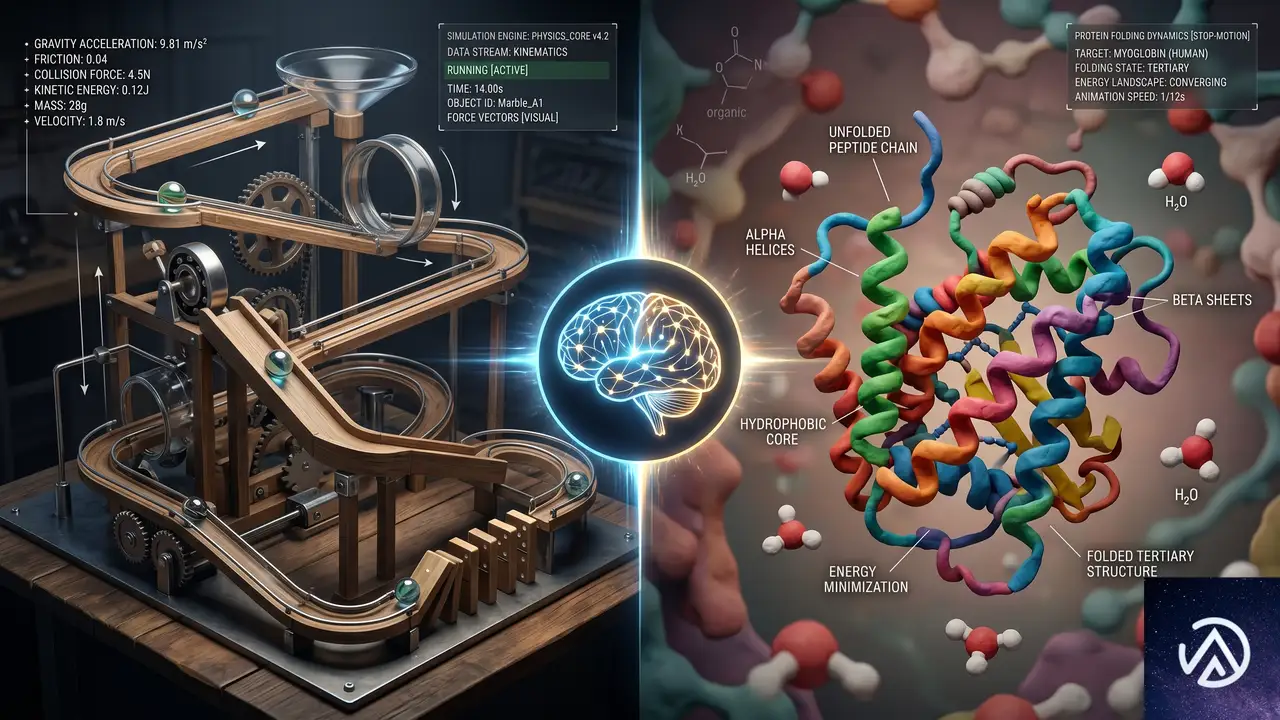
Gemini Omniのもうひとつの核は、Google DeepMindが「世界知識(world knowledge)」と呼ぶ能力だ。Omniは単に見た目がリアルなシーンを構築するだけでなく、「次に何が起こるべきか」を推論する。物理法則、歴史的事実、科学的知識、文化的文脈を踏まえた映像生成が、単なるフォトリアルを超えた説得力のあるストーリーテリングを可能にする。
より正確な物理演算の再現
Omniは重力、運動エネルギー、流体力学といった物理法則の直感的な理解が従来よりも改善されているという。DeepMindが示した「ビー玉が高速でカラクリ装置の上を転がる連続ショット」のプロンプト例では、ビー玉の動きが物理的に破綻しない映像が生成された。
動画制作の現場では、物理演算が破綻した映像は視聴者に違和感を与え、説得力を損なう。特に製品の動作デモや、教育用の科学解説動画では、物理的正確さが信頼性に直結する。Omniのこの改善は、商用・教育コンテンツの品質を引き上げる要素だ。
知識と創造性の融合
Omniはパターンマッチングを超えたレベルで、言語と映像、意味を結びつける。DeepMindの例として挙げられた「AからZまでの珍しいアイテムを各文字ごとに表示する動画」では、カピバラ(C)、ディスコグローブ(D)、ラバランプ(L)といった具合に、各文字に対応するアイテムをAIが自律的に選定し、映像化している。
これは「指示された映像を生成する」というより、「概念を理解した上で映像化する」という質的に異なる能力だ。クリエイターがアイデアを言葉で伝えれば、AIがそれを映像的な表現に落とし込んでくれる。企画段階でのモックアップ作成や、プレゼンテーション用のビジュアル資料作成が大幅に効率化する可能性がある。
複雑な概念を視覚化する説明動画の生成
Omniは短いプロンプトから、複雑な概念をわかりやすく解説する説明動画を生成できる。DeepMindの例では、タンパク質の折り畳み(プロテインフォールディング)を、すべて粘土で作られたクレイメーション(粘土アニメ)風の映像で解説したデモが紹介された。
「複雑なトピックを短時間で視覚化できる」という点は、教育コンテンツや企業の研修資料、製品のオンボーディング動画など、幅広い用途に応用できる。特にスタートアップや中小企業にとって、高品質な説明動画を低コストで制作できる可能性は大きい。
あらゆる組み合わせから動画を生成する力
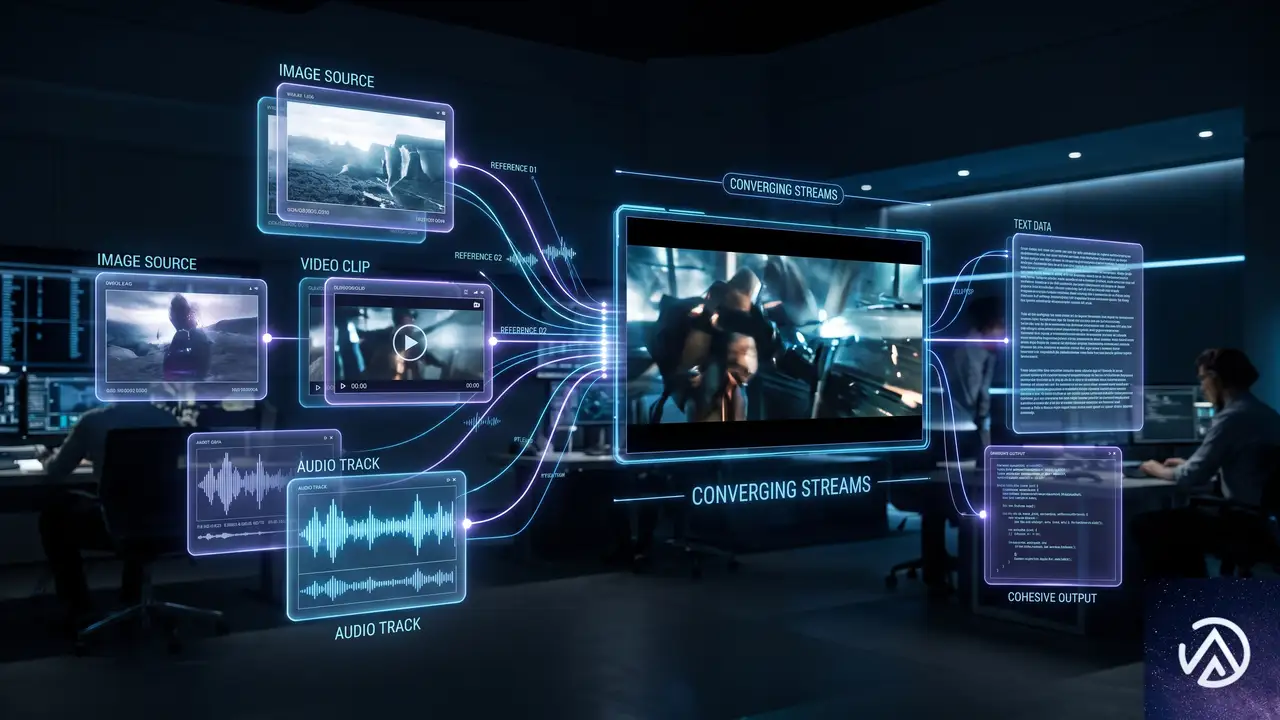
Gemini Omniのインプットの柔軟性を示す機能として、DeepMindは「複数形式の参照入力」を強調している。画像、テキスト、動画、音声のいずれかを「参照素材」として与えることで、それらをブレンドしたひとつの映像を生成できる。
現時点で音声入力は「声」による参照のみサポートされているが、DeepMindは他の形式の音声入力にも順次対応していく方針だ。画像からキャラクターの外見を、動画から動きのパターンを、音声からリズムやトーンを取り込むといった複合的な制作が可能になる。
画像・音声・動画を「参照」して統一された映像を出力
DeepMindの発表では、3つの異なる素材(画像、動画、音声)を組み合わせて「SF映画風の映像」を生成する例が示された。画像でシーンのスタイルを、動画でカメラワークやエフェクトを、音声で映像のリズムをコントロールできる。
別の例では、人物のイラストとウォークサイクルの動画を組み合わせて、歩きながらリアルな実写映像に変化していく映像を生成している。これらは、クリエイターが持つ複数の素材アセットをAIが「調和」させてひとつの作品に仕上げるという、新しい制作フローを示唆する。
スタイル、動き、エフェクトを自在に適用
参照素材を使うことで、映像のスタイル、動き、エフェクトを細かくコントロールできる。プロンプトだけで指示する場合と比べて、参照素材があることで「こういう感じ」というニュアンスをAIに正確に伝えやすくなる。
「スケートボードにアニメーションのモーションエフェクトを追加する」という例では、撮影済みの映像とAIによるエフェクト生成がシームレスに融合した。実写とCGの境界線が曖昧になっている現在、Omniは実写素材を出発点に、AIによる拡張を重ねるというハイブリッドな制作スタイルを加速させるだろう。
自分のアバターで動画を制作、そして責任ある開発
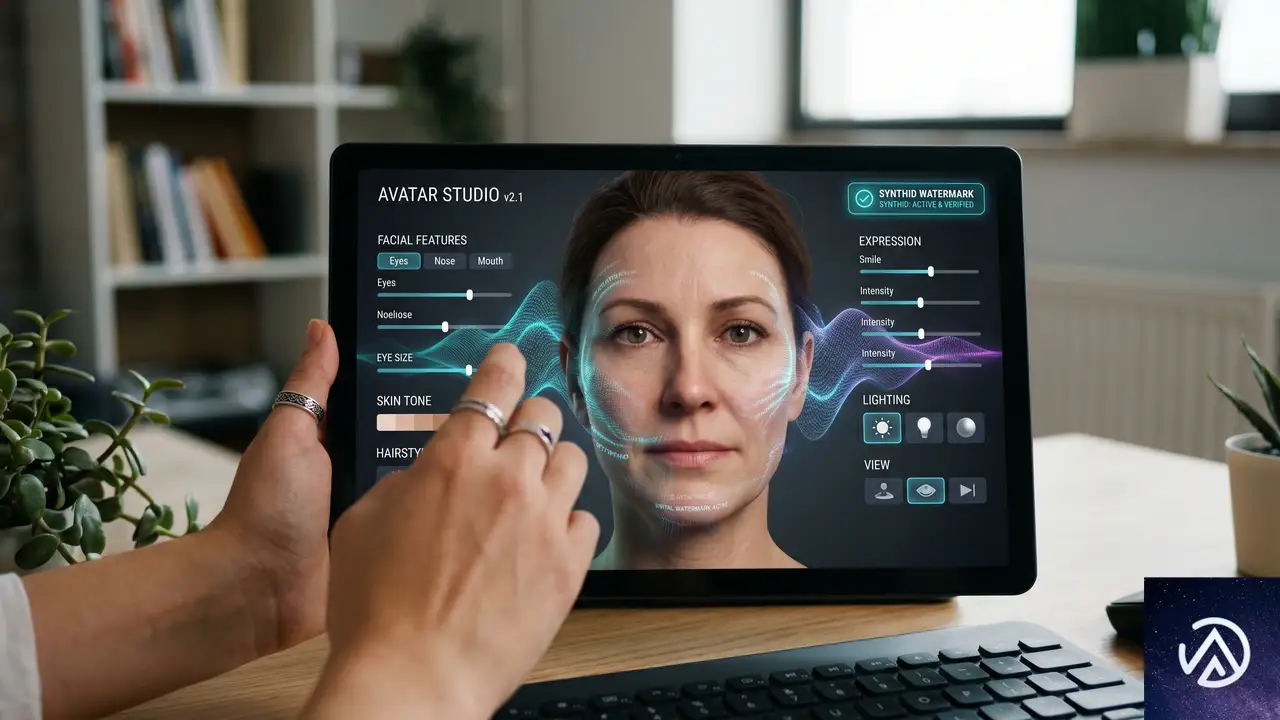
Google DeepMindは、AIの責任ある開発と利用のためのポリシーを明確にしている。その一環として提供されるのが「Avatars」機能だ。これは自分の声と姿をデジタル化したアバターを作成し、そのアバターを使って動画を生成できるというもの。
デジタルアバター機能
アバター機能を使うと、生成された動画はユーザー自身の声と姿を反映したものになる。これはパーソナライズされたコンテンツ制作を可能にする一方、なりすましや悪用のリスクもはらむ。DeepMindは、音声や発話を伴う動画編集機能については、テストを重ねた上で責任ある形での提供方法を模索している段階だとしている。
SynthIDによる電子透かしとコンテンツの透明性
Omniで生成されたすべての動画には、人間の目では認識できないSynthIDのデジタル透かしが埋め込まれる。これにより、GeminiアプリやChrome、Google検索を通じて、その動画がAIによって生成されたものであることを簡単に検証できる。
AIによるコンテンツ生成が一般化するにつれ、その真正性を担保する仕組みの重要性は高まっている。動画メディアの信頼性に関わるこの取り組みは、プラットフォームとしてのGoogleの姿勢を示すものだ。Web制作者やマーケターにとっては、配信する映像コンテンツの透明性を確保する手段として注目に値する。
Gemini Omniの利用を開始するには
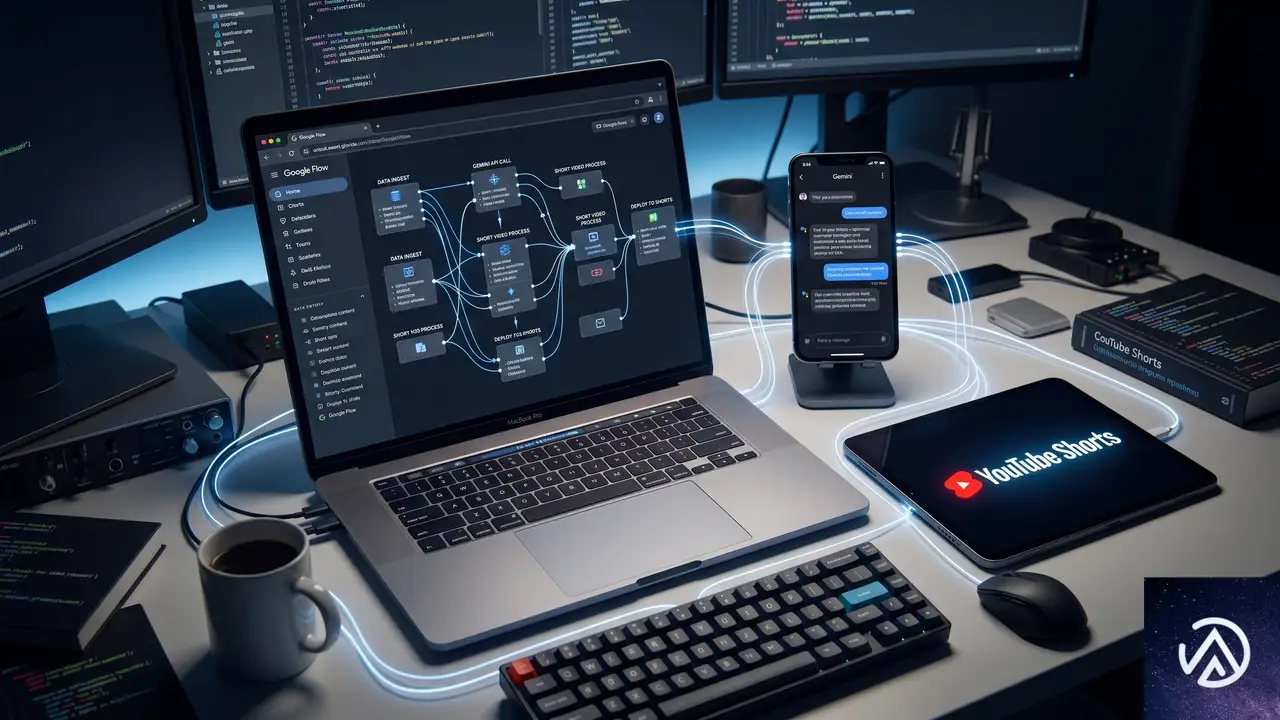
現在提供されているのは「Gemini Omni Flash」モデルで、Google AI Plus、Pro、Ultraの各プラン加入者がGeminiアプリとGoogle Flowで利用できる。また今週より、YouTube ShortsとYouTube Create Appでは無償で提供が開始される予定だ。
今後数週間以内には、API経由で開発者やエンタープライズ顧客にも提供が拡大される。これにより、既存の制作ワークフローやサービスにOmniの動画生成機能を組み込んだアプリケーションの登場が期待される。
この記事のポイント
- Gemini Omniはテキスト・画像・音声・動画の組み合わせ入力に対応した動画生成AIで、最初のモデル「Flash」が提供開始された
- 自然言語による会話形式で動画を編集でき、複数ターンの指示で映像を段階的に洗練できる
- 物理法則や世界知識に基づいたリアルで一貫性のある映像生成が可能になった
- 生成動画にはSynthIDの電子透かしが埋め込まれ、コンテンツの透明性が確保される
- API提供により、今後のサービス連携や制作フローへの組み込みが加速する見込みだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GoogleがAI最適化ガイドを発表、核心は「従来のSEOこそがAI対策」
Googleが2026年5月15日、生成AI検索向けのサイト最適化ガイダンスを公式に公開した。多くのマーケターが待ち望んでいたこのガイドだが、その中身は全く目新しいものではなかった。Googleは「AIのための最適化は、これまでの検索体験のための最適化であり、すなわちSEOだ」と断言している。
AI OverviewsやAI Modeで自社のECサイトが参照されるようにするための特別な技術は存在しない。新しい構造化データも不要、専用のマークダウンページも不要、AI向けの特別な文章術すら求められていない。求められているのは、人間にとって価値あるコンテンツを作り、クロール可能な状態に保つという基本中の基本だ。
今回のGoogleの公式見解は、AI時代のSEO対策に踊らされていたEC事業者にとって、立ち止まり基本を見直す契機となる。小手先のハックではなく、本質的なサイト改善がそのままAIにも通用するという事実を解説する。
この図が示す通り、SNSや一部メディアで話題になった「GEO(Generative Engine Optimization)」の独自手法の多くは、Googleによって完全に否定された形だ。
Googleが定義するAI時代のSEOの正体

Googleが公開したガイドライン「Optimizing your website for generative AI features on Google Search」の最大のポイントは、AI最適化を特別視していない点にある。実務者は腰を据えてこの前提を理解する必要がある。
AI OverviewsやAI Modeは、独自のクローラーでWebを巡回しているわけではない。これらは通常のGoogle検索エンジンが収集したインデックスを参照し、そこから回答を生成する。つまり、そもそもオーガニック検索で認知されていないページは、AIの回答にも決して登場しない仕組みだ。
「AIに読まれるための特殊なマークアップ」や「AI専用のテキスト要約」を用意する動きも一部で見られたが、Googleはそれらを不要と切り捨てている。むしろ、機械向けの不自然な最適化はスパム判定のリスクすらある。
AIが読むからこそ、人間を第一に考えたサイト設計を
Googleのガイドラインは「人間を第一に考えたコンテンツを作成せよ」という従来のポリシーを改めて強調している。独自の視点や専門知識、経験に基づく情報こそが、AIによる情報抽出の対象になる。
ECサイトでいえば、商品のコピーをメーカー提供のまま掲載するのではなく、実際の使用感やスタッフのレビュー、独自の比較情報を加えることが有効だ。AIはWeb上の膨大なテキストを学習しているため、どこにでもある汎用的な文言よりも、固有の情報を優先して抽出する傾向がある。
ECサイトが今すぐ見直すべき7つの基本対策

Googleが提示したAI時代のSEO対策は、すべて従来のGoogleサーチエッセンシャルズに準拠している。ここでは特にEC事業者に影響が大きい7つのポイントを深掘りする。
商品フィードはAI時代の生命線
この中で特にEC事業者が注力すべきは、STEP 6の商品フィード最適化だ。Googleはガイドライン内で、ECサイトの商品データを詳細かつ正確にMerchant Centerへ送信することを強く推奨している。
AI Overviewsが商品に関する質問に答える際、構造化された商品フィードデータは非常に処理しやすい。価格、在庫状況、送料、商品画像、レビュー評価といった情報が正確に提供されていれば、ユーザーの「比較検討」フェーズでAIに参照されやすくなる。
軽量化とクロール最適化の実務
STEP 4の「JavaScript無効環境でのコンテンツ可視性」も見逃せない。GooglebotはJavaScriptを実行する能力を持つが、クロールバジェットの観点から、サーバーサイドレンダリングや静的HTMLでのコンテンツ配信が依然として有利だ。特にWooCommerceサイトでは、商品バリエーションの切り替えなどでJavaScriptに依存しすぎていないか、今一度確認が必要になる。
Googleが一蹴した「GEO神話」とその真実

AI時代のSEOに関して、ここ半年で様々な「GEOテクニック」が提唱されてきた。Googleの今回のガイドラインは、それらの大半を無価値と断じている。
EC事業者にとっての教訓は明快だ。AIに理解してもらうために「裏口」を探すのではなく、正面から人間の顧客に価値を提供し、それを検索エンジンが問題なく読み取れるようにすること。それ以上でも以下でもない。
EC事業者が備えるべき「エージェント時代」の新常識

Googleのガイドラインは、近い将来の「AIエージェント」の到来にも言及している。AI Overviewsのように単に情報を要約するだけでなく、ユーザーに代わってホテルの予約や商品の購入といった「行動」を実行するエージェント機能の開発が進んでいる。
この文脈でGoogleがEC事業者に推奨しているのが、Universal Commerce Protocol(ユニバーサルコマースプロトコル / UCP)への理解だ。UCPは、AIエージェントがECサイト上で商品の検索や購入をプログラム的に実行するための共通仕様である。まだ広く普及しているとは言えないが、今後の標準になる可能性がある。
もちろんこれは未来の話だ。現在はUCPに対応していなければ売上が立たないというわけではない。しかしECサイトのデータ構造を整理し、構造化データを充実させておくことは、このようなエージェント経済への自然な準備となる。
この記事のポイント
- GoogleのAI最適化ガイドラインは、従来のSEO対策と完全に一致している
- AI OverviewsやAI Modeはオーガニック検索結果を参照しており、特別な経路は存在しない
- LLMs.txt や専用マークダウンなど、巷の「GEOテクニック」は大部分が不要
- ECサイトは独自の商品説明の作成、商品フィードの充実、技術的SEOの徹底が最優先
- UCPのようなエージェント時代のプロトコルにも、構造化データで間接的に備えられる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google Universal Cart発表。AIが越境する新買い物体験と検索広告への波及
Googleは2026年5月のI/Oにおいて、新たなAI買い物かご「Universal Cart(ユニバーサルカート)」を発表した。検索、Gemini、YouTube、Gmail、そして提携小売店を横断し、ユーザーの購買行動をAIが継続的に支援する仕組みだ。単なる商品推薦を超え、価格監視や在庫確認、適合性チェック、決済補助までを自律的にこなす「代理型商取引(エージェンティックコマース)」への本格的な布石といえる。
この発表は、検索広告やEC事業に携わる企業にとって看過できない転換点を含んでいる。Googleが単なる情報の入り口から、商取引自体を内包するプラットフォームへと進化する過程で、広告の役割や商品データの重要性が根本的に変わるからだ。ここでは、Universal Cartの仕組み、基盤となるUniversal Commerce Protocol(UCP)、そして広告主やリテーラーへの影響を掘り下げる。
Universal Cartがもたらす「永続する買い物体験」とは

Universal Cartの核心は、買い物かごを「その場限りの仮置き場」から「AIが能動的に管理する永続的な購買アシスタント」へと変える点にある。Search Engine Journalの記事によれば、Googleはこの機能を「ユーザーを追いかけるインテリジェントなショッピングカート」と表現しているという。
具体的には、ユーザーがGoogle検索で商品を調べ、Geminiとの対話で比較検討し、YouTubeのレビュー動画を見て、Gmailのクーポンを確認するといった一連の行動が、すべて単一のカートに集約される。裏側ではGeminiモデルが稼働し、価格変動や在庫状況、製品同士の互換性までを自動判定する仕組みだ。
AIが「待つ買い物」から「代行する買い物」へ変える
従来のオンラインショッピングでは、ユーザーが自ら価格を監視し、クーポンを探し、セールを待つ必要があった。Universal Cartはこれを反転させる。AIがユーザーに代わってバックグラウンドで価格下落を追跡し、ロイヤルティ特典の適用機会を探し、より適合性の高い代替商品を提案する。
Google Walletとの統合も発表されており、支払い方法やポイントプログラムの情報をAIが参照しながら、購入手続きの手間を減らす方向だ。Search Engine Journalの記事では、Nike、Sephora、Target、Walmart、Wayfair、そしてShopify加盟店などの大手小売業者が、この夏から決済機能の展開に参加すると報じられている。
カスタムPCのような複雑な買い物でも互換性を自動検証
Googleは、複数の小売店にまたがる部品で構成されるカスタムPCの購入においても、Universal Cartが部品間の互換性問題を決済前に検証できると説明している。これは単なるレコメンド機能の延長ではなく、購買判断そのものにAIが深く関与する設計であることを示している。
この能動性こそが、今回の発表の最大の特徴だ。Search Engine Journalの記事も「Googleがいかに積極的にUniversal Cartをリアクティブではなくプロアクティブなものとして位置づけているかが注目に値する」と指摘している。ユーザーが質問するのを待つのではなく、AIが先回りして提案する姿勢への転換である。
Universal Commerce Protocol(UCP)が切り拓く商取引インフラ

Universal Cartの裏側で動くのが、Googleが2026年初頭に発表したUniversal Commerce Protocol(UCP)だ。これは、異なる商取引システムやAIエージェントが共通言語でやり取りするためのインフラ層と位置づけられている。GoogleはI/Oで、すでに複数の小売業者やテクノロジーパートナーがUCPの採用を進めていることを明らかにした。
UCPの役割を簡単にたとえるなら、商取引の世界における「共通通貨」のようなものだ。これまでECサイトごとにバラバラだった商品情報や在庫データ、決済手段の記述方式を統一し、AIがサイトを越えてシームレスに買い物を支援できるようにする。
UCPの地理的・業種的拡大
I/OではUCPに関する以下の拡大計画も発表された。
- UCP経由の決済機能がカナダとオーストラリアに拡大。英国も後日対応予定
- 米国内でYouTubeにUCPが導入される
- ホテル予約や地域のフードデリバリーなど、新たな商取引カテゴリへの展開を計画
特にYouTubeへのUCP導入は、動画コンテンツと商取引の結びつきを一段と強める動きとして重要だ。Search Engine Journalの記事も「YouTubeの拡大は際立っている」と評しており、ブランドにとってYouTubeを単なる認知チャネルではなく、ECチャネルとして捉え直す必要性が高まることを示唆している。
広告主にとってUCPが意味するもの
Search Engine Journalの記事は、UCPの拡大が広告主やリテーラーにとって「カートそのものよりも最終的に重要かもしれない」と指摘している。これは本質を突いた見方だ。Googleは商品の発見から購買行動、決済、AIエージェントまでを包含する商取引インフラを構築しつつある。
このインフラ上では、Merchant Centerの商品データ品質が従来以上に重要になる。AIが商品を理解し、推薦し、互換性を判断するための基盤データとなるからだ。構造化された商品情報の正確さが、AIによる露出機会を左右する時代に入りつつある。
広告主とEC事業者に迫る3つの変化

Universal CartとUCPの登場は、広告主やEC事業者にとって以下の3つの変化をもたらす。
変化1、購買ジャーニーのGoogle内包化
これまでのGoogle検索は、商品情報を提供した後、ユーザーを小売店のサイトへ送り出す役割だった。Universal Cartはこの流れを逆転させ、比較検討や価格監視、再訪問、決済までをGoogleのエコシステム内に引き戻す。
Search Engine Journalの記事でも「歴史的にGoogle検索は主にユーザーを小売店サイトへ送り出していたが、Universal Cartはその活動の多くをGoogle内部に引き戻し始めている」と指摘されている。これは機会であると同時に課題でもある。Google内での露出を最大化できる事業者と、そうでない事業者の差が拡大する可能性が高い。
変化2、商品データがAI時代の新たな広告資産に
AIが能動的に商品を推薦し、価格下落を通知し、互換性を検証する世界では、商品データの質がそのまま販売機会に直結する。正確な在庫情報、詳細な製品スペック、競争力のある価格設定、ロイヤルティプログラムとの統合が、AIによる露出の前提条件となる。
これは従来のShoppingキャンペーンの最適化を超えた、より根源的なデータ戦略を求めている。Merchant Centerのフィード最適化は、もはや運用施策ではなく、AI時代の事業基盤そのものだ。
変化3、YouTubeがECチャネルとして本格化
YouTubeへのUCP導入は、動画プラットフォームが商取引の場へと進化する決定的な一歩だ。商品レビュー動画を見ながらワンクリックでカートに追加し、そのまま購入まで至る体験が現実になる。
この変化は、ブランドのYouTube戦略にも影響を与える。認知獲得のための動画広告から、直接的な売上に結びつく商取引動画へのシフトが加速するだろう。Search Engine Journalの記事も「ブランドはYouTubeを単なる動画認知プラットフォームとしてではなく、ECチャネルとして考える必要性が高まる」と述べている。
計測とアトリビューションの再考が迫られる

Universal Cartが普及すれば、購買行動のより多くの部分がGoogleインターフェース内で完結する。これは広告の効果測定にも大きな影響を与える。従来のクリックベースのアトリビューションモデルでは、Google内で進む比較検討やAIによる価格監視の影響を捉えきれない。
Search Engine Journalの記事は「より多くのショッピング活動がGoogleインターフェース内で発生するようになれば、広告主はアトリビューションやアシストコンバージョン、クロスチャネルのカスタマージャーニーレポートの評価方法を再考する必要があるかもしれない」と指摘している。これは単なる技術的な課題ではなく、広告予算の配分やROI評価の根幹に関わる問題だ。
具体的には、以下のような再考が求められる。
- ラストクリック至上主義からの脱却。AIが長期にわたって関与する購買ジャーニーでは、初期の商品発見や中期の価格監視が持つ価値を適切に評価する必要がある
- Googleエコシステム内の複数タッチポイント(検索、YouTube、Gmail、Gemini)を横断した統合的な計測手法の確立
- AIによるプロアクティブな提案(価格下落通知や互換性アラート)がコンバージョンに与える影響の定量化
代理型商取引の成熟と今後の展望
Universal Cartはまだ初期段階にある。Search Engine Journalの記事も「より高度な代理型商取引機能の多くは成熟に時間がかかるだろう」と現実的な見方を示している。それでも、今回の発表はGoogleがショッピング領域でどこへ向かおうとしているのか、かなり明確な絵を示したといえる。
GoogleはAIによる商品発見の強化を超え、購買ジャーニーのより深い部分へと進出している。商品推薦やカート管理から、価格洞察、決済インフラに至るまで、購買プロセスの占有率を着実に高めているのだ。
広告主やリテーラーにとって、これは単に「広告の表示場所が変わる」という話ではない。ブランドが影響力を測定する方法、コンバージョンを帰属させる枠組み、購買ジャーニーの中で可視性を競う土俵そのものが変わる可能性を秘めている。
こうした変化に備えるには、以下の3点が当面の具体的なアクションとなるだろう。
- Merchant Centerの商品データ品質を最優先で引き上げること。AIが商品を理解し推薦するための「原材料」はデータであり、その質が露出機会を決める
- YouTubeをECチャネルとして位置づけ直し、商取引に直結する動画コンテンツ戦略を構築すること
- アトリビューションモデルを再評価し、AIが介在する長期の購買ジャーニーを捉えられる計測基盤を整えること
この記事のポイント
- Universal Cartは検索・YouTube・Gmailを横断するAI駆動の永続的買い物かごであり、価格監視や互換性チェックまで自律的に実行する
- 基盤となるUCPは商取引の共通言語として機能し、Googleエコシステム内外の決済や商品情報連携を支えるインフラである
- 広告主には購買ジャーニーのGoogle内包化、商品データの戦略的重要性の高まり、YouTubeのECチャネル化という3つの変化が訪れる
- AIが購買判断に深く関与する時代には、アトリビューションや効果測定の抜本的な再考が避けられない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Gemini 3.5 Flash がVercel AI Gatewayで利用可能に。並列処理能力と推論機能が大幅向上
Googleの最新モデル「Gemini 3.5 Flash」が2026年5月19日からVercel AI Gatewayで利用可能になった。このモデルはコーディング能力と並列エージェント実行ループの性能が大きく向上し、複雑なタスクでも高い推論精度を発揮する。
AI Gatewayの統合APIを通じて呼び出せ、使用量の追跡やコスト管理、リトライやフェイルオーバーの設定も標準で備わっている。開発者は面倒な基盤管理なしに、最新のAIモデルを本番環境へ素早く組み込める。
この記事では、Gemini 3.5 Flash の進化点、AI Gateway での具体的な使い方、実装時の注意点までを整理する。
Gemini 3.5 Flash の概要と新モデルの位置づけ

Flash シリーズの進化
Gemini Flash シリーズは、Google が提供する軽量で応答速度に優れたAIモデル群だ。前世代のFlash 2.0と比べて、3.5 Flash では単なる速度向上にとどまらず、複数ステップのタスクを自律的に並列実行できるようになった点が大きな違いだ。
これにより、コーディングの効率化や、複数のAPIを同時に呼び出すようなエージェント型アプリケーションで強力なパフォーマンスを発揮する。
今回のアップデートで強化された点
- コーディング補完の精度向上
- 並列エージェント実行ループの大幅な最適化
- コア推論能力と命令追従性の改善
- マルチターン会話の一貫性向上
- 思考モード(thinking mode)での高品質な推論トレースの生成
並列エージェント実行ループの進化

並列化によるパフォーマンス向上
従来のFlashモデルは、一連のタスクを逐次的に処理する傾向があった。たとえばコードリファクタリングの際に「API呼び出しAの完了を待ってからAPI呼び出しBを実行する」といった流れになる。これに対し、3.5 Flash は複数の独立した処理を同時に並列実行する能力が格段に上がっている。
並列実行のメリットは、応答待ち時間の大幅な短縮と、システム全体のスループット向上だ。特にマイクロサービス間の連携や、複数の外部データソースを一括で処理する場面で効果を発揮する。
この比較はあくまで概念図だが、実際のアプリケーションでは複数の独立した処理を同時に走らせることで、体感速度やスループットが大きく改善される。
thinking モードと推論トレースの強化

thinking level の選択
Gemini 3.5 Flash はデフォルトで「medium」のthinking levelが設定されている。これは、応答の品質と生成速度、そしてコスト効率のバランスを取るための設計だ。より複雑な推論が必要な場合は high レベルに変更することも可能で、その場合は推論プロセスがより深く行われる。
たとえば、コードのリファクタリングや多段階の意思決定が必要なタスクでは、thinking level を high に設定することで、AIが問題をより細かく分解し、質の高い答えを導き出す。
マルチターンコヒーレンスと複雑タスク
3.5 Flash では、マルチターンの会話における一貫性も改善されている。以前のFlashモデルに比べて、前のやり取りを適切に保持しながら、矛盾のない回答を返す精度が向上している。これにより、長時間のコード生成や、会話型のエージェントアプリケーションでも安定した挙動が期待できる。
複雑なタスクでは「thinking traces(思考の痕跡)」がより詳細に出力されるため、モデルがどのような過程で結論に至ったかを検証しやすい。デバッグや品質管理の面で大きなメリットだ。
Vercel AI Gateway の機能とメリット

統合APIとプロバイダールーティング
Vercel AI Gatewayは、複数のAIプロバイダーを統一的なインターフェースで利用できるプラットフォームだ。開発者はプロバイダーごとに異なるAPIキー管理やエンドポイントを意識することなく、model の指定だけでモデルを切り替えられる。
さらに、AI Gatewayはインテリジェントなルーティング機能を備えており、特定のプロバイダーに障害が発生した場合に自動で別のモデルへフェイルオーバーしたり、リクエストをリトライしたりできる。これにより、単一プロバイダーを直接使うよりも可用性が向上する。
観測性とカスタムレポート
AI Gatewayには、使用量の追跡やコスト分析のためのカスタムレポート機能が組み込まれている。プロジェクトごと、環境ごとにAPI呼び出し回数やトークン消費量を可視化できるため、予算管理やボトルネックの発見に役立つ。
また、AI SDK Observability との連携により、モデルの応答時間やエラーレートを詳細に監視できる。Bring Your Own Key にも対応しており、自社で契約したAPIキーをAI Gateway経由で安全に利用できる点も企業ユースに適している。
AI SDK での実装方法と注意点

コード例
AI SDK を用いて Gemini 3.5 Flash を呼び出すには、以下のように streamText 関数を使う。モデル名に google/gemini-3.5-flash を指定し、必要に応じて thinking level を設定する。
import { streamText } from 'ai';

const result = streamText({
  model: 'google/gemini-3.5-flash',
  prompt: 'Refactor this service to run API calls in parallel.',
  providerOptions: {
    google: {
      thinkingConfig: {
        thinkingLevel: 'high',
        includeThoughts: true,
      },
    },
  },
});
thinking level は 'medium'(デフォルト)と 'high' から選択でき、複雑なタスクでは 'high' を指定すると良い。なお、includeThoughts: true にすると推論過程のトレースもレスポンスに含められる。
サポート外のパラメータと制約
Gemini 3.5 Flash では temperature、topP、topK、thinking_budget といったパラメータはサポートされていない。以前のモデルでこれらの値を調整していた場合は、デフォルトの挙動に任せるか、他のモデルを検討する必要がある。
特に thinking_budget が使えない点は、推論にかかるコストを細かく制御したい場合に注意が必要だ。そのぶん thinking level の切り替えで大まかな品質とコストのバランスを取る設計になっている。
この記事のポイント
- Gemini 3.5 Flash は並列エージェント実行ループの性能が大幅に向上し、コーディングや複数API呼び出しに強い
- デフォルトで medium の thinking level を採用し、品質・速度・コストのバランスを最適化
- Vercel AI Gateway によって統合API、リトライ、フェイルオーバー、観測機能をフル活用できる
- temperature や topP などの一部パラメータは非対応のため、移行時には注意が必要
- AI SDK 経由で数行のコードで導入可能、並列化のメリットをすぐに享受できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験