

WordPress 7.1.1セキュリティリリース公開。11件の脆弱性修正と即時更新のすすめ
WordPress 7.1.1が2026年9月17日に公開された。セキュリティリリースと位置づけられ、11件の脆弱性修正を含む。コアのバグ修正は17件、ブロックエディタのバグ修正は19件だ。
今回のリリースはセキュリティ修正を主目的としている。すべてのサイト管理者に即時更新が推奨される。自動更新が有効なサイトでは、すでに適用が始まっている場合もある。
セキュリティリリースの最大の特徴は、放置した場合のリスクが高いことだ。XSS(クロスサイトスクリプティング)やパストラバーサルなど、攻撃者に悪用されかねない脆弱性が多数修正されている。サイトを守るには更新が最優先となる。
WordPress 7.1.1リリースの概要
WordPress 7.1.1は「ショートサイクルリリース」と呼ばれる短い間隔で提供される更新だ。メジャーリリースの7.1から間もない段階で、セキュリティと安定性の向上を目的に公開された。次のメジャーリリースは7.2で、12月を予定している。
今回の修正内容は、コア17件、ブロックエディタ19件、セキュリティ11件の合計47件にのぼる。セキュリティ修正が全体の約4分の1を占めており、いかにセキュリティ面が重視されたリリースかがわかる。
セキュリティリリースの最大の特徴は、対応の緊急性だ。通常の更新と異なり、脆弱性がすでに公開されている可能性があるため、更新を先延ばしにすると攻撃の標的になりやすい。公式発表でも「直ちに更新すること」が明記されている。
更新は管理画面から4ステップで完了する。自動更新が有効な環境では、手動操作なしで適用される。
修正されたセキュリティ脆弱性の詳細
11件のセキュリティ修正は、XSS、パストラバーサル、権限チェックの欠落、情報漏洩の4つに大別できる。それぞれ攻撃の仕組みや影響範囲が異なるため、サイト運営者は全体像を把握しておくとよい。
11件のセキュリティ修正を種類ごとに分類すると、XSS、パストラバーサル、権限チェック欠落、情報漏洩の4つに大別される。それぞれの詳細を確認していく。
XSS関連の重大修正
XSS(クロスサイトスクリプティング)とは、悪意のあるスクリプトをWebページに埋め込む攻撃手法を指す。閲覧者がそのページを開くとスクリプトが実行され、クッキーの窃取やセッションハイジャックなどの被害につながる。
今回修正された中でも特に注意が必要なのが、wpautop()関数の格納型XSSだ。コメントを処理する際に悪意のあるスクリプトが保存され、コメントが承認されると訪問者のブラウザ上で実行される可能性があった。報告者はAwesome MotiveのRafie Muhammad氏だ。
カスタムヘッダーをサポートする一部テーマでも、同様の格納型XSSが確認された。テーマの機能を利用してスクリプトが保存され、後から閲覧したユーザーに影響が及ぶ構造だった。こちらはWordPressセキュリティチームのJeremy Felt氏が報告した。
wpautop()のXSS脆弱性が修正された。コメント内に埋め込まれたスクリプトが、実行可能なコードではなく単なる文字列として扱われるようになる。
権限・アクセス制御の修正
2件目はHTML APIのset_modifiable_text()関数で見つかった。突然閉じるシーケンスを使うことで、コメントの範囲を脱出できるという問題だ。WordPressセキュリティチームのJeremy Felt氏が報告した。
3件目は、特別に細工されたURLで非アクティブなテーマを自動的にインストールし、プレビューできる問題。攻撃者が意図しないテーマを読み込ませる可能性があった。Paulos Yibelo氏とpwn.aiの報告だ。
権限チェックの欠落も深刻だ。サイト管理者がネットワーク専用プラグインをネットワーク有効化できる問題、寄稿者(Contributor)以上の権限を持つユーザーが任意の投稿を上書きできる問題、WP REST Templates Controllerでの認証済みパストラバーサルなどが修正された。
パストラバーサルとは、ファイルパスを操作して本来アクセスできないファイルやディレクトリにアクセスする攻撃を指す。WP REST Templates Controllerの脆弱性では、認証済みユーザーがサーバー上のファイルに不正アクセスできる可能性があった。Anthropicの報告によるものだ。
寄稿者(Contributor)はWordPressのユーザー役割の一つで、投稿の作成はできるが公開はできない。この役割以上のユーザーによる不正な投稿上書きや、下書き・保留中投稿のスラッグ開示なども今回修正された。
XML-RPC経由の脆弱性も見逃せない。customize_changeset投稿を公開することでedit_cssのチェックを迂回できる問題が、WordPressセキュリティチームのBen Bidner氏によって報告された。XML-RPCはWordPressの外部アプリからの操作を受け付けるAPIで、これを悪用した攻撃が可能だった。
情報漏洩を防ぐ修正
attachment_submitbox_metadata()関数にread_postチェックが欠落しており、プライベートな親投稿のタイトルが漏れる問題が修正された。HDWSecの報告によるものだ。メディアライブラリの添付ファイル表示画面で、本来なら見えないはずの親投稿タイトルが露出する可能性があった。
コメントが認証済みユーザーなら誰でも再親付けできる問題も修正された。コメントの親子関係を任意に変更できることで、スレッド構造が破壊されたり、悪意のある内容が目立つ位置に表示されたりする可能性があった。Justin Hart氏とViridis Securityの報告だ。
コアとブロックエディタのバグ修正
セキュリティ修正以外にも、コア17件とブロックエディタ19件のバグ修正が含まれる。コアの修正はTracというバグ追跡システムで管理され、ブロックエディタの修正はGitHub上のGutenbergリポジトリで進められた。
ブロックエディタの19件の修正は、GitHubのPull Request #82383にまとめられている。エディタの安定性や操作性を向上させる修正が中心で、サイト制作に携わるユーザーにとっては作業効率の改善につながる。
メンテナンスリリースの目的は、新機能の追加ではなく既存機能の安定化だ。7.1系で発生していたバグが解消され、より快適な運用が可能になる。特にブロックエディタは日々のサイト更新作業に直結するため、19件の修正は実務での効果が期待できる。
更新手順と自動更新の仕組み
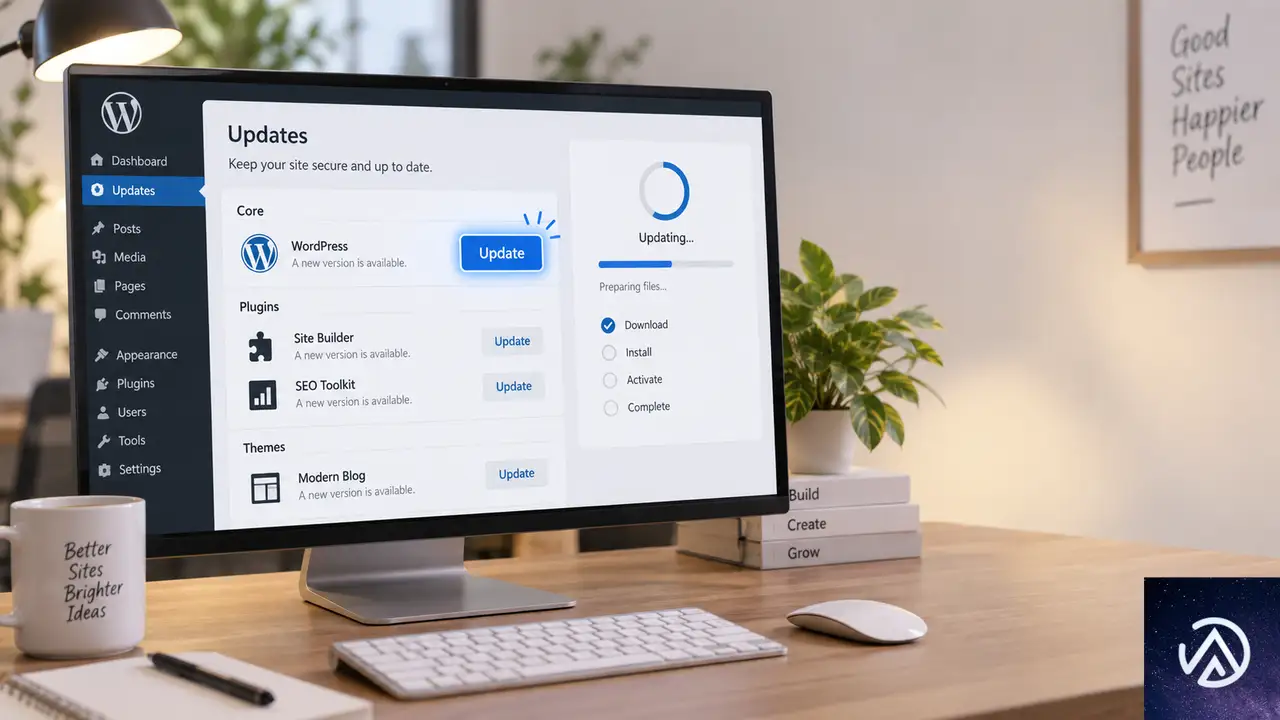
WordPress 7.1.1への更新は、公式サイトからZIPファイルをダウンロードするか、管理画面の「更新」セクションから行う。管理画面では「更新」をクリックし、「今すぐ更新」をクリックするだけの簡単な操作で完了する。
自動バックグラウンド更新を有効にしているサイトでは、更新プロセスが自動的に開始される。共有サーバーやVPSなど、サーバー環境によって自動更新の動作は異なるが、手動更新でも数分以内に完了する。
更新前にバックアップを取得しておくのが望ましい。セキュリティリリースは即時適用が推奨されるが、万一のトラブルに備えて、データベースとwp-contentディレクトリのバックアップを取ってから更新するのが安全策だ。
更新前にバックアップを取り、更新後にサイト表示を確認する流れが安全だ。セキュリティリリースは緊急性が高いが、手順を守って適用する。
バックポートとサポート対象
今回のセキュリティ修正は、WordPress 4.7まで遡ってバックポートされる。バックポートとは、最新版で修正された内容を古いバージョンにも適用することで、セキュリティ対策を広範囲に届ける仕組みだ。
ただし、公式にアクティブサポートされているのは最新版のWordPressのみだ。古いバージョンを使い続けるのはセキュリティリスクが高いため、できるだけ早く最新版へ移行するのが望ましい。バックポートはあくまで移行期間の猶予として機能する。
バックポートは順次進められており、準備が整い次第リリースされる。対象バージョンを使用している場合も、最新版への更新を優先して検討するのが推奨される。古いバージョンはセキュリティ面だけでなく、機能面でも取り残されるためだ。
この記事のポイント
- WordPress 7.1.1はセキュリティリリースで、11件の脆弱性修正を含む
- 格納型XSSやパストラバーサルなど、悪用リスクの高い問題が修正された
- コア17件とブロックエディタ19件のバグ修正も含まれる
- すべてのサイト管理者に即時更新が推奨される
- バックポートは4.7まで提供されるが、最新版への移行が最優先

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleのAIコンテンツ支払い、CloudflareとMicrosoftが示す3つの設計思想
Google、Cloudflare、Microsoftの3社がAIによるコンテンツ利用への対価支払いモデルをそれぞれ試験している。支払いの発生条件、価格設定の主導権、運営者に返るレポートの中身は3社で大きく異なる。
Googleは「重要な貢献」と判定した場合のみ支払う招待制パイロットだ。Cloudflareはクロール1回ごとに課金する独自モデルを持つ。Microsoftはライセンス型マーケットプレイスを2月に発表した。
この違いが、サイト運営者がAIにコンテンツを提供する際の収益性とリスクを左右する。本記事では3モデルの設計思想とSEOへの影響を整理する。
3社のAIコンテンツ支払いモデルの全容
Google、Cloudflare、Microsoftは2026年に入り、AIがウェブサイトのコンテンツを利用する際の対価支払いモデルをそれぞれ提示した。3社のアプローチは課金の単位、価格設定の主導権、レポートの粒度で根本から異なる。
3社のモデルは支払い方式とコントロール権限のバランスで大きく異なる。
Googleは「貢献度」判定、Cloudflareは「取得単位」課金
Googleのパイロットプログラムは、Gemini、AI Overviews、AI Modeのいずれかで、サイトのコンテンツがAI生成応答に「重要な貢献をした」と判断された場合に支払いが発生する。回答生成後のリンク表示や確認だけでは条件を満たさない。Googleは6月18日の公式投稿で、AI回答の根拠となる情報を提供するウェブサイト向けの新モデルを試験する方針を示した。
一方、CloudflareのPay Per Crawlは2025年から非公開ベータとして提供されてきた。クローラーがコンテンツを正常に取得するたびに課金が発生する仕組みで、サイト運営者はクロール1回あたりの価格を設定できる。最低価格は0.001ドルだ。価格に同意したクローラーには正常応答コードでページが返る。
Microsoftはライセンス型マーケットプレイス
Microsoftは2月3日にPublisher Content Marketplaceを発表した。Copilotの回答を支えるためのプレミアムコンテンツのライセンスを提供する仕組みで、パブリッシャーは提供価値に基づいて支払いを受ける。利用条件とライセンス条件はパブリッシャーが定義し、利用ベースのレポートも提供される。Copilotが最初の需要パートナーとなり、Yahooも導入を進めている。
関連する動きとして、Ceramic.aiは自社の検索結果にサイトのコンテンツが表示された際に参加サイトへ支払うモデルを採用している。You.comは特定のプレミアムコンテンツをオンデマンドで利用した時点で支払う仕組みだ。
支払いトリガーを決めるのは誰か
各モデルは支払い発生のイベント定義が異なる。ここが運営者の収益予測を難しくする根本原因だ。Googleは「重要な貢献」という質的基準、Cloudflareは「取得成功」という機械的基準、Microsoftは「提供価値」という経済的基準を採用している。
判定者が誰かによって、収益予測の立てやすさが変わる。
Googleの「重要な貢献」はブラックボックス
Digidayの報道によれば、Googleのパイロットでは支払いがコンテンツの使用量ではなく価値に基づくとされている。Googleが自社で「意味のある貢献だったか」を判断する仕組みで、プログラムに詳しい企業幹部はDigidayの取材に対し「かなりブラックボックスだ」と述べている。Googleは判定基準を公表していない。
サイト運営者から見れば、この構造は収益の予測可能性を著しく下げる。何が支払いにつながるかの明確な基準が分からない状態で、コンテンツ戦略の投資判断を下すのは難しい。
Cloudflareは機械的なイベント、Microsoftは定義自体が不明
Pay Per Crawlのイベントは機械的だ。価格に同意したクローラーへの正常応答が課金の条件と明確に定義されている。ただしCloudflareの7月1日の投稿は、クロール回数が価値の粗い指標であると自認している。1回だけクロールされたページが何千もの回答に引用されることもあれば、何度もクロールされながら一度も使われないページもある。
Microsoftは支払い単位を公開していない。提供価値に基づくと説明するが、具体的な計算式や契約上の定義は明らかにされていない。価格設定もパブリッシャーとの共同設計の対象とされるが、誰が最終決定するかは公開情報では分からない。
サイト運営者がコントロールできる範囲
3社のモデルはサイト運営者がどのような条件を設定できるかも異なる。価格を自分で決められるのか、参加の是非だけなのか、利用条件まで定義できるのか。この差は収益性と交渉力に直結する。
Googleは参加の是非のみ、条件交渉の余地なし
Googleのパイロットは招待制だ。参加者はSearch Consoleからいつでもオプトアウトできるが、参加するかどうか以外の条件交渉の余地は公開情報から見えてこない。Digidayによれば、ある企業幹部は提示された金額が低すぎてオプトインしなかったと述べ、Googleとの交渉は継続中だという。
この点は小規模なサイト運営者ほど不利になる。招待を受けるか、提示された条件で飲むか。その二択しか選べない状況では、交渉力のある大手メディアと中小サイトの間に収益格差が生まれやすい。
Cloudflareは価格を運営者が設定、Microsoftは利用条件を定義
Pay Per Crawlでは、サイト運営者がドメインごとの価格を設定できる。パス単位で価格を変える動的プライシングにも対応し、クローラーごとに課金、許可、ブロックを選べる。Pay Per Useでは、サイト運営者はパートナーのプログラムに参加する形で、パートナーによって支払い条件が変わる。
Microsoftのマーケットプレイスは加入が任意で、パブリッシャーはコンテンツの所有権と編集の独立性を保持する。ただし、ライセンス条件と利用条件の具体的な内容は公開されていない。価格決定者も不明のままだ。
レポートで見える情報と見えない情報
収益化の判断には、どれだけの情報が返ってくるかが重要だ。3社のレポート粒度と透明性にも明確な差がある。
Googleの月次収益表示と計算式の非公開
Googleの参加者はSearch ConsoleのAI貢献パネルで月次収益額と履歴を確認できる。しかしDigidayは、支払い計算の詳細は提供されないと報じている。Googleは一部のパートナーと週次会議も行っている。パブリッシャー連合SpurのDavid Buttle氏は、第一歩として「パブリッシャーが自分のコンテンツが回答に影響したことを知る権利がある」という前例を作ることだと述べた。
月次収益という数字は見えるが、その数字がどう算出されたかは見えない。この非対称性は、運営者が支払い額の妥当性を検証できないことを意味する。
Cloudflareの残高非表示とCeramicの詳細レポート
Pay Per Crawlでは、課金イベント発生時に記録が残る。ダッシュボードにはどのクローラーがアクセスしたか、課金が何回発生したかが表示される。ただし獲得残高はダッシュボードに表示されず、Cloudflareチームへの問い合わせが必要だ。
Pay Per Useでは、Ceramicプログラムに参加するサイトが、コンテンツが表示された検索クエリ、該当ページ、スニペット、検索結果内の平均順位まで含むレポートを受け取れる。こちらの方が実務的には使える情報が多い設計だ。
Microsoftの利用ベースレポートは中身が非公開
Microsoftは「コンテンツがどのように評価され、どこでさらに価値を提供できるか」を確認できる利用ベースのレポートを約束している。ただし、レポートに含まれる具体的な項目は公開されていない。参加者がレポート内容について説明した記録も見つからない。
Googlebotへの従量課金が招くSEOリスク
CloudflareのPay Per Crawlは、ディレクトリに登録されたあらゆるクローラーに従量課金を設定できる。Googlebotも対象だ。ここにSEO上の大きな落とし穴がある。
CloudflareのBlock設定をGooglebotに適用すると、検索インデックスからの削除リスクが連鎖的に発生する。
Googleのクローラードキュメントによれば、4xxステータスコードを返すURLのコンテンツは使用されない。402 Payment Requiredも4xxに該当するため、Googlebotに課金を設定して402を返すと、時間の経過とともに検索インデックスから削除される可能性がある。
Cloudflareが9月15日に公開した新設定はこの状況を変えるものではない。Disallow AI Training設定はrobots.txtに学習拒否の意思を公開し、GoogleとAppleはこれを尊重しつつ検索クローリングは続ける。一方、BlockオプションはGooglebotを含むクローラーを完全に停止する。
つまり、Googlebotに対して「学習は拒否したいが検索クロールは許可したい」場合は、BlockではなくDisallow AI Trainingを選ぶ必要がある。Cloudflareの報告では、検索ボットをブロックしているサイトは1%未満、何らかの学習ブロックを使っているサイトは17%に上る。
また、Googleは数週間以内にGoogle-Extendedに関連するURL単位の透明性ツールを提供する予定だとCloudflareは伝えている。これはパイロットの貢献レポートとは別のものだ。
サイト運営者が今取るべき行動
3社のモデルは完成形ではなく、すべて試験段階にある。運営者が今できるのは、自社のコンテンツの性質とリスク許容度に合わせて選択肢を評価することだ。
Cloudflare設定の見直しが最優先
すでにCloudflareを利用しているサイトは、現在の設定状態を確認すべきだ。従来の設定が移行されている可能性があり、Googlebotに対して意図しないBlockがかかっていないかを確認する必要がある。学習拒否と検索継続を両立するには、Training controlをDisallow AI Trainingに設定する。Blockにしてしまうと検索クロールも停止する。
この設定の分岐は、サイト運営者にとって「収益化のチャンス」と「検索順位のリスク」を同時に含む。学習を拒否するか、検索クロールを維持するか、あるいは課金対象としてGooglebotに支払いを求めるか。それぞれの選択肢の帰結を理解した上で決める必要がある。
契約前に確認すべき情報
Googleのパイロット招待を受けた場合、オプトイン前に「重要な貢献」の定義、計算方法、Search Consoleの生成AIコントロールとの関連性についてGoogleに確認するべきだ。Microsoftのマーケットプレイスを検討する場合は、誰が価格を決定するのか、レポートに何が含まれるのかを契約前に明確にする必要がある。公開情報だけではこれらの質問に答えられない。
3社のモデルは「支払いの透明性」に対するアプローチが根本から異なる。Googleは判定をブラックボックスにすることで柔軟性を確保し、Cloudflareは機械的なイベントで透明性を確保し、Microsoftはパブリッシャーに条件定義を委ねる。いずれもまだ実験段階であり、最終的な設計が現在の形のまま展開されるとは限らない。
特に重要なのは、Cloudflareが自ら「クロール回数は価値の粗い指標」と認めた点だ。同じコンテンツでも1回のクロールで何千回も引用される場合と、何度もクロールされながら全く利用されない場合がある。この非対称性は、現在のすべての支払いモデルが「価値の正確な測定」にまだ到達していないことを示している。
サイト運営者は、今後のレポート精度の向上と透明性ツールの展開を注視しつつ、自社のコンテンツがAI応答にどう使われているかを定期的に確認する姿勢が求められる。
この記事のポイント
- Googleは招待制で「重要な貢献」と判定した場合のみ支払う。判定基準は非公開
- Cloudflareはクロール取得単位の課金とパートナー主導の利用課金の2軸で展開
- Microsoftはライセンス型で利用条件はパブリッシャーが定義するが価格決定者は不明
- Googlebotを含むクローラーにBlock設定を適用するとSEOリスクが連鎖する
- 3社とも試験段階で、価値測定の正確性が今後の焦点となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWSが低コストなEC2 T8iインスタンスを発表!T3比で最大70%の性能向上
AWSが新型の低コストバースト可能インスタンス「Amazon EC2 T8i」の一般提供を開始した。T3インスタンスの後継となるもので、価格性能比が最大30%改善している。
T8iはカスタム設計された第6世代Intel Xeon Scalable Processorを搭載し、AWSのNitro System上で動作する。既存のT3ユーザーは同じCPUクレジット方式のまま移行できる設計だ。
T8iインスタンスの位置づけ
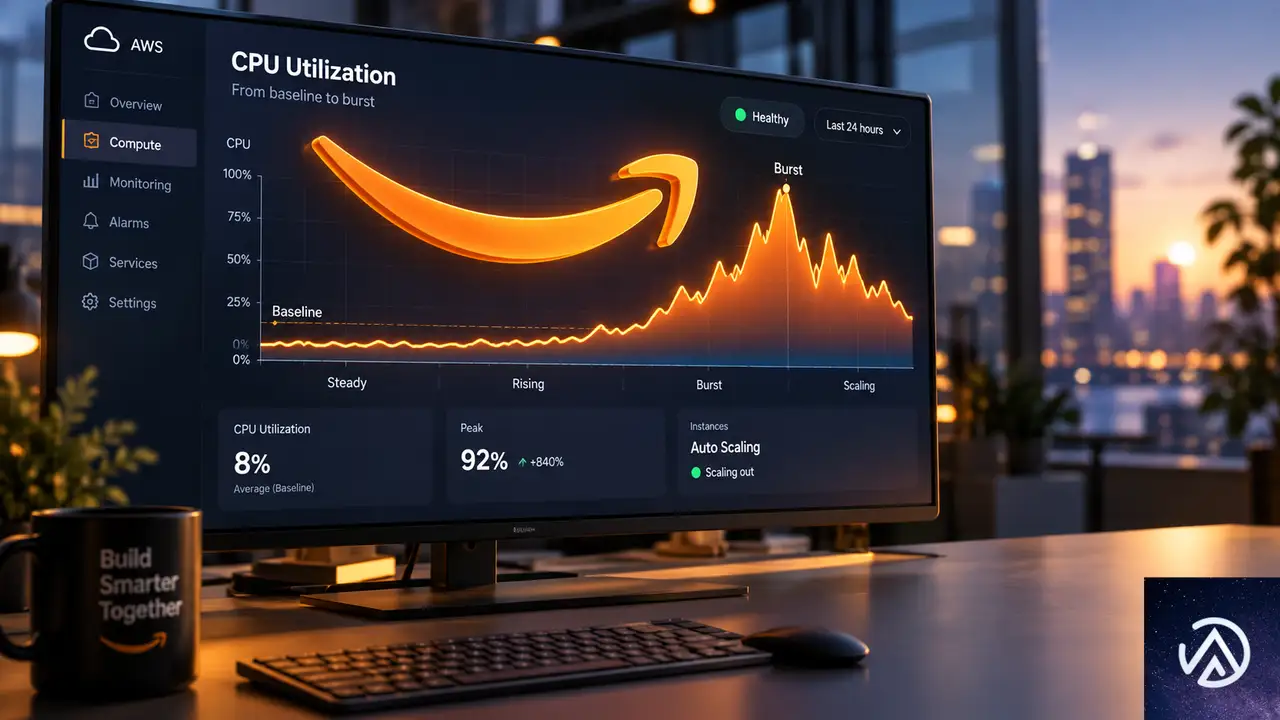
EC2のTシリーズは「バースト可能インスタンス」と呼ばれる。平時はベースライン性能で動作し、負荷が上がった時にCPUクレジットを消費して性能を一時的に引き上げる仕組みを持っている。
この仕組みが適しているのは、普段はCPU使用率が低いが瞬間的に負荷が上がるワークロードだ。低トラフィックのWebサイト、開発・テスト環境、小規模データベース、マイクロサービス、ログインゲートウェイなどが代表例になる。
T8iはこのバーストモデルを踏襲しつつ、CPUとネットワーク性能を大幅に引き上げたモデルだ。
性能向上の内訳
価格性能比とコンピューティング性能
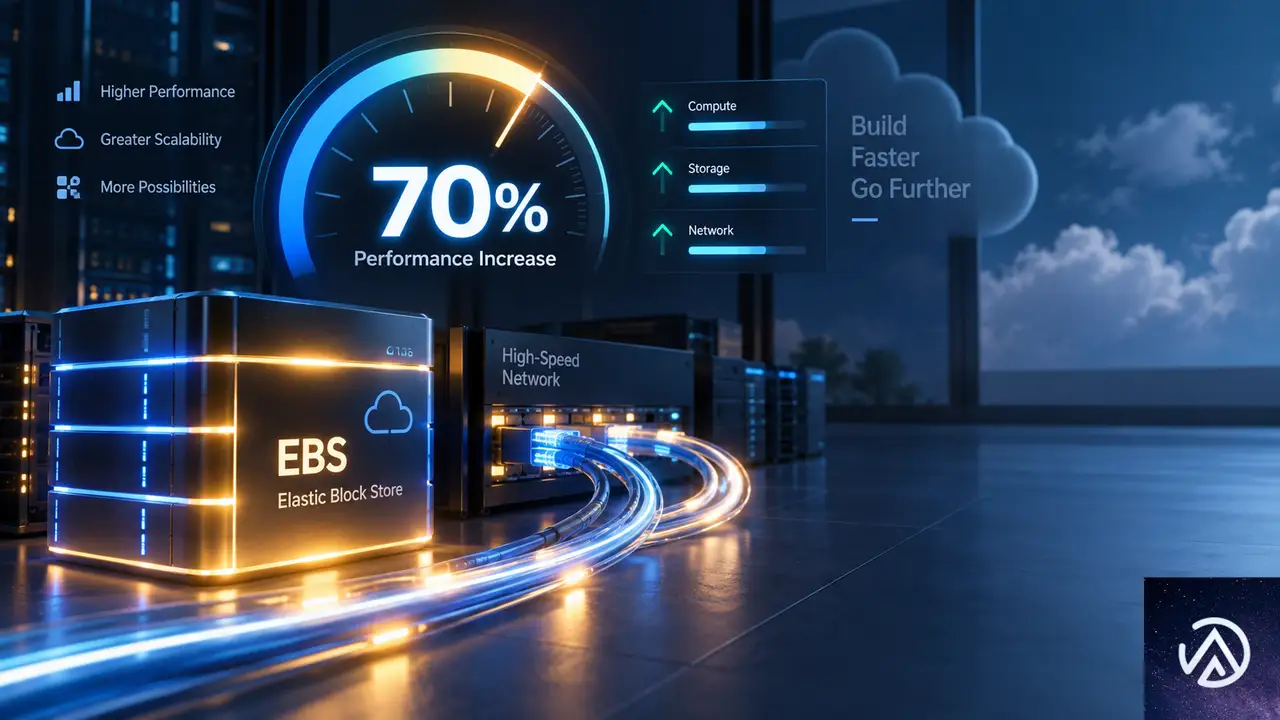
AWSの発表によると、T8iはT3と比較して以下の改善が実現されている。
- 価格性能比が最大30%向上
- コンピューティング性能が最大70%向上
- ネットワーク帯域が最大1.25倍
- EBS帯域が最大2.4倍
特にEBS帯域の2.4倍という数字は見逃せない。ディスクI/Oがボトルネックになりがちな小規模データベースやデータ処理ジョブでは、体感できる改善が期待できる。
CPUクレジット方式と無制限モード
T8iはT3と同じCPUクレジット方式を採用している。StandardとUnlimitedの2つのモードがあり、デフォルトはUnlimitedモードだ。Unlimitedモードではクレジット残高がゼロになっても、追加料金を支払うことでベースラインを超える性能を維持できる。
クレジットは時間の経過とともに自動で蓄積される。例えばt8i.microなら1時間に6クレジット、t8i.smallなら12クレジットが付与される仕組みだ。
インスタンスタイプとスペック
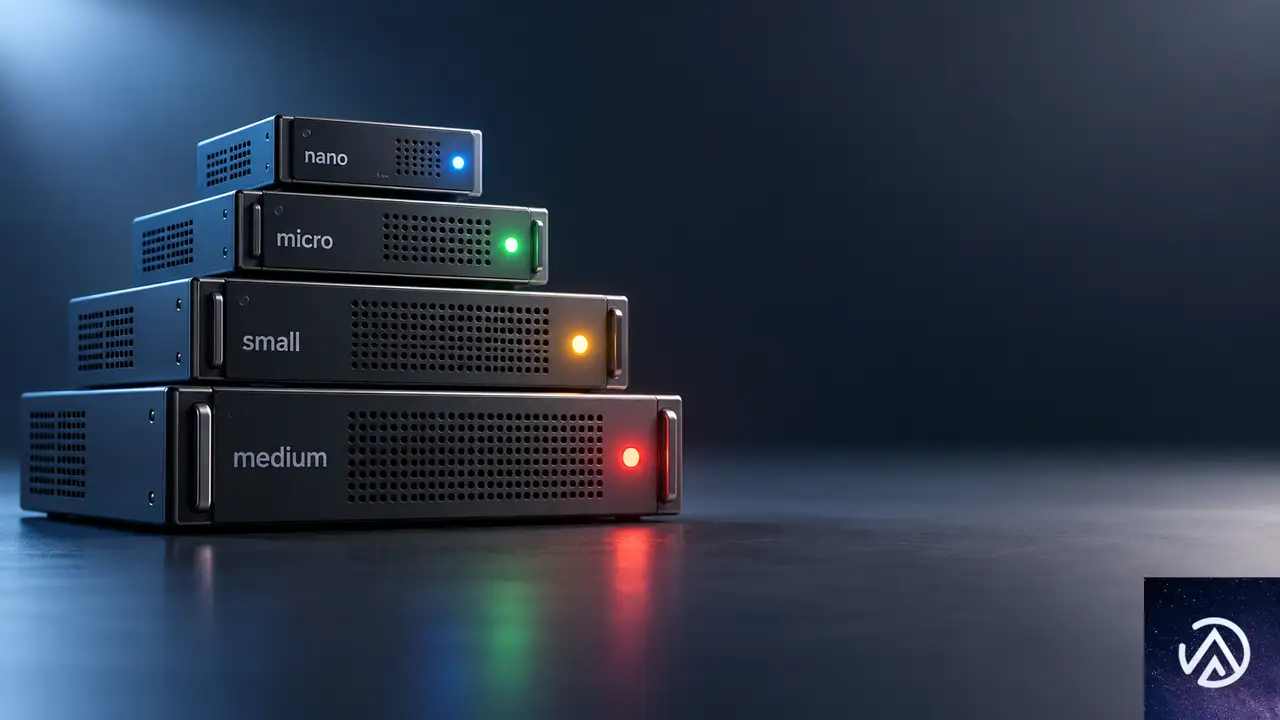
T8iは4つのサイズで提供される。すべて2 vCPUを1コアとして提供するのが特徴で、vCPUとメモリの比率が他シリーズにはない特殊な構成になっている。
- t8i.nano
- t8i.micro
- t8i.small
- t8i.medium
メモリ比率はnanoが1対0.25、microが1対0.5、smallが1対1、mediumが1対1となっている。2 vCPUでメモリ0.25GiBという構成は他のEC2インスタンスにはない特徴的なスペックだ。
利用シーンと移行方法
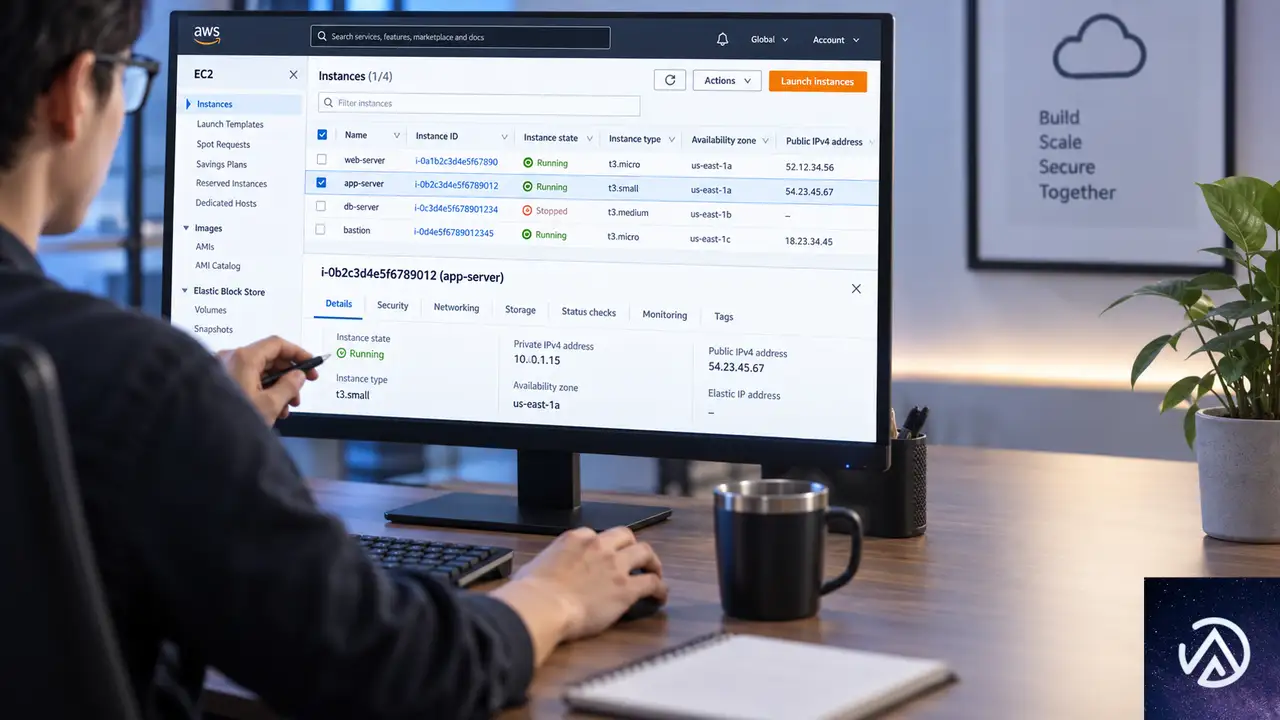
どんな場面で使うべきか
T8iは低〜中程度のCPU使用率で動くワークロードに向いている。具体的には以下のようなケースが想定されている。
- フリーミアムサービスの小規模プラン
- トレーニング・デモ環境
- ステージング・開発環境
- データ処理ジョブ
- マイクロサービスアーキテクチャの一部
- 低トラフィックのWebサイト
- ログインゲートウェイ
- バッチ処理やCI/CDパイプライン
常に高いCPU使用率が続く本番環境や、大規模なデータベースサーバーには向かない。そうした用途ではM8i Flexなど、より大きなインスタンスの選択が推奨されている。
T3からの移行手順
既存のT3ユーザーにとって移行はシンプルだ。インスタンスタイプをT3からT8iに変更するだけで、アプリケーションの設定変更やコードの書き換えは原則不要とされている。
CPUクレジット方式もT3と同じなので、運用ノウハウはそのまま活かせる。Auto ScalingやCloudWatchの設定も流用できるため、移行コストは最小限だ。
提供リージョンと利用方法
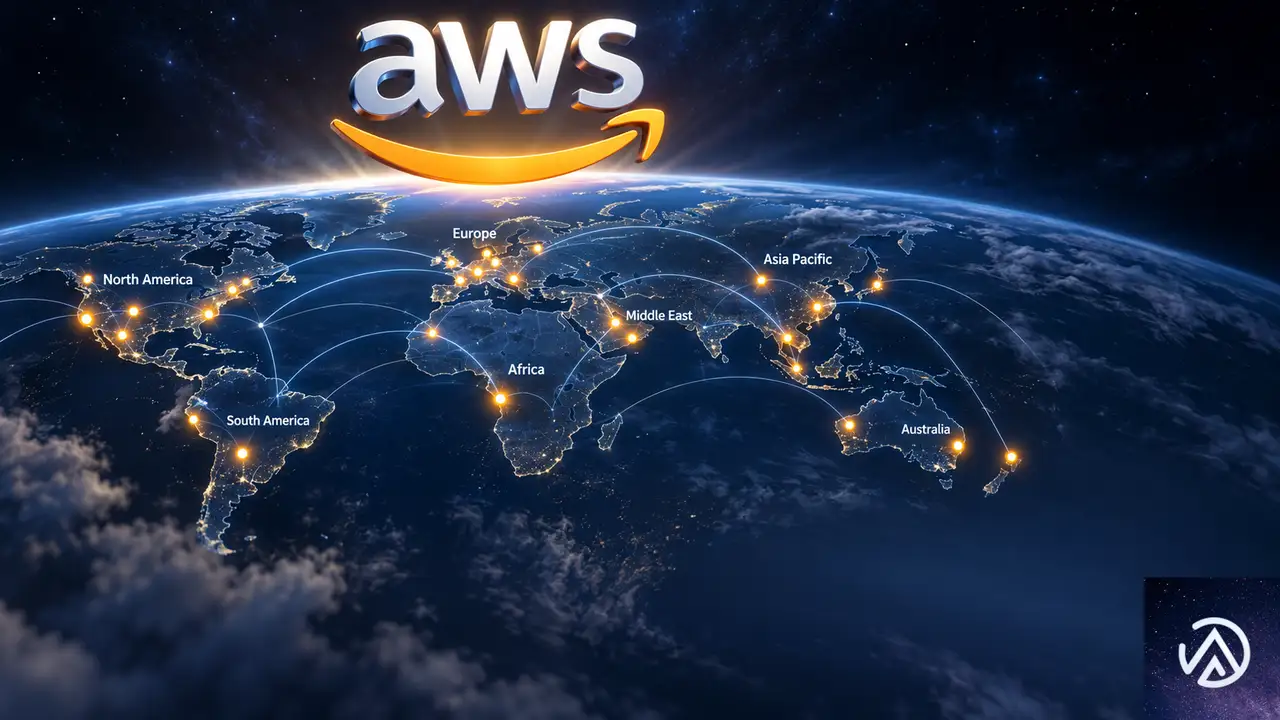
T8iは以下のAWSリージョンで利用できる。
- 米国東部(バージニア北部・オハイオ)
- 米国西部(オレゴン・北カリフォルニア)
- アジアパシフィック(ハイデラバード・マレーシア・ムンバイ・ソウル・シンガポール・シドニー・東京)
- カナダ(中部)
- ヨーロッパ(フランクフルト・アイルランド・ロンドン・パリ)
購入方法はオンデマンドとスポットインスタンスに対応している。Savings Planは近日対応予定だ。t8i.microとt8i.smallはAWS無料利用枠でも使えるため、新規ユーザーがAWSの使い方を学ぶ用途にも適している。
共有テナンシーのみ対応しており、専有テナンシーや専有ホストは利用できない点には注意が必要だ。
この記事のポイント
- T8iはT3の後継となる低コストバースト可能インスタンス
- コンピューティング性能が最大70%向上し、EBS帯域は2.4倍に
- CPUクレジット方式はT3と同じで移行が容易
- 4サイズ構成で東京リージョンでも利用可能
- 無料利用枠の対象サイズもあり、新規ユーザーの入門にも適している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
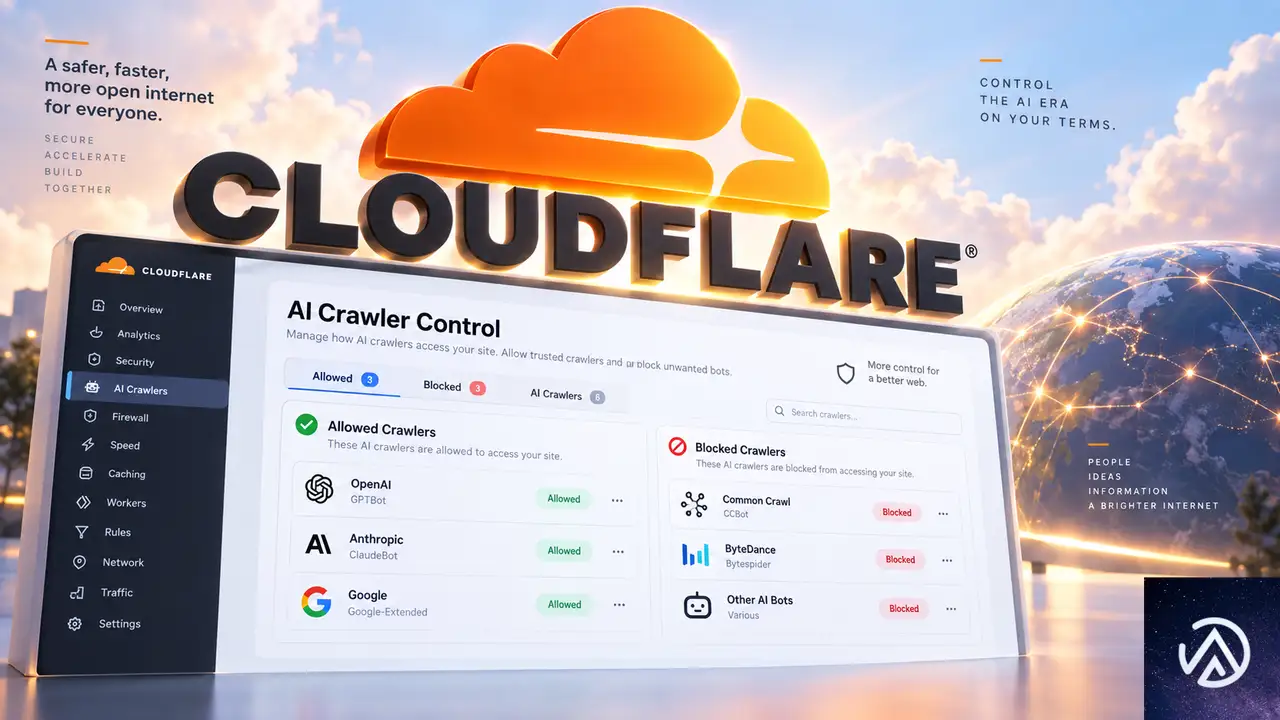
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
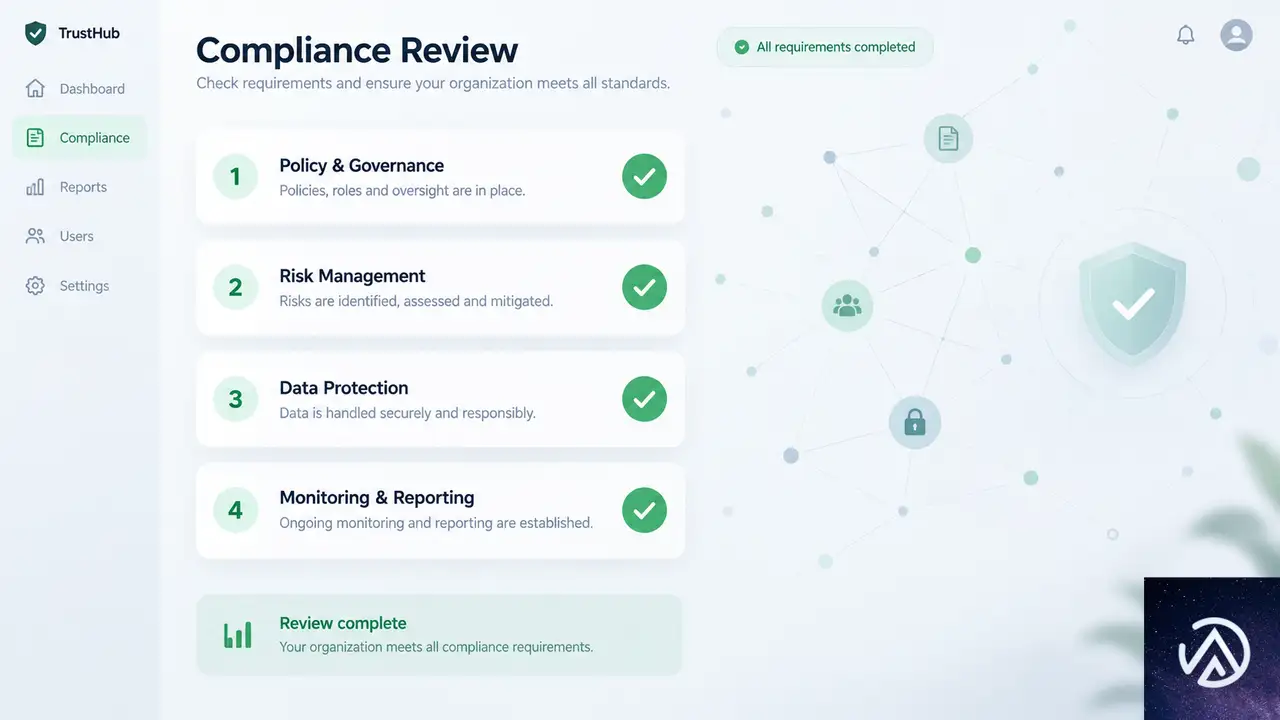
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
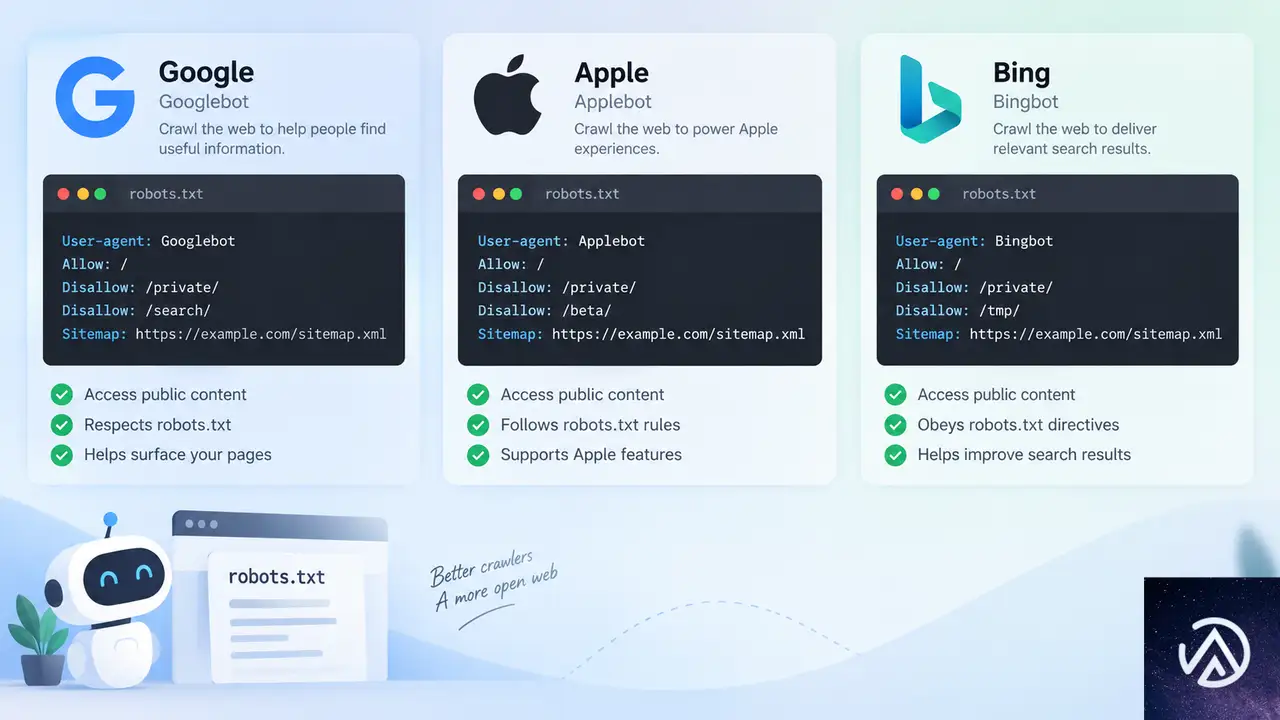
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.8 Liveシリーズ登場、音声AIエージェントの新基盤に
Google DeepMindが9月15日、Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表した。音声エージェント向けに設計された2つの新モデルで、リアルタイム推論能力が大幅に強化されている。
Gemini 3.8 Liveはスケールとコスト効率を重視したモデルだ。Gemini 3.8 Live Extended Thinkingは高複雑度タスク向けで、複数ステップの推論を会話の流れを止めずに実行できる。
開発者API、Google Workspace、Search Liveなど幅広い経路で提供が始まっている。音声で複雑なタスクを処理する新しい基盤になる。
Gemini 3.8 Liveシリーズの全体像
会話知能と自然な対話、視覚的な理解を組み合わせたモデル。スケールとコスト効率を重視しており、大量の同時接続を処理する音声エージェントに向く。
高複雑度タスク向けに設計されたモデル。複数ステップの推論と、より高い知能を備える。会話の流れを止めずに深い思考ができるのが特徴。
2つのモデルは用途が明確に分かれている。音声エージェントを大量に展開する場合は標準版、複雑な業務フローを音声で処理する場合はExtended Thinkingを選ぶ形になる。
2つのモデルの役割分担
Gemini 3.8 Liveは会話の自然さと視覚的な文脈理解を兼ね備えている。コストパフォーマンスを重視する開発者や企業に向く設計だ。
Gemini 3.8 Live Extended Thinkingは、より複雑な推論が必要な場面を想定している。話しながら考え、バックグラウンドで複数ステップのタスクを進められる点が最大の違いだ。
展開される利用経路
両モデルとも、Geminiアプリ、Google Workspace、Search Liveに順次展開される。特にWorkspaceではDocs Live、Gmail Live、Keep Liveといったアプリ内の音声機能として利用できる。
コンシューマー向けにはSearch Liveが最初の接点になる。検索中に音声で質問し、そのまま会話を続けられる体験が提供される。
ベンチマークが示す性能とコスト効率
音声品質とエージェント性能の両面で、既存モデルを上回る結果が示されている。コスト面でも競争力のある価格帯を維持している点が特徴だ。
音声品質とエージェント性能
Artificial AnalysisのSpeech to Speech Quality Indexでは82.6を獲得し、総合第1位となった。音声の自然さと応答品質のバランスで他モデルを上回っている。
エージェントタスクの完了率でも強さを示している。τ-Voiceベンチマークで68.6%、Sierraのτ-Voiceバンキングベンチマークでは35.1%を記録した。音声だけで業務フローを完結させる能力が評価された形だ。
推論能力を示すBig Bench Audioでは97.7%と高いスコアを出している。音声を聞いて正しく推論する基盤能力の高さが確認できる。
コスト競争力とユーザー評価
Gemini 3.8 LiveはSpeech Agent Arenaで第2位を獲得している。ユーザーからの選好度が高いモデルでありながら、高いコスト効率を実現している点が重要だ。
ServiceNowのEVA-Benchでは、複雑なワークフローにおける正確性と会話品質のバランスでパレートフロンティアを更新した。エンタープライズ向け音声エージェントの実用性が裏付けられている。
リアルタイム推論の技術的進化
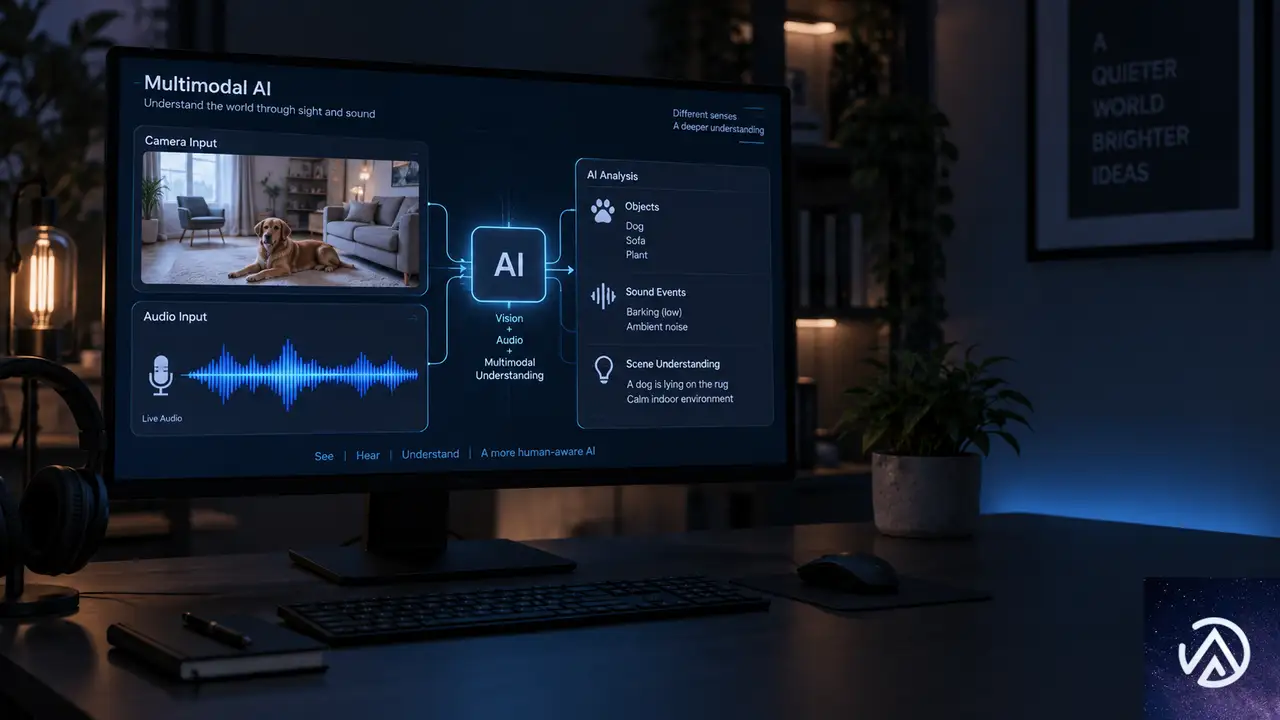
会話を止めずに裏側でタスクを進める設計が、これまでの音声AIと大きく異なる点だ。
視覚入力と言語対応
Gemini 3.8 Liveは視覚入力をほぼリアルタイムで処理する。カメラに映ったものや画面上の情報を文脈として会話に取り込めるため、状況に応じた助言が可能になった。
言語対応も強力だ。97の言語を自動的に検出し、会話の途中でもシームレスに切り替えられる。多言語環境で使う音声エージェントに適している。
公式デモでは、従業員のオンボーディングをリアルタイムで案内する様子や、チェスの盤面を見ながら対局を進める様子が紹介されている。視覚と会話の統合が実用レベルに達していることを示す例だ。
バックグラウンド実行と同時推論
ツールやAPIの実行はバックグラウンドで進められる。ユーザーの要求を受け付けたら、処理が終わるまで待たせず、会話を続けながら結果を伝える動きができる。
Extended Thinking版は「話しながら考える」能力を持つ。「確認させてください」といった短い言葉で応答しながら、裏側で複数ステップの推論を進める。進捗状況を自然な会話で伝える機能も備わっている。
公式デモでは、手書きスケッチと音声フィードバックからReactコンポーネントを生成する例や、複数ステップの予約を非同期で処理する例が公開された。音声だけで開発作業や業務処理を進められる可能性が広がっている。
開発者と企業のエコシステム
Gemini Live APIと開発者プラットフォーム
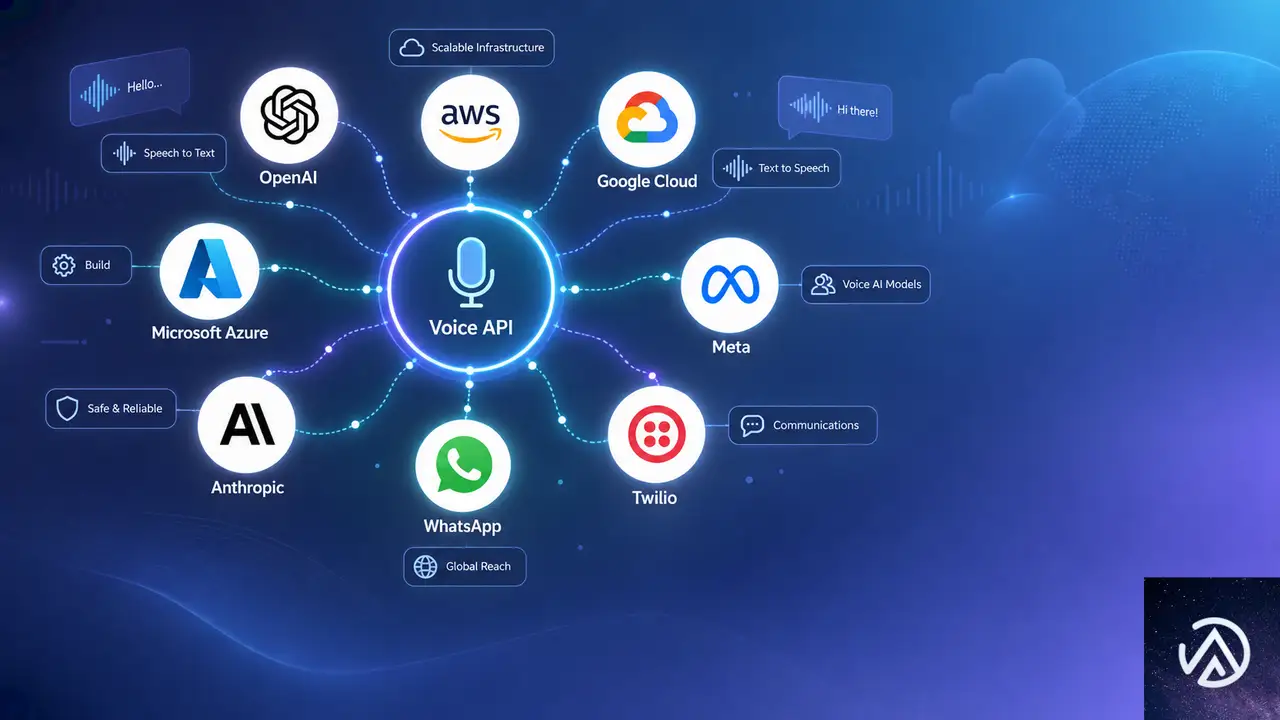
両モデルはGemini Live APIを通じて利用できる。開発者はこのAPIを使い、音声駆動のインターフェースを自社サービスに組み込める。リアルタイムのメディアストリーミング基盤はプラットフォーム側が処理してくれるため、UX設計に集中できる。
Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision AgentsなどのプラットフォームがGemini Live APIに統合済みだ。これらのツールを使えば、音声エージェントの構築からデプロイまでを短縮できる。
企業パートナーと展開スケジュール
Salesforce、Genspark、Lumerisなどの企業が3.8 Liveシリーズの導入に意欲を示している。低遅延性、会話の流暢さ、ツール呼び出し能力が評価されている。
展開スケジュールは以下の通りだ。開発者向けにはGemini APIとGoogle AI Studioで即日利用できる。企業向けにはGemini Enterpriseでプライベートプレビューが始まり、Gemini Enterprise for Customer Experienceにも順次提供される。
コンシューマー向けでは、Search Liveが最初の提供経路になる。Gemini Liveでも利用可能で、Google AI ProおよびUltraの加入者はWorkspaceのDocs、Gmail、KeepでExtended Thinking版を試せる。
透明性確保の仕組み
SynthIDによる音声ウォーターマーク
AIが生成した音声にはすべてSynthIDのウォーターマークが埋め込まれる。人間の耳には聞こえない形で音声出力に直接織り込まれており、AI生成コンテンツの検出を可能にする。誤情報の拡散防止が狙いだ。
安全性と責任あるAIへの取り組みの詳細は、モデルカードで確認できる。音声AIが社会に広がる中で、透明性の確保は実用化の前提条件になっている。
この記事のポイント
- Gemini 3.8 LiveとLive Extended Thinkingが9月15日に発表された
- 標準版はコスト効率、Extended Thinking版は複雑タスク向けと役割が分かれている
- Speech to Speech Quality Indexで82.6を獲得し総合第1位
- 97言語対応、視覚入力、バックグラウンド実行など技術面が大幅強化
- Gemini Live API経由で開発者が即日利用できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce公式ブロックテーマPurpleがベータテスト開始。テスト方法と注目機能
WooCommerce初の公式ブロックテーマ「Purple」がベータテストを開始した。GitHubからダウンロードできる状態で、正式版はWordPressテーマディレクトリとWooCommerceマーケットプレイスで配布される予定だ。
PurpleはECサイト向けに作られたスターターテーマで、テンプレート一式、10種類のカラーパレット、10種類のフォント組み合わせ、EC向けパターンライブラリを備える。ブロックテーマのため、従来のクラシックテーマより軽量で柔軟なカスタマイズが可能だ。
この記事ではPurpleの特徴、WooCommerceコアに加わったブロック改善、テスト手順を解説する。ストア運営者や制作会社がベータテストに参加する際の参考にしてほしい。
Purpleテーマとは何か
PurpleはWooCommerceチームが開発したオープンソースのスターターテーマだ。ブロック対応のWooCommerceページ用テンプレートをほぼ網羅しており、WooCommerceとWordPressコアブロックのカスタムスタイルも含む。ストアを立ち上げる事業者が、モダンで高速な土台として使える設計になっている。
ブロックテーマとは、WordPressのブロックエディタだけでサイトの見た目やレイアウトを編集できるテーマ形式のことだ。従来のテーマはPHPテンプレートとCSSが中心だったが、ブロックテーマはブロックの組み合わせでページを構成する。エディタ上で完結するため、コードを書かずにデザインを変更できるのが特徴だ。
Purpleには商品グリッド、フィルター、コレクション、CTA、商品詳細ページなどを含むEC特化のパターンライブラリも同梱されている。パターンとは、あらかじめ組み立てられたブロックのセットで、ワンクリックでページに挿入できる部品のことだ。
このデモはPurpleテーマの中核となる4つの要素を示している。開発者や制作会社はこれらのテンプレートとスタイルを拡張し、独自のストアデザインの出発点として使える。
Storefrontとの違い
WooCommerceの従来の代表テーマであるStorefrontと比較すると、Purpleの違いが分かりやすい。Storefrontはクラシックテーマで、商品ヒーローデザイン、カスタムホームページ、商品ギャラリー、ミニカート、高度なヘッダーやフッターを実現するには拡張機能が必要だった。
一方、ブロックテーマではWooCommerceのブロックライブラリとブロックエディタだけで、これらのカスタマイズを実現できる。拡張機能に依存せず、テーマとコア機能だけでストアを構築できるのがPurpleの大きな利点だ。
WooCommerceコアに加わったブロック改善
Purpleプロジェクトの価値はテーマそのものだけではない。開発の過程で、WooCommerceコアに多数のブロック改善が加わった。この改善はPurpleに限らず、影響を受けるブロックやAPIを使うすべてのブロックテーマで利用できる。
バージョン11.0の基盤整備
WooCommerce 11.0では、ブロックテーマを軽量かつ一貫性のあるものにするための基盤が整えられた。まず、パターンコンテンツの読み込みが必要になった時だけ行われるようになった。これにより、パターンを必要としないリクエストでの無駄な処理が減る。
商品画像まわりも改善された。Product Imageブロックはより大きなサムネイルを使い、トリミングされた画像でも正しいアスペクト比を保持する。商品カタログの見た目がテーマ設定と調和しやすくなった。
そのほか、Product CollectionブロックがQuery Loopの内側にネストされた際に正しいコンテキストを保持するようになり、複合テンプレートやパターン内で商品ブロックが正しく描画されるようになった。Breadcrumbsブロックはtheme.jsonによるスタイリングに対応し、Product Filtersブロックはフィルタードロワーを無効化するオプションを追加した。カートテーブルのヘッダーにはARIAロールが付与され、支援技術でのアクセシビリティも向上している。
バージョン11.1のレスポンシブ対応
WordPress 7.1がブロックエディタにレスポンシブデザインコントロールを導入したことを受け、WooCommerce 11.1では主要なブロックがこのコントロールに対応した。Product Priceはタイポグラフィ、色、パディング、マージンのレスポンシブスタイリングに対応し、Product Reviewsも画面幅ごとのスタイルを反映できるようになった。
Product Detailsはパディング、マージン、背景、ボーダーをブロックとグローバルスタイルの両方から設定できる。Product Galleryはカスタムアスペクト比に対応し、大きな画像エリアとサムネイルレールの同期も改善された。
パフォーマンス面では、ブロック登録の改善が大きい。ブロックを描画できないリクエストではブロックとパターンの登録をスキップする仕組みが入り、公開された測定値ではStore APIとRESTリクエストが30〜42%高速化した。統合ブロックエディタアセットの実験的サポートも導入され、サイト編集中のネットワーク転送サイズは48.3%削減された。
このデモはブロック登録の最適化前後の違いを示している。不要な登録処理を省くことで、APIリクエストの応答時間が大幅に短縮された。
バージョン11.2の注目機能
WooCommerce 11.2は現在開発中だが、テーマ作業の成果が最も目に見える形で現れているバージョンだ。Product Filtersブロックはレスポンシブオーバーレイとスティッキー配置のコントロールを獲得した。インライン表示のままにするか、モバイルやタブレットでオーバーレイに切り替えるか、全画面幅でオーバーレイを使うかを選べる。WordPress 7.1の設定可能なレスポンシブブレークポイントにも対応する。
Product Quantityブロックはテキスト色、背景色、ボーダー半径、ボーダー、シャドウをブロックスタイルから設定できるようになった。グループ商品の数量コントロールも同じスタイリングモデルを使う。Product Imageブロックはテーマ定義のボーダーに対応し、商品グリッドやコレクションパターンにストアのビジュアルシステムを反映しやすくなった。
Chipsブロックもテーマ化が進んだ。商品フィルターや「カートに追加+オプション」で使われるChipsブロックにタイポグラフィとボーダー半径のコントロールが追加され、ストア全体と一貫したスタイルを適用できる。パターンのインサーターカテゴリ名は「WooCommerce」から「Shop」に変更され、パターンを探しやすくなった。
Purpleのテスト方法
Purpleはベータ版のため、必ずステージング環境またはローカルサイトでテストしてほしい。本番環境でのテストは推奨されない。最新のWordPressとWooCommerceを使うことで、前述のレスポンシブコントロールを実際に試せる。
この手順でテーマをインストールした後、フロントページ、ショップまたは商品カタログ、商品詳細、カート、チェックアウト、マイアカウント、検索の各テンプレートを確認する。特にProduct Filtersブロックはデスクトップ、タブレット、モバイルの3つの画面幅でテストし、インラインモードとオーバーレイモードの両方を試す。
商品ブロックについては、Product Price、Product Details、Product Reviews、Product Gallery、Product Quantity、Catalog Sorting、Mini-Cartを、シンプル商品、バリエーション商品、グループ商品の3種類でテストする。通常使っている拡張機能や子テーマのカスタマイズを追加して、エディタとフロントエンドの両方で再テストするのが望ましい。なお、GitHubから直接ダウンロードした場合、自動更新は受けられない。
フィードバックの送り方
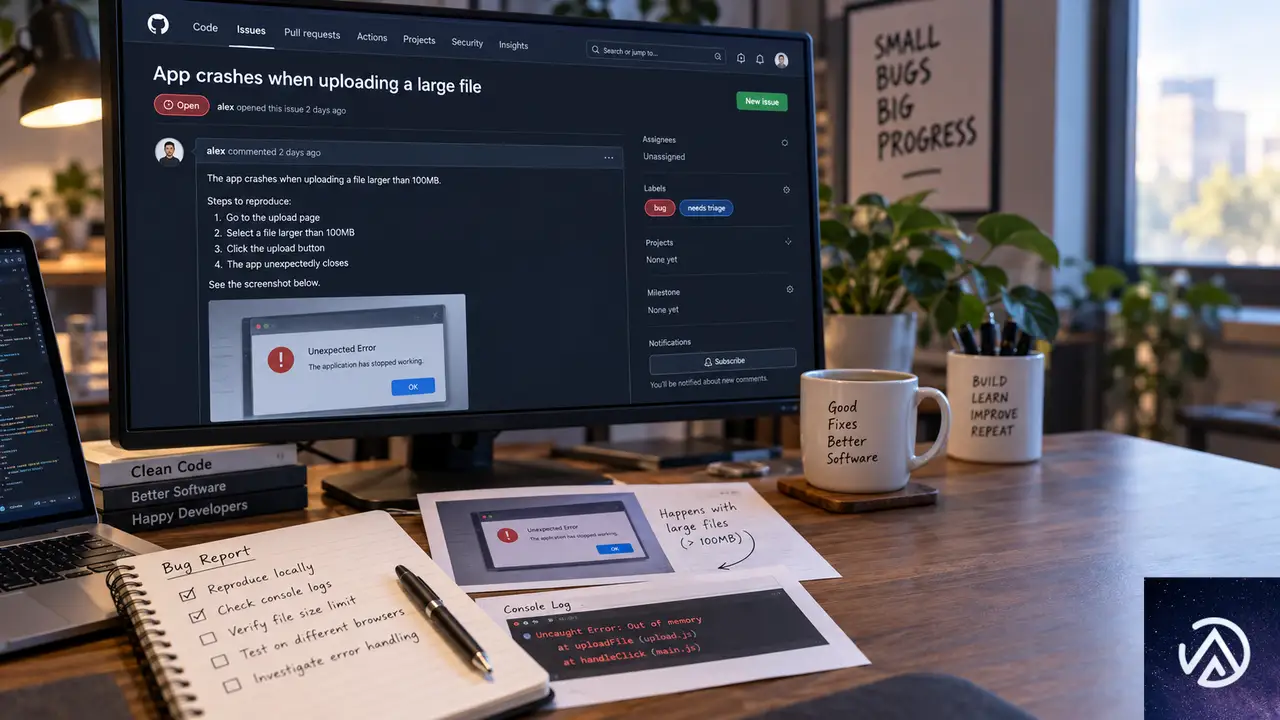
問題を発見した場合や提案がある場合は、GitHubのWoo Themesリポジトリでissueを開く。その際、WordPress、WooCommerce、PHP、Purpleの各バージョン、テストしていたテンプレートまたはブロック、問題の再現手順を含める。視覚的な問題ならスクリーンショットや録画も添付する。
フィードバックはデフォルトのWooCommerceストアフロントの改善と、すべてのブロックテーマで利用できるブロックとテンプレートの改善に直結する。ベータテストへの参加は、WooCommerceのブロックエコシステム全体を育てる貢献になる。
この記事のポイント
- PurpleはWooCommerce初の公式ブロックテーマで、ベータテストが始まった
- テンプレート一式、10種類のカラーパレットとフォント組み合わせ、EC向けパターンライブラリを備える
- WooCommerce 11.0から11.2にかけて、ブロック改善とパフォーマンス最適化がコアに加わった
- テストはステージング環境またはローカルサイトで行い、各ブロックとテンプレートを確認する
- フィードバックはGitHubのissueで受け付けている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI攻撃は自律化へ移行!6時間で数千件の認証情報を奪う新手口を解説
Google Threat Intelligence Group(GTIG)は2026年9月8日、敵対的AI利用の進化をまとめた四半期レポートを公開した。攻撃者が単純なプロンプト入力から、自律的に動くエージェンティックAIの活用へ移行している実態が明らかになっている。
2026年第2四半期には、クラウド環境を侵害した攻撃者が6時間未満で認証情報の大量収集キャンペーンを計画し、構築し、実行した事例が確認された。数千件規模の認証情報が奪取されている。
この変化は、防御側が攻撃を検知して対応するまでの時間を大きく縮める。AIを使う側の企業にとって、単なる技術トレンドではなく、クラウドと認証情報の管理体制に直結する問題だ。
攻撃者は「AIに聞く」から「AIに任せる」へ移行した
2026年5月の前回レポート以降、GTIGは攻撃者が基本的なプロンプト入力から、エージェンティックAIワークフローとAI対応自動化へ踏み出しているのを観測している。ここでいうエージェンティックAIとは、人間が1つずつ指示を出さなくても、目標を与えれば自分で計画を立てて実行するAIシステムのことだ。チャット型AIが1往復で終わるのに対し、エージェンティックAIはツールやAPIを呼び出しながら複数の工程を連続で進める。
従来の攻撃では、攻撃者がAIの出力を確認し、コマンドを実行し、結果を見て次の指示を出すというループが発生していた。エージェンティックAIはこの人間の介在を大幅に減らし、エラー修正やIPアドレスの切り替えまで自律的に行う。その結果、防御側が気づく前に攻撃が完了するケースが増えている。
この違いが攻撃スピードの差につながる。GTIGは2026年第2四半期に、このエージェンティックAIを使った攻撃が実戦投入された事例を確認した。
6時間で数千件の認証情報を奪ったキャンペーンの中身
Mandiantが観測した事例では、金銭目的とみられる攻撃者が組織のクラウド基盤を侵害し、自律型のマルチエージェント攻撃フレームワークを展開した。攻撃者はAIコーディングチャットボット、プロンプト、エージェント指示書を組み合わせ、計画・構築・実行を6時間未満で完了させている。通常は大規模なグループが持つリソースと同等の規模と速度で、数千件の第三者認証情報が奪取された。
攻撃者はマークダウン形式の指示書を運用プレイブックとして使った。マークダウンとは文書を書くための軽量な記法で、AIへの指示書としても扱いやすい。AIはこの指示書に従い、脆弱性スキャンパイプラインを自律的に管理し、リアルタイムでトラブルシューティングを行い、IPアドレスのローテーションまで自動実行した。攻撃トラフィックは被害者のクラウド基盤から正当なIPアドレスを経由して送信され、検知を難しくしていた。
この事例では、指示書とプロンプトを組み合わせることで、AIが自律的にパイプラインを管理した。人間の操作を挟まないため、防御側が気づく前に攻撃が完了してしまう。
GTIGはこの動きを、受動的なインフォスティーラーから攻撃的なエージェンティック収集への転換点と位置づけている。インフォスティーラーとは、端末に保存されたパスワードやCookieなどを盗み出すマルウェアだ。従来は端末を起点に情報を集めるだけだったが、新たな手法ではサーバーサイドの脆弱性を自ら探索し、狙いを定めて攻撃する。
AIコーディングが広げたオープンソースの死角
AI支援コーディングの普及でオープンソース資産の量が増え、開発速度が上がった。一方でサードパーティパッケージや依存関係の精査が甘くなり、攻撃者に付け込まれる余地が生まれている。GTIGは、AI支援コーディングが2025年から2026年初めに観測された大規模サプライチェーン侵害の一因になったとみている。
具体的な事例も確認された。2026年初めには、北米とアジアの企業環境で悪意あるオープンソースAI資源のダウンロード試行が検知された。2026年4月には、AIコーディングエージェントが暗号資産プロジェクトのコードベースに悪意ある依存関係を組み込んだ事例が公表されている。2026年5月には、LLMプロキシサービスを密かにインストールする悪意あるパッケージも特定された。これは地域的なLLMアクセス制限を迂回するために使われる。
金銭目的の攻撃者UNC6780(TeamPCP)は、こうしたリスクの深刻さを示す存在だ。UNC6780はPyPIやnpm、Docker Hubといったエコシステムを標的にし、侵害後にDUSTMAKERと呼ばれる認証情報窃取マルウェアを展開する。窃取したデータは直接売ったり、ランサムウェアグループとの提携で利益に変えられたりする。
UNC6780はAIコーディングアシスタントやLLMセキュリティスキャナーを騙す複数の手口も実装している。代表的なのがプロンプトインジェクションだ。これはAIが読むテキストの中に悪意ある指示を忍ばせる攻撃で、コードを自動分析するAIに「安全だ」と誤認させる偽の指示を仕込む。GitHub Actionsのワークフローを悪用して専有AIリポジトリを盗み出し、別の攻撃者に渡して恐喝に使わせた事例もあった。
専有AIモデルとクラウド計算資源が次の標的
2026年第2四半期、最先端モデルへの直接攻撃は確認されなかった。しかし専有AIの研究やモデルを盗む事例は増加している。標的はAIラボや先端AI企業にとどまらず、政府・軍事・医療・メディア・エンターテインメント分野にも広がった。攻撃者もサイバーエスピオナージ集団だけでなく、データ窃取恐喝グループまで含まれる。
中国関連の脅威アクターUNC6508は、北米の学術・医療・軍事研究機関を対象にした複数年キャンペーンを展開している。UNC6508は専有AI研究を標的にするだけでなく、クラウド環境を侵害してローカルLLM基盤を展開し、商用AI APIの監視を避けながら被害者の計算資源を利用していた。
データ窃取恐喝の事例も複数確認された。医療分野では企業データと製薬研究、専有AIモデルが盗まれ、身代金を支払わなければ公開すると脅迫された。AIメディア生成企業の事例では、ソースコード、プロンプト、スキル、モデルスクリプト、シークレットが流出した。モデル重みとはAIモデルが学習で得た知識を数値として保存したデータで、これが盗まれるとAIの再現や改変に悪用される恐れがある。
アカウント売買とLLMJackingの実態
プレミアムモデルや高性能計算へのアクセスコストは、攻撃者にとって大きな障壁だ。そのためAIアカウントの窃取・購入・販売が地下フォーラムで増加している。ClaudeやGeminiの認証情報に加え、Cursor ProやDevinなど自律型コーディングIDEの需要も高く、アカウント単価は2026年に平均で2倍以上に跳ね上がった。
認証情報の入手経路として広く使われるのがインフォスティーラーだ。LUMMAC.V2、STEALC.V2、VIDAR、ACRSTEALERなどの制御者は、従来のAIブラウザプロファイルに加えて、AI開発者設定を狙い始めた。2026年5月には、ACRSTEALERがClineのsecrets.jsonやContinue AIのconfig.yamlを標的にする命令を配布した事例が確認されている。これらのファイルには平文のAPIキーが保存されることがあり、APIキーとはシステム同士がやりとりするための合言葉のようなものだ。これが漏れると、被害者の有料モデル利用枠を攻撃者が直接使えてしまう。
LLMJackingも増えている。LLMJackingとは、被害者のクラウド環境を侵害して計算資源を乗っ取り、AIワークロードを不正に実行する手口だ。2026年4月の侵入事例では、GitHubの個人アクセストークン(PAT)が露出したことが起点となった。攻撃者はこれを使ってクラウド環境に初期アクセスし、不正なAIインフラを展開して高性能計算資源を拡張した。
LLMJackingは、被害者が気づかないうちに高額なクラウド利用料が発生する点でも厄介だ。GTIGは2026年に入り、地下フォーラムでのAIアカウント売買と並んでこの手口の増加を確認している。
企業が取るべき対策とGoogleの防御
Googleは多層的な防御戦略を取っている。モデルレベルの安全策、脅威インテリジェンス、封じ込めプロトコルを組み合わせ、モデル抽出攻撃に対してはリアルタイム防御を展開する。モデル抽出攻撃とは、既存のAIモデルに大量の質問をして応答を学習させ、模倣モデルを作る手口だ。Googleは不正な模倣モデルの性能を落とし、専有ロジックの複製を検知する対策を導入している。
2026年6月には、中国拠点のサイバー犯罪サービス「Outsider Enterprise」を遮断した。このサービスはフィッシングキットを提供し、Googleなどの有名ブランドを大量になりすましていた。運営者はGeminiを使ってコードを生成し、キャンペーンを大規模に実行していた。GoogleがGeminiの悪用で法的措置に踏み切ったのはこれが初めてだ。
企業向けにはGoogle AI Threat Defense(AITD)を提供している。AITDはGeminiなどの推論力、Wizのリスク優先順位付け、GeminiとCodeMenderの自動修復、Mandiantの最前線インテリジェンスを統合した自律型アーキテクチャだ。軽量モデルで継続スキャンを行い、高リスクの脆弱性には特化型の先端モデルを割り当てる。さらに脆弱性検出と自動パッチ適用に特化したGemini 3.8 Flash Cyberも投入している。
実務面では、クラウド認証情報の定期的なスキャンとローテーション、GitHubの個人アクセストークン管理、AIアカウントの多要素認証、オープンソース依存関係の精査が基本になる。AIを業務に導入する場合は、通常のセキュリティ監視に加えて、AI特有の脅威を検出する仕組みを組み込むことが欠かせない。
この記事のポイント
- 攻撃者はチャット型のAI利用から、自律的に動くエージェンティックAIへ移行している
- 2026年第2四半期には6時間未満で数千件の認証情報を奪うキャンペーンが確認された
- AIコーディングの普及でオープンソース経由のサプライチェーンリスクが拡大している
- 専有AIモデルやAPIクレデンシャルが窃取と恐喝の標的になっている
- AIアカウントの売買とLLMJackingが増加し、クラウド計算資源が乗っ取られている
- 防御には認証情報管理、依存関係の精査、AI特有の脅威検出が欠かせない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-Live-1がAPIで提供開始。同時通話型音声AIで割り込み処理が大幅改善
OpenAIが2026年9月10日、音声対話モデル「GPT-Live-1」のAPI提供を開始した。このモデルは同時に聞いて話すフルデュプレックス方式を採用し、従来の音声AIが抱えていた会話の遅延や不自然な割り込みを大幅に改善する。音声フロントエンド部分の料金は1分あたり0.05ドルに設定されている。
GPT-Live-1はChatGPTでの先行導入を経て、今回API経由で開発者に開放された。音声認識と音声合成を単一モデルに統合した設計が特徴で、人間同士の会話に近い自然なインタラクションを実現する。この記事ではGPT-Live-1の技術的な仕組み、性能評価、料金体系、そして開発者にとっての活用可能性を解説する。
単一モデルで実現する同時対話の仕組み
従来方式の構造的な課題
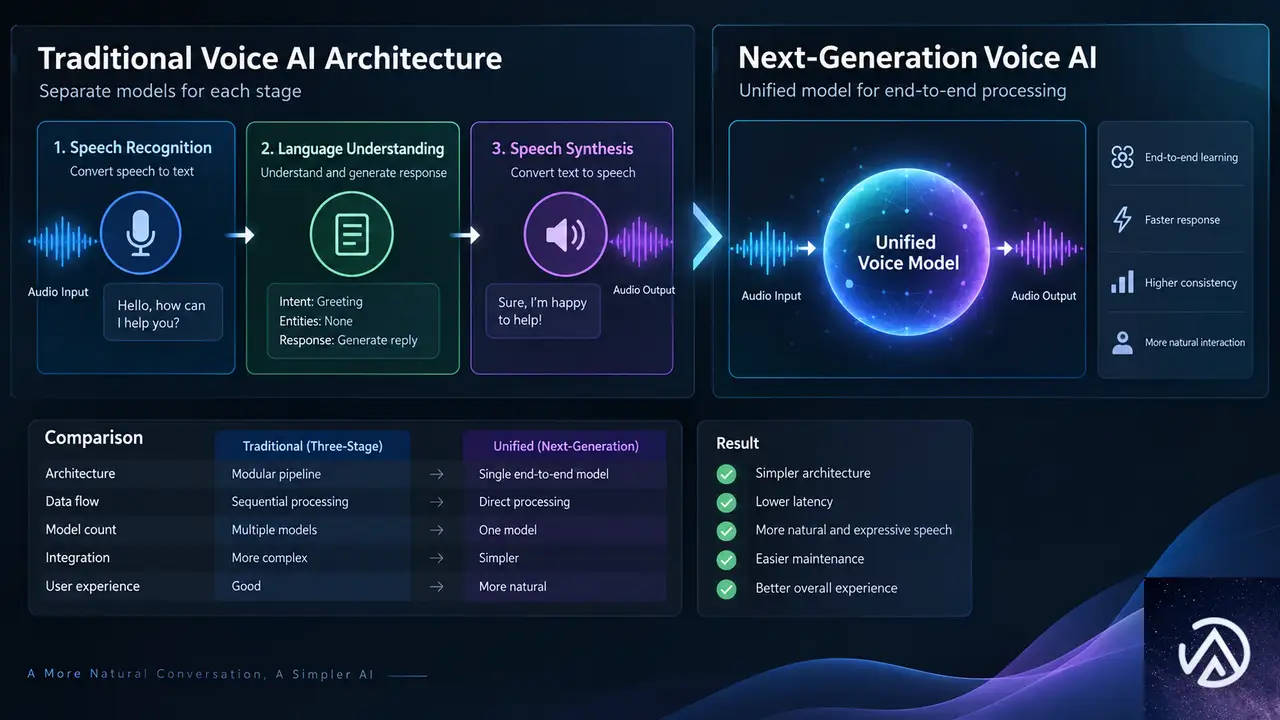
従来の音声AIは3つの工程を連結する方式が主流だった。まず音声をテキストに変換するSTT(音声認識)、次に内容を理解して回答を考えるLLM(大規模言語モデル)、最後にテキストを音声に戻すTTS(音声合成)だ。各工程が別々のモデルで処理されるため、段階ごとに処理待ちの遅延が積み重なる。
この構成では割り込みへの対応も難しい。ユーザーが話し始めるタイミングを検知するには、音声入力を常時監視しながら出力側の状態も把握しておく必要がある。3つのモデルをまたぐ情報の受け渡しにタイムラグが生じるため、人間同士の会話のような即時の割り込みは実現しづらかった。開発者は各段階のつなぎ目を手動で調整しなければならず、運用の手間も大きい。
単一モデルへの統合がもたらす変化
GPT-Live-1はSTTとLLMとTTSを単一モデルに統合する。入ってくる音声と出ていく音声を同じモデル内で同時に推論するため、段階間のつなぎ目が構造的に存在しない。これにより遅延が減るだけでなく、相手の言葉を遮って新しい質問を投げかけたり、相槌を打ったりする自然な会話のリズムを保てる。
背景ノイズや無音状態の扱いも改善された。従来方式では無音を「発話の終わり」と誤判定して会話を切ってしまう事態が起きやすかったが、GPT-Live-1は静寂を会話の一部として処理できる。ユーザーが考え込んでいる時間を待つ、周囲の雑音に反応しない、といった対話の質を左右する細かな制御がモデル側で吸収される。
3段階のモデルを連結する方式では、それぞれの処理待ち時間が会話のテンポを損なっていた。GPT-Live-1はこの問題を単一モデルへの統合で解決している。
割り込み処理の改善がビジネス効果を生む
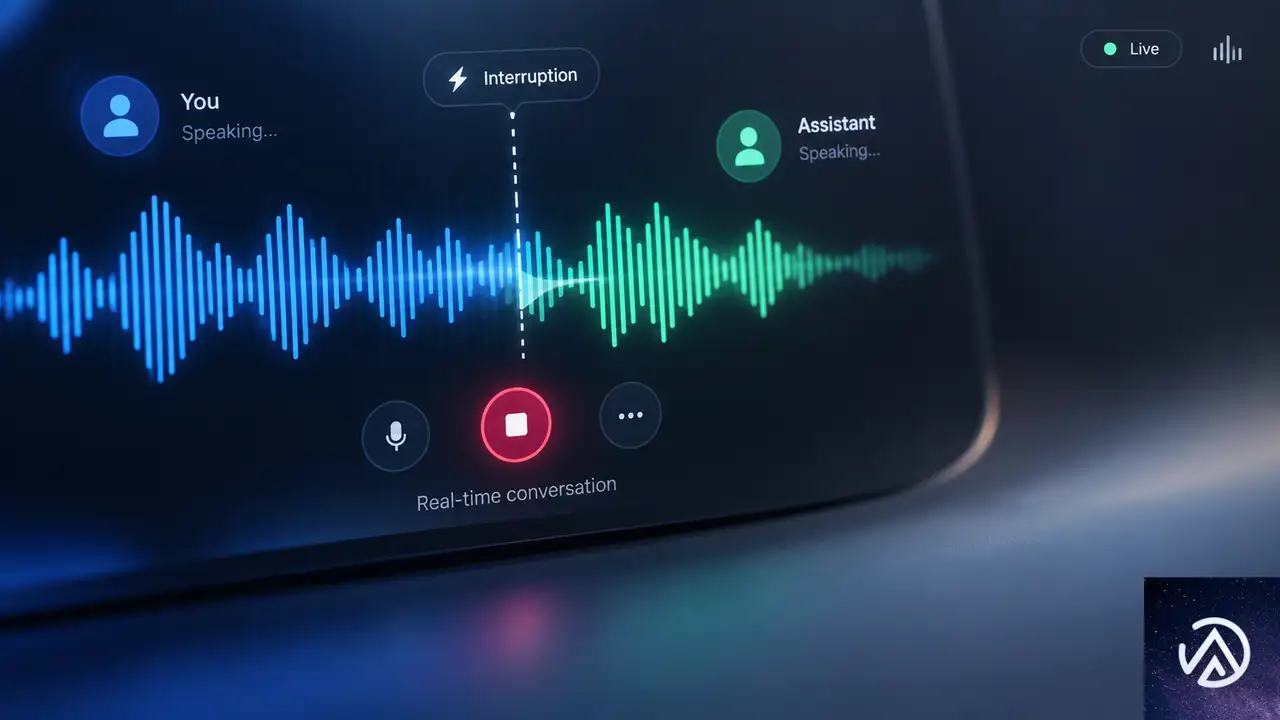
音声エージェントの実用化で最大の障壁が「割り込み」への対応だ。人間同士の会話では、相手の話の途中で情報を追加する、言い直す、短い相槌を打つ、といった行為が自然に発生する。従来のターン制システムではこの対応が難しく、一方が話し終えるのを待ってから返答する不自然な体験になりがちだった。
OpenAIの公開した早期評価では、語学学習プラットフォームのSpeakがGPT-Live-1を導入した結果、学習者が考える時間を確保できるようになり、割り込み回数が従来のターン制システムと比べて約80%削減された。この数字は、音声AIが教育分野で実用化できる水準に近づいていることを示している。学習者が発話を躊躇しても、AIが先回りして話し始めない。この「待つ」能力が学習体験の質を大きく左右する。
またGPT-Live-1は、短い笑い声や「うん」「ええ」といった相槌、近くにいる他者への短い話しかけなど、会話に混じる非定型的な音声を適切に処理できる。これらは従来の音声認識では誤検知や過剰反応の原因になりやすかったが、GPT-Live-1は文脈を踏まえて取捨選択する。
従来のターン制システムでは、STEP 2の割り込みを検知するまでにタイムラグが発生し、ユーザーが話し終えるのを待ってから処理を切り替える必要があった。GPT-Live-1は音声入力を常時監視しているため、この切り替えがほぼ即座に行われる。
バックエンド推論モデルへの委任という設計
タスクに応じたモデル選択
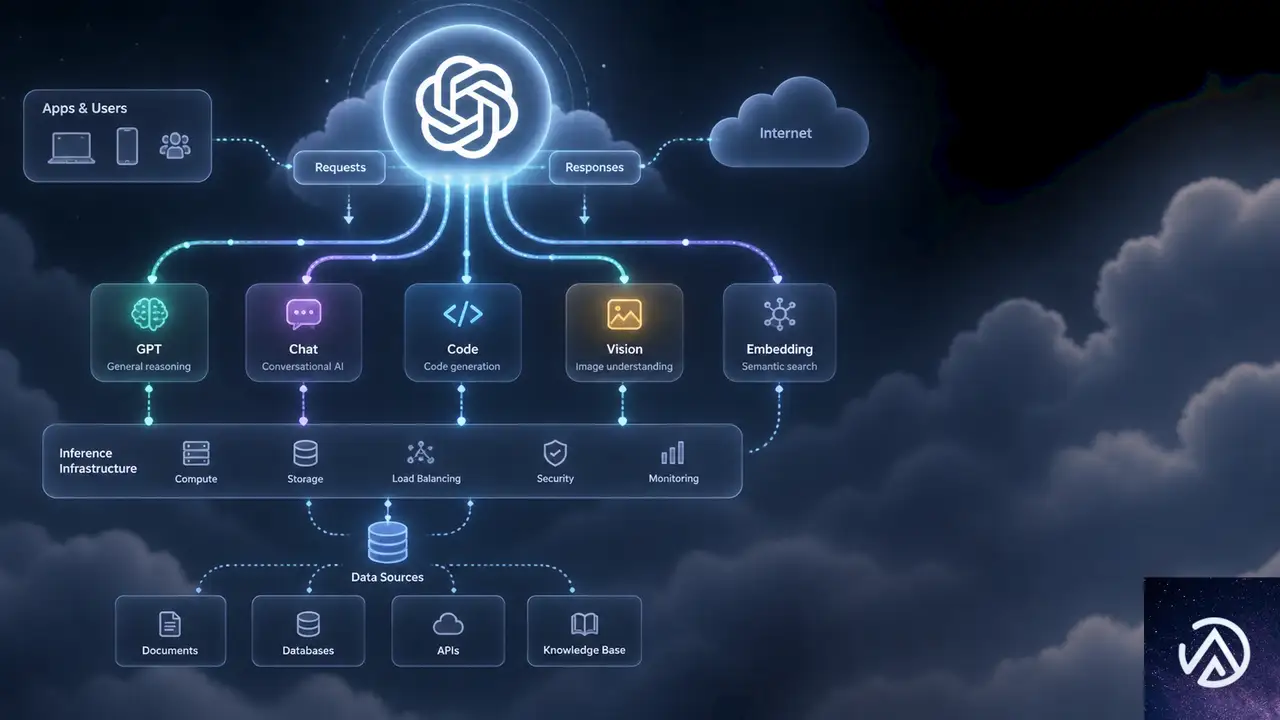
GPT-Live-1の設計で注目すべき点は、すべてを自身で解決するわけではないという姿勢だ。音声レイヤーと推論レイヤーを分離し、複雑な判断やツール呼び出しはバックエンドのテキストモデルに委任できる。開発者はGPT-6 Astraやサードパーティモデルを組み合わせ、タスクの難易度に応じて推論深度を使い分けられる。
たとえばレストランの予約確認や配送状況の案内といった定型的なタスクには軽量なモデルを使い、複雑な顧客対応には高性能なモデルを割り当てる構成が可能だ。推論深度と応答速度とコストをタスクごとに最適化できるため、大規模な音声エージェントの運用コストを抑えながら品質を維持できる。この柔軟性は、単一モデルですべてを処理する構成では得られない利点だ。
音声処理と推論を分離することで、タスクごとに最適なモデルを組み合わせられる。この柔軟性がGPT-Live-1の大きな特徴だ。会話を続けながらバックグラウンドで推論が進むため、ユーザーを待たせない体験も実現できる。
ネイティブ機能の充実
GPT-Live-1はASR(自動音声認識)のトランスクリプトと応答テキストをネイティブに提供する。英数字の認識精度が高く、特定のキーワードを優先的に認識させるキーワードバイアス機能も備える。ターン制モデルではないが、明示的な発話ターンの境界を検出するターン検出機能もネイティブサポートしており、既存のターン制ベースのワークフローからの移行も容易だ。
開発者はシステムプロンプトを通じてエージェントの声のトーン、話す速度、会話スタイルを制御できる。音声の選択肢も従来のリアルタイム音声から大幅に拡充され、アクセントや方言、言語のバリエーションが増やされる予定だ。音声オプションと言語の対応範囲は今後数か月にわたって継続的に拡大される。
評価指標と料金体系
ベンチマークで示された実力
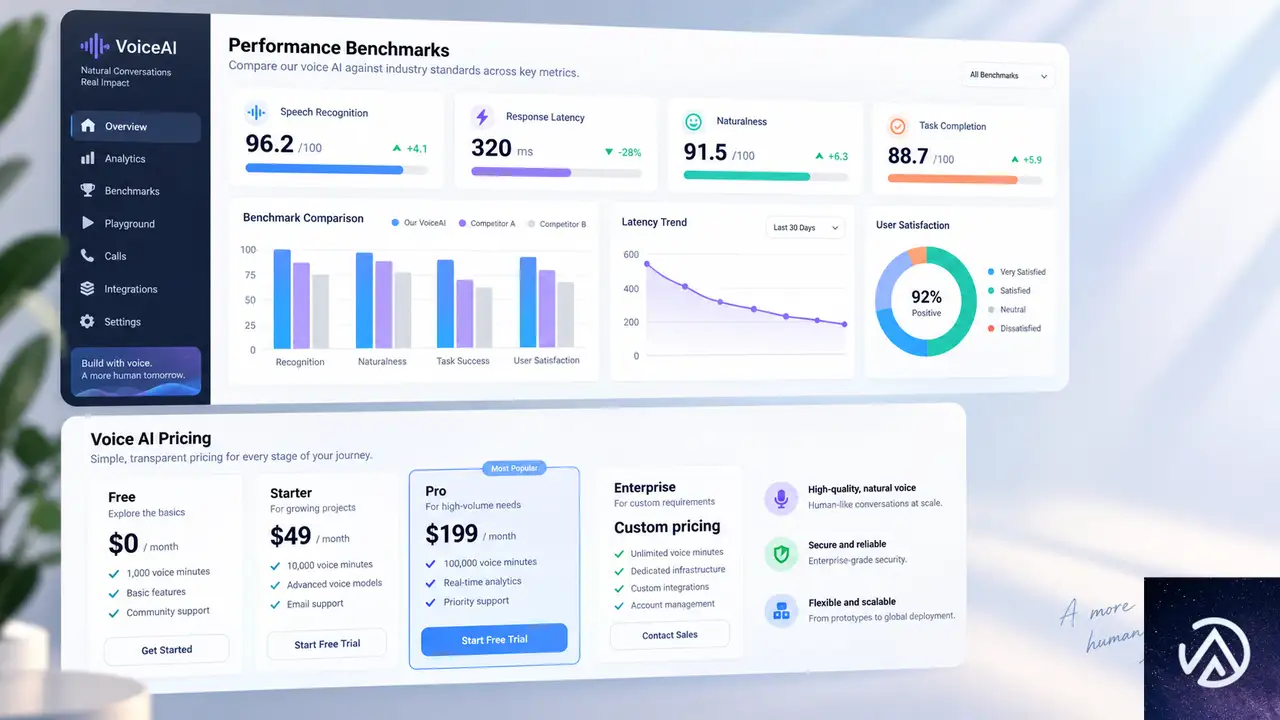
OpenAIの評価では、GPT-Live-1はFull Duplex BenchのスコアをGPT-Realtime-2.1から30ポイント改善した。特にターンテイクの遅延と対話的行動で大きな向上が見られた。GPT-6 Astra(中程度の推論エフォート)と組み合わせた構成では、音声エージェントの総合知能を測定するTau3ベンチマークで1位を獲得している。
評価対象は航空、小売、通信の各ドメインにおける音声カスタマーサービス対応、銀行業務の音声サポート、発話の一時停止への対応、ターンテイク、割り込み処理、バックチャネル(相槌や短い応答)への反応、自然な間や言い直しを含む音声経由のツール呼び出しなど多岐にわたる。満足度と完了率の両面で高いパフォーマンスを示した。
料金体系と展開オプション
GPT-Live-1の料金は、音声フロントエンド部分が1分あたり0.05ドルだ。バックエンドの推論モデルとエージェントハーネスは別途組み合わせる構成になる。推論深度の異なるモデルを使い分けることで、プロダクトの要件に合わせたコスト設計が可能だ。独自のカスタム音声へのアクセスは、OpenAIの営業チームへの問い合わせを通じて申請する。
電話回線を使ったフルデュプレックス音声エージェントの展開もサポートされている。レストラン予約からカスタマーサポートまで、従来は有人対応が必要だった領域に音声AIを導入できる。また、リアルタイム音声対話を企業内システムに統合する「OpenAI Presence」と組み合わせることで、社内システムへのアクセス、承認済みアクションの実行、必要時の人間へのエスカレーションまでを含むエンタープライズ向けの音声エージェントも構築できる。
音声AIの実用化が進む中で、GPT-Live-1のAPI提供は開発者にとって重要な転換点になる。フルデュプレックス方式の導入により、音声エージェントの体験品質が人間との自然な対話に近づくからだ。特に割り込み処理の改善は、教育、カスタマーサポート、ヘルスケアなど対話の質が成果に直結する分野で大きな意味を持つ。従来のターン制音声AIでは実現できなかった「考えながら話す」「話の途中で方向転換する」といった人間らしい対話が、API経由で誰でも利用できるようになった点が重要だ。
この記事のポイント
- GPT-Live-1がAPIで提供開始。同時に聞いて話せるフルデュプレックス音声モデルだ
- 単一モデルで音声入出力を処理し、STTとLLMとTTSをつなぐ従来方式の遅延を構造的に解消する
- Speak社の評価では割り込み回数が約80%削減された
- バックエンドのテキストモデルに推論を委任できる柔軟な構成が特徴だ
- 料金は音声フロントエンドが1分あたり0.05ドル。電話回線への展開も可能だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PerplexityがGPT-6 Astraを本番採用、監視頻度が大幅に減少
PerplexityがGPT-6 Astraを本番システムに採用した。コミュニケーション作成、ソフトウェア変更、本番環境の監視までを任せている。従来モデルと比べてチェック頻度が大幅に減ったという。
PerplexityはAI回答エンジンとして検索と精度に注力してきた。大量の情報を処理する能力が重要であり、コード生成の精度が上がるたびに検索エンジンも改善してきた。今回のAstra採用はその延長線上にある。
なぜ今回の発表が注目されるのか。理由は「エンドツーエンドのシステムをモデルに任せる」という信頼度の高さにある。コード生成だけでなく、テスト、監視、コミュニケーションまで一貫して任せる事例はまだ少ない。
GPT-6 Astraを本番運用に組み込んだPerplexity
OpenAI Blogの記事によると、PerplexityはAstraを使ってコミュニケーションの作成、ソフトウェアの変更、本番システムの監視を行っている。Perplexityの共同創業者兼CSOであるJohnny Ho氏は、以前の世代のモデルでは実現できなかった方法で、これらのタスクをモデルに任せられると述べている。
コミュニケーション作成からソフトウェア変更まで
従来のAIモデルはコード生成や文章作成など特定のタスクに強かった。しかし実世界のシステムに適用するには、人間が細かく確認する必要があった。Astraではコミュニケーションの作成、システムの編集、本番ソフトウェアの監視を一つのモデルにまとめて任せられる。
監視頻度が大幅に低下
Johnny Ho氏は、完全なエンドツーエンドのシステムをAstraに信頼して任せられ、以前の世代のモデルと比べてチェックする頻度がはるかに少なくなったと述べている。これはモデルの判断精度と信頼性が実用レベルに達したことを示す。
この比較は、モデルの信頼度が実運用に耐える水準へ上がったことを示す。人による確認作業が減ることで、開発チームはより高度な判断や新機能の設計に集中できる。
コード生成の精度向上が検索エンジン改善に直結
PerplexityはAI回答エンジンとして、検索と精度を最重要視してきた。Johnny Ho氏によると、モデルがコードを書く能力を高めるたびに、Perplexityの検索エンジンも改善してきたという。より良いプログラムを作れるようになると、ウェブと内部情報を検索し、それを簡潔に要約する能力も上がる。
検索と要約の精度が上がる循環
コード生成能力の向上は、検索プログラムの品質に直接影響する。検索プログラムが優れていれば、より関連性の高い情報を集め、より簡潔な回答を生成できる。Perplexityはこの循環をエンジンの中核としてきた。
実世界システムへの適用が課題だった
Johnny Ho氏は、本当の課題は情報処理の側面を実世界のシステムに適用することだと指摘する。生成したコードを実際のソフトウェアに変更として反映し、本番環境の監視まで行うのは、従来モデルでは難しかった。Astraはこの壁を越えた。
この流れが実現したことで、Perplexityはモデルを「情報処理の道具」ではなく「システム運用の担い手」として扱えるようになった。
エンドツーエンドのテストを自動生成するAstra
Johnny Ho氏にとって、AIの最も有用な応用の一つはコードのテストだ。手動テストに割ける時間は限られている。そこでAstraにアプリケーションの周りに小さなテストプログラムを構築するよう依頼する。
モックサービスの自動生成
モデルは、別のサービスが送信するような現実的な応答を生成する。例えば言語モデルAPIやコネクタの応答を模倣する。モデルがサービスの代わりを務めることで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。
この仕組みにより、開発者は限られた時間でもアプリケーション全体の動作を網羅的に確認できる。モック応答が現実的であるほど、テストの信頼性も高まる。
ワークフロー全体を検証
モデルがサービスを代行することで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。これは単体テストだけでなく、統合テストやシステムテストに近い。従来は人手や専用ツールが必要だったが、Astraは自然言語の指示だけでこれを実行する。
AIエージェントの信頼性が変える開発フロー
Perplexityの事例は、AIエージェントの信頼性が実用段階に入ったことを示す。チェック頻度の減少は、モデルの判断が人間の承認なしにシステムを変更できる水準に達したことを意味する。開発フローそのものが変わりつつある。
チェック頻度の減少が意味すること
チェック頻度が減るということは、モデルが失敗したときの影響範囲が大きくなる可能性もある。しかしPerplexityは、モデルが生成する応答の現実性と、テストの網羅性を評価した上で、この判断を下している。信頼は実績の積み重ねから生まれる。
開発者の役割変化
モデルがコード生成、テスト、監視までを担うようになると、開発者の役割は「命令を出す人」から「結果を評価し、方向性を決める人」へ移る。Johnny Ho氏がテストコード生成を「最も有用な応用の一つ」と述べるのは、この変化を象徴している。
この記事のポイント
- PerplexityがGPT-6 Astraを本番システムに採用し、コミュニケーション作成、ソフトウェア変更、本番監視を任せている
- コード生成能力の向上が検索エンジンの改善に直結し、実世界システムへの適用が可能になった
- Astraはモックサービスを自動生成し、エンドツーエンドのテストを自然言語の指示だけで実行する
- チェック頻度が大幅に減り、開発者の役割は実行から評価と方向性決定へ移行しつつある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
FTCが個人別価格表示に透明性要求。WooCommerce事業者の備え
米FTC(連邦取引委員会)がパーソナライズドプライシング、つまり顧客データに基づいて個人ごとに価格を変える手法に対する執行方針を提案した。2026年8月19日付の提案で、この手法そのものを禁止するものではない。価格がどのように決まったのかを消費者に明確に伝える透明性を求める内容だ。
ECサイトを運営する事業者、特にWooCommerceを使う中小企業にとって、今後の価格戦略とデータ活用の見直しにつながる重要な動きである。パブリックコメントは2026年9月25日まで受け付けている。
FTCがパーソナライズドプライシングの透明性を要求
パーソナライズドプライシング(個人別価格設定)とは、顧客の購買履歴や行動データを使って、同じ商品でも顧客ごとに異なる価格を提示する手法だ。FTCはこの手法を禁止する権限はないとしつつ、FTC法第5条(不公正または欺瞞的な行為の禁止)を根拠に透明性の確保を図る。
FTCが事業者に求めている内容は大きく3つある。
- 価格がパーソナライズされたものであることの明示
- なぜその価格になったのかの理由
- どのようなデータを使ったのかの説明
提案された執行方針の内容
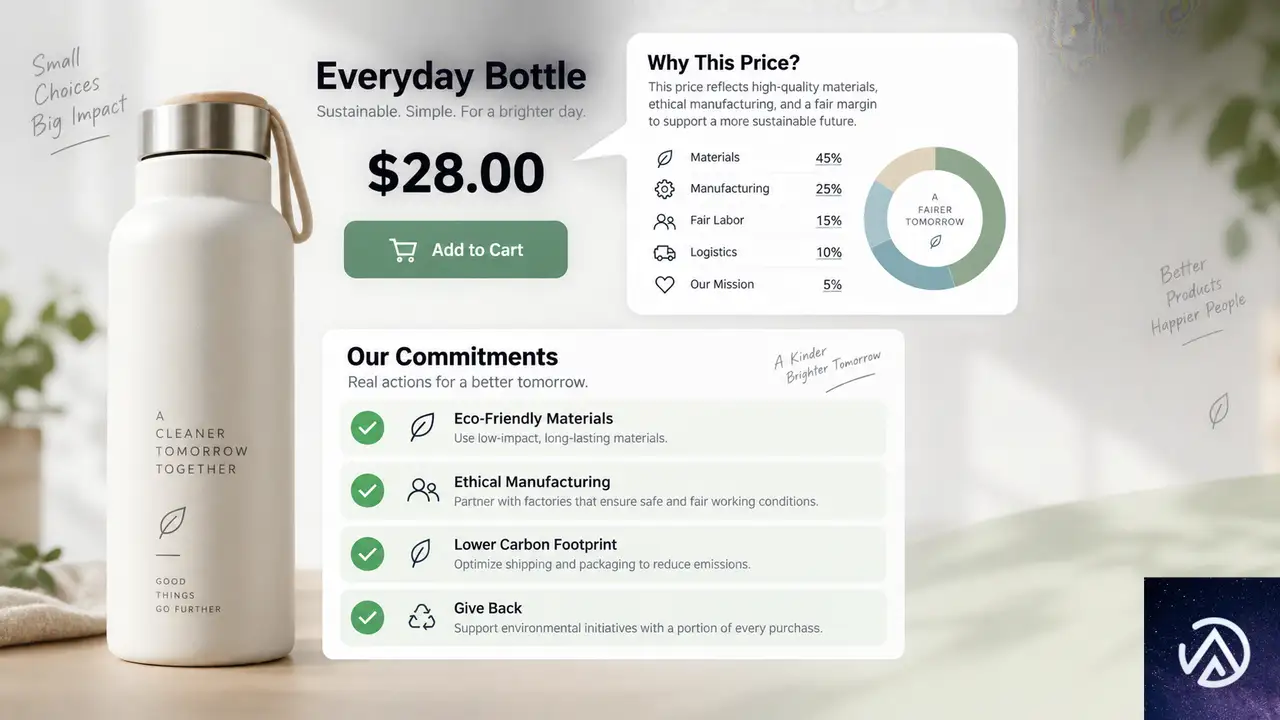
FTCが示した方針では、価格がパーソナライズされたことを消費者に知らせる免責事項の表示が必要になる。たとえば「この価格はあなたの購買履歴に基づいてパーソナライズされています」といった説明を商品ページに追加することが想定される。
このデモは、価格表示に透明性の説明を追加する変化を示している。FTCの方針は、価格そのものの変更ではなく、消費者への説明責任を問うものだ。
マーケターへの影響
ここ数年、マーケターはサードパーティCookieの衰退を受けて、ファーストパーティデータ(自社で直接収集した顧客データ)を集めるよう奨励されてきた。そのデータ活用が「体験のパーソナライズ」から「価格のパーソナライズ」にまで拡大しているケースがある。FTCの提案は、この流れに透明性という歯止めをかけるものだ。
たとえば、ある小売業者が顧客の過去の購買履歴を分析し、この顧客は高くても買う傾向があると判断して、同じ商品を他の顧客より高い価格で提示するケースを考えてみる。FTCの提案では、この場合「価格が過去の購入履歴に基づいてパーソナライズされている」という説明が必須になる。
パーソナライズドプライシングとダイナミックプライシングの違い
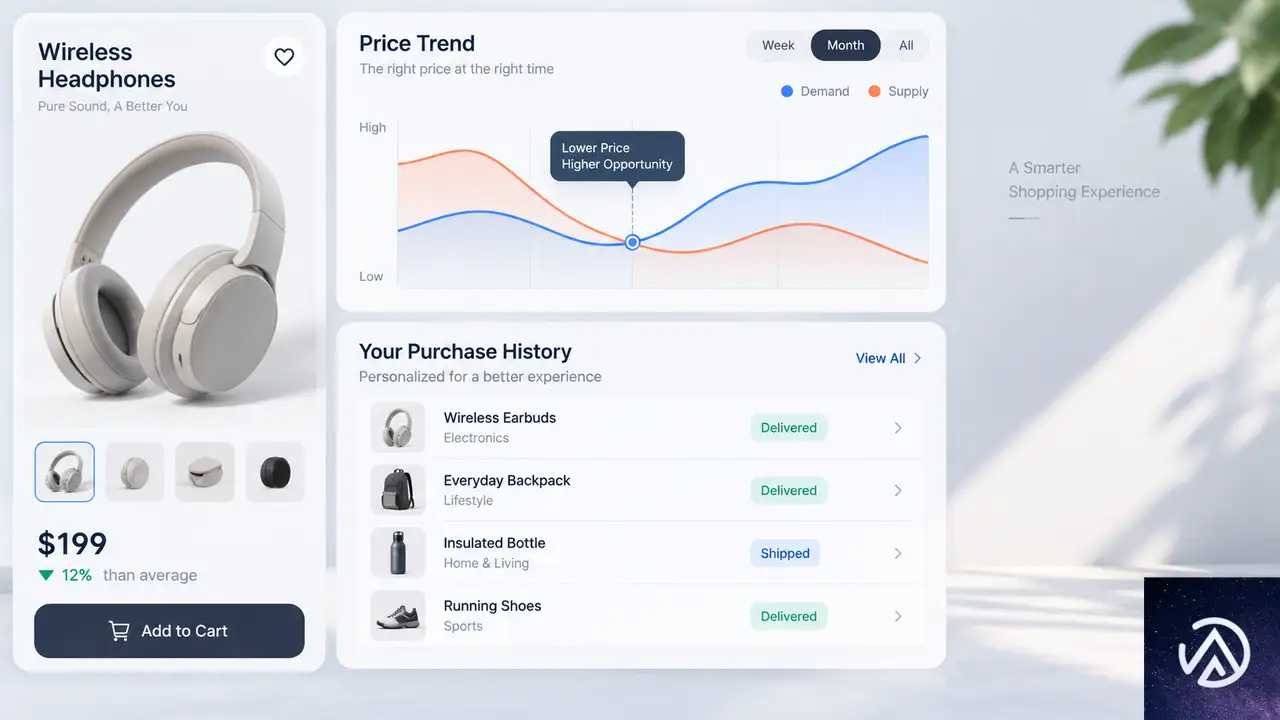
FTCはパーソナライズドプライシングとダイナミックプライシングを明確に区別している。この区別は重要だ。ダイナミックプライシング(変動価格設定)は需要と供給に応じて価格を変動させる手法で、航空券やホテルの宿泊料金、配車アプリのサーチャージが代表例だ。繁忙期や悪天候時に価格が上がるのは、個人のデータではなく市場全体の需給に基づく。
一方、パーソナライズドプライシングは個人のデータに基づく。過去の購買履歴から「この顧客は高くても買う傾向がある」と判断して、同じ商品を他の顧客より高い価格で提示するようなケースだ。
この比較図は、2つの価格設定手法の根本的な違いを示している。FTCが問題視するのは後者のパーソナライズドプライシングである。
FTCが監視対象として挙げた具体例
FTCが挙げた具体例はかなり踏み込んでいる。外出が難しい消費者への食品販売、複数の子供のために牛乳を買う消費者、葬儀や緊急の用事で移動する消費者、医療緊急時の交通手段を必要とする消費者、犯罪被害に遭った直後に防犯カメラを探す消費者、店舗や駐車場にいながら小売サイトを閲覧する消費者などが挙げられた。これらは消費者が弱い立場にある状況で、パーソナライズドプライシングが使われることを特に問題視している。
この具体例から読み取れるのは、FTCが「事業者はデータをたくさん集めているが、すべてを理解しているわけではない」というメッセージをマーケターに送っている点だ。
WooCommerce事業者への実務的影響
日本のEC事業者にとって、FTCの方針は直接の規制対象ではない。ただし、海外向けに販売するWooCommerceサイトや、グローバルに展開する企業は注意が必要だ。また、日本でも個人情報保護法や景品表示法の観点から、同様の透明性が求められる可能性がある。
動的価格設定プラグインの注意点
WooCommerceでパーソナライズドプライシングを実装する場合、動的価格設定プラグインを使うことが多い。これらのプラグインは、顧客のログイン情報や過去の注文履歴、カートの中身などに基づいて価格を変更できる。今回のFTC方針を踏まえると、こうした機能を使う際に「価格がパーソナライズされていること」を明示する仕組みを追加する必要が出てくる。
このフローは、WooCommerceでパーソナライズドプライシングを導入する際の基本的な流れを示している。STEP 4の透明性の説明が、FTC方針への対応に該当する。
データガバナンスの課題
FTC方針への対応で最も難しいのが、データの出所と利用目的の管理だ。顧客データはCDP(カスタマーデータプラットフォーム)、ロイヤルティプログラム、パーソナライゼーションエンジン、AIエージェントなど複数のシステムに分散している。どのデータを価格設定に使ったのかを追跡できる状態にしておく必要がある。
MarTechの記事で、In-Store MarketplaceのPaul Brenner氏は「データの許可利用範囲と禁止範囲の線引きが難しく、多くの加盟店がシステムと透明性を備えていない」と指摘している。この課題は、FTCの執行方針が現実になった場合、EC事業者にとって大きなハードルになる。
今すぐできる3つの対策
FTCの方針はまだ提案段階だが、今から準備しておくことで、執行が始まった際の混乱を避けられる。具体的には次の3つだ。
1つ目は、価格表示に説明を追加すること。パーソナライズドプライシングを使っている場合、その旨を商品ページやカート画面に明記する。使っていない場合でも、価格がどのように決まるのかを説明しておくと、消費者の信頼につながる。
2つ目は、データ利用の同意取得を見直すこと。他社から取得したデータを価格設定に使う場合、消費者がその用途に同意しているかを確認する必要がある。単に「同意があるはず」と仮定するだけでは不十分だ。
3つ目は、データの利用目的を文書化すること。価格設定にどのデータを、どのように使っているのかを社内で整理し、必要に応じて開示できる状態にしておく。これがデータガバナンスの第一歩になる。
この記事のポイント
- FTCはパーソナライズドプライシングそのものを禁止せず、透明性の確保を求めている
- パーソナライズドプライシングは個人データに基づく価格設定で、ダイナミックプライシングとは異なる
- WooCommerce事業者は動的価格設定プラグインの利用時に説明表示を追加する必要がある
- データの出所と利用目的を追跡できるデータガバナンスが今後の課題になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験