


Astro 7.2が登場、増分静的ビルドを実験導入。大規模サイトのビルド時間短縮に道
Astro 7.2が2026年8月末にリリースされた。今回のマイナーアップデートでは、実験的な増分静的ビルド機能が追加されている。変更したページだけを再ビルドする仕組みで、大規模サイトのビルド時間を大幅に短縮できる可能性がある。あわせて、開発プレビューのバックグラウンドモードや相対ロガーエントリポイントも導入された。
Astroはコンテンツ中心のWebサイトを高速に構築するためのフレームワークだ。ビルド時に静的HTMLを生成し、必要な部分にだけJavaScriptを追加するアイランドアーキテクチャを採用している。今回の増分静的ビルドは、数千ページ規模のサイトで毎回フルビルドする非効率を解消する一手となる。
プロジェクト体制にも動きがあった。AstroのプロジェクトスチュワードがMatthew Phillips氏に交代している。Microsoftが公式ドキュメントサイトにAstroを採用するなど、エコシステムの広がりも加速している。本記事では、Astro 7.2の技術的な中身と、開発者コミュニティの最新動向を整理して伝える。
増分静的ビルドとは何か。Astro 7.2が示すビルド高速化の方向性

このデモは増分静的ビルドの概念を視覚化したイメージだ。静的サイトジェネレーターの多くは、1ページでも更新すると全ページを再ビルドする。増分ビルドはその常識を覆す。
増分静的ビルドとは、前回のビルド結果と現在のソースコードを比較し、変更の影響を受けたページだけを再生成する仕組みだ。たとえばブログ記事を1本追加した場合、カテゴリ一覧やタグページ、RSSフィードなど関連するページは再生成が必要だが、無関係な過去記事や固定ページはそのまま流用できる。この差分検出によって、ビルド全体の処理量を大幅に削減できる。
なぜ増分ビルドが重要なのか
静的サイトのビルド時間は、ページ数が増えるほど長くなる傾向がある。1,000ページを超える規模になると、フルビルドに数分から数十分かかることも珍しくない。開発中にプレビューを確認するたびに待たされるのは、開発体験を大きく損なう。
増分ビルドが実用化すれば、ビルド時間は変更の影響範囲に比例するようになる。1ページの記事を追加しただけで全ページを再処理する必要がなくなるため、大規模サイトほど恩恵が大きい。とくに企業ブログやドキュメントサイト、ECサイトの商品ページ一覧など、ページ数の多いコンテンツサイトで効果を発揮する。
実験段階の注意点と将来性
Astro 7.2の増分静的ビルドは実験的な機能として提供されている。プロダクション環境での利用はまだ推奨されておらず、今後のリリースで挙動が変わる可能性がある。ただし、Astroチームがこの機能を前面に押し出してきたことは、静的サイト生成のボトルネック解消に本腰を入れるという明確なシグナルだ。
実験的機能を使うには、設定ファイルで明示的に有効化する必要がある。安定版になるまでは、開発環境でのビルド時間短縮を試す用途に留めておくのが安全だろう。
Astro 7.2の追加機能。開発プレビューとログ出力が改善

増分静的ビルド以外にも、開発者の日常作業を改善する機能が2つ追加された。
1つ目は astro preview コマンドのバックグラウンドモードだ。ビルド済みのサイトをローカルで確認する際、従来はターミナルが占有されて他のコマンドを実行できなかった。バックグラウンドモードを使えば、プレビューサーバーを起動したまま別の作業に移れる。
2つ目は相対ロガーエントリポイントである。Astroのログ出力では、ファイルパスが絶対パスで表示されることがあった。相対表示に変わったことで、複数人での開発やCI環境のログ確認がしやすくなっている。
プロジェクトスチュワード交代。Astroの舵取り役が新体制に

2026年8月、AstroのプロジェクトスチュワードがMatthew Phillips氏に交代した。プロジェクトスチュワードは技術的な方向性やコミュニティ運営の最終責任者にあたる役割だ。前職のFred K. Schott氏からバトンが引き継がれた。
Matthew Phillips氏はAstroのコアメンテナーとして長く活動してきた人物で、公式ブログでも「これまで通りコミュニティとともにAstroを育てていく」という趣旨のコメントを発表している。オープンソースプロジェクトにおいて、ガバナンスの透明な引き継ぎは健全性の証でもある。
Astroのイベント展開も活発だ。日本では10月開催のVue Fes JapanにAstroメンテナーのKenji氏が登壇する。また、ドイツのヴィースバーデンでは9月5日にパートナー企業Seibertとの共同イベントが開催される。グローバルなコミュニティ拡大が続いている。
Microsoftも採用。エコシステムとパートナー連携の広がり

Astroの導入事例として、Microsoft関連のドキュメントサイトが2件確認された。TypeSpec AzureはAzureサービスのAPI仕様を記述するためのドキュメントで、Orleansは.NET向け分散システムフレームワークである。いずれも公式ドキュメントとしてAstroが採用されており、技術文書分野での信頼性が高まっている。
パートナー企業の動きも注目に値する。画像最適化サービスのImageKitがAstro統合を正式に提供開始した。Astroで構築したサイトから画像や動画をImageKitのグローバルCDN経由で配信でき、デバイスに応じたフォーマット変換も自動化される。画像の多いメディアサイトでは表示速度の改善に直結する連携だ。
また、CloudCannonがAstro向けの多言語スターターテンプレートを公開した。英語、フランス語、ドイツ語が初期設定済みで、静的サイトの翻訳ワークフローをOSSとして提供する。グローバル展開を視野に入れたサイト構築の敷居を下げる取り組みといえる。
開発者向けツールの充実。Astro Playgroundと注目の統合群

2026年8月は開発者向けツールの発表も相次いだ。中でも注目はAstro Playgroundだ。ブラウザ上でAstroコンポーネントを試せる公式プレイグラウンドで、新規プロジェクトを作らずに単一コンポーネントの動作確認ができる。内部では動的Worker上で実際のAstroコンパイラが動作しており、ローカル環境と同一の結果を得られる設計になっている。
Astro Playgroundは、Astroの学習コストを下げるうえで重要な役割を果たす。これまでAstroコンポーネントを試すには、プロジェクトの初期化が必要だった。ブラウザで開くだけで実験できる環境は、初学者の入り口としても、経験者の素早いプロトタイピング用途としても有用だ。
コミュニティ製の統合も多数リリースされている。AWS Architecture Iconsをビルド時にSVGインライン化する @aws-icons/astro、最終レンダリング結果から目次を生成する astro-toc-smol、サイトマップを自動出力する @datadeft/astro-sitemap など、実務で即戦力になるものばかりだ。
SEO関連では、JSON-LD構造化データの生成を支援する @miyamo2/astro-jsonld や、ビルドごとにSEOスコアを監査する astro-seo-audit が登場している。Google検索の「優先ソース」ボタンに対応する統合も2種類リリースされており、AI Overviewsを見据えたSEO対策の関心の高さがうかがえる。
テーマカタログも大幅に拡充された。Astro公式テーマカタログには8月だけで80以上のテーマが追加または更新されている。SaaS向けランディングページ、ポートフォリオ、ECサイト、ドキュメントサイトなど、用途別のテンプレートが揃ってきた。Astroでの新規プロジェクト立ち上げがますます手軽になっている。
この記事のポイント
- Astro 7.2が2026年8月末にリリース。実験的な増分静的ビルドが最大のトピックだ
- 増分静的ビルドは変更の影響範囲だけを再生成する仕組みで、大規模サイトほどビルド時間短縮の恩恵が大きい
- astro previewのバックグラウンドモードと相対ロガーエントリポイントも追加され、開発体験が改善した
- プロジェクトスチュワードがMatthew Phillips氏に交代し、プロジェクト体制に変化があった
- Microsoft公式ドキュメントでの採用やImageKit連携など、エコシステムの信頼性と実用性が向上している

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AWS Graviton5搭載のEC2 R9gが一般提供開始。R8g比で最大25%の性能向上
AWSがGraviton5プロセッサを搭載したEC2 R9gとR9gdインスタンスを一般提供開始した。メモリ最適化インスタンスの新世代で、R8gと比較してコンピュート性能が最大25%向上している。
Graviton5はDDR5メモリの高速化、L3キャッシュの5倍拡大、ネットワーク帯域幅の最大2倍化など、複数のハードウェア改良を備える。データベースやインメモリキャッシュなどメモリ集約型のワークロードで効果が大きい。
この記事ではR9gの技術的な変更点、インスタンススペック、移行手順、利用可能リージョンを解説する。
Graviton5がもたらす性能向上の全容

Graviton5プロセッサはGraviton4から複数のハードウェア改良が加えられた。まずコンピュート性能がvCPUあたり最大25%向上している。これは命令処理の効率化と高クロック動作によるものだ。またAWSがこれまでに構築した中で最もエネルギー効率の高いプロセッサでもある。
このデモはGraviton4(R8g)とGraviton5(R9g)の主要スペックを比較している。特にL3キャッシュの5倍拡大とメモリ帯域の高速化がデータ処理の遅延低減に効く。
メモリとキャッシュの大幅強化
メモリはDDR5 8800 MT/sに対応した。Graviton4の5600 MT/sから大幅に高速化されており、AWSのクラウド上で利用可能な最速のメモリ帯域を実現している。これは大量のデータを扱うインメモリキャッシュ・データベースにとって応答時間の短縮に直結する。
L3キャッシュも5倍に拡大された。L3キャッシュとはCPU内部にある高速なメモリ領域で、頻繁にアクセスするデータを一時的に保持する役割を持つ。この容量が増えると、主メモリへのアクセス回数が減り、データ処理の遅延が小さくなる。データ局所性が高いワークロードほど恩恵を受けやすい。
ネットワーク帯域幅とパケット処理の改善
ネットワーク帯域幅とAmazon EBSの帯域幅は、最大サイズのインスタンスで最大2倍に向上した。48xlargeではネットワークが最大100 Gbps、EBSが最大72 Gbpsに達する。またパケット処理性能は最大3倍に改善されている。
さらにR9gとR9gdはInstance Bandwidth Configuration(IBC)に対応している。これはEBSとネットワークの帯域配分を25%単位で調整できる機能だ。データベースやキャッシュなど、帯域要件が特定方向に偏るワークロードで性能を最適化できる。例えばネットワーク処理が少なくディスクI/Oが多いワークロードでは、帯域をEBS側に寄せるといった調整が可能になる。
Nitro Isolation Engineによるセキュリティ強化

すべてのR9gとR9gdインスタンスはAWS Nitro System上で動作する。Nitro Systemは仮想化、ストレージ、ネットワークを専用ハードウェアにオフロードする仕組みだ。これにより仮想マシンのオーバーヘッドが減り、ベアメタルに近い性能と強固なセキュリティ分離を両立できる。
R9gとR9gdにはNitro Isolation Engine(NIE)が搭載されている。NIEはC9gとM9gで今年前半に導入されたコンポーネントで、仮想マシン間の分離を強制する役割を担う。仮想マシンのメモリ、CPUレジスタ状態、I/Oデバイスへのすべてのアクセスを最小限のAPIセットで仲介する。
このデモはNIEが仮想マシンとハードウェアの間に位置し、すべてのアクセスを仲介する関係を示している。分離の保証はソフトウェア的な工夫ではなく、形式的な数学証明によって裏付けられている点が特徴だ。
NIEの特徴は形式検証(formal verification)という手法を活用している点にある。これはハードウェアやソフトウェアが意図通りに動作することを数学的に証明する手法だ。特定のテストケースだけでなく、あらゆる条件下で正しく動作することを保証する。この取り組みにより、Nitroはクラウドハイパーバイザーとして初めて形式検証を受けた存在になった。
形式検証の対象範囲や前提条件などの詳細はAWSのテクニカルホワイトペーパーで公開されている。セキュリティ要件が厳しい金融系ワークロードやマルチテナント環境を扱う場合には、このホワイトペーパーを参照してリスク評価に役立てるとよい。
R9gとR9gdのインスタンススペック

R9gとR9gdはそれぞれ11サイズで提供される。最小のmediumから最大のmetal-48xlまで、幅広い要件に対応する。以下では2つの違いを中心に説明する。
このデモはR9gとR9gdの違いを整理している。NVMe SSDの有無が唯一の差で、用途に応じて選べる。
R9gのスペック
R9gはEBSストレージのみを使用する構成だ。最小のr9g.mediumは1 vCPUと8 GiBメモリ、最大のr9g.48xlargeとr9g.metal-48xlは192 vCPUと1536 GiBメモリを搭載する。ネットワーク帯域幅はmediumから2xlargeまで最大15 Gbps、8xlargeで17 Gbps、12xlargeで25 Gbps、16xlargeで34 Gbps、24xlargeで50 Gbps、48xlargeで100 Gbpsに達する。
EBS帯域幅はmediumから4xlargeまで最大12 Gbps、8xlargeで12 Gbps、12xlargeで18 Gbps、16xlargeで24 Gbps、24xlargeで36 Gbps、48xlargeで72 Gbpsとなっている。データベース用途ではEBS帯域幅が性能のボトルネックになりやすいため、サイズ選定の際はこの値にも注目したい。
R9gdのNVMeストレージ
R9gdはR9gと同じコンピュート性能とネットワーク性能を持ちながら、ローカルNVMe SSDを搭載している。mediumでは59 GB、largeで118 GB、xlargeで237 GBとサイズに応じて容量が増える。最大のr9gd.48xlargeでは3台の3800 GB NVMe SSD(合計11.4 TB)を備える。
ローカルNVMe SSDはEBSと比べてレイテンシが低く、一時的なスクラッチ領域やキャッシュ用途に向いている。オープンソースデータベース、分散リアルタイムビッグデータ分析、大規模インメモリデータベース、大容量キャッシュワークロードで効果を発揮する。
R8gからの移行と始め方

R8gで運用中のワークロードがある場合、R9gへの移行はシンプルだ。多くのアプリケーションでコード変更は不要。同等サイズのR9gインスタンスを選択すれば、そのままより高い性能を得られる。
このデモはR8gからR9gへの移行手順を4ステップで示している。インスタンスタイプを変更するだけで性能が向上するケースが多い。
対応OSとコンテナ環境
R9gはAmazon Linux 2023、Amazon Linux 2、Ubuntu 22.04以降、RHEL 8.4以降、SUSE Linux Enterprise Server 15 SP3以降、Debian 12以降など主要なLinuxディストリビューションに対応する。EC2コンソールからArmベースのAMIを選択すれば、すぐに起動できる。
コンテナワークロードではAmazon EKS、Amazon ECS、標準的なKubernetes環境で動作する。Arm64向けにビルドされたマルチアーキテクチャのコンテナイメージなら変更なしで動く。Dockerイメージをマルチアーキテクチャ対応にしておくと、x86からArmへの移行がスムーズになる。
移行を支援するツール
AWSはGravitonへの移行を支援する複数のリソースを提供している。Graviton Getting Started Guideは構築、実行、最適化の方法をまとめたガイドだ。Graviton Savings Dashboardではコスト削減効果を追跡できる。AWS TransformはJavaアプリケーションをx86からGraviton向けに変換するコード変換を自動化するツールだ。
Javaアプリケーションの場合、依存ライブラリにネイティブコードが含まれているとArm64への移行が難しいことがある。AWS Transformはこうしたコード変換を自動化して移行の手間を減らす。まず小規模なワークロードで試し、問題がないことを確認してから本番移行に進むのが現実的な進め方だ。
料金と利用可能リージョン

R9gとR9gdは米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、欧州(フランクフルト)の各リージョンで利用できる。日本国内のリージョン(アジアパシフィック東京)では現時点で提供されておらず、今後の展開が待たれる。
購入オプションはSavings Plans、On-Demand、Spot Instances、Dedicated Instances、Dedicated Hostsから選択可能だ。長期運用する場合はSavings Plans、一時的なバッチ処理やテスト用途ではSpot Instancesがコスト効率に優れる。料金の詳細はAmazon EC2の料金ページで確認できる。
インスタンスサイズや購入オプションによって価格が異なるため、ワークロードに合わせて最適な組み合わせを選ぶことが重要だ。特にR8gと比較した場合、同じサイズでも性能が向上しているため、より小さなサイズに移行してコストを削減できる可能性もある。
この記事のポイント
- AWS Graviton5搭載のEC2 R9gとR9gdが一般提供を開始した
- R8g比でコンピュート性能が最大25%向上し、エネルギー効率も改善
- DDR5 8800 MT/sメモリとL3キャッシュ5倍拡大でデータ処理が高速化
- Nitro Isolation Engineにより形式検証されたセキュリティ分離を実現
- R9gはEBSのみ、R9gdはローカルNVMe SSDを搭載した構成
- R8gからの移行はコード変更不要のケースが多く、Arm64対応イメージでそのまま動作
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WooCommerce 11.1でREST APIとStore APIが最大42%高速化。ブロック登録スキップの仕組み
WooCommerce 11.1がブロック登録の仕組みを大きく変更する。REST APIとStore APIのリクエストが従来より13〜18ミリ秒、割合で30〜42%速くなる見込みだ。
これまでWooCommerceはほぼすべてのリクエストでブロックタイプとパターンを登録していた。画面にブロックを描画しないAPIリクエストでも同じ準備処理が走り、無駄なコストになっていた。
この記事では変更の背景と仕組み、影響を受ける開発者の条件、具体的な対応方法を解説する。11.1は正式リリース前の段階のため、エクステンションを配布している開発者は事前テストが求められる。
なぜブロック登録をスキップするのか
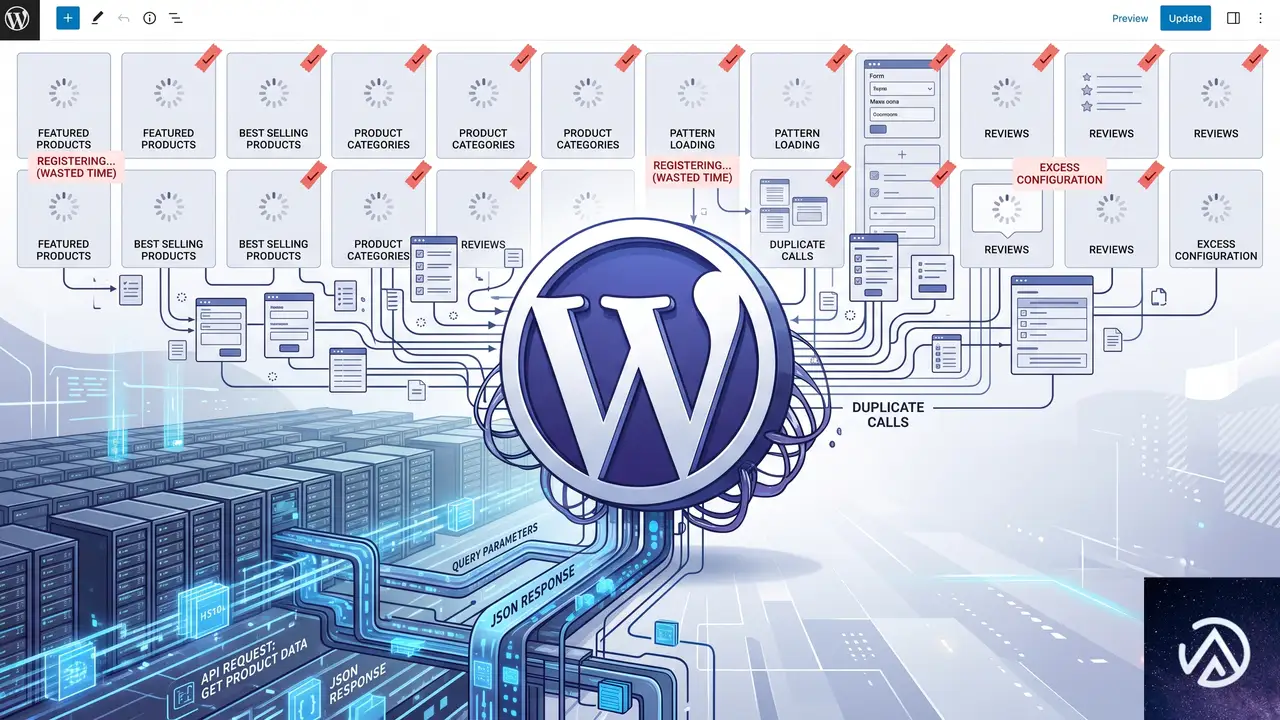
ほぼ全リクエストで発生していた無駄な処理
WooCommerceはこれまで、ブロックタイプとパターンをほぼすべてのリクエストで登録していた。商品データを返すだけのREST APIリクエストでも、カート情報を返すStore APIリクエストでも、ブロックを描画しないのに登録処理が実行されていた。
ブロック登録にはファイル読み込みやメタデータ解析が伴う。1リクエストあたりの負荷は小さくても、APIを多用する店舗やヘッドレスコマース構成では応答速度に影響する。WooCommerceチームは「リクエストはブロックを描画または編集できる場合にのみ、ブロック登録のコストを支払うべき」という方針を取った。
Beforeではすべてのリクエストがブロック登録を経由していた。Afterではブロックを描画しないAPIリクエストが登録処理を飛ばし、その分だけレスポンスが速くなる。
描画しないリクエストに課されるコスト
従来の挙動は、ブロックを編集も描画もしないリクエストまでブロックエディタの準備をさせるものだった。この無駄はアクセス数に比例して増える。とくにモバイルアプリやフロントエンドを別システムで構築し、WooCommerceをAPI経由で使う構成では影響が大きい。
今回の最適化は、APIリクエスト全体に占めるブロック登録のコストが想定以上に大きかったことを示している。13〜18ミリ秒の改善は体感的には小さいが、ピーク時に多数のリクエストを処理する店舗では合計の短縮効果が積み上がる。
11.0から11.1へ段階的に進めた変更

11.0で導入したパターンの遅延読み込み
第一段階はWooCommerce 11.0で実装された。パターンがファイルパスで登録され、エディタから要求されたときだけ内容が読み込まれるようになった。WordPressコアと同じ挙動だ。ブロックを登録するリクエストごとに5〜8ミリ秒の節約が確認されている。
11.1のBlockRegistrationContextガード
11.1では新しいBlockRegistrationContextガードが追加された。このガードがリクエストを判定し、ブロックを描画しない場面ではブロックタイプとパターンの登録をまとめてスキップする。
商品説明を守るオンデマンド登録の例外
1つだけ例外がある。商品説明やバリエーション説明にWooCommerceブロックが含まれる場合、woocommerce_short_descriptionフィルター経由で必要なときにブロックタイプが登録される。これにより商品REST API、Store API、バリエーションAJAXエンドポイント、商品のWebhookでも説明が正しく描画される。
2段階の変更により、パターン読み込みとブロック登録という2つの重い処理がAPIリクエストから外れた。完成した最適化の効果が30〜42%という数字に表れている。
対象リクエストと安全性の設計

スキップ対象と従来どおりのリクエスト
スキップされるのはブロックを描画しないリクエストのみだ。フロントエンド、管理画面、ブロックエディタ、サイトエディタのリクエストは従来どおりブロックを登録する。
見落としがあっても表示は壊れない
ガードは自身が認識したコンテキストだけをスキップする。認識できない場面では登録を継続するため、分類に漏れがあったとしても描画の後退にはつながらない。性能が少し落ちるだけで済む設計だ。
この設計は保守性の面でも合理的だ。未知のリクエストに対して安全側に倒すため、WooCommerceの内部判断が変わっても既存サイトの表示が突然崩れるリスクを抑えられる。
開発者が確認すべき影響範囲

影響を受けるエクステンションの条件
この変更はWooCommerce 11.1.0から適用される。スキップされるリクエスト中にWooCommerceブロックを描画するエクステンション、またはWooCommerceのブロックタイプ、パターン、ブロックごとのアセット登録に依存するエクステンションが影響を受ける。
スキップされた場面では、WooCommerceブロックは生のブロックマークアップか、動的出力のない静的なHTMLとして返る。テンプレートに直接ブロックを組み込んでいるエクステンションは、表示内容が変わらないか確認が必要だ。
コードで確認する方法
影響の有無はコードで確認できる。以下のコードはWooCommerce 11.1以降のスキップ対象リクエストでfalseを返す。
// WooCommerce 11.1以降、スキップされた場面では false を返す。
WP_Block_Type_Registry::get_instance()->is_registered( 'woocommerce/mini-cart' );
商品説明と自前ブロックは影響なし
商品説明とバリエーション説明はオンデマンドで処理されるため対応は不要だ。register_block_type()で自前登録しているブロックも影響を受けない。今回の変更はWooCommerce自身が行う登録だけが対象になる。
実務では「自前でブロックを登録しているか」「WooCommerceのブロック登録に依存しているか」の切り分けが重要になる。前者は今回の変更を意識する必要がなく、後者だけが対応を検討すればよい。
開発者が取るべき対応と正しいブロック作成

woocommerce_should_register_blocksフィルターで復帰
影響を受けるエクステンションは、新しいwoocommerce_should_register_blocksフィルターを使い、実際にブロックを描画するリクエストのときだけtrueを返す。
add_filter(
    'woocommerce_should_register_blocks',
    function ( $should_register ) {
        return my_context_renders_blocks() ? true : $should_register;
    }
);フィルターはプラグイン読み込み時に実行され、メインクエリが解析される前の段階で呼ばれる。そのため条件には$_SERVERや$_GETなど、この初期段階で利用できる情報だけを使うことになる。
復帰させる範囲を絞りすぎるとブロックが見つからず表示が変わることがある。逆に広げすぎると今回の性能改善が失われる。描画が実際に発生するリクエストを正確に判定する条件を書くのが開発者の作業になる。
内部クラスAbstractBlockを避ける
WooCommerceはブロックをAbstractBlockという内部クラスの上に構築しないよう推奨している。内部クラスを継承すると、WooCommerceが下すすべての登録判断、今回のスキップも含めて引き継ぐことになる。
登録の最適化が進むにつれ、内部クラスのライフサイクルは今後も変わり続ける。依存すると将来のアップデートで予期しない挙動になる可能性が高い。
標準のWordPress Block APIを使う
サポートされる方法は標準のWordPress Block APIだ。ブロックをblock.jsonに定義し、init時にregister_block_type()で登録する。カートやチェックアウトの内部ブロックには@woocommerce/extend-cart-checkout-blockテンプレートがある。
WooCommerceの公式ドキュメントにあるスキャフォールディングとサンプルストアデータ、@wordpress/create-blockも出発点として適している。標準APIに沿って作れば、今後の最適化に追随しやすい。
正式リリース前の段階で、WooCommerceはエクステンション開発者に11.1へのテストを呼びかけている。とくに商品データやカート情報をAPIで扱う拡張を配布している場合は、早めの動作確認が安全だ。
この記事のポイント
- WooCommerce 11.1はブロックを描画しないリクエストでブロック登録をスキップする
- Store APIとREST APIは13〜18ミリ秒、割合で30〜42%高速化する
- 商品説明や自前登録ブロックは影響を受けず対応不要
- 影響を受ける場合のみ woocommerce_should_register_blocks フィルターで復帰させる
- 内部クラスAbstractBlockではなく標準のWordPress Block APIでブロックを作る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Googleサーチコンソールの生成AIレポートが全世界展開。見方とオプトアウトの注意点
Googleサーチコンソールの生成AIレポートが、2026年8月31日付で全世界のサイトに展開された。AI OverviewsやAI Modeなど生成AI機能での表示回数を、ページ別・国別・日付別に確認できる。
一方で、クリックデータはまだ提供されていない。表示はされても実際のサイト訪問につながったかは分からない。この記事ではレポートの見方、オプトアウト設定の仕組み、SEO担当者が取るべき対応を整理する。
生成AIレポートの全体像

2026年6月から段階的に展開が始まった生成AIレポートは、8月31日付の公式注記で全世界のサイトに行き渡った。Search Consoleにログインすると、検索レポートとDiscoverレポートのそれぞれで生成AI関連のデータを確認できる。
レポートが対象とするのは、AI Overviews、AI Mode、Discoverの生成AI機能だ。AI Overviewsは検索結果の上部に生成AIが回答の要約を表示する機能を指す。AI Modeは対話形式で検索を続けられる専用モードだ。DiscoverはGoogleアプリのフィードで、ここにも生成AIによるコンテンツ表示が含まれる。
従来の検索ではクリックが発生してサイト訪問につながっていた。生成AI検索ではサイトが回答の参照元として表示されても、ユーザーがクリックするとは限らない。この違いがレポートの重要性を高めている。
レポートで確認できる指標
レポートには生成AI機能での表示回数、つまりインプレッションが記録される。検索レポートではページ別・国別・日付別に加えて、デバイス別の内訳も確認できる。Discoverレポートでも同様に、ページ・国・日付の切り口でデータを見られる。
たとえば、自社の記事がAI Overviewsの中でどの国で多く表示されているか、日を追って伸びているかを把握できる。特定のページが頻繁に参照されているなら、その分野のコンテンツが生成AIに評価されている可能性を示す。
クリックデータは含まれない
公開時点でレポートにクリックデータは含まれていない。クリック数やクリック率は確認できず、表示が実際のサイト訪問につながったのかは分からない。この制約は、レポートの活用方法を考えるうえで大きなポイントになる。
Googleはアクセスについても、すべてのプロパティに展開が完了したわけではないとヘルプページで説明している。AIインプレッションが十分に蓄積されていないサイトでは、レポート自体が表示されない可能性がある。
オプトアウト設定の仕組み

レポートと同時に提供されているのが「Search generative AI control」というオプトアウト設定だ。Search Consoleの設定画面に配置されており、プロパティ単位で有効にできる。この設定を使うと、AI Overviews、AI Mode、Discover生成AIの3つの表示面からサイトのリンクとコンテンツを除外できる。
オプトアウトしたサイトは、これらの生成AI機能からのトラフィックとインプレッションが一切発生しなくなる。Googleは公式発表で、この設定が通常の検索ランキングのシグナルとして使われることはないと明言している。生成AI機能に表示されないことが、通常の検索順位に影響することはないという意味だ。
レポートはこの3つの表示面を対象にインプレッションを集計する。オプトアウト設定も同じ3面が対象になるため、運用の判断ではこの対応関係を理解しておきたい。
設定の効果と影響範囲
オプトアウトはプロパティ単位で適用される。つまり、サイト全体がまとめて生成AI機能から除外される形だ。ページ単位で一部だけ除外するような細かい制御は、現時点では提供されていない。
除外を有効にすると、生成AI機能からの表示は完全に止まる。生成AI経由の露出をすべて断つことになるため、ブランド認知や間接的な流入を期待している場合は慎重な判断が求められる。
AIトレーニングとは別の設定
このオプトアウトは、生成AIの学習データへの利用を制御する仕組みとは別物だ。Googleの生成AIトレーニングへの利用可否は、Google-Extendedという別の制御で管理される。Search generative AI controlを有効にしても、AIトレーニングへの利用は止まらない。
「生成AI機能への表示」と「AIの学習利用」は異なる設定で管理されている。SEO担当者は、この2つを混同せずに運用方針を決める必要がある。
ここまでの展開経緯
生成AIレポートとオプトアウト設定は、2026年6月3日にGoogleから同時に発表された。当初は英国のウェブサイト運営者の一部を対象にした限定的なテストとして始まっている。
同日、英国の競争・市場庁(Competition and Markets Authority / CMA)は行動要件を発行した。Googleに対し、サイトが通常の検索結果でペナルティを受けることなくAI検索機能からオプトアウトできるようにすることを求めた。
6月の発表と英国限定テスト
6月の時点では、レポートとオプトアウト設定は英国の選ばれたサイト運営者にのみ提供された。規制当局の要求と同時期に動き出した形だ。検索市場における競争環境を意識した展開だったといえる。
7月以降の段階的な拡大
7月になると、英国以外のアカウントでも設定が表示され始めた。その後、8月31日付の注記で全世界のサイトへの展開が完了したとされた。ただし、ヘルプページには展開が進行中であるとの記載が残っており、実際のアクセスにはタイムラグがあるようだ。
なぜ重要なのか

レポートが見えるようになると、オプトアウトを判断する前に生成AI機能での表示状況を確認できる。これまではブラックボックスだったAI検索内での露出が、数字として見えるようになる。
ただし、インプレッションの真の価値はまだ明確ではない。表示回数が多くても、クリックにつながるかどうかは別の問題だ。生成AI検索では、ユーザーが回答だけで満足してサイトを訪れないケースが増えると指摘されている。
レポートで見えるのは表示回数のみ。実際のトラフィック効果を測るにはクリックデータが必要になる。SEO担当者はこの制約を踏まえたうえでデータを読む必要がある。
SEO担当者が取るべき対応
まずはSearch Consoleでレポートの有無を確認する。すでに表示されている場合は、どのページがどの表示面でインプレッションを得ているかを把握できる。AIインプレッションが少ないサイトでは、レポート自体が表示されないこともある。
表示回数が少ない場合や、自社ブランドと合わない文脈で引用されている場合は、オプトアウトを検討する余地がある。ただし、クリックデータがないため、露出を継続した場合の潜在的な影響を過小評価しないことも重要だ。
既存の検索パフォーマンスレポートと併用し、通常検索の推移と生成AI検索の露出を比較しながら総合的に判断する。オプトアウトはプロパティ単位でしか実行できないため、サイト全体への影響を考慮する必要がある。
インプレッションデータの限界
最大の限界は、クリック数が分からない点だ。表示回数が増えても、サイトへの訪問が増えていなければビジネス上の価値は低い。生成AI回答にサイトの情報が引用されても、ユーザーがリンクを押さなければ意味がない。
加えて、引用位置や文脈も確認できない。自社サイトが回答の根拠として適切に扱われているのか、単に名前が出ているだけなのかをレポートから読み取ることはできない。インプレッションの質を評価する材料が不足しているのが現状だ。
今後の展望
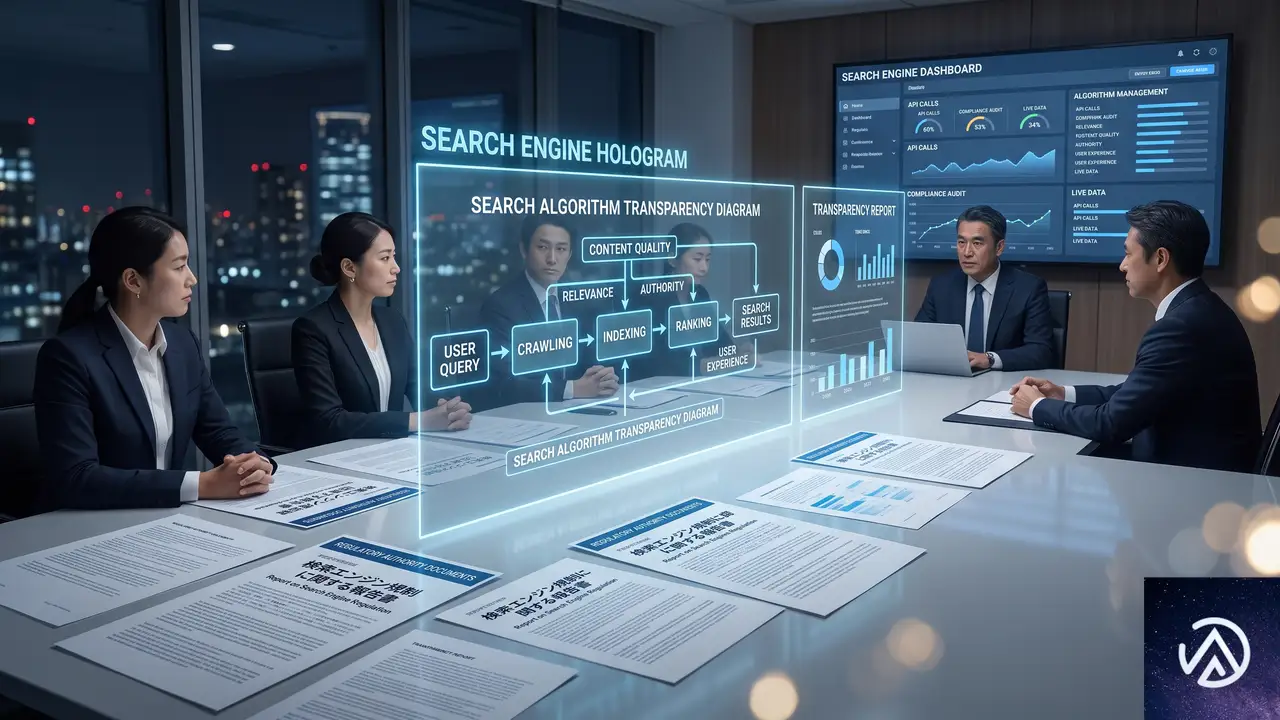
CMAは2027年3月までに、ページ単位の生成AI機能コントロールを導入するようタイムラインを設定している。現在のプロパティ単位の設定より細かい制御が求められている。
規制当局はクリックデータの提供も期待している。しかし、8月31日の更新ではクリックレポートへの言及はなかった。クリックデータが追加されれば、レポートの実用性は大きく高まる。
CMAの要求とタイムライン
ページ単位のコントロールは、サイト全体ではなく特定のページだけを生成AI機能から除外できる仕組みを指す。これが実現すれば、オプトアウトの判断がより柔軟になる。生成AI経由の露出を活かしたいページと、除外したいページを分けて運用できるようになる。
クリックデータ提供の行方
クリックデータが追加されるかは、現時点では未定だ。Googleは最初の1年間、コンプライアンス状況を6か月ごとに報告する義務を負っている。規制当局の継続的な監視が、レポートの改善を後押しする可能性は高い。
この記事のポイント
- 生成AIレポートは2026年8月31日付で全世界のサイトに展開された
- 対象はAI Overviews、AI Mode、Discover生成AIの3面で、ページ別・国別・日付別に表示回数を確認できる
- クリックデータはまだ提供されておらず、表示がトラフィックにつながるかは分からない
- オプトアウトはプロパティ単位で、検索ランキングには影響しないとGoogleが明言している
- CMAは2027年3月までにページ単位のコントロールを要求しており、今後の仕様変更に注意が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Rank Mathプラグインが管理者権限を無断取得か。WordPressセキュリティ問題
Rank Mathプラグインに重大なセキュリティ懸念が持ち上がっている。無料アカウントに連携した状態で「ヘルプ&サポート」セクションを開くと、管理者権限を持つアプリケーションパスワードが無断で生成されるという指摘が、開発者コミュニティからあがった。
指摘したのは、競合するThe SEO Frameworkプラグインの開発者Sybre Waaijer氏だ。Rank Mathは400万以上のサイトで利用される人気プラグインであり、影響範囲は極めて広い。今回はこの問題の仕組みと、サイト運営者が取るべき対処法を整理する。
このデモは、Rank Mathが取っているとされる方式と、WordPress公式が定める方式の違いを図式化したものだ。無承認での生成が問題の核となっている。
Rank Mathプラグインに何が起きているのか
指摘の発端と具体的な動作
2026年8月30日、Search Engine JournalはRank Mathプラグインに関する新たな疑惑を報じた。The SEO Frameworkの開発者Sybre Waaijer氏が、Rank Mathの「ヘルプ&サポート」セクションを開くだけで管理者権限が外部に渡ると指摘したのだ。
Waaijer氏によれば、Rank Mathは1.0.277へのアップデートでセキュリティ問題を修正した。しかし同じアップデートに、group.one(WP Rocketの所有者でもある企業)がサイトの管理者権限を取得できる機能が含まれていたという。
対象となるファイルは vendor/groupone/wap-client/includes/class-app-password-manager.php だ。無料のrankmath.comアカウントに接続されたサイトで、管理者が「ヘルプ&サポート」を開くと、プラグインが即座に「WAP – Rank Math Support Agent」という名前のアプリケーションパスワードを生成する。そのパスワードはgroup.oneのサーバーへ送信され、同社のAIエージェントがユーザーに代わってサイトを操作できる状態になる。
許可なき権限委譲という問題
Waaijer氏は「プラグインは最初にユーザーへ確認しない。「利用規約」ボックスは表示されるが、パスワードの生成と送信を止めることはできない。送信はボックスが表示される前に始まっている」と説明している。
つまりユーザーは、何の操作もしないうちに、自分のサイトの管理者権限を第三者へ委譲してしまう。しかも、その事実を知らされることはない。ヘルプ&サポートを閉じてもパスワードは失効せず、無期限に有効なままだ。
影響範囲と深刻度
Rank Mathは400万以上のサイトで利用されている。管理者権限があれば、プラグインの更新、テーマの変更、投稿の削除、ユーザー情報の閲覧といった、サイト運営の中核的な操作が可能になる。これはSEOプラグインの枠を超えた、サイト全体の安全性に関わる問題だ。
問題の中核にあるアプリケーションパスワードとは
WordPress標準の正当な仕組み
WordPressアプリケーションパスワードは、WordPressコアに含まれる正規の機能である。外部アプリケーションがWordPressサイトへ安全に接続するための仕組みで、ユーザーはいつでも個別に取り消せる。プラグインがこの仕組みを利用すること自体は、公式に認められている。
重要なのは、公式の仕様ではアプリケーションパスワードを発行する前に、必ず承認画面が表示されることだ。ユーザーがプラグインの身元を確認し、接続を許可するか拒否するかを選べる。パスワードがプラグインに渡るのは、ユーザーが承認した後でなければならない。
Rank Mathがガイドラインから外れている点
Rank Mathの動作は、この公式プロセスを完全に飛ばしている。承認画面は表示されず、ユーザーが何かをクリックする前にパスワードが生成され、外部サーバーへ送信される。Waaijer氏が指摘する通り、過去に同氏が「バックドア」と分類したものと構造が似ている。
WordPress.orgのプラグインガイドラインでは、外部サーバーと通信する際にはユーザーの明示的な同意が必要だと定められている。オプトインのチェックボックスや、サービスへの登録を経た同意が求められるのだ。Rank Mathの実装は、この原則に真っ向から反している。
取り消し方法が明示されない
アプリケーションパスワードは本来、ユーザーが確認して取り消せることを前提にしている。しかしRank Mathの場合、「ヘルプ&サポート」を開いただけでは、パスワードが発行された事実に気づく手がかりがない。プロフィール画面に「WAP – Rank Math Support Agent」という名前で表示されるため、知っていれば探せるが、知らなければ発見は難しい。
ユーザーコミュニティの反応
ソーシャルメディア上の反応は、一貫して否定的だった。一部のユーザーはWordPressコアにSEO機能を統合すべきだと主張し、別のユーザーはRank Mathから別のSEOプラグインへ移行する意思を示した。
フォーラムスレッド削除の疑惑
議論の中で、Rank Mathの公式フォーラムに大きなスレッドが立っていたが、その後削除されたという報告もあった。ユーザーの一人は「数日前にフォーラムで大きなスレッドが立っていたが、今日削除通知が来た。ユーザーフォーラムが大荒れになった後に削除されたようだ」と述べている。
もし事実なら、これはコミュニティの懸念を正面から受け止めていない姿勢と映る。透明性を求める声に対して、静かな対処を選んでいるように見えるからだ。
ユーザーが感じている不信感
「管理者アクセスが無断で?」という短い反応に、多くのユーザーの驚きが凝縮されている。SEOプラグインは検索順位を改善するための道具であって、サイトの制御権を委譲するものではない。誰もがそう考えていたからこそ、今回の発覚は衝撃を持って受け止められた。
Rank Mathの過去の脆弱性と信頼性
脆弱性の履歴
Rank Mathは2024年に7件、2025年に4件、2026年に入って3件の脆弱性が発見されている。直近では、認証されていない状態で保存型クロスサイトスクリプティング(XSS)を実行される脆弱性も報告されていた。
1つのプラグインにこれだけの脆弱性が続くこと自体が、セキュリティ管理の甘さを示す。その上に今回の無断権限取得が加われば、信頼はさらに揺らぐ。
Search Engine Journalの推奨リストから外れている
Search Engine Journalは、自社の推奨WordPressプラグインリストにRank Mathを含めていない。推奨条件の1つが「脆弱性の履歴がないこと」であり、Rank Mathはこの基準を満たせていないためだ。
プラグインの選択では、機能の豊富さだけでなく、セキュリティ面の信頼性を確認することが重要になる。今回の件は、その判断基準を改めて浮き彫りにした。
WordPressサイト運営者が取るべき対処法
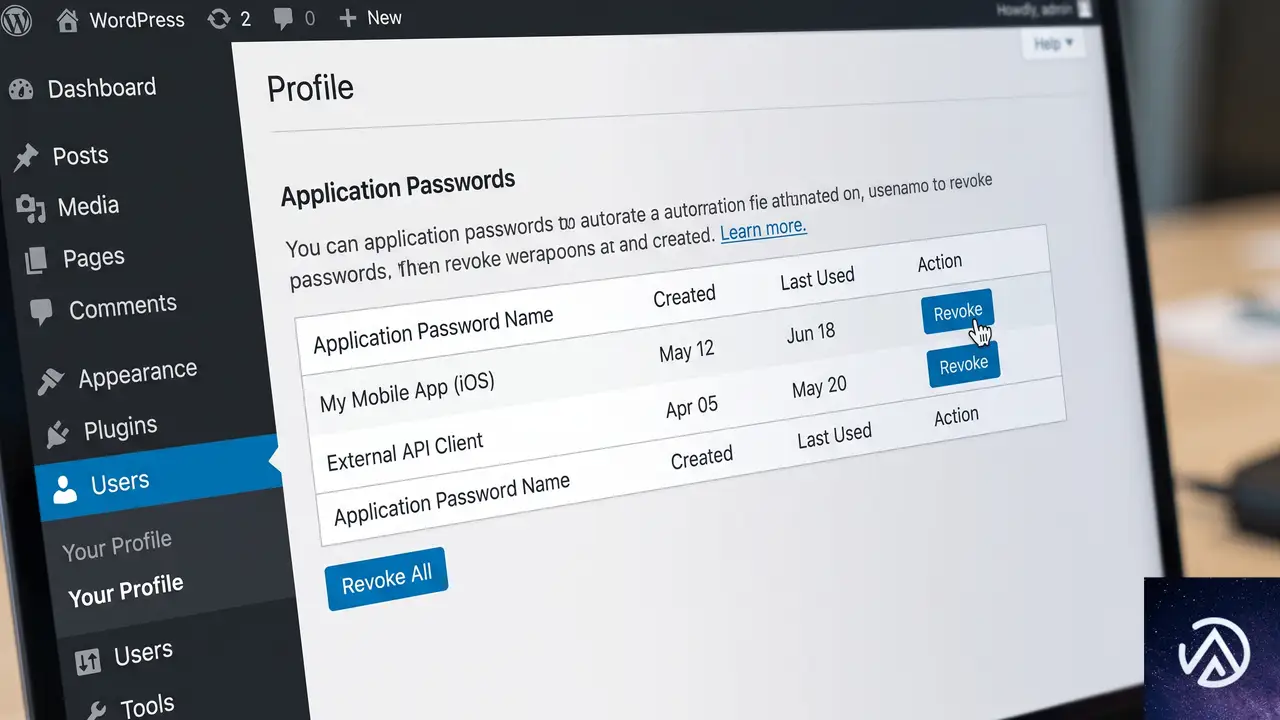
まずはパスワードを取り消す
Rank Mathを利用していて、無料アカウントに接続した状態で「ヘルプ&サポート」を開いたことがあるなら、すぐにアプリケーションパスワードを取り消すべきだ。Waaijer氏が具体的な手順を示している。
- WordPress管理画面の「ユーザー」から「プロフィール」を開く
- 「アプリケーションパスワード」セクションを確認する
- 「WAP -」で始まるパスワードをすべて取り消す
この操作により、Rank Mathのサポートエージェントが保持している管理者権限を無効化できる。手順は数分で済むが、放置すればリスクは残り続ける。
接続解除と設定の見直し
Rank Mathアカウントとの接続を解除することも有効な対策だ。接続していなければ、ヘルプ&サポートを開いてもパスワードは生成されない。必要になるまで無料アカウントへの接続を切っておくのが無難だ。
また、プラグインの権限設計そのものを見直す機会にしてほしい。管理者以外のユーザーがプラグイン設定を触れるようになっていないか、不要なプラグインが残っていないかを確認する。サイトのセキュリティは、積み重ねた小さな確認で守られる。
他プラグインの移行を検討する
今回の件を受けて、別のSEOプラグインへの移行を検討するユーザーも増えている。The SEO FrameworkやYoast SEOなど、信頼性の高い選択肢は複数ある。重要なのは、移行前に既存の設定やリダイレクト情報をバックアップしておくことだ。
上記のステップを順に実行することで、無断で付与された権限を無効化し、今後のリスクを低減できる。最初のステップが最も緊急性が高い。
この記事のポイント
- Rank Mathはヘルプ&サポートを開くと管理者権限のアプリケーションパスワードを無断生成すると指摘された
- 承認画面なしでパスワードが外部サーバーへ送信される仕組みはWordPress公式ガイドラインに違反する
- Rank Mathは2024年から2026年にかけて合計14件の脆弱性が報告されている
- 利用者は「ユーザー → プロフィール → アプリケーションパスワード」から「WAP -」をすべて取り消すべき
- アカウント接続の解除と他SEOプラグインへの移行も有効な対策になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.2のライフサイクルフック変更。保存と並び替えでSQL最大45%削減
WooCommerce 11.1と11.2で、商品保存と商品並び替えの内部処理が大きく変わった。商品保存時のSQLクエリ数は最大45%削減され、並び替えアルゴリズムは大規模カタログ向けに再設計された。
プラグインやカスタムコードで商品データを操作している場合、レガシーフックの移行が必要になる。本記事では変更の全体像、技術的な詳細、そして移行の具体的な手順を解説する。
WooCommerce 11.1と11.2の変更点を俯瞰する
2つの変更はいずれも、後方互換性を優先しつつ、大規模な商品カタログでパフォーマンスを改善することを目的としている。
大規模カタログ向けのパフォーマンス改善
WooCommerceチームは、商品数が数千・数万を超えるストアで発生する管理画面の遅延やデータベース負荷を問題視していた。特に商品保存と並び替えは、カタログ全体に影響が及ぶ処理であり、これまでの実装ではカタログが大きくなるほど処理時間が線形に悪化する構造だった。
今回の変更は、商品データストアが不要な書き込みを行わないようにし、並び替えでは全カタログの再インデックスを避ける設計へと置き換えるものだ。これにより、大規模ストアの管理画面レスポンスが大幅に改善される見込みである。
後方互換性の優先とレガシーフックの扱い
重要なのは、非推奨になったフックを使い続けた場合、自動的に旧アルゴリズムへフォールバックする点だ。互換性は保たれるが、その分パフォーマンス改善の恩恵は受けられない。
プラグイン開発者にとっては、古いフックへの依存を解消し、新しいフックへ移行するかどうかの判断が必要になる。次のセクションから、各変更の詳細を見ていく。
商品保存処理の最適化でSQL数を45%削減
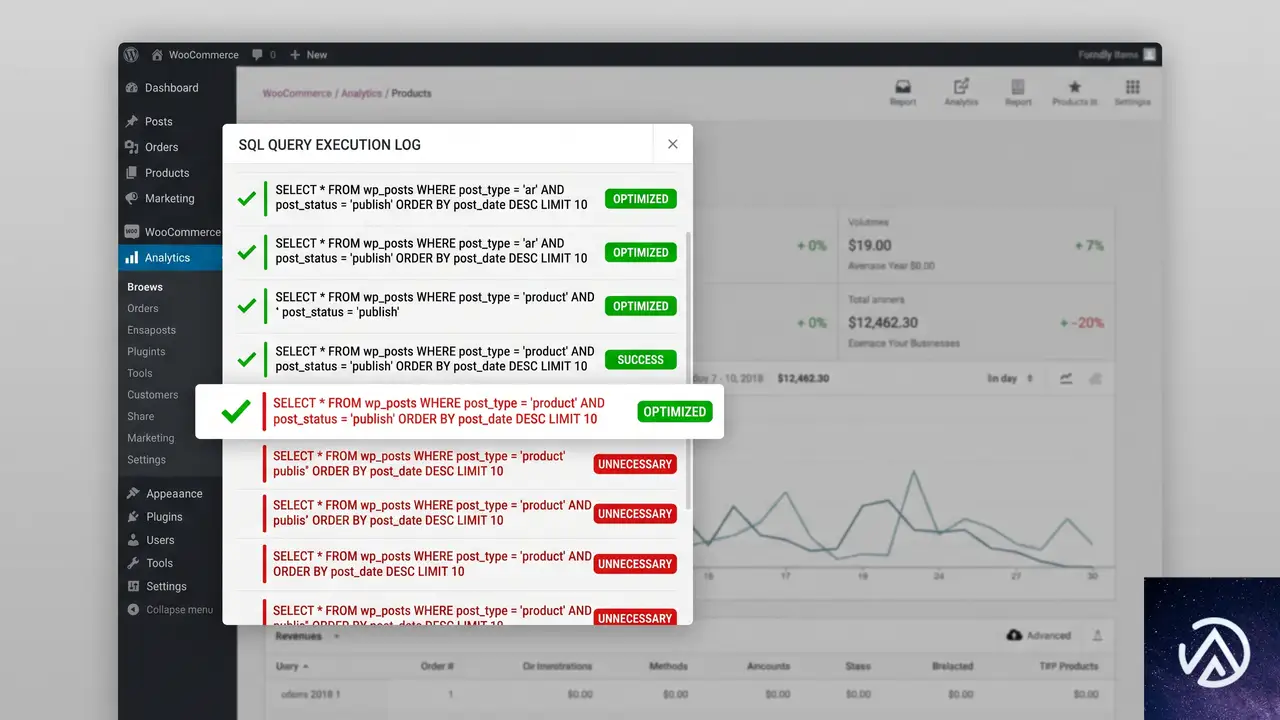
商品保存時の動作が変わり、値に変更がない場合はAPI呼び出しをスキップする。この最適化により、保存1回あたりのSQLクエリ数が最大45%削減される。
no-op書き込みの削減がもたらす効果
今回の最適化は、wp_set_object_terms() と delete_post_meta() というWordPressの関数に着目したものだ。これらの関数は、データが変わっていない場合でも呼び出されるとキャッシュを無効化する動作をしていた。いわば「変更がないのに掃除をする」ような無駄が毎回発生していた。
WooCommerce 11.1以降では、保存前の値と保存後の値を比較し、同じ値であればこれらのAPIを呼び出さない。この小さな変更が、商品保存を頻繁に行う大規模ストアでは大きなDB負荷の削減につながる。
フック発火頻度の変化による副作用
ただし注意点がある。set_object_terms フックは、これまで商品保存のたびに発火していた。最適化後は、値が変わった場合のみ発火するようになる。このフックに依存して何らかの処理を実行しているカスタムコードがある場合、想定よりも発火回数が減る可能性がある。
具体的には、商品タイプが変わっていなくても毎回の保存で処理を行うことを前提としたコールバックは、移行が必要だ。次のセクションで確認手順を詳しく解説する。
商品並び替えアルゴリズムの刷新とフック移行
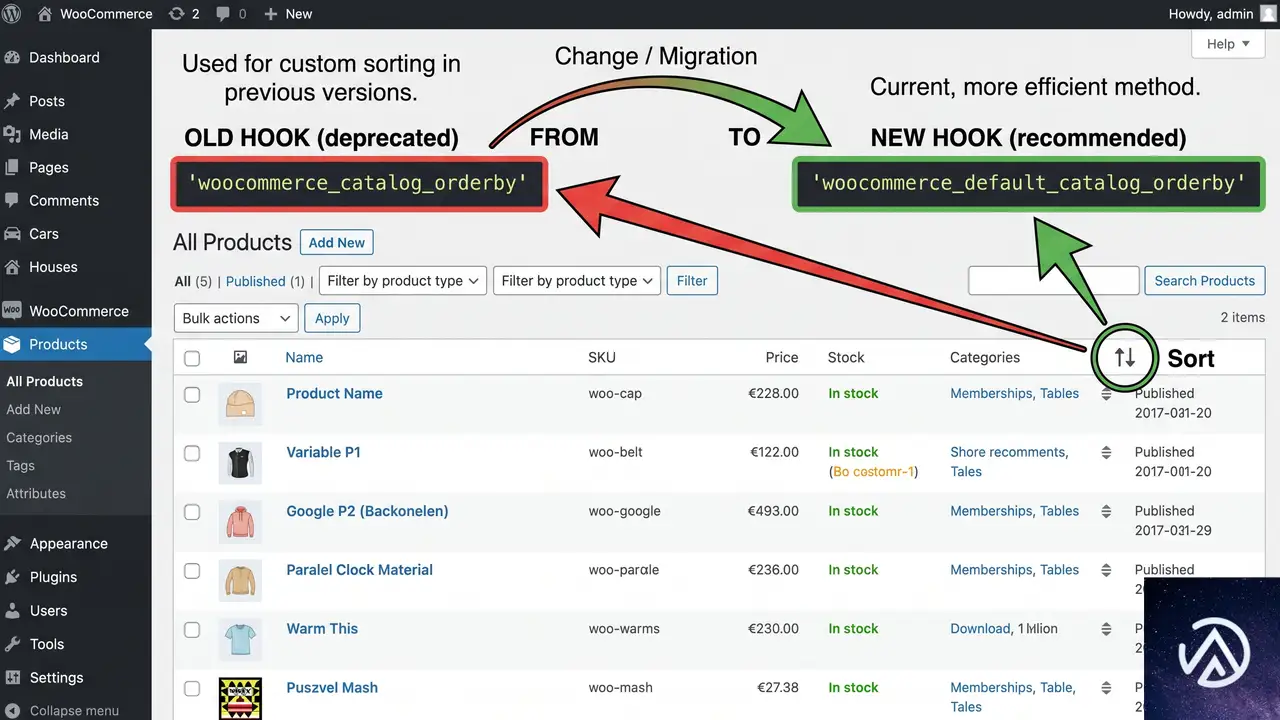
並び替えに関わるフックは2つが非推奨になり、2つの新しいフックが追加された。非推奨フックを使うと旧アルゴリズムにフォールバックする。
旧アルゴリズムから新アルゴリズムへ
従来の商品並び替えは、管理画面の「商品 → すべての商品 → 並び替え」で操作するたびに、カタログ全体を再インデックスしていた。商品数が1万件を超えると、この処理は数十秒かかることもあり、実用に耐えないケースがあった。
新しいアルゴリズムは、大規模カタログを前提に設計されている。再インデックスを高速化し、範囲ベースの並び替えを採用することで、変更された範囲だけを効率的に処理する。これにより、大規模ストアでも並び替え操作が快適になる。
非推奨フックと新フックの対応表
以下の表が、今回変更されたフックの全体像だ。非推奨になったフックを今も使っている場合、対応する新しいフックへの移行を検討する必要がある。
woocommerce_after_single_product_orderingは非推奨。カタログ再インデックス中に商品ごとに発火していたwoocommerce_after_product_orderingは非推奨。並び替え完了後に一度だけ発火していたclean_post_cacheは変更なし。レガシーと高速パスの両方で影響を受けた商品ごとに発火するwoocommerce_product_ordering_process_reindexed_productsは新設。フルカタログ再インデックス後に発火するwoocommerce_product_ordering_process_moved_productsは新設。商品が再配置された後に発火する
元の動作を再現するには、clean_post_cache、wp_ajax_woocommerce_product_ordering、woocommerce_product_ordering_process_reindexed_products、woocommerce_product_ordering_process_moved_products をプリミティブとして組み合わせる方法が公式に案内されている。
既存サイトが受ける影響と確認手順
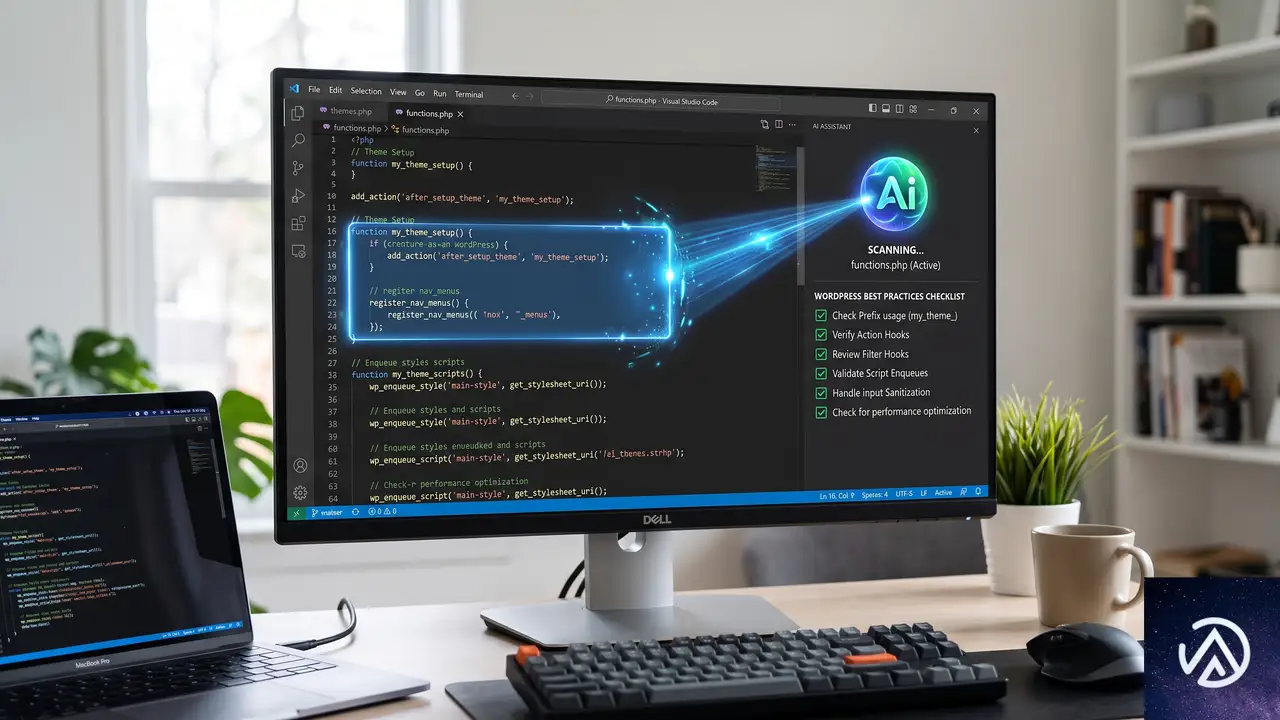
公式ブログでは、AIツールを使ってカスタムコードを確認する方法が提示されている。上の手順で、フックへの依存を洗い出せる。
カスタムコードの確認方法
まず、アクティブなプラグイン、MUプラグイン、テーマの functions.php を対象に、add_action('set_object_terms', ...) というコールバックを検索する。該当があれば、そのコールバックが「商品タイプが変わっていなくても毎回発火すること」を前提にしていないかを確認する。
もし前提にしていた場合、そのコールバックは woocommerce_update_product や save_post_product など、より適切なフックへ移動する必要がある。
移行が必要なケースと不要なケース
移行が必要なのは、set_object_terms フックが毎回発火することを前提にしたコードが存在する場合だ。逆に、商品タイプの変更やカテゴリの変更など、実際に値が変わる場合のみ処理を行いたいというコードは、そのままでも問題ない。
並び替え関連では、woocommerce_after_single_product_ordering と woocommerce_after_product_ordering を使っているコードは、新しいフックへの移行を検討する。非推奨フックを使い続けても動作はするが、旧アルゴリズムにフォールバックするため、パフォーマンス改善の効果を得られない。
この記事のポイント
- 商品保存処理は、値が変わらない場合はAPI呼び出しをスキップしてSQL数を最大45%削減する
- 商品並び替えは、全カタログ再インデックスから範囲ベースの新アルゴリズムへ刷新された
set_object_termsフックの発火頻度が変わるため、毎回発火を前提としたコードは移行が必要- 並び替えの旧フック2つは非推奨になり、新フック2つが追加された
- 非推奨フックを使い続けると旧アルゴリズムにフォールバックし、高速化の恩恵を受けられない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.1で注文撤回機能が登場、14日以内の自己対応を実現
WooCommerce 11.1に注文撤回(Order Withdrawal)機能が追加された。EU域内の消費者が持つ14日間の契約撤回権に対応するための仕組みで、顧客が店舗にメールや電話で問い合わせることなく、注文から14日以内であれば自分で撤回リクエストを送信できるようになる。
この機能は既定では無効化されている。すべてのストアに必要な機能ではないため、事業者が設定画面から明示的に有効化する方式だ。顧客向けのリクエストフォーム、自動確認メール、店舗側の通知まで一連のフローが組み込まれている。
本記事では注文撤回機能の概要、有効化の手順、顧客と店舗それぞれの画面で何が起きるのかを解説する。EU向けに販売するストア運営者は特に確認しておきたい内容だ。
注文撤回機能とは何か
注文撤回機能は、EUの消費者保護規則で定められた「注文撤回権」に対応するための機能だ。EU域内の消費者は、商品やサービスを注文した日から14日以内であれば、理由を説明せずに契約を撤回する権利を持つ。従来はこの手続きをメールや電話で行う必要があり、店舗側も個別に対応する必要があった。
EUの14日間撤回権とは
14日間の撤回権はEU消費者権利指令に基づく制度で、オンライン購入を含む通信販売に適用される。消費者は商品を受け取った日から14日以内に撤回を申し出ることができ、事業者は返金に応じる義務を負う。この規則はEU域内の消費者との取引に適用されるため、日本からEU向けに販売するストアも対象になりうる。
重要なのは、注文撤回機能は法的手続きの自動化ツールであって、コンプライアンスを保証するものではないという点だ。WooCommerce Developer Blogの記事でも、事業の内容や顧客の所在地に応じて法律専門家に相談するよう明記されている。
従来の対応との違い
従来のフローでは、顧客がメールや電話で撤回の意思を伝え、店舗担当者が手動で注文を確認し、返金処理を行っていた。この方式には対応漏れや記録不足のリスクが伴う。注文撤回機能は、顧客が自己対応フォームからリクエストを送信し、システムが自動で記録と通知を行う。
このデモで示した違いは大きい。顧客からの撤回リクエストがシステムに記録され、確認メールが自動送信されることで、店舗と顧客の双方に証跡が残る。対応の属人化を防ぎ、処理の一貫性を保てる。
有効化の手順
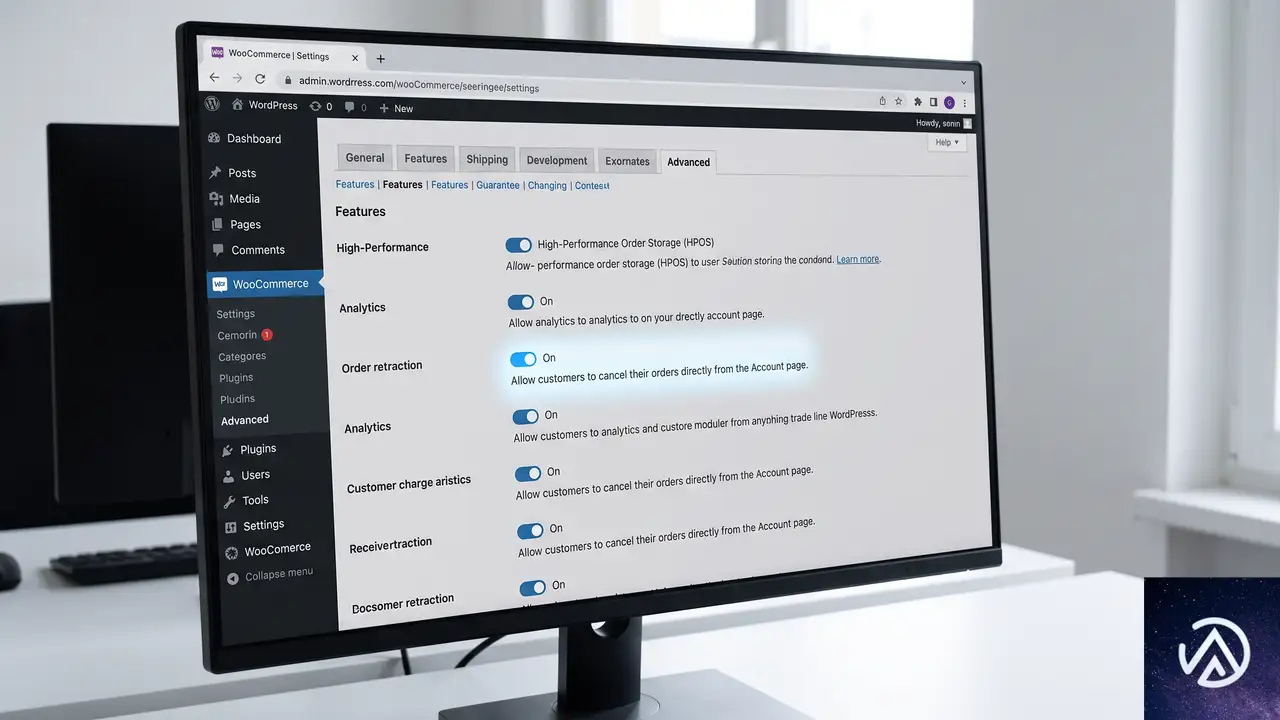
注文撤回機能は既定では無効化されている。EU向け販売を行っていないストアでは不要な機能のため、必要な事業者だけが有効化する設計だ。設定はWooCommerceの管理画面から数ステップで完了する。
設定画面での操作
WooCommerceの設定画面を開き、詳細設定タブから機能セクションに移動する。そこに注文撤回のオプションが表示されるので、有効化して変更を保存するだけだ。設定完了後、顧客向けのリクエストフォームが /my-account/withdraw-order というURLで公開される。
エンドポイントのカスタマイズ
リクエストフォームのURLは変更できる。詳細設定のページ設定セクションでエンドポイントを編集すれば、自社の導線に合わせたURLに調整できる。標準のURLは /my-account/withdraw-order だ。
もう1つの重要な特徴として、このページはログイン状態に関わらず動作する。ゲスト購入した顧客でもフォームにアクセスしてリクエストを送信できる。EUの撤回権はゲスト購入者にも適用されるため、この設計は実務上欠かせない。
顧客から見た注文撤回フロー
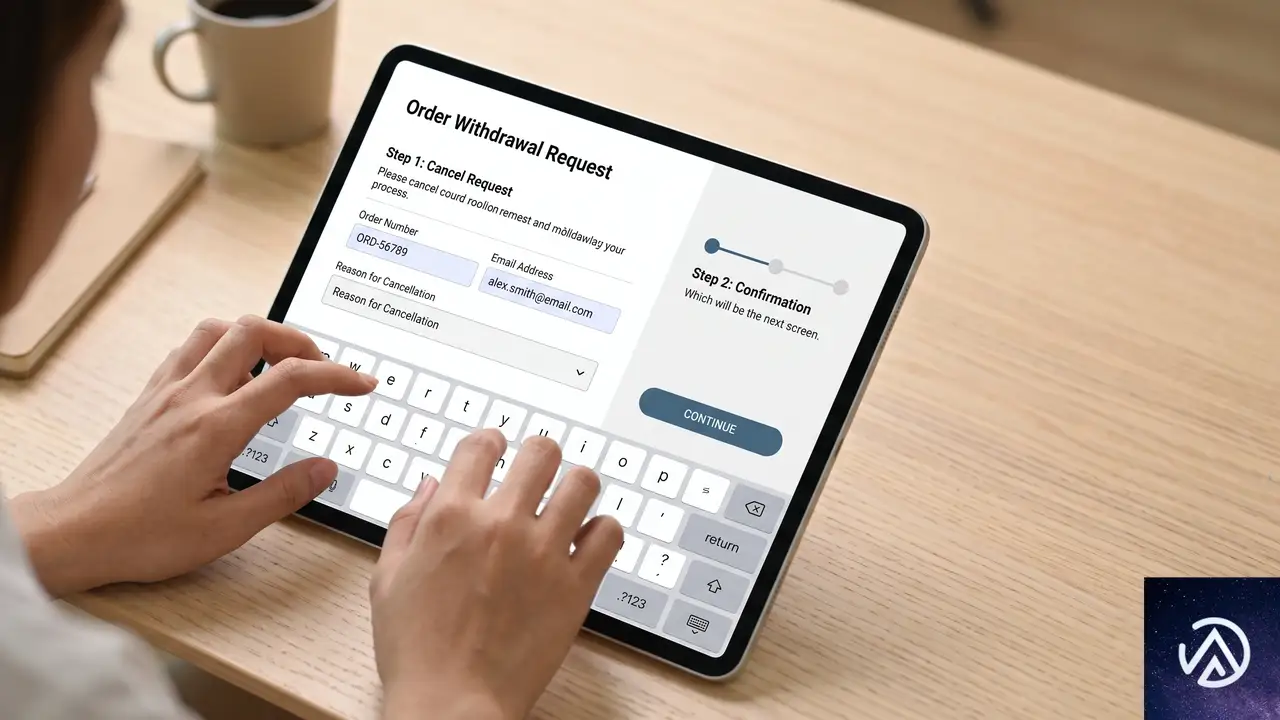
顧客が注文撤回ページにアクセスすると、短いリクエストフォームが表示される。必要な情報を入力し、送信前に内容を確認する画面を経てから送信する。送信後は確認画面が表示され、入力した内容を含む確認メールが自動的に届く。
この4ステップのフローは、顧客が自分の操作だけで撤回リクエストを完了できることを示している。確認メールには顧客が入力した内容が含まれるため、顧客はリクエストの記録を残せる。店舗側への電話やメールが不要になり、双方の手間を削減する。
確認メールが自動送信される点は法的にも意味がある。撤回権の行使を顧客が証明できる記録が残るため、後日のトラブルを防ぐ効果が期待できる。
店舗運営者から見た通知と管理
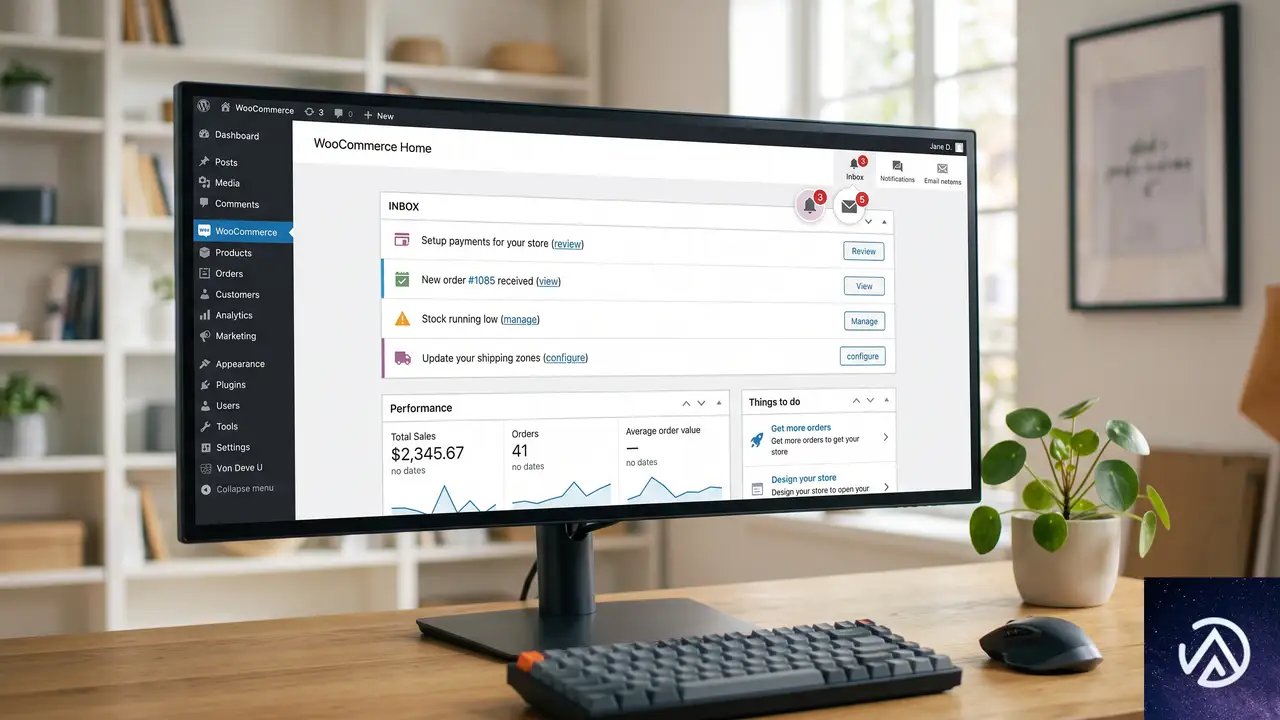
顧客がリクエストを送信すると、店舗運営者には2つの経路で通知が届く。1つは撤回リクエストを知らせるメール通知、もう1つはWooCommerceホーム画面のインボックス通知だ。この二重の仕組みにより、リクエストの見落としを防ぐ。
リクエスト内容に含まれる注文番号と請求先メールアドレスが既存の注文と一致する場合、リクエストは自動的にその注文に紐付けられ、注文メモが追加される。これにより、店舗担当者は注文詳細画面からリクエストの存在を確認できる。
一致する注文が見つからない場合でも、リクエスト自体は受け付けられ、顧客には確認メールが送信される。通知には手動確認が必要であることを示すフラグが付けられ、注文へのリンクはスキップされる。この設計により、注文番号の入力ミスやゲスト購入の注文でも、リクエストが拒否されることはない。
重要な点として、撤回リクエストの送信は注文ステータスを変更しない。注文が自動的にキャンセルされたり、返金が実行されたりすることもない。リクエストはあくまで「撤回の申し出」であり、その後の対応(返金の承認、商品返送の依頼、追加情報の確認など)は店舗側の判断に委ねられる。
導入前に確認すべき注意点
注文撤回機能は店舗運営の効率化に寄与するが、いくつかの注意点がある。まず、この機能がEUの法的要件への準拠を保証するわけではないという点を理解しておく必要がある。WooCommerce Developer Blogの記事でも、事業内容や顧客の所在地に応じて法律専門家に相談するよう明記されている。
リクエスト処理のワークフロー設計
撤回リクエストが届いた後の対応フローは、店舗自身で設計する必要がある。返金を承認するのか、商品の返送を求めるのか、追加情報を確認するのか。これらの判断基準を事前に決めておかないと、リクエストが届いてから担当者が迷うことになる。
特に、注文ステータスが自動変更されない点は運用上のポイントだ。リクエストが届いても注文は「処理中」などの状態のまま残るため、店舗側で明示的に注文をキャンセルする処理が必要になる。この部分を社内で共有しておかないと、注文が放置されるリスクがある。
ゲスト購入への対応
ログインしていない顧客でもリクエストを送信できる設計は、ゲスト購入が多いストアにとって重要な特徴だ。ただし、ゲスト購入の注文は注文番号とメールアドレスの照合が手動になる可能性がある。手動確認フラグが付いたリクエストを担当者が見逃さないよう、通知の確認ルールを決めておく必要がある。
実務的には、EU向け販売を行うストアにとって注文撤回機能は顧客対応の手間を大幅に減らす可能性がある。メールや電話での個別対応から、システム化されたリクエスト処理へ移行することで、対応の一貫性と記録の完全性が向上する。一方で、リクエスト受信後のワークフローが未整備のままでは、かえって対応が遅れるリスクもある。
注文撤回機能は、WooCommerce 11.1の新機能としてEU対応ストアに実用的な選択肢を提供する。導入を検討する場合は、機能の有効化だけでなく、社内の対応フローまで含めて計画することをおすすめする。
この記事のポイント
- WooCommerce 11.1に注文撤回機能が追加され、顧客が自己対応で撤回リクエストを送信できる
- EUの14日間撤回権に対応する仕組みで、既定では無効化されている
- 顧客はフォーム入力から確認メール受信まで自動フローで完了できる
- 店舗にはメールとインボックスの二重通知が届き、注文への自動リンクも行われる
- 注文ステータスは自動変更されないため、受信後のワークフロー設計が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Run instances登場!AIエージェントを月額6ドル弱で常時稼働
Google Cloudが2026年8月27日、常時稼働するAIエージェント向けの新サービス「Cloud Run instances」をプレビュー公開した。サーバーレスの利便性を保ちながら、単一インスタンスを長期間動かし続けるための専用ランタイムだ。
1vCPU・1GiBメモリの構成なら、30日間連続稼働して月額5.70ドル。従来の専用VMと比較すると運用コストと管理負担を大幅に抑えられる。
パーソナルAIエージェントを自宅のPCや専用サーバーで動かしていた開発者にとって、クラウド移行の有力な選択肢になる。本記事ではCloud Run instancesの特徴、料金構造、実際のデプロイ手順までを解説する。
Cloud Run instancesの基本と既存サービスとの違い
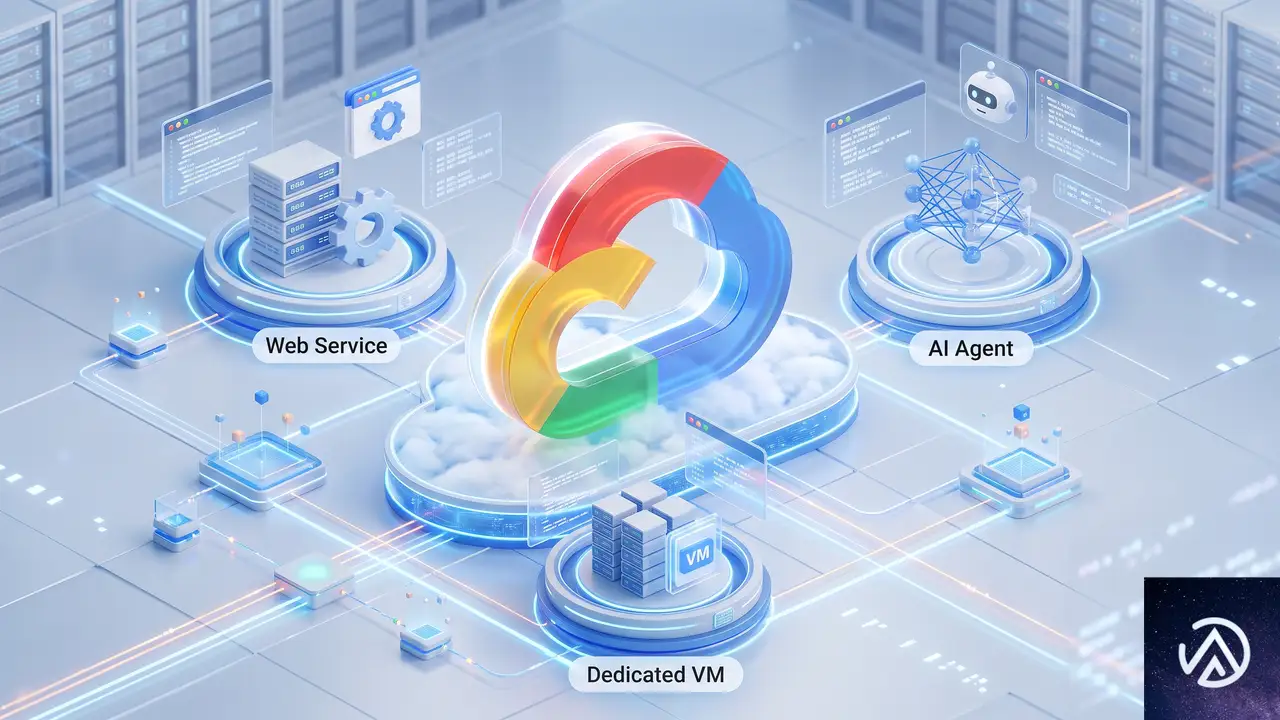
Cloud Run instancesは、Google Cloudのサーバーレスコンテナ基盤であるCloud Runの新しい実行モードだ。既存のCloud Run servicesが高スループットなWebサービス向けに設計されているのに対し、Cloud Run instancesは「1つのインスタンスを確実に動かし続ける」ことに特化している。
主な特徴は次の4つにまとめられる。
- オートスケーリングなしの単一インスタンスのみを実行する
- 最大7日間の連続実行と自動再起動ポリシーを標準で備える
- 更新や再起動後も変わらない固定HTTPS URLが発行される
- 使わないときは停止し、必要なときに再開できる
3つの実行環境の違いを比較した図だ。Cloud Run instancesは既存Cloud Runと専用VMの中間的な位置づけで、サーバーレスの手軽さと常時稼働の確実性を両立している。
既存のCloud Run servicesとの決定的な違い
Cloud Run servicesは、リクエストが途絶えるとインスタンスがスケールゼロになる。これは高トラフィックなWeb APIには効率的だが、常に1つのコピーが動き続けることを期待するAIエージェントには不向きだ。一方、Cloud Run instancesはオートスケーリングを行わず、指定した設定のインスタンスを1つだけ動かし続ける。これが最大の設計上の違いになる。
なぜAIエージェントに最適なのか
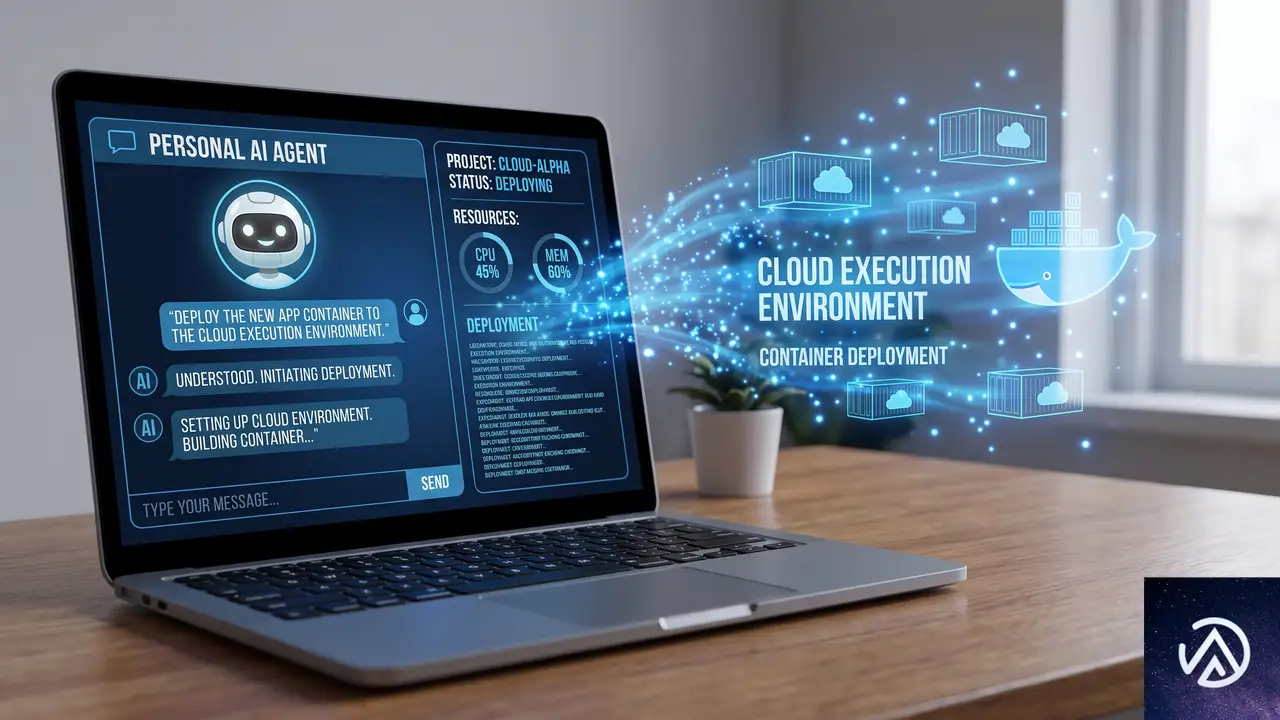
OpenClawやHermesといったパーソナルAIエージェントは、継続的に動作し、通常は一度に1人のユーザーにしかサービスしない。これらの特性は、ステートレスな高スループットWebサービスとはインフラ要件が大きく異なる。
OpenClawは、ユーザーの代わりにさまざまなタスクを実行するオープンソースのパーソナルAIエージェントだ。使うほど学習して賢くなる。多くのOpenClawユーザーは最初に自分のノートPCで実行し始めるが、ノートPCがスリープするたびに停止してしまう問題に直面する。ここでクラウド上の常時稼働環境が必要になる。
従来の選択肢の問題点
専用VMを借りる方法もあるが、24時間365日の課金、OSのアップデート管理、ファイアウォールのポート開放、HTTPSエンドポイントの構築といった手間が発生する。Cloud Run instancesはこれらの管理タスクをクラウド側に任せつつ、低コストで常時稼働を実現する。
ここでのポイントは、AIエージェントのワークロードが「バースト型」であることだ。普段は待機状態でCPUをほとんど使わず、ユーザーが指示を出した瞬間だけ計算リソースを消費する。共有vCPUとバーストバジェットによる課金モデルは、このバースト型の特性と相性が良い。常時フルパワーのCPUを確保する必要がないため、価格を抑えられる。
料金とコスト構造の分析
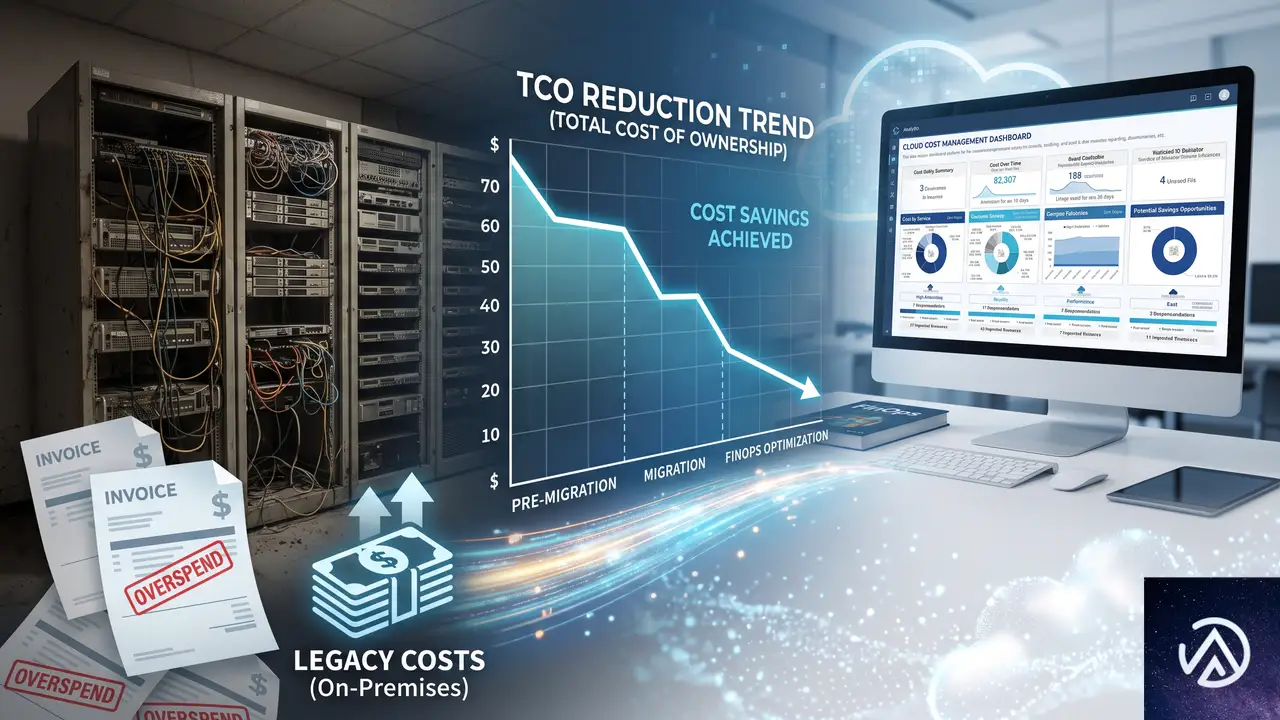
1vCPU・1GiBメモリのCloud Run instanceを30日間連続稼働させた場合のコストは5.70ドル。共有vCPUとvCPUバーストバジェットを利用して、低く予測可能な価格で連続実行を実現している。
従来の専用VMと比べると、クラウド料金に大きな差がある。30日間連続稼働でわずか5.70ドルという価格は、個人開発者が気軽に試せる水準だ。
価格設定の分析
5.70ドルという価格は、パーソナルAIエージェントの利用シーンを想定した戦略的な設定だ。個人開発者がノートPCの代わりにクラウドでAIエージェントを常時稼働させるには、月額10ドル以下という心理的なハードルが大きい。Cloud Run instancesはこの価格帯を実現したことで、パーソナルAIエージェントのクラウド移行を加速する可能性がある。
OpenClawデプロイの実践手順
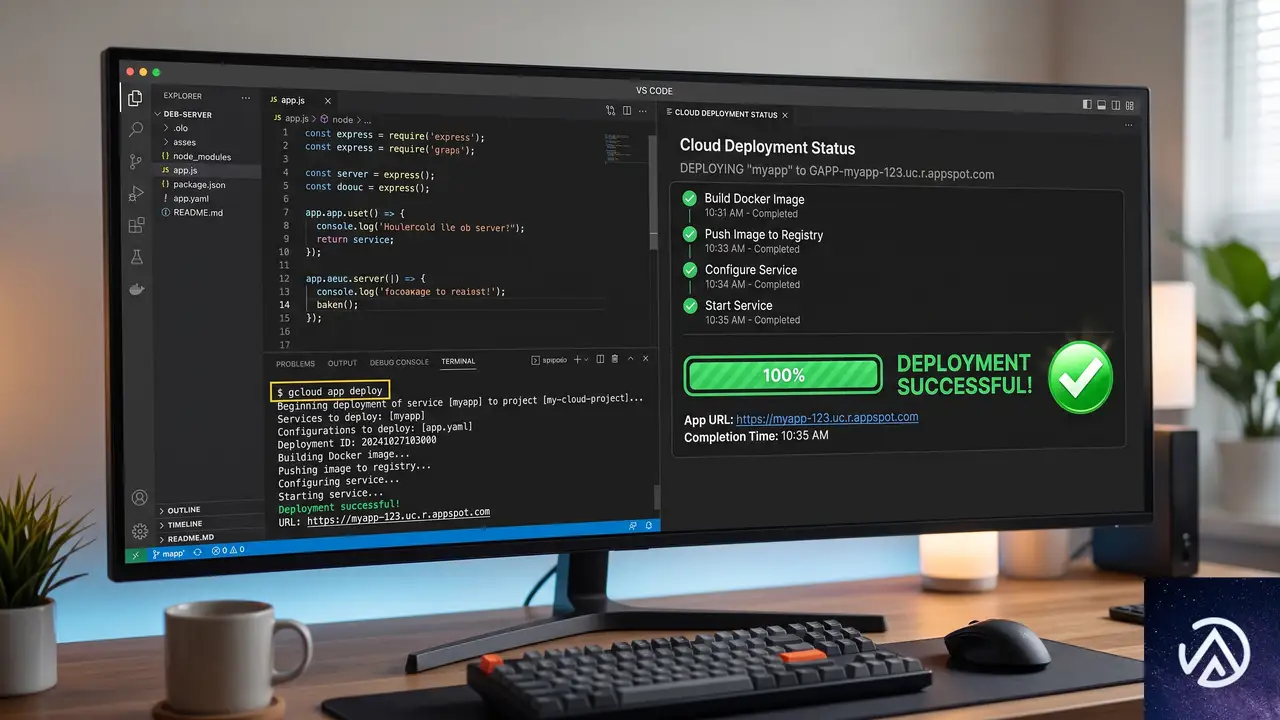
OpenClawをCloud Run instancesにデプロイする手順はシンプルだ。設定ファイルをCloud Storageバケットにアップロードした後、1つのコマンドを実行するだけでデプロイが完了する。
デプロイ後のOpenClawは、使いたい限り動かし続けられる。メッセージングアプリと接続してタスクを任せることも、必要なツールと連携させることも可能だ。
SSHアクセスと今後のアップデート
Cloud Run instancesとCloud Run servicesの両方で、SSHアクセス機能が近日中に提供される予定だ。これにより、実行中のコンテナに直接ログインしてデバッグや設定変更ができるようになる。詳しい手順はCloud Runのcodelabで公開されている。
ユーザー事例と今後の展望
OffDeal社の導入効果
中小企業向けのAI投資銀行を提供するOffDealは、Cloud Run instancesを長期間稼働するエージェントの主要インフラとして利用している。OffDeal社のLuis Ruiz Morel氏によれば、コールドスタートが88%削減され、実装も非常にシンプルで信頼性が高いとのことだ。
コールドスタート88%削減とは、エージェントが待機状態からタスクを開始するまでの起動時間が大幅に短縮されたことを意味する。AIエージェントの応答性がビジネス成果に直結するユースケースでは、この改善は大きな価値となる。
プレビューからGAへ
Cloud Run instancesは現在プレビュー段階で、パフォーマンスを犠牲にせずに新しい種類のワークロードをコスト効率よく実行する手段として提供されている。今後、GA(一般提供)への移行とともに、より多くのAIエージェントワークロードがこの基盤に集約される可能性がある。
Cloud Run instancesの登場は、サーバーレスコンピューティングの適用範囲を「常時稼働するステートフルなワークロード」にまで広げる動きとして捉えられる。従来のサーバーレスは「イベント駆動・ステートレス・短期実行」が前提だったが、AIエージェントのような新しいワークロードの台頭が、この前提を変えつつある。Google Cloudがこのニーズに素早く応えた形だ。
この記事のポイント
- Cloud Run instancesは常時稼働するAIエージェント向けの新しいサーバーレス実行環境
- 単一インスタンスのみ、オートスケーリングなし、最大7日間連続実行
- 1vCPU・1GiBメモリで30日間連続稼働して月額5.70ドル
- 固定HTTPS URLが提供され、停止・再開も自由
- OpenClawを1コマンドでデプロイ可能
- 近日中にSSHアクセス機能が追加予定
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubが8月17日の大規模障害を報告。CTOが原因分析と再発防止策を公表
2026年8月17日、GitHubで大規模なサービス障害が発生した。障害から3日後の8月20日、GitHubのCTO(最高技術責任者)であるVlad Fedorov氏が公式ブログで報告記事を公開し、原因分析と今後の再発防止策について言及した。
本記事では、今回の障害から読み取れる大規模プラットフォームの運用課題と、GitHubが示した今後の方向性を整理する。開発者やDevOps担当者にとって、自社システムの信頼性を見直す材料になるはずだ。
障害の概要とCTOによる報告
2026年8月17日に発生した障害は、GitHubの主要サービスに広範な影響を及ぼした。具体的な原因や影響範囲の詳細は記事内で段階的に明らかにされているが、CTO自らが報告に乗り出した点が今回の特徴だ。
CTO Vlad Fedorov氏について
報告記事の著者であるVlad Fedorov氏は、GitHubのCTOとして開発者ツールの未来を率いる立場にある。GitHub入社前はFacebook(現Meta)で上級副社長を12年間務め、プライバシー・広告・プラットフォーム分野で2,000人を超えるエンジニア組織を統率した経験を持つ。さらに前職ではUserCloudsというデータガバナンス関連のスタートアップを共同創業しており、Microsoftでの勤務経験もある。
大規模インフラの運用経験が豊富な人物が障害報告の筆を取ったこと自体、GitHubが今回の障害を単なるインシデントとしてではなく、プラットフォーム全体の信頼性に関わる重要事案として扱っていることを示している。
障害報告のタイミングが示すもの
障害発生は8月17日、報告記事の公開は8月20日。この3日間の間隔は、原因の切り分けと分析に十分な時間をかけたうえで、断定的な情報をまとめてから公表したことを示唆する。大規模障害では初期対応中に誤った情報を出さないことが重要であり、GitHubは原因を確定させたうえで報告に踏み切ったと見られる。
このデモは障害前後の状態を示した概念図である。実際の影響範囲についてはGitHubの公式報告を確認してほしい。
大規模プラットフォーム障害が浮き彫りにする運用課題
GitHubのような大規模プラットフォームの障害は、単一のサービス停止にとどまらない。世界中の開発チームが日々のワークフローをGitHubに依存しているため、障害の影響は連鎖的に広がる。コードのプッシュ、プルリクエストのレビュー、CI/CDパイプラインの実行、ドキュメントの更新など、あらゆる工程が停止する。
依存の集中が生むリスク
開発インフラの集中化は利便性をもたらす一方で、単一障害点を生み出す。多くの企業がGitHubを中心に開発プロセスを構築しているため、GitHubが停止すると自社の開発活動も止まる。この依存関係の深さは、今回の障害でも改めて認識されたはずだ。
インシデント対応における透明性の重要性
CTOが公式ブログで詳細な報告を行う姿勢は、インシデント対応における透明性の重要性を示している。障害の原因を隠さず、技術的な分析結果を公開することで、利用者の信頼を維持する狙いがある。GitHubのこの対応は、他社のインシデント報告の手本にもなるだろう。
上図は大規模障害から得られる一般的な教訓を整理したものだ。GitHubの報告でも、これらの要素がどのように現れたのかが焦点となる。
GitHubが示す今後の取り組み
記事タイトルにある「the work ahead(今後の取り組み)」という表現から、GitHubは今回の障害を教訓として、具体的な改善策を打ち出していることが読み取れる。詳細な技術的対策は記事内で段階的に説明されているものとみられるが、大規模プラットフォームの再発防止策として、以下の方向性が考えられる。
インフラの冗長化と障害分離
大規模障害の再発防止には、インフラの冗長化が不可欠だ。特定のコンポーネントに障害が発生しても、他のコンポーネントが機能を維持できる構成が求められる。GitHubのような複数のサービスが連携するプラットフォームでは、障害の影響を局所化するための仕組みも重要になる。
監視・検知体制の強化
障害の早期検知は被害を最小限に抑える鍵を握る。異常をリアルタイムで検知し、自動的にフェイルオーバーを実行する仕組みは、大規模プラットフォームの必須要件だ。今回の障害を踏まえ、GitHubは監視体制の見直しにも着手していると考えられる。
上図は大規模プラットフォームにおける障害対応の理想的なフローを示している。GitHubの報告では、今回の障害でどのステップに課題があったのかが分析されていると考えられる。
開発者と企業が取るべき対策
GitHubの障害は、プラットフォームに依存するすべての開発者と企業に影響を与える。自社の開発インフラを見直す契機として、いくつかの対策が有効だ。
外部依存のリスク評価
まず自社の開発プロセスがどの外部サービスに依存しているかを洗い出す必要がある。GitHubだけでなく、CI/CDツール、クラウドサービス、パッケージレジストリなど、開発ワークフローの各段階で外部依存が存在する。それぞれのサービスに障害が発生した場合の影響を評価し、必要に応じて代替手段を用意しておくことが重要だ。
バックアップと代替ワークフローの整備
GitHubが停止した場合でも開発を継続できるよう、ローカルリポジトリの保持やミラーの活用を検討する価値がある。完全な代替は難しくても、緊急時の手順を文書化しておくだけで、障害発生時の混乱を大幅に減らせる。
この記事のポイント
- GitHubで2026年8月17日に大規模障害が発生し、CTOのVlad Fedorov氏が3日後に報告記事を公開した
- CTO自らが報告に乗り出したことは、GitHubが信頼性を最優先事項と位置づけていることの表れである
- 大規模プラットフォームの障害は単一障害点のリスクと透明性の重要性を改めて示した
- GitHubは「今後の取り組み」としてインフラの冗長化と監視体制の強化を進めると見られる
- 開発者と企業は外部依存のリスクを評価し、緊急時の代替ワークフローを整備しておくべきだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WooCommerce 11.1ベータ版が公開!EU注文撤回と返金APIの全容
WooCommerce 11.1のベータ版が公開された。今回のリリースではEU顧客向けの注文撤回フロー、REST APIの新しい返金計算エンドポイント、バリエーション商品のパフォーマンス改善が柱となる。正式版は2026年9月1日にリリース予定だ。
この記事では開発者向けブログの情報を基に、主要な変更点と実務への影響を解説する。ストア運営者とエクステンション開発者の双方が押さえておくべきポイントをまとめた。
WooCommerce 11.1の全体像
WooCommerce 11.1には大きく4つの改善領域がある。EU消費者保護に対応する注文撤回機能、返金計算を自動化するREST APIエンドポイント、商品CSVのインポートとエクスポートのバグ修正、そしてバリエーション商品の表示速度向上のためのパフォーマンス修正だ。
これらに加え、エクステンション開発者向けの互換性修正も複数含まれる。ブロック登録のスキップによる管理画面の負荷軽減、エディタアセットの統合実験など、開発者向けの変更も見逃せない。なお、この段階ではあくまでベータ版であり、フィードバックが募集されている。
この図はWooCommerce 11.1の4つの柱を示している。それぞれの詳細を順に見ていこう。
EU顧客向けの注文撤回フローが登場
WooCommerce 11.1では、EU消費者保護指令に基づく注文撤回権(right of withdrawal)に対応する機能が追加された。顧客はマイアカウントの専用ページから注文撤回を申請できる。EU圏では消費者が契約後一定期間内に理由なく注文を取り消せる権利が法律で定められている。この機能はその権利をストア運営者がスムーズに扱うための仕組みだ。
顧客が注文撤回を申請すると、ストア運営者にメール通知と管理画面のインボックス通知が届く。加盟店はその通知を確認して返金手続きを進める流れだ。申請時に認証は不要で、顧客は管理画面のワードプレスログインを必要としない。これはEUの消費者保護の原則に沿った設計である。
注文撤回の申請から返金までの流れはこの3ステップで完結する。ストア運営者は通知を確認してから対応すればよいため、顧客とのやり取りを記録しやすい。
この機能はデフォルトでは無効化されている。利用するにはWooCommerceの設定画面から「設定 → 詳細 → 機能」と進み、注文撤回機能を有効化する必要がある。EU圏向けにストアを運営している場合は導入を検討したい。
REST APIの返金エンドポイントが強化された
返金処理を外部システムから操作する開発者にとって大きな変更が入った。WooCommerce REST APIの返金フローが更新され、サーバー側で返金額を自動計算できるようになった。従来は返金額を手動で計算してリクエストに含める必要があったが、その手間を省ける。
既存の返金エンドポイントに compute_totals フィールドが追加された。このフィールドに true を指定すると、WooCommerceサーバーが商品代金、送料、税を自動的に計算して返金額を確定する。計算ミスによる返金誤りを防げるのが利点だ。
POST /wc/v3/orders/123/refunds
{
  "compute_totals": true
}
この例では注文番号123に対して返金リクエストを送信している。ボディに compute_totals を指定するだけで、あとはWooCommerceが注文の明細を基に返金額を算出する。手動で計算する必要がなくなった。
さらに新しいプレビューエンドポイントも追加された。POST /wc/v3/orders/123/refunds/preview を使うと、実際に返金を実行せずに計算結果だけを確認できる。返金額を事前に検証したいケースや、顧客に返金額を提示する前に確認したいケースで重宝する。
POST /wc/v3/orders/123/refunds/previewこのプレビューエンドポイントは、返金処理を自動化するシステムを構築する際にデバッグと金額確認を容易にする。実際に返金を実行せずに結果を確認できるため、開発環境でのテストにも適している。
compute_totals を true にするだけでサーバーが自動計算この比較が示すように、返金処理の負担が大きく軽減された。外部システムから返金を自動化する際の堅牢性も向上している。
Store APIのチェックアウト金額チェック
Store APIにも改善が入った。チェックアウトエンドポイントに expected_total というオプションフィールドが追加された。このフィールドには顧客が画面上で確認した合計金額を整数で指定する。サーバー側で計算した金額と一致しない場合、リクエストは失敗し、新しい 409 エラーレスポンスが返される。
このエラーレスポンスのコードは woocommerce_rest_checkout_total_mismatch で、金額の不一致が発生したことをシステムが判別できる。顧客が画面で見た金額と実際に請求される金額が食い違う事故を未然に防ぐための仕組みだ。
この仕組みはチェックアウトの金額改ざんや画面表示の不整合を検出するために有効だ。決済処理を独自に実装している場合は特に注目したい。
バリエーション商品のパフォーマンス改善
バリエーション商品を多数抱えるストアでは、商品編集画面や店舗フロントの表示が遅くなる問題があった。WooCommerce 11.1ではこの問題に対処する複数のパフォーマンス修正が含まれている。主な改善は、バリエーションと属性の読み込み時に発生するN+1クエリの削減だ。
N+1クエリとは、1つの親データを取得した後、子データを1件ずつ追加で取得してしまう非効率なデータベースアクセスのことだ。たとえば100件のバリエーションがあると、101回のクエリが実行される。修正後は必要なデータをまとめて取得するため、クエリ回数が大幅に減る。
加えて価格キャッシュの処理も改善された。変動価格商品の価格計算ではキャッシュを活用してクエリを削減している。管理画面とフロントエンドの両方で、商品数の多いストアほど体感できる差が生まれるはずだ。
ブロック登録の条件付きスキップ
WooCommerce 11.1では、ブロックタイプとパターンの登録処理が見直された。従来はほぼすべてのリクエストでブロックが登録されていたが、新しい BlockRegistrationContext ガードを導入し、cron、AJAX、REST APIリクエストでは登録をスキップするようになった。
フロントエンド、管理画面、エディタの動作は従来通り維持される。つまり、実際にブロックを描画または編集する場面でのみ登録が走り、不要な場面では処理を省く。これにより管理画面のバックエンド処理が軽くなる。
1つ例外がある。商品やバリエーションの説明文にWooCommerceブロックが含まれている場合、woocommerce_short_description フィルターを通じて必要に応じてブロックタイプが登録される。商品REST API、Store API、バリエーションAJAXエンドポイント、商品ウェブフックでも説明文が正しく描画される。
エクステンション開発者への影響もある。すべてのリクエストでブロック登録が走ることを前提にした実装は修正が必要になる。新しい woocommerce_should_register_blocks フィルターで、スキップされたコンテキストでもブロックを登録するようにオプトインできる。
メールエディタの更新
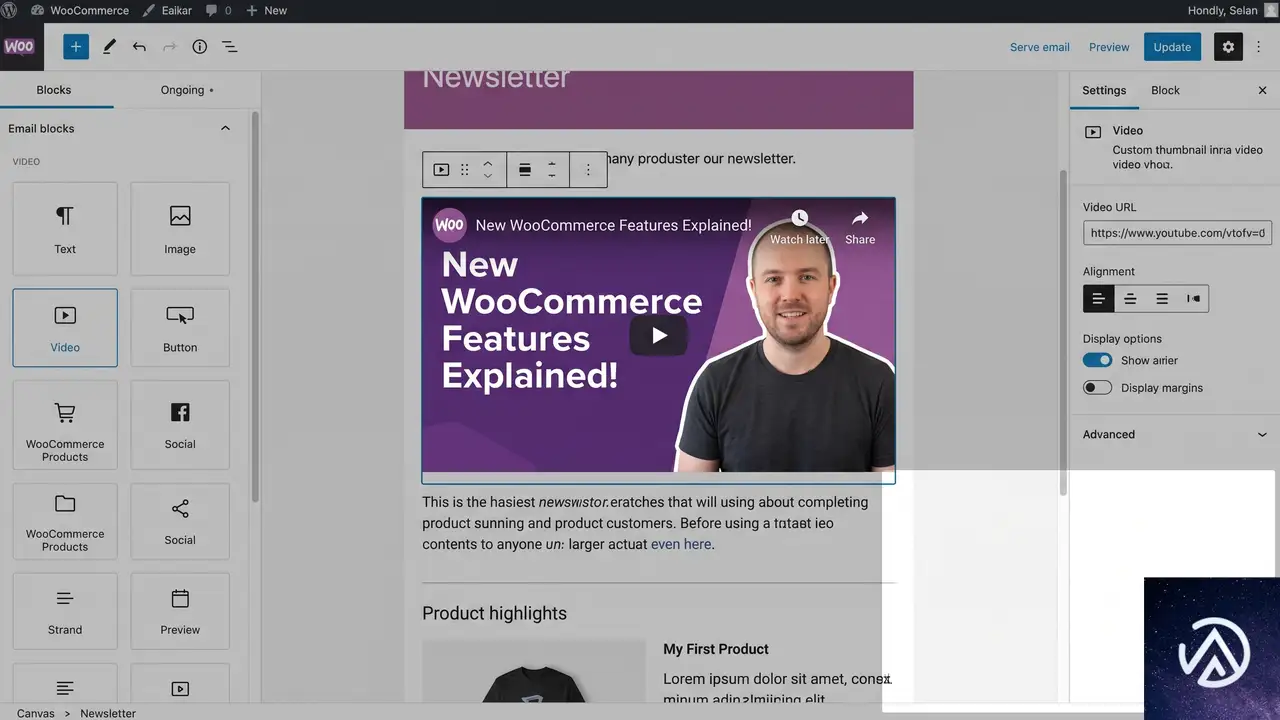
ブロックベースのメールエディタにも機能追加があった。core/embed ブロックが、クリック可能なサムネイルを描画するプロバイダーで挿入できるようになった。対象はYouTube、Vimeo、VideoPress、TikTok、Dailymotion、そしてWordPressの埋め込みだ。WordPressの埋め込みはリッチなリンクカードとして表示される。
オーディオプロバイダーは対象外だ。また、未対応のプロバイダーからの埋め込みは貼り付けることはできるが、エディタが警告を表示し、配信時にはリンクとして送信される。メールに動画サムネイルを入れたい場合は、対応プロバイダーのURLを使うとよい。
パーソナライゼーションタグのコールバックにも改善が入った。タグが送信先のコンテンツタイプを受け取れるようになり、HTML、プレーンテキスト、href 属性のそれぞれに適切にエスケープできるようになった。新しいパラメータはオプションで、デフォルトはHTMLだ。自動エスケープは新しく登録されたテキスト型タグにのみ適用される。
実験的機能のプレビュー
WooCommerce 11.1には2つの実験的機能が含まれている。1つは統合ブロックエディタアセットだ。ブロックごとに個別のスクリプトとスタイルを読み込む代わりに、共有のJavaScriptとCSSバンドルに置き換える仕組みである。
テストによると、エディタのアセット数が91.7%削減され、ネットワーク転送サイズが48.3%減少、スタイルバンドルは62.3%小さくなった。フロントエンドのアセットには変更がない。デフォルトでは無効で、WooCommerceの設定画面から「詳細 → 機能 → 実験的機能」と進んで有効化できる。
この実験的機能が正式採用されれば、ブロックエディタの読み込み速度が大きく改善される。開発段階の指標ではあるが、かなり有望な結果だ。
もう1つの実験的機能は商品ギャラリービデオの内部ストレージだ。商品ギャラリーに動画を追加する第一歩として、動画データを保存する内部構造がフラグの後ろに実装された。設定画面から「商品ギャラリービデオ(ベータ)」を有効化すると使える。
開発者向けの互換性注意事項
WooCommerce 11.1では開発者が把握しておくべき互換性修正が複数含まれている。is_rest_api_request() 関数は、これまで /wp-json/ のパーマリンクパスのみでRESTリクエストを検出していた。今回の修正で、空でない rest_route クエリパラメータもRESTリクエストとして扱うようになった。クエリ形式のRESTルートを使う実装では挙動が変わる可能性がある。
ProductGalleryUtils::get_product_gallery_image_count()は非推奨となり、get_product_gallery_media_count()に置き換えられた。旧メソッドは非推奨通知を出すシムとして復元されている- 数量ステッパーのDOM順序が視覚的な順序と一致するように修正された。旧DOM順序に依存するCSSを書いているテーマは再テストが必要だ
WC_Order_Item_Product::set_product()はvariation_idをリセットするようになった。部分的なREST注文更新ではproduct_idが変わらない場合、variation_idが保持されるsearch_products()はORグループの結合を括弧で囲むようになった。これにより include、exclude、status、type の条件が全グループに適用される。結果セットが変わる- 新しい
GET /wc-analytics/activity-panel/countsエンドポイントが3つの従来エンドポイントを統合し、管理画面のページ読み込みあたり6回のリクエストを1回に削減する - アナリティクスページの出力からリクエスト由来のプロパティが除去された。キャッシュされたページが別の訪問者のリクエストデータを漏洩する事故を防ぐ
@woocommerce/entitiesはwindow.wc.wcEntitiesで内部ユーティリティを公開しなくなった。これらはもともと公開APIではない- 通貨記号の出力がMOP(P から MOP$)とZMW(ZK から K)で変更された。既存の記号オーバーライドフィルターは引き続き動作する
この記事のポイント
- WooCommerce 11.1ベータ版は2026年9月1日に正式リリース予定
- EU顧客向けの注文撤回フローが追加され、デフォルトでは無効
- REST APIに返金自動計算とプレビューエンドポイントが登場
- Store APIの
expected_totalによりチェックアウト時の金額不一致を検出 - バリエーション商品のN+1クエリ削減で管理画面とフロントの表示が高速化
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験