

WordPress 7.1 Mary Louリリース。レスポンシブ対応強化と新メディアエディタ搭載
WordPress 7.1「Mary Lou」が2026年8月19日に正式リリースされた。今回のメジャーアップデートでは、カスタムCSSなしでレスポンシブ対応ができるスタイル機能、新しいメディアエディタ、リッチテキスト対応のNotes機能などが追加されている。800人以上の貢献者による1,500以上の改良と修正が含まれる大規模リリースだ。
従来のWordPressでは、画面サイズごとに表示を調整するにはカスタムCSSを書く必要があった。WordPress 7.1ではサイトエディタ内で完結するため、中小企業のサイト担当者やコーディングに不慣れなユーザーでも直感的にレスポンシブ対応できるようになる。画像処理のブラウザ内実行や新ブロックの追加も見逃せない変更点だ。
WordPress 7.1の全体像と主要な新機能
WordPress 7.1のコードネーム「Mary Lou」は、ジャズピアニストのメアリー・ルー・ウィリアムズに由来する。彼女はスウィング、ビバップ、セイクリッドジャズとジャンルを横断しながら常にサウンドを再発明し続けた。その革新と協働の精神が今回のリリースに反映されている。
リリース全体の規模を見ると、世界中から800人以上の貢献者が参加し、170人以上が初めてコントリビュートした。修正と改良の総数は1,500を超える。主要な変更点は、レスポンシブスタイルのビジュアル編集、管理バーの全エディタ対応、新しいメディアエディタ、Notes機能の拡張、PlaylistとTabsの2つの新ブロック、そして開発者向けAPI群の公開だ。
このデモでは、WordPress 7.1の主要な変更点を分野別に色分けして示している。青がレスポンシブ対応、橙がメディア編集、紫がコラボレーション、緑がパフォーマンス、赤が新ブロックを表す。
今回のリリースの特徴を一言でまとめると、「サイト制作の作業導線を管理画面内に集約する」方向性が鮮明になったことだ。従来はCSSファイルの編集や複数の画面を行き来する必要があった作業が、ブロックエディタやサイトエディタの中で完結するようになっている。特に中小企業のサイト担当者にとっては、外注や開発者への依頼なしで調整できる範囲が広がる。
レスポンシブスタイルと管理バーの改善
カスタムCSSなしのレスポンシブ対応
WordPress 7.1では、サイトエディタのグローバルスタイルと個別ブロック設定の両方にレスポンシブコントロールが追加された。具体的には、デスクトップ・タブレット・モバイルの各画面サイズでブロックの表示をどう変えるかを、ビジュアル操作だけで設定できる。
編集中の画面でビューポート(表示領域の幅)を切り替えながらスタイルを調整できるため、仕上がりを確認しやすい。従来のようにカスタムCSSでメディアクエリを手書きする必要がない。この変更は、コーディングに不慣れなユーザーにとって特に大きな意味を持つ。
このデモでは、従来のカスタムCSSによる対応と、WordPress 7.1のビジュアル編集による対応の違いを示している。上段の赤い枠がBefore、下段の緑の枠がAfterを表す。CSSの記述が不要になり、プレビューを見ながら調整できるようになった点が大きな変化だ。
管理バーがすべてのエディタで表示される
管理バーがサイトエディタを含むすべてのエディタで追従するようになった。投稿執筆中でもサイトデザインの編集中でも、ダッシュボードや関連ツールへのショートカットが常に画面上部に表示される。WordPressの管理画面を行き来する手間が減り、作業導線が分断されにくくなった。
さらに、ブロックテーマではテーマの設定ファイル(theme.json)にタブレットとモバイルのブレークポイントを独自に定義できるようになった。レスポンシブスタイルとブロック表示の切り替えに使う画面幅の基準を、サイトごとに調整できる。
メディア編集の刷新と画像処理の高速化
新しいメディアエディタ
従来はインラインで行われていた画像の切り抜きが、新しいモーダル形式のメディアエディタに置き換わった。自由な切り抜き、アスペクト比を固定した切り抜き、水平・垂直の反転、細かな角度調整ができるスナップ回転、そしてメタデータ編集が1つの専用画面に統合されている。
エントリーポイントは従来と同じ「切り抜き」ボタンのまま。既存の操作感を維持しつつ、機能が大幅に拡張されたかたちだ。画像編集のためにプラグインを追加していたユーザーにとっては、標準機能だけで済むケースが増える。
このデモは、新しいメディアエディタの操作手順を4ステップで示している。青・緑・橙・紫の順に進み、1つのモーダル内で画像編集からメタデータ更新まで完結する流れが分かる。
ブラウザ内での画像処理
画像の圧縮・リサイズ・サムネイル生成が、サーバーではなくブラウザ内で実行されるようになった。libvipsのWebAssemblyビルドを利用しており、大きな画像をアップロードしてもPHPのメモリ制限やアップロードタイムアウトに引っかかりにくくなる。
サーバー負荷の軽減は、共有サーバーや低スペックのレンタルサーバーを利用しているサイトにとって特に有効だ。画像の多いメディアサイトやECサイトでは、アップロード時のタイムアウトエラーが減ることが期待できる。
対応画像形式も拡充された。AVIF、HEIC、HDRゲインマップのネイティブサポートが追加され、最新のスマートフォンやカメラで撮影した画像をそのまま扱えるようになった。GIFを動画に自動変換するオプションもあり、ファイルサイズの削減が進む。
Notes機能の進化とコラボレーション強化
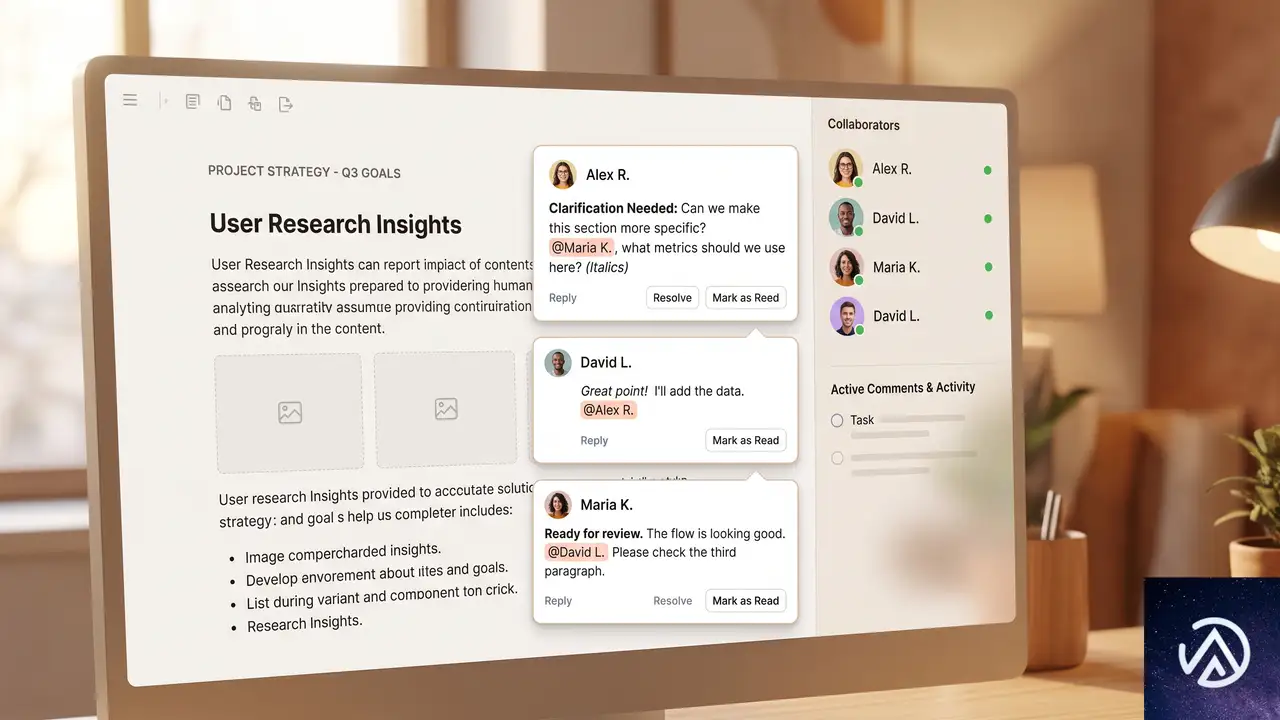
WordPress 7.1では、コンテンツのレビュー作業を支援するNotes機能が大幅に拡張された。従来はブロック単位でしかコメントを残せなかったが、今回から特定のテキスト範囲に対してノートを付けられるようになった。
リッチテキストにも対応した。太字、斜体、コード表示、リンクの挿入がノート内で使える。さらに「@」を入力すると共同編集者をメンションでき、通知が飛ぶ。複数の会話を同じブロック内で並行して進められるほか、長いノートを折りたたんでサイドバーをすっきり保つことも可能だ。
この機能強化は、複数人で記事をレビューする編集部や、クライアントとの校正作業を行う制作会社にとって実用的な価値がある。フィードバックの場所が明確になり、メールやチャットでのやり取りをWordPress内に集約できる。
執筆中の投稿エディタも全テーマでiframe化された。編集キャンバスが管理画面のスタイルから分離されるため、テーマのCSSが管理画面のスタイルと衝突しにくくなる。ビューポート単位やメディアクエリが編集キャンバスを正確に参照するようになり、レスポンシブレイアウトのプレビュー精度が向上した。
新ブロックと開発者向けAPIの拡充
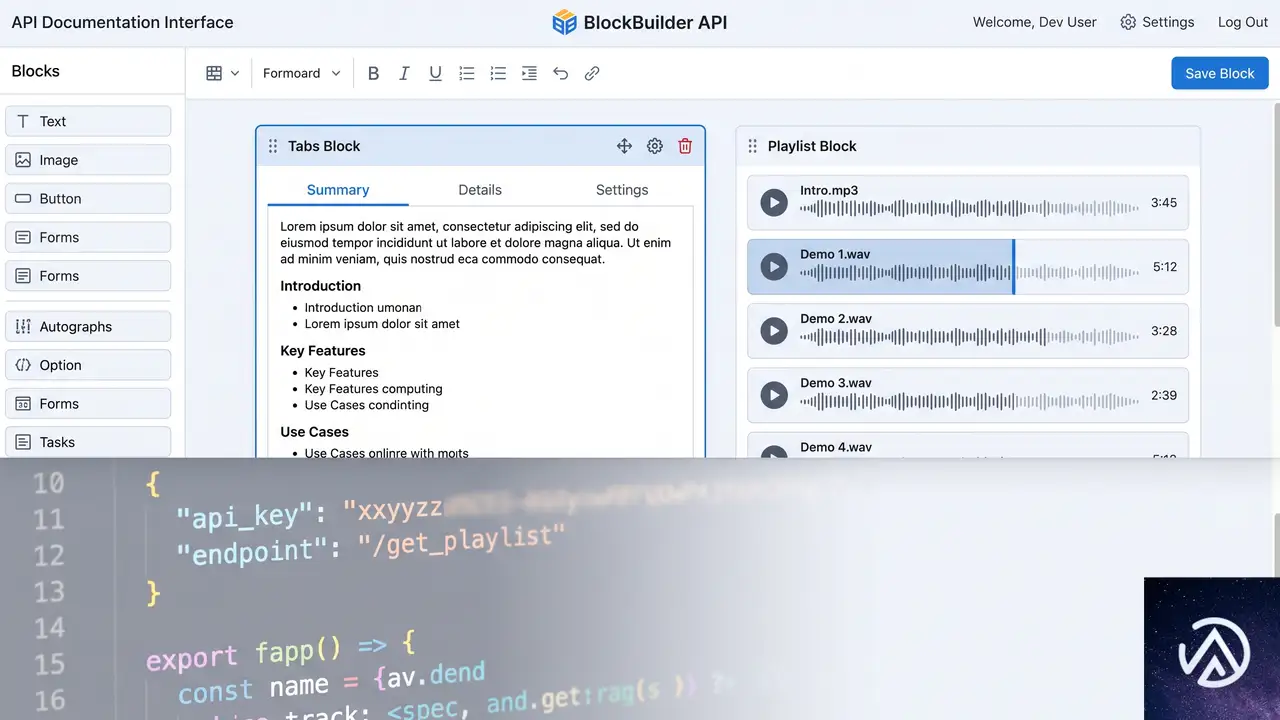
PlaylistブロックとTabsブロック
WordPress 7.1では2つの新しいブロックが追加された。Playlistブロックは複数の音声トラックを1つのプレイリストにまとめて再生できる。オプションで波形表示も付けられ、リスナーは各トラックの長さや進行具合を視覚的に把握できる。
Tabsブロックは、関連する情報をタブ形式で整理するためのブロックだ。すべてのコンテンツを一度に表示するのではなく、タブを切り替えて必要な内容だけを見せる。FAQ、料金プランの比較、製品仕様など、関連情報をコンパクトに提示したい場面で役立つ。
開発者向けAPI群
開発者向けの変更も大きい。SVG Icon APIが公開APIとなり、wp_register_icon_collection()、wp_register_icon()、wp_get_icon()といった関数で独自のアイコンコレクションを登録し、エディタ全体で利用できるようになった。
Abilities APIは前バージョンで導入された基盤を拡張し、フィルタ可能な実行ライフサイクル、カスタムバリデーション、共有ディスカバリーを追加した。WordPress上での統合機能や自動化、AI搭載ツールの構築が容易になる。
新しいDesign Systemは、色、角丸、カーソルスタイルを含むWordPress管理画面のテーマリングを支援する。開発者はセマンティックなデザイントークンとThemeProvider Reactコンポーネントを使って、WordPressに馴染むカスタム管理画面を構築できる。
テーマ開発者には、theme.jsonでレスポンシブスタイルと疑似状態(hover、focus、focus-visible、active)のスタイリングが可能になった。DataViewsとDataForm画面を設定する新しいフィルタも追加され、サイトエディタのページ・テンプレート・パーツ管理画面をカスタマイズできる。
パフォーマンスとアクセシビリティの改善
パフォーマンス面では、前述のブラウザ内画像処理に加えて、GIFから動画への自動変換が導入された。GIFアニメは動画ファイルよりサイズが大きくなりがちで、この変換によりページの読み込み速度が改善する。アップロードの進捗インジケーターと自動リトライも追加され、接続が途中で切れてもアップロードが再開できるようになった。
メディアライブラリはデフォルトで無限スクロールになった。ページネーションに戻すオプションもユーザーごとに用意されている。多数の画像を扱うサイトでは、ページを切り替える操作なしで目的のメディアを探しやすくなる。
Speculative loadingのデフォルト設定を、環境変数や定数で指定できるようになった。ホスティング事業者やサイト運営者は、プラグインを書かずにWordPressの先読み動作を設定できる。これはサイト速度の調整手段として、特にトラフィックの多いサイトで有用だ。
アクセシビリティの改善も続いている。wp_get_tooltip()とwp_get_toggletip()という新しい関数が追加され、投稿メタボックスやログイン画面を含む管理画面の各所でアクセシブルなツールチップを利用できるようになった。スクリーンリーダーのサポートも強化され、投稿一覧テーブルでのラベル付けとナビゲーションがより予測しやすくなっている。
この記事のポイント
- WordPress 7.1「Mary Lou」が2026年8月19日にリリースされた
- カスタムCSSなしでレスポンシブスタイルを設定できるようになった
- 新しいメディアエディタが切り抜き・反転・回転・メタデータ編集を統合
- 画像処理がブラウザ内で実行され、サーバー負荷とタイムアウトが軽減された
- Notes機能がリッチテキストとメンションに対応し、コラボレーションが強化された
- PlaylistブロックとTabsブロックが標準搭載された
- 開発者向けにSVG Icon API、Abilities API、Design Systemが公開された

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
2026年8月スパムアップデート開始!Google検索への影響と対策を解説
Googleが2026年8月18日、8月のスパムアップデートの展開を開始した。全言語・全地域が対象で、完了までに数日かかる見込みだ。Search Status Dashboardにランキングへ影響を与えるインシデントとして記録されている。
これは2026年に入って3回目のスパムアップデートとなる。3月の更新は過去最速の19時間30分で完了し、6月の更新は生成AI検索への操作対策もスパムポリシーの対象に含める方針が示された直後に行われた。
検索順位に動きが出た場合、スパムポリシー違反がないか確認することが重要になる。復旧には数ヶ月かかることもあるため、早期の対応が求められる。
8月スパムアップデートの概要
今回のアップデートは太平洋時間8月18日午前9時27分に開始された。日本時間では8月19日午前1時27分となる。Search Status Dashboardには開始時刻の約1分後、午前9時28分にリリースノートが掲載された。
適用範囲は全世界・全言語だ。Googleは完了までに数日かかる可能性があると案内している。この種のアップデートは、展開中に順位の変動が大きくなることがある。短期間のデータだけで判断せず、数日単位で傾向を見る必要がある。
公開時点では、Search Status Dashboardの注記に加えて公式ブログ記事は投稿されていない。スパムアップデートの概要ページも2025年12月から変更されていない。今回は新しいスパムポリシーの種類は追加されていない。既存のポリシーがそのまま判断基準になる。
このデモは8月スパムアップデートの展開フローを示している。各ステップの色分けは進行段階を表しており、青が開始、緑が適用範囲、橙が展開期間、紫が完了通知を意味する。
2026年のスパムアップデート史
2026年はスパムアップデートが立て続けに実施されている。8月の更新は3回目だ。過去2回の傾向を把握しておくと、今回の展開期間や影響範囲を推測しやすくなる。
3月の更新は過去最速で完了
3月のスパムアップデートは19時間30分で完了した。これはSearch Status Dashboardの記録上、確認済みの展開としては最速だった。展開期間が短いほど、順位変動も短期間に集中しやすい。
6月の更新は生成AI検索の操作対策も対象に
6月のスパムアップデートは2日と1時間かけて完了した。その前月の5月15日には、GoogleのスパムポリシーがAI OverviewsやAI Modeなど、生成AI検索の結果を操作しようとする試みにも適用されるという方針が明確化されている。6月の更新がこの種の操作を具体的に狙ったものかどうかは、Googleから公式な説明はない。
8月の更新についても、生成AI検索の操作を特に標的にしているかどうかは明らかにされていない。ただし、スパムポリシーは検索結果全般に適用されるため、生成AI検索への操作も対象範囲に含まれると考えるのが自然だ。
このデモは2026年に実施された3回のスパムアップデートを比較したものだ。青が3月、緑が6月、橙が8月を表す。完了までの時間が回を追うごとに長くなる傾向が見える。
サイト運営者が取るべき行動
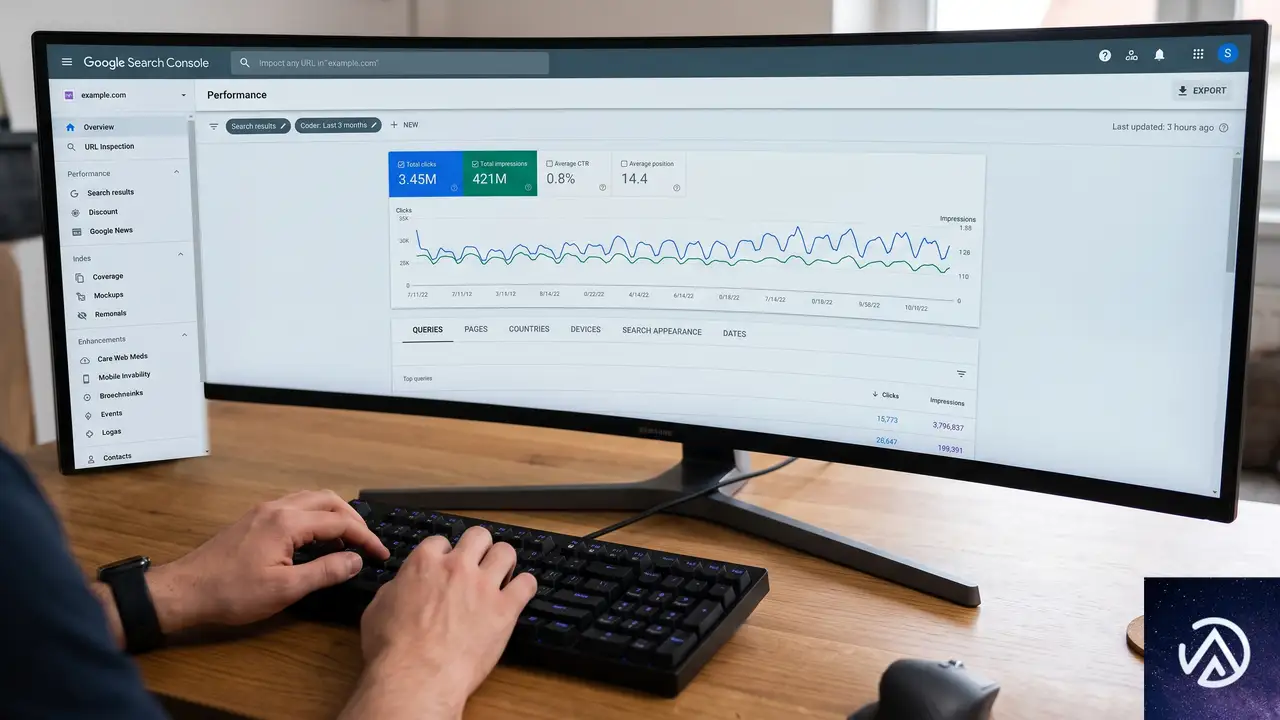
スパムアップデートの展開中は、検索順位が一時的に変動することがある。1日だけのデータで判断せず、Search Consoleのデータを数日分確認するのが基本だ。特に8月18日以降の動きに注目する必要がある。
Search Consoleで順位変動を確認する
順位の変動を確認するには、Search Consoleのパフォーマンスレポートが最も信頼できる。表示回数・クリック数・平均掲載順位を日別で確認し、8月18日以降に急激な変化が出ていないかを見る。
もし変動が見つかったら、それがスパムアップデートの影響なのか、他の要因によるものなのかを切り分ける必要がある。季節要因や自サイトの変更、競合サイトの動きなども同時に確認することだ。
このデモはSearch Consoleを使った確認手順を示している。青から紫への色分けは、各ステップの進行順を表す。
スパムポリシーの見直しが復旧の最短経路
順位が大きく下がった場合、Googleのスパムポリシーに違反していないかを見直す必要がある。主なポリシーには、クローキング、隠しテキスト、リンクスパム、キーワードの乱用、ユーザー生成スパムなどがある。自サイトが該当する可能性がないか、コンテンツとリンクの両面から確認する。
Googleの公式ドキュメントによると、スパムポリシー違反からの復旧には数ヶ月かかることがある。自動化されたシステムが、サイトがルールに従うようになったことを認識するまでに時間が必要なためだ。違反を修正しても、すぐに順位が戻るわけではないことを理解しておく必要がある。
このデモはGoogleのスパムポリシーで代表的な違反の種類を示している。赤い左線が注意を促す配色だ。
今後の展開と監視ポイント
Googleはアップデートの展開が完了すると、Search Status Dashboardに完了記録を掲載する。3月は19時間30分、6月は2日と1時間で完了しており、今回も同様に記録される見込みだ。
サイト運営者としては、完了通知が出るまでの間、Search Consoleのデータを注視するのが現実的な対応になる。特に8月18日以降の表示回数と平均掲載順位の推移を数日分まとめて確認し、変動の傾向を掴むことだ。
Search Engine JournalはGoogleが完了を確認次第、続報を伝えるとしている。今回のアップデートで新たなスパムポリシーが追加されたり、特定のスパム手法が集中的に取り締まられたりした場合は、その情報も出てくるだろう。
この記事のポイント
- 8月スパムアップデートは2026年8月18日に開始、全言語・全地域が対象
- 今年3回目のスパムアップデートで、新ポリシーの追加はなし
- 完了までに数日かかる見込みで、完了後にSearch Status Dashboardで通知される
- 順位変動があればSearch Consoleで8月18日以降のデータを確認する
- スパムポリシー違反からの復旧には数ヶ月かかることがある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gmailが政治メールに専用レーンを新設。EC事業者が学ぶべき送信者検証と苦情率0.3%の意味
Gmailが政治メール向けにスパムフィルタを迂回できる新プログラムを発表した。2026年9月8日から、資格を満たす政治団体はGmailのVerified Sender Programに参加できる。この動きは政治メールだけでなく、EC事業者のメールマーケティングにも重要な示唆を与える。
プログラムの核心は、送信者検証と苦情率0.3%という2つの条件だ。検証済みの送信者は標準のスパムフィルタを回避できる一方、受信者からのスパム報告が一定を超えると資格を失う。本記事ではこの仕組みをECメール運用にどう活かすかを解説する。
Gmailが政治メールに専用レーンを新設
Gmailは2026年9月8日から、政治団体向けの新制度「Verified Sender Program」を開始する。この制度に参加した政治団体は、ポリシーに準拠したメールを個人のGmailアカウントに送る際、通常のスパムフィルタを経由せずに受信トレイへ届けられる。
対象となるのは、連邦選挙委員会や州・地方の選挙管理当局に登録された候補者、政党、政治活動委員会などだ。参加にはCampaign Verifyを通じた本人確認と経歴チェックが必要になる。キャンペーンドメインごとに検証できるメールアドレスは1つだけに限られる。
この制度は、Gmailが政治メールの扱いをめぐって長年続いてきた論争への回答でもある。2022年には共和党全国委員会がGoogleを提訴した。Googleは以前にも政治メールを一部のスパムフィルタから除外する試験運用を行っていたが、2023年初めに終了している。
送信者検証と苦情率0.3%の仕組み
新プログラムの参加条件は、送信者検証と苦情率の2つに集約される。送信者検証とは、メールの送信元が本人であることを技術的・制度的に確認する仕組みだ。政治団体はCampaign Verifyによる本人確認と経歴チェックを受け、セキュリティ要件とコンプライアンス要件も満たす必要がある。
もう1つの条件が苦情率0.3%未満だ。これは受信者が「スパム」と報告した割合を指す。14日間の平均が0.3%を超えると、プログラムのポリシー違反となる。つまり、検証済みの送信者であっても、受信者からのネガティブな反応が続けば優先レーンを失う。
この図は、送信者検証がメールの初期処理を変える一方で、受信者のフィードバックが依然として重要な役割を果たすことを示している。
EC事業者が学ぶべき3つのポイント
政治メール向けの制度だが、EC事業者にとっても学びは大きい。特にWooCommerceで注文確認メールやプロモーションメールを送る事業者は、この仕組みを自社の運用に置き換えて考えたい。
1つ目は送信者検証の重要性だ。Gmailが優先レーンの条件に検証を求めたのは、なりすましやフィッシングを防ぐためだ。EC事業者もSPF、DKIM、DMARCといった送信ドメイン認証を設定し、メールの正当性を示す必要がある。これらはメールの「身分証明書」のようなもので、設定していないと正規のメールでもスパム扱いされやすくなる。
2つ目は苦情率の監視だ。0.3%という閾値は政治メール向けだが、ECメールでも苦情率が高いと到達率が下がる。目安として0.3%は非常に厳しい数字だが、日々のモニタリングとリスト管理が欠かせない。購読解除の導線を明確にし、関与の低い宛先への配信を控えるだけでも改善できる。
3つ目は受信者フィードバックを運用に活かすことだ。Gmailのプログラムでは、検証済みでも受信者がスパム報告すれば通常のフィルタに戻る。EC事業者も同じで、開封率やクリック率だけでなく、スパム報告率や購読解除率を追う必要がある。
この3ステップを回すことで、Gmailのようなプラットフォームの変更にも強いメール基盤を作れる。
この記事のポイント
- Gmailは9月8日から政治メール向けにスパムフィルタ迂回の新制度を開始する
- 参加条件は送信者検証と苦情率0.3%未満の2つ
- 検証済みでも受信者のスパム報告が続けば優先レーンを失う
- EC事業者はSPF、DKIM、DMARCと苦情率監視をセットで運用したい
- WooCommerceのメールも送信者検証とフィードバック管理が到達率を左右する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
EUのAIラベリング規則が8月2日施行。サイト運営者が知るべき4つの義務
EUでAI生成コンテンツのラベリング義務が2026年8月2日から始まった。対象はディープフェイク、チャットボット、完全AI生成テキスト、感情認識ツールの4種類に絞られる。
この規則はEU企業に限らない。EU圏のユーザーにAI出力を提供する世界中の企業が対象になる。つまり、日本語のサイトでもEUからのアクセスがあれば義務を負う可能性がある。
違反時の罰則は各国の監督機関が定めるが、GDPRと同様に高額な制裁金が科される可能性がある。AI生成コンテンツを公開するサイト運営者は、対象範囲と正しい表示方法を押さえておきたい。
ラベリング義務の対象は4つに絞られる
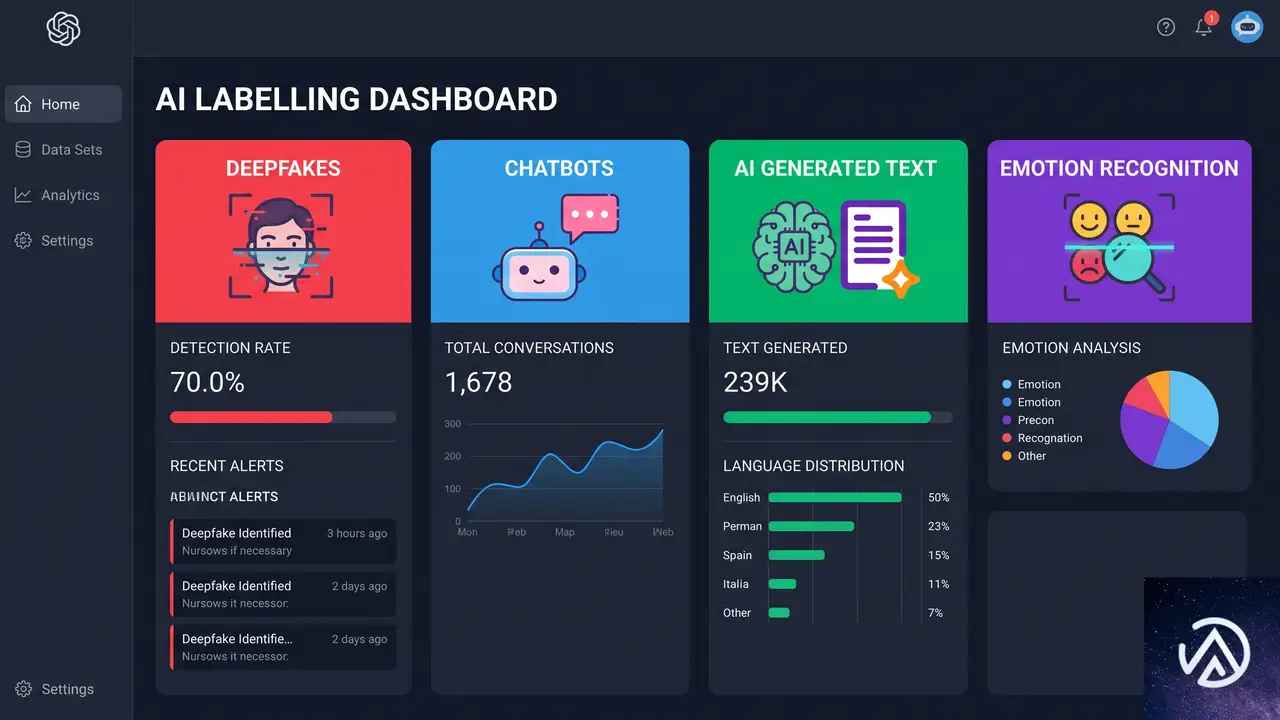
EUのAI法第50条(4)に基づく透明性義務では、ラベリングが必要なケースを4種類に限定している。すべてのAI生成コンテンツにラベルが必要なわけではない点が重要だ。
この4つのカテゴリに該当するAI生成物を提供する企業は、プロバイダー(AIシステムの開発・供給者)とデプロイヤー(利用者)の双方が法的義務を負う。外部製AIツールを使っていても免責にはならない。
ディープフェイクは「本物らしさ」が判断基準
ディープフェイクに該当するのは、実在の人物、物体、場所、出来事に似せていて、本物だと誤認させる画像・音声・動画だ。逆に、明らかにフィクションとわかるものや、本物らしく見せていないコンテンツは対象外になる。
広告やマーケティングで使うAI生成の商品画像、人物写真、ポスターも、実在のものに似せている場合は開示が必要になる。特にECサイトの商品画像には注意したい。
完全AI生成テキストは「公共の利益」が条件
完全にAIが書いた文章のラベリング義務は、公共の利益に関する事項が対象だ。公共の利益とは、健康、安全、環境、経済、金融、政治、科学、文化などを指す。人間による実質的な編集がない場合に開示が必要になる。
通常のブログ記事や商品説明でも、内容が健康や金融など公共性の高いテーマに触れる場合は対象になり得る。一方、単なる日記や創作は対象外だ。
人間が編集すればラベル不要になる境界線
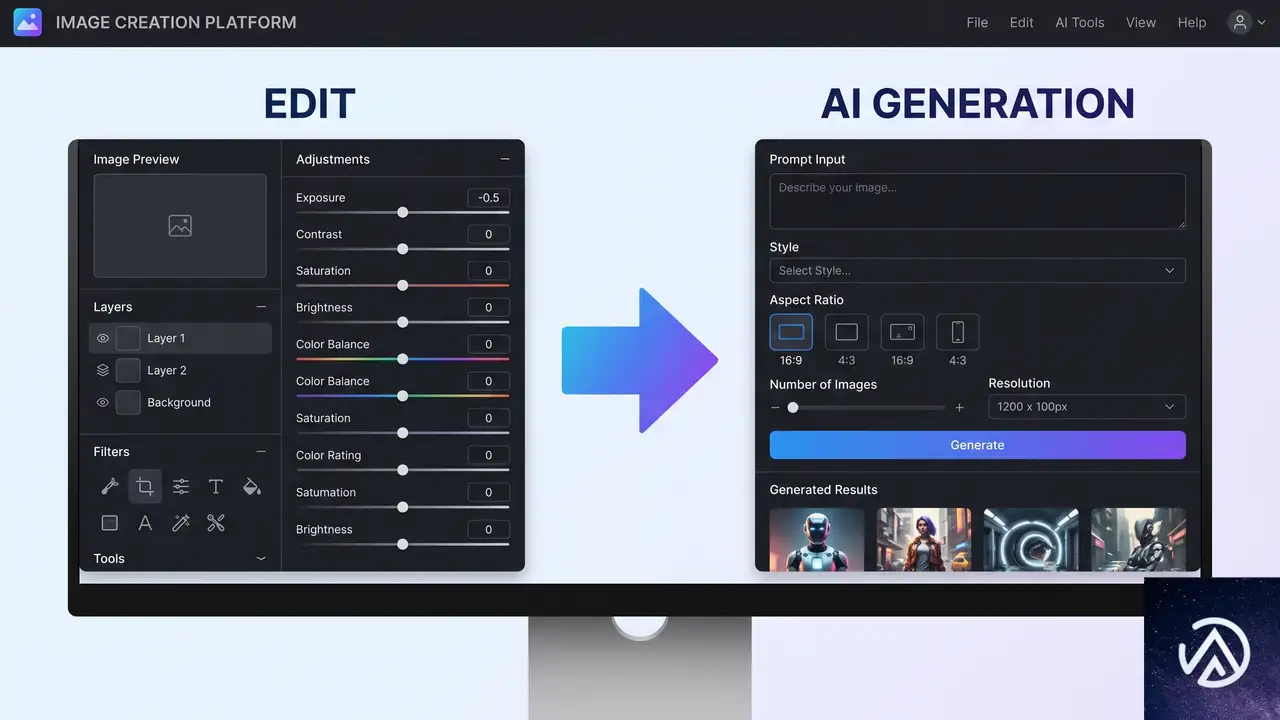
「AIで下書きを作り、人間が編集した」場合、どこからラベルが必要になるのか。EU委員会のガイダンスでは、軽微な編集と実質的な編集の境界線が示されている。
文章の言い回しを微調整する程度ならラベル不要だが、文章全体をAIに生成させた場合は開示が必要になる。「公開前に人がざっと目を通した」だけでは実質的な編集とは認められない。
実務での判断ポイント
EUのガイダンスは、編集責任者を明示した上で実質的な編集管理を行うことを求めている。つまり、誰が責任を持って内容を確認し、修正したのかという記録が重要になる。
WordPressサイトでAI生成下書きを使う場合は、編集フローを整備しておくとよい。人間による確認作業を経た記事と、AI出力をそのまま公開する記事を区別し、後者にはラベルを付ける運用が現実的だ。
スパークルアイコンだけでは不十分
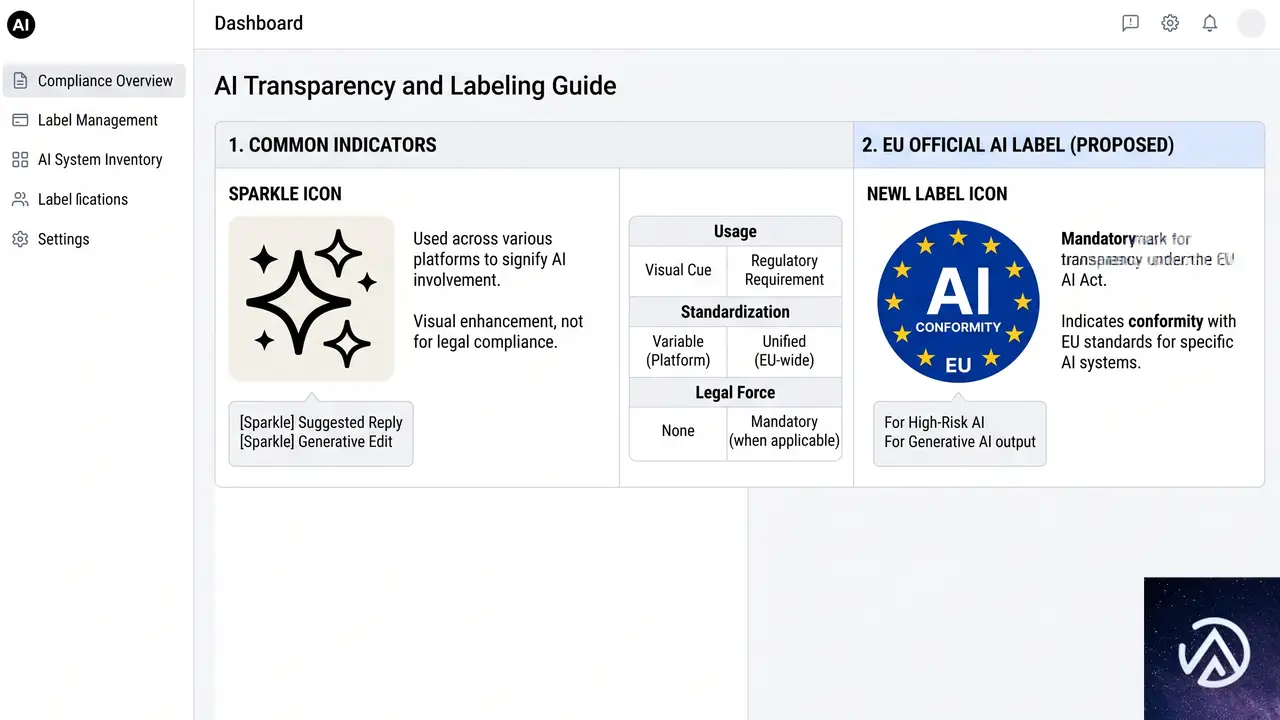
多くの製品がAI機能を示すために使うスパークル(✨)アイコンは、EUの要件を満たさない可能性が高い。スパークルは「AI搭載機能」という意味で使われることが多く、「この特定のコンテンツがAI生成」という意味にはならないからだ。
EUは公式のAIアイコンセットを公開している。これは「AI」の文字を含む専用バッジで、スパークルとは異なる。ただし、アイコンを使うだけでは法的準拠にはならない。アイコンは明確に見え、プレーンテキストと併用し、支援技術からアクセスできる必要がある。
適切なラベルの表示方法
EUのガイドラインでは、アイコンが小さすぎる、フッターに埋もれている、一瞬だけ表示される、といったパターンはすべて不適合とされる。ラベルはコンテンツの近くに常時表示し、共有やダウンロード後も保持される必要がある。
サイトでAI生成画像を掲載する場合は、画像の近くに「AI生成」というテキストラベルを置くのが現実的だ。altテキストにも「AI生成画像」と記載しておくと、スクリーンリーダー利用者にも伝わる。
世界で同時多発するAIラベリング規制
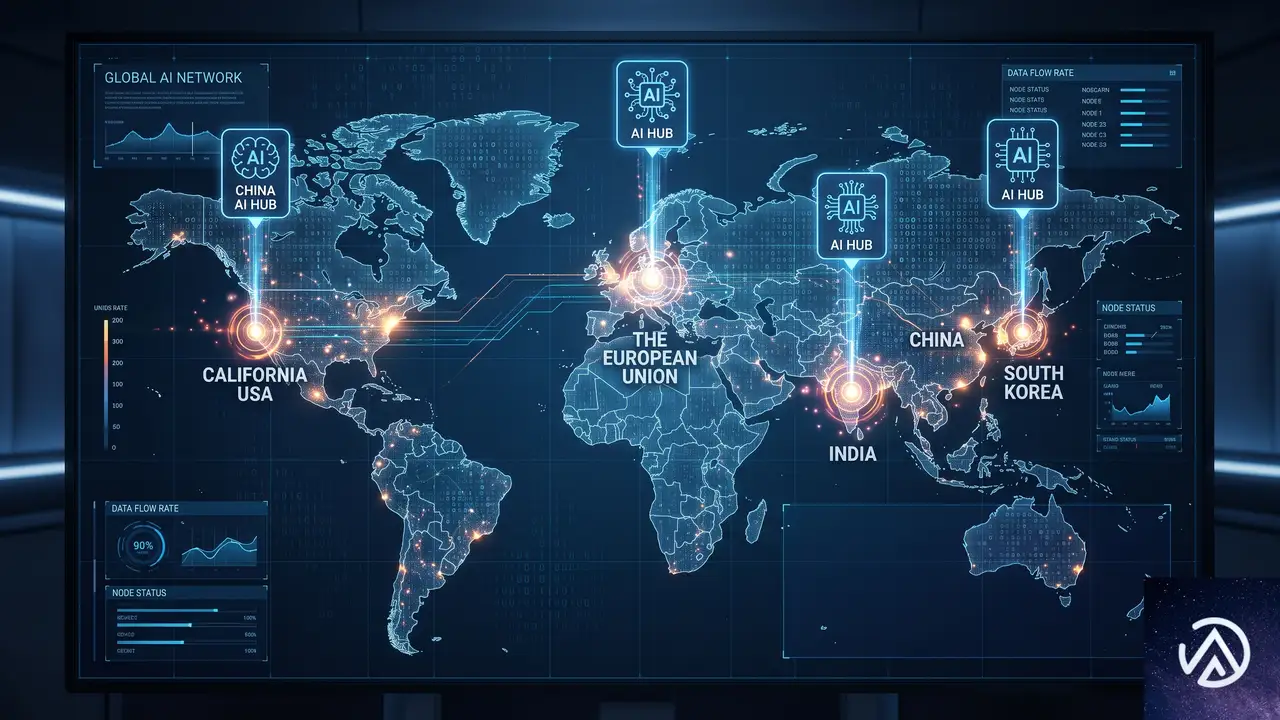
今回のEU規則は単独の動きではない。中国、カリフォルニア州、韓国、インドでも同様のAIラベリング規制が相次いで施行されている。
- 中国では2025年9月1日からAIコンテンツの表示義務が始まっている
- 米カリフォルニア州のSB 942はEUと同じ2026年8月2日に施行された
- 韓国ではAI基本法が2026年1月22日に施行され、ディープフェイク表示を義務化
- インドではIT規則改正により2026年2月20日から合成情報のラベル表示が必須になった
各国の規制は細部が異なるが、方向性は同じだ。AIが生成したコンテンツが人間の制作物と誤認される場合、明確に開示するという共通パターンが浮かび上がる。
サイト運営者が今からできる準備
AI生成コンテンツを扱うサイト運営者は、まず自社サイトでどの部分がAI生成に該当するかを棚卸しするところから始めたい。特に、商品画像、チャットボット、自動生成されるブログ記事、AIによる要約表示などが対象になる。
次に、ラベルの表示ルールを整備する。AI生成コンテンツには「AI生成」というテキストラベルと公式アイコンを併用し、目立つ位置に配置する。WordPressの場合はテーマのテンプレートやカスタムフィールドを使って、AI生成フラグを管理する方法もある。
最後に、編集フローを文書化しておく。人間が実質的に編集した場合と、AI出力をそのまま使った場合を区別し、後者だけにラベルを付ける運用にすると、無駄なラベル表示を避けられる。
この記事のポイント
- EUのAIラベリング義務は2026年8月2日から施行され、EU圏のユーザーにAI出力を提供する全世界の企業が対象
- ラベリングが必要なのはディープフェイク、チャットボット、完全AI生成テキスト(公共の利益)、感情認識ツールの4種類
- 人間が実質的に編集したAI生成コンテンツは開示不要。軽微な編集はAI生成に該当しない
- スパークルアイコンだけでは不十分。公式アイコンと「AI生成」というテキストラベルを併用する
- 中国、カリフォルニア、韓国、インドでも同様の規制が始まっており、サイト運営者は早めの対応が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

OpenAIがGPT-5.6 SolのUltrafastモード発表。最大14倍速で毎秒750トークン出力
OpenAIは8月13日、GPT-5.6 Sol向けの新サービス階層「Ultrafast」を発表した。標準処理と比べて最大14倍の速度で推論を実行できる。まずOpenAI APIで提供を開始する。
Cerebrasの推論基盤を活用し、1秒あたり最大750トークンを出力する。この速度は高知能モデルをリアルタイムアプリケーションに組み込める水準だ。
速さと知能のトレードオフが崩れると何が起きるか。この発表は今後のAI活用の方向を左右する転換点になる。
Ultrafastモードの概要
UltrafastはGPT-5.6 Sol専用の高速推論サービス階層である。同じモデルを使いながら、推論を実行するハードウェアとソフトウェアの最適化によって出力速度を大幅に引き上げる。現在は限定的なプレビュー期間中で、順次アクセスが拡大される予定だ。
性能と提供方法
出力速度は1秒あたり最大750トークンに達する。750トークンは日本語で約1500文字程度に相当し、画面上にほぼ瞬時に表示される。従来のフロンティアモデルは高知能ゆえに応答が遅く、リアルタイム用途には不向きだった。Ultrafastはこの前提を覆す。
OpenAIは同じテキストプロンプトから3D倉庫シミュレーターを構築するデモを公開した。標準モードとUltrafastモードを並べて比較する形で、同じタスクがどれだけ速く完了するかを示している。速度差は体感で明らかなレベルだ。
このデモは、同じ1000トークンを出力する場合の時間差を示している。Ultrafastならチャットの応答が返る前に別のタスクへ移れるレベルだ。
標準モードとの違い
同じGPT-5.6 Solでも、標準処理とUltrafastでは推論を実行する基盤が異なる。標準処理が汎用的な推論基盤を使うのに対し、UltrafastはCerebrasの専用シリコンによる低遅延推論を利用する。モデルの知能は同一であり、速度だけが変わる点が重要だ。
実用シーンでの活用事例

OpenAIはプレビュー期間中、コーディング、EC、金融リサーチ、サポートなど多様な業種の企業と連携して検証を進めている。実運用環境でのフィードバックを収集し、速度向上が最も価値を生む領域を特定する狙いだ。
障害対応と金融リサーチ
障害対応では、システム障害の発生中にアプリケーションログや直近のコード変更、エンジニアの報告を解析し、原因の特定と修正案の準備を進められる。状況が変化し続ける間に解析を完了できる点が従来のAIと大きく異なる。
金融リサーチでは、市場シグナルの分析や取引の評価、不審な活動の検出を相場が動いている最中に実行できる。時間差がそのまま機会損失やリスク拡大につながる領域だ。
カスタマーサポートとEC
カスタマーサポートでは、複数のステップやシステムをまたぐ回答でも会話を途切れさせずに返せる。音声対話でも自然なテンポを維持できるため、人間のオペレーターに近い体験を提供できる。
ECでは、買い物客が迷っている間に商品の質問に答え、在庫を確認し、パーソナライズしたレコメンドを表示できる。迷いがカゴ落ちに変わる前に回答を届けられる点が成約率に直結する。
上図はOpenAIが挙げた5つの主要な活用シーンを整理したものだ。共通するのは「状況が変化している間に結果を返す」必要性である。
ライブリサーチ
研究用途では、一晩かけて実行していた実験バッチが勤務時間内に複数回の反復を回せるようになる。アイデアを試し、結果を確認し、アプローチを調整し、次の実験を回す。このサイクルが対話型セッションに変わる。
Cerebrasとの技術提携
Ultrafastの高速化を支えるのがCerebrasとの提携である。Cerebrasはウエハースケール推論チップを開発する企業で、低遅延推論に特化したハードウェアを持つ。従来のGPUクラスタとは異なるアプローチで、メモリ帯域幅と通信遅延を大幅に削減する。
超低遅延推論の実現
通常のGPUクラスタでは、複数のチップ間でデータをやり取りする際に通信遅延が発生する。Cerebrasのウエハースケールチップは1枚のシリコン上に多数の演算コアを集約しており、チップ間通信を伴わずに推論を完結できる。これが低遅延の鍵だ。
最上位モデルを支えるハードウェア
今回、Cerebrasの推論基盤がOpenAIの最上位モデルであるGPT-5.6 Solを支えることになった。小型モデルや特化モデルではなく、フロンティアモデルそのものを高速化する点がこれまでにない試みだ。両社の提携は次の段階に入ったと言える。
速度が知能を捨てない時代へ
従来のAI活用では「高知能だが遅い」モデルと「高速だが知能が劣る」モデルの二択が存在した。リアルタイム用途では小型モデルや特化モデルを選ぶのが一般的だった。Ultrafastはこの二択を不要にする。
このデモは、AI選択のパラダイムがどう変わったかを示している。速度を理由に知能を犠牲にする必要がなくなる点が最大の変化だ。
二択の終焉
技術的な観点では、推論の低遅延化はモデルの小型化とは異なるベクトルである。モデルを縮小せず、ハードウェアとソフトウェアの最適化だけで速度を上げる。これにより、最先端の知能をそのままリアルタイムシステムに組み込める。
この変化は、AIを導入できる業務の範囲を大きく広げる。従来は「時間がかかるから」という理由で見送られていた用途に、フロンティアモデルが入り込めるようになる。
研究開発サイクルの圧縮
OpenAI社内でも、研究用途でUltrafastの効果が確認されている。ナレッジソースの高速検索やデータクエリの実行、接続されたツールを横断した情報収集と整理を短時間で完了できる。一晩かかった実験が、勤務時間内の対話的な試行錯誤に変わる。
研究開発のサイクルが圧縮される効果は、外部企業よりもむしろOpenAI自身のモデル開発速度に影響を与える可能性がある。次のモデルを生み出すスピードがさらに加速するだろう。
この記事のポイント
- UltrafastはGPT-5.6 Solを最大14倍高速化する新しい推論サービス階層だ
- Cerebrasの専用シリコンにより1秒あたり最大750トークンを出力する
- 高知能モデルをリアルタイム用途に使えることが最大の価値だ
- 障害対応や金融リサーチなど時間が重要な業務での活用が期待される
- 現在は限定的なプレビュー段階で、順次アクセスが拡大される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索で消えるブランド、SEO上位でもAI回答に登場しない実態。Fractl調査が明かす視認性格差
SEOで上位を獲得しているブランドの一部が、AIチャットの回答にはほとんど登場しない。検索エンジン向けの最適化だけでは、生成AI時代のブランド視認性を確保できないことが明らかになってきた。
Fractlの調査では、GPT-4o、Gemini 2.5 Flash、Claude Sonnet 4.6の3つのモデルに96種の業界別プロンプトを投げ、4,320件の回答と8,500件超のブランド言及を分析した。SEO指標とAI回答での言及頻度を突き合わせ、その乖離を数値化している。
この記事では、AI検索から消えつつあるブランドの特徴、逆にAIで過剰に登場するブランドの共通点、そしてブランド戦略に必要な対応を解説する。
AI回答に潜む「デフォルトブランド」の存在
調査対象の全業界に共通して、プロンプトの言い回しを変えても繰り返し登場する「デフォルトブランド」が存在した。ただし、その顔ぶれは検索エンジンの上位表示とは必ずしも一致しない。ドメイン評価が高く、大量のキーワードで上位表示されているブランドが、AI回答では自社カテゴリにすら登場しないケースが目立つ。
逆に、従来のSEO指標では目立たないブランドが、AI回答では頻繁に推奨される事例も多かった。注目すべきは、デフォルトブランドの顔ぶれが業界ごとに大きく異なる点だ。
旅行カテゴリではBooking.com(285回)、Airbnb(227回)、Expedia(215回)の3ブランドが、カテゴリ全体の言及量の約20%を占めた。3社で推奨の5分の1を握る集中度だ。保険カテゴリではLemonade(213回)がState Farm(172回)を上回り、Root Insurance(165回)がProgressive(114回)を超えた。デジタルネイティブの保険会社が先に挙げられ、従来の大手は代替案として扱われている。
ライフスタイルカテゴリでは、Patagonia、Allbirds、Eileen Fisher、Everlaneといったサステナビリティ系D2Cブランドが、SephoraやSamsung、Whirlpoolを上回った。Fractlの記事では、この傾向は第三者コンテンツで語られるブランドストーリーがAIの訓練データに強く反映された結果だと指摘している。
このデモが示す通り、検索エンジンでの強さとAI回答でのプレゼンスは一致しない。AI回答内の競争集合は、検索結果ページよりはるかに小さい。自社カテゴリでAIが想起する上位5〜10ブランドに入れなければ、Googleで上位表示できていても、AIが生成する検討リストには載らない。
伝統的なSEO権威性とAIリコールの乖離
Fractlの分析によれば、データセット全体の9割超のブランドでは、従来の検索権威性とAI視認性がほぼ連動していた。つまり、SEOの基本原則が無効になったわけではない。ただし、データの端に位置するブランド群にこそ戦略の変化が見える。
全体の約5%、471ブランドが「AI過少露出」だった。ドメイン評価が高く、オーガニック流入も多く、大量のキーワードで上位表示しているにもかかわらず、AIモデルからはほとんど参照されなかった。SEO指標上は市場リーダーに見えるのに、LLMからの言及では「誰も書いたことがない企業」のように映る。
一方、全体の約4%、377ブランドが「AIオーバーパフォーマー」だった。控えめなSEO指標に比べて、AIモデルからの参照が大幅に多かった。さらに9%は、第三者コンテンツでの言及頻度とAI視認性が一致した。
ここから見える最大の示唆は、自社が発信するコンテンツよりも、外部サイトが繰り返し語ってきた内容の方がAIの回答に強く影響するという点だ。まとめ記事、専門家リスト、比較レビューに登場する頻度が高いブランドほど、AIモデルの訓練データに取り込まれやすい。
カテゴリ誤分類で消える大手ブランド
AI過少露出のブランドには、従来の指標ではカテゴリの勝者とみなされてきた大手が並ぶ。ドメイン評価80以上、月間訪問数数百万、数十万のキーワードで上位表示しているブランドが、自社カテゴリのプロンプトで一切言及されない。
この問題の根底にあるのが、カテゴリ分類のズレだ。MicrosoftとSpotifyはFinTechのプロンプトで言及されなかった。両社とも伝統的な視認性は巨大だが、AIモデルはFinTechカテゴリに分類していない。Microsoftは生産性ソフトやクラウドの文脈では頻繁に引用される。FinTechの回答セットには含まれないだけだ。
同様の構図は保険、小売、ヘルスケアでも見られた。Aetna、Cigna、Humana、Liberty Mutualはドメイン評価80以上でも、AI回答ではLemonadeやRootに置き換えられた。Sephora、Samsung、Whirlpoolも、ライフスタイルのプロンプトではPatagoniaやAllbirdsに劣位した。
言及されない理由は、AIがブランドを知らないからではない。検索者が使うカテゴリと異なる引き出しに、そのブランドがしまわれているからだ。コンテンツ量を増やすだけでは解決しない。AIモデルがブランドを正しいカテゴリに結び付けるための外部シグナルが必要になる。
AIモデルがブランドをどのカテゴリに分類しているかを把握し、ズレがあれば修正する方が先だ。カテゴリの結び付きを強化するには、アナリスト記事、業界メディア、比較ページ、パートナーページ、カスタマーストーリー、レビューサイトでの露出が有効になる。
AIで際立つオーバーパフォーマーの戦略
AIオーバーパフォーマー377ブランドの動きは、マーケターにとって他山の石になる。小さいSEOプロフィールでも、AIの回答に繰り返し登場するブランドは、共通してAIモデルの訓練データに使われた第三者コンテンツに複数回登場している。
データセット最大のオーバーパフォーマーはMonday.comだ。AI視認性スコアは0.71を記録した。オーガニック訪問数は約100万、上位キーワードは5万以上。すでに大きなSEO基盤を持ちながら、SaaSプレイヤーの平均を大きく上回る頻度でAIに参照されている。
保険カテゴリではRoot Insuranceが突出した。大手保険会社の規模に遠く及ばないにもかかわらず、AI参照数ではすべての従来型保険会社を上回った。オーバーパフォーマーの上位15ブランドのうち6つは教育分野で、Stanford、MIT、Khan Academy、LinkedIn Learning、IBM Data Science、Google Career Certificatesが並ぶ。AIモデルは商用的なプラットフォームではなく、信頼性の高さで教育ブランドを参照している。
共通項は「良いSEO」ではなく、他者のコンテンツにカテゴリレベルで登場していることだ。製品まとめ記事、エキスパートリスト、比較記事に取り上げられる頻度が、AI視認性を押し上げる。AI視認性の向上は、デジタルPRやカテゴリ権威性の構築に近づいている。
モデル間で異なるAI視認性の実態
調査対象のうち、3モデルすべてに参照されたブランドは11%、900ブランドにとどまった。2モデルに登場したのは12%。残りの77%は、1つのモデルにしか登場しなかった。これはAI視認性の測定に深刻な課題を突き付ける。
ChatGPTで勝てるブランドがGeminiでは消える。Claudeで登場してもChatGPTからは出てこない。1つのモデルの回答を制しても、別のモデルではほとんど登録されない。AI視認性の「総合スコア」だけで改善を判断すると、実態を見誤る原因になる。
モデルごとの「指紋」も異なる。ClaudeはSaaSと保険に偏り、Notion、Linear、Lemonadeが他モデルより頻繁に登場した。Geminiは旅行とヘルスケアに偏り、Booking.com、Teladoc、Livongoの言及が多かった。ChatGPTは3モデルの中で最も合意型で、他モデルとの重複が最も多い。
NotionはClaudeからの引用がGeminiの17倍に達し、Whoopは約4倍だった。State FarmはChatGPTに言及のほぼ半分を依存し、Geminiからは約4分の1しか得られなかった。総合スコアが同じでも、どこで差が出ているかを確認しないと対策は打てない。
ブランド戦略に必要な5つの視点
Fractlの記事は、この調査から導ける5つの教訓を提示している。実行しやすい順に並べると、次の通りだ。
1. 検索権威性とAIリコールを分けて測る
ドメイン評価、オーガニック流入、キーワード順位は引き続き重要だ。ただし、それだけでは全体像を捉えられない。Googleでの順位とAI回答での登場を別々に追跡し、乖離を探す。そのズレにこそ戦略のヒントがある。
2. 第三者による検証を増やす
自社サイトのコンテンツだけではAI回答への登場を保証できない。まとめ記事、ベストリスト、比較記事、専門家レビュー、アナリストページ、ポッドキャスト、YouTubeの文字起こし、コミュニティの議論など、外部コンテンツでの言及を積み重ねることが、AI視認性の実用的なレバーになる。
3. モデルごとに個別測定する
3モデルすべてに参照されたブランドは11%に過ぎない。「AI視認性」を1つの指標として扱うのは誤解を招く。ChatGPT、Gemini、Claudeを分けて計測し、プロンプトをカテゴリ別、購買意図別、比較セット別に分解する。どのモデルで、どの文脈で、どの競合と共に登場するかを追跡する。
4. カテゴリ分類の修正を優先する
ブランド全体の認知度が高くても、狙うカテゴリでのリコールが弱いなら、問題は分類にある可能性が高い。AIモデルはブランドを知っているが、重要なクエリの回答セットに含めるべき存在だとは考えていない。メディア報道、比較コンテンツ、パートナー参照、カスタマーストーリー、受賞歴、レビュー、第三者ページなどを通じて、ブランドとカテゴリの結び付きを繰り返し強化する必要がある。
5. デフォルト回答の枠が固まる前に動く
ウェルネス、ライフスタイル、ヘルステックの一部では、デフォルト回答の座がまだ空白だ。一方、旅行、主要SaaS、FinTechの一部では、AIが返す顔ぶれがすでに固定化しつつある。カテゴリとの結び付きを早期に築いたブランドほど、AIの回答に残りやすい。後発が割り込む余地は徐々に狭まる。
この記事のポイント
- SEO上位でもAI回答に登場しないブランドが全体の約5%存在する
- AI回答での競争集合は検索結果ページよりはるかに小さい
- 第三者コンテンツでの言及頻度がAI視認性を左右する
- 3モデルすべてに参照されるブランドは11%に過ぎない
- カテゴリ誤分類の修正がAI視認性改善の近道になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazonが欧州で一括保管サービスAWDを開始 5カ国で8月20日から
Amazonが欧州で一括保管サービスAWD(Amazon Warehousing & Distribution)を開始する。8月20日からドイツ、フランス、イタリア、スペイン、英国の5カ国で利用可能になる。同サービスはAmazonセラーが大量の在庫を長期保管し、需要に応じてFBAフルフィルメントセンターへ自動補充する仕組みだ。
欧州でAmazonの販売を手がける中小事業者にとって、このサービスは物流面の大きな変化になる。特に繁忙期の在庫管理に悩むセラーには有効な選択肢となり得る。本記事ではAWDの仕組みと利点、そして物流チェーンへの影響を解説する。
AWDとは何か
AWD(Amazon Warehousing & Distribution)は、Amazonセラーが商品を一括でAmazonの配送センターに預け、長期間保管できるサービスだ。保管された在庫は、需要に応じてFBA(Fulfilment by Amazon)フルフィルメントセンターへ自動的に補充される。FBAとは、Amazonが商品の保管、梱包、発送、カスタマーサービスまでを代行する仕組みである。
一括保管と自動補充の仕組み
従来のFBAでは、セラーは商品をフルフィルメントセンターに直接納入する。しかしFBAには保管容量の制限があり、大量の在庫を一度に預けることは難しかった。AWDはAmazonの配送センターで長期の一括保管を行い、FBA側の在庫が減ると自動で補充する。これによりセラーは在庫を手動で移動させる手間から解放される。
AWDは物流の上流に位置する保管拠点の役割を果たし、FBAは注文に応じた出荷を担う。この2つの層をAmazonが一括管理することで、セラーの在庫管理業務が簡素化される。
AWDの料金体系
AWDの料金は、保管料に加えてFBAセンターへの処理費と輸送費が発生する。Amazonはセラー向けの説明で「定額制の長期一括保管」と表現しており、保管コストを予測しやすい設計になっている。ただし処理費と輸送費が別途かかるため、導入前に自社の物流コストと比較する必要がある。
欧州5カ国での提供開始
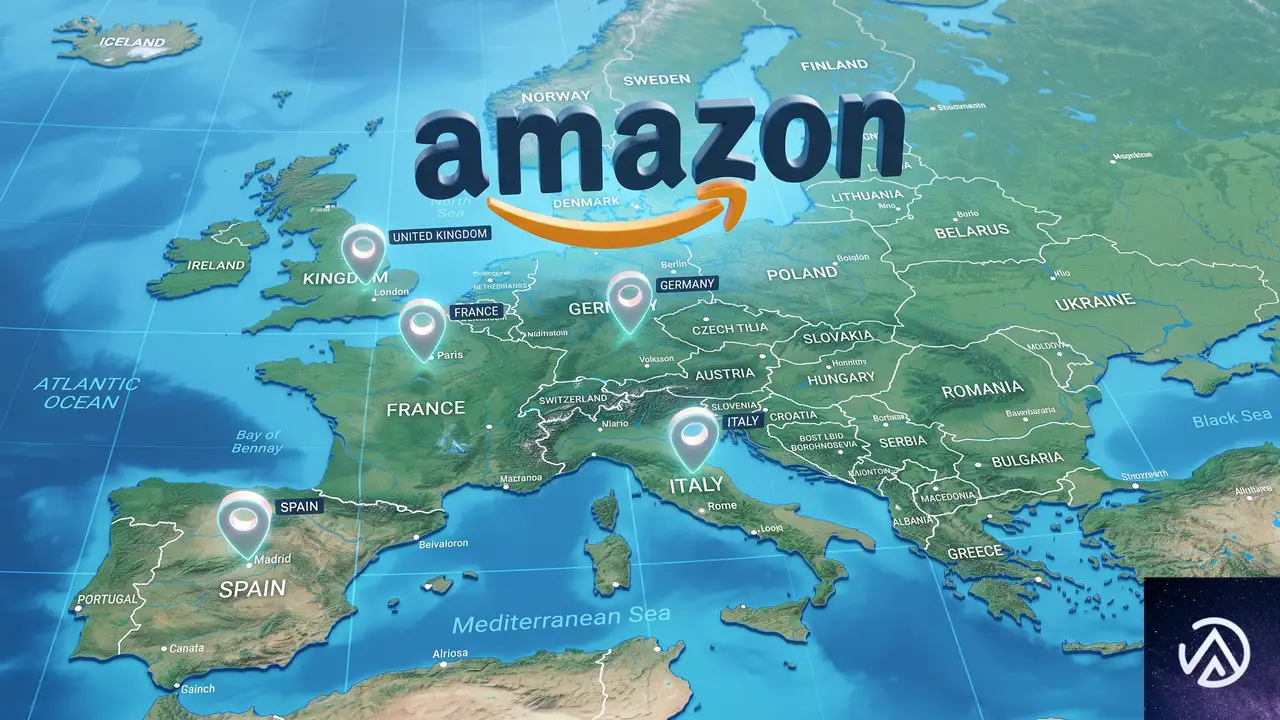
8月20日からAWDはドイツ、フランス、イタリア、スペイン、英国で利用可能になる。これらは欧州最大のEC市場であり、Amazonが各市場でトップの地位を築いている。欧州のセラーにとって、AWDの開始は物流インフラの選択肢が増えることを意味する。
対象市場とAmazonの地位
欧州のEC市場は国ごとに商慣行や物流網が異なる。しかしAmazonは5カ国すべてで市場リーダーであり、多数の中小セラーが出店している。これらのセラーがAWDをどう活用するかが、今後の普及を左右するだろう。
セラーにとっての3つのメリット
AWDの導入により、セラーは主に3つのメリットを得られる。FBA容量制約からの解放、自動補充による品切れ防止、繁忙期の在庫管理の容易化だ。いずれも売上機会の損失を減らす効果が期待できる。
FBA容量制約からの解放
FBAには保管容量の制限があり、セラーは在庫を増やしたくても受け入れ枠の問題で制約を受けることがあった。AWDを利用すれば、Amazonの配送センターで大量の在庫を長期保管できるため、FBAの容量制約に縛られずに商品を仕入れることが可能になる。
AWDを利用する前と後では、在庫管理の自由度に大きな差が出る。容量制約に縛られずに仕入れができる点は、売れ筋商品の取り扱い数を増やしたいセラーに特に有効だ。
自動補充で品切れを防ぐ
Amazonの説明によると、AWDの自動補充機能は手動での在庫補充作業を不要にし、品切れリスクを低減する。売れ筋商品の在庫が減れば、Amazonが需要を判断してFBAへ補充する。これによりセラーは商品管理から発注業務に時間を割かずに済む。
繁忙期の在庫管理が容易になる
Prime DayやBlack Fridayなどの繁忙期は、短期間で需要が急増する。こうした時期に在庫切れを起こすと、大きな売上機会を失う。AWDなら事前に大量の在庫を保管しておき、需要の高まりに応じて自動でFBAへ補充できる。繁忙期特有の在庫不足を防ぐ手段として、特に中小セラーには実用性が高い。
物流チェーンの支配強化とセラー依存
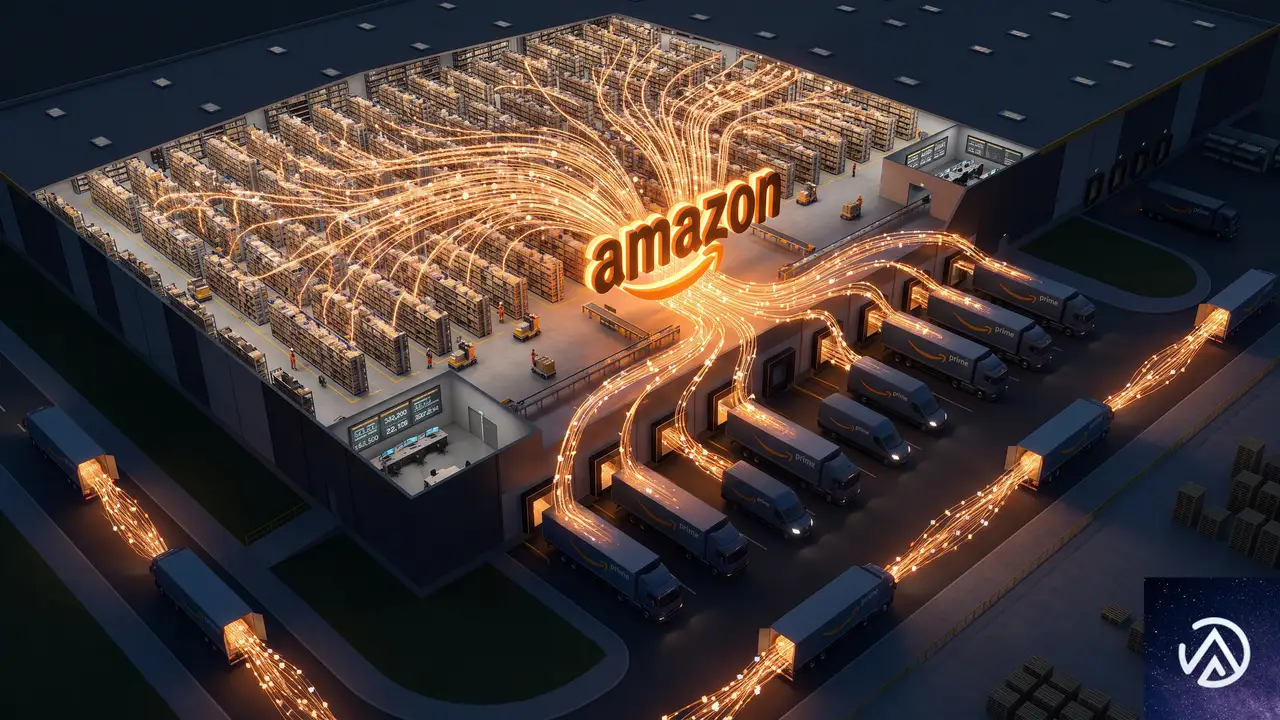
AWDはセラーの在庫とFBAネットワークの間に、新たな物流の段階を追加する。これは利便性の向上と同時に、Amazonが物流チェーン全体を掌握する動きとも読み取れる。
物流チェーンにAWDが加わることで、商品の保管から出荷までの工程がAmazonの管理下に置かれる。セラーにとっては手間が減る一方、Amazonへの依存度が高まる構造になる。
Amazonの物流支配が強まる
AWDは、Amazonがセラーの在庫保管から配送までを一貫して担う流れを加速させる。Amazonは昨年、欧州でセラー向け手数料を引き下げる施策を実施している。物流サービスを拡充する一方で手数料を調整し、より多くのセラーを自社物流網に取り込む戦略が見える。
セラーの依存度増加
欧州には10万を超えるサードパーティセラーが存在し、Amazonの欧州店舗における売上の大部分はこれらのセラーによって生み出されている。特に中小企業が多い。AWDによって業務が簡素化される一方で、在庫保管から配送までAmazonに委ねる割合が増えれば、プラットフォームへの依存はさらに深まる。Amazonは自社を欧州の中小企業の「味方」と位置づけているが、その関係性は常に緊張をはらんでいる。
米国での展開と今後の可能性
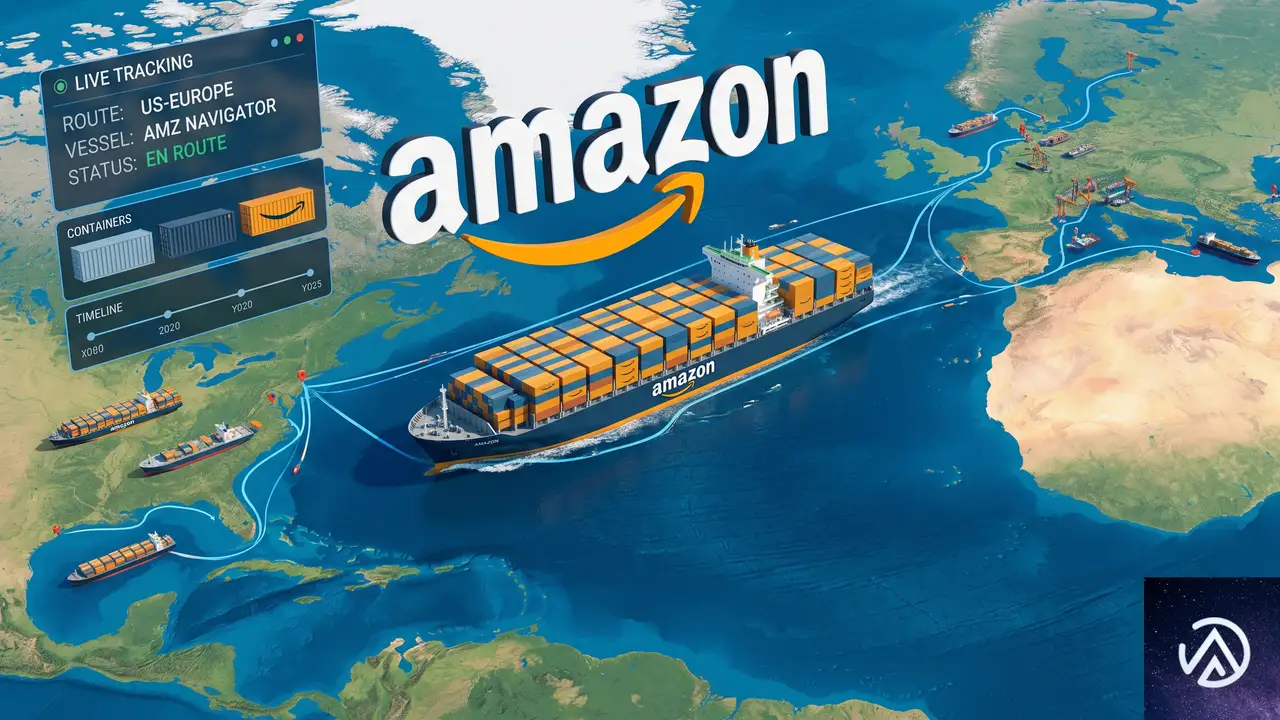
AWDは米国で4年前にサービスを開始しており、すでに一定の実績がある。欧州への展開はその成功を踏まえたものだ。ただし欧州版には現時点で含まれない機能もある。
米国では外部販売チャネルにも供給可能
米国ではAWDに預けた在庫を、Amazonの販売チャネル以外にも供給できるオプションが提供されている。つまりセラーは自社のオンラインストアや他社のECモールへ商品を供給する際にも、Amazonの保管拠点を利用できる。しかし欧州版のローンチ時点では、この外部チャネルへの供給オプションは含まれていない。
欧州の今後の展開は未定
現時点で、AWDが欧州の5カ国以外に展開されるかどうかは明らかになっていない。ただ欧州のEC市場規模を考えると、今後対象国を拡大する可能性は十分にある。外部販売チャネルへの供給機能が欧州でも提供されれば、AWDの価値はさらに高まるだろう。
この記事のポイント
- Amazonが欧州5カ国で一括保管サービスAWDを8月20日から開始する
- AWDは長期の一括保管とFBAへの自動補充が特徴だ
- セラーはFBA容量制約なしで在庫を保管でき、品切れリスクを抑えられる
- 一方でAmazonへの物流依存度が高まる側面もある
- 米国では外部販売チャネルへの供給も可能だが、欧州版では未対応だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare DDoS脅威レポート2026年上半期、1Tbps攻撃が935件に急増
Cloudflareが2026年8月11日、DDoS脅威レポートの2026年上半期版を公開した。今回で通算25回目の発行となる。四半期ごとの発表を統合し、1月から6月までを単一のレポートにまとめた形式だ。
レポートによれば、Cloudflareは上半期で2,320万件のネットワーク層DDoS攻撃と29兆6,400億件のHTTP DDoSリクエストを軽減した。1時間あたり約5,343件、1日あたり約12万8,000件の攻撃に相当する。
なかでも1Tbps(テラビット毎秒)を超える超大規模攻撃の急増が目を引く。攻撃ベクトルはボットネット直撃型から反射・増幅型へ移行しつつあり、防御側の自動化がこれまで以上に重要になっている。
2026年上半期のDDoS攻撃概況
4月にピーク、国際摘発作戦で減少へ
4月は攻撃のピーク月だった。攻撃リクエストは6兆4,600億件、通信量は165PB(ペタバイト)に達した。この量は大手動画プラットフォームが1日で処理するデータ量に匹敵する規模だ。
その後、攻撃件数と通信量は減少に転じた。同時期に実施された国際法執行作戦「Operation PowerOFF」が影響したとみられる。21カ国が参加し、DDoS攻撃代行サービスの利用者7万5,000人超を標的に、53のドメインを停止、25件の家宅捜索、4人の逮捕という成果を上げた。
法執行の直接的な抑止効果は計測しにくい。ただし摘発の直後に攻撃数が減少した事実は、DDoS攻撃代行サービス(いわゆるブートストレスサービス)の利用層がインターネット全体の攻撃量に与える影響の大きさを示している。個人が安価に攻撃を「注文」できる構造が、この規模の攻撃増加を支えている構図だ。
1Tbps超の攻撃が6倍以上に急増
1Tbps超の超大規模攻撃は第2四半期だけで805件に達した。前期比で6倍以上の増加だ。上半期全体では935件の1Tbps超ネットワーク層攻撃を軽減している。
DDoS対策の世界では「ハイパーボリュメトリック攻撃」という分類がある。1Tbps以上、または毎秒10億パケット(Bpps)以上、または毎秒100万リクエスト(Mrps)以上のいずれかを満たす攻撃だ。2026年はこの分類に入る攻撃が順調に増えている。
ただし攻撃の中央値は小規模だ。ネットワーク層攻撃の96.62%が500Mbps未満、90.60%が10分未満で終了している。「小規模」といっても相対的な話だ。100Mbpsの攻撃だけで一般的なサーバーやWebサイトは十分にダウンし得る。100Gbpsなら無保護のデータセンターを停止させる威力がある。
攻撃者は帯域とパケットレートの組み合わせも工夫する。高パケットレート(Mpps単位)と低帯域幅(Gbps単位)を組み合わせ、ネットワーク機器の処理限界と回線容量の限界という異なる弱点を同時に狙う手口が観測されている。
攻撃ベクトルの変化とCLDAP急増
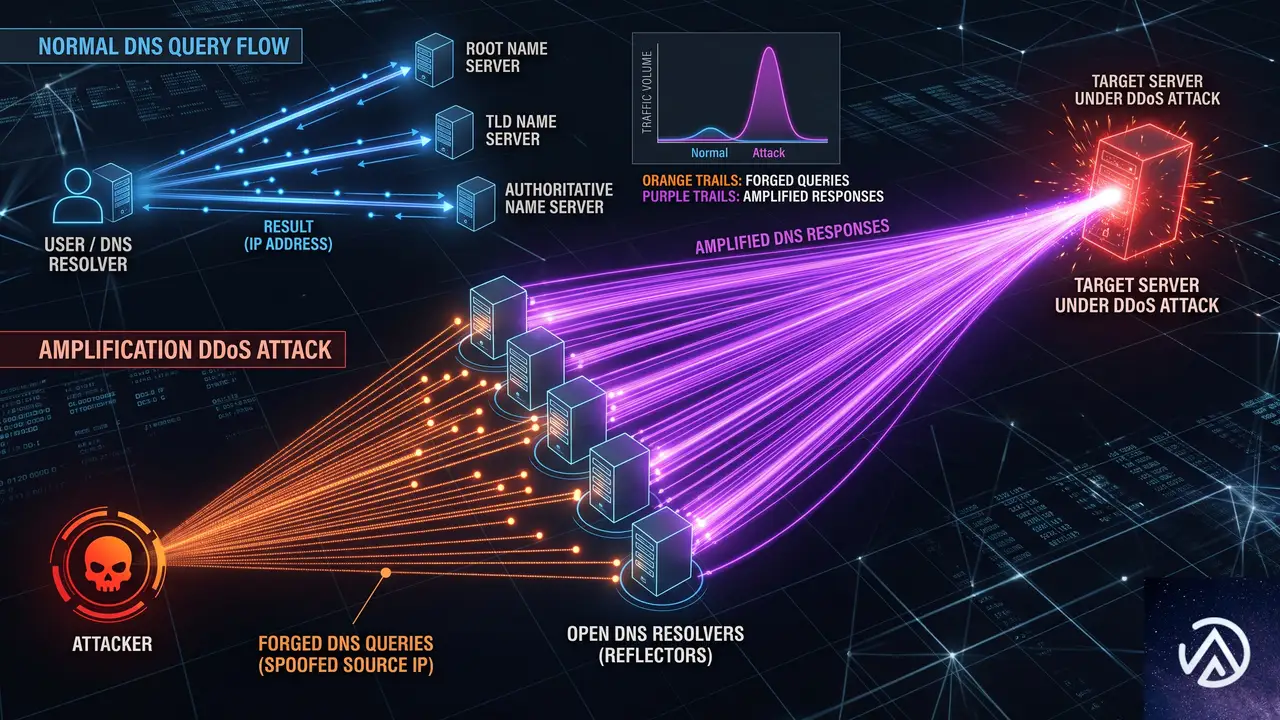
DNS系攻撃がネットワーク層の3分の1を占める
攻撃の中心はボットネット直撃型から反射・増幅型へ移っている。DNS系攻撃が上半期のネットワーク層攻撃全体の34.3%を占めた。第2四半期にはDNSフラッドの割合が25.7%から40.0%へ急拡大している。
DNSフラッドは、ボットネットが被害者の権威DNSサーバーへ大量のクエリを直接送りつける攻撃だ。このドメインの「電話帳」に当たるDNSサーバーが応答不能になると、そのドメインに依存するサービスはすべて機能を失う。
DNSアンプリフィケーションは別の仕組みだ。攻撃者は送信元IPを偽装した小さなクエリを公開DNSリゾルバへ送る。リゾルバは元のクエリよりはるかに大きな応答を、偽装されたIP(つまり被害者)へ返す。少ない帯域で大きな攻撃を生み出せるため、攻撃者にとって効率がよい。
上の図は3つの攻撃ベクトルの違いを整理したものだ。直撃型は攻撃者自身の帯域がそのまま攻撃力になる。反射・増幅型は第三者のサーバーを踏み台にするため、攻撃者側の帯域が少なくても大きな打撃を与えられる。
CLDAPフラッドが580%増
CLDAPフラッドの伸びは顕著だ。前期比580%増となり、第2四半期だけで第3位の攻撃ベクトルに浮上した。
CLDAP(Connectionless Lightweight Directory Access Protocol)はLDAPのUDP版だ。UDPはTCPと違いハンドシェイクが不要で、送信元IPの偽装が容易になる。攻撃者はUDPポート389で公開されたドメインコントローラーへ偽装クエリを送り、元の数十倍から数百倍の応答を被害者へ反射させる。
CLDAPの急増が示すのは、公開されたUDPサービスの危険性だ。ポート389が外部に開いている組織は、自覚のないまま攻撃者の踏み台にされている可能性がある。インフラ管理者にとっての実務的な教訓は「UDPポートの露出を監査し、不要なら閉じる」という基本対策の重要性が再確認されたことにある。
標的産業と地域の動向
メディア産業が最大の標的に
メディア・制作・出版産業が両四半期で最も攻撃された産業になった。全HTTP DDoSリクエストの14.2%を占め、2位の約4倍に相当する。イランとウクライナの戦況報道、そしてワールドカップ関連の報道が攻撃対象になったとみられる。
報道機関へのDDoS攻撃は、単なる金銭目的や愉快犯ではなく、情報の流れを止める意図を持つことが多い。特定の報道を続けるメディアのサイトを落とすことで、世論に影響を与えようとする動機が背景にある。
この図が示すように、標的と攻撃元の分布は対称ではない。標的は中国・米国など経済規模の大きい国に集中し、攻撃元はブラジル・インドネシアなどボットネット感染端末が多いとされる国に偏る。
政府部門が29位から9位へ急浮上
政府部門の動きは今年最大のトピックだ。2026年2月28日にイスラエルと米国が「Operation Epic Fury」を開始。その72時間以内に、16カ国110組織に対する149件のハクティビストDDoS攻撃が記録された。標的組織の47.8%が政府部門だった。
この結果、政府部門のシェアは第1四半期の29位から第2四半期には9位へ急上昇した。単一セクターの移動幅としては2026年最大だ。地政学的な緊張がDDoS攻撃の規模と方向性に直接影響を与える構図が、データとして明確に現れた。
国別では中国が最多の標的になった。第2四半期に全世界のHTTP DDoSリクエストの22.4%を吸収した。米国は18.8%で2位を維持している。トルコは攻撃シェアが倍増し、第3位に浮上した。6月から7月にかけてのアンカラNATOサミット準備期間中、治安当局が209人以上を逮捕する大規模な事前摘発を行った時期と重なる。
攻撃元の国ではブラジルが米国を逆転して1位になった。上半期のシェアはブラジル14.9%に対して米国13.4%だ。ブラジルは第2四半期に21.4%まで急伸した。インドネシアは両四半期とも3位を維持し、複数四半期連続で上位3カ国に入る常連になっている。
短時間攻撃と自動防御の重要性
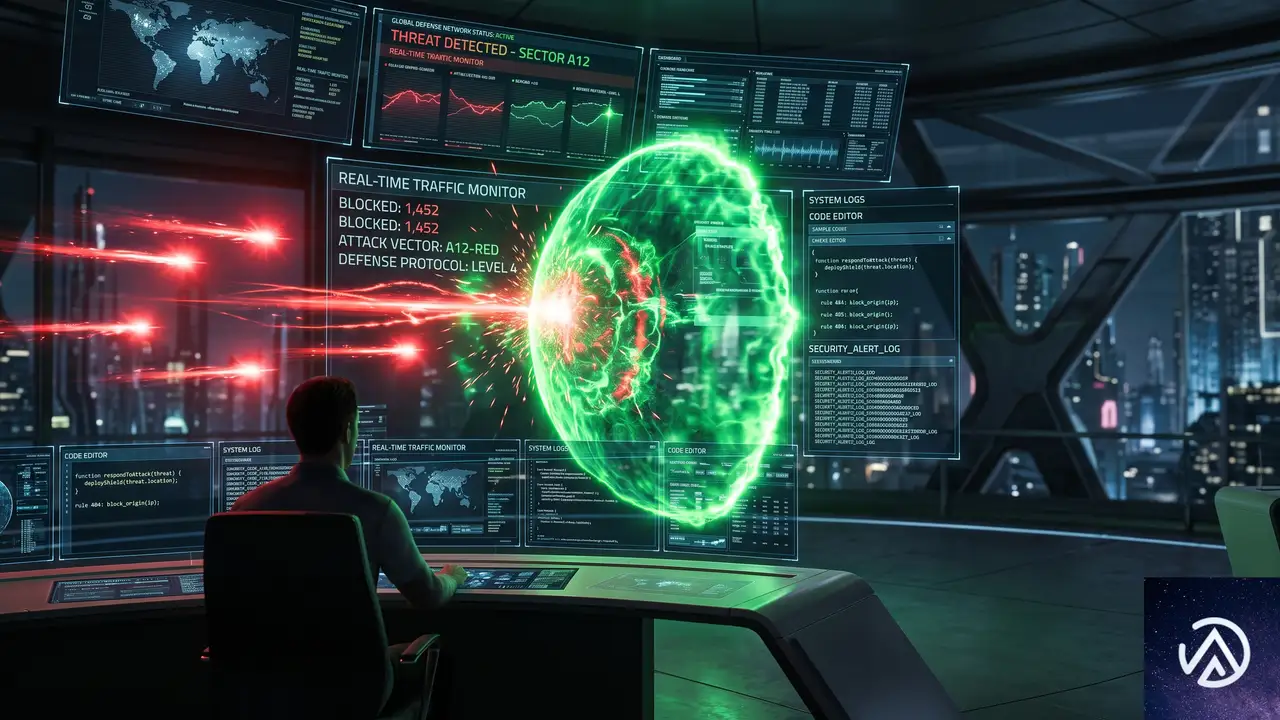
90%以上が10分未満で終了
DDoS攻撃の大半は驚くほど短い。上位の超大規模攻撃ですら秒単位で終了する。過去には開始から終了までわずか35秒という記録的な攻撃も観測されている。
攻撃が30秒でも10分でも、人間が介入する実質的な時間窓は存在しない。セキュリティ担当者にアラートが届いた時点で、攻撃はすでに完了しているからだ。手動での軽減策やオンデマンド型の防御はこの現実に対して遅すぎる。
この図のとおり、攻撃の持続時間と人手による対応時間は圧倒的に乖離している。従来型の「監視して手動で対応する」運用モデルは、DDoS対策においては成立しない。
自動防御が唯一の実効策
さらに、短い攻撃の余波は長引く。ルーティングの不安定化、TCP再送、アプリケーションのタイムアウト、下流サービスの劣化などが数時間から数日続くことがある。サービス停止や品質低下は攻撃の終了後も継続するのだ。
この環境では、常時稼働する自動防御が「あったほうがよい」ものではなく必須の要件になる。Cloudflareは330以上の都市に分散したネットワーク全体で、人間の介入なしに攻撃を検知・軽減する仕組みを運用している。ネットワーク容量は500Tbps規模だ。
同社はさらに、DDoS攻撃を仕掛けるIPアドレスやアカウントを特定する無料のフィードをホスティング事業者やISP向けに提供している。世界800以上のネットワークが登録しており、ボットネットノードの撤去に一定の成果を上げている。
日本の事業者にとっての示唆は明確だ。自社サイトが直接の標的でなくても、反射型攻撃の踏み台にされたり、同じホスティング上の他サイトへの攻撃に巻き込まれたりするリスクは常にある。小規模サイトでも「攻撃を受けたら止まる」前提ではなく、自動防御を標準装備する発想が必要になる。
この記事のポイント
- 1Tbps超のネットワーク層DDoS攻撃が上半期で935件に達した
- DNS系攻撃がネットワーク層全体の34.3%を占め、反射・増幅型への移行が進む
- CLDAPフラッドが前期比580%増で第3位の攻撃ベクトルに浮上
- メディア・制作・出版が最も攻撃され、政府部門は29位から9位へ急上昇
- 攻撃の90.60%が10分未満で終了し、自動防御が実質唯一の対策になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloudが2029年までに耐量子暗号へ完全移行。PQCロードマップの全容と企業が取るべき3ステップ
Google Cloudが2026年8月11日、2029年までに耐量子暗号(PQC / Post-Quantum Cryptography)へ完全移行するためのロードマップを公開した。量子コンピュータによる将来の暗号解読リスクに備え、APIエンドポイントやロードバランサーの対応はすでに始まっている。
今回の発表では、移行戦略の3つの重点領域、2026年に完了した基盤整備、2027年から2028年にかけてのドメイン別計画が示された。企業が今すぐ着手すべき3つのステップも提示されている。
量子コンピュータが実用化されれば、現在広く使われているRSAやECDSAなどの公開鍵暗号は解読可能になる。その影響はクラウドサービス全体に及ぶ。本記事では、Google CloudのPQCロードマップの全容と、企業に求められる対応を整理する。
PQC移行の全体像と2029年目標
Google CloudのPQC移行戦略は「セキュアバイデザイン」を基本方針とする。設計段階から量子安全を組み込むアプローチであり、単なる後付けの対策ではない。Google Quantum Threat Modelという独自の脅威モデルを土台に、3つの重点領域で保護を進める。
SNDLリスクとは何か
SNDL(Store Now, Decrypt Later)は「今保存して後で復号する」攻撃だ。攻撃者が現在の暗号化通信を傍受してデータを蓄積しておき、量子コンピュータが実用化された時点で一括して復号する。今日の暗号化データが将来の量子コンピュータで解読されるリスクは、すでに現実のものとなっている。
これがPQC移行を急ぐ最大の理由だ。機密データの保存期間が数十年に及ぶ場合、現在の暗号化方式のままでは将来の解読リスクを抱え続けることになる。特に金融機関や政府機関、医療機関では、このリスクへの対応が喫緊の課題だ。
このデモはSNDL攻撃のリスクとPQCによる防御の違いを示している。攻撃者がどれだけデータを蓄積しても、量子安全な鍵交換を使っていれば将来の解読は不可能になる。
Googleが定める3つの重点領域
Google CloudがPQC移行戦略で優先するのは、以下の3領域である。
- SNDLリスクの緩和。現在の暗号化データが将来の量子コンピュータで解読されることを防ぐ。
- 偽造に対する完全性の確保。デジタル署名を強化し、データやIDの偽造を防ぐ。
- 暗号アジリティの基盤強化。暗号標準の進化に合わせて、新しい方式を最小限の工数で採用できる柔軟なシステムを構築する。
3番目の「暗号アジリティ」は特に重要だ。暗号標準は今後も進化し続ける。特定のアルゴリズムに依存せず、新しい標準が出たら容易に切り替えられる仕組みがあれば、将来の移行コストを大幅に抑えられる。Googleはこの基盤への投資を戦略の中核に置く。
Google Cloudは規制期限を待たずに、内部インフラと顧客向けサービスのPQC移行を前倒しで進めている。2029年の完全対応を目標に、Sovereign Cloudの取り組み(Google Cloud DedicatedやGoogle Distributed Cloud)にもPQCソリューションを展開中だ。
2026年に完了した基盤整備
2026年時点で、すでに複数の基盤的マイルストーンが達成されている。これらは顧客に対して即座の保護を提供するものだ。
APIエンドポイントとロードバランサーの対応
Google CloudのAPIエンドポイントは、量子安全な鍵交換に対応した。google.comと*.googleapis.comの両方が、NIST標準化済みのML-KEM(FIPS 203)をハイブリッドモードで実装している。ハイブリッドモードとは、従来の暗号とPQCを併用する方式だ。互換性を保ちながら量子安全性を確保できる。
アプリケーションロードバランサーとプロキシロードバランサーも、TLS 1.3における量子安全ハイブリッド鍵交換(X25519MLKEM768)をサポートする。当初はオプトイン方式で提供され、顧客は既存アプリケーションへの影響を最小限に抑えながら検証を進められる。
さらに、ChromeとCloudflareが進めるMerkle Tree Certificatesの実験にも参画している。PQC署名をWebPKIに適用する際の課題(署名サイズの肥大化など)に対処する取り組みだ。
Cloud KMSのPQCアルゴリズム一般提供
Cloud KMSでは、NIST標準化済みのPQCアルゴリズム(ML-KEM、ML-DSA、SLH-DSA)が一般提供(GA)に達した。暗号化鍵と署名鍵の両方で量子安全なアルゴリズムを利用できる。
これは企業にとって大きな意味を持つ。既存のCloud KMS利用者は、新しいPQCアルゴリズムを試すために特別な準備をする必要がない。すでに一般提供されているため、本番環境での利用も可能だ。
ドメイン別ロードマップ(2027〜2028年)
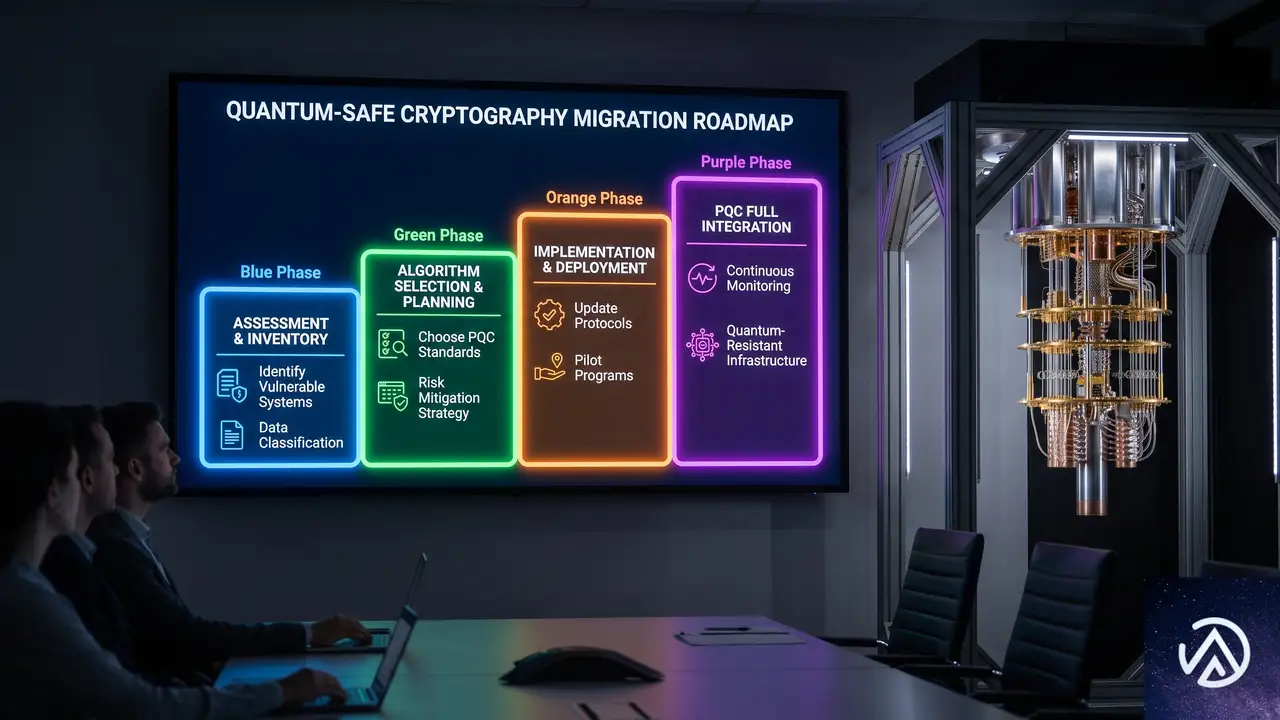
Google Cloudは2029年の完全対応に向けて、リスクベースのアプローチで3つのドメインを定義した。各ドメインには目標完了時期が設定されている。サービスによって個別のタイムラインは調整される可能性があるが、大多数のサービスは目標時期に合わせて移行を完了する見込みだ。
このタイムラインは、Google CloudのPQC移行が段階的に進むことを示している。2026年の基盤整備から始まり、2027年には通信経路の保護、2028年には署名と鍵管理、2029年に全体の収束を目指す。
ドメイン1 SNDL対策(2027年目標)
ドメイン1は非対称暗号の脆弱性に対処する。将来の量子コンピュータが今日の暗号化データを復号するリスクを防ぐのが目的だ。対象となるのは以下の3つの経路である。
- 顧客ワークロードの保護。Google Cloudサービスとロードバランサーに量子機密TLS 1.3ハンドシェイクを提供する。
- 管理者・開発者フローの保護。Cloud VPNやInterconnectを含む管理者経路をSNDLから守る。開発者向けにはクライアントライブラリ、SDK、オープンソース暗号ライブラリのTinkを対応させる。
- データパイプラインの保護。分析・ストレージプラットフォームのデータ転送を保護し、機密情報が傍受・蓄積されても将来復号されないようにする。
このドメインの特徴は、通信経路の保護に焦点を当てている点だ。特にTinkの対応は重要である。TinkはGoogleが開発したオープンソース暗号ライブラリで、多くの開発者が利用している。TinkがPQCに対応することで、開発者はアプリケーションレベルで量子安全な暗号を容易に導入できる。
ドメイン2 完全性と否認防止(2028年目標)
ドメイン2はデジタル署名と証明の量子対応を扱う。量子コンピュータによる偽造攻撃からデータの完全性と信頼性を守る。3つの主要分野がある。
1つ目はソフトウェアサプライチェーンの保護だ。Binary Authorization、Cloud Build、Assured Open Source Softwareなどのサービスで、量子耐性のある証明(アテステーション)を導入する。信頼できる変更されていないイメージだけが本番環境で実行されることを保証する。
2つ目は量子安全な証明書の発行だ。内部および外部の認証局(CA)をML-DSA証明書に対応させる。状況に応じてSLH-DSA証明書もサポートする。IETF(Internet Engineering Task Force)の標準化に積極的に貢献しており、大規模な署名サイズ問題にはMerkle Tree Certificatesなどの新しいアプローチを検証中だ。
3つ目はIDとアクセスの保護である。サービスアカウントキーやトークン(JWT / OAuth)を量子偽造に対して耐性のある方式に移行する。
ドメイン3 基盤と鍵管理(2028年目標)
ドメイン3はPQC移行の土台となる暗号アジリティを扱う。ここでの投資が、ドメイン1と2の実現を支える。
基盤となる鍵管理とライブラリでは、Cloud KMSとBoringSSL、Tinkを通じてNIST承認アルゴリズムを有効にする。Cloud KMSはすでにML-KEM、ML-DSA、SLH-DSAの一般提供を開始しており、量子安全な鍵のインポートも準備中だ。
ハードウェアが関わる部分では、Confidential ComputingとCloud HSMにPQCを組み込む。量子的なルートオブトラストを確立し、物理的な基盤を保護する。OpenTitanやCaliptra v2.1、TPM 2.0 v185などのオープンソースシリコン基盤もPQC対応を進めている。
Google Workspaceのクライアントサイド暗号化(CSE)と外部鍵マネージャー(EKM)にもPQCオーケストレーションを導入する。オンプレミスの鍵プロバイダーとの連携も進める計画だ。
量子安全における共有責任モデル
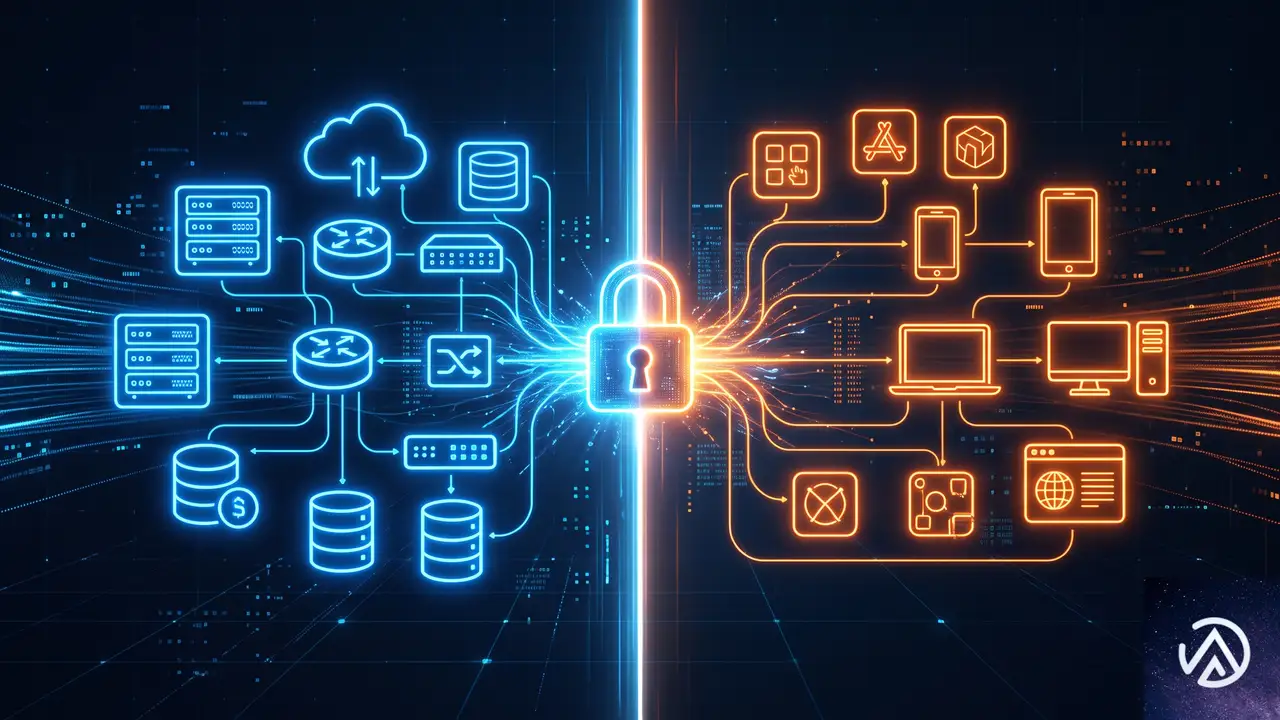
量子安全はGoogle Cloudと顧客の共同作業である。クラウドセキュリティの共有責任モデルがPQCにもそのまま適用される。
この図は責任の境界を明確にしている。重要なのは、Google Cloud側のPQC対応が完了しても、顧客がクライアントソフトウェアを更新しなければ量子安全な接続は確立しない点だ。
Google側の責任範囲
Googleはサーバー、ネットワーク、転送中の暗号化、グローバルフロントエンド、ALTSプロトコルのPQC移行を一括して管理する。ハードウェアの移行は、積極的な交換と自然な機器更新サイクルを組み合わせて段階的に進める。物理コンポーネントの中には2029年を超えて移行が続くものもあるが、安定性を優先したフェーズドアプローチを取る。
顧客側の責任範囲
顧客は自社アプリケーションの管理に責任を持つ。クライアントソフトウェアをPQCハンドシェイク対応に更新すること、非対称鍵のライフサイクル管理、Google Cloudサービスの設定変更が含まれる。
ここが最も見落とされやすいポイントだ。インフラ側がPQC対応しても、クライアント側が古い暗号方式で接続すれば、量子安全性は確保されない。企業のセキュリティチームは、自社のクライアントソフトウェアがPQC対応済みかどうかを確認する必要がある。
企業が今すぐ着手すべき3つのステップ
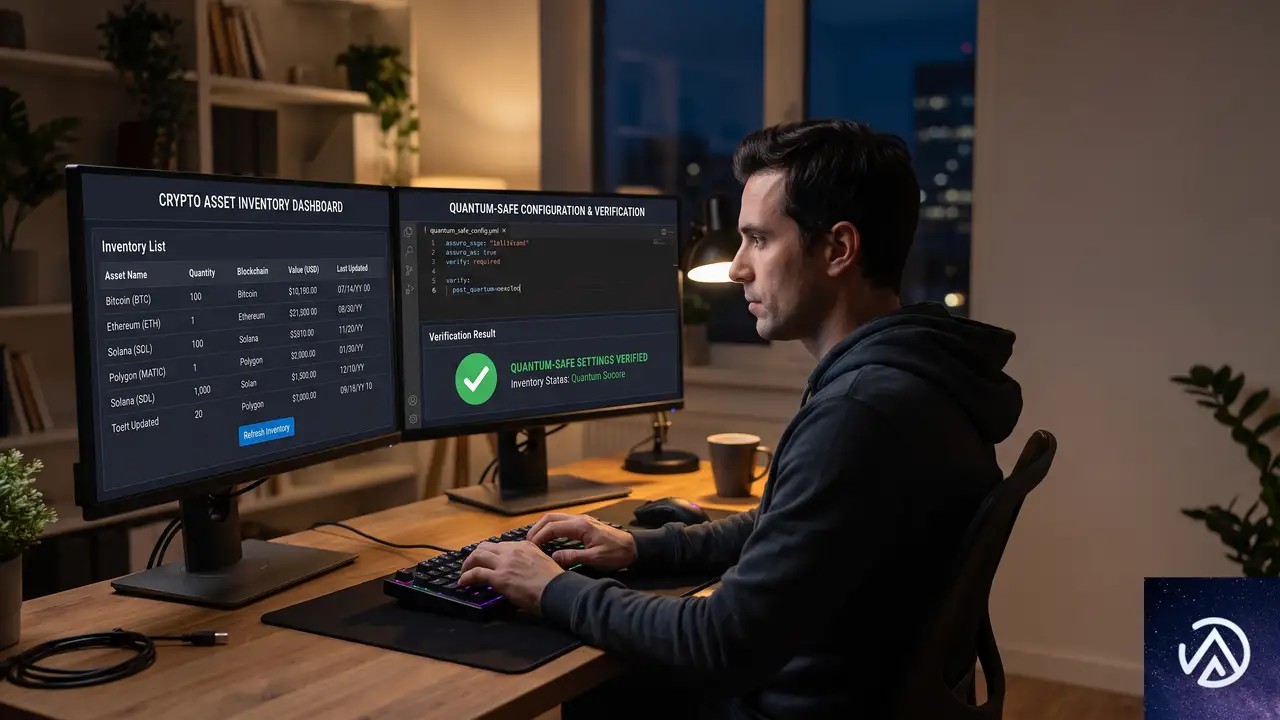
Google CloudはPQC移行の第一歩として、企業が即座に着手できる3つのステップを提示している。どれも実務に直結する具体的なアクションだ。
- 棚卸し(Inventory)。Cloud Asset InventoryやWizなどのツールを使って、鍵や証明書などの暗号資産を特定する。組織全体の暗号リソースをマッピングし、移行バックログの優先順位を定義する。
- 更新(Update)。開発チームとSREチームが使うソフトウェアが、BoringSSL、Chrome、SDKなどPQCアルゴリズムに対応していることを確認する。エッジで量子安全接続が有効化された際に、社内ワークフローが準備できている状態を作る。
- 検証(Validate)。Google Cloudの量子安全APIとロードバランサーを使って既存アプリケーションの挙動をテストする。本番環境に影響が出る前に、アーキテクチャ上のボトルネックを特定できる。
この3ステップは、PQC移行を「待つ」のではなく「準備する」アプローチだ。特に検証は重要である。量子安全なTLS接続は従来よりオーバーヘッドが大きい場合があり、アプリケーションのパフォーマンスに影響を与える可能性がある。事前のテストで課題を洗い出しておけば、本番移行時のリスクを大幅に減らせる。
この記事のポイント
- Google Cloudは2029年までにPQC完全対応を目指し、ロードマップを公開した
- SNDLリスク(今保存して後で復号)は企業にとって喫緊の課題である
- 2026年時点でAPIエンドポイント、ロードバランサー、Cloud KMSのPQC対応が完了している
- 3つのドメイン(SNDL対策、完全性確保、鍵管理基盤)で2027〜2028年に移行を進める
- 企業は棚卸し、更新、検証の3ステップで今すぐ準備を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.7 Flash登場。エージェント向け性能向上と半額価格の全容
Google DeepMindは8月13日、新しいAIモデル「Gemini 3.7 Flash」を発表した。コーディングとエージェント用途に特化したFlashシリーズの最新版で、わずか3週間前に登場したGemini 3.6 Flashから大幅な性能向上を実現している。
特に注目したいのは価格だ。導入価格として入力トークン100万個あたり0.75ドル、出力トークン100万個あたり3.75ドルに設定された。これは3.6 Flashの当初価格の半額にあたる。
本記事では、ソフトウェアエンジニアリング、Web開発、知識処理の各ベンチマークを掘り下げつつ、エージェント開発者にとって何が変わるのかを具体的に解説する。
Gemini 3.7 Flashの概要と位置付け
Gemini 3.7 Flashは「Flashシリーズ史上もっとも知的な作業用モデル」という位置付けで投入された。3.6 Flashの発表からわずか3週間という短期間での後継モデル登場は異例の速さだが、Google DeepMindによればこれは開発者からのフィードバックとアルゴリズムの革新的な改善によるものだという。
モデル名の「Flash」は、大規模モデルと比べて応答速度を重視した軽量版という意味を持つ。処理速度を保ちながら推論能力を高めるのがFlashシリーズの設計思想で、3.7 Flashはそのバランスを一段階引き上げている。
改善領域はソフトウェアエンジニアリング、ナレッジワーク、Web開発ワークフローの3つに大別される。単にベンチマーク数値が上がっただけでなく、実務のワークフローに組み込んだ際の体感品質が向上している点が特徴的だ。
コーディング性能の飛躍的向上
ソフトウェアエンジニアリングのベンチマーク
デバッグやイシュー解決などのコーディングタスクで、3.7 Flashは3.6 Flashに対して明確な差をつけた。フロンティアコードと呼ばれる本番品質のコード生成ベンチマークでは43.6%を記録し、3.6 Flashの34.4%から約9ポイント向上している。
長期にわたるソフトウェアエンジニアリングタスクを測るDeepSWE v1.1でも、65.3%と3.6 Flashの49.0%から16ポイント以上の伸びを示した。初回のコード精度が上がったことで、修正のための再試行が減り、開発サイクル全体の効率が改善する。
このデモでは2つのベンチマークを比較している。FrontierCodeとDeepSWEのいずれも、3.7 Flashは3.6 Flashを大きく上回る結果を示している。
Web開発とUI生成の実力
Web開発では、より機能的なレイアウトと完成度の高いアプリを少ないプロンプト数で生成できるようになった。UI生成では、スクリーンショット、画像、デザインシステムのいずれを参照として与えた場合でも、高いデザイン忠実度を発揮する。
Arena.aiのWebDev Arenaというベンチマークでは、Eloスコア1588を記録し、3.6 Flashの1538から50ポイント上回った。Eloスコアとはチェスなどで使われる相対評価の指標で、数値が高いほど他のプレイヤーとの対戦で勝率が高いことを意味する。
実際のユースケースとしては、シンプルなテキストプロンプトからプレイ可能な3Dゲームを動的生成するデモや、パララックス効果を使ったインタラクティブなランディングページを一発生成するデモが紹介されている。副次的なエージェントをオーケストレーションする能力も備えており、複数コンポーネントを連携させたUI構築が可能になった。
知識集約分野での大幅改善
複雑文書処理の進化
金融、法律、バイオサイエンスなど、専門知識が求められる分野でも3.7 Flashは大幅な改善を見せた。複雑なPDF文書を処理する能力を測るGDP.pdfベンチマークでは34.0%を記録し、3.6 Flashの22.0%から12ポイント向上している。
この改善は、静的なPDFをインタラクティブなデータストーリーに変換するというデモで具体的に示されている。複雑な年次報告書を、ライブチャートや集計済みの洞察を含むWeb体験に変換できるというものだ。単なるテキスト抽出を超え、文書構造の理解と再構築が可能になっている。
業務自動化ワークフロー
実世界のビジネスワークフローを完遂する能力を測るAutomationBenchでは、30.4%を記録し、3.6 Flashの17.0%を大きく上回った。この数値は、複数のアプリケーションやデータソースをまたいだ業務フローを、どれだけ正確に遂行できるかを示す指標だ。
このステップ図は、3.7 Flashが複数ツールを連携させて実業務を自動化する流れを示している。分解したタスクを順番に実行し、最終成果物までまとめ上げる自律性が向上した。
価格改定と開発者体験の改善
導入価格の詳細
3.7 Flashの導入価格は、入力トークン100万個あたり0.75ドル、出力トークン100万個あたり3.75ドルに設定された。これは3.6 Flashの当初価格と比較して半額である。年内いっぱいこの価格が適用される。
価格が半額になったことと性能向上が組み合わさることで、本番環境でのエージェントを大規模に展開する際のコスト効率が大きく改善する。特に出力トークンの価格引き下げは、長い推論を必要とするエージェント用途で効果を発揮する。
エージェントワークフローへの適合
3.7 Flashは開発者体験の面でも改善されている。障害に遭遇した際の適応力が高まり、必要に応じて意図を明確化するための質問を行う。指示への忠実度も向上した。複数ステップの計画立案とツール呼び出しに、より多くの推論リソースを費やすようになったことで、手動の監視や再試行が減る。
この「規律のある実行」は、エージェントワークフローにおいて重要な意味を持つ。エージェントが途中で誤った判断をして軌道修正が必要になる回数が減れば、開発者の介入コストが削減され、自動化の信頼性が高まるからだ。
Gemini Sparkとの統合と安全性
Sparkへの適用
Google AI ProおよびUltraプランの加入者が利用できるパーソナルAIエージェント「Gemini Spark」は、8月13日からGemini 3.7 Flashを基盤モデルとして使用するようになった。SparkはGoogle I/Oで発表された24時間稼働の個人向けエージェントで、ユーザーの指示のもとで自律的にタスクを実行する。
今回のモデル更新により、Sparkはファイルの整理、メールの下書き、ステータス文書の更新などの知識作業をより効率的にこなせるようになった。Google Workspaceアプリとの連携も改善され、複数のスキルを組み合わせた複雑なワークフローの精度が向上している。
安全対策の強化
3.7 Flashは、化学・生物・放射線・核(CBRN)分野およびサイバー攻撃分野における悪用を防ぐための最新の安全対策を備えて出荷される。Google DeepMindのフロンティアセーフティの枠組みに基づき、有益なユースケースを維持しながら悪用リスクを低減する設計になっている。
モデルの詳細な安全性情報や性能データは、公開されているモデルカードで確認できる。エンタープライズ環境で導入を検討する際には、このモデルカードを確認しておくとよい。
利用方法と提供チャネル
3.7 Flashはすでに複数の経路で利用可能だ。開発者はGoogle Antigravityでエージェントファーストのワークフローを試せるほか、Google AI StudioからGemini APIを直接呼び出すことができる。Androidアプリ開発者はAndroid Studioからもアクセス可能だ。
エンタープライズ向けには、Gemini Enterprise Agent PlatformとGemini Enterpriseアプリで提供される。個人ユーザーはGeminiアプリ内のSparkを通じて利用できる。対応国や地域の詳細はGoogleのサポートページに掲載されている。
この記事のポイント
- Gemini 3.7 Flashは3.6 Flashからわずか3週間で登場した後継モデル
- コーディングの初回精度が大幅に向上し、再試行コストを削減できる
- Web開発では少ないプロンプト数で機能的なUIを生成可能
- 導入価格は3.6 Flash当初価格の半額に設定され、年内いっぱい適用
- Gemini Sparkの基盤モデルとしても即日採用された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験