

WordPress 7.1正式版が8月19日リリース。レスポンシブスタイルと疑似状態の全容
WordPress 7.1の正式版が2026年8月19日にリリースされる。WordCamp US最終日と重なるタイミングで、すでにRC1とRC2が公開され、機能セットは確定済みだ。先月にはセキュリティリリース2件も出ており、影響を受けるサイトは自動更新が強制された。
今回のアップデートで注目が大きいのは、レスポンシブブロックスタイルと疑似状態スタイルのコア導入だ。テーマ開発者はモバイルとタブレットの表示をtheme.jsonだけで制御できるようになる。プラグイン開発者もリストテーブルの構造変更に注意が必要だ。正式版まで残り数日、互換性確認のポイントを解説する。
WordPress 7.1は8月19日リリース、RC2まで公開済み
正式版はWordCamp US最終日に到着
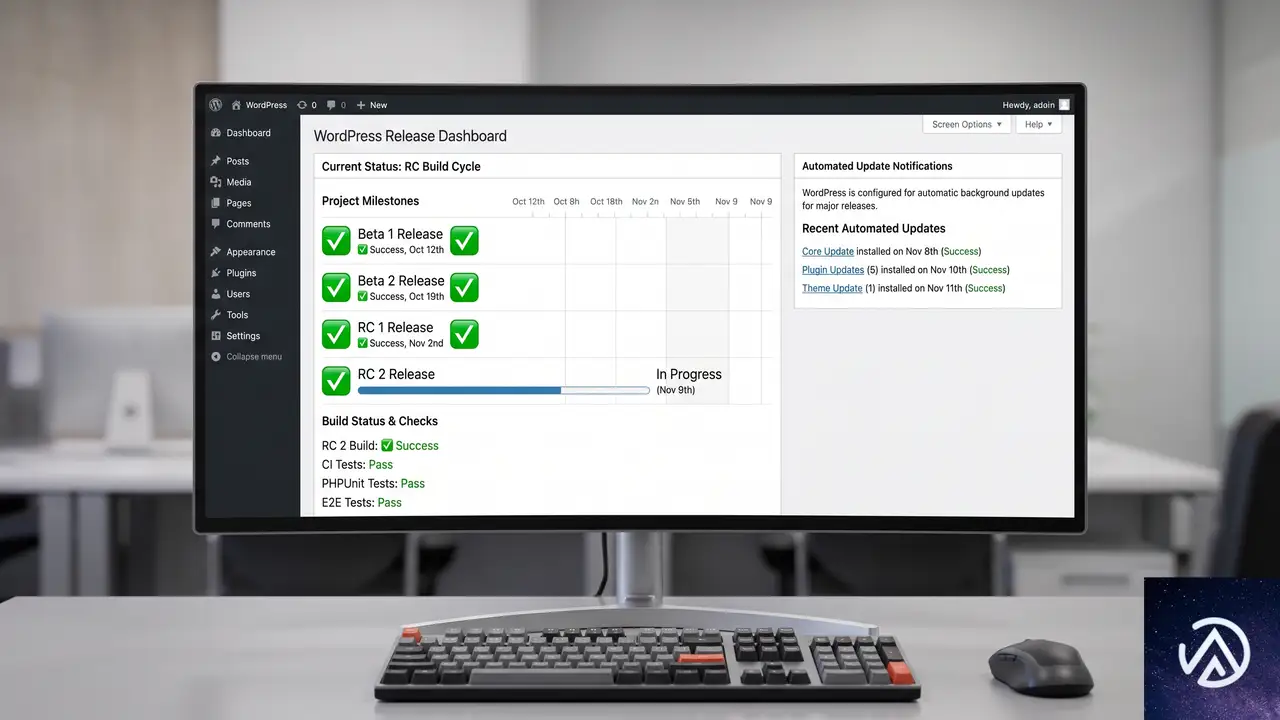
WordPress 7.1は8月19日にリリース予定だ。ちょうど8月16日から19日にかけて米国フェニックスで開催されるWordCamp USの最終日と重なる。年次フラッグシップイベントの最終日に正式版が出るのは珍しいスケジュールで、現地参加者はその瞬間をライブで目撃できる。
先週までにRC1とRC2が立て続けに公開された。RC(Release Candidate / リリース候補版)とは、正式版の一歩手前の段階だ。ここまで来ると新機能の追加は終了し、バグ修正だけが行われる。Field Guideも公開済みで、全機能の開発者向け詳細がまとまっている。
セキュリティリリース2件、強制自動更新も発動
先月はセキュリティリリースが2件公開された。7月17日に出たWordPress 7.0.2は、重大な脆弱性1件と高深刻度の脆弱性1件に対処したものだ。深刻度が高かったため、影響を受けるバージョンのサイトには強制自動更新が適用された。続いて8月6日には7.0.3が公開され、十数件の追加修正が入っている。
管理しているサイトが両方の自動更新を何らかの理由で逃していた場合、先にそちらの更新を済ませることが最優先になる。7.1のテストはその後でかまわない。
レスポンシブスタイルがコアに登場
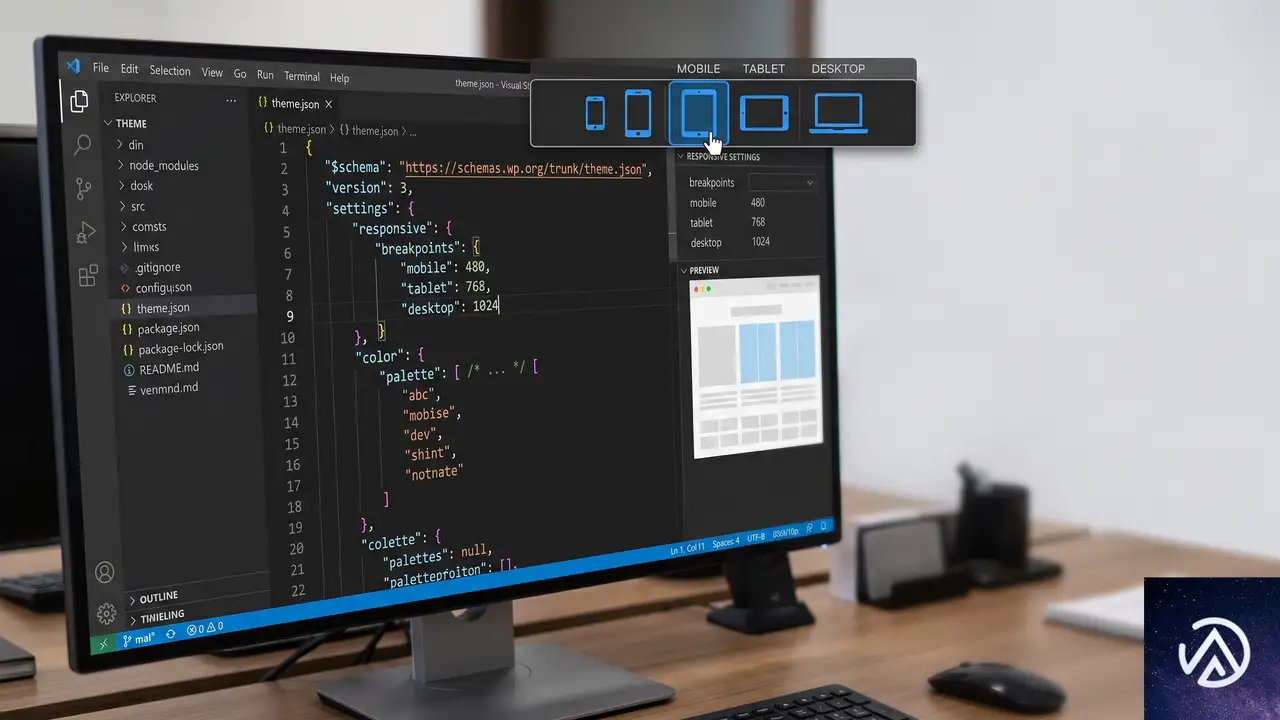
上記の図は、theme.jsonでデスクトップ・タブレット・モバイルのパディングを切り替える様子を視覚化したものだ。実際には端末の画面幅に応じて、この3つの状態が自動的に切り替わる。
theme.jsonでモバイルとタブレットのスタイルを定義
春先から開発が進められていたレスポンシブスタイルが、WordPress 7.1で正式にコアに導入された。ブロックのスタイルをタブレットとモバイルのビューポートごとに定義できる。Global Styles(グローバルスタイル)ではブロックタイプ単位で、個別のブロック単位でも設定可能だ。theme.jsonでは@mobileと@tabletというキーの中にネストして記述する。
ここで押さえておきたいのは、@desktopキーが存在しない点だ。ブロックのデフォルトスタイルがそのままデスクトップスタイルになる。モバイルやタブレットで上書きしなかったプロパティは、すべてのビューポートでデフォルト値が適用される。
さらにテーマ側でブレークポイントを設定できる。theme.jsonのトップレベルにsettings.viewportプロパティを追加する仕組みだ。デフォルトはモバイルが480px、タブレットが782px。値はpx、em、remの非負の長さのみ許可され、CSS関数やパーセント、単位なしの値は無視される。タブレット値がモバイル値と同じか小さい場合は、モバイルのみが使われる。
標準ブロックサポートを使っているブロックは、タイポグラフィ、カラー、背景、ボーダー、寸法、スペーシング、レイアウトが自動的に対応する。逆に独自のスタイルコントロールを持つブロックは対象外だ。自作ブロックがある場合、この線引きで対応有無を確認してほしい。
疑似状態スタイルでホバーやフォーカスを制御
ホバーやフォーカスは実際の操作で状態が変わるため、上記は4つの状態を並べて示したものだ。実際の編集画面では「Hover」タブを選んでスタイルを設定する。
かねてから要望の多かった疑似状態スタイルも7.1で実装された。:hover、:focus、:focus-visible、:activeをtheme.jsonとエディタで定義できる。現時点ではButtonブロックとNavigation Linkブロックに限定されている。
さらに初期段階のカスタムステート機能も入った。現状はtheme.jsonのみで、管理画面のUIはまだない。Navigation Linkブロックが現在のメニュー項目をスタイルするために-currentプロパティを使う仕組みだ。カスタムステートは-接頭辞を使い、ブロックのblock.jsonにあるselectors.statesプロパティで宣言したクラス名をターゲットにCSSを生成する。現時点では限定的だが、今後の拡張に向けた重要な布石だ。
新しいデザインツール3点
テーマ開発者が長年待っていた変更を含む、デザインツールの追加が3つある。グラデーションと背景画像を同時に使えるようになるのは特に大きい。
背景グラデーションと背景画像を併用可能に
新しいbackground.gradientは既存のcolor.gradientとは別のサポートとして追加された。違いはCSSの出力先にある。従来のサポートはbackgroundショートハンドを通じて描画されるため、background-imageを含むすべてのbackground関連プロパティをリセットしてしまっていた。ブロックにグラデーションか画像のどちらか一方しか使えなかった理由だ。
新しいサポートはbackground-imageロングハンドで描画される。スタイルエンジンが1つの宣言内にグラデーションと画像をカンマ区切りで出力できるようになった。7.1ではGroup、Accordion、Pullquote、Post Content、Quoteがコアで対応する。値はstyle.background.gradientに保存される。
最小幅とテキストシャドウ
dimensions.minWidthは既存のminHeightと同じパターンで、CSSのmin-widthとして適用される。テーマがdimensionSizesプリセットを提供していれば、それを活用できる。1点注意があり、この設定はデフォルトではブロックインスペクターに表示されない。ブロック側で__experimentalDefaultControlsを通じてopt-inした場合のみ表示される。Global Stylesではデフォルトで表示される。
テキストシャドウもGlobal Stylesでサポートされた。これまでは個別ブロックやCSSでしか指定できなかったが、theme.jsonからサイト全体またはブロックタイプ単位で制御できる。
SVG Icon APIが正式公開
アイコン名の衝突を防ぐため、コレクション名が名前空間の接頭辞になる。プラグイン独自のアイコンを登録しても、コアのアイコンと混同される心配がない。
WordPress 7.0でエディタとIconブロック向けにSVGアイコンのセットが同梱された。7.1ではこれが正式な公開APIになり、プラグインやテーマから登録できるようになった。wp_register_icon_collection()でコレクションを登録し、wp_register_icon()でアイコンを追加する。PHPの任意の場所でwp_get_icon()を使えば、サイズやクラス、ラベルを指定してアイコンを表示できる。
計画時に意識したい制限が2つある。登録したSVGはwp_ksesによって保守的な許可リストでサニタイズされる。許可されるのは<svg>、<path>、<polygon>のみ。許可リストの拡大作業は進行中だ。fillは図形部分にのみ許可され、外側の<svg>には付けられない。またwp_get_icon()単体で呼び出すとSVG自身のfill(黒)で描画される。周囲のテキスト色に合わせたい場合は、渡したクラスに対して自前でCSSを指定するのが推奨される。
エディタのiframe化とプラグインへの影響
投稿エディタは常時iframe表示へ
テンプレートエディタがiframe化されたのはWordPress 5.8からだ。それ以来、投稿エディタも段階的に移行してきたが、7.1で最終段階に入った。テーマの種類や登録ブロックのAPIバージョン、コンテンツ内のブロックのAPIバージョンに関係なく、投稿エディタは常にiframeで表示される。レガシーメタボックスを登録しているサイトも同様だ。
7.0では投稿ごとに挿入されたブロックに基づいて判断されていた。つまりコンテンツによってiframedモードと非iframedモードが切り替わり得た。この条件付き動作がなくなり、挙動が単純化された。
大半のブロックは変更なしで動作する。問題が起きる場合、ほとんどは1つの根本原因にたどり着く。iframeは管理者ページとは別のdocumentとwindowを持つ。エディタスクリプトが実行される管理者ページからグローバルのdocumentやwindowにアクセスしてキャンバスを操作しようとすると、間違ったドキュメントを見ていることになる。対処としては、キャンバス内の要素からownerDocumentとdefaultViewでドキュメントを取得するか、useRefEffectでキャンバス要素にリスナーをアタッチ・クリーンアップするのが一般的だ。
リストテーブルの行ヘッダーが移動
カスタムCSSやJavaScriptを書いているプラグインにとって、静かに何かを壊す可能性が高いのがリストテーブルの変更だ。投稿一覧テーブルで、プライマリのth scope="row"がチェックボックス列からタイトル列に移動した。チェックボックスセルはtdになり、タイトルセルがthとして投稿タイトルを含むaria-labelを持つ。レスポンシブ表示で折りたたまれるセルはflexレイアウトを使うようになった。
これはアクセシビリティの大きな改善だ。スクリーンリーダーは各行を、場合によっては存在しないチェックボックスではなく投稿名で認識できるようになる。ただしこのマークアップは2010年以降ほぼ安定していたため、多くの拡張が暗黙的に依存している。th.check-columnを選択するCSSやJavaScript、td内の行アクションや投稿タイトルを期待するコードがある場合は確認が必要だ。
この記事のポイント
- WordPress 7.1は8月19日リリース予定、RC2まで公開済みで機能セットは確定
- セキュリティリリース7.0.2と7.0.3が先月公開され、強制自動更新も適用された
- レスポンシブスタイルがコアに入り、モバイルとタブレットのスタイルをtheme.jsonで定義可能に
- 疑似状態スタイルでホバー、フォーカス、アクティブをテーマから制御できる
- SVG Icon APIが公開され、プラグインが名前空間付きでアイコンを登録可能に
- 投稿エディタは常時iframe化され、リストテーブルの行ヘッダー移動も要確認

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google広告が検索キャンペーンの言語ターゲティング設定を廃止。9月下旬から順次適用
Google広告が2026年9月下旬から、検索キャンペーンとP-MAX(パフォーマンスマックス)の検索枠におけるキャンペーンレベルの言語ターゲティング設定を廃止する。広告文とランディングページの言語が配信判断の主な基準となり、GoogleのAIによる言語理解がより大きな役割を担う。
この変更により、多言語キャンペーンの運用方法が変わる。既存キャンペーンの再構築は不要だが、規制業界の広告主には配信実績の文書化という未解決の課題が残る。
本記事では、言語ターゲティング廃止の具体的な内容、Googleの判定ロジック、広告主が取るべき対応を解説する。
言語ターゲティングで何が変わるのか
現行の仕組みと変更後
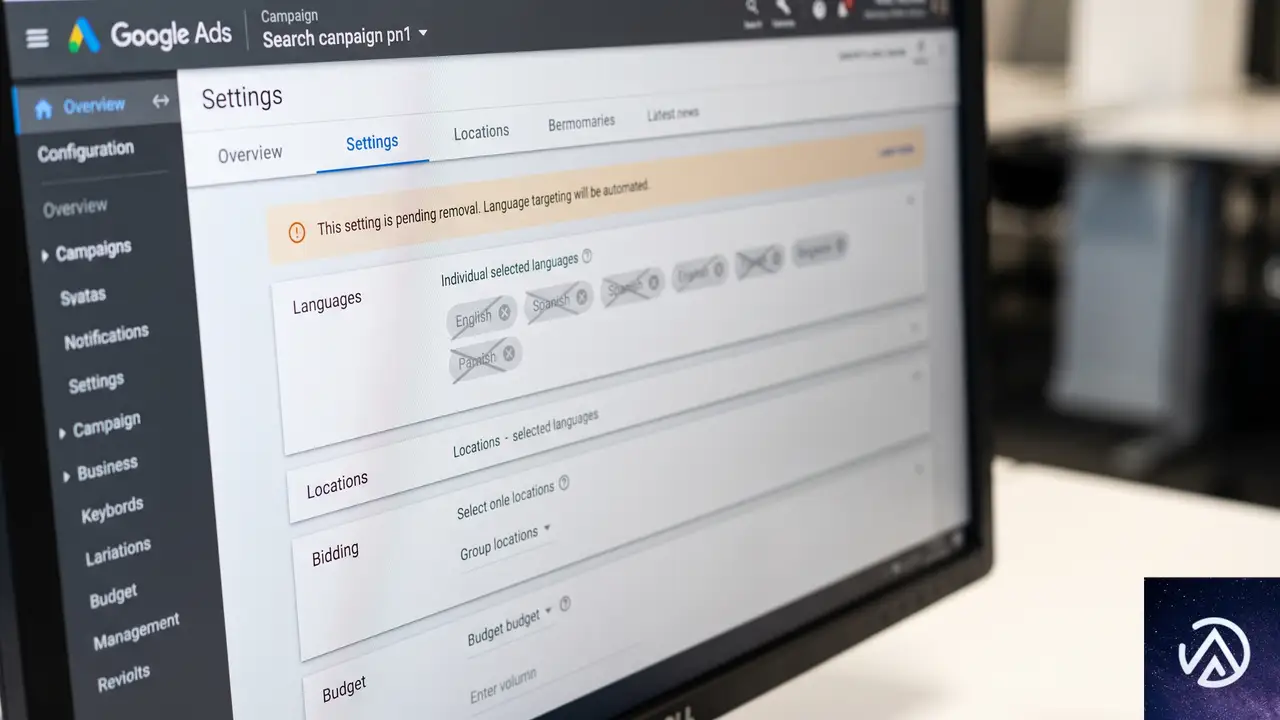
現在のGoogle広告では、キャンペーン設定で広告主が1つ以上の言語を選択する仕組みだ。同時にGoogleは検索クエリ、ユーザー設定、その他のAI由来のシグナルを基に、ユーザーが理解する言語を独自に判定している。この2つの条件が重なったときにだけ検索広告が配信される。
9月下旬以降、キャンペーンレベルの言語設定が検索キャンペーンから削除される。代わりにGoogleは広告クリエイティブとランディングページの言語、およびユーザーの理解言語に関する既存のAI判断を組み合わせて配信を決定する。
この変更により、キャンペーン設定で言語を指定する手間がなくなる。広告文とランディングページの言語がそのまま配信基準として機能するようになるのだ。
P-MAXへの影響範囲
P-MAX(パフォーマンスマックス)では、この変更の影響を受けるのは検索枠のみ。検索以外のチャネルではキャンペーンレベルの言語設定が引き続き使用される。つまりP-MAX全体が変わるわけではなく、Google検索に表示される部分だけが対象になる。
複数言語ユーザーへの広告配信ロジック
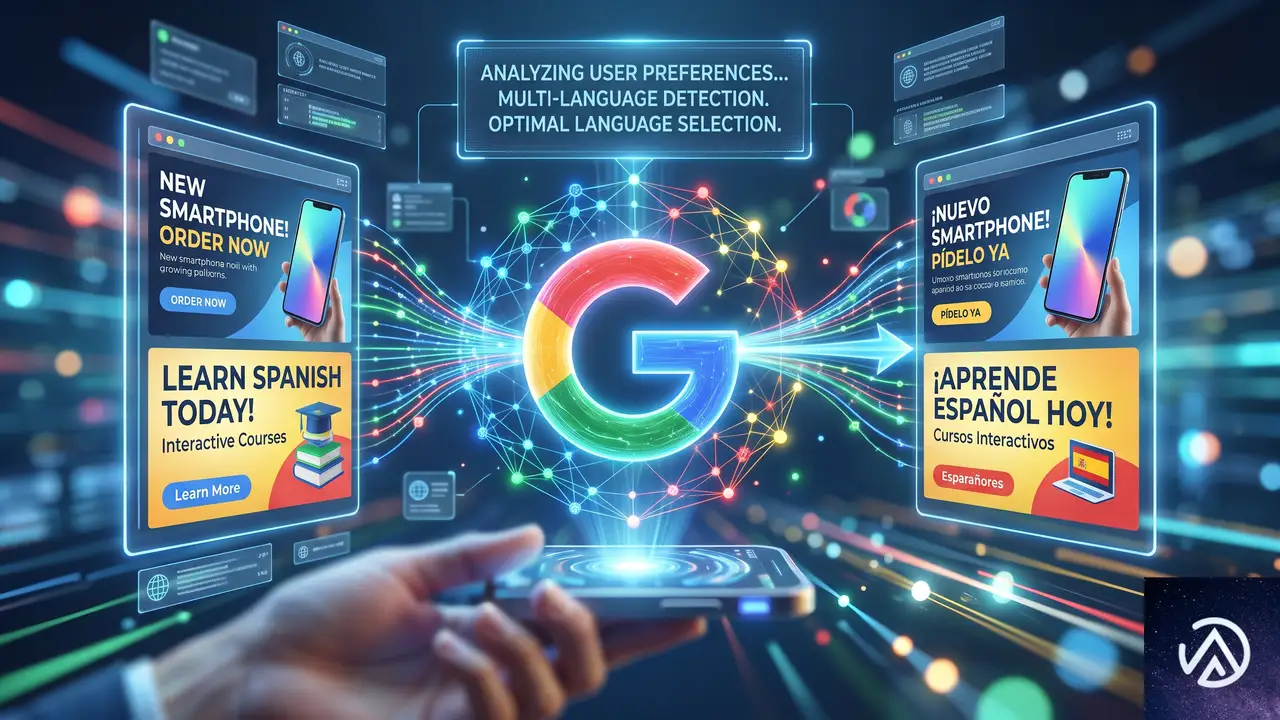
変更後の大きなポイントは、複数言語を理解するユーザーへの配信方法だ。英語とスペイン語の両方を理解するユーザーには、どちらの言語の広告も配信される可能性がある。GoogleのAIが広告グループ単位で優先順位付けを行い、検索に対して最適な言語を選ぶ。
検索クエリに明確な言語がある場合は、その言語の広告とランディングページが優先される。たとえばスペイン語で検索したユーザーには、スペイン語の広告が優先的に表示される仕組みだ。
Googleはクエリの言語だけでなく、ユーザー設定や過去の行動など複数のシグナルを組み合わせて最適な言語を選ぶ。複数言語を理解するユーザーに対しては、AIが広告グループ単位でより適切な言語を優先する仕組みだ。
ブランド検索における言語判断
ブランド検索では状況が少し複雑になる。ブランド名が複数言語で同一であることが多く、クエリ自体から言語を判断する手がかりが少ないからだ。たとえば「Nike」というブランド名は英語でもスペイン語でも同じ表記になる。
このような場合、Googleはクエリ以外の言語シグナルに依存し、ユーザーの優先言語を重視する。日常的に英語とスペイン語の両方で検索するユーザーには、どちらの言語の広告も配信対象になり得る。
Googleはこの変更が、キャンペーン設定による意図しないトラフィック制限を減らすとも説明している。たとえば英語でターゲティングしたキャンペーンにスペイン語の広告文やランディングページが含まれる場合、従来はキャンペーン設定がブロック役を果たしていた。今後はGoogleの言語理解に委ねられ、関連トラフィックを取りこぼしにくくなる見込みだ。
広告主が懸念する規制対応とAI生成クリエイティブ
規制業界の配信実績の文書化
発表前に行われたバーチャルラウンドテーブルでは、広告主からいくつかの質問が寄せられた。特に規制対象業界の広告主は、コンプライアンスに関する懸念を示した。
保険業界の広告主を例にとると、英語話者とスペイン語話者の両方に広告が公平に届いていることを文書で示さなければならない場合がある。Googleは両言語で広告を提供していれば、両方のグループにリーチする意図があると判断されると説明した。
ただし、ラウンドテーブルで出た質問は意図の話だけにとどまらなかった。キャンペーン設定ではなくGoogleの自動判定が言語ごとの配信を決めるようになった場合、広告主がどのように配信実績を証明するかという点は未解決のままだ。Googleは言語別の配信状況やパフォーマンスの差を確認できる追加のレポート機能を発表していない。
AI Maxと自動生成クリエイティブ
P-MAXと自動生成クリエイティブに関しても質問があった。ケベック州をターゲットにしたAI Maxキャンペーンで、AIがフランス語のクリエイティブを生成した場合、英語で検索するユーザーにそのフランス語広告が表示される可能性はあるのか。Googleは「可能性がある」と回答した。
クリエイティブの生成が先に行われ、その後Googleが利用可能な広告とランディングページをユーザーが理解できるかをチェックする。クエリの言語と広告の言語が一致していなくても、ユーザーが理解できると判断されれば配信される仕組みだ。
検索クエリの言語と広告の言語は必ずしも一致する必要がない。Googleがユーザーの理解言語を判断し、優先順位付けシステムが最適なクリエイティブを選ぶためだ。
広告主が取るべき具体的な対応
既存キャンペーン構造の扱い
大多数の広告主にとって、この変更は大きな影響を及ぼさない。Googleも既存キャンペーンの再構築は不要だと明言している。言語別にキャンペーンを分けている場合も、そのままの構造を維持してよい。言語設定が検索からなくなったからといって、キャンペーンを統合する必要はない。
注意が必要なのは、言語ターゲティングを本来の目的以外に使っていたケースだ。旅行、国際展開、規制対象などの業界では、言語設定がオーディエンスの絞り込みやコンプライアンス要件に影響していることがある。
Google広告APIを利用する広告主は、検索キャンペーンの作成・更新時に言語条件を送信するのをやめることが推奨されている。既存の言語条件は残っても構わないが、検索ターゲティングには影響しなくなる。
適用後に監視すべき指標
具体的には、広告文とランディングページが意図した言語で書かれているか確認するべきだ。特に多言語キャンペーンやAI生成アセットを利用する場合は注意が必要。Googleが広告文とランディングページの言語を基準にするため、これらの言語が正確に設定されていないと配信に影響する。
変更が適用された後は、検索語句や地理的トラフィックの変化、流入ユーザーの言語属性などを確認し、パフォーマンスを監視する。国際展開や多言語運用を行う広告主は、特にこれらの指標に注意を払う必要がある。
パフォーマンスと流入ユーザーの構成がおおむね安定していれば、Googleの主張どおり言語設定が実質的に重複していたと言える。一方、言語設定を追加のオーディエンス制御層として使っていたケースでは、適用後の変化を見極めるのに時間がかかるかもしれない。
この記事のポイント
- Google広告が検索キャンペーンとP-MAXの検索枠からキャンペーンレベルの言語ターゲティング設定を廃止する
- 変更は2026年9月下旬から順次適用され、広告文とランディングページの言語が配信判断の主な基準になる
- 既存キャンペーンの再構築は不要で、言語別に分けている場合もそのまま維持できる
- 規制業界では配信実績の文書化について未解決の課題が残る
- P-MAXでは検索以外のチャネルでキャンペーンレベルの言語設定が引き続き使われる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

ChatGPT広告に製品カルーセルとAppsFlyer統合、EC向けパフォーマンス広告の基盤が加速
OpenAIがChatGPT上の広告に製品カルーセルを導入し、モバイルアプリ向けの計測基盤としてAppsFlyerとの連携を発表した。8月10日、マーケティングテクノロジー専門メディアMarTechが報じた内容だ。
小規模ECや個人事業主にもなじみ深いWooCommerceを使ったサイト運営をする事業者にとって、これらのアップデートはChatGPTをパフォーマンス広告のチャネルとして考えるきっかけになる。製品フィードから自動生成されるカルーセル、アプリインストールや購入のコンバージョンを計測できる仕組みがいよいよ揃ってきたからだ。
製品フィードがカルーセル広告に進化
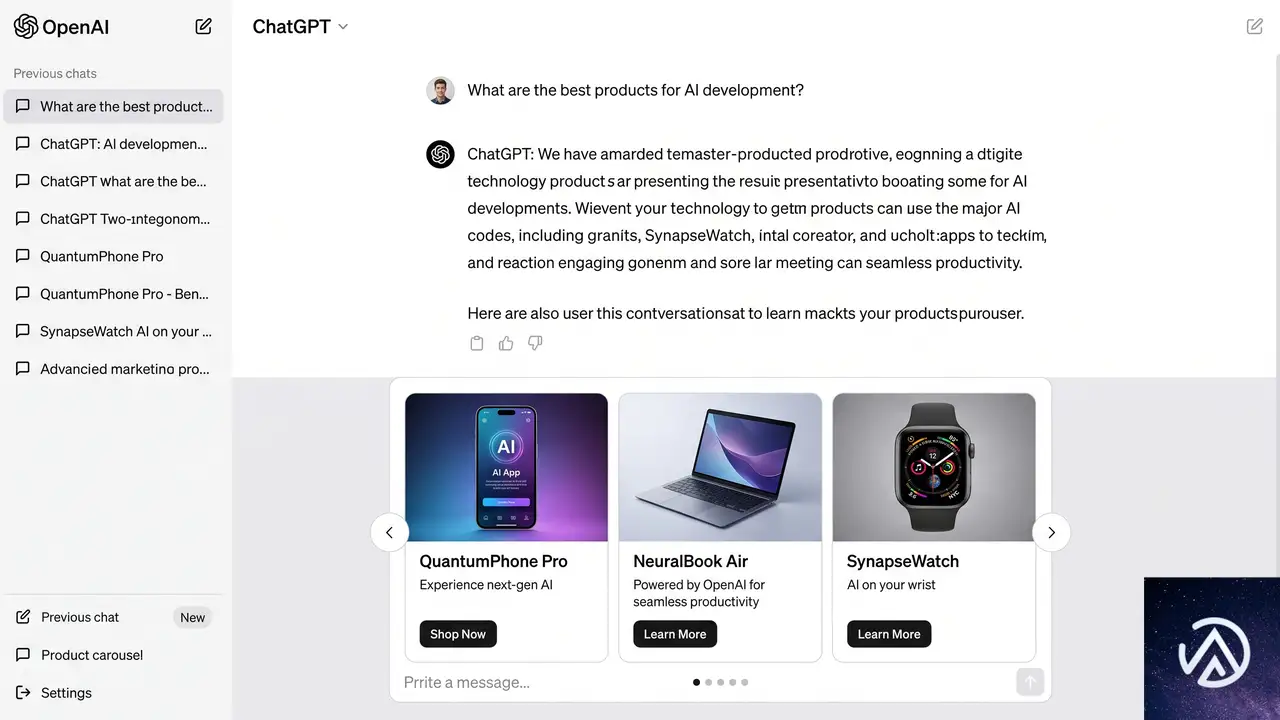
ChatGPT広告はこれまで、会話の下に1つの商品が表示されるだけのシンプルな形式だった。しかしOpenAIは約3カ月前にリリースした自動製品フィード機能を拡張し、同一広告内に複数の商品をカルーセル形式で並べる表示パターンを加えた。広告主が商品カタログを提供すると、OpenAIのシステムが単品表示かカルーセルかを自動で判断して表示する。
広告表示の自動最適化
広告のフォーマットは広告主が選べず、OpenAIが会話の文脈やユーザーの傾向を見て決める。カルーセルには現在、同一店舗・ブランドの商品が並ぶ仕様だ。広告主がコントロールできるのは、製品フィードに載せるデータの質と量だけという設計になっている。
これは一見すると広告主にとって不自由に映る。しかし、AIが最適な表示を選ぶことで、ユーザー体験を損なわずに商品訴求のバリエーションを増やせる利点がある。たとえば初めてそのブランドを知るユーザーには複数商品を見せるほうが有効だし、具体的な商品を質問してきたユーザーには1点に絞るような制御が期待される。
ChatGPT会話の下部に表示される広告エリアで、こうしたカルーセルがスワイプ操作によって商品を切り替えられるイメージだ。実際の表示は広告枠のサイズや文脈に応じて変化し、1商品の場合もある。
WooCommerceとの親和性
OpenAIの製品フィードは、Google Merchant CenterやFacebookカタログに似た仕組みで、オンラインストアの商品データを取り込む。WooCommerceを使うEC事業者なら、既存の商品フィード作成プラグイン(Google Product Feed、CTX Feedなど)を活用し、ChatGPT用にデータを整形するルートが考えられる。
現時点では公式のWooCommerce専用プラグインは存在しないものの、商品名・画像・価格・在庫状況を含むCSVやAPI経由でのアップロードが可能になれば、Shopifyストアと同様に少ない手間で連携できる見込みだ。広告フォーマットの自動選択をOpenAIに任せるため、広告主の運用負荷を下げつつ、商品露出の機会を増やすことができる。
AppsFlyer統合でアプリコンバージョン計測が可能に
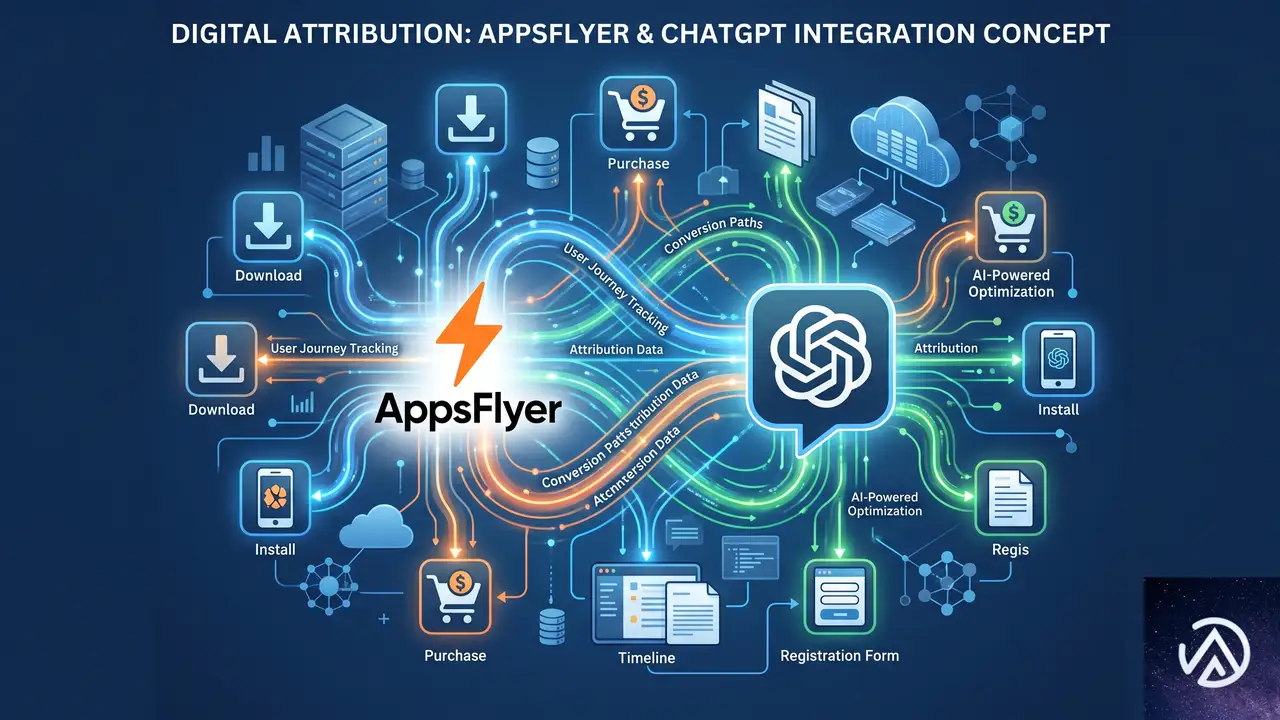
OpenAIはモバイル計測プラットフォームのAppsFlyerと提携し、ChatGPT広告経由のアプリインストール、アプリ内課金、サブスクリプション契約を計測できるようにした。Adweekの報道によると、Grubhubを含む約40ブランドがテストに参加している。
アプリマーケターに新たな計測チャネル
アプリプロモーションを行う企業は、ChatGPTを他の有料チャネルと同じ指標で比較できるようになった。AppsFlyerのダッシュボード上で「ChatGPT」というメディアソースが追加され、クリックからインストール、初回購入までのアトリビューションデータが取得できる。これまで実験的な位置づけだったChatGPT広告が、ROAS(広告費用対効果)を測定できる本格的なパフォーマンスチャネルに近づいたといえる。
EC事業者への波及効果はこれから
この統合は現時点でアプリ内のコンバージョンに特化しており、Webストアの購入や会員登録を直接計測する機能は含まれていない。WooCommerceを中心に据えた純粋なWeb EC事業者にとっては、すぐに使えるソリューションとは言い難い。
しかし、OpenAIがアドテクノロジーへの投資を加速させている流れからすると、将来的にWebピクセルやサーバー間連携によるウェブコンバージョン計測が追加される可能性は高い。アプリとWebの両方を持つビジネスであれば、ChatGPT広告をアプリ向けの獲得経路として試験的に活用しつつ、今後の拡張に備えるのが現実的な一手だ。
パフォーマンス広告システムとしての基盤が整う
製品フィード、自動カルーセル表示、サードパーティによるアトリビューション。この3要素が揃ったことで、ChatGPT広告は「何を表示し、どんな成果があったか」を一気通貫で管理できるパフォーマンス広告のインフラを手にした。MarTechの記事は、OpenAIが第4四半期とホリデー商戦に向けて、フィードベースのキャンペーンに関する広告主向けガイダンスを強化しているとも伝えている。
広告主のコントロール不足が課題
カルーセル表示の可否をOpenAIが決める設計は、広告主にとって不確実性を生む。どのような条件で単品と複数品を使い分けるのか、各フォーマットのパフォーマンスに差があるのか、透明性はまだ十分とは言えない。
広告テストを進める段階で、自分たちの商品が適切に露出されているかを検証しづらいのは痛手だ。OpenAIが今後、キャンペーン管理画面で表示ロジックの詳細を開示するかどうかが、広告主の予算拡大を左右するポイントになる。
スケール面の未知数
カルーセルや計測が整備されたことは、ChatGPT広告のテストを容易にする。しかし、それが「競争力のあるCPA(顧客獲得単価)で十分なコンバージョン量を継続的に生み出せるか」は別の問題だ。
ChatGPTのユーザー数は巨大だが、検索連動型広告やソーシャルメディア広告と比較した場合、購買意欲の高いユーザーにリーチできるかは未知数だ。WooCommerceサイトの運営者は、他の広告チャネルと同様に、CPAと獲得数のバランスを見ながらChatGPT広告の出稿判断を下すことになる。
この記事のポイント
- ChatGPT広告に製品カルーセルが導入され、1広告で複数商品を表示できるようになった。
- AppsFlyerとの提携により、アプリインストールやアプリ内購入のアトリビューションが可能になった。
- 製品フィード、自動表示、計測というパフォーマンス広告の基本インフラが揃ったが、広告主の表示制御やスケール面の課題は残る。
- WooCommerceなどのECプラットフォームでも、商品フィード連携を通じてChatGPT広告を活用する道が開かれている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WPForms Liteにバックドア疑惑、セットアップウィザードが管理者権限を外部に渡す仕組み
WordPressプラグイン「WPForms Lite」にバックドアが仕込まれているという疑惑が、2026年8月にX(旧Twitter)上で提起された。発端はSEOプラグイン「The SEO Framework」の開発者Sybre Waaijer氏の投稿だ。同氏はWPForms Liteのバージョン2.0.0に含まれるセットアップウィザードが、1時間有効の管理者トークンを外部に渡し、ユーザーのサイトにプラグインをインストールできる状態を作り出していると指摘した。
Search Engine Journalの著者Roger Montti氏が実際にWPForms Liteをインストールしてテストしたところ、セットアップウィザードがユーザーを外部サイトに誘導し、気づかぬうちに追加プラグインのインストールを強制するという実態が明らかになった。この記事では疑惑の内容、テスト結果、そしてこれが本当にバックドアと呼べるのかを検証する。
WPForms Liteにバックドア疑惑、発端はThe SEO Framework開発者の投稿

2026年8月、Sybre Waaijer氏がX上でWPForms Liteにバックドアが仕込まれていると投稿した。WPForms LiteはAwesome Motive社が開発する無料のフォーム作成プラグインで、500万以上のサイトにインストールされている。Waaijer氏は、バージョン2.0.0で追加されたセットアップウィザードが、管理者権限を持つ1時間有効のトークンを発行し、Awesome Motiveのサーバーに渡す仕組みになっていると指摘した。
問題となったコードは「wpforms-lite/src/SetupWizard/Bridge.php」というファイルに含まれているという。セットアップウィザードを起動すると、ユーザーのブラウザはWPFormsの外部サイトにリダイレクトされ、そこで管理者トークンが発行される。このトークンを使ってAwesome Motive側は、ユーザーに代わってプラグインのインストールや有効化、さらにはフォームの送信データを自社サーバーに送る設定の有効化まで可能になるとされる。
この概念図はWaaijer氏の主張を簡略化したものだ。ユーザーがセットアップを進めると、知らないうちに自サイトの管理者権限が外部に渡り、プラグインが追加される流れになる。
インストール可能なプラグインの一覧
Waaijer氏の投稿によると、この仕組みでインストール可能なプラグインは以下の13種類だ。驚くべきことに、競合するコンタクトフォームプラグインであるContact Form 7やNinja Forms、Pirate Formsも含まれており、同氏はこれを「おそらくバグ」と指摘している。
- WP Mail SMTP
- WPConsent
- Uncanny Automator
- AIOSEO(All In One SEO)
- Universally
- Duplicator
- Reviews Feed
- OptinMonster
- MonsterInsights
- ActiveLayer
- Contact Form 7(競合プラグイン、バグの可能性)
- Ninja Forms(競合プラグイン、バグの可能性)
- Pirate Forms(競合プラグイン、バグの可能性)
また、WPFormsのアドオンやPro版を自社サーバーから直接プルすることも可能で、これらのサーバーはWordPress.orgのモデレーションを受けないため、悪意あるコードをプッシュするリスクもあるとWaaijer氏は警告している。
コミュニティからの反論とWaaijer氏の立場

Waaijer氏の投稿に対して、WordPressコミュニティからは「Awesome Motiveは10年にわたり信頼されてきたプラグイン開発者であり、公に非難するのは不公平だ」という意見が上がった。ユーザー@BuildInBitsは「これは非公開で議論すべき内容であり、公開で非難するのは行き過ぎだ」と投稿している。
しかしWaaijer氏は、Awesome Motiveが自らの競合であると明かした。同氏が開発するThe SEO Frameworkは、Awesome Motiveが提供するAll In One SEO(AIOSEO)と直接競合するSEOプラグインだ。Waaijer氏は「彼らは意図的に管理者権限の第二チャネルを構築し、オープンソースに見せかけている。WPBeginnerは10年以上にわたり、チュートリアルの最終着地点が常に自社スタックに誘導するファネルだった」と批判している。
本当にバックドアなのか、異論も
一方で、Waaijer氏の「バックドア」という表現に対しては異論も出ている。Xユーザー@marckranatは「これは従来の意味でのバックドアではない。ベンダーが自発的にアクセスを開始する経路はなく、認証バイパスも隠しリスナーも存在しない。ログインした管理者がウィザードを起動する必要がある」と指摘した。
米国立標準技術研究所(NIST)の定義によれば、バックドアとは「コンピューターシステムにアクセスするための文書化されていない手段」であり、セキュリティリスクになり得るものだ。しかしWPForms Liteのケースでは、管理者が自らセットアップウィザードを起動しなければ外部からの操作は始まらない。つまり、外部から一方的に侵入される経路が存在するわけではないという視点も成り立つ。
この比較からわかるように、WPForms Liteの仕組みは厳密な意味でのバックドアとは異なる。しかし管理者が認識しないまま外部に権限を渡す点は、透明性の観点で問題があると指摘されている。
Search Engine Journal著者が実際にテスト、セットアップウィザードの実態
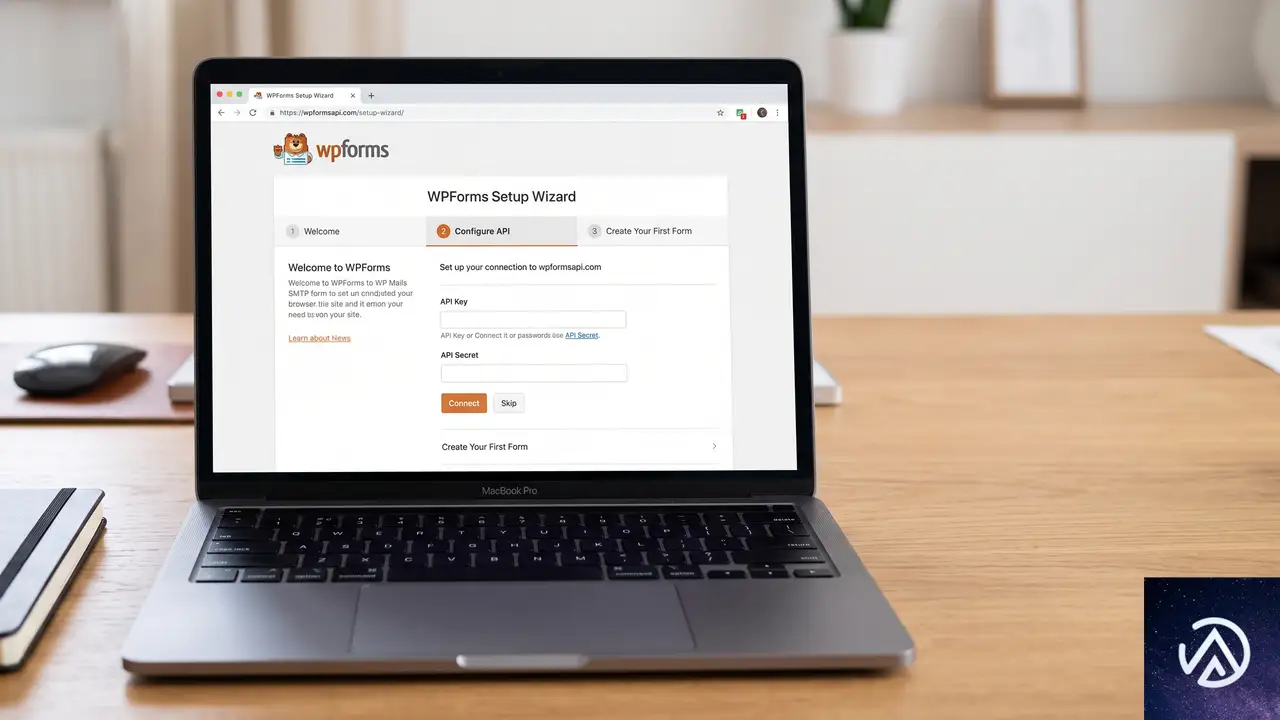
Search Engine JournalのRoger Montti氏は、この疑惑を検証するためWPForms Liteを実際にインストールした。Montti氏はすでに別のサイトで同プラグインを使用していたが、テスト用のサイトに新規インストールしたところ、セットアップウィザードが表示されたという。
注目すべきは、セットアップウィザードの最初の画面がすでにWPFormsの外部サイト(wpformsapi.com)に切り替わっていた点だ。Montti氏は「自分のサイトにいると思っていたが、すでに別のサイトに移動していた」と述べている。URLバーを注意深く見ていなければ、気づかないレベルの遷移だったという。
Montti氏が実際に体験したセットアップの流れは上図のとおりだ。同氏は「Install and Continue」をクリックしてしまったが、これが自サイト内の操作だと信じていたと振り返っている。
2つのプラグインが強制インストール、オプトアウト不可
セットアップウィザードの途中には「Select Your Features」という画面が表示され、「AI Form Generation」と「Privacy Compliance」のチェックボックスが最初からオンになっており、外せない状態だった。さらに画面下部には、無料の「WPConsent」プラグインがインストールされる旨の通知があり、これも拒否できなかった。
結果として、Montti氏のテストサイトにはWP Mail SMTP、WPConsent、そしてWPForms Liteの3つのプラグインがインストールされた。同氏はその後プラグインをアンインストールし、同じワークフローを再現しようとしたが、2回目以降は発生しなかったという。
バックドア疑惑の本質とWordPressサイト運営者が取るべき対応

WPForms Liteのセットアップウィザードが外部サイトに誘導し、管理者トークンを発行して他プラグインをインストールする仕組みは、Montti氏のテストでも確認された。これは「密かに不正アクセスを可能にする」典型的なバックドアとは異なるが、管理者が認識しないままサイトの変更を許す点で、透明性に問題がある。
NISTの定義に照らせば「文書化されていない手段」には該当し得る。しかし実際にはセットアップウィザードの一部として動作し、管理者がトリガーを引く必要があるため、「バックドア」という表現は強すぎるという見方もある。とはいえ、ユーザーが外部サイトに移動したことに気づかないまま、プラグインが追加される体験は、セキュリティ意識の高いサイト運営者にとって懸念材料だ。
この問題の核心は「バックドアかどうか」の定義論争よりも、プラグインのセットアッププロセスにおける透明性の欠如にある。500万以上のサイトに影響を与え得る仕様だけに、開発者側の説明責任が問われている。
この記事のポイント
- WPForms Lite 2.0.0のセットアップウィザードが、外部サイトで管理者トークンを発行し、ユーザーに無断でプラグインをインストールできる状態を作る
- Search Engine Journalのテストで、WP Mail SMTPとWPConsentが強制インストールされ、AI機能もオプトアウト不可だった
- 「バックドア」という表現には異論もあるが、管理者が気づかないまま外部サイトに誘導される点は透明性に問題がある
- サイト運営者はプラグインインストール時のURL確認と、定期的なプラグイン一覧のチェックを習慣化すべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPTが商業クエリの26%に広告表示、関連性に課題も浮上
ChatGPTが商業目的のクエリの約4回に1回の割合で広告を表示していることが、SEOツール企業SE Rankingの調査で明らかになった。表示頻度はGoogleのAIモードに迫る水準だが、広告の関連性や広告主の可視性に課題が残る。
今回の調査は20分野にわたる5万件以上の商業クエリを分析したもので、会話型AI上での広告配信の実態が初めて大規模に可視化された。AI検索時代の新たな広告チャネルとして注目されるChatGPT Adsだが、その仕組みにはGoogle検索とは異なる独自の難しさがある。
商業クエリの約26%で広告が出現、Google AIモードに肉薄
SE Rankingの調査によると、ChatGPTは商業クエリの25.94%でスポンサードプレースメント(広告)を表示した。これは同社が以前調査したGoogle AIモードの29.45%にかなり近い数字だ。AIチャットボットの広告表示率が、従来型検索エンジンのAIモードと肩を並べつつある状況が浮かび上がった。
表示スタイルはシンプル、1クエリに単一広告
広告の表示スタイルは現在のところ非常にクリーンだ。調査で観測されたすべての広告は、生成された回答の下部に表示され、他の広告主と並んで競合することはなかった。1つの回答に対して常に1つのスポンサーオファーのみが表示される。
Googleの検索結果画面とは異なり、ユーザー体験を大きく阻害しない形で広告が統合されている点は注目に値する。ただし、このシンプルさは広告枠の稀少性を意味しており、将来的に入札競争が激化した際にどう変化するかは未知数だ。
広告の関連性に課題、約14%が的外れな表示
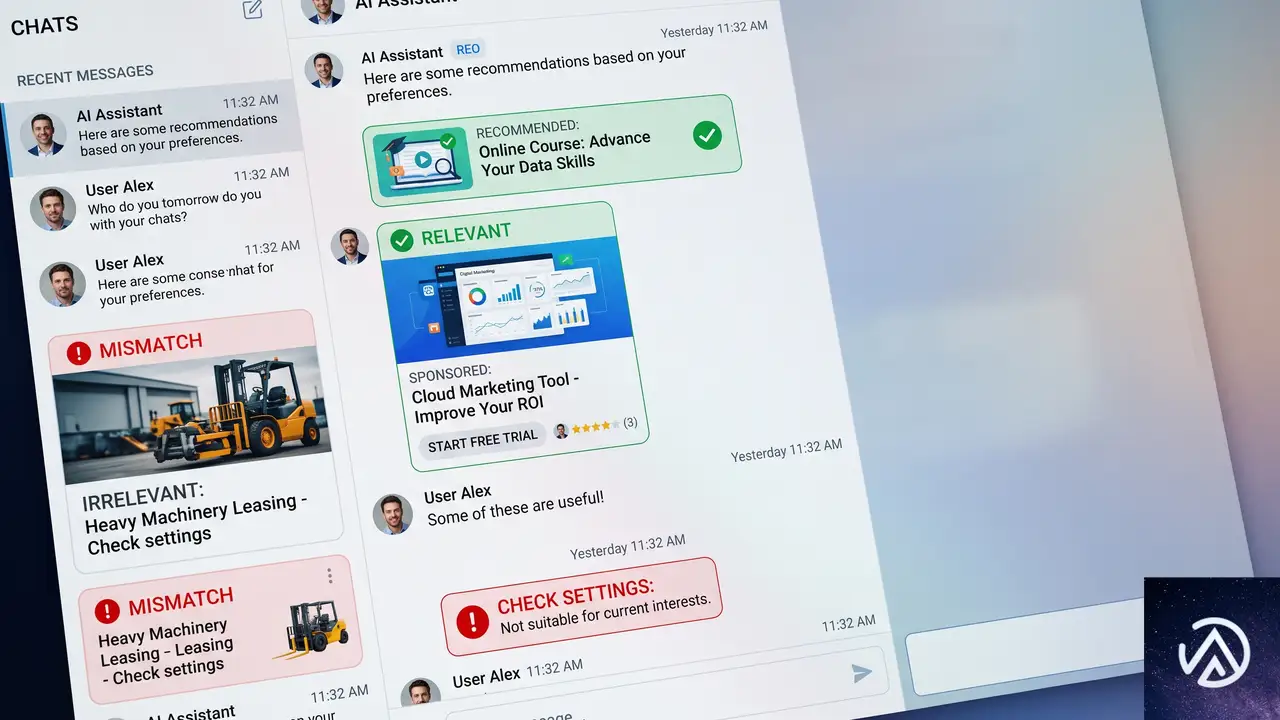
ChatGPT Adsの大きな課題として浮上したのが、広告の関連性だ。SE Rankingのセマンティック分析によると、表示された広告の約14.35%が、ユーザーのプロンプトと実質的な関連性を持たなかった。これは7件に1件の割合で、的外れな広告が表示されている計算になる。
カテゴリによるばらつきが顕著
ミスマッチの発生率はカテゴリによって大きく異なる。ペット分野ではわずか2.6%だったのに対し、人間関係やニュース・政治分野では半数以上が無関係な広告だった。特定のトピックでは、会話の文脈を正しく解釈して適切な広告を選ぶことが依然として難しいことがわかる。
実際のミスマッチ例
調査で観測された例では、デートアプリに関するプロンプトに衣料品小売店の広告が表示されたり、新聞の購読を尋ねるクエリに電力会社の広告が出たりといったケースがあった。ユーザーの意図と広告の内容が明らかにずれている。
このようなミスマッチは、広告主にとって広告費の無駄遣いになるだけでなく、ユーザーのAI体験の質を下げる要因にもなる。ChatGPTが広告プラットフォームとして成熟するためには、文脈理解の精度向上が不可欠だ。
従来のキーワードターゲティングとは根本的に異なる仕組み
ミスマッチが起きる背景には、ChatGPT Ads特有のターゲティング方式がある。広告主はキーワードリストではなく、自然言語で書かれた「コンテキストヒント」を提供する。これは「自社の広告を表示したい会話の文脈」を説明するテキストで、厳密なマッチングルールではなく、AIによるゆるやかなマッチングのガイドとして使われる。
加えて、広告主は現在のところ、実際にどのクエリや会話が自社の広告表示をトリガーしたのかを確認できない。これでは不適切なプレースメントが起きても原因を特定しづらく、改善のためのフィードバックループを回すのが難しい。
広告出稿とAI回答でのブランド露出はほぼ無関係

調査の中で特に注目すべき知見は、ChatGPT上で広告を出稿しても、それが生成AIの回答本文にブランドとして登場する確率はほとんど上がらないという点だ。
広告が表示されたクエリのうち、同じブランドが回答の情報源として引用されたケースはわずか3.63%だった。さらに、広告のURLがそのまま引用に現れたのは0.09%にすぎない。ブランド名の言及も4.44%にとどまる。
つまり、ChatGPTに広告費を投下しても、AIが生成するオーガニックな情報として認識される可能性は極めて低い。有料プレースメントとオーガニックなAI可視性は、今のところ完全に分離していると考えてよい。
YMYL分野で目立つ広告表示、Google AIモードとの違い
ChatGPT Adsは、健康やニュースといったYMYL(Your Money or Your Life)分野で、Google AIモードに比べて顕著に多くの広告を表示している。
調査によると、ヘルスケア関連のプロンプトでは28.69%で広告が表示されたのに対し、Google AIモードではわずか2.64%だった。ニュース・政治カテゴリでも同様に、ChatGPTが28.76%、AIモードは6.8%と大きな開きがある。
この差は、ChatGPTの広告セーフガードが緩いことを必ずしも意味しない。むしろ、2つのAIプラットフォームが広告表示に対して異なるポリシーやマッチングモデルを採用している証拠と見るべきだ。広告主は、AI検索チャネルごとにまったく異なる配信傾向があることを前提に戦略を立てる必要がある。
広告主が今おさえておくべきポイントと今後の展望
ChatGPT Adsは急速に成長する有料メディアチャネルだが、Google検索広告と同じ感覚で運用すると期待はずれに終わる可能性が高い。会話型AI上の広告は、キーワードではなくコンテキストに依存するため、精度の高いコンテキストヒントの設計と継続的な実験が欠かせない。
また、どのような会話で広告が表示されたかというレポートの不足は、最適化の足かせとなる。OpenAIが今後、広告主向けにより詳細な分析ダッシュボードを提供するかどうかが、チャネルとしての成熟度を左右するだろう。
さらに、AI検索の世界では、有料広告とオーガニックなブランド認知が直接リンクしない構造が鮮明になった。SEOにおけるブランド構築や被リンク獲得といった従来手法は、AIが回答を生成する時代にも強みを発揮する。広告だけでAI上の可視性を買おうとする発想は現実的ではない。
この記事のポイント
- ChatGPTは商業クエリの約26%で広告を表示し、Google AIモードと同等の水準に達している
- 広告の約14%がクエリと無関係で、会話ターゲティングの精度に課題が残る
- 広告出稿しても、ブランドがAI回答内で情報源として引用される確率は3%程度と低い
- 健康やニュース分野では、ChatGPTの広告表示率がGoogle AIモードより顕著に高い
- 会話型AI広告の最適化には、精密なコンテキストヒント設計と、広告表示ログの透明性が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon Bedrock AgentCoreにランタイムインスタンス発表、本番AIエージェント向け永続コンピューティング
AWSは2026年8月6日、Amazon Bedrock AgentCoreに新たな計算オプション「ランタイムインスタンス」を追加した。AIエージェントのプロトタイプを本番環境に移行する際、長時間の状態維持やマルチエージェント協調、GPUアクセスといった要求に応える、永続的なマネージドインフラだ。
従来のAgentCore Runtimeでは、マイクロVM上で最大8時間のステートフルな呼び出しが可能だったが、日をまたぐワークフローやOSレベルへの直接アクセスが必要なシナリオには限界があった。ランタイムインスタンスは、14日間のセッション永続化とEC2ベースのフルマネージド環境を提供し、本格的なエージェント運用基盤を実現する。
ランタイムインスタンスが解決する本番運用の3つの課題

AIエージェントをプロダクションに投入するとき、開発者はインフラの壁にぶつかる。ランタイムインスタンスはその3つの主要な課題を解消する。
長時間の状態維持とセッション永続化
通常のサーバーレス実行環境では、処理が終わるとメモリやストレージが破棄される。エージェントが数時間〜数日にわたる複数ステップのワークフローを扱う場合、途中結果を外部ストレージに退避させるなどの手間が生まれる。ランタイムインスタンスでは、最大14日間の共有セッションストレージが標準で提供される。セッションは停止・再開が可能で、アイドル期間のコストを抑えながら、必要なときに前回の状態から処理を再開できる。
マルチエージェントの同一ホスト協調
現実の複雑なタスクは、コード生成・レビュー・テスト・デプロイといった複数の専門エージェントが連携して初めて完結する。ランタイムインスタンスでは、複数のエージェントを同一のEC2ホストにデプロイし、共有ファイルシステムを介して直接データをやり取りできる。API呼び出しやネットワーク越しのストレージを挟むオーバーヘッドがなく、シームレスな協調が可能だ。
GPUとOSへの直接アクセス
画像認識や動画解析、重い数値計算を伴うエージェントはGPUを必要とする。ランタイムインスタンスはGPUアクセラレーテッドなインスタンスタイプに対応し、OSレベルへのアクセスも提供する。コードのコンパイル、セキュリティスキャン、GUI自動操作など、コンテナだけでは実現しにくいタスクをエージェントに任せられる。
コードライターとレビュアーの連携を実際に見る
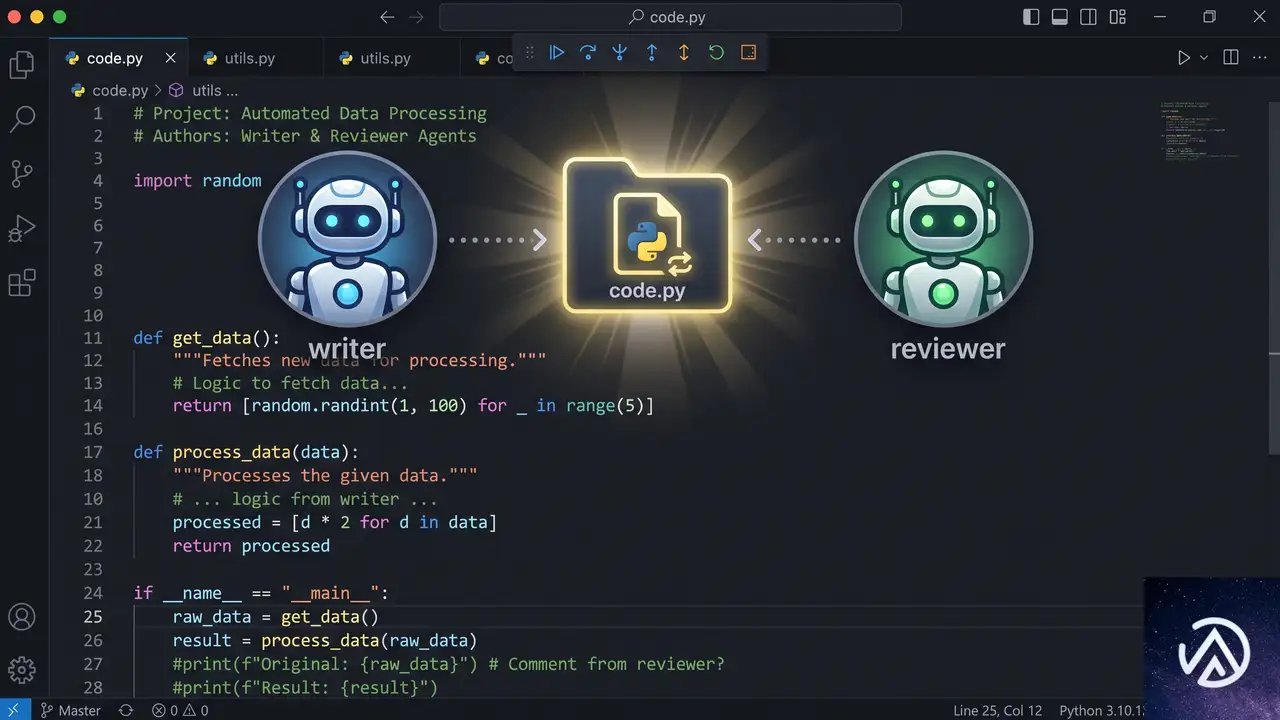
公式デモでは、自然言語でPythonコードを生成する「コードライターエージェント」と、生成されたコードのバグやスタイルをレビューする「コードレビュアーエージェント」を同じランタイムインスタンス上にデプロイし、協調動作させる手順が紹介された。
このデモのポイントは、2つのエージェントが完全に独立したアプリケーションでありながら、セッションIDで紐づく共有ディレクトリを経由してファイルをやり取りする点にある。外部APIを呼び出すことなく、同一ホストのファイルシステム上で完結するため、レイテンシが極めて小さい。
/tmp/agentcore-session/{session_id}/code.py に書き込む各エージェントはStrands Agentsフレームワークと好みのモデル(デモではClaude Sonnet)を使い、単一のPythonファイルに @app.entrypoint デコレータを付けるだけで実装できる。パッケージングもzipまたはコンテナイメージで済み、インフラ管理の負担は大きく軽減される。
セットアップから初回実行までの流れ

ランタイムインスタンスの利用は、大きく3つのステップで完了する。AWSマネジメントコンソールを使う場合の手順を簡潔にまとめた。
- 容量プロバイダの作成 、 エージェントが稼働するEC2インスタンスのスペックとネットワークを定義する。OS(ARM64またはx86_64)、インスタンスタイプ、VPC、サブネット、セキュリティグループを設定。ストレージはgp3ボリュームがデフォルトで用意される。
- ランタイムの作成とエージェントのデプロイ 、 コンピュートタイプに「Instances」を選び、先ほど作成した容量プロバイダを紐づける。エージェントのコードをzipでアップロードし、ランタイム(Python 3.11〜3.14)とエントリポイントを指定。IAMロールもコンソールが自動生成する。
- エージェントの呼び出しと協調 、 デプロイ完了後、コンソールの「Runtime playground」からテスト用のJSONペイロードを送信できる。セッションIDを明示的に指定し、同じIDで別のエージェントを呼び出せば、両者が同一の共有ストレージを使ってシームレスに連携する。
容量プロバイダは一度作成するとOSやインスタンスタイプの変更ができない。本番用と検証用を分けるなど、事前の設計が求められる。
主要スペックと料金モデル
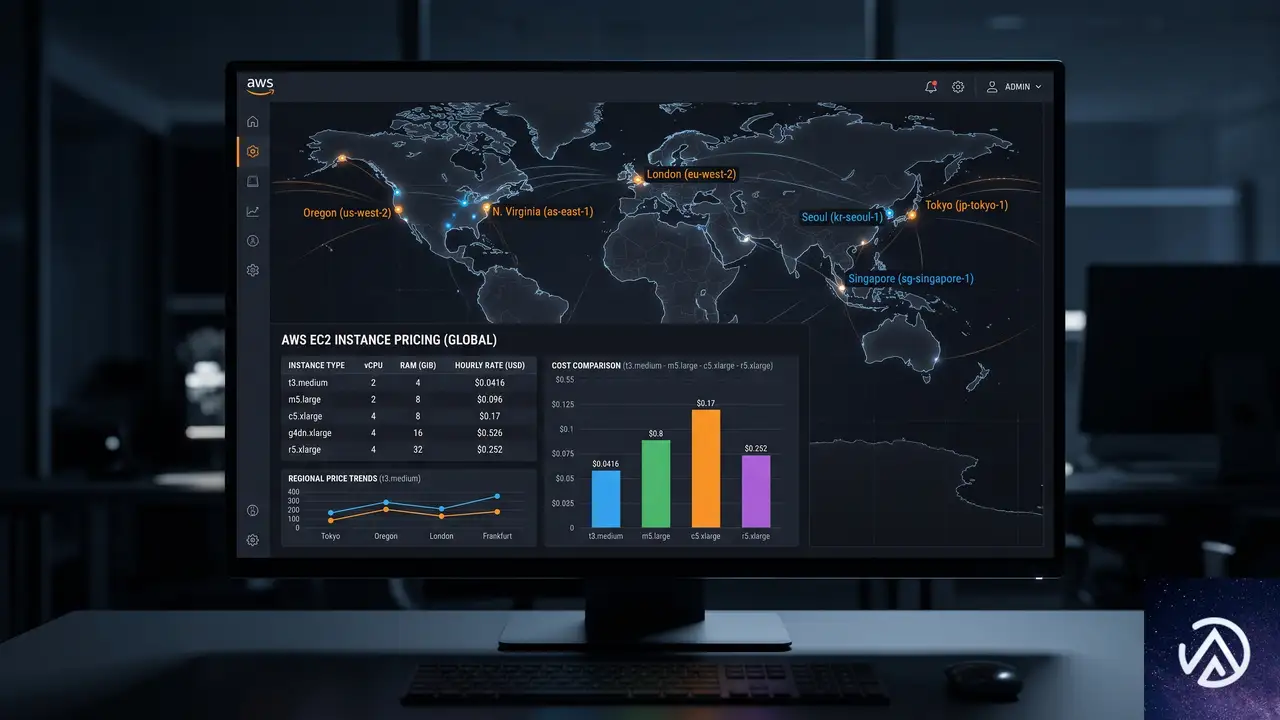
- 対応OS 、 Linux(ARM64、x86_64)。Windowsは現時点ではサポート外
- セッション持続 、 最大14日間。停止・再開が可能で、アイドル中のコスト削減に有効
- ランタイム 、 Python 3.11〜3.14(ネイティブコードに対応)。コンテナイメージのデプロイもサポート
- GPU 、 対応インスタンスタイプを選択すれば、GPUを使った推論や計算が可能
- 統合 、 既存のAgentCore API、IAM、監視機能と完全互換。マイクロVMとのハイブリッド構成も取れる
- 料金 、 使用したEC2インスタンスの標準料金に、AgentCoreオーケストレーションの管理手数料が加算される
- リージョン 、 米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、アジアパシフィック(ムンバイ、シンガポール、シドニー、東京)、欧州(フランクフルト、アイルランド)
マイクロVMベースの従来のAgentCore Runtimeとランタイムインスタンスは、同じAPIセットで併用できる。軽量なオーケストレーターエージェントをマイクロVM側に置き、重い処理や永続状態が必要なワーカーエージェントをインスタンス側に委譲するハイブリッド構成が、現実的なアーキテクチャパターンとして紹介されている。
始め方と最初の一歩
ランタイムインスタンスを試すには、Amazon Bedrock AgentCoreのドキュメントに掲載されているランタイムインスタンスの公式ガイドを参照し、容量プロバイダの作成から始めるのが近道だ。コンソールの左ナビゲーションから「Runtime」→「Capacity providers」を選び、今回紹介した手順に沿って設定すれば、最初のエージェントデプロイまで数分で到達できる。
この記事のポイント
- ランタイムインスタンスは、最大14日間のセッション永続化とEC2ベースのマネージド環境を提供するAgentCore新オプション
- 同一ホスト上でのマルチエージェントファイル共有により、APIを介さないシームレスな協調が可能
- GPUインスタンスやOS直接アクセスが必要な高度なエージェントワークロードに対応
- 従来のマイクロVMと組み合わせたハイブリッド構成で、軽量なオーケストレーションと重いバックエンド処理を分離できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GoogleのAI責任者ジェフ・ディーン氏が退任、新会社を設立。AI研究の巨人の軌跡とSEOの今後
GoogleのアルファベットCEO、サンダー・ピチャイ氏が2026年8月5日、大規模な組織改編と重要人物の退任を発表した。今回のニュースの核心は、27年にわたりGoogleの検索基盤と現代のAI技術を支えてきたチーフサイエンティスト、ジェフ・ディーン氏が退任し、新会社を設立することだ。
彼の退任は、単なる一社の人事異動ではない。TensorFlowの共同発明、知識蒸留の概念、MapReduceといった、今日の検索エンジンと生成AIの土台そのものを築いた人物の離脱である。この記事では、今回の発表内容、ディーン氏の技術的遺産、そしてこの出来事がSEO業界に投げかける長期的な影響を読み解く。
Google DeepMind新体制とデミス・ハサビス氏の役割拡大

今回の発表で、GoogleのAI研究開発におけるリーダーシップ体制が一新された。Google DeepMindの共同創業者でありCEOであるデミス・ハサビス氏が、新たにアルファベット社全体のチーフサイエンティスト、そしてGoogle DeepMindの会長に就任する。彼はDeepMindの顔としての役割を維持しつつ、Googleが持つ他のAI関連部門に対しても影響力を拡大することになる。
とりわけ注目すべきは、医薬品開発を行うアイソモルフィック・ラボ(Isomorphic Labs)への関与だ。この部門はAIを駆使して新たなバイオ医薬品や治療薬を発見することを目的としており、既にイーライリリーやノバルティス、ジョンソン・エンド・ジョンソンといった製薬大手と提携している。数兆円規模の巨大市場である医薬品産業において、GoogleがAIを中核に据えた事業展開を本格化させる意思が明確に示された形だ。
また、DeepMindのCTOを務めてきたコライ・カブクチュオール氏は、Google DeepMindのシニアバイスプレジデントに昇格し、実務的な日々のリーダーシップを担う。彼の管掌範囲には、Geminiモデルとアプリケーションの開発チーム、そして最先端のフロンティアモデルが含まれる。ピチャイCEOは声明の中で「彼は13年間DeepMindに在籍し、深層学習チームを立ち上げ、WaveNetやDQNといったブレークスルーを主導してきた」と評しており、まさに技術面での最高責任者としてGoogleのAI開発を牽引する役割を負う。
この一連の体制変更は、GoogleがAI研究の成果を検索やクラウドだけでなく、より実体経済に近い分野へと応用する段階に入ったことを示唆している。
ジェフ・ディーン氏の退任とその考古学的な功績
SEOやサイト運営者の間ではあまり知られていないかもしれないが、ジェフ・ディーン氏の名前は現代のインターネットの風景を語る上で欠かせない存在だ。彼はGoogleの初期検索インフラから、ニューラルネットワークによる現代AIの時代に至るまで、最も重要な技術的転換点の数々を牽引してきた。ピチャイCEOが「現代AI時代の創造に貢献した」と述べるのも当然のことである。
彼の退任が「巨大な損失」と形容される理由は、その業績リストを見れば一目瞭然だ。以下に、ディーン氏が関わった主要な研究論文と、その歴史的意義をまとめる。
MapReduce(2004年)
大規模クラスター上でのシンプルなデータ処理手法を提示したこの論文は、後のApache Hadoopの開発に強い影響を与え、ビッグデータ産業そのものの創出を可能にした。検索エンジンが扱う膨大なウェブデータの分散処理は、この着想なくしては実現しなかったと言っても過言ではない。
Bigtable(2006年)
構造化データを数千台のサーバーに分散して保存し、ペタバイト級にスケールさせる方法を示した。これは、超巨大規模でのウェブインデックス作成に直接的な影響を与え、Google検索の根幹技術のひとつとなった。
Large Scale Distributed Deep NetworksとDistBelief(2012年)
この論文は、数十億のパラメータを持つモデルのトレーニング手法を提示した。ここで紹介された分散学習フレームワーク「DistBelief」は、TensorFlowの直接の前身にあたる。スケーラブルな深層学習という、現在の巨大AIモデル時代の扉を開けたものだ。
知識蒸留(Distilling the Knowledge in a Neural Network、2015年)
大小さまざまなAIモデルを扱う企業や研究者にとって、知識蒸留は今や常識とも言える重要な技術である。これは、大規模で高性能な「教師モデル」の振る舞いを、より小さく高速な「生徒モデル」に学習させる手法を指す。簡単に言えば、ベテラン職人の技術を新人に凝縮して継承するイメージだ。ディーン氏は、この概念の主要な発明者の一人である。
この技術は、OpenAIやAnthropicのトップモデルを模倣するために中国企業が使用したと非難されたり、AIによる検索結果をリバースエンジニアリングする際に使われたりと、模倣や分析の文脈でも頻繁に話題に上る。AIの民主化と技術流出という、現代的な課題の根源にも関わる発明なのだ。
TensorFlow(2016年)
そして、おそらく最も広く知られているのが、機械学習ライブラリ「TensorFlow」の共同発明である。TensorFlowは、今日のAIを形作ることを可能にした柔軟なインフラ層だ。開発者が機械学習モデルを構築し、トレーニングするためのツールキットであり、現在の生成AIブームの縁の下の力持ちとも言える。TensorFlowの存在なくして、ChatGPTに代表される大規模言語モデルの急速な発展はありえなかった。
今回の退任がSEOとサイト運営に与える長期的な影響

SEOコミュニティの多くは、ジェフ・ディーンという個人名に馴染みが薄いかもしれない。しかし、彼の存在はこれまでの検索エンジンの進化、つまりSEOそのもののゲームルールを決定づけてきた。ここでは、彼の退任がもたらすであろう、より深い地殻変動を考察する。
GoogleのAI研究開発の方向性変化
最高技術責任者の退任と後任者の就任は、組織としての研究開発の優先順位や文化に変化をもたらすことが一般的だ。ディーン氏の代わりに実務のトップに立つコライ・カブクチュオール氏は、Geminのような大規模言語モデルと、その先のフロンティアモデルに直接責任を持つ。この体制が続く限り、Googleの研究開発リソースは「より賢く、より大きなAI」を追求する方向性が加速するだろう。
AIによる検索品質とアルゴリズム進化の加速
同時に、ディーン氏が積み上げてきた分散処理と大規模学習の基盤は、既にGoogle検索の血肉となっている。Googleが「AIによる検索体験」をどこまで推し進めるのか。AI Overviewsのような機能の進化は、後任者たちの手腕にかかっている。ディーン氏の退任は、ある種の完成を迎えた基盤技術の上で、応用レイヤーの競争がいよいよ本格化する合図とも読み取れる。
AIスタートアップ「Discovery Loop」とGoogleの特別な関係
サンダー・ピチャイ氏は、ディーン氏とGoogleのシニアフェローであるサンジェイ・ゲマワット氏が、機械学習や科学、工学における発見を加速させる独立した公益法人(Public Benefit Corporation)を設立すると述べた。この新会社「Discovery Loop」はGoogleからの独立組織だが、Google自身が出資者かつクラウドパートナーとなり、研究フレームワークでも協業するという。つまり、まったくの別会社というわけではなく、Googleのエコシステムと強固に結びついた「外部の頭脳」として機能する可能性が高い。両社の研究成果が間接的にGoogle検索に還流する未来も十分に考えられる。
この記事のポイント
- Googleのチーフサイエンティスト、ジェフ・ディーン氏が27年のキャリアに幕を下ろし、AI研究の新会社「Discovery Loop」を設立。
- ディーン氏はMapReduce、Bigtable、TensorFlow、知識蒸留など、現代の検索とAIの基盤技術を数多く発明。事実上の「検索エンジンの父」の一人。
- 後任のハサビス氏はDeepMind会長兼アルファベット全体のチーフサイエンティストとなり、医薬品開発などAIの応用領域を拡大する方針。
- この人事は、GoogleのAI研究が「基盤づくり」から「応用と収益化」へとフェーズを移行させるシンボリックな出来事。
- SEO実務者にとっては、AI Overviewsの高度化など、検索体験のさらなる変貌を前提とした長期的視点でのサイト運営がこれまで以上に求められる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

cats.txtが暴いたGEOの証拠水準。AIクロールは機能の証明にならない
AI検索時代におけるSEOの延長線上にあるGEO(生成AIエンジン最適化)。その効果を裏付ける「証拠」として、しばしば4つの観測があげられる。AIボットがファイルをクロールした、Googleがインデックスした、LLMがその内容を出力した、ChatGPTが有効性を認めた。しかし、これらの観測は本当に「有効性の証明」と言えるのか。
Search Engine JournalのMark Williams-Cook氏が公開した風刺的な検証が、この疑問に痛烈な答えを出している。同氏は架空の規格「cats.txt」を考案し、上記4つの証拠すべてをクリアすることを実証した。つまり、ウェブ上に置かれたどんなテキストファイルにも同様の現象は起こり得るのであり、それらは機能を保証するものではないというわけだ。
GEO業界でまかり通る「4つの証拠」とその問題点
以下、それぞれを詳しく見ていこう。
1. AIボットがクロールしている
クローラーの役割は、Web上にあるファイルを片端から取得することだ。そのため、cats.txtのような冗談まじりのファイルにも、PerplexityBotやGPTBot、ClaudeBotがアクセスしてくる。サーバーログにボットの痕跡があったからといって、そのファイルが「特別に利用されている」証拠にはならない。配達員が門を通るのと、家の中のゴミ箱の中身が役立っているというのは別の話である。
2. Googleにインデックスされた
Googleはテキストファイルをきわめて積極的にインデックスする。cats.txtもGoogle検索結果に現れ、Search Consoleで「インデックス登録されました」と表示された。しかしそれは、URLが存在し、何かしらの文字が書かれているという事実を確認しただけだ。信ぴょう性や有用性とは無関係である。
3. LLMがファイルの内容を出力した
検索拡張生成(RAG)は、LLMが検索結果を参照して回答を生成する仕組みだ。cats.txtが検索上位に登場すると、AIはその猫情報を何の疑いもなく引用する。これはファイルが特別な「プロトコル」として機能しているのではなく、単に1つのWebページとして扱われた結果に過ぎない。
4. ChatGPTが有効性を認めた
ChatGPTに「cats.txtは役立ちますか」と尋ねると、公開直後は「検索エンジンやLLM駆動システムでのランク向上に寄与する可能性があります」という回答が返ってきた。これはネット上に「有効だ」と書かれたテキストが多かったからであり、AI自身が何かを判断したわけではない。興味深いことに、このファイルが風刺であると知れ渡った後は、同じChatGPTが「これは冗談です」と答えるようになった。AIの意見は、周囲の言説の平均値にすぎないのである。
「収束問題」が引き起こす根拠の循環
この「収束問題」こそが、4つの証拠の背後にある根本的なメカニズムだ。LLMは与えられたネット上の言説の平均的な意見を出力するに過ぎない。cats.txtが「効果的だ」と答えたのも、公開当初に肯定的な書き込みが一定数集まったからである。もし皆が「これはデタラメだ」と書いていれば、AIもそう答えたはずだ。
このように、AI自身の意見を「お墨付き」と捉えるのは危険である。流動的な世の中の雰囲気に左右される出力を、数値や因果関係の証拠と混同してはいけない。
真のSEO・GEO最適化が目指すべきもの

cats.txtの実験が示したのは、あるGEO施策の効果を主張するために使われる「証拠」があまりにも脆弱だという事実だ。AIボットのクロール、インデックス、LLMの出力、ChatGPTの賛同。これらはどれも、「施策が機能していること」の証明にはならない。
問題は、こうした根拠不十分な手法に時間と予算を費やすことにある。確かな価値が実証されている基本的なSEO改善(コンテンツ品質、サイト速度、ユーザー体験の向上)こそが、長期的にAI検索からのトラフィックを伸ばす土台となる。最適化とは、検証可能な小さな改善を積み重ね、競合よりもわずかに優位に立つことだ。まだ誰も検証していない「次のGEOの秘策」を追いかけることではない。
この記事のポイント
- AI検索最適化の「証拠」とされる4つの観測(クロール、インデックス、LLM出力、ChatGPT賛同)は、どのテキストファイルにも起こる現象であり、施策の有効性を担保しない
- 2026年8月に公開されたcats.txtは、この4つの証拠すべてをクリアし、根拠の脆弱性を浮き彫りにした
- LLMの自己評価はネット上の意見の平均を返しているに過ぎず、エコーチェンバー効果によって「有効」と誤認されやすい
- 限られたリソースは、検証済みの基本SEO改善に集中させるべきであり、エビデンスの弱い新手法に振り回されてはならない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPressのdo_action()を見直す イベントをオブジェクト化し、フックをクラス名にする最新の開発パターン
WordPressの開発でdo_action()を一度も使ったことがない人はまずいないだろう。カスタムフックを定義して他のプラグインやテーマから振る舞いを拡張する手法は、バージョン1.2で導入されて以来変わらず愛用されている。
しかし長年の使い込みの中で、いくつかの「小さな摩擦」が無視されてきたのも事実だ。引数の順序を覚えきれない、フック名が大域空間で衝突する、戻り値の返し忘れでフィルターが壊れる、といった問題は大規模なコードベースになるほど開発者の時間を食う。
この記事では、do_action()に1つのオブジェクトを渡し、そのクラス名をフック名として使うことで、これらの問題を一掃するパターンを解説する。独自のライブラリもフレームワークも不要で、PHPの標準機能だけで実装できる。2026年8月にDeveloper WordPress Newsで公開された洞察をもとに、実装例と仕組みを詳しく見ていこう。
do_action()で起きていた4つの摩擦
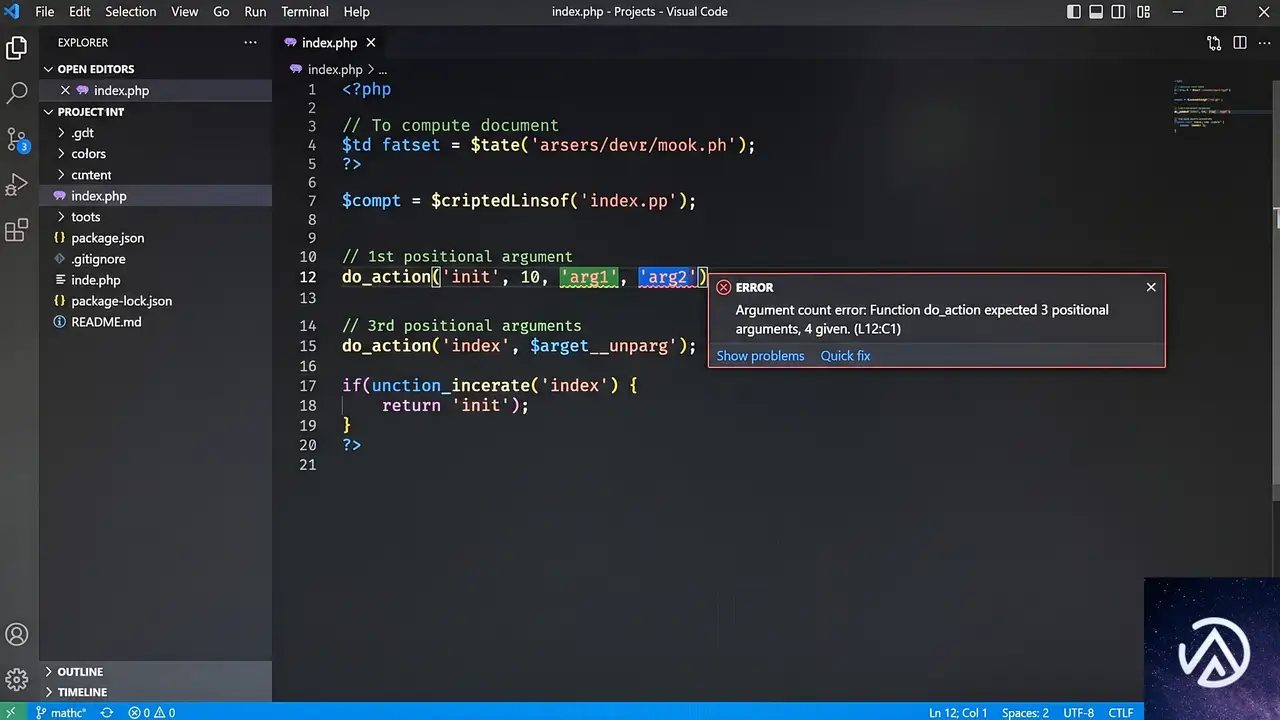
従来のdo_action()は「フック名」と「任意の数の引数」を受け取るシンプルなAPIだ。会員登録をトリガーとするプラグインであれば、次のようにフックを発火させるのが一般的な書き方になる。
do_action( 'myplugin_member_registered', $userId, $plan );これを受け取る側のコードは以下のようになる。
add_action( 'myplugin_member_registered', static function ( $userId, $plan ) {
    // ... 何らかの処理
}, 10, 2 );
動作自体に問題はない。だが、よく見ると運用上のストレスがいくつも潜んでいる。Developer WordPress Newsの記事が指摘する摩擦点は大きく次の4つだ。
- 引数が位置に依存する
$userIdと$planの順序を覚えておかなければならず、間違えた場合のエラーは追跡しにくい。 - フック名がグローバルな名前空間
'myplugin_member_registered'という文字列が他のプラグインと衝突しないよう、prefixをつけて管理する必要がある。 - 型情報が一切ない
$planは文字列かもしれないしIDかもしれない。コードエディタの補完も静的解析も効かず、ドキュメントを読まなければ正体がわからない。 - フィルターの戻り値忘れ
apply_filters()を使うと、どのリスナーも必ず値を返さなければならない。うっかりreturnを書き忘れると、後続のフィルターがすべて破綻する。
これらはフックの仕組みそのものの問題ではなく、ペイロード(運ぶデータ)の渡し方に起因する。そして、このペイロード設計を見直すだけで、すべてがきれいに解決する。
上の比較でわかるとおり、do_action()に渡す情報をオブジェクトにまとめるだけで多くの摩擦が消える。フック名の衝突リスクがなくなり、コードエディタの補完も効く。
イベントオブジェクトとクラス名フック 1行で変わる設計
解決策の核心は驚くほど単純だ。Developer WordPress Newsの記事の著者が試みたのは、「引数をバラバラに渡すのではなく、起こった出来事を表すオブジェクトを1つだけ渡す」というやり方である。
具体的には、次のように書く。
do_action( $event::class, $event );$event::classが何が起きたかを示すフック名になり、$eventがその詳細を運ぶ。フック名にはそのクラスの完全修飾名が使われるため、名前空間が自動的に適用され、他のプラグインと衝突することはまずない。
フック名を::classで決めるか、あるいは固定の文字列にするかは選択できる。クラス名を使えば、IDEでクラスをリネームするとフックも追従する。文字列(例:'myplugin/member-registered')を指定すれば、後からクラスを移動させてもフック名は変わらない。移行の危険を減らしたいなら固定文字列のほうが安全だが、どちらにせよペイロードは整ったオブジェクトになる。
また、このテクニックはapply_filters()を使わなくてもフィルター的な振る舞いを実現できる。オブジェクトのプロパティを書き換え可能にしておけば、リスナーが自由に値を変更し、ディスパッチャ側が後から読み取れるからだ。戻り値の管理に頭を悩ませる必要がなくなる。
具体例 会員登録のDispatcherとListener
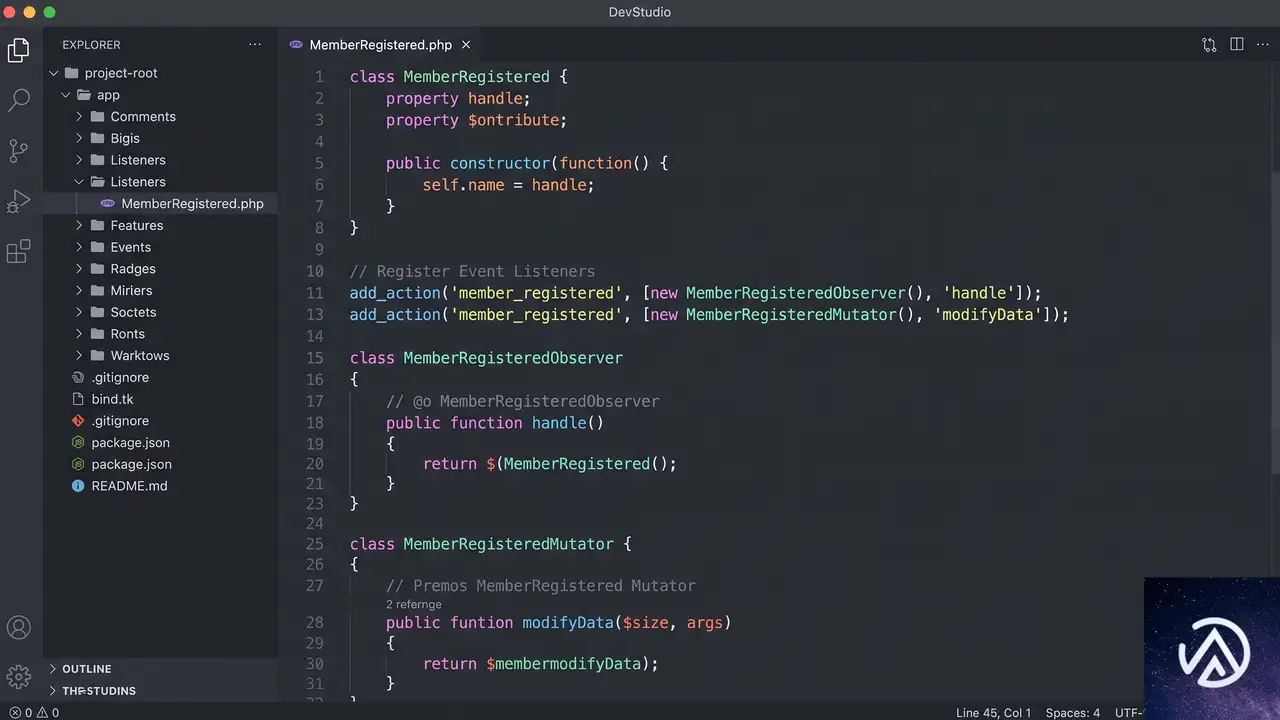
ここでは会員登録を題材に、イベントオブジェクトを使ったフックの流れを具体的に見ていこう。名前空間MyPlugin\Membersの下に、登録イベントを表すクラスと、それを発行するクラス、そして受け取る側のコードを用意する。
イベントクラスの定義
namespace MyPlugin\Members;

final class MemberRegistered
{
    public function __construct(
        public readonly int    $userId,
        public readonly string $plan,
        public          bool   $sendWelcomeEmail = true,
    ) {}
}$userIdと$planはreadonlyとして宣言され、リスナーは読み取り専用で使用する。一方、$sendWelcomeEmailは書き換え可能にしておき、ウェルカムメールを送るかどうかの判断をリスナーに委ねる。
Dispatcher(発行側)
namespace MyPlugin\Members;

final class MemberRegistrar
{
    public function register( int $userId, string $plan ): void
    {
        // アカウント作成処理...

        $event = new MemberRegistered( userId: $userId, plan: $plan );

        do_action( $event::class, $event );

        if ( $event->sendWelcomeEmail ) {
            // ウェルカムメールをキューに追加
        }
    }
}ポイントは、do_action()の後で$event->sendWelcomeEmailを評価しているところだ。この値は後続のリスナーが変更したかもしれない。オブジェクトは参照で渡されるため、ディスパッチャはリスナーによる変更をそのまま拾える。ここにapply_filters()は必要ない。
ObserverとMutatorの2パターン
受け側はおおまかに2種類に分かれる。1つはイベントを観測するだけのObserverで、値を読み取るが変更はしない。もう1つはプロパティを書き換えるMutatorだ。
// Observer ログ出力のみ
add_action( MemberRegistered::class, static function ( MemberRegistered $event ): void {
    error_log( sprintf(
        'Member #%d registered on the %s plan.',
        $event->userId,
        $event->plan
    ) );
} );

// Mutator 無料プランの場合はウェルカムメールを無効化
add_action( MemberRegistered::class, function ( MemberRegistered $event ): void {
    if ( 'free' === $event->plan ) {
        $event->sendWelcomeEmail = false;
    }
} );Mutatorのコールバックを見ると、型ヒントによって$eventのプロパティが自動補完されることがわかる。$userIdや$planの順序を気にする必要はなく、add_action()の第4引数で引数の数を指定する手間もない。これがオブジェクト化の地味ながら大きな恩恵だ。
$sendWelcomeEmailをfalseにすることで、メール送信の挙動を変更する。このように、1つのオブジェクトを受け渡すだけで、従来のアクションとフィルターの両方の役割を統一的に扱える。コードの見通しは飛躍的に良くなるはずだ。
オブジェクト化がもたらすメリットのまとめ

これまでの例から、イベントオブジェクトパターンを採用することで得られる具体的な利点を整理する。
- 型安全なリスナー すべてのコールバックがイベントクラスで型を宣言するため、エディタの補完と静的解析がフルに働く。
- 名前衝突からの解放 フック名は完全修飾クラス名(または明示的な文字列)で管理されるため、prefixを手動で付ける必要がなくなる。
- フィルターのような書き換えをアクションで実現 オブジェクトのプロパティをミュータブルにしておけば、
apply_filters()を使わずとも値の変更が可能。戻り値の返し忘れによるバグも消える。 - 自己文書化 各イベントクラスが独立したファイルになるため、どの拡張ポイントが存在するかがディレクトリを見るだけで把握できる。
これらの改善は、特別なライブラリを導入しなくても、今日から自社のプラグインに適用できる。既存のdo_action()やadd_action()をそのまま使いつつ、ペイロードをオブジェクトに切り替えるだけだ。
WordPressのルーツとPSR-14の関係
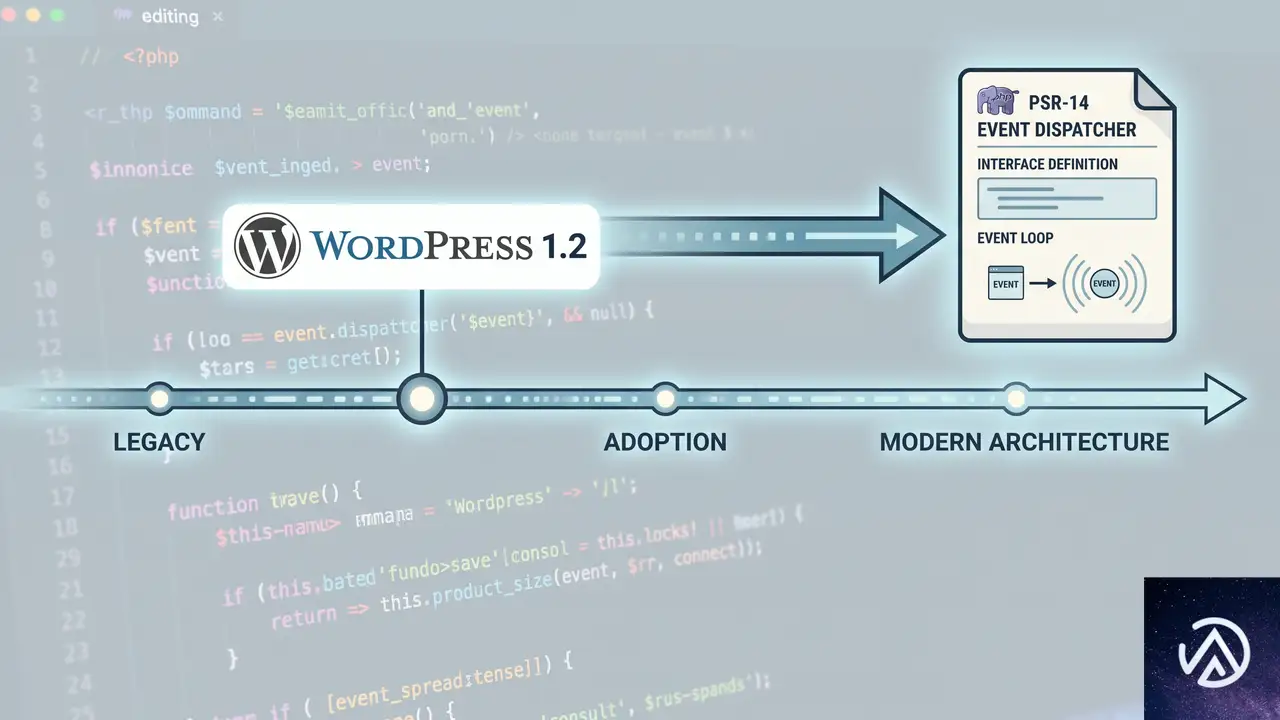
このパターンを「新しいアイデア」と感じるかもしれないが、実はWordPressが2004年のバージョン1.2で搭載したプラグインAPIの時点で、根幹の設計は既に存在していた。
PHPの世界でPSR-14(Event Dispatcher)として標準化された「イベント、リスナー、ディスパッチャ」の概念は、do_action()とadd_action()の組み合わせでほぼ表現できる。つまり、WordPressはとっくにイベント駆動の基盤を持っていたことになる。
PSR-14が定める厳密な契約(伝播制御、リスナープロバイダー、ディスパッチャの交換など)はWordPressには組み込まれていない。だが、「イベントをオブジェクトで表現し、そのクラス名でフックする」という発想は、PSR-14のイベントモデルと驚くほど調和する。結果として、WordPressのネイティブな関数の上に、よりモダンで安全なイベント設計を載せられるわけだ。
Developer WordPress Newsの記事の著者も、PSR-14を完全実装する試みの中で、大半の価値がこの小さな習慣に詰まっていることに気づいたと述べている。段階的な移行が可能で、いきなり大掛かりなフレームワークに乗り換える必要はない。
このパターンの限界と発展の方向性
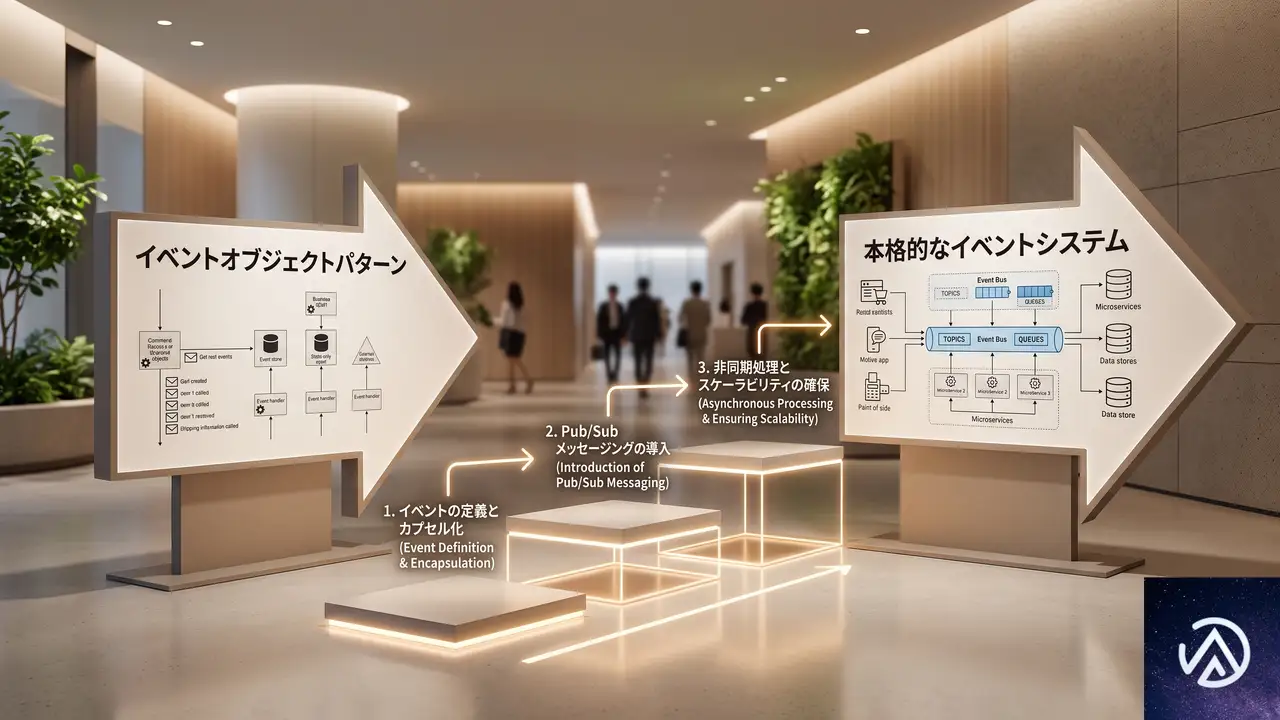
ここまでのテクニックで、自作プラグインのカスタムフックの多くは十分に改善できる。ただし、次のような高度な要件に直面したときは、より本格的なイベントシステムの導入を検討してもいい。
- 伝播の停止 あるリスナーが「以降のリスナーは実行するな」と指示する仕組み。これは
remove_action()と優先度では再現しきれない場面がある。 - 複雑なリスナー管理 数十個のリスナーを手作業で登録するのではなく、1つのサブスクライバークラスにまとめて登録したいケース。
- テストのための差し替え ディスパッチャ自体を丸ごと入れ替えて、イベントの発生をテストダブルで差し替えたい状況。
これらの必要性を感じ始めた時が、PSR-14準拠のディスパッチャを導入する潮時といえる。しかし、そこに至るまでは、「do_action()にオブジェクトを渡す」習慣だけで、保守性も開発体験も大きく前進させられる。
今日からすぐに実践できる小さな設計変更が、コードベースの品質を長期にわたって支える土台になる。次のカスタムフックを書くときに、このパターンをぜひ試してみてほしい。
この記事のポイント
do_action()にバラバラの引数ではなく1つのイベントオブジェクトを渡すと、引数の順序問題や型の不明瞭さが解消される。- フック名にクラスの完全修飾名を使うことで、名前空間が自然に確保され、衝突リスクが劇的に下がる。
- オブジェクトの書き換え可能プロパティを利用すれば、
apply_filters()を使わずにフィルター的な挙動を安全に実装できる。 - オブザーバーとミューテーターの2種類のリスナーを型安全に記述でき、コードエディタの補完がフルに働く。
- PSR-14のような本格的なイベントシステムを導入しなくても、小さな習慣を変えるだけで開発体験が大幅に改善する。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
DynamoDBにベクトル検索がGA、リアルタイムな類似検索が可能に
AWSは2026年8月5日、Amazon DynamoDBにベクトル検索機能を正式に追加した。これにより、既存の運用データと同じテーブルに埋め込みベクトルを格納し、類似度にもとづくリアルタイムな検索が可能になる。
従来、ベクトル検索を追加するには専用のベクトルデータベースを用意し、データの同期パイプラインを自前で維持する必要があった。今回の発表によって、DynamoDBだけでミリ秒単位の低レイテンシと99%以上の再現率、トリリオン規模のベクトルに対応するスケーラビリティが手に入る。サーバーやソフトウェアの管理は一切不要で、ゼロダウンタイムのメンテナンスが保証される。
DynamoDBにベクトル検索が一般提供開始

ベクトルインデックスにはストレージ制限がなく、データの増大に合わせて水平スケールする。セマンティックな検索が必要なエージェント向けメモリ、検索拡張生成(RAG)、レコメンデーションエンジン、パーソナライズされた体験、異常検知などのユースケースを、DynamoDBのネイティブ機能として実装できる。
ベクトル検索の機能は、最大4096次元のベクトルに対応し、ユークリッド距離、コサイン類似度、ドット積のいずれかの距離関数を選択可能。また、パーティションキーによるスコープ指定や、インラインフィルタを使った絞り込みにも対応する。
ベクトル検索統合の背景とメリット
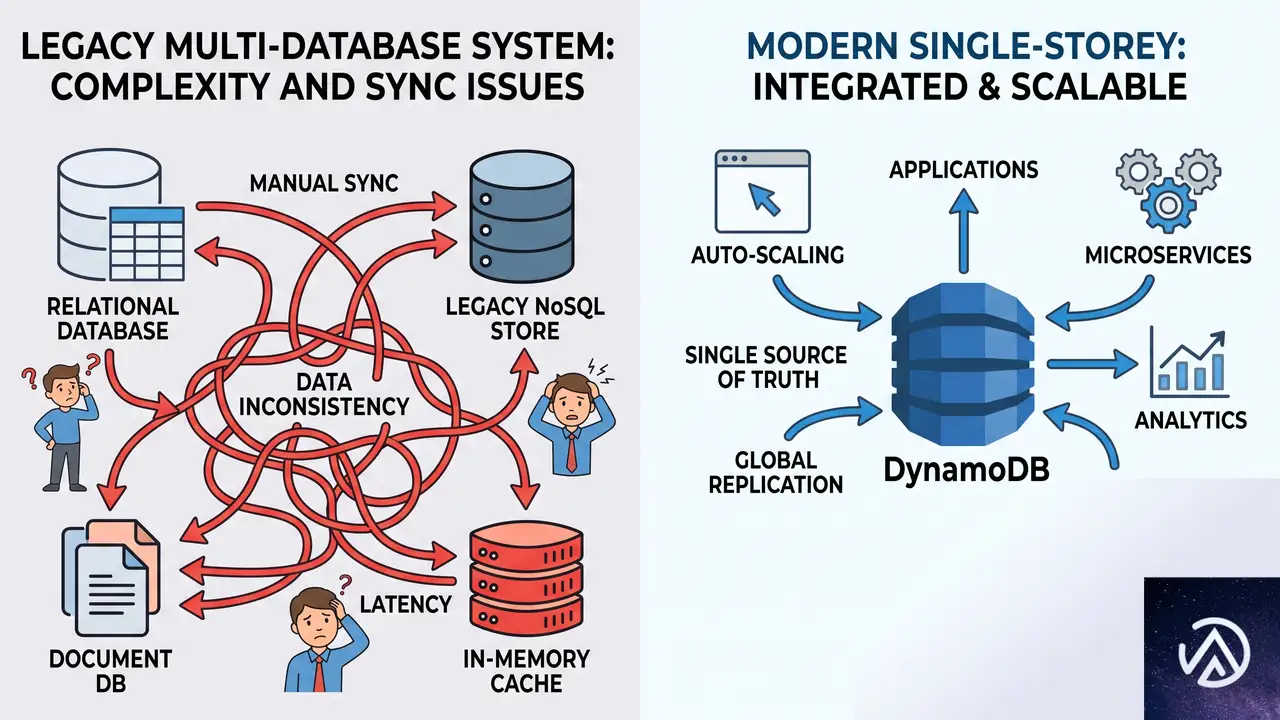
DynamoDBをすでに利用しているアプリケーションでは、これまでセマンティック検索を追加するために、専用のベクトルデータベースを別途プロビジョニングし、テーブル間でデータの同期を維持するパイプラインを構築・運用する必要があった。この構成は追加の運用コスト、データ転送料金、ライセンス費用に加え、大規模環境での低レイテンシ維持を難しくする要因だった。
DynamoDBのベクトル検索では、ベクトルと運用データが同一のサーバーレス基盤で管理され、同じ従量課金モデルが適用される。これにより、同期パイプラインや外部ベクトルストアの運用から解放される。
検索の仕組みとAPIの使い方
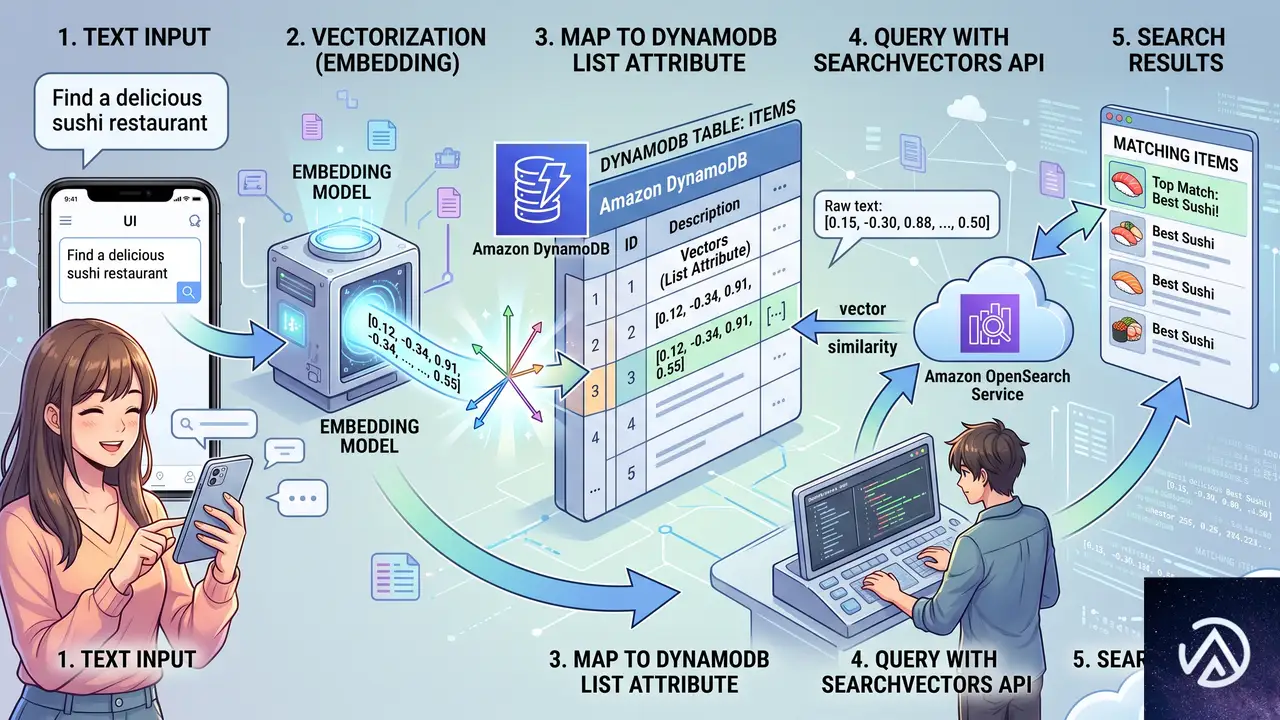
DynamoDBのベクトル検索は、既存のテーブルに新しいタイプのインデックスを追加する方式で実現する。ユーザーは任意の埋め込みモデル(Amazon Bedrock Titan Text Embeddings、Cohere Embed、OpenAIの埋め込みモデルなど)を使ってベクトルを生成し、標準のPutItemまたはUpdateItem APIでフロート値のリストとしてテーブルに格納する。その後、対象の属性に対してベクトルインデックスを作成し、次元数と距離関数、オプションのフィルタ属性を指定する。
List型でベクトルを格納検索時はSearchVectors APIを使い、クエリベクトルと返却件数(最大100件)、オプションのフィルタ条件を指定する。結果は類似度順にランキングされて返る。パーティションキーを指定すれば、特定の市場やテナントに対象を絞り込んだ検索も可能だ。インラインフィルタでは完全一致のみサポートしており、範囲条件(BETWEENなど)は利用できない。
距離関数は、コサイン類似度がテキスト埋め込みの意味比較に効果的だが、ユークリッド距離はベクトルの大きさが意味を持つ場合(購入数によるクラスタリングなど)に、ドット積は方向と大きさの両方を評価するレコメンデーションシステムに適する。埋め込みモデルを訓練した際の距離関数と合わせるのが精度を上げる基本になる。
既存テーブルへの追加手順

AWSの公式ブログでは、スポーツ用品のオンラインストアを例に、商品カタログテーブルへのベクトル検索の追加手順が紹介されている。すでにproductId、category、descriptionなどの属性を持つテーブルに、商品説明の埋め込みベクトルを追加していく流れだ。
まず、既存の商品説明テキストから埋め込みモデルを使ってベクトルを生成し、UpdateItem呼び出しでdescriptionEmbeddingという新しい属性として各アイテムに追加する。DynamoDBは既存のListデータ型をそのまま使い、スキーマ変更や新しいデータ型の追加は不要。各要素が埋め込みの1次元に対応するNumber型のリストとして格納される。
次に、DynamoDBコンソールでテーブルの「インデックス」タブを開き、「ベクトルインデックスの作成」を選択する。インデックス名、ベクトル属性(descriptionEmbedding)、次元数(埋め込みモデルに合わせる)、距離関数(ここではコサイン)、パーティションキー(例:marketplace)、インラインフィルタ属性(例:category)を設定する。パーティションキーはオプションだが、大規模データで高スループットを保つために推奨される。
インデックスがアクティブになったら、同じ埋め込みモデルで生成したクエリベクトルを使って検索を実行する。コンソールの「項目の探索」からベクトル検索モードに切り替え、インデックスとクエリベクトル、トップK、パーティションキー値、フィルタ条件を入力する。この例では「US」マーケットプレイスに絞り、カテゴリを「footwear」に限定して「軽量の夏用ランニングシューズ」といった自然言語に近いクエリで類似商品を取得できる。
返却される結果には、類似度スコアと共に商品名や価格などの運用属性が含まれる。コサイン距離とユークリッド距離ではスコアが小さいほど類似度が高く、0は同一ベクトルを示す。ドット積では大きい値が類似度の高さを示す。
想定されるユースケースと拡張性

ベクトル検索がDynamoDBに統合されたことで、セマンティック検索が必要な様々なアプリケーションを単一のデータベースで実現できる。たとえば、エージェントの過去の対話や記憶をベクトル化して素早く参照するエージェントメモリ、大規模言語モデルの回答精度を高めるRAG、ユーザーの行動履歴から類似商品を即座に提示するレコメンデーション、個人の好みに応じたコンテンツのパーソナライズ、過去のパターンとの類似性から異常を検出する監視システムなどが挙げられる。
また、4096次元までのベクトルに対応し、距離関数やフィルタの選択肢も実用的だ。マルチテナントアプリケーションでは、パーティションキーで検索範囲をテナント単位に区切れるため、全データをスキャンすることなく高いスループットを維持できる。あらゆる商用AWSリージョンおよびGovCloudリージョンで利用可能となっている。
この記事のポイント
- DynamoDBのネイティブ機能としてベクトル検索が一般提供開始された
- 運用データと同じテーブルに埋め込みを格納し、ミリ秒単位で類似検索が可能
- 専用ベクトルDBや同期パイプラインが不要になり、サーバーレスでスケールする
- 最大4096次元、コサイン・ユークリッド・ドット積の距離関数をサポート
- RAG、レコメンデーション、エージェントメモリ、異常検知など幅広い用途に対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験