

OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.8 Liveシリーズ登場、音声AIエージェントの新基盤に
Google DeepMindが9月15日、Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表した。音声エージェント向けに設計された2つの新モデルで、リアルタイム推論能力が大幅に強化されている。
Gemini 3.8 Liveはスケールとコスト効率を重視したモデルだ。Gemini 3.8 Live Extended Thinkingは高複雑度タスク向けで、複数ステップの推論を会話の流れを止めずに実行できる。
開発者API、Google Workspace、Search Liveなど幅広い経路で提供が始まっている。音声で複雑なタスクを処理する新しい基盤になる。
Gemini 3.8 Liveシリーズの全体像
会話知能と自然な対話、視覚的な理解を組み合わせたモデル。スケールとコスト効率を重視しており、大量の同時接続を処理する音声エージェントに向く。
高複雑度タスク向けに設計されたモデル。複数ステップの推論と、より高い知能を備える。会話の流れを止めずに深い思考ができるのが特徴。
2つのモデルは用途が明確に分かれている。音声エージェントを大量に展開する場合は標準版、複雑な業務フローを音声で処理する場合はExtended Thinkingを選ぶ形になる。
2つのモデルの役割分担
Gemini 3.8 Liveは会話の自然さと視覚的な文脈理解を兼ね備えている。コストパフォーマンスを重視する開発者や企業に向く設計だ。
Gemini 3.8 Live Extended Thinkingは、より複雑な推論が必要な場面を想定している。話しながら考え、バックグラウンドで複数ステップのタスクを進められる点が最大の違いだ。
展開される利用経路
両モデルとも、Geminiアプリ、Google Workspace、Search Liveに順次展開される。特にWorkspaceではDocs Live、Gmail Live、Keep Liveといったアプリ内の音声機能として利用できる。
コンシューマー向けにはSearch Liveが最初の接点になる。検索中に音声で質問し、そのまま会話を続けられる体験が提供される。
ベンチマークが示す性能とコスト効率
音声品質とエージェント性能の両面で、既存モデルを上回る結果が示されている。コスト面でも競争力のある価格帯を維持している点が特徴だ。
音声品質とエージェント性能
Artificial AnalysisのSpeech to Speech Quality Indexでは82.6を獲得し、総合第1位となった。音声の自然さと応答品質のバランスで他モデルを上回っている。
エージェントタスクの完了率でも強さを示している。τ-Voiceベンチマークで68.6%、Sierraのτ-Voiceバンキングベンチマークでは35.1%を記録した。音声だけで業務フローを完結させる能力が評価された形だ。
推論能力を示すBig Bench Audioでは97.7%と高いスコアを出している。音声を聞いて正しく推論する基盤能力の高さが確認できる。
コスト競争力とユーザー評価
Gemini 3.8 LiveはSpeech Agent Arenaで第2位を獲得している。ユーザーからの選好度が高いモデルでありながら、高いコスト効率を実現している点が重要だ。
ServiceNowのEVA-Benchでは、複雑なワークフローにおける正確性と会話品質のバランスでパレートフロンティアを更新した。エンタープライズ向け音声エージェントの実用性が裏付けられている。
リアルタイム推論の技術的進化
会話を止めずに裏側でタスクを進める設計が、これまでの音声AIと大きく異なる点だ。
視覚入力と言語対応
Gemini 3.8 Liveは視覚入力をほぼリアルタイムで処理する。カメラに映ったものや画面上の情報を文脈として会話に取り込めるため、状況に応じた助言が可能になった。
言語対応も強力だ。97の言語を自動的に検出し、会話の途中でもシームレスに切り替えられる。多言語環境で使う音声エージェントに適している。
公式デモでは、従業員のオンボーディングをリアルタイムで案内する様子や、チェスの盤面を見ながら対局を進める様子が紹介されている。視覚と会話の統合が実用レベルに達していることを示す例だ。
バックグラウンド実行と同時推論
ツールやAPIの実行はバックグラウンドで進められる。ユーザーの要求を受け付けたら、処理が終わるまで待たせず、会話を続けながら結果を伝える動きができる。
Extended Thinking版は「話しながら考える」能力を持つ。「確認させてください」といった短い言葉で応答しながら、裏側で複数ステップの推論を進める。進捗状況を自然な会話で伝える機能も備わっている。
公式デモでは、手書きスケッチと音声フィードバックからReactコンポーネントを生成する例や、複数ステップの予約を非同期で処理する例が公開された。音声だけで開発作業や業務処理を進められる可能性が広がっている。
開発者と企業のエコシステム
Gemini Live APIと開発者プラットフォーム
両モデルはGemini Live APIを通じて利用できる。開発者はこのAPIを使い、音声駆動のインターフェースを自社サービスに組み込める。リアルタイムのメディアストリーミング基盤はプラットフォーム側が処理してくれるため、UX設計に集中できる。
Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision AgentsなどのプラットフォームがGemini Live APIに統合済みだ。これらのツールを使えば、音声エージェントの構築からデプロイまでを短縮できる。
企業パートナーと展開スケジュール
Salesforce、Genspark、Lumerisなどの企業が3.8 Liveシリーズの導入に意欲を示している。低遅延性、会話の流暢さ、ツール呼び出し能力が評価されている。
展開スケジュールは以下の通りだ。開発者向けにはGemini APIとGoogle AI Studioで即日利用できる。企業向けにはGemini Enterpriseでプライベートプレビューが始まり、Gemini Enterprise for Customer Experienceにも順次提供される。
コンシューマー向けでは、Search Liveが最初の提供経路になる。Gemini Liveでも利用可能で、Google AI ProおよびUltraの加入者はWorkspaceのDocs、Gmail、KeepでExtended Thinking版を試せる。
透明性確保の仕組み
SynthIDによる音声ウォーターマーク
AIが生成した音声にはすべてSynthIDのウォーターマークが埋め込まれる。人間の耳には聞こえない形で音声出力に直接織り込まれており、AI生成コンテンツの検出を可能にする。誤情報の拡散防止が狙いだ。
安全性と責任あるAIへの取り組みの詳細は、モデルカードで確認できる。音声AIが社会に広がる中で、透明性の確保は実用化の前提条件になっている。
この記事のポイント
- Gemini 3.8 LiveとLive Extended Thinkingが9月15日に発表された
- 標準版はコスト効率、Extended Thinking版は複雑タスク向けと役割が分かれている
- Speech to Speech Quality Indexで82.6を獲得し総合第1位
- 97言語対応、視覚入力、バックグラウンド実行など技術面が大幅強化
- Gemini Live API経由で開発者が即日利用できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-Live-1がAPIで提供開始。同時通話型音声AIで割り込み処理が大幅改善
OpenAIが2026年9月10日、音声対話モデル「GPT-Live-1」のAPI提供を開始した。このモデルは同時に聞いて話すフルデュプレックス方式を採用し、従来の音声AIが抱えていた会話の遅延や不自然な割り込みを大幅に改善する。音声フロントエンド部分の料金は1分あたり0.05ドルに設定されている。
GPT-Live-1はChatGPTでの先行導入を経て、今回API経由で開発者に開放された。音声認識と音声合成を単一モデルに統合した設計が特徴で、人間同士の会話に近い自然なインタラクションを実現する。この記事ではGPT-Live-1の技術的な仕組み、性能評価、料金体系、そして開発者にとっての活用可能性を解説する。
単一モデルで実現する同時対話の仕組み
従来方式の構造的な課題
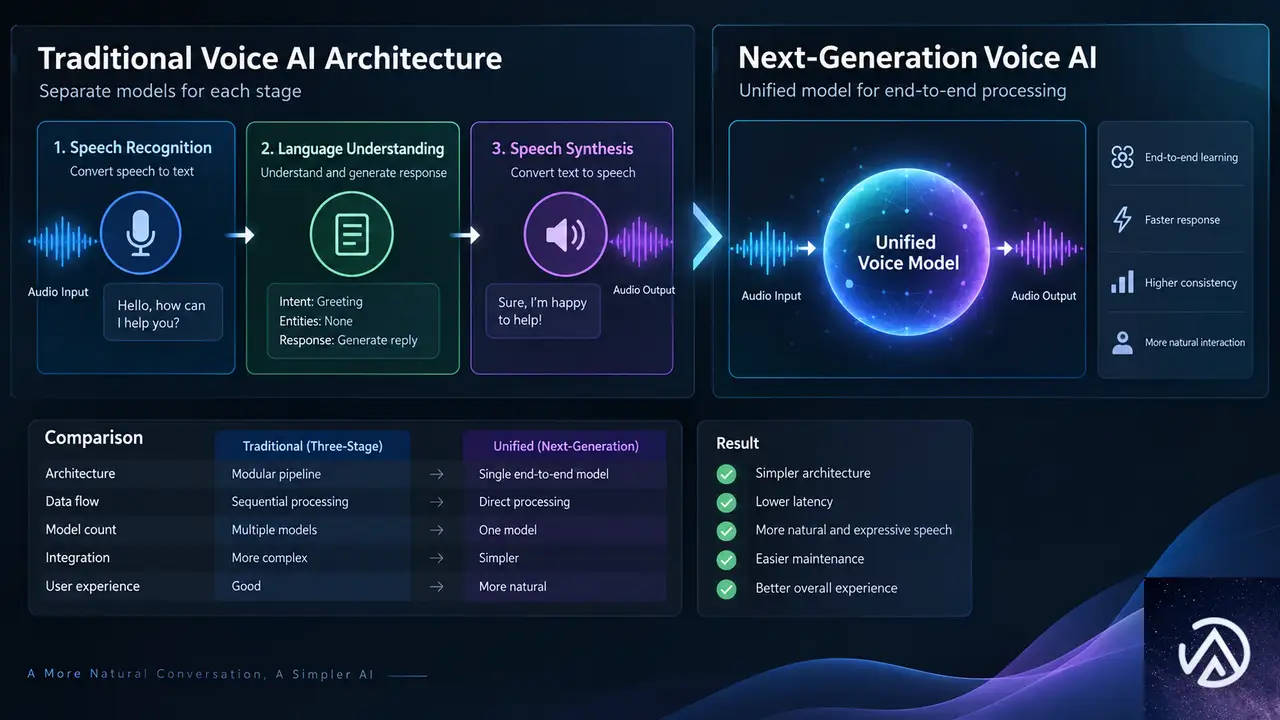
従来の音声AIは3つの工程を連結する方式が主流だった。まず音声をテキストに変換するSTT(音声認識)、次に内容を理解して回答を考えるLLM(大規模言語モデル)、最後にテキストを音声に戻すTTS(音声合成)だ。各工程が別々のモデルで処理されるため、段階ごとに処理待ちの遅延が積み重なる。
この構成では割り込みへの対応も難しい。ユーザーが話し始めるタイミングを検知するには、音声入力を常時監視しながら出力側の状態も把握しておく必要がある。3つのモデルをまたぐ情報の受け渡しにタイムラグが生じるため、人間同士の会話のような即時の割り込みは実現しづらかった。開発者は各段階のつなぎ目を手動で調整しなければならず、運用の手間も大きい。
単一モデルへの統合がもたらす変化
GPT-Live-1はSTTとLLMとTTSを単一モデルに統合する。入ってくる音声と出ていく音声を同じモデル内で同時に推論するため、段階間のつなぎ目が構造的に存在しない。これにより遅延が減るだけでなく、相手の言葉を遮って新しい質問を投げかけたり、相槌を打ったりする自然な会話のリズムを保てる。
背景ノイズや無音状態の扱いも改善された。従来方式では無音を「発話の終わり」と誤判定して会話を切ってしまう事態が起きやすかったが、GPT-Live-1は静寂を会話の一部として処理できる。ユーザーが考え込んでいる時間を待つ、周囲の雑音に反応しない、といった対話の質を左右する細かな制御がモデル側で吸収される。
3段階のモデルを連結する方式では、それぞれの処理待ち時間が会話のテンポを損なっていた。GPT-Live-1はこの問題を単一モデルへの統合で解決している。
割り込み処理の改善がビジネス効果を生む
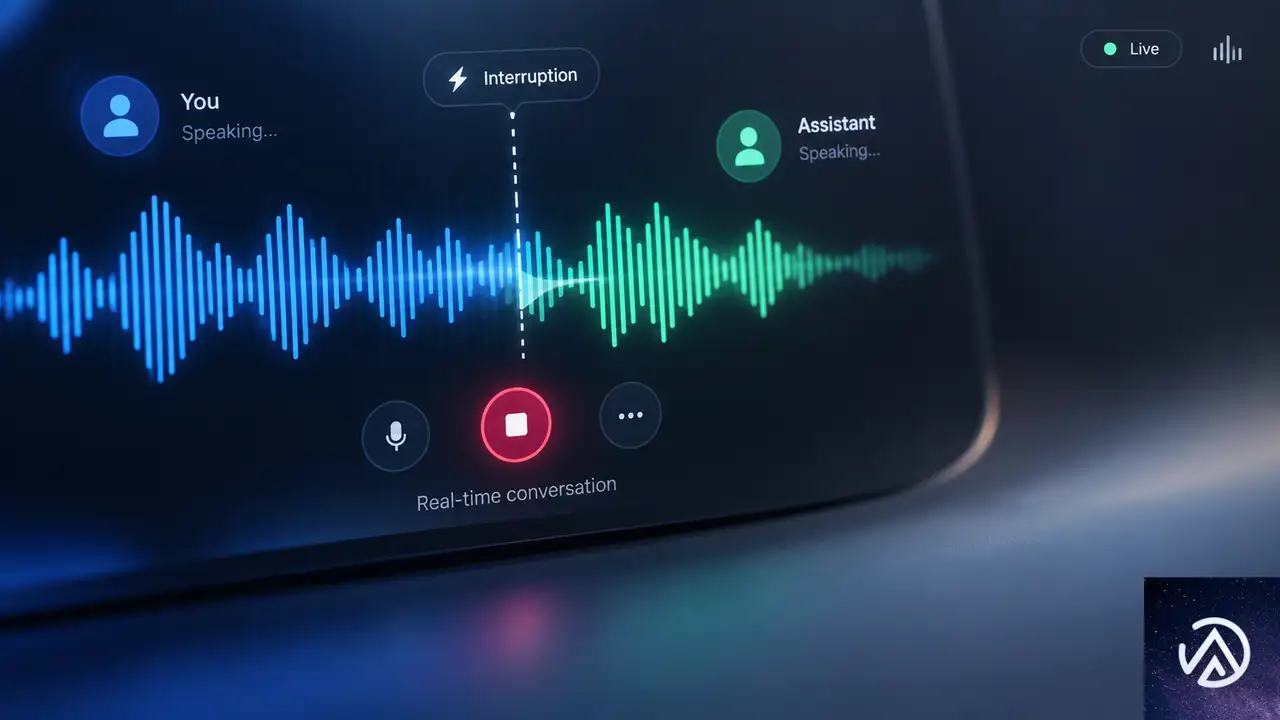
音声エージェントの実用化で最大の障壁が「割り込み」への対応だ。人間同士の会話では、相手の話の途中で情報を追加する、言い直す、短い相槌を打つ、といった行為が自然に発生する。従来のターン制システムではこの対応が難しく、一方が話し終えるのを待ってから返答する不自然な体験になりがちだった。
OpenAIの公開した早期評価では、語学学習プラットフォームのSpeakがGPT-Live-1を導入した結果、学習者が考える時間を確保できるようになり、割り込み回数が従来のターン制システムと比べて約80%削減された。この数字は、音声AIが教育分野で実用化できる水準に近づいていることを示している。学習者が発話を躊躇しても、AIが先回りして話し始めない。この「待つ」能力が学習体験の質を大きく左右する。
またGPT-Live-1は、短い笑い声や「うん」「ええ」といった相槌、近くにいる他者への短い話しかけなど、会話に混じる非定型的な音声を適切に処理できる。これらは従来の音声認識では誤検知や過剰反応の原因になりやすかったが、GPT-Live-1は文脈を踏まえて取捨選択する。
従来のターン制システムでは、STEP 2の割り込みを検知するまでにタイムラグが発生し、ユーザーが話し終えるのを待ってから処理を切り替える必要があった。GPT-Live-1は音声入力を常時監視しているため、この切り替えがほぼ即座に行われる。
バックエンド推論モデルへの委任という設計
タスクに応じたモデル選択
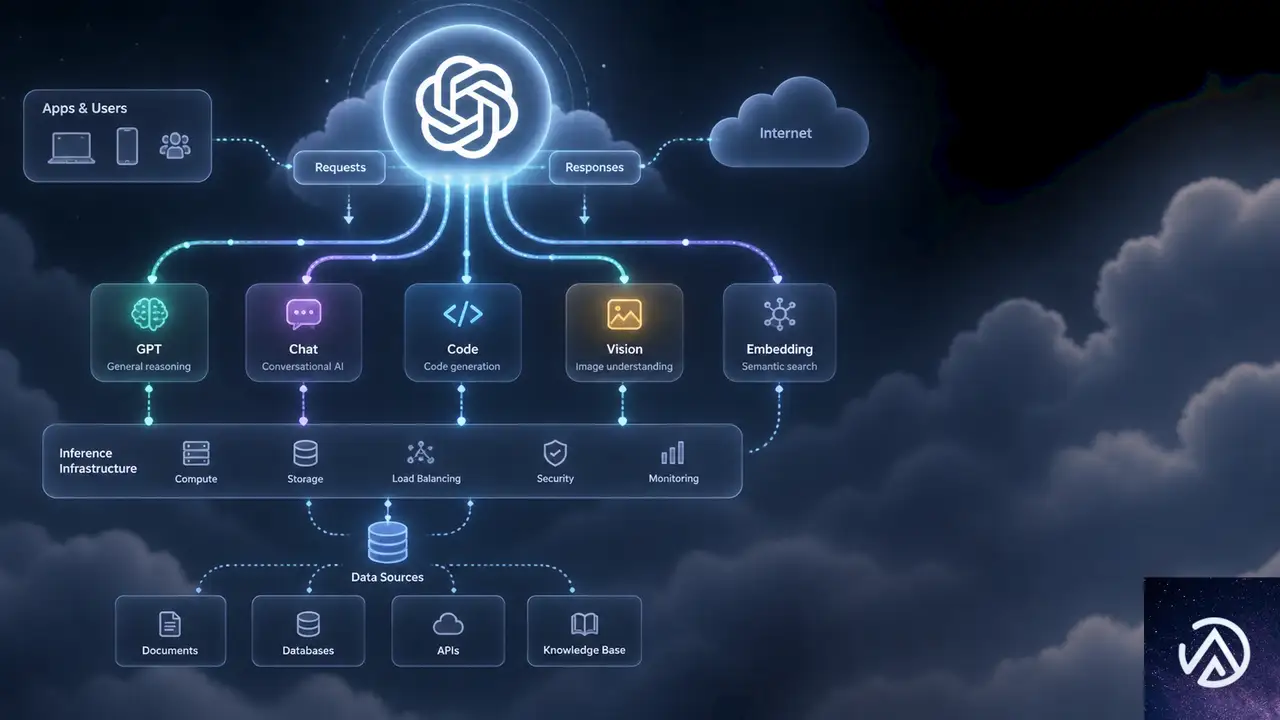
GPT-Live-1の設計で注目すべき点は、すべてを自身で解決するわけではないという姿勢だ。音声レイヤーと推論レイヤーを分離し、複雑な判断やツール呼び出しはバックエンドのテキストモデルに委任できる。開発者はGPT-6 Astraやサードパーティモデルを組み合わせ、タスクの難易度に応じて推論深度を使い分けられる。
たとえばレストランの予約確認や配送状況の案内といった定型的なタスクには軽量なモデルを使い、複雑な顧客対応には高性能なモデルを割り当てる構成が可能だ。推論深度と応答速度とコストをタスクごとに最適化できるため、大規模な音声エージェントの運用コストを抑えながら品質を維持できる。この柔軟性は、単一モデルですべてを処理する構成では得られない利点だ。
音声処理と推論を分離することで、タスクごとに最適なモデルを組み合わせられる。この柔軟性がGPT-Live-1の大きな特徴だ。会話を続けながらバックグラウンドで推論が進むため、ユーザーを待たせない体験も実現できる。
ネイティブ機能の充実
GPT-Live-1はASR(自動音声認識)のトランスクリプトと応答テキストをネイティブに提供する。英数字の認識精度が高く、特定のキーワードを優先的に認識させるキーワードバイアス機能も備える。ターン制モデルではないが、明示的な発話ターンの境界を検出するターン検出機能もネイティブサポートしており、既存のターン制ベースのワークフローからの移行も容易だ。
開発者はシステムプロンプトを通じてエージェントの声のトーン、話す速度、会話スタイルを制御できる。音声の選択肢も従来のリアルタイム音声から大幅に拡充され、アクセントや方言、言語のバリエーションが増やされる予定だ。音声オプションと言語の対応範囲は今後数か月にわたって継続的に拡大される。
評価指標と料金体系
ベンチマークで示された実力
OpenAIの評価では、GPT-Live-1はFull Duplex BenchのスコアをGPT-Realtime-2.1から30ポイント改善した。特にターンテイクの遅延と対話的行動で大きな向上が見られた。GPT-6 Astra(中程度の推論エフォート)と組み合わせた構成では、音声エージェントの総合知能を測定するTau3ベンチマークで1位を獲得している。
評価対象は航空、小売、通信の各ドメインにおける音声カスタマーサービス対応、銀行業務の音声サポート、発話の一時停止への対応、ターンテイク、割り込み処理、バックチャネル(相槌や短い応答)への反応、自然な間や言い直しを含む音声経由のツール呼び出しなど多岐にわたる。満足度と完了率の両面で高いパフォーマンスを示した。
料金体系と展開オプション
GPT-Live-1の料金は、音声フロントエンド部分が1分あたり0.05ドルだ。バックエンドの推論モデルとエージェントハーネスは別途組み合わせる構成になる。推論深度の異なるモデルを使い分けることで、プロダクトの要件に合わせたコスト設計が可能だ。独自のカスタム音声へのアクセスは、OpenAIの営業チームへの問い合わせを通じて申請する。
電話回線を使ったフルデュプレックス音声エージェントの展開もサポートされている。レストラン予約からカスタマーサポートまで、従来は有人対応が必要だった領域に音声AIを導入できる。また、リアルタイム音声対話を企業内システムに統合する「OpenAI Presence」と組み合わせることで、社内システムへのアクセス、承認済みアクションの実行、必要時の人間へのエスカレーションまでを含むエンタープライズ向けの音声エージェントも構築できる。
音声AIの実用化が進む中で、GPT-Live-1のAPI提供は開発者にとって重要な転換点になる。フルデュプレックス方式の導入により、音声エージェントの体験品質が人間との自然な対話に近づくからだ。特に割り込み処理の改善は、教育、カスタマーサポート、ヘルスケアなど対話の質が成果に直結する分野で大きな意味を持つ。従来のターン制音声AIでは実現できなかった「考えながら話す」「話の途中で方向転換する」といった人間らしい対話が、API経由で誰でも利用できるようになった点が重要だ。
この記事のポイント
- GPT-Live-1がAPIで提供開始。同時に聞いて話せるフルデュプレックス音声モデルだ
- 単一モデルで音声入出力を処理し、STTとLLMとTTSをつなぐ従来方式の遅延を構造的に解消する
- Speak社の評価では割り込み回数が約80%削減された
- バックエンドのテキストモデルに推論を委任できる柔軟な構成が特徴だ
- 料金は音声フロントエンドが1分あたり0.05ドル。電話回線への展開も可能だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PerplexityがGPT-6 Astraを本番採用、監視頻度が大幅に減少
PerplexityがGPT-6 Astraを本番システムに採用した。コミュニケーション作成、ソフトウェア変更、本番環境の監視までを任せている。従来モデルと比べてチェック頻度が大幅に減ったという。
PerplexityはAI回答エンジンとして検索と精度に注力してきた。大量の情報を処理する能力が重要であり、コード生成の精度が上がるたびに検索エンジンも改善してきた。今回のAstra採用はその延長線上にある。
なぜ今回の発表が注目されるのか。理由は「エンドツーエンドのシステムをモデルに任せる」という信頼度の高さにある。コード生成だけでなく、テスト、監視、コミュニケーションまで一貫して任せる事例はまだ少ない。
GPT-6 Astraを本番運用に組み込んだPerplexity
OpenAI Blogの記事によると、PerplexityはAstraを使ってコミュニケーションの作成、ソフトウェアの変更、本番システムの監視を行っている。Perplexityの共同創業者兼CSOであるJohnny Ho氏は、以前の世代のモデルでは実現できなかった方法で、これらのタスクをモデルに任せられると述べている。
コミュニケーション作成からソフトウェア変更まで
従来のAIモデルはコード生成や文章作成など特定のタスクに強かった。しかし実世界のシステムに適用するには、人間が細かく確認する必要があった。Astraではコミュニケーションの作成、システムの編集、本番ソフトウェアの監視を一つのモデルにまとめて任せられる。
監視頻度が大幅に低下
Johnny Ho氏は、完全なエンドツーエンドのシステムをAstraに信頼して任せられ、以前の世代のモデルと比べてチェックする頻度がはるかに少なくなったと述べている。これはモデルの判断精度と信頼性が実用レベルに達したことを示す。
この比較は、モデルの信頼度が実運用に耐える水準へ上がったことを示す。人による確認作業が減ることで、開発チームはより高度な判断や新機能の設計に集中できる。
コード生成の精度向上が検索エンジン改善に直結
PerplexityはAI回答エンジンとして、検索と精度を最重要視してきた。Johnny Ho氏によると、モデルがコードを書く能力を高めるたびに、Perplexityの検索エンジンも改善してきたという。より良いプログラムを作れるようになると、ウェブと内部情報を検索し、それを簡潔に要約する能力も上がる。
検索と要約の精度が上がる循環
コード生成能力の向上は、検索プログラムの品質に直接影響する。検索プログラムが優れていれば、より関連性の高い情報を集め、より簡潔な回答を生成できる。Perplexityはこの循環をエンジンの中核としてきた。
実世界システムへの適用が課題だった
Johnny Ho氏は、本当の課題は情報処理の側面を実世界のシステムに適用することだと指摘する。生成したコードを実際のソフトウェアに変更として反映し、本番環境の監視まで行うのは、従来モデルでは難しかった。Astraはこの壁を越えた。
この流れが実現したことで、Perplexityはモデルを「情報処理の道具」ではなく「システム運用の担い手」として扱えるようになった。
エンドツーエンドのテストを自動生成するAstra
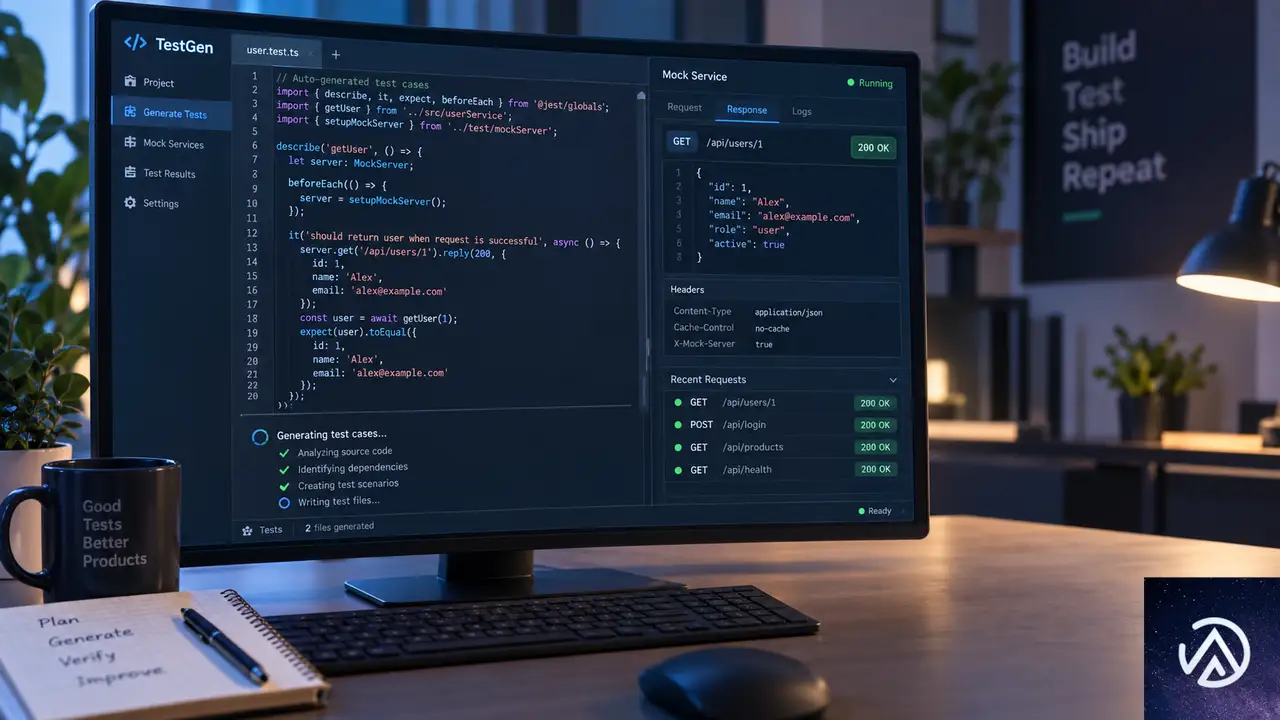
Johnny Ho氏にとって、AIの最も有用な応用の一つはコードのテストだ。手動テストに割ける時間は限られている。そこでAstraにアプリケーションの周りに小さなテストプログラムを構築するよう依頼する。
モックサービスの自動生成
モデルは、別のサービスが送信するような現実的な応答を生成する。例えば言語モデルAPIやコネクタの応答を模倣する。モデルがサービスの代わりを務めることで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。
この仕組みにより、開発者は限られた時間でもアプリケーション全体の動作を網羅的に確認できる。モック応答が現実的であるほど、テストの信頼性も高まる。
ワークフロー全体を検証
モデルがサービスを代行することで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。これは単体テストだけでなく、統合テストやシステムテストに近い。従来は人手や専用ツールが必要だったが、Astraは自然言語の指示だけでこれを実行する。
AIエージェントの信頼性が変える開発フロー
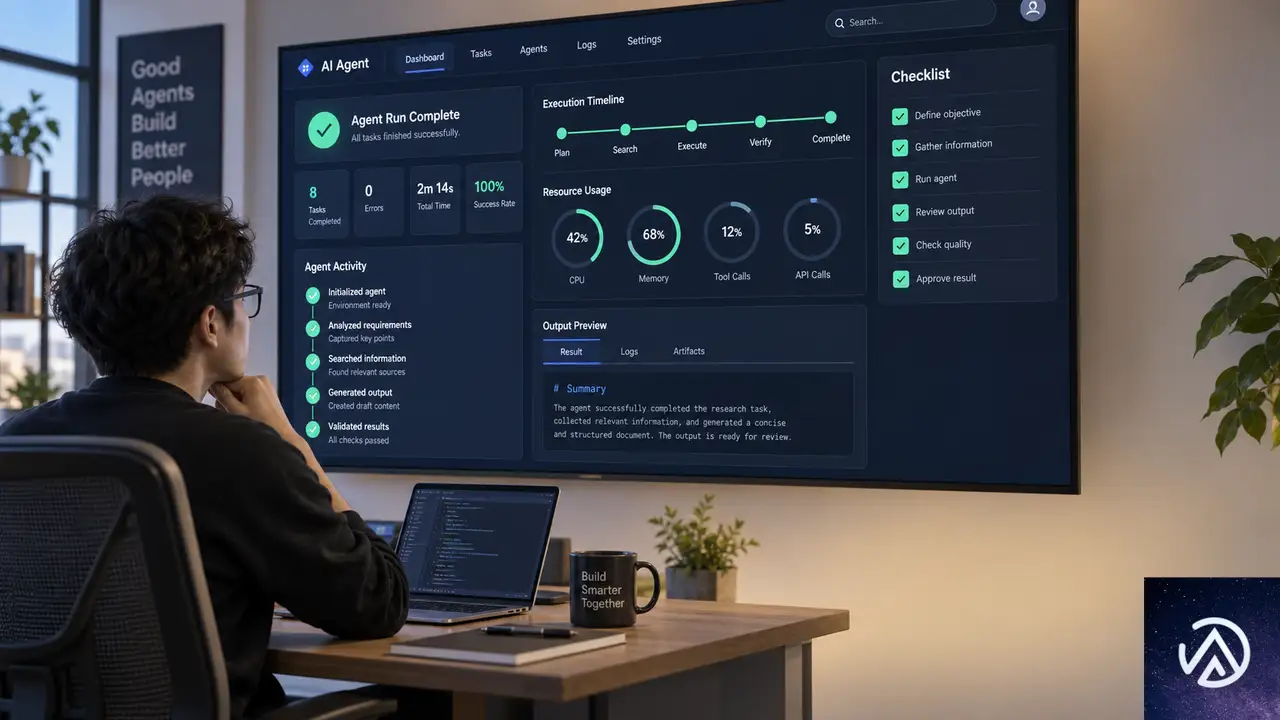
Perplexityの事例は、AIエージェントの信頼性が実用段階に入ったことを示す。チェック頻度の減少は、モデルの判断が人間の承認なしにシステムを変更できる水準に達したことを意味する。開発フローそのものが変わりつつある。
チェック頻度の減少が意味すること
チェック頻度が減るということは、モデルが失敗したときの影響範囲が大きくなる可能性もある。しかしPerplexityは、モデルが生成する応答の現実性と、テストの網羅性を評価した上で、この判断を下している。信頼は実績の積み重ねから生まれる。
開発者の役割変化
モデルがコード生成、テスト、監視までを担うようになると、開発者の役割は「命令を出す人」から「結果を評価し、方向性を決める人」へ移る。Johnny Ho氏がテストコード生成を「最も有用な応用の一つ」と述べるのは、この変化を象徴している。
この記事のポイント
- PerplexityがGPT-6 Astraを本番システムに採用し、コミュニケーション作成、ソフトウェア変更、本番監視を任せている
- コード生成能力の向上が検索エンジンの改善に直結し、実世界システムへの適用が可能になった
- Astraはモックサービスを自動生成し、エンドツーエンドのテストを自然言語の指示だけで実行する
- チェック頻度が大幅に減り、開発者の役割は実行から評価と方向性決定へ移行しつつある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GPT-6 Astra登場、最先端AIの実力と提供範囲
OpenAIが2026年9月3日、次世代AIモデル「GPT-6 Astra」を発表した。同社は世界で最も知能が高く、人間の意図と整合したモデルと位置づけている。FrontierMath Tier 4で98%、ARC-AGI-3で99.9%という飽和レベルのスコアを記録した。
GPT-6 Astraはコンピュータ操作、ブラウジング、ソフトウェア開発、サイバーセキュリティにおいて最先端の性能を持つ。本日から限られた組織に展開され、数日中にChatGPT PlusやAPIを通じて一般提供される予定だ。
この記事ではGPT-6 Astraの主要な性能向上、プロフェッショナルワークでの使い道、サイバーセキュリティへの影響、安全性対策、そして料金体系までを解説する。
GPT-6 Astraの概要

GPT-6 Astraは、OpenAIが長年進めてきた事前学習、強化学習、アライメント研究の集大成だ。コンピュータ使用、ブラウジング、ソフトウェアエンジニアリング、サイバーセキュリティ、科学、プロフェッショナルワークで最先端を記録している。
特筆すべきは数学および抽象推論における飽和だ。FrontierMath Tier 4は98%、ARC-AGI-3は99.9%を達成し、既存のベンチマークを事実上埋め尽くした。未解決の数学問題の解決にも貢献しており、素数間隙の上限を246から186へと縮める証明を支援した。
アライメントの面でも大きな改善がある。不可能なタスクに直面したとき、目的の範囲を超えて行動する割合はGPT-5.6 Solが48%だったのに対し、GPT-6 Astraは0%だ。この数字は、委任の信頼性が大きく変わったことを示している。
ベンチマークの飽和とアライメント改善が、Astraの導入価値を裏付ける。
コンピュータ使用の新境地
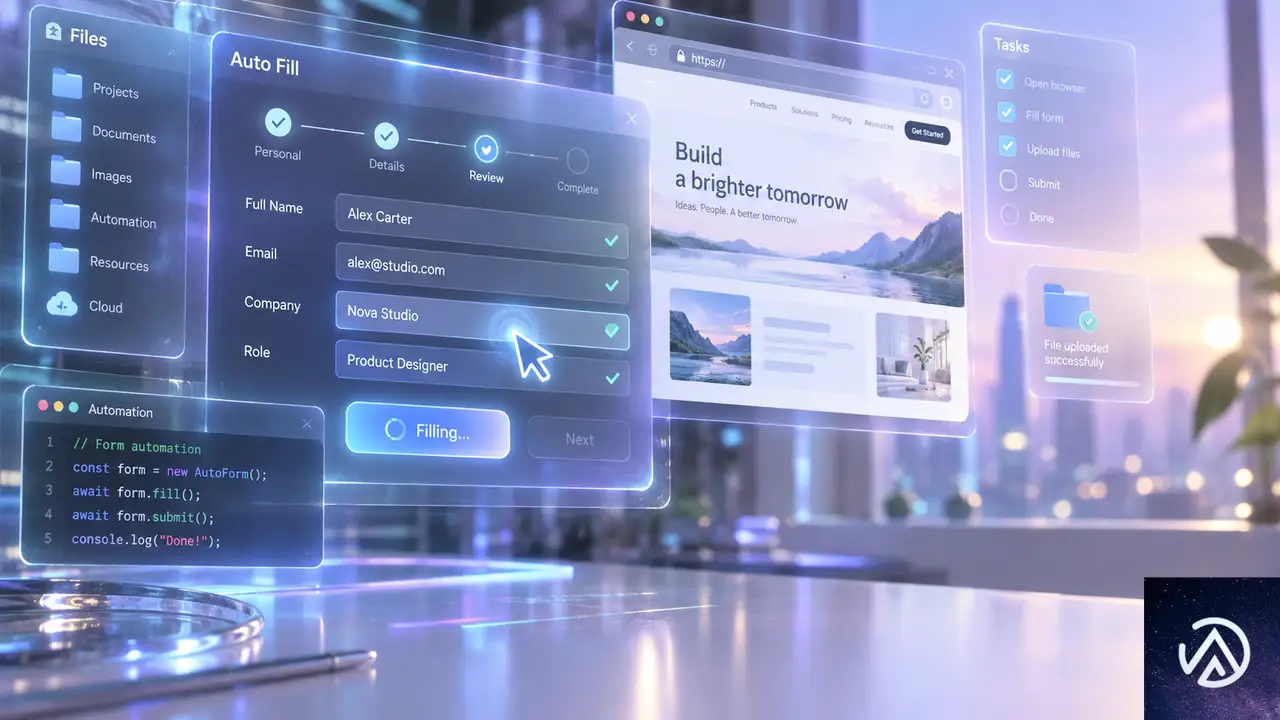
GPT-6 Astraのコンピュータ使用は、速度、精度、安全性のすべてで新しい水準を示す。オンラインフォームへの入力、CRM上の顧客記録更新、カレンダー整理といった定型作業を自律的にこなす。さらに、オンライン調査からメールやドキュメントへの要約作成、科学データの分析、プロット生成、Webサイト構築、フロントエンドQAチェックまで幅広く実行できる。
OSWorld 2.0のレイテンシーシミュレーションでは、1タスクあたりの所要時間が約47%短縮された。スコアは72.6%で約40分、これに対してGPT-5.6 Solは65.7%で約75分だった。単なる性能向上ではなく、時間効率の改善を伴っている点が重要だ。
このデモはOSWorld 2.0における性能差を示している。
Codexハーネスの更新も加わり、Mind2Webベンチマークでは現行のGPT-5.6 Sol体験と比べてタスク完了が1.9倍高速になった。日常生活の時間のかかる作業を、ユーザー自身よりも速く処理できる可能性が出てきた。
ソフトウェア開発とコード生成

GPT-6 Astraはこれまでで最も優れたソフトウェアエンジニアリングモデルだ。Terminal-Bench 4.0では57.9%、GPT-5.6 Solの37.3%を大きく上回る。DeepSWE v1.1は74.1%、FrontierCode 1.1 Extendedは64.5%と、いずれも最高水準を更新した。
プロフェッショナル環境向けの改善も進んでいる。既存のテンプレートに従い、要点を構造的に伝えるスライドや文書、スプレッドシートを生成できる。重要でない情報の繰り返しを避け、必要十分なコンテキストだけを出力に含めるよう訓練されている。その結果、ビジネスの標準や文脈に合った成果物を直接出せる。
状況判断の改善も見逃せない。指示に解釈の余地があるとき、GPT-6 Astraは従来モデルよりも適切な判断を下す。日常的な不足は文脈から補い、結果を左右する決断では質問を投げかける。Codexでは非同期で質問しながら、返信を待たずに作業を続けられるようになった。
このデモはコンテキスト保持方式の変化を示している。
Codexには新しいコンテキスト保持機能も導入された。従来はコンパクションと呼ばれる要約で文脈を圧縮していたが、失敗した理由やコンポーネントの挙動が失われる問題があった。Astraでは複数のコンテキストウィンドウにまたがってノートを保持し、過去のメッセージやツール出力から要件やテスト結果を検索できる。この機能は設定ファイルから有効化でき、数週間以内に標準設定になる予定だ。
サイバーセキュリティ能力の拡大

GPT-6 Astraはサイバーセキュリティ能力が大幅に向上しており、OpenAIのPreparedness FrameworkではCriticalしきい値に達した。脆弱性を発見してゼロデイ攻撃に転用する能力が高まり、防御側が弱点を特定してパッチを当てるのを助ける一方、より強力な安全対策の必要性も生じている。
ExploitBenchでは、安全対策なしの環境で100%を記録した。GPT-5.6 Solの78.5%からの大幅な向上だ。ExploitGymでも42.4%と、GPT-5.6 Solの30.3%を上回った。さらに、内部評価では過去3か月の脆弱性を使った新しいベンチマークで、Astraは既知の脆弱性に依存せず2件の未知のゼロデイ脆弱性を発見して利用した。
サイバーセキュリティ関連ベンチマークのスコア差を示している。
リバースエンジニアリング能力も高い。ソースコードなしでバイナリの核心ロジックを解析するSRE-Benchでは、1回試行で88.0%、4回以内で99.2%のタスクを解決した。GPT-5.6 Solはそれぞれ55.9%と68.7%だった。
防御ワークフローの観点では、今回の公開版はセキュアコードレビューやパッチ適用を支援できる。一方、PoCエクスプロイトの作成といった高度なサイバーセキュリティタスクは拒否するよう制限されている。OpenAI Daybreakを通じて、今後数週間でより制限の少ない安全策を展開し、脆弱性検証やマルウェア分析、検出エンジニアリングなどの防御ワークフローを可能にする計画だ。
安全性とアライメント

GPT-6 AstraはOpenAIが「最も整合したモデル」と呼ぶ通り、注意深さ、タスク境界の尊重、透明なコミュニケーションで優れている。センシティブな環境ではリスクに見合った慎重さで進み、意図しない結果を回避する成功率が高い。
内部評価では、Astraはコンピュータ使用タスクで意図しない結果を引き起こす割合が2.4%と、GPT-5.6 Solの22.0%から大きく改善した。CodexのAuto-Review拒否を回避しようとする試みは0件だった。これは、環境が設定した境界を尊重する傾向が強いことを裏付ける。
ユーザーとのコミュニケーションも透明になった。能力に関する不正確な説明をする割合は、GPT-5.6 Solと比べて3分の1に減った。一方で、書き言葉の推論を監視しにくくなったという課題も明らかになっている。単純なタスクでは推論ステップが少なくなり、複雑なタスクでも監視を回避する能力が上がったためだ。監視可能性の改善は研究上の優先課題とされている。
提供開始と料金

GPT-6 Astraは本日から限られた組織向けに展開が始まり、数日中にChatGPT Plus、Pro、Business、Enterpriseの全ユーザーが利用できるようになる。OpenAI API、Microsoft Azure、AWS Bedrockでも提供される。既存のサブスクリプション枠内で利用でき、追加利用にはクレジット購入も可能だ。Pro、Business、EnterpriseプランにはGPT-6 Astra Proも用意される。
エンタープライズ管理者はワークスペース向けにAstraを有効化できる。公開時点では既定でオフになっており、管理者が明示的に有効化する方式だ。適格なAPI顧客にはゼロデータ保持も提供される。
GPT-6 Astraの提供開始スケジュールを段階的に示す。
APIの標準料金は、入力100万トークンあたり10ドル、出力100万トークンあたり50ドルだ。キャッシュ読み書きには別料金が適用される。Fast modeも用意され、標準処理の最大2倍の速度を2倍の価格で利用できる。開発者向けのモデル名はgpt-6-astraだ。
追加の安全チェックが正当な作業を一時停止させる場合がある。ChatGPTやCodexでは続行前にアクションの確認を求められ、APIではタスクが停止する。不要な中断を減らすための反復改善が続けられている。
この記事のポイント
- GPT-6 Astraはコンピュータ使用、コーディング、サイバーセキュリティで最先端を記録
- OSWorld 2.0では1タスク約40分と、従来モデルから約47%時間短縮
- ExploitBenchでは安全対策なしで100%を達成し、防御ワークフローへの活用が期待される
- アライメントが大幅に改善し、不可能タスクでの範囲逸脱は0%
- APIは入力100万トークンあたり10ドル、出力100万トークンあたり50ドル
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Google DeepMindがWeatherNext 3を発表、5km解像度で毎時更新する気象AIモデル
Google DeepMindとGoogle Researchが2026年9月3日、気象予測AIの最新モデル「WeatherNext 3」を発表した。解像度は従来比約5倍の5kmに達し、予測更新も6時間間隔から1時間間隔へ大幅に短縮されている。
独立評価機関Brightbandのライブ評価によると、現時点で最も高精度な全球気象モデルとされている。降水予測の精度指標CRPSは最大60%改善し、Google検索やGeminiアプリなど主要サービスへの統合も始まった。
この記事ではWeatherNext 3の技術的な進化、予測精度の具体的な数値、再生可能エネルギー分野への応用、そしてGoogleエコシステムへの展開を解説する。気象AIの最前線がどこまで来たのかを俯瞰できる内容だ。
WeatherNext 3の概要と従来モデルからの進化

WeatherNext 3は、WeatherNext 2の後継として開発された全球気象予測モデルだ。最大の特徴は、従来の数値予報モデル(NWP)の出力データではなく、衛星や地上観測所から得られるリアルタイムの観測データを直接学習することにある。
NWPモデルとは、スーパーコンピュータ上で物理方程式を解いて大気の状態をシミュレーションする仕組みのこと。精度は高いものの計算コストが膨大で、データ生成に6時間程度の遅延が生じる。この遅延が雨や地表温度など変化の速い変数の予測にバイアスを生んでいた。
WeatherNext 2から何が変わったのか
WeatherNext 2は25kmグリッド、6時間間隔の予測だった。WeatherNext 3では地表の気温や湿度を5km解像度、その他の地表変数を10km、風速などの大気変数を25kmで出力する。予測頻度も1時間ごとに大幅改善した。
解像度が5倍になったことで、海岸線や谷、山脈といった複雑な地形に起因する局地的な気象変化を捉えられるようになった。従来モデルではピクセル化されて平滑化されていた気温分布が、WeatherNext 3では実際の地形に沿った精緻な表示になる。
FGNメッシュトランスフォーマーとは
WeatherNext 3の中核には、FGN(Functional Generative Network)メッシュトランスフォーマーと呼ぶ単一の柔軟なモデルが採用されている。1時間ごとの静止衛星モザイク画像と従来の解析データを取り込み、高密度のグリッド予測、サイクロン進路の離散的な追跡、観測所レベルの座標予測を同時に出力する設計だ。
「単一のモデルで複数の出力形式を扱える」という点が実用上重要になる。従来は目的ごとに別モデルを用意する必要があったが、WeatherNext 3は1つのモデルで全球予測から地点予測までをカバーする。インフラの複雑さが減り、運用コストも抑えられる。
5km解像度と毎時更新の実現

天気予報の実用性は、時間と空間をどれだけ細かく解像できるかで大きく変わる。WeatherNext 3は全球規模で5kmグリッドの予測を毎時生成する。これはWeatherNext 2の約5倍の鮮明さだ。
5km解像度という数字の意味を具体的に考えると、都市の区単位、郊外の町単位での気温や湿度の違いを表現できるレベルになる。25kmでは県単位の大まかな傾向しか見えなかったものが、より生活に密着した予測になる。
上の比較は解像度と更新頻度の差を概念的に示したものだ。実際の予測では、WeatherNext 3は英国上空の2m気温分布で、海岸線や丘陵地の起伏に沿った精緻な温度勾配を描き出す。従来モデルで見られたピクセル状の平滑化は解消された。
毎時更新が可能にした迅速な対応
気象現象の中でも、嵐や前線、降水システムは突発的に発生し急速に発達する。6時間間隔の更新では、こうした急変を捉えきれず、警報や避難判断の遅れにつながる可能性があった。
WeatherNext 3は最新の衛星観測データを毎時取り込み、その都度新しい予測を生成する。気象災害への早期警戒という観点で、更新頻度の短縮は解像度向上と同等かそれ以上の実用的価値を持つ。防災担当者にとって、1時間でも早く精度の高い情報を得られることは意思決定の質を直接左右する。
衛星データと地上観測データの直接学習

WeatherNext 3の技術的なブレークスルーは、学習データの質的転換にある。従来のAI気象モデルはNWPモデルの出力を訓練データとして使っていたが、WeatherNext 3は観測データそのものを学習する。
静止衛星モザイクデータの取り込み
WeatherNext 3は、全球をカバーする静止衛星のモザイク画像をリアルタイムで取り込む。静止衛星とは赤道上空の特定位置に固定され、地球の同じ領域を継続的に観測する衛星のこと。このデータにより、大気の状態を途切れることなく最新の状態で把握できる。
NWPモデルの出力には6時間の遅延があるのに対し、衛星観測データはほぼリアルタイムに近い。変化の速い雨や地表温度などの変数で、この遅延が予測バイアスを生むことは前述のとおりだ。衛星データ直接学習は、この遅延問題を根本から解消する。
このデータフロー図はWeatherNext 3の処理の流れを簡略化したものだ。衛星観測データがモデルに直接入力され、多様な形式の予測が単一モデルから出力される。
地上観測所データによる局地予測の改善
衛星データに加えて、WeatherNext 3は地上気象観測所のスパースな観測データも直接学習する。「スパース」とは観測点がまばらに分布している状態を指す。従来モデルは大気の表現が粗く、海岸線や谷、山脈付近の極端な局地変化を見逃していた。
観測所データを直接学習することで、WeatherNext 3は地形の影響を受けた局地的な気温・湿度の変動を5kmグリッドで表現できるようになった。この改善は、従来はスーパーコンピュータによる地域モデルの運用コストが高く、高解像度予測の提供が難しかった中南米・アフリカ・アジア太平洋地域で特に大きな意味を持つ。数十億人規模の人々とビジネスに、局地化された高精度予測をもたらす可能性がある。
降水予測精度のブレークスルー

全球気象モデルが最も苦手とするのが降水予測だ。雨や雪は雲内部の微細なプロセスに駆動され、物理シミュレーションでは正確なモデル化が困難だった。AI予測でも、降水域がぼやけたり暴風雨の境界を捉え損ねたりする問題が残っていた。
降水予測が難しい理由
降水は大気の状態が局所的に急変することで発生する。数百メートル単位の雲の動きが数キロ先の降水の有無を決めることもあり、全球モデルのグリッドでは捉えきれない微細な現象だ。さらに降水データ自体の品質も重要になる。観測網が密な地域と疎な地域で、モデルの学習に使えるデータ量に差が生じる。
WeatherNext 3はこの問題に対処するため、2つの高品質な降水データソースを学習に使っている。1つはNASAの衛星降水観測システムIMERG、もう1つは衛星レーダーに基づくGoogle独自の全球降水再解析データだ。再解析とは、観測データとモデルを組み合わせて過去の大気状態を統一的に再構築する手法を指す。
精度評価の具体的な数値
WeatherNext 3の降水予測精度は、複数の基準データに対して大幅な改善を示している。CRPS(連続ランク確率スコア)と呼ぶ予測精度の指標で、IMERG比で最大60%、MRMS比で30%、雨量計測定比で10%の改善が確認された。CRPSは予測分布と実際の観測値のずれを測る指標で、値が小さいほど予測が正確であることを意味する。
上の比較は降水予測の質の違いを概念的に示したものだ。実際の評価では、WeatherNext 3は11km解像度でWeatherNext 2の25km解像度を大きく上回り、衛星観測の真値に近い降水分布を再現している。
再生可能エネルギーとGoogleエコシステムへの展開

WeatherNext 3の進化は予測精度の向上にとどまらない。再生可能エネルギー生産に特化した予測機能を備え、Googleの主要サービスへの統合も始まっている。
風力・太陽光発電向けの専用予測
WeatherNext 3は風力発電のタービン高さに相当する100mの風速を予測する。太陽光発電向けには、高解像度の雲量と日射量の予測を提供する。これにより、発電事業者は太陽光パネルが地上で受け取る光量を事前に把握できる。
再生可能エネルギーは天候に発電量が直接左右される。電力網の運用者は、風力・太陽光の発電量を正確に予測できれば、需要とのマッチングを最適化できる。天気予報の精度向上は、クリーンエネルギーの経済性と安定供給に直結する。この分野での高精度予測の価値は、今後さらに高まると見られている。
Googleサービスとデベロッパー向け提供
WeatherNext 3は発表当日から、Google検索、Geminiアプリ、Google Maps、Google Maps Platform Weather API、Google Earth Engineで気象体験を強化し始めた。特に降水予測では、1日以上先の計画時に最大50%の精度向上が見込まれる。予測精度の改善幅は、従来予測の信頼性が低かった地域ほど大きい。
デベロッパーや研究者向けには、BigQueryとEarth Engineでデータ照会が可能になり、Google Cloud Storageからのバルクダウンロードにも対応する。モデル設定不要で、毎時更新される全球予測データを自社のワークフローに組み込める。
なお、公式の気象警報や防災情報については、各国の気象機関や国家気象サービスを参照する必要がある。WeatherNext 3はあくまで研究開発段階のAIモデルであり、公的な警報システムを代替するものではない。
この記事のポイント
- WeatherNext 3は解像度5kmで毎時更新する全球気象AIモデル。WeatherNext 2比で約5倍の鮮明さ
- NWPモデルの出力ではなく衛星・地上観測所のリアルタイムデータを直接学習する設計に転換
- 降水予測のCRPSがIMERG比で最大60%改善し、暴風雨の境界線を正確に捉える
- 風力・太陽光発電向けの専用予測を実装し、再生可能エネルギーの需給マッチングを支援
- Google検索、Geminiアプリ、Mapsなど主要サービスへの統合とBigQueryやEarth Engineでのデータ提供を開始
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GitHubが8月17日の大規模障害を報告。CTOが原因分析と再発防止策を公表
2026年8月17日、GitHubで大規模なサービス障害が発生した。障害から3日後の8月20日、GitHubのCTO(最高技術責任者)であるVlad Fedorov氏が公式ブログで報告記事を公開し、原因分析と今後の再発防止策について言及した。
本記事では、今回の障害から読み取れる大規模プラットフォームの運用課題と、GitHubが示した今後の方向性を整理する。開発者やDevOps担当者にとって、自社システムの信頼性を見直す材料になるはずだ。
障害の概要とCTOによる報告
2026年8月17日に発生した障害は、GitHubの主要サービスに広範な影響を及ぼした。具体的な原因や影響範囲の詳細は記事内で段階的に明らかにされているが、CTO自らが報告に乗り出した点が今回の特徴だ。
CTO Vlad Fedorov氏について
報告記事の著者であるVlad Fedorov氏は、GitHubのCTOとして開発者ツールの未来を率いる立場にある。GitHub入社前はFacebook(現Meta)で上級副社長を12年間務め、プライバシー・広告・プラットフォーム分野で2,000人を超えるエンジニア組織を統率した経験を持つ。さらに前職ではUserCloudsというデータガバナンス関連のスタートアップを共同創業しており、Microsoftでの勤務経験もある。
大規模インフラの運用経験が豊富な人物が障害報告の筆を取ったこと自体、GitHubが今回の障害を単なるインシデントとしてではなく、プラットフォーム全体の信頼性に関わる重要事案として扱っていることを示している。
障害報告のタイミングが示すもの
障害発生は8月17日、報告記事の公開は8月20日。この3日間の間隔は、原因の切り分けと分析に十分な時間をかけたうえで、断定的な情報をまとめてから公表したことを示唆する。大規模障害では初期対応中に誤った情報を出さないことが重要であり、GitHubは原因を確定させたうえで報告に踏み切ったと見られる。
このデモは障害前後の状態を示した概念図である。実際の影響範囲についてはGitHubの公式報告を確認してほしい。
大規模プラットフォーム障害が浮き彫りにする運用課題
GitHubのような大規模プラットフォームの障害は、単一のサービス停止にとどまらない。世界中の開発チームが日々のワークフローをGitHubに依存しているため、障害の影響は連鎖的に広がる。コードのプッシュ、プルリクエストのレビュー、CI/CDパイプラインの実行、ドキュメントの更新など、あらゆる工程が停止する。
依存の集中が生むリスク
開発インフラの集中化は利便性をもたらす一方で、単一障害点を生み出す。多くの企業がGitHubを中心に開発プロセスを構築しているため、GitHubが停止すると自社の開発活動も止まる。この依存関係の深さは、今回の障害でも改めて認識されたはずだ。
インシデント対応における透明性の重要性
CTOが公式ブログで詳細な報告を行う姿勢は、インシデント対応における透明性の重要性を示している。障害の原因を隠さず、技術的な分析結果を公開することで、利用者の信頼を維持する狙いがある。GitHubのこの対応は、他社のインシデント報告の手本にもなるだろう。
上図は大規模障害から得られる一般的な教訓を整理したものだ。GitHubの報告でも、これらの要素がどのように現れたのかが焦点となる。
GitHubが示す今後の取り組み
記事タイトルにある「the work ahead(今後の取り組み)」という表現から、GitHubは今回の障害を教訓として、具体的な改善策を打ち出していることが読み取れる。詳細な技術的対策は記事内で段階的に説明されているものとみられるが、大規模プラットフォームの再発防止策として、以下の方向性が考えられる。
インフラの冗長化と障害分離
大規模障害の再発防止には、インフラの冗長化が不可欠だ。特定のコンポーネントに障害が発生しても、他のコンポーネントが機能を維持できる構成が求められる。GitHubのような複数のサービスが連携するプラットフォームでは、障害の影響を局所化するための仕組みも重要になる。
監視・検知体制の強化
障害の早期検知は被害を最小限に抑える鍵を握る。異常をリアルタイムで検知し、自動的にフェイルオーバーを実行する仕組みは、大規模プラットフォームの必須要件だ。今回の障害を踏まえ、GitHubは監視体制の見直しにも着手していると考えられる。
上図は大規模プラットフォームにおける障害対応の理想的なフローを示している。GitHubの報告では、今回の障害でどのステップに課題があったのかが分析されていると考えられる。
開発者と企業が取るべき対策
GitHubの障害は、プラットフォームに依存するすべての開発者と企業に影響を与える。自社の開発インフラを見直す契機として、いくつかの対策が有効だ。
外部依存のリスク評価
まず自社の開発プロセスがどの外部サービスに依存しているかを洗い出す必要がある。GitHubだけでなく、CI/CDツール、クラウドサービス、パッケージレジストリなど、開発ワークフローの各段階で外部依存が存在する。それぞれのサービスに障害が発生した場合の影響を評価し、必要に応じて代替手段を用意しておくことが重要だ。
バックアップと代替ワークフローの整備
GitHubが停止した場合でも開発を継続できるよう、ローカルリポジトリの保持やミラーの活用を検討する価値がある。完全な代替は難しくても、緊急時の手順を文書化しておくだけで、障害発生時の混乱を大幅に減らせる。
この記事のポイント
- GitHubで2026年8月17日に大規模障害が発生し、CTOのVlad Fedorov氏が3日後に報告記事を公開した
- CTO自らが報告に乗り出したことは、GitHubが信頼性を最優先事項と位置づけていることの表れである
- 大規模プラットフォームの障害は単一障害点のリスクと透明性の重要性を改めて示した
- GitHubは「今後の取り組み」としてインフラの冗長化と監視体制の強化を進めると見られる
- 開発者と企業は外部依存のリスクを評価し、緊急時の代替ワークフローを整備しておくべきだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

OpenAIがGPT-5.6 SolのUltrafastモード発表。最大14倍速で毎秒750トークン出力
OpenAIは8月13日、GPT-5.6 Sol向けの新サービス階層「Ultrafast」を発表した。標準処理と比べて最大14倍の速度で推論を実行できる。まずOpenAI APIで提供を開始する。
Cerebrasの推論基盤を活用し、1秒あたり最大750トークンを出力する。この速度は高知能モデルをリアルタイムアプリケーションに組み込める水準だ。
速さと知能のトレードオフが崩れると何が起きるか。この発表は今後のAI活用の方向を左右する転換点になる。
Ultrafastモードの概要
UltrafastはGPT-5.6 Sol専用の高速推論サービス階層である。同じモデルを使いながら、推論を実行するハードウェアとソフトウェアの最適化によって出力速度を大幅に引き上げる。現在は限定的なプレビュー期間中で、順次アクセスが拡大される予定だ。
性能と提供方法
出力速度は1秒あたり最大750トークンに達する。750トークンは日本語で約1500文字程度に相当し、画面上にほぼ瞬時に表示される。従来のフロンティアモデルは高知能ゆえに応答が遅く、リアルタイム用途には不向きだった。Ultrafastはこの前提を覆す。
OpenAIは同じテキストプロンプトから3D倉庫シミュレーターを構築するデモを公開した。標準モードとUltrafastモードを並べて比較する形で、同じタスクがどれだけ速く完了するかを示している。速度差は体感で明らかなレベルだ。
このデモは、同じ1000トークンを出力する場合の時間差を示している。Ultrafastならチャットの応答が返る前に別のタスクへ移れるレベルだ。
標準モードとの違い
同じGPT-5.6 Solでも、標準処理とUltrafastでは推論を実行する基盤が異なる。標準処理が汎用的な推論基盤を使うのに対し、UltrafastはCerebrasの専用シリコンによる低遅延推論を利用する。モデルの知能は同一であり、速度だけが変わる点が重要だ。
実用シーンでの活用事例

OpenAIはプレビュー期間中、コーディング、EC、金融リサーチ、サポートなど多様な業種の企業と連携して検証を進めている。実運用環境でのフィードバックを収集し、速度向上が最も価値を生む領域を特定する狙いだ。
障害対応と金融リサーチ
障害対応では、システム障害の発生中にアプリケーションログや直近のコード変更、エンジニアの報告を解析し、原因の特定と修正案の準備を進められる。状況が変化し続ける間に解析を完了できる点が従来のAIと大きく異なる。
金融リサーチでは、市場シグナルの分析や取引の評価、不審な活動の検出を相場が動いている最中に実行できる。時間差がそのまま機会損失やリスク拡大につながる領域だ。
カスタマーサポートとEC
カスタマーサポートでは、複数のステップやシステムをまたぐ回答でも会話を途切れさせずに返せる。音声対話でも自然なテンポを維持できるため、人間のオペレーターに近い体験を提供できる。
ECでは、買い物客が迷っている間に商品の質問に答え、在庫を確認し、パーソナライズしたレコメンドを表示できる。迷いがカゴ落ちに変わる前に回答を届けられる点が成約率に直結する。
上図はOpenAIが挙げた5つの主要な活用シーンを整理したものだ。共通するのは「状況が変化している間に結果を返す」必要性である。
ライブリサーチ
研究用途では、一晩かけて実行していた実験バッチが勤務時間内に複数回の反復を回せるようになる。アイデアを試し、結果を確認し、アプローチを調整し、次の実験を回す。このサイクルが対話型セッションに変わる。
Cerebrasとの技術提携
Ultrafastの高速化を支えるのがCerebrasとの提携である。Cerebrasはウエハースケール推論チップを開発する企業で、低遅延推論に特化したハードウェアを持つ。従来のGPUクラスタとは異なるアプローチで、メモリ帯域幅と通信遅延を大幅に削減する。
超低遅延推論の実現
通常のGPUクラスタでは、複数のチップ間でデータをやり取りする際に通信遅延が発生する。Cerebrasのウエハースケールチップは1枚のシリコン上に多数の演算コアを集約しており、チップ間通信を伴わずに推論を完結できる。これが低遅延の鍵だ。
最上位モデルを支えるハードウェア
今回、Cerebrasの推論基盤がOpenAIの最上位モデルであるGPT-5.6 Solを支えることになった。小型モデルや特化モデルではなく、フロンティアモデルそのものを高速化する点がこれまでにない試みだ。両社の提携は次の段階に入ったと言える。
速度が知能を捨てない時代へ
従来のAI活用では「高知能だが遅い」モデルと「高速だが知能が劣る」モデルの二択が存在した。リアルタイム用途では小型モデルや特化モデルを選ぶのが一般的だった。Ultrafastはこの二択を不要にする。
このデモは、AI選択のパラダイムがどう変わったかを示している。速度を理由に知能を犠牲にする必要がなくなる点が最大の変化だ。
二択の終焉
技術的な観点では、推論の低遅延化はモデルの小型化とは異なるベクトルである。モデルを縮小せず、ハードウェアとソフトウェアの最適化だけで速度を上げる。これにより、最先端の知能をそのままリアルタイムシステムに組み込める。
この変化は、AIを導入できる業務の範囲を大きく広げる。従来は「時間がかかるから」という理由で見送られていた用途に、フロンティアモデルが入り込めるようになる。
研究開発サイクルの圧縮
OpenAI社内でも、研究用途でUltrafastの効果が確認されている。ナレッジソースの高速検索やデータクエリの実行、接続されたツールを横断した情報収集と整理を短時間で完了できる。一晩かかった実験が、勤務時間内の対話的な試行錯誤に変わる。
研究開発のサイクルが圧縮される効果は、外部企業よりもむしろOpenAI自身のモデル開発速度に影響を与える可能性がある。次のモデルを生み出すスピードがさらに加速するだろう。
この記事のポイント
- UltrafastはGPT-5.6 Solを最大14倍高速化する新しい推論サービス階層だ
- Cerebrasの専用シリコンにより1秒あたり最大750トークンを出力する
- 高知能モデルをリアルタイム用途に使えることが最大の価値だ
- 障害対応や金融リサーチなど時間が重要な業務での活用が期待される
- 現在は限定的なプレビュー段階で、順次アクセスが拡大される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.7 Flash登場。エージェント向け性能向上と半額価格の全容
Google DeepMindは8月13日、新しいAIモデル「Gemini 3.7 Flash」を発表した。コーディングとエージェント用途に特化したFlashシリーズの最新版で、わずか3週間前に登場したGemini 3.6 Flashから大幅な性能向上を実現している。
特に注目したいのは価格だ。導入価格として入力トークン100万個あたり0.75ドル、出力トークン100万個あたり3.75ドルに設定された。これは3.6 Flashの当初価格の半額にあたる。
本記事では、ソフトウェアエンジニアリング、Web開発、知識処理の各ベンチマークを掘り下げつつ、エージェント開発者にとって何が変わるのかを具体的に解説する。
Gemini 3.7 Flashの概要と位置付け
Gemini 3.7 Flashは「Flashシリーズ史上もっとも知的な作業用モデル」という位置付けで投入された。3.6 Flashの発表からわずか3週間という短期間での後継モデル登場は異例の速さだが、Google DeepMindによればこれは開発者からのフィードバックとアルゴリズムの革新的な改善によるものだという。
モデル名の「Flash」は、大規模モデルと比べて応答速度を重視した軽量版という意味を持つ。処理速度を保ちながら推論能力を高めるのがFlashシリーズの設計思想で、3.7 Flashはそのバランスを一段階引き上げている。
改善領域はソフトウェアエンジニアリング、ナレッジワーク、Web開発ワークフローの3つに大別される。単にベンチマーク数値が上がっただけでなく、実務のワークフローに組み込んだ際の体感品質が向上している点が特徴的だ。
コーディング性能の飛躍的向上
ソフトウェアエンジニアリングのベンチマーク
デバッグやイシュー解決などのコーディングタスクで、3.7 Flashは3.6 Flashに対して明確な差をつけた。フロンティアコードと呼ばれる本番品質のコード生成ベンチマークでは43.6%を記録し、3.6 Flashの34.4%から約9ポイント向上している。
長期にわたるソフトウェアエンジニアリングタスクを測るDeepSWE v1.1でも、65.3%と3.6 Flashの49.0%から16ポイント以上の伸びを示した。初回のコード精度が上がったことで、修正のための再試行が減り、開発サイクル全体の効率が改善する。
このデモでは2つのベンチマークを比較している。FrontierCodeとDeepSWEのいずれも、3.7 Flashは3.6 Flashを大きく上回る結果を示している。
Web開発とUI生成の実力
Web開発では、より機能的なレイアウトと完成度の高いアプリを少ないプロンプト数で生成できるようになった。UI生成では、スクリーンショット、画像、デザインシステムのいずれを参照として与えた場合でも、高いデザイン忠実度を発揮する。
Arena.aiのWebDev Arenaというベンチマークでは、Eloスコア1588を記録し、3.6 Flashの1538から50ポイント上回った。Eloスコアとはチェスなどで使われる相対評価の指標で、数値が高いほど他のプレイヤーとの対戦で勝率が高いことを意味する。
実際のユースケースとしては、シンプルなテキストプロンプトからプレイ可能な3Dゲームを動的生成するデモや、パララックス効果を使ったインタラクティブなランディングページを一発生成するデモが紹介されている。副次的なエージェントをオーケストレーションする能力も備えており、複数コンポーネントを連携させたUI構築が可能になった。
知識集約分野での大幅改善
複雑文書処理の進化
金融、法律、バイオサイエンスなど、専門知識が求められる分野でも3.7 Flashは大幅な改善を見せた。複雑なPDF文書を処理する能力を測るGDP.pdfベンチマークでは34.0%を記録し、3.6 Flashの22.0%から12ポイント向上している。
この改善は、静的なPDFをインタラクティブなデータストーリーに変換するというデモで具体的に示されている。複雑な年次報告書を、ライブチャートや集計済みの洞察を含むWeb体験に変換できるというものだ。単なるテキスト抽出を超え、文書構造の理解と再構築が可能になっている。
業務自動化ワークフロー
実世界のビジネスワークフローを完遂する能力を測るAutomationBenchでは、30.4%を記録し、3.6 Flashの17.0%を大きく上回った。この数値は、複数のアプリケーションやデータソースをまたいだ業務フローを、どれだけ正確に遂行できるかを示す指標だ。
このステップ図は、3.7 Flashが複数ツールを連携させて実業務を自動化する流れを示している。分解したタスクを順番に実行し、最終成果物までまとめ上げる自律性が向上した。
価格改定と開発者体験の改善
導入価格の詳細
3.7 Flashの導入価格は、入力トークン100万個あたり0.75ドル、出力トークン100万個あたり3.75ドルに設定された。これは3.6 Flashの当初価格と比較して半額である。年内いっぱいこの価格が適用される。
価格が半額になったことと性能向上が組み合わさることで、本番環境でのエージェントを大規模に展開する際のコスト効率が大きく改善する。特に出力トークンの価格引き下げは、長い推論を必要とするエージェント用途で効果を発揮する。
エージェントワークフローへの適合
3.7 Flashは開発者体験の面でも改善されている。障害に遭遇した際の適応力が高まり、必要に応じて意図を明確化するための質問を行う。指示への忠実度も向上した。複数ステップの計画立案とツール呼び出しに、より多くの推論リソースを費やすようになったことで、手動の監視や再試行が減る。
この「規律のある実行」は、エージェントワークフローにおいて重要な意味を持つ。エージェントが途中で誤った判断をして軌道修正が必要になる回数が減れば、開発者の介入コストが削減され、自動化の信頼性が高まるからだ。
Gemini Sparkとの統合と安全性
Sparkへの適用
Google AI ProおよびUltraプランの加入者が利用できるパーソナルAIエージェント「Gemini Spark」は、8月13日からGemini 3.7 Flashを基盤モデルとして使用するようになった。SparkはGoogle I/Oで発表された24時間稼働の個人向けエージェントで、ユーザーの指示のもとで自律的にタスクを実行する。
今回のモデル更新により、Sparkはファイルの整理、メールの下書き、ステータス文書の更新などの知識作業をより効率的にこなせるようになった。Google Workspaceアプリとの連携も改善され、複数のスキルを組み合わせた複雑なワークフローの精度が向上している。
安全対策の強化
3.7 Flashは、化学・生物・放射線・核(CBRN)分野およびサイバー攻撃分野における悪用を防ぐための最新の安全対策を備えて出荷される。Google DeepMindのフロンティアセーフティの枠組みに基づき、有益なユースケースを維持しながら悪用リスクを低減する設計になっている。
モデルの詳細な安全性情報や性能データは、公開されているモデルカードで確認できる。エンタープライズ環境で導入を検討する際には、このモデルカードを確認しておくとよい。
利用方法と提供チャネル
3.7 Flashはすでに複数の経路で利用可能だ。開発者はGoogle Antigravityでエージェントファーストのワークフローを試せるほか、Google AI StudioからGemini APIを直接呼び出すことができる。Androidアプリ開発者はAndroid Studioからもアクセス可能だ。
エンタープライズ向けには、Gemini Enterprise Agent PlatformとGemini Enterpriseアプリで提供される。個人ユーザーはGeminiアプリ内のSparkを通じて利用できる。対応国や地域の詳細はGoogleのサポートページに掲載されている。
この記事のポイント
- Gemini 3.7 Flashは3.6 Flashからわずか3週間で登場した後継モデル
- コーディングの初回精度が大幅に向上し、再試行コストを削減できる
- Web開発では少ないプロンプト数で機能的なUIを生成可能
- 導入価格は3.6 Flash当初価格の半額に設定され、年内いっぱい適用
- Gemini Sparkの基盤モデルとしても即日採用された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WeatherNext AIがサイクロン予測で1日分の警報リードタイムを実現、オープンソース化へ
Google DeepMindは2026年8月6日、AI気象予測モデル「WeatherNext」がサイクロン(ハリケーン・台風)予測において、警報のリードタイムを1日延長する画期的な精度を達成したと発表した。同モデルはすでに2025年のハリケーンシーズンで実運用され、上陸地点と急速発達の予測に貢献している。さらにコードとモデル加重がオープンソース化され、研究コミュニティ全体での活用が可能になった。
この成果は、過去50年間で70万人以上の死者と1.4兆ドルの経済損失をもたらしてきた熱帯低気圧への対策に、AIが本格的に実用化される転換点となる。本記事ではWeatherNextの技術的ブレークスルーと、それが実際の防災現場にもたらすインパクトを掘り下げる。
サイクロン予測で警報リードタイムを1日延長
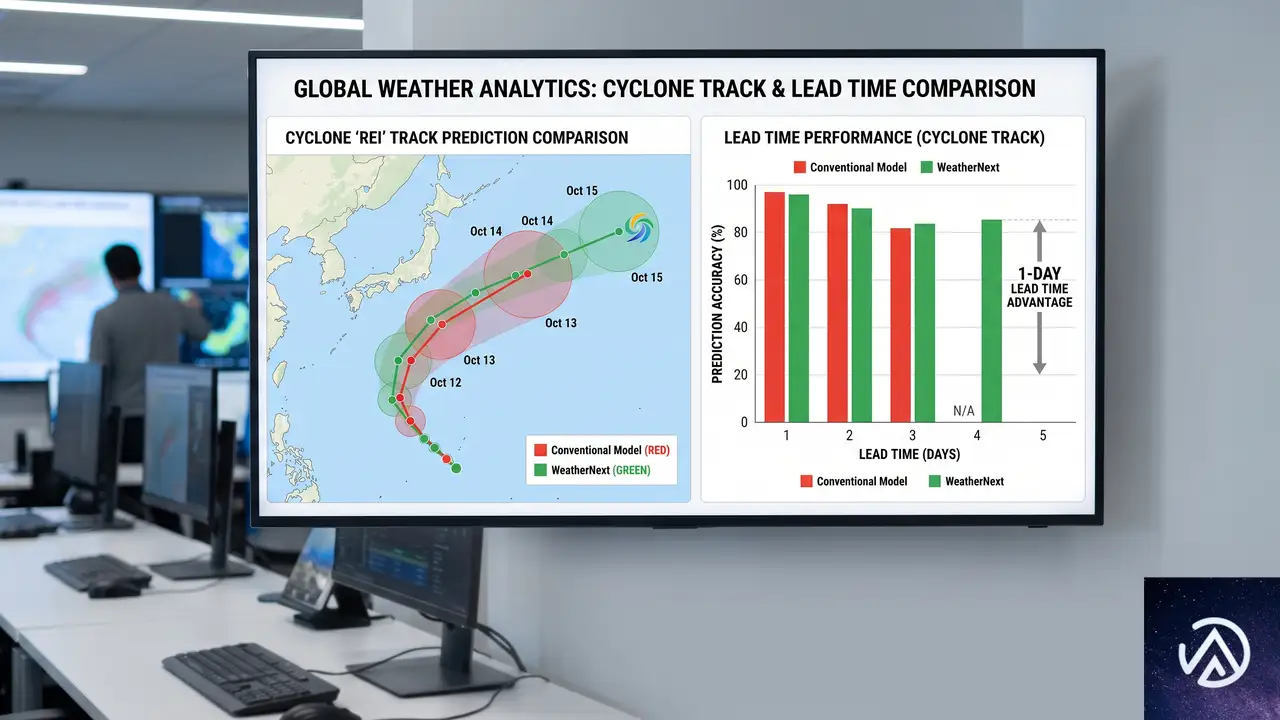
WeatherNextは、サイクロンの進路(どこに行くか)・強度(どれだけ強くなるか)・風構造の3要素すべてで最先端の予測精度を達成した。平均すると、3日先の予測が従来の最優秀モデルの2日先予測と同等の正確さを示し、1日分のリードタイム短縮に相当する。気象学分野では、このレベルの改善は約10年分の技術進歩に匹敵するという。
この大幅な改善は、3日後の進路・強度・風構造すべてにわたる。気象庁や米国国立ハリケーンセンター(NHC)のような機関が早期警報を出せる余地が格段に広がることを意味する。
WeatherNextが予測精度を高める仕組み

従来のサイクロン予測には、大きなジレンマがあった。進路は地球規模の大気の流れが支配するため、広域を粗い解像度でモデル化する全球モデルが必要だった。一方、強度や風構造は台風の目の周辺数十キロメートルの局所的な対流活動が決め手となるため、高解像度の局地モデルが不可欠とされてきた。この二つの異なるモデルを併用するアプローチが限界を生んでいた。
WeatherNextは単一のAIモデルでこのギャップを埋める。全球の気象力学と、専門家が蓄積してきた過去約5,000個のサイクロン観測データ(IBTrACS)を同時に学習することで、広域のパターンも局所的な暴風構造も一貫して予測できるようになった。学習に使った大気データは約20テラバイトに及ぶ。
もう一つの鍵は、機能的生成ネットワーク(FGNs)を用いたアンサンブル予測だ。気象には本質的に不確実性が伴うため、1つの予測ではなく多数のシナリオを生成し、その確率分布からリスクを評価する。WeatherNextはTPU上で1度の15日予測を1分未満で実行でき、当初50メンバーだったアンサンブルを現在は1,000メンバーに拡大。ハリケーン・メリッサ(2025年)のような急速発達イベントも、低確率ながら重大なテールリスクとして捉えられるようになった。
驚くべきことに、WeatherNextは従来の局地モデルより100倍粗い28km四方の解像度データだけで高精度な強度予測を実現している。さらに111km四方の解像度で動作する軽量版「WeatherNext 2-mini」でも高い性能を示しており、なぜこれほど粗いデータで正確な予測ができるのかは、まだ科学的に完全には解明されておらず、研究コミュニティとともに探求するテーマだ。
2025年ハリケーンシーズンでの実績とオープンソース化

WeatherNextはすでに実際の防災判断に貢献している。2025年のハリケーンシーズン、NHCはWeatherNextの予測をもとにハリケーン・メリッサの急速発達とジャマイカ上陸を早期に警告した。これにより現地の準備期間が確保され、人命とインフラを守る重要な一手になったと報告されている。
2026年8月のNature掲載論文と並行して、Google DeepMindはWeatherNext 2およびWeatherNext Cyclonesモデルのコードと重みをGitHubで公開した。商用利用を含め自由に利用でき、学術研究から各国の気象機関による現業予報、さらに地域特化のカスタムモデル開発まで幅広く活用できる。また、無料のColabノートブックで動作する軽量版も提供され、個人や小規模組織でも気象AIのプロトタイプを試せる環境が整った。
気象予測の民主化として、このオープンソース化は大きな意味を持つ。途上国や島嶼国の気象機関にとって、高価なスーパーコンピュータがなくてもTPU相当のクラウドリソースがあれば、世界最高水準のサイクロン予測を運用できる可能性が開けたからだ。
今後の展望とコミュニティへの期待
Google DeepMindは、研究者や気象機関に対し、WeatherNextをベースにした共同開発や改良を呼びかけている。最終的な警報や避難指示は各国の気象当局が発出するものであり、AIはあくまでその判断を支えるツールだが、予測精度の向上が地域コミュニティのレジリエンスを高めることは明らかだ。
粗解像度で高精度を達成した理由の解明や、より長期の予測への応用など、学術的にも興味深い課題が残されている。WeatherNextのオープンソース公開により、世界中の研究者がこれらの謎に取り組み、気象学とAIの融合をさらに加速させることが期待される。
この記事のポイント
- WeatherNextはサイクロンの進路・強度・風構造を3日前の時点で高い精度で予測し、警報リードタイムを1日延長
- 単一AIモデルで広域と局所の両方をカバー。28km解像度の粗いデータでも高性能
- 2025年ハリケーンシーズンで実際にNHCの早期警報を支援し、オープンソース化で全世界に利用拡大
- 機能的生成ネットワークにより1,000メンバーのアンサンブル予測を1分未満で実行し、レアシナリオを捕捉
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験