

AWS CloudWatch Omniが登場。AIとチームで行う新しい可観測性
AWSがCloudWatch Omniを発表した。アプリケーションとAIエージェントの両方を監視できる新しい可観測性体験で、チーム全体が同じワークスペースで調査を進められる。
OpenTelemetryベースで構築されており、既存のCloudWatchテレメトリをそのまま活用できる。AWSマネジメントコンソールへのアクセス権限がなくても、専用URLとSSOで利用可能だ。
この記事では、CloudWatch Omniの主要機能、AI調査の仕組み、セットアップ手順、既存環境との関係を解説する。運用チームが抱えるダッシュボード管理や障害調査の負担をどう軽減するかが焦点だ。
CloudWatch Omniとは何か
アプリケーション中心の可観測性
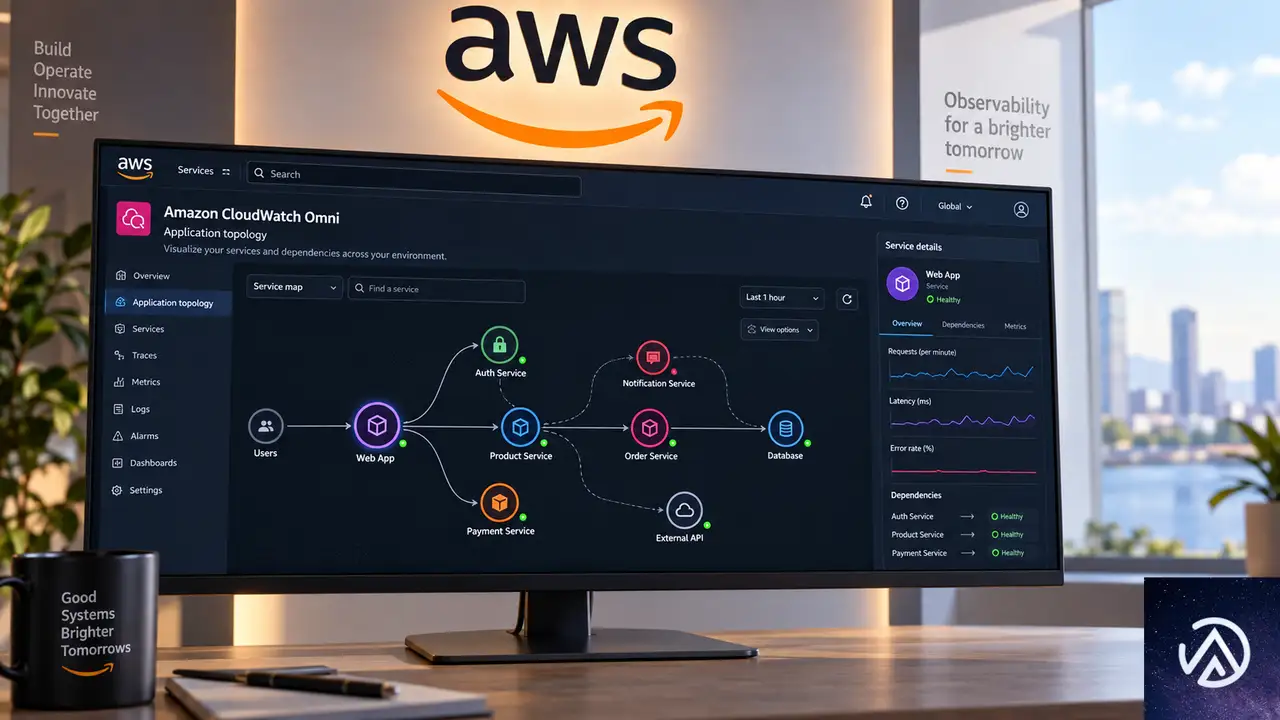
CloudWatch Omniは、インフラストラクチャ単位ではなく、アプリケーション単位でテレメトリを整理する。従来のモニタリングツールはサーバーやコンテナといったリソースごとに指標を表示するが、Omniはサービス同士の依存関係を自動的にマッピングし、システム全体をひとつの接続された構造として見せる。
このアプローチにより、担当者は「どのサーバーでエラーが出たか」ではなく「どのアプリケーションで問題が起きているか」を即座に把握できる。ダッシュボードを手動で更新する手間も減る。
この比較デモは、リソース中心からアプリ中心への考え方の転換を示している。Omniは自動検出とトポロジーマッピングにより、運用者が全体像を維持する負担を軽減する。
OpenTelemetryとの統合
CloudWatch OmniはOpenTelemetryを基盤としている。OpenTelemetryは、メトリクス・ログ・トレースなどのテレメトリデータを収集するためのオープン標準だ。すでにCloudWatchに送信しているテレメトリは、再設定なしでOmniに表示される。
さらに、OpenTelemetryで計装された他のワークロードも、OTLP(OpenTelemetry Protocol)エンドポイントを通じてOmniに取り込める。これにより、オンプレミス環境や別のクラウドで稼働するアプリケーションも同じワークスペースで監視できる。
チーム全体で使える共同作業の仕組み
CloudWatch Omniの大きな特徴は、チーム全員が同じワークスペースを共有できる点にある。エンジニアは専用URLにアクセスし、企業のSSO(シングルサインオン)でログインする。AWSマネジメントコンソールへのアクセス権限は不要だ。
IAM Identity Centerを通じてOktaやAzure ADなどのIDプロバイダーと連携できる。SRE、開発者、データベースエンジニア、マネージャーが同じデータと調査コンテキストを共有する。
このフローは、通常のインシデント対応時にOmniがどのように進行するかを示している。チーム間の引き継ぎ時にコンテキストが失われる問題が解消される。
エスカレーション時の連携強化
障害がチームの境界を越えると、Slackのスレッドやスクリーンショットでの情報共有になりがちだ。Omniでは次の担当者が同じセッションに参加し、これまでの調査内容をそのまま引き継げる。
調査履歴は自動的に記録されるため、インシデントレポートを別途作成する必要もない。
AIが調査を支援するAmazon DevOps Agent
CloudWatch Omniには、Amazon DevOps Agentと呼ばれるAIアシスタントが組み込まれている。調査セッションの中で、シグナルの相関分析や次のアクションの提案を行う。
このエージェントは、エンジニアが見ているのと同じテレメトリデータを参照する。そのため、提案内容はアプリケーションの実際の状態に基づいたものになる。
DevOps Agentは、相関イベントの特定や依存関係グラフを通じた根本原因の追跡を支援する。調査履歴は事後レビューにも活用できる。
エージェントの役割と限界
DevOps Agentはあくまで支援ツールであり、人間の判断を代替するものではない。提案内容をそのまま鵜呑みにするのではなく、エンジニアの専門知識と組み合わせて使うことが重要だ。
また、エージェントはテレメトリデータのみに基づいており、コードのビジネスロジックや組織固有の事情までは考慮しない。この点は運用チームが補完する必要がある。
セットアップ手順
CloudWatch Omniのセットアップは数分で完了する。既存のCloudWatch環境を再設定する必要はない。
既存CloudWatchユーザーの場合
CloudWatchコンソールで「Try CloudWatch Omni」をクリックするだけで、既存のログ、メトリクス、トレース、アラームが即座に利用可能になる。ワークロードは自動的に検出され、アプリケーショントポロジーをすぐに確認できる。
組織全体への展開
管理者はドメインを設定し、IAM Identity Center経由でIDプロバイダーを接続する。その後、チームと環境ごとにSpaceを定義し、ユーザーを招待する。各Spaceは既存のCloudWatchデータを参照するため、データの移動は不要だ。
他環境のアプリケーション取り込み
オンプレミスや他クラウドで稼働するアプリケーションも、コネクターを利用してテレメトリをOmniに取り込める。取得したデータはAWSデータと同じSpaceや調査セッションに表示される。
既存のCloudWatchとの関係と料金
CloudWatch OmniはCloudWatchを置き換えるものではなく、拡張するものだ。既存のアラーム、ダッシュボード、API、コンソールのワークフローはそのまま機能する。
アクセスは専用のWebアプリケーション経由で、エンタープライズSSOに対応する。セットアップ後、DevOps AgentはすべてのOmni調査セッションでデフォルトで有効になる。
料金体系
料金の詳細はAWSの公式価格ページで確認できる。既存のCloudWatchユーザーはコンソールから直接試用できる。
導入コストの見積もりには、監視対象のワークロード数と取り込むテレメトリ量が影響する。
生成AIワークロードへの対応
CloudWatch Omniは、生成AIやエージェントワークロード向けの専用可観測性も提供する。トレース探索、評価フレームワーク、リアルタイムモニタリングが含まれる。
詳細はAWSの別記事で紹介されている。エージェント可観測性のハンズオンも参照できる。
この記事のポイント
- CloudWatch Omniはアプリケーション中心の可観測性を提供する
- OpenTelemetryベースで既存テレメトリを活用できる
- チーム全体が同じワークスペースで共同調査できる
- Amazon DevOps AgentがAI支援で根本原因特定を助ける
- セットアップは数分で完了し、既存環境への影響はない

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWSが低コストなEC2 T8iインスタンスを発表!T3比で最大70%の性能向上
AWSが新型の低コストバースト可能インスタンス「Amazon EC2 T8i」の一般提供を開始した。T3インスタンスの後継となるもので、価格性能比が最大30%改善している。
T8iはカスタム設計された第6世代Intel Xeon Scalable Processorを搭載し、AWSのNitro System上で動作する。既存のT3ユーザーは同じCPUクレジット方式のまま移行できる設計だ。
T8iインスタンスの位置づけ
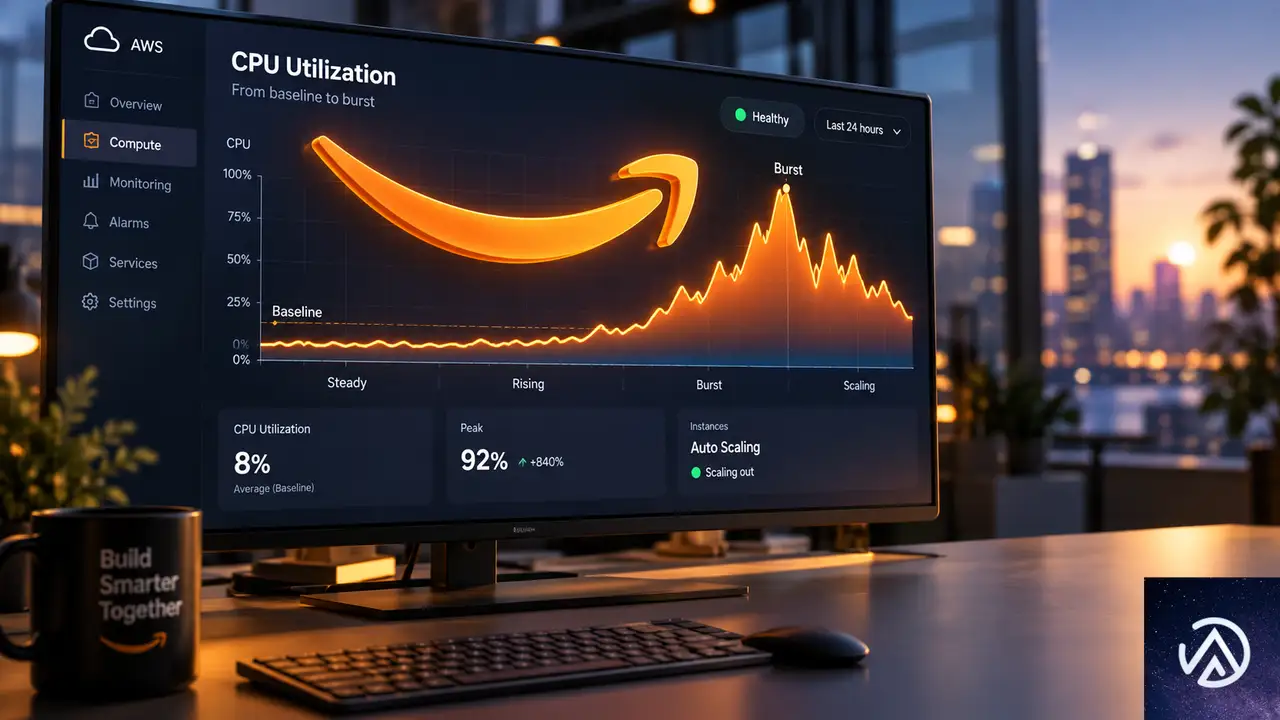
EC2のTシリーズは「バースト可能インスタンス」と呼ばれる。平時はベースライン性能で動作し、負荷が上がった時にCPUクレジットを消費して性能を一時的に引き上げる仕組みを持っている。
この仕組みが適しているのは、普段はCPU使用率が低いが瞬間的に負荷が上がるワークロードだ。低トラフィックのWebサイト、開発・テスト環境、小規模データベース、マイクロサービス、ログインゲートウェイなどが代表例になる。
T8iはこのバーストモデルを踏襲しつつ、CPUとネットワーク性能を大幅に引き上げたモデルだ。
性能向上の内訳
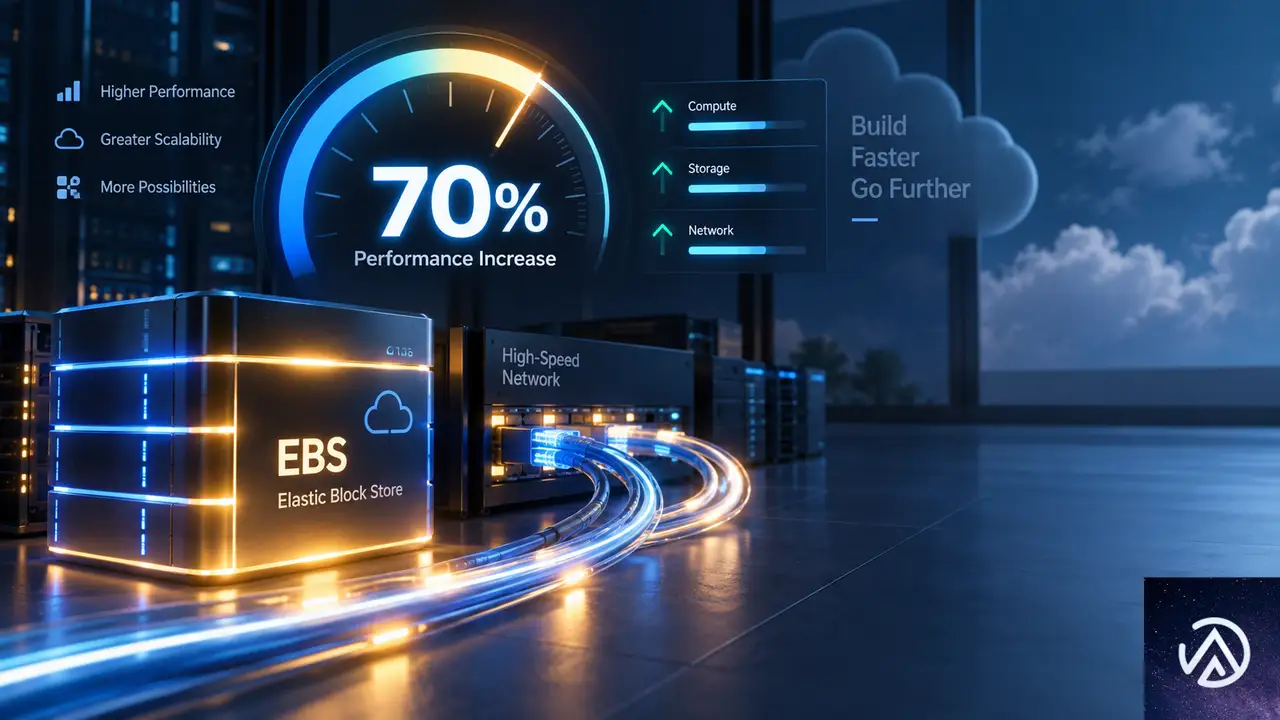
価格性能比とコンピューティング性能
AWSの発表によると、T8iはT3と比較して以下の改善が実現されている。
- 価格性能比が最大30%向上
- コンピューティング性能が最大70%向上
- ネットワーク帯域が最大1.25倍
- EBS帯域が最大2.4倍
特にEBS帯域の2.4倍という数字は見逃せない。ディスクI/Oがボトルネックになりがちな小規模データベースやデータ処理ジョブでは、体感できる改善が期待できる。
CPUクレジット方式と無制限モード
T8iはT3と同じCPUクレジット方式を採用している。StandardとUnlimitedの2つのモードがあり、デフォルトはUnlimitedモードだ。Unlimitedモードではクレジット残高がゼロになっても、追加料金を支払うことでベースラインを超える性能を維持できる。
クレジットは時間の経過とともに自動で蓄積される。例えばt8i.microなら1時間に6クレジット、t8i.smallなら12クレジットが付与される仕組みだ。
インスタンスタイプとスペック
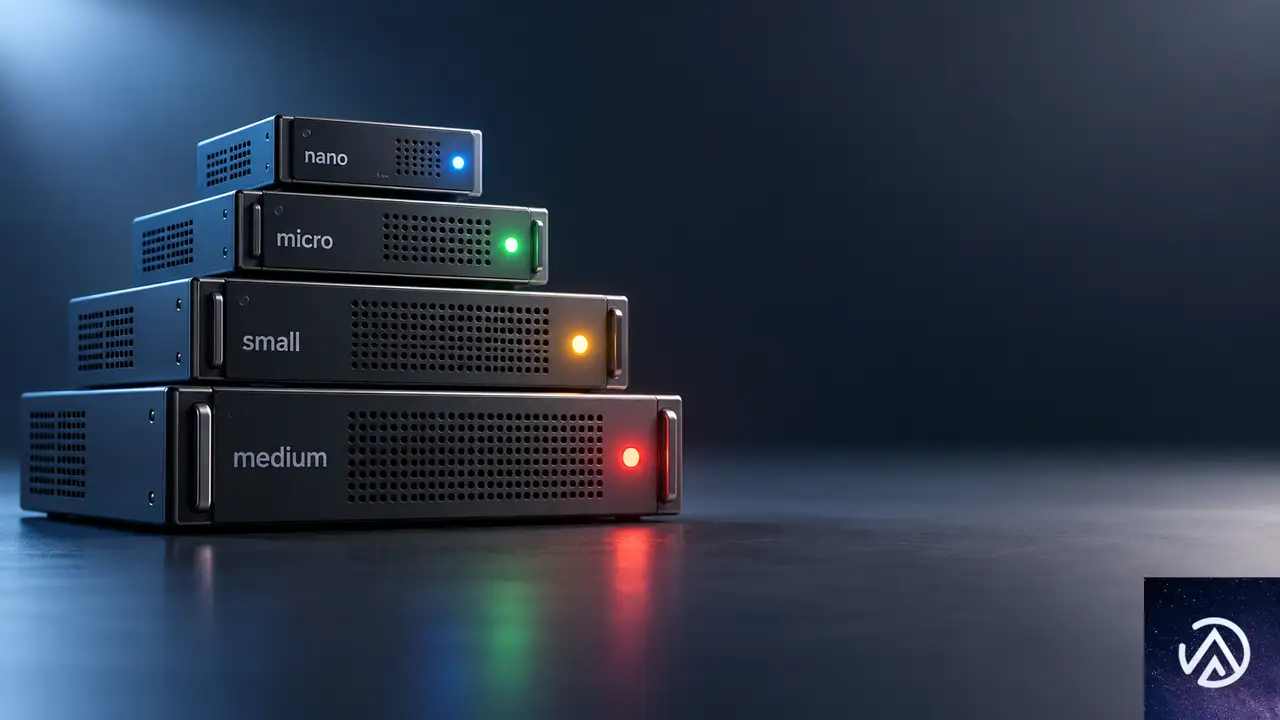
T8iは4つのサイズで提供される。すべて2 vCPUを1コアとして提供するのが特徴で、vCPUとメモリの比率が他シリーズにはない特殊な構成になっている。
- t8i.nano
- t8i.micro
- t8i.small
- t8i.medium
メモリ比率はnanoが1対0.25、microが1対0.5、smallが1対1、mediumが1対1となっている。2 vCPUでメモリ0.25GiBという構成は他のEC2インスタンスにはない特徴的なスペックだ。
利用シーンと移行方法
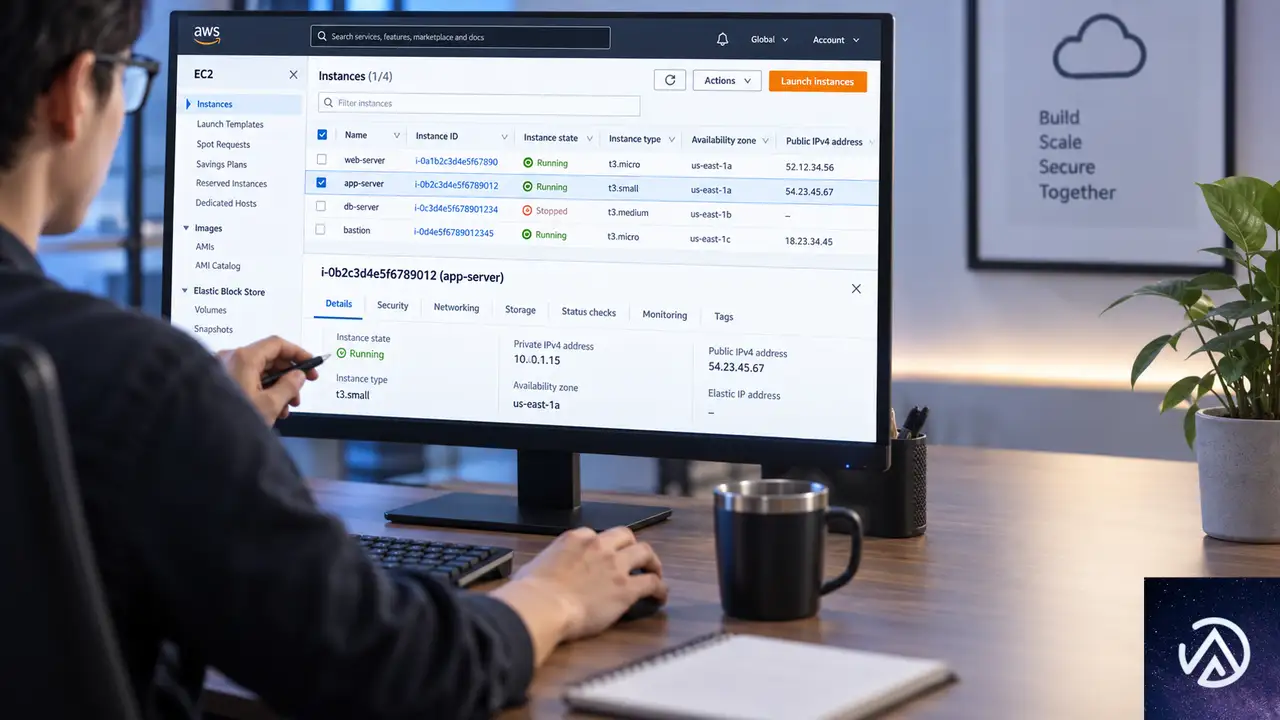
どんな場面で使うべきか
T8iは低〜中程度のCPU使用率で動くワークロードに向いている。具体的には以下のようなケースが想定されている。
- フリーミアムサービスの小規模プラン
- トレーニング・デモ環境
- ステージング・開発環境
- データ処理ジョブ
- マイクロサービスアーキテクチャの一部
- 低トラフィックのWebサイト
- ログインゲートウェイ
- バッチ処理やCI/CDパイプライン
常に高いCPU使用率が続く本番環境や、大規模なデータベースサーバーには向かない。そうした用途ではM8i Flexなど、より大きなインスタンスの選択が推奨されている。
T3からの移行手順
既存のT3ユーザーにとって移行はシンプルだ。インスタンスタイプをT3からT8iに変更するだけで、アプリケーションの設定変更やコードの書き換えは原則不要とされている。
CPUクレジット方式もT3と同じなので、運用ノウハウはそのまま活かせる。Auto ScalingやCloudWatchの設定も流用できるため、移行コストは最小限だ。
提供リージョンと利用方法
T8iは以下のAWSリージョンで利用できる。
- 米国東部(バージニア北部・オハイオ)
- 米国西部(オレゴン・北カリフォルニア)
- アジアパシフィック(ハイデラバード・マレーシア・ムンバイ・ソウル・シンガポール・シドニー・東京)
- カナダ(中部)
- ヨーロッパ(フランクフルト・アイルランド・ロンドン・パリ)
購入方法はオンデマンドとスポットインスタンスに対応している。Savings Planは近日対応予定だ。t8i.microとt8i.smallはAWS無料利用枠でも使えるため、新規ユーザーがAWSの使い方を学ぶ用途にも適している。
共有テナンシーのみ対応しており、専有テナンシーや専有ホストは利用できない点には注意が必要だ。
この記事のポイント
- T8iはT3の後継となる低コストバースト可能インスタンス
- コンピューティング性能が最大70%向上し、EBS帯域は2.4倍に
- CPUクレジット方式はT3と同じで移行が容易
- 4サイズ構成で東京リージョンでも利用可能
- 無料利用枠の対象サイズもあり、新規ユーザーの入門にも適している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI攻撃は自律化へ移行!6時間で数千件の認証情報を奪う新手口を解説
Google Threat Intelligence Group(GTIG)は2026年9月8日、敵対的AI利用の進化をまとめた四半期レポートを公開した。攻撃者が単純なプロンプト入力から、自律的に動くエージェンティックAIの活用へ移行している実態が明らかになっている。
2026年第2四半期には、クラウド環境を侵害した攻撃者が6時間未満で認証情報の大量収集キャンペーンを計画し、構築し、実行した事例が確認された。数千件規模の認証情報が奪取されている。
この変化は、防御側が攻撃を検知して対応するまでの時間を大きく縮める。AIを使う側の企業にとって、単なる技術トレンドではなく、クラウドと認証情報の管理体制に直結する問題だ。
攻撃者は「AIに聞く」から「AIに任せる」へ移行した
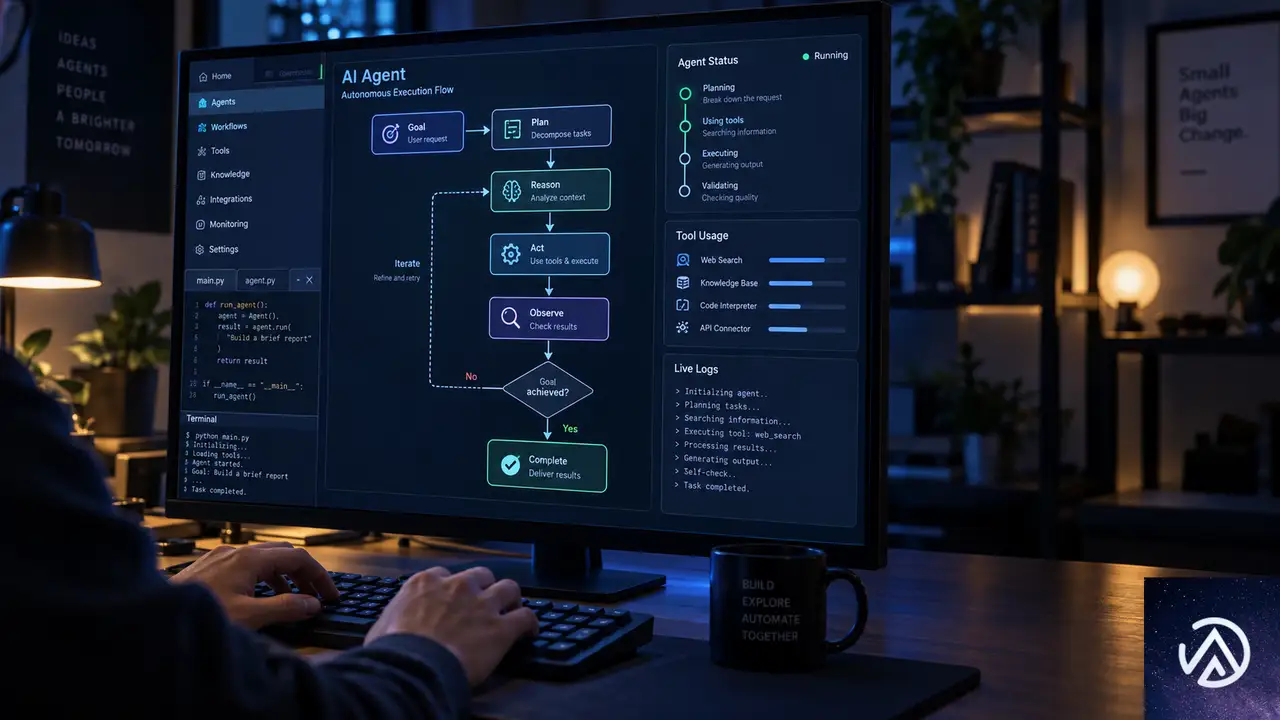
2026年5月の前回レポート以降、GTIGは攻撃者が基本的なプロンプト入力から、エージェンティックAIワークフローとAI対応自動化へ踏み出しているのを観測している。ここでいうエージェンティックAIとは、人間が1つずつ指示を出さなくても、目標を与えれば自分で計画を立てて実行するAIシステムのことだ。チャット型AIが1往復で終わるのに対し、エージェンティックAIはツールやAPIを呼び出しながら複数の工程を連続で進める。
従来の攻撃では、攻撃者がAIの出力を確認し、コマンドを実行し、結果を見て次の指示を出すというループが発生していた。エージェンティックAIはこの人間の介在を大幅に減らし、エラー修正やIPアドレスの切り替えまで自律的に行う。その結果、防御側が気づく前に攻撃が完了するケースが増えている。
この違いが攻撃スピードの差につながる。GTIGは2026年第2四半期に、このエージェンティックAIを使った攻撃が実戦投入された事例を確認した。
6時間で数千件の認証情報を奪ったキャンペーンの中身
Mandiantが観測した事例では、金銭目的とみられる攻撃者が組織のクラウド基盤を侵害し、自律型のマルチエージェント攻撃フレームワークを展開した。攻撃者はAIコーディングチャットボット、プロンプト、エージェント指示書を組み合わせ、計画・構築・実行を6時間未満で完了させている。通常は大規模なグループが持つリソースと同等の規模と速度で、数千件の第三者認証情報が奪取された。
攻撃者はマークダウン形式の指示書を運用プレイブックとして使った。マークダウンとは文書を書くための軽量な記法で、AIへの指示書としても扱いやすい。AIはこの指示書に従い、脆弱性スキャンパイプラインを自律的に管理し、リアルタイムでトラブルシューティングを行い、IPアドレスのローテーションまで自動実行した。攻撃トラフィックは被害者のクラウド基盤から正当なIPアドレスを経由して送信され、検知を難しくしていた。
この事例では、指示書とプロンプトを組み合わせることで、AIが自律的にパイプラインを管理した。人間の操作を挟まないため、防御側が気づく前に攻撃が完了してしまう。
GTIGはこの動きを、受動的なインフォスティーラーから攻撃的なエージェンティック収集への転換点と位置づけている。インフォスティーラーとは、端末に保存されたパスワードやCookieなどを盗み出すマルウェアだ。従来は端末を起点に情報を集めるだけだったが、新たな手法ではサーバーサイドの脆弱性を自ら探索し、狙いを定めて攻撃する。
AIコーディングが広げたオープンソースの死角
AI支援コーディングの普及でオープンソース資産の量が増え、開発速度が上がった。一方でサードパーティパッケージや依存関係の精査が甘くなり、攻撃者に付け込まれる余地が生まれている。GTIGは、AI支援コーディングが2025年から2026年初めに観測された大規模サプライチェーン侵害の一因になったとみている。
具体的な事例も確認された。2026年初めには、北米とアジアの企業環境で悪意あるオープンソースAI資源のダウンロード試行が検知された。2026年4月には、AIコーディングエージェントが暗号資産プロジェクトのコードベースに悪意ある依存関係を組み込んだ事例が公表されている。2026年5月には、LLMプロキシサービスを密かにインストールする悪意あるパッケージも特定された。これは地域的なLLMアクセス制限を迂回するために使われる。
金銭目的の攻撃者UNC6780(TeamPCP)は、こうしたリスクの深刻さを示す存在だ。UNC6780はPyPIやnpm、Docker Hubといったエコシステムを標的にし、侵害後にDUSTMAKERと呼ばれる認証情報窃取マルウェアを展開する。窃取したデータは直接売ったり、ランサムウェアグループとの提携で利益に変えられたりする。
UNC6780はAIコーディングアシスタントやLLMセキュリティスキャナーを騙す複数の手口も実装している。代表的なのがプロンプトインジェクションだ。これはAIが読むテキストの中に悪意ある指示を忍ばせる攻撃で、コードを自動分析するAIに「安全だ」と誤認させる偽の指示を仕込む。GitHub Actionsのワークフローを悪用して専有AIリポジトリを盗み出し、別の攻撃者に渡して恐喝に使わせた事例もあった。
専有AIモデルとクラウド計算資源が次の標的
2026年第2四半期、最先端モデルへの直接攻撃は確認されなかった。しかし専有AIの研究やモデルを盗む事例は増加している。標的はAIラボや先端AI企業にとどまらず、政府・軍事・医療・メディア・エンターテインメント分野にも広がった。攻撃者もサイバーエスピオナージ集団だけでなく、データ窃取恐喝グループまで含まれる。
中国関連の脅威アクターUNC6508は、北米の学術・医療・軍事研究機関を対象にした複数年キャンペーンを展開している。UNC6508は専有AI研究を標的にするだけでなく、クラウド環境を侵害してローカルLLM基盤を展開し、商用AI APIの監視を避けながら被害者の計算資源を利用していた。
データ窃取恐喝の事例も複数確認された。医療分野では企業データと製薬研究、専有AIモデルが盗まれ、身代金を支払わなければ公開すると脅迫された。AIメディア生成企業の事例では、ソースコード、プロンプト、スキル、モデルスクリプト、シークレットが流出した。モデル重みとはAIモデルが学習で得た知識を数値として保存したデータで、これが盗まれるとAIの再現や改変に悪用される恐れがある。
アカウント売買とLLMJackingの実態
プレミアムモデルや高性能計算へのアクセスコストは、攻撃者にとって大きな障壁だ。そのためAIアカウントの窃取・購入・販売が地下フォーラムで増加している。ClaudeやGeminiの認証情報に加え、Cursor ProやDevinなど自律型コーディングIDEの需要も高く、アカウント単価は2026年に平均で2倍以上に跳ね上がった。
認証情報の入手経路として広く使われるのがインフォスティーラーだ。LUMMAC.V2、STEALC.V2、VIDAR、ACRSTEALERなどの制御者は、従来のAIブラウザプロファイルに加えて、AI開発者設定を狙い始めた。2026年5月には、ACRSTEALERがClineのsecrets.jsonやContinue AIのconfig.yamlを標的にする命令を配布した事例が確認されている。これらのファイルには平文のAPIキーが保存されることがあり、APIキーとはシステム同士がやりとりするための合言葉のようなものだ。これが漏れると、被害者の有料モデル利用枠を攻撃者が直接使えてしまう。
LLMJackingも増えている。LLMJackingとは、被害者のクラウド環境を侵害して計算資源を乗っ取り、AIワークロードを不正に実行する手口だ。2026年4月の侵入事例では、GitHubの個人アクセストークン(PAT)が露出したことが起点となった。攻撃者はこれを使ってクラウド環境に初期アクセスし、不正なAIインフラを展開して高性能計算資源を拡張した。
LLMJackingは、被害者が気づかないうちに高額なクラウド利用料が発生する点でも厄介だ。GTIGは2026年に入り、地下フォーラムでのAIアカウント売買と並んでこの手口の増加を確認している。
企業が取るべき対策とGoogleの防御
Googleは多層的な防御戦略を取っている。モデルレベルの安全策、脅威インテリジェンス、封じ込めプロトコルを組み合わせ、モデル抽出攻撃に対してはリアルタイム防御を展開する。モデル抽出攻撃とは、既存のAIモデルに大量の質問をして応答を学習させ、模倣モデルを作る手口だ。Googleは不正な模倣モデルの性能を落とし、専有ロジックの複製を検知する対策を導入している。
2026年6月には、中国拠点のサイバー犯罪サービス「Outsider Enterprise」を遮断した。このサービスはフィッシングキットを提供し、Googleなどの有名ブランドを大量になりすましていた。運営者はGeminiを使ってコードを生成し、キャンペーンを大規模に実行していた。GoogleがGeminiの悪用で法的措置に踏み切ったのはこれが初めてだ。
企業向けにはGoogle AI Threat Defense(AITD)を提供している。AITDはGeminiなどの推論力、Wizのリスク優先順位付け、GeminiとCodeMenderの自動修復、Mandiantの最前線インテリジェンスを統合した自律型アーキテクチャだ。軽量モデルで継続スキャンを行い、高リスクの脆弱性には特化型の先端モデルを割り当てる。さらに脆弱性検出と自動パッチ適用に特化したGemini 3.8 Flash Cyberも投入している。
実務面では、クラウド認証情報の定期的なスキャンとローテーション、GitHubの個人アクセストークン管理、AIアカウントの多要素認証、オープンソース依存関係の精査が基本になる。AIを業務に導入する場合は、通常のセキュリティ監視に加えて、AI特有の脅威を検出する仕組みを組み込むことが欠かせない。
この記事のポイント
- 攻撃者はチャット型のAI利用から、自律的に動くエージェンティックAIへ移行している
- 2026年第2四半期には6時間未満で数千件の認証情報を奪うキャンペーンが確認された
- AIコーディングの普及でオープンソース経由のサプライチェーンリスクが拡大している
- 専有AIモデルやAPIクレデンシャルが窃取と恐喝の標的になっている
- AIアカウントの売買とLLMJackingが増加し、クラウド計算資源が乗っ取られている
- 防御には認証情報管理、依存関係の精査、AI特有の脅威検出が欠かせない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AWS Graviton5搭載のEC2 R9gが一般提供開始。R8g比で最大25%の性能向上
AWSがGraviton5プロセッサを搭載したEC2 R9gとR9gdインスタンスを一般提供開始した。メモリ最適化インスタンスの新世代で、R8gと比較してコンピュート性能が最大25%向上している。
Graviton5はDDR5メモリの高速化、L3キャッシュの5倍拡大、ネットワーク帯域幅の最大2倍化など、複数のハードウェア改良を備える。データベースやインメモリキャッシュなどメモリ集約型のワークロードで効果が大きい。
この記事ではR9gの技術的な変更点、インスタンススペック、移行手順、利用可能リージョンを解説する。
Graviton5がもたらす性能向上の全容

Graviton5プロセッサはGraviton4から複数のハードウェア改良が加えられた。まずコンピュート性能がvCPUあたり最大25%向上している。これは命令処理の効率化と高クロック動作によるものだ。またAWSがこれまでに構築した中で最もエネルギー効率の高いプロセッサでもある。
このデモはGraviton4(R8g)とGraviton5(R9g)の主要スペックを比較している。特にL3キャッシュの5倍拡大とメモリ帯域の高速化がデータ処理の遅延低減に効く。
メモリとキャッシュの大幅強化
メモリはDDR5 8800 MT/sに対応した。Graviton4の5600 MT/sから大幅に高速化されており、AWSのクラウド上で利用可能な最速のメモリ帯域を実現している。これは大量のデータを扱うインメモリキャッシュ・データベースにとって応答時間の短縮に直結する。
L3キャッシュも5倍に拡大された。L3キャッシュとはCPU内部にある高速なメモリ領域で、頻繁にアクセスするデータを一時的に保持する役割を持つ。この容量が増えると、主メモリへのアクセス回数が減り、データ処理の遅延が小さくなる。データ局所性が高いワークロードほど恩恵を受けやすい。
ネットワーク帯域幅とパケット処理の改善
ネットワーク帯域幅とAmazon EBSの帯域幅は、最大サイズのインスタンスで最大2倍に向上した。48xlargeではネットワークが最大100 Gbps、EBSが最大72 Gbpsに達する。またパケット処理性能は最大3倍に改善されている。
さらにR9gとR9gdはInstance Bandwidth Configuration(IBC)に対応している。これはEBSとネットワークの帯域配分を25%単位で調整できる機能だ。データベースやキャッシュなど、帯域要件が特定方向に偏るワークロードで性能を最適化できる。例えばネットワーク処理が少なくディスクI/Oが多いワークロードでは、帯域をEBS側に寄せるといった調整が可能になる。
Nitro Isolation Engineによるセキュリティ強化

すべてのR9gとR9gdインスタンスはAWS Nitro System上で動作する。Nitro Systemは仮想化、ストレージ、ネットワークを専用ハードウェアにオフロードする仕組みだ。これにより仮想マシンのオーバーヘッドが減り、ベアメタルに近い性能と強固なセキュリティ分離を両立できる。
R9gとR9gdにはNitro Isolation Engine(NIE)が搭載されている。NIEはC9gとM9gで今年前半に導入されたコンポーネントで、仮想マシン間の分離を強制する役割を担う。仮想マシンのメモリ、CPUレジスタ状態、I/Oデバイスへのすべてのアクセスを最小限のAPIセットで仲介する。
このデモはNIEが仮想マシンとハードウェアの間に位置し、すべてのアクセスを仲介する関係を示している。分離の保証はソフトウェア的な工夫ではなく、形式的な数学証明によって裏付けられている点が特徴だ。
NIEの特徴は形式検証(formal verification)という手法を活用している点にある。これはハードウェアやソフトウェアが意図通りに動作することを数学的に証明する手法だ。特定のテストケースだけでなく、あらゆる条件下で正しく動作することを保証する。この取り組みにより、Nitroはクラウドハイパーバイザーとして初めて形式検証を受けた存在になった。
形式検証の対象範囲や前提条件などの詳細はAWSのテクニカルホワイトペーパーで公開されている。セキュリティ要件が厳しい金融系ワークロードやマルチテナント環境を扱う場合には、このホワイトペーパーを参照してリスク評価に役立てるとよい。
R9gとR9gdのインスタンススペック

R9gとR9gdはそれぞれ11サイズで提供される。最小のmediumから最大のmetal-48xlまで、幅広い要件に対応する。以下では2つの違いを中心に説明する。
このデモはR9gとR9gdの違いを整理している。NVMe SSDの有無が唯一の差で、用途に応じて選べる。
R9gのスペック
R9gはEBSストレージのみを使用する構成だ。最小のr9g.mediumは1 vCPUと8 GiBメモリ、最大のr9g.48xlargeとr9g.metal-48xlは192 vCPUと1536 GiBメモリを搭載する。ネットワーク帯域幅はmediumから2xlargeまで最大15 Gbps、8xlargeで17 Gbps、12xlargeで25 Gbps、16xlargeで34 Gbps、24xlargeで50 Gbps、48xlargeで100 Gbpsに達する。
EBS帯域幅はmediumから4xlargeまで最大12 Gbps、8xlargeで12 Gbps、12xlargeで18 Gbps、16xlargeで24 Gbps、24xlargeで36 Gbps、48xlargeで72 Gbpsとなっている。データベース用途ではEBS帯域幅が性能のボトルネックになりやすいため、サイズ選定の際はこの値にも注目したい。
R9gdのNVMeストレージ
R9gdはR9gと同じコンピュート性能とネットワーク性能を持ちながら、ローカルNVMe SSDを搭載している。mediumでは59 GB、largeで118 GB、xlargeで237 GBとサイズに応じて容量が増える。最大のr9gd.48xlargeでは3台の3800 GB NVMe SSD(合計11.4 TB)を備える。
ローカルNVMe SSDはEBSと比べてレイテンシが低く、一時的なスクラッチ領域やキャッシュ用途に向いている。オープンソースデータベース、分散リアルタイムビッグデータ分析、大規模インメモリデータベース、大容量キャッシュワークロードで効果を発揮する。
R8gからの移行と始め方

R8gで運用中のワークロードがある場合、R9gへの移行はシンプルだ。多くのアプリケーションでコード変更は不要。同等サイズのR9gインスタンスを選択すれば、そのままより高い性能を得られる。
このデモはR8gからR9gへの移行手順を4ステップで示している。インスタンスタイプを変更するだけで性能が向上するケースが多い。
対応OSとコンテナ環境
R9gはAmazon Linux 2023、Amazon Linux 2、Ubuntu 22.04以降、RHEL 8.4以降、SUSE Linux Enterprise Server 15 SP3以降、Debian 12以降など主要なLinuxディストリビューションに対応する。EC2コンソールからArmベースのAMIを選択すれば、すぐに起動できる。
コンテナワークロードではAmazon EKS、Amazon ECS、標準的なKubernetes環境で動作する。Arm64向けにビルドされたマルチアーキテクチャのコンテナイメージなら変更なしで動く。Dockerイメージをマルチアーキテクチャ対応にしておくと、x86からArmへの移行がスムーズになる。
移行を支援するツール
AWSはGravitonへの移行を支援する複数のリソースを提供している。Graviton Getting Started Guideは構築、実行、最適化の方法をまとめたガイドだ。Graviton Savings Dashboardではコスト削減効果を追跡できる。AWS TransformはJavaアプリケーションをx86からGraviton向けに変換するコード変換を自動化するツールだ。
Javaアプリケーションの場合、依存ライブラリにネイティブコードが含まれているとArm64への移行が難しいことがある。AWS Transformはこうしたコード変換を自動化して移行の手間を減らす。まず小規模なワークロードで試し、問題がないことを確認してから本番移行に進むのが現実的な進め方だ。
料金と利用可能リージョン

R9gとR9gdは米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、欧州(フランクフルト)の各リージョンで利用できる。日本国内のリージョン(アジアパシフィック東京)では現時点で提供されておらず、今後の展開が待たれる。
購入オプションはSavings Plans、On-Demand、Spot Instances、Dedicated Instances、Dedicated Hostsから選択可能だ。長期運用する場合はSavings Plans、一時的なバッチ処理やテスト用途ではSpot Instancesがコスト効率に優れる。料金の詳細はAmazon EC2の料金ページで確認できる。
インスタンスサイズや購入オプションによって価格が異なるため、ワークロードに合わせて最適な組み合わせを選ぶことが重要だ。特にR8gと比較した場合、同じサイズでも性能が向上しているため、より小さなサイズに移行してコストを削減できる可能性もある。
この記事のポイント
- AWS Graviton5搭載のEC2 R9gとR9gdが一般提供を開始した
- R8g比でコンピュート性能が最大25%向上し、エネルギー効率も改善
- DDR5 8800 MT/sメモリとL3キャッシュ5倍拡大でデータ処理が高速化
- Nitro Isolation Engineにより形式検証されたセキュリティ分離を実現
- R9gはEBSのみ、R9gdはローカルNVMe SSDを搭載した構成
- R8gからの移行はコード変更不要のケースが多く、Arm64対応イメージでそのまま動作
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Run instances登場!AIエージェントを月額6ドル弱で常時稼働
Google Cloudが2026年8月27日、常時稼働するAIエージェント向けの新サービス「Cloud Run instances」をプレビュー公開した。サーバーレスの利便性を保ちながら、単一インスタンスを長期間動かし続けるための専用ランタイムだ。
1vCPU・1GiBメモリの構成なら、30日間連続稼働して月額5.70ドル。従来の専用VMと比較すると運用コストと管理負担を大幅に抑えられる。
パーソナルAIエージェントを自宅のPCや専用サーバーで動かしていた開発者にとって、クラウド移行の有力な選択肢になる。本記事ではCloud Run instancesの特徴、料金構造、実際のデプロイ手順までを解説する。
Cloud Run instancesの基本と既存サービスとの違い
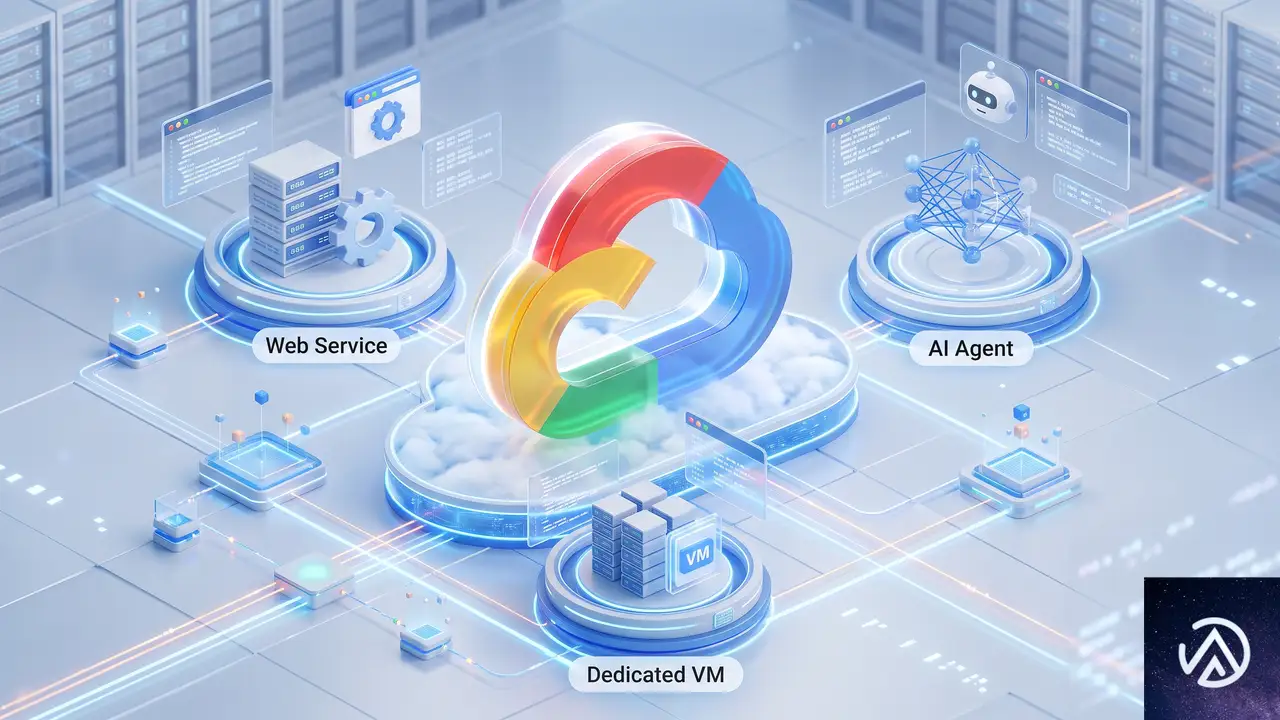
Cloud Run instancesは、Google Cloudのサーバーレスコンテナ基盤であるCloud Runの新しい実行モードだ。既存のCloud Run servicesが高スループットなWebサービス向けに設計されているのに対し、Cloud Run instancesは「1つのインスタンスを確実に動かし続ける」ことに特化している。
主な特徴は次の4つにまとめられる。
- オートスケーリングなしの単一インスタンスのみを実行する
- 最大7日間の連続実行と自動再起動ポリシーを標準で備える
- 更新や再起動後も変わらない固定HTTPS URLが発行される
- 使わないときは停止し、必要なときに再開できる
3つの実行環境の違いを比較した図だ。Cloud Run instancesは既存Cloud Runと専用VMの中間的な位置づけで、サーバーレスの手軽さと常時稼働の確実性を両立している。
既存のCloud Run servicesとの決定的な違い
Cloud Run servicesは、リクエストが途絶えるとインスタンスがスケールゼロになる。これは高トラフィックなWeb APIには効率的だが、常に1つのコピーが動き続けることを期待するAIエージェントには不向きだ。一方、Cloud Run instancesはオートスケーリングを行わず、指定した設定のインスタンスを1つだけ動かし続ける。これが最大の設計上の違いになる。
なぜAIエージェントに最適なのか
OpenClawやHermesといったパーソナルAIエージェントは、継続的に動作し、通常は一度に1人のユーザーにしかサービスしない。これらの特性は、ステートレスな高スループットWebサービスとはインフラ要件が大きく異なる。
OpenClawは、ユーザーの代わりにさまざまなタスクを実行するオープンソースのパーソナルAIエージェントだ。使うほど学習して賢くなる。多くのOpenClawユーザーは最初に自分のノートPCで実行し始めるが、ノートPCがスリープするたびに停止してしまう問題に直面する。ここでクラウド上の常時稼働環境が必要になる。
従来の選択肢の問題点
専用VMを借りる方法もあるが、24時間365日の課金、OSのアップデート管理、ファイアウォールのポート開放、HTTPSエンドポイントの構築といった手間が発生する。Cloud Run instancesはこれらの管理タスクをクラウド側に任せつつ、低コストで常時稼働を実現する。
ここでのポイントは、AIエージェントのワークロードが「バースト型」であることだ。普段は待機状態でCPUをほとんど使わず、ユーザーが指示を出した瞬間だけ計算リソースを消費する。共有vCPUとバーストバジェットによる課金モデルは、このバースト型の特性と相性が良い。常時フルパワーのCPUを確保する必要がないため、価格を抑えられる。
料金とコスト構造の分析
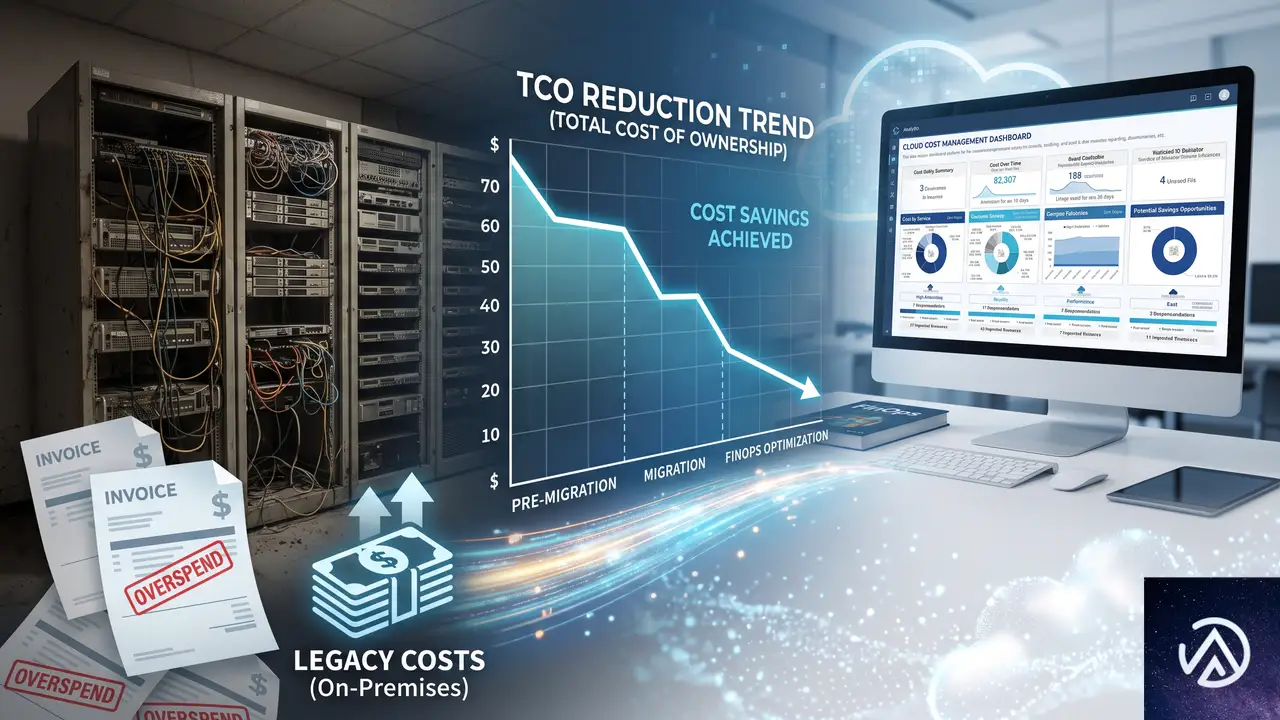
1vCPU・1GiBメモリのCloud Run instanceを30日間連続稼働させた場合のコストは5.70ドル。共有vCPUとvCPUバーストバジェットを利用して、低く予測可能な価格で連続実行を実現している。
従来の専用VMと比べると、クラウド料金に大きな差がある。30日間連続稼働でわずか5.70ドルという価格は、個人開発者が気軽に試せる水準だ。
価格設定の分析
5.70ドルという価格は、パーソナルAIエージェントの利用シーンを想定した戦略的な設定だ。個人開発者がノートPCの代わりにクラウドでAIエージェントを常時稼働させるには、月額10ドル以下という心理的なハードルが大きい。Cloud Run instancesはこの価格帯を実現したことで、パーソナルAIエージェントのクラウド移行を加速する可能性がある。
OpenClawデプロイの実践手順
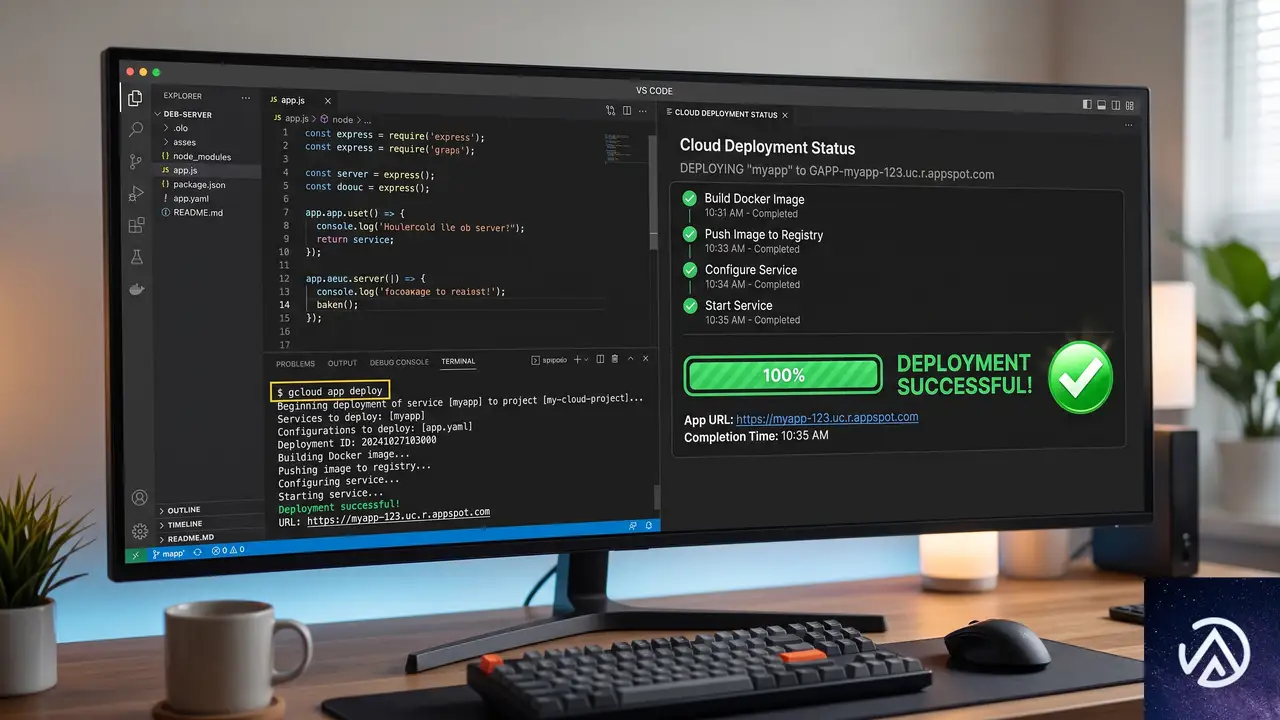
OpenClawをCloud Run instancesにデプロイする手順はシンプルだ。設定ファイルをCloud Storageバケットにアップロードした後、1つのコマンドを実行するだけでデプロイが完了する。
デプロイ後のOpenClawは、使いたい限り動かし続けられる。メッセージングアプリと接続してタスクを任せることも、必要なツールと連携させることも可能だ。
SSHアクセスと今後のアップデート
Cloud Run instancesとCloud Run servicesの両方で、SSHアクセス機能が近日中に提供される予定だ。これにより、実行中のコンテナに直接ログインしてデバッグや設定変更ができるようになる。詳しい手順はCloud Runのcodelabで公開されている。
ユーザー事例と今後の展望
OffDeal社の導入効果
中小企業向けのAI投資銀行を提供するOffDealは、Cloud Run instancesを長期間稼働するエージェントの主要インフラとして利用している。OffDeal社のLuis Ruiz Morel氏によれば、コールドスタートが88%削減され、実装も非常にシンプルで信頼性が高いとのことだ。
コールドスタート88%削減とは、エージェントが待機状態からタスクを開始するまでの起動時間が大幅に短縮されたことを意味する。AIエージェントの応答性がビジネス成果に直結するユースケースでは、この改善は大きな価値となる。
プレビューからGAへ
Cloud Run instancesは現在プレビュー段階で、パフォーマンスを犠牲にせずに新しい種類のワークロードをコスト効率よく実行する手段として提供されている。今後、GA(一般提供)への移行とともに、より多くのAIエージェントワークロードがこの基盤に集約される可能性がある。
Cloud Run instancesの登場は、サーバーレスコンピューティングの適用範囲を「常時稼働するステートフルなワークロード」にまで広げる動きとして捉えられる。従来のサーバーレスは「イベント駆動・ステートレス・短期実行」が前提だったが、AIエージェントのような新しいワークロードの台頭が、この前提を変えつつある。Google Cloudがこのニーズに素早く応えた形だ。
この記事のポイント
- Cloud Run instancesは常時稼働するAIエージェント向けの新しいサーバーレス実行環境
- 単一インスタンスのみ、オートスケーリングなし、最大7日間連続実行
- 1vCPU・1GiBメモリで30日間連続稼働して月額5.70ドル
- 固定HTTPS URLが提供され、停止・再開も自由
- OpenClawを1コマンドでデプロイ可能
- 近日中にSSHアクセス機能が追加予定
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare DDoS脅威レポート2026年上半期、1Tbps攻撃が935件に急増
Cloudflareが2026年8月11日、DDoS脅威レポートの2026年上半期版を公開した。今回で通算25回目の発行となる。四半期ごとの発表を統合し、1月から6月までを単一のレポートにまとめた形式だ。
レポートによれば、Cloudflareは上半期で2,320万件のネットワーク層DDoS攻撃と29兆6,400億件のHTTP DDoSリクエストを軽減した。1時間あたり約5,343件、1日あたり約12万8,000件の攻撃に相当する。
なかでも1Tbps(テラビット毎秒)を超える超大規模攻撃の急増が目を引く。攻撃ベクトルはボットネット直撃型から反射・増幅型へ移行しつつあり、防御側の自動化がこれまで以上に重要になっている。
2026年上半期のDDoS攻撃概況
4月にピーク、国際摘発作戦で減少へ
4月は攻撃のピーク月だった。攻撃リクエストは6兆4,600億件、通信量は165PB(ペタバイト)に達した。この量は大手動画プラットフォームが1日で処理するデータ量に匹敵する規模だ。
その後、攻撃件数と通信量は減少に転じた。同時期に実施された国際法執行作戦「Operation PowerOFF」が影響したとみられる。21カ国が参加し、DDoS攻撃代行サービスの利用者7万5,000人超を標的に、53のドメインを停止、25件の家宅捜索、4人の逮捕という成果を上げた。
法執行の直接的な抑止効果は計測しにくい。ただし摘発の直後に攻撃数が減少した事実は、DDoS攻撃代行サービス(いわゆるブートストレスサービス)の利用層がインターネット全体の攻撃量に与える影響の大きさを示している。個人が安価に攻撃を「注文」できる構造が、この規模の攻撃増加を支えている構図だ。
1Tbps超の攻撃が6倍以上に急増
1Tbps超の超大規模攻撃は第2四半期だけで805件に達した。前期比で6倍以上の増加だ。上半期全体では935件の1Tbps超ネットワーク層攻撃を軽減している。
DDoS対策の世界では「ハイパーボリュメトリック攻撃」という分類がある。1Tbps以上、または毎秒10億パケット(Bpps)以上、または毎秒100万リクエスト(Mrps)以上のいずれかを満たす攻撃だ。2026年はこの分類に入る攻撃が順調に増えている。
ただし攻撃の中央値は小規模だ。ネットワーク層攻撃の96.62%が500Mbps未満、90.60%が10分未満で終了している。「小規模」といっても相対的な話だ。100Mbpsの攻撃だけで一般的なサーバーやWebサイトは十分にダウンし得る。100Gbpsなら無保護のデータセンターを停止させる威力がある。
攻撃者は帯域とパケットレートの組み合わせも工夫する。高パケットレート(Mpps単位)と低帯域幅(Gbps単位)を組み合わせ、ネットワーク機器の処理限界と回線容量の限界という異なる弱点を同時に狙う手口が観測されている。
攻撃ベクトルの変化とCLDAP急増
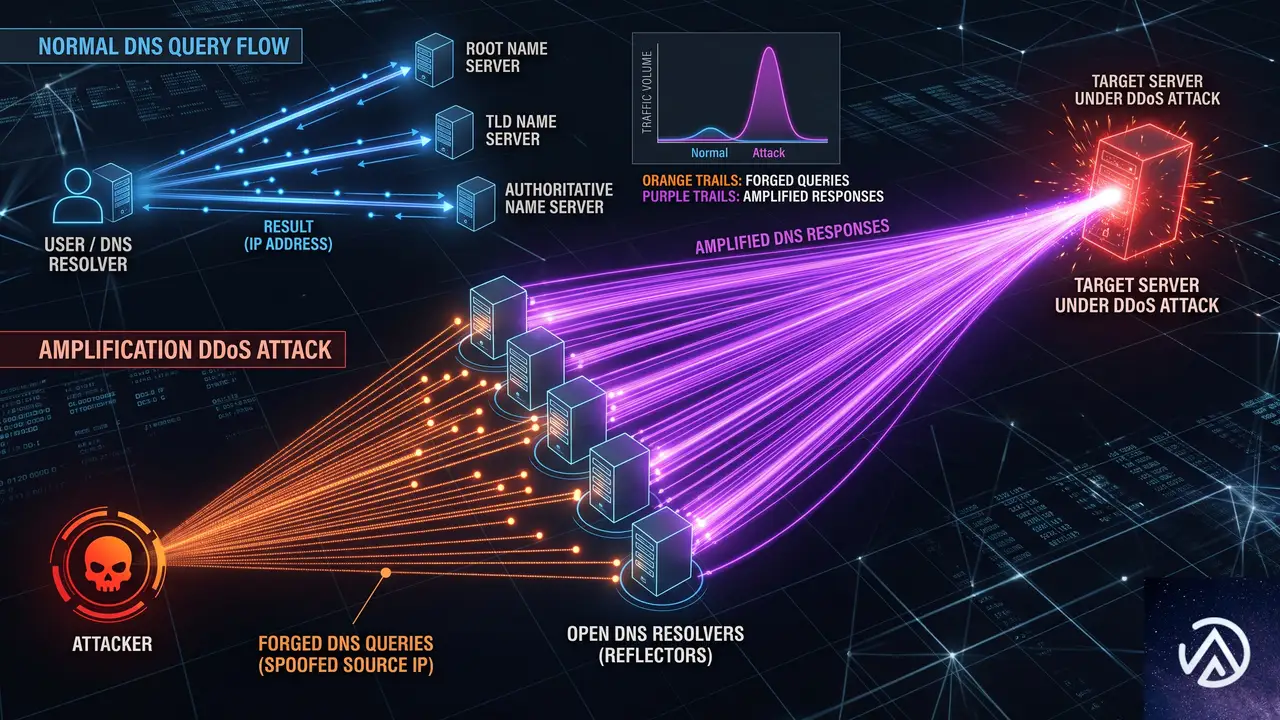
DNS系攻撃がネットワーク層の3分の1を占める
攻撃の中心はボットネット直撃型から反射・増幅型へ移っている。DNS系攻撃が上半期のネットワーク層攻撃全体の34.3%を占めた。第2四半期にはDNSフラッドの割合が25.7%から40.0%へ急拡大している。
DNSフラッドは、ボットネットが被害者の権威DNSサーバーへ大量のクエリを直接送りつける攻撃だ。このドメインの「電話帳」に当たるDNSサーバーが応答不能になると、そのドメインに依存するサービスはすべて機能を失う。
DNSアンプリフィケーションは別の仕組みだ。攻撃者は送信元IPを偽装した小さなクエリを公開DNSリゾルバへ送る。リゾルバは元のクエリよりはるかに大きな応答を、偽装されたIP(つまり被害者)へ返す。少ない帯域で大きな攻撃を生み出せるため、攻撃者にとって効率がよい。
上の図は3つの攻撃ベクトルの違いを整理したものだ。直撃型は攻撃者自身の帯域がそのまま攻撃力になる。反射・増幅型は第三者のサーバーを踏み台にするため、攻撃者側の帯域が少なくても大きな打撃を与えられる。
CLDAPフラッドが580%増
CLDAPフラッドの伸びは顕著だ。前期比580%増となり、第2四半期だけで第3位の攻撃ベクトルに浮上した。
CLDAP(Connectionless Lightweight Directory Access Protocol)はLDAPのUDP版だ。UDPはTCPと違いハンドシェイクが不要で、送信元IPの偽装が容易になる。攻撃者はUDPポート389で公開されたドメインコントローラーへ偽装クエリを送り、元の数十倍から数百倍の応答を被害者へ反射させる。
CLDAPの急増が示すのは、公開されたUDPサービスの危険性だ。ポート389が外部に開いている組織は、自覚のないまま攻撃者の踏み台にされている可能性がある。インフラ管理者にとっての実務的な教訓は「UDPポートの露出を監査し、不要なら閉じる」という基本対策の重要性が再確認されたことにある。
標的産業と地域の動向
メディア産業が最大の標的に
メディア・制作・出版産業が両四半期で最も攻撃された産業になった。全HTTP DDoSリクエストの14.2%を占め、2位の約4倍に相当する。イランとウクライナの戦況報道、そしてワールドカップ関連の報道が攻撃対象になったとみられる。
報道機関へのDDoS攻撃は、単なる金銭目的や愉快犯ではなく、情報の流れを止める意図を持つことが多い。特定の報道を続けるメディアのサイトを落とすことで、世論に影響を与えようとする動機が背景にある。
この図が示すように、標的と攻撃元の分布は対称ではない。標的は中国・米国など経済規模の大きい国に集中し、攻撃元はブラジル・インドネシアなどボットネット感染端末が多いとされる国に偏る。
政府部門が29位から9位へ急浮上
政府部門の動きは今年最大のトピックだ。2026年2月28日にイスラエルと米国が「Operation Epic Fury」を開始。その72時間以内に、16カ国110組織に対する149件のハクティビストDDoS攻撃が記録された。標的組織の47.8%が政府部門だった。
この結果、政府部門のシェアは第1四半期の29位から第2四半期には9位へ急上昇した。単一セクターの移動幅としては2026年最大だ。地政学的な緊張がDDoS攻撃の規模と方向性に直接影響を与える構図が、データとして明確に現れた。
国別では中国が最多の標的になった。第2四半期に全世界のHTTP DDoSリクエストの22.4%を吸収した。米国は18.8%で2位を維持している。トルコは攻撃シェアが倍増し、第3位に浮上した。6月から7月にかけてのアンカラNATOサミット準備期間中、治安当局が209人以上を逮捕する大規模な事前摘発を行った時期と重なる。
攻撃元の国ではブラジルが米国を逆転して1位になった。上半期のシェアはブラジル14.9%に対して米国13.4%だ。ブラジルは第2四半期に21.4%まで急伸した。インドネシアは両四半期とも3位を維持し、複数四半期連続で上位3カ国に入る常連になっている。
短時間攻撃と自動防御の重要性
90%以上が10分未満で終了
DDoS攻撃の大半は驚くほど短い。上位の超大規模攻撃ですら秒単位で終了する。過去には開始から終了までわずか35秒という記録的な攻撃も観測されている。
攻撃が30秒でも10分でも、人間が介入する実質的な時間窓は存在しない。セキュリティ担当者にアラートが届いた時点で、攻撃はすでに完了しているからだ。手動での軽減策やオンデマンド型の防御はこの現実に対して遅すぎる。
この図のとおり、攻撃の持続時間と人手による対応時間は圧倒的に乖離している。従来型の「監視して手動で対応する」運用モデルは、DDoS対策においては成立しない。
自動防御が唯一の実効策
さらに、短い攻撃の余波は長引く。ルーティングの不安定化、TCP再送、アプリケーションのタイムアウト、下流サービスの劣化などが数時間から数日続くことがある。サービス停止や品質低下は攻撃の終了後も継続するのだ。
この環境では、常時稼働する自動防御が「あったほうがよい」ものではなく必須の要件になる。Cloudflareは330以上の都市に分散したネットワーク全体で、人間の介入なしに攻撃を検知・軽減する仕組みを運用している。ネットワーク容量は500Tbps規模だ。
同社はさらに、DDoS攻撃を仕掛けるIPアドレスやアカウントを特定する無料のフィードをホスティング事業者やISP向けに提供している。世界800以上のネットワークが登録しており、ボットネットノードの撤去に一定の成果を上げている。
日本の事業者にとっての示唆は明確だ。自社サイトが直接の標的でなくても、反射型攻撃の踏み台にされたり、同じホスティング上の他サイトへの攻撃に巻き込まれたりするリスクは常にある。小規模サイトでも「攻撃を受けたら止まる」前提ではなく、自動防御を標準装備する発想が必要になる。
この記事のポイント
- 1Tbps超のネットワーク層DDoS攻撃が上半期で935件に達した
- DNS系攻撃がネットワーク層全体の34.3%を占め、反射・増幅型への移行が進む
- CLDAPフラッドが前期比580%増で第3位の攻撃ベクトルに浮上
- メディア・制作・出版が最も攻撃され、政府部門は29位から9位へ急上昇
- 攻撃の90.60%が10分未満で終了し、自動防御が実質唯一の対策になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloudが2029年までに耐量子暗号へ完全移行。PQCロードマップの全容と企業が取るべき3ステップ
Google Cloudが2026年8月11日、2029年までに耐量子暗号(PQC / Post-Quantum Cryptography)へ完全移行するためのロードマップを公開した。量子コンピュータによる将来の暗号解読リスクに備え、APIエンドポイントやロードバランサーの対応はすでに始まっている。
今回の発表では、移行戦略の3つの重点領域、2026年に完了した基盤整備、2027年から2028年にかけてのドメイン別計画が示された。企業が今すぐ着手すべき3つのステップも提示されている。
量子コンピュータが実用化されれば、現在広く使われているRSAやECDSAなどの公開鍵暗号は解読可能になる。その影響はクラウドサービス全体に及ぶ。本記事では、Google CloudのPQCロードマップの全容と、企業に求められる対応を整理する。
PQC移行の全体像と2029年目標
Google CloudのPQC移行戦略は「セキュアバイデザイン」を基本方針とする。設計段階から量子安全を組み込むアプローチであり、単なる後付けの対策ではない。Google Quantum Threat Modelという独自の脅威モデルを土台に、3つの重点領域で保護を進める。
SNDLリスクとは何か
SNDL(Store Now, Decrypt Later)は「今保存して後で復号する」攻撃だ。攻撃者が現在の暗号化通信を傍受してデータを蓄積しておき、量子コンピュータが実用化された時点で一括して復号する。今日の暗号化データが将来の量子コンピュータで解読されるリスクは、すでに現実のものとなっている。
これがPQC移行を急ぐ最大の理由だ。機密データの保存期間が数十年に及ぶ場合、現在の暗号化方式のままでは将来の解読リスクを抱え続けることになる。特に金融機関や政府機関、医療機関では、このリスクへの対応が喫緊の課題だ。
このデモはSNDL攻撃のリスクとPQCによる防御の違いを示している。攻撃者がどれだけデータを蓄積しても、量子安全な鍵交換を使っていれば将来の解読は不可能になる。
Googleが定める3つの重点領域
Google CloudがPQC移行戦略で優先するのは、以下の3領域である。
- SNDLリスクの緩和。現在の暗号化データが将来の量子コンピュータで解読されることを防ぐ。
- 偽造に対する完全性の確保。デジタル署名を強化し、データやIDの偽造を防ぐ。
- 暗号アジリティの基盤強化。暗号標準の進化に合わせて、新しい方式を最小限の工数で採用できる柔軟なシステムを構築する。
3番目の「暗号アジリティ」は特に重要だ。暗号標準は今後も進化し続ける。特定のアルゴリズムに依存せず、新しい標準が出たら容易に切り替えられる仕組みがあれば、将来の移行コストを大幅に抑えられる。Googleはこの基盤への投資を戦略の中核に置く。
Google Cloudは規制期限を待たずに、内部インフラと顧客向けサービスのPQC移行を前倒しで進めている。2029年の完全対応を目標に、Sovereign Cloudの取り組み(Google Cloud DedicatedやGoogle Distributed Cloud)にもPQCソリューションを展開中だ。
2026年に完了した基盤整備
2026年時点で、すでに複数の基盤的マイルストーンが達成されている。これらは顧客に対して即座の保護を提供するものだ。
APIエンドポイントとロードバランサーの対応
Google CloudのAPIエンドポイントは、量子安全な鍵交換に対応した。google.comと*.googleapis.comの両方が、NIST標準化済みのML-KEM(FIPS 203)をハイブリッドモードで実装している。ハイブリッドモードとは、従来の暗号とPQCを併用する方式だ。互換性を保ちながら量子安全性を確保できる。
アプリケーションロードバランサーとプロキシロードバランサーも、TLS 1.3における量子安全ハイブリッド鍵交換(X25519MLKEM768)をサポートする。当初はオプトイン方式で提供され、顧客は既存アプリケーションへの影響を最小限に抑えながら検証を進められる。
さらに、ChromeとCloudflareが進めるMerkle Tree Certificatesの実験にも参画している。PQC署名をWebPKIに適用する際の課題(署名サイズの肥大化など)に対処する取り組みだ。
Cloud KMSのPQCアルゴリズム一般提供
Cloud KMSでは、NIST標準化済みのPQCアルゴリズム(ML-KEM、ML-DSA、SLH-DSA)が一般提供(GA)に達した。暗号化鍵と署名鍵の両方で量子安全なアルゴリズムを利用できる。
これは企業にとって大きな意味を持つ。既存のCloud KMS利用者は、新しいPQCアルゴリズムを試すために特別な準備をする必要がない。すでに一般提供されているため、本番環境での利用も可能だ。
ドメイン別ロードマップ(2027〜2028年)
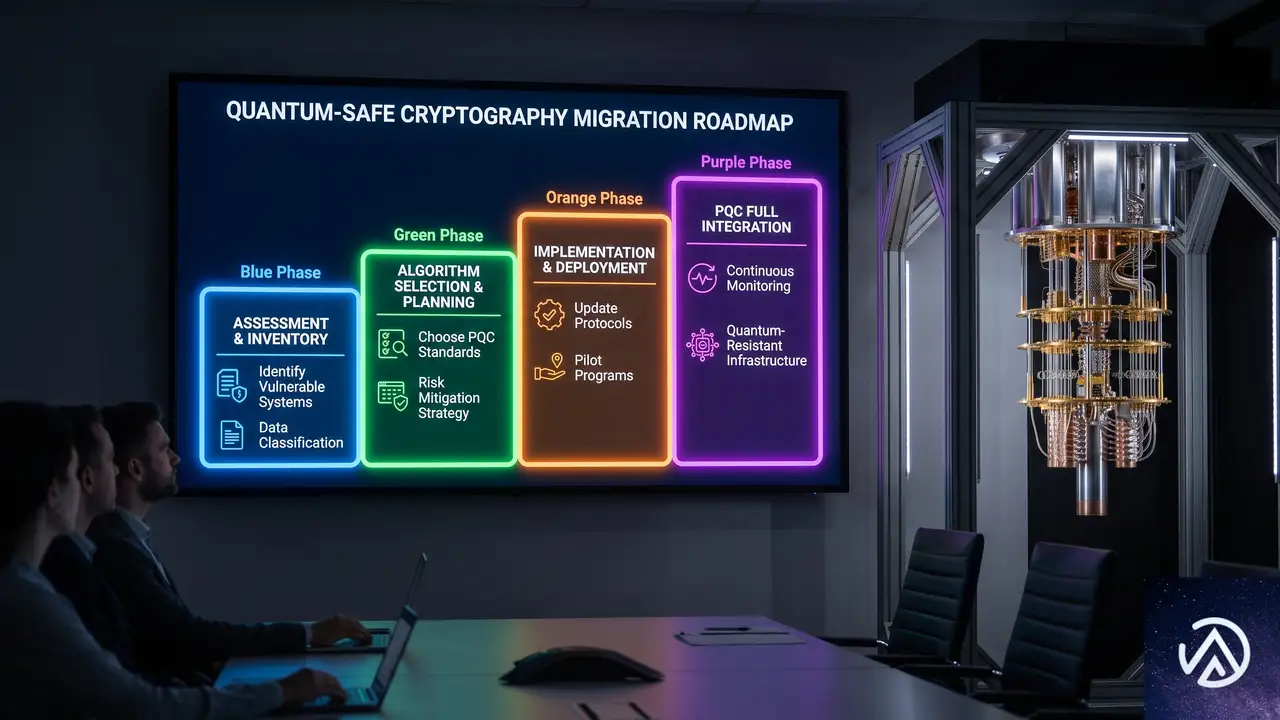
Google Cloudは2029年の完全対応に向けて、リスクベースのアプローチで3つのドメインを定義した。各ドメインには目標完了時期が設定されている。サービスによって個別のタイムラインは調整される可能性があるが、大多数のサービスは目標時期に合わせて移行を完了する見込みだ。
このタイムラインは、Google CloudのPQC移行が段階的に進むことを示している。2026年の基盤整備から始まり、2027年には通信経路の保護、2028年には署名と鍵管理、2029年に全体の収束を目指す。
ドメイン1 SNDL対策(2027年目標)
ドメイン1は非対称暗号の脆弱性に対処する。将来の量子コンピュータが今日の暗号化データを復号するリスクを防ぐのが目的だ。対象となるのは以下の3つの経路である。
- 顧客ワークロードの保護。Google Cloudサービスとロードバランサーに量子機密TLS 1.3ハンドシェイクを提供する。
- 管理者・開発者フローの保護。Cloud VPNやInterconnectを含む管理者経路をSNDLから守る。開発者向けにはクライアントライブラリ、SDK、オープンソース暗号ライブラリのTinkを対応させる。
- データパイプラインの保護。分析・ストレージプラットフォームのデータ転送を保護し、機密情報が傍受・蓄積されても将来復号されないようにする。
このドメインの特徴は、通信経路の保護に焦点を当てている点だ。特にTinkの対応は重要である。TinkはGoogleが開発したオープンソース暗号ライブラリで、多くの開発者が利用している。TinkがPQCに対応することで、開発者はアプリケーションレベルで量子安全な暗号を容易に導入できる。
ドメイン2 完全性と否認防止(2028年目標)
ドメイン2はデジタル署名と証明の量子対応を扱う。量子コンピュータによる偽造攻撃からデータの完全性と信頼性を守る。3つの主要分野がある。
1つ目はソフトウェアサプライチェーンの保護だ。Binary Authorization、Cloud Build、Assured Open Source Softwareなどのサービスで、量子耐性のある証明(アテステーション)を導入する。信頼できる変更されていないイメージだけが本番環境で実行されることを保証する。
2つ目は量子安全な証明書の発行だ。内部および外部の認証局(CA)をML-DSA証明書に対応させる。状況に応じてSLH-DSA証明書もサポートする。IETF(Internet Engineering Task Force)の標準化に積極的に貢献しており、大規模な署名サイズ問題にはMerkle Tree Certificatesなどの新しいアプローチを検証中だ。
3つ目はIDとアクセスの保護である。サービスアカウントキーやトークン(JWT / OAuth)を量子偽造に対して耐性のある方式に移行する。
ドメイン3 基盤と鍵管理(2028年目標)
ドメイン3はPQC移行の土台となる暗号アジリティを扱う。ここでの投資が、ドメイン1と2の実現を支える。
基盤となる鍵管理とライブラリでは、Cloud KMSとBoringSSL、Tinkを通じてNIST承認アルゴリズムを有効にする。Cloud KMSはすでにML-KEM、ML-DSA、SLH-DSAの一般提供を開始しており、量子安全な鍵のインポートも準備中だ。
ハードウェアが関わる部分では、Confidential ComputingとCloud HSMにPQCを組み込む。量子的なルートオブトラストを確立し、物理的な基盤を保護する。OpenTitanやCaliptra v2.1、TPM 2.0 v185などのオープンソースシリコン基盤もPQC対応を進めている。
Google Workspaceのクライアントサイド暗号化(CSE)と外部鍵マネージャー(EKM)にもPQCオーケストレーションを導入する。オンプレミスの鍵プロバイダーとの連携も進める計画だ。
量子安全における共有責任モデル
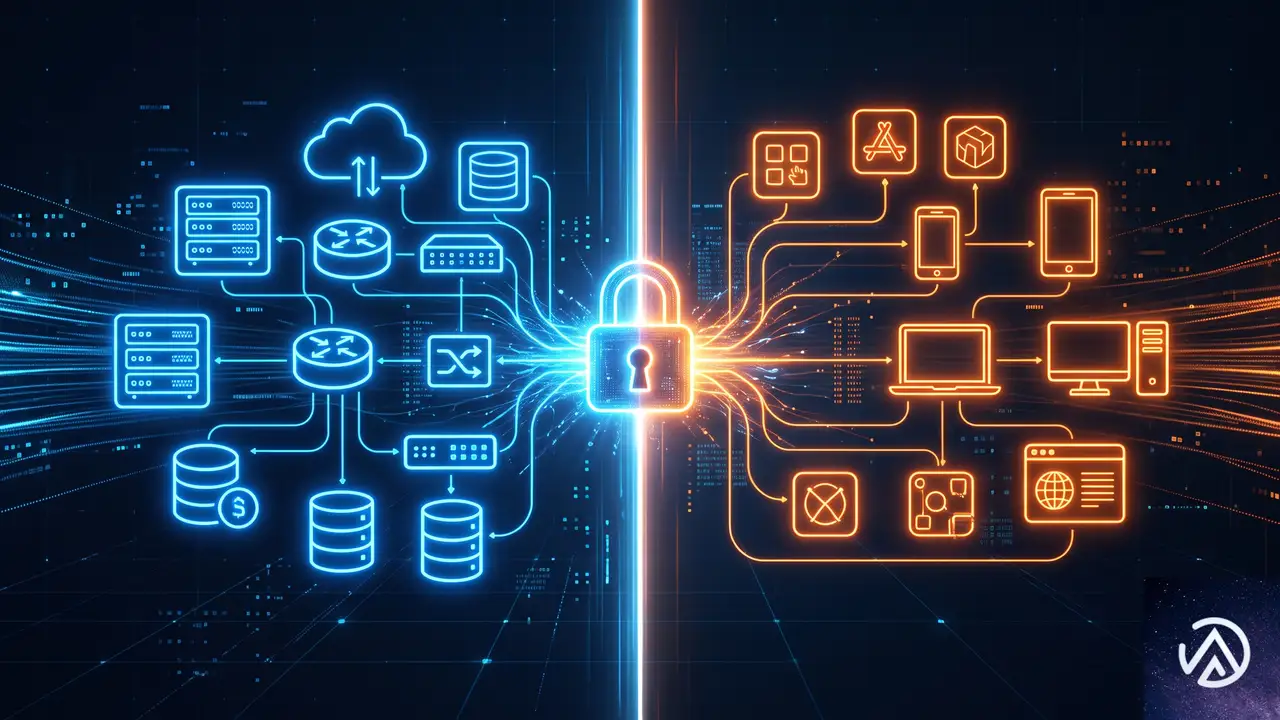
量子安全はGoogle Cloudと顧客の共同作業である。クラウドセキュリティの共有責任モデルがPQCにもそのまま適用される。
この図は責任の境界を明確にしている。重要なのは、Google Cloud側のPQC対応が完了しても、顧客がクライアントソフトウェアを更新しなければ量子安全な接続は確立しない点だ。
Google側の責任範囲
Googleはサーバー、ネットワーク、転送中の暗号化、グローバルフロントエンド、ALTSプロトコルのPQC移行を一括して管理する。ハードウェアの移行は、積極的な交換と自然な機器更新サイクルを組み合わせて段階的に進める。物理コンポーネントの中には2029年を超えて移行が続くものもあるが、安定性を優先したフェーズドアプローチを取る。
顧客側の責任範囲
顧客は自社アプリケーションの管理に責任を持つ。クライアントソフトウェアをPQCハンドシェイク対応に更新すること、非対称鍵のライフサイクル管理、Google Cloudサービスの設定変更が含まれる。
ここが最も見落とされやすいポイントだ。インフラ側がPQC対応しても、クライアント側が古い暗号方式で接続すれば、量子安全性は確保されない。企業のセキュリティチームは、自社のクライアントソフトウェアがPQC対応済みかどうかを確認する必要がある。
企業が今すぐ着手すべき3つのステップ
Google CloudはPQC移行の第一歩として、企業が即座に着手できる3つのステップを提示している。どれも実務に直結する具体的なアクションだ。
- 棚卸し(Inventory)。Cloud Asset InventoryやWizなどのツールを使って、鍵や証明書などの暗号資産を特定する。組織全体の暗号リソースをマッピングし、移行バックログの優先順位を定義する。
- 更新(Update)。開発チームとSREチームが使うソフトウェアが、BoringSSL、Chrome、SDKなどPQCアルゴリズムに対応していることを確認する。エッジで量子安全接続が有効化された際に、社内ワークフローが準備できている状態を作る。
- 検証(Validate)。Google Cloudの量子安全APIとロードバランサーを使って既存アプリケーションの挙動をテストする。本番環境に影響が出る前に、アーキテクチャ上のボトルネックを特定できる。
この3ステップは、PQC移行を「待つ」のではなく「準備する」アプローチだ。特に検証は重要である。量子安全なTLS接続は従来よりオーバーヘッドが大きい場合があり、アプリケーションのパフォーマンスに影響を与える可能性がある。事前のテストで課題を洗い出しておけば、本番移行時のリスクを大幅に減らせる。
この記事のポイント
- Google Cloudは2029年までにPQC完全対応を目指し、ロードマップを公開した
- SNDLリスク(今保存して後で復号)は企業にとって喫緊の課題である
- 2026年時点でAPIエンドポイント、ロードバランサー、Cloud KMSのPQC対応が完了している
- 3つのドメイン(SNDL対策、完全性確保、鍵管理基盤)で2027〜2028年に移行を進める
- 企業は棚卸し、更新、検証の3ステップで今すぐ準備を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon Bedrock AgentCoreにランタイムインスタンス発表、本番AIエージェント向け永続コンピューティング
AWSは2026年8月6日、Amazon Bedrock AgentCoreに新たな計算オプション「ランタイムインスタンス」を追加した。AIエージェントのプロトタイプを本番環境に移行する際、長時間の状態維持やマルチエージェント協調、GPUアクセスといった要求に応える、永続的なマネージドインフラだ。
従来のAgentCore Runtimeでは、マイクロVM上で最大8時間のステートフルな呼び出しが可能だったが、日をまたぐワークフローやOSレベルへの直接アクセスが必要なシナリオには限界があった。ランタイムインスタンスは、14日間のセッション永続化とEC2ベースのフルマネージド環境を提供し、本格的なエージェント運用基盤を実現する。
ランタイムインスタンスが解決する本番運用の3つの課題

AIエージェントをプロダクションに投入するとき、開発者はインフラの壁にぶつかる。ランタイムインスタンスはその3つの主要な課題を解消する。
長時間の状態維持とセッション永続化
通常のサーバーレス実行環境では、処理が終わるとメモリやストレージが破棄される。エージェントが数時間〜数日にわたる複数ステップのワークフローを扱う場合、途中結果を外部ストレージに退避させるなどの手間が生まれる。ランタイムインスタンスでは、最大14日間の共有セッションストレージが標準で提供される。セッションは停止・再開が可能で、アイドル期間のコストを抑えながら、必要なときに前回の状態から処理を再開できる。
マルチエージェントの同一ホスト協調
現実の複雑なタスクは、コード生成・レビュー・テスト・デプロイといった複数の専門エージェントが連携して初めて完結する。ランタイムインスタンスでは、複数のエージェントを同一のEC2ホストにデプロイし、共有ファイルシステムを介して直接データをやり取りできる。API呼び出しやネットワーク越しのストレージを挟むオーバーヘッドがなく、シームレスな協調が可能だ。
GPUとOSへの直接アクセス
画像認識や動画解析、重い数値計算を伴うエージェントはGPUを必要とする。ランタイムインスタンスはGPUアクセラレーテッドなインスタンスタイプに対応し、OSレベルへのアクセスも提供する。コードのコンパイル、セキュリティスキャン、GUI自動操作など、コンテナだけでは実現しにくいタスクをエージェントに任せられる。
コードライターとレビュアーの連携を実際に見る
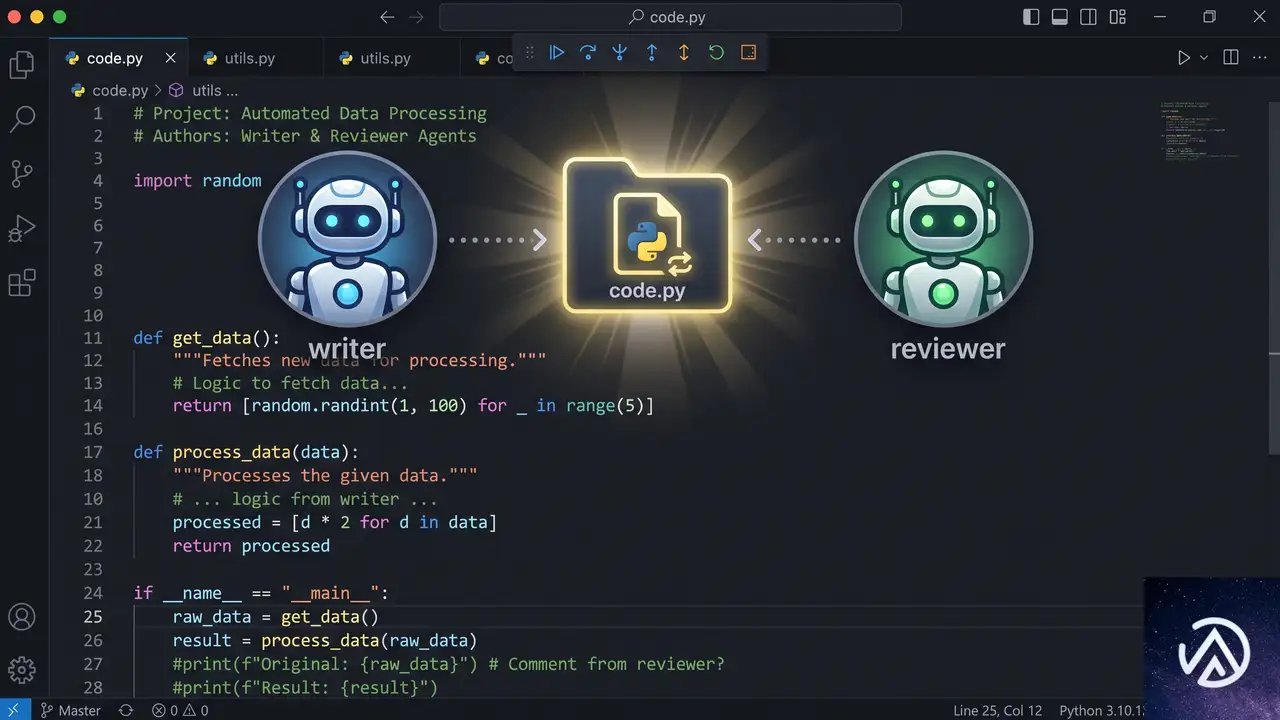
公式デモでは、自然言語でPythonコードを生成する「コードライターエージェント」と、生成されたコードのバグやスタイルをレビューする「コードレビュアーエージェント」を同じランタイムインスタンス上にデプロイし、協調動作させる手順が紹介された。
このデモのポイントは、2つのエージェントが完全に独立したアプリケーションでありながら、セッションIDで紐づく共有ディレクトリを経由してファイルをやり取りする点にある。外部APIを呼び出すことなく、同一ホストのファイルシステム上で完結するため、レイテンシが極めて小さい。
/tmp/agentcore-session/{session_id}/code.py に書き込む各エージェントはStrands Agentsフレームワークと好みのモデル(デモではClaude Sonnet)を使い、単一のPythonファイルに @app.entrypoint デコレータを付けるだけで実装できる。パッケージングもzipまたはコンテナイメージで済み、インフラ管理の負担は大きく軽減される。
セットアップから初回実行までの流れ

ランタイムインスタンスの利用は、大きく3つのステップで完了する。AWSマネジメントコンソールを使う場合の手順を簡潔にまとめた。
- 容量プロバイダの作成 、 エージェントが稼働するEC2インスタンスのスペックとネットワークを定義する。OS(ARM64またはx86_64)、インスタンスタイプ、VPC、サブネット、セキュリティグループを設定。ストレージはgp3ボリュームがデフォルトで用意される。
- ランタイムの作成とエージェントのデプロイ 、 コンピュートタイプに「Instances」を選び、先ほど作成した容量プロバイダを紐づける。エージェントのコードをzipでアップロードし、ランタイム(Python 3.11〜3.14)とエントリポイントを指定。IAMロールもコンソールが自動生成する。
- エージェントの呼び出しと協調 、 デプロイ完了後、コンソールの「Runtime playground」からテスト用のJSONペイロードを送信できる。セッションIDを明示的に指定し、同じIDで別のエージェントを呼び出せば、両者が同一の共有ストレージを使ってシームレスに連携する。
容量プロバイダは一度作成するとOSやインスタンスタイプの変更ができない。本番用と検証用を分けるなど、事前の設計が求められる。
主要スペックと料金モデル
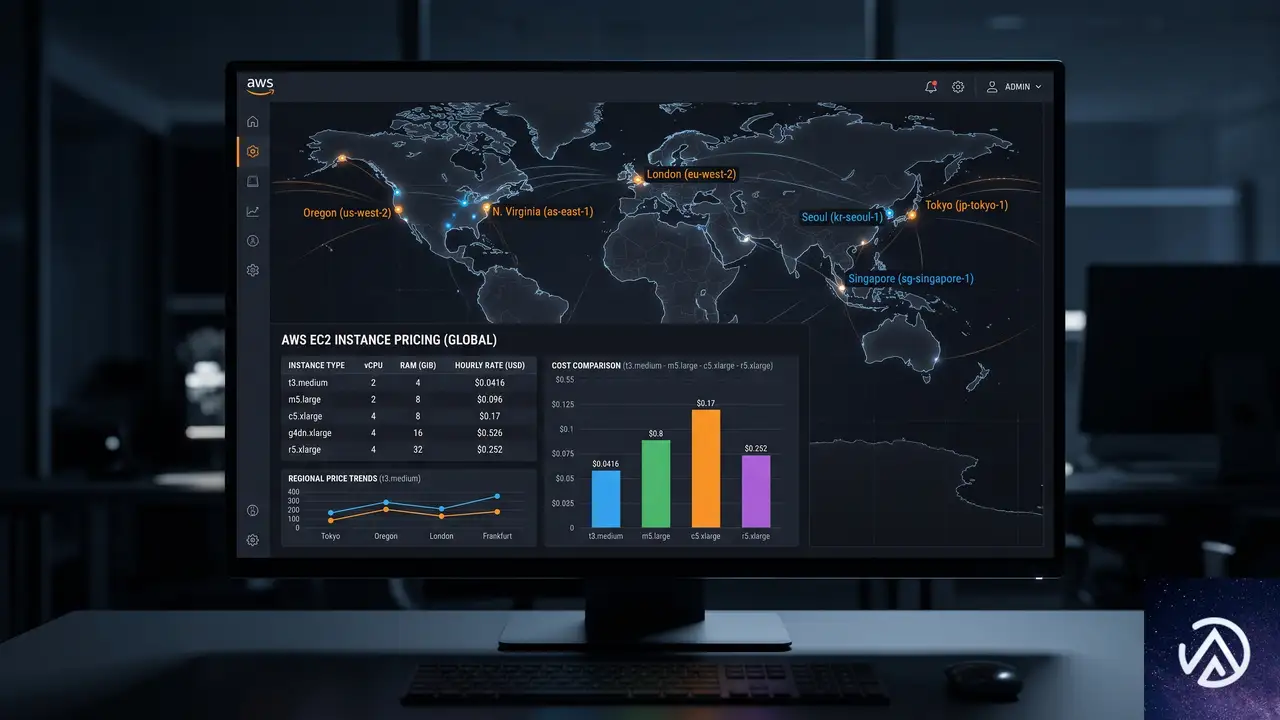
- 対応OS 、 Linux(ARM64、x86_64)。Windowsは現時点ではサポート外
- セッション持続 、 最大14日間。停止・再開が可能で、アイドル中のコスト削減に有効
- ランタイム 、 Python 3.11〜3.14(ネイティブコードに対応)。コンテナイメージのデプロイもサポート
- GPU 、 対応インスタンスタイプを選択すれば、GPUを使った推論や計算が可能
- 統合 、 既存のAgentCore API、IAM、監視機能と完全互換。マイクロVMとのハイブリッド構成も取れる
- 料金 、 使用したEC2インスタンスの標準料金に、AgentCoreオーケストレーションの管理手数料が加算される
- リージョン 、 米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、アジアパシフィック(ムンバイ、シンガポール、シドニー、東京)、欧州(フランクフルト、アイルランド)
マイクロVMベースの従来のAgentCore Runtimeとランタイムインスタンスは、同じAPIセットで併用できる。軽量なオーケストレーターエージェントをマイクロVM側に置き、重い処理や永続状態が必要なワーカーエージェントをインスタンス側に委譲するハイブリッド構成が、現実的なアーキテクチャパターンとして紹介されている。
始め方と最初の一歩
ランタイムインスタンスを試すには、Amazon Bedrock AgentCoreのドキュメントに掲載されているランタイムインスタンスの公式ガイドを参照し、容量プロバイダの作成から始めるのが近道だ。コンソールの左ナビゲーションから「Runtime」→「Capacity providers」を選び、今回紹介した手順に沿って設定すれば、最初のエージェントデプロイまで数分で到達できる。
この記事のポイント
- ランタイムインスタンスは、最大14日間のセッション永続化とEC2ベースのマネージド環境を提供するAgentCore新オプション
- 同一ホスト上でのマルチエージェントファイル共有により、APIを介さないシームレスな協調が可能
- GPUインスタンスやOS直接アクセスが必要な高度なエージェントワークロードに対応
- 従来のマイクロVMと組み合わせたハイブリッド構成で、軽量なオーケストレーションと重いバックエンド処理を分離できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

DynamoDBにベクトル検索がGA、リアルタイムな類似検索が可能に
AWSは2026年8月5日、Amazon DynamoDBにベクトル検索機能を正式に追加した。これにより、既存の運用データと同じテーブルに埋め込みベクトルを格納し、類似度にもとづくリアルタイムな検索が可能になる。
従来、ベクトル検索を追加するには専用のベクトルデータベースを用意し、データの同期パイプラインを自前で維持する必要があった。今回の発表によって、DynamoDBだけでミリ秒単位の低レイテンシと99%以上の再現率、トリリオン規模のベクトルに対応するスケーラビリティが手に入る。サーバーやソフトウェアの管理は一切不要で、ゼロダウンタイムのメンテナンスが保証される。
DynamoDBにベクトル検索が一般提供開始

ベクトルインデックスにはストレージ制限がなく、データの増大に合わせて水平スケールする。セマンティックな検索が必要なエージェント向けメモリ、検索拡張生成(RAG)、レコメンデーションエンジン、パーソナライズされた体験、異常検知などのユースケースを、DynamoDBのネイティブ機能として実装できる。
ベクトル検索の機能は、最大4096次元のベクトルに対応し、ユークリッド距離、コサイン類似度、ドット積のいずれかの距離関数を選択可能。また、パーティションキーによるスコープ指定や、インラインフィルタを使った絞り込みにも対応する。
ベクトル検索統合の背景とメリット

DynamoDBをすでに利用しているアプリケーションでは、これまでセマンティック検索を追加するために、専用のベクトルデータベースを別途プロビジョニングし、テーブル間でデータの同期を維持するパイプラインを構築・運用する必要があった。この構成は追加の運用コスト、データ転送料金、ライセンス費用に加え、大規模環境での低レイテンシ維持を難しくする要因だった。
DynamoDBのベクトル検索では、ベクトルと運用データが同一のサーバーレス基盤で管理され、同じ従量課金モデルが適用される。これにより、同期パイプラインや外部ベクトルストアの運用から解放される。
検索の仕組みとAPIの使い方

DynamoDBのベクトル検索は、既存のテーブルに新しいタイプのインデックスを追加する方式で実現する。ユーザーは任意の埋め込みモデル(Amazon Bedrock Titan Text Embeddings、Cohere Embed、OpenAIの埋め込みモデルなど)を使ってベクトルを生成し、標準のPutItemまたはUpdateItem APIでフロート値のリストとしてテーブルに格納する。その後、対象の属性に対してベクトルインデックスを作成し、次元数と距離関数、オプションのフィルタ属性を指定する。
List型でベクトルを格納検索時はSearchVectors APIを使い、クエリベクトルと返却件数(最大100件)、オプションのフィルタ条件を指定する。結果は類似度順にランキングされて返る。パーティションキーを指定すれば、特定の市場やテナントに対象を絞り込んだ検索も可能だ。インラインフィルタでは完全一致のみサポートしており、範囲条件(BETWEENなど)は利用できない。
距離関数は、コサイン類似度がテキスト埋め込みの意味比較に効果的だが、ユークリッド距離はベクトルの大きさが意味を持つ場合(購入数によるクラスタリングなど)に、ドット積は方向と大きさの両方を評価するレコメンデーションシステムに適する。埋め込みモデルを訓練した際の距離関数と合わせるのが精度を上げる基本になる。
既存テーブルへの追加手順

AWSの公式ブログでは、スポーツ用品のオンラインストアを例に、商品カタログテーブルへのベクトル検索の追加手順が紹介されている。すでにproductId、category、descriptionなどの属性を持つテーブルに、商品説明の埋め込みベクトルを追加していく流れだ。
まず、既存の商品説明テキストから埋め込みモデルを使ってベクトルを生成し、UpdateItem呼び出しでdescriptionEmbeddingという新しい属性として各アイテムに追加する。DynamoDBは既存のListデータ型をそのまま使い、スキーマ変更や新しいデータ型の追加は不要。各要素が埋め込みの1次元に対応するNumber型のリストとして格納される。
次に、DynamoDBコンソールでテーブルの「インデックス」タブを開き、「ベクトルインデックスの作成」を選択する。インデックス名、ベクトル属性(descriptionEmbedding)、次元数(埋め込みモデルに合わせる)、距離関数(ここではコサイン)、パーティションキー(例:marketplace)、インラインフィルタ属性(例:category)を設定する。パーティションキーはオプションだが、大規模データで高スループットを保つために推奨される。
インデックスがアクティブになったら、同じ埋め込みモデルで生成したクエリベクトルを使って検索を実行する。コンソールの「項目の探索」からベクトル検索モードに切り替え、インデックスとクエリベクトル、トップK、パーティションキー値、フィルタ条件を入力する。この例では「US」マーケットプレイスに絞り、カテゴリを「footwear」に限定して「軽量の夏用ランニングシューズ」といった自然言語に近いクエリで類似商品を取得できる。
返却される結果には、類似度スコアと共に商品名や価格などの運用属性が含まれる。コサイン距離とユークリッド距離ではスコアが小さいほど類似度が高く、0は同一ベクトルを示す。ドット積では大きい値が類似度の高さを示す。
想定されるユースケースと拡張性

ベクトル検索がDynamoDBに統合されたことで、セマンティック検索が必要な様々なアプリケーションを単一のデータベースで実現できる。たとえば、エージェントの過去の対話や記憶をベクトル化して素早く参照するエージェントメモリ、大規模言語モデルの回答精度を高めるRAG、ユーザーの行動履歴から類似商品を即座に提示するレコメンデーション、個人の好みに応じたコンテンツのパーソナライズ、過去のパターンとの類似性から異常を検出する監視システムなどが挙げられる。
また、4096次元までのベクトルに対応し、距離関数やフィルタの選択肢も実用的だ。マルチテナントアプリケーションでは、パーティションキーで検索範囲をテナント単位に区切れるため、全データをスキャンすることなく高いスループットを維持できる。あらゆる商用AWSリージョンおよびGovCloudリージョンで利用可能となっている。
この記事のポイント
- DynamoDBのネイティブ機能としてベクトル検索が一般提供開始された
- 運用データと同じテーブルに埋め込みを格納し、ミリ秒単位で類似検索が可能
- 専用ベクトルDBや同期パイプラインが不要になり、サーバーレスでスケールする
- 最大4096次元、コサイン・ユークリッド・ドット積の距離関数をサポート
- RAG、レコメンデーション、エージェントメモリ、異常検知など幅広い用途に対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare AI Searchがエージェント検索を簡素化、公開エンドポイントと価格プレビュー発表
Cloudflareは2026年8月6日、AI Searchに大規模な機能拡張を発表した。従来はWorkers AIやVectorize、R2、Browser Runといった複数のプリミティブを組み合わせて独自の検索パイプラインを構築する必要があった。今回のアップデートによりAI Searchがこれらの処理を自動化し、開発者やエージェントが、まるで自前の検索エンジンを持っているかのような感覚で扱えるようになった。
新機能として、複数のWebサイトやファイルを横断して検索できる公開エンドポイントの提供、サイトマップ不要のクロール機能、カスタムドメインによるブランディング、EmDash CMS向けの検索プラグインなどが追加された。さらにプレビュー価格モデルも発表され、デフォルトの埋め込み・リランキングモデルを利用すれば、これらの処理が無料になる予測可能な料金体系が示されている。エージェントが信頼できる情報源から回答を引き出せるインフラが、これまでより格段に手軽になった。
AI Searchの主な機能強化点

AI Searchを導入する前は、ベクトル化したデータの格納先やクローリングの仕組み、リランキングのパイプラインなどを開発者が自前で組み上げる必要があった。しかし今回の強化により、それらの低レベルなサービスを意識せずに済む。結果としてエージェントが信頼できる最新情報を引き出せるインフラが、数分で立ち上がるようになった。
インデックス作成の簡素化
これまでAI SearchでWebサイトをインデックスに追加する際は、サイトマップが必須だった。しかし新たに追加された「Discover」パースオプションを使えば、サイトマップがなくてもページ内のリンクを辿って自動的にコンテンツを収集できる。Cloudflareアカウントに登録されたゾーンであれば、特定のページから始まる全サイトデータを取り込めるようになった。
さらに、HTMLやPDFなどの非構造化データから構造化データまで、幅広いファイル形式に対応した取り込みが可能になった。これにより社内Wikiや製品マニュアルといった多様なデータソースをエージェントの検索対象に加えやすくなっている。
公開検索/MCPエンドポイント
ネームスペースに対して公開URLを有効化すると、/search と /mcp のエンドポイントが即座に利用できるようになる。/search は通常のREST APIとして、/mcp はモデルコンテキストプロトコル(MCP)に対応した形で提供される。どちらも認証不要で、複数のインスタンスにまたがる横断検索を1つのリクエストで実行できる。
外部のエージェントやアプリケーションに検索機能を提供したい場合、このエンドポイントをそのまま公開するだけで済む。Cloudflare以外の顧客に自社データへアクセスしてもらうシナリオでも、認証が不要で、URLを渡すだけのシンプルな共有が可能になっている。
EmDashとの統合とbotポリシー
Cloudflareが公開しているOSSのCMS「EmDash」向けに、AI Searchプラグインが提供された。これを導入すると、EmDashで構築したサイト内にセマンティック検索を組み込める。実際にCloudflare BlogやDeveloper Docsもこの仕組みで動いている。
また、AI Searchのクローラは独自のユーザーエージェント「Cloudflare-AI-Search」を使い、各サイトのrobots.txtに従う。ブラウザベースのクローリング機能を使う場合でも、このポリシーは変わらない。サイト運営者がクロールを拒否すれば収集が停止されるため、著作権や利用規約上の配慮が十分になされている。
Cloudflare Dev Stack MCPの実装事例
Cloudflare自身がAI Searchをどう活用しているかを示す好例が、新しく公開された「Cloudflare Dev Stack MCP」だ。これはCloudflareのエコシステム全体(ドキュメント、ブログ、APIリファレンス、コミュニティなど)を横断検索し、コーディングエージェントへ最新の引用付き回答を返す仕組みである。古いトレーニングデータではなく、常にフレッシュな情報を基にコードを生成できる。
インスタンス作成とクロール
CloudflareはDocs、Blog、API Docs、コミュニティ、Astro、Viteなど計10以上のサイトに対して、それぞれ個別のAI Searchインスタンスを作成した。各インスタンスはドメインが異なるが、Cloudflareが所有するサイトデータであるため、統一的な方法でクロールできる。
npx wrangler ai-search instance create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
--parse-type discover上記のコマンドでは、--parse-type discover を指定することでサイトマップなしにページを発見するクロールを実行している。この内部ではBrowser Runの/crawl機能が使用され、リンクを辿って再帰的にページを見つけ出す。
Workerを使ったマルチインスタンス統合
10個のインスタンスにまたがる横断検索を実現するため、CloudflareはWorkerを用いたMCPサーバを構築した。wrangler.jsonにAI Searchネームスペースのバインディングを追加し、1つのツール呼び出しで全インスタンスを同時に検索する。
{
  "ai_search_namespaces": [
    { "binding": "AI_SEARCH", "namespace": "cloudflare-stack" }
  ]
}
context.registerTool(
'search_dev_stack',
{
description: 'Search current docs across the Cloudflare stack.',
inputSchema: z.object({ query: z.string() }),
},
async ({ query }) => {
const res = await context.env.AI_SEARCH.search({
query,
ai_search_options: {
instance_ids: ['developers-cloudflare-com', 'astro', /* ... */],
retrieval: { max_num_results: 10 },
reranking: { enabled: true },
},
})
return { content: [{ type: 'text', text: format(res.chunks) }] }
}
)この方式により、エージェントが単一のツール呼び出しで全ドキュメントを検索でき、結果にはどのインスタンスから取得されたかのメタデータが付与される。複数の検索先を順に叩く必要がなく、応答速度も一括で処理される。
コード不要の公開エンドポイントも選択可能
Workerを書かずに済ませたい場合、ネームスペースの公開URLを有効化するだけで、すべてのインスタンスにクエリを投げる/searchおよび/mcpエンドポイントが得られる。設定画面からワンクリックで有効化でき、即座に利用を開始できる。Cloudflare自身のMCPサーバもこの公開エンドポイントを活用している。
コードを書く場合は細かいチューニングやMCPツールとしての統合が可能で、コードを書かない場合は設定画面上の操作だけで外部共有が完了する。どちらの選択肢も提供されている点が、利用者のスキルや要件に応じた柔軟な導入を後押しする。
公開エンドポイントとカスタムドメインで検索を共有
AI Searchでは、公開エンドポイントに独自のカスタムドメインを割り当てられる。デフォルトのCloudflare管理URLではなく、search.example.com/mcpといったブランド化されたエンドポイントを用意できるため、サービス提供時の信頼感が高まる。
さらに、検索を限定公開したいケースではCloudflare Accessを介した認証ゲートを追加できる。これによりエンドポイントへのアクセスを許可された人物やエージェントだけに制限し、認証情報を持たない第三者からの不正なクエリを防げる。社内データや顧客限定の検索サービスを安全に運用できる設計になっている。
このカスタムドメイン機能は、SaaSプロダクトやエージェントサービスを展開する事業者にとってとくに有用だ。自社ブランドのURLで検索APIを提供することで、サービス全体の統一感が生まれ、導入先からの信頼獲得につながる。
プレビュー価格モデルでコストを予測可能に
AI Searchは現在ベータ版として無料提供されているが、正式版に向けたプレビュー価格が公開された。課金開始前には十分な通知が行われる予定だ。料金設計の中心にある考え方は「予測可能でスケーラブル」であり、埋め込みとリランキングをデフォルトモデル利用時に無料化することで、トークン数の見積もりに頭を悩ませる必要をなくしている。
料金の主な内訳
- インジェスト(テキスト): $0.75 / 1Mトークン。月間無料枠5Mトークン。
- 画像処理アドオン: +$0.50 / 1Mトークン。画像の埋め込みに使用される。
- ストレージ: $2.00 / GB・月。月間無料枠10GB。
- セマンティック検索(ハイブリッド+ベクトル): $0.75 / 1,000クエリ。無料枠2,000クエリ。
- 全文検索: $0.10 / 1,000クエリ。同上の無料枠と共有。
- 埋め込みとリランキング: 指定モデル利用時は無料。それ以外はWorkers AIの従量課金。
無料枠はインジェスト5Mトークンと検索2,000クエリがそれぞれ一つのプールとしてまとめられており、用途を気にせず使い切れる。埋め込みやリランキングのコストが気にならないため、データ更新や再インデックスの頻度を高めやすい。これは頻繁に情報が変わるナレッジベースをエージェントに与えたい開発者にとって大きなメリットだ。
2万ドキュメント規模の試算例
以下は、2万件の文書(約2,000万トークン)と1,000枚の画像をインジェストし、月間3万回のセマンティッククエリを実行した場合の想定コストである。ワーカーズ有料プランが前提で、埋め込みとリランキングにはデフォルトモデルを使用する。
- インジェスト(テキスト): 18.1Mトークン × $0.75/1M = $13.58
- 画像アドオン: 1.1Mトークン × $0.50/1M = $0.55
- ストレージ: 約1.2GB → 無料枠内で$0
- 検索: 28,000クエリ × $0.75/1k = $21.00
- 埋め込み・リランキング: $0
- 合計: 約$35.13
初月にインジェスト費用がかかるが、2か月目以降は主に検索クエリ分だけ(この例では約$21)で運用できる。ドキュメントの大幅な増加がなければ、ランニングコストを低く抑えられる構造だ。
このように、AI Searchのコストは初回のデータ登録が大部分を占め、その後は利用量に比例した検索料金のみになる。大規模なデータベースを抱える場合でも、固定費ではなく使った分だけ支払うモデルのため、予算計画が立てやすい。
AI Searchの導入方法
AI SearchはCloudflareダッシュボードから有効化し、すぐに使い始められる。もっとも簡単な導入は、次のwranglerコマンドでインスタンスを作成する方法だ。
npx wrangler ai-search create my-search \
  --namespace my-namespace \
  --source https://my-website.com \
  --type web-crawler \
--hybrid-searchこの1行でWebクローラー型のインスタンスが立ち上がり、ハイブリッド検索(セマンティック+キーワード)が有効になる。クロールが完了すれば、/searchエンドポイントで検索APIとして利用できる。さらに/mcpエンドポイントを使えば、ChatGPTやClaudeなどのモデルが直接ツールとして呼び出せる。
既存のアプリに組み込む場合はWorker経由でバインドし、エージェントと連携させればよい。カスタムドメインやCloudflare Accessを設定すれば、プライベートな検索サービスとしても公開できる。詳しい手順は公式ドキュメントを参照してほしい。
この記事のポイント
- Cloudflare AI Searchは、複数サービスの組み合わせを自動化し、データ検索基盤をワンストップで提供する。
- 公開/MCPエンドポイントやカスタムドメインにより、エージェントへの組み込みや外部共有が容易になった。
- サイトマップ不要のクロールやEmDash CMSとの統合で、あらゆるデータソースを取り込める。
- プレビュー価格ではデフォルトモデルの埋め込み・リランキングが無料で、予測しやすいコスト構造が示された。
- wranglerコマンド1行でセットアップが完了し、すぐにエージェント向け検索エンジンとして利用開始できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験