

Google Discoverが大規模刷新へ。AI搭載のコンシェルジュ体験に進化するのか
Google Discoverが大規模な転換期を迎える可能性が出てきた。Googleの採用情報から、Discoverが「レコメンドエンジン」から「AI搭載のコンシェルジュ体験」へ再定義されようとしていることが明らかになった。
2026年10月に公開されたPrincipal UX Leadの求人では「Discoverをプロアクティブでハイパーパーソナライズされたコンシェルジュ体験に変革する」という文言が明記されている。これは単なるアップデートではなく、サービスの根本的な方向転換を示唆するものだ。
パブリッシャーやクリエイターにとっては、Discoverからの流入の質と量が変わる可能性がある。この記事では求人情報から読み取れる5つの変更点を整理し、コンテンツ戦略への影響を考察する。
Google Discoverがコンシェルジュ型へ再定義する
求人情報の中で特に目を引くのは、Discoverの役割が「レコメンドエンジン」から「コンシェルジュ」へ再定義されている点だ。コンシェルジュとはホテルなどで宿泊客の要望を先回りして手配する人のこと。Googleはこの概念をDiscoverに適用しようとしている。
このデモで示したように、Discoverは「記事を届ける仕組み」から「ユーザーの目標達成を支援する仕組み」へ変わろうとしている。求人には「ユーザーが自分のゴールに向かって進歩できるよう支援する」という文言がある。
レコメンドエンジンから「目標達成支援ツール」への転換
従来のDiscoverは、ユーザーの検索履歴や閲覧パターンから興味・関心を推定し、関連する記事を表示する仕組みだった。新しいDiscoverは、単に記事を推薦するだけでなく、ユーザーが抱える継続的な関心や目標を認識し、その達成に必要な情報・商品・サービス・次のステップまで提案する。
たとえば「ランニングを始めたい」という関心を持つユーザーに対して、従来はランニングに関する記事を表示するだけだった。新しいコンシェルジュ型では、ランニングシューズの比較記事、近所のランニングコース、初心者向けトレーニングプラン、シューズの購入リンクまで一貫して提案することが想定される。
ピチャイCEOが語るエージェンティック検索との接続
この方向性は、Googleのスンダー・ピチャイCEOが提唱する「エージェンティック検索」の考え方と一致する。ピチャイ氏は検索の未来について「情報を探すだけのクエリの多くは、タスクを完了するエージェンティック検索に置き換わる」と述べている。
エージェンティック検索とは、ユーザーが情報を探すだけでなく、検索を通じて実際のタスクを完了できるようにする仕組みだ。Discoverのコンシェルジュ型への転換は、このビジョンをフィード体験に適用したものと位置づけられる。
フィードの仕組みが変わる。AI駆動の新フォーマット
求人情報にはフィードのインタラクション、コンテンツフォーマット、AI駆動の探索体験を再定義する責任が明記されている。具体的には、AI対応フォーマットの拡充、新しいエンゲージメントメカニズムの設計、フィード内での人間の声や視点の向上が挙げられている。
上記のステップ図は、新しいDiscoverのフィード生成フローを概念化したものだ。AIによるパーソナライズと人間のクリエイターのコンテンツを組み合わせる点が特徴になる。
AI対応フォーマットと人間の声の両立
求人情報には「AI対応フォーマットをスケールさせ、フィード内で人間の声と視点を高める」という記述がある。AIによる効率的なコンテンツ生成と、人間クリエイターの独自性を両立させる設計方針が示されている。
この点はパブリッシャーにとって重要だ。AIが生成した要約や情報だけが表示されるのではなく、人間によるオリジナルな視点や体験がフィード内で明確に評価される可能性がある。
セマンティックインテントの理解
Googleの2026年の研究論文では、ユーザーのセマンティックインテント(意味的な意図)を検出するレコメンダーシステムが解説されている。この仕組みは、主観的でパーソナライズされた「ソフト属性」の理解に重点を置く。
ソフト属性とは「心地よい」「刺激的」「上質な」といった、人によって解釈が異なる主観的な特徴のこと。従来のレコメンドはクリックや滞在時間などの行動データに依存していたが、新しい仕組みはコンテンツの持つ曖昧で主観的な特性まで理解しようとする。
検索を超えたGoogleサービスとの統合
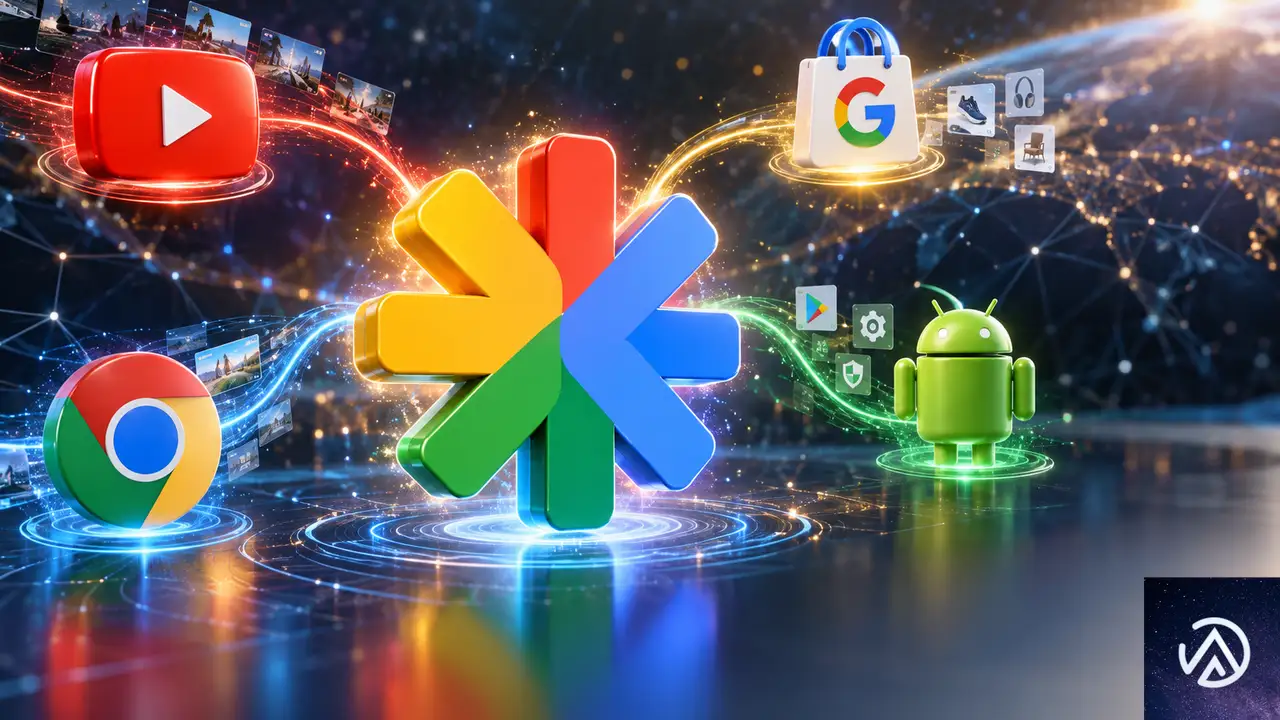
Discoverは現在、Google Search Console上で検索の一部として扱われている。しかし求人情報では、YouTube、Shopping、Chrome、Androidなどの他プロダクトとの緊密な連携が求められている。
この統合図は、Discoverが単独のフィードではなく、Googleエコシステム全体をつなぐハブとして機能する可能性を示している。ユーザーはDiscoverでコンテンツを発見し、そのままYouTubeの動画を視聴したり、Shoppingで商品を購入したりできるようになる。
YouTubeやShoppingとの連携強化
求人情報では「Product Management、Engineering、Data Science、UX Research、そして組織横断的なパートナー(YouTube、Shopping、Chrome、Android)と緊密に連携し、統一された体験を提供する」と明記されている。
これは単なるリンクの追加ではない。ユーザーがDiscoverで見つけた情報から、YouTubeの動画視聴、Google Shoppingでの商品購入、Chromeでの閲覧、Androidでの通知まで、一貫した体験を提供する構想が見える。
若年層を狙う戦略
求人情報には「若年層向けの製品戦略を定義し、競争の激しいコンテンツエコシステムで製品市場適合性を推進した実績」が求められている。GoogleはDiscoverを若年層にとってより魅力的なサービスにしたい考えだ。
製品市場適合性とは、製品がターゲットとする層の期待にどれだけ応えているかを示す指標。Googleがこれを明示した背景には、TikTokやInstagramなどのソーシャルメディアに若年層の時間を奪われている危機感がある。
パブリッシャーとクリエイターへの影響
Discoverのコンシェルジュ型への転換は、パブリッシャーやクリエイターがDiscoverから読者を獲得する方法を変える可能性がある。従来の「記事を推薦する」仕組みから「目標達成を支援する」仕組みへの変化は、コンテンツが評価される基準自体の変化を意味する。
Search Engine Journalの記事によれば、同記事の著者は最近DiscoverでMeta Threadsの提案を経験したと報告している。これは一部の変更がすでにテスト段階にある可能性を示唆する。
Discover流入の質が変わる可能性
従来のDiscover流入は「偶然の閲覧」に近い性質が強かった。ユーザーが興味を持ちそうな記事が表示され、クリックして訪問するという流れだ。コンシェルジュ型では、ユーザーが特定の目標に向かって行動している文脈でコンテンツが表示されるため、流入の意図がより明確になる。
たとえば「筋トレを始めたい」という目標を持つユーザーに対して、トレーニング記事、ジムの比較、プロテインの購入情報などが一連の流れとして表示される。パブリッシャーは単発の記事ではなく、ユーザーの目標達成プロセス全体を見据えたコンテンツ設計が求められる。
コンテンツ戦略の再考
Discoverの新しい方向性は、コンテンツの文脈がより重要になることを示している。孤立した記事よりも、ユーザーのゴール達成に役立つ一連のコンテンツや、次のアクションにつながる情報が評価される可能性が高い。
また、求人情報に「人間の声と視点を高める」とあるように、AIが生成した画一的なコンテンツよりも、実際の体験に基づく独自の視点が重視される方向性が見える。パブリッシャーは量より質、そして独自性に投資する必要がありそうだ。
特に重要なのは、Discoverが検索よりもソーシャルメディアのフィードに近い性質を持つようになる点だ。ユーザーは受動的にコンテンツを消費し、その中から興味を持つものを選ぶ。パブリッシャーは「検索で見つけてもらう」発想から「フィードで選ばれる」発想への転換を迫られるだろう。
この記事のポイント
- Google DiscoverはレコメンドエンジンからAI搭載のコンシェルジュ体験へ再定義される可能性がある
- 求人情報から「目標達成支援」「AI対応フォーマット」「人間の声の重視」という3つの方向性が見える
- YouTube、Shopping、Chrome、Androidとの統合が進み、エコシステム全体をつなぐハブになる構想だ
- 若年層の取り込みを狙い、ソーシャルメディアに対抗するエンゲージメント戦略が示されている
- パブリッシャーは単発記事ではなく、ユーザーの目標達成プロセスを見据えたコンテンツ設計が求められる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleがインデックス不要のランキングを理論実証。検索結果ページは見えなくなる
Googleの研究チームが、インデックスなしで文書をランキングできる計算手法を理論的に証明した。検索結果ページは「見るもの」から「モデルが内部で処理するステップ」に変わる可能性がある。
この研究は2026年1月に発表されたAutoRegressive Ranking(ARR、自己回帰ランキング)という手法に関する論文が基盤になる。Googleは2021年から同じ方向の研究を積み重ねてきた。
実務者にとって重要なのは、ビームサーチと呼ばれる生成プロセスが可視性の境界線になることだ。ランキング上位の限られた件数に入れない限り、そもそも生成されないため「圏外」と「生成されず」の区別すらできなくなる。
Googleが2021年から進めてきた研究の集大成
この論文は突然出てきたものではない。2021年にGoogleの研究者4人が発表した「Rethinking Search(検索の再考)」では、検索システムは参照リストを提示するのではなく、引用可能なコーパスから直接回答すべきだと主張していた。これは研究提案であり製品ロードマップではないとの但し書きが付いていた。
2022年にはほぼ同じ研究グループがDifferentiable Search Index(微分可能検索インデックス、DSI)を発表した。1つのTransformerモデルがクエリを文書識別子に直接マッピングできることを示した。コーパス全体がモデルのパラメータにエンコードされる。これが新しいランキング手法の原型だ。
2026年1月の論文はその理論を埋める。デュアルエンコーダの埋め込み次元は文書数に比例して拡大する必要があるのに対し、固定の隠れ次元を持つ自己回帰モデルは任意の数をランキングできることを証明した。さらにSToICaLという学習ロスを導入し、モデルが上位1件だけでなくリスト全体を意識して学習するようにした。提案、プロトタイプ、証明という流れで、5年間の研究が1つの方向に収束している。
従来の検索は「検索してから並べ替える」2段階だったが、新しい手法では1つのモデルが文書識別子を生成しながらランキングまで完了する。この違いはアーキテクチャの変更ではなく、検索という概念の再定義に近い。
文書はコードになり、コードがランクされる
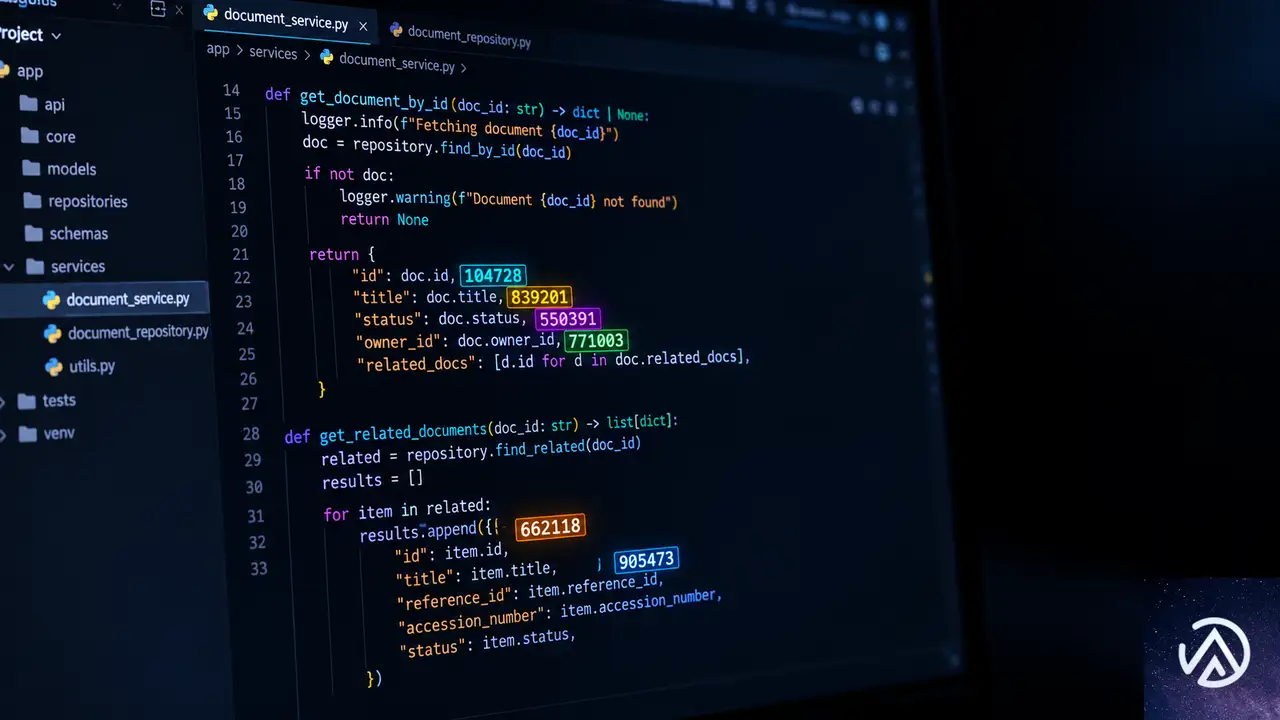
このアーキテクチャでは文書はURLではない。docID(文書識別子)という短いトークン列として扱われる。モデルは単語を生成するのと同じ仕組みで、文書識別子を1つずつ生成していく。
ショッピング実験では、各商品の識別子を商品タイトルの埋め込みベクトルから3つの数字に圧縮して作った。識別子自体が意味を持ち、似た商品は似た数字の並びを共有する。モデルは最も確からしい識別子から順にビームサーチで生成していく。調べるのではなく、アドレスを生成する。検索ルックアップが存在しない点が本質的な違いだ。
ショッピング実験では、商品タイトルの埋め込みベクトルを3つの数字に圧縮して識別子を作った。似た商品は似た識別子を持つため、ランキングが意味を持つ。
識別性が最適化目標になる
ページが埋め込み空間で隣接するページと区別できない場合、安定した識別子を持てない。2つの重複に近い商品ページは隣接する順位を争うのではなく、同じアドレスを争うことになる。そして片方は完全に負ける。
ランキング関数はトレーニングセットそのものになる。SToICaLはクエリ、文書識別子、真のランクの3つ組で学習する。クリックログ、評価者の判断、エンゲージメント信号など、グレード付きリストを生成したものがアルゴリズムになる。リバースエンジニアリングすべきランキング要素の層は存在しなくなる。
鮮度がトレーニング問題に変わる
従来のインデックスでは新しいページはクロールして挿入するだけでよかった。パラメトリック生成インデックスでは学習する必要がある。Googleの後続研究DSI++では、新しい文書を継続的にインデックスすると既存文書の記憶が大幅に失われることが分かっている。
ニュースパブリッシャーにとって「インデックスされた」と「ランカーに認識された」は別のイベントになる。ARR実験では候補をプロンプト内に置くことで回避している。実際の展開も古典的検索が生成ランカーに候補を供給するハイブリッドから始まる可能性が高い。純粋な生成インデックスは長期的な方向性だ。
ビームサーチが可視性の境界線になる
ビームサーチは生成モデルが1つの答えではなく短いリストを生成する仕組みだ。各生成ステップで確率の高い部分列を一定数(ビーム幅)だけ保持し、他は捨てる。ビーム幅が10なら最終リストは10件を超えない。
ポイントは11位が「悪い結果」ではなく「存在しない」ことだ。従来のデュアルエンコーダなら最近傍インデックスで上位1000件をほぼ無料で取得できた。スコアリングが安価だからリストは副産物だった。しかしビーム幅10の生成モデルでは11位はそもそも生成されない。
ビームサーチでは各ステップで一定数(ビーム幅)の候補だけが生き残る。ビーム幅が10なら結果は10件止まりで、11位は計算すらされない。
ランクトラッキングの意味が消える
ページ2は設計上の決定ではなく、存在しないものになる。ビーム幅以下のランクトラッキングは何も測定しない。可視性は2値化する。「生成されたセットに入っているか、入っていないか」だ。
外部からは「ランキングが悪い」と「生成されなかった」を区別できない。どちらも見た目は同じだからだ。実務者の問いは「何位か」から「生成セットに入っているか、どのクエリ形状で、どれだけ一貫して」に変わる。これが可視性計測プラットフォームが答えるべき問いになる。
論文には皮肉な点がある。実際の貢献は1位以下の改善だ。WordNetでの実験では、ランク認識型トレーニングが2位から5位の再現率を50%台から90%台半ばまで押し上げた。2位から5位の並び順が改善される瞬間に、検索結果画面には表示されない領域が広がっていく。
広告と収益モデルへの影響
Alphabetの2026年第2四半期のGoogle検索およびその他収益は632億7000万ドル、前年比17%増だった。広告オークションは別システムであり、この論文は直接触れない。収益に関係するのはコスト面だ。
2段階パイプラインが存在するのは、クロスエンコーダをコーパス全体に実行するのが高すぎるからだ。自己回帰ランキングは最近傍インデックスを不要にし、全文書を個別にスコアリングしない。生成結果の構造的なコスト削減になる。
コストはGoogleがAI回答をデフォルト体験としてどこまで押し広げるかの静かな制約だった。十分なコスト削減が実現すれば、広告在庫が存在する10個の青いリンクを維持する構造的な理由が弱くなる。広告が消えるのではなく、広告を載せる面が変わる。広告も一緒に移動するのだ。
広告システムの変容は始まっている
Search Engine Journalの著者Duane Forrester氏は2025年8月に「Cohorts, Clusters, and the Coming AI Ad System(コホート、クラスタ、到来するAI広告システム)」という記事を公開し、Intent Vector Bidding(意図ベクトル入札)という概念を提唱した。広告主のコンテンツがユーザープロンプトの意味とどれだけ近いかで掲載が決まり、広告自体もクエリ時に広告主の資産から組み立てられるという仕組みだ。
9か月後のGoogle Marketing Liveで、GoogleはAI検索向けの広告フォーマットを発表した。ユーザー固有のクエリに即座に合わせ、質問の具体的な言い回しからクリエイティブを生成する。キャンペーンを実行し資産を供給する点は従来通りだが、クリエイティブの半分は実現した。
ARR論文はそのメカニズムを完成させる。Google Researchのトークンオークション論文は、広告主がトークンごとに生成される広告テキストに影響を与えるために入札するオークションを設計した。自己回帰ランキングは有機的な文書識別子をトークンごとに生成する。同じ生成プロセスが答え、有機ソース、スポンサード掲載を同時に生成できる可能性がある。
実務者が今着手すべき3つの対策
研究論文を基盤にプログラム全体を再構築する必要はない。この段階では3つの小さな動きが釣り合いの取れた対応になる。
この3つの対策は即座に実行可能で、研究の進展を待たずとも価値がある。識別性の監査と可視性測定の移行は、現在の検索環境でも有効な施策だ。
この記事のポイント
- Googleがインデックスなしで文書をランキングできる計算手法を理論的に証明した
- 文書はdocIDというコードになり、モデルが生成するアドレスに変わる
- ビームサーチが可視性の境界線になり、上位10件以外は存在しない扱いになる
- ランクトラッキングより生成セットへの含有率測定が重要になる
- 広告システムはトークン単位の入札と生成型クリエイティブへ進化する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Shopifyが全AIショッピングチャネルに自動登録。デフォルト設定の全容
Shopifyが2026年1月から、対象ストアを新しいAIショッピングチャネルへ自動登録する仕組みを本格稼働させている。2026年9月8日のMeta「Muse」ローンチ当日には、対象ストアの商品情報が即座にMetaへ共有された。
現在、ChatGPT・Google・Microsoft Copilot・Metaの主要4チャネルでAIエージェント経由の販売が可能だ。チャット内で決済まで完了する「ダイレクトチェックアウト」もデフォルトで有効になっている。
この記事では自動登録の仕組み、ダイレクトチェックアウトの影響、アナリティクス計測で発生する盲点、停止手順までを解説する。
ShopifyのAIショッピングチャネル自動登録の仕組み
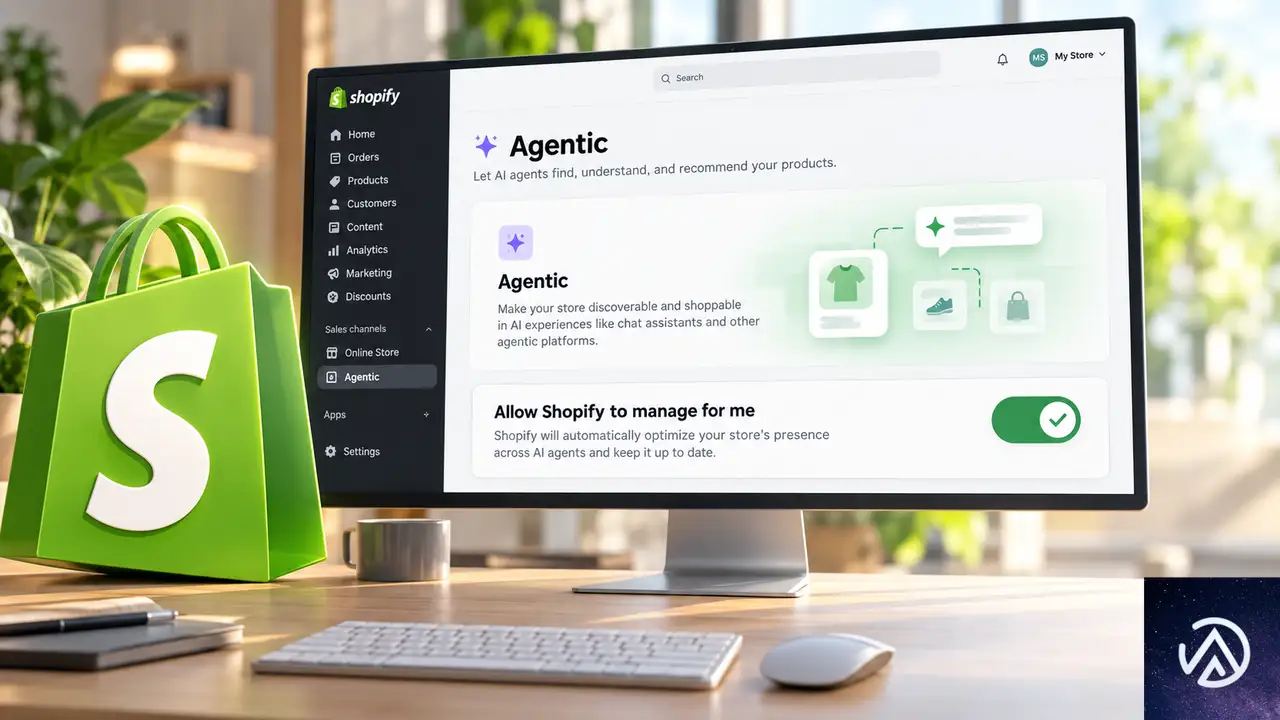
このデモは「Shopifyに管理を任せる」設定のオン・オフで表示がどう変わるかを示している。オフにすると3つの独立したスイッチが現れ、細かな制御が可能になる。
Shopify管理画面の「販売チャネル → Agentic」ページには「Allow Shopify to manage for me(Shopifyに管理を任せる)」という設定がある。この設定がオンの場合、Shopifyは対象ストアを新しいAIショッピングチャネルへ自動で登録する。デフォルトで有効だ。
Shopifyの公式ドキュメントによると、この設定では次の3つが自動的に行われる。Shopify Catalogを通じた商品アクセスの提供、関連チャネルでのダイレクトチェックアウトの有効化、新しいエージェンティックストアフロントチャネルへの自動登録だ。
Shopify Catalogは、多くのAIアプリが商品リストを取得する仕組みだ。Googleは例外で、Google Merchant Centerから商品情報を読み取る。
自動登録の最初の大規模適用は2026年1月12日に実施された。その後2026年9月8日のMeta「Muse」ローンチ時に、対象ストアの商品が即座にMetaへ共有された。MuseはMetaのAIエージェントで、ブラウザの操作やフォーム入力、価格交渉まで行える。2026年9月20日には、AmazonがMuseを自社ストアからブロックしている。Shopifyの自動共有からわずか12日後のことだ。
自動登録の対象となる主要チャネル
管理画面には「その他のチャネル」という行もあり、PerplexityのようなAIプラットフォームや、実験的なショッピングエージェントを開発するスタートアップが含まれる。この行もデフォルトでオンになっている。
ダイレクトチェックアウトで店舗訪問不要の購入が可能に
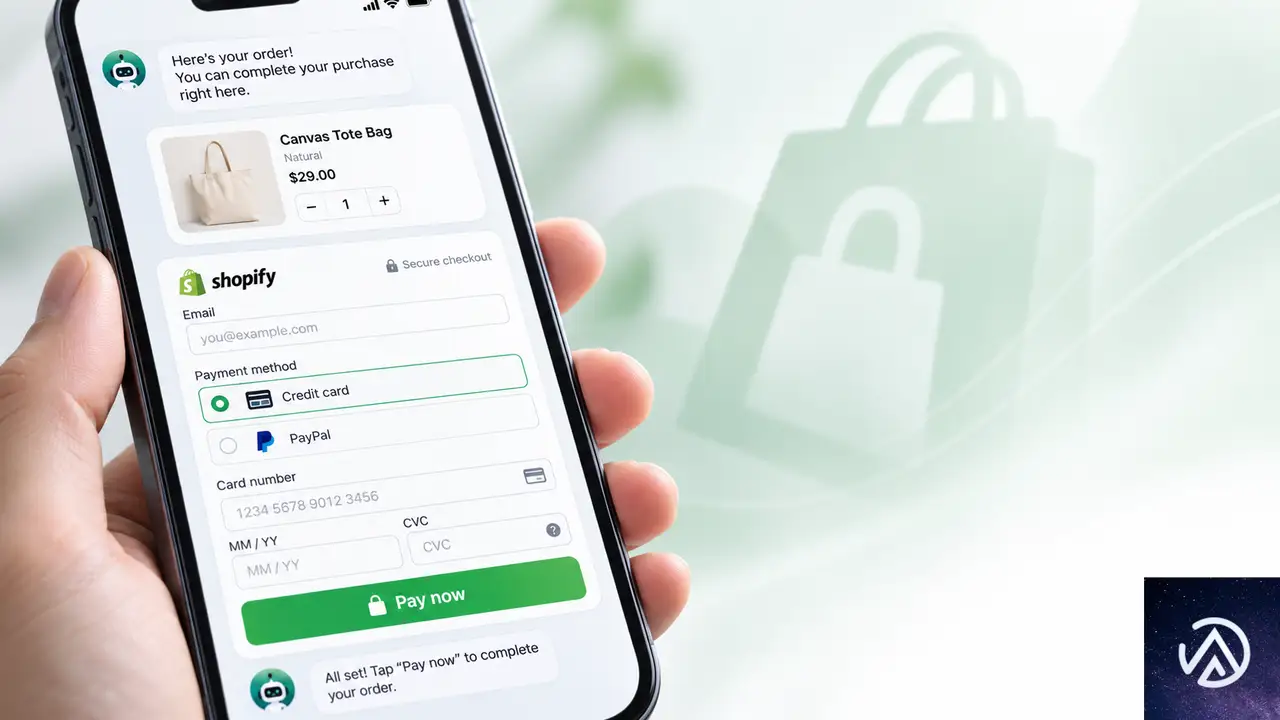
従来フローではサイト訪問が必須だったが、ダイレクトチェックアウトではチャットアプリ内で決済まで完了する。この違いがアナリティクス計測に影響を与える。
ダイレクトチェックアウトとは、顧客がAIチャットアプリ内のShopifyチェックアウトで決済を完了し、自社サイトを一切開かない購入方法だ。条件を満たすストアではデフォルトで有効になっている。
- Meta、米国・カナダ・メキシコ向けに販売するストア
- Google AI ModeとGemini、米国のストアが米国顧客向けに販売し、Google Merchant Centerアカウントを持つこと
- Microsoft Copilot、米国内で販売するストア
ChatGPTは仕組みが少し異なり、顧客を自社ストアのチェックアウトへ誘導する。ChatGPTアプリ内ブラウザで表示されるか、Web版なら新しいタブでチェックアウトが開く。
アナリティクス計測に生じる盲点
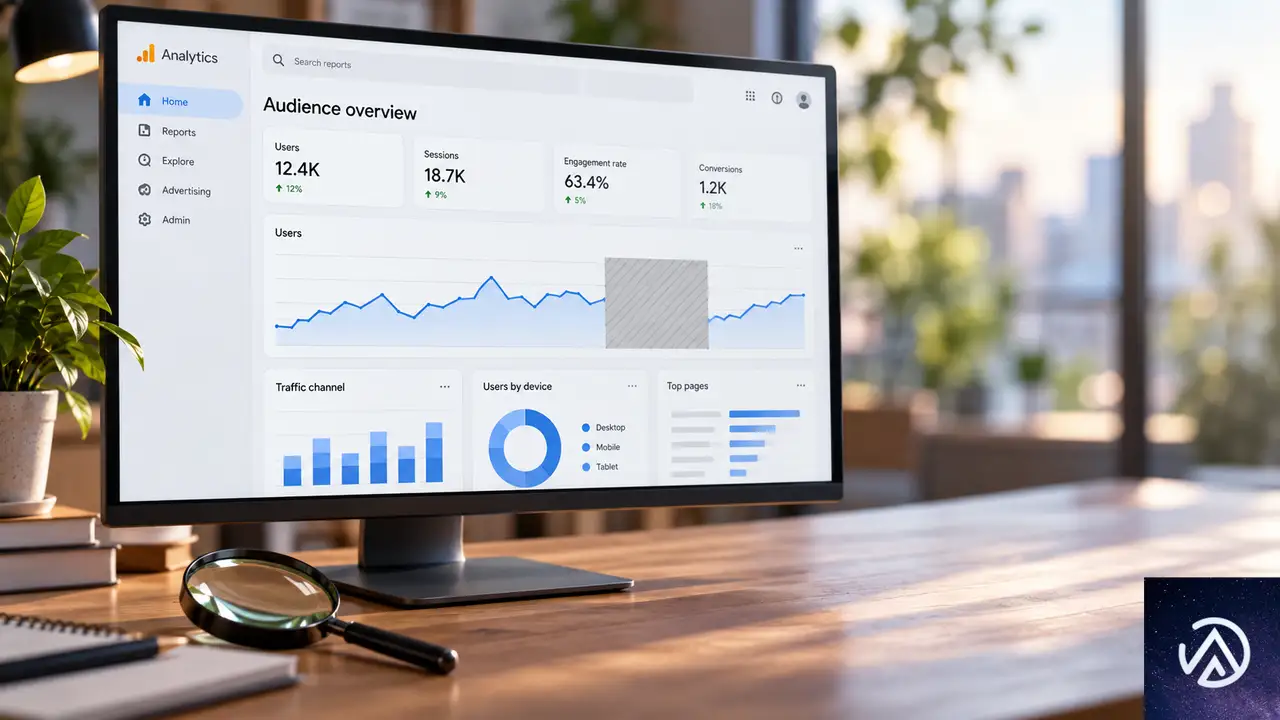
カスタムピクセル あり
サーバーサイド計測 あり
カスタムピクセル なし
サーバーサイド計測 あり
Shopify管理画面の注文記録 あり
ダイレクトチェックアウトではクライアントサイドの計測が止まる一方、Shopify管理画面には注文が記録される。売上分析の際は計測経路の違いを理解しておく必要がある。
ダイレクトチェックアウトでの購入では、自社サイトのトラッキングコードが実行されない。Shopifyによると、Google AnalyticsとカスタムピクセルはGoogle・Copilotのチェックアウトで発火せず、サーバーサイドトラッキングのみが機能する。Metaのチェックアウトではサードパーティ製アナリティクスピクセルが発火しない。
ただしShopify管理画面には注文が記録される。Meta経由の注文も「他の販売チャネルと同じ方法で」表示されるため、Shopifyの管理画面を見ていれば売上自体は把握できる。
このため、Google Analyticsや広告ダッシュボードで売上を確認しているストア運営者は、AI経由の売上を見落とす可能性がある。月に1回程度、注文リストをチャネル別にフィルタして確認する運用が推奨される。
自動登録を停止する手順と注意点
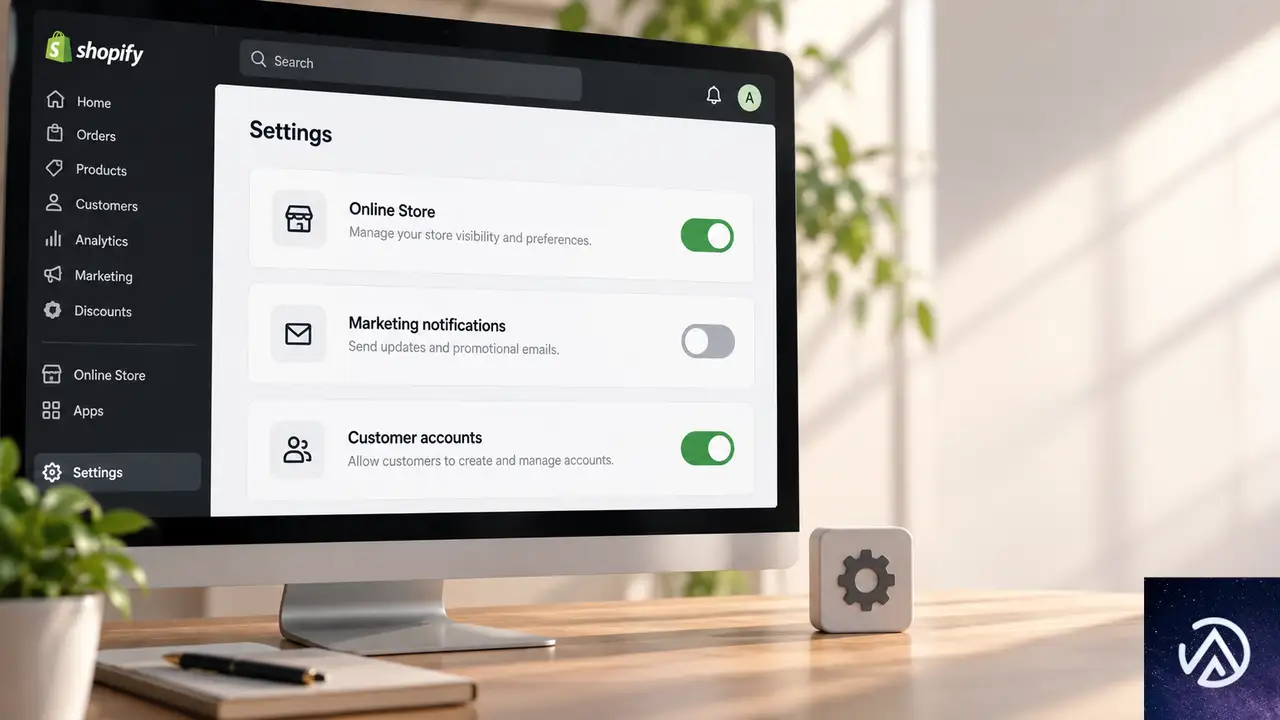
「Shopifyに管理を任せる」設定をオフにすると、次の3つのスイッチが表示される。
- Shopify Catalogアクセス
- 新しいストアフロントの自動登録
- ダイレクトチェックアウト
「新しいストアフロントの自動登録」をオフにすれば、既存チャネルは維持しつつ新規チャネルへの自動登録だけを停止できる。
チャネル別にも設定がある。MetaとCopilotはカタログアクセスとダイレクトチェックアウトのそれぞれにスイッチを備える。ChatGPTはカタログアクセスのみ、Googleはダイレクトチェックアウトのみだ。
カタログアクセスをオフにした場合、Shopifyは商品データの共有が停止するまで最大7日かかるとしている。即時に共有が止まるわけではない点に注意が必要だ。
特定商品だけをAIアプリから隠すには「unlisted(非公開)」に設定する。ただし非公開にするとサイトマップやGoogle検索、自社サイト内検索からも除外される。AIチャネル限定の除外はできない。
手数料は当面無料、Metaは将来の手数料徴収を示唆
2026年9月時点で、ChatGPT・Google・Microsoft Copilot・Metaはいずれも手数料を請求していない。ストア運営者が支払うのは通常の決済処理手数料のみだ。販売者としての立場も変わらず、発送・返品・カスタマーサービスは引き続きストア側が担当する。
ただしMetaは将来の手数料徴収を明確に示唆している。Mark Zuckerberg氏は2026年9月8日公開のポッドキャストで、Museについて「時間の経過とともに、取引額のごくわずかなカットを徴収するビジネスモデルを期待している」と発言した。手数料はMuseが取引を仲介する事業者から徴収する形になる見通しだ。
GoogleとMicrosoftからは同様の手数料計画は明らかにされていない。No HacksのポッドキャストEpisode 233では、MetaがMuseについて述べた内容と手数料の見通しを詳しく検証している。
AI参照トラフィックは急増中
Agenticページ上部に表示される「ショッパー数」は、AIアプリから自社ストアへの訪問数を表す。Shopifyのドキュメントでは「指定期間内にAIチャネルからオンラインストアへの総訪問数」と定義されている。
ただしダイレクトチェックアウトでの購入はWebサイトを開かないため、この数には含まれない。つまりこの数値は「AIエージェントが購入した数」ではなく「AIチャットアプリの回答からリンクをクリックして訪問した人数」だ。
Search Engine Journalの記事では、このショッパー数を「エージェンティックショッピングではなくLLM参照トラフィック」と整理している。AIチャットアプリの回答経由でストアに送られてきた訪問者という位置づけだ。
Shopifyは2026年8月、2026年第2四半期に「AI参照セッションが前年同期比197%増、注文数も3倍に増加した」と発表している。一方、AIエージェントがチャットアプリ内で完了した購入の具体的な件数は、Shopifyからも他社からも公表されていない。
Search Engine Journalの記事は、当面はすべての設定をオンにしたまま、Shopifyがチャネルリストに追加する項目を注視することを推奨している。ダイレクトチェックアウトの売上は、チャネル別にフィルタした注文リストでしか把握できないためだ。
この記事のポイント
- Shopifyの自動登録設定はデフォルトで有効、対象ストアは新AIチャネルに自動参加する
- ダイレクトチェックアウトではGAやピクセルが発火せず、計測の盲点が生じる
- 自動登録は「Shopifyに管理を任せる」設定をオフにすれば停止できる
- 現在は手数料無料だが、Metaは将来の手数料徴収を示唆している
- AI参照トラフィックは前年比197%増と急成長している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CloudflareがAI決済2製品をベータ公開、サイト運営者が知るべき課金モデルとは
CloudflareがAI決済分野で動きを加速させている。9月30日に2つの製品をベータへ移行した。Monetization GatewayとPay Per Useだ。いずれもサイト運営者がAIエージェントやAI企業から収益を得るための仕組みである。
Monetization GatewayはAIエージェントからのリクエスト単位で課金する。Pay Per UseはAI企業がコンテンツを使用した際にパブリッシャーへ支払う。どちらも現在は米国拠点の利用者に限定したクローズドベータだ。
AI検索の普及でコンテンツの無断利用が問題視される中、この発表はサイト運営者にとって新たな収益化の選択肢となる。本記事では仕組みと実務への影響を解説する。
CloudflareがAI決済製品をベータ公開、収益化の選択肢が拡大
この比較図は3つの支払いモデルの課金タイミングを示している。縦に並んだ各モデルは、それぞれ異なる課金ポイントを持つ。
Cloudflareは7月1日にMonetization Gatewayを発表し、順番待ちリストを開設していた。今回のベータ移行で実際の利用が始まった形だ。Pay Per Useも同じくベータ段階に入っている。
3つの支払いモデルが揃った
Cloudflareが提供するAI関連の支払いモデルはこれで3つになった。既存のPay Per Crawlに加え、今回の2製品が加わった。それぞれ課金のタイミングと主体が異なる。
- Pay Per Crawlはクローラーがアクセスした時点でサイト所有者が設定した料金を支払う
- Monetization GatewayはAIエージェントからのリクエストごとに売り手が設定した料金を請求する
- Pay Per UseはAI企業がコンテンツを使用したと報告した時点でAI企業が設定した料金をパブリッシャーに支払う
この3モデルを理解すると、AI時代のコンテンツ課金の全体像が見えてくる。
Monetization Gatewayの仕組み
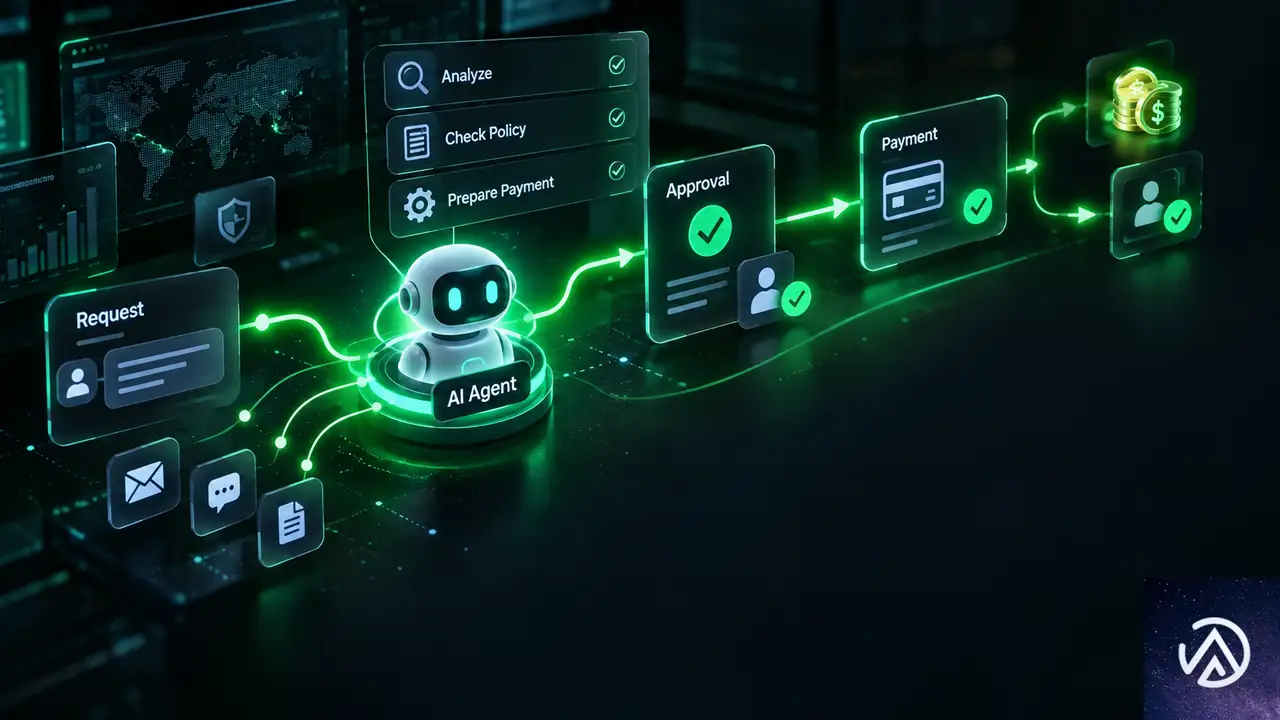
このフロー図はMonetization Gatewayの処理手順を示している。支払いが完了するまでコンテンツは提供されない。
Monetization GatewayはAIエージェントに対してリクエスト単位で課金する仕組みだ。API、MCPツール、データセット、サイトなど、リクエストがあるたびに使用が発生するリソース向けに設計されている。MCPツールとは、AIアシスタントが外部の機能を呼び出すための標準規格Model Context Protocolに対応したツールを指す。
リクエスト単位の課金フロー
このゲートウェイはx402プロトコルとHTTP 402 Payment Requiredステータスコードを使用する。x402プロトコルは、HTTP 402を利用した機械支払いのための規約だ。人間の介入なしにAIエージェント同士が支払いを処理できるよう設計されている。
HTTP 402は「支払いが必要」という意味のレスポンスコードだ。AIエージェントが保護されたリソースへアクセスすると、まず支払い条件を受け取り、支払い承認に署名してから再試行する。支払いはこのリクエスト内で処理され、売り手のサーバーが応答する前に検証される。つまり、支払いが確認できなければコンテンツは提供されない仕組みだ。
料金設定は固定と変動の2種類から選べる。固定価格は入力が同じなら常に同じ料金になる。変動価格は上限額を設定し、実際の使用量に応じて売り手側が請求額を報告する。決済は1回0.001ドルから100ドルまで対応する。
支払い処理にはUSDCステーブルコインを採用した。Baseブロックチェーン上でCoinbaseのx402 Facilitatorを経由する。将来的には他の支払い方法も追加する予定だ。
導入に必要な条件
現在はクローズドベータのため、利用するには条件がある。売り手と買い手の双方が米国に拠点を置く必要がある。売り手側はクレジットカードの登録、確認済みメールアドレス、開設から60日以上経過したアカウントが求められる。
さらにサイトがCloudflare経由でプロキシされており、作成から30日以上経過していること、ゾーンのセキュリティチェックを通過することが条件だ。アクセス申請はダッシュボードから行う。
4つのライブ実装も公表されている。Ceramic.aiはエージェント向けのWeb検索APIを固定価格で提供する。AI Gatewayは4つのオープンモデルで推論リクエストごとの支払いを受け付ける。Stocktwitsは市場シグナルをリクエスト単位で課金する。API2PDFはリクエストの計算量と帯域幅に基づく変動価格でPDF生成APIを提供する。
API2PDFの事例は示唆的だ。初月無料の後にクレジットカードを要求すると変換率が50%以上低下したという。AIエージェント向けの決済はスムーズさが重要だと示している。
Pay Per Useの仕組み
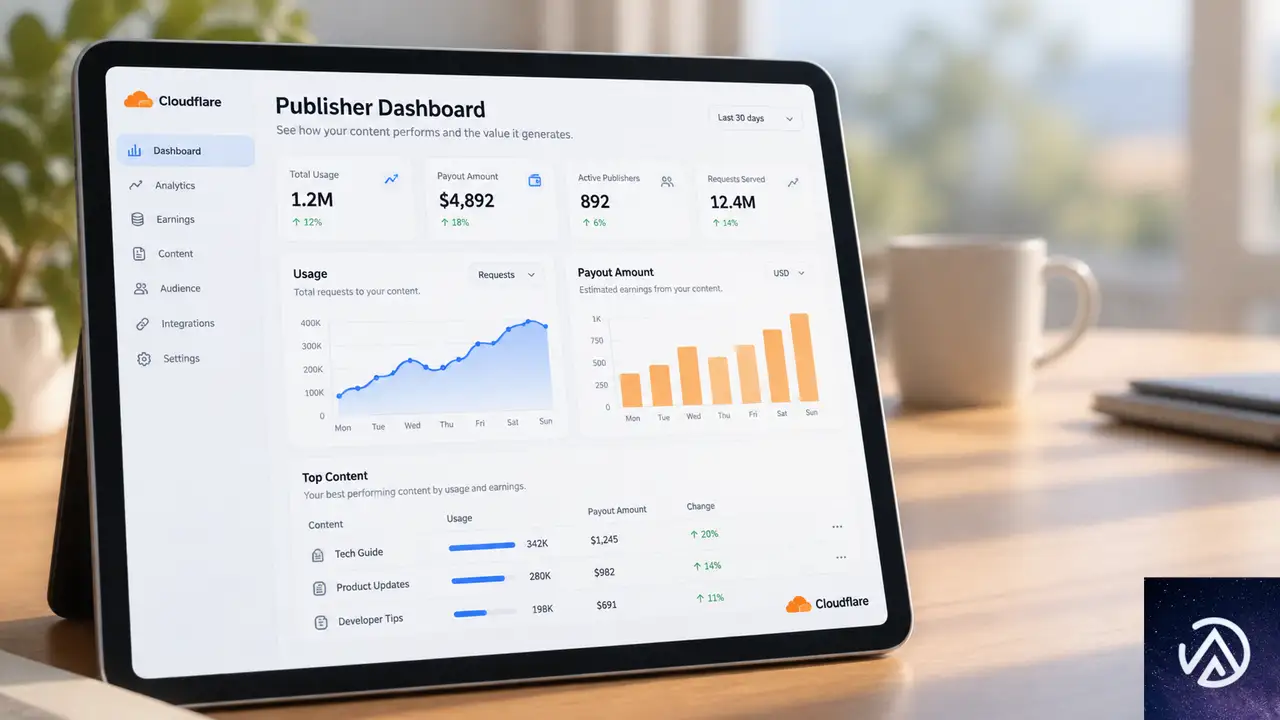
このフロー図はPay Per Useの役割分担を示している。AI企業が使用を報告し、Cloudflareが照合してパブリッシャーへ支払う流れだ。
Pay Per Useは別のアプローチを取る。パブリッシャーがコンテンツを提供し、AI企業がそのコンテンツを使用したと報告した場合に、AI企業からパブリッシャーへ支払いが発生する。
使用報告の流れ
役割分担は明確だ。AI企業が支払う用途と価格を定義する。パブリッシャーは提示されたオファーを承認するか拒否するかを決める。承認後は自分のコンテンツがどれだけ使われ、いくら稼いだかを確認できる。Cloudflareは登録、使用記録、請求、支払いを担当する。
使用の記録はAI企業側が自己申告する。タイムスタンプ、ソースURL、イベントIDを報告し、Cloudflareが各使用報告が登録済みパブリッシャーのものか照合する。そこから買い手に請求し、毎月パブリッシャーへ支払う流れだ。
ベータ期間中、Cloudflareは個々の買い手および参加を選択したパブリッシャーと直接連携している。買い手の企業名はまだ公表されていない。
パブリッシャーが注意すべき点
Pay Per UseではAI企業が使用用途と価格を設定する。パブリッシャーはオファーを承認するか否かの判断のみで、価格交渉はできない。また、使用データは買い手の報告に依存するため、実際の使用頻度との乖離があり得る。
各プログラムの規約には、AI企業がコンテンツをどう扱えるか、学習用途の制限なども含まれる。参加前に規約を確認する必要がある。
サイト運営者への実務的な影響
これら2製品は、AIエージェントの台頭でコンテンツ収益が脅かされているサイト運営者に新たな選択肢をもたらす。特にMonetization GatewayはAPIやデータセットを提供する事業者との相性が良い。Pay Per Useはコンテンツメディア向けだ。
SEO観点での評価
SEO対策の観点では、AI検索エンジンがコンテンツを読み取る動きが加速する中、その利用に対して対価を求める仕組みが整ってきた点が重要だ。これまで無断でクロールされ、引用される一方だったパブリッシャーに交渉の余地が生まれる。
ただし現段階では取引件数や支払い実績は公表されていない。収益化の効果を実証するデータはまだない。ベータ期間中の成果報告が待たれる。
導入を検討する際のチェックポイント
現時点で導入できるのは米国拠点の事業者に限られる。日本からはまだ利用できない。地理的な拡大は予告されているが、時期は明らかではない。まずは動向を追い、仕組みを理解しておくことが現実的だ。
- 自社コンテンツがAIエージェントに利用される頻度を把握する
- Pay Per Crawl、Gateway、Pay Per Useの違いを理解する
- Cloudflareを利用しているか、利用予定があるか確認する
- ベータが日本に開放された際にすぐ試せるよう準備する
今後の展開と注目ポイント
CloudflareはPay Per Useのベータで、パブリッシャーが買い手の提示価格に対抗してカウンターオファーを出したり、用途別に異なる料金を設定したりする方法を模索している。
また、Pay Per Useで購入するAI企業の社名が公表されるかも注目点だ。Gatewayについては新たな地域への対応が予告されている。日本からの利用開始時期も気になるところだ。
AIエージェント経済のインフラが整いつつある。サイト運営者はこの変化を収益化のチャンスと捉え、早期に情報をキャッチアップしておくべきだ。
この記事のポイント
- Cloudflareが2つのAI決済製品をベータ公開した
- Monetization Gatewayはリクエスト単位でAIエージェントに課金する
- Pay Per UseはAI企業の使用報告に基づきパブリッシャーへ支払う
- どちらも現段階では米国拠点の限定ベータである
- AI時代のコンテンツ収益化に新たな選択肢が加わった
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ShopifyがWebMCPをチェックアウトに拡張、AIエージェントが注文確定まで対応
Shopifyが9月28日、WebMCPツールをチェックアウトに拡張した。ブラウザエージェントは購入者のタブで開いているチェックアウトを読み取り、更新し、購入者の確認を得た上で注文を確定できるようになった。
8月時点のWebMCPは商品検索とカート管理が中心だった。チェックアウトページへの誘導はできたが、注文の確定は購入者自身が行う必要があった。今回の拡張でAIエージェントが購入完了まで関与する形になる。
この記事では4つの新ツールの役割、購入者が制御を取り戻す場面、ブラウザ自動化との比較テスト結果を解説する。
WebMCPチェックアウト拡張の概要
8月の展開からの進化
WebMCPとは、ブラウザ内でAIエージェントがWebサイトの機能を利用するための仕組みだ。Shopifyは2026年8月に最初のWebMCPツールを公開した。当時は商品検索とカート管理が中心で、エージェントは購入者をチェックアウトページまで誘導するに留まっていた。
9月28日の拡張により、ブラウザエージェントはチェックアウトの状態を読み取り、配送先や支払い方法を更新し、購入者の確認を得た上で注文を確定できる。Shopifyの開発者向けチェンジログは「新しいAPIを公開するわけではなく、マーチャントの設定も不要」と説明している。
新しいツールの仕組み
新しいツールは購入者が見ているチェックアウトページと同じ状態を利用する。エージェントが裏側で別のセッションを操作するのではなく、実際に開いているチェックアウトの状態を読み書きする仕組みだ。
これにより購入者とエージェントの間で情報のずれが生じにくい。チェックアウトは各更新時に独自の検証を行い、エージェントが注文の商品を変更することはできない設計になっている。
このデモは8月時点と9月28日以降のWebMCPの機能差を示している。エージェントが「誘導役」から「取引実行役」に変わった点が今回の拡張の本質だ。
チェックアウトで利用できる4つのツール
各ツールの役割
ShopifyのチェックアウトWebMCPドキュメントによると、対象となるチェックアウトには4つのツールが登録される。
- get_checkoutはチェックアウトを読み取り、購入後は注文詳細も取得する
- update_checkoutは連絡先、配送または受け取り方法、割引コード、支払い方法、税番号などの追加項目を変更する
- complete_checkoutは注文を確定する
- navigate_to_storefrontはタブをストアに戻す
4つのツールは役割が明確に分かれている。読み取り、更新、確定、移動という一連の流れをエージェントが実行できる設計だ。
支払い方法の制限
これらのツールは新しいカード情報を受け付けない。エージェントは保存済みのShop Payカードを選択するか、ゲストチェックアウトが許可している場合はエージェントが持っているShop Pay承認を利用して支援できる。
それ以外の支払い方法は購入者がチェックアウトページで直接選択する必要がある。エージェントはあくまでもShop Payの範囲内で支払いを支援する形だ。これはエージェントがクレジットカード情報を扱うリスクを避ける設計といえる。
また、エージェントはWeb Bot Authを使用してブラウザリクエストに署名する必要がある。Web Bot AuthとはShopifyがエージェントを認識するための署名方式だ。署名がない場合、リクエストは優先度が下がったり、ボット検出システムによってブロックされたりする可能性がある。
購入者が制御を取り戻す場面
注文確定前の同意
Shopifyのドキュメントは、complete_checkoutを呼び出す前に現在の注文と合計を購入者に表示し、「注文の許可を得ること」をエージェントに指示している。
注目すべきは、Web Bot Auth署名、Shop Pay承認、準備完了ステータスはこの同意には該当しない点だ。エージェントが技術的に注文を確定できる状態であっても、人間の購入者が最終確認を行わない限り注文は実行されない。
これはAIエージェントの暴走を防ぐ安全設計として評価できる。自動化が進んでも、最終的な購入判断は人間が行うという原則を守っている。EC事業者にとっては、エージェントが勝手に注文を確定してしまうリスクを抑えられる仕組みだ。
支払いチャレンジとUI拡張
Shop Payログインや3D Secureなどの支払いチャレンジは、購入者にページ上での制御を戻す。3D Secureとはオンラインカード決済の追加認証方式で、不正利用を防ぐためにパスワードや生体認証を求める仕組みだ。
ブロッキングUI拡張機能やレビューステップも同様に、購入者が直接操作する場面となる。購入者はアプリが定義するチェックアウト拡張機能とのやり取りも管理する。エージェントがすべてを代行するのではなく、特定の場面では必ず人間が介入する仕組みになっている。
対象チェックアウトの条件と利用環境
Shop Pay必須の制限
Shopifyの標準3ページチェックアウトは、購入者がShop Payでチェックアウトする場合を除き、WebMCPツールを取得しない。B2Bチェックアウト、埋め込みチェックアウト、モバイルチェックアウトSDK内のチェックアウトも対象外だ。
他のショップの商品を含むチェックアウト、ドラフト注文、注文編集、支払い回収も除外される。この制限はマーチャントにとって重要な意味を持つ。すべてのチェックアウトでAIエージェントが注文を確定できるわけではない。
現時点ではWebMCPチェックアウトの適用範囲は「Shop Payを使う標準チェックアウト」に限られる。Shop Pay以外の支払い方法を選ぶ購入者には、エージェントはチェックアウトの支援ができない。この制限がWebMCPチェックアウトの普及にどの程度影響するかは、今後の利用データを見る必要がある。
Chromiumブラウザ限定
現時点では、エージェントがWebMCPを使用できるのはChromiumベースのブラウザのみだ。ChromiumとはGoogleが開発するオープンソースのブラウザエンジンで、Google ChromeやMicrosoft Edgeが採用している。
FirefoxやSafariでは利用できない。この制限はWebMCPの普及に影響を与える可能性がある。ただしChromeとEdgeがブラウザ市場の大部分を占めていることを考えると、実用上の影響は限定的かもしれない。
Checkout WebMCPとCheckout MCPの選択
2つのルートの違い
Shopifyはチェックアウトでのエージェント向けに2つのルートを文書化している。サーバーベースのCheckout MCPと、ブラウザ内で動作するCheckout WebMCPだ。
ShopifyはサーバーベースのCheckout MCPを推奨している。この方式ではエージェントが自身のサーバーからチェックアウトセッションを管理する。Checkout WebMCPは「エージェントがすでに購入者のブラウザで動作している場合のみ」使用するよう案内している。
両方ともUniversal Commerce Protocolのチェックアウト機能に依存し、同じチェックアウトオブジェクトを使用する。Universal Commerce ProtocolとはShopifyが提唱する商取引の共通プロトコルで、異なるシステム間で取引情報をやり取りするための標準仕様だ。
Checkout WebMCPはチェックアウトページが購入者のブラウザに登録するツールを通じて動作する。一方、Checkout MCPはサーバー側でリクエストを処理する。実行場所が異なるだけで、扱うデータは同じだ。
マーチャントの立場
どちらの方法でも、Shopifyはマーチャントが記録上のマーチャントのままであると説明している。エージェントが仲介者になっても、販売者としての責任はマーチャントに残る。
これは法的・会計的な観点で重要なポイントだ。AIエージェントが注文を確定しても、取引の主体はあくまでもマーチャントである。エージェントが誤った注文を確定した場合の責任の所在も、マーチャントが負うことになる。
ブラウザ自動化との比較テスト
成功率と速度の差
Shopifyのエージェンティックコマース担当チームに所属するGil Greenberg氏は、WebMCPとブラウザ自動化を比較する社内テストの結果を公開した。ブラウザ自動化とは、エージェントがページを読み取ってクリック操作を行う方式だ。画面上の要素を視覚的に認識して操作する必要があるため、処理が遅くなりがちだ。
テストはGPT-6 Solを使って、同じプロンプトと開始条件で実施された。2つのテストショップで合計10のチェックアウトタスクを実行した結果、WebMCPは60回すべて成功した。一方、ブラウザ自動化は60回中56回の成功だった。
ページセットアップ時間を除いた1回あたりの時間は、WebMCPが10.3秒、ブラウザ自動化が27.4秒だった。WebMCPが約2.7倍高速だった計算になる。
1回あたり 10.3秒
コスト 58%削減
1回あたり 27.4秒
コスト 基準値
この比較はWebMCPの優位性を示している。成功率、速度、コストの3つの指標すべてでWebMCPが上回った。
コスト面の優位性
コスト面でもWebMCPが優位だった。OpenAIのリスト価格で比較すると、WebMCPのコストは1回あたり58%低かった。速度が速いだけでなく、API呼び出し回数やトークン消費量も抑えられるためだ。
ただし、この結果には注意点がある。テストはShopifyのテストショップと単一モデルで行われたもので、実際の注文やコンバージョン率などの実データは含まれていない。また、Greenberg氏の投稿には1行だけ60回の試行と一致しない合計値が含まれている。
とはいえ、WebMCPが「有望な方向性」を示していることは間違いない。ブラウザの画面を読み取ってクリックする方式よりも、専用のツールを介して直接操作する方式のほうが効率的であることは、このテスト結果から十分に裏付けられている。
この記事のポイント
- Shopifyが9月28日、WebMCPをチェックアウトに拡張した
- エージェントがチェックアウトの読み取り、更新、注文確定まで実行できる
- 注文確定には購入者の明示的な同意が必須
- Shop Pay必須の制限があり、対象チェックアウトは限定的
- ブラウザ自動化との比較テストで成功率100%、速度2.7倍、コスト58%削減を達成
- マーチャントが個々のツールをオフにできるかは未確認
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareがrobots.txtを自動生成するBot Preference Syncの仕組みと検証
Cloudflareが2026年8月21日、サイトのrobots.txtを自動生成する新機能「Bot Preference Sync」を発表した。Search、Agent、Trainingの3つのカテゴリ設定から、Cloudflareがrobots.txtの該当部分を自動的に書き換える仕組みだ。robots.txtとエッジ強制設定の矛盾を解消すると期待される。
この機能は無料プランから利用でき、新規顧客にはデフォルトでオンになる予定だ。一方でカテゴリ単位の設定には粗さがあり、個別クローラー単位のビジネス判断を表現できないという課題もある。本記事では機能の仕組みと限界、サイト運営者が取るべき対応を検証する。
robots.txtとエッジ強制の矛盾が生んだ新機能
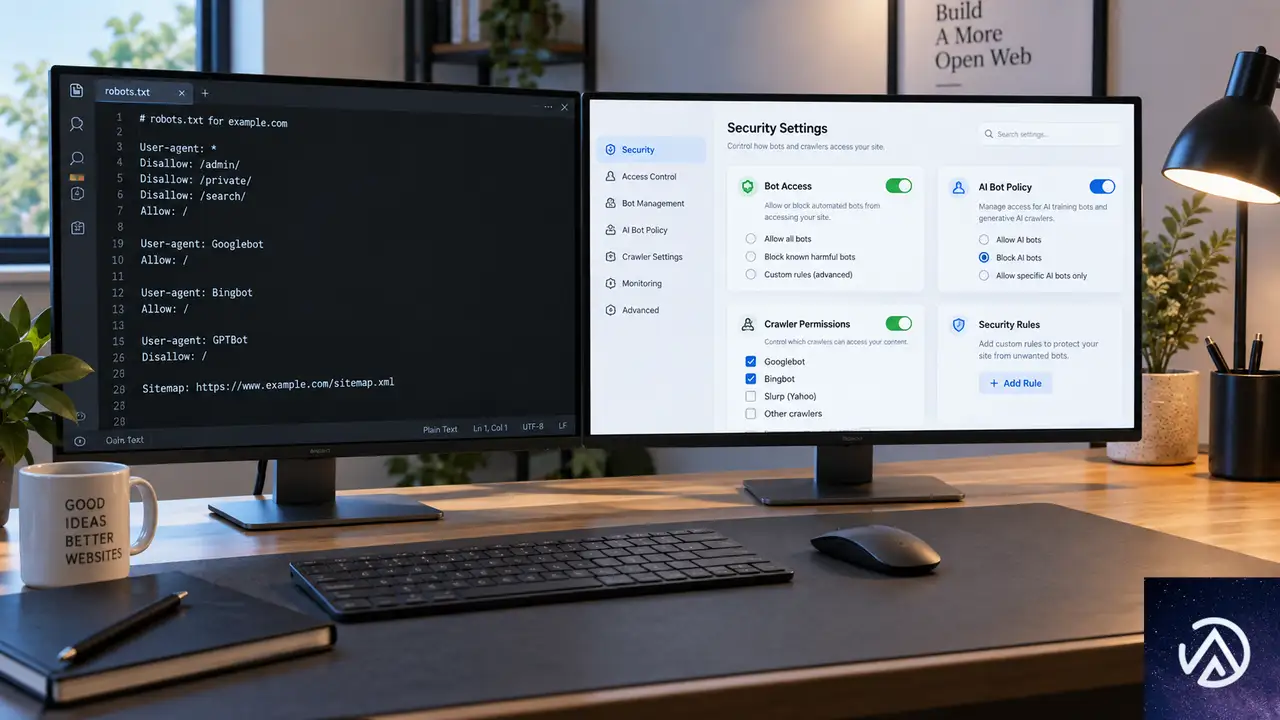
Webサイトのクローラーポリシーは2つの場所で管理される。1つはrobots.txtファイル、もう1つはWAFやCDNのエッジ側で動作するブロック設定だ。robots.txtはテキストファイルであり、クローラーへのリクエスト(お願い)を記述する。エッジ強制設定はダッシュボードで操作し、実際にHTTPリクエストを拒否する。
この2つは別々の場所で管理されるため、時間とともに矛盾が生じやすい。robots.txtは一度作成すると放置されがちで、エッジ設定は後から変更されることが多い。No Hacksの記事は、運営者自身のサイトでこの問題が発生していた例を報告している。robots.txtではBytespiderを許可する記述が数ヶ月間残っており、意図しないクローラーを歓迎する状態だったという。
CloudflareのBot Preference Syncは、この矛盾を自動的に解消する。ダッシュボードで設定したAIボットポリシーをrobots.txtに反映し、エッジ強制設定との乖離を防ぐ。Cloudflareがrobots.txtを書くという行為は、サイト運営者の代わりにポリシーを文書化することでもある。
Bot Preference Syncの仕組みと3つのカテゴリ設定
Bot Preference Syncは、セキュリティ設定の「AIボットポリシー」で設定した内容をrobots.txtに変換する。設定項目はSearch(検索)、Agent(エージェント)、Training(トレーニング)の3カテゴリだ。各カテゴリには「全ページでブロック」「広告表示ページのみブロック」「許可」の選択肢がある。
生成されたrobots.txtには、Cloudflare Bot Preference Syncの開始マーカーと終了マーカーが付与される。既存のrobots.txtコンテンツはその下に保持される。つまりCloudflareが書き込むのはマーカーの間の部分だけで、サイト運営者が手動で書いた部分は残る仕組みだ。
Bot Preference Syncは設定をrobots.txtへ反映する一連の流れを自動化する。
Cloudflareの発表によると、この機能は無料プランから利用可能で、新規顧客にはデフォルトでオンになる。ただし2026年9月13日時点では、Bot Preference Syncの公式Changelogへの記載がなく、Cloudflareのボットドキュメントにも言及がない。また一部のサイトではrobots.txtに生成ブロックがまだ現れていない。本記事は発表内容に基づく検証となる。
カテゴリ単位の設定では表現できない個別ポリシー
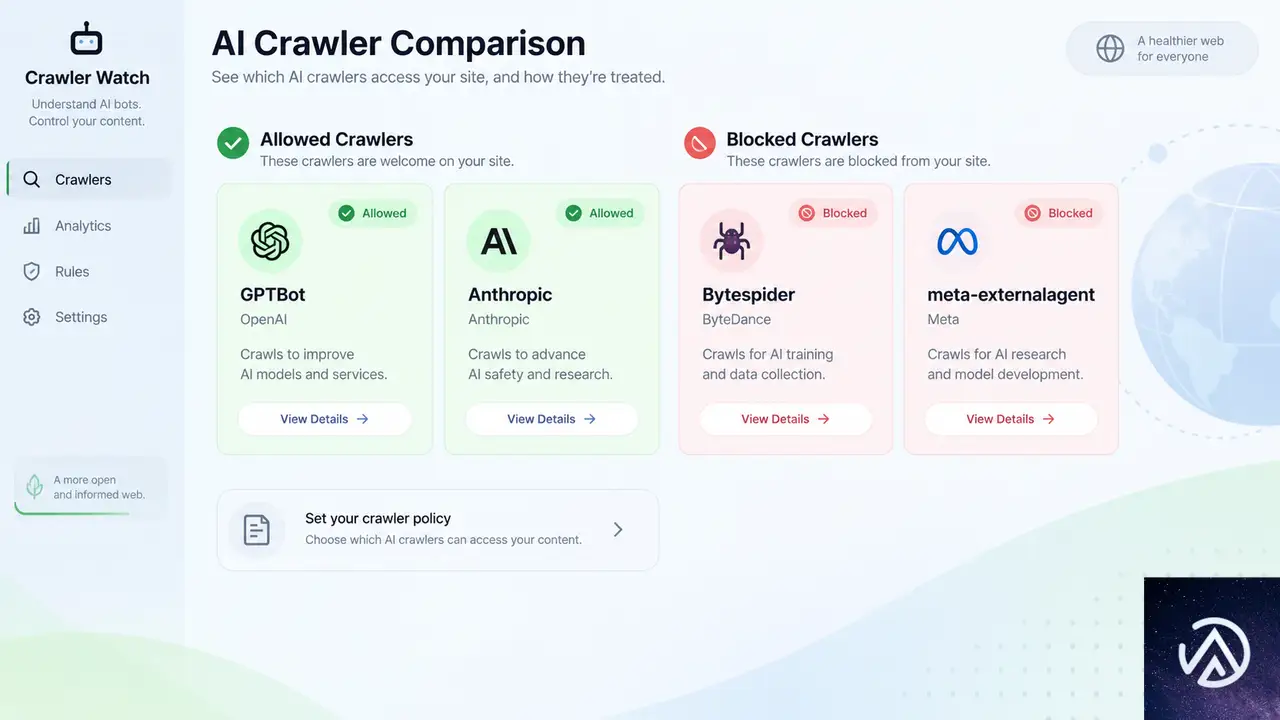
Bot Preference Syncの3カテゴリ設定は、サイト運営者のビジネス判断を必ずしも表現できない。No Hacksの記事の運営者は、OpenAIのGPTBot、Anthropicのクローラー、PerplexityBotを許可し、Bytespiderとmeta-externalagentをブロックしている。この判断は企業ごとの見返りに基づく。前者は自社ページをアシスタントの回答に表示してくれるが、後者は何も返さない、という理由だ。
このポリシーを3カテゴリ設定で表現しようとすると、矛盾が生じる。Trainingをブロックに設定すれば、許可したいGPTBotまでブロックされる。Trainingを許可に設定すれば、ブロックしたいBytespiderまで許可される。個別クローラー単位のビジネス上の決定は、カテゴリ単位の設定では表現できない。
個別クローラー単位のポリシーは3カテゴリ設定では表現できない。許可したいクローラーの扱いが、設定次第で逆転してしまう。
Cloudflareは、より細かい制御が必要な場合の対応策として、同期機能をオフにして手動でrobots.txtを管理することを挙げている。これはBot Preference Syncが万人向けではなく、カテゴリ単位の粗さを受け入れられるサイトに向けた機能だということを示している。
独自の見解として、日本のサイト運営者にもこの課題は当てはまる。コンテンツをAIトレーニングに提供する見返りを個別に評価している企業は、3カテゴリの設定では対応できない。Bot Preference Syncはあくまで「全許可」か「全拒否」に近いポリシーを持つサイト向けの省力化ツールと捉えるべきだ。
Cloudflareが公開した4つの開示条件とブロッキング
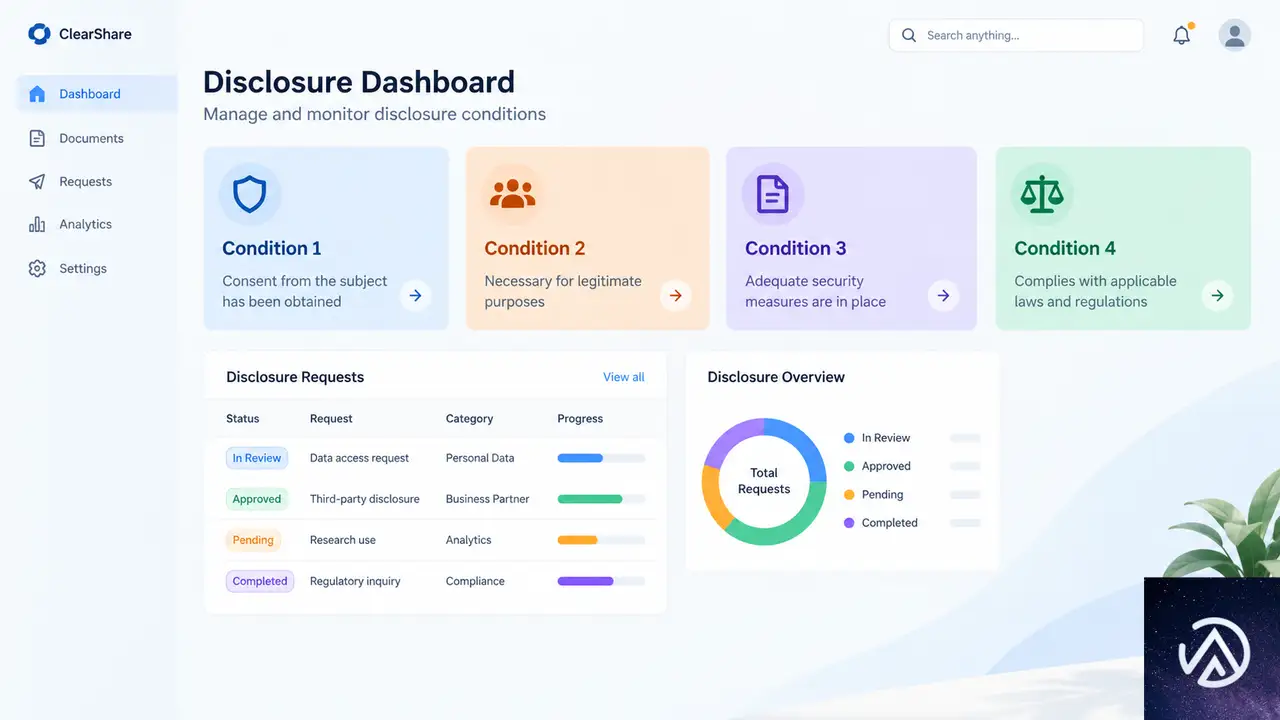
TrainingをDisallowに設定すると、robots.txtにno-training行が書き込まれる。同時に、Cloudflareが「不透明」と判断したAIクローラーがブロックされる。Cloudflareはこのブロックを回避するために、クローラーが満たすべき4つの条件を公開している。
4つの条件を満たさないクローラーは不透明とみなされ、TrainingをDisallowに設定したサイトではブロック対象となる。
条件2と条件4はGoogleを記述している。条件4についてGoogleはすでに満たしている。Googleのクローラードキュメントは、Google-ExtendedがGeminiモデルのトレーニングを制御し、検索結果への掲載やランキングシグナルには影響しないと明記している。これは条件4が求める公開声明に該当する。
一方で条件2はGoogleが答えを持っていない。条件2はAIサマリーからオプトアウトする方法を求めている。GoogleのAI機能のドキュメントによると、AI概要から除外するにはnosnippet、data-nosnippet、max-snippet、noindexのいずれかを使うことになる。しかし、これらはすべて通常の検索表示にも影響する。AI概要だけから外れて通常の検索スニペットは残す、という設定は存在しない。
Microsoftは2023年9月に条件2への回答を示している。NOARCHIVEタグを付けたコンテンツはBing Chatの回答に含まれないが、検索結果には引き続き表示される。検索インデックスから除外せず、チャットの回答からだけ除外できる仕組みだ。Cloudflareは2026年7月の記事で、BingBotとGooglebotを混合用途クローラーとしてこの条件の対象に挙げている。
CloudflareがAI企業への開示要求を明文化した点は評価できる。ただし、その条件を書いたのも執行するのもCloudflareという単一ベンダーだ。条件を読まずにダッシュボードのトグルをクリックしたサイト運営者も多い。パブリッシャーがAI企業に求めてきた説明責任は、いまやCloudflareにも向けられている。
新規顧客にデフォルト適用される意味とリスク
2026年9月15日から、Cloudflareは新規ドメインのデフォルト設定を変更する。広告を表示するページではTrainingとAgentがブロックされ、Searchは許可される。オンボーディング時に「広告付きページで収益化している」を選択すると、TrainingがDisallowに自動設定される。
これはビジネスモデルに関する質問であり、その回答がrobots.txt上のAIトレーニングに関する公開ポジションになる。広告収益に依存するサイトは、AIトレーニングを拒否する立場を自動的に表明することになる。サイト運営者がこの設定を認識していなければ、意図しないポジションが公開され続ける。
リスクが大きいのは、robots.txtを二度と開かず、自分の代わりに書かれたポジションを読まないサイトだ。Cloudflareはすでにアナリティクススクリプトを無料プランのサイトにデフォルトで書き込んでいる。同じオンデフォルトのパターンがrobots.txtにも及ぶ。サイト運営者が設定を確認しなければ、AIトレーニングに関する自社の立場を外部ベンダーに委ねることになる。
SEO担当者の観点では、このデフォルト変更を黙認してはいけない。自社サイトがAIトレーニングを拒否しているのか許可しているのかは、AI時代の検索戦略を左右する。デフォルト設定のまま放置するのではなく、自社のビジネスモデルに合わせて意図的に選択することが重要だ。
robots.txtが守れる範囲と守れない範囲
robots.txtのルールは、停止することを選ぶクローラーを停止させるだけだ。ルールを無視するクローラーには何も影響しない。No Hacksの記事は、同サイトのログで最大のAIクローラーが認証情報を探していたと報告している。非営利研究アーカイブの名前を使い、/.envやSSHキーを要求するクローラーがいたという。テキストファイルのルールはそのようなクローラーを不便にさせることすらできない。
それでもBot Preference Syncは有用だ。インターネットの誠実な側、つまりルールを守るクローラーに対しては機能する。エッジでの強制が実際の防御であり、robots.txtは意図の文書化として、後から紛争になった時に意味を持つ。リクエストが到着した瞬間の防御にはならないが、自社のポリシーを明確に残しておく価値はある。
最終的には、robots.txtとCloudflareのAIボットポリシーを突き合わせて確認する作業が欠かせない。Bot Preference Syncが自サイトに到達したら、書かれた内容を必ず確認すること。読んでいないポリシーファイルは、他人が自分の代わりに表明した立場になる。
この記事のポイント
- CloudflareのBot Preference Syncはrobots.txtとエッジ強制設定の矛盾を解消する自動化機能である
- Search、Agent、Trainingの3カテゴリ設定では個別クローラー単位のビジネス判断を表現できない
- Cloudflareは4つの開示条件を公開し、不透明なクローラーをブロック対象にした
- 新規顧客にはデフォルトでオンになり、広告収益化サイトではTrainingがブロックされる
- robots.txtは誠実なクローラーにしか効かないため、エッジ強制が依然として重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleのAIコンテンツ支払い、CloudflareとMicrosoftが示す3つの設計思想
Google、Cloudflare、Microsoftの3社がAIによるコンテンツ利用への対価支払いモデルをそれぞれ試験している。支払いの発生条件、価格設定の主導権、運営者に返るレポートの中身は3社で大きく異なる。
Googleは「重要な貢献」と判定した場合のみ支払う招待制パイロットだ。Cloudflareはクロール1回ごとに課金する独自モデルを持つ。Microsoftはライセンス型マーケットプレイスを2月に発表した。
この違いが、サイト運営者がAIにコンテンツを提供する際の収益性とリスクを左右する。本記事では3モデルの設計思想とSEOへの影響を整理する。
3社のAIコンテンツ支払いモデルの全容
Google、Cloudflare、Microsoftは2026年に入り、AIがウェブサイトのコンテンツを利用する際の対価支払いモデルをそれぞれ提示した。3社のアプローチは課金の単位、価格設定の主導権、レポートの粒度で根本から異なる。
3社のモデルは支払い方式とコントロール権限のバランスで大きく異なる。
Googleは「貢献度」判定、Cloudflareは「取得単位」課金
Googleのパイロットプログラムは、Gemini、AI Overviews、AI Modeのいずれかで、サイトのコンテンツがAI生成応答に「重要な貢献をした」と判断された場合に支払いが発生する。回答生成後のリンク表示や確認だけでは条件を満たさない。Googleは6月18日の公式投稿で、AI回答の根拠となる情報を提供するウェブサイト向けの新モデルを試験する方針を示した。
一方、CloudflareのPay Per Crawlは2025年から非公開ベータとして提供されてきた。クローラーがコンテンツを正常に取得するたびに課金が発生する仕組みで、サイト運営者はクロール1回あたりの価格を設定できる。最低価格は0.001ドルだ。価格に同意したクローラーには正常応答コードでページが返る。
Microsoftはライセンス型マーケットプレイス
Microsoftは2月3日にPublisher Content Marketplaceを発表した。Copilotの回答を支えるためのプレミアムコンテンツのライセンスを提供する仕組みで、パブリッシャーは提供価値に基づいて支払いを受ける。利用条件とライセンス条件はパブリッシャーが定義し、利用ベースのレポートも提供される。Copilotが最初の需要パートナーとなり、Yahooも導入を進めている。
関連する動きとして、Ceramic.aiは自社の検索結果にサイトのコンテンツが表示された際に参加サイトへ支払うモデルを採用している。You.comは特定のプレミアムコンテンツをオンデマンドで利用した時点で支払う仕組みだ。
支払いトリガーを決めるのは誰か
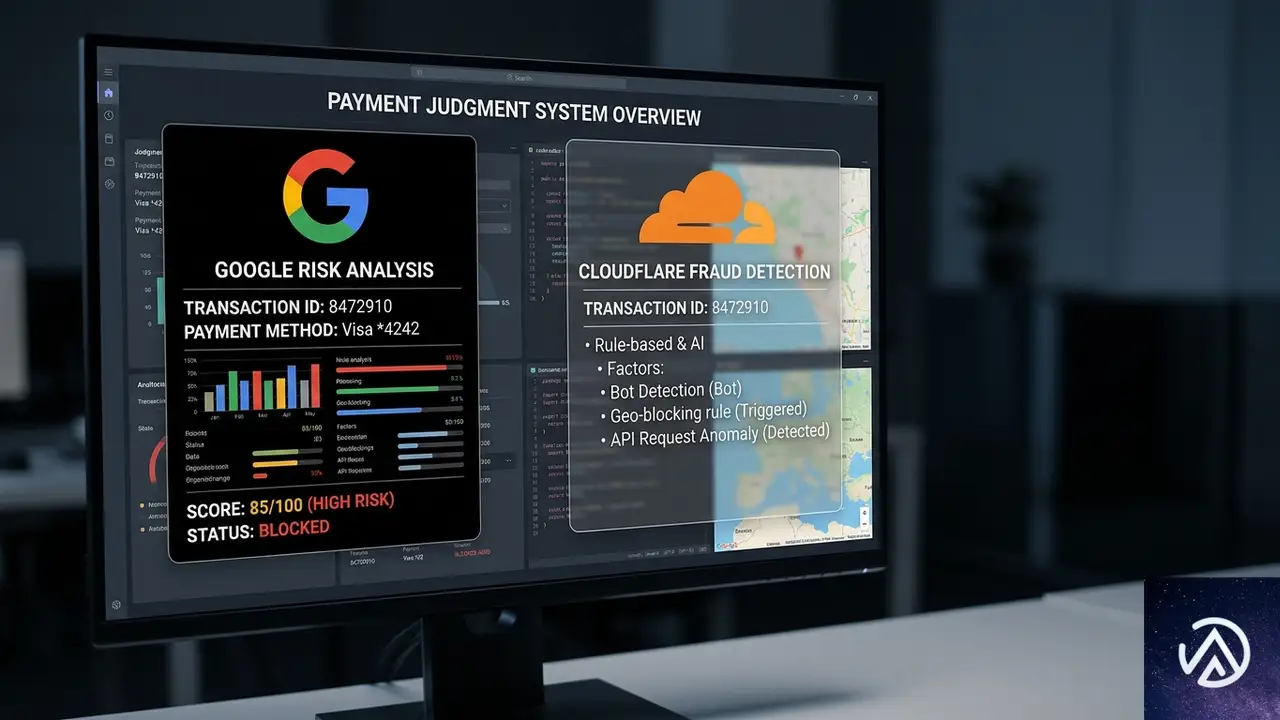
各モデルは支払い発生のイベント定義が異なる。ここが運営者の収益予測を難しくする根本原因だ。Googleは「重要な貢献」という質的基準、Cloudflareは「取得成功」という機械的基準、Microsoftは「提供価値」という経済的基準を採用している。
判定者が誰かによって、収益予測の立てやすさが変わる。
Googleの「重要な貢献」はブラックボックス
Digidayの報道によれば、Googleのパイロットでは支払いがコンテンツの使用量ではなく価値に基づくとされている。Googleが自社で「意味のある貢献だったか」を判断する仕組みで、プログラムに詳しい企業幹部はDigidayの取材に対し「かなりブラックボックスだ」と述べている。Googleは判定基準を公表していない。
サイト運営者から見れば、この構造は収益の予測可能性を著しく下げる。何が支払いにつながるかの明確な基準が分からない状態で、コンテンツ戦略の投資判断を下すのは難しい。
Cloudflareは機械的なイベント、Microsoftは定義自体が不明
Pay Per Crawlのイベントは機械的だ。価格に同意したクローラーへの正常応答が課金の条件と明確に定義されている。ただしCloudflareの7月1日の投稿は、クロール回数が価値の粗い指標であると自認している。1回だけクロールされたページが何千もの回答に引用されることもあれば、何度もクロールされながら一度も使われないページもある。
Microsoftは支払い単位を公開していない。提供価値に基づくと説明するが、具体的な計算式や契約上の定義は明らかにされていない。価格設定もパブリッシャーとの共同設計の対象とされるが、誰が最終決定するかは公開情報では分からない。
サイト運営者がコントロールできる範囲
3社のモデルはサイト運営者がどのような条件を設定できるかも異なる。価格を自分で決められるのか、参加の是非だけなのか、利用条件まで定義できるのか。この差は収益性と交渉力に直結する。
Googleは参加の是非のみ、条件交渉の余地なし
Googleのパイロットは招待制だ。参加者はSearch Consoleからいつでもオプトアウトできるが、参加するかどうか以外の条件交渉の余地は公開情報から見えてこない。Digidayによれば、ある企業幹部は提示された金額が低すぎてオプトインしなかったと述べ、Googleとの交渉は継続中だという。
この点は小規模なサイト運営者ほど不利になる。招待を受けるか、提示された条件で飲むか。その二択しか選べない状況では、交渉力のある大手メディアと中小サイトの間に収益格差が生まれやすい。
Cloudflareは価格を運営者が設定、Microsoftは利用条件を定義
Pay Per Crawlでは、サイト運営者がドメインごとの価格を設定できる。パス単位で価格を変える動的プライシングにも対応し、クローラーごとに課金、許可、ブロックを選べる。Pay Per Useでは、サイト運営者はパートナーのプログラムに参加する形で、パートナーによって支払い条件が変わる。
Microsoftのマーケットプレイスは加入が任意で、パブリッシャーはコンテンツの所有権と編集の独立性を保持する。ただし、ライセンス条件と利用条件の具体的な内容は公開されていない。価格決定者も不明のままだ。
レポートで見える情報と見えない情報
収益化の判断には、どれだけの情報が返ってくるかが重要だ。3社のレポート粒度と透明性にも明確な差がある。
Googleの月次収益表示と計算式の非公開
Googleの参加者はSearch ConsoleのAI貢献パネルで月次収益額と履歴を確認できる。しかしDigidayは、支払い計算の詳細は提供されないと報じている。Googleは一部のパートナーと週次会議も行っている。パブリッシャー連合SpurのDavid Buttle氏は、第一歩として「パブリッシャーが自分のコンテンツが回答に影響したことを知る権利がある」という前例を作ることだと述べた。
月次収益という数字は見えるが、その数字がどう算出されたかは見えない。この非対称性は、運営者が支払い額の妥当性を検証できないことを意味する。
Cloudflareの残高非表示とCeramicの詳細レポート
Pay Per Crawlでは、課金イベント発生時に記録が残る。ダッシュボードにはどのクローラーがアクセスしたか、課金が何回発生したかが表示される。ただし獲得残高はダッシュボードに表示されず、Cloudflareチームへの問い合わせが必要だ。
Pay Per Useでは、Ceramicプログラムに参加するサイトが、コンテンツが表示された検索クエリ、該当ページ、スニペット、検索結果内の平均順位まで含むレポートを受け取れる。こちらの方が実務的には使える情報が多い設計だ。
Microsoftの利用ベースレポートは中身が非公開
Microsoftは「コンテンツがどのように評価され、どこでさらに価値を提供できるか」を確認できる利用ベースのレポートを約束している。ただし、レポートに含まれる具体的な項目は公開されていない。参加者がレポート内容について説明した記録も見つからない。
Googlebotへの従量課金が招くSEOリスク
CloudflareのPay Per Crawlは、ディレクトリに登録されたあらゆるクローラーに従量課金を設定できる。Googlebotも対象だ。ここにSEO上の大きな落とし穴がある。
CloudflareのBlock設定をGooglebotに適用すると、検索インデックスからの削除リスクが連鎖的に発生する。
Googleのクローラードキュメントによれば、4xxステータスコードを返すURLのコンテンツは使用されない。402 Payment Requiredも4xxに該当するため、Googlebotに課金を設定して402を返すと、時間の経過とともに検索インデックスから削除される可能性がある。
Cloudflareが9月15日に公開した新設定はこの状況を変えるものではない。Disallow AI Training設定はrobots.txtに学習拒否の意思を公開し、GoogleとAppleはこれを尊重しつつ検索クローリングは続ける。一方、BlockオプションはGooglebotを含むクローラーを完全に停止する。
つまり、Googlebotに対して「学習は拒否したいが検索クロールは許可したい」場合は、BlockではなくDisallow AI Trainingを選ぶ必要がある。Cloudflareの報告では、検索ボットをブロックしているサイトは1%未満、何らかの学習ブロックを使っているサイトは17%に上る。
また、Googleは数週間以内にGoogle-Extendedに関連するURL単位の透明性ツールを提供する予定だとCloudflareは伝えている。これはパイロットの貢献レポートとは別のものだ。
サイト運営者が今取るべき行動
3社のモデルは完成形ではなく、すべて試験段階にある。運営者が今できるのは、自社のコンテンツの性質とリスク許容度に合わせて選択肢を評価することだ。
Cloudflare設定の見直しが最優先
すでにCloudflareを利用しているサイトは、現在の設定状態を確認すべきだ。従来の設定が移行されている可能性があり、Googlebotに対して意図しないBlockがかかっていないかを確認する必要がある。学習拒否と検索継続を両立するには、Training controlをDisallow AI Trainingに設定する。Blockにしてしまうと検索クロールも停止する。
この設定の分岐は、サイト運営者にとって「収益化のチャンス」と「検索順位のリスク」を同時に含む。学習を拒否するか、検索クロールを維持するか、あるいは課金対象としてGooglebotに支払いを求めるか。それぞれの選択肢の帰結を理解した上で決める必要がある。
契約前に確認すべき情報
Googleのパイロット招待を受けた場合、オプトイン前に「重要な貢献」の定義、計算方法、Search Consoleの生成AIコントロールとの関連性についてGoogleに確認するべきだ。Microsoftのマーケットプレイスを検討する場合は、誰が価格を決定するのか、レポートに何が含まれるのかを契約前に明確にする必要がある。公開情報だけではこれらの質問に答えられない。
3社のモデルは「支払いの透明性」に対するアプローチが根本から異なる。Googleは判定をブラックボックスにすることで柔軟性を確保し、Cloudflareは機械的なイベントで透明性を確保し、Microsoftはパブリッシャーに条件定義を委ねる。いずれもまだ実験段階であり、最終的な設計が現在の形のまま展開されるとは限らない。
特に重要なのは、Cloudflareが自ら「クロール回数は価値の粗い指標」と認めた点だ。同じコンテンツでも1回のクロールで何千回も引用される場合と、何度もクロールされながら全く利用されない場合がある。この非対称性は、現在のすべての支払いモデルが「価値の正確な測定」にまだ到達していないことを示している。
サイト運営者は、今後のレポート精度の向上と透明性ツールの展開を注視しつつ、自社のコンテンツがAI応答にどう使われているかを定期的に確認する姿勢が求められる。
この記事のポイント
- Googleは招待制で「重要な貢献」と判定した場合のみ支払う。判定基準は非公開
- Cloudflareはクロール取得単位の課金とパートナー主導の利用課金の2軸で展開
- Microsoftはライセンス型で利用条件はパブリッシャーが定義するが価格決定者は不明
- Googlebotを含むクローラーにBlock設定を適用するとSEOリスクが連鎖する
- 3社とも試験段階で、価値測定の正確性が今後の焦点となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
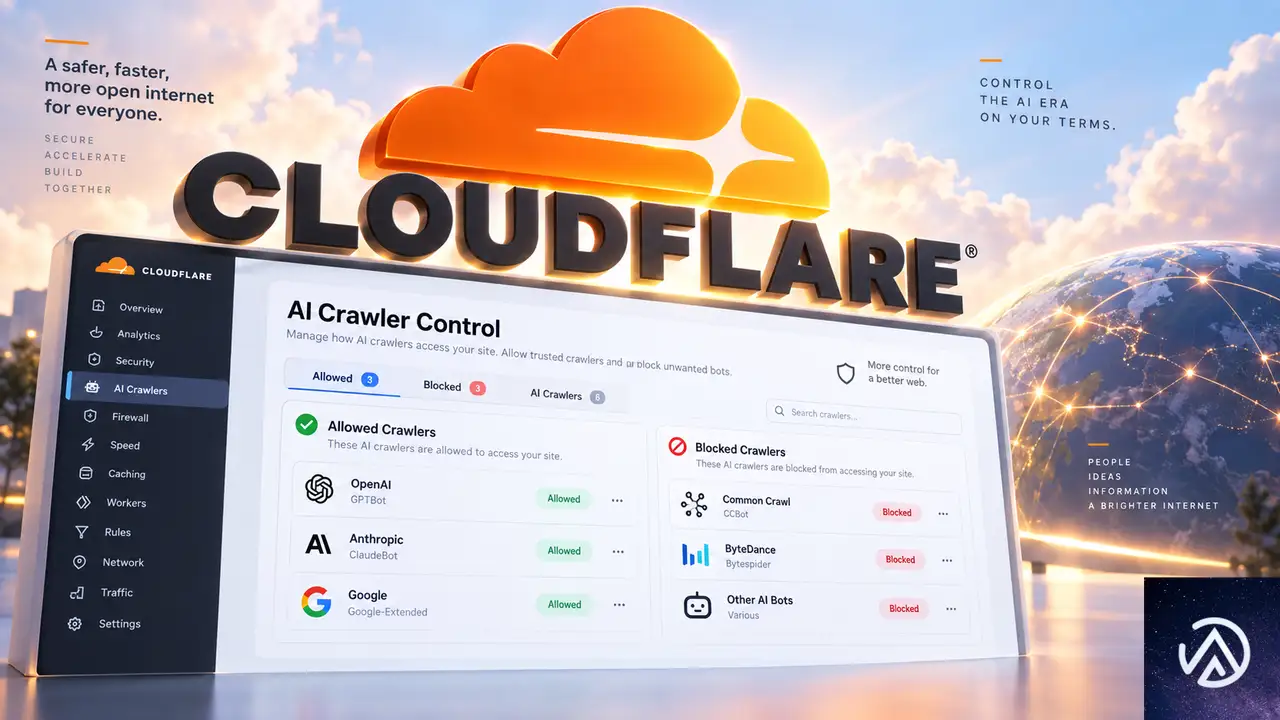
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
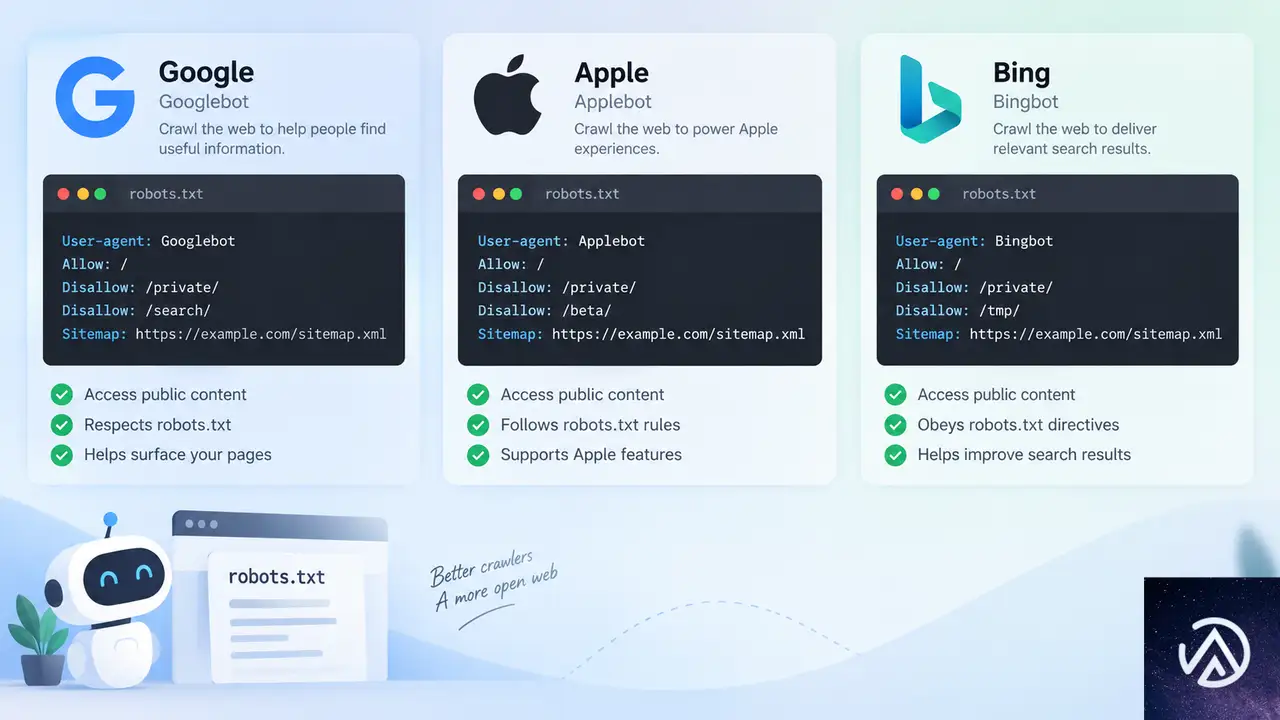
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
WordPress共同創業者Matt Mullenweg氏、Automattic CEOを解任される
WordPressの共同創業者であるMatt Mullenweg氏が、AutomatticのCEOを解任された。後任にはMark Davies CFO(最高財務責任者)が就く。Mullenweg氏は有給休暇扱いとなる。
解任の投票は、Mullenweg氏に事前通知からわずか50分しか与えられなかった。同氏は独立した法律顧問によるレビューを繰り返し求めたが、拒否されたと報じられている。
この解任劇は、WP Engineとの法廷闘争やWordPressの市場シェア低下が続く中で起きた。WordPressエコシステム全体に波及する出来事だ。
解任の経緯と社内発表

Mullenweg氏は社内Slackで、解任の知らせを受けた状況を詳しく説明している。投票の決議を受け取ったのは会議開始の50分前で、独立した法律顧問によるレビュー時間を数時間でも確保したいと繰り返し要請したが、すべて拒否されたという。
同氏はSlackで、CFOのMark Davies氏が取締役会と共謀して背後で動いていたと非難した。解任の動きは急激で、事前の協議や段階的な移行プロセスはなかったと見られる。
このデモは、Automatticの経営体制が急速に変化した状況を示している。わずか50分の事前通知でCEO交代が決まった点が異例だ。
取締役会の判断は何を意味するか
取締役会がMullenweg氏の要請を拒否した点は、単なる人事異動ではない。法的リスクを抱えるCEOの続投を認めないという強い意思表示と受け取れる。
WP Engineとの訴訟では、Mullenweg氏が証拠を破壊または保存しなかったとする制裁動議が出ている。取締役会はこの法的リスクを重く見た可能性が高い。
WP Engine紛争との深い関係

Mullenweg氏の解任は、WP Engineとの長期化する紛争と切り離せない。同氏は自ら「nuclear(核兵器級)」と表現した攻撃をWP Engineに仕掛け、WordPressコミュニティに大きな亀裂を生んだ。
WP EngineはAutomatticとMullenweg氏に対して訴訟を起こしており、裁判所はWP Engine側の仮差止命令を認める方向に傾いているとされる。さらに、Mullenweg氏が証拠を破棄したとする制裁動議も提出されている。
この紛争の影響は法廷だけにとどまらない。WordPressの市場シェアは低下し、コミュニティの求心力も弱まっている。
失われた証拠の問題
Automatticの電子証拠開示ベンダーであるJonathan Robins氏によると、Mullenweg氏のノートPCと電話1台が所在不明になっているという。バックアップ失敗と2台のデバイス紛失が重なり、メッセージが失われたと報告されている。
制裁動議では、この証拠喪失が意図的だったかどうかが争点になる。電子証拠開示とは、訴訟で必要となるデジタルデータを収集・保存するプロセスのことだ。
WordPressエコシステムへの影響

Mullenweg氏の解任は、WordPressエコシステムが直面する複合的な課題の象徴だ。市場シェアの低下、WordCamp参加者の減少、プラグイン開発者の収益悪化、脆弱性の発見増加が同時に進行している。
このデモは、WordPressが現在直面している4つの主要な課題を示している。いずれもAIの進化と無関係ではない。
AIによるコーディング支援の普及は、プラグイン開発者の収益基盤を揺るがしている。また、AIを使った脆弱性スキャンの高度化により、これまで見逃されていた問題が次々と発見されている。
市場シェア低下の背景
WordPressのCMS市場シェアは長年トップを維持してきたが、近年は減少が続く。Astroのようなモダンな静的サイトジェネレーターが開発者の支持を集め、従来型CMSの牙城を崩しつつある。
WP Engine紛争による混乱も、企業ユーザーの信頼を損ねた。大規模サイトの運営者は、WordPressのガバナンス不安定化をリスクと見なし、代替プラットフォームへの移行を検討し始めている。
Mullenweg氏の反応
Mullenweg氏は解任後、X(旧Twitter)でユーモアを交えた投稿を行った。「一日中会議に出ていた。何か見逃したかな?新しいiPhoneでも出たのかな?」という内容だ。
この投稿は、深刻な状況に対する同氏の軽妙なスタンスを示している。しかし、法的な争いが続く中で、この反応がコミュニティにどう受け止められるかは不透明だ。
この記事のポイント
- Matt Mullenweg氏がAutomattic CEOを解任され、Mark Davies CFOが後任に就いた
- 解任は50分前の通知で、法的レビューの要請は拒否された
- WP Engineとの紛争、市場シェア低下、コミュニティ離れが背景にある
- 証拠破棄疑惑で制裁動議も提出されており、法的リスクが深刻化している
- WordPressエコシステムはガバナンスとAI対応の両面で岐路に立つ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIが検索意図を再定義。68%がクリックされない検索の新常識
Google検索の68%がクリックなしで終わる時代に入った。2019年には49%だった「ゼロクリック」の割合が、わずか7年で20ポイント近く上昇したことになる。検索結果から外部サイトへ移動しないユーザーが、すでに3分の2を超えている。
この変化の中心にあるのが、AI ModeとAI Overviewsの急速な普及だ。月間アクティブユーザー10億人を超えたAI Modeの利用データは、検索意図の構造が根本から変わったことを如実に示す。もはやキーワードを入力して青いリンクを探す時代ではない。
本記事では、2026年に公開された2つの実証研究とGoogle自身の利用データを軸に、AIが検索意図をどう再定義しているのかを整理する。旧来のSEO指標では捉えきれない変化の実態と、これからの戦略立案に必要な視点を提示する。
ゼロクリック検索の実態。68%という衝撃の数字

SparkToroが発表した2026年のクリックストリームデータによると、米国におけるGoogle検索の68%がクリックを生まない。この数値は2019年の49%から一貫して上昇を続けており、単なる一時的な現象ではない。検索行動の地殻変動が10年単位で蓄積してきた結果だ。
ゼロクリックの広がりは、生成AIの登場によって突然始まったものではない。ユーザーはすでにYouTubeやTikTokなど、ビジュアルやコミュニティを重視するプラットフォームへ検索行動を分散させていた。Googleはこの流出を食い止めるため、検索結果画面の中で即時に答えを返す仕組みを強化してきた経緯がある。
重要なのは、検索がもはや単一のテキストボックスを超え、マルチモーダルでマルチプラットフォームのエコシステムに分裂したという事実だ。従来のSERP(検索結果ページ)での可視性だけを追いかけても、オーディエンスの意図が生まれる場所を捉えきれなくなっている。
検索結果画面の中で情報取得が完結するほど、外部サイトへの送客は減っていく。この構造変化こそがゼロクリック検索の核心であり、SEO戦略の前提を揺るがす要因だ。
Google AI Modeのデータが示す会話型検索の台頭

クエリは3倍長く、40%が追加質問
Googleが2026年のI/Oで公開したAI Modeの利用データは、検索行動の変化を具体的に裏付ける。AI Modeは月間アクティブユーザーが10億人を突破し、平均クエリの長さは従来型検索の3倍に達している。「説明する」「要約する」といった行動指向のコマンドが目立ち、一人称「私」の使用頻度が高い点も特徴だ。
これは単なるキーワード検索ではなく、会話型の対話に近い。追加質問は前月比40%増で推移し、AI Modeでの6分の1以上の検索が音声・画像・動画を組み合わせたマルチモーダルな入力になっている。ユーザーは青いリンクの一覧を求めておらず、即座に統合された価値を対話の中で求めている。
この変化は検索意図の捉え方そのものを変える。従来の「情報を探す」という受動的な行動から、「決める」「学ぶ」「創る」という能動的な行動へと、検索の役割が拡張しているのだ。
4語クエリがAI回答を起動する確率は48.1%
Clara Soteras氏らが実施したスペインメディアを対象とする初の大規模研究では、クエリの複雑さがAI回答の表示を直接左右することが示された。4語を含む検索では48.1%の確率でAIO(AI Overviews)が表示され、3語と4語のクエリだけで全AI生成結果の約70%を占める。
長いクエリの背後にある意図は、根本的に問いかけ型だ。常緑コンテンツ(長期間にわたって価値が変わらない情報)が75.2%を占め、ジャーナリズムの基本である「6W」を含むキーワードは高い確率でAI要約を誘発する。「why」は92.3%、「what」は85.7%、「who」は68.4%という数値が出ている。
ここから導かれる結論は明確だ。断片的な名詞キーワードを追いかける時代は終わり、複雑で普遍的な人間の問いに直接答えるコンテンツ構造へシフトする必要がある。
クエリの語数が増えるほど、また「なぜ」という問いかけが含まれるほど、AI回答は高い確率で表示される。コンテンツ設計では、複雑な問いに直接答える構成が求められる。
速報とAI回答は別世界。ブランド可視性の逆説も
同じ研究で注目すべきなのが、生成AIと速報ニュースが完全に別の生態系で動いている事実だ。AIOは常緑コンテンツの検索で34.6%表示されるのに対し、現在進行形のニュースでは1.1%まで急減する。速報を扱うTop Storiesモジュールとの同時表示率も1.4%に留まる。
さらに重要な発見として、分析対象となったSERPの43.6%はAIOもTop Storiesも表示されない「ブルーオーシャン」だった。この領域では従来のオーガニック順位が依然として高い効果を発揮する。
ブランド可視性の逆説も見逃せない。20 Minutosはブランド関連クエリで38.9%のAIO表示率を獲得した一方、トラフィック全体のリーダーであるEl Españolは11.1%に留まった。大量の訪問数が生成AI時代のシェア・オブ・ボイスを保証しないという端的な証明だ。
検索意図の5つの柱。探索から実行へ

Googleが発表した米国におけるAI Mode利用調査は、検索意図の境界を公式に再定義した。ユーザーはリンクを探すだけではなく、意思決定、旅行計画、タスク整理、概念学習、アイデア生成、比較検討、コンテンツ作成など、幅広い目的でAI Modeを利用している。
Googleはこの変化を5つの行動指向の柱として整理する。「探求する」「決める」「学ぶ」「創る」「実行する」の5つだ。検索が受動的な情報レイヤーから能動的なユーティリティレイヤーへ進化したことを、この分類は明確に示している。
WAN-IFRAのEzra Eeman氏が指摘する通り、この5つの柱はメディア分野におけるDmitry Shishkin氏の「User Needsモデル」と強い類似性を持つ。事実を報じるだけでなく、教育し、インスピレーションを与え、視点を提供する。そうした深いユーザー・ニーズを生成検索エンジンがインターフェース内で直接満たそうとしているのだ。
5つの柱はすべて動詞で構成されている点が重要だ。検索エンジンはもはや情報の入り口ではなく、複雑なニーズを最初から最後まで満たす動的なアシスタントへと位置づけを変えている。
視線追跡が暴く「見られるがクリックされない」領域

Laika Teamが実施した視線追跡調査は、SERP上でのユーザー行動をさらに深く解明した。Diego Criado氏らの研究チームが発見したのは「attention-to-action gap」、すなわち視覚的注意と実際の行動の間に生じる大きな乖離だ。
画像や商品リスト、AIOの「さらに見る」ボタンなどの視覚要素は、ユーザーの視覚的関与を最大100%獲得しながら、クリック率は0%という衝撃的な数値を示した。ユーザーはこれらの要素をわずか数ミリ秒で走り読みするだけで、実際の意思決定には利用しない。
一方で真の「コンバーター」は、AI Overviewの核心テキスト部分と従来のオーガニックリンクだった。AIO本体は86.4%、上位オーガニックリンクは95.5%という高いクリック率を記録している。生成AI機能が基本的な探索を完結させるため、周辺要素は視覚的ノイズと化し、クリックを獲得できる領域は限られていく。
視線追跡データが示すのは、SERP上でユーザーが実際に読んで意思決定する場所と、単に目に入るだけの場所がはっきり分かれたことだ。意図の高いトラフィックを獲得するには、この2つの領域の違いを理解する必要がある。
注目から互酬へ。新しい評価指標の必要性

検索行動の変化がここまで明確になると、KPI(主要業績評価指標)の見直しは避けられない。クリック数やクエリ量などの既存指標を捨てる必要はないが、量だけでなく深さを測る定性指標の補完が必須になる。
Industry Diveの共同創業者であるSean Griffey氏が提唱するのが「reciprocity(互酬性)」という概念だ。「注目は取引であり、互酬は持続可能である。それは堀になる」という同氏の言葉が示す通り、既存のダッシュボードは読者が消費する時点までしか測れていない。読者が購読する瞬間まで追跡できても、その先にある真のファン度を測る指標は存在しない。
互酬性が問うのは、より難しい質問だ。助けを求めたとき、オーディエンスは本能的な応答欲求を感じるか。見返りがなくても支えたいと思うほどのつながりがあるか。クリエイターエコシステムがこのつながりを常に検証してきたのに対し、メディアブランドも同様の実践を学ぶ必要がある。
tchop.ioのHeiko Scherer氏が指摘する「到達から所属へ」という視点も同じ方向を向く。単なるリーチでは測れない帰属意識こそが、ゼロクリック時代の最も価値ある資産になる。編集プロダクトの質を磨く、学びを目的としたコンテンツを設計する、活発なコミュニティを育てる、創作の場を提供する。これらの取り組みが、互酬性を育む具体的な道筋だ。
数値化しにくい指標を追いかけるのは実務的に難しい。しかしゼロクリックが進むほど、取引型の指標だけではブランドの持続可能性を測れなくなる。感覚的でも手応えのある定性指標を補完することが、これからのメディア運営に不可欠だ。
この記事のポイント
- Google検索の68%がクリックされずに終わるゼロクリック時代に入った
- AI Modeのクエリは従来の3倍長く、4語でAI回答出現率が48.1%に達する
- 検索意図は「探求する・決める・学ぶ・創る・実行する」の5つの柱に再定義された
- 視線追跡では画像やボタンが100%見られてもクリック率0%という乖離が判明した
- 新しい評価指標として、取引型の注目ではなく互酬性と所属の概念が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験