

AI引用シェア率をBingが公開、llms.txtの効果に疑問符
AI検索の可視性をどう測るか、そして構造化データファイルにどこまで期待すべきか。この一週間でその答えに直結する動きが複数出てきた。
MicrosoftがAI引用のシェア率を計測する新機能を公開し、GoogleとAhrefsのデータはllms.txtの効果に冷や水を浴びせた。さらにAIエージェント向けの新仕様が2つ登場するなど、情報が一気に動いている。英国CMAによる公正ランキング命令も含め、今週のトップ4ニュースを実務視点で整理する。
BingがAI引用シェア率を公開。競合との差が初めて数値化された
MicrosoftはBing Webmaster ToolsのAIパフォーマンスダッシュボードに、新たな4機能をプレビュー公開した。追加されたのは「Citation Share(引用シェア率)」「Intents(検索意図別グループ)」「Topics(トピック別グループ)」「Compare(期間比較)」だ。いずれも現在はプレビュー段階でグローバルに順次ロールアウトされている。
このCitation Shareによって、AI検索結果における自サイトの存在感が、競合との比較で初めて把握できるようになる。ただしこのデータはBing独自であり、CopilotやBingの回答を対象とする。Google検索側では検索コンソールにこれに相当する引用カウント機能は提供されていない。
SEO担当者の受け止めと実務への示唆
ILoveSEO.netの創業者Gianluca Fiorelli氏はLinkedInで「Bing Webmaster Toolsこそ、我々がGoogleサーチコンソールに望んでいた姿だ」と評価した。AI可視性を測る新しい物差しが登場したことは、今後の施策優先度をデータドリブンに決める上で大きい。
現時点ではBingに限られた指標だが、AI検索のトラフィックが今後さらに一般化すれば、Googleも類似の指標を導入せざるを得なくなる可能性がある。先行してBing側でのデータ取得と分析のノウハウを積んでおくことは、将来のAI検索対策で優位に立つ一手になる。
llms.txtへの期待に新データが疑問符。97%がアクセスゼロ
llms.txtは、大規模言語モデル(LLM)向けにサイト情報を構造化して提供するテキストファイルだ。AIがサイト内容を理解しやすくする目的で提唱され、導入が進んでいる。しかし今週、その効果に疑念を投げかける材料が二つ重なった。
Mueller氏は「Search Off the Record」ポッドキャストで、llms.txtが自己申告型のファイルである以上、LLMがサイトを発見したり他サイトと比較して評価したりする用途には使えないと明言した。本質的に重要なのは従来のHTMLと内部リンク構造だという立場だ。
Ahrefsのデータも同じ方向を指している。13万7000ドメインのうち、97%のllms.txtファイルには一度もボットからのアクセスがなかった。さらにアクセスが確認されたケースでも、ChatGPTやPerplexityといった引用生成ボットからのリクエストは全体の1%に過ぎない。この結果は、数ヶ月前にSE Rankingが30万ドメインを調査して導いた「llms.txtはAI引用に明確な効果を示さない」という結論とも整合する。
SEO専門家の見解と実務上の落とし所
Clio Websitesの創業者Nat Miletic氏はLinkedInで「llms.txtは公開コストが低いので置いておくのは構わない。ただしそれでAI可視性が上がるとは今は期待しないほうがいい」と総括した。コーディングエージェントや学習用クローラー向けに一部で参照されているため維持コストに見合う面はあるが、AI検索結果への表示を目的とした投資としては優先度を下げる判断が妥当だ。
AIエージェント向け新仕様が2つ登場。OKFとARDの注目点
Google Cloudは「OKF(Open Knowledge Format)」を公開した。組織内の知識(データセット、メトリクス、運用手順書など)をAIエージェントが読めるマークダウン形式でパッケージングする仕様だ。ほぼ同時期に、GoogleやMicrosoft、GitHub、Hugging Faceを含む連合が「ARD(Agentic Resource Discovery)」の草案を発表した。こちらはAIエージェントがツールやスキル、他のエージェントを発見・検証するためのプロトコルを定義する。
両仕様とも現時点で即時の対応を求めるものではない。OKFはバージョン0.1、ARDは0.9と初期段階だ。Harton Worksの創業者Martin Jeffrey氏はARDを「ページではなく機能のためのサイトマップが再来したようなものだ」と表現した。Snippet Digitalの共同創業者Suganthan Mohanadasan氏は「魔法のキノコではない。これで一夜にしてAI可視性が上がるわけではない」と期待値を引き締めている。
実務的には、どのフォーマットが実際に普及するかを見極める観察期間に入る。llms.txtの事例が示すように、仕様の存在と実際の効果は別問題だ。導入判断は普及の兆候を確認してからでも遅くない。
英国CMAがGoogleに公正ランキングを命令。事前通知義務が実務に波及
英国の競争市場庁(CMA)がGoogle検索に対し、新たなルールを設定した。オーガニック検索結果のランキングに客観的かつ非差別的な基準を使うこと、そして大規模な変更の際には事前通知を行うことを義務づける内容だ。
このルールの適用範囲は英国のオーガニック検索結果で、AI Overviewsも対象に含まれる(広告は除く)。Googleは「現行のランキングはすでに公正かつ透明だ」と反論しているが、CMAは6月初旬にもAI検索機能からのオプトアウトを認めるよう命令しており、規制圧力は強まっている。
SEO専門家の反応から読む今後の展開
Searchpediaの創業者Laura Iancu氏はLinkedInで「もうこれで『コアアップデートを突然リリースしました』なんてことはできなくなる」と単刀直入に表現した。Blue Arrayの戦略SEO責任者Chloe Smith氏は「Googleは何らかの回避策を探るだろう」と予測しつつも、事前通知と異議申し立ての枠組みができたこと自体に意味があると見ている。
現状では英国限定の措置だが、EUや他の地域にも波及する可能性は否定できない。特に、大規模アップデートの事前通知が実務化すれば、SEO施策の計画立案や緊急対応のあり方そのものが変わる。今後のGoogleの実装方法を注視する必要がある。
構造化ファイルを置くだけでは済まない。AI可視性の本質に立ち返る
今週のニュースを横断して浮かび上がるテーマは、「構造化ファイルを自ドメインに置いておけばAIに見つけてもらえる」という発想への再考だ。llms.txtはその教訓をすでに示している。ファイルを公開しても、Googleはサイト差別化に寄与しないと断言し、データは大半のファイルが読まれていない事実を突きつけた。
OKFやARDが登場したことで、構造化ファイルへの要求はこれからも繰り返されるだろう。しかし破綻しているのは「ファイルを置けば報われる」という期待のほうだ。BingのCitation Shareは、そうした取り組みが実際に引用に結びついているかを数値で示してくれる、貴重なフィードバックループになり得る。
AI検索時代の可視性は、小手先のファイル配置ではなく、コンテンツそのものの強さと、信頼される情報源としてサイト全体を設計し続ける積み重ねで決まる。今週のデータと専門家の声は、その原則を改めて強調する結果になった。
この記事のポイント
- Bing Webmaster Toolsの新機能「AI Citation Share」で、AI検索での競合とのシェア比較が初めて可能になった。Googleにはまだ同等機能はない
- llms.txtは97%がアクセスゼロ。AI検索可視性への効果はデータで否定され、自己申告ファイルの限界が明確になった
- OKFとARDという新たなAIエージェント向け仕様が登場したが、普及は未知数。llms.txtの教訓を踏まえ導入判断は慎重に行うべきだ
- 英国CMAがGoogleに対し、検索順位の公正化と大規模変更前の事前通知を義務づけた。SEO施策の計画立案に影響する可能性がある
- 結局、AI可視性の本質は構造化ファイルではなく、通常のHTMLコンテンツの品質と情報設計にある

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AnthropicのFable 5が米政府命令で強制停止、SEO業界に衝撃
Fable 5とMythos 5、米国政府の輸出管理命令で突然の利用停止
米国政府は2026年6月13日、国家セキュリティを理由にAnthropicへ輸出管理命令を出し、同社の最新AIモデル「Fable 5」および「Mythos 5」の全利用停止を強制した。命令は外国籍の個人によるアクセスを禁じており、実質的に全顧客の接続を遮断せざるを得ない内容だ。
Anthropicは同日に声明を発表し、政府の見解に反論した。両モデルには強固なセーフガードが重層的に組み込まれており、既存のAIモデルと同等のリスク水準に留まっていると主張している。しかし、命令受領からわずか数時間でFable 5とMythos 5のアクセスは世界中で停止された。
この措置は、SEOやデジタルマーケティングで最先端AIを活用してきた企業・個人に直接的な影響を及ぼす。高性能モデルの急な遮断は、コンテンツ制作フローや競合分析の自動化パイプラインを根底から揺るがすためだ。
このデモでは、Fable 5が突然使えなくなり、SEOワークフローに穴が空く状況を図示している。高性能なモデルに依存していた自動化プロセスは、一気に精度と速度が落ちる。
輸出管理命令の具体的な中身
命令は輸出管理指令と呼ばれる法的措置で、技術やデータの国外移転を制限する。Anthropicはこの命令を「外国籍の者へのアクセスを一切禁じる」と解釈せざるを得ず、結果的に全世界のユーザーが利用不能になった。同社が受けたのは東部夏時間17時21分。ほぼその日のうちに、サービス停止が現実となった。
政府はFable 5のセーフガードを突破する手法があると指摘しているが、Anthropicは提示された事例を「軽微な脆弱性」と一蹴。同社は既に多層防御と厳重なモニタリングでリスクを抑え込んでいる立場だ。
SEO業界が受ける打撃、AI駆動型ワークフローの寸断
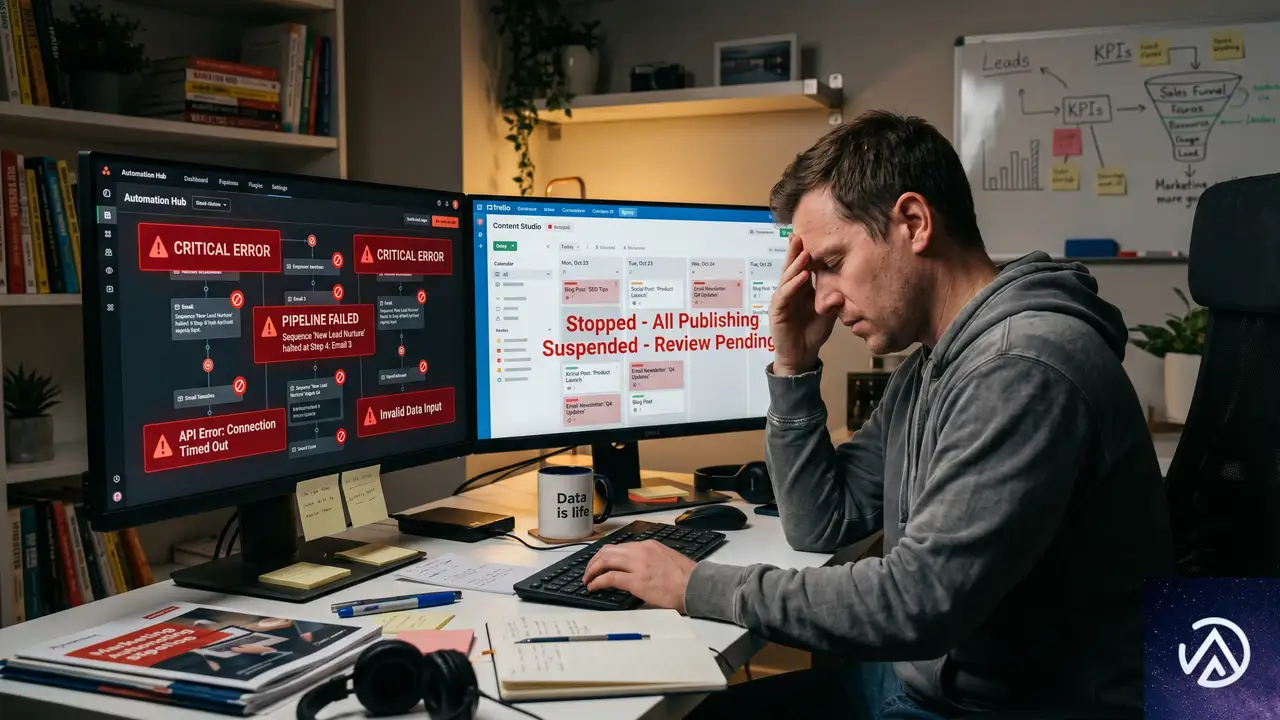
Fable 5の急停止は、SEO担当者やアフィリエイトマーケターに具体的な痛みをもたらした。特に月額200ドルの「Claude Max」プランに切り替えたばかりのユーザーからは、返金を求める声がXで相次いだ。新しいモデルを前提にした記事生成や分析タスクが突然止まったためだ。
この流れは、AIモデルをコンテンツ制作パイプラインに組み込んできたSEOチームにとって、サプライチェーン途絶に近い。短納期の記事更新や、多言語でのローカライズ、高度なエンティティ抽出にFable 5を使っていたケースでは、代替モデルへの切り替えに伴う品質低下と工数増加が避けられない。
上のフローは、AIモデルを活用したSEOコンテンツ制作の典型的な手順だ。Fable 5が消失すれば、STEP 1の時点で生産性が大幅に落ちる。
返金要求とMaxプランの混乱
Xの投稿では、多くのユーザーが「Fable 5を使うためにMaxプランに切り替えたのに、当日に遮断された」と訴えている。あるユーザーは「生物学の基本的な質問さえできなかった」と、セーフガードの過剰さを指摘。多額の課金が一瞬で無駄になった苛立ちが広がった。
これはBtoBのSEO支援会社にとっても同様で、クライアント向けのコンテンツをFable 5に依存していた場合、納期の遅延と追加コストが発生する。急速なAI導入が裏目に出る典型例と言える。
国家セキュリティとAI規制、SEOに迫る論点
今回の措置は、AIによるサイバーセキュリティリスクを巡る政府とAnthropicの長年の対立の延長線上にある。Anthropicは大量監視や自律型兵器への技術提供を拒否してきた経緯があり、それが政府の不信感を強めたと見られる。
SEO業界への教訓は単純だ。極めて高性能なAIモデルは、常に地政学的リスクの影響を受ける。特定のベンダーに過度に依存したコンテンツ戦略は、突如として停止する可能性がある。複数のAIプロバイダーを使い分けるマルチベンダー戦略が、今後の安定運用の鍵を握る。
上の図は、リスク分散のためのマルチベンダー構成の一例だ。1つのモデルが遮断されても、他のプロバイダーや自社ホストのモデルでカバーできる。
「強力すぎるAI」を喧伝したツケ
批判の矛先はAnthropic自身にも向いた。同社が長年「極めて強力で危険なAI」と自社モデルを位置付けてきたことが、政府の深刻な受け止めを招いたという指摘だ。Xでは「恐怖をブランドにして政府に輸出管理をかけられ、今更『誤解』と言うのか」と皮肉る投稿が散見された。
SEO担当者にとっては、AIの性能を過大にアピールするマーケティングが規制を早める可能性を認識する契機になる。クライアントや社内で「最強のAIを使っている」と謳う前に、その文言が持つ政治的な重みを考慮すべき局面だ。
SEO戦略に組み込むAIレジリエンス、今後の備え
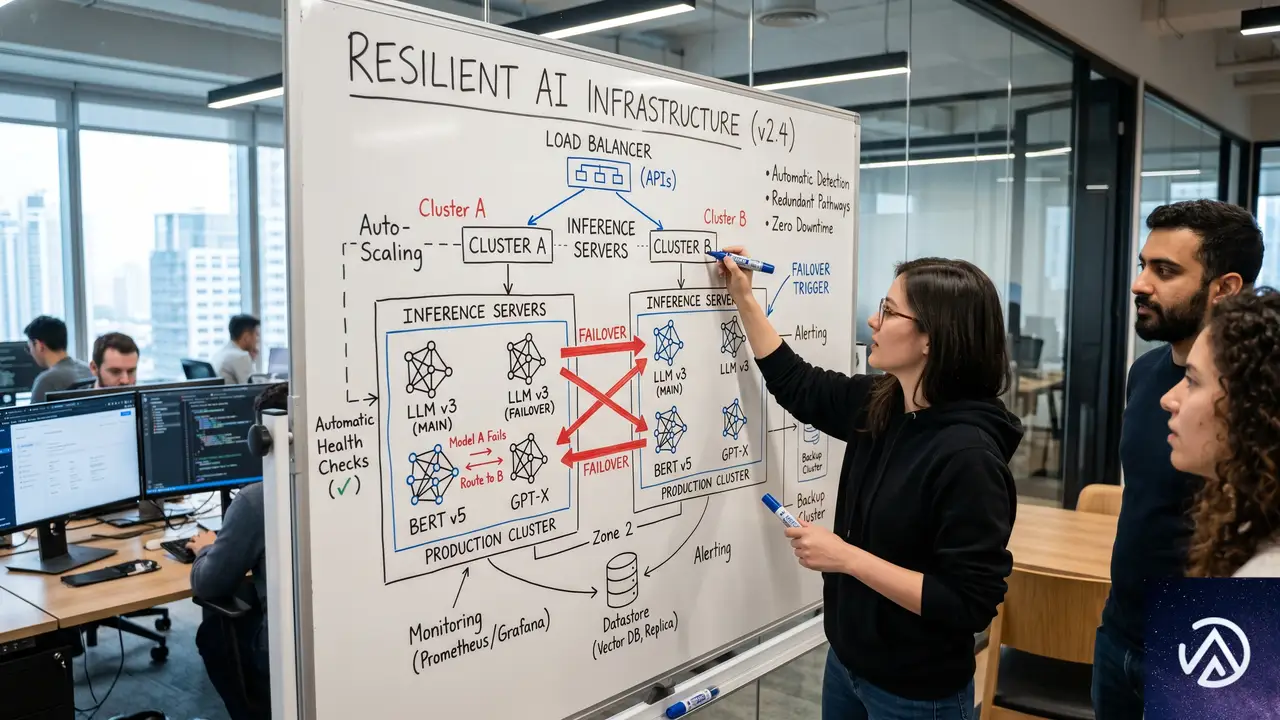
Fable 5停止のような事態に備え、SEO担当者は次の3つの柱を早急に固める必要がある。第一に、複数AIモデルへのアクセス経路の確保。第二に、AI非依存の編集プロセスとの併用。第三に、オープンソースLLMの社内導入検討だ。
Anthropicは「サービスの早期復旧を目指す」と表明しているが、法的な結末は不透明だ。最悪の場合、最先端モデルへのパブリックアクセスが恒久的に制限される可能性もゼロではない。そのとき、手元に自前の代替手段を持たないチームは、検索順位を維持するための初速で致命的な遅れを取る。
この比較が示す通り、AIに依存するほど、その供給停止がもたらすダメージは大きくなる。今のうちにバックアップのAIパイプラインをテストし、実際に切り替え可能な状態にしておくことが重要だ。
この記事のポイント
- 米国政府の輸出管理命令によりAnthropicのFable 5とMythos 5が全ユーザーに対して突然停止された
- SEO業界では高精度AIを前提としたコンテンツ制作フローが寸断され、返金要求や納期遅延が発生
- 高性能AIのブランディングが規制を呼び込むリスクが現実化した
- マルチベンダー戦略やオープンソースLLMの導入で、AIサービス遮断に強いSEO体制を構築すべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
MonsterInsights公式サイトが攻撃、フィッシングメールに警戒を
WordPress向けGoogle Analytics連携プラグイン「MonsterInsights」の公式サイトがサイバー攻撃を受け、一時的にオフラインとなった。さらに深刻なのは、同プラグインを装ったフィッシングメールがユーザーに送信されている点だ。無料版だけでも200万サイト以上にインストールされており、影響は広範囲に及ぶ。
この記事では、MonsterInsightsが直面している攻撃の実態と、ユーザー側が直ちに取るべき対策を整理する。サイトに同プラグインを導入している運営者は、偽の更新通知やダウンロードリンクに十分な警戒が必要だ。
MonsterInsightsとは何か、なぜ影響が大きいのか
MonsterInsightsは、WordPressサイトにGoogle Analytics(GA)のデータを直感的に表示するプラグインだ。管理画面内のダッシュボードでアクセス解析を完結できる点が評価され、広く普及している。無料版のインストール数は200万サイトを超え、有料版を含めると約300万サイトに導入されているとされる。
上図のように、MonsterInsightsは本来、GAデータをWordPress管理画面に橋渡しする安全なツールだ。しかし今回、攻撃者がその信頼性を逆手に取り、ユーザーを偽サイトへ誘導する手口が確認されている。
インストールベースが極めて大きいため、被害が連鎖的に広がるリスクがある。攻撃者がMonsterInsightsの顧客リストにアクセスした場合、正規のユーザー情報を使って説得力のあるフィッシングメールを送信できるからだ。
公式サイトのダウンと攻撃の兆候
Search Engine Journalの記事によれば、MonsterInsightsの公式サイトは2026年6月12日時点でオフラインとなり、トップページには以下のような告知が表示されている。
Our website is offline as we’re mitigating an attack. Your analytics and tracking aren’t affected. Please DO NOT download MonsterInsights from any 3rd party website as there is a known phishing attempt happening right now.
この告知から読み取れるのは、攻撃がWebサイトそのものを標的にしている一方で、既存ユーザーのアナリティクス機能やトラッキングには影響が出ていないという点だ。MonsterInsightsはプラグインとして各サイトにローカルインストールされているため、公式サイトが落ちても、すでに導入済みのサイトでGAデータの取得が止まることはない。
ただし、公式サイトにアクセスできない状態が続くと、正規のアップデートを受け取れなくなるリスクがある。攻撃者はその隙を突き、「MonsterInsightsの緊急アップデート」を装ったメールを流している。
攻撃の種類とフィッシングの手口
現時点で攻撃の詳細な手法は明らかにされていない。しかし、公式サイトの差し替えと顧客へのフィッシングメール送信が同時に発生していることから、次のようなシナリオが推測される。
- 攻撃者が何らかの方法でMonsterInsightsの顧客データベースまたはメール配信システムにアクセスした
- 入手したメールアドレスに対して、MonsterInsightsを装ったフィッシングメールを一斉送信している
- メールには偽のダウンロードリンクが含まれ、サードパーティサイトから不正なプラグインをインストールさせる狙いがある
フィッシングメールを受け取ったユーザーがリンクをクリックし、指示に従って「更新」を実行すると、マルウェアを含む偽のプラグインがWordPressサイトにインストールされる可能性がある。これにより、サイトの乗っ取りや情報漏洩といった二次被害が発生するリスクが高まる。
✅ 公式サイト(復旧後)またはWordPress管理画面からのみ更新する
✅ 不審なメールは support@monsterinsights.com に報告する
上記のような緊急性を煽る文言が使われている場合、特に注意が必要だ。MonsterInsightsの公式Xアカウントも、サードパーティサイトからのダウンロードをしないよう強く呼びかけている。
ユーザーからの報告とSNS上の反応
X(旧Twitter)上では、実際にフィッシングメールを受け取ったユーザーが複数報告している。
ユーザーの @alliemims 氏は、フィッシングメールを受け取ったがリンクには触れず、公式サイトの問い合わせフォームから報告しようとしたところ、403エラーでアクセスできなかったと投稿している。別のユーザー @biancavandepoel 氏は、攻撃者がすでに顧客リストを入手している可能性を指摘し、MonsterInsights側から全顧客への迅速な警告メール送信を求めている。
これらの投稿からは、ユーザーが混乱しつつも冷静に対処しようとしている様子がうかがえる。報告しようとしても公式サイトにアクセスできないという状況が、事態をより複雑にしている。
MonsterInsightsの公式対応と今後の展望
MonsterInsightsは公式Xアカウントで、攻撃を緩和するための対応を進めていると発表している。また、サードパーティサイトからのダウンロード禁止を改めて警告し、ユーザーに対しては support@monsterinsights.com への問い合わせを案内している。
現時点では、公式サイトの復旧時期や攻撃の全容については明らかにされていない。しかし、過去のWordPressプラグインに対するサプライチェーン攻撃の事例から見ると、今回のインシデントは以下のような段階を経て収束に向かうと予想される。
- 攻撃経路の特定と遮断
- 流出した可能性のある顧客データの範囲特定
- 公式サイトの復旧とセキュリティ強化
- 影響を受けたユーザーへの個別通知
重要なのは、MonsterInsightsのプラグインそのものに脆弱性が見つかったわけではないという点だ。今回の問題は公式サイトと顧客コミュニケーション経路への攻撃であり、既存のインストール済みプラグインが直接危険にさらされているわけではない。ただし、フィッシングによって偽のプラグインをインストールさせられるリスクは現実に存在する。
サイト運営者が直ちに取るべき5つの対策
MonsterInsightsを導入している、または同プラグインの利用を検討しているサイト運営者は、以下の対策を即座に実行することを推奨する。
特に重要なのは、落ち着いて公式情報を待つことだ。攻撃者は混乱に乗じてユーザーを騙そうとする。MonsterInsightsのプラグイン自体が危険になったわけではないため、慌ててプラグインを削除したり、非公式の「修正版」をインストールしたりする必要はない。
WordPressプラグインのエコシステム全体を見渡すと、今回のようなサプライチェーン攻撃は増加傾向にある。2024年にも複数の人気プラグインが同様の手口で攻撃を受けた事例がある。自社サイトのセキュリティ対策として、以下の日常的な施策も合わせて見直すことを推奨する。
- プラグインの自動更新を有効にし、公式リポジトリからの更新のみを許可する
- 管理画面へのアクセスに二要素認証を導入する
- 定期的にサイトのプラグイン一覧を監査し、不要なものは削除する
- セキュリティプラグインでファイル変更の監視を行う
この記事のポイント
- MonsterInsights公式サイトが攻撃を受け、フィッシングメールが顧客に送信されている
- 既存のプラグイン機能(アナリティクス・トラッキング)には影響なし
- メール内のリンクからサードパーティサイトでプラグインをダウンロードしないこと
- プラグイン更新はWordPress管理画面または公式サイトからのみ行う
- 不審なメールは公式サポートに報告し、自社サイトのプラグイン一覧も確認する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
UpdraftPlusに深刻な脆弱性、300万サイトが認証迂回の危険
WordPressの人気バックアッププラグイン「UpdraftPlus Backup & Migration」に深刻な脆弱性が発見された。インストール数は300万サイトを超えており、影響範囲は極めて広い。この問題を悪用されると、ログイン情報を持たない攻撃者がサイトの管理者権限を取得し、悪意あるプラグインを設置できる。
脆弱性が確認されたのはバージョン1.26.4以前の全バージョン。開発元はすでに修正版1.26.5をリリースしている。Wordfenceの報告によれば、24時間で8,000件を超える攻撃が観測されており、早急な対応が求められる。
脆弱性の概要と影響範囲
UpdraftPlusはWordPressサイトのバックアップ、復元、移行を一手に担う定番プラグインだ。Google DriveやDropboxなど多数のクラウドストレージへのバックアップに対応し、無料版でも一通りの機能を使える。300万というアクティブインストール数は、WordPressプラグイン全体でもトップクラスに位置する。
これだけの規模で使われているプラグインに認証回避の脆弱性が見つかったことは、WordPressエコシステム全体にとって大きな脅威である。とくに今回の問題は、攻撃者がログインする必要すらない点で深刻度が一段高い。
上図のとおり、1.26.4以前はすべてのバージョンが影響を受ける。1.26.5への更新で修正されるため、管理画面から利用可能なアップデートがないかすぐに確認してほしい。
すべてのサイトが攻撃対象になるわけではない
注意すべき点として、UpdraftPlusをインストールしているだけでは攻撃が成立しない。プラグインの変更履歴によれば、攻撃が可能になるのは「アクティブなMigratorキー」または「UpdraftCentralキー」が設定されているサイトに限られる。
Migratorキーは有料版でのみ使われる移行機能で、UpdraftCentralキーは無料版・有料版の両方で利用できるリモート管理機能である。これらのキーを有効化しているサイト運営者は、とくに注意が必要だ。
認証バイパスの仕組み
この脆弱性は「認証バイパス(Authentication Bypass)」に分類される。認証バイパスとは、本来必要なはずの本人確認の仕組みをすり抜けてしまう欠陥のことだ。
UpdraftPlusはリモート通信を受け取る際、その命令が正当な管理者から送信されたものかを検証する仕組みを持っている。ところが今回の問題では、この検証プロセス自体を迂回できてしまう。結果として、攻撃者の偽造命令が「正規の管理者命令」として処理されてしまうのだ。
暗号署名の検証が機能しない根本原因
Wordfenceの技術分析によれば、問題の核心は「リモート通信メッセージの検証不備」にある。
通常、プラグインは受信した命令の署名(デジタルな印鑑のようなもの)を検証し、改ざんや偽造がないことを確認する。検証に失敗した場合、システムはその命令を拒否するべきだ。ところがUpdraftPlusのコードには、署名検証に失敗したときにエラーを返して処理を停止するのではなく、暗号鍵として「オールゼロ(すべてのビットが0の鍵)」に陥ってしまう欠陥があった。
これをもっと身近なたとえで説明しよう。たとえば、オフィスの入館ゲートでICカード認証が失敗したとする。本来ならゲートは閉じたままでなければならない。しかし今回の問題は、認証に失敗したときに「鍵が全部0の状態のマスターキー」が自動的に発行されてしまうようなものだ。攻撃者はそれを知っていれば、簡単にゲートを通れてしまう。
この欠陥により、攻撃者は任意のRPC(リモートプロシージャコール、遠隔操作命令)を偽造し、接続中の管理者として実行できるようになる。
攻撃の実態とリモートコード実行の危険性
認証バイパスによって攻撃者が得るのは、単なる閲覧権限ではない。管理者権限での操作が可能になるため、サイトの運命を左右する重大な操作を自由に行える。
もっとも危険なシナリオは、悪意あるWordPressプラグインのアップロードと有効化だ。攻撃者は見た目は普通のプラグインに見せかけたバックドア(裏口)を設置できる。このバックドアが有効化されると、サーバー上で任意のコードが実行可能になり、以下のような被害が現実のものとなる。
- サイトデータの窃取(顧客情報、メールアドレス、パスワードハッシュなど)
- マルウェアの注入による訪問者への二次被害
- サイトの改ざんやフィッシングページの設置
- 管理者アカウントの不正作成と恒久的な支配
- 他のサーバーへの攻撃拠点としての悪用
すでに8,000件以上の攻撃を観測
Wordfenceの脅威インテリジェンスチームは、24時間で8,172件の攻撃試行をブロックしたと報告している。これは実際に悪用が試みられている明確な証拠だ。
ブロックされた攻撃の数だけでは、実際に侵入に成功したサイトの数はわからない。しかし攻撃者が積極的にスキャンと攻撃を仕掛けている以上、未対策のサイトはきわめて危険な状態にあると言わざるを得ない。
サイト運営者がいますぐ取るべき対策
脆弱性への対応はシンプルだ。UpdraftPlusをバージョン1.26.5以降にアップデートすること。これだけで問題は解消される。
UpdraftPlusの変更履歴では「すべてのユーザーは直ちに更新すべき」と明記されている。有料版・無料版を問わず、更新の猶予はない。
更新以外に検討すべき安全策
今回の脆弱性は、WordPressサイトの基本的なセキュリティ対策の重要性を改めて示している。以下の対策もあわせて検討してほしい。
- プラグインの定期的な自動更新を有効にする
- 使用していないプラグインは削除し、攻撃対象を減らす
- セキュリティプラグインを導入し、不審な通信を監視する
- 定期的にバックアップを取得し、復旧手順を確認しておく
- UpdraftCentralやMigratorキーを現在使っていないなら、無効化を検討する
この記事のポイント
- UpdraftPlus 1.26.4以前に認証バイパスの脆弱性が存在し、300万以上のサイトが影響を受ける
- 攻撃者はログイン不要で管理者権限を取得し、悪意あるプラグインの設置が可能
- 24時間で8,000件以上の攻撃が観測されており、すでに悪用が進行中
- バージョン1.26.5への即時更新で修正される
- MigratorキーまたはUpdraftCentralキーを有効化しているサイトはとくに危険
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Shopify障害で店舗停止、広告費消失のリスクと対策
2026年6月3日、Shopifyで大規模なサービス障害が発生した。店舗フロントの表示不具合やチェックアウト機能の停止により、世界中のEC事業者が売上機会を失った。とりわけGoogleやMetaに広告予算を投下していた事業者は、クリックを集めながら購入完了に結びつけられないという致命的な状況に陥っている。
本記事では、この障害がECサイトの広告パフォーマンスとSEOに及ぼす実務的な影響、および同様の事態を想定したリスク分散策を整理する。Shopifyに限らず、SaaS型ECプラットフォームに依存する事業者共通の課題として捉えてほしい。
障害の概要と影響範囲
Shopifyは米国東部時間9時27分に問題を認識し、管理画面やPOSレジ、カスタマーサポートへのアクセス障害を公表した。店舗フロントやチェックアウトにも波及し、購入完了ができない状態が約1時間にわたって続いた。10時37分には根本原因を特定し、回復に向かっていると発表している。
影響を受けたのは以下の4領域だ。いずれもEC事業の中核を担う機能であり、たとえ短時間の停止でも事業者の損失は無視できない。
- 店舗フロントの表示
- チェックアウト処理
- 管理画面へのログイン
- 実店舗向けPOSレジ
Search Engine Landの記事によれば、この障害を最初に報告したのはSenior Paid Media ManagerのAyisha Yousef氏だ。同氏はLinkedIn上でエラーメッセージのスクリーンショットを共有し、広告運用担当者へ注意を呼びかけた。
Shopify障害の時系列
このタイムラインからわかるのは、障害検知から復旧まで約1時間10分というスピード感だ。しかしEC事業者にとって、ピーク時間帯の1時間は致命的な機会損失になりうる。
チェックアウト停止が広告運用に直撃する仕組み
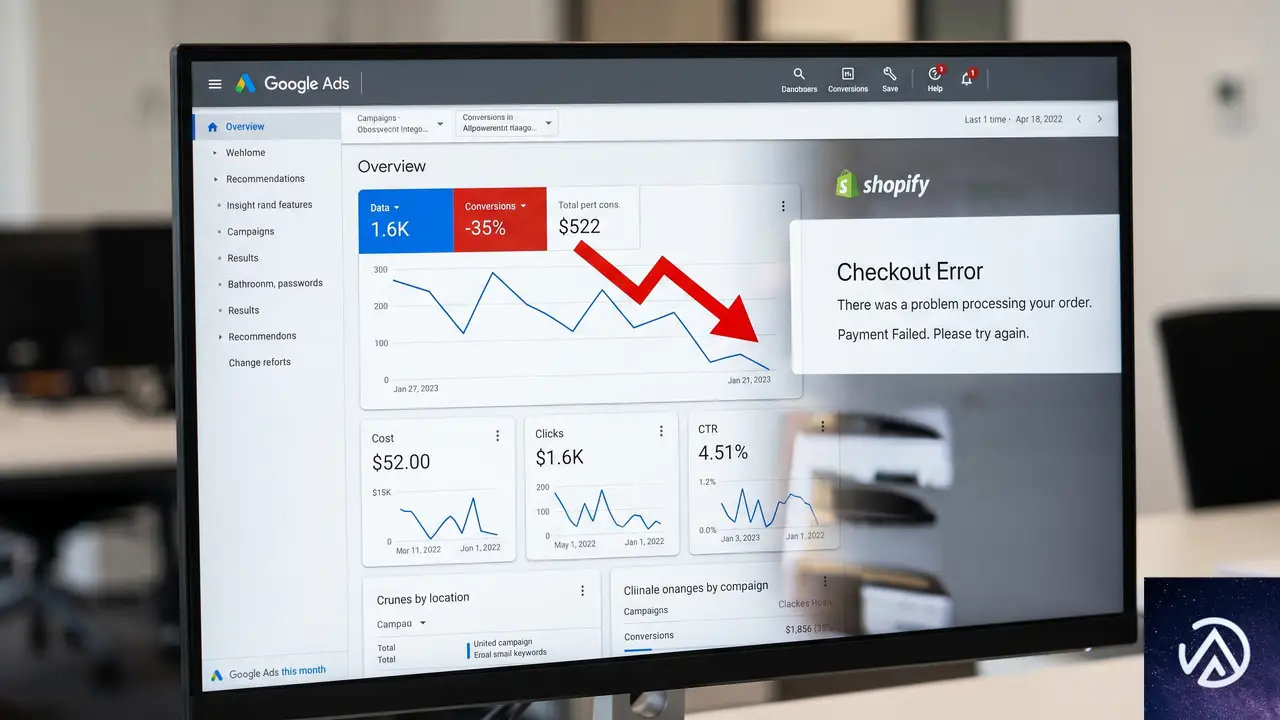
最も深刻なのが、広告経由で流入したトラフィックが一切売上に結びつかない状況だ。Googleショッピング広告やMetaのダイナミック広告で商品を表示し、ユーザーがクリックして店舗に到達しても、チェックアウト画面でエラーが発生すれば購入は成立しない。
広告費はクリック単位で課金される。つまり「クリックは発生するがコンバージョンはゼロ」という状態が続けば、ROAS(広告費用対効果)は急落する。以下の図は、障害発生中に起こる広告費消失のメカニズムを単純化したものだ。
この構造は、広告キャンペーンのパフォーマンスデータにも深刻な歪みをもたらす。障害時間帯のコンバージョン率が異常に低くなるため、キャンペーン全体の平均値を押し下げ、自動入札戦略の学習にも悪影響を与える可能性がある。
Google広告とMeta広告への具体的な影響
Google広告では、コンバージョンデータがスマート自動入札のシグナルとして使われる。障害によるゼロコンバージョンが一定期間続くと、アルゴリズムが「このキャンペーンは効果が低い」と判断し、入札単価の引き下げや表示頻度の低下を招く。
Meta広告(Facebook・Instagram)も同様だ。コンバージョンAPIで送信される購入イベントが途絶えると、アルゴリズムが最適なオーディエンスを見失い、その後の配信精度が低下する。特に障害直後の数日間は、通常よりもCPA(顧客獲得単価)が跳ね上がる傾向があると指摘する広告運用者もいる。
Search Engine Landの記事では、Shopify障害中は広告キャンペーンの成果を通常通り評価できないため、後日パフォーマンスを検証する際には障害時間帯を除外するか、別途注釈を加えることが推奨されている。
EC事業者が直面するプラットフォーム依存リスク
今回の障害は、多くのEC事業者が単一のプラットフォームに売上インフラのすべてを依存している現実を浮き彫りにした。Shopifyは数百万のオンラインストアを支える巨大プラットフォームであり、その停止は個別店舗の努力ではどうにもならないレイヤーで発生する。
とりわけ、以下のような状況にある事業者ほど影響が大きい。
- プロモーションや新商品発売のタイミングと重なったケース
- インフルエンサー施策で集中的にトラフィックを集めていたケース
- Shopifyペイメント以外の決済手段を持たないケース
これは「SaaS型ECの構造的リスク」と言い換えられる。自社サーバーでECサイトを構築するオンプレミス型に比べ、SaaS型は運用負荷が低い半面、障害発生時のコントロール権はゼロに等しい。復旧を待つ以外に打てる手が限られるのだ。
依存度を下げるための分散戦略
完全にShopifyから離れるのは現実的ではない。しかし、致命的な売上機会損失を減らすための「保険」として、以下のような分散策を検討する価値はある。
- バックアップ用のランディングページを外部で用意しておく(NotionやGoogleサイトで簡易的な注文フォームを設置するなど)
- InstagramショップやAmazonストアなど、販売チャネルを複数持つ
- 広告のリンク先をShopifyストア以外にも切り替えられる体制を整える
- Shopifyとは別の決済リンク(Stripe Payment Linksなど)をSNSプロフィールに常設する
これらの対応は、日常的には使わなくても、緊急時に即座に切り替え可能な「避難経路」として機能する。障害発生から復旧までの1時間を耐え抜くための備えだ。
障害発生時に取るべき3つの即時対応
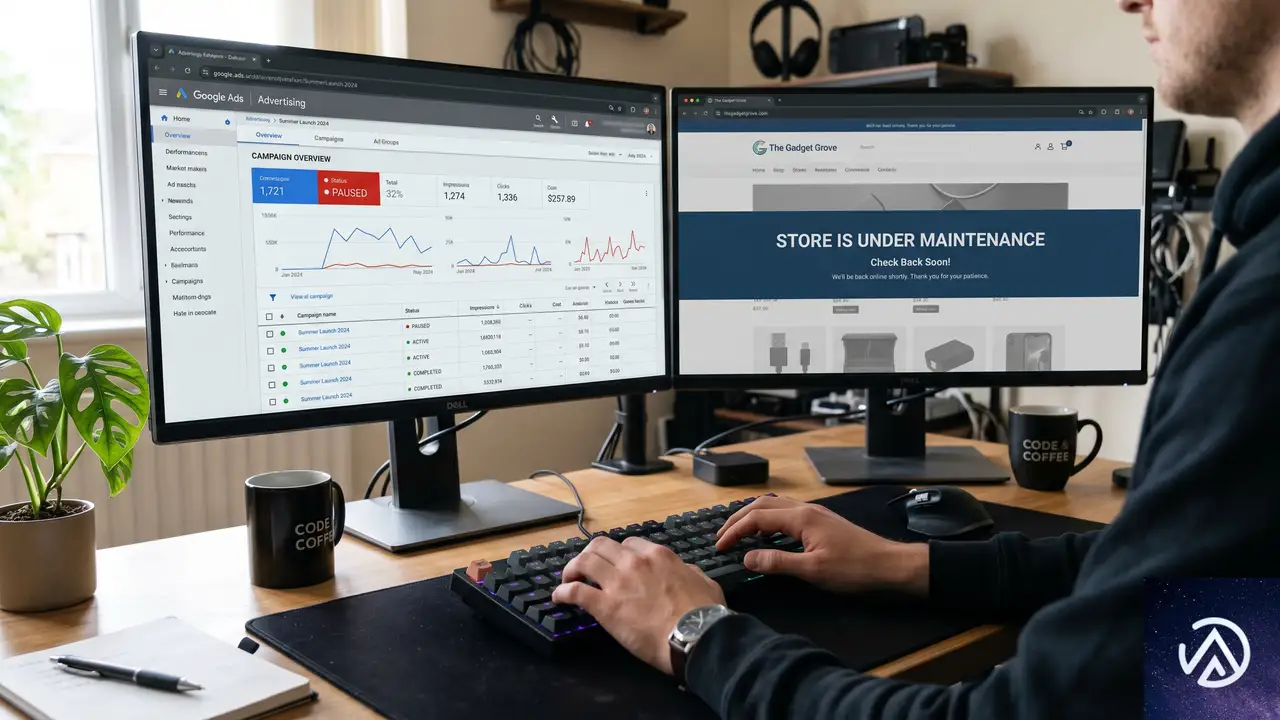
Shopifyに限らず、ECプラットフォームの障害を検知した際に、広告運用とSEOの両面で即座に実行すべき対応を整理した。以下の3ステップは、今回のShopify障害の事例をもとに構成している。
STEP 1の広告停止が最も重要だ。検索広告のクリック単価はリアルタイムで消費され続けるため、障害を検知してから数分以内に対応できるかどうかで、無駄になる広告費の額が大きく変わる。Google広告の自動化ルールで「コンバージョンがゼロになったらキャンペーンを停止する」条件を事前に設定しておくと、人的対応の遅れを防げる。
SEO視点で見る障害時の注意点
チェックアウトや管理画面の障害が直接的にSEOにペナルティを与えることはない。ただし、店舗フロントが完全に表示されない状態が長時間続くと、Googlebotがクロールに失敗し、インデックスの鮮度が落ちる可能性はある。
より実務的に注意すべきは、SNSや口コミで「このストア使えない」というネガティブな評判が広がることだ。ブランド検索の増加に対して、表示される検索結果がネガティブな情報に偏ると、その後のオーガニック流入にも影響が出る。障害発生時には、自社のSNSアカウントで状況を説明し、検索結果のコントロールに努めることが重要になる。
この記事のポイント
- Shopifyの大規模障害はEC事業者に広告費の無駄遣いと機会損失をもたらした
- チェックアウト停止中は広告キャンペーンを即座に停止し、復旧後にデータ補正を行う必要がある
- 単一プラットフォームへの依存度を下げるため、販売チャネルと決済手段の分散が有効
- 障害発生時に備えた広告自動化ルールの設定が、被害を最小化する鍵となる
- 復旧後はキャンペーンパフォーマンスを適切に評価し、アルゴリズムの誤学習を防ぐこと
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Microsoft Web IQでAIエージェントがBing検索を利用可能に。SEOへの影響を考察
Microsoftが2026年6月2日、AIエージェント向けの検索基盤「Web IQ」を発表した。Bingの検索インデックスに蓄積された情報を、AIシステムが推論やタスク実行に直接利用できるようにするAPI群である。
従来のBingが人間にウェブページを提供するのに対し、Web IQはAIに「パッセージ」と呼ばれる情報の断片を返す。この違いがAI時代のコンテンツ最適化とSEO戦略に大きな影響を与える可能性がある。
この記事では、Web IQの技術的な仕組み、従来の検索エンジンとの違い、パフォーマンス、そしてパブリッシャーにとっての意味を詳しく解説する。
Web IQの基本構造 〜AIエージェントが必要とする情報だけを届ける〜
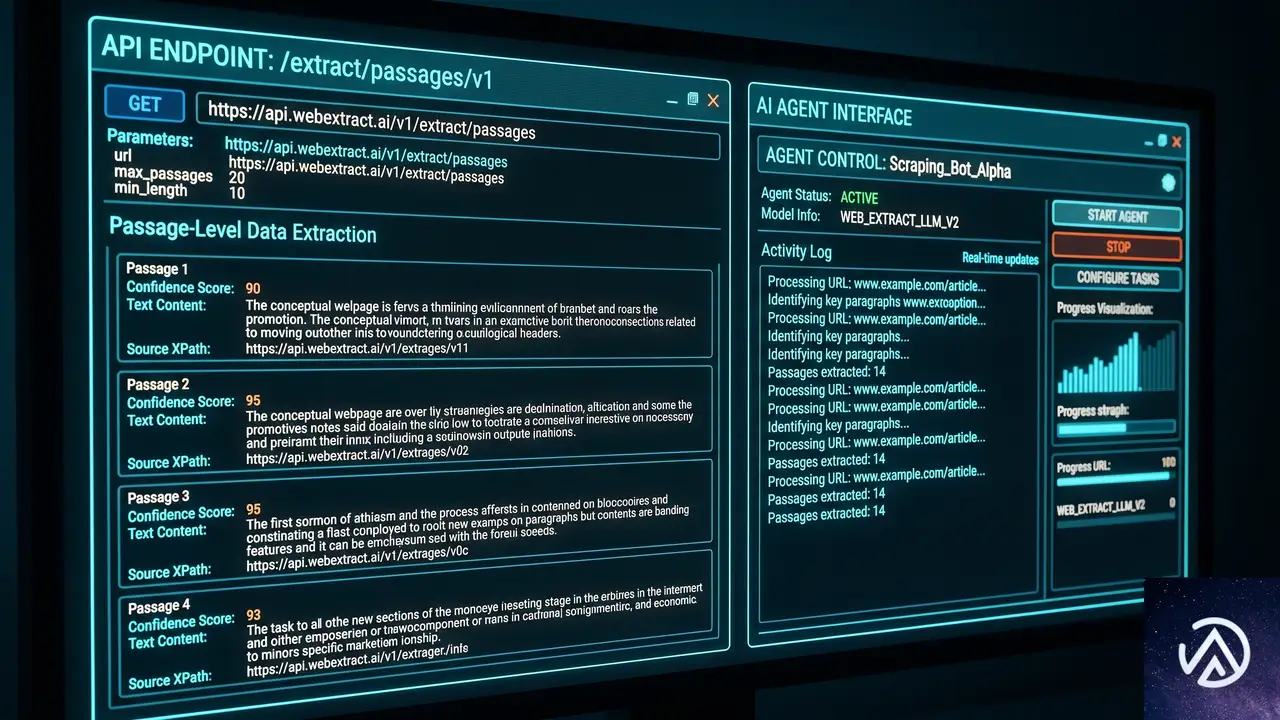
Web IQの中核にあるのは、Bingのインデックスを土台に再構築された検索スタックだ。コンテンツのインデックス化、ランキング、選択の仕組みがAIエージェントの利用を前提に設計し直されている。AIエージェントはタスクの複数ステップにわたって厳しい時間制約の中で繰り返し検索を行うため、その動作特性に合わせた設計が求められた。
パッセージ単位の情報提供
Web IQが返すのは、ウェブページ全体ではない。「パッセージ」と「構造化されたエビデンスオブジェクト」だ。ページ中からAIにとって有用な部分だけを切り出して渡す。
AIモデルが処理するトークン(テキストの最小単位)にはコストがかかり、レイテンシ(応答遅延)にも直結する。Microsoftによれば、「少ないトークンでより良い回答を、1回の呼び出しあたりのコストを抑える」という三拍子を実現するのがWeb IQの設計思想だ。
このアプローチは、SEOの世界で徐々に広がっている「パッセージベースの検索」という概念とも整合する。Googleが2020年に導入したPassage Ranking(パッセージランキング)は、ページ全体ではなくその一部を検索クエリに最も関連する情報として抽出する技術だ。Web IQはこの考え方をAIエージェント向けに特化させたものと見ることができる。
従来の検索エンジンとは何が違うのか 〜ランキングと評価基準の再設計〜
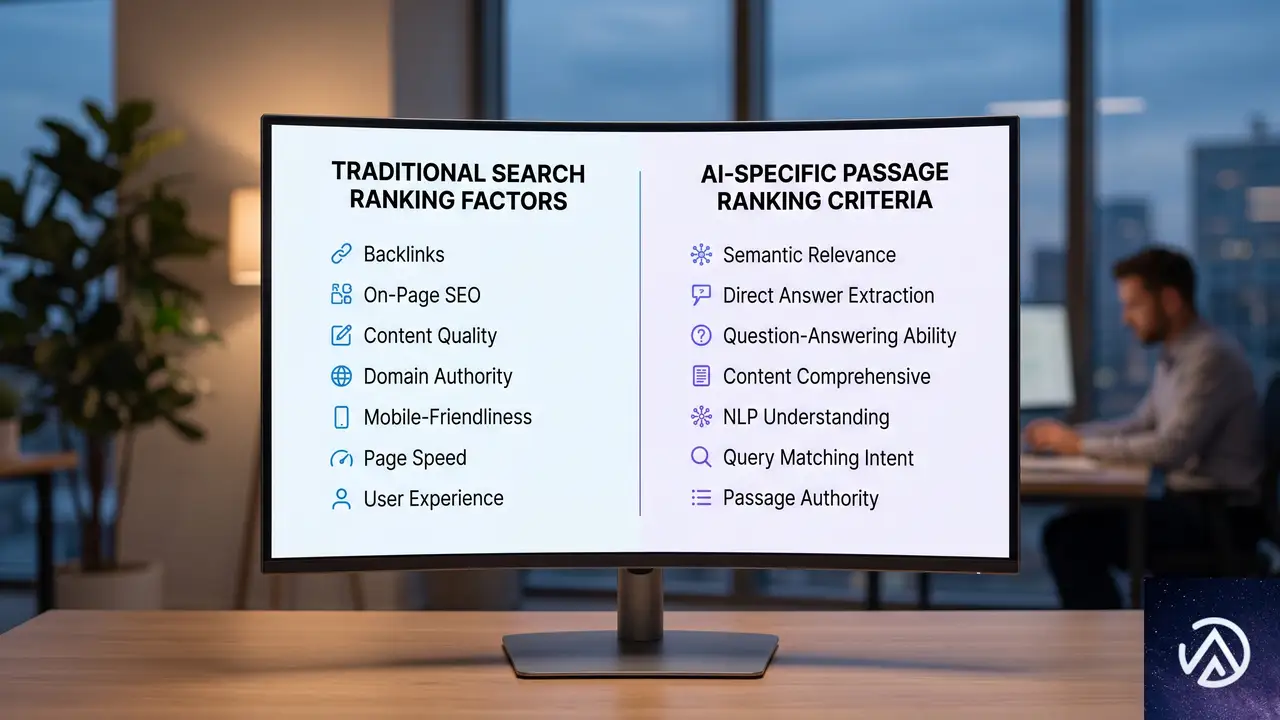
MicrosoftがWeb IQの品質評価に使う指標は「GDSAT(Grounding Satisfaction / グラウンディング満足度)」と呼ばれる。情報の新鮮さと信頼性を測定するために設計された指標で、3,000件のサンプルクエリを用いたテストでは競合他社より高いスコアを記録したと発表している。
応答速度についても具体的な数字が示された。5つのデータセンターにまたがるテストで、P95(リクエストの95%がこの時間内に完了する値)で165ミリ秒未満を達成。競合と比較して約2.5倍高速だとしている。
ここで重要なのは、Web IQが従来の検索エンジンとまったく異なる評価軸で動いている点だ。人間向けの検索では、ページ全体の権威性や被リンクプロファイル、滞在時間など多面的なシグナルが使われる。一方、Web IQでは「AIエージェントがその情報を使ってどれだけ正確にタスクを遂行できるか」という一点が重視される。
全文からパッセージへの転換が意味すること
Search Engine Journalの記事で、Microsoftの発表を引用する形で指摘されているのは「従来の検索で上位表示されるページの特徴と、AIのグラウンディングに有用なパッセージの特徴は必ずしも重ならない」という点だ。同社が2026年前半に公開したグラウンディングフレームワークの記事でも、検索インデックスとグラウンディングの違いが詳述されている。
たとえば、あるページが検索キーワードに対して高い順位を得ていても、そのページ内のどの部分がAIにとって最も価値があるかは別問題だ。見出し構造、段落のまとまり、事実と意見の明確な区別など、AIが情報を抽出しやすい構造になっているかどうかが新たな評価ポイントになる可能性が高い。
検索体験からAI体験へ 〜パブリッシャーが知っておくべき変化〜
Bing Webmaster Toolsとの連携
Web IQは突然現れたわけではない。Microsoftは2026年に入って、段階的にAI向け検索の基盤整備を進めてきた。
- 2月、Bing Webmaster ToolsにAI引用データ(AI Citation Data)機能を追加
- 3月、グラウンディングクエリと引用ページを関連付けるAIダッシュボードを公開
- SEO Week期間中、Citation Share(AI向け引用シェア)のプレビューを発表
これらはいずれも、パブリッシャーが自分のコンテンツがAIにどのように使われているかを把握するためのツールだ。Web IQは、その裏側でAIがコンテンツを取得する仕組みに当たる。表と裏の関係にある。
つまり、Web IQの登場は「AI検索時代のSEO指標」が具体的な形を取り始めたことを意味する。従来の検索順位チェックに加えて、AIによる引用回数やパッセージ採用率といった新しいKPIが重要になる展開が予想される。
パッセージ最適化という新しい考え方
Web IQがパッセージ単位で情報を返す以上、パブリッシャー側もパッセージ単位でコンテンツを最適化する必要性が出てくる。具体的には以下のような施策が考えられる。
- 見出しと本文の関係を明確にし、各セクションが独立して意味を持つように書く
- 箇条書きや表組みを使って、AIが情報を構造的に読み取りやすくする
- 事実情報と意見・解釈を明確に分け、どちらを参照しているかAIが判断しやすくする
- 更新日を明示し、情報の鮮度をAIが評価できるようにする
これらの手法は、従来のSEOで言われてきた「E-E-A-T(経験・専門性・権威性・信頼性)」の強化とも多くの部分で重なる。違いは、AIが評価する点まで意識するかどうかだ。たとえば、ページの末尾にある免責事項や、サイドバーの関連記事リンクは従来の検索評価には影響しても、AIのパッセージ抽出ではノイズとして無視される可能性が高い。
技術面の詳細 〜オープンソース埋め込みモデルと高速検索〜
Web IQの検索パイプラインは3つの主要コンポーネントで構成される。埋め込みモデル、高速検索エンジン、そしてパッセージ選定モデルだ。
埋め込みモデルとDiskANN
Microsoftは2026年4月に、業界トップクラスの埋め込みモデル(Embedding Model)をオープンソース化した。テキストをベクトル(数値列)に変換し、意味の近さを計算できるようにする技術だ。Web IQはこのモデルを使って関連コンテンツを特定する。
大規模なインデックスを高速に検索するために使われるのが「DiskANN」という技術だ。これは全データをメモリに読み込まずに、ディスク上で効率的に類似検索を行うための仕組みだ。膨大なBingインデックスを対象に、165ミリ秒未満の応答を実現する鍵がここにある。
特筆すべきは、これらのモデルが単体のベンチマークスコアではなく、AI推論の中で実際に使われる状況を想定して訓練されている点だ。実用性を重視した設計と言える。
パブリッシャーコントロールと業界標準化
Web IQは、Bingがすでに準拠しているrobots.txtやメタタグによるクロール制御ルールを継承する。パブリッシャーが「AIにコンテンツを使われたくない」と設定していれば、Web IQもその指示に従う。
MicrosoftはIETF(インターネット技術標準化委員会)や他の業界団体とも協力し、AIシステムがウェブコンテンツにアクセスする際の標準ルール策定にも参加している。この動きは、Googleが進める「AIモード」や、その他のAI検索プロダクトとの間で、コンテンツ利用に関する共通ルールが形成されつつある兆候だ。
今後の展望と未解決の課題
現時点でWeb IQは「関心表明」を受け付けている段階であり、一般提供開始時期や価格、どのAIプラットフォームが採用するかは発表されていない。Microsoftの既存製品であるCopilotやBing Chatのグラウンディング機能がWeb IQを使っているのか、それとも別系統なのかも明らかにされていない。
とはいえ、Web IQの登場はAI検索時代の本格的な到来を示すマイルストーンだ。パブリッシャーは従来の検索エンジン最適化に加えて、「AIエージェントにどう使われるか」という視点でのコンテンツ設計を求められる局面に入ったと言える。
Bing Webmaster Toolsが提供を始めたAI引用データやCitation Shareは、そのための具体的な指標になる。まだ試験段階の数値ではあるが、早期にこれらのデータを確認し、自社コンテンツがAIにどう評価されているかを把握しておくことが競争優位につながるだろう。
この記事のポイント
- Web IQはAIエージェント向けのBing検索基盤APIであり、全文ではなくパッセージ単位で情報を返す
- 従来の検索評価とAI向け評価は異なる基準で動くため、SEO戦略の再考が必要になる
- Bing Webmaster ToolsのAI引用データやCitation Shareを使えば、AIからの評価を可視化できる
- パッセージ単位の情報設計が、今後のコンテンツ最適化の鍵になる
- 一般提供の時期や価格、対応AIプラットフォームは未発表だが、早期の動向把握が競争力を左右する
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google、Search ConsoleでAI検索専用レポートをテスト開始
Googleが2026年6月3日、Search Consoleに2つの新機能を追加するテストを開始した。生成AI検索機能への表示を制御するトグルと、AI検索内での表示回数やインプレッションを確認できる専用レポートだ。
まずはイギリスの一部サイトを対象に提供され、その後に全世界へ展開される予定だ。サイト運営者にとって、これまで「ブラックボックス」だったAI検索経由のパフォーマンスを可視化する第一歩となる。
この記事では、2つの新機能の具体的な内容と、現場のSEO担当者がどう受け止め、どのような準備をすればよいかを詳しく解説する。
GoogleがSearch Consoleでテストする2つの新機能
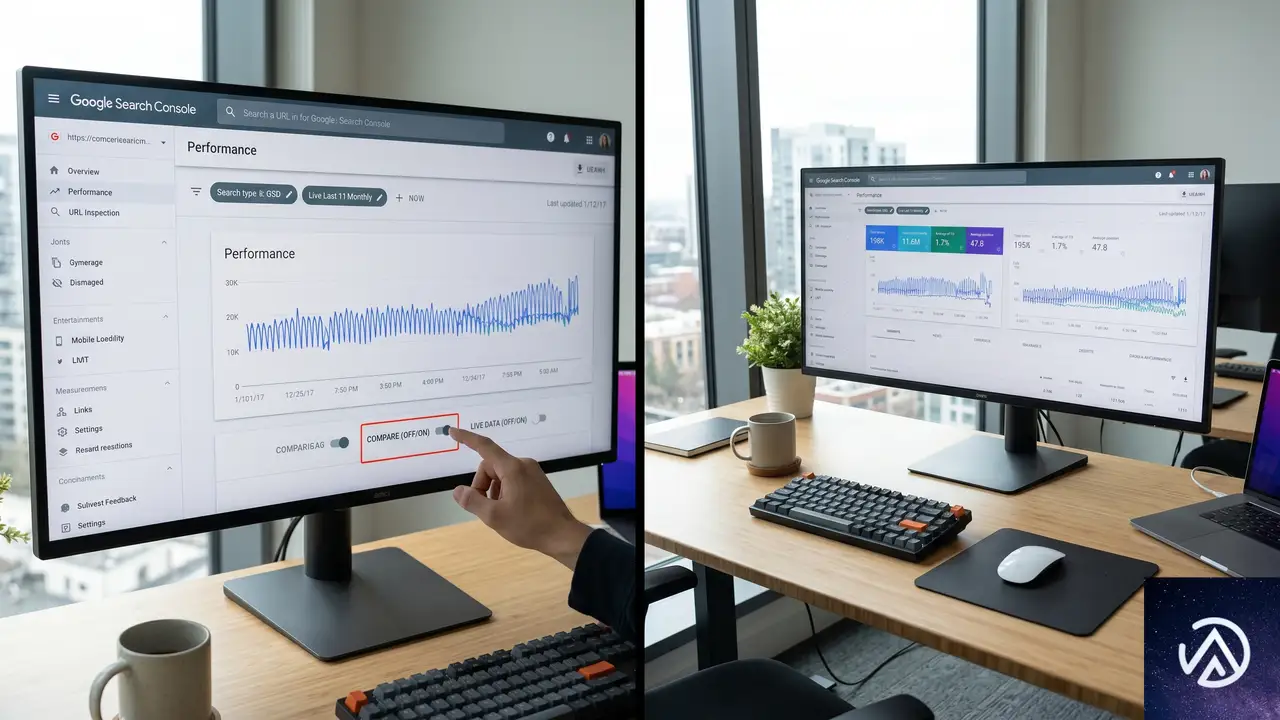
今回テストが始まったのは、AI表示制御トグルとAI専用パフォーマンスレポートの2つだ。いずれも、生成AIが検索体験に深く入り込む中で、サイト運営者が自サイトの表示状況を把握し、必要に応じて制御できるようにするための機能である。
AI表示制御トグル
1つ目のAI表示制御トグルは、文字通り「自サイトをAI検索機能に表示させるかどうか」を切り替えられる設定だ。このトグルをオフにすると、AI OverviewsやAI Mode、Discover上のAI Overviewsなど、Googleの生成AI検索機能から自サイトへの表示が一切行われなくなる。
なお、この制御はAI検索機能のみに適用され、従来の検索結果ランキングには影響しないとGoogleは明言している。いわゆるランキングシグナルとして利用されることはないというわけだ。
このトグルは、従来のスニペット制御やGoogle-Extendedの延長線上にある。スニペット制御は従来型の検索結果での表示内容を管理するものだったが、今回のトグルは「AI検索機能での表示そのもの」を対象にしている点が新しい。
AI専用パフォーマンスレポート
2つ目は、生成AI検索機能における表示回数(インプレッション)を、サイト単位・ページ単位・国別・デバイス別・日時別に確認できる専用レポートだ。データ粒度は1時間単位まで対応するという。
これまでAI検索上のデータは、Search Consoleの総合パフォーマンスレポートにまとめられており、通常の検索とAI検索を分離して分析することができなかった。今回の専用レポートによって、AI検索だけの表示傾向を把握できるようになる。
ただし、現時点ではクリック数や検索クエリ別の指標は含まれていない。Googleは「サイト運営者と協力しながら、どのような指標が最も役立つかを継続的に検討している」と述べており、今後の拡充が期待される。
新機能の詳細と現場への影響
トグル機能の仕組みと注意点
AI表示制御トグルをオンからオフに切り替えた場合、AI OverviewsやAI Mode、Discover上のAI Overviewsからのトラフィックとインプレッションがすべてゼロになる。AI経由の流入を意図的に避けたいサイトにとっては、明確なコントロール手段となる。
一方で、このトグルはあくまでもAI検索「機能」への表示を制御するものであり、Google-ExtendedのようにAIモデルの学習データとしての利用を制御するものではない。両者は目的が異なるため、必要に応じて併用する必要がある。
また、Googleはトグルの状態をランキングシグナルに使わないとしているが、長期的な検索エコシステムへの影響は未知数だ。AI検索が検索体験の主流になった場合、「AI機能に表示されない」という選択がサイト運営者にどのような機会損失をもたらすかを、慎重に見極める必要がある。
レポートが示すデータと欠落情報
新レポートでは、AI検索機能での自サイトのインプレッション数が詳細に把握できる。たとえば「特定のページがAI Overviewsで1日あたり何回表示されたか」「AI Mode上での国別の表示頻度」といった分析が可能になる。
しかし、大きな課題としてクリックデータが欠落している。インプレッション数だけでは、表示されたコンテンツが実際にクリックされ、サイトへの訪問に結びついたかどうかがわからない。Search Engine Journalの記事でも、この計測ギャップが1年以上にわたってAI検索の評価における最大の論点であり、今回の発表でもいまだ解消されていないと指摘している。
SEO担当者にとって、AI検索でのクリック率(CTR)は、コンテンツが実際にどの程度ユーザーの行動を促せているかを測る重要な指標だ。Googleがこのデータの提供を急ぐべき理由は明白だが、現時点ではスケジュールや具体的な追加指標は発表されていない。
AI計測をめぐるこれまでの経緯
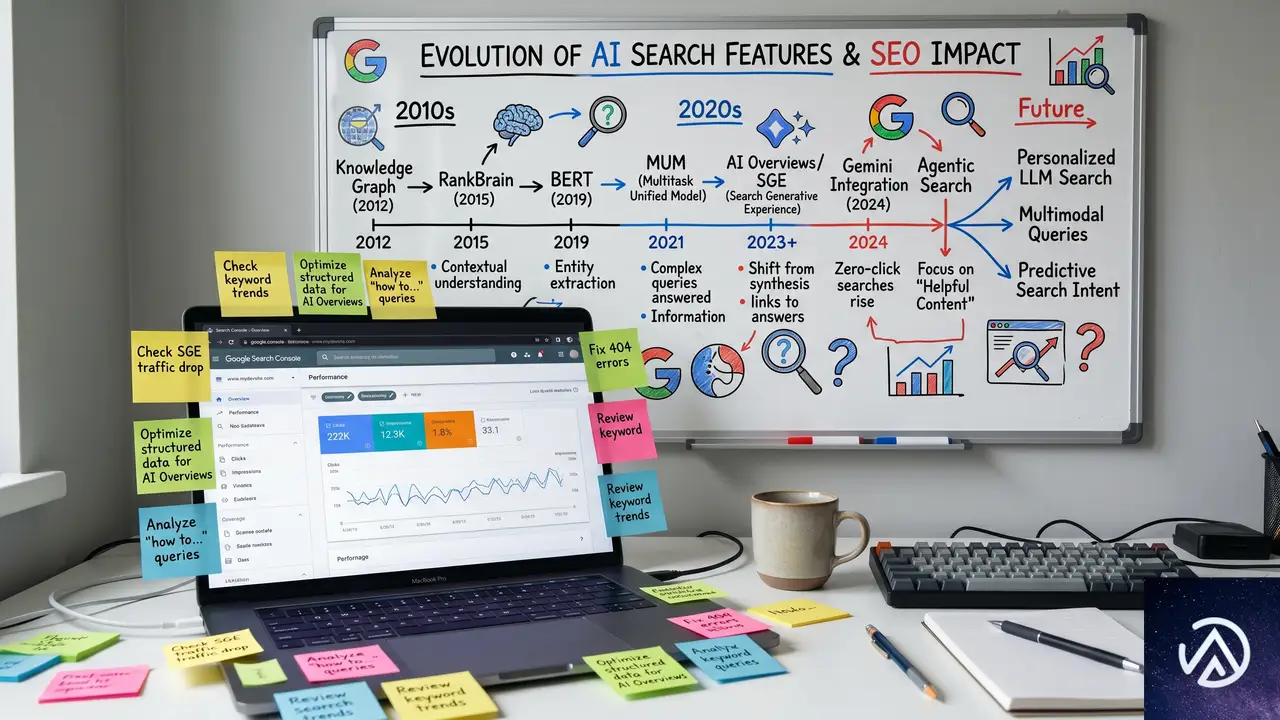
AI Overviewsが2024年にアメリカで初めて導入されて以来、Search Console上でAI固有のパフォーマンスを把握したいという要望がサイト運営者やSEO専門家から繰り返し上がっていた。Search Engine Journalも、AI専用データの提供をGoogleに求め続けてきたと記事で述べている。
2025年には、AI ModeのトラフィックがSearch Consoleの総合データに統合されることが確認されたが、その際も通常のオーガニック検索との区別はできなかった。さらに、John Mueller氏は「AI Overview内のすべてのリンクはSearch Console上で単一のポジションを共有する」と説明しており、どのリンクが実際に成果を上げているのかを評価するのが難しい状況が続いていた。
そして2026年5月、GoogleはAI機能におけるリンク表示面を拡大したものの、その表示面に特化したクリックデータは依然として提供されなかった。この発表はSEOコミュニティに「計測のブラックボックス化がさらに進むのでは」という懸念をもたらした。
競合の動き、Bingの先行事例
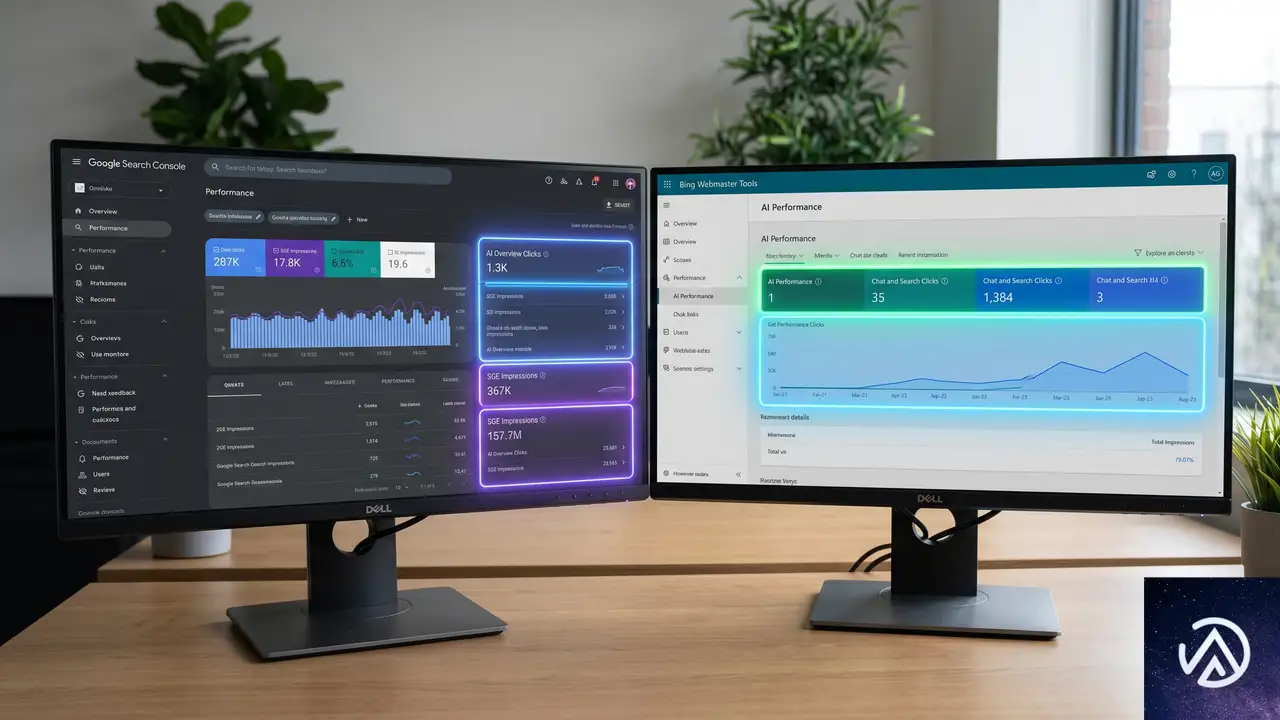
AI検索のレポーティングにおいて、MicrosoftのBingはGoogleよりも早く動いている。Bing Webmaster Toolsは2026年2月にAIパフォーマンスダッシュボードを導入し、AI検索機能で自サイトが引用された際のデータを提供し始めた。同年3月には、AIが参照したクエリと実際に引用されたページをマッピングする機能を追加し、5月のSEO WeekではCitation Share(引用シェア)のプレビューを公開している。
Bingのこれらの機能は、AI検索での自サイトの立ち位置を定量的に把握するうえで有効なツールとなっている。Googleが今回のテストでようやく第一歩を踏み出した形だが、機能面では依然としてBingに後れを取っていると言わざるを得ない。
競合が先行する状況は、Googleにとってレポーティング機能の拡充を急がせる圧力となるだろう。Search Engine Journalもこの点を指摘しており、今後のGoogleの動きに注目が集まっている。
サイト運営者が取るべき対応
現時点では、このテストはイギリスの一部サイトに限定されているが、グローバル展開後の準備は今から始めておくべきだ。
まず、自サイトがAI検索でどの程度表示されているのか、既存のSearch Consoleデータの中で手がかりを探しておくこと。AI Overviewsの表示傾向は、検索クエリの傾向や特定のページの急激なインプレッション増加などから、ある程度推測できる場合がある。
次に、AI表示制御トグルをどのように扱うかの社内方針を検討しておくこと。AI検索への表示を許容するのか、あるいは制限するのかは、サイトの収益モデルやコンテンツ戦略によって判断が分かれる。迷った場合は、当面はトグルをオン(表示を許容)にしたままデータを蓄積し、レポートが充実してから判断するのが賢明だ。
さらに、Bing Webmaster ToolsのAIレポートも並行して確認する習慣をつけておくと、AI検索全体のトレンドをより早く把握できる。Googleのレポート機能が成熟するまでの間、マルチプラットフォームでのデータ収集がリスクヘッジにもなる。
この記事のポイント
- GoogleがSearch ConsoleでAI表示制御トグルとAI専用パフォーマンスレポートのテストをイギリスで開始した
- AI表示制御トグルはAI検索機能への表示を制御するもので、ランキングシグナルには使われない
- AI専用レポートではインプレッションを詳細に分析できるが、クリックデータは未提供
- BingはすでにAI引用データやクエリマッピングを提供しており、Googleは後れを取っている
- グローバル展開に備え、既存データの分析と社内方針の検討を今から進めておくべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleが5月コアアップデートの完了を発表。11日間の不安定な変動を振り返る
Googleは2026年6月2日、5月のコアアップデートが完了したと公式に発表した。検索ステータスダッシュボード上で、ロールアウト開始から11日と21時間を経て終了したとの報告が上がっている。
今回のアップデートは、5月21日午前8時40分(太平洋夏時間)に始まり、6月2日午前5時40分(同)に終了した。約12日間の展開期間は、3月のコアアップデートとほぼ同じ長さだ。
実務者が観測したアップデートの激しさ
アップデートの開始と同時に、多くのSEO実務者が大きな変動を報告し始めた。特に注目されたのは、Google I/Oと同日に発表された点だ。
このデモが示すのは、今回の変動が単なる順位付けルールの変更ではなく、検索結果の生成プロセス自体の変化を伴う可能性があったという点だ。
SEOコンサルタントのGlenn Gabe氏は「今回の5月のコアアップデートは、従来の典型的なコアアップデートに近い強力さを見せている。3月のアップデートは地味だったが、5月は大きな動きだ」とXに投稿している。彼の観測では、この影響は特定の業種や国を超え、多岐にわたって見られたという。
また、AmsiveのLily Ray氏もXで週末の動きについて「一握りのサイトで週末に急上昇が見られた」と報告している。これらの投稿から、変動のピークが一過性のものではなく、ロールアウト期間中に何度か訪れたことがわかる。
データ分析を難しくする「多点変動」の正体
今回のアップデートで最も厄介なのは、完了したからといって、ロールアウト期間中のすべての変動が同じ原因で起きたとは言い切れない点だ。
このデモは、単日のランキング比較がいかに危険かを示している。Googleの公式ドキュメントも、アップデート完了から最低1週間はデータを寝かせ、その1週間分のデータとロールアウト開始前の1週間分を比較検証するよう強く推奨している。これに従うと、最も早く正確な比較が可能になるのは6月9日ごろという計算になる。
2026年のアップデートタイムライン
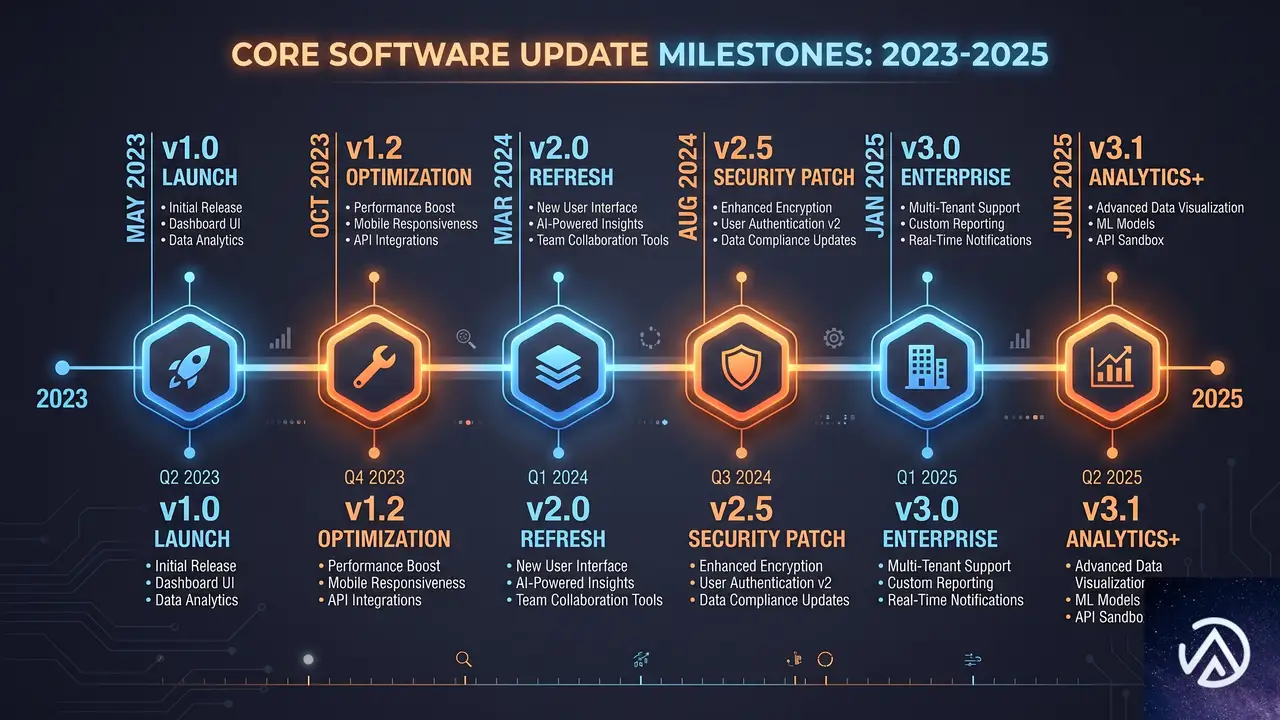
今回の5月コアアップデートは、2026年にGoogleが検索ステータスダッシュボードで確認した4回目のアップデートであり、2回目の検索コアアップデートだ。3月のコアアップデート完了(4月8日)から、5月の開始(5月21日)までは約6週間の間隔があった。
ここ最近のアップデート期間を振り返ると、コアアップデートの展開期間は平均2週間弱で推移していることがわかる。
このタイムラインから読み取れるのは、Googleがコアアップデートを年4〜5回のペースで定期的に配信している現状だ。特に2026年は、スパムアップデートを短時間で差し込むなど、検索品質の維持に対する姿勢がより機動的になっている。
分析を始める前に押さえるべき3つの視点
6月9日のクリーンな比較ウィンドウを待つ間、そしてデータ分析を始めるにあたり、以下の3つの視点を持つことが重要だ。
これらの視点をもとに、6月9日以降、Search Consoleのデータを丁寧に分析することが、今回の大規模アップデートから次なる施策を導き出すための最善の道となる。
この記事のポイント
- Googleの5月コアアップデートは6月2日に完了した。変動は全期間を通じて激しく、複数回のピークが観測された
- 完了直後の単日比較は危険であり、少なくとも1週間後の6月9日以降に週次データで比較分析を行うべきだ
- 今回の変動は、Google I/Oで発表されたAI基盤の更新とタイミングが重なり、AI検索機能との連動が示唆される
- 結局のところ、最も有効な対策は、ユーザーにとって真に価値あるコンテンツの提供であるという原則に変わりはない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon対Perplexity訴訟、AIエージェントのアクセス権限を問う
AIブラウザがユーザーの代わりにECサイトで買い物をする時代になった。AmazonはPerplexityのAIブラウザ「Comet」を相手取り、米国で異例の訴訟を起こしている。争点は「ユーザーが明示的に許可したAIエージェントのアクセスは、サイト運営者に対する不正アクセスになるのか」という一点だ。2026年6月11日に第9巡回区控訴裁判所で口頭弁論が開かれるこの裁判は、ECサイト、予約プラットフォーム、SaaS事業者すべてのログイン領域設計を変える分岐点になる。
本裁判はCFAA(Computer Fraud and Abuse Act、コンピュータ不正アクセス法)という1986年に制定された法律が、AIエージェント時代にどう適用されるのかを初めて本格的に問うものだ。差止命令、控訴審での一時停止、そして口頭弁論と、わずか8週間で局面が3度動いた。本記事では、事件の流れを整理しつつ、AIエージェントの訪問権限をめぐる法的構図を平易に解説する。そして、ウェブサイト運営者が今週中に着手できる3つの実務対応を具体的に示す。
事件の経緯と現在地
Search Engine Journalの記事によると、2026年初頭にAmazonがPerplexityをカリフォルニア州北部地区連邦地方裁判所に提訴した。PerplexityのAIブラウザ「Comet」は、ユーザーから預かった認証情報でAmazonアカウントにログインし、商品を閲覧して購入まで完了できる。AmazonはこれがCFAA違反にあたると主張した。商標権侵害や不正競争の訴えも追加されている。
地裁判決で下った差止命令
2026年3月10日、Maxine Chesney連邦地裁判事はAmazonの申し立てを認め、予備的差止命令を出した。CometはAmazon.comのパスワード保護領域(アカウントページ、注文履歴、決済画面)にアクセスできなくなった。公開ページへのアクセスは引き続き許可された。地裁は、Amazonの利用規約がログイン領域へのアクセス権限者を定めており、ユーザーがエージェントに指示したとしても、その権限はエージェント自身には及ばないと判断した。
控訴審での一時停止とPerplexityの反論
差止命令から約1週間後、第9巡回区控訴裁判所はPerplexityの控訴を待つ間、差止命令の効力を一時停止した。Cometは再びAmazonのログイン領域にアクセスできる状態で控訴審を迎えた。控訴審で予備的差止命令が停止されるのは珍しく、地裁判決への懐疑を示すシグナルと受け止められた。
2026年5月8日、Perplexityは控訴趣意書を提出した。Search Engine Journalの記事によれば、Perplexityの主張は次の3点に集約される。第1に、CFAAは本来ハッキング対策の法律であり、ユーザーが明示的に許可したエージェントのアクセスには適用されない。第2に、権限を持つのは常にユーザー本人であり、Cometはユーザーの委任のもとで行動しているにすぎない。第3に、Amazonの利用規約違反を連邦刑事法違反に格上げする解釈は、法律の趣旨を大きく逸脱する。MozillaやEFF(電子フロンティア財団)をはじめとするデジタル権利団体も、Perplexityを支持する法廷助言書を提出した。
CFAA(コンピュータ不正アクセス法)をめぐる両陣営の主張
CFAAは1986年に制定された連邦法だ。映画『ウォー・ゲームズ』の時代にハッキング行為を取り締まる目的で作られた。しかしその後20年で、スクレイピング、自動アクセス、アカウント共有など本来の射程を超える民事訴訟に援用されるようになった。2021年、連邦最高裁はVan Buren対アメリカ合衆国事件でCFAAの適用範囲を狭め、「システムへのアクセス権限を持つ者が、不適切な目的でアクセスしてもCFAA違反にはならない」と判示した。このVan Buren判決の射程が、AIエージェントによるユーザー委任アクセスに及ぶかどうかが、本件の中核的論点だ。
Amazonの3段階ロジック
AmazonのCFAA理論は3つの段階で構成される。第1に、Amazonの利用規約は自動アクセスを明示的に禁止している。アクセス権は自然人によるブラウジングに限定されており、ユーザーの代理として動作するソフトウェアエージェントは対象外だ。第2に、CometがユーザーのAmazonアカウントにログインするとき、リクエストを発行しているのはComet自身である。Amazonから見れば、訪問者はユーザーではなくエージェントだ。第3に、AmazonはCometにアクセスを許可したことが一度もない。したがってCometのアクセスはCFAA上の「権限なし」に該当する。ユーザーがCometに指示した事実は、AmazonがCometに権限を付与したかどうかとは無関係だ。
Perplexityが依拠する委任の法理
Perplexityの反論は正反対の方向から来る。ユーザーが本人(プリンシパル)であり、Cometは法律上の代理人(エージェント)だ。ユーザーがCometに自分のアカウントでログインし、自分が権限を持つ取引を完了するよう指示したとき、Cometのアクセスはユーザー自身のアクセスをソフトウェア経由で実現したものにすぎない。取引のどこにも権限のない当事者は存在しない。CFAAは明示的なユーザー委任のもとで動くソフトウェアを想定しておらず、適用範囲外だ。
この「委任の法理(agency doctrine)」は、代理人が委任者の代わりに行動するとき、代理人の行為の法的効果は委任者に帰属するという、何世紀も前から確立している原則だ。ソフトウェアが明示的なユーザー指示で動くことは、この原則を現代に自動化して拡張したものにほかならない。CFAAがこの原則を無視すれば、オンライン上のタスクをソフトウェアに委任するあらゆるユーザーが、連邦刑事法の罠にかかることになる。
第9巡回区控訴裁が差止命令を一時停止した理由
控訴審で予備的差止命令が停止されるのは異例であり、それ自体が重要なシグナルだ。第9巡回区控訴裁判所は差止命令の停止判断に4要素テストを用いるが、その第一要素は「本案で勝訴する見込み」である。停止を認めたということは、パネル(裁判官団)がPerplexity側に合理的な勝訴可能性を見ていることを示唆する。
Search Engine Journalの記事では、パネルが地裁のCFAA解釈に懐疑的である可能性を示す2つの法的圧力が指摘されている。1つ目は前述のVan Buren判決だ。連邦最高裁は2021年に、アクセス権限を持つ者が不適切な目的でシステムにアクセスしてもCFAA違反にはならないと判断した。地裁の判断はVan Buren以前の拡大解釈に近く、Van Burenが狭めたはずの範囲を再び広げているように見える。
2つ目は委任の法理だ。人間が別の人間に代理を頼むとき、代理人の行為は本人に帰属する。ソフトウェアエージェントがユーザーの明示的指示で動くことは、この原則を現代化したものにすぎない。CFAAがこの原則を無視すれば、オンラインタスクをソフトウェアに委任するすべてのユーザーが刑事罰のリスクに晒される。両方の圧力がそろったことで、パネルは地裁判決の維持に慎重な姿勢を示したと考えられる。
判決がWebサイト運営者にもたらす影響
この裁判の帰結は、AmazonとPerplexityの一訴訟にとどまらない。AIエージェントの訪問権限に関する米国初の本格的な司法判断として、あらゆるECサイト、予約プラットフォーム、金融機関、SaaS事業者のログイン領域設計に波及する。
地裁理論が維持された場合
Search Engine Journalの記事によれば、地裁のCFAA理論が控訴審で維持された場合の帰結は明快だ。主要なウェブサイトはすべて、ユーザーが完全に所有するアカウントに対しても、AIエージェントのアクセスをブロックする法的武器を手にする。利用規約に自動アクセス禁止条項を書けば、ユーザーが明示的に許可したエージェントでもCFAA違反で訴えられる。AmazonがCometに対して使った設計図が、あらゆるプラットフォームの標準プレイブックになる。
影響は業種ごとに連鎖する。小売サイトはAIショッピングエージェントによる価格比較をブロックできる。予約サイトはAI旅行エージェントによる予約完了を拒否できる。銀行や証券会社はAI資産管理エージェントをダッシュボードから締め出せる。マーケットプレイスはAIエージェントが出品するのを防げる。SaaS事業者はAIエージェントがサブスクリプションを管理したりワークフローを実行したりするのをブロックできる。いずれのケースでも、利用規約の文言が支配的文書となり、ユーザーの明示的指示は法的に無意味になる。
控訴裁が地裁判決を覆した場合
第9巡回区控訴裁が地裁判決を覆せば、CFAAは本来の狭い射程に押し戻される。ウェブサイトはユーザー委任エージェントをブロックする連邦刑事法の手段を失い、エージェントアクセスの問題は契約と技術のレイヤーに移る。Search Engine Journalの記事が指摘する通り、ウェブサイトは引き続き技術的手段、民事救済を伴う規約、あるいはパートナーシップAPIを通じてエージェントをブロックできる。しかし連邦刑事法をテコとして使うことはできなくなる。
中間的判断の可能性
全面勝訴か全面敗訴かだけではない。Search Engine Journalの記事は中間的結果の可能性も指摘している。控訴裁はより狭い理由で差止命令を維持したり、エージェントアクセスの種類を区別したり、事実審理の差し戻しを命じたりするかもしれない。たとえば、取引を完了するエージェントとデータ取得のみのエージェント、保存された認証情報を使うエージェントと毎回ユーザーにログインを求めるエージェント、検証済みプロトコルを使うエージェントと未識別のブラウザ自動化ツールを区別する可能性だ。線引きを伴う判決は、全面肯定・全面否定の判決以上に、ウェブサイトがアクセスポリシーを設計する際の実務を細かく規定することになる。
口頭弁論で注目すべき3つのシグナル
6月11日の口頭弁論では、3つのシグナルに注目する価値がある。Search Engine Journalの記事が挙げる観測点を紹介する。
第1に委任の法理への言及だ。裁判官がAmazon側の弁護士に対し「ユーザーの明示的指示が、なぜユーザーが選んだ代理人に権限を拡張しないのか」と強く追及するようなら、パネルが地裁の解釈に違和感を持っているサインだ。逆にPerplexity側に対し「自動化エージェントを人間のユーザーと同一に扱うべき理由は何か」と追及するようなら、地裁の枠組みに親和的な可能性がある。
第2にエージェントアクセスの種類の区別だ。これまでの審理では「エージェントアクセス」はひとまとめに扱われてきた。パネルは、取引を完了するエージェントとデータ取得のみのエージェント、保存された認証情報を使うエージェントと毎回ログインを求めるエージェントなど、線引きを試みるかもしれない。線引きのある判決は、全面勝敗の判決以上に実務を規定する。
第3にCFAAの将来的解釈だ。裁判官には、AIエージェント全般に対するCFAAの適用枠組みを書く機会がある。AmazonとPerplexity固有の事実に絞った狭い判決なら、より大きな問題は別の巡回区の別の事件に委ねられる。広い判決なら、カテゴリー全体の法的枠組みが決まる。
第9巡回区控訴裁の口頭弁論は公開されており、音声は通常数時間以内に公開される。パネルの構成が判明すれば、どのような聴取になるかの手がかりにもなる。この3つのシグナルを追うことが、ウェブサイト運営者にとって最も低コストで方向性を読む方法だ。
今週から着手すべき3つの実務対応
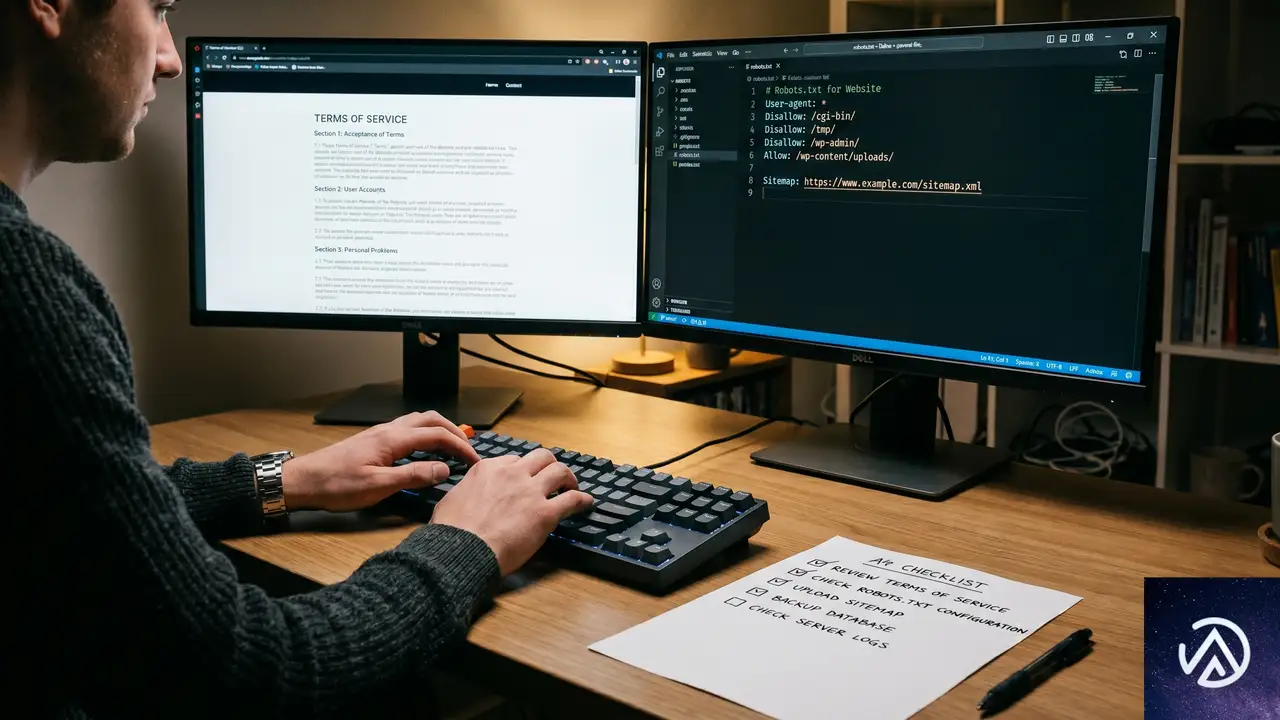
6月11日の口頭弁論を前に、Search Engine Journalの記事はウェブサイト運営者が今週中に実行できる3つの具体的アクションを挙げている。判決がどう転んでも、デフォルトのまま放置することが最大のリスクになる。
1. 利用規約の自動アクセス条項を読み直す
多くのウェブサイトの利用規約にある自動アクセス禁止文言は、「自動アクセス=スクレイピングボットや不正スクリプト」を想定したエージェント以前の時代に書かれたものだ。ユーザー自身のAIエージェントが明示的指示で動いているときに、その文言が自社の意図を正確に表現しているかを確認する必要がある。ユーザー委任エージェントを歓迎するなら、その旨を明記すべきだ。ブロックするなら、それも明記し、robots.txtやアクセス制御の設定と整合させるべきだ。
2. AIエージェントのユーザーエージェントを監査する
現在、主要なAIエージェントのユーザーエージェント(UA)には、GPTBot、OAI-SearchBot、ChatGPT-User、PerplexityBot、ClaudeBot、Google-Extended(検索・引用クローラー)に加え、Perplexity Comet、ChatGPT Atlas、各種Geminiサーフェス(ユーザー委任ブラウザ)が含まれる。Search Engine Journalの記事によれば、robots.txtやWAF(Webアプリケーションファイアウォール)がこれらをデフォルトでブロックしている場合、ユーザーはすでに自分のアカウントで壁にぶつかっている可能性がある。ブロックするか許可するかは運営者の判断だが、デフォルト設定に任せるのではなく、意図的な判断であるべきだ。
3. エージェントアクセスへの自社姿勢を決める
3つの一貫した姿勢がある。第1は「歓迎」だ。ユーザー委任エージェントのアカウントアクセスを受け入れ、エージェント駆動の取引に異なる料金体系を設定し、エージェントが読み取りやすい専用インターフェースを公開する。第2は「ブロック」だ。ユーザー委任エージェントを不正アクセスと見なし、規約と技術的制御で裏打ちし、一部のユーザーが歓迎姿勢のサイトに移行することを受け入れる。第3は「パートナー」だ。エージェントがログインページをスクレイピングせずに使えるAPIを構築し、正面玄関ではなく専用ドアを通す。
現在ほとんどのウェブサイトが取っているデフォルト姿勢は、エージェントが訪問者として実在する以前に作られたものだ。6月11日に第9巡回区控訴裁がどのような判断を下すにせよ、そのデフォルトはすでに多くのサイトにとって誤った姿勢になっている。意図的に選び直すべきタイミングだ。
この記事のポイント
- Amazon対Perplexity裁判は、AIエージェントの訪問権限を問う米国初の本格的司法判断となる
- 争点は「ユーザーが明示許可したAIエージェントのアクセスがCFAA上の不正アクセスに該当するか」だ
- 第9巡回区控訴裁が差止命令を一時停止した事実自体が、地裁判決への懐疑を示している
- 判決結果によってEC、予約、金融、SaaSの全ログイン領域設計が変わる
- 今週中に利用規約の見直し、UA監査、自社のエージェントアクセス方針決定を進めるべきだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleで1位でも半数は画面外。検索順位より「ピクセル」で測る新常識
Google検索で1位を獲得しても、ユーザーの半数近くはその存在にすら気づかない。これは仮説ではなく、最新のSERP(検索結果ページ)ピクセル分析で明らかになった事実だ。
デスクトップでオーガニック1位が画面内に収まる確率は57%。スマートフォンではわずか40%ほどに低下する。1位でも画面の可視領域(ファーストビュー)からはみ出しているケースが日常化している。
この記事では、従来の「順位」という指標が陳腐化しつつある理由と、代わりに何を追うべきかを数字で整理する。検索マーケティングの成果指標をピクセル単位で捉え直す時代が来ている。
順位だけでは測れない。SERPの物理的変化
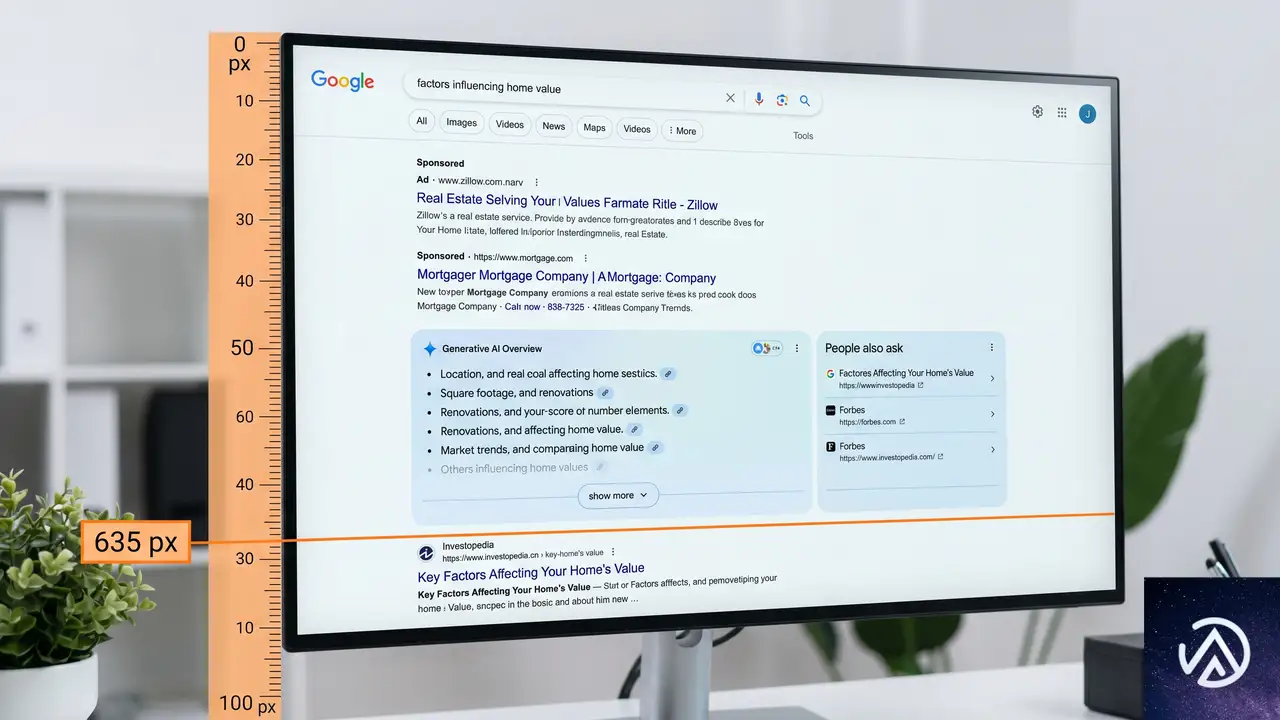
1位の中央値は635ピクセル下
Search Engine Journalの記事によると、デスクトップにおけるオーガニック検索1位の表示位置は、ページ最上部から平均635ピクセルも下がっている。標準的なノートPCのビューポート(画面の表示領域)が約800ピクセルであることを考えると、1位の半分以上はスクロールしなければ見えない計算だ。
2位になると、状況はさらに厳しい。もはや過半数のケースでファーストビューから完全に外れている。10位に至っては、スクロールを約5画面分も重ねなければ到達できない。
順位という数字が「視認される確率」と直結しなくなった要因は明確だ。AI Overviews(旧SGE)やナレッジグラフ、広告枠の拡大が、オーガニック検索結果を物理的に押し下げている。
情報系クエリと商業系クエリ、それぞれの侵食度
オーガニック検索結果を押しのけている要素は、検索意図によって顔ぶれが異なる。
情報検索型のSERPでは、AI Overviewsだけでファーストビュー領域の約3分の1を占有する。これにナレッジグラフが加わると、その割合は約41%に達する。ユーザーがスクロールする前に目にする領域のうち、実に5分の2がオーガニック以外の要素で埋まっている計算だ。
商業検索型のSERPはさらに偏りが激しい。リスティング広告とショッピングユニットの合計で、ファーストビューの60%超を占める。カテゴリによっては「人気商品」枠がそれに拍車をかけ、オーガニックの占有率は約16%にまで縮小する。
業種やクエリの種類によって侵食パターンは異なるため、自社の主要キーワードがどのカテゴリに属するかを把握しておく必要がある。情報系と商業系では、画面内での戦い方がまったく変わるからだ。
順位ではなく「結果サイズ」で戦う発想
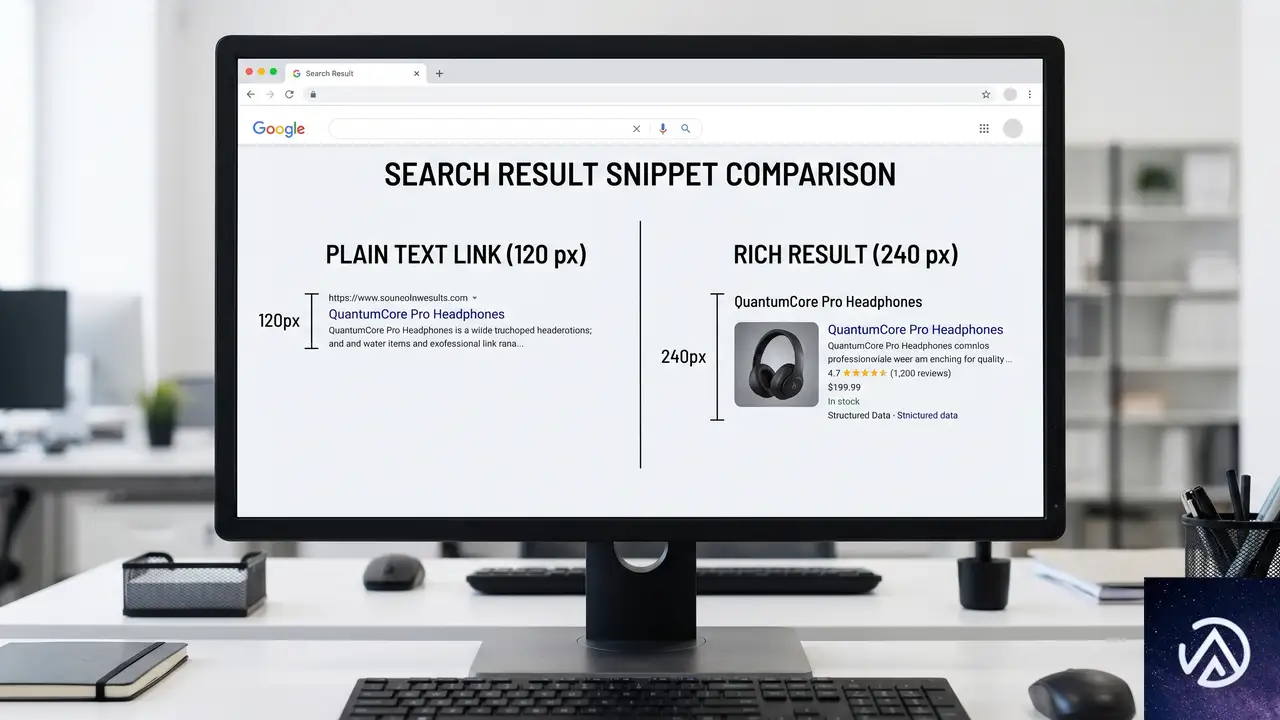
Search Engine Journalの記事において、順位トラッキング企業のTom Capper氏が提示した最も実践的な視点転換がこれだ。キーワードの優先順位を検索ボリュームや順位だけで決めるのではなく、SERP上でその結果が占める「ピクセルサイズ」で判断する。
通常スニペットは120ピクセル、リッチリザルトは240ピクセル
標準的なオーガニック検索結果1件の高さは約120ピクセル。これに対し、画像・価格・評価スター(IPR / Images Prices Ratings)を伴うリッチリザルトは約240ピクセルを占める。視覚的な存在感は単純計算で2倍だ。
Capper氏はこの差を『ロード・オブ・ザ・リング』の戦闘シーンに例えている。巨大な戦象を倒しても「1体としてしか数えない」と言うギムリに対し、それは明らかにおかしい、という指摘だ。SERP上でも、画像や価格が並ぶリッチな表示と、プレーンなテキストリンク1行を「同じ1位」と括ってはならない、というわけだ。
実務に落とし込むなら、主要な商業キーワードをIPR対応可能かどうかで棚卸しし、獲得できるピクセルサイズの大きい施策から優先的に構造化データの実装を進めるのが合理的だ。検索ボリュームの大小より、表示されたときの視覚的インパクトを基準にする発想である。
ブランド検索ボリュームが順位予測因子としてドメインオーソリティを上回る
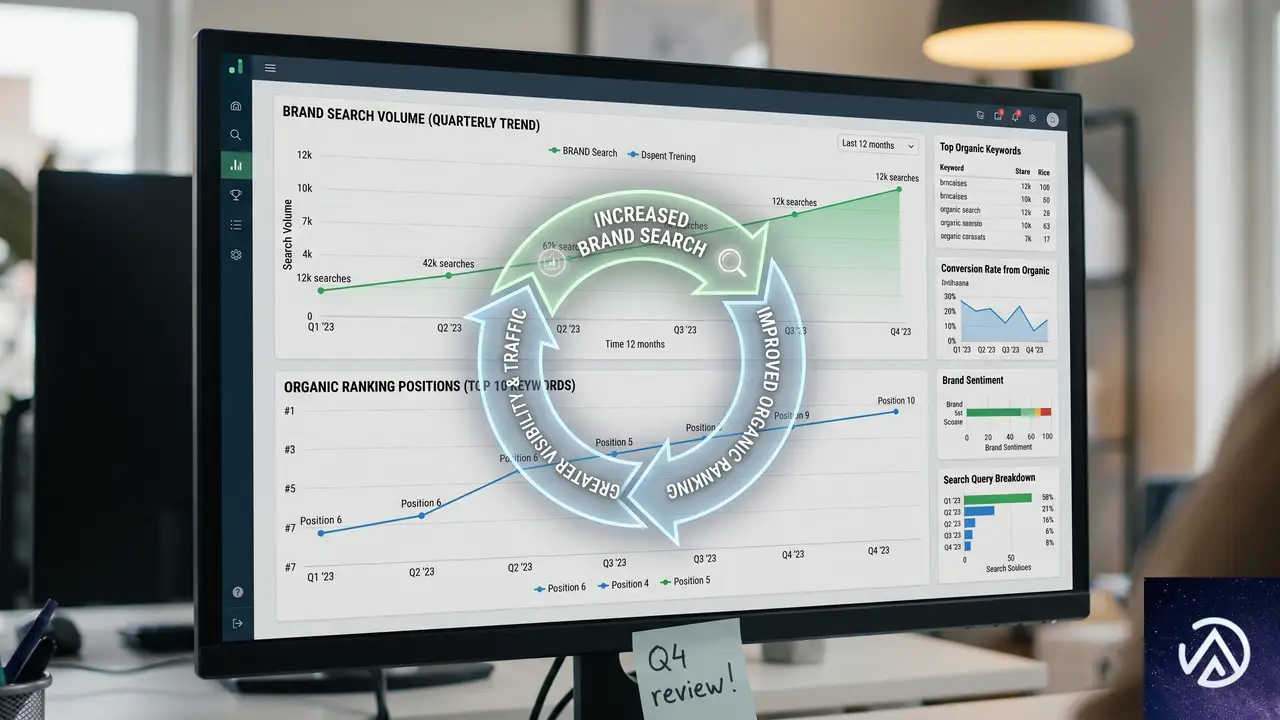
Search Engine Journalの記事ではさらに、順位トラッキング企業のCapper氏が9年前に行った分析が再紹介されている。当時から「ブランド検索ボリューム」はドメインオーソリティよりもオーガニック順位との相関が強かった。そして現在、同じ分析をやり直すと、その相関はさらに強まっている。
「ブランドは順位の予測因子として、ますます強力になっている」とCapper氏は指摘する。そしてブランドを構築する手段こそが、SEOによる可視性の確保だ、と。
ここにフライホイール(弾み車)効果が生まれる。検索結果での可視性がブランド認知を高め、ブランド名での検索が増え、それが順位を押し上げ、さらに可視性が強化される。SEO担当者が長年うまく言語化できなかったこの循環を、「ふわっとした認知施策」ではなく「計測可能なオーガニックパフォーマンスの入力値」として扱う視点が求められている。
オーソリティ指標を無視してよいわけではない。だが、ブランドを「成果」ではなく「投入資源」として捉え直すことが、これからのSEOに求められる姿勢だ。
上位層に可視性指標をどう売り込むか
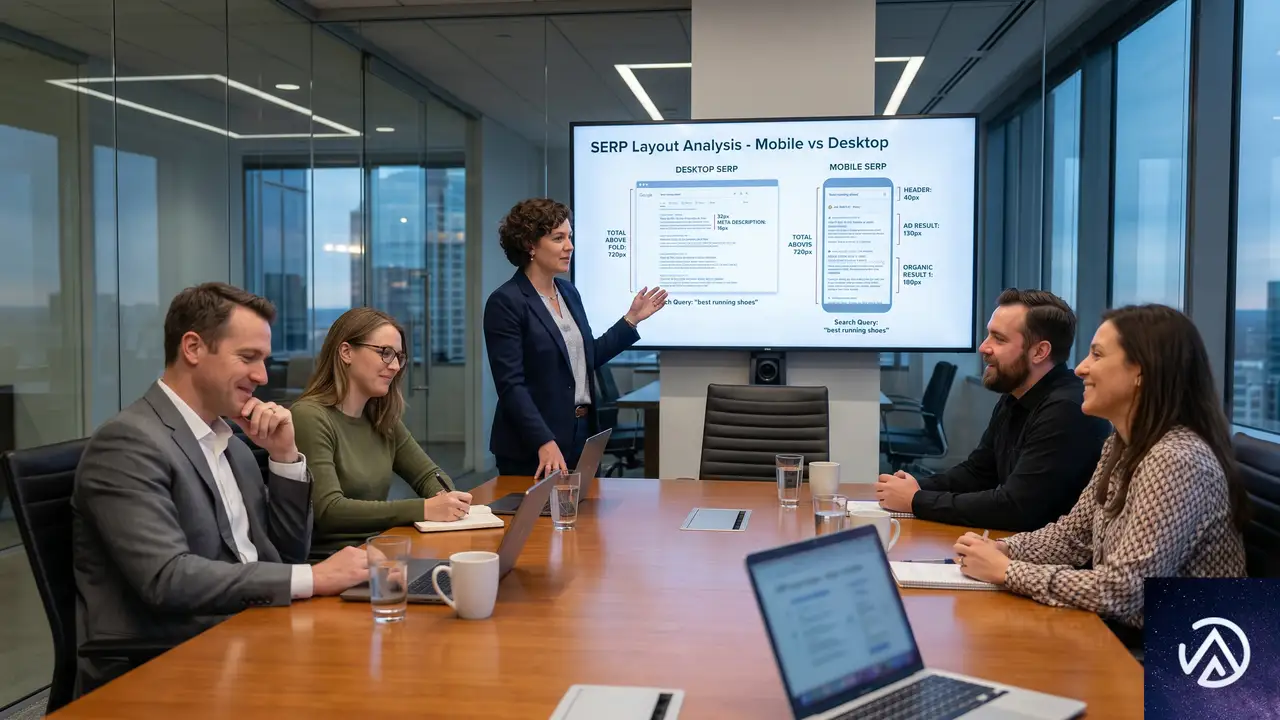
Search Engine Journalのウェビナーでは、このピクセル基準の考え方を社内上層部にどう説明するかについても具体的な助言があった。
ピクセル指標は従来のシェア・オブ・ボイスより直感的に通る
記事によると、Capper氏は「ピクセルデータのほうが上層部への説明がしやすい」と述べている。理由はシンプルだ。従来のシェア・オブ・ボイス(SOV / 声の占有率)という指標は、本来「どれだけ見えているか」の代替指標だった。しかし順位だけを基準にしたSOVは、実際の視認性を反映していない。SERPのスクリーンショットを並べて「この指標では勝っているが、実際はこう見えている」と示せば、ピクセル計測の必要性は一目で伝わる。
より難易度が高いのは「SEOをブランドチャネルとして再定義する」という提案だ。しかしこれにも近道がある。「他の施策で獲得しているインプレッションデータを用意し、SEOで生成しているインプレッション数と並べて提示する」という方法だ。SEOは極めて効率のよいインプレッション獲得チャネルであり、その事実を他のマーケティング指標と同じテーブルに載せることで、予算獲得の説得力が増す。
AEO・GEOの可視性をどう測るか
AI OverviewsやLLM(大規模言語モデル)経由の検索に対する可視性計測についても、記事では実践的な方針が示されている。現時点でSearch Consoleに相当するLLM向けダッシュボードは存在しないが、以下の3つのアプローチが現実的だ。
- プロンプトレベルのブランド視認性を追跡する。ただし「キーワード1万件を追うのにプロンプトは50件」という運用は避ける。LLMは回答のバリエーションが大きいため、統計的に意味のあるサンプルサイズが必要
- プロンプト数ではなくトピック数で考える。個別のプロンプトは検索ボリュームが1に等しいケースが大半であるため、トピック単位でカバレッジを評価する
- 引用ではなく「言及・推奨」を追う。従来の順位トラッキングとは異なり、「どのツール・製品・ブランドが回答の中で推奨されているか」を見る。また、サーバーログを分析し、LLMのグラウンディングボットが実際にどのページをクロールしているかを把握するのも有効だ
有機検索はこのまま悪化し続けるのか
Search Engine Journalの記事でCapper氏は、オーガニック検索の表示領域が改善に向かう可能性は低いが、悪化のペースは鈍化するかもしれないとの見方を示している。
根拠の一つが、Google I/OでAI Modeの広範な展開が見送られたことだ。情報検索にはある程度対応できるものの、ナビゲーショナル(特定サイトへの移動目的)検索や天気ウィジェットのような即時情報には弱く、Google社内でもユーザーの受け入れ準備が整っていないという空気がある。また、ChatGPTもAI Modeも、時間の経過とともに表示するリンクの数を増やしている。ユーザーが依然として「サイトに到達したい」という欲求を持っている証拠だ。
ただし、「以前の状態に戻るとは考えていない」と記事の見解は締めくくっている。ユーザーは「自分で探すより、答えを出してもらう」体験を気に入りつつある。有機検索の未来は、機械可読な形でSERPに情報を供給し続けるインフラとしての役割にシフトしていくだろう。
この記事のポイント
- オーガニック1位の可視率はデスクトップ57%、スマホ40%。順位だけでは視認性を保証できない
- SERP上での結果サイズ(ピクセル高さ)を基準にキーワード優先度を再評価する必要がある
- ブランド検索ボリュームはドメインオーソリティ以上に順位との相関が強い
- ピクセル指標は経営層への説明ツールとしても有効。SERPのスクリーンショット比較が決め手になる
- AI OverviewsやLLM経由の可視性計測は、トピック単位・推奨ベース・サーバーログ分析で手がかりを得る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験