

AI検索エンジンの引用傾向比較、ブランド戦略に示唆
主要なAI検索エンジン5つを比較した調査で、引用されるウェブサイトの種類に大きな差があることがわかった。一方で、特定の製品やサービスと結びついたブランド名は、どのAIでも共通して引用されやすい傾向にある。
この記事では、BrightEdge社の調査データを基に、ChatGPTやGoogle AI Overviews、Gemini、PerplexityといったAIが「何を情報源として選ぶのか」を分析する。AI時代のSEO対策として、自社サイトの情報設計やブランディングにどう活かすべきか、具体的な論点を提示する。
5つのAIサーチエンジンが示す、引用ソースの「分散」と「集中」
今回の調査は、2026年4月にBrightEdge社が実施したものだ。ChatGPT、Google AI Overviews、Google AI Mode、Google Gemini、Perplexityの5つについて、生成された回答の中でどのようなサイトが引用されているかを分析している。
まず注目されたのは、各AIエンジンが引用する上位サイトの重なり具合、つまり「ソース重複率」だ。最も重複が少なかった組み合わせでは、わずか16%の一致率にとどまった。対照的に、最も高い組み合わせでは59%のサイトが重複していた。
この数字が意味するのは、AIによって情報源の選び方が全く異なり得るという事実だ。あるAIで引用されるからといって、別のAIでも同様に扱われる保証はない。複数のAI検索エンジンでの露出を狙うなら、それぞれの特性を踏まえた対策が必要になる。
ブランド名の一致率は相対的に高い
ソース重複率とは対照的に、回答内で言及される「ブランド名」に関しては、AI間でより高い一致が見られた。最も低い組み合わせでも36%、高い組み合わせでは最大55%のブランド名重複率が記録されている。
つまり、各AIは異なるウェブサイトを参照しているにもかかわらず、結果として同じブランド名にたどり着く傾向がある。これは、製品やサービスと強く結びついたブランドが、業界全体で広く認知されていることの反映だ。信頼できるウェブサイトから繰り返し言及されるブランドは、AIの学習や検索プロセスでも再現性が高まる。
Search Engine Journalの著者Roger Montti氏は、この点について「消費者の頭の中でブランドと製品・サービスを結びつけることが、ブランド検索の増加につながる」と指摘している。Googleが2004年頃からNavboostと呼ばれる仕組みでユーザー行動シグナルをランキングに活用してきたことや、ブランドナビゲーションに関する特許を取得している事実も、この考えを裏付けている。
信頼されるサイトの種類はAIごとに大きく異なる
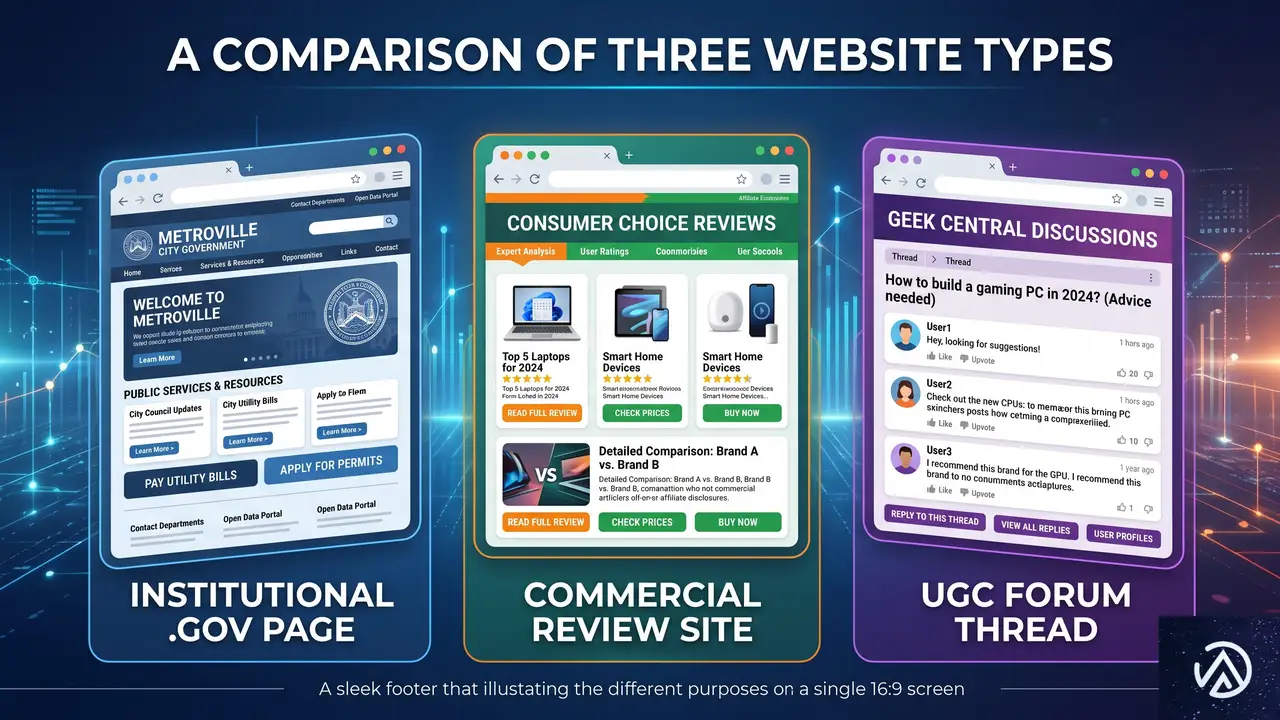
BrightEdgeは引用されたサイトを3つのカテゴリに分類した。政府や教育機関、大企業のサイトを含む「機関系サイト」、メディアやレビューサイト、リスティングを含む「商業・編集系サイト」、そしてフォーラムや動画プラットフォームなどの「UGC(User Generated Content / ユーザー生成コンテンツ)」だ。
分析の結果、すべてのAIエンジンがこれら3つを情報源として使っているが、そのバランスには大きな差があることが判明した。機関系サイトの引用率は低いエンジンで10%、高いエンジンで26%。UGCの引用率に至っては、わずか0.2%から18%まで開いている。
最も引用率が高いのは商業・編集系サイトで、AI Overviewsが51%、Geminiでも37%と、どのエンジンでも大きな割合を占める。BrightEdgeはこの結果を受け、「レビューサイト、比較コンテンツ、業界メディア、小売のリスティング、財務データがAIに最もよく参照される」とまとめている。企業はパブリックリレーションズ(PR)活動、業界メディアへの露出、カテゴリ比較コンテンツへの投資が、単独のエンジンだけでなく全てのAI検索エンジンでの可視性向上につながると考えるべきだ。
GeminiとAI Overviewsで異なる「信頼のベクトル」
同じGoogleが提供するAIサービスでも、GeminiとAI Overviewsの間には明確な傾向の違いがある。Geminiは機関系サイトの引用率が26%と突出して高く、UGCは0.2%と極端に低い。つまり、権威ある公式情報を優先する「保守的なAI」といえる。.govドメインの引用率は13%、.orgは23%にのぼる。
一方、AI OverviewsはUGCの引用率が18%と5つのAIの中で最も高い。機関系サイトは10%と相対的に低く、コミュニティの声を積極的に拾う姿勢が見える。この違いは、AI Overviewsの基盤に「FastSearch」と呼ばれる速度優先の仕組みが使われている可能性を示唆するが、Googleから公式な説明はない。
実際の使用感を調べるため、Roger Montti氏が非公式な実験として、特定の電子部品(オペアンプ)の使用感を両方のAIに質問したところ、Geminiはメーカー公式サイトのみを引用したのに対し、AI Overviewsは公式情報に加えて複数のUGCを引用した。UGCには実際のユーザーによる測定データや比較情報が含まれており、質問の文脈によっては非常に有益だ。このことから、質問の種類やユーザーの目的によって、最適な情報源の組み合わせが変わるといえる。
ChatGPTとPerplexity、それぞれの選び方
ChatGPTは他のAIと比較して、引用ソースの多様性が最も高いというデータが出ている。上位10サイトが総引用に占める割合はわずか18.5%で、特定のサイトへの依存度が低い。対照的にPerplexityは26.7%、Geminiは26.3%と、ChatGPTの約1.5倍の集中度だ。
Perplexityは機関系サイトの引用率が22%と高く、.eduドメインも3.2%と他のAIより多く引用している。BrightEdgeのレポートによれば、Perplexityの引用の約30%は医療機関、政府、百科事典、医学出版社のサイトで占められている。つまり、Perplexityは「権威性」を重視するエンジンと位置づけられる。
興味深いのは、.eduドメイン(教育機関のサイト)の扱いだ。SEOコミュニティでは長らく「.eduサイトは権威性が高い」という信念があったが、今回の調査では、いずれのAIも.eduサイトをさほど引用していない。最も高いPerplexityですら3.2%に過ぎず、ユーザーがAIに尋ねる多くの質問において、.eduサイトは権威ある情報源として選ばれにくい現実が明らかになった。
同じGoogleでも異なるAI、3系統の使い分け
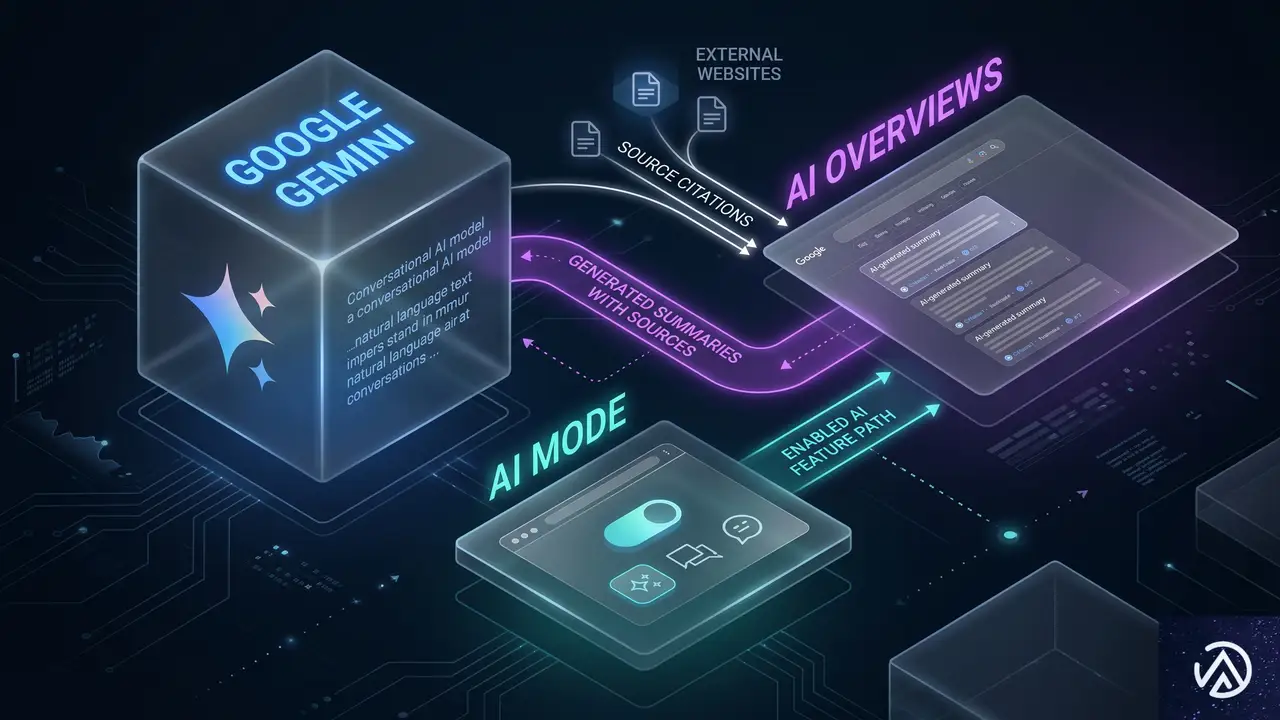
GoogleにはGemini、AI Overviews、AI Modeという3つのAI検索サービスが存在するが、これらは同じ会社のプロダクトでありながら、引用傾向は一様ではない。最もサイト重複率が高いAI OverviewsとAI Modeですら一致率は59%で、GeminiとなるとAI Overviewsとの重複率は34%、AI Modeとは27%まで下がる。
このデータから、「Google AIは単一のシステムではない」という現実が浮かび上がる。各サービスは異なるアルゴリズムやデータセットに基づいて情報を選択しており、同じ質問でも表示される情報源が大きく変わる可能性がある。ウェブサイト運営者にとっては、「Google対策」という単一の施策ではなく、どのAI検索面をターゲットにするかを明確にした戦略立案が求められる。
AIエンジンに選ばれるサイトになるための実践論点
今回の調査データを踏まえると、AI検索エンジンでの可視性を高めるための方針が見えてくる。すべてのエンジンに共通して効くのは、製品やサービスとブランドの結びつきを強化することだ。具体的には、業界メディアやレビューサイトでの記事露出、比較コンテンツへの掲載、プレスリリースの配信などが有効な手段になる。
一方で、AIごとの特性に合わせた対策も検討すべきだ。GeminiやPerplexityでの露出を狙うなら、公的機関や業界団体との協業、公式データの公開、学術的な裏付けの提示といった「権威性」の構築が重要になる。AI Overviewsを意識するなら、フォーラムやコミュニティでの自然な言及、ユーザーレビューの充実といったUGCの活性化も効果が見込める。
また、AI検索は信頼できるウェブサイトに掲載されたスポンサード記事(広告であることが明示された記事)も情報源として引用する。FTC(米国連邦取引委員会)のネイティブ広告ガイドラインや、Googleのスポンサード投稿ポリシーに準拠した形でブランドを訴求する手法も、引き続き検討に値する。
重要なのは、どのAIに最適化するかではなく、自社のブランドがどのカテゴリの情報として認識されるかを設計することだ。AIに「選ばれる」サイトになるには、単なるSEOテクニックではなく、実体のあるブランド価値の醸成と、それを多様なメディアに拡散させる情報戦略が欠かせない。
この記事のポイント
- AI検索エンジン5つのソース重複率は最低16%から最高59%で、引用傾向に大きな差がある
- ブランド名の重複率は最低36%と、製品・サービスに結びついたブランドは横断的に強い
- 商業・編集系サイトが最も多く引用され、PRや比較コンテンツの重要性が高まっている
- Geminiは権威性重視、AI OverviewsはUGC重視と、同じGoogle内でも戦略が異なる
- AI時代のSEOでは、個別のエンジン対策よりブランド価値の醸成と多面的な情報発信が鍵を握る

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AI OverviewのCTRが61%減少 クリック数は横ばいという新データ
AI Overview(旧SGE)に自社ページが引用されるとCTR(クリックスルーレート/表示回数に対するクリック率)が大きく下がる。Search Engine Journalが紹介したSeer Interactiveの分析によれば、2025年第4四半期にブランド引用ページのCTRが前期比61%減少した。ところがクリック数そのものはほとんど動いていない。
一見すると深刻な数字だが、ダッシュボードの数字をどう読み解くかで評価は変わる。CTRが下がったからといって、すぐに「検索パフォーマンスが落ちた」と判断するのは早計だ。547万クエリを対象にしたSeerの分析をもとに、数字の裏側にある構造を整理する。
Q4に起きた数字の動き

10月のインプレッション急増がCTRを押し下げた
2025年9月時点で、AI Overview内にブランド引用されたページのインプレッション数は1,580万回、クリック数は398,798回、CTRは2.52%だった。これが10月になるとインプレッションが3,310万回へと倍増する。一方でクリック数は400,271回と微増にとどまり、CTRは1.21%に半減した。
CTRが急落した原因は、クリック自体が減ったわけではない。インプレッションの伸びがクリックの伸びを大きく上回ったことで、計算上のCTRが割り算の結果として下がったにすぎない。Search Engine Journalの記事でも「これはパフォーマンスの崩壊ではなく、クリックより速くインプレッションが成長したことによる数学的な問題だ」と指摘されている。
11月は別のパターン
11月になると傾向が変わる。インプレッションは3,950万回へさらに増えたが、クリック数は301,783回に減少し、CTRは0.76%まで落ち込んだ。インプレッションが増えているのにクリックが減る。10月とは異なる動きだ。
Seerのデータではこの原因を特定できていない。Search Consoleのデータを月ごとに分けて分析することの重要性がここにある。四半期でまとめて「CTR61%減」とだけ見ると、10月の数学的要因と11月の実質的なクリック減が混ざってしまう。
CTR低下に隠れた2つの解釈

Seerの分析が明確に切り分けられなかった点がある。10月のインプレッション急増が「GoogleがAI Overviewを表示するクエリを増やしたから」なのか、「各ブランドがSEO施策で引用を獲得したから」なのかは、集計データだけでは判断できない。
前者なら、検索結果の表示形式が変わっただけで、自社の実力とは関係ないノイズだ。後者なら、SEOの成果として素直に評価できる。多くのサイト運営者はこのどちらかに直面しているはずだ。ダッシュボードのインプレッション増加をどう読むかは、アカウント単位でクエリを掘り下げないとわからない。
CTRが下がったときに確認すべきは、同じ期間のインプレッション数だ。インプレッションが増えているなら、表示機会自体は拡大している。クリック数が横ばいか微増であれば、問題の本質はCTRの低下ではなく、表示回数あたりのクリック効率が薄まったという話になる。
これまでのAI Overview CTR研究との整合性

AI Overview表示時のクリック率は軒並み低い
AI Overviewが表示されるとオーガニック検索結果のCTRが下がることは、複数の調査で報告されている。Ahrefsが1億4,600万件の検索結果を分析した調査では、AI Overviewの表示トリガー率が20.5%に達し、特に情報検索や質問形式のクエリで高いとされた。
ドイツで実施されたSISTRIXの分析では、AI Overview表示時に検索順位1位のCTRが59%低下した。Pew Researchの調査でも、米国ユーザーのクリック率はAI Overview表示時に8%、非表示時は15%だった。AI Overviewが上位を占有することで、その下にある従来の検索結果へのクリックが奪われる構造は、国やクエリタイプを問わず共通している。
引用の有無がクリック効率を左右する
Seerのデータでは、AI Overview内でブランド引用されたページは、引用されていないページよりインプレッションあたりのクリック数が約120%多い。AI Overviewに自社ページが表示されること自体には、一定のクリック獲得効果がある。
ただし、AI Overviewが表示されない通常の検索結果と比べると、引用ページのクリック効率は38%低い。引用は「ないよりはマシ」だが、かつての1位表示の代替にはなっていない。Search Engine Journalはこの点を「引用は助けになるが、以前の順位を取り戻すものではない」と総括している。
実務にどう活かすか

AI Overview関連のCTR低下に直面したとき、まず確認すべきはクリック数の絶対値だ。CTRが下がっていても、クリック数が維持または微増しているなら、それは表示機会の拡大に伴う希釈であり、検索パフォーマンスの低下ではない。
Seerが指摘しているように、ベンチマークはあくまで傾向を示す参考値であり、自社データの実数を見るのが基本になる。インプレッションとクリックの増減を月単位で分解し、CTRだけを追わない分析習慣が求められる。
また、2025年12月から2026年2月にかけてAI Overview表示時のオーガニックCTRが1.3%から2.4%へ上昇したというデータもある。ただしSeerはこれを「回復というより横ばいへの落ち着き」と評価しており、2か月分のデータで先行きを予測するのは避けるべきだとしている。
この記事のポイント
- AI Overviewのブランド引用ページCTRはQ4で61%減少したが、クリック数はほぼ横ばい
- 10月はインプレッション急増による数学的CTR低下、11月は実質的なクリック減と原因が異なる
- インプレッション増がGoogleの仕様変更か自社SEOの成果かは、アカウント単位の分析が必要
- CTRだけを見ず、インプレッションとクリックの絶対数を月別に追うことが実務では重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google検索結果の「続きを読む」リンク表示を増やす3つの法則!robots.txtドキュメント拡充と最新SEO動向
Googleが検索結果の表示をより詳細にする「続きを読む(Read more)」ディープリンクのベストプラクティスを公開した。これは検索結果のスニペット内に、ページ内の特定セクションへ直接ジャンプできるリンクを表示させるための指針だ。これまで経験則で語られてきた部分が、公式ドキュメントによって明確化された形となる。
あわせて、robots.txtのドキュメント拡充や、EUでのAIチャットボットに対するデータ共有規制、さらには検索画面上でタスクを完結させる新機能についても動きがある。2026年4月の最新情報を踏まえ、Webサイト運営者が今取り組むべき構造改革について解説する。
これらのアップデートは単なる表示の変化ではなく、Googleが「AIエージェントにとって読みやすい構造」をWebサイトに求めていることの表れだ。サイトの構造が古いままでは、検索結果での露出機会を大きく損なう可能性がある。技術的な背景とともに、具体的な対策を確認していこう。
Google検索のディープリンク表示を増やす3つの鉄則
Googleは検索結果のスニペット(説明文)の下に表示される「続きを読む」リンクについて、その出現率を高めるための具体的な方法を明らかにした。ディープリンクとは、ページ全体ではなくページ内の特定の章や節に直接ユーザーを誘導するリンクのことだ。これが表示されると、検索結果の占有面積が増え、クリック率の向上が期待できる。
コンテンツはページ読み込み時に即座に表示させる
最も重要なポイントは、ユーザーがページを開いた瞬間にコンテンツが人間にとって可視化されていることだ。クリックしないと中身が見えない「折りたたみ式(アコーディオン)」や「タブ切り替え」の中に重要な情報を隠している場合、ディープリンクとして採用される確率は下がる。Googleは、ユーザーの操作なしにレンダリングされる情報を優先して評価している。
これは「隠れたテキスト」がインデックスされないという意味ではないが、検索結果の拡張機能(リッチスニペットやディープリンク)においては、露出の優先度が低くなることを示唆している。特にモバイルユーザー向けに情報をコンパクトにまとめようとして、重要な見出しや本文をアコーディオン内に閉じ込める設計には注意が必要だ。
H2やH3の見出しタグを適切に活用する
ディープリンクのリンク先となるセクションには、必ず <h2> や <h3> といった見出しタグを使用する必要がある。Googleのシステムは、これらの見出しをページの構造的な区切りとして認識し、リンクのアンカー(目的地)として利用するからだ。
また、検索結果に表示されるスニペットのテキストと、実際のページ内の見出しや本文の内容が一致していることも条件となる。見出しが画像だけで構成されていたり、装飾目的で <div> タグにスタイルを当てただけの「見出し風」のデザインになっていたりすると、Googleはそこをセクションの開始点として正しく認識できない。
UIデザインのBeforeとAfter比較
ディープリンクが表示されにくい構造(タブ・アコーディオン)と、表示されやすい構造(フラットな見出し構成)を比較してみよう。以下のデモは、コンテンツの露出度による構造の違いを視覚化したものだ。
このデモのように、すべての主要コンテンツがページロード時に露出している構成の方が、Googleは各セクションをディープリンクとして採用しやすくなる。ユーザーの利便性を損なわない範囲で、情報の「隠しすぎ」を避けることが重要だ。
robots.txtの公式ドキュメント拡充とスペルミスへの寛容さ
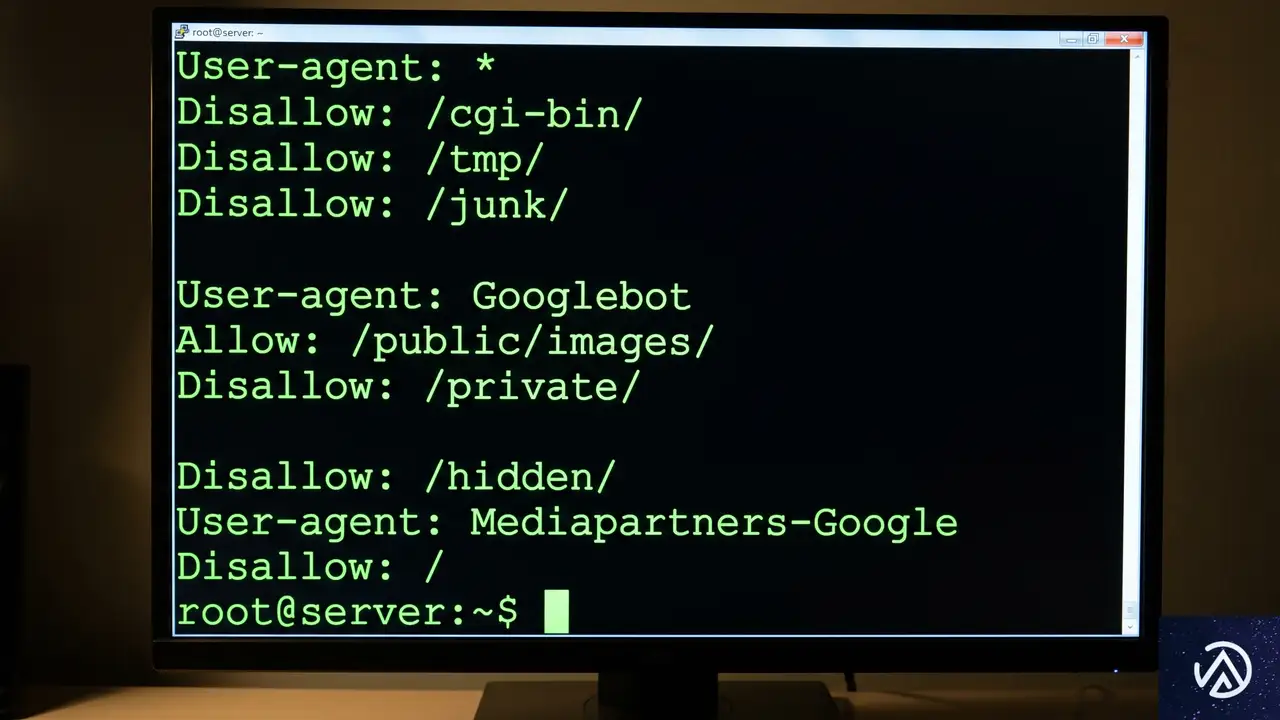
GoogleのGary Illyes(ゲイリー・イリェーシュ)氏とMartin Splitt(マーティン・スプリット)氏は、ポッドキャスト「Search Off the Record」にて、robots.txtに関する新たなプロジェクトについて語った。Googleは現在、HTTP Archiveのデータを分析し、実際に世界中のサイトで使用されているrobots.txtの記述パターンを調査している。
非サポートルールの明文化
robots.txtには、Googleが公式にサポートしていない独自の命令(ディレクティブ)が記述されているケースが多々ある。例えば、クロールの頻度を指定する Crawl-delay や、特定の条件下でのみ適用されるカスタムルールなどだ。Googleは今回の分析に基づき、よく使われているが実際にはGoogleが無視している「非サポートルール」のトップ10から15をドキュメントに追加する予定だ。
これにより、Webサイト運営者は「自分が設定しているルールがGoogleに効いているのか」を正確に判断できるようになる。もしGoogleがサポートしていないルールに頼ってクロール制御を行っている場合、それは期待通りに機能していない可能性が高い。公式ドキュメントが更新された際には、自サイトのrobots.txtを改めて監査する必要があるだろう。
記述ミスの自動補完が進む可能性
さらに興味深い点として、Googleのrobots.txtパーサー(解析機)が、記述のスペルミスをより柔軟に受け入れるようになる可能性が示唆された。例えば disallow を dissallow と書き間違えた場合でも、Googleがそれを意図通りの命令として解釈してくれるようになるかもしれない。
ただし、これはあくまで「Googleが親切に解釈してくれる」という話であり、ミスを放置してよいという意味ではない。他の検索エンジン(Bingなど)が同様の寛容さを持っているとは限らないからだ。robots.txtはサイトの立ち入り禁止区域を指定する「地図」のようなものだ。記述ミスがあれば、検索エンジンにインデックスさせたくないページが公開されてしまうリスクがある。基本的には、標準的なスペルを厳守すべきだ。
EUのデータ共有規制がAIチャットボットに波及
欧州委員会(EC)は、デジタル市場法(DMA)に基づき、Googleに対して検索データを競合他社と共有するよう求める予備的な見解を示した。この規制の対象には、従来の検索エンジンだけでなく、特定の条件を満たす「AIチャットボット」も含まれる見通しだ。
AIチャットボットが「検索エンジン」として定義される日
これまでSEO業界では、Googleのような検索エンジンと、ChatGPTやPerplexityのようなAIチャットボットを別物として扱ってきた。しかし、EUの規制当局は「オンライン検索エンジン」の定義を広げ、AIチャットボットもその範疇に含める動きを見せている。これが確定すれば、Googleが持つ膨大なランキングデータやクリックデータが、競合するAIサービスに提供されることになる。
この変化は、EU圏内での検索市場の流動性を高める可能性がある。Googleのデータを活用して精度を高めたAIチャットボットが普及すれば、ユーザーの検索行動はさらに分散するだろう。Webサイト運営者にとっては、Googleだけでなく「AIチャットボットからどう参照されるか」という視点が、法規制の面からも裏付けられた重要な課題となる。
匿名化された検索シグナルの行方
共有されるデータは匿名化されるものの、ランキング、クエリ、クリック、閲覧データといった核心的な情報が含まれる。これにより、新興のAI検索サービスが「どのコンテンツがユーザーに支持されているか」をより正確に把握できるようになる。日本国内のサイトであっても、EUからのアクセスがある場合は、これらのデータ共有の影響を間接的に受けることになるだろう。
検索結果でタスクを完結させる新機能の追加
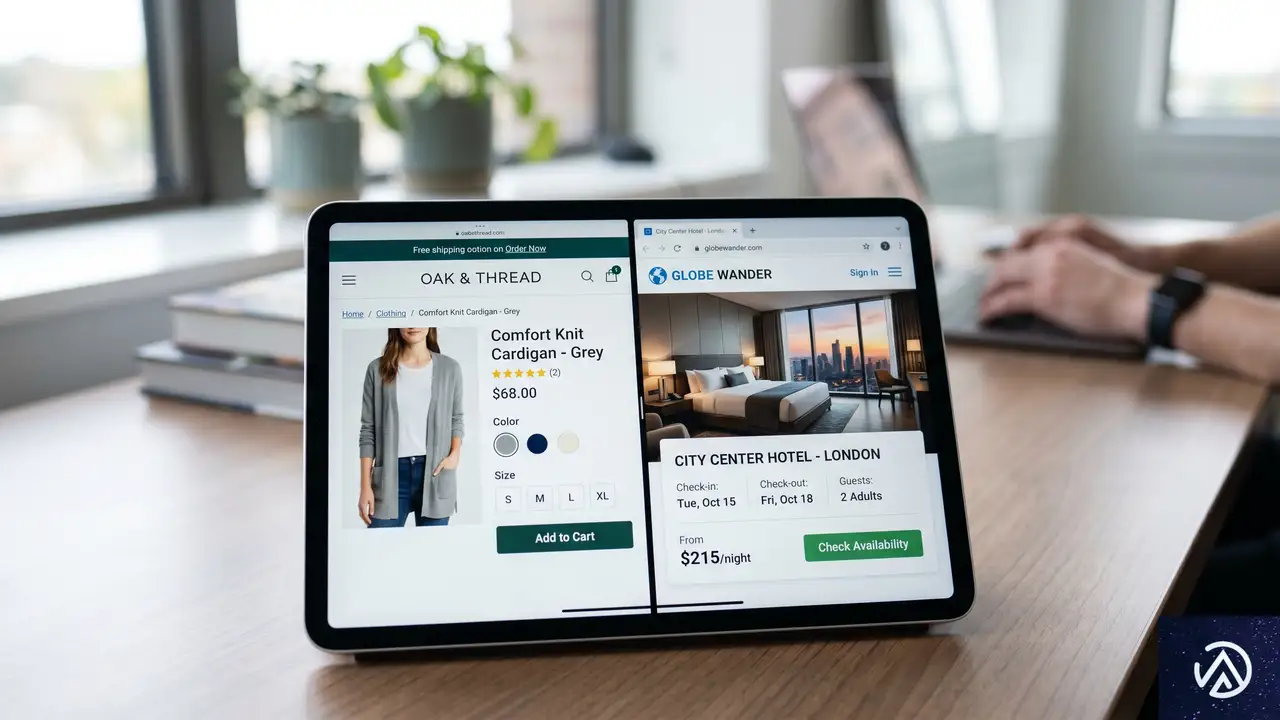
Googleは検索結果画面(SERP)上で直接ユーザーの目的を達成させる「タスクベース」の機能を強化している。その一環として、特定のホテルの価格下落を追跡できるトグルスイッチが導入された。これは、ユーザーがホテル予約サイトへ移動することなく、Google内で価格監視を開始できる機能だ。
Webサイトへの流入機会が「Google内」に吸収される
これまで、価格下落通知は旅行予約サイトや比較サイトが提供する主要なサービスの一つだった。Googleがこの機能を検索結果に直接組み込むことで、ユーザーが各サイトを再訪する動機が減少する可能性がある。GoogleのSundar Pichai(サンダー・ピチャイ)CEOが語っていた「エージェントとしての検索」が、着実に具現化していると言える。
この変化への対策として、ホテルなどのサービス事業者はGoogleビジネスプロフィールの情報を最新に保ち、Googleのフィードに対して正確なデータを提供し続ける必要がある。検索結果が単なる「リンク集」から「実行プラットフォーム」へと進化する中で、プラットフォームとのデータ連携の重要性はかつてないほど高まっている。
AIエージェントの起動ボタン
また、Googleの「AIモード」から直接AIエージェントを起動し、複雑なタスクを委任できる機能もテストされている。例えば「旅行の計画を立てて予約まで進める」といった一連の動作を、AIが代行する仕組みだ。この際、AIがどのWebサイトの情報をソース(情報源)として採用するかは、前述した「ディープリンクのベストプラクティス」のような構造化された情報の有無に左右される。
AIエージェントは、人間と同じようにWebページを「読み」に行く。その際、Javascriptの実行や複雑なクリック操作を必要とするページよりも、シンプルで見出し構造が明確なページを好む。検索がタスク完結型になればなるほど、Webサイトは「人間が見る場所」であると同時に「AIがデータを取得するAPI」のような役割を求められるようになるのだ。
この記事のポイント
- 「続きを読む」リンクを表示させるには、コンテンツをアコーディオンやタブに隠さず、ページロード時に露出させることが重要だ。
- 適切な見出しタグ(H2、H3)を使用し、検索スニペットとページ内容の整合性を保つことで、ディープリンクの採用率が高まる。
- robots.txtの公式ドキュメントが拡充され、Googleがサポートしていないルールの実態が明確になるため、定期的な記述の監査が推奨される。
- EUの規制によりAIチャットボットが「検索エンジン」として扱われ始め、Googleの検索データが競合AIに共有される道が開かれつつある。
- Google検索は「情報を探す場所」から「タスクを完結させる場所」へ進化しており、WebサイトにはAIエージェントが読み取りやすい構造が求められている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Googleへのスパム報告に新ルール。個人情報を含むと処理されない理由
Googleがスパム報告に関する公式ドキュメントを更新し、報告プロセスにおける重要な変更を明らかにした。今後、報告内容に個人を特定できる情報が含まれている場合、Googleはその報告に基づいた調査や対処を行わない方針だ。
この変更は、スパムサイトに対して「手動対策(マニュアルアクション)」が実施される際、報告内容の一部がサイト所有者に共有される仕組みに起因している。Googleはプライバシー保護と法規制への対応を優先し、不適切な情報を含む報告をあらかじめ排除する決断を下した。
SEO担当者やサイト運営者にとって、この変更は単なる手続きの修正ではない。悪質なサイトを排除するための正当な報告が無効化されるリスクを避けるため、報告の作法を再確認する必要がある。
Googleスパム報告の仕様変更。個人情報の記載が「無効」に
Googleは検索結果の品質を維持するため、ユーザーからのスパム報告を受け付けている。しかし、2026年4月に更新されたドキュメントによれば、報告フォームの自由記述欄に個人情報が含まれている場合、その報告は処理されなくなった。これは、報告者が意図せず自身の身元を相手に明かしてしまうリスクを防ぐための措置だ。
なぜ個人情報が含まれると処理されないのか
最大の理由は、Googleがスパムサイトの所有者に送る通知の仕組みにある。Googleが報告に基づいて手動対策を下した場合、その根拠となった情報をサイト所有者に伝えることがある。この際、報告者が記述したテキストがそのまま引用される可能性があるためだ。
もし報告文の中に、報告者の名前や会社名、あるいは特定のサイト運営者であることを示唆する情報が含まれていれば、スパムサイト側に報告者の正体が筒抜けになってしまう。Googleはこのような事態を避けるため、個人情報が含まれる報告自体を「破棄」するというルールを明文化した。
ドキュメントから削除された「匿名性」の記述
以前のドキュメントでは、自由記述欄に個人情報を書かない限り、報告は匿名に保たれるという主旨の記述があった。しかし、今回の更新でこの文言は削除された。代わりに「法規制を遵守するため、手動対策の文脈を理解させる目的で、提出されたテキストをサイト所有者に送信しなければならない」という強い表現が追加されている。
これは、Googleが報告者の匿名性を保証する努力をするのではなく、報告者自身に「特定される情報を一切書かないこと」を義務付けたことを意味する。ルールを守らない報告は、どれほど証拠が揃っていても無視されることになるため、注意が必要だ。
手動対策通知の仕組みと報告者が負うべきリスク
手動対策(マニュアルアクション)とは、Googleの担当者が目視でサイトを確認し、ガイドライン違反と判断した場合に検索順位を下げたり、インデックスから削除したりする処置を指す。このプロセスにおいて、ユーザーからの報告は重要な判断材料の一つとなる。
報告内容がそのまま相手に届くという事実
Googleが違反サイトの運営者に送る通知には、どのような違反があったのかを説明するテキストが含まれる。このテキストに、報告者がフォームに記入した内容が「原文のまま」転載されるケースがある。これは、違反者が自サイトのどこに問題があるのかを正確に把握させ、修正を促すための透明性を確保する目的で行われる。
しかし、この透明性が報告者にとってはリスクとなる。例えば「私のサイトの画像を盗用している」といった文言で報告すれば、相手は即座に報告者が誰であるかを特定できる。このような情報の流出は、報告者への逆恨みやさらなる攻撃を招く恐れがある。
情報の流れを視覚化する
スパム報告がどのように処理され、どの段階で情報が共有されるのかを整理しておくことは重要だ。以下のデモは、不適切な報告と適切な報告で情報の伝わり方がどう変わるかを示している。
このデモのように、自分を特定する情報を削ぎ落とし、客観的な事実のみを伝えることが、報告を有効にするための鉄則だ。
プライバシー保護と透明性のジレンマ。Googleの狙い
Googleがなぜこのような厳しいルールを設けたのか。その背景には、欧州のGDPR(一般データ保護規則)をはじめとする、世界的なプライバシー保護規制の強化がある。個人データの取り扱いには極めて慎重な対応が求められており、検索エンジンも例外ではない。
法規制への対応とユーザー保護の両立
GDPRなどの法規制下では、データの主体(この場合はサイト所有者)は、自分に関するどのような情報が収集され、誰から提供されたのかを知る権利を持つ場合がある。Googleが「報告文を相手に送る」としているのは、こうした法的要求に応えるための苦肉の策とも言える。
一方で、報告者の身の安全を守る必要もある。そこでGoogleが導き出した答えが、「個人情報が含まれる報告は最初から受け取らない(処理しない)」というフィルタリングだ。これにより、法的義務を果たしつつ、報告者が不用意に特定される事態を未然に防いでいる。
「質の高い報告」を求めるGoogleの姿勢
今回の変更は、スパム報告の「質」を向上させる狙いもあると考えられる。感情的な訴えや個人的な利害関係を排除し、アルゴリズムやガイドラインに照らして何が違反なのかを論理的に説明する報告を、Googleは求めている。
報告が無効化される条件を明確にすることで、Google側の処理コストも削減される。明らかにガイドラインを理解していない報告や、嫌がらせ目的の報告を、情報の形式だけで自動的に弾くことができるからだ。
効果的なスパム報告を行うための実践的なアドバイス
スパムサイトによって検索順位を下げられたり、コンテンツを盗用されたりした場合、冷静に報告を行うのは難しい。しかし、確実にGoogleに対処してもらうためには、以下のポイントを意識してフォームを記入する必要がある。
匿名性を保ちつつ証拠を提示するコツ
まず、一人称(私、弊社など)や固有名詞を避けることだ。例えば「私のサイトのこの記事がコピーされた」と書くのではなく、「該当URLのコンテンツは、別のドメイン(URLを提示)のオリジナルコンテンツを無断で複製している」といった書き方にする。
次に、違反の種類を具体的に指摘することだ。単に「スパムだ」と主張するのではなく、「隠しテキストが使用されている」「リンクプログラムに参加している」「クローキングが行われている」など、Googleのスパムポリシーに基づいた用語を使うと、担当者の理解が早まる。
報告文のチェックリスト
送信ボタンを押す前に、以下の項目が含まれていないか確認しよう。一つでも当てはまる場合は、処理されない可能性が高い。
- 自分の氏名や会社名、部署名
- 自分のメールアドレスや電話番号
- 自分が管理しているサイトのドメイン名(証拠として必要な場合を除く)
- 相手を非難する感情的な言葉
- 過去のやり取りや個人的なトラブルの経緯
独自の分析。SEO担当者が今後意識すべき報告の作法
今回のGoogleの対応は、SEO業界における「スパム報告」の立ち位置を大きく変える可能性がある。これまでは「困った時の神頼み」のような側面もあったが、今後はより専門的で客観的な「証拠提出」の場へと変わっていくだろう。
競合への嫌がらせ対策としての側面
この新ルールは、競合サイトを陥れるための「虚偽の報告」に対する牽制にもなる。報告内容が相手に公開される可能性がある以上、安易な嘘や根拠のない誹謗中傷は、報告者自身の首を絞めることになるからだ。Googleは情報の透明性を高めることで、報告システム自体の健全性を保とうとしている。
AI時代におけるスパム報告の価値
AIによって生成された低品質なコンテンツが急増する中、Googleのアルゴリズムだけですべてを検知するのは難しくなっている。人間の目による「これはスパムだ」というフィードバックの価値はむしろ高まっていると言えるだろう。
だからこそ、私たちは「正しい報告の作法」を身につけるべきだ。適切な形式で、個人情報を排除し、事実に基づいた報告を行うことは、検索エンジンのエコシステムを守るための貢献にもなる。今回の仕様変更を機に、社内での報告フローやテンプレートを見直してみるのも良いだろう。
この記事のポイント
- Googleへのスパム報告に個人情報が含まれている場合、調査は行われず破棄される。
- 手動対策が実施される際、報告文がそのままサイト所有者に共有されるリスクがあるためだ。
- 報告文には自分の名前や会社名を入れず、客観的な事実と違反箇所のみを記述する。
- この変更は、プライバシー保護規制への対応と報告システムの健全化を目的としている。
- 正当な報告を有効にするため、送信前のセルフチェックがこれまで以上に重要となる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AI検索でブランドが消える?「没個性税」を回避する最新SEO戦略
AIは検索の仕組みを変えるだけでなく、どのブランドを「無視するか」を決定する審判になりつつある。従来の検索エンジン最適化(SEO)が通用しなくなる中で、企業は自社の存在がAIによって消し去られるリスクに直面している。
Adobe Summitにおいて、SemrushのCMO(最高マーケティング責任者)であるAndrew Warden氏は、ブランドの可視性が根本から変化したと指摘した。AIシステムが情報をフィルタリングする過程で、特徴のないブランドは組織的に排除される可能性があるという。
本記事では、Warden氏が提唱する「Bland Tax(没個性税)」という概念を中心に、AI検索時代に生き残るためのブランド戦略を深掘りする。AIに選ばれ、ユーザーに届くための新しいルールを理解することが、これからのマーケティングの成否を分けるだろう。
AIが情報のゲートキーパーになるエージェント時代の到来

現在、検索行動のデータには明らかな変化が現れている。Google検索の約60%が、Webサイトへのクリックを伴わずに終了しているという。これは、ユーザーが検索結果画面でAIが生成した回答を読み、そのまま満足して離脱していることを意味する。
GoogleのAI Overviews(AIオーバービュー)やChatGPT、Perplexityといったツールは、もはや単なる検索ツールではない。これらは「新しいゲートキーパー」として機能し、ユーザーと情報の間に立って、どの情報を提示し、どのブランドを紹介するかを選別している。
検索行動の変化とクリックゼロの現実
ユーザーは以前のように複数のサイトを巡回して情報を比較検討する手間をかけなくなっている。対話型のインターフェース内で質問を重ね、解決策を絞り込んでいく「エージェント型」の利用が一般的になりつつある。この環境下では、AIの回答に含まれないブランドは、ユーザーの視界から完全に消滅してしまう。
LLMユーザーのコンバージョン率は4倍高い
一方で、クリック数が減ることは必ずしも悪いことばかりではない。Warden氏は、大規模言語モデル(LLM)を利用している消費者は、従来の検索のみを利用するユーザーに比べて、コンバージョン率が少なくとも4倍高いというデータを提示している。AIを通じて情報を探しているユーザーは、より具体的で強い購入意図を持っているため、AIに選ばれることの価値は極めて高い。
● サイトA ● サイトB ● サイトC
■ 選ばれたブランドのみが表示される
この図は、検索体験が「分散」から「集約」へと変化している様子を示している。AIが情報を統合するため、選ばれなかった情報は存在しないも同然となる。
没個性なブランドを襲うBland Tax(没個性税)の正体

Warden氏が提唱する最も重要な概念が「Bland Tax(没個性税)」だ。これは、特徴のない平凡なコンテンツを発信し続けるブランドが支払うことになる、目に見えないペナルティを指す。AIは現在、平凡な内容(Blandness)を無視するように学習を進めているという。
「平均的であること」や「ジェネリックであること」は、AI検索の世界では「透明であること」と同義だ。どこにでもあるような情報を発信しているブランドは、AIによって他の情報とひとまとめに要約され、ブランド名が引用されることすらなくなる。
平均的なコンテンツはAIに吸収される
AIは複数のソースから似たような情報を集め、1つの簡潔な回答を作成する。この際、独自の見解や新しい事実が含まれていないコンテンツは、AIの知識の一部として吸収されるだけで、出典として明記される価値がないと判断される。これが、ブランドアイデンティティが消去されるプロセスだ。
ブランド名が消え、AIの学習データにされるリスク
独自の価値を提供できないブランドのコンテンツは、AIを賢くするための「無料のトレーニング場」に成り下がってしまう。情報の提供元としての認知を得られないまま、コンテンツだけがAIの回答精度を高めるために消費される。これはマーケティング投資として極めて効率が悪い状態だといえる。
AIに選ばれるための発見可能性と権威性
AI検索時代において、ブランドの可視性は「発見可能性(Discoverability)」と「権威性(Authority)」の掛け合わせで決まる。Warden氏は、この両方が不可欠であると強調している。どちらか一方が欠けても、AIの回答に食い込むことはできない。
「発見可能性」とは、AIがそのブランドの情報を技術的に見つけられるかどうかを指す。そして「権威性」とは、AIがそのブランドを信頼し、回答に含める価値があると判断するかどうかを指す。この2つを高い次元で両立させることが、新時代のSEO戦略の核心だ。
基礎としてのSEOはAIの教本になる
SEOは死んだという極端な意見もあるが、Warden氏はこれを明確に否定している。むしろ、SEOはこれまで以上に基礎的な役割を担うようになっている。現在のSEOは人間に見せるためだけのものではなく、AIに対する「トレーニングマニュアル」としての側面が強まっているからだ。
以下の要素が欠けているブランドは、AIの会話から完全に排除されるリスクがある。
- クローラビリティ(AIが情報を収集できるか)
- インデクサビリティ(情報がデータベースに登録されるか)
- 構造化データ(情報の意味をAIが正しく理解できるか)
- 権威シグナル(信頼に足る情報源か)
エンティティ権威を確立するブランド需要
AIは「エンティティ(実体)」とその関係性を地図のようにマッピングして理解している。AIに特定のトピックの権威として認識されるためには、ブランドそのものに対する需要、つまり「指名検索」が重要になる。人々がそのブランドを探していなければ、AIもまたそのブランドを探そうとはしないからだ。
独自の価値を証明する3つの重要シグナル

Warden氏は、ブランドがAIにフィルタリングされず、優先的に表示されるために必要な3つの具体的なシグナルを挙げている。これらは、AIが「この情報は特別だ」と判断するための基準となるものだ。
単に記事を量産するのではなく、これらのシグナルを意識したコンテンツ制作が求められる。独自性(オリジナリティ)を担保することで、AIの回答における可視性は30%から40%向上する可能性があるという。
1. 情報の密度とオリジナリティ
AIは「新しい事実」を引用することを好む。既存の情報の焼き直しではなく、以下のような要素を含むコンテンツが評価される。
- 独自の調査データや統計
- 自社だけが持つ一次情報
- 専門家による独自の視点や分析
- 具体的な成功事例や失敗談
2. シグナルの整合性と合意
AIは自社サイトの情報だけでなく、ネット上のあらゆる場所にある「他者の声」を参照している。Redditでの議論、YouTubeのレビュー、SNSでの言及、メディアでの報道などが、ブランドの信頼性を裏付ける「合意シグナル」となる。これらの情報が矛盾している場合、AIはそのブランドを「信頼できない」とフラグ立てする恐れがある。
3. エンティティの関連付け
特定のキーワードだけでなく、トピック全体においてブランドがどのように位置づけられているかが問われる。関連するコミュニティでの会話に参加し、専門的なメディアで取り上げられることで、AIの知識グラフ内でのブランドの結びつきを強化できる。
これらの要素が組み合わさることで、AIは「このブランドは引用する価値がある」と確信する。単一の施策ではなく、多角的なシグナルの構築が必要だ。
組織全体で取り組む可視性の再定義
AI検索への対応を難しくしている要因の1つは、組織の断絶にあるとWarden氏は指摘している。多くの企業では、SEOチーム、広報(PR)チーム、ブランドチーム、広告チームが個別に動いており、情報の整合性が取れていないケースが多い。
しかし、AIはこれらすべてのチャネルからデータを吸い上げている。SEOチームがどれほど最適化しても、PRチームが発信するメッセージが異なっていたり、SNSでの評判が悪かったりすれば、AIはそのブランドを高く評価しない。可視性はもはや特定のチームの問題ではなく、組織全体で取り組むべき課題だ。
トラフィックから関連性への評価軸シフト
従来の評価指標も通用しなくなっている。検索順位は安定しているのにトラフィックが減る、という現象が多くのサイトで起きている。これはAIが回答を肩代わりしているためだ。一方で、リード(見込み客)の質や数は向上している場合もある。
マーケターは「何回のクリックを得たか」という指標から、「AIの回答においてどれほど関連性の高い存在として扱われているか」という指標へと視点を移す必要がある。トラフィックはもはや、ブランドの成功を測る唯一の代理指標ではなくなっている。
アルゴリズムはもはや味方ではない
かつてのSEOは、Googleのアルゴリズムを理解し、それに合わせることで「順位」を競うゲームだった。しかし、今のAIは「何が有意義か」を判断する究極の裁定者となっている。アルゴリズムを攻略するハック(手法)よりも、リアルな世界での信頼と独自の価値を積み上げることこそが、最大の防御であり攻撃となる。
この記事のポイント
- AIは平凡なコンテンツを無視する「没個性税(Bland Tax)」を課し始めている
- AI検索時代はトラフィックが減る一方で、コンバージョン率が4倍高まる可能性がある
- SEOはAIにブランドの情報を教えるための「トレーニングマニュアル」として機能する
- 独自の調査データ、外部評価の整合性、専門的な権威性がAIに選ばれる鍵となる
- 可視性の向上には、SEO・PR・ブランドの各チームが連携した一貫した戦略が不可欠だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

MicrosoftがAI Maxを発表!AIエージェントが主役の「Agentic Web」時代に備える新広告ツールとは
Microsoftが「エージェンティック・ウェブ(Agentic Web)」という新しい時代の到来を見据えた、次世代の広告ツール群を発表した。これは人間だけでなく、AIエージェントがネット上の情報を探索し、意思決定や購買を代行する世界を想定したものだ。
2026年4月、Microsoft Advertisingは「AI Max」を含む一連のアップデートを公開した。これには広告配信の最適化だけでなく、AIによるブランドの露出状況を可視化する分析ツールや、AIが直接決済まで完結させるための新しいプロトコルが含まれている。
従来の「検索してクリックする」というユーザー行動が、AIによる「最適な選択と実行」へと置き換わりつつある。企業にとって、この変化は単なる広告手法の変更ではなく、Web上での存在意義を再定義する重要な転換点となるはずだ。
エージェンティック・ウェブの到来とAIエージェントの役割

エージェンティック・ウェブとは、AIエージェントがユーザーの代わりにタスクを遂行するWeb環境を指す。これまでのWebは、人間がブラウザを開き、検索エンジンにキーワードを入力して、表示されたリンク先を一つずつ確認する場所だった。
しかしAIエージェントの普及により、このプロセスが劇的に変化している。ユーザーは「週末の旅行プランを立てて、予算に合うホテルを予約しておいて」とAIに頼むだけで済むようになる。AIは複数のサイトを巡回し、価格や評価を比較し、最終的な選択までを行う。
クリックから「選択」へのパラダイムシフト
これまでの広告ビジネスは「クリック」を指標にしてきた。ユーザーを自社サイトへ誘導し、そこでコンバージョンを狙うのが一般的だ。しかし、AIエージェントが情報を集約して回答する場合、ユーザーは必ずしも元のサイトを訪問する必要がなくなる。
ここで重要になるのが、AIに「選ばれる」ことだ。AIがユーザーに提示する回答の中に、自社の製品やサービスが適切に含まれているか。そして、AIがその情報を信頼できると判断しているか。この「選択の最適化」が、次世代のマーケティングの中心となる。
このデモは、Web利用の構造がどのように変化しているかを視覚化したものだ。ユーザーの行動が簡略化される一方で、AIが裏側で行う処理の重要性が増していることがわかる。
AI MaxとOffer Highlightsの仕組み

Microsoftが導入した「AI Max for Search」は、AI環境に特化した新しいキャンペーン形式だ。これは従来の検索広告を拡張し、CopilotやBingのAIチャット回答内など、AIが生成するあらゆるインターフェースに広告を最適化して配信する。
AI Maxの特徴は、クエリのマッチング精度が大幅に向上している点だ。ユーザーがAIと対話する中で、文脈を深く理解し、最も関連性の高いタイミングで広告を表示する。これにより、単なるキーワード一致を超えた、意図に基づいたリーチが可能になる。
会話の中に溶け込むOffer Highlights
もう一つの注目機能が「Offer Highlights」だ。これはAIとの会話の中で、製品の主要なセールスポイントを直接提示する広告フォーマットである。例えば「送料無料」や「期間限定の割引」といった情報が、AIの回答の一部として自然に組み込まれる。
AIチャットを利用しているユーザーは、情報を素早く得たいと考えている。別サイトに移動して詳細を確認させるのではなく、会話の流れの中でメリットを伝えることで、離脱を防ぎながら購買意欲を高めることができる。これは「AI時代のリスティング広告」とも呼べる進化だ。
AI Visibilityによる露出状況の可視化

新しい時代において、自社がAIにどのように認識されているかを知ることは極めて重要だ。そこでMicrosoftは、ウェブ分析ツール「Microsoft Clarity」に「AI Visibility」という新機能を搭載した。これはAIの回答内で自社ブランドがどのように表示されているかを分析するツールだ。
AI Visibilityでは、どのコンテンツがAIに引用されたか、どのキーワードで自社が推奨されたかを詳しく追跡できる。また、競合他社がAIの回答内でどのような位置を占めているかを比較することも可能だ。これは従来のSEOにおける検索順位チェックの、AI回答版と言えるだろう。
引用元としての信頼性を高める
AIは回答を生成する際、信頼できるソースを引用する。Clarityの新しいレポートを使えば、自社のどのページがAIにとって「引用しやすい」と判断されているかが明確になる。データ構造が整理されているか、主張が明確かといった要素が、AIによる露出度に直結するのだ。
このイメージ図は、AI Visibilityが提供するインサイトを簡略化したものだ。自社サイトのどの部分がAIに評価され、引用されているかを把握することで、次にとるべき施策が明確になる。
Universal Commerce Protocolと直接購入

AIエージェントが「買い物」を代行するためには、商品データがAIにとって読み取りやすい形式である必要がある。Microsoftは「Microsoft Merchant Center」において「Universal Commerce Protocol」のサポートを開始した。これはAIエージェントが製品を発見し、取引を円滑に行うための標準規格だ。
このプロトコルに準拠することで、AIは商品の価格、在庫、仕様だけでなく、配送条件や返品ポリシーまでを正確に把握できるようになる。AIエージェントがユーザーの代理人として「最も条件の良い商品」を選ぶ際、このデータ構造化が勝敗を分けることになる。
Copilot Checkoutで摩擦のない購買体験を
さらにMicrosoftは、Copilot内で直接決済を完結させる「Copilot Checkout」の強化も進めている。ユーザーがAIとの対話で商品を決めた後、外部サイトへ移動することなく、その場で注文を確定できる仕組みだ。
発見から購入までの摩擦(フリクション)を最小限に抑えることで、コンバージョン率は飛躍的に向上すると期待されている。企業側は自社サイトへの流入を失うことになるが、その代わりに「AIエージェント経由の売上」という新しいチャネルを確保することになる。
独自分析:SEOからAIO(AI最適化)への戦略的転換

Microsoftの今回の発表は、Webマーケティングの軸足が「人間向けのSEO」から「AI向けのAIO(AI Optimization)」へ移りつつあることを示唆している。AIエージェントに選ばれるためには、単にキーワードを散りばめるだけでは不十分だ。
AIOにおいて最も重要になるのは、情報の「正確性」と「構造化」である。AIは不確かな情報を嫌う。出典が明確で、構造化データ(Schema.orgなど)によって意味が厳密に定義された情報は、AIに採用される確率が高まる。また、自然言語によるターゲット設定ツールの登場により、広告主は「誰に」届けたいかをより直感的に指定できるようになる。
中小企業が今から準備すべきこと
この変化は、リソースの限られた中小企業にとってもチャンスだ。巨大な広告予算がなくても、特定のニッチな分野で「最もAIに信頼される情報源」になれば、AIエージェントを通じて多くのユーザーにリーチできる可能性がある。
まずは、自社サイトの情報を整理し、AIが理解しやすい形に整えることから始めよう。具体的には、製品のスペックをテーブル形式で明記する、独自の調査データを公開する、といった「AIが引用したくなるコンテンツ」の作成が有効だ。AIエージェントという新しい「顧客」とどう付き合うかが、今後の成長を左右するだろう。
この記事のポイント
- MicrosoftがAIエージェント時代を見据えた広告ツール「AI Max」を発表した
- エージェンティック・ウェブでは、AIがユーザーの代わりに情報を探し、意思決定を行う
- 「AI Visibility」により、自社ブランドがAIの回答にどう露出しているか分析可能になった
- 「Universal Commerce Protocol」により、AIエージェントが直接購入を代行する仕組みが整いつつある
- これからのマーケティングは、検索順位だけでなく「AIに選ばれるための最適化(AIO)」が重要になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AI時代のSEOで検索エンジンが信頼する3要素——権威性・鮮度・独自性の新基準
検索エンジンの評価基準が根本から変わった。従来のSEO対策だけでは通用しない時代が来ている。
Search Engine Journalの記事によると、AI駆動の検索システムは権威性・鮮度・独自性の3要素を重視する。これらの要素が連動して、コンテンツが検索結果に表示されるか、AI生成回答に引用されるかを決める。
この変化を理解しないと、どんなにキーワードを最適化しても、どんなにバックリンクを増やしても、成果は上がらない。AIが信頼するコンテンツを作るための新たな基準を解説する。
検索エンジンの評価システムが変わった
かつての検索エンジンは定期的なアルゴリズム更新で評価基準を調整していた。コアアップデートが発表され、順位が変動し、業界がパターンを分析して対策を練る。このサイクルは予測可能だった。
しかし今は違う。AI駆動の検索システムは常に学習し、評価基準を微調整している。Search Engine Journalの記事では、この状態を「連続的な調整」と表現する。アルゴリズムの更新のように見える現象の多くは、実際にはAIモデルの継続的な最適化の結果だ。
従来の「ランキング」から「評価」への移行
従来のSEOはページ単位のランキングを競うものだった。バックリンクや関連性、技術的な最適化が評価基準となり、ページ全体が1つの単位として扱われた。
AI駆動の検索では、ページ全体のランキングに加えて「情報の抽出と合成」という第2の層が加わった。検索エンジンは複数のソースから情報を抜き出し、再構成して回答を生成する。この変化により、競争の単位がページ全体から「情報の断片」へと移行している。
具体的には、コンテンツ内の各セクション、各段落、各リストがAI生成回答に引用される候補となる。ページが検索結果に表示されるかどうかだけでなく、ページ内のどの部分がAIによって利用されるかが重要になった。
信頼の評価が「継続的」になった
信頼性の評価も変化した。かつての信頼性は、権威性のシグナル、コンテンツ品質、技術的な健全性を組み合わせた「スコア」のようなものだった。一度高い評価を得れば、しばらくは維持できた。
現在の信頼性評価は「確率」のように振る舞う。継続的に評価され、再計算され、新しいデータに基づいて強化される。一度得た信頼を保持するのではなく、繰り返し獲得し続ける必要がある。
AIが信頼する3つの要素
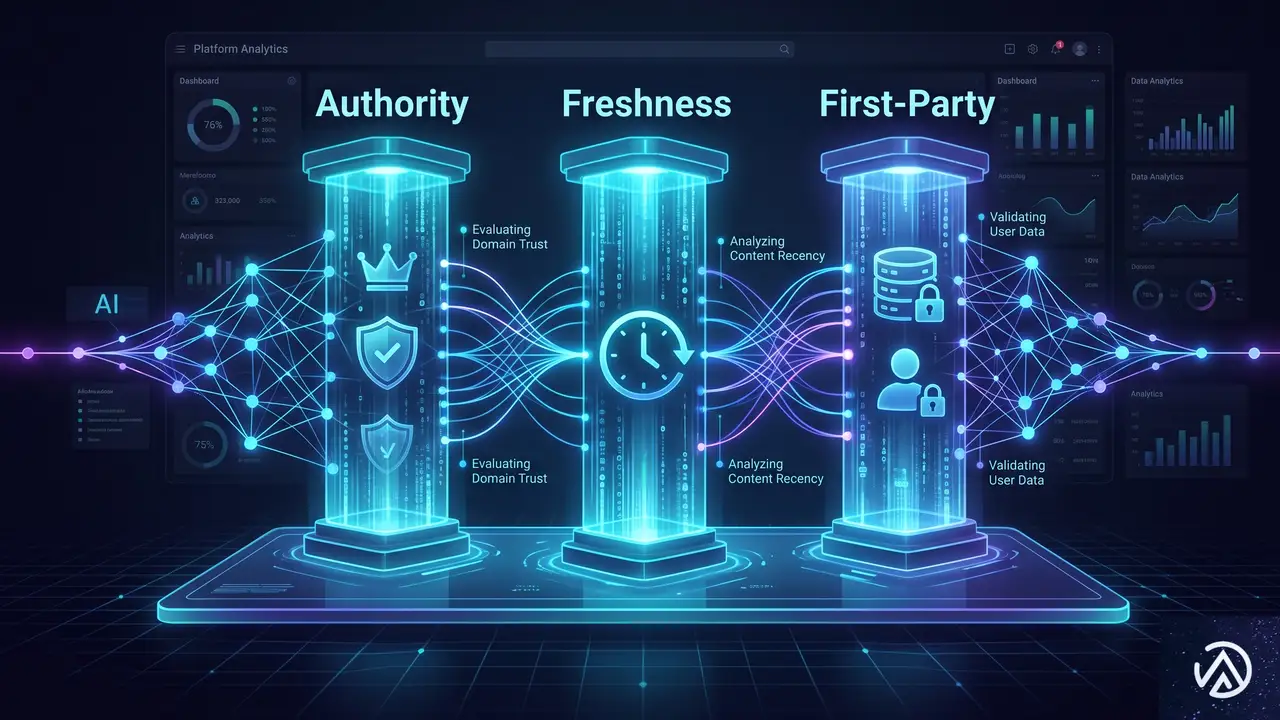
AI駆動の検索システムが信頼性を判断する際、特に重視する要素が3つある。権威性、鮮度、独自性のシグナルだ。それぞれが異なる役割を果たし、コンテンツが検索結果に表示されるか、AI回答に引用されるかを決める。
権威性——評価の入り口
権威性は常に重要だったが、その役割が変化した。AI駆動のシステムでは、権威性は「フィルター」として機能する。コンテンツが評価の対象になるかどうかを最初に決める要素だ。
すべての情報源が平等に扱われるわけではない。検索エンジンは認識しているエンティティ(ブランド、著者、ドメイン)を優先する。これらのエンティティは、ウェブ全体で一貫した専門性と可視性を示している必要がある。
バックリンクの数だけが権威性の指標ではなくなった。エンティティレベルの権威性を証明するには、以下の要素が重要になる。
- 他の権威あるサイトでの言及
- 一貫した著者性とトピックへの集中
- 特定の分野でのブランド認知
- 構造化された知識システムへの組み込み
Search Engine Journalの記事では、これらのシグナルが「エンティティ重力」を作り出すと説明する。存在感が強ければ強いほど、コンテンツが情報抽出の候補セットに含まれやすくなる。
重要なのは、権威性が可視性を保証するわけではないことだ。権威性は「資格」を保証する。権威性がなければ、コンテンツがよく書かれ、よく構成され、技術的に健全であっても、無視される可能性がある。
鮮度——継続的な関連性の証明
鮮度の概念も進化した。あるいは「分化した」と言う方が正確かもしれない。
かつては、すべての種類のコンテンツが鮮度の恩恵を受けた。新しいコンテンツは、特に時間に敏感なクエリに対して一時的なブーストを得られた。
現在、この従来型の鮮度はニュースメディアのような時間に敏感な発信者にしか利益をもたらさない。それ以外の発信者にとって、鮮度は「いつ公開されたか」ではなく「維持されているか」が重要になる。
AI駆動のシステムは、継続的な関連性を示す情報源を優先する。具体的には以下の要素だ。
- 定期的に更新されるコンテンツ
- 明確なタイムスタンプと改訂履歴
- 時間の経過とともに重要なトピックが強化されていること
- 現在の情報と文脈との整合性
古くなったコンテンツはリスクを生む。情報がまだ正確かどうかをシステムが判断できない場合、合成された回答に含まれる可能性が低くなる。
鮮度は、この意味で信頼強化のループになる。コンテンツを更新することは、継続的な専門性を示すシグナルだ。不確実性を減らし、含まれる可能性を高める。
独自性——確かな情報源の証明
3つ目の大きな変化は、独自性のシグナルの重要性が劇的に高まったことだ。AIシステムは情報を合成するように設計されているが、依然としてソース素材に依存している。その素材の品質は、出力の品質に直接影響する。
その結果、システムはリサイクルされた要約ではなく、オリジナルで検証可能な入力を表すコンテンツを重視する。独自性のシグナルには以下が含まれる。
- 独自の調査とデータ
- 独自の洞察と分析
- 直接的な製品やサービス情報
- 直接的な経験と専門知識
これらのシグナルは曖昧さを減らす。明確な情報源を提供し、帰属が容易で、複製が難しい。
これが「大量コンテンツ」モデルが近年苦戦している理由の1つだ。派生コンテンツの大量生産は、新しい情報をほとんど提供しない。価値を増やすことなくノイズを増やすだけだ。
AIシステムはより多くのコンテンツを探しているのではなく、より良い入力を探している。コンテンツが何か独自のものを追加しない限り、選択される可能性は低い。
見落とされがちな第4の要素——使いやすさ

権威性が評価の対象にし、鮮度が関連性を保ち、独自性が信頼性を確立する。しかし、コンテンツが利用できなければ、これらの要素はすべて無意味になる。ここで多くのサイトが失敗している。
ページがよくランキングしていても、AI生成回答に存在しないことがある。その場合、問題はランキングではなく「抽出のしやすさ」にあることがほとんどだ。
AIシステムは人間のようにページを読まない。探索的にナビゲートし、解釈し、合成することはない。抽出しやすいものを取得し、次に進む。
この環境でうまく機能するコンテンツには、いくつかの特徴がある。
- 明確で説明的な見出し
- 論理的な階層構造(H1、H2、H3)
- 段落ごとに1つの主要なアイデア
- 直接的で断定的な表現
- 適切な箇条書きと表
- 重要なポイントは早い段階で紹介(埋もれさせない)
これは文章スタイルの問題ではない。摩擦を減らす問題だ。
システムが回答を分離するためにコンテンツを再解釈する必要がある場合、利用される可能性は低くなる。文やリストを直接引き抜ける場合、含まれる可能性は高くなる。この意味で、構造は見た目の問題ではなく、機能的な問題だ。
- キーワード調査
- メタタグ最適化
- コンテンツ作成
- バックリンク構築
このデモは、同じ内容でも構造化の違いでAIによる抽出のしやすさが変わることを示している。左側は情報が段落内に埋もれており、AIが特定の情報を抽出するには文章全体を解析する必要がある。右側は見出しと箇条書きで明確に構造化されており、AIが「SEOの主要手法」という見出しの下のリストを直接取得できる。
「良いSEO」だけでは不十分な理由

多くのチームが直面しているのは、以下のようなパターンだ。検索順位は良好で、トラフィックも安定しているが、AI生成回答には存在しない。
最初の直感はランキングの問題を探すことだ。それで問題が解決しないと、キーワードの再最適化、より多くのバックリンク構築、より多くのコンテンツ公開に移行する。これらは真の問題に対処しない解決策だ。
ランキングは検索結果に表示されるかどうかを決める。情報抽出は回答に利用されるかどうかを決める。これらは同じシステムではない。ページが従来のSEO指標でうまく機能していても、AIシステムにとってきれいで抽出可能なセグメントを提供できないことがある。
その場合、より明確な構造やより強い権威性を持つ競合他社が、たとえ順位が低くても引用される可能性が高くなる。これは矛盾ではなく、評価の変化だ。
この比較図は、評価基準の変化を視覚化している。左側の従来型SEOでは、バックリンクやキーワードなどの要素が検索結果での表示位置(ランキング)につながる。右側のAI時代の評価では、権威性や鮮度などの要素が、検索結果での表示に加えてAI生成回答への引用有無にも影響する。評価基準が追加され、複雑化した。
実践的な対策——4つのアクションプラン

これらの変化に対する実践的な対策は明確だ。実行は簡単ではないが、方向性ははっきりしている。
1. アップデートを孤立したイベントとして扱うのをやめる
アルゴリズムのアップデートは、連続的なシステムの出力に過ぎない。短期的な変動に対応するよりも、長期的な方向性に向けて最適化する方が効果的だ。
Search Engine Journalの記事では、信号の半減期が短くなったと指摘する。6ヶ月前に有効だった手法が今も重要かもしれないが、定期的ではなく継続的に再評価されている。
2. エンティティレベルでの権威性への投資
自社サイトを超えた認知を構築する。どこで、どのように言及されるかは、何を公開するかと同じくらい重要だ。
PR、パートナーシップ、思想のリーダーシップ、ブランドの存在感などのエンティティ構築努力は、SEOから切り離せなくなった。これらはランキングだけでなく、情報抽出の候補に含まれるかどうかにも影響する。
3. コンテンツの継続的なメンテナンス
鮮度は一度きりのシグナルではない。関連性の継続的な実証だ。重要なコンテンツを維持する。すべてを常に書き直す必要はないが、重要な情報が最新であることを確認する。
4. 独自性のある価値を優先する
独自の洞察、データ、専門知識は、派生コンテンツよりも耐久性がある。AIシステムはより多くのコンテンツを求めているのではなく、より良い入力を求めている。
5. 使いやすさのために構造化する
コンテンツを読みやすくするだけでなく、抽出しやすくする。明確な見出し、論理的な階層、直接的な表現を採用する。AIが情報を簡単に引き抜けるように設計する。
この記事のポイント
- AI駆動の検索システムは権威性・鮮度・独自性の3要素を重視する
- 権威性は評価の「入り口」であり、これがないとコンテンツは考慮されない
- 鮮度は「いつ公開されたか」ではなく「維持されているか」が重要になった
- 独自性のある情報(調査・データ・洞察)がAIに高く評価される
- コンテンツ構造は「見た目」ではなく「抽出のしやすさ」のために重要
- 従来のSEO対策だけではAI生成回答への引用は獲得できない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIが買い物をする時代へ!エージェント・コマース(Agentic Commerce)の仕組みと対応策
ネット通販における「決済ページ」という概念が消えようとしている。これまで30年間、オンラインで物を買うには名前や住所、クレジットカード番号をフォームに入力するのが当たり前だった。しかし、AIエージェントがユーザーの代わりに商品を探し、そのまま購入まで完了させる「エージェント・コマース」が急速に現実のものとなっている。
2025年から2026年にかけて、Stripe、OpenAI、Shopify、Googleといったテック巨人が相次いで新しい決済プロトコルを発表した。これにより、チェックアウトは「Webページ」で行う作業から、システム間で完結する「プロトコル」へと進化を遂げている。もはや人間がフォームを埋める必要はない。
この変化は、Web制作やECサイト運営に携わる者にとって無視できないパラダイムシフトだ。AIエージェントに自社の商品を見つけてもらい、スムーズに決済してもらうためには、サイトの構造そのものを「マシン・リーダブル(機械が理解可能)」に変えていく必要がある。本記事では、最新の業界動向と技術仕様を基に、エージェント・コマースの全貌を解説する。
決済は「ページ」から「プロトコル」へ進化する
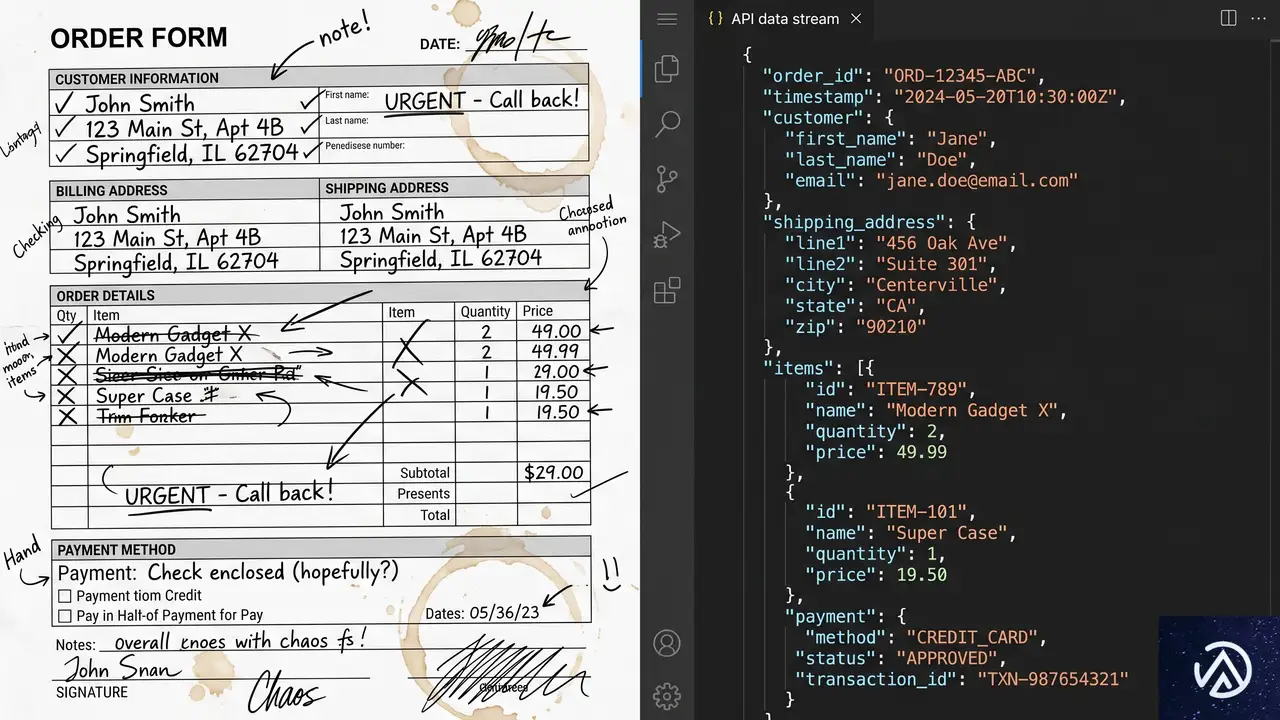
1994年に世界で初めてオンライン決済が行われて以来、ECの歴史は「摩擦の解消」の歴史だった。物理的な店舗に行く手間を省き、価格比較の手間を省き、レコメンド機能によって探す手間を省いてきた。エージェント・コマースは、その進化の最終段階といえる。ユーザーが「これを買っておいて」とAIに頼むだけで、決済まで完了するからだ。
30年続いた「フォーム入力」の終焉
従来のECサイトでは、売り手がチェックアウト体験を設計していた。ボタンの色やフォームの配置を工夫し、いかにカゴ落ちを防ぐかがコンバージョン率向上の鍵だった。しかし、エージェント・コマースでは、チェックアウトのインターフェースを作るのはAIエージェント側だ。ChatGPTなどのAIが、チャット画面の中で商品情報と購入ボタンを提示する。ユーザーがそこで承認すれば、裏側でAPIが呼び出され、決済が完了する。
売り手側の仕事は、魅力的なページを作ることではなく、構造化された商品データを提供し、注文を処理するAPIエンドポイントを用意することにシフトする。Stripeの情報によれば、コマースの課題はユーザー体験(UX)の問題からプロトコルの問題へと変化しているという。つまり、見た目の美しさよりも、機械がいかに正確にデータを読み取れるかが重要になるのだ。
AIエージェントが購入を代行する仕組み
AIエージェントによる購入は、人間がブラウザを操作するのとは全く異なるプロセスを辿る。エージェントはサイトの視覚的なデザインを無視し、テキストデータやメタデータ、APIを通じて情報を取得する。決済時には、ユーザーがあらかじめAIプラットフォームに登録しておいた支払い情報が使われる。売り手側のサイトにユーザーが直接クレジットカード情報を入力することはない。
このデモは、購入プロセスの構造的な変化を視覚化したものだ。人間が介在するステップが大幅に短縮されていることがわかる。
二大勢力が競う「エージェント・コマース」の標準規格
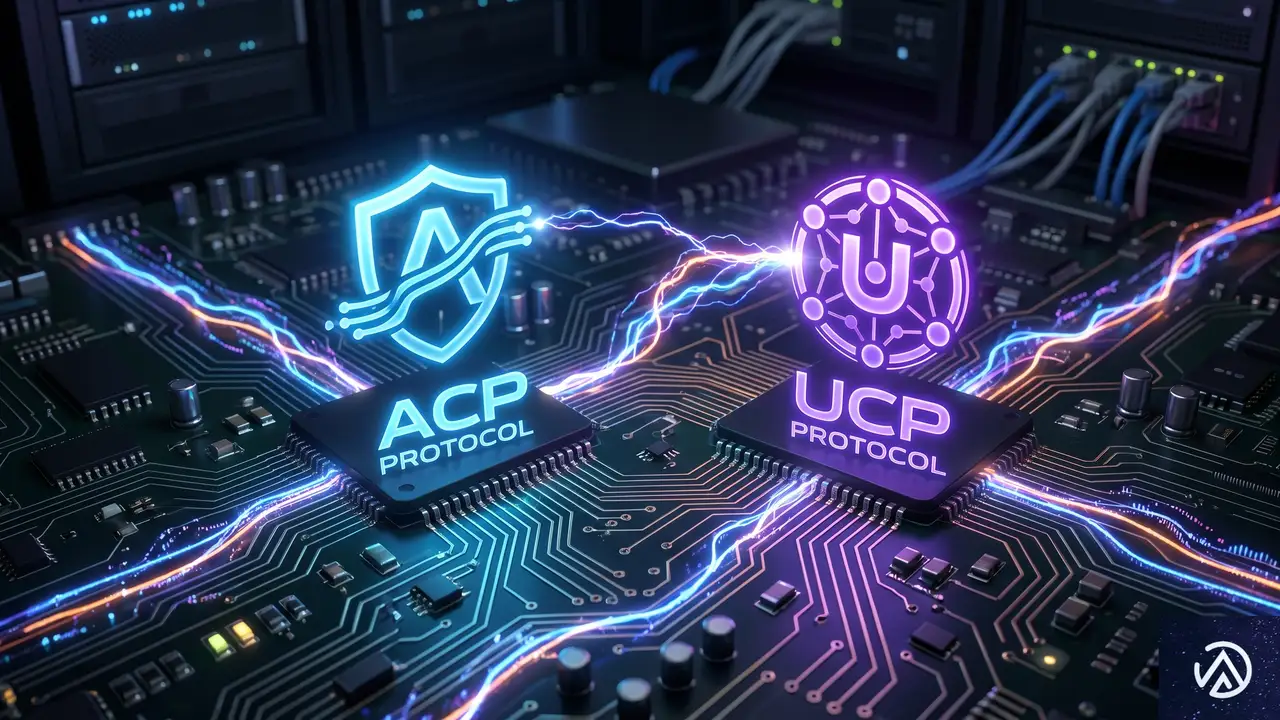
現在、この新しい市場を支配しようと、二つの大きなプロトコルが標準化を競っている。一つはOpenAIとStripeが主導する「ACP」、もう一つはGoogleとShopifyが主導する「UCP」だ。これらは対立するものではなく、補完し合う関係にあるが、それぞれの設計思想には違いがある。
StripeとOpenAIによる「ACP」
ACP(Agentic Commerce Protocol / エージェント・コマース・プロトコル)は、2025年9月に発表されたオープン標準だ。主にChatGPT内での「インスタント・チェックアウト」を実現するために設計されている。ACPは、AIエージェント、売り手、支払いサービスプロバイダーの三者が通信するための4つのAPIエンドポイントを定義している。
具体的には、カートの作成、情報の更新、決済の完了、そしてキャンセルの4段階だ。売り手は自社のシステムをこれらのエンドポイントに対応させるだけで、ChatGPTを通じて商品を販売できるようになる。Stripeはこの導入を容易にするために「Agentic Commerce Suite」を提供しており、既存のStripeユーザーであれば最小限のコードで対応が可能だ。すでにWalmartやInstacartといった大手がこの仕組みを導入し、ChatGPT経由での販売を開始している。
ShopifyとGoogleによる「UCP」
UCP(Universal Commerce Protocol / ユニバーサル・コマース・プロトコル)は、2026年1月にGoogleとShopifyが発表した。ACPが決済フローに特化しているのに対し、UCPは商品の発見から購入後のサポートまで、コマース体験の全工程をカバーすることを目指している。その構造はインターネットの基本プロトコルであるTCP/IPをモデルにしており、非常に拡張性が高い。
UCPの特徴は、サイトの特定の場所に設置された「/.well-known/ucp」というエンドポイントを通じて、AIエージェントがそのサイトの販売能力を自動的に認識できる点にある。Google検索やShopifyのプラットフォームと深く統合されており、多くのEC事業者が意識せずともAIエージェントに対応できる環境を整えようとしている。MastercardやVisaといったカードネットワークもUCPへの支持を表明しており、より広範なエコシステムを形成している。
「人がいない決済」を支えるセキュリティ技術
エージェント・コマースにおける最大の課題はセキュリティだ。クレジットカードの持ち主がその場にいない「Person-not-present(本人が不在の決済)」において、どうやって不正を防ぎ、信頼を担保するのか。これまでの「カード番号とCVVを知っていれば本人とみなす」という前提は、AIの時代には通用しない。
Shared Payment Tokens(共有支払いトークン)の役割
この問題に対するStripeの回答が「Shared Payment Tokens(SPT)」だ。これは、AIプラットフォームが発行する、特定の取引専用の使い捨てトークンである。ユーザーがChatGPTで「購入」を承認すると、ChatGPTは特定の売り手、特定の金額、特定の有効期限に限定されたトークンを発行する。売り手はこのトークンを使ってStripeに決済を依頼する。
この仕組みの優れた点は、売り手にもAIエージェントにも、ユーザーの本物のクレジットカード情報が渡らないことだ。万が一データが漏洩しても、そのトークンは他の場所では使えない。また、Googleが推進するAP2プロトコルでは、デジタル署名を用いてユーザーの同意を厳密に検証する仕組みが導入されている。これにより、AIが勝手に高額な買い物をするといったリスクを技術的に排除している。
クレジットカード各社の「Trusted Agent」対応
VisaやMastercardといったカードネットワークも、AI時代に合わせた新しい枠組みを構築している。Visaが発表した「Trusted Agent Protocol」は、正規のAIエージェントと悪意のあるボットを識別するためのフレームワークだ。従来の不正検知システムは、マウスの動きやタイピングの癖といった「人間らしい振る舞い」を指標にしていたが、AIエージェントにはそれが存在しない。
そのため、新しいシステムでは、AIエージェントの身元を暗号学的に証明し、そのエージェントがユーザーから正当な権限を与えられているかを確認することに主眼が置かれている。Stripeの調査によれば、消費者の88%がAIによるなりすまし詐欺を懸念しているが、こうした堅牢なインフラが整備されることで、徐々に信頼が醸成されていくとの見方がある。
自社の商品を「AIに売る」ための具体策
エージェント・コマースの波に乗るために、ECサイトの運営者は今何をするべきか。最新のプロトコルに対応することも重要だが、その基礎となるのは「データ」の質だ。AIエージェントがサイトを訪れた際、迷うことなく商品を理解し、推奨できるように準備しておく必要がある。
マシン・リーダブルな商品データの整備
AIエージェントはプログラムによってカタログを解析する。そのため、曖昧な表現や、画像の中にだけ書かれた情報は理解できない。例えば、商品タイトルを「青いシャツ」とするのではなく、「メンズ オーガニックコットン クルーネック Tシャツ、ネイビー」のように具体的かつ詳細に記述することが求められる。素材、寸法、お手入れ方法、用途といった情報を、すべてテキストデータとして網羅しておくことが重要だ。
また、価格や在庫状況がリアルタイムで正確であることも欠かせない。AIエージェントが「在庫あり」と判断してユーザーに提案したのに、いざ決済しようとしたら「在庫切れ」だったという体験は、エージェントからの信頼を失う原因になる。AIは信頼性の高いソースを優先的に選ぶ傾向があるため、正確な情報提供はSEOならぬ「AI-SEO」の根幹となる。
構造化データ(Schema.org)の重要性
プロトコルへの直接的な統合が難しい場合でも、構造化データのマークアップは今すぐ実行できる強力な対策だ。Schema.orgの Product スキーマを使い、名前、説明、画像、SKU、ブランドなどの情報を正しくタグ付けする。さらに、その中に Offer スキーマをネストさせ、価格、通貨、在庫状況、販売者を明記する。
BingでSchema.orgの立ち上げに携わったDuane Forrester氏によれば、一貫した構造化データを提供し続けることで、AIシステムの中に「マシン・コンフォート・バイアス(機械的な安心感による偏り)」が生まれるという。つまり、AIが「このサイトの情報は常に正確で読み取りやすい」と学習すれば、競合他社よりも優先的に引用・推奨されるようになる可能性があるのだ。
- 商品タイトルを具体的かつ詳細にする
- 素材、サイズ、用途をテキストで網羅する
- Schema.org(Product/Offer)を全商品に適用する
- 在庫と価格をリアルタイムで同期する
- 画像に適切なaltテキスト(代替テキスト)を付与する
このリストにある項目は、従来のSEO対策とも共通する部分が多いが、AIエージェントを意識する場合は「より厳密な正確性」が求められる点に注意が必要だ。
独自の分析:AI SEOがECの勝敗を分ける
エージェント・コマースの普及に伴い、EC業界には「選択の均質化」という新たなリスクが浮上している。コロンビア大学とイェール大学の共同研究によれば、現在のAIショッピングエージェントは、少数の特定商品に需要を集中させる傾向があるという。人間のように検索結果の2ページ目や3ページ目まで丹念に探すことはせず、アルゴリズムが「最適」と判断したトップ数件だけが選ばれる「勝者総取り」の構図が強まるのだ。
これは、中小規模のブランドにとっては大きな脅威であると同時に、チャンスでもある。巨大な広告予算がなくても、AIが理解しやすい高品質なデータを提供し、特定のニッチなニーズに対して「最も正確な回答」を提示できれば、AIエージェントに選ばれる可能性が高まるからだ。これからのEC戦略は、人間の感性に訴えるデザインと、機械の論理に応えるデータの両立が不可欠になる。
また、今後は「AIエージェント向けの広告」という概念も登場するだろう。しかし、Anthropic(Claudeの開発元)のように、広告やスポンサーリンクを一切排除したクリーンなコマース体験を標榜するプラットフォームも存在する。売り手としては、特定のプラットフォームに依存するのではなく、ACPやUCPといったオープンな標準規格に対応し、どこからでも「見つけられ、買える」状態を作っておくことが、長期的な生存戦略となるはずだ。
この記事のポイント
- 決済は「ページ」から「プロトコル」へ移行し、人間によるフォーム入力が不要になる
- StripeとOpenAIの「ACP」、ShopifyとGoogleの「UCP」という二大規格が標準化を競っている
- 「共有支払いトークン(SPT)」などの技術により、本人が不在でも安全な決済が可能になる
- ECサイトは、詳細なテキストデータとSchema.orgの導入により、AIに選ばれる準備をすべきだ
- AIエージェントによる「選択の均質化」が進むため、正確な情報の提供が生き残りの鍵となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
生成AIの普及率は3年で53%に到達。PCやネットを超える速度がSEOに与える衝撃
スタンフォード大学の人間中心人工知能研究所(HAI)が、最新の調査報告書「2026 AI Index Report」を公開した。このレポートは400ページを超え、技術的パフォーマンスから投資状況、労働市場への影響まで多岐にわたるデータを網羅している。
報告書の中で最も大きな反響を呼んでいるのが、生成AIの普及スピードだ。ChatGPTのリリースからわずか3年で、世界人口の53%が生成AIを採用するに至った。これは、かつてのパーソナルコンピュータ(PC)やインターネットが辿った普及速度を大きく上回る数字である。
検索エンジン最適化(SEO)に携わる実務者にとって、この急速な変化は無視できない。ユーザーの検索行動が根本から塗り替えられつつある現状において、データの背後にある真実を理解することが、これからの戦略を左右するだろう。
生成AIの普及速度はPC・インターネットを凌駕
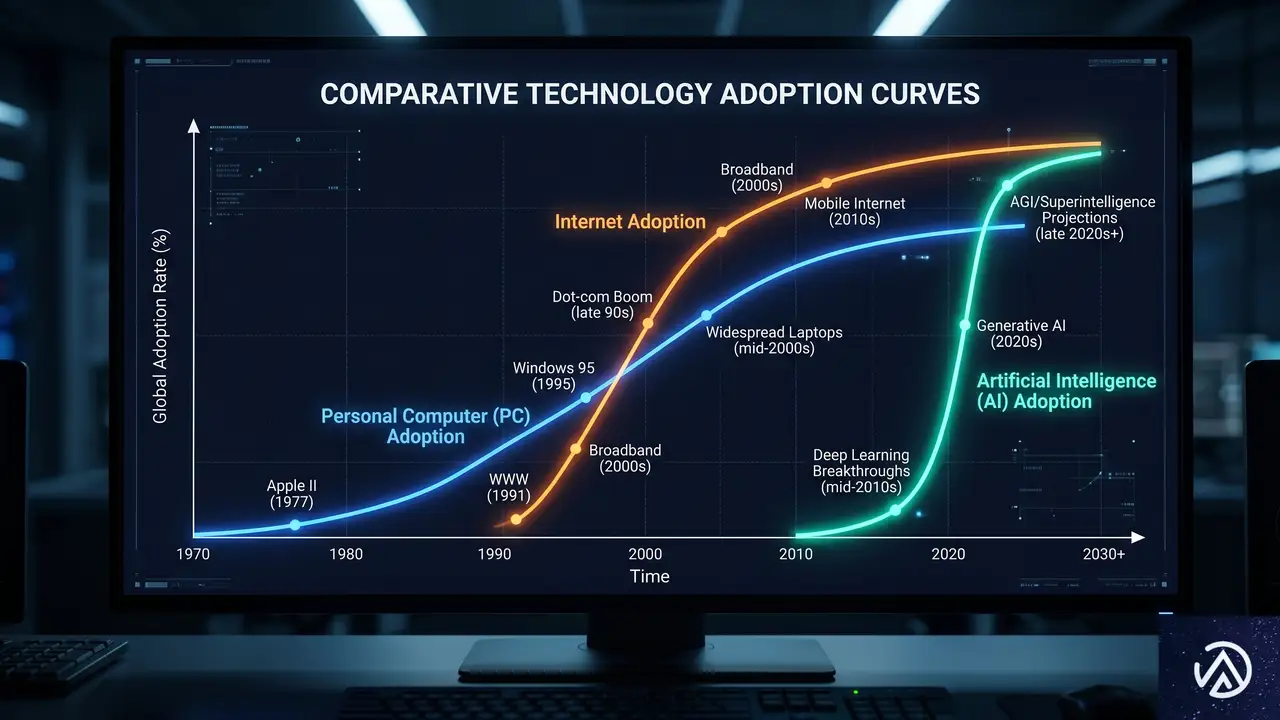
生成AIの普及は、過去のどの技術革新よりも速い。レポートによれば、主要なテクノロジーが一般に浸透するまでの期間を比較した際、生成AIの立ち上がりは際立っている。1981年のIBM PC登場や1995年のインターネット商用化と比較しても、普及曲線は急峻だ。
なぜこれほどまでに速いのか
この爆発的な普及には、先行したインフラの存在が大きく寄与している。ハーバード大学のデビッド・デミング氏は、AIが既存のPCやインターネットの上に構築されたツールであることを理由に挙げている。ユーザーは新しいハードウェアを購入する必要がなく、すでに手元にあるスマートフォンやPCから即座にアクセスできたためだ。
水道や電気が通っている家に、新しい蛇口を取り付けるような手軽さが、53%という驚異的な数字を支えている。インフラ整備の時間を飛び越えて、アプリケーションとしての利便性だけが先行して広がった結果といえる。
「普及」の定義と実態の差
ただし、この53%という数字を鵜呑みにするのは注意が必要だ。レポートでは、一度でもChatGPTなどのツールを試したユーザーも「採用者」としてカウントされている可能性がある。毎日8時間フル活用している専門家と、一度だけ挨拶を入力してみただけのユーザーが同列に扱われている側面がある。
また、国によっても普及率には大きな開きがある。スタンフォードのデータでは米国の普及率を28%としているが、セントルイス連邦準備銀行の調査では54%と、倍近い開きが出ている。これは調査の質問順序や定義の微妙な違いによるものだ。SEO担当者は、数字の大きさに圧倒されるのではなく、ユーザーが「どれほど深く、どのような文脈で」AIを使っているのかを注視すべきである。
能力の「ギザギザのフロンティア」と検索の不安定さ
AIの能力向上は目覚ましいが、その進化は均一ではない。レポートでは「ギザギザのフロンティア(Jagged Frontier)」という概念を用いて、AIの得意不得意が極端に分かれている現状を説明している。
高度な知性と単純なミスが同居する現状
最新のAIモデルは、博士レベルの科学問題や数学の難問で人間を凌駕するスコアを叩き出す。しかしその一方で、アナログ時計の針を正しく読み取るという単純なタスクにおいて、正解率が10%を切るようなケースも報告されている。複雑な推論は得意だが、直感的な視覚理解や多段階の計画立案には依然として課題が残っているのだ。
この「能力のムラ」は、検索体験にも直結している。特定の専門的な質問には驚くほど正確な回答を返す一方で、日常的な事実関係の確認で突拍子もない間違い(ハルシネーション)を犯す。AI Index運営委員会のレイ・ペロー氏は、ベンチマークテストの結果が必ずしも実世界の業務での信頼性を保証するものではないと警鐘を鳴らしている。
AI検索結果の不確実性をどう捉えるか
SEOの現場では、Googleの「AI Overviews(AIによる概要)」や「AI Mode」の挙動がクエリによって大きく変動することが確認されている。Ahrefsの調査によれば、同じクエリであってもAI OverviewsとAI Modeが参照するURLの重複率はわずか13%に過ぎない。システムごとに異なる情報源を選択しており、その基準は依然として不透明だ。
Googleのロビー・スタイン氏は、ユーザーが反応を示さない場合、AIによる回答を意図的に抑制していることを認めている。つまり、AI検索の表示は固定されたものではなく、ユーザーのエンゲージメントに応じて動的に変化する不安定なものだ。私たちは、特定のキーワードで「AIに選ばれる」ことの難しさと、その持続性の低さを認識しなければならない。
※既存の情報を要約しただけで、具体的な戦略や独自性がない。
※実体験と具体的な数字に基づき、AIには真似できない価値を提供している。
このデモは、AIによる一般的な要約と、人間が提供すべき独自情報の違いを視覚化したものだ。
低下する透明性とブラックボックス化するSEO
SEO業界にとって最も懸念すべきデータの一つが、AIモデルの「透明性の低下」だ。レポートによれば、主要なAIモデルの透明性指数は、1年間で58から40へと急落した。モデルが高度になればなるほど、その中身が隠される傾向にある。
公開されないトレーニングデータ
Google、Anthropic、OpenAIといった主要プレイヤーは、最新モデルのトレーニングデータセットのサイズや、トレーニングに要した期間の開示を停止している。2025年にリリースされた著名なAIモデル95個のうち、トレーニングコードを公開したのはわずか15個にとどまる。
これは、検索エンジンのアルゴリズムがかつてないほど「ブラックボックス化」していることを意味する。どのようなコンテンツが評価され、なぜそのURLが引用されたのかという根拠を、プラットフォーム側が説明しなくなっているのだ。最適化のヒントが減り、推測に頼らざるを得ない領域が増えている。
「説明できない」アルゴリズムへの対策
透明性が失われる中で、SEO担当者が取るべき道は「アルゴリズムのハック」から「ユーザー価値の構築」へのシフトだ。レポート内では、AIに対する一般市民の信頼が低下していることも示されている。特に米国の公的機関によるAI規制能力への信頼度は31%と低い。
プラットフォームが詳細を明かさない以上、私たちは「AIが何を好むか」ではなく、「ユーザーが何を信頼するか」に立ち返る必要がある。AIによる回答が不透明で説明責任を果たせないからこそ、発信者の顔が見え、根拠が明示されたコンテンツの価値が相対的に高まっていく。透明性の欠如を、自サイトの透明性向上で補う戦略が求められる。
労働市場の変化と「独自の価値」の再定義
AIの普及は、コンテンツ制作の現場にも直接的な影響を及ぼしている。レポートが指摘する労働市場の変化は、Web制作やSEOに携わるチームの構成にも示唆を与えている。
若手エンジニアの雇用減少が示唆するもの
22歳から25歳のソフトウェアデベロッパーの雇用が、2024年以降で約20%減少したというデータがある。一方で、経験豊富なシニア層の雇用数は維持、あるいは増加傾向にある。これは、AIが「ジュニアレベルの定型業務」を代替し始めている可能性を示唆している。
SEOやライティングの分野でも同様のことがいえる。既存の情報を整理し、無難な構成で記事を書くといったエントリーレベルの仕事は、AIによって急速に置き換えられている。20%の雇用減少という数字は、単なる不況の影響だけでなく、業務プロセスの構造的な変化を反映していると見るべきだ。
AIに代替されない「ゴールデン・ナレッジ」
こうした状況下で提唱されているのが、シェリー・ウォルシュ氏らが言及する「ゴールデン・ナレッジ(黄金の知識)」という概念だ。これは、AIのトレーニングデータには含まれていない、独自の調査データや実体験、深い洞察に基づくコンテンツを指す。
スタンフォードのレポートが示す「AIの普及」と「能力のムラ」は、この戦略の正しさを裏付けている。AIは広く普及したが、その回答は依然として不安定で、深みに欠ける。AIがどれほど速く情報を要約しても、その元となる「新しい事実」を作り出すことはできない。一次情報の発信者としての地位を確立することが、AI時代を生き抜くための構造的なアドバンテージとなる。
2026年以降のSEO戦略(独自の分析)
スタンフォードのレポートから読み解ける未来は、AIと共存しつつ、その「隙間」を埋める戦略の重要性だ。AI Overviewsが月間15億人のユーザーにリーチし、AI Modeが日常化する中で、従来の「検索順位」という指標だけでは不十分になっている。
まず、モニタリングの単位を細分化する必要がある。AIの能力が「ギザギザ」である以上、カテゴリー単位の分析では実態を見誤る。特定のクエリでは正確な回答が出るが、少し表現を変えるだけでハルシネーションが起きる。この不安定さを逆手に取り、AIが正しく答えられない「複雑で多面的な問い」に対して、人間が最高の回答を用意しておくべきだ。
次に、検索コンソールなどのツールに頼りすぎない姿勢も重要だ。現在のツールでは、AI Overviews経由のトラフィックと通常の検索トラフィックを明確に分離して把握することが難しい。不透明なプラットフォームに依存するリスクを分散するためにも、SNSやメールマガジンといった、ユーザーと直接つながる「脱検索エンジン」のチャネル強化を並行して進めるべきだろう。
最後に、AIの普及速度を脅威ではなく「機会」として捉え直したい。53%の人がAIを使うということは、それだけ多くの人が「迅速な回答」を求めている証拠だ。しかし、迅速さと正確さは必ずしも両立しない。人々がAIの回答に物足りなさを感じたとき、真っ先に参照される「信頼の拠点」になれるかどうかが、2026年以降の勝負を分けることになる。
この記事のポイント
- 生成AIはChatGPT登場から3年で53%の普及率に達し、PCやネットを凌駕する速度で浸透している。
- AIの能力は「ギザギザのフロンティア」と呼ばれ、高度な推論と初歩的なミスの同居が検索結果の不安定さを招いている。
- AIモデルの透明性は低下しており、トレーニングデータやアルゴリズムのブラックボックス化が加速している。
- 労働市場では若手の定型業務がAIに代替され始めており、SEOでも「独自の一次情報」の価値が相対的に高まっている。
- 今後のSEOは、AIが苦手とする領域を特定し、ユーザーとの直接的な信頼関係を構築する戦略への転換が不可欠だ。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChromeのAI Modeが進化!サイドバイサイド表示と「タブ・PDF」のコンテキスト追加でブラウジングはどう変わるか
Googleはデスクトップ版Chromeにおける「AI Mode」の機能を大幅に拡張した。今回のアップデートにより、AIが提示したリンクを現在の画面を維持したまま横に並べて表示できる「サイドバイサイド」機能が導入された。
さらに、検索の際に開いているタブやPDF、画像を「コンテキスト(文脈)」として追加できる新しいメニューも実装されている。Googleの検索部門バイスプレジデントであるRobby Stein氏らによれば、これらの機能は米国で先行公開され、順次世界各国へ展開される予定だ。
この変更は単なるUIの調整にとどまらず、ユーザーのブラウジング習慣や情報の消費方法を根本から変える可能性がある。特にリサーチ業務やWeb制作に携わるプロフェッショナルにとって、情報収集の効率を劇的に高める武器となるはずだ。
AI Modeの進化と「サイドバイサイド」表示の導入
Google ChromeのAI Modeは、これまでアドレスバー(オムニボックス)から直接AIに質問を投げかけることができる機能として展開されてきた。今回のアップデートで最も視覚的な変化をもたらしたのが、リンクの開き方だ。
画面遷移なしで情報を深掘りできる仕組み
これまでのAI検索では、AIが生成した回答内のリンクをクリックすると、ページ全体がそのリンク先に遷移してしまっていた。しかし、新機能ではAI Modeのパネルを閉じることなく、その右側にウェブページが並んで表示されるようになる。
この「サイドバイサイド(横並び)」表示のメリットは、元のAIの回答を参照しながら、遷移先の詳細情報を読み進められる点にある。例えば、AIに専門的な用語の解説を求め、その参考文献をクリックした場合、解説文と論文を同時に見比べることが可能だ。
ユーザーはページを移動した後に「戻る」ボタンを押す手間から解放される。さらに、開いたページの内容について、そのままAIに追加の質問を投げかけることもできる。情報の断片を繋ぎ合わせる作業が、一つの画面内で完結するのだ。
リサーチ効率を最大化するUIの工夫
このUIの変更は、ブラウザを「単なる閲覧ツール」から「思考をサポートするワークスペース」へと進化させる狙いが見て取れる。サイドパネルという限られた空間を有効活用することで、ユーザーの集中力を削ぐことなく、複数の情報源を同時に扱うことができる。
以下のデモは、従来の「画面遷移型」と新しい「サイドバイサイド型」の視覚的な違いを概念化したものだ。画面を切り替えるストレスがいかに軽減されるかをイメージしてほしい。
パネル
ウェブページ
このデモは、AI Modeにおける画面構成の進化を視覚化したイメージだ。左側にAIの思考プロセスや回答を残したまま、右側で実際のサイトを確認できる構造になっている。
「コンテキスト検索」の強化!タブやPDFを検索の材料に
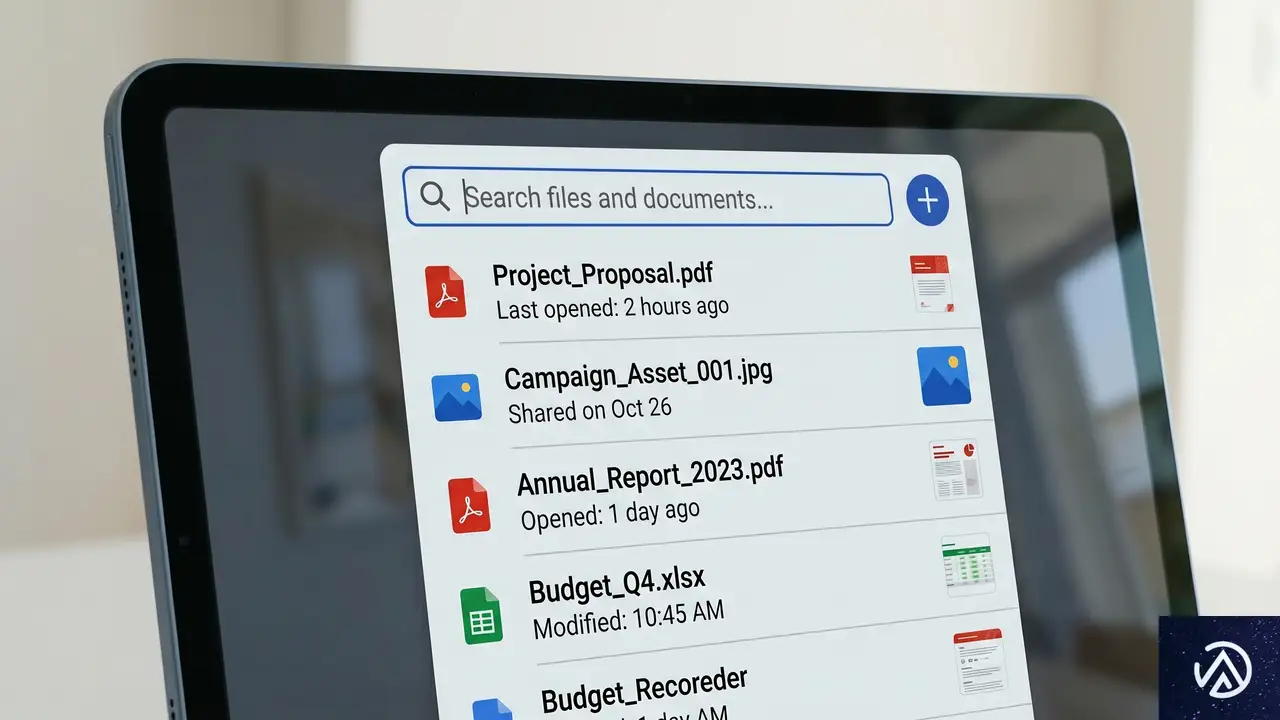
もう一つの重要なアップデートは、検索の「材料」をユーザーが自由に指定できるようになった点だ。Chromeの新しいタブページやAI Mode内の検索ボックスに「プラス(+)メニュー」が追加された。
プラスメニューからシームレスに素材を追加
このプラスメニューをクリックすると、最近開いたタブの一覧が表示される。そこから特定のタブを選択することで、そのページの内容を検索の文脈(コンテキスト)としてAIに与えることができるのだ。また、画像やPDFファイルを直接アップロードして、その内容に基づいた質問をすることも可能になった。
例えば、複数のニュースサイトを開いている状態で「これらの記事を総合して、今回の市場動向を要約して」と指示を出すことができる。これまでは各ページのテキストをコピー&ペーストしてAIに渡す必要があったが、その手間が完全に解消される。
PDFのサポートも強力だ。マニュアルや技術仕様書など、長大なドキュメントをAIに読み込ませ、「このPDFの3章にある設定手順を箇条書きにして」といった具体的な指示が可能になる。これにより、ブラウザは単なる「窓」から、高度な「データ解析ツール」へと変貌を遂げたと言えるだろう。
画像生成やCanvas機能へのアクセス性向上
これまでAI Modeの内部機能として提供されていた「Canvas(キャンバス)」や画像生成機能も、このプラスメニューから直接呼び出せるようになった。Chrome上のあらゆる場所から、必要な時にすぐクリエイティブな作業を開始できる。
これは、GoogleがAI機能をブラウザの「一部」としてではなく、ブラウジング体験の「核」として位置づけている証拠だ。ユーザーは目的の機能を探して設定画面や特定のサイトへ移動する必要がなくなり、直感的な操作でAIの恩恵を受けられるようになる。
ブラウザとAIが融合する「ネイティブ化」の狙い
Googleが進めている一連のアップデートには、明確な意図がある。それは、AIを独立した「検索先」ではなく、Chromeというブラウザの中に完全に溶け込ませる「ネイティブ化」だ。
単なる検索窓から「作業のハブ」への転換
従来、ユーザーがAIを利用する際は、ChatGPTやGeminiのサイトへ移動し、そこで質問を入力するのが一般的だった。しかし、ChromeのAI Modeは、ユーザーが現在見ているページや開いているファイルと連動する。つまり、ブラウザそのものがユーザーの作業状況を理解する「秘書」のような役割を果たすようになるのだ。
「ページを理解したプロンプト(指示文)」を送れるようになった前回のアップデートに続き、今回のサイドバイサイド表示やコンテキスト追加は、その流れをさらに加速させる。ユーザーはブラウザから一歩も出ることなく、情報の収集、分析、そしてアウトプットまでを完結できるようになる。
Googleが目指す「文脈を理解するAI」の姿
Googleが重視しているのは「Context(文脈)」だ。単一の検索クエリ(検索語句)に答えるだけでなく、ユーザーが今何をしようとしているのか、どのような資料を参考にしているのかという背景をAIが共有することを目指している。
ブラウザのタブやPDFを検索の材料に含める機能は、まさにこの「文脈の共有」を具現化したものだ。AIがユーザーの置かれた状況を正確に把握できれば、回答の精度は飛躍的に向上する。これは他社のブラウザやAIサービスに対する、Googleの強力な差別化要因となるだろう。
Web制作・SEO担当者が知っておくべき影響と対策
ブラウザの挙動が変わるということは、ユーザーがWebサイトに訪れる経路や、サイト内での行動も変わることを意味する。Web制作やSEOに携わる者にとって、この変化は無視できない。
ユーザーの滞在時間とクリック行動の変化
サイドバイサイド表示の導入により、ユーザーは「AIの回答」と「自社サイト」を同時に見るようになる。これは、サイトへの流入が減ることを意味するのではなく、むしろ「より質の高いクリック」が増える可能性がある。
ユーザーはAIの要約で興味を持ち、さらに詳しい情報を求めてサイドパネルでサイトを開く。この時、サイト側は「AIの要約を補完する詳細なデータ」や「信頼性の高い根拠」を提示できているかが重要になる。パッと見てAIの回答と同じことしか書いていないサイトは、すぐに閉じられてしまうだろう。
参照元としての価値とAI Modeへの最適化
AIが複数のタブやPDFをコンテキストとして利用するようになると、自社のコンテンツが「AIの判断材料」として選ばれるかどうかが重要になる。構造化データの適切な設定や、セマンティック(意味的)に正しいHTML構造は、今後ますますその価値を高めるはずだ。
また、PDFが検索のコンテキストに含まれるようになった点も注目すべきだ。ホワイトペーパーや製品カタログなどのPDFファイルも、AIが読み取りやすいようにテキストベースで作成し、メタデータを最適化しておく必要がある。以下の表は、今後のコンテンツ制作で意識すべきポイントをまとめたものだ。
AIが要約できない一次情報や、独自の調査結果を強調する。
画像化されたテキストを避け、AIが解析可能なテキスト形式でPDFを作成する。
Schema.orgなどを用い、情報の意味をAIに正しく伝える。
これらの対策は、従来のSEOの延長線上にあるが、ターゲットが「検索エンジン」から「ブラウザ一体型のAI」へと広がっていることを意識しなければならない。
独自の分析!このアップデートがもたらす未来のブラウジング
今回のアップデートを深く分析すると、Googleが描く「ポスト検索」の姿が見えてくる。これまでの検索は「キーワードを入力し、リストから選ぶ」という能動的な行動が必要だった。しかし、これからのブラウジングは「現在進行形の作業をAIがサポートし続ける」という受動的かつ随伴的なものに変わる。
サイドバイサイド表示は、ユーザーが情報の海で迷子になるのを防ぐ命綱のような役割を果たす。AIというガイドと一緒に、複数のサイトを並行して読み解くスタイルが定着すれば、ブラウザの利用時間はさらに伸びるだろう。これは、単に「検索が便利になる」というレベルの話ではなく、人間の認知プロセスをデジタルが拡張している状態と言える。
また、タブやファイルをコンテキストとして取り込む機能は、情報の「サイロ化(孤立化)」を防ぐ効果がある。別々のタブに分断されていた知識が、AIという触媒を通じて一つの文脈に統合される。このインパクトは、情報の整理に悩む現代のナレッジワーカーにとって計り知れない。
一方で、この利便性はGoogleエコシステムへのさらなる依存を招く可能性もある。Chromeの中で全てが完結するようになれば、ユーザーが他のツールや検索エンジンへ移動する動機は薄れる。Web制作者としては、この強力なプラットフォームの変化をいち早く捉え、AIに選ばれる良質なコンテンツを供給し続ける姿勢が求められる。
この記事のポイント
- ChromeのAI Modeに「サイドバイサイド」表示が導入され、回答とリンク先を同時に閲覧可能になった。
- プラスメニューから開いているタブ、画像、PDFを検索の「文脈(コンテキスト)」として追加できる。
- GoogleはAI機能をブラウザへネイティブに統合し、ユーザーの作業を中断させないUIを目指している。
- Web制作者は、AIが参照しやすい構造化データやPDFの最適化、独自性の高いコンテンツ提供が重要になる。
- このアップデートは、ブラウザを単なる閲覧ツールから、高度な思考・解析ワークスペースへと進化させる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験