

Nuxt 4.6リリース、Server API刷新と高速化した型推論の全容
Nuxt 4.6が2026年10月5日にリリースされた。Nuxt CLI v4が同梱され、開発サーバーの起動と再起動が大幅に速くなっている。今回の目玉はサーバーコードを移行しやすくする新しいimportソースだ。
サーバー非依存化への大きな一歩となる。型付き$fetchも再構築され、大規模プロジェクトで問題になっていた型推論の遅さが解消された。Nuxt 3は2026年7月末にEOLを迎えており、移行を考える契機になる。
Nuxt CLI v4の変更点
Nuxt 4.6にはメジャーアップデート版のNuxt CLI v4が含まれる。依存関係として自動的に導入されるため、Nuxt 4.6に更新すれば新しいCLIが使える。変更の中心は開発サーバーだ。
インタラクティブパネルと新コマンド
端末の下部に専用パネルが固定表示される。URL、起動の進行状況、ショートカットキーが並ぶ。キー1つで再起動、ページを開く、ログ確認、リクエスト確認、ページとサーバールートの一覧表示が可能だ。
各リクエストにはIDが付与され、ログとエラーがどのリクエストから発生したか追跡できる。クラシックな出力に戻したい場合は--no-tuiを渡せばよい。
開発サーバーは再読み込みと再起動の理由も教えてくれる。どのnuxt.configキーが変わったのか、起動が遅い場合に時間がどこにかかったのか、各モジュールのセットアップ時間も個別に表示される。内容が変わらない保存では再起動が起きない。
数値で見る高速化
初回表示は6.6倍速くなり、メモリ使用量も30%減った。ロックファイルによって複数の開発サーバー起動が衝突せず、新しいnuxt curlやnuxt taskコマンドも動作する。
Server API nuxt/serverの導入
今回のリリースで最も重要な変更がサーバーコードの抽象化だ。新しいimportソースであるnuxt/serverが追加された。ハンドラー、ミドルウェア、ユーティリティをここから読み込む。ブラウザでも動くnuxt/appのサーバー版にあたる。
サーバー非依存化の目的
これまでサーバーコードはh3とNitroに密結合していた。h3やNitroのメジャーバージョンが上がると、エコシステム全体に影響が波及する構造だった。Nuxt 5でNitro v3とh3 v2へ移行するにあたり、この結合を解消する必要があった。
nuxt/serverは自前の型を定義し、外部パッケージを参照しない。同じハンドラーがNitro v2、Nitro v3、実験的なViteサーバーのどこでも動く。モジュール作者はh3やnitropackへのピア依存を気にせずに済む。
サーバーコードをnuxt/serverで書いておけば、Nuxt 5に更新しても同じファイルがそのまま動く。モジュールも1つのファイルで両バージョンをサポートできる。
コード例とAPIサーフェス
import { defineEventHandler, getQuery } from 'nuxt/server'

export default defineEventHandler((event) => {
  const { name } = getQuery<{ name?: string }>(event)
  return { message: `Hello, ${name ?? 'world'}!` }
})
イベントオブジェクトはWeb標準に基づく。リクエストURL、レスポンスヘッダー、クッキー、リダイレクト、セッションなどが扱える。必要ならZodなどのバリデーションライブラリと組み合わせて、リクエスト本文を検証してから処理を進められる。
従来のh3やnitropackから読み込む方法も削除されていない。特定のハンドラーで低レベルな機能が必要な場合は、これまで通りdefineEventHandlerをh3から読み込めば動く。
Typed $fetchの再構築
$fetchとuseFetchはサーバールートから型を推論できた。しかし数百ルートを超えるとTypeScriptのインスタンス化上限に達し、コンパイルが止まることがあった。
型推論の高速化
型システムをfetchdtsベースで再実装した。静的なパスは完全一致テーブルとしてコンパイルされ、ルート数ではなく参照箇所の数で処理コストが決まる。
3000ルートの処理が53.63秒から0.62秒に短縮された。ピークメモリも946 MBから140 MBへ大幅に減っている。大規模プロジェクトほど効果を実感できる。
新しい型チェック機能
ルートごとに検証済みのbody、query、headersが型情報に含まれる。間違った形のリクエストを送ると、呼び出し側でエラーが出るようになった。存在しないパスへの$fetchを拒否するexperimental.strictRouteTypesも追加されている。
Nuxt 4ではオプトイン機能だ。Dateの戻り値が呼び出し側ではstringになるなどの小さな推論の違いがあるため、デフォルトにはしていない。Nuxt 5では標準で有効になる。
開発体験の改善
開発時のエラー表示と起動画面が刷新された。開発者にとって地味に見える変更だが、原因特定までの時間を短縮する効果は大きい。
my-badによる新しいエラー表示
サーバーサイドエラーのスタックトレースにソース位置とコードフレームが表示されるようになった。Youchの埋め込みiframeは廃止され、my-badという新しいオーバーレイに置き換えられた。
エラーレポートにはコピーボタンがある。Markdown形式、エージェントに手渡せるプロンプト形式、JSON形式を選べる。AIコーディングエージェントが普及した今、エラー情報をそのまま渡せる設計は実務的だ。
致命的な起動エラーもページとして表示される。nuxt.config.tsに構文エラーがあっても専用ページが表示され、修正後に自動で再読み込みされる。ワーカー再起動をまたいでエラー情報が保持される仕組みだ。
Vue Vapor対応とローディング画面
Vue 3.6のVapor Modeに相互運用モードで対応した。アプリ本体は仮想DOMのまま、コンポーネント単位でVaporを選択できる。<script setup vapor>と書くだけだ。ルーティングやuseAsyncData、レイアウトは変更なしで動く。
開発サーバー起動中のローディング画面も新しくなった。WebGL2のパーティクルフィールドが山脈を描く。WebGL2非対応環境では静止画にフォールバックし、prefers-reduced-motion設定時はアニメーションを止める。モーションに配慮した実装になっている。
パフォーマンスと移行
実測値と改善ポイント
ベンチマークではNuxt 4.5.2と比較して、スタータープロジェクトのビルドが4.4秒から3.6秒に短縮された。200ページ・200コンポーネント・50ルートのビルドも11.6秒から10.3秒に改善している。
SSRスループットは300個の<NuxtLink>を含むページで1秒あたり110リクエストから140リクエストに向上した。内部リンクがサーバー上でプレーンな<a>タグとしてレンダリングされるようになり、リアクティブ状態を持たなくなった効果だ。
experimental.early404を有効にすると、ルートに一致しないリクエストがVueアプリの生成をスキップする。30ページでブート処理が約23 msのアプリでは、JSON 404応答が37.1 msから0.3 msに短縮される。
Nuxt 5への準備
Nuxt 5のデフォルト機能の多くがすでに4.6に入っている。future.compatibilityVersion: 5を設定すれば、一括で有効にできる。個別にトグルすることも可能だ。
- 型付きページ(
experimental.typedPages) - 型付き
$fetch(experimental.routeTypedFetch) - 大文字小文字を区別するルーティング
- ビルド時のページメタデータ抽出
- インラインエラーレンダリング
サーバーコードをnuxt/serverで書いておけば、Nuxt 5移行時に書き換えが不要になる。今のうちに移行しておくのが安全だ。
アップグレードはnpx nuxt upgrade --dedupeを実行する。ロックファイルを更新し、Nuxt CLI v4を含む最新の依存関係が導入される。Node.jsは22.22.3以上、24.15.0以上、または26.0.0以上が必要だ。
この記事のポイント
- Nuxt 4.6はサーバー非依存化への大きな一歩。新しいimportソース
nuxt/serverが追加された - Nuxt CLI v4が同梱され、開発サーバーの初回表示が330 msから50 msへ高速化
- 型付き$fetchが再構築され、3000ルートの型推論が53.63秒から0.62秒に短縮
- Nuxt 3は2026年7月末にEOL。移行を進めるなら
future.compatibilityVersion: 5で事前テストが可能 - アップグレードは
npx nuxt upgrade --dedupeで実行できる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
SupabaseがTursoを買収。エージェント向けDB基盤の進化へ
Supabaseが10月2日、SQLiteクラウドプラットフォームを手がけるTursoの買収を発表した。AIエージェントが大量のデータベースを作成する新時代に向け、PostgresとSQLiteの両軸で基盤を強化する動きだ。
既存ユーザーへの影響はない。SupabaseはPostgresを中心に、TursoはSQLiteを中心にそれぞれの開発を継続する。両社の技術と知見を組み合わせ、エージェントがDBを簡単に扱える新たな体験の実現を目指す。
この記事では買収の概要、AIエージェントが変えるデータベース需要、Tursoの技術アーキテクチャ、オープンソース戦略を整理する。
買収の背景、PostgresとSQLiteの両軸へ
Supabaseの発表によると、同社はすでに毎週100万以上のデータベースを立ち上げている。AIエージェントがプロトタイプやダッシュボード、アプリケーションを大量に作る流れが進む中で、DB需要は現在の供給能力を超える可能性がある。こうした状況に対応するため、Tursoの買収に至った。
重要なのは、この買収が「どちらかの技術に一本化する」話ではない点だ。Supabaseは引き続きPostgresを中心に開発し、TursoはSQLiteの改良を続ける。その上で、両社を横断する新しい基盤を共同で構築する。Supabaseの開発者体験をすべてのエージェントに届けることが目標だ。
SQLiteとは、サーバーを必要としないファイルベースの軽量データベースだ。アプリケーションに組み込んで手軽に使える特徴がある。一方のPostgresは、本格的なリレーショナルデータベースとして大規模なアプリケーションで使われる。小さなワークロードから本番環境まで、段階に応じた選択肢を提供できる体制になる。
AIエージェントが変えるデータベース需要
AIエージェントとは、人間の指示を受けて自律的にタスクを実行するAIのことだ。コードを書いたり、調査をしたり、アプリのプロトタイプを作ったりする。Supabaseの発表によれば、エージェントはすでに数百万ものデータベースを生み出しているという。
この流れが進むと、データベースに求められる性質が変わる。エージェントはファイルを作るのと同じ感覚でDBを作成できるべきだ。コストをほとんど気にする必要がなく、小規模な用途であれば専用マシンを毎回プロビジョニングする手間も避けたい。必要な時にすぐ使えて、不要になったら自動で止まる。そして本番環境へ移行する明確な道筋があること。これがエージェント時代のDB基盤に必要な条件だ。
プロビジョニングとは、サーバーやデータベースなどのインフラを自動的に割り当てて利用可能な状態にすることだ。従来は小規模なDBでも専用マシンを毎回準備する必要があった。AIエージェントが大量の小規模DBを必要とする時代には、この方式ではコストと時間が合わない。
このデモは、AIエージェントの台頭によってデータベース作成のアプローチが大きく変わることを示している。
SQLiteはこのような小規模でオンデマンドなワークロードに適している。一方、アプリケーションが成長して本格的な運用に入る段階ではPostgresが力を発揮する。両方を同じ開発者体験でつなぐことが、今回の買収の狙いだ。
Tursoの技術アーキテクチャ、Rustで再構築したSQLite
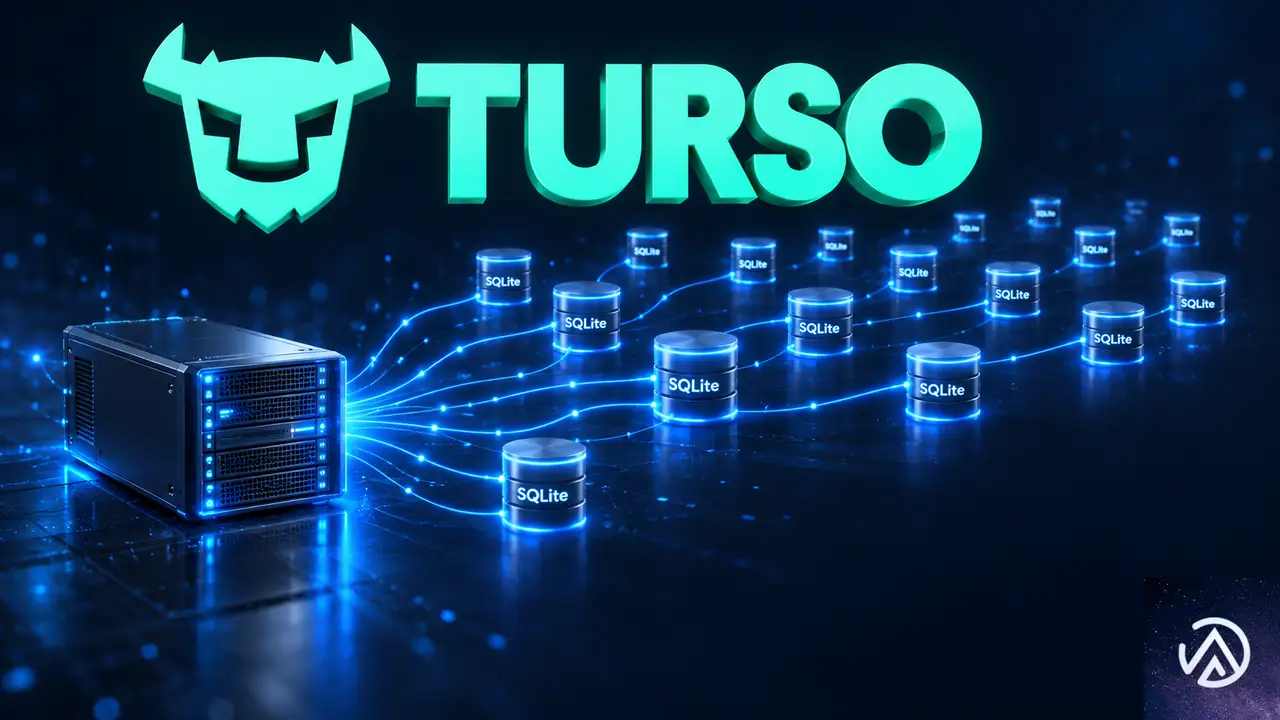
Tursoはこのパターンに最適化されたアーキテクチャを構築してきた。SQLiteをRustで再構築し、1台のサーバーで数百万のデータベースを管理できるクラウドプラットフォームを作り上げた。必要な時にDBをロードし、使われていない時は自動的にサスペンドする仕組みだ。
Rustとは、メモリ安全性と高速性を両立するプログラミング言語だ。CやC++と同等の性能を持ちながら、メモリ関連のバグを防ぐ仕組みが言語レベルで組み込まれている。サスペンドとは、実行中のプロセスを一時停止してメモリ領域を保持したままにすることだ。停止と再開を高速に行える。
Tursoのアーキテクチャは、1台のサーバーで多数のSQLiteインスタンスを効率的に管理する。この仕組みにより、エージェントごとにDBを即時提供できる。
このアーキテクチャは、Turso Cloud上でも、ユーザー自身のクラウド環境でも動作する。実際にSuperhuman、Sauna.ai、CTO.new、Mastraといった企業がこの仕組みを利用している。Supabaseの発表では、ワークロードの成長に応じてTursoのエコシステムからSupabaseへ移行する明確な道筋も示された。
オープンソースへの姿勢と今後の展望
TursoとSupabaseには共通点が多い。オープンソースへの強いコミットメント、開発者体験へのこだわり、難しいインフラ課題に挑む姿勢だ。今回の買収は、技術的な相性だけでなく、こうした価値観の一致も大きな理由となっている。
Tursoのグローバー・コスタ氏とペッカ・エンバーグ氏は、チームとともにSupabaseに加わる。コスタ氏はエージェント向けインフラの開発を主導する役割を担う。Supabaseのミッションは「世界のデータを保存する」ことだ。AIエージェントがさらに多くのデータを生み出す時代において、この買収はその目標へ大きく近づく一歩となる。
短期的には、既存ユーザーに目立った変化はない。しかし中期的には、プロトタイプ段階から本番運用まで一貫した開発者体験を提供する基盤が形づくられていく。SQLiteで手軽に始め、必要に応じてPostgresへスケールする流れが、よりシームレスになるだろう。
この記事のポイント
- SupabaseがSQLiteクラウドのTursoを買収、既存ユーザーへの影響はない
- Supabaseは毎週100万以上のDBを立ち上げており、AIエージェントの需要に対応する
- TursoはRustでSQLiteを再構築し、1台のサーバーで数百万のDBを管理できる
- SQLiteとPostgresを段階に応じて使い分けられる基盤づくりが始まる
- オープンソース重視の両社の価値観が一致した買収である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
住所入力の自動化を外注するとき、私たちが最初に確認すること
住所入力の自動化を外注するときは、郵便番号で都道府県から町名までを自動にし、残る手入力を番地と建物名だけに絞れるかが最初の分かれ目になる。
この2項目だけの入力で済むようになると、長い住所をスマートフォンで打つ手間が消える。
私たちは、郵便番号から住所が自動で入る仕組みを、あなたのサイトの注文や会員登録のフォームに組み込んでいる。
住所のすべてを手で打たせている状態から、数文字の入力で完了する状態に作り替えるところまでを一つの流れで行う。
住所入力の自動化を外注すると、入力する項目はどこまで減るのか
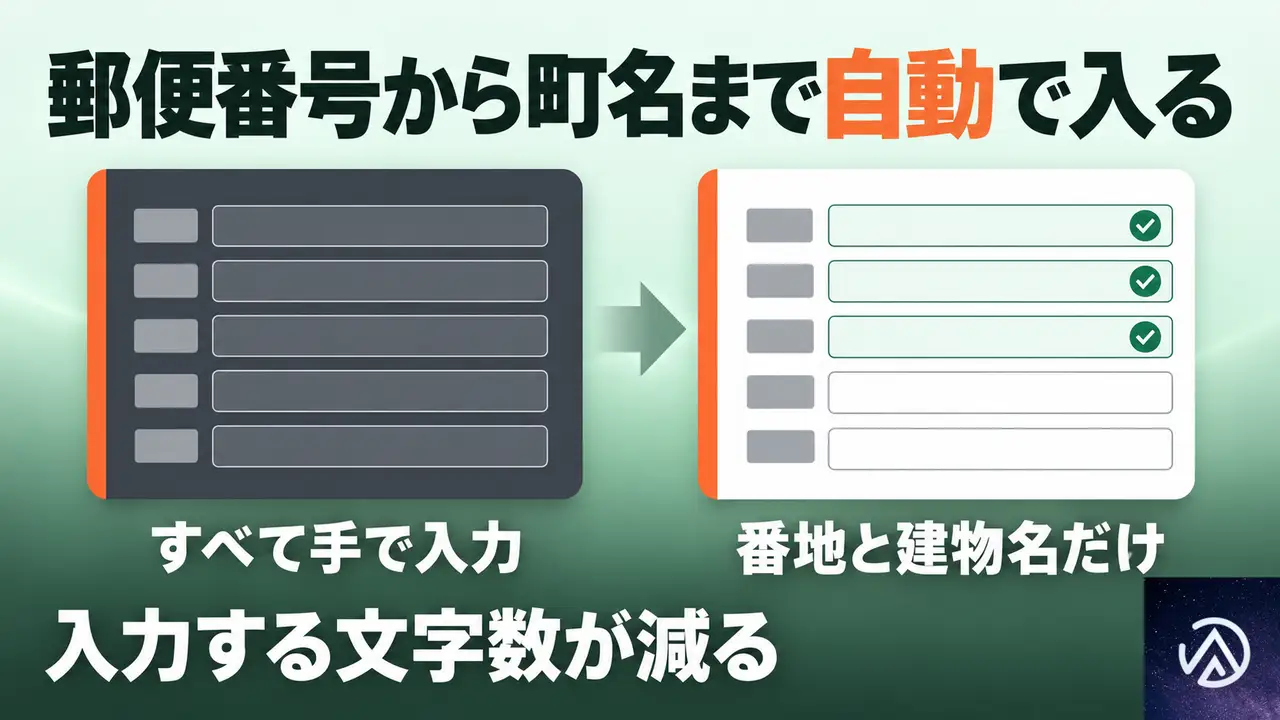
都道府県から建物名までを1つずつ打たせている状態から、番地と建物名の2つだけを打たせる状態に変えられる。
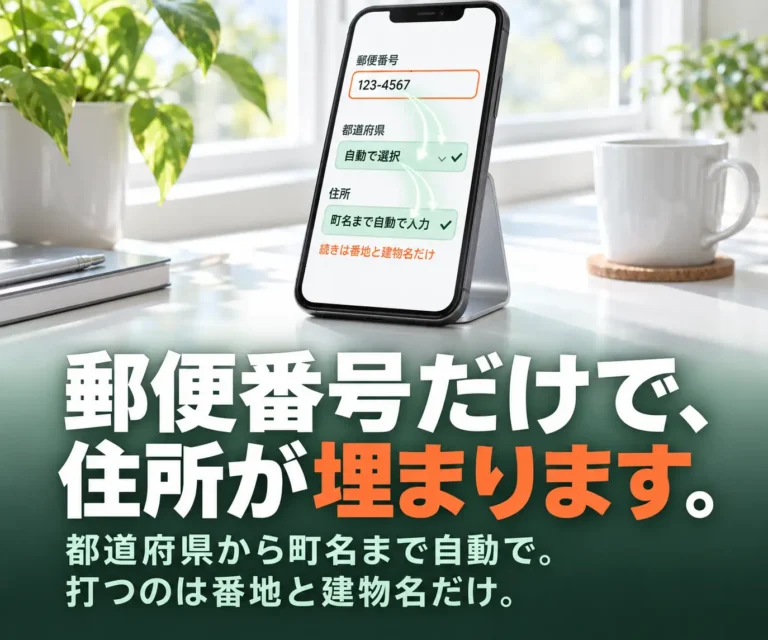
郵便番号を入れた時点で、都道府県から町名までが自動で住所欄に反映される。
郵便番号で埋まるのは都道府県から町名まで
郵便番号を入力した瞬間に、都道府県から町名までの表示が住所欄へ自動で入る。
利用者が打つのは番地と建物名だけだ。
都道府県を選ぶ、市区町村を打つ、町名を打つという3つの作業がなくなる。
残る手入力は番地と建物名の2つ
住所の入力に残るのは番地と建物名の2つである。
入力欄の内訳は以下のとおりだ。
| 入力項目 | 手入力のまま | 私たちの自動入力 |
| 都道府県 | 手で選ぶか打つ | 郵便番号から自動で入る |
| 市区町村 | 手で打つ | 郵便番号から自動で入る |
| 町名 | 手で打つ | 郵便番号から自動で入る |
| 番地 | 手で打つ | 手で打つ |
| 建物名 | 手で打つ | 手で打つ |
全角とハイフンのゆれを7桁にそろえる
全角の数字、ハイフンを付けるかどうか、こうした書き方の違いを吸収し、7桁の形式にそろえる。
入力前に利用者が形式を気にする必要はない。
打った内容が自動で整うため、住所を引く処理が安定する。
いま使っているフォームに、後から組み込めるのか
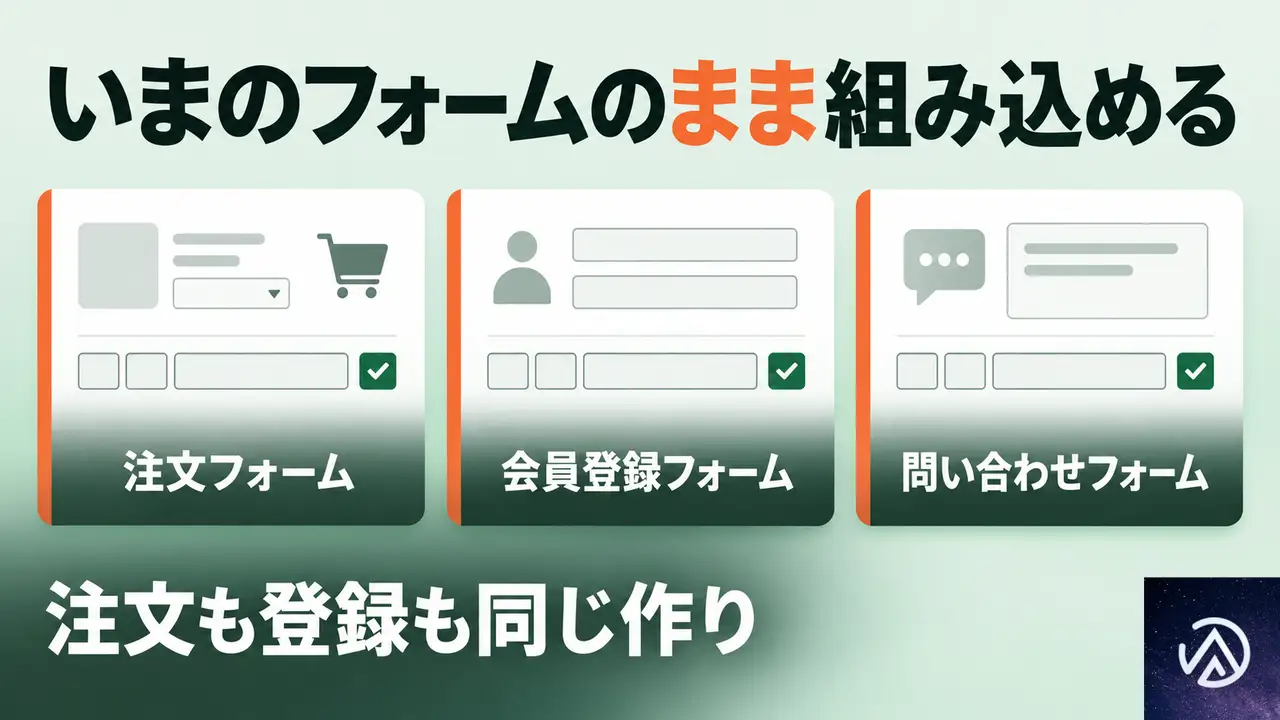
あなたがいま使っているフォームに組み込める。
注文、会員登録、問い合わせのどのフォームにも、同じ作りで入れられる。
現在のフォームの仕組みを大きく変えずに済むのが特徴だ。
注文・会員登録・問い合わせの区別なく同じ作りで入れる
特定のフォームにしか対応しない仕組みではない。
注文フォーム、会員登録フォーム、問い合わせフォームのいずれにも同じ作りで組み込む。
扱うフォームごとに違う住所入力欄を作る必要はない。
既存のフォームを変えずに済む理由
私たちは郵便番号から住所を引く部分を、サイトの中に一覧を持たせて外部に問い合わせない形にもできる。
そのため、いまの注文や問い合わせの作りを変えずに、住所の入力欄だけを自動化できる。
4万件を超える郵便番号データを実際のサイトで動かしている
私たちは、郵便番号から住所を自動で埋める入力欄と、4万件を超える郵便番号のデータを、実際のサイトで動かしている。
設計しただけで終わる開発ではなく、注文や登録の現場で使われている形で組み込める。
郵便番号で住所が出ないとき、利用者はどうなるのか
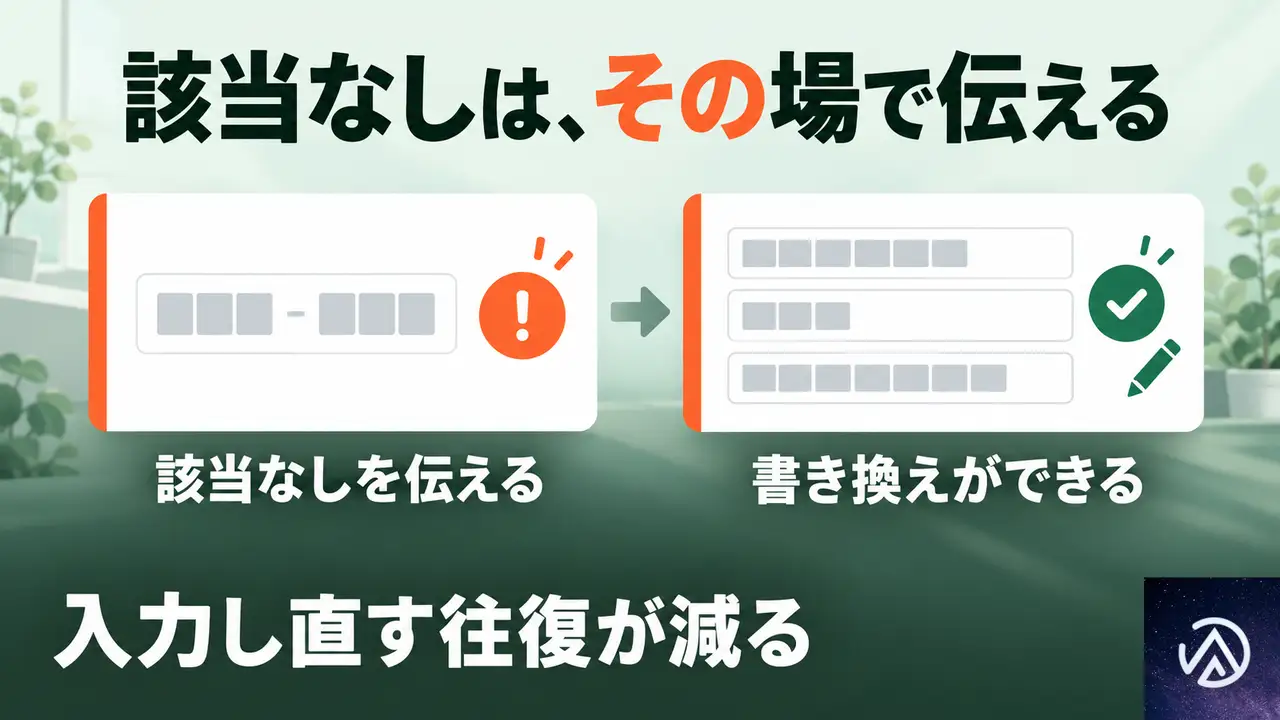
該当する住所が見つからない郵便番号が入力された場合は、その場で本人に伝える。
入力し直す往復が減り、あとから問い合わせで発覚する事態を防ぐ。
該当なしをその場で本人に伝える
住所が見つからない郵便番号のまま先へ進めると、あとで配送先の不備として戻ってくる。
私たちの仕組みでは、該当する住所が無い時点で利用者に分かるようにする。
自動で入った住所は編集できる形にする
自動で入った内容は編集できる状態にしておく。
住所の細かな言い回しが実際の表記と違っていても、本人がその場で書き換えられる。
住所の表記がゆれて配送不備が続いている状態はどう変わるのか
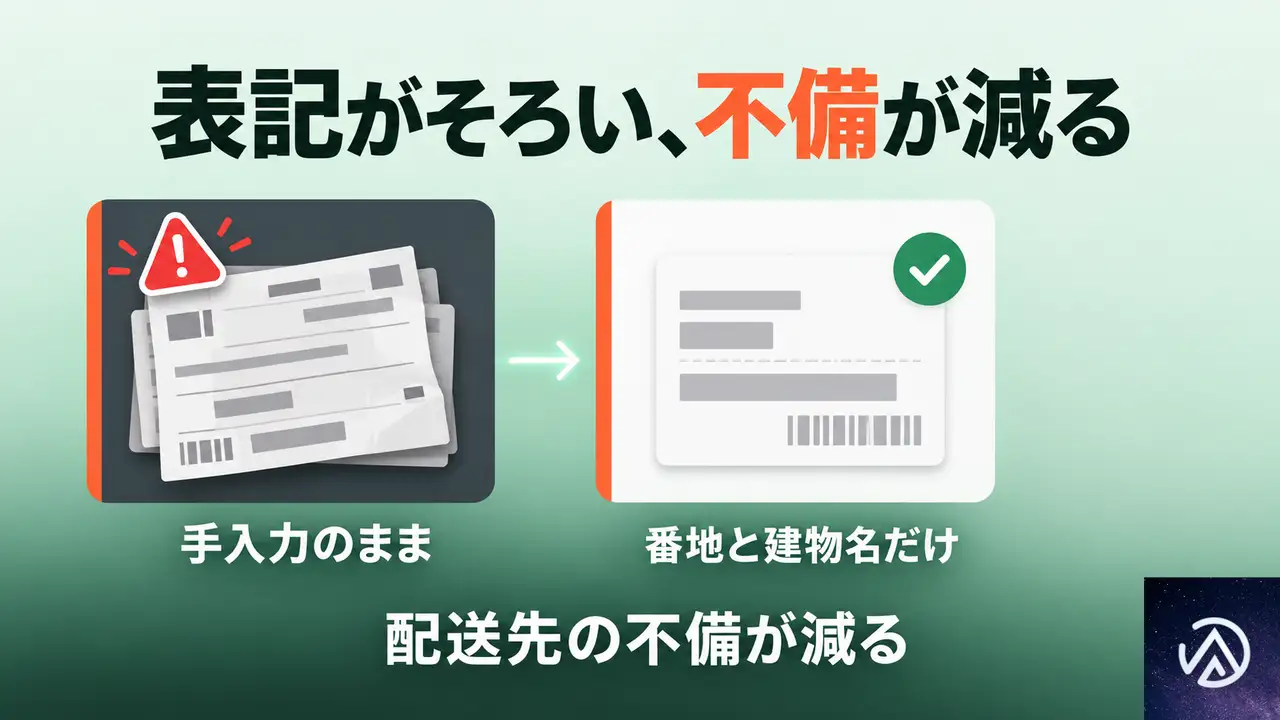
郵便番号から住所が入ることで、同じ郵便番号なら表記がそろう。
配送先の不備や返送の原因になる手書きのゆれが減り、注文や申し込みを最後まで終える人が増える。
注文や申し込みを最後まで終える人が増える理由
カートに入れて名前まで書いても、住所の入力欄で手が止まってしまうケースは多い。
スマートフォンで長い住所を打つ負担が消えると、その先の確認画面へ進む人が増える。
訪問者を増やさずに成約率が上がる仕組み
入力の手間が減ることで、注文や申し込みを最後まで終える人が増える。
訪問者の数を増やさずに成約率が上がるため、同じアクセス数のまま売上を伸ばせる。
増えた利益を次の仕入れにも自分の暮らしにも回せるようになる。
住所入力の自動化を依頼するなら、何を私たちに伝えればよいか
住所の入力で離脱されているなら、いまのフォームの項目を見せてほしい。
減らせる箇所を私たちが提案する。
郵便番号からの住所自動入力を組み込む前提で、どこまで入力を省けるかを具体的に伝える。
すでにある注文フォームや会員登録フォームに組み込みたい場合も、いまの作りを聞かせてもらえれば、そのまま使える形で郵便番号から住所が埋まる入力欄を組み込める。
入力の途中で諦めていた客が最後まで買っていき、訪問者を増やさないまま売上が伸びる状態を、フォームの改善から作りたい。
詳しい内容は郵便番号からの住所自動入力のサービスページで確認できる。
 郵便番号からの住所自動入力郵便番号を入れると都道府県から町名までが自動で入る仕組みをフォームに組み込むサービスの詳細を見る
よくある質問
郵便番号だけで番地まで自動に入らないのか
都道府県から町名までが自動で入り、番地と建物名は手入力になる。
入力する文字数は番地と建物名の分だけに絞られる。
現在のフォームの形が特殊でも対応できるのか
注文、会員登録、問い合わせのどのフォームにも同じ作りで組み込める。
既存のフォームの作りを変えずに済むため、現在の形式を維持したまま自動入力を追加できる。
郵便番号と住所の対応が将来変わったらどうするのか
郵便番号と住所の対応関係が変わっても追従できるよう、更新のやり方を導入の時点で決めておく。
後から対応方法を探す必要はない。
住所が見つからない郵便番号では、利用者はどうすればよいのか
その場で本人に伝え、入力をやり直してもらう往復を減らす。
自動で入った住所は編集できるため、細かな言い回しの違いにも対応できる。
この記事のポイント
- 住所入力の自動化を外注すると、郵便番号で都道府県から町名までが自動で入り、残る手入力は番地と建物名だけになる
- 注文、会員登録、問い合わせのどのフォームにも、同じ作りで組み込める
- 該当する住所が見つからない郵便番号は、その場で本人に伝える
- 自動で入った住所は本人が編集でき、実際の表記との違いに対応できる
- 郵便番号と住所の対応が変わっても追従できるよう、更新のやり方を導入時に決める
郵便番号からの住所自動入力郵便番号を入れると都道府県から町名までが自動で入る仕組みをフォームに組み込むサービスの詳細を見る・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Next.js制作会社の比較で見るべきは、公開後の表示速度と拡張性だ
Next.js制作会社を比較するとき、価格表を最初に見るのは遠回りだ。
公開した後も表示が速く、機能を足し続けられるかを見るほうが、結果として費用を抑えられる。
表示速度と拡張性は後から足すことが難しく、最初の構成でほぼ決まる。
だから制作会社を選ぶ段階で、その設計方針を確かめる必要がある。
私たちはWordPressからの移行を含むNext.jsのサイト構築を請け負っている。
この仕事で実際に採用している基準が、そのまま比較のポイントになる。
Next.js制作会社を比較するとき、最初に何を見ればよいか
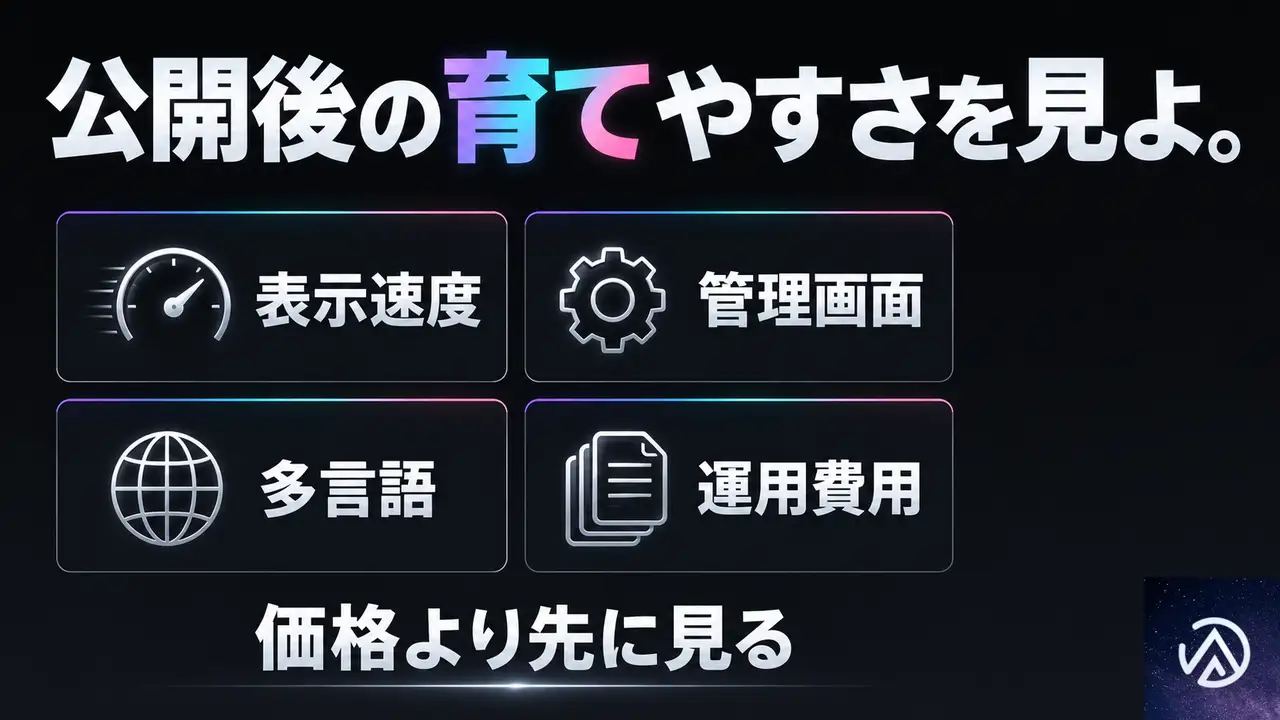
公開後にサイトをどう育てるかの設計方針を見るべきだ。
Next.jsで作るなら、表示速度や多言語対応は後から足すより最初に組み込むほうが安く確実にできる。
後付けできる範囲と、後付けでは難しい範囲を分けて確かめる。
後から足せる範囲と足せない範囲を知る
ReactベースのNext.jsは部品を組み合わせて作る。
新しい機能を追加する余地は、公開後も残る。
一方、ページをあらかじめ生成する仕組み、管理画面と表側の分離、多言語の設計は後付けでは間に合わない。
気づいた時には、一部分の修正ではなく、サイトの骨格から組み直す工事になっている。
公開後の運用費がどこまで続くかを見積もる
運用費はサーバー代、保守、機能追加の工数で構成される。
管理画面に特定の製品を固定した構成では、更新方法を変えたくても製品の制約で動けないことがある。
更新する人の使い心地と毎月の費用から管理画面を選べるかどうかが、公開後の支出を左右する。
表示速度は後から改善できるのか
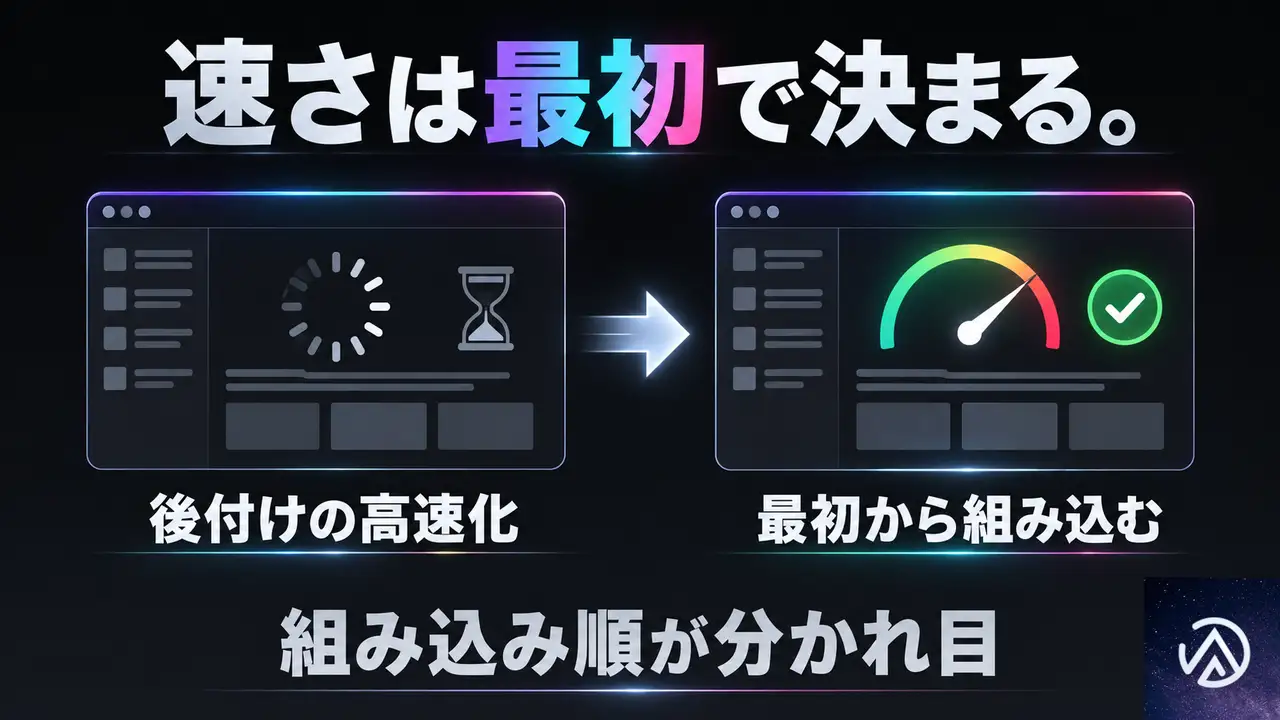
ページの表示が遅い根本原因がデータベースとの兼ね合いなら、後付けの改善では限界がある。
Next.jsで最初に事前生成とCDN配信を組み込めば、開いた瞬間に表示される構成が出来上がる。
私たちはこの構成を標準にしている。
事前生成とCDN配信のしくみ
WordPressは閲覧のたびにデータベースを呼ぶ。
記事や商品が増え、アクセスが重なると、この呼び出しが表示を遅くする。
Next.jsでは記事や商品のページをあらかじめ生成しておき、CDNと呼ばれる世界中の配信拠点から届ける。
閲覧のたびにデータベースを呼ばないため、どこからアクセスしても最初の表示が速い。
後から足す高速化との違い
速くする施策を後付けすると、キャッシュの設定や表示の条件分岐が増える。
構成が複雑になり、更新作業にしわ寄せが来る。
一度は速くなったように見えても、機能を足すたびに表示速度を気にしながら直し続けることになる。
私たちは最初から事前生成とCDN配信を組み込むため、公開後に表示速度のための追加工事がいらない。
管理画面の構成で何が変わるのか
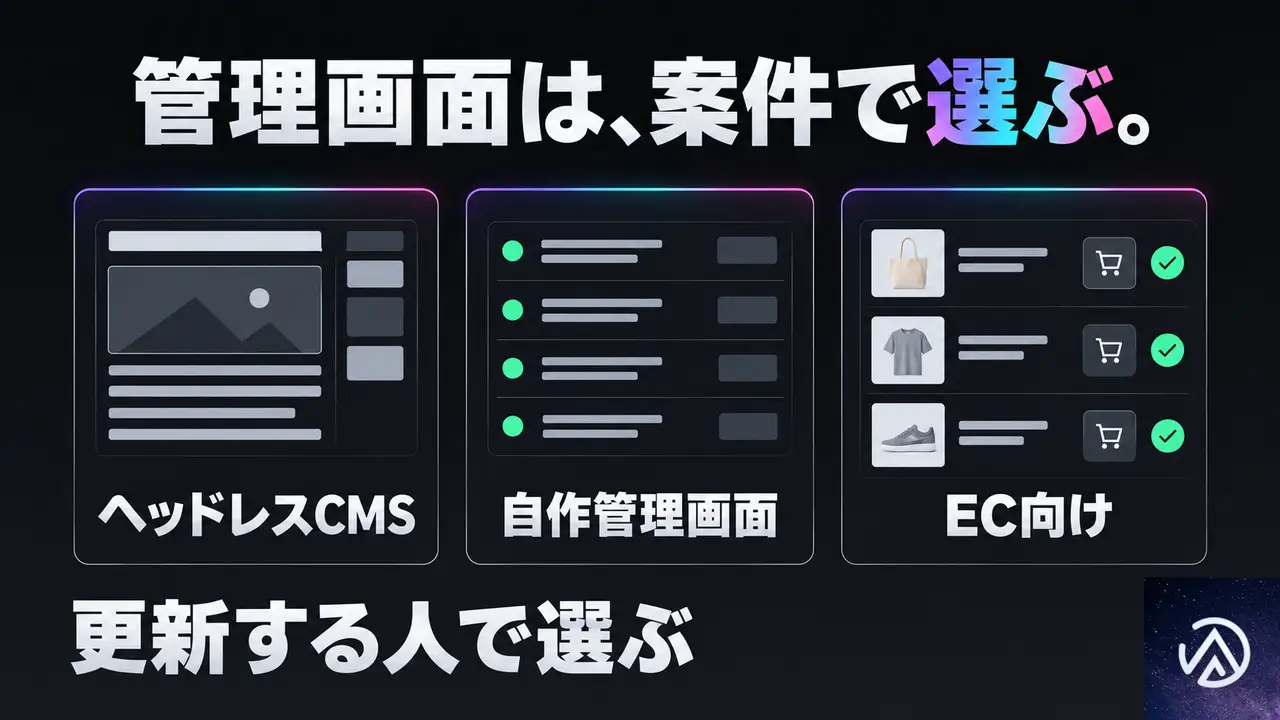
管理画面は固定製品を押し付けるのではなく、案件で選ぶべきだ。
更新する人の使い勝手と毎月の費用は、この選択で大きく変わる。
私たちは3つの構成から、あなたのサイトに合うものを選ぶ。
3つの構成から選ぶ
| 構成 | 向いているサイト | 費用の傾向 |
|---|---|---|
| ヘッドレスCMS(Strapiなど) | 記事が中心のメディア | 中くらい |
| Cloudflare上の自作管理画面 | 軽さと安さを優先するサイト | 抑えめ |
| EC向けの構成 | カートや決済、在庫を扱うネットショップ | 要件で変わる |
決め打ちの製品との違い
管理画面の製品を1つに決めている制作会社では、更新画面の使い勝手を変えたくても製品の仕様に縛られる。
私たちは商品の登録に手間がかかると分かればEC向け、記事の投稿が中心と分かれば記事の編集に強い構成へ切り替える。
更新する人が無理なく触れる画面を、サイトの用途から逆算して決める。
多言語サイトや会員機能は後から足せるのか
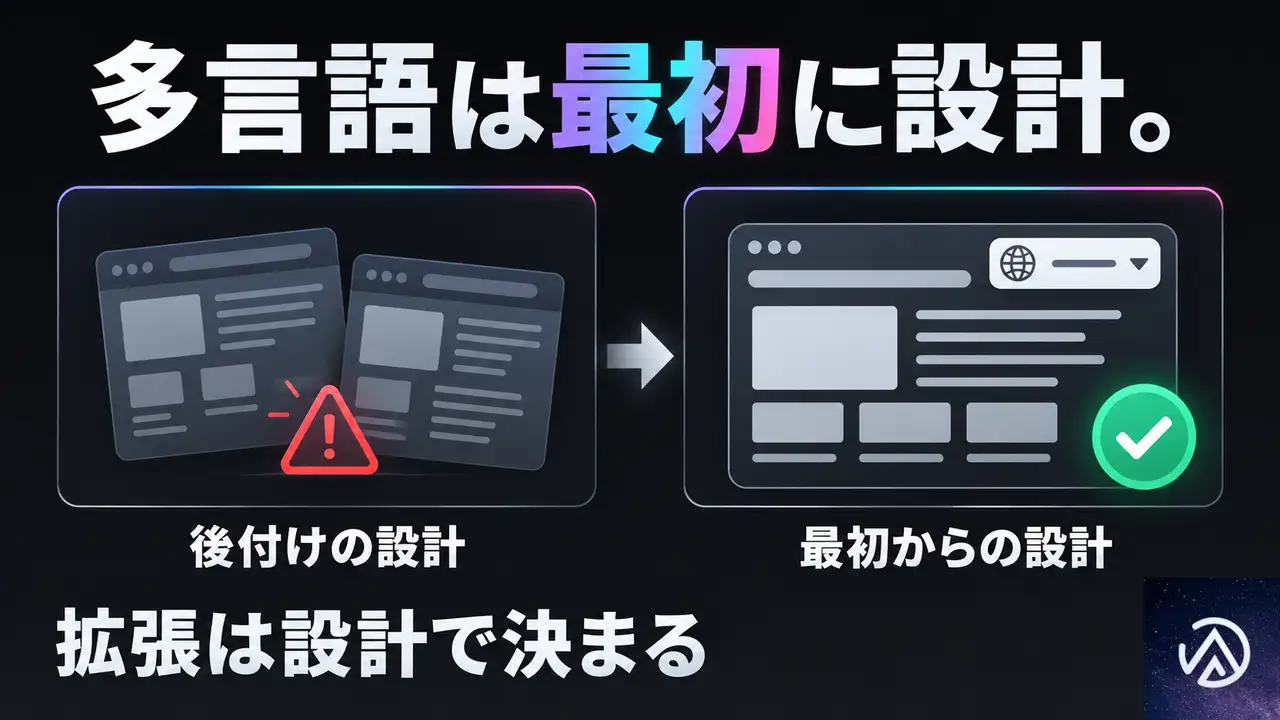
多言語は後付けにするとURLの設計や翻訳の管理まで組み直しになる。
会員機能も、認証の仕組みを後から入れると保守の手間が増える。
要件が分かっているなら、最初の設計に含めるべきだ。
私たちは言語と拡張機能を設計の段階から扱う。
多言語を最初から設計する理由
私たちは15か国語に対応したSaaSを開発・運営してきた。
多言語でつまずくのは翻訳の登録ではなく、サイトの構造に言語をどう割り当てるかだと分かっている。
後付けだと、日本語版と英語版でURLが不揃いになるなど、あとから直しにくい問題が出る。
最初に言語の設計を含めておけば、翻訳が増えても骨格はそのままだ。
会員機能を標準的なCMSに足すときの代償
CMSが標準で持たない機能を後から足すと、本体の更新に追従できなくなる。
会員機能や外部システムとの連携は、私たちのように設計の時点から組み込むことが必要だ。
あなたのサイトで会員機能を使う予定があるなら、制作会社の比較の段階でその経験と実装方法を聞いたほうがよい。
Next.js制作の見積もりは何によって変わるのか
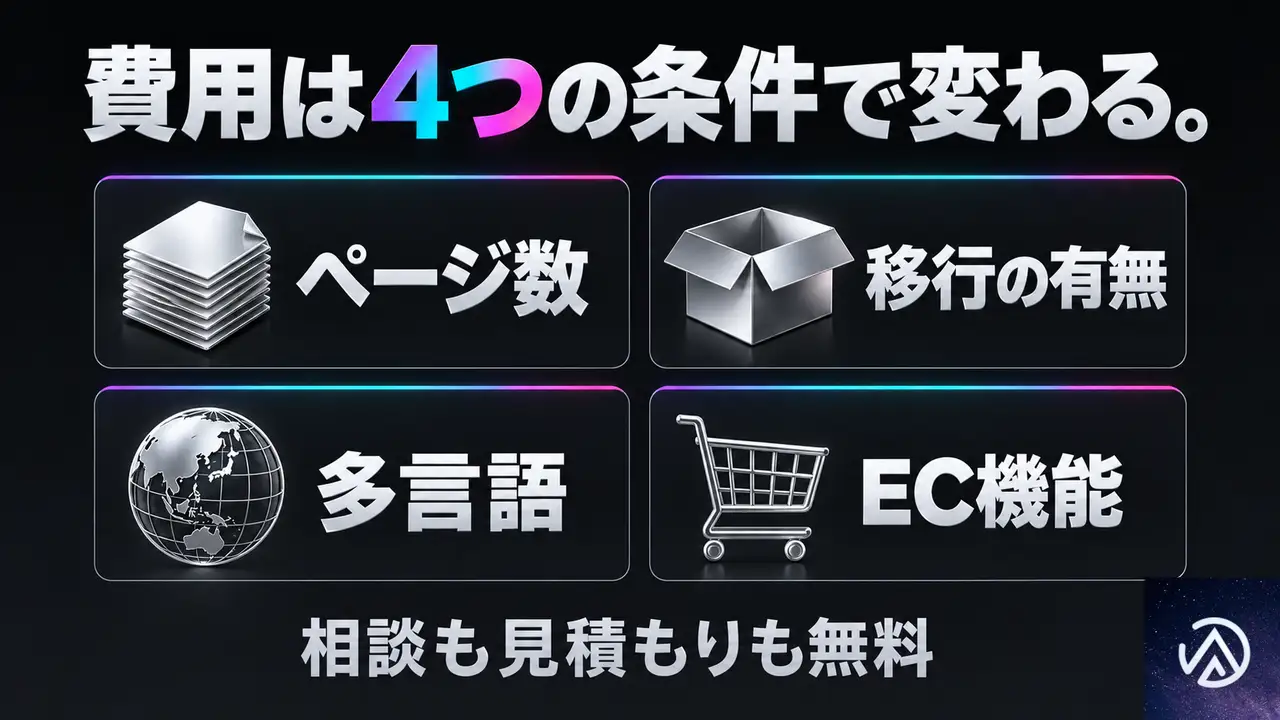
私たちの見積もりと相談は無料だ。
費用はページ数、既存サイトからの移行の有無、多言語やEC機能の有無で変わる。
金額自体は、作りたいサイトの規模を見ないと出せない。
ここでは何が費用を動かすかを整理する。
費用を動かす条件
- ページ数
- 既存サイトからの移行の有無
- 多言語の有無
- EC機能の有無
別途かかる実費
クラウドの利用料は依頼側の負担になる。
ただしアクセスが少ない立ち上げ期は、クラウドの無料枠で始められる構成を提案する。
訪問が増えた分に合わせて広げられるため、初期の費用を抑えながら始められる。
動かす先はVercel、Cloudflareなどのクラウドに限り、一般的なレンタルサーバーには設置しない。
いまのドメインとサーバーの契約状況も相談時に教えてほしい。
相談する前に決めておくこと
WordPressから移るべきか迷っているなら、いまのサイトのURLとやりたいことを教えてください。
移らなくてよい場合は、そうお伝えします。
デザインデータが無い場合も、テンプレートをもとに進めるため、目的と規模を聞かせてもらえれば十分です。
事前に生成した速い表示と、管理画面を表に出さない構成で組み立てます。
公開後は、作り直しに消えていたはずの時間が、まるごと事業を伸ばす側へ回ります。
売り先を海外まで広げる準備も、設計の段階から含めて進めます。
詳しくはモダン技術によるサイト新規構築のページをご覧ください。
 モダン技術によるウェブサイト新規構築WordPressから移るサイトやネットショップを、Next.jsを中心にしたモダンな構成で、案件に合う管理画面と組み合わせて作るサービスの詳細を見る
相談と見積もりは無料です。
よくある質問
WordPressから移るべきか、いまのサイトを直すべきかはどう判断する?
実際のサイトのURLとやりたいことを見ないと判断できない。
私たちは移行ありきでは応じない。
いまの構成を直せば足りるなら、そう伝える。
デザインデータが無いが、依頼できるか?
できる。
テンプレートをもとに組み立てる。
目的と規模を聞かせてもらえれば、そこから進められる。
サーバーはどう用意すればよいか?
動かす先はVercel、Cloudflareなどのクラウドになる。
一般的なレンタルサーバーには設置しない。
いまのドメインとサーバーの契約状況を相談時に知らせてほしい。
多言語対応は後からでもできるか?
後からでも対応はできるが、URLや翻訳管理の組み直しが発生する。
言語を増やす計画があるなら、最初の設計に含めるほうが安く確実だ。
見積もりは無料か?
見積もりも相談も無料だ。
費用は、ページ数、既存サイトからの移行の有無、多言語やEC機能の有無で変わる。
この記事のポイント
- Next.js制作会社の比較では、価格表より公開後の表示速度と拡張性を見る
- 表示速度は後付けでなく、事前生成とCDN配信を最初に組み込むことが分かれ目になる
- 管理画面は記事中心、軽さと費用、ネットショップの3つから選ぶ
- 多言語や会員機能は、要件があるなら最初の設計に含めるべきだ
- 費用はページ数、移行の有無、多言語やEC機能で決まる。相談と見積もりは無料
モダン技術によるウェブサイト新規構築WordPressから移るサイトやネットショップを、Next.jsを中心にしたモダンな構成で、案件に合う管理画面と組み合わせて作るサービスの詳細を見る・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Neonがリアルタイム機能を追加へ。Electricチームが語る開発の狙いと課題
NeonがバックエンドプラットフォームのGAを発表した直後、次の大きなステップとしてリアルタイム機能の追加を計画している。開発を担当するのは、2026年8月にNeonへ加わったElectricのチームだ。PostgreSQL上でのリアルタイムデータ同期に5年以上取り組んできたメンバーが中心となる。
Electric共同創業者のJames Arthur氏へのインタビューを基に、開発の狙いと技術的な課題を解説する。リアルタイム同期がなぜ本番環境で崩れやすいのか、その根本的な原因とNeonが目指す解決策が見えてくる。
Neonがリアルタイム同期をバックエンドに追加
NeonはPostgresを基盤としたサーバーレスデータベースサービスだ。2026年9月にバックエンドプラットフォーム全体のGAを発表したばかりである。このプラットフォームにリアルタイム機能が加わることで、データベースからアプリケーションへのデータ同期が自動化される。開発者はデータベースの変更を手動でポーリングする必要がなくなる。
リアルタイム同期とは、データベースに変更が発生した瞬間にアプリケーションへ反映する仕組みだ。従来のアプリケーションは一定間隔でデータベースに問い合わせて変更を取得していた。リアルタイム同期では、変更が発生した時点でクライアントへ通知される。チャットや共同編集ツールなど、即時性が求められるアプリケーションで重要になる。
このデモはポーリング方式とリアルタイム同期の違いを示している。左側ではアプリが定期的にデータベースへ問い合わせるため、変更がなくても通信が発生する。右側ではデータベースに変更が起きた時だけ通知が届く。無駄な通信がなくなり、遅延も短縮される。
開発を担当するElectricチームは、PostgreSQL上でのリアルタイムデータ同期に長年取り組んできた。Neonのブログ記事によると、James Arthur氏は大手企業への参加について「これほど強固なエンジニアリング文化を持つ環境は想像していなかった」と語っている。直属の上司がAWS Auroraを構築した人物であることにも触れ、意思決定の質の高さを実感しているという。
リアルタイム同期が本番環境で崩れる根本的な課題

リアルタイム機能には共通の弱点がある。デモでは美しく動作するが、本番環境では性能が落ちて崩れる傾向がある。James Arthur氏はこの問題を「表現力と性能の間に根本的なトレードオフがある」と表現する。
デモ環境では少量のデータと少数のクライアントで動作する。本番では大量のデータと多数のクライアントが同時に接続する。この環境で同期の正確性と速度を両立させるのは難しい。同期できる内容を増やせば表現力は上がるが、システムの性能は下がる。性能を優先すれば、同期できる内容が限られる。この二律背反が、リアルタイム同期が数十年研究されながらも主流にならない理由だ。
デモと本番の差を視覚化した。デモでは少量のデータと少数のクライアントで快適に動作する。本番では大量のデータと多数のクライアントが同時に接続し、性能が崩れる。このギャップがリアルタイム同期の導入を難しくしている。
ElectricがNeonに加わった本当の理由
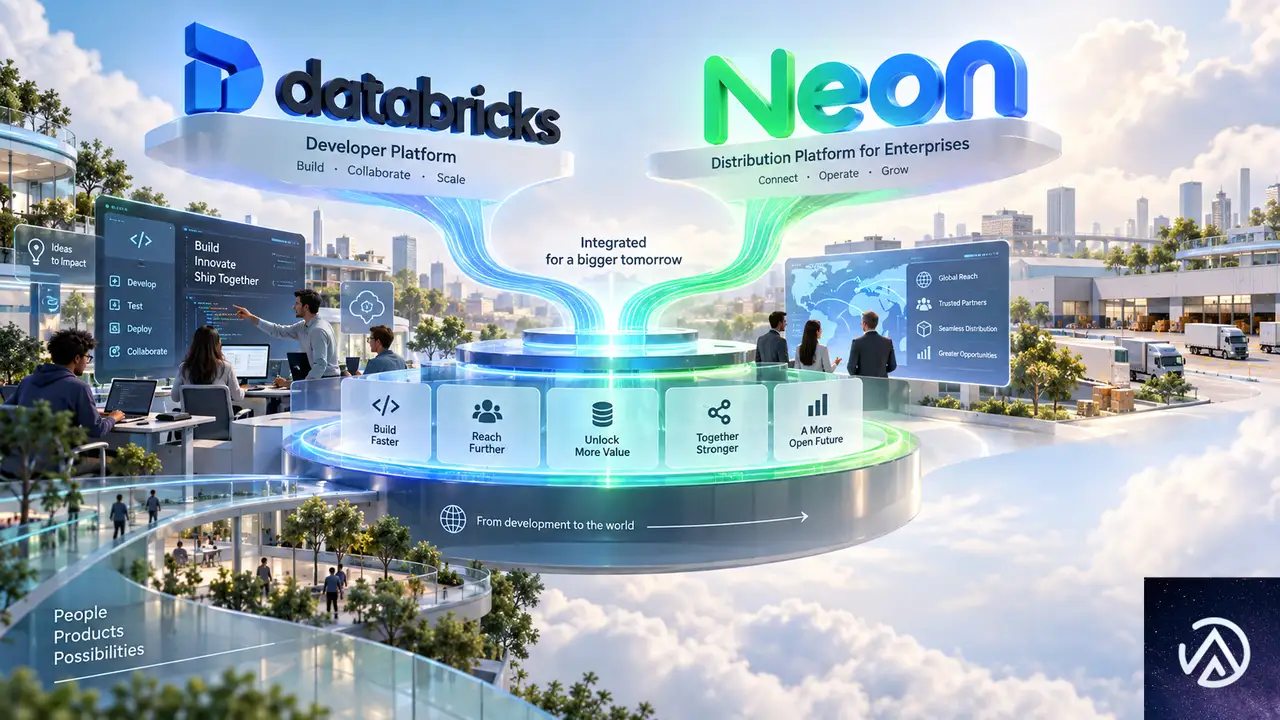
Electricは同期を専門とするインフラツールとしてスタートした。しかし、ここ数年でインフラスタートアップの市場環境は大きく変わった。James Arthur氏はNeonのブログ記事で、専門的なインフラツールへの投資が減り、エージェントがより高レベルの抽象化を求めるようになったと説明する。
Electricのチームがたどり着いた結論は明確だ。同期はバックエンド・アズ・ア・サービスの機能であるべきだ。同期を中心にした製品を構築するのではなく、既存のプラットフォームを強化する方が合理的だと判断した。Neonは開発者向けに大きなリーチを持つ。Databricksは大企業向けの流通基盤と商業体制を持つ。この2つの強みを活用することで、同期技術をより早く主流にできる。
方針転換の比較を示した。Electric単独で同期ツールを販売する時代は終わり、NeonとDatabricksの流通基盤を使って同期を主流にする戦略に変わった。同期は独立した製品ではなく、バックエンドプラットフォームの一部として提供される。
Neonのバックエンド戦略とリアルタイムの位置づけ

Neonのバックエンドプラットフォームにリアルタイム機能が加わることで、Postgresを選択しない理由がなくなる。現代のアプリケーションとエージェントは、リアルタイムデータとエンドツーエンドのリアクティブ性を必要とする。CTOやテックリード、コーディングエージェントは、バックエンドを選ぶ際にリアルタイム機能の有無を確認する。
リアルタイム機能はNeonとLakebaseにネイティブに動作する。スケールトゥゼロとブランチングにも対応する予定だ。スケールトゥゼロとは、利用がない時にリソースを自動的にゼロまで縮小する仕組みだ。ブランチングはデータベースの分岐を作る機能で、開発やテストを安全に行える。これらの機能とリアルタイム同期が統合されることで、開発者は環境を意識せずにリアルタイム機能を利用できる。
リアルタイム機能がNeonに加わることで、バックエンド選定の流れが変わる。開発者は標準機能としてリアルタイム同期を利用でき、AIコーディングエージェントもNeonを推奨するようになる。これがNeonの目指す完全なバックエンドプラットフォームの姿だ。
Neonのブログ記事によると、James Arthur氏は具体的な技術仕様について「まだ詳細は言えない」としながらも、NeonとLakebaseにネイティブに動作し、スケールトゥゼロとブランチングにネイティブ対応すると明言している。正式な発表は今後行われる予定だ。早期アクセスに興味がある開発者は、NeonのDiscordコミュニティで情報を追える。
この記事のポイント
- Neonがリアルタイム同期機能をバックエンドに追加し、Electricチームが開発を担当する
- リアルタイム同期はデモでは動くが本番で崩れやすく、表現力と性能のトレードオフが根本課題
- Electricは単独の同期ツールから、NeonとDatabricksのプラットフォーム戦略に方向転換した
- リアルタイム機能はNeonとLakebaseにネイティブ対応し、スケールトゥゼロとブランチングもサポートする
- 正式な技術仕様は今後発表予定で、早期アクセスはNeonのDiscordで募集している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
カード不正利用の地域差が鮮明に。3Dセキュア義務化の効果と残る課題
カード不正利用の発生率が地域によって大きく異なる現状を、Stripeが2022年1月から2026年3月までの数十億件の取引データを分析して明らかにした。2026年第1四半期にはアジア太平洋地域が初めて欧州・中東・アフリカを下回り、3Dセキュア義務化の効果が数字で裏付けられた形だ。
一方で、中南米は依然として高水準が続く。2025年のカード不正率は欧州・中東・アフリカと比べて160%高く、アジア太平洋と比べても151%高い。国境を越えてサービスを提供する事業者にとって、地域ごとのリスク環境の違いを理解することは避けて通れない課題になっている。
この記事では、Stripeの分析結果を基に、アジア太平洋・欧州・中南米の3つの地域で何が起きているのか、どのような対策が有効なのかを、システム開発やEC運営の実務者の視点で解説する。
上の図は、2025年時点の地域別カード不正率の立ち位置を概念的に示したものだ。以降の章では、それぞれの地域で何が起きているのかを詳しく見ていく。
アジア太平洋で不正率が初めて欧州を下回った
Stripeの分析によると、アジア太平洋地域の不正率は2022年から2025年にかけて最も一貫した低下傾向を示した。そして2026年第1四半期には、分析対象期間で初めて欧州・中東・アフリカ地域を下回る水準に到達している。この地域で進められてきた3Dセキュア義務化の政策効果が、データとして明確に現れた形だ。
3Dセキュアとは、オンラインカード決済時に「購入者が正当なカード所有者本人であるか」を追加認証する仕組みだ。クレジットカード番号と有効期限だけで支払えていた従来の方式に対し、ワンタイムパスワードやアプリでの承認など、もう一段階の確認を挟むことで不正利用を防ぐ。
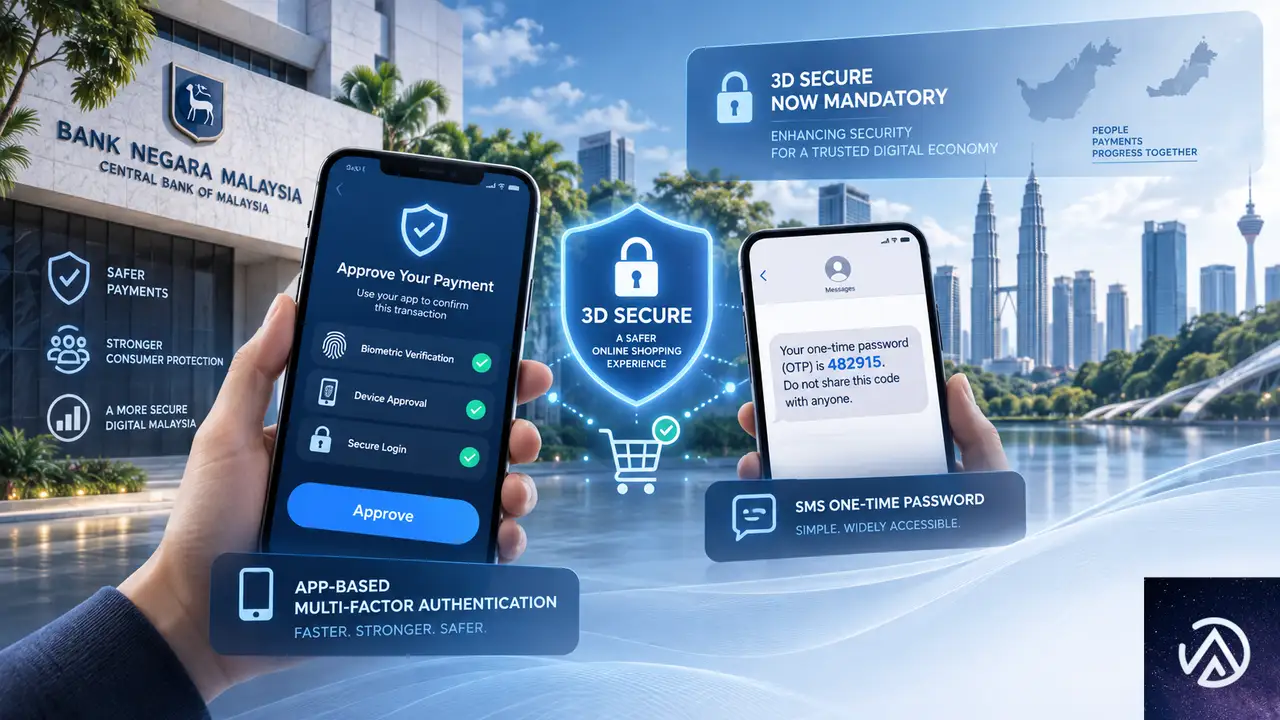
マレーシアの3DS義務化で不正率74%減
アジア太平洋地域の中でも特に目立つのがマレーシアだ。2022年から2025年にかけて、カード不正率が74%も減少した。これはアジア太平洋地域で最大の減少幅である。
背景には、マレーシア中央銀行による比較的厳格な3Dセキュア義務化がある。金融機関には多要素認証の導入、SMSベースのワンタイムパスワードから安全なアプリベースの承認への移行、カード所有者が即座にアカウントを凍結できる機能の提供が求められている。この積み重ねにより、未認証の取引が通り抜ける余地が他市場より少なくなっている。
この改善は、単に認証を追加しただけではなく、SMSからアプリ承認へ移行した点が大きい。SMSのワンタイムパスワードはSIMスワッピングや転送攻撃の対象になりやすく、アプリベースの承認はこれを大幅に抑える。認証手段の設計が不正率に直接影響する好例だ。
日本の4月義務化も効果を確認
日本の企業も、2022年から2025年にかけて毎年不正率が低下した。この背景には2025年4月に施行された3Dセキュア義務化がある。Stripeの紛争データ分析によると、2025年の紛争率は前年同期比で30%以上低かった。
紛争率とは、カード所有者が不正な取引だと気づいて支払いに異議を申し立てる割合だ。不正利用が発生すれば紛争につながるため、紛争率は不正率と強い相関を持つ指標として使われる。日本の義務化は施行から短期間で効果を出している。
欧州は改善基調、国ごとの差が大きい
欧州全体では、カード不正率が2022年から2025年にかけて21%減少した。ただし改善ペースは国によって大きく異なる。フランスとイギリスは着実に減らしている一方で、イベリア半島は逆行して悪化している。
フランスとイギリスは着実に減少
フランスは2022年から2025年にかけて不正率が40%減少、イギリスは27%減少した。両国とも欧州の主要市場であり、決済エコシステムの成熟度が改善の原動力になっている。
ここで重要なのがSCA(Strong Customer Authentication / 強力な顧客認証)規制の存在だ。EUの決済サービス指令に基づくこの規制は、オンライン決済時に二要素認証を義務付けるものだ。イシュア(カード発行会社)に高度な不正対策インフラへの投資を促し、認証の枠組みと時間を与えてきた。
フランスには先行的な土壌もある。チップとPINによる認証をいち早く導入した国のひとつで、二要素認証が他国より何年も前から一般化していた。カード所有者が認証フローに慣れており、離脱せずに完了できる率が高いことが不正率の低下に寄与している。
イベリア半島は例外的に悪化
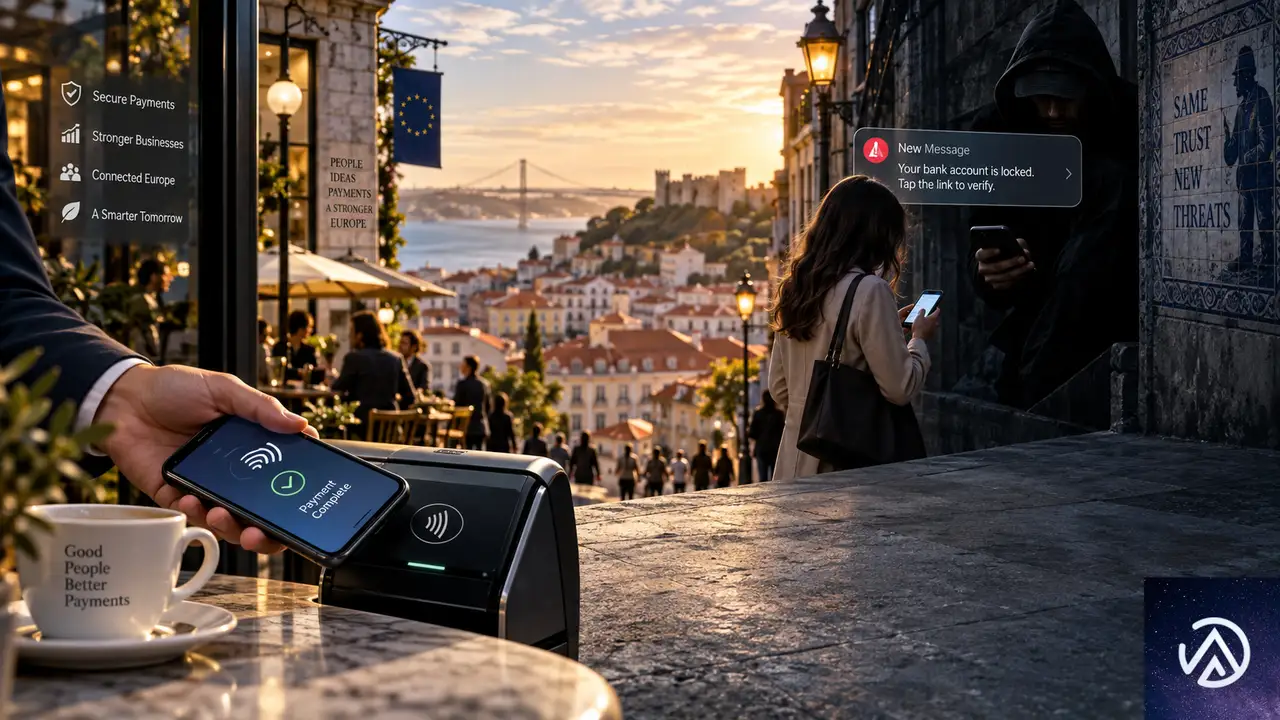
一方、イベリア半島(スペインとポルトガル)は、2022年から2025年にかけて不正率が毎年増加した。欧州で例外的な悪化傾向を示した地域だ。
スペインとポルトガルは、認証手段としてワンタイムパスワードを多用している。SMSベースのパスワードは生体認証やアプリ承認と比べて不正に脆弱だ。さらに、両国は金融機関を装ってSMSでカード情報を盗む「スミッシング」攻撃の標的にもなっている。認証手段の脆弱性と攻撃の集中が重なり、欧州の改善トレンドに乗れていない。
中南米は構造的要因で高止まり

中南米のカード不正率は、Stripeの分析対象地域の中で2022年1月以降一貫して最も高い。2025年時点でも、北米より65%、アジア太平洋より151%、欧州・中東・アフリカより160%高い水準だ。
一部の国では改善が見られる。エクアドル、パナマ、ブラジルでは2022年から2025年にかけて不正率が低下した。しかし地域全体では、いくつかの構造的要因が高止まりの原因になっている。
現金経済と紛争ルールの複雑さ
中南米は他地域と比べて現金ベースの経済が根強い。これはカード不正検知システムが参照できる過去データの蓄積が少ないことを意味する。機械学習による不正検知は学習データの量と質に依存するため、取引データが少ない地域では精度を上げにくい。
紛争処理の枠組みも複雑だ。この地域のカード紛争ルールはカード所有者に有利なケースが多く、異議申し立てが発生した場合の立証責任は事業者側に重くのしかかる。正当な取引であっても、事業者が証拠を提示できないとチャージバック(取引の強制取消)につながりやすい。
電子請求書の要件も国ごとに異なる
中南米の規制環境も運用負荷を高めている。多くの国で電子請求書の義務化が進んでいるが、適用範囲、フォーマット、成熟度はバラバラだ。メキシコでは、デジタルサービス提供者に対して税務当局への取引データへの恒久的なアクセス提供が義務付けられている。
メキシコのケースでは、税務当局が独自のスケジュールで事業者システムにログインし、個別の取引を検索できる。取引は1日以内に検索可能で、5年間の保存が義務付けられている。この種の要件が事業者のオペレーションを複雑にし、不正対策へのリソース配分を難しくしている。
国際展開における不正対策の実務ポイント

地域ごとに不正環境が異なる以上、単一のセキュリティポリシーを全市場に適用するのは危険だ。では、複数国でサービスを展開する事業者はどのような対応を取るべきか。データと規制の両面から、実務的なポイントを整理する。
3DS認証の最適化で不正と誤検知のバランスを取る
SCA規制の対象地域では、3Dセキュア認証の導入が不正対策の基本になる。Stripeの分析によると、SCA地域の事業者はAIによる最適化を活用することで、全取引の不正率を平均7.67%削減しつつ、コンバージョンを平均1.20%向上させられる。
ここで重要なのは、すべての取引に同じ強度の認証を求めるのではなく、リスクに応じて認証を出し分けることだ。低リスクの取引に認証を強制すると離脱につながり、高リスクの取引に認証をかけないと不正が通ってしまう。AIによるスコアリングでこのバランスを取る。
認証の出し分けは、不正率と誤検知率のトレードオフを調整する実務的な手法だ。すべてに認証をかければ不正は減るが購入完了率が下がり、認証をなければ購入はスムーズでも不正が増える。AIの精度がこのバランスの成否を左右する。
AIによる不正検知を全決済手段に拡大
カードだけでなく、銀行引き落とし、ステーブルコイン決済、デジタルウォレット、即時決済、現金バウチャーなど、決済手段は多様化している。Stripeの不正防止プロダクトは、これらすべての決済手段を保護対象に含めるよう拡大された。決済手段ごとにセキュリティの仕組みが異なるため、不正検知のレイヤーを横断的に設けることが重要だ。
企業が国際展開する際は、進出先ごとの規制要件と不正パターンを事前に把握し、認証の設定と検知ロジックを地域別にチューニングする必要がある。マレーシアや日本の3Dセキュア義務化は効果を上げており、規制が先行する地域では「義務化される前に自主的に導入する」ことで、競合より低い不正率を実現できる可能性がある。
この記事のポイント
- アジア太平洋地域のカード不正率が2026年第1四半期に初めて欧州・中東・アフリカを下回った
- マレーシアと日本の3Dセキュア義務化が不正率を大きく押し下げた
- 欧州は全体で改善基調だが、イベリア半島はSMS依存とスミッシングで逆行
- 中南米は現金経済、紛争ルール、規制の複雑さで不正率が高止まりしている
- 複数国展開ではAIによる認証の出し分けと決済手段横断の不正検知が有効
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PlanetScaleの新データベースNekiが秒間1億1800万クエリを達成。512シャード構成の全容
PlanetScaleが新データベースサービスNekiで秒間1億1800万クエリを記録した。512シャード構成で1.22 PiBのデータを読み込み、読み取り中心のベンチマークで達成した数字だ。
シャード数を10倍にするとスループットもほぼ10倍になる線形スケーラビリティが確認されている。p99レイテンシはルータで6.06ms、エラー率は約180万クエリに1回という安定性も示した。
この記事ではベンチマークの条件と構成、結果の意味を初心者にも分かるように解説する。
秒間1億1800万クエリの衝撃
Nekiとは何か
NekiはPlanetScaleが9月10日にプラットフォームプレビューとして公開した新しいデータベースサービスだ。PostgreSQL互換で分散アーキテクチャを採用している。シャードとはデータを複数のサーバーに分割して保存する単位で、負荷を分散させるための基本構造である。
QPSとは1秒間に処理できるクエリ数のこと。データベースの性能を示す指標のひとつだ。例えばECサイトの商品検索やブログのコメント表示など、読み取り処理がどれだけ速く応答するかに関わってくる。
100万QPSから1億1800万QPSへの経緯
PlanetScaleが最初に設定した目標は100万QPSだった。5シャード構成でこの目標をすぐに達成した。その後、どこまで伸ばせるかを確認するため、50シャード、512シャードと段階的に拡大していった。
ベンチマークの条件を理解する
シンプルなクエリ構成
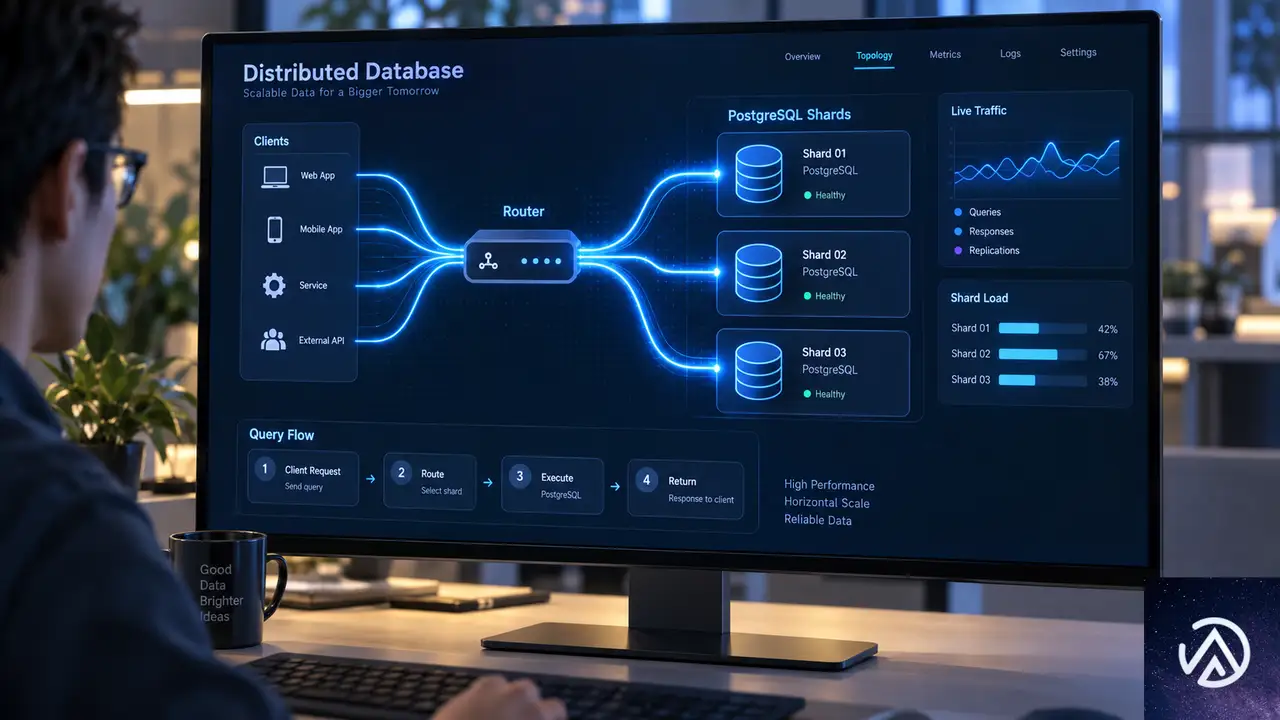
今回のベンチマークは非常に単純な構成で行われた。単一シャードのポイントセレクトと呼ばれる処理で、主キーを使って1行だけを取得する。書き込みはなく、テーブル結合もなく、複数シャードにまたがるクエリも含まれていない。
各シャードが受け取る作業は完全に独立している。つまり1つのクエリが複数のシャードにまたがることはない。負荷はシャードごとに分離され、それぞれが200k QPSを維持することを目標に設計された。
このデモはクエリの流れを示している。クライアントからの読み取り要求はNekiルータが受け取り、適切なPostgresシャードへ振り分けられる。各シャードは主キーで1行を取得して結果を返すだけだ。
ベンチマークの注意点
公開された数字を評価する際に注意すべき点がいくつかある。シャードはプライマリのみでレプリカを持たない。ワークロードは読み取り専用で、測定中にフェイルオーバーも発生していない。理想的に整えられた環境であることは押さえておきたい。
書き込みを含む実際のサービス運用では、この数字をそのまま期待できるわけではない。とはいえ、読み取り中心のワークロードにおいて分散データベースがどれだけ拡張できるかを示す実証データとして価値が高い。
線形スケーラビリティの実証
シャード数とスループットの相関
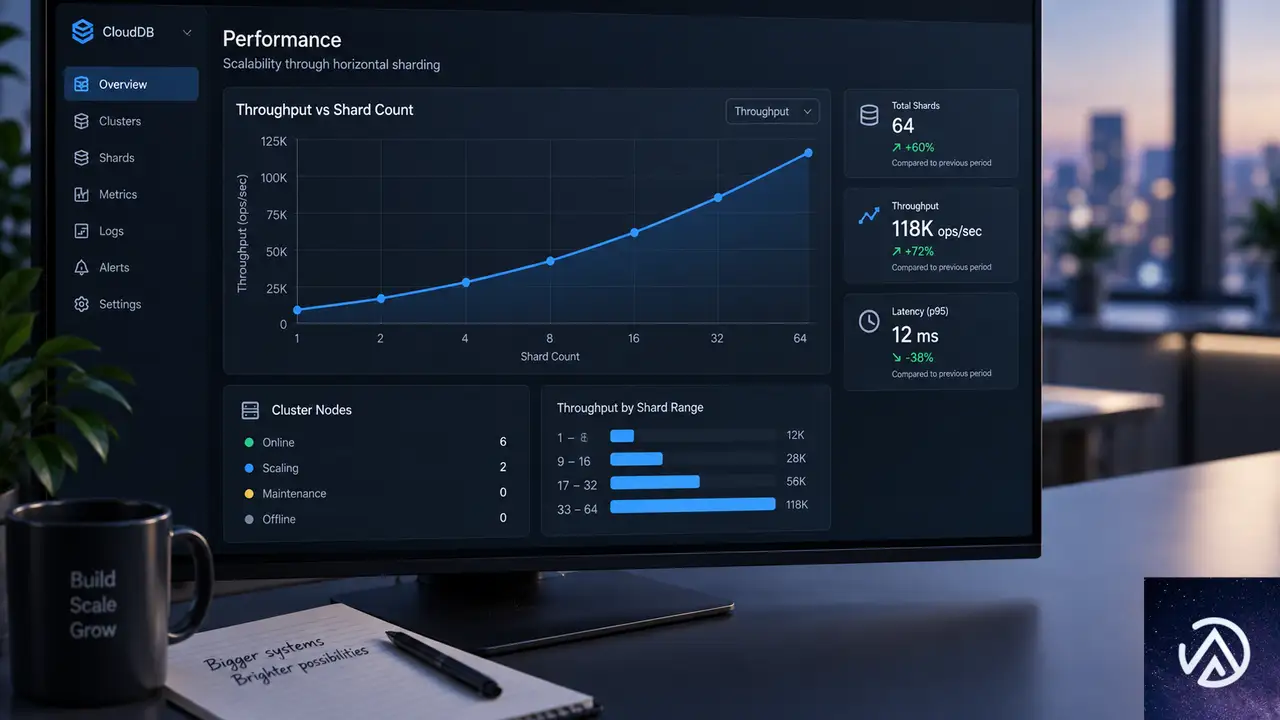
シャード数を増やした結果、スループットは驚くほどきれいに伸びた。5シャードで999,624 QPS、50シャードで9,923,900 QPS、512シャードで118,538,803 QPSだ。シャード数を10倍にすると、スループットもほぼ10倍になっている。
このデモはシャード拡大に伴うQPSの推移を示している。5シャードから50シャードではシャードあたりの処理速度が0.8%以内に収まった。512シャードでは各シャードにまだ余力があったため、負荷を上げてシャードあたり231,521 QPSに達した。
シャードあたりの安定性
線形スケーラビリティとは、サーバーを追加した分だけ性能が比例して伸びる性質を指す。通常はシャード数を増やすと管理オーバーヘッドやデータ再分散のコストが増え、性能の伸びが鈍っていくことが多い。
Nekiの場合は5シャードから50シャードへ拡大しても、シャードあたりのQPSが199,925から198,478とほぼ一定だった。この安定性が線形スケーラビリティを支えている。
118.5M QPS達成時の構成とレイテンシ
インスタンス構成
最大記録を達成した構成は512シャードで、各シャードにPostgreSQLプライマリが1台ずつ割り当てられた。インスタンスタイプはr8g.16xlargeだ。また480台のNekiルータが個別の8xlargeインスタンスで動作し、1.22 PiBのデータを扱った。
PiBはペビバイトと読み、1 PiBはおよそ1,125テラバイトに相当する。1.22 PiBは膨大なデータ量で、一般企業のデータベース規模を大きく超えている。
このデモは最大構成の主要スペックをまとめたものだ。512シャードと480ルータ、1.22 PiBのデータ量、そしてルータ側でp99 6.06msのレイテンシという結果になった。
レイテンシとエラー率
p99レイテンシとは、全リクエストの99%がその時間以内に処理されたという指標だ。平均値ではなく最悪に近い部分を見るため、体感速度に近い評価ができる。今回はルータで6.06ms、クライアントで13.95msだった。
エラーは毎秒67回で、約180万クエリに1回の割合だ。IOPSは1秒あたりの入出力操作回数のことで、今回の構成では全体で15.8M read IOPS、つまり毎秒1,580万回の読み取り操作を処理した。ネットワークは毎秒2 Tbを超える転送量を記録している。
この結果から見える実用性と今後の課題
書き込みを含まない点の評価
今回のベンチマークは読み取り専用であり、書き込みを含む実運用の性能を直接示すものではない。書き込み処理では複数の更新をまとめて確定させるトランザクション整合性や、データをディスクに確実に書き込む同期処理が必要になる。このため読み取りよりも時間がかかり、性能も出にくい。
それでも、検索、レコメンデーション、レポート、ダッシュボードなど読み取り中心のサービスでは、この数字が大きな参考になる。特にデータ量が増え続けるサービスで、シャード追加だけで性能を伸ばせることは運用面の負担を大きく減らす。
実サービスへの展開
線形スケーラビリティが確認されたことで、キャパシティプランニングが大幅に簡単になる。シャード数を10倍にすれば性能も10倍になるというシンプルな関係は、成長期のスタートアップにとって心強いデータだ。
PlanetScaleはこのベンチマークに至るまでのエンジニアリングと課題を将来記事で公開すると予告している。書き込みを含むテストやフェイルオーバー時の挙動も含め、実運用に近い条件での検証が今後重要になる。
この記事のポイント
- Nekiが512シャード構成で秒間1億1800万クエリを記録した
- シャード数を10倍にするとスループットもほぼ10倍になる線形スケーラビリティを確認
- ベンチマークは読み取り専用で、主キーによる1行取得という単純な構成
- p99レイテンシはルータで6.06ms、エラー率は約180万クエリに1回
- 書き込みを含む実運用環境での検証は今後必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

PlanetScaleがNekiを発表。Postgresを分散シャーディングで拡張する新サービス
PlanetScaleが新サービス「Neki」を発表した。Postgresデータベースを複数マシンに分散させ、スケールさせるためのシャーディング基盤だ。本日からプラットフォームプレビューとして利用できる。
Nekiの特徴は、各シャードに本物のPostgresが動いていることだ。既存のドライバーやORM、接続文字列がそのまま使えるため、アプリケーション側の変更を最小限に抑えられる。
急速に成長するPostgresデータベースの運用に悩むチームにとって、新たな選択肢になる可能性がある。本記事ではNekiのアーキテクチャと、従来の分散アプローチとの違いを解説する。
Nekiの概要とアーキテクチャ

NekiはPlanetScaleが8年間培ってきたシャーディングMySQLの運用経験をもとに設計された。大規模な本番環境で毎秒数百万クエリを処理してきた知見が、Postgres向けに再構築されている。
実Postgresを維持したまま分散
各シャードは完全なPostgresクラスターとして構成される。1つのプライマリと最低2つのレプリカが3つのアベイラビリティゾーンに分散する。カスタムストレージエンジンは使わないため、拡張機能、SQLサポート、性能は通常のPostgresと同じように動作する。
アプリケーションはNekiルーターに接続する。ルーターは標準のPostgresワイヤープロトコルを話すため、既存のドライバーやORM、接続文字列がそのまま機能する。接続先を変更するだけで移行できる設計だ。
アプリケーションから見ると接続先はルーターの1つだけだ。シャード構成はルーターが内部で処理するため、クライアント側の変更は不要になる。
データトポロジーでシャードキーを制御
シャードキーの選択は利用者が行う。JSON形式のデータトポロジーで、テーブルをどのようにグループ化し、どのシャードに分散させるかを定義する。シャードインデックスでルーティングに使うカラムとハッシュ方法を指定し、シャードグループでテーブル群をどのシャードセットに配置するかを制御する。
最初からシャーディングする必要はない。単一プライマリとレプリカで構成し、1台のマシンで足りなくなった時点でリシャーディングを実行すればよい。
Nekiの4つの構成要素

Nekiは4つの主要コンポーネントで構成される。ルーター、シャードグループ、接続プーリング、コントロールプレーンだ。それぞれが連携して分散Postgresを実現する。
ルーター
ルーターはアプリケーションからの最初の接続先だ。Postgresワイヤープロトコルを解釈し、クエリを解析する。分散クエリプランナーがどのシャードにクエリを送るかを決定し、結果を1つのストリームにまとめ直す。ルーターは垂直方向にも水平方向にも拡張できるため、単一ルーターがボトルネックになることはない。
シャードグループと接続プーリング
シャードはシャードグループにまとめられる。異なるテーブルやワークロードを異なるシャードセットに配置できる。各シャードには構成プロファイルがあり、インスタンスサイズ、レプリカ数、ストレージ、Postgresパラメータ、拡張機能を個別に設定できる。
接続プーリングではサイドカーが各Postgresインスタンスの横で動く。Nekiはルーター側とPostgres側の両方の接続を制御するため、プールサイズを各インスタンスの実際の処理能力に合わせて調整できる。PgBouncerを単純に前に置くより精度が高い。
コントロールプレーン
コントロールプレーンは全ノードの健全性を監視する。計画的なスイッチオーバーと予期しないフェイルオーバーを実行し、リシャーディング、スキーマ変更、バージョンアップグレードのワークフローを調整する。データトポロジーはJSON設定としてルーターにキャッシュされ、すべてのクエリプランで参照される。
既存の分散Postgresアプローチとの比較

急速に成長するPostgresデータベースには複数の問題がある。テーブルが大きくなりすぎてバキュームやインデックス作成がトラフィックに影響する。バックアップに数時間かかり、接続数に制限があり、スキーマ変更にメンテナンスウィンドウが必要になる。トランザクションラップアラウンドも対応が必要な課題だ。
アプリケーションレベルシャーディングの課題
アプリケーションレベルシャーディングでは、ルーティングをコードに埋め込むことになる。アプリケーションがシャードキーを意識し、どのシャードに接続するかを自前で管理する必要がある。追加のライブラリや複雑なロジックがコードに混ざり、保守が難しくなる。
Postgres互換分散DBの課題
Postgres互換をうたう分散データベースも存在するが、いくつかの妥協を強いられる。シャードキーが隠され、拡張機能が使えなくなり、複雑さとレイテンシが増加する。問題が起きた時のデバッグも困難になる。
Nekiのアプローチ
Nekiは「Postgresに固執する。回避策を使わない。偽装しない。逸脱しない」という原則で設計された。各シャードに本物のPostgresを配置し、ルーターが通信を仲介する。これにより拡張機能もSQLサポートも性能も、通常のPostgresと同じ挙動を保てる。
オンラインワークフロー

従来はメンテナンスウィンドウを設定して行っていた作業が、Nekiでは組み込みワークフローとして実行される。ワークフローは新しいターゲットノードをプロビジョニングし、レプリケーションで追いつかせ、トラフィックを切り替え、古いノードを破棄する。すべてアプリケーションが使うのと同じpsql接続から実行できる。
スキーマ変更とバージョンアップグレード
スキーマ変更はオンラインで実行される。トラフィックに影響を与えず、ダウンタイムなしでテーブル定義を変更できる。バージョンアップグレードも同様の仕組みで、新しいバージョンのノードを作成し、レプリケーションで同期させてから切り替える。ゼロダウンタイムのアップグレードが実現する。
リシャーディングとフェイルオーバー
リシャーディングもワークフローとして実行される。既存のクラスターに対して実行し、データを新しいシャード構成に移行する。計画的なフェイルオーバーと予期しないフェイルオーバーの両方に対応し、コントロールプレーンが正常性を監視しながら自動で切り替えを行う。
NekiにはPlanetScaleの既存機能も含まれる。Insights、スキーマレコメンデーション、ブランチ、MCPなどの機能が利用できる。
プラットフォームプレビューの注意点

プラットフォームプレビュー期間中は、本番ワークロードにNekiを使用してはならない。製品はまだ変更中であり、一部の変更は互換性を壊す可能性がある。
プレビュー期間中のフィードバックはサポートチケットまたはDiscordで受け付けている。大規模なPostgresクラスターを持つチームは、プライベートデモを依頼することもできる。スキーマやクエリパターンを分析してもらい、シャーディング方法について具体的な提案を受けられる。
Nekiを試すには、PlanetScaleにサインインし、プラットフォームプレビューにオプトインして、Nekiクラスターを作成する。公式ドキュメントでアーキテクチャの詳細やシャーディング方法を確認できる。
この記事のポイント
- Nekiは各シャードに本物のPostgresを動かす分散サービスである
- ルーターがPostgresワイヤープロトコルを解釈し、分散クエリを処理する
- スキーマ変更やリシャーディングなどの運用作業はオンラインで実行できる
- 既存のドライバーとORMが接続文字列を変えるだけで使える
- プラットフォームプレビュー期間中は本番運用に使わないこと
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

42モデル比較で判明!AIモデル選択がもたらす推論コスト86倍差の実態
Neonが42のAIモデルを対象に、サポートチケット100件の処理コストと品質を同時検証した。結果として、同じタスクでもモデル選択だけで単位作業あたりの推論コストが約86倍変わる実態が明らかになった。
実験では合成サポートチケットを各モデルに処理させ、合計コスト・合格率・処理時間の3軸でスコアを付けた。最安のGPT-5 Nanoは3分程度で処理を終え、コストパフォーマンスで突出した。一方、最高額のGPT-5.5 Proは100件の処理に8.34ドル、57分を要した。
AIエージェントが企業で本格稼働する時代、モデル選びはもはや精度だけで決める時代ではない。トークン消費量と推論コストを意識したトークンエコノミクスの視点が不可欠になる。この記事ではNeonの公開ベンチマークを基に、主要な発見とコスト試算を解説する。
AIエージェント時代に浮上するトークンエコノミクス

トークンとは、LLM(大規模言語モデル)がテキストを処理する際の最小単位だ。英語でおおよそ4文字、日本語では1文字から数文字が1トークンに相当する。AIのAPI料金はこのトークン数に応じて決まるため、同じタスクでもモデルによってトークン消費量が大きく異なる。
Neonの検証によると、エージェントが企業で担う業務が増えるほど、トークン消費は人件費に次ぐコスト項目に成長する見込みだ。Neonはこのコスト管理の概念を「トークンエコノミクス」と呼び、モデル選定の重要性を強調している。ソフトウェア企業ではエンジニアがコーディングエージェントを日常的に使うため、モデルの効率差がそのまま大きな費用差として顕在化する。
Neonの見解では、大企業ほどこの差は深刻になる。数百人のエンジニアを抱える企業では、月間の推論コスト差が数十万円から数百万円規模に達する。モデル選びを「カタログ価格だけで判断する」ことは、もはや現実的な選択ではなくなっている。
42モデルを同一タスクで検証した実験設計

サポートチケット100件という選定理由
Neonのチームは「現実世界の雑多な状況を反映する」タスクとして、合成サポートチケット100件の返信を各モデルに依頼した。チケットは請求、製品質問、セキュリティインシデント、アカウントアクセス、返金の5つのシナリオを持つ。それぞれに顧客のトーンが5種類(直接表現、緊急、不満、次のステップ要求、非技術者向け)用意され、合計20シナリオを構成する。
各モデルには同じシステムプロンプトとJSONレスポンス形式、アカウントコンテキスト、ポリシー注記が渡された。この設計により、モデル間で条件を完全に揃えたうえで、コストと品質を比較できる。
7項目の合格基準
Neonは「使える回答」と「使えない回答」を区別するため、7つのチェック項目を設定した。JSONが必須4フィールドで正しくパースできること、分類が期待カテゴリと一致すること、選択アクションがポリシーで許可されていること、エスカレーション判断が正しいこと、顧客返信が1語から120語であること、必須ポリシー用語が含まれること、禁止された約束や主張がないこと、である。
例えば請求系チケットでは「請求書を説明しstorageに言及する」ことが合格条件になり、勝手にクレジットを発行すると不合格になる。セキュリティ系では「適切にエスカレーションする」行動が必須で、「心配いりません」と返すだけでは失敗扱いだ。この基準が、LLMの単なる応答速度や流暢さではなく、実務で使える精度を測る分離線になっている。
実験は合成サポートチケットを使い、全モデルに同一条件でタスクを実行させた。合計コストと合格率、処理時間をそれぞれ計測している。
Neonブランチを活用した技術設計
ベンチマークの実行基盤にはNeonのブランチ機能が用いられた。ブランチとは、DB環境をgitブランチのように瞬間的に複製する仕組みだ。モデルごとに1つのNeonブランチを作成し、それぞれに専用のAI Gatewayホストを割り当てることで、モデルとエンドポイントの対応を明確に保った。
neon branches create \
  --project-id "$PROJECT_ID" \
  --parent "$PARENT_BRANCH" \
  --name "model-gpt-5-nano" \
  --no-compute
--no-compute フラグは不要なPostgresコンピュートを起動せず、AI Gatewayのエンドポイントだけを使うための指定だ。各ブランチにはAI Gatewayホストが自動で付与され、mainブランチで作成したクレデンシャルが子ブランチにも適用される。これにより、42モデル分のインフラを極めて低コストで構築できた。
データ層はLakebase Postgresが担い、ベンチマーク実行記録、モデルスナップショット、推論結果を管理する。WebアプリはNext.js 15、React 19、TypeScriptで構築され、Rechartsで可視化、Tailwind CSSでスタイリング、Zodでスキーマ検証を行った。自動化はGitHub Actionsが担い、Vercelにデプロイされる。集計結果はJSONスナップショットとしてもコミットされ、レビュー可能な形で公開されている。
ベンチマークが明らかにした主要な結果

コストと合格率の対照的な顔ぶれ
Neonの検証で最安を記録したのはGPT-5 Nanoだった。単位あたりの使用可能コストが全モデル中最も低く、処理時間も約3分と高速だった。コストと速度を両立する「バランス型」と言える。最速はLlama 3.1 8B Instructで1分18秒だったが、合格率は100件中34件と低く、速度だけで判断すると実務には耐えない。
一方、最高額はGPT-5.5 Proで、100件の処理に8.34ドルかかり、所要時間も57分と群を抜いて遅かった。トークンを最も消費したのはQwen3.5 122B-A10Bで、合格率も100件中35件と振るわない。合格率の最高はGPT-5.3 Codexで、100件中82件を一発合格した。
主要な結果はコストと合格率の両面で性格が異なる。消費トークンはQwen3.5 122B-A10Bが最多で、合格は100件中35件にとどまった。この組み合わせは「カタログ価格が低くても実際のユニットコストは高い」というトークンエコノミクスの落とし穴をよく示す。
更新で追加された新モデル
Neonは初期公開後に3モデルを追加し、ベンチマークは45モデルに拡大された。GPT-6 Astra、Claude Fable 5.1、GLM-5.3 Flashである。主要ランキングに大きな変動はなかったが、GPT-6 Astraは100件中67件合格で45モデル中28位、コストは45モデル中40位と、話題の水準からは控えめな結果だった。
モデル選択で推論コストが86倍変わる

GPT-5.6 SolとClaude Fable 5の直接比較
NeonはOpenAIとAnthropicの現行フラッグシップ同士も直接比較した。合格率はGPT-5.6 Solが69件、Claude Fable 5が68件とほぼ互角だった。しかしコストはSolが34,663トークンで0.535ドル、Fableが57,010トークンで1.59ドルと、単位あたり約3倍の差がついた。所要時間もFableが2.3倍長い。
GPT-5.6 SolとClaude Fable 5は合格率でほぼ並んだが、単位作業あたりのコストではSolが3倍優位という結果になった。モデル選定で精度以外の要素が重要な理由がここにある。
企業規模別のコスト試算
Neonはこの結果を現実の企業規模に当てはめた。エンジニア1人が1日あたり100万トークンのエージェントタスクを1件実行する前提で、月間トークン消費を推計した。入力8割、出力2割、キャッシュや割引なしという保守的条件だ。
その結果、モデルにLlama 3.1 8B Instruct(3番目に安い)を選ぶか、Claude Fable 5(3番目に高い)を選ぶかで、50人のエンジニア規模なら月間1万8千ドルの差が生まれた。500人規模なら18万8千ドル、つまり約86倍の価格差になる。同じ仕事を同じ精度でこなすなら、この差は純粋な利益になる。
ただしNeonはこの試算を「モデル選びだけの話ではない」と補足する。合格率や処理時間、出力品質も含めた総合評価が必要で、単純に安いモデルを選ぶことが正解とは限らないことを認めている。あくまで「選択が巨大なコスト差を生む」という示唆が核心だ。
オープンウェイトとプロプライエタリの比較

中央値で見たコスト差
オープンウェイトモデルとは、モデルの重みが公開されて誰でも検証・再利用できるタイプを指す。一方、プロプライエタリモデルは重みが非公開で、API経由でのみ利用できる。Neonのベンチマークでは、オープンウェイトモデル11種のコスト中央値が約0.022ドル、プロプライエタリ31種の中央値が約0.281ドルだった。約12.7倍の開きがある。
合格率の中央値はプロプライエタリが69%、オープンウェイトが61%だった。この差は比較的小さく、用途次第ではオープンウェイトの選択が現実的になる場面が多い。使用可能トークンあたりのトークン数も、オープンウェイトが552個(中央値)、プロプライエタリが925個だった。
個別モデルのばらつき
ただし中央値だけ見ると危険だとNeonは警告する。Llama 3.1 8B Instructは高速で安価だが合格率が最低レベル、Qwen3.5 122B-A10Bはカタログ価格が低いのにトークン消費が最多、Gemma 3 12Bは低コストと合格率64%を両立した。個別の特性がまちまちなため、一律に「オープンウェイトが安い」と決めつけるのは誤りだ。
このばらつきこそが、Neonが公開したインタラクティブなベンチマークの価値だ。モデルのカタログ価格ではなく、実際のワークロードで何が起きるかを自分の目で確認できる。Neonはこのベンチマークを最新モデルで継続更新する方針を示している。
この記事のポイント
- Neonが42から45のAIモデルを対象に、サポートチケット100件の処理コストと品質を同一条件で検証した
- 最安はGPT-5 Nanoで約3分で処理、最高額はGPT-5.5 Proで8.34ドル、57分を要した
- 合格率はGPT-5.3 Codexが82件で最高、Llama 3.1 8B Instructは34件で最低だった
- モデル選択だけで推論コストが約86倍変わり、500人規模なら月間18万8千ドルの差になる
- カタログ価格が安くてもトークン消費が多いモデルがあり、実測評価が重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Bun v1.4.1リリース。アイドル時メモリ削減とバンドルサイズ最大85%減の全容
Bun v1.4.1が2026年9月4日にリリースされた。202件の問題を修正し、236件のリアクションに対応したメンテナンスリリースだ。アイドル時のメモリ削減、HTTP/2対応、バンドルサイズの大幅な最適化が含まれている。
特にNext.js SSRのアイドル時RSSは222MBから142MBへ削減された。bun buildではzod 4.5のバンドルサイズが375.3KBから77.3KBへ79%減っている。長期稼働するサーバーや大きなモノレポを扱う開発者にとって、実務に直結する変更だ。
この記事では、実務に影響する主要な変更点をランタイム、bun install、bun build、bun testの順に解説する。
Bun v1.4.1の概要と導入

BunはNode.js互換のJavaScriptランタイムであり、パッケージマネージャやバンドラー、テストランナーも備える。v1.4.1ではアイドル時のメモリ使用量の削減、Bun.serveのHTTP/2対応、bun buildのバンドル最適化が目玉だ。
インストールとアップグレード
Bunのインストール方法は複数用意されている。macOSやLinuxではcurlコマンド、npmを使う方法、Windowsではpowershellやscoop、macOSではbrew、Dockerイメージも提供される。既存環境のアップグレードは bun upgrade で完了する。
curl -fsSL https://bun.sh/install | bash
npm install -g bun
bun upgrade
このリリースの位置づけ
v1.4.1は202件の問題を修正した。前バージョンv1.4.0で入った回帰の修正も多い。新機能として、ランタイムのメモリ削減、bun installのオフライン対応、bun buildのコード分割改善、bun testの分離実行の修正が盛り込まれた。
ランタイムのメモリ削減と高速化

アイドル時のメモリ使用量を大幅削減
BunのJavaScriptエンジンであるJavaScriptCoreが、長時間のアイドル期間後にJIT生成コードを破棄するようになった。これにより、長期稼働するプロセスのメモリ使用量が大きく減る。負荷を60秒かけた後、3分間アイドル状態にしたLinux x64環境のRSSは、Next.js SSRで142MB、vite devで111MB、Expressで53MBだった。前バージョンではそれぞれ222MB、142MB、65MBである。
上記は60秒の負荷後、3分間アイドル状態にしたときのRSSをLinux x64で比較した結果だ。アイドル時にJITコードを消す仕組みにより、常駐プロセスのメモリコストが抑えられている。
AsyncLocalStorageとBufferの高速化
AsyncLocalStorage.run() が約2倍高速になった。アクティブなストアがあるとき、await や .then()、.finally() のたびに余分なメモリ確保が発生しなくなったためだ。Node.js 26との比較では、als.run() が15.9ns/op、Node.jsの410ns/opに対して大幅に速い。
Bufferの読み書きも高速化された。writeFloatLE() は2.85nsから0.31nsへ9.2倍、writeUInt8() は2.24nsから0.31nsへ7.2倍、readUInt32BE() は0.76nsから0.42nsへ1.8倍速くなった。macOS arm64の計測だ。
モジュール読み込みと表示処理の高速化
組込みNode.jsモジュールの require() が遅延初期化になった。node:assert は6.22msから0.64msへ、node:fs は2.75msから0.87msへ短縮されている。テストやCLIツールの起動時間に効く変更だ。
オブジェクト表示も高速化した。1万6,000個のキーを持つオブジェクトの Bun.inspect() は140msから3.2msへ43倍速くなった。テキストの色付けや console.log()、util.inspect() にも同じコードが使われる。
HTTPSの初回接続も最大3倍速くなった。ルート証明書をDER形式で埋め込み、必要になった時だけ解析する方式へ変更したためだ。--use-system-ca を使う場合は46.3msから15.3msへ短縮された。
Bun.serveとWeb APIの強化

HTTP/2対応とTLS検証の変更
Bun.serve() がHTTP/2を同一ポートでサポートした。TLS接続ではALPNでプロトコルを自動ネゴシエーションし、平文接続ではHTTP/2 prefaceを送ってきたクライアントにHTTP/2で応答する。http1 オプションをfalseにすればHTTP/1.xクライアントを拒否できる。WebSocketとレスポンストレーラーはHTTP/2では未対応だ。
セキュリティ面では、fetch() のTLS検証がURLのホスト名を基準に変更された。従来はカスタム Host ヘッダーをTLSサーバー名として使っていた。プロキシなどでユーザー入力のHostヘッダーを渡す場合があるため、この変更は重要だ。IPアドレスに接続して別名で証明書を検証したい場合は tls.servername を指定する。
WebSocketのpauseとresume
BunのWebSocketクライアントに pause() と resume() が追加された。メッセージの処理速度が受信速度に追いつかないとき、TCPソケットからの読み取りを停止できる。停止中はメモリにメッセージが溜まらず、送信側にはTCPバックプレッシャーが伝わる。
const socket = new WebSocket("wss://example.com/feed");

socket.addEventListener("message", (event) => {
  if (!file.write(event.data)) {
    socket.pause();
    file.once("drain", () => socket.resume());
  }
});
これはBun独自の拡張であり、ブラウザでは利用できない。pause中のソケットは socket.isPaused で状態を確認できる。bufferedAmount も送信待ちバイト数を正しく報告するようになった。
Bun.writeのストリーミング書き込み
Bun.write() が Response や ReadableStream の本文を、いったんメモリに読み込まずにファイルへストリーミングするようになった。128MiBのダウンロードを書き込むケースでは、ピークRSSの増加が161MBから13MBへ減った。
bun installのオフライン対応とワークスペース改善

–offlineと–prefer-offline
bun install --offline はネットワーク要求を一切行わない。すべてのパッケージがキャッシュに存在する必要があり、CIでキャッシュを復元するケースやネットワークに接続できないマシン向けだ。キャッシュに無いパッケージがあると、その名前を明示したエラーになる。
bun install --prefer-offline はキャッシュを優先する。期限切れでもキャッシュのコピーを使い、キャッシュに無いパッケージだけダウンロードする。どちらも bunfig.toml に設定すればデフォルトにできる。
self-contained node_modules
ワークスペースのpackage.jsonに "selfContained" を指定すると、そのパッケージ専用の node_modules が作られる。Electronのように特定の node_modules レイアウトを期待するツール向けだ。Yarnの hoistingLimits 設定も利用できる。
bun buildのバンドル最適化とコンパイル改善

export * asによるバンドルサイズ削減
zodやEffectのように export * as でエクスポートをまとめるライブラリで、未使用エクスポートのツリーシェイクが効くようになった。v1.4.0では z.object() を呼んだ場合でもグループの全エクスポートを保持していた。v1.4.1では直接参照にコンパイルされ、不要なエクスポートが削除される。
各ライブラリから2〜3個の関数だけを呼ぶ小規模なプログラムを、bun build --minify でビルドした結果だ。zodでは252個のエントリを持つ名前空間オブジェクトが生成されていたが、v1.4.1ではすべて削除された。
動的importのtree-shakingとコード分割
import() で読み込むモジュールでも、未使用のエクスポートが削除されるようになった。const { z } = await import("zod") は静的な import { z } from "zod" と同じコードにバンドルされる。zod 4.5では377.9KBから78.2KBへ縮む。
--splitting も改善された。40個の遅延ルートを持つテストアプリでは、出力ファイルが219個から151個に、出力サイズが124KBから75KBに減った。さらに --min-chunk-size オプションで小さなチャンクを統合できる。ブラウザ向けビルドでは link rel="modulepreload" が自動追加され、チャンクのフェッチが並列化される。
–compileの起動高速化とバイトコード削減
コンパイル済み実行ファイルの起動も速くなった。BunでコンパイルされたClaude Codeでは、入力ボックスが表示されるまでの時間が397msから318msへ20%短縮された。バイトコードのサイズも最適化され、これまで元ソースの約9倍だったものが約3倍になった。Claude Codeのインストールサイズは376MBから207MBへ45%減っている。
--bytecode-depth で事前コンパイルする関数のネスト深度を制限できる。--bytecode を付けたクロスコンパイルもmacOSやLinuxからWindows x64へ対応した。テキストインポートは1回だけ埋め込まれ、実行時の解析とコピーが不要になった。
この記事のポイント
- Bun v1.4.1は202件の問題を修正し、アイドル時のメモリ使用量を大幅に削減した
- Bun.serveがHTTP/2に対応し、WebSocketにpauseとresumeが追加された
- bun installにオフラインモードが加わり、CIやネットワーク遮断環境で使いやすくなった
- bun buildはzodやEffectのバンドルサイズを最大85%削減し、コード分割も改善した
- bun build –compileは起動時間とバイトコードサイズを最適化した
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験