

WooCommerce 11.0が商品オブジェクトキャッシュを標準化!新規ストアは自動有効
WooCommerce 11.0がリリースされ、商品オブジェクトキャッシュが新規ストア向けにデフォルトで有効化された。この機能は、商品ページやチェックアウト処理で同じ商品データを何度もデータベースから取得する無駄を省き、ECサイトの表示速度を底上げする。
可変商品がある製品ページでは約9〜12%、バンドル商品を含むチェックアウト処理では6〜12%の処理速度改善が報告されている。今回の変更は、WooCommerce 10.5で実験的導入が始まったキャッシュ機構が安定動作の段階に達したことを示している。
新規にWooCommerce 11.0以上をインストールしたストアには自動で適用されるが、アップグレードした既存ストアの設定は一切変更されない。必要に応じて管理画面から手動でオンにできる仕組みだ。
商品オブジェクトキャッシュの仕組みとパフォーマンス改善の数字
リクエスト内で商品データを使い回すメモリ内キャッシュ
このキャッシュは、一度のHTTPリクエストの間だけ生きている、揮発性のメモリ内キャッシュだ。wc_get_product(123)が呼ばれると、キャッシュに保存されていればデータベースに問い合わせず、すぐに商品オブジェクトの複製を返す。リクエストが終わればキャッシュは完全に消去されるため、次のリクエストで古い情報が残る心配はない。
特に、wc_get_product()を同じIDで何度もコールするパターンが多いテーマやプラグインで効果が大きい。各呼び出しが独立したオブジェクトのクローンを返すため、意図せず商品データの状態を共有してしまうバグも防げるようになった。
このデモは、同じ商品IDに対する繰り返し呼び出しがキャッシュによってどれだけ無駄を省けるかを示している。実際のECサイトでは、商品ループやセール情報の取得、決済フローの中で wc_get_product() が頻繁に呼ばれるため、体感速度の改善が期待できる。
実測値として9〜12%の高速化
WooCommerce 10.5の実験的導入時に公表されたパフォーマンス測定値は、今回の正式適用後も同じだ。可変商品(サイズや色のバリエーションがある商品)の製品ページでは、読み込み時間が9〜12%短縮された。バンドル商品を含むチェックアウト処理では6〜12%高速化されている。
この改善幅は、商品データを繰り返し取得する重いクエリがページ表示のボトルネックになっている状況で顕著だ。小規模なサイトでは効果が体感しにくいケースもあるが、商品数が多いストアや複雑な製品構成のサイトでは、目に見える速度向上が得られる。
WooCommerce 10.5から11.0への段階的な導入プロセス

10.5で実験的機能として登場、10.6で互換性の宣言が「互換」に
商品オブジェクトキャッシュは、WooCommerce 10.5で「実験的機能」として初めて公開された。当時はデフォルトで無効であり、ストア運営者が手動でオンにする必要があった。機能自体は、wc_get_product()の呼び出しをインターセプトし、リクエスト単位のメモリ内キャッシュからデータを返す仕組みだ。
WooCommerce 10.6では、この機能のプラグイン互換性宣言が「非互換」から「互換」に変更された。実験期間中に拡張機能エコシステム全体で互換性の問題が一切報告されなかったため、明示的に互換性を宣言していない拡張機能も、デフォルトで互換とみなされるようになった。
もし拡張機能が明示的に「この機能とは非互換」と宣言している場合は、WooCommerceの機能画面に従来通り非互換の通知が表示される。しかし、そのような宣言が必要になった拡張機能は見つかっていない。
11.0で新規ストアへの自動有効化を実装
WooCommerce 11.0のクリーンインストール時には、インストールプロセスの一環として商品オブジェクトキャッシュが自動で有効になる。機能登録自体は enabled_by_default => false のまま変更されていないが、新規インストール時に明示的に有効化が書き込まれる仕組みをとっている。
これは、HPOS(High-Performance Order Storage)など、他の機能がオプトインから新規インストール時デフォルトへ移行した際と同じパターンだ。バージョンアップだけでは既存ストアの設定を変更しない、慎重な設計が貫かれている。
既存ストアの挙動と手動有効化の手順

アップグレードしても設定は一切変わらない
WooCommerce 11.0より前に構築されたストアは、11.0へアップグレードしても既存のキャッシュ設定がそのまま維持される。もし以前に無効だった(それが11.0以前のストアのデフォルト設定だ)なら、アップグレード後も無効のままだ。すでに手動で有効にしていたストアは、そのまま有効が継続される。
つまり、次の3パターンに整理できる。
- WooCommerce 11.0以降を新規インストール → 自動的に有効(操作不要)
- 既存ストアで機能が無効だった → アップグレード後も無効のまま(手動で有効にできる)
- 既存ストアで機能が有効だった → アップグレード後も有効のまま(操作不要)
手動で有効化する方法
既存ストアでこの機能を試したい場合、管理画面の WooCommerce → 設定 → 詳細設定 → 機能 にアクセスし、「商品オブジェクトをキャッシュする(Cache Product Objects)」のトグルをオンにすればよい。ただし、設定変更後にサイト全体の動作を一通りチェックしておくことが推奨される。
トグルをオンにすると、その瞬間からリクエスト単位の商品キャッシュが働き始める。とくに、複数の拡張機能が同じ商品データにアクセスする大規模ストアでは、即効性のある改善が期待できるだろう。
拡張機能開発者への影響と注意点

標準APIを使っていればコード変更は不要
wc_get_product() やその他 WooCommerce 標準 API を通じて商品を取得している拡張機能は、このキャッシュの影響をまったく受けない。キャッシュは内部で透過的に動作し、呼び出し元には変わらず正しい商品オブジェクトが返る。
キャッシュから返されるのは、あくまで独立したクローンなので、取得した商品オブジェクトを編集しても他の処理に副作用が及ぶことはない。したがって、従来のコーディング規約に従っている拡張機能は、そのまま動作し続ける。
直接SQLを実行する拡張機能が注意すべきポイント
注意が必要なのは、WooCommerceのメタフックを経由せずに、商品データに対して直接SQLクエリを発行している拡張機能だ。これらのクエリはキャッシュの無効化フックを迂回するため、更新後のデータがキャッシュに反映されず、古い情報が返ってしまう可能性がある。
この問題は、商品オブジェクトキャッシュに限った話ではなく、WooCommerceのデータ整合性全般に関わる設計課題だ。該当する拡張機能を開発している場合は、標準の wc_get_product() やメタデータ更新用のAPIを使うことで、キャッシュの恩恵を受けつつ、データ不整合も回避できる。
今後のロードマップと全ストアへの有効化計画

データ蓄積後に全ストアで有効化へ
今回のリリースは通過点であり、最終的にはすべてのストア(既存ストアも含む)で商品オブジェクトキャッシュを有効化する計画が示されている。現時点で具体的な実施時期は明言されていないが、十分なストアでの稼働データが蓄積された段階で判断される。
すでに実験期間で問題が報告されていないこと、新規インストールのデフォルト有効化でさらなる実績が積み上がることを踏まえると、早ければ数バージョン後には全ユーザー対象の強制有効化に踏み切る可能性が高い。
問題が発生した場合の報告先
もし商品オブジェクトキャッシュに関連して予期せぬ挙動が見つかった場合、WooCommerceのGitHubリポジトリでIssueを報告してほしいと開発チームは呼びかけている。拡張機能開発者やストア運営者からのフィードバックが、今後の安定化に直結する。
この記事のポイント
- WooCommerce 11.0 で商品オブジェクトキャッシュが新規ストア向けに自動有効化された
- 可変商品の製品ページ読み込みは 9〜12% 高速化、バンドル商品のチェックアウトは 6〜12% 改善
- 既存ストアはアップグレードしても設定変更なし、管理画面から手動でオンにできる
- 標準の WooCommerce API を使う拡張機能はコード変更不要で動作する
- 最終的には全ストアで有効化される予定で、Issue 報告を募っている

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
JavaScriptがログアウト時に動かない原因と直し方
管理画面にログインしているときだけ JavaScript が動き、ログアウトすると止まる。この現象の原因は、ほぼ「スクリプトの読み込み順序」と「キャッシュ・最適化プラグインの挙動」のどちらか、あるいは両方の組み合わせだ。ログイン時は管理バー用のスクリプト等が読み込まれるため依存関係が偶然成立し、ログアウト時にそれが外れてエラーになるケースが多い。
ログアウト時だけ JavaScript が動かなくなる仕組み
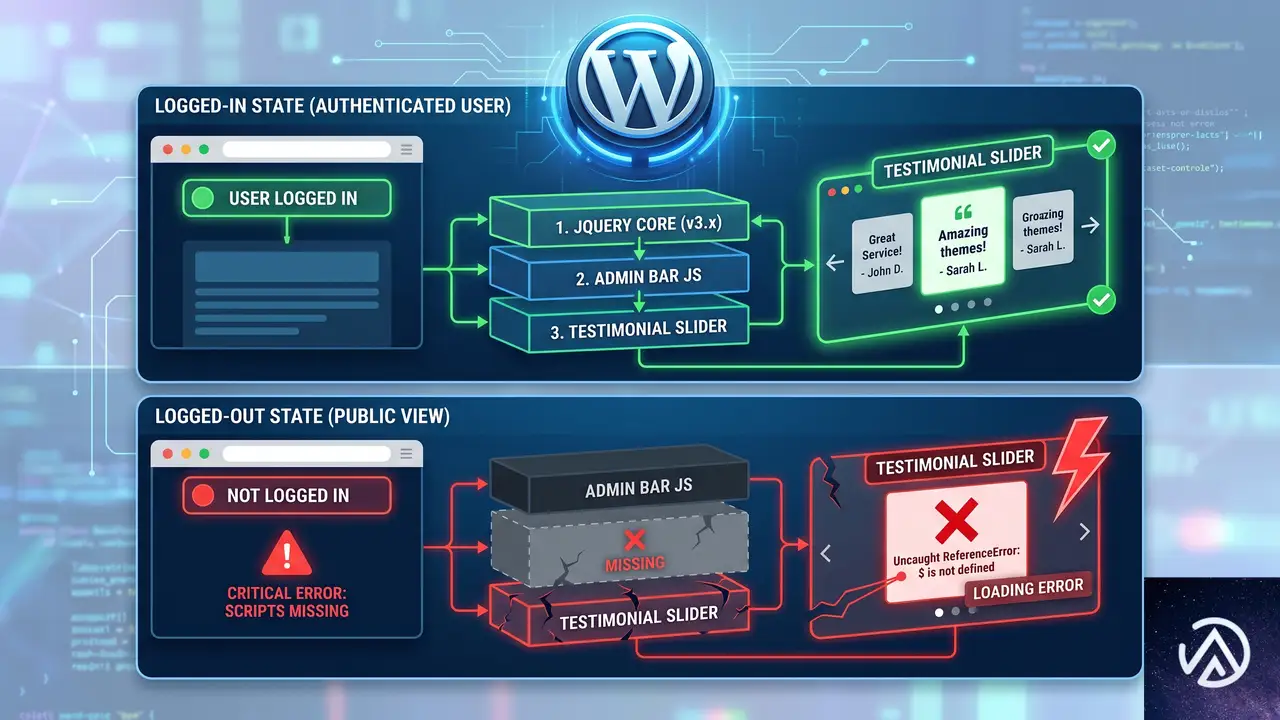
このデモは典型的な依存関係の崩れを示している。ログイン中は WordPress が管理バーやフッターに jQuery を読み込むため、その後に記述されたスクリプトが偶然動く。ログアウトすると jQuery が存在せず、$ is not defined や jQuery is not defined といったエラーで止まる。
HTML ブロックに直接書いた JavaScript が招く問題
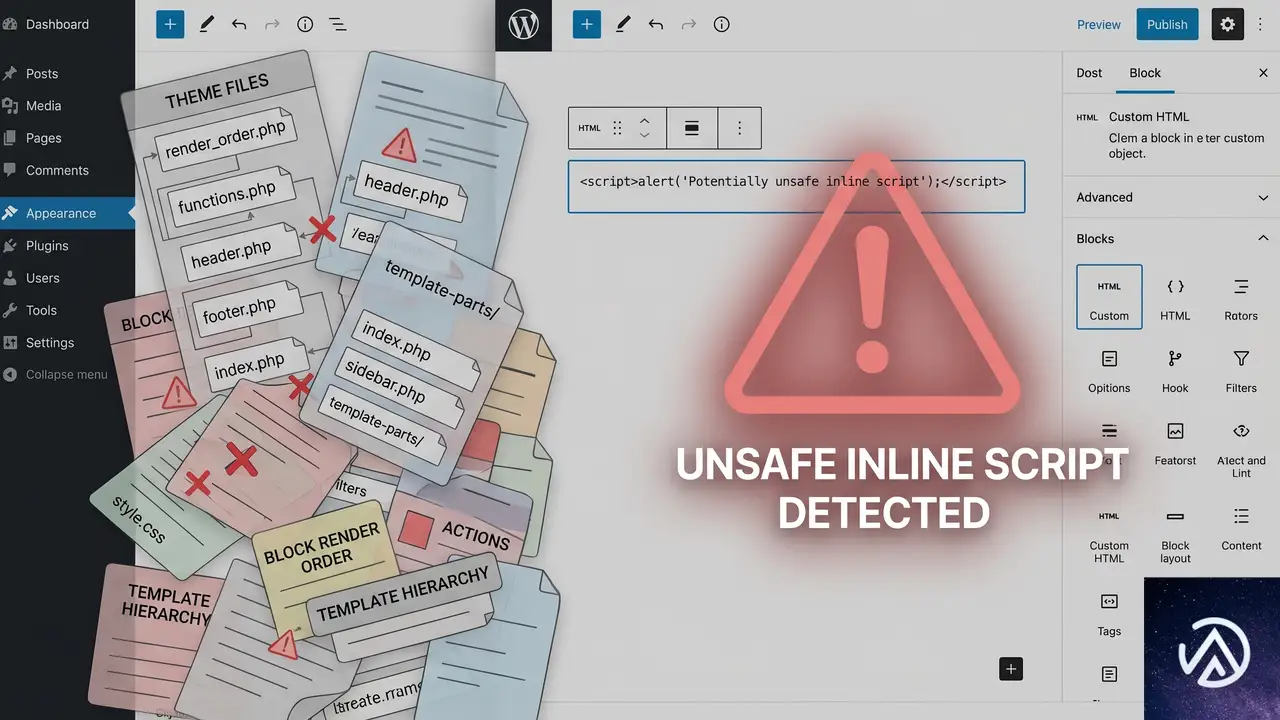
WordPress の「カスタム HTML」ブロックに <script> タグを直書きする方法は、一見手軽だが制御が難しい。出力される位置がテーマやブロック配置に依存し、jQuery などのライブラリより前に実行されれば必ず失敗する。さらにインラインスクリプトは多くのキャッシュプラグインで最適化対象から外されたり、結合・遅延読み込みの対象にならず、ログアウト時だけ二重に不利な状況を生む。
HTML ブロック直書きスクリプトの3つの弱点
- 読み込み順序を制御できない(テーマの render 順に依存する)
- jQuery の依存関係を WordPress に伝えられない
- キャッシュ・圧縮プラグインがスクリプトとして認識しない場合がある
ログアウト時でも動くようにする正しい組み込み手順
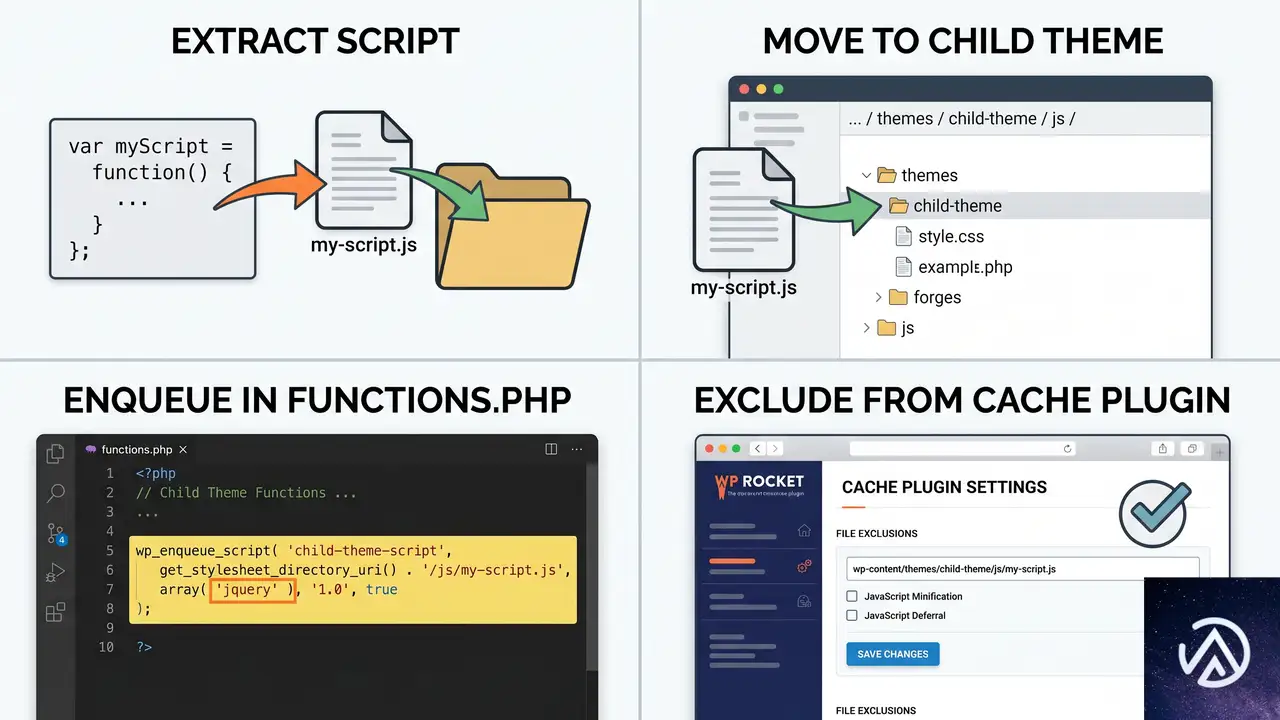
原則は「JavaScript は HTML ブロックに直書きせず、WordPress の仕組み(wp_enqueue_script)で読み込む」ことだ。すでに直書きで動いているものを移行するには、以下の手順で進める。
STEP 1 既存の script タグを外部ファイルに移す
HTML ブロック内の <script>〜</script> 部分だけを抜き出し、子テーマのフォルダ内に testimonial-slider.js のような名前で保存する。<script> タグそのものは不要で、中身のコードだけを移す。HTML ブロックにはスライダーの構造(ul や div のマークアップ)だけを残す。
STEP 2 functions.php で安全に読み込む
子テーマの functions.php に以下のコードを追加する。管理画面ではなくフロントエンドだけに読み込ませるために wp_enqueue_scripts フックを使う。依存関係として jquery を指定すれば、WordPress 本体の jQuery が先に読み込まれてから実行される。
function my_testimonial_slider_script() {
    wp_enqueue_script(
        'testimonial-slider',
        get_stylesheet_directory_uri() . '/testimonial-slider.js',
        array('jquery'),
        '1.0.0',
        true
    );
}
add_action('wp_enqueue_scripts', 'my_testimonial_slider_script');
最後の引数 true はフッターで読み込む指定だ。スライダーの DOM 要素が本文中に存在する場合はフッター読み込みで問題ない。もしスライダーを本文より前に実行する必要があるなら false にしてヘッダーで読ませるが、多くのケースではフッターで十分だ。
STEP 3 $ の衝突を防ぐ
WordPress の jQuery は noConflict モードで動作しているため、$ がそのまま使えない環境がある。古いコードを流用している場合は $ is not a function エラーが起きやすい。回避策として、外部ファイル全体を即時実行関数で囲み、引数で $ を受け取る記法が安全だ。
(function($) {
    $(document).ready(function() {
        // ここにスライダーのコード
    });
})(jQuery);
STEP 4 キャッシュプラグインでスクリプトを除外する
ここまで対応しても直らない場合、キャッシュや最適化プラグインが原因の可能性が高い。ログアウト時はページキャッシュが有効になり、スクリプトの遅延読み込みや結合が適用される。自前の testimonial-slider.js をこれらの処理から除外する必要がある。
プラグインの設定画面で「スクリプトの除外」「遅延読み込みの除外」といった項目を探し、testimonial-slider(ハンドル名)または testimonial-slider.js(ファイル名の一部)を指定する。除外後は必ずキャッシュを全削除してからログアウト状態で確認する。
Elementor のフックやテーマのアクションフックを使った場合の注意点
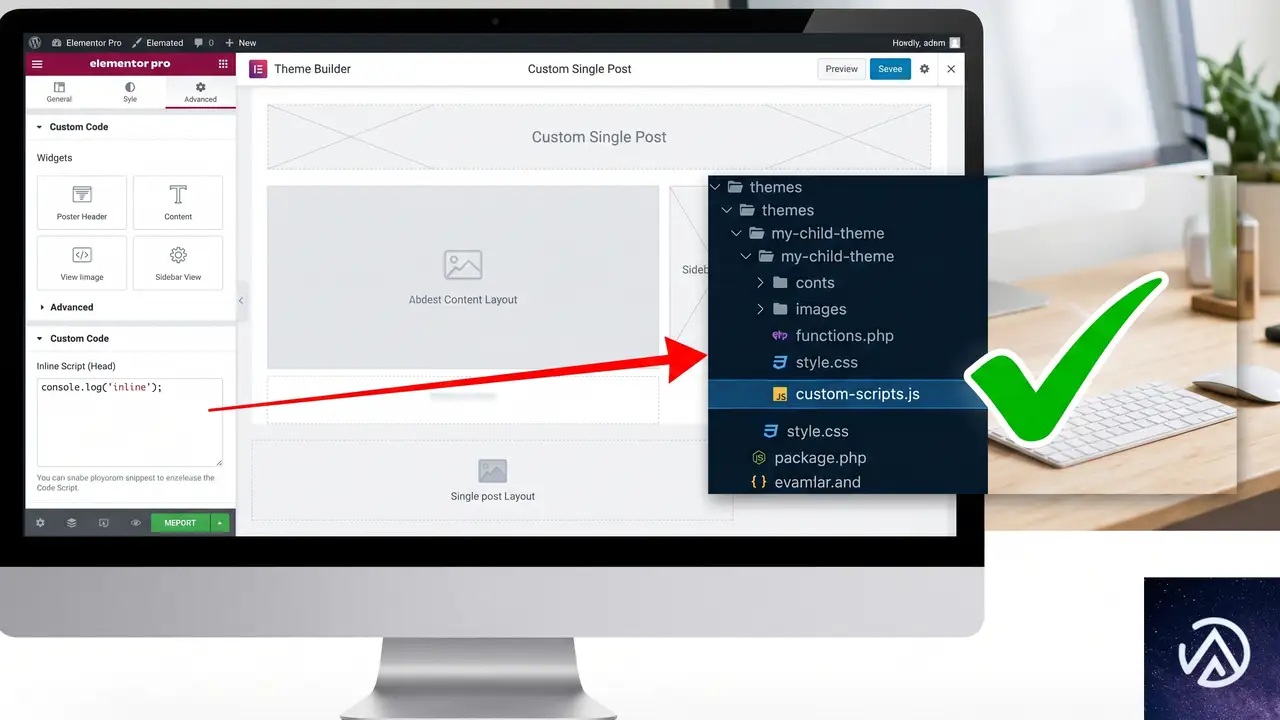
テーマ付属のフック(GeneratePress の Element など)に HTML ブロックごと差し込む方法も考えられるが、根本的にはスクリプトの読み込み順序問題は同じだ。フックで出力する位置を変えても、jQuery より前に呼ばれるリスクは残る。フックを使う場合でも、スクリプト部分は wp_enqueue_script に任せ、フックにはマークアップだけを出力する形が堅実だ。
Elementor Pro の「カスタムコード」機能を使っているなら、その中に script タグを書くのではなく、同様に子テーマのファイルとして切り出してハンドル登録するほうが制御できる。どうしても直書きが必要なら、カスタムコードの「場所」設定を「本文の終了タグ直前」にし、さらにコード内で jQuery を明示的に使う($ を使わない)ことでエラーを減らせる。
よくある質問
コンソールに「$ is not defined」と出るがどう直せばいいか
jQuery が読み込まれる前に $ を使っているか、noConflict モードで $ が無効になっている。即時関数で (function($) { ... })(jQuery); とラップし、すべての $ をこのスコープ内に収めれば解決する。
functions.php を編集せずに直す方法はあるか
「WPCode」などのコードスニペット管理プラグインを使えば、管理画面から wp_enqueue_script のコードを登録できる。functions.php を直接触りたくない場合の現実的な代替手段だ。スニペットの実行場所を「フロントエンドのみ」に設定するのを忘れないようにする。
キャッシュを削除しても直らないのはなぜか
ブラウザキャッシュだけを消していて、サーバー側のページキャッシュや CDN キャッシュが残っているケースが多い。WordPress のキャッシュプラグインの「すべてのキャッシュを削除」を実行し、さらに CDN を使っている場合はその管理画面からもパージする。シークレットウィンドウで確認するとブラウザキャッシュの影響を除外できる。
スライダーのマークアップだけ残して script を外したら表示が消えた
新しく作った JS ファイルが正しく読み込まれていない。ブラウザの開発者ツールの「ネットワーク」タブで testimonial-slider.js が 200 番で返っているか確認する。404 ならパスが間違っている。読み込まれているのに動かない場合は、コンソールに別のエラーが出ていないか調べる。
この記事のポイント
- ログアウト時だけ JavaScript が動かない原因は、jQuery の依存切れとキャッシュ最適化の複合
- HTML ブロックへの script 直書きは読み込み順序を制御できず、根本対策にならない
- wp_enqueue_script で jQuery 依存を明示し、外部ファイルとして切り出すのが正攻法
- 即時関数で $ の衝突を防ぎ、キャッシュプラグインでは独自スクリプトを除外対象に追加する
- Elementor やテーマフックを使う場合も、スクリプトだけは enqueue に任せる設計が堅実

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている

AI時代のキャッシュ設計を再考する——AIクローラーがCDNに与える影響と対策
CDN(コンテンツデリバリネットワーク)のキャッシュ設計が、AIクローラーの台頭によって根本的な見直しを迫られている。Cloudflareのデータによると、同社ネットワーク上のトラフィックの32%は自動化されたトラフィックが占める。検索エンジンクローラーや監視ツールに加え、近年はAIアシスタントが回答生成のためにWebから情報を取得するケースが増加している。
AIエージェントは人間とは異なるアクセスパターンを示す。高頻度の並列リクエスト、人気ページではなく長尾コンテンツへの集中的なアクセス、サイト全体の網羅的なスキャンなどが特徴だ。このような振る舞いは、従来の人間向けに最適化されたキャッシュアルゴリズムを無効化し、キャッシュミス率の上昇とオリジンサーバー負荷の増大を引き起こす。
サイト運営者はAIクローラーへの対応に迫られる。ブロックするか、サービスを提供するかの選択を迫られるが、両者のトラフィックパターンは大きく異なるため、既存のキャッシュアーキテクチャでは一方に最適化するしかない。本記事では、AIトラフィックがCDNキャッシュに与える影響を分析し、新しいキャッシュ設計の方向性を探る。
AIクローラーと人間のトラフィックの根本的な違い

AIクローラーのトラフィックは、人間のブラウジング行動と比較して3つの主要な特徴を持つ。高ユニークURL比率、コンテンツの多様性、クロールの非効率性だ。
高ユニークURL比率と長尾コンテンツへのアクセス
Common Crawlの公開データによると、大規模Webクロールでは90%以上のページがコンテンツ的にユニークだ。AIクローラーは特定のコンテンツタイプに特化する傾向があり、技術文書、ソースコード、メディアファイル、ブログ記事など、目的に応じて異なるコンテンツを対象とする。
人間のユーザーがトップページや人気記事に集中するのに対し、AIクローラーはサイトの奥深くまで探索する。Wikipediaの利用データは、かつて「長尾」とされていたほとんどアクセスされないページが、現在では頻繁にリクエストされるようになったことを示している。これはCDNキャッシュ内のコンテンツ人気度分布そのものを変化させている。
クロールの非効率性と反復ループ
AIクローラーは必ずしも最適なクロールパスをたどらない。人気のあるAIクローラーからのフェッチのかなりの割合が404エラーやリダイレクトで終わる。これはURL処理の不備によることが多い。また、ブラウザ側のキャッシュやセッション管理を人間のユーザーと同じように利用しない。
AIエージェントは検索結果を改良するために反復ループを行うことがある。これはRAG(Retrieval-Augmented Generation)における一般的なパターンだ。この反復ループは、エージェントの精度を高める一方で、一貫して高いユニークアクセス比率(70%から100%)を維持する。つまり、各ループで以前に見たページを再訪するのではなく、常に新しいユニークなコンテンツを取得し続ける。
キャッシュへの直接的な影響
長尾アセットへのこのような反復アクセスは、人間のトラフィックが依存するキャッシュをかき回す。既存のプリフェッチや従来のキャッシュ無効化戦略は、クローラートラフィックの量が増加するにつれて効果が低下する。Cloudflareの単一ノードにおけるキャッシュヒット率は、AIクローラーを含む場合と含まない場合で明確な差が見られる。ヒット率の低下は、LRU(Least Recently Used)アルゴリズムがAIクローラーの反復スキャン行動に対処できていないことを示唆している。
実例から見るAIクローラーのインパクト

AIボットトラフィックの急増は、実際のWebサービスに深刻な影響を与えている。大規模サイトにおける影響と対応策は以下の通りだ。
Wikipedia:マルチメディア帯域幅の50%急増
モデル訓練のための画像一括スクレイピングにより、マルチメディア帯域幅使用量が50%急増した。Wikimediaは最終的にクローラートラフィックをブロックする対応を取った。
SourceHutとRead the Docs:サービス不安定化
ソースコードリポジトリをスクレイピングするLLMクローラーにより、サービス不安定化と速度低下が発生。Read the Docsでは、AIクローラーが大きなファイルを1日に数百回ダウンロードし、帯域幅の大幅な増加を引き起こした。両サービスとも一時的にクローラートラフィックをブロックし、IPベースのレート制限を実施した。
FedoraとDiaspora:人間ユーザーへの影響
Fedoraはパッケージミラーを再帰的にクロールするAIスクレイパーにより、人間ユーザーに対する応答速度が低下。Diasporaソーシャルネットワークは、robots.txtを尊重しない積極的なスクレイピングにより、応答速度の低下とダウンタイムを経験した。両者とも既知のボットソースからのトラフィックを地理的にブロックするなどの対応を取った。
これらの事例が示すのは、AIクローラーを単純にブロックするだけでは根本的な解決にならないということだ。よりスマートなキャッシュアーキテクチャがあれば、サイト運営者はAIクローラーにサービスを提供しつつ、人間ユーザーの応答時間を維持できる。
AI時代に向けたキャッシュ設計の新たな方向性

AIトラフィックの特性を考慮した新しいキャッシュ設計が必要とされている。主なアプローチは2つある。AIを意識したキャッシュアルゴリズムによるトラフィックフィルタリングと、AIクローラートラフィック専用の新しいキャッシュ層の追加だ。
ワークロード対応型キャッシュアルゴリズム
現在広く使用されているLRU(Least Recently Used)アルゴリズムは、汎用状況においてシンプルさ、低オーバーヘッド、有効性のバランスが取れている。しかし、人間とAIボットの混合トラフィックに対しては、別のキャッシュ置換アルゴリズムの選択が有効かもしれない。
初期実験では、SEIVEやS3FIFOといったアルゴリズムを使用することで、AIの干渉の有無にかかわらず、人間トラフィックが同じヒット率を達成できる可能性が示されている。さらに、ワークロードを直接意識した機械学習ベースのキャッシュアルゴリズムを開発し、リアルタイムでキャッシュ応答をカスタマイズする実験も進められている。これにより、より高速でコスト効率の高いキャッシュが実現できる。
トラフィック種別に応じた階層化キャッシュアーキテクチャ
長期的には、AIトラフィック専用の別個のキャッシュ層が最善の道となる。人間とAIのトラフィックをネットワークの異なる層に配置された別個の階層にルーティングするキャッシュアーキテクチャが考えられる。
人間トラフィックは、応答性とキャッシュヒット率を優先するCDN PoP(Point of Presence)のエッジキャッシュから引き続きサービスされる。一方、AIトラフィックのキャッシュ処理はタスクタイプによって変えることができる。
RAGやリアルタイム要約のようなライブアプリケーションを支えるAIクローラーでは、レイテンシが重要だ。これらのリクエストは、より大きな容量と適度な応答時間のバランスが取れたキャッシュにルーティングされるべきである。これらのキャッシュは鮮度を保ちつつも、人間向けキャッシュよりもわずかに高いアクセスレイテンシを許容できる。
訓練セットの構築や大規模コンテンツ収集ジョブに使用されるAIクローラーは、かなり高いレイテンシを許容し、時間的制約がない。これらのワークロードは、到達までに時間がかかる深いキャッシュ階層(オリジン側のSSDキャッシュなど)からサービスできる。あるいは、キューベースのアドミッションやレートリミッターを使用して遅延させ、バックエンドの過負荷を防ぐことも可能だ。これにより、インフラに負荷がかかっている場合にバルクスクレイピングを延期する機会も生まれる。
この記事のポイント
- AIクローラーは全ネットワークトラフィックの約3分の1を占め、そのアクセスパターンは人間のブラウジング行動と根本的に異なる。
- 高ユニークURL比率、長尾コンテンツへの集中アクセス、反復ループによるキャッシュチャーンが、従来のLRUキャッシュアルゴリズムの効果を低下させている。
- WikipediaやFedoraなどの大規模サイトでは、AIクローラーによる帯域幅急増やサービス不安定化が実際に発生し、多くのサイトがクローラーブロックに頼らざるを得なくなっている。
- 根本的な解決策として、SEIVEやS3FIFOなどの新しいキャッシュアルゴリズムの採用と、AIトラフィック専用の階層化キャッシュアーキテクチャの構築が検討されている。
- 今後のCDN設計では、人間トラフィックとAIトラフィックを分離し、それぞれの特性に最適化したキャッシュ戦略を適用することが重要になる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Seraphinite Acceleratorの脆弱性、6万サイトに影響 認証済みユーザーが内部データを取得可能
WordPressの高速化プラグイン「Seraphinite Accelerator」に深刻なセキュリティ脆弱性が発見された。この脆弱性により、最低限の権限を持つ認証済みユーザーがサイトの内部データを取得できる状態だった。
影響を受けるのはバージョン2.28.14までの全バージョンで、インストールサイト数は6万以上に及ぶ。開発元はバージョン2.28.15で修正を実施した。
この問題は、パフォーマンス向上を目的としたプラグインが、逆にセキュリティリスクを生み出すという構造的な課題を示している。
脆弱性の概要と影響範囲

2026年3月4日、セキュリティ企業のWordfenceがSeraphinite Acceleratorプラグインに関する2件の脆弱性を公表した。これらの脆弱性は「CVE-2026-XXXXX」および「CVE-2026-XXXXY」として追跡されている。
認証済みユーザーによる情報取得
1つ目の脆弱性は情報漏洩に関わる。プラグインが提供するAPIエンドポイント「seraph_accel_api」に、権限チェックの不備が存在した。
このエンドポイントを通じて「GetData」関数を呼び出すと、内部の「OnAdminApi_GetData()」関数が実行される。本来、この関数は管理者のみがアクセス可能なシステム情報を返すものだ。
しかし、関数内に適切な権限チェック(capability check)が実装されていなかった。その結果、購読者レベル(Subscriber)以上の権限を持つすべての認証済みユーザーが、このAPIを呼び出せた。
取得可能な内部データの具体例
攻撃者がこの脆弱性を悪用した場合、以下のような運用上の機密情報を取得できた。
- キャッシュの状態情報
- スケジュールされたタスクの詳細
- 外部データベースの状態
これらの情報は、サイトの内部構造やプラグインの動作状況を外部から可視化するものだ。直接的な管理者権限の奪取にはつながらないが、サイトのインフラを調査する足がかりとなる。
第二の脆弱性:ログの無許可消去
2つ目の脆弱性も同様の権限チェック不備に起因する。今度は「LogClear」関数に問題があった。
攻撃者はこの関数を呼び出すことで、プラグインのデバッグログや操作ログを消去できた。ログの改ざんや消去は、攻撃の痕跡を隠蔽するために利用される。
Seraphinite Acceleratorの役割とリスクの逆説

Seraphinite AcceleratorはWordPressサイトの表示速度を向上させるパフォーマンスプラグインだ。主な機能はページのキャッシュ生成にある。
サーバーは訪問者が来るたびにページを生成する必要がなくなる。これによりサーバー負荷が軽減され、ページ読み込みが高速化する。プラグインはGZip、Deflate、Brotliといった複数の圧縮形式をサポートする。ブラウザキャッシュの有効化や、デバイス・環境ごとのキャッシュ分離にも対応している。
パフォーマンスとセキュリティのトレードオフ
今回の事例は、パフォーマンス最適化ツールがセキュリティホールになり得ることを示している。キャッシュプラグインはサーバーとクライアントの間に立つ。高度な最適化処理を行うため、システムの深部にアクセスする権限が必要となる。
この特権的なアクセス権を、適切なセキュリティ境界(セキュリティバウンダリ)で保護しなければならない。Seraphinite Acceleratorの場合、管理機能を提供するAPIエンドポイントの実装に不備があった。
「管理者API」の誤った実装
脆弱性の核心は「OnAdminApi_GetData()」という関数名が示す通りだ。この関数は「管理者向けAPI」の一部として設計された。関数名には「Admin」が含まれている。
しかし、実際の実装では管理者権限の有無を確認していなかった。WordPressのプラグイン開発において、管理機能には通常「manage_options」という権限(キャパビリティ)が必要だ。このチェックが欠落していた。
筆者の分析では、これは単純な実装ミスというより、権限モデルの設計段階での見落としの可能性が高い。パフォーマンス系プラグインは、しばしば高度なシステム操作と一般ユーザー向け機能の境界が曖昧になりがちだ。
攻撃シナリオと実際のリスク

この脆弱性を悪用するには、攻撃者はまず対象サイトに「購読者」アカウントを登録する必要がある。多くのWordPressサイトでは、コメント投稿やニュースレター登録のためにユーザー登録を開放している。
低権限アカウントの取得方法
攻撃者は以下のような方法で購読者アカウントを取得する。
- 公開されたユーザー登録フォームを利用する
- ソーシャルエンジニアリングで既存ユーザーの資格情報を窃取する
- 他の脆弱性やパスワード漏洩を利用する
一度購読者権限を取得すれば、攻撃者は特別なツールや高度な技術なしに脆弱性を悪用できる。通常のWebリクエストを送信するだけで済む。
情報収集からさらなる攻撃へ
取得した内部データは、より深刻な攻撃の前段階として利用される。キャッシュの状態やスケジュールタスクの情報から、サイトの運用パターンや使用している技術スタックを推測できる。
例えば、特定のキャッシュシステムの既知の脆弱性を探す材料となる。外部データベースの状態が分かれば、データベースに対する攻撃を計画する際の情報となる。
ログ消去機能の悪用は、防御側の可視性を奪う。攻撃者が他の方法でサイトに侵入した後、痕跡を消すためにこの機能を使う可能性がある。
開発元の対応と修正内容

脆弱性の報告を受け、Seraphinite Acceleratorの開発チームは速やかに対応した。バージョン2.28.15で修正パッチをリリースしている。
修正の技術的詳細
修正内容は明確だ。問題のあった「OnAdminApi_GetData()」関数および「LogClear」関連関数に、適切な権限チェックを追加した。
具体的には、関数の実行前に現在のユーザーが「manage_options」権限を持っているか確認するコードを追加した。この権限はWordPressにおいて、管理画面の設定を変更できる管理者ユーザーに与えられる。
変更履歴(チェンジログ)には、「LogClearおよびGetData API関数が、manage_options権限を持たないユーザーによって呼び出される可能性があった」と記載されている。修正により、これらの関数へのアクセスは管理者のみに制限された。
自動更新の有無と適用状況
WordPressのプラグインは、マイナーアップデートについては自動更新機能が働く場合がある。しかし、セキュリティアップデートが自動的に適用されるかは、サイトの設定に依存する。
多くのレンタルサーバーや管理サービスは、セキュリティ更新を自動適用する設定を推奨している。とはいえ、すべてのサイトが即座に更新されるわけではない。6万サイトという影響範囲を考えると、未適用のサイトが相当数残っている可能性がある。
サイト運営者が取るべき対策

Seraphinite Acceleratorを使用しているサイト運営者は、直ちに行動する必要がある。以下の手順に従って対応すべきだ。
緊急措置:プラグインの更新
まず、プラグインをバージョン2.28.15以降に更新する。WordPress管理画面の「プラグイン」セクションにアクセスし、Seraphinite Acceleratorの横に「更新あり」と表示されていないか確認する。
更新が利用可能な場合は、速やかに実行する。更新後はサイトの表示や機能に問題がないか確認する。パフォーマンスプラグインの更新は、キャッシュの再構築を伴う場合がある。
更新ができない場合の暫定対策
何らかの理由で直ちに更新できない場合、以下の暫定対策を検討する。
- プラグインを一時的に無効化する
- ユーザー登録機能を一時的に停止する
- Webアプリケーションファイアウォール(WAF)で該当APIへのリクエストをブロックする
プラグイン無効化の影響
Seraphinite Acceleratorを無効化すると、キャッシュ機能が停止する。サイトの表示速度が一時的に低下する可能性がある。特にトラフィックの多いサイトではサーバー負荷が増加する。
代替として、他のキャッシュプラグインを一時導入する方法もある。ただし、新たなプラグインの設定や互換性の問題が生じるリスクは承知すべきだ。
長期的なセキュリティ体制の見直し
今回の事例を機に、サイト全体のセキュリティ体制を見直す価値がある。
- 使用プラグインの定期的な監査
- 最小権限の原則に基づくユーザー権限設定
- セキュリティプラグインの導入と適切な設定
- ログの定期的な監視とバックアップ
パフォーマンスプラグインは、その性質上、システムへの深いアクセス権を要求する。導入前に開発元のセキュリティ対応実績を調べる。アクティブインストール数が多いからといって、安全が保証されるわけではない。
パフォーマンスプラグイン選定の新たな視点

Seraphinite Acceleratorの脆弱性は、パフォーマンスツールの選定基準にセキュリティ評価を加える必要性を浮き彫りにした。
コードの質とセキュリティ文化
プラグインを選ぶ際、機能や速度向上効果だけで判断すべきではない。開発チームのセキュリティへの取り組みを評価する材料を探す。
定期的な更新が行われているか。セキュリティアドバイザリに対して迅速に対応しているか。コードが適切に構造化され、権限チェックが一貫して実装されているか。これらの点は、プラグインの長期にわたる信頼性を示す指標となる。
代替手段の検討
サイトの高速化は、単一のプラグインに依存せず、多層的なアプローチで達成できる。サーバーレベルのキャッシュ、CDN(コンテンツデリバリネットワーク)の利用、画像最適化など、リスクを分散させる方法がある。
例えば、信頼性の高い共用サーバーやクラウドサービスでは、サーバー側でキャッシュ機能を提供している場合が多い。これらの機能を最大限活用することで、プラグインへの依存度を下げられる。
この記事のポイント
- Seraphinite Acceleratorの脆弱性は、認証済みユーザーが内部データを取得可能にするものだ。
- 影響を受けるのはバージョン2.28.14までで、6万以上のサイトが該当する。
- 脆弱性の根本原因は、API関数における権限チェックの欠如にある。
- サイト運営者はプラグインをバージョン2.28.15以降に即時更新すべきだ。
- パフォーマンスプラグイン選定には、セキュリティ対応実績の評価が不可欠である。
出典
- Search Engine Journal “Seraphinite Accelerator WordPress Plugin Vulnerabilities Affect 60K Sites” (2026年3月4日)
- Wordfence Threat Intelligence “Seraphinite Accelerator 2.28.14 – Authenticated (Subscriber+) Exposure of Sensitive Information” (2026年3月)
- Wordfence Threat Intelligence “Seraphinite Accelerator 2.28.14 – Missing Authorization to Authenticated (Subscriber+) Log Clearing” (2026年3月)
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験