

Google Cloud、AlloyDB向けリモートMCPサーバーがGA。AIエージェントとDBの安全な統合を実現
Google CloudがAlloyDB向けのリモートMCP(Model Context Protocol)サーバーの一般提供を発表した。これまでローカル開発が中心だったMCPだが、本番環境での運用に耐えるフルマネージドな仕組みとして登場した。AIエージェントが企業のオペレーショナルデータベースに直接アクセスし、安全にクエリを実行できるようになる。
この記事では、リモートMCPサーバーが解決する技術的課題と、AlloyDBを基盤にしたエージェントアプリケーションの構築方法を解説する。データの鮮度、セキュリティ、運用負荷のバランスを取るアーキテクチャを具体的に示す。
リモートMCPとは何か(ローカルMCPとの違い)
MCP(Model Context Protocol)とは、大規模言語モデル(LLM)が外部のデータソースやツールと安全に通信するためのオープン標準プロトコルだ。Anthropicが提唱し、現在では多くのAIエージェントフレームワークで採用されている。従来は開発者のローカルマシン上で動作する「ローカルMCPサーバー」が主流だった。
ローカルMCPサーバーは標準入出力(stdio)を使ってプロセス間通信を行う。これは開発段階では手軽だが、本番環境に持ち込むと途端に問題が顕在化する。複数のエージェントインスタンスが同時にデータベースへアクセスする場合、プロセス管理が複雑化し、ネットワーク越しのセキュリティ確保も難しくなる。
リモートMCPサーバーは、これらの課題をHTTPエンドポイント経由で解決する。Google Cloudのマネージドインフラ上で動作し、OAuth 2.0ベアラートークンによる認証とIAM(Identity and Access Management)によるきめ細かな権限制御を提供する。エージェント開発者はインフラ管理から解放され、クエリ実行に集中できる。
なぜAlloyDBと組み合わせるのか
AlloyDBはGoogle CloudのフルマネージドPostgreSQL互換データベースだ。標準PostgreSQLと比較して、ベクトル検索では最大6倍高速、フィルタ付きクエリでは最大10倍高速というパフォーマンスを備える。ScaNNインデックスを使えば100億ベクトル規模まで拡張でき、AIエージェントのRAG(検索拡張生成)ワークロードに最適化されている。
さらにAlloyDBには、データベース内で直接埋め込みベクトルを生成するAI Functionsや、Gemini Enterprise Platformモデルを使った検索結果のリランキング機能が組み込まれている。エージェントがデータベースにクエリを投げるだけで、最新のオペレーショナルデータに基づいた回答を得られる。データの鮮度を保つためのETLパイプラインが不要になるケースも多い。
リモートMCPサーバーが解決する5つの本番課題
Google Cloudブログの発表によると、リモートMCPサーバーは単なる通信方式の変更にとどまらない。本番環境でAIエージェントを運用するチームが直面する、以下の5つの課題を包括的に解決する設計になっている。
特に注目すべきはIAMによる権限制御だ。従来のデータベース接続では、共有パスワードやAPIキーを使うことが多かった。しかしリモートMCPでは、エージェントごとに特定のテーブルやビューへのアクセス権をIAMで付与できる。読み取り専用のSQL実行ツールを選択すれば、エージェントが誤ってデータを削除するリスクを根本から排除できる。
Model Armorによるプロンプトセキュリティ
リモートMCPサーバーは、Google CloudのModel Armorと統合されている。Model Armorはプロンプトとレスポンスの両方をスクリーニングし、プロンプトインジェクション攻撃や機密データの意図しない流出を防ぐ。エージェントのサービスアカウントが広範なデータベース権限を持っていても、Model Armorがデータの出し方をフィルタリングする仕組みだ。
たとえば、エージェントが顧客のクレジットカード番号を含むカラムにアクセスできる権限を持っていたとしても、Model Armorがレスポンスからその情報を除去できる。これは「権限はあるが出力は制限する」という新しいセキュリティモデルであり、ゼロトラストの考え方をAIエージェントに適用した形だ。
エージェントから見たAlloyDBの強み

リモートMCPサーバーは接続の仕組みを提供するが、その先にあるデータベース自体の性能も重要だ。AlloyDBはエージェントアプリケーションに特化したいくつかの特徴を持つ。
まず、ベクトル検索性能だ。ScaNNインデックスを使うと、標準PostgreSQLの最大6倍の速度でベクトルクエリを実行できる。100億ベクトルまでスケールするため、大規模なRAGアプリケーションでもパフォーマンスが劣化しない。フィルタ条件付きのベクトル検索では最大10倍高速化される。これは「直近30日以内のドキュメントから類似検索」のような実用的なクエリで差が出る。
次に、ハイブリッド検索とリランキングだ。RUM(RUMインデックス / Row Usage Matrix)を使った全文検索とベクトル検索の組み合わせや、Reciprocal Rank Fusionによる結果の融合が可能だ。さらにGemini Enterprise Platformモデルを使ったインテリジェントなリランキングにより、エージェントは最も関連性の高い情報を優先的に取得できる。
また、AlloyDBのAI Functionsはデータベース内部で埋め込みを生成する。外部の埋め込みAPIを呼び出す必要がなく、数百万件の埋め込みを効率的に生成できる。Lakehouse Federationを使えば、BigQueryの分析データやIcebergテーブルのアーカイブデータにも、同じPostgreSQLインターフェースから透過的にアクセスできる。
AIエージェントにとって重要なのは「データの鮮度」と「アクセスの容易さ」だ。AlloyDBのリアルタイム埋め込み生成とLakehouse Federationの組み合わせにより、エージェントは最新のオペレーショナルデータと過去の分析データを区別なく扱える。配送車両の位置情報のような刻々と変化するデータでも、クエリを発行した瞬間の状態を取得できる。
実際の導入手順とデモの流れ
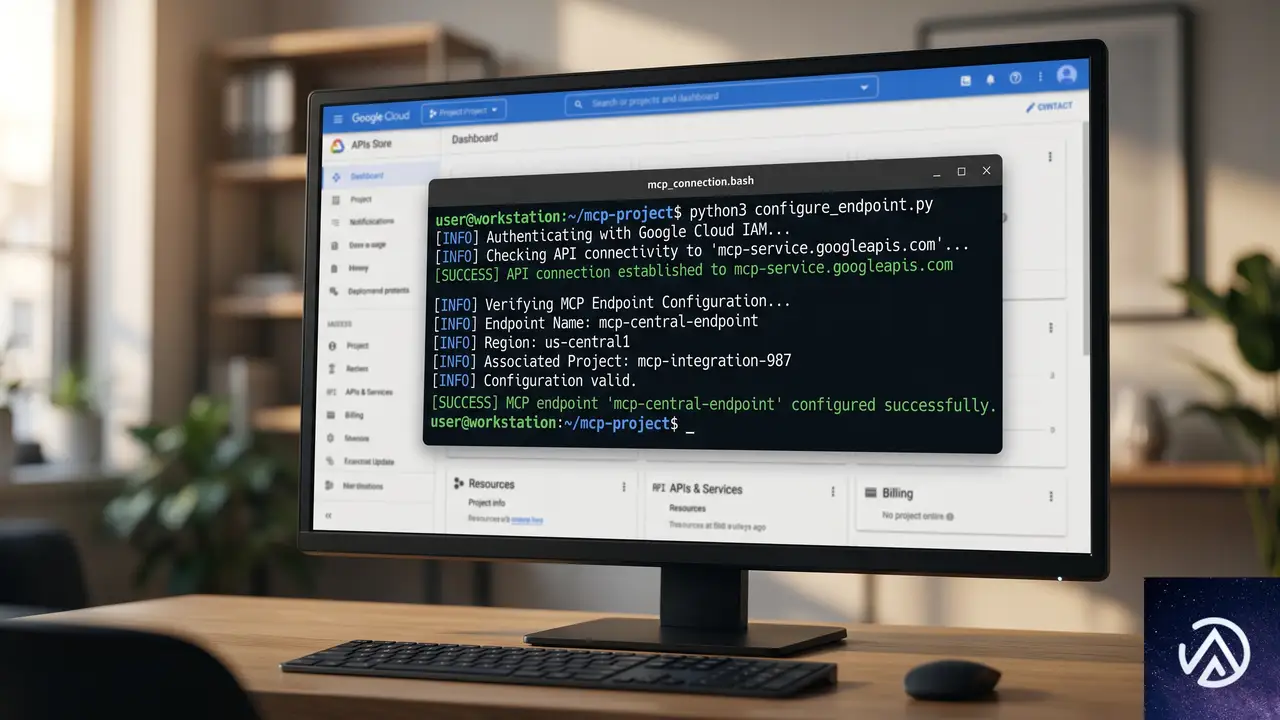
Google Cloudは今回のGA発表にあわせて、Codelab(ハンズオン形式のチュートリアル)を公開した。導入手順は以下の4ステップに整理されている。
接続が確立すると、エージェントは自動的にデータベースのスキーマを把握する。テーブル名やカラム名をイントロスペクションクエリで取得し、ユーザーの質問に応じて適切なJOINや集計クエリを組み立てられる。たとえば「過去24時間で最も遅延が発生している配送ルートは?」という質問に対して、エージェントが配送テーブルと車両テーブルをJOINし、リアルタイムの位置情報と組み合わせて回答する。
AIエージェントが実行できる操作の範囲
リモートMCPサーバー経由でエージェントが実行できる操作は、単なるSELECTクエリにとどまらない。AlloyDBのツールセットを使うと、以下のような運用操作も可能になる。
- データのエクスポートとインポート
- バックアップの作成とリストア
- クラスタの設定更新
- AI Functionsを使ったテキストのランキング(AI.RANK())
もちろん、これらの操作はIAM権限の範囲内でのみ実行される。読み取り専用のSQLツールを選択していれば、データ定義や変更を伴う操作はブロックされる。本番環境での安全な運用を第一に設計されている点が重要だ。
導入時に検討すべきポイント
リモートMCPサーバーのGAは、AIエージェントとデータベースの統合を大きく前進させる。しかし導入にあたっては、いくつかの点を事前に検討する必要がある。
まず、コスト構造の把握だ。AlloyDB自体がエンタープライズ向けのプレミアムデータベースであり、さらにMCPサーバーの利用にもGoogle Cloudの料金が発生する。30日間の無料トライアルが提供されているので、まずは小規模なクラスタで検証し、ワークロードに応じたコストを見積もることを推奨する。
次に、IAMポリシーの設計だ。エージェントに必要最小限の権限を付与する「最小権限の原則」を徹底する必要がある。テーブル単位、カラム単位でのアクセス制御が可能だが、データベースの規模が大きくなるとポリシー管理が複雑化する。事前にアクセス制御のルールを整理しておくことが重要だ。
最後に、プロンプト設計の重要性も変わらない。MCPサーバーがデータへのアクセスを提供しても、エージェントが適切なクエリを生成できるかどうかはプロンプトの質に依存する。スキーマの説明やクエリの方針をプロンプトに含めることで、より正確な結果を得られる。
この記事のポイント
- AlloyDB向けリモートMCPサーバーがGAとなり、HTTPエンドポイント経由でAIエージェントが安全にデータベースへアクセス可能になった
- IAMによるテーブル単位の権限制御と、Model Armorによるプロンプトセキュリティで本番運用に耐える設計
- AlloyDBのベクトル検索性能とAI Functionsの組み合わせにより、RAGアプリケーションの構築が効率化される
- 30日間の無料トライアルとCodelabが提供されており、小規模な検証から始められる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Neon、有料プランのデータ転送量を5倍に増量。500GBで実質エグレスフリー
サーバーレスPostgreSQLサービスのNeonは2026年6月1日、全有料プランに含まれる月間データ転送量を従来の100GBから500GBへと5倍に引き上げた。この変更は自動的に適用され、利用者側での設定変更は不要だ。
500GBという上限は、ほとんどの一般的なワークロードにおける全データ転送(エグレス)コストを実質的にゼロにする水準だ。Neonのブログによれば、チャットボットのバックフィル処理や設定ミスによる超過リスクも、この増量によって大幅に緩和される。
本記事では、増量の具体的な内容と背景、利用者が知っておくべきポイントを整理する。
月間500GBへの増量。その具体的な内容
今回の変更の核心はシンプルだ。Neonの全有料プラン(Launch、Scale、Enterprise)において、月間のパブリックデータ転送(エグレス)の無料枠が100GBから500GBに拡大された。
500GBを超過した場合の追加課金体系に変更はない。超過分はこれまでと同一の従量課金レートで計算される。Neonの記事では「データ転送の計測方法や料金体系に変更は一切ない」と明言されている。
変更は自動適用。請求書にも即時反映
この増量は2026年6月1日からユーザー側の操作なしで自動適用される。Neonのコンソール(管理画面)で利用状況を確認可能で、6月分の請求書には新たな500GBの枠が反映される。
なぜNeonは5倍への増量を決断したのか
Neonのブログ記事は、意思決定の背景を率直に説明している。最大の動機は「予期せぬエグレス課金の排除」だ。
エグレス課金のストレスを根本から減らす
クラウドデータベースにおけるデータ転送料金は、しばしば利用者にとっての「見えないコスト」となる。チャットボットが想定以上にデータを取得したケース、分析ジョブが大量の履歴データを読み込んだケース、設定ミスでループ接続が発生したケースなど、原因は多岐にわたる。
これらの超過は後になってから請求書で気づくことが多く、事後対応が難しい。Neonの著者Carlo Daniele氏は「請求書に届いてからでは遅すぎる」と指摘している。500GBへの増量は、この「事後ショック」をほとんどのユーザーから無くす狙いがある。
競合との差別化とサーバーレスの信頼性向上
サーバーレスデータベース市場では、Vercel PostgresやSupabaseなどもデータ転送枠を設けている。500GBという閾値は、これらのサービスと比較しても実質的な「エグレスフリー」を実現する水準だ。
Neonにとって、この変更はプラットフォームの信頼性向上と、サーバーレスアーキテクチャへの移行障壁を下げる施策といえる。特にスタートアップや個人開発者にとって、突発的なコスト増はサービス継続のリスクになりうる。その不安を軽減する効果は大きい。
利用者に求められる対応と確認方法
必要な対応は一切なし
繰り返しになるが、利用者が実施すべき設定変更や申し込みは存在しない。Neonの全有料プラン契約者に対し、2026年6月1日以降の月間データ転送量が自動的に500GBへと引き上げられている。
利用状況の確認方法
自身のデータ転送量を把握したい場合は、Neon Consoleにログインし、請求および利用状況のダッシュボードでエグレス使用量を追跡できる。不明点はNeon公式Discordコミュニティで質問することも可能だ。
今後のデータ転送戦略とユーザーへの影響
今回の増量は、Neonが「データ転送をコスト障壁にしない」という姿勢を明確に打ち出したものと捉えられる。サーバーレスデータベースの利点である「従量課金の柔軟性」は、往々にして「予測不能なコスト」と紙一重だ。
500GBの無料枠は、その両面を切り離す試みだ。実際の利用データにもとづきNeonが「ほとんどのワークロードでエグレス課金が発生しなくなる」と明言している点は、単なるマーケティングではなくユーザー利用統計に裏付けられた判断といえる。
将来的にNeonがさらなるデータ転送枠の拡大や、完全なエグレスフリー化に踏み切る可能性もあるが、現時点ではこの変更が最大のハードルを解消したと評価できる。
この記事のポイント
- Neonは2026年6月1日より、全有料プランの月間データ転送量を100GBから500GBに増量
- 変更は完全自動適用。利用者による操作や設定変更は不要
- 500GB超過分の従量課金体系に変更はなく、データ転送の計測方法も据え置き
- 大半の一般的なワークロードがエグレス課金の対象外に。実質的なコスト障壁が大幅に低下
- 予期せぬエグレス課金への不安を解消し、サーバーレスデータベースの信頼性を強化
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Prisma Next早期アクセス開始、型安全DBコントラクトとエージェント連携
Prisma Nextの早期アクセスが2026年5月22日に開始された。PostgresとMongoDBを対象に、データベース定義をコントラクトとして記述すれば、マイグレーションや型チェックをフレームワークが自動処理する。エージェントと連携する開発ワークフローにより、データ層の構築速度が大幅に向上する見込みだ。
開発者がコントラクトを書くと、あとはPrisma Nextがデータベースマイグレーション、クエリの型検査、エラー時の意味のあるメッセージを生成する。エージェントがコードを提案し、型検査を通過することで、安全なクエリが担保される仕組みだ。
1行のコマンドで始まるオンボーディング

新しいフレームワークを習得するには、ドキュメントを読み、小さなプロジェクトで試行錯誤を重ねる。慣れるまでに数週間を要することも多い。Prisma Nextはその学習曲線を1行のコマンドで解消する。npm create prisma@next を実行すれば、プロジェクトの骨組みと、エージェントを即座に専門家にする多数のスキルが自動生成される。
npm create prisma@nextドキュメントを熟読する代わりに、エージェントがフレームワークの慣用句をリアルタイムに提示する。質問があればエージェントに尋ねればよく、コマンドの意味や設計の意図をその場で説明してくれる。まるで熟練者が隣で教えてくれているような体験だ。
既存プロジェクトへの導入
既存のプロジェクトに追加する場合もnpx prisma-next@latest initで簡単にセットアップできる。その後、エージェントに「読んでいる本を追跡する小さなアプリを構築して」と指示するだけで、スキーマ定義からクエリ作成までを自律的に進める。
コントラクトを書けばデータベース管理はフレームワーク任せ

Prisma Nextの中心にあるのが、アプリケーションとデータベースの間の契約であるコントラクトだ。開発者はモデルを定義するだけで、クエリの型検査や自動補完、そしてデータベースマイグレーションの計画と実行をフレームワークに委ねられる。
// contract.prisma
model Book {
  id       String   @id @default(uuid())
  title    String
  author   String
  addedAt  DateTime @default(now())
}このコントラクトは可読性が高く、更新も容易だ。Prisma Nextではこれが唯一の真実の情報源となる。モデルを変更すると、フレームワークが自動的にマイグレーションを計画し、データベースが常にコントラクトを満たすように調整する。
エージェントによる機能追加の流れ
「著者テーブルを追加し、名前と経歴を持たせ、書籍と紐付けてほしい」といった自然言語での指示をエージェントに与えるだけで、コントラクトが更新される。エージェントは型検査を通過するまで内部でクエリの検証を繰り返し、最終的に安全なコードを出力する。
型安全クエリと高速な反復開発

Prisma Nextのクエリはすべてコントラクトに対して型検査される。開発者(あるいはエージェント)がクエリを書くと、型エラーが即座にフィードバックされる。このループが高速なため、アプリケーションの出荷速度が格段に上がる。
const books = await db.orm.Book
  .where({ addedThisWeek: true })
  .all();
このクエリは、コントラクトで定義されたBookモデルに基づいて型が決定される。エージェントが生成したクエリも同じ型検査を通過するため、人間が書いたコードと同等の安全性が保証される。
マイグレーションを記述する必要がなくなる

データベースのマイグレーションは、多くの開発者にとって最も苦痛を伴う作業の一つだ。構文を正しく記述し、エラーをデバッグし、本番環境で失敗した場合にはさらに時間を費やす。Prisma Nextでは、この負荷から完全に開放される。
TypeScriptで書かれたマイグレーションファイル
生成されるマイグレーションファイルはTypeScriptで記述され、人間が確認しやすい形式だ。prisma-next migration plan を実行すると、ops.json とともにレビュー可能なマイグレーションが出力される。エージェントがSQLを生成するのではなく、フレームワークが決定論的に生成するため、信頼性が高い。
// migrations/app/20260515T0900_add_book_published_at/migration.ts
export default class M extends Migration {
  override describe() {
    return { from: "sha256:…prev", to: "sha256:…next" };
  }

  override get operations() {
    return [
      addColumn("public", "book", {
        name: "publishedAt",
        typeSql: "timestamptz",
        defaultSql: "",
        nullable: true,
      }),
    ];
  }
}
Postgresでは、マイグレーション全体が単一のトランザクション内で実行される。どこかで問題が発生してもロールバックされ、データベースは元の状態を保つ。MongoDBの場合は段階的に安全な手順で計画される。こうした保護機構によって、エージェントに安全に作業を委任できる。
並行ブランチでのマイグレーション競合を自動解決

複数ブランチで同時にマイグレーションを作成すると、マージ時に順序の衝突が起きることがある。Prisma NextはGitのコミットグラフのようにマイグレーション履歴を扱い、この問題を解消する。
prisma-next migration graph で可視化できる。prisma-next-migration-review スキルをエージェントが活用することで、新しいマイグレーションがmainに到達した場合も、グラフを読み取り、ブランチをリベースし、migration planを再実行する。結果として、衝突なくクリーンにマージできる。複数のエージェントが並行して作業しても、特別な手順を覚える必要はない。
定期的なアップグレードとフィードバックの簡便さ

Prisma Nextは日々アップデートされており、アップグレードも簡単だ。エージェントに「prisma nextをアップグレードして」と指示するだけで、最新バージョンに更新してくれる。問題が見つかった場合も、エージェントに「これはバグだ」「この機能が欲しい」と伝えれば、適切な報告チャンネルを選び、構造化されたフィードバックを提出してくれる。
コミュニティでの成果発表も歓迎されている。Prismaの公式アカウントで紹介されたり、Prisma NextのREADMEにリンクが掲載される可能性もある。本格的にデプロイする場合、Prisma Postgresの無料枠を活用できる。なお、Prisma Nextはまだ本番環境向けではない。プロダクションには引き続きPrisma 7を推奨するが、一般提供時にはPrisma 8となる予定だ。
この記事のポイント
- Prisma NextはPostgresとMongoDBに対応し、データベース定義をコントラクトとして扱う
- 1行のコマンドでプロジェクトをセットアップし、エージェントが即座に開発を支援する
- 型安全クエリにより、人間とエージェントのどちらが書いたコードも信頼できる
- マイグレーションはフレームワークが自動生成し、トランザクションで安全に適用される
- 並行ブランチでの競合もグラフベースの履歴管理で自動解決される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
SupabaseがChatGPT公式アプリに。データベースとEdge Functionsを自然言語で操作可能に
SupabaseがChatGPTの公式アプリとして提供を開始した。これにより、ChatGPTの対話画面から直接Supabaseプロジェクトのデータベース管理やEdge Functionsのデプロイが可能になる。コードを書かずに自然言語でインフラを操作できる時代が一歩進んだ形だ。
今回の連携では、全部で29種類のツールが提供される。SQLクエリの実行、テーブルスキーマの設計変更、セキュリティアドバイザーの確認と修正、開発用ブランチの作成とマージなど、データベース運用に必要なほぼすべての操作をカバーしている。対象は全Supabaseプランと、ChatGPTの有料プラン(Plus / Pro / Team / Enterprise)だ。
この記事では、Supabase ChatGPTアプリで実現できること、導入方法、技術的な仕組み、そして国産の類似サービスと比較した実務的な評価を解説する。データベース管理の自動化に興味がある開発者や、Supabaseを使ったプロダクト開発の効率化を目指すチームにとって役立つ情報をまとめた。
ChatGPT側からSupabaseを直接操作できるようになった背景
これまでSupabaseの管理は、公式ダッシュボードやCLI(コマンドラインインターフェース)から手動で行うのが一般的だった。開発者であればSQLクライアントを起動し、APIキーを確認し、適切なエンドポイントを叩く。これらの手順に慣れている人にとっては日常的な作業だが、チームに非エンジニアが加わったり、素早いプロトタイピングが求められる場面では操作のハードルが高かった。
一方でChatGPTは、2025年以降、外部アプリとの連携機能を急速に拡充してきた。単なるテキスト生成AIから、実際のサービスを操作する「AIエージェント」としての側面を強めている。この流れの中で、SupabaseがChatGPTの公式アプリとして認定されたのは、両者の方向性が一致した自然な結果といえる。
この連携を支える技術が、MCP(Model Context Protocol / モデルコンテキストプロトコル)だ。MCPは、AIモデルが外部のツールやサービスと安全にやり取りするための標準プロトコルである。ChatGPTはこのMCPを通じてSupabaseのAPIを呼び出し、ユーザーの自然言語による指示を実際のデータベース操作に変換している。
従来のデータベース管理とChatGPT連携の比較
従来のSupabase管理(Before)
※非エンジニアが操作できない。ツールの切り替えが発生
ChatGPTアプリ連携後(After)
※対話の中でデータベース操作が完結。非エンジニアも参加可能
この仕組みは、単に検索して情報を得るだけの従来のAIアシスタントとは一線を画す。ChatGPTはSupabaseのAPIを通じて実際にテーブルを作成し、SQLを実行し、Edge Functionsをデプロイする。つまり「調べるAI」から「実行するAI」への進化を象徴する連携だ。
実務におけるインパクト
開発現場では、ちょっとしたデータ確認のためにSQLクライアントを起動する手間が意外に大きい。ChatGPT上で「先週登録したユーザーの数を教えて」と入力するだけで結果が返ってくれば、コンテキストスイッチ(作業の切り替えにかかる認知的負荷)が大幅に減る。また、セキュリティアドバイザーの指摘に対して「修正して」と指示するだけで実際の設定変更が行われる点は、運用負荷の軽減に直結する。
Supabaseの記事によれば、ChatGPTの「プロジェクト」機能と組み合わせることで、特定のSupabaseプロジェクトに会話のスコープを固定することもできる。プロジェクトの参照IDを一度設定しておけば、その後の会話では自動的に正しいデータベースに接続される仕組みだ。
ChatGPTアプリが提供する29種類の操作ツール
Supabase ChatGPTアプリには、以下の5カテゴリにわたる29種類のツールが実装されている。いずれも自然言語での指示をChatGPTが解釈し、適切なAPI呼び出しに変換して実行する形式だ。
データベース管理(Database Management)
Postgresデータベースに対するSQLクエリの実行、テーブルスキーマの設計と変更、テーブルや拡張機能の一覧表示、セキュリティに関する推奨事項の取得が含まれる。たとえば「usersテーブルに最終ログイン日時のカラムを追加して」と依頼すれば、ChatGPTが適切なALTER TABLE文を生成し、実行する。
セキュリティアドバイザーの確認機能はとくに実用的だ。RLS(Row Level Security / 行レベルセキュリティ)の設定漏れや、公開すべきでないAPIエンドポイントの検出など、見落としがちな設定項目を自動でチェックし、必要に応じて修正まで行える。
プロジェクト運用(Project Operations)
プロジェクトの作成と一覧表示、コスト見積もりの取得、プロジェクトの一時停止と再開、リアルタイムログへのアクセスといった運用系の操作をカバーする。開発用に一時的なプロジェクトを作成して使い終わったら停止する、といったライフサイクル管理をChatGPT上で完結できる。
ブランチとマイグレーション(Branching and Migrations)
データベースの開発用ブランチ作成、変更のマージ、リベースやリセット、マイグレーションの一覧表示と適用が可能だ。Supabaseのブランチ機能は、Gitを使ったコード管理と同様の考え方をデータベースに適用したもので、スキーマ変更を安全にテストしてから本番環境に反映できる。ChatGPT経由で「開発ブランチを作って、そこに新しいインデックスを追加して」と指示するだけで、一連の作業が実行される。
Edge Functions(エッジファンクション)
サーバーレス関数の一覧表示、デプロイ、管理を行う。Edge Functionsとは、ユーザーに近い地理的に分散したサーバー上で実行される軽量なサーバーレス関数のことで、低レイテンシでの処理が求められるAPIエンドポイントやWebhook処理に適している。ChatGPTに「新規ユーザー登録時にウェルカムメールを送信するEdge Functionを作ってデプロイして」と指示すれば、コードの生成からデプロイまでを自動で処理する。
ドキュメント検索(Documentation)
ChatGPTから直接Supabaseの公式ドキュメントを検索できる。コーディング中に詰まったとき、別タブでドキュメントを開かずに会話の流れの中で解決策を見つけられるのは、開発スピードの向上に寄与する。
29ツールのカテゴリ構成
データベース管理
■ SQL実行 ■ スキーマ設計 ■ テーブル一覧 ■ セキュリティ推奨
プロジェクト運用
■ プロジェクト作成・一覧 ■ コスト見積もり ■ 一時停止・再開 ■ リアルタイムログ
ブランチとマイグレーション
■ 開発ブランチ作成 ■ マージ ■ リベース ■ マイグレーション適用
Edge Functions
■ 一覧表示 ■ デプロイ ■ 関数管理
ドキュメント検索
■ Supabase Docsの直接検索
※各カテゴリのツール数はSupabase公式ブログの発表に基づく(2026年5月8日時点)
これらのツールは単独でも有用だが、組み合わせることで真価を発揮する。たとえば「セキュリティアドバイザーを実行して、問題があれば修正用のブランチを作成し、修正後に本番へマージして」という一連の指示を自然言語で伝えられる。従来であれば複数の画面とCLI操作を往復する必要があったフローが、1つの会話で完結する。
利用開始手順と対応プラン
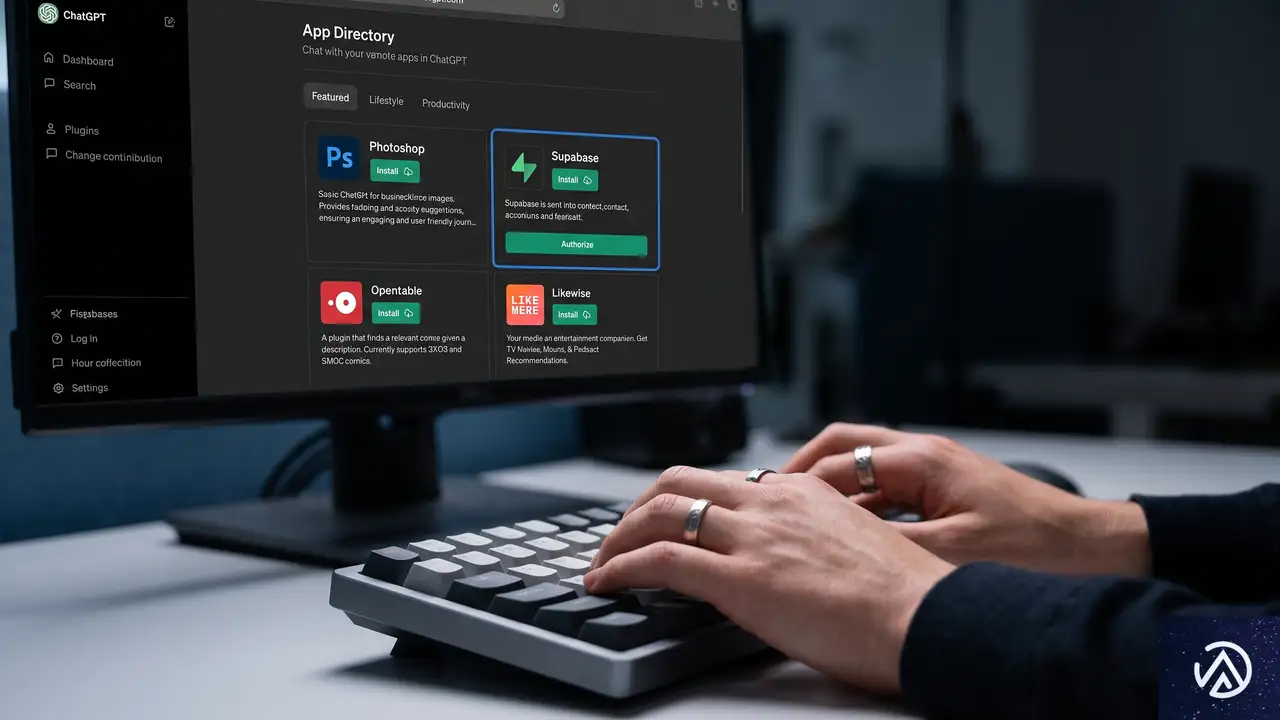
利用開始はシンプルだ。ChatGPTのアプリディレクトリで「Supabase」を検索するか、直接Supabaseのアプリページにアクセスして認証を行う。ChatGPTにSupabase組織へのアクセスを許可すれば、すぐに使い始められる。
対応しているのは全Supabaseプラン(無料プランを含む)と、ChatGPTの有料プランだ。ChatGPT側はPlus、Pro、Team、Enterpriseのいずれかの契約が必要になる。無料のChatGPTアカウントではこのアプリを利用できない点に注意したい。Supabase側に有料プランの制限はなく、無料枠のプロジェクトでも問題なく連携できる。
Supabaseアカウントをまだ持っていない場合は、supabase.comから無料でプロジェクトを開始できる。作成後、ChatGPTに接続して自然言語での管理を始める流れになる。認証にはSupabaseのアクセストークンが使用され、ChatGPTがユーザーに代わってAPIを呼び出す際の権限管理はこのトークンを通じて行われる。
ChatGPTプロジェクトとの連携で効率をさらに上げる
OpenAIが提供する「ChatGPT Projects」機能を使えば、会話のスコープを特定のSupabaseプロジェクトに固定できる。プロジェクトの参照IDをプロジェクト指示に一度設定しておくと、そのプロジェクト内のすべての会話が自動的に正しいデータベースを参照する。複数のSupabaseプロジェクトを抱えるチームでは、この設定で誤操作を防ぎつつ作業効率を高められる。
技術的な仕組みとMCPプロトコル
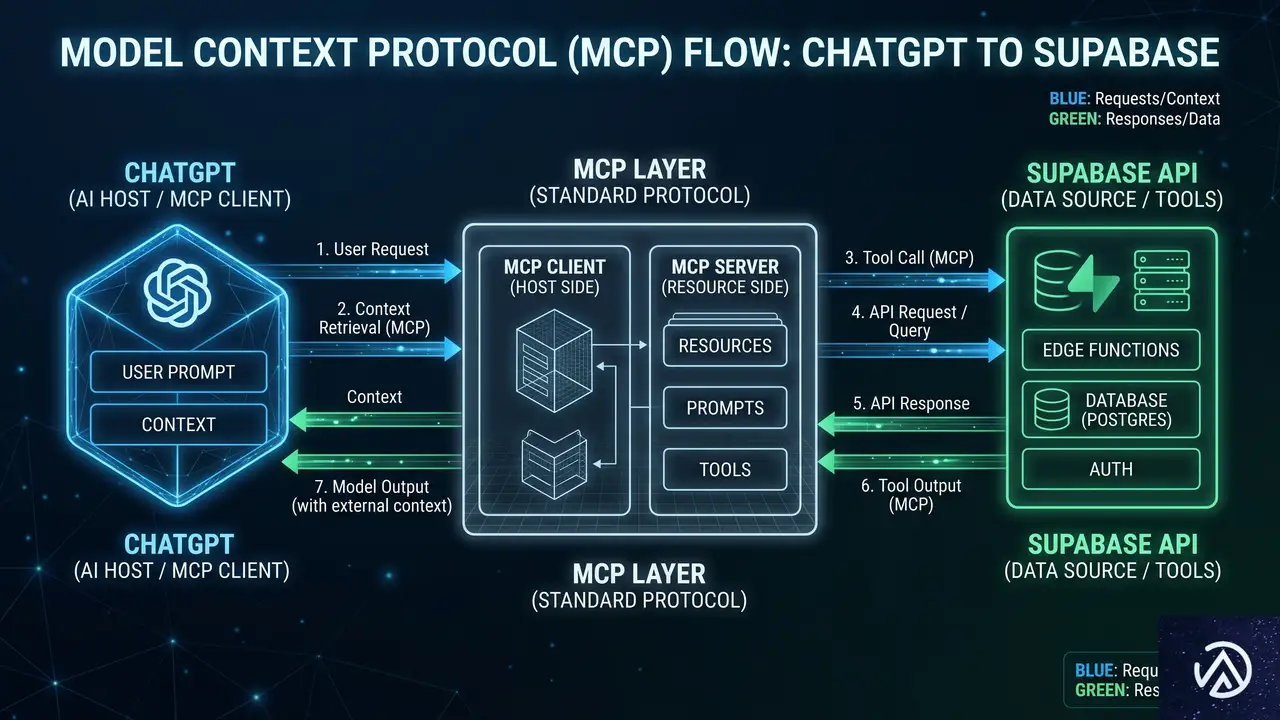
この連携の技術基盤となっているのが、MCP(Model Context Protocol)だ。MCPは2024年にAnthropicが提唱し、現在ではOpenAIを含む複数のAIプラットフォームで採用が進んでいるオープンプロトコルである。AIモデルが外部ツールやデータソースとやり取りするための共通言語のような役割を果たす。
MCPの仕組みを簡単に説明すると、AIモデルに対して「このツールはこういう機能を持っていて、こういう引数を受け取る」という定義(ツールディスクリプション)を提供する。ユーザーが自然言語で指示を出すと、AIはその定義を参照して適切なツールを選択し、必要なパラメータを推論して実行する。Supabaseの29ツールも、このMCPの枠組みに沿ってChatGPTに公開されている。
認証にはOAuth 2.0が使われており、ChatGPTがユーザーのSupabaseアカウントに代わってAPIを呼び出す際の権限は、ユーザーが許可した範囲に制限される。すべての操作はユーザーの認可の下で実行され、ChatGPTが勝手にデータベースを変更することはない。また、実行前にはChatGPTが「これからこういう操作をしますがよろしいですか」と確認を求める設計になっており、安全性にも配慮されている。
MCPによるSupabase操作の流れ
例「先月の売上を商品カテゴリ別に集計して」
「execute_sql_query」ツールを呼び出し、適切なSQLを生成
OAuth認証を通じてユーザーの権限でPostgresにクエリを発行
クエリ結果を要約してチャットで表示。必要に応じてグラフ化も提案
※実際の処理では、破壊的操作の前にChatGPTが確認を求める安全機構が働く
特筆すべきは、この仕組みが単なる「自然言語からSQLへの変換」にとどまらない点だ。ChatGPTはSupabaseから返ってきたデータを解釈し、必要に応じて追加の質問をしたり、結果をわかりやすく要約したりする。エラーが発生した場合も、ログを解析して原因を特定し、修正案を提示できる。
セキュリティと権限管理
AIにデータベースの操作権限を与えることに対する懸念は当然ある。SupabaseのChatGPTアプリでは、以下の3層の安全機構が実装されている。1つ目はOAuth 2.0によるスコープ制限で、ChatGPTがアクセスできる操作はユーザーが明示的に許可した範囲に限定される。2つ目は破壊的操作(DROP、DELETE、スキーマ変更など)の実行前確認だ。3つ目は、すべての操作がSupabaseの監査ログに記録される点で、事後的な追跡と検証が可能になっている。
国産データベースサービスとの比較と実務評価
SupabaseとChatGPTの連携は、BaaS(Backend as a Service / バックエンドをサービスとして提供する形態)市場全体に波及効果をもたらす可能性がある。現時点で国内の類似サービスには、このレベルのAI連携を実装しているものは見当たらない。国産BaaSの多くは管理画面のUI/UX改善に注力しており、自然言語による操作という発想自体がまだ新しい。
ただし、実務に導入する際にはいくつかの注意点がある。第一に、ChatGPTが生成するSQLが常に最適とは限らない点だ。複雑なJOINやサブクエリを含むクエリでは、パフォーマンスの観点から人手によるレビューが推奨される。第二に、ChatGPTの有料プランが必要なため、チーム全体で利用する場合はコストの試算が欠かせない。第三に、プロダクション環境での破壊的操作をAIに委ねることのリスクは依然として存在する。スキーマ変更やデータ削除を伴う操作は、ステージング環境でのテストを挟む運用ルールを設けるのが現実的だ。
一方で、この連携が真価を発揮するのはプロトタイピングとトラブルシューティングの場面だ。アイデアを素早く形にしたいとき、あるいは深夜の障害対応で素早く原因を特定したいときに、ChatGPT上でSupabaseを直接操作できる利便性は大きい。とくにスタートアップや少人数チームでは、開発リソースの制約を補う手段として有効に機能するだろう。
今後の展望
SupabaseがChatGPT公式アプリとなったことで、他のBaaSやクラウドサービスにもAI連携の波が広がるのはほぼ確実だ。すでにVercelやCloudflareもAIエージェントとの統合を進めており、2026年後半には「ChatGPTから操作できるクラウドサービス」が標準的な提供形態になっていく可能性がある。
開発者にとっては、コーディングの効率化だけでなく、インフラ管理や運用監視といった領域までAIがカバーする時代が目前に迫っている。Supabaseの今回の発表は、その転換点を象徴する出来事といえる。
この記事のポイント
- SupabaseがChatGPT公式アプリとして提供開始。チャットからデータベース管理が可能になった
- SQL実行、スキーマ変更、Edge Functionsのデプロイなど29種類のツールを搭載
- 全SupabaseプランとChatGPT有料プランで利用可能。無料枠のプロジェクトでも連携できる
- 技術基盤はMCP(Model Context Protocol)。OAuth 2.0による権限制御で安全性を確保
- 実務導入ではSQLの最適性確認や本番操作の運用ルール整備が推奨される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験