

GPT-6がChatGPTに搭載、対話で動くUIを自動生成するIntelligent UIを解説
OpenAIは2026年10月7日、ChatGPT向けにGPT-6を正式展開した。最大の変更点はIntelligent UIと呼ばれる新機能で、質問ごとにボタンやグラフなどの操作画面を対話の中で動的に生成する。これにより回答が単なるテキストではなく、実際に触れて操作できる体験に変わる。
対象は当初Plus、Pro、Business、Enterpriseの各プランで、翌10月8日からFreeとGoにも展開される。ChatGPTの週間利用者数は12億人を超えており、この規模に次世代の対話型UIが一気に広がる。
さらにGPT-6は回答を書き始める速度も大幅に改善した。従来の推論モデルは思考が完了してから回答を開始していたが、GPT-6は考えながら回答を進める。これはAIとのやり取りの体感時間を変える変更だ。
Intelligent UIの正体、質問ごとに操作画面を組み立てる
Intelligent UIは、ChatGPTが回答をテキストだけでなく、図表、タップ可能なボタン、フォーム、グラフ、そして対話内で直接使えるインタラクティブな体験として構成する機能だ。OpenAIはGPT-6にこうした要素を使い分ける訓練を施したとしている。
回答のフォーマットは質問内容に応じて変わる。商品の比較なら並べて見られるレイアウト、仕組みの説明なら操作できる図、単純な答えで足りる問いにはテキストだけを返す。GPT-6自身がその都度、最も有用な形を選ぶ。
従来のテキスト回答との違い
従来のChatGPTは、ほぼすべての質問を同じ会話フォーマットに当てはめていた。Intelligent UIが加わったことで、1つの質問に対してUI、データ、操作を組み合わせた回答が可能になった。ChatGPTがソフトウェアの固定画面ではなく、その場で作った専用画面を提供する方向への第一歩だ。
上記はコンセプトを示した例だ。従来は文章で説明されていた内容が、ボタンや数値カードを備えた操作画面に置き換わる。ユーザーは表示された値を動かして、自分の条件に合う結果をその場で確かめられる。
フォーマットは質問内容が決める
すべての質問にUIが付くわけではない。比較は左右に並べる、説明は操作できる図にする、簡単な質問にはテキストのみを返す。GPT-6が内容に応じてフォーマットを決めることで、必要以上に凝った画面を表示して速度を落とす事態を避けている。
生成されるUIの具体例、旅程から計算ツールまで
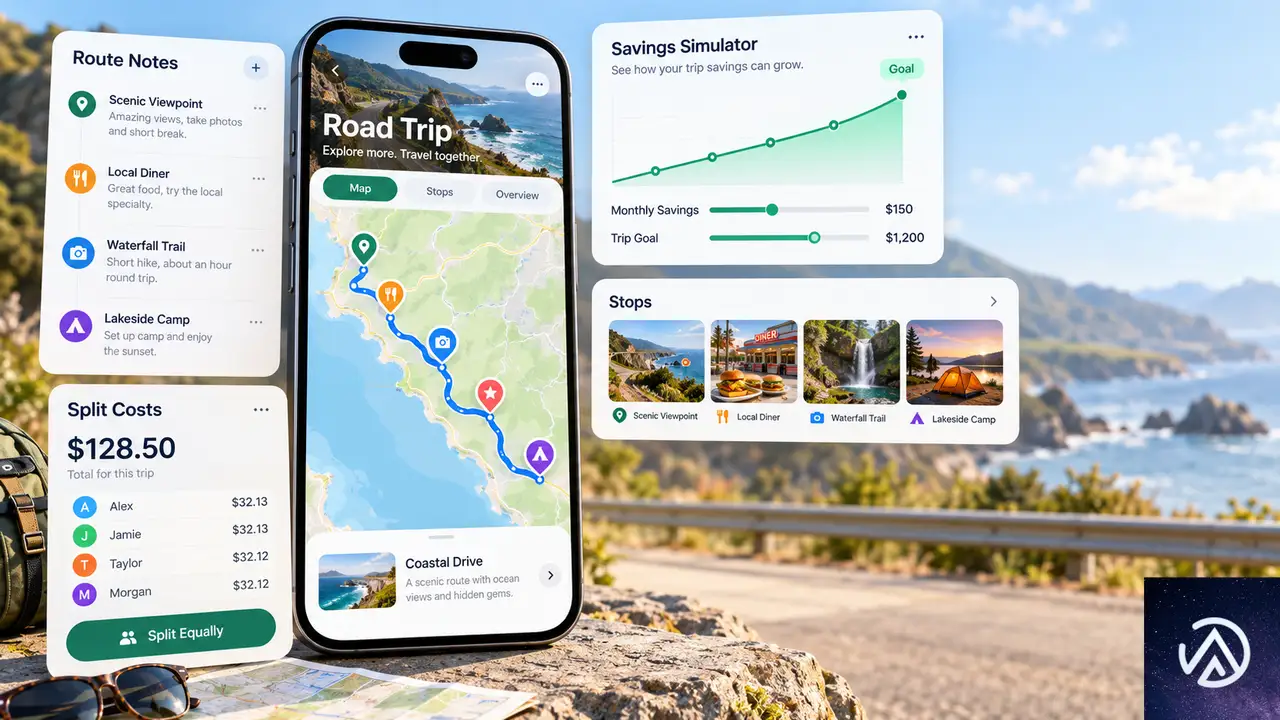
Intelligent UIが作る画面は、日常のあらゆる問いに対応する。例えばサンデーローストの献立を尋ねた場合、レシピの横に調理タイミングを並べて表示する。ロードトリップの相談では、地図上に立ち寄り先をマークし、立ち寄る価値のある場所のメモを添える。単に文章を読むより、予定や段取りが把握しやすい。
視覚的で操作可能な説明も特徴だ。仕組みを理解するために図を動かして入力値を変えたり、問題を順番に解いたりできる。従来なら数回に分けて質問していた内容が、1つの回答画面の中で完結する。
その場でツールを作れる
ChatGPTに対話の中でツールの作成を頼むこともできる。貯金の増え方を試算する電卓、友人との食事代を割り勘するスプリッター、会話の中で遊べるゲームなどだ。OpenAIは「目の前のタスクを解決するツールをその場で作れる」と説明している。
比較・説明・テキストの使い分け
Intelligent UIの出力形式は固定されていない。比較は並べて見せる、説明は操作できる図にする、テキストだけで十分な場面では余計なUIを出さない。GPT-6は質問の意図を読み取り、その答えを最も理解しやすい形に整える。
技術的な仕組み、部品ライブラリとコンパイラが支える
Intelligent UIの土台には、ネイティブでストリーミング可能な部品ライブラリと、モデルが生成するインターフェースを処理するコンパイラがある。部品ライブラリは回答に共通のデザイン基盤を与えつつ、モデルが部品の組み合わせ方を柔軟に選べる余地を残す。
コンパイラは、モデルが回答を生成している途中でインターフェースを段階的に表示する。回答全体の完成を待たずに、画面が少しずつ組み上がっていく。これにより体感速度が維持される。
ストリーミング表示を支える2つの要素
このデモは、モデルが部品を選び、コンパイラがそれを画面へ段階的に反映する流れを示している。ユーザーから見ると、回答が完成する前からUIが少しずつ現れてくる。
訓練で設計判断を学習
訓練手法も拡張された。インターフェースの明瞭さ、有用性、完成度を評価する仕組みを追加し、GPT-6は情報を整理して見せる方法、操作を付け足すタイミング、テキストだけで済ませる場面を学習した。OpenAIは設計判断の改善と作れるものの拡張は今後の課題だとしつつ、人々がChatGPTとやり取りする方法の大きな転換だと位置づけている。
待たずに答え始める、推論と回答を同時に進める改善
推論モデルが登場してより難しい問題に対応できるようになった一方、回答開始までにモデルが思考を終えるのを待つ必要があった。今回のGPT-6は、思考と回答を交互に進めるよう訓練されている。ユーザーの待ち時間を考慮し、その時点までの知識と発見を使って少しずつ回答を組み立てる。複数の部分回答を積み上げても、まとまりと正確さは一気に書いた回答と同等になるよう設計されている。
OpenAIの社内評価によると、日常的なエージェントタスクでGPT-6 Extra HighはGPT-5.6 Mediumと同じ時間で回答を開始しつつ、スコアはGPT-5.6 Extra Highを上回った。Web検索を必要とする質問では、GPT-6 InstantがGPT-5.6 Instantより平均44%早く回答を始める。
質問に応じた速度改善の実測値
この比較は、Web検索を伴う質問で回答開始までの時間が短縮された様子を表している。44%という数字はOpenAIの社内評価によるものだ。
Web検索の質も向上
Web検索を使う回答の質も改善されている。調べるべきタイミングをより正しく判断し、回答の裏付けとなる情報をより確実に探し出す。難しい問題を対象にした社内評価では、ユーザーの質問の核心に正しく対処する割合がGPT-5.6より高まったとしている。
安全性の改善と展開対象プラン
安全性と整合性の評価
GPT-6はAstraの安全面の進歩を土台に、安全訓練をすり抜けようとする試みへの耐性を高めた。実利用からの教訓を訓練に反映し、サイバー攻撃、生物学的脅威、暴力に関わる悪用への保護を強化している。複数ターンにまたがる攻撃など、単一のプロンプトからは見えにくいリスクも文脈や会話履歴から認識する。
無害な依頼に対する不要な拒否は避けつつ、高リスクな場面では安全に応答する。自身の能力の限界を認識して伝える点でも改善が見られ、評価結果の詳細はシステムカードにまとめられている。
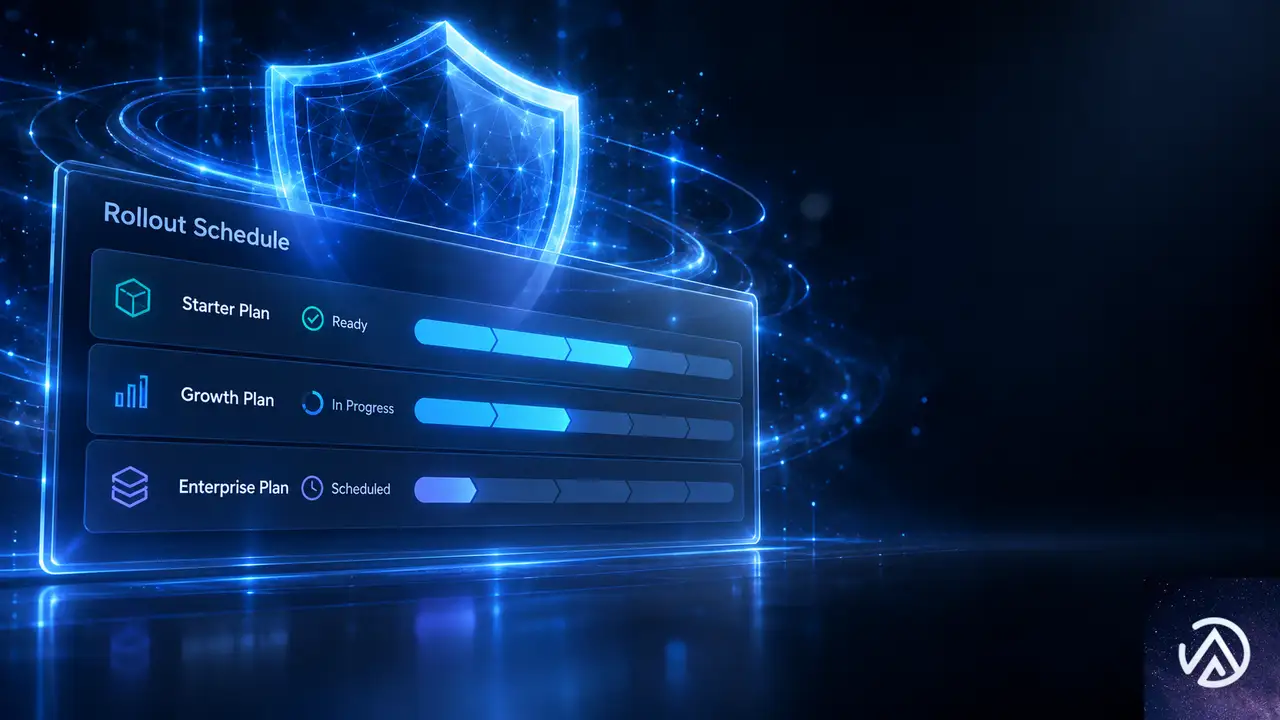
展開スケジュールと利用モデル
Intelligent UIを備えたGPT-6は、発表日時点でPlus、Pro、Business、EnterpriseのChatタブに順次展開された。翌日にはFreeとGoにも展開が広がる。Enterpriseでの利用可否は企業の管理者設定に依存する。
有料プランはGPT-6 Sol、無料およびGoはGPT-6 Lunaが会話向けに調整されたモデルとして動作する。今回の変更はChat体験のみが対象で、WorkとCodexを支えるモデルは変わらない。
この記事のポイント
- OpenAIがGPT-6とIntelligent UIをChatGPTに展開した
- 質問ごとにボタンやグラフなどの操作画面を動的に生成する
- 推論と回答を並行して進め、待ち時間を短縮した
- 部品ライブラリとコンパイラで高速にUIを表示する
- 安全性と整合性の評価も強化された

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
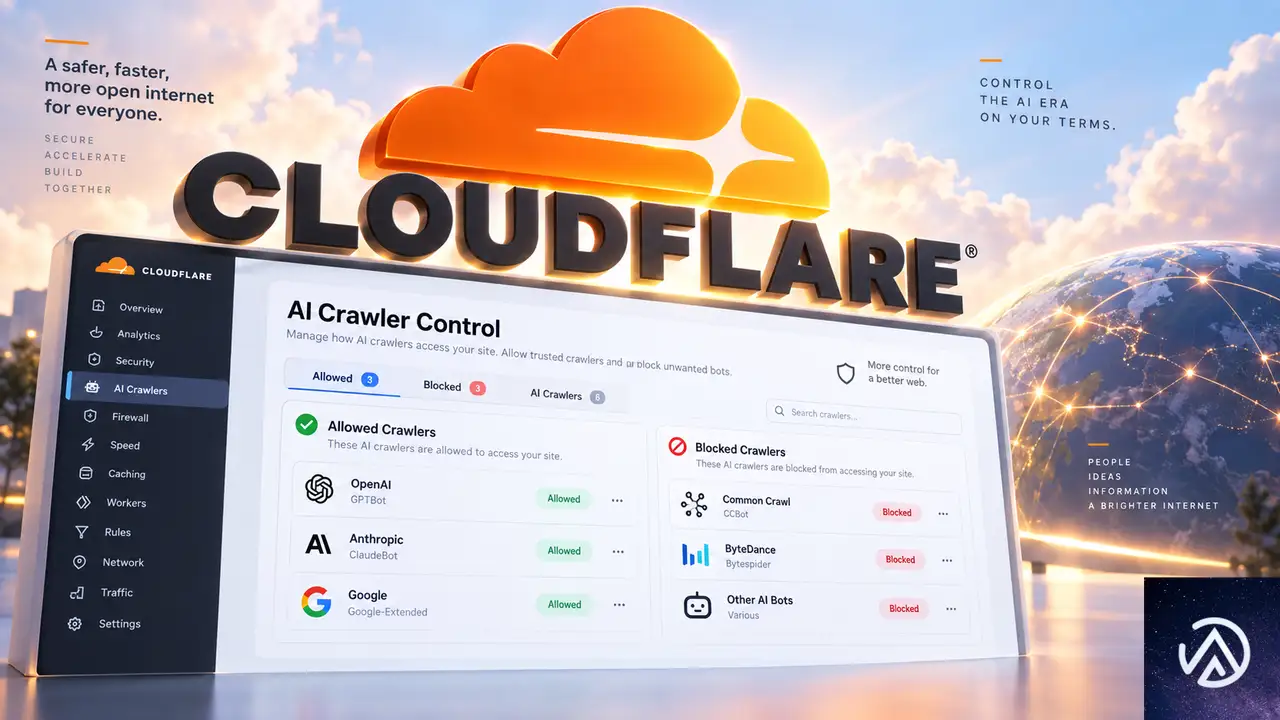
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
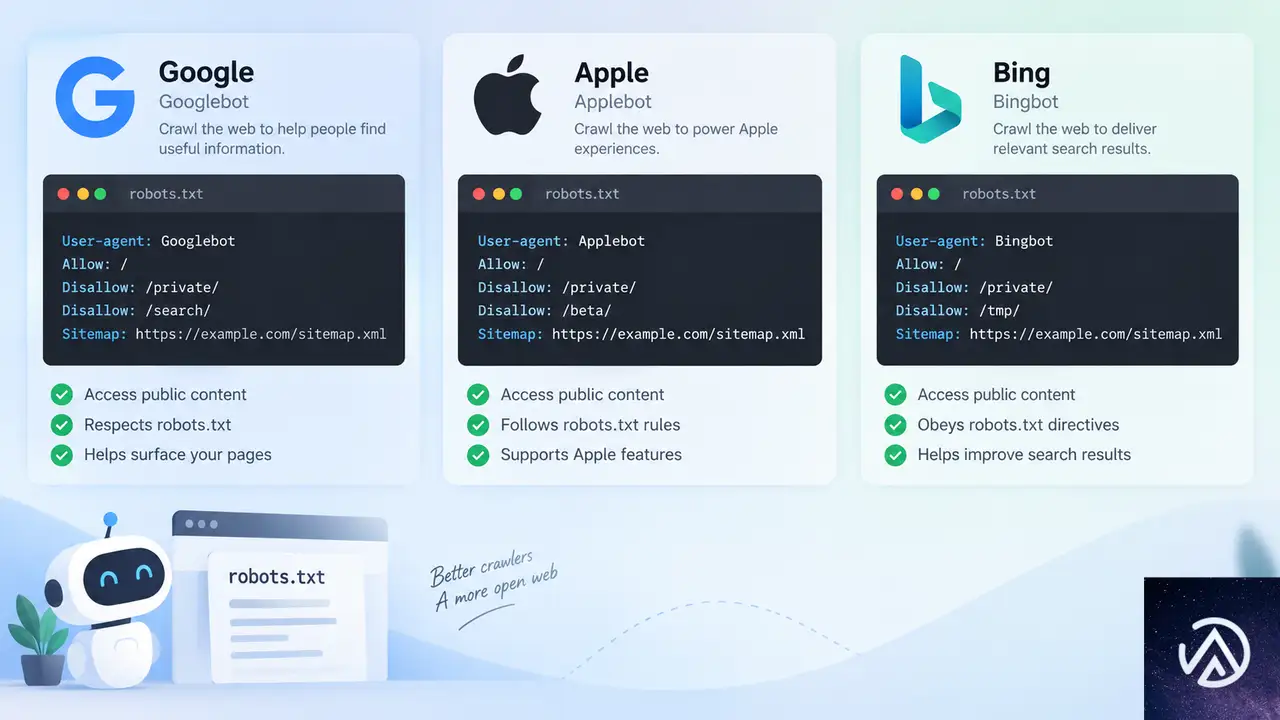
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.8 Liveシリーズ登場、音声AIエージェントの新基盤に
Google DeepMindが9月15日、Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表した。音声エージェント向けに設計された2つの新モデルで、リアルタイム推論能力が大幅に強化されている。
Gemini 3.8 Liveはスケールとコスト効率を重視したモデルだ。Gemini 3.8 Live Extended Thinkingは高複雑度タスク向けで、複数ステップの推論を会話の流れを止めずに実行できる。
開発者API、Google Workspace、Search Liveなど幅広い経路で提供が始まっている。音声で複雑なタスクを処理する新しい基盤になる。
Gemini 3.8 Liveシリーズの全体像
会話知能と自然な対話、視覚的な理解を組み合わせたモデル。スケールとコスト効率を重視しており、大量の同時接続を処理する音声エージェントに向く。
高複雑度タスク向けに設計されたモデル。複数ステップの推論と、より高い知能を備える。会話の流れを止めずに深い思考ができるのが特徴。
2つのモデルは用途が明確に分かれている。音声エージェントを大量に展開する場合は標準版、複雑な業務フローを音声で処理する場合はExtended Thinkingを選ぶ形になる。
2つのモデルの役割分担
Gemini 3.8 Liveは会話の自然さと視覚的な文脈理解を兼ね備えている。コストパフォーマンスを重視する開発者や企業に向く設計だ。
Gemini 3.8 Live Extended Thinkingは、より複雑な推論が必要な場面を想定している。話しながら考え、バックグラウンドで複数ステップのタスクを進められる点が最大の違いだ。
展開される利用経路
両モデルとも、Geminiアプリ、Google Workspace、Search Liveに順次展開される。特にWorkspaceではDocs Live、Gmail Live、Keep Liveといったアプリ内の音声機能として利用できる。
コンシューマー向けにはSearch Liveが最初の接点になる。検索中に音声で質問し、そのまま会話を続けられる体験が提供される。
ベンチマークが示す性能とコスト効率
音声品質とエージェント性能の両面で、既存モデルを上回る結果が示されている。コスト面でも競争力のある価格帯を維持している点が特徴だ。
音声品質とエージェント性能
Artificial AnalysisのSpeech to Speech Quality Indexでは82.6を獲得し、総合第1位となった。音声の自然さと応答品質のバランスで他モデルを上回っている。
エージェントタスクの完了率でも強さを示している。τ-Voiceベンチマークで68.6%、Sierraのτ-Voiceバンキングベンチマークでは35.1%を記録した。音声だけで業務フローを完結させる能力が評価された形だ。
推論能力を示すBig Bench Audioでは97.7%と高いスコアを出している。音声を聞いて正しく推論する基盤能力の高さが確認できる。
コスト競争力とユーザー評価
Gemini 3.8 LiveはSpeech Agent Arenaで第2位を獲得している。ユーザーからの選好度が高いモデルでありながら、高いコスト効率を実現している点が重要だ。
ServiceNowのEVA-Benchでは、複雑なワークフローにおける正確性と会話品質のバランスでパレートフロンティアを更新した。エンタープライズ向け音声エージェントの実用性が裏付けられている。
リアルタイム推論の技術的進化
会話を止めずに裏側でタスクを進める設計が、これまでの音声AIと大きく異なる点だ。
視覚入力と言語対応
Gemini 3.8 Liveは視覚入力をほぼリアルタイムで処理する。カメラに映ったものや画面上の情報を文脈として会話に取り込めるため、状況に応じた助言が可能になった。
言語対応も強力だ。97の言語を自動的に検出し、会話の途中でもシームレスに切り替えられる。多言語環境で使う音声エージェントに適している。
公式デモでは、従業員のオンボーディングをリアルタイムで案内する様子や、チェスの盤面を見ながら対局を進める様子が紹介されている。視覚と会話の統合が実用レベルに達していることを示す例だ。
バックグラウンド実行と同時推論
ツールやAPIの実行はバックグラウンドで進められる。ユーザーの要求を受け付けたら、処理が終わるまで待たせず、会話を続けながら結果を伝える動きができる。
Extended Thinking版は「話しながら考える」能力を持つ。「確認させてください」といった短い言葉で応答しながら、裏側で複数ステップの推論を進める。進捗状況を自然な会話で伝える機能も備わっている。
公式デモでは、手書きスケッチと音声フィードバックからReactコンポーネントを生成する例や、複数ステップの予約を非同期で処理する例が公開された。音声だけで開発作業や業務処理を進められる可能性が広がっている。
開発者と企業のエコシステム
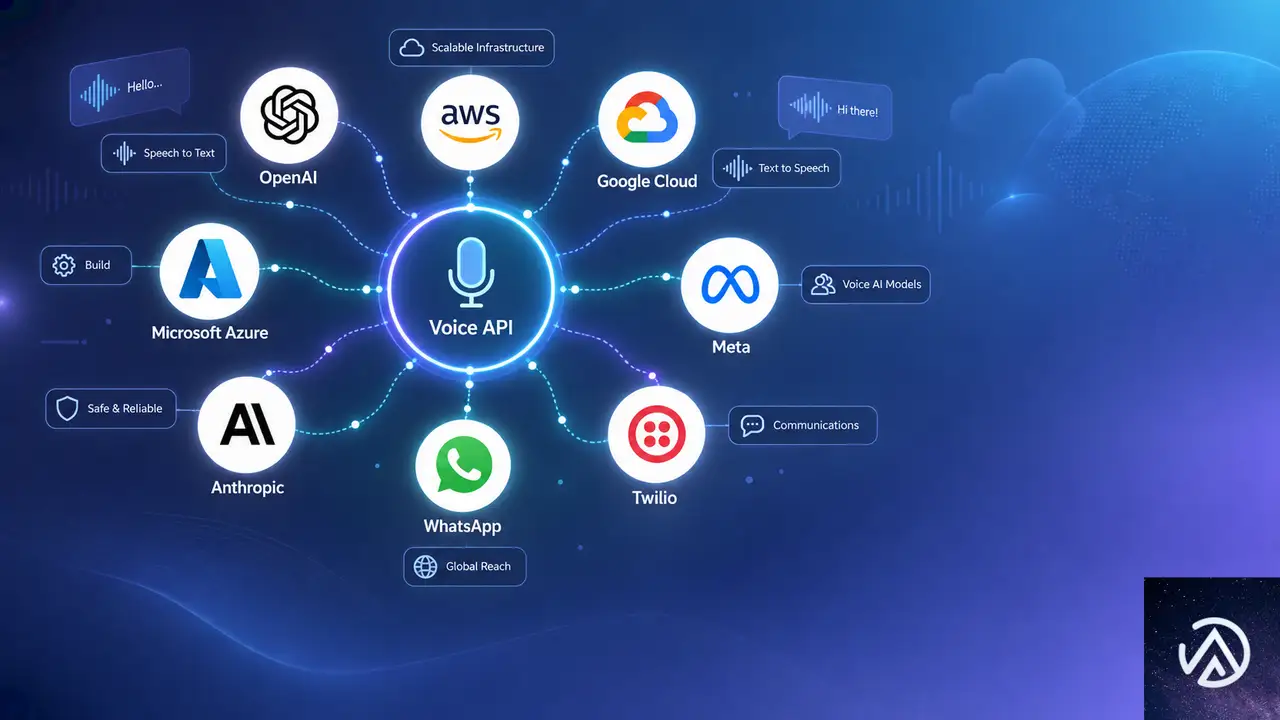
Gemini Live APIと開発者プラットフォーム
両モデルはGemini Live APIを通じて利用できる。開発者はこのAPIを使い、音声駆動のインターフェースを自社サービスに組み込める。リアルタイムのメディアストリーミング基盤はプラットフォーム側が処理してくれるため、UX設計に集中できる。
Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision AgentsなどのプラットフォームがGemini Live APIに統合済みだ。これらのツールを使えば、音声エージェントの構築からデプロイまでを短縮できる。
企業パートナーと展開スケジュール
Salesforce、Genspark、Lumerisなどの企業が3.8 Liveシリーズの導入に意欲を示している。低遅延性、会話の流暢さ、ツール呼び出し能力が評価されている。
展開スケジュールは以下の通りだ。開発者向けにはGemini APIとGoogle AI Studioで即日利用できる。企業向けにはGemini Enterpriseでプライベートプレビューが始まり、Gemini Enterprise for Customer Experienceにも順次提供される。
コンシューマー向けでは、Search Liveが最初の提供経路になる。Gemini Liveでも利用可能で、Google AI ProおよびUltraの加入者はWorkspaceのDocs、Gmail、KeepでExtended Thinking版を試せる。
透明性確保の仕組み
SynthIDによる音声ウォーターマーク
AIが生成した音声にはすべてSynthIDのウォーターマークが埋め込まれる。人間の耳には聞こえない形で音声出力に直接織り込まれており、AI生成コンテンツの検出を可能にする。誤情報の拡散防止が狙いだ。
安全性と責任あるAIへの取り組みの詳細は、モデルカードで確認できる。音声AIが社会に広がる中で、透明性の確保は実用化の前提条件になっている。
この記事のポイント
- Gemini 3.8 LiveとLive Extended Thinkingが9月15日に発表された
- 標準版はコスト効率、Extended Thinking版は複雑タスク向けと役割が分かれている
- Speech to Speech Quality Indexで82.6を獲得し総合第1位
- 97言語対応、視覚入力、バックグラウンド実行など技術面が大幅強化
- Gemini Live API経由で開発者が即日利用できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Googleサーチコンソールの生成AIレポートが全世界展開。見方とオプトアウトの注意点
Googleサーチコンソールの生成AIレポートが、2026年8月31日付で全世界のサイトに展開された。AI OverviewsやAI Modeなど生成AI機能での表示回数を、ページ別・国別・日付別に確認できる。
一方で、クリックデータはまだ提供されていない。表示はされても実際のサイト訪問につながったかは分からない。この記事ではレポートの見方、オプトアウト設定の仕組み、SEO担当者が取るべき対応を整理する。
生成AIレポートの全体像

2026年6月から段階的に展開が始まった生成AIレポートは、8月31日付の公式注記で全世界のサイトに行き渡った。Search Consoleにログインすると、検索レポートとDiscoverレポートのそれぞれで生成AI関連のデータを確認できる。
レポートが対象とするのは、AI Overviews、AI Mode、Discoverの生成AI機能だ。AI Overviewsは検索結果の上部に生成AIが回答の要約を表示する機能を指す。AI Modeは対話形式で検索を続けられる専用モードだ。DiscoverはGoogleアプリのフィードで、ここにも生成AIによるコンテンツ表示が含まれる。
従来の検索ではクリックが発生してサイト訪問につながっていた。生成AI検索ではサイトが回答の参照元として表示されても、ユーザーがクリックするとは限らない。この違いがレポートの重要性を高めている。
レポートで確認できる指標
レポートには生成AI機能での表示回数、つまりインプレッションが記録される。検索レポートではページ別・国別・日付別に加えて、デバイス別の内訳も確認できる。Discoverレポートでも同様に、ページ・国・日付の切り口でデータを見られる。
たとえば、自社の記事がAI Overviewsの中でどの国で多く表示されているか、日を追って伸びているかを把握できる。特定のページが頻繁に参照されているなら、その分野のコンテンツが生成AIに評価されている可能性を示す。
クリックデータは含まれない
公開時点でレポートにクリックデータは含まれていない。クリック数やクリック率は確認できず、表示が実際のサイト訪問につながったのかは分からない。この制約は、レポートの活用方法を考えるうえで大きなポイントになる。
Googleはアクセスについても、すべてのプロパティに展開が完了したわけではないとヘルプページで説明している。AIインプレッションが十分に蓄積されていないサイトでは、レポート自体が表示されない可能性がある。
オプトアウト設定の仕組み

レポートと同時に提供されているのが「Search generative AI control」というオプトアウト設定だ。Search Consoleの設定画面に配置されており、プロパティ単位で有効にできる。この設定を使うと、AI Overviews、AI Mode、Discover生成AIの3つの表示面からサイトのリンクとコンテンツを除外できる。
オプトアウトしたサイトは、これらの生成AI機能からのトラフィックとインプレッションが一切発生しなくなる。Googleは公式発表で、この設定が通常の検索ランキングのシグナルとして使われることはないと明言している。生成AI機能に表示されないことが、通常の検索順位に影響することはないという意味だ。
レポートはこの3つの表示面を対象にインプレッションを集計する。オプトアウト設定も同じ3面が対象になるため、運用の判断ではこの対応関係を理解しておきたい。
設定の効果と影響範囲
オプトアウトはプロパティ単位で適用される。つまり、サイト全体がまとめて生成AI機能から除外される形だ。ページ単位で一部だけ除外するような細かい制御は、現時点では提供されていない。
除外を有効にすると、生成AI機能からの表示は完全に止まる。生成AI経由の露出をすべて断つことになるため、ブランド認知や間接的な流入を期待している場合は慎重な判断が求められる。
AIトレーニングとは別の設定
このオプトアウトは、生成AIの学習データへの利用を制御する仕組みとは別物だ。Googleの生成AIトレーニングへの利用可否は、Google-Extendedという別の制御で管理される。Search generative AI controlを有効にしても、AIトレーニングへの利用は止まらない。
「生成AI機能への表示」と「AIの学習利用」は異なる設定で管理されている。SEO担当者は、この2つを混同せずに運用方針を決める必要がある。
ここまでの展開経緯
生成AIレポートとオプトアウト設定は、2026年6月3日にGoogleから同時に発表された。当初は英国のウェブサイト運営者の一部を対象にした限定的なテストとして始まっている。
同日、英国の競争・市場庁(Competition and Markets Authority / CMA)は行動要件を発行した。Googleに対し、サイトが通常の検索結果でペナルティを受けることなくAI検索機能からオプトアウトできるようにすることを求めた。
6月の発表と英国限定テスト
6月の時点では、レポートとオプトアウト設定は英国の選ばれたサイト運営者にのみ提供された。規制当局の要求と同時期に動き出した形だ。検索市場における競争環境を意識した展開だったといえる。
7月以降の段階的な拡大
7月になると、英国以外のアカウントでも設定が表示され始めた。その後、8月31日付の注記で全世界のサイトへの展開が完了したとされた。ただし、ヘルプページには展開が進行中であるとの記載が残っており、実際のアクセスにはタイムラグがあるようだ。
なぜ重要なのか

レポートが見えるようになると、オプトアウトを判断する前に生成AI機能での表示状況を確認できる。これまではブラックボックスだったAI検索内での露出が、数字として見えるようになる。
ただし、インプレッションの真の価値はまだ明確ではない。表示回数が多くても、クリックにつながるかどうかは別の問題だ。生成AI検索では、ユーザーが回答だけで満足してサイトを訪れないケースが増えると指摘されている。
レポートで見えるのは表示回数のみ。実際のトラフィック効果を測るにはクリックデータが必要になる。SEO担当者はこの制約を踏まえたうえでデータを読む必要がある。
SEO担当者が取るべき対応
まずはSearch Consoleでレポートの有無を確認する。すでに表示されている場合は、どのページがどの表示面でインプレッションを得ているかを把握できる。AIインプレッションが少ないサイトでは、レポート自体が表示されないこともある。
表示回数が少ない場合や、自社ブランドと合わない文脈で引用されている場合は、オプトアウトを検討する余地がある。ただし、クリックデータがないため、露出を継続した場合の潜在的な影響を過小評価しないことも重要だ。
既存の検索パフォーマンスレポートと併用し、通常検索の推移と生成AI検索の露出を比較しながら総合的に判断する。オプトアウトはプロパティ単位でしか実行できないため、サイト全体への影響を考慮する必要がある。
インプレッションデータの限界
最大の限界は、クリック数が分からない点だ。表示回数が増えても、サイトへの訪問が増えていなければビジネス上の価値は低い。生成AI回答にサイトの情報が引用されても、ユーザーがリンクを押さなければ意味がない。
加えて、引用位置や文脈も確認できない。自社サイトが回答の根拠として適切に扱われているのか、単に名前が出ているだけなのかをレポートから読み取ることはできない。インプレッションの質を評価する材料が不足しているのが現状だ。
今後の展望
CMAは2027年3月までに、ページ単位の生成AI機能コントロールを導入するようタイムラインを設定している。現在のプロパティ単位の設定より細かい制御が求められている。
規制当局はクリックデータの提供も期待している。しかし、8月31日の更新ではクリックレポートへの言及はなかった。クリックデータが追加されれば、レポートの実用性は大きく高まる。
CMAの要求とタイムライン
ページ単位のコントロールは、サイト全体ではなく特定のページだけを生成AI機能から除外できる仕組みを指す。これが実現すれば、オプトアウトの判断がより柔軟になる。生成AI経由の露出を活かしたいページと、除外したいページを分けて運用できるようになる。
クリックデータ提供の行方
クリックデータが追加されるかは、現時点では未定だ。Googleは最初の1年間、コンプライアンス状況を6か月ごとに報告する義務を負っている。規制当局の継続的な監視が、レポートの改善を後押しする可能性は高い。
この記事のポイント
- 生成AIレポートは2026年8月31日付で全世界のサイトに展開された
- 対象はAI Overviews、AI Mode、Discover生成AIの3面で、ページ別・国別・日付別に表示回数を確認できる
- クリックデータはまだ提供されておらず、表示がトラフィックにつながるかは分からない
- オプトアウトはプロパティ単位で、検索ランキングには影響しないとGoogleが明言している
- CMAは2027年3月までにページ単位のコントロールを要求しており、今後の仕様変更に注意が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

OpenAIがGPT-5.6 SolのUltrafastモード発表。最大14倍速で毎秒750トークン出力
OpenAIは8月13日、GPT-5.6 Sol向けの新サービス階層「Ultrafast」を発表した。標準処理と比べて最大14倍の速度で推論を実行できる。まずOpenAI APIで提供を開始する。
Cerebrasの推論基盤を活用し、1秒あたり最大750トークンを出力する。この速度は高知能モデルをリアルタイムアプリケーションに組み込める水準だ。
速さと知能のトレードオフが崩れると何が起きるか。この発表は今後のAI活用の方向を左右する転換点になる。
Ultrafastモードの概要
UltrafastはGPT-5.6 Sol専用の高速推論サービス階層である。同じモデルを使いながら、推論を実行するハードウェアとソフトウェアの最適化によって出力速度を大幅に引き上げる。現在は限定的なプレビュー期間中で、順次アクセスが拡大される予定だ。
性能と提供方法
出力速度は1秒あたり最大750トークンに達する。750トークンは日本語で約1500文字程度に相当し、画面上にほぼ瞬時に表示される。従来のフロンティアモデルは高知能ゆえに応答が遅く、リアルタイム用途には不向きだった。Ultrafastはこの前提を覆す。
OpenAIは同じテキストプロンプトから3D倉庫シミュレーターを構築するデモを公開した。標準モードとUltrafastモードを並べて比較する形で、同じタスクがどれだけ速く完了するかを示している。速度差は体感で明らかなレベルだ。
このデモは、同じ1000トークンを出力する場合の時間差を示している。Ultrafastならチャットの応答が返る前に別のタスクへ移れるレベルだ。
標準モードとの違い
同じGPT-5.6 Solでも、標準処理とUltrafastでは推論を実行する基盤が異なる。標準処理が汎用的な推論基盤を使うのに対し、UltrafastはCerebrasの専用シリコンによる低遅延推論を利用する。モデルの知能は同一であり、速度だけが変わる点が重要だ。
実用シーンでの活用事例

OpenAIはプレビュー期間中、コーディング、EC、金融リサーチ、サポートなど多様な業種の企業と連携して検証を進めている。実運用環境でのフィードバックを収集し、速度向上が最も価値を生む領域を特定する狙いだ。
障害対応と金融リサーチ
障害対応では、システム障害の発生中にアプリケーションログや直近のコード変更、エンジニアの報告を解析し、原因の特定と修正案の準備を進められる。状況が変化し続ける間に解析を完了できる点が従来のAIと大きく異なる。
金融リサーチでは、市場シグナルの分析や取引の評価、不審な活動の検出を相場が動いている最中に実行できる。時間差がそのまま機会損失やリスク拡大につながる領域だ。
カスタマーサポートとEC
カスタマーサポートでは、複数のステップやシステムをまたぐ回答でも会話を途切れさせずに返せる。音声対話でも自然なテンポを維持できるため、人間のオペレーターに近い体験を提供できる。
ECでは、買い物客が迷っている間に商品の質問に答え、在庫を確認し、パーソナライズしたレコメンドを表示できる。迷いがカゴ落ちに変わる前に回答を届けられる点が成約率に直結する。
上図はOpenAIが挙げた5つの主要な活用シーンを整理したものだ。共通するのは「状況が変化している間に結果を返す」必要性である。
ライブリサーチ
研究用途では、一晩かけて実行していた実験バッチが勤務時間内に複数回の反復を回せるようになる。アイデアを試し、結果を確認し、アプローチを調整し、次の実験を回す。このサイクルが対話型セッションに変わる。
Cerebrasとの技術提携
Ultrafastの高速化を支えるのがCerebrasとの提携である。Cerebrasはウエハースケール推論チップを開発する企業で、低遅延推論に特化したハードウェアを持つ。従来のGPUクラスタとは異なるアプローチで、メモリ帯域幅と通信遅延を大幅に削減する。
超低遅延推論の実現
通常のGPUクラスタでは、複数のチップ間でデータをやり取りする際に通信遅延が発生する。Cerebrasのウエハースケールチップは1枚のシリコン上に多数の演算コアを集約しており、チップ間通信を伴わずに推論を完結できる。これが低遅延の鍵だ。
最上位モデルを支えるハードウェア
今回、Cerebrasの推論基盤がOpenAIの最上位モデルであるGPT-5.6 Solを支えることになった。小型モデルや特化モデルではなく、フロンティアモデルそのものを高速化する点がこれまでにない試みだ。両社の提携は次の段階に入ったと言える。
速度が知能を捨てない時代へ
従来のAI活用では「高知能だが遅い」モデルと「高速だが知能が劣る」モデルの二択が存在した。リアルタイム用途では小型モデルや特化モデルを選ぶのが一般的だった。Ultrafastはこの二択を不要にする。
このデモは、AI選択のパラダイムがどう変わったかを示している。速度を理由に知能を犠牲にする必要がなくなる点が最大の変化だ。
二択の終焉
技術的な観点では、推論の低遅延化はモデルの小型化とは異なるベクトルである。モデルを縮小せず、ハードウェアとソフトウェアの最適化だけで速度を上げる。これにより、最先端の知能をそのままリアルタイムシステムに組み込める。
この変化は、AIを導入できる業務の範囲を大きく広げる。従来は「時間がかかるから」という理由で見送られていた用途に、フロンティアモデルが入り込めるようになる。
研究開発サイクルの圧縮
OpenAI社内でも、研究用途でUltrafastの効果が確認されている。ナレッジソースの高速検索やデータクエリの実行、接続されたツールを横断した情報収集と整理を短時間で完了できる。一晩かかった実験が、勤務時間内の対話的な試行錯誤に変わる。
研究開発のサイクルが圧縮される効果は、外部企業よりもむしろOpenAI自身のモデル開発速度に影響を与える可能性がある。次のモデルを生み出すスピードがさらに加速するだろう。
この記事のポイント
- UltrafastはGPT-5.6 Solを最大14倍高速化する新しい推論サービス階層だ
- Cerebrasの専用シリコンにより1秒あたり最大750トークンを出力する
- 高知能モデルをリアルタイム用途に使えることが最大の価値だ
- 障害対応や金融リサーチなど時間が重要な業務での活用が期待される
- 現在は限定的なプレビュー段階で、順次アクセスが拡大される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索で消えるブランド、SEO上位でもAI回答に登場しない実態。Fractl調査が明かす視認性格差
SEOで上位を獲得しているブランドの一部が、AIチャットの回答にはほとんど登場しない。検索エンジン向けの最適化だけでは、生成AI時代のブランド視認性を確保できないことが明らかになってきた。
Fractlの調査では、GPT-4o、Gemini 2.5 Flash、Claude Sonnet 4.6の3つのモデルに96種の業界別プロンプトを投げ、4,320件の回答と8,500件超のブランド言及を分析した。SEO指標とAI回答での言及頻度を突き合わせ、その乖離を数値化している。
この記事では、AI検索から消えつつあるブランドの特徴、逆にAIで過剰に登場するブランドの共通点、そしてブランド戦略に必要な対応を解説する。
AI回答に潜む「デフォルトブランド」の存在
調査対象の全業界に共通して、プロンプトの言い回しを変えても繰り返し登場する「デフォルトブランド」が存在した。ただし、その顔ぶれは検索エンジンの上位表示とは必ずしも一致しない。ドメイン評価が高く、大量のキーワードで上位表示されているブランドが、AI回答では自社カテゴリにすら登場しないケースが目立つ。
逆に、従来のSEO指標では目立たないブランドが、AI回答では頻繁に推奨される事例も多かった。注目すべきは、デフォルトブランドの顔ぶれが業界ごとに大きく異なる点だ。
旅行カテゴリではBooking.com(285回)、Airbnb(227回)、Expedia(215回)の3ブランドが、カテゴリ全体の言及量の約20%を占めた。3社で推奨の5分の1を握る集中度だ。保険カテゴリではLemonade(213回)がState Farm(172回)を上回り、Root Insurance(165回)がProgressive(114回)を超えた。デジタルネイティブの保険会社が先に挙げられ、従来の大手は代替案として扱われている。
ライフスタイルカテゴリでは、Patagonia、Allbirds、Eileen Fisher、Everlaneといったサステナビリティ系D2Cブランドが、SephoraやSamsung、Whirlpoolを上回った。Fractlの記事では、この傾向は第三者コンテンツで語られるブランドストーリーがAIの訓練データに強く反映された結果だと指摘している。
このデモが示す通り、検索エンジンでの強さとAI回答でのプレゼンスは一致しない。AI回答内の競争集合は、検索結果ページよりはるかに小さい。自社カテゴリでAIが想起する上位5〜10ブランドに入れなければ、Googleで上位表示できていても、AIが生成する検討リストには載らない。
伝統的なSEO権威性とAIリコールの乖離
Fractlの分析によれば、データセット全体の9割超のブランドでは、従来の検索権威性とAI視認性がほぼ連動していた。つまり、SEOの基本原則が無効になったわけではない。ただし、データの端に位置するブランド群にこそ戦略の変化が見える。
全体の約5%、471ブランドが「AI過少露出」だった。ドメイン評価が高く、オーガニック流入も多く、大量のキーワードで上位表示しているにもかかわらず、AIモデルからはほとんど参照されなかった。SEO指標上は市場リーダーに見えるのに、LLMからの言及では「誰も書いたことがない企業」のように映る。
一方、全体の約4%、377ブランドが「AIオーバーパフォーマー」だった。控えめなSEO指標に比べて、AIモデルからの参照が大幅に多かった。さらに9%は、第三者コンテンツでの言及頻度とAI視認性が一致した。
ここから見える最大の示唆は、自社が発信するコンテンツよりも、外部サイトが繰り返し語ってきた内容の方がAIの回答に強く影響するという点だ。まとめ記事、専門家リスト、比較レビューに登場する頻度が高いブランドほど、AIモデルの訓練データに取り込まれやすい。
カテゴリ誤分類で消える大手ブランド
AI過少露出のブランドには、従来の指標ではカテゴリの勝者とみなされてきた大手が並ぶ。ドメイン評価80以上、月間訪問数数百万、数十万のキーワードで上位表示しているブランドが、自社カテゴリのプロンプトで一切言及されない。
この問題の根底にあるのが、カテゴリ分類のズレだ。MicrosoftとSpotifyはFinTechのプロンプトで言及されなかった。両社とも伝統的な視認性は巨大だが、AIモデルはFinTechカテゴリに分類していない。Microsoftは生産性ソフトやクラウドの文脈では頻繁に引用される。FinTechの回答セットには含まれないだけだ。
同様の構図は保険、小売、ヘルスケアでも見られた。Aetna、Cigna、Humana、Liberty Mutualはドメイン評価80以上でも、AI回答ではLemonadeやRootに置き換えられた。Sephora、Samsung、Whirlpoolも、ライフスタイルのプロンプトではPatagoniaやAllbirdsに劣位した。
言及されない理由は、AIがブランドを知らないからではない。検索者が使うカテゴリと異なる引き出しに、そのブランドがしまわれているからだ。コンテンツ量を増やすだけでは解決しない。AIモデルがブランドを正しいカテゴリに結び付けるための外部シグナルが必要になる。
AIモデルがブランドをどのカテゴリに分類しているかを把握し、ズレがあれば修正する方が先だ。カテゴリの結び付きを強化するには、アナリスト記事、業界メディア、比較ページ、パートナーページ、カスタマーストーリー、レビューサイトでの露出が有効になる。
AIで際立つオーバーパフォーマーの戦略
AIオーバーパフォーマー377ブランドの動きは、マーケターにとって他山の石になる。小さいSEOプロフィールでも、AIの回答に繰り返し登場するブランドは、共通してAIモデルの訓練データに使われた第三者コンテンツに複数回登場している。
データセット最大のオーバーパフォーマーはMonday.comだ。AI視認性スコアは0.71を記録した。オーガニック訪問数は約100万、上位キーワードは5万以上。すでに大きなSEO基盤を持ちながら、SaaSプレイヤーの平均を大きく上回る頻度でAIに参照されている。
保険カテゴリではRoot Insuranceが突出した。大手保険会社の規模に遠く及ばないにもかかわらず、AI参照数ではすべての従来型保険会社を上回った。オーバーパフォーマーの上位15ブランドのうち6つは教育分野で、Stanford、MIT、Khan Academy、LinkedIn Learning、IBM Data Science、Google Career Certificatesが並ぶ。AIモデルは商用的なプラットフォームではなく、信頼性の高さで教育ブランドを参照している。
共通項は「良いSEO」ではなく、他者のコンテンツにカテゴリレベルで登場していることだ。製品まとめ記事、エキスパートリスト、比較記事に取り上げられる頻度が、AI視認性を押し上げる。AI視認性の向上は、デジタルPRやカテゴリ権威性の構築に近づいている。
モデル間で異なるAI視認性の実態
調査対象のうち、3モデルすべてに参照されたブランドは11%、900ブランドにとどまった。2モデルに登場したのは12%。残りの77%は、1つのモデルにしか登場しなかった。これはAI視認性の測定に深刻な課題を突き付ける。
ChatGPTで勝てるブランドがGeminiでは消える。Claudeで登場してもChatGPTからは出てこない。1つのモデルの回答を制しても、別のモデルではほとんど登録されない。AI視認性の「総合スコア」だけで改善を判断すると、実態を見誤る原因になる。
モデルごとの「指紋」も異なる。ClaudeはSaaSと保険に偏り、Notion、Linear、Lemonadeが他モデルより頻繁に登場した。Geminiは旅行とヘルスケアに偏り、Booking.com、Teladoc、Livongoの言及が多かった。ChatGPTは3モデルの中で最も合意型で、他モデルとの重複が最も多い。
NotionはClaudeからの引用がGeminiの17倍に達し、Whoopは約4倍だった。State FarmはChatGPTに言及のほぼ半分を依存し、Geminiからは約4分の1しか得られなかった。総合スコアが同じでも、どこで差が出ているかを確認しないと対策は打てない。
ブランド戦略に必要な5つの視点
Fractlの記事は、この調査から導ける5つの教訓を提示している。実行しやすい順に並べると、次の通りだ。
1. 検索権威性とAIリコールを分けて測る
ドメイン評価、オーガニック流入、キーワード順位は引き続き重要だ。ただし、それだけでは全体像を捉えられない。Googleでの順位とAI回答での登場を別々に追跡し、乖離を探す。そのズレにこそ戦略のヒントがある。
2. 第三者による検証を増やす
自社サイトのコンテンツだけではAI回答への登場を保証できない。まとめ記事、ベストリスト、比較記事、専門家レビュー、アナリストページ、ポッドキャスト、YouTubeの文字起こし、コミュニティの議論など、外部コンテンツでの言及を積み重ねることが、AI視認性の実用的なレバーになる。
3. モデルごとに個別測定する
3モデルすべてに参照されたブランドは11%に過ぎない。「AI視認性」を1つの指標として扱うのは誤解を招く。ChatGPT、Gemini、Claudeを分けて計測し、プロンプトをカテゴリ別、購買意図別、比較セット別に分解する。どのモデルで、どの文脈で、どの競合と共に登場するかを追跡する。
4. カテゴリ分類の修正を優先する
ブランド全体の認知度が高くても、狙うカテゴリでのリコールが弱いなら、問題は分類にある可能性が高い。AIモデルはブランドを知っているが、重要なクエリの回答セットに含めるべき存在だとは考えていない。メディア報道、比較コンテンツ、パートナー参照、カスタマーストーリー、受賞歴、レビュー、第三者ページなどを通じて、ブランドとカテゴリの結び付きを繰り返し強化する必要がある。
5. デフォルト回答の枠が固まる前に動く
ウェルネス、ライフスタイル、ヘルステックの一部では、デフォルト回答の座がまだ空白だ。一方、旅行、主要SaaS、FinTechの一部では、AIが返す顔ぶれがすでに固定化しつつある。カテゴリとの結び付きを早期に築いたブランドほど、AIの回答に残りやすい。後発が割り込む余地は徐々に狭まる。
この記事のポイント
- SEO上位でもAI回答に登場しないブランドが全体の約5%存在する
- AI回答での競争集合は検索結果ページよりはるかに小さい
- 第三者コンテンツでの言及頻度がAI視認性を左右する
- 3モデルすべてに参照されるブランドは11%に過ぎない
- カテゴリ誤分類の修正がAI視認性改善の近道になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
DynamoDBにベクトル検索がGA、リアルタイムな類似検索が可能に
AWSは2026年8月5日、Amazon DynamoDBにベクトル検索機能を正式に追加した。これにより、既存の運用データと同じテーブルに埋め込みベクトルを格納し、類似度にもとづくリアルタイムな検索が可能になる。
従来、ベクトル検索を追加するには専用のベクトルデータベースを用意し、データの同期パイプラインを自前で維持する必要があった。今回の発表によって、DynamoDBだけでミリ秒単位の低レイテンシと99%以上の再現率、トリリオン規模のベクトルに対応するスケーラビリティが手に入る。サーバーやソフトウェアの管理は一切不要で、ゼロダウンタイムのメンテナンスが保証される。
DynamoDBにベクトル検索が一般提供開始

ベクトルインデックスにはストレージ制限がなく、データの増大に合わせて水平スケールする。セマンティックな検索が必要なエージェント向けメモリ、検索拡張生成(RAG)、レコメンデーションエンジン、パーソナライズされた体験、異常検知などのユースケースを、DynamoDBのネイティブ機能として実装できる。
ベクトル検索の機能は、最大4096次元のベクトルに対応し、ユークリッド距離、コサイン類似度、ドット積のいずれかの距離関数を選択可能。また、パーティションキーによるスコープ指定や、インラインフィルタを使った絞り込みにも対応する。
ベクトル検索統合の背景とメリット
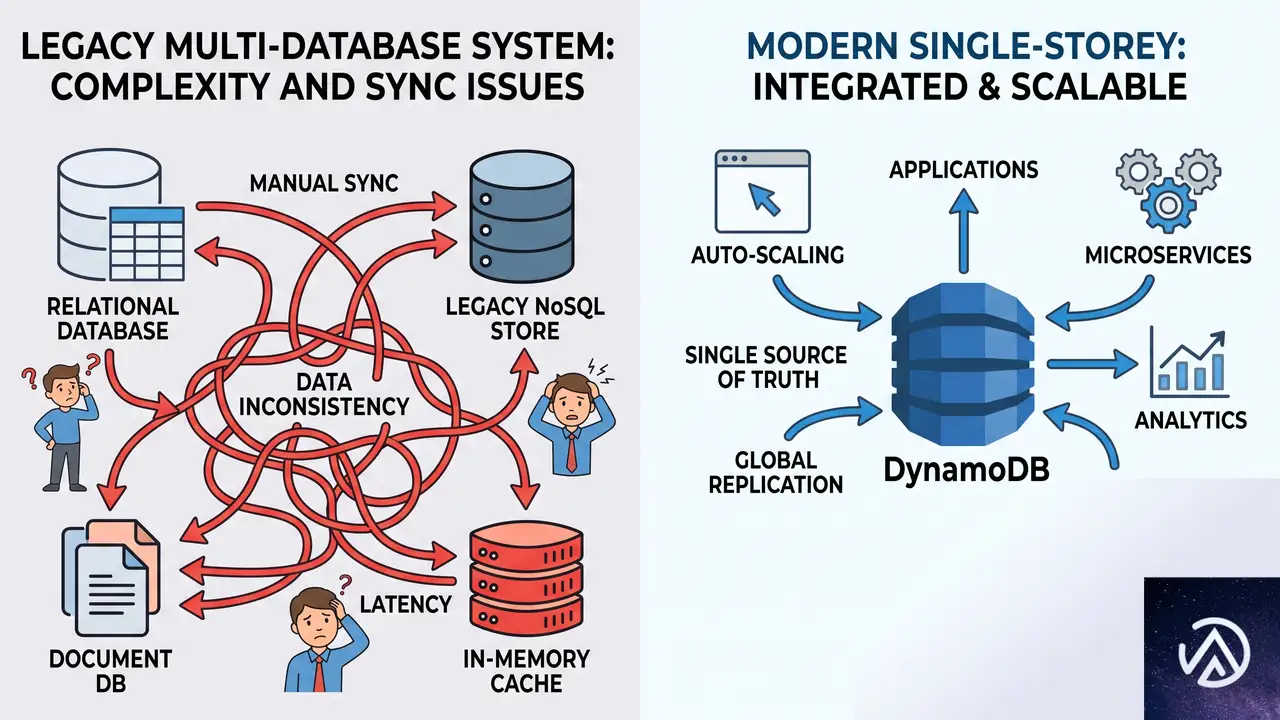
DynamoDBをすでに利用しているアプリケーションでは、これまでセマンティック検索を追加するために、専用のベクトルデータベースを別途プロビジョニングし、テーブル間でデータの同期を維持するパイプラインを構築・運用する必要があった。この構成は追加の運用コスト、データ転送料金、ライセンス費用に加え、大規模環境での低レイテンシ維持を難しくする要因だった。
DynamoDBのベクトル検索では、ベクトルと運用データが同一のサーバーレス基盤で管理され、同じ従量課金モデルが適用される。これにより、同期パイプラインや外部ベクトルストアの運用から解放される。
検索の仕組みとAPIの使い方
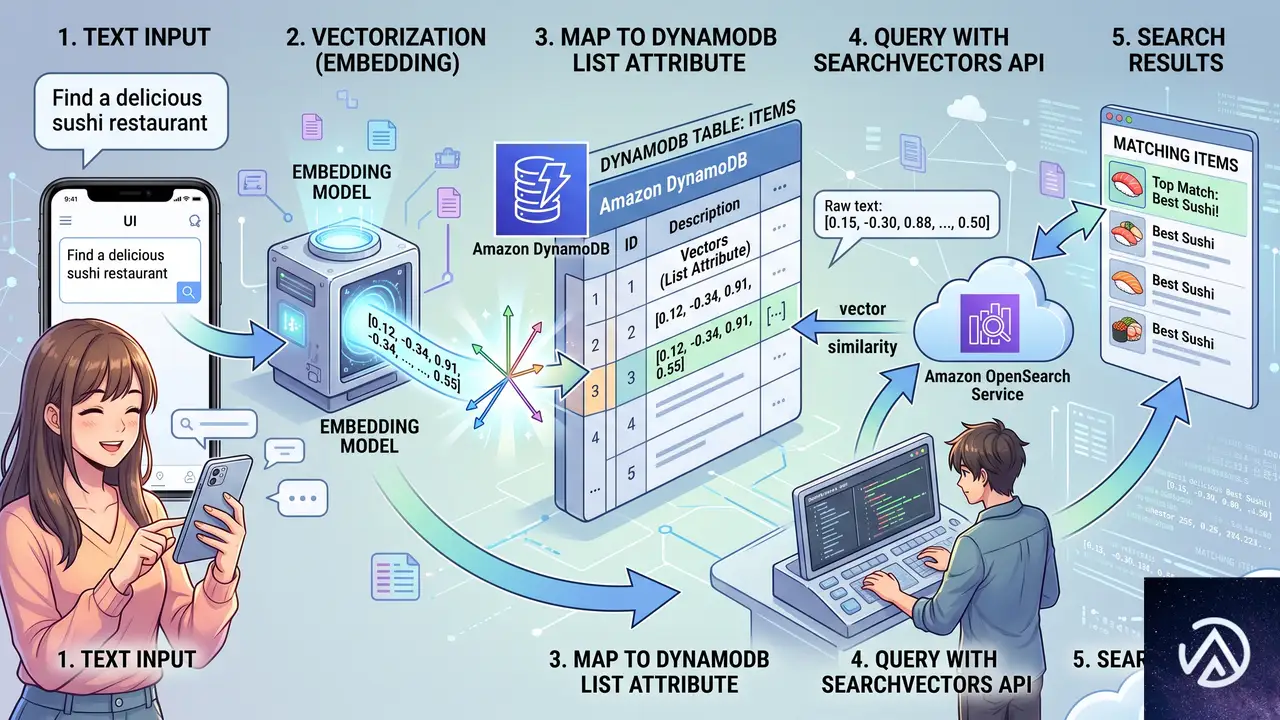
DynamoDBのベクトル検索は、既存のテーブルに新しいタイプのインデックスを追加する方式で実現する。ユーザーは任意の埋め込みモデル(Amazon Bedrock Titan Text Embeddings、Cohere Embed、OpenAIの埋め込みモデルなど)を使ってベクトルを生成し、標準のPutItemまたはUpdateItem APIでフロート値のリストとしてテーブルに格納する。その後、対象の属性に対してベクトルインデックスを作成し、次元数と距離関数、オプションのフィルタ属性を指定する。
List型でベクトルを格納検索時はSearchVectors APIを使い、クエリベクトルと返却件数(最大100件)、オプションのフィルタ条件を指定する。結果は類似度順にランキングされて返る。パーティションキーを指定すれば、特定の市場やテナントに対象を絞り込んだ検索も可能だ。インラインフィルタでは完全一致のみサポートしており、範囲条件(BETWEENなど)は利用できない。
距離関数は、コサイン類似度がテキスト埋め込みの意味比較に効果的だが、ユークリッド距離はベクトルの大きさが意味を持つ場合(購入数によるクラスタリングなど)に、ドット積は方向と大きさの両方を評価するレコメンデーションシステムに適する。埋め込みモデルを訓練した際の距離関数と合わせるのが精度を上げる基本になる。
既存テーブルへの追加手順

AWSの公式ブログでは、スポーツ用品のオンラインストアを例に、商品カタログテーブルへのベクトル検索の追加手順が紹介されている。すでにproductId、category、descriptionなどの属性を持つテーブルに、商品説明の埋め込みベクトルを追加していく流れだ。
まず、既存の商品説明テキストから埋め込みモデルを使ってベクトルを生成し、UpdateItem呼び出しでdescriptionEmbeddingという新しい属性として各アイテムに追加する。DynamoDBは既存のListデータ型をそのまま使い、スキーマ変更や新しいデータ型の追加は不要。各要素が埋め込みの1次元に対応するNumber型のリストとして格納される。
次に、DynamoDBコンソールでテーブルの「インデックス」タブを開き、「ベクトルインデックスの作成」を選択する。インデックス名、ベクトル属性(descriptionEmbedding)、次元数(埋め込みモデルに合わせる)、距離関数(ここではコサイン)、パーティションキー(例:marketplace)、インラインフィルタ属性(例:category)を設定する。パーティションキーはオプションだが、大規模データで高スループットを保つために推奨される。
インデックスがアクティブになったら、同じ埋め込みモデルで生成したクエリベクトルを使って検索を実行する。コンソールの「項目の探索」からベクトル検索モードに切り替え、インデックスとクエリベクトル、トップK、パーティションキー値、フィルタ条件を入力する。この例では「US」マーケットプレイスに絞り、カテゴリを「footwear」に限定して「軽量の夏用ランニングシューズ」といった自然言語に近いクエリで類似商品を取得できる。
返却される結果には、類似度スコアと共に商品名や価格などの運用属性が含まれる。コサイン距離とユークリッド距離ではスコアが小さいほど類似度が高く、0は同一ベクトルを示す。ドット積では大きい値が類似度の高さを示す。
想定されるユースケースと拡張性

ベクトル検索がDynamoDBに統合されたことで、セマンティック検索が必要な様々なアプリケーションを単一のデータベースで実現できる。たとえば、エージェントの過去の対話や記憶をベクトル化して素早く参照するエージェントメモリ、大規模言語モデルの回答精度を高めるRAG、ユーザーの行動履歴から類似商品を即座に提示するレコメンデーション、個人の好みに応じたコンテンツのパーソナライズ、過去のパターンとの類似性から異常を検出する監視システムなどが挙げられる。
また、4096次元までのベクトルに対応し、距離関数やフィルタの選択肢も実用的だ。マルチテナントアプリケーションでは、パーティションキーで検索範囲をテナント単位に区切れるため、全データをスキャンすることなく高いスループットを維持できる。あらゆる商用AWSリージョンおよびGovCloudリージョンで利用可能となっている。
この記事のポイント
- DynamoDBのネイティブ機能としてベクトル検索が一般提供開始された
- 運用データと同じテーブルに埋め込みを格納し、ミリ秒単位で類似検索が可能
- 専用ベクトルDBや同期パイプラインが不要になり、サーバーレスでスケールする
- 最大4096次元、コサイン・ユークリッド・ドット積の距離関数をサポート
- RAG、レコメンデーション、エージェントメモリ、異常検知など幅広い用途に対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIで返金証拠の偽造が容易に、EC事業者に迫る新たな脅威
オンラインストアにおける返金申請に、生成AIで偽造された証拠写真や配送記録を使う手口が急増している。実店舗を持たずに商品を販売するEC事業者にとって、返品プロセスのデジタル化はコスト削減に直結するが、その裏で「証拠の信頼性」という前提が根底から揺らぎ始めたのだ。特に自動審査システムを導入する事業者ほど、巧妙化するAI画像に脆弱になりやすい。
米国では2025年の返品総額が約8,499億ドルに達し、そのうち約9%が不正申告と推計されている。ECの返品率は実店舗の2倍以上に上る。実務に詳しい業界関係者の間では、これまで人の手で検知できていた偽装が、AIによって誰でも量産できる段階へ移行したとの危機感が強い。この記事では、AI返金詐欺の実態と、事業者が現実的に取りうる対策、そしてその経済的なジレンマまでを整理する。
EC返金の仕組みと「証拠写真」の脆さ
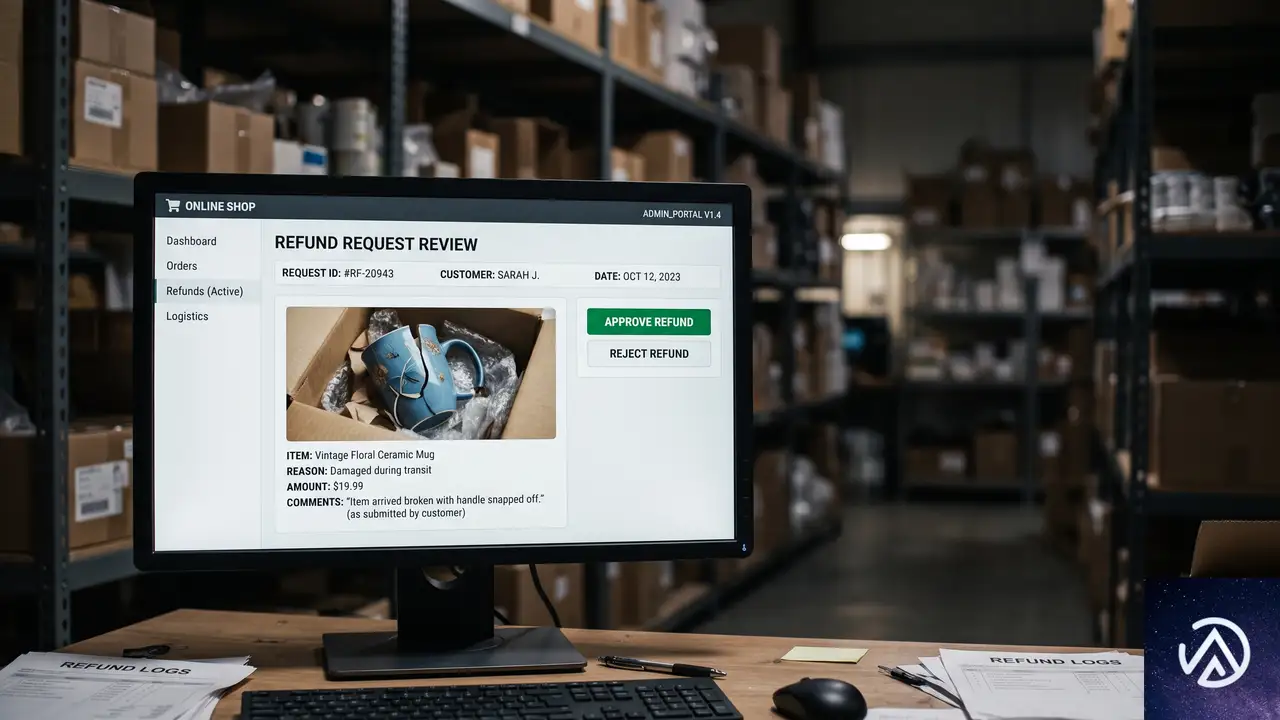
写真1枚で成立していた返金審査
一般的なECサイトでは、返品返金の審査を写真と購入者の申告文のみで完了させるケースが多い。商品の破損やパッケージの潰れを写した画像を確認し、配送記録と照合して問題がないと判断すれば、そのまま返金が実行される。
この流れを支える前提は「購入者が提出する写真は、実際の商品を写したものだ」という一点に尽きる。生成AIはこの前提そのものを無力化してしまう。実在しない破損をあたかも本物のように描写できるため、写真1枚の信頼性では太刀打ちできなくなるからだ。
特に低額商品や食品など、返送コストが商品価格を上回るケースでは、商品の返却を求めずに返金に応じる「返品不要返金」が多用される。詐欺師がこの仕組みを悪用するのは以前からだが、AI画像の登場でそのハードルは大幅に下がった。
返品不要返金が狙われる理由
送料と検品コストを考慮し、商品を送り返させずに返金する方式は、カスタマーサポートの効率化に寄与する。しかし同時に、詐欺師にとっては「商品を手元に残したまま返金だけを受け取れる」絶好の抜け穴になる。生成AIによる偽造証拠は、この穴をさらに拡大する存在だ。
Practical Ecommerceの記事は、米国の小売企業Bogg BagとBoll & Branchが、実際にAIで改ざんされた返品証拠に遭遇したと報じている。こうした事例は大企業に限らず、中規模以下のネットショップにも波及しつつある。
生成AIが作る偽造証拠の手口
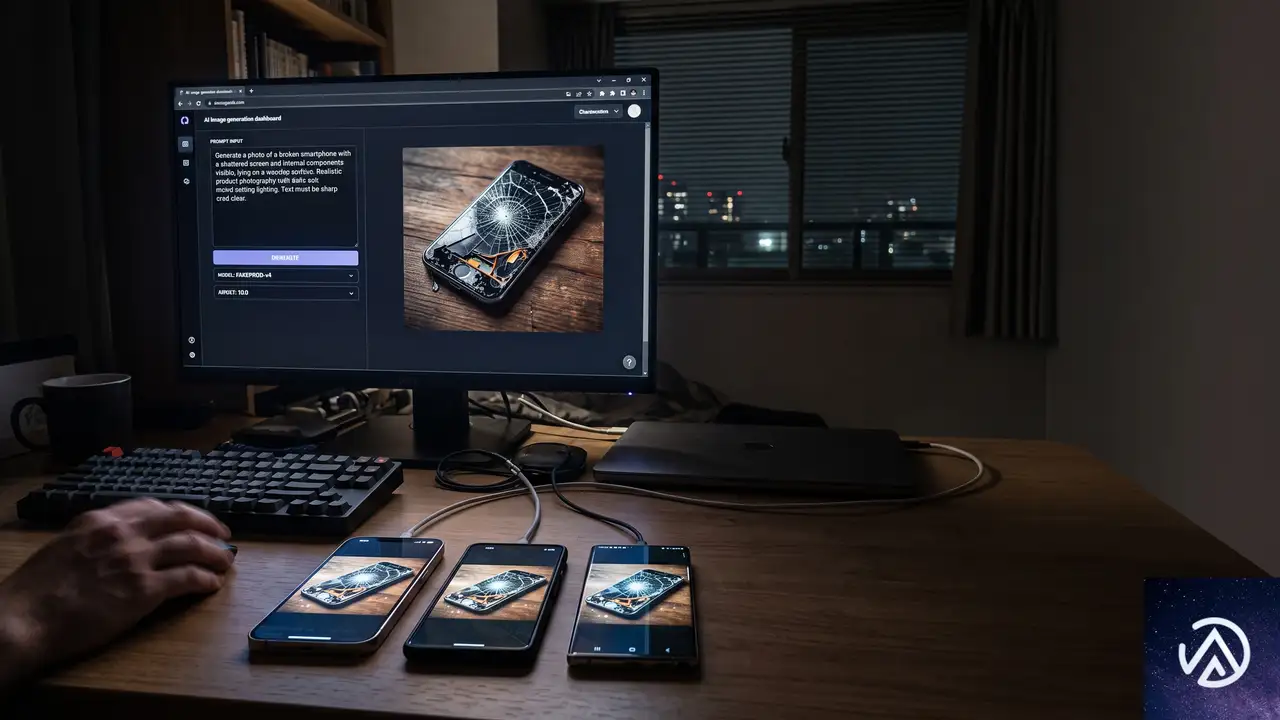
AIによる返金詐欺は、単に商品画像を改変するだけにとどまらない。返品プロセス全体のストーリーを捏造できる点が、これまでの手口と一線を画す。
偽造できる証拠の範囲
詐欺師が短時間で生成できる偽造証拠の範囲は広い。以下に主な種類を整理する。
- 商品のひび割れ、汚れ、カビ、破れ、漏れ、へこみ、部品欠落
- 損傷したパッケージや潰れた配送箱の写真
- 掲載写真と色・機能が異なると見せかける加工
- 「返金を承諾した」とする架空のカスタマーサポートチャット
- 配送記録、運送会社の書類、配達完了画面の偽スクリーンショット
- 各ストアの返品ポリシーに合わせた苦情文の自動生成
- 複数店舗で使い回すためのバリエーション作成
いずれの偽造も、数回のプロンプト入力で完成させられる。写真編集ソフトの知識や文書の改ざんスキルはもはや不要だ。これが「誰でも詐欺師になれる」と言われるゆえんである。
AI画像のリアリティと簡単さ
Practical Ecommerceの記事では、わずか10単語のプロンプトから、ガラス花瓶が粉々に割れた説得力のある画像が生成された例が紹介されている。照明の反射や影の付き方まで自然で、一見しただけでは実写と区別がつかない。
詐欺の実行に必要なコストも時間も極小化され、同時に複数アカウントや複数店舗を横断して悪用できる。従来のように一人の詐欺師が手作業で細工する手法とは、規模感がまったく異なる。AI返金詐欺は、取引・紛争・物流・カスタマーサポートの各段階にまたがる「拡張可能な欺瞞」と呼べるレベルに達している。
この比較で示すように、詐欺の効率性と拡張性が段違いに向上した。事業者は、こうした「量産型の偽装」への耐性を今から備えなければならない。
AI詐欺に立ち向かうための対策とコスト
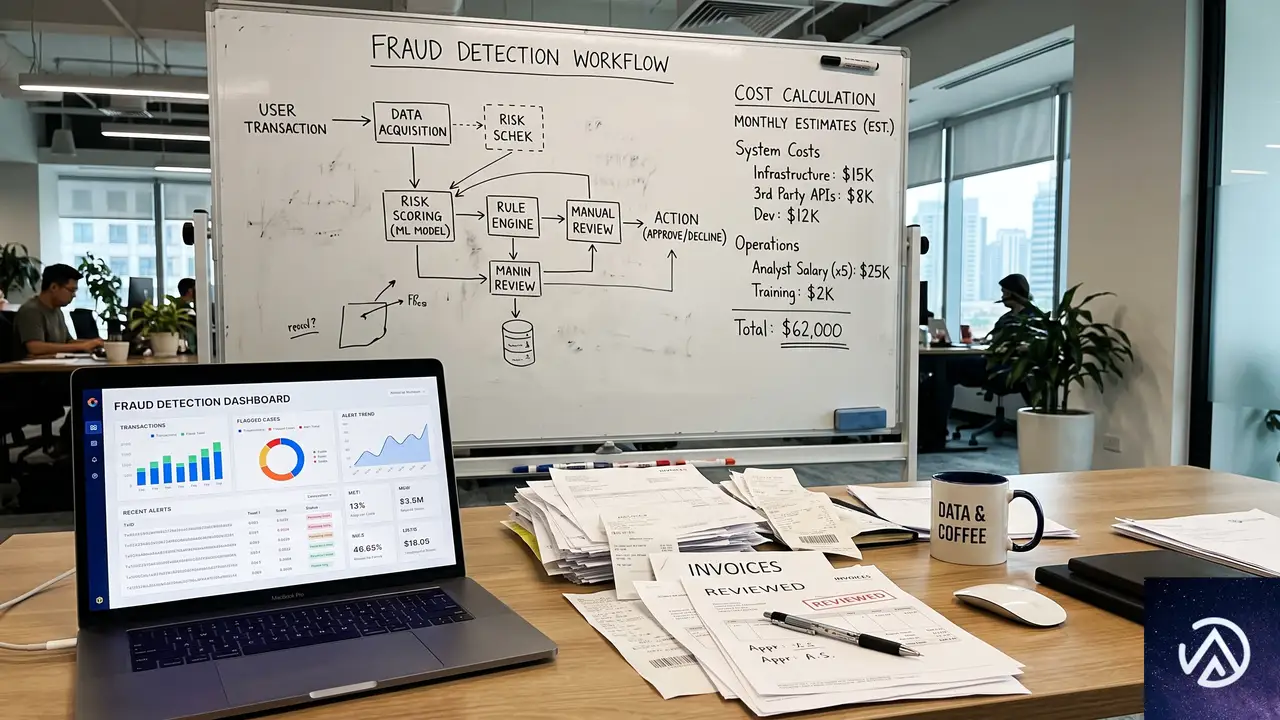
検知技術と審査プロセスの強化
EC事業者が取れる防御策はいくつか存在する。画像のメタデータ分析や圧縮パターンの精査、逆画像検索による使い回し画像の発見、アカウントの返品履歴や行動ログのスコアリングなどは、従来からある不正検知の延長線上にある手法だ。
さらに実効性が高いとされるのは、次のような対策である。
- 商品写真を1枚だけでなく、別アングルや短い動画の提出を必須にする
- 高額商品や返品履歴に不審な動きがあるアカウントは、人手による詳細審査に切り替える
- 特定の商品カテゴリや顧客セグメントに対して、返品時に現物の返送を義務付ける
- 提出された画像をAIでスキャンし、合成や改変の痕跡を自動判定する
ただし、これらの対策にも限界はある。AIによる画像生成技術は日進月歩で進化しており、検知ツールが誤って正当な申告を不正とみなす「偽陽性」も無視できない。偽陽性が増えれば、誠実な顧客に無用な負担を強いることになり、サポートコストやブランドイメージへの悪影響につながる。
対策コストが上回るジレンマ
より深刻なのは、不正防止にかけるコストが、防げる被害額を上回ってしまうケースだ。Practical Ecommerceの記事は「3万ドルの不正を防ぐために10万ドルのコストをかけるのは無意味だ」という端的な指摘を紹介している。
厳格な返品ポリシーを設ければ、返送送料や検品費用、カスタマーサポートの問い合わせ対応が増大する。顧客満足度の低下がリピート率やLTV(顧客生涯価値)に及ぼす影響を加味すれば、単純に「不正をゼロにする」施策は経済合理性を欠くのだ。
このジレンマは、AI詐欺のコストがあまりに低いことに起因する。詐欺師側は数分で偽造証拠を作れる一方、事業者側はそれを証明するためにサポートスタッフの確認作業、倉庫記録の照合、運送会社との連携、場合によっては正式な異議申し立て手続きまでが必要になる。攻撃と防御の非対称性が、年々拡大しているのが現状だ。
攻撃側と防御側の非対称性を視覚化すると、その差は歴然としている。AIがもたらすインパクトは、単に詐欺が増えたという量的な問題にとどまらず、防御の経済性そのものを破綻させかねない質的な変化だ。
実務に落とし込む現実的なアプローチ
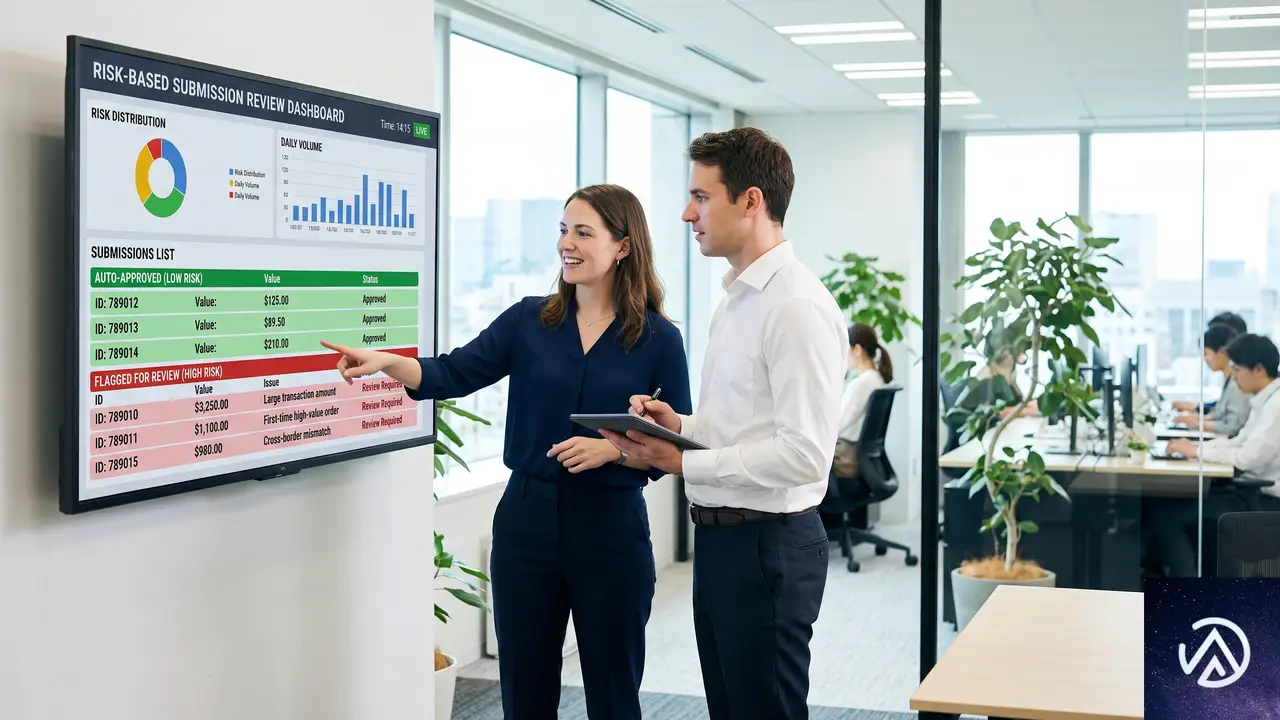
全件精査ではなく「優先度ベースの審査」へ
限られたリソースの中でAI詐欺に対抗するには、「全件を完璧に防ぐ」発想を手放すことが出発点になる。代わりに、不正のリスクが高い申告を優先的に精査し、それ以外はある程度の漏れを許容する設計が現実的だ。
具体的には、商品単価の高い申告、返品頻度が異常に高い顧客、新規アカウントからの高額返金申請、画像のメタデータに不自然な欠落があるケースなどをスコアリングし、閾値を超えたものだけを手動で再確認する仕組みが考えられる。これらのルールベースのフィルタは、AI検知ツールと組み合わせることで精度を上げられる。
不正対策とCXのバランス設計
返品ポリシーを厳格化するほど、一般的な顧客の購入障壁は上がる。「返品時に動画を必須とする」「返送を全商品に義務付ける」といった一律のルール変更は、CX(顧客体験)を大きく毀損し、売上全体に悪影響を及ぼす可能性が高い。
むしろ有効なのは、優良顧客と疑わしい顧客をセグメントし、前者にはこれまで通りのスムーズな返金体験を維持しつつ、後者にのみ追加の証拠提出を求める段階的なアプローチだ。購買履歴や会員登録からの経過期間、過去の返品率などは、セグメントの判断材料として実装しやすい。
また、AIによる画像スクリーニングを導入する場合も、完全自動化ではなく「疑わしい画像を人間の担当者に提示する」補助ツールとして位置づけることで、偽陽性による誤った拒否を減らせる。
この段階的なアプローチなら、防御コストを抑えつつ、AIが生成した偽装画像の多くを発見できる可能性が高まる。最初から完璧を目指さず、リスクベースでリソースを集中させる考え方こそ、AI時代の返金審査に求められる現実解である。
今後広がるAI詐欺とEC事業者の備え
画像生成AIの進化はさらに加速する
画像生成AIの品質は、ここ1〜2年だけでも目覚ましく向上してきた。指の本数に違和感が残っていた初期段階はすでに過去のものとなり、テクスチャの再現性や光の反射、被写界深度の自然さは、人間の目では実写と区別できない水準に近づいている。
音声や動画の生成技術も同時に進化しており、将来的には「壊れた商品を手にした購入者が不満を訴える短い動画」すら数クリックで捏造される可能性がある。そうなれば、動画による証拠提出ですら防御策としての有効性を失いかねない。
まずは直近の返金履歴を監査する
Practical Ecommerceの記事は「問題を認識することが戦いの半分だ」と述べ、近い時期の返金記録を精査し、AIによる偽装がすでに紛れ込んでいないか確認することを推奨している。
具体的には、過去3〜6ヶ月の返金申請から、同じような構図・影の付き方・背景の写真が複数アカウントで使われていないか、メタデータに不自然な欠落や一貫性のなさがないか、という観点でのチェックが有効だ。AI画像生成ツールは撮影機器情報やGPSタグを埋め込まないため、Exifデータの不在そのものが一つのシグナルになりうる。
AI返金詐欺はまだ黎明期にある。にもかかわらず、手口の洗練と低コスト化は予想以上の速度で進んでいる。EC事業者にとっての最善手は、抜本的な対策を急ぎつつ、経済的なバランスを冷静に見極めることだ。
この記事のポイント
- 生成AIにより、返金詐欺の証拠写真や文書が誰でも短時間で偽造できるようになった
- 「返品不要返金」のような効率重視のプロセスが、AI詐欺に悪用されやすい構造になっている
- 防御策には画像解析や動画提出の義務化があるが、偽陽性やコスト増という副作用を伴う
- 不正額を上回る防御コストをかけることは経済的に無意味であり、リスクベースの優先審査が現実解
- まずは直近の返金履歴を監査し、AIによる偽装の混入有無を確認することから始めるべきである
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI可視性スコアは無意味、EC事業者が取るべき代替指標と施策
AI検索の可視性スコアは、特定のプロンプトと計測条件に強く依存する。実務的な指標として機能しないケースが多く、一部の代理店ではスコアの水増しまで行われているのが現状だ。
Practical Ecommerceに掲載された論考は、この問題を「AI Visibility Scores Are Useless(AI可視性スコアは役に立たない)」と断じている。本記事では、EC事業者がすぐに着手できる代替指標と、AI検索で自社のプレゼンスを高めるための具体的な施策を解説する。
AI可視性スコアが当てにならない3つの理由
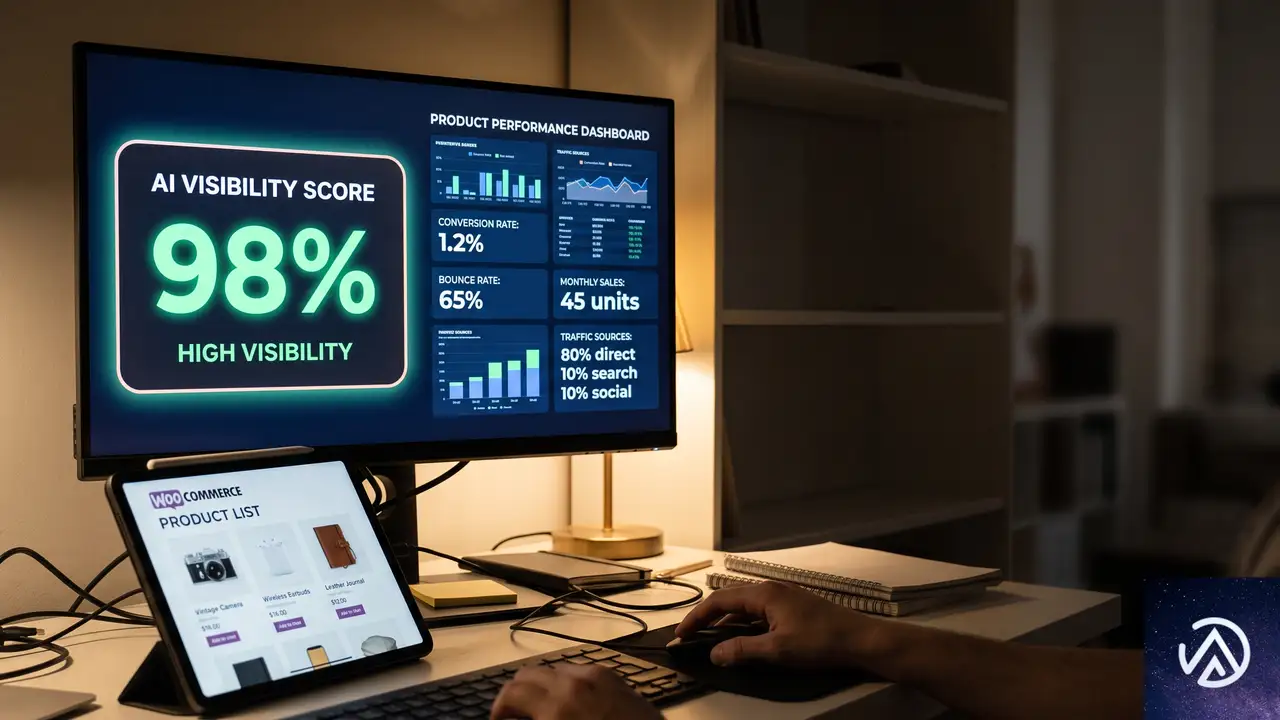
AI可視性スコアとは、ChatGPTやPerplexityといった生成AIの回答に、自社のブランドや商品がどれだけ登場するかを数値化した指標を指す。直感的には便利に思えるが、現場で使うには欠陥が多い。
プロンプトに結果が左右される脆弱さ
AIの回答は、与えられたプロンプト(質問文)によって内容が大きく変わる。たとえば「東京 おすすめ ランニングシューズ」と「[自社ブランド名] ランニングシューズ 評判」では、同じAIでも表示される情報がまったく異なるのだ。
可視性ツールの多くは、事前に用意された少数のプロンプトでスコアを算出する。そのプロンプトに自社名が含まれていればスコアは跳ね上がり、含まれていなければゼロになる。実務を反映しない、操作しやすい設計といえる。
プロンプトに自社名が入った「仕込み」の質問でスコアを稼ぐ行為は、実務的な意味を持たない。実際の消費者は、もっと漠然とした言葉で商品を探しているからだ。
スコアを水増しする手法が横行している
業界の一部では、プロンプトを加工してわざと自社が上位表示されるように誘導する操作が行われている。Practical Ecommerceの記事もこの点を指摘しており、自社名を盛り込んだプロンプトを大量に使えば、全体の平均スコアを簡単に引き上げられてしまう。
外部のコンサルタントや代理店から「AI可視性スコアが○%向上しました」といった報告を受けても、その数字がどんなプロンプトに基づくのかを確かめなければ、まったく意味が変わってくる。
引用されても購買につながらないケース
生成AIの回答には、ブランド名が明示される「見える引用」と、リンクだけが貼られてブランド名が出ない「見えない引用」の2種類がある。後者はクリックされる確率が極めて低く、トラフィックにほとんど寄与しない。
Redditの報告によれば、ChatGPT経由のトラフィックはGoogle検索と比べて極端に少ない。引用数だけをKPIにすると、実態とかけ離れた数値を追いかけることになる。
EC事業者が追うべき実践的なAI指標
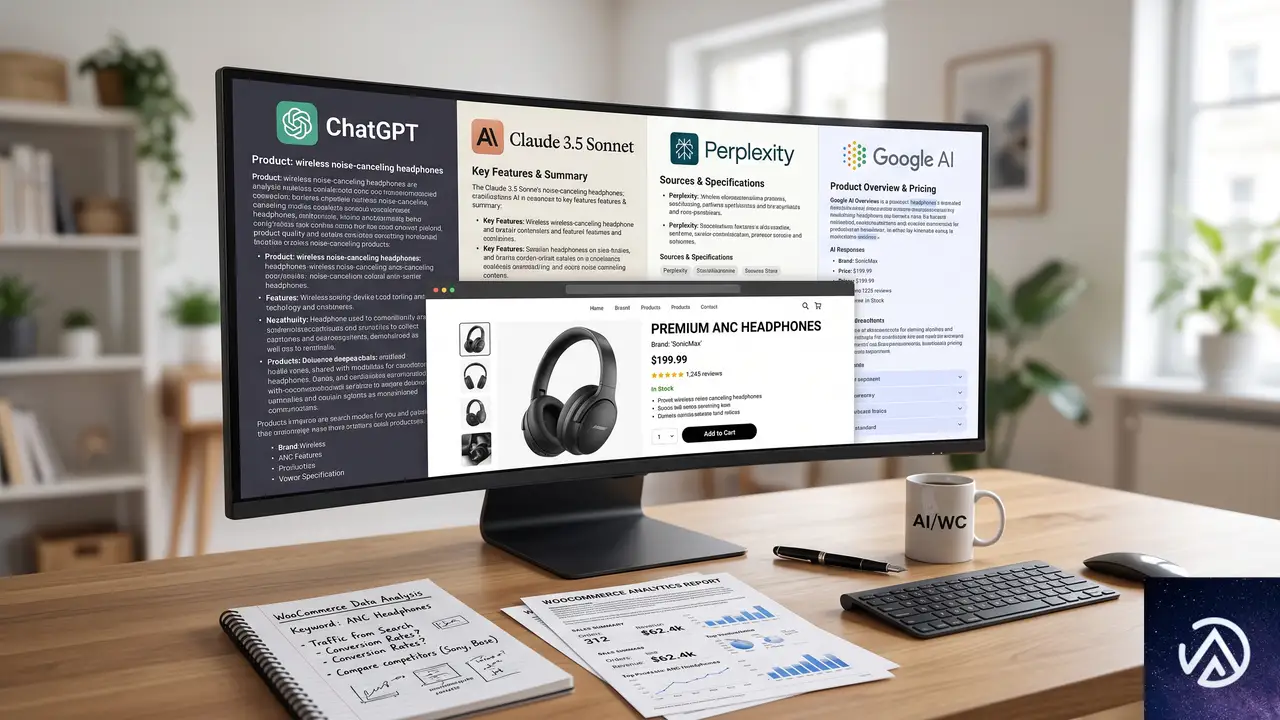
AI可視性スコアに代わる指標として、Practical Ecommerceの著者は大きく4つのポイントを挙げている。いずれも特定のツールに依存せず、自社のコンテンツ戦略に直結する項目だ。
複数AIで引用されるドメインを分析する
単一のAIモデルでの引用率ではなく、ChatGPT、Claude、Perplexity、Google AI Overviewsなど、複数の生成AIプラットフォームにまたがって引用されているドメインを追う方が有益だ。このアプローチにより、次の3つを把握できる。
- AIが回答の根拠として信頼するメディアやパブリッシャー
- AIに影響力を持つUGC(ユーザー生成コンテンツ)やSNSプラットフォーム
- 高頻度で引用されている競合サイト
複数プラットフォームで共通して引用されるドメインは、AIが「信頼できる情報源」と評価している証拠だ。ECサイトであれば、商品説明の充実度や口コミの多さ、専門メディアでの露出が共通項になりやすい。
競合の引用状況からコンテンツの穴を探す
従来のSEOではキーワードギャップ分析が行われてきたが、AI検索の文脈では「引用ギャップ」とも呼べる視点が重要になる。特定の質問に対して競合が引用されているのに自社が引用されていない場合、サイト上の情報に不足があると考えられる。
たとえば、競合ECサイトが「サイズ選びの失敗を防ぐ方法」という記事で頻繁に引用されているなら、消費者はその情報をAIに求めているとわかる。自社も同様のコンテンツを用意し、AIに拾われやすい構造で公開すれば、自然と引用対象に入りやすくなる。
見えない引用を「見える引用」に変える
AI回答にリンクは貼られているが、ブランド名やサイト名が一切表示されない状態を「見えない引用」と呼ぶ。この状態では、ユーザーがリンクをクリックする動機が弱く、トラフィック増加にはつながりにくい。
一方、ブランド名が明示される「見える引用」は、ユーザーの購買判断に直接的な影響を与える。Practical Ecommerceの著者のテストでも、見える引用が購買決定を後押しする結果が出ているという。
見えない引用を改善するには、AIが回答の要約を作る際に「ブランド名を自然に含められる」形でオンページのテキストを整備する必要がある。「当店のシューズは」ではなく「[ブランド名]のシューズは」と書くだけでも、AIの引用表記は変わりうる。
ブランドプロンプトで自社の情報鮮度を測る
AIに自社情報がどの程度正確に、どの程度詳しく伝わっているかを確かめるには、ブランド名を明示したプロンプトが有効だ。実務の文脈で使える質問例として、以下が挙げられる。
- 「[自社ブランド名]とはどんなブランドか?」
- 「[自社ブランド名]と[競合ブランド名]の違いは?」
- 「[自社ブランド名]の評判や口コミは?」
- 「[自社ブランド名]は信頼できるか?」
これらの質問に対してAIが具体的かつ最新の情報を返せるなら、オンページの情報整備とブランドシグナルが機能している証拠といえる。回答が古かったり、内容が薄い場合は、AIが参照できる情報源が不足している可能性が高い。
ECサイトが今すぐ始めるAI検索対策
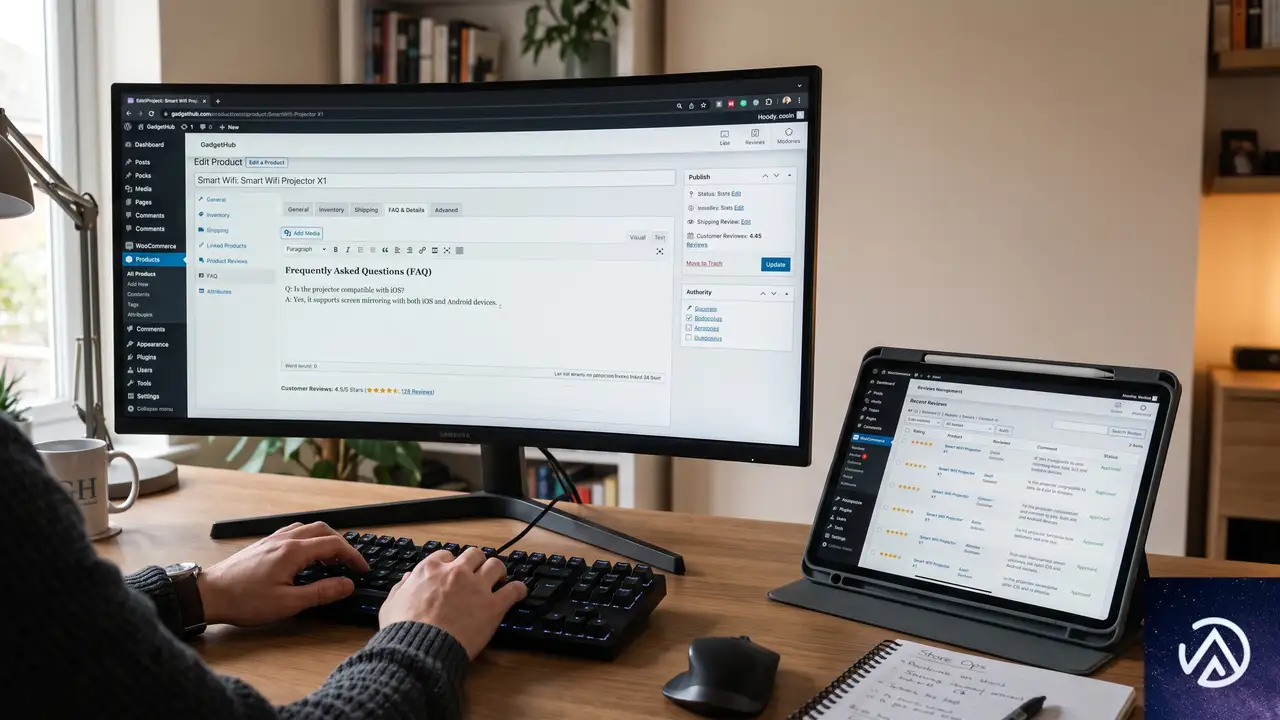
上記の指標を踏まえ、EC事業者がすぐに取り組める具体的な施策を整理する。特別なツールへの投資は不要で、サイト運営の延長線上にある作業ばかりだ。
商品ページの情報を「AIが引用しやすい形」に整える
AIは構造化された情報を好む。商品ページでは、箇条書きのスペック表、FAQ、Q&A形式の説明文などを積極的に挿入しよう。とくに、ユーザーが検索しそうな疑問文をそのまま見出しにしたFAQセクションは、AI回答の直接的な引用元になりやすい。
また、商品説明にブランド名を適度に繰り返し入れることで、「見える引用」を誘発しやすくなる。過剰なキーワード連打は避けるが、自然な文脈でブランド名を含める意識が重要だ。
UGC(口コミ・レビュー)を強化する
AIはユーザー生成コンテンツ(UGC)を重視する傾向がある。商品レビューやQ&A、SNS上の口コミなど、実際の購入者による生の声が豊富なECサイトは、AIの回答で引用される確率が上がる。
レビュー数の少ない商品については、購入後のフォローメールでレビュー依頼を自動化したり、レビュー投稿者にクーポンを提供する仕組みを導入するとよい。WooCommerceであれば、プラグインを使ってこうした導線を簡単に追加できる。
外部メディアや比較記事での露出を増やす
AIが高頻度で引用するのは、編集プロセスを経た信頼性の高いメディア記事だ。自社商品が比較記事やレビュー記事で取り上げられれば、その記事経由でAIの回答に自社ブランドが登場しやすくなる。
AI検索の時代は「自社サイトだけで完結させない」発想が求められる。第三者メディアへの露出や、インフルエンサーによる紹介記事の獲得が、間接的にAI可視性を押し上げるのだ。
この記事のポイント
- AI可視性スコアはプロンプト依存度が高く、水増し操作も容易なため実務指標として機能しない
- 複数の生成AIプラットフォームにまたがる引用ドメイン分析が、より正確な現状把握につながる
- 競合の引用状況を調べれば、自社サイトに足りないコンテンツテーマが明らかになる
- ブランド名が表示される「見える引用」を増やすために、オンページの表現とUGCの充実が有効
- 特別なツールに頼らず、商品ページのFAQ拡充やレビュー施策から着手できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Search Consoleに生成AIレポート登場、ECサイト運営への影響を解説
Search Consoleの生成AIレポートが登場、ECサイト運営に何をもたらすか
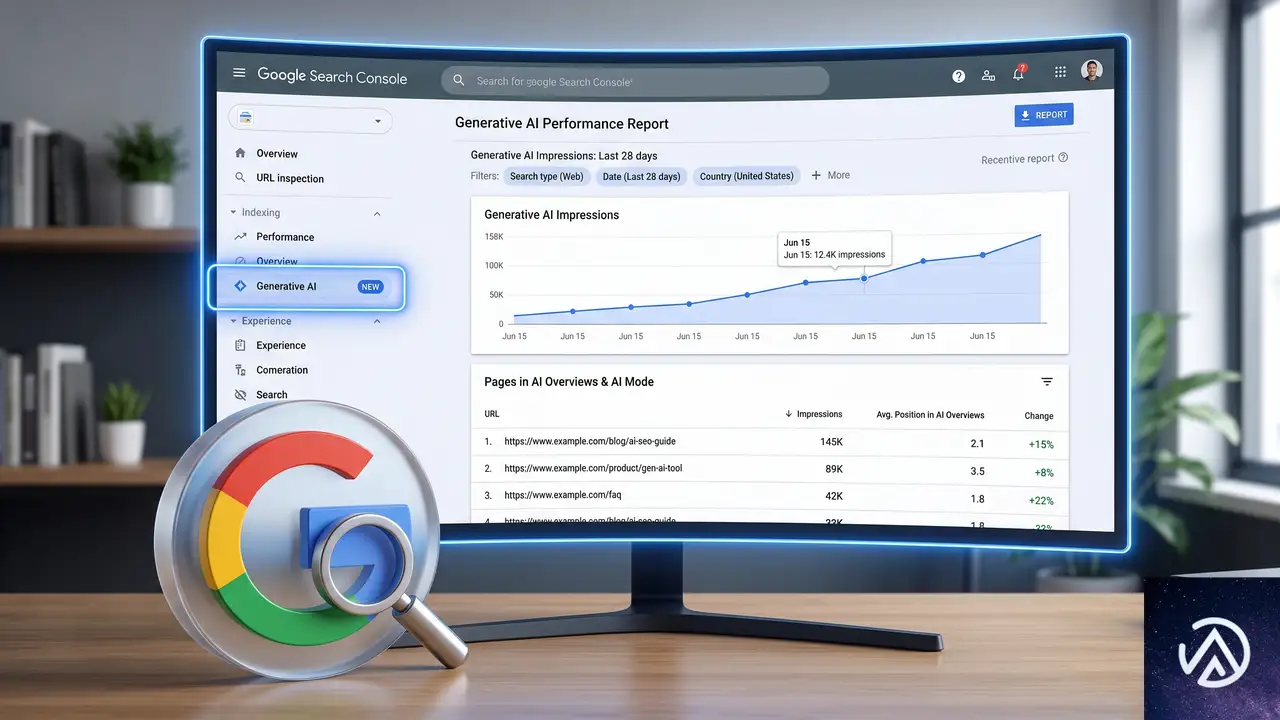
Google Search Consoleに「生成AI」セクションが追加され、全ユーザーが利用可能になった。このレポートは、ECサイトのページがAI OverviewやAI Modeでどれだけ表示されているかを確認できる初めての公式データだ。Google検索のAI回答に自社の商品ページやブログ記事が引用されているかを把握する手がかりになる。
ただし提供される指標は「インプレッション」のみであり、クリック率や実際の閲覧数は含まれない。しかもこのインプレッションの定義には大きな注意点がある。カウントの仕組みを正しく理解しないまま数字を追うと、誤った施策につながりかねない。
この新レポートは「パフォーマンス>検索結果>生成AI」に配置されている。AI回答に表示されたURLのリスト、期間別のインプレッション数、検索者の国とデバイス情報が確認できる。ただしAI Overview、AI Mode、Discoverといった検索機能を区別するフィルターは用意されていない。
ECサイトでAI回答が目立つ意味
オンラインストアにとって、AI回答への掲載は新たな流入経路になりうる。たとえば「小型ビジネス向けSMSマーケティングツール」のような質問に対して、AIがカテゴリ別にツールを紹介するケースが増えている。自社の商品カテゴリページや比較記事が引用されれば、見込み客の目に触れる機会が広がる。
しかしAI回答内で表示されるURLは、必ずしもユーザーに実際に見られているとは限らない。その点を次章で詳しく見ていく。
「インプレッション」の落とし穴、表示されていなくてもカウントされる仕組み
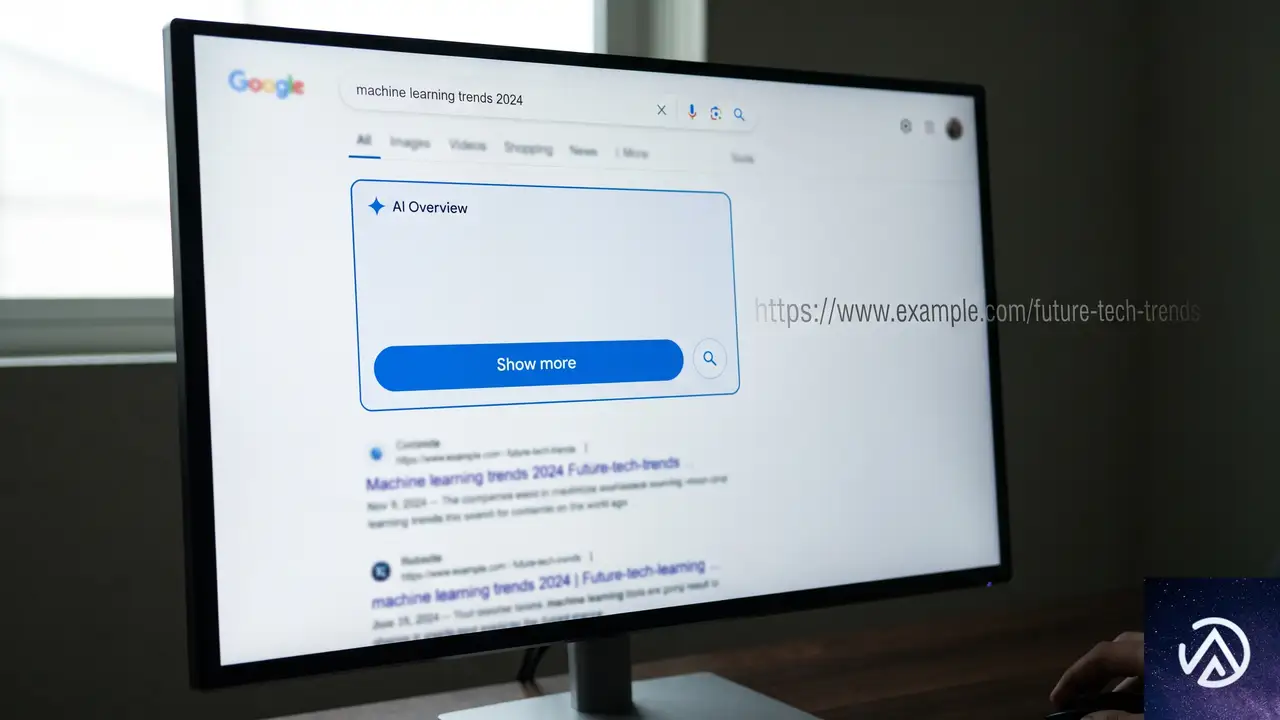
生成AIレポートの唯一の指標であるインプレッションについて、GoogleのJohn Mueller氏は「URLがAI回答のどこかに含まれていれば、ユーザーの操作がなくてもカウントされる」と説明している。つまり、検索者が実際にそのURLを目にしたかどうかは問われない。
このカウント方式によって「自社ページがAI回答で大量に表示されている」という表面的な数字が生まれやすい。だがその大半は、検索者が「もっと見る」を押さずに離脱したかもしれない。インプレッション数だけを根拠にAI最適化の成否を判断するのは危うい。
フォローアップ質問や「他のユーザーも質問」もインプレッションを生む
AI Modeで検索者が追加入力した場合も、回答に含まれるURLは新たなインプレッションとして計上される。また「他のユーザーも質問」ボックスは、質問をクリックしてAI回答が開かない限りインプレッションは発生しない。つまりクリックを経て初めてカウントが始まるが、展開後の回答内のURLはやはりユーザーが実際に目を向けたかに関わらずインプレッションに含まれる。
AI回答にECサイトが取り上げられるパターンと「クリックなき表示」の実態
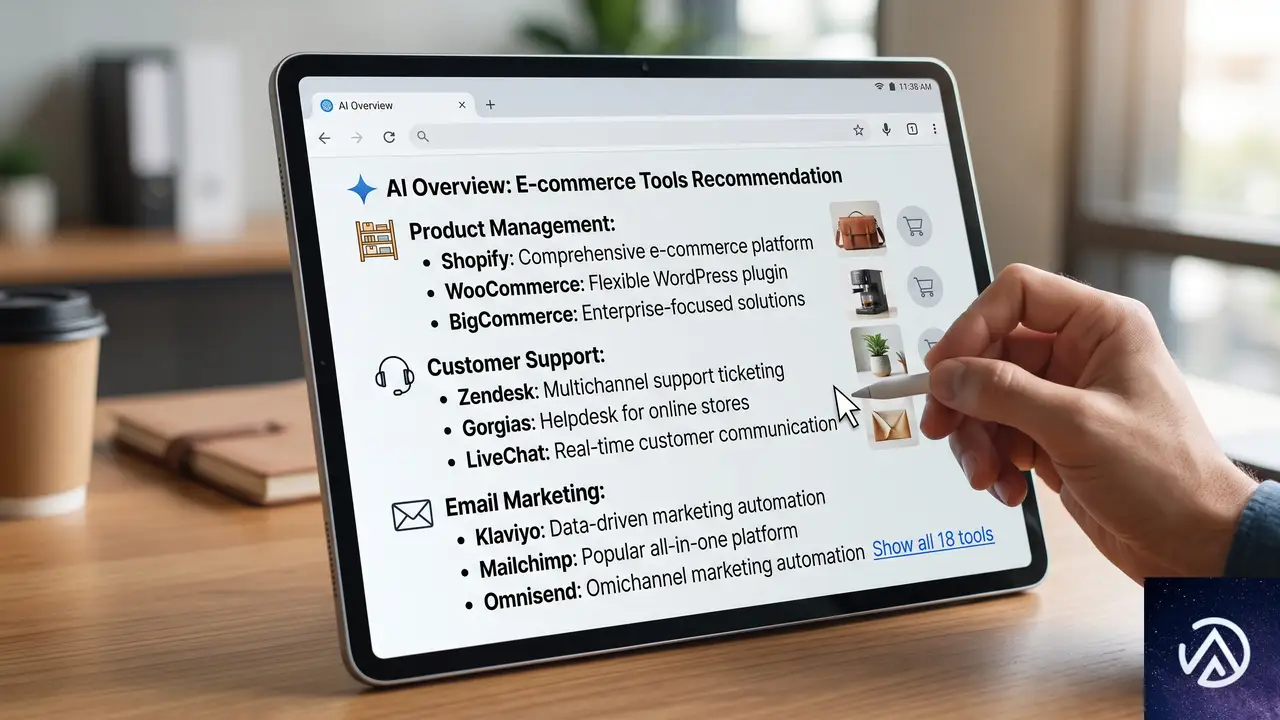
オンラインストアの商品比較記事やガイドコンテンツは、AI Overviewでカテゴリ推薦やリスト形式で引用されることが多い。たとえば「ベストSMSマーケティングツール」の検索では、AIが使用用途別にツールを整理し、出典として複数の記事URLを提示する。
ここで重要なのは、初期表示では引用元が完全には見えていない点だ。「もっと見る」ボタンで回答全文が展開され、さらに「すべて表示」を押すとすべての出典が列挙される。この2段階の操作を検索者が実行したかは分からない。それでもSearch Consoleの生成AIレポート上は、該当URLが「インプレッションを獲得した」と記録される。
この流れを理解しておけば、生成AIレポートの数値に振り回されずに済む。ECサイトのSEO担当者は「本当に読まれているのか」という視点を常に持つ必要がある。
実践的な活用法〜通常トラフィックとAIインプレッションをExcelで突き合わせる
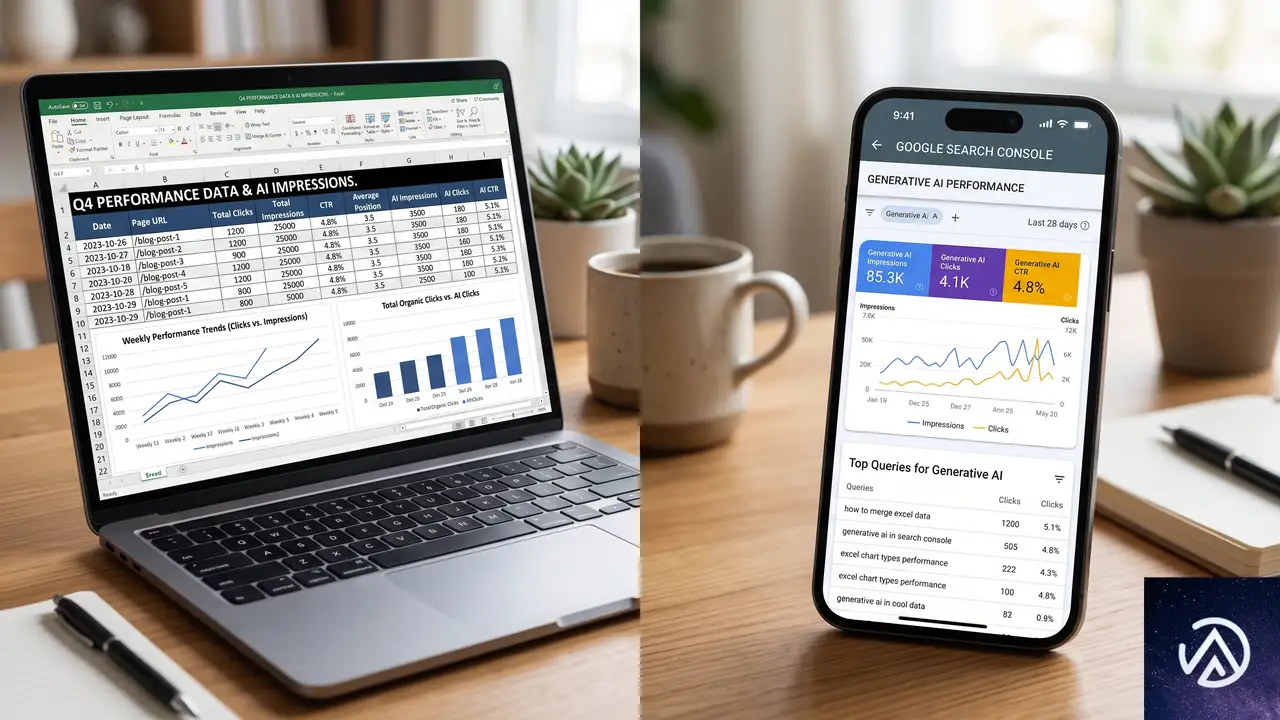
クリックデータがない以上、AIインプレッション単体では施策の優先順位を決めにくい。そこで有効なのが、通常の検索パフォーマンスレポートのデータとの組み合わせだ。具体的な手順は以下の通り。
- 「検索パフォーマンス」レポートから、トラフィックの多い上位URLリストをダウンロードする
- 「生成AI」セクションから、インプレッション数の多いURLリストをダウンロードする
- 両方をExcelでVLOOKUPなどを使って紐づけ、URLごとのトラフィックとAIインプレッションを可視化する
この突き合わせ作業は手間がかかるが、ECサイトがAI時代に取るべき施策の方向性を見極めるうえで欠かせない。とくにパターンBの「AIには表示されるがクリックが少ない」ページは、商品詳細の充実や関連商品への導線強化が効果を発揮しやすい。
AI回答への表示をブロックできるが、ECサイトは原則不要
Search Consoleには新たに「AI制御」機能が追加され、サイト単位でAI回答へのコンテンツ表示をブロックできるようになった。設定は「設定>AI制御>検索生成AI」から行い、デフォルトでは許可状態になっている。
ブロックを有効にすると、AI OverviewやAI Modeから自社の商品ページや記事が完全に除外される。Practical Ecommerceの記事でも「EC事業者がこれを行う理由は見当たらない」と指摘されている通り、販売機会を自ら狭める行為になる。むしろAI回答に表示されることで、検索者が能動的にクリックしなくてもブランド認知が高まる可能性を考慮すべきだ。
この記事のポイント
- Search Consoleに生成AIレポートが追加され、AI回答での表示状況を確認できるようになった
- インプレッションはユーザーの閲覧有無を問わずカウントされるため、数字を鵜呑みにしない
- 通常の検索パフォーマンスデータとAIインプレッションをExcelで紐づけ、ギャップを分析する
- AI回答への表示ブロックはECサイトにとってメリットがなく、原則不要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験