

GitHubが8月17日の大規模障害を報告。CTOが原因分析と再発防止策を公表
2026年8月17日、GitHubで大規模なサービス障害が発生した。障害から3日後の8月20日、GitHubのCTO(最高技術責任者)であるVlad Fedorov氏が公式ブログで報告記事を公開し、原因分析と今後の再発防止策について言及した。
本記事では、今回の障害から読み取れる大規模プラットフォームの運用課題と、GitHubが示した今後の方向性を整理する。開発者やDevOps担当者にとって、自社システムの信頼性を見直す材料になるはずだ。
障害の概要とCTOによる報告
2026年8月17日に発生した障害は、GitHubの主要サービスに広範な影響を及ぼした。具体的な原因や影響範囲の詳細は記事内で段階的に明らかにされているが、CTO自らが報告に乗り出した点が今回の特徴だ。
CTO Vlad Fedorov氏について
報告記事の著者であるVlad Fedorov氏は、GitHubのCTOとして開発者ツールの未来を率いる立場にある。GitHub入社前はFacebook(現Meta)で上級副社長を12年間務め、プライバシー・広告・プラットフォーム分野で2,000人を超えるエンジニア組織を統率した経験を持つ。さらに前職ではUserCloudsというデータガバナンス関連のスタートアップを共同創業しており、Microsoftでの勤務経験もある。
大規模インフラの運用経験が豊富な人物が障害報告の筆を取ったこと自体、GitHubが今回の障害を単なるインシデントとしてではなく、プラットフォーム全体の信頼性に関わる重要事案として扱っていることを示している。
障害報告のタイミングが示すもの
障害発生は8月17日、報告記事の公開は8月20日。この3日間の間隔は、原因の切り分けと分析に十分な時間をかけたうえで、断定的な情報をまとめてから公表したことを示唆する。大規模障害では初期対応中に誤った情報を出さないことが重要であり、GitHubは原因を確定させたうえで報告に踏み切ったと見られる。
このデモは障害前後の状態を示した概念図である。実際の影響範囲についてはGitHubの公式報告を確認してほしい。
大規模プラットフォーム障害が浮き彫りにする運用課題
GitHubのような大規模プラットフォームの障害は、単一のサービス停止にとどまらない。世界中の開発チームが日々のワークフローをGitHubに依存しているため、障害の影響は連鎖的に広がる。コードのプッシュ、プルリクエストのレビュー、CI/CDパイプラインの実行、ドキュメントの更新など、あらゆる工程が停止する。
依存の集中が生むリスク
開発インフラの集中化は利便性をもたらす一方で、単一障害点を生み出す。多くの企業がGitHubを中心に開発プロセスを構築しているため、GitHubが停止すると自社の開発活動も止まる。この依存関係の深さは、今回の障害でも改めて認識されたはずだ。
インシデント対応における透明性の重要性
CTOが公式ブログで詳細な報告を行う姿勢は、インシデント対応における透明性の重要性を示している。障害の原因を隠さず、技術的な分析結果を公開することで、利用者の信頼を維持する狙いがある。GitHubのこの対応は、他社のインシデント報告の手本にもなるだろう。
上図は大規模障害から得られる一般的な教訓を整理したものだ。GitHubの報告でも、これらの要素がどのように現れたのかが焦点となる。
GitHubが示す今後の取り組み
記事タイトルにある「the work ahead(今後の取り組み)」という表現から、GitHubは今回の障害を教訓として、具体的な改善策を打ち出していることが読み取れる。詳細な技術的対策は記事内で段階的に説明されているものとみられるが、大規模プラットフォームの再発防止策として、以下の方向性が考えられる。
インフラの冗長化と障害分離
大規模障害の再発防止には、インフラの冗長化が不可欠だ。特定のコンポーネントに障害が発生しても、他のコンポーネントが機能を維持できる構成が求められる。GitHubのような複数のサービスが連携するプラットフォームでは、障害の影響を局所化するための仕組みも重要になる。
監視・検知体制の強化
障害の早期検知は被害を最小限に抑える鍵を握る。異常をリアルタイムで検知し、自動的にフェイルオーバーを実行する仕組みは、大規模プラットフォームの必須要件だ。今回の障害を踏まえ、GitHubは監視体制の見直しにも着手していると考えられる。
上図は大規模プラットフォームにおける障害対応の理想的なフローを示している。GitHubの報告では、今回の障害でどのステップに課題があったのかが分析されていると考えられる。
開発者と企業が取るべき対策
GitHubの障害は、プラットフォームに依存するすべての開発者と企業に影響を与える。自社の開発インフラを見直す契機として、いくつかの対策が有効だ。
外部依存のリスク評価
まず自社の開発プロセスがどの外部サービスに依存しているかを洗い出す必要がある。GitHubだけでなく、CI/CDツール、クラウドサービス、パッケージレジストリなど、開発ワークフローの各段階で外部依存が存在する。それぞれのサービスに障害が発生した場合の影響を評価し、必要に応じて代替手段を用意しておくことが重要だ。
バックアップと代替ワークフローの整備
GitHubが停止した場合でも開発を継続できるよう、ローカルリポジトリの保持やミラーの活用を検討する価値がある。完全な代替は難しくても、緊急時の手順を文書化しておくだけで、障害発生時の混乱を大幅に減らせる。
この記事のポイント
- GitHubで2026年8月17日に大規模障害が発生し、CTOのVlad Fedorov氏が3日後に報告記事を公開した
- CTO自らが報告に乗り出したことは、GitHubが信頼性を最優先事項と位置づけていることの表れである
- 大規模プラットフォームの障害は単一障害点のリスクと透明性の重要性を改めて示した
- GitHubは「今後の取り組み」としてインフラの冗長化と監視体制の強化を進めると見られる
- 開発者と企業は外部依存のリスクを評価し、緊急時の代替ワークフローを整備しておくべきだ

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google SREが語る、エージェントAIで変わる運用の新常識
GoogleがSRE(Site Reliability Engineering)にエージェントAIを本格導入し、運用の自動化レベルを引き上げている。異常検知やインシデント管理、信頼性設計といった領域で、AIエージェントが「力の倍増器」として機能し始めたのだ。
この取り組みは、2026年5月に公開されたホワイトペーパー「AI in SRE Practice」で詳細に語られている。本記事ではその核心にある5つの重点領域と、Googleが定めた7つの設計原則を整理しながら、エージェントAIがSREにもたらす変化を読み解く。
なぜ今、SREにエージェントAIなのか
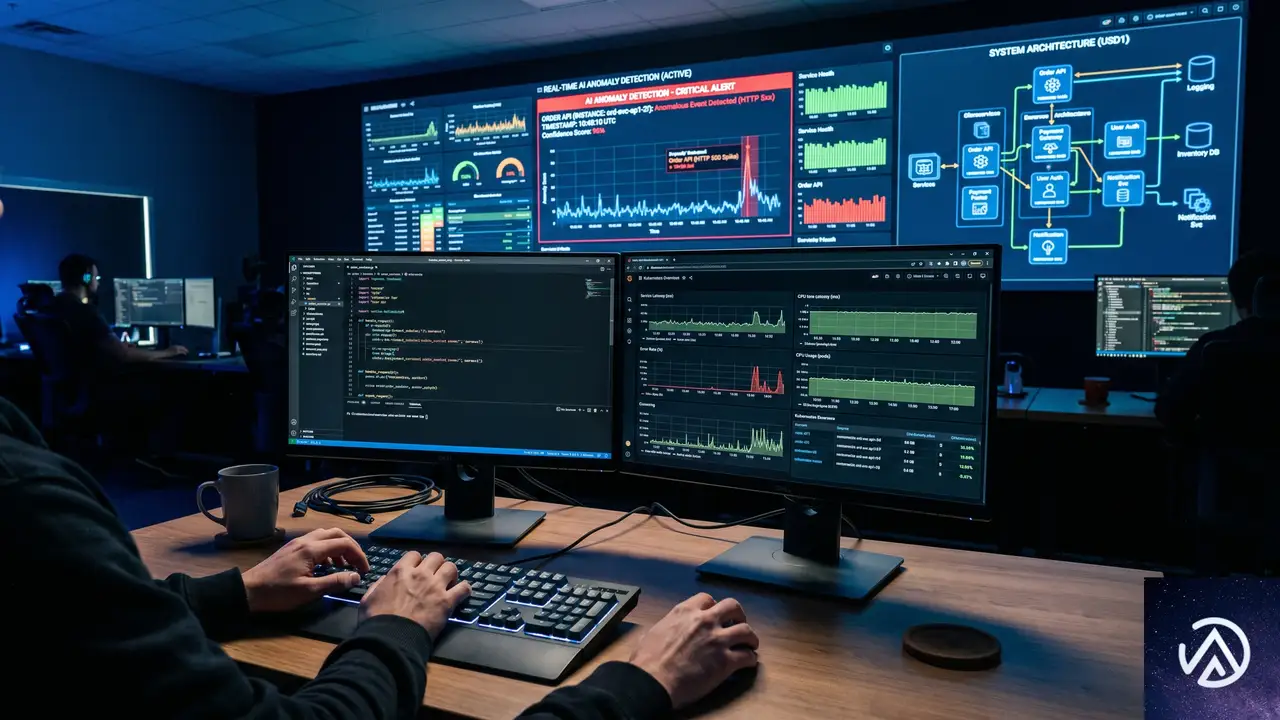
GoogleがSREの概念を提唱してから20年以上が経つ。その間、信頼性を担保すべきシステムは幾重にも複雑化した。マイクロサービス化による分散配置の拡大、クラウド製品群の機能爆発、そしてAIコード生成によるソースコード量の急増。それぞれが単独でも運用負荷を押し上げる要因だが、これらが同時に進行している点が問題を大きくしている。
SREチームは従来、サービスレベル指標(SLI)やサービスレベル目標(SLO)に基づく静的な閾値監視で信頼性を守ってきた。しかし、多様な顧客ワークロードを扱うGoogle Cloudのような製品では、一律の閾値で異常を捉えきれないケースが増えている。そこで注目されるのが、AIによる異常検知とエージェント型の自律対応だ。
エラーレート > 1% でアラート
このデモが示すように、AIエージェントは単に閾値を超えたかどうかではなく、平常時の振る舞いパターンからの逸脱を捉える。これにより、多様なワークロードが混在する環境でも、真に対処すべき異常だけを抽出できる確度が高まる。
SRE AIがカバーする5つの重点領域
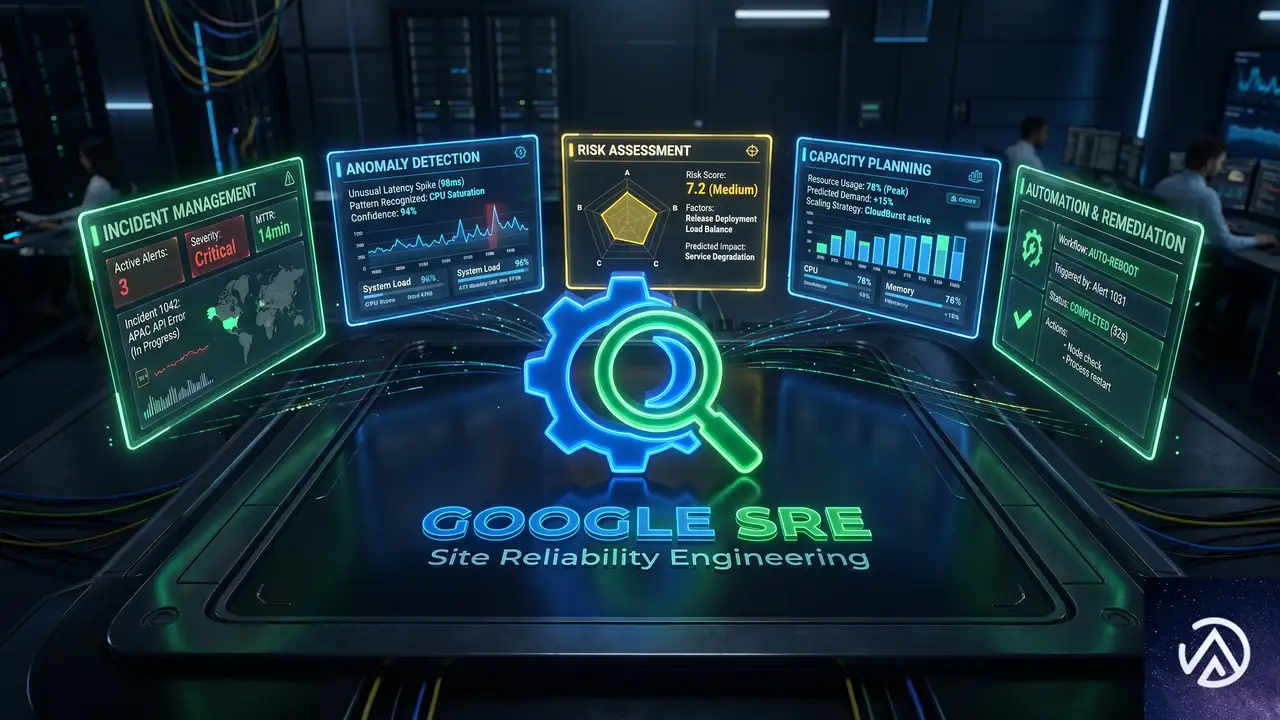
Google SREチームは、ソフトウェア開発ライフサイクル(SDLC)全体を見渡し、AIエージェントが価値を発揮できる領域を5つに整理した。いずれも従来のSREプラクティスを補完し、人間の意思決定を加速させることを狙いとしている。
信頼性設計への組み込み
従来、SREは設計段階から信頼性を織り込むため、ポリシー策定やランブック(運用手順書)の整備に多くの時間を割いてきた。AIエージェントはこのプロセスを効率化する。具体的には、過去のインシデントから得た知見を基にランブックを自動生成し、本番環境に近い構成に対して信頼性リスクを事前検出する。人間のレビューは高リスクな変更に絞られ、トイル(労苦)の大幅な削減が見込めるという。
異常検知とアラート処理
この領域はエージェントAIの導入効果が最も顕著に表れる部分だ。Google SREは、TimesFMのような時系列予測モデルを使い、過去の正常パターンから逸脱する動きをAIが検知する仕組みを採用している。異常が検知されると、専用のアラート処理エージェントが起動し、関連情報の集約やコンテキスト付与を自動実行する。その後、自律型のアラートハンドラが可能な範囲で一次対応まで完遂する。
このパイプラインにより、人間のSREが対応すべきアラート件数そのものを減らせる。大事なのは、エージェントがどのデータをどう評価したのか、一貫して透明性を保つ設計になっている点だ。本番状態に意図しない変更を加えないための制御機構も当然組み込まれている。
インシデント管理の高度化
GoogleにはIMAG(Incident Management at Google)という確立されたインシデント管理プロセスがある。SRE AIはその上にエージェント型のオーケストレーション層を追加する形で実装されている。
- チャットや動画、追跡ドキュメントなどインシデント中に発生するコミュニケーションを集約・要約
- 担当者交代時のハンドオフドキュメントを自動生成
- ポストモーテム(障害分析書)のドラフトを自動作成し、品質向上と工数削減に貢献
- 社内外向けのインシデント報告の管理
これらは一見地味だが、大規模インシデントでは情報の混乱が復旧遅延の最大要因になる。エージェントが情報整理を肩代わりすることで、SREは本質的な判断と対応に集中できる。
インシデント調査の自律化
AIエージェントは監視データ(ログ、メトリクス、トレース)に加え、システムトポロジや依存関係情報を使い、ドメイン知識を獲得した上で調査を開始する。ランブックのナビゲーション、アラート参照、異常検知、インサイト抽出といった個別の機能エージェントと連携しながら、仮説形成から緩和策の提案までを行う。状況によっては自律的な緩和実行も視野に入れている。
インサイトとリスク管理
AIエージェントが継続的に学習し続けるための仕組みとして、Google SREは「AI Insights」というシステムを開発した。これは過去の全インシデントを分析し、構造化された知見を抽出する。Geminiの埋め込みモデルとベクターデータベースを活用し、各インシデントにリスクカテゴリを自動付与する。これにより、エージェントは将来の調査時により精度の高い緩和策を提案でき、人間のSREも優先的に対処すべき領域を俯瞰できる。
このように複数のエージェントが役割分担しながら、一つのインシデントに対して協調的に動作する。単一の巨大なAIではなく、目的別に分割されたエージェント群が連携する設計思想がGoogle SREの特徴だ。
エージェント導入に先立つ7つの設計原則
Google SREはエージェントAIを闇雲に導入したわけではない。顧客への約束を守りながら信頼性を向上させるため、以下の7つの高レベル原則を定めている。
- 既存の自動化が機能している領域は、ビジネス要件を満たしている限り無理に置き換えない。
- 新しいAIシステムは、既存および将来のポリシーと手順に準拠すること。
- SRE AIエージェントは、人間と同等のセキュリティ・安全性・プライバシー要件を満たすこと。
- エージェントは強力なアイデンティティを持ち、ロールベースで権限が割り当てられること。
- エージェント自体に高い信頼性SLOを設定し、自動または手動のバックアップ手段を明確に用意すること。
- エージェントは実行したアクションの理由と、検討し却下した選択肢を説明できなければならない。ブラックボックス自動化より透明性を重視する。
- 事業継続計画にAI障害時のコンティンジェンシーを含めること。
とりわけ6番目の「説明可能性」は、SREという領域において極めて重要だ。なぜそのインシデントが発生し、なぜその緩和策を選んだのか。説明できない自動化は、ポストモーテム文化と相性が悪い。GoogleがエージェントAIに対して透明性を強く要求しているのは、SREの根本思想である「非難しない文化」と「学習する組織」をAI時代にも維持するためといえる。
この対比は、単なる技術選定の話ではない。SREの運用文化そのものをどう進化させるかという問いに直結している。
SRE AIを支えるGoogleの基盤技術
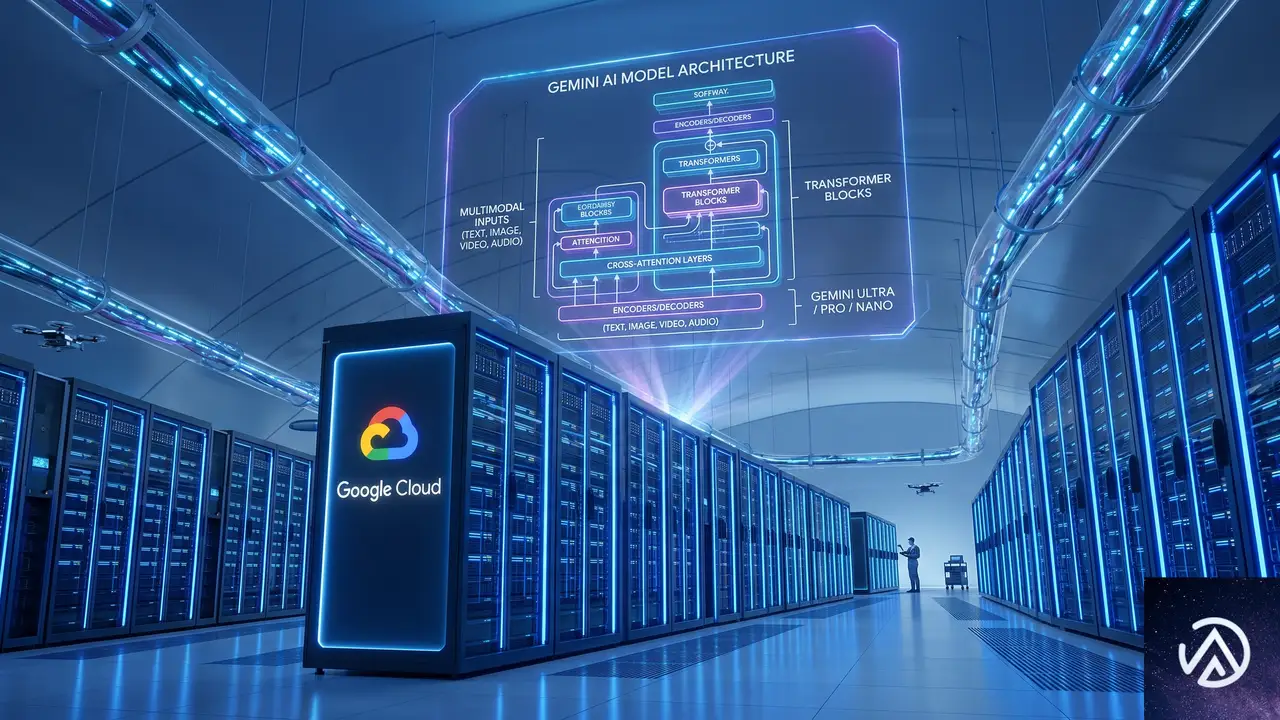
これらのエージェント群は、個別の新規プロジェクトとして開発されたものではない。Googleが長年培ってきたインフラストラクチャの上に構築されている。主要な構成要素は次のとおりだ。
- Gemini — 基盤モデル。SREチームは社内データでファインチューニングしたカスタムGeminiモデルも併用。
- Gemini Enterprise Agent Platform(旧Vertex AI) — エージェント開発のためのフルAIスタック。
- Agent Development Kit(ADK) — エージェント構築の開発プラットフォーム。
- MCPサーバー — 標準のGoogle APIインフラ上で動作し、外部顧客向けMCPサポートにも使われるものと同一基盤。
- BigQuery / ベクターデータベース — AI Insightsシステムのデータ基盤。Gemini埋め込みモデルと連携。
- 標準Observabilityインフラ — 監視、ログ、トレーシング。
特筆すべきは、これらの技術がすでにGoogle Cloudの顧客向けにも提供されている点だ。ホワイトペーパーで語られているSRE AIのアーキテクチャは、決してGoogle内部だけの秘伝のたれではなく、クラウド利用者にとっても参照可能な設計パターンとして公開されている。
SRE AIが目指す先
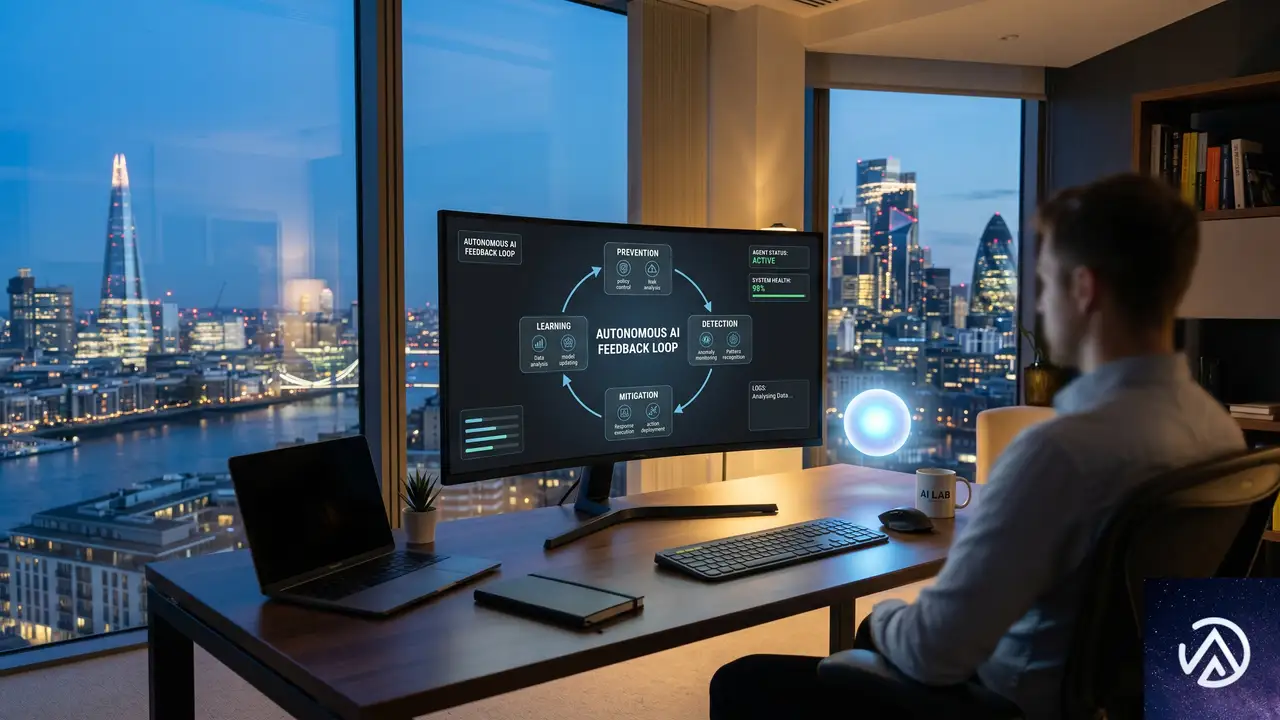
Google SREチームは、SRE AIが達成すべき目標として、次の5つを掲げている。
- 退屈で反復的な運用からエンジニアを解放する
- 意思決定と実行の質と速度を向上させる
- これまで対処できなかった問題の予防・検知・緩和を可能にする
- 信頼性向上に向けた自律的なフィードバックループを形成する
- 全体的な運用コストを削減する
これらは一見するとAI導入の一般的な利点に見える。しかしGoogle SREが強調するのは、単なる効率化ではない。AIが複雑さを増幅させた側面があるからこそ、同じAIを使って複雑さを制御するという考え方だ。SRE AIの本質は「AIがもたらした運用課題を、AI自身の力で解決する」逆説的なアプローチにある。
Googleは以前から自律システムを本番運用してきた実績を持つ。しかし現在のAIベースの自律システムは、非決定的な振る舞いをする点で従来と大きく異なる。この性質を正しく理解し制御するために、自律レベルのトラッキング手法も開発されている。詳細はホワイトペーパー「AI in SRE Practice: Moving Beyond Automation at Google」に譲るが、決定論的自動化からエージェントAIへの移行は、SREという分野にとって20年来の転換点になる可能性を秘めている。
この記事のポイント
- Google SREはAIエージェントを「力の倍増器」と位置づけ、運用の自動化レベルを次の段階へ引き上げている
- 静的な閾値監視からAIによる異常検知への移行は、多様なワークロードに対応するための不可避な進化である
- 7つの設計原則のなかでも「説明可能性」の重視は、SRE文化との整合性を保つ上でとりわけ重要だ
- SRE AIの構成要素はGoogle Cloudの顧客向け技術スタックと地続きであり、外部組織も同様のアーキテクチャを参照できる
- 決定論的自動化からエージェントAIへの移行は、SREの根本的な運用思想を再定義する可能性がある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験