

Cloudflare Workers Cache登場、Worker専用キャッシュでコスト削減
Workers Cache の登場でCloudflare Workersが「オリジン」から「静的配信」へ進化
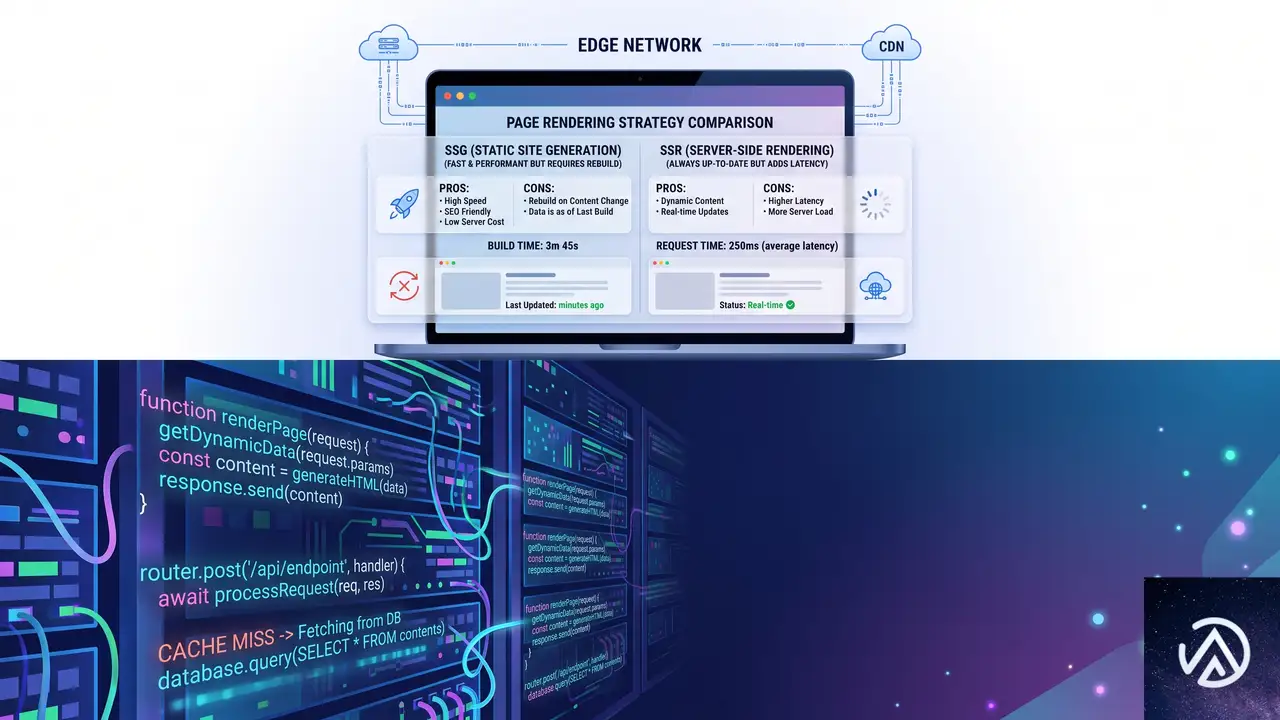
CloudflareがWorkers Cacheを正式にリリースした。これは単なるキャッシュ機能の追加ではない。Workersのアーキテクチャを根本から覆し、コストとパフォーマンスのトレードオフを解消する大きな転換点だ。一言で表せば「あなたのWorkerの前に、そのWorker専用のキャッシュを置ける機能」である。
1行の設定を追加するだけで、Workerが生成したレスポンスはCloudflareのエッジネットワークにキャッシュされる。キャッシュが有効な間はWorkerそのものが実行されず、CPU時間の課金もゼロになる。これは特に、サーバーサイドレンダリング(SSR)を行うアプリケーションにとって、待望のソリューションだ。
本記事では、なぜこの機能が必要とされていたのか、具体的に何が変わるのか、そして開発者がどのように活用できるのかを詳しく解説する。
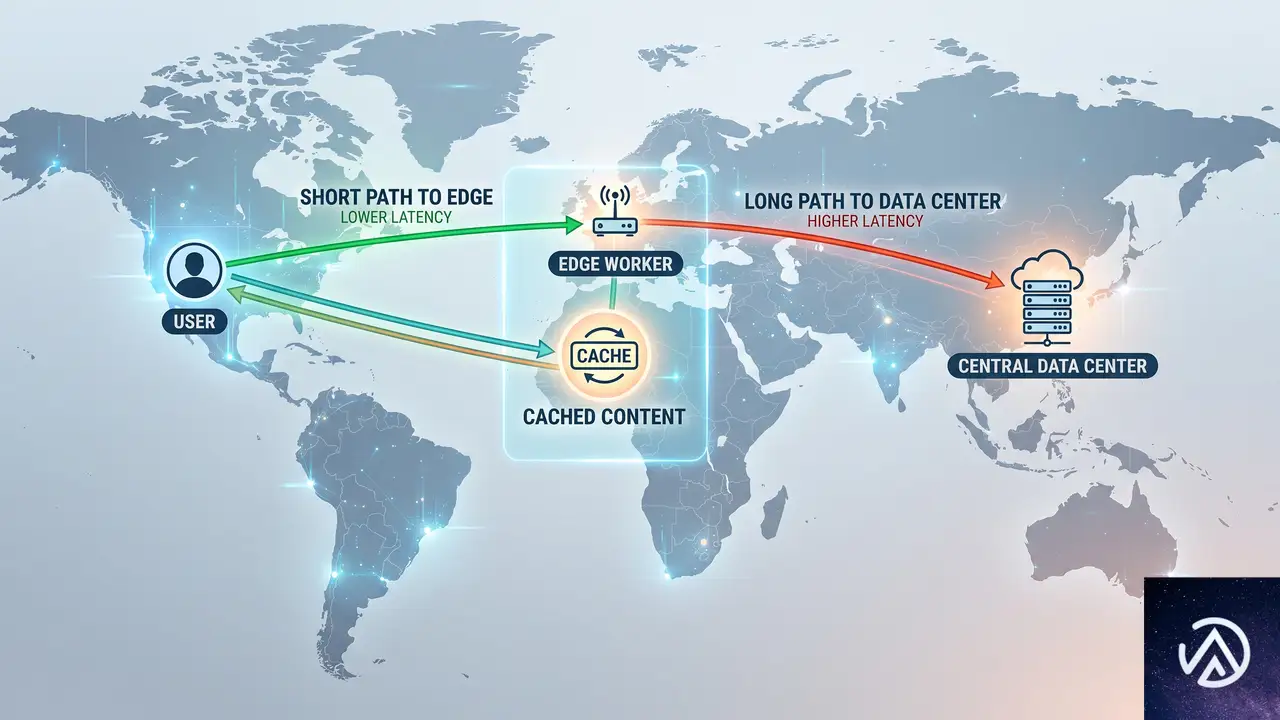
問題: Workerがオリジンの場合、処理のたびにコードが実行され、キャッシュの恩恵を受けにくい。
効果: レスポンスが高速化し、WorkerのCPU実行コストが削減される。
この図が示すように、Workers Cacheはリクエストの最前線に立つ。これにより、Workerが事実上のオリジンサーバーとして振る舞う現代的なアプリケーションのパフォーマンスとコスト構造が劇的に改善される。
なぜサーバーサイドアプリに「Workerの前のキャッシュ」が必要だったのか
Workerが「経由点」から「オリジン」へ変わった世界
2017年のリリース当初、Cloudflare Workersはオリジンサーバーの手前でリクエストを書き換える「中間処理層」として設計された。A/Bテストの振り分けやヘッダーの追加といった、軽量な処理をエッジで実行するユースケースが中心だったのだ。当時、Workerはキャッシュよりもさらにオリジンに近い位置にあった。
しかし状況は一変した。AstroやNext.js、SvelteKitといった主要フレームワークが、ビルド成果物をCloudflare Workersで直接動かすアダプターを提供し始めたのである。これにより、Workerはもはや単なる中継点ではない。アプリケーションそのものがWorker上で動作する「サーバー」になった。裏側に別のオリジンサーバーは存在しなくなり、Worker自体がリクエストを処理するようになったのだ。
この変化は大きな問題を生んだ。従来のアーキテクチャでは、Workerがオリジンになると、すべてのリクエストがコードの実行を必要とするようになる。たとえ1秒前と全く同じHTMLを返す場合でも、だ。これはパフォーマンス上のレイテンシと、無視できないCPU実行コストを常に発生させることを意味していた。
静的生成と動的レンダリングのジレンマを解決する第三の道
この問題に対し、開発者はこれまで2つの選択肢から選ぶしかなかった。
- 静的サイト生成(SSG):すべてのページをビルド時に事前生成する。表示は高速だが、コンテンツを更新するたびに全ページを再ビルドする必要がある。数千ページのサイトでは、このビルド時間が大きなボトルネックになる。
- サーバーサイドレンダリング(SSR):リクエストのたびにページを動的に生成する。コンテンツは常に最新だが、全てのアクセスでレンダリングコストとレイテンシが発生する。
Workers Cacheはここに第三の選択肢、つまり「オンデマンドでサーバーレンダリングし、結果をキャッシュし、指定したTTL(生存期間)で更新する」という新しい手法を提供する。最初のリクエストだけがレンダリングコストを支払い、後続のリクエストはキャッシュから静的ファイルのように配信されるのだ。これはフレームワーク独自の複雑な仕組み(ISRなど)に依存しない、HTTP標準に則った解決策である。
パフォーマンスを極める主要機能「SWR」と「Vary」の内部動作
stale-while-revalidate が「待ち時間ゼロ」を実現する仕組み
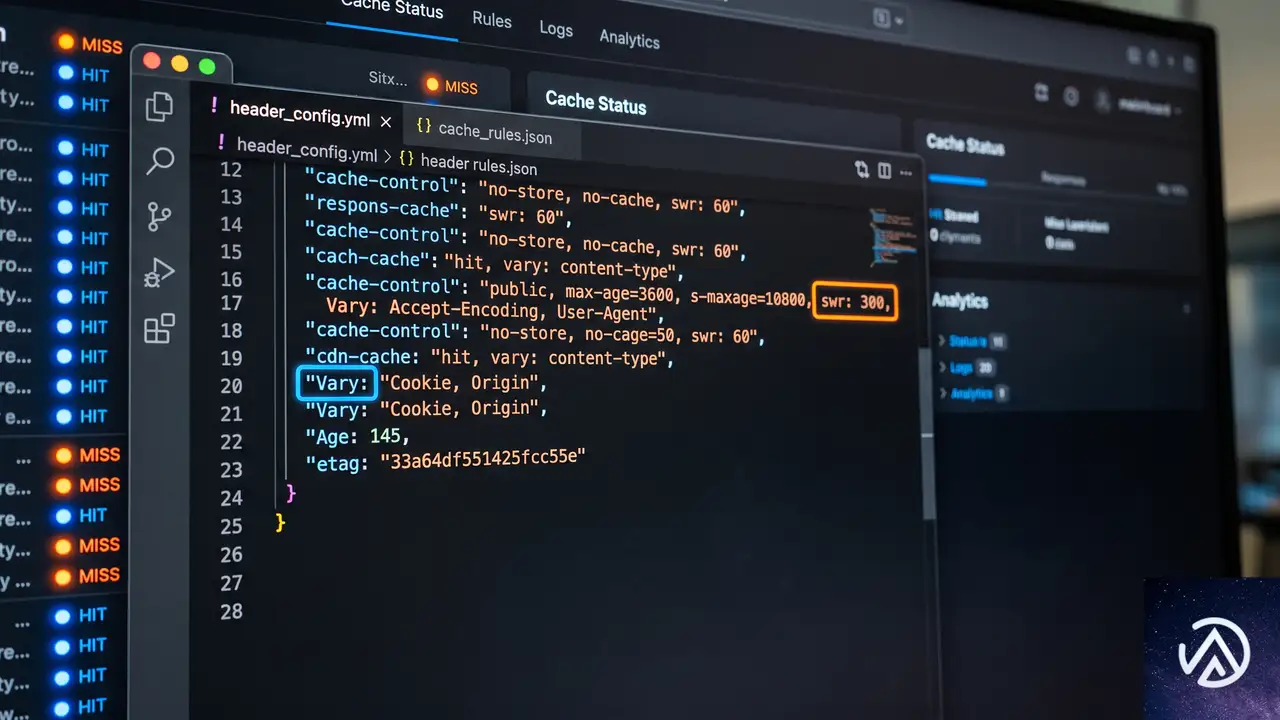
Workers Cacheの真価を引き出すのが、stale-while-revalidate(SWR)ディレクティブだ。これはキャッシュされたレスポンスがTTLを超過した「古い(Stale)」状態でも、とりあえずその古いデータをユーザーに返しつつ、バックグラウンドで最新のデータを取得し直すHTTPの仕組みである。
SWRがない場合、キャッシュの有効期限が切れた後の最初のリクエストは、必ずWorkerが一からページをレンダリングするまで待たされる。しかしSWRがあれば、この最初のリクエストに対しても古いキャッシュが即座に返され、ユーザーは待ち時間を感じない。Workers CacheはこのSWRを完全にサポートしており、これによって「動的なサイトなのに、まるで静的サイトのように感じる」という体験を実現している。
この図の通り、SWRはTTLが切れた後の「最初の一人」が被る待ち時間を帳消しにする。Cloudflare Blogの記事によれば、Cloudflareは今年の早期にこのSWR機能をフルサポートしており、Workers Cacheはその上に構築されていることがわかる。
Vary ヘッダーが複数の表現をキャッシュする
現実のアプリケーションは、同じURLでもクライアントに応じて異なるレスポンスを返す必要がある。例えばブラウザにはHTMLを、APIクライアントにはJSONを返す場合や、対応状況に応じてWebPとJPEGを出し分ける場合だ。Workers Cacheは、このコンテンツネゴシエーションをHTTP標準のVaryヘッダーで解決する。
WorkerがVary: Acceptというヘッダーを付けてレスポンスを返すと、Cloudflareは「Acceptリクエストヘッダーの値」ごとに別々のキャッシュエントリを自動で作成・管理する。これにより、WebPに対応したブラウザにはWebP画像のキャッシュが、そうでない環境にはJPEG画像のキャッシュが返るようになる。開発者は複雑なキャッシュキーの設定を意識する必要はなく、標準的なHTTPのルールに従うだけで、安全かつ効率的に複数表現をキャッシュできるのだ。
開発者が知っておくべき設計思想「ゾーンではなくWorkerのキャッシュ」
エントリーポイント単位の柔軟なキャッシュ制御
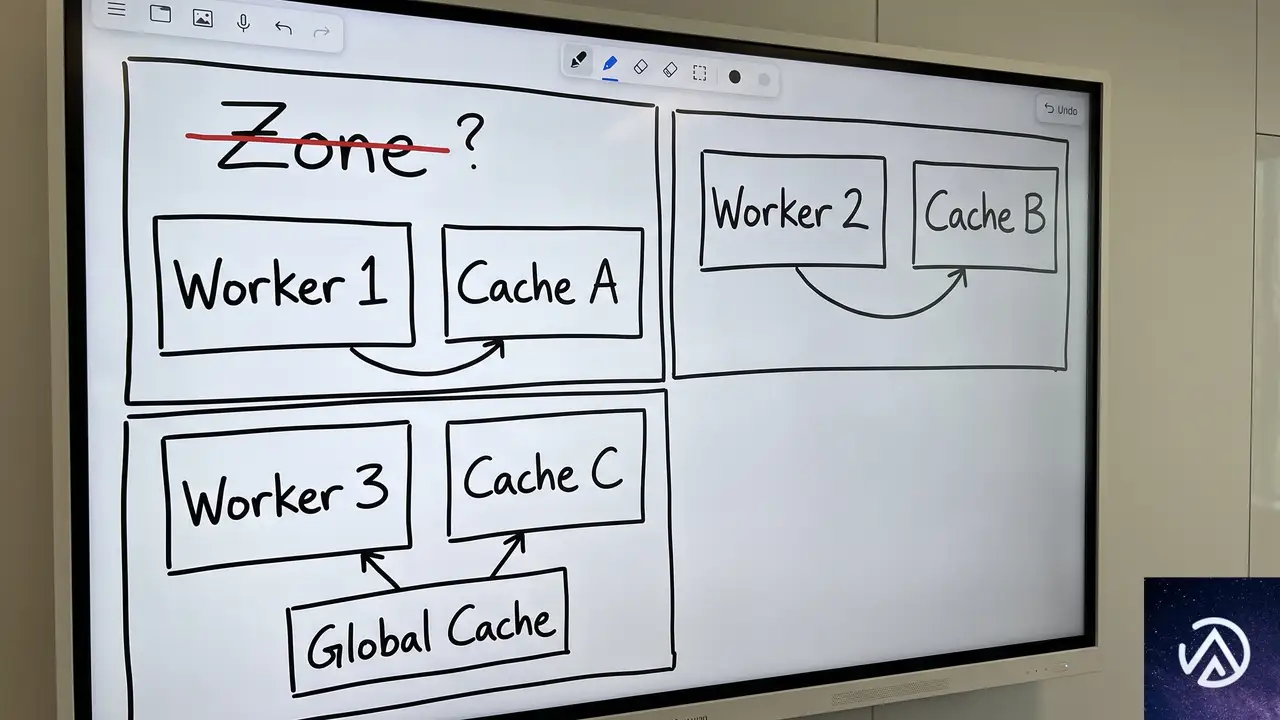
Workers Cacheの最も革新的な部分は、それが「ゾーン(ドメイン)」ではなく「Worker」に紐づくという設計思想にある。この思想が、従来のCDNでは実現できなかったいくつもの高度なユースケースを可能にしている。
特に重要なのが、Workerのエントリーポイントごとにキャッシュの有効・無効を設定できる点だ。設定ファイルでエクスポート名("default"や"CachedBackend")を指定するだけで、認証処理を行うゲートウェイWorkerはキャッシュを無効化し(常にコードを実行するため)、その背後で重い処理を行うバックエンドWorkerだけにキャッシュを有効化する、といった構成が可能になる。
このエントリーポイント単位の制御により、キャッシュはアプリケーションアーキテクチャの一部として自然に組み込めるようになる。単一のWorkerの中に、キャッシュするレイヤーとしないレイヤーを共存させ、それらをコードで自在に結合できるのだ。これは、CDNキャッシュを単一のオリジンの前に置くという従来の考え方とは一線を画す。
マルチテナントを安全にする ctx.props の仕組み
ユーザーごとに異なる情報を返すAPIのキャッシュは、セキュリティ上の大きな課題を伴う。ユーザーAのキャッシュがユーザーBに見えてしまうような事故は、絶対に避けなければならない。Workers Cacheはこの問題を、ctx.propsの一部を自動的にキャッシュキーに含めることで根本的に解決している。
例えば、ゲートウェイWorkerで認証したユーザーIDをctx.propsにセットし、キャッシュが有効なバックエンドWorkerを呼び出すとする。Workers Cacheはこの「ユーザーID」の違いを認識し、ユーザーごとに完全に独立したキャッシュ空間を作り出す。これにより、「認証済みAPIはキャッシュできない」という固定観念を覆し、ユーザー単位で安全にレスポンスをキャッシュできるようになる。Cloudflare Blogによれば、これは他の主要CDNでは提供されていない、Workers Cache独自の強力な利点だという。
Workers Cacheがもたらすプラットフォームとしての進化
パフォーマンスとデータの近接性を両立するアーキテクチャ
Webパフォーマンスにおいては、コードを「ユーザーの近く」で実行するのと「データの近く」で実行するのは、しばしばトレードオフの関係になる。Workers Cacheはこのジレンマに対して、キャッシュを「糊(にかわ)」として利用する解決策を提示する。
具体的には、次のような構成が現実的になる。ユーザーの近くで動き、認証やルーティングといった軽量な処理を担当するWorker Aを配置する。一方、データベースへの重いクエリやレンダリングを実行するWorker Bを、Smart Placement機能でデータの近くに配置する。Workers Cacheは、このWorker Bの手前にのみ配置する。
リクエストが来ると、Worker Aが処理した後、サービスバインディングを通じてWorker Bを呼び出す。この時、Worker Bのキャッシュがヒットすれば、データの近くにあるWorker Bは実行されることなく、ユーザーの近くにあるキャッシュからレスポンスが返る。キャッシュミス時のみ、実際のデータへのアクセスが発生する。これにより、「ユーザー近接性」と「データ近接性」の良いとこ取りが可能になるのだ。
フレームワークとの統合とコストの透明性
Workers CacheはすでにAstroフレームワークのアダプターでネイティブサポートされている。設定ファイルに数行追加するだけで、ページ単位のTTLやタグベースのキャッシュパージが利用できる。TanStack StartやNext.js(Vinext経由)など他のフレームワークへの統合も現在進行中だ。
コスト面も明快だ。Workers Cacheのキャッシュヒット時は、通常のリクエスト課金は発生するが、WorkerのCPU実行時間に対する課金はゼロになる。キャッシュストレージに対する追加のGB単位の課金もないため、コスト削減効果を予測しやすい。ダッシュボードでは、キャッシュヒット率やヒット/ミス/バイパスの内訳が確認でき、パフォーマンスチューニングに必要なデータが一元管理されている。
この記事のポイント
- Workers Cacheは、Workerの手前に専用の階層型キャッシュを配置する新機能である。
- これにより、サーバーサイドアプリが静的サイトのような速度を実現しつつ、CPU実行コストを削減できる。
stale-while-revalidateの完全サポートにより、キャッシュ更新中もユーザーを待たせない。- ゾーンではなくWorkerに紐づく設計により、エントリーポイント単位で柔軟なキャッシュ戦略をコードで記述できる。
ctx.propsをキャッシュキーに含めることで、マルチテナント環境でも安全なキャッシュが実現する。

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Codexで開発速度20倍、WasmerがNode.jsエッジランタイムを2週間で構築
OpenAIのCodexとGPT-5.5を活用し、開発速度を10倍から20倍に引き上げたチームが現れた。エッジコンピューティングプラットフォームを手がけるWasmerは、これを用いてNode.jsのエッジ向けランタイム「Edge.js」をわずか2週間で構築したのだ。従来なら1年を要する規模のプロジェクトである。
Wasmerは少人数のチームながら、WebAssemblyサンドボックス内でNode.jsワークロードを実行するという技術的挑戦を達成した。これにより、開発者はDockerを使わずにJavaScriptアプリケーションやMCP(Model Context Protocol)エージェントを動作させられるようになる。この成果の背後にあるCodex活用の実態と、小規模チームが大企業並みの開発速度を実現したプロセスを掘り下げる。
プロジェクトの全容と達成された技術的ブレークスルー
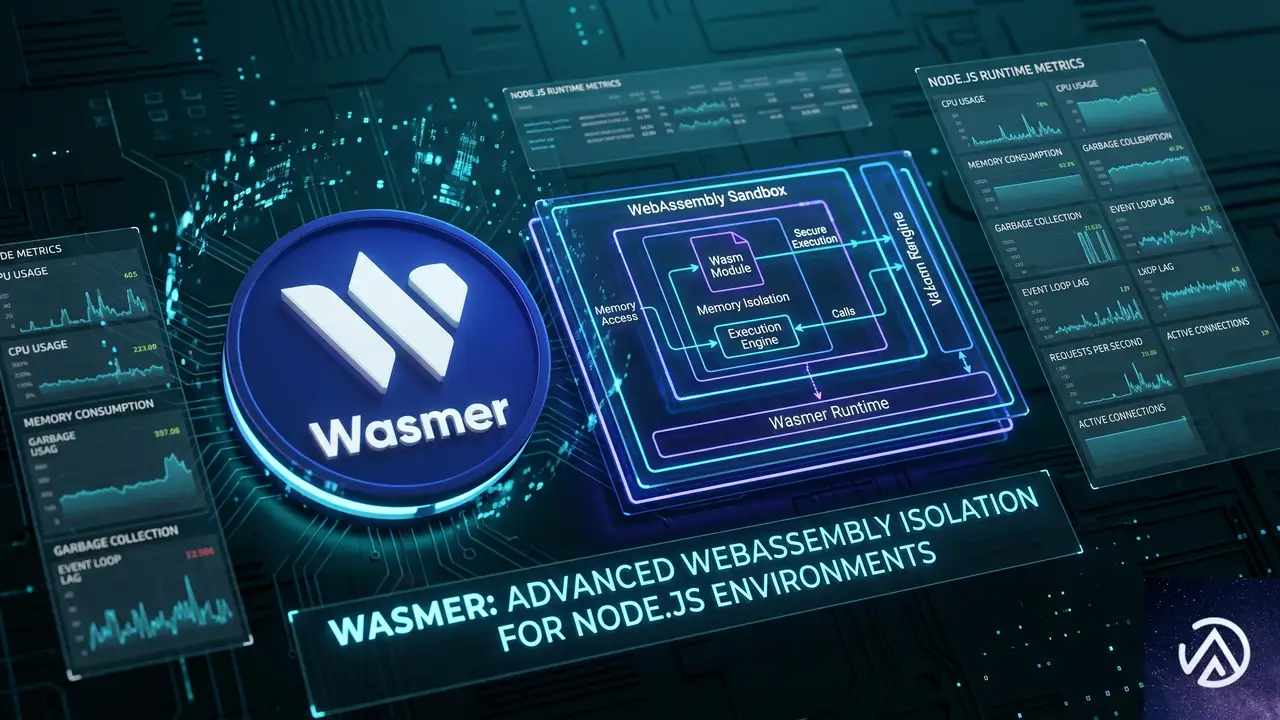
Wasmerが今回リリースしたEdge.jsは、Node.jsのワークロードをWebAssembly(Wasm)サンドボックス内で安全に実行するJavaScriptランタイムだ。WebAssemblyはブラウザやサーバーで高速に動作するバイナリ命令形式で、いわば「アプリケーションを隔離された環境で動かすための軽量な箱」のような役割を果たす。サンドボックス化により、ホストシステムへの不正アクセスやリソースの浪費を防ぎつつ、高いパフォーマンスを維持できる。
この技術の最大の意義は、Dockerコンテナを使わずにNode.jsアプリをデプロイできる点にある。コンテナ技術は強力だが、イメージのビルドやレジストリ管理、起動時間などのオーバーヘッドを伴う。Wasmerのアプローチなら、より軽量かつ瞬時にエッジ環境へ展開可能だ。同社の創業者兼CEOであるSyrus Akbary Nieto氏はOpenAIのブログ記事で「AIやエッジコンピューティング向けのNode.jsワークロードを動かせる初のクラウドホストになった」と述べている。
Wasmサンドボックスは「アプリを小さな防護壁で囲む」ような仕組みで、Node.jsの全機能を安全にエッジ層で提供できるようにする。これにより、レイテンシに敏感なAI推論やリアルタイムAPI、MCPエージェントといった用途で威力を発揮する。
Codexによる開発速度の飛躍的向上
WasmerがEdge.jsを構築するのにかかった期間は、わずか2週間だ。Nieto氏によれば、AIを使わなければ「容易に1年はかかっていた」プロジェクトである。CodexとGPT-5.5の導入により、開発速度は10倍から20倍に跳ね上がったという。この数字は単なる体感ではなく、実際のプロジェクト完了までの期間短縮に基づく。
Wasmerのエンジニアはプロジェクトの最初から最後までCodexを活用した。初期のアーキテクチャ設計から、最終製品の仕上げに至るまで、あらゆる段階でAIが開発を支援した形だ。特に効果を発揮したのは、バグの発見と原因特定のプロセスである。
上記のフローは、従来の開発サイクルに比べて圧倒的に短い時間で完了する。特にステップ3のデバッグ工程で、Codexは人間のエンジニアが気づきにくい低レイヤーの問題を素早く見つけ出した。
Codexがもたらしたデバッグの質的変化
Edge.jsの開発で特に印象的だったのは、Codexのデバッグ能力だとNieto氏は語る。通常、WebAssemblyやNode.js内部のような低レイヤーのバグを特定するには、C++やアセンブリレベルの深い知識が必要になる。しかし、少人数のチームではそうした専門家を常に確保できるわけではない。
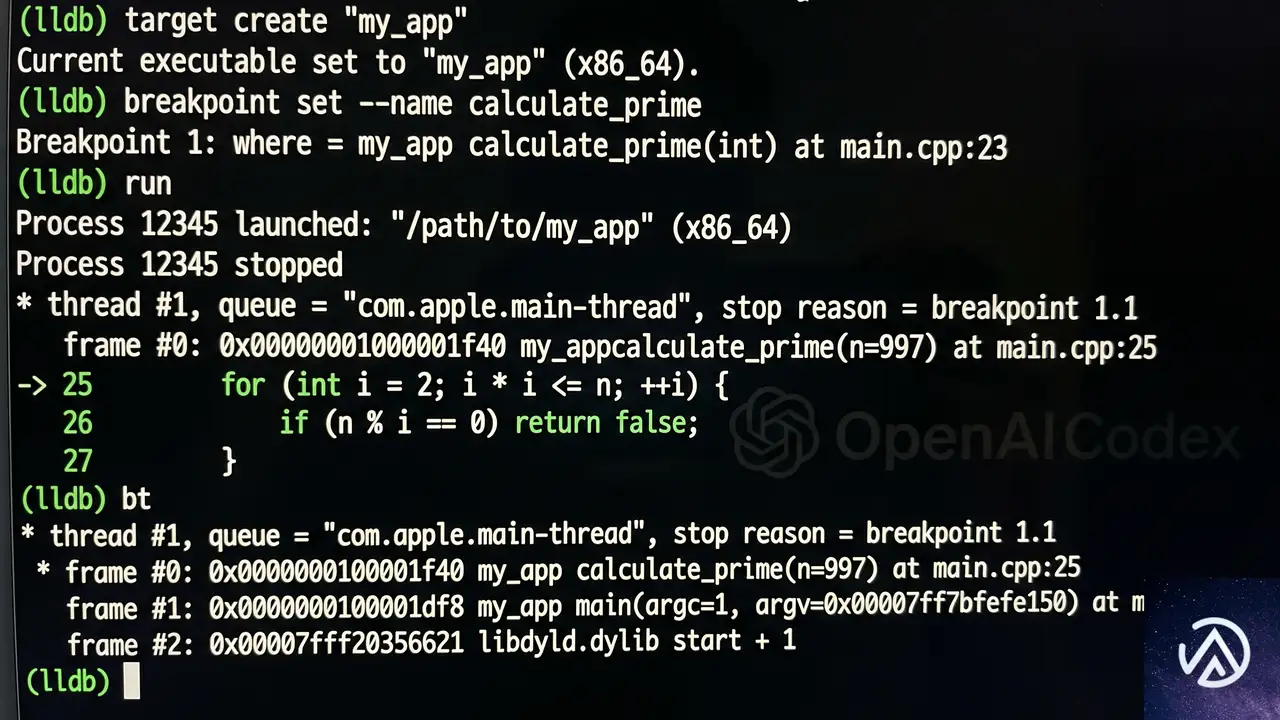
CodexはLLD(LLVM Debugger)のような低レベルデバッガを使いこなし、アセンブリレベルでコードの挙動を追跡した。さらに、コンソールログを活用して関数呼び出しのトレースを行い、問題の根本原因を特定するまでの時間を大幅に短縮したという。Nieto氏はOpenAIの記事で「我々はC++の専門家ではないため気づけない微妙な問題を、Codexはかなり早い段階で見つけ出した」と述べている。
ここでいうLLDとは、コンパイル済みプログラムの動作を命令単位で追跡できるツールだ。通常のデバッガがソースコード行単位で止めるのに対し、LLDはCPUが実際に実行する機械語レベルで問題を観察できる。Codexはこのツールを自律的に操作し、バグの兆候から原因、解決策までを一気通貫で提示したことになる。
IDEから離れる開発スタイルへの移行
Wasmerのエンジニアたちは、Codexの推論能力が向上するにつれて、次第にIDE(統合開発環境)から手を離し始めたという。Nieto氏は「我々は実際にIDE自体から離れつつある。コードに直接触れるのではなく、どこに向かいたいかを指示するだけになっている」と述べている。
これは開発者の役割が「コードを書く人」から「AIに方向性を与える人」へと変化していることを示す。もちろん、最終的な判断や設計の意図は人間が持つ。しかし、実装の大部分をAIが担うことで、小規模チームでも大規模プロジェクトに挑戦できるようになった。
この変化は、開発生産性の概念そのものを再定義する可能性を秘めている。コードを書く速度ではなく、AIに適切な指示を与え、出力を評価し、設計判断を下す能力が重要になるからだ。
AI活用に懐疑的だったチームの変遷
Wasmerのエンジニアたちも、当初はAIの出力に懐疑的だった。Nieto氏は「最初はAIのアウトプットをあまり信用していなかった」と振り返る。これは多くの開発者が経験する感覚だろう。AIが生成するコードが本当に正しいのか、セキュリティ上の問題はないのかといった懸念は自然なものだ。
しかし、実験を重ねるうちに結果が期待を上回り始めた。特にここ数カ月でCodexの推論能力が飛躍的に向上し、信頼性が格段に高まったという。Nieto氏は「ここ1年、特にここ数カ月間Codexと仕事をしてきたが、結果は本当に非常に良かった」と述べている。
信頼構築のプロセスは段階的だった。最初は小さなタスクから任せ、出力を丹念にレビューする。やがて、より複雑な問題を任せられるようになり、最終的には前述のようにIDEから手を離す段階に至った。この流れは、AI開発支援ツールを導入する多くのチームにとって参考になるパターンだ。
Codexが解き放つ小規模チームの可能性
Wasmerの事例が示す最大の教訓は、AI開発支援が「チーム規模の制約」を打ち破る力を持つことだ。Nieto氏は「Codexによって、小さな会社が大企業でしか不可能だったことを達成できるようになった。このプロジェクトは文字通り、Codexなしでは不可能だった」と断言している。
Node.jsのエッジランタイムをゼロから構築するという挑戦は、通常なら専門のインフラエンジニアやC++のエキスパートを複数抱える大企業のプロジェクトだ。Wasmerのような小規模チームがこれに挑むこと自体が、AIの存在を前提とした新たな開発パラダイムの到来を感じさせる。
Nieto氏は今後について「以前は不可能だったことが手の届く範囲にある。我々はさらに困難な問題に目を向ける必要がある」と語っている。Wasmerのチームは既に、次の野心的なプロジェクトを見据えている段階だ。
エッジコンピューティングとNode.jsの新しい関係
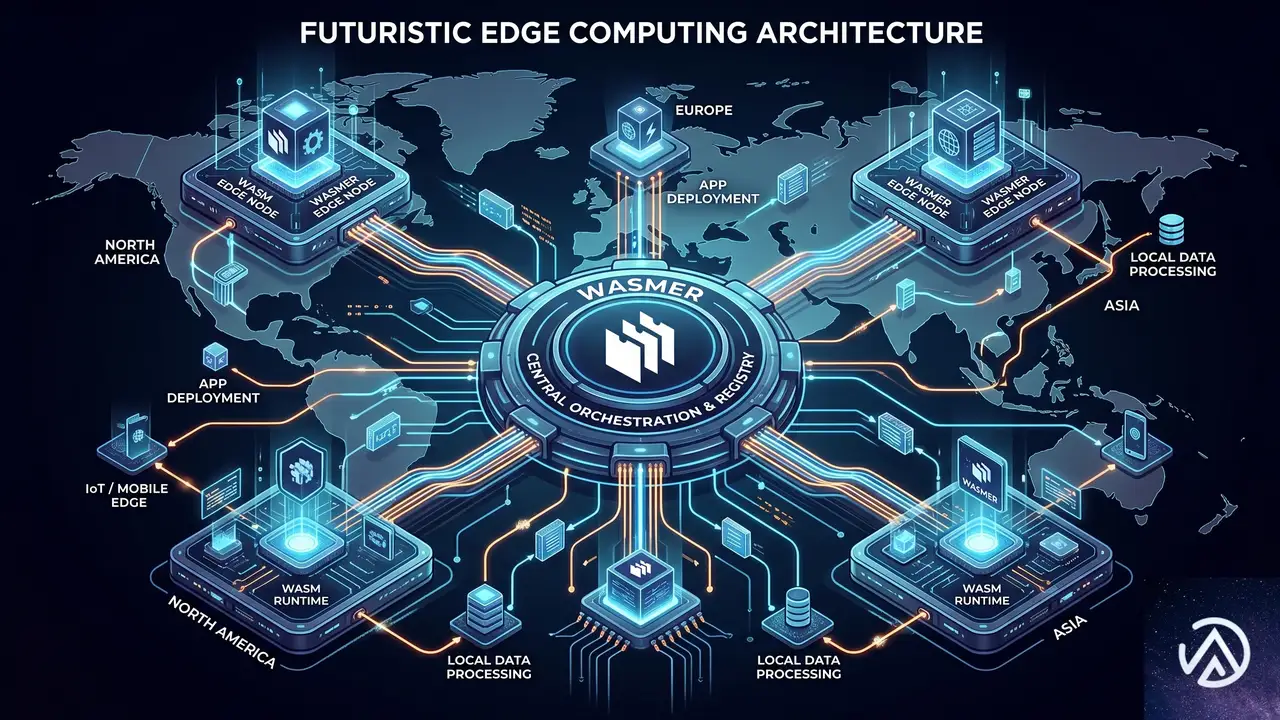
Edge.jsの登場は、エッジコンピューティングにおけるNode.jsの位置づけを大きく変える可能性がある。エッジコンピューティングとは、データの発生源に近い場所で処理を行うアーキテクチャだ。ユーザーの近くにサーバーを置くことで、応答速度を高め、中央サーバーへの負荷を減らせる。CDN(コンテンツ配信ネットワーク)がその代表例だが、近年はより複雑なアプリケーションロジックをエッジで動かす需要が高まっている。
従来、エッジ環境でJavaScriptを本格的に動かすには、Cloudflare Workersのような専用ランタイムを使う必要があった。これらはNode.jsと完全な互換性があるわけではなく、多くのnpmパッケージやNode.js組み込みモジュールが使えなかった。Edge.jsはこの制約をWebAssemblyサンドボックスで解決する。Node.jsアプリをほぼそのままエッジで動かせる道を開いたことになる。
MCP(Model Context Protocol)エージェントへの対応も見逃せない。MCPはAIモデルが外部ツールやデータソースと連携するための標準プロトコルで、AIエージェントの基盤として注目されている。エッジで動作するNode.jsランタイムがMCPをサポートすることで、低レイテンシのAIエージェントを構築しやすくなる。
実運用で期待される効果
Edge.jsを利用すると、具体的に以下のような恩恵が見込まれる。まず、コールドスタート(初回起動時の遅延)が大幅に短縮される。Dockerコンテナの起動には数百ミリ秒から数秒かかることがあるが、Wasmサンドボックスならマイクロ秒単位で実行を開始できる。
次に、リソースの隔離が強固になる。WebAssemblyは設計段階からサンドボックス化を前提としており、メモリアクセスやシステムコールを厳格に制限する。これにより、マルチテナント環境でも安全にNode.jsアプリをホストできる。また、デプロイの簡素化も大きな利点だ。コンテナイメージのビルドやレジストリへのプッシュが不要になり、コードを書いてすぐにエッジへ展開できるワークフローが実現する。
この記事のポイント
- WasmerはOpenAI CodexとGPT-5.5を使い、Node.jsエッジランタイム「Edge.js」を2週間で開発した
- AIを活用しない場合の開発期間は約1年と見積もられており、速度は10〜20倍に向上した
- Codexは低レベルデバッガLLDを使いこなし、人間のエンジニアが気づきにくいバグの根本原因を迅速に特定した
- 小規模チームでも大企業レベルのプロジェクトに挑戦できるようになり、開発のパラダイムシフトが起きつつある
- WebAssemblyサンドボックスにより、Docker不要で安全かつ高速にNode.jsをエッジで実行できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験