

AWSが低コストなEC2 T8iインスタンスを発表!T3比で最大70%の性能向上
AWSが新型の低コストバースト可能インスタンス「Amazon EC2 T8i」の一般提供を開始した。T3インスタンスの後継となるもので、価格性能比が最大30%改善している。
T8iはカスタム設計された第6世代Intel Xeon Scalable Processorを搭載し、AWSのNitro System上で動作する。既存のT3ユーザーは同じCPUクレジット方式のまま移行できる設計だ。
T8iインスタンスの位置づけ
EC2のTシリーズは「バースト可能インスタンス」と呼ばれる。平時はベースライン性能で動作し、負荷が上がった時にCPUクレジットを消費して性能を一時的に引き上げる仕組みを持っている。
この仕組みが適しているのは、普段はCPU使用率が低いが瞬間的に負荷が上がるワークロードだ。低トラフィックのWebサイト、開発・テスト環境、小規模データベース、マイクロサービス、ログインゲートウェイなどが代表例になる。
T8iはこのバーストモデルを踏襲しつつ、CPUとネットワーク性能を大幅に引き上げたモデルだ。
性能向上の内訳
価格性能比とコンピューティング性能
AWSの発表によると、T8iはT3と比較して以下の改善が実現されている。
- 価格性能比が最大30%向上
- コンピューティング性能が最大70%向上
- ネットワーク帯域が最大1.25倍
- EBS帯域が最大2.4倍
特にEBS帯域の2.4倍という数字は見逃せない。ディスクI/Oがボトルネックになりがちな小規模データベースやデータ処理ジョブでは、体感できる改善が期待できる。
CPUクレジット方式と無制限モード
T8iはT3と同じCPUクレジット方式を採用している。StandardとUnlimitedの2つのモードがあり、デフォルトはUnlimitedモードだ。Unlimitedモードではクレジット残高がゼロになっても、追加料金を支払うことでベースラインを超える性能を維持できる。
クレジットは時間の経過とともに自動で蓄積される。例えばt8i.microなら1時間に6クレジット、t8i.smallなら12クレジットが付与される仕組みだ。
インスタンスタイプとスペック
T8iは4つのサイズで提供される。すべて2 vCPUを1コアとして提供するのが特徴で、vCPUとメモリの比率が他シリーズにはない特殊な構成になっている。
- t8i.nano
- t8i.micro
- t8i.small
- t8i.medium
メモリ比率はnanoが1対0.25、microが1対0.5、smallが1対1、mediumが1対1となっている。2 vCPUでメモリ0.25GiBという構成は他のEC2インスタンスにはない特徴的なスペックだ。
利用シーンと移行方法
どんな場面で使うべきか
T8iは低〜中程度のCPU使用率で動くワークロードに向いている。具体的には以下のようなケースが想定されている。
- フリーミアムサービスの小規模プラン
- トレーニング・デモ環境
- ステージング・開発環境
- データ処理ジョブ
- マイクロサービスアーキテクチャの一部
- 低トラフィックのWebサイト
- ログインゲートウェイ
- バッチ処理やCI/CDパイプライン
常に高いCPU使用率が続く本番環境や、大規模なデータベースサーバーには向かない。そうした用途ではM8i Flexなど、より大きなインスタンスの選択が推奨されている。
T3からの移行手順
既存のT3ユーザーにとって移行はシンプルだ。インスタンスタイプをT3からT8iに変更するだけで、アプリケーションの設定変更やコードの書き換えは原則不要とされている。
CPUクレジット方式もT3と同じなので、運用ノウハウはそのまま活かせる。Auto ScalingやCloudWatchの設定も流用できるため、移行コストは最小限だ。
提供リージョンと利用方法
T8iは以下のAWSリージョンで利用できる。
- 米国東部(バージニア北部・オハイオ)
- 米国西部(オレゴン・北カリフォルニア)
- アジアパシフィック(ハイデラバード・マレーシア・ムンバイ・ソウル・シンガポール・シドニー・東京)
- カナダ(中部)
- ヨーロッパ(フランクフルト・アイルランド・ロンドン・パリ)
購入方法はオンデマンドとスポットインスタンスに対応している。Savings Planは近日対応予定だ。t8i.microとt8i.smallはAWS無料利用枠でも使えるため、新規ユーザーがAWSの使い方を学ぶ用途にも適している。
共有テナンシーのみ対応しており、専有テナンシーや専有ホストは利用できない点には注意が必要だ。
この記事のポイント
- T8iはT3の後継となる低コストバースト可能インスタンス
- コンピューティング性能が最大70%向上し、EBS帯域は2.4倍に
- CPUクレジット方式はT3と同じで移行が容易
- 4サイズ構成で東京リージョンでも利用可能
- 無料利用枠の対象サイズもあり、新規ユーザーの入門にも適している

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI攻撃は自律化へ移行!6時間で数千件の認証情報を奪う新手口を解説
Google Threat Intelligence Group(GTIG)は2026年9月8日、敵対的AI利用の進化をまとめた四半期レポートを公開した。攻撃者が単純なプロンプト入力から、自律的に動くエージェンティックAIの活用へ移行している実態が明らかになっている。
2026年第2四半期には、クラウド環境を侵害した攻撃者が6時間未満で認証情報の大量収集キャンペーンを計画し、構築し、実行した事例が確認された。数千件規模の認証情報が奪取されている。
この変化は、防御側が攻撃を検知して対応するまでの時間を大きく縮める。AIを使う側の企業にとって、単なる技術トレンドではなく、クラウドと認証情報の管理体制に直結する問題だ。
攻撃者は「AIに聞く」から「AIに任せる」へ移行した
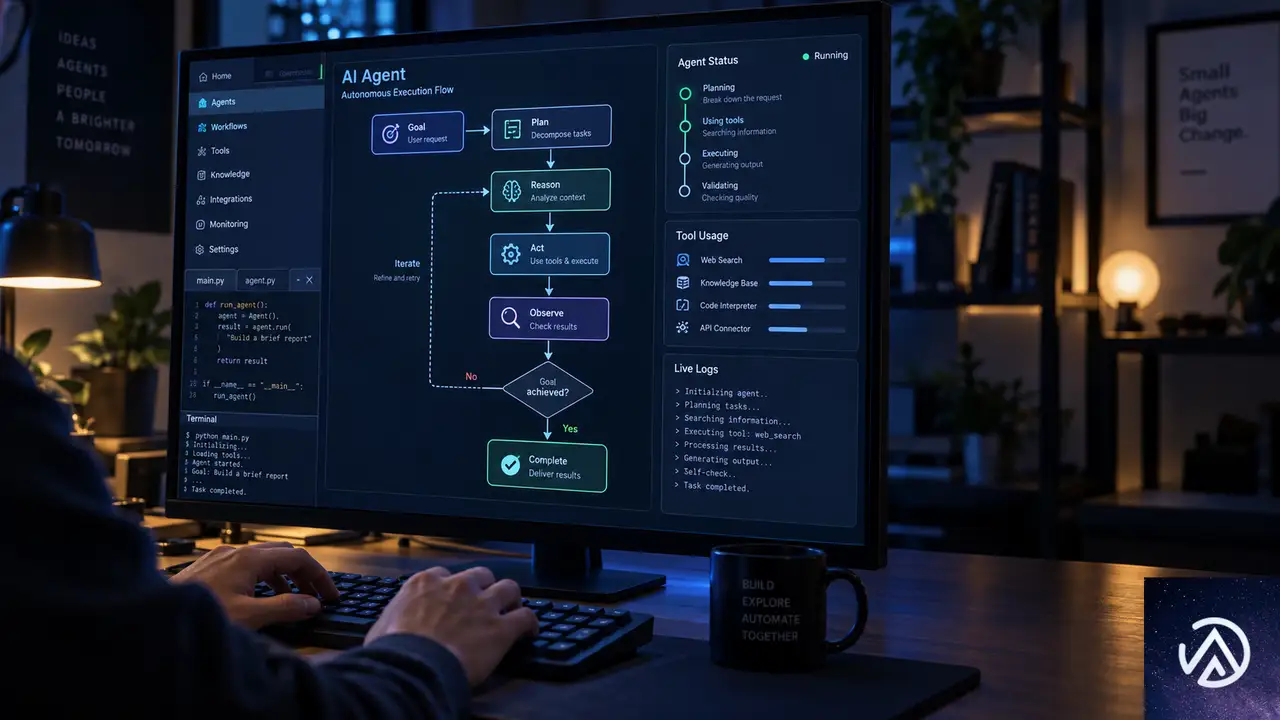
2026年5月の前回レポート以降、GTIGは攻撃者が基本的なプロンプト入力から、エージェンティックAIワークフローとAI対応自動化へ踏み出しているのを観測している。ここでいうエージェンティックAIとは、人間が1つずつ指示を出さなくても、目標を与えれば自分で計画を立てて実行するAIシステムのことだ。チャット型AIが1往復で終わるのに対し、エージェンティックAIはツールやAPIを呼び出しながら複数の工程を連続で進める。
従来の攻撃では、攻撃者がAIの出力を確認し、コマンドを実行し、結果を見て次の指示を出すというループが発生していた。エージェンティックAIはこの人間の介在を大幅に減らし、エラー修正やIPアドレスの切り替えまで自律的に行う。その結果、防御側が気づく前に攻撃が完了するケースが増えている。
この違いが攻撃スピードの差につながる。GTIGは2026年第2四半期に、このエージェンティックAIを使った攻撃が実戦投入された事例を確認した。
6時間で数千件の認証情報を奪ったキャンペーンの中身
Mandiantが観測した事例では、金銭目的とみられる攻撃者が組織のクラウド基盤を侵害し、自律型のマルチエージェント攻撃フレームワークを展開した。攻撃者はAIコーディングチャットボット、プロンプト、エージェント指示書を組み合わせ、計画・構築・実行を6時間未満で完了させている。通常は大規模なグループが持つリソースと同等の規模と速度で、数千件の第三者認証情報が奪取された。
攻撃者はマークダウン形式の指示書を運用プレイブックとして使った。マークダウンとは文書を書くための軽量な記法で、AIへの指示書としても扱いやすい。AIはこの指示書に従い、脆弱性スキャンパイプラインを自律的に管理し、リアルタイムでトラブルシューティングを行い、IPアドレスのローテーションまで自動実行した。攻撃トラフィックは被害者のクラウド基盤から正当なIPアドレスを経由して送信され、検知を難しくしていた。
この事例では、指示書とプロンプトを組み合わせることで、AIが自律的にパイプラインを管理した。人間の操作を挟まないため、防御側が気づく前に攻撃が完了してしまう。
GTIGはこの動きを、受動的なインフォスティーラーから攻撃的なエージェンティック収集への転換点と位置づけている。インフォスティーラーとは、端末に保存されたパスワードやCookieなどを盗み出すマルウェアだ。従来は端末を起点に情報を集めるだけだったが、新たな手法ではサーバーサイドの脆弱性を自ら探索し、狙いを定めて攻撃する。
AIコーディングが広げたオープンソースの死角
AI支援コーディングの普及でオープンソース資産の量が増え、開発速度が上がった。一方でサードパーティパッケージや依存関係の精査が甘くなり、攻撃者に付け込まれる余地が生まれている。GTIGは、AI支援コーディングが2025年から2026年初めに観測された大規模サプライチェーン侵害の一因になったとみている。
具体的な事例も確認された。2026年初めには、北米とアジアの企業環境で悪意あるオープンソースAI資源のダウンロード試行が検知された。2026年4月には、AIコーディングエージェントが暗号資産プロジェクトのコードベースに悪意ある依存関係を組み込んだ事例が公表されている。2026年5月には、LLMプロキシサービスを密かにインストールする悪意あるパッケージも特定された。これは地域的なLLMアクセス制限を迂回するために使われる。
金銭目的の攻撃者UNC6780(TeamPCP)は、こうしたリスクの深刻さを示す存在だ。UNC6780はPyPIやnpm、Docker Hubといったエコシステムを標的にし、侵害後にDUSTMAKERと呼ばれる認証情報窃取マルウェアを展開する。窃取したデータは直接売ったり、ランサムウェアグループとの提携で利益に変えられたりする。
UNC6780はAIコーディングアシスタントやLLMセキュリティスキャナーを騙す複数の手口も実装している。代表的なのがプロンプトインジェクションだ。これはAIが読むテキストの中に悪意ある指示を忍ばせる攻撃で、コードを自動分析するAIに「安全だ」と誤認させる偽の指示を仕込む。GitHub Actionsのワークフローを悪用して専有AIリポジトリを盗み出し、別の攻撃者に渡して恐喝に使わせた事例もあった。
専有AIモデルとクラウド計算資源が次の標的
2026年第2四半期、最先端モデルへの直接攻撃は確認されなかった。しかし専有AIの研究やモデルを盗む事例は増加している。標的はAIラボや先端AI企業にとどまらず、政府・軍事・医療・メディア・エンターテインメント分野にも広がった。攻撃者もサイバーエスピオナージ集団だけでなく、データ窃取恐喝グループまで含まれる。
中国関連の脅威アクターUNC6508は、北米の学術・医療・軍事研究機関を対象にした複数年キャンペーンを展開している。UNC6508は専有AI研究を標的にするだけでなく、クラウド環境を侵害してローカルLLM基盤を展開し、商用AI APIの監視を避けながら被害者の計算資源を利用していた。
データ窃取恐喝の事例も複数確認された。医療分野では企業データと製薬研究、専有AIモデルが盗まれ、身代金を支払わなければ公開すると脅迫された。AIメディア生成企業の事例では、ソースコード、プロンプト、スキル、モデルスクリプト、シークレットが流出した。モデル重みとはAIモデルが学習で得た知識を数値として保存したデータで、これが盗まれるとAIの再現や改変に悪用される恐れがある。
アカウント売買とLLMJackingの実態
プレミアムモデルや高性能計算へのアクセスコストは、攻撃者にとって大きな障壁だ。そのためAIアカウントの窃取・購入・販売が地下フォーラムで増加している。ClaudeやGeminiの認証情報に加え、Cursor ProやDevinなど自律型コーディングIDEの需要も高く、アカウント単価は2026年に平均で2倍以上に跳ね上がった。
認証情報の入手経路として広く使われるのがインフォスティーラーだ。LUMMAC.V2、STEALC.V2、VIDAR、ACRSTEALERなどの制御者は、従来のAIブラウザプロファイルに加えて、AI開発者設定を狙い始めた。2026年5月には、ACRSTEALERがClineのsecrets.jsonやContinue AIのconfig.yamlを標的にする命令を配布した事例が確認されている。これらのファイルには平文のAPIキーが保存されることがあり、APIキーとはシステム同士がやりとりするための合言葉のようなものだ。これが漏れると、被害者の有料モデル利用枠を攻撃者が直接使えてしまう。
LLMJackingも増えている。LLMJackingとは、被害者のクラウド環境を侵害して計算資源を乗っ取り、AIワークロードを不正に実行する手口だ。2026年4月の侵入事例では、GitHubの個人アクセストークン(PAT)が露出したことが起点となった。攻撃者はこれを使ってクラウド環境に初期アクセスし、不正なAIインフラを展開して高性能計算資源を拡張した。
LLMJackingは、被害者が気づかないうちに高額なクラウド利用料が発生する点でも厄介だ。GTIGは2026年に入り、地下フォーラムでのAIアカウント売買と並んでこの手口の増加を確認している。
企業が取るべき対策とGoogleの防御
Googleは多層的な防御戦略を取っている。モデルレベルの安全策、脅威インテリジェンス、封じ込めプロトコルを組み合わせ、モデル抽出攻撃に対してはリアルタイム防御を展開する。モデル抽出攻撃とは、既存のAIモデルに大量の質問をして応答を学習させ、模倣モデルを作る手口だ。Googleは不正な模倣モデルの性能を落とし、専有ロジックの複製を検知する対策を導入している。
2026年6月には、中国拠点のサイバー犯罪サービス「Outsider Enterprise」を遮断した。このサービスはフィッシングキットを提供し、Googleなどの有名ブランドを大量になりすましていた。運営者はGeminiを使ってコードを生成し、キャンペーンを大規模に実行していた。GoogleがGeminiの悪用で法的措置に踏み切ったのはこれが初めてだ。
企業向けにはGoogle AI Threat Defense(AITD)を提供している。AITDはGeminiなどの推論力、Wizのリスク優先順位付け、GeminiとCodeMenderの自動修復、Mandiantの最前線インテリジェンスを統合した自律型アーキテクチャだ。軽量モデルで継続スキャンを行い、高リスクの脆弱性には特化型の先端モデルを割り当てる。さらに脆弱性検出と自動パッチ適用に特化したGemini 3.8 Flash Cyberも投入している。
実務面では、クラウド認証情報の定期的なスキャンとローテーション、GitHubの個人アクセストークン管理、AIアカウントの多要素認証、オープンソース依存関係の精査が基本になる。AIを業務に導入する場合は、通常のセキュリティ監視に加えて、AI特有の脅威を検出する仕組みを組み込むことが欠かせない。
この記事のポイント
- 攻撃者はチャット型のAI利用から、自律的に動くエージェンティックAIへ移行している
- 2026年第2四半期には6時間未満で数千件の認証情報を奪うキャンペーンが確認された
- AIコーディングの普及でオープンソース経由のサプライチェーンリスクが拡大している
- 専有AIモデルやAPIクレデンシャルが窃取と恐喝の標的になっている
- AIアカウントの売買とLLMJackingが増加し、クラウド計算資源が乗っ取られている
- 防御には認証情報管理、依存関係の精査、AI特有の脅威検出が欠かせない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AWS Graviton5搭載のEC2 R9gが一般提供開始。R8g比で最大25%の性能向上
AWSがGraviton5プロセッサを搭載したEC2 R9gとR9gdインスタンスを一般提供開始した。メモリ最適化インスタンスの新世代で、R8gと比較してコンピュート性能が最大25%向上している。
Graviton5はDDR5メモリの高速化、L3キャッシュの5倍拡大、ネットワーク帯域幅の最大2倍化など、複数のハードウェア改良を備える。データベースやインメモリキャッシュなどメモリ集約型のワークロードで効果が大きい。
この記事ではR9gの技術的な変更点、インスタンススペック、移行手順、利用可能リージョンを解説する。
Graviton5がもたらす性能向上の全容

Graviton5プロセッサはGraviton4から複数のハードウェア改良が加えられた。まずコンピュート性能がvCPUあたり最大25%向上している。これは命令処理の効率化と高クロック動作によるものだ。またAWSがこれまでに構築した中で最もエネルギー効率の高いプロセッサでもある。
このデモはGraviton4(R8g)とGraviton5(R9g)の主要スペックを比較している。特にL3キャッシュの5倍拡大とメモリ帯域の高速化がデータ処理の遅延低減に効く。
メモリとキャッシュの大幅強化
メモリはDDR5 8800 MT/sに対応した。Graviton4の5600 MT/sから大幅に高速化されており、AWSのクラウド上で利用可能な最速のメモリ帯域を実現している。これは大量のデータを扱うインメモリキャッシュ・データベースにとって応答時間の短縮に直結する。
L3キャッシュも5倍に拡大された。L3キャッシュとはCPU内部にある高速なメモリ領域で、頻繁にアクセスするデータを一時的に保持する役割を持つ。この容量が増えると、主メモリへのアクセス回数が減り、データ処理の遅延が小さくなる。データ局所性が高いワークロードほど恩恵を受けやすい。
ネットワーク帯域幅とパケット処理の改善
ネットワーク帯域幅とAmazon EBSの帯域幅は、最大サイズのインスタンスで最大2倍に向上した。48xlargeではネットワークが最大100 Gbps、EBSが最大72 Gbpsに達する。またパケット処理性能は最大3倍に改善されている。
さらにR9gとR9gdはInstance Bandwidth Configuration(IBC)に対応している。これはEBSとネットワークの帯域配分を25%単位で調整できる機能だ。データベースやキャッシュなど、帯域要件が特定方向に偏るワークロードで性能を最適化できる。例えばネットワーク処理が少なくディスクI/Oが多いワークロードでは、帯域をEBS側に寄せるといった調整が可能になる。
Nitro Isolation Engineによるセキュリティ強化

すべてのR9gとR9gdインスタンスはAWS Nitro System上で動作する。Nitro Systemは仮想化、ストレージ、ネットワークを専用ハードウェアにオフロードする仕組みだ。これにより仮想マシンのオーバーヘッドが減り、ベアメタルに近い性能と強固なセキュリティ分離を両立できる。
R9gとR9gdにはNitro Isolation Engine(NIE)が搭載されている。NIEはC9gとM9gで今年前半に導入されたコンポーネントで、仮想マシン間の分離を強制する役割を担う。仮想マシンのメモリ、CPUレジスタ状態、I/Oデバイスへのすべてのアクセスを最小限のAPIセットで仲介する。
このデモはNIEが仮想マシンとハードウェアの間に位置し、すべてのアクセスを仲介する関係を示している。分離の保証はソフトウェア的な工夫ではなく、形式的な数学証明によって裏付けられている点が特徴だ。
NIEの特徴は形式検証(formal verification)という手法を活用している点にある。これはハードウェアやソフトウェアが意図通りに動作することを数学的に証明する手法だ。特定のテストケースだけでなく、あらゆる条件下で正しく動作することを保証する。この取り組みにより、Nitroはクラウドハイパーバイザーとして初めて形式検証を受けた存在になった。
形式検証の対象範囲や前提条件などの詳細はAWSのテクニカルホワイトペーパーで公開されている。セキュリティ要件が厳しい金融系ワークロードやマルチテナント環境を扱う場合には、このホワイトペーパーを参照してリスク評価に役立てるとよい。
R9gとR9gdのインスタンススペック

R9gとR9gdはそれぞれ11サイズで提供される。最小のmediumから最大のmetal-48xlまで、幅広い要件に対応する。以下では2つの違いを中心に説明する。
このデモはR9gとR9gdの違いを整理している。NVMe SSDの有無が唯一の差で、用途に応じて選べる。
R9gのスペック
R9gはEBSストレージのみを使用する構成だ。最小のr9g.mediumは1 vCPUと8 GiBメモリ、最大のr9g.48xlargeとr9g.metal-48xlは192 vCPUと1536 GiBメモリを搭載する。ネットワーク帯域幅はmediumから2xlargeまで最大15 Gbps、8xlargeで17 Gbps、12xlargeで25 Gbps、16xlargeで34 Gbps、24xlargeで50 Gbps、48xlargeで100 Gbpsに達する。
EBS帯域幅はmediumから4xlargeまで最大12 Gbps、8xlargeで12 Gbps、12xlargeで18 Gbps、16xlargeで24 Gbps、24xlargeで36 Gbps、48xlargeで72 Gbpsとなっている。データベース用途ではEBS帯域幅が性能のボトルネックになりやすいため、サイズ選定の際はこの値にも注目したい。
R9gdのNVMeストレージ
R9gdはR9gと同じコンピュート性能とネットワーク性能を持ちながら、ローカルNVMe SSDを搭載している。mediumでは59 GB、largeで118 GB、xlargeで237 GBとサイズに応じて容量が増える。最大のr9gd.48xlargeでは3台の3800 GB NVMe SSD(合計11.4 TB)を備える。
ローカルNVMe SSDはEBSと比べてレイテンシが低く、一時的なスクラッチ領域やキャッシュ用途に向いている。オープンソースデータベース、分散リアルタイムビッグデータ分析、大規模インメモリデータベース、大容量キャッシュワークロードで効果を発揮する。
R8gからの移行と始め方

R8gで運用中のワークロードがある場合、R9gへの移行はシンプルだ。多くのアプリケーションでコード変更は不要。同等サイズのR9gインスタンスを選択すれば、そのままより高い性能を得られる。
このデモはR8gからR9gへの移行手順を4ステップで示している。インスタンスタイプを変更するだけで性能が向上するケースが多い。
対応OSとコンテナ環境
R9gはAmazon Linux 2023、Amazon Linux 2、Ubuntu 22.04以降、RHEL 8.4以降、SUSE Linux Enterprise Server 15 SP3以降、Debian 12以降など主要なLinuxディストリビューションに対応する。EC2コンソールからArmベースのAMIを選択すれば、すぐに起動できる。
コンテナワークロードではAmazon EKS、Amazon ECS、標準的なKubernetes環境で動作する。Arm64向けにビルドされたマルチアーキテクチャのコンテナイメージなら変更なしで動く。Dockerイメージをマルチアーキテクチャ対応にしておくと、x86からArmへの移行がスムーズになる。
移行を支援するツール
AWSはGravitonへの移行を支援する複数のリソースを提供している。Graviton Getting Started Guideは構築、実行、最適化の方法をまとめたガイドだ。Graviton Savings Dashboardではコスト削減効果を追跡できる。AWS TransformはJavaアプリケーションをx86からGraviton向けに変換するコード変換を自動化するツールだ。
Javaアプリケーションの場合、依存ライブラリにネイティブコードが含まれているとArm64への移行が難しいことがある。AWS Transformはこうしたコード変換を自動化して移行の手間を減らす。まず小規模なワークロードで試し、問題がないことを確認してから本番移行に進むのが現実的な進め方だ。
料金と利用可能リージョン

R9gとR9gdは米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、欧州(フランクフルト)の各リージョンで利用できる。日本国内のリージョン(アジアパシフィック東京)では現時点で提供されておらず、今後の展開が待たれる。
購入オプションはSavings Plans、On-Demand、Spot Instances、Dedicated Instances、Dedicated Hostsから選択可能だ。長期運用する場合はSavings Plans、一時的なバッチ処理やテスト用途ではSpot Instancesがコスト効率に優れる。料金の詳細はAmazon EC2の料金ページで確認できる。
インスタンスサイズや購入オプションによって価格が異なるため、ワークロードに合わせて最適な組み合わせを選ぶことが重要だ。特にR8gと比較した場合、同じサイズでも性能が向上しているため、より小さなサイズに移行してコストを削減できる可能性もある。
この記事のポイント
- AWS Graviton5搭載のEC2 R9gとR9gdが一般提供を開始した
- R8g比でコンピュート性能が最大25%向上し、エネルギー効率も改善
- DDR5 8800 MT/sメモリとL3キャッシュ5倍拡大でデータ処理が高速化
- Nitro Isolation Engineにより形式検証されたセキュリティ分離を実現
- R9gはEBSのみ、R9gdはローカルNVMe SSDを搭載した構成
- R8gからの移行はコード変更不要のケースが多く、Arm64対応イメージでそのまま動作
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloudが2029年までに耐量子暗号へ完全移行。PQCロードマップの全容と企業が取るべき3ステップ
Google Cloudが2026年8月11日、2029年までに耐量子暗号(PQC / Post-Quantum Cryptography)へ完全移行するためのロードマップを公開した。量子コンピュータによる将来の暗号解読リスクに備え、APIエンドポイントやロードバランサーの対応はすでに始まっている。
今回の発表では、移行戦略の3つの重点領域、2026年に完了した基盤整備、2027年から2028年にかけてのドメイン別計画が示された。企業が今すぐ着手すべき3つのステップも提示されている。
量子コンピュータが実用化されれば、現在広く使われているRSAやECDSAなどの公開鍵暗号は解読可能になる。その影響はクラウドサービス全体に及ぶ。本記事では、Google CloudのPQCロードマップの全容と、企業に求められる対応を整理する。
PQC移行の全体像と2029年目標
Google CloudのPQC移行戦略は「セキュアバイデザイン」を基本方針とする。設計段階から量子安全を組み込むアプローチであり、単なる後付けの対策ではない。Google Quantum Threat Modelという独自の脅威モデルを土台に、3つの重点領域で保護を進める。
SNDLリスクとは何か
SNDL(Store Now, Decrypt Later)は「今保存して後で復号する」攻撃だ。攻撃者が現在の暗号化通信を傍受してデータを蓄積しておき、量子コンピュータが実用化された時点で一括して復号する。今日の暗号化データが将来の量子コンピュータで解読されるリスクは、すでに現実のものとなっている。
これがPQC移行を急ぐ最大の理由だ。機密データの保存期間が数十年に及ぶ場合、現在の暗号化方式のままでは将来の解読リスクを抱え続けることになる。特に金融機関や政府機関、医療機関では、このリスクへの対応が喫緊の課題だ。
このデモはSNDL攻撃のリスクとPQCによる防御の違いを示している。攻撃者がどれだけデータを蓄積しても、量子安全な鍵交換を使っていれば将来の解読は不可能になる。
Googleが定める3つの重点領域
Google CloudがPQC移行戦略で優先するのは、以下の3領域である。
- SNDLリスクの緩和。現在の暗号化データが将来の量子コンピュータで解読されることを防ぐ。
- 偽造に対する完全性の確保。デジタル署名を強化し、データやIDの偽造を防ぐ。
- 暗号アジリティの基盤強化。暗号標準の進化に合わせて、新しい方式を最小限の工数で採用できる柔軟なシステムを構築する。
3番目の「暗号アジリティ」は特に重要だ。暗号標準は今後も進化し続ける。特定のアルゴリズムに依存せず、新しい標準が出たら容易に切り替えられる仕組みがあれば、将来の移行コストを大幅に抑えられる。Googleはこの基盤への投資を戦略の中核に置く。
Google Cloudは規制期限を待たずに、内部インフラと顧客向けサービスのPQC移行を前倒しで進めている。2029年の完全対応を目標に、Sovereign Cloudの取り組み(Google Cloud DedicatedやGoogle Distributed Cloud)にもPQCソリューションを展開中だ。
2026年に完了した基盤整備
2026年時点で、すでに複数の基盤的マイルストーンが達成されている。これらは顧客に対して即座の保護を提供するものだ。
APIエンドポイントとロードバランサーの対応
Google CloudのAPIエンドポイントは、量子安全な鍵交換に対応した。google.comと*.googleapis.comの両方が、NIST標準化済みのML-KEM(FIPS 203)をハイブリッドモードで実装している。ハイブリッドモードとは、従来の暗号とPQCを併用する方式だ。互換性を保ちながら量子安全性を確保できる。
アプリケーションロードバランサーとプロキシロードバランサーも、TLS 1.3における量子安全ハイブリッド鍵交換(X25519MLKEM768)をサポートする。当初はオプトイン方式で提供され、顧客は既存アプリケーションへの影響を最小限に抑えながら検証を進められる。
さらに、ChromeとCloudflareが進めるMerkle Tree Certificatesの実験にも参画している。PQC署名をWebPKIに適用する際の課題(署名サイズの肥大化など)に対処する取り組みだ。
Cloud KMSのPQCアルゴリズム一般提供
Cloud KMSでは、NIST標準化済みのPQCアルゴリズム(ML-KEM、ML-DSA、SLH-DSA)が一般提供(GA)に達した。暗号化鍵と署名鍵の両方で量子安全なアルゴリズムを利用できる。
これは企業にとって大きな意味を持つ。既存のCloud KMS利用者は、新しいPQCアルゴリズムを試すために特別な準備をする必要がない。すでに一般提供されているため、本番環境での利用も可能だ。
ドメイン別ロードマップ(2027〜2028年)
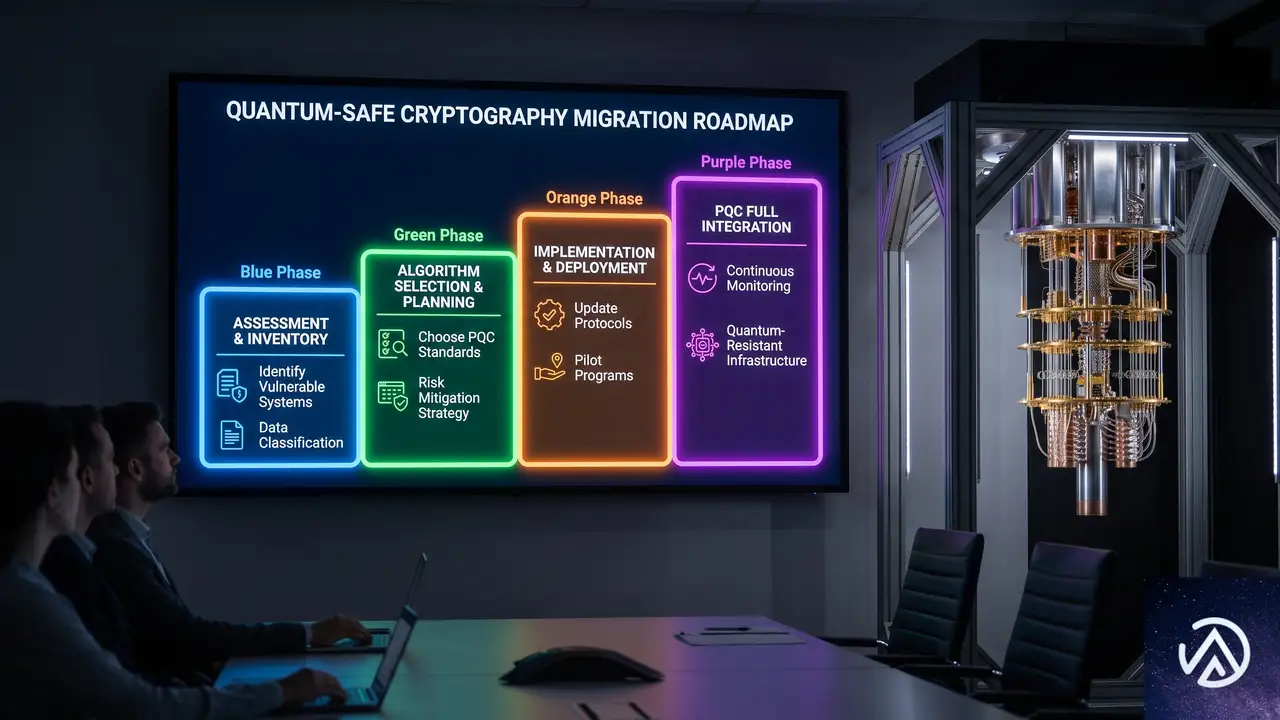
Google Cloudは2029年の完全対応に向けて、リスクベースのアプローチで3つのドメインを定義した。各ドメインには目標完了時期が設定されている。サービスによって個別のタイムラインは調整される可能性があるが、大多数のサービスは目標時期に合わせて移行を完了する見込みだ。
このタイムラインは、Google CloudのPQC移行が段階的に進むことを示している。2026年の基盤整備から始まり、2027年には通信経路の保護、2028年には署名と鍵管理、2029年に全体の収束を目指す。
ドメイン1 SNDL対策(2027年目標)
ドメイン1は非対称暗号の脆弱性に対処する。将来の量子コンピュータが今日の暗号化データを復号するリスクを防ぐのが目的だ。対象となるのは以下の3つの経路である。
- 顧客ワークロードの保護。Google Cloudサービスとロードバランサーに量子機密TLS 1.3ハンドシェイクを提供する。
- 管理者・開発者フローの保護。Cloud VPNやInterconnectを含む管理者経路をSNDLから守る。開発者向けにはクライアントライブラリ、SDK、オープンソース暗号ライブラリのTinkを対応させる。
- データパイプラインの保護。分析・ストレージプラットフォームのデータ転送を保護し、機密情報が傍受・蓄積されても将来復号されないようにする。
このドメインの特徴は、通信経路の保護に焦点を当てている点だ。特にTinkの対応は重要である。TinkはGoogleが開発したオープンソース暗号ライブラリで、多くの開発者が利用している。TinkがPQCに対応することで、開発者はアプリケーションレベルで量子安全な暗号を容易に導入できる。
ドメイン2 完全性と否認防止(2028年目標)
ドメイン2はデジタル署名と証明の量子対応を扱う。量子コンピュータによる偽造攻撃からデータの完全性と信頼性を守る。3つの主要分野がある。
1つ目はソフトウェアサプライチェーンの保護だ。Binary Authorization、Cloud Build、Assured Open Source Softwareなどのサービスで、量子耐性のある証明(アテステーション)を導入する。信頼できる変更されていないイメージだけが本番環境で実行されることを保証する。
2つ目は量子安全な証明書の発行だ。内部および外部の認証局(CA)をML-DSA証明書に対応させる。状況に応じてSLH-DSA証明書もサポートする。IETF(Internet Engineering Task Force)の標準化に積極的に貢献しており、大規模な署名サイズ問題にはMerkle Tree Certificatesなどの新しいアプローチを検証中だ。
3つ目はIDとアクセスの保護である。サービスアカウントキーやトークン(JWT / OAuth)を量子偽造に対して耐性のある方式に移行する。
ドメイン3 基盤と鍵管理(2028年目標)
ドメイン3はPQC移行の土台となる暗号アジリティを扱う。ここでの投資が、ドメイン1と2の実現を支える。
基盤となる鍵管理とライブラリでは、Cloud KMSとBoringSSL、Tinkを通じてNIST承認アルゴリズムを有効にする。Cloud KMSはすでにML-KEM、ML-DSA、SLH-DSAの一般提供を開始しており、量子安全な鍵のインポートも準備中だ。
ハードウェアが関わる部分では、Confidential ComputingとCloud HSMにPQCを組み込む。量子的なルートオブトラストを確立し、物理的な基盤を保護する。OpenTitanやCaliptra v2.1、TPM 2.0 v185などのオープンソースシリコン基盤もPQC対応を進めている。
Google Workspaceのクライアントサイド暗号化(CSE)と外部鍵マネージャー(EKM)にもPQCオーケストレーションを導入する。オンプレミスの鍵プロバイダーとの連携も進める計画だ。
量子安全における共有責任モデル
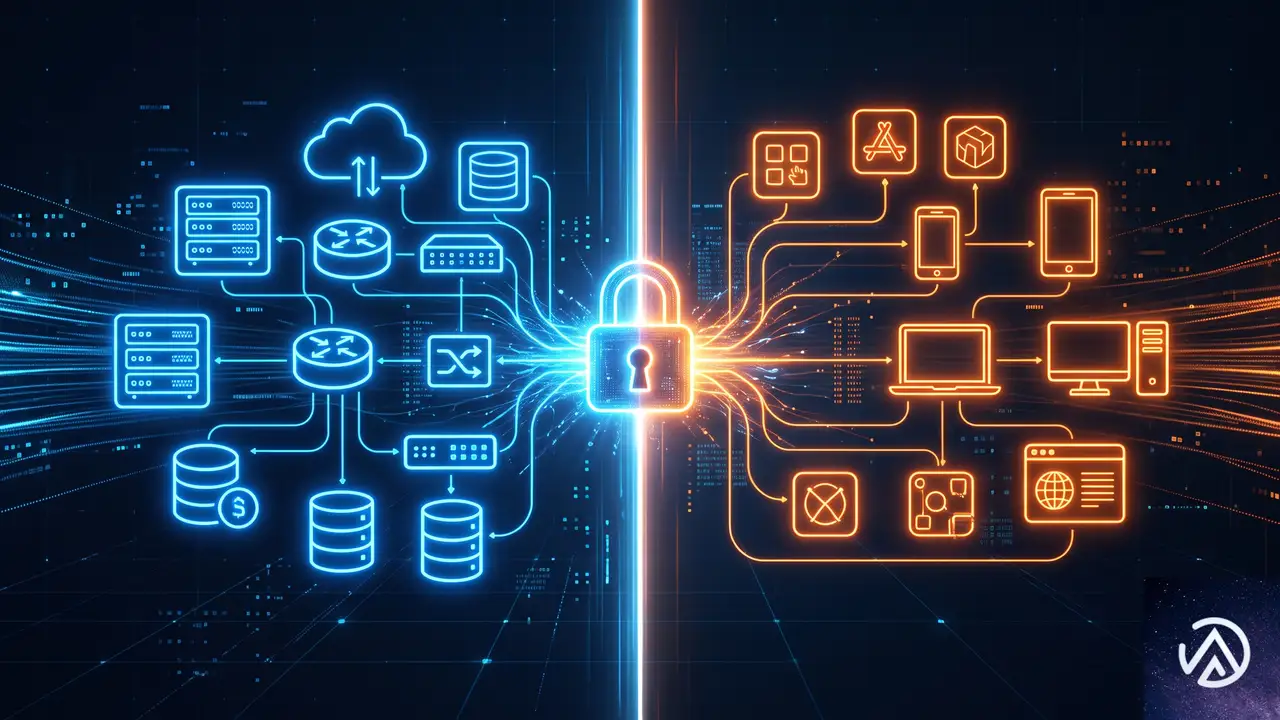
量子安全はGoogle Cloudと顧客の共同作業である。クラウドセキュリティの共有責任モデルがPQCにもそのまま適用される。
この図は責任の境界を明確にしている。重要なのは、Google Cloud側のPQC対応が完了しても、顧客がクライアントソフトウェアを更新しなければ量子安全な接続は確立しない点だ。
Google側の責任範囲
Googleはサーバー、ネットワーク、転送中の暗号化、グローバルフロントエンド、ALTSプロトコルのPQC移行を一括して管理する。ハードウェアの移行は、積極的な交換と自然な機器更新サイクルを組み合わせて段階的に進める。物理コンポーネントの中には2029年を超えて移行が続くものもあるが、安定性を優先したフェーズドアプローチを取る。
顧客側の責任範囲
顧客は自社アプリケーションの管理に責任を持つ。クライアントソフトウェアをPQCハンドシェイク対応に更新すること、非対称鍵のライフサイクル管理、Google Cloudサービスの設定変更が含まれる。
ここが最も見落とされやすいポイントだ。インフラ側がPQC対応しても、クライアント側が古い暗号方式で接続すれば、量子安全性は確保されない。企業のセキュリティチームは、自社のクライアントソフトウェアがPQC対応済みかどうかを確認する必要がある。
企業が今すぐ着手すべき3つのステップ
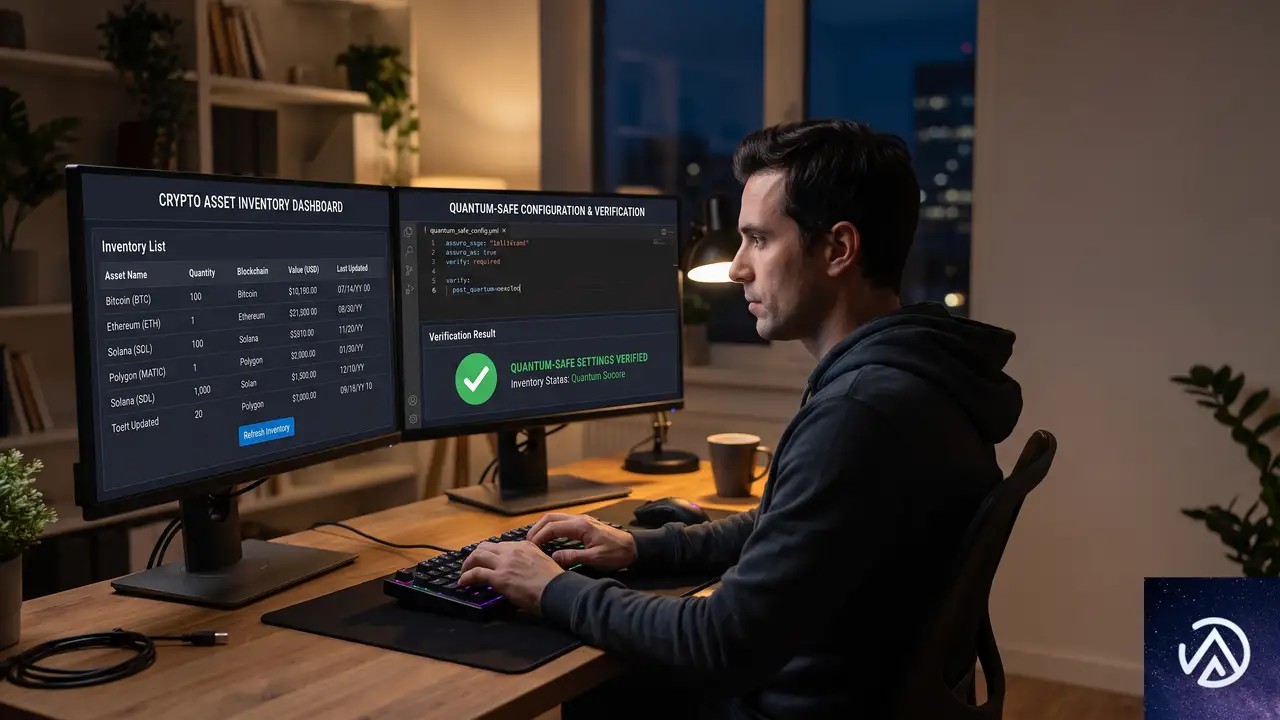
Google CloudはPQC移行の第一歩として、企業が即座に着手できる3つのステップを提示している。どれも実務に直結する具体的なアクションだ。
- 棚卸し(Inventory)。Cloud Asset InventoryやWizなどのツールを使って、鍵や証明書などの暗号資産を特定する。組織全体の暗号リソースをマッピングし、移行バックログの優先順位を定義する。
- 更新(Update)。開発チームとSREチームが使うソフトウェアが、BoringSSL、Chrome、SDKなどPQCアルゴリズムに対応していることを確認する。エッジで量子安全接続が有効化された際に、社内ワークフローが準備できている状態を作る。
- 検証(Validate)。Google Cloudの量子安全APIとロードバランサーを使って既存アプリケーションの挙動をテストする。本番環境に影響が出る前に、アーキテクチャ上のボトルネックを特定できる。
この3ステップは、PQC移行を「待つ」のではなく「準備する」アプローチだ。特に検証は重要である。量子安全なTLS接続は従来よりオーバーヘッドが大きい場合があり、アプリケーションのパフォーマンスに影響を与える可能性がある。事前のテストで課題を洗い出しておけば、本番移行時のリスクを大幅に減らせる。
この記事のポイント
- Google Cloudは2029年までにPQC完全対応を目指し、ロードマップを公開した
- SNDLリスク(今保存して後で復号)は企業にとって喫緊の課題である
- 2026年時点でAPIエンドポイント、ロードバランサー、Cloud KMSのPQC対応が完了している
- 3つのドメイン(SNDL対策、完全性確保、鍵管理基盤)で2027〜2028年に移行を進める
- 企業は棚卸し、更新、検証の3ステップで今すぐ準備を開始できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GKE Agent Sandboxがエージェント1台あたりのコストを75%削減する仕組み
AIエージェントを本番環境でスケールさせようとすると、すぐにコストとリソースの壁にぶつかる。Google Cloudが2026年7月30日に公開したブログ記事では、Google Kubernetes Engine(GKE)の新機能「GKE Agent Sandbox」とオーケストレーションを組み合わせることで、同一の仮想マシン上で動かせるエージェント数を最大3.5倍に増やし、エージェント1台あたりのコストを最大75%削減できるという検証結果が示された。
エージェントは要求に応じて動作するバースト型のワークロードであり、何もしない待機時間が長い。従来のように固定的なコンピュートリソースを割り当てる方法では、遊休状態のエージェントが貴重なCPUやメモリを消費し続けてしまう。この問題に対するGKEのアプローチを詳しく見ていく。
マイクロVM方式の限界とGKE Agent Sandboxの登場
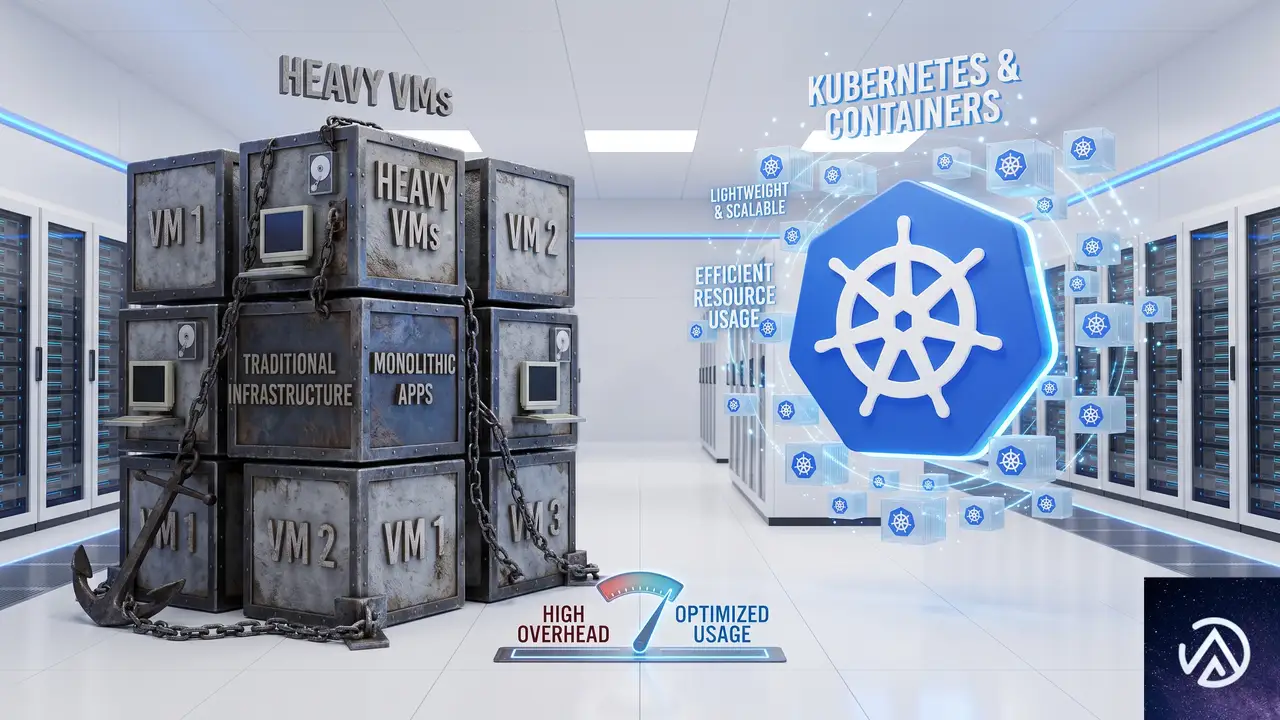
マルチエージェントを安全に動かすための一般的な方法として、各エージェントを専用のマイクロVM(Kata Containersなど)で隔離するやり方がある。ハードウェアレベルの隔離によってセキュリティを確保する狙いだ。しかしこの方式には大きな落とし穴がある。
マイクロVMはエージェントごとにゲストOSを起動するため、メモリとCPUに無視できないオーバーヘッドが生じる。実際にGoogle CloudのチームがOpenClawプロファイルを使い、48vCPUの標準VMインスタンス(n2-standard-48)上でテストしたところ、61個のエージェントを起動した時点で信頼性が低下し、ヘルスチェックの失敗が頻発し始めたという。
これに対してGKE Agent Sandboxは、gVisorというオープンソースのセキュアコンテナサンドボックスを土台にしている。gVisorはユーザー空間カーネル(Sentry)でシステムコールを捕捉・フィルタリングし、ハードウェア隔離に近いセキュリティを実現しつつ、ゲストOSを丸ごと動かす必要をなくした。
結果として、同一VM上で動作可能なエージェント数は88個まで増加。これはベースライン比で44%の密度向上であり、エージェント1台あたりのコストは30%以上削減された計算になる。しかも性能プロファイルはほぼ維持できると報告されている。
この方式が評価を得たのは早く、2026年5月の一般提供開始から4週間足らずで利用量が7倍以上に急増した事実が、その実用性を裏付けている。
遊休エージェントを「凍結」するオーケストレーションの威力
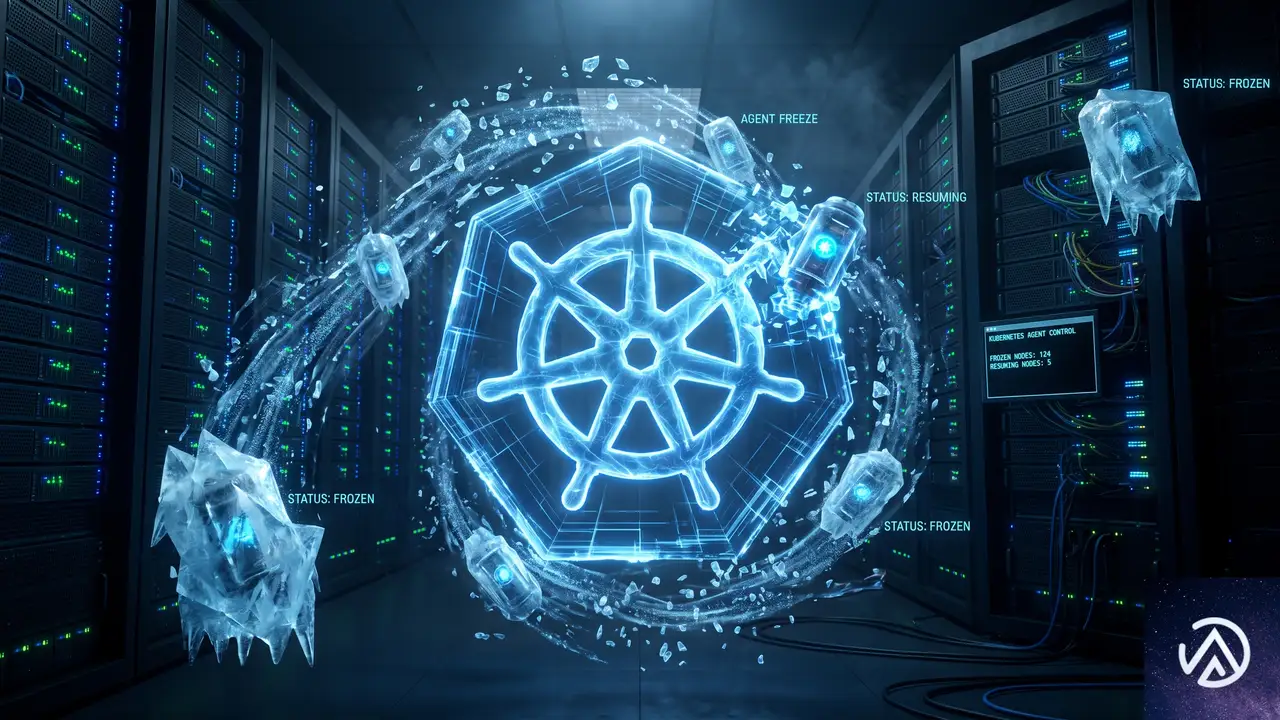
GKE Agent Sandboxは稼働中のワークロードを効率化するが、遊休状態のエージェントがリソースを占有し続ける問題は残る。そこでカギを握るのが、Kubernetes本来のオーケストレーション機能とGKE Podスナップショットを組み合わせた「凍結・再開」パターンだ。
具体的には、エージェントが待機状態に入ったタイミングでPodスナップショットを作成し、永続ストレージにチェックポイント(凍結)として保存する。これにより物理的なCPUとメモリが解放され、クラスタに返却される。新しいトリガーが届くと、軽量なコントローラやイベントゲートウェイがリクエストを捕捉し、ミリ秒単位でスナップショットからエージェントを再開する。
この仕組みによって、物理リソースをワークロードの実態に基づいて「オーバーサブスクライブ(超過割り当て)」できるようになる。つまり、実際の瞬間的な需要以上のエージェントを同じノードに詰め込めるわけだ。その結果、間欠的にしか動かないエージェントであれば、ベースラインの3.5倍にあたる274個のエージェントを単一ノードで動作させることが可能になった。
ただし、やみくもに詰め込めばよいわけではない。エージェントの種類によって求められる起動時間やレイテンシは大きく異なるからだ。
エージェントの特性に合わせた3つのデプロイ戦略
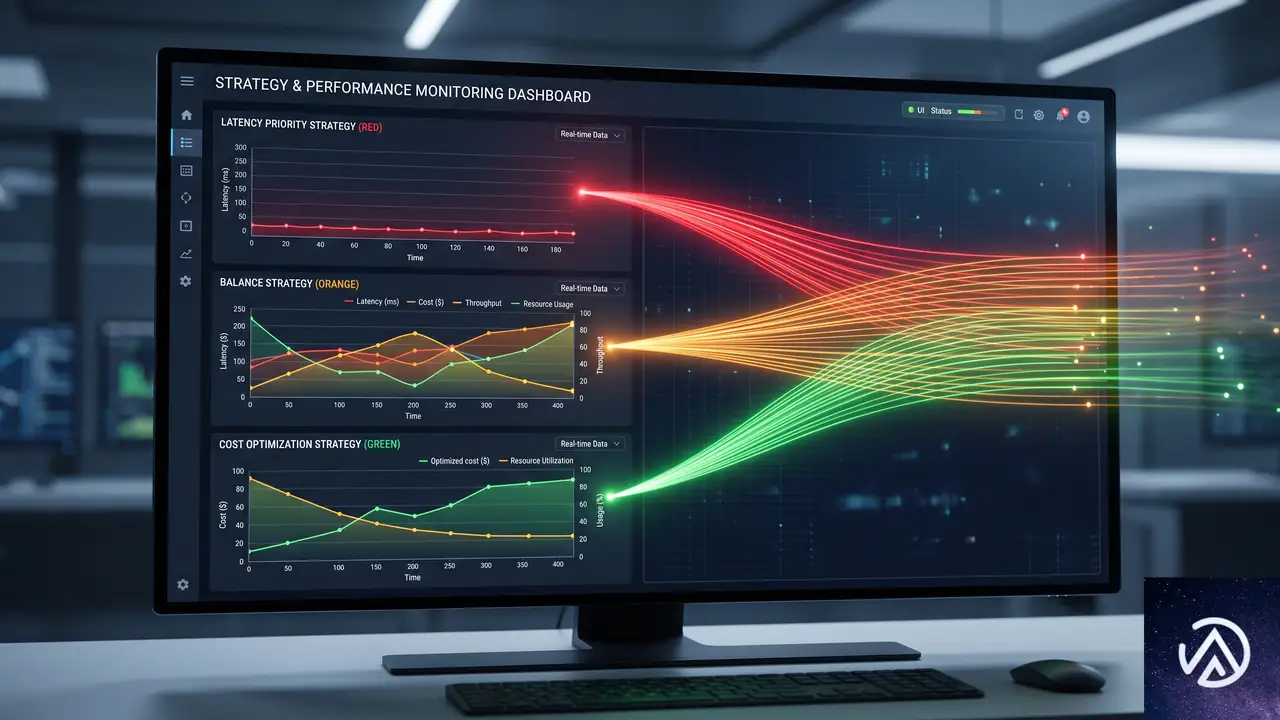
GKEでは、すべてのエージェントに一律の戦略を強制するのではなく、ノードプールやワークロード設定ごとに異なる挙動を共存させられる。Google Cloudのブログでは、レイテンシ要件に応じた3つの典型例が紹介されている。
リアルタイムコーディングアシスタント(レイテンシ重視)
開発者向けの対話型エージェントでは、起動時間が1秒未満であることと、待ち行列が一切発生しないことが絶対条件だ。このケースでは、GKE Podスナップショットと「Agent Sandboxウォームプール」を組み合わせる。事前にウォームアップされた隔離サンドボックスを常時待機させておくことで、ほぼ瞬時に実行を開始できる。この構成で同一ノード上に133個のエージェントを収容できたと報告されている。
自律的なチームメイト型エージェント(バランス型)
バックグラウンドで対話的に動くエージェントは、平均的な起動時間(数秒)を許容できる。サスペンド&レジューム機能を利用し、遊休時にはリソースを解放、必要時にオンデマンドで復元する。待機中のコンピュートコストを支払う必要はない。
ヘッドレスなバックグラウンドエージェント(レイテンシ許容型)
日次レポートの生成や調査タスクのような定期ジョブは、多少の待ち時間があってもビジネス成果に支障をきたさない。こうしたエージェントには最大限のリソース超過割り当てを適用し、クラスタに空きが出るまで1時間ほど待つ戦略も有効だ。
このように、ワークロードの性質に合わせて「パフォーマンス最適化」と「コスト最適化」のバランスをチューニングできるのがGKEの強みだ。サンダリングハード(多数のエージェントが一斉に起動してコンピュートを要求する問題)に対しても、ウォームプールやサスペンド&レジュームの設定で自由度の高い制御が可能になる。
コスト削減を実現するための実践的なアプローチ
GKE Agent Sandboxとオーケストレーションの組み合わせによって、エージェントの台数に比例してインフラ予算が増えていく構図を抜本的に変えられる。Google Cloudの検証では、パフォーマンスを重視する構成でも133個のエージェント(ベースライン比約2.2倍)、コスト最適化を突き詰めた構成では274個(同3.5倍)のエージェントを同一ノードで動作させることに成功した。
実務に落とし込む際のポイントは3つある。第一に、セキュリティを保ったままオーバーヘッドを削減するGKE Agent Sandboxへの移行を検討すること。第二に、Podスナップショットによる「凍結・再開」をアーキテクチャに組み込み、遊休リソースを徹底的に活用すること。第三に、すべてのエージェントを同じ扱いにせず、レイテンシ要件に応じてデプロイ設定を変えることだ。
なお、GKE Agent Sandboxの詳細な設定やウォームプール、サスペンド&レジュームの具体的な手順は、Google Cloudの公式ドキュメントで公開されている。まずは既存のエージェントワークロードを対象に、小規模なPoCから始めてみるとよいだろう。
この記事のポイント
- GKE Agent SandboxはgVisorベースの軽量サンドボックスで、マイクロVMに比べてエージェント密度を44%向上させ、1台あたりのコストを30%以上削減する
- Podスナップショットとサスペンド&レジュームの組み合わせにより、遊休エージェントを凍結して物理リソースを解放し、理論上3.5倍の密度(最大75%のコスト削減)を達成可能
- ワークロードのレイテンシ要件に応じて「リアルタイム型」「バランス型」「コスト最適化型」の3戦略を使い分けることで、無理なくスケールできる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

83%の組織がエージェントAI対応にインフラ刷新が必要と回答、Google Cloud調査
Google Cloudが2026年7月に公開した「State of AI Infrastructure」レポートによると、実に83%の組織が「本番レベルのエージェントAIを支えるにはインフラの刷新が不可欠だ」と回答した。この数字はもはや一部の先進企業だけの課題ではなく、業種を問わず広がる構造的な問題を浮き彫りにしている。
本記事では、Google Cloud Blogの調査概要をもとに、エージェントAIが既存のクラウド基盤に与える負荷と、企業が次に打つべきインフラ戦略を解説する。推論コストの急増やエージェントの統制不能、データの断片化、エネルギー制約といったテーマを具体的なデータとともに取り上げる。
推論コストの急増と流動的コンピューティング

推論税の正体
エージェントAIは1回の指示で数百の後続アクションを連鎖的に引き起こす。チャット型AIのように単発で完結する処理とは根本的に負荷の性質が異なる。Google Cloud BlogのDrew Bradstock氏によれば、この連続推論ループがレガシーアーキテクチャに加わる経済的負担を「推論税」と呼んでいる。
調査では62%のリーダーが「データエグレス料金やストレージ肥大化、アイドル状態の専用ハードウェアによって深刻な推論税が発生している」と回答した。81%は運用の複雑さをAIスケーリングの隠れたコストとして挙げている。
上図が示すのは、エージェントAIの負荷特性と基盤の適合性がコストを左右する構図だ。ストレージ肥大化を放置すれば推論税は雪だるま式に膨らみ、競争力を大きく損なう。
TPU 8tとTPU 8iが示す選択肢
規模の大きいトレーニングにはTPU 8t、低レイテンシ推論にはTPU 8iといった具合に、用途に合わせた計算リソースを動的に組み合わせる発想が鍵になる。Google Cloud Blogの記事では、重いトレーニング、リアルタイム推論、オーケストレーションの3層に分けた「流動的コンピュート」が提案されている。
- 大規模学習向け:TPU 8t(第8世代)は第7世代比で約3倍の性能と最大2倍の電力効率を達成。超大規模モデルの学習時間を大幅に短縮する
- 低レイテンシ推論向け:TPU 8iはオンチップメモリを最大化し、リアルタイム応答が求められるエージェントの思考と反応を高速化する
- 制御プレーン向け:ArmベースのGoogle Axion CPUが強化学習シミュレーションやエージェントのオーケストレーションをコスト効率よく実行する
こうした選択肢を使い分けることで、ピーク負荷時だけ専用チップを割り当て、普段は汎用プロセッサに戻すといった柔軟なリソース管理が可能になる。
急拡大するエージェントの統制

エージェントスプロールの現実
エージェントはメールの読み取りからデータベース照会、業務ワークフロー実行まで自律的に動く。組織内で数十、数百のエージェントが稼働し始めると、個別管理が極めて難しくなる。これを業界では「エージェントスプロール(agent sprawl)」と呼び始めており、調査でも79%のリーダーがセキュリティ・ガバナンス・MLOpsを推論スケーリングの最大の課題に挙げている。
上図のように、統制プレーンを導入することで、これまで管理者が人力で追いかけていた権限設定や操作ログが集約され、監査や緊急停止も一元的に実施できる。調査では78%の組織が生成AIソリューションをメインのクラウドパートナーから直接調達しており、この集中傾向は2025年から30ポイント上昇している。
Agent Gatewayが担う役割
Google Cloud Blogで紹介されているAgent Gatewayは、企業向けに設計されたエージェント統制のハブだ。エージェント同士のデータ共有を可視化し、読み取りと書き込みのスコープを細かく設定できる。重要なアクションの前には人間の承認を挟むヒューマンインザループ機能も提供する。
- 全エージェントの認証を統一し、分散ツールをつなぎ合わせる必要がない
- データ共有のログと監査証跡を完全に管理できる
- エージェント単独では実行できない重要操作に対して、人による承認フローを組み込める
スケールする自律エージェント群を安全に運用するうえで、こうした統制基盤はもはやオプションではなく必須のレイヤーになりつつある。
データ基盤の統一

自律型エージェントは推論のたびに組織全体へ重いクエリを発行する。Drew Bradstock氏の指摘では、データがサイロ化して断片化していると「エージェントは事実上、目隠しをされたまま飛んでいる」状態になるという。このため、断片化したデータを単一の文脈で扱える統合データ層の整備が急務とされている。
統合データ層が整うと、エージェントはデータの置き場所を意識せずに検索・推論できる。非構造化データを自動的に構造化するSmart Storageと、マルチクラウド環境を横断するCross-Cloud Lakehouseが、この層を現実のものにしている。
ハイブリッドマルチクラウドとデジタル主権

パブリッククラウドかオンプレミスかという二者択一はすでに終わっている。調査では52%の組織がハイブリッドマルチクラウド構成を採用していた。これは単なるコスト分散ではなく、デジタル主権とデータの重力が強い推進力になっているからだ。
- データ所在地規制への対応:調査参加者の48%が厳格なデータレジデンシー管理を優先事項に挙げている。各国の法改正に即応できる柔軟な配置が求められる
- 完全隔離環境の需要:Google Distributed Cloudのようにパブリッククラウド技術をオフラインで利用できるサービスが、政府機関や金融機関を中心に拡大している
- データ重力の現実:巨大なデータセットは動かすより「その場で処理する」方が現実的で、エッジやオンプレとの組み合わせが不可欠になる
つまり、単一のクラウドに依存する時代は終わり、データの物理的な位置と主権に合わせてAIを走らせる場所を選べるアーキテクチャが標準になりつつある。
エッジでのAI実行が必然になる理由

調査結果の中で特に目を引くのが、90%の組織が「エッジへのAI配置が重要」と回答し、72%は「極めて重要」または「非常に重要」と位置づけた点だ。エージェントAIのリアルタイム性を追求するほど、集中型クラウドだけでは限界が露呈する。
エッジに推論機能を分散させると、クラウド往復のレイテンシが不要になるだけでなく、通信断でも業務が停止しない耐障害性と、トークンあたりの変動費削減を同時に実現できる。製造現場や病院、小売店舗など「止まらない自律処理」が求められる現場にとって、これが決定的な価値になる。
エネルギー壁を突破する設計

91%のリーダーがハードウェア選定時に消費電力を考慮し、61%はそれを「主要または極めて重要な要素」と位置づけている。かつて年次報告書のサステナビリティ指標でしかなかった電力消費が、今ではデータセンターの立地や事業継続そのものを左右する制約に変わっている。
- 電力網の逼迫:一部地域では追加電力の調達が不可能で、新規の計算インフラをプロビジョニングできない
- 規制圧力の強化:ドイツでは新設データセンターにPUE 1.2以下が義務化。アイルランドは大規模データセンターに100%のオンサイト発電能力を要求
- TCOへの影響:高消費電力のハードウェアは冷却設備やラック設計の大規模投資を強いり、総保有コストを押し上げる
Google Cloud Blogによれば、ワットあたりの性能向上が「戦略的資産」として位置づけられている。TPU 8tは第7世代比で最大2倍の電力効率を達成しており、規制基準を満たしながら高性能を維持する設計思想がエネルギー壁を突破するカギだとされている。
まとめ
本レポートの核心は「エージェントAI時代のインフラは、計算・セキュリティ・データ・エッジ・電力のすべてを統合的に設計しなければならない」という一点に集約される。AI Hypercomputerのような各レイヤーを共同設計するアーキテクチャが、高コストで機能不全に陥る従来モデルからの脱却策として注目されている。
物理世界とデジタルを結ぶフィジカルAIの波も現実化しつつあり、ロボットのトレーニングにデジタルツインを使う取り組みがGoogle Cloud上で始まっている。インフラ戦略を抜本的に見直すタイミングが、いま訪れていると言える。
この記事のポイント
- 83%の組織がエージェントAI本番運用にインフラ刷新が必要と回答
- 62%が推論税、81%が運用の複雑さをスケーリングの隠れコストと認識
- 79%がセキュリティ・ガバナンス・MLOpsを最大の課題に挙げている
- 90%がエッジAIを重要視し、72%は「極めて重要」と回答
- 91%がハードウェア選定で消費電力を考慮し、ワットあたり性能が新たな指標に
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Certificate ManagerがACME対応、TLS証明書の自動更新を実現
AWS Certificate Manager が ACME プロトコルに対応
2026年6月30日、AWS Certificate Manager(ACM)が ACME(Automatic Certificate Management Environment)プロトコルに対応した。この機能追加により、AWS 上で稼働するアプリケーションの公開 TLS 証明書の取得・更新を、Certbot や cert-manager といった既存の ACME クライアントから自動化できるようになる。
証明書の有効期限は短縮の一途をたどっている。CA/Browser Forum の規定により、公開 TLS 証明書の最大有効期間は 2027 年 3 月に 100 日へ、さらに 2029 年までに 47 日へと段階的に引き下げられる見通しだ。手動での更新運用はもはや現実的ではなく、自動化が不可避の状況にある。
ACM の ACME 対応は、単なる証明書自動化の一手を超えて、組織全体の証明書ガバナンスを一元化する大きな転換点となる。PKI 管理者は DNS 管理権限をエンドポイントに集約しつつ、アプリケーション担当者には EAB(External Account Binding)認証情報だけを配布すればよく、DNS キーを組織内にばらまくリスクを排除できる。
短命化する証明書と自動化の必然性
従来の TLS 証明書は最大 1 年を超える有効期間が一般的だった。しかし、CA/Browser Forum は証明書のライフサイクル短縮を段階的に進めており、2027 年 3 月には最大 100 日、2029 年までには 47 日への短縮が義務付けられる。これは証明書の更新頻度が年 1 回から年 3〜4 回、最終的には年 7〜8 回に跳ね上がることを意味する。
手動による更新フローでは、この頻度に耐えられない。更新漏れによる証明書切れは顧客にエラー画面を表示させ、サービス自体の停止を招く。ACME プロトコルはこうした課題に対処するために策定されたオープン標準であり、Let’s Encrypt をはじめとする多数の認証局が採用している。
このデモで示すように、ACME プロトコルを利用すると証明書ライフサイクルから人手を排除できる。AWS が ACME エンドポイントをマネージドサービスとして提供することで、利用者は証明書発行インフラの運用負荷からも解放される。
Amazon Trust Services による証明書発行
ACM が ACME 経由で発行するのは、Amazon Trust Services(ATS)を認証局とする公開証明書だ。ATS のルート証明書は主要なブラウザおよび OS にデフォルトで信頼されているため、発行された証明書は即座に本番環境で利用できる。
証明書の鍵タイプは ECDSA P-256 がデフォルトだが、RSA 2048 や ECDSA P-384 も選択可能だ。クライアント側の要件に合わせて設定できる柔軟性を持ちつつ、デフォルトではより高速でセキュアな ECDSA が推奨されている。
ACME エンドポイントの設定とドメイン検証の仕組み
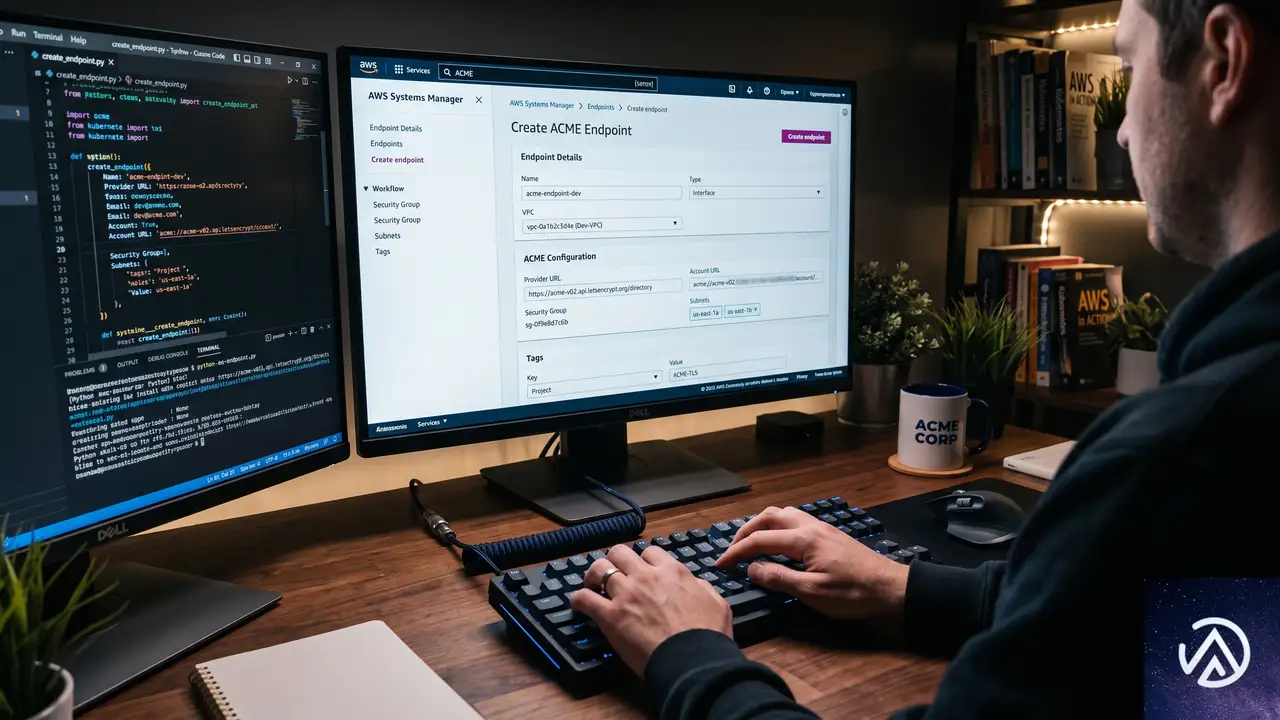
ACM の ACME 対応で最も特徴的なのは、ドメイン検証を PKI 管理者がエンドポイントレベルで一括実施する点だ。一般的な ACME 環境では、証明書を必要とするクライアントごとに DNS レコードの設定権限が必要になる。これに対して ACM の方式では、管理者がエンドポイント作成時にドメインを検証し、以後の証明書リクエストはそのエンドポイントが管理する。
エンドポイントの作成手順
ACM コンソールの「ACME 証明書」ページからエンドポイントを作成する。設定項目は以下の通りだ。
- エンドポイント名(任意の識別名)
- エンドポイントタイプ(Public を選択)
- 証明書タイプ(Public を選択)
- 鍵タイプ(ECDSA P-256 がデフォルト)
- ドメイン名(証明書を発行する対象ドメイン)
- ドメインスコープ(厳密なドメイン、サブドメイン、ワイルドカードの許可設定)
ドメインスコープの設定はガバナンス上とくに重要だ。Exact domain(完全一致ドメイン)だけを許可すれば、サブドメインやワイルドカード証明書の発行を防げる。たとえば本番系のエンドポイントでは Exact domain と Subdomains のみを有効化し、Wildcards は無効にすることで、証明書の発行範囲を厳格に制限できる。
エンドポイント作成後、DNS 検証が実行される。Route 53 を利用していれば CNAME レコードが自動で作成されるため、手動での DNS 設定は不要だ。外部の DNS プロバイダーを使っている場合は、表示される CNAME レコードを手動で登録する必要がある。
EAB 認証情報によるクライアント登録
エンドポイントの準備が整ったら、EAB(External Account Binding)認証情報を発行する。EAB は Key ID と HMAC Key のペアで構成され、ACME クライアントがエンドポイントにアカウントを登録する際の初回認証に使われる。
一度クライアントが登録されれば、以降の証明書リクエストはクライアント自身が生成した非対称鍵ペアで認証される。EAB 認証情報はあくまで登録時のみの使い切りであり、有効期限を設定して不要な長期保管を防ぐのが望ましい。
この仕組みにより、PKI 管理者はドメイン検証という強力な権限をエンドポイントに閉じ込めつつ、アプリケーション担当者には EAB 認証情報だけを安全に配布できる。DNS キーを組織全体に配る必要がなくなる点が、従来の ACME 運用と決定的に異なる。
Certbot を使った証明書リクエストの実例
ACM コンソールには、Certbot と acme.sh 向けの CLI リファレンスが用意されている。以下は AWS News Blog の記事で紹介されている Certbot のコマンド例を再構成したものだ。
certbot certonly --standalone --non-interactive --agree-tos \
    --email <EMAIL> \
    --server https://acm-acme-enroll.us-east-1.api.aws/<ENDPOINT_ID>/directory \
    --eab-kid <EAB_KID> \
    --eab-hmac-key <EAB_HMAC_KEY> \
    --issuance-timeout <ISSUANCE_TIMEOUT> \
    -d <DOMAIN>
--eab-kid と --eab-hmac-key に、先ほど発行した EAB 認証情報を指定する。各 ACME クライアントで引数名や設定ファイルの記法は異なるため、利用するクライアントのドキュメントを参照する必要がある。
コマンドが成功すると、Amazon Trust Services によって署名された有効な証明書が発行される。openssl コマンドで証明書の内容を確認したうえで、アプリケーションにインストールすればよい。発行された証明書は ACM コンソールの「ACME 証明書」タブにも表示され、コンソールや API 経由で発行した証明書と統合管理される。
一元管理がもたらす運用面の利点
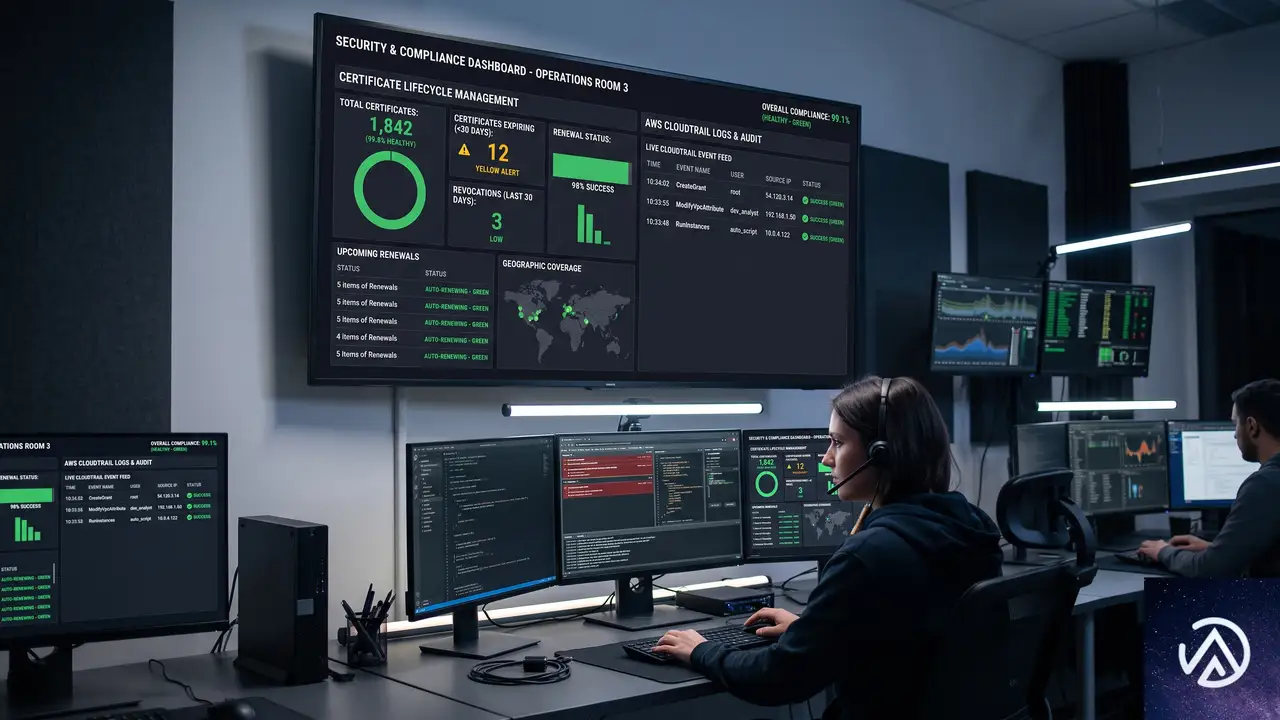
ACM による ACME 対応は、単に証明書の自動発行を可能にするだけではない。最大の価値は、組織全体の証明書ライフサイクルを可視化し、ガバナンスを一元化できる点にある。
IAM ロールによるきめ細かなアクセス制御
ACM の ACME エンドポイントは IAM ロールと統合されている。ACME アカウントに対して IAM ロールをバインドすることで、どのクライアントがどのドメインの証明書をリクエストできるかを細かく制御できる。これにより、開発チームごとに発行可能なドメイン範囲を限定するといった運用が実現する。
監査ログとメトリクスの統合
すべての証明書リクエストは AWS CloudTrail に記録される。誰がいつどのドメインの証明書を要求したかを完全に追跡できるため、監査要件を満たすうえで強力な武器となる。また Amazon CloudWatch と連携することで、証明書の発行数やエラー率といった運用メトリクスもリアルタイムに把握できる。
ACM が標準で備える有効期限通知機能も ACME 経由で発行された証明書に適用される。更新が迫った証明書のアラートを一元管理でき、従来のように証明書管理ダッシュボードと ACME クライアントの管理画面を行き来する必要はなくなる。
上記のスタックは、ACM 単体で証明書管理から監査、予防までをカバーできることを示している。従来は外部の認証局と ACM の間で証明書管理が分断されていたが、ACME 対応によってこの断絶が解消された。
利用可能リージョンと料金体系
ACM の ACME 対応は、発表時点で全商用 AWS リージョンで利用可能だ。AWS GovCloud(US)および中国リージョン、AWS European Sovereign Cloud パーティションについては、後日の対応が予定されている。
料金は証明書発行時に含まれるドメインごとに課金される方式で、完全修飾ドメイン名(FQDN)とワイルドカードで単価が異なる。ボリュームティアは AWS アカウント単位で月間の全証明書における総ドメイン出現数に基づいて計算される。具体的な価格は ACM の公式料金ページで確認できる。
この課金体系は、ACME 経由で発行される証明書も従来の ACM 証明書と同じ仕組みでカウントされるため、新たなコスト管理の複雑さは生じない。
この記事のポイント
- ACM が ACME プロトコルに対応し、Certbot や cert-manager など既存クライアントからの証明書自動発行が可能になった
- PKI 管理者はエンドポイントレベルでドメイン検証とスコープ制御を一括管理でき、DNS キーを組織内に配布する必要がなくなる
- CloudTrail・CloudWatch・有効期限通知により、証明書ライフサイクル全体を単一ダッシュボードで可視化・監査できる
- 証明書の有効期間短縮が進む中、手動運用からの脱却と自動化基盤の構築が急務となっている
- 全商用リージョンで即日利用可能。費用はドメイン数ベースで、従来の ACM 料金体系に準じる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Graviton5搭載EC2 C9gインスタンスが一般提供開始
計算負荷の高いワークロードを扱う企業にとって、「もう少しだけ処理が速ければ」という場面は多い。AWSが6月30日に発表したEC2 C9g/C9gdインスタンスは、その不満を根本から解決する新世代の計算特化型インスタンスだ。Graviton5プロセッサの投入により、前世代からvCPUあたり最大25%の性能向上を実現した。今回の発表で特に注目すべきは、クラウド最速級となるDDR5-8800MT/sメモリの採用と、正式検証済みのハイパーバイザー分離エンジン「Nitro Isolation Engine」の搭載だ。本記事では、CPU負荷の高いバッチ処理や動画エンコーディングを中心に、新しいインスタンスがどのような場面で威力を発揮するのかを詳しく解説する。
C9g/C9gdインスタンスの位置づけを見極める
AWSのEC2には多様なインスタンスファミリーが存在する。頭文字の「C」はCompute Optimized(計算最適化)を意味し、他のメモリ最適化(Rシリーズ)やストレージ最適化(Iシリーズ)とは設計思想が異なる。計算最適化インスタンスは、vCPUあたりの演算性能を最大化することに特化している。リアルタイム分析、機械学習の推論、動画エンコーディングなど、1秒でも短く計算を終えたい処理に適している。
今回発表されたC9g/C9gdは、2024年秋に登場したGraviton4搭載C8gの後継にあたる。AWS GravitonシリーズはArmベースの独自プロセッサで、x86系のIntel XeonやAMD EPYCと比較して、コストパフォーマンスに優れる点が強みだ。C9gの「g」はGravitonを示し、末尾に「d」がつくC9gdはNVMe SSDによる高速なローカルストレージを内蔵する。
Graviton5プロセッサの進化点を知る
Graviton5の最大の改良点は、メモリ帯域幅の拡張とレイテンシの低減にある。C9gインスタンスはDDR5-8800MT/sのDIMMを採用し、これは現在クラウド上で提供されているプロセッサインスタンスの中で最速のメモリ速度だ。数字だけでは実感しにくいが、これはメモリとCPU間のデータ転送速度が秒間8800メガトランスファー(MT/s)ということを意味する。前世代のC8gがDDR5-5600MT/sだったため、実に57%もの速度向上にあたる。
さらに、CPUのL3キャッシュ容量が5倍に拡張された。キャッシュはCPUとメインメモリの間に位置する超高速なデータ置き場で、容量が大きいほどメモリアクセスの待ち時間を減らせる。AWS News Blogの著者Seb氏によると、これらの改善により、インメモリ分析のスループット向上や、より応答性の高いエージェント型AIループが期待できるという。
ネットワーク面でも強化が施されている。パケット処理性能はGraviton4ベースのインスタンスと比較して最大3倍に向上し、インスタンスサイズ全体の平均でネットワーク帯域が約15%、EBS帯域が約20%増加した。
C9g/C9gdの主要スペック詳細と設計思想
スペック表を見ると、C9g/C9gdは最小のmedium(1vCPU/2GBメモリ)から、最大のmetal-48xl(192vCPU/384GBメモリ)まで11サイズで展開される。48xlargeではネットワーク帯域が100Gbps、EBS帯域が72Gbpsに達し、これは前世代の2倍にあたる。大規模な分散処理やリアルタイム分析基盤において、ネットワークがボトルネックになる状況を回避しやすくなるだろう。
C9gdシリーズには、ローカルのNVMe SSDストレージが追加される。容量は最小のmediumで59GB、最大の48xlargeでは3台合計で11,400GB(3×3,800GB)に達する。NVMe SSDはEBSよりもレイテンシが低いため、以下のような用途に適している。
- HPCシミュレーションのスクラッチスペース(一時的な作業領域)
- 機械学習推論の一時キャッシュ
- アドサーバーのローカルバッファ
ストレージ性能も向上しており、ローカルストレージのパフォーマンスは前世代比で約30%向上した。NVMe経由の詳細なI/Oパフォーマンス統計はCloudWatchやnvme-cli経由で取得可能で、I/Oサイズ別のレイテンシヒストグラムが1秒単位で確認できる。この機能は追加料金なしで利用できる。
Instance Bandwidth Configurationの実用性を測る
C9g/C9gdには、Instance Bandwidth Configuration(IBC)と呼ばれる帯域調整機能が搭載されている。これは、EBSとVPCネットワークの帯域配分を最大25%の範囲で調整できる仕組みだ。例えば、データベースやキャッシュ用途でEBSの帯域を優先したい場合、ネットワーク側を絞ってEBS側に割り当てを寄せることが可能になる。逆に、ネットワーク集約型の分散処理ではVPC側を優先すればよい。固定的な割り当てに縛られない柔軟性は、実運用のチューニングで大きな武器になる。
C9gとC9gdの使い分けフローを整理する
C9gとC9gdはスペックが似ているため、どちらを選ぶべきか迷う場面があるだろう。選択の決め手は「ローカルのNVMe SSDが必要かどうか」に尽きる。AWS News Blogでは、C9gを「バッチジョブ、動画エンコードパイプライン、分散分析」向け、C9gdを「HPCシミュレーションのスクラッチスペース、ML推論の一時キャッシュ、アドサーバーのローカルバッファ」向けとしている。EBSで十分な永続ストレージが足りるならC9g、一時的でも高速なローカルストレージが不可欠ならC9gdを選べばよい。
Graviton5がもたらすエージェント型AIへの適性を読み解く
AWS News Blogの発表では、C9gのワークロード例として「エージェント型AI(agentic AI)」が明記されている。エージェント型AIとは、単なる質問応答を超えて、コードを実行し、複数ステップのタスクを自律的に組み立てて完了させるAIシステムを指す。OpenAIのOperatorやAnthropicのComputer Useが代表例だ。
この種のワークロードでは、大規模言語モデル(LLM)の推論そのものに加えて、Pythonコードの実行、API呼び出し、結果の検証といったCPUバウンドな処理が連続的に発生する。Graviton5のコア数向上と大容量キャッシュは、こうした「思考と行動のループ」を高速化する土台となる。AWSの著者Seb氏によれば、アプリケーションがデータを待つ時間を削減し、結果的にエージェントループの応答性が高まるとのことだ。
AI推論といえばGPUの印象が強いが、実際には前処理、後処理、オーケストレーションの多くがCPU上で動く。ArmベースのGraviton5は、これらの処理を低コストでさばける点が実務的な魅力となる。
Nitro Isolation Engineのセキュリティ強化を理解する
C9g/C9gdは、計算最適化インスタンスとして初めて「Nitro Isolation Engine」を搭載した。これはAWS Nitro Systemの拡張機能で、仮想マシン間のメモリ空間、CPUレジスタ状態、I/Oデバイスへのアクセスを数学的正確さで強制的に分離する仕組みだ。
通常、ハイパーバイザーによる分離はソフトウェアの実装品質に依存する部分があるが、Nitro Isolation Engineは形式検証(formal verification)と呼ばれる数学的手法を用いて分離の正しさを証明している。形式検証とは、仕様を数理論理で記述し、実装がその仕様を厳密に満たすことを機械的に検証する手法だ。テストのように「見つかったバグがない」ではなく、「特定の前提条件下でバグが存在し得ない」ことを保証する。
AWSは2025年にこの技術を発表した際、ハイパーバイザーの分離を形式検証する取り組みについてホワイトペーパーを公開している。今回のC9g/C9gdで初めて、計算最適化インスタンスに実装されたことになる。
セキュリティ要件の厳しい金融サービスや医療データの分析をEC2上で行うケースでは、この正式検証済みの分離機構はインフラ選定の重要な判断材料になる。ソフトウェアレベルではなく、ハードウェア支援と形式検証の組み合わせで隔離を実現している点は、AWSの設計思想として特筆に値する。
利用可能リージョンと料金モデルを確認する
2026年6月30日時点で、C9g/C9gdは米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、欧州(フランクフルト)の4リージョンで利用可能だ。AWSは追加リージョンへの展開も予定している。
料金モデルはSavings Plans、オンデマンド、スポットインスタンス、Dedicated Instances、Dedicated Hostsに対応する。常時稼働させるワークロードではSavings Plans、短期的なバッチ処理ではスポットインスタンスと使い分けられる。EBSボリュームは仮想インスタンス1台あたり最大128個までアタッチ可能で、大規模データの処理でもストレージ不足に悩むことは少ない。
インスタンスの起動はAWSマネジメントコンソール、AWS CLI、AWS SDKのいずれからでも可能だ。GravitonはArmアーキテクチャのため、AMIやコンテナイメージはArm向けにビルドされたものを選ぶ必要がある。公式のAmazon Linux 2023やUbuntuのArm版AMIはすでに提供されているため、新規導入時の障壁は低い。
この記事のポイント
- C9g/C9gdはGraviton5搭載の計算最適化インスタンス、vCPUあたり25%の性能向上を達成
- DDR5-8800MT/sメモリと5倍のL3キャッシュにより、メモリ待ち時間を大幅に削減
- 48xlargeでは100Gbpsネットワーク帯域と72GbpsのEBS帯域、前世代比2倍に拡張
- Nitro Isolation Engine搭載、形式検証による仮想マシン分離を実現
- エージェント型AIやHPC、動画エンコードなどCPU負荷の高い処理に最適
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
VercelがDockerfileサポートを発表、任意のHTTPサーバーをデプロイ
VercelがDockerfileサポートを発表、任意のHTTPサーバーをワンコマンドでデプロイ可能に

2026年6月30日、VercelはDockerfileサポートを正式に発表した。プロジェクトにDockerfile.vercelというファイルを追加するだけで、Vercel上でコンテナイメージのビルド、保存、デプロイ、そしてオートスケールが完結する。
従来、Vercelはフロントエンドとサーバーレス関数のプラットフォームだった。今回の発表で、Express、Rails、Spring Boot、FastAPIといったフル機能を持つHTTPサーバーも、同一のプラットフォームで運用できるようになる。バックエンドとフロントエンドの垣根は、ほぼゼロになった。
この記事では、Dockerfile.vercelの仕組み、対応スタック、Fluid computeによる運用面の利点、そしてVercelが10年越しでこの機能を実現した理由について解説する。
Dockerfile.vercelの基本的な使い方
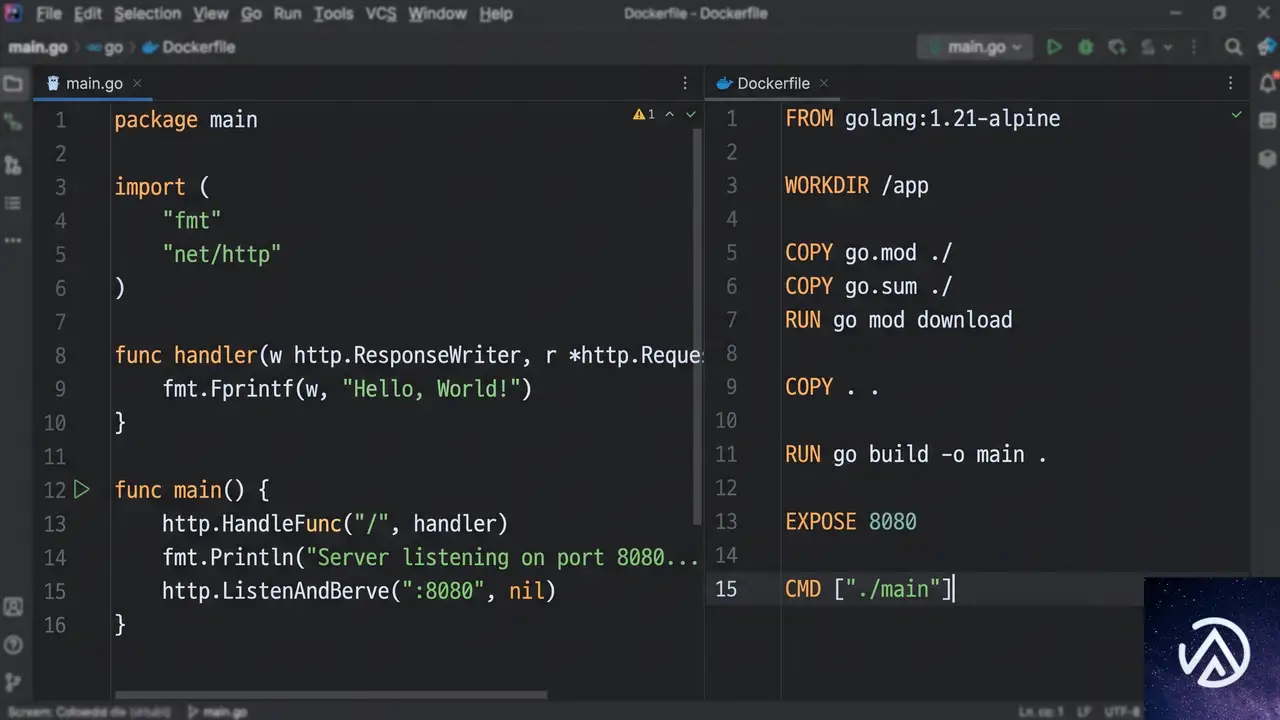
最小限のHTTPサーバーをデプロイする手順
仕組みを理解するため、Goで書かれた最低限のHTTPサーバーを例に見ていこう。このサーバーは環境変数PORTからポート番号を読み取り、全リクエストに挨拶文を返すだけのシンプルなものだ。
package main

import (
	"fmt"
	"net/http"
	"os"
)

func main() {
	port := os.Getenv("PORT")
	if port == "" {
		port = "80"
	}

	http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {
		fmt.Fprintln(w, "Hello from a container on Vercel 👋")
	})

	http.ListenAndServe(":"+port, nil)
}
このコードを動作させるため、Dockerfile.vercelをプロジェクトルートに置く。内容は次のような2段階ビルドだ。ビルドステージでバイナリをコンパイルし、軽量なAlpineイメージにコピーして実行する。
FROM golang:1.24-alpine AS build
WORKDIR /src
COPY . .
RUN go build -o /server main.go

FROM alpine:3.20
COPY --from=build /server /server
CMD ["/server"]
あとはvercelコマンドを実行するだけだ。
vercel deploy
Vercel CLI
✓ Building image from Dockerfile.vercel
✓ Stored image in your project's registry
✓ Deployed to Fluid compute
Production: https://my-server.vercel.app
たった2ファイルで、本番公開まで完了する。git pushのたびにイメージが再ビルドされ、プレビューURLも自動生成される。ブラウザでそのURLを開けば、すぐに応答が返ってくるはずだ。
この例ではGoを使ったが、仕組みはどの言語でも同じだ。サーバーが$PORTで待ち受けること、これが唯一のルールである。HTTPプロトコルを話すサーバーであれば、すべてVercel上で動作する。
すべての言語とフレームワークに対応

VercelのDockerfileサポートは、特定の言語やフレームワークに縛られない。Rails、Spring Boot、Express、Laravel、ASP․NET、FastAPI、そしてnginxの背後にあるウェブサーバーまで、同じ手順でデプロイできる。記事によれば、JavaもPHPも例外ではない。
フレームワーク自動検出がVercelの主軸だが、検出対象外のフレームワークや、FFmpegやChromiumのようなシステムライブラリを必要とするサービスは、Dockerfileで直接定義できる。既存のアプリケーションを、今の構成のまま移行したい場合の受け皿にもなる。
Fluid computeがもたらす自動スケールとコスト最適化

コンテナはVercelプラットフォームのファーストクラス市民として扱われる。フロントエンドや他のVercelサービスと同一のコンピュート基盤、Fluid compute上で動作し、以下の恩恵を受けられる。
- プッシュごとのプレビューデプロイ 全コミットに不変のURLが付与され、共有やロールバックが容易になる
- 双方向オートスケール トラフィック到来でスケールアウトし、アイドル時はインスタンスが縮退する。フリートのサイジングや同時実行数の見積もりは不要
- アクティブCPU課金 コードが実際に動作している時間だけ支払う。遅いクエリや上流API待ちでサーバーが待機している間は、CPU時間を消費しない
- オブザーバビリティの統合 ログ、トレース、メトリクスを同一のダッシュボードで確認できる
- 単一プロジェクト・単一ドメイン コンテナはフロントエンドや他のサービスと並んで配置され、Vercelネットワーク上でプライベートに通信する。フルスタックが1デプロイで完了する
とくにアクティブCPU課金は、トラフィックが散発的なサービスにとってコスト面のインパクトが大きい。常時稼働のサーバーを抱える必要がなくなり、使った分だけの支払いで済む。
高速起動を支える最適化技術
コンテナの価値は、最初のリクエストに応答するまでの速さで決まる。Vercelはイメージビルド時に、最適化ブートイメージを生成する。これはコンテナのディスクスナップショットを圧縮し、起動速度に特化させた形式だ。
コンテナ起動時には、イメージ全体をダウンロードし終える前に、必要な部分からストリーミングと解凍が行われる。大きなイメージでも、ダウンロード完了を待たずにリクエスト処理を開始できる仕組みだ。
インスタンスが立ち上がった後は、Fluid computeがそのインスタンスを温かく保ち、複数のリクエストを処理する。リクエストごとに新しいコピーを起動するわけではないので、応答性は常時稼働サーバー並みでありながら、アイドル時はスリープするという課金上の利点が両立する。
各コンテナはステートレスプロセスとして設計される。リクエストを受け取り、レスポンスを返し、その間に状態を保持しない。永続的なデータはVercel Marketplaceで提供されるデータベースやキャッシュなどのバッキングサービスに依存する。これにより、インスタンスの追加と削除が自由に行え、トラフィック変動への追従がシンプルになる。記事によれば、コンテナに永続ストレージを直接接続する機能も現在開発中とのことだ。
10年越しで実現したDockerfileサポートの背景
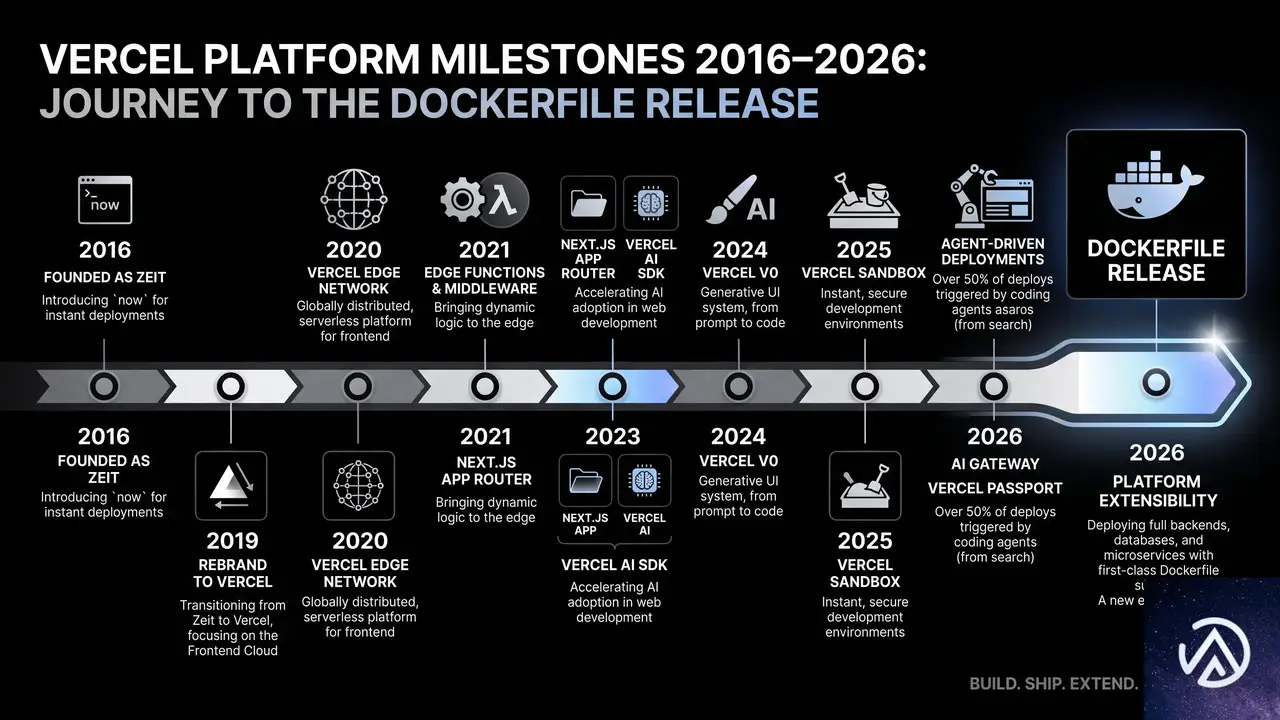
Vercelの最初のプラットフォームは、1コマンドでDockerfileをデプロイできるツールだった。2016年頃の話だ。アイデア自体は正しかったが、当時のインフラでは十分に扱いきれなかった。
その後、Vercelはビルド、Functions、Sandboxと、プラットフォームを構成する基盤技術を一つひとつ磨いてきた。これらは現在、Vercel上で動作するすべてのワークロードを支えている。今回のDockerfileサポートは、それらの積み重ねの上に成り立っている。コンテナも、それらと同一のシステム上で動くファーストクラス市民になった。
フレームワーク自動検出はVercelの入り口だ。コードを読んでインフラを導出する。ほとんどのアプリではそれが最速の出荷手段となる。Dockerfileは、それ以外のすべてをカバーする。FFmpegやChromiumのようなシステムライブラリが必要なサービス、まだ自動検出が対応していないフレームワーク、あるいは既存の構成をそのまま持ち込みたいアプリケーション。Dockerfileは、プログラムのビルド方法を定義する普遍的な手段であり、フレームワークが読めない場合にはそれを直に受け取る。
Dockerfile以外の設定は不要だ。イメージを指定するだけで、ビルド、レジストリ、ロールアウト、スケーリング、URL発行まですべてが自動的に行われる。Vercelの発表文には「ゼロコンフィグレーション」という言葉が使われているが、まさにそれを体現する機能と言える。
バックエンド開発の新しい当たり前

バックエンドが、フロントエンドと同じ方法で出荷される時代が来た。ワンプッシュ、ワンプレビュー、ワンプラットフォーム。VercelのDockerfileサポートは、その簡潔さとスケーラビリティにおいて、バックエンド開発の風景を変える可能性を秘めている。
具体的な手順やテンプレートは公式ドキュメントで公開されている。GoやRailsだけでなく、あらゆるHTTPサーバーが対象だ。既存のDockerfileを持つプロジェクトがあれば、それをDockerfile.vercelにリネームするだけでVercel上での稼働を試せる。
コンテナを扱うためにローカルでデーモンを動かす必要も、レジストリを用意する必要も、クラスタを管理する必要もない。必要なのは、Dockerfile.vercelという1つのファイルと、vercel deployという1つのコマンドだけだ。その先の複雑さは、すべてVercelが引き受ける。
この記事のポイント
- VercelがDockerfileサポートを開始し、任意のHTTPサーバーをワンコマンドでデプロイ可能になった
- サーバーが$PORTで待ち受けることさえ守れば、Go、Rails、Spring Boot、PHPなど全スタックが動作する
- Fluid computeにより、トラフィックに応じた自動スケールと、CPU実行時間のみの課金が実現する
- イメージのストリーミング起動技術により、大きなコンテナでも高速にリクエスト処理を開始できる
- この機能は10年にわたるプラットフォーム基盤の改良の上に成り立っており、コンテナがVercelのファーストクラス市民として統合された
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Graviton5搭載EC2 M9g/M9gdがGA。汎用インスタンス性能限界突破の全容
AWSが2026年6月10日、Graviton5プロセッサを搭載したEC2 M9gおよびM9gdインスタンスの一般提供を開始した。Armアーキテクチャベースの第5世代カスタムシリコンであり、前世代比で最大25%の計算性能向上を実現したとされている。
2025年末のプレビュー公開から半年、ClickHouseやHoneycombといった企業が実運用環境で検証を重ね、コード変更ゼロで36%の性能向上を確認している。HubSpotではMySQLデータベースのクエリ処理時間が最大60%短縮されたとの報告もある。
Arm系インスタンスはこれまでも存在したが、192コア、5倍のL3キャッシュ、DDR5-8800対応メモリを搭載したGraviton5は次元が異なる。本記事ではM9g/M9gdの技術的進化と、それがビジネスにどう影響するかを具体的に解説する。
Graviton5とは何か。5世代の進化がもたらしたもの
AWSのGravitonプロセッサは、Armアーキテクチャを採用したAWS独自設計のカスタムシリコンだ。第1世代が登場したのは2018年。以来8年にわたり継続的に投資が続けられ、現在では350以上のインスタンスタイプがGravitonで稼働している。
Arm系クラウドインスタンスの現在地
Armアーキテクチャとは、スマートフォンやタブレットで広く使われている省電力設計のCPU命令セットだ。これに対し、従来のサーバCPUの多くはx86アーキテクチャ(IntelやAMDが採用)で動作していた。Armは消費電力あたりの処理効率に優れており、クラウドの大規模データセンターで電気代を抑えつつ高性能を発揮できる点が評価されている。
AWS広報情報によれば、現在12万以上の顧客がGravitonを採用。スタートアップから大企業まで幅広く、Webアプリケーション、マイクロサービス、データベース、機械学習推論、ゲームサーバ、動画エンコーディングなど多様な用途で使われている。x86依存の強い従来のクラウド常識を、Armが着実に塗り替えつつある。
クラウドインスタンスの選択肢は、この5年で一変した。Armはもはや「実験的な選択肢」ではなく、x86と並ぶ本流の一つとして位置づけられる。特にGraviton5では、その傾向がさらに加速するだろう。
Graviton5が前世代から飛躍した3つの要素
Graviton5の改良点を、AWS公式発表から整理する。最も注目すべきは次の3つだ。
- 計算性能の大幅向上:Graviton4比で最大25%の計算性能向上。Webアプリケーションで最大35%、機械学習推論で最大35%、データベースで最大30%の高速化が実測されている
- 5倍のL3キャッシュ:CPUが頻繁にアクセスするデータを一時保存する高速メモリ領域が前世代比5倍に拡大。コア間のデータ待ち時間が最大33%削減された
- DDR5-8800メモリとPCIe Gen6対応:クラウド上のプロセッサインスタンスとして最速水準のメモリ帯域幅を実現。PCIe Gen6はGen5比でデータ転送速度が2倍となり、NVMeストレージや高速ネットワークとの連携性能が飛躍的に伸びる
L3キャッシュの増量は、単なる数値スペックの向上ではない。CPUは計算のたびにメインメモリまでデータを取りに行くと時間がかかる。L3キャッシュが大きければ近くにデータを置けるため、処理待ちが減り、結果として体感性能が大きく向上する仕組みだ。
実際にAWSの広報記事で紹介された顧客事例では、ClickHouseがコード変更なしでM8g比36%の性能向上を達成。Honeycombは6カ月にわたるA/Bテストで、コアあたりのスループットが36%向上したと報告している。これらの数字は、CPUそのものの改良がアプリケーションレベルで直接的な効果を生むことを示している。
M9g/M9gdのラインアップと性能スペック
インスタンスサイズと性能の詳細
M9gは汎用用途向けで、1vCPUあたり4GiBのメモリ比率を採用している。M9gdはこれに加え、高速ローカルNVMe SSDストレージを搭載したバリエーションだ。ラインアップは1vCPUの小規模構成から、192vCPU・768GiBメモリの大規模構成まで幅広く用意されている。
最大サイズの48xlarge(192vCPU)では、ネットワーク帯域が100Gbpsに達する。前世代比で最大2倍の帯域幅になっており、大量のデータを扱うデータベースやログ処理基盤での効果が特に大きい。
IBC(Instance Bandwidth Configuration)の実用性
M9g/M9gdでは、IBC(インスタンス帯域幅設定)と呼ばれる新機能が利用可能になった。これはEBS(永続ストレージ)とVPCネットワーク間で、帯域幅の配分を最大25%調整できる仕組みだ。
たとえばデータベースサーバではEBSへの書き込み性能がボトルネックになりやすい。IBCを使えばEBS側に帯域を多めに割り当て、クエリ処理やログ書き込みを高速化できる。ネットワーク通信が少ないバッチ処理やキャッシュサーバでも有効だ。
Nitro Isolation Engineが実現する「数学的に証明されたセキュリティ」
Graviton5と同時に発表された技術の中で、最も静かでありながら最も革新的なものがNitro Isolation Engineだ。聞き慣れない用語だが、クラウドセキュリティの考え方を根本から変える可能性がある。
形式検証(Formal Verification)とは何か
通常、ソフトウェアのセキュリティは「テスト」で検証する。攻撃パターンを想定し、実際に動かして問題がないかを確認する手法だ。しかしこの方法では、想定外の攻撃や未知の脆弱性を見逃すリスクが常に残る。
形式検証(Formal Verification)はこれとは根本的に異なる。数学の定理証明と同じアプローチで、「このシステムは絶対に想定外の動作をしない」ことを数理的に証明する技術だ。特定のテストケースだけでなく、あらゆる入力パターンで期待通りに動作することを保証する。
AWSによれば、Nitro Isolation Engineはこの形式検証を適用したクラウドハイパーバイザーとして業界初の事例となる。ハイパーバイザーとは、1台の物理サーバ上で複数の仮想マシンを安全に隔離する基盤ソフトウェアだ。この隔離機能が破られると、他の顧客のデータにアクセスされる重大なセキュリティ事故につながる。Nitro Isolation Engineは、その隔離が破られる可能性を数学的にゼロにする設計となっている。
この技術は金融機関や医療機関など、厳格なデータ保護が求められる業界にとって特に重要な意味を持つ。セキュリティ監査のレベルが一段引き上げられることになるからだ。なおNitro Isolation EngineはM9g/M9gd専用の機能であり、既存のインスタンスタイプには搭載されない。
エージェントAI時代のCPU需要とGraviton5の位置づけ
AIが「考える」から「行動する」へのシフト
ここ数年、AIの進化は大規模言語モデル(LLM)のテキスト生成能力に注目が集まってきた。しかし現在、AIの主戦場は「質問に答える」から「行動を実行する」へと急速に移行している。いわゆるエージェントAIと呼ばれる分野だ。
エージェントAIとは、ユーザーの指示に対して、コードを実行し、ツールを使い、結果を評価し、複数ステップのタスクを自律的に組み立てるAIシステムを指す。たとえば「今月の売上データを分析してグラフ化し、経営陣向けのサマリをSlackに投稿して」という指示に対し、AIがデータベースに接続し、集計処理を実行し、グラフを生成し、メッセージを送信する一連の流れを自律的に処理する。
このような処理は、GPUなどのアクセラレータだけで完結しない。指示の解釈、コードのコンパイル、データベースクエリの実行、APIの呼び出しなど、CPUに依存する処理が大量に発生する。AWSの広報記事で、MetaがエージェントAI基盤として数千万コア規模のGravitonを導入していると報告されているのは、このトレンドを象徴している。
エージェントAIが実用段階に入るにつれ、クラウド上のCPU需要はむしろ増大する。Graviton5が192コアという高密度設計を採用したのは、こうした並列処理ニーズを先取りしたものといえる。
Web開発者にとっての実務的意味
中小企業のWeb担当者や個人事業主にとって、「エージェントAI」や「192コア」という言葉は遠い世界に感じられるかもしれない。しかし実際には、以下のような形でM9gの恩恵は身近な領域に及ぶ。
- MySQL/PostgreSQLの応答速度向上:HubSpotの事例ではクエリ時間が最大60%短縮。WordPressサイトやECサイトのデータベース応答が高速化する可能性がある
- コスト効率の改善:Graviton5はGraviton4比でエネルギー効率も向上。同じ処理をより少ない電力で実行できるため、ランニングコストの削減につながる
- セキュリティの底上げ:Nitro Isolation Engineによる隔離保証は、顧客データを扱うあらゆるサービスに恩恵がある
重要なのは、これらの恩恵がコード変更ゼロで得られるケースが多い点だ。ClickHouseやHoneycombの報告にあるように、Armネイティブ対応が済んでいるアプリケーションであれば、インスタンスタイプをM8gからM9gに変更するだけで性能向上が見込める。
M9g/M9gdへの移行を検討する際の実践ステップ
Graviton5インスタンスの利用を始めるには、いくつかの準備と確認が必要だ。AWS公式が提供する移行ガイドやツールを活用すれば、想定よりスムーズに移行できる。
Arm対応状況の確認と移行パス
最初に行うべきは、現在稼働中のアプリケーションがArmアーキテクチャに対応しているかの確認だ。Java、Python、Node.js、Go、PHPなど主要な言語ランタイムはすでにArm対応が完了している。ただし、x86固有のアセンブリコードを含むC/C++プログラムや、特定のx86向けバイナリに依存しているアプリケーションでは注意が必要になる。
Javaアプリケーションの場合、AWSが提供する「AWS Transform」というAI支援サービスが利用できる。x86用にコンパイルされたJavaアプリケーションをArm向けに自動変換し、互換性分析や依存関係の更新まで処理するツールだ。コードの書き換えが必要なケースでも、変換作業の多くを自動化できる。
コスト面の評価ポイント
M9g/M9gdは、Savings Plans、オンデマンド、スポットインスタンス、Dedicated Hostsのいずれでも購入可能だ。一般にGraviton系インスタンスはx86系より低価格に設定されており、さらにSavings Plansを組み合わせることで長期利用時のコストを大幅に抑えられる。
AWS公式が提供する「Graviton Savings Dashboard」を使えば、Graviton移行によるコスト削減効果を可視化できる。費用対効果を数字で把握しながら、段階的に移行を進めるのが実務的なアプローチだ。
この記事のポイント
- AWS Graviton5搭載M9g/M9gdが一般提供開始。前世代Graviton4比で最大25%の計算性能向上
- ClickHouseで36%、HubSpotのMySQLクエリで最大60%の高速化を実測。コード変更不要のケースが多い
- Nitro Isolation Engineにより、形式検証を用いた数学的に証明されたVM隔離をクラウドで初めて実現
- エージェントAIの普及でCPU需要が急増する中、192コアの高密度設計が新たな計算基盤として台頭
- 移行にはArm対応状況の確認から段階的に進めるのが安全。AWS TransformやSavings Dashboardが支援ツールとして利用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験