

AWSが低コストなEC2 T8iインスタンスを発表!T3比で最大70%の性能向上
AWSが新型の低コストバースト可能インスタンス「Amazon EC2 T8i」の一般提供を開始した。T3インスタンスの後継となるもので、価格性能比が最大30%改善している。
T8iはカスタム設計された第6世代Intel Xeon Scalable Processorを搭載し、AWSのNitro System上で動作する。既存のT3ユーザーは同じCPUクレジット方式のまま移行できる設計だ。
T8iインスタンスの位置づけ
EC2のTシリーズは「バースト可能インスタンス」と呼ばれる。平時はベースライン性能で動作し、負荷が上がった時にCPUクレジットを消費して性能を一時的に引き上げる仕組みを持っている。
この仕組みが適しているのは、普段はCPU使用率が低いが瞬間的に負荷が上がるワークロードだ。低トラフィックのWebサイト、開発・テスト環境、小規模データベース、マイクロサービス、ログインゲートウェイなどが代表例になる。
T8iはこのバーストモデルを踏襲しつつ、CPUとネットワーク性能を大幅に引き上げたモデルだ。
性能向上の内訳
価格性能比とコンピューティング性能
AWSの発表によると、T8iはT3と比較して以下の改善が実現されている。
- 価格性能比が最大30%向上
- コンピューティング性能が最大70%向上
- ネットワーク帯域が最大1.25倍
- EBS帯域が最大2.4倍
特にEBS帯域の2.4倍という数字は見逃せない。ディスクI/Oがボトルネックになりがちな小規模データベースやデータ処理ジョブでは、体感できる改善が期待できる。
CPUクレジット方式と無制限モード
T8iはT3と同じCPUクレジット方式を採用している。StandardとUnlimitedの2つのモードがあり、デフォルトはUnlimitedモードだ。Unlimitedモードではクレジット残高がゼロになっても、追加料金を支払うことでベースラインを超える性能を維持できる。
クレジットは時間の経過とともに自動で蓄積される。例えばt8i.microなら1時間に6クレジット、t8i.smallなら12クレジットが付与される仕組みだ。
インスタンスタイプとスペック
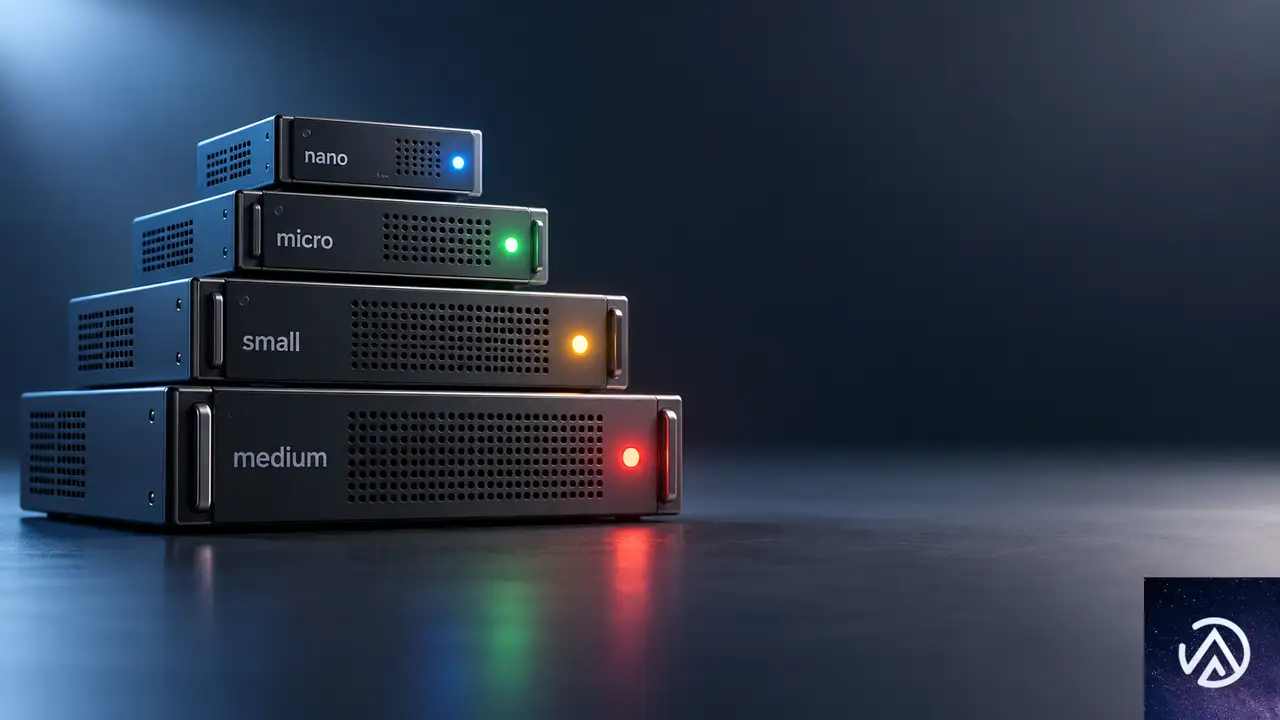
T8iは4つのサイズで提供される。すべて2 vCPUを1コアとして提供するのが特徴で、vCPUとメモリの比率が他シリーズにはない特殊な構成になっている。
- t8i.nano
- t8i.micro
- t8i.small
- t8i.medium
メモリ比率はnanoが1対0.25、microが1対0.5、smallが1対1、mediumが1対1となっている。2 vCPUでメモリ0.25GiBという構成は他のEC2インスタンスにはない特徴的なスペックだ。
利用シーンと移行方法
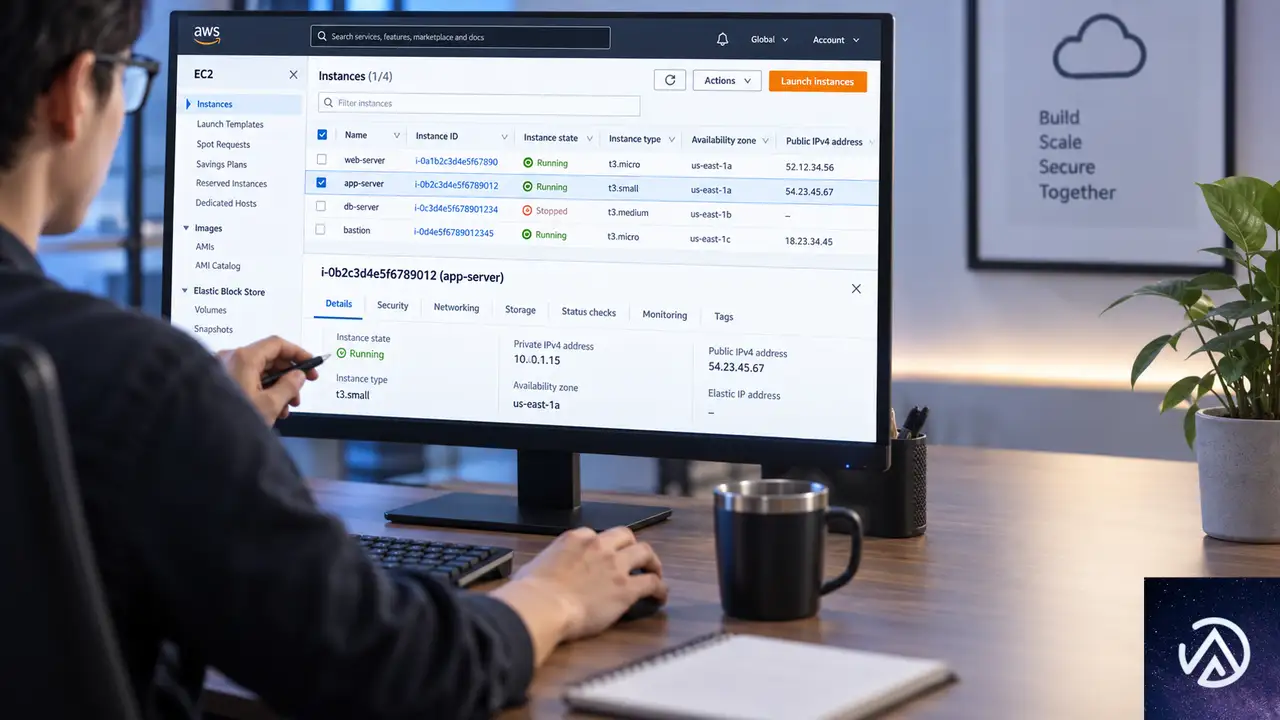
どんな場面で使うべきか
T8iは低〜中程度のCPU使用率で動くワークロードに向いている。具体的には以下のようなケースが想定されている。
- フリーミアムサービスの小規模プラン
- トレーニング・デモ環境
- ステージング・開発環境
- データ処理ジョブ
- マイクロサービスアーキテクチャの一部
- 低トラフィックのWebサイト
- ログインゲートウェイ
- バッチ処理やCI/CDパイプライン
常に高いCPU使用率が続く本番環境や、大規模なデータベースサーバーには向かない。そうした用途ではM8i Flexなど、より大きなインスタンスの選択が推奨されている。
T3からの移行手順
既存のT3ユーザーにとって移行はシンプルだ。インスタンスタイプをT3からT8iに変更するだけで、アプリケーションの設定変更やコードの書き換えは原則不要とされている。
CPUクレジット方式もT3と同じなので、運用ノウハウはそのまま活かせる。Auto ScalingやCloudWatchの設定も流用できるため、移行コストは最小限だ。
提供リージョンと利用方法
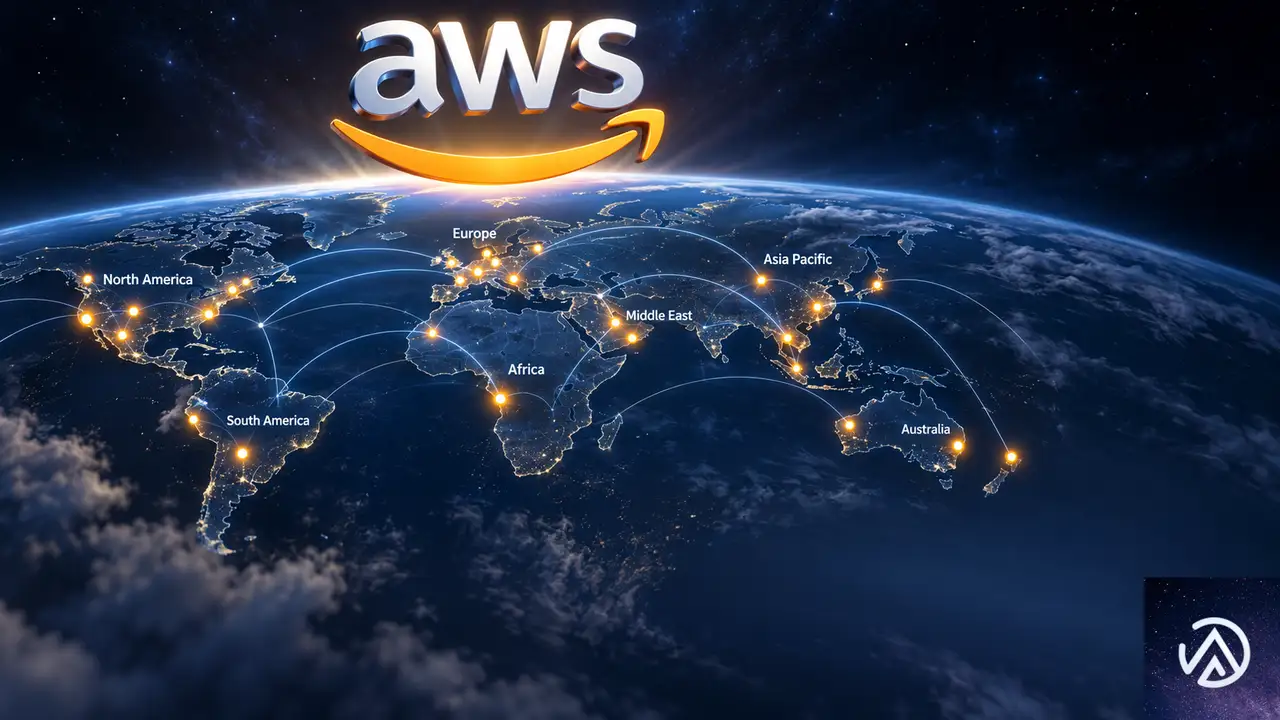
T8iは以下のAWSリージョンで利用できる。
- 米国東部(バージニア北部・オハイオ)
- 米国西部(オレゴン・北カリフォルニア)
- アジアパシフィック(ハイデラバード・マレーシア・ムンバイ・ソウル・シンガポール・シドニー・東京)
- カナダ(中部)
- ヨーロッパ(フランクフルト・アイルランド・ロンドン・パリ)
購入方法はオンデマンドとスポットインスタンスに対応している。Savings Planは近日対応予定だ。t8i.microとt8i.smallはAWS無料利用枠でも使えるため、新規ユーザーがAWSの使い方を学ぶ用途にも適している。
共有テナンシーのみ対応しており、専有テナンシーや専有ホストは利用できない点には注意が必要だ。
この記事のポイント
- T8iはT3の後継となる低コストバースト可能インスタンス
- コンピューティング性能が最大70%向上し、EBS帯域は2.4倍に
- CPUクレジット方式はT3と同じで移行が容易
- 4サイズ構成で東京リージョンでも利用可能
- 無料利用枠の対象サイズもあり、新規ユーザーの入門にも適している

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

42モデル比較で判明!AIモデル選択がもたらす推論コスト86倍差の実態
Neonが42のAIモデルを対象に、サポートチケット100件の処理コストと品質を同時検証した。結果として、同じタスクでもモデル選択だけで単位作業あたりの推論コストが約86倍変わる実態が明らかになった。
実験では合成サポートチケットを各モデルに処理させ、合計コスト・合格率・処理時間の3軸でスコアを付けた。最安のGPT-5 Nanoは3分程度で処理を終え、コストパフォーマンスで突出した。一方、最高額のGPT-5.5 Proは100件の処理に8.34ドル、57分を要した。
AIエージェントが企業で本格稼働する時代、モデル選びはもはや精度だけで決める時代ではない。トークン消費量と推論コストを意識したトークンエコノミクスの視点が不可欠になる。この記事ではNeonの公開ベンチマークを基に、主要な発見とコスト試算を解説する。
AIエージェント時代に浮上するトークンエコノミクス

トークンとは、LLM(大規模言語モデル)がテキストを処理する際の最小単位だ。英語でおおよそ4文字、日本語では1文字から数文字が1トークンに相当する。AIのAPI料金はこのトークン数に応じて決まるため、同じタスクでもモデルによってトークン消費量が大きく異なる。
Neonの検証によると、エージェントが企業で担う業務が増えるほど、トークン消費は人件費に次ぐコスト項目に成長する見込みだ。Neonはこのコスト管理の概念を「トークンエコノミクス」と呼び、モデル選定の重要性を強調している。ソフトウェア企業ではエンジニアがコーディングエージェントを日常的に使うため、モデルの効率差がそのまま大きな費用差として顕在化する。
Neonの見解では、大企業ほどこの差は深刻になる。数百人のエンジニアを抱える企業では、月間の推論コスト差が数十万円から数百万円規模に達する。モデル選びを「カタログ価格だけで判断する」ことは、もはや現実的な選択ではなくなっている。
42モデルを同一タスクで検証した実験設計

サポートチケット100件という選定理由
Neonのチームは「現実世界の雑多な状況を反映する」タスクとして、合成サポートチケット100件の返信を各モデルに依頼した。チケットは請求、製品質問、セキュリティインシデント、アカウントアクセス、返金の5つのシナリオを持つ。それぞれに顧客のトーンが5種類(直接表現、緊急、不満、次のステップ要求、非技術者向け)用意され、合計20シナリオを構成する。
各モデルには同じシステムプロンプトとJSONレスポンス形式、アカウントコンテキスト、ポリシー注記が渡された。この設計により、モデル間で条件を完全に揃えたうえで、コストと品質を比較できる。
7項目の合格基準
Neonは「使える回答」と「使えない回答」を区別するため、7つのチェック項目を設定した。JSONが必須4フィールドで正しくパースできること、分類が期待カテゴリと一致すること、選択アクションがポリシーで許可されていること、エスカレーション判断が正しいこと、顧客返信が1語から120語であること、必須ポリシー用語が含まれること、禁止された約束や主張がないこと、である。
例えば請求系チケットでは「請求書を説明しstorageに言及する」ことが合格条件になり、勝手にクレジットを発行すると不合格になる。セキュリティ系では「適切にエスカレーションする」行動が必須で、「心配いりません」と返すだけでは失敗扱いだ。この基準が、LLMの単なる応答速度や流暢さではなく、実務で使える精度を測る分離線になっている。
実験は合成サポートチケットを使い、全モデルに同一条件でタスクを実行させた。合計コストと合格率、処理時間をそれぞれ計測している。
Neonブランチを活用した技術設計
ベンチマークの実行基盤にはNeonのブランチ機能が用いられた。ブランチとは、DB環境をgitブランチのように瞬間的に複製する仕組みだ。モデルごとに1つのNeonブランチを作成し、それぞれに専用のAI Gatewayホストを割り当てることで、モデルとエンドポイントの対応を明確に保った。
neon branches create \
  --project-id "$PROJECT_ID" \
  --parent "$PARENT_BRANCH" \
  --name "model-gpt-5-nano" \
  --no-compute
--no-compute フラグは不要なPostgresコンピュートを起動せず、AI Gatewayのエンドポイントだけを使うための指定だ。各ブランチにはAI Gatewayホストが自動で付与され、mainブランチで作成したクレデンシャルが子ブランチにも適用される。これにより、42モデル分のインフラを極めて低コストで構築できた。
データ層はLakebase Postgresが担い、ベンチマーク実行記録、モデルスナップショット、推論結果を管理する。WebアプリはNext.js 15、React 19、TypeScriptで構築され、Rechartsで可視化、Tailwind CSSでスタイリング、Zodでスキーマ検証を行った。自動化はGitHub Actionsが担い、Vercelにデプロイされる。集計結果はJSONスナップショットとしてもコミットされ、レビュー可能な形で公開されている。
ベンチマークが明らかにした主要な結果

コストと合格率の対照的な顔ぶれ
Neonの検証で最安を記録したのはGPT-5 Nanoだった。単位あたりの使用可能コストが全モデル中最も低く、処理時間も約3分と高速だった。コストと速度を両立する「バランス型」と言える。最速はLlama 3.1 8B Instructで1分18秒だったが、合格率は100件中34件と低く、速度だけで判断すると実務には耐えない。
一方、最高額はGPT-5.5 Proで、100件の処理に8.34ドルかかり、所要時間も57分と群を抜いて遅かった。トークンを最も消費したのはQwen3.5 122B-A10Bで、合格率も100件中35件と振るわない。合格率の最高はGPT-5.3 Codexで、100件中82件を一発合格した。
主要な結果はコストと合格率の両面で性格が異なる。消費トークンはQwen3.5 122B-A10Bが最多で、合格は100件中35件にとどまった。この組み合わせは「カタログ価格が低くても実際のユニットコストは高い」というトークンエコノミクスの落とし穴をよく示す。
更新で追加された新モデル
Neonは初期公開後に3モデルを追加し、ベンチマークは45モデルに拡大された。GPT-6 Astra、Claude Fable 5.1、GLM-5.3 Flashである。主要ランキングに大きな変動はなかったが、GPT-6 Astraは100件中67件合格で45モデル中28位、コストは45モデル中40位と、話題の水準からは控えめな結果だった。
モデル選択で推論コストが86倍変わる

GPT-5.6 SolとClaude Fable 5の直接比較
NeonはOpenAIとAnthropicの現行フラッグシップ同士も直接比較した。合格率はGPT-5.6 Solが69件、Claude Fable 5が68件とほぼ互角だった。しかしコストはSolが34,663トークンで0.535ドル、Fableが57,010トークンで1.59ドルと、単位あたり約3倍の差がついた。所要時間もFableが2.3倍長い。
GPT-5.6 SolとClaude Fable 5は合格率でほぼ並んだが、単位作業あたりのコストではSolが3倍優位という結果になった。モデル選定で精度以外の要素が重要な理由がここにある。
企業規模別のコスト試算
Neonはこの結果を現実の企業規模に当てはめた。エンジニア1人が1日あたり100万トークンのエージェントタスクを1件実行する前提で、月間トークン消費を推計した。入力8割、出力2割、キャッシュや割引なしという保守的条件だ。
その結果、モデルにLlama 3.1 8B Instruct(3番目に安い)を選ぶか、Claude Fable 5(3番目に高い)を選ぶかで、50人のエンジニア規模なら月間1万8千ドルの差が生まれた。500人規模なら18万8千ドル、つまり約86倍の価格差になる。同じ仕事を同じ精度でこなすなら、この差は純粋な利益になる。
ただしNeonはこの試算を「モデル選びだけの話ではない」と補足する。合格率や処理時間、出力品質も含めた総合評価が必要で、単純に安いモデルを選ぶことが正解とは限らないことを認めている。あくまで「選択が巨大なコスト差を生む」という示唆が核心だ。
オープンウェイトとプロプライエタリの比較

中央値で見たコスト差
オープンウェイトモデルとは、モデルの重みが公開されて誰でも検証・再利用できるタイプを指す。一方、プロプライエタリモデルは重みが非公開で、API経由でのみ利用できる。Neonのベンチマークでは、オープンウェイトモデル11種のコスト中央値が約0.022ドル、プロプライエタリ31種の中央値が約0.281ドルだった。約12.7倍の開きがある。
合格率の中央値はプロプライエタリが69%、オープンウェイトが61%だった。この差は比較的小さく、用途次第ではオープンウェイトの選択が現実的になる場面が多い。使用可能トークンあたりのトークン数も、オープンウェイトが552個(中央値)、プロプライエタリが925個だった。
個別モデルのばらつき
ただし中央値だけ見ると危険だとNeonは警告する。Llama 3.1 8B Instructは高速で安価だが合格率が最低レベル、Qwen3.5 122B-A10Bはカタログ価格が低いのにトークン消費が最多、Gemma 3 12Bは低コストと合格率64%を両立した。個別の特性がまちまちなため、一律に「オープンウェイトが安い」と決めつけるのは誤りだ。
このばらつきこそが、Neonが公開したインタラクティブなベンチマークの価値だ。モデルのカタログ価格ではなく、実際のワークロードで何が起きるかを自分の目で確認できる。Neonはこのベンチマークを最新モデルで継続更新する方針を示している。
この記事のポイント
- Neonが42から45のAIモデルを対象に、サポートチケット100件の処理コストと品質を同一条件で検証した
- 最安はGPT-5 Nanoで約3分で処理、最高額はGPT-5.5 Proで8.34ドル、57分を要した
- 合格率はGPT-5.3 Codexが82件で最高、Llama 3.1 8B Instructは34件で最低だった
- モデル選択だけで推論コストが約86倍変わり、500人規模なら月間18万8千ドルの差になる
- カタログ価格が安くてもトークン消費が多いモデルがあり、実測評価が重要である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GKE Agent Sandboxがエージェント1台あたりのコストを75%削減する仕組み
AIエージェントを本番環境でスケールさせようとすると、すぐにコストとリソースの壁にぶつかる。Google Cloudが2026年7月30日に公開したブログ記事では、Google Kubernetes Engine(GKE)の新機能「GKE Agent Sandbox」とオーケストレーションを組み合わせることで、同一の仮想マシン上で動かせるエージェント数を最大3.5倍に増やし、エージェント1台あたりのコストを最大75%削減できるという検証結果が示された。
エージェントは要求に応じて動作するバースト型のワークロードであり、何もしない待機時間が長い。従来のように固定的なコンピュートリソースを割り当てる方法では、遊休状態のエージェントが貴重なCPUやメモリを消費し続けてしまう。この問題に対するGKEのアプローチを詳しく見ていく。
マイクロVM方式の限界とGKE Agent Sandboxの登場
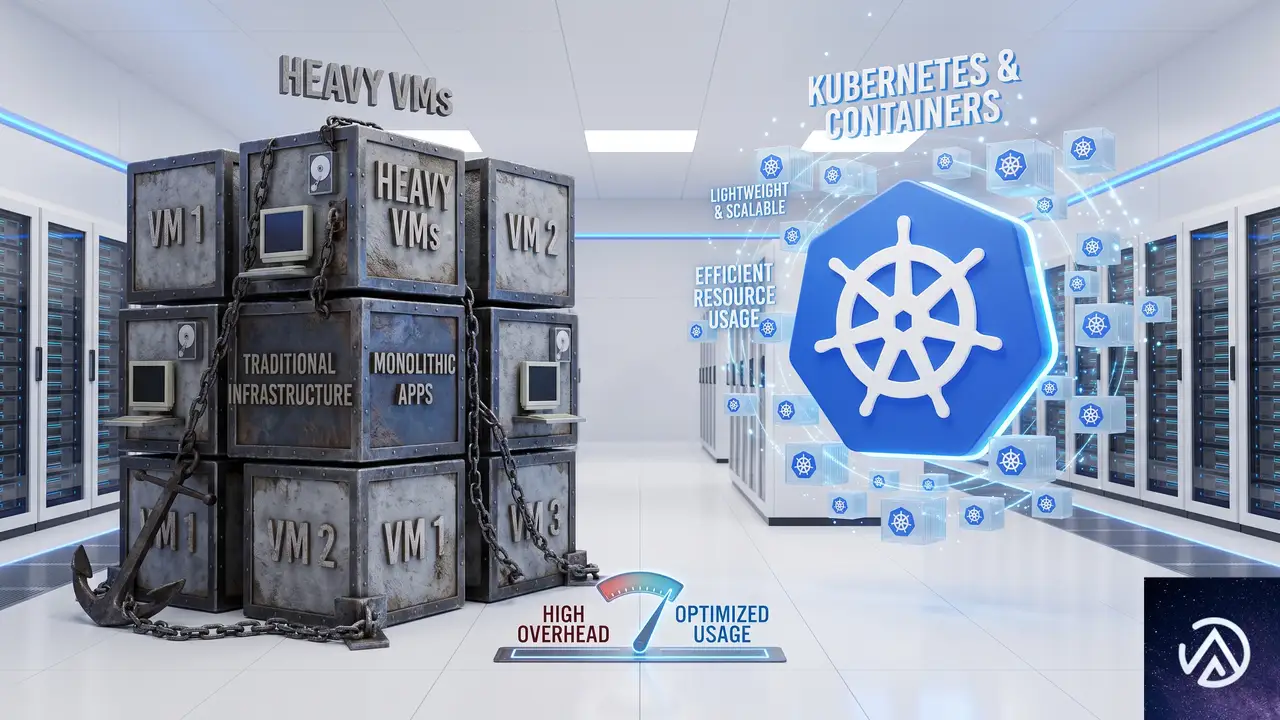
マルチエージェントを安全に動かすための一般的な方法として、各エージェントを専用のマイクロVM(Kata Containersなど)で隔離するやり方がある。ハードウェアレベルの隔離によってセキュリティを確保する狙いだ。しかしこの方式には大きな落とし穴がある。
マイクロVMはエージェントごとにゲストOSを起動するため、メモリとCPUに無視できないオーバーヘッドが生じる。実際にGoogle CloudのチームがOpenClawプロファイルを使い、48vCPUの標準VMインスタンス(n2-standard-48)上でテストしたところ、61個のエージェントを起動した時点で信頼性が低下し、ヘルスチェックの失敗が頻発し始めたという。
これに対してGKE Agent Sandboxは、gVisorというオープンソースのセキュアコンテナサンドボックスを土台にしている。gVisorはユーザー空間カーネル(Sentry)でシステムコールを捕捉・フィルタリングし、ハードウェア隔離に近いセキュリティを実現しつつ、ゲストOSを丸ごと動かす必要をなくした。
結果として、同一VM上で動作可能なエージェント数は88個まで増加。これはベースライン比で44%の密度向上であり、エージェント1台あたりのコストは30%以上削減された計算になる。しかも性能プロファイルはほぼ維持できると報告されている。
この方式が評価を得たのは早く、2026年5月の一般提供開始から4週間足らずで利用量が7倍以上に急増した事実が、その実用性を裏付けている。
遊休エージェントを「凍結」するオーケストレーションの威力
GKE Agent Sandboxは稼働中のワークロードを効率化するが、遊休状態のエージェントがリソースを占有し続ける問題は残る。そこでカギを握るのが、Kubernetes本来のオーケストレーション機能とGKE Podスナップショットを組み合わせた「凍結・再開」パターンだ。
具体的には、エージェントが待機状態に入ったタイミングでPodスナップショットを作成し、永続ストレージにチェックポイント(凍結)として保存する。これにより物理的なCPUとメモリが解放され、クラスタに返却される。新しいトリガーが届くと、軽量なコントローラやイベントゲートウェイがリクエストを捕捉し、ミリ秒単位でスナップショットからエージェントを再開する。
この仕組みによって、物理リソースをワークロードの実態に基づいて「オーバーサブスクライブ(超過割り当て)」できるようになる。つまり、実際の瞬間的な需要以上のエージェントを同じノードに詰め込めるわけだ。その結果、間欠的にしか動かないエージェントであれば、ベースラインの3.5倍にあたる274個のエージェントを単一ノードで動作させることが可能になった。
ただし、やみくもに詰め込めばよいわけではない。エージェントの種類によって求められる起動時間やレイテンシは大きく異なるからだ。
エージェントの特性に合わせた3つのデプロイ戦略
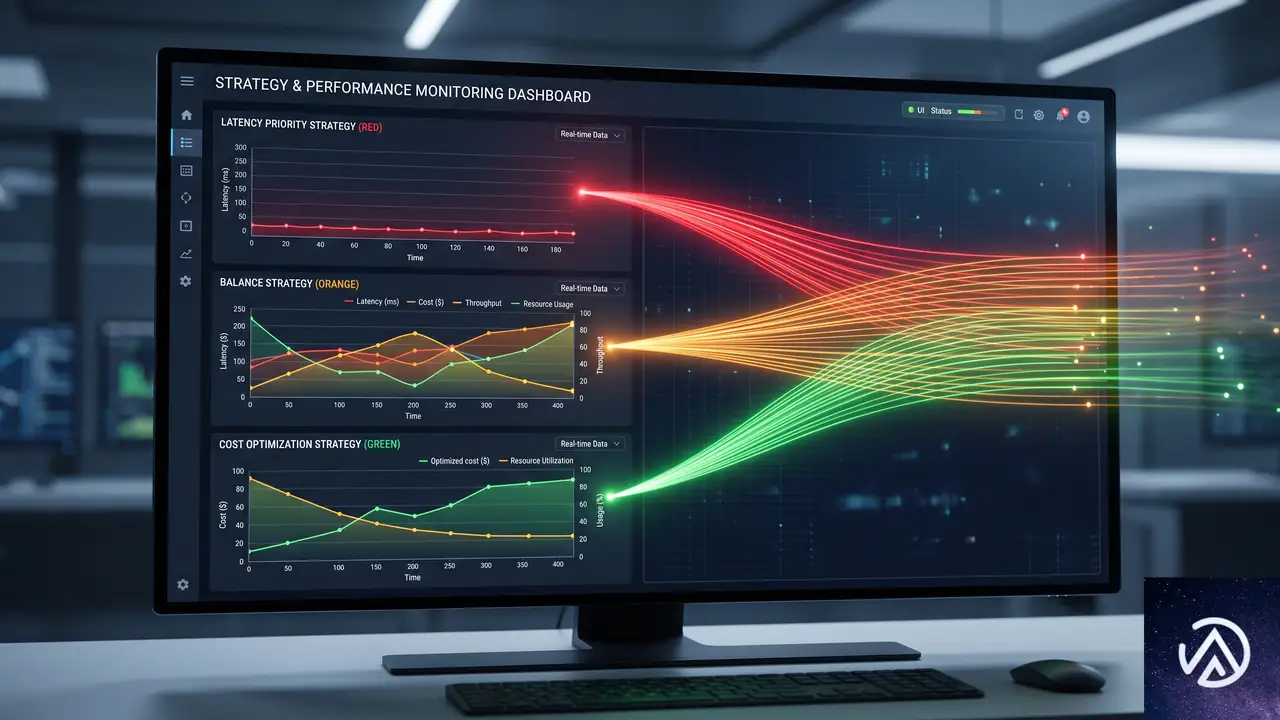
GKEでは、すべてのエージェントに一律の戦略を強制するのではなく、ノードプールやワークロード設定ごとに異なる挙動を共存させられる。Google Cloudのブログでは、レイテンシ要件に応じた3つの典型例が紹介されている。
リアルタイムコーディングアシスタント(レイテンシ重視)
開発者向けの対話型エージェントでは、起動時間が1秒未満であることと、待ち行列が一切発生しないことが絶対条件だ。このケースでは、GKE Podスナップショットと「Agent Sandboxウォームプール」を組み合わせる。事前にウォームアップされた隔離サンドボックスを常時待機させておくことで、ほぼ瞬時に実行を開始できる。この構成で同一ノード上に133個のエージェントを収容できたと報告されている。
自律的なチームメイト型エージェント(バランス型)
バックグラウンドで対話的に動くエージェントは、平均的な起動時間(数秒)を許容できる。サスペンド&レジューム機能を利用し、遊休時にはリソースを解放、必要時にオンデマンドで復元する。待機中のコンピュートコストを支払う必要はない。
ヘッドレスなバックグラウンドエージェント(レイテンシ許容型)
日次レポートの生成や調査タスクのような定期ジョブは、多少の待ち時間があってもビジネス成果に支障をきたさない。こうしたエージェントには最大限のリソース超過割り当てを適用し、クラスタに空きが出るまで1時間ほど待つ戦略も有効だ。
このように、ワークロードの性質に合わせて「パフォーマンス最適化」と「コスト最適化」のバランスをチューニングできるのがGKEの強みだ。サンダリングハード(多数のエージェントが一斉に起動してコンピュートを要求する問題)に対しても、ウォームプールやサスペンド&レジュームの設定で自由度の高い制御が可能になる。
コスト削減を実現するための実践的なアプローチ
GKE Agent Sandboxとオーケストレーションの組み合わせによって、エージェントの台数に比例してインフラ予算が増えていく構図を抜本的に変えられる。Google Cloudの検証では、パフォーマンスを重視する構成でも133個のエージェント(ベースライン比約2.2倍)、コスト最適化を突き詰めた構成では274個(同3.5倍)のエージェントを同一ノードで動作させることに成功した。
実務に落とし込む際のポイントは3つある。第一に、セキュリティを保ったままオーバーヘッドを削減するGKE Agent Sandboxへの移行を検討すること。第二に、Podスナップショットによる「凍結・再開」をアーキテクチャに組み込み、遊休リソースを徹底的に活用すること。第三に、すべてのエージェントを同じ扱いにせず、レイテンシ要件に応じてデプロイ設定を変えることだ。
なお、GKE Agent Sandboxの詳細な設定やウォームプール、サスペンド&レジュームの具体的な手順は、Google Cloudの公式ドキュメントで公開されている。まずは既存のエージェントワークロードを対象に、小規模なPoCから始めてみるとよいだろう。
この記事のポイント
- GKE Agent SandboxはgVisorベースの軽量サンドボックスで、マイクロVMに比べてエージェント密度を44%向上させ、1台あたりのコストを30%以上削減する
- Podスナップショットとサスペンド&レジュームの組み合わせにより、遊休エージェントを凍結して物理リソースを解放し、理論上3.5倍の密度(最大75%のコスト削減)を達成可能
- ワークロードのレイテンシ要件に応じて「リアルタイム型」「バランス型」「コスト最適化型」の3戦略を使い分けることで、無理なくスケールできる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflareが企業のAIコスト爆発を制御、AI Gatewayに利用上限を搭載
企業におけるAI導入の最大の壁はもはや技術力ではない。管理不能なコストの爆発だ。2026年6月5日、Cloudflareは自社のAI Gatewayに新たな「利用上限」機能を搭載し、この課題への直接的な解決策を提示した。
多くの企業では全エンジニアに最先端モデルのAPIキーを共有している。月末に届く高額な請求書を見て、経理とCTOが頭を抱える。誰が何に使ったのか全く分からないのだ。Cloudflareの今回の発表は、まさにこの無法地帯に統制をもたらすものだ。
併せて発表されたアイデンティティベースの予算管理は、Cloudflare Accessと既存のIdP(Identity Provider / アイデンティティプロバイダー)を組み合わせ、個人やチーム単位での正確なコスト帰属を実現する。
なぜAIコストは制御不能に陥るのか
AI導入を進める企業で、まったく同じストーリーが繰り返されている。現場には「まずは最速でAIを使え。勘定は後でなんとかする」という号令が飛ぶ。これは大抵の場合うまくいく。実際、AIを積極的に取り入れたチームの生産性は飛躍的に向上している。しかし、その代償は安くない。月末に経理がAPI利用料の請求書を開くと、にわかには信じがたい桁の数字が目に飛び込んでくるのだ。
Cloudflareのブログ記事でも、この構図は明確に描写されている。社内で共有されているAPIキーでは、コストの発生源を追跡できない。機械学習チームの新規パイプライン構築が原因なのか、インターンがメールの仕分けに高額なClaude Opusを使い倒したのか、あるいはCI/CDジョブが週末のうちに何千万トークンも消費したのか、誰にも分からない。
問題の本質は、指標と制御の欠如により、合理的な判断が歪められてしまうことにある。予算も可視化もなければ、常に最も強力で高価なモデルを選ぶのが個々のエンジニアにとっては合理的な行動となる。コードレビューの要約に、大規模なアーキテクチャ再設計と同じモデルは必要ない。ログパーサーに、顧客向けコンテンツ生成と同じモデルは不要だ。しかし、現場には適切な道具を選ぶ動機も手段も存在しなかったのである。
利用上限機能を深掘りする
中核となる仕組み
AI GatewayはアプリケーションとAIプロバイダーの中継点として機能する。OpenAIやAnthropicへの直接APIコールを、まずこのゲートウェイを経由させる仕組みだ。これにより、リクエストの永続化ログ、キャッシュ、レート制限、リトライ、分析といった恩恵が得られていた。しかし、従来は「誰がいくら使ったか」の正確なトラッキングに限界があった。
ここに新たに導入された利用上限機能は、真のコスト統制を実現する。トークンベースではなく、ドルベースの予算で累積支出を追跡する点が実務的だ。制限のスコープは、モデル、プロバイダー、ユーザーやチームといった管理者定義のカスタム属性の任意の組み合わせで設定できる。期間も固定(月初リセットや月曜リセット)かローリング(直近N日間)かを選べ、日次、週次、月次での運用が可能だ。
予算超過時の現実的な選択肢
最も重要なポイントは、上限到達時の処理だろう。デフォルトではリクエストをブロックする。だが、ワークフローを完全に止めないための工夫として、ダイナミックルートと連携したフォールバックモデルへの切り替えが可能だ。これなら、最大予算額に達してもエンジニアの作業が完全に停止することはない。
この機能群は本日から全プランの全ユーザーにオープンベータとして提供されており、ダッシュボードかAPI経由で即座に設定できる。
アイデンティティ駆動の予算管理がもたらす透明性
利用上限機能と同時に、Cloudflareはアイデンティティベースの予算とポリシーを限定ベータとして発表した。利用上限がモデルやカスタム属性による制御であるのに対し、こちらは実在の個人とチームに紐づく。アプリケーション側でメタデータを渡す必要はなく、信頼性の低いヘッダー情報に頼る必要もない。
Cloudflare Accessとの統合が生む確実な帰属
AI GatewayをCloudflare Accessと連携させると、リクエストの送信者が誰かを確実に特定できる。単なるアカウント単位ではなく、個々の従業員、IdPグループ、サービス単位だ。Cloudflare社内では既にこの仕組みを実践しており、全従業員がAIツールを利用する中で月間数十億トークンが流れるトラフィックを可視化している。
仕組みはシンプルだ。従業員がCloudflare Access経由で認証されると、そのアイデンティティがJWT(JSON Web Token)から抽出され、AI Gatewayのリクエストにメタデータとして添付される。これにより、ユーザー単位のトークン消費、チーム単位の使用量内訳、組織全体のコスト帰属が一元管理できるようになる。
CI/CDパイプラインへの適用とボット予算
この機能は人間だけのものではない。Accessサービスアカウントを利用すれば、自律的なエージェントやCI/CDパイプラインにも名前付きのIDを付与できる。コードレビューボットが今週500万トークンを消費し、ドキュメント生成器が50万トークンだった、といった詳細が手に取るように分かる。あるエージェントが制御不能に陥ったとしても、他のエージェントに影響を与えることなく個別に予算ポリシーを適用できるのだ。
Cloudflare自身、全社でこのスタックを運用した経験に基づいて本機能を公開した。自社で構築したものを他社もゼロから作る必要はない、という明快なスタンスである。
次の段階はコスト最適化の自動化
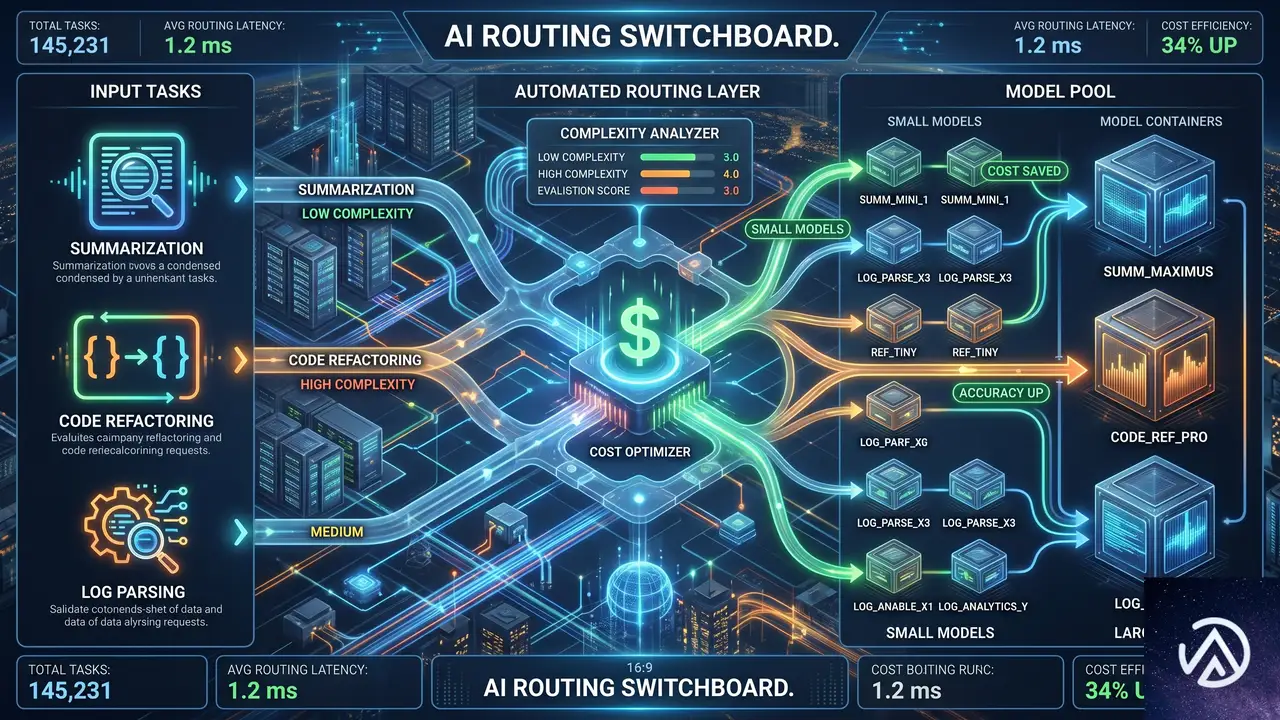
予算を設定し可視化することは、第一段階に過ぎない。次の課題は、限られた予算で最大の成果をどう引き出すかだ。現実には、すべてのリクエストに最先端モデルは不要である。要約タスクはより小さな安価なモデルでも品質を損なわずに実行できる。一方、大規模なコードリファクタリングには最新鋭のモデルが必要だ。しかし、制御がなければ人は常に最も高機能なモデルへ流れてしまう。
この問題に対し、Cloudflareはタスクベースのインテリジェントルーティングを鋭意開発中であると明かした。リクエストを分析し、最もコスト効率の良い結果を導くモデルへ自動的にルーティングする機能だ。詳細はデベロッパードキュメントとチェンジログで追って発表される。
この記事のポイント
- Cloudflare AI Gatewayにドル建ての利用上限機能が全プラン向けに登場した
- 上限到達時はリクエストをブロックするか、より安価なフォールバックモデルに自動で切り替えられる
- 限定ベータのアイデンティティベース予算は、個人やチーム単位で正確なコスト管理を実現する
- これらの機能はCloudflareが自社の大規模AI運用で実証した手法を外部化したものである
- 今後はタスクの複雑さに応じて最適なモデルへ自動ルーティングする機能の開発が予定されている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験