


PlanetScaleがNekiを発表。Postgresを分散シャーディングで拡張する新サービス
PlanetScaleが新サービス「Neki」を発表した。Postgresデータベースを複数マシンに分散させ、スケールさせるためのシャーディング基盤だ。本日からプラットフォームプレビューとして利用できる。
Nekiの特徴は、各シャードに本物のPostgresが動いていることだ。既存のドライバーやORM、接続文字列がそのまま使えるため、アプリケーション側の変更を最小限に抑えられる。
急速に成長するPostgresデータベースの運用に悩むチームにとって、新たな選択肢になる可能性がある。本記事ではNekiのアーキテクチャと、従来の分散アプローチとの違いを解説する。
Nekiの概要とアーキテクチャ

NekiはPlanetScaleが8年間培ってきたシャーディングMySQLの運用経験をもとに設計された。大規模な本番環境で毎秒数百万クエリを処理してきた知見が、Postgres向けに再構築されている。
実Postgresを維持したまま分散
各シャードは完全なPostgresクラスターとして構成される。1つのプライマリと最低2つのレプリカが3つのアベイラビリティゾーンに分散する。カスタムストレージエンジンは使わないため、拡張機能、SQLサポート、性能は通常のPostgresと同じように動作する。
アプリケーションはNekiルーターに接続する。ルーターは標準のPostgresワイヤープロトコルを話すため、既存のドライバーやORM、接続文字列がそのまま機能する。接続先を変更するだけで移行できる設計だ。
アプリケーションから見ると接続先はルーターの1つだけだ。シャード構成はルーターが内部で処理するため、クライアント側の変更は不要になる。
データトポロジーでシャードキーを制御
シャードキーの選択は利用者が行う。JSON形式のデータトポロジーで、テーブルをどのようにグループ化し、どのシャードに分散させるかを定義する。シャードインデックスでルーティングに使うカラムとハッシュ方法を指定し、シャードグループでテーブル群をどのシャードセットに配置するかを制御する。
最初からシャーディングする必要はない。単一プライマリとレプリカで構成し、1台のマシンで足りなくなった時点でリシャーディングを実行すればよい。
Nekiの4つの構成要素

Nekiは4つの主要コンポーネントで構成される。ルーター、シャードグループ、接続プーリング、コントロールプレーンだ。それぞれが連携して分散Postgresを実現する。
ルーター
ルーターはアプリケーションからの最初の接続先だ。Postgresワイヤープロトコルを解釈し、クエリを解析する。分散クエリプランナーがどのシャードにクエリを送るかを決定し、結果を1つのストリームにまとめ直す。ルーターは垂直方向にも水平方向にも拡張できるため、単一ルーターがボトルネックになることはない。
シャードグループと接続プーリング
シャードはシャードグループにまとめられる。異なるテーブルやワークロードを異なるシャードセットに配置できる。各シャードには構成プロファイルがあり、インスタンスサイズ、レプリカ数、ストレージ、Postgresパラメータ、拡張機能を個別に設定できる。
接続プーリングではサイドカーが各Postgresインスタンスの横で動く。Nekiはルーター側とPostgres側の両方の接続を制御するため、プールサイズを各インスタンスの実際の処理能力に合わせて調整できる。PgBouncerを単純に前に置くより精度が高い。
コントロールプレーン
コントロールプレーンは全ノードの健全性を監視する。計画的なスイッチオーバーと予期しないフェイルオーバーを実行し、リシャーディング、スキーマ変更、バージョンアップグレードのワークフローを調整する。データトポロジーはJSON設定としてルーターにキャッシュされ、すべてのクエリプランで参照される。
既存の分散Postgresアプローチとの比較

急速に成長するPostgresデータベースには複数の問題がある。テーブルが大きくなりすぎてバキュームやインデックス作成がトラフィックに影響する。バックアップに数時間かかり、接続数に制限があり、スキーマ変更にメンテナンスウィンドウが必要になる。トランザクションラップアラウンドも対応が必要な課題だ。
アプリケーションレベルシャーディングの課題
アプリケーションレベルシャーディングでは、ルーティングをコードに埋め込むことになる。アプリケーションがシャードキーを意識し、どのシャードに接続するかを自前で管理する必要がある。追加のライブラリや複雑なロジックがコードに混ざり、保守が難しくなる。
Postgres互換分散DBの課題
Postgres互換をうたう分散データベースも存在するが、いくつかの妥協を強いられる。シャードキーが隠され、拡張機能が使えなくなり、複雑さとレイテンシが増加する。問題が起きた時のデバッグも困難になる。
Nekiのアプローチ
Nekiは「Postgresに固執する。回避策を使わない。偽装しない。逸脱しない」という原則で設計された。各シャードに本物のPostgresを配置し、ルーターが通信を仲介する。これにより拡張機能もSQLサポートも性能も、通常のPostgresと同じ挙動を保てる。
オンラインワークフロー

従来はメンテナンスウィンドウを設定して行っていた作業が、Nekiでは組み込みワークフローとして実行される。ワークフローは新しいターゲットノードをプロビジョニングし、レプリケーションで追いつかせ、トラフィックを切り替え、古いノードを破棄する。すべてアプリケーションが使うのと同じpsql接続から実行できる。
スキーマ変更とバージョンアップグレード
スキーマ変更はオンラインで実行される。トラフィックに影響を与えず、ダウンタイムなしでテーブル定義を変更できる。バージョンアップグレードも同様の仕組みで、新しいバージョンのノードを作成し、レプリケーションで同期させてから切り替える。ゼロダウンタイムのアップグレードが実現する。
リシャーディングとフェイルオーバー
リシャーディングもワークフローとして実行される。既存のクラスターに対して実行し、データを新しいシャード構成に移行する。計画的なフェイルオーバーと予期しないフェイルオーバーの両方に対応し、コントロールプレーンが正常性を監視しながら自動で切り替えを行う。
NekiにはPlanetScaleの既存機能も含まれる。Insights、スキーマレコメンデーション、ブランチ、MCPなどの機能が利用できる。
プラットフォームプレビューの注意点

プラットフォームプレビュー期間中は、本番ワークロードにNekiを使用してはならない。製品はまだ変更中であり、一部の変更は互換性を壊す可能性がある。
プレビュー期間中のフィードバックはサポートチケットまたはDiscordで受け付けている。大規模なPostgresクラスターを持つチームは、プライベートデモを依頼することもできる。スキーマやクエリパターンを分析してもらい、シャーディング方法について具体的な提案を受けられる。
Nekiを試すには、PlanetScaleにサインインし、プラットフォームプレビューにオプトインして、Nekiクラスターを作成する。公式ドキュメントでアーキテクチャの詳細やシャーディング方法を確認できる。
この記事のポイント
- Nekiは各シャードに本物のPostgresを動かす分散サービスである
- ルーターがPostgresワイヤープロトコルを解釈し、分散クエリを処理する
- スキーマ変更やリシャーディングなどの運用作業はオンラインで実行できる
- 既存のドライバーとORMが接続文字列を変えるだけで使える
- プラットフォームプレビュー期間中は本番運用に使わないこと

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Bun v1.4.1リリース。アイドル時メモリ削減とバンドルサイズ最大85%減の全容
Bun v1.4.1が2026年9月4日にリリースされた。202件の問題を修正し、236件のリアクションに対応したメンテナンスリリースだ。アイドル時のメモリ削減、HTTP/2対応、バンドルサイズの大幅な最適化が含まれている。
特にNext.js SSRのアイドル時RSSは222MBから142MBへ削減された。bun buildではzod 4.5のバンドルサイズが375.3KBから77.3KBへ79%減っている。長期稼働するサーバーや大きなモノレポを扱う開発者にとって、実務に直結する変更だ。
この記事では、実務に影響する主要な変更点をランタイム、bun install、bun build、bun testの順に解説する。
Bun v1.4.1の概要と導入

BunはNode.js互換のJavaScriptランタイムであり、パッケージマネージャやバンドラー、テストランナーも備える。v1.4.1ではアイドル時のメモリ使用量の削減、Bun.serveのHTTP/2対応、bun buildのバンドル最適化が目玉だ。
インストールとアップグレード
Bunのインストール方法は複数用意されている。macOSやLinuxではcurlコマンド、npmを使う方法、Windowsではpowershellやscoop、macOSではbrew、Dockerイメージも提供される。既存環境のアップグレードは bun upgrade で完了する。
curl -fsSL https://bun.sh/install | bash
npm install -g bun
bun upgrade
このリリースの位置づけ
v1.4.1は202件の問題を修正した。前バージョンv1.4.0で入った回帰の修正も多い。新機能として、ランタイムのメモリ削減、bun installのオフライン対応、bun buildのコード分割改善、bun testの分離実行の修正が盛り込まれた。
ランタイムのメモリ削減と高速化

アイドル時のメモリ使用量を大幅削減
BunのJavaScriptエンジンであるJavaScriptCoreが、長時間のアイドル期間後にJIT生成コードを破棄するようになった。これにより、長期稼働するプロセスのメモリ使用量が大きく減る。負荷を60秒かけた後、3分間アイドル状態にしたLinux x64環境のRSSは、Next.js SSRで142MB、vite devで111MB、Expressで53MBだった。前バージョンではそれぞれ222MB、142MB、65MBである。
上記は60秒の負荷後、3分間アイドル状態にしたときのRSSをLinux x64で比較した結果だ。アイドル時にJITコードを消す仕組みにより、常駐プロセスのメモリコストが抑えられている。
AsyncLocalStorageとBufferの高速化
AsyncLocalStorage.run() が約2倍高速になった。アクティブなストアがあるとき、await や .then()、.finally() のたびに余分なメモリ確保が発生しなくなったためだ。Node.js 26との比較では、als.run() が15.9ns/op、Node.jsの410ns/opに対して大幅に速い。
Bufferの読み書きも高速化された。writeFloatLE() は2.85nsから0.31nsへ9.2倍、writeUInt8() は2.24nsから0.31nsへ7.2倍、readUInt32BE() は0.76nsから0.42nsへ1.8倍速くなった。macOS arm64の計測だ。
モジュール読み込みと表示処理の高速化
組込みNode.jsモジュールの require() が遅延初期化になった。node:assert は6.22msから0.64msへ、node:fs は2.75msから0.87msへ短縮されている。テストやCLIツールの起動時間に効く変更だ。
オブジェクト表示も高速化した。1万6,000個のキーを持つオブジェクトの Bun.inspect() は140msから3.2msへ43倍速くなった。テキストの色付けや console.log()、util.inspect() にも同じコードが使われる。
HTTPSの初回接続も最大3倍速くなった。ルート証明書をDER形式で埋め込み、必要になった時だけ解析する方式へ変更したためだ。--use-system-ca を使う場合は46.3msから15.3msへ短縮された。
Bun.serveとWeb APIの強化

HTTP/2対応とTLS検証の変更
Bun.serve() がHTTP/2を同一ポートでサポートした。TLS接続ではALPNでプロトコルを自動ネゴシエーションし、平文接続ではHTTP/2 prefaceを送ってきたクライアントにHTTP/2で応答する。http1 オプションをfalseにすればHTTP/1.xクライアントを拒否できる。WebSocketとレスポンストレーラーはHTTP/2では未対応だ。
セキュリティ面では、fetch() のTLS検証がURLのホスト名を基準に変更された。従来はカスタム Host ヘッダーをTLSサーバー名として使っていた。プロキシなどでユーザー入力のHostヘッダーを渡す場合があるため、この変更は重要だ。IPアドレスに接続して別名で証明書を検証したい場合は tls.servername を指定する。
WebSocketのpauseとresume
BunのWebSocketクライアントに pause() と resume() が追加された。メッセージの処理速度が受信速度に追いつかないとき、TCPソケットからの読み取りを停止できる。停止中はメモリにメッセージが溜まらず、送信側にはTCPバックプレッシャーが伝わる。
const socket = new WebSocket("wss://example.com/feed");

socket.addEventListener("message", (event) => {
  if (!file.write(event.data)) {
    socket.pause();
    file.once("drain", () => socket.resume());
  }
});
これはBun独自の拡張であり、ブラウザでは利用できない。pause中のソケットは socket.isPaused で状態を確認できる。bufferedAmount も送信待ちバイト数を正しく報告するようになった。
Bun.writeのストリーミング書き込み
Bun.write() が Response や ReadableStream の本文を、いったんメモリに読み込まずにファイルへストリーミングするようになった。128MiBのダウンロードを書き込むケースでは、ピークRSSの増加が161MBから13MBへ減った。
bun installのオフライン対応とワークスペース改善

–offlineと–prefer-offline
bun install --offline はネットワーク要求を一切行わない。すべてのパッケージがキャッシュに存在する必要があり、CIでキャッシュを復元するケースやネットワークに接続できないマシン向けだ。キャッシュに無いパッケージがあると、その名前を明示したエラーになる。
bun install --prefer-offline はキャッシュを優先する。期限切れでもキャッシュのコピーを使い、キャッシュに無いパッケージだけダウンロードする。どちらも bunfig.toml に設定すればデフォルトにできる。
self-contained node_modules
ワークスペースのpackage.jsonに "selfContained" を指定すると、そのパッケージ専用の node_modules が作られる。Electronのように特定の node_modules レイアウトを期待するツール向けだ。Yarnの hoistingLimits 設定も利用できる。
bun buildのバンドル最適化とコンパイル改善

export * asによるバンドルサイズ削減
zodやEffectのように export * as でエクスポートをまとめるライブラリで、未使用エクスポートのツリーシェイクが効くようになった。v1.4.0では z.object() を呼んだ場合でもグループの全エクスポートを保持していた。v1.4.1では直接参照にコンパイルされ、不要なエクスポートが削除される。
各ライブラリから2〜3個の関数だけを呼ぶ小規模なプログラムを、bun build --minify でビルドした結果だ。zodでは252個のエントリを持つ名前空間オブジェクトが生成されていたが、v1.4.1ではすべて削除された。
動的importのtree-shakingとコード分割
import() で読み込むモジュールでも、未使用のエクスポートが削除されるようになった。const { z } = await import("zod") は静的な import { z } from "zod" と同じコードにバンドルされる。zod 4.5では377.9KBから78.2KBへ縮む。
--splitting も改善された。40個の遅延ルートを持つテストアプリでは、出力ファイルが219個から151個に、出力サイズが124KBから75KBに減った。さらに --min-chunk-size オプションで小さなチャンクを統合できる。ブラウザ向けビルドでは link rel="modulepreload" が自動追加され、チャンクのフェッチが並列化される。
–compileの起動高速化とバイトコード削減
コンパイル済み実行ファイルの起動も速くなった。BunでコンパイルされたClaude Codeでは、入力ボックスが表示されるまでの時間が397msから318msへ20%短縮された。バイトコードのサイズも最適化され、これまで元ソースの約9倍だったものが約3倍になった。Claude Codeのインストールサイズは376MBから207MBへ45%減っている。
--bytecode-depth で事前コンパイルする関数のネスト深度を制限できる。--bytecode を付けたクロスコンパイルもmacOSやLinuxからWindows x64へ対応した。テキストインポートは1回だけ埋め込まれ、実行時の解析とコピーが不要になった。
この記事のポイント
- Bun v1.4.1は202件の問題を修正し、アイドル時のメモリ使用量を大幅に削減した
- Bun.serveがHTTP/2に対応し、WebSocketにpauseとresumeが追加された
- bun installにオフラインモードが加わり、CIやネットワーク遮断環境で使いやすくなった
- bun buildはzodやEffectのバンドルサイズを最大85%削減し、コード分割も改善した
- bun build –compileは起動時間とバイトコードサイズを最適化した
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIが解説、GPT-Liveのリアルタイム音声AI基盤 6か月で会話応答を実現へ
OpenAIが2026年8月、新たな音声AIシステム「GPT‑Live」の設計を解説するブログ記事を公開した。同社の音声AIは、従来のターンベースからフルデュプレックスへと進化し、人が会話で無意識に行う「間」の制御を大幅に改善したという。わずか6か月で実用化にこぎつけたその裏側には、ストリーミング推論、状態管理、プロトコル最適化といった多層的な技術的挑戦があった。
本記事では、このブログで語られたGPT‑Liveのシステム設計に焦点を当てる。なぜ従来の音声応答では違和感が残ったのか、そしてどのようにして「息の合った」会話をスケールさせたのかを、具体的な設計上の工夫とともに紹介する。
ターンベースの限界、なぜ音声AIは「間」に弱いのか

人間同士の会話では、わずか0.5秒以下の間で話者交替が行われる。しかし従来の音声AIはテキスト向けLLMの流れを引き継ぎ、音声をテキストに変換し、推論してから音声を合成するという逐次処理が基本だった。スピーチトゥスピーチモデルの登場で音声を直接扱えるようになったが、依然として「発話が終わったか」を判断する小さなターン検出器に依存していた。
この検出器はジレンマを抱える。早すぎる判断はユーザの言葉を遮り、遅すぎる判断は応答の間延びを生む。しかも検出器の判断後に大規模なLLMが起動するため、応答までの遅延は避けられなかった。
OpenAIのブログ記事では、この課題を「誰がいつ話すかを決める小さなモデルに会話のリズムを委ねることは非効率だった」と指摘している。
上の図のように、GPT‑Liveはターン検出器を音声パスから完全に排除した。音声の送受信を同時に行うフルデュプレックス方式により、会話の流れが途切れず、より自然なやり取りを実現している。
GPT‑Liveの中核、フルデュプレックスと非同期委任の仕組み
GPT‑Liveでは、音声そのものを処理する経路と、より深い思考やツール実行を担う経路を意図的に分離している。会話のリアルタイム性を支える「メディア高速パス」と、大規模なフロンティアモデルGPT‑5.5を呼び出す「アプリケーション低速パス」だ。音声モデルは常に会話を続けながら、必要に応じて非同期RPCでGPT‑5.5に委任する。これにより、たとえ委任先の応答に時間がかかっても、音声の流れが止まることはない。
この分離設計は、機能拡張の面でも恩恵が大きい。アプリケーション側のツールやポリシーを変更しても、音声応答の核となるメディアパスに影響を与えずに済む。今後、ChatGPTのデスクトップアプリでコンピュータ操作やエージェント連携といった新機能を追加する際も、音声体験の即時性を犠牲にしない基盤がすでに整っている。
途切れない音声を保つ、推論基盤の最適化

フルデュプレックスの会話をスケールさせるには、ステートフルな推論と動的なコンテクスト管理が欠かせない。音声セッションは長時間に及び、その間コンテクストが増え続ける。モデルインスタンスも需要に応じて増減するため、途切れのない体験を維持するには高度なハンドオフ機構が必要になる。
GPT‑Liveは、モデルインスタンス間のシームレスな切り替えを導入した。切り替えが必要な場合、既存のインスタンスと並行して新しいインスタンスを立ち上げ、現在のセッションコンテクストを事前に読み込ませる。両方のインスタンスで推論を並行して行い、新しいインスタンスの準備が整った時点で切り替える。この一連の処理はメディアパスの外側で実行されるため、会話が中断される心配はない。
同様に、コンテクストがモデルの上限を超えた場合も、同じ並行ハンドオフの考え方で対応する。従来は推論を止めてコンテクストを圧縮し、KVキャッシュを再構築する必要があったが、GPT‑Liveでは圧縮作業と新インスタンスの準備をバックグラウンドで行う。元のインスタンスが会話を続けている間に、圧縮済みコンテクストを持った代替インスタンスが準備され、問題なく切り替えられる。この仕組みにより、長時間の通話でも音声が途切れず、ユーザはコンテクストの上限を意識することがない。
起動遅延を1回のUDPパケットに、プロトコル改善の舞台裏
音声AIの応答速度は、会話の開始ボタンを押した瞬間から問われる。GPT‑Liveでは、WebRTCをベースにメディアパスを確立し、モデルへの音声入力を開始するまでの時間を極限まで削り取った。そのために生み出されたのが、WARP(WebRTC Abridged Roundtrip Protocol)とInstant Connectという2つの新技術だ。
標準的なWebRTCでは、メディアとデータの開始までにICE、DTLS、SCTP、データチャネルの確立と、最大6回のネットワーク往復が必要だった。OpenAIのエンジニアは、DTLSハンドシェイクをICEに便乗させるSPEDや、SCTPのネゴシエーションを事前共有するSNAPなどを考案し、これらの手順を1往復に圧縮した。さらにInstant Connectにより、SDPパラメータの事前共有を実現。ユーザがボタンを押した瞬間、最初のUDPパケットでセッションが成立し、即座に音声ストリームが流れ始める。
これらのプロトコル改良は、OpenAIだけでなくWebRTCコミュニティにも公開されており、すでにlibwebrtcやPionに実装が進んでいる。IETFのTSVWGワーキンググループを通じて標準化も目指されているという。
本番さながらのテストが教えた教訓

理論上の性能がいくら優れていても、実際の音声トラフィックの前では想定外のボトルネックが顔を出す。OpenAIはGPT‑Liveの本格提供前に、サイレントシャドーテストと呼ばれる手法を採用した。ChatGPT Voiceの実際のユーザセッションの一部を、既存のAdvanced Voice Modeと並行して、新しいシステムに読み取り専用で流し込むのだ。
このテストで最初に判明したのは、GPUの処理能力だけを見ていては不十分だという事実だった。音声セッションは継続的にフレームを送り続けるため、CPU側のストリームハンドラやキュー、ネットワーク経路もGPUと同等にスケールしなければならない。サイレントテストにより、負荷試験では見落とされがちなCPU飽和が検出され、レイテンシの蓄積を防ぐ対策が取られた。
- GPUあたりのリクエスト数だけを見る
- 長時間接続や再接続のパターンを検証できない
- 地理的な遅延差が考慮されない
- 実際のユーザーの音声セッションを読み取り専用で流す
- CPU側のストリーム処理やネットワーク経路も含めて検証
- 地域別の遅延や長時間の状態圧縮の挙動を観測
また地理的な要素も無視できない教訓をもたらした。ユーザに近い場所に推論リソースを配置しなければ、起動時やストリーミング中の遅延が増加する。OpenAIは地域別の容量とトラフィック誘導を定常的に検証し、エンドツーエンドの応答性を部品ごとに可視化する監視体制を整えた。さらに、メトリクスの粒度を上げ、ダッシュボードが不健全なエンジンを埋もれさせないように改善。段階的なロールアウトやパスの隔離など、本番品質を支える運用技術も同時に鍛え上げられた。
この記事のポイント
- GPT‑Liveはターン検出器を排除したフルデュプレックス方式で、発話中の同時送受信を実現
- 音声モデルとフロンティアモデルを非同期に分離し、深い思考を会話の遅延なく組み込む設計
- ステートフル推論と動的コンパクションにより、長時間の会話でも途切れない音声を維持
- WebRTCのハンドシェイクを1往復に圧縮するWARPやInstant Connectで、起動遅延を極限まで低減
- 本番トラフィックを使ったサイレントテストで、実際の運用に耐えるシステムへと練り上げた
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPTでSupabaseにログイン可能に。ベータ提供が開始
Supabaseは2026年7月29日、ChatGPTアカウントを使ったサインイン機能のベータ提供を開始した。supabase.comのログインページと、デスクトップ、Web、モバイル版のChatGPTプラグインの両方で利用できる。
ChatGPT WorkやCodexで開発プロジェクトを始める場面では、プロンプトとバックエンドの間のアカウント管理がシームレスになる。既存のChatGPTアカウントをそのまま使ってSupabaseアカウントを作成または連携でき、少ない手順でデータベースの準備に移れるようになった。
ChatGPTアカウントでSupabaseにログインする仕組み
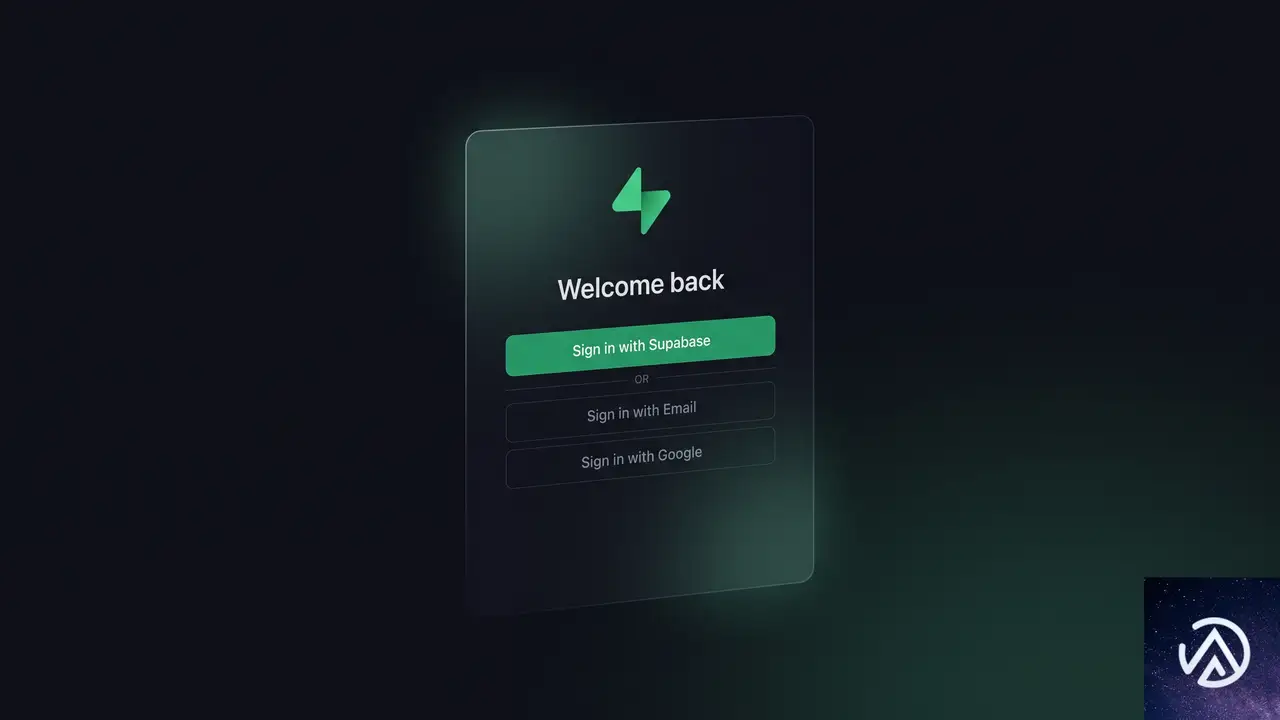
GitHubアカウントでログインするのと同じ感覚で、ChatGPTアカウントを認証プロバイダーとして使えるようになる。Supabaseのログインページで「ChatGPT」を選択すると、ChatGPT側の承認画面が表示され、数クリックでダッシュボードにアクセスできる。
このサインインフローにより、初回のアカウント登録からプロジェクト作成までのハードルが大きく下がる。メールの確認リンクを待つステップがなくなり、思考の流れを止めずにバックエンドの準備に入れる。
新規アカウント作成と既存アカウントの自動連携
ChatGPTサインインは、Supabaseをまだ使ったことがない人にも、既にアカウントを持っている人にも対応する設計だ。
- 新規ユーザーの場合、ChatGPTでサインインすると自動的にSupabaseアカウントが作成される。以降はそのChatGPTアカウントのみで管理できる。
- 既存ユーザーの場合、ChatGPTアカウントに登録されているメールアドレスがSupabaseのものと一致していれば、自動的に連携が行われる。新しいアカウントは作られず、既存のSupabaseアカウントにChatGPTがもうひとつのログイン手段として追加されるだけだ。ただし、SSO(シングルサインオン)アカウントはこの自動連携の対象外となり、別管理になる。
ChatGPTがプロジェクトの出発点なら、バックエンドのアカウントも同じ場所から始められる。管理するパスワードがひとつ減り、アカウント管理の手間も軽減される。
ChatGPTやCodexからSupabaseを直接接続する手順
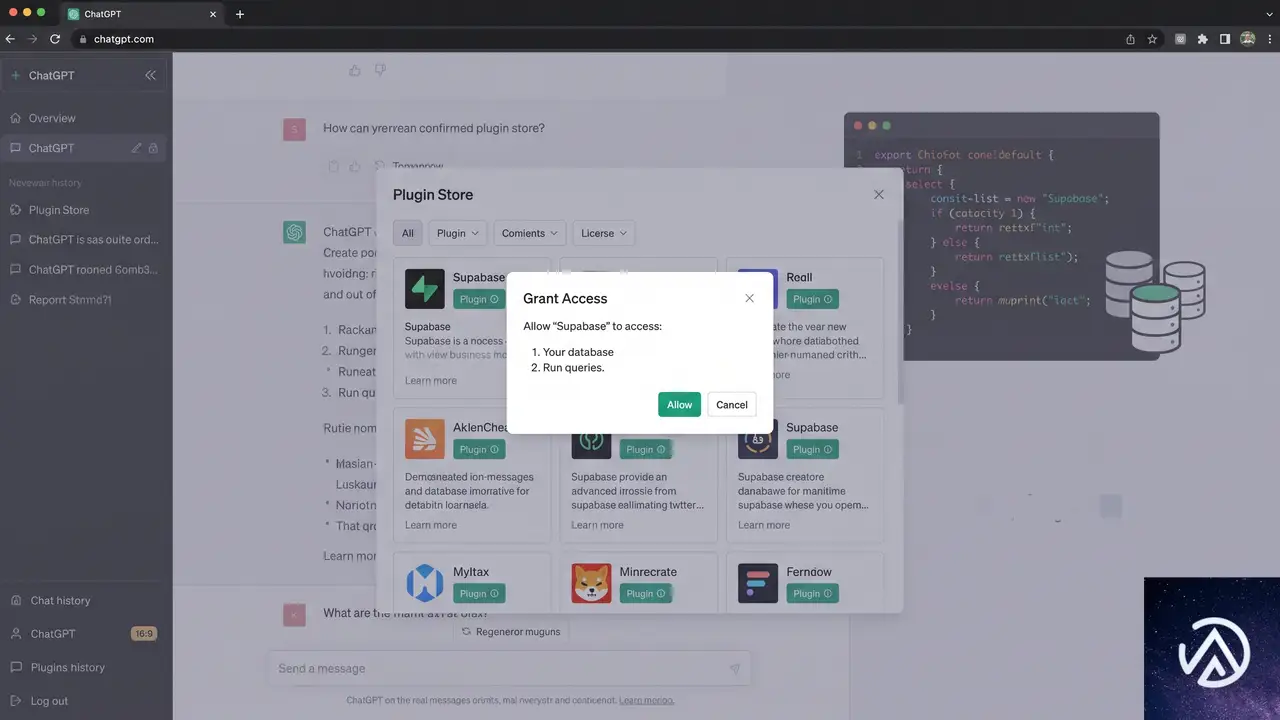
SupabaseをChatGPTに接続する操作は、クリックと承認だけで完了する。認証済みのアカウントを使い、プラグインの追加から接続までが短いステップでまとまっている。
この接続フローは認証と権限付与を明確に分離している。サインインしたあと、改めてプラグインがアクセスできる範囲が表示され、利用者がそれを確認・承認する。承認後に初めてSupabaseがChatGPTの会話に連携される仕組みだ。
許可の管理と取り消し
接続の許可はいつでもSupabaseダッシュボードから取り消せる。プロジェクトの途中で方針が変わっても、ワンクリックでChatGPTからのアクセスを遮断できるため、セキュリティ面でも柔軟に対応できる。
初めてSupabaseを使う場合、ダッシュボードで組織を作成しておく必要がある。組織がひとつでもあれば、その後はChatGPT側からプロジェクトを作成・操作できるようになる。
OpenAIとのパートナーシップで実現
この機能は、Supabaseが「Sign in with ChatGPT」のローンチパートナーに選ばれたことで実現した。OpenAIはサードパーティサービスがChatGPTアカウントを認証に使える仕組みをベータ提供しており、Supabaseはその初期導入企業のひとつにあたる。
日常的にChatGPTやCodexからSupabaseのデータベース構築や認証周りを操作している開発者は多い。今回の統合は、その導線をさらに短くする一手であり、プロンプトから本番稼働までの時間を縮める流れを加速させるものと考えられる。
この記事のポイント
- SupabaseのログインページとChatGPTプラグインで「Sign in with ChatGPT」ベータが利用可能になった
- GitHubログインと同様の操作感で、既存のChatGPTアカウントを使ったワンクリック認証ができる
- ChatGPT側からSupabaseを接続する手順は4ステップ。認証と権限付与が分離され、いつでも取り消し可能
- SupabaseはOpenAIのローンチパートナーとして、この認証機能をいち早く導入した
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Node.jsが6月17日に緊急セキュリティリリース。26.x/24.x/22.xにHIGHの脆弱性修正
Node.jsプロジェクトは2026年6月17日、現行の全サポートラインを対象とする緊急セキュリティリリースを実施する。対象はバージョン26.x、24.x、22.xの3系統だ。
今回修正される脆弱性の最高深刻度は「HIGH」に分類されている。本番サーバーに直接影響しうるレベルのため、運用担当者は即日適用を検討する必要がある。
本記事では、公開された情報をもとに影響範囲と具体的なアップデート手順、放置した場合のリスクを整理する。セキュリティリリースの背景にあるプロセスや、サポート終了バージョンを依然使っているシステムへの警鐘も合わせて伝える。
今回のセキュリティリリースの概要
公開日と対象バージョン
リリースは2026年6月17日(水)またはその直後に行われる。Node.jsのセキュリティポリシーでは、深刻度が高い脆弱性が報告された場合、定例外の緊急パッチとして全アクティブなリリースラインにバックポートされる。
今回の対象は26.x系、24.x系、22.x系の3つ。いずれもNode.jsの長期サポート(LTS)または現行のメンテナンス対象ラインだ。26.xは最新の偶数系で、本記事執筆時点ではActive LTSのステータスにある。
修正される脆弱性の深刻度
Node.jsのセキュリティアドバイザリでは、脆弱性はCritical(最重要)、High(重要)、Moderate(中程度)、Low(低)の4段階で評価される。今回のリリースで修正される問題の最大深刻度は、3つのラインすべてで「HIGH」とされた。
深刻度がHIGHということは、攻撃者がリモートから比較的容易に悪用できる、あるいはサービス停止や情報漏洩につながる可能性があることを示す。具体的にどのモジュールやプロトコルが影響を受けるかは、リリース当日まで伏せられる慣行だ。
上の図はあくまで概念的な例だが、今回のパッチも同様に、OSや依存ライブラリのレイヤーではなくNode.jsランタイム自身の脆弱性に対応するものだ。
影響を受けるバージョンと深刻度の内訳
各リリースラインの深刻度
- 26.x系:修正される最も高い深刻度はHIGH
- 24.x系:修正される最も高い深刻度はHIGH
- 22.x系:修正される最も高い深刻度はHIGH
いずれもHIGHに分類されている点に注意が必要だ。これらは独立したリリースラインであり、別のコードベースに別個の修正が適用される。つまり、共通の根本問題を共有している可能性もあるが、ラインごとに異なる種類の脆弱性が含まれているケースもある。
EOLバージョンにも注意
Node.jsのセキュリティリリースでは、公式サポートが終了したバージョン(End-of-Life)にも同様の脆弱性が存在する。セキュリティパッチは提供されないため、EOLバージョンをまだ利用しているプロジェクトは早急にサポート対象のラインへ移行すべきだ。
例えば2025年4月にEOLを迎えた20.x系は、今回のセキュリティ修正の対象外だが、内部では同様の問題を抱えている可能性が高い。Node.jsのリリーススケジュールに沿った定期的なアップグレードが、システム全体の防御力を高める。
なぜこのセキュリティリリースが重要なのか
実装別のリスクと実例
Node.jsはHTTPサーバーとして単体で動くケースも多いが、リバースプロキシの背後で利用される場面が一般的だ。脆弱性の種類によっては、WAFや前段のネットワーク機器で防御しきれないケースがある。
過去のNode.js HIGHレベルのセキュリティアドバイザリでは、HTTP/2のフレーム解析の不備によるリソース枯渇や、TLSハンドシェイク時のメモリ破損などが報告されてきた。今回詳細は未公表だが、同様にネットワーク越しの攻撃が想定されると考えるのが妥当だ。
アップデートしない場合の想定被害
深刻度HIGHの脆弱性を放置すると、サービス停止(DoS)、情報漏えい、リモートコード実行のいずれかのリスクが残る。特にNode.jsは多くのWebアプリケーションやAPIサーバー、マイクロサービスの基盤として動作しているため、単一のパッチ未適用が複数システムに波及しうる。
また、パブリックなアドバイザリが公開された後は、攻撃者による実証コード(PoC)の拡散が早まる。リリース後24時間以内に対応を完了するのが、業界標準の目安だ。
推奨される対応とアップデート手順
アップデートのチェックリスト
- 稼働中のNode.jsバージョンを確認し、26.x/24.x/22.xのいずれかに該当するか調べる
- 開発環境・ステージング環境で先にアップデートし、自動テストを通過させる
- 本番環境にローリングアップデートで適用する(Blue-Greenデプロイが理想)
- 適用後にアプリケーションのログとパフォーマンスメトリクスを監視する
この流れを自動化しているチームであれば、多くの場合パイプラインに新バージョン番号を設定するだけで済む。Node.jsのマイナーアップデートは互換性を壊さない想定だが、念のため結合テストの再実行が推奨される。
本番環境での注意点
コンテナを使っているならベースイメージの更新で対応できる。Dockerfileで指定している FROM node:22-alpine のような行をリビルドすれば、自動的に最新のパッチバージョンが取り込まれる。
一方、OSのパッケージマネージャーで管理している場合は、NodeSourceなどの公式リポジトリから提供されるまでタイムラグがある場合がある。その際は nvm や fnm などのバージョンマネージャーを使って直接バイナリを切り替える方法も選択肢だ。
リリースタイミングと今後の情報収集
セキュリティパッチは2026年6月17日(水)に公開される。タイムゾーンは明示されていないが、通常はUTCの昼頃にGitHubと公式サイトで同時公開されるパターンが多い。
アップデート後も、Node.jsのセキュリティメーリングリスト(nodejs-sec)を購読しておくと、次の緊急リリースや脆弱性の詳細をいち早く受け取れる。日頃から依存する基盤ソフトウェアの情報をキャッチアップする習慣が、致命的なインシデントを防ぐ最後の砦となる。
この記事のポイント
- Node.js 26.x/24.x/22.xの3系統に緊急セキュリティリリースが公開される
- 修正される脆弱性の最高深刻度はすべてHIGH。早急なアップデートが必要
- EOLバージョンの利用者はサポート対象ラインへの移行を急ぐべき
- アップデートはステージング検証→本番ローリングデプロイの標準フローで対処可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Astro 6.4リリース。プラグ可能なMarkdownパイプラインとRust製プロセッサーSätteriが登場
Astro 6.4が2026年5月28日にリリースされた。Markdown処理パイプラインを自由に差し替え可能にする新API「markdown.processor」、Rustで書かれた高速MarkdownプロセッサーSätteriの試験的導入、そしてCloudflare環境向けのルーティングヘルパーが追加された。
これまでの設定方法は非推奨となり、将来的なAstro 8.0では完全に廃止される予定だ。今回のアップデートで、静的サイト構築におけるMarkdown処理の柔軟性とパフォーマンスが大幅に向上する。
プラグ可能なMarkdownプロセッサーAPI

AstroのMarkdownパイプラインはこれまで、unified(remark/rehype)エコシステムを中心に構築されてきた。強力で数千ものプラグインが利用できる一方、特定のプロジェクトの要求に合わない場合もあった。今回追加されたmarkdown.processor設定オプションでは、そのパイプライン全体を丸ごと差し替えられる。
設定の変更方法
デフォルトのプロセッサーは従来通りunified()が使われるため、既存プロジェクトは何も変更せずにそのまま動き続ける。remark/rehypeプラグインも同じ挙動を保つが、設定場所がトップレベルのmarkdownからプロセッサー内に移行した。
import { defineConfig } from 'astro/config';
import { unified } from '@astrojs/markdown-remark';
import remarkToc from 'remark-toc';

export default defineConfig({
  markdown: {
    processor: unified({
      remarkPlugins: [remarkToc],
    }),
  },
});従来のトップレベルオプション(markdown.remarkPlugins, markdown.rehypePlugins, markdown.remarkRehype, markdown.gfm, markdown.smartypants)も引き続き動作するが非推奨となり、Astro 8.0で完全に削除される予定だ。
移行の注意点
既存プロジェクトの移行は比較的簡単だ。unified({...})内にプラグインをまとめて記述するだけでよい。ただし、マークダウン処理をカスタマイズした複雑な設定を行っている場合は、コードの再構成が必要になる。公式ドキュメントのMarkdownガイドが更新されているため、詳細はそちらを参照してほしい。
Rust製MarkdownプロセッサーSätteri

プラグ可能なプロセッサーAPIの追加により、Astroは標準とは異なるMarkdownプロセッサーも同梱できるようになった。今回導入された@astrojs/markdown-satteriパッケージは、Rustで書かれた高速なMarkdown/MDXパイプライン「Sätteri」をベースにしている。
パフォーマンスの劇的な向上
Sätteriはデフォルトのunifiedベースのパイプラインよりも大幅に高速で、多くのMarkdown機能をプラグインなしでネイティブ実装している。Astroの公式ブログによれば、自社のドキュメントサイトをSätteriに切り替えたところ、ビルド時間が1分以上短縮されたという。
npm install @astrojs/markdown-satteriimport { defineConfig } from 'astro/config';
import { satteri } from '@astrojs/markdown-satteri';
export default defineConfig({
markdown: {
processor: satteri({
features: { directive: true },
}),
},
});この数値はあくまで一例だが、コンテンツ量の多いサイトでは特に効果が大きい。Rustで記述されているため、CPUバウンドな処理が高速化される仕組みだ。
プラグイン互換性と今後のデフォルト化
Sätteriはremark/rehypeプラグインを実行しない。unifiedエコシステムのプラグインに依存している場合は、当面unified()を使い続けるか、SätteriのMDAST/HASTプラグインに移植する必要がある。Astroチームは、将来のメジャーバージョンでSätteriをデフォルトのMarkdownプロセッサーにすることを目指している。
Rustプロセッサーや新APIに関するフィードバックは、公式のRFCDiscussionで受け付けている。興味がある開発者はぜひ参加してほしい。
Cloudflare向け高度ルーティングヘルパー

Astro 6.3で導入された実験的な高度ルーティング機能をCloudflare環境で使いやすくするため、@astrojs/cloudflareパッケージにcf()ヘルパーが追加された。SESSION KVバインディングの注入、ASSETSバインディングによる静的アセット配信、クライアントIPアドレスやwaitUntilの処理など、Cloudflare特有の面倒な設定を一手に引き受ける。
Fetchハンドラでの利用
import { astro, FetchState } from 'astro/fetch';
import { cf } from '@astrojs/cloudflare/fetch';

export default {
  async fetch(request: Request, env: Env, ctx: ExecutionContext) {
    const state = new FetchState(request);
    const asset = await cf(state, env, ctx);
    if (asset) return asset;
    return astro(state);
  },
};
Honoミドルウェアでの利用
import { Hono } from 'hono';
import { actions, middleware, pages, i18n } from 'astro/hono';
import { cf } from '@astrojs/cloudflare/hono';

const app = new Hono<{ Bindings: Env }>();
app.use(cf());
app.use(actions());
app.use(middleware());
app.use(pages());
app.use(i18n());

export default app;このヘルパーにより、Cloudflare上で高度なルーティングを実装する際のボイラープレートコードが大幅に削減される。実験的機能ではあるが、実用段階に入りつつあると言えるだろう。
その他の改善とアップグレード手順

細かなバグ修正と今後のロードマップ
今回のリリースには、上記の主要機能以外にも多数のバグ修正と小さな改善が含まれている。詳細は公式の変更履歴を確認してほしい。また、Astroコアチームは活発に開発を続けており、コミュニティからのコントリビュートも盛んだ。
アップグレードの手順
既存のAstroプロジェクトをアップグレードするには、自動アップグレードツールを使うのが推奨だ。
# 推奨
npx @astrojs/upgrade

# 手動の場合
npm install astro@latest
pnpm upgrade astro --latest
yarn upgrade astro --latest
自動ツールは非推奨設定の移行などもサポートする。手動で行う場合は、設定ファイルの変更点を確認しながらアップデートしよう。
この記事のポイント
- Markdown処理を差し替え可能にする
markdown.processorAPIが追加された - RustベースのSätteriプロセッサーによりビルド時間を大幅に短縮できる
- Cloudflare向け
cf()ヘルパーで高度ルーティングの設定が簡略化された - 従来の設定方法は非推奨となり、Astro 8.0で廃止予定。早めの移行が望ましい
- アップグレードは
npx @astrojs/upgradeで簡単に行える
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google I/O 2026 Firebase新機能、AIエージェント統合とCrashlytics Web対応発表
Google I/O 2026でFirebaseは、AIエージェント主導の開発時代に対応する多数の新機能を発表した。
Google Antigravityへのワンクリック統合、Android Studioへの標準組み込み、AI LogicのGemini 3対応、そしてWeb向けCrashlyticsの予告まで、フルスタックアプリ開発の効率を一段と高める内容だ。
これらの更新により、開発者はAIアシスタントとFirebaseバックエンドをシームレスに連携させ、より高速に本番品質のアプリを構築できるようになる。
AIエージェントと統合したフルスタック開発の加速
Google Antigravity 2.0とのワンクリック連携
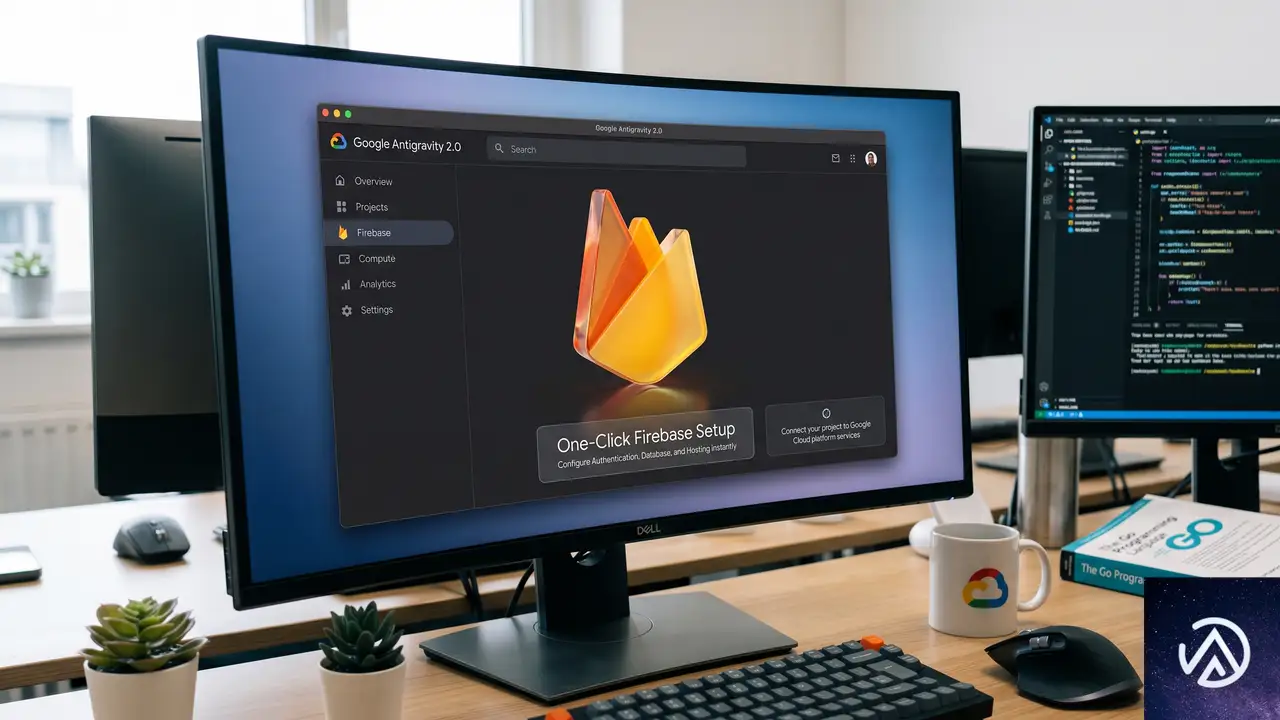
Google Antigravity 2.0は、エージェントを中心とした開発環境を提供するデスクトップアプリだ。今回、そのオンボーディングプロセスにFirebaseをワンクリックでセットアップする機能が組み込まれた。これにより、Antigravity上でAgent SkillsとMCPサーバーを含む必要なコンポーネントが自動でインストールされ、すぐにFirebaseを利用したエージェント主導の開発を始められる。
この一連の流れにより、開発者はバックエンド設定にかかる時間を大幅に削減し、エージェントとの対話に集中できる。
Android StudioへのAgent Skills標準搭載
Android開発者にとって大きな変化は、Android StudioのエージェントモードでFirebaseのAgent Skillsがデフォルトで利用可能になった点だ。これまでは個別のセットアップが必要だったが、追加の設定なしで、エージェントがFirestoreの設定、認証コードの生成、セキュリティルールの記述まで支援してくれる。IDE内でFirebaseバックエンドを対話的に構築できるため、ドキュメントを調べる手間が省ける。
開発者の手を動かす作業が大幅に減り、アプリロジックに集中しやすくなる。
Agent Skillsがモバイル開発にも対応
これまでWeb向けに提供されていたAgent Skillsが、Android、iOS、Flutterにも拡張された。さらにCrashlyticsとRemote Configにも対応し、エージェントがクラッシュ解析や設定管理を手助けできる。例えば、IDE内で発生したクラッシュ情報をエージェントが解釈し、修正案を提示するため、ダッシュボードを切り替える必要がなくなる。
Google AI Studioの新機能、Workspace連携とデプロイ簡略化
Google AI StudioでのFirebase統合が一段と進んだ。まず、AI Studioで生成したFirebase対応アプリをワンクリックでCloud Runにデプロイできるようになり、最初の2アプリはGoogle Cloud Starter Tierにより支払い情報不要で無料公開できる。また、自然言語で「受信トレイを整理するアプリを作って」と指示するだけで、Firebase Authentication経由の「Sign in with Google」フローを通じてGmailやGoogleドキュメントといったWorkspaceデータに安全にアクセスし、自分専用の業務アプリを構築できるようになった。
さらに、マルチエージェントによる本格的な開発に進みたい場合、AI StudioからAntigravityへアプリをエクスポートできる。エクスポート時にはソースコードとAgent Skillsが自動で引き継がれ、Antigravity上で引き続き高度な調整が可能だ。
Firebase AI Logicの進化、Gemini 3対応とセキュリティ強化
Gemini 3.xモデル対応とグラウンディング強化
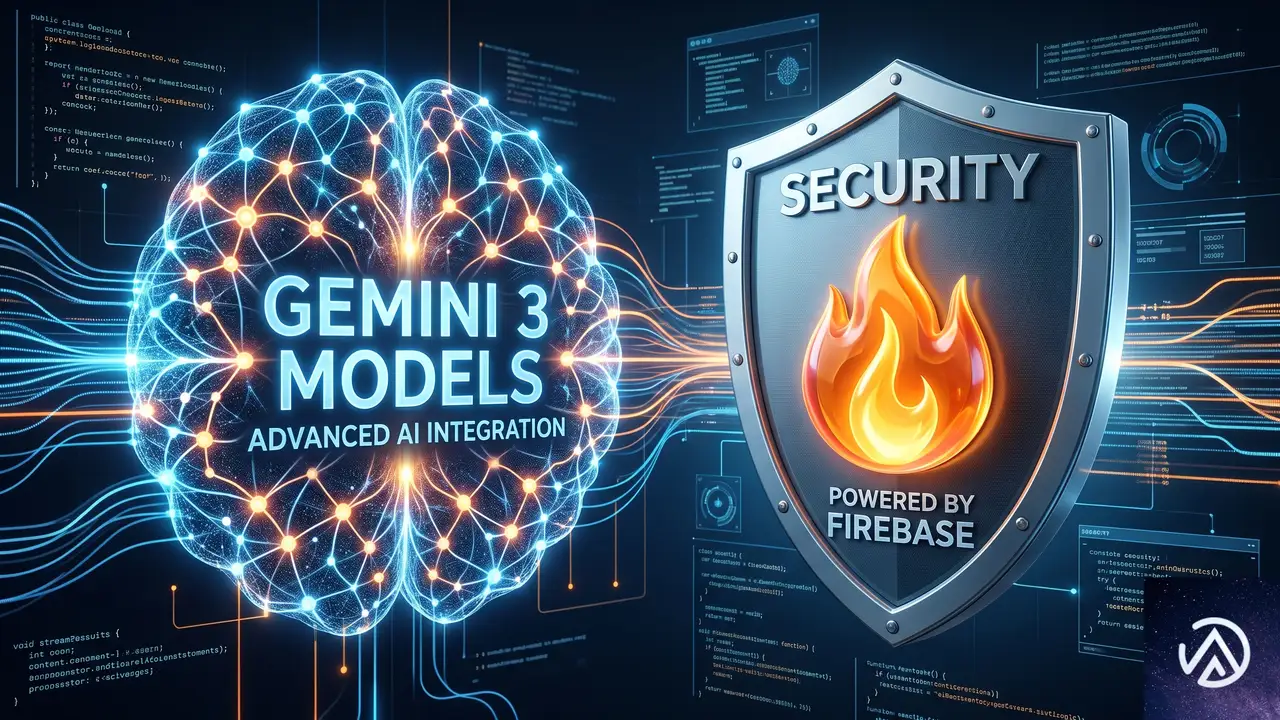
Firebase AI Logicは、クライアントサイドから直接Geminiモデルを呼び出すためのSDKだ。今回のアップデートでGemini 3.xシリーズに完全対応し、Google Mapsによるリアルタイムな地理情報のグラウンディング(正確な根拠をもとにした出力)でハルシネーションを抑制する。画像生成ではアスペクト比やサイズのプログラム制御が可能になり、生成に失敗した場合は「finish reasons」で原因(安全性フィルターによるブロックなど)が表示される。また、Gemini Live APIではセッション再開とコンテキスト圧縮がサポートされ、不安定なネットワークでも長時間の対話型アプリが途切れず動作する。
- モデル出力の正確性が不安定
- 画像生成に失敗しても理由が不明
- 長い会話でネットワーク切断時にリセット
- Google Maps を使ったグラウンディングでハルシネーション低減
- 画像生成失敗時に「finish reasons」で原因を表示
- セッション再開とコンテキスト圧縮で継続的対話が可能
テンプレートのみモードと認証モードでセキュリティ向上
AI機能のセキュリティも大きく強化された。新しい「テンプレートのみモード」では、クライアントが送信できるのはサーバー側に安全に保存されたプロンプトテンプレートのIDだけで、任意の指示を注入できなくなる。まもなく提供開始の「認証モード」では、有効なFirebase Authenticationトークンを伴わない限りGemini呼び出しが実行されない。さらに、Firebase App Checkにワンタイムトークンによるリプレイ攻撃保護が導入され、悪意あるAPI消費を防止する。
ハイブリッド推論のプラットフォーム拡大
ハイブリッド推論機能がiOSでも利用可能になり、Android版はGemma 4に対応した。近くChrome上でのローカルWeb推論も一般提供され、オンデバイスの軽量モデルとクラウドのGeminiを使い分けられる。これにより、プライバシーやコストを最適化しながら、ネットワーク状況に応じて常に最適な推論経路を選択できる。
エンタープライズインフラとの統合とA/B Testingの強化
Application Design Center向けFirebaseテンプレート
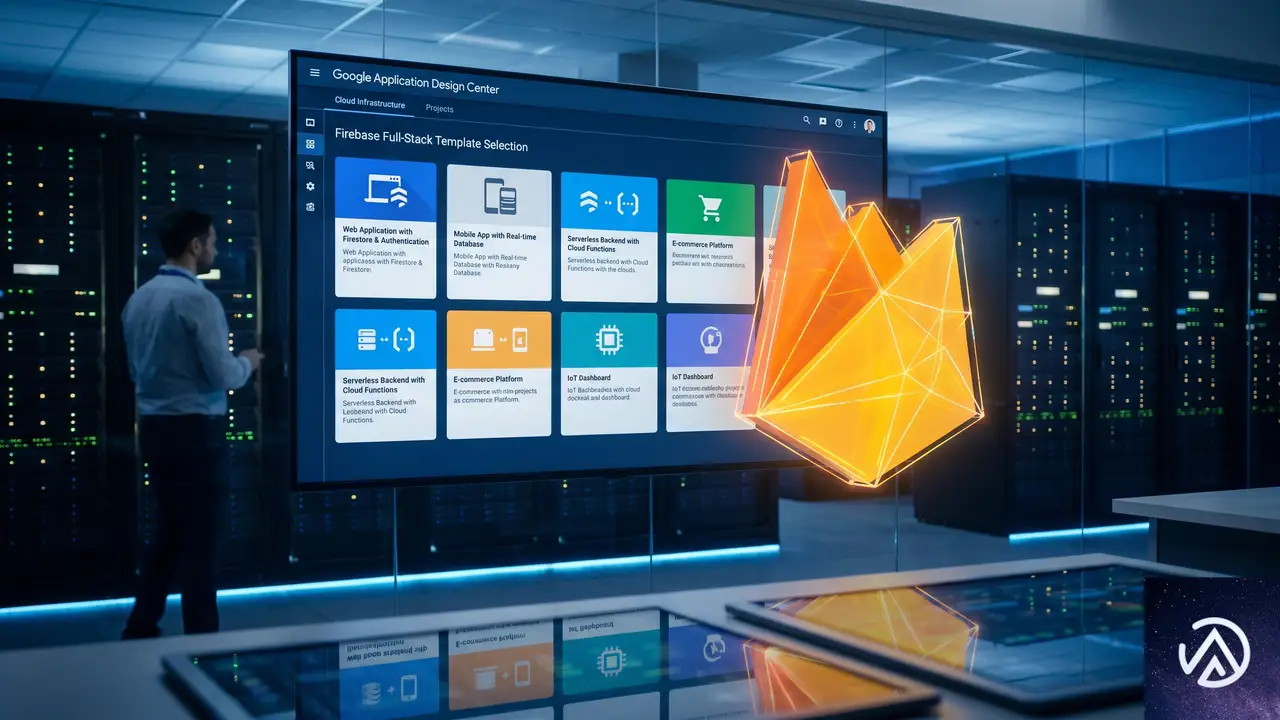
Google CloudのApplication Design Center(ADC)に、Firebaseのフルスタックテンプレートが登場した。このテンプレートはFirestore(セキュリティルール付き)、Firebase Authentication、Firebase AI Logicを事前構成済みで、数クリックでプロジェクトに追加できる。ADC内で他のGoogle Cloudリソースと同じ管理モデルでFirebaseを扱えるため、大規模なクラウドインフラとモバイル・Webバックエンドを統一的に運用できる。
A/B Testingのリッチターゲティング
Firebase A/B Testingの実験作成画面が強化され、より細かいユーザーセグメントを指定できるようになった。Remote Configのリアルタイム配信と組み合わせることで、カスタムシグナルにもとづく柔軟な条件設定が可能になる。このアップデートは段階的にロールアウトされる。
Web向けCrashlyticsが登場、フロントエンドのエラー監視が可能に
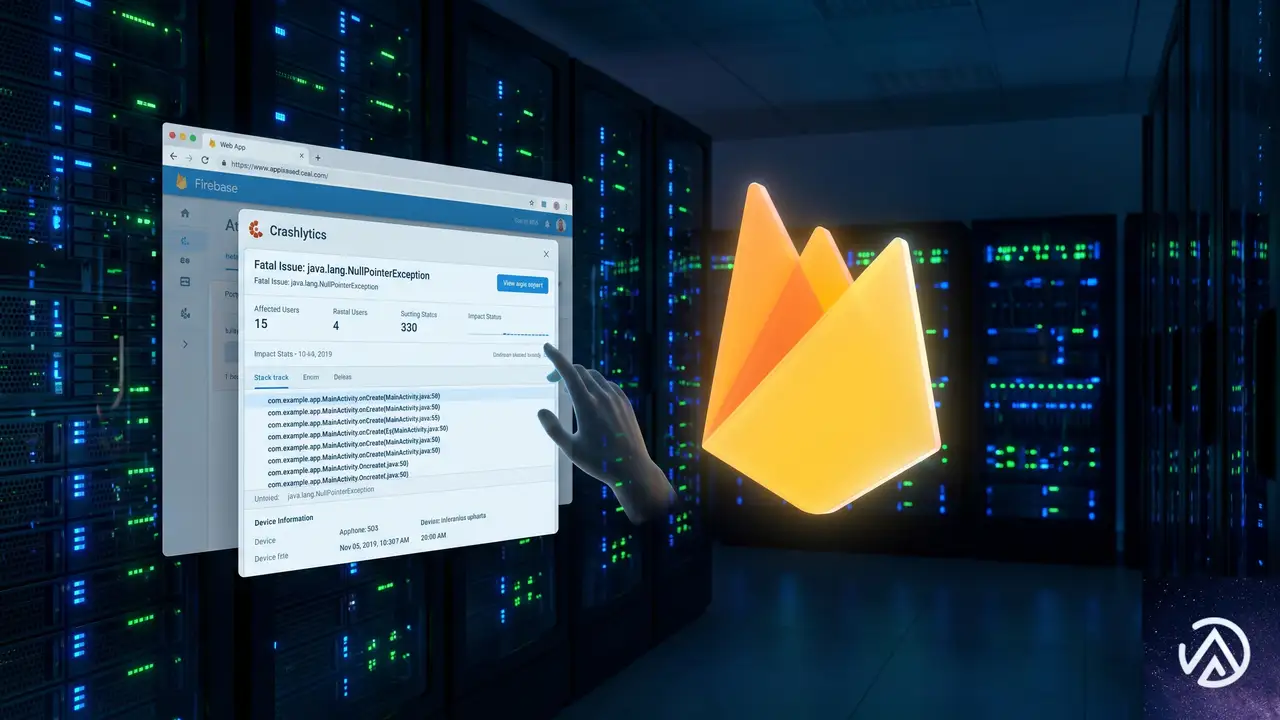
従来Crashlyticsはモバイルアプリ専用のクラッシュレポートツールだったが、Web版が間もなく提供開始される。このWebサポートはGoogle Cloud Observability Suite上に構築され、エラー情報やトレースがCloud LoggingとTraceに一括保存される。モバイルとWebの両方のデータを統合的に分析できるようになり、将来的にはクライアントからサーバーまでのエンドツーエンドデバッグが実現する。開発者はCloud Observabilityのアラート機能やカスタムダッシュボードを活用し、ユーザー体験への影響を詳細に把握できる。
Firebaseが描くエージェント時代の開発基盤
今回のアップデート群は、Firebaseが単なるモバイル向けBaaSから、AIエージェントを中心としたフルスタック開発プラットフォームへ進化していることを示している。Google AntigravityやAI Studioといったエージェント環境との統合、SQL不要の自然言語操作、そしてWebを含む包括的なオブザーバビリティにより、開発者は「何を作りたいか」に集中できるようになる。Firebaseは、エージェント主導のアプリ開発とクラウドのインフラ力を結ぶ架け橋として、今後もアップデートを続ける見込みだ。
この記事のポイント
- Google I/O 2026でFirebaseはAIエージェントとの統合を大幅に強化、Google AntigravityやAndroid Studioにワンクリックで組み込めるようになった
- Agent Skillsがモバイル(Android、iOS、Flutter)に対応し、CrashlyticsやRemote Configの設定もエージェント任せにできる
- Google AI Studioでは、Firebase Authenticationを使ったWorkspaceデータ連携が自然言語で可能になり、ワンクリックでCloud Runに無料デプロイできる
- Firebase AI LogicがGemini 3モデルに対応し、グラウンディングやハイブリッド推論で精度とコストを最適化。セキュリティ面でもテンプレート専用モードやApp Check改善が加わった
- Web向けCrashlyticsが間もなく登場し、モバイルとWebを横断したエラー監視・デバッグがGoogle Cloud Observabilityと統合される
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Cloudflareが提唱するエージェント指向クラウド。Agents Week 2026の全発表まとめ
AIエージェントが自律的にコードを書き、顧客サポートを完結させ、複雑なリサーチを数分でこなす時代が到来した。これまでのクラウドは「1つのアプリケーションが多くのユーザーにサービスを提供する」というモデルで設計されていたが、その前提が根底から覆されようとしている。
Cloudflareは2026年4月、AIエージェントが主役となる新しいインフラ「Agentic Cloud(エージェント指向クラウド)」の構築に向けた大規模なアップデート「Agents Week」を実施した。数千万のエージェントが並列稼働する世界を支えるため、計算資源からセキュリティ、開発ツールまで、全レイヤーにわたる新機能が公開された。
本記事では、Cloudflareが目指す「Cloud 2.0」の全容と、発表された膨大な新機能のポイントを整理して解説する。開発者がプロトタイプから本番環境へとエージェントをスケールさせるための、具体的な武器が揃ったと言える。
エージェントのための新しい計算基盤と実行環境

エージェントは人間とは異なり、24時間365日、膨大な数で並列に動作する。そのため、従来の仮想マシンやコンテナよりも軽量で、かつ持続性のある計算資源が必要だ。Cloudflareは、エージェントが自由にコードを書き、実行できる専用の環境を整備した。
Git互換ストレージ「Artifacts」と隔離環境「Sandboxes」
「Artifacts(アーティファクツ)」は、エージェントが生成したコードやデータを保存するための、Git互換のバージョン管理ストレージだ。エージェントは数千万のリポジトリを動的に作成し、既存のリモート環境からフォーク(複製)して作業を進めることができる。これにより、エージェントが書いたコードを即座にGitクライアントで引き継ぐことが可能になった。
また、エージェントが実際にコマンドを実行し、パッケージをインストールするための環境として「Cloudflare Sandboxes」が正式リリース(GA)された。これは、ファイルシステムやシェルを備えた本物のコンピュータのような環境でありながら、ミリ秒単位で起動し、必要に応じて状態を保存・再開できる。エージェントごとに「専用のパソコン」を割り当てるイメージだ。
Durable Objectsによるエージェント専用データベース
「Durable Objects(デュラブル・オブジェクト)」は、特定の状態を保持できるサーバーレスの仕組みだ。今回のアップデートでは、Durable ObjectsにSQLiteデータベースを内蔵できる「Facets」という機能が追加された。これにより、エージェントが動的に生成したアプリケーションごとに、完全に隔離された専用のデータベースを持たせることが可能になる。
エージェントごとの隔離が難しく、管理が複雑。
エージェント B ➔ 専用SQLite DB
個別に隔離され、ミリ秒で起動・破棄が可能。
この仕組みにより、開発者は数万人のユーザーに対して、それぞれ専用のAIエージェントと専用のDBを瞬時に提供するプラットフォームを構築できる。スケーラビリティの概念が、ユーザー単位からエージェント単位へとシフトしている。
自律動作を支えるセキュリティとネットワーク

エージェントが社内ネットワークにアクセスしたり、ユーザーに代わって決済を行ったりする場合、セキュリティが最大の懸念となる。Cloudflareは、エージェントを「非人間(Non-human)のアイデンティティ」として定義し、その行動を厳密に制御する仕組みを導入した。
プライベート接続を簡素化する「Cloudflare Mesh」
「Cloudflare Mesh(クラウドフレア・メッシュ)」は、ユーザー、デバイス、そしてAIエージェントを安全につなぐプライベートネットワーク機能だ。これまでは、エージェントが社内のデータベースにアクセスするためには複雑なトンネル設定が必要だったが、Meshを使えば、エージェントに最小限の権限(最小特権原則)を与えて直接接続させることができる。
ユーザーに代わって認証する「Managed OAuth」
エージェントがユーザーの代わりにSaaSツールを操作する場合、これまではセキュリティ的に危うい「サービスアカウント」が使われることが多かった。今回発表された「Managed OAuth for Access」は、RFC 9728という新しい規格を採用し、エージェントがユーザーの権限を安全に借用して認証を行う仕組みを提供する。これにより、エージェントが何をしたかの監査ログも正確に残るようになる。
エージェントを「知能」に変えるツールボックス
計算資源があるだけではエージェントは動けない。適切なモデル(脳)、記憶(メモリー)、そして外部世界を認識する手段(ブラウザや音声)が必要だ。Cloudflareはこれらを「Agents SDK」として統合し、数行のコードで実装可能にした。
長期記憶と高度な検索機能
エージェントが過去の会話や作業内容を忘れないようにするための「Agent Memory」が導入された。これは、エージェントに必要な情報を記憶させ、不要な情報を忘れさせるマネージドサービスだ。また、「AI Search」という新しい検索プリミティブ(基本要素)を使えば、エージェントが膨大な文書の中から必要な情報をハイブリッド検索(キーワードと意味の両方で検索)して取り出せるようになる。
ブラウザ操作とマルチモーダル対応
「Browser Run(旧Browser Rendering)」は、エージェントにブラウザを与える機能だ。エージェントはウェブサイトを閲覧し、フォームを入力し、スクリーンショットを撮ることができる。新機能の「Human in the Loop」を使えば、エージェントが判断に迷ったときだけ人間に確認を求めるフローも構築可能だ。
さらに、音声認識(STT)と音声合成(TTS)をリアルタイムで行うパイプラインも追加された。WebSocket(ウェブソケット:双方向通信を行うための規格)を使い、わずか30行程度のコードで「声で会話するエージェント」を実装できる。メールの送受信も「Cloudflare Email Service」を通じてネイティブにサポートされた。
開発効率を最大化するインターフェースの進化

Cloudflareそのものの使い勝手も、エージェント時代に合わせて変化している。開発者が管理画面でポチポチと設定を変えるのではなく、エージェントがAPIを通じてインフラを操作するシーンが増えるからだ。
統一CLI「cf」と管理画面AI「Agent Lee」
約3,000ものAPI操作を統合した新しいCLI(コマンドライン・インターフェース)「cf」が登場した。これは人間だけでなく、エージェントがインフラを操作する際の一貫性を保つために設計されている。また、Cloudflareのダッシュボード内には「Agent Lee」というAIアシスタントが常駐するようになった。ユーザーはプロンプトを入力するだけで、複雑なスタックのトラブルシューティングや設定変更を行える。
ドメイン登録もAPIから可能に
「Cloudflare Registrar API」がベータ版として公開された。これにより、エージェントが自らドメインを検索し、空き状況を確認して登録するまでを完全に自動化できる。エージェントが新しいサービスを立ち上げ、ドメインを取得し、デプロイするまでの全工程がプログラム可能になったことを意味する。
ウェブ全体をエージェント対応へアップデートする

現在のインターネットは人間が読むことを前提に作られているが、これからはエージェントが読みやすい「Agentic Web」への適応が求められる。Cloudflareは、サイト運営者がこの変化に対応するためのツールも提供開始した。
Agent Readiness ScoreとAIトレーニング用リダイレクト
自分のサイトがどれだけAIエージェントにとって読みやすいかを測定する「Agent Readiness Score」が導入された。構造化データが適切か、ボットのアクセスを過度に制限していないかなどを評価する。また、古いコンテンツをAIが学習しないように、検証済みのクローラーを最新のページへ自動で誘導する「Redirects for AI Training」機能も追加された。これにより、古い情報に基づいたAIの回答(ハルシネーション)を防ぐことができる。
独自の分析:Cloudflareが描く「Cloud 2.0」の正体

今回のAgents Weekを通じて見えてきたのは、Cloudflareが「エッジコンピューティング」の強みを最大限に活かし、他社とは異なるアプローチでAIインフラを構築しようとしている点だ。AWSやGoogle Cloudが巨大なGPUセンターに注力する一方で、Cloudflareは「エージェントの実行場所(推論と実行の融合)」という独自のポジションを狙っている。
筆者の見解では、Cloudflareが提唱する「Cloud 2.0」の核心は、ステート(状態)とコンピューティングの極限までの近接にある。Durable Objectsによる超低遅延な状態管理と、ミリ秒で起動するSandboxesの組み合わせは、数千万という単位で増殖するエージェントを効率よく捌くための唯一の解かもしれない。中央集権的なクラウドでは、これほど大量の独立したセッションを低コストで維持するのは困難だからだ。
また、セキュリティを「後付け」ではなく「デフォルト」に置いている点も重要だ。エージェントが自律的に動く世界では、一度の権限設定ミスが致命的な被害を招く。MeshやManaged OAuthをインフラ層で提供することで、開発者はセキュリティの専門知識がなくても「安全なエージェント」を構築できるようになる。これはエージェントの普及を加速させる大きな要因になるだろう。
この記事のポイント
- Cloudflareは、AIエージェントが主役となる「Agentic Cloud(Cloud 2.0)」への進化を宣言した。
- Git互換ストレージ「Artifacts」や隔離環境「Sandboxes」により、エージェント専用の計算基盤が整った。
- 「Cloudflare Mesh」や「Managed OAuth」により、非人間(エージェント)の安全な認証とアクセス制御が可能になった。
- 「Agents SDK」に記憶、検索、ブラウザ操作、音声、メール機能が統合され、開発効率が飛躍的に向上した。
- サイトのエージェント親和性を測る「Agent Readiness Score」など、ウェブ自体をエージェント向けに最適化するツールが登場した。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AIアプリに専用DBを即時提供!CloudflareのDurable Objects Facetsを解説
Cloudflareは、AIが生成したアプリケーションごとに専用のデータベースを割り当てることができる新機能「Durable Objects Facets(デュラブル・オブジェクト・ファセット)」をベータ公開した。この機能は、同社が提供する「Dynamic Workers」の仕組みを拡張したもので、動的に生成されたコードに対して、永続的なストレージを安全かつ高速に提供することを目的としている。
従来のサーバーレス環境では、実行時にコードをロードして実行する「動的なサンドボックス」において、データの永続化を管理することが技術的な障壁となっていた。しかし、Durable Objects Facetsの登場により、AIエージェントが作成した小さなツールや個人用アプリが、それぞれ独自のSQLiteデータベースを持ち、状態を保持し続けることが可能になる。
なぜこのアップデートがAI開発の現場において重要なのか、その背景にある「アイソレート」の技術や、新しいストレージの概念について詳しく紐解いていこう。AIが単にコードを書くだけでなく、自律的にデータを管理する「記憶を持つエージェント」へと進化する大きな一歩だと言える。
Dynamic Workersとアイソレートが支える高速な実行環境

Durable Objects Facetsを理解するためには、まずその基盤となる「Dynamic Workers(ダイナミック・ワーカーズ)」について知る必要がある。Dynamic Workersとは、実行時にWorkerのコードをオンデマンドでロードし、安全なサンドボックス内で実行できる機能だ。
コンテナではなくアイソレートが実現する100倍の起動速度
Cloudflare Workersの最大の特徴は、一般的なクラウドサービスが採用している「コンテナ」技術ではなく、「アイソレート(Isolate)」という仕組みを利用している点にある。アイソレートとは、Google Chromeなどのブラウザを支えるV8エンジンが提供する、非常に軽量な実行環境の単位だ。
アイソレートはコンテナと比較して、起動速度が最大100倍速く、メモリ使用量は10分の1程度で済むという。この圧倒的な軽さにより、コードを実行するたびに環境を立ち上げ、終わったら即座に破棄するという「使い捨てのコンピューティング」が可能になった。Dynamic Workersは、このアイソレートの特性を最大限に活かし、AIが生成した数行のコードを即座に実行するセキュアな「eval()」のような役割を果たす。
このデモは、コンテナとアイソレートの構造的な違いを視覚化したものだ。アイソレートの軽量さが、AIによる動的なコード実行を支えている。
AIエージェントによるコード実行の課題
AIエージェントがユーザーの依頼に応じてコードを書き、それを実行する場合、これまでは「一度きりのタスク」として処理されることが多かった。例えば、データの集計や特定のAPI呼び出しなどは、実行後に結果を返せばコード自体を保持し続ける必要はない。
しかし、ユーザーが「自分専用の家計簿アプリを作って」と依頼した場合、AIはUI(ユーザーインターフェース)だけでなく、入力されたデータを保存し続ける「ストレージ」も提供しなければならない。動的に生成されたコードが、どのようにして安全に、かつ自分専用のデータベースにアクセスするかが大きな課題となっていた。
Durable Objectsがもたらす超低遅延ストレージの仕組み

この課題を解決するための強力な武器が「Durable Objects(デュラブル・オブジェクト)」だ。これはCloudflare Workersの中でも特殊な種類で、世界中で一意の名前を持つインスタンスを作成し、その状態を永続化できる仕組みを指す。
SQLiteをローカルディスクに持つ特殊なWorker
Durable Objectsの最大の特徴は、各インスタンスが自分専用のSQLiteデータベースを持っていることだ。しかも、このデータベースはDurable Objectsが動作している物理マシンの「ローカルディスク」上に配置される。通常のデータベースのようにネットワークを介してリクエストを送る必要がないため、データアクセスにおける遅延は実質的にゼロとなる。
CWV(Core Web Vitals / コアウェブバイタル)などの指標を気にするWeb制作の現場においても、この「ネットワーク遅延がないストレージ」は非常に魅力的だ。ユーザーに近い場所(エッジ)で計算と保存が完結するため、極めてレスポンスの速いアプリケーションを構築できる。
動的なコードとストレージの「相性の悪さ」
しかし、Durable ObjectsをDynamic Workersと組み合わせるには問題があった。通常、Durable Objectsを使用するには、開発者が事前にクラスを定義し、設定ファイル(wrangler.jsonc)で名前空間を宣言し、CloudflareのAPIを通じてプロビジョニング(利用準備)を行う必要がある。AIがその場で生成した未知のコードに対して、この一連の手順を動的に行うことは困難だった。
また、セキュリティ上の懸念もある。AIが生成したコードに、無制限にデータベースを作成する権限を与えてしまうと、リソースの乱用や管理不能なデータの増殖を招く恐れがある。開発者は「AIが書いたコードを実行しつつ、その裏側でストレージやログを適切に管理する」という、監督者のような役割を必要としていた。
新機能「Durable Objects Facets」による解決策

そこで登場したのが、Durable Objects Facets(ファセット)だ。「Facet」とは「切り口」や「側面」を意味する言葉で、一つのDurable Objectの中に、複数の独立した実行環境とデータベースを持たせる概念を指す。
監視役(Supervisor)と実行役(Facet)の分離
この機能の核となるのは、開発者が書いた「監視役(Supervisor)」のコードの中で、AIが書いた「実行役(Facet)」のコードを動的にロードする仕組みだ。監視役は通常のDurable Objectとして動作し、リクエストを受け取ると、必要に応じてAIのコードをFacetとして呼び出す。
FacetとしてロードされたAIのコードは、自分専用のSQLiteデータベースを与えられる。このデータベースは監視役のデータベースとは論理的に分離されており、AIのコードが監視役の重要なデータ(課金情報や管理ログなど)を読み書きすることはできない。一方で、物理的には同じDurable Objectの一部として管理されるため、パフォーマンスの高さは維持される。
・ログ記録、レート制限
・管理用データベースを保持
・アプリ専用のSQLite DB
・親のDBにはアクセス不可
この図のように、一つのDurable Objectの中に「管理領域」と「AIの自由領域」を共存させるのがFacetの狙いだ。これにより、安全性を確保しながら動的なデータ永続化が可能になる。
親子関係で実現するセキュリティと制御
開発者は、AIが作成できるFacetの数を制限したり、各Facetが使用するストレージ容量を監視したりすることができる。これにより、AIが勝手に大量のデータを保存してコストを増大させるリスクを防げる。また、監視役のコードを通じてネットワークアクセスを制限(globalOutbound: null)することで、AIが生成したコードが外部にデータを送信するのを遮断することも可能だ。
これは、大規模なAIプラットフォームを構築するエンジニアにとって非常に重要な制御機能となる。ユーザーごとに異なるAIアプリを動かしても、インフラ側での統制が容易になるからだ。
実装例から見るAIアプリのプラットフォーム構築

実際に、どのようにしてこの仕組みを構築するのか、Cloudflareが公開したコード例を基に解説しよう。ここでは、AIが生成した「アクセス回数をカウントするアプリ」を動的にロードする例を考える。
コードの動的ロードとクラスのインスタンス化
まず、監視役となる AppRunner クラスを作成する。このクラスは this.ctx.facets.get() という新しいメソッドを使い、AIのコードをFacetとして取得する。もしFacetがまだ存在しない場合は、コールバック関数内でDynamic Workerをロードし、その中からAIが定義したクラスを取り出す。
// 監視役のコード例
export class AppRunner extends DurableObject {
  async fetch(request) {
    // "app" という名前のFacetを取得。なければ作成する。
    let facet = this.ctx.facets.get("app", async () => {
      // AIのコードをロード
      let worker = this.#loadDynamicWorker();
      // コード内から "App" という名前のクラスを取得
      let appClass = worker.getDurableObjectClass("App");
      return { class: appClass };
    });

    // リクエストをFacet(AIアプリ)に転送
    return await facet.fetch(request);
  }
}
注目すべきは、AIが書いたコード側でも extends DurableObject を使っている点だ。AIは通常のDurable Objectを書くのと同じ感覚でコードを生成でき、特別なFacet用の記法を覚える必要はない。
データベースの分離と永続化の管理
AIアプリ(Facet)が this.ctx.storage.kv.put() などのメソッドを使ってデータを保存すると、それはそのFacet専用のSQLiteデータベースに書き込まれる。監視役の AppRunner も自身のストレージを持っているが、これらは完全に別のファイルとして管理される。
この構造により、例えばあるユーザーのAIアプリがバグでデータを壊したとしても、監視役が持っている管理データや、他のユーザーのアプリには一切影響が及ばない。マルチテナント(複数のユーザーが一つのシステムを共有すること)な環境を構築する上で、この分離は極めて強力な防御壁となる。
今後のAIエージェント開発への影響と展望

Durable Objects Facetsの登場は、AIエージェントのあり方を大きく変える可能性を秘めている。これまでは「指示を聞いて答えるだけ」だったエージェントが、ユーザー固有のデータを蓄積し、それを基にパーソナライズされた体験を提供する「自律的なアプリケーション」へと進化するからだ。
「使い捨て」から「自律的な成長」へ
これまでのAI生成コードは、実行が終われば消えてしまう「刹那的」なものだった。しかし、専用のデータベースを持つことで、AIアプリは前回の実行時の状態を覚えていることができる。例えば、ユーザーの好みを学習し続けるレコメンドエンジンや、過去の対話履歴を構造化して保存する秘書アプリなどが、AI自身の手によって構築・運用されるようになるだろう。
Cloudflareの著者であるCarlo Daniele氏によれば、これは「Vibe-coded(雰囲気で書かれた)」個人用アプリを、セキュアな環境で永続化するための最適な解決策だという。プログラミングの知識がなくても、AIとの対話を通じて自分専用のツールを作り、それをクラウド上で安全に動かし続けることができる時代の到来だ。
開発者が考慮すべきコストとガバナンス
一方で、この技術を活用する開発者には、新たな責任も生じる。動的にデータベースが増えていくため、リソースのライフサイクル管理が不可欠だ。使われなくなったFacetをいつ削除するのか、バックアップはどうするのかといった、データガバナンスの設計が重要になる。
幸い、Durable ObjectsはCloudflareのインフラによって高度に抽象化されており、運用負荷は低い。しかし、AIが生成するコードの品質やデータの正当性をどう保証するかという点は、依然として人間(プラットフォーム開発者)が設計すべき領域として残っている。Durable Objects Facetsは、そのための「管理ツール」を開発者に提供したと言えるだろう。
この記事のポイント
- Durable Objects Facetsは、AI生成コードごとに専用のSQLiteデータベースを割り当てる新機能である。
- アイソレート技術により、コンテナよりも圧倒的に高速かつ軽量に動的なサンドボックスを起動できる。
- 監視役(Supervisor)がAIのコードを制御することで、セキュリティと管理性を両立させている。
- AIエージェントが「記憶」を持つことが可能になり、パーソナライズされたアプリ開発が加速する。
- 現在はWorkers Paidプランのユーザー向けにオープンベータとして提供されている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare Workflowsの可視化技術——ASTを活用したコードから図への変換プロセスを解説
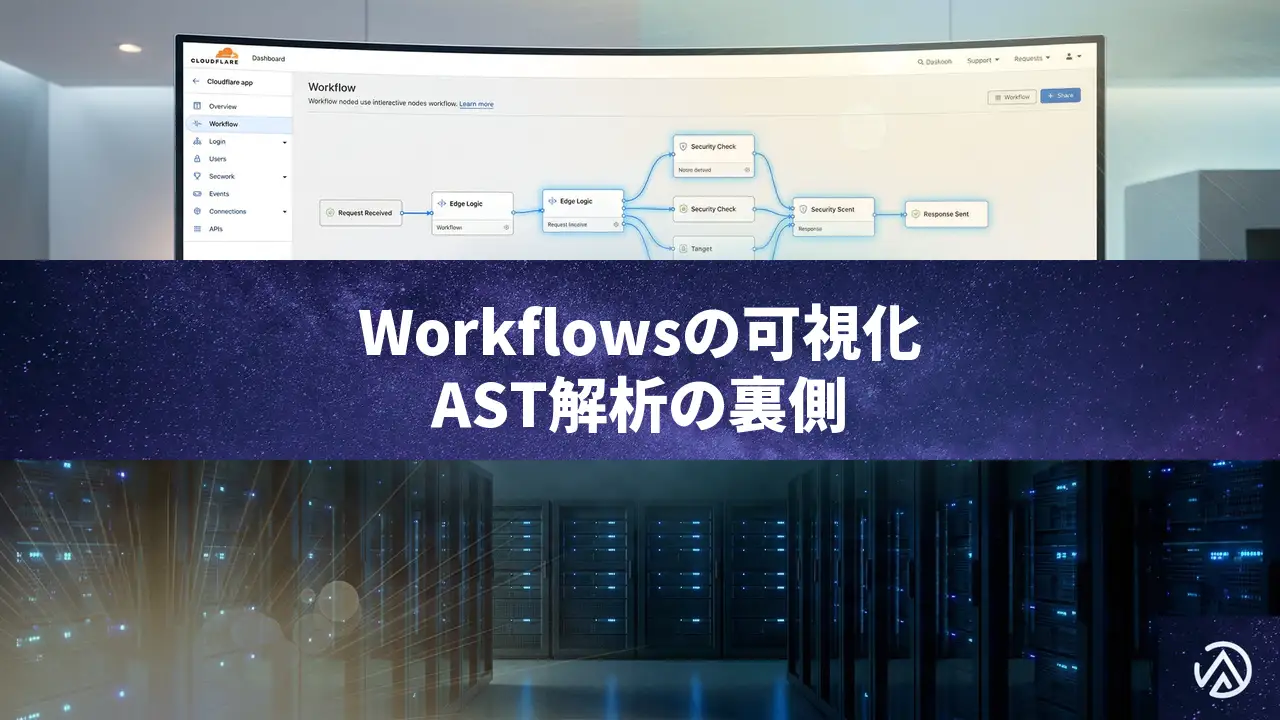
Cloudflare Workflowsでデプロイされたすべてのワークフローに対し、ダッシュボード上で完全な視覚的図解(ダイアグラム)を表示する機能が追加された。この機能は、YAMLやJSONのような宣言的な設定ファイルからではなく、実際に記述されたJavaScript/TypeScriptのコードを直接解析して生成される点が最大の特徴だ。
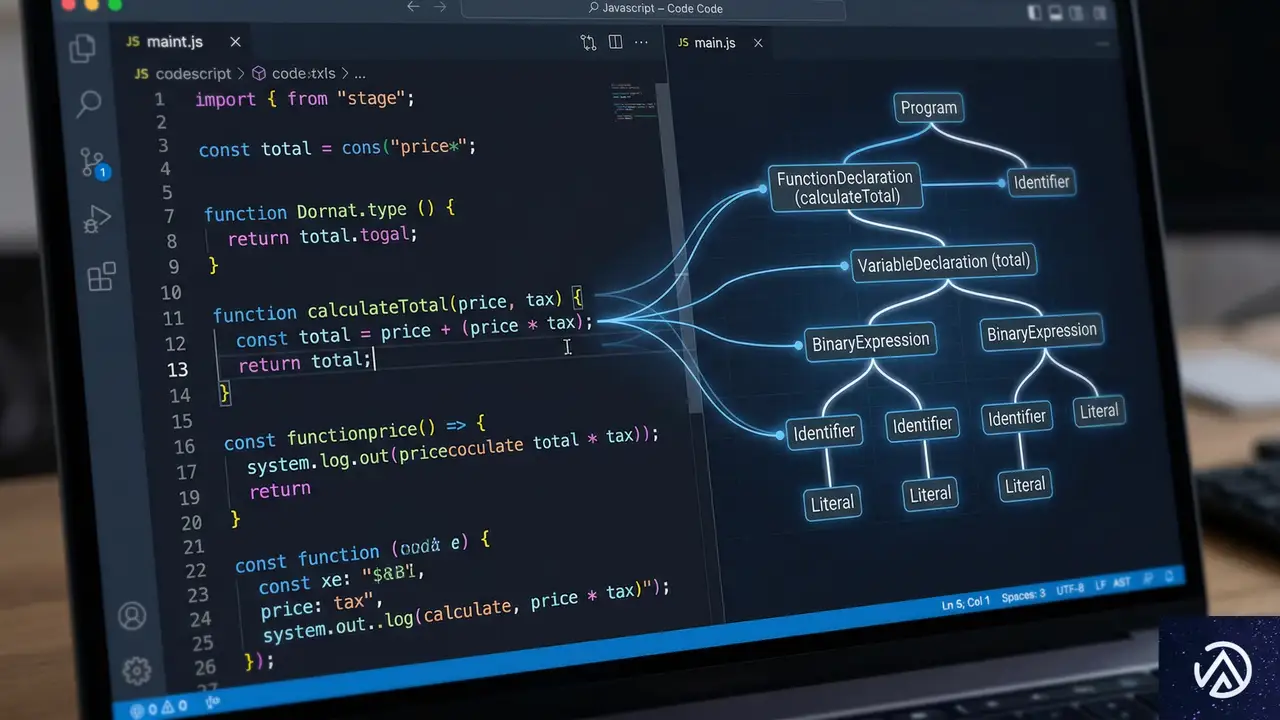
開発者が記述したコードを「oxc-parser」を用いてAST(Abstract Syntax Tree / 抽象構文木)へと変換し、静的解析によってステップ間の依存関係や並列処理を抽出している。これにより、複雑なループや条件分岐を含む動的なワークフローであっても、その構造を一目で把握することが可能になった。
AIエージェントによるコード生成が増加する現代において、人間がコードの全容を即座に理解するための補助ツールとして、この可視化技術は極めて重要な役割を果たす。本記事では、難解な最小化済みコードからどのようにして意味のある図を導き出しているのか、その技術的な裏側を詳しく見ていく。
Cloudflare Workflowsの可視化機能とその背景
なぜ「コードからの可視化」が必要なのか
従来のワークフロー構築ツールの多くは、ドラッグ&ドロップのビジュアルエディタや、YAML/JSONによる宣言的な定義をベースにしていた。これらは図解しやすい反面、複雑なロジックを記述する際の柔軟性に欠けるという弱点がある。
対してCloudflare Workflowsは「コードがすべて」というモデルを採用している。Promise.allによる並列実行、複雑なforループ、条件分岐などが通常のJavaScriptとして記述できる。しかし、自由度が高い反面、コードが複雑になると全体の流れを把握するのが難しくなる。記事によれば、特にAIが生成したコードを人間が確認する際、その「形状(shape)」を視覚的に理解できるメリットは大きいという。
動的実行モデルという技術的ハードル
Workflowsは「動的実行モデル」に従っている。これは、ランタイムがコードを実行中にステップ(step.do)に遭遇するたびに、制御をエンジン(Durable Object)に渡す仕組みだ。エンジンは実行されたステップの結果を保存するが、次にどのステップが来るかを事前には知らない。
図を作成するには、実行前(デプロイ時)に全体の構造を知る必要がある。しかし、エンジンが実行時にしかステップを把握できないのであれば、静的な図を作ることはできない。そこで、Cloudflareのチームはデプロイ時にスクリプトを解析し、コードの構造を「読み解く」アプローチを選択した。
AST(抽象構文木)を用いたコード解析の仕組み
最小化されたJavaScriptという難問
デプロイされるコードは、通常esbuildやrspack、viteなどのツールによって「最小化(Minify)」されている。変数名はaやbに書き換えられ、改行は消え、人間には解読不能な1行の巨大な文字列となる。この状態からワークフローのステップを抽出するのは容易ではない。
AST(Abstract Syntax Tree / 抽象構文木)とは、プログラミング言語の構文構造を樹木構造で表現したデータ形式だ。コードをトークンに分解し、どの関数がどの引数で呼び出されているかを構造的に把握できる。Cloudflareは、このASTを利用して最小化されたコードのジャングルからstep.doやstep.sleepといった特定の呼び出しを特定している。
高速な解析を実現するoxc-parserの採用
解析エンジンには、Rust製の高速なJavaScriptツールチェーンである「OXC(JavaScript Oxidation Compiler)」のoxc-parserが採用された。当初はコンテナ上でRustを動かしていたが、最終的にはWebAssembly(Wasm)を介してCloudflare Workers上で動作するRust Workerへと移行されたという。
このRust Workerが最小化されたJSをASTに変換し、定義されたノードタイプ(LoopNode, ParallelNode, IfNodeなど)にマッピングしていく。以下に、コードがどのようにASTを経て図の要素へ変換されるかの概念図を示す。
step.do('task', ...)このデモは、ソースコードがAST解析を経て、最終的にダッシュボード上の視覚的なステップノードへとマッピングされる流れを視覚化したものだ。
複雑なロジックをグラフ構造にマッピングする手法
並列処理を表現する「開始」と「解決」のインデックス
Workflowsにおいて最も表現が難しいのが、並列処理だ。JavaScriptではawaitを付けずにステップを呼び出すと並列に実行され、Promise.allでそれらをまとめて待機できる。これを図にするため、Cloudflareのチームは各ノードにstartsとresolvesというフィールドを持たせた。
解析中にawaitされていないPromiseに遭遇すると、そのノードに「開始(starts)」のインデックスを付与する。その後、awaitに遭遇した時点でインデックスを増やし、「解決(resolves)」として記録する。この数値の重なりを見ることで、どのステップが垂直方向に並ぶべきか(=並列か)、どのステップが完了を待って次に進むべきかを正確に判定している。
制御構文(ループ・分岐)のパターン網羅
単なる直線的なフローだけでなく、実務では多様な構文が使われる。著者のAndré氏とMia氏は、以下のような多岐にわたるパターンをASTから抽出できるように設計したと述べている。
- ループ:
for...of,while,items.map,forEach - 分岐:
switch/case,if/else, 三項演算子 - エラーハンドリング:
try/catch/finally - 関数呼び出し: ステップをラップした関数の追跡
特に、関数の中に隠れたステップの追跡は工夫が必要だ。ある関数が直接ステップを呼び出していなくても、その中で呼び出している別の関数がステップを含んでいる場合、その依存関係をグラフに含める必要がある。記事によれば、関数ごとのサブグラフを作成し、最終的にステップを含まない「葉」の部分をトリミングすることで、ノイズのない図を実現している。
開発体験(DX)における可視化の価値と今後の展望
デバッグ効率を劇的に高めるリアルタイム追跡
この可視化機能は単なる「清書された図」ではない。Cloudflareは、これをフルサービスのデバッグツールへと進化させる計画だ。具体的には、実行中のワークフローが今どのノードにいるのかをグラフ上でリアルタイムに追跡できるようにするという。
エラーが発生した場所の特定、人間による承認待ちの状態確認、あるいはテスト目的での特定ステップのスキップなど、ビジュアルインターフェースを通じて操作できる未来を目指している。さらに、ローカル開発環境での可視化も視野に入れているとのことで、開発サイクル全体での利便性向上が期待される。
独自の分析:コードを「正解」とするアプローチの意義
今回のCloudflareの取り組みで特筆すべきは、「ビジュアルエディタで作ったものをコードに書き出す」のではなく、「コードからビジュアルを逆生成する」という方向性を徹底している点だ。これは、エンジニアにとっての真実の源泉(Source of Truth)が常にコードであることを尊重している。
このアプローチの利点は、Gitによるバージョン管理やコードレビューといった既存の開発フローと完全に共存できることにある。図を作成するために特別な設定ファイルを書く必要がなく、普段通りにコードを書くだけで、非エンジニアのステークホルダーにも共有しやすい図が手に入る。これは、開発組織におけるコミュニケーションコストを大幅に下げる可能性を秘めている。
また、AST解析という「枯れた」技術を、最小化されたJSという「汚れた」実データに適用し、それをWasmでエッジ上で高速実行するという構成は、非常にCloudflareらしい合理的でパワフルな解決策だと言えるだろう。
この記事のポイント
- コードから図を自動生成: Cloudflare Workflowsは、JS/TSコードを解析して視覚的な図を自動作成する。
- AST(抽象構文木)の活用: 最小化された難解なコードも、AST解析によって構造的に理解し、ステップを抽出する。
- oxc-parserによる高速処理: Rust製の解析器をWasmで動かすことで、デプロイ時の高速な図解生成を実現した。
- 並列処理の可視化:
startsとresolvesというインデックスを用いて、複雑な並列実行の関係を正確に図示する。 - デバッグツールへの進化: 今後はリアルタイムの実行追跡や、図からの操作機能も追加される予定だ。
出典
- Cloudflare Blog「How we use Abstract Syntax Trees (ASTs) to turn Workflows code into visual diagrams」(2026年3月27日)
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験