

SupabaseがTursoを買収。エージェント向けDB基盤の進化へ
Supabaseが10月2日、SQLiteクラウドプラットフォームを手がけるTursoの買収を発表した。AIエージェントが大量のデータベースを作成する新時代に向け、PostgresとSQLiteの両軸で基盤を強化する動きだ。
既存ユーザーへの影響はない。SupabaseはPostgresを中心に、TursoはSQLiteを中心にそれぞれの開発を継続する。両社の技術と知見を組み合わせ、エージェントがDBを簡単に扱える新たな体験の実現を目指す。
この記事では買収の概要、AIエージェントが変えるデータベース需要、Tursoの技術アーキテクチャ、オープンソース戦略を整理する。
買収の背景、PostgresとSQLiteの両軸へ
Supabaseの発表によると、同社はすでに毎週100万以上のデータベースを立ち上げている。AIエージェントがプロトタイプやダッシュボード、アプリケーションを大量に作る流れが進む中で、DB需要は現在の供給能力を超える可能性がある。こうした状況に対応するため、Tursoの買収に至った。
重要なのは、この買収が「どちらかの技術に一本化する」話ではない点だ。Supabaseは引き続きPostgresを中心に開発し、TursoはSQLiteの改良を続ける。その上で、両社を横断する新しい基盤を共同で構築する。Supabaseの開発者体験をすべてのエージェントに届けることが目標だ。
SQLiteとは、サーバーを必要としないファイルベースの軽量データベースだ。アプリケーションに組み込んで手軽に使える特徴がある。一方のPostgresは、本格的なリレーショナルデータベースとして大規模なアプリケーションで使われる。小さなワークロードから本番環境まで、段階に応じた選択肢を提供できる体制になる。
AIエージェントが変えるデータベース需要
AIエージェントとは、人間の指示を受けて自律的にタスクを実行するAIのことだ。コードを書いたり、調査をしたり、アプリのプロトタイプを作ったりする。Supabaseの発表によれば、エージェントはすでに数百万ものデータベースを生み出しているという。
この流れが進むと、データベースに求められる性質が変わる。エージェントはファイルを作るのと同じ感覚でDBを作成できるべきだ。コストをほとんど気にする必要がなく、小規模な用途であれば専用マシンを毎回プロビジョニングする手間も避けたい。必要な時にすぐ使えて、不要になったら自動で止まる。そして本番環境へ移行する明確な道筋があること。これがエージェント時代のDB基盤に必要な条件だ。
プロビジョニングとは、サーバーやデータベースなどのインフラを自動的に割り当てて利用可能な状態にすることだ。従来は小規模なDBでも専用マシンを毎回準備する必要があった。AIエージェントが大量の小規模DBを必要とする時代には、この方式ではコストと時間が合わない。
このデモは、AIエージェントの台頭によってデータベース作成のアプローチが大きく変わることを示している。
SQLiteはこのような小規模でオンデマンドなワークロードに適している。一方、アプリケーションが成長して本格的な運用に入る段階ではPostgresが力を発揮する。両方を同じ開発者体験でつなぐことが、今回の買収の狙いだ。
Tursoの技術アーキテクチャ、Rustで再構築したSQLite
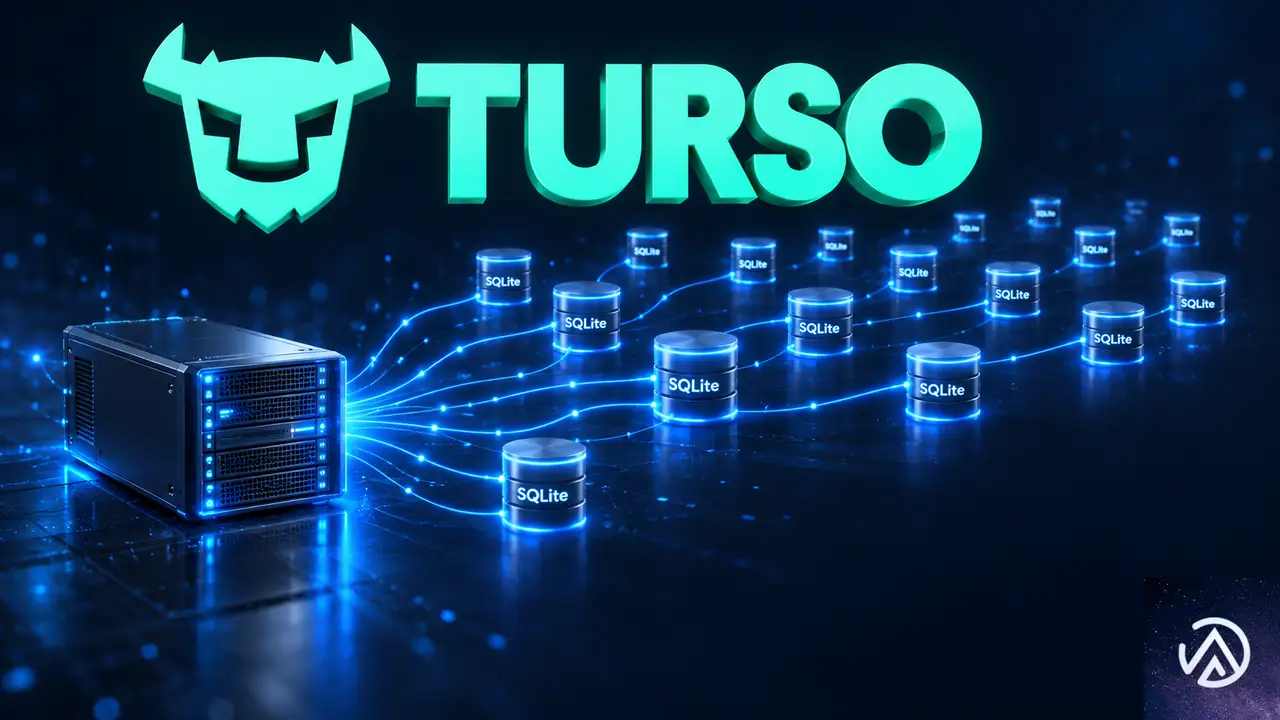
Tursoはこのパターンに最適化されたアーキテクチャを構築してきた。SQLiteをRustで再構築し、1台のサーバーで数百万のデータベースを管理できるクラウドプラットフォームを作り上げた。必要な時にDBをロードし、使われていない時は自動的にサスペンドする仕組みだ。
Rustとは、メモリ安全性と高速性を両立するプログラミング言語だ。CやC++と同等の性能を持ちながら、メモリ関連のバグを防ぐ仕組みが言語レベルで組み込まれている。サスペンドとは、実行中のプロセスを一時停止してメモリ領域を保持したままにすることだ。停止と再開を高速に行える。
Tursoのアーキテクチャは、1台のサーバーで多数のSQLiteインスタンスを効率的に管理する。この仕組みにより、エージェントごとにDBを即時提供できる。
このアーキテクチャは、Turso Cloud上でも、ユーザー自身のクラウド環境でも動作する。実際にSuperhuman、Sauna.ai、CTO.new、Mastraといった企業がこの仕組みを利用している。Supabaseの発表では、ワークロードの成長に応じてTursoのエコシステムからSupabaseへ移行する明確な道筋も示された。
オープンソースへの姿勢と今後の展望
TursoとSupabaseには共通点が多い。オープンソースへの強いコミットメント、開発者体験へのこだわり、難しいインフラ課題に挑む姿勢だ。今回の買収は、技術的な相性だけでなく、こうした価値観の一致も大きな理由となっている。
Tursoのグローバー・コスタ氏とペッカ・エンバーグ氏は、チームとともにSupabaseに加わる。コスタ氏はエージェント向けインフラの開発を主導する役割を担う。Supabaseのミッションは「世界のデータを保存する」ことだ。AIエージェントがさらに多くのデータを生み出す時代において、この買収はその目標へ大きく近づく一歩となる。
短期的には、既存ユーザーに目立った変化はない。しかし中期的には、プロトタイプ段階から本番運用まで一貫した開発者体験を提供する基盤が形づくられていく。SQLiteで手軽に始め、必要に応じてPostgresへスケールする流れが、よりシームレスになるだろう。
この記事のポイント
- SupabaseがSQLiteクラウドのTursoを買収、既存ユーザーへの影響はない
- Supabaseは毎週100万以上のDBを立ち上げており、AIエージェントの需要に対応する
- TursoはRustでSQLiteを再構築し、1台のサーバーで数百万のDBを管理できる
- SQLiteとPostgresを段階に応じて使い分けられる基盤づくりが始まる
- オープンソース重視の両社の価値観が一致した買収である

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PlanetScaleの新データベースNekiが秒間1億1800万クエリを達成。512シャード構成の全容
PlanetScaleが新データベースサービスNekiで秒間1億1800万クエリを記録した。512シャード構成で1.22 PiBのデータを読み込み、読み取り中心のベンチマークで達成した数字だ。
シャード数を10倍にするとスループットもほぼ10倍になる線形スケーラビリティが確認されている。p99レイテンシはルータで6.06ms、エラー率は約180万クエリに1回という安定性も示した。
この記事ではベンチマークの条件と構成、結果の意味を初心者にも分かるように解説する。
秒間1億1800万クエリの衝撃
Nekiとは何か
NekiはPlanetScaleが9月10日にプラットフォームプレビューとして公開した新しいデータベースサービスだ。PostgreSQL互換で分散アーキテクチャを採用している。シャードとはデータを複数のサーバーに分割して保存する単位で、負荷を分散させるための基本構造である。
QPSとは1秒間に処理できるクエリ数のこと。データベースの性能を示す指標のひとつだ。例えばECサイトの商品検索やブログのコメント表示など、読み取り処理がどれだけ速く応答するかに関わってくる。
100万QPSから1億1800万QPSへの経緯
PlanetScaleが最初に設定した目標は100万QPSだった。5シャード構成でこの目標をすぐに達成した。その後、どこまで伸ばせるかを確認するため、50シャード、512シャードと段階的に拡大していった。
ベンチマークの条件を理解する
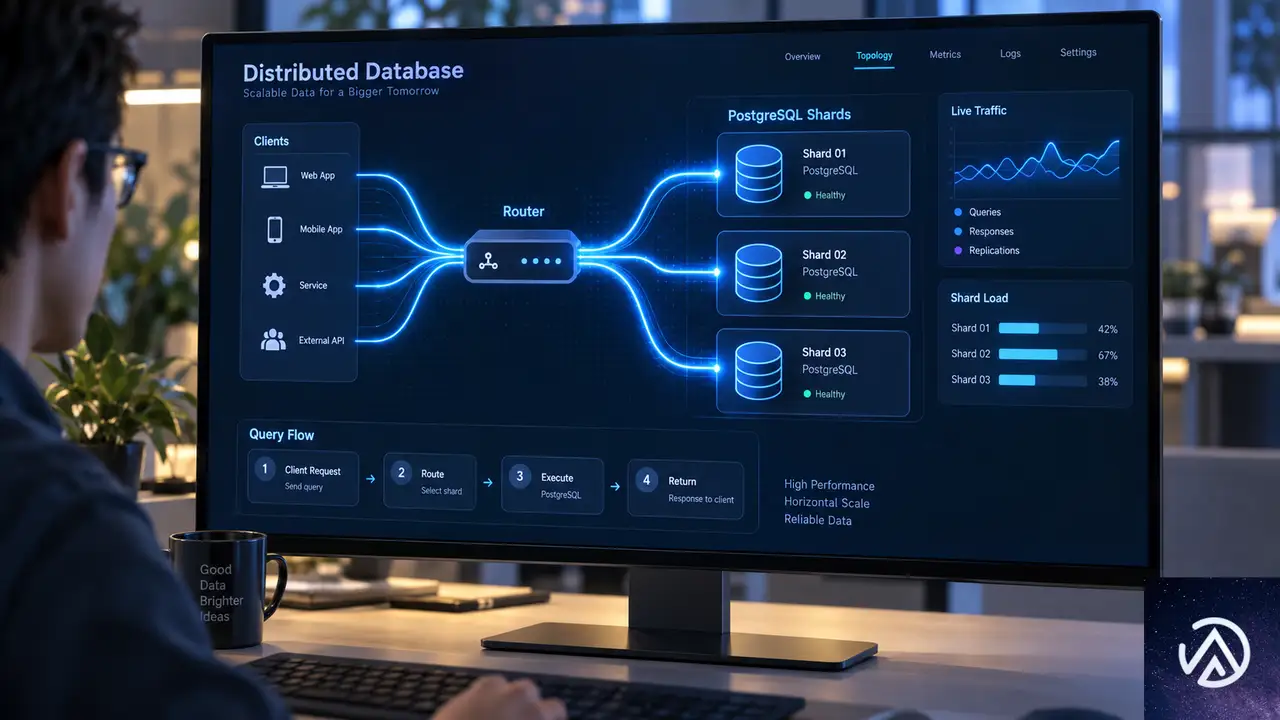
シンプルなクエリ構成
今回のベンチマークは非常に単純な構成で行われた。単一シャードのポイントセレクトと呼ばれる処理で、主キーを使って1行だけを取得する。書き込みはなく、テーブル結合もなく、複数シャードにまたがるクエリも含まれていない。
各シャードが受け取る作業は完全に独立している。つまり1つのクエリが複数のシャードにまたがることはない。負荷はシャードごとに分離され、それぞれが200k QPSを維持することを目標に設計された。
このデモはクエリの流れを示している。クライアントからの読み取り要求はNekiルータが受け取り、適切なPostgresシャードへ振り分けられる。各シャードは主キーで1行を取得して結果を返すだけだ。
ベンチマークの注意点
公開された数字を評価する際に注意すべき点がいくつかある。シャードはプライマリのみでレプリカを持たない。ワークロードは読み取り専用で、測定中にフェイルオーバーも発生していない。理想的に整えられた環境であることは押さえておきたい。
書き込みを含む実際のサービス運用では、この数字をそのまま期待できるわけではない。とはいえ、読み取り中心のワークロードにおいて分散データベースがどれだけ拡張できるかを示す実証データとして価値が高い。
線形スケーラビリティの実証
シャード数とスループットの相関
シャード数を増やした結果、スループットは驚くほどきれいに伸びた。5シャードで999,624 QPS、50シャードで9,923,900 QPS、512シャードで118,538,803 QPSだ。シャード数を10倍にすると、スループットもほぼ10倍になっている。
このデモはシャード拡大に伴うQPSの推移を示している。5シャードから50シャードではシャードあたりの処理速度が0.8%以内に収まった。512シャードでは各シャードにまだ余力があったため、負荷を上げてシャードあたり231,521 QPSに達した。
シャードあたりの安定性
線形スケーラビリティとは、サーバーを追加した分だけ性能が比例して伸びる性質を指す。通常はシャード数を増やすと管理オーバーヘッドやデータ再分散のコストが増え、性能の伸びが鈍っていくことが多い。
Nekiの場合は5シャードから50シャードへ拡大しても、シャードあたりのQPSが199,925から198,478とほぼ一定だった。この安定性が線形スケーラビリティを支えている。
118.5M QPS達成時の構成とレイテンシ
インスタンス構成
最大記録を達成した構成は512シャードで、各シャードにPostgreSQLプライマリが1台ずつ割り当てられた。インスタンスタイプはr8g.16xlargeだ。また480台のNekiルータが個別の8xlargeインスタンスで動作し、1.22 PiBのデータを扱った。
PiBはペビバイトと読み、1 PiBはおよそ1,125テラバイトに相当する。1.22 PiBは膨大なデータ量で、一般企業のデータベース規模を大きく超えている。
このデモは最大構成の主要スペックをまとめたものだ。512シャードと480ルータ、1.22 PiBのデータ量、そしてルータ側でp99 6.06msのレイテンシという結果になった。
レイテンシとエラー率
p99レイテンシとは、全リクエストの99%がその時間以内に処理されたという指標だ。平均値ではなく最悪に近い部分を見るため、体感速度に近い評価ができる。今回はルータで6.06ms、クライアントで13.95msだった。
エラーは毎秒67回で、約180万クエリに1回の割合だ。IOPSは1秒あたりの入出力操作回数のことで、今回の構成では全体で15.8M read IOPS、つまり毎秒1,580万回の読み取り操作を処理した。ネットワークは毎秒2 Tbを超える転送量を記録している。
この結果から見える実用性と今後の課題
書き込みを含まない点の評価
今回のベンチマークは読み取り専用であり、書き込みを含む実運用の性能を直接示すものではない。書き込み処理では複数の更新をまとめて確定させるトランザクション整合性や、データをディスクに確実に書き込む同期処理が必要になる。このため読み取りよりも時間がかかり、性能も出にくい。
それでも、検索、レコメンデーション、レポート、ダッシュボードなど読み取り中心のサービスでは、この数字が大きな参考になる。特にデータ量が増え続けるサービスで、シャード追加だけで性能を伸ばせることは運用面の負担を大きく減らす。
実サービスへの展開
線形スケーラビリティが確認されたことで、キャパシティプランニングが大幅に簡単になる。シャード数を10倍にすれば性能も10倍になるというシンプルな関係は、成長期のスタートアップにとって心強いデータだ。
PlanetScaleはこのベンチマークに至るまでのエンジニアリングと課題を将来記事で公開すると予告している。書き込みを含むテストやフェイルオーバー時の挙動も含め、実運用に近い条件での検証が今後重要になる。
この記事のポイント
- Nekiが512シャード構成で秒間1億1800万クエリを記録した
- シャード数を10倍にするとスループットもほぼ10倍になる線形スケーラビリティを確認
- ベンチマークは読み取り専用で、主キーによる1行取得という単純な構成
- p99レイテンシはルータで6.06ms、エラー率は約180万クエリに1回
- 書き込みを含む実運用環境での検証は今後必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Rank MathでWooCommerceモジュールが開けない時の原因と対処法
Rank MathのWooCommerceモジュールがグレーアウトして切り替えられない場合、原因はプラグインのデータベースマイグレーションが完了していないことにある。管理画面に表示されるデータベースバージョンが初期値の1のままなら、まずキャッシュの全削除とメモリ上限の確認を行い、その上で不要オプションを削除して再マイグレーションを発生させる。
なぜWooCommerceモジュールだけがロックされるのか

Rank Mathは各機能をモジュール単位で管理している。WooCommerceモジュールもその一つで、商品の構造化データや詳細設定をまとめて扱う。ところがこのモジュールは、プラグインのデータベーススキーマが特定のバージョン以上になった時だけ有効化できる仕組みだ。
管理画面のステータス情報で「database_version」がいつまでも初期値の1のままだと、WooCommerceモジュールを含む一部の機能が「未導入」と判断されたままになる。トグルにマウスを重ねると「Please activate WooCommerce to use this module」という趣旨のツールチップが表示されるが、WooCommerce本体が有効化されていてもこのエラーは出る。
つまり、WooCommerceの有効・無効が問題なのではなく、Rank Math側のデータベース情報が古いまま更新されていないことが本質のトラブルだ。
database_versionが1のまま進まない主な原因

Rank Mathのインストール時やセットアップウィザード実行時、プラグイン内部でデータベーステーブルの作成とデータ移行が走る。この処理が最後まで到達しないと、バージョン情報が初期値の1から更新されない。具体的な原因は大きく三つに分けられる。
キャッシュプラグインが古いオプションを保持している
WP Super Cacheに代表されるキャッシュプラグインは、ページ表示を高速化するために一時データを保持する。まれにデータベースのオプション情報まで古い状態のまま配信することがあり、これが原因でRank Mathのバージョン情報が更新されないケースがある。
PHPメモリ上限が低くマイグレーションが途中で止まる
WooCommerceサイトは通常のWordPressサイトより管理画面のメモリ消費が大きい。Elementorや高機能テーマも動いている場合、PHPのメモリ上限を超えてRank Mathのデータベース処理が途中で終了してしまうことがある。具体的にはwp-config.phpで定義されたWP_MEMORY_LIMITが40M程度だと、重い環境では不足しやすい。
rank_math_db_versionオプションが破損している
WordPressのオプションテーブル(wp_options)には、Rank Mathが利用する複数のオプションが保存されている。このうち「rank_math_db_version」という値が破損したり、不正な状態で固定されたりすると、セットアップウィザードを再実行しても値が更新されない。
モジュールロックを解除する具体的な手順

以下の手順は、データベースバージョンが初期値から更新されない場合に有効だ。順に実行することで、Rank Mathのマイグレーションが正常に走り、WooCommerceモジュールのロックが外れる。
このデモは、Rank Mathのデータベースバージョンを固定している原因を取り除き、マイグレーションを再実行させる流れを示している。
キャッシュを完全に無害化する
管理画面のプラグインページでWP Super Cacheを一時的に無効化する。次に「設定」→「WP Super Cache」からキャッシュの削除を実行し、サーバー上のwp-contentディレクトリにあるcacheディレクトリ内のファイルも手動で削除しておく。
共有サーバーで管理画面から操作できない場合は、FTPソフトでwp-content/cacheに入り、中身を空にする。キャッシュを消した後は、ブラウザのキャッシュも混ざらないようシークレットウィンドウで確認すると確実だ。
WP_MEMORY_LIMITを引き上げる
FTPまたはサーバーのファイルマネージャーでwp-config.phpを開き、WP_MEMORY_LIMITの定義を探す。設定されていなければ「/* That’s all, stop editing! */」の直前に以下の行を追加する。
define( 'WP_MEMORY_LIMIT', '128M' );すでに40Mなど低い値が指定されている場合は、128Mまたは256Mに書き換える。変更後にWordPress管理画面の「ツール」→「サイトヘルス」からPHPのメモリ上限が更新されているか確認できる。
rank_math_db_versionオプションを直接削除する
サーバーのphpMyAdminにアクセスし、該当サイトのデータベースを選択する。wp_optionsテーブルを開き、option_nameが「rank_math_db_version」の行を探して削除する。
SQLを直接実行できる環境なら、次のようにしても同じ結果になる。
DELETE FROM wp_options WHERE option_name = 'rank_math_db_version';テーブルの接頭辞がwp_以外の場合は、実際の接頭辞に置き換える。削除後、Rank Mathの管理画面を開くとマイグレーションが自動的に再実行され、正常ならデータベースバージョンが初期値より大きい値に更新される。
rank_math_modulesオプションも削除する
rank_math_db_versionを削除してもWooCommerceモジュールがロックされたままの場合、rank_math_modulesというオプションも同様に削除する。この値には有効化済みモジュールのリストが保存されており、破損しているとモジュールの出し分けが正常に機能しない。
DELETE FROM wp_options WHERE option_name IN ('rank_math_db_version', 'rank_math_modules');この二つを削除した後、Rank Mathのセットアップウィザードを「詳細モード」で最後まで実行する。WooCommerceモジュールのトグルが青くなり、切り替え可能になっていれば成功だ。
それでも直らない場合の最終確認
データベースユーザーにテーブル作成権限があるか
Rank Mathのマイグレーションは、専用のテーブル(rank_math_analytics_objectsなど)を作成してデータを保存する。データベースユーザーに「CREATE TABLE」権限がないと、処理が裏側で失敗し続ける。レンタルサーバーの管理画面からデータベースユーザーの権限を確認し、不足していれば付与する。
重いプラグインを停止してからもう一度
ElementorやSlider Revolutionなど、管理画面の動作を重くするプラグインがマイグレーションを妨げている可能性がある。Health Check & Troubleshootingプラグインのトラブルシューティングモードを使い、Rank MathとWooCommerceだけを有効化した状態で手順をもう一度試す。
Rank Mathのデータベースツールでテーブルを作り直す
Rank Mathの管理画面から「ステータスとツール」→「データベースツール」を開く。「テーブルを作り直す」や「データベースを修復」といったボタンが用意されているので、順に実行してテーブルの再作成とデータの再構築を行う。
その後、もう一度セットアップウィザードを完了させ、データベースバージョンの値が更新されるかを確認する。それでも値が1のままなら、プラグインのアップデート待ちか、サーバー環境固有の制約が残っている可能性が高い。
よくある質問
トグルをクリックしても何も反応しないのはなぜ?
WooCommerceモジュールがロックされていると、トグル自体がグレーアウトした状態になる。クリックしても切り替わらず、ツールチップだけが表示される。これは操作ミスではなく、Rank Math内部でモジュールが使えない状態として認識されているためだ。
WooCommerce本体が壊れている可能性はある?
WooCommerceがプラグインページで有効化されており、商品管理やカートなど通常機能が動いているなら本体は正常だ。今回の問題はRank Math側のデータベース情報が古いことが原因なので、WooCommerceを再インストールしても解決しない。
Rank Mathを削除して入れ直しても直らないのはなぜ?
プラグインを削除しても、wp_optionsテーブルに保存されたオプションは残る。再インストール時に古いオプションを読み込んでしまい、同じ状態が再現される。必ずデータベースからrank_math_db_versionを削除してから再インストールする必要がある。
キャッシュプラグインは原因になりうる?
WP Super Cacheなどのキャッシュプラグインはページキャッシュが主体だが、環境によってはデータベースの一時情報も保持することがある。Rank Mathのバージョン情報が更新されない状態が続くなら、キャッシュプラグインを停止して切り分けるのが有効だ。
セットアップウィザードは毎回完了しているのに直らない
ウィザード自体は設定画面を進めるだけで、データベースのマイグレーションは別プロセスで走る。マイグレーションが裏側で失敗していると、ウィザード完了後もdatabase_versionが1のままになる。オプション削除とメモリ上限の引き上げを先に行うことが重要だ。
この記事のポイント
- WooCommerceモジュールのロックはRank Mathのデータベースバージョンが原因
- database_versionが1のままならマイグレーションが未完了
- キャッシュ削除とWP_MEMORY_LIMITの引き上げを先に行う
- rank_math_db_versionとrank_math_modulesオプションを直接削除して再実行
- テーブル作成権限の確認と重いプラグインの停止も有効

・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
WordPressでデータベースのテーブルが見つからないエラーの原因と対処法
WordPressで「テーブルが見つからない」エラーが表示されたら、まずwp-config.phpのテーブル接頭辞($table_prefix)とデータベース内の実際のテーブル名を照合する。接頭辞が一致していなければ設定を修正し、そもそもテーブルが存在しない場合はバックアップからの復元が必要になる。
なぜWordPressで「テーブルが存在しない」エラーが発生するのか

WordPressは投稿や固定ページ、ユーザー情報をすべてデータベースに保存している。データベースの中には複数のテーブルがあり、それぞれ「接頭辞+テーブル名」という形式で管理される。接頭辞はセキュリティ対策としてサイトごとに変えられる仕組みだ。たとえば初期状態ではwp_posts、wp_optionsという名前になる。
この接頭辞はwp-config.phpという設定ファイルの$table_prefixで指定する。実際のデータベースにあるテーブル名と、この設定ファイルの値が食い違うと、WordPressが存在しない名前のテーブルを探しに行き「テーブルが見つからない」エラーを起こす。サイト移転や手動バックアップの復元時に、データベースだけ別の接頭辞で持ってきてしまった場合に起きやすい。
データベース修復機能は破損したテーブルを直すためのもので、存在しないテーブルを新しく作ることはできない。そのため「修復」を実行してもエラーは解消されない。問題の切り分けには、まず実際にどんなテーブルが存在するのかを確認する必要がある。
データベース内の実際のテーブル接頭辞を調べる方法
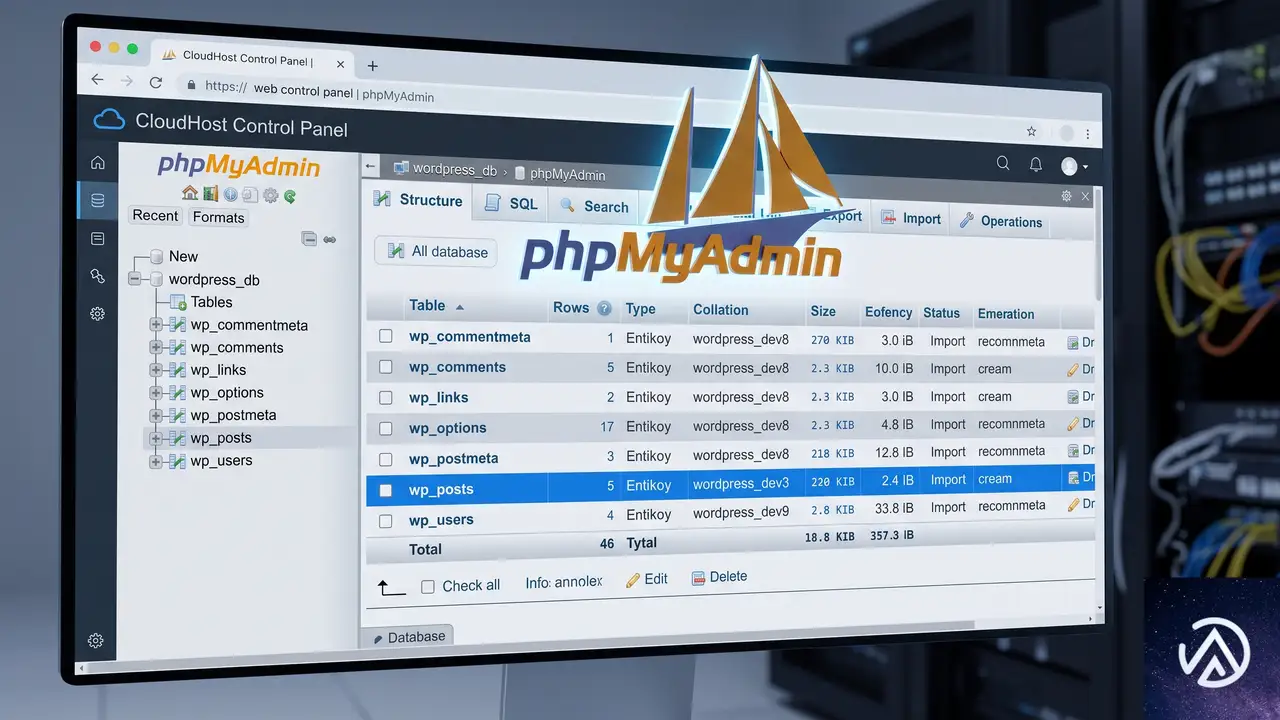
エラーの原因が接頭辞の不一致か、それともテーブル自体が消えているのかを切り分けるには、データベース管理ツールを開いて実在するテーブル名を確認する。レンタルサーバーの管理画面にログインし、phpMyAdminと呼ばれるデータベース管理ツールを選択するのが最も確実だ。
テーブル一覧にwp_postsやwp_optionsという名前が見えたら、実際の接頭辞はwp_だ。この場合、設定ファイルが別の値を指していることが原因なので、次の手順で修正する。一方、テーブル一覧が空だったり、別の名前でも見当たらない場合は、テーブル自体が失われている可能性が高い。
wp-config.phpのテーブル接頭辞を正しい値に直す手順
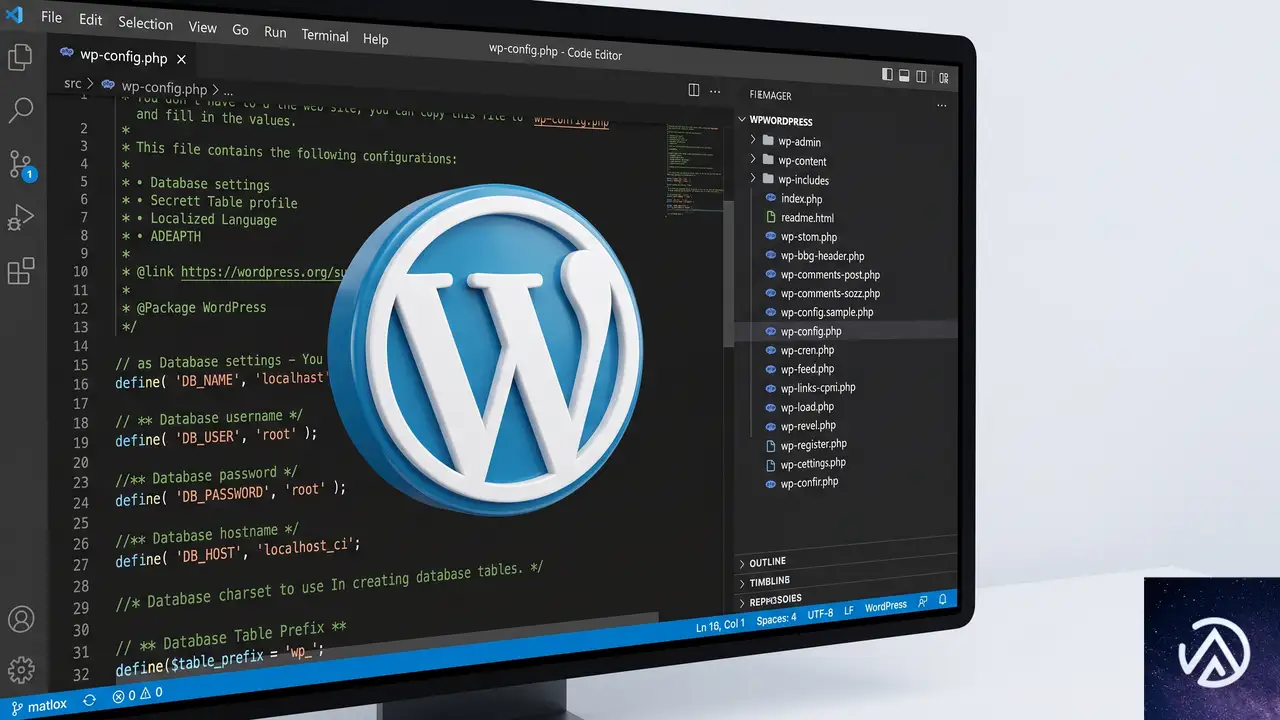
設定ファイルの修正は、FTPソフトかレンタルサーバーのファイルマネージャでwp-config.phpを直接編集する。WordPressをインストールしたルートディレクトリにあるこのファイルを開き、$table_prefixが書かれた行を探す。
保存後にサイトを再読み込みすると、これまで表示されていたテーブル関連のエラーが消えて通常の画面が戻る。管理画面にもアクセスできるようになるはずだ。なお、wp-config.phpを編集する前には必ずファイルのバックアップを取っておくこと。
ファイルマネージャで編集できない場合は、FTPソフトでサーバーに接続して同じファイルをダウンロードし、テキストエディタで修正してアップロードする。文字コードはUTF-8のまま保存する。
テーブルが実際に消えている場合の復元方法
phpMyAdminで確認しても該当するテーブル自体が存在しない時は、設定の不一致ではなくデータが失われている状態だ。この場合は修復機能では戻らないため、バックアップからの復元が必要になる。
- レンタルサーバーの自動バックアップ機能を確認する
- 運用中に取得していたバックアップデータから復元する
- ホスティング事業者のサポートに問い合わせる
バックアップが手元にない場合でも、ホスティング事業者が定期的にサーバー全体のバックアップを保持していることが多い。データベースだけを復元できるか、サポートに確認するのが得策だ。復元後は接頭辞の一致を必ず確かめる。
テーブル接頭辞の不一致を防ぐための確認ポイント
サイト移転やバックアップ復元の後に同じエラーを再発させないためには、接頭辞とデータベースの状態を習慣的に確認しておくとよい。最低限のポイントを挙げる。
- サイト移転時は設定ファイルとデータベースの接頭辞を照合する
- テスト環境と本番環境では同じ接頭辞にそろえる
- wp-config.php を編集する前に必ずバックアップを取る
- 不要なデータベース修復を連続実行しない
よくある質問
接頭辞を直したのにまだテーブルが見つからないエラーが出る
設定ファイルを保存した後もブラウザやサーバーのキャッシュが残っていると表示が変わらない場合がある。ブラウザをスーパーリロードし、サーバー側のキャッシュを削除してから確認する。それでも出る場合は、実際に存在するテーブル名と設定値をもう一度照合し、データベース名やホスト名も確認する。
phpMyAdmin を使わずに接頭辞を確認できるか
wp-config.php の設定だけでは実際のテーブル名は分からない。データベース管理ツールか、ホスティング事業者の管理画面にあるデータベース一覧で確認する。どうしても見つからない時はサポートに問い合わせると接頭辞を教えてもらえる場合がある。
WordPress の修復機能でテーブルが消えることはあるか
修復機能は既存テーブルの破損を修復するのが目的で、テーブル自体を削除する動作ではない。ただし存在しないテーブルは作成できないため、修復を実行してもテーブルがないエラーは解消しない。元のテーブルが消える主な原因はデータベースの操作ミスやインポート時の上書きだ。
バックアップからデータベースだけ復元する手順は
ホスティングの管理画面にあるバックアップ機能を開き、復元したい日時のデータベースを選ぶ。phpMyAdmin からインポートできる SQL ファイルがある場合は、該当するデータベースを選択してインポートを実行する。操作前に現在のデータを追加でエクスポートしておくと安全だ。
接頭辞を wp_ に変更すると既存データは消えるか
接頭辞の変更そのものはテーブル名を読み替えるだけで、データを削除しない。ただし実在しない接頭辞に変更すると WordPress がテーブルを見つけられず、同じエラーになる。必ずデータベース内の実名と一致する値に変更する。
この記事のポイント
- テーブルが見つからないエラーは接頭辞の不一致が第一原因
- phpMyAdmin で実際のテーブル名を確認する
- wp-config.php の $table_prefix を実在の接頭辞に合わせる
- テーブル自体が無い時はバックアップ復元が最短ルート
- 設定変更前に必ず wp-config.php とデータベースのバックアップを取る
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
WordPress会員データが大量削除された時の原因と復旧手順
WordPress サイトで会員データが突然数千件単位で削除され、WP Activity Log に「Unknown user」として記録される事態は、データベースへの直接アクセスか管理者権限の乗っ取りによる攻撃の可能性が高い。即座にサイトをメンテナンスモードに切り替え、被害拡大を防ぎつつバックアップから復旧し、侵入経路を特定して再発を防ぐ必要がある。
なぜ突然会員データが大量削除されたのか
この事象の最大の特徴は、削除を実行したユーザーが「Unknown user」と表示される点にある。通常、WordPress の操作ログにはユーザー名かユーザー ID が記録されるが、ここに名前が出ないということは、wp_users テーブルを経由しない削除が行われていることを示している。考えられる原因は大きく3つに絞られる。
データベースへの直接操作
最も深刻なケースとして、攻撃者が SQL インジェクションや phpMyAdmin への不正アクセス、あるいはサーバーに仕込んだマルウェア経由でデータベースに直接 DELETE 文を実行している状況だ。この場合、WordPress のアクションやフィルターフックを一切通過しないため、WP Activity Log を含むどの監査プラグインもユーザーを特定できず「Unknown」となる。
管理者アカウントの乗っ取り
管理者権限を持つアカウントが乗っ取られ、攻撃者がそのアカウントで MemberPress の会員一括操作機能やデータベースクリーニング系プラグインを実行したケースだ。ただし、この場合は通常ユーザー名がログに残る。残っていないということは、攻撃者が操作後にユーザーごと削除したか、別の手段を使った可能性が高い。
REST API や XML-RPC の悪用
WordPress の REST API や XML-RPC に認証の弱点があると、外部から会員データの削除リクエストを送信される場合がある。特に、API 経由で直接データベース操作を行うカスタムエンドポイントがテーマやプラグインに存在すると、認証をすり抜けて大量削除が実行される危険がある。
同時に多数のプラグイン更新が表示され、WordPress 7.0.1 への更新も同日にリリースされたという状況は、実際に重大な脆弱性が公表され、各開発者が一斉にパッチを配布している可能性を示唆している。更新が突如10件以上積み上がるのは、テーマやプラグインに含まれる共通ライブラリに脆弱性が見つかった場合によく見られるパターンだ。
攻撃を受けた直後にとるべき緊急対応の手順

被害の発覚から時間が経つほど、データ消失や情報流出の範囲は広がる。以下の手順を発見後30分以内に実行することで、二次被害を最小限に抑えられる。
メンテナンスモードでアクセスを遮断する
まず、攻撃が継続している可能性を想定し、サイト全体をメンテナンスモードに切り替える。管理画面にアクセスできる状態であれば、.maintenance ファイルを手動で作成する方法が最も確実だ。WordPress のルートディレクトリに .maintenance ファイルを配置し、以下の内容を記述すると、全訪問者にメンテナンス画面が表示される。
<?php
$upgrading = time();
?>
FTP やサーバーのファイルマネージャーでアクセスできない場合は、サーバー管理パネルから Web サーバー(Apache や Nginx)自体を停止するか、.htaccess に IP 制限をかけて特定の IP 以外をすべて拒否する方法も有効だ。
プラグインとテーマを強制的に無効化する
管理画面からプラグインを一括停止できない、あるいは管理画面自体が攻撃者にロックされている場合、FTP で /wp-content/plugins/ ディレクトリごとリネームする(例: plugins_backup)。これにより、WordPress は全プラグインを無効化した状態で起動する。同様に、/wp-content/themes/ から現在のテーマを除く全テーマを別ディレクトリに退避し、標準テーマ(Twenty Twenty-Five 等)のみを残す。
ログを保全して侵入経路を特定する
WP Activity Log のデータは攻撃者に消去される前にエクスポートする。CSV または JSON でダウンロードし、ローカルに保存する。このとき、サーバーのアクセスログ(access.log)とエラーログ(error.log)も必ず取得する。ログから得るべき情報は「攻撃元 IP」「削除が実行された正確な日時」「リクエスト URL(特に POST リクエスト)」「User-Agent」の4点だ。
「Unknown user」による削除操作が大量に記録されている場合、リクエスト URL が wp-admin/admin-ajax.php や wp-json/ を含んでいないかを重点的に確認する。これらが含まれていれば、AJAX や REST API 経由の攻撃である可能性が高い。
バックアップからの復旧とデータ整合性の確認

攻撃発生前の正常な状態がわかっているバックアップがあれば、それをリストアする。このケースのように2日前のバックアップが存在する場合、消失した会員データはその時点のものに戻るが、2日間に新規登録した会員や更新されたデータは失われるため、復旧後に差分を手動で補完する必要がある。
データベースをリストアする手順
バックアップが SQL ダンプファイル(.sql または .sql.gz)の場合、phpMyAdmin またはサーバーのコマンドラインからインポートする。WordPress のデータベース全体を置き換える場合は、まず現在の全テーブルを削除(DROP)してからインポートする。この操作は取り返しがつかないため、必ず現在のデータベースも別名でエクスポートしてから実行する。
# コマンドラインでのリストア例
mysql -u ユーザー名 -p データベース名 < backup.sql
リストア後、MemberPress の会員数が期待通りに戻っているか、会員のサブスクリプション状況や支払い履歴が正しく関連付けられているかを必ず確認する。特に、WooCommerce と連携している場合は wp_usermeta テーブルの整合性もチェックする必要がある。
再発を防ぐための恒久対策

復旧が完了したら、同じ攻撃を二度と受けないようにするための対策を即座に実施する。サーバー侵入を許した原因が残ったままだと、再度同じ経路から攻撃される危険が極めて高い。
全ファイルの改ざんチェックとマルウェアスキャン
WordPress のコアファイル、プラグイン、テーマのすべてについて、オリジナルの配布ファイルと比較して改ざんされていないかを確認する。WordPress の管理画面から「サイトヘルス」→「情報」→「ファイルの整合性」でコアファイルのチェックが可能だが、プラグインとテーマは手動かセキュリティプラグイン(Wordfence や Sucuri 等)を使ってスキャンする。特に、wp-content/uploads/ 内に .php ファイルが存在していないかを重点的に調べる。
管理者アカウントの総点検とパスワード再設定
すべての管理者アカウントについて、覚えのないユーザーが追加されていないか、権限が勝手に昇格されていないかを確認する。wp_users テーブルと wp_usermeta を直接確認し、不審な管理者を削除する。その上で、全管理者と編集者のパスワードを強制的にリセットし、可能であれば二要素認証(2FA)を導入する。WordPress 6.8 以降は標準でパスキー認証が利用できるため、セキュリティキーを使ったログインも有効な選択肢だ。
データベースのアクセス制限と監査の強化
データベースへの外部からの直接アクセスを遮断するため、phpMyAdmin などの管理ツールを公開ディレクトリに置かない、または IP 制限と HTTP 認証をかける。また、wp-config.php に以下の定数を追加して、WordPress のファイル編集機能を無効化しておくことで、管理画面を乗っ取られた場合でもテーマやプラグインのコードが書き換えられることを防げる。
define('DISALLOW_FILE_EDIT', true);
define('DISALLOW_FILE_MODS', true); // 必要な場合のみ
XML-RPC と REST API のアクセス制限
XML-RPC を使用していない場合は .htaccess でブロックするか、プラグインで完全に無効化する。REST API は多くのプラグインが依存しているため完全には無効化できないが、認証が必要なエンドポイントに対して適切な権限チェックが実装されているかを確認する。特に、MemberPress やカスタムプラグインが提供する REST API エンドポイントは、開発元のドキュメントでセキュリティ設定を再確認する。
よくある質問
WP Activity Log に「Unknown user」と表示されるのは必ずハッキングか
必ずしもそうとは限らないが、高い確率で不正アクセスが疑われる。プラグインのバグやデータベースの不整合でも発生しうるが、同時に大量のデータが削除されている場合は攻撃の可能性を第一に考えるべきだ。特に、管理者権限を持たない IP からの操作が記録されている場合はほぼ確実に侵入されている。
プラグインの更新が突然大量に表示されたのはなぜか
共通ライブラリやフレームワークに重大な脆弱性が見つかり、複数のプラグインが一斉にセキュリティアップデートをリリースした可能性が高い。WordPress 本体の緊急アップデートが同日にリリースされていることも、何らかの広範囲に影響する脆弱性が公表されたことを示唆している。これらの更新は速やかに適用すべきだ。
バックアップから復旧した後、消えたデータは完全に戻るのか
バックアップ取得時点のデータは戻るが、それ以降に追加・変更されたデータは復元されない。MemberPress の会員情報の場合、新規登録者やサブスクリプションの変更履歴が失われるため、復旧後に会員からの問い合わせをもとに手動で補完する必要がある。決済情報は決済代行サービス側に残っていることが多いため、そちらを参照して復元できる場合もある。
WP 7.0.1 への更新はすぐに適用すべきか
重大なセキュリティ修正を含むマイナーアップデートの場合、速やかな適用が推奨される。ただし、大量削除が発生した環境では、まずバックアップからの復旧と侵入経路の遮断を完了させてから更新を行う。更新前に全ファイルの改ざんチェックを済ませ、マルウェアが残っていない状態で適用するのが安全だ。
この記事のポイント
- 「Unknown user」による大量削除はデータベース直接操作か管理者乗っ取りが原因の可能性が高い
- 発見後は即座にメンテナンスモードでサイトを遮断し、プラグインを強制無効化して攻撃を止める
- WP Activity Log とサーバーログを直ちにエクスポートし、攻撃元 IP と侵入経路を特定する
- バックアップからデータベースをリストアし、復旧後に全ファイルの改ざんチェックとマルウェアスキャンを実施する
- XML-RPC の無効化、REST API の権限確認、二要素認証の導入で再発を防ぐ
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
Events Manager更新後に公開イベントが下書きに戻る原因と修正
Events Manager 7.3.7.4 にアップデート後、公開済みイベントの編集画面で「更新」をクリックすると、ステータスが「下書き」に戻ってしまう現象が報告されている。原因は、終日設定のイベントに対してタイムレンジ(時間範囲)が重複してデータベースに登録されてしまうことだ。このバグにより、プラグイン内部のバリデーションが失敗し、自動的に下書きへと巻き戻される。データベースの重複を削除し、プラグインファイルに一時的なパッチをあてることで解決する。
なぜ公開済みイベントが更新時に下書きに戻ってしまうのか

Events Manager はイベントを表す EM_Event クラスが、記事が保存される前に validate_meta() メソッドで内部データの整合性をチェックしている。このチェックに引っかかると wp_insert_post_data フックが介入し、投稿ステータスを強制的に「下書き」に変更する仕様だ。
今回の問題では、「Timeranges cannot overlap with each other.(タイムレンジが重複しています)」というエラーが発生している。しかし、エディタ上では終日(All Day)設定の単一の時間範囲しか表示されていない。実際にデバッグ出力を取得すると、同一イベントに属する同一の終日タイムレンジ(開始 00:00:00、終了 23:59:59)が2件存在しており、これが重複エラーの直接的な原因だ。
データベースで重複したタイムレンジを削除する手順

STEP 1:必ずデータベースをバックアップする
今回の作業ではデータを直接操作するため、必ず事前にデータベース全体のエクスポートを取得する。何か問題が起きても元に戻せるようにしておこう。
STEP 2:重複タイムレンジを検出する
テーブル名はプラグインの設定により異なるが、多くは wp_em_timeranges となる。phpMyAdmin のSQLタブで次のクエリを実行し、同一 event_id・同一 timerange_start・timerange_end の組み合わせが複数存在しないか確認する。
SELECT event_id, timerange_start, timerange_end, COUNT(*)
FROM wp_em_timeranges
GROUP BY event_id, timerange_start, timerange_end
HAVING COUNT(*) > 1;
結果が返ってきたら、該当の event_id をメモしておく。
STEP 3:重複行のうち一方を削除する
重複している行のうち、より古いIDの行を削除する。以下のクエリは最も小さい ID 以外を削除する例だ。必ず削除対象を SELECT で事前確認してから実行する。
DELETE t1 FROM wp_em_timeranges t1
INNER JOIN wp_em_timeranges t2
WHERE t1.timerange_start = t2.timerange_start
AND t1.timerange_end = t2.timerange_end
AND t1.event_id = t2.event_id
AND t1.ID > t2.ID;
STEP 4:イベントを再編集して正常に保存されるか確認する
データベースの重複を除いたら、WordPress管理画面に戻り、該当のイベント編集画面を開く。内容を微修正して「更新」をクリックし、再び「下書き」に戻らず公開状態が維持されることを確かめる。
プラグインファイルの一時修正で重複登録を防ぐ

根本的な原因は、何らかのトリガーでタイムレンジオブジェクトが二重に追加されてしまうことだ。以下は EM_Event::validate_meta() の中で重複を除去する応急処置のコード例だ。必ずファイルのバックアップを取ったうえで追記する。
// events-manager/classes/em-event.php の validate_meta メソッド内
public function validate_meta( $data, $postarr ) {
    // タイムレンジを取得して重複を排除する
    $timeranges = $this->get_timeranges();
    $unique_timeranges = [];
    foreach ( $timeranges as $timerange ) {
        // timerange_group_id などのキーで一意にする
        $key = $timerange->timerange_group_id . '_' . $timerange->timerange_start . '_' . $timerange->timerange_end;
        if ( ! isset( $unique_timeranges[ $key ] ) ) {
            $unique_timeranges[ $key ] = $timerange;
        }
    }
    // 重複排除済みのコレクションでバリデーション
    if ( ! $unique_timeranges || ! $this->validate_timeranges_collection( $unique_timeranges ) ) {
        // エラー処理...
    }
    // 以下略
}
ただし、このパッチはあくまで暫定的なものだ。プラグインが公式に修正をリリースするまでは、更新のたびに再適用が必要になる。公式サポートフォーラムを定期的に確認し、バグ修正版がリリースされたら速やかにアップデートしよう。
よくある質問
この問題はイベントマネージャーのどのバージョンから発生したのか
少なくとも 7.3.7.4 で報告されている。それ以前のバージョンでは発生していなかった可能性が高いが、同様の重複が偶発的に起きているケースもある。
クラシックエディターを使えば回避できるか
根本原因はデータ保存時のバリデーションにあるため、グーテンベルクエディターかクラシックエディターかは関係ない。ただし、編集画面のUIの違いでトリガーが変わる可能性は否定できない。試す価値はある。
終日イベント以外でも起こるのか
現在報告されているのは終日設定時のケースだ。しかし、時間指定のあるイベントでも重複が起きれば同じエラーで下書きに戻る。該当イベントの編集時は要注意だ。
データベースを直接触らずに直す方法はあるか
現時点では、管理画面から重複を操作できる機能はない。比較的安全な方法としては、一度イベントを複製→元のイベントを削除→複製イベントを公開する、という手順でタイムレンジが正常な状態になることがある。
公式の修正はいつリリースされるのか
これはバグトラッカーや公式フォーラムを見守るしかない。開発チームが認識している問題であれば、次のパッチに含まれる可能性がある。
この記事のポイント
- Events Manager 7.3.7.4 で発生する既知のバグで、バリデーションエラーによってステータスが下書きに変更される
- 原因は終日イベントのタイムレンジがデータベース上で重複していること
- phpMyAdmin から重複行を削除することで一時的に解決する
- プラグインファイルの修正パッチで再発を防げるが、公式アップデートまでは注意が必要
- データベース操作前には必ずバックアップを取得する
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
Relevanssiで日本語検索クエリが原因のテーブルフルスキャンを防ぐ
—
Relevanssiで日本語だけの検索クエリがデータベースの全テーブルスキャンを引き起こす問題は、トークナイズ結果が空文字になるケースをカスタムコードで事前に検知し、SQLを発行せずに空の結果を返すことで根本的に回避できる。設定のチューニングと併用すれば、サイト全体の検索パフォーマンスを維持できる。
なぜ日本語の検索クエリでRelevanssiがテーブル全体を読み込むのか
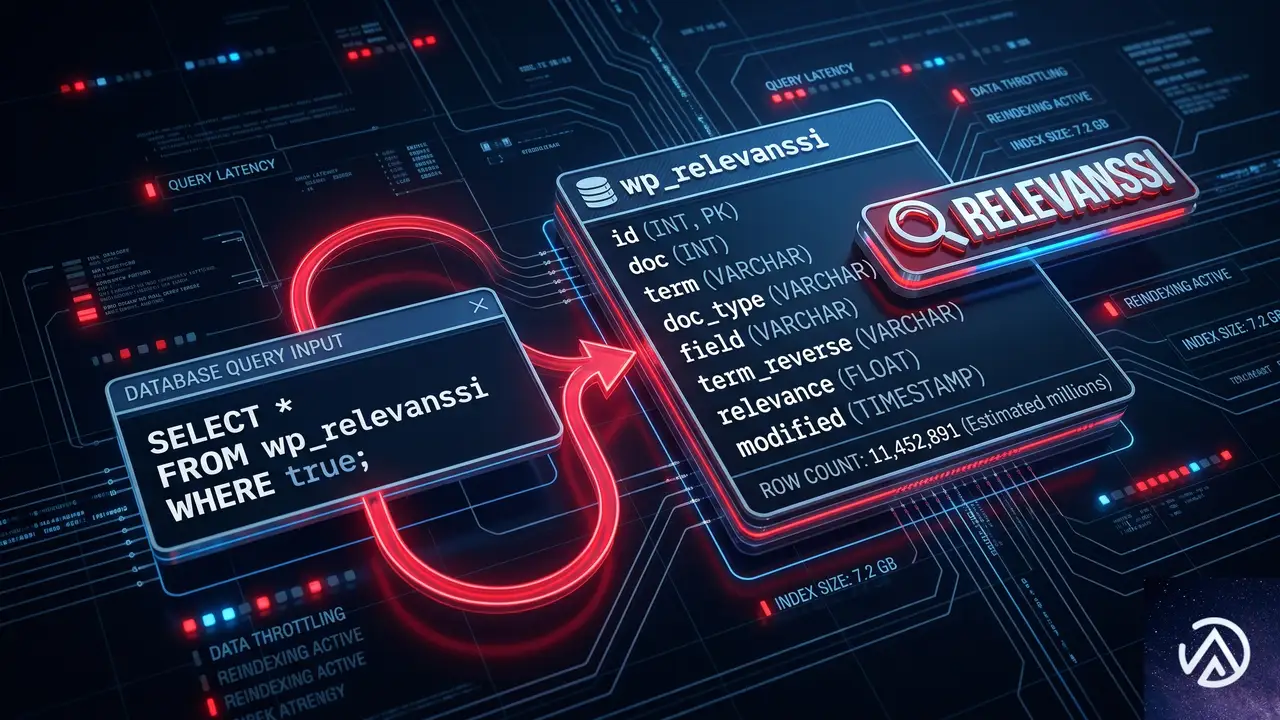
Relevanssiは登録された投稿のタイトルや本文を分解し、単語単位でインデックスを作る全文検索プラグインだ。英語などスペースで区切られた言語では問題なく機能するが、日本語や中国語、韓国語といったCJK(中国語・日本語・韓国語)テキストでは事情が異なる。
CJKの文字列は単語境界の空白が存在しないため、Relevanssiが検索クエリを受け取ると、内部のトークナイザ(単語への分割処理)で適切な単位に区切れないことがある。特に、形態素解析エンジンがインストールされていない標準環境では、クエリが解析不能と見なされ、トークンがゼロ個、つまり空の状態になりやすい。
この「空のクエリ」が問題の本質だ。Relevanssiの検索SQLでは、本来なら検索語に基づいてWHERE term = '検索語'のように絞り込む。しかしトークンが空になると、検索語を表す変数に何も入らず、SQLがWHERE term = termという常に真になる条件へと崩れる。結果としてwp_relevanssiテーブルの何百万行という全レコードを走査するフルスキャンに陥り、応答に数十秒かかる事態を引き起こす。
これはバグではなく、空のクエリに対するフォールバック(予備動作)が設計上考慮されていないために発生する。本来なら検索語が存在しないと判断された時点で、データベースに問い合わせず「該当なし」を返すのが望ましい。
検索クエリが空になるのをコードで検出し早期リターンする
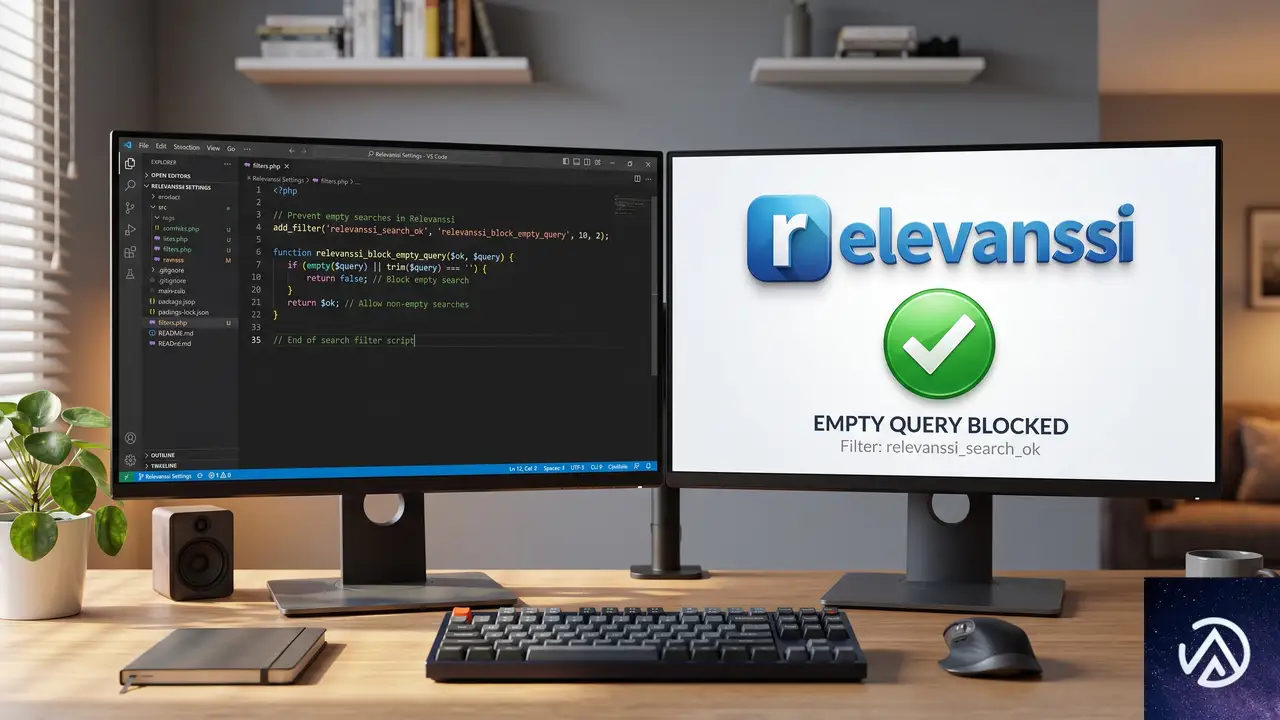
最も確実な解決策は、RelevanssiがSQLを構築する前に検索クエリの内容をチェックし、有効なトークンがなければ検索処理を打ち切る仕組みをテーマのfunctions.phpに組み込むことだ。Relevanssiは複数のフィルターフックを提供しており、そのうちrelevanssi_search_okまたはrelevanssi_modify_wp_queryを利用する。
具体的な実装コードと設置手順
このデモが示す流れで、コードを追加する。以下は実際に利用できる実装例だ。
add_filter( 'relevanssi_search_ok', function( $ok, $query ) {
    // 検索クエリが文字列であり、内容が空でないか確認する
    if ( ! is_string( $query->query_vars['s'] ) || '' === trim( $query->query_vars['s'] ) ) {
        return false; // 検索を実行せず早期リターン
    }

    // スペースを除いたテキストがCJK文字だけで構成されているか簡易チェック
    $search_term = trim( $query->query_vars['s'] );
    // CJK統合漢字・ひらがな・カタカナ・ハングルの正規表現
    $cjk_pattern = '/[\x{4e00}-\x{9faf}\x{3040}-\x{309f}\x{30a0}-\x{30ff}\x{ac00}-\x{d7af}]+/u';
    preg_match_all( $cjk_pattern, $search_term, $matches );

    // マッチしたCJK文字列が存在するかを確認
    if ( empty( $matches[0] ) ) {
        // CJK文字がなければ通常の検索を続行
        return $ok;
    }

    // 簡易的なトークン判定: Relevanssiが実際に使うトークナイザを再現
    // ここではCJKクエリが本当にインデックス可能か簡易判定する
    $tokens = relevanssi_tokenize( $search_term, true );
    if ( empty( $tokens[0] ) ) {
        return false; // 有効なトークンがないため検索中止
    }

    return $ok;
}, 10, 2 );このコードでは、Relevanssiの内部関数relevanssi_tokenize()を呼び出し、実際に検索に使われるトークンが生成されるかどうかを見ている。もし空の配列が返ってきたら、それは全テーブルスキャンを引き起こす危険な状態だと判断し、falseを返すことで検索SQLの実行そのものをブロックする。
もうひとつ重要なのは、relevanssi_search_okフィルターがSQL構築の直前で動作するため、無駄なクエリがデータベースに発行される前に検索を止められる点だ。サイトの規模が大きく、wp_relevanssiテーブルが数百万行を超える場合でも、安全に空の結果を返せるようになる。
テーマの functions.php に追加する際の注意点
コードは必ず子テーマのfunctions.phpまたは専用のカスタムプラグインに記述する。親テーマのfunctions.phpを直接編集すると、テーマのアップデートで変更が失われる。また、PHPのバージョンが7.4以上であることをあらかじめ確認しておく。
コードを追加したら、日本語だけで構成された検索クエリを実際に投げてみる。検索結果がゼロ件で返ってくることを確認し、同時にMySQLのスロークエリログやQuery Monitorプラグインで、フルスキャンが発生していないかチェックすると確実だ。
データベースの負荷を根本的に下げるRelevanssiの設定
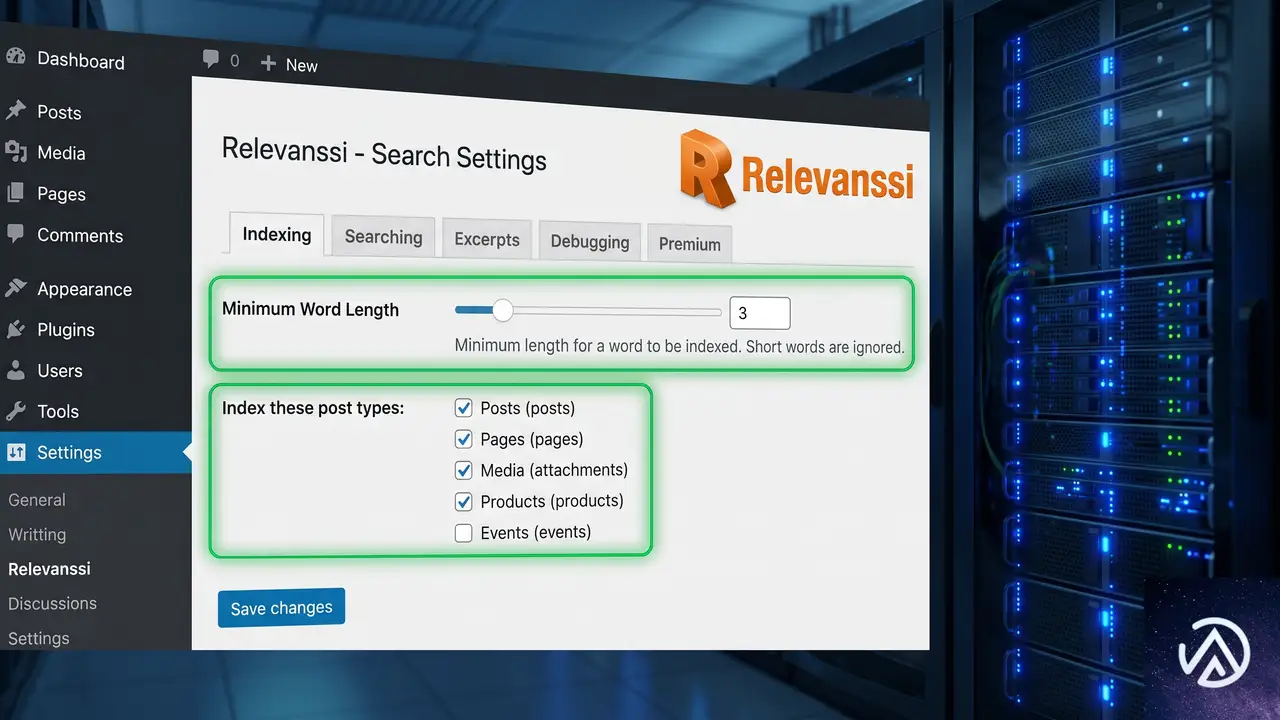
コードによる早期リターンと並行して、インデックスと検索設定そのものを見直すことで、CJKクエリ以外の場面でもパフォーマンスを向上させられる。
最小文字数制限をCJKに合わせて調整する
Relevanssiの管理画面には「インデックスを作成する最小文字数」という設定がある。デフォルトでは2文字程度に設定されていることが多いが、CJK環境では1文字でも意味を持つ(例: 「本」「水」など)ため、1に下げるのが基本だ。ただし、1文字にするとインデックスサイズが膨張しやすいため、サイトの投稿規模に応じて2以上にするか、あるいは後述の文字種フィルタリングと組み合わせる。
検索から除外する投稿タイプやステータスを絞る
wp_relevanssiテーブルが肥大化する大きな要因は、リビジョンや自動下書き、非公開のカスタム投稿タイプまでインデックスに含めているケースだ。設定画面の「インデックスを作成する投稿タイプ」で、実際にサイトのフロントエンド検索で必要になる投稿タイプと公開済みのものだけに限定する。リビジョンが無駄に行を占有しているだけで、テーブルサイズが数割変わることもある。
MySQL / MariaDB のバッファ設定を最適化する
13万投稿、1300万行のインデックスを持つ規模では、サーバーのデータベース設定そのものがボトルネックになる。特にinnodb_buffer_pool_sizeをサーバーの物理メモリの70%程度に設定し、Relevanssiのテーブル全体がメモリに収まるようにすると、たとえスキャンが発生してもディスクI/Oを避けられる。設定変更は必ず本番環境でテストした後に適用する。
よくある質問
コードを追加した後、通常の英語検索に影響はないか
上記のコードは、トークンが空になる場合にのみ検索を中止する。英語のスペース区切りクエリや、英数字が混在する日本語クエリでは通常どおりRelevanssiのインデックスが使われるため、影響はない。万が一、正常な検索がブロックされていると感じたら、relevanssi_tokenize()の結果をエラーログに出力して確認する。
Relevanssi以外の全文検索プラグインでもこの問題は起こるのか
起こりうる。特にPHPベースのトークナイザに依存するプラグインでは、CJK文字の分割に失敗すると同様の空クエリ問題が発生する可能性がある。検索プラグインを選定する際は、形態素解析(MeCabなど)に対応しているか、もしくは外部の検索エンジン(Elasticsearch、Algoliaなど)と統合できるかを基準にするとよい。
大量のクローラーからCJKクエリを繰り返し受けている場合の対策は
検索クエリが空になるパターンは、ボットがランダムな文字列や日本語の記事タイトルを検索ボックスに投げ込むことで頻発する。コードによる早期リターンでサーバー負荷は防げるが、さらにCloudflareやWAFのレート制限で同一IPからの過剰な検索リクエストを制限すると、クローラー起因のリソース浪費全体を抑えられる。
functions.php を触れない環境で他にできることはあるか
管理画面のRelevanssi設定で「検索を許可する最低文字数」を意図的に上げる(例: 3文字)方法がある。ただし、これは短い日本語の単語が検索できなくなる副作用を伴う。根本解決にはならないが、緊急のパフォーマンス低下を抑える応急処置としては有効だ。
この記事のポイント
- 日本語のみの検索クエリでRelevanssiが全テーブルスキャンに陥る根本原因は、トークナイズ結果が空になりSQLが常に真になるため
- カスタムコードでSQL実行前に空トークンを検出し、早期リターンさせることでデータベース負荷を回避できる
- インデックスの最小文字数制限や対象投稿タイプの絞り込みをCJK向けに最適化すると、さらなるパフォーマンス改善につながる
- コード追加後も通常の英数字検索には影響を与えず、安全に運用できる
- クローラーからの大量アクセスに対してはWAFやレート制限との併用が効果的
・ Reddit、Stack Overflow、WordPress.org フォーラムを日々巡回し、現場の悩みを拾い上げて記事化
・ WordPress、WooCommerce、Next.js などモダンWeb制作領域のトラブルシューティングが専門
・ 「検索しても答えが見つからなかった」を一つでも減らすことが目標
・ エラーメッセージから根本原因にたどり着く粘り強い調査が得意
・ 初心者がつまずきやすい箇所を先回りで解決する記事作りを心がけている
Action Scheduler 4.0.0の変更点、WooCommerceのテーブル肥大化を抑制
WooCommerceの裏側で動くAction Schedulerは、多くのデータベースの中でも特に負荷の高いテーブルを持つ。高トラフィックのストアでは、完了した処理を削除する仕組みが追いつかず、失敗したアクションは一切消えないまま蓄積し続けることが問題になっていた。4.0.0はその根本に手を入れたメジャーアップデートだ。失敗アクションの保持期間をデフォルトで3か月に制限し、クリーンアップを専用のデイリージョブとして分離した。これにより、アクションとログのテーブルサイズが際限なく肥大化する状態を防げる。
本バージョンは7月28日リリース予定のWooCommerce 11.0にバンドルされ、すでにWordPress.orgで単独でも入手可能だ。互換性を壊す変更が複数含まれているため、拡張機能を開発している人や大規模ストアを運用している人は、4.0.0での動作検証を早めに始める必要がある。
4.0.0が狙う根本的なテーブル肥大化の抑制
Action SchedulerはWordPress管理画面での注文処理やメール送信など、WooCommerceの非同期ジョブを支えるコアライブラリだ。これまでは小さなバグフィックスが中心で、3.9.x台を刻んでいた。しかし今回、互換性を壊す複数の変更をまとめて投入するため、バージョン番号が4.0.0にジャンプした。WordPress形式のバージョン付けでは3.9.3の次は3.10ではなく4.0だから、意図的な動きといえる。
失敗アクション 無期限で保持
クリーンアップ キュー処理のついでに小分け
専用ジョブ 毎日3時に一括処理
バッチサイズ 最低250件、最大まで連続
このデモが示すように、クリーンアップの仕組みが根本から見直された。特に失敗アクションが自動削除の対象になった点と、削除処理が専用ジョブとして分離された点が、テーブル肥大化を抑える大きな柱だ。
互換性の壁を越えるメジャーバージョンアップ
4.0.0ではWordPress 6.8以上の動作要件が課せられ、WordPress 7.0との互換性も明示された。これは今後のWooCommerceエコシステムにとって、基盤環境を一段上げる布石でもある。また、後述するユニークアクションの判定変更は、同じフックでも引数が異なれば別物として生成されるようになり、既存コードの重複防止ロジックに影響を与える可能性がある。
失敗アクションの保持期間を3か月に制限
これまでAction Schedulerは、完了とキャンセルのアクションだけを削除していた。失敗ステータスのアクションは、自らフィルターで追加しない限り永久に残り続けた。多忙なストアではこれが原因でアクションテーブルとログテーブルが無制限に成長し、自力で回復できない状況に陥っていた。4.0.0では、失敗アクションが発生から3か月を超えると自動的に削除される専用のクリーンアップパスがデフォルトで有効化された。
3か月という期間は、典型的な四半期会計サイクルに合わせつつ、障害調査のための十分な猶予を残す設計だ。より厳格なデータ保持ポリシーを持つストアでは、action_scheduler_retention_period_for_failedフィルターで秒単位の期間を変更できる。あるいはaction_scheduler_enable_failed_action_cleanupに__return_falseを渡せば、4.0.0以前と同じく無期限保持に戻せる。
注目すべき点は、既にaction_scheduler_default_cleaner_statusesフィルターで失敗ステータスを追加していた場合、そちらの設定が優先されることだ。その場合は、4.0.0の新しい失敗専用パスではなく、既存のクリーンアップサイクルに統合されるため、動作が変わることはない。
クリーンアップを専用のデイリージョブに分離
旧バージョンでは、古いアクションの削除はキューの各バッチ処理にインラインで埋め込まれ、一度に少量しか処理されなかった。そのため、処理量の多いストアではクリーンアップが追いつかず、テーブルが大きくなる一方だった。4.0.0では、クリーンアップを独立したタスクとし、サイト時刻で毎日午前3時に一度だけ実行する方式に変更された。
この方式により、削除処理が通常のキュー処理のパフォーマンスに影響を与えなくなり、大規模テーブルでも遅延なく追いつけるようになった。バッチサイズはaction_scheduler_cleanup_batch_sizeフィルターで変更可能で、デフォルトの250件より少なくも多くもできる。もし従来のインライン方式に戻したい場合は、カスタムキュークリーナーを実装すれば自動的にそちらが使われるが、ほとんどのサイトではその必要はないだろう。
ユニークアクションの判定に引数が加わった
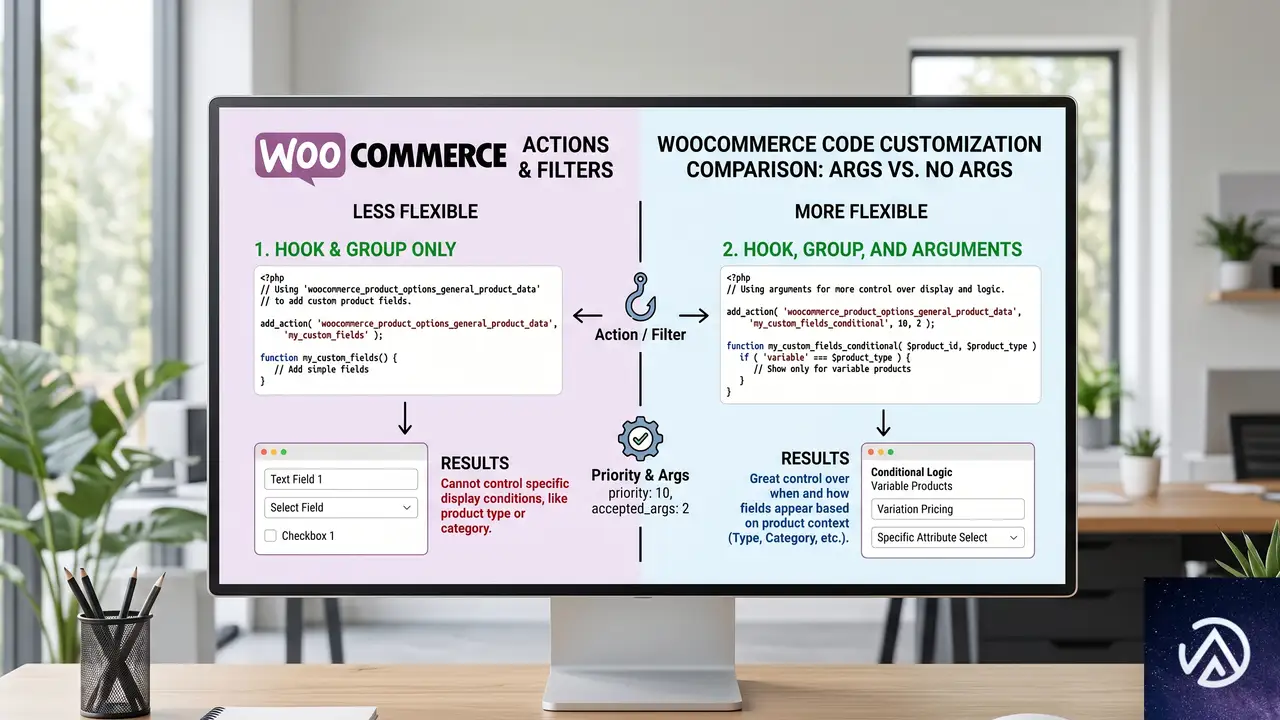
as_enqueue_async_action()やスケジュール系関数の$uniqueパラメータは、同じアクションが重複して生成されるのを防ぐためのものだ。従来はフック名とグループだけを比較していたため、引数が異なる2つのアクションでも同一とみなされ、後のほうが黙って破棄される挙動だった。これが4.0.0では、引数の内容まで含めて同一性を判定するように変更された。
この変更は互換性を壊すため、特に注意が必要だ。旧来のフックとグループだけの重複防止に依存していたコードでは、これまでよりも多くのアクションが生成されるようになる。意図しない大量のジョブがキューに積まれないよう、$uniqueを使っている箇所は必ず見直してほしい。
WooCommerceサイトへの実務的な影響と移行のポイント
4.0.0はWooCommerce 11.0のバンドルに先立って単独テストが可能だ。大規模ストアや独自の拡張機能でAction Schedulerを利用している開発者は、以下の3点を中心にステージング環境で動作検証を行うことを推奨する。
- 失敗アクションの保持ポリシー
3か月のデフォルトが自社のデータ保持要件に合致するか確認し、必要ならフィルターで調整する。 - ユニークアクションの重複防止ロジック
$unique=trueを使用している全箇所を洗い出し、引数が異なるアクションが正しく生成されるかテストする。 - クリーンアップの実行タイミング
デイリージョブへの移行により、削除がバッチ処理から外れたことで、期待していたリアルタイム性が失われていないか確認する。必要に応じてカスタムクリーナーを実装する。
開発元のWooCommerceチームはGitHubでフィードバックを募集しており、予期しない動作があれば早期に報告するよう呼びかけている。WooCommerce 11.0の正式リリースまで1か月あまり。致命的なトラブルを回避するために、今のうちに4.0.0との互換性テストを済ませておくことが賢明だ。
この記事のポイント
- Action Scheduler 4.0.0はテーブル肥大化を防ぐため、クリーンアップの仕組みを根本から見直したメジャーアップデート
- 失敗アクションがデフォルトで3か月後に自動削除されるようになり、保持期間のカスタマイズも可能
- クリーンアップが専用のデイリージョブとして実行され、キュー処理のパフォーマンスに影響しなくなった
- ユニークアクションの重複チェックに引数が含まれるようになり、既存の重複防止ロジックへの影響に注意が必要
- WooCommerce 11.0へのバンドル前に単体テストを行い、互換性の問題を早期に発見することが重要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PostgreSQLで大規模削除をスケールさせるならDROP TABLE一択
PostgreSQLでテーブルから大量の行を削除する必要に迫られたとき、DELETE文をそのまま使うのは最悪の選択肢のひとつだ。一見直感的ではないが、大規模なDELETEはデータベースに余計な仕事を追加するだけに終わる。
一方で、DROP TABLEやTRUNCATEはテーブルごと削除することで、デッドタプルやバキュームといった負債を生まず、即座にディスク領域を開放する。この記事では、なぜDELETEがスケールしないのか、そしてDROP TABLEがなぜ高速なのかをMVCCや物理ストレージの観点から解説する。
さらに、大量の不要データが混入したテーブルを安全にクリーンアップする実践的な手法や、日常的な削除処理をパーティショニングでDROPに変える設計術も紹介する。
なぜDELETEはスケールしないのか
このデモはDELETEとDROP TABLEのデータ処理フローの違いを示している。DELETEはデッドタプルとバキュームという負債を生み、領域をOSに返さない。DROP TABLEはファイル削除だけで完了する。
MVCCとデッドタプルの正体
PostgreSQLは行が更新されるたびに、元の行を「古いバージョン」として内部に保持する。これはMVCC(Multi-Version Concurrency Control / マルチバージョン同時実行制御)と呼ばれ、異なるトランザクションがそれぞれの時点のデータを正しく読み取れるようにする仕組みだ。
この設計では、DELETE文を実行しても行が物理的に即座に消えるわけではない。削除された行は「デッドタプル」としてテーブルやインデックスに残り続ける。後にバキューム処理がそれらを回収して領域を再利用可能にするが、その間も読み取りクエリはデッドタプルをスキップするためのオーバーヘッドを負う。
さらに、通常のバキュームや自動バキューム(autovacuum)は、デッドタプルが占めていたページを「書き込み可能」とマークするだけで、OSにディスク領域を返還しない。PostgreSQLはINSERTとDELETEが混在するワークロードで領域を再利用しやすいようにこの挙動を選んでいる。OSへの領域返還にはVACUUM FULLが必要だが、長時間の強力なロックを伴う。
レプリケーションとバキュームの重み
DELETEは書き込み操作としてWAL(Write Ahead Log)に記録され、レプリカにも転送される。同期レプリケーション環境では、大量のDELETEがコミットされるまで他の書き込みトランザクションが待たされる可能性がある。つまり、DELETEは「それ自体が負荷を増やす」のであり、後片付けもバキュームに丸投げする形になる。
インデックスに関しても、DELETE実行時にインデックスのエントリは即座に消されない。読み取り時に「このタプルは無効か」を逐一判定する必要があり、インデックススキャンがデッドタプルを見つけた場合、ベストエフォートでそのエントリを無効化する最適化はあるものの、根本的なオーバーヘッドは残る。
DROP TABLE/TRUNCATEが高速な理由
DROP TABLEとTRUNCATEはテーブルに対してAccessExclusiveLock(アクセス排他ロック)を取得するため、他のトランザクションがそのテーブルを読み書きできなくなる。しかし、処理そのものはデータ量にほぼ依存しない。内部的にはテーブルに関連する物理ファイルをOSから直接削除し、共有バッファキャッシュからも該当ページのメタデータを一掃する。
PostgreSQLの共有バッファは8KBのページ単位で管理され、各ページに64バイトの固定サイズのヘッダが付与される。テーブル削除時にスキャンするのはページ本体ではなく、このヘッダ情報のみだ。例えば128GBの共有バッファがあっても、スキャンするメタデータは全体の1/128の約1GBに過ぎず、シーケンシャルアクセスで高速に処理できる。これがデータサイズに依存しない真の理由である。
一時的な大量削除への実践アプローチ
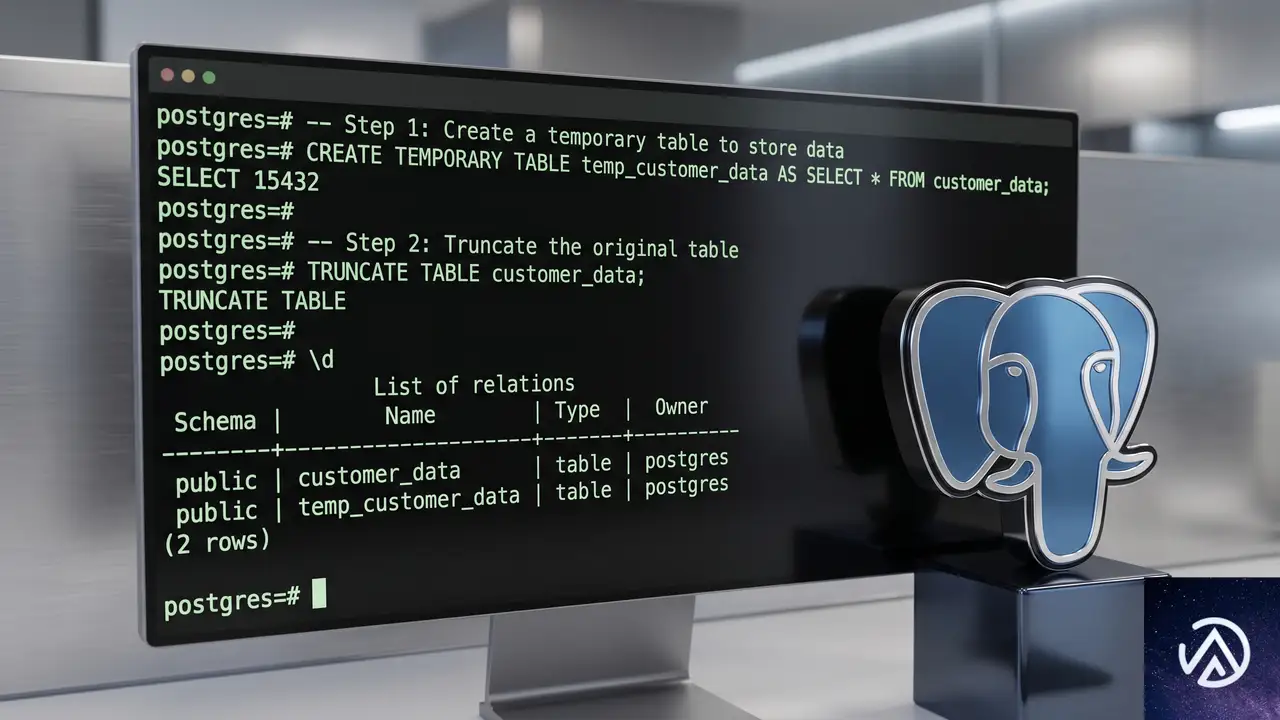
テンポラリテーブルを使った外科手術
バグによってテーブルに大量の不要データが混入したケースを考えよう。保持すべきデータは数十万行程度で、残りはすべて削除対象だ。ダウンタイムが数分許容できるなら、以下の手順で一気にクリーンアップできる。
-- 1. 対象テーブルを排他ロック
LOCK TABLE big_table IN ACCESS EXCLUSIVE MODE;

-- 2. テンポラリテーブルに保持したいデータだけコピー
CREATE TEMP TABLE temp_keep_big_table AS
  SELECT * FROM big_table
  WHERE updated_at >= '2026-04-01';

-- 3. 元テーブルをTRUNCATE
TRUNCATE big_table;

-- 4. テンポラリテーブルからデータを再挿入
INSERT INTO big_table SELECT * FROM temp_keep_big_table;
この手順ではテーブルを完全にロックするため、オンラインサービスではダウンタイムが発生する。しかし、ロック時間が分単位で許容できるメンテナンスウィンドウがあるなら、数十万行のテーブルでも数分で処理できる。実際にPlanetScale社内のオブザーバビリティツールで同様のケースが発生し、この手法で問題を解決している。WALに書き込まれるのは、4の再挿入で戻された行だけであり、DELETEによる膨大なログは一切発生しない。
トリガーを使ったゼロダウンタイムの切り替え
より高度な手法として、テーブルへの書き込みを新しいテーブルにミラーリングし、タイミングを見計らってアトミックなリネームで切り替える方法がある。具体的には、元のテーブルにトリガーを設定して、INSERTやUPDATE、DELETEを新テーブルにも反映させる。十分にデータが同期された段階で、短時間の排他ロックを取得し、テーブルをリネームして差し替える。
このアプローチはPostgreSQLの拡張であるpg_squeeze(pg_repackの後継)が行っていることと本質的に同じだ。ただし、pg_squeezeは既に肥大化したテーブルを最適化するためのツールであり、この記事で伝えたいのは「設計段階で大規模DELETEを避けておく」ことである。初めからスキーマをコントロールできれば、こうした事後対応は不要になる。
パーティショニングで日常的な削除をDROPに置き換える
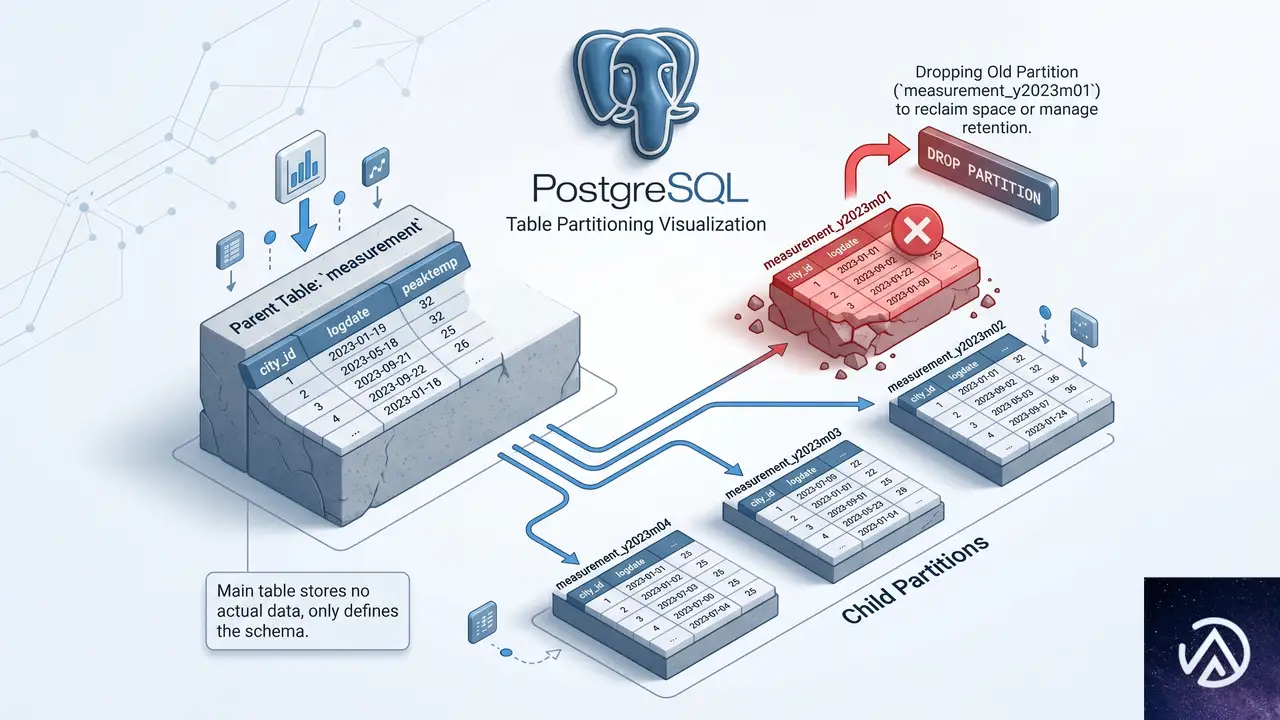
このデモは日付パーティションを使ったエージングアウトと、DROP TABLEによる高速な領域解放の流れを示している。
PostgreSQL 10以降、パーティショニング機能が大幅に強化された。親テーブルの背後に子テーブルを複数持ち、クエリは自動的に該当の子テーブルに振り分けられる。日付ベースのRANGEパーティションを使えば、過去のデータを保持する子テーブルを定期的にDROP TABLEするだけで、古いデータを一瞬で削除できる。これは、数百万行単位のDELETEを定常的に実行していたワークロードを、数秒のDROP TABLEに置き換える強力なテクニックだ。
pg_partman拡張を利用すれば、子テーブルの自動作成や古いパーティションの削除をスケジュール実行できる。また、パーティショニングは再帰的に構成できるため、より高度な設計も可能だ。たとえば、最上位をLISTパーティションで「可視行」と「不可視行」に分け、「不可視行」の子テーブルをさらにRANGEパーティションで日付ごとにエージアウトさせる、といった多次元の構成が組める。
スキーマ設計でDELETEをDROPに置き換える視点
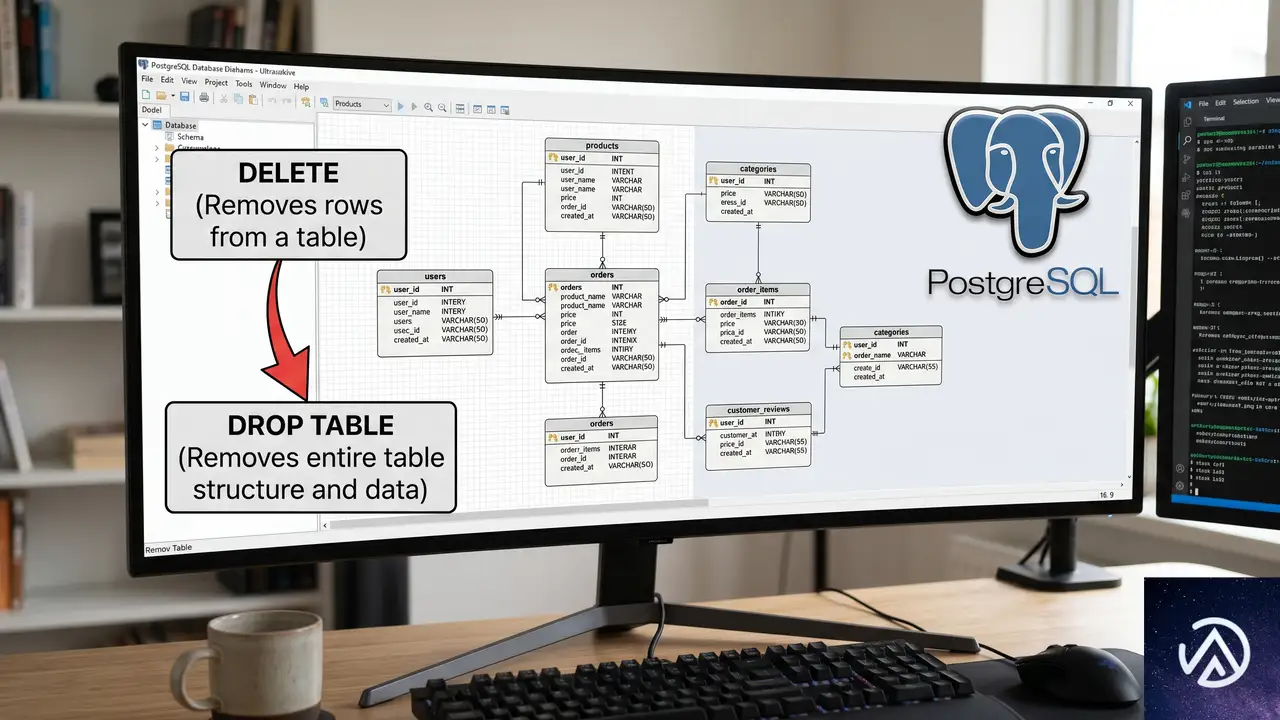
大量データを削除する必要が生じるアプリケーションでは、テーブル設計の段階からDELETEをDROPやTRUNCATEで代替できるか検討することが重要だ。DELETEを多用しない設計にすることで、読み取りクエリのレイテンシ低減、レプリケーションラグの抑制、バキューム負荷の軽減といった効果が期待できる。
パーティショニングしかり、トリガーベースのテーブル差し替えしかり、選択肢は多様だ。PostgreSQLのMVCCが持つ根本的な制約を理解し、大規模な行削除は「テーブルごと破棄して必要なデータだけを再構築する」という発想でスキーマを組み立てる。その結果、データベースの健全性は飛躍的に向上する。
この記事のポイント
- DELETEはデッドタプルを生成し、バキュームやレプリケーションに余計な負荷をかける。大規模削除には向かない
- DROP TABLEやTRUNCATEはデータ量に依存せず、物理ファイルの削除とバッファキャッシュのメタデータスイープで瞬時に領域を解放する
- 一度きりの大量削除はテンポラリテーブルとTRUNCATEの組み合わせが有効。ダウンタイムを許容できるなら強力な手法
- 定常的な古いデータの削除には、パーティショニングでDROP TABLEに置き換える設計が有効。日付パーティションとpg_partman拡張で自動化できる
- アプリケーション設計時に「大量削除が必要なテーブル」をDROPできるようスキーマを工夫することで、データベースの健全性を大幅に向上できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Multigres v0.1 α版リリース、Postgres向け水平スケーリングOSの概要
2026年6月4日、SupabaseのチームがオープンソースプロジェクトMultigresの初のパブリックマイルストーンとなるv0.1 Alphaを公開した。このプロジェクトはPostgresにVitess級の水平スケーリング、高可用性、運用のシンプルさをもたらす「オペレーティングシステム」を目指している。
v0.1 Alphaでは高度なコネクションプーリング、自動フェイルオーバー、Kubernetesオペレーターが提供される。シャーディング機能は今後のリリースで追加予定だ。以下の記事ではその設計思想と仕組みを掘り下げる。
Multigresとは
・フェイルオーバーは運用者が判断
・コネクション制限への個別対処
・バックアップは別ツールで管理
・自動フェイルオーバーでダウンタイム最小
・コンテキスト認識型コネクションプーリング
・バックアップとリストアを統合管理
MultigresはPostgresインスタンスを包括的に管理する「スケーラブルなオペレーティングシステム」だ。シャーディング、コネクションプーリング、自動フェイルオーバー、バックアップオーケストレーションを単一のシステムで提供する。
Postgresスケーリングの課題
Postgresを大規模に運用する際、読み取りレプリカの管理、フェイルオーバーの対応、コネクション上限対策、バックアップのスケジューリングなど、運用負荷が高い。これらをバラバラのツールで解決しようとすると、複雑さが増していく。
Multigresが解決すること
Multigresはこれらを一貫したシステムとして自動化する。データベースのスケールが必要になったタイミングでシャーディングも処理し、水平スケーリングを実現する。v0.1 Alphaではまだ単一シャードだが、基盤は整っている。
Kubernetesオペレーター
Kubernetesオペレーターによって、Multigresクラスタのデプロイと管理が抽象化される。必要なのはKubernetesクラスタとバックアップ用のストレージ(共有ファイルシステムやAWS S3バケット)だけだ。ローカルのKindクラスタでも動作検証が可能で、必要なコンテナイメージはすべて公開されている。
高可用性(HA)の仕組み
データの不整合やコミット消失のリスク
耐久性ポリシーをユーザーが自由に定義可能
MultigresはHAを合意形成の問題として扱い、スプリットブレインが起きてもコミット済みデータを失わない。これを一般化合意(generalized consensus)モデルで実現している。これは従来のコンセンサスベースシステムにはない柔軟性をもたらす。
一般化合意モデル
Multigresは無修正のPostgresレプリケーションの上に実装されており、厳密な一貫性要件を満たす。さらに、過半数のクォーラムのような制約に縛られず、ユーザーが任意の耐久性ポリシーを定義できる。例えば「単一のアベイラビリティゾーン(AZ)障害に耐える」を設定すれば、それ以上のゾーンにスタンバイを配置することも可能だ。
レプリカの動的追加と削除
クラスタ稼働中にレプリカを安全に増減できる。パフォーマンスに影響を与えず、設定された耐久性ポリシーと整合性を保ったままスケーリングが可能だ。
コネクションプーリングの革新
Multigresは独自の2サービスアーキテクチャによるコネクションプーリングを採用している。クライアント接続を受け付ける「multigateway」と、バックエンド接続を管理する「multipooler」で構成され、単一プロセスのプーラーにはない利点がある。
トラフィックルーティングとフェイルオーバー
HAシステムとの統合により、multigatewayは常に現在のプライマリに透過的に接続を転送する。フェイルオーバー発生時は新しいプライマリが昇格するまでリクエストを保留し、エラーを最小化する。読み取り負荷は複数レプリカに分散可能で、将来的にはシャード間のルーティングにも対応予定だ。
コンテキストアウェアプーリング
Multigresはトランザクションやセッションといったプーリングモードを明示的に選択する必要がない。組み込みのパーサーが各リクエストの効果を理解し、接続状態を追跡する。ステートフルなトランザクションが必要な場合だけ接続をそのクライアントに固定し、それ以外は再利用する。
ユーザー別プールとプリペアドステートメント
ユーザーごとに独立したコネクションプールを保持し、SET ROLEによるなりすましを使わない。固定の接続予算をフェアシェアアルゴリズムで分配する。さらに、プリペアドステートメントはゲートウェイ間で重複排除され、Postgres側で文の解析、計画、キャッシュが1回だけ行われる。
バックアップ戦略
MultigresはバックアップにpgBackRestを使用し、プライマリに負荷をかけないようレプリカから取得する。バックアップの種類は完全、増分、差分の3つで、通常は定期的な完全バックアップと短い間隔の増分・差分を組み合わせる。
オンデマンドとスケジュール
CLIでバックアップの一覧表示や手動バックアップ、リストアが可能だ。スケジュール機能は今後のクラスタスペックを通じて追加予定となっている。
クラスターブートストラップ
クラスタ起動時にMultigresが自動的にプライマリを特定し、バックアップを取得して他のレプリカを初期化する。これにより人手を介さずに即座に利用可能なクラスタが立ち上がる。
アルファ版の制限と今後の展望
・既知の課題がGitHubイシューにあり
・将来バージョンとの後方互換性は保証されない
・CR APIが安定していない
・パフォーマンスベンチマーク未公開
・スケジュールバックアップのサポート
・APIの安定化とベンチマークの公開
・コミュニティからのフィードバック集約
v0.1 Alphaは実験とフィードバックに十分な安定性を持つが、本番運用にはまだ適さない。シャーディングは今後のリリースで追加予定の主力機能であり、現在はHAとプーリングを備えた単一シャードクラスタの形で提供されている。ベータやv1.0に向けてAPIの安定化とベンチマークの公開が進められる見通しだ。
この記事のポイント
- MultigresはPostgresのスケーリングと運用を自動化するオープンソースOS
- v0.1 AlphaでKubernetesオペレーター、HA、高度なコネクションプーリングを提供
- 一般化合意モデルによりスプリットブレインを安全に解決
- コンテキストアウェアプーリングでモード選択不要、ユーザー別プールも実装
- シャーディングは将来リリース予定、現在はフィードバック収集段階
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験