

Googleがインデックス不要のランキングを理論実証。検索結果ページは見えなくなる
Googleの研究チームが、インデックスなしで文書をランキングできる計算手法を理論的に証明した。検索結果ページは「見るもの」から「モデルが内部で処理するステップ」に変わる可能性がある。
この研究は2026年1月に発表されたAutoRegressive Ranking(ARR、自己回帰ランキング)という手法に関する論文が基盤になる。Googleは2021年から同じ方向の研究を積み重ねてきた。
実務者にとって重要なのは、ビームサーチと呼ばれる生成プロセスが可視性の境界線になることだ。ランキング上位の限られた件数に入れない限り、そもそも生成されないため「圏外」と「生成されず」の区別すらできなくなる。
Googleが2021年から進めてきた研究の集大成
この論文は突然出てきたものではない。2021年にGoogleの研究者4人が発表した「Rethinking Search(検索の再考)」では、検索システムは参照リストを提示するのではなく、引用可能なコーパスから直接回答すべきだと主張していた。これは研究提案であり製品ロードマップではないとの但し書きが付いていた。
2022年にはほぼ同じ研究グループがDifferentiable Search Index(微分可能検索インデックス、DSI)を発表した。1つのTransformerモデルがクエリを文書識別子に直接マッピングできることを示した。コーパス全体がモデルのパラメータにエンコードされる。これが新しいランキング手法の原型だ。
2026年1月の論文はその理論を埋める。デュアルエンコーダの埋め込み次元は文書数に比例して拡大する必要があるのに対し、固定の隠れ次元を持つ自己回帰モデルは任意の数をランキングできることを証明した。さらにSToICaLという学習ロスを導入し、モデルが上位1件だけでなくリスト全体を意識して学習するようにした。提案、プロトタイプ、証明という流れで、5年間の研究が1つの方向に収束している。
従来の検索は「検索してから並べ替える」2段階だったが、新しい手法では1つのモデルが文書識別子を生成しながらランキングまで完了する。この違いはアーキテクチャの変更ではなく、検索という概念の再定義に近い。
文書はコードになり、コードがランクされる
このアーキテクチャでは文書はURLではない。docID(文書識別子)という短いトークン列として扱われる。モデルは単語を生成するのと同じ仕組みで、文書識別子を1つずつ生成していく。
ショッピング実験では、各商品の識別子を商品タイトルの埋め込みベクトルから3つの数字に圧縮して作った。識別子自体が意味を持ち、似た商品は似た数字の並びを共有する。モデルは最も確からしい識別子から順にビームサーチで生成していく。調べるのではなく、アドレスを生成する。検索ルックアップが存在しない点が本質的な違いだ。
ショッピング実験では、商品タイトルの埋め込みベクトルを3つの数字に圧縮して識別子を作った。似た商品は似た識別子を持つため、ランキングが意味を持つ。
識別性が最適化目標になる
ページが埋め込み空間で隣接するページと区別できない場合、安定した識別子を持てない。2つの重複に近い商品ページは隣接する順位を争うのではなく、同じアドレスを争うことになる。そして片方は完全に負ける。
ランキング関数はトレーニングセットそのものになる。SToICaLはクエリ、文書識別子、真のランクの3つ組で学習する。クリックログ、評価者の判断、エンゲージメント信号など、グレード付きリストを生成したものがアルゴリズムになる。リバースエンジニアリングすべきランキング要素の層は存在しなくなる。
鮮度がトレーニング問題に変わる
従来のインデックスでは新しいページはクロールして挿入するだけでよかった。パラメトリック生成インデックスでは学習する必要がある。Googleの後続研究DSI++では、新しい文書を継続的にインデックスすると既存文書の記憶が大幅に失われることが分かっている。
ニュースパブリッシャーにとって「インデックスされた」と「ランカーに認識された」は別のイベントになる。ARR実験では候補をプロンプト内に置くことで回避している。実際の展開も古典的検索が生成ランカーに候補を供給するハイブリッドから始まる可能性が高い。純粋な生成インデックスは長期的な方向性だ。
ビームサーチが可視性の境界線になる
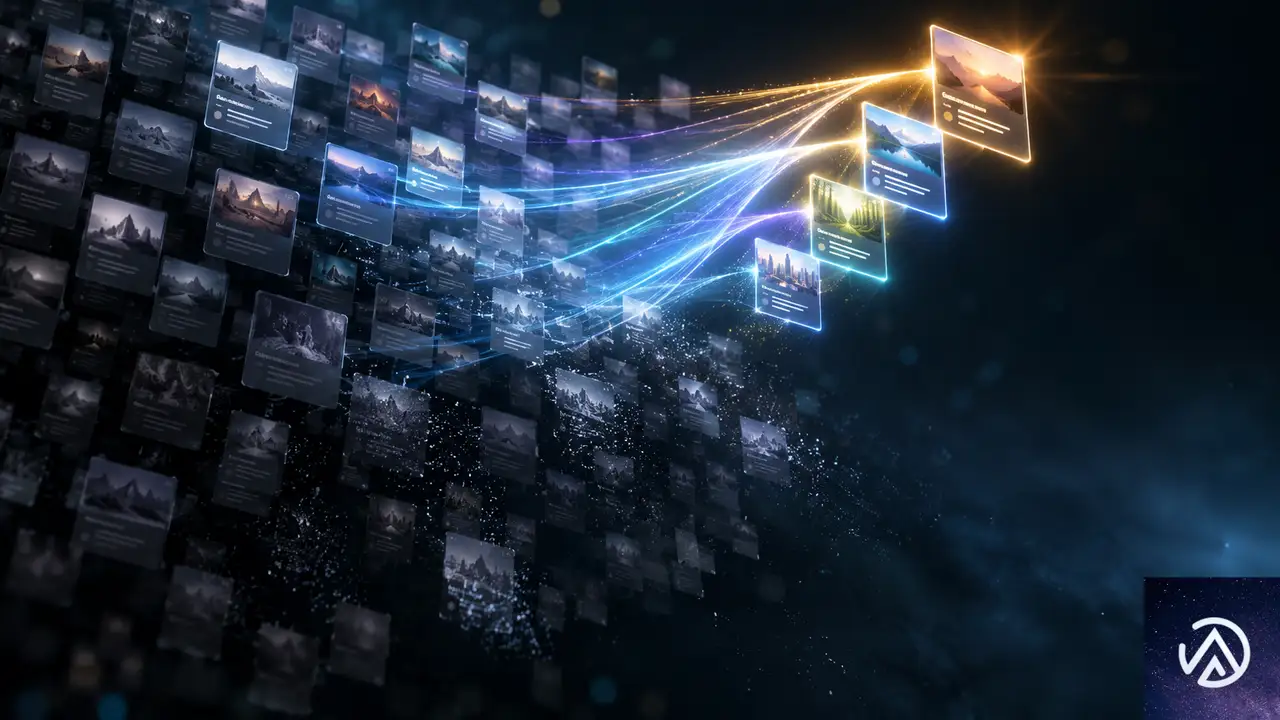
ビームサーチは生成モデルが1つの答えではなく短いリストを生成する仕組みだ。各生成ステップで確率の高い部分列を一定数(ビーム幅)だけ保持し、他は捨てる。ビーム幅が10なら最終リストは10件を超えない。
ポイントは11位が「悪い結果」ではなく「存在しない」ことだ。従来のデュアルエンコーダなら最近傍インデックスで上位1000件をほぼ無料で取得できた。スコアリングが安価だからリストは副産物だった。しかしビーム幅10の生成モデルでは11位はそもそも生成されない。
ビームサーチでは各ステップで一定数(ビーム幅)の候補だけが生き残る。ビーム幅が10なら結果は10件止まりで、11位は計算すらされない。
ランクトラッキングの意味が消える
ページ2は設計上の決定ではなく、存在しないものになる。ビーム幅以下のランクトラッキングは何も測定しない。可視性は2値化する。「生成されたセットに入っているか、入っていないか」だ。
外部からは「ランキングが悪い」と「生成されなかった」を区別できない。どちらも見た目は同じだからだ。実務者の問いは「何位か」から「生成セットに入っているか、どのクエリ形状で、どれだけ一貫して」に変わる。これが可視性計測プラットフォームが答えるべき問いになる。
論文には皮肉な点がある。実際の貢献は1位以下の改善だ。WordNetでの実験では、ランク認識型トレーニングが2位から5位の再現率を50%台から90%台半ばまで押し上げた。2位から5位の並び順が改善される瞬間に、検索結果画面には表示されない領域が広がっていく。
広告と収益モデルへの影響
Alphabetの2026年第2四半期のGoogle検索およびその他収益は632億7000万ドル、前年比17%増だった。広告オークションは別システムであり、この論文は直接触れない。収益に関係するのはコスト面だ。
2段階パイプラインが存在するのは、クロスエンコーダをコーパス全体に実行するのが高すぎるからだ。自己回帰ランキングは最近傍インデックスを不要にし、全文書を個別にスコアリングしない。生成結果の構造的なコスト削減になる。
コストはGoogleがAI回答をデフォルト体験としてどこまで押し広げるかの静かな制約だった。十分なコスト削減が実現すれば、広告在庫が存在する10個の青いリンクを維持する構造的な理由が弱くなる。広告が消えるのではなく、広告を載せる面が変わる。広告も一緒に移動するのだ。
広告システムの変容は始まっている
Search Engine Journalの著者Duane Forrester氏は2025年8月に「Cohorts, Clusters, and the Coming AI Ad System(コホート、クラスタ、到来するAI広告システム)」という記事を公開し、Intent Vector Bidding(意図ベクトル入札)という概念を提唱した。広告主のコンテンツがユーザープロンプトの意味とどれだけ近いかで掲載が決まり、広告自体もクエリ時に広告主の資産から組み立てられるという仕組みだ。
9か月後のGoogle Marketing Liveで、GoogleはAI検索向けの広告フォーマットを発表した。ユーザー固有のクエリに即座に合わせ、質問の具体的な言い回しからクリエイティブを生成する。キャンペーンを実行し資産を供給する点は従来通りだが、クリエイティブの半分は実現した。
ARR論文はそのメカニズムを完成させる。Google Researchのトークンオークション論文は、広告主がトークンごとに生成される広告テキストに影響を与えるために入札するオークションを設計した。自己回帰ランキングは有機的な文書識別子をトークンごとに生成する。同じ生成プロセスが答え、有機ソース、スポンサード掲載を同時に生成できる可能性がある。
実務者が今着手すべき3つの対策
研究論文を基盤にプログラム全体を再構築する必要はない。この段階では3つの小さな動きが釣り合いの取れた対応になる。
この3つの対策は即座に実行可能で、研究の進展を待たずとも価値がある。識別性の監査と可視性測定の移行は、現在の検索環境でも有効な施策だ。
この記事のポイント
- Googleがインデックスなしで文書をランキングできる計算手法を理論的に証明した
- 文書はdocIDというコードになり、モデルが生成するアドレスに変わる
- ビームサーチが可視性の境界線になり、上位10件以外は存在しない扱いになる
- ランクトラッキングより生成セットへの含有率測定が重要になる
- 広告システムはトークン単位の入札と生成型クリエイティブへ進化する

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験