

OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPT for Small Businessプログラム開始、GPT-5.6搭載のChatGPT Workを提供
ChatGPT WorkとGPT-5.6が中小企業向けプログラムで提供開始
OpenAIは2026年7月21日、中小企業の生産性向上を支援する「ChatGPT for small businesses program」の開始を発表した。このプログラムの中核となるのが、複数の工程にわたる複雑なタスクを最後まで実行できるエージェント「ChatGPT Work」であり、最新モデル「GPT-5.6」を搭載する。
小規模なチーム、限られた時間、そして少数のリソース。中小企業の経営者はマーケティング、経理、営業、オペレーション、戦略立案まで、あらゆる役割をひとりでこなすことが求められる。OpenAIのこのプログラムは、AIを「一人ひとりの専門性を拡張し、処理能力を底上げする力の増幅装置」として位置づけ、誰もが大企業並みのツールを手にできる世界を目指している。
本記事では、プログラムの具体的な内容、ChatGPT Workが中小企業の現場で何を変えるのか、そして実際に得られた導入効果の数字をもとに、この動きが持つ意味を読み解いていく。
上図のとおり、ChatGPT Workは単なるチャットボットではない。ファイルやアプリケーションと接続し、利用者の思考パターンや執筆スタイルを記憶したうえで、複数の手順を必要とする業務をエンドツーエンドで完遂する自律型エージェントである。
プログラムの4つの柱 オンライン学習から対面イベントまで
今回発表されたプログラムは、以下の4つの要素で構成されている。単なるツール提供にとどまらず、具体的な業務に即した「使いこなし」までをパッケージにした点が特徴だ。
4つの柱はいずれも「すぐに使える」「具体的な業務に直結する」点で共通している。注目すべきなのはSTEP 2の対面型AIアカデミーの実績データで、参加者の78%がわずか1日で実用的なAIワークフローを構築し、42%がAIの活用によって週5時間以上の時間を節約できたという。この数字は、適切なガイドがあればAI導入のハードルは大きく下がることを示している。
業務別にみるChatGPT Work活用の具体例
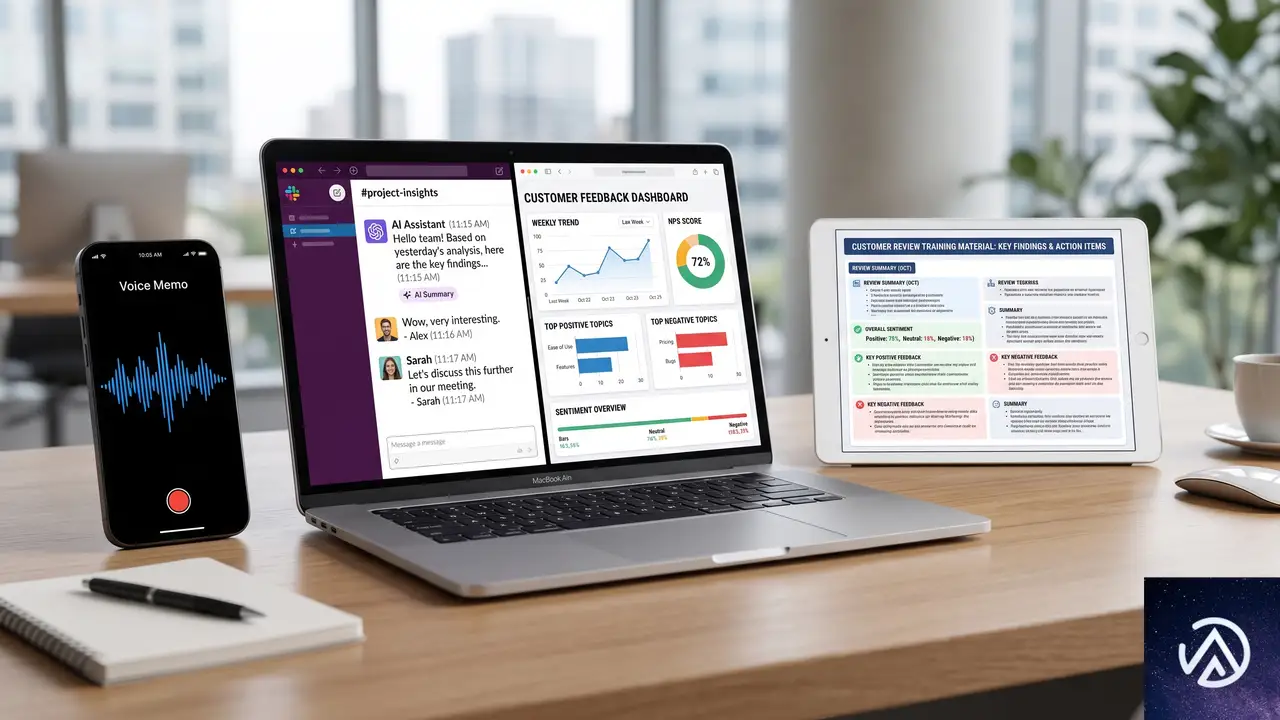
ChatGPT Workは、設計事務所からテック系スタートアップ、非営利団体まで、業種を問わずに利用できる汎用性を持つ。OpenAIの発表では、特に以下の3つのユースケースが紹介されている。
これらのユースケースに共通するのは、「これまで外注するか、手付かずで放置されるか、あるいは経営者が無理をして片づけていたタスク」をAIが肩代わりするという点である。とくに音声メモを起点としたワークフロー自動化は、デスクに座る時間すら惜しい現場経営者にとって現実的な省力化手段といえる。
なぜいま中小企業にAIが必要なのか 数字が示す現実
AI導入の具体的なリターン
AI導入の効果は抽象的な話ではない。OpenAIが2025年に開催した「Small Business AI Jams」では、具体的な数字が報告されている。
- 参加者の78%が、わずか1日で実用的なAIワークフローを構築
- 42%が、AIの活用で週5時間以上の時間を節約
週5時間の節約は、年間に換算すると約260時間に相当する。これは約6.5週間分の労働時間に匹敵し、中小企業の経営者にとっては事業戦略や新規顧客開拓といった、より付加価値の高い業務へ時間を振り向けられることを意味する。
GPT-5.6がもたらす民主化
ChatGPT Workに搭載されるGPT-5.6は、あらゆる規模のビジネスとすべてのサブスクリプションプランで利用できる最先端モデルである。これは重要な意味を持つ。従来、最高性能のAIモデルは大企業の専有物になりがちだったが、OpenAIはこの垣根を取り払った。
中小企業は、必要なときに必要なだけ高度なAIの知能を呼び出し、品質とスピード、コストのバランスを柔軟に調整できる。デスクでの集中作業中でも、外出先の移動中でも、同じモデルにアクセスできる環境が整ったことになる。
この「AIの民主化」は、中小企業の競争環境を大きく変える可能性を持つ。限られた人材と予算のなかで、AIが文字どおり「チームの一員」として機能し始めるからである。
フィードバックが製品ロードマップを動かす 参加型プログラムの狙い
本プログラムのもうひとつの特徴は、OpenAIが参加者からのフィードバックを製品開発に直接反映させる仕組みを組み込んでいる点である。ウェビナー後のQ&Aセッション、地域イベントでの対話、アンケート調査を通じて、「何が機能し、何が欠けているか、次に何を見たいか」という声を集めるという。
これは、単なるプロモーション施策ではない。実際の業務でAIを使うユーザーの生の声が、ChatGPT Workの機能改善や今後のリソース開発、ひいては中小企業向けの製品体験全体を方向づける。参加者は単なる受益者ではなく、製品の共創者として位置づけられているのである。
OpenAIは専用の登録フォームを用意しており、最新情報やイベントへの参加機会をメールで受け取ることができる。
この記事のポイント
- OpenAIが中小企業向けプログラムを発表し、ChatGPT WorkとGPT-5.6を全プランで提供開始
- プログラムはウェビナー、対面トレーニング、導入ガイド、パートナー連携の4本柱で構成
- 2025年の対面イベントでは参加者の78%が1日でAIワークフローを構築、42%が週5時間以上を節約
- 音声メモの自動Slack変換、市場分析の自動更新、カスタマーレビュー分析など具体的な活用例を提示
- 参加者からのフィードバックが製品ロードマップに直接反映される双方向型の設計
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

GPT-5.5が企業向けエージェントにもたらす変革、Databricks導入事例
大規模言語モデルの進化が、企業の実務ワークフローに直接的な成果をもたらし始めている。データ分析基盤を提供するDatabricksが、OpenAIの最新モデルGPT-5.5を社内向けAIエージェントに組み込んだ結果、複雑な文書処理タスクを評価するベンチマーク「OfficeQA Pro」でエラーが46%も減少した。GPT-5.5はこのベンチマークで初めて正解率50%を超えたモデルとなった。
この結果は「モデルの性能向上が、実際のビジネス指標にどう結びつくか」を示す重要な事例だ。単なる会話能力の評価ではなく、スキャンされたPDFや古い社内フォーマットの文書を解析し、複数ステップのタスクを自律的に遂行する能力が問われている。本記事ではGPT-5.5がどのような技術的進歩を遂げ、企業のAI活用にどんな可能性を開くのかを解説する。
企業向けAIエージェントの現在地、なぜ文書処理が壁になるのか

企業がAIエージェントを導入する際、最初にぶつかる壁が「社内文書の解析」だ。契約書や見積書、古いシステムから出力されたレポートなど、形式がバラバラな文書をAIに理解させるのは想像以上に難しい。特にスキャンされたPDF(画像として取り込まれた文書)や、数十年前のレガシーフォーマットで保存されたファイルは、最新のAIでも正確なテキスト抽出に失敗することが多い。
この問題の深刻さは、小さな認識ミスが後続の処理全体を狂わせる点にある。たとえば請求書の金額を一桁間違えて抽出すれば、その後の経理処理やレポート作成がすべて誤った情報で進んでしまう。人間なら「明らかにおかしい」と気づくようなエラーでも、AIエージェントは抽出した数値をそのまま信じて処理を続ける。これが企業現場でのAI導入を妨げる最大の障壁となっていた。
OfficeQA Proベンチマークの評価観点とは
Databricksが開発したOfficeQA Proは、こうした実務課題を忠実に再現する評価指標だ。このベンチマークでは、モデルに対して以下の3つの能力が求められる。
- 文書解析(Parsing):スキャンPDFやレガシーファイルから正確に情報を抽出する能力
- 情報検索(Retrieval):長大な文書群の中から必要な情報を見つけ出す能力
- 根拠に基づく推論(Grounded Reasoning):抽出した情報をもとに、論理的な判断や回答を生成する能力
単なる知識クイズではない。バラバラなフォーマットの文書を理解し、複数のステップを経て最終的なアウトプットを出す「エージェントとしての実務能力」が試される設計になっている。
上図のように、GPT-5.5への切り替えによって文書解析のエラーが大幅に減り、後続のワークフロー全体の信頼性が向上した。この改善の背景には、モデルの視覚認識能力と言語理解の統合が進んだことがあると見られている。
GPT-5.5が達成した二つの飛躍的改善

Databricksが報告したGPT-5.5の改善点は、大きく二つの領域に分かれる。一つは文書解析精度の劇的な向上、もう一つは複数ステップのタスクを効率的に管理するオーケストレーション能力の進化だ。
スキャン文書解析の「ステップ関数的」な進歩
Databricksの記事で同社のSinghvi氏が指摘するように、GPT-5.4まではスキャンされた古い文書から数字を正確に読み取れないケースが頻発していた。これに対しGPT-5.5は、古い文書やスキャンPDFの解析において「ステップ関数的な性能向上」を見せたという。「ステップ関数的」とは、なだらかな改善ではなく、階段を一段上がるように非連続的な飛躍があったことを意味する。
この進歩が特に重要なのは、企業が保有する文書の多くが過去の資産だからだ。10年前の契約書、5年前の監査レポート、紙をスキャンしてPDF化した資料。こうした「過去の遺産」を正確に解析できるかどうかが、AIエージェントの実用性を左右する。GPT-5.5はこの壁を一つ越えたと言える。
ムダな遠回りをしないタスク実行能力
もう一つの重要な改善が、複数ステップのタスクを実行する際の軌道(Trajectory)の最適化だ。GPT-5.4では、目的に対して不必要な検索を繰り返す「遠回り」が発生し、非効率な処理経路をたどることがあった。これはエージェントが過剰に「慎重」になりすぎる、あるいは文脈を適切に把握できずに余計な確認作業を挟んでしまう問題だ。
GPT-5.5では、必要な情報を必要なタイミングで的確に取得し、最短のステップでタスクを完了する能力が高まった。追加の監視や人間による修正なしに、複雑なワークフローを完遂できる信頼性が向上している。
この改善は、企業がAIエージェントに求める「人間の監視なしで動く自律性」に直結する。タスクが長引けばそれだけコストも増え、途中で人間が介入する必要性も高まる。GPT-5.5はこの課題に対して明確な前進を示した。
企業ワークフローへの実装、AgentBricksとAI Unity Gateway

DatabricksはGPT-5.5を単独のチャットボットとして使っているわけではない。同社の「AI Unity Gateway」を通じて、AgentBricksやAgent Supervisor APIといったエージェント構築基盤と統合し、実際のビジネスワークフローに組み込んでいる。
AgentBricksとは、Databricksが提供するエージェント構築フレームワークだ。専門特化した複数のエージェントを組み合わせ、複雑な業務プロセスを自動化できる。ここでGPT-5.5は「監督者(Supervisor)」として機能する。各専門エージェントが文書解析やデータ検索、レポート生成といった個別タスクを担当し、GPT-5.5が全体の流れを管理して適切なタイミングで適切なエージェントに指示を出す。このアーキテクチャによって、単一モデルでは扱いきれない複雑な業務フローが実現できる。
この「監督者モデル」のアプローチは、今後の企業向けAI活用の主流になると考えられる。一つの巨大モデルがすべてを処理するのではなく、専門エージェントを束ねる統括役としてLLMを配置する設計だ。GPT-5.5のオーケストレーション能力の向上は、この設計思想と見事にマッチしている。
ナレッジワークにおけるGPT-5.5のインパクト

DatabricksのSinghvi氏は「GPT-5.5は知識作業においてステップ関数的な変化をもたらした」と評している。単に質問に答えるだけでなく、複数の文書を横断して情報を統合し、文脈を理解した上で判断を下す「知識労働の代替」としての性能が大きく向上したという評価だ。
この評価が特に重要なのは、AIが「単なる道具」から「業務のパートナー」へと役割を変えつつあることを示唆しているからだ。従来のAIアシスタントは、人間が明確に指示したタスクを実行するのが限界だった。GPT-5.5を中核に据えたエージェントは、曖昧な指示や複雑な文脈でも自律的に判断し、複数ステップの業務を完遂できる水準に近づきつつある。
日本企業への示唆、データ資産の再活用という視点
この事例から日本企業が学ぶべきポイントは明確だ。多くの企業が「過去の文書資産」を抱えている。紙で保管された契約書、古い基幹システムから出力された帳票、スキャンされたPDFの山。これらをAIで解析し、活用可能なデータに変換する技術が現実のものになりつつある。
ただし注意点もある。GPT-5.5の性能向上が顕著だったのは「スキャン文書の解析」と「複数ステップのオーケストレーション」であり、これはモデル自体の進化に加えて、Databricksのエージェント基盤との統合設計が効いている。単に高性能なLLMを導入するだけでは同様の成果は得られない。データ基盤とエージェント設計の両面からアプローチする必要がある。
この記事のポイント
- GPT-5.5は企業の実務ベンチマークOfficeQA Proでエラーを46%削減し、初めて正解率50%を突破した
- 特にスキャンPDFやレガシー文書の解析精度が飛躍的に向上し、古い文書資産の活用が現実的に
- 複数ステップのタスクを効率的に管理するオーケストレーション能力も改善し、自律的な業務遂行が可能に
- DatabricksではGPT-5.5を監督エージェントとして配置し、専門エージェント群を統括する設計を採用
- 日本企業にとっては、過去の文書資産をAIで再活用できる可能性が開けた事例として注目すべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験