

Claude Fable 5がGoogle Cloudで一般提供開始。エージェント構築の新たな基盤を考察
Anthropicの最新モデル「Claude Fable 5」が、Google Cloud上で一般提供を開始した。このモデルは複雑な多段階推論や高度なコード生成を得意とし、長期間にわたって自律的に動作するエージェントの構築に適している。クラウドAIの基盤に何が起きているのかを読み解く。
Claude Fable 5の登場とその戦略的な位置付け
Anthropicのモデル群には、Haiku(軽量高速)、Sonnet(バランス)、Opus(超高性能)がある。今回登場したFableシリーズは、これらのニックネームとは明らかに異なる文脈を持つ。筆者の見解では、Fableは「物語(ストーリー)の生成」、つまり長文脈の一貫性維持や、複雑なオーケストレーションを必要とするエージェントタスクに特化した系統と位置付けられる。
このモデルは単に速度や知識量を競うだけでなく、「どれだけ複雑な仕事を最後までやり遂げられるか」を重視している。特に、長期稼働エージェントとしての使用が強く想定されている点が、他のモデルとの差別化要因だ。
Fable 5は、単発のレスポンスを返すだけではない。途中で文脈を見失ったり、指示を忘れたりする問題を大幅に低減し、ソフトウェア開発や分析業務といった長時間の集中を要するタスクで真価を発揮する。
Fable 5の主要な能力と想定されるユースケース
Google Cloudの公式発表とAnthropicのリリースノートから、Fable 5の中核的な機能強化点を読み解くと、以下の3つに集約される。
複雑な多段階推論と高度なコード生成
Fable 5は、数学的推論やコード生成ベンチマークで大幅な性能向上を達成している。これは単にコードを出力するだけでなく、既存のリポジトリ全体を理解し、アーキテクチャレベルの提案ができることを示す。典型的な「次のトークン予測」を超え、人間のソフトウェアアーキテクトのように数手先を読む能力が強化された。
長期稼働エージェントの実現
多くのLLMは文脈が長くなると応答精度が落ちる。Fable 5は「長時間にわたって自律的にツールを使い、タスクを完了させる」というエージェント動作に最適化されている。カスタマーサポートの自動化、継続的なデータ収集、IT運用の自動化など、数時間から数日単位で動くAIエージェント基盤として機能する。
深いマルチモーダル文書分析
テキストだけでなく、PDF内のグラフ、パワーポイントの図表、画像内のテキストまでを横断的に理解する能力が向上した。これにより、企業内に散在する非構造化データの分析ハードルが大幅に下がる。数百ページの契約書や仕様書を読み込ませ、瞬時に要約や矛盾点の洗い出しを行うといった使い方が視野に入る。
これらの能力は、もはや「優秀なアシスタント」ではなく「自立したチームメンバー」という表現が近い。開発現場ではコードレビューを完全自動化し、法務部門では契約書の精査を任せられる。人間が最終判断する仕事の質とスピードが、根本から変わる可能性をはらんでいる。
Google CloudのAgent Platformがもたらす実用性
モデル単体の性能もさることながら、今回の発表で注目すべきはGoogle Cloudの「Agent Platform」上で提供される点だ。これは単なるAPIゲートウェイではない。エージェントの構築、テスト、デプロイ、監視までを垂直統合した基盤である。
具体的には、Googleが持つエンタープライズグレードのセキュリティ(IAM、VPC Service Controls)、Vertex AIのMLOps機能(モデル評価、メタデータ管理)、そしてCloud RunやBigQueryといった周辺サービスとの統合がシームレスに行える。Fable 5のような高度なモデルを「安全に」「堅牢に」本番環境で動かすために必要なピースがあらかじめ揃っている。
ここで重要なのは、強力なモデルを手に入れることと、それをビジネスで使いこなすことの間にあるギャップが、Agent Platformによって埋められる点だ。認証基盤や監査ログが整っていない状態でAIエージェントに重要な業務を任せることは難しい。Google Cloudのプレゼンスは、企業のAI導入における「最後の1マイル」を解決する。
開発者が今日から試すべき3つのアプローチ
Fable 5とAgent Platformが利用可能になったことで、Web制作やシステム開発の現場で即座に試せる実験領域が広がった。筆者の視点から、特に費用対効果が高いと想定される3つのシナリオを提示する。
コードレビューの完全自動化プロトタイプ
GitHub連携をトリガーに、Fable 5がPull Request全体を解析する。コーディング規約のチェックだけでなく、コードの脆弱性、パフォーマンス劣化リスク、過去の類似実装との矛盾点までを自然言語でレビューコメントする。人間のレビューアは、Fable 5が出した指摘が正しいかどうかの最終判断だけに集中できる。
非構造化ドキュメントのデータベース化
クライアントから提供された古い仕様書のPDF、競合分析のスライド、展示会で撮影したホワイトボードの写真などをまとめてFable 5に投入する。モデルはこれらを横断的に解析し、共通する要求定義や矛盾する記述を抽出して構造化データとして出力する。データベースに格納することで、後続の検索やレポート作成が自動化される。
社内向け「なんでも調査エージェント」の起案
定型的なリサーチ業務をエージェント化する。例えば「3ヶ月以内に更新された特定分野の法改正情報を、週次で一覧化してSlackに投げる」といったタスクをFable 5に任せる。モデルが自律的にGoogle検索や社内Wikiを巡回し、複数ステップの推論を経て最終的なサマリーを生成するPoCは、数日あれば構築可能だ。
このアプローチによって、人間の工数は「クリエイティブな問題解決」と「AIの提案に対する最終的な意思決定」に集中できるようになる。
この記事のポイント
- Anthropicの最新モデルClaude Fable 5は、複雑な推論と長期稼働エージェントに特化してGoogle Cloud上で一般提供が開始された
- 高いコード生成能力と深いマルチモーダル分析を持ち、単なるテキスト生成を超えたタスクの自動化が可能になった
- Google CloudのAgent Platformとの統合により、エンタープライズレベルのセキュリティと運用基盤が整備されている
- 人間はAIの最終判断に集中する働き方へシフトするため、コードレビューや文書分析のプロトタイプを早期に試す価値がある

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Claude Fable 5がAWSで利用可能に。長時間実行と安全策を両立する新モデル
AWSがClaude Fable 5のAmazon Bedrock対応を発表した。Anthropicの新モデルはMythosクラスの最高性能を備えつつ、有害利用リスクへの安全策を組み込んだ点が最大の特徴だ。ソフトウェア開発や文書解析など長時間の自律作業を任せられる設計になっている。
Fable 5はほぼすべてのベンチマークで最先端のスコアを記録する。注目すべきは、人間の介入なしで複雑なコーディングやナレッジワークを長時間継続できる実行能力だ。単発の応答を超えた「作業の持続」が可能になったことで、開発現場やビジネスプロセスへの組み込みが現実味を帯びてきた。
Claude Fable 5の3つの技術的特徴
従来のLLM(大規模言語モデル)が得意としてきた「質問への即答」とは異なり、Fable 5は「長時間タスクの遂行」にフォーカスしている。AWS公式ブログとAnthropicの技術発表から、その差別化要素を整理した。
長時間の非同期実行
従来のモデルは数分を超えるタスクで精度が低下したり、文脈を見失ったりする課題があった。Fable 5は複雑なコーディングや調査作業を長時間・自律的に続行できる。具体的には、複数ファイルにまたがる大規模なリファクタリングや、長大なドキュメントの横断的分析といった作業を途中で止めずに完了させる。
これは単にトークン数が増えただけではない。モデル内部のアーキテクチャが「途中経過の自己管理」を強化しており、タスクのゴールを見失わずに作業を継続する仕組みだ。AWSの発表では「長時間のコーディングや知識労働を継続的に実行する」と表現されている。
この変化により、ソフトウェア開発における「任せっぱなし運用」の幅が広がる。たとえばコードベース全体のリファクタリングを夜間に任せ、朝には完了しているというワークフローが視野に入る。
高度なビジョン機能
Fable 5はテキストだけでなく、図表、グラフ、PDF内に埋め込まれた表などを高精度で理解する。金融や法務、建築、ゲーム開発など、文書や設計図を扱う業種での活用が期待される領域だ。
コーディングの文脈でも大きな意味を持つ。デザインファイルを読み取ってUIを実装したり、出力結果のスクリーンショットを自己チェックして「要件と合っているか」を検証したりできる。従来のモデルはテキスト情報だけを頼りにしていたが、Fable 5は「見て判断する」能力を作業フローに組み込める。
プロアクティブな自己検証
Fable 5はタスク実行中に得た学習をもとにスキルを自己更新し、自ら評価用のハーネス(テストフレームワーク)を作成する。AWSの発表では「自身の出力を目標と照らし合わせて批判的に評価する」と説明されている。
これはソフトウェアテストの自動化と深く関わる。たとえば「単体テストのコードを生成する」という指示ではなく「この機能を実装し、テストを作成し、通るまで修正を繰り返せ」という指示が現実的になる。モデルが自律的にPDCAを回すため、人間は成果物の最終確認に集中できる。
安全策の仕組みとMythos 5との棲み分け
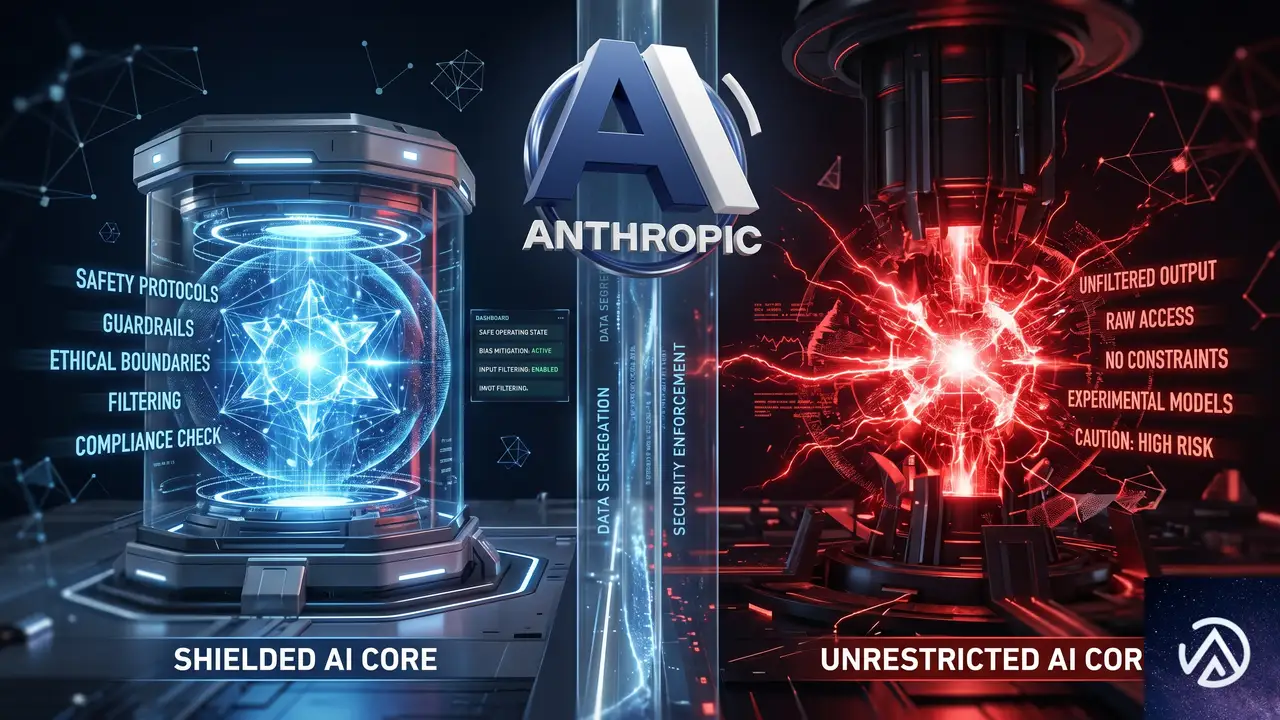
Fable 5の最大の独自性は「性能と安全策の両立」にある。同じモデルから安全性を引き上げたFable 5と、制限を外したMythos 5という2つのバリエーションが用意されている。
有害プロンプトは自動でOpus 4.8にルーティング
Fable 5はサイバーセキュリティ、生物学、化学、健康に関連する有害プロンプトを受け取ると、内部で自動的にOpus 4.8へルーティングする。AWSの公式発表では「安全策によって、ほぼすべての最先端機能へのアクセスを提供しつつ、誤用リスクの高い領域では応答を制限する」と説明されている。
重要なのは、ユーザー側で切り替えを意識する必要がない点だ。通常のAPIコールでFable 5を指定しておけば、安全と判断されたプロンプトにはFable 5が、リスクありと判断されたプロンプトにはOpus 4.8が自動で応答する。
Mythos 5は限定的なプレビュー提供
Fable 5の制限を取り払ったMythos 5も、Amazon Bedrockで限定的に利用可能だ。ただしMythos 5はサイバーセキュリティやライフサイエンス(創薬、バイオディフェンススクリーニング等)といった専門領域向けであり、審査を受けた一部の顧客のみアクセスできる。一般提供は行われない。
この「制限付きスーパーモデル」と「制限なし最強モデル」の二層構造は、AIの社会実装における新たなパラダイムとなり得る。AWSの発表でも、Mythos 5はデュアルユース(軍民両用)の性質を持つため厳格な管理下に置かれていると明記されている。
Amazon Bedrockでの利用環境とセットアップ
Fable 5はAmazon BedrockとClaude Platform on AWSの両方で利用できる。ここではBedrock経由のセットアップ手順を中心に解説する。
データ共有へのオプトインが必須
Fable 5を利用するには、データ保持ポリシーでプロバイダーデータ共有(provider_data_share)にオプトインする必要がある。AnthropicはMythosクラスの全モデルで、入力と出力の30日間保持および人間によるレビューを必須としている。これは単一のやり取りでは検出できない誤用パターンを長期的に監視するためだ。
オプトインするとデータはAWSのセキュリティ境界を離れる。機密性の高いデータを扱う場合は、この点を事前に評価しておく必要がある。設定はAWS CLIで以下のように実行する(bedrock-mantleエンジン向け)。
curl -X PUT https://bedrock-mantle.us-east-1.api.aws/v1/data_retention \
  -H "x-api-key: <your-bedrock-api-key>" \
  -H "Content-Type: application/json" \
  -d '{ "mode": "provider_data_share" }'
bedrock-runtimeエンジンを使う場合は、エンドポイントと認証方式が異なる点に注意が必要だ。詳細はAWSの公式ドキュメントを参照してほしい。
Python SDKからの呼び出し例
Anthropic SDKをインストールした後、Messages API経由でFable 5を呼び出すコードは以下の通りになる。リージョンは現時点で米国東部(バージニア北部)と欧州(ストックホルム)に対応している。
import anthropic

client = anthropic.Anthropic(
    base_url="https://bedrock-mantle.us-east-1.api.aws/anthropic",
    api_key=<your-bedrock-api-key>
)

message = client.messages.create(
    model="anthropic.claude-fable-5",
    max_tokens=4096,
    messages=[
        {
            "role": "user",
            "content": "秒間10万リクエストを複数リージョンで処理するAWS分散アーキテクチャを設計してほしい"
        }
    ]
)

print(message.content[0].text)
BedrockのConverse APIを使う場合はBoto3経由となる。マルチモデル対応の統一インターフェースが使えるため、既存のBedrockワークロードとの統合が容易だ。
課金体系の注意点
有害プロンプトがOpus 4.8にルーティングされた場合、そのリクエストの課金はOpusの価格で計算される。また途中でブロックされた会話では、Fable 5が処理した初期トークンはFable 5の料金、それ以降はOpusの料金が適用される。大規模なワークロードを計画する際は、見積もりにこの変動要素を含めておく必要がある。
ソフトウェア開発の現場に与える影響
Fable 5の登場は、とりわけソフトウェアエンジニアリングのワークフローを変える可能性が高い。AWSの発表でも「長時間のコーディングタスク」と「自己検証」が前面に押し出されている。
「コードを書く」から「コードを任せる」へ
従来のLLMは「関数を1つ書いて」という短い指示には強かったが、プロジェクト全体を見渡すようなタスクには限界があった。Fable 5は「このリポジトリの全テストを補充し、カバレッジが90%を超えるまで繰り返せ」といった高レベルな指示を理解し、自律的に遂行できる。
これは開発者の役割を「実装者」から「設計者・監督者」へとシフトさせる。コードを書く時間が減り、アーキテクチャの意思決定やビジネスロジックの検討に集中できるようになる。ただし出力の品質チェックは依然として人間の責任だ。
CI/CDパイプラインとの統合可能性
Fable 5の自己検証機能は、CI/CD(継続的インテグレーション/継続的デリバリー)の自動化範囲を拡大する。プルリクエストの自動レビュー、テスト自動生成、失敗時の自律的な修正までを一気通貫で行える可能性がある。
ただし現時点でFable 5は非同期実行向けに設計されており、リアルタイムのチャット応答を前提とした従来のCI/CDトリガーとはワークフローが異なる。ジョブキューと組み合わせたバッチ処理型の統合が現実的なアプローチになるだろう。
日本市場での受け入れと課題
国内のソフトウェア開発現場では、セキュリティ要件の厳しさから「データを外部に出せない」という制約が根強い。Fable 5の必須条件である30日間のデータ保持と人間によるレビューは、金融や医療分野での採用ハードルになる。AWSの東京リージョンでの利用可能時期も現時点では未発表だ。
一方で、スタートアップやゲーム開発のようにスピードを重視する領域では、Fable 5の長時間自律実行能力は強力な武器になる。日本でも段階的に導入が進むと見られる。
この記事のポイント
- Claude Fable 5はMythosクラスの性能を持ちつつ、有害利用を自動遮断する安全策を内蔵している
- 長時間の非同期実行により、コードの大規模リファクタリングや文書横断分析を自律的に完了できる
- 図表やPDFを読み取るビジョン機能が加わり、金融・法務・建築など文書集約型の業種で活用が広がる
- 有害プロンプトは自動でOpus 4.8にルーティングされ、ユーザーはモデルを意識せず使える
- Amazon Bedrockでの利用には30日間のデータ保持オプトインが必須。機密データの扱いには注意が必要だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Redditが生成AIの表示順位を左右する。実データが示す影響力と企業が取るべき対策
生成AIが回答の情報源として最も参照するプラットフォームがRedditだ。SEO対策から「AI最適化」へと重心が移りつつある今、Redditでの立ち振る舞いを無視することはビジネス上のリスクになりつつある。
AI最適化プラットフォームProfoundが2026年5月に公開した分析によれば、ChatGPTがユーザーの質問に回答する際、訓練データとリアルタイム検索の双方でRedditの情報を最大の情報源として利用しているという。Redditはもはや単なる掲示板ではない。大規模言語モデル(LLM)があなたのブランドについて「知っていること」そのものを形成する場になっている。
この記事では、Redditの投稿がどのように生成AIの回答を左右するのか、その具体的なデータを示すとともに、企業が取るべき具体的な対策を解説する。
ChatGPTがRedditを最重要視する理由
実務者の間では「Redditの影響力が増している」という肌感覚が広がっていた。だが、AIリサーチ企業Profoundの分析は、それを単なるトレンドではなく確固たるデータとして裏付けた。同社が2026年1月から5月にかけてChatGPTの引用と「ファンアウト」データを解析した結果、Redditは引用回数でトップに立った。
ファンアウトとは、AIが1つの質問に対してどれだけ多角的に情報源を展開したかを示す指標だ。Redditはこのファンアウト数においても他を圧倒していた。つまり、ChatGPTは単にRedditを引用するだけでなく、1つのスレッドから複数の関連情報を芋づる式に収集し、回答の骨格を作っている。
検索クエリへの「reddit」自動付与
この解析で興味深いのは、ChatGPTがリアルタイム検索を実行する際、クエリの末尾に「reddit」というキーワードを自発的に追加する挙動が確認された点だ。人間が「商品名 レビュー Reddit」と検索するのと同じ行動を、AIが自律的に行っている。生成AIが「実体験に基づく生の声」を求めている証左といえる。
従来の検索エンジン最適化が「アルゴリズムに評価される公式情報」を重視していたのに対し、AI最適化では「訓練データとライブ検索の両方で参照される草の根の評判」が問われる。Redditがその中心にある。
安易な口コミ操作が通用しない構造的理由
ここで多くの企業が「ならばRedditに肯定的な投稿を大量にすればいい」と短絡的に考える。だが、生成AI時代のReddit戦略は、そうした「やらせレビュー」的な手法とは根本的に相性が悪い。構造的な理由が2つある。
訓練データに刻まれたネガティブ情報は消せない
1つ目は、LLMの訓練データの問題だ。仮にReddit上の自社に不都合なスレッドをModeratorに削除してもらえたとしても、その情報はすでにGPT-4やClaudeといったモデルの訓練データに組み込まれている。モデルの重みの中にネガティブな文脈が残り続けるため、単純な「投稿削除」ではAIの感情分析(センチメント)を覆せない。
Redditのコミュニティは作為を見抜く
2つ目は、サブレディット(コミュニティ単位の掲示板)の自主管理能力の高さだ。各サブレディットには人間のModeratorが存在し、不自然なプロモーション投稿や作為的なポジティブレビューは極めて高い精度で検知される。露骨なステマが削除されるだけでなく、アカウントがスパム判定を受ければドメイン単位でブランドの信用が失墜するリスクもある。
重要なのは、AIは情報の「出所」よりも「文脈」と「一貫性」を評価する傾向がある点だ。作為的なポジティブキャンペーンは、むしろAIによる評価を歪ませ、長期的にはブランド毀損につながりかねない。
RedditでAI表示を味方につける3段階のプロセス
では、企業は具体的に何をすればいいのか。短期的なハックではなく、AIとアルゴリズムの両方に評価される正攻法のプロセスを3段階に分けて解説する。
STEP 1. 観察に徹してコミュニティの文法を学ぶ
Redditビジネスアカウントを作成したら、すぐに投稿やコメントを始めてはいけない。少なくとも数週間は「ROM(Read Only Member)」として、ターゲットとするサブレディットの文化を観察する期間を設ける。
各サブレディットには明文化されたルールに加え、暗黙の行動規範がある。企業アカウントがそれを無視して宣伝めいた投稿をすれば、即座にアカウント停止(BAN)の対象となる。Redditのアカウント停止は異議申し立てが極めて困難なことで知られており、一度BANされるとブランド名で再登録すること自体が難しくなる。
STEP 2. Reddit Proで自社の立ち位置を可視化する
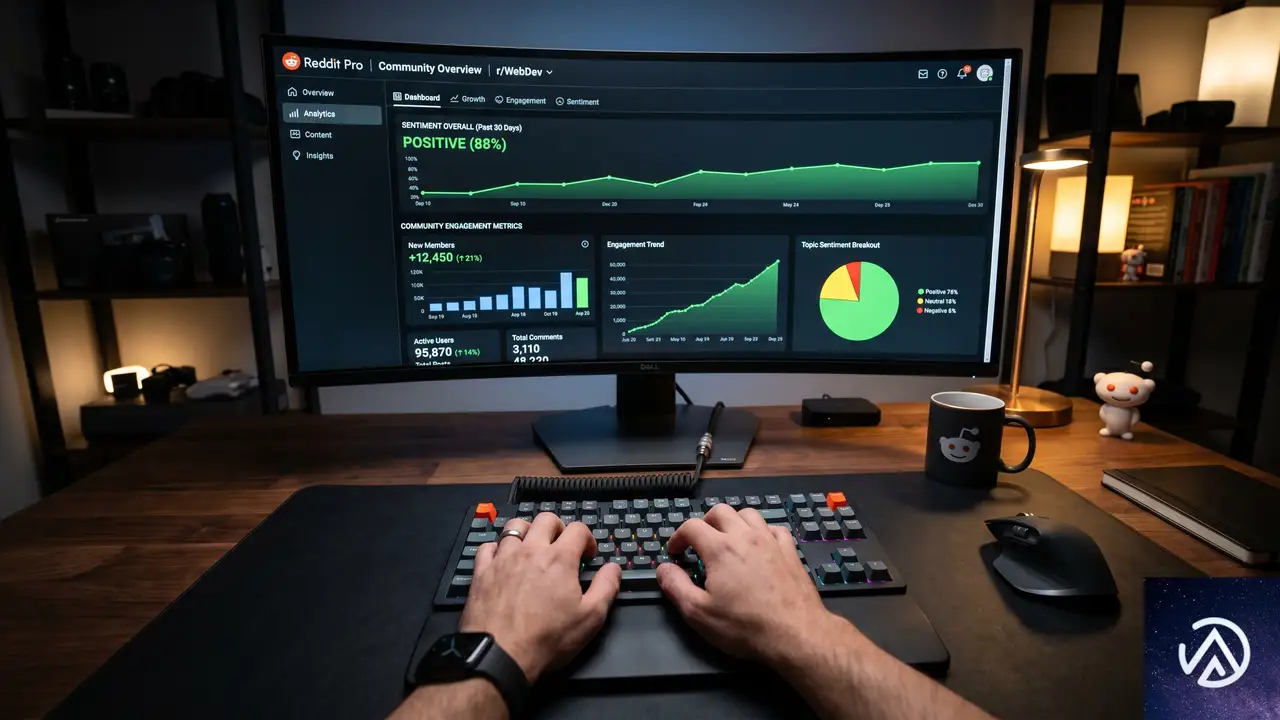
観察期間と並行して、Reddit Pro(無料のビジネス向け分析ツール)の導入をお勧めする。このツールを使うと、以下の情報がダッシュボードで把握できる。
- ユーザーが自社ブランドについてどのような文脈で言及しているか
- 競合ブランドと比較した際のセンチメント(肯定的・否定的感情)の差異
- 自社の製品カテゴリに関連して今活発に議論されているスレッド
闇雲に投稿する前に、データに基づいて「どのサブレディットで、どんなトピックなら、企業として価値を提供できるか」を特定することが先決だ。
STEP 3. ブランド認知より「権威構築」を優先する
初期の投稿やコメントでは、自社製品の宣伝を一切排除し、純粋に専門知識を提供することに集中する。たとえば、ECプラットフォームを提供する企業なら「物流のボトルネックを解消するパッキングの工夫」、マーケティングツール企業なら「GA4で離脱率を下げるレポートの読み方」といった具合だ。
この段階でブランド名を出すことは、コミュニティから「売り込み」と見なされるリスクが高い。まずは個人としての信頼を積み上げ、その後に「そういえば、この分野のプロダクトを開発している」と自然に言及できる流れを作る。
ブランド専用サブレディットという選択肢
自社ブランドへの言及が一定数を超えてきた段階で、ブランド専用のサブレディットを開設することも有効な一手だ。すでに多くのテック企業がこの手法を取り入れている。
専用サブレディットの利点は、分散していた自社関連の会話を一箇所に集約できる点にある。ユーザー同士のQAやトラブルシューティングが活発になれば、それはそのままLLMが参照する「構造化されたナレッジベース」として機能する。サポートコストの削減とAI表示の最適化を同時に実現できるわけだ。
ただし、ここでも運営姿勢が問われる。企業が一方的に情報を発信する場ではなく、ユーザーが自由に意見を交わせる「公共広場」としての設計が不可欠だ。Moderatorが批判的な投稿を削除するような運営は、Reddit全体からの強い反発を招く。
この記事のポイント
- RedditはChatGPTが回答を生成する際の最重要情報源であり、訓練データとリアルタイム検索の双方で参照される
- ネガティブスレッドの削除や偽のポジティブ投稿は、LLMの訓練データに残る情報を覆せず、コミュニティからも排除されるリスクが高い
- アカウント作成後はまず観察に徹し、Reddit Proでデータを分析した上で、ブランド宣伝ではなく専門知識の提供による権威構築を優先する
- 長期的な視点でコミュニティに貢献し、AIに「信頼できる情報源」として学習させることが、生成AI時代のブランド防衛につながる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Bedrock刷新、OpenAIとAnthropic API互換コンソールが登場
AWSが2026年6月5日、Amazon Bedrockの管理コンソールを刷新した。この新体験は「bedrock-mantle」エンジン向けに設計されており、Anthropic Messages APIとOpenAI Responses APIに最適化されている。
従来のBedrockコンソールはマネージド機能(AgentsやKnowledge Basesなど)を中心に据えていたが、今回の刷新はAPI直接呼び出しを前提とする開発者向けに設計し直されている。モデル選定からプロダクション実装までの時間を大幅に短縮する狙いだ。
この記事では、新コンソールの主要機能と開発ワークフローへの影響を詳しく見ていく。API互換性を活かしたコードの簡略化や、複数モデルの並列評価がどのように実現されるのかを解説する。
Bedrockの新コンソールが生まれた背景
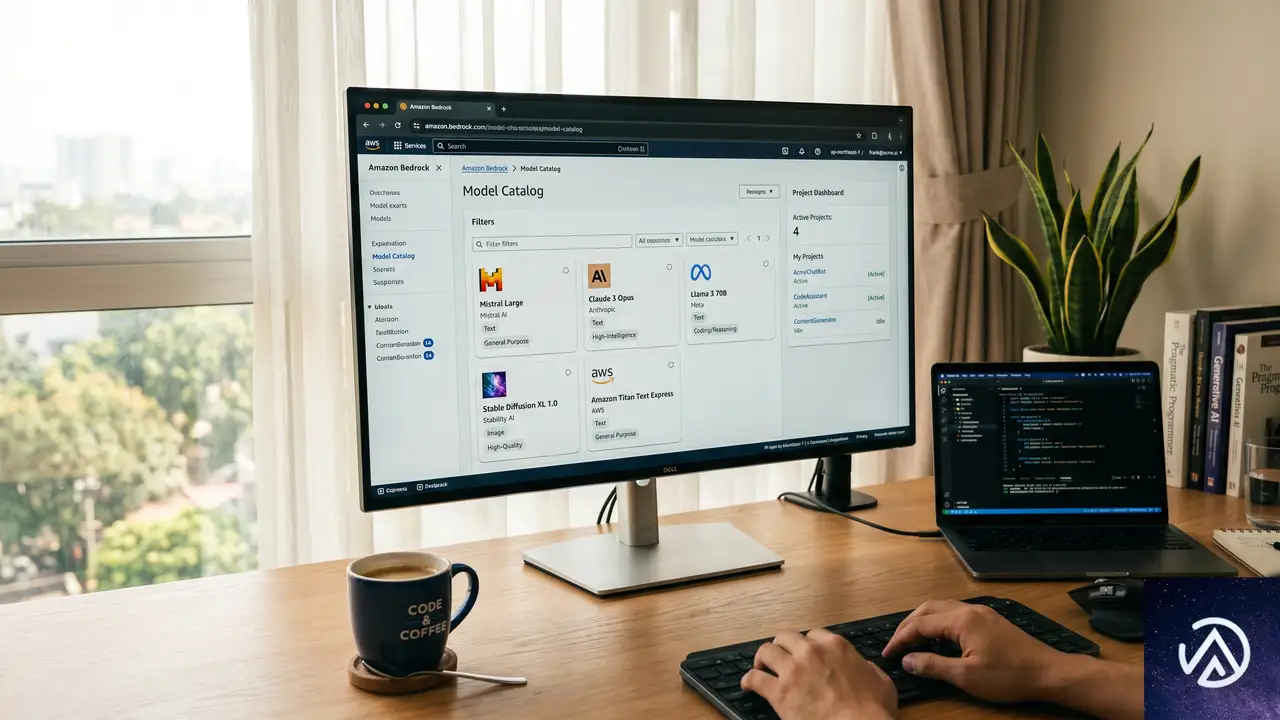
この図が示すように、新コンソールは「プロジェクト」を軸にした作りになっている。モデルの評価から実装、モニタリングまでをひとつの画面で完結させる狙いだ。
bedrock-mantleエンジンとは何か
bedrock-mantleは、Bedrockの第2世代推論エンジンとして位置づけられる。高速な処理性能と高い信頼性、そしてエンタープライズレベルのセキュリティを兼ね備えている。
最大の特徴はAnthropicとOpenAIのAPIプロトコルに互換性を提供することだ。ClaudeモデルにはAnthropic Messages API(メッセージAPI)を、GPTモデルにはOpenAI Responses API(レスポンスAPI)とOpenAI Chat Completions API(チャット補完API)を使える。これにより、既存のSDKコードをほぼ変更せずにBedrockへ移行できる。
従来のbedrock-runtimeエンドポイントを使う既存機能(InvokeModelやConverse API、Agentsなど)は、引き続き従来のBedrockコンソールから利用できる。両者は併存する設計で、急な移行は求められない。
新モデルカタログが提供する高速な比較体験
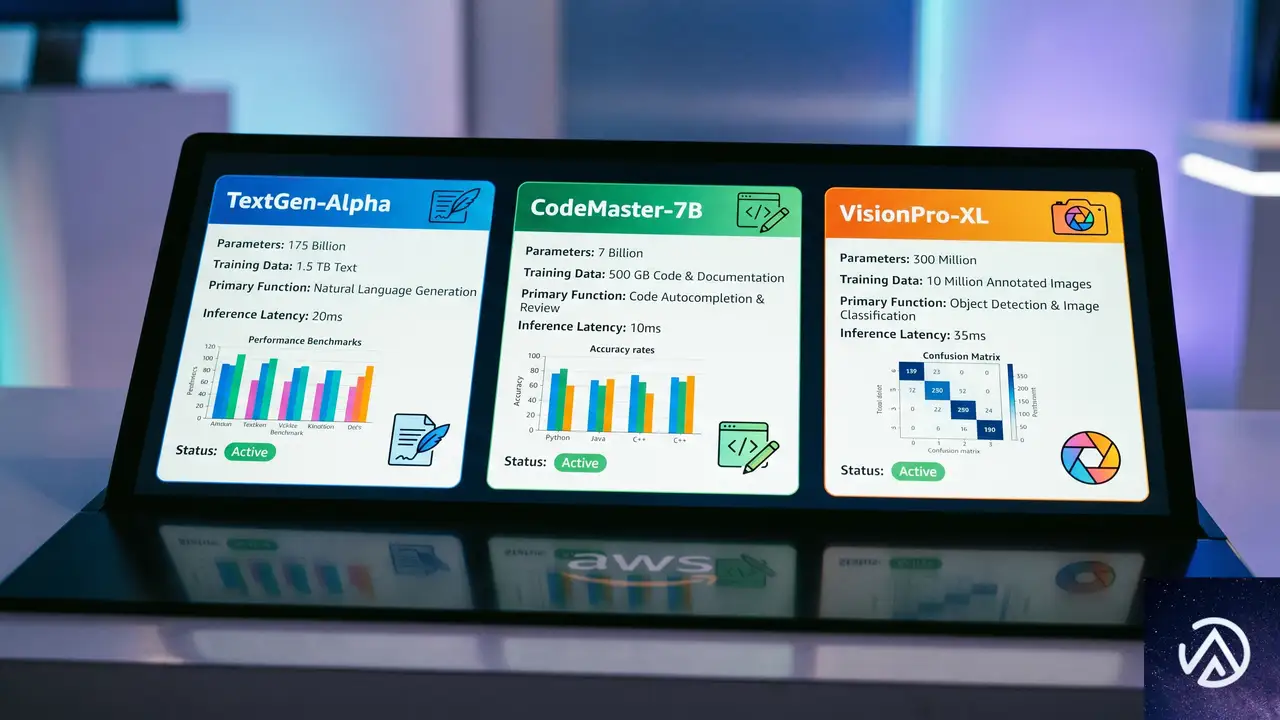
新コンソールの目玉のひとつが、刷新されたモデルカタログだ。従来は各モデルの仕様を調べるためにドキュメントや料金計算ツールを行き来する必要があったが、それが1画面で完結するようになった。
最大3モデルを並べて比較
カタログ上で最大3つのモデルを選択し、機能、モダリティの対応状況、コンテキストウィンドウの大きさ、利用可能なリージョン、料金体系を横並びで比較できる。
この比較機能は、チーム内でのモデル選定会議や、PoC(概念検証)フェーズでの迅速な意思決定に力を発揮する。料金と性能のトレードオフを視覚的に把握できるのが強みだ。
プロジェクト単位で完結する開発ワークフロー
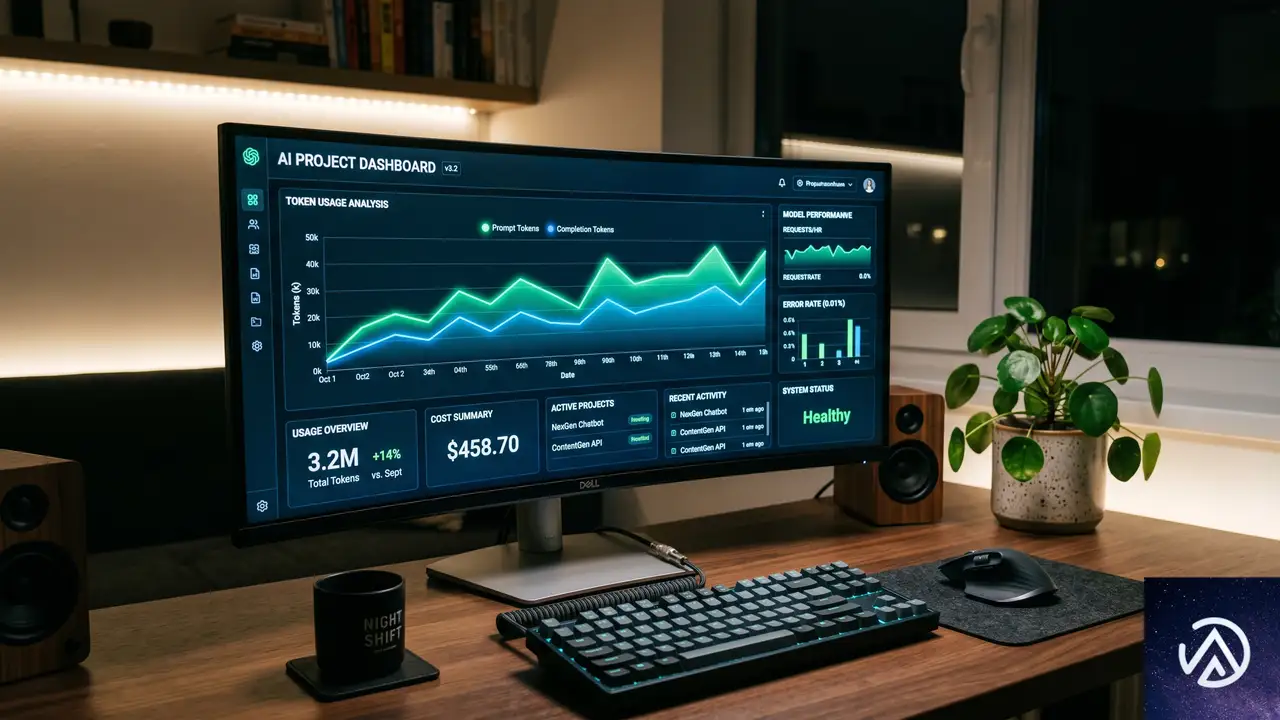
新コンソールの中核は「プロジェクト」という概念だ。生成AIアプリケーションの開発ライフサイクルをプロジェクトとして管理し、モデルの割り当てからAPIキーの発行、推論リクエストの送信までを一気通貫で行える。
ダッシュボードでトークン消費を可視化
プロジェクトダッシュボードでは、直近の推論リクエスト数やエラー発生率を日付範囲でフィルタリングできる。さらに、総トークン消費量、1分あたりのトークン使用量、推論リクエストの回数、1リクエストあたりの平均トークン数がグラフ表示される。
このデータは、モデルの選択ミスや過剰なトークン消費を早期に発見する手がかりになる。チームの予算管理にも直結するため、プロダクション環境では特に価値が高い。
サイドバイサイド評価でプロンプトを最適化
プロジェクト内で最大3つのモデルを選択し、同じプロンプトに対する応答を横に並べて比較できる評価モードが用意されている。これにより、どのモデルが自社のユースケースに最適かを実データで判断できる。
評価結果はそのままプロダクション環境へ移行する際の根拠資料としても使える。カスタマーサポート用チャットボットであれば、回答の質と応答速度のバランスを定量的に比較できる。
コード生成とAIアシスタント連携の新機能
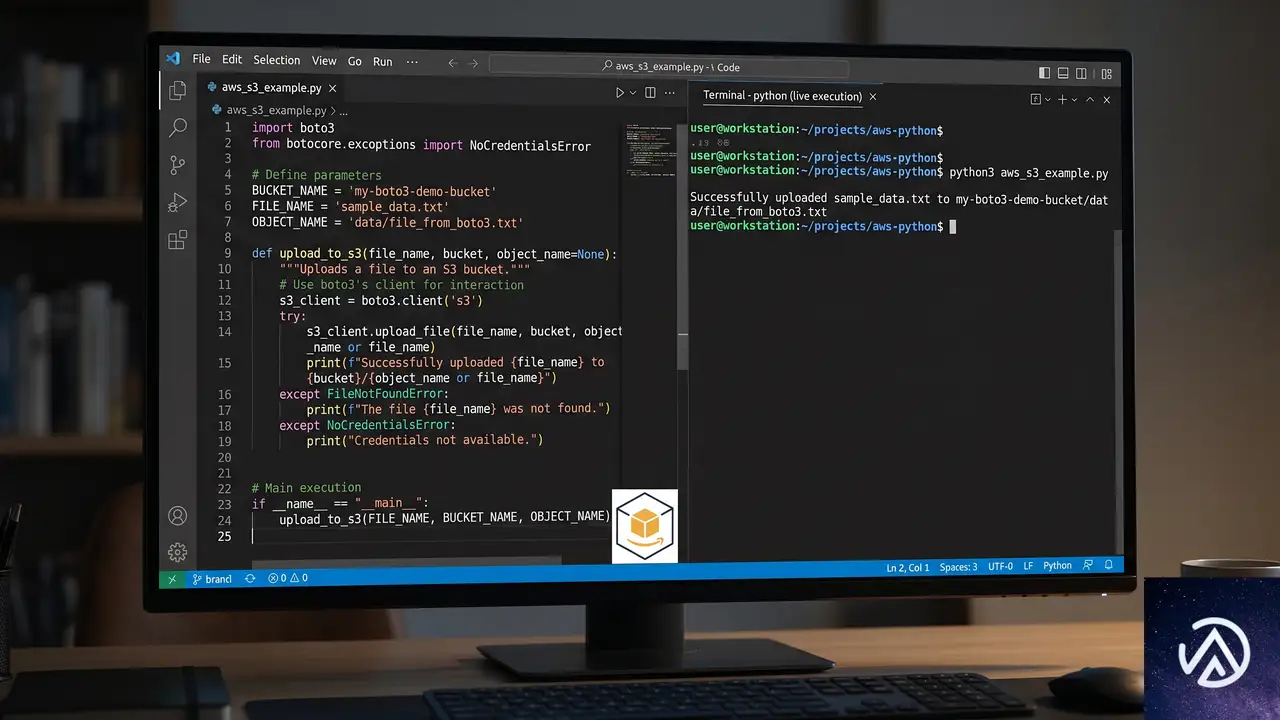
最も実務インパクトが大きいのが、プロジェクトに紐づいた「ライブドキュメント」機能だ。コードサンプルやSDKスニペット、APIリファレンスにプロジェクトの変数(モデルID、リージョン、エンドポイントURL、APIキー)が自動で埋め込まれる。
コピーするだけで動くコードスニペット
開発者はコンソール上で表示されたコードをそのままコピーし、ローカル環境のアプリケーションに貼り付けるだけで動作確認できる。環境変数の手動設定やエンドポイントURLの確認といった手間が省ける。
AWS_REGION=us-east-1
ENDPOINT=bedrock-mantle
API_KEY=sk-xxxxxx
client = boto3.client()
response = client.invoke(modelId=MODEL_ID)
この仕組みにより、環境構築のミスが大幅に減る。特に複数プロジェクトを抱えるチームでは、設定の食い違いによるトラブルシューティング時間を削減できる。
AIコーディングエージェントとの統合
新コンソールはAIコーディングエージェントとの連携もサポートする。Claude Code、Cline、Codex、Cursor、OpenCodeといった主要なAIアシスタントをBedrockのmantleエンジンにルーティングする手順がガイドされる。
具体的には、AWS IAM認証情報かBedrock APIキーを使い、環境変数を設定したうえで各エージェントからのリクエストをBedrock経由にする設定が案内される。これにより、AIアシスタントのバックエンドをOpenAIやAnthropicのクラウドからAWS環境に切り替えられる。企業ポリシーでデータの外部送信を制限しているケースで有効だ。
利用可能リージョンと今後の展開
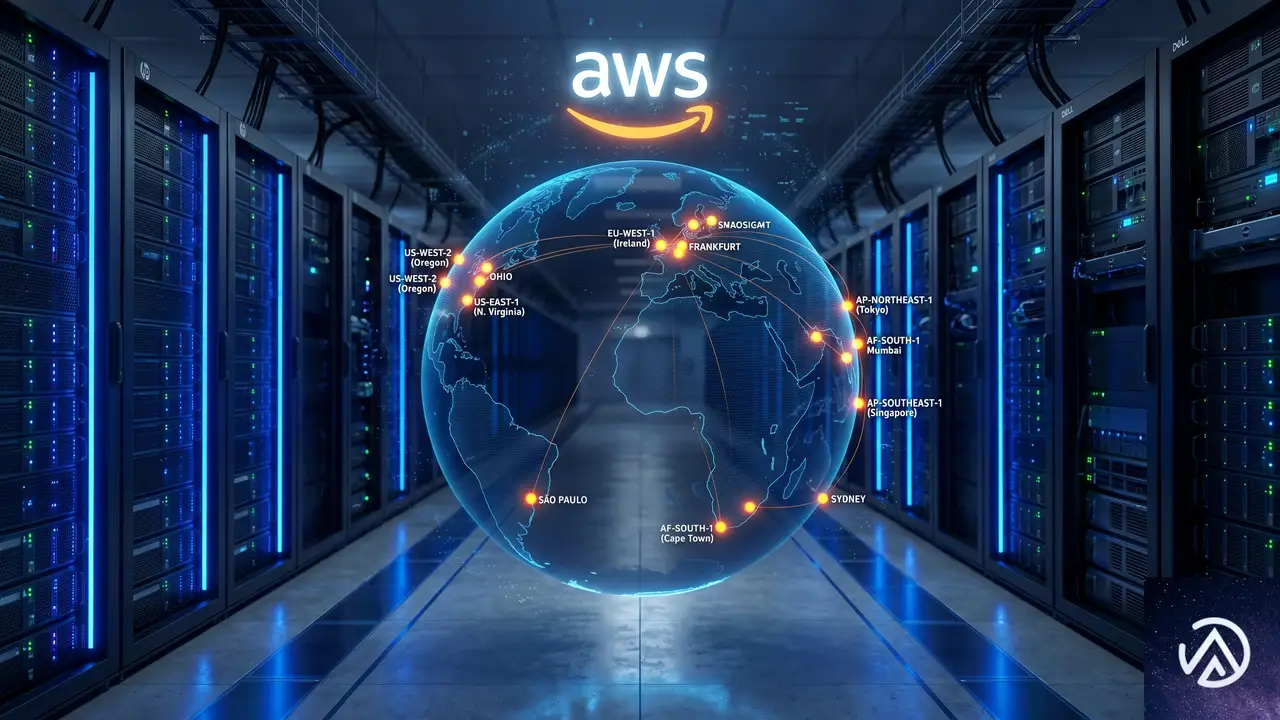
新コンソール体験は、bedrock-mantleエンドポイントが提供されている全リージョンで利用可能だ。2026年6月時点での対象は以下の通り。
AWSのドキュメントにはリージョン互換性の一覧ページが用意されており、将来的な拡大があれば随時更新される見込みだ。フィードバックはAWS re:Post for Amazon Bedrock、または通常のAWSサポート窓口を通じて送ることができる。
新コンソールは既存のBedrockコンソールと並行して運用される。急な切り替えを迫られることはなく、チームの準備が整った段階で徐々に移行できる設計だ。
この記事のポイント
- Amazon BedrockにAPI互換性を重視した新コンソールが登場し、モデル評価から実装までの時間が大幅に短縮される
- bedrock-mantleエンジンはAnthropic Messages APIとOpenAI Responses APIに対応し、既存SDKコードの流用が容易
- 最大3モデルのサイドバイサイド比較と、プロジェクト単位のトークン消費可視化が組み込まれている
- コンソール上のコードスニペットはプロジェクト変数が自動プレフィルされ、コピー後即実行できる
- 東京リージョンを含む複数リージョンで利用可能、既存コンソールとの併存もサポートされる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google、Search ConsoleでAI検索専用レポートをテスト開始
Googleが2026年6月3日、Search Consoleに2つの新機能を追加するテストを開始した。生成AI検索機能への表示を制御するトグルと、AI検索内での表示回数やインプレッションを確認できる専用レポートだ。
まずはイギリスの一部サイトを対象に提供され、その後に全世界へ展開される予定だ。サイト運営者にとって、これまで「ブラックボックス」だったAI検索経由のパフォーマンスを可視化する第一歩となる。
この記事では、2つの新機能の具体的な内容と、現場のSEO担当者がどう受け止め、どのような準備をすればよいかを詳しく解説する。
GoogleがSearch Consoleでテストする2つの新機能
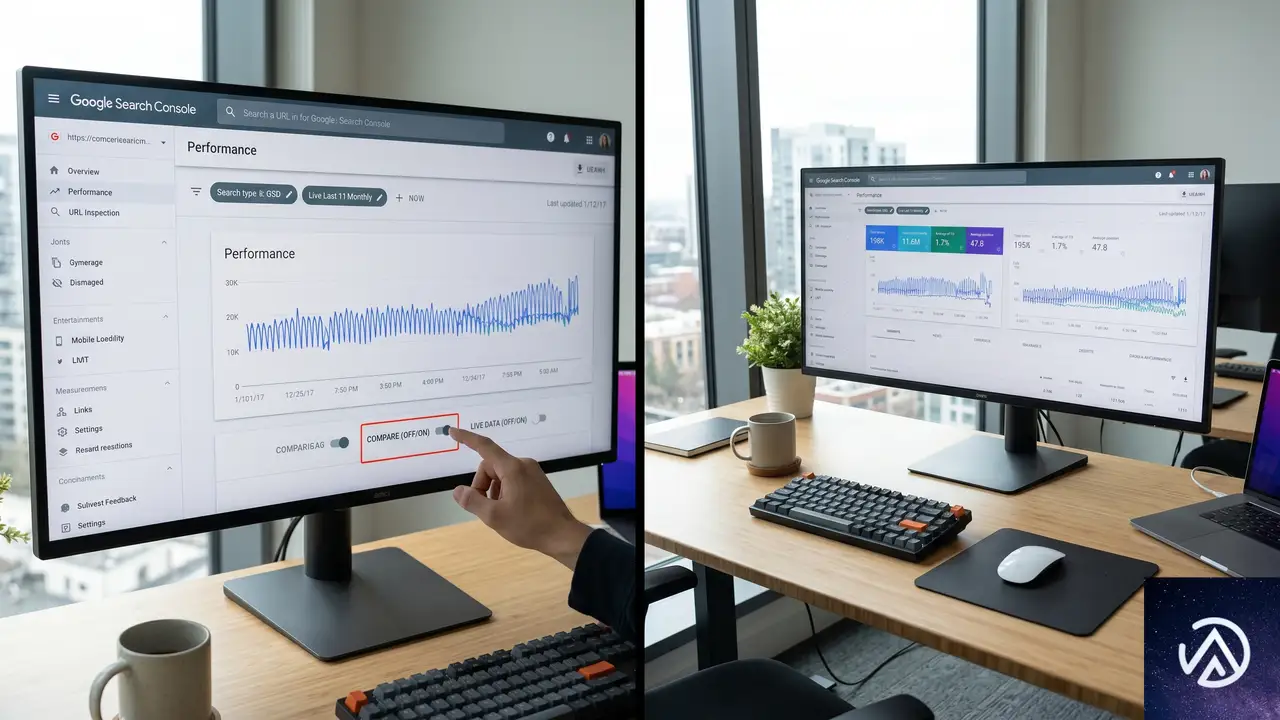
今回テストが始まったのは、AI表示制御トグルとAI専用パフォーマンスレポートの2つだ。いずれも、生成AIが検索体験に深く入り込む中で、サイト運営者が自サイトの表示状況を把握し、必要に応じて制御できるようにするための機能である。
AI表示制御トグル
1つ目のAI表示制御トグルは、文字通り「自サイトをAI検索機能に表示させるかどうか」を切り替えられる設定だ。このトグルをオフにすると、AI OverviewsやAI Mode、Discover上のAI Overviewsなど、Googleの生成AI検索機能から自サイトへの表示が一切行われなくなる。
なお、この制御はAI検索機能のみに適用され、従来の検索結果ランキングには影響しないとGoogleは明言している。いわゆるランキングシグナルとして利用されることはないというわけだ。
このトグルは、従来のスニペット制御やGoogle-Extendedの延長線上にある。スニペット制御は従来型の検索結果での表示内容を管理するものだったが、今回のトグルは「AI検索機能での表示そのもの」を対象にしている点が新しい。
AI専用パフォーマンスレポート
2つ目は、生成AI検索機能における表示回数(インプレッション)を、サイト単位・ページ単位・国別・デバイス別・日時別に確認できる専用レポートだ。データ粒度は1時間単位まで対応するという。
これまでAI検索上のデータは、Search Consoleの総合パフォーマンスレポートにまとめられており、通常の検索とAI検索を分離して分析することができなかった。今回の専用レポートによって、AI検索だけの表示傾向を把握できるようになる。
ただし、現時点ではクリック数や検索クエリ別の指標は含まれていない。Googleは「サイト運営者と協力しながら、どのような指標が最も役立つかを継続的に検討している」と述べており、今後の拡充が期待される。
新機能の詳細と現場への影響
トグル機能の仕組みと注意点
AI表示制御トグルをオンからオフに切り替えた場合、AI OverviewsやAI Mode、Discover上のAI Overviewsからのトラフィックとインプレッションがすべてゼロになる。AI経由の流入を意図的に避けたいサイトにとっては、明確なコントロール手段となる。
一方で、このトグルはあくまでもAI検索「機能」への表示を制御するものであり、Google-ExtendedのようにAIモデルの学習データとしての利用を制御するものではない。両者は目的が異なるため、必要に応じて併用する必要がある。
また、Googleはトグルの状態をランキングシグナルに使わないとしているが、長期的な検索エコシステムへの影響は未知数だ。AI検索が検索体験の主流になった場合、「AI機能に表示されない」という選択がサイト運営者にどのような機会損失をもたらすかを、慎重に見極める必要がある。
レポートが示すデータと欠落情報
新レポートでは、AI検索機能での自サイトのインプレッション数が詳細に把握できる。たとえば「特定のページがAI Overviewsで1日あたり何回表示されたか」「AI Mode上での国別の表示頻度」といった分析が可能になる。
しかし、大きな課題としてクリックデータが欠落している。インプレッション数だけでは、表示されたコンテンツが実際にクリックされ、サイトへの訪問に結びついたかどうかがわからない。Search Engine Journalの記事でも、この計測ギャップが1年以上にわたってAI検索の評価における最大の論点であり、今回の発表でもいまだ解消されていないと指摘している。
SEO担当者にとって、AI検索でのクリック率(CTR)は、コンテンツが実際にどの程度ユーザーの行動を促せているかを測る重要な指標だ。Googleがこのデータの提供を急ぐべき理由は明白だが、現時点ではスケジュールや具体的な追加指標は発表されていない。
AI計測をめぐるこれまでの経緯
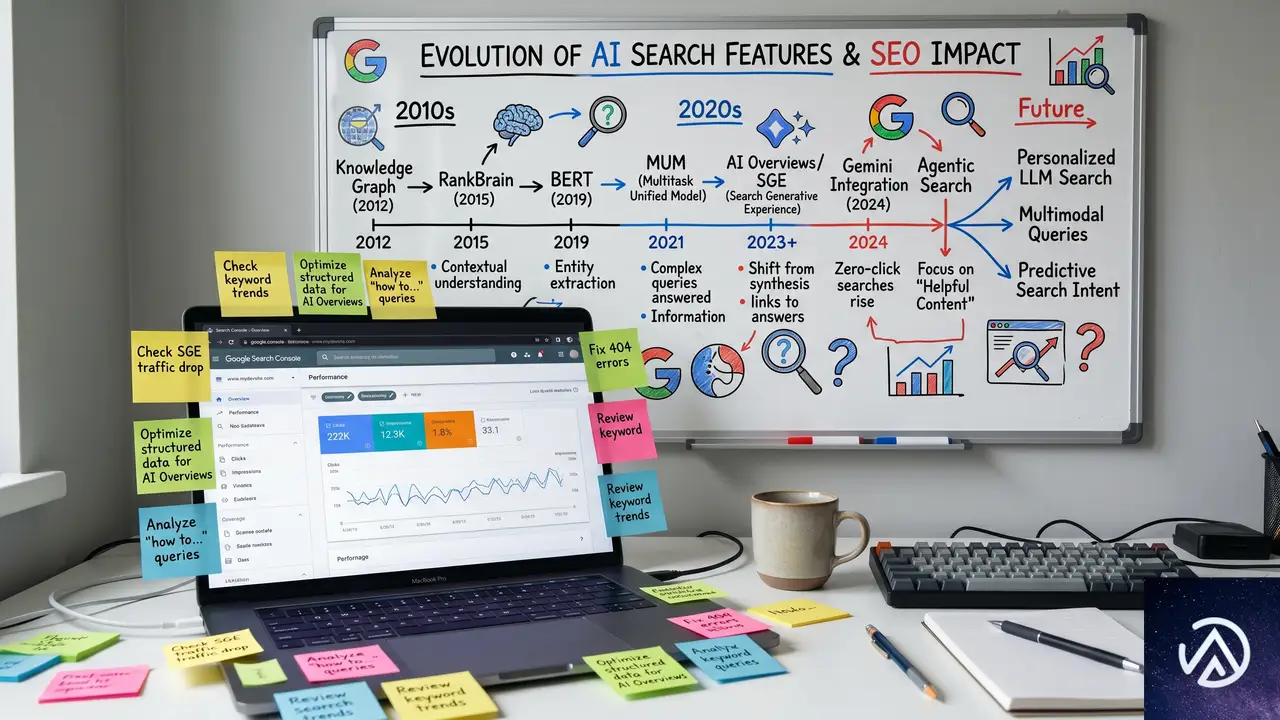
AI Overviewsが2024年にアメリカで初めて導入されて以来、Search Console上でAI固有のパフォーマンスを把握したいという要望がサイト運営者やSEO専門家から繰り返し上がっていた。Search Engine Journalも、AI専用データの提供をGoogleに求め続けてきたと記事で述べている。
2025年には、AI ModeのトラフィックがSearch Consoleの総合データに統合されることが確認されたが、その際も通常のオーガニック検索との区別はできなかった。さらに、John Mueller氏は「AI Overview内のすべてのリンクはSearch Console上で単一のポジションを共有する」と説明しており、どのリンクが実際に成果を上げているのかを評価するのが難しい状況が続いていた。
そして2026年5月、GoogleはAI機能におけるリンク表示面を拡大したものの、その表示面に特化したクリックデータは依然として提供されなかった。この発表はSEOコミュニティに「計測のブラックボックス化がさらに進むのでは」という懸念をもたらした。
競合の動き、Bingの先行事例
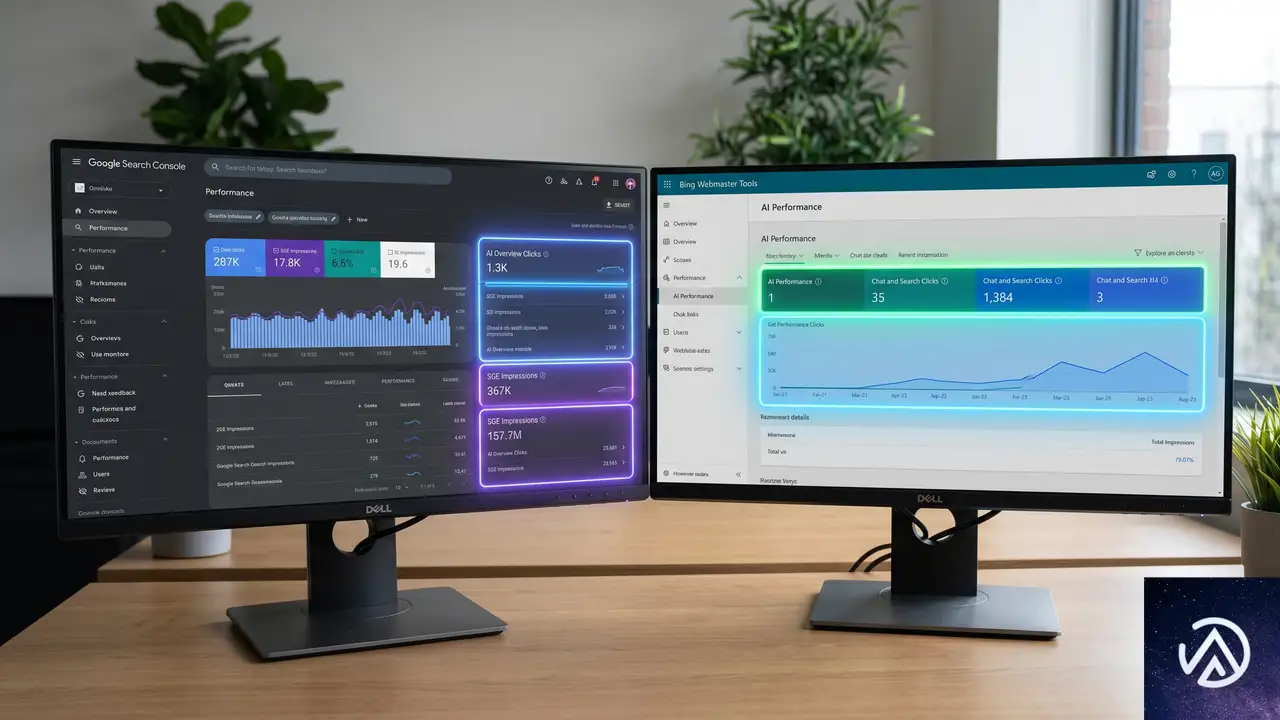
AI検索のレポーティングにおいて、MicrosoftのBingはGoogleよりも早く動いている。Bing Webmaster Toolsは2026年2月にAIパフォーマンスダッシュボードを導入し、AI検索機能で自サイトが引用された際のデータを提供し始めた。同年3月には、AIが参照したクエリと実際に引用されたページをマッピングする機能を追加し、5月のSEO WeekではCitation Share(引用シェア)のプレビューを公開している。
Bingのこれらの機能は、AI検索での自サイトの立ち位置を定量的に把握するうえで有効なツールとなっている。Googleが今回のテストでようやく第一歩を踏み出した形だが、機能面では依然としてBingに後れを取っていると言わざるを得ない。
競合が先行する状況は、Googleにとってレポーティング機能の拡充を急がせる圧力となるだろう。Search Engine Journalもこの点を指摘しており、今後のGoogleの動きに注目が集まっている。
サイト運営者が取るべき対応
現時点では、このテストはイギリスの一部サイトに限定されているが、グローバル展開後の準備は今から始めておくべきだ。
まず、自サイトがAI検索でどの程度表示されているのか、既存のSearch Consoleデータの中で手がかりを探しておくこと。AI Overviewsの表示傾向は、検索クエリの傾向や特定のページの急激なインプレッション増加などから、ある程度推測できる場合がある。
次に、AI表示制御トグルをどのように扱うかの社内方針を検討しておくこと。AI検索への表示を許容するのか、あるいは制限するのかは、サイトの収益モデルやコンテンツ戦略によって判断が分かれる。迷った場合は、当面はトグルをオン(表示を許容)にしたままデータを蓄積し、レポートが充実してから判断するのが賢明だ。
さらに、Bing Webmaster ToolsのAIレポートも並行して確認する習慣をつけておくと、AI検索全体のトレンドをより早く把握できる。Googleのレポート機能が成熟するまでの間、マルチプラットフォームでのデータ収集がリスクヘッジにもなる。
この記事のポイント
- GoogleがSearch ConsoleでAI表示制御トグルとAI専用パフォーマンスレポートのテストをイギリスで開始した
- AI表示制御トグルはAI検索機能への表示を制御するもので、ランキングシグナルには使われない
- AI専用レポートではインプレッションを詳細に分析できるが、クリックデータは未提供
- BingはすでにAI引用データやクエリマッピングを提供しており、Googleは後れを取っている
- グローバル展開に備え、既存データの分析と社内方針の検討を今から進めておくべき
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Google Cloud、AlloyDB向けリモートMCPサーバーがGA。AIエージェントとDBの安全な統合を実現
Google CloudがAlloyDB向けのリモートMCP(Model Context Protocol)サーバーの一般提供を発表した。これまでローカル開発が中心だったMCPだが、本番環境での運用に耐えるフルマネージドな仕組みとして登場した。AIエージェントが企業のオペレーショナルデータベースに直接アクセスし、安全にクエリを実行できるようになる。
この記事では、リモートMCPサーバーが解決する技術的課題と、AlloyDBを基盤にしたエージェントアプリケーションの構築方法を解説する。データの鮮度、セキュリティ、運用負荷のバランスを取るアーキテクチャを具体的に示す。
リモートMCPとは何か(ローカルMCPとの違い)
MCP(Model Context Protocol)とは、大規模言語モデル(LLM)が外部のデータソースやツールと安全に通信するためのオープン標準プロトコルだ。Anthropicが提唱し、現在では多くのAIエージェントフレームワークで採用されている。従来は開発者のローカルマシン上で動作する「ローカルMCPサーバー」が主流だった。
ローカルMCPサーバーは標準入出力(stdio)を使ってプロセス間通信を行う。これは開発段階では手軽だが、本番環境に持ち込むと途端に問題が顕在化する。複数のエージェントインスタンスが同時にデータベースへアクセスする場合、プロセス管理が複雑化し、ネットワーク越しのセキュリティ確保も難しくなる。
リモートMCPサーバーは、これらの課題をHTTPエンドポイント経由で解決する。Google Cloudのマネージドインフラ上で動作し、OAuth 2.0ベアラートークンによる認証とIAM(Identity and Access Management)によるきめ細かな権限制御を提供する。エージェント開発者はインフラ管理から解放され、クエリ実行に集中できる。
なぜAlloyDBと組み合わせるのか
AlloyDBはGoogle CloudのフルマネージドPostgreSQL互換データベースだ。標準PostgreSQLと比較して、ベクトル検索では最大6倍高速、フィルタ付きクエリでは最大10倍高速というパフォーマンスを備える。ScaNNインデックスを使えば100億ベクトル規模まで拡張でき、AIエージェントのRAG(検索拡張生成)ワークロードに最適化されている。
さらにAlloyDBには、データベース内で直接埋め込みベクトルを生成するAI Functionsや、Gemini Enterprise Platformモデルを使った検索結果のリランキング機能が組み込まれている。エージェントがデータベースにクエリを投げるだけで、最新のオペレーショナルデータに基づいた回答を得られる。データの鮮度を保つためのETLパイプラインが不要になるケースも多い。
リモートMCPサーバーが解決する5つの本番課題
Google Cloudブログの発表によると、リモートMCPサーバーは単なる通信方式の変更にとどまらない。本番環境でAIエージェントを運用するチームが直面する、以下の5つの課題を包括的に解決する設計になっている。
特に注目すべきはIAMによる権限制御だ。従来のデータベース接続では、共有パスワードやAPIキーを使うことが多かった。しかしリモートMCPでは、エージェントごとに特定のテーブルやビューへのアクセス権をIAMで付与できる。読み取り専用のSQL実行ツールを選択すれば、エージェントが誤ってデータを削除するリスクを根本から排除できる。
Model Armorによるプロンプトセキュリティ
リモートMCPサーバーは、Google CloudのModel Armorと統合されている。Model Armorはプロンプトとレスポンスの両方をスクリーニングし、プロンプトインジェクション攻撃や機密データの意図しない流出を防ぐ。エージェントのサービスアカウントが広範なデータベース権限を持っていても、Model Armorがデータの出し方をフィルタリングする仕組みだ。
たとえば、エージェントが顧客のクレジットカード番号を含むカラムにアクセスできる権限を持っていたとしても、Model Armorがレスポンスからその情報を除去できる。これは「権限はあるが出力は制限する」という新しいセキュリティモデルであり、ゼロトラストの考え方をAIエージェントに適用した形だ。
エージェントから見たAlloyDBの強み

リモートMCPサーバーは接続の仕組みを提供するが、その先にあるデータベース自体の性能も重要だ。AlloyDBはエージェントアプリケーションに特化したいくつかの特徴を持つ。
まず、ベクトル検索性能だ。ScaNNインデックスを使うと、標準PostgreSQLの最大6倍の速度でベクトルクエリを実行できる。100億ベクトルまでスケールするため、大規模なRAGアプリケーションでもパフォーマンスが劣化しない。フィルタ条件付きのベクトル検索では最大10倍高速化される。これは「直近30日以内のドキュメントから類似検索」のような実用的なクエリで差が出る。
次に、ハイブリッド検索とリランキングだ。RUM(RUMインデックス / Row Usage Matrix)を使った全文検索とベクトル検索の組み合わせや、Reciprocal Rank Fusionによる結果の融合が可能だ。さらにGemini Enterprise Platformモデルを使ったインテリジェントなリランキングにより、エージェントは最も関連性の高い情報を優先的に取得できる。
また、AlloyDBのAI Functionsはデータベース内部で埋め込みを生成する。外部の埋め込みAPIを呼び出す必要がなく、数百万件の埋め込みを効率的に生成できる。Lakehouse Federationを使えば、BigQueryの分析データやIcebergテーブルのアーカイブデータにも、同じPostgreSQLインターフェースから透過的にアクセスできる。
AIエージェントにとって重要なのは「データの鮮度」と「アクセスの容易さ」だ。AlloyDBのリアルタイム埋め込み生成とLakehouse Federationの組み合わせにより、エージェントは最新のオペレーショナルデータと過去の分析データを区別なく扱える。配送車両の位置情報のような刻々と変化するデータでも、クエリを発行した瞬間の状態を取得できる。
実際の導入手順とデモの流れ
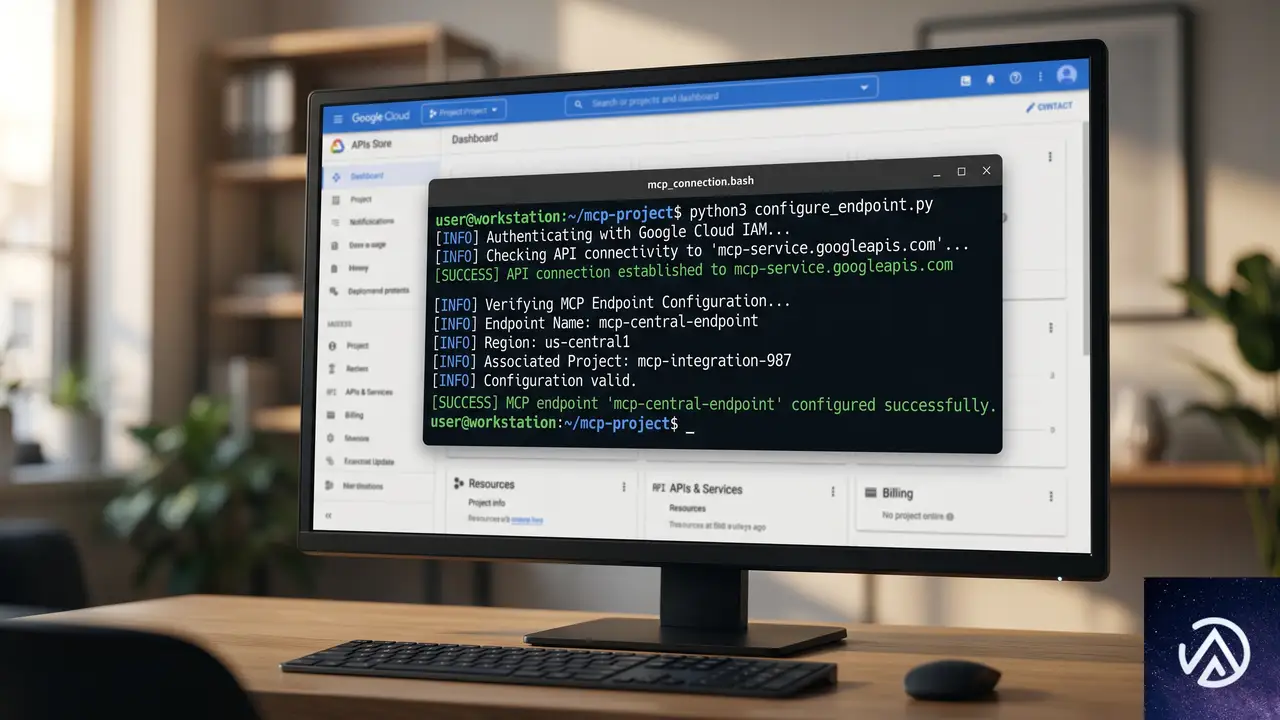
Google Cloudは今回のGA発表にあわせて、Codelab(ハンズオン形式のチュートリアル)を公開した。導入手順は以下の4ステップに整理されている。
接続が確立すると、エージェントは自動的にデータベースのスキーマを把握する。テーブル名やカラム名をイントロスペクションクエリで取得し、ユーザーの質問に応じて適切なJOINや集計クエリを組み立てられる。たとえば「過去24時間で最も遅延が発生している配送ルートは?」という質問に対して、エージェントが配送テーブルと車両テーブルをJOINし、リアルタイムの位置情報と組み合わせて回答する。
AIエージェントが実行できる操作の範囲
リモートMCPサーバー経由でエージェントが実行できる操作は、単なるSELECTクエリにとどまらない。AlloyDBのツールセットを使うと、以下のような運用操作も可能になる。
- データのエクスポートとインポート
- バックアップの作成とリストア
- クラスタの設定更新
- AI Functionsを使ったテキストのランキング(AI.RANK())
もちろん、これらの操作はIAM権限の範囲内でのみ実行される。読み取り専用のSQLツールを選択していれば、データ定義や変更を伴う操作はブロックされる。本番環境での安全な運用を第一に設計されている点が重要だ。
導入時に検討すべきポイント
リモートMCPサーバーのGAは、AIエージェントとデータベースの統合を大きく前進させる。しかし導入にあたっては、いくつかの点を事前に検討する必要がある。
まず、コスト構造の把握だ。AlloyDB自体がエンタープライズ向けのプレミアムデータベースであり、さらにMCPサーバーの利用にもGoogle Cloudの料金が発生する。30日間の無料トライアルが提供されているので、まずは小規模なクラスタで検証し、ワークロードに応じたコストを見積もることを推奨する。
次に、IAMポリシーの設計だ。エージェントに必要最小限の権限を付与する「最小権限の原則」を徹底する必要がある。テーブル単位、カラム単位でのアクセス制御が可能だが、データベースの規模が大きくなるとポリシー管理が複雑化する。事前にアクセス制御のルールを整理しておくことが重要だ。
最後に、プロンプト設計の重要性も変わらない。MCPサーバーがデータへのアクセスを提供しても、エージェントが適切なクエリを生成できるかどうかはプロンプトの質に依存する。スキーマの説明やクエリの方針をプロンプトに含めることで、より正確な結果を得られる。
この記事のポイント
- AlloyDB向けリモートMCPサーバーがGAとなり、HTTPエンドポイント経由でAIエージェントが安全にデータベースへアクセス可能になった
- IAMによるテーブル単位の権限制御と、Model Armorによるプロンプトセキュリティで本番運用に耐える設計
- AlloyDBのベクトル検索性能とAI Functionsの組み合わせにより、RAGアプリケーションの構築が効率化される
- 30日間の無料トライアルとCodelabが提供されており、小規模な検証から始められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Resilience Hubが大幅刷新、生成AIで障害モードを分析しSREの信頼性管理を効率化
AWSが「Resilience Hub」の次世代版を一般公開した。最大の変更点は生成AIを活用した障害モード評価の搭載だ。組織全体の信頼性を構造化されたポリシーで管理し、数百に及ぶアプリケーションの可用性リスクを一元的に可視化する。
今回の刷新では新たなアプリケーションモデルが導入され、依存関係の自動検出機能やモジュール式の信頼性ポリシーも追加された。SREチームと開発チームが同じ指標で対話し、エンタープライズ全体のレジリエンスを継続的に改善する基盤が整った形だ。
従来のResilience Hubが個々のアプリケーション評価に留まっていたのに対し、今回の刷新は「信頼性の管理」を組織のガバナンス領域に引き上げる。本記事ではその具体的な機能と実務への影響を詳しく解説する。
AWS Resilience Hubの全体像と考え方の変化
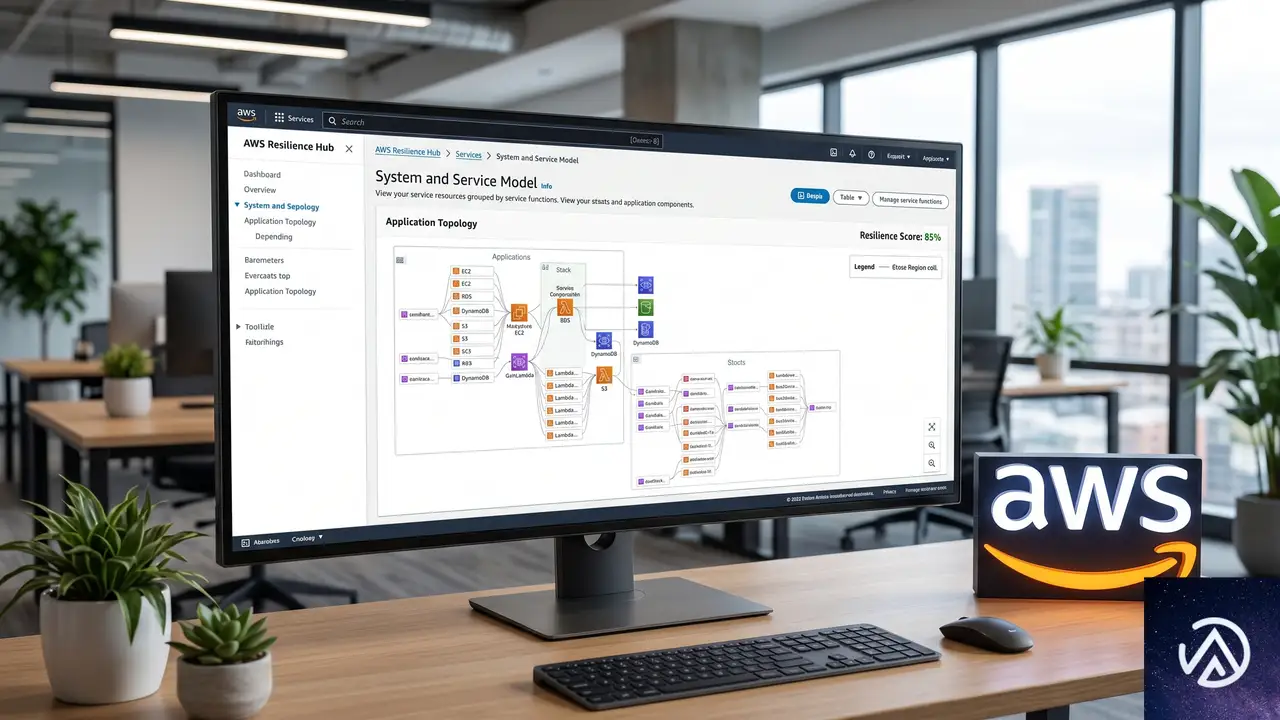
この比較が示すように、次世代版の本質は「個別最適から全体最適への転換」だ。AWS Organizationsとの統合により、委任管理者アカウントから複数アカウントを横断したレジリエンス評価が可能になった。
「ビジネス視点」で捉え直されたアプリケーションモデル
新しいモデルは3層構造になっている。最上位にビジネスアプリケーション全体を表す「システム」、その下にクリティカルな業務経路を示す「ユーザージャーニー」、さらに実際のデプロイ単位である「サービス」が配置される。サービスはAWSリソースやコード、オブザーバビリティの構成要素を束ねる役割だ。
この構造により「ログインできないと売上が止まる」という業務インパクトと、IAMロールの設定ミスという技術的リスクが地続きで評価できるようになる。AWS News Blogの記事でChanny氏は「ビジネス成果に直接結びつくクリティカルなエンドユーザー経路」という表現でこの概念を説明している。
モジュール式ポリシーでチーム間の共通言語を確立
信頼性ポリシーも大きく変わった。旧来は固定されたポリシータイプを選ぶ方式だったが、次世代版では必要な要件を組み合わせて構築できる。たとえば「可用性SLO 99.95%」「マルチリージョン災害復旧」「RTO 15分、RPO 5分」といった要素を選択し、金融系アプリケーション用のポリシーとして再利用する運用が可能だ。
SREと開発チームの間で「どの水準を目指すか」の共通理解が生まれ、属人的な判断を減らせる効果が期待できる。特に複数の開発チームを持つ組織では、この統一ポリシーがガバナンスの要になる。
生成AIが障害モードを評価する仕組み

次世代版の目玉機能が、生成AIを用いた障害モード評価である。サービスにポリシーを紐付けて評価を実行すると、AIが自動的に設定ミスや単一障害点を洗い出し、具体的な改善策を提案する。
この4ステップのフローにより、人手では発見が難しいクロスアカウントの依存関係や、リージョンをまたぐ意図しない呼び出しまで検出できる。AIは単にデータを収集するだけでなく、障害が発生した場合の影響範囲を推定し、優先度付きの修正ガイダンスを出力する。
AWS Well-Architectedと分析フレームワークの統合
AIの評価ロジックはAWS Well-Architectedフレームワークのベストプラクティスと、AWS Resilience Analysis Frameworkを参照している。これにより「なんとなく不安」ではなく、定義された基準に照らした再現性のある評価が実現する。
評価結果では「どのポリシー要件に違反しているか」が明示される。たとえば「RTO 15分を満たすには、このAuto Scalingグループのインスタンスが起動するまでの時間が長すぎる」といった具体的な指摘が得られる。対策の優先順位をビジネスインパクトに基づいて判断できる点が実務的に価値が高い。
また、ユーザーがAssertion(表明)を追加してAIの分析精度を高める仕組みも用意されている。たとえば「このサービスは特定のリージョンでのみ稼働する」といった前提条件をAIに伝えることで、無関係なマルチリージョン構成の提案を除外できる。
依存関係の自動検出がもたらす可視性の向上

多くの障害は「認識されていない依存関係」から発生する。次世代Resilience HubはDNSクエリログを解析し、VPC内のエンドポイントから呼び出されているAWSサービスや内部API、サードパーティの外部エンドポイントを自動で特定する。
この機能の価値は運用の暗黙知を形式知に変換する点にある。「ベテランSREだけが知っている」依存関係を、システムが自動でドキュメント化してくれる。異動や退職によるナレッジロスを防ぎ、障害対応の属人性を低減する効果が期待できる。
依存関係検出はサービス作成時に有効化する。VPCフローログではなくDNSクエリログを解析する仕組みのため、ネットワークトラフィックの暗号化状況に影響されず、比較的軽量に動作する設計だ。不要な場合は管理画面の設定から無効化できる。
実際の利用フローと移行パス

新規導入の基本的な流れ
導入の流れはシンプルだ。まず信頼性ポリシーを作成し、次にビジネスアプリケーションを表す「システム」を登録する。システム配下に、マイクロサービスなどのデプロイ単位である「サービス」を作成し、AWSリソースのタグやCloudFormationスタック、Terraformのステートファイル、EKSクラスタなどを指定してリソースを関連付ける。
準備が整ったら「障害モード評価の実行」をクリックする。Resilience HubがInvokerロールを引き受け、指定されたリソースの親子関係を解析し、トポロジを構築。その上でAIがポリシーに対するギャップを評価する。
評価完了後は「サービス詳細」画面の「Assessment」タブで発見事項を確認できる。各項目には障害モードの説明、アーキテクチャへの影響、修正方法、関連するポリシー要件が明記される。対応が完了した項目は「Mark as resolved」でクローズし、未対応の課題だけをトラッキングできる。
既存ユーザー向けの移行API
すでに従来版のResilience Hubを利用している組織向けには、移行用APIが提供されている。従来の評価ポリシーを新ポリシー形式に変換し、複数の関連アプリケーションを新モデルの「1システム配下の複数サービス」構造に再マッピングする機能だ。
手動での再設定が不要なため、既存の評価データを活かしつつスムーズな移行が可能になっている。大規模組織ほどこの移行APIの価値は大きい。
運用に組み込む際のポイントと今後の展望
Resilience Hubの次世代版を実運用に組み込む場合、いくつか意識すべき点がある。第1にポリシー設計の重要性だ。SLOやRTO、RPOの値はビジネス要件から逆算する必要がある。「とりあえず99.99%」といった一律設定では、過剰なコストを生むか、逆に重要なサービスを見落とすリスクがある。
第2に、依存関係検出のスコープ調整だ。DNSクエリログ解析は強力だが、ノイズとなる外部通信も拾う可能性がある。検出結果を精査し、クリティカルでない依存関係をフィルタリングする運用プロセスを組み込むことが望ましい。
第3に、AIの分析結果を鵜呑みにしないことだ。Assertion機能を活用し、自社のアーキテクチャ特性をAIに正しく伝える努力が求められる。あくまで「AIの提案をSREが判断する」という協調モデルが効果的である。
料金体系は新たなサービスベースモデルに移行した。各サービスにつき月2回の障害モード評価が含まれ、依存関係の自動評価はオプションとなる。大規模環境では評価回数がボトルネックになる可能性があるため、クリティカルなサービスに絞って評価頻度を設定するなどの工夫が必要だ。
今後はAWS Organizationsとの統合がさらに強化され、組織全体のレジリエンススコアをスコアカード化する機能や、CI/CDパイプラインへの組み込みによるシフトレフトな信頼性評価への展開が期待される。
この記事のポイント
- 生成AIによる障害モード評価で、人手では困難な依存関係や設定ミスを自動的に発見できる
- ビジネス視点のアプリケーションモデルにより、技術リスクと業務インパクトを地続きで評価可能になった
- モジュール式ポリシーがチーム間の共通言語として機能し、ガバナンスの実効性が高まる
- DNSクエリログ解析による依存関係の自動可視化で、運用の暗黙知を形式知に変換できる
- 既存ユーザー向けの移行APIが用意されており、大規模組織でもスムーズに移行可能である
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini Omni登場、マルチモーダル動画生成の新時代
Google DeepMindは2026年5月17日、新たなマルチモーダル生成AIモデル「Gemini Omni」を発表した。テキスト、画像、音声、動画といったあらゆる形式の入力を組み合わせ、高品質な動画を生成・編集できる点が最大の特徴だ。
ファーストモデルとなる「Gemini Omni Flash」は、発表と同時にGeminiアプリ、Google Flow、YouTube Shortsで提供が開始された。自然言語による会話形式での動画編集や、現実世界の物理法則を反映したリアルな映像生成が可能になっている。
この記事では、Gemini Omniが従来の動画生成AIと何が異なるのか、具体的な機能とその仕組み、そしてコンテンツ制作の現場にもたらす変化について解説する。
上の概念図にあるように、Gemini Omniの最大の進化はインプットの柔軟性にある。テキストプロンプトだけでなく、画像や音声、既存の動画そのものを「参照素材」として組み合わせ、そこからまったく新しい映像を生み出せるのだ。DeepMindの記事によれば、将来的には画像や音声の出力にも対応する予定だという。
自然言語で動画を編集する新体験
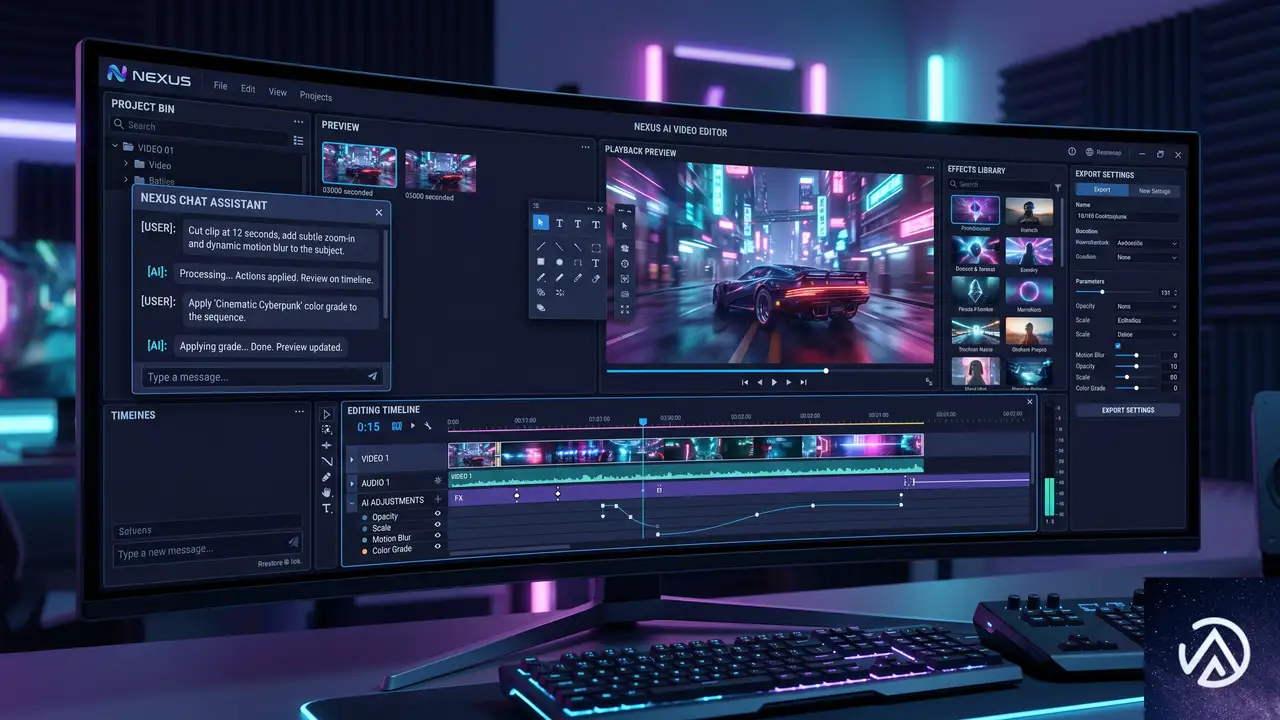
Gemini Omniが提供する最も画期的な機能のひとつが、会話形式による動画編集だ。従来の動画編集は、タイムライン上でクリップを切り貼りし、エフェクトを重ねる作業の連続だった。Omniでは、編集内容を自然言語で指示するだけで、AIが映像を理解して変更を加える。
DeepMindの発表によれば、Omniは過去の指示内容を記憶し、編集のたびに映像全体の一貫性を維持する。登場人物の見た目や物理法則、シーンの流れが破綻しない。これは単なる「映像の切り貼り」ではなく、AIが映像の文脈を理解しているからこそ実現するものだ。
映像の一部を変更、または一変させる「トランスフォーム」
Omniは、映像内の特定のオブジェクトだけを変更する、あるいはシーン全体をガラリと変えることができる。DeepMindのデモでは、「彫刻をバブル材質に変える」というプロンプトで、彫刻だけが泡状に変化する映像が紹介されている。
この機能は、例えば商品紹介動画の背景だけを差し替えたい、プロモーション映像の季節感を変更したいといった実務ニーズに直結する。撮影済みの映像を素材として、新たなクリエイティブの出発点にできるのだ。
アクションを再構築し、予想外の映像を生成
撮影済みの動画に対して「このシーンで起こっていることを変えてほしい」と指示するだけで、Omniは映像内のアクションそのものを再構築する。新しいキャラクターの追加も、光が音楽に同期して灯るような複雑な演出も可能だ。
発表資料には「手が鏡に触れた瞬間、鏡が美しい液体のように波打つ」というプロンプト例が掲載されている。こうした物理法則に基づく映像表現は、従来の動画生成AIでは難しかった領域だ。
複数ターンにわたる動画の洗練
Omniの編集は、1回の指示で終わらない。環境の変更、アングルの切り替え、スタイルの変更、特定のディテール調整といった指示を段階的に重ねることで、映像を徐々に洗練させていける。DeepMindは「バイオリニストの演奏動画」を例に、環境変更→バイオリンを透明化→肩越しのアングル変更という一連の編集を示している。
この「対話的な編集の積み重ね」は、ディレクターが編集者に指示を出す感覚に近い。クリエイティブの方向性を言葉で伝え、結果を見ながら微調整するワークフローが、AIによって実現しつつある。
世界知識が映像にリアルな文脈を与える
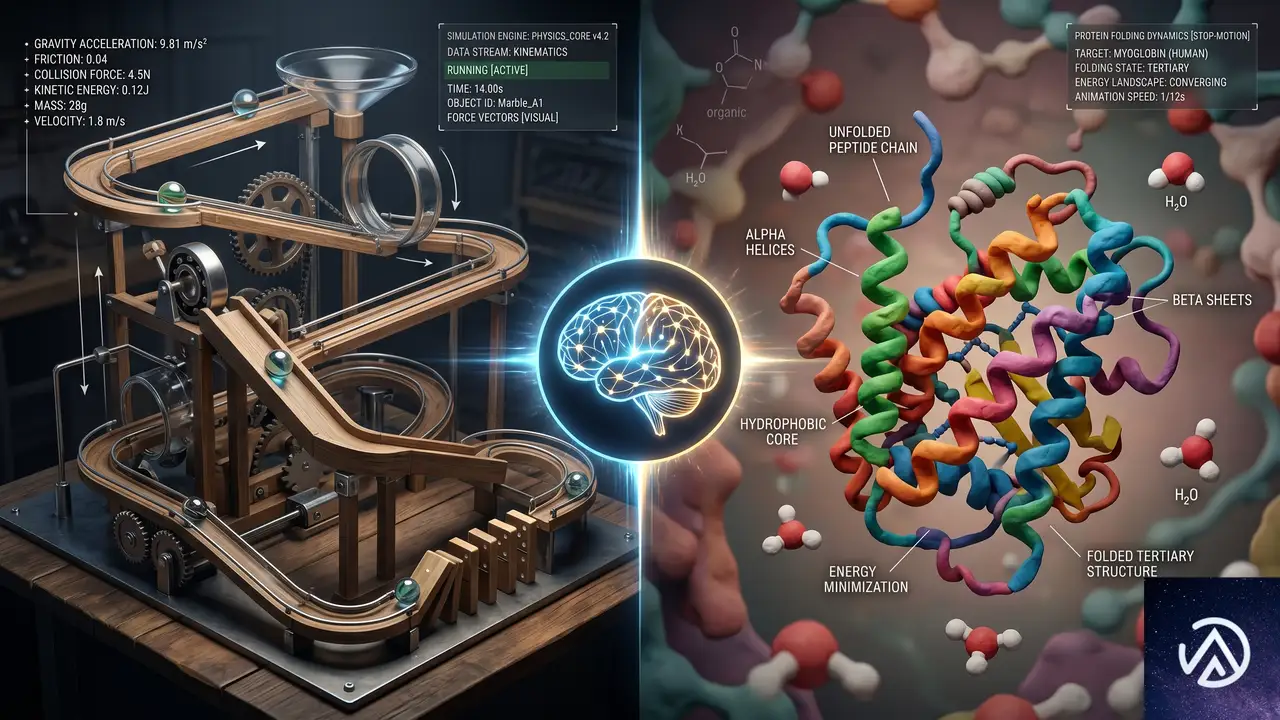
Gemini Omniのもうひとつの核は、Google DeepMindが「世界知識(world knowledge)」と呼ぶ能力だ。Omniは単に見た目がリアルなシーンを構築するだけでなく、「次に何が起こるべきか」を推論する。物理法則、歴史的事実、科学的知識、文化的文脈を踏まえた映像生成が、単なるフォトリアルを超えた説得力のあるストーリーテリングを可能にする。
より正確な物理演算の再現
Omniは重力、運動エネルギー、流体力学といった物理法則の直感的な理解が従来よりも改善されているという。DeepMindが示した「ビー玉が高速でカラクリ装置の上を転がる連続ショット」のプロンプト例では、ビー玉の動きが物理的に破綻しない映像が生成された。
動画制作の現場では、物理演算が破綻した映像は視聴者に違和感を与え、説得力を損なう。特に製品の動作デモや、教育用の科学解説動画では、物理的正確さが信頼性に直結する。Omniのこの改善は、商用・教育コンテンツの品質を引き上げる要素だ。
知識と創造性の融合
Omniはパターンマッチングを超えたレベルで、言語と映像、意味を結びつける。DeepMindの例として挙げられた「AからZまでの珍しいアイテムを各文字ごとに表示する動画」では、カピバラ(C)、ディスコグローブ(D)、ラバランプ(L)といった具合に、各文字に対応するアイテムをAIが自律的に選定し、映像化している。
これは「指示された映像を生成する」というより、「概念を理解した上で映像化する」という質的に異なる能力だ。クリエイターがアイデアを言葉で伝えれば、AIがそれを映像的な表現に落とし込んでくれる。企画段階でのモックアップ作成や、プレゼンテーション用のビジュアル資料作成が大幅に効率化する可能性がある。
複雑な概念を視覚化する説明動画の生成
Omniは短いプロンプトから、複雑な概念をわかりやすく解説する説明動画を生成できる。DeepMindの例では、タンパク質の折り畳み(プロテインフォールディング)を、すべて粘土で作られたクレイメーション(粘土アニメ)風の映像で解説したデモが紹介された。
「複雑なトピックを短時間で視覚化できる」という点は、教育コンテンツや企業の研修資料、製品のオンボーディング動画など、幅広い用途に応用できる。特にスタートアップや中小企業にとって、高品質な説明動画を低コストで制作できる可能性は大きい。
あらゆる組み合わせから動画を生成する力
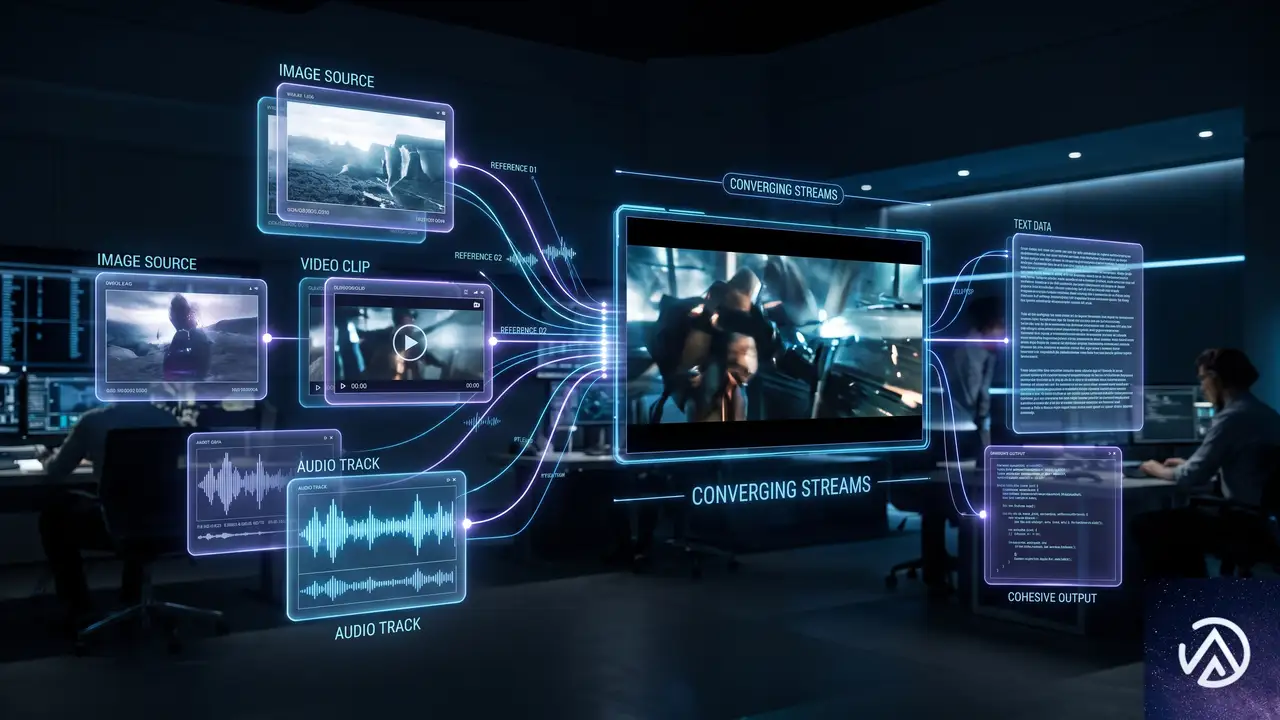
Gemini Omniのインプットの柔軟性を示す機能として、DeepMindは「複数形式の参照入力」を強調している。画像、テキスト、動画、音声のいずれかを「参照素材」として与えることで、それらをブレンドしたひとつの映像を生成できる。
現時点で音声入力は「声」による参照のみサポートされているが、DeepMindは他の形式の音声入力にも順次対応していく方針だ。画像からキャラクターの外見を、動画から動きのパターンを、音声からリズムやトーンを取り込むといった複合的な制作が可能になる。
画像・音声・動画を「参照」して統一された映像を出力
DeepMindの発表では、3つの異なる素材(画像、動画、音声)を組み合わせて「SF映画風の映像」を生成する例が示された。画像でシーンのスタイルを、動画でカメラワークやエフェクトを、音声で映像のリズムをコントロールできる。
別の例では、人物のイラストとウォークサイクルの動画を組み合わせて、歩きながらリアルな実写映像に変化していく映像を生成している。これらは、クリエイターが持つ複数の素材アセットをAIが「調和」させてひとつの作品に仕上げるという、新しい制作フローを示唆する。
スタイル、動き、エフェクトを自在に適用
参照素材を使うことで、映像のスタイル、動き、エフェクトを細かくコントロールできる。プロンプトだけで指示する場合と比べて、参照素材があることで「こういう感じ」というニュアンスをAIに正確に伝えやすくなる。
「スケートボードにアニメーションのモーションエフェクトを追加する」という例では、撮影済みの映像とAIによるエフェクト生成がシームレスに融合した。実写とCGの境界線が曖昧になっている現在、Omniは実写素材を出発点に、AIによる拡張を重ねるというハイブリッドな制作スタイルを加速させるだろう。
自分のアバターで動画を制作、そして責任ある開発
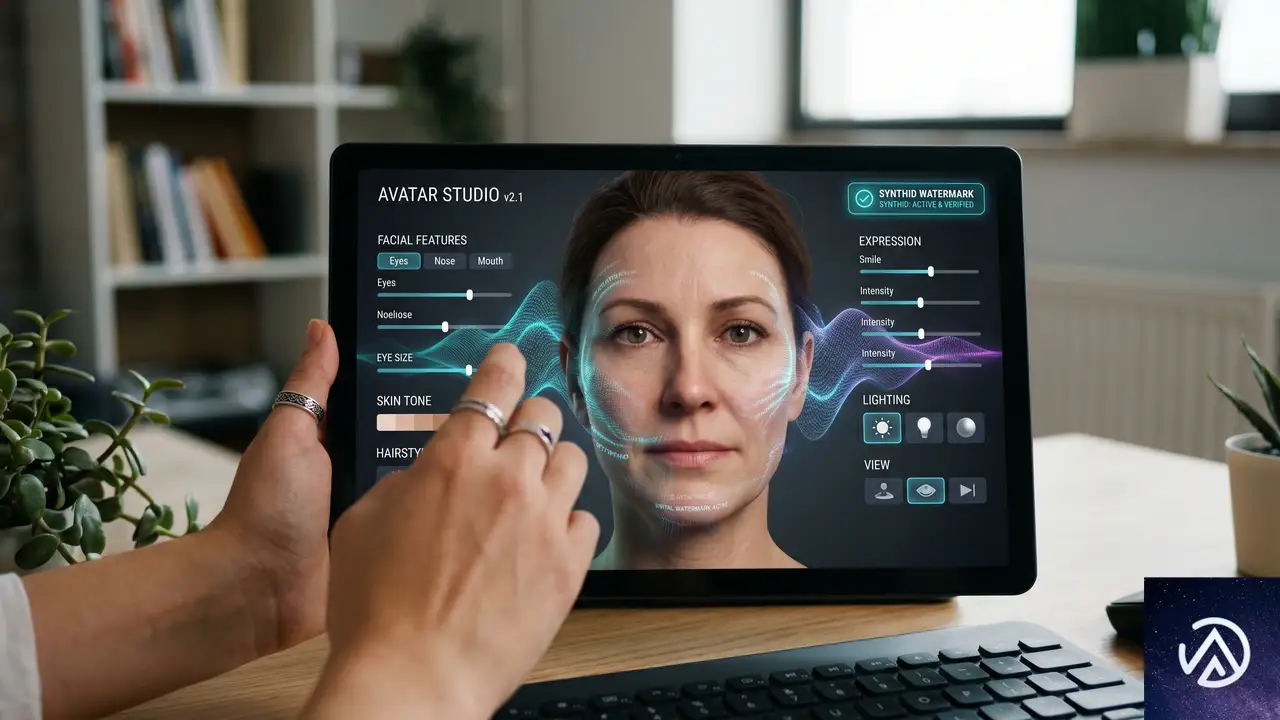
Google DeepMindは、AIの責任ある開発と利用のためのポリシーを明確にしている。その一環として提供されるのが「Avatars」機能だ。これは自分の声と姿をデジタル化したアバターを作成し、そのアバターを使って動画を生成できるというもの。
デジタルアバター機能
アバター機能を使うと、生成された動画はユーザー自身の声と姿を反映したものになる。これはパーソナライズされたコンテンツ制作を可能にする一方、なりすましや悪用のリスクもはらむ。DeepMindは、音声や発話を伴う動画編集機能については、テストを重ねた上で責任ある形での提供方法を模索している段階だとしている。
SynthIDによる電子透かしとコンテンツの透明性
Omniで生成されたすべての動画には、人間の目では認識できないSynthIDのデジタル透かしが埋め込まれる。これにより、GeminiアプリやChrome、Google検索を通じて、その動画がAIによって生成されたものであることを簡単に検証できる。
AIによるコンテンツ生成が一般化するにつれ、その真正性を担保する仕組みの重要性は高まっている。動画メディアの信頼性に関わるこの取り組みは、プラットフォームとしてのGoogleの姿勢を示すものだ。Web制作者やマーケターにとっては、配信する映像コンテンツの透明性を確保する手段として注目に値する。
Gemini Omniの利用を開始するには
現在提供されているのは「Gemini Omni Flash」モデルで、Google AI Plus、Pro、Ultraの各プラン加入者がGeminiアプリとGoogle Flowで利用できる。また今週より、YouTube ShortsとYouTube Create Appでは無償で提供が開始される予定だ。
今後数週間以内には、API経由で開発者やエンタープライズ顧客にも提供が拡大される。これにより、既存の制作ワークフローやサービスにOmniの動画生成機能を組み込んだアプリケーションの登場が期待される。
この記事のポイント
- Gemini Omniはテキスト・画像・音声・動画の組み合わせ入力に対応した動画生成AIで、最初のモデル「Flash」が提供開始された
- 自然言語による会話形式で動画を編集でき、複数ターンの指示で映像を段階的に洗練できる
- 物理法則や世界知識に基づいたリアルで一貫性のある映像生成が可能になった
- 生成動画にはSynthIDの電子透かしが埋め込まれ、コンテンツの透明性が確保される
- API提供により、今後のサービス連携や制作フローへの組み込みが加速する見込みだ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AWS最新動向(5月11日週) Bedrock AgentCoreの支払い機能とAgent Toolkitを解説
2026年5月11日の週、AWSはAIエージェントの自律的な動作を根本から変える発表を相次いで行った。最も注目すべきは、Amazon Bedrock AgentCoreがエージェント自身による支払い機能のプレビューを開始したことだ。これによりAIエージェントはAPIや外部サービスの利用料を自ら決済し、実行タスクに必要なリソースを動的に調達できるようになる。
AWS News Blogの著者であるChanny Yun氏が執筆した週次ラウンドアップによれば、この支払い機能はCoinbaseおよびStripeとの提携で構築された。さらに、AIコーディングエージェント向けの「Agent Toolkit for AWS」や、エージェントにデスクトップ環境を提供する「WorkSpaces for AI agents」も発表されている。本記事ではこれらの新機能を技術面とビジネスインパクトの両面から分析する。
Amazon Bedrock AgentCoreの支払い機能が示す「エージェント経済圏」の到来

AIエージェントが「考える」だけでなく「支払う」時代が来た。Amazon Bedrock AgentCoreにプレビューとして追加された支払い管理機能は、エージェントがAPI、MCPサーバー、Webコンテンツ、さらには他のエージェントの利用料を自律的に支払うことを可能にする。これは単なる便利機能ではない。エージェントが経済活動の主体になるための第一歩といえる。
この図が示すように、従来は有料サービスへのアクセスがエージェントのボトルネックだった。AgentCore Paymentsによってその制約が取り払われる。
CoinbaseとStripeとの提携が意味するもの
AWSはこの支払い基盤を単独で構築しなかった。暗号資産ウォレットのCoinbase(CDP Wallet)と決済プラットフォームのStripe(Privy Wallet)という、まったく異なる決済レイヤーの企業と提携している。Coinbase連携によりオンチェーン決済が可能になり、Stripe連携は従来型の法定通貨決済をカバーする。この二段構えが示唆するのは、AWSが特定の決済手段に依存せず、マルチペイメントレイヤーのエコシステムを目指しているということだ。
セッション単位の支出制限とガバナンス設計
エージェントに支払い権限を与えると聞いて、真っ先に浮かぶ懸念は「使いすぎ」や「不正利用」だろう。AWSはこの点をセッションレベルの支出制限で対策している。開発者はエージェントの実行セッションごとに予算上限を設定でき、その範囲内でのみ決済が実行される。企業の与信管理と同じ考え方をエージェント単位に落とし込んだ設計だ。
さらに、認証情報管理とコンプライアンス対応も組み込まれている。各エージェントは決済手段に直接アクセスするのではなく、事前に登録されたウォレット接続を通じて取引を実行する。AWSのIAM(Identity and Access Management)に似た権限管理の考え方が、支払い領域にも適用された形だ。
エージェント経済圏が実務にもたらす変化
Channy Yun氏がブログ記事で最も興奮していると述べたポイントは、この機能が解き放つユースケースの広がりだ。たとえば、リサーチエージェントがリアルタイムの市場データを動的に購入して分析に組み込む、あるいはコーディングエージェントがタスク実行中に有料APIを呼び出して機能を補完する、といった動作が実現する。
これはクラウドの従量課金モデルをエージェント自身が直接操作できるようになることを意味する。開発者はあらかじめすべてのAPI契約を整備する必要がなくなり、エージェントが実行時に必要なリソースを判断して調達する。インフラ構築の手間が一段階抽象化されるわけだ。
Agent Toolkit for AWSが実現する「AI時代のインフラ構築」
AgentCore Paymentsと並んで注目を集めたのが、AIコーディングエージェント向けの「Agent Toolkit for AWS」の発表だ。これはエージェントがAWS上で構築作業を行う際のエラー削減、トークンコスト低減、エンタープライズグレードのセキュリティ制御を実現する本番環境向けツールスイートである。追加料金なしで利用できる。
AWS MCPサーバーの一般提供とAgent Toolkitの関係
Agent Toolkitの中核コンポーネントとして、AWS MCP Serverが一般提供(GA)に移行した。MCP(Model Context Protocol)サーバーは、AIエージェントやコーディングアシスタントがAWSの全サービスに対して安全かつ認証付きでアクセスするためのマネージドなリモートサーバーだ。少数の固定ツールセットを通じて、複雑なAWS APIを抽象化する。
端的にいえば、エージェントに「AWS全体への安全なアクセス権」を渡す仕組みである。従来は開発者がIAMポリシーやAPIキーを個別に設定し、エージェントに渡す必要があった。MCPサーバーを使えば、これが統合認証のレイヤーで一元管理される。
ツールキットがエンジニアのワークフローをどう変えるか
Agent Toolkitは、これまでAWS Labsで提供されていたMCPサーバーやプラグイン、スキルの後継に位置づけられる。実験段階から本番利用への移行を意図した製品だ。具体的には以下の3つの価値を提供する。
- エラー削減: エージェントがAWSリソースを操作する際の設定ミスや権限違反を減らす
- トークンコスト低減: 最小限のツール呼び出しで済むよう最適化され、LLMのAPI利用料を抑える
- セキュリティ制御: 企業のセキュリティポリシーに準拠したアクセス制御を適用できる
開発者にとっては、AIエージェントに「AWSの操作方法」を一から教え込む必要がなくなる点が大きい。ツールキットが提供するスキルとプラグインを組み込むだけで、エージェントはAWSリソースのプロビジョニングや監視、トラブルシューティングを標準化された方法で実行できる。
AIエージェントにデスクトップを提供するWorkSpacesの狙い

プレビューとして発表された「Amazon WorkSpaces for AI agents」は、一見すると奇妙な機能に思える。AIエージェントが仮想デスクトップを使うとはどういうことか。狙いは、エージェントにGUIアプリケーションを操作させることにある。
多くの企業には、Web APIを持たない古い業務アプリケーションが残っている。WorkSpaces for AI agentsは、エージェントがこうしたGUIアプリケーションの画面を認識し、クリックやキー入力をエミュレートすることで、人間のオペレーターと同じ操作を実行できるようにする。
セキュリティ面では、エージェント専用のマネージドWorkSpaces環境が割り当てられ、エンタープライズグレードのガバナンスとコンプライアンスを維持したまま動作する。企業が長年抱えてきた「API化できない業務の自動化」という課題に対する、AWSなりの回答といえる。
第6世代Intel搭載の新型EC2インスタンスがもたらす性能向上

AI関連の発表に隠れがちだが、基盤となるコンピュートリソースにも重要なアップデートがあった。Amazon EC2のM8idn/M8idbおよびR8idn/R8idbインスタンスが発表されたのだ。これらはAWS専用にカスタマイズされた第6世代Intel Xeon Scalableプロセッサと、最新の第6世代AWS Nitroカードを搭載する。
vCPUあたり最大43%の性能向上
発表データによれば、前世代インスタンスと比較してvCPUあたりのコンピュート性能が最大43%向上している。この数字は単なるベンチマーク上の改善ではない。同じコストでより多くのワークロードを処理できることを意味する。
ネットワーク帯域とEBS帯域の強化
インスタンスタイプによって提供されるネットワーク性能も明確に差別化されている。M8idn/R8idnは最大600Gbpsのネットワーク帯域を提供し、M8idb/R8idbは最大300GbpsのEBS(Elastic Block Store)帯域に対応する。前者はネットワーク集約型ワークロードに、後者はストレージI/Oが重要なデータベースや分析ワークロードに最適化されている。
実務的には、機械学習のトレーニングデータを高速に読み込む必要があるケースや、大規模な分散データベースを運用するケースで効果を発揮する。M8idnとR8idnの選択肢が増えたことで、ワークロード特性に応じた細かいインスタンス選定が可能になった。
ValkeyとS3 Vectorsに見るデータ基盤の「ベクトル化」と「オープン化」

5月11日の週には、データ基盤に関する注目すべき動きもあった。OSS(オープンソースソフトウェア)のキーバリューストアであるValkeyが2周年を迎え、Amazon S3 VectorsとAurora PostgreSQLの統合に関する詳細なガイドが公開された。
Valkeyの急成長が証明するコミュニティ駆動開発の強さ
AWSのデータベースブログが報じたところによれば、ValkeyはDocker Pull数が1億を突破し、前年比17倍という急成長を遂げた。225人以上のコントリビューターが1,500以上のプルリクエストを提出しており、これは同期間におけるRedisの開発ペースの約2倍に相当する。
この数字が示すのは、単一ベンダー主導の開発モデルよりも、オープンでコミュニティ駆動の開発の方が速く、広範囲にイノベーションを起こせるという事実だ。Valkey 9.0はすでにAmazon ElastiCacheでも利用可能になっており、マネージドサービスとしての利便性とOSSの革新性を両立させている。
10億スケールのベクトル検索をSQLで
Aurora PostgreSQLからS3 Vectorsを標準SQLでクエリできるようになったことも見逃せない。具体的には、ベクトル類似度検索の結果とリレーショナルフィルタを1つのSQL文で組み合わせられる。たとえば、「意味的に最も類似した商品を検索し、その中から価格や在庫状況で絞り込む」といったクエリが単一ステートメントで完結する。
これはベクトルデータベース専用のクエリ言語を習得する必要がなくなることを意味する。すでにSQLを使いこなしているエンジニアであれば、追加学習なしでベクトル検索を業務に組み込める。データ基盤の民主化という観点から、非常に実用的なアップデートだ。
この記事のポイント
- Amazon Bedrock AgentCoreに支払い管理機能が追加され、AIエージェントが自律的にAPIやサービスの利用料を決済できるようになった
- Agent Toolkit for AWSが発表され、AIコーディングエージェントのエラー削減やトークンコスト低減を実現する
- WorkSpaces for AI agentsのプレビュー開始により、レガシーGUIアプリケーションの自動化が現実的になった
- 新型EC2インスタンスはvCPUあたり最大43%の性能向上を達成し、ネットワーク帯域とEBS帯域も強化された
- Valkeyの成長とS3 VectorsのSQL統合は、データ基盤のオープン化とベクトル検索の民主化が加速していることを示している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.5 Instant 登場。回答精度とパーソナライズ性能が大幅に向上
OpenAIがChatGPTのデフォルトモデルを「GPT-5.5 Instant」に更新した。これまで標準搭載されていたGPT-5.3 Instantを置き換える形で、全ユーザーに順次提供が開始されている。
今回のアップデートの核心は3つだ。事実誤認の大幅な減少、回答の簡潔さの向上、そして過去のチャット履歴や接続アプリを活用した高度なパーソナライズ機能の追加である。内部評価では、医療や法律、金融といった高精度が求められる分野でのハルシネーション(もっともらしい嘘)が52.5%も削減された。
何億人ものユーザーが日常的に利用するデフォルトモデルだからこそ、小さな改善の積み重ねが実用面では大きな差を生む。本記事ではGPT-5.5 Instantの具体的な進化点と、それが実際の利用体験にどう影響するのかを掘り下げていく。
事実誤認を半減させた精度向上の仕組み
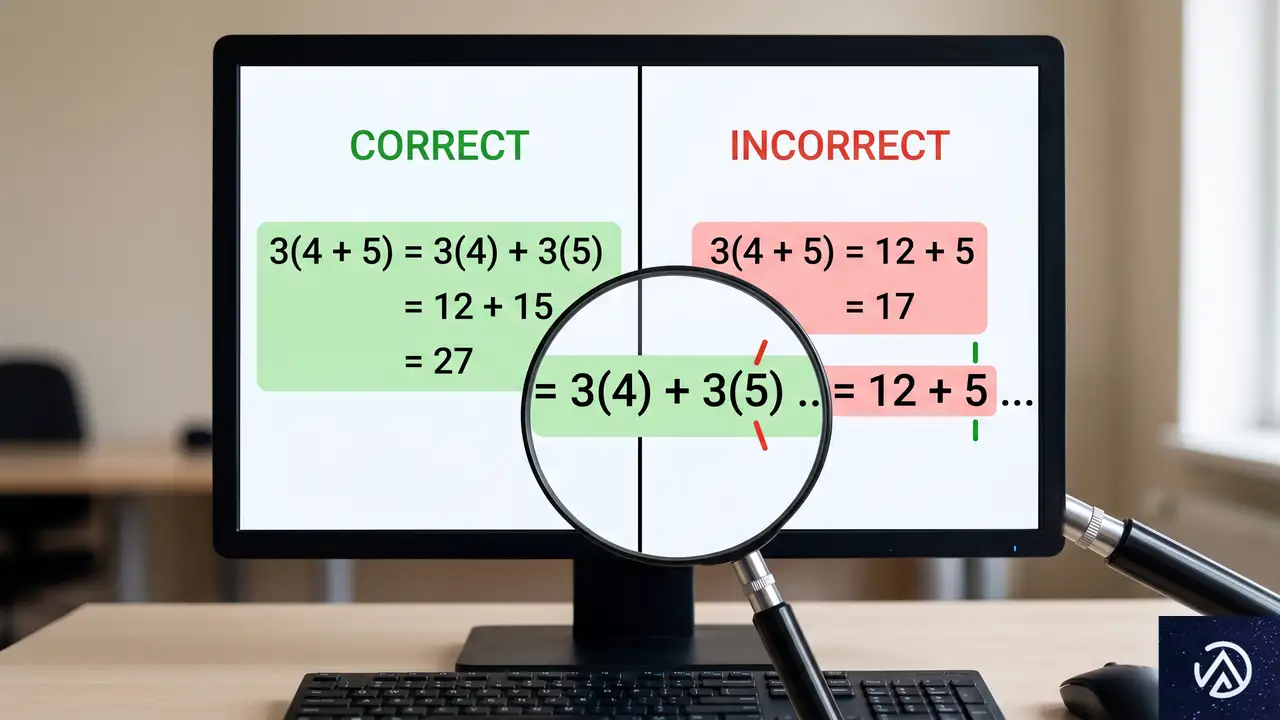
GPT-5.5 Instantにおける最大の改善点は、事実誤認(ハルシネーション)の劇的な減少だ。特に医療、法律、金融といった「間違いが許されない領域」で顕著な成果が出ている。
なぜここまでの改善が実現できたのか
OpenAIの公式ブログによると、GPT-5.5 Instantは高精度が求められるプロンプトにおいて、GPT-5.3 Instantと比較してハルシネーション(幻覚)を52.5%削減した。さらに、ユーザーが事実誤認を指摘したチャレンジングな会話においても、不正確な回答を37.3%減らしている。
この改善は単なる「よくわからないときは正直にわからないと言う」といった表面的な振る舞いの調整ではない。モデル自身が回答の妥当性を検証する能力が底上げされており、途中で誤りに気づいた際には自律的に修正できるようになった点が本質的な進化だ。
具体的な改善例から見えるもの
OpenAIが公開した比較例では、GPT-5.5 Instantは数学の問題に対して最初に不正確な解法を提示してしまった場合でも、代入チェックによって誤りを検出し、二次方程式の正しい解へと自力で修正している。一方でGPT-5.3 Instantは誤りに気づいてはいるものの、「解がない」と早々に結論づけてしまい、問題の本質に迫れなかった。
日常生活で使うAIアシスタントにとって、この「自己修正能力」は極めて重要だ。最初の回答が100%正しい必要はないが、誤りに気づいて軌道修正できるかどうかが実用性を大きく左右する。GPT-5.5 Instantのこの特性は、ビジネス文書の作成やデータ分析など、正確性が求められるシーンで特に頼りになるだろう。
冗長な表現を30.2%削減、それでも情報量は落とさない
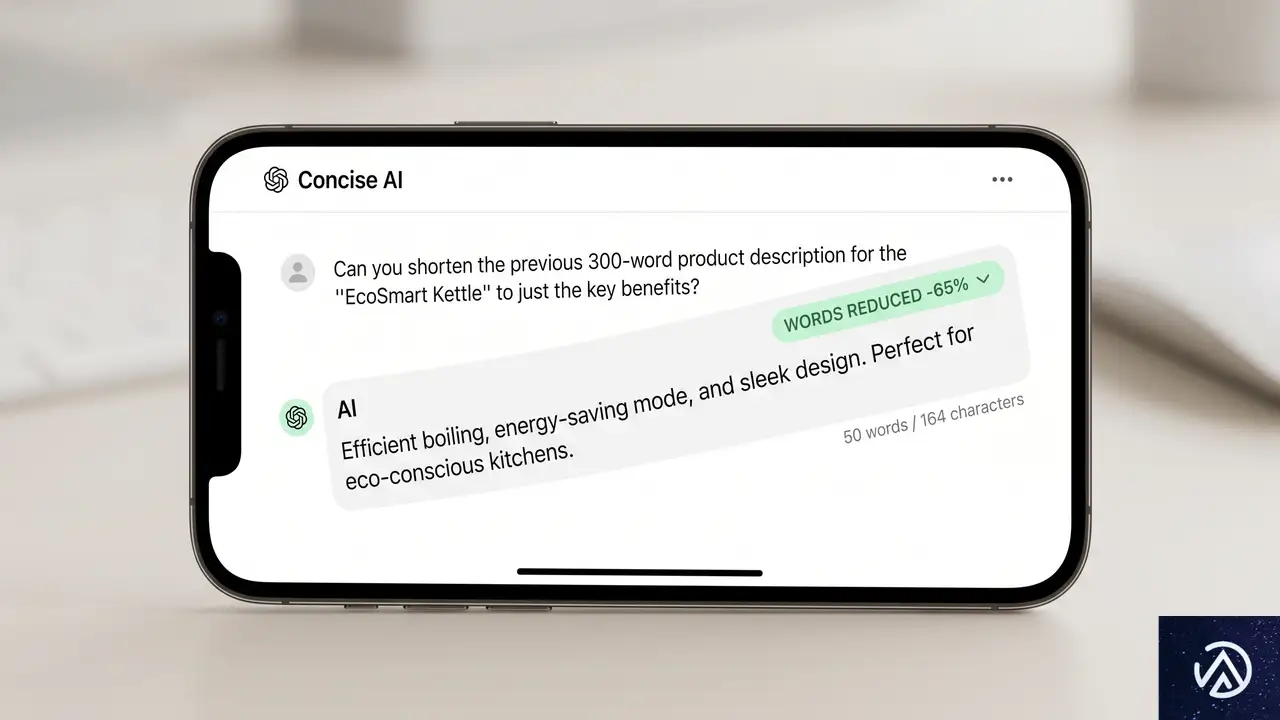
行数:基準値
過剰な絵文字:あり
行数:29.2%削減
不要な装飾:ほぼなし
GPT-5.5 Instantの回答は、前世代モデルと比較して単語数が30.2%、行数が29.2%も削減されている。この数字だけ見ると「情報量が減ったのでは」と心配になるが、実際は逆だ。余計な説明や過剰なフォーマットを省くことで、本当に必要な情報が見つけやすくなっている。
減ったのは「無駄」であって「中身」ではない
OpenAIの説明によると、新モデルは同じ情報をより少ない言葉で届けつつ、むしろ実用性は向上しているという。たとえば職場の人間関係に関するアドバイスを求めるプロンプトでは、GPT-5.3 Instantが「してはいけないこと」を含めた完全なフォーマットで回答するのに対し、GPT-5.5 Instantは状況に応じた実践的な言い回し例を提示し、問題を相手の人格ではなく「境界線」の問題として捉え直す視点を提供している。
ビジネスシーンで重要なのは、この「トーンの適切さ」だ。カジュアルな質問に過剰にフォーマルな回答が返ってくると、むしろ使う側のストレスになる。GPT-5.5 Instantは、状況に応じてフォーマル度を調整できるようになった点で、より人間らしい対話が可能になっている。
チャット履歴や接続アプリを活用した高度なパーソナライズ
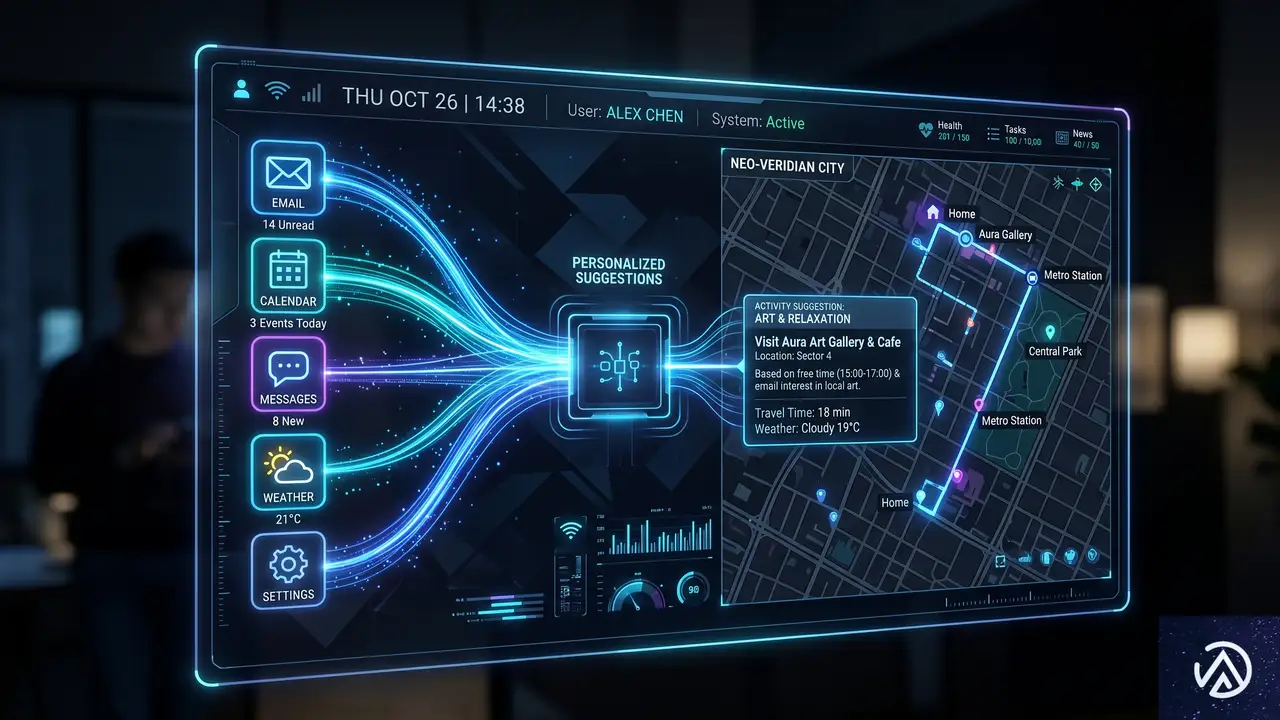
会話の開始 → 過去履歴を検索 → 関連コンテキストを取得 → カスタマイズされた回答を生成
GPT-5.5 Instantのもう一つの大きな進化が、パーソナライズ機能だ。過去のチャット履歴やアップロードしたファイル、さらに接続を許可したGmailの情報などを横断的に参照し、より個人に最適化された回答を提供できるようになった。
「メモリーソース」で見える化されたパーソナライズ
今回のアップデートで特筆すべきは「メモリーソース(Memory Sources)」という新機能の導入だ。これは、AIがどの情報を根拠にパーソナライズされた回答を生成したのかを明示する仕組みである。保存されたメモリーや過去のチャットのうち、回答に使用されたものをユーザーが直接確認でき、不要になった情報は削除や修正ができる。
OpenAIのブログ記事では、サンフランシスコ在住のユーザーに対するレストラン提案の比較例が紹介されている。GPT-5.3 Instantが居住地を考慮した一般的な提案にとどまるのに対し、GPT-5.5 Instantは過去の好みや予定をふまえた、より洗練された個別提案を行っている。この差は日常的な使い勝手に直結するだろう。
プライバシーはユーザーが制御できる設計
パーソナライズが強化されると、当然「どこまで自分の情報が使われるのか」という懸念が出てくる。この点についてOpenAIは、メモリーソースはチャットを共有しても他の人には表示されないこと、不要なチャットは削除できること、一時的なチャット(Temporary Chat)を使えばメモリーが使用も更新もされないことを明記している。
また個人情報の扱いについては、企業や教育機関向けプラン(Business、Enterprise、Edu)では、ユーザーデータがモデル学習に使用されない設定がデフォルトで適用される。個人利用でも、設定からデータ提供の可否を切り替えられる。
APIとロールアウトのスケジュール
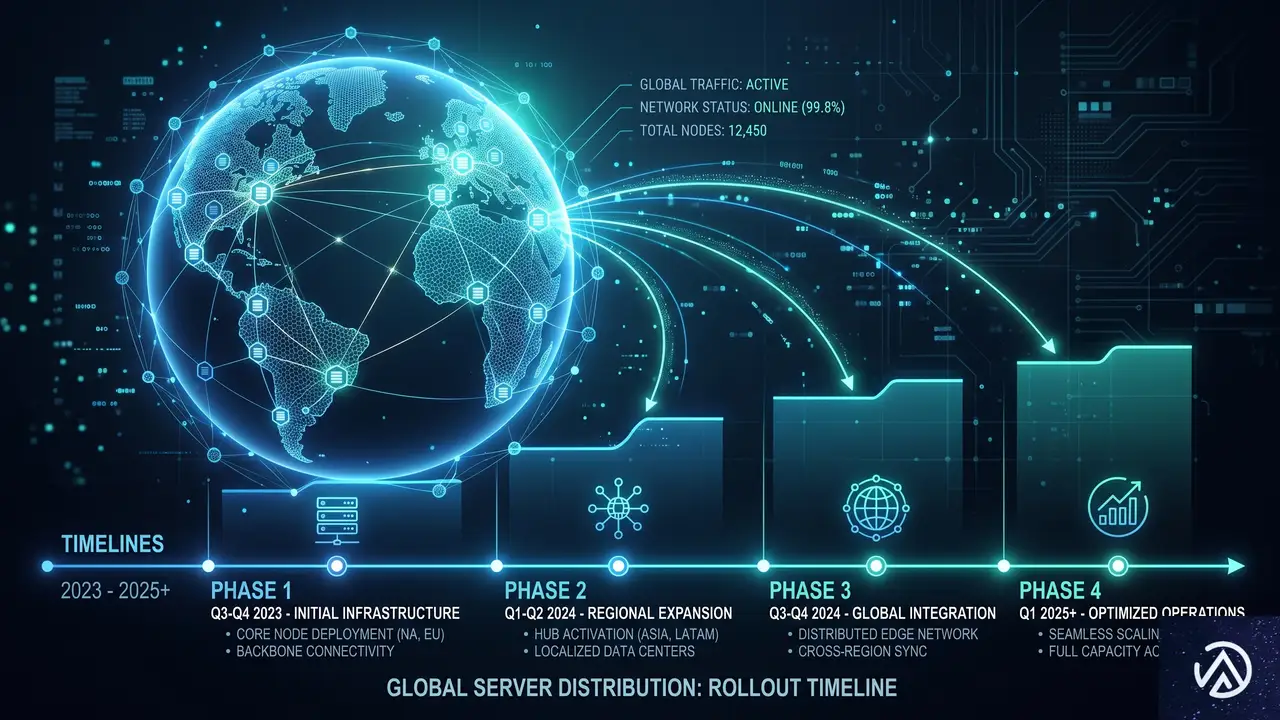
GPT-5.5 InstantはChatGPTの全ユーザー向けに5月5日から順次提供が開始されている。APIではchat-latestとして利用可能だ。有料ユーザー向けには、旧モデルのGPT-5.3 Instantも3ヶ月間はモデル設定から選択できる形で残される。
パーソナライズ機能の強化は、まずPlusおよびProユーザー向けにWeb版で展開され、モバイル版にもまもなく対応する予定だ。その後、数週間以内にFree、Go、Business、Enterpriseプランにも拡大される。メモリーソース機能はすべてのコンシューマープランでWeb版から提供開始され、モバイル版も順次対応する。
この記事のポイント
- GPT-5.5 Instantは医療や法律など高精度が求められる分野でハルシネーションを52.5%削減した
- 回答の単語数が30.2%削減され、より簡潔で実践的なアドバイスが得られるようになった
- 過去のチャット履歴やGmailなどの接続アプリを活用したパーソナライズ機能が大幅に強化された
- メモリーソースにより、AIが参照した情報をユーザー自身が確認・管理できるようになった
- 全ユーザー向けに順次提供開始、旧モデルは有料プランで3ヶ月間利用可能
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験