

GitHubが8月17日の大規模障害を報告。CTOが原因分析と再発防止策を公表
2026年8月17日、GitHubで大規模なサービス障害が発生した。障害から3日後の8月20日、GitHubのCTO(最高技術責任者)であるVlad Fedorov氏が公式ブログで報告記事を公開し、原因分析と今後の再発防止策について言及した。
本記事では、今回の障害から読み取れる大規模プラットフォームの運用課題と、GitHubが示した今後の方向性を整理する。開発者やDevOps担当者にとって、自社システムの信頼性を見直す材料になるはずだ。
障害の概要とCTOによる報告
2026年8月17日に発生した障害は、GitHubの主要サービスに広範な影響を及ぼした。具体的な原因や影響範囲の詳細は記事内で段階的に明らかにされているが、CTO自らが報告に乗り出した点が今回の特徴だ。
CTO Vlad Fedorov氏について
報告記事の著者であるVlad Fedorov氏は、GitHubのCTOとして開発者ツールの未来を率いる立場にある。GitHub入社前はFacebook(現Meta)で上級副社長を12年間務め、プライバシー・広告・プラットフォーム分野で2,000人を超えるエンジニア組織を統率した経験を持つ。さらに前職ではUserCloudsというデータガバナンス関連のスタートアップを共同創業しており、Microsoftでの勤務経験もある。
大規模インフラの運用経験が豊富な人物が障害報告の筆を取ったこと自体、GitHubが今回の障害を単なるインシデントとしてではなく、プラットフォーム全体の信頼性に関わる重要事案として扱っていることを示している。
障害報告のタイミングが示すもの
障害発生は8月17日、報告記事の公開は8月20日。この3日間の間隔は、原因の切り分けと分析に十分な時間をかけたうえで、断定的な情報をまとめてから公表したことを示唆する。大規模障害では初期対応中に誤った情報を出さないことが重要であり、GitHubは原因を確定させたうえで報告に踏み切ったと見られる。
このデモは障害前後の状態を示した概念図である。実際の影響範囲についてはGitHubの公式報告を確認してほしい。
大規模プラットフォーム障害が浮き彫りにする運用課題
GitHubのような大規模プラットフォームの障害は、単一のサービス停止にとどまらない。世界中の開発チームが日々のワークフローをGitHubに依存しているため、障害の影響は連鎖的に広がる。コードのプッシュ、プルリクエストのレビュー、CI/CDパイプラインの実行、ドキュメントの更新など、あらゆる工程が停止する。
依存の集中が生むリスク
開発インフラの集中化は利便性をもたらす一方で、単一障害点を生み出す。多くの企業がGitHubを中心に開発プロセスを構築しているため、GitHubが停止すると自社の開発活動も止まる。この依存関係の深さは、今回の障害でも改めて認識されたはずだ。
インシデント対応における透明性の重要性
CTOが公式ブログで詳細な報告を行う姿勢は、インシデント対応における透明性の重要性を示している。障害の原因を隠さず、技術的な分析結果を公開することで、利用者の信頼を維持する狙いがある。GitHubのこの対応は、他社のインシデント報告の手本にもなるだろう。
上図は大規模障害から得られる一般的な教訓を整理したものだ。GitHubの報告でも、これらの要素がどのように現れたのかが焦点となる。
GitHubが示す今後の取り組み
記事タイトルにある「the work ahead(今後の取り組み)」という表現から、GitHubは今回の障害を教訓として、具体的な改善策を打ち出していることが読み取れる。詳細な技術的対策は記事内で段階的に説明されているものとみられるが、大規模プラットフォームの再発防止策として、以下の方向性が考えられる。
インフラの冗長化と障害分離
大規模障害の再発防止には、インフラの冗長化が不可欠だ。特定のコンポーネントに障害が発生しても、他のコンポーネントが機能を維持できる構成が求められる。GitHubのような複数のサービスが連携するプラットフォームでは、障害の影響を局所化するための仕組みも重要になる。
監視・検知体制の強化
障害の早期検知は被害を最小限に抑える鍵を握る。異常をリアルタイムで検知し、自動的にフェイルオーバーを実行する仕組みは、大規模プラットフォームの必須要件だ。今回の障害を踏まえ、GitHubは監視体制の見直しにも着手していると考えられる。
上図は大規模プラットフォームにおける障害対応の理想的なフローを示している。GitHubの報告では、今回の障害でどのステップに課題があったのかが分析されていると考えられる。
開発者と企業が取るべき対策
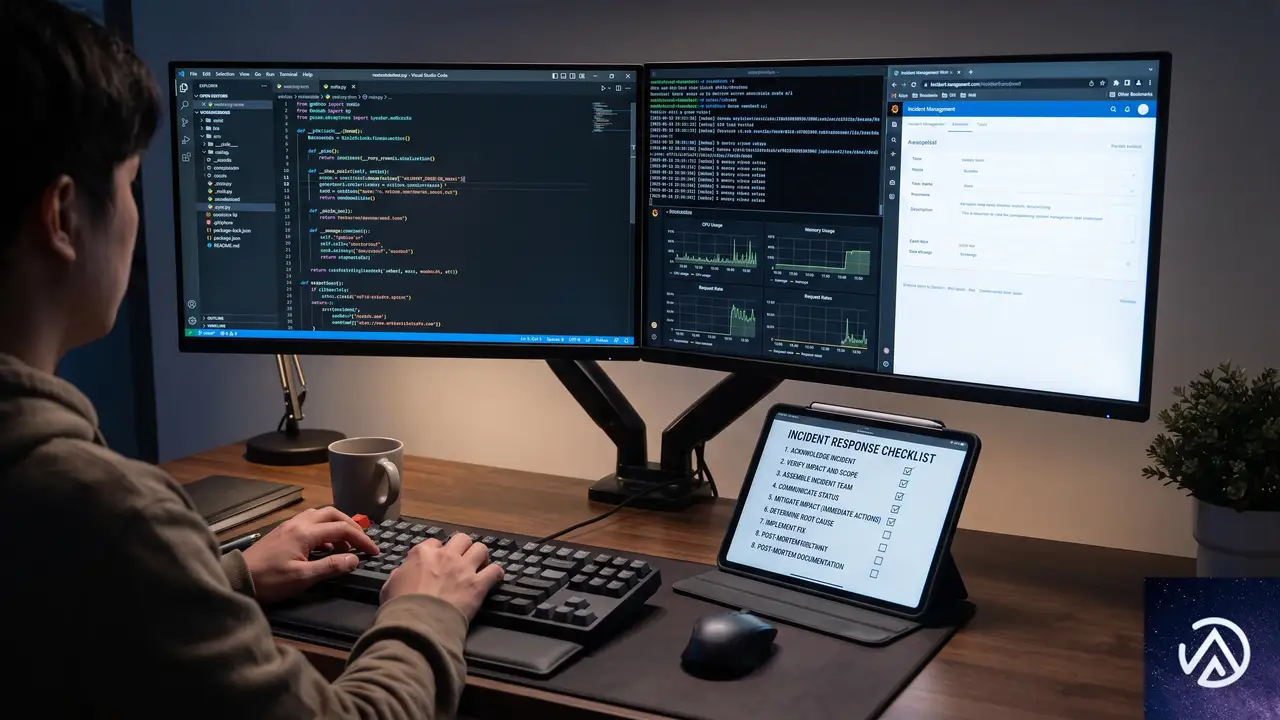
GitHubの障害は、プラットフォームに依存するすべての開発者と企業に影響を与える。自社の開発インフラを見直す契機として、いくつかの対策が有効だ。
外部依存のリスク評価
まず自社の開発プロセスがどの外部サービスに依存しているかを洗い出す必要がある。GitHubだけでなく、CI/CDツール、クラウドサービス、パッケージレジストリなど、開発ワークフローの各段階で外部依存が存在する。それぞれのサービスに障害が発生した場合の影響を評価し、必要に応じて代替手段を用意しておくことが重要だ。
バックアップと代替ワークフローの整備
GitHubが停止した場合でも開発を継続できるよう、ローカルリポジトリの保持やミラーの活用を検討する価値がある。完全な代替は難しくても、緊急時の手順を文書化しておくだけで、障害発生時の混乱を大幅に減らせる。
この記事のポイント
- GitHubで2026年8月17日に大規模障害が発生し、CTOのVlad Fedorov氏が3日後に報告記事を公開した
- CTO自らが報告に乗り出したことは、GitHubが信頼性を最優先事項と位置づけていることの表れである
- 大規模プラットフォームの障害は単一障害点のリスクと透明性の重要性を改めて示した
- GitHubは「今後の取り組み」としてインフラの冗長化と監視体制の強化を進めると見られる
- 開発者と企業は外部依存のリスクを評価し、緊急時の代替ワークフローを整備しておくべきだ

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare AI Searchがエージェント検索を簡素化、公開エンドポイントと価格プレビュー発表
Cloudflareは2026年8月6日、AI Searchに大規模な機能拡張を発表した。従来はWorkers AIやVectorize、R2、Browser Runといった複数のプリミティブを組み合わせて独自の検索パイプラインを構築する必要があった。今回のアップデートによりAI Searchがこれらの処理を自動化し、開発者やエージェントが、まるで自前の検索エンジンを持っているかのような感覚で扱えるようになった。
新機能として、複数のWebサイトやファイルを横断して検索できる公開エンドポイントの提供、サイトマップ不要のクロール機能、カスタムドメインによるブランディング、EmDash CMS向けの検索プラグインなどが追加された。さらにプレビュー価格モデルも発表され、デフォルトの埋め込み・リランキングモデルを利用すれば、これらの処理が無料になる予測可能な料金体系が示されている。エージェントが信頼できる情報源から回答を引き出せるインフラが、これまでより格段に手軽になった。
AI Searchの主な機能強化点

AI Searchを導入する前は、ベクトル化したデータの格納先やクローリングの仕組み、リランキングのパイプラインなどを開発者が自前で組み上げる必要があった。しかし今回の強化により、それらの低レベルなサービスを意識せずに済む。結果としてエージェントが信頼できる最新情報を引き出せるインフラが、数分で立ち上がるようになった。
インデックス作成の簡素化
これまでAI SearchでWebサイトをインデックスに追加する際は、サイトマップが必須だった。しかし新たに追加された「Discover」パースオプションを使えば、サイトマップがなくてもページ内のリンクを辿って自動的にコンテンツを収集できる。Cloudflareアカウントに登録されたゾーンであれば、特定のページから始まる全サイトデータを取り込めるようになった。
さらに、HTMLやPDFなどの非構造化データから構造化データまで、幅広いファイル形式に対応した取り込みが可能になった。これにより社内Wikiや製品マニュアルといった多様なデータソースをエージェントの検索対象に加えやすくなっている。
公開検索/MCPエンドポイント
ネームスペースに対して公開URLを有効化すると、/search と /mcp のエンドポイントが即座に利用できるようになる。/search は通常のREST APIとして、/mcp はモデルコンテキストプロトコル(MCP)に対応した形で提供される。どちらも認証不要で、複数のインスタンスにまたがる横断検索を1つのリクエストで実行できる。
外部のエージェントやアプリケーションに検索機能を提供したい場合、このエンドポイントをそのまま公開するだけで済む。Cloudflare以外の顧客に自社データへアクセスしてもらうシナリオでも、認証が不要で、URLを渡すだけのシンプルな共有が可能になっている。
EmDashとの統合とbotポリシー
Cloudflareが公開しているOSSのCMS「EmDash」向けに、AI Searchプラグインが提供された。これを導入すると、EmDashで構築したサイト内にセマンティック検索を組み込める。実際にCloudflare BlogやDeveloper Docsもこの仕組みで動いている。
また、AI Searchのクローラは独自のユーザーエージェント「Cloudflare-AI-Search」を使い、各サイトのrobots.txtに従う。ブラウザベースのクローリング機能を使う場合でも、このポリシーは変わらない。サイト運営者がクロールを拒否すれば収集が停止されるため、著作権や利用規約上の配慮が十分になされている。
Cloudflare Dev Stack MCPの実装事例
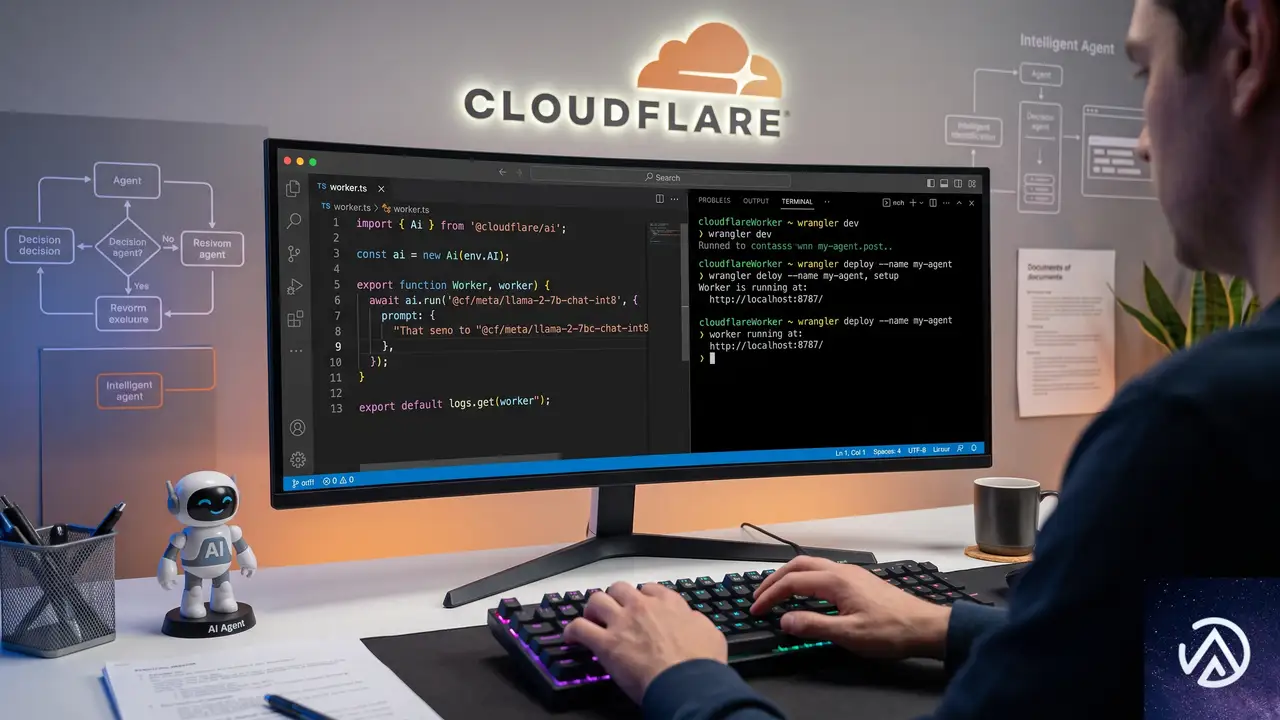
Cloudflare自身がAI Searchをどう活用しているかを示す好例が、新しく公開された「Cloudflare Dev Stack MCP」だ。これはCloudflareのエコシステム全体(ドキュメント、ブログ、APIリファレンス、コミュニティなど)を横断検索し、コーディングエージェントへ最新の引用付き回答を返す仕組みである。古いトレーニングデータではなく、常にフレッシュな情報を基にコードを生成できる。
インスタンス作成とクロール
CloudflareはDocs、Blog、API Docs、コミュニティ、Astro、Viteなど計10以上のサイトに対して、それぞれ個別のAI Searchインスタンスを作成した。各インスタンスはドメインが異なるが、Cloudflareが所有するサイトデータであるため、統一的な方法でクロールできる。
npx wrangler ai-search instance create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
--parse-type discover上記のコマンドでは、--parse-type discover を指定することでサイトマップなしにページを発見するクロールを実行している。この内部ではBrowser Runの/crawl機能が使用され、リンクを辿って再帰的にページを見つけ出す。
Workerを使ったマルチインスタンス統合
10個のインスタンスにまたがる横断検索を実現するため、CloudflareはWorkerを用いたMCPサーバを構築した。wrangler.jsonにAI Searchネームスペースのバインディングを追加し、1つのツール呼び出しで全インスタンスを同時に検索する。
{
  "ai_search_namespaces": [
    { "binding": "AI_SEARCH", "namespace": "cloudflare-stack" }
  ]
}
context.registerTool(
'search_dev_stack',
{
description: 'Search current docs across the Cloudflare stack.',
inputSchema: z.object({ query: z.string() }),
},
async ({ query }) => {
const res = await context.env.AI_SEARCH.search({
query,
ai_search_options: {
instance_ids: ['developers-cloudflare-com', 'astro', /* ... */],
retrieval: { max_num_results: 10 },
reranking: { enabled: true },
},
})
return { content: [{ type: 'text', text: format(res.chunks) }] }
}
)この方式により、エージェントが単一のツール呼び出しで全ドキュメントを検索でき、結果にはどのインスタンスから取得されたかのメタデータが付与される。複数の検索先を順に叩く必要がなく、応答速度も一括で処理される。
コード不要の公開エンドポイントも選択可能
Workerを書かずに済ませたい場合、ネームスペースの公開URLを有効化するだけで、すべてのインスタンスにクエリを投げる/searchおよび/mcpエンドポイントが得られる。設定画面からワンクリックで有効化でき、即座に利用を開始できる。Cloudflare自身のMCPサーバもこの公開エンドポイントを活用している。
コードを書く場合は細かいチューニングやMCPツールとしての統合が可能で、コードを書かない場合は設定画面上の操作だけで外部共有が完了する。どちらの選択肢も提供されている点が、利用者のスキルや要件に応じた柔軟な導入を後押しする。
公開エンドポイントとカスタムドメインで検索を共有
AI Searchでは、公開エンドポイントに独自のカスタムドメインを割り当てられる。デフォルトのCloudflare管理URLではなく、search.example.com/mcpといったブランド化されたエンドポイントを用意できるため、サービス提供時の信頼感が高まる。
さらに、検索を限定公開したいケースではCloudflare Accessを介した認証ゲートを追加できる。これによりエンドポイントへのアクセスを許可された人物やエージェントだけに制限し、認証情報を持たない第三者からの不正なクエリを防げる。社内データや顧客限定の検索サービスを安全に運用できる設計になっている。
このカスタムドメイン機能は、SaaSプロダクトやエージェントサービスを展開する事業者にとってとくに有用だ。自社ブランドのURLで検索APIを提供することで、サービス全体の統一感が生まれ、導入先からの信頼獲得につながる。
プレビュー価格モデルでコストを予測可能に
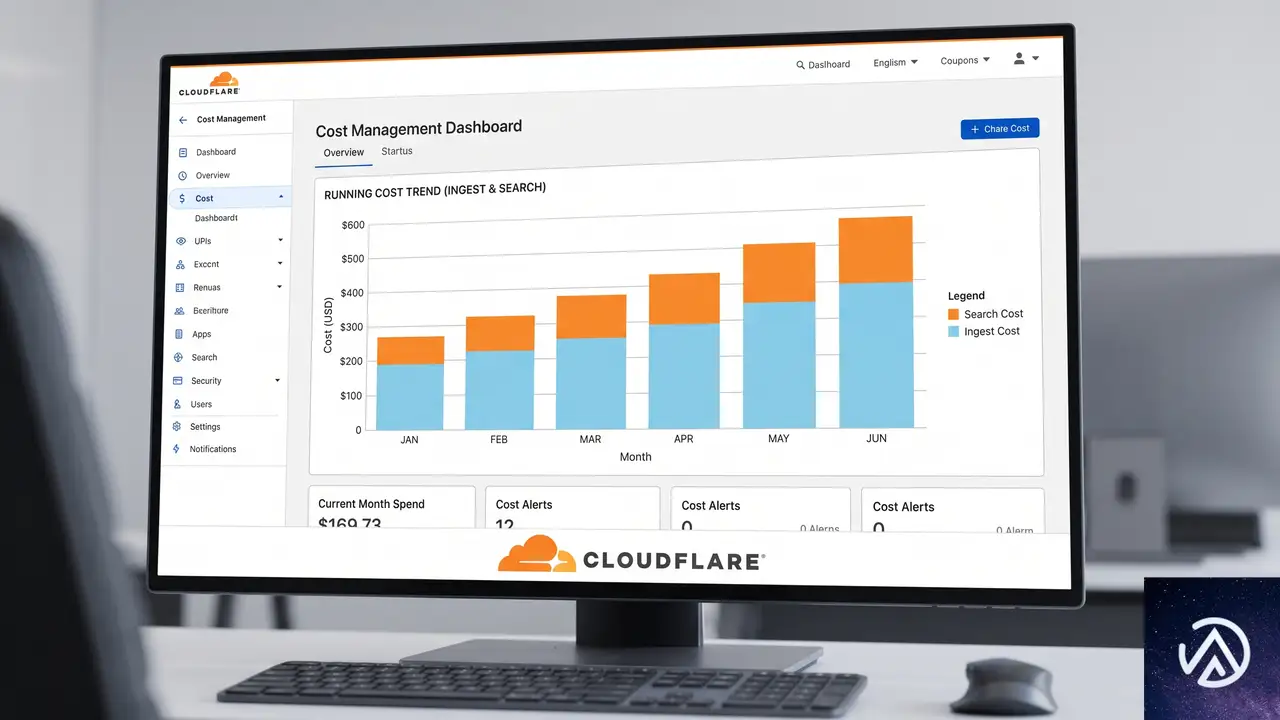
AI Searchは現在ベータ版として無料提供されているが、正式版に向けたプレビュー価格が公開された。課金開始前には十分な通知が行われる予定だ。料金設計の中心にある考え方は「予測可能でスケーラブル」であり、埋め込みとリランキングをデフォルトモデル利用時に無料化することで、トークン数の見積もりに頭を悩ませる必要をなくしている。
料金の主な内訳
- インジェスト(テキスト): $0.75 / 1Mトークン。月間無料枠5Mトークン。
- 画像処理アドオン: +$0.50 / 1Mトークン。画像の埋め込みに使用される。
- ストレージ: $2.00 / GB・月。月間無料枠10GB。
- セマンティック検索(ハイブリッド+ベクトル): $0.75 / 1,000クエリ。無料枠2,000クエリ。
- 全文検索: $0.10 / 1,000クエリ。同上の無料枠と共有。
- 埋め込みとリランキング: 指定モデル利用時は無料。それ以外はWorkers AIの従量課金。
無料枠はインジェスト5Mトークンと検索2,000クエリがそれぞれ一つのプールとしてまとめられており、用途を気にせず使い切れる。埋め込みやリランキングのコストが気にならないため、データ更新や再インデックスの頻度を高めやすい。これは頻繁に情報が変わるナレッジベースをエージェントに与えたい開発者にとって大きなメリットだ。
2万ドキュメント規模の試算例
以下は、2万件の文書(約2,000万トークン)と1,000枚の画像をインジェストし、月間3万回のセマンティッククエリを実行した場合の想定コストである。ワーカーズ有料プランが前提で、埋め込みとリランキングにはデフォルトモデルを使用する。
- インジェスト(テキスト): 18.1Mトークン × $0.75/1M = $13.58
- 画像アドオン: 1.1Mトークン × $0.50/1M = $0.55
- ストレージ: 約1.2GB → 無料枠内で$0
- 検索: 28,000クエリ × $0.75/1k = $21.00
- 埋め込み・リランキング: $0
- 合計: 約$35.13
初月にインジェスト費用がかかるが、2か月目以降は主に検索クエリ分だけ(この例では約$21)で運用できる。ドキュメントの大幅な増加がなければ、ランニングコストを低く抑えられる構造だ。
このように、AI Searchのコストは初回のデータ登録が大部分を占め、その後は利用量に比例した検索料金のみになる。大規模なデータベースを抱える場合でも、固定費ではなく使った分だけ支払うモデルのため、予算計画が立てやすい。
AI Searchの導入方法
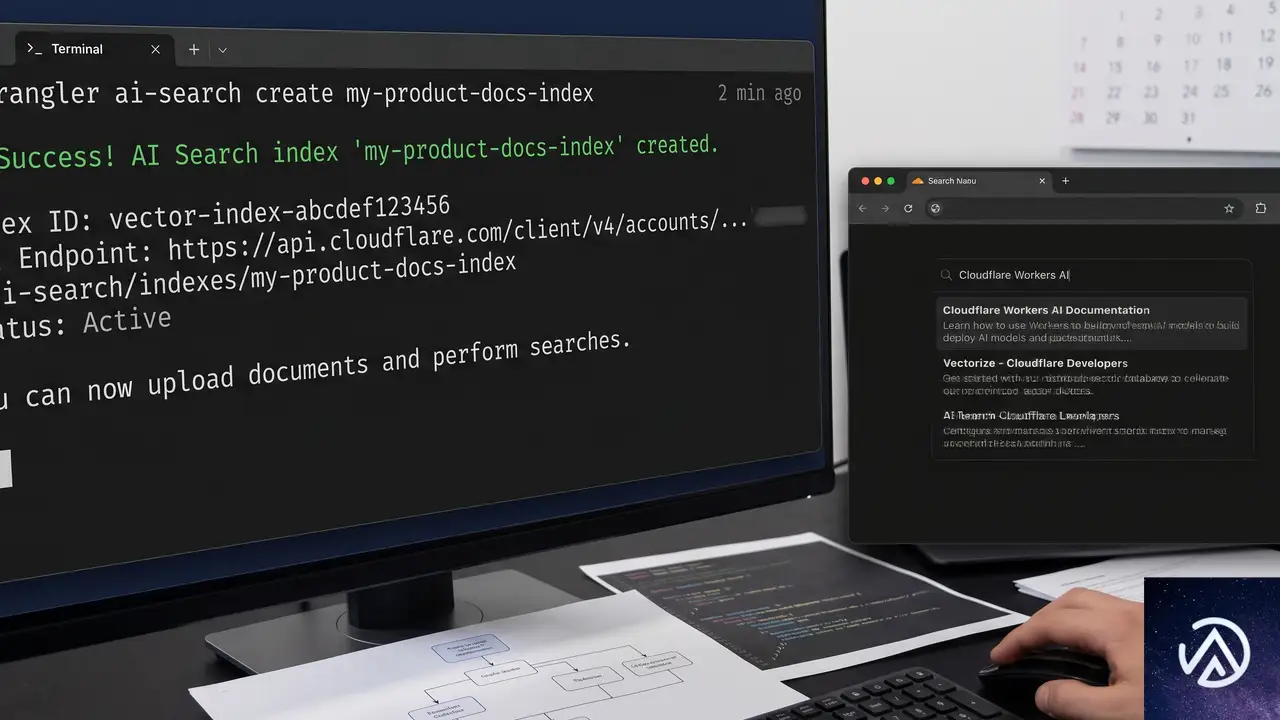
AI SearchはCloudflareダッシュボードから有効化し、すぐに使い始められる。もっとも簡単な導入は、次のwranglerコマンドでインスタンスを作成する方法だ。
npx wrangler ai-search create my-search \
  --namespace my-namespace \
  --source https://my-website.com \
  --type web-crawler \
--hybrid-searchこの1行でWebクローラー型のインスタンスが立ち上がり、ハイブリッド検索(セマンティック+キーワード)が有効になる。クロールが完了すれば、/searchエンドポイントで検索APIとして利用できる。さらに/mcpエンドポイントを使えば、ChatGPTやClaudeなどのモデルが直接ツールとして呼び出せる。
既存のアプリに組み込む場合はWorker経由でバインドし、エージェントと連携させればよい。カスタムドメインやCloudflare Accessを設定すれば、プライベートな検索サービスとしても公開できる。詳しい手順は公式ドキュメントを参照してほしい。
この記事のポイント
- Cloudflare AI Searchは、複数サービスの組み合わせを自動化し、データ検索基盤をワンストップで提供する。
- 公開/MCPエンドポイントやカスタムドメインにより、エージェントへの組み込みや外部共有が容易になった。
- サイトマップ不要のクロールやEmDash CMSとの統合で、あらゆるデータソースを取り込める。
- プレビュー価格ではデフォルトモデルの埋め込み・リランキングが無料で、予測しやすいコスト構造が示された。
- wranglerコマンド1行でセットアップが完了し、すぐにエージェント向け検索エンジンとして利用開始できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験