

Gemini 3.8 Liveシリーズ登場、音声AIエージェントの新基盤に
Google DeepMindが9月15日、Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表した。音声エージェント向けに設計された2つの新モデルで、リアルタイム推論能力が大幅に強化されている。
Gemini 3.8 Liveはスケールとコスト効率を重視したモデルだ。Gemini 3.8 Live Extended Thinkingは高複雑度タスク向けで、複数ステップの推論を会話の流れを止めずに実行できる。
開発者API、Google Workspace、Search Liveなど幅広い経路で提供が始まっている。音声で複雑なタスクを処理する新しい基盤になる。
Gemini 3.8 Liveシリーズの全体像
会話知能と自然な対話、視覚的な理解を組み合わせたモデル。スケールとコスト効率を重視しており、大量の同時接続を処理する音声エージェントに向く。
高複雑度タスク向けに設計されたモデル。複数ステップの推論と、より高い知能を備える。会話の流れを止めずに深い思考ができるのが特徴。
2つのモデルは用途が明確に分かれている。音声エージェントを大量に展開する場合は標準版、複雑な業務フローを音声で処理する場合はExtended Thinkingを選ぶ形になる。
2つのモデルの役割分担
Gemini 3.8 Liveは会話の自然さと視覚的な文脈理解を兼ね備えている。コストパフォーマンスを重視する開発者や企業に向く設計だ。
Gemini 3.8 Live Extended Thinkingは、より複雑な推論が必要な場面を想定している。話しながら考え、バックグラウンドで複数ステップのタスクを進められる点が最大の違いだ。
展開される利用経路
両モデルとも、Geminiアプリ、Google Workspace、Search Liveに順次展開される。特にWorkspaceではDocs Live、Gmail Live、Keep Liveといったアプリ内の音声機能として利用できる。
コンシューマー向けにはSearch Liveが最初の接点になる。検索中に音声で質問し、そのまま会話を続けられる体験が提供される。
ベンチマークが示す性能とコスト効率
音声品質とエージェント性能の両面で、既存モデルを上回る結果が示されている。コスト面でも競争力のある価格帯を維持している点が特徴だ。
音声品質とエージェント性能
Artificial AnalysisのSpeech to Speech Quality Indexでは82.6を獲得し、総合第1位となった。音声の自然さと応答品質のバランスで他モデルを上回っている。
エージェントタスクの完了率でも強さを示している。τ-Voiceベンチマークで68.6%、Sierraのτ-Voiceバンキングベンチマークでは35.1%を記録した。音声だけで業務フローを完結させる能力が評価された形だ。
推論能力を示すBig Bench Audioでは97.7%と高いスコアを出している。音声を聞いて正しく推論する基盤能力の高さが確認できる。
コスト競争力とユーザー評価
Gemini 3.8 LiveはSpeech Agent Arenaで第2位を獲得している。ユーザーからの選好度が高いモデルでありながら、高いコスト効率を実現している点が重要だ。
ServiceNowのEVA-Benchでは、複雑なワークフローにおける正確性と会話品質のバランスでパレートフロンティアを更新した。エンタープライズ向け音声エージェントの実用性が裏付けられている。
リアルタイム推論の技術的進化
会話を止めずに裏側でタスクを進める設計が、これまでの音声AIと大きく異なる点だ。
視覚入力と言語対応
Gemini 3.8 Liveは視覚入力をほぼリアルタイムで処理する。カメラに映ったものや画面上の情報を文脈として会話に取り込めるため、状況に応じた助言が可能になった。
言語対応も強力だ。97の言語を自動的に検出し、会話の途中でもシームレスに切り替えられる。多言語環境で使う音声エージェントに適している。
公式デモでは、従業員のオンボーディングをリアルタイムで案内する様子や、チェスの盤面を見ながら対局を進める様子が紹介されている。視覚と会話の統合が実用レベルに達していることを示す例だ。
バックグラウンド実行と同時推論
ツールやAPIの実行はバックグラウンドで進められる。ユーザーの要求を受け付けたら、処理が終わるまで待たせず、会話を続けながら結果を伝える動きができる。
Extended Thinking版は「話しながら考える」能力を持つ。「確認させてください」といった短い言葉で応答しながら、裏側で複数ステップの推論を進める。進捗状況を自然な会話で伝える機能も備わっている。
公式デモでは、手書きスケッチと音声フィードバックからReactコンポーネントを生成する例や、複数ステップの予約を非同期で処理する例が公開された。音声だけで開発作業や業務処理を進められる可能性が広がっている。
開発者と企業のエコシステム
Gemini Live APIと開発者プラットフォーム
両モデルはGemini Live APIを通じて利用できる。開発者はこのAPIを使い、音声駆動のインターフェースを自社サービスに組み込める。リアルタイムのメディアストリーミング基盤はプラットフォーム側が処理してくれるため、UX設計に集中できる。
Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision AgentsなどのプラットフォームがGemini Live APIに統合済みだ。これらのツールを使えば、音声エージェントの構築からデプロイまでを短縮できる。
企業パートナーと展開スケジュール
Salesforce、Genspark、Lumerisなどの企業が3.8 Liveシリーズの導入に意欲を示している。低遅延性、会話の流暢さ、ツール呼び出し能力が評価されている。
展開スケジュールは以下の通りだ。開発者向けにはGemini APIとGoogle AI Studioで即日利用できる。企業向けにはGemini Enterpriseでプライベートプレビューが始まり、Gemini Enterprise for Customer Experienceにも順次提供される。
コンシューマー向けでは、Search Liveが最初の提供経路になる。Gemini Liveでも利用可能で、Google AI ProおよびUltraの加入者はWorkspaceのDocs、Gmail、KeepでExtended Thinking版を試せる。
透明性確保の仕組み
SynthIDによる音声ウォーターマーク
AIが生成した音声にはすべてSynthIDのウォーターマークが埋め込まれる。人間の耳には聞こえない形で音声出力に直接織り込まれており、AI生成コンテンツの検出を可能にする。誤情報の拡散防止が狙いだ。
安全性と責任あるAIへの取り組みの詳細は、モデルカードで確認できる。音声AIが社会に広がる中で、透明性の確保は実用化の前提条件になっている。
この記事のポイント
- Gemini 3.8 LiveとLive Extended Thinkingが9月15日に発表された
- 標準版はコスト効率、Extended Thinking版は複雑タスク向けと役割が分かれている
- Speech to Speech Quality Indexで82.6を獲得し総合第1位
- 97言語対応、視覚入力、バックグラウンド実行など技術面が大幅強化
- Gemini Live API経由で開発者が即日利用できる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-Live-1がAPIで提供開始。同時通話型音声AIで割り込み処理が大幅改善
OpenAIが2026年9月10日、音声対話モデル「GPT-Live-1」のAPI提供を開始した。このモデルは同時に聞いて話すフルデュプレックス方式を採用し、従来の音声AIが抱えていた会話の遅延や不自然な割り込みを大幅に改善する。音声フロントエンド部分の料金は1分あたり0.05ドルに設定されている。
GPT-Live-1はChatGPTでの先行導入を経て、今回API経由で開発者に開放された。音声認識と音声合成を単一モデルに統合した設計が特徴で、人間同士の会話に近い自然なインタラクションを実現する。この記事ではGPT-Live-1の技術的な仕組み、性能評価、料金体系、そして開発者にとっての活用可能性を解説する。
単一モデルで実現する同時対話の仕組み
従来方式の構造的な課題
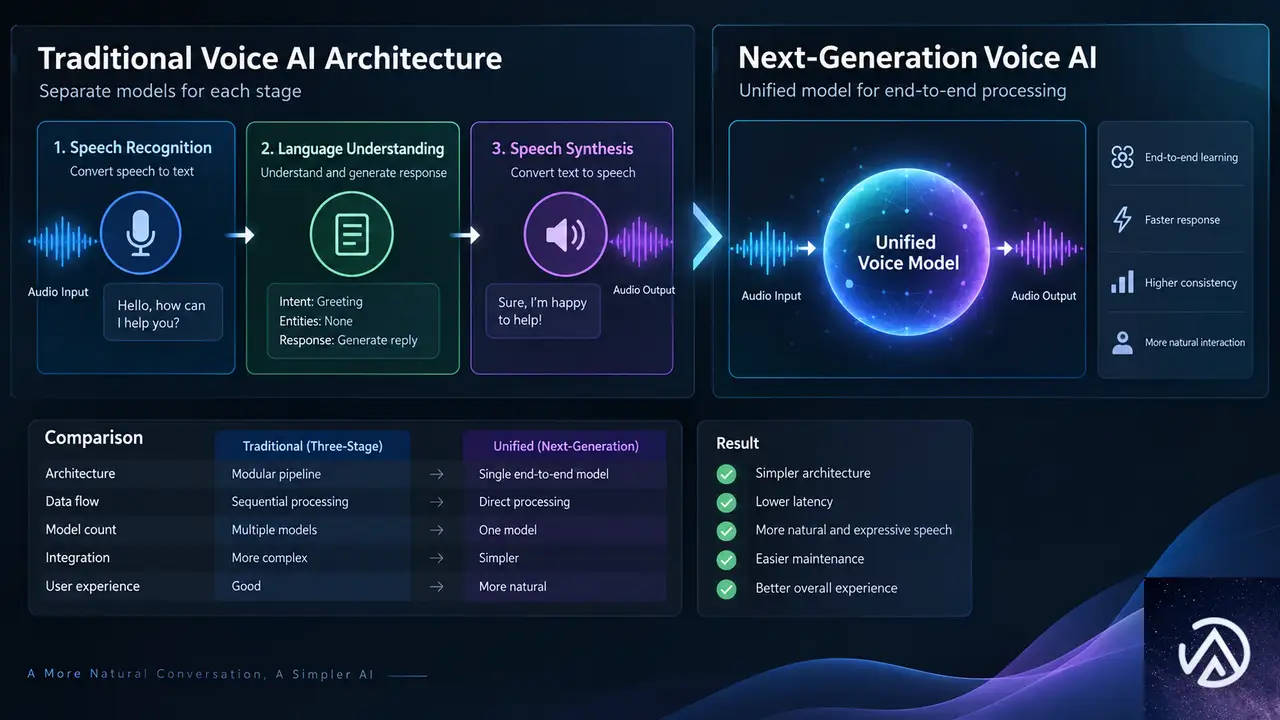
従来の音声AIは3つの工程を連結する方式が主流だった。まず音声をテキストに変換するSTT(音声認識)、次に内容を理解して回答を考えるLLM(大規模言語モデル)、最後にテキストを音声に戻すTTS(音声合成)だ。各工程が別々のモデルで処理されるため、段階ごとに処理待ちの遅延が積み重なる。
この構成では割り込みへの対応も難しい。ユーザーが話し始めるタイミングを検知するには、音声入力を常時監視しながら出力側の状態も把握しておく必要がある。3つのモデルをまたぐ情報の受け渡しにタイムラグが生じるため、人間同士の会話のような即時の割り込みは実現しづらかった。開発者は各段階のつなぎ目を手動で調整しなければならず、運用の手間も大きい。
単一モデルへの統合がもたらす変化
GPT-Live-1はSTTとLLMとTTSを単一モデルに統合する。入ってくる音声と出ていく音声を同じモデル内で同時に推論するため、段階間のつなぎ目が構造的に存在しない。これにより遅延が減るだけでなく、相手の言葉を遮って新しい質問を投げかけたり、相槌を打ったりする自然な会話のリズムを保てる。
背景ノイズや無音状態の扱いも改善された。従来方式では無音を「発話の終わり」と誤判定して会話を切ってしまう事態が起きやすかったが、GPT-Live-1は静寂を会話の一部として処理できる。ユーザーが考え込んでいる時間を待つ、周囲の雑音に反応しない、といった対話の質を左右する細かな制御がモデル側で吸収される。
3段階のモデルを連結する方式では、それぞれの処理待ち時間が会話のテンポを損なっていた。GPT-Live-1はこの問題を単一モデルへの統合で解決している。
割り込み処理の改善がビジネス効果を生む
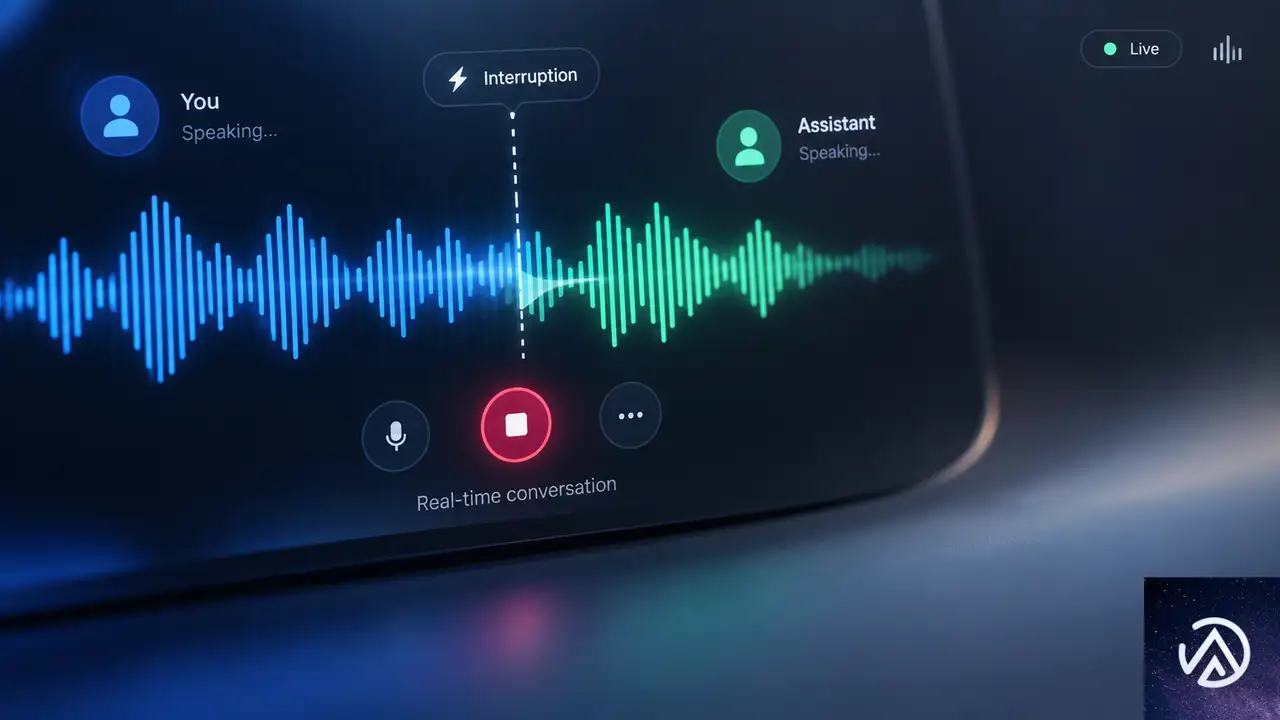
音声エージェントの実用化で最大の障壁が「割り込み」への対応だ。人間同士の会話では、相手の話の途中で情報を追加する、言い直す、短い相槌を打つ、といった行為が自然に発生する。従来のターン制システムではこの対応が難しく、一方が話し終えるのを待ってから返答する不自然な体験になりがちだった。
OpenAIの公開した早期評価では、語学学習プラットフォームのSpeakがGPT-Live-1を導入した結果、学習者が考える時間を確保できるようになり、割り込み回数が従来のターン制システムと比べて約80%削減された。この数字は、音声AIが教育分野で実用化できる水準に近づいていることを示している。学習者が発話を躊躇しても、AIが先回りして話し始めない。この「待つ」能力が学習体験の質を大きく左右する。
またGPT-Live-1は、短い笑い声や「うん」「ええ」といった相槌、近くにいる他者への短い話しかけなど、会話に混じる非定型的な音声を適切に処理できる。これらは従来の音声認識では誤検知や過剰反応の原因になりやすかったが、GPT-Live-1は文脈を踏まえて取捨選択する。
従来のターン制システムでは、STEP 2の割り込みを検知するまでにタイムラグが発生し、ユーザーが話し終えるのを待ってから処理を切り替える必要があった。GPT-Live-1は音声入力を常時監視しているため、この切り替えがほぼ即座に行われる。
バックエンド推論モデルへの委任という設計
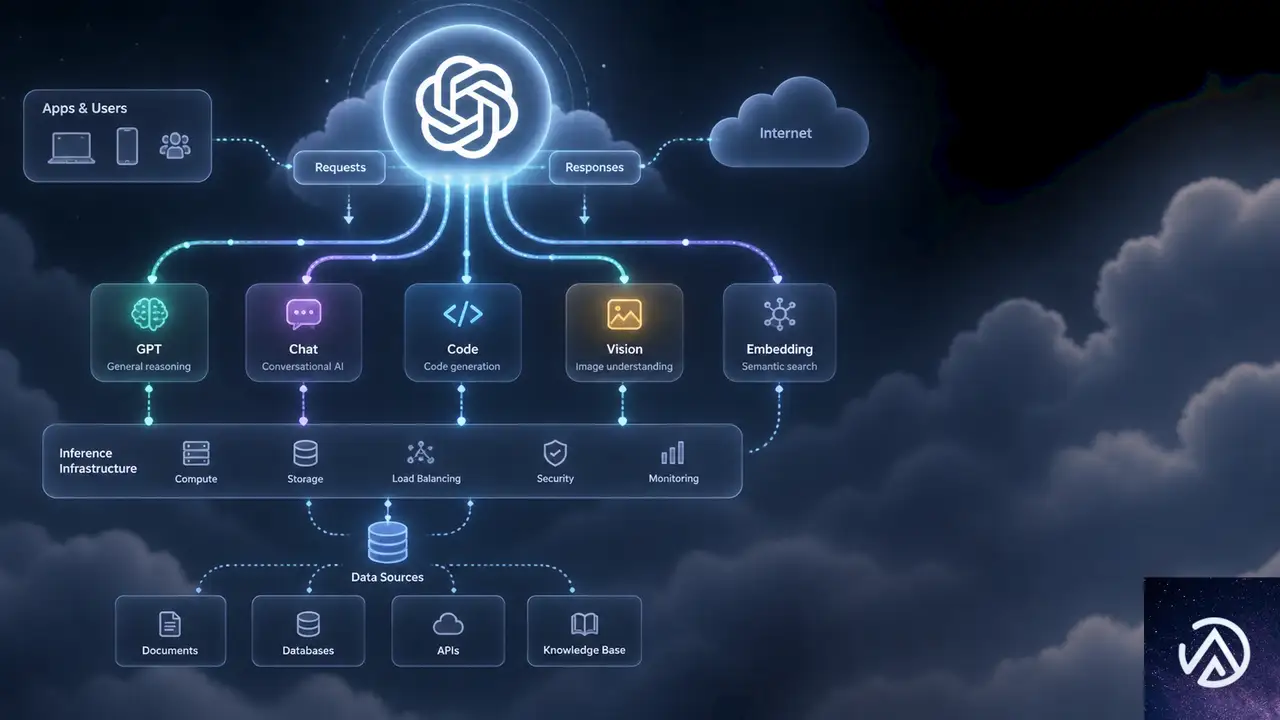
タスクに応じたモデル選択
GPT-Live-1の設計で注目すべき点は、すべてを自身で解決するわけではないという姿勢だ。音声レイヤーと推論レイヤーを分離し、複雑な判断やツール呼び出しはバックエンドのテキストモデルに委任できる。開発者はGPT-6 Astraやサードパーティモデルを組み合わせ、タスクの難易度に応じて推論深度を使い分けられる。
たとえばレストランの予約確認や配送状況の案内といった定型的なタスクには軽量なモデルを使い、複雑な顧客対応には高性能なモデルを割り当てる構成が可能だ。推論深度と応答速度とコストをタスクごとに最適化できるため、大規模な音声エージェントの運用コストを抑えながら品質を維持できる。この柔軟性は、単一モデルですべてを処理する構成では得られない利点だ。
音声処理と推論を分離することで、タスクごとに最適なモデルを組み合わせられる。この柔軟性がGPT-Live-1の大きな特徴だ。会話を続けながらバックグラウンドで推論が進むため、ユーザーを待たせない体験も実現できる。
ネイティブ機能の充実
GPT-Live-1はASR(自動音声認識)のトランスクリプトと応答テキストをネイティブに提供する。英数字の認識精度が高く、特定のキーワードを優先的に認識させるキーワードバイアス機能も備える。ターン制モデルではないが、明示的な発話ターンの境界を検出するターン検出機能もネイティブサポートしており、既存のターン制ベースのワークフローからの移行も容易だ。
開発者はシステムプロンプトを通じてエージェントの声のトーン、話す速度、会話スタイルを制御できる。音声の選択肢も従来のリアルタイム音声から大幅に拡充され、アクセントや方言、言語のバリエーションが増やされる予定だ。音声オプションと言語の対応範囲は今後数か月にわたって継続的に拡大される。
評価指標と料金体系
ベンチマークで示された実力
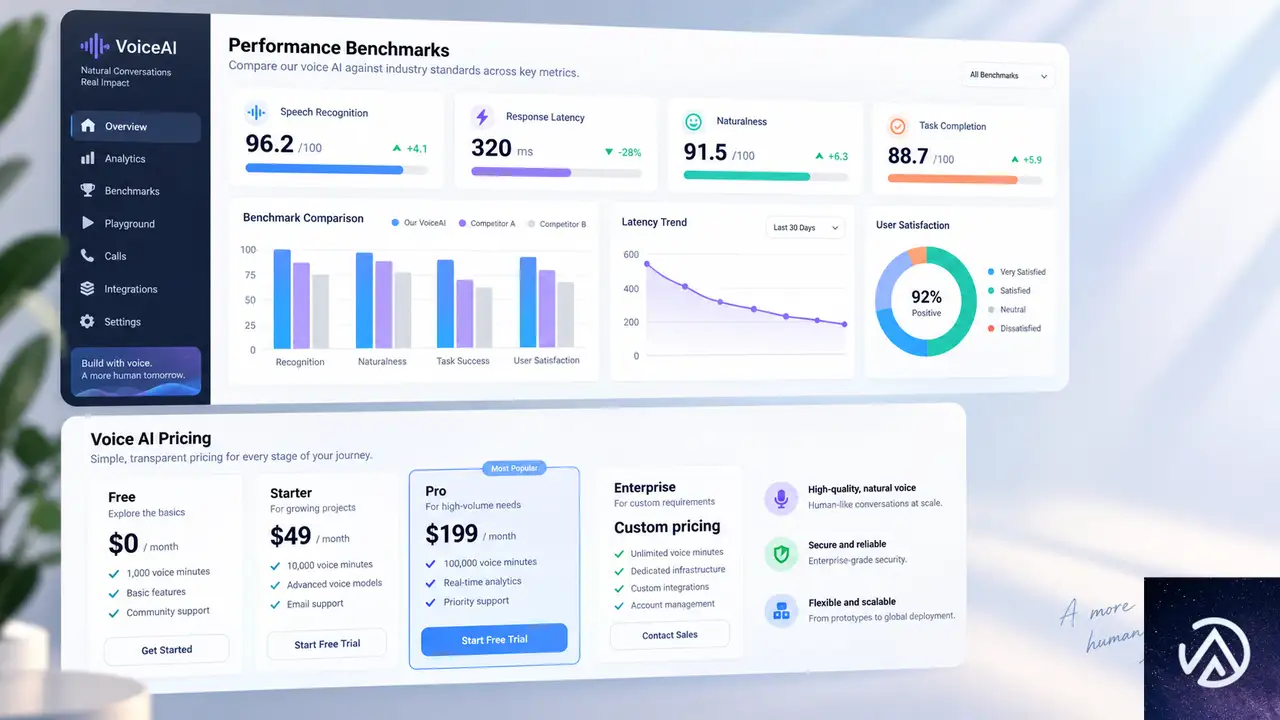
OpenAIの評価では、GPT-Live-1はFull Duplex BenchのスコアをGPT-Realtime-2.1から30ポイント改善した。特にターンテイクの遅延と対話的行動で大きな向上が見られた。GPT-6 Astra(中程度の推論エフォート)と組み合わせた構成では、音声エージェントの総合知能を測定するTau3ベンチマークで1位を獲得している。
評価対象は航空、小売、通信の各ドメインにおける音声カスタマーサービス対応、銀行業務の音声サポート、発話の一時停止への対応、ターンテイク、割り込み処理、バックチャネル(相槌や短い応答)への反応、自然な間や言い直しを含む音声経由のツール呼び出しなど多岐にわたる。満足度と完了率の両面で高いパフォーマンスを示した。
料金体系と展開オプション
GPT-Live-1の料金は、音声フロントエンド部分が1分あたり0.05ドルだ。バックエンドの推論モデルとエージェントハーネスは別途組み合わせる構成になる。推論深度の異なるモデルを使い分けることで、プロダクトの要件に合わせたコスト設計が可能だ。独自のカスタム音声へのアクセスは、OpenAIの営業チームへの問い合わせを通じて申請する。
電話回線を使ったフルデュプレックス音声エージェントの展開もサポートされている。レストラン予約からカスタマーサポートまで、従来は有人対応が必要だった領域に音声AIを導入できる。また、リアルタイム音声対話を企業内システムに統合する「OpenAI Presence」と組み合わせることで、社内システムへのアクセス、承認済みアクションの実行、必要時の人間へのエスカレーションまでを含むエンタープライズ向けの音声エージェントも構築できる。
音声AIの実用化が進む中で、GPT-Live-1のAPI提供は開発者にとって重要な転換点になる。フルデュプレックス方式の導入により、音声エージェントの体験品質が人間との自然な対話に近づくからだ。特に割り込み処理の改善は、教育、カスタマーサポート、ヘルスケアなど対話の質が成果に直結する分野で大きな意味を持つ。従来のターン制音声AIでは実現できなかった「考えながら話す」「話の途中で方向転換する」といった人間らしい対話が、API経由で誰でも利用できるようになった点が重要だ。
この記事のポイント
- GPT-Live-1がAPIで提供開始。同時に聞いて話せるフルデュプレックス音声モデルだ
- 単一モデルで音声入出力を処理し、STTとLLMとTTSをつなぐ従来方式の遅延を構造的に解消する
- Speak社の評価では割り込み回数が約80%削減された
- バックエンドのテキストモデルに推論を委任できる柔軟な構成が特徴だ
- 料金は音声フロントエンドが1分あたり0.05ドル。電話回線への展開も可能だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIが解説、GPT-Liveのリアルタイム音声AI基盤 6か月で会話応答を実現へ
OpenAIが2026年8月、新たな音声AIシステム「GPT‑Live」の設計を解説するブログ記事を公開した。同社の音声AIは、従来のターンベースからフルデュプレックスへと進化し、人が会話で無意識に行う「間」の制御を大幅に改善したという。わずか6か月で実用化にこぎつけたその裏側には、ストリーミング推論、状態管理、プロトコル最適化といった多層的な技術的挑戦があった。
本記事では、このブログで語られたGPT‑Liveのシステム設計に焦点を当てる。なぜ従来の音声応答では違和感が残ったのか、そしてどのようにして「息の合った」会話をスケールさせたのかを、具体的な設計上の工夫とともに紹介する。
ターンベースの限界、なぜ音声AIは「間」に弱いのか

人間同士の会話では、わずか0.5秒以下の間で話者交替が行われる。しかし従来の音声AIはテキスト向けLLMの流れを引き継ぎ、音声をテキストに変換し、推論してから音声を合成するという逐次処理が基本だった。スピーチトゥスピーチモデルの登場で音声を直接扱えるようになったが、依然として「発話が終わったか」を判断する小さなターン検出器に依存していた。
この検出器はジレンマを抱える。早すぎる判断はユーザの言葉を遮り、遅すぎる判断は応答の間延びを生む。しかも検出器の判断後に大規模なLLMが起動するため、応答までの遅延は避けられなかった。
OpenAIのブログ記事では、この課題を「誰がいつ話すかを決める小さなモデルに会話のリズムを委ねることは非効率だった」と指摘している。
上の図のように、GPT‑Liveはターン検出器を音声パスから完全に排除した。音声の送受信を同時に行うフルデュプレックス方式により、会話の流れが途切れず、より自然なやり取りを実現している。
GPT‑Liveの中核、フルデュプレックスと非同期委任の仕組み
GPT‑Liveでは、音声そのものを処理する経路と、より深い思考やツール実行を担う経路を意図的に分離している。会話のリアルタイム性を支える「メディア高速パス」と、大規模なフロンティアモデルGPT‑5.5を呼び出す「アプリケーション低速パス」だ。音声モデルは常に会話を続けながら、必要に応じて非同期RPCでGPT‑5.5に委任する。これにより、たとえ委任先の応答に時間がかかっても、音声の流れが止まることはない。
この分離設計は、機能拡張の面でも恩恵が大きい。アプリケーション側のツールやポリシーを変更しても、音声応答の核となるメディアパスに影響を与えずに済む。今後、ChatGPTのデスクトップアプリでコンピュータ操作やエージェント連携といった新機能を追加する際も、音声体験の即時性を犠牲にしない基盤がすでに整っている。
途切れない音声を保つ、推論基盤の最適化

フルデュプレックスの会話をスケールさせるには、ステートフルな推論と動的なコンテクスト管理が欠かせない。音声セッションは長時間に及び、その間コンテクストが増え続ける。モデルインスタンスも需要に応じて増減するため、途切れのない体験を維持するには高度なハンドオフ機構が必要になる。
GPT‑Liveは、モデルインスタンス間のシームレスな切り替えを導入した。切り替えが必要な場合、既存のインスタンスと並行して新しいインスタンスを立ち上げ、現在のセッションコンテクストを事前に読み込ませる。両方のインスタンスで推論を並行して行い、新しいインスタンスの準備が整った時点で切り替える。この一連の処理はメディアパスの外側で実行されるため、会話が中断される心配はない。
同様に、コンテクストがモデルの上限を超えた場合も、同じ並行ハンドオフの考え方で対応する。従来は推論を止めてコンテクストを圧縮し、KVキャッシュを再構築する必要があったが、GPT‑Liveでは圧縮作業と新インスタンスの準備をバックグラウンドで行う。元のインスタンスが会話を続けている間に、圧縮済みコンテクストを持った代替インスタンスが準備され、問題なく切り替えられる。この仕組みにより、長時間の通話でも音声が途切れず、ユーザはコンテクストの上限を意識することがない。
起動遅延を1回のUDPパケットに、プロトコル改善の舞台裏
音声AIの応答速度は、会話の開始ボタンを押した瞬間から問われる。GPT‑Liveでは、WebRTCをベースにメディアパスを確立し、モデルへの音声入力を開始するまでの時間を極限まで削り取った。そのために生み出されたのが、WARP(WebRTC Abridged Roundtrip Protocol)とInstant Connectという2つの新技術だ。
標準的なWebRTCでは、メディアとデータの開始までにICE、DTLS、SCTP、データチャネルの確立と、最大6回のネットワーク往復が必要だった。OpenAIのエンジニアは、DTLSハンドシェイクをICEに便乗させるSPEDや、SCTPのネゴシエーションを事前共有するSNAPなどを考案し、これらの手順を1往復に圧縮した。さらにInstant Connectにより、SDPパラメータの事前共有を実現。ユーザがボタンを押した瞬間、最初のUDPパケットでセッションが成立し、即座に音声ストリームが流れ始める。
これらのプロトコル改良は、OpenAIだけでなくWebRTCコミュニティにも公開されており、すでにlibwebrtcやPionに実装が進んでいる。IETFのTSVWGワーキンググループを通じて標準化も目指されているという。
本番さながらのテストが教えた教訓

理論上の性能がいくら優れていても、実際の音声トラフィックの前では想定外のボトルネックが顔を出す。OpenAIはGPT‑Liveの本格提供前に、サイレントシャドーテストと呼ばれる手法を採用した。ChatGPT Voiceの実際のユーザセッションの一部を、既存のAdvanced Voice Modeと並行して、新しいシステムに読み取り専用で流し込むのだ。
このテストで最初に判明したのは、GPUの処理能力だけを見ていては不十分だという事実だった。音声セッションは継続的にフレームを送り続けるため、CPU側のストリームハンドラやキュー、ネットワーク経路もGPUと同等にスケールしなければならない。サイレントテストにより、負荷試験では見落とされがちなCPU飽和が検出され、レイテンシの蓄積を防ぐ対策が取られた。
- GPUあたりのリクエスト数だけを見る
- 長時間接続や再接続のパターンを検証できない
- 地理的な遅延差が考慮されない
- 実際のユーザーの音声セッションを読み取り専用で流す
- CPU側のストリーム処理やネットワーク経路も含めて検証
- 地域別の遅延や長時間の状態圧縮の挙動を観測
また地理的な要素も無視できない教訓をもたらした。ユーザに近い場所に推論リソースを配置しなければ、起動時やストリーミング中の遅延が増加する。OpenAIは地域別の容量とトラフィック誘導を定常的に検証し、エンドツーエンドの応答性を部品ごとに可視化する監視体制を整えた。さらに、メトリクスの粒度を上げ、ダッシュボードが不健全なエンジンを埋もれさせないように改善。段階的なロールアウトやパスの隔離など、本番品質を支える運用技術も同時に鍛え上げられた。
この記事のポイント
- GPT‑Liveはターン検出器を排除したフルデュプレックス方式で、発話中の同時送受信を実現
- 音声モデルとフロンティアモデルを非同期に分離し、深い思考を会話の遅延なく組み込む設計
- ステートフル推論と動的コンパクションにより、長時間の会話でも途切れない音声を維持
- WebRTCのハンドシェイクを1往復に圧縮するWARPやInstant Connectで、起動遅延を極限まで低減
- 本番トラフィックを使ったサイレントテストで、実際の運用に耐えるシステムへと練り上げた
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAI、フルデュプレックス音声モデルGPT‑Liveを発表、会話の自然さを大幅向上
OpenAIは2026年7月8日、新しい音声対話モデル「GPT‑Live」を発表した。人が話しかけるのと同時に聞き取り、相槌を打ったり沈黙を尊重したりできるフルデュプレックスアーキテクチャが最大の特徴だ。
モデル自体は単体の音声モデルでありながら、高度な質問に対してはバックエンドのGPT‑5.5に自動で推論を委譲する。これにより、速さと知性を両立させた自然な会話体験を実現している。
フルデュプレックスアーキテクチャが会話の自然さを変える

従来の音声AIが抱えていた限界
これまでのChatGPT音声機能は、大きく分けて2つの方式を経て進化してきた。最初のカスケード型は、音声認識→テキスト生成→音声合成という3つのモデルを直列に繋いでいた。各段階で情報が欠落し、応答までに長い沈黙が生まれる欠点があった。
次世代のターンベース型(Advanced Voice Mode)は単一モデルで音声を処理し、レイテンシを削減した。しかし「ユーザーが話し終えるまで待つ」というターン制のため、割り込みや考え込む間といった自然なやり取りができず、わずかな無音で誤って応答を開始する問題も残っていた。
このデモはGPT‑Liveがもつ同時双方向処理の概念を簡略化したものだ。実際の会話では秒単位で割り込みやツール呼び出しの判断が行われている。
連続的な相互作用が生むリアルタイム性
GPT‑Liveのフルデュプレックス構造では、入力と出力が同時に連続的に処理される。モデルは1秒間に何度も発話や傾聴、一時停止、割り込み、ツール起動といった行動を判断できる。この仕組みが、相槌や「ええ」といった自然なフィードバック、沈黙の尊重、さらには会話中のリアルタイム翻訳まで可能にしている。
バックエンド委譲で高度な推論をリアルタイム対話に統合

対話と思考の分離がもたらすメリット
GPT‑Liveはフロントエンドの自然な対話と、バックエンドの深い処理を分離した。Web検索や複雑な推論が必要な質問が来ると、自身は会話を続けながらGPT‑5.5にタスクを委譲する。回答が用意でき次第、会話に自然に織り込まれる。
この分離により、常に最新のフロンティアモデルが活用され、モデル更新のたびにGPT‑Liveの知性も自動的に向上する。発表時点ではGPT‑5.5がバックエンドとして使われる。
この委譲の仕組みにより、GPT‑Liveは会話のテンポを保ちつつ、最新のフロンティアモデルの知性を引き出せる。
評価指標が示す会話品質の飛躍的向上
人間による比較評価でAdvanced Voice Modeを圧倒
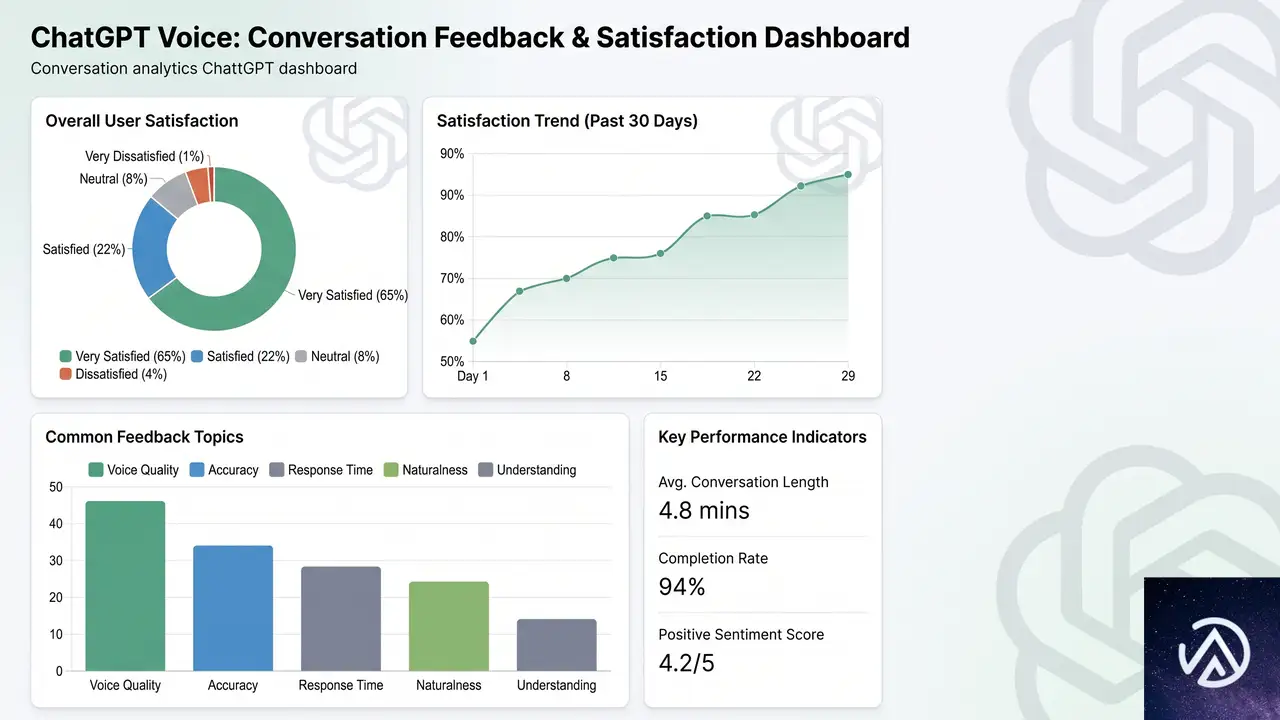
OpenAIの発表によれば、5〜10分の会話を対象にした人間評価では、GPT‑Live‑1とGPT‑Live‑1 miniの両方がAdvanced Voice Modeより強く選好された。話者交替のスムーズさ、割り込みの自然さ、会話全体の心地よさで高い評価を得ている。
専門的な推論力を測るGPQA(物理学・化学・生物学の高度な質問)ではGPT‑Live‑1が大幅に上回り、Web検索能力を問うBrowseCompでも強い改善を見せた。音声エージェントとしての電話サポートタスクでも、内部指標でAdvanced Voice Modeを凌駕した。
ChatGPT Voiceに搭載される新機能と使い勝手

相槌や割り込み、視覚的応答の追加
GPT‑Liveの導入により、ChatGPTの音声ボタンを押すとすぐに自然な会話が始まる。ユーザーは質問を遮ったり、考え込む間を作ったり、「ゆっくり話して」と頼んだりできる。モデルは「うん」「なるほど」といった相槌で話を聞いていることを伝え、背景ノイズがあっても話者の声に集中する。
さらに、天気や株価、スポーツの試合予定などの情報は、音声会話中にビジュアルカードとして画面に表示される。従来通り画像やファイルのアップロードにも対応し、Web検索やメモリー機能とも連携する。
回答の思考深度も選択可能で、「Instant」なら即答、「Medium」や「High」にするとモデルが時間をかけて深く推論する。全9種類の声もGPT‑Live向けにリマスターされた。
音声特化の安全性設計と継続的な監視

リアルタイムの有害出力検出と介入
GPT‑Liveは音声会話の即時性に対応するため、発話中でも安全性チェックが動作する。不適切な内容が検出されると、より安全な応答へ誘導したり、追加の安全メッセージを表示したり、深刻なケースでは会話を終了させたりする。
自傷行為に関する会話では、専門家が確認したクライシスヘルプライン情報を音声で案内する仕組みも組み込まれた。10代のユーザー向けには年齢に適した振る舞いを直接モデルに学習させ、保護者がChatGPT Voiceの利用を制限できる機能も用意されている。
実利用データに基づく安全対策の進化
OpenAIは感情的な依存に関する長期モニタリングを展開し、実際の利用パターンから新たなリスクを特定して対策を強化する方針だ。音声のなりすましを防ぐため、GPT‑LiveはChatGPTに用意された定義済みの声のみを使用し、実在の人物の声を模倣しないように設計されている。
この記事のポイント
- GPT‑Liveはフルデュプレックス構造で同時に聞きながら話し、相槌や沈黙を自然に扱える音声モデル
- 高度な質問はバックエンドのGPT‑5.5に自動委譲し、会話のテンポを保ったまま深い推論結果を返す
- 人間評価やGPQAなどのベンチマークでAdvanced Voice Modeを大きく上回る会話品質と知性を達成
- ChatGPT Voiceに即日導入され、ビジュアル応答や思考深度の選択が可能に
- リアルタイムの安全性介入や利用後監視により、音声ならではのリスクに対処している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験