

Amazon Bedrock AgentCoreにランタイムインスタンス発表、本番AIエージェント向け永続コンピューティング
AWSは2026年8月6日、Amazon Bedrock AgentCoreに新たな計算オプション「ランタイムインスタンス」を追加した。AIエージェントのプロトタイプを本番環境に移行する際、長時間の状態維持やマルチエージェント協調、GPUアクセスといった要求に応える、永続的なマネージドインフラだ。
従来のAgentCore Runtimeでは、マイクロVM上で最大8時間のステートフルな呼び出しが可能だったが、日をまたぐワークフローやOSレベルへの直接アクセスが必要なシナリオには限界があった。ランタイムインスタンスは、14日間のセッション永続化とEC2ベースのフルマネージド環境を提供し、本格的なエージェント運用基盤を実現する。
ランタイムインスタンスが解決する本番運用の3つの課題

AIエージェントをプロダクションに投入するとき、開発者はインフラの壁にぶつかる。ランタイムインスタンスはその3つの主要な課題を解消する。
長時間の状態維持とセッション永続化
通常のサーバーレス実行環境では、処理が終わるとメモリやストレージが破棄される。エージェントが数時間〜数日にわたる複数ステップのワークフローを扱う場合、途中結果を外部ストレージに退避させるなどの手間が生まれる。ランタイムインスタンスでは、最大14日間の共有セッションストレージが標準で提供される。セッションは停止・再開が可能で、アイドル期間のコストを抑えながら、必要なときに前回の状態から処理を再開できる。
マルチエージェントの同一ホスト協調
現実の複雑なタスクは、コード生成・レビュー・テスト・デプロイといった複数の専門エージェントが連携して初めて完結する。ランタイムインスタンスでは、複数のエージェントを同一のEC2ホストにデプロイし、共有ファイルシステムを介して直接データをやり取りできる。API呼び出しやネットワーク越しのストレージを挟むオーバーヘッドがなく、シームレスな協調が可能だ。
GPUとOSへの直接アクセス
画像認識や動画解析、重い数値計算を伴うエージェントはGPUを必要とする。ランタイムインスタンスはGPUアクセラレーテッドなインスタンスタイプに対応し、OSレベルへのアクセスも提供する。コードのコンパイル、セキュリティスキャン、GUI自動操作など、コンテナだけでは実現しにくいタスクをエージェントに任せられる。
コードライターとレビュアーの連携を実際に見る
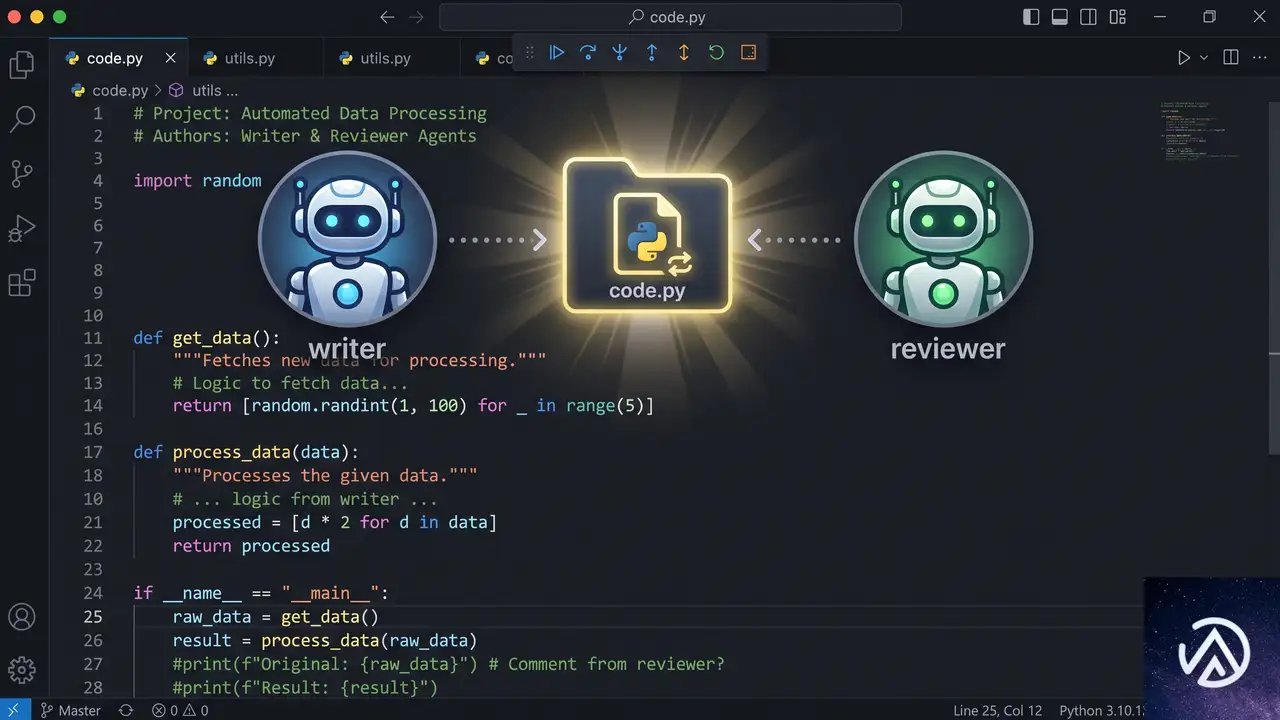
公式デモでは、自然言語でPythonコードを生成する「コードライターエージェント」と、生成されたコードのバグやスタイルをレビューする「コードレビュアーエージェント」を同じランタイムインスタンス上にデプロイし、協調動作させる手順が紹介された。
このデモのポイントは、2つのエージェントが完全に独立したアプリケーションでありながら、セッションIDで紐づく共有ディレクトリを経由してファイルをやり取りする点にある。外部APIを呼び出すことなく、同一ホストのファイルシステム上で完結するため、レイテンシが極めて小さい。
/tmp/agentcore-session/{session_id}/code.py に書き込む各エージェントはStrands Agentsフレームワークと好みのモデル(デモではClaude Sonnet)を使い、単一のPythonファイルに @app.entrypoint デコレータを付けるだけで実装できる。パッケージングもzipまたはコンテナイメージで済み、インフラ管理の負担は大きく軽減される。
セットアップから初回実行までの流れ

ランタイムインスタンスの利用は、大きく3つのステップで完了する。AWSマネジメントコンソールを使う場合の手順を簡潔にまとめた。
- 容量プロバイダの作成 、 エージェントが稼働するEC2インスタンスのスペックとネットワークを定義する。OS(ARM64またはx86_64)、インスタンスタイプ、VPC、サブネット、セキュリティグループを設定。ストレージはgp3ボリュームがデフォルトで用意される。
- ランタイムの作成とエージェントのデプロイ 、 コンピュートタイプに「Instances」を選び、先ほど作成した容量プロバイダを紐づける。エージェントのコードをzipでアップロードし、ランタイム(Python 3.11〜3.14)とエントリポイントを指定。IAMロールもコンソールが自動生成する。
- エージェントの呼び出しと協調 、 デプロイ完了後、コンソールの「Runtime playground」からテスト用のJSONペイロードを送信できる。セッションIDを明示的に指定し、同じIDで別のエージェントを呼び出せば、両者が同一の共有ストレージを使ってシームレスに連携する。
容量プロバイダは一度作成するとOSやインスタンスタイプの変更ができない。本番用と検証用を分けるなど、事前の設計が求められる。
主要スペックと料金モデル
- 対応OS 、 Linux(ARM64、x86_64)。Windowsは現時点ではサポート外
- セッション持続 、 最大14日間。停止・再開が可能で、アイドル中のコスト削減に有効
- ランタイム 、 Python 3.11〜3.14(ネイティブコードに対応)。コンテナイメージのデプロイもサポート
- GPU 、 対応インスタンスタイプを選択すれば、GPUを使った推論や計算が可能
- 統合 、 既存のAgentCore API、IAM、監視機能と完全互換。マイクロVMとのハイブリッド構成も取れる
- 料金 、 使用したEC2インスタンスの標準料金に、AgentCoreオーケストレーションの管理手数料が加算される
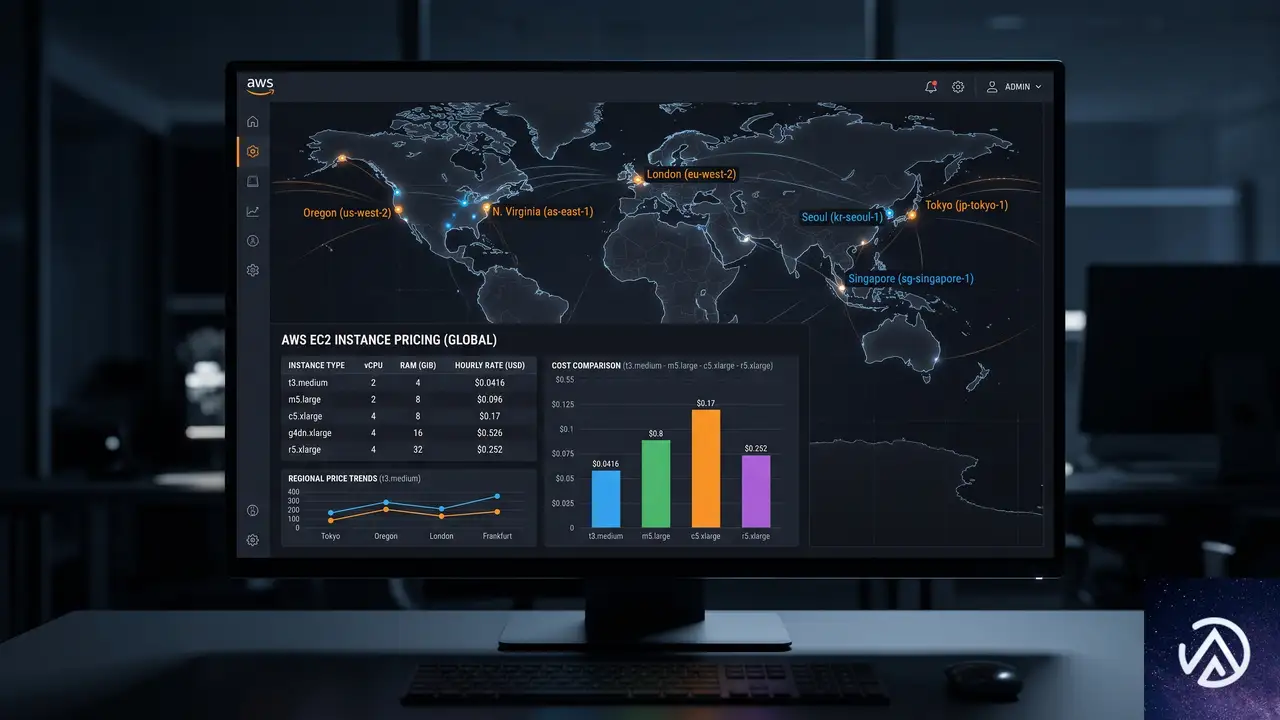
- リージョン 、 米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、アジアパシフィック(ムンバイ、シンガポール、シドニー、東京)、欧州(フランクフルト、アイルランド)
マイクロVMベースの従来のAgentCore Runtimeとランタイムインスタンスは、同じAPIセットで併用できる。軽量なオーケストレーターエージェントをマイクロVM側に置き、重い処理や永続状態が必要なワーカーエージェントをインスタンス側に委譲するハイブリッド構成が、現実的なアーキテクチャパターンとして紹介されている。
始め方と最初の一歩
ランタイムインスタンスを試すには、Amazon Bedrock AgentCoreのドキュメントに掲載されているランタイムインスタンスの公式ガイドを参照し、容量プロバイダの作成から始めるのが近道だ。コンソールの左ナビゲーションから「Runtime」→「Capacity providers」を選び、今回紹介した手順に沿って設定すれば、最初のエージェントデプロイまで数分で到達できる。
この記事のポイント
- ランタイムインスタンスは、最大14日間のセッション永続化とEC2ベースのマネージド環境を提供するAgentCore新オプション
- 同一ホスト上でのマルチエージェントファイル共有により、APIを介さないシームレスな協調が可能
- GPUインスタンスやOS直接アクセスが必要な高度なエージェントワークロードに対応
- 従来のマイクロVMと組み合わせたハイブリッド構成で、軽量なオーケストレーションと重いバックエンド処理を分離できる

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon Bedrock AgentCoreにWeb Search機能が一般提供開始、AIエージェントの回答を最新Web情報で根拠づけ
AWSは2026年6月17日、Amazon Bedrock AgentCoreにWeb Search機能の一般提供を開始した。AIエージェントがユーザーからの質問に対し、最新のWeb情報を参照しながら根拠のある回答を提示できるようにする。トレーニングデータだけではカバーしきれない直近の出来事や新事実を、AWS環境内で安全に取得できる点が最大の特徴だ。
この機能は、Amazonが長年培ってきた検索インフラ上に構築されている。Alexa+やAmazon Quick、Kiroといった製品で実績のある基盤を活用し、WebインデックスとAmazon Knowledge Graphを組み合わせたマルチソースな根拠付けを実現する。検索クエリは外部APIプロバイダに送信されず、AWS環境内で完結するため、企業のガバナンス要件にも適合する。
本記事では、Bedrock AgentCore Web Searchの仕組み、料金体系、導入事例を詳しく解説する。
Web Search機能の概要と背景
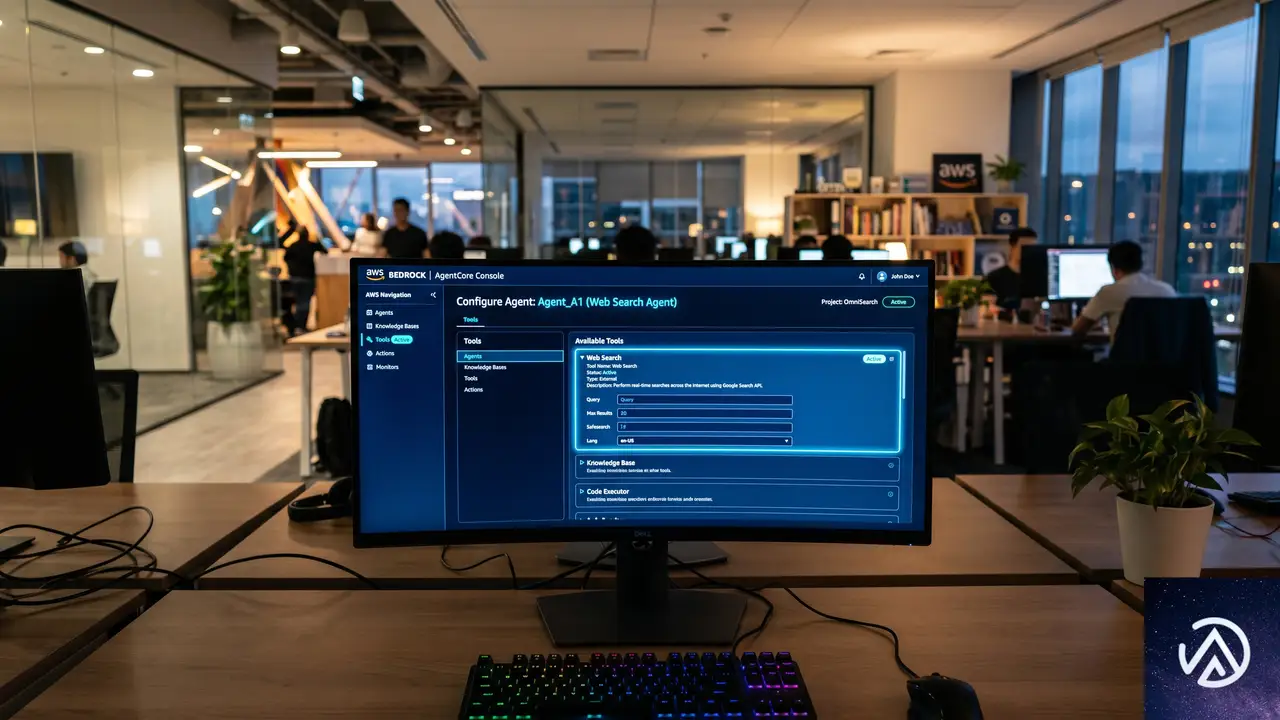
Bedrock AgentCoreの位置づけ
Amazon Bedrock AgentCoreは、AIエージェントの構築と運用を管理するフレームワークである。エージェントに必要なツールやデータソースとの接続をGatewayという仕組みで一元管理し、モデルの推論と外部機能の呼び出しを連携させる。今回発表されたWeb Searchは、AgentCore Gateway上で利用できる組み込みコネクタターゲットのひとつだ。
Web Searchが解決する課題
LLM(大規模言語モデル)は、学習時点のデータに基づいて回答を生成するため、つねに最新の情報を反映できるとは限らない。たとえば、企業の決算発表や法改正、製品アップデートなど、学習後に発生した出来事には対応できない。Web Searchを用いれば、エージェントがリアルタイムにWeb検索を実行し、得られたスニペットやURLを参照して回答を生成できる。回答には引用元が明示されるため、情報の信頼性をユーザーが確認しやすくなる。
仕組み:MCP接続とAmazon知識グラフによる根拠付け
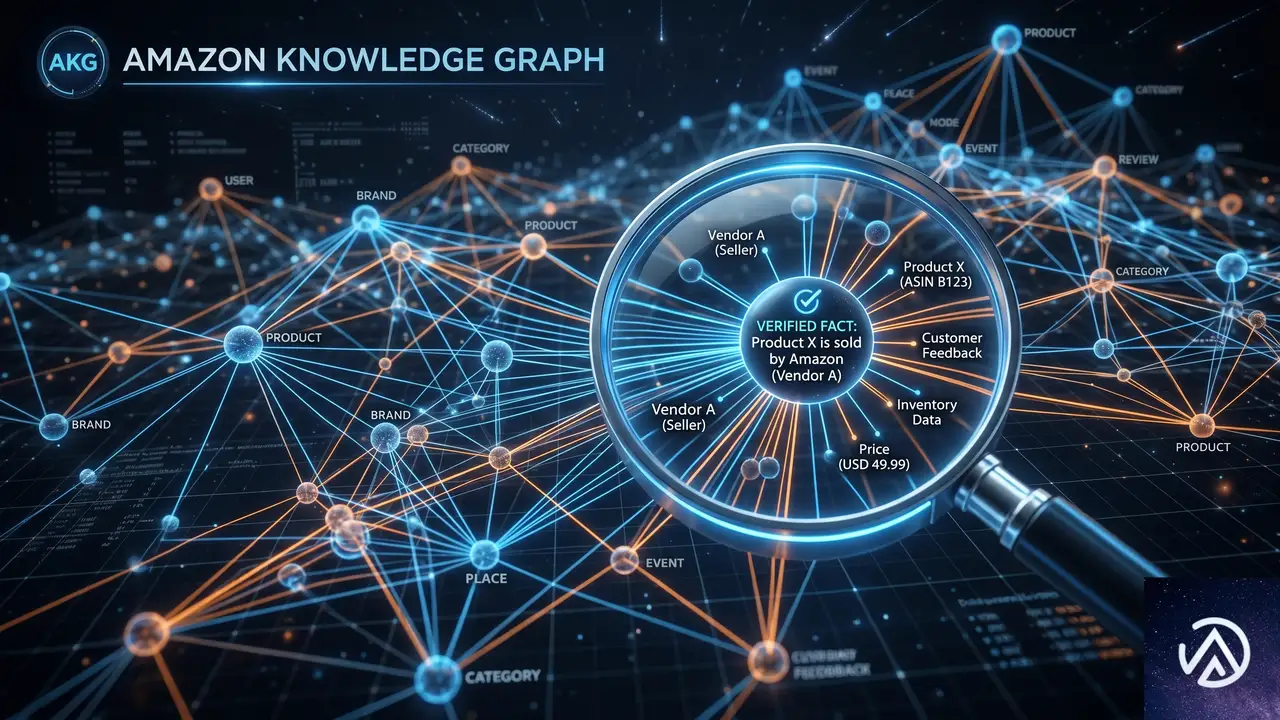
MCP(Model Context Protocol)の役割
Web Searchは、MCP(Model Context Protocol)と呼ばれる標準プロトコルを介してAgentCore Gatewayに接続される。MCPを使うことで、エージェントは自然言語のクエリを送信し、関連性の高い検索結果(スニペット、URL、タイトル、公開日)を取得できる。GatewayがMCPターゲットとしてWeb Searchツールを仲介するため、開発者が個別に検索APIを実装する必要はない。
Amazon知識グラフとの統合
一般的なWeb検索に加え、Amazon Knowledge Graphの構造化データが検索結果に組み込まれる。これにより、単なるWebスニペットではカバーしきれない検証済みの事実情報をエージェントが参照できるようになる。AWSのブログ記事によれば、このマルチソースアプローチが従来のWeb検索だけに頼る場合と比較して、より的確な回答につながるとされている。
エージェントが回答を生成するまでの流れ
以下のデモは、ユーザーが質問してからエージェントが根拠付き回答を返すまでの一連のステップを図示したものだ。
STEP 3の段階でAmazon Knowledge Graphが活用される点が、単なるWeb検索を超えた信頼性につながる。エージェントは受け取った情報をそのまま返すのではなく、モデルが内容を推論した上で回答を構成するため、質問の文脈に合った自然な応答になる。
AWS環境内で閉じるセキュアなWeb検索の価値
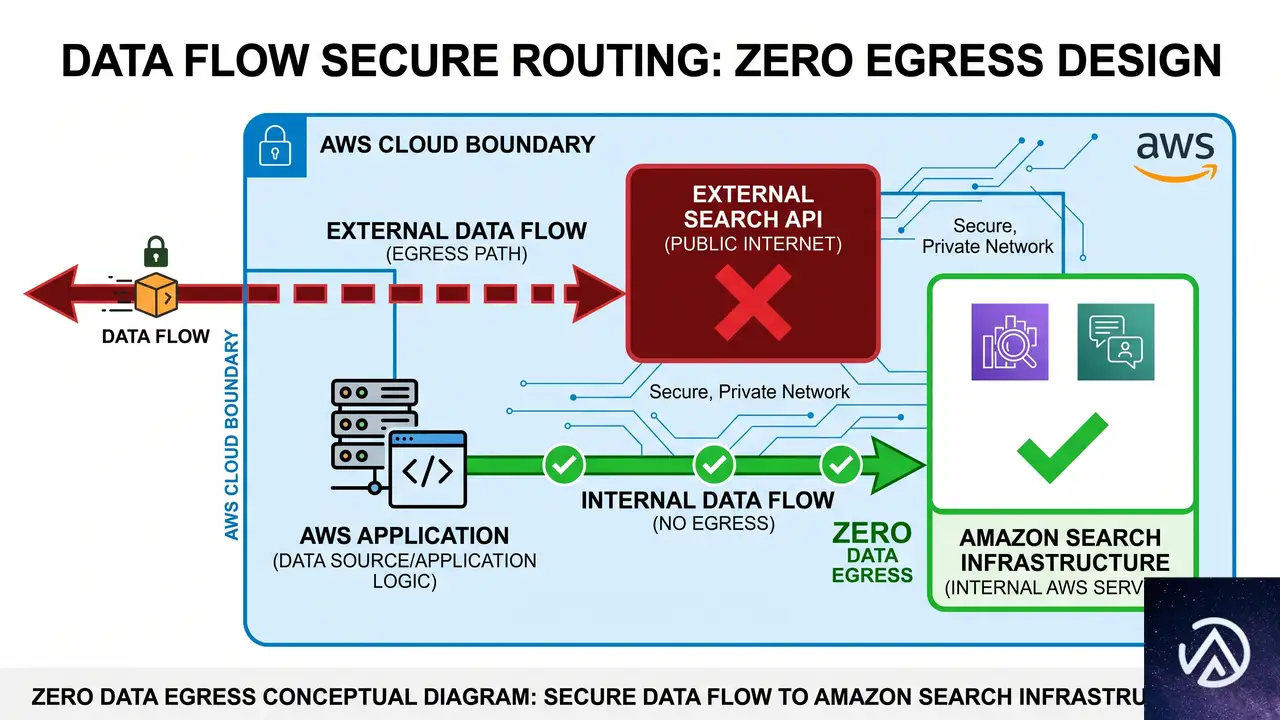
多くのAIエージェント向けWeb検索ソリューションでは、ユーザーのクエリやプロンプトが外部の検索APIプロバイダに送信される。これに対しBedrock AgentCoreのWeb Searchは、Amazon自身の検索インフラを使用するため、データがAWS環境の外に流出しない。これにより、機密性の高い業務データを扱う企業でも、ガバナンスやコンプライアンスの要件を満たしながらエージェントにWeb検索機能を組み込める。
AWSの説明によれば、この仕組みはAlexa+やKiroなどのプロダクトで培われた検索技術を基盤にしており、信頼性とスケーラビリティの両面で実績がある。ユーザーは外部の検索サービス契約やAPIキー管理を気にすることなく、AgentCoreの設定画面上でWeb Searchを有効化するだけで利用を開始できる。
料金体系と利用開始手順
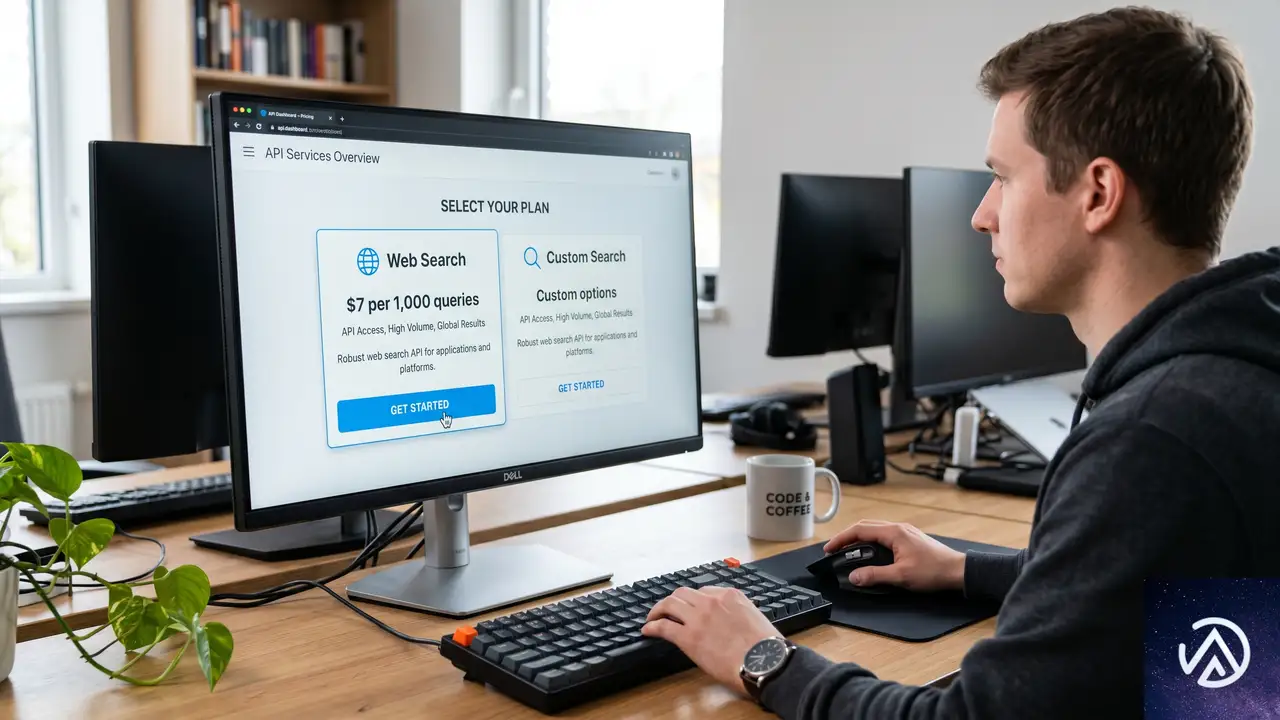
料金詳細
Web Searchの料金は従量課金制で、エージェントが実行した検索クエリの数に応じて計算される。具体的には、1,000クエリあたり7ドルである。新規のAWS顧客には最大200ドル相当の無料利用枠も提供される。利用料はすべてAWSの請求に統合されるため、別途外部サービスへの支払い管理は不要だ。
セットアップ手順
Bedrock AgentCoreコンソール(us-east-1リージョン)にアクセスし、Gatewayを作成する。ターゲットの追加時に「MCP target」プロトコルと「Connectors」タイプを選択し、プリコンフィギュアされた「Web Search tool」を指定する。Gatewayの詳細ページに遷移すると、PythonやMCP Inspectorを用いた呼び出しコードのサンプルが表示されるため、これをコピーして自環境に組み込むだけで統合が完了する。
テスト用途であれば、MCP InspectorをGatewayのリソースURLに接続し、Web Searchツールにクエリを直接入力して動作を確認できる。実運用では、エージェントのプロンプト設計にWeb検索の呼び出しトリガーを組み込み、回答生成時に適宜検索が走るように構成することになる。
企業での活用事例
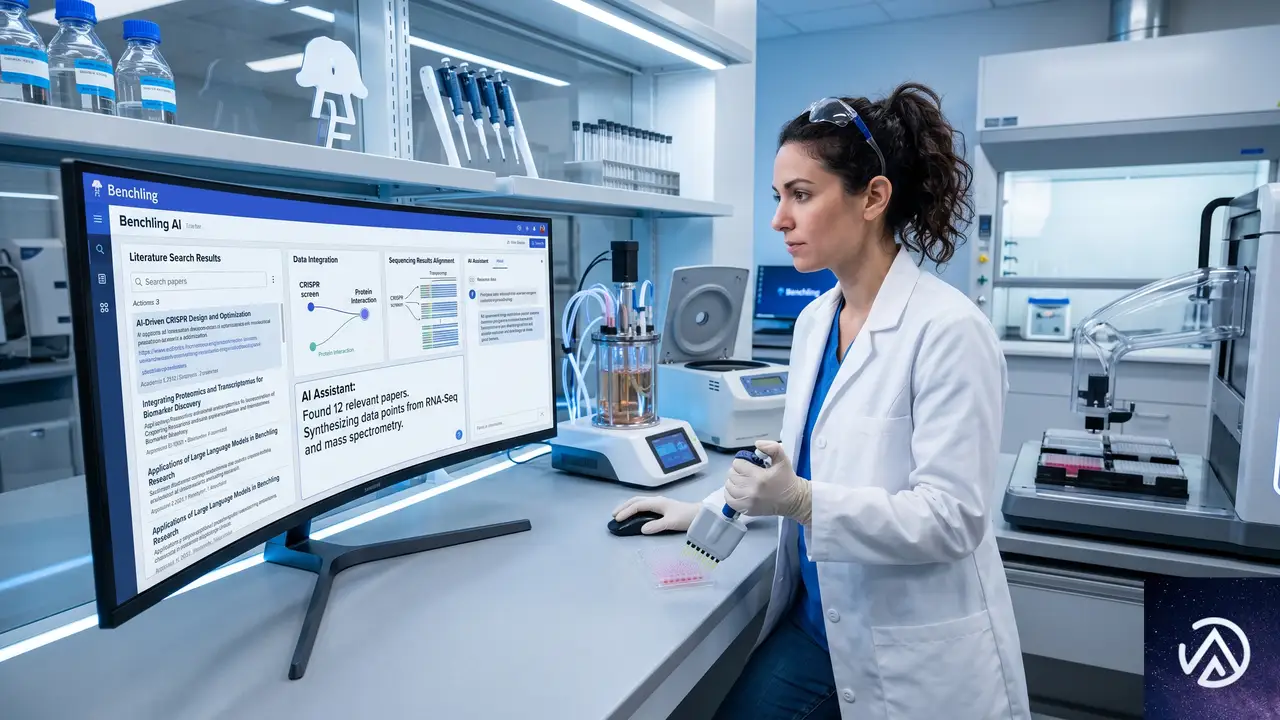
Benchling:科学研究の加速
ライフサイエンス分野のR&Dプラットフォームを提供するBenchlingは、早期アクセスを通じてWeb Searchを試験導入した。同社AIエージェント責任者Nicholas Larus-Stone氏によると、科学者が研究対象について質問すると、Benchling内の組織データと公開文献の両方に基づく回答が得られるようになったという。これにより、仮説生成の質が向上し、顧客のデータ管理ポリシーにも適合する安全な環境を維持できている。
Gen Digital:オンライン評判管理の強化
消費者向けセキュリティ製品を展開するGen Digital(Nortonブランド)は、Norton RevampというサービスにWeb Searchを組み込んだ。プロフェッショナルが自身のオンライン評判を構築する際、最新のトレンドや事実に基づいたコンテンツアイデアをエージェントが提案できるようになる。同社AI・イノベーション部門シニアディレクターIskander Sanchez-Rola氏は、すべてのクエリが信頼できるAWS環境内で処理される点を高く評価しているとコメントした。
いずれの事例でも、外部サービスを利用せずにAWS内で完結するセキュリティと、Amazon独自の検索インデックスによる高精度な情報取得が決め手となっている。
この記事のポイント
- Amazon Bedrock AgentCoreでWeb Search機能が一般提供開始。MCP経由でWeb検索と知識グラフを統合し、エージェントの回答を最新情報で根拠づける
- 検索クエリはAWS環境外に出ず、Amazonの検索インフラで処理されるため、データガバナンスとコンプライアンスに対応
- 料金は1,000クエリあたり7ドルの従量課金。新規顧客向けに200ドル分の無料枠あり
- BenchlingやGen Digitalなどの企業がすでに導入し、研究支援や評判管理の精度向上に活用している
- us-east-1リージョンで利用可能。AgentCoreコンソールから数ステップで設定できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験