

SupabaseがTursoを買収。エージェント向けDB基盤の進化へ
Supabaseが10月2日、SQLiteクラウドプラットフォームを手がけるTursoの買収を発表した。AIエージェントが大量のデータベースを作成する新時代に向け、PostgresとSQLiteの両軸で基盤を強化する動きだ。
既存ユーザーへの影響はない。SupabaseはPostgresを中心に、TursoはSQLiteを中心にそれぞれの開発を継続する。両社の技術と知見を組み合わせ、エージェントがDBを簡単に扱える新たな体験の実現を目指す。
この記事では買収の概要、AIエージェントが変えるデータベース需要、Tursoの技術アーキテクチャ、オープンソース戦略を整理する。
買収の背景、PostgresとSQLiteの両軸へ
Supabaseの発表によると、同社はすでに毎週100万以上のデータベースを立ち上げている。AIエージェントがプロトタイプやダッシュボード、アプリケーションを大量に作る流れが進む中で、DB需要は現在の供給能力を超える可能性がある。こうした状況に対応するため、Tursoの買収に至った。
重要なのは、この買収が「どちらかの技術に一本化する」話ではない点だ。Supabaseは引き続きPostgresを中心に開発し、TursoはSQLiteの改良を続ける。その上で、両社を横断する新しい基盤を共同で構築する。Supabaseの開発者体験をすべてのエージェントに届けることが目標だ。
SQLiteとは、サーバーを必要としないファイルベースの軽量データベースだ。アプリケーションに組み込んで手軽に使える特徴がある。一方のPostgresは、本格的なリレーショナルデータベースとして大規模なアプリケーションで使われる。小さなワークロードから本番環境まで、段階に応じた選択肢を提供できる体制になる。
AIエージェントが変えるデータベース需要
AIエージェントとは、人間の指示を受けて自律的にタスクを実行するAIのことだ。コードを書いたり、調査をしたり、アプリのプロトタイプを作ったりする。Supabaseの発表によれば、エージェントはすでに数百万ものデータベースを生み出しているという。
この流れが進むと、データベースに求められる性質が変わる。エージェントはファイルを作るのと同じ感覚でDBを作成できるべきだ。コストをほとんど気にする必要がなく、小規模な用途であれば専用マシンを毎回プロビジョニングする手間も避けたい。必要な時にすぐ使えて、不要になったら自動で止まる。そして本番環境へ移行する明確な道筋があること。これがエージェント時代のDB基盤に必要な条件だ。
プロビジョニングとは、サーバーやデータベースなどのインフラを自動的に割り当てて利用可能な状態にすることだ。従来は小規模なDBでも専用マシンを毎回準備する必要があった。AIエージェントが大量の小規模DBを必要とする時代には、この方式ではコストと時間が合わない。
このデモは、AIエージェントの台頭によってデータベース作成のアプローチが大きく変わることを示している。
SQLiteはこのような小規模でオンデマンドなワークロードに適している。一方、アプリケーションが成長して本格的な運用に入る段階ではPostgresが力を発揮する。両方を同じ開発者体験でつなぐことが、今回の買収の狙いだ。
Tursoの技術アーキテクチャ、Rustで再構築したSQLite
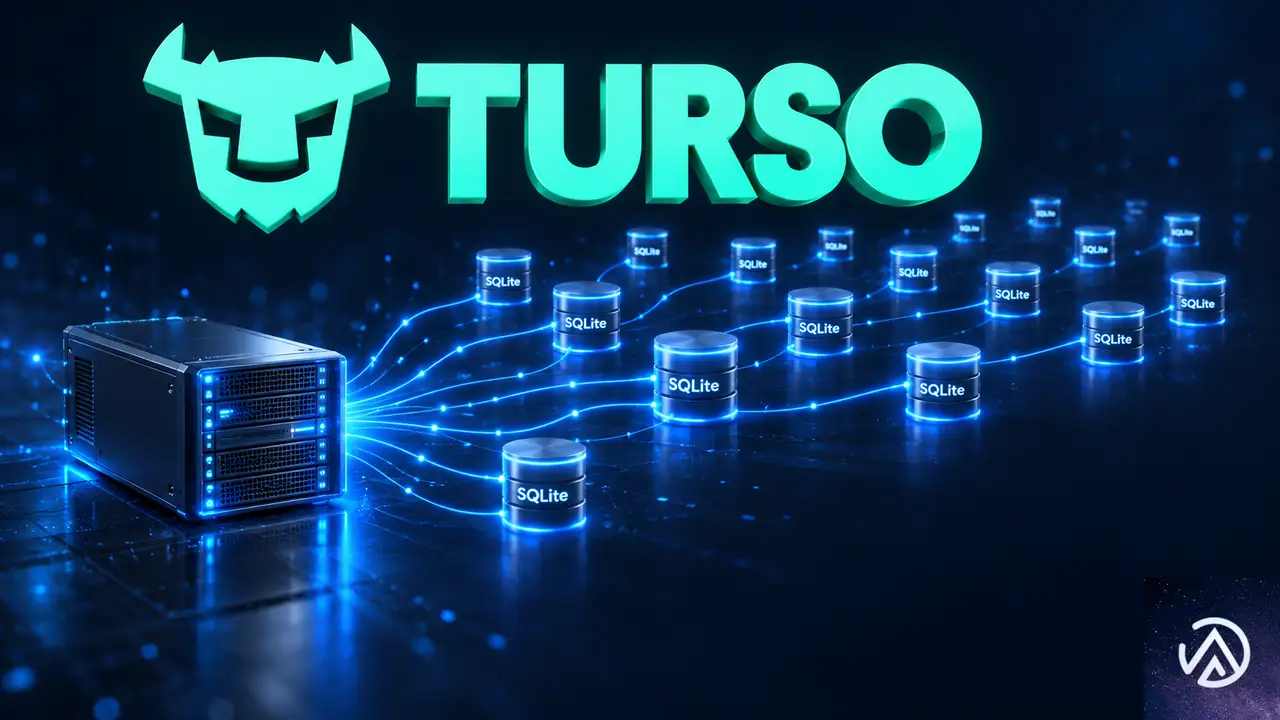
Tursoはこのパターンに最適化されたアーキテクチャを構築してきた。SQLiteをRustで再構築し、1台のサーバーで数百万のデータベースを管理できるクラウドプラットフォームを作り上げた。必要な時にDBをロードし、使われていない時は自動的にサスペンドする仕組みだ。
Rustとは、メモリ安全性と高速性を両立するプログラミング言語だ。CやC++と同等の性能を持ちながら、メモリ関連のバグを防ぐ仕組みが言語レベルで組み込まれている。サスペンドとは、実行中のプロセスを一時停止してメモリ領域を保持したままにすることだ。停止と再開を高速に行える。
Tursoのアーキテクチャは、1台のサーバーで多数のSQLiteインスタンスを効率的に管理する。この仕組みにより、エージェントごとにDBを即時提供できる。
このアーキテクチャは、Turso Cloud上でも、ユーザー自身のクラウド環境でも動作する。実際にSuperhuman、Sauna.ai、CTO.new、Mastraといった企業がこの仕組みを利用している。Supabaseの発表では、ワークロードの成長に応じてTursoのエコシステムからSupabaseへ移行する明確な道筋も示された。
オープンソースへの姿勢と今後の展望
TursoとSupabaseには共通点が多い。オープンソースへの強いコミットメント、開発者体験へのこだわり、難しいインフラ課題に挑む姿勢だ。今回の買収は、技術的な相性だけでなく、こうした価値観の一致も大きな理由となっている。
Tursoのグローバー・コスタ氏とペッカ・エンバーグ氏は、チームとともにSupabaseに加わる。コスタ氏はエージェント向けインフラの開発を主導する役割を担う。Supabaseのミッションは「世界のデータを保存する」ことだ。AIエージェントがさらに多くのデータを生み出す時代において、この買収はその目標へ大きく近づく一歩となる。
短期的には、既存ユーザーに目立った変化はない。しかし中期的には、プロトタイプ段階から本番運用まで一貫した開発者体験を提供する基盤が形づくられていく。SQLiteで手軽に始め、必要に応じてPostgresへスケールする流れが、よりシームレスになるだろう。
この記事のポイント
- SupabaseがSQLiteクラウドのTursoを買収、既存ユーザーへの影響はない
- Supabaseは毎週100万以上のDBを立ち上げており、AIエージェントの需要に対応する
- TursoはRustでSQLiteを再構築し、1台のサーバーで数百万のDBを管理できる
- SQLiteとPostgresを段階に応じて使い分けられる基盤づくりが始まる
- オープンソース重視の両社の価値観が一致した買収である

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
CloudflareがAI決済2製品をベータ公開、サイト運営者が知るべき課金モデルとは
CloudflareがAI決済分野で動きを加速させている。9月30日に2つの製品をベータへ移行した。Monetization GatewayとPay Per Useだ。いずれもサイト運営者がAIエージェントやAI企業から収益を得るための仕組みである。
Monetization GatewayはAIエージェントからのリクエスト単位で課金する。Pay Per UseはAI企業がコンテンツを使用した際にパブリッシャーへ支払う。どちらも現在は米国拠点の利用者に限定したクローズドベータだ。
AI検索の普及でコンテンツの無断利用が問題視される中、この発表はサイト運営者にとって新たな収益化の選択肢となる。本記事では仕組みと実務への影響を解説する。
CloudflareがAI決済製品をベータ公開、収益化の選択肢が拡大
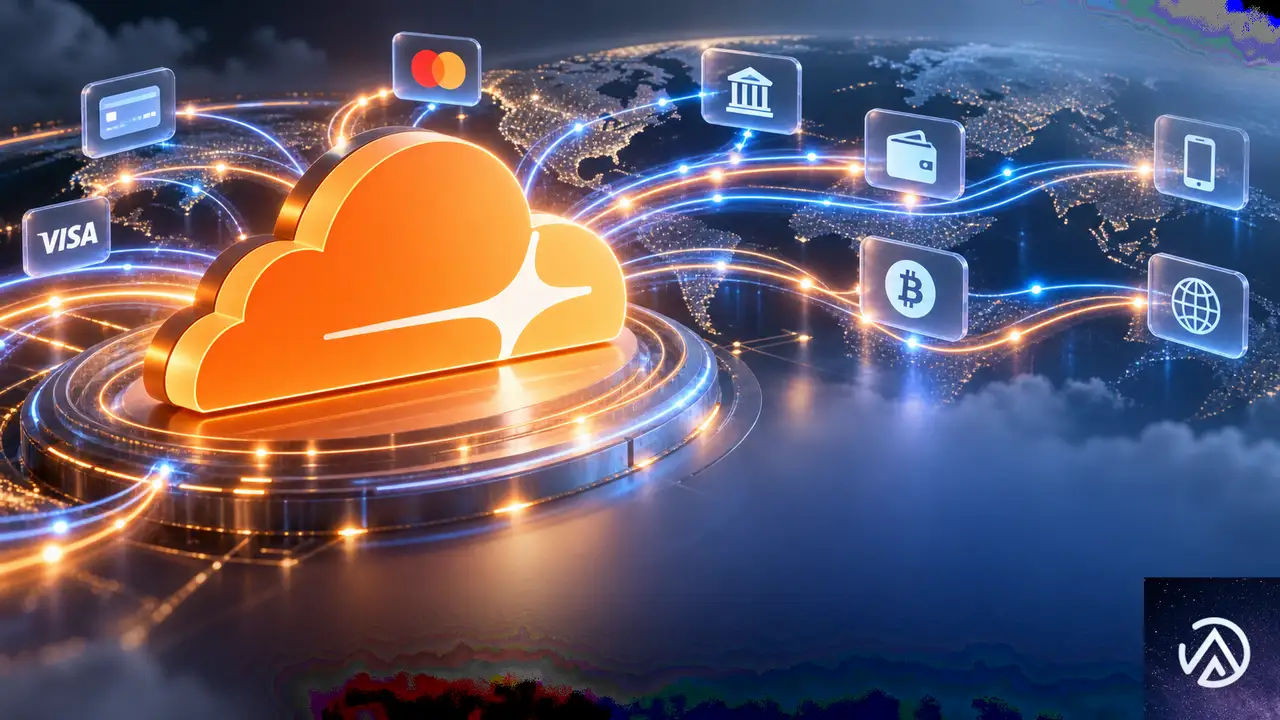
この比較図は3つの支払いモデルの課金タイミングを示している。縦に並んだ各モデルは、それぞれ異なる課金ポイントを持つ。
Cloudflareは7月1日にMonetization Gatewayを発表し、順番待ちリストを開設していた。今回のベータ移行で実際の利用が始まった形だ。Pay Per Useも同じくベータ段階に入っている。
3つの支払いモデルが揃った
Cloudflareが提供するAI関連の支払いモデルはこれで3つになった。既存のPay Per Crawlに加え、今回の2製品が加わった。それぞれ課金のタイミングと主体が異なる。
- Pay Per Crawlはクローラーがアクセスした時点でサイト所有者が設定した料金を支払う
- Monetization GatewayはAIエージェントからのリクエストごとに売り手が設定した料金を請求する
- Pay Per UseはAI企業がコンテンツを使用したと報告した時点でAI企業が設定した料金をパブリッシャーに支払う
この3モデルを理解すると、AI時代のコンテンツ課金の全体像が見えてくる。
Monetization Gatewayの仕組み
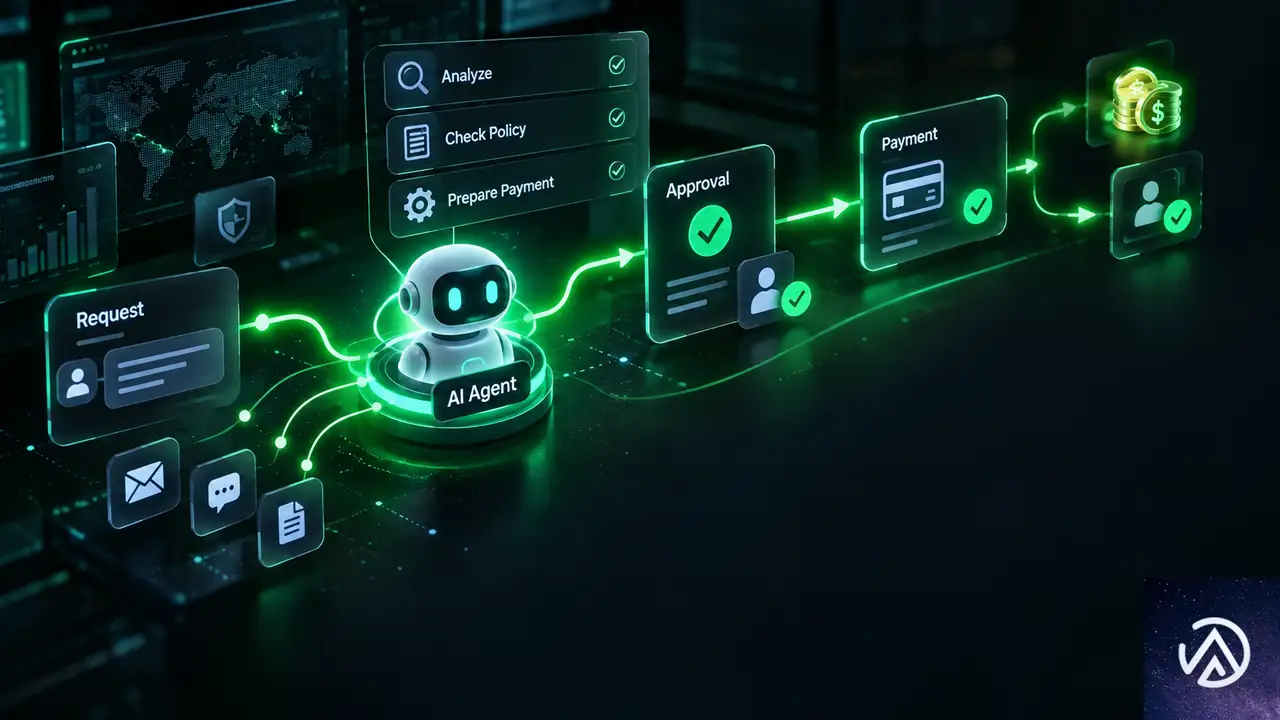
このフロー図はMonetization Gatewayの処理手順を示している。支払いが完了するまでコンテンツは提供されない。
Monetization GatewayはAIエージェントに対してリクエスト単位で課金する仕組みだ。API、MCPツール、データセット、サイトなど、リクエストがあるたびに使用が発生するリソース向けに設計されている。MCPツールとは、AIアシスタントが外部の機能を呼び出すための標準規格Model Context Protocolに対応したツールを指す。
リクエスト単位の課金フロー
このゲートウェイはx402プロトコルとHTTP 402 Payment Requiredステータスコードを使用する。x402プロトコルは、HTTP 402を利用した機械支払いのための規約だ。人間の介入なしにAIエージェント同士が支払いを処理できるよう設計されている。
HTTP 402は「支払いが必要」という意味のレスポンスコードだ。AIエージェントが保護されたリソースへアクセスすると、まず支払い条件を受け取り、支払い承認に署名してから再試行する。支払いはこのリクエスト内で処理され、売り手のサーバーが応答する前に検証される。つまり、支払いが確認できなければコンテンツは提供されない仕組みだ。
料金設定は固定と変動の2種類から選べる。固定価格は入力が同じなら常に同じ料金になる。変動価格は上限額を設定し、実際の使用量に応じて売り手側が請求額を報告する。決済は1回0.001ドルから100ドルまで対応する。
支払い処理にはUSDCステーブルコインを採用した。Baseブロックチェーン上でCoinbaseのx402 Facilitatorを経由する。将来的には他の支払い方法も追加する予定だ。
導入に必要な条件
現在はクローズドベータのため、利用するには条件がある。売り手と買い手の双方が米国に拠点を置く必要がある。売り手側はクレジットカードの登録、確認済みメールアドレス、開設から60日以上経過したアカウントが求められる。
さらにサイトがCloudflare経由でプロキシされており、作成から30日以上経過していること、ゾーンのセキュリティチェックを通過することが条件だ。アクセス申請はダッシュボードから行う。
4つのライブ実装も公表されている。Ceramic.aiはエージェント向けのWeb検索APIを固定価格で提供する。AI Gatewayは4つのオープンモデルで推論リクエストごとの支払いを受け付ける。Stocktwitsは市場シグナルをリクエスト単位で課金する。API2PDFはリクエストの計算量と帯域幅に基づく変動価格でPDF生成APIを提供する。
API2PDFの事例は示唆的だ。初月無料の後にクレジットカードを要求すると変換率が50%以上低下したという。AIエージェント向けの決済はスムーズさが重要だと示している。
Pay Per Useの仕組み
このフロー図はPay Per Useの役割分担を示している。AI企業が使用を報告し、Cloudflareが照合してパブリッシャーへ支払う流れだ。
Pay Per Useは別のアプローチを取る。パブリッシャーがコンテンツを提供し、AI企業がそのコンテンツを使用したと報告した場合に、AI企業からパブリッシャーへ支払いが発生する。
使用報告の流れ
役割分担は明確だ。AI企業が支払う用途と価格を定義する。パブリッシャーは提示されたオファーを承認するか拒否するかを決める。承認後は自分のコンテンツがどれだけ使われ、いくら稼いだかを確認できる。Cloudflareは登録、使用記録、請求、支払いを担当する。
使用の記録はAI企業側が自己申告する。タイムスタンプ、ソースURL、イベントIDを報告し、Cloudflareが各使用報告が登録済みパブリッシャーのものか照合する。そこから買い手に請求し、毎月パブリッシャーへ支払う流れだ。
ベータ期間中、Cloudflareは個々の買い手および参加を選択したパブリッシャーと直接連携している。買い手の企業名はまだ公表されていない。
パブリッシャーが注意すべき点
Pay Per UseではAI企業が使用用途と価格を設定する。パブリッシャーはオファーを承認するか否かの判断のみで、価格交渉はできない。また、使用データは買い手の報告に依存するため、実際の使用頻度との乖離があり得る。
各プログラムの規約には、AI企業がコンテンツをどう扱えるか、学習用途の制限なども含まれる。参加前に規約を確認する必要がある。
サイト運営者への実務的な影響
これら2製品は、AIエージェントの台頭でコンテンツ収益が脅かされているサイト運営者に新たな選択肢をもたらす。特にMonetization GatewayはAPIやデータセットを提供する事業者との相性が良い。Pay Per Useはコンテンツメディア向けだ。
SEO観点での評価
SEO対策の観点では、AI検索エンジンがコンテンツを読み取る動きが加速する中、その利用に対して対価を求める仕組みが整ってきた点が重要だ。これまで無断でクロールされ、引用される一方だったパブリッシャーに交渉の余地が生まれる。
ただし現段階では取引件数や支払い実績は公表されていない。収益化の効果を実証するデータはまだない。ベータ期間中の成果報告が待たれる。
導入を検討する際のチェックポイント
現時点で導入できるのは米国拠点の事業者に限られる。日本からはまだ利用できない。地理的な拡大は予告されているが、時期は明らかではない。まずは動向を追い、仕組みを理解しておくことが現実的だ。
- 自社コンテンツがAIエージェントに利用される頻度を把握する
- Pay Per Crawl、Gateway、Pay Per Useの違いを理解する
- Cloudflareを利用しているか、利用予定があるか確認する
- ベータが日本に開放された際にすぐ試せるよう準備する
今後の展開と注目ポイント
CloudflareはPay Per Useのベータで、パブリッシャーが買い手の提示価格に対抗してカウンターオファーを出したり、用途別に異なる料金を設定したりする方法を模索している。
また、Pay Per Useで購入するAI企業の社名が公表されるかも注目点だ。Gatewayについては新たな地域への対応が予告されている。日本からの利用開始時期も気になるところだ。
AIエージェント経済のインフラが整いつつある。サイト運営者はこの変化を収益化のチャンスと捉え、早期に情報をキャッチアップしておくべきだ。
この記事のポイント
- Cloudflareが2つのAI決済製品をベータ公開した
- Monetization Gatewayはリクエスト単位でAIエージェントに課金する
- Pay Per UseはAI企業の使用報告に基づきパブリッシャーへ支払う
- どちらも現段階では米国拠点の限定ベータである
- AI時代のコンテンツ収益化に新たな選択肢が加わった
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ShopifyがWebMCPをチェックアウトに拡張、AIエージェントが注文確定まで対応
Shopifyが9月28日、WebMCPツールをチェックアウトに拡張した。ブラウザエージェントは購入者のタブで開いているチェックアウトを読み取り、更新し、購入者の確認を得た上で注文を確定できるようになった。
8月時点のWebMCPは商品検索とカート管理が中心だった。チェックアウトページへの誘導はできたが、注文の確定は購入者自身が行う必要があった。今回の拡張でAIエージェントが購入完了まで関与する形になる。
この記事では4つの新ツールの役割、購入者が制御を取り戻す場面、ブラウザ自動化との比較テスト結果を解説する。
WebMCPチェックアウト拡張の概要
8月の展開からの進化
WebMCPとは、ブラウザ内でAIエージェントがWebサイトの機能を利用するための仕組みだ。Shopifyは2026年8月に最初のWebMCPツールを公開した。当時は商品検索とカート管理が中心で、エージェントは購入者をチェックアウトページまで誘導するに留まっていた。
9月28日の拡張により、ブラウザエージェントはチェックアウトの状態を読み取り、配送先や支払い方法を更新し、購入者の確認を得た上で注文を確定できる。Shopifyの開発者向けチェンジログは「新しいAPIを公開するわけではなく、マーチャントの設定も不要」と説明している。
新しいツールの仕組み
新しいツールは購入者が見ているチェックアウトページと同じ状態を利用する。エージェントが裏側で別のセッションを操作するのではなく、実際に開いているチェックアウトの状態を読み書きする仕組みだ。
これにより購入者とエージェントの間で情報のずれが生じにくい。チェックアウトは各更新時に独自の検証を行い、エージェントが注文の商品を変更することはできない設計になっている。
このデモは8月時点と9月28日以降のWebMCPの機能差を示している。エージェントが「誘導役」から「取引実行役」に変わった点が今回の拡張の本質だ。
チェックアウトで利用できる4つのツール
各ツールの役割
ShopifyのチェックアウトWebMCPドキュメントによると、対象となるチェックアウトには4つのツールが登録される。
- get_checkoutはチェックアウトを読み取り、購入後は注文詳細も取得する
- update_checkoutは連絡先、配送または受け取り方法、割引コード、支払い方法、税番号などの追加項目を変更する
- complete_checkoutは注文を確定する
- navigate_to_storefrontはタブをストアに戻す
4つのツールは役割が明確に分かれている。読み取り、更新、確定、移動という一連の流れをエージェントが実行できる設計だ。
支払い方法の制限
これらのツールは新しいカード情報を受け付けない。エージェントは保存済みのShop Payカードを選択するか、ゲストチェックアウトが許可している場合はエージェントが持っているShop Pay承認を利用して支援できる。
それ以外の支払い方法は購入者がチェックアウトページで直接選択する必要がある。エージェントはあくまでもShop Payの範囲内で支払いを支援する形だ。これはエージェントがクレジットカード情報を扱うリスクを避ける設計といえる。
また、エージェントはWeb Bot Authを使用してブラウザリクエストに署名する必要がある。Web Bot AuthとはShopifyがエージェントを認識するための署名方式だ。署名がない場合、リクエストは優先度が下がったり、ボット検出システムによってブロックされたりする可能性がある。
購入者が制御を取り戻す場面
注文確定前の同意
Shopifyのドキュメントは、complete_checkoutを呼び出す前に現在の注文と合計を購入者に表示し、「注文の許可を得ること」をエージェントに指示している。
注目すべきは、Web Bot Auth署名、Shop Pay承認、準備完了ステータスはこの同意には該当しない点だ。エージェントが技術的に注文を確定できる状態であっても、人間の購入者が最終確認を行わない限り注文は実行されない。
これはAIエージェントの暴走を防ぐ安全設計として評価できる。自動化が進んでも、最終的な購入判断は人間が行うという原則を守っている。EC事業者にとっては、エージェントが勝手に注文を確定してしまうリスクを抑えられる仕組みだ。
支払いチャレンジとUI拡張
Shop Payログインや3D Secureなどの支払いチャレンジは、購入者にページ上での制御を戻す。3D Secureとはオンラインカード決済の追加認証方式で、不正利用を防ぐためにパスワードや生体認証を求める仕組みだ。
ブロッキングUI拡張機能やレビューステップも同様に、購入者が直接操作する場面となる。購入者はアプリが定義するチェックアウト拡張機能とのやり取りも管理する。エージェントがすべてを代行するのではなく、特定の場面では必ず人間が介入する仕組みになっている。
対象チェックアウトの条件と利用環境
Shop Pay必須の制限
Shopifyの標準3ページチェックアウトは、購入者がShop Payでチェックアウトする場合を除き、WebMCPツールを取得しない。B2Bチェックアウト、埋め込みチェックアウト、モバイルチェックアウトSDK内のチェックアウトも対象外だ。
他のショップの商品を含むチェックアウト、ドラフト注文、注文編集、支払い回収も除外される。この制限はマーチャントにとって重要な意味を持つ。すべてのチェックアウトでAIエージェントが注文を確定できるわけではない。
現時点ではWebMCPチェックアウトの適用範囲は「Shop Payを使う標準チェックアウト」に限られる。Shop Pay以外の支払い方法を選ぶ購入者には、エージェントはチェックアウトの支援ができない。この制限がWebMCPチェックアウトの普及にどの程度影響するかは、今後の利用データを見る必要がある。
Chromiumブラウザ限定
現時点では、エージェントがWebMCPを使用できるのはChromiumベースのブラウザのみだ。ChromiumとはGoogleが開発するオープンソースのブラウザエンジンで、Google ChromeやMicrosoft Edgeが採用している。
FirefoxやSafariでは利用できない。この制限はWebMCPの普及に影響を与える可能性がある。ただしChromeとEdgeがブラウザ市場の大部分を占めていることを考えると、実用上の影響は限定的かもしれない。
Checkout WebMCPとCheckout MCPの選択
2つのルートの違い
Shopifyはチェックアウトでのエージェント向けに2つのルートを文書化している。サーバーベースのCheckout MCPと、ブラウザ内で動作するCheckout WebMCPだ。
ShopifyはサーバーベースのCheckout MCPを推奨している。この方式ではエージェントが自身のサーバーからチェックアウトセッションを管理する。Checkout WebMCPは「エージェントがすでに購入者のブラウザで動作している場合のみ」使用するよう案内している。
両方ともUniversal Commerce Protocolのチェックアウト機能に依存し、同じチェックアウトオブジェクトを使用する。Universal Commerce ProtocolとはShopifyが提唱する商取引の共通プロトコルで、異なるシステム間で取引情報をやり取りするための標準仕様だ。
Checkout WebMCPはチェックアウトページが購入者のブラウザに登録するツールを通じて動作する。一方、Checkout MCPはサーバー側でリクエストを処理する。実行場所が異なるだけで、扱うデータは同じだ。
マーチャントの立場
どちらの方法でも、Shopifyはマーチャントが記録上のマーチャントのままであると説明している。エージェントが仲介者になっても、販売者としての責任はマーチャントに残る。
これは法的・会計的な観点で重要なポイントだ。AIエージェントが注文を確定しても、取引の主体はあくまでもマーチャントである。エージェントが誤った注文を確定した場合の責任の所在も、マーチャントが負うことになる。
ブラウザ自動化との比較テスト
成功率と速度の差
Shopifyのエージェンティックコマース担当チームに所属するGil Greenberg氏は、WebMCPとブラウザ自動化を比較する社内テストの結果を公開した。ブラウザ自動化とは、エージェントがページを読み取ってクリック操作を行う方式だ。画面上の要素を視覚的に認識して操作する必要があるため、処理が遅くなりがちだ。
テストはGPT-6 Solを使って、同じプロンプトと開始条件で実施された。2つのテストショップで合計10のチェックアウトタスクを実行した結果、WebMCPは60回すべて成功した。一方、ブラウザ自動化は60回中56回の成功だった。
ページセットアップ時間を除いた1回あたりの時間は、WebMCPが10.3秒、ブラウザ自動化が27.4秒だった。WebMCPが約2.7倍高速だった計算になる。
1回あたり 10.3秒
コスト 58%削減
1回あたり 27.4秒
コスト 基準値
この比較はWebMCPの優位性を示している。成功率、速度、コストの3つの指標すべてでWebMCPが上回った。
コスト面の優位性
コスト面でもWebMCPが優位だった。OpenAIのリスト価格で比較すると、WebMCPのコストは1回あたり58%低かった。速度が速いだけでなく、API呼び出し回数やトークン消費量も抑えられるためだ。
ただし、この結果には注意点がある。テストはShopifyのテストショップと単一モデルで行われたもので、実際の注文やコンバージョン率などの実データは含まれていない。また、Greenberg氏の投稿には1行だけ60回の試行と一致しない合計値が含まれている。
とはいえ、WebMCPが「有望な方向性」を示していることは間違いない。ブラウザの画面を読み取ってクリックする方式よりも、専用のツールを介して直接操作する方式のほうが効率的であることは、このテスト結果から十分に裏付けられている。
この記事のポイント
- Shopifyが9月28日、WebMCPをチェックアウトに拡張した
- エージェントがチェックアウトの読み取り、更新、注文確定まで実行できる
- 注文確定には購入者の明示的な同意が必須
- Shop Pay必須の制限があり、対象チェックアウトは限定的
- ブラウザ自動化との比較テストで成功率100%、速度2.7倍、コスト58%削減を達成
- マーチャントが個々のツールをオフにできるかは未確認
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.8 Liveシリーズ登場、音声AIエージェントの新基盤に
Google DeepMindが9月15日、Gemini 3.8 LiveとGemini 3.8 Live Extended Thinkingを発表した。音声エージェント向けに設計された2つの新モデルで、リアルタイム推論能力が大幅に強化されている。
Gemini 3.8 Liveはスケールとコスト効率を重視したモデルだ。Gemini 3.8 Live Extended Thinkingは高複雑度タスク向けで、複数ステップの推論を会話の流れを止めずに実行できる。
開発者API、Google Workspace、Search Liveなど幅広い経路で提供が始まっている。音声で複雑なタスクを処理する新しい基盤になる。
Gemini 3.8 Liveシリーズの全体像
会話知能と自然な対話、視覚的な理解を組み合わせたモデル。スケールとコスト効率を重視しており、大量の同時接続を処理する音声エージェントに向く。
高複雑度タスク向けに設計されたモデル。複数ステップの推論と、より高い知能を備える。会話の流れを止めずに深い思考ができるのが特徴。
2つのモデルは用途が明確に分かれている。音声エージェントを大量に展開する場合は標準版、複雑な業務フローを音声で処理する場合はExtended Thinkingを選ぶ形になる。
2つのモデルの役割分担
Gemini 3.8 Liveは会話の自然さと視覚的な文脈理解を兼ね備えている。コストパフォーマンスを重視する開発者や企業に向く設計だ。
Gemini 3.8 Live Extended Thinkingは、より複雑な推論が必要な場面を想定している。話しながら考え、バックグラウンドで複数ステップのタスクを進められる点が最大の違いだ。
展開される利用経路
両モデルとも、Geminiアプリ、Google Workspace、Search Liveに順次展開される。特にWorkspaceではDocs Live、Gmail Live、Keep Liveといったアプリ内の音声機能として利用できる。
コンシューマー向けにはSearch Liveが最初の接点になる。検索中に音声で質問し、そのまま会話を続けられる体験が提供される。
ベンチマークが示す性能とコスト効率
音声品質とエージェント性能の両面で、既存モデルを上回る結果が示されている。コスト面でも競争力のある価格帯を維持している点が特徴だ。
音声品質とエージェント性能
Artificial AnalysisのSpeech to Speech Quality Indexでは82.6を獲得し、総合第1位となった。音声の自然さと応答品質のバランスで他モデルを上回っている。
エージェントタスクの完了率でも強さを示している。τ-Voiceベンチマークで68.6%、Sierraのτ-Voiceバンキングベンチマークでは35.1%を記録した。音声だけで業務フローを完結させる能力が評価された形だ。
推論能力を示すBig Bench Audioでは97.7%と高いスコアを出している。音声を聞いて正しく推論する基盤能力の高さが確認できる。
コスト競争力とユーザー評価
Gemini 3.8 LiveはSpeech Agent Arenaで第2位を獲得している。ユーザーからの選好度が高いモデルでありながら、高いコスト効率を実現している点が重要だ。
ServiceNowのEVA-Benchでは、複雑なワークフローにおける正確性と会話品質のバランスでパレートフロンティアを更新した。エンタープライズ向け音声エージェントの実用性が裏付けられている。
リアルタイム推論の技術的進化
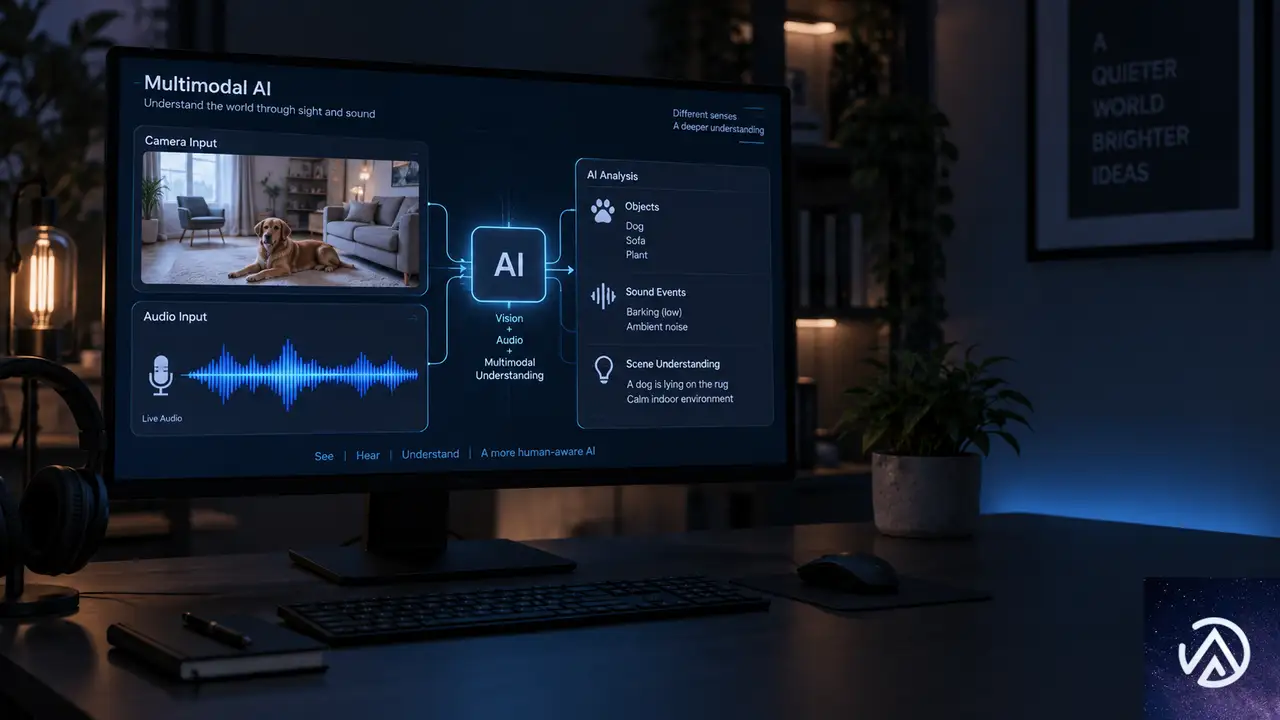
会話を止めずに裏側でタスクを進める設計が、これまでの音声AIと大きく異なる点だ。
視覚入力と言語対応
Gemini 3.8 Liveは視覚入力をほぼリアルタイムで処理する。カメラに映ったものや画面上の情報を文脈として会話に取り込めるため、状況に応じた助言が可能になった。
言語対応も強力だ。97の言語を自動的に検出し、会話の途中でもシームレスに切り替えられる。多言語環境で使う音声エージェントに適している。
公式デモでは、従業員のオンボーディングをリアルタイムで案内する様子や、チェスの盤面を見ながら対局を進める様子が紹介されている。視覚と会話の統合が実用レベルに達していることを示す例だ。
バックグラウンド実行と同時推論
ツールやAPIの実行はバックグラウンドで進められる。ユーザーの要求を受け付けたら、処理が終わるまで待たせず、会話を続けながら結果を伝える動きができる。
Extended Thinking版は「話しながら考える」能力を持つ。「確認させてください」といった短い言葉で応答しながら、裏側で複数ステップの推論を進める。進捗状況を自然な会話で伝える機能も備わっている。
公式デモでは、手書きスケッチと音声フィードバックからReactコンポーネントを生成する例や、複数ステップの予約を非同期で処理する例が公開された。音声だけで開発作業や業務処理を進められる可能性が広がっている。
開発者と企業のエコシステム
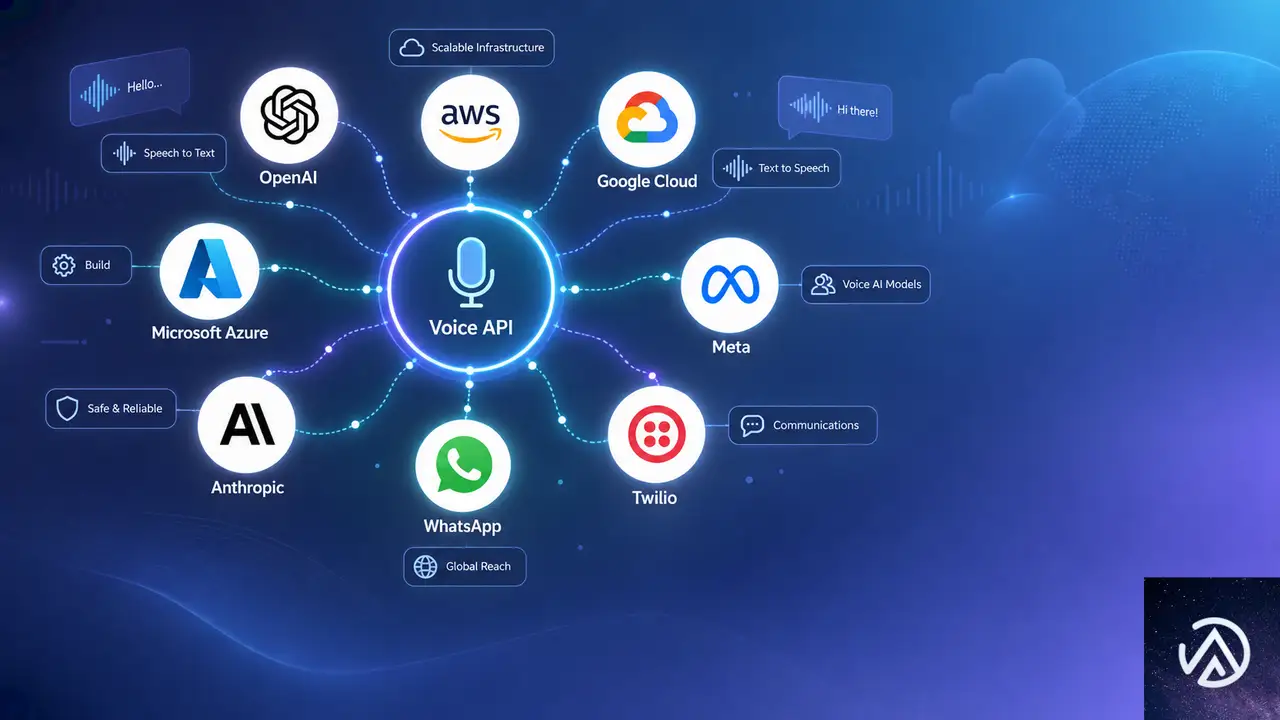
Gemini Live APIと開発者プラットフォーム
両モデルはGemini Live APIを通じて利用できる。開発者はこのAPIを使い、音声駆動のインターフェースを自社サービスに組み込める。リアルタイムのメディアストリーミング基盤はプラットフォーム側が処理してくれるため、UX設計に集中できる。
Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision AgentsなどのプラットフォームがGemini Live APIに統合済みだ。これらのツールを使えば、音声エージェントの構築からデプロイまでを短縮できる。
企業パートナーと展開スケジュール
Salesforce、Genspark、Lumerisなどの企業が3.8 Liveシリーズの導入に意欲を示している。低遅延性、会話の流暢さ、ツール呼び出し能力が評価されている。
展開スケジュールは以下の通りだ。開発者向けにはGemini APIとGoogle AI Studioで即日利用できる。企業向けにはGemini Enterpriseでプライベートプレビューが始まり、Gemini Enterprise for Customer Experienceにも順次提供される。
コンシューマー向けでは、Search Liveが最初の提供経路になる。Gemini Liveでも利用可能で、Google AI ProおよびUltraの加入者はWorkspaceのDocs、Gmail、KeepでExtended Thinking版を試せる。
透明性確保の仕組み
SynthIDによる音声ウォーターマーク
AIが生成した音声にはすべてSynthIDのウォーターマークが埋め込まれる。人間の耳には聞こえない形で音声出力に直接織り込まれており、AI生成コンテンツの検出を可能にする。誤情報の拡散防止が狙いだ。
安全性と責任あるAIへの取り組みの詳細は、モデルカードで確認できる。音声AIが社会に広がる中で、透明性の確保は実用化の前提条件になっている。
この記事のポイント
- Gemini 3.8 LiveとLive Extended Thinkingが9月15日に発表された
- 標準版はコスト効率、Extended Thinking版は複雑タスク向けと役割が分かれている
- Speech to Speech Quality Indexで82.6を獲得し総合第1位
- 97言語対応、視覚入力、バックグラウンド実行など技術面が大幅強化
- Gemini Live API経由で開発者が即日利用できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
PerplexityがGPT-6 Astraを本番採用、監視頻度が大幅に減少
PerplexityがGPT-6 Astraを本番システムに採用した。コミュニケーション作成、ソフトウェア変更、本番環境の監視までを任せている。従来モデルと比べてチェック頻度が大幅に減ったという。
PerplexityはAI回答エンジンとして検索と精度に注力してきた。大量の情報を処理する能力が重要であり、コード生成の精度が上がるたびに検索エンジンも改善してきた。今回のAstra採用はその延長線上にある。
なぜ今回の発表が注目されるのか。理由は「エンドツーエンドのシステムをモデルに任せる」という信頼度の高さにある。コード生成だけでなく、テスト、監視、コミュニケーションまで一貫して任せる事例はまだ少ない。
GPT-6 Astraを本番運用に組み込んだPerplexity
OpenAI Blogの記事によると、PerplexityはAstraを使ってコミュニケーションの作成、ソフトウェアの変更、本番システムの監視を行っている。Perplexityの共同創業者兼CSOであるJohnny Ho氏は、以前の世代のモデルでは実現できなかった方法で、これらのタスクをモデルに任せられると述べている。
コミュニケーション作成からソフトウェア変更まで
従来のAIモデルはコード生成や文章作成など特定のタスクに強かった。しかし実世界のシステムに適用するには、人間が細かく確認する必要があった。Astraではコミュニケーションの作成、システムの編集、本番ソフトウェアの監視を一つのモデルにまとめて任せられる。
監視頻度が大幅に低下
Johnny Ho氏は、完全なエンドツーエンドのシステムをAstraに信頼して任せられ、以前の世代のモデルと比べてチェックする頻度がはるかに少なくなったと述べている。これはモデルの判断精度と信頼性が実用レベルに達したことを示す。
この比較は、モデルの信頼度が実運用に耐える水準へ上がったことを示す。人による確認作業が減ることで、開発チームはより高度な判断や新機能の設計に集中できる。
コード生成の精度向上が検索エンジン改善に直結
PerplexityはAI回答エンジンとして、検索と精度を最重要視してきた。Johnny Ho氏によると、モデルがコードを書く能力を高めるたびに、Perplexityの検索エンジンも改善してきたという。より良いプログラムを作れるようになると、ウェブと内部情報を検索し、それを簡潔に要約する能力も上がる。
検索と要約の精度が上がる循環
コード生成能力の向上は、検索プログラムの品質に直接影響する。検索プログラムが優れていれば、より関連性の高い情報を集め、より簡潔な回答を生成できる。Perplexityはこの循環をエンジンの中核としてきた。
実世界システムへの適用が課題だった
Johnny Ho氏は、本当の課題は情報処理の側面を実世界のシステムに適用することだと指摘する。生成したコードを実際のソフトウェアに変更として反映し、本番環境の監視まで行うのは、従来モデルでは難しかった。Astraはこの壁を越えた。
この流れが実現したことで、Perplexityはモデルを「情報処理の道具」ではなく「システム運用の担い手」として扱えるようになった。
エンドツーエンドのテストを自動生成するAstra
Johnny Ho氏にとって、AIの最も有用な応用の一つはコードのテストだ。手動テストに割ける時間は限られている。そこでAstraにアプリケーションの周りに小さなテストプログラムを構築するよう依頼する。
モックサービスの自動生成
モデルは、別のサービスが送信するような現実的な応答を生成する。例えば言語モデルAPIやコネクタの応答を模倣する。モデルがサービスの代わりを務めることで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。
この仕組みにより、開発者は限られた時間でもアプリケーション全体の動作を網羅的に確認できる。モック応答が現実的であるほど、テストの信頼性も高まる。
ワークフロー全体を検証
モデルがサービスを代行することで、アプリケーションの応答を確認し、ワークフローを最初から最後までテストできる。これは単体テストだけでなく、統合テストやシステムテストに近い。従来は人手や専用ツールが必要だったが、Astraは自然言語の指示だけでこれを実行する。
AIエージェントの信頼性が変える開発フロー
Perplexityの事例は、AIエージェントの信頼性が実用段階に入ったことを示す。チェック頻度の減少は、モデルの判断が人間の承認なしにシステムを変更できる水準に達したことを意味する。開発フローそのものが変わりつつある。
チェック頻度の減少が意味すること
チェック頻度が減るということは、モデルが失敗したときの影響範囲が大きくなる可能性もある。しかしPerplexityは、モデルが生成する応答の現実性と、テストの網羅性を評価した上で、この判断を下している。信頼は実績の積み重ねから生まれる。
開発者の役割変化
モデルがコード生成、テスト、監視までを担うようになると、開発者の役割は「命令を出す人」から「結果を評価し、方向性を決める人」へ移る。Johnny Ho氏がテストコード生成を「最も有用な応用の一つ」と述べるのは、この変化を象徴している。
この記事のポイント
- PerplexityがGPT-6 Astraを本番システムに採用し、コミュニケーション作成、ソフトウェア変更、本番監視を任せている
- コード生成能力の向上が検索エンジンの改善に直結し、実世界システムへの適用が可能になった
- Astraはモックサービスを自動生成し、エンドツーエンドのテストを自然言語の指示だけで実行する
- チェック頻度が大幅に減り、開発者の役割は実行から評価と方向性決定へ移行しつつある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloud Run instances登場!AIエージェントを月額6ドル弱で常時稼働
Google Cloudが2026年8月27日、常時稼働するAIエージェント向けの新サービス「Cloud Run instances」をプレビュー公開した。サーバーレスの利便性を保ちながら、単一インスタンスを長期間動かし続けるための専用ランタイムだ。
1vCPU・1GiBメモリの構成なら、30日間連続稼働して月額5.70ドル。従来の専用VMと比較すると運用コストと管理負担を大幅に抑えられる。
パーソナルAIエージェントを自宅のPCや専用サーバーで動かしていた開発者にとって、クラウド移行の有力な選択肢になる。本記事ではCloud Run instancesの特徴、料金構造、実際のデプロイ手順までを解説する。
Cloud Run instancesの基本と既存サービスとの違い
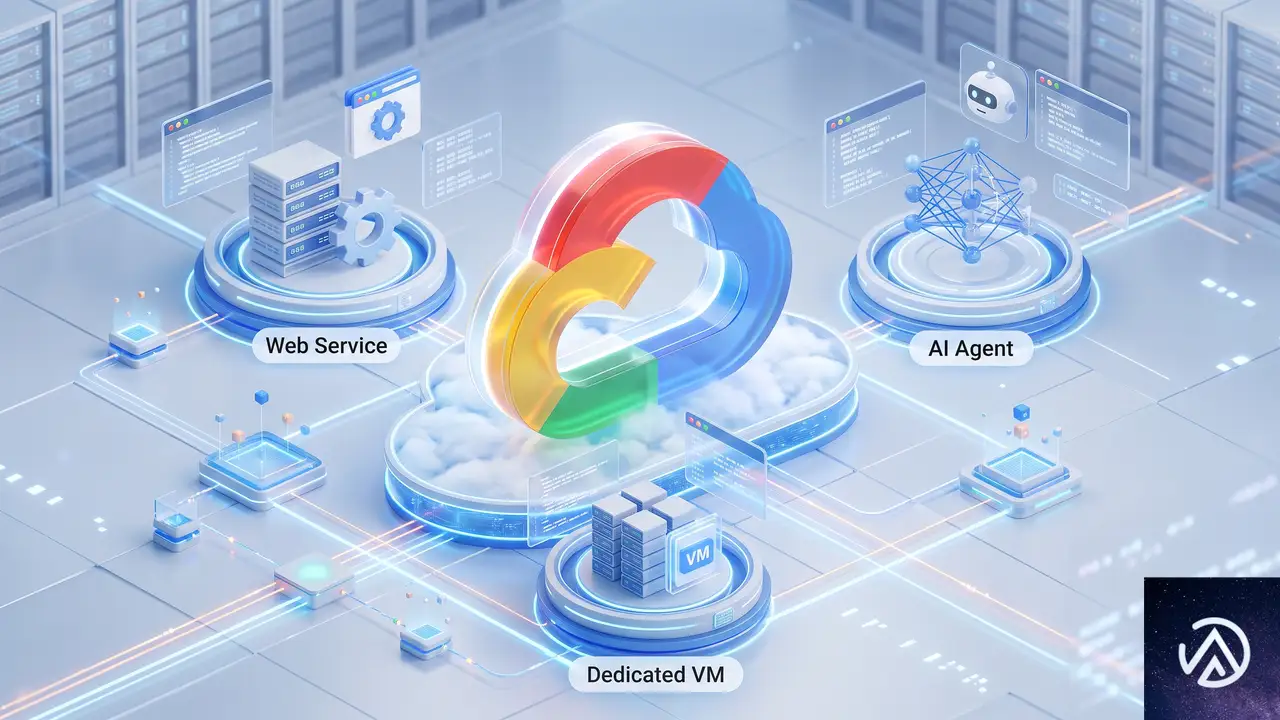
Cloud Run instancesは、Google Cloudのサーバーレスコンテナ基盤であるCloud Runの新しい実行モードだ。既存のCloud Run servicesが高スループットなWebサービス向けに設計されているのに対し、Cloud Run instancesは「1つのインスタンスを確実に動かし続ける」ことに特化している。
主な特徴は次の4つにまとめられる。
- オートスケーリングなしの単一インスタンスのみを実行する
- 最大7日間の連続実行と自動再起動ポリシーを標準で備える
- 更新や再起動後も変わらない固定HTTPS URLが発行される
- 使わないときは停止し、必要なときに再開できる
3つの実行環境の違いを比較した図だ。Cloud Run instancesは既存Cloud Runと専用VMの中間的な位置づけで、サーバーレスの手軽さと常時稼働の確実性を両立している。
既存のCloud Run servicesとの決定的な違い
Cloud Run servicesは、リクエストが途絶えるとインスタンスがスケールゼロになる。これは高トラフィックなWeb APIには効率的だが、常に1つのコピーが動き続けることを期待するAIエージェントには不向きだ。一方、Cloud Run instancesはオートスケーリングを行わず、指定した設定のインスタンスを1つだけ動かし続ける。これが最大の設計上の違いになる。
なぜAIエージェントに最適なのか
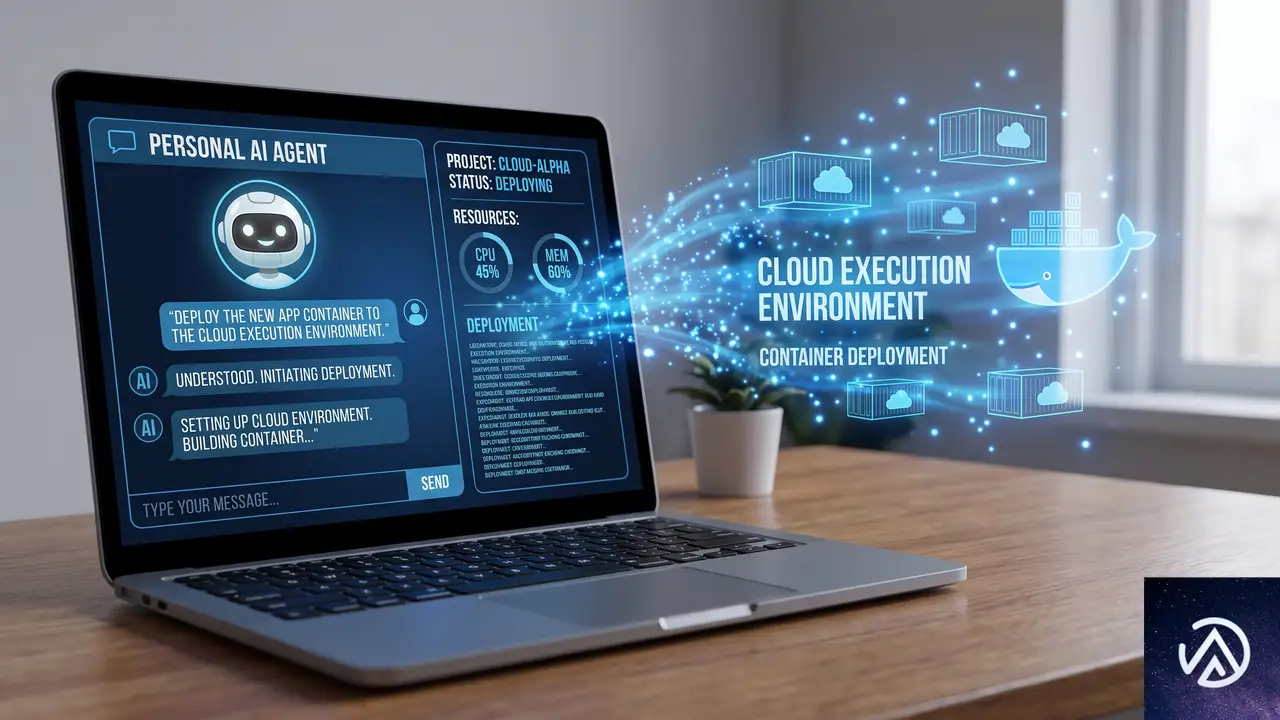
OpenClawやHermesといったパーソナルAIエージェントは、継続的に動作し、通常は一度に1人のユーザーにしかサービスしない。これらの特性は、ステートレスな高スループットWebサービスとはインフラ要件が大きく異なる。
OpenClawは、ユーザーの代わりにさまざまなタスクを実行するオープンソースのパーソナルAIエージェントだ。使うほど学習して賢くなる。多くのOpenClawユーザーは最初に自分のノートPCで実行し始めるが、ノートPCがスリープするたびに停止してしまう問題に直面する。ここでクラウド上の常時稼働環境が必要になる。
従来の選択肢の問題点
専用VMを借りる方法もあるが、24時間365日の課金、OSのアップデート管理、ファイアウォールのポート開放、HTTPSエンドポイントの構築といった手間が発生する。Cloud Run instancesはこれらの管理タスクをクラウド側に任せつつ、低コストで常時稼働を実現する。
ここでのポイントは、AIエージェントのワークロードが「バースト型」であることだ。普段は待機状態でCPUをほとんど使わず、ユーザーが指示を出した瞬間だけ計算リソースを消費する。共有vCPUとバーストバジェットによる課金モデルは、このバースト型の特性と相性が良い。常時フルパワーのCPUを確保する必要がないため、価格を抑えられる。
料金とコスト構造の分析
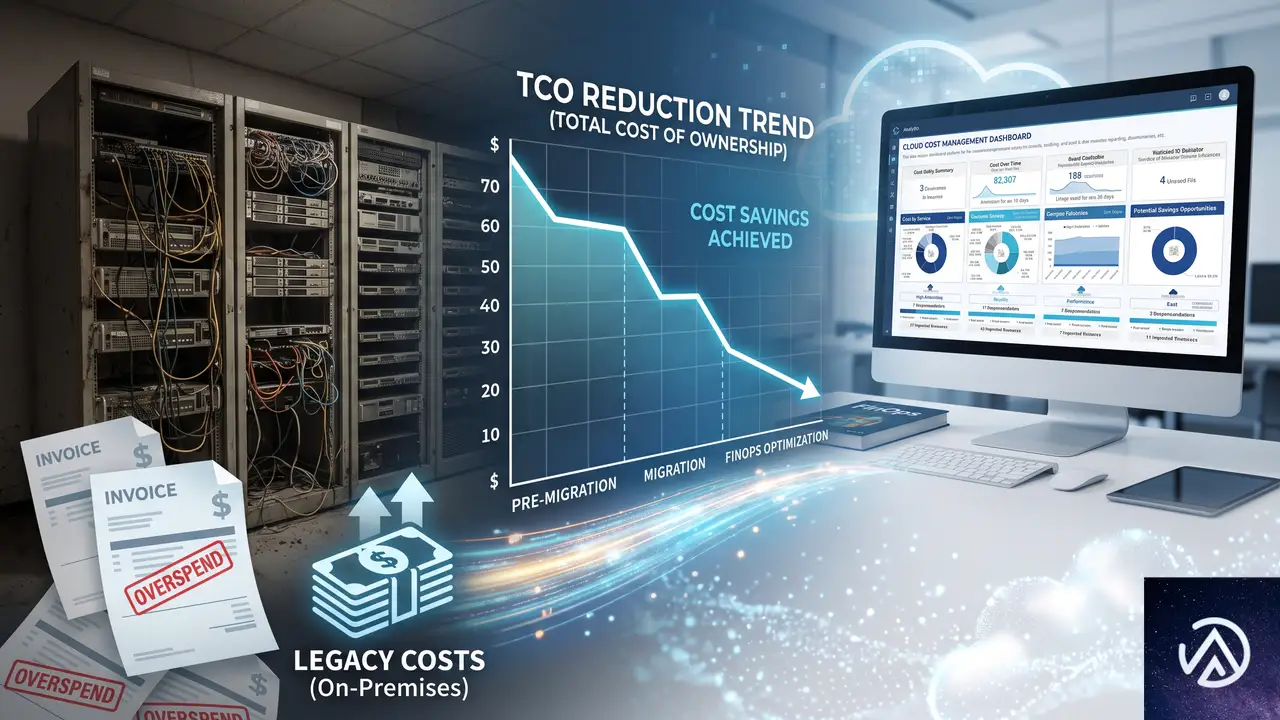
1vCPU・1GiBメモリのCloud Run instanceを30日間連続稼働させた場合のコストは5.70ドル。共有vCPUとvCPUバーストバジェットを利用して、低く予測可能な価格で連続実行を実現している。
従来の専用VMと比べると、クラウド料金に大きな差がある。30日間連続稼働でわずか5.70ドルという価格は、個人開発者が気軽に試せる水準だ。
価格設定の分析
5.70ドルという価格は、パーソナルAIエージェントの利用シーンを想定した戦略的な設定だ。個人開発者がノートPCの代わりにクラウドでAIエージェントを常時稼働させるには、月額10ドル以下という心理的なハードルが大きい。Cloud Run instancesはこの価格帯を実現したことで、パーソナルAIエージェントのクラウド移行を加速する可能性がある。
OpenClawデプロイの実践手順
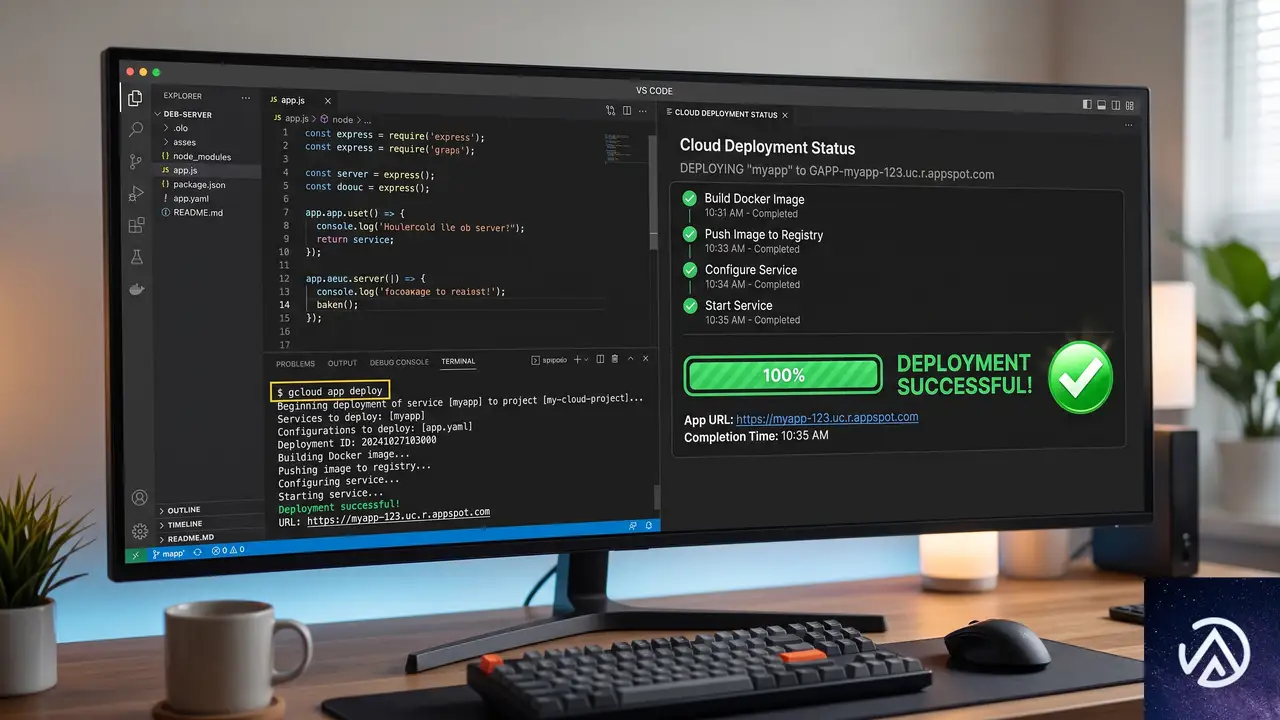
OpenClawをCloud Run instancesにデプロイする手順はシンプルだ。設定ファイルをCloud Storageバケットにアップロードした後、1つのコマンドを実行するだけでデプロイが完了する。
デプロイ後のOpenClawは、使いたい限り動かし続けられる。メッセージングアプリと接続してタスクを任せることも、必要なツールと連携させることも可能だ。
SSHアクセスと今後のアップデート
Cloud Run instancesとCloud Run servicesの両方で、SSHアクセス機能が近日中に提供される予定だ。これにより、実行中のコンテナに直接ログインしてデバッグや設定変更ができるようになる。詳しい手順はCloud Runのcodelabで公開されている。
ユーザー事例と今後の展望
OffDeal社の導入効果
中小企業向けのAI投資銀行を提供するOffDealは、Cloud Run instancesを長期間稼働するエージェントの主要インフラとして利用している。OffDeal社のLuis Ruiz Morel氏によれば、コールドスタートが88%削減され、実装も非常にシンプルで信頼性が高いとのことだ。
コールドスタート88%削減とは、エージェントが待機状態からタスクを開始するまでの起動時間が大幅に短縮されたことを意味する。AIエージェントの応答性がビジネス成果に直結するユースケースでは、この改善は大きな価値となる。
プレビューからGAへ
Cloud Run instancesは現在プレビュー段階で、パフォーマンスを犠牲にせずに新しい種類のワークロードをコスト効率よく実行する手段として提供されている。今後、GA(一般提供)への移行とともに、より多くのAIエージェントワークロードがこの基盤に集約される可能性がある。
Cloud Run instancesの登場は、サーバーレスコンピューティングの適用範囲を「常時稼働するステートフルなワークロード」にまで広げる動きとして捉えられる。従来のサーバーレスは「イベント駆動・ステートレス・短期実行」が前提だったが、AIエージェントのような新しいワークロードの台頭が、この前提を変えつつある。Google Cloudがこのニーズに素早く応えた形だ。
この記事のポイント
- Cloud Run instancesは常時稼働するAIエージェント向けの新しいサーバーレス実行環境
- 単一インスタンスのみ、オートスケーリングなし、最大7日間連続実行
- 1vCPU・1GiBメモリで30日間連続稼働して月額5.70ドル
- 固定HTTPS URLが提供され、停止・再開も自由
- OpenClawを1コマンドでデプロイ可能
- 近日中にSSHアクセス機能が追加予定
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon Bedrock AgentCoreにランタイムインスタンス発表、本番AIエージェント向け永続コンピューティング
AWSは2026年8月6日、Amazon Bedrock AgentCoreに新たな計算オプション「ランタイムインスタンス」を追加した。AIエージェントのプロトタイプを本番環境に移行する際、長時間の状態維持やマルチエージェント協調、GPUアクセスといった要求に応える、永続的なマネージドインフラだ。
従来のAgentCore Runtimeでは、マイクロVM上で最大8時間のステートフルな呼び出しが可能だったが、日をまたぐワークフローやOSレベルへの直接アクセスが必要なシナリオには限界があった。ランタイムインスタンスは、14日間のセッション永続化とEC2ベースのフルマネージド環境を提供し、本格的なエージェント運用基盤を実現する。
ランタイムインスタンスが解決する本番運用の3つの課題

AIエージェントをプロダクションに投入するとき、開発者はインフラの壁にぶつかる。ランタイムインスタンスはその3つの主要な課題を解消する。
長時間の状態維持とセッション永続化
通常のサーバーレス実行環境では、処理が終わるとメモリやストレージが破棄される。エージェントが数時間〜数日にわたる複数ステップのワークフローを扱う場合、途中結果を外部ストレージに退避させるなどの手間が生まれる。ランタイムインスタンスでは、最大14日間の共有セッションストレージが標準で提供される。セッションは停止・再開が可能で、アイドル期間のコストを抑えながら、必要なときに前回の状態から処理を再開できる。
マルチエージェントの同一ホスト協調
現実の複雑なタスクは、コード生成・レビュー・テスト・デプロイといった複数の専門エージェントが連携して初めて完結する。ランタイムインスタンスでは、複数のエージェントを同一のEC2ホストにデプロイし、共有ファイルシステムを介して直接データをやり取りできる。API呼び出しやネットワーク越しのストレージを挟むオーバーヘッドがなく、シームレスな協調が可能だ。
GPUとOSへの直接アクセス
画像認識や動画解析、重い数値計算を伴うエージェントはGPUを必要とする。ランタイムインスタンスはGPUアクセラレーテッドなインスタンスタイプに対応し、OSレベルへのアクセスも提供する。コードのコンパイル、セキュリティスキャン、GUI自動操作など、コンテナだけでは実現しにくいタスクをエージェントに任せられる。
コードライターとレビュアーの連携を実際に見る
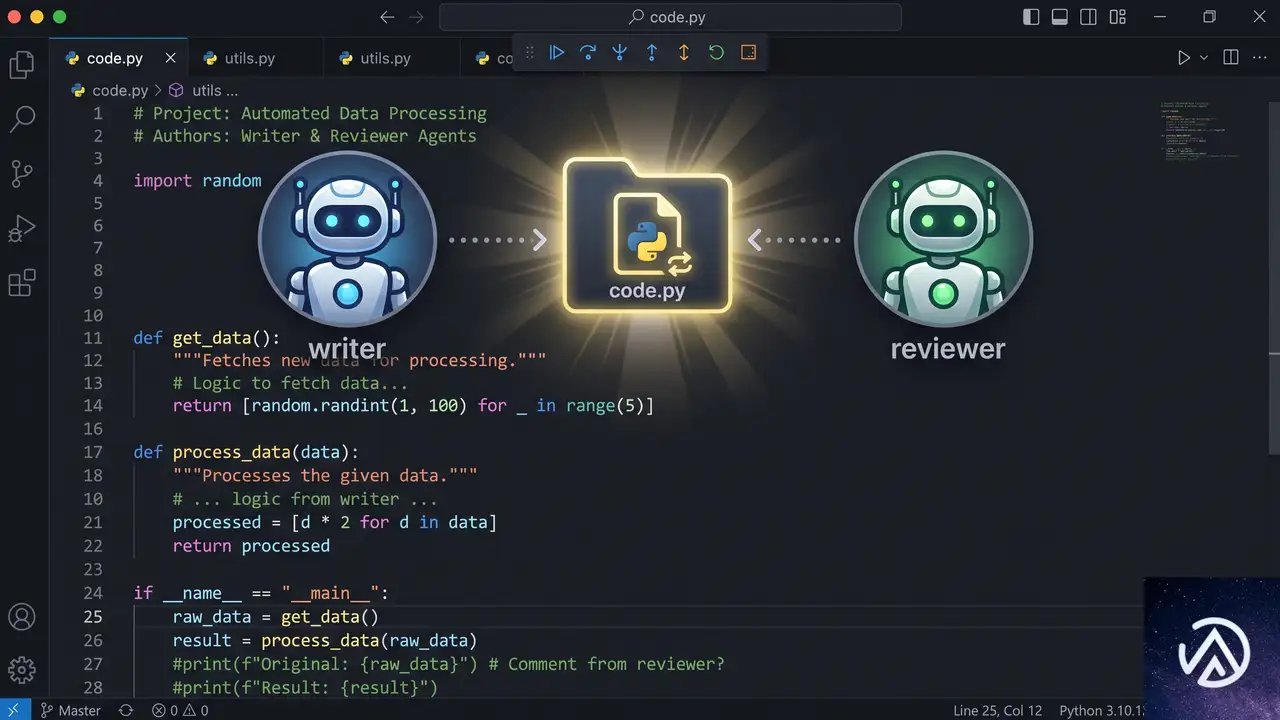
公式デモでは、自然言語でPythonコードを生成する「コードライターエージェント」と、生成されたコードのバグやスタイルをレビューする「コードレビュアーエージェント」を同じランタイムインスタンス上にデプロイし、協調動作させる手順が紹介された。
このデモのポイントは、2つのエージェントが完全に独立したアプリケーションでありながら、セッションIDで紐づく共有ディレクトリを経由してファイルをやり取りする点にある。外部APIを呼び出すことなく、同一ホストのファイルシステム上で完結するため、レイテンシが極めて小さい。
/tmp/agentcore-session/{session_id}/code.py に書き込む各エージェントはStrands Agentsフレームワークと好みのモデル(デモではClaude Sonnet)を使い、単一のPythonファイルに @app.entrypoint デコレータを付けるだけで実装できる。パッケージングもzipまたはコンテナイメージで済み、インフラ管理の負担は大きく軽減される。
セットアップから初回実行までの流れ

ランタイムインスタンスの利用は、大きく3つのステップで完了する。AWSマネジメントコンソールを使う場合の手順を簡潔にまとめた。
- 容量プロバイダの作成 、 エージェントが稼働するEC2インスタンスのスペックとネットワークを定義する。OS(ARM64またはx86_64)、インスタンスタイプ、VPC、サブネット、セキュリティグループを設定。ストレージはgp3ボリュームがデフォルトで用意される。
- ランタイムの作成とエージェントのデプロイ 、 コンピュートタイプに「Instances」を選び、先ほど作成した容量プロバイダを紐づける。エージェントのコードをzipでアップロードし、ランタイム(Python 3.11〜3.14)とエントリポイントを指定。IAMロールもコンソールが自動生成する。
- エージェントの呼び出しと協調 、 デプロイ完了後、コンソールの「Runtime playground」からテスト用のJSONペイロードを送信できる。セッションIDを明示的に指定し、同じIDで別のエージェントを呼び出せば、両者が同一の共有ストレージを使ってシームレスに連携する。
容量プロバイダは一度作成するとOSやインスタンスタイプの変更ができない。本番用と検証用を分けるなど、事前の設計が求められる。
主要スペックと料金モデル
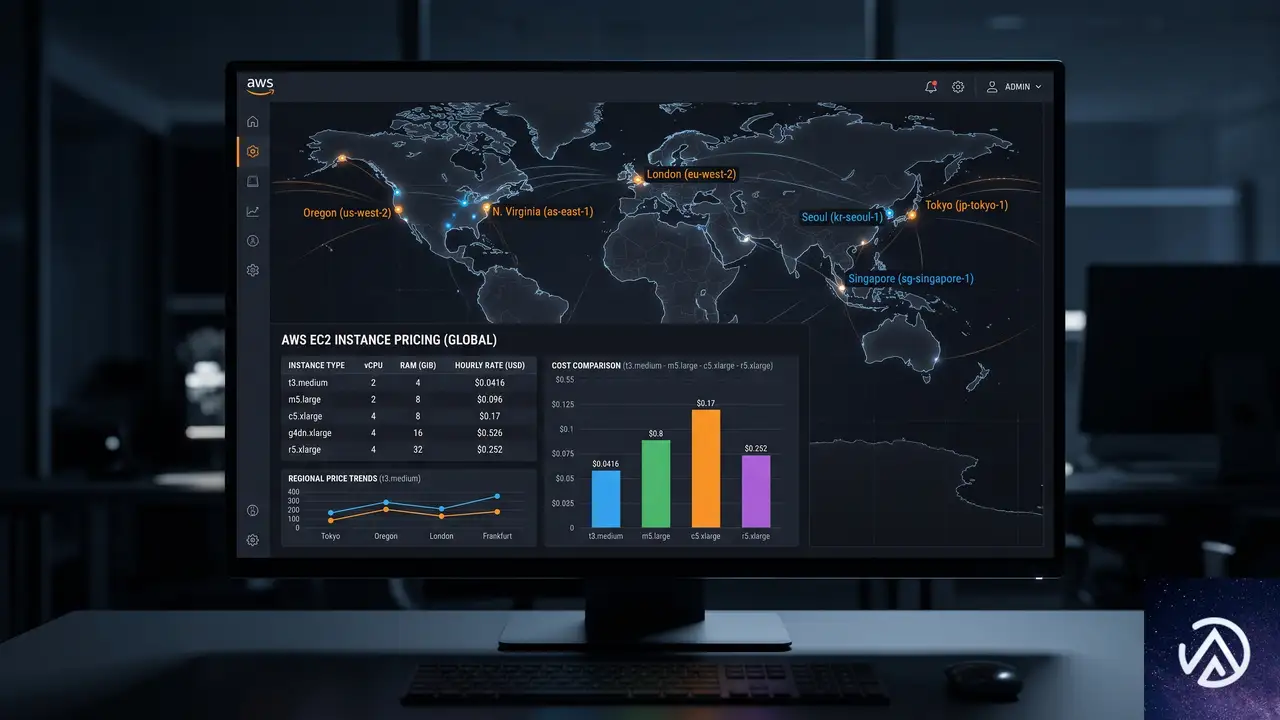
- 対応OS 、 Linux(ARM64、x86_64)。Windowsは現時点ではサポート外
- セッション持続 、 最大14日間。停止・再開が可能で、アイドル中のコスト削減に有効
- ランタイム 、 Python 3.11〜3.14(ネイティブコードに対応)。コンテナイメージのデプロイもサポート
- GPU 、 対応インスタンスタイプを選択すれば、GPUを使った推論や計算が可能
- 統合 、 既存のAgentCore API、IAM、監視機能と完全互換。マイクロVMとのハイブリッド構成も取れる
- 料金 、 使用したEC2インスタンスの標準料金に、AgentCoreオーケストレーションの管理手数料が加算される
- リージョン 、 米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、アジアパシフィック(ムンバイ、シンガポール、シドニー、東京)、欧州(フランクフルト、アイルランド)
マイクロVMベースの従来のAgentCore Runtimeとランタイムインスタンスは、同じAPIセットで併用できる。軽量なオーケストレーターエージェントをマイクロVM側に置き、重い処理や永続状態が必要なワーカーエージェントをインスタンス側に委譲するハイブリッド構成が、現実的なアーキテクチャパターンとして紹介されている。
始め方と最初の一歩
ランタイムインスタンスを試すには、Amazon Bedrock AgentCoreのドキュメントに掲載されているランタイムインスタンスの公式ガイドを参照し、容量プロバイダの作成から始めるのが近道だ。コンソールの左ナビゲーションから「Runtime」→「Capacity providers」を選び、今回紹介した手順に沿って設定すれば、最初のエージェントデプロイまで数分で到達できる。
この記事のポイント
- ランタイムインスタンスは、最大14日間のセッション永続化とEC2ベースのマネージド環境を提供するAgentCore新オプション
- 同一ホスト上でのマルチエージェントファイル共有により、APIを介さないシームレスな協調が可能
- GPUインスタンスやOS直接アクセスが必要な高度なエージェントワークロードに対応
- 従来のマイクロVMと組み合わせたハイブリッド構成で、軽量なオーケストレーションと重いバックエンド処理を分離できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare AI Searchがエージェント検索を簡素化、公開エンドポイントと価格プレビュー発表
Cloudflareは2026年8月6日、AI Searchに大規模な機能拡張を発表した。従来はWorkers AIやVectorize、R2、Browser Runといった複数のプリミティブを組み合わせて独自の検索パイプラインを構築する必要があった。今回のアップデートによりAI Searchがこれらの処理を自動化し、開発者やエージェントが、まるで自前の検索エンジンを持っているかのような感覚で扱えるようになった。
新機能として、複数のWebサイトやファイルを横断して検索できる公開エンドポイントの提供、サイトマップ不要のクロール機能、カスタムドメインによるブランディング、EmDash CMS向けの検索プラグインなどが追加された。さらにプレビュー価格モデルも発表され、デフォルトの埋め込み・リランキングモデルを利用すれば、これらの処理が無料になる予測可能な料金体系が示されている。エージェントが信頼できる情報源から回答を引き出せるインフラが、これまでより格段に手軽になった。
AI Searchの主な機能強化点

AI Searchを導入する前は、ベクトル化したデータの格納先やクローリングの仕組み、リランキングのパイプラインなどを開発者が自前で組み上げる必要があった。しかし今回の強化により、それらの低レベルなサービスを意識せずに済む。結果としてエージェントが信頼できる最新情報を引き出せるインフラが、数分で立ち上がるようになった。
インデックス作成の簡素化
これまでAI SearchでWebサイトをインデックスに追加する際は、サイトマップが必須だった。しかし新たに追加された「Discover」パースオプションを使えば、サイトマップがなくてもページ内のリンクを辿って自動的にコンテンツを収集できる。Cloudflareアカウントに登録されたゾーンであれば、特定のページから始まる全サイトデータを取り込めるようになった。
さらに、HTMLやPDFなどの非構造化データから構造化データまで、幅広いファイル形式に対応した取り込みが可能になった。これにより社内Wikiや製品マニュアルといった多様なデータソースをエージェントの検索対象に加えやすくなっている。
公開検索/MCPエンドポイント
ネームスペースに対して公開URLを有効化すると、/search と /mcp のエンドポイントが即座に利用できるようになる。/search は通常のREST APIとして、/mcp はモデルコンテキストプロトコル(MCP)に対応した形で提供される。どちらも認証不要で、複数のインスタンスにまたがる横断検索を1つのリクエストで実行できる。
外部のエージェントやアプリケーションに検索機能を提供したい場合、このエンドポイントをそのまま公開するだけで済む。Cloudflare以外の顧客に自社データへアクセスしてもらうシナリオでも、認証が不要で、URLを渡すだけのシンプルな共有が可能になっている。
EmDashとの統合とbotポリシー
Cloudflareが公開しているOSSのCMS「EmDash」向けに、AI Searchプラグインが提供された。これを導入すると、EmDashで構築したサイト内にセマンティック検索を組み込める。実際にCloudflare BlogやDeveloper Docsもこの仕組みで動いている。
また、AI Searchのクローラは独自のユーザーエージェント「Cloudflare-AI-Search」を使い、各サイトのrobots.txtに従う。ブラウザベースのクローリング機能を使う場合でも、このポリシーは変わらない。サイト運営者がクロールを拒否すれば収集が停止されるため、著作権や利用規約上の配慮が十分になされている。
Cloudflare Dev Stack MCPの実装事例
Cloudflare自身がAI Searchをどう活用しているかを示す好例が、新しく公開された「Cloudflare Dev Stack MCP」だ。これはCloudflareのエコシステム全体(ドキュメント、ブログ、APIリファレンス、コミュニティなど)を横断検索し、コーディングエージェントへ最新の引用付き回答を返す仕組みである。古いトレーニングデータではなく、常にフレッシュな情報を基にコードを生成できる。
インスタンス作成とクロール
CloudflareはDocs、Blog、API Docs、コミュニティ、Astro、Viteなど計10以上のサイトに対して、それぞれ個別のAI Searchインスタンスを作成した。各インスタンスはドメインが異なるが、Cloudflareが所有するサイトデータであるため、統一的な方法でクロールできる。
npx wrangler ai-search instance create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
--parse-type discover上記のコマンドでは、--parse-type discover を指定することでサイトマップなしにページを発見するクロールを実行している。この内部ではBrowser Runの/crawl機能が使用され、リンクを辿って再帰的にページを見つけ出す。
Workerを使ったマルチインスタンス統合
10個のインスタンスにまたがる横断検索を実現するため、CloudflareはWorkerを用いたMCPサーバを構築した。wrangler.jsonにAI Searchネームスペースのバインディングを追加し、1つのツール呼び出しで全インスタンスを同時に検索する。
{
  "ai_search_namespaces": [
    { "binding": "AI_SEARCH", "namespace": "cloudflare-stack" }
  ]
}
context.registerTool(
'search_dev_stack',
{
description: 'Search current docs across the Cloudflare stack.',
inputSchema: z.object({ query: z.string() }),
},
async ({ query }) => {
const res = await context.env.AI_SEARCH.search({
query,
ai_search_options: {
instance_ids: ['developers-cloudflare-com', 'astro', /* ... */],
retrieval: { max_num_results: 10 },
reranking: { enabled: true },
},
})
return { content: [{ type: 'text', text: format(res.chunks) }] }
}
)この方式により、エージェントが単一のツール呼び出しで全ドキュメントを検索でき、結果にはどのインスタンスから取得されたかのメタデータが付与される。複数の検索先を順に叩く必要がなく、応答速度も一括で処理される。
コード不要の公開エンドポイントも選択可能
Workerを書かずに済ませたい場合、ネームスペースの公開URLを有効化するだけで、すべてのインスタンスにクエリを投げる/searchおよび/mcpエンドポイントが得られる。設定画面からワンクリックで有効化でき、即座に利用を開始できる。Cloudflare自身のMCPサーバもこの公開エンドポイントを活用している。
コードを書く場合は細かいチューニングやMCPツールとしての統合が可能で、コードを書かない場合は設定画面上の操作だけで外部共有が完了する。どちらの選択肢も提供されている点が、利用者のスキルや要件に応じた柔軟な導入を後押しする。
公開エンドポイントとカスタムドメインで検索を共有
AI Searchでは、公開エンドポイントに独自のカスタムドメインを割り当てられる。デフォルトのCloudflare管理URLではなく、search.example.com/mcpといったブランド化されたエンドポイントを用意できるため、サービス提供時の信頼感が高まる。
さらに、検索を限定公開したいケースではCloudflare Accessを介した認証ゲートを追加できる。これによりエンドポイントへのアクセスを許可された人物やエージェントだけに制限し、認証情報を持たない第三者からの不正なクエリを防げる。社内データや顧客限定の検索サービスを安全に運用できる設計になっている。
このカスタムドメイン機能は、SaaSプロダクトやエージェントサービスを展開する事業者にとってとくに有用だ。自社ブランドのURLで検索APIを提供することで、サービス全体の統一感が生まれ、導入先からの信頼獲得につながる。
プレビュー価格モデルでコストを予測可能に
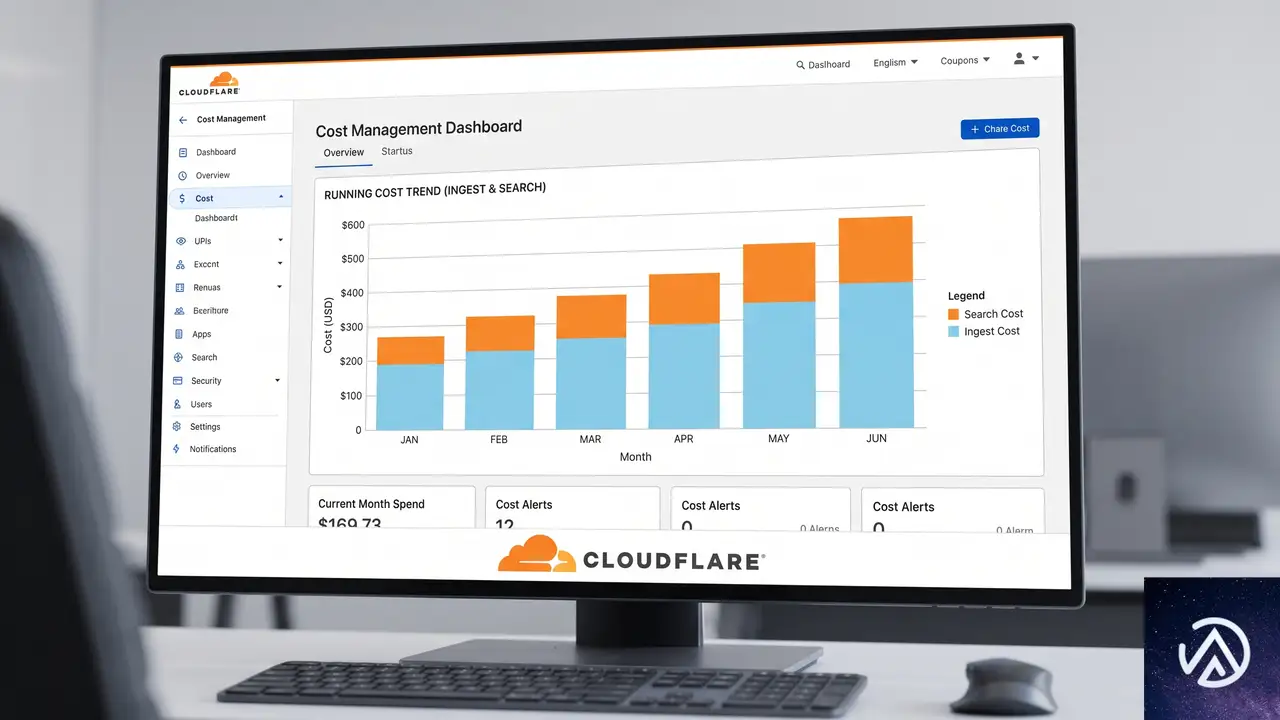
AI Searchは現在ベータ版として無料提供されているが、正式版に向けたプレビュー価格が公開された。課金開始前には十分な通知が行われる予定だ。料金設計の中心にある考え方は「予測可能でスケーラブル」であり、埋め込みとリランキングをデフォルトモデル利用時に無料化することで、トークン数の見積もりに頭を悩ませる必要をなくしている。
料金の主な内訳
- インジェスト(テキスト): $0.75 / 1Mトークン。月間無料枠5Mトークン。
- 画像処理アドオン: +$0.50 / 1Mトークン。画像の埋め込みに使用される。
- ストレージ: $2.00 / GB・月。月間無料枠10GB。
- セマンティック検索(ハイブリッド+ベクトル): $0.75 / 1,000クエリ。無料枠2,000クエリ。
- 全文検索: $0.10 / 1,000クエリ。同上の無料枠と共有。
- 埋め込みとリランキング: 指定モデル利用時は無料。それ以外はWorkers AIの従量課金。
無料枠はインジェスト5Mトークンと検索2,000クエリがそれぞれ一つのプールとしてまとめられており、用途を気にせず使い切れる。埋め込みやリランキングのコストが気にならないため、データ更新や再インデックスの頻度を高めやすい。これは頻繁に情報が変わるナレッジベースをエージェントに与えたい開発者にとって大きなメリットだ。
2万ドキュメント規模の試算例
以下は、2万件の文書(約2,000万トークン)と1,000枚の画像をインジェストし、月間3万回のセマンティッククエリを実行した場合の想定コストである。ワーカーズ有料プランが前提で、埋め込みとリランキングにはデフォルトモデルを使用する。
- インジェスト(テキスト): 18.1Mトークン × $0.75/1M = $13.58
- 画像アドオン: 1.1Mトークン × $0.50/1M = $0.55
- ストレージ: 約1.2GB → 無料枠内で$0
- 検索: 28,000クエリ × $0.75/1k = $21.00
- 埋め込み・リランキング: $0
- 合計: 約$35.13
初月にインジェスト費用がかかるが、2か月目以降は主に検索クエリ分だけ(この例では約$21)で運用できる。ドキュメントの大幅な増加がなければ、ランニングコストを低く抑えられる構造だ。
このように、AI Searchのコストは初回のデータ登録が大部分を占め、その後は利用量に比例した検索料金のみになる。大規模なデータベースを抱える場合でも、固定費ではなく使った分だけ支払うモデルのため、予算計画が立てやすい。
AI Searchの導入方法
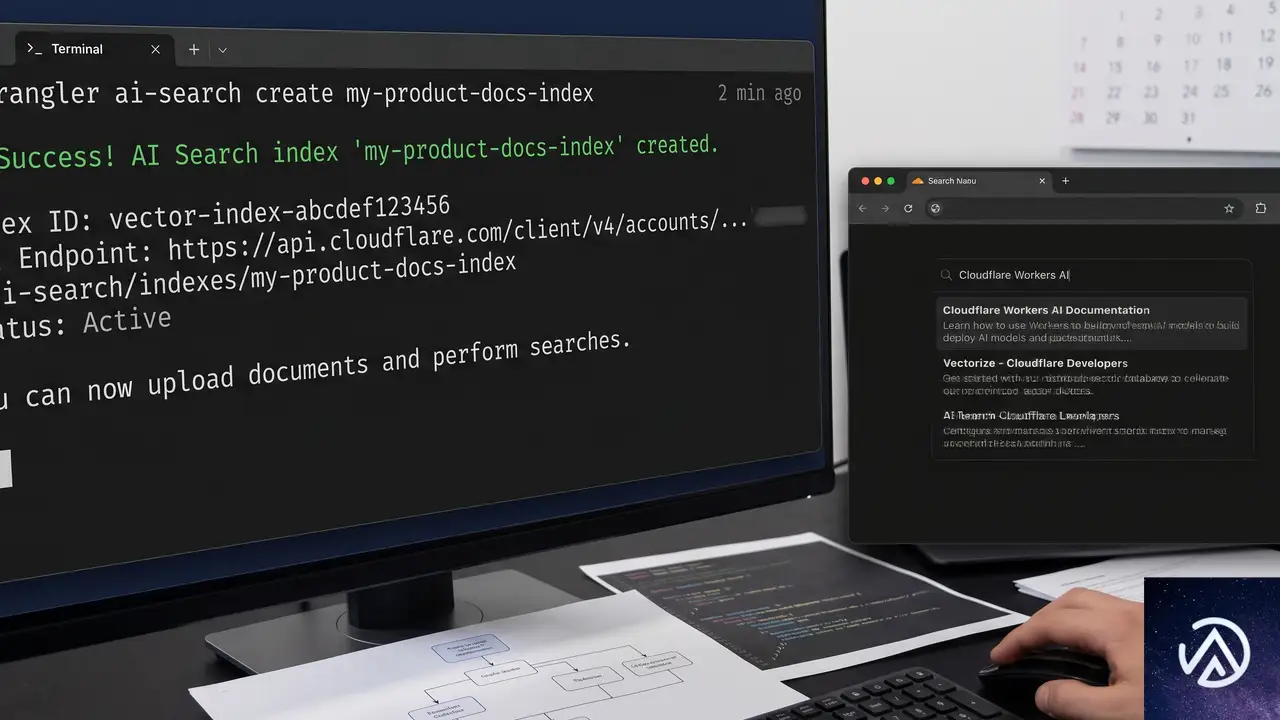
AI SearchはCloudflareダッシュボードから有効化し、すぐに使い始められる。もっとも簡単な導入は、次のwranglerコマンドでインスタンスを作成する方法だ。
npx wrangler ai-search create my-search \
  --namespace my-namespace \
  --source https://my-website.com \
  --type web-crawler \
--hybrid-searchこの1行でWebクローラー型のインスタンスが立ち上がり、ハイブリッド検索(セマンティック+キーワード)が有効になる。クロールが完了すれば、/searchエンドポイントで検索APIとして利用できる。さらに/mcpエンドポイントを使えば、ChatGPTやClaudeなどのモデルが直接ツールとして呼び出せる。
既存のアプリに組み込む場合はWorker経由でバインドし、エージェントと連携させればよい。カスタムドメインやCloudflare Accessを設定すれば、プライベートな検索サービスとしても公開できる。詳しい手順は公式ドキュメントを参照してほしい。
この記事のポイント
- Cloudflare AI Searchは、複数サービスの組み合わせを自動化し、データ検索基盤をワンストップで提供する。
- 公開/MCPエンドポイントやカスタムドメインにより、エージェントへの組み込みや外部共有が容易になった。
- サイトマップ不要のクロールやEmDash CMSとの統合で、あらゆるデータソースを取り込める。
- プレビュー価格ではデフォルトモデルの埋め込み・リランキングが無料で、予測しやすいコスト構造が示された。
- wranglerコマンド1行でセットアップが完了し、すぐにエージェント向け検索エンジンとして利用開始できる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Supabase Evals公開、AIエージェントのコード品質を自動評価する基盤
Supabaseが2026年7月31日、AIコーディングエージェント向けの評価フレームワーク「Supabase Evals」をオープンソースで公開した。Claude CodeやCodex、OpenCodeといった主要エージェントを使い、実際のSupabaseプロジェクト開発を自動で試行し、その成否を定量的に測る仕組みだ。
このフレームワークは、エージェントがデータベーススキーマの構築やEdge Functionsのデバッグ、RLSポリシーの修正といったタスクをどれだけ正確にこなせるかを評価する。公開されたベンチマーク結果は誰でも閲覧でき、エージェントの得意分野や弱点が数値で把握できる。
なぜSupabaseがこの基盤を作ったのか。AIを使ってSupabase上にアプリを構築する開発者が急増する中、エージェントの「実力」を正確に把握し、改善につなげる必要があった。本記事ではその仕組みと、初期の評価で明らかになったエージェントの弱点、そして今後の展望を解説する。
Supabase Evalsが目指すもの
Supabase Evalsは、AIコーディングエージェントがSupabaseを使った開発タスクを実行する際のパフォーマンスを評価するためのフレームワークだ。ベンチマークテストとリグレッション(回帰)テストの2つのスイートを持ち、エージェントの実力を多角的に測る。
具体的には、エージェントがCLIやMCPサーバー、各種ドキュメントを活用しながらスキーマ設計やEdge Functionsの作成、RLSポリシーの修正などを行う。その結果を「ユーザーが特定のデータにアクセスできるか」「Edge Functionが期待通りのレスポンスを返すか」といった決定論的なチェックと、LLMによる判定(LLM-as-a-judge)でスコア化する。
この基盤は、Supabaseが公開する公式ベンチマークのほか、日次で動作する内部のリグレッションスイートにも利用されている。これにより、新しい機能がエージェントの動作を悪化させていないかを継続的に監視できる。
なぜ今、AIエージェント評価基盤が必要なのか

AIコーディングエージェントを使った開発は日常化しつつある。SupabaseのCLIやMCPサーバー、エージェントスキル、ドキュメントを介してエージェントがプロジェクトを構築するケースが増えてきた。しかし、各エージェントがどこでつまずき、どの機能がうまく使えていないのかを体系的に把握する手段が不足していた。
Supabaseの公式ブログ記事によれば、エージェントが苦手とするパターンを特定し、それを修正した上で再発防止(リグレッション)を確認するサイクルを回すことが目的だ。単一のツールだけではなく、Supabaseが提供するすべてのインターフェースを横断的に評価できる点が特徴である。
従来は開発者自身が手動でコードを書く前提だったため、エージェントに特化したテスト基盤は存在しなかった。Evalsの登場により、AI時代の開発者体験を数値で議論できる土台が整ったと言える。
評価の仕組みとベンチマーク/リグレッションの二層構造

このフレームワークでは、エージェントが実際のSupabase環境で作業するため、机上の空論ではない実用的な評価が可能だ。テスト結果はWebアプリで可視化され、誰でも確認できる。
初期ベンチマークが明らかにしたAIエージェントの弱点

スキル読み込みの効果は想定以上に限定的、ただしドキュメント参照は改善
Supabase Evalsのベンチマーク結果では、エージェントがスキル(エージェント向けの最適化ガイド)を読み込んでいない状態でも、多くのシナリオをクリアできることがわかった。ビルド段階では、Opus 5とKimi K3がスキルなしで100%のスコアを達成している。
スキル読み込みの効果は限定的だが、Sonnet 5は78%から100%へ、GPT-5.6 Solは89%から100%へ、GPT-5.4 miniは78%から89%へと改善した。特に、スキルを有効にするとSupabaseドキュメントの参照頻度が一貫して増え、古い事前学習知識を上書きする必要があるエッジケースで差がついた形だ。
宣言的スキーマを使わず、マイグレーションを手書きする傾向
Supabaseには宣言的スキーマという、データベースの構造を一つのファイルで管理できる仕組みがある。本来は複数のマイグレーションファイルをつなぎ合わせるより効率的だが、エージェントは既に宣言的スキーマが使われているプロジェクトでも、手書きのマイグレーションを作成しようとする傾向があった。
この問題を受け、Supabaseはエージェントスキルの中で「どのワークフローを選ぶべきか」の指針を明確に改訂し、Evalsを使って修正が正しく反映されたことを確認した。
新しいライブラリ「@supabase/server」の発見率が低い
Supabaseは最近、Edge Functionsを安全に書くためのボイラープレートを簡略化する@supabase/serverパッケージをリリースした。しかし、エージェントは依然としてsupabase-jsを使い、手動で認証を検証する方法を選んでしまう。
このためSupabaseは「どのパッケージを選ぶべきか」を解説する専用ガイドを公開し、エージェントの判断材料として提供している。
Postgresベストプラクティススキルの有効化が不安定
Evalsは、エージェントがセッション中にどのスキルを読み込んだかを追跡している。主要な「supabase」スキルはほぼ常に読み込まれるのに対し、Postgresのベストプラクティスを教えるスキルは当初、約1割のシナリオでしか有効化されなかった。
スキルの説明文を具体的なトリガーで書き直した結果、有効化率は60%まで向上したが、それでもOpenAIモデルの方がより安定してスキルを活用する傾向が見られる。
ドキュメント参照の頻度に大きなばらつき
Evalsの実行中、エージェントがSupabaseドキュメントを読む頻度も測定している。CodexベースのエージェントはClaude Codeよりもドキュメントをチェックする傾向があり、最も高性能なOpenAIモデルは毎シナリオ約8ページを読むのに対し、Claude Codeは約2ページにとどまる。
しかもClaude Codeはスキルを読み込んでいても、40%未満のシナリオでしかドキュメントを確認しない。Supabaseはエージェントが必要な情報を確実に見つけられるよう、改善を進めている。
AIエージェント時代のSupabase開発体験を支える展望
Supabase Evalsはまだ出発点に過ぎない。今後はエッジケースのカバレッジを広げ、エージェントやプロダクトの進化に合わせて新しいシナリオを追加していく計画だ。スコアリングの精度と安定性も引き続き強化される。
また、内部のリグレッションシナリオのなかで信頼性が確認されたものは、順次公開ベンチマークへと格上げされる方針である。さらに、エージェントがタスクに失敗した際にフィードバックを提出できるCLIコマンドやMCPツールも開発中で、これにより次の改善優先度をデータドリブンに決定できるようになる見込みだ。
AIコーディングエージェントを本格的にプロダクト開発に組み込むチームにとって、Supabase Evalsは「エージェントが何を得意とし、どこでつまずくのか」を数値で判断する貴重な羅針盤になる。公開されたベンチマークはsupabase.com/evalsで誰でも確認できる。
この記事のポイント
- SupabaseがAIコーディングエージェント向け評価フレームワーク「Supabase Evals」をOSS公開
- 実際のSupabase環境でエージェントを動作させ、ベンチマークとリグレッションの2層でスコア化
- 初期のベンチマークでは、スキル無しでも高スコアの一方、宣言的スキーマの無視や新ライブラリの未発見など弱点が判明
- ドキュメント参照頻度のばらつきやスキル活性化の不安定さも浮き彫りに
- 今後はエッジケースの拡充やエージェントからのフィードバック収集機能の追加を予定
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
エージェント開発ライフサイクル(ADLC)がCloudflareで始動。SDLCを超える新たな枠組み
ソフトウェア開発のライフサイクル(SDLC)が、AIエージェントの登場によって根本から再定義されようとしている。Cloudflareは2026年8月4日、エージェント中心の新たな開発モデル「Agent Development Lifecycle(ADLC)」の構想と、それを支える具体的なツールセットを発表した。
従来のSDLCは「計画→設計→実装→テスト→デプロイ→保守」という人間中心の工程だった。しかしAIエージェントがコード生成の速度を劇的に高めた結果、周辺の工程がボトルネック化している。ADLCはこの課題を解決し、エージェントがライフサイクル全体を自律的に管理できる環境を提供する。
ADLC(エージェント開発ライフサイクル)とは何か
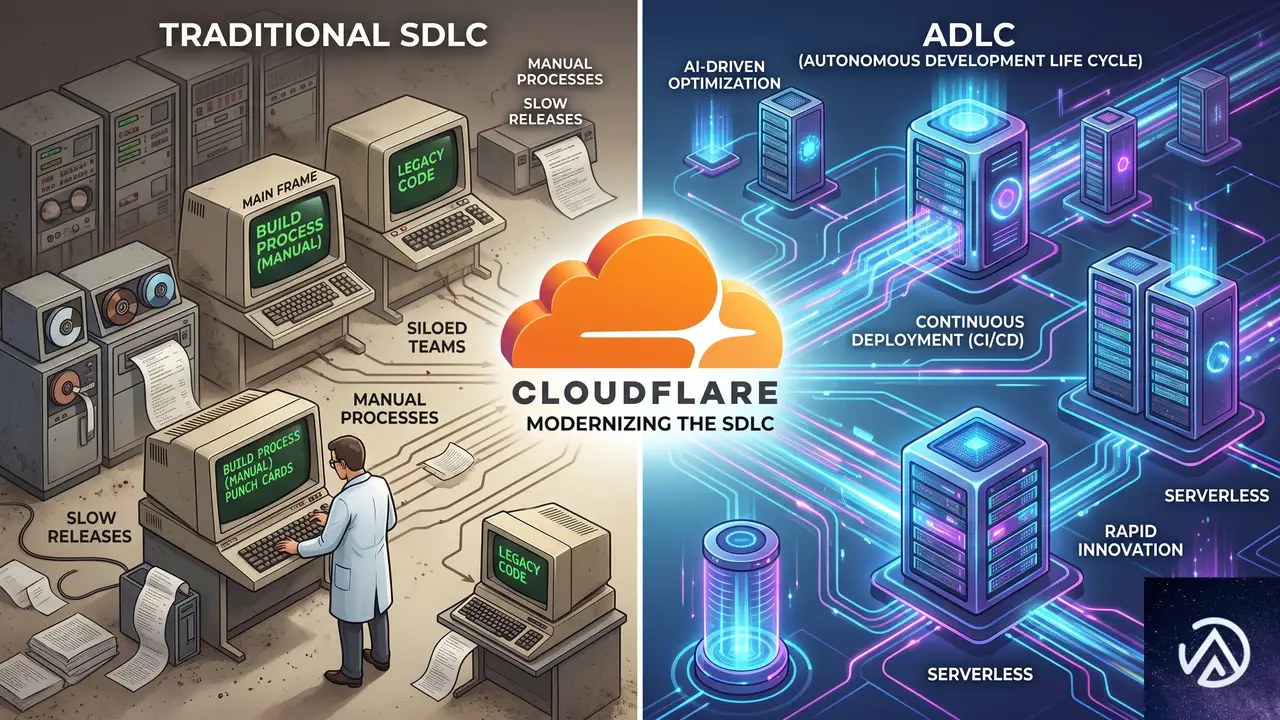
ADLCは、従来のSDLC(Software Development Lifecycle)をエージェント時代に合わせて再設計した概念だ。SDLCは1975年にランド研究所が提唱した「Systems Development Lifecycle」を起源とし、長年にわたりソフトウェア開発プロセスの標準だった。しかし、AIエージェントがコードを実装する速度は人間の比ではなく、テストやレビュー、デプロイといった他の工程が追いつかなくなっている。
Cloudflare Blogの著者Carlo Daniele氏によると、AIによって「実装」が最速かつ最安になった一方で、他の工程に携わる人々が膨大なプルリクエストやイシューに圧倒されるという逆説的な状況が生まれている。オープンソースメンテナの疲弊や本番環境の不安定化は、まさにこの非対称性の表れだ。
ADLCは、エージェントが実装だけでなく、テスト・デプロイ・監視・改善までを一貫して担うことを前提とする。そのために必要な要件は、プログラムによる操作が可能(Programmatic)、水平スケーラブル、再現可能、リアルタイムのプッシュ型イベント対応、アトミックな変更管理、適切な権限制御、そして自己改善能力の7つに整理されている。
ADLCへの移行は、単にエージェントにタスクを委譲するだけでは実現しない。Cloudflareが提唱する7要件は、いずれも人間向けに設計された既存の開発基盤では満たせないものだ。次のセクションでは、なぜこのタイミングでパラダイムシフトが必要なのかを掘り下げる。
SDLCからADLCへ なぜ今パラダイムシフトが必要なのか
エージェント時代の「人間ボトルネック」
ChatGPTやClaude、GitHub CopilotといったAIツールの普及により、コード生成のスピードは飛躍的に向上した。ところが開発現場の実態を見ると、生成されたコードのレビューやテスト、本番デプロイは依然として人間が担っている。結果として、プルリクエストの滞留が慢性化し、オープンソースプロジェクトではメンテナが数千件のイシューに対処しきれずに疲弊する事例が相次いでいる。
Cloudflareの見解では、これは「エージェントを部分的にしか使えていない」ことに起因する。実装だけをエージェントに任せ、他の工程を人間が管理するという中途半端な状態が、かえって現場の負荷を増大させているのだ。
自律走行車に学ぶ「全体最適」の視点
Cloudflare Blogの記事では、ADLCの必要性を自律走行車に例えて説明している。人間向けの車にAIを載せただけでは、80%の性能は出せても、残りの20%が致命的な事故を引き起こす。安全に走行するには、LiDARや高性能コンピュータ、遠隔制御システムといった専用設計の技術が必要だ。
ソフトウェア開発でも同じで、エージェントが安全にコードをマージし、本番にデプロイするには、人間向けのCI/CDパイプラインでは不十分だ。エージェント専用のインフラ、トレーシング、権限管理、自己修復の仕組みが求められる。
ここで鍵となるのが、Cloudflare Workflowsとエージェントの組み合わせだ。従来のGitHub Actionsのような線形のパイプラインではなく、動的に分岐し、コンテナやブラウザを立ち上げ、ログを解析しながら自律的にソフトウェアを出荷する「ワークフロー」がADLCの中核を担う。
Cloudflareが提供するADLC基盤の全容

Workflowsが実現する動的なCI/CD
Cloudflare Workflowsは、複数のステップをチェーンし、失敗したタスクを自動リトライし、数時間から数週間にわたって状態を保持できるサービスだ。従来のCI/CDパイプラインが静的なYAML定義だったのに対し、WorkflowsはTypeScriptで動的にワークフローを定義できる。
さらにWorkflowsは、エージェントや別のWorkflowを子プロセスとして起動できる。たとえば、毎晩収集したデータをエージェントにレビューさせ、その結果を元に次のステップを動的に決定する、といった高度なオーケストレーションが可能だ。
import { CIWorkflow } from '@cloudflare/ci'

// CIパイプラインの例: 依存関係インストール後、lint/test/typecheck/buildを並列実行
const deps = await ci.runner({
  name: 'install',
  command: 'bun install --frozen-lockfile',
  cache: { inputs: ['package.json', 'bun.lock'] },
});
await Promise.all([
  deps.runner({ name: 'lint', command: 'bun run lint' }),
  deps.runner({ name: 'test', command: 'bun run test' }),
  deps.runner({ name: 'typecheck', command: 'bun run typecheck' }),
  deps.runner({ name: 'build', command: 'bun run build' }),
]);
await deps.runner({
  name: 'deploy',
  command: 'bun wrangler deploy',
  cloudflareCredentials: { accountId: this.env.CLOUDFLARE_DEPLOY_ACCOUNT_ID },
});
このコードは、依存関係のインストールをキャッシュしつつ、後続のlintやテスト、ビルドを並列で実行するパイプラインを簡潔に表現している。Workflowsによって、エージェントが生成したコードを安全に検証し、本番へデプロイするまでの一連の流れを自動化できる。
エージェントの可観測性と自己改善
ADLCにおいて、エージェントの動作を監視し、改善につなげる仕組みは欠かせない。Cloudflareは、OpenTelemetryベースのトレーシングをローカル開発環境(WranglerやViteプラグイン)に組み込み、本番環境と同等の可観測性を提供する。また、Agent Tracesによってエージェントのセッション全体をキャプチャし、パフォーマンス向上に活用できる。
さらに、Feature Flag管理のFlagshipや、段階的デプロイメント(Gradual Deployments)、Browser Runによるヘッドレスブラウザのプログラム操作など、エージェントが自律的にソフトウェアをテストし、リリースするためのプリミティブが一通り揃っている。
エージェントが主導するソフトウェアファクトリーの実践例
Cloudflare自身のエンジニアリング標準化
Cloudflareは自社の全プロダクトとシステムリポジトリにわたり、AIを用いてエンジニアリング標準の遵守を強制している。具体的には、コードレビューや仕様チェックをエージェントが補助し、人間のレビュアーの負荷を軽減する仕組みだ。
これにより、コーディング規約の違反やセキュリティパターンの逸脱を自動検出し、修正案まで提示できる。人間はより創造的な設計判断や顧客との対話に時間を割けるようになったという。
Astroプロジェクトにおけるイシューゼロへの挑戦
また、CloudflareはAstroというオープンソースプロジェクトにおいて、イシューの自動トリアージ、再現、修正を行うシステムを構築した。この「ソフトウェアファクトリー」により、GitHub上のイシュー件数をゼロに近づける試みが行われている。
エージェントがバグレポートを受け取り、自動で再現環境をセットアップし、修正PRを作成する。Workflowsがこれらのステップをオーケストレーションし、テストと検証を経てマージする流れだ。この事例は、ADLCが現実のプロジェクトで有効に機能することを示している。
ADLCがもたらす開発現場の未来と課題
ソフトウェアファクトリーの民主化
現在、最先端の企業だけがソフトウェアファクトリーを構築できているのが実情だ。Cloudflareは、WorkflowsやAgent Traces、Browser Runといったプリミティブを誰でも使える形で提供することで、この格差を埋めようとしている。小規模なスタートアップでも、ADLCの恩恵を受けられるようにする狙いだ。
具体的には、@cloudflare/ciパッケージによるCI/CDの簡素化や、Flueエージェントフレームワークとの統合によって、複雑なオーケストレーションを少ないコードで実装できるようになっている。
残る課題と人間の役割
ただし、ADLCへの移行には越えるべきハードルもある。エージェントが本番環境に直接変更を加えることへの心理的な抵抗感は依然として強い。Cloudflare自身も、権限の段階的な委譲(エスカレーション)の仕組みや、監査証跡の確保が不可欠だと認識している。
また、エージェントが生成するコードの品質をどう担保するか、未知のエッジケースにどう対応するかは、自律走行車と同じく「99%の壁」をどう突破するかの問題だ。CloudflareはAgent Tracesを通じてエージェントの経験値を蓄積し、時間とともにパフォーマンスが向上する仕組みを描いているが、実運用でのデータ蓄積がこれから本格化する。
それでも、コードを書くだけのエージェントから、ソフトウェアのライフサイクル全体を駆動するエージェントへの進化は、もはや避けられない流れだろう。ADLCは、そのための地図と道路を提供するものだ。
この記事のポイント
- ADLC(Agent Development Lifecycle)は、従来のSDLCをエージェント中心に再設計した新しい開発モデルである。
- AIエージェントの実装速度に他の工程が追いつかない「人間ボトルネック」の解決を目指す。
- Cloudflare Workflowsを中核に、動的でスケーラブルなCI/CDとエージェントオーケストレーションを実現する。
- Agent TracesやBrowser Runなどのプリミティブが、エージェントの自己改善と安全な本番運用を支える。
- ソフトウェアファクトリーの民主化により、スタートアップから大企業までADLCの恩恵を受けられる時代が近づいている。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験