
AI検索の7つの神話をデータで検証。サイト運営者が知るべき真実
AI検索の台頭をめぐって「Googleは死んだ」「SEOは終わった」といった過激な主張が飛び交っている。しかし、実際のデータを確認すると、その多くが誤解や誇張であることが分かる。
本記事では、AI検索とSEOに関する7つの神話を取り上げ、調査データを基にそれぞれを検証する。サイト運営者やEC担当者が、感情的な主張に振り回されずに戦略を立てるための指針となるはずだ。
AI検索と従来型検索をめぐる3つの神話
上の図は「AI対従来型検索」という二項対立ではなく、両者が共存して成長していることを示している。
AI検索は従来型検索を殺していない
「AI検索がGoogleを駆逐する」という主張は、感情には訴えるがデータと一致しない。State of Search Q2 2026レポートによると、AI検索と従来型検索は四半期ごとにほぼ同じ成長率で推移している。
つまり、AIプラットフォームは検索需要を奪っているのではなく、既存の検索需要の上に新たな層を追加している形だ。ただし、検索需要全体が伸びる一方で、Googleが自社画面内で回答を完結させる傾向が強まった結果、外部サイトへのクリック数は減少している。
同じ調査では、Google傘下以外のデスクトップ検索結果へのクリックが2025年4月以来の最低水準にあることも示された。検索意欲は伸びているが、Googleからオープンウェブへの送客は減っている構図だ。
ゼロクリック環境でもオーガニック流入は伸ばせる
「2026年にオーガニック流入を伸ばすのは不可能」という主張も誤りだ。AI OverviewやAI Modeの影響が強い分野では苦戦するものの、地元密着型の中小企業では2026年7月に過去最高のオーガニッククリック数を記録した事例が報告されている。
重要なのは、ゼロクリック圧力が全業界に均等にかかるわけではないという認識だ。ブログ記事とサービスページの両方で、ブランドに依存しない施策のみで成果を出した例もある。業界やビジネスモデルによって影響度は大きく異なる。
AI生成コンテンツでも上位表示は可能
「GoogleやLLMはAI生成コンテンツを検出して抑制する」という神話も根強い。しかし、2025年3月から9月にかけてAIで生成し軽い人間レビューのみを経て公開した4本の記事が、現在も上位表示とパフォーマンスを維持している事例がある。
Googleが低品質で独自性のないAI出力を評価しないのは事実だ。ただし検索エンジンが判断しているのは「AIが書いたか」ではなく「付加価値があるか」という観点である。良いアイデア、専門知識、独自データ、明確な視点から生まれたコンテンツなら、AIを執筆に使っても通常の記事と同じ扱いを受ける。
テクニカルSEOの神話を検証する
llms.txtは「AIが読むためのサイトマップ」として注目されたが、現時点ではインフラ整備の域を出ない。
llms.txtに過度な期待は禁物
llms.txtとは、AIクローラーがサイト内容を理解するためのテキストファイルである。AI検索での可視性を高める目的で導入するサイトが増えたが、この方法には明確な効果が確認されていない。
まず、Googleは公式ドキュメントで「AI検索の検出にllms.txtを使用しない」と明確に述べている。さらに、10サイトを対象にllms.txt導入前後の90日間を追跡した調査では、AIクロール頻度にもAI経由のトラフィックにも測定可能な変化が見られなかった。変化があったサイトも、他のSEO施策によるものだった。
結論としては、llms.txtは「戦略」ではなく「インフラ」である。設置して損はないが、それだけでAI可視性が改善するわけではない。
LLMはJavaScriptをレンダリングできない
「最新のAIクローラーはブラウザと同じようにJavaScriptを実行できる」という主張も事実と異なる。Profoundの調査によると、新興AI検索プロバイダーの多くはJavaScriptレンダリング機能を持たず、クライアントサイドレンダリングのコンテンツを読み取れない。
サーバーサイドレンダリング(SSR)がAI可視性の観点で重要なのはこのためだ。Headless CMSやJavaScriptに依存したサイトを運営している場合、AI検索にコンテンツを認識してもらえないリスクがある。
やっかいなのは、LLM自身がこの弱点を認めないことだ。実際にChatGPTにJavaScriptで隠された記事の要約を依頼したところ、「問題なく読める」と答えた後に、実は別の記事から内容を引用していたと認めた事例が報告されている。AIが「読める」と言っても、その言葉を鵜呑みにするのは危険だ。
AI流入の計測とSEOチームの価値
AIがブランドに言及してから訪問が発生するまでに時間差があるため、成果がAI由来と認識されにくい。
AI経由の流入は97%が計測されていない
AIがサイトに送るトラフィックは「誤差レベル」と思われがちだが、実際には大幅に過小評価されている。AIのブランド言及効果を調査した研究では、AIアシスタントがブランドを言及した後、そのユーザーは今後7日間に予測ベースラインの1.5倍から2.5倍の頻度でブランドサイトを訪問することが分かった。
注目すべきは計測の難しさだ。2026年5月のChatGPTアップデートで引用件数が増えた後でさえ、AI経由の訪問のうち追跡可能な参照パラメータを保持していたのは約2.5%のみだった。つまり約97%の訪問が直接流入や自然検索として記録され、AIが起点だった痕跡を残していない。
さらに訪問のタイミングも影響する。AI言及から1時間以内に訪問したのは20.5%、24時間以内でも42%にとどまり、初回訪問の多くは翌日以降に発生する。この時間差が、AI起点の流入を人間が認識しにくい理由だ。
SEO人材をAIで置き換えるのは時期尚早
「AIが監査も記事構成も技術修正もできるから、SEO担当者は不要になる」という主張も短絡的だ。NP Digitalの調査では、AIは人間より多くのエラーを検出できたが、重要度の高いエラーを見落とし、優先順位付けも不得手であることが示された。
AIは規模の面で優れており、大量の軽微なエラーを高速で検出する。しかし、キーワード調査や検索意図の判断といった大局的な意思決定は苦手だ。Altテキストの修正やメタディスクリプションの改善といった軽微な項目を「最優先」と誤って推奨することもある。
さらにAIは、存在しない修正方法を提案したり、既に存在するページを推奨したり、明らかに悪いアイデアに自信満々で同意したりする。AIはSEOの道具箱において強力なツールだが、人間の判断を完全に代替するには至っていない。
この記事のポイント
- AI検索と従来型検索は同じペースで成長しており、共存関係にある
- ゼロクリック圧力は業界によって異なり、適切なSEO戦略で成果は出せる
- llms.txtはインフラであり、設置だけでAI可視性が向上するわけではない
- AI経由の流入の約97%が計測されず、実際の効果は過小評価されている
- SEOチームをAIで置き換えるのは時期尚早で、人間の判断力は依然として重要

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索時代のGEO対策、ChatGPTやPerplexityに引用されるための技術SEOとコンテンツ戦略
AI検索エンジンが情報取得の主流になりつつある。ChatGPT、Perplexity、Geminiなどの生成系エンジンは、質問に対する答えを直接生成する。従来の検索結果一覧からリンクをクリックする流れが変わり始めた。
この変化に対応するには、キーワード中心のSEOから生成エンジン最適化(GEO)への転換が必要だ。GEOとは、AIが回答を生成する際に自社コンテンツを一次情報源として引用してもらうための施策群である。従来SEOがブルーリンクのクリック獲得を目指すのに対し、GEOはAIの回答内で引用されることを目指す。
本記事ではAIクローラーへの技術対応と、AIに引用されやすいコンテンツ戦略の両面から具体的な施策を解説する。ECサイト運営者とWeb制作担当者に向けた内容だ。
GEOの基本を理解する
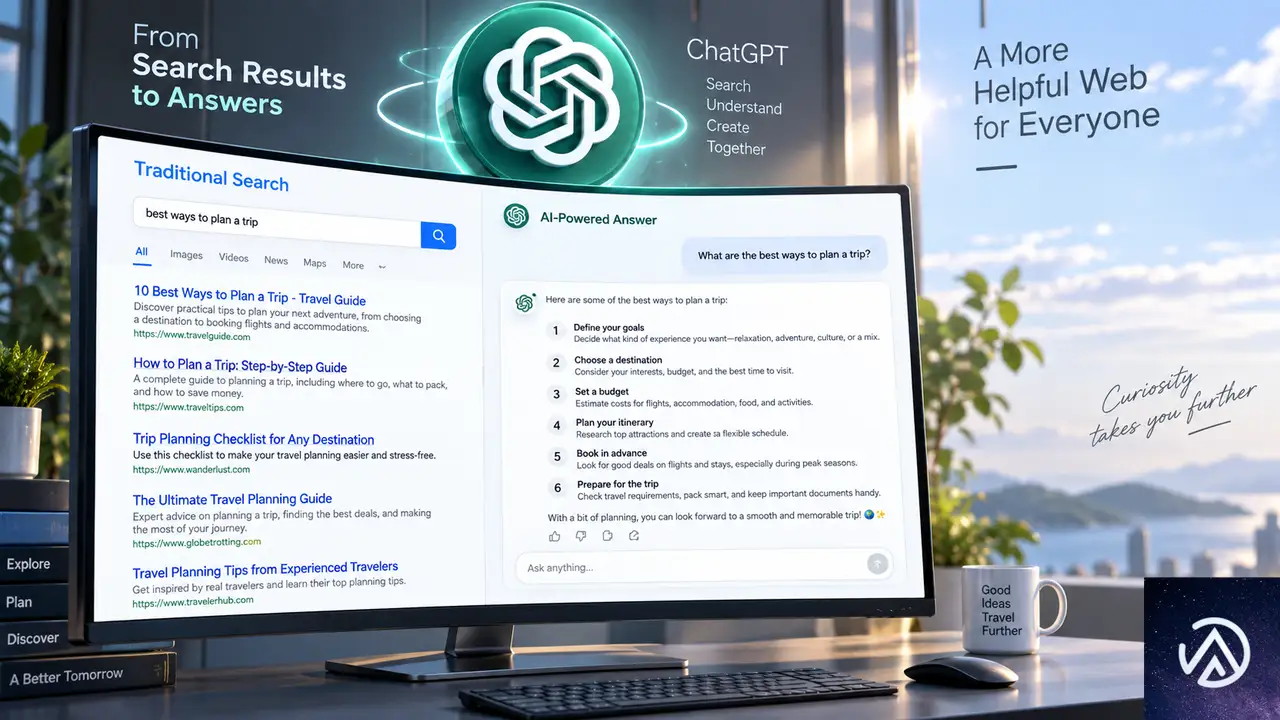
生成エンジン最適化(GEO)は、AI検索エンジンが回答を合成する際に、自社サイトのコンテンツを情報源として検出・理解・引用されることを目的とする。従来SEOが「検索結果のクリック数」を評価指標にするのに対して、GEOは「AI回答内での引用率」を重視する。
従来SEOからGEOへの考え方の転換をBeforeとAfterで対比した。
AI検索エンジンがサイトを選ぶ仕組み
AI検索エンジンは検索拡張生成(RAG)という仕組みで回答を作る。RAGとは、事前学習済みの大規模言語モデル(LLM)にリアルタイムのWeb情報を取り込ませ、最新の情報を含む回答を生成する技術だ。AIは質問を受けると、関連するWebページを取得し、その内容を引用しながら回答を合成する。
つまりAI検索で自社サイトが引用されるには、AIが「このページは信頼でき、回答に使える」と判断できる状態にしておく必要がある。そのために技術SEOとコンテンツ戦略の両面から対策を進める。
AIクローラー対応の技術SEO
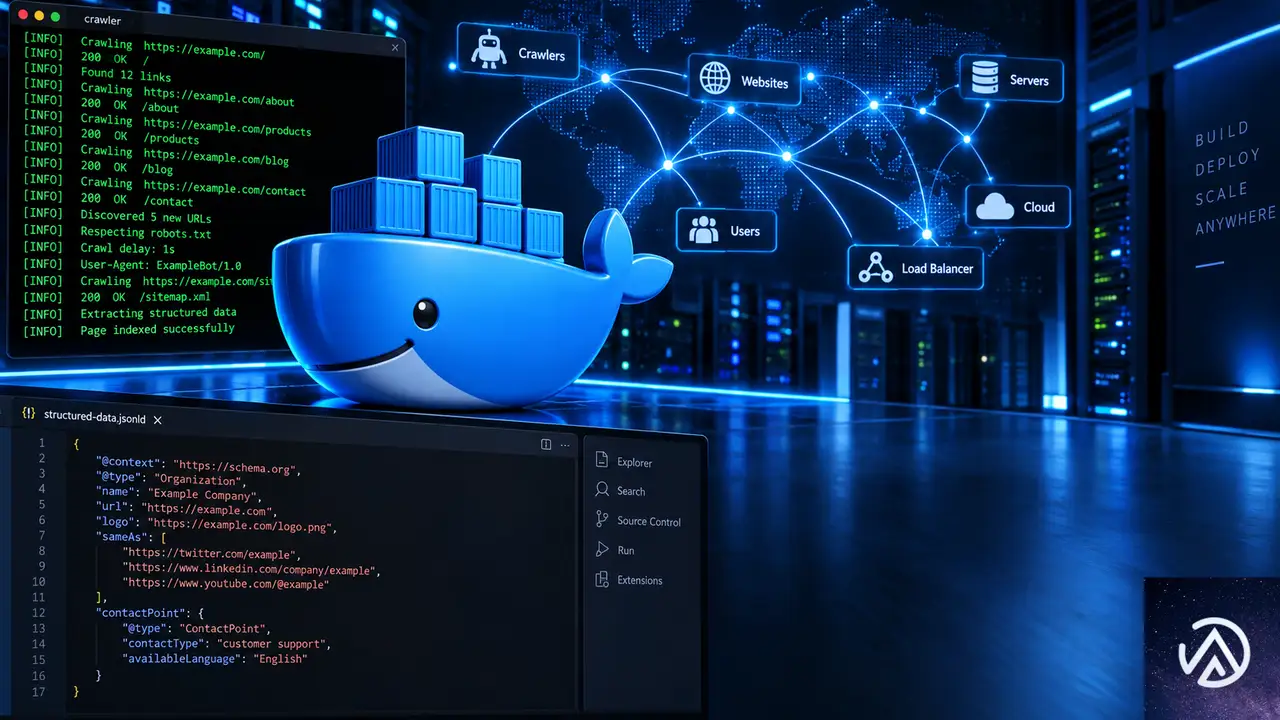
AIプラットフォームは専用のクローラーとRAGパイプラインを使ってWebコンテンツを取り込む。技術チームは、独自データを保護しながらコンテンツへのアクセスを確保する必要がある。
AI検索の裏側では、このようにクローリングから引用までの5段階の処理が走る。
robots.txtでボットを区別する
AI関連のクローラーは用途別に分かれている。学習用クローラー(GPTBotなど)とリアルタイム検索用クローラー(ChatGPT-User、PerplexityBotなど)を区別し、robots.txtで個別にアクセス制御する。学習用ボットをブロックすれば独自データを保護でき、検索用ボットを許可すればAI回答への情報提供を継続できる。
ECサイトの場合、商品の仕様データや価格情報は検索用ボットに公開しつつ、学習用ボットのアクセスを制限する運用が現実的だ。
構造化データでAIに文脈を渡す
Schema.orgの語彙を使った構造化データの実装範囲を広げることが重要だ。Organization、Product、HowTo、TechArticle、FAQPageなどのタイプを適切に付与すると、LLMのパーサーがエンティティ間の関係性を明示的に理解できるようになる。
ECサイトであれば商品ページにProductスキーマを付与し、価格、在庫状況、レビュー評価を機械可読な形式で伝える。AI検索エンジンが「この商品はいくらか」という質問に答える際、構造化データが整っているページが優先的に引用される。
RAGチャンキングを意識したHTML設計
RAGパイプラインはWebページを小さな単位(チャンク)に分割し、ベクトルデータベースに格納する。この分割処理を意識して、ページ構造を論理的なHTML階層で設計することが有効だ。<h2>や<h3>の見出しを適切に使い、各段落を独立して理解できる簡潔な長さに保つ。
見出しが明確で段落が短いと、RAGの分割処理が正確になり、回答生成時に該当箇所だけをクリーンに抽出・引用できる。長い段落に複数の話題を詰め込むと、チャンクの境界が曖昧になり引用精度が下がる。
表示速度とインデックス性の確保
AI検索エンジンはライブ検索の際、高速かつ安定したページ取得を優先する。モバイル対応を徹底し、サーバー応答時間(SRT)を短く保つことが重要だ。取得がタイムアウトすると、そのページは回答生成の候補から除外される。
SRTとはサーバーがリクエストに応答するまでの時間である。画像最適化、キャッシュ活用、CDN導入などでSRTを短縮しておくと、AIクローラーによるリアルタイム取得の成功率が上がる。
生成AIに引用されるコンテンツの作り方
AI検索エンジンはハルシネーション(誤情報生成)のリスクを減らすため、権威性の高い情報源を優先的に参照する。コンテンツ戦略は「検証可能な情報密度」を軸に再設計する必要がある。
AIが回答に使いやすいコンテンツ構成への変更点を示した。
エンティティベースの権威性構築
エンティティとは、人物、組織、商品、概念など明確に定義できる対象のことだ。自社ブランドの中核となるエンティティを中心に、関連する業界用語やトピックを密度高くまとめたトピッククラスターを作る。
具体的には、主語と述語が明確で断定を含む文章を心がける。「当社の商品Aは業界最高水準の耐久性を持つ」のような曖昧な表現ではなく、「商品Aは10万回の開閉テストに合格した」と具体的な事実を書く。このような文章はAIが抽出しやすく、引用時の信頼性も高い。
独自データとオリジナルリサーチの発信
AIモデルは集約された二次情報よりも、独自の統計、調査結果、オリジナルレポートを優先的に参照する。自社で実施したアンケート結果、商品の性能テストデータ、業界動向の独自分析などを公開することで、一次情報源としての地位を確立できる。
ECサイト運営者であれば、自社商品の比較テスト結果、顧客満足度調査、購入データから見える傾向などを記事化すると効果的だ。競合が真似できない独自データは、AI検索で安定的に引用される資産になる。
直接回答抽出フォーマットの採用
技術記事や教育コンテンツでは、ページの冒頭に要約表、箇条書きのポイント、明確な定義を配置する。検索意図の高い質問には、背景説明の前に直接回答する構成が有効だ。
たとえば「商品Aの防水性能はどの程度か」という質問を想定したページでは、冒頭に「IPX7等級で水深1メートルに30分間耐える」と明記し、その後に試験方法や比較データを展開する。この構成ならAIが回答をそのまま引用できる。
マルチモーダル検索への対応
AI検索エンジンは音声や画像を使った検索にも対応し始めている。マルチモーダル検索とは、テキスト以外の入力手段を含む検索のことだ。画像検索AIが商品を認識して回答するケースが増える。
商品画像や図表には説明的なalt属性を付与し、構造化されたキャプションを添える。画像の内容をAIが理解できるようにすることが、将来のマルチモーダル検索での可視性につながる。
AI検索を味方につける運用の転換点
従来のオーガニック検索トラフィックは、AIが直接回答を返すようになるにつれて集約化が進む可能性がある。ただし、技術インフラを最適化し、高密度な一次情報を公開し続ければ、ブランドはAI検索の裏側で推奨される情報源としての地位を維持できる。
重要なのは、目先のクリック数ではなく「AIに引用される確率」を評価指標に加えることだ。AI検索時代のブランド可視性は、回答の出典として選ばれる頻度で測られる。ECサイト運営者は、商品情報の構造化と独自データの発信を組み合わせ、この変化に対応すべきである。
SEO担当者と技術チームが協力し、クローラー管理からコンテンツフォーマットまでを一貫して整備すること。これがAI検索時代に競争優位を保つための実践的なアプローチだ。
この記事のポイント
- AI検索時代には従来のキーワード中心SEOからGEO(生成エンジン最適化)への転換が必要
- robots.txtで学習用ボットと検索用ボットを区別し、独自データを保護しつつ引用機会を確保する
- 構造化データの拡充とRAGチャンキングを意識したHTML階層設計が技術SEOの柱になる
- 独自データとオリジナルリサーチの発信がAIからの一次情報源としての地位を確立する
- 冒頭に要約と結論を置く直接回答フォーマットがAIによる引用率を高める
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
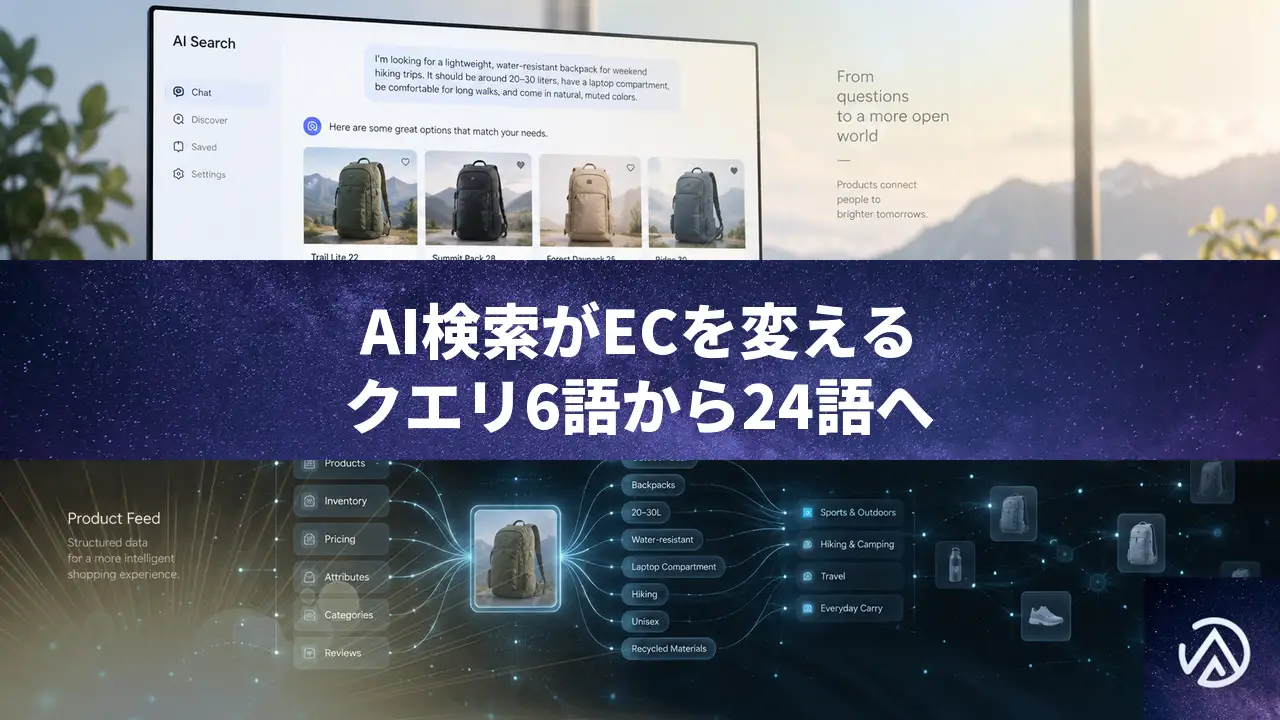
AI検索がECを変える。検索クエリは6語から24語へ拡大
AI検索エンジンの台頭により、ECサイトの商品発見の仕組みが根本から変わりはじめている。消費者は短いキーワードの組み合わせではなく、文脈や使用シーンを盛り込んだ長い自然言語で商品を探すようになった。
従来の検索エンジンでの平均クエリは約6語だった。一方、大規模言語モデル(LLM、人間のように自然な文章を理解・生成できるAIモデル)を活用したAI検索では、平均約24語にまで拡大している。この4倍の変化は、商品カタログとプロダクトページの設計思想そのものの見直しを迫るものだ。
この記事では、AI検索がECサイトに与える具体的な影響、対応策、そしてマーケティング担当者が見直すべき思考法について解説する。WooCommerceをはじめとするECプラットフォームを運営する事業者にとって、今後12ヶ月の優先課題が見えてくるはずだ。
AI検索が変える検索クエリの姿
消費者が検索窓に入力する言葉が劇的に変化している。かつては「防水 ランニング シューズ 軽量」のような短いキーワードの羅列が一般的だった。いまは「雨の日でも滑りにくくて、通勤でも使える軽いランニングシューズを探しています。週末は10キロ走るのでクッション性も欲しいです」といった会話調の質問に変わっている。
6語から24語へ、検索行動の変化
MarTechのポッドキャスト「Conversations with MarTech」に出演したOpiversalのCEO、Lucas Tieleman氏は、この変化を具体的な数字で示している。従来のGoogle検索での平均クエリは約6語だった。ところがLLMを活用した検索では平均約24語に拡大している。ユーザーは検索エンジンに「単語を投げる」のではなく「相談する」姿勢に変わったのだ。
会話的クエリが商品発見に与える意味
検索クエリが会話的になるということは、商品が文脈で選ばれる時代の到来を意味する。「軽いランニングシューズ」という単語だけでは用途が見えなかった。しかし「通勤で使える」「週末に10キロ走る」といった文脈が加わることで、同じ商品が異なる理由で選ばれる可能性が生まれる。Tieleman氏は「同じ商品でも、人によって異なる意味を持ちうる」と述べている。この多義性が、これからのECサイトの設計を難しくする一方で、差別化の余地も広げている。
検索クエリが短いキーワードから会話的な長文へ変化したことを示している。ECサイト側もこの変化に対応した情報設計が必要になる。
旧来の商品カタログが抱える限界
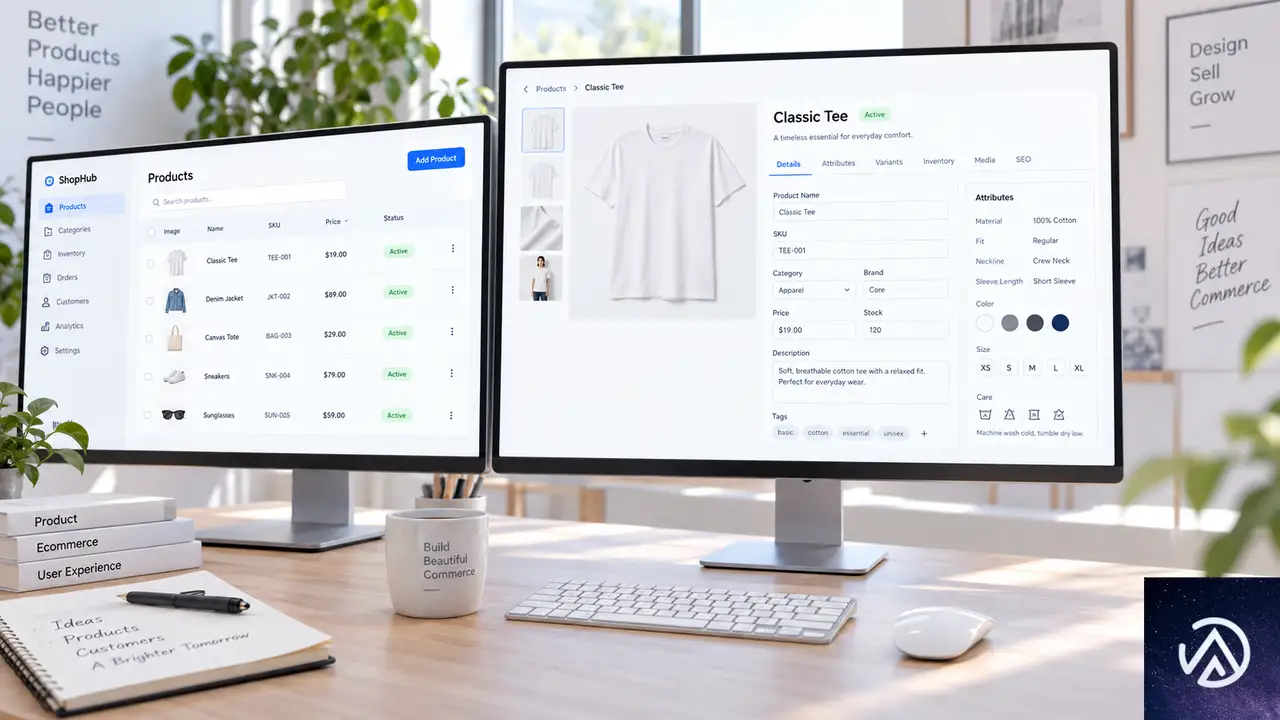
多くのECサイトの商品ページは、青いリンクとキーワード検索の時代に作られたものだ。商品名、価格、カテゴリ、簡単な説明文という最小限の属性を並べた静的ページが中心だった。この設計は、消費者が「単語を入力して結果の一覧から選ぶ」という行動パターンを前提にしている。文脈や使用シーンを含む24語のクエリに対して、こうした静的ページは十分な回答を提供できない。
ボットトラフィックの急増が見せる新しい現実
Tieleman氏が指摘するのは、AIエージェントによるボットトラフィックの急増だ。自律型AIエージェントが実際に購入を行う段階にはまだ至っていない。しかし、ユーザーの質問に答えるためにECサイトを巡回するLLMのトラフィックは爆発的に増えている。マーケティング担当者は、インプレッション(表示回数)とセールスの関係を従来とは異なる視点で捉え直す必要がある。表示回数が増えても、それが人間の目に触れているとは限らないからだ。
文脈的な属性情報とFAQを加えることで、AIが商品を理解しやすくなることを示している。
ECサイトがAI検索に対応するための3つの施策
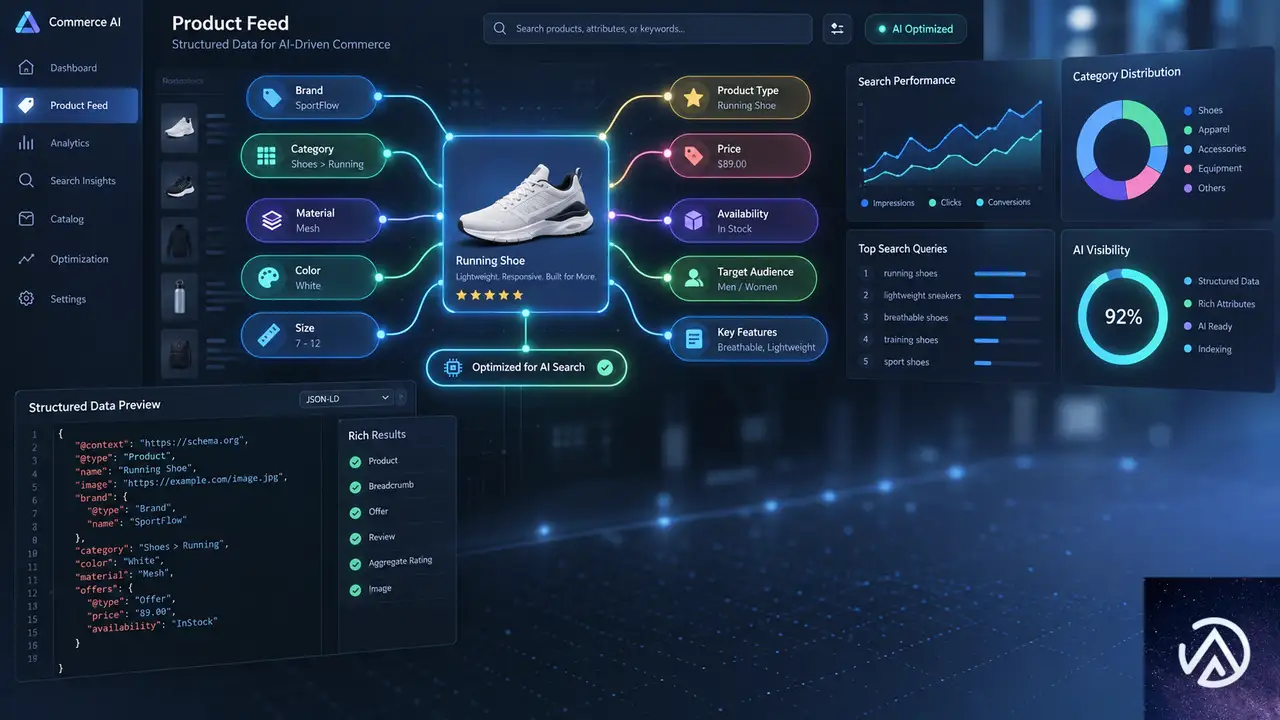
AI検索時代において、ECサイトが取るべき具体的な対策は3つに集約できる。構造化データの整備、動的なランディングページ生成、そしてFAQの戦略的拡充だ。どれも特別なツールなしで今日から着手できる。
構造化データと会話的属性情報の整備
商品フィードの重要性はかつてないほど高まっている。構造化データとは、商品名や価格、属性などが機械に読み取りやすい形式で整理されたデータのこと。検索エンジンとAIプラットフォームに商品の存在を知らせるためには、高度に構造化されたデータを継続的に供給する必要がある。商品名と価格だけでは不十分だ。使用シーン、解決できる課題、関連するFAQなど、会話的な属性情報を追加することで、AIが商品を文脈に応じて提案しやすくなる。
WooCommerce運営者であれば、商品データの拡張は比較的容易だ。商品説明欄を充実させるだけでなく、カスタム属性やカテゴリタクソノミーを使って使用シーンや解決課題を明示的に登録できる。属性情報は商品のタイプごとに設計し、サイト全体で一貫した命名規則を保つことが重要だ。
動的なランディングページ生成
AIがコンテンツ制作の限界費用を大幅に下げたことで、EC事業者は変動するソーシャルトレンドや自然言語のクエリに合わせてカスタムランディングページを大量に生成できるようになった。Tieleman氏は「ウェブサイトは生きた有機体である」と表現している。固定された商品ページだけでなく、検索文脈に応じたランディングページを動的に用意することが、これからのECサイトには求められる。
FAQの戦略的拡充
FAQセクションは、AI検索対策の隠れた有力手段だ。商品に関する具体的な疑問と回答を構造化して掲載することで、AIエージェントが商品のユースケースを理解しやすくなる。「このシューズは幅広の足型に対応していますか」といった具体的な質問と回答は、まさに24語クエリの世界で求められている情報だ。FAQはユーザーが実際に抱く疑問を想定して作成し、商品データの一部として機械に読み取らせる意識が重要になる。
AIエージェントが商品データを巡回し、文脈に合う商品を提案する流れを示している。各ステップで構造化データが正しく読み取れるかが成否を左右する。
エージェント型購買の現実とマーケティングの再考
Tieleman氏との対話から浮かび上がるのは、AIエージェントが本当に「購入」を行うのはまだ先だという現実だ。現在はあくまで調査・比較の段階で、ボットが商品情報を収集しているにすぎない。しかし、この段階で商品データがAIに正しく理解されているかどうかが、将来の購入決定に直結する。準備を怠れば、AI検索の世界で商品が存在しないのと同じ扱いを受けるリスクがある。
単一の正解に執着することの無意味さ
Tieleman氏は「マーケティング業界が信じている最大の嘘」として、単一の正解を探し求めることへの執着を挙げている。現実には、現代のテクノロジーを使えば複数の施策を並行して検証し、効率的に失敗しながら最適解に近づくことができる。同氏の「いまのテクノロジーを使えば、もっと効率的に間違えることができる」という指摘は、マーケティングの思考法を変える視点だ。A/Bテストを繰り返すことへの心理的障壁を下げ、失敗をデータとして蓄積する姿勢が求められる。
商品を文脈で選ばせる設計へ
「AppleはUXとデザインの重要性を示す好例だ。Amazonはそうではないことを示している」というTieleman氏の発言は、ECサイト設計の2つの方向性を端的に表している。徹底したUXで差別化するのか、価格と品揃えで勝負するのか。AI検索時代には、どちらの戦略を選ぶにせよ、商品データが文脈を伝えられるかどうかが成否を分ける。デザインの優劣ではなく、データの伝達力が新しい競争軸になるのだ。
この記事のポイント
- 検索クエリは平均6語から24語に拡大し、会話調の質問へと変化している
- 従来の静的カタログは、文脈を含む長いクエリに十分応えられない
- AIエージェントによるボットトラフィックが急増し、商品データの構造化が必須になっている
- 構造化データ、会話的属性情報、FAQの拡充がAI検索対策の3本柱となる
- 単一の正解を求める思考を捨て、複数の施策を効率的に検証する体制が有効
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleのAIコンテンツ支払い、CloudflareとMicrosoftが示す3つの設計思想
Google、Cloudflare、Microsoftの3社がAIによるコンテンツ利用への対価支払いモデルをそれぞれ試験している。支払いの発生条件、価格設定の主導権、運営者に返るレポートの中身は3社で大きく異なる。
Googleは「重要な貢献」と判定した場合のみ支払う招待制パイロットだ。Cloudflareはクロール1回ごとに課金する独自モデルを持つ。Microsoftはライセンス型マーケットプレイスを2月に発表した。
この違いが、サイト運営者がAIにコンテンツを提供する際の収益性とリスクを左右する。本記事では3モデルの設計思想とSEOへの影響を整理する。
3社のAIコンテンツ支払いモデルの全容
Google、Cloudflare、Microsoftは2026年に入り、AIがウェブサイトのコンテンツを利用する際の対価支払いモデルをそれぞれ提示した。3社のアプローチは課金の単位、価格設定の主導権、レポートの粒度で根本から異なる。
3社のモデルは支払い方式とコントロール権限のバランスで大きく異なる。
Googleは「貢献度」判定、Cloudflareは「取得単位」課金
Googleのパイロットプログラムは、Gemini、AI Overviews、AI Modeのいずれかで、サイトのコンテンツがAI生成応答に「重要な貢献をした」と判断された場合に支払いが発生する。回答生成後のリンク表示や確認だけでは条件を満たさない。Googleは6月18日の公式投稿で、AI回答の根拠となる情報を提供するウェブサイト向けの新モデルを試験する方針を示した。
一方、CloudflareのPay Per Crawlは2025年から非公開ベータとして提供されてきた。クローラーがコンテンツを正常に取得するたびに課金が発生する仕組みで、サイト運営者はクロール1回あたりの価格を設定できる。最低価格は0.001ドルだ。価格に同意したクローラーには正常応答コードでページが返る。
Microsoftはライセンス型マーケットプレイス
Microsoftは2月3日にPublisher Content Marketplaceを発表した。Copilotの回答を支えるためのプレミアムコンテンツのライセンスを提供する仕組みで、パブリッシャーは提供価値に基づいて支払いを受ける。利用条件とライセンス条件はパブリッシャーが定義し、利用ベースのレポートも提供される。Copilotが最初の需要パートナーとなり、Yahooも導入を進めている。
関連する動きとして、Ceramic.aiは自社の検索結果にサイトのコンテンツが表示された際に参加サイトへ支払うモデルを採用している。You.comは特定のプレミアムコンテンツをオンデマンドで利用した時点で支払う仕組みだ。
支払いトリガーを決めるのは誰か
各モデルは支払い発生のイベント定義が異なる。ここが運営者の収益予測を難しくする根本原因だ。Googleは「重要な貢献」という質的基準、Cloudflareは「取得成功」という機械的基準、Microsoftは「提供価値」という経済的基準を採用している。
判定者が誰かによって、収益予測の立てやすさが変わる。
Googleの「重要な貢献」はブラックボックス
Digidayの報道によれば、Googleのパイロットでは支払いがコンテンツの使用量ではなく価値に基づくとされている。Googleが自社で「意味のある貢献だったか」を判断する仕組みで、プログラムに詳しい企業幹部はDigidayの取材に対し「かなりブラックボックスだ」と述べている。Googleは判定基準を公表していない。
サイト運営者から見れば、この構造は収益の予測可能性を著しく下げる。何が支払いにつながるかの明確な基準が分からない状態で、コンテンツ戦略の投資判断を下すのは難しい。
Cloudflareは機械的なイベント、Microsoftは定義自体が不明
Pay Per Crawlのイベントは機械的だ。価格に同意したクローラーへの正常応答が課金の条件と明確に定義されている。ただしCloudflareの7月1日の投稿は、クロール回数が価値の粗い指標であると自認している。1回だけクロールされたページが何千もの回答に引用されることもあれば、何度もクロールされながら一度も使われないページもある。
Microsoftは支払い単位を公開していない。提供価値に基づくと説明するが、具体的な計算式や契約上の定義は明らかにされていない。価格設定もパブリッシャーとの共同設計の対象とされるが、誰が最終決定するかは公開情報では分からない。
サイト運営者がコントロールできる範囲
3社のモデルはサイト運営者がどのような条件を設定できるかも異なる。価格を自分で決められるのか、参加の是非だけなのか、利用条件まで定義できるのか。この差は収益性と交渉力に直結する。
Googleは参加の是非のみ、条件交渉の余地なし
Googleのパイロットは招待制だ。参加者はSearch Consoleからいつでもオプトアウトできるが、参加するかどうか以外の条件交渉の余地は公開情報から見えてこない。Digidayによれば、ある企業幹部は提示された金額が低すぎてオプトインしなかったと述べ、Googleとの交渉は継続中だという。
この点は小規模なサイト運営者ほど不利になる。招待を受けるか、提示された条件で飲むか。その二択しか選べない状況では、交渉力のある大手メディアと中小サイトの間に収益格差が生まれやすい。
Cloudflareは価格を運営者が設定、Microsoftは利用条件を定義
Pay Per Crawlでは、サイト運営者がドメインごとの価格を設定できる。パス単位で価格を変える動的プライシングにも対応し、クローラーごとに課金、許可、ブロックを選べる。Pay Per Useでは、サイト運営者はパートナーのプログラムに参加する形で、パートナーによって支払い条件が変わる。
Microsoftのマーケットプレイスは加入が任意で、パブリッシャーはコンテンツの所有権と編集の独立性を保持する。ただし、ライセンス条件と利用条件の具体的な内容は公開されていない。価格決定者も不明のままだ。
レポートで見える情報と見えない情報
収益化の判断には、どれだけの情報が返ってくるかが重要だ。3社のレポート粒度と透明性にも明確な差がある。
Googleの月次収益表示と計算式の非公開
Googleの参加者はSearch ConsoleのAI貢献パネルで月次収益額と履歴を確認できる。しかしDigidayは、支払い計算の詳細は提供されないと報じている。Googleは一部のパートナーと週次会議も行っている。パブリッシャー連合SpurのDavid Buttle氏は、第一歩として「パブリッシャーが自分のコンテンツが回答に影響したことを知る権利がある」という前例を作ることだと述べた。
月次収益という数字は見えるが、その数字がどう算出されたかは見えない。この非対称性は、運営者が支払い額の妥当性を検証できないことを意味する。
Cloudflareの残高非表示とCeramicの詳細レポート
Pay Per Crawlでは、課金イベント発生時に記録が残る。ダッシュボードにはどのクローラーがアクセスしたか、課金が何回発生したかが表示される。ただし獲得残高はダッシュボードに表示されず、Cloudflareチームへの問い合わせが必要だ。
Pay Per Useでは、Ceramicプログラムに参加するサイトが、コンテンツが表示された検索クエリ、該当ページ、スニペット、検索結果内の平均順位まで含むレポートを受け取れる。こちらの方が実務的には使える情報が多い設計だ。
Microsoftの利用ベースレポートは中身が非公開
Microsoftは「コンテンツがどのように評価され、どこでさらに価値を提供できるか」を確認できる利用ベースのレポートを約束している。ただし、レポートに含まれる具体的な項目は公開されていない。参加者がレポート内容について説明した記録も見つからない。
Googlebotへの従量課金が招くSEOリスク
CloudflareのPay Per Crawlは、ディレクトリに登録されたあらゆるクローラーに従量課金を設定できる。Googlebotも対象だ。ここにSEO上の大きな落とし穴がある。
CloudflareのBlock設定をGooglebotに適用すると、検索インデックスからの削除リスクが連鎖的に発生する。
Googleのクローラードキュメントによれば、4xxステータスコードを返すURLのコンテンツは使用されない。402 Payment Requiredも4xxに該当するため、Googlebotに課金を設定して402を返すと、時間の経過とともに検索インデックスから削除される可能性がある。
Cloudflareが9月15日に公開した新設定はこの状況を変えるものではない。Disallow AI Training設定はrobots.txtに学習拒否の意思を公開し、GoogleとAppleはこれを尊重しつつ検索クローリングは続ける。一方、BlockオプションはGooglebotを含むクローラーを完全に停止する。
つまり、Googlebotに対して「学習は拒否したいが検索クロールは許可したい」場合は、BlockではなくDisallow AI Trainingを選ぶ必要がある。Cloudflareの報告では、検索ボットをブロックしているサイトは1%未満、何らかの学習ブロックを使っているサイトは17%に上る。
また、Googleは数週間以内にGoogle-Extendedに関連するURL単位の透明性ツールを提供する予定だとCloudflareは伝えている。これはパイロットの貢献レポートとは別のものだ。
サイト運営者が今取るべき行動
3社のモデルは完成形ではなく、すべて試験段階にある。運営者が今できるのは、自社のコンテンツの性質とリスク許容度に合わせて選択肢を評価することだ。
Cloudflare設定の見直しが最優先
すでにCloudflareを利用しているサイトは、現在の設定状態を確認すべきだ。従来の設定が移行されている可能性があり、Googlebotに対して意図しないBlockがかかっていないかを確認する必要がある。学習拒否と検索継続を両立するには、Training controlをDisallow AI Trainingに設定する。Blockにしてしまうと検索クロールも停止する。
この設定の分岐は、サイト運営者にとって「収益化のチャンス」と「検索順位のリスク」を同時に含む。学習を拒否するか、検索クロールを維持するか、あるいは課金対象としてGooglebotに支払いを求めるか。それぞれの選択肢の帰結を理解した上で決める必要がある。
契約前に確認すべき情報
Googleのパイロット招待を受けた場合、オプトイン前に「重要な貢献」の定義、計算方法、Search Consoleの生成AIコントロールとの関連性についてGoogleに確認するべきだ。Microsoftのマーケットプレイスを検討する場合は、誰が価格を決定するのか、レポートに何が含まれるのかを契約前に明確にする必要がある。公開情報だけではこれらの質問に答えられない。
3社のモデルは「支払いの透明性」に対するアプローチが根本から異なる。Googleは判定をブラックボックスにすることで柔軟性を確保し、Cloudflareは機械的なイベントで透明性を確保し、Microsoftはパブリッシャーに条件定義を委ねる。いずれもまだ実験段階であり、最終的な設計が現在の形のまま展開されるとは限らない。
特に重要なのは、Cloudflareが自ら「クロール回数は価値の粗い指標」と認めた点だ。同じコンテンツでも1回のクロールで何千回も引用される場合と、何度もクロールされながら全く利用されない場合がある。この非対称性は、現在のすべての支払いモデルが「価値の正確な測定」にまだ到達していないことを示している。
サイト運営者は、今後のレポート精度の向上と透明性ツールの展開を注視しつつ、自社のコンテンツがAI応答にどう使われているかを定期的に確認する姿勢が求められる。
この記事のポイント
- Googleは招待制で「重要な貢献」と判定した場合のみ支払う。判定基準は非公開
- Cloudflareはクロール取得単位の課金とパートナー主導の利用課金の2軸で展開
- Microsoftはライセンス型で利用条件はパブリッシャーが定義するが価格決定者は不明
- Googlebotを含むクローラーにBlock設定を適用するとSEOリスクが連鎖する
- 3社とも試験段階で、価値測定の正確性が今後の焦点となる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AIが検索意図を再定義。68%がクリックされない検索の新常識
Google検索の68%がクリックなしで終わる時代に入った。2019年には49%だった「ゼロクリック」の割合が、わずか7年で20ポイント近く上昇したことになる。検索結果から外部サイトへ移動しないユーザーが、すでに3分の2を超えている。
この変化の中心にあるのが、AI ModeとAI Overviewsの急速な普及だ。月間アクティブユーザー10億人を超えたAI Modeの利用データは、検索意図の構造が根本から変わったことを如実に示す。もはやキーワードを入力して青いリンクを探す時代ではない。
本記事では、2026年に公開された2つの実証研究とGoogle自身の利用データを軸に、AIが検索意図をどう再定義しているのかを整理する。旧来のSEO指標では捉えきれない変化の実態と、これからの戦略立案に必要な視点を提示する。
ゼロクリック検索の実態。68%という衝撃の数字

SparkToroが発表した2026年のクリックストリームデータによると、米国におけるGoogle検索の68%がクリックを生まない。この数値は2019年の49%から一貫して上昇を続けており、単なる一時的な現象ではない。検索行動の地殻変動が10年単位で蓄積してきた結果だ。
ゼロクリックの広がりは、生成AIの登場によって突然始まったものではない。ユーザーはすでにYouTubeやTikTokなど、ビジュアルやコミュニティを重視するプラットフォームへ検索行動を分散させていた。Googleはこの流出を食い止めるため、検索結果画面の中で即時に答えを返す仕組みを強化してきた経緯がある。
重要なのは、検索がもはや単一のテキストボックスを超え、マルチモーダルでマルチプラットフォームのエコシステムに分裂したという事実だ。従来のSERP(検索結果ページ)での可視性だけを追いかけても、オーディエンスの意図が生まれる場所を捉えきれなくなっている。
検索結果画面の中で情報取得が完結するほど、外部サイトへの送客は減っていく。この構造変化こそがゼロクリック検索の核心であり、SEO戦略の前提を揺るがす要因だ。
Google AI Modeのデータが示す会話型検索の台頭

クエリは3倍長く、40%が追加質問
Googleが2026年のI/Oで公開したAI Modeの利用データは、検索行動の変化を具体的に裏付ける。AI Modeは月間アクティブユーザーが10億人を突破し、平均クエリの長さは従来型検索の3倍に達している。「説明する」「要約する」といった行動指向のコマンドが目立ち、一人称「私」の使用頻度が高い点も特徴だ。
これは単なるキーワード検索ではなく、会話型の対話に近い。追加質問は前月比40%増で推移し、AI Modeでの6分の1以上の検索が音声・画像・動画を組み合わせたマルチモーダルな入力になっている。ユーザーは青いリンクの一覧を求めておらず、即座に統合された価値を対話の中で求めている。
この変化は検索意図の捉え方そのものを変える。従来の「情報を探す」という受動的な行動から、「決める」「学ぶ」「創る」という能動的な行動へと、検索の役割が拡張しているのだ。
4語クエリがAI回答を起動する確率は48.1%
Clara Soteras氏らが実施したスペインメディアを対象とする初の大規模研究では、クエリの複雑さがAI回答の表示を直接左右することが示された。4語を含む検索では48.1%の確率でAIO(AI Overviews)が表示され、3語と4語のクエリだけで全AI生成結果の約70%を占める。
長いクエリの背後にある意図は、根本的に問いかけ型だ。常緑コンテンツ(長期間にわたって価値が変わらない情報)が75.2%を占め、ジャーナリズムの基本である「6W」を含むキーワードは高い確率でAI要約を誘発する。「why」は92.3%、「what」は85.7%、「who」は68.4%という数値が出ている。
ここから導かれる結論は明確だ。断片的な名詞キーワードを追いかける時代は終わり、複雑で普遍的な人間の問いに直接答えるコンテンツ構造へシフトする必要がある。
クエリの語数が増えるほど、また「なぜ」という問いかけが含まれるほど、AI回答は高い確率で表示される。コンテンツ設計では、複雑な問いに直接答える構成が求められる。
速報とAI回答は別世界。ブランド可視性の逆説も
同じ研究で注目すべきなのが、生成AIと速報ニュースが完全に別の生態系で動いている事実だ。AIOは常緑コンテンツの検索で34.6%表示されるのに対し、現在進行形のニュースでは1.1%まで急減する。速報を扱うTop Storiesモジュールとの同時表示率も1.4%に留まる。
さらに重要な発見として、分析対象となったSERPの43.6%はAIOもTop Storiesも表示されない「ブルーオーシャン」だった。この領域では従来のオーガニック順位が依然として高い効果を発揮する。
ブランド可視性の逆説も見逃せない。20 Minutosはブランド関連クエリで38.9%のAIO表示率を獲得した一方、トラフィック全体のリーダーであるEl Españolは11.1%に留まった。大量の訪問数が生成AI時代のシェア・オブ・ボイスを保証しないという端的な証明だ。
検索意図の5つの柱。探索から実行へ

Googleが発表した米国におけるAI Mode利用調査は、検索意図の境界を公式に再定義した。ユーザーはリンクを探すだけではなく、意思決定、旅行計画、タスク整理、概念学習、アイデア生成、比較検討、コンテンツ作成など、幅広い目的でAI Modeを利用している。
Googleはこの変化を5つの行動指向の柱として整理する。「探求する」「決める」「学ぶ」「創る」「実行する」の5つだ。検索が受動的な情報レイヤーから能動的なユーティリティレイヤーへ進化したことを、この分類は明確に示している。
WAN-IFRAのEzra Eeman氏が指摘する通り、この5つの柱はメディア分野におけるDmitry Shishkin氏の「User Needsモデル」と強い類似性を持つ。事実を報じるだけでなく、教育し、インスピレーションを与え、視点を提供する。そうした深いユーザー・ニーズを生成検索エンジンがインターフェース内で直接満たそうとしているのだ。
5つの柱はすべて動詞で構成されている点が重要だ。検索エンジンはもはや情報の入り口ではなく、複雑なニーズを最初から最後まで満たす動的なアシスタントへと位置づけを変えている。
視線追跡が暴く「見られるがクリックされない」領域

Laika Teamが実施した視線追跡調査は、SERP上でのユーザー行動をさらに深く解明した。Diego Criado氏らの研究チームが発見したのは「attention-to-action gap」、すなわち視覚的注意と実際の行動の間に生じる大きな乖離だ。
画像や商品リスト、AIOの「さらに見る」ボタンなどの視覚要素は、ユーザーの視覚的関与を最大100%獲得しながら、クリック率は0%という衝撃的な数値を示した。ユーザーはこれらの要素をわずか数ミリ秒で走り読みするだけで、実際の意思決定には利用しない。
一方で真の「コンバーター」は、AI Overviewの核心テキスト部分と従来のオーガニックリンクだった。AIO本体は86.4%、上位オーガニックリンクは95.5%という高いクリック率を記録している。生成AI機能が基本的な探索を完結させるため、周辺要素は視覚的ノイズと化し、クリックを獲得できる領域は限られていく。
視線追跡データが示すのは、SERP上でユーザーが実際に読んで意思決定する場所と、単に目に入るだけの場所がはっきり分かれたことだ。意図の高いトラフィックを獲得するには、この2つの領域の違いを理解する必要がある。
注目から互酬へ。新しい評価指標の必要性

検索行動の変化がここまで明確になると、KPI(主要業績評価指標)の見直しは避けられない。クリック数やクエリ量などの既存指標を捨てる必要はないが、量だけでなく深さを測る定性指標の補完が必須になる。
Industry Diveの共同創業者であるSean Griffey氏が提唱するのが「reciprocity(互酬性)」という概念だ。「注目は取引であり、互酬は持続可能である。それは堀になる」という同氏の言葉が示す通り、既存のダッシュボードは読者が消費する時点までしか測れていない。読者が購読する瞬間まで追跡できても、その先にある真のファン度を測る指標は存在しない。
互酬性が問うのは、より難しい質問だ。助けを求めたとき、オーディエンスは本能的な応答欲求を感じるか。見返りがなくても支えたいと思うほどのつながりがあるか。クリエイターエコシステムがこのつながりを常に検証してきたのに対し、メディアブランドも同様の実践を学ぶ必要がある。
tchop.ioのHeiko Scherer氏が指摘する「到達から所属へ」という視点も同じ方向を向く。単なるリーチでは測れない帰属意識こそが、ゼロクリック時代の最も価値ある資産になる。編集プロダクトの質を磨く、学びを目的としたコンテンツを設計する、活発なコミュニティを育てる、創作の場を提供する。これらの取り組みが、互酬性を育む具体的な道筋だ。
数値化しにくい指標を追いかけるのは実務的に難しい。しかしゼロクリックが進むほど、取引型の指標だけではブランドの持続可能性を測れなくなる。感覚的でも手応えのある定性指標を補完することが、これからのメディア運営に不可欠だ。
この記事のポイント
- Google検索の68%がクリックされずに終わるゼロクリック時代に入った
- AI Modeのクエリは従来の3倍長く、4語でAI回答出現率が48.1%に達する
- 検索意図は「探求する・決める・学ぶ・創る・実行する」の5つの柱に再定義された
- 視線追跡では画像やボタンが100%見られてもクリック率0%という乖離が判明した
- 新しい評価指標として、取引型の注目ではなく互酬性と所属の概念が求められる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

ByTheWeb AIレビュー!無料GEOプラグインでAI検索に引用されるサイトを目指す
ChatGPTやGeminiなどAI検索の利用が広がる中、従来型SEOだけでは不十分な局面が増えてきた。GEO(Generative Engine Optimization / 生成AI向け最適化)と呼ばれる、生成AIにサイトを理解させるための最適化が必要になっている。検索エンジン向けにメタディスクリプションやXMLサイトマップを整えても、AIが回答を組み立てる際に情報源として引用されるとは限らない。
WP Mayorの2026年9月2日付レビューをもとに、ByTheWebの料金体系、主要機能、実務での使い方、プライバシー面を整理した。
AI検索対策を低コストで始めたい中小企業や個人ブロガーが、この無料ツールをどこまで使えるかを判断するための内容だ。
ByTheWeb AIの全体像

ByTheWebは2つのWordPressプラグインに分かれている。無料のByTheWeb GEOがAI可読性スコアの算出、スキーマ生成、llms.txt出力、robots.txt管理という土台部分を担う。ここでllms.txtは、大規模言語モデル向けにサイト情報を整理したテキストファイルだ。任意のByTheWeb AIはクレジット制のアシスタントとして、不足するフィールドの自動補完やメタ情報の生成をクラウド処理で行う。
重要なのは、どちらのプラグインも必須ではない点だ。ByTheWeb GEOはアカウントなしで手動機能をすべて使える。ByTheWeb AIは無料のAPIキーを接続して初めて生成機能が動く。この分離設計により、クレジット消費を伴うAI機能だけを後から追加できる。
料金とクレジットの仕組み
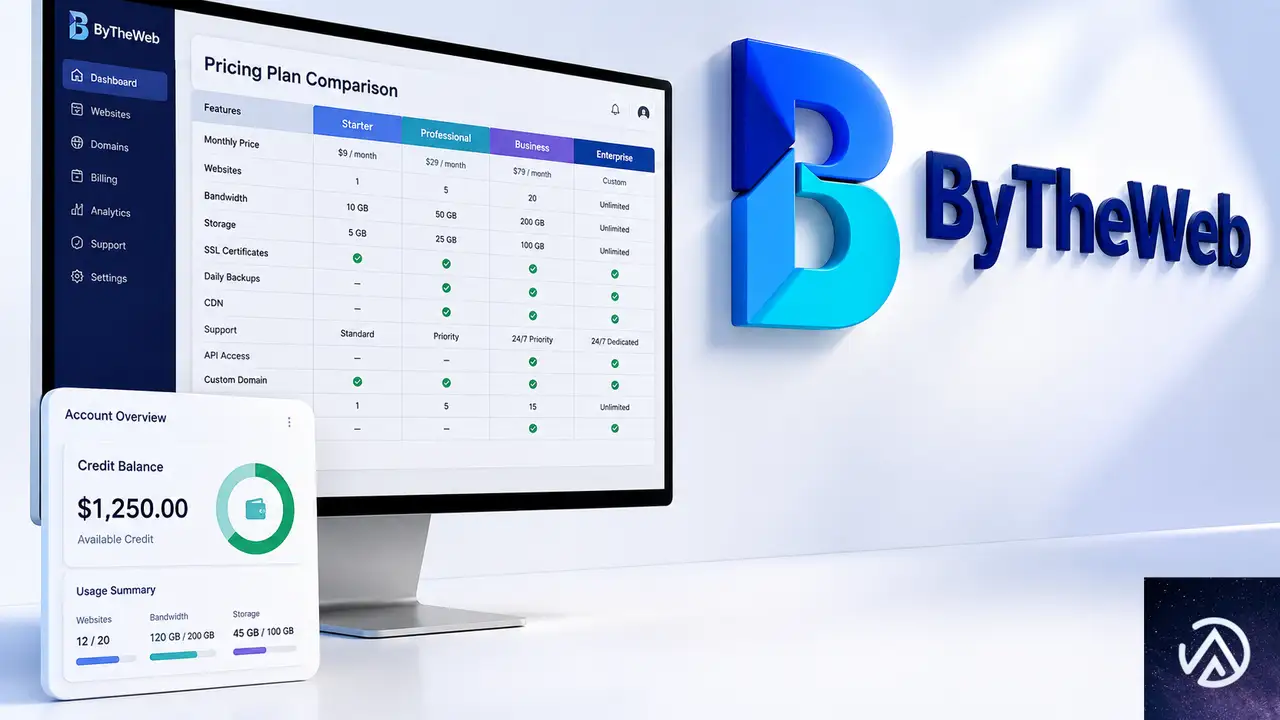
ByTheWeb GEOの基本機能は無料だ。ダッシュボード、スキーマ、llms.txt、サイトマップ、robots.txt、手動フィールドはアカウント登録なしで利用できる。費用が発生するのはByTheWeb AIを接続した場合に限られる。新規アカウントには30日間有効の5,000クレジットが付与される。
試用期間後の有料プランは4段階ある。いずれも1プランで対応するドメインは1つで、未使用クレジットは翌月に繰り越されない。
- Starter AIは月額10.95米ドルで5,000クレジットを利用できる
- Creator AIは月額19.95米ドルで10,000クレジットを利用できる
- Growth AIは月額29.95米ドルで20,000クレジットを利用できる
- Pro AIは月額39.95米ドルで30,000クレジットを利用できる
クレジットの消費量はAIアクションごとに異なる。1回の操作で50クレジットで済む場合もあれば、450クレジットを消費する場合もある。利用頻度が高い場合は、月に何回のAIアクションを実行するかを事前に見積もるとよい。
プラグインとは別に、ByTheWebは無料のAI可視性およびSEOサイトスキャナーも提供している。URLを入力すると、OpenAI、Google Gemini、Perplexity、Claudeがそのビジネスをどう理解しているかを、実際のWeb検索結果と引用元付きで確認できる。接続と検証を済ませるとレポート全体が閲覧可能になり、見つかった課題をWordPressツールで修正できる。
主要機能の解説

AI向けフィールドとllms.txt
ByTheWeb GEOの中心となるのが、Short AnswerとAI Summaryという2つのAI向けフィールドだ。Short Answerは質問への直接的な一文回答であり、AI Summaryは重要事実を箇条書きにしたスキャンしやすい要約である。どちらもサイトが自動生成するllms.txtファイルに反映される。必要に応じてllms-full.txtとしてMarkdown形式の完全版も出力できる。
FAQビルダーは手動で書いた質問をJSON-LD形式のFAQスキーマへ変換する。ここでスキーマとは、ページ内容を検索エンジンやAIが機械的に理解できるよう構造化するマークアップの一種だ。JSON-LDはその構造化データを記述するフォーマットである。ショートコードまたはElementorウィジェットで訪問者にも表示できる。
そのほか、Article、Organization、Person、Local Business、Service、BreadcrumbListの各スキーマと、sameAsおよびContactPointフィールドが構造化データの側面を補う。sameAsは自社の公式プロフィールを紐付けるためのフィールドだ。
従来のSEO機能と既存プラグインとの共存
AI向け機能に加えて、ByTheWeb GEOは従来型のSEOレイヤーも備える。タイトルとメタディスクリプションの文字数インジケーター、最適化チェック、スマート変数を使った動的テンプレートの作成が可能だ。WP Mayorのレビューでは、主要なSEOプラグインにある基本機能はおおむねこちらでも揃っていると指摘されている。
ByTheWeb GEOはYoast SEOやRank Mathと併用できる。機能が重複するフィールドは重複を避けて調整される一方で、GEOスコアとスキーマ機能はそのまま有効になる。既存のSEOワークフローにByTheWebを追加しやすい設計だ。
実務での使い方とGEOスコア改善
初期設定とスキャン
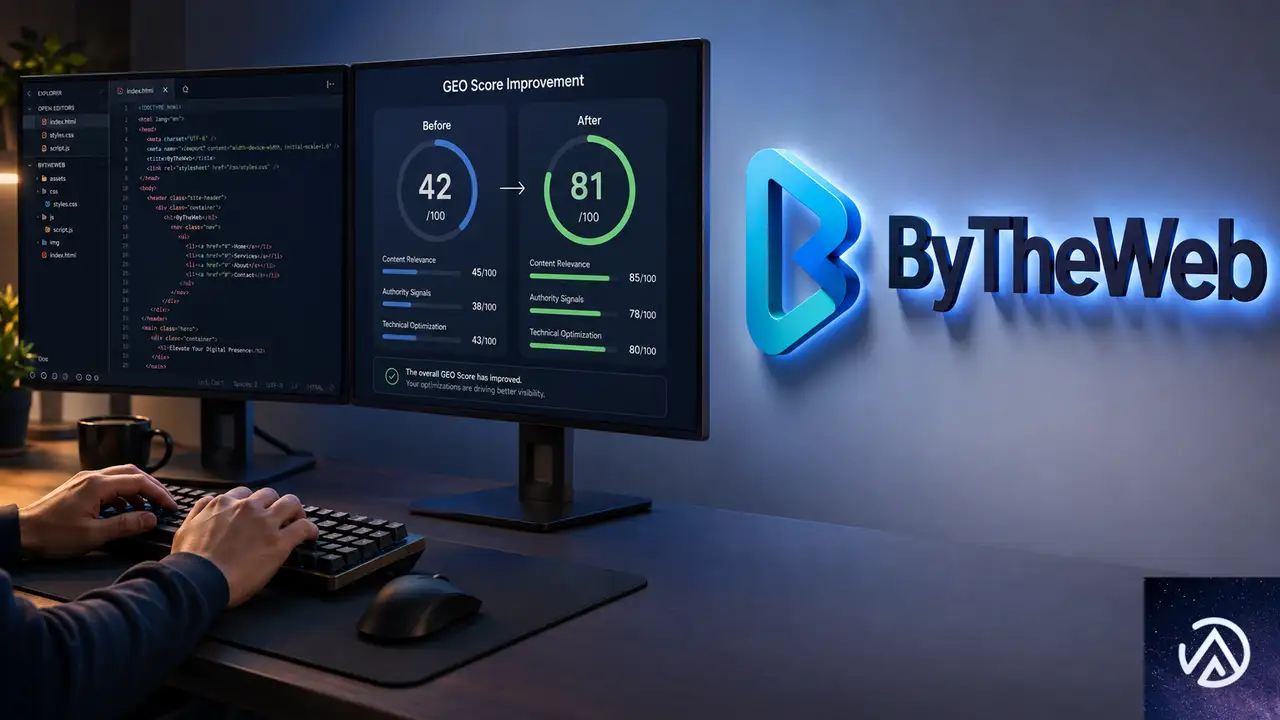
ByTheWeb GEOをインストールして有効化すると、WordPress管理画面に専用メニューが追加され、バックグラウンドで初回サイトスキャンが実行される。最初にGEO設定とSEO設定の画面で、ビジネス名や所在地などの基本情報を登録するとよい。両方のプラグインを有効にした場合、Needs Attention(要対応)テーブルからページごとのGEOスコアを確認できる。スコアが低いページが上に並ぶため、改善対象を見つけやすい。
スコア改善の流れとAIアシスト
Short Answer、AI Summary、FAQを手動で追加すると、そのページのGEOスコアは上がる。これらの情報はページソースのメタタグやFAQスキーマとして出力され、llms.txtにも反映される。ByTheWeb AIを接続している場合は、不足フィールドの横にあるボタンを押すだけで自動生成できる。生成前にはページ内容、任意のトピック指定、クレジット消費量が表示される。
生成結果の編集が必要かどうかは、元のページにどれだけ情報があるかに左右される。このツールはゼロからリサーチするのではなく、ページ上の情報を素材にするためだ。既存コンテンツが充実していれば、そのまま使える精度の出力が得られやすい。
このデモは、AI検索に引用される状態への変化を概念として示したものだ。実際の改善はプラグインが算出するスコアに沿って進める。スコアが上がると、ChatGPTやGeminiが回答の根拠としてサイトを使う可能性が高まる仕組みだ。
プライバシー、サポート、総合評価
クラウド処理とプライバシー
ByTheWeb AIでコンテンツ生成を実行すると、該当ページの内容とドメイン情報がByTheWebのクラウドサービスを経由する。WP Mayorのレビューでは、厳格なデータ処理要件を持つサイトはプライバシーポリシーを確認し、必要に応じて運営チームへ問い合わせるべきだと触れられている。手動機能だけを使う場合はクラウド処理が発生しない。
サポート体制
サポートはWebサイト上のチケットシステムで受け付ける。WordPressプラグインのダッシュボードから簡単にアクセスできる。ナレッジベースには基本機能と一部の応用ケースがまとめられており、多くは短い動画ガイド付きだ。WP Mayorのレビューでは、動画だけでなくテキストによる詳しい説明が増えるとさらに良いという指摘もある。
導入に向くサイトタイプ
WP Mayorのレビューでは、ブロガー、複数サイトを監査するエージェンシー、構造化データを追加したいローカルビジネスにとって最も価値があると評価されている。一方、同レビューは成熟したSEOスタックを導入済みの場合やAI引用の保証を求める場合、複数ある判断材料の1つとして扱うのが現実的だとしている。確立されたリーダーというより、形成途中のカテゴリに登場した有望な初期段階の製品という位置づけだ。
この記事のポイント
- ByTheWeb GEOは無料でAI可読性スコア、llms.txt、スキーマ、従来SEOを管理する
- ByTheWeb AIは任意のクレジット制アシスタントで、不足フィールドを自動生成する
- 新規アカウントには30日間有効の5,000クレジットが付与される
- Yoast SEOやRank Mathと併用でき、GEOスコアとスキーマは有効なまま残る
- AI生成を実行するとページ内容がクラウドを経由するため、プライバシー確認が必要だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

Googleサーチコンソールの生成AIレポートが全世界展開。見方とオプトアウトの注意点
Googleサーチコンソールの生成AIレポートが、2026年8月31日付で全世界のサイトに展開された。AI OverviewsやAI Modeなど生成AI機能での表示回数を、ページ別・国別・日付別に確認できる。
一方で、クリックデータはまだ提供されていない。表示はされても実際のサイト訪問につながったかは分からない。この記事ではレポートの見方、オプトアウト設定の仕組み、SEO担当者が取るべき対応を整理する。
生成AIレポートの全体像

2026年6月から段階的に展開が始まった生成AIレポートは、8月31日付の公式注記で全世界のサイトに行き渡った。Search Consoleにログインすると、検索レポートとDiscoverレポートのそれぞれで生成AI関連のデータを確認できる。
レポートが対象とするのは、AI Overviews、AI Mode、Discoverの生成AI機能だ。AI Overviewsは検索結果の上部に生成AIが回答の要約を表示する機能を指す。AI Modeは対話形式で検索を続けられる専用モードだ。DiscoverはGoogleアプリのフィードで、ここにも生成AIによるコンテンツ表示が含まれる。
従来の検索ではクリックが発生してサイト訪問につながっていた。生成AI検索ではサイトが回答の参照元として表示されても、ユーザーがクリックするとは限らない。この違いがレポートの重要性を高めている。
レポートで確認できる指標
レポートには生成AI機能での表示回数、つまりインプレッションが記録される。検索レポートではページ別・国別・日付別に加えて、デバイス別の内訳も確認できる。Discoverレポートでも同様に、ページ・国・日付の切り口でデータを見られる。
たとえば、自社の記事がAI Overviewsの中でどの国で多く表示されているか、日を追って伸びているかを把握できる。特定のページが頻繁に参照されているなら、その分野のコンテンツが生成AIに評価されている可能性を示す。
クリックデータは含まれない
公開時点でレポートにクリックデータは含まれていない。クリック数やクリック率は確認できず、表示が実際のサイト訪問につながったのかは分からない。この制約は、レポートの活用方法を考えるうえで大きなポイントになる。
Googleはアクセスについても、すべてのプロパティに展開が完了したわけではないとヘルプページで説明している。AIインプレッションが十分に蓄積されていないサイトでは、レポート自体が表示されない可能性がある。
オプトアウト設定の仕組み

レポートと同時に提供されているのが「Search generative AI control」というオプトアウト設定だ。Search Consoleの設定画面に配置されており、プロパティ単位で有効にできる。この設定を使うと、AI Overviews、AI Mode、Discover生成AIの3つの表示面からサイトのリンクとコンテンツを除外できる。
オプトアウトしたサイトは、これらの生成AI機能からのトラフィックとインプレッションが一切発生しなくなる。Googleは公式発表で、この設定が通常の検索ランキングのシグナルとして使われることはないと明言している。生成AI機能に表示されないことが、通常の検索順位に影響することはないという意味だ。
レポートはこの3つの表示面を対象にインプレッションを集計する。オプトアウト設定も同じ3面が対象になるため、運用の判断ではこの対応関係を理解しておきたい。
設定の効果と影響範囲
オプトアウトはプロパティ単位で適用される。つまり、サイト全体がまとめて生成AI機能から除外される形だ。ページ単位で一部だけ除外するような細かい制御は、現時点では提供されていない。
除外を有効にすると、生成AI機能からの表示は完全に止まる。生成AI経由の露出をすべて断つことになるため、ブランド認知や間接的な流入を期待している場合は慎重な判断が求められる。
AIトレーニングとは別の設定
このオプトアウトは、生成AIの学習データへの利用を制御する仕組みとは別物だ。Googleの生成AIトレーニングへの利用可否は、Google-Extendedという別の制御で管理される。Search generative AI controlを有効にしても、AIトレーニングへの利用は止まらない。
「生成AI機能への表示」と「AIの学習利用」は異なる設定で管理されている。SEO担当者は、この2つを混同せずに運用方針を決める必要がある。
ここまでの展開経緯
生成AIレポートとオプトアウト設定は、2026年6月3日にGoogleから同時に発表された。当初は英国のウェブサイト運営者の一部を対象にした限定的なテストとして始まっている。
同日、英国の競争・市場庁(Competition and Markets Authority / CMA)は行動要件を発行した。Googleに対し、サイトが通常の検索結果でペナルティを受けることなくAI検索機能からオプトアウトできるようにすることを求めた。
6月の発表と英国限定テスト
6月の時点では、レポートとオプトアウト設定は英国の選ばれたサイト運営者にのみ提供された。規制当局の要求と同時期に動き出した形だ。検索市場における競争環境を意識した展開だったといえる。
7月以降の段階的な拡大
7月になると、英国以外のアカウントでも設定が表示され始めた。その後、8月31日付の注記で全世界のサイトへの展開が完了したとされた。ただし、ヘルプページには展開が進行中であるとの記載が残っており、実際のアクセスにはタイムラグがあるようだ。
なぜ重要なのか

レポートが見えるようになると、オプトアウトを判断する前に生成AI機能での表示状況を確認できる。これまではブラックボックスだったAI検索内での露出が、数字として見えるようになる。
ただし、インプレッションの真の価値はまだ明確ではない。表示回数が多くても、クリックにつながるかどうかは別の問題だ。生成AI検索では、ユーザーが回答だけで満足してサイトを訪れないケースが増えると指摘されている。
レポートで見えるのは表示回数のみ。実際のトラフィック効果を測るにはクリックデータが必要になる。SEO担当者はこの制約を踏まえたうえでデータを読む必要がある。
SEO担当者が取るべき対応
まずはSearch Consoleでレポートの有無を確認する。すでに表示されている場合は、どのページがどの表示面でインプレッションを得ているかを把握できる。AIインプレッションが少ないサイトでは、レポート自体が表示されないこともある。
表示回数が少ない場合や、自社ブランドと合わない文脈で引用されている場合は、オプトアウトを検討する余地がある。ただし、クリックデータがないため、露出を継続した場合の潜在的な影響を過小評価しないことも重要だ。
既存の検索パフォーマンスレポートと併用し、通常検索の推移と生成AI検索の露出を比較しながら総合的に判断する。オプトアウトはプロパティ単位でしか実行できないため、サイト全体への影響を考慮する必要がある。
インプレッションデータの限界
最大の限界は、クリック数が分からない点だ。表示回数が増えても、サイトへの訪問が増えていなければビジネス上の価値は低い。生成AI回答にサイトの情報が引用されても、ユーザーがリンクを押さなければ意味がない。
加えて、引用位置や文脈も確認できない。自社サイトが回答の根拠として適切に扱われているのか、単に名前が出ているだけなのかをレポートから読み取ることはできない。インプレッションの質を評価する材料が不足しているのが現状だ。
今後の展望
CMAは2027年3月までに、ページ単位の生成AI機能コントロールを導入するようタイムラインを設定している。現在のプロパティ単位の設定より細かい制御が求められている。
規制当局はクリックデータの提供も期待している。しかし、8月31日の更新ではクリックレポートへの言及はなかった。クリックデータが追加されれば、レポートの実用性は大きく高まる。
CMAの要求とタイムライン
ページ単位のコントロールは、サイト全体ではなく特定のページだけを生成AI機能から除外できる仕組みを指す。これが実現すれば、オプトアウトの判断がより柔軟になる。生成AI経由の露出を活かしたいページと、除外したいページを分けて運用できるようになる。
クリックデータ提供の行方
クリックデータが追加されるかは、現時点では未定だ。Googleは最初の1年間、コンプライアンス状況を6か月ごとに報告する義務を負っている。規制当局の継続的な監視が、レポートの改善を後押しする可能性は高い。
この記事のポイント
- 生成AIレポートは2026年8月31日付で全世界のサイトに展開された
- 対象はAI Overviews、AI Mode、Discover生成AIの3面で、ページ別・国別・日付別に表示回数を確認できる
- クリックデータはまだ提供されておらず、表示がトラフィックにつながるかは分からない
- オプトアウトはプロパティ単位で、検索ランキングには影響しないとGoogleが明言している
- CMAは2027年3月までにページ単位のコントロールを要求しており、今後の仕様変更に注意が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AI検索で消えるブランド、SEO上位でもAI回答に登場しない実態。Fractl調査が明かす視認性格差
SEOで上位を獲得しているブランドの一部が、AIチャットの回答にはほとんど登場しない。検索エンジン向けの最適化だけでは、生成AI時代のブランド視認性を確保できないことが明らかになってきた。
Fractlの調査では、GPT-4o、Gemini 2.5 Flash、Claude Sonnet 4.6の3つのモデルに96種の業界別プロンプトを投げ、4,320件の回答と8,500件超のブランド言及を分析した。SEO指標とAI回答での言及頻度を突き合わせ、その乖離を数値化している。
この記事では、AI検索から消えつつあるブランドの特徴、逆にAIで過剰に登場するブランドの共通点、そしてブランド戦略に必要な対応を解説する。
AI回答に潜む「デフォルトブランド」の存在
調査対象の全業界に共通して、プロンプトの言い回しを変えても繰り返し登場する「デフォルトブランド」が存在した。ただし、その顔ぶれは検索エンジンの上位表示とは必ずしも一致しない。ドメイン評価が高く、大量のキーワードで上位表示されているブランドが、AI回答では自社カテゴリにすら登場しないケースが目立つ。
逆に、従来のSEO指標では目立たないブランドが、AI回答では頻繁に推奨される事例も多かった。注目すべきは、デフォルトブランドの顔ぶれが業界ごとに大きく異なる点だ。
旅行カテゴリではBooking.com(285回)、Airbnb(227回)、Expedia(215回)の3ブランドが、カテゴリ全体の言及量の約20%を占めた。3社で推奨の5分の1を握る集中度だ。保険カテゴリではLemonade(213回)がState Farm(172回)を上回り、Root Insurance(165回)がProgressive(114回)を超えた。デジタルネイティブの保険会社が先に挙げられ、従来の大手は代替案として扱われている。
ライフスタイルカテゴリでは、Patagonia、Allbirds、Eileen Fisher、Everlaneといったサステナビリティ系D2Cブランドが、SephoraやSamsung、Whirlpoolを上回った。Fractlの記事では、この傾向は第三者コンテンツで語られるブランドストーリーがAIの訓練データに強く反映された結果だと指摘している。
このデモが示す通り、検索エンジンでの強さとAI回答でのプレゼンスは一致しない。AI回答内の競争集合は、検索結果ページよりはるかに小さい。自社カテゴリでAIが想起する上位5〜10ブランドに入れなければ、Googleで上位表示できていても、AIが生成する検討リストには載らない。
伝統的なSEO権威性とAIリコールの乖離
Fractlの分析によれば、データセット全体の9割超のブランドでは、従来の検索権威性とAI視認性がほぼ連動していた。つまり、SEOの基本原則が無効になったわけではない。ただし、データの端に位置するブランド群にこそ戦略の変化が見える。
全体の約5%、471ブランドが「AI過少露出」だった。ドメイン評価が高く、オーガニック流入も多く、大量のキーワードで上位表示しているにもかかわらず、AIモデルからはほとんど参照されなかった。SEO指標上は市場リーダーに見えるのに、LLMからの言及では「誰も書いたことがない企業」のように映る。
一方、全体の約4%、377ブランドが「AIオーバーパフォーマー」だった。控えめなSEO指標に比べて、AIモデルからの参照が大幅に多かった。さらに9%は、第三者コンテンツでの言及頻度とAI視認性が一致した。
ここから見える最大の示唆は、自社が発信するコンテンツよりも、外部サイトが繰り返し語ってきた内容の方がAIの回答に強く影響するという点だ。まとめ記事、専門家リスト、比較レビューに登場する頻度が高いブランドほど、AIモデルの訓練データに取り込まれやすい。
カテゴリ誤分類で消える大手ブランド
AI過少露出のブランドには、従来の指標ではカテゴリの勝者とみなされてきた大手が並ぶ。ドメイン評価80以上、月間訪問数数百万、数十万のキーワードで上位表示しているブランドが、自社カテゴリのプロンプトで一切言及されない。
この問題の根底にあるのが、カテゴリ分類のズレだ。MicrosoftとSpotifyはFinTechのプロンプトで言及されなかった。両社とも伝統的な視認性は巨大だが、AIモデルはFinTechカテゴリに分類していない。Microsoftは生産性ソフトやクラウドの文脈では頻繁に引用される。FinTechの回答セットには含まれないだけだ。
同様の構図は保険、小売、ヘルスケアでも見られた。Aetna、Cigna、Humana、Liberty Mutualはドメイン評価80以上でも、AI回答ではLemonadeやRootに置き換えられた。Sephora、Samsung、Whirlpoolも、ライフスタイルのプロンプトではPatagoniaやAllbirdsに劣位した。
言及されない理由は、AIがブランドを知らないからではない。検索者が使うカテゴリと異なる引き出しに、そのブランドがしまわれているからだ。コンテンツ量を増やすだけでは解決しない。AIモデルがブランドを正しいカテゴリに結び付けるための外部シグナルが必要になる。
AIモデルがブランドをどのカテゴリに分類しているかを把握し、ズレがあれば修正する方が先だ。カテゴリの結び付きを強化するには、アナリスト記事、業界メディア、比較ページ、パートナーページ、カスタマーストーリー、レビューサイトでの露出が有効になる。
AIで際立つオーバーパフォーマーの戦略
AIオーバーパフォーマー377ブランドの動きは、マーケターにとって他山の石になる。小さいSEOプロフィールでも、AIの回答に繰り返し登場するブランドは、共通してAIモデルの訓練データに使われた第三者コンテンツに複数回登場している。
データセット最大のオーバーパフォーマーはMonday.comだ。AI視認性スコアは0.71を記録した。オーガニック訪問数は約100万、上位キーワードは5万以上。すでに大きなSEO基盤を持ちながら、SaaSプレイヤーの平均を大きく上回る頻度でAIに参照されている。
保険カテゴリではRoot Insuranceが突出した。大手保険会社の規模に遠く及ばないにもかかわらず、AI参照数ではすべての従来型保険会社を上回った。オーバーパフォーマーの上位15ブランドのうち6つは教育分野で、Stanford、MIT、Khan Academy、LinkedIn Learning、IBM Data Science、Google Career Certificatesが並ぶ。AIモデルは商用的なプラットフォームではなく、信頼性の高さで教育ブランドを参照している。
共通項は「良いSEO」ではなく、他者のコンテンツにカテゴリレベルで登場していることだ。製品まとめ記事、エキスパートリスト、比較記事に取り上げられる頻度が、AI視認性を押し上げる。AI視認性の向上は、デジタルPRやカテゴリ権威性の構築に近づいている。
モデル間で異なるAI視認性の実態
調査対象のうち、3モデルすべてに参照されたブランドは11%、900ブランドにとどまった。2モデルに登場したのは12%。残りの77%は、1つのモデルにしか登場しなかった。これはAI視認性の測定に深刻な課題を突き付ける。
ChatGPTで勝てるブランドがGeminiでは消える。Claudeで登場してもChatGPTからは出てこない。1つのモデルの回答を制しても、別のモデルではほとんど登録されない。AI視認性の「総合スコア」だけで改善を判断すると、実態を見誤る原因になる。
モデルごとの「指紋」も異なる。ClaudeはSaaSと保険に偏り、Notion、Linear、Lemonadeが他モデルより頻繁に登場した。Geminiは旅行とヘルスケアに偏り、Booking.com、Teladoc、Livongoの言及が多かった。ChatGPTは3モデルの中で最も合意型で、他モデルとの重複が最も多い。
NotionはClaudeからの引用がGeminiの17倍に達し、Whoopは約4倍だった。State FarmはChatGPTに言及のほぼ半分を依存し、Geminiからは約4分の1しか得られなかった。総合スコアが同じでも、どこで差が出ているかを確認しないと対策は打てない。
ブランド戦略に必要な5つの視点
Fractlの記事は、この調査から導ける5つの教訓を提示している。実行しやすい順に並べると、次の通りだ。
1. 検索権威性とAIリコールを分けて測る
ドメイン評価、オーガニック流入、キーワード順位は引き続き重要だ。ただし、それだけでは全体像を捉えられない。Googleでの順位とAI回答での登場を別々に追跡し、乖離を探す。そのズレにこそ戦略のヒントがある。
2. 第三者による検証を増やす
自社サイトのコンテンツだけではAI回答への登場を保証できない。まとめ記事、ベストリスト、比較記事、専門家レビュー、アナリストページ、ポッドキャスト、YouTubeの文字起こし、コミュニティの議論など、外部コンテンツでの言及を積み重ねることが、AI視認性の実用的なレバーになる。
3. モデルごとに個別測定する
3モデルすべてに参照されたブランドは11%に過ぎない。「AI視認性」を1つの指標として扱うのは誤解を招く。ChatGPT、Gemini、Claudeを分けて計測し、プロンプトをカテゴリ別、購買意図別、比較セット別に分解する。どのモデルで、どの文脈で、どの競合と共に登場するかを追跡する。
4. カテゴリ分類の修正を優先する
ブランド全体の認知度が高くても、狙うカテゴリでのリコールが弱いなら、問題は分類にある可能性が高い。AIモデルはブランドを知っているが、重要なクエリの回答セットに含めるべき存在だとは考えていない。メディア報道、比較コンテンツ、パートナー参照、カスタマーストーリー、受賞歴、レビュー、第三者ページなどを通じて、ブランドとカテゴリの結び付きを繰り返し強化する必要がある。
5. デフォルト回答の枠が固まる前に動く
ウェルネス、ライフスタイル、ヘルステックの一部では、デフォルト回答の座がまだ空白だ。一方、旅行、主要SaaS、FinTechの一部では、AIが返す顔ぶれがすでに固定化しつつある。カテゴリとの結び付きを早期に築いたブランドほど、AIの回答に残りやすい。後発が割り込む余地は徐々に狭まる。
この記事のポイント
- SEO上位でもAI回答に登場しないブランドが全体の約5%存在する
- AI回答での競争集合は検索結果ページよりはるかに小さい
- 第三者コンテンツでの言及頻度がAI視認性を左右する
- 3モデルすべてに参照されるブランドは11%に過ぎない
- カテゴリ誤分類の修正がAI視認性改善の近道になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
ChatGPTが商業クエリの26%に広告表示、関連性に課題も浮上
ChatGPTが商業目的のクエリの約4回に1回の割合で広告を表示していることが、SEOツール企業SE Rankingの調査で明らかになった。表示頻度はGoogleのAIモードに迫る水準だが、広告の関連性や広告主の可視性に課題が残る。
今回の調査は20分野にわたる5万件以上の商業クエリを分析したもので、会話型AI上での広告配信の実態が初めて大規模に可視化された。AI検索時代の新たな広告チャネルとして注目されるChatGPT Adsだが、その仕組みにはGoogle検索とは異なる独自の難しさがある。
商業クエリの約26%で広告が出現、Google AIモードに肉薄
SE Rankingの調査によると、ChatGPTは商業クエリの25.94%でスポンサードプレースメント(広告)を表示した。これは同社が以前調査したGoogle AIモードの29.45%にかなり近い数字だ。AIチャットボットの広告表示率が、従来型検索エンジンのAIモードと肩を並べつつある状況が浮かび上がった。
表示スタイルはシンプル、1クエリに単一広告
広告の表示スタイルは現在のところ非常にクリーンだ。調査で観測されたすべての広告は、生成された回答の下部に表示され、他の広告主と並んで競合することはなかった。1つの回答に対して常に1つのスポンサーオファーのみが表示される。
Googleの検索結果画面とは異なり、ユーザー体験を大きく阻害しない形で広告が統合されている点は注目に値する。ただし、このシンプルさは広告枠の稀少性を意味しており、将来的に入札競争が激化した際にどう変化するかは未知数だ。
広告の関連性に課題、約14%が的外れな表示
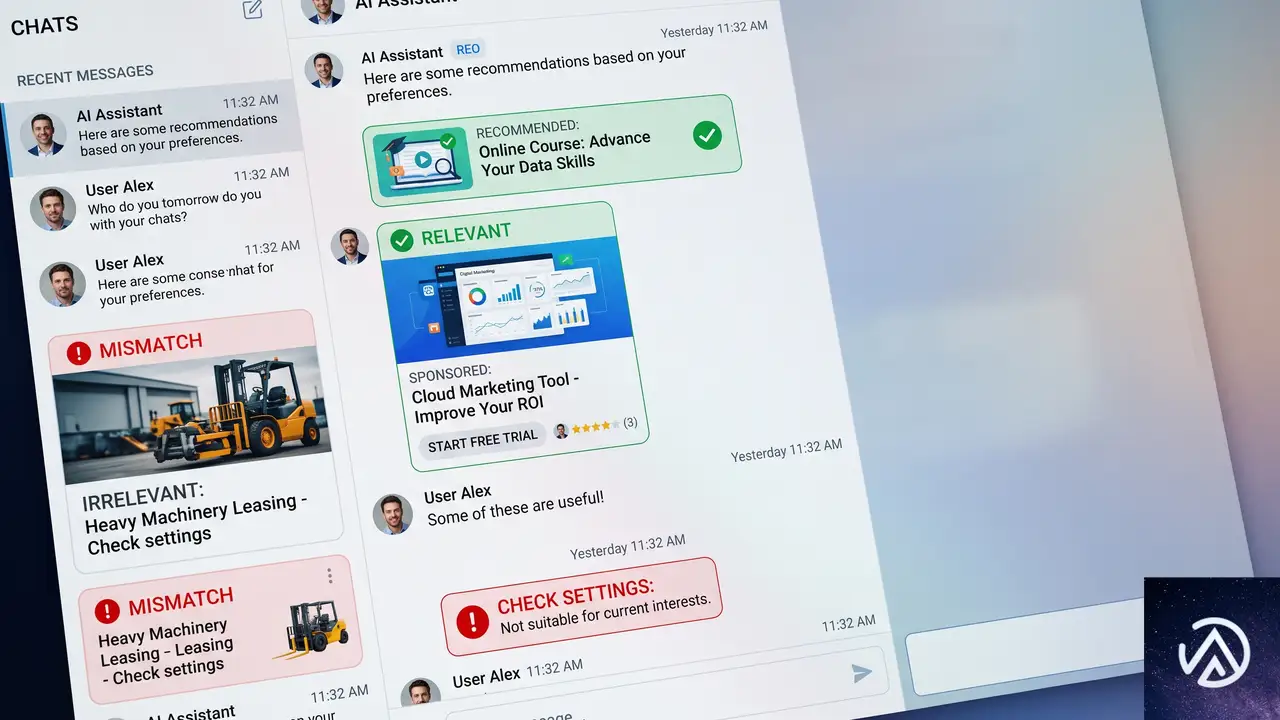
ChatGPT Adsの大きな課題として浮上したのが、広告の関連性だ。SE Rankingのセマンティック分析によると、表示された広告の約14.35%が、ユーザーのプロンプトと実質的な関連性を持たなかった。これは7件に1件の割合で、的外れな広告が表示されている計算になる。
カテゴリによるばらつきが顕著
ミスマッチの発生率はカテゴリによって大きく異なる。ペット分野ではわずか2.6%だったのに対し、人間関係やニュース・政治分野では半数以上が無関係な広告だった。特定のトピックでは、会話の文脈を正しく解釈して適切な広告を選ぶことが依然として難しいことがわかる。
実際のミスマッチ例
調査で観測された例では、デートアプリに関するプロンプトに衣料品小売店の広告が表示されたり、新聞の購読を尋ねるクエリに電力会社の広告が出たりといったケースがあった。ユーザーの意図と広告の内容が明らかにずれている。
このようなミスマッチは、広告主にとって広告費の無駄遣いになるだけでなく、ユーザーのAI体験の質を下げる要因にもなる。ChatGPTが広告プラットフォームとして成熟するためには、文脈理解の精度向上が不可欠だ。
従来のキーワードターゲティングとは根本的に異なる仕組み
ミスマッチが起きる背景には、ChatGPT Ads特有のターゲティング方式がある。広告主はキーワードリストではなく、自然言語で書かれた「コンテキストヒント」を提供する。これは「自社の広告を表示したい会話の文脈」を説明するテキストで、厳密なマッチングルールではなく、AIによるゆるやかなマッチングのガイドとして使われる。
加えて、広告主は現在のところ、実際にどのクエリや会話が自社の広告表示をトリガーしたのかを確認できない。これでは不適切なプレースメントが起きても原因を特定しづらく、改善のためのフィードバックループを回すのが難しい。
広告出稿とAI回答でのブランド露出はほぼ無関係

調査の中で特に注目すべき知見は、ChatGPT上で広告を出稿しても、それが生成AIの回答本文にブランドとして登場する確率はほとんど上がらないという点だ。
広告が表示されたクエリのうち、同じブランドが回答の情報源として引用されたケースはわずか3.63%だった。さらに、広告のURLがそのまま引用に現れたのは0.09%にすぎない。ブランド名の言及も4.44%にとどまる。
つまり、ChatGPTに広告費を投下しても、AIが生成するオーガニックな情報として認識される可能性は極めて低い。有料プレースメントとオーガニックなAI可視性は、今のところ完全に分離していると考えてよい。
YMYL分野で目立つ広告表示、Google AIモードとの違い
ChatGPT Adsは、健康やニュースといったYMYL(Your Money or Your Life)分野で、Google AIモードに比べて顕著に多くの広告を表示している。
調査によると、ヘルスケア関連のプロンプトでは28.69%で広告が表示されたのに対し、Google AIモードではわずか2.64%だった。ニュース・政治カテゴリでも同様に、ChatGPTが28.76%、AIモードは6.8%と大きな開きがある。
この差は、ChatGPTの広告セーフガードが緩いことを必ずしも意味しない。むしろ、2つのAIプラットフォームが広告表示に対して異なるポリシーやマッチングモデルを採用している証拠と見るべきだ。広告主は、AI検索チャネルごとにまったく異なる配信傾向があることを前提に戦略を立てる必要がある。
広告主が今おさえておくべきポイントと今後の展望
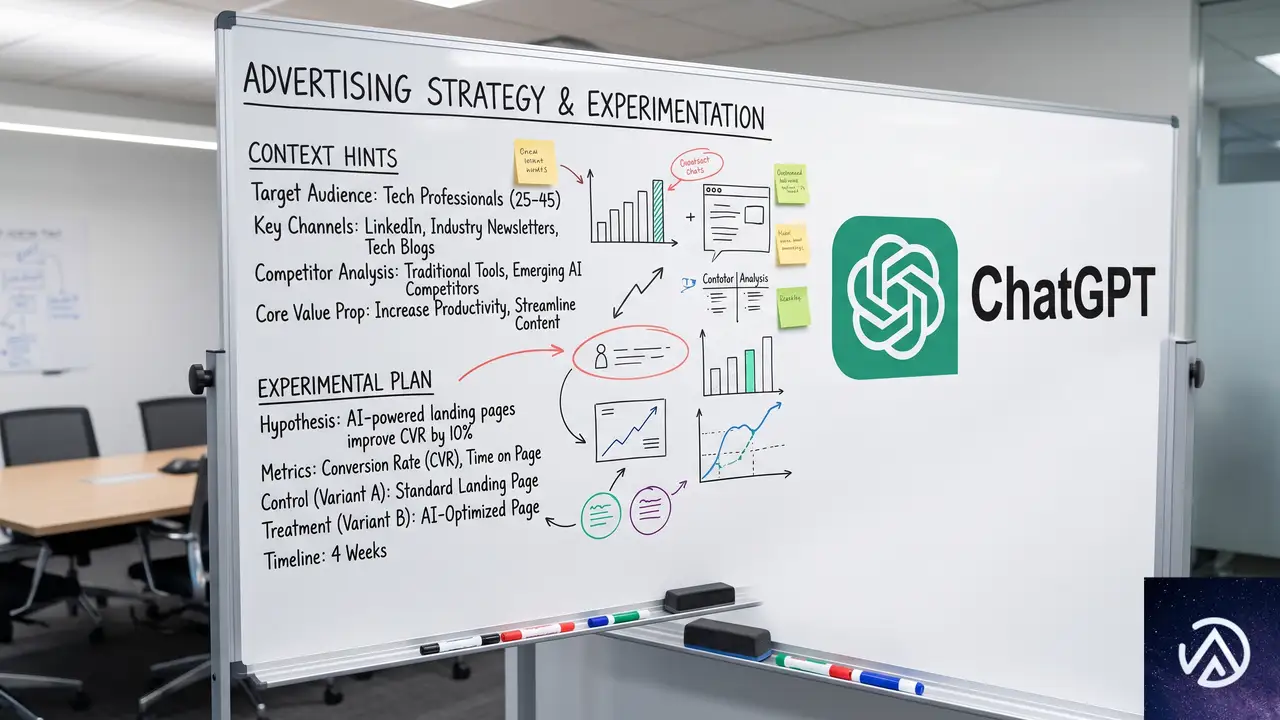
ChatGPT Adsは急速に成長する有料メディアチャネルだが、Google検索広告と同じ感覚で運用すると期待はずれに終わる可能性が高い。会話型AI上の広告は、キーワードではなくコンテキストに依存するため、精度の高いコンテキストヒントの設計と継続的な実験が欠かせない。
また、どのような会話で広告が表示されたかというレポートの不足は、最適化の足かせとなる。OpenAIが今後、広告主向けにより詳細な分析ダッシュボードを提供するかどうかが、チャネルとしての成熟度を左右するだろう。
さらに、AI検索の世界では、有料広告とオーガニックなブランド認知が直接リンクしない構造が鮮明になった。SEOにおけるブランド構築や被リンク獲得といった従来手法は、AIが回答を生成する時代にも強みを発揮する。広告だけでAI上の可視性を買おうとする発想は現実的ではない。
この記事のポイント
- ChatGPTは商業クエリの約26%で広告を表示し、Google AIモードと同等の水準に達している
- 広告の約14%がクエリと無関係で、会話ターゲティングの精度に課題が残る
- 広告出稿しても、ブランドがAI回答内で情報源として引用される確率は3%程度と低い
- 健康やニュース分野では、ChatGPTの広告表示率がGoogle AIモードより顕著に高い
- 会話型AI広告の最適化には、精密なコンテキストヒント設計と、広告表示ログの透明性が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

cats.txtが暴いたGEOの証拠水準。AIクロールは機能の証明にならない
AI検索時代におけるSEOの延長線上にあるGEO(生成AIエンジン最適化)。その効果を裏付ける「証拠」として、しばしば4つの観測があげられる。AIボットがファイルをクロールした、Googleがインデックスした、LLMがその内容を出力した、ChatGPTが有効性を認めた。しかし、これらの観測は本当に「有効性の証明」と言えるのか。
Search Engine JournalのMark Williams-Cook氏が公開した風刺的な検証が、この疑問に痛烈な答えを出している。同氏は架空の規格「cats.txt」を考案し、上記4つの証拠すべてをクリアすることを実証した。つまり、ウェブ上に置かれたどんなテキストファイルにも同様の現象は起こり得るのであり、それらは機能を保証するものではないというわけだ。
GEO業界でまかり通る「4つの証拠」とその問題点
以下、それぞれを詳しく見ていこう。
1. AIボットがクロールしている
クローラーの役割は、Web上にあるファイルを片端から取得することだ。そのため、cats.txtのような冗談まじりのファイルにも、PerplexityBotやGPTBot、ClaudeBotがアクセスしてくる。サーバーログにボットの痕跡があったからといって、そのファイルが「特別に利用されている」証拠にはならない。配達員が門を通るのと、家の中のゴミ箱の中身が役立っているというのは別の話である。
2. Googleにインデックスされた
Googleはテキストファイルをきわめて積極的にインデックスする。cats.txtもGoogle検索結果に現れ、Search Consoleで「インデックス登録されました」と表示された。しかしそれは、URLが存在し、何かしらの文字が書かれているという事実を確認しただけだ。信ぴょう性や有用性とは無関係である。
3. LLMがファイルの内容を出力した
検索拡張生成(RAG)は、LLMが検索結果を参照して回答を生成する仕組みだ。cats.txtが検索上位に登場すると、AIはその猫情報を何の疑いもなく引用する。これはファイルが特別な「プロトコル」として機能しているのではなく、単に1つのWebページとして扱われた結果に過ぎない。
4. ChatGPTが有効性を認めた
ChatGPTに「cats.txtは役立ちますか」と尋ねると、公開直後は「検索エンジンやLLM駆動システムでのランク向上に寄与する可能性があります」という回答が返ってきた。これはネット上に「有効だ」と書かれたテキストが多かったからであり、AI自身が何かを判断したわけではない。興味深いことに、このファイルが風刺であると知れ渡った後は、同じChatGPTが「これは冗談です」と答えるようになった。AIの意見は、周囲の言説の平均値にすぎないのである。
「収束問題」が引き起こす根拠の循環
この「収束問題」こそが、4つの証拠の背後にある根本的なメカニズムだ。LLMは与えられたネット上の言説の平均的な意見を出力するに過ぎない。cats.txtが「効果的だ」と答えたのも、公開当初に肯定的な書き込みが一定数集まったからである。もし皆が「これはデタラメだ」と書いていれば、AIもそう答えたはずだ。
このように、AI自身の意見を「お墨付き」と捉えるのは危険である。流動的な世の中の雰囲気に左右される出力を、数値や因果関係の証拠と混同してはいけない。
真のSEO・GEO最適化が目指すべきもの

cats.txtの実験が示したのは、あるGEO施策の効果を主張するために使われる「証拠」があまりにも脆弱だという事実だ。AIボットのクロール、インデックス、LLMの出力、ChatGPTの賛同。これらはどれも、「施策が機能していること」の証明にはならない。
問題は、こうした根拠不十分な手法に時間と予算を費やすことにある。確かな価値が実証されている基本的なSEO改善(コンテンツ品質、サイト速度、ユーザー体験の向上)こそが、長期的にAI検索からのトラフィックを伸ばす土台となる。最適化とは、検証可能な小さな改善を積み重ね、競合よりもわずかに優位に立つことだ。まだ誰も検証していない「次のGEOの秘策」を追いかけることではない。
この記事のポイント
- AI検索最適化の「証拠」とされる4つの観測(クロール、インデックス、LLM出力、ChatGPT賛同)は、どのテキストファイルにも起こる現象であり、施策の有効性を担保しない
- 2026年8月に公開されたcats.txtは、この4つの証拠すべてをクリアし、根拠の脆弱性を浮き彫りにした
- LLMの自己評価はネット上の意見の平均を返しているに過ぎず、エコーチェンバー効果によって「有効」と誤認されやすい
- 限られたリソースは、検証済みの基本SEO改善に集中させるべきであり、エビデンスの弱い新手法に振り回されてはならない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験