

Cloudflareがrobots.txtを自動生成するBot Preference Syncの仕組みと検証
Cloudflareが2026年8月21日、サイトのrobots.txtを自動生成する新機能「Bot Preference Sync」を発表した。Search、Agent、Trainingの3つのカテゴリ設定から、Cloudflareがrobots.txtの該当部分を自動的に書き換える仕組みだ。robots.txtとエッジ強制設定の矛盾を解消すると期待される。
この機能は無料プランから利用でき、新規顧客にはデフォルトでオンになる予定だ。一方でカテゴリ単位の設定には粗さがあり、個別クローラー単位のビジネス判断を表現できないという課題もある。本記事では機能の仕組みと限界、サイト運営者が取るべき対応を検証する。
robots.txtとエッジ強制の矛盾が生んだ新機能
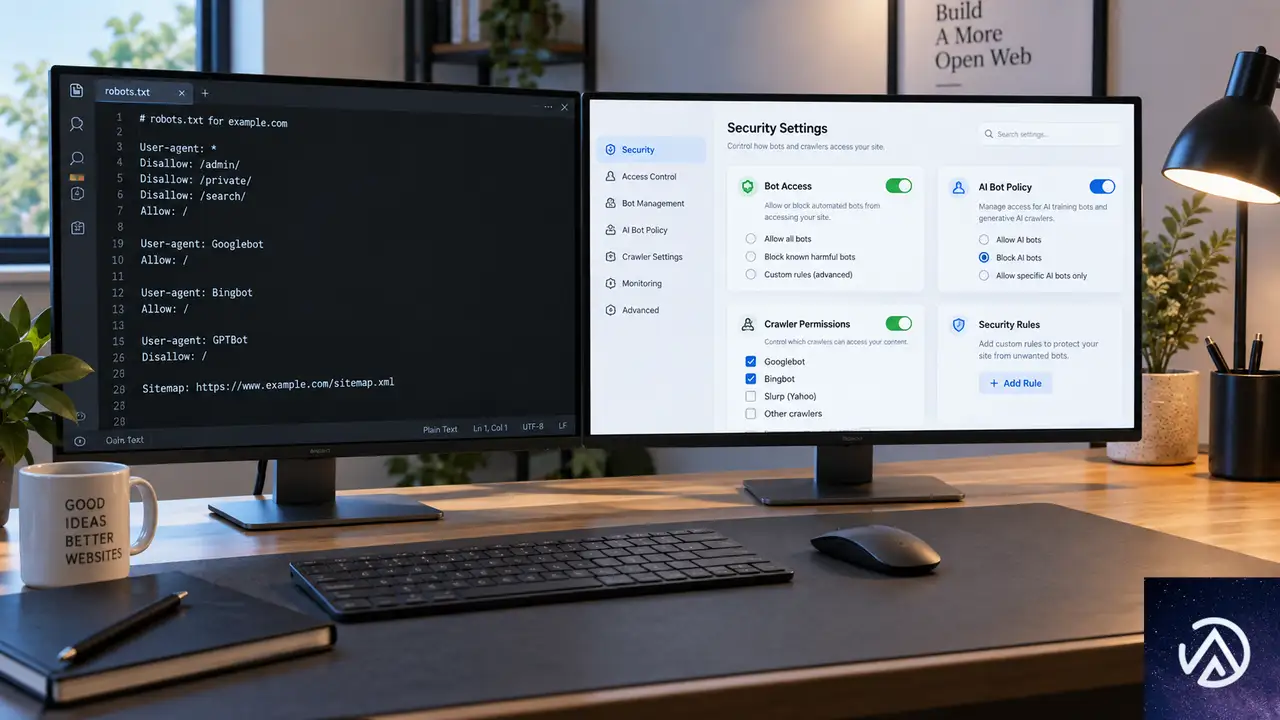
Webサイトのクローラーポリシーは2つの場所で管理される。1つはrobots.txtファイル、もう1つはWAFやCDNのエッジ側で動作するブロック設定だ。robots.txtはテキストファイルであり、クローラーへのリクエスト(お願い)を記述する。エッジ強制設定はダッシュボードで操作し、実際にHTTPリクエストを拒否する。
この2つは別々の場所で管理されるため、時間とともに矛盾が生じやすい。robots.txtは一度作成すると放置されがちで、エッジ設定は後から変更されることが多い。No Hacksの記事は、運営者自身のサイトでこの問題が発生していた例を報告している。robots.txtではBytespiderを許可する記述が数ヶ月間残っており、意図しないクローラーを歓迎する状態だったという。
CloudflareのBot Preference Syncは、この矛盾を自動的に解消する。ダッシュボードで設定したAIボットポリシーをrobots.txtに反映し、エッジ強制設定との乖離を防ぐ。Cloudflareがrobots.txtを書くという行為は、サイト運営者の代わりにポリシーを文書化することでもある。
Bot Preference Syncの仕組みと3つのカテゴリ設定
Bot Preference Syncは、セキュリティ設定の「AIボットポリシー」で設定した内容をrobots.txtに変換する。設定項目はSearch(検索)、Agent(エージェント)、Training(トレーニング)の3カテゴリだ。各カテゴリには「全ページでブロック」「広告表示ページのみブロック」「許可」の選択肢がある。
生成されたrobots.txtには、Cloudflare Bot Preference Syncの開始マーカーと終了マーカーが付与される。既存のrobots.txtコンテンツはその下に保持される。つまりCloudflareが書き込むのはマーカーの間の部分だけで、サイト運営者が手動で書いた部分は残る仕組みだ。
Bot Preference Syncは設定をrobots.txtへ反映する一連の流れを自動化する。
Cloudflareの発表によると、この機能は無料プランから利用可能で、新規顧客にはデフォルトでオンになる。ただし2026年9月13日時点では、Bot Preference Syncの公式Changelogへの記載がなく、Cloudflareのボットドキュメントにも言及がない。また一部のサイトではrobots.txtに生成ブロックがまだ現れていない。本記事は発表内容に基づく検証となる。
カテゴリ単位の設定では表現できない個別ポリシー
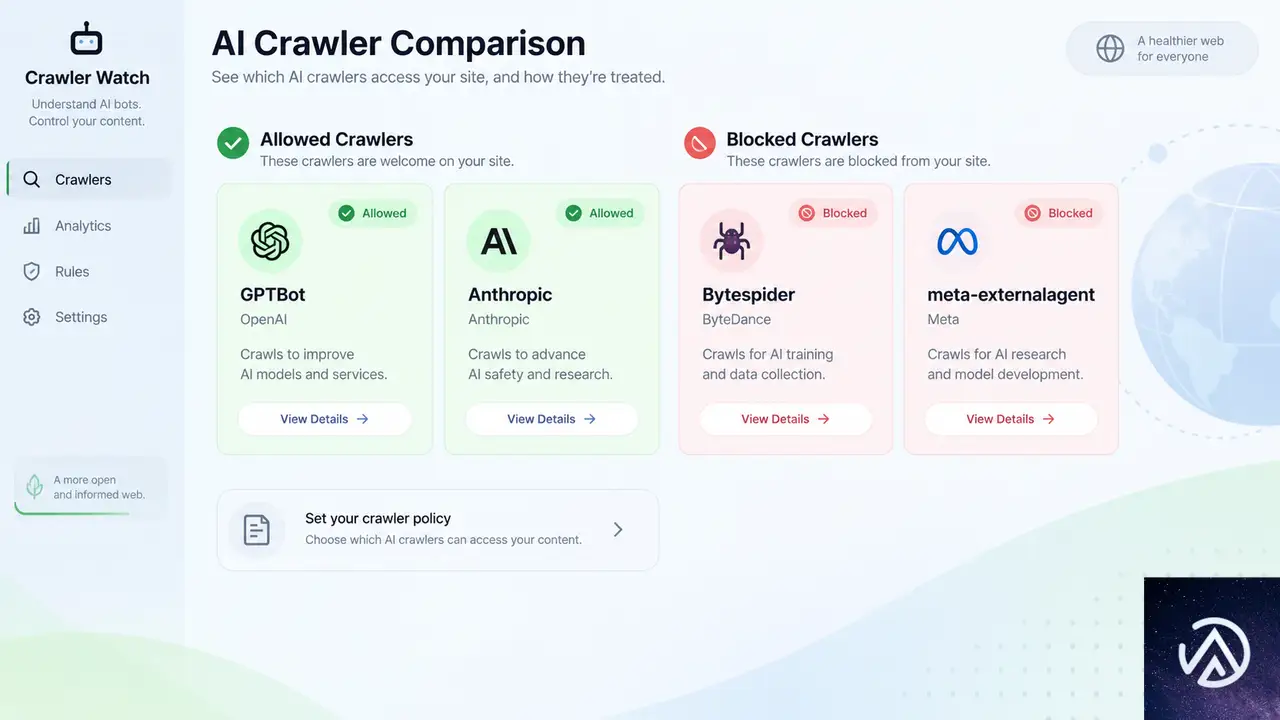
Bot Preference Syncの3カテゴリ設定は、サイト運営者のビジネス判断を必ずしも表現できない。No Hacksの記事の運営者は、OpenAIのGPTBot、Anthropicのクローラー、PerplexityBotを許可し、Bytespiderとmeta-externalagentをブロックしている。この判断は企業ごとの見返りに基づく。前者は自社ページをアシスタントの回答に表示してくれるが、後者は何も返さない、という理由だ。
このポリシーを3カテゴリ設定で表現しようとすると、矛盾が生じる。Trainingをブロックに設定すれば、許可したいGPTBotまでブロックされる。Trainingを許可に設定すれば、ブロックしたいBytespiderまで許可される。個別クローラー単位のビジネス上の決定は、カテゴリ単位の設定では表現できない。
個別クローラー単位のポリシーは3カテゴリ設定では表現できない。許可したいクローラーの扱いが、設定次第で逆転してしまう。
Cloudflareは、より細かい制御が必要な場合の対応策として、同期機能をオフにして手動でrobots.txtを管理することを挙げている。これはBot Preference Syncが万人向けではなく、カテゴリ単位の粗さを受け入れられるサイトに向けた機能だということを示している。
独自の見解として、日本のサイト運営者にもこの課題は当てはまる。コンテンツをAIトレーニングに提供する見返りを個別に評価している企業は、3カテゴリの設定では対応できない。Bot Preference Syncはあくまで「全許可」か「全拒否」に近いポリシーを持つサイト向けの省力化ツールと捉えるべきだ。
Cloudflareが公開した4つの開示条件とブロッキング
TrainingをDisallowに設定すると、robots.txtにno-training行が書き込まれる。同時に、Cloudflareが「不透明」と判断したAIクローラーがブロックされる。Cloudflareはこのブロックを回避するために、クローラーが満たすべき4つの条件を公開している。
4つの条件を満たさないクローラーは不透明とみなされ、TrainingをDisallowに設定したサイトではブロック対象となる。
条件2と条件4はGoogleを記述している。条件4についてGoogleはすでに満たしている。Googleのクローラードキュメントは、Google-ExtendedがGeminiモデルのトレーニングを制御し、検索結果への掲載やランキングシグナルには影響しないと明記している。これは条件4が求める公開声明に該当する。
一方で条件2はGoogleが答えを持っていない。条件2はAIサマリーからオプトアウトする方法を求めている。GoogleのAI機能のドキュメントによると、AI概要から除外するにはnosnippet、data-nosnippet、max-snippet、noindexのいずれかを使うことになる。しかし、これらはすべて通常の検索表示にも影響する。AI概要だけから外れて通常の検索スニペットは残す、という設定は存在しない。
Microsoftは2023年9月に条件2への回答を示している。NOARCHIVEタグを付けたコンテンツはBing Chatの回答に含まれないが、検索結果には引き続き表示される。検索インデックスから除外せず、チャットの回答からだけ除外できる仕組みだ。Cloudflareは2026年7月の記事で、BingBotとGooglebotを混合用途クローラーとしてこの条件の対象に挙げている。
CloudflareがAI企業への開示要求を明文化した点は評価できる。ただし、その条件を書いたのも執行するのもCloudflareという単一ベンダーだ。条件を読まずにダッシュボードのトグルをクリックしたサイト運営者も多い。パブリッシャーがAI企業に求めてきた説明責任は、いまやCloudflareにも向けられている。
新規顧客にデフォルト適用される意味とリスク
2026年9月15日から、Cloudflareは新規ドメインのデフォルト設定を変更する。広告を表示するページではTrainingとAgentがブロックされ、Searchは許可される。オンボーディング時に「広告付きページで収益化している」を選択すると、TrainingがDisallowに自動設定される。
これはビジネスモデルに関する質問であり、その回答がrobots.txt上のAIトレーニングに関する公開ポジションになる。広告収益に依存するサイトは、AIトレーニングを拒否する立場を自動的に表明することになる。サイト運営者がこの設定を認識していなければ、意図しないポジションが公開され続ける。
リスクが大きいのは、robots.txtを二度と開かず、自分の代わりに書かれたポジションを読まないサイトだ。Cloudflareはすでにアナリティクススクリプトを無料プランのサイトにデフォルトで書き込んでいる。同じオンデフォルトのパターンがrobots.txtにも及ぶ。サイト運営者が設定を確認しなければ、AIトレーニングに関する自社の立場を外部ベンダーに委ねることになる。
SEO担当者の観点では、このデフォルト変更を黙認してはいけない。自社サイトがAIトレーニングを拒否しているのか許可しているのかは、AI時代の検索戦略を左右する。デフォルト設定のまま放置するのではなく、自社のビジネスモデルに合わせて意図的に選択することが重要だ。
robots.txtが守れる範囲と守れない範囲
robots.txtのルールは、停止することを選ぶクローラーを停止させるだけだ。ルールを無視するクローラーには何も影響しない。No Hacksの記事は、同サイトのログで最大のAIクローラーが認証情報を探していたと報告している。非営利研究アーカイブの名前を使い、/.envやSSHキーを要求するクローラーがいたという。テキストファイルのルールはそのようなクローラーを不便にさせることすらできない。
それでもBot Preference Syncは有用だ。インターネットの誠実な側、つまりルールを守るクローラーに対しては機能する。エッジでの強制が実際の防御であり、robots.txtは意図の文書化として、後から紛争になった時に意味を持つ。リクエストが到着した瞬間の防御にはならないが、自社のポリシーを明確に残しておく価値はある。
最終的には、robots.txtとCloudflareのAIボットポリシーを突き合わせて確認する作業が欠かせない。Bot Preference Syncが自サイトに到達したら、書かれた内容を必ず確認すること。読んでいないポリシーファイルは、他人が自分の代わりに表明した立場になる。
この記事のポイント
- CloudflareのBot Preference Syncはrobots.txtとエッジ強制設定の矛盾を解消する自動化機能である
- Search、Agent、Trainingの3カテゴリ設定では個別クローラー単位のビジネス判断を表現できない
- Cloudflareは4つの開示条件を公開し、不透明なクローラーをブロック対象にした
- 新規顧客にはデフォルトでオンになり、広告収益化サイトではTrainingがブロックされる
- robots.txtは誠実なクローラーにしか効かないため、エッジ強制が依然として重要である

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Cloudflare新設定が公開。Disallow AI TrainingでGooglebotを残してAI学習だけを拒否
Cloudflareが9月15日から新しいクローラー制御設定「Disallow AI Training」の提供を開始した。AI学習に使われるクローラーを拒否しつつ、Googlebotなどの検索クロールは維持できる設定だ。
従来はAI学習をブロックするとGooglebot、Applebot、Bingbotまで停止する仕様だった。新設定ではこの3つのクローラーが検索目的のクロールを継続できる。
検索流入を維持しながら生成AIへの無断利用を防ぎたいサイト運営者にとって、判断軸が明確になる変更だ。SEOを担当する立場からは設定の仕組みと影響範囲を把握しておく必要がある。
9月15日に何が変わったのか
Cloudflareはクローラー制御を3つの設定に再編した。検索クローラーを制御するSearch、AIエージェントを制御するAgent、AI学習を制御するTrainingだ。今回の目玉となるDisallow AI TrainingはTrainingに属する新設の選択肢である。
重要なのは、7月時点の告知からの方針転換だ。当初はAI学習を拒否するサイトはGooglebot、Applebot、Bingbotもブロックされると説明されていた。3つのクローラーが検索と学習の両方に使われるため、切り分けができないという理由だった。
転換のカギは「Accountable(説明責任)」という新しい認定だ。検索と学習を兼ねるクローラーのうち、学習拒否の仕組みを整えた事業者のクローラーだけが検索クロールを許される。この枠組みにより、検索と学習の分離が可能になった。
3つの設定項目の新しい役割
Disallow AI Trainingを選ぶと、Accountable認定を受けたクローラーは検索目的に限ってクロールを継続する。学習用のクロールは拒否される。一方、Blockを選ぶとGooglebot、Applebot、Bingbotを含むすべてのクローラーが完全に停止する。検索クロールも止まる点に注意が必要だ。
検索との両立を狙うならDisallow AI Training、完全遮断を望むならBlockという使い分けになる。誤ってBlockを選ぶと検索エンジンからの評価に影響するため、設定変更時は現状を確認してから操作したい。
既存ユーザーの設定は自動移行される
Cloudflareの公式ブログによると、既存ユーザーの多くは何も変更する必要がない。旧設定で「Block」または「Block on pages with ads」を選択していたサイトは、自動的にDisallow AI Trainingへ移行される。旧Block AI Botsトグルを使っていたサイトは、SearchがAllow、TrainingがDisallow AI Training、AgentがBlock on pages with adsに振り分けられる。
なお、旧機能のBlock AI BotsとManaged Robots.txtは廃止予定だ。混在利用型クローラーをサイトから完全に締め出したい場合は、新設のBlockを明示的に選ぶ必要がある。広告で収益化する新規ドメインには、Disallow AI TrainingがTrainingの初期設定として適用される。
このデモは旧計画と新設定の挙動の違いを示している。7月時点では検索クロールの継続が困難とされていたが、Accountable認定の導入により分離が実現した。
Accountableクローラーの4つの要件
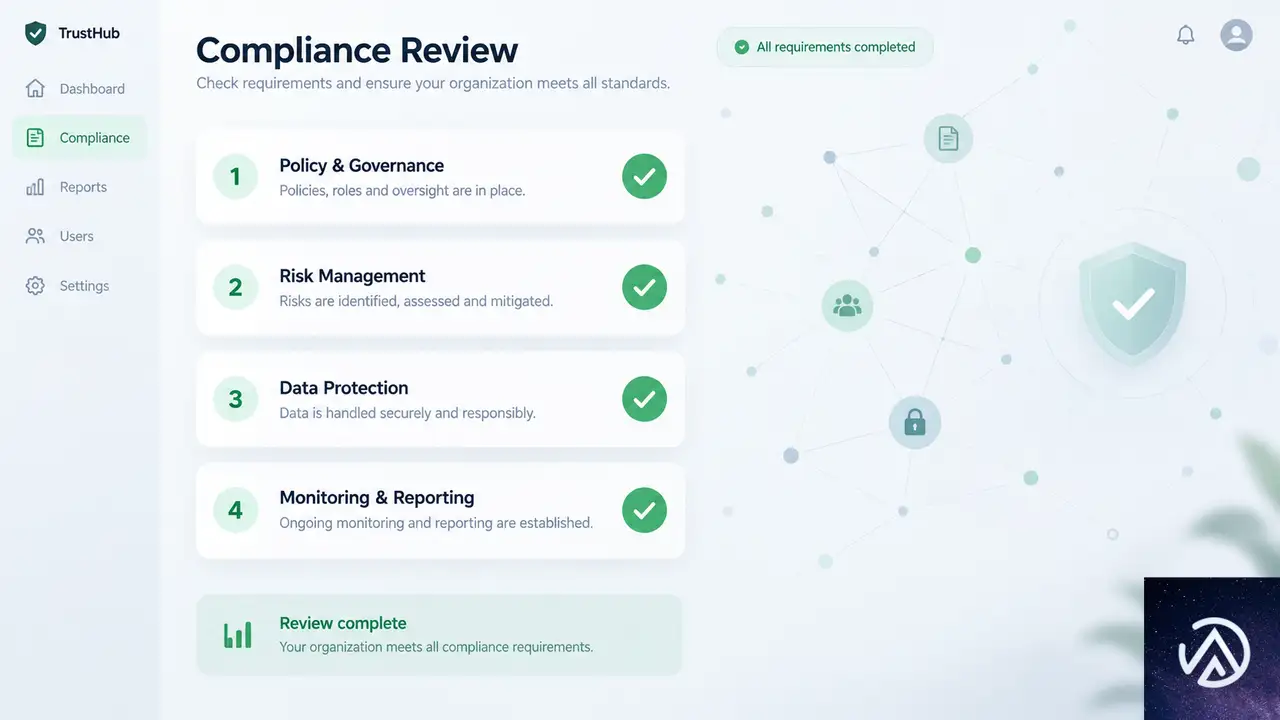
AccountableはCloudflareが2026年7月からクローラー運営事業者との協議を経て設けた認定だ。検索と学習を兼ねるクローラーが検索目的でクロールを継続するには、この認定を取得している必要がある。
4つの要件の具体的内容
認定には4つの要件がある。robots.txt経由でAI学習を拒否できる仕組み、AIサマリーからの除外手段、どのページが学習に使われたかの可視性と検索表示の指標開示、学習拒否が検索結果に影響しないことの保証だ。
Cloudflareの公式ブログによると、Apple、Google、Microsoftがこれらの要件を満たしている。提供済みの機能に加え、残りの項目についても期限付きのコミットメントを出しているという。Amazon、Anthropic、Meta、OpenAIもAccountableとしてリストに載っている。これらは検索クローラーと学習クローラーを別々に運用しているため、学習クローラーはDisallow AI Trainingで引き続きブロックされる。
このチェックリストはクローラー運営事業者が開示した内容を基にしている。サイト運営者側で個別に審査する必要はなく、Cloudflareが認定状況を管理する。
Google・Apple・Bingで動作はどう違うのか
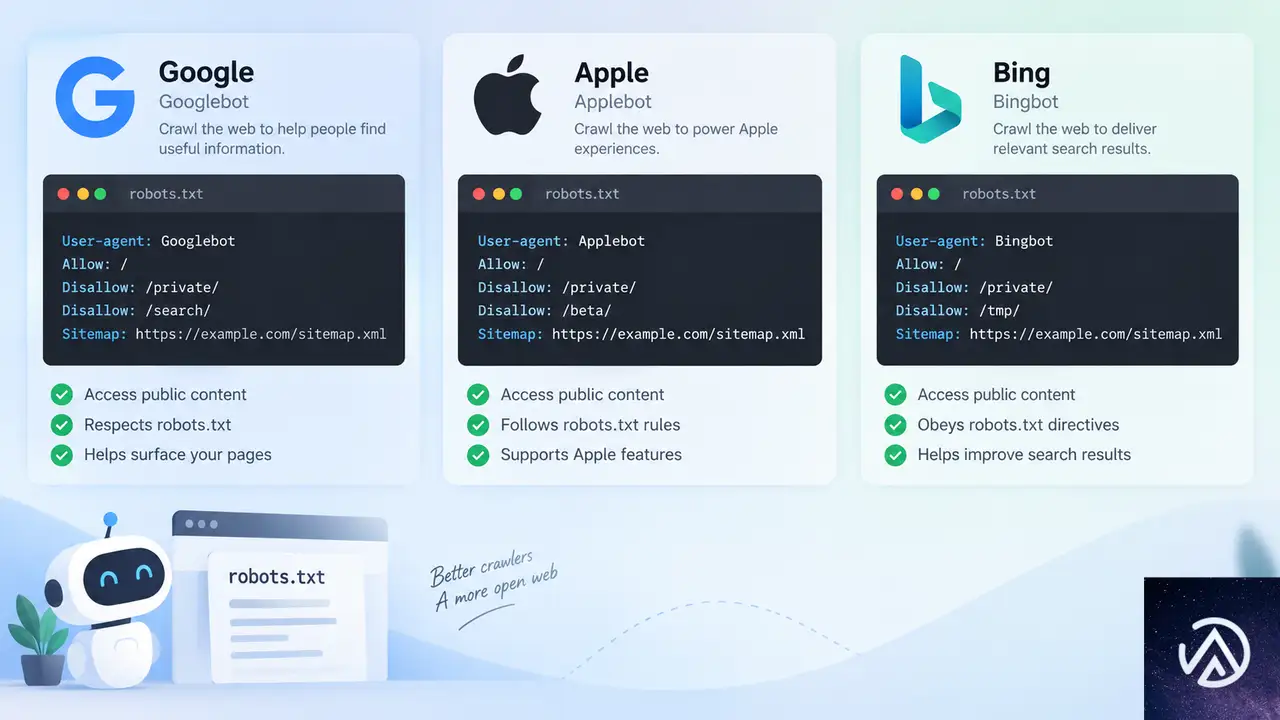
Disallow AI Trainingは各プラットフォームごとに異なる仕組みで実装される。robots.txtのトークンにマッピングされる点は共通だが、Bingは対応が遅れている。
GoogleのGoogle-Extended
Googleではrobots.txtのDisallowルールでGoogle-Extendedを拒否する形式になる。Google-ExtendedはGeminiモデルの学習からコンテンツを除外するためのトークンだ。Googleのクローラードキュメントによると、Google-Extendedを拒否しても検索結果への掲載や順位には影響しない。
注意したいのは、AI OverviewsやAI Mode、Discoverの生成AI機能への表示はSearch Consoleで別途制御する点だ。Googleのヘルプページでは、この設定はAI学習には影響しないと明記されている。検索表示と学習拒否は完全に別ルートで管理される。
AppleとBingの対応状況
AppleではApplebot-ExtendedのDisallowルールで対応する。Appleのドキュメントによると、Applebot-Extendedはページをクロールせず、検索順位にも考慮されない。Siriや検索のAI回答からコンテンツを除外するにはnosnippetメタタグが必要だ。
Bingはまだrobots.txtのno-trainingプリファレンスに対応していない。Microsoft側の実装待ちで、Cloudflareの公式ブログでは2027年初頭のサポートを目標としている。現状の学習拒否手段はNOARCHIVEメタタグだ。Bingのドキュメントによると、NOARCHIVEを付けたコンテンツはMicrosoftの生成AIモデルの学習に使われず、ChatやCopilotにもリンクされない。
3つのプラットフォームで対応状況が異なるため、アクセス解析で各検索エンジンからの流入比率を確認しておくとよい。Bingの比率が高いサイトでは、NOARCHIVEメタタグの併用も検討したい。
SEO担当者が意識すべき実務ポイント
この変更はサイト運営者の判断を迫る場面を増やす。検索流入を守るのか、AI学習への露出を完全に断つのか。目的に応じて設定を使い分ける必要がある。
BlockとDisallow AI Trainingの使い分け
Blockを選ぶとGooglebot、Applebot、Bingbotの検索クロールまで停止する。検索からの流入が重要なサイトでは現実的ではない選択肢だ。Disallow AI Trainingを選べば、検索クロールを維持したまま学習だけを拒否できる。
サイト運営者は「AI学習への露出を許容できるか」を最初に決めるべきだ。許容できるならBlockでもDisallow AI Trainingでも大きな差はない。許容できないならDisallow AI Trainingを選び、BingのNOARCHIVEを併用する形が現実的だ。
AIサマリーへの影響は別設定
Disallow AI TrainingはAI OverviewsやAI Modeへの表示を制御しない。GoogleではSearch Consoleの設定が担当領域だ。AI学習を拒否しても、生成AIの回答に自社コンテンツが要約として表示される可能性は残る。
逆に、AI学習を許可していてもSearch Console側でAIサマリーへの表示を制御できる。学習拒否とサマリー表示は独立した2つの軸として考えると分かりやすい。両方の設定を確認して、自社の方針に合わせて調整したい。
Cloudflareの今後の目標は、AIサマリーに含まれるコンテンツ量を単一の設定で制御できる仕組みだ。現状は事業者ごとに個別調整が必要だが、2027年初頭には一元管理が可能になる見込みという。
今後のロードマップ
Cloudflareの公式ブログによると、Googleは今後数週間でGoogle-ExtendedのURLレベルの透明性ツールを展開する予定だ。どのページが学習対象になったのかをサイト運営者が確認できるようになる。Appleも同様のツールを来年提供する予定である。
Microsoftのrobots.txt no-trainingプリファレンス対応は2027年初頭が目標だ。これが実装されれば、BingでもCloudflare経由で学習拒否を指示できるようになる。NOARCHIVEメタタグの代替として機能する見込みだ。
AIサマリーの制御についてもCloudflareは単一設定での一元管理を目指している。事業者ごとの調整を不要にし、Cloudflareの設定だけでコンテンツの露出量を制御できる仕組みだ。2027年初頭の提供が目標とされている。
この記事のポイント
- Disallow AI TrainingはGooglebotなどの検索クロールを維持したままAI学習だけを拒否する新設定
- Blockを選ぶと検索クロールも含めて完全に停止するため使い分けが重要
- Accountable認定はApple、Google、Microsoftが取得済みで検索クロールの継続が保証される
- Bingはrobots.txt対応が2027年初頭まで待つ必要があり、当面はNOARCHIVEメタタグで拒否する
- AI Overviewsへの表示制御はSearch Consoleで別途行う。学習拒否とは独立した設定だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

CloudflareのAIクローラールールがGooglebotをブロックする危険性
CloudflareがAIクローラー対策の仕組みを抜本的に見直し、2026年9月15日から新たなデフォルト設定を適用する。この変更は単なるAIボット対策の強化にとどまらず、Googlebotのような検索クローラーまで巻き込む可能性がある。AIにコンテンツを学習されたくないという意図で設定したブロックが、結果的に検索エンジンからの流入を断つリスクをはらんでいるのだ。
特に影響が大きいのは、Cloudflareの無料プランを利用するWordPressサイトや中小企業のオウンドメディアだ。AI学習ブロックの意図がなくても、9月15日以降にデフォルト設定が自動適用され、知らぬ間にGooglebotのクロールが制限される可能性がある。本記事では3つの振る舞い分類、デフォルト変更の詳細、そして今すぐ取るべき対応策を解説する。
CloudflareがAIクローラー対策の方針を転換した背景
Cloudflareは2026年7月2日、第2回「Content Independence Day」の一環として、AIクローラー管理の新方式を発表した。従来の単一の「AIボットをブロック」スイッチを廃止し、クローラーの振る舞いに基づいた3つのカテゴリで制御する仕組みへ移行する。この変更は全顧客(無料プランを含む)に即時適用され、9月15日にはデフォルト設定も自動変更される。
背景にあるのは、AIクローラーによるコンテンツ収集の爆発的な増加だ。Cloudflareのネットワーク上では、AI訓練目的のクローラーリクエストが全体の過半数を占めるまでに成長した。2025年春時点では約20%だったが、1年で状況は一変した。AIエージェントのリクエスト数も前年比1700%増と、指数関数的な伸びを示している。
この急増に対し、多くのパブリッシャーやサイト運営者はAIクローラーを一律ブロックする方向に動いてきた。しかし、その「一律ブロック」が検索クローラーまで巻き込む副作用を生みつつあった。Cloudflareの今回の方針転換は、この問題に正面から取り組むものだが、同時に新たなリスクも生じさせている。
3つの振る舞い分類がクローラー制御を変える

Cloudflareの新方式は、クローラーを「AIかどうか」ではなく「サイト上で何をするか」で分類する。この考え方は、サイト運営者にとってクローラー制御の解像度を格段に上げるものだ。3つのカテゴリは以下のとおり。
Cloudflareは、ボット運営者に対して「振る舞いごとに別々のクローラーを用意すべき」と要求している。サイト側が「なぜそのボットが来ているのか」を判断し、許可・ブロックを適切に選択できるようにするためだ。この考え方自体は合理的だが、現実にはGooglebotのように検索とAI訓練の両方を行う「マルチパーパスクローラー」が存在する。この点が後述する問題の核心となる。
検索クロールとAI訓練クロールの同居がリスクを生む
Googlebot、Applebot、Bingbotは、いずれも検索インデックス作成とAIモデル訓練の両方に使用される。Cloudflareの新ルールでは、こうした「混合用途のクローラー」に対して最も厳しい制限が適用される。つまり、AI訓練目的のクロールをブロックしているサイトでは、同じクローラーによる検索目的のアクセスも自動的にブロックされるのだ。
これはrobots.txtとは根本的に異なる。robots.txtはクローラーへの「お願い」に過ぎず、無視されることもある。しかしCloudflareのブロックはネットワークレベルで動作するため、robots.txtよりはるかに強力だ。グーグルでさえバイパスできない。AI訓練を止めたい一心で設定したブロックが、検索流入というサイトの生命線を断ち切ってしまう皮肉な構造が生まれている。
9月15日のデフォルト変更が生む3つのリスク
2026年9月15日に自動適用されるデフォルト設定の変更は、Cloudflareを利用するあらゆるサイトに影響を及ぼす。特に注意すべきは以下の3点だ。
とりわけ危険なのはリスク3だ。従来の「AIボットをブロック」設定を有効にしたまま放置しているサイトは、9月15日以降にGooglebotのアクセスがネットワークレベルで遮断される可能性がある。検索クロールが停止すれば、新規コンテンツのインデックス登録が滞り、既存ページの再クロール頻度も低下する。検索順位への影響は数週間から数カ月かけて徐々に表面化するため、原因特定が遅れやすい。
robots.txtとの違いを理解しておくべき理由
多くのサイト運営者は「robots.txtでブロックしているから大丈夫」と考えがちだ。しかし、robots.txtはクローラーに対する紳士協定に過ぎず、グーグルも状況によって無視することがある。一方、Cloudflareのブロックはリクエストがオリジンサーバーに到達する前にネットワークエッジで遮断する。この違いは決定的だ。
robots.txtでのブロックは「できれば来ないでほしい」というお願いであり、Cloudflareのネットワークブロックは物理的な門番が門を閉ざすようなものだ。後者のほうが確実だが、その分だけ設定ミスの代償も大きい。AI訓練ブロックのつもりが検索クローラーまで締め出してしまうと、サイトの検索パフォーマンスは確実に悪化する。
実務者が今すぐ取るべき対応チェックリスト

9月15日までに対応を完了する必要がある。以下に具体的なアクションを時系列で整理した。
STEP 5のクロール統計監視は特に重要だ。9月15日以降にGooglebotのクロール頻度が急落した場合、Cloudflare設定に原因がある可能性が高い。Search Consoleの「クロール統計レポート」で1日あたりのクロールリクエスト数を確認し、急激な減少があれば即座にCloudflareダッシュボードを再確認する習慣をつけておきたい。
無料プランユーザーが特に注意すべきポイント
Cloudflareの無料プランを利用しているサイトは、9月15日までに一度もAIクローラー設定を変更していない場合、自動的に新デフォルトへ移行される。つまり「設定を触っていないから大丈夫」という認識が最も危険だ。何もしないことが、意図せずGooglebotブロックを招く可能性がある。
無料プランであっても、ダッシュボードから3カテゴリの設定を手動で確認・変更することは可能だ。Searchカテゴリだけは明示的に「許可」に設定し、TrainingやAgentはサイトのポリシーに応じて判断する。この一手間をかけるかどうかで、9月15日以降の検索パフォーマンスが大きく変わる。
今後の展望とサイト運営者が持つべき視点

Cloudflareは、マルチパーパスクローラーの運営者に対して「振る舞いごとにクローラーを分離する」ことを求めている。グーグルやアップル、マイクロソフトがこの要求に応じてGooglebotを用途別に分割するかどうかが、今後の分岐点となる。仮に分割が実現すれば、サイト運営者はAI訓練だけをブロックし、検索インデックスは許可するという選択が可能になる。
しかし、現時点ではその保証はない。9月15日以降もGooglebotは単一のクローラーとして動作し続ける可能性が高い。つまり、AI訓練をブロックするという選択は、当面の間「検索流入とのトレードオフ」であり続ける。この現実を直視した上で、サイト運営者は自社のコンテンツ戦略とAIポリシーを再定義する必要がある。
Cloudflareは新しいコンテンツ利用シグナルもテスト中だ。robots.txtに記述するContent Signalsの拡張で、immediate(保存しない)、reference(インデックスしてリンクバック、新デフォルト)、full(要約・複製を許可)の3段階を指定できるようにする。ただしこれは設定上の「希望表明」であり、単体ではブロック機能を持たない点に注意が必要だ。
サイト運営者が今から準備すべき3つのこと
AIにコンテンツを学習されることを完全に拒否するのか、それとも検索流入を優先するのか。この問いに明確な答えを持たないまま9月15日を迎えると、Cloudflareの新デフォルトによって想定外のブロックが発生し、検索パフォーマンスが毀損するリスクがある。サイトの規模や収益構造に応じて、今のうちに方針を固めておくことが重要だ。
この記事のポイント
- CloudflareのAIクローラー管理が3つの振る舞い分類(Search、Agent、Training)に再編された
- 9月15日から広告表示ページでTrainingとAgentがデフォルトブロックされ、無料プランユーザーも自動移行の対象
- Googlebotのような混合用途クローラーは、AI訓練をブロックすると検索クロールも停止する
- robots.txtと異なり、Cloudflareのブロックはネットワークレベルで動作しバイパスが困難
- Searchカテゴリの許可確認とSearch Consoleでのクロール統計監視が当面の最優先対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AdobeのAIトラフィックレポート コンバージョン率が逆転 中小サイトに必要な対策
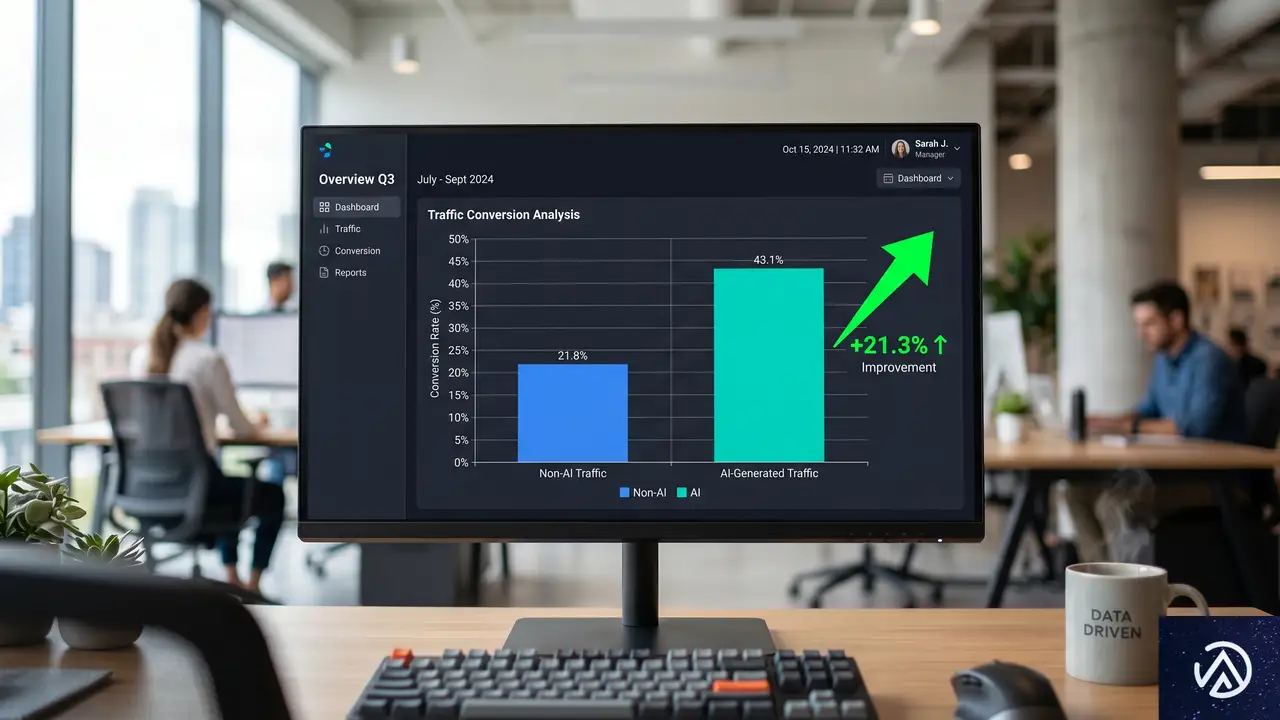
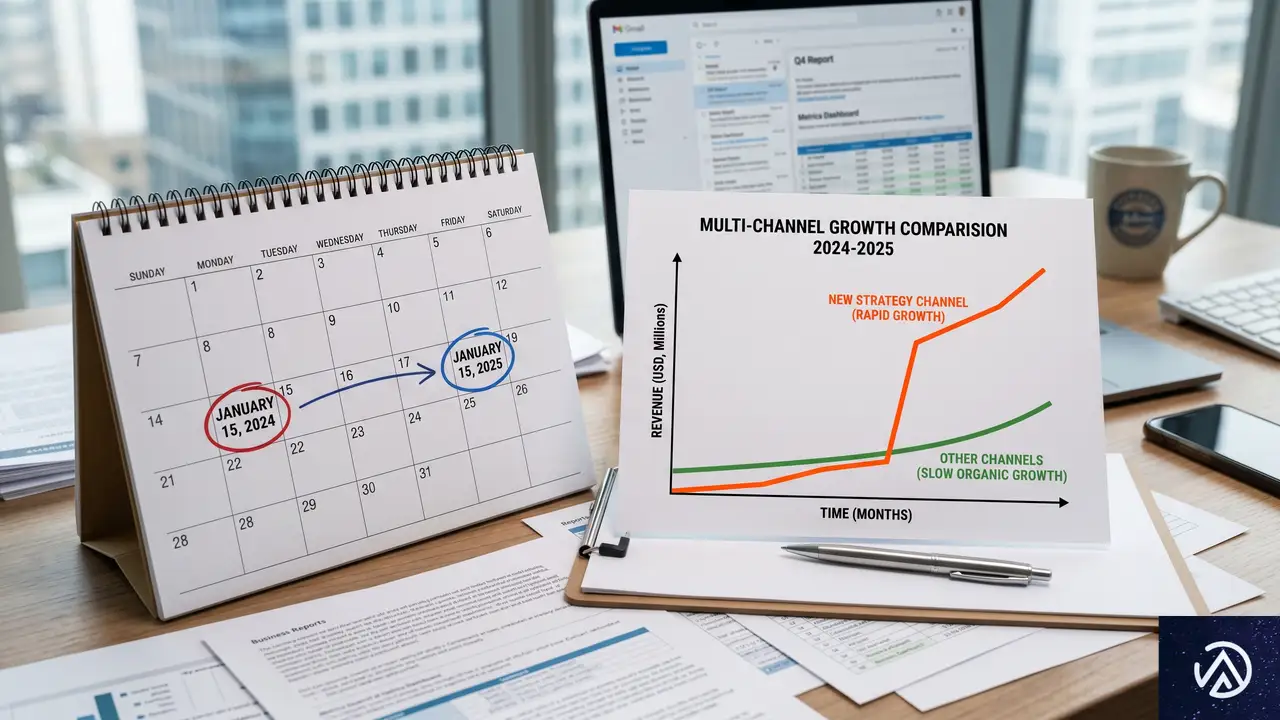
AIアシスタント経由で小売サイトを訪れるユーザーのコンバージョン率が、2025年春から2026年春の1年間で劇的に変わった。前年は他のチャネルの約半分だったが、2026年3月には逆に42%高くなった。同じチャネル、同じ店舗群だ。
Adobe Analyticsが2026年4月16日に公開した「2026年第2四半期AIトラフィックレポート」によると、米国小売サイトへのAI経由トラフィックは前年同期比393%増、ピークの2025年12月には前年比1,151%に達した。エンゲージメントは12%増、ページ滞在時間は48%増、訪問あたりのページ数は13%増、収益は37%増という数字も並ぶ。
しかし本命は率の逆転だ。1年前は「AIレファラル」が他の流入元よりもはるかに低かった。そのチャネルが今、小売において最も収益性の高い流入経路になっている。
AIトラフィックが小売の最優良チャネルに 2025年春からの大逆転
2025年は非AIの半分、2026年3月は42%上回る
Adobeのデータを具体的に見る。2025年3月の時点で、AIアシスタントから米国小売サイトに到達した訪問者のコンバージョン率は、他のチャネル全体の約半分だった。これが2026年3月になると、非AI流入を42%上回るまでに改善している。同じ店舗、同じシステムで、たった12か月の間にチャネルとしての評価が反転したことになる。
成長率393%の内訳 エンゲージメントと収益も向上
量だけではない。AI経由の訪問者は、サイト内での行動もよい。エンゲージメント率は12%増、ページ滞在時間は48%長くなり、訪問あたりのページビューも13%増。さらに重要なのは、訪問あたりの収益が37%増えている点だ。単に流入数が増えただけでなく、質の高い見込み客がAIから直接サイトに送られていることを示している。
「AIトラフィックは未成熟」という見立てが過去のものに
ペイドサーチやSNSが辿った緩やかな成熟カーブとの違い
新しいチャネルが成熟するとき、普通はゆっくりと改善していく。ペイドサーチも、モバイルも、ソーシャルもそうだった。初年度は非AIの半分のコンバージョン率だったものが、25%劣り、10%劣り、やがて均衡し、わずかに上回る。3〜4年をかけてようやく逆転するのが一般的なパターンだ。しかしAdobeのレポートが示すAIレファラルは、この曲線をまったく描いていない。たった2回の測定ポイント、12か月の間に優劣が完全に逆転した。
古い前提で動くエージェンシーへの警告
SEJのSlobodan Manic氏は、「AIトラフィックはまだ初期段階だから、段階的に最適化しよう」という発想そのものが、すでに賞味期限切れだと指摘する。「今年の数字を読んでいなければ、いまだに『未成熟』とか『準備不足』という言葉を使うエージェンシーやコンサルタントがいるが、それは1年前の情報で動いているに等しい」という。同氏は、もし提案が「これから1年かけて何が効くか学びましょう」というものなら、その提案は完全に機会を逃していると分析する。
AIがサイトを読めない根本原因 Citation Readabilityが明かす格差
トップとボトムで可読性スコアが60%以上違う
Adobeのレポートには「Citation Readability(引用可読性)」という指標が紹介されている。これは、ページがAIシステムによってどれだけ正確に解析され、引用されやすいかを示すものだ。トップの小売サイト(AI訪問シェアが高いサイト)のホームページは、下位のサイトと比べて62%も高いスコアを記録した。検索結果ページでは32%高、ブログや記事コンテンツでも30%高い。この差が、AI経由の流入が一部のサイトに偏る理由を明確にしている。
自社サイトの「機械可読性」を把握している経営者はほぼいない
多くのサイト運営者は、毎朝アクセス解析を見て、週次でコンバージョン率を確認し、四半期ごとにCRO(コンバージョン率最適化)戦略を議論している。しかし、GPTBotやClaudeBot、PerplexityBotが自社の商品ページをクロールしたときに、何が見えているのかを把握している企業はほとんどない。ダッシュボードには表示されず、セッション記録にも残らず、正確に「AI経由」とアトリビューションを取れているケースも稀だ。
実際のところ、機械可読性が高いサイトが達成しているコンバージョン率の向上幅は、全体平均の数字よりもさらに大きいと推測される。平均値は、読めないサイトによって押し下げられているからだ。
Dellの「成果なし」とAdobeの「チャネル逆転」 両立する理由
Dell社内データが示した平坦な結果
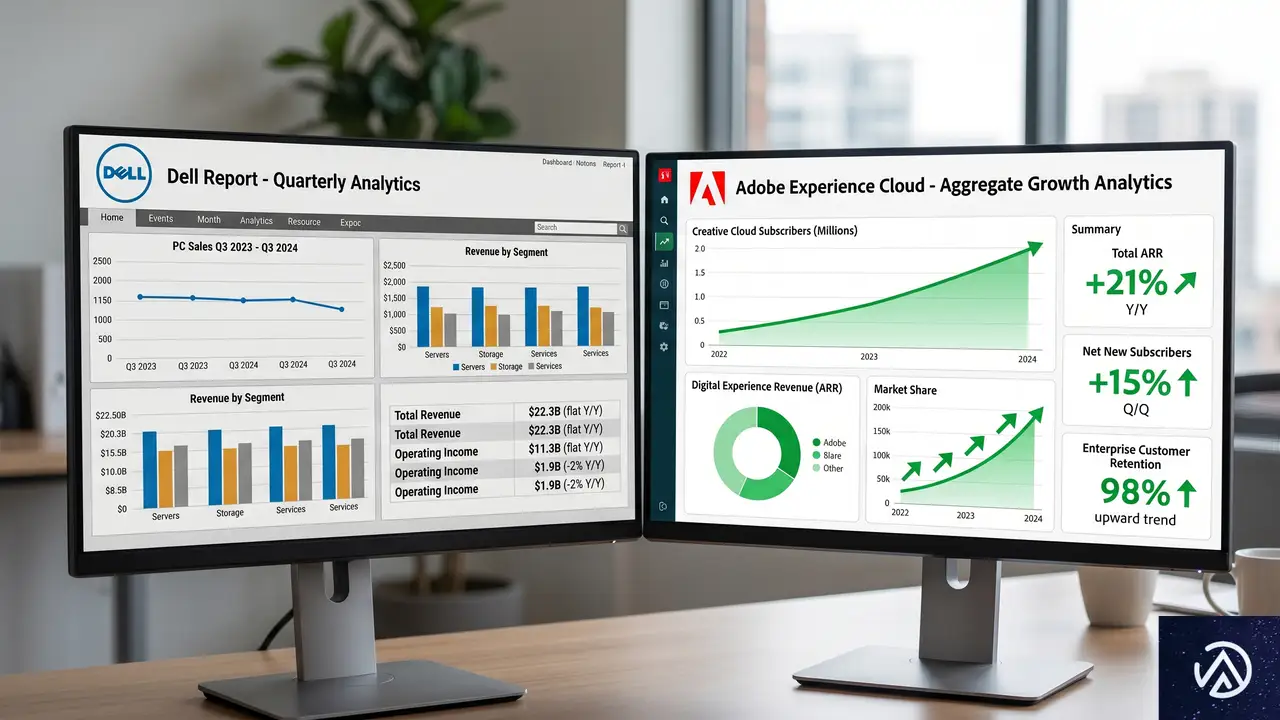
Adobeのレポートが公開される8日前、Dellのグローバルコンシューマー収益責任者がDigital Commerce 360の取材に対し、「エージェンティックショッピングは、まだ特に大きな成果をもたらしていない」と語った。同社の内部データでは、コンバージョンに目立った変化は見られなかったという。
サイト単位の監査こそが正しいアクション
SEJのManic氏は、この2つのデータは矛盾しないと解説する。Dellは1つのWebサイトを測定し、その結果が横ばいだった。一方、AdobeはAIモデルがきちんと読み取れる多数の小売サイトの集計を見て、チャネル全体が逆転したと結論づけた。自社のコンバージョン率がDellのように停滞しているなら、チャネルの成熟を待つのではなく、まず自社サイトの監査から始めるべきだ。Dellの数字はdell.comの問題を示しており、Adobeのデータはチャネル全体の方向性を示している、と同氏は分析している。
AIアシスタントが購買ファネルを短縮 求められるのは「可読性」
セッション数やインプレッションはもはや重要指標ではない
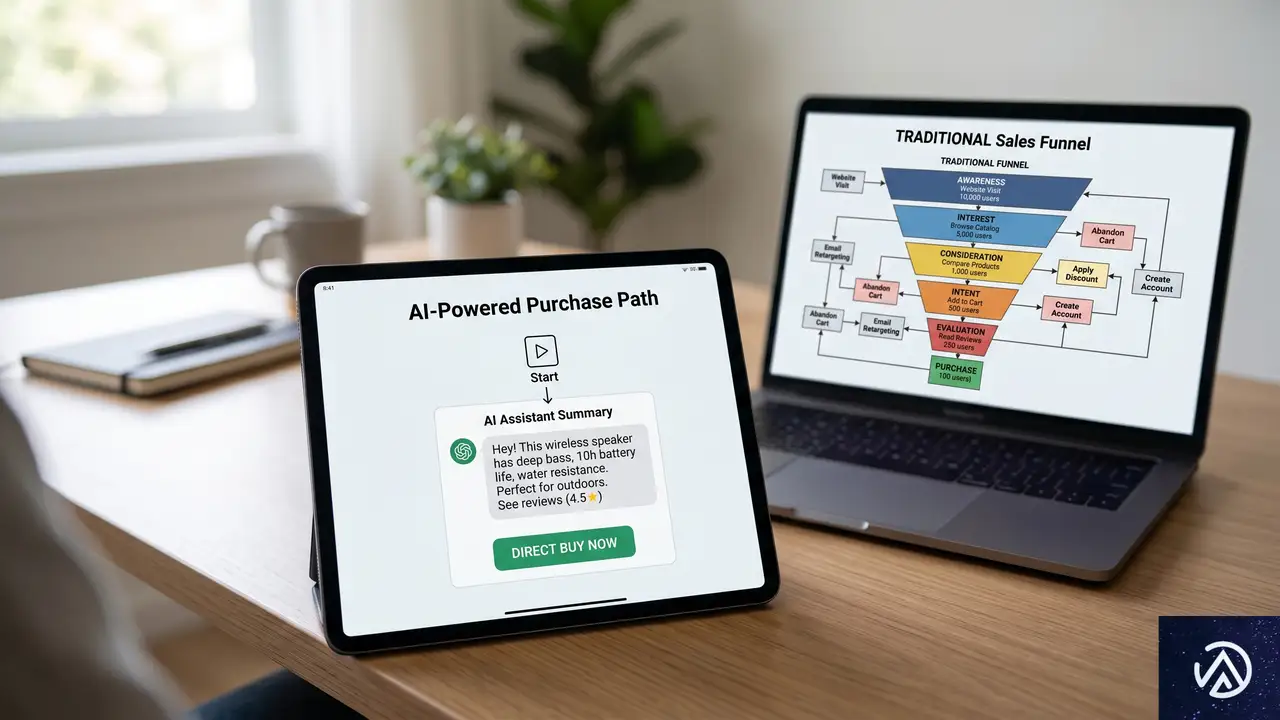
ここ30年、SEOとCROの世界では「インプレッション」「セッション」「ユニークユーザー」「ページビュー」を増やすことが正義だった。ファネルの入口を広げれば、検討するユーザーが増え、コンバージョンにつながるという計算である。しかしAIレファラルはこの前提を覆す。ChatGPTやPerplexity、Geminiからサイトに訪れるユーザーは、すでにアシスタント内で調査を終え、比較検討し、候補を絞った状態でクリックしている。サイトへの訪問は、意思決定プロセスの最終段階なのである。
上図のように、AI経由ではファネルが大幅に短縮されている。コンバージョンの瞬間だけが可視化されるため、従来型の「流入数を追う」指標は意味を失う。Adobeのデータにあるエンゲージメント48%増や収益37%増は、この短縮された購買行動の結果だ。
AIに引用されリンクされる可読性が勝敗を分ける
393%の成長全体を引き上げているのは、AIアシスタントが実際に引用し、リンクし、購入意欲の高い見込み客を送り込めているサイトだ。これは従来の「検索エンジン向け最適化」ではなく、マシンリーダビリティ(可読性)の問題である。AIに読まれる状態になっているかどうかが、アクセスの有無を決めてしまう。SEJのManic氏は、これを「可読性こそが新しいSEO」と表現し、可読性の低いサイトはチャネル全体の成長から完全に取り残されると警告する。
今週末にできるAIクローラー向けサイト監査の2ステップ
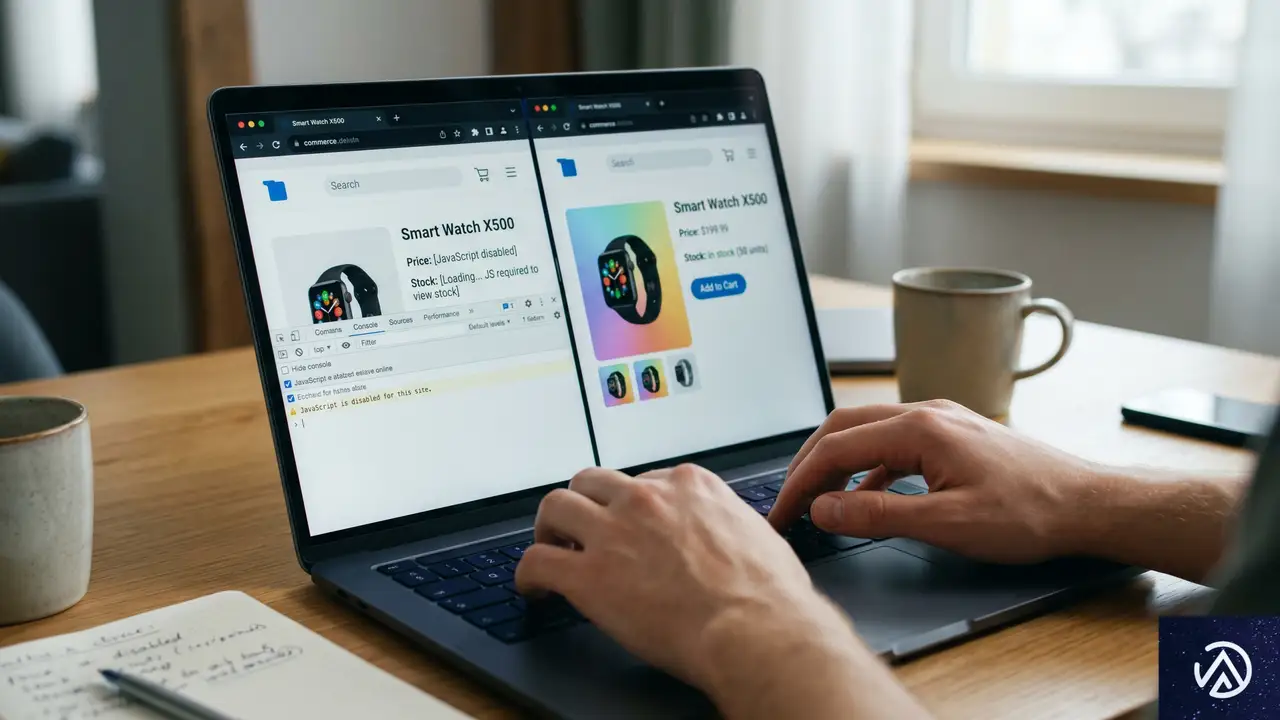
JavaScriptをオフにして価格と在庫を確認する
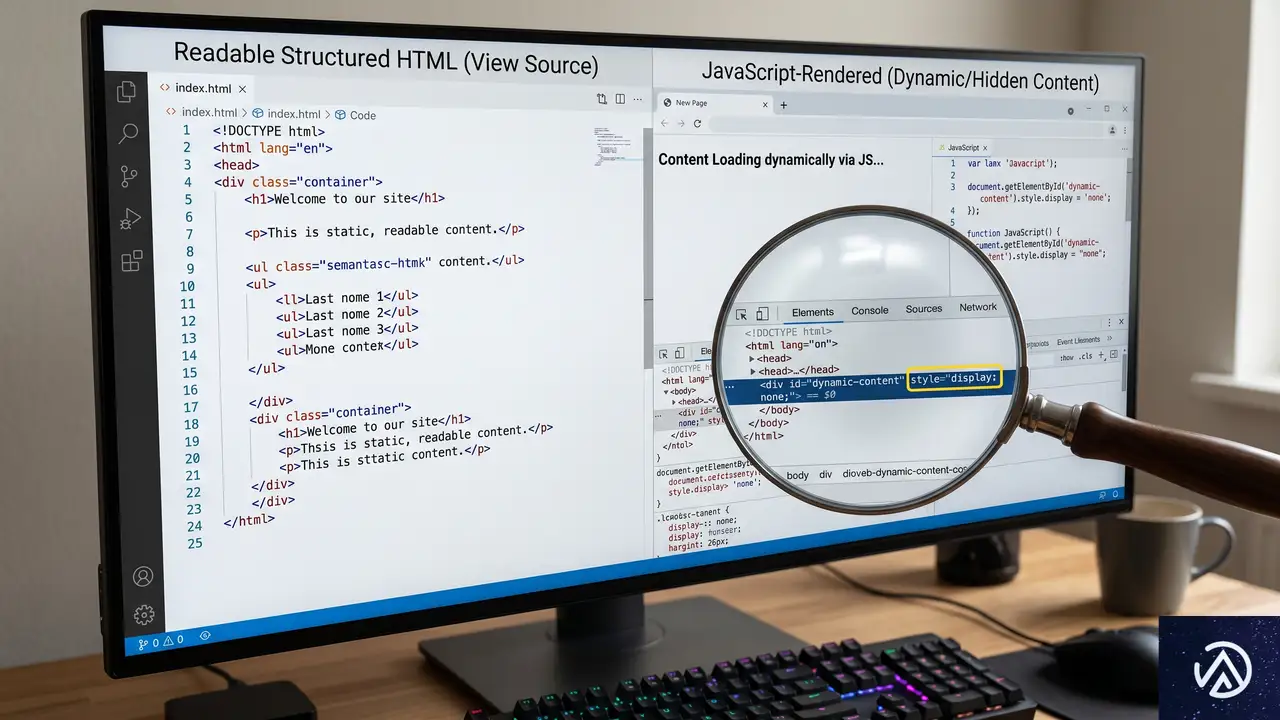
専門ツールやチームがなくても、すぐに着手できる監査がある。1つ目はJavaScriptを無効化したブラウザで商品ページを再読み込みする方法だ。商品名、価格、在庫状況、購入ボタンがHTMLソース内に静的に存在しているかを確認する。多くのAIクローラーはJavaScriptを実行しない、あるいは実行が不安定なため、重要な情報がすべてJSでレンダリングされていると、AIはその情報を引用できない。引用されなければ、アシスタントの回答にサイトが登場することはない。
上の比較のように、JSオフ時に商品情報が欠落している場合、AIクローラーからは中身のないページに見えている可能性が高い。修正の優先度は非常に高い。
回答先頭テスト ブランド演出よりも事実を最初に置く
2つ目は「回答先頭テスト」と呼ぶチェックだ。商品ページを開いて、最初に目に入るのがブランドナビゲーションやヒーローイメージ、キャッチコピーではなく、「その商品が何か、いくらか、在庫があるか」という事実情報かどうかを確かめる。AIモデルがページを要約するとき、先頭にある構造化された事実を優先的に拾う。人間はブランドの演出を許容するが、AIインデクサーはそれをスクロールで飛ばして価格を探したりはしない。
どちらかが達成できていなければ、それはトラフィックの問題ではなく、サイトアーキテクチャの問題だ。393%という成長の波は、可読性を満たしたサイトにしか届いていない。
この記事のポイント
AI経由の小売トラフィックは、わずか1年でコンバージョン率が非AIを42%上回る優良チャネルに変わった。流入数だけでなく、滞在時間や収益も大幅に伸びている。
「AIは未成熟」という前提はもはや通用しない。緩やかな成熟ではなく、急激な質的逆転が起きているため、段階的最適化という考え方では機会損失になる。
勝敗を分けるのは、AIに正しく読まれ、引用される「可読性」である。自社サイトが機械可読かどうかの監査が、セッション数やインプレッションよりも優先すべき指標になった。
今すぐJavaScriptをオフにした表示確認と、回答先頭テストを実施すれば、AIトラフィックの恩恵を受けられない根本原因を見つけられる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AI時代のキャッシュ設計を再考する——AIクローラーがCDNに与える影響と対策
CDN(コンテンツデリバリネットワーク)のキャッシュ設計が、AIクローラーの台頭によって根本的な見直しを迫られている。Cloudflareのデータによると、同社ネットワーク上のトラフィックの32%は自動化されたトラフィックが占める。検索エンジンクローラーや監視ツールに加え、近年はAIアシスタントが回答生成のためにWebから情報を取得するケースが増加している。
AIエージェントは人間とは異なるアクセスパターンを示す。高頻度の並列リクエスト、人気ページではなく長尾コンテンツへの集中的なアクセス、サイト全体の網羅的なスキャンなどが特徴だ。このような振る舞いは、従来の人間向けに最適化されたキャッシュアルゴリズムを無効化し、キャッシュミス率の上昇とオリジンサーバー負荷の増大を引き起こす。
サイト運営者はAIクローラーへの対応に迫られる。ブロックするか、サービスを提供するかの選択を迫られるが、両者のトラフィックパターンは大きく異なるため、既存のキャッシュアーキテクチャでは一方に最適化するしかない。本記事では、AIトラフィックがCDNキャッシュに与える影響を分析し、新しいキャッシュ設計の方向性を探る。
AIクローラーと人間のトラフィックの根本的な違い

AIクローラーのトラフィックは、人間のブラウジング行動と比較して3つの主要な特徴を持つ。高ユニークURL比率、コンテンツの多様性、クロールの非効率性だ。
高ユニークURL比率と長尾コンテンツへのアクセス
Common Crawlの公開データによると、大規模Webクロールでは90%以上のページがコンテンツ的にユニークだ。AIクローラーは特定のコンテンツタイプに特化する傾向があり、技術文書、ソースコード、メディアファイル、ブログ記事など、目的に応じて異なるコンテンツを対象とする。
人間のユーザーがトップページや人気記事に集中するのに対し、AIクローラーはサイトの奥深くまで探索する。Wikipediaの利用データは、かつて「長尾」とされていたほとんどアクセスされないページが、現在では頻繁にリクエストされるようになったことを示している。これはCDNキャッシュ内のコンテンツ人気度分布そのものを変化させている。
クロールの非効率性と反復ループ
AIクローラーは必ずしも最適なクロールパスをたどらない。人気のあるAIクローラーからのフェッチのかなりの割合が404エラーやリダイレクトで終わる。これはURL処理の不備によることが多い。また、ブラウザ側のキャッシュやセッション管理を人間のユーザーと同じように利用しない。
AIエージェントは検索結果を改良するために反復ループを行うことがある。これはRAG(Retrieval-Augmented Generation)における一般的なパターンだ。この反復ループは、エージェントの精度を高める一方で、一貫して高いユニークアクセス比率(70%から100%)を維持する。つまり、各ループで以前に見たページを再訪するのではなく、常に新しいユニークなコンテンツを取得し続ける。
キャッシュへの直接的な影響
長尾アセットへのこのような反復アクセスは、人間のトラフィックが依存するキャッシュをかき回す。既存のプリフェッチや従来のキャッシュ無効化戦略は、クローラートラフィックの量が増加するにつれて効果が低下する。Cloudflareの単一ノードにおけるキャッシュヒット率は、AIクローラーを含む場合と含まない場合で明確な差が見られる。ヒット率の低下は、LRU(Least Recently Used)アルゴリズムがAIクローラーの反復スキャン行動に対処できていないことを示唆している。
実例から見るAIクローラーのインパクト

AIボットトラフィックの急増は、実際のWebサービスに深刻な影響を与えている。大規模サイトにおける影響と対応策は以下の通りだ。
Wikipedia:マルチメディア帯域幅の50%急増
モデル訓練のための画像一括スクレイピングにより、マルチメディア帯域幅使用量が50%急増した。Wikimediaは最終的にクローラートラフィックをブロックする対応を取った。
SourceHutとRead the Docs:サービス不安定化
ソースコードリポジトリをスクレイピングするLLMクローラーにより、サービス不安定化と速度低下が発生。Read the Docsでは、AIクローラーが大きなファイルを1日に数百回ダウンロードし、帯域幅の大幅な増加を引き起こした。両サービスとも一時的にクローラートラフィックをブロックし、IPベースのレート制限を実施した。
FedoraとDiaspora:人間ユーザーへの影響
Fedoraはパッケージミラーを再帰的にクロールするAIスクレイパーにより、人間ユーザーに対する応答速度が低下。Diasporaソーシャルネットワークは、robots.txtを尊重しない積極的なスクレイピングにより、応答速度の低下とダウンタイムを経験した。両者とも既知のボットソースからのトラフィックを地理的にブロックするなどの対応を取った。
これらの事例が示すのは、AIクローラーを単純にブロックするだけでは根本的な解決にならないということだ。よりスマートなキャッシュアーキテクチャがあれば、サイト運営者はAIクローラーにサービスを提供しつつ、人間ユーザーの応答時間を維持できる。
AI時代に向けたキャッシュ設計の新たな方向性

AIトラフィックの特性を考慮した新しいキャッシュ設計が必要とされている。主なアプローチは2つある。AIを意識したキャッシュアルゴリズムによるトラフィックフィルタリングと、AIクローラートラフィック専用の新しいキャッシュ層の追加だ。
ワークロード対応型キャッシュアルゴリズム
現在広く使用されているLRU(Least Recently Used)アルゴリズムは、汎用状況においてシンプルさ、低オーバーヘッド、有効性のバランスが取れている。しかし、人間とAIボットの混合トラフィックに対しては、別のキャッシュ置換アルゴリズムの選択が有効かもしれない。
初期実験では、SEIVEやS3FIFOといったアルゴリズムを使用することで、AIの干渉の有無にかかわらず、人間トラフィックが同じヒット率を達成できる可能性が示されている。さらに、ワークロードを直接意識した機械学習ベースのキャッシュアルゴリズムを開発し、リアルタイムでキャッシュ応答をカスタマイズする実験も進められている。これにより、より高速でコスト効率の高いキャッシュが実現できる。
トラフィック種別に応じた階層化キャッシュアーキテクチャ
長期的には、AIトラフィック専用の別個のキャッシュ層が最善の道となる。人間とAIのトラフィックをネットワークの異なる層に配置された別個の階層にルーティングするキャッシュアーキテクチャが考えられる。
人間トラフィックは、応答性とキャッシュヒット率を優先するCDN PoP(Point of Presence)のエッジキャッシュから引き続きサービスされる。一方、AIトラフィックのキャッシュ処理はタスクタイプによって変えることができる。
RAGやリアルタイム要約のようなライブアプリケーションを支えるAIクローラーでは、レイテンシが重要だ。これらのリクエストは、より大きな容量と適度な応答時間のバランスが取れたキャッシュにルーティングされるべきである。これらのキャッシュは鮮度を保ちつつも、人間向けキャッシュよりもわずかに高いアクセスレイテンシを許容できる。
訓練セットの構築や大規模コンテンツ収集ジョブに使用されるAIクローラーは、かなり高いレイテンシを許容し、時間的制約がない。これらのワークロードは、到達までに時間がかかる深いキャッシュ階層(オリジン側のSSDキャッシュなど)からサービスできる。あるいは、キューベースのアドミッションやレートリミッターを使用して遅延させ、バックエンドの過負荷を防ぐことも可能だ。これにより、インフラに負荷がかかっている場合にバルクスクレイピングを延期する機会も生まれる。
この記事のポイント
- AIクローラーは全ネットワークトラフィックの約3分の1を占め、そのアクセスパターンは人間のブラウジング行動と根本的に異なる。
- 高ユニークURL比率、長尾コンテンツへの集中アクセス、反復ループによるキャッシュチャーンが、従来のLRUキャッシュアルゴリズムの効果を低下させている。
- WikipediaやFedoraなどの大規模サイトでは、AIクローラーによる帯域幅急増やサービス不安定化が実際に発生し、多くのサイトがクローラーブロックに頼らざるを得なくなっている。
- 根本的な解決策として、SEIVEやS3FIFOなどの新しいキャッシュアルゴリズムの採用と、AIトラフィック専用の階層化キャッシュアーキテクチャの構築が検討されている。
- 今後のCDN設計では、人間トラフィックとAIトラフィックを分離し、それぞれの特性に最適化したキャッシュ戦略を適用することが重要になる。
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験