

WooCommerce Dual APIが専用プラグインに移行、コアから削除へ
WooCommerce 11.2で、実験的なDual APIエンジンがコアから削除され、専用プラグインとして提供される。10.9から11.1まで利用できた検証用の商品・クーポンAPIも廃止されるため、使っていた開発者は対応が必要だ。
Dual APIとはPHPクラスからGraphQLエンドポイントを自動生成するコードファーストな仕組みで、WooCommerce 10.9で実験機能として導入された。今回の変更は、開発の自由度を高めるための構成変更である。
WooCommerce 11.2でDual APIの提供形態が変わる
WooCommerce 10.9で導入されたDual APIは、PHPクラスを定義するだけでGraphQLエンドポイントを生成できる実験的な拡張機能だった。これまではWooCommerce本体に組み込まれ、フィーチャーフラグで有効化する方式だった。
WooCommerce 11.2では、このDual APIエンジンがWooCommerceコアから削除される。代わりに、WooCommerce Dual APIプラグインとして独立したリポジトリで提供される形だ。
この変更により、WooCommerce本体のリリースサイクルに縛られず、Dual APIだけを柔軟にアップデートできるようになる。Dual APIエンジン自体は、独自のAPIを開発したいエクステンション開発者にとって引き続き有用だ。
検証用の商品・クーポンAPIは削除される
WooCommerce 10.9から11.1まで、商品とクーポンに関する検証用APIが組み込みで提供されていた。このAPIはWooCommerce 11.2で削除される。
この検証用APIを使っていた開発者は、利用を停止するか、自前のエクステンションで同等のAPIを構築する必要がある。注意点として、Dual APIプラグインをインストールしても、この検証用エンドポイントが復活することはない。
Dual API移行で開発者が知るべき変更点
独自のDual APIを開発しているエクステンション開発者には、いくつか重要な変更がある。フィーチャーフラグの廃止、APIビルダースクリプトの移設、ドキュメントの場所変更、そして依存関係の宣言方法だ。
プラグイン依存関係をヘッダーに宣言する
これまでDual APIエンジンを有効化していたフィーチャーフラグは利用できなくなる。代わりに、Dual APIプラグインをインストールして有効化することでエンジンが使えるようになる。プラグインの要件はWooCommerce 11.2以上、PHP 8.1以上だ。
エクステンションがDual APIエンジンに依存する場合、プラグインのヘッダーで両方の依存関係を宣言する必要がある。具体的には以下のように記述する。
Requires Plugins: woocommerce, woocommerce-dual-apiこの記述により、エクステンションのインストール時にWooCommerce本体とDual APIプラグインの両方が必要であることが明示される。依存関係の宣言は、プラグインの動作に必要な前提条件をユーザーに伝える重要な役割を果たす。
APIビルダーとドキュメントの場所が変わる
APIビルダースクリプトは、WooCommerce Dual APIプラグインのリポジトリに移動した。利用するには、プラグインをインストールするか、リポジトリをローカルにクローンする。
ドキュメントもDual APIプラグインのリポジトリ内に移設された。GitHub Pagesでも閲覧できる形で提供されている。開発者は最新のドキュメントをプラグインリポジトリで確認することになる。
エンドポイント登録のコード例
Dual APIプラグインはエンジンを提供し、エクステンション側で独自のGraphQLエンドポイントを登録する。WooCommerceのシンプルイベントサンプルプラグインから、登録方法のコードを示す。
use Automattic\WooCommerce\Api\Infrastructure\Main as DualApiMain;

add_action(
	'plugins_loaded',
	static function () {
		if ( method_exists( DualApiMain::class, 'register_graphql_endpoint' ) ) {
			DualApiMain::register_graphql_endpoint(
				__DIR__,
				'wc',
				'/graphql/simple-events'
			);
		}
	}
);
このコードは、プラグインの読み込み時にDual APIエンジンが利用可能か確認し、利用可能であればGraphQLエンドポイントを登録する。エンドポイントのパスや名前空間はエクステンションごとに自由に設定できる。
Dual APIは引き続き実験的ステータス
Dual APIはプラグインに移行した後も、実験的なステータスは変わらない。Automattic\WooCommerce\Api名前空間以下のすべての要素は、後方互換性のない形で変更される可能性がある。
つまり、将来のリリースでAPIの構造が変わったり、削除されたりする可能性があるということだ。このため、本番環境のエクステンションでDual APIを使用することは推奨されていない。開発用途や検証目的に限定して使うべきだろう。
開発者コミュニティへのフィードバック募集
WooCommerceチームは、Dual APIエンジンが実際に有用かどうか、非実験的な状態でWooCommerce本体に含めるべきか、改善点はないかについて、開発者からの意見を求めている。
フィードバックはGitHubの専用ディスカッションページで受け付けている。Dual APIを試した開発者は、実際の使用感や要望を共有することで、今後の方向性に影響を与えることができる。
この記事のポイント
- WooCommerce 11.2でDual APIエンジンがコアから削除され、専用プラグインとして独立した
- 10.9〜11.1の検証用商品・クーポンAPIは削除されるため、利用者は移行が必要
- プラグインの要件はWooCommerce 11.2以上、PHP 8.1以上
- 依存関係はプラグインヘッダーで宣言する
- 引き続き実験的ステータスであり、本番利用は推奨されない

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAIがGPT-6 SolとLunaを発表、API価格を50%値下げ
OpenAIが2026年9月22日、GPT-6シリーズの新しいモデル「GPT-6 Sol」と「GPT-6 Luna」を発表した。今月上旬に公開された最上位モデルGPT-6 Astraに続く2モデルで、API価格をGPT-5.6世代のプロモーション価格から50%引き下げた点が最大の特徴だ。
GPT-6 Solは1Mトークンあたり入力$4、出力$20。GPT-6 Lunaは入力$0.20、出力$1.20という価格帯に設定された。即ちGPT-5.6 Solのプロモーション価格から半額に引き下げられ、企業がAIを大規模に導入する際のコスト障壁を大きく下げる。
今回の発表は単なる価格改定ではない。OpenAIが「コストインテリジェンス曲線」と呼ぶ指標で全価格帯をリードしようとする戦略の一環であり、最上位Astraの知能を中位層と軽量層に分配する試みでもある。本記事ではベンチマーク結果とキャッシュ改善の詳細まで掘り下げる。
GPT-6ファミリーの全容と価格戦略
GPT-6シリーズは3層構成になっている。最上位がGPT-6 Astraで、最も高い知能と安全性を持つが、コストも最大だ。今回追加されたGPT-6 Solは中位層、GPT-6 Lunaは軽量層に位置する。この構成は、クラウドコンピューティングにおけるプレミアム・スタンダード・エコノミーの3段階に似ている。
Astraのトレーニング手法をSolとLunaにも適用し、専門業務・事実性・コーディング・コンピュータ操作・アライメントの各分野でAstraに迫る性能を、より低コストで提供する。用途に応じてモデルを選び分けられるようにする狙いだ。
3層それぞれに役割分担があり、Astraは妥協なき最高精度を求める場合、Solは実務的な業務ワークフロー、Lunaは高頻度かつ低コストな運用に向く。利用者はタスクの難易度と予算に応じてモデルを切り替えられる。
業務自動化とファクトチェックの実力
業務自動化のベンチマークであるAutomationBenchでは、GPT-6 Solがxhigh努力設定で33.2%を記録した。対するClaude Opus 5のmax努力設定は26.9%。しかもSolのタスクあたりコストは$0.27で、Opus 5のわずか9%に抑えられている。
AutomationBenchは営業・マーケティング・運用・サポート・財務・人事の6分野にまたがる47種類のツールを使い、エンドツーエンドのワークフローをAIエージェントに実行させる評価だ。実業務に近い環境で、モデルの総合力を測る。
より複雑な専門ワークフローを評価するAgents’ Last Examでも、GPT-6 Solはmax努力設定で56.4%を獲得し、Claude Opus 5の最高スコアを上回った。この時点でタスクあたりコストはOpus 5より60%低い。性能で勝りながらコストで大幅に下回る構図が浮かび上がる。
事実性の評価でも改善が報告されている。ユーザーが事実誤りを指摘した実チャット会話を元にした内部評価では、GPT-6 Solの誤り率が前世代の約半分に低減した。GPT-6 Lunaも高努力設定でGPT-5.6 Solと同等の事実性を、約100分の1のコストで実現している。
コーディングベンチマークの詳細結果
コーディングエージェントの性能評価であるFrontierCodeでは、GPT-6 SolがGPT-5.6 Solから大幅に改善した。実際のコードベースにマージ可能なコードを生成できるか、テスト品質やスコープ規律、コードスタイル準拠まで含めて採点される。SolはClaude Fable 5.1のxhigh設定と同等の性能を、はるかに低いコストでマークした。
より難易度の高いDeepSWE v1.1では、実在するコードベースでの複雑なソフトウェア工学タスクが評価対象だ。GPT-6 Solのmax努力設定は68.8%を記録し、Claude Fable 5の最高スコア69.9%まで1.1ポイント差に迫った。タスクあたりのコストは約80%低い。GPT-6 Lunaもmax努力設定で66.6%を獲得し、Claude Opus 5やFable 5の中努力設定と同等の性能を示した。コストはOpus 5比で93%減、Fable 5比で96%減だ。
コンピュータ操作の評価であるOSWorld 2.0オフラインでも、GPT-6 Solのxhigh設定は60.5%を記録。Claude Opus 5の中努力設定60.3%とほぼ並びながら、タスクあたりコストは約80%低い。GPU時間や運用費を気にする開発チームにとって、このコスト差はプロジェクト規模の意思決定を左右する。
OpenAI内部でもコーディングエージェントの利用が急拡大している。API価格換算で、研究者の1日あたりトークン使用量は中央値で$600超、上位90%では$7,000に達した。エージェントが長時間・大規模なタスクを担うにつれ、継続利用のコストが重要になる。SolとLunaは高いコーディング性能を低価格で提供し、開発者がより野心的なタスクをCodexに任せられる環境を整える。
プロンプトキャッシュの改善が生む実質コスト削減
トークン単価の値下げに加え、プロンプトキャッシュの改善も発表された。プロンプトキャッシュとは、同じ文脈を繰り返し送るエージェントが、既に処理済みの入力トークンを再利用する仕組みだ。GPT-6ではキャッシュヒット率がデフォルトで向上し、キャッシュされた入力トークンの読み取りには90%の割引が適用される。
エージェントが同じ前提文脈を使って複数回のリクエストを送るケースでは、この改善が大きなコスト削減につながる。GitHubの報告によれば、過去数ヶ月でOpenAIモデルへの数十億リクエストにわたり、新規処理が必要なプロンプトトークンの割合が50%以上削減されたという。GitHub Copilotの応答速度向上にも寄与している。
開発者向けには新しい診断ツールも提供される。Prompt Caching Dashboardは、どれだけの入力がキャッシュされ、時間経過でどう変化するかを可視化する。診断ツールはキャッシュの取りこぼし原因を特定し、修正ポイントを示す。さらに、推論努力の調整やツールの有効化・無効化を切り替えてもキャッシュが保持されるようになり、エージェントのニーズ変化に柔軟に対応できる。
明示的なブレークポイントを設定すれば、キャッシュするプレフィックスの終端を開発者が制御できる。これによりキャッシュ再利用の効率がさらに高まる。大規模なエージェントシステムを運用するチームにとって、この制御性の向上はトークン料金の値下げと同じかそれ以上の価値がある。
アライメント強化と提供範囲
GPT-6 SolとLunaは、Astraで導入されたアライメント作業を基盤にしている。アライメント評価では、両モデルともGPT-5.6の対応モデルより改善し、特にコーディング作業に関する誤解を招く主張の比率が低下した。実際の利用環境での失敗率を測るものではないが、困難な状況でモデルがどのように振る舞うかを検証する指標として機能する。
コミュニケーションスタイルもAstraの改善点が引き継がれた。専門的・コーディング関連の会話で明確さが増し、専門用語の過剰使用が減り、低価値な詳細情報が削られ、全体として無駄のない応答になった。情報量を保ちながら回答がわずかに短くなる傾向がある。
提供範囲はChatGPT WorkとCodexが中心だ。Plus・Pro・Business・Enterprise・Eduユーザーは本日から両モデルを利用できる。FreeとGoのユーザーはデスクトップアプリでGPT-6 Lunaにアクセス可能。Chat機能ではまだ利用できず、段階的なロールアウトが予定されている。APIではgpt-6-solとgpt-6-lunaとして利用できる。
注目すべきはChatGPT WorkとCodexに限定されている点だ。OpenAIはモデルを「作業用」と「チャット用」で使い分ける方針を明確にしつつある。業務ワークフローに向けたモデルを先行させ、一般チャットへの展開は慎重に進める姿勢が読み取れる。これはGPT-6シリーズが企業利用を主戦場に据えていることの表れだ。
この記事のポイント
- GPT-6 SolとLunaが発表され、API価格はGPT-5.6世代から50%引き下げられた
- AutomationBenchでSolがClaude Opus 5を上回るスコアを、約9%のコストで達成
- DeepSWEではSolが68.8%を記録し、競合の最高スコアに1.1ポイント差まで接近
- プロンプトキャッシュの改善で、キャッシュ読み取りに90%割引が適用される
- ChatGPT WorkとCodexで即日利用可能。一般チャットへの展開は段階的
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-Live-1がAPIで提供開始。同時通話型音声AIで割り込み処理が大幅改善
OpenAIが2026年9月10日、音声対話モデル「GPT-Live-1」のAPI提供を開始した。このモデルは同時に聞いて話すフルデュプレックス方式を採用し、従来の音声AIが抱えていた会話の遅延や不自然な割り込みを大幅に改善する。音声フロントエンド部分の料金は1分あたり0.05ドルに設定されている。
GPT-Live-1はChatGPTでの先行導入を経て、今回API経由で開発者に開放された。音声認識と音声合成を単一モデルに統合した設計が特徴で、人間同士の会話に近い自然なインタラクションを実現する。この記事ではGPT-Live-1の技術的な仕組み、性能評価、料金体系、そして開発者にとっての活用可能性を解説する。
単一モデルで実現する同時対話の仕組み
従来方式の構造的な課題
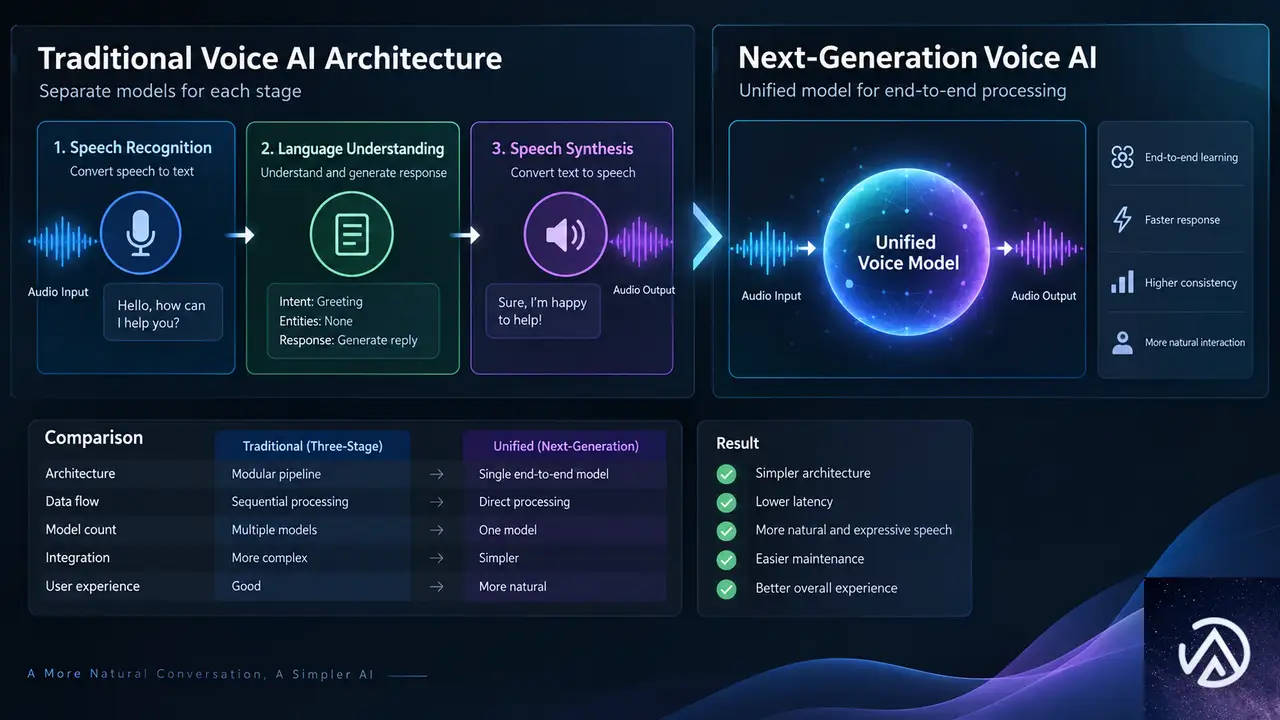
従来の音声AIは3つの工程を連結する方式が主流だった。まず音声をテキストに変換するSTT(音声認識)、次に内容を理解して回答を考えるLLM(大規模言語モデル)、最後にテキストを音声に戻すTTS(音声合成)だ。各工程が別々のモデルで処理されるため、段階ごとに処理待ちの遅延が積み重なる。
この構成では割り込みへの対応も難しい。ユーザーが話し始めるタイミングを検知するには、音声入力を常時監視しながら出力側の状態も把握しておく必要がある。3つのモデルをまたぐ情報の受け渡しにタイムラグが生じるため、人間同士の会話のような即時の割り込みは実現しづらかった。開発者は各段階のつなぎ目を手動で調整しなければならず、運用の手間も大きい。
単一モデルへの統合がもたらす変化
GPT-Live-1はSTTとLLMとTTSを単一モデルに統合する。入ってくる音声と出ていく音声を同じモデル内で同時に推論するため、段階間のつなぎ目が構造的に存在しない。これにより遅延が減るだけでなく、相手の言葉を遮って新しい質問を投げかけたり、相槌を打ったりする自然な会話のリズムを保てる。
背景ノイズや無音状態の扱いも改善された。従来方式では無音を「発話の終わり」と誤判定して会話を切ってしまう事態が起きやすかったが、GPT-Live-1は静寂を会話の一部として処理できる。ユーザーが考え込んでいる時間を待つ、周囲の雑音に反応しない、といった対話の質を左右する細かな制御がモデル側で吸収される。
3段階のモデルを連結する方式では、それぞれの処理待ち時間が会話のテンポを損なっていた。GPT-Live-1はこの問題を単一モデルへの統合で解決している。
割り込み処理の改善がビジネス効果を生む
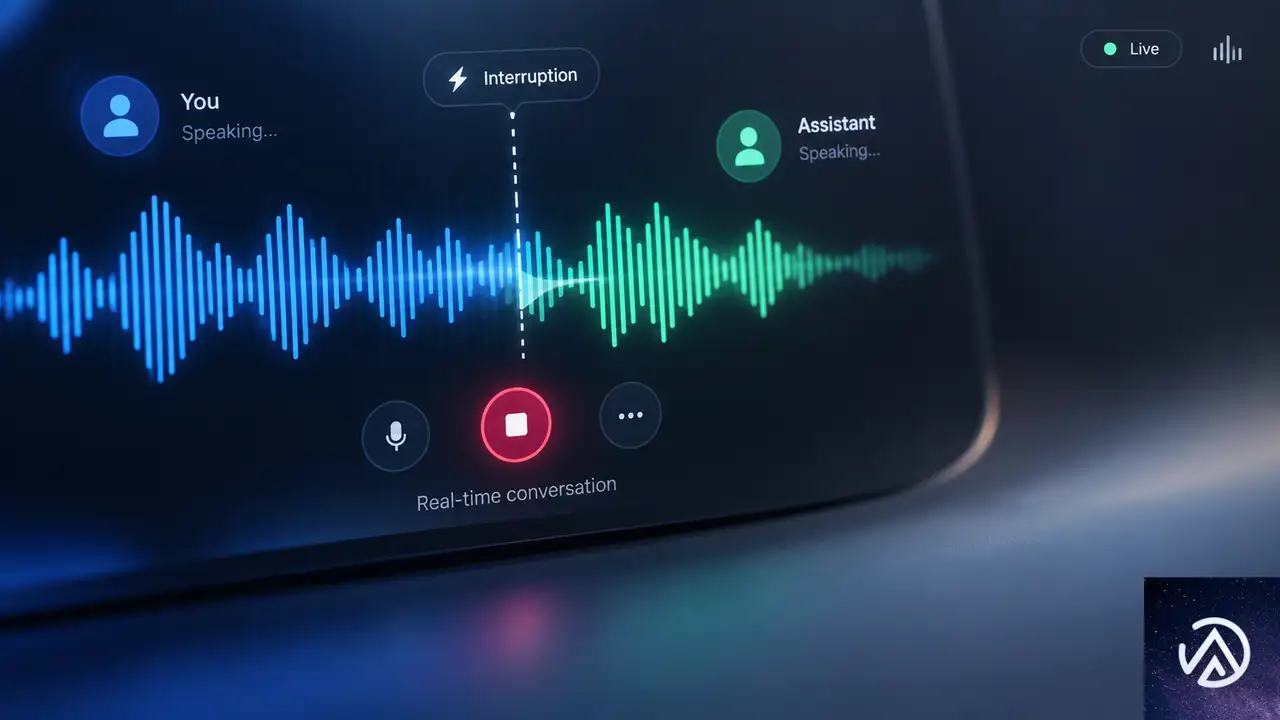
音声エージェントの実用化で最大の障壁が「割り込み」への対応だ。人間同士の会話では、相手の話の途中で情報を追加する、言い直す、短い相槌を打つ、といった行為が自然に発生する。従来のターン制システムではこの対応が難しく、一方が話し終えるのを待ってから返答する不自然な体験になりがちだった。
OpenAIの公開した早期評価では、語学学習プラットフォームのSpeakがGPT-Live-1を導入した結果、学習者が考える時間を確保できるようになり、割り込み回数が従来のターン制システムと比べて約80%削減された。この数字は、音声AIが教育分野で実用化できる水準に近づいていることを示している。学習者が発話を躊躇しても、AIが先回りして話し始めない。この「待つ」能力が学習体験の質を大きく左右する。
またGPT-Live-1は、短い笑い声や「うん」「ええ」といった相槌、近くにいる他者への短い話しかけなど、会話に混じる非定型的な音声を適切に処理できる。これらは従来の音声認識では誤検知や過剰反応の原因になりやすかったが、GPT-Live-1は文脈を踏まえて取捨選択する。
従来のターン制システムでは、STEP 2の割り込みを検知するまでにタイムラグが発生し、ユーザーが話し終えるのを待ってから処理を切り替える必要があった。GPT-Live-1は音声入力を常時監視しているため、この切り替えがほぼ即座に行われる。
バックエンド推論モデルへの委任という設計
タスクに応じたモデル選択
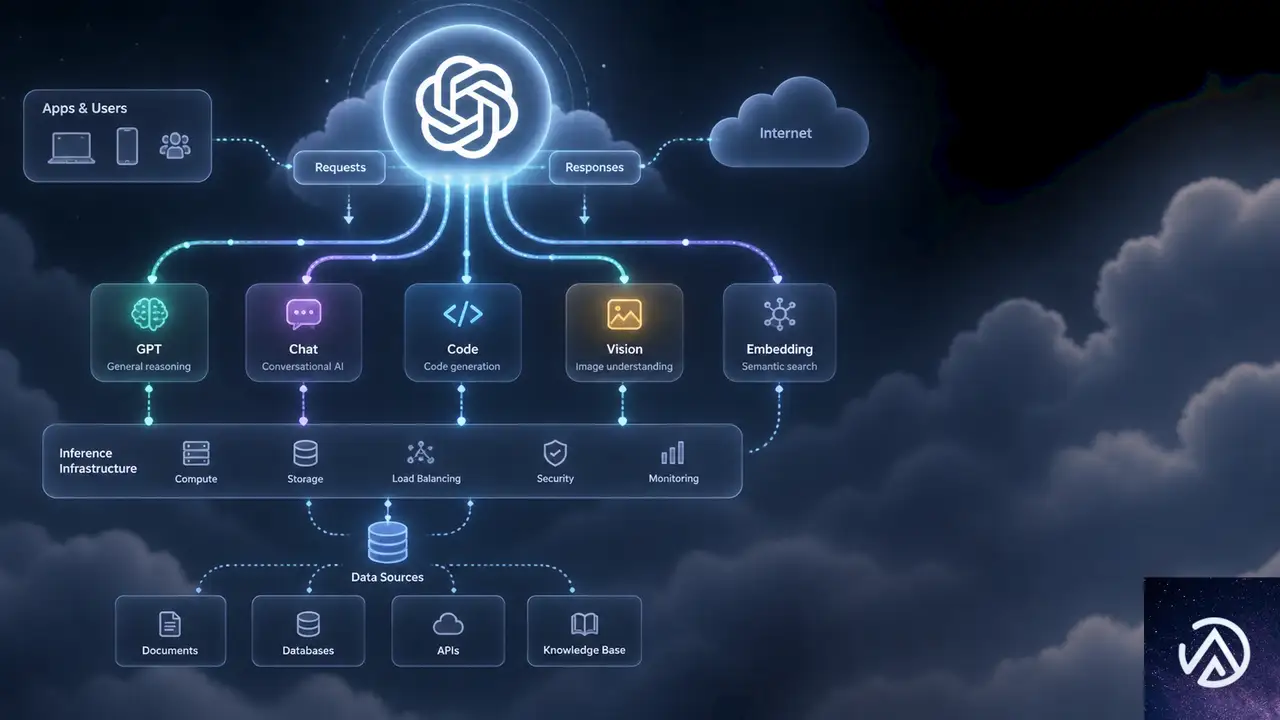
GPT-Live-1の設計で注目すべき点は、すべてを自身で解決するわけではないという姿勢だ。音声レイヤーと推論レイヤーを分離し、複雑な判断やツール呼び出しはバックエンドのテキストモデルに委任できる。開発者はGPT-6 Astraやサードパーティモデルを組み合わせ、タスクの難易度に応じて推論深度を使い分けられる。
たとえばレストランの予約確認や配送状況の案内といった定型的なタスクには軽量なモデルを使い、複雑な顧客対応には高性能なモデルを割り当てる構成が可能だ。推論深度と応答速度とコストをタスクごとに最適化できるため、大規模な音声エージェントの運用コストを抑えながら品質を維持できる。この柔軟性は、単一モデルですべてを処理する構成では得られない利点だ。
音声処理と推論を分離することで、タスクごとに最適なモデルを組み合わせられる。この柔軟性がGPT-Live-1の大きな特徴だ。会話を続けながらバックグラウンドで推論が進むため、ユーザーを待たせない体験も実現できる。
ネイティブ機能の充実
GPT-Live-1はASR(自動音声認識)のトランスクリプトと応答テキストをネイティブに提供する。英数字の認識精度が高く、特定のキーワードを優先的に認識させるキーワードバイアス機能も備える。ターン制モデルではないが、明示的な発話ターンの境界を検出するターン検出機能もネイティブサポートしており、既存のターン制ベースのワークフローからの移行も容易だ。
開発者はシステムプロンプトを通じてエージェントの声のトーン、話す速度、会話スタイルを制御できる。音声の選択肢も従来のリアルタイム音声から大幅に拡充され、アクセントや方言、言語のバリエーションが増やされる予定だ。音声オプションと言語の対応範囲は今後数か月にわたって継続的に拡大される。
評価指標と料金体系
ベンチマークで示された実力
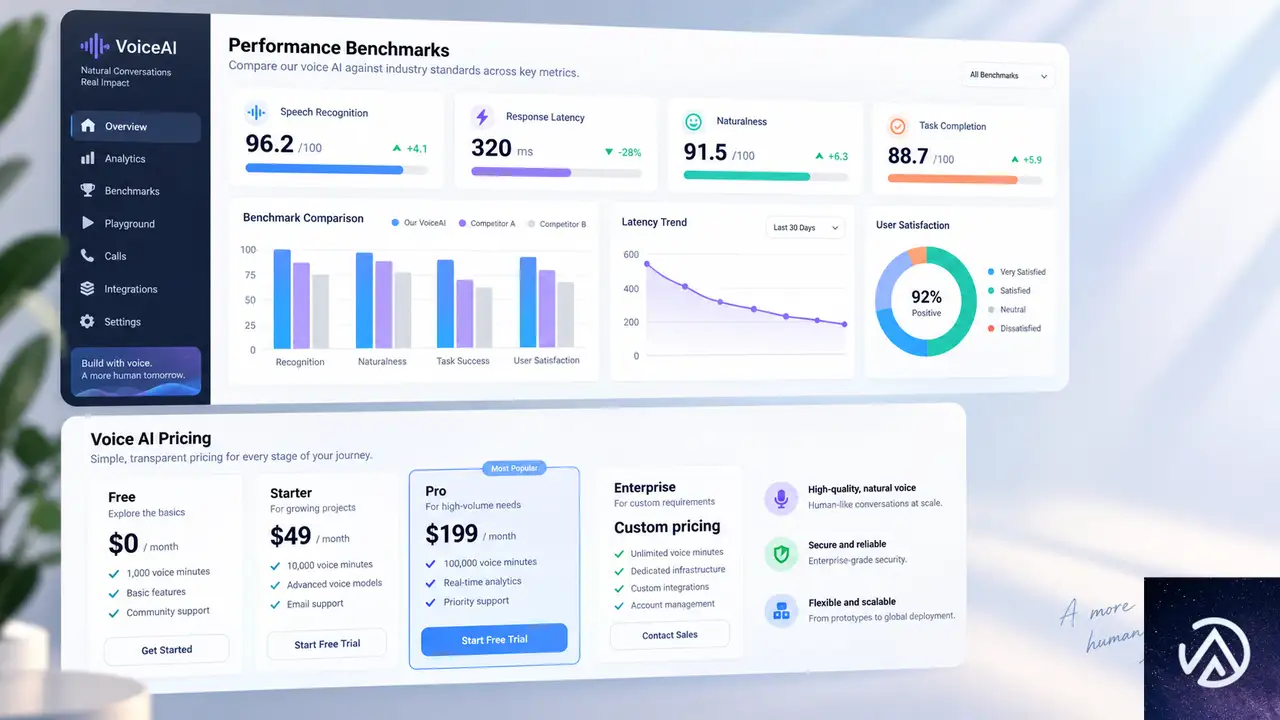
OpenAIの評価では、GPT-Live-1はFull Duplex BenchのスコアをGPT-Realtime-2.1から30ポイント改善した。特にターンテイクの遅延と対話的行動で大きな向上が見られた。GPT-6 Astra(中程度の推論エフォート)と組み合わせた構成では、音声エージェントの総合知能を測定するTau3ベンチマークで1位を獲得している。
評価対象は航空、小売、通信の各ドメインにおける音声カスタマーサービス対応、銀行業務の音声サポート、発話の一時停止への対応、ターンテイク、割り込み処理、バックチャネル(相槌や短い応答)への反応、自然な間や言い直しを含む音声経由のツール呼び出しなど多岐にわたる。満足度と完了率の両面で高いパフォーマンスを示した。
料金体系と展開オプション
GPT-Live-1の料金は、音声フロントエンド部分が1分あたり0.05ドルだ。バックエンドの推論モデルとエージェントハーネスは別途組み合わせる構成になる。推論深度の異なるモデルを使い分けることで、プロダクトの要件に合わせたコスト設計が可能だ。独自のカスタム音声へのアクセスは、OpenAIの営業チームへの問い合わせを通じて申請する。
電話回線を使ったフルデュプレックス音声エージェントの展開もサポートされている。レストラン予約からカスタマーサポートまで、従来は有人対応が必要だった領域に音声AIを導入できる。また、リアルタイム音声対話を企業内システムに統合する「OpenAI Presence」と組み合わせることで、社内システムへのアクセス、承認済みアクションの実行、必要時の人間へのエスカレーションまでを含むエンタープライズ向けの音声エージェントも構築できる。
音声AIの実用化が進む中で、GPT-Live-1のAPI提供は開発者にとって重要な転換点になる。フルデュプレックス方式の導入により、音声エージェントの体験品質が人間との自然な対話に近づくからだ。特に割り込み処理の改善は、教育、カスタマーサポート、ヘルスケアなど対話の質が成果に直結する分野で大きな意味を持つ。従来のターン制音声AIでは実現できなかった「考えながら話す」「話の途中で方向転換する」といった人間らしい対話が、API経由で誰でも利用できるようになった点が重要だ。
この記事のポイント
- GPT-Live-1がAPIで提供開始。同時に聞いて話せるフルデュプレックス音声モデルだ
- 単一モデルで音声入出力を処理し、STTとLLMとTTSをつなぐ従来方式の遅延を構造的に解消する
- Speak社の評価では割り込み回数が約80%削減された
- バックエンドのテキストモデルに推論を委任できる柔軟な構成が特徴だ
- 料金は音声フロントエンドが1分あたり0.05ドル。電話回線への展開も可能だ
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

WooCommerce 11.1でREST APIとStore APIが最大42%高速化。ブロック登録スキップの仕組み
WooCommerce 11.1がブロック登録の仕組みを大きく変更する。REST APIとStore APIのリクエストが従来より13〜18ミリ秒、割合で30〜42%速くなる見込みだ。
これまでWooCommerceはほぼすべてのリクエストでブロックタイプとパターンを登録していた。画面にブロックを描画しないAPIリクエストでも同じ準備処理が走り、無駄なコストになっていた。
この記事では変更の背景と仕組み、影響を受ける開発者の条件、具体的な対応方法を解説する。11.1は正式リリース前の段階のため、エクステンションを配布している開発者は事前テストが求められる。
なぜブロック登録をスキップするのか
ほぼ全リクエストで発生していた無駄な処理
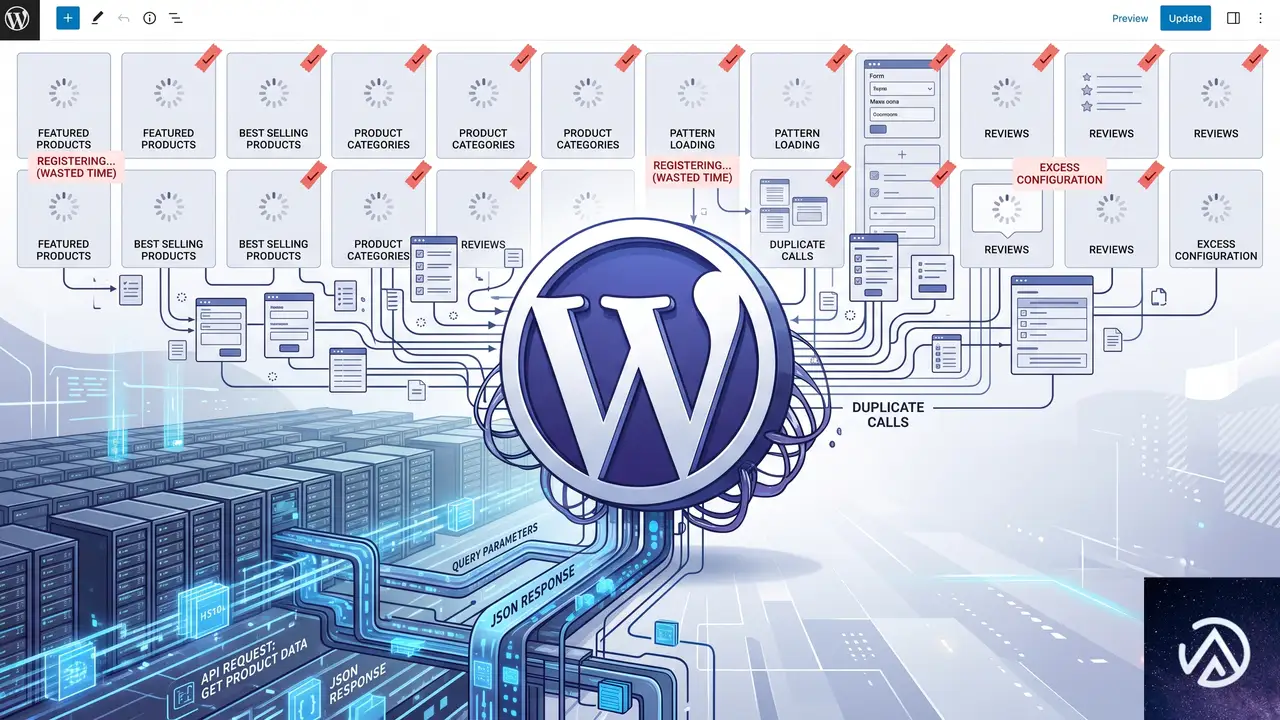
WooCommerceはこれまで、ブロックタイプとパターンをほぼすべてのリクエストで登録していた。商品データを返すだけのREST APIリクエストでも、カート情報を返すStore APIリクエストでも、ブロックを描画しないのに登録処理が実行されていた。
ブロック登録にはファイル読み込みやメタデータ解析が伴う。1リクエストあたりの負荷は小さくても、APIを多用する店舗やヘッドレスコマース構成では応答速度に影響する。WooCommerceチームは「リクエストはブロックを描画または編集できる場合にのみ、ブロック登録のコストを支払うべき」という方針を取った。
Beforeではすべてのリクエストがブロック登録を経由していた。Afterではブロックを描画しないAPIリクエストが登録処理を飛ばし、その分だけレスポンスが速くなる。
描画しないリクエストに課されるコスト
従来の挙動は、ブロックを編集も描画もしないリクエストまでブロックエディタの準備をさせるものだった。この無駄はアクセス数に比例して増える。とくにモバイルアプリやフロントエンドを別システムで構築し、WooCommerceをAPI経由で使う構成では影響が大きい。
今回の最適化は、APIリクエスト全体に占めるブロック登録のコストが想定以上に大きかったことを示している。13〜18ミリ秒の改善は体感的には小さいが、ピーク時に多数のリクエストを処理する店舗では合計の短縮効果が積み上がる。
11.0から11.1へ段階的に進めた変更

11.0で導入したパターンの遅延読み込み
第一段階はWooCommerce 11.0で実装された。パターンがファイルパスで登録され、エディタから要求されたときだけ内容が読み込まれるようになった。WordPressコアと同じ挙動だ。ブロックを登録するリクエストごとに5〜8ミリ秒の節約が確認されている。
11.1のBlockRegistrationContextガード
11.1では新しいBlockRegistrationContextガードが追加された。このガードがリクエストを判定し、ブロックを描画しない場面ではブロックタイプとパターンの登録をまとめてスキップする。
商品説明を守るオンデマンド登録の例外
1つだけ例外がある。商品説明やバリエーション説明にWooCommerceブロックが含まれる場合、woocommerce_short_descriptionフィルター経由で必要なときにブロックタイプが登録される。これにより商品REST API、Store API、バリエーションAJAXエンドポイント、商品のWebhookでも説明が正しく描画される。
2段階の変更により、パターン読み込みとブロック登録という2つの重い処理がAPIリクエストから外れた。完成した最適化の効果が30〜42%という数字に表れている。
対象リクエストと安全性の設計

スキップ対象と従来どおりのリクエスト
スキップされるのはブロックを描画しないリクエストのみだ。フロントエンド、管理画面、ブロックエディタ、サイトエディタのリクエストは従来どおりブロックを登録する。
見落としがあっても表示は壊れない
ガードは自身が認識したコンテキストだけをスキップする。認識できない場面では登録を継続するため、分類に漏れがあったとしても描画の後退にはつながらない。性能が少し落ちるだけで済む設計だ。
この設計は保守性の面でも合理的だ。未知のリクエストに対して安全側に倒すため、WooCommerceの内部判断が変わっても既存サイトの表示が突然崩れるリスクを抑えられる。
開発者が確認すべき影響範囲

影響を受けるエクステンションの条件
この変更はWooCommerce 11.1.0から適用される。スキップされるリクエスト中にWooCommerceブロックを描画するエクステンション、またはWooCommerceのブロックタイプ、パターン、ブロックごとのアセット登録に依存するエクステンションが影響を受ける。
スキップされた場面では、WooCommerceブロックは生のブロックマークアップか、動的出力のない静的なHTMLとして返る。テンプレートに直接ブロックを組み込んでいるエクステンションは、表示内容が変わらないか確認が必要だ。
コードで確認する方法
影響の有無はコードで確認できる。以下のコードはWooCommerce 11.1以降のスキップ対象リクエストでfalseを返す。
// WooCommerce 11.1以降、スキップされた場面では false を返す。
WP_Block_Type_Registry::get_instance()->is_registered( 'woocommerce/mini-cart' );
商品説明と自前ブロックは影響なし
商品説明とバリエーション説明はオンデマンドで処理されるため対応は不要だ。register_block_type()で自前登録しているブロックも影響を受けない。今回の変更はWooCommerce自身が行う登録だけが対象になる。
実務では「自前でブロックを登録しているか」「WooCommerceのブロック登録に依存しているか」の切り分けが重要になる。前者は今回の変更を意識する必要がなく、後者だけが対応を検討すればよい。
開発者が取るべき対応と正しいブロック作成

woocommerce_should_register_blocksフィルターで復帰
影響を受けるエクステンションは、新しいwoocommerce_should_register_blocksフィルターを使い、実際にブロックを描画するリクエストのときだけtrueを返す。
add_filter(
    'woocommerce_should_register_blocks',
    function ( $should_register ) {
        return my_context_renders_blocks() ? true : $should_register;
    }
);フィルターはプラグイン読み込み時に実行され、メインクエリが解析される前の段階で呼ばれる。そのため条件には$_SERVERや$_GETなど、この初期段階で利用できる情報だけを使うことになる。
復帰させる範囲を絞りすぎるとブロックが見つからず表示が変わることがある。逆に広げすぎると今回の性能改善が失われる。描画が実際に発生するリクエストを正確に判定する条件を書くのが開発者の作業になる。
内部クラスAbstractBlockを避ける
WooCommerceはブロックをAbstractBlockという内部クラスの上に構築しないよう推奨している。内部クラスを継承すると、WooCommerceが下すすべての登録判断、今回のスキップも含めて引き継ぐことになる。
登録の最適化が進むにつれ、内部クラスのライフサイクルは今後も変わり続ける。依存すると将来のアップデートで予期しない挙動になる可能性が高い。
標準のWordPress Block APIを使う
サポートされる方法は標準のWordPress Block APIだ。ブロックをblock.jsonに定義し、init時にregister_block_type()で登録する。カートやチェックアウトの内部ブロックには@woocommerce/extend-cart-checkout-blockテンプレートがある。
WooCommerceの公式ドキュメントにあるスキャフォールディングとサンプルストアデータ、@wordpress/create-blockも出発点として適している。標準APIに沿って作れば、今後の最適化に追随しやすい。
正式リリース前の段階で、WooCommerceはエクステンション開発者に11.1へのテストを呼びかけている。とくに商品データやカート情報をAPIで扱う拡張を配布している場合は、早めの動作確認が安全だ。
この記事のポイント
- WooCommerce 11.1はブロックを描画しないリクエストでブロック登録をスキップする
- Store APIとREST APIは13〜18ミリ秒、割合で30〜42%高速化する
- 商品説明や自前登録ブロックは影響を受けず対応不要
- 影響を受ける場合のみ woocommerce_should_register_blocks フィルターで復帰させる
- 内部クラスAbstractBlockではなく標準のWordPress Block APIでブロックを作る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GPT-5.6 API料金改定、Lunaは80%値下げでTerraも20%減。Fastモード登場
OpenAIは2026年7月30日、大規模言語モデル「GPT-5.6」シリーズのAPI料金を大幅に引き下げた。最速かつ最安価なモデル「Luna」は80%値下げされ、バランス型の「Terra」も20%安くなる。あわせて最上位「Sol」向けにFastモードも導入され、標準処理の最大2.5倍の速度を提供する。
これらの改定は、OpenAIが掲げる「高度な知能をより豊富で手頃なものにする」という目標の実践だ。企業はコストと処理速度をワークフローごとに最適化できるため、AI利用の幅が大きく広がる。
GPT-5.6 LunaとTerraの大幅値下げ

今回の値下げの中心は、高速処理向けのLunaだ。LunaはAPI料金が80%引き下げられ、100万入力トークンあたり0.20ドル、同出力トークンあたり1.20ドルという破格の水準になった。一方、日常的な業務全般に使えるTerraは20%値下げされ、入力トークン100万あたり2ドル、出力は12ドルとなっている。
この値下げによって、Lunaは1タスクあたりのコストが非常に低くなり、大量処理に適したモデルへと進化した。OpenAIのブログによれば、専門的な作業指標で測った場合、同社の旧モデルFable 5と比べてLunaの推定タスク単価は99%近く低いという。小規模事業者が高度なAIを日常的に使うハードルが格段に下がったと言える。
FastモードでSolが最大2.5倍高速化
最上位モデルのGPT-5.6 Solには、新たにFastモードが追加された。これは従来の優先処理(Priority Processing)を置き換えるもので、APIでFastモードを有効にすると、標準処理の最大2.5倍の速度で応答が得られる。価格は標準の2倍だが、知能の質はまったく変わらない。既存の優先処理指定リクエストは自動的にFastモードに移行するため、コードの修正は不要だ。
応答速度が重要な場面、たとえばユーザー向けのリアルタイムチャットボットや緊急度の高い意思決定支援などで効果を発揮する。一方で、コストが2倍になるため、処理の内容に応じて標準モードとの使い分けが鍵になる。OpenAIはこの仕組みによって、企業が「結果に対して適正な価格を払う」バランスを取りやすくしたとしている。
効率化を支えるモデル自身の最適化ループ

今回の値下げを支えているのは、GPT-5.6シリーズの稼働効率の劇的な向上だ。OpenAIはモデルそのもの、推論システム、そしてツールやコンテキストを扱うエージェント機構のあらゆる層で改良を重ねた。より直接的な処理経路の選択、ハードウェア生産性を維持するルーティング、トークン生成の最適化、重複作業を避ける賢いコンテキスト管理などが組み合わさり、同じ計算資源でより多くの有用な成果を出せるようになっている。
とりわけ注目されるのが、Sol自身が効率改善のプロセスに貢献した点だ。人間の管理のもと、Solは本番カーネルを自律的に書き換えて最適化し、トークン生成効率を高める数百の実験を設計・実行した。この取り組みによって、モデル提供にかかるエンドツーエンドのコストが20%削減され、トークン生成効率は15%以上向上した。AIがAIの運用コストを下げるフィードバックループが動き始めている。
こうした自己最適化のループは、OpenAIが目指す「インテリジェンスの価格性能比を継続的に向上させる」戦略の中核をなす。モデルが賢くなるほど、次の効率化のサイクルが加速するというわけだ。
企業がAI活用を進める際の新たな選択肢
LunaとTerraの値下げ、そしてSolのFastモードの登場によって、企業がワークフローごとに最適なモデルを選べる幅が大きく広がった。コストと速度、知能のバランスをタスク単位で調整できるようになったことで、AIの適用範囲を無理なく拡大できる。
たとえば、コード生成のワークフローを考えてみる。要件が曖昧で高度な判断が必要な設計段階ではSolを使い、確定した仕様に沿ったコード実装やテストの実行は低コストのLunaに任せる、といった割り振りが現実的になる。ドキュメントの大量分析や顧客対応の振り分けといった高頻度の業務も、Lunaを活用すれば予算内に収めやすい。
このように、単一のモデルですべてをこなすのではなく、処理の性質と求める品質に応じて使い分ける設計が、これからのAI戦略の基本になるだろう。SolのFastモードは、応答速度が収益に直結する顧客向けサービスなどで即効性が期待できる。
OpenAIのブログによれば、今回の改定によって、1年前に最先端とされたモデル並みのパフォーマンスをLunaで1タスク約6%のコストで実現できるという。AI活用が一部の専門領域から、あらゆる業務の日常ツールへと移行する大きな一歩だ。
この記事のポイント
- GPT-5.6 LunaのAPI料金が80%値下げされ、100万入力トークンあたり0.20ドルに。Terraも20%引き
- Sol向けFastモードが追加され、標準の最大2.5倍の速度を2倍の価格で提供
- 値下げの背景には、Sol自身がカーネル最適化などで推論コストを20%削減した成果がある
- 企業はタスクの難易度や処理量に応じてLuna、Terra、Solを柔軟に組み合わせ、コストと品質を両立できる
- ChatGPT WorkやCodexのサブスクリプション価格は据え置きのまま、LunaとTerraの消費クレジットが減少
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
OpenAI、推論保持とコンパクションでARC-AGI-3スコア3倍化
OpenAIの最新モデル「GPT-5.6 Sol」が、ARC-AGI-3ベンチマークで当初のスコアを約3倍に伸ばした。わずか2つのAPI設定を切り替えただけである。単にベンチマーク成績を上げただけでなく、出力トークン量も6分の1に削減した。
GPT-5.6 Solは数学の未解決問題を証明し、ポケモンなどのゲームをクリアする実力がある。それにもかかわらず、2Dパズルゲームで構成されるARC-AGI-3では開始直後ほぼ無力に見えた。スコアはわずか7.8%である。
問題はモデルそのものではなく、評価を実行する「ハーネス(テスト環境)」の設計にあった。OpenAIが本番環境で使っている推論保持とコンパクションを適用したところ、スコアは13.3%から38.3%へと跳ね上がった。これは人間の平均スコア(48%)に大きく近づく数字である。
なぜGPT-5.6 SolはARC-AGI-3で苦戦したのか
ARC-AGI-3ベンチマークの概要
ARC-AGI-3は、AIエージェントが未知の2Dゲームを探索しながらルールを推論し、自力で解く能力を測るベンチマークである。人間には直感的に分かるような簡単なパズルでも、AIにとっては説明なしに仕組みを理解するのが極めて難しい。
このベンチマークは、AIがどれだけ「学習し、推論できるか」を厳密に評価するために設計されており、特殊なツールや支援機能は一切与えられない。公式が用意するハーネスは、どのモデルでも同じ条件で比較できるよう、意図的に簡素な作りになっている。
公式ハーネスの2つの問題点
OpenAIの調査チームは、GPT-5.6 Solがゲーム内でひとつ行動するたびに「思考が真っ白に戻っている」ことに気づいた。公式ハーネスは、次の行動を起こす前に、モデルが直前に行った非公開の推論メッセージをすべて破棄していた。
一連の行動記録や簡単なメモは残るものの、その行動を導いた計画やひらめきは記憶に残らない。つまり、モデルは毎ターン、ゲームの仕組みを一から考え直さなければならなかった。
さらに、会話のコンテキストが長くなると「ローリング打ち切り」が発動し、古い行動履歴から順に削除されていく。推論が消えたうえに、過去の行動すら見えなくなるため、長期的な学習がほぼ不可能だった。この2つの設計が、GPT-5.6 Solの性能を著しく抑え込んでいたのである。
この図のように、ハーネスの設計ひとつで、同じモデルの振る舞いが大きく変わる。単純な推論保持と圧縮によって、アシスタントとしての性能が劇的に改善することをOpenAIは示した。
推論保持とコンパクションがもたらした改善
推論保持の効果
GPT-5.6は、ChatGPTやCodexでも使われている仕組みとして、返答やツール呼び出しの前に非公開の推論メッセージを生成する。通常、この推論は会話履歴の一部として保持される。公式ハーネスではこれが破棄されていたが、OpenAIのResponses APIを使うと、前のレスポンスIDを次に渡すだけで自動的に推論が引き継がれる。
推論が保持されると、2つの大きな変化が起きた。まず、毎回ゲームのルールを最初から解釈する必要がなくなり、1回の行動にかかる思考時間が短縮された。次に、過去の思考を思い出せるようになったことで、モデルは時間をかけて学習し、一貫した戦略を取れるようになった。
コンパクションの効果
公式ハーネスは、コンテキストが175,000文字を超えると古いメッセージを削除する「ローリング打ち切り」を採用していた。これに対し、Responses APIのコンパクションは、会話が長くなったときに内容を要約して保持する。これにより、過去の観察や行動を失うことなく、より少ないトークンで同じ情報を維持できる。
コンパクションを有効にした環境では、GPT-5.6 Solはゲーム内で学んだことを長いプレイ時間にわたって保持しやすくなり、スコアがさらに向上した。結果として、出力トークン数も大幅に削減された。
パフォーマンスの大幅向上とトークン削減

公開タスクセットにおいて、公式ハーネスでのGPT-5.6 Sol(max)のスコアは13.3%だった。推論保持とコンパクションを適用した結果、38.3%まで上昇した。これは約3倍の改善であり、出力トークンはおよそ6分の1に減少している。
スコアに用いられている「RHAE(Relative Human Action Efficiency)」は、人間のパフォーマンスを基準にした指標である。ARC-AGI-3の公式プレイヤーログから推定される人間の平均スコアは48%であり、GPT-5.6 Solはその80%近くに達した。この数字は、適切なハーネスがいかに重要かを雄弁に物語る。
実務開発者への示唆

Responses API の活用推奨
OpenAIは、API利用者に対して、旧来のChat Completions APIではなくResponses APIを使うこと、そして推論保持とコンパクションを有効にすることを強く推奨している。これらの設定は、ChatGPTやCodexなどのプロダクトで実際に使われている本番構成と同じである。
特に、エージェント的な挙動や長期的なタスクをAIに任せる場合、推論保持とコンパクションは必須に近い。実装上の手間は最小限であり、Responses APIを使えばレスポンスIDを引き継ぐだけで実現できる。
ベンチマーク比較の注意点
今回の事例は、ベンチマーク評価がモデル単体の能力だけでなく、API設定やハーネス設計といった目に見えない要素も測っていることを思い出させる。低いスコアが報告されても、それはモデルの本質的な限界ではなく、評価環境の不備かもしれない。
OpenAI自身、過去にも公開ベンチマークで成績が低く驚いた後に、評価ランナーが推論メッセージを捨てる汎用ハーネスを使っていたことに気づいたという経験がある。モデルを比較する際は、ChatGPTやCodexの実運用に近い設定で評価された結果を基準にすることが望ましい。
この記事のポイント
- GPT-5.6 SolはARC-AGI-3で当初7.8%のスコアだったが、API設定変更後は38.3%まで向上
- 推論保持を有効にすると、過去の思考を再利用でき学習効率が上がる
- コンパクションによって古い情報を要約し、少ないトークンで文脈を維持できる
- Responses API を用いることで、ChatGPTと同等のパフォーマンスを引き出せる
- ベンチマーク評価にはハーネス設計が大きく影響するため注意が必要
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Gemini 3.6 Flash登場、3.5 Flash-LiteとCyberも発表。AIエージェント開発の新定番へ
Google DeepMindは7月21日、AIエージェント開発の最前線を支える3つの新モデル、Gemini 3.6 Flash、3.5 Flash-Lite、3.5 Flash Cyberを発表した。今回のアップデートは、トークン効率の大幅な改善と、速度・コストの両立を追求した点が特徴だ。
3.6 Flashはコード生成や知識処理の精度を高めつつ、出力トークン数を最大65%削減するケースも報告されている。3.5 Flash-Liteは毎秒350トークンという爆速で、エージェントの大規模運用を想定した設計。そして3.5 Flash Cyberは、コードの脆弱性発見と修正に特化し、限定的な提供が始まる。
本記事では、それぞれのモデルの性能と実用面へのインパクトを、開発者視点で詳しく掘り下げる。AIエージェントのコスト構造やアーキテクチャ設計に直結する情報なので、Gemini API を扱うエンジニアは必見だ。
3.6 Flashで加速するトークン効率革命

出力トークン17%削減がもたらすコストインパクト
3.6 Flashの最大のセールスポイントは、3.5 Flash比で出力トークンを平均17%削減した点だ。Artificial Analysis Indexによる計測で明らかになったこの数字は、単なる省サイズ化を超えた意味を持つ。AIエージェントがマルチステップのワークフローを回す際、出力トークン量はAPI利用料金に直結するからだ。
具体的には、3.6 Flashの価格は入力100万トークンあたり1.50ドル、出力100万トークンあたり7.50ドル。3.5 Flashより安く、かつ出力が短くなったことで、1タスクあたりの実質コストが明確に下がった。エージェントが複数回の推論やツール呼び出しを繰り返すシナリオでは、コスト削減効果が累積的に効いてくる。
コード生成とナレッジワークでの明確なスコア向上
効率化と同時に、ベンチマークスコアも軒並み向上している。ソフトウェアエンジニアリングタスクを評価するDeepSWEでは、3.5 Flashの37%から49%へ向上。機械学習研究向けのMLE Benchでは49.7%から63.9%へと大幅に伸びた。不要なコード編集や実行ループの削減が、精度向上に寄与したと見られる。
また、OSWorld-Verifiedというコンピュータ操作タスクでは78.4%から83.0%へ改善。ドキュメント解析やチャート分析、レポート作成といった知識処理の指標GDPval-AA v2でもスコアを伸ばしている。企業ユーザーのFigmaやHarvey、Hebbiaからも「複雑なワークフローでのコストと品質の両立が進んだ」と高い評価が寄せられている。
上の図は、エージェントが1つのタスクを処理する際の出力トークン数の違いを模式化したものだ。実際のDeepSWEベンチマークでは最大65%のトークン削減が観測されており、コード生成のような長大な出力が求められる分野ほど恩恵が大きい。
3.5 Flash-Liteが切り開く高速エージェント運用
毎秒350トークン、低レイテンシと高スループットの両立
Gemini 3.5 Flash-Liteは、速度を極限まで追求したモデルだ。Artificial Analysisの計測では毎秒350トークンの出力を達成。前世代の3.1 Flash-Liteと比較してコーディングやエージェントタスクのスコアが大幅に向上し、実務に耐える品質を備えた。
価格は入力100万トークンあたり0.30ドル、出力100万トークンあたり2.50ドルと、3.6 Flashよりさらに安い。大規模なドキュメント処理やエージェント検索など、大量のリクエストをさばく必要があるシステムに最適だ。開発者は「思考レベル」を設定できるため、低レイテンシが求められる単純タスクでは最小限の推論に抑え、複雑なサブエージェント処理には高思考レベルを割り当てるといった柔軟な運用が可能になる。
3 Flashをも凌駕するエージェント性能
興味深いのは、3.5 Flash-Liteが先代の3 Flashを上回るベンチマーク結果を残している点だ。SWE-Bench Proでは54.2%(3 Flashは49.6%)、OSWorld-Verifiedでは74.0%(同65.1%)と、より高速でありながら高精度を実現している。長期コンテキストタスクのGDM-MRCR v2でも72.2%と、3.1 Flash-Liteの60.1%から大きく伸びた。
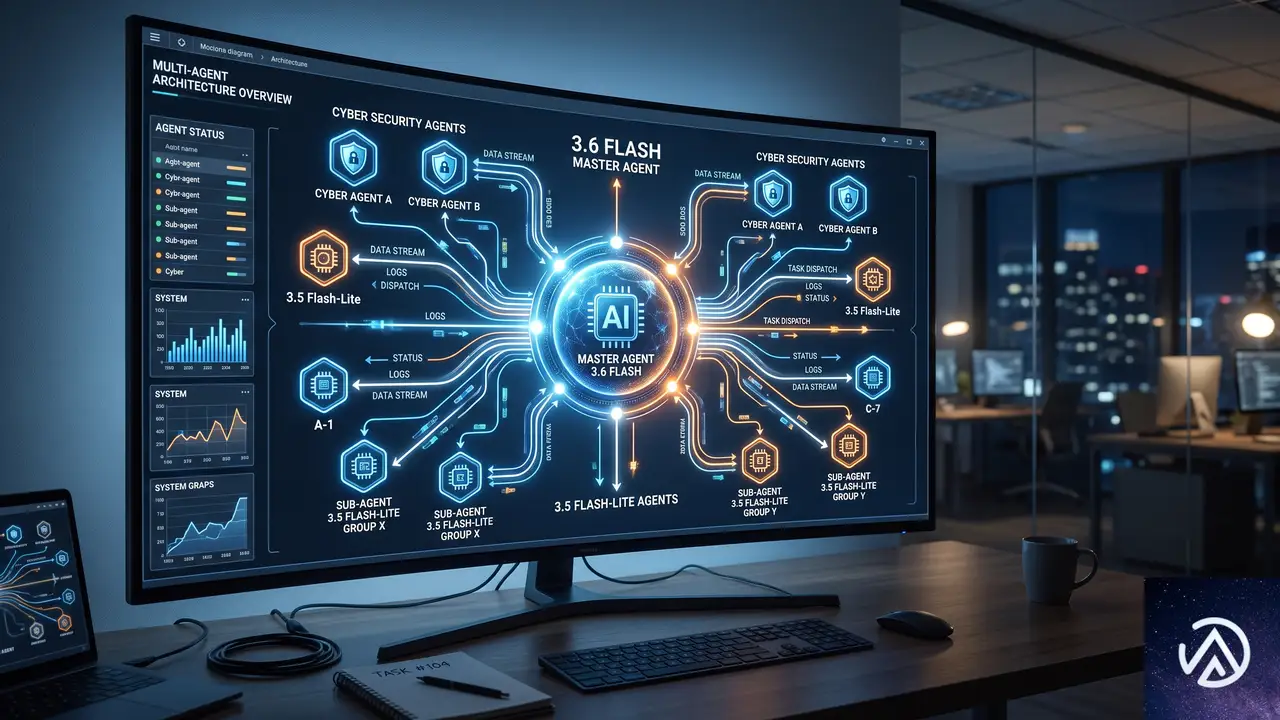
Google DeepMindの発表では、3.6 Flashをマスターエージェント、3.5 Flash-Liteをサブエージェントとして組み合わせるユースケースが紹介されている。マスターが全体の指示を出し、大量のサブタスクをLiteが高速に処理するアーキテクチャだ。これにより、Webデザインの複数案を瞬時に生成するといったワークフローが実用的な速度で回せるようになる。
この構成は、従来の「1つの大きなモデルに全部任せる」スタイルから、役割に応じたモデルを組み合わせるマルチエージェント設計への移行を象徴している。コストと速度のバランスを取る上で、3.5 Flash-Liteの存在は極めて重要になるだろう。
3.5 Flash Cyberがセキュアなコードを変える
脆弱性の発見と修正に特化したファインチューニング
3つ目の発表であるGemini 3.5 Flash Cyberは、3.5 Flashをベースにサイバーセキュリティ用途に特化して調整されたモデルだ。コードの脆弱性を高効率で検出し、修正パッチを生成する能力に優れている。単体で使うのではなく、Google DeepMindが開発したコードセキュリティエージェント「CodeMender」と組み合わせることで、複数のCyberエージェントが協調して1つの統合レポートを出力する。
ベンチマークCyberGymにおいて、CodeMender上の3.5 Flash Cyberは最前線クラスの競争力を持つことが示された。大規模モデルに頼らず、価格あたりのトークン単価を抑えつつ高い検出精度を実現している点がポイントだ。
限定的な提供と悪用防止の枠組み
この種の技術には悪用リスクがつきまとう。Google DeepMindは意図的に配布を制限し、政府機関と信頼できるパートナーに対してのみ、CodeMender経由の限定的なアクセスパイロットプログラムとして提供を開始する。フロントラインの防御側が脆弱性を早期に発見・修正できるようになる一方で、広範な悪用を防ぐ設計だ。
このアプローチは、セキュリティAIがいたずらに攻撃者の手に渡ることを防ぎつつ、本来の防御目的を達成する現実的な落とし所と言える。企業のセキュリティチームにとっては、コードレビューの自動化とパッチ生成の高速化が期待できるが、現時点では一般のAPIとしては利用できない点に注意が必要だ。
Gemini Flashシリーズが描くAIエージェントの次なる潮流
効率・速度・専門性の3軸で攻めるGoogleの戦略
今回の発表から読み取れるGoogleの戦略は明確だ。AIエージェントの実用化においてボトルネックとなる「コスト」「レイテンシ」「専門精度」の3つを、それぞれ最適化したモデルラインナップでカバーしようとしている。
- 3.6 Flashは汎用的な頭脳として、コストパフォーマンスと品質を高次元でバランス
- 3.5 Flash-Liteはスピードと低コストを武器に、大量のサブタスクや高スループット処理を担当
- 3.5 Flash Cyberはセキュリティという特定領域に深く特化し、専門エージェントとして機能
これは単なるモデルバリエーションの追加ではない。開発者がエージェントを設計する際に、「重いモデル1つで全てを処理する」のではなく、役割に応じたモデルを組み合わせるマルチエージェントアーキテクチャを標準化しようとする意図が感じられる。
競合との差別化と実務へのインパクト
OpenAIやAnthropicもエージェント向けの高速モデルを提供しているが、Googleはモデルのバリエーションと価格設定の粒度で一歩抜きん出た印象だ。特に3.5 Flash-Liteの「0.30ドル/1M入力トークン」という価格は、大量のAPIコールが発生するエージェント運用において強力な競争力になる。
さらに、3.6 Flashのトークン効率改善は、単にAPI利用料を下げるだけでなく、出力が短くなることで後続のコンテキストウィンドウ消費を抑え、長大な会話や複数ステップのタスクでも破綻しにくくなる。開発者体験としての「扱いやすさ」が向上している点も見逃せない。
上の図は、AIエージェントの設計思想の変化を模式化したものだ。Flashシリーズの充実により、開発者は「全部入り」の巨大モデルに頼らず、適材適所でモデルを組み合わせるアーキテクチャを選択しやすくなる。
この記事のポイント
- Gemini 3.6 Flashは出力トークンを平均17%削減、コードやナレッジ処理の精度も向上
- 3.5 Flash-Liteは毎秒350トークンの速度で、高スループットなエージェント処理に最適
- 3.5 Flash CyberはCodeMenderと連携し、コード脆弱性の検出と修正を効率化(限定提供)
- 3つのモデルは役割を分担するマルチエージェント設計を前提に開発されており、コストと速度の最適化を実現
- AIエージェント開発は「1つの巨大モデル」から「目的別モデルの組み合わせ」へと移行しつつある
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Nano Banana 2 LiteとGemini Omni Flash登場、高速画像生成と動画編集がAPIで利用可能に
Google DeepMindは2026年6月30日、高速画像生成モデル「Nano Banana 2 Lite」と、動画生成・編集モデル「Gemini Omni Flash」を開発者向けに公開した。どちらもGoogle AI StudioとGemini APIから即日利用できる。
Nano Banana 2 Liteはテキストから画像をわずか4秒で生成し、1,000枚あたり0.034ドルという低コストが売りだ。Gemini Omni Flashは自然言語による動画編集と高品質な動画生成を両立し、1秒あたり0.10ドルで提供される。
この2つのモデルを組み合わせることで、画像を生成して即座に動画化するといったマルチメディア制作のワークフローが一気に加速する。本記事では各モデルの性能、活用シナリオ、連携方法を詳しく見ていく。
Nano Banana 2 Liteの概要と位置づけ

Nano Banana 2 Lite(モデル名 gemini-3.1-flash-lite-image)は、Nano Bananaファミリーの中で最も高速かつ低コストな画像生成モデルだ。主に短時間でのプロトタイピングや大量の画像生成が必要な開発パイプラインを想定している。
旧モデルであるNano Banana(gemini-2.5-flash-image)からの置き換えが推奨されており、差し替えるだけで速度・品質・コストのすべてで改善が見込める。
速度とコストの具体的な数値
- レイテンシ(処理時間) テキストから画像を出力するまでの時間は約4秒。対話的なプロトタイピングや下書き用途に向く。
- 料金 1,000枚あたり0.034ドル。大量生成や予算管理が求められるプロジェクトでコストを抑えやすい。
- 品質のバランス 速度優先ながら、プロンプトへの忠実度・キャラクターの一貫性・画像内テキストの可読性は確保されている。
Nano Bananaファミリー全体の比較
Nano Bananaシリーズには4つのモデルが存在し、用途に応じて使い分ける設計だ。以下が各モデルの位置づけである。
開発者は自分たちのプロジェクトが「速度」を求めるのか「品質」を求めるのかによって、Lite・標準・Proを切り替えられる。たとえば広告バナーの大量生成ならNano Banana 2 Lite、製品写真の精密な加工ならNano Banana Proといった使い分けが現実的だ。
Gemini Omni Flashがもたらす動画編集の変化
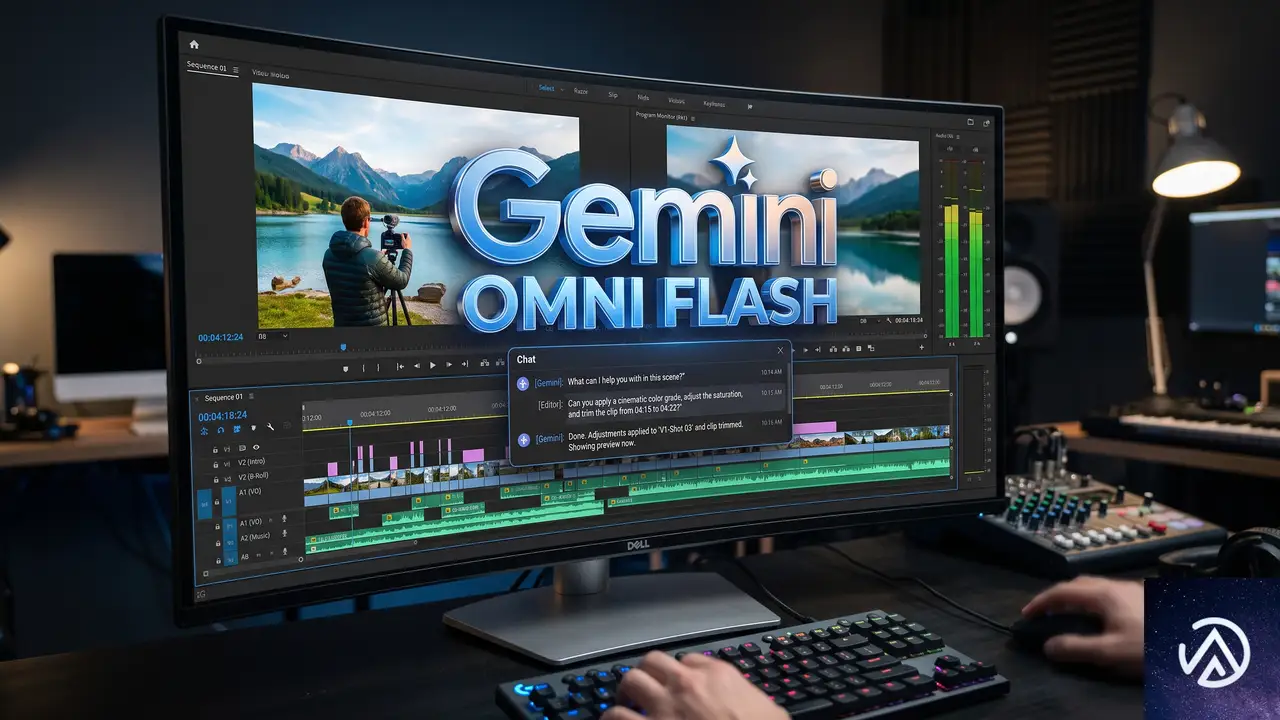
Gemini Omni Flash(gemini-omni-flash-preview)は、テキスト・画像・動画を組み合わせたマルチモーダル入力をネイティブに扱い、高品質な動画生成と会話型編集を実現するモデルだ。2026年5月のGoogle I/Oで発表され、今回初めてGemini APIとGoogle AI Studioに公開された。
料金は出力動画1秒あたり0.10ドル。Veo 3.1 Fastと同水準であり、動画生成AIとしては競争力のある価格設定だ。
4つの得意領域
従来の動画生成AIでは「1回のプロンプトで動画を出力して終わり」という単発的な使い方が多かった。Omni Flashは会話を重ねながら微調整できる点が大きく異なる。動画の一部だけを修正したり、複数回の編集を積み重ねたりするワークフローが自然に回せるようになる。
現在の制限事項
- 生成できる動画の長さは現時点で10秒まで。長時間の動画生成は今後対応予定。
- 音声参照のアップロードとシーン延長機能は、今回のAPIでは未サポート。
- APIの仕様上は3秒までの動画参照を受け付けるが、現時点では正しく処理されない。
- シーン切り替えやパン(カメラの横移動)時のキャラクター一貫性に制限あり。改善中。
「10秒制限」は短く感じるかもしれないが、SNS向けショート動画やeコマースの商品紹介動画であれば十分な長さだ。3秒の動画参照制限についても、短いクリップを下敷きにした編集という使い方であれば実用範囲内といえる。
2つのモデルを連携させた実践ワークフロー

Nano Banana 2 LiteとGemini Omni Flashの真価は、両者を組み合わせることで発揮される。具体的には次のような流れだ。
Interactions APIを使うことでセッション履歴とコンテキストが保持されるため、ユーザーは最大3回まで連続した編集を積み重ねられる。1回の生成で終わらない、試行錯誤を前提としたクリエイティブ制作に適した設計だ。
公式デモアプリに見る実用例
Google DeepMindは両モデルを組み合わせた3つのデモアプリを公開している。いずれもGoogle AI Studio上で動作し、ソースコードをリミックスして自社サービスに組み込める。
これらのデモは、画像生成と動画編集を別々のAIに任せるのではなく、一つのワークフローとして統合することで生まれる価値を示している。eコマース事業者であれば、商品写真のバリエーションを大量生成し、その中から選んだ数枚だけを動画化するといった効率的な運用が可能になる。
開発者が知っておくべき安全性とモデル情報
両モデルともGoogleのセキュアなインフラ上で動作し、SynthIDによる電子透かし(ウォーターマーク)が埋め込まれる。SynthIDはAI生成コンテンツであることを検証可能にする技術で、GeminiアプリやChrome、Google検索を通じてコンテンツの来歴を確認できる。
すでにNano Banana 2 Liteは検索のAI Mode、Geminiアプリ、NotebookLM、Google Photos、Stitch、Google Flow、Google Adsなど、Googleの一般向けサービスにも順次展開されている。
API経由での利用にあたっては、各モデルの詳細な機能やリージョン別の制限が公式ドキュメントにまとめられている。開発を始める前に、Google AI Studioのプレイグラウンドで実際の挙動を試すのが確実だ。
この記事のポイント
- Nano Banana 2 Liteは4秒で画像を生成し、1,000枚あたり0.034ドルの低コストで利用できる
- Gemini Omni Flashは自然言語による動画編集と高品質な動画生成を両立し、1秒あたり0.10ドルで提供される
- 両モデルを連携させると、画像生成から動画化・編集までを一貫したワークフローで回せる
- Google AI StudioとGemini APIから即日利用可能で、具体的なデモアプリも公開済み
- SynthIDによるAI生成コンテンツの検証機能が組み込まれており、商用利用にも配慮されている
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

MetaがInstagram埋め込みのトークン要件を撤回、WordPressで復活
Metaは2026年6月15日、約6年前に導入したoEmbed APIのアクセストークン要件を撤回した。Instagram、Facebook、Threadsの投稿URLをWordPressに貼り付けるだけで埋め込み表示が可能になる。2020年10月にそれまで動いていた機能が突然使えなくなって以降、多くのサイト運営者が埋め込み手段を模索してきたが、ようやく以前の手軽さが戻った格好だ。
今回の方針転換に合わせて、Metaは公式WordPressプラグイン「Meta Embeds」も公開している。トークン管理不要で動作し、コードはGitHubで公開されている。本記事では技術的な変更点と実務への影響、そしてこの変更がカバーしない領域についても整理する。
2026年6月15日の変更内容
今回の発表でトークン不要となったのは、以下の4つのエンドポイントだ。
- Threads oEmbed
- Instagram oEmbed
- Facebook oEmbed(投稿)
- Facebook oEmbed(動画)
従来は、これらのエンドポイントを呼び出すためにMetaの開発者アカウント登録、アプリ作成、App Review申請、そして毎回のアクセストークン付与が必要だった。2026年6月15日以降は、URLさえあれば直接APIを叩ける。レスポンスの形式自体は以前と同じで、埋め込みHTML、プロバイダ名、幅、コンテンツタイプが返ってくる。
ただし2つの注意点がある。1つ目はレート制限だ。トークンレスアクセスはトークン付きのルートよりも呼び出し回数が制限される可能性があり、高頻度で埋め込みを行うサイトでは影響が出るかもしれない。2つ目は、エンドポイントがパブリックな投稿にしか対応しない点だ。非公開アカウントや限定公開の投稿は対象外となる。
この比較図からもわかるように、開発者向けの複雑な手続きが不要になった。個人ブログの運営者でも迷わずにMetaの投稿を埋め込めるようになっている。
元の変更が起きた経緯

2020年10月の衝撃
2020年10月、Metaは同社のoEmbedエンドポイントにアクセストークンを必須とする変更を発表した。WordPressにとってInstagramやFacebookのURLを貼るだけで埋め込みが表示される機能は標準装備だったが、この発表で状況は一変する。WordPressのコアチームは、数千万ものサイト運営者にトークン管理を要求することは現実的ではないと判断し、FacebookとInstagramをoEmbedプロバイダーから削除した。
すでに埋め込まれていた投稿は、WordPressがoEmbedレスポンスをデータベースにキャッシュしていたため表示が維持された。しかし新規の埋め込みは一切動作しなくなった。影響はWordPressサイト全体に及び、埋め込み機能を前提にしていたコンテンツ戦略を大きく狂わせた。
プラグイン市場への波及
この混乱に対応するため、JetpackはAutomattic社が保有するトークン経由でリクエストをプロキシする仕組みを急遽導入した。oEmbed Plusのようなサードパーティ製プラグインも登場し、一般のサイト運営者が自前でFacebook App IDとシークレットキーを生成して設定する手順を案内していた。
しかし多くの運営者はこれらの対策を取らず、埋め込み自体を諦めるか、API接続を内部で処理する専用プラグインに移行した。WP Mayorの記事によれば、この一件だけで「壊れたInstagram埋め込みを修正する」ためのコンテンツやツール群が一つのカテゴリを形成するほどだったという。
6年ぶりの方針転換の背景
Metaが2020年に掲げていた理由はプライバシーとセキュリティの強化だった。しかし今回の発表では「パブリックなMetaコンテンツの埋め込みを容易にする」という簡潔な説明にとどまっている。WP Mayorの著者Mark Zahra氏は、このタイミングでの撤回について「各プラットフォームがユーザーの注意を奪い合い、AIによる回答がリファラルトラフィックを侵食する中で、Metaが自社コンテンツを再びオープンウェブ上で流通させたいという意図が透けて見える」と分析している。
Metaが公式WordPressプラグインを公開

APIの方針転換と同時に、Metaは公式のWordPressプラグイン「Meta Embeds」をリリースした。ソースコードはGitHubで公開されており、オープンソースで開発が進められている。
このプラグインは、Threads、Instagram、Facebookの投稿URLをエディタに貼り付けるだけでリッチな埋め込みを表示する。設定画面はなく、トークンも不要。ブロックエディタとクラシックエディタの両方に対応している。Metaが自社製のWordPressプラグインを公式リポジトリに直接公開するのは異例の動きだ。
プラグインのReadmeに含まれるFAQには、今後の展開をうかがわせる記述がある。このプラグインは、WordPressのバージョンがすでにThreadsのoEmbedプロバイダーを登録しているかどうかをチェックし、重複登録を回避する仕様になっている。WP Mayorの記事は、この実装を「Metaの埋め込み機能がWordPressコアに再統合される布石」と見ており、今後のWordPressリリースでInstagramとFacebookのネイティブ埋め込みが復活する可能性に注目すべきだと指摘している。
Meta Embedsプラグインを有効化するだけで、これまで埋め込みが動作しなかった環境でも即座に表示が改善する。WordPressコアへの統合が実現すれば、プラグインすら不要になる可能性もある。
今回の変更が影響しない領域
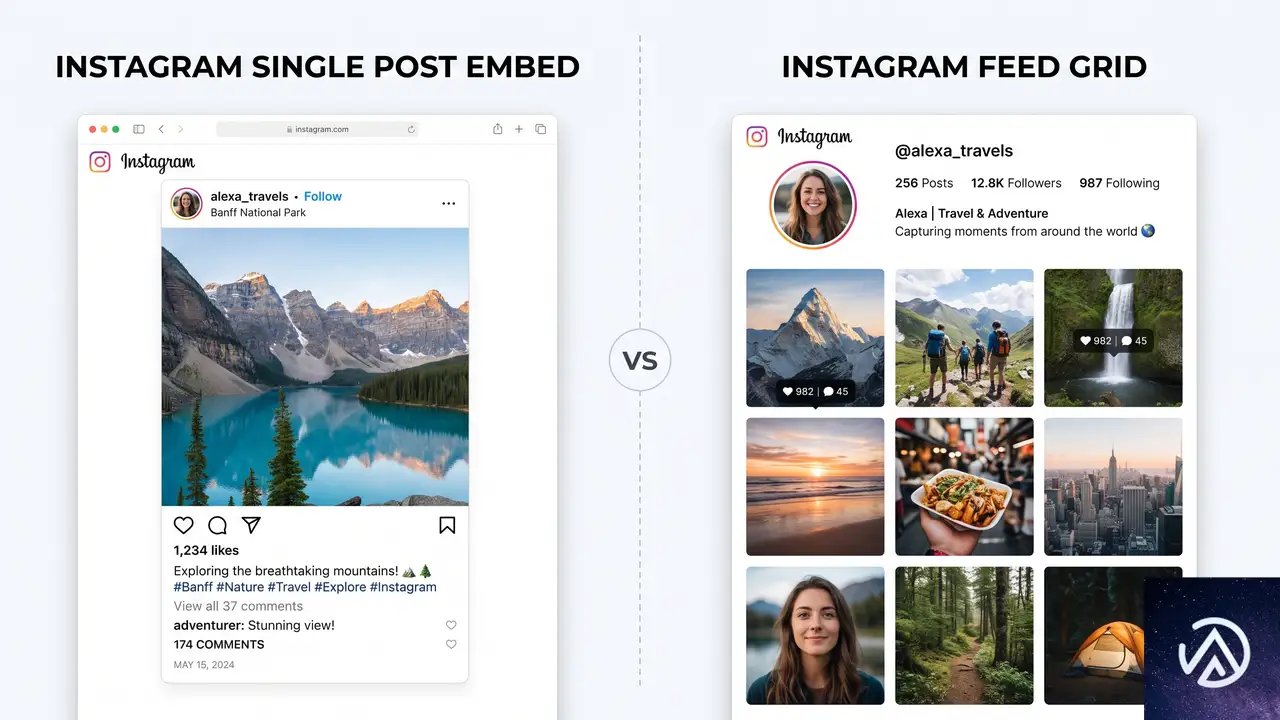
oEmbedは単一投稿のAPIである
「トークンレスになったならInstagramフィードプラグインは不要では」という見方が一部で出ているが、それは誤解だ。oEmbedはあくまで1つの公開投稿URLを受け取り、その1投稿の埋め込みコードを返すAPIに過ぎない。
アカウントの最新投稿一覧を取得する機能、ハッシュタグフィード、ストーリーズの表示、自動更新といった機能は、oEmbedでは提供されない。これらは従来通りInstagram Graph APIを使い、アクセストークンによる認証が必要となる。
ブログ記事の中に特定のInstagram投稿を1つだけ埋め込みたいケースでは、今回の無料ルートが再び使えるようになった。逆に、サイトのトップページに最新のInstagram投稿を自動表示したい場合、レイアウトやフィルタリング、モデレーション機能も含めて、Instagramフィード専用プラグインの出番は変わらない。
フロントエンドでのスクリプト読み込みとプライバシー
もう1つ理解しておくべき違いは、oEmbedから返される埋め込みHTMLの動作だ。MetaのoEmbedは、投稿をレンダリングするためにMetaのJavaScriptを訪問者のブラウザに読み込む。Meta EmbedsプラグインのReadmeにも、フロントエンドでのレンダリングはMetaのプライバシーポリシーに準拠すると明記されている。
これは、Metaのスクリプトを一切読み込まずにコンテンツをネイティブ表示するソリューションとは性質が異なる。EU圏のクライアント向けにサイトを構築している場合、GDPRの観点からこの違いは重要だ。埋め込みを有効にする前に、プライバシーポリシーとの整合性を確認しておく必要がある。
実務者への実践ガイド

ドキュメントとナレッジベースの更新
Instagram埋め込みにトークンやMetaアプリが必要だと説明しているコンテンツやドキュメントは、2026年6月15日以降は誤りとなった。WP Mayor自身も自社アーカイブの監査を進めていると述べており、チュートリアル記事や社内マニュアルを保有している場合は速やかな見直しが求められる。
クライアントサイトでの対応
クライアント向けにWordPressサイトを構築している場合、単発のMeta投稿埋め込みは開発者向けのセットアップなしで利用可能になった。Meta Embedsプラグインを導入すればすぐに動作する。WordPressコアへの統合が進めば、近い将来プラグインすら不要になる可能性も視野に入れておきたい。
Instagramフィードプラグインの利用者
既存のInstagramフィードプラグインを使用しているサイトには、今回の変更は一切影響しない。フィード機能はInstagram Graph APIに依存しており、oEmbedのトークン要件撤廃とは無関係だ。不安があればプラグインの開発元に確認するのが確実だが、WP Mayorの記事ではRebelCode社が開発するSpotlight Instagram Feeds(6万以上のアクティブインストールを誇る高評価プラグイン)を含め、APIベースのフィードソリューションはすべて影響を受けないと明言されている。
この記事のポイント
- Metaが2026年6月15日、oEmbed APIのトークン必須化を撤回。Instagram、Facebook、Threadsの埋め込みがURL貼り付けだけで動作する
- 併せて公式WordPressプラグイン「Meta Embeds」をリリース。コードはGitHubで公開され、WordPressコアへの統合も視野に入っている
- oEmbedは単一投稿APIであるため、アカウントの最新フィード表示やストーリーズ機能は従来通りAPIトークンが必要。Instagramフィードプラグインの役割は変わらない
- 埋め込み表示にはMetaのJavaScriptが読み込まれるため、GDPR対応が必要なサイトではプライバシーポリシーとの整合性確認が欠かせない
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
GoogleとMicrosoftがAIエージェント共通仕様ARDを公開、11社が賛同
GoogleとMicrosoftを含む11社が、AIエージェントがウェブ上のツールやスキルを自動検出するための共通仕様「ARD(Agentic Resource Discovery)」を2026年6月17日に公開した。
GitHubやHugging Face、NVIDIA、Salesforceも名を連ねるこの仕様は、各社が公開するAIエージェント向け機能を、事前の手動接続なしに実行時に見つけ出せる仕組みだ。Apache 2.0ライセンスで公開され、同日に複数の参照実装もリリースされた。
この仕様が実用化されれば、AIエージェントは必要なツールを自ら探し出して接続できるようになる。開発者やサービス提供者にとっては、自社のAPIやエージェント機能をAIシステムに自動的に見つけてもらうための新たな方法が生まれることになる。
ARDとは何か
ARD(Agentic Resource Discovery)は、AIエージェントがウェブ上で「使えるツールや機能」を自動的に見つけ出すための共通ルールを定めた仕様だ。Linux Foundationのワーキンググループが管理するAI Catalogデータモデルを基盤に構築されている。
現在のAIエージェントは、あらかじめ各ツールやMCPサーバー、APIとの接続を手動で設定する必要がある。企業が公開する機能が増え続けるなか、この「事前配線」方式では拡張性に限界があった。ARDはこの問題に対処するために設計されている。
ARDの仕組みは、企業が自社ドメインに公開するカタログと、それを収集してインデックス化するレジストリの2層構造で成り立っている。人手による接続設定を実行時の検索に置き換えることで、AIエージェントが自律的に機能を発見できる世界を目指している。
ARDの技術的な仕組み
カタログとレジストリの2層構造
ARDの中核は「カタログ」と「レジストリ」という2つの要素だ。まず、ツールやエージェントを提供する企業は、自社ドメインの定められたパスにai-catalog.jsonというファイルを設置する。このファイルには、公開するツール、MCPサーバー、エージェント、APIの一覧が記述される。
次に「レジストリ」がこれらのカタログを巡回(クロール)してインデックス化する。AIエージェントが「この処理に使えるツールはないか」と自然言語で問い合わせると、レジストリが該当するカタログ情報を返す仕組みだ。
ai-catalog.json を設置カタログが公開者の自社ドメインに置かれることで、ドメイン所有権が公開者の検証手段として機能する。本番運用では、暗号化された信頼メタデータを付与し、接続前に公開者の身元を確認することも可能だ。ツールが選定された後は、ARDの役割は終了し、実際の接続は各ツール固有のプロトコルで直接行われる。
誰に向けた仕様なのか
ARDが主に対象とするのは、APIやMCPサーバー、エージェントといった「呼び出し可能な機能」を提供する企業だ。ツールを公開する企業には、AIエージェントに見つけてもらい、信頼してもらうための明確な方法が提供される。
一方、一般的なコンテンツサイトにとっては、現時点で直接的な活用方法は示されていない。Search Engine Journalの記事でも「典型的なコンテンツサイトに今日すぐ取るべきアクションはない」と指摘されている。
公開当日に登場した参照実装
ARDの草案公開と同日に、複数の参加企業が実際に動作するツールをリリースした。
- GitHub Copilot向けに「Agent Finder」を導入。選択したレジストリからMCPサーバー、スキル、ツール、エージェントを検出し、ユーザーが接続対象を制御できる仕組みだ。
- Hugging Face ARDサービス全体からスキルやMCPサーバーを検索する「Discover Tool」を公開した。
- Cisco Linux Foundation傘下のオープンソースプロジェクト「AGNTCY Agent Directory」にARDを統合した。
GitHubのAgent Finderは特に関心を集めている。Copilotのユーザーがレジストリから必要な機能を見つけ出し、自分の判断で接続を許可できる設計は、エージェントの自律性とユーザー制御のバランスを取る試みといえる。
この流れは、ウェブの「機械可読層」を整備する一連のオープン仕様の延長線上にある。GoogleはARD公開の2日前にも、AIシステム間で組織知識を共有するための「Open Knowledge Format」仕様を発表している。いずれも自社ドメインに構造化ファイルを設置するだけで、AIシステムが人手の配線なしに情報を利用できるようにする考え方だ。
Googleの立ち位置と今後の展開
GoogleはARDにおいて、Gemini Enterprise Agent Platformの一部である「Agent Registry」を中心的な役割として位置づけている。これはエージェント向けリソースのホスティングと検索、企業向けのガバナンス管理を担う基盤だ。
Search Engine Journalの記事によれば、Agent RegistryへのネイティブARD対応は数カ月以内に予定されている。これが実現すれば、組織は内部レジストリを広域ネットワークに接続できるようになる。
ただし現時点でこの対応は稼働しておらず、ARDはあくまで「仕様」であってGoogle検索の機能ではない。検索エンジンとしてのGoogleがARDカタログを直接検索結果に反映するわけではない点は、区別して理解しておく必要がある。
コンテンツ制作者が今考えるべきこと
ARDがもたらす影響は、ビジネスの性質によって大きく異なる。ツールやAPIを提供する企業には、AIエージェントに発見されるための具体的な手段が用意された。一方で、一般的なコンテンツサイト運営者にとっての即効性は限定的だ。
この仕様の価値については業界内でも議論がある。GoogleのJohn Mueller氏は、LLMシステムがllms.txtのようなファイルでサイトを区別することはできないと指摘し、将来のエージェント向け戦略よりも現在のニーズに注力するよう助言している。ARDが対象とするのはツールやエージェントであり、コンテンツではないという点は、こうした議論の背景として押さえておきたい。
仕様はまだv0.9草案であり、GitHubリポジトリで変更提案を受け付けている段階だ。実用性を左右するのは、カタログを大規模にクロールしてインデックス化できるレジストリのエコシステムだが、それもまだ初期段階にある。
エコシステムが成熟した場合に最も恩恵を受けるのは、他者が必要とするツールやエージェントを提供する企業だ。GoogleがUlrtaユーザー向けに展開し始めたエージェント主導の検索機能も、この方向性を示唆している。今すぐ取るべき現実的なアクションは、自社が使っているプラットフォームやツールがARDに対応するかどうか、そして対応時にどのような公開情報が求められるかを注視することだ。
この記事のポイント
- ARDはAIエージェントがツールやAPIを実行時に自動発見するためのオープン仕様である
- カタログ(ai-catalog.json)とレジストリの2層構造で、ドメイン所有権が信頼の基盤となる
- GitHubやHugging Faceが公開初日から参照実装を提供しており、実用化に向けた動きは速い
- 一般的なコンテンツサイトよりも、ツールやAPIを公開する企業に直接的な恩恵がある
- v0.9草案段階であり、レジストリのエコシステム構築が今後の鍵を握る
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験