
AWS CloudWatch Omniが登場。AIとチームで行う新しい可観測性
AWSがCloudWatch Omniを発表した。アプリケーションとAIエージェントの両方を監視できる新しい可観測性体験で、チーム全体が同じワークスペースで調査を進められる。
OpenTelemetryベースで構築されており、既存のCloudWatchテレメトリをそのまま活用できる。AWSマネジメントコンソールへのアクセス権限がなくても、専用URLとSSOで利用可能だ。
この記事では、CloudWatch Omniの主要機能、AI調査の仕組み、セットアップ手順、既存環境との関係を解説する。運用チームが抱えるダッシュボード管理や障害調査の負担をどう軽減するかが焦点だ。
CloudWatch Omniとは何か
アプリケーション中心の可観測性
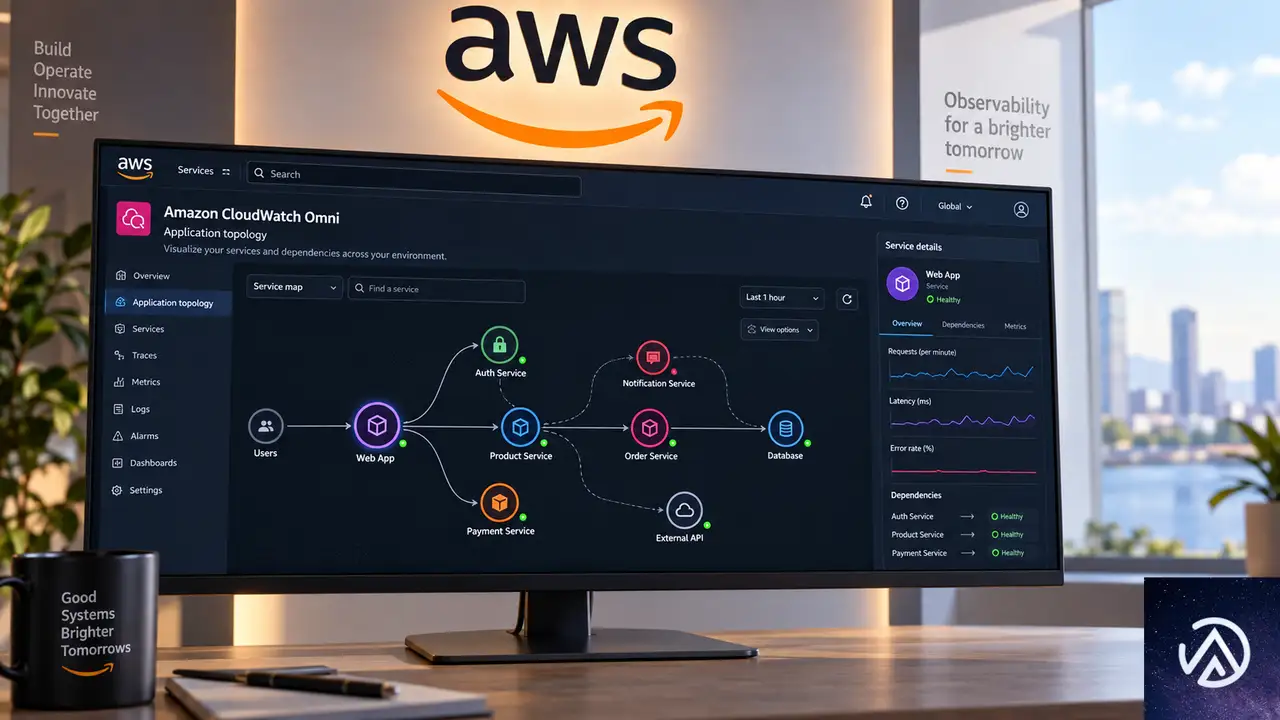
CloudWatch Omniは、インフラストラクチャ単位ではなく、アプリケーション単位でテレメトリを整理する。従来のモニタリングツールはサーバーやコンテナといったリソースごとに指標を表示するが、Omniはサービス同士の依存関係を自動的にマッピングし、システム全体をひとつの接続された構造として見せる。
このアプローチにより、担当者は「どのサーバーでエラーが出たか」ではなく「どのアプリケーションで問題が起きているか」を即座に把握できる。ダッシュボードを手動で更新する手間も減る。
この比較デモは、リソース中心からアプリ中心への考え方の転換を示している。Omniは自動検出とトポロジーマッピングにより、運用者が全体像を維持する負担を軽減する。
OpenTelemetryとの統合
CloudWatch OmniはOpenTelemetryを基盤としている。OpenTelemetryは、メトリクス・ログ・トレースなどのテレメトリデータを収集するためのオープン標準だ。すでにCloudWatchに送信しているテレメトリは、再設定なしでOmniに表示される。
さらに、OpenTelemetryで計装された他のワークロードも、OTLP(OpenTelemetry Protocol)エンドポイントを通じてOmniに取り込める。これにより、オンプレミス環境や別のクラウドで稼働するアプリケーションも同じワークスペースで監視できる。
チーム全体で使える共同作業の仕組み
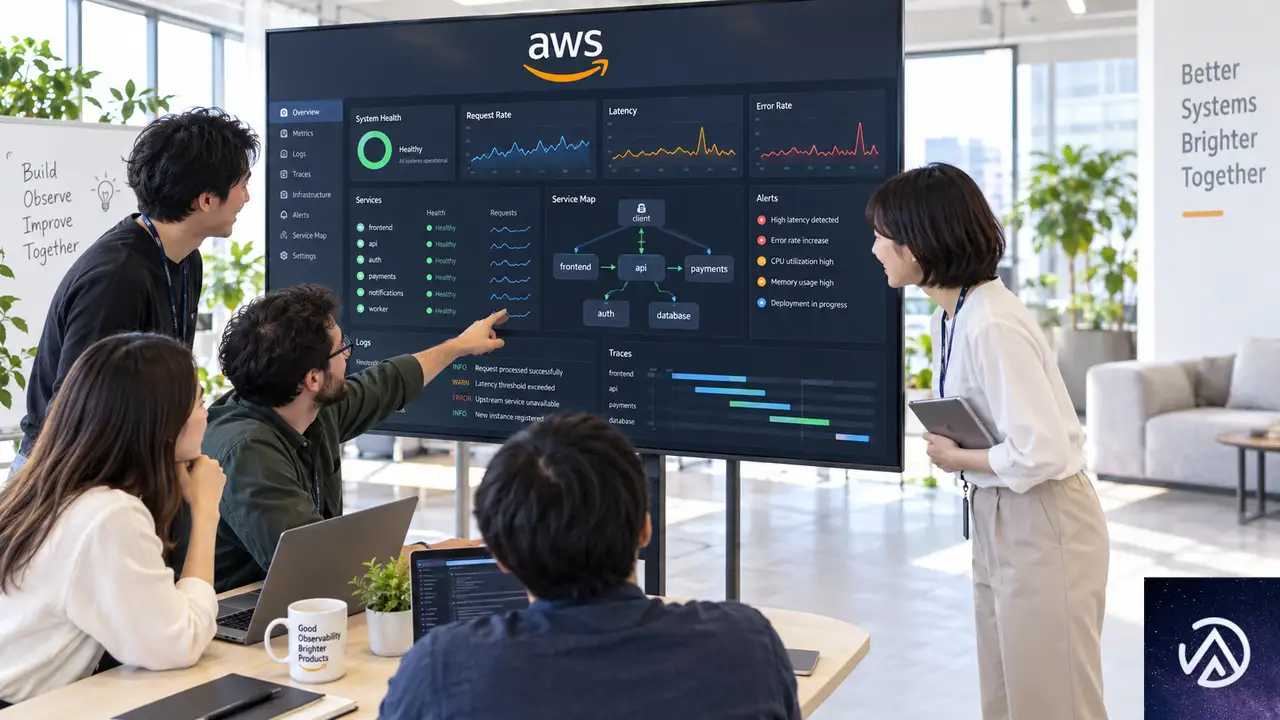
CloudWatch Omniの大きな特徴は、チーム全員が同じワークスペースを共有できる点にある。エンジニアは専用URLにアクセスし、企業のSSO(シングルサインオン)でログインする。AWSマネジメントコンソールへのアクセス権限は不要だ。
IAM Identity Centerを通じてOktaやAzure ADなどのIDプロバイダーと連携できる。SRE、開発者、データベースエンジニア、マネージャーが同じデータと調査コンテキストを共有する。
このフローは、通常のインシデント対応時にOmniがどのように進行するかを示している。チーム間の引き継ぎ時にコンテキストが失われる問題が解消される。
エスカレーション時の連携強化
障害がチームの境界を越えると、Slackのスレッドやスクリーンショットでの情報共有になりがちだ。Omniでは次の担当者が同じセッションに参加し、これまでの調査内容をそのまま引き継げる。
調査履歴は自動的に記録されるため、インシデントレポートを別途作成する必要もない。
AIが調査を支援するAmazon DevOps Agent
CloudWatch Omniには、Amazon DevOps Agentと呼ばれるAIアシスタントが組み込まれている。調査セッションの中で、シグナルの相関分析や次のアクションの提案を行う。
このエージェントは、エンジニアが見ているのと同じテレメトリデータを参照する。そのため、提案内容はアプリケーションの実際の状態に基づいたものになる。
DevOps Agentは、相関イベントの特定や依存関係グラフを通じた根本原因の追跡を支援する。調査履歴は事後レビューにも活用できる。
エージェントの役割と限界
DevOps Agentはあくまで支援ツールであり、人間の判断を代替するものではない。提案内容をそのまま鵜呑みにするのではなく、エンジニアの専門知識と組み合わせて使うことが重要だ。
また、エージェントはテレメトリデータのみに基づいており、コードのビジネスロジックや組織固有の事情までは考慮しない。この点は運用チームが補完する必要がある。
セットアップ手順
CloudWatch Omniのセットアップは数分で完了する。既存のCloudWatch環境を再設定する必要はない。
既存CloudWatchユーザーの場合
CloudWatchコンソールで「Try CloudWatch Omni」をクリックするだけで、既存のログ、メトリクス、トレース、アラームが即座に利用可能になる。ワークロードは自動的に検出され、アプリケーショントポロジーをすぐに確認できる。
組織全体への展開
管理者はドメインを設定し、IAM Identity Center経由でIDプロバイダーを接続する。その後、チームと環境ごとにSpaceを定義し、ユーザーを招待する。各Spaceは既存のCloudWatchデータを参照するため、データの移動は不要だ。
他環境のアプリケーション取り込み
オンプレミスや他クラウドで稼働するアプリケーションも、コネクターを利用してテレメトリをOmniに取り込める。取得したデータはAWSデータと同じSpaceや調査セッションに表示される。
既存のCloudWatchとの関係と料金
CloudWatch OmniはCloudWatchを置き換えるものではなく、拡張するものだ。既存のアラーム、ダッシュボード、API、コンソールのワークフローはそのまま機能する。
アクセスは専用のWebアプリケーション経由で、エンタープライズSSOに対応する。セットアップ後、DevOps AgentはすべてのOmni調査セッションでデフォルトで有効になる。
料金体系
料金の詳細はAWSの公式価格ページで確認できる。既存のCloudWatchユーザーはコンソールから直接試用できる。
導入コストの見積もりには、監視対象のワークロード数と取り込むテレメトリ量が影響する。
生成AIワークロードへの対応
CloudWatch Omniは、生成AIやエージェントワークロード向けの専用可観測性も提供する。トレース探索、評価フレームワーク、リアルタイムモニタリングが含まれる。
詳細はAWSの別記事で紹介されている。エージェント可観測性のハンズオンも参照できる。
この記事のポイント
- CloudWatch Omniはアプリケーション中心の可観測性を提供する
- OpenTelemetryベースで既存テレメトリを活用できる
- チーム全体が同じワークスペースで共同調査できる
- Amazon DevOps AgentがAI支援で根本原因特定を助ける
- セットアップは数分で完了し、既存環境への影響はない

・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWSが低コストなEC2 T8iインスタンスを発表!T3比で最大70%の性能向上
AWSが新型の低コストバースト可能インスタンス「Amazon EC2 T8i」の一般提供を開始した。T3インスタンスの後継となるもので、価格性能比が最大30%改善している。
T8iはカスタム設計された第6世代Intel Xeon Scalable Processorを搭載し、AWSのNitro System上で動作する。既存のT3ユーザーは同じCPUクレジット方式のまま移行できる設計だ。
T8iインスタンスの位置づけ
EC2のTシリーズは「バースト可能インスタンス」と呼ばれる。平時はベースライン性能で動作し、負荷が上がった時にCPUクレジットを消費して性能を一時的に引き上げる仕組みを持っている。
この仕組みが適しているのは、普段はCPU使用率が低いが瞬間的に負荷が上がるワークロードだ。低トラフィックのWebサイト、開発・テスト環境、小規模データベース、マイクロサービス、ログインゲートウェイなどが代表例になる。
T8iはこのバーストモデルを踏襲しつつ、CPUとネットワーク性能を大幅に引き上げたモデルだ。
性能向上の内訳
価格性能比とコンピューティング性能
AWSの発表によると、T8iはT3と比較して以下の改善が実現されている。
- 価格性能比が最大30%向上
- コンピューティング性能が最大70%向上
- ネットワーク帯域が最大1.25倍
- EBS帯域が最大2.4倍
特にEBS帯域の2.4倍という数字は見逃せない。ディスクI/Oがボトルネックになりがちな小規模データベースやデータ処理ジョブでは、体感できる改善が期待できる。
CPUクレジット方式と無制限モード
T8iはT3と同じCPUクレジット方式を採用している。StandardとUnlimitedの2つのモードがあり、デフォルトはUnlimitedモードだ。Unlimitedモードではクレジット残高がゼロになっても、追加料金を支払うことでベースラインを超える性能を維持できる。
クレジットは時間の経過とともに自動で蓄積される。例えばt8i.microなら1時間に6クレジット、t8i.smallなら12クレジットが付与される仕組みだ。
インスタンスタイプとスペック
T8iは4つのサイズで提供される。すべて2 vCPUを1コアとして提供するのが特徴で、vCPUとメモリの比率が他シリーズにはない特殊な構成になっている。
- t8i.nano
- t8i.micro
- t8i.small
- t8i.medium
メモリ比率はnanoが1対0.25、microが1対0.5、smallが1対1、mediumが1対1となっている。2 vCPUでメモリ0.25GiBという構成は他のEC2インスタンスにはない特徴的なスペックだ。
利用シーンと移行方法
どんな場面で使うべきか
T8iは低〜中程度のCPU使用率で動くワークロードに向いている。具体的には以下のようなケースが想定されている。
- フリーミアムサービスの小規模プラン
- トレーニング・デモ環境
- ステージング・開発環境
- データ処理ジョブ
- マイクロサービスアーキテクチャの一部
- 低トラフィックのWebサイト
- ログインゲートウェイ
- バッチ処理やCI/CDパイプライン
常に高いCPU使用率が続く本番環境や、大規模なデータベースサーバーには向かない。そうした用途ではM8i Flexなど、より大きなインスタンスの選択が推奨されている。
T3からの移行手順
既存のT3ユーザーにとって移行はシンプルだ。インスタンスタイプをT3からT8iに変更するだけで、アプリケーションの設定変更やコードの書き換えは原則不要とされている。
CPUクレジット方式もT3と同じなので、運用ノウハウはそのまま活かせる。Auto ScalingやCloudWatchの設定も流用できるため、移行コストは最小限だ。
提供リージョンと利用方法
T8iは以下のAWSリージョンで利用できる。
- 米国東部(バージニア北部・オハイオ)
- 米国西部(オレゴン・北カリフォルニア)
- アジアパシフィック(ハイデラバード・マレーシア・ムンバイ・ソウル・シンガポール・シドニー・東京)
- カナダ(中部)
- ヨーロッパ(フランクフルト・アイルランド・ロンドン・パリ)
購入方法はオンデマンドとスポットインスタンスに対応している。Savings Planは近日対応予定だ。t8i.microとt8i.smallはAWS無料利用枠でも使えるため、新規ユーザーがAWSの使い方を学ぶ用途にも適している。
共有テナンシーのみ対応しており、専有テナンシーや専有ホストは利用できない点には注意が必要だ。
この記事のポイント
- T8iはT3の後継となる低コストバースト可能インスタンス
- コンピューティング性能が最大70%向上し、EBS帯域は2.4倍に
- CPUクレジット方式はT3と同じで移行が容易
- 4サイズ構成で東京リージョンでも利用可能
- 無料利用枠の対象サイズもあり、新規ユーザーの入門にも適している
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験

AWS Graviton5搭載のEC2 R9gが一般提供開始。R8g比で最大25%の性能向上
AWSがGraviton5プロセッサを搭載したEC2 R9gとR9gdインスタンスを一般提供開始した。メモリ最適化インスタンスの新世代で、R8gと比較してコンピュート性能が最大25%向上している。
Graviton5はDDR5メモリの高速化、L3キャッシュの5倍拡大、ネットワーク帯域幅の最大2倍化など、複数のハードウェア改良を備える。データベースやインメモリキャッシュなどメモリ集約型のワークロードで効果が大きい。
この記事ではR9gの技術的な変更点、インスタンススペック、移行手順、利用可能リージョンを解説する。
Graviton5がもたらす性能向上の全容

Graviton5プロセッサはGraviton4から複数のハードウェア改良が加えられた。まずコンピュート性能がvCPUあたり最大25%向上している。これは命令処理の効率化と高クロック動作によるものだ。またAWSがこれまでに構築した中で最もエネルギー効率の高いプロセッサでもある。
このデモはGraviton4(R8g)とGraviton5(R9g)の主要スペックを比較している。特にL3キャッシュの5倍拡大とメモリ帯域の高速化がデータ処理の遅延低減に効く。
メモリとキャッシュの大幅強化
メモリはDDR5 8800 MT/sに対応した。Graviton4の5600 MT/sから大幅に高速化されており、AWSのクラウド上で利用可能な最速のメモリ帯域を実現している。これは大量のデータを扱うインメモリキャッシュ・データベースにとって応答時間の短縮に直結する。
L3キャッシュも5倍に拡大された。L3キャッシュとはCPU内部にある高速なメモリ領域で、頻繁にアクセスするデータを一時的に保持する役割を持つ。この容量が増えると、主メモリへのアクセス回数が減り、データ処理の遅延が小さくなる。データ局所性が高いワークロードほど恩恵を受けやすい。
ネットワーク帯域幅とパケット処理の改善
ネットワーク帯域幅とAmazon EBSの帯域幅は、最大サイズのインスタンスで最大2倍に向上した。48xlargeではネットワークが最大100 Gbps、EBSが最大72 Gbpsに達する。またパケット処理性能は最大3倍に改善されている。
さらにR9gとR9gdはInstance Bandwidth Configuration(IBC)に対応している。これはEBSとネットワークの帯域配分を25%単位で調整できる機能だ。データベースやキャッシュなど、帯域要件が特定方向に偏るワークロードで性能を最適化できる。例えばネットワーク処理が少なくディスクI/Oが多いワークロードでは、帯域をEBS側に寄せるといった調整が可能になる。
Nitro Isolation Engineによるセキュリティ強化

すべてのR9gとR9gdインスタンスはAWS Nitro System上で動作する。Nitro Systemは仮想化、ストレージ、ネットワークを専用ハードウェアにオフロードする仕組みだ。これにより仮想マシンのオーバーヘッドが減り、ベアメタルに近い性能と強固なセキュリティ分離を両立できる。
R9gとR9gdにはNitro Isolation Engine(NIE)が搭載されている。NIEはC9gとM9gで今年前半に導入されたコンポーネントで、仮想マシン間の分離を強制する役割を担う。仮想マシンのメモリ、CPUレジスタ状態、I/Oデバイスへのすべてのアクセスを最小限のAPIセットで仲介する。
このデモはNIEが仮想マシンとハードウェアの間に位置し、すべてのアクセスを仲介する関係を示している。分離の保証はソフトウェア的な工夫ではなく、形式的な数学証明によって裏付けられている点が特徴だ。
NIEの特徴は形式検証(formal verification)という手法を活用している点にある。これはハードウェアやソフトウェアが意図通りに動作することを数学的に証明する手法だ。特定のテストケースだけでなく、あらゆる条件下で正しく動作することを保証する。この取り組みにより、Nitroはクラウドハイパーバイザーとして初めて形式検証を受けた存在になった。
形式検証の対象範囲や前提条件などの詳細はAWSのテクニカルホワイトペーパーで公開されている。セキュリティ要件が厳しい金融系ワークロードやマルチテナント環境を扱う場合には、このホワイトペーパーを参照してリスク評価に役立てるとよい。
R9gとR9gdのインスタンススペック

R9gとR9gdはそれぞれ11サイズで提供される。最小のmediumから最大のmetal-48xlまで、幅広い要件に対応する。以下では2つの違いを中心に説明する。
このデモはR9gとR9gdの違いを整理している。NVMe SSDの有無が唯一の差で、用途に応じて選べる。
R9gのスペック
R9gはEBSストレージのみを使用する構成だ。最小のr9g.mediumは1 vCPUと8 GiBメモリ、最大のr9g.48xlargeとr9g.metal-48xlは192 vCPUと1536 GiBメモリを搭載する。ネットワーク帯域幅はmediumから2xlargeまで最大15 Gbps、8xlargeで17 Gbps、12xlargeで25 Gbps、16xlargeで34 Gbps、24xlargeで50 Gbps、48xlargeで100 Gbpsに達する。
EBS帯域幅はmediumから4xlargeまで最大12 Gbps、8xlargeで12 Gbps、12xlargeで18 Gbps、16xlargeで24 Gbps、24xlargeで36 Gbps、48xlargeで72 Gbpsとなっている。データベース用途ではEBS帯域幅が性能のボトルネックになりやすいため、サイズ選定の際はこの値にも注目したい。
R9gdのNVMeストレージ
R9gdはR9gと同じコンピュート性能とネットワーク性能を持ちながら、ローカルNVMe SSDを搭載している。mediumでは59 GB、largeで118 GB、xlargeで237 GBとサイズに応じて容量が増える。最大のr9gd.48xlargeでは3台の3800 GB NVMe SSD(合計11.4 TB)を備える。
ローカルNVMe SSDはEBSと比べてレイテンシが低く、一時的なスクラッチ領域やキャッシュ用途に向いている。オープンソースデータベース、分散リアルタイムビッグデータ分析、大規模インメモリデータベース、大容量キャッシュワークロードで効果を発揮する。
R8gからの移行と始め方

R8gで運用中のワークロードがある場合、R9gへの移行はシンプルだ。多くのアプリケーションでコード変更は不要。同等サイズのR9gインスタンスを選択すれば、そのままより高い性能を得られる。
このデモはR8gからR9gへの移行手順を4ステップで示している。インスタンスタイプを変更するだけで性能が向上するケースが多い。
対応OSとコンテナ環境
R9gはAmazon Linux 2023、Amazon Linux 2、Ubuntu 22.04以降、RHEL 8.4以降、SUSE Linux Enterprise Server 15 SP3以降、Debian 12以降など主要なLinuxディストリビューションに対応する。EC2コンソールからArmベースのAMIを選択すれば、すぐに起動できる。
コンテナワークロードではAmazon EKS、Amazon ECS、標準的なKubernetes環境で動作する。Arm64向けにビルドされたマルチアーキテクチャのコンテナイメージなら変更なしで動く。Dockerイメージをマルチアーキテクチャ対応にしておくと、x86からArmへの移行がスムーズになる。
移行を支援するツール
AWSはGravitonへの移行を支援する複数のリソースを提供している。Graviton Getting Started Guideは構築、実行、最適化の方法をまとめたガイドだ。Graviton Savings Dashboardではコスト削減効果を追跡できる。AWS TransformはJavaアプリケーションをx86からGraviton向けに変換するコード変換を自動化するツールだ。
Javaアプリケーションの場合、依存ライブラリにネイティブコードが含まれているとArm64への移行が難しいことがある。AWS Transformはこうしたコード変換を自動化して移行の手間を減らす。まず小規模なワークロードで試し、問題がないことを確認してから本番移行に進むのが現実的な進め方だ。
料金と利用可能リージョン

R9gとR9gdは米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、欧州(フランクフルト)の各リージョンで利用できる。日本国内のリージョン(アジアパシフィック東京)では現時点で提供されておらず、今後の展開が待たれる。
購入オプションはSavings Plans、On-Demand、Spot Instances、Dedicated Instances、Dedicated Hostsから選択可能だ。長期運用する場合はSavings Plans、一時的なバッチ処理やテスト用途ではSpot Instancesがコスト効率に優れる。料金の詳細はAmazon EC2の料金ページで確認できる。
インスタンスサイズや購入オプションによって価格が異なるため、ワークロードに合わせて最適な組み合わせを選ぶことが重要だ。特にR8gと比較した場合、同じサイズでも性能が向上しているため、より小さなサイズに移行してコストを削減できる可能性もある。
この記事のポイント
- AWS Graviton5搭載のEC2 R9gとR9gdが一般提供を開始した
- R8g比でコンピュート性能が最大25%向上し、エネルギー効率も改善
- DDR5 8800 MT/sメモリとL3キャッシュ5倍拡大でデータ処理が高速化
- Nitro Isolation Engineにより形式検証されたセキュリティ分離を実現
- R9gはEBSのみ、R9gdはローカルNVMe SSDを搭載した構成
- R8gからの移行はコード変更不要のケースが多く、Arm64対応イメージでそのまま動作
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon Bedrock AgentCoreにランタイムインスタンス発表、本番AIエージェント向け永続コンピューティング
AWSは2026年8月6日、Amazon Bedrock AgentCoreに新たな計算オプション「ランタイムインスタンス」を追加した。AIエージェントのプロトタイプを本番環境に移行する際、長時間の状態維持やマルチエージェント協調、GPUアクセスといった要求に応える、永続的なマネージドインフラだ。
従来のAgentCore Runtimeでは、マイクロVM上で最大8時間のステートフルな呼び出しが可能だったが、日をまたぐワークフローやOSレベルへの直接アクセスが必要なシナリオには限界があった。ランタイムインスタンスは、14日間のセッション永続化とEC2ベースのフルマネージド環境を提供し、本格的なエージェント運用基盤を実現する。
ランタイムインスタンスが解決する本番運用の3つの課題

AIエージェントをプロダクションに投入するとき、開発者はインフラの壁にぶつかる。ランタイムインスタンスはその3つの主要な課題を解消する。
長時間の状態維持とセッション永続化
通常のサーバーレス実行環境では、処理が終わるとメモリやストレージが破棄される。エージェントが数時間〜数日にわたる複数ステップのワークフローを扱う場合、途中結果を外部ストレージに退避させるなどの手間が生まれる。ランタイムインスタンスでは、最大14日間の共有セッションストレージが標準で提供される。セッションは停止・再開が可能で、アイドル期間のコストを抑えながら、必要なときに前回の状態から処理を再開できる。
マルチエージェントの同一ホスト協調
現実の複雑なタスクは、コード生成・レビュー・テスト・デプロイといった複数の専門エージェントが連携して初めて完結する。ランタイムインスタンスでは、複数のエージェントを同一のEC2ホストにデプロイし、共有ファイルシステムを介して直接データをやり取りできる。API呼び出しやネットワーク越しのストレージを挟むオーバーヘッドがなく、シームレスな協調が可能だ。
GPUとOSへの直接アクセス
画像認識や動画解析、重い数値計算を伴うエージェントはGPUを必要とする。ランタイムインスタンスはGPUアクセラレーテッドなインスタンスタイプに対応し、OSレベルへのアクセスも提供する。コードのコンパイル、セキュリティスキャン、GUI自動操作など、コンテナだけでは実現しにくいタスクをエージェントに任せられる。
コードライターとレビュアーの連携を実際に見る
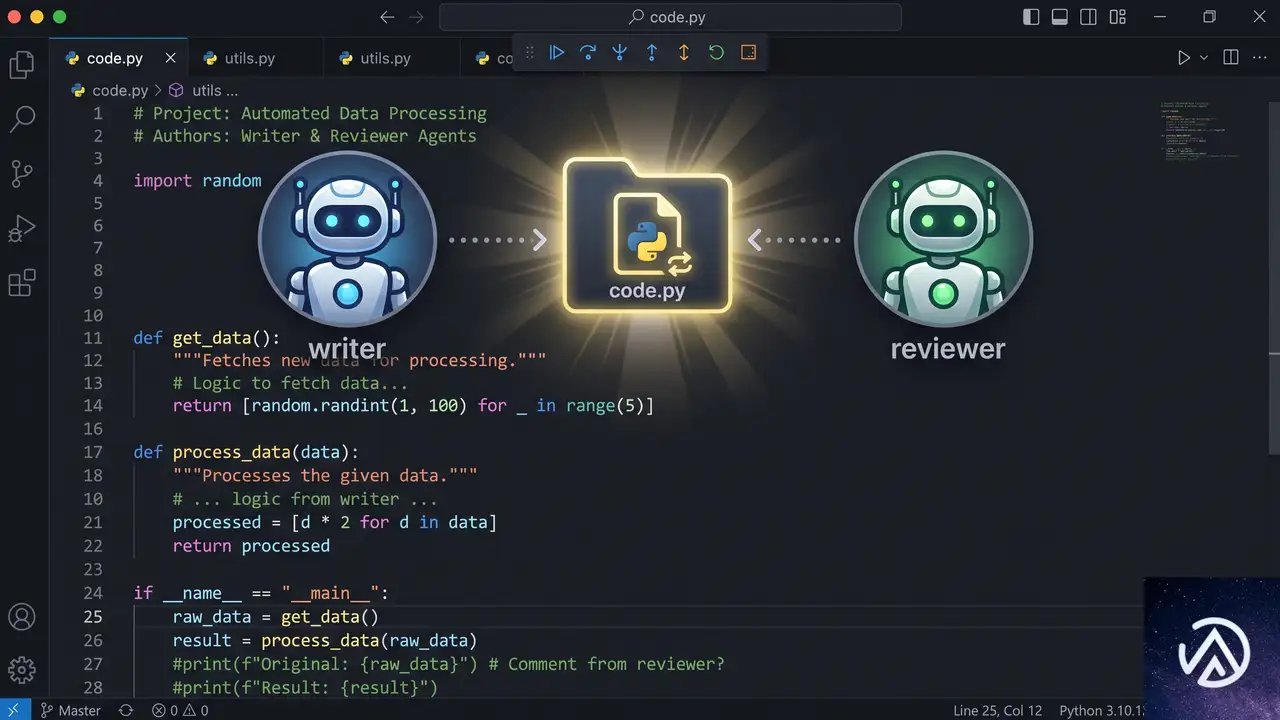
公式デモでは、自然言語でPythonコードを生成する「コードライターエージェント」と、生成されたコードのバグやスタイルをレビューする「コードレビュアーエージェント」を同じランタイムインスタンス上にデプロイし、協調動作させる手順が紹介された。
このデモのポイントは、2つのエージェントが完全に独立したアプリケーションでありながら、セッションIDで紐づく共有ディレクトリを経由してファイルをやり取りする点にある。外部APIを呼び出すことなく、同一ホストのファイルシステム上で完結するため、レイテンシが極めて小さい。
/tmp/agentcore-session/{session_id}/code.py に書き込む各エージェントはStrands Agentsフレームワークと好みのモデル(デモではClaude Sonnet)を使い、単一のPythonファイルに @app.entrypoint デコレータを付けるだけで実装できる。パッケージングもzipまたはコンテナイメージで済み、インフラ管理の負担は大きく軽減される。
セットアップから初回実行までの流れ

ランタイムインスタンスの利用は、大きく3つのステップで完了する。AWSマネジメントコンソールを使う場合の手順を簡潔にまとめた。
- 容量プロバイダの作成 、 エージェントが稼働するEC2インスタンスのスペックとネットワークを定義する。OS(ARM64またはx86_64)、インスタンスタイプ、VPC、サブネット、セキュリティグループを設定。ストレージはgp3ボリュームがデフォルトで用意される。
- ランタイムの作成とエージェントのデプロイ 、 コンピュートタイプに「Instances」を選び、先ほど作成した容量プロバイダを紐づける。エージェントのコードをzipでアップロードし、ランタイム(Python 3.11〜3.14)とエントリポイントを指定。IAMロールもコンソールが自動生成する。
- エージェントの呼び出しと協調 、 デプロイ完了後、コンソールの「Runtime playground」からテスト用のJSONペイロードを送信できる。セッションIDを明示的に指定し、同じIDで別のエージェントを呼び出せば、両者が同一の共有ストレージを使ってシームレスに連携する。
容量プロバイダは一度作成するとOSやインスタンスタイプの変更ができない。本番用と検証用を分けるなど、事前の設計が求められる。
主要スペックと料金モデル
- 対応OS 、 Linux(ARM64、x86_64)。Windowsは現時点ではサポート外
- セッション持続 、 最大14日間。停止・再開が可能で、アイドル中のコスト削減に有効
- ランタイム 、 Python 3.11〜3.14(ネイティブコードに対応)。コンテナイメージのデプロイもサポート
- GPU 、 対応インスタンスタイプを選択すれば、GPUを使った推論や計算が可能
- 統合 、 既存のAgentCore API、IAM、監視機能と完全互換。マイクロVMとのハイブリッド構成も取れる
- 料金 、 使用したEC2インスタンスの標準料金に、AgentCoreオーケストレーションの管理手数料が加算される
- リージョン 、 米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、アジアパシフィック(ムンバイ、シンガポール、シドニー、東京)、欧州(フランクフルト、アイルランド)
マイクロVMベースの従来のAgentCore Runtimeとランタイムインスタンスは、同じAPIセットで併用できる。軽量なオーケストレーターエージェントをマイクロVM側に置き、重い処理や永続状態が必要なワーカーエージェントをインスタンス側に委譲するハイブリッド構成が、現実的なアーキテクチャパターンとして紹介されている。
始め方と最初の一歩
ランタイムインスタンスを試すには、Amazon Bedrock AgentCoreのドキュメントに掲載されているランタイムインスタンスの公式ガイドを参照し、容量プロバイダの作成から始めるのが近道だ。コンソールの左ナビゲーションから「Runtime」→「Capacity providers」を選び、今回紹介した手順に沿って設定すれば、最初のエージェントデプロイまで数分で到達できる。
この記事のポイント
- ランタイムインスタンスは、最大14日間のセッション永続化とEC2ベースのマネージド環境を提供するAgentCore新オプション
- 同一ホスト上でのマルチエージェントファイル共有により、APIを介さないシームレスな協調が可能
- GPUインスタンスやOS直接アクセスが必要な高度なエージェントワークロードに対応
- 従来のマイクロVMと組み合わせたハイブリッド構成で、軽量なオーケストレーションと重いバックエンド処理を分離できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
DynamoDBにベクトル検索がGA、リアルタイムな類似検索が可能に
AWSは2026年8月5日、Amazon DynamoDBにベクトル検索機能を正式に追加した。これにより、既存の運用データと同じテーブルに埋め込みベクトルを格納し、類似度にもとづくリアルタイムな検索が可能になる。
従来、ベクトル検索を追加するには専用のベクトルデータベースを用意し、データの同期パイプラインを自前で維持する必要があった。今回の発表によって、DynamoDBだけでミリ秒単位の低レイテンシと99%以上の再現率、トリリオン規模のベクトルに対応するスケーラビリティが手に入る。サーバーやソフトウェアの管理は一切不要で、ゼロダウンタイムのメンテナンスが保証される。
DynamoDBにベクトル検索が一般提供開始

ベクトルインデックスにはストレージ制限がなく、データの増大に合わせて水平スケールする。セマンティックな検索が必要なエージェント向けメモリ、検索拡張生成(RAG)、レコメンデーションエンジン、パーソナライズされた体験、異常検知などのユースケースを、DynamoDBのネイティブ機能として実装できる。
ベクトル検索の機能は、最大4096次元のベクトルに対応し、ユークリッド距離、コサイン類似度、ドット積のいずれかの距離関数を選択可能。また、パーティションキーによるスコープ指定や、インラインフィルタを使った絞り込みにも対応する。
ベクトル検索統合の背景とメリット
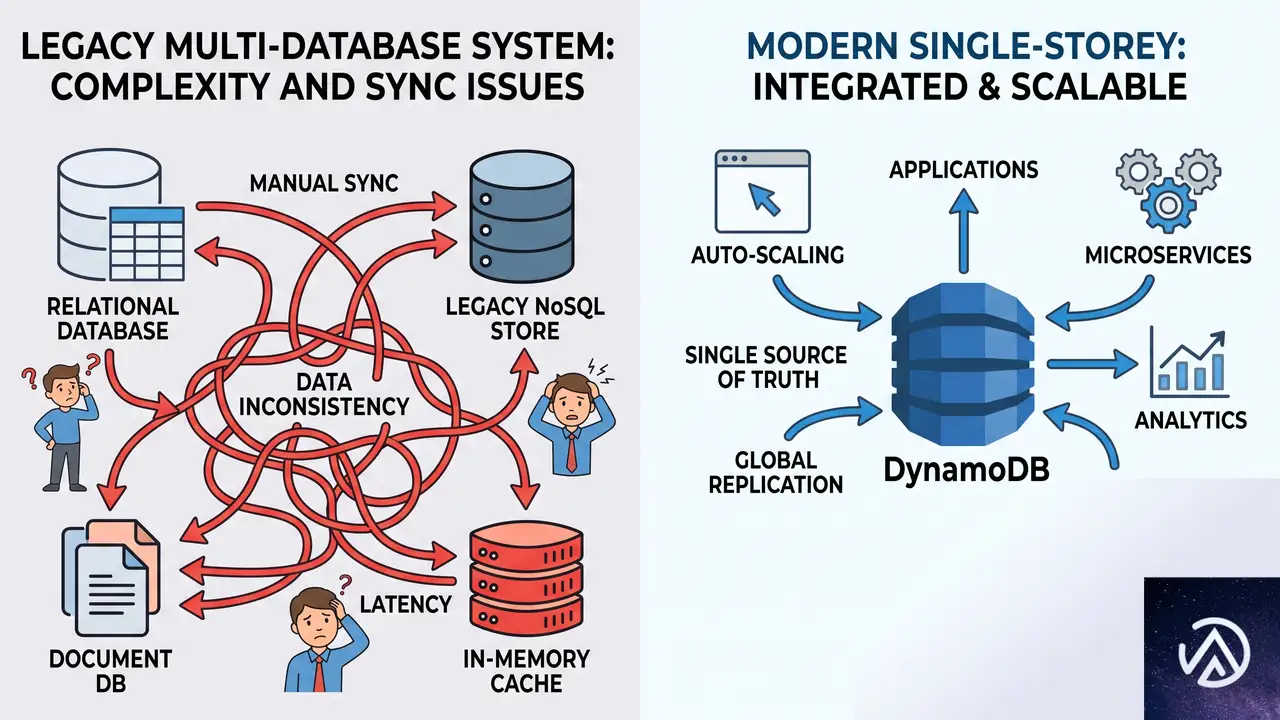
DynamoDBをすでに利用しているアプリケーションでは、これまでセマンティック検索を追加するために、専用のベクトルデータベースを別途プロビジョニングし、テーブル間でデータの同期を維持するパイプラインを構築・運用する必要があった。この構成は追加の運用コスト、データ転送料金、ライセンス費用に加え、大規模環境での低レイテンシ維持を難しくする要因だった。
DynamoDBのベクトル検索では、ベクトルと運用データが同一のサーバーレス基盤で管理され、同じ従量課金モデルが適用される。これにより、同期パイプラインや外部ベクトルストアの運用から解放される。
検索の仕組みとAPIの使い方
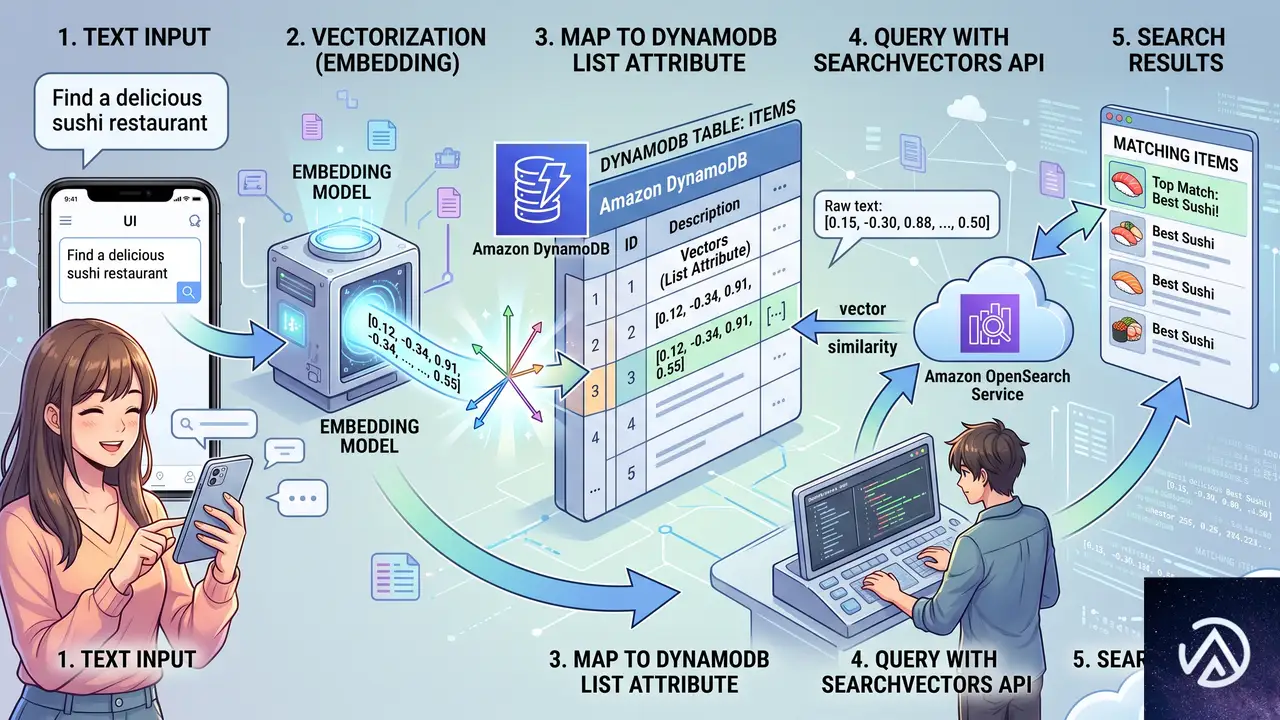
DynamoDBのベクトル検索は、既存のテーブルに新しいタイプのインデックスを追加する方式で実現する。ユーザーは任意の埋め込みモデル(Amazon Bedrock Titan Text Embeddings、Cohere Embed、OpenAIの埋め込みモデルなど)を使ってベクトルを生成し、標準のPutItemまたはUpdateItem APIでフロート値のリストとしてテーブルに格納する。その後、対象の属性に対してベクトルインデックスを作成し、次元数と距離関数、オプションのフィルタ属性を指定する。
List型でベクトルを格納検索時はSearchVectors APIを使い、クエリベクトルと返却件数(最大100件)、オプションのフィルタ条件を指定する。結果は類似度順にランキングされて返る。パーティションキーを指定すれば、特定の市場やテナントに対象を絞り込んだ検索も可能だ。インラインフィルタでは完全一致のみサポートしており、範囲条件(BETWEENなど)は利用できない。
距離関数は、コサイン類似度がテキスト埋め込みの意味比較に効果的だが、ユークリッド距離はベクトルの大きさが意味を持つ場合(購入数によるクラスタリングなど)に、ドット積は方向と大きさの両方を評価するレコメンデーションシステムに適する。埋め込みモデルを訓練した際の距離関数と合わせるのが精度を上げる基本になる。
既存テーブルへの追加手順

AWSの公式ブログでは、スポーツ用品のオンラインストアを例に、商品カタログテーブルへのベクトル検索の追加手順が紹介されている。すでにproductId、category、descriptionなどの属性を持つテーブルに、商品説明の埋め込みベクトルを追加していく流れだ。
まず、既存の商品説明テキストから埋め込みモデルを使ってベクトルを生成し、UpdateItem呼び出しでdescriptionEmbeddingという新しい属性として各アイテムに追加する。DynamoDBは既存のListデータ型をそのまま使い、スキーマ変更や新しいデータ型の追加は不要。各要素が埋め込みの1次元に対応するNumber型のリストとして格納される。
次に、DynamoDBコンソールでテーブルの「インデックス」タブを開き、「ベクトルインデックスの作成」を選択する。インデックス名、ベクトル属性(descriptionEmbedding)、次元数(埋め込みモデルに合わせる)、距離関数(ここではコサイン)、パーティションキー(例:marketplace)、インラインフィルタ属性(例:category)を設定する。パーティションキーはオプションだが、大規模データで高スループットを保つために推奨される。
インデックスがアクティブになったら、同じ埋め込みモデルで生成したクエリベクトルを使って検索を実行する。コンソールの「項目の探索」からベクトル検索モードに切り替え、インデックスとクエリベクトル、トップK、パーティションキー値、フィルタ条件を入力する。この例では「US」マーケットプレイスに絞り、カテゴリを「footwear」に限定して「軽量の夏用ランニングシューズ」といった自然言語に近いクエリで類似商品を取得できる。
返却される結果には、類似度スコアと共に商品名や価格などの運用属性が含まれる。コサイン距離とユークリッド距離ではスコアが小さいほど類似度が高く、0は同一ベクトルを示す。ドット積では大きい値が類似度の高さを示す。
想定されるユースケースと拡張性

ベクトル検索がDynamoDBに統合されたことで、セマンティック検索が必要な様々なアプリケーションを単一のデータベースで実現できる。たとえば、エージェントの過去の対話や記憶をベクトル化して素早く参照するエージェントメモリ、大規模言語モデルの回答精度を高めるRAG、ユーザーの行動履歴から類似商品を即座に提示するレコメンデーション、個人の好みに応じたコンテンツのパーソナライズ、過去のパターンとの類似性から異常を検出する監視システムなどが挙げられる。
また、4096次元までのベクトルに対応し、距離関数やフィルタの選択肢も実用的だ。マルチテナントアプリケーションでは、パーティションキーで検索範囲をテナント単位に区切れるため、全データをスキャンすることなく高いスループットを維持できる。あらゆる商用AWSリージョンおよびGovCloudリージョンで利用可能となっている。
この記事のポイント
- DynamoDBのネイティブ機能としてベクトル検索が一般提供開始された
- 運用データと同じテーブルに埋め込みを格納し、ミリ秒単位で類似検索が可能
- 専用ベクトルDBや同期パイプラインが不要になり、サーバーレスでスケールする
- 最大4096次元、コサイン・ユークリッド・ドット積の距離関数をサポート
- RAG、レコメンデーション、エージェントメモリ、異常検知など幅広い用途に対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Certificate ManagerがACME対応、TLS証明書の自動更新を実現
AWS Certificate Manager が ACME プロトコルに対応
2026年6月30日、AWS Certificate Manager(ACM)が ACME(Automatic Certificate Management Environment)プロトコルに対応した。この機能追加により、AWS 上で稼働するアプリケーションの公開 TLS 証明書の取得・更新を、Certbot や cert-manager といった既存の ACME クライアントから自動化できるようになる。
証明書の有効期限は短縮の一途をたどっている。CA/Browser Forum の規定により、公開 TLS 証明書の最大有効期間は 2027 年 3 月に 100 日へ、さらに 2029 年までに 47 日へと段階的に引き下げられる見通しだ。手動での更新運用はもはや現実的ではなく、自動化が不可避の状況にある。
ACM の ACME 対応は、単なる証明書自動化の一手を超えて、組織全体の証明書ガバナンスを一元化する大きな転換点となる。PKI 管理者は DNS 管理権限をエンドポイントに集約しつつ、アプリケーション担当者には EAB(External Account Binding)認証情報だけを配布すればよく、DNS キーを組織内にばらまくリスクを排除できる。
短命化する証明書と自動化の必然性
従来の TLS 証明書は最大 1 年を超える有効期間が一般的だった。しかし、CA/Browser Forum は証明書のライフサイクル短縮を段階的に進めており、2027 年 3 月には最大 100 日、2029 年までには 47 日への短縮が義務付けられる。これは証明書の更新頻度が年 1 回から年 3〜4 回、最終的には年 7〜8 回に跳ね上がることを意味する。
手動による更新フローでは、この頻度に耐えられない。更新漏れによる証明書切れは顧客にエラー画面を表示させ、サービス自体の停止を招く。ACME プロトコルはこうした課題に対処するために策定されたオープン標準であり、Let’s Encrypt をはじめとする多数の認証局が採用している。
このデモで示すように、ACME プロトコルを利用すると証明書ライフサイクルから人手を排除できる。AWS が ACME エンドポイントをマネージドサービスとして提供することで、利用者は証明書発行インフラの運用負荷からも解放される。
Amazon Trust Services による証明書発行
ACM が ACME 経由で発行するのは、Amazon Trust Services(ATS)を認証局とする公開証明書だ。ATS のルート証明書は主要なブラウザおよび OS にデフォルトで信頼されているため、発行された証明書は即座に本番環境で利用できる。
証明書の鍵タイプは ECDSA P-256 がデフォルトだが、RSA 2048 や ECDSA P-384 も選択可能だ。クライアント側の要件に合わせて設定できる柔軟性を持ちつつ、デフォルトではより高速でセキュアな ECDSA が推奨されている。
ACME エンドポイントの設定とドメイン検証の仕組み
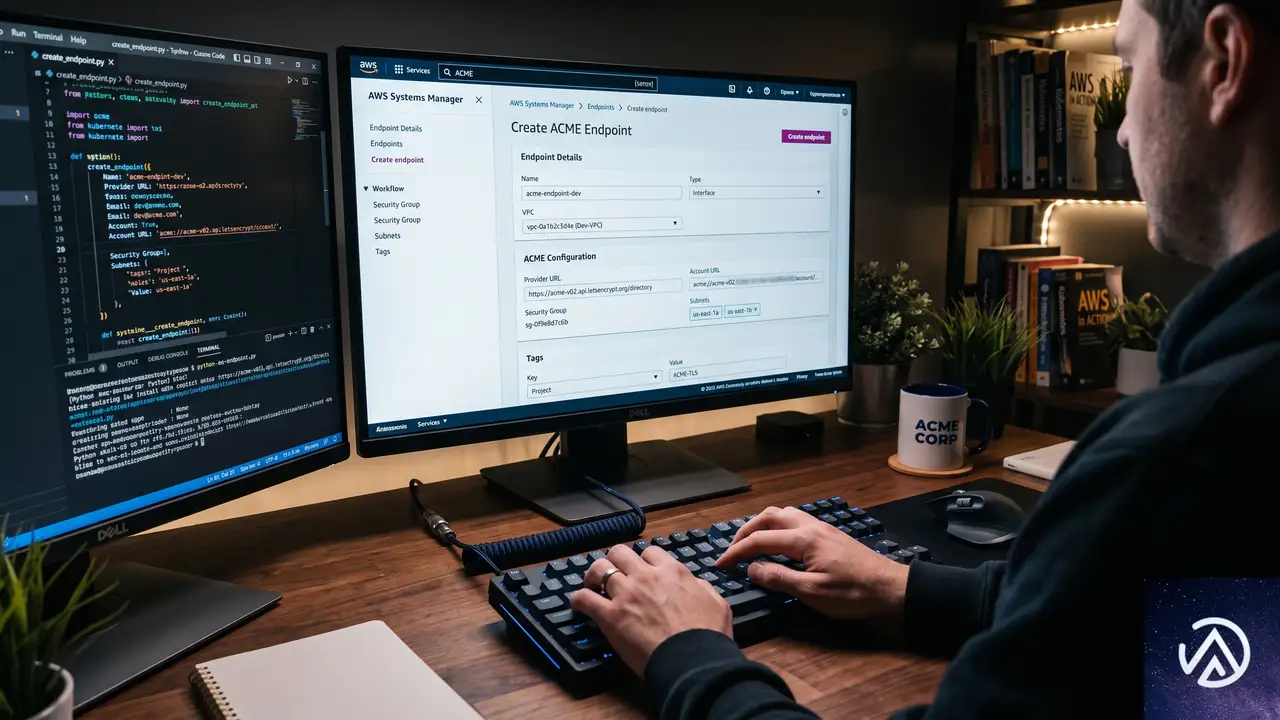
ACM の ACME 対応で最も特徴的なのは、ドメイン検証を PKI 管理者がエンドポイントレベルで一括実施する点だ。一般的な ACME 環境では、証明書を必要とするクライアントごとに DNS レコードの設定権限が必要になる。これに対して ACM の方式では、管理者がエンドポイント作成時にドメインを検証し、以後の証明書リクエストはそのエンドポイントが管理する。
エンドポイントの作成手順
ACM コンソールの「ACME 証明書」ページからエンドポイントを作成する。設定項目は以下の通りだ。
- エンドポイント名(任意の識別名)
- エンドポイントタイプ(Public を選択)
- 証明書タイプ(Public を選択)
- 鍵タイプ(ECDSA P-256 がデフォルト)
- ドメイン名(証明書を発行する対象ドメイン)
- ドメインスコープ(厳密なドメイン、サブドメイン、ワイルドカードの許可設定)
ドメインスコープの設定はガバナンス上とくに重要だ。Exact domain(完全一致ドメイン)だけを許可すれば、サブドメインやワイルドカード証明書の発行を防げる。たとえば本番系のエンドポイントでは Exact domain と Subdomains のみを有効化し、Wildcards は無効にすることで、証明書の発行範囲を厳格に制限できる。
エンドポイント作成後、DNS 検証が実行される。Route 53 を利用していれば CNAME レコードが自動で作成されるため、手動での DNS 設定は不要だ。外部の DNS プロバイダーを使っている場合は、表示される CNAME レコードを手動で登録する必要がある。
EAB 認証情報によるクライアント登録
エンドポイントの準備が整ったら、EAB(External Account Binding)認証情報を発行する。EAB は Key ID と HMAC Key のペアで構成され、ACME クライアントがエンドポイントにアカウントを登録する際の初回認証に使われる。
一度クライアントが登録されれば、以降の証明書リクエストはクライアント自身が生成した非対称鍵ペアで認証される。EAB 認証情報はあくまで登録時のみの使い切りであり、有効期限を設定して不要な長期保管を防ぐのが望ましい。
この仕組みにより、PKI 管理者はドメイン検証という強力な権限をエンドポイントに閉じ込めつつ、アプリケーション担当者には EAB 認証情報だけを安全に配布できる。DNS キーを組織全体に配る必要がなくなる点が、従来の ACME 運用と決定的に異なる。
Certbot を使った証明書リクエストの実例
ACM コンソールには、Certbot と acme.sh 向けの CLI リファレンスが用意されている。以下は AWS News Blog の記事で紹介されている Certbot のコマンド例を再構成したものだ。
certbot certonly --standalone --non-interactive --agree-tos \
    --email <EMAIL> \
    --server https://acm-acme-enroll.us-east-1.api.aws/<ENDPOINT_ID>/directory \
    --eab-kid <EAB_KID> \
    --eab-hmac-key <EAB_HMAC_KEY> \
    --issuance-timeout <ISSUANCE_TIMEOUT> \
    -d <DOMAIN>
--eab-kid と --eab-hmac-key に、先ほど発行した EAB 認証情報を指定する。各 ACME クライアントで引数名や設定ファイルの記法は異なるため、利用するクライアントのドキュメントを参照する必要がある。
コマンドが成功すると、Amazon Trust Services によって署名された有効な証明書が発行される。openssl コマンドで証明書の内容を確認したうえで、アプリケーションにインストールすればよい。発行された証明書は ACM コンソールの「ACME 証明書」タブにも表示され、コンソールや API 経由で発行した証明書と統合管理される。
一元管理がもたらす運用面の利点
ACM による ACME 対応は、単に証明書の自動発行を可能にするだけではない。最大の価値は、組織全体の証明書ライフサイクルを可視化し、ガバナンスを一元化できる点にある。
IAM ロールによるきめ細かなアクセス制御
ACM の ACME エンドポイントは IAM ロールと統合されている。ACME アカウントに対して IAM ロールをバインドすることで、どのクライアントがどのドメインの証明書をリクエストできるかを細かく制御できる。これにより、開発チームごとに発行可能なドメイン範囲を限定するといった運用が実現する。
監査ログとメトリクスの統合
すべての証明書リクエストは AWS CloudTrail に記録される。誰がいつどのドメインの証明書を要求したかを完全に追跡できるため、監査要件を満たすうえで強力な武器となる。また Amazon CloudWatch と連携することで、証明書の発行数やエラー率といった運用メトリクスもリアルタイムに把握できる。
ACM が標準で備える有効期限通知機能も ACME 経由で発行された証明書に適用される。更新が迫った証明書のアラートを一元管理でき、従来のように証明書管理ダッシュボードと ACME クライアントの管理画面を行き来する必要はなくなる。
上記のスタックは、ACM 単体で証明書管理から監査、予防までをカバーできることを示している。従来は外部の認証局と ACM の間で証明書管理が分断されていたが、ACME 対応によってこの断絶が解消された。
利用可能リージョンと料金体系
ACM の ACME 対応は、発表時点で全商用 AWS リージョンで利用可能だ。AWS GovCloud(US)および中国リージョン、AWS European Sovereign Cloud パーティションについては、後日の対応が予定されている。
料金は証明書発行時に含まれるドメインごとに課金される方式で、完全修飾ドメイン名(FQDN)とワイルドカードで単価が異なる。ボリュームティアは AWS アカウント単位で月間の全証明書における総ドメイン出現数に基づいて計算される。具体的な価格は ACM の公式料金ページで確認できる。
この課金体系は、ACME 経由で発行される証明書も従来の ACM 証明書と同じ仕組みでカウントされるため、新たなコスト管理の複雑さは生じない。
この記事のポイント
- ACM が ACME プロトコルに対応し、Certbot や cert-manager など既存クライアントからの証明書自動発行が可能になった
- PKI 管理者はエンドポイントレベルでドメイン検証とスコープ制御を一括管理でき、DNS キーを組織内に配布する必要がなくなる
- CloudTrail・CloudWatch・有効期限通知により、証明書ライフサイクル全体を単一ダッシュボードで可視化・監査できる
- 証明書の有効期間短縮が進む中、手動運用からの脱却と自動化基盤の構築が急務となっている
- 全商用リージョンで即日利用可能。費用はドメイン数ベースで、従来の ACM 料金体系に準じる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
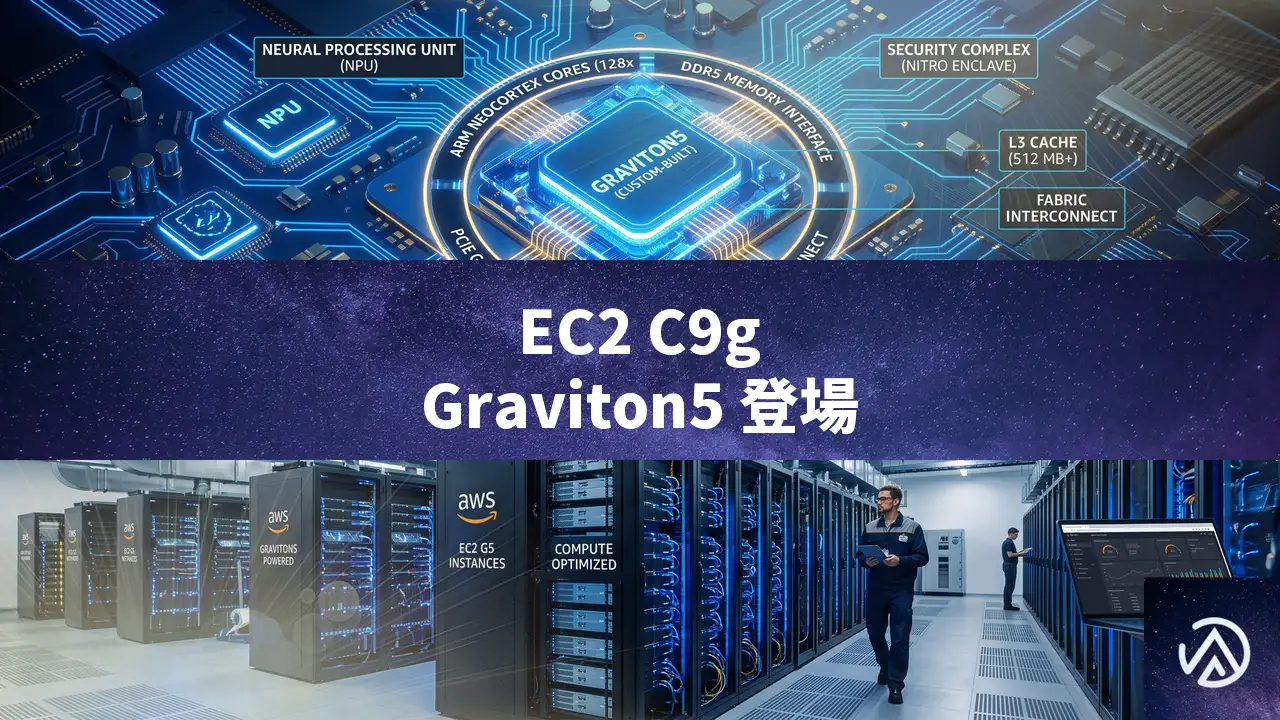
AWS Graviton5搭載EC2 C9gインスタンスが一般提供開始
計算負荷の高いワークロードを扱う企業にとって、「もう少しだけ処理が速ければ」という場面は多い。AWSが6月30日に発表したEC2 C9g/C9gdインスタンスは、その不満を根本から解決する新世代の計算特化型インスタンスだ。Graviton5プロセッサの投入により、前世代からvCPUあたり最大25%の性能向上を実現した。今回の発表で特に注目すべきは、クラウド最速級となるDDR5-8800MT/sメモリの採用と、正式検証済みのハイパーバイザー分離エンジン「Nitro Isolation Engine」の搭載だ。本記事では、CPU負荷の高いバッチ処理や動画エンコーディングを中心に、新しいインスタンスがどのような場面で威力を発揮するのかを詳しく解説する。
C9g/C9gdインスタンスの位置づけを見極める
AWSのEC2には多様なインスタンスファミリーが存在する。頭文字の「C」はCompute Optimized(計算最適化)を意味し、他のメモリ最適化(Rシリーズ)やストレージ最適化(Iシリーズ)とは設計思想が異なる。計算最適化インスタンスは、vCPUあたりの演算性能を最大化することに特化している。リアルタイム分析、機械学習の推論、動画エンコーディングなど、1秒でも短く計算を終えたい処理に適している。
今回発表されたC9g/C9gdは、2024年秋に登場したGraviton4搭載C8gの後継にあたる。AWS GravitonシリーズはArmベースの独自プロセッサで、x86系のIntel XeonやAMD EPYCと比較して、コストパフォーマンスに優れる点が強みだ。C9gの「g」はGravitonを示し、末尾に「d」がつくC9gdはNVMe SSDによる高速なローカルストレージを内蔵する。
Graviton5プロセッサの進化点を知る
Graviton5の最大の改良点は、メモリ帯域幅の拡張とレイテンシの低減にある。C9gインスタンスはDDR5-8800MT/sのDIMMを採用し、これは現在クラウド上で提供されているプロセッサインスタンスの中で最速のメモリ速度だ。数字だけでは実感しにくいが、これはメモリとCPU間のデータ転送速度が秒間8800メガトランスファー(MT/s)ということを意味する。前世代のC8gがDDR5-5600MT/sだったため、実に57%もの速度向上にあたる。
さらに、CPUのL3キャッシュ容量が5倍に拡張された。キャッシュはCPUとメインメモリの間に位置する超高速なデータ置き場で、容量が大きいほどメモリアクセスの待ち時間を減らせる。AWS News Blogの著者Seb氏によると、これらの改善により、インメモリ分析のスループット向上や、より応答性の高いエージェント型AIループが期待できるという。
ネットワーク面でも強化が施されている。パケット処理性能はGraviton4ベースのインスタンスと比較して最大3倍に向上し、インスタンスサイズ全体の平均でネットワーク帯域が約15%、EBS帯域が約20%増加した。
C9g/C9gdの主要スペック詳細と設計思想
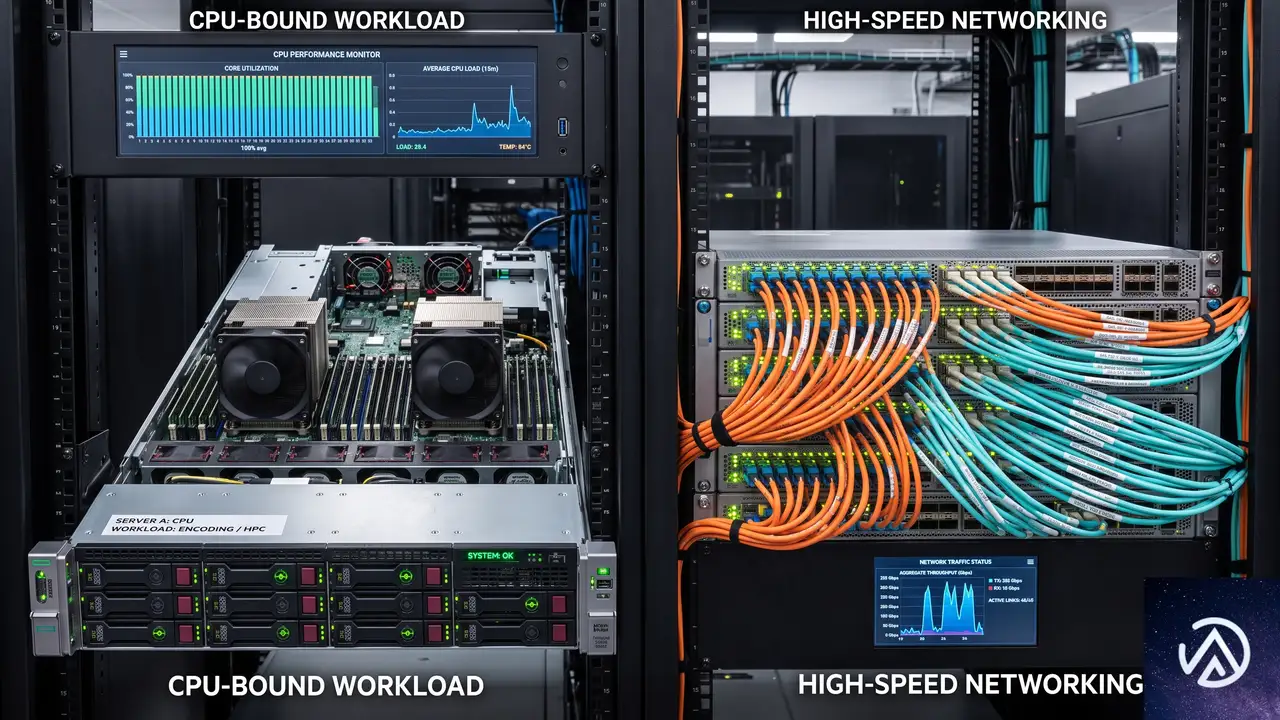
スペック表を見ると、C9g/C9gdは最小のmedium(1vCPU/2GBメモリ)から、最大のmetal-48xl(192vCPU/384GBメモリ)まで11サイズで展開される。48xlargeではネットワーク帯域が100Gbps、EBS帯域が72Gbpsに達し、これは前世代の2倍にあたる。大規模な分散処理やリアルタイム分析基盤において、ネットワークがボトルネックになる状況を回避しやすくなるだろう。
C9gdシリーズには、ローカルのNVMe SSDストレージが追加される。容量は最小のmediumで59GB、最大の48xlargeでは3台合計で11,400GB(3×3,800GB)に達する。NVMe SSDはEBSよりもレイテンシが低いため、以下のような用途に適している。
- HPCシミュレーションのスクラッチスペース(一時的な作業領域)
- 機械学習推論の一時キャッシュ
- アドサーバーのローカルバッファ
ストレージ性能も向上しており、ローカルストレージのパフォーマンスは前世代比で約30%向上した。NVMe経由の詳細なI/Oパフォーマンス統計はCloudWatchやnvme-cli経由で取得可能で、I/Oサイズ別のレイテンシヒストグラムが1秒単位で確認できる。この機能は追加料金なしで利用できる。
Instance Bandwidth Configurationの実用性を測る
C9g/C9gdには、Instance Bandwidth Configuration(IBC)と呼ばれる帯域調整機能が搭載されている。これは、EBSとVPCネットワークの帯域配分を最大25%の範囲で調整できる仕組みだ。例えば、データベースやキャッシュ用途でEBSの帯域を優先したい場合、ネットワーク側を絞ってEBS側に割り当てを寄せることが可能になる。逆に、ネットワーク集約型の分散処理ではVPC側を優先すればよい。固定的な割り当てに縛られない柔軟性は、実運用のチューニングで大きな武器になる。
C9gとC9gdの使い分けフローを整理する
C9gとC9gdはスペックが似ているため、どちらを選ぶべきか迷う場面があるだろう。選択の決め手は「ローカルのNVMe SSDが必要かどうか」に尽きる。AWS News Blogでは、C9gを「バッチジョブ、動画エンコードパイプライン、分散分析」向け、C9gdを「HPCシミュレーションのスクラッチスペース、ML推論の一時キャッシュ、アドサーバーのローカルバッファ」向けとしている。EBSで十分な永続ストレージが足りるならC9g、一時的でも高速なローカルストレージが不可欠ならC9gdを選べばよい。
Graviton5がもたらすエージェント型AIへの適性を読み解く
AWS News Blogの発表では、C9gのワークロード例として「エージェント型AI(agentic AI)」が明記されている。エージェント型AIとは、単なる質問応答を超えて、コードを実行し、複数ステップのタスクを自律的に組み立てて完了させるAIシステムを指す。OpenAIのOperatorやAnthropicのComputer Useが代表例だ。
この種のワークロードでは、大規模言語モデル(LLM)の推論そのものに加えて、Pythonコードの実行、API呼び出し、結果の検証といったCPUバウンドな処理が連続的に発生する。Graviton5のコア数向上と大容量キャッシュは、こうした「思考と行動のループ」を高速化する土台となる。AWSの著者Seb氏によれば、アプリケーションがデータを待つ時間を削減し、結果的にエージェントループの応答性が高まるとのことだ。
AI推論といえばGPUの印象が強いが、実際には前処理、後処理、オーケストレーションの多くがCPU上で動く。ArmベースのGraviton5は、これらの処理を低コストでさばける点が実務的な魅力となる。
Nitro Isolation Engineのセキュリティ強化を理解する
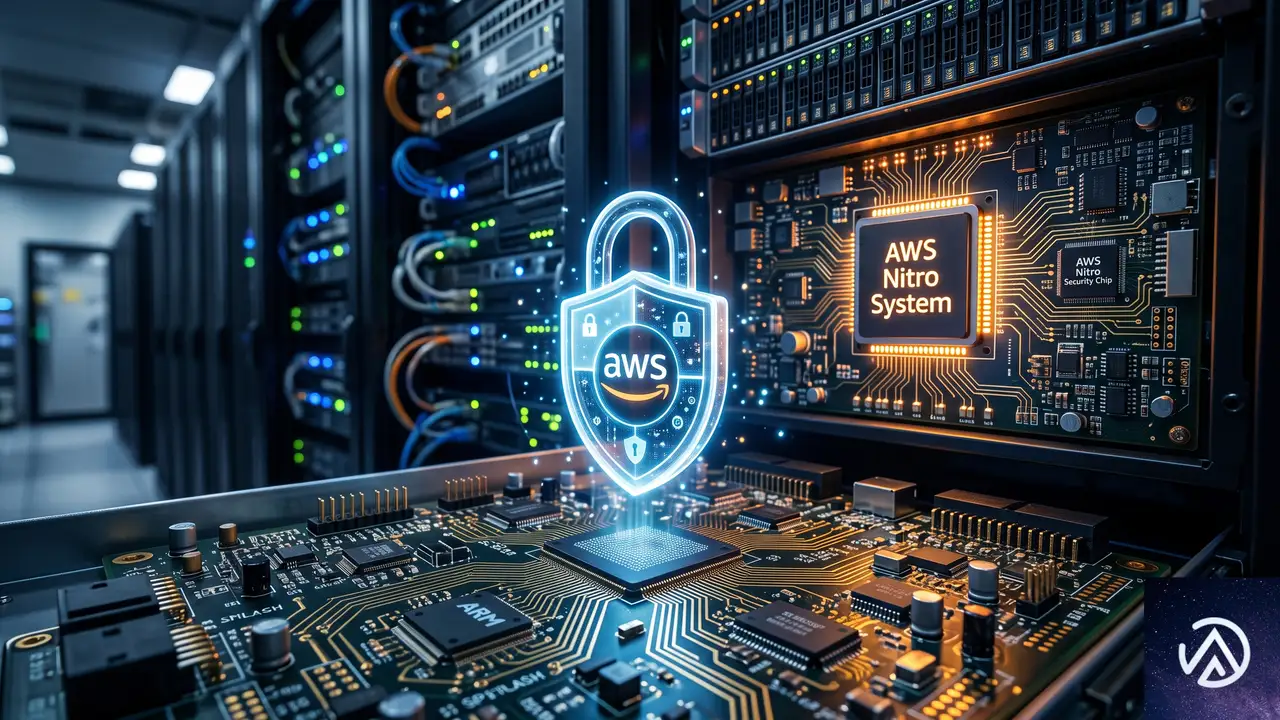
C9g/C9gdは、計算最適化インスタンスとして初めて「Nitro Isolation Engine」を搭載した。これはAWS Nitro Systemの拡張機能で、仮想マシン間のメモリ空間、CPUレジスタ状態、I/Oデバイスへのアクセスを数学的正確さで強制的に分離する仕組みだ。
通常、ハイパーバイザーによる分離はソフトウェアの実装品質に依存する部分があるが、Nitro Isolation Engineは形式検証(formal verification)と呼ばれる数学的手法を用いて分離の正しさを証明している。形式検証とは、仕様を数理論理で記述し、実装がその仕様を厳密に満たすことを機械的に検証する手法だ。テストのように「見つかったバグがない」ではなく、「特定の前提条件下でバグが存在し得ない」ことを保証する。
AWSは2025年にこの技術を発表した際、ハイパーバイザーの分離を形式検証する取り組みについてホワイトペーパーを公開している。今回のC9g/C9gdで初めて、計算最適化インスタンスに実装されたことになる。
セキュリティ要件の厳しい金融サービスや医療データの分析をEC2上で行うケースでは、この正式検証済みの分離機構はインフラ選定の重要な判断材料になる。ソフトウェアレベルではなく、ハードウェア支援と形式検証の組み合わせで隔離を実現している点は、AWSの設計思想として特筆に値する。
利用可能リージョンと料金モデルを確認する
2026年6月30日時点で、C9g/C9gdは米国東部(オハイオ、バージニア北部)、米国西部(オレゴン)、欧州(フランクフルト)の4リージョンで利用可能だ。AWSは追加リージョンへの展開も予定している。
料金モデルはSavings Plans、オンデマンド、スポットインスタンス、Dedicated Instances、Dedicated Hostsに対応する。常時稼働させるワークロードではSavings Plans、短期的なバッチ処理ではスポットインスタンスと使い分けられる。EBSボリュームは仮想インスタンス1台あたり最大128個までアタッチ可能で、大規模データの処理でもストレージ不足に悩むことは少ない。
インスタンスの起動はAWSマネジメントコンソール、AWS CLI、AWS SDKのいずれからでも可能だ。GravitonはArmアーキテクチャのため、AMIやコンテナイメージはArm向けにビルドされたものを選ぶ必要がある。公式のAmazon Linux 2023やUbuntuのArm版AMIはすでに提供されているため、新規導入時の障壁は低い。
この記事のポイント
- C9g/C9gdはGraviton5搭載の計算最適化インスタンス、vCPUあたり25%の性能向上を達成
- DDR5-8800MT/sメモリと5倍のL3キャッシュにより、メモリ待ち時間を大幅に削減
- 48xlargeでは100Gbpsネットワーク帯域と72GbpsのEBS帯域、前世代比2倍に拡張
- Nitro Isolation Engine搭載、形式検証による仮想マシン分離を実現
- エージェント型AIやHPC、動画エンコードなどCPU負荷の高い処理に最適
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
Amazon EKSにKubernetesロールバック機能、アップグレードの不安を解消
Amazon EKSにKubernetesバージョンロールバック機能が導入された。クラスタのバージョンアップグレードはこれまで戻り道のない一方通行だったが、今回の機能により最大7日間であれば以前のバージョンに巻き戻せる。AWSのDonnie Prakoso氏とChanny Yun氏が2026年7月1日付のAWS News Blogで発表した内容だ。
KubernetesコミュニティではKEP-4330に基づくエミュレートバージョンでロールバックを緩和する動きが進んでいる。しかしEKSのロールバックはエミュレーションではなく、本番環境で事前に検証済みの状態へ完全に戻る点が異なる。クラスタ管理者にとってはアップグレード作業の心理的ハードルを大幅に下げる機能だ。
本記事では、この新機能の仕組みや利用手順、EKS Auto Modeでの挙動の違いを中心に、運用現場へのインパクトを具体的に整理する。
Kubernetesバージョンロールバックの概要
この図はアップグレード失敗時の対応の違いを示している。従来はクラスタ再構築が必要だったが、新機能では「元に戻す」操作が可能になった。
ロールバックが求められてきた背景
Kubernetesは年に3回のマイナーバージョンアップがリリースされる。多数のクラスタを抱える組織、とりわけ金融や医療など規制の厳しい業界では、アップグレードに数か月単位の準備期間を設ける例も珍しくない。問題発生時に復旧できる確証がなければ、アップグレードそのものを先送りする判断になりやすい。
この結果、クラスタは古いバージョンに留まり、セキュリティパッチが未適用のまま延長サポート期間に突入するケースが増えていた。ロールバック機能はこうした「アップグレード恐怖症」を解消する安全装置として位置づけられる。
エミュレートバージョンとの違い
KEP-4330で提案されているエミュレートバージョンは、クラスタを移行用の中間状態に置くアプローチだ。対してEKSのロールバックは、実際に本番で稼働していた検証済みの状態へ戻る。エミュレーションではないため、ロールバック後の動作は以前のバージョンそのものになる。運用チームにとっては「テスト環境で確認済みの状態」に復帰できる点が安心材料だ。
基本的な制約と料金
ロールバック可能な期間はアップグレード後7日間である。バージョンは1つ前のマイナーバージョンのみ戻せる。たとえば1.34から1.35にアップグレードした場合、戻り先は1.34だ。1.33へ一気に下げることはできない。
料金はロールバック機能そのものに追加コストは発生しない。標準のEKS料金とコンピューティングコストのみで利用できる。全商用AWSリージョンで本日から提供開始されている。
ロールバックの実践的な利用手順
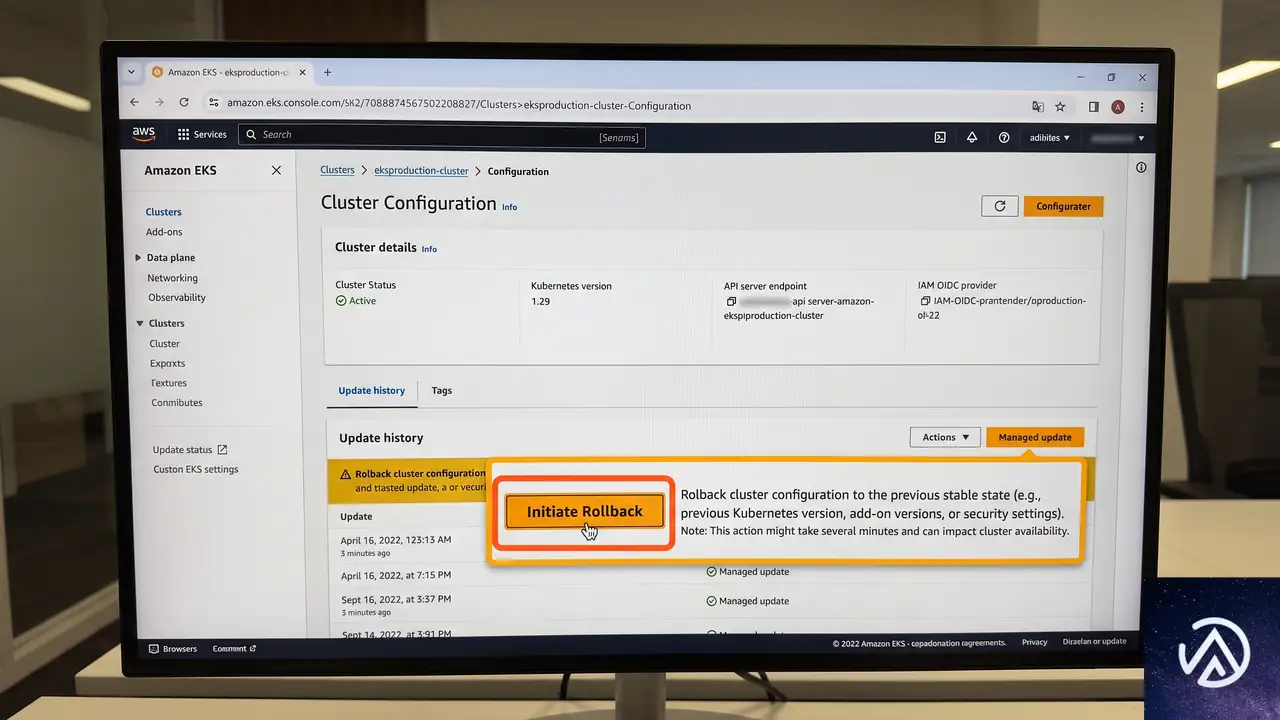
AWSのブログでは、Donnie Prakoso氏が実際にEKSコンソールからロールバックを試した手順が紹介されている。ここではその流れを整理しつつ、運用現場で意識すべきポイントを補足する。
この手順は標準的なアップグレード操作と大きく変わらない。所要時間は制御プレーンのロールバックが約20分で、通常のアップグレードと同程度だ。
ロールバックインサイトによる事前評価
EKSはロールバック実行前に、クラスタインサイト機能を使ってロールバックの準備状況を自動評価する。ノードのバージョン互換性やアドオン依存関係に問題があれば事前にフラグが立つ仕組みだ。事前評価をスキップして強制的にロールバックを進めたい場合は、--forceフラグが用意されている。
トラブルシューティング中の緊急時にはこの強制実行が有効だが、通常はインサイトの結果を確認してから進めるのが安全だ。互換性の警告を見落とすと、ロールバック後に別の問題が顕在化するリスクがある。
制御プレーンとノードのロールバック
制御プレーンのロールバックはすべてのEKSクラスタで利用できる。一方、ノードのロールバックはEKS Auto Modeを利用しているクラスタが対象となる。自分でノードを管理している構成では、制御プレーンだけがロールバックされ、ノード側は別途対応が必要になる点に注意したい。
EKS Auto ModeでのロールバックとキャンセルAPI
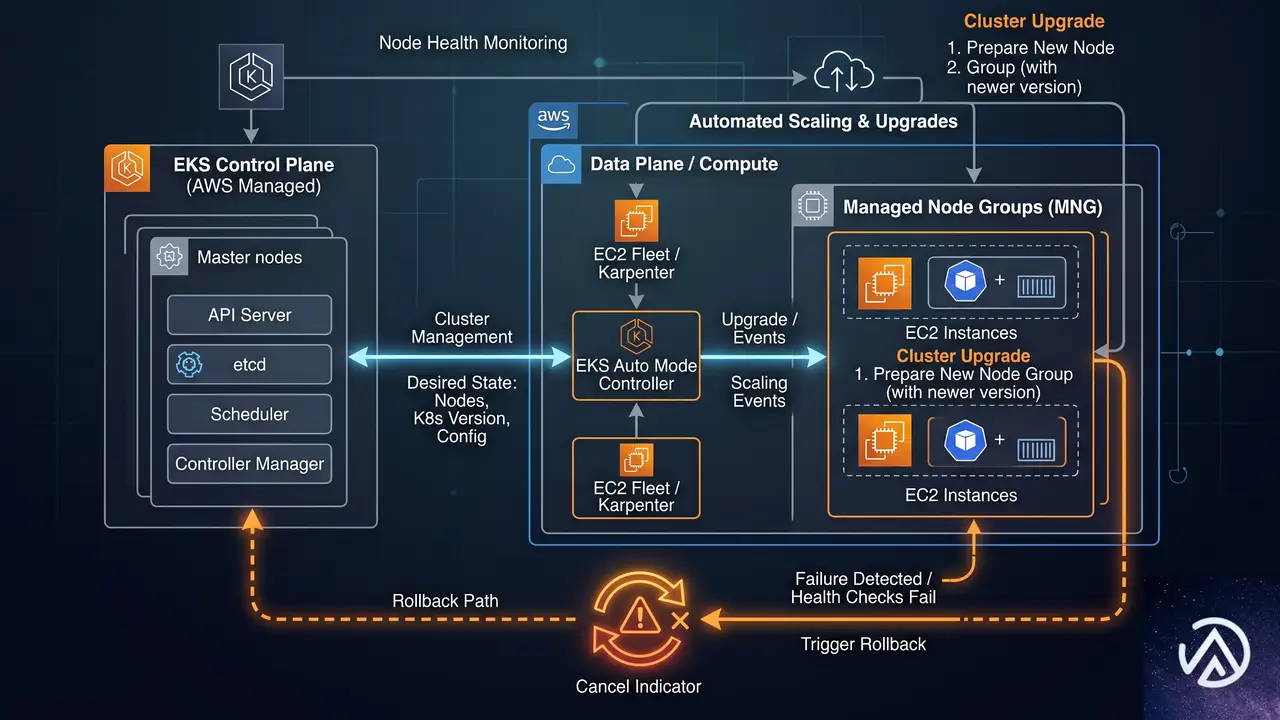
EKS Auto Modeはコンピューティング、ネットワーク、ストレージ管理を自動化するフルマネージドオプションだ。このモードでは制御プレーンと管理ノードの両方をロールバックする必要があり、ノードのロールバックはPod Disruption Budget(PDB)を尊重しながら進むため、設定によっては時間がかかる。
Auto Modeでは制御プレーンとノードが連動してロールバックされる。キャンセルAPIを使えば、所要時間が長すぎる場合に中断して戦略を練り直せる。
PDBを尊重する設計の意図
EKSはロールバック中にデフォルトでPDBをバイパスしない。ワークロードの安定性を最優先する設計思想だ。ノードの切り戻し中にPodが過剰に停止すると、アプリケーションの可用性が損なわれるからである。
ロールバックを急ぎたい場合は、運用者が自らPDBを修正または削除することで高速化できる。システムが一方的にPDBを無視しないため、安全性とスピードのバランスを利用者側でコントロールできる仕組みになっている。
キャンセルAPIの実用シナリオ
キャンセルAPIはノードロールバックの進行中に中断を指示できる機能だ。次のような状況で役立つ。ロールバックにかかる時間が想定以上に長く、ビジネスへの影響が懸念される場合。あるいはロールバック以外の代替手段(特定ノードだけの切り戻しなど)の方が適切と判断した場合だ。
中断後はPDBの調整やロールバック戦略の見直しを行い、再度実行するか別の手段を選ぶかを決められる。この柔軟性は、大規模クラスタを運用するチームにとって重要なセーフティネットになる。
運用現場へのインパクトと今後の展望
ロールバック機能の登場は、Kubernetes運用の前提を変える可能性がある。これまでは「アップグレードの前に数週間の検証期間を設けるのが常識」だったが、ロールバックが可能になったことで「まず上げてみて、問題があれば戻す」というアプローチが現実的になる。
アップグレードサイクルの短縮
Kubernetesのマイナーバージョンアップは年3回のペースで進む。これに追従するには、アップグレードサイクルを四半期以内に収める必要がある。ロールバック機能によって心理的ハードルが下がれば、検証期間を短縮しつつ最新バージョンへの追随速度を上げられる。
規制業界でも「7日間の戻し窓口がある」という事実が監査対応やリスク評価でプラスに働く可能性がある。セキュリティパッチの適用遅延リスクを低減する効果も見込めるだろう。
注意すべき制約
ロールバックは万能ではない。7日間の期間制限を過ぎると元に戻せないため、アップグレード後の監視と問題検知の仕組みは引き続き重要だ。またノードを自前管理している構成ではノードロールバックが自動化されないため、制御プレーンのみの切り戻しでは不十分なケースも想定される。
ロールバックインサイトが示す警告を無視して強制実行した場合、アドオンの互換性問題などが残る可能性もある。事前チェックを飛ばすのはあくまで緊急時の手段と心得たい。
この記事のポイント
- EKSの新機能「バージョンロールバック」はアップグレード後7日間、1つ前のマイナーバージョンに戻せる
- 制御プレーンのロールバックは全EKSクラスタ、ノードロールバックはAuto Modeクラスタが対象
- ロールバックインサイトで互換性リスクを事前評価し、
--forceでスキップも可能 - PDBを尊重する設計でワークロードの安定性を維持しつつ、キャンセルAPIで中断も選べる
- 追加料金は不要で全商用リージョンで提供開始。アップグレードサイクル短縮の追い風になる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
AWS Lambda MicroVMs発表、Firecrackerで隔離サンドボックスを即時起動
AWS Lambda MicroVMs発表、Firecrackerで隔離サンドボックスを即時起動する新サーバーレス
AWSが2026年6月22日、Lambdaファミリーの新たなコンピュートサービス「Lambda MicroVMs」を発表した。Firecrackerを基盤に、VMレベルの強固な隔離とスナップショットからの即時起動を両立する。AIが生成したコードやユーザー提供のスクリプトを安全に実行したいマルチテナントアプリケーション向けに設計されている。
この新サービスは、従来の仮想マシンとコンテナ、FaaS(Function as a Service)の間にあった溝を埋める。強い隔離が必要だが起動速度も妥協できない、さらにセッション中の状態も保持したい。そうした要件を単一のサービスで満たす選択肢がついに登場した。
Lambda MicroVMsとは何か
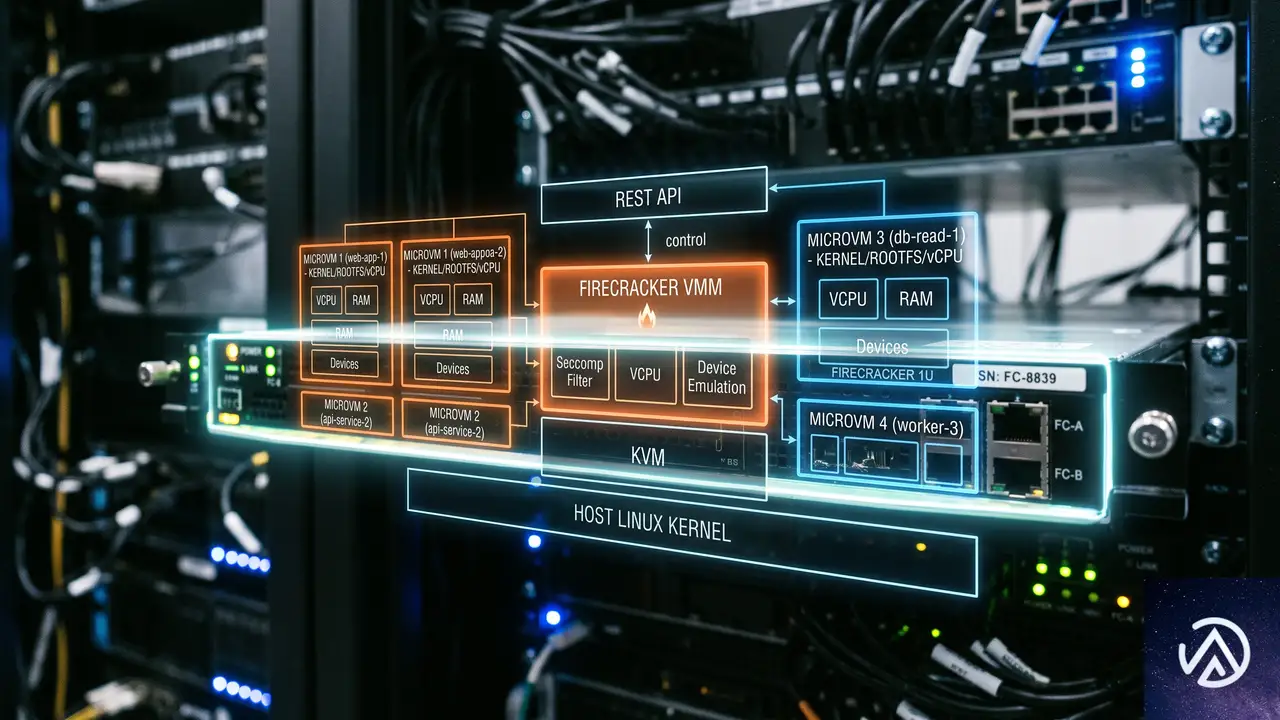
Lambda MicroVMsはAWS Lambdaの一部として提供される新しいサーバーレスコンピュートだ。最大の特徴は、エンドユーザーごと、あるいはセッションごとに専用の隔離実行環境を割り当てられる点にある。基盤技術にはFirecrackerを採用しており、この技術はすでに月間15兆回以上のLambda関数呼び出しを支える実績を持つ。
従来の選択肢との違い
従来、隔離されたコード実行環境を構築するには3つの選択肢があった。それぞれにトレードオフが存在する。仮想マシン(VM)は隔離性能に優れるが起動に数分かかる。コンテナは数秒で起動するが、カーネルを共有するため信頼できないコードを安全に実行するには追加の堅牢化が必須だ。FaaSはイベント駆動のリクエスト-レスポンス型ワークロードに最適だが、長時間の対話セッションや状態保持には向いていない。
Lambda MicroVMsはこの3つの間隙を埋める。VMレベルの隔離を持ちながら、スナップショットからの即時起動で高速なレスポンスを実現し、セッション中の状態も保持できる。さらにアイドル時には自動サスペンドでコストを抑えつつ、トラフィック受信時に自動レジュームする仕組みを備えている。
この比較図が示すように、Lambda MicroVMsは3つの要件を単一サービスで満たす。開発者はインフラ管理から解放され、アプリケーションの構築に専念できる。
なぜ今MicroVMsが必要なのか
ここ数年で、アプリケーション開発者が書いていないコードをエンドユーザーごとに安全に実行する必要があるマルチテナントアプリケーションが急増している。AIコーディングアシスタント、対話型コード実行環境、データ分析プラットフォーム、脆弱性スキャナ、ユーザースクリプトを実行するゲームサーバーなどがその代表例だ。
市場が求める新たな実行環境
こうしたアプリケーションに共通する要件は明確だ。強い隔離で安全性を担保しつつ、エンドユーザーが待たされない起動速度を実現し、対話セッション中は状態を保持し続けること。しかし従来のサービス群では、このすべてを満たす選択肢が存在しなかった。開発者は性能と隔離のトレードオフを受け入れるか、独自の仮想化基盤を構築するために多大なエンジニアリングリソースを投じるかの二者択一を迫られていた。
Firecrackerが支える信頼性
Lambda MicroVMsの基盤となるFirecrackerは、AWSがオープンソースで提供する軽量仮想化技術だ。すでにLambda FunctionsとFargateで運用実績があり、月間15兆回の呼び出しを支える実績は、この新サービスの信頼性を裏付ける。各MicroVMは独立したカーネルで動作し、ユーザー間のリソース共有は一切ない。あるユーザーが実行した信頼できないコードが、他の環境や基盤システムにアクセスすることはない。
技術的な仕組み
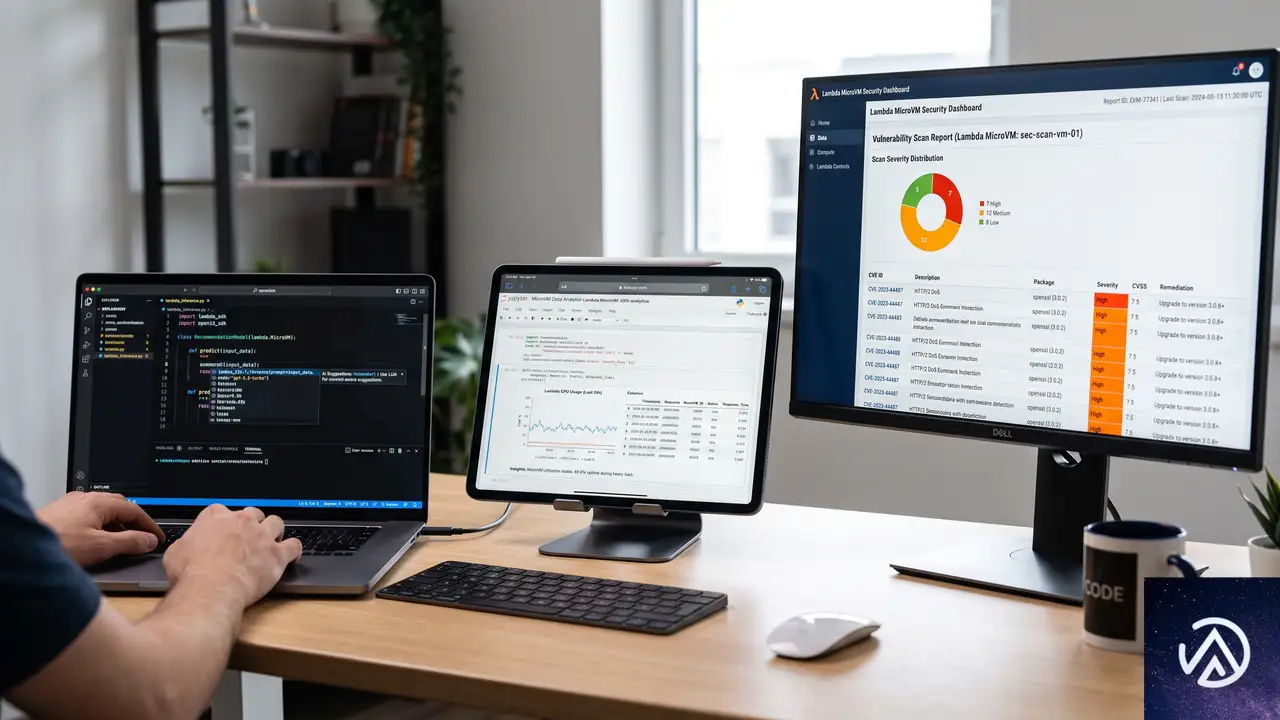
Lambda MicroVMsの中核には3つの技術要素がある。VMレベルの隔離、スナップショットベースの高速起動とレジューム、そしてステートフルな実行だ。これらが組み合わさることで、従来にない実行環境が実現されている。
イメージ作成から起動までの流れ
MicroVMsのライフサイクルは「イメージ作成→起動→実行→サスペンド→レジューム」という流れをたどる。まずDockerfileとアプリケーションコードをzipアーティファクトとしてS3にアップロードし、MicroVM Imageを作成する。AWS LambdaがDockerfileを実行し、アプリケーションを初期化したあと、実行環境のメモリとディスク状態のFirecrackerスナップショットを取得する。以降のMicroVM起動はすべて、このスナップショットからレジュームされるため、コールドスタートが発生しない。
このフローにより、数ギガバイト規模の対話セッションでもエンドユーザーが体感できるレスポンス速度でレジュームされる。アプリケーションはスナップショット時点で完全に初期化済みのため、起動完了と同時にリクエストを受け付けられる状態になる。
サスペンドとレジュームの自動化
Lambda MicroVMsにはアイドルポリシーが設定できる。設定可能な最大アイドル時間を超過すると自動的にサスペンドされ、メモリとディスク状態がスナップショットとして保存される。サスペンド中は実行コストが大幅に低減し、次のリクエストが到着すると自動的にレジュームされる。クライアント側からはサスペンドの発生を意識することなく、一貫した対話セッションが維持される。1MicroVMあたり最大8時間の連続実行が可能で、vCPUは最大16基、メモリは32GB、ディスクも32GBまでサポートする。
実際の利用シーン
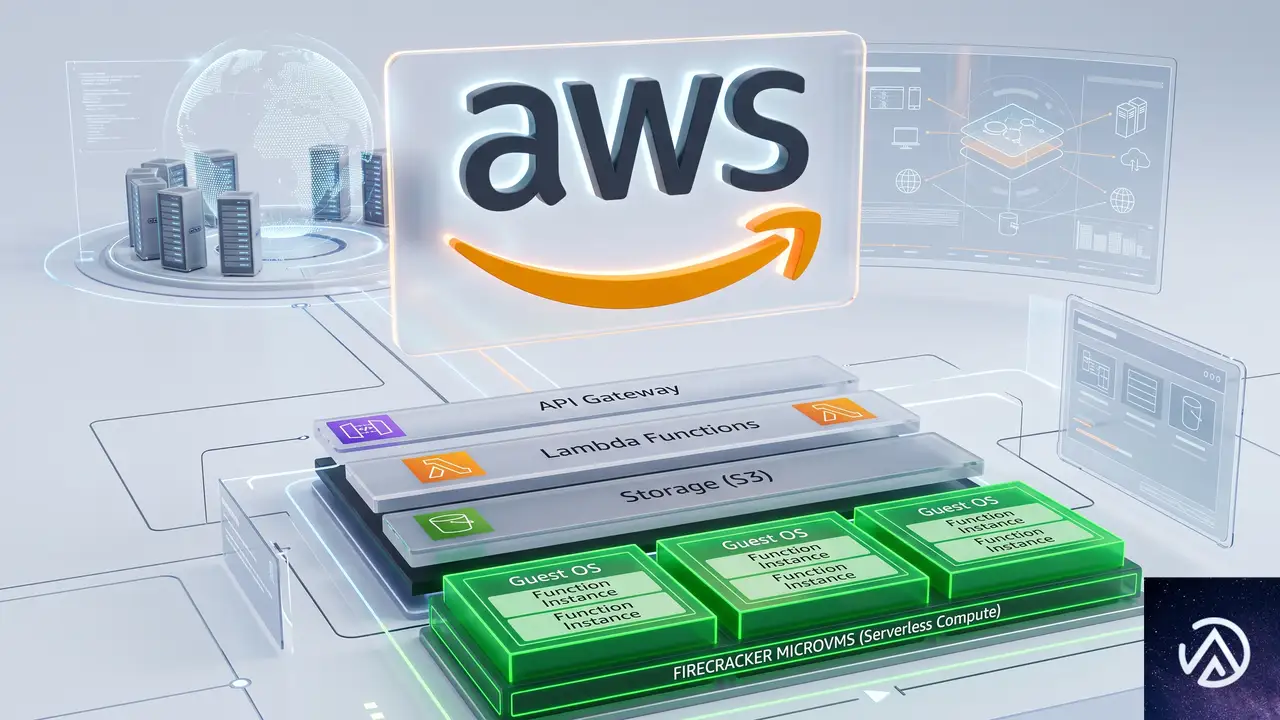
発表時点で対応リージョンは米国東部(バージニア北部、オハイオ)、米国西部(オレゴン)、欧州(アイルランド)、アジア太平洋(東京)だ。アーキテクチャはARM64で、価格はAWS Lambdaの料金ページで公開されている。
想定されるユースケース
AIコーディングアシスタントは最も直接的なユースケースだ。ユーザーがAIに生成させたコードを、安全な隔離環境で即座に実行し結果を返す。データ分析プラットフォームでは、ユーザーごとに専用の分析環境を割り当て、ノートブック形式の対話セッションを長時間維持できる。脆弱性スキャナでは、疑わしいコードを隔離環境で安全に実行し、その振る舞いを観察するといった使い方が考えられる。
Lambda Functionsとの共存
Lambda FunctionsとLambda MicroVMsは競合ではなく補完関係にある。イベント駆動のバックボーンにはLambda Functionsを使い、信頼できないコードを隔離実行する必要がある処理だけをMicroVMsに委ねる構成が自然だ。両者は異なるAPIサーフェスを持ち、それぞれの得意領域で使い分ける設計になっている。
クラウド実行環境の新たな選択肢
Lambda MicroVMsの登場は、サーバーレスコンピュートの概念を一歩拡張するものだ。従来のサーバーレスが「インフラ管理からの解放」を旗印にしてきたのに対し、MicroVMsは「隔離実行環境の構築からの解放」を目指している。開発者は仮想化の専門知識を持たずとも、VMレベルの隔離と高速な起動を両立した環境を手に入れられる。
コスト設計のポイント
サスペンド機能の活用がコスト最適化の鍵を握る。対話型アプリケーションでは、ユーザーが考え込んでいる時間や離席中の時間が少なくない。こうしたアイドル時間に自動サスペンドを適用すれば、状態を保持したまま実行コストを抑えられる。アイドルポリシーの設定値はアプリケーションの特性に合わせて調整する必要がある。短すぎると頻繁なサスペンドとレジュームが発生し、長すぎると不要な実行コストが蓄積する。
今後の展望
初期リリースではARM64アーキテクチャのみのサポートだが、今後のアップデートでx86対応やリージョン拡大が期待される。また、スナップショット作成時にネットワーク接続を確立するアプリケーションや、エフェメラルデータを読み込むアプリケーションでは、サービス提供のフックとの統合が必要になる点にも注意が必要だ。
この記事のポイント
- Lambda MicroVMsはFirecrackerベースでVMレベルの隔離とスナップショット即時起動を両立する新サーバーレス
- AIコーディング支援やデータ分析など、ユーザー提供コードを安全実行するマルチテナントアプリに最適
- アイドル時の自動サスペンドとレジュームで、状態を保持したままコストを最適化できる
- Lambda Functionsとは補完関係にあり、イベント駆動処理と隔離実行を使い分ける設計が推奨される
- 東京リージョン含む5リージョンで即日利用可能、最大8時間の連続実行に対応
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験
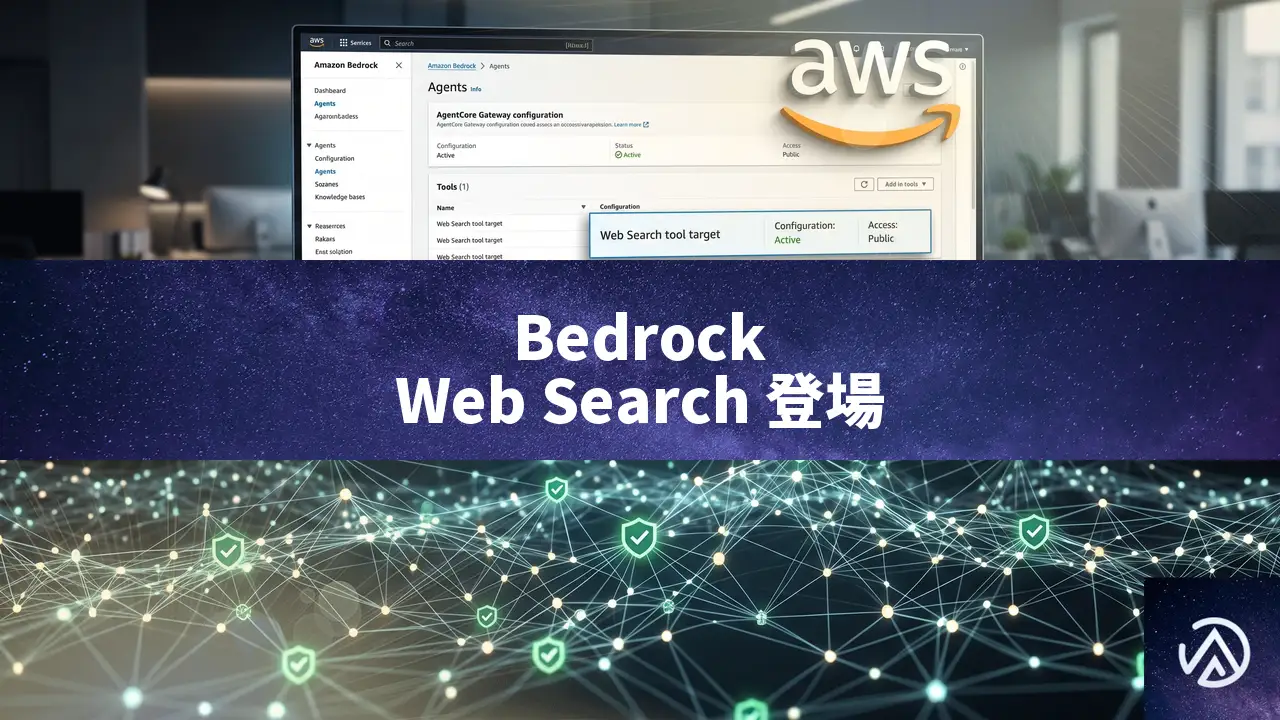
Amazon Bedrock AgentCoreにWeb Search機能が一般提供開始、AIエージェントの回答を最新Web情報で根拠づけ
AWSは2026年6月17日、Amazon Bedrock AgentCoreにWeb Search機能の一般提供を開始した。AIエージェントがユーザーからの質問に対し、最新のWeb情報を参照しながら根拠のある回答を提示できるようにする。トレーニングデータだけではカバーしきれない直近の出来事や新事実を、AWS環境内で安全に取得できる点が最大の特徴だ。
この機能は、Amazonが長年培ってきた検索インフラ上に構築されている。Alexa+やAmazon Quick、Kiroといった製品で実績のある基盤を活用し、WebインデックスとAmazon Knowledge Graphを組み合わせたマルチソースな根拠付けを実現する。検索クエリは外部APIプロバイダに送信されず、AWS環境内で完結するため、企業のガバナンス要件にも適合する。
本記事では、Bedrock AgentCore Web Searchの仕組み、料金体系、導入事例を詳しく解説する。
Web Search機能の概要と背景
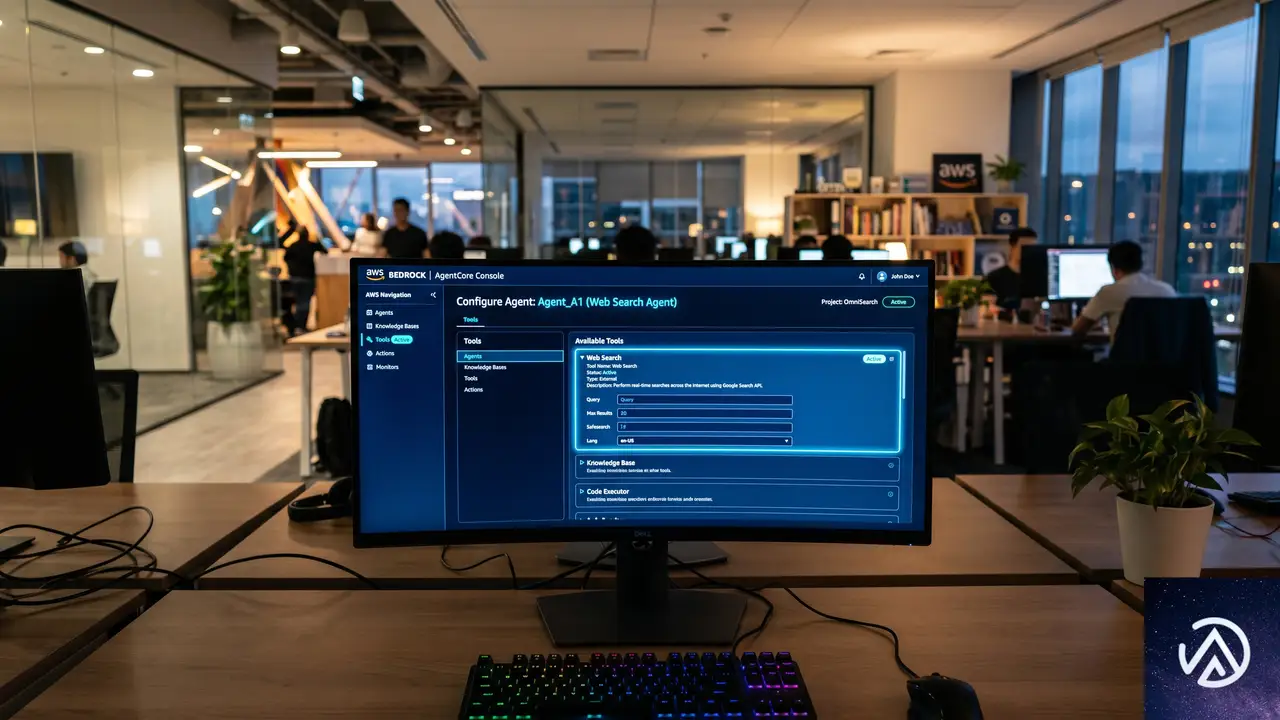
Bedrock AgentCoreの位置づけ
Amazon Bedrock AgentCoreは、AIエージェントの構築と運用を管理するフレームワークである。エージェントに必要なツールやデータソースとの接続をGatewayという仕組みで一元管理し、モデルの推論と外部機能の呼び出しを連携させる。今回発表されたWeb Searchは、AgentCore Gateway上で利用できる組み込みコネクタターゲットのひとつだ。
Web Searchが解決する課題
LLM(大規模言語モデル)は、学習時点のデータに基づいて回答を生成するため、つねに最新の情報を反映できるとは限らない。たとえば、企業の決算発表や法改正、製品アップデートなど、学習後に発生した出来事には対応できない。Web Searchを用いれば、エージェントがリアルタイムにWeb検索を実行し、得られたスニペットやURLを参照して回答を生成できる。回答には引用元が明示されるため、情報の信頼性をユーザーが確認しやすくなる。
仕組み:MCP接続とAmazon知識グラフによる根拠付け
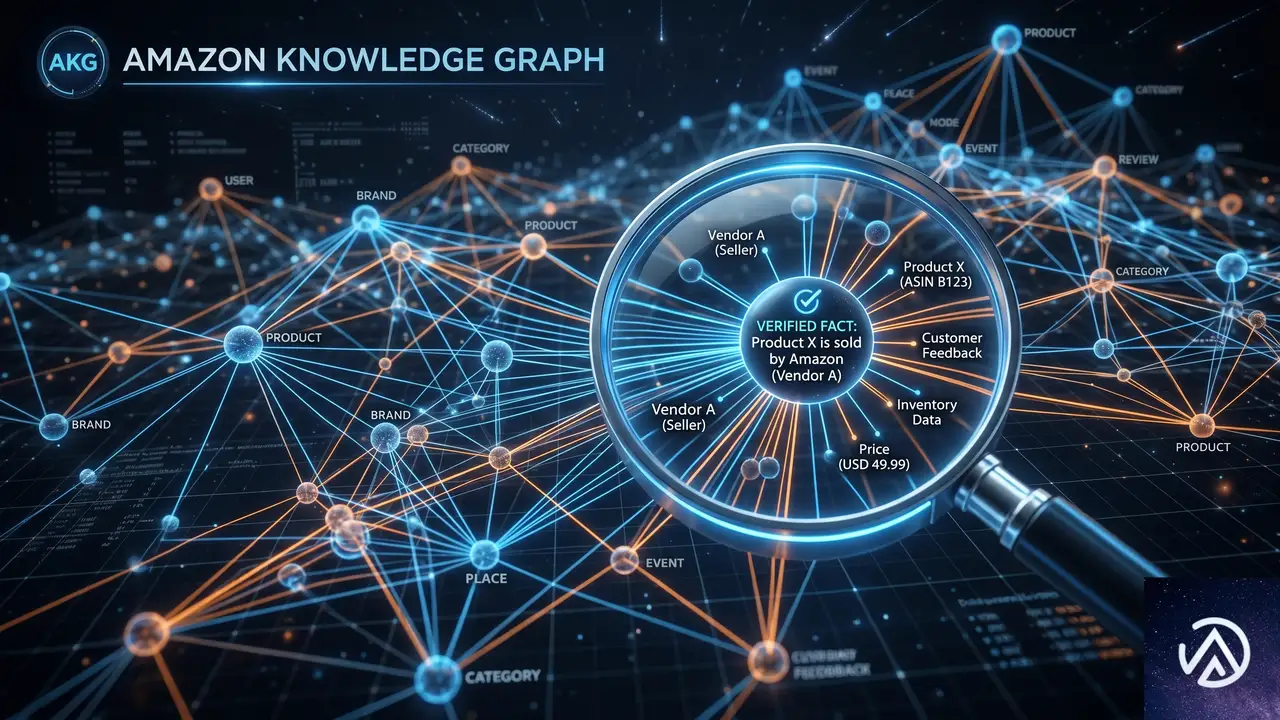
MCP(Model Context Protocol)の役割
Web Searchは、MCP(Model Context Protocol)と呼ばれる標準プロトコルを介してAgentCore Gatewayに接続される。MCPを使うことで、エージェントは自然言語のクエリを送信し、関連性の高い検索結果(スニペット、URL、タイトル、公開日)を取得できる。GatewayがMCPターゲットとしてWeb Searchツールを仲介するため、開発者が個別に検索APIを実装する必要はない。
Amazon知識グラフとの統合
一般的なWeb検索に加え、Amazon Knowledge Graphの構造化データが検索結果に組み込まれる。これにより、単なるWebスニペットではカバーしきれない検証済みの事実情報をエージェントが参照できるようになる。AWSのブログ記事によれば、このマルチソースアプローチが従来のWeb検索だけに頼る場合と比較して、より的確な回答につながるとされている。
エージェントが回答を生成するまでの流れ
以下のデモは、ユーザーが質問してからエージェントが根拠付き回答を返すまでの一連のステップを図示したものだ。
STEP 3の段階でAmazon Knowledge Graphが活用される点が、単なるWeb検索を超えた信頼性につながる。エージェントは受け取った情報をそのまま返すのではなく、モデルが内容を推論した上で回答を構成するため、質問の文脈に合った自然な応答になる。
AWS環境内で閉じるセキュアなWeb検索の価値
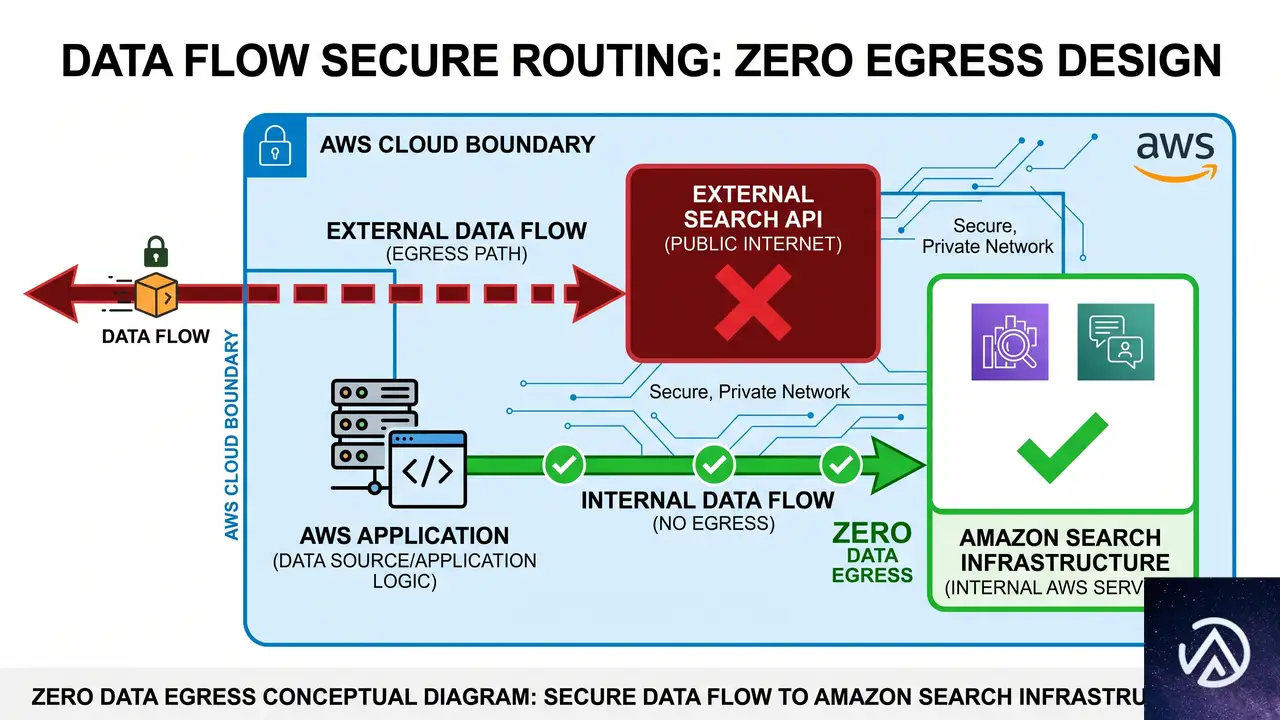
多くのAIエージェント向けWeb検索ソリューションでは、ユーザーのクエリやプロンプトが外部の検索APIプロバイダに送信される。これに対しBedrock AgentCoreのWeb Searchは、Amazon自身の検索インフラを使用するため、データがAWS環境の外に流出しない。これにより、機密性の高い業務データを扱う企業でも、ガバナンスやコンプライアンスの要件を満たしながらエージェントにWeb検索機能を組み込める。
AWSの説明によれば、この仕組みはAlexa+やKiroなどのプロダクトで培われた検索技術を基盤にしており、信頼性とスケーラビリティの両面で実績がある。ユーザーは外部の検索サービス契約やAPIキー管理を気にすることなく、AgentCoreの設定画面上でWeb Searchを有効化するだけで利用を開始できる。
料金体系と利用開始手順
料金詳細
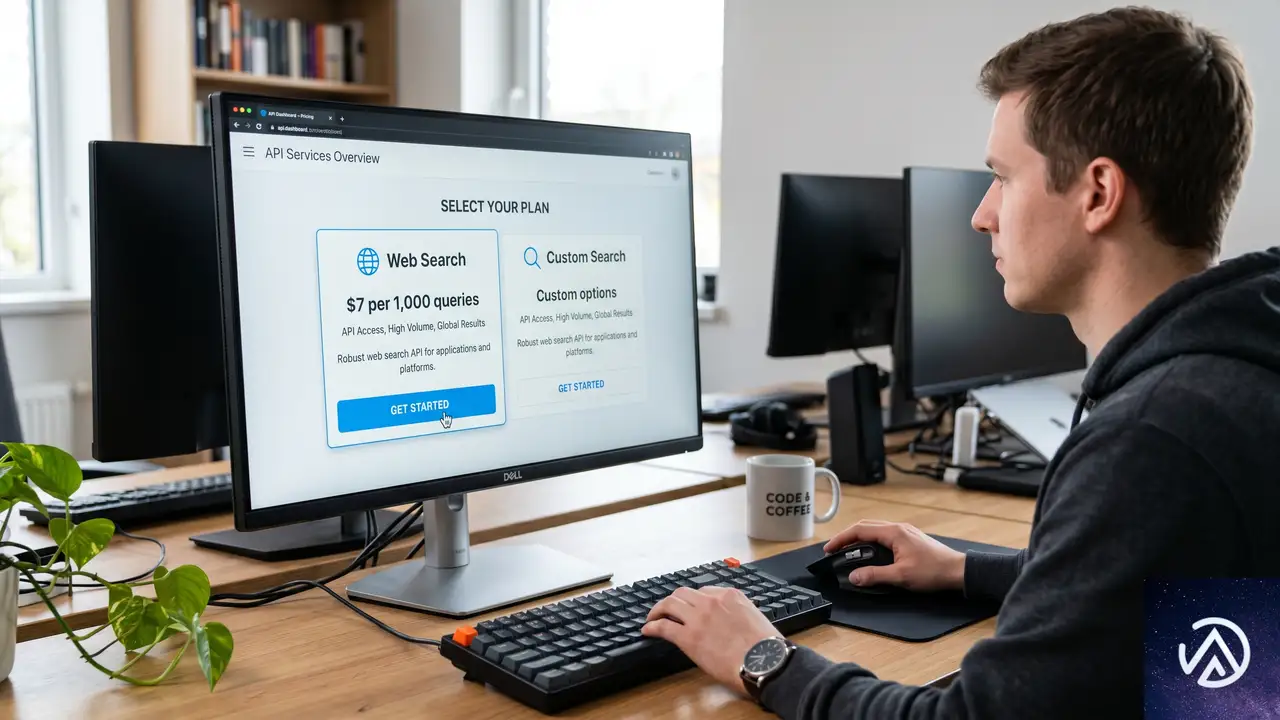
Web Searchの料金は従量課金制で、エージェントが実行した検索クエリの数に応じて計算される。具体的には、1,000クエリあたり7ドルである。新規のAWS顧客には最大200ドル相当の無料利用枠も提供される。利用料はすべてAWSの請求に統合されるため、別途外部サービスへの支払い管理は不要だ。
セットアップ手順
Bedrock AgentCoreコンソール(us-east-1リージョン)にアクセスし、Gatewayを作成する。ターゲットの追加時に「MCP target」プロトコルと「Connectors」タイプを選択し、プリコンフィギュアされた「Web Search tool」を指定する。Gatewayの詳細ページに遷移すると、PythonやMCP Inspectorを用いた呼び出しコードのサンプルが表示されるため、これをコピーして自環境に組み込むだけで統合が完了する。
テスト用途であれば、MCP InspectorをGatewayのリソースURLに接続し、Web Searchツールにクエリを直接入力して動作を確認できる。実運用では、エージェントのプロンプト設計にWeb検索の呼び出しトリガーを組み込み、回答生成時に適宜検索が走るように構成することになる。
企業での活用事例
Benchling:科学研究の加速
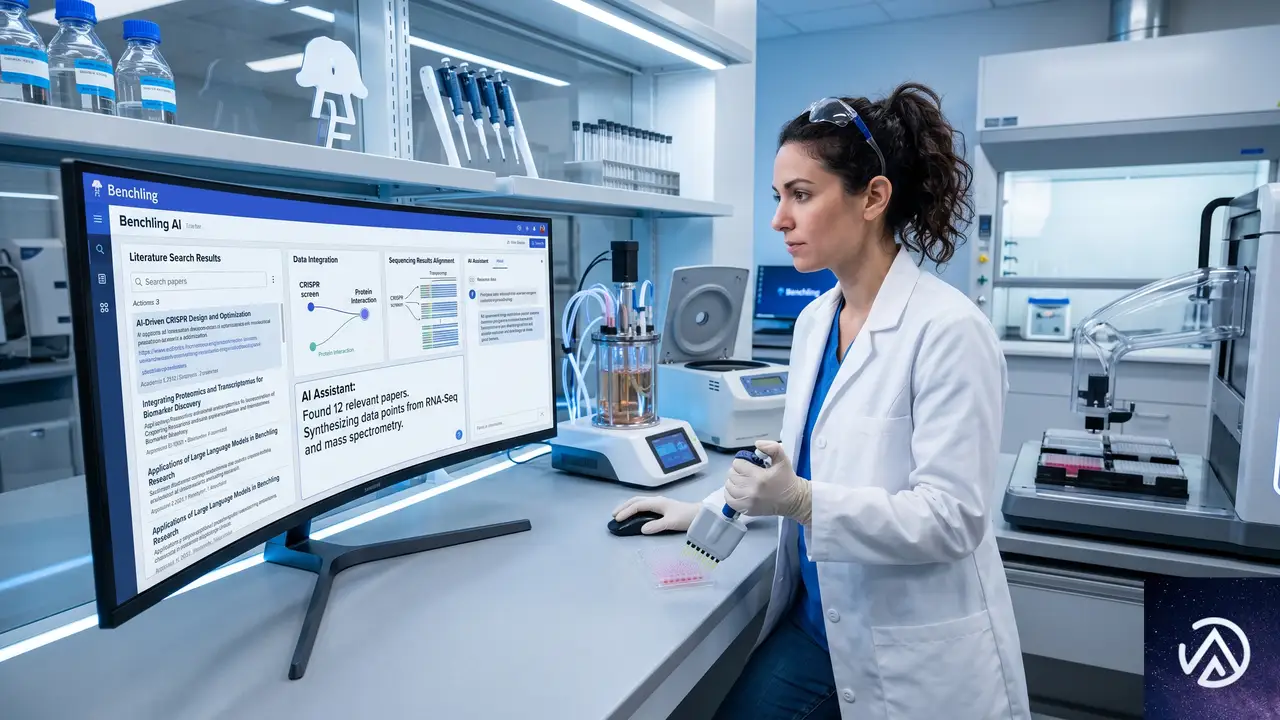
ライフサイエンス分野のR&Dプラットフォームを提供するBenchlingは、早期アクセスを通じてWeb Searchを試験導入した。同社AIエージェント責任者Nicholas Larus-Stone氏によると、科学者が研究対象について質問すると、Benchling内の組織データと公開文献の両方に基づく回答が得られるようになったという。これにより、仮説生成の質が向上し、顧客のデータ管理ポリシーにも適合する安全な環境を維持できている。
Gen Digital:オンライン評判管理の強化
消費者向けセキュリティ製品を展開するGen Digital(Nortonブランド)は、Norton RevampというサービスにWeb Searchを組み込んだ。プロフェッショナルが自身のオンライン評判を構築する際、最新のトレンドや事実に基づいたコンテンツアイデアをエージェントが提案できるようになる。同社AI・イノベーション部門シニアディレクターIskander Sanchez-Rola氏は、すべてのクエリが信頼できるAWS環境内で処理される点を高く評価しているとコメントした。
いずれの事例でも、外部サービスを利用せずにAWS内で完結するセキュリティと、Amazon独自の検索インデックスによる高精度な情報取得が決め手となっている。
この記事のポイント
- Amazon Bedrock AgentCoreでWeb Search機能が一般提供開始。MCP経由でWeb検索と知識グラフを統合し、エージェントの回答を最新情報で根拠づける
- 検索クエリはAWS環境外に出ず、Amazonの検索インフラで処理されるため、データガバナンスとコンプライアンスに対応
- 料金は1,000クエリあたり7ドルの従量課金。新規顧客向けに200ドル分の無料枠あり
- BenchlingやGen Digitalなどの企業がすでに導入し、研究支援や評判管理の精度向上に活用している
- us-east-1リージョンで利用可能。AgentCoreコンソールから数ステップで設定できる
・ 複数業界における17年間のデジタルビジネス開発経験
・ ウェブサイト開発のためのHTML、PHP、CSS、JavaScript等の実用的知識
・ 15ヶ国語対応の多言語SaaSの開発経験
・ 17年間にも及ぶ、Eコマース長期運営経験
・ 幅広い業界でのSEO最適化の豊富な経験